Stable Diffusion 架构与文生图流程
扩散全程发生在一张 4×64×64 的小草稿纸上,像素图只在最后一步由 VAE 解码器生成一次——这是 Stable Diffusion 又快又省的全部秘密。
30″30 秒看懂 Stable Diffusion
把 Stable Diffusion 想成一间三个人接力的画室:你开口说一句话,最后拿到一张 512×512 的成品图,中间经手的不是一个人,而是翻译官、雕刻师、放大师三位。
翻译官先把你那句人话翻成画室内部通用的「设计语言」——一叠固定 77 行、每行 768 个数字的表格。雕刻师拿到这份设计语言后,并不在那张大画布上动手,而是抽出一张巴掌大的小草稿纸,纸上事先撒满了雪花点;他照着设计语言,一轮一轮把不该有的雪花擦掉,擦二十几轮,一个模糊但正确的轮廓就浮出来了。最后放大师把这张小草稿送进放大机,一次成像,输出那张 512×512 的大图。
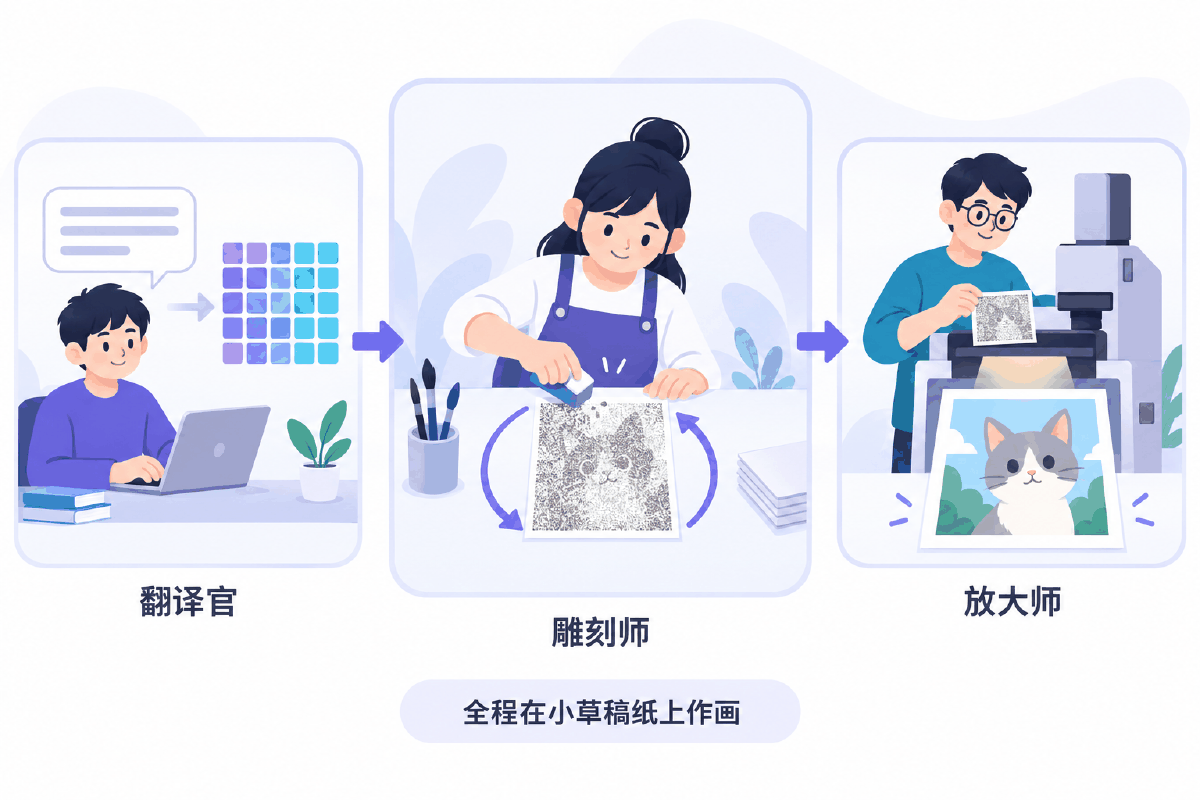
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 翻译官 | ClipText 文本编码器 | 把 prompt 变成 (77, 768) 的 token 嵌入向量,全程参数冻结,不学习 |
| 小草稿纸 | latent space 潜空间 | 一张 4×64×64 的低维张量,扩散的全部动作都在这上面发生 |
| 雪花点 | 高斯噪声 | 起点的随机潜噪声,由 seed 唯一决定 |
| 雕刻师 | U-Net | 看着草稿纸和设计语言,预测这张纸上哪些是噪声,交给下一步减掉 |
| 擦法与进度表 | Scheduler(采样器) | 决定一共擦几轮、每轮减掉多少、带不带随机性 |
| 放大师 | VAE 解码器 | 把 4×64×64 的潜变量还原成 3×512×512 的像素图,整个流程只跑一次 |
| 成品大图 | 像素空间的输出 | 红/绿/蓝 三通道,宽 512、高 512 |
拿这条铁律先算一笔账:一张 512×512 的 RGB 图有 512×512×3 = 786432 个数;而草稿纸只有 4×64×64 = 16384 个数。整整小了 48 倍。雕刻师每一轮要处理的数据量差了 48 倍,二十几轮下来,这就是「本地显卡也能几秒出一张图」与「排队等几分钟」的分水岭。
01概念:Stable Diffusion 到底是什么
四个长得很像的名字、它的来历,以及它凭什么被称作分水岭
1.1 先把四个容易混的名字分清
刚接触 AI 绘画时,Diffusion Model、Latent Diffusion Model、Stable Diffusion、Stable Diffusion WebUI 这四个词会同时砸过来,而它们分属四个层级:一个是算法思想,一个是算法改进,一个是具体模型,还有一个只是网页界面。混淆它们会让后面所有讨论都跑偏。
| 名称 | 层级 | 含义 |
|---|---|---|
Diffusion Model扩散模型 | 算法思想 | 一款支持图像生成的算法模型。市面上主流的 DALL·E、Midjourney、Imagen、Stable Diffusion 等 AI 绘画工具,底层都基于它。核心动作是「不断加噪,再学着逐步还原」。 |
Latent Diffusion Model潜在扩散模型 | 算法改进 | 在扩散模型基础上研制出的更高级模型。图像生成速度更快,对计算资源和内存的消耗需求更低。改进点只有一个:把扩散过程搬进潜空间。 |
Stable Diffusion简称 SD 模型 | 具体模型 | 底层模型就是上面的潜在扩散模型。之所以叫这个名字,是因为研发公司名叫 Stability AI。它比 Latent Diffusion 更强大,生成更准确、支持的分辨率也更高。 |
Stable Diffusion WebUI简称 SD WebUI | 操作界面 | 用于操作 SD 模型的网页端界面。通过它就能控制模型出图,而无需学习代码。它不是模型,只是一层壳。 |
1.2 它是怎么来的
Stable Diffusion 不是一家公司闷头做出来的,而是三方合作的产物:由 Stability AI、CompVis 和 Runway 团队合作开发。三方各自补上了一块缺口:
Latent Diffusion 模型由慕尼黑大学的机器学习研究小组 CompVis 和纽约的 Runway 团队合作研发,特点是生成速度快、消耗需求小。算法这一块的地基是他们打的。
训练模型需要高昂的计算成本和资源要求。Stability 投入资源,三个团队共同开发。最初的训练跑在 Stability 那座 4000 卡 A100 集群上(模型本身约用 256 张 A100、约 15 万 GPU 小时)——这也是小团队复现不了底模、只能做微调的现实原因。
2022 年 8 月 10 日 Stable Diffusion 先向研究者小范围内测,生成更准确、支持的图像分辨率更高,比 Latent Diffusion 模型更加强大;8 月 22 日正式开源(CreativeML Open RAIL-M 许可,商用非商用皆可)。同年 10 月公司完成 1 亿美元级融资,估值约 10 亿美元。
开源这一步是整件事的转折点。模型权重和论文代码公开之后,个人开发者可以把它下载到自己的机器上跑,社区随即涌现出海量的微调模型、插件和界面——这也是下一讲 DreamBooth 与 LoRA 得以存在的前提。
1.3 三个特点:可拓展、出图快、数据安全
同样是 AI 绘画,Stable Diffusion 被单独拎出来讲,靠的是三件事。
① 可拓展性强
任何人都可以通过官方免费公开的论文和模型代码进行学习与创作。在此之上,社区为它做了 110 多个扩展插件,包括局部重绘、人物姿势控制、图像高清修复和线稿提取等,用户可以根据需要选择不同插件来扩展功能。行业内普遍头疼的无法精准控图、图像分辨率低这两个痛点,在 Stable Diffusion 里通过 ControlNet 和 UpScale 等插件都能解决。
② 出图快
用过 Midjourney 的人都体验过排队等几分钟才出一张图的情况,而要得到一张合适的目标图,往往需要试验多次。原因不在模型本身:商业级的 AI 应用都是通过访问云服务器进行操作,除了排队等候服务器响应,网络延迟和资源过载都会拉低绘图效率。
而部署在本地的 Stable Diffusion,绘图效率完全由硬件设备决定。只要显卡算力跟得上,甚至能实现 3 秒一张的出图效率。请把这个结论和铁律连起来看——之所以本地显卡跑得动,正是因为雕刻师每一轮只在 16384 个数上干活,而不是 786432 个。
③ 数据安全
因为部署在本地,Stable Diffusion 在数据安全性上是其他在线绘画工具无法比拟的。商业化的绘画应用为了运营和丰富素材,会主动将用户的绘图结果作为案例进行传播;而 Stable Diffusion 所有的绘图过程完全在本地进行,基本不用担心信息泄漏。涉及未公开的产品原型、客户素材、人物肖像时,这一条往往是决定性的。
1.4 和邻近方案的区别
同属扩散模型家族,选谁取决于你更在意哪一头:
| 维度 | Stable Diffusion | Midjourney | DALL·E / Imagen |
|---|---|---|---|
| 部署方式 | 开源,可本地部署 | 云端服务 | 云端服务(Imagen 目前不对外开放) |
| 出图速度 | 由本地显卡决定,可达 3s/张 | 排队 + 网络延迟 | 排队 + 网络延迟 |
| 可控性 | 高,插件可控姿势、线稿、分辨率 | 靠 prompt 与参数 | 靠 prompt |
| 数据安全 | 本地闭环 | 结果可能被平台传播 | 结果上传云端 |
| 定制自己的模型 | 可以,DreamBooth / LoRA 都基于它 | 不可以 | 不可以 |
| 上手门槛 | 需要显卡与环境配置 | 低,开箱即用 | 低,开箱即用 |
注意最后两行的对照:「能不能训成你自己的」几乎是选择 Stable Diffusion 的唯一硬理由。如果只是偶尔出几张概念图,云端服务反而更省事;但凡涉及固定的 IP 形象、固定画风、固定人物,就只有开源这条路走得通。
02原理:一句话是怎么变成一张图的
加噪与降噪、潜空间的账、三个子模型的分工、张量维度、采样循环、seed 与 Scheduler
2.1 先理解「扩散」这两个字
扩散模型之所以用 Diffusion 来命名,是因为它的运作过程就是向训练图像不断地添加噪声,直到变为一张无意义的纯噪声图,再逐步恢复的过程。
加噪过程类似于在干净的水中滴墨汁:颜料会逐渐扩散,导致整个水体变浑。而 AI 绘画的过程正好相反,是从模糊的噪声图逐渐变为清晰的图像,也就是逆向降噪的过程。
这里有一个关键的工程判断:我们希望把 t 时刻的高斯噪声一步变回 0 时刻的图像,这是很难一步到位的。所以和正向过程一样,反向过程也先只考虑「t 时刻图像和 t−1 时刻图像」的关系,然后一步步向前推导。「一步做不到就拆成很多小步」——这是整个扩散模型最核心的工程智慧,后面那个循环二十几次的采样循环,就是这句话的直接产物。
训练阶段模型学的到底是什么?不是「怎么画一只猫」,而是「给你一张带噪声的图和一个时间步 t,请你指出这张图上哪些成分是噪声」。学会了预测噪声,减法就自然会做了。这也是为什么后面代码里 U-Net 的输出变量名叫 noise_pred 而不是 image_pred。
2.2 为什么非要搬进潜空间
标准扩散模型在像素空间中进行,需要处理大量数据和高性能显卡。这句话听起来抽象,算一笔账就具体了:
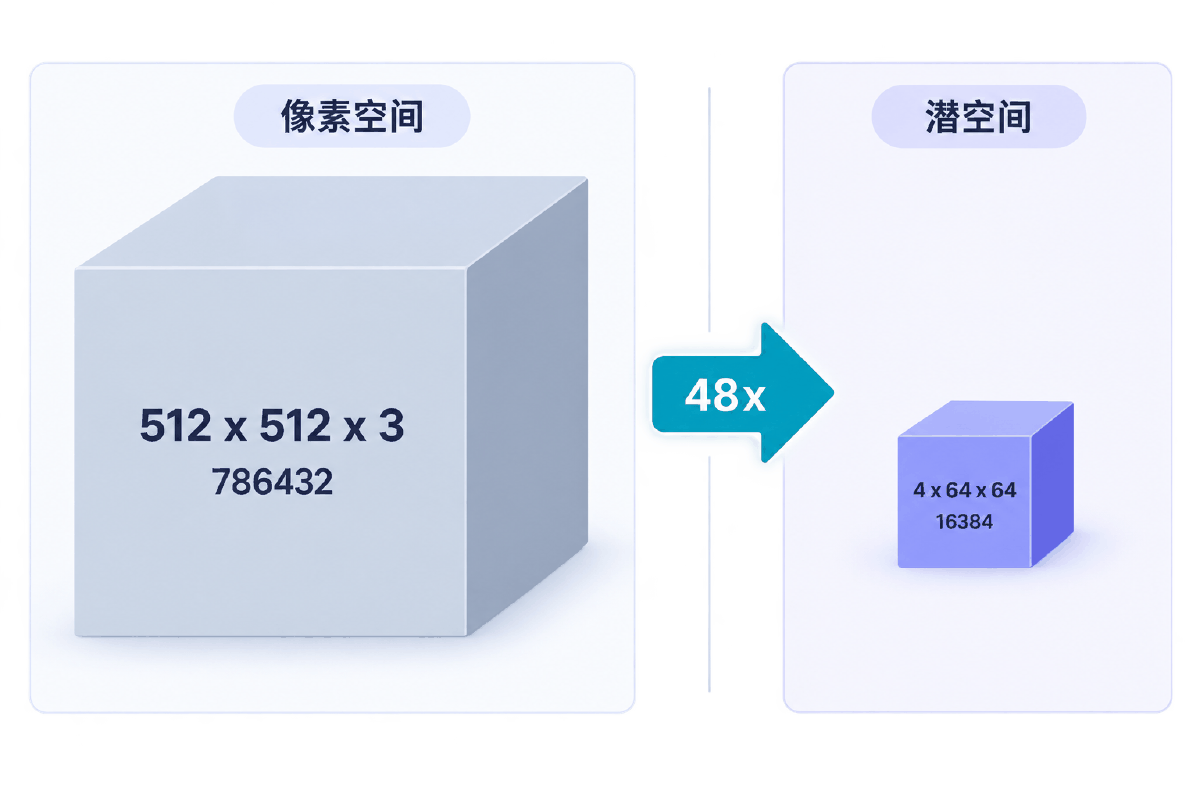
图像空间是巨大的。具有三个颜色通道的 512×512 图像,是一个 786432 维的空间。扩散过程要在这个空间里反复跑二十几轮,每一轮都是对 78 万个数做一次完整的神经网络前向传播。
Stable Diffusion 旨在解决速度问题。它采用潜在空间扩散(latent diffusion):不是在高维图像空间中操作,而是首先将图像压缩到潜空间(latent space)中。潜空间相对于原始图像空间小了很多倍,所以速度会有较大的提升。
| 对比项 | 像素空间(标准扩散) | 潜空间(Stable Diffusion) |
|---|---|---|
| 张量形状 | 3 × 512 × 512 | 4 × 64 × 64 |
| 元素个数 | 786432 | 16384 |
| 体量比 | 48 × | 1 × |
| 边长关系 | 512 | 512 ÷ 8 = 64(8 倍下采样) |
| 通道含义 | 红 / 绿 / 蓝 | 4 个抽象特征通道,肉眼看不出内容 |
| 硬件要求 | 需要高性能显卡 | 消费级 8G 显存即可 |
2.3 三个子模型:Stable Diffusion 不是一个模型
这是最容易被忽略的一点:Stable Diffusion 模型并不是单一的一个模型,而是多个模型组成的运作系统。其中的技术可以拆解为 3 个结构来看:
用于解析提示词的 Clip 模型。
输入:文本 prompt
输出:文本的 token 嵌入向量,其中每个向量包含 768 个维度。
对应比喻里的翻译官。
用于生成图像的 U-Net 和 Scheduler。
输入:文本嵌入和一个由噪声组成的初始多维数组
输出:一个经过处理的数据。
对应比喻里的雕刻师和他的擦法。
用于压缩和恢复的图像解码器。
输入:处理过的信息矩阵,维度为 (4, 64, 64)
输出:结果图像,各维度为 (3, 512, 512),即(红/绿/蓝,宽,高)。
对应比喻里的放大师。
ClipText:模型凭什么听得懂人话
CLIP 是由 OpenAI 提出的一种多模态神经网络,它能有效地借助自然语言的监督来学习视觉的概念。它要解决的是这样一个老问题:典型的视觉数据集是劳动密集型的,创建成本很高,而且用它们训练出的标准视觉模型只擅长一项任务,适应新任务并不容易。CLIP 则在各种各样的图像上训练,同时依赖互联网上大量自然语言的监督。
它的训练分两个阶段:
- 首先训练一个处理图像的 CNN 和一个处理文本的 Transformer 模型,来预测图像的 caption。
- 对比学习阶段:给定一个 Batch 的 N 个(图片,文本)对,图片输入 Image Encoder 得到表征 I₁…In,文本输入 Text Encoder 得到表征 T₁…Tn。其中 (Ij, Tj) 属于正样本,(Ij, Tk) 属于负样本。训练目标是最大化 N 个正样本的 Cosine 相似度,最小化 N²−N 个负样本的 Cosine 相似度。
- Zero-Shot Transfer:使用预训练好的 Image Encoder 和 Text Encoder 直接做迁移。比如拿一张 ImageNet-1K 验证集的图片,用 CLIP 预训练好的模型就能完成分类任务,不需要再训练。
在 SD 模型的运作过程中,它提取提示词文本部分的特征传递给图像生成器,让模型理解我们输入的提示词内容,从而达到文本控制图像生成的目的。
train_text_encoder)。
U-Net 与 Scheduler:雕刻师和他的进度表
U-Net 原本是用于生物医学图像分割的神经网络模型,因为工作结构像一个 U 型字母,因此被称为 U 型神经网络。在扩散模型中,U-Net 可以辅助提取并解构训练图像的特征,有了它就能在较少训练样本的情况下获得更加准确多样的数据信息,从而使模型在出图结果上更加精确。
Scheduler 则是另一码事。在训练扩散模型的过程中,可以采用不同的算法来添加噪声,而 Scheduler 就是用来定义使用哪种算法来运行程序的。它可以定义降噪的步骤、是否具备随机性、查找去噪后样本的算法等,因此它又被称为采样算法(采样器)。在 WebUI 中,它是可调节的一项,我们可以根据图像类型和使用的模型来选择不同的采样器,从而达到更佳的出图效果。
| 对比 | U-Net | Scheduler |
|---|---|---|
| 身份 | 神经网络,有权重 | 算法,没有权重 |
| 干什么 | 预测当前潜变量里的噪声 | 决定这一步该减掉多少、下一步跳到哪个时间点 |
| 换掉它 | 换模型 = 换画风,要重新加载几 GB 权重 | 换采样器 = 换一行代码,不用换模型 |
| 微调涉及 | DreamBooth / LoRA 改的主要就是它 | 不参与训练,永远不用训 |
所以「换个采样器出图就好看了」这件事之所以成立,是因为同一个雕刻师,换一套擦法,落笔节奏就不一样。而「换个模型画风全变了」,是因为换了雕刻师本人。
VAE:只用解码器的那一半
最后的解码器 VAE,全称是 Variational Auto Encoder 变分自动编码器。简单来说,它的作用是将高维数据(像素空间)映射到低维空间(潜空间),从而实现数据的压缩和降维。它由编码器(Encoder)和解码器(Decoder)两部分组成:编码器用于将图像信息降维并传入潜空间中,解码器将潜在数据表示转换回原始图像。
编码器什么时候才登场?两个时候:① 训练底模时,把训练图压进潜空间;② 图生图和图像修复时,把你给的那张起点图压进潜空间。这正是 2.5 节末尾三种用法差异的根源。
2.4 张量维度是怎么一步步变的
把上面三个子模型串起来,数据的形状变化是这样一条链。把这张表背下来,代码里每一行在做什么就都对得上号了:
| 阶段 | 张量形状 | 元素个数 | 说明 |
|---|---|---|---|
| 用户输入 | 一句话 | — | 任意长度的 prompt 字符串 |
| tokenize 之后 | (1, 77) | 77 | 不足补齐、超出截断,固定 77 个 token |
| ClipText 输出 | (1, 77, 768) | 59136 | 每个 token 一个 768 维向量,这就是「设计语言」 |
| 拼上负向提示 | (2, 77, 768) | 118272 | uncond 与 cond 拼成一个 batch,一次前向算两个方向 |
| 初始潜噪声 | (1, 4, 64, 64) | 16384 | 由 seed 决定的随机高斯噪声,草稿纸 |
| U-Net 每轮输出 | (1, 4, 64, 64) | 16384 | 预测出的噪声,形状和输入一模一样 |
| 循环 N 轮之后 | (1, 4, 64, 64) | 16384 | 擦干净的潜变量,形状始终没变过 |
| VAE 解码之后 | (1, 3, 512, 512) | 786432 | 红/绿/蓝三通道的像素图,只在这一步放大 |
注意中间那四行:从搓出噪声到循环结束,形状一直是 (1, 4, 64, 64),一次都没变过。U-Net 是一个「输入什么形状、输出什么形状」的等尺寸网络,它做的是原地擦除,不是逐步放大。真正的尺寸跃迁只发生在最后一行,由 VAE 解码器一次性完成。这正是铁律在维度表上的样子。
2.5 采样循环:文生图的五步
现在把所有部件装起来。Stable Diffusion 从文本生成图像的流程如下:
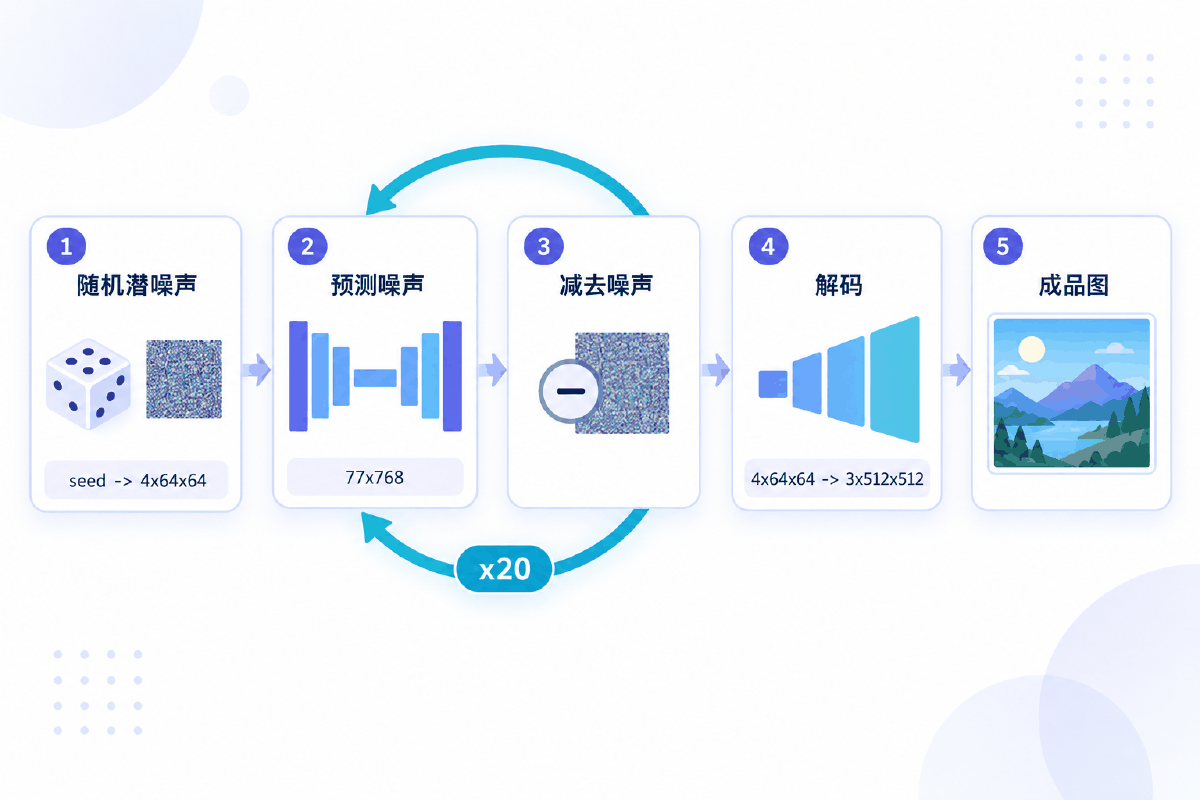
Stable Diffusion 在潜空间中生成随机张量。可以通过设置随机数生成器来控制此张量:如果将种子设置为某个值,就会获得相同的随机张量。
网络 U-Net 将潜在噪声图像和文本提示作为输入,并预测噪声,预测结果也在潜在空间(4×64×64 张量)中。
从潜在图像中减去潜在噪声。这将成为新的潜在图像。
步骤 2 和 3 重复一定数量的采样步骤,例如 20 次。
最后,VAE 的解码器将潜在图像转换回像素空间。这就是运行 Stable Diffusion 后获得的图像。
第 1 到第 4 步全部发生在 4×64×64 上,只有第 5 步碰到了 512×512,而且只碰一次。
这里有个初学者常见的误解要点破:第 3 步的「减去噪声」并不是把 U-Net 预测出来的噪声原样减掉。如果那样做,一步就该干净了,实际却会得到一张糊掉的图。真正发生的是——U-Net 预测「从当前状态一路到干净图,总共混进去多少噪声」,而 Scheduler 根据当前处在第几步,只按比例减掉其中一小部分,把剩下的留给下一轮。步数越多,每一步迈得越小、越稳。
负向提示词是怎么起作用的
代码里还有一个循环内部的动作,流程图上没有画,但它是 negative_prompt 和 guidance_scale 生效的地方,叫 classifier-free guidance:
- 把同一份潜变量复制成两份,一份配正向提示词的嵌入,一份配负向提示词的嵌入,拼成 batch 一起送进 U-Net,一次前向拿到两个噪声预测。
- 然后做外推:
noise = noise_uncond + guidance_scale × (noise_cond − noise_uncond)。 - 括号里那一项是「朝着提示词的方向」;
guidance_scale就是沿这个方向走多远。7~8 是通用值;调到 15 以上,画面会过饱和、细节崩坏,因为外推过头了。
这也解释了一个反直觉的现象:负向提示词写得越多,出图不一定越快——因为它本来就和正向提示词共用同一次前向传播,加词只影响那 77 个 token 的内容,不增加循环次数。
2.6 seed 与采样器:两个你真正能拧的旋钮
seed 为什么能复现同一张图
整条流水线里,唯一的随机来源就是第 1 步那张噪声草稿。U-Net 的前向传播是确定性的,VAE 解码也是确定性的。所以只要起点那 16384 个随机数一样,后面每一步的结果都必然一样。
seed 就是随机数生成器的起始状态编号。给定同一个 seed,生成器吐出的随机数序列完全相同,草稿纸上的雪花排布就完全相同——同一个 seed + 同一套参数 = 同一张图。
| 固定 seed 后,改动什么会让图变化 | 会变吗 |
|---|---|
| prompt 改一个词 | 会,文本嵌入变了 |
| steps 从 20 改成 25 | 会,每一步的减法比例全变了 |
| guidance_scale 从 7.5 改成 8 | 会,外推距离变了 |
| 采样器从 PNDM 换成 DPM++ | 会,擦法变了 |
| 出图尺寸从 512 改成 768 | 会,草稿纸形状都变了 |
| 换一张显卡 / 换 fp16 与 fp32 | 可能会,浮点累积误差不同,通常只有细微差别 |
| 只把 batch 里的图片数从 1 改成 4 | 会,随机数按批次消耗,第一张不一定对得上 |
为什么采样器可调
回到 Scheduler 的定义:它定义降噪的步骤、是否具备随机性、查找去噪后样本的算法。不同采样器在「用多少步逼近同一条降噪轨迹」上有不同的数值策略——有的收敛快、20 步就稳定,有的带随机性、每一步都再掺一点噪声因而细节更丰富但不易收敛。
| 采样器 | 带随机性 | 常用步数 | 特点 |
|---|---|---|---|
Euler | 否 | 20~30 | 最直白的一阶方法,收敛稳定,出图干净,适合做基线对照 |
Euler a | 是 | 20~30 | 末尾的 a 是 ancestral,每步掺新噪声;步数改一点图就大变,细节多但不收敛 |
DDIM | 否 | 20~50 | 经典确定性采样,支持从图片反推潜变量,图生图链路常用 |
PNDM | 否 | 25~50 | diffusers 里 SD v1 的默认项,兼容性最好 |
DPM++ 2M Karras | 否 | 15~25 | 高阶方法,少步数就能出高质量图,社区默认首选 |
挑采样器的实操原则很简单:先用一个确定性采样器把 prompt 和 seed 调稳,再换采样器做最后的质感微调。一上来就用带随机性的 Euler a,会让你误以为是 prompt 写得不对,其实只是步数动了一格。
03最小代码:十几行跑通文生图
先把最短的一条路走完,再去看拆开的版本
前面那一大套原理,用 diffusers 写出来只有十几行——因为 StableDiffusionPipeline 把翻译官、雕刻师、放大师打包成了一个对象,三人接力在 pipe(...) 这一次调用里全部走完。
# -*- coding: utf-8 -*-
"""最小文生图:13 行跑通 Stable Diffusion。

环境:
    pip install diffusers transformers accelerate torch safetensors
显存:
    fp16 下约 4~6 GB;没有 NVIDIA 显卡时把 device 改成 "cpu",一张图要几分钟。
"""
import torch
from diffusers import StableDiffusionPipeline

# ① 载入整条流水线:翻译官(text_encoder)、雕刻师(unet + scheduler)、
#    放大师(vae)三个子模型一次性被打包进 pipe 里。
pipe = StableDiffusionPipeline.from_pretrained(
    "runwayml/stable-diffusion-v1-5",   # 本地已下好就写目录路径
    torch_dtype=torch.float16,          # fp16 省一半显存
)
pipe = pipe.to("cuda")                  # 没显卡就改 "cpu",并把 dtype 改回 float32

# ② 固定随机种子。同一个 seed + 同一套参数 = 同一张图,这是复现的唯一开关。
generator = torch.Generator(device="cuda").manual_seed(1024)

# ③ 出图。num_inference_steps 就是「雕刻师擦几轮」,guidance_scale 是「多听话」。
image = pipe(
    prompt="a photo of a corgi wearing sunglasses, studio lighting, 8k",
    negative_prompt="lowres, blurry, watermark, extra fingers",
    num_inference_steps=25,
    guidance_scale=7.5,
    height=512,
    width=512,
    generator=generator,
).images[0]

# ④ 这里拿到的已经是 PIL 图片,潜空间那一套在 pipe 内部走完了。
image.save("corgi.png")
print("saved corgi.png", image.size)   # (512, 512)
| 参数 | 常用值 | 它在原理里对应哪一步 |
|---|---|---|
prompt | 主体 + 细节 + 风格 | 翻译官的输入,最终变成 (1, 77, 768) |
negative_prompt | 质量缺陷词 | classifier-free guidance 里的 uncond 那一支 |
num_inference_steps | 20~30 | 第 2、3 步重复几轮;再高收益递减、耗时线性增长 |
guidance_scale | 7~8 | 朝提示词方向外推多远;调太高画面过饱和 |
height / width | 512,必须是 8 的倍数 | 决定草稿纸形状:512 → 64×64 |
generator | 固定 seed | 第 1 步那张随机潜噪声 |
64×64 的草稿纸校准的。直接把边长拉到 1024,草稿纸变成 128×128,模型会在同一张图里画出两个头、四条腿——这是社区里最著名的翻车现象。要出大图,正确做法是先按 512 出图,再走 upscale 流程放大。
pip install diffusers transformers accelerate torch safetensors。torch_dtype=torch.float16 能把显存从 10 GB 压到 4~6 GB;没有 NVIDIA 显卡时必须同时改两处——to("cpu") 且 torch_dtype 改回 float32,因为 CPU 上的 fp16 算子支持很不完整,只改一处会直接报错。CPU 出一张图要几分钟,能跑通但不适合调参。
04完整案例:把流水线拆开,再装三种用法
逐步版打印每一步的 shape,然后是图生图与图像修复
4.1 拆开流水线:亲眼看见每一步的张量
上一节那十几行代码有个问题:三个子模型都藏在 pipe 里,看不见维度怎么变。所以这里把 StableDiffusionPipeline 做的事手写一遍——加载四个部件、编码文本、搓噪声、循环、解码,每一步都把 shape 打出来。
这份代码不追求速度,只追求「每一步都看得见」。跑完之后,2.4 节那张维度表就从纸面变成了终端里的真实输出。
# -*- coding: utf-8 -*-
"""把 StableDiffusionPipeline 拆开手写一遍,并打印每一步的 tensor shape。

跑一次就能亲眼看到:
    文本  → (1, 77, 768)      翻译官的产物
    潜噪声 → (1, 4, 64, 64)    雕刻师的草稿纸
    成品  → (1, 3, 512, 512)  放大师的输出

这份代码不追求速度,只追求「每一步都看得见」。
"""
import torch
from diffusers import AutoencoderKL, UNet2DConditionModel, PNDMScheduler
from transformers import CLIPTextModel, CLIPTokenizer
from PIL import Image
import numpy as np

MODEL = "runwayml/stable-diffusion-v1-5"
DEVICE = "cuda" if torch.cuda.is_available() else "cpu"
DTYPE = torch.float16 if DEVICE == "cuda" else torch.float32

PROMPT = "a photo of a corgi wearing sunglasses, studio lighting, 8k"
NEGATIVE = "lowres, blurry, watermark"
STEPS = 25
GUIDANCE = 7.5
HEIGHT, WIDTH = 512, 512
SEED = 1024


# ---------------------------------------------------------------- 子模型
# 四个部件分开加载,正好对应架构图里的三个子模型 + 一个采样器。
tokenizer = CLIPTokenizer.from_pretrained(MODEL, subfolder="tokenizer")
text_encoder = CLIPTextModel.from_pretrained(
    MODEL, subfolder="text_encoder", torch_dtype=DTYPE).to(DEVICE)
unet = UNet2DConditionModel.from_pretrained(
    MODEL, subfolder="unet", torch_dtype=DTYPE).to(DEVICE)
vae = AutoencoderKL.from_pretrained(
    MODEL, subfolder="vae", torch_dtype=DTYPE).to(DEVICE)
scheduler = PNDMScheduler.from_pretrained(MODEL, subfolder="scheduler")

# CLIP 的参数在出图过程中是冻结的,这三个模型都只做前向推理。
text_encoder.requires_grad_(False)
unet.requires_grad_(False)
vae.requires_grad_(False)


# ---------------------------------------------- 第一步:翻译官把文字变成向量
def encode(text):
    """任何长度的 prompt 都会被 padding / 截断到固定 77 个 token。"""
    ids = tokenizer(
        text,
        padding="max_length",
        max_length=tokenizer.model_max_length,   # 77
        truncation=True,
        return_tensors="pt",
    ).input_ids.to(DEVICE)
    with torch.no_grad():
        return text_encoder(ids)[0]              # (1, 77, 768)


cond = encode(PROMPT)
uncond = encode(NEGATIVE)
print("[1] 文本嵌入          cond:", tuple(cond.shape), " uncond:", tuple(uncond.shape))

# classifier-free guidance:把「要的」和「不要的」拼成一个 batch 一起算,
# 这样一次 U-Net 前向就能同时拿到两个方向的噪声预测。
text_embeddings = torch.cat([uncond, cond])
print("[2] 拼接后送入 U-Net      :", tuple(text_embeddings.shape))


# ---------------------------------------------- 第二步:在潜空间里搓一张噪声
generator = torch.Generator(device="cpu").manual_seed(SEED)
latents = torch.randn(
    (1, unet.config.in_channels, HEIGHT // 8, WIDTH // 8),   # 8 倍下采样
    generator=generator,
).to(DEVICE, dtype=DTYPE)
print("[3] 初始潜噪声            :", tuple(latents.shape),
      " 元素数 =", latents.numel())

scheduler.set_timesteps(STEPS)
latents = latents * scheduler.init_noise_sigma


# ---------------------------------------------- 第三步:擦 STEPS 轮
for i, t in enumerate(scheduler.timesteps):
    # 同一份潜变量复制两份,分别配 uncond 与 cond 的文本嵌入
    model_input = torch.cat([latents] * 2)
    model_input = scheduler.scale_model_input(model_input, t)

    with torch.no_grad():
        noise_pred = unet(model_input, t,
                          encoder_hidden_states=text_embeddings).sample

    # 拆回两半,按 guidance_scale 在「没有提示词的方向」与
    # 「有提示词的方向」之间外推
    noise_uncond, noise_cond = noise_pred.chunk(2)
    noise_pred = noise_uncond + GUIDANCE * (noise_cond - noise_uncond)

    # 由 scheduler 决定这一步到底减掉多少——这就是「采样算法」的位置
    latents = scheduler.step(noise_pred, t, latents).prev_sample

    if i in (0, STEPS // 2, STEPS - 1):
        print("    step %2d/%d  t=%-4s  latents:" % (i + 1, STEPS, int(t)),
              tuple(latents.shape))

print("[4] 降噪完成的潜变量      :", tuple(latents.shape))


# ---------------------------------------------- 第四步:放大师解码一次
# 0.18215 是 SD v1 系列训练时给潜变量用的缩放因子,解码前必须除回去
latents = latents / vae.config.scaling_factor
with torch.no_grad():
    image = vae.decode(latents).sample
print("[5] VAE 解码后            :", tuple(image.shape))

# [-1, 1] → [0, 1] → uint8 → PIL
image = (image / 2 + 0.5).clamp(0, 1)
image = image.detach().cpu().permute(0, 2, 3, 1).float().numpy()
image = (image * 255).round().astype(np.uint8)
Image.fromarray(image[0]).save("corgi_stepwise.png")
print("[6] 已保存 corgi_stepwise.png  像素尺寸:", (WIDTH, HEIGHT))
这份代码里有五个值得停下来看的地方
| 代码位置 | 为什么这么写 |
|---|---|
padding="max_length"max_length=77 | 不管 prompt 多长,都补齐或截断到 77 个 token。这一行就是 2.4 节那条「写在最后的形容词可能没进模型」的出处。 |
HEIGHT // 8WIDTH // 8 | 8 倍下采样写死在这里:512 的图对应 64 的草稿纸。想出 768 的图,草稿纸就是 96,显存开销按面积涨。 |
latents * scheduler.init_noise_sigma | 不同采样器对「初始噪声该多大」有不同约定。漏掉这一步,前几轮的减法比例就全错,出图发灰发糊。 |
torch.cat([latents] * 2) | classifier-free guidance 的实现:同一份潜变量复制两份,配 uncond 与 cond 的嵌入,一次前向拿两个预测。 |
latents / vae.config.scaling_factor | 0.18215 这个魔数是 SD v1 训练时给潜变量用的缩放因子。解码前不除回去,出来的图颜色会整体偏掉。 |
终端输出长什么样
在一张 12 GB 显存的卡上跑 25 步,输出如下:
| 打印行 | 内容 |
|---|---|
| [1] | 文本嵌入 cond: (1, 77, 768) uncond: (1, 77, 768) |
| [2] | 拼接后送入 U-Net: (2, 77, 768) |
| [3] | 初始潜噪声: (1, 4, 64, 64) 元素数 = 16384 |
| 循环 | step 1/25 t=961 latents: (1, 4, 64, 64)step 13/25 t=481 latents: (1, 4, 64, 64)step 25/25 t=1 latents: (1, 4, 64, 64) |
| [4] | 降噪完成的潜变量: (1, 4, 64, 64) |
| [5] | VAE 解码后: (1, 3, 512, 512) |
| [6] | 已保存 corgi_stepwise.png 像素尺寸: (512, 512) |
(1, 4, 64, 64) 从头到尾一个数都没变,[5] 那一行是唯一一次尺寸跃迁。雕刻师二十五轮全在草稿纸上干活,放大师只出手一次。顺带注意
t 的走向:961 → 481 → 1,时间步是从大往小走的。t 大代表噪声多、离干净图远,所以降噪是「时间倒流」的过程。
4.2 图生图:不从纯噪声起步
图生图就是依赖图片和提示词进行二次创作,从而减少图片生成的随机性,更好地满足需求;它也可以生成带有深度信息的图像。
结构上它和文生图只差一处,但这一处是整节的关键:
换成比喻:文生图是给雕刻师一张全新的、撒满雪花的空白草稿纸;图生图是把你已有的画先缩微成一张草稿,再往上撒一层薄雪花交给他。原画的构图还透得出来,他擦掉雪花时自然会顺着原有的轮廓走。
撒多厚,由 strength 决定——这是图生图唯一的新参数:
| strength | 实际步数(steps=30) | 原图还剩多少 | 适合做什么 |
|---|---|---|---|
| 0.2 | 6 | 几乎全保留 | 轻微润色、调质感,构图纹丝不动 |
| 0.4 | 12 | 构图与配色保留 | 局部细节重画、小幅换材质 |
| 0.6 | 18 | 只剩构图 | 换风格(照片转水彩、线稿上色),常用起点 |
| 0.8 | 24 | 仅剩大色块 | 只借个构图,内容基本重画 |
| 1.0 | 30 | 全没了 | 等价于文生图,你给的图完全不起作用 |
# -*- coding: utf-8 -*-
"""图生图:不从纯噪声起步,而是从一张已有图片的潜表示起步。

和文生图唯一的结构差别在 strength:
    strength=1.0  → 原图的潜表示被噪声完全淹没,等价于文生图
    strength=0.6  → 只走 60% 的降噪步数,原图的构图与色块还看得出来
    strength=0.2  → 几乎只做轻微润色
"""
import torch
from diffusers import StableDiffusionImg2ImgPipeline
from PIL import Image

DEVICE = "cuda" if torch.cuda.is_available() else "cpu"
DTYPE = torch.float16 if DEVICE == "cuda" else torch.float32

pipe = StableDiffusionImg2ImgPipeline.from_pretrained(
    "runwayml/stable-diffusion-v1-5", torch_dtype=DTYPE).to(DEVICE)

# ① 读入起点图。SD v1 的潜空间是 8 倍下采样,边长建议是 8 的倍数,
#    否则内部会自动裁剪,出图和你给的图对不齐。
init = Image.open("input.png").convert("RGB").resize((512, 512))

generator = torch.Generator(device="cpu").manual_seed(1024)

# ② strength 决定「往原图上撒多厚的一层噪声」。
#    实际执行的步数 = int(num_inference_steps * strength),
#    所以 strength 调小时,出图也会更快。
out = pipe(
    prompt="watercolor painting, soft pastel colors, delicate brush strokes",
    negative_prompt="photo, 3d render, lowres",
    image=init,
    strength=0.6,
    num_inference_steps=30,     # 实际只跑 30 * 0.6 ≈ 18 步
    guidance_scale=7.5,
    generator=generator,
).images[0]

out.save("img2img_out.png")
print("saved img2img_out.png", out.size)
int(num_inference_steps × strength)。所以 strength=0.4 时只跑 12 轮,比文生图的 30 轮快一倍多。做批量微调润色时,这是白捡的速度。
4.3 图像修复:只让一块地方重画
图像修复通过替换和填充图像中指定区域的纹理与像素,使其与周围纹理和像素融为一体,达到自然和谐的修复效果。典型用途是抹掉路人、把裁掉的边重新画出来、换掉画面里的某个物体。
它比图生图又多了一个输入:mask(掩码)。约定是白色区域要重画、黑色区域原样保留。潜空间里的动作变成了「只在 mask 圈中的那一块撒雪花,其余部分每一轮都用原图的潜表示按住」——所以周围纹理才接得上。
# -*- coding: utf-8 -*-
"""图像修复(inpaint):只让潜空间里被 mask 圈中的那一块重新生成。

mask 的约定:
    白色(255)= 要重画的区域
    黑色(0)  = 要原样保留的区域
mask 必须和原图同尺寸,否则内部 resize 会让边界错位。
"""
import torch
from diffusers import StableDiffusionInpaintPipeline
from PIL import Image

DEVICE = "cuda" if torch.cuda.is_available() else "cpu"
DTYPE = torch.float16 if DEVICE == "cuda" else torch.float32

# 注意模型不是 v1-5 那个:inpaint 用的是专门多训了一路 mask 输入的权重,
# U-Net 的输入通道数从 4 变成 9(4 潜变量 + 4 掩码图潜变量 + 1 掩码)。
pipe = StableDiffusionInpaintPipeline.from_pretrained(
    "runwayml/stable-diffusion-inpainting", torch_dtype=DTYPE).to(DEVICE)

init = Image.open("room.png").convert("RGB").resize((512, 512))
mask = Image.open("room_mask.png").convert("L").resize((512, 512))

generator = torch.Generator(device="cpu").manual_seed(2048)

out = pipe(
    prompt="a green potted plant on the table, natural light",
    negative_prompt="blurry, distorted, artifacts",
    image=init,
    mask_image=mask,
    num_inference_steps=30,
    guidance_scale=7.5,
    generator=generator,
).images[0]

out.save("inpaint_out.png")
print("saved inpaint_out.png", out.size)
runwayml/stable-diffusion-inpainting 而不是 v1-5。原因在 U-Net 的输入通道数上:普通模型是 4 通道(就是那张草稿纸),inpaint 模型是 9 通道——4 个潜变量 + 4 个掩码图的潜变量 + 1 个掩码本身。拿普通模型硬做 inpaint 不会报错,但边界会明显接不上,出现一圈突兀的痕迹。
4.4 看着雪花一轮轮被擦掉
4.1 那份代码打印的是形状,形状全程不变,看久了反而让人怀疑「到底有没有在变」。变的是内容——那 16384 个数的分布。想看见它,只需要在循环中途临时调一次 VAE 解码,把当前潜变量还原成图片。
diffusers 为此留了一个回调钩子 callback_on_step_end:每一步结束后被调用一次,参数里带着当前的 latents,可以看、也可以改,原样返回就等于不干预循环。
# -*- coding: utf-8 -*-
"""把降噪循环中途的潜变量解码出来,看雕刻师是怎么一轮轮把雪花擦掉的。

这份脚本的唯一目的是「眼见为实」:
它在循环里每隔几步就临时调一次 VAE 解码,把当前潜变量还原成图片存盘。
跑完会得到一组 step_00.png … step_24.png,连起来就是一张图的诞生过程。

注意:中途解码只是为了观察。正式出图时 VAE 只在最后跑一次——
每解码一次就多一次完整的放大开销,中途解码会让出图慢好几倍。
"""
import os

import numpy as np
import torch
from diffusers import StableDiffusionPipeline
from PIL import Image

MODEL = "runwayml/stable-diffusion-v1-5"
DEVICE = "cuda" if torch.cuda.is_available() else "cpu"
DTYPE = torch.float16 if DEVICE == "cuda" else torch.float32

PROMPT = "a photo of a corgi wearing sunglasses, studio lighting, 8k"
NEGATIVE = "lowres, blurry, watermark"
STEPS = 25
GUIDANCE = 7.5
SEED = 1024
PEEK_EVERY = 3            # 每隔几步存一张
OUT_DIR = "peek"

pipe = StableDiffusionPipeline.from_pretrained(MODEL, torch_dtype=DTYPE).to(DEVICE)
os.makedirs(OUT_DIR, exist_ok=True)


def latents_to_image(latents):
    """把 (1, 4, 64, 64) 的潜变量解码成 PIL 图片。

    0.18215 这个缩放因子必须先除回去,否则颜色整体偏掉。
    """
    with torch.no_grad():
        img = pipe.vae.decode(latents / pipe.vae.config.scaling_factor).sample
    img = (img / 2 + 0.5).clamp(0, 1)
    img = img.detach().cpu().permute(0, 2, 3, 1).float().numpy()
    return Image.fromarray((img * 255).round().astype(np.uint8)[0])


def on_step(pipe_ref, step_index, timestep, callback_kwargs):
    """diffusers 的回调钩子:每一步结束后被调用一次。

    callback_kwargs 里带着当前的 latents,可以看、也可以改;
    原样返回就等于不干预循环。
    """
    latents = callback_kwargs["latents"]
    if step_index % PEEK_EVERY == 0 or step_index == STEPS - 1:
        path = os.path.join(OUT_DIR, "step_%02d.png" % step_index)
        latents_to_image(latents).save(path)
        # 顺便打印潜变量的统计量:标准差会随着噪声被擦掉而单调下降
        print("step %2d  t=%-4d  std=%.3f  -> %s"
              % (step_index, int(timestep), float(latents.std()), path))
    return callback_kwargs


generator = torch.Generator(device="cpu").manual_seed(SEED)
image = pipe(
    prompt=PROMPT,
    negative_prompt=NEGATIVE,
    num_inference_steps=STEPS,
    guidance_scale=GUIDANCE,
    generator=generator,
    callback_on_step_end=on_step,
    callback_on_step_end_tensor_inputs=["latents"],
).images[0]

image.save(os.path.join(OUT_DIR, "final.png"))
print("完成,逐步图在 %s/ 下" % OUT_DIR)
跑完会得到一组 step_00.png … step_24.png,连起来就是一张图的诞生过程。终端输出里那个 std 值最能说明问题——它是潜变量的标准差,随着噪声被擦掉而单调下降:
| step | timestep t | latents 标准差 | 解码出来长什么样 |
|---|---|---|---|
| 0 | 961 | 高 | 一团彩色噪点,看不出任何内容 |
| 3 | 841 | ↓ | 大色块浮现,能看出主体大致在哪、背景什么色调 |
| 9 | 601 | ↓ | 轮廓成形,能认出是只狗,五官还是糊的 |
| 15 | 361 | ↓ | 五官、毛发纹理开始清晰,墨镜出现 |
| 24 | 1 | 低 | 细节收敛,与最终成品几乎没有区别 |
② 为什么图生图的 strength 能控制「保留多少原图」——从第 15 步那个状态起步,构图已经被原图钉住了,剩下的 10 步只够改质感;从第 3 步起步,则连主体位置都还能挪。
4.5 参数对照实验:一次只改一个
知道了每个参数对应原理里的哪一步,还得知道它们各自调到什么程度会出什么事。唯一靠谱的做法是固定 seed,一次只改一个参数,出一张横向网格图。
# -*- coding: utf-8 -*-
"""参数对照实验:固定 seed,一次只改一个参数,出一张网格图。

这是调参唯一靠谱的做法。seed 一旦随机,你就永远分不清
「这次好看」是参数调对了,还是单纯抽到了好牌。

跑完得到三张网格:
    grid_steps.png      只改 steps
    grid_guidance.png   只改 guidance_scale
    grid_sampler.png    只改采样器
"""
import torch
from diffusers import (StableDiffusionPipeline, DDIMScheduler,
                       EulerDiscreteScheduler, EulerAncestralDiscreteScheduler,
                       DPMSolverMultistepScheduler)
from PIL import Image

MODEL = "runwayml/stable-diffusion-v1-5"
DEVICE = "cuda" if torch.cuda.is_available() else "cpu"
DTYPE = torch.float16 if DEVICE == "cuda" else torch.float32

# 全程不变的基准设置
PROMPT = "a photo of a corgi wearing sunglasses, studio lighting, 8k"
NEGATIVE = "lowres, bad anatomy, watermark"
SEED = 1024
BASE_STEPS = 25
BASE_GUIDANCE = 7.5

pipe = StableDiffusionPipeline.from_pretrained(MODEL, torch_dtype=DTYPE).to(DEVICE)
default_scheduler_config = pipe.scheduler.config


def draw(**over):
    """每次都用同一个 seed 新建 generator——这是「唯一变量」的保证。

    generator 用一次就被消耗掉一部分随机状态,
    复用同一个对象会导致第二张图的起点噪声和第一张不同。
    """
    generator = torch.Generator(device="cpu").manual_seed(SEED)
    kwargs = dict(prompt=PROMPT, negative_prompt=NEGATIVE,
                  num_inference_steps=BASE_STEPS,
                  guidance_scale=BASE_GUIDANCE, generator=generator)
    kwargs.update(over)
    return pipe(**kwargs).images[0]


def grid(images, labels, path, cell=512):
    """把若干张图横向拼成一张网格,便于一眼横向对比。"""
    canvas = Image.new("RGB", (cell * len(images), cell), "white")
    for i, img in enumerate(images):
        canvas.paste(img.resize((cell, cell)), (i * cell, 0))
    canvas.save(path)
    print("%s  <-  %s" % (path, " | ".join(str(x) for x in labels)))


def sweep_steps():
    """步数:20~30 之后收益急剧递减,耗时却是线性增长的。"""
    values = [5, 10, 20, 30, 50]
    imgs = [draw(num_inference_steps=v) for v in values]
    grid(imgs, values, "grid_steps.png")


def sweep_guidance():
    """引导强度:1 几乎不听提示词,7~8 通用,15 以上过饱和、细节崩坏。"""
    values = [1.0, 4.0, 7.5, 12.0, 20.0]
    imgs = [draw(guidance_scale=v) for v in values]
    grid(imgs, values, "grid_guidance.png")


def sweep_sampler():
    """采样器:换它不需要重新加载模型,因为它没有权重。

    Euler a 带随机性(ancestral),步数改一格图就大变;
    其余几个是确定性采样器,适合先把 prompt 和 seed 调稳。
    """
    schedulers = {
        "DDIM": DDIMScheduler,
        "Euler": EulerDiscreteScheduler,
        "Euler_a": EulerAncestralDiscreteScheduler,
        "DPMpp2M": DPMSolverMultistepScheduler,
    }
    imgs, labels = [], []
    for name, cls in schedulers.items():
        pipe.scheduler = cls.from_config(default_scheduler_config)
        imgs.append(draw())
        labels.append(name)
    # 用完把采样器换回默认,免得影响后续调用
    pipe.scheduler = type(pipe.scheduler).from_config(default_scheduler_config)
    grid(imgs, labels, "grid_sampler.png")


if __name__ == "__main__":
    sweep_steps()
    sweep_guidance()
    sweep_sampler()
这份代码里有一个坑值得单独点出来:draw() 每次都新建一个 generator,而不是复用外面那一个。因为 generator 用一次就会消耗掉一部分随机状态,复用同一个对象的话,第二张图的起点噪声和第一张根本不同,「唯一变量」的前提就塌了——这种翻车很隐蔽,图看起来也是正常的,只是对照实验彻底失效。
三组扫描分别会看到什么
| steps | 现象 |
|---|---|
| 5 | 明显未收敛,画面糊、结构断裂,像没擦完的草稿 |
| 10 | 主体成形但细节毛躁,边缘有噪点残留 |
| 20~30 | 收敛区间,两张图之间的差别已经很小 |
| 50 | 与 30 步几乎看不出差别,耗时却翻了近一倍 |
| guidance_scale | 现象 |
|---|---|
| 1.0 | 几乎不听提示词,输出接近底模的「随便画点什么」 |
| 4.0 | 听了一半,主体对了但风格词基本没落实 |
| 7.5 | 通用值,提示词落实且画面自然 |
| 12.0 | 开始过饱和,颜色变艳、对比拉高 |
| 20.0 | 崩坏:边缘焦黑、纹理碎裂,典型的外推过头 |
| 采样器 | 同 seed 同步数下的差异 |
|---|---|
DDIM | 确定性,构图与其他确定性采样器接近,质感偏平实 |
Euler | 确定性,干净利落,适合做基线对照 |
Euler a | 构图可能和上面两个完全不同——它每步掺新噪声,步数改一格图就大变 |
DPM++ 2M | 同样步数下细节更扎实,所以社区默认拿它当首选 |
把三组网格摆在一起看,一个规律会自己浮出来:steps 和 guidance_scale 都有一个「够用就停」的甜区,越界只会变差;而采样器没有好坏,只有合不合适。这也是为什么骨架模板把这三个参数放在最顶上——它们是你每天都要拧的旋钮,其余的基本一次设定终身不动。
4.6 三种用法对比
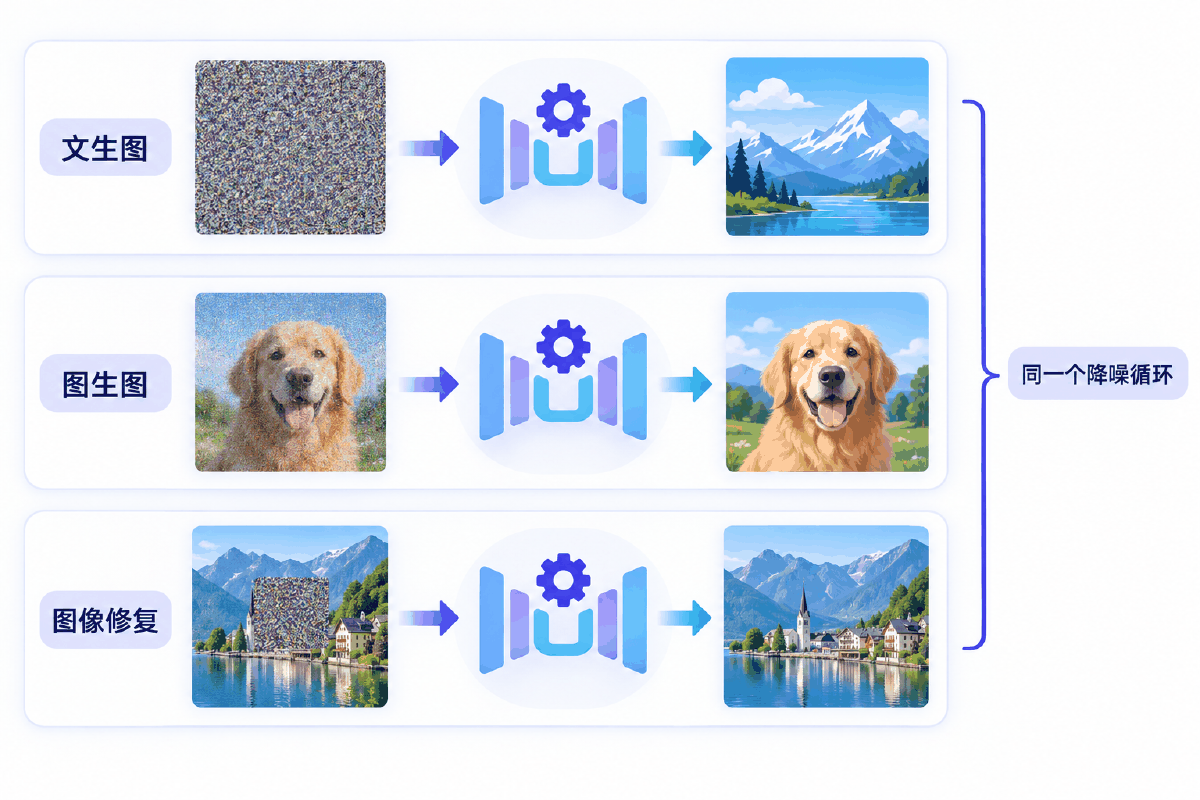
Stable Diffusion 的三个应用场景——文生图把输入的文字转化为图像效果,使文本更加生动;图生图依赖图片和提示词进行二次创作;图像修复替换和填充指定区域。三者的差别,全部集中在「循环的起点是什么」这一件事上:
| 对比项 | 文生图 txt2img | 图生图 img2img | 图像修复 inpaint |
|---|---|---|---|
| 起点 | 纯随机噪声 | 原图潜表示 + 部分噪声 | 原图潜表示,仅 mask 区加噪 |
| 用到 VAE 编码器 | 否 | 是 | 是 |
| 额外输入 | 无 | image + strength | image + mask_image |
| 实际循环轮数 | steps | steps × strength | steps |
| U-Net 输入通道 | 4 | 4 | 9(需专用权重) |
| 降噪循环 | 完全相同的一套——预测噪声、按比例减、重复 | ||
| VAE 解码 | 都只在最后跑一次 | ||
最后两行是本节的结论:三种用法共用同一个雕刻师、同一套擦法、同一个放大师,差别只在交到雕刻师手上的那张草稿纸是什么样的。理解了这一点,以后遇到 ControlNet、图生视频这类新玩法,第一个该问的问题也就明确了——它改的是起点,还是改了循环本身。
05骨架模板:拿去改就能用
参数集中在顶部,出图参数与图片一起落盘
前面四份代码各讲一件事,真正天天用的是这一份。它把所有可调项集中在文件顶部的参数区,下面的逻辑一个字都不用动;改 TODO 处即可。
| 它比前面的示例多做了什么 | 为什么必须有 |
|---|---|
| 参数区与逻辑区分离 | 改 prompt 不用在代码里翻找,也不会误删别的行 |
| seed 写成列表批量出图 | 同一套参数多抽几张再挑,比反复手动改 seed 快得多 |
每张图配一份同名 .json | 三天后还能复现。只存图不存参数,等于把这张图判了死刑 |
| 模型路径走环境变量 | 本地调试与服务器部署共用一份代码,不用改源码 |
| 显存兜底两行注释 | 爆显存时打开 enable_attention_slicing,用时间换空间 |
# -*- coding: utf-8 -*-
"""可复制的出图脚本骨架:所有可调参数集中在顶部,下面的逻辑一个字都不用改。

用法:
    python3 sd_generate_skeleton.py
    改 TODO 处即可;批量出图把 SEEDS 写成多个值。
"""
import os
import json
import torch
from diffusers import StableDiffusionPipeline

# ==========================================================================
# 参数区:只改这一块
# ==========================================================================
# TODO 1:模型路径。可以是 HuggingFace 仓库名,也可以是本地目录。
MODEL_PATH = os.environ.get("SD_MODEL", "runwayml/stable-diffusion-v1-5")

# TODO 2:正向提示词。主体 → 细节 → 风格 → 画质,逗号分隔,越靠前权重越高。
PROMPT = "a photo of a corgi wearing sunglasses, studio lighting, 8k, highly detailed"

# TODO 3:负向提示词。写你「不想要」的东西,这是最省事的质量开关。
NEGATIVE_PROMPT = "lowres, bad anatomy, extra fingers, watermark, text, blurry"

# TODO 4:采样步数。20~30 足够,再高收益递减、耗时线性增长。
STEPS = 25

# TODO 5:提示词引导强度。7~8 是通用值;调太高画面会过饱和、细节崩坏。
GUIDANCE_SCALE = 7.5

# TODO 6:随机种子列表。同一个 seed + 同一套参数 = 同一张图。
#         写 None 表示每次都随机(不可复现,调参阶段不要用)。
SEEDS = [1024, 2048, 4096]

# TODO 7:出图尺寸。必须是 8 的倍数;SD v1 系列在 512 附近训练,
#         直接拉到 1024 容易出现「双头/重复肢体」,要放大请用 upscale 流程。
WIDTH, HEIGHT = 512, 512

# TODO 8:输出目录
OUT_DIR = "outputs"
# ==========================================================================


def build_pipe():
    device = "cuda" if torch.cuda.is_available() else "cpu"
    dtype = torch.float16 if device == "cuda" else torch.float32
    pipe = StableDiffusionPipeline.from_pretrained(MODEL_PATH, torch_dtype=dtype)
    pipe = pipe.to(device)
    # 显存紧张时打开下面两行,用时间换空间
    # pipe.enable_attention_slicing()
    # pipe.enable_vae_slicing()
    return pipe, device


def main():
    os.makedirs(OUT_DIR, exist_ok=True)
    pipe, device = build_pipe()

    seeds = SEEDS if SEEDS else [torch.seed() % (2 ** 32)]
    for seed in seeds:
        generator = torch.Generator(device="cpu").manual_seed(int(seed))
        image = pipe(
            prompt=PROMPT,
            negative_prompt=NEGATIVE_PROMPT,
            num_inference_steps=STEPS,
            guidance_scale=GUIDANCE_SCALE,
            width=WIDTH,
            height=HEIGHT,
            generator=generator,
        ).images[0]

        stem = os.path.join(OUT_DIR, "seed_%d" % seed)
        image.save(stem + ".png")

        # 出图参数与图片一起落盘。没有这一步,三天后你就再也复现不出这张图。
        meta = {
            "model": MODEL_PATH, "prompt": PROMPT,
            "negative_prompt": NEGATIVE_PROMPT, "steps": STEPS,
            "guidance_scale": GUIDANCE_SCALE, "seed": int(seed),
            "size": [WIDTH, HEIGHT], "device": device,
        }
        with open(stem + ".json", "w", encoding="utf-8") as f:
            json.dump(meta, f, ensure_ascii=False, indent=2)
        print("saved", stem + ".png")


if __name__ == "__main__":
    main()
prompt 该怎么写
模板里 PROMPT 的写法遵循一个固定顺序,这不是玄学,而是由 2.4 节那个「77 个 token」的事实决定的——越靠前的词越不容易被截断,权重也更高:
| 位置 | 写什么 | 例子 |
|---|---|---|
| ① | 主体 | a photo of a corgi |
| ② | 主体的细节 | wearing sunglasses, sitting on grass |
| ③ | 风格与光线 | studio lighting, watercolor style |
| ④ | 画质词 | 8k, highly detailed |
负向提示词则是最省事的质量开关,通用起手式:lowres, bad anatomy, extra fingers, watermark, text, blurry。它不需要对应画面里的任何东西,写的是「不想要的方向」,由 classifier-free guidance 反向推开。
masterpiece, best quality, ultra detailed, 8k, uhd, hdr... 堆一长串。这些词挤占的是那 77 个 token 的名额,把真正描述主体的词顶出去。四到六个画质词就够了,多出来的收益几乎为零,代价却是主体描述被截断。
06易错点汇总
按「概念 / 维度 / 参数 / 环境 / 三种用法」五类归并,踩过一次就别再踩
⚠️ 一、概念层面
- 以为 Stable Diffusion 是一个模型。 它是多个模型组成的运作系统:ClipText 文本编码器、U-Net 与 Scheduler、VAE 解码器。下载一个 4 GB 的
.safetensors时,你拿到的是这三者打包在一起的权重,不是单一网络。 - 把 SD WebUI 当成 Stable Diffusion 本身。 WebUI 只是操作模型的网页端界面,通过它控制模型出图而无需学习代码。界面没装、界面崩了,模型本身一点事没有。
- 分不清 Latent Diffusion 与 Stable Diffusion。 前者是慕尼黑大学 CompVis 与 Runway 合作研发的算法改进,后者是 Stability AI 参与、基于它训出来的具体模型,名字来自公司名 Stability AI。
- 以为扩散模型是「一步把噪声变成图」。 一步到位是做不到的,所以才拆成「先想清 t 与 t−1 的关系,再一步步向前推导」。这正是采样循环存在的理由。
- 以为 U-Net 输出的是图像。 它输出的是预测出来的噪声,形状和输入完全一样。变量名叫
noise_pred不是随便起的。 - 以为 CLIP 在出图过程中会学习。 模型的参数是冻结的,在图像生成过程中参数不会发生变化。翻译官只翻译,不学新词。
⚠️ 二、维度与潜空间
- 把潜空间的
4×64×64当成「64×64 的缩略图」。 那 4 个通道不是 RGB,是抽象特征通道,直接当图片存出来是一团彩色噪点。它是语义骨架,不是缩略图。 - 忘了 8 倍下采样的换算。 出图边长 ÷ 8 = 潜空间边长。要 768 的图,草稿纸是 96×96,显存按面积涨而不是按边长涨。
- 出图尺寸没写成 8 的倍数。 比如写 500,内部会自动裁到 496,导致你给的 mask 或初始图和输出错位半个像素块。
- 以为 prompt 越长模型看得越全。 固定 77 个 token,超出直接截断。把画质词堆成长串,真正的主体描述反而被顶出去了。
- 手写流水线时漏了
vae.config.scaling_factor(0.18215)。 解码前不除回去,出图颜色整体偏掉,还会误以为是模型坏了。 - 漏了
scheduler.init_noise_sigma。 初始噪声尺度不对,前几轮减法比例全错,出图发灰发糊。
⚠️ 三、参数与复现
- 不固定 seed 就调参。 图变好看了,你分不清是参数对了还是抽到了好牌。固定 seed、一次只改一个参数,差异才归因得清。
- 只存图不存参数。 三天后想复现同一张图,prompt 的某个逗号记不清了就永远回不去。出图脚本必须把参数写进同名 JSON。
- 以为固定了 seed 就一定复现。 换显卡、换 fp16/fp32、换
diffusers版本、把 batch 从 1 改成 4,都可能让结果变化。复现的前提是整套环境也一致。 guidance_scale拉到 15 以上。 外推过头,画面过饱和、边缘焦黑、细节崩坏。7~8 是通用值。- 步数开到 100 求质量。 20~30 步之后收益急剧递减,耗时却是线性增长的。想提质量该换采样器或换模型,不是加步数。
- 一上来就用
Euler a调 prompt。 它带随机性,步数改一格图就大变,你会误判成 prompt 写错了。先用确定性采样器把 prompt 和 seed 调稳。 - 把 512 直接改成 1024 求大图。 SD v1 在 512 附近训练,直接拉大会出现双头、多肢。正确做法是 512 出图 + upscale 放大。
⚠️ 四、环境与显存
- 没显卡时只把
to("cuda")改成to("cpu")。 必须同时把torch_dtype从float16改回float32,否则 CPU 上的 fp16 算子直接报错。 torch.Generator(device=...)写错设备。 在 CUDA 与 CPU 上用同一个 seed 生成的随机张量并不相同。想跨设备复现,统一写device="cpu"再搬上显卡。- 爆显存就换小模型。 先试
enable_attention_slicing()和enable_vae_slicing(),用时间换空间;再不行才考虑降分辨率。 - MacOS 上按默认配置硬跑。 MacOS 默认配置下仅支持 CPU 运算,图形性能较差、插件支持有限、训练模型困难。推荐使用搭载 N 卡的 Windows 系统,或直接上云端 GPU。
- 显存看着够却还是 OOM。 注意最低配置是显存 6 GB、推荐 8 GB 以上;同时开着浏览器、别的模型或 WebUI 时,实际可用显存远小于标称值。
⚠️ 五、图生图与图像修复
- 图生图把
strength设成 1.0 还纳闷原图没起作用。 1.0 就是把原图的潜表示彻底淹没,等价于文生图。想保留构图用 0.4~0.6。 - 忘了
strength会连带改变实际步数。 实际步数是steps × strength。设steps=10, strength=0.2只跑 2 步,出图必然是半成品。 - 起点图尺寸不是 8 的倍数、或和输出尺寸不一致。 内部 resize 会让构图偏移,看起来像模型没听话。
- inpaint 用了普通的 v1-5 权重。 普通模型 U-Net 是 4 通道输入,inpaint 专用模型是 9 通道。混用不报错,但修复边界会留下一圈明显痕迹。
- mask 的黑白反了。 白色是要重画的区域,黑色是保留。反了就变成把整张图重画、只留那一小块。
- mask 和原图尺寸不一致。 两者必须同尺寸,否则缩放后边界错位,修复区域会歪。
- 指望 inpaint 修一个占满全图的区域。 mask 太大时它就退化成了文生图,周围没有足够的上下文可以参照,融合自然接不上。
07自测题
点击题目展开答案;能把这 12 题说清楚,这一讲就通了
Diffusion Model、Latent Diffusion Model、Stable Diffusion、SD WebUI 分别是什么关系?
四个层级。Diffusion Model 是算法思想,DALL·E、Midjourney、Imagen、Stable Diffusion 底层都基于它;Latent Diffusion Model 是在它基础上的算法改进,把扩散搬进潜空间,速度更快、资源消耗更低;Stable Diffusion 是底层采用潜在扩散模型的具体模型,名字来自研发公司 Stability AI;SD WebUI 只是操作这个模型的网页端界面,通过它控制模型出图而无需学习代码。
Stable Diffusion 是由哪些团队合作开发的?各自贡献了什么?
由 Stability AI、CompVis 和 Runway 三方合作开发。Latent Diffusion 模型由慕尼黑大学的机器学习研究小组 CompVis 和纽约的 Runway 团队合作研发,特点是生成速度快、消耗需求小;训练模型需要高昂的计算成本,Stability 投入资源。2022 年 8 月 10 日先向研究者小范围内测,8 月 22 日正式开源。
为什么说 Stable Diffusion 的「出图快」不是模型本身更聪明?
快慢的分水岭在部署位置和数据量两件事上。商业级 AI 应用都是通过访问云服务器操作,除了排队等候,网络延迟和资源过载都会降低效率;而本地部署的 SD 绘图效率完全由硬件决定,显卡跟得上甚至能 3 秒一张。更底层的原因是潜空间:每一轮只处理 16384 个数而不是 786432 个,少了 48 倍的计算量。
为什么要在潜空间而不是像素空间做扩散?用数字说。
图像空间是巨大的:具有三个颜色通道的 512×512 图像是一个 786432 维的空间,标准扩散模型在像素空间中进行,需要处理大量数据和高性能显卡。Stable Diffusion 先把图像压缩到潜空间,潜空间的张量是 4×64×64,只有 16384 个元素,小了 48 倍,而扩散循环要跑二十几轮,所以速度提升非常可观。
Stable Diffusion 的三个子模型各自的输入输出是什么?
ClipText 文本编码器:输入是文本 prompt,输出是文本的 token 嵌入向量,其中每个向量包含 768 个维度。
Diffusion 扩散模型(U-Net 和 Scheduler):输入是文本嵌入和一个由噪声组成的初始多维数组,输出是一个经过处理的数据。
VAE 模型:输入是处理过的信息矩阵,维度为 (4, 64, 64);输出是结果图像,各维度为 (3, 512, 512),即(红/绿/蓝,宽,高)。
U-Net 和 Scheduler 有什么区别?换掉哪一个不需要重新加载模型?
U-Net 是有权重的神经网络,负责预测当前潜变量里的噪声;Scheduler 没有权重,是一套算法,它定义降噪的步骤、是否具备随机性、查找去噪后样本的算法,因此又被称为采样算法。换采样器只是换一行代码,不用换模型;换 U-Net 就意味着换模型,要重新加载几 GB 权重。DreamBooth 与 LoRA 微调改的主要是 U-Net,Scheduler 永远不参与训练。
推理时 VAE 的编码器和解码器都会用到吗?
文生图只用解码器,而且整个过程只运行一次即可生成最终的像素图像。编码器在两种情况下才登场:训练底模时把训练图压进潜空间;图生图和图像修复时把你提供的起点图压进潜空间。这正是三种用法的差异来源。
完整复述文生图的五个步骤。
① Stable Diffusion 在潜空间中生成随机张量,可以通过设置随机数生成器来控制此张量,种子固定就能获得相同的随机张量。
② 网络 U-Net 将潜在噪声图像和文本提示作为输入,并预测噪声,也在潜在空间(4×64×64 张量)中。
③ 从潜在图像中减去潜在噪声,这将成为新潜在图像。
④ 步骤 2 和 3 重复一定数量的采样步骤,例如 20 次。
⑤ 最后,VAE 的解码器将潜在图像转换回像素空间,这就是运行 Stable Diffusion 后获得的图像。
从 prompt 到成品图,张量形状经历了哪几次变化?哪一步是唯一的尺寸跃迁?
文本 → (1, 77) token → (1, 77, 768) 嵌入;噪声起点 (1, 4, 64, 64),U-Net 每轮输出仍是 (1, 4, 64, 64),循环 N 轮之后形状始终没变;最后 VAE 解码输出 (1, 3, 512, 512)。唯一的尺寸跃迁就是最后这一次 VAE 解码,这正是本讲铁律的直接体现。
seed 为什么能复现同一张图?固定了 seed 就一定能复现吗?
整条流水线里唯一的随机来源是第 1 步那张潜噪声,U-Net 前向和 VAE 解码都是确定性的。seed 决定随机数生成器的起始状态,同一个 seed 就得到同一张初始张量,后面每一步必然一致。
但不一定能复现:改 steps、guidance_scale、采样器、出图尺寸、batch 大小都会变;换显卡、换 fp16/fp32、换库版本也可能因浮点累积误差产生细微差别。复现的前提是整套环境一致。
为什么第 3 步不能把 U-Net 预测出的噪声一次性全减掉?
因为「希望将 t 时刻的高斯噪声变成 0 时刻的图像,是很难一步到位的」。U-Net 预测的是「从当前状态到干净图总共混进去多少噪声」,Scheduler 根据当前处在第几步只按比例减掉其中一小部分,剩下的留给下一轮。一次全减掉会得到一张糊图。步数越多,每一步迈得越小越稳。
图生图和文生图在结构上到底差在哪?strength 控制的是什么?
只差起点:文生图从纯随机潜噪声开始;图生图先用 VAE 编码器把你的图压成潜表示,再往上加部分噪声,从这里开始降噪。strength 决定撒多厚的噪声,同时决定实际步数 = steps × strength。strength=1.0 时原图被彻底淹没,等价于文生图;0.4~0.6 保留构图、换风格。
图像修复为什么要用专门的权重?mask 的黑白怎么约定?
图像修复是通过替换和填充图像中指定区域的纹理与像素,使其与周围融为一体。inpaint 专用模型的 U-Net 输入通道是 9(4 潜变量 + 4 掩码图潜变量 + 1 掩码),普通模型只有 4 通道;混用不报错但边界会留下明显痕迹。mask 白色是要重画的区域,黑色是保留,且必须与原图同尺寸。
词术语表
| 术语 | 含义 |
|---|---|
| Diffusion Model | 扩散模型,向训练图像不断添加噪声直到变成纯噪声图、再学着逐步恢复的算法模型 |
| Latent Diffusion Model | 潜在扩散模型,把扩散过程搬进潜空间的改进版,速度更快、资源消耗更低 |
| latent space | 潜空间,低维空间。SD v1 里是 4×64×64 的张量,扩散的全部动作都在这里发生 |
| ClipText | 解析提示词的文本编码器,输出每个 token 768 维的嵌入向量,出图时参数冻结 |
| CLIP | OpenAI 提出的多模态神经网络,用对比学习把图文对齐,是文本控制图像生成的基础 |
| U-Net | 因形似 U 型字母得名的神经网络,原用于生物医学图像分割;在扩散模型里负责预测噪声 |
| Scheduler | 采样算法/采样器,定义降噪步骤、是否具备随机性、查找去噪后样本的算法;无权重,可随时更换 |
| VAE | 变分自动编码器,由编码器与解码器组成;推理时只用解码器,把潜变量还原成像素图,全程只跑一次 |
| token | 文本被切分后的最小单位。SD v1 固定 77 个,不足补齐、超出截断 |
| seed | 随机数生成器的起始状态编号;决定初始潜噪声,是复现同一张图的唯一开关 |
| steps | 采样步数,即「预测噪声 → 减去噪声」重复的轮数,常用 20~30 |
| guidance_scale | 提示词引导强度,classifier-free guidance 的外推距离,常用 7~8 |
| classifier-free guidance | 把正向与负向提示词拼成一个 batch 一次前向,再按引导强度外推的技巧 |
| negative prompt | 负向提示词,描述「不想要的方向」,由 guidance 反向推开 |
| strength | 图生图参数,决定往原图潜表示上撒多厚的噪声,同时决定实际步数 |
| inpaint | 图像修复,替换和填充指定区域的纹理与像素使其与周围融为一体;需 9 通道专用权重 |
| mask | 掩码图,白色区域重画、黑色区域保留,必须与原图同尺寸 |
| ControlNet / UpScale | 解决无法精准控图与图像分辨率低这两个痛点的扩展插件 |