循环神经网络 RNN 与词嵌入
文字是有先后的,全连接网络看不见这个先后。RNN 用一张随时被重写的便签把「刚才说了什么」带到下一步——这一页把词怎么变成向量、便签怎么被改写、以及它为什么记不住太远的话,全部拆开讲透。
30″30 秒看懂 RNN 与词嵌入
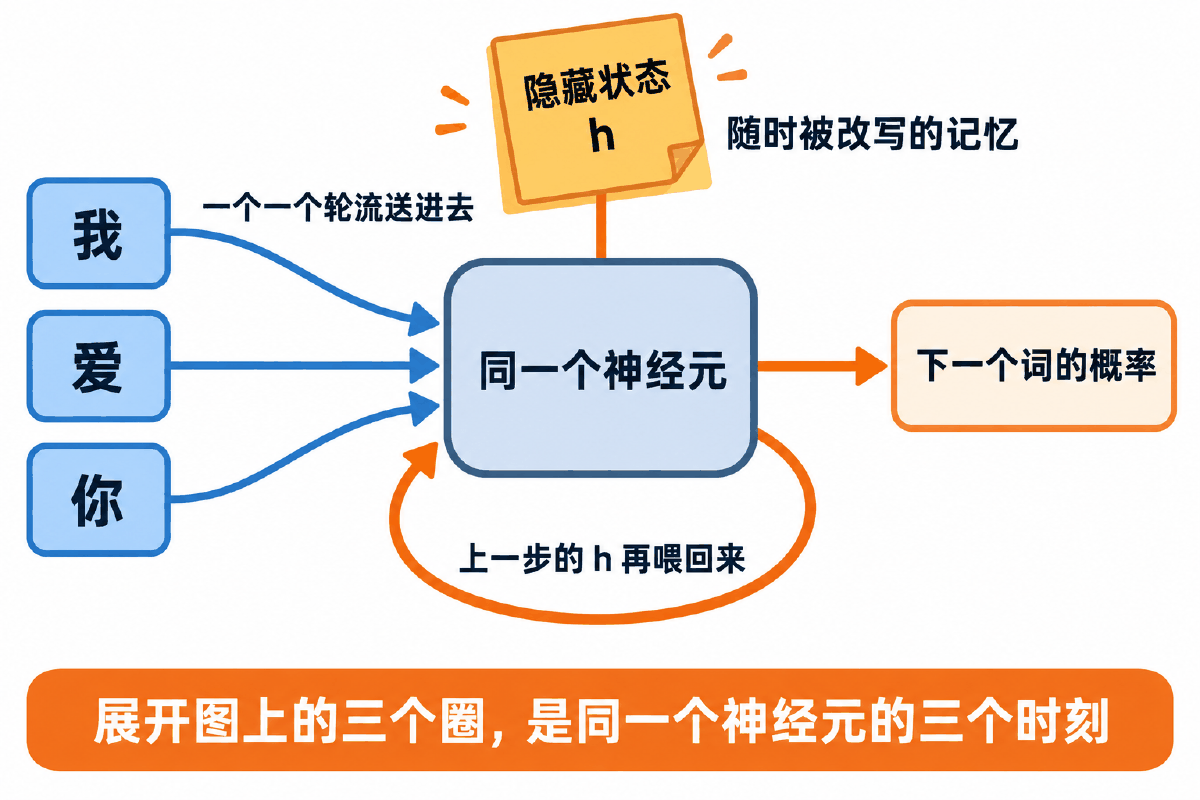
把 RNN 想成一个只有一张便签纸的速记员:你把一句话一个词一个词念给他听,他每听一个词,就把便签上的内容整张擦掉、重写一遍。他手上永远只有这一张便签,没有第二张,也不许回头翻记录。要他猜下一个词时,他就照着便签上此刻的内容猜。
这个速记员从头到尾只有一个人。后面所有展开图里画出来的三个、五个、一百个方块,画的都是同一个人在不同时刻——就像连环画里同一个角色出现在每一格,不代表有一百个角色。这是初学 RNN 时最容易看岔的一处。
还有一个前置问题:速记员听不懂汉字,他只认识数字。所以在开口念之前,得先把每个词翻译成一串数字——这就是词嵌入(embedding)干的活。它本质上是一本翻译词典:词表里有多少个词,词典就有多少页,每一页记着这个词对应的那一串数字。
| 比喻里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 速记员本人 | RNN 单元 | 全程只有一个,所有时间步共用同一套权重;展开图上的多个方块是同一个人的不同时刻 |
| 那张便签纸 | 隐藏状态 h | 网络对「到目前为止听到了什么」的全部记忆,是一个固定长度的向量 |
| 擦掉重写一遍 | h_t = tanh(…) | 每一步用「上一步的便签」和「这一步的词」算出新便签,整张覆盖,不是追加 |
| 开工前的空白便签 | h0 | 一般是全 0 张量,形状 (num_layers, batch, hidden_size) |
| 翻译词典 | nn.Embedding | 一张 词表大小 × embedding_dim 的矩阵,按索引取行,本身也是会被训练的参数 |
| 词典的页码 | 词表索引 | 每个词在词表里唯一的编号;送进 embedding 的是编号,不是汉字 |
| 照便签猜下一个词 | 全连接 + softmax | 把 h 映射到「词表里每个词的分数」,再归一化成概率 |
| 念得太久,开头记不清了 | 梯度消失 / 长依赖失效 | 便签被反复整张重写,早期信息一步步被稀释掉 |
h、BPTT、梯度消失、LSTM 的门控,全都是在这一句上做文章。
01概念:序列数据,以及它凭什么需要新结构
什么算序列、全连接网络卡在哪两点、词怎么从汉字变成向量
1.1 什么是序列数据
序列数据的唯一判据是:后面的数据和前面的数据有关系,调换顺序意思就变了。 这句话比「按时间排列的数据」更准,因为序列不一定和时间有关:
| 数据 | 一条样本长什么样 | 顺序一动会怎样 |
|---|---|---|
| 文本 | 「我 爱 你」三个词 | 换成「你 爱 我」意思就反了;换成「爱 你 我」直接不通顺 |
| 股价 | 连续 30 天的收盘价 | 打乱之后涨跌趋势完全消失,只剩一堆数字 |
| 语音 | 一段波形按帧切开 | 帧序一乱,音节就拼不出词 |
| 用户行为 | 浏览 → 加购 → 下单 | 顺序本身就是意图信号,倒过来毫无意义 |
| 反例:一张表的特征列 | 年龄、身高、收入 | 换列顺序结果不变——这就不是序列数据,用全连接就够了 |
最后一行很关键:判断该不该上 RNN,先问「把输入打乱,答案会不会变」。会变,才谈得上序列建模;不会变,硬上 RNN 只是白白增加训练难度。
1.2 全连接网络卡在哪两点
全连接网络处理文本时,会同时撞上两堵墙,而且两堵墙都绕不过去:
nn.Linear(in_features, …) 的 in_features 建层时就写死了。可句子有三个词的,也有三十个词的。要么全部截断/补齐到同一长度(丢信息、浪费算力),要么根本建不出这个层。
就算强行补齐,全连接把所有词一次性铺平成一个长向量。「我爱你」和「你爱我」铺平之后是同一堆数字的不同排列,网络得靠权重硬记每个位置——换个位置就不认识了,这叫没有位置泛化能力。
RNN 的解法是把这两堵墙一起拆掉:不一次性吃完整句话,改成一个词一个词地吃,中间带一张便签。于是句子多长都行(便签大小不变,循环多跑几步而已),而顺序天然被编码进了「谁先改写便签、谁后改写」里。
| 对比项 | 全连接网络 | RNN |
|---|---|---|
| 输入长度 | 建层时固定死 | 任意长度,循环次数随句子变化 |
| 参数量与句长的关系 | 正比增长,句子越长参数越多 | 无关,一套权重被所有时间步复用 |
| 顺序信息 | 只能靠位置权重硬记 | 由计算的先后顺序天然承载 |
| 能并行吗 | 能,整层一次矩阵乘 | 不能,第 t 步必须等第 t−1 步算完 |
| 长距离依赖 | 理论上能连,实际难学 | 近处好,远处会衰减——这是它最终被取代的原因 |
最后两行是伏笔:RNN 解决了长度和顺序,却新添了「不能并行」和「记不住远处」两个毛病。下一页的 Transformer 正是冲着这两条来的。
1.3 从 one-hot 到词嵌入
词要变成数字,最直觉的办法是 one-hot:词表有 N 个词,就用一个长度为 N 的向量,属于第几个词就把第几位置成 1、其余全是 0。这个方案有三个致命问题:
中文词表动辄五万起步,每个词就是一个五万维向量,其中 49999 个是 0。一句 20 个词的话,光输入就是 100 万个数。
任意两个 one-hot 向量的点积都是 0。在这套表示里,「北京」和「天安门」的关系,跟「北京」和「香蕉」的关系一模一样——全都是零相关。
向量里只有 0 和 1,是人为规定死的,训练过程改不动它,也就无法从数据里学到任何语义。
词嵌入把这三条一次解决:不再用「第几位是 1」表示一个词,而是给每个词分配一串稠密的小数(比如 128 个数)。这串数字是网络参数,会跟着训练一起被反向传播更新。训练充分之后,语义相近的词,它们的向量在空间里也会靠得更近。
"""one-hot 与 embedding 的正面对照:为什么查表比稀疏编码划算。

结论可以纯算术推导,不需要跑起来也能验证:
    词表 50000 词、想要 128 维表示
    one-hot   : 每个词 50000 维,其中 49999 个是 0
    embedding : 每个词 128 维,全是有意义的小数
"""
import torch
import torch.nn as nn


def one_hot(idx, vocab_size):
    """手写 one-hot:开一排 0,只有第 idx 位是 1。"""
    vec = torch.zeros(vocab_size)
    vec[idx] = 1.0
    return vec


def main():
    torch.manual_seed(0)

    vocab = ['我', '爱', '你', '北京', '天安门']
    vocab_size, embed_dim = len(vocab), 4

    # ------------------------------------------------------------ one-hot
    print('=== one-hot ===')
    for i, w in enumerate(vocab):
        print('%6s' % w, one_hot(i, vocab_size).tolist())
    # 看得出来三件事:
    #   1) 维度 = 词表大小,词表一大就爆炸
    #   2) 任意两个词的向量点积都是 0,"北京" 和 "天安门" 一样不相关
    #   3) 全是 0 和 1,没有任何可学的东西

    # ------------------------------------------------------------ embedding
    print('=== embedding ===')
    embed = nn.Embedding(num_embeddings=vocab_size, embedding_dim=embed_dim)
    print('嵌入矩阵形状', embed.weight.shape)       # (5, 4)

    ids = torch.tensor([0, 1, 2])                   # 我 爱 你
    vecs = embed(ids)
    print('三个词一次查表的输出形状', vecs.shape)     # (3, 4)

    # 查表的本质:embedding 的输出 = one-hot 矩阵乘嵌入矩阵,
    # 只是没人会真去乘一个 99.998% 都是 0 的矩阵,直接按下标取行就行
    manual = torch.stack([one_hot(i, vocab_size) for i in [0, 1, 2]]) @ embed.weight
    print('按下标取行 与 one-hot 乘矩阵 是否一致:',
          torch.allclose(vecs, manual))             # True

    # ------------------------------------------------------------ 规模账
    print('=== 规模账(50000 词,128 维)===')
    big_vocab, dim = 50000, 128
    print('one-hot   单词向量元素数 :', big_vocab)
    print('embedding 单词向量元素数 :', dim)
    print('embedding 矩阵总参数    :', big_vocab * dim)   # 6,400,000
    print('压缩比                  : %.1f 倍' % (big_vocab / dim))  # 390.6 倍

    # 注意:embedding 矩阵是网络参数,会被反向传播更新。
    # 一开始是随机数,训练之后语义相近的词,向量也会靠得更近。
    print('嵌入矩阵需要梯度吗:', embed.weight.requires_grad)   # True


if __name__ == '__main__':
    main()
代码里有一行值得单独拎出来:one_hot 矩阵 @ 嵌入矩阵 的结果,和直接按下标取行完全相等。这就是词嵌入的数学本质——它就是一次 one-hot 乘矩阵,只是没人会真去乘一个 99.998% 都是 0 的矩阵,直接按行号取就行了。所以 nn.Embedding 常被称作「查表层」,它的前向传播比任何一层都便宜。
| 对比项 | one-hot | 词嵌入 embedding |
|---|---|---|
| 向量长度 | = 词表大小(五万起步) | 人为指定,常见 64 / 128 / 256 / 768 |
| 稀疏还是稠密 | 极度稀疏,只有一个 1 | 稠密,每一维都有值 |
| 能否表达相似度 | 不能,任意两词点积恒为 0 | 能,相近的词向量距离更近 |
| 参数 | 没有参数,规则写死 | 整张矩阵都是参数,随训练更新 |
| 怎么取值 | 按规则构造 | 按索引查表(等价于乘 one-hot) |
02原理:从汉字到便签,再到便签为什么记不住远处
分词、查表、单元内部公式、API 形状、时间轴展开、梯度消失,以及门控的补救思路
2.1 分词与词表:一切的第一步
速记员只认数字,所以开工前必须先把文本加工成一串编号。这一步叫构建词表,只有三个动作:
中文没有天然空格,所以第一步要用分词器。工程上最常见的是 jieba:jieba.lcut(text) 返回一个词列表。切分粒度直接决定词表大小——按词切词表大但每个单位语义完整,按字切词表小(中文常用字几千个)但需要模型自己学词的组合。短文本生成任务按字切往往更稳,因为不会遇到未登录词。
| 切分粒度 | 词表规模 | 未登录词 | 适合场景 |
|---|---|---|---|
| 按字 | 几千 | 几乎没有 | 歌词/诗歌生成、小语料,模型要自己学词的边界 |
| 按词 | 几万到几十万 | 多,是主要痛点 | 分类、检索等语义单位更重要的任务 |
| 子词(BPE 等) | 三万左右 | 没有,拆成碎片兜底 | 今天的大模型几乎全用这一种,兼顾两者 |
去重这一步有个容易忽略的细节:必须保持稳定的顺序。用 list(set(words)) 去重虽然短,但 set 不保证顺序,每次跑同一份语料,同一个词拿到的索引可能都不一样——存下来的模型权重和新建的词表就对不上号了。正确做法是「不在列表里就追加」,保留首次出现的顺序。
2.2 词嵌入层在做什么
翻译词典建好之后,查表就是一行 API。nn.Embedding 建的时候只关心两个数:
| 参数 | 含义 | 写错的后果 |
|---|---|---|
num_embeddings | 词表里一共多少个词 = 矩阵有多少行 | 写小了,遇到大索引直接 IndexError;写大了白占参数 |
embedding_dim | 每个词用多少维表示 = 每行多长 | 要和后面 nn.RNN 的 input_size 严格对齐,否则矩阵乘法报错 |
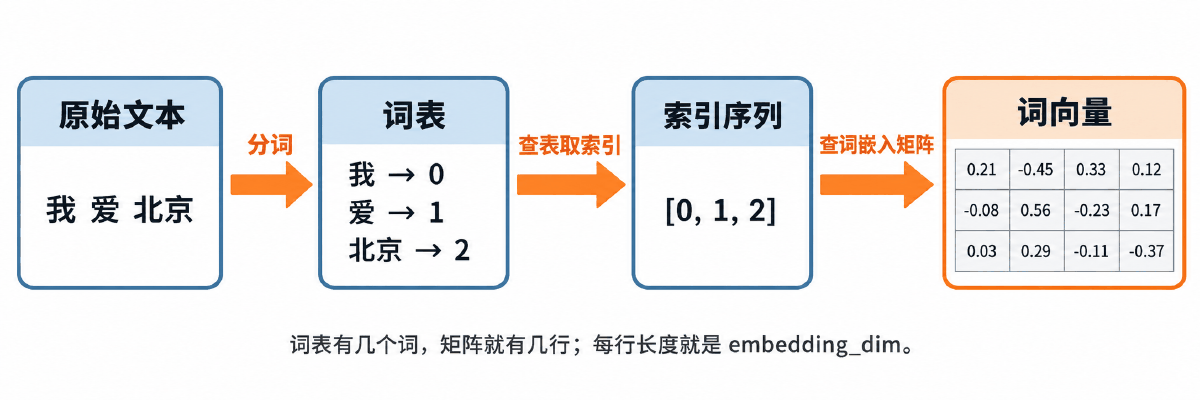
图里这条链要逐段读清楚,每一段都有一个具体的数据形态:
- 原始文本 →(分词)→ 词列表。 这一步的产物是字符串列表,还没有任何数字。
- 词列表 →(去重编号)→ 词表。 产物是两个字典:
word_to_index用于把文本转成索引,index_to_word用于把模型输出的索引翻回汉字。两个方向都要留着,生成任务里缺一个就没法把结果打印出来。 - 词表 →(查表取索引)→ 索引序列。 产物是一串
int64。注意送进nn.Embedding的必须是整型,传浮点会直接报错。 - 索引序列 →(查嵌入矩阵)→ 词向量矩阵。 产物形状是
(词数, embedding_dim)。图底下那句话是判断形状对不对的口诀:词表有几个词,矩阵就有几行;每行长度就是embedding_dim。
形状的变化规律只有一条,记住就不会算错:embedding 层在输入张量的最后添加一个维度。输入 (batch, seq_len) 的索引,输出就是 (batch, seq_len, embedding_dim);输入一个标量索引,输出就是一个 (embedding_dim,) 的向量。
embed.weight 是一堆随机数,这时候「北京」和「香蕉」的向量并不比随机两个词更接近。语义是训练出来的,不是建层时就有的。要开局就带语义,就加载预训练词向量(Word2Vec、GloVe)来初始化,小语料上这能省下大量训练量。
2.3 RNN 单元内部:便签到底怎么被改写
现在进到速记员的脑子里。每个时间步,他做的事可以写成一条公式——而且只有这一条:
h_t = tanh( x_t · W_ihT + b_ih + h_t−1 · W_hhT + b_hh )
公式看着长,拆开只有三件事:
| 部件 | 形状 | 在比喻里是什么 |
|---|---|---|
x_t | (batch, input_size) | 这一步念给他听的那个词(已经查过表,是向量) |
h_t−1 | (batch, hidden_size) | 上一步写完的那张便签 |
W_ih / b_ih | (hidden, input) / (hidden,) | 「新听到的词该怎么记」的规则 |
W_hh / b_hh | (hidden, hidden) / (hidden,) | 「旧便签该怎么保留」的规则 |
tanh | — | 把结果压进 (−1, 1),防止便签上的数字一路放大到失控 |
h_t | (batch, hidden_size) | 新便签,整张覆盖旧的 |
两个加号是全部秘密所在:新便签 = 这一步的词贡献一份 + 上一步的便签贡献一份,加起来再压一压。「记忆」这件事没有任何神秘机制,就是这个加法。
还有一件事必须钉死:W_ih、W_hh、b_ih、b_hh 这四个张量,在所有时间步里是同一份。句子有 100 个词,就用这同一套权重循环 100 次。这叫参数共享,也正是「只有一个速记员」在代码层面的含义。下面这份把 nn.RNN 的权重搬出来、自己按公式循环一遍,两边数值对得上才算真看懂:
"""手写一个 RNN 单元,再和 nn.RNN 对账。

单元内部只有一条公式:
    h_t = tanh(x_t @ W_ih^T + b_ih  +  h_{t-1} @ W_hh^T + b_hh)
把 nn.RNN 的权重搬过来自己算一遍,两边数值一致才算真看懂。
"""
import torch
import torch.nn as nn


def rnn_cell(x_t, h_prev, w_ih, b_ih, w_hh, b_hh):
    """一个时间步:吃「这一步的词向量」和「上一步的 h」,吐新的 h。"""
    from_input = x_t @ w_ih.T + b_ih        # 当前输入贡献的那一份
    from_state = h_prev @ w_hh.T + b_hh     # 历史记忆贡献的那一份
    return torch.tanh(from_input + from_state)   # 两份相加再压到 (-1, 1)


def main():
    torch.manual_seed(0)

    input_size, hidden_size, seq_len = 3, 4, 5

    rnn = nn.RNN(input_size=input_size, hidden_size=hidden_size, num_layers=1)

    # nn.RNN 把四个参数摊在 _l0 后缀的属性里,形状分别是:
    #   weight_ih_l0 (hidden_size, input_size)
    #   weight_hh_l0 (hidden_size, hidden_size)
    #   bias_ih_l0 / bias_hh_l0 (hidden_size,)
    w_ih, b_ih = rnn.weight_ih_l0.detach(), rnn.bias_ih_l0.detach()
    w_hh, b_hh = rnn.weight_hh_l0.detach(), rnn.bias_hh_l0.detach()
    print('w_ih', tuple(w_ih.shape), ' w_hh', tuple(w_hh.shape))

    # 一句话、batch=1,默认布局是 (seq_len, batch, input_size)
    x = torch.randn(seq_len, 1, input_size)
    h0 = torch.zeros(1, 1, hidden_size)      # 全 0 起步:还没有任何记忆

    # -------------------------------------------------- 官方实现
    output, hn = rnn(x, h0)

    # -------------------------------------------------- 自己按公式循环
    h = h0[0]                                # (batch, hidden_size)
    manual_outputs = []
    for t in range(seq_len):
        h = rnn_cell(x[t], h, w_ih, b_ih, w_hh, b_hh)
        manual_outputs.append(h)             # 每一步的 h 就是这一步的 output
    manual_output = torch.stack(manual_outputs)

    print('官方 output 形状', output.shape)           # (5, 1, 4)
    print('手写 output 形状', manual_output.shape)    # (5, 1, 4)
    print('两边是否一致 :', torch.allclose(output, manual_output, atol=1e-6))
    print('hn 就是最后一步的 h :',
          torch.allclose(hn[0], manual_output[-1], atol=1e-6))

    # 三个必须记住的结论:
    #   1) output 是「每一步的 h 摞起来」,hn 是「最后一步的 h」,
    #      单层网络里 output[-1] 和 hn[0] 是同一个东西
    #   2) 所有时间步共用同一套 w_ih / w_hh —— 这就是「同一个神经元」的含义
    #   3) 参数量与句子长度无关:句子再长,参数还是这四个张量
    total = sum(p.numel() for p in rnn.parameters())
    print('参数量 :', total,
          '= 4*3 + 4*4 + 4 + 4 =', hidden_size * input_size
          + hidden_size * hidden_size + 2 * hidden_size)


if __name__ == '__main__':
    main()
代码末尾那行参数量核对值得留意:hidden×input + hidden×hidden + 2×hidden,整个式子里没有 seq_len。这就是 1.2 节那张表里「参数量与句长无关」的具体来源。
tanh 把每一步的输出锁死在 (−1, 1),是 RNN 能稳定跑起来的前提。代价是它的导数最大只有 1、且大部分区域远小于 1——这直接埋下了 2.6 节梯度消失的根。ReLU 在 RNN 里不是不能用,但必须配合严格的梯度裁剪和初始化,默认选择仍是 tanh。
2.4 nn.RNN 的入参与返回:形状是这一节的全部难点
实际写代码不需要自己写循环,nn.RNN 一层就把整个序列跑完了。建层时四个参数:
| 参数 | 含义 | 怎么定 |
|---|---|---|
input_size | 每个时间步输入向量的维度 | 必须等于上游 embedding_dim,这是最常见的对接点 |
hidden_size | 便签的长度,也是每步输出的维度 | 自己定。越大记得越多、也越容易过拟合;常见 128 / 256 |
num_layers | 堆几层 RNN,默认 1 | 第一层的每步输出当作第二层的每步输入。两层以上收益迅速递减 |
batch_first | batch 维放不放最前面,默认 False | 默认布局是 (seq_len, batch, input_size),和直觉相反,这一条是踩坑重灾区 |
调用时传两个、收两个:output, hn = rnn(x, h0)。四个张量的形状必须背下来:
| 张量 | 形状(默认布局) | 它是什么 |
|---|---|---|
x | (seq_len, batch, input_size) | 输入序列:句长 × 句子数 × 词向量维度 |
h0 | (num_layers, batch, hidden_size) | 初始便签,一般全 0;第一维是层数不是句长 |
output | (seq_len, batch, hidden_size) | 每一个时间步的 h 摞起来,只含最后一层 |
hn | (num_layers, batch, hidden_size) | 最后一个时间步的 h,含每一层 |
output 和 hn 的关系最容易讲糊涂,用一句话钉住:output 是「横着切」——沿时间轴把每一步都留下来;hn 是「竖着切」——只留最后一刻,但每层都留。 单层网络里 output[-1] 和 hn[0] 是同一个张量,上面那份手写代码已经用 allclose 验证过了。
选哪个,取决于任务:
文本生成、序列标注、词性标注这类每个位置都要出一个结果的任务,把 output 整个送进全连接层。
情感分类、意图识别这类一整句只出一个结果的任务,取 hn[-1](或 output[-1])当作整句的表示。
"""nn.RNN 的输入输出形状:搞错维度顺序是这一讲最常见的报错来源。"""
import torch
import torch.nn as nn

# input_size:每个词向量多少维;hidden_size:隐藏状态多少维;num_layers:堆几层
rnn = nn.RNN(input_size=128, hidden_size=256, num_layers=1)

# 默认布局是 (seq_len, batch, input_size)——句子长度在最前面,不是 batch
inputs = torch.randn(5, 32, 128)      # 5 个词、32 句话、每词 128 维
h0 = torch.zeros(1, 32, 256)          # (num_layers, batch, hidden_size),一般全 0 起步

output, hn = rnn(inputs, h0)

print('output 形状', output.shape)    # (5, 32, 256):每个时间步都有一个输出
print('hn 形状    ', hn.shape)        # (1, 32, 256):只有最后一个时间步的隐藏状态

# 如果你的数据是 (batch, seq_len, input_size),两条路二选一:
#   1) 建层时写 nn.RNN(..., batch_first=True)
#   2) 送进去之前 x.transpose(0, 1)
rnn_bf = nn.RNN(128, 256, 1, batch_first=True)
out_bf, hn_bf = rnn_bf(torch.randn(32, 5, 128))
print('batch_first 时 output 形状', out_bf.shape)   # (32, 5, 256)
nn.Linear、nn.Conv2d 的习惯完全相反,是这一讲报错率最高的地方。更糟的是,把 (batch, seq_len, dim) 直接丢进默认布局的 nn.RNN 往往不报错——只要两个数都合法,它就会把 batch 当成句长算下去,静默给出错误结果。要么建层时统一写 batch_first=True,要么送进去之前 x.transpose(0, 1),整个项目只选一种并贯彻到底。
2.5 时间步展开与 BPTT
把循环沿时间轴摊平画出来,就得到教科书上最常见的那张展开图:
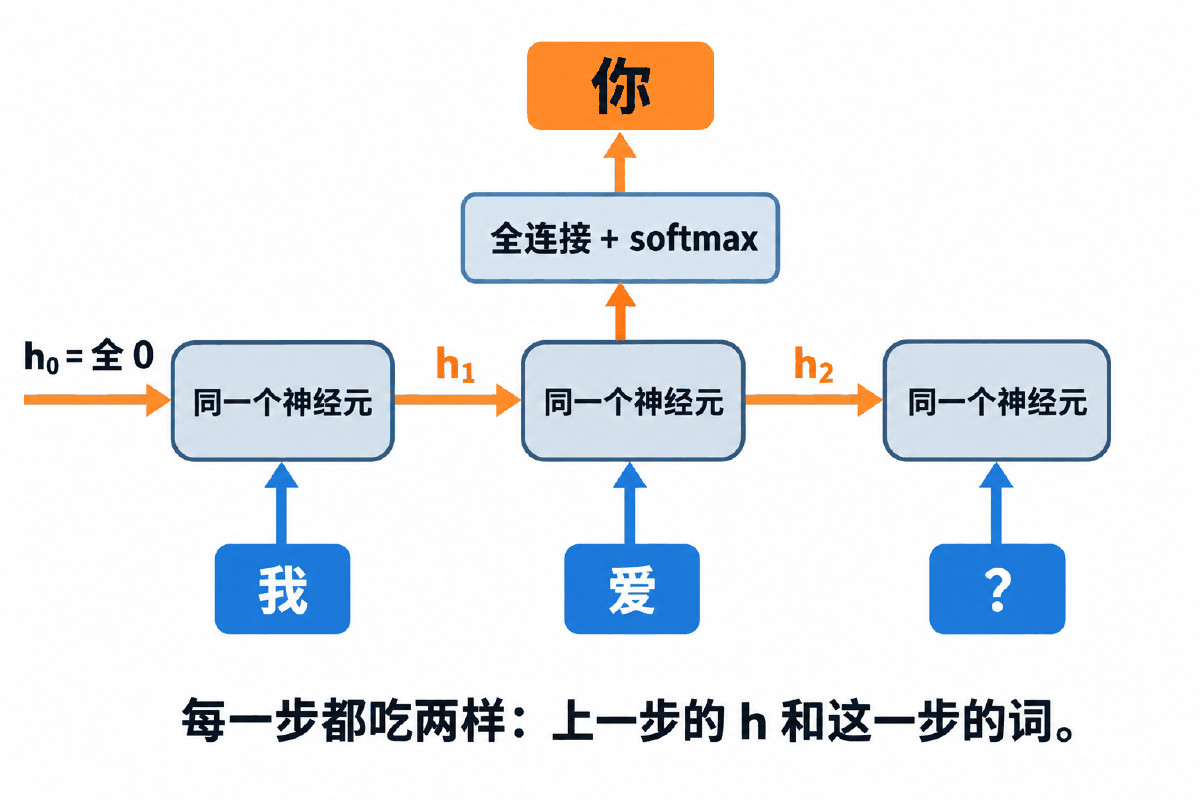
照着图把「输入『我爱』预测『你』」这件事走一遍:
- 准备空白便签。
h0初始化为全 0,形状(1, batch, hidden_size)。此刻网络对这句话一无所知。 - 第一步:吃「我」。 「我」查表得到词向量,和
h0一起送进单元,算出h1。 - 第二步:吃「爱」。 「爱」的词向量和
h1一起送进同一个单元,算出h2。此时h2里同时含着「我」和「爱」的信息。 - 出结果。 把
h2送进全连接层,映射成「词表里每个词的分数」,再 softmax 成概率,取概率最大的那个词——期望它是「你」。
图底下那句「每一步都吃两样:上一步的 h 和这一步的词」就是整张图的读法。注意第三个方块的输入画的是问号——生成时下一步吃的正是上一步刚吐出来的词,这叫自回归,是 4.3 节生成循环的依据。
反向传播为什么改叫 BPTT
训练时梯度要沿着这条链往回传。因为链是沿时间轴展开的,这个过程有个专门的名字:BPTT(Backpropagation Through Time,沿时间反向传播)。它和普通反向传播不是两种算法,就是同一套链式法则用在展开后的图上,只不过有两个特点:
- 梯度要连乘
seq_len段。 句子有 50 个词,从最后一步回到第一步就要乘 50 段。 - 同一套权重收到
seq_len份梯度,全部累加。 因为每个时间步都用了同一个W_hh,它在每一步都要负一次责任。这里正好用上了自动微分那一页讲的「.grad默认累加」——对 RNN 来说,这个累加不是坑,而是正确行为。
h 的数值而不传梯度(用 h.detach() 切断)。这叫截断 BPTT,是所有长序列训练脚本的默认姿势。
2.6 梯度消失:便签为什么记不住远处
现在可以解释铁律的后半句了。BPTT 要把每一段的导数连乘起来,而每一段的大小大致是 |W_hh · tanh′|。tanh 的导数最大值是 1,绝大多数区域远小于 1,所以单段系数通常小于 1。小于 1 的数连乘几十次会发生什么,算一遍就一目了然:
"""梯度消失为什么会发生:把 BPTT 的连乘用纯算术跑一遍。

反向传播沿时间轴往回走时,梯度要一段一段连乘:
    dL/dh_1 = dL/dh_T  ×  (dh_T/dh_{T-1}) × … × (dh_2/dh_1)
每一段的大小大致就是 |w_hh · tanh'|。tanh' 最大是 1,一般远小于 1,
所以这串乘积的数量级完全由「单段系数」的 T 次方决定。
本文件只用标准库,跑出来的数字就是 factor ** step,可以拿计算器核对。
"""


def chain(factor, steps):
    """连乘 steps 段,返回每一段之后的累计梯度倍率。"""
    value, trace = 1.0, []
    for _ in range(steps):
        value *= factor
        trace.append(value)
    return trace


def main():
    steps = 50

    print('时间步    系数 0.5        系数 0.9        系数 1.0        系数 1.1')
    print('-' * 68)
    t05, t09, t10, t11 = (chain(f, steps) for f in (0.5, 0.9, 1.0, 1.1))
    for t in (1, 5, 10, 20, 30, 50):
        print('%5d  %14.6e  %14.6e  %14.6e  %14.6e'
              % (t, t05[t - 1], t09[t - 1], t10[t - 1], t11[t - 1]))

    print()
    print('读法:')
    print('  系数 0.5 → 第 20 步梯度只剩 %.3e,20 步以前的词等于没参与训练'
          % t05[19])
    print('  系数 0.9 → 衰减慢一些,第 50 步也只剩 %.3e' % t09[49])
    print('  系数 1.0 → 唯一不衰减也不爆炸的临界点,现实中碰不到')
    print('  系数 1.1 → 第 50 步放大到 %.3e,这就是梯度爆炸' % t11[49])

    # ------------------------------------------------------------ 半衰期
    # 想知道「多少步之后梯度掉到千分之一」,解 factor**n = 0.001
    import math
    for f in (0.5, 0.8, 0.9, 0.95):
        n = math.log(0.001) / math.log(f)
        print('系数 %.2f:约 %.1f 步之后梯度掉到千分之一' % (f, n))

    # 三条可以直接带走的结论:
    #   1) 梯度消失不是 bug,是连乘的必然结果,网络越深/句子越长越明显
    #   2) 梯度爆炸能救(裁剪梯度),梯度消失救不了——信息本身没传过来
    #   3) LSTM / GRU 的门控就是给这条链加一条「系数接近 1」的旁路,
    #      让远处的梯度有机会不被连乘吃掉
    print()
    print('梯度爆炸可以用 torch.nn.utils.clip_grad_norm_(params, max_norm) 压住;')
    print('梯度消失压不住,只能换结构(LSTM / GRU / Transformer)。')


if __name__ == '__main__':
    main()
这份代码不依赖任何框架,跑出来的数就是 系数 ** 步数,可以拿计算器逐格核对。几个值得记住的数:
| 单段系数 | 第 20 步剩余 | 第 50 步剩余 | 含义 |
|---|---|---|---|
| 0.5 | 9.54e−07 | 8.88e−16 | 20 步之前的词等于完全没参与训练 |
| 0.9 | 0.1216 | 5.15e−03 | 衰减慢一些,但 50 步外仍然可忽略 |
| 1.0 | 1.0 | 1.0 | 唯一不衰减也不爆炸的临界点,现实中碰不到 |
| 1.1 | 6.73 | 117.4 | 梯度爆炸,loss 直接变 nan |
两种失效的处理难度完全不同,这一点常被混为一谈:
现象是 loss 突然飙到 nan。一行 torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0) 把梯度范数压回去就行,信息本身没丢,只是步子迈太大。
现象是 loss 降到某个值就不动、模型只会用最近几个词。裁剪、调学习率都没用——远处的信息压根没传过来,不是步子大小的问题。只能换结构。
回到比喻:便签每一步都被整张重写,二十步前那个词留下的痕迹,早就被后面二十次重写冲得干干净净。这不是 RNN 没训练好,这是它的结构决定的天花板。
2.7 LSTM 与 GRU:给便签加几道闸门
既然问题出在「每一步整张重写」,改法的方向就很清楚了:别整张重写,让网络自己决定哪些该留、哪些该删、哪些该写。这就是门控(gate)的全部思想。
所谓「门」,就是一个用 sigmoid 算出来的、取值在 0 到 1 之间的向量,拿它去逐元素乘另一个向量:乘 0 就是彻底关掉,乘 1 就是原样放行,乘 0.3 就是放行三成。名字听着高级,做的就是这件事。
| 结构 | 门的数量 | 状态 | 核心改动 |
|---|---|---|---|
| RNN | 0 | h | 每步整张重写,远处信息被反复稀释 |
| LSTM | 3(遗忘 / 输入 / 输出) | h + c | 另开一条细胞状态 c,它主要靠加法更新,给梯度留了一条系数接近 1 的旁路 |
| GRU | 2(更新 / 重置) | h | 把 LSTM 简化:不另设 c,用一个门同时管「忘多少」和「写多少」 |
LSTM 能缓解梯度消失的关键,不在于门多,而在于细胞状态 c 的更新以加法为主。加法的导数是 1,连乘一百个 1 还是 1——这就绕开了 2.6 节里那串小于 1 的连乘。门控给的是「可以不衰减」的通道,不是「一定不衰减」的保证,超长序列上 LSTM 同样会力不从心,这一点不要夸大。
"""RNN / LSTM / GRU 三者的接口与参数量对照。

三个层的用法几乎一样,换名字就能换结构,区别只有两处:
    1) LSTM 的隐藏状态是 (h, c) 两个张量,RNN 和 GRU 只有 h
    2) 参数量:RNN 一份,GRU 三份,LSTM 四份 —— 门越多参数越多
"""
import torch
import torch.nn as nn


def param_count(layer):
    return sum(p.numel() for p in layer.parameters())


def expected(gates, input_size, hidden_size):
    """按公式推参数量:gates × (hidden×input + hidden×hidden + 2×hidden)。

    每个门都是一套完整的「输入权重 + 状态权重 + 两个偏置」。
    """
    return gates * (hidden_size * input_size
                    + hidden_size * hidden_size
                    + 2 * hidden_size)


def main():
    torch.manual_seed(0)

    input_size, hidden_size = 128, 256
    batch, seq_len = 8, 12
    x = torch.randn(batch, seq_len, input_size)      # batch_first 布局

    rnn = nn.RNN(input_size, hidden_size, batch_first=True)
    lstm = nn.LSTM(input_size, hidden_size, batch_first=True)
    gru = nn.GRU(input_size, hidden_size, batch_first=True)

    # ---------------------------------------------------------- 返回值
    out_rnn, hn_rnn = rnn(x)
    print('RNN  output', out_rnn.shape, ' hn', hn_rnn.shape)

    out_gru, hn_gru = gru(x)
    print('GRU  output', out_gru.shape, ' hn', hn_gru.shape)

    # LSTM 多一个细胞状态 c:h 是「对外说的话」,c 是「自己记的账」
    out_lstm, (hn_lstm, cn_lstm) = lstm(x)
    print('LSTM output', out_lstm.shape, ' hn', hn_lstm.shape, ' cn', cn_lstm.shape)
    # 写成 out, hn = lstm(x) 也不报错,但 hn 会是一个元组,
    # 下一步拿它当张量用就会抛 AttributeError —— 换 LSTM 最常见的坑

    # ---------------------------------------------------------- 参数量
    print()
    print('%-6s %-10s %-12s %s' % ('层', '门数', '实际参数量', '公式推导'))
    for name, layer, gates in (('RNN', rnn, 1), ('GRU', gru, 3), ('LSTM', lstm, 4)):
        print('%-6s %-10d %-12d %d'
              % (name, gates, param_count(layer),
                 expected(gates, input_size, hidden_size)))
    # 三行数字完全对得上,说明「门控 = 复制几套同样的权重」这个理解是对的。
    # 代价也很直白:LSTM 的参数和计算量是同规模 RNN 的 4 倍。

    # ---------------------------------------------------------- 手动传状态
    print()
    h0 = torch.zeros(1, batch, hidden_size)
    c0 = torch.zeros(1, batch, hidden_size)
    out, (hn, cn) = lstm(x, (h0, c0))        # LSTM 要成对传,元组不能拆
    print('显式传 (h0, c0) 之后 output', out.shape)
    # 不传初始状态时 PyTorch 自动填一份全 0 的状态,效果一样;
    # 逐词生成时必须自己带着状态走,否则每一步都从零记忆开始。

    print()
    print('选型建议:短序列先用 GRU(参数比 LSTM 少 1/4,效果常常持平);')
    print('需要更强的长期记忆再上 LSTM;纯 RNN 基本只用于教学和极短序列。')


if __name__ == '__main__':
    main()
代码里参数量那张表一算就清楚:门越多,参数越多。同规模下 GRU 是 RNN 的 3 倍、LSTM 是 4 倍,计算量同比例增长。所以选型不是「越高级越好」:
nn.RNN 基本只用于教学和极短序列,生产上很少直接用 · ② 先上 GRU:参数比 LSTM 少四分之一,多数任务上效果持平,训练更快 · ③ 确实需要更强的长期记忆再换 LSTM。三者 API 几乎一致,换名字就能换结构,唯一要改的是 LSTM 的隐藏状态是 (h, c) 元组。
output, hn = lstm(x) 不会报错,但此时 hn 是一个元组 (h, c),下一步拿它当张量用(比如 hn[-1].shape 之后再送进 Linear)就会抛出莫名其妙的类型错误。正确写法是 output, (hn, cn) = lstm(x)。
03最小代码:把词表和查表各跑一次
先用两段最短的代码确认「文本 → 索引 → 向量」这条链是通的,再去看完整案例
3.1 建词表:文本变成一串整数
这一段没有网络、没有训练,只把 2.1 节那三个动作跑一遍:分词、去重编号、转索引。它不依赖任何第三方分词器,没装 jieba 也能跑通,真实项目里把 tokenize() 换成 jieba.lcut 即可。
"""构建词表:把一段文本变成「词 → 索引」的字典和一串索引。

这一步在任何 NLP 任务里都排第一位,做错了后面全错。
本文件不依赖 jieba,用一个极简的中文单字 + 英文单词切分器代替,
这样没装分词器也能跑;真实项目把 tokenize() 换成 jieba.lcut 即可。
"""


def tokenize(line):
    """极简切分:中文按单字切,连续的英文字母/数字算一个词。"""
    tokens, buf = [], ''
    for ch in line:
        if ch.isascii() and ch.isalnum():
            buf += ch                      # 英文数字先攒着,凑成一个完整单词
            continue
        if buf:
            tokens.append(buf)
            buf = ''
        if not ch.isspace():
            tokens.append(ch)              # 中文和标点一个字一个词
    if buf:
        tokens.append(buf)
    return tokens


def build_vocab(lines):
    """返回四件套:index_to_word / word_to_index / vocab_size / corpus_idx。"""
    index_to_word = []                     # 下标 i 对应第 i 个词,顺序即索引
    all_lines = []

    for line in lines:
        words = tokenize(line)
        all_lines.append(words)
        for word in words:
            # 用「不在就追加」保持首次出现的顺序,结果可复现;
            # 换成 set() 会丢顺序,每次跑索引都不一样,调试时对不上号
            if word not in index_to_word:
                index_to_word.append(word)

    # 换行符本身也要进词表,否则拼接语料时无法表示句子边界
    if '\n' not in index_to_word:
        index_to_word.append('\n')

    word_to_index = {w: i for i, w in enumerate(index_to_word)}

    corpus_idx = []                        # 整个语料摊平成一串索引
    for words in all_lines:
        corpus_idx.extend(word_to_index[w] for w in words)
        corpus_idx.append(word_to_index['\n'])

    return index_to_word, word_to_index, len(index_to_word), corpus_idx


if __name__ == '__main__':
    corpus = ['我爱你', '我爱北京']

    i2w, w2i, vocab_size, idx_seq = build_vocab(corpus)

    print('词表      :', i2w)
    print('词表大小  :', vocab_size)
    print('词到索引  :', w2i)
    print('语料索引串:', idx_seq)

    # 两行文本一共 3 + 4 = 7 个词 + 2 个换行 = 9 个索引,
    # 去重后是 我 爱 你 北 京 \n 共 6 个词,所以 vocab_size = 6。
    assert vocab_size == 6, '词表大小推导不符,先检查 tokenize'
    assert len(idx_seq) == 9, '语料索引串长度推导不符'

    # 反查:索引串还原回文本,验证映射是双向可逆的
    print('还原文本  :', ''.join(i2w[i] for i in idx_seq))
这份代码的输出可以完全手推,不用猜:语料是「我爱你」和「我爱北京」两行,按字切分后去重得到 我 爱 你 北 京 五个字,再加上表示换行的一个符号,词表大小恰好是 6。语料索引串则是 3 + 1 + 4 + 1 = 9 个整数。代码末尾的两行 assert 就是把这两个推导钉死——能写出 assert 的地方就别用 print 靠眼睛看,改坏了会立刻炸出来。
| 产物 | 类型 | 干什么用 |
|---|---|---|
index_to_word | 列表 | 把模型输出的索引翻回汉字,生成任务里没有它就打印不出结果 |
word_to_index | 字典 | 把输入文本转成索引,喂给 embedding |
vocab_size | 整数 | 同时决定 nn.Embedding 的行数和输出层的宽度 |
corpus_idx | 整数列表 | 整个语料摊平成的一长串索引,供数据集切片 |
最后一行「还原文本」是一个廉价但极有用的自检:索引串能原样翻回原文,说明映射是双向可逆的。这一步不做,后面生成出乱码时你分不清是模型没学好还是词表就错了。
3.2 查表:索引变成向量
词表就位之后,词嵌入只有两行:建层、传索引。
"""词嵌入最小例子:文字 -> 索引 -> 向量。"""
import torch
import torch.nn as nn
import jieba

text = '北京冬奥的进度条已经过半,不少外国运动员在完成自己的比赛后踏上归途。'

# 1. 分词:中文没有天然空格,先切成词
words = jieba.lcut(text)
print('分词结果:', words)

# 2. 去重得到词表:词表有几个词,嵌入矩阵就有几行
unique_words = list(set(words))
print('去重后词数:', len(unique_words))

# 3. 建词嵌入层:num_embeddings 是词表大小,embedding_dim 是每个词用几维表示
embed = nn.Embedding(num_embeddings=len(unique_words), embedding_dim=4)
print('嵌入矩阵形状:', embed.weight.shape)     # (词表大小, 4)

# 4. 查表:传进去的是索引(int64),拿回来的是那一行向量
for i, word in enumerate(unique_words[:5]):
    print('%4s' % word, embed(torch.tensor(i)).detach())

# 这些向量一开始是随机的,靠训练才会把语义学进去——
# 嵌入矩阵本身就是网络参数,会被反向传播更新
这段代码需要 jieba。它演示的三件事各对应 2.2 节的一条结论:嵌入矩阵形状是 (词表大小, embedding_dim)、传进去的是索引张量而不是汉字、拿回来的向量一开始全是随机数。最后那句注释点出了最关键的一点:embed.weight 本身就是网络参数,会被反向传播更新,所以语义是训练出来的。
nn.Embedding(num_embeddings=100, …) 只接受 0 ~ 99 的索引,传 100 进去会抛 IndexError: index out of range in self。报这个错八成是词表大小和建层时写的数对不上——常见于「用训练集建词表,预测时遇到新词」,或者「词表重建过但模型还是旧的」。工程上的标准解法是留一个 <unk> 索引兜底所有未登录词。
3.3 两段代码合起来是什么
把 3.1 和 3.2 串起来,就得到任何 NLP 模型的前两层:
shape (3,)
形状的推导值得再走一遍,因为下一节全靠它:一批 32 句话、每句 10 个词,索引张量是 (32, 10);过 nn.Embedding(vocab, 128) 之后变成 (32, 10, 128);如果 nn.RNN 用默认布局,还要 transpose(0, 1) 转成 (10, 32, 128) 才能送进去。这三个形状写在纸上比背 API 文档管用。
pip install torch(CPU 版即可跑完本页大部分代码)。分词相关的两份需要 pip install jieba。vocab_build.py 和 bptt_vanishing.py 只用标准库,装不上任何东西也能跑。是否有 GPU 不影响本页任何结论。
04完整案例:歌词生成器
从一堆歌词文本出发,训练一个能续写的模型,再讲清「选词」这一步为什么决定成败
这个案例把前面所有零件串起来:词表、词嵌入、循环层、全连接层、训练循环、逐词生成。任务本身很直白——给一个起始词,让模型一个词一个词往下写。它的本质是多分类:每一步都在词表里选一个词,词表有多少个词就是多少分类。
4.1 建词表与切样本
训练数据不是一句一句的,而是整个语料摊平成的一长串索引,再从这条长串上按固定长度切窗口。切法是本案例最巧妙的一处:
| 项 | 取值 | 说明 |
|---|---|---|
输入 x | corpus_idx[i : i+32] | 连续 32 个词 |
目标 y | corpus_idx[i+1 : i+33] | 把输入整体右移一位 |
为什么右移一位就是标准答案?因为模型在每个位置都要预测「下一个词」:读到第 1 个词时该猜第 2 个,读到第 2 个词时该猜第 3 个……把这些答案排起来,正好就是原序列右移一位。一条 32 词的样本,同时提供了 32 个训练信号——这是自监督的典型做法,不需要任何人工标注,语料本身就是答案。
__getitem__ 里还有一行防御性代码值得学:start = min(max(idx, 0), word_count - num_chars - 2)。它把起点夹在合法区间里,避免取到语料末尾时 y 越界。不写这一行,训练跑到最后一个批次才崩,前面几分钟白等。
4.2 三层模型与训练
模型结构只有三层,每一层的职责在前面都讲过了:
nn.Embedding(word_count, 128)。把索引翻译成 128 维向量。输入 (batch, seq_len),输出 (batch, seq_len, 128)。
nn.RNN(128, 128, 1)。提取上下文,把每个位置的词向量变成「带着前文记忆的表示」。
nn.Linear(128, word_count)。输出维度必须等于词表大小——每个位置都要给词表里每个词打一个分。
"""完整案例:用 RNN 生成歌词。

流程:建词表 -> 切成定长样本 -> 嵌入层 + RNN + 全连接 -> 训练 -> 逐词生成。
"""
import time
import jieba
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader

DATA = 'data/jaychou_lyrics.txt'


# ------------------------------------------------------------------ 词表
def build_vocab(file_name=DATA):
    unique_words, all_words = [], []

    for line in open(file_name, 'r', encoding='utf-8'):
        words = jieba.lcut(line)
        all_words.append(words)
        for word in words:
            if word not in unique_words:
                unique_words.append(word)

    word_count = len(unique_words)
    word_to_index = {word: idx for idx, word in enumerate(unique_words)}

    # 把整个语料摊平成一串索引,行与行之间用空格这个词隔开
    corpus_idx = []
    for words in all_words:
        temp = [word_to_index[word] for word in words]
        temp.append(word_to_index[' '])
        corpus_idx.extend(temp)

    return unique_words, word_to_index, word_count, corpus_idx


# ------------------------------------------------------------------ 数据集
class LyricsDataset(torch.utils.data.Dataset):
    """从语料里切定长片段:输入是第 i 到 i+n 个词,目标是整体右移一位。"""

    def __init__(self, corpus_idx, num_chars):
        self.corpus_idx = corpus_idx
        self.num_chars = num_chars
        self.word_count = len(corpus_idx)
        self.number = self.word_count // self.num_chars

    def __len__(self):
        return self.number

    def __getitem__(self, idx):
        # 夹一下起点,避免尾部越界
        start = min(max(idx, 0), self.word_count - self.num_chars - 2)
        x = self.corpus_idx[start: start + self.num_chars]
        y = self.corpus_idx[start + 1: start + 1 + self.num_chars]   # 右移一位
        return torch.tensor(x), torch.tensor(y)


# ------------------------------------------------------------------ 模型
class TextGenerator(nn.Module):
    def __init__(self, word_count, embed_dim=128, hidden_dim=128):
        super().__init__()
        self.hidden_dim = hidden_dim
        self.ebd = nn.Embedding(word_count, embed_dim)       # 词 -> 向量
        self.rnn = nn.RNN(embed_dim, hidden_dim, 1)          # 提取上下文
        self.out = nn.Linear(hidden_dim, word_count)         # 给词表里每个词打分

    def forward(self, inputs, hidden):
        # inputs: (batch, seq_len) -> embed: (batch, seq_len, embed_dim)
        embed = self.ebd(inputs)
        # nn.RNN 默认要 (seq_len, batch, embed_dim),所以转置前两维
        output, hidden = self.rnn(embed.transpose(0, 1), hidden)
        # 把时间步和 batch 压到一起再过全连接:(seq_len*batch, hidden_dim)
        output = self.out(output.reshape(-1, output.shape[-1]))
        return output, hidden

    def init_hidden(self, bs=1):
        return torch.zeros(1, bs, self.hidden_dim)


# ------------------------------------------------------------------ 训练
def train(epochs=10, seq_len=32, lr=1e-3):
    _, _, word_count, corpus_idx = build_vocab()
    lyrics = LyricsDataset(corpus_idx, seq_len)

    model = TextGenerator(word_count)
    criterion = nn.CrossEntropyLoss()
    optimizer = optim.Adam(model.parameters(), lr=lr)

    for epoch_idx in range(epochs):
        dataloader = DataLoader(lyrics, shuffle=True, batch_size=1)
        start, iter_num, total_loss = time.time(), 0, 0.0

        for x, y in dataloader:
            hidden = model.init_hidden(bs=1)
            output, hidden = model(x, hidden)

            # 目标值要和 output 的排列方式对齐:
            # y 是 (batch, seq_len) -> 转成 (seq_len, batch) -> 拉平成一维
            y = torch.transpose(y, 0, 1).contiguous().view(-1)
            loss = criterion(output, y)

            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

            iter_num += 1
            total_loss += loss.item()

        print('epoch %3d  loss %.5f  time %.2fs'
              % (epoch_idx + 1, total_loss / iter_num, time.time() - start))
        torch.save(model.state_dict(), 'data/lyrics_model_%d.pth' % (epoch_idx + 1))


# ------------------------------------------------------------------ 生成
def predict(start_word, sentence_length, weight='data/lyrics_model_10.pth'):
    index_to_word, word_to_index, word_count, _ = build_vocab()

    model = TextGenerator(word_count)
    model.load_state_dict(torch.load(weight))
    model.eval()

    hidden = model.init_hidden()
    word_idx = word_to_index[start_word]      # 起始词必须在词表里,否则 KeyError
    generated = [word_idx]

    with torch.no_grad():
        for _ in range(sentence_length):
            # 每一步只送一个词,但 hidden 要一路带着走,记忆才不断
            output, hidden = model(torch.tensor([[word_idx]]), hidden)
            word_idx = torch.argmax(output).item()
            generated.append(word_idx)

    return ''.join(index_to_word[i] for i in generated)


if __name__ == '__main__':
    train()
    print(predict('分手', 50))
逐段拆解
| 代码位置 | 在干什么 / 为什么这么写 |
|---|---|
if word not in unique_words | 保持首次出现顺序去重。用 set 更短但顺序不稳定,下次跑同一份语料索引就变了,存下来的权重会对不上。 |
temp.append(word_to_index[' ']) | 在行与行之间插一个分隔词,否则上一句的末尾会和下一句的开头直接粘成一个不存在的搭配。 |
embed.transpose(0, 1) | 嵌入层输出是 (batch, seq_len, 128),而 nn.RNN 默认要 (seq_len, batch, 128)。这一行就是 2.4 节那条铁律的现场。 |
output.reshape(-1, output.shape[-1]) | 把时间步和 batch 压平,从 (seq_len, batch, 128) 变成 (seq_len*batch, 128),再过全连接。等于把「一批句子的所有位置」当成一堆独立的多分类样本。 |
y.transpose(0,1).contiguous().view(-1) | 标签也要按同样的顺序压平,必须和 output 的排列方式严格对齐。transpose 之后内存不连续,所以要 contiguous() 才能 view。 |
nn.CrossEntropyLoss() | 预测下一个词是多分类问题,所以用交叉熵。它内部已含 softmax,模型最后一层不要再加。 |
hidden = model.init_hidden(bs=1) | 每个批次开头重新给一张空白便签。不重置的话,上一批句子的记忆会串到这一批。 |
optim.Adam(lr=1e-3) | 词表大、各词频率悬殊,用梯度自适应的 Adam 比朴素 SGD 收敛快得多。 |
torch.save(model.state_dict(), …) | 每轮存一次权重。训练可能中途被打断,存盘是唯一的保险;存 state_dict 而不是整个模型对象。 |
DataLoader(batch_size=1) 让每次只处理一个样本,好处是不用处理变长补齐、代码最简单,坏处是慢,而且梯度噪声大。真实项目会把 batch_size 提到 32 或 64,同时把 init_hidden(bs=batch_size) 跟着改。改 batch 时 h0 的第二维必须同步改,这是最常见的一处漏改。
怎么判断这次训练成功了
训练脚本打印的是每轮的平均交叉熵损失。判断标准不能只看它降没降,要看三件事:
- loss 的量级是否合理。 随机初始化时,模型对词表里每个词一视同仁,此时的交叉熵约等于
ln(词表大小)。词表一万词时,起始 loss 应该在 9.2 附近——如果第一轮就远低于这个数,多半是数据泄漏或者标签对错了位;如果一直不降,检查是不是忘了optimizer.step()。 - 生成结果是否通顺。 这是最终标准。loss 降了但生成一团糟,通常是采样策略的问题(见 4.3),不一定是模型的问题。
- 是不是背下来了。 小语料上跑很多轮,模型会把训练文本整段背出来。loss 极低、生成「完美」,实则是过拟合。拿一个训练集里没有的起始词试一试,立刻现形。
4.3 逐词生成与采样策略
生成阶段的循环只有四步,并且要一路带着同一张便签走:
第四步是新手最容易写错的地方:每一步只送一个词,但 hidden 必须在循环外面接住、下一轮传回去。写成每轮都 init_hidden(),模型就成了失忆症患者,每个词都从零记忆开始猜,生成结果必然是胡话。
第三步则决定了生成质量的上限。最简单的选法是 argmax——永远挑分数最高的那个词:
"""argmax:把一排分数变成「选哪个词」。"""
import torch

# 假设词表只有 5 个词,模型给出这一步的 5 个分数
logits = torch.tensor([1.2, -0.3, 3.4, 0.8, 2.9])
vocab = ['我', '爱', '你', '的', '歌']

prob = torch.softmax(logits, dim=0)
print('概率分布', prob)
print('概率之和', prob.sum().item())          # 1.0

idx = torch.argmax(logits)                    # 分数最大的下标
print('选中下标', idx.item(), '对应词', vocab[idx])

# 注意:argmax 每次都挑最高分,生成出来的句子会很单调、容易循环。
# 要多样性就改成按概率采样:
sampled = torch.multinomial(prob, num_samples=1)
print('按概率采样到', vocab[sampled.item()])
argmax 有一个致命性质:它是确定性的。同样的输入永远给同样的输出,于是一旦模型进入某个「自己指向自己」的状态,就会原地打转,生成出「你你你你你」或者一句话反复循环。这不是模型没训练好,是选词方式的必然结果。
解法是引入随机性,同时控制随机的程度——这就是温度采样和 top-k:
"""采样策略:argmax、温度采样、top-k 三种选词方式的差别。

生成任务里,模型每一步给出的是「词表上的一组分数」,
真正决定生成效果的,是你怎么把这组分数变成一个词。
这一步不参与训练,纯粹是推理时的选择,改它不用重训模型。
"""
import torch


VOCAB = ['我', '爱', '你', '的', '歌', '雨', '天']
# 假设某一步模型给出这 7 个分数(logits,没过 softmax 的原始分)
LOGITS = torch.tensor([1.2, -0.3, 3.4, 0.8, 2.9, 0.1, -1.5])


def softmax_with_temperature(logits, temperature):
    """温度缩放:先把 logits 除以 T,再做 softmax。

    T < 1:差距被放大,分布更尖,输出更保守
    T = 1:原样
    T > 1:差距被压缩,分布更平,输出更发散
    """
    return torch.softmax(logits / temperature, dim=-1)


def main():
    torch.manual_seed(0)

    print('原始分数 :', LOGITS.tolist())
    prob = torch.softmax(LOGITS, dim=-1)
    print('softmax  :', [round(p, 4) for p in prob.tolist()])
    print('概率之和 :', round(prob.sum().item(), 6))    # 恒为 1.0

    # ---------------------------------------------------------- argmax
    idx = torch.argmax(LOGITS).item()
    print('\nargmax 选中 :', VOCAB[idx], '(分数最高的 3.4)')
    # argmax 是确定性的:同样的输入永远给同样的词。
    # 后果是生成的句子容易原地打转 —— 「你你你你」这种循环就是这么来的。

    # ---------------------------------------------------------- 温度
    print('\n不同温度下的概率分布:')
    print('%-6s' % 'T', ''.join('%7s' % w for w in VOCAB))
    for t in (0.5, 1.0, 1.5, 3.0):
        p = softmax_with_temperature(LOGITS, t)
        print('%-6.1f' % t, ''.join('%7.3f' % v for v in p.tolist()))
    # 看最后一行:T=3 时最高分和最低分的概率已经拉不开,
    # 生成会开始胡言乱语;T 太小又退化成 argmax。常用区间是 0.7 ~ 1.0。

    # ---------------------------------------------------------- 按概率采样
    print('\n按 T=1.0 概率采样 10 次:')
    p = softmax_with_temperature(LOGITS, 1.0)
    picks = [VOCAB[torch.multinomial(p, 1).item()] for _ in range(10)]
    print(' '.join(picks))
    # multinomial 按概率抽签:高分词抽中的次数多,但低分词也有机会,
    # 这就是生成结果有变化的来源。注意它要的是概率不是 logits。

    # ---------------------------------------------------------- top-k
    print('\ntop-k 采样(k=3):')
    k = 3
    topk_vals, topk_idx = torch.topk(LOGITS, k)
    print('候选词  :', [VOCAB[i] for i in topk_idx.tolist()])
    topk_prob = torch.softmax(topk_vals, dim=-1)        # 只在候选里重新归一化
    print('候选概率:', [round(v, 4) for v in topk_prob.tolist()])
    chosen = topk_idx[torch.multinomial(topk_prob, 1)].item()
    print('抽中    :', VOCAB[chosen])
    # top-k 的价值:先砍掉长尾里那些明显不通顺的词,再在靠谱的候选里随机,
    # 兼顾「不跑题」和「不重复」。工程上常和温度一起用。


if __name__ == '__main__':
    main()
| 策略 | 怎么做 | 确定性 | 典型问题 |
|---|---|---|---|
| argmax | 永远取最高分 | 完全确定 | 单调、易循环 |
| 温度 T < 1 | 分数先除以 T 再 softmax | 接近确定 | T→0 退化成 argmax |
| 温度 T = 1 | 按原始概率抽签 | 随机 | 长尾里的怪词偶尔被抽中 |
| 温度 T > 1 | 差距被压平 | 很随机 | T 过大开始胡言乱语 |
| top-k | 只在前 k 个候选里抽 | 可控随机 | k 选太小又回到单调 |
工程上最常见的组合是 top-k 加温度:先用 top-k 砍掉长尾里那些明显不通顺的词,再在靠谱的候选里按温度抽签,兼顾「不跑题」和「不重复」。这三个参数都在推理阶段生效,改它们不需要重新训练模型——生成效果不好时,先调这里,比重训划算得多。
temperature、top_k、top_p 这几个名字,后面调用大模型 API 时还会原样遇到。它们背后就是这一节讲的东西:模型永远只输出一组分数,怎么从分数变成词,是调用方的选择。
05骨架模板:拿去改就能用
一份同时覆盖「逐词生成」和「整句分类」两类序列任务的模型骨架
4.2 的歌词生成器把词表、数据集、模型、训练搅在一个文件里,适合通读,不适合改造。下面这份只保留模型部分,并把两类序列任务的分叉点标成 TODO——序列任务九成的差异都集中在那三处,其余部分一个字不用动。
"""序列模型骨架模板:词表、数据集、模型三件套。"""
import torch
import torch.nn as nn


class SeqModel(nn.Module):
    def __init__(self, vocab_size, embed_dim=128, hidden_dim=256,
                 num_layers=1, n_class=None):
        super().__init__()
        self.hidden_dim = hidden_dim
        self.num_layers = num_layers

        self.embedding = nn.Embedding(vocab_size, embed_dim)

        # TODO: 序列长、要记更久就把 nn.RNN 换成 nn.LSTM / nn.GRU,
        #       接口一致,LSTM 的隐藏状态是 (h, c) 两个张量
        self.rnn = nn.RNN(embed_dim, hidden_dim, num_layers, batch_first=True)

        # TODO: 逐词生成时输出维度 = 词表大小;整句分类时 = 类别数
        self.out = nn.Linear(hidden_dim, n_class or vocab_size)

    def forward(self, inputs, hidden=None):
        # inputs: (batch, seq_len) 的词索引
        x = self.embedding(inputs)               # (batch, seq_len, embed_dim)
        output, hidden = self.rnn(x, hidden)     # (batch, seq_len, hidden_dim)

        # TODO: 逐词预测保留所有时间步;整句分类只取最后一步 output[:, -1, :]
        logits = self.out(output)
        return logits, hidden

    def init_hidden(self, batch_size=1):
        return torch.zeros(self.num_layers, batch_size, self.hidden_dim)


if __name__ == '__main__':
    model = SeqModel(vocab_size=1000)
    x = torch.randint(0, 1000, (4, 10))          # 4 句话,每句 10 个词
    logits, hidden = model(x, model.init_hidden(batch_size=4))
    print(logits.shape, hidden.shape)            # (4, 10, 1000)  (1, 4, 256)
三个 TODO 分别怎么改
| 位置 | 逐词生成 / 序列标注 | 整句分类 |
|---|---|---|
| 循环层类型 | nn.RNN 起步,长序列换 nn.GRU | 同左;换 LSTM 时记得隐藏状态变成 (h, c) 元组 |
输出层宽度 n_class | = 词表大小,每个位置在整个词表里选一个 | = 类别数,比如情感三分类就是 3 |
| 取哪一部分输出 | 保留所有时间步 self.out(output) | 只取最后一步 output[:, -1, :](batch_first=True 时) |
| 标签形状 | (batch, seq_len),算损失前压平成一维 | (batch,),直接用 |
| 损失函数 | nn.CrossEntropyLoss() | 同左(都是多分类) |
配套的训练循环长什么样
模型之外的训练部分,和上一页那份通用骨架完全一致,五步主循环一个字不变。序列任务只多两件事要照顾:
每个 batch 开头调用 model.init_hidden(batch_size),否则上一批的记忆会串味。最后一个 batch 可能不满,用 len(bx) 动态取 batch 大小,别写死。
在 backward() 之后、step() 之前插入 torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)。序列越长越有必要,它专治 2.6 节那种 loss 突然变 nan。
把这两条加进去,顺序就是:前向 → 算损失 → 清零 → 反向 → 裁剪 → 更新。裁剪必须夹在反向和更新之间,放在 step() 之后等于没裁,放在 backward() 之前则无梯度可裁。
batch_first=True,全项目只用一种布局,从源头躲开 2.4 节那条铁律 · ② init_hidden 把 num_layers 和 hidden_dim 从属性里取,改超参时不用改两处 · ③ forward 的 hidden 参数默认 None,PyTorch 会自动填一张全 0 的便签,训练时可以不传、生成时再手动带着走 · ④ 输出层宽度用 n_class or vocab_size 兜底,不传就按生成任务处理。
pack_padded_sequence、没有验证集、没有梯度裁剪、没有 GPU 搬运。前两项是因为不同任务差别太大,需要按数据选;后两项在上面已经说明怎么加。先用最朴素的版本把数据跑通,再逐样加,一次性堆齐所有工程细节反而定位不了问题。
nn.utils.rnn.pack_padded_sequence 告诉 RNN「每句真实长度是多少」,让它跳过补出来的位置。不做这一步不会报错,但补位的 0 会被当成真词参与便签改写,句子越短被污染得越厉害。下一页的 Transformer 用掩码解决同一个问题。
06易错点汇总
按「词表 / 形状 / 隐藏状态 / 训练与生成」四类归并,每条都给现象和修法
⚠️ 一、词表与词嵌入
- 用
list(set(words))去重。 现象:同一份语料两次跑出来的索引不一样,旧权重加载后生成全是乱码。set不保证顺序。修法:用「不在列表里就追加」保留首次出现顺序,或sorted(set(words))强制稳定。 - 词表没和权重一起保存。 现象:模型文件还在,但重建词表后预测结果毫无意义。模型学的是「编号 37 的向量」,不是「『分手』的向量」。修法:存 checkpoint 时把
index_to_word一起序列化。 - 索引越界
IndexError: index out of range in self。 现象:训练好好的,预测时突然崩。多半是预测数据里有训练时没见过的词。修法:词表里留一个<unk>索引兜底,查表时用word_to_index.get(w, unk_idx)。 - 给
nn.Embedding传了浮点张量。 现象:RuntimeError: Expected tensor for argument #1 'indices' to have scalar type Long。修法:索引必须是int64,用torch.tensor(idx_list)(整数列表自然是 int64),别做.float()。 embedding_dim和nn.RNN的input_size对不上。 现象:矩阵乘法维度报错。修法:这两个数必须相等,把它抽成一个变量传给两处,别各写各的字面量。
⚠️ 二、形状与维度顺序
- 把
(batch, seq_len, dim)直接丢进默认布局的nn.RNN。 现象:不报错,但 batch 被当成句长算,模型永远学不好。这是本讲最阴险的一类问题。修法:全项目统一batch_first=True,或送进去前transpose(0, 1),二选一并贯彻到底。 h0第一维写成了 batch。 正确形状是(num_layers, batch, hidden_size),层数在最前。现象:RuntimeError: Expected hidden size …。修法:记住「h0 的第一维跟着层数走,不跟着数据走」。num_layers改了但h0没跟着改。 现象同上。把nn.RNN(..., num_layers=2)之后仍传torch.zeros(1, batch, hidden)就会报。修法:init_hidden里从self.num_layers取值,别写死 1。- 混淆
output和hn。output是所有时间步、只含最后一层;hn是最后一个时间步、含所有层。整句分类误用output全量、逐词生成误用hn,都会让损失算在错误的东西上。 transpose之后直接view。 现象:view size is not compatible with input tensor's size and stride。修法:中间补一个.contiguous(),或改用reshape。- 逐词任务算交叉熵时形状没压平。
CrossEntropyLoss要的是(N, 类别数)的预测和(N,)的标签。修法:logits.reshape(-1, vocab_size)配targets.reshape(-1),且两边的压平顺序必须一致。
把报错现场跑一遍
上面这些条目读一遍记不住,自己触发一遍就记住了。下面这份把四类形状问题全部原地复现,用 try/except 抓住并打印报错原文,跑到底不会中断:
"""RNN 四类形状报错的原地复现:每一段都用 try/except 抓住,跑到底不中断。

序列模型的报错九成出在「谁在第几维」上,自己触发一遍比背十遍管用。
"""
import torch
import torch.nn as nn


def show(title):
    print('\n' + '=' * 12 + ' ' + title)


def main():
    torch.manual_seed(0)
    vocab_size, embed_dim, hidden_dim = 100, 16, 32
    batch, seq_len = 4, 7

    embedding = nn.Embedding(vocab_size, embed_dim)
    rnn_seq_first = nn.RNN(embed_dim, hidden_dim, num_layers=1)
    rnn_batch_first = nn.RNN(embed_dim, hidden_dim, num_layers=1, batch_first=True)

    tokens = torch.randint(0, vocab_size, (batch, seq_len))   # (batch, seq_len)
    x = embedding(tokens)                                     # (batch, seq_len, embed_dim)
    print('嵌入之后的形状', x.shape)

    # ---------------------------------------------------------------- 一
    show('一、batch 和 seq_len 放反')
    # nn.RNN 默认要 (seq_len, batch, input_size),直接把 (batch, seq_len, dim) 丢进去
    # 不一定报错——它会把 batch 当成句长、把句长当成 batch,静默算错
    out_wrong, _ = rnn_seq_first(x)
    print('不报错,但 output 形状是', out_wrong.shape,
          '→ 它把', batch, '当成了句长')
    out_right, _ = rnn_seq_first(x.transpose(0, 1))
    print('转置之后才对   ', out_right.shape)
    out_bf, _ = rnn_batch_first(x)
    print('或者建层时写 batch_first=True', out_bf.shape)
    # 这是本讲最阴险的一类问题:没有任何异常,只是模型永远学不好

    # ---------------------------------------------------------------- 二
    show('二、h0 的第一维写成了 batch')
    try:
        bad_h0 = torch.zeros(batch, 1, hidden_dim)     # 写反了
        rnn_seq_first(x.transpose(0, 1), bad_h0)
    except RuntimeError as e:
        print('RuntimeError:', str(e).split('\n')[0])
    good_h0 = torch.zeros(1, batch, hidden_dim)        # (num_layers, batch, hidden)
    out, hn = rnn_seq_first(x.transpose(0, 1), good_h0)
    print('正确的 h0 形状', good_h0.shape, '→ hn', hn.shape)

    # ---------------------------------------------------------------- 三
    show('三、num_layers 改了但 h0 没跟着改')
    rnn2 = nn.RNN(embed_dim, hidden_dim, num_layers=2)
    try:
        rnn2(x.transpose(0, 1), torch.zeros(1, batch, hidden_dim))
    except RuntimeError as e:
        print('RuntimeError:', str(e).split('\n')[0])
    out2, hn2 = rnn2(x.transpose(0, 1), torch.zeros(2, batch, hidden_dim))
    print('两层时 output', out2.shape, ' hn', hn2.shape,
          '→ output 永远只有最后一层,hn 才是每一层都有')

    # ---------------------------------------------------------------- 四
    show('四、逐词预测时 CrossEntropyLoss 的形状没对齐')
    head = nn.Linear(hidden_dim, vocab_size)
    logits = head(out_bf)                       # (batch, seq_len, vocab_size)
    targets = torch.randint(0, vocab_size, (batch, seq_len))
    criterion = nn.CrossEntropyLoss()
    try:
        criterion(logits, targets)              # 三维预测 + 二维标签,直接不收
    except (RuntimeError, ValueError) as e:
        print('报错:', str(e).split('\n')[0])
    # 正确做法:把 batch 和时间步压平,变成「一共 batch*seq_len 条独立的多分类」
    loss = criterion(logits.reshape(-1, vocab_size), targets.reshape(-1))
    print('压平之后可以算:', logits.reshape(-1, vocab_size).shape,
          targets.reshape(-1).shape, '→ loss 是标量:', loss.dim() == 0)


if __name__ == '__main__':
    main()
x.shape」的习惯,一秒钟的事。
⚠️ 三、隐藏状态
- 生成时每一步都重新
init_hidden()。 现象:生成结果前言不搭后语,像失忆。因为每个词都从零记忆开始猜。修法:hidden要在循环外面接住、下一轮传回去,一路带着走。 - 训练时忘了每批重置。 和上一条相反:批与批之间不重置,上一批句子的记忆会串进这一批。修法:每个 batch 开头
hidden = model.init_hidden(len(bx))。 - 改了
batch_size但init_hidden里写死了 1。 现象:Expected hidden size (1, 32, 128), got (1, 1, 128)。修法:batch 大小动态传入;最后一个 batch 往往不满,用len(bx)而不是配置里的batch_size。 - 把
hidden跨批次传下去却没detach()。 现象:第二个 batch 反向传播时报Trying to backward through the graph a second time,或者显存持续增长。因为计算图一直挂着没释放。修法:需要跨批保留记忆时写hidden = hidden.detach(),只传数值不传图——这就是截断 BPTT。 - 换成 LSTM 后仍写
output, hn = lstm(x)。 现象:不报错,但hn是元组,后续当张量用时抛类型错误。修法:output, (hn, cn) = lstm(x)。
⚠️ 四、训练与生成
- 模型最后一层加了 softmax。 现象:loss 降得异常慢或者卡住。
nn.CrossEntropyLoss内部已经含了 softmax,再加一层等于做了两次。修法:输出层直接返回 logits。 - loss 突然变
nan。 序列越长越容易遇到,是梯度爆炸。修法:在backward()和step()之间插clip_grad_norm_(model.parameters(), 1.0)。注意位置:放step()之后等于没裁。 - loss 降到某个值就不动,模型只会用最近几个词。 这是梯度消失,裁剪和调学习率都没用。修法:换 GRU / LSTM,或者直接上下一页的 Transformer。
- 拿 loss 绝对值判断好坏。 词表一万时,随机初始化的交叉熵约
ln(10000) ≈ 9.2;词表大小不同,可比的基线也不同。修法:先算出ln(vocab_size)当参照,再看降了多少;最终标准始终是生成结果是否通顺。 - 生成结果原地打转,反复输出同一个词。 多半不是模型问题,是
argmax的确定性导致的。修法:改用温度采样或 top-k,这一步不需要重新训练。 - 生成时忘了
model.eval()和torch.no_grad()。 现象:结果不稳定(Dropout 仍在生效)、显存持续增长(计算图被保留)。修法:预测函数开头model.eval(),循环包在with torch.no_grad():里。 - 起始词不在词表里。 现象:
KeyError。修法:查表用.get(word, unk_idx),或在调用前先校验并给出友好提示。
07自测题
点击题目展开答案;这 11 题都能说清楚,这一页就通了
怎么判断一份数据该不该用序列模型?
问一句:把输入打乱,答案会不会变。 会变(文本、股价、语音、用户行为)就是序列数据;不会变(一张表的年龄、身高、收入三列)就不是,用全连接就够了。硬给非序列数据上 RNN,只是白白增加训练难度。
全连接网络处理文本时卡在哪两点?RNN 各自怎么解决?
① 长度不定:nn.Linear 的 in_features 建层时写死,而句子有长有短。RNN 改成一个词一个词地吃,句子多长就多循环几步,参数量不随句长变化。
② 看不见顺序:全连接把所有词铺平,「我爱你」和「你爱我」只是同一堆数字的不同排列。RNN 里顺序由「谁先改写便签」天然承载。
代价是 RNN 新添了两个毛病:不能并行、远处会衰减。
one-hot 有哪三个问题?词嵌入分别怎么解决?
① 维度爆炸:长度等于词表大小,五万词就是五万维、其中 49999 个是 0 → 词嵌入用人为指定的稠密维度(常见 128)。
② 语义全丢:任意两个 one-hot 点积恒为 0,「北京」和「天安门」的相关性与「北京」和「香蕉」一样 → 词嵌入里相近的词向量距离更近。
③ 没有可学的东西:0 和 1 是人为规定死的 → 嵌入矩阵本身就是网络参数,会被反向传播更新。
nn.Embedding 的本质是什么?为什么说它是「查表」?
它的输出等价于 one-hot 向量乘嵌入矩阵,只是没人会真去乘一个 99.998% 都是 0 的矩阵——直接按行号取那一行就行了,所以叫查表层。形状规律是在输入张量最后添加一维:输入 (batch, seq_len) 的索引,输出 (batch, seq_len, embedding_dim)。
展开图上画了三个方块,是三个神经元吗?
不是,是同一个神经元的三个时刻。 就像连环画里同一个角色出现在每一格。所有时间步共用同一套 W_ih / W_hh / b_ih / b_hh,这叫参数共享,也正是「参数量与句长无关」的来源。
RNN 单元每一步吃什么、吐什么?写出那条公式。
吃两样:上一步的隐藏状态 h_t−1 和这一步的词向量 x_t;吐一样:新的隐藏状态 h_t(它同时也是这一步的输出)。
公式:h_t = tanh(x_t·W_ih^T + b_ih + h_t−1·W_hh^T + b_hh)。
两个加号就是全部秘密:这一步的词贡献一份 + 上一步的便签贡献一份,加起来再用 tanh 压一压。
h0 一般取什么?形状是什么?为什么第一维不是 batch?
一般取全 0,表示开工前网络对这句话一无所知。形状是 (num_layers, batch, hidden_size)——第一维跟着层数走,不跟着数据走,因为每一层都需要自己的一张初始便签。把 batch 写在第一维是最常见的报错之一。
output 和 hn 分别是什么?什么任务用哪个?
output 是横着切:沿时间轴把每一步的 h 都留下来,形状 (seq_len, batch, hidden_size),但只含最后一层。hn 是竖着切:只留最后一刻,形状 (num_layers, batch, hidden_size),但含每一层。
逐词预测(文本生成、序列标注)用 output;整句判断(情感分类、意图识别)用 hn[-1]。单层网络里 output[-1] 和 hn[0] 是同一个张量。
把 (batch, seq_len, dim) 直接丢进默认布局的 nn.RNN,会报错吗?
往往不报错,这才是最危险的地方。默认布局是 (seq_len, batch, input_size),只要两个数都合法,它就会把 batch 当成句长一路算下去,训练能跑完、loss 也会降一点,但模型学到的东西毫无意义。修法:全项目统一 batch_first=True,或送进去前 transpose(0, 1),二选一并贯彻到底。
为什么 RNN 记不住太远的话?用铁律解释一遍。
因为便签只有一张,而且每一步都被整张重写。反向传播要把每一段的导数连乘起来,每段大小约为 |W_hh·tanh′|,而 tanh 的导数最大才 1、多数区域远小于 1。单段系数 0.5 时,第 20 步只剩 9.5e−07——20 步之前的词等于完全没参与训练。这不是没训练好,是结构决定的天花板。
梯度爆炸和梯度消失,哪个能救、哪个救不了?
梯度爆炸能救:现象是 loss 突然变 nan,一行 clip_grad_norm_(model.parameters(), 1.0) 就压住了,信息本身没丢,只是步子迈太大。注意它必须夹在 backward() 和 step() 之间。
梯度消失救不了:现象是 loss 降到平台、模型只会用最近几个词,裁剪和调学习率都无效——远处的信息压根没传过来。只能换结构:GRU / LSTM / Transformer。
LSTM 靠什么缓解梯度消失?GRU 和它怎么选?
关键不在门多,而在另开的细胞状态 c 以加法为主更新。加法的导数是 1,连乘一百个 1 还是 1,于是绕开了那串小于 1 的连乘。注意这是「可以不衰减」的通道,不是保证,超长序列上 LSTM 同样会力不从心。
选型:先上 GRU(2 个门,参数比 LSTM 少四分之一,多数任务效果持平且更快),确实需要更强长期记忆再换 LSTM(3 个门,参数是 RNN 的 4 倍)。
歌词生成的标签是怎么来的?为什么说它是今天大模型预训练的雏形?
标签就是把输入整体右移一位:读到第 1 个词时该猜第 2 个,读到第 2 个词时该猜第 3 个。一条 32 词的样本同时提供 32 个训练信号,不需要任何人工标注,语料本身就是答案。
「输入一段文本、预测下一个词、标签由文本自身右移得到」这套自监督范式,从这个几百行的脚本到千亿参数大模型目标函数完全一样,变的只是数据规模、模型结构和工程手段。
生成结果反复输出同一个词,是模型没训练好吗?
多半不是。 这是 argmax 确定性的必然结果:同样输入永远给同样输出,一旦进入「自己指向自己」的状态就原地打转。修法是换选词方式——温度采样或 top-k,工程上常把两者组合:先用 top-k 砍掉长尾怪词,再按温度抽签。这些都在推理阶段生效,改它们不需要重新训练模型,比重训划算得多。
词术语表
| 术语 | 含义 |
|---|---|
| 序列数据 | 后面的数据和前面的数据有关系、调换顺序意思就变的数据;判据是「打乱输入,答案会不会变」 |
| RNN | 循环神经网络,一个词一个词地处理序列,中间带着一个会被反复重写的隐藏状态 |
隐藏状态 h | 网络对「到目前为止听到了什么」的全部记忆,是一个固定长度的向量;每一步被整张覆盖 |
h0 | 初始隐藏状态,一般全 0;形状 (num_layers, batch, hidden_size),第一维是层数不是 batch |
| 参数共享 | 所有时间步复用同一套 W_ih / W_hh / b_ih / b_hh;这是参数量与句长无关的原因 |
| 时间步 time step | 序列里的一个位置;「展开」就是把循环沿时间轴摊平画出来 |
| 分词 tokenize | 把文本切成词或字;中文没有天然空格,工程上常用 jieba,大模型则用子词切分 |
| 词表 vocabulary | 去重后的词与唯一编号的映射;必须和模型权重一起保存,重建后编号变了旧权重就作废 |
| one-hot | 只有一位是 1 的稀疏编码;维度等于词表大小,任意两词点积恒为 0,无法表达语义相似度 |
| 词嵌入 embedding | 用一串稠密小数表示一个词;本质是 one-hot 乘矩阵,实现上直接按索引取行,所以叫查表层 |
num_embeddings | 嵌入矩阵的行数 = 词表大小;索引超出这个数会抛 IndexError |
embedding_dim | 每个词用多少维表示;必须等于 nn.RNN 的 input_size,常见 64 / 128 / 256 |
hidden_size | 隐藏状态的长度,也是每个时间步输出的维度;越大记得越多也越容易过拟合 |
batch_first | 决定张量布局;默认 False 时是 (seq_len, batch, input_size),与其他层的习惯相反 |
output | nn.RNN 的第一个返回值:所有时间步的 h,只含最后一层;逐词任务用它 |
hn | 第二个返回值:最后一个时间步的 h,含所有层;整句分类任务用它 |
| BPTT | 沿时间反向传播;就是链式法则用在展开图上,梯度要连乘 seq_len 段,同一套权重收到多份梯度累加 |
| 截断 BPTT | 把长序列切成片段分别反传,片段之间只用 detach() 传数值不传梯度 |
| 梯度消失 | 单段系数小于 1 时连乘趋零,远处的词等于没参与训练;裁剪和调学习率都无效,只能换结构 |
| 梯度爆炸 | 单段系数大于 1 时连乘放大,loss 变 nan;用 clip_grad_norm_ 压住即可,须夹在反向与更新之间 |
| 门 gate | 用 sigmoid 算出的 0~1 向量,逐元素乘另一个向量:乘 0 关掉、乘 1 放行、乘 0.3 放行三成 |
| LSTM | 三个门 + 额外的细胞状态 c;c 以加法更新,给梯度留了一条不衰减的旁路;参数是 RNN 的 4 倍 |
| GRU | 两个门、只有 h;参数是 RNN 的 3 倍,多数任务上与 LSTM 效果持平而更快,常作首选 |
| 自回归 | 把上一步吐出来的词当作下一步的输入,逐词往下写 |
| argmax | 永远取分数最高的词;完全确定性,容易让生成原地打转 |
| 温度 temperature | softmax 之前先把分数除以 T:T<1 更保守、T>1 更发散;常用区间 0.7~1.0 |
| top-k | 只在分数最高的 k 个候选里按概率抽签,先砍长尾再随机;常与温度组合使用 |