私有化部署选型:把模型搬回自己的机器
私有化部署要回答的不是「能不能跑起来」,而是「这台机器的显存,配得上哪个尺寸的模型」。
30″30 秒看懂私有化部署
调云端大模型 API,像是把食材寄到城里的中央厨房:厨子手艺一流、设备顶级,但你的食材必须先离开自己家,交到别人手上,做好了再寄回来。
私有化部署就是在自家后厨支一口灶:厨子可能没那位名厨那么强,但食材从头到尾没出过家门,你想什么时候开火就什么时候开火,也不按次收费。企业愿意折腾这件事,几乎都不是因为模型更聪明,而是因为那袋食材见不得人——病历、合同、工资表、代码库。
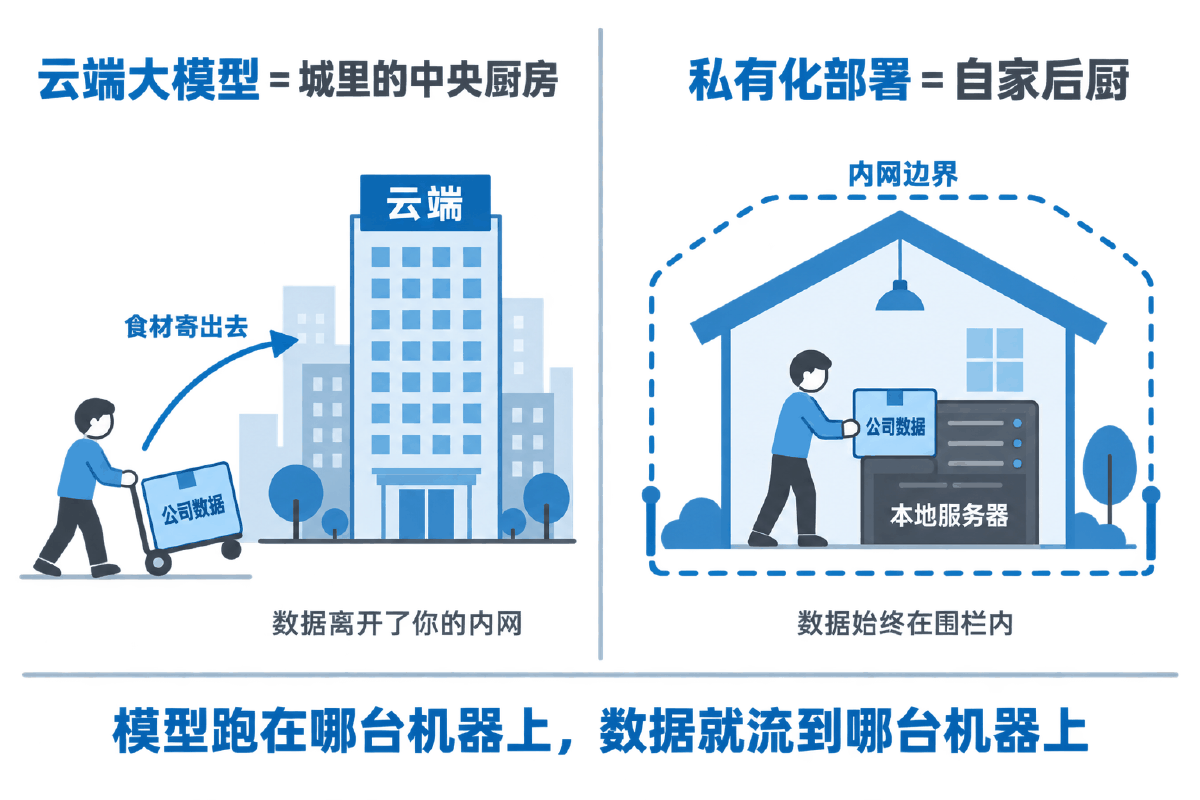
| 比喻里的角色 | 对应的技术概念 | 它到底意味着什么 |
|---|---|---|
| 中央厨房 | 云端大模型 API | 模型在厂商机房,你发请求、按 token 付费,数据必然出网 |
| 自家后厨 | 私有化部署 | 模型权重落在你自己的磁盘上,推理在你自己的机器上发生 |
| 灶台面积 | 显存(VRAM) | 决定你能炒多大的锅——也就是能跑多大参数量的模型 |
| 菜谱的厚薄 | 量化档位(Q4 / Q8 / FP16) | 同一道菜的精简版,占地小了,细节也丢了一些 |
| 傻瓜料理机 | Ollama | 把「下载权重、装推理引擎、起服务」压成几条命令 |
| 食材 | 你的业务数据 | 私有化真正要守住的东西,也是整件事唯一的出发点 |
01概念:私有化部署到底私有了什么
先把「私有」这两个字拆清楚,再谈怎么装
1.1 什么是私有化部署
一句话定义:把大模型的权重文件放在你自己控制的机器上,推理过程完全在这台机器内部完成,不依赖任何外部服务。
注意「你自己控制」这个限定——它不等于「本地」。下面三种都算私有化部署:
- 开发机本地跑。笔记本插着显卡,模型在自己电脑上,最典型的入门形态。
- 公司内网服务器跑。模型在机房的一台 GPU 服务器上,全公司通过内网访问。企业里最常见的就是这种。
- 自己租的云服务器跑。机器是租来的,但操作系统权限、模型文件、日志都归你,厂商拿不到推理内容。
而调 OpenAI、智谱、通义这些厂商提供的 API,无论包装成什么形态,推理都发生在厂商的机器上,都不是私有化。
1.2 六个维度对比云端 API
这张表是选型的主要依据。没有哪一列全是优势——真做决策时,往往只有一两行是决定性的,剩下的都是次要因素。
| 维度 | 云端 API | 私有化部署 |
|---|---|---|
| 数据流向 | 必然出网 | 始终在内网,这是绝大多数项目选私有化的唯一真实理由 |
| 模型能力 | 明显更强 | 同等预算下能跑的模型小得多,复杂推理、长文本写作差距很明显 |
| 成本结构 | 按 token 付费,用多少付多少 | 一次性买卡 + 长期电费运维,低频使用反而更贵 |
| 响应速度 | 受公网和厂商限流影响 | 内网延迟低,但生成速度取决于你的卡,小显存机器可能更慢 |
| 可用性 | 厂商负责,但会限流、会改价、会下线模型 | 版本你自己钉死,代价是挂了没人管,得自己值班 |
| 合规审计 | 要看厂商的资质和协议 | 日志、访问记录全在自己手上,好过审 |
这笔账口算容易漏项,干脆写成脚本。关键设计是把私有化的月支出和调用量解耦——卡买了就在那儿,跑不跑都要交电费和运维工时,这正是低频场景吃亏的根源:
"""成本测算:私有化部署 vs 调云端 API,到底几个月才回本。

写这个脚本的原因:
    立项会上最常见的说法是「自己部署省钱」。
    但真实账单里除了电费,还有显卡采购、机房托管、运维人力、升级回归测试。
    很多低频场景算下来,私有化比调 API 贵好几倍 —— 只是没人算过。

这个脚本不替你做决定,它只做一件事:
    把两条路的钱都摊到「每月」,然后告诉你回本点在第几个月。
    如果回本点超过显卡的服役年限,那「省钱」这个理由就不成立,
    该老实承认真正的理由是「数据不能出网」。

用法:
    python3 cost_compare.py                      # 用内置的默认参数跑一遍
    python3 cost_compare.py --calls-per-day 5000 # 换成你自己的调用量
"""
import argparse
import sys

# --------------------------------------------------------------------------
# 默认参数:全部按 TODO 换成你们自己的真实数字,别直接拿去汇报
# --------------------------------------------------------------------------
DEFAULTS = {
    # ---- 业务量 ----
    "calls_per_day": 500,          # 每天调用次数
    "tokens_in": 800,              # 单次输入 token 数(含提示词和历史)
    "tokens_out": 400,             # 单次输出 token 数

    # ---- 云端 API 侧(单位:元 / 百万 token)----
    # 各家价格差别很大,且经常调整,务必以当天官网报价为准
    "api_price_in": 2.0,
    "api_price_out": 8.0,

    # ---- 私有化侧:一次性投入(元)----
    "gpu_cost": 16000,             # 显卡采购
    "server_cost": 8000,           # 主机其余部分
    "setup_hours": 24,             # 首次部署投入的人力工时

    # ---- 私有化侧:每月固定支出(元)----
    "power_watt": 450,             # 整机平均功耗(瓦)
    "power_price": 0.8,            # 电价,元 / 度
    "hosting_month": 0,            # 机房托管费;放办公室就是 0
    "ops_hours_month": 8,          # 每月运维工时

    # ---- 人力单价与服役年限 ----
    "hourly_rate": 150,            # 工程师时薪(元)
    "service_months": 36,          # 显卡预计服役月数
}


# --------------------------------------------------------------------------
def api_monthly(p):
    """云端 API 的每月支出:纯粹按量计费,用多少付多少。"""
    calls_month = p["calls_per_day"] * 30
    tin = calls_month * p["tokens_in"] / 1e6
    tout = calls_month * p["tokens_out"] / 1e6
    return tin * p["api_price_in"] + tout * p["api_price_out"]


def private_upfront(p):
    """私有化的一次性投入:硬件 + 首次部署人力。"""
    return p["gpu_cost"] + p["server_cost"] + p["setup_hours"] * p["hourly_rate"]


def private_monthly(p):
    """私有化的每月固定支出。

    注意这里和调用量无关:卡买了就在那儿,跑不跑都要交电费和运维。
    这正是低频场景吃亏的根源 —— 调用量再低,月支出也降不下来。
    """
    # 按 7×24 全天开机估电费:功率(W) ÷ 1000 × 24 × 30 = 每月度数
    power = p["power_watt"] / 1000 * 24 * 30 * p["power_price"]
    ops = p["ops_hours_month"] * p["hourly_rate"]
    return power + p["hosting_month"] + ops


def breakeven_month(p):
    """回本点:第几个月开始,私有化的累计成本低于 API 的累计成本。

    返回 None 表示在服役期内始终不回本。
    """
    up = private_upfront(p)
    pm = private_monthly(p)
    am = api_monthly(p)
    # 每月省下来的钱;不为正说明连月支出都打不过 API,永远回不了本
    saved = am - pm
    if saved <= 0:
        return None
    months = up / saved
    return months if months <= p["service_months"] else None


# --------------------------------------------------------------------------
def report(p):
    am = api_monthly(p)
    up = private_upfront(p)
    pm = private_monthly(p)
    calls_month = p["calls_per_day"] * 30

    print("=" * 58)
    print("业务量:每天 %d 次,每月约 %d 次" % (p["calls_per_day"], calls_month))
    print("        单次 %d token 进 / %d token 出"
          % (p["tokens_in"], p["tokens_out"]))
    print("-" * 58)
    print("【云端 API】")
    print("  一次性投入      0 元")
    print("  每月支出        %8.0f 元(随调用量涨落)" % am)
    print("【私有化部署】")
    print("  一次性投入      %8.0f 元(显卡 %d + 主机 %d + 部署人力 %d)"
          % (up, p["gpu_cost"], p["server_cost"],
             p["setup_hours"] * p["hourly_rate"]))
    print("  每月支出        %8.0f 元(电费 + 托管 + 运维,与调用量无关)" % pm)
    print("-" * 58)

    be = breakeven_month(p)
    if be is None:
        if am - pm <= 0:
            print("结论:私有化【永远不回本】。")
            print("      光是每月固定支出(%.0f 元)就已经超过 API 的月账单(%.0f 元)。"
                  % (pm, am))
        else:
            print("结论:私有化在 %d 个月服役期内【回不了本】。" % p["service_months"])
        print()
        print("  ⚠️ 这不代表不该私有化,只代表【省钱】这个理由不成立。")
        print("     如果数据确实不能出网,那就用这个理由立项,别用省钱。")
    else:
        print("结论:约第 %.1f 个月回本(服役期 %d 个月)。"
              % (be, p["service_months"]))
        total_saved = (am - pm) * p["service_months"] - up
        print("      整个服役期预计净省 %.0f 元。" % total_saved)
        print()
        print("  ⚠️ 前提是调用量能稳定维持。量掉下来,回本点会立刻往后推。")

    print("=" * 58)
    print("没有计入的成本,评估时请自行补上:")
    print("  · 模型升级时的回归测试人力")
    print("  · 服务故障期间的业务损失")
    print("  · 显卡残值与更换周期")
    print("  · 云端 API 侧的限流重试、以及涨价风险")


def main():
    ap = argparse.ArgumentParser()
    for k, v in DEFAULTS.items():
        ap.add_argument("--" + k.replace("_", "-"), type=type(v), default=v)
    args = ap.parse_args()
    report({k: getattr(args, k) for k in DEFAULTS})
    return 0


if __name__ == "__main__":
    sys.exit(main())
按脚本内置的默认参数(每天 500 次调用、单卡 1.6 万、每月 8 小时运维)跑出来的结论是:
| 路线 | 一次性投入 | 每月支出 | 回本点 |
|---|---|---|---|
| 云端 API | 0 元 | 约 72 元 | — |
| 私有化部署 | 约 27600 元 | 约 1459 元 | 永远不回本 |
光是每月固定支出就已经是 API 月账单的二十倍,一次性投入根本摊不回来。这个量级的业务,选私有化的唯一正当理由就是数据不能出网——把「省钱」写进立项报告,第一轮评审就会被问穿。
--calls-per-day 往上调,结论会翻转:调用量足够大时,API 的月账单随量线性上涨,而私有化的月支出基本不动,回本点就出现了。自己拿真实调用量跑一遍,别用别人的结论。
1.3 什么时候不该私有化
说清楚反面比说正面更有用。在此之前,先看一眼本地部署常用的两个模型家族有哪些尺寸可选——尺寸决定了你需要多大的卡,也就决定了这件事划不划算。
| 模型家族 | 可选尺寸 | 特点与适用 |
|---|---|---|
| qwen3 | 0.6b / 1.7b / 4b / 8b / 14b / 30b / 32b / 235b | 中文场景的常规选择,尺寸梯度密,容易找到贴合显存的那一档 |
| deepseek-r1 | 1.5b / 7b / 8b / 14b / 32b / 70b / 671b | 偏推理链条的模型,回答里会带思考过程,输出更长、更吃生成时间 |
| qwen2 | 0.5b / 1.5b / 7b / 72b | 课程演示常用,体积小、拉取快,本讲的示例都用它 |
qwen2:1.5b。只写 qwen2 会拉到仓库的默认标签,具体是哪一档取决于仓库当时的设置——团队里两个人各拉一次,很可能拿到不同的模型,后面对不上性能数据就会互相扯皮。
说清楚反面比说正面更有用。下面几种情况,建议直接用云端 API:
- 处理的是公开数据。写营销文案、翻译公开资料、做公开知识问答——食材本来就不怕出门,没必要支灶。
- 任务需要很强的推理能力。复杂代码生成、长链条逻辑推理,本地能跑的小模型和顶级云端模型差距是数量级的,不是调参能补上的。
- 调用量很小且不稳定。一天几十次的内部工具,租一张卡全天空转,纯属浪费。
- 没人负责运维。私有化是一个需要长期值班的系统:服务会挂、磁盘会满、显存会泄漏。没人管的私有化部署,三个月后一定是一台没人敢重启的僵尸机器。
02原理:显存决定你能跑多大的模型
选型的全部算术,就集中在这一节
2.1 参数量怎么换算成显存
模型名字里的 0.5B、7B、32B 指的是参数个数:B 是 billion,十亿。7B 就是七十亿个参数。每个参数都要占显存,占多少取决于每个参数用几个字节存:
| 精度 | 每参数字节 | 7B 模型权重约占 |
|---|---|---|
| FP32 单精度 | 4 字节 | 约 28 GB,本地部署基本不用 |
| FP16 半精度 | 2 字节 | 约 14 GB,训练和高精度推理的常见档 |
| Q8 八位量化 | 1 字节 | 约 7 GB |
| Q4 四位量化 | 约 0.5 字节 | 约 3.5~4.5 GB,Ollama 默认档位 |
换算口诀很简单:参数量(B)× 每参数字节数 = 权重占用(GB)。7B 的 Q4 模型约 4GB,32B 的 Q4 约 18GB,把这两个数字记住,一眼就能判断一台机器跑不跑得动。
num_ctx 从 4096 拉到 32768,缓存能翻好几倍。所以选型时要在权重之上留 20%~30% 余量,卡得刚刚好的配置上线就会 OOM。
把这条口诀和手上的卡对一遍,选型范围立刻就收窄了:
| 显存 | 常见卡型 | Q4 下的甜点尺寸 | 说明 |
|---|---|---|---|
| 6 GB | 入门独显 | 1.5B 左右 | 只够跑通流程,回答质量有限 |
| 8 GB | RTX 3060 / 4060 | 7B | 约占 5 GB,留得出上下文余量,学习阶段的主流配置 |
| 16 GB | RTX 4060 Ti 16G / A4000 | 14B | 约占 10 GB,可以把并发开到 2~4 |
| 24 GB | RTX 4090 / A10 | 14B(推荐)或 32B(吃紧) | 多人共用时选 14B,把余量让给并发和上下文 |
| 48 GB 以上 | A6000 / 双卡 | 32B 及以上 | 到这一档才谈得上「本地跑大模型」,但成本也另一个量级了 |
num_ctx、是否同时加载向量模型,都会把甜点尺寸往下压一档。拿它筛掉明显不可能的选项,别拿它当验收标准。
2.2 量化:把菜谱压薄
量化就是用更少的比特去存每一个参数。原本每个参数用 16 位浮点数记录,量化后压到 8 位甚至 4 位整数——像把一本厚厚的精装菜谱缩印成便携本:菜还是那些菜,步骤还在,但一些细微的火候描述被四舍五入掉了。
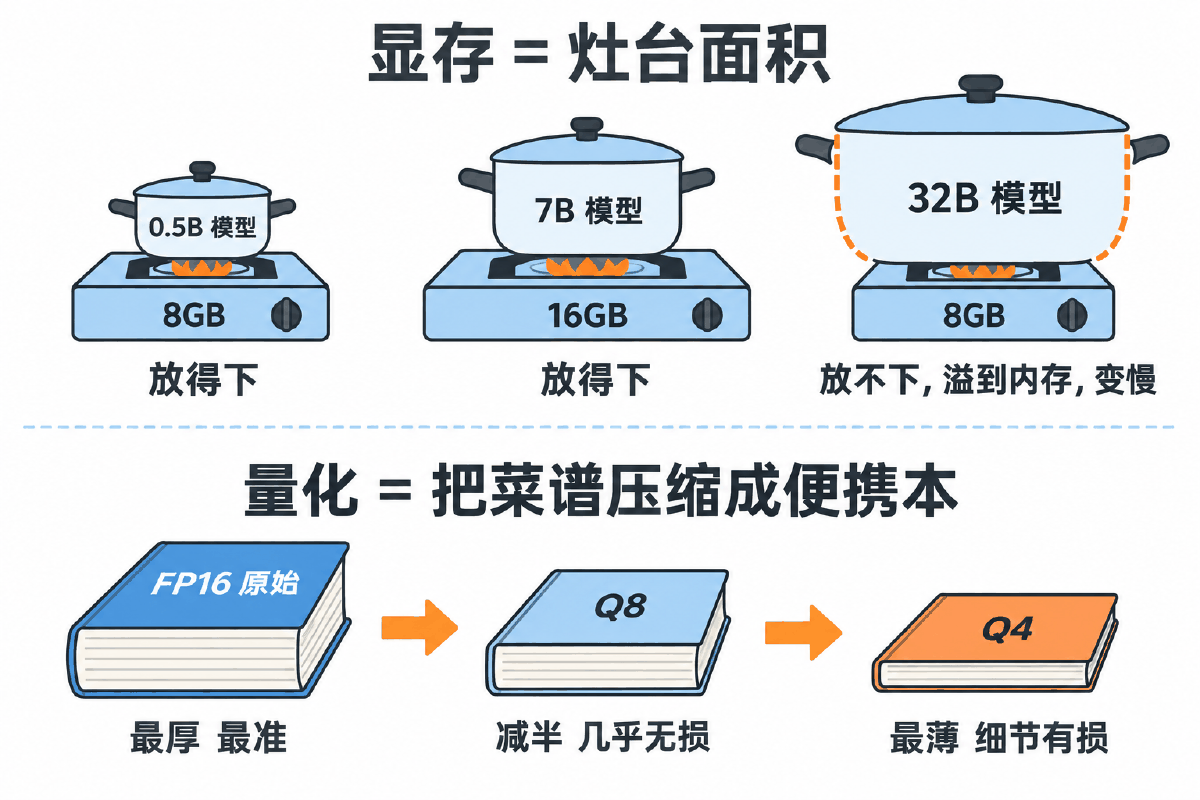
| 档位 | 体积 | 质量 | 什么时候选 |
|---|---|---|---|
| FP16 | 最大 | 最高 | 显存充裕、对输出质量极敏感,或者要做后续微调 |
| Q8 | 约一半 | 几乎无损 | 显存够用时的稳妥选择,质量损失一般感知不到 |
| Q4 | 约四分之一 | 有可感损失 | 本地部署默认档,同显存下能跑更大的模型,性价比最高 |
2.3 显存装不下会怎样
不会直接报错崩掉,而是悄悄变慢——这比报错更坑,因为你不看监控根本不知道发生了什么。
判断当前落在哪一档,方法只有一个:跑起来以后看进程实际占用。Ollama 提供了 ollama ps,会直接告诉你这个模型是 100% GPU、还是 GPU/CPU 混合。不要凭感觉判断,一定要看这个输出。
2.4 并发怎么吃显存
前面反复提到「并发上去就 OOM」,这里把账算清楚。模型权重是所有请求共用的一份,不会因为来了两个人就加载两份;但 KV 缓存是每个请求一份,来一个人就多一份。
| 显存构成 | 随并发变化吗 | 说明 |
|---|---|---|
| 模型权重 | 不变 | 只加载一份,所有并发请求共用 |
| KV 缓存 | 成倍增长 | 每个并发请求一份,且随上下文长度线性上涨 |
| 运行时开销 | 小幅增长 | 激活值、中间结果等,量级比前两项小 |
所以那个经常被问的问题——「14B 占 10G,我 24G 的卡是不是能跑两个」——答案是不需要跑两个:同一个模型支持多路并发,只要把 OLLAMA_NUM_PARALLEL 调上去就行,多出来的开销只是 KV 缓存,而不是再来一份 10G 的权重。
OLLAMA_NUM_PARALLEL 时,多出来的会进队列等着,表现是单次耗时线性变长,而不是报错。直到队列也满了(OLLAMA_MAX_QUEUE,默认 512),服务端才会直接返回 503。排查「变慢」时记得先看是不是排队,而不是一上来就怀疑模型。
2.5 Ollama 在技术栈里的位置
把模型跑起来,本来要做四件事:下载权重、装推理引擎、做格式转换、写一个服务把它包成接口。Ollama 把这四件事全包了,对外只留几条命令。
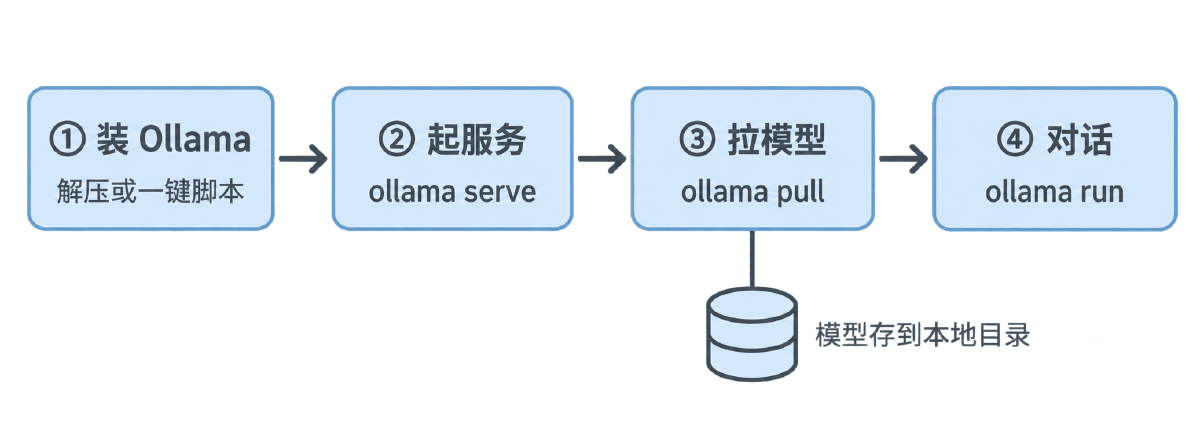
| 方案 | 上手难度 | 适用场景 |
|---|---|---|
| Ollama | 最低 | 个人开发、中小规模内部服务;本讲全程用它 |
| vLLM | 中 | 高并发线上服务,吞吐量明显优于 Ollama,配置也复杂得多 |
| LM Studio | 最低 | 纯桌面图形界面,适合完全不碰命令行的使用者 |
| 原生 transformers | 高 | 要改模型结构、做研究或微调时才直接用 |
03最小代码:先算清楚这台机器能跑什么
选型不是拍脑袋,三十行就能把账算明白
装 Ollama 之前先做一次估算,能省掉「拉了 20GB 模型才发现跑不动」的整晚时间。下面这个脚本不需要联网,也不需要装任何依赖,纯算术:输入显存大小,输出这块卡放得下哪些模型。
"""选型估算:这块卡到底放得下多大的模型。

估算口径(务必理解,别当成精确值):
    权重占用 ≈ 参数量 × 每参数字节数
    每参数字节数由量化等级决定:FP16 约 2.0,Q8 约 1.0,Q4 约 0.55
    实际还要再加 KV cache 与运行时开销,这里按经验留 1.2 倍余量

真实占用请以 `ollama ps` 的 SIZE 列和 PROCESSOR 列为准:
PROCESSOR 显示 100% GPU 才是全部装进显存,出现 CPU 就说明溢出了。
"""

# 每个参数在不同量化等级下大致占多少字节
BYTES_PER_PARAM = {
    "FP16": 2.0,
    "Q8": 1.0,
    "Q4": 0.55,
}

# 运行时还要放 KV cache、激活值等,按 1.2 倍留余量
OVERHEAD = 1.2


def estimate_gb(params_b, quant):
    """params_b:参数量,单位 B(十亿)。返回预估显存占用 GB。"""
    per = BYTES_PER_PARAM[quant]
    # params_b × 1e9 个参数 × per 字节 ÷ 1024^3 换成 GiB
    weights = params_b * 1e9 * per / 1024 ** 3
    return weights * OVERHEAD


def fits(vram_gb, params_b, quant):
    need = estimate_gb(params_b, quant)
    return need <= vram_gb, need


def main():
    # 常见显卡显存档位
    cards = [("笔记本核显/无卡(纯CPU)", 0), ("8GB 显卡", 8), ("16GB 显卡", 16), ("24GB 显卡", 24)]
    # 常见模型规模
    models = [("0.5B", 0.5), ("1.5B", 1.5), ("7B", 7), ("14B", 14), ("32B", 32)]

    for quant in ("FP16", "Q4"):
        print("\n量化等级:%s(每参数约 %.2f 字节)" % (quant, BYTES_PER_PARAM[quant]))
        header = "%-12s" % "模型" + "".join("%-22s" % c[0] for c in cards)
        print(header)
        for name, pb in models:
            row = "%-12s" % name
            for _cname, vram in cards:
                ok, need = fits(vram, pb, quant)
                if vram == 0:
                    # 没有独立显卡时跑在内存里,能跑但速度是数量级的差距
                    row += "%-22s" % ("约%.1fGB 内存/慢" % need)
                else:
                    row += "%-22s" % ("%.1fGB %s" % (need, "放得下" if ok else "放不下"))
            print(row)

    print("\n同一个模型,Q4 相对 FP16 大约省下:")
    for name, pb in models:
        a = estimate_gb(pb, "FP16")
        b = estimate_gb(pb, "Q4")
        print("  %-6s %5.1fGB → %5.1fGB  省 %.0f%%" % (name, a, b, (1 - b / a) * 100))


if __name__ == "__main__":
    main()
参数量 × 1e9 × 每参数字节数 ÷ 1024³。BYTES_PER_PARAM 里 Q4 取 0.55 而不是 0.5,是因为量化模型里还有一部分层通常保持较高精度,实际体积总会比理论值略大一点。最后乘的 OVERHEAD = 1.2 是给 KV 缓存和运行时留的余量——这个余量不留,上线并发一上来就 OOM。
ollama ps 的输出为准:PROCESSOR 列显示 100% GPU 才算全部装进了显存。
04完整案例:三种机器怎么选型
同一套算术,落到三种真实配置上会得出完全不同的结论
4.1 案例一 · 8GB 显卡的个人开发机
典型配置:RTX 3060 / 4060 笔记本,8GB 显存。这是学习阶段最常见的机器。
| 候选模型 | Q4 预估占用 | 结论 |
|---|---|---|
| qwen2:0.5b | 不到 1 GB | 随便跑,适合调通链路、写 demo,但回答质量很有限 |
| qwen2:1.5b | 约 1 GB | 入门首选,速度快,简单问答够用 |
| qwen2:7b | 约 5 GB | 这块卡的甜点位,留得出上下文余量,质量明显上一个台阶 |
| 14B 级别 | 约 10 GB | 装不下,会溢到内存,速度掉到难以接受 |
结论:选 7B 的 Q4,上下文别开太大。这台机器的定位是「把流程跑通、做本地实验」,不要指望它承载线上业务。
4.2 案例二 · 24GB 显卡的部门服务器
典型配置:RTX 4090 或 A10,24GB 显存,供一个部门十几个人内网使用。
| 候选方案 | Q4 预估占用 | 结论 |
|---|---|---|
| 单个 14B | 约 10 GB | 余量充足,可以把上下文开大、并发开到 2~4 |
| 单个 32B | 约 22 GB | 能装下但几乎没余量,并发只能是 1,上下文也得压着 |
| 14B + 一个向量模型 | 约 11 GB | 为将来接 RAG 留位置,是更常见的真实排布 |
结论:选 14B,不要贪 32B。把省下来的显存用于提高并发和上下文长度,十几个人同时用的体验,远比单次回答质量高一点更重要。
4.3 案例三 · 纯 CPU 的老机器
没有显卡,只有内存。Ollama 支持纯 CPU 推理,能跑,但要接受速度。
- 1.5B 及以下:可用。每秒十几个 token,做简单分类、抽取任务体验尚可。
- 7B:勉强能跑,每秒几个 token。用户会明显感觉到「一个字一个字往外蹦」。
- 14B 以上:不建议。一次回答要等几分钟,没有实用价值。
结论:纯 CPU 的机器只适合做离线批处理,不适合做交互式问答。如果业务确实需要实时对话,这条路走不通,得老实去申请显卡,或者回头考虑云端 API。
4.4 选型验收:用真实样本压一遍
前面三个案例给的都是估算结论,回答的是「跑不跑得起」。但拍板前还得回答第二个问题:跑得多快、答得好不好。这两件事估算不出来,只能实测。
| 要回答的问题 | 怎么得到答案 | 判断标准 |
|---|---|---|
| 跑不跑得起 | 显存估算 + ollama ps | PROCESSOR 显示 100% GPU |
| 跑得多快 | 串行压测看生成速度 | 交互式问答至少要 15 token/s 以上才不憋得慌 |
| 多人用会不会崩 | 并发压测看耗时退化 | 并发上去后单请求耗时线性变长,就是在排队了 |
| 答得好不好 | 人工逐条看存档答案 | 没有自动标准,这一步省不得 |
"""选型验收:拿自己的真实样本,把候选模型逐个压一遍。

为什么必须有这一步:
    跑分榜测的是通用能力,和你的业务样本关系有限。
    「能装进显存」只说明跑得起来,不说明答得好。
    真正能拍板的证据只有一个 —— 你自己的三十条数据,各模型跑一遍的结果。

这个脚本负责把**可量化的部分**测出来(首 token 延迟、生成速度、并发下的退化),
并把每个模型的答案原样落盘,方便人工逐条对比质量。
质量这件事没法自动打分,必须人看。

用法:
    # 先把你的真实问题写进 samples.txt,一行一条
    python3 bench_local.py --models qwen2:1.5b,qwen2:7b --samples samples.txt
    python3 bench_local.py --models qwen2:7b --concurrency 4

依赖:只用标准库,不需要 pip 装任何东西。
"""
import argparse
import json
import os
import statistics
import sys
import threading
import time
import urllib.error
import urllib.request

BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434").rstrip("/")


# --------------------------------------------------------------------------
def call_once(model, prompt, timeout=300):
    """发一次非流式请求,返回 (答案, 指标字典)。

    Ollama 的响应里自带耗时统计,单位是纳秒:
        total_duration   整次请求耗时
        load_duration    加载模型耗时(模型已在内存里时接近 0)
        prompt_eval_count/duration   读题阶段
        eval_count/eval_duration     生成阶段
    生成速度 = eval_count / (eval_duration / 1e9),这是最该关注的数字。
    """
    payload = {
        "model": model,
        "messages": [{"role": "user", "content": prompt}],
        "stream": False,
        "options": {"temperature": 0},   # 压测固定为 0,保证可复现
    }
    req = urllib.request.Request(
        BASE + "/api/chat",
        data=json.dumps(payload).encode("utf-8"),
        headers={"Content-Type": "application/json"},
    )
    t0 = time.time()
    with urllib.request.urlopen(req, timeout=timeout) as resp:
        data = json.loads(resp.read().decode("utf-8"))
    wall = time.time() - t0

    eval_count = data.get("eval_count", 0)
    eval_dur = data.get("eval_duration", 0) / 1e9
    metrics = {
        "wall": wall,
        "load_s": data.get("load_duration", 0) / 1e9,
        "prompt_tokens": data.get("prompt_eval_count", 0),
        "gen_tokens": eval_count,
        "tps": eval_count / eval_dur if eval_dur else 0,
    }
    return data["message"]["content"], metrics


# --------------------------------------------------------------------------
def warmup(model):
    """先空跑一次,把模型加载进显存。

    不预热的话,第一条样本会把几十秒的加载时间算进成绩,
    整组数据直接废掉 —— 这是压测里最常见的错误。
    """
    try:
        call_once(model, "hi", timeout=600)
        return True
    except Exception as exc:
        print("  预热失败:%s" % exc)
        return False


def bench_serial(model, samples, outdir):
    """串行跑完所有样本,统计速度并把答案落盘。"""
    rows, answers = [], []
    for i, s in enumerate(samples, 1):
        try:
            ans, m = call_once(model, s)
        except Exception as exc:
            print("  样本 %d 失败:%s" % (i, exc))
            continue
        rows.append(m)
        answers.append({"index": i, "prompt": s, "answer": ans, "metrics": m})
        print("  [%2d/%d] %5.1fs  %5.1f token/s  生成 %d token"
              % (i, len(samples), m["wall"], m["tps"], m["gen_tokens"]))

    if not rows:
        return None

    # 答案落盘,人工逐条看质量。自动打分不可信,这一步不能省。
    os.makedirs(outdir, exist_ok=True)
    path = os.path.join(outdir, model.replace(":", "_").replace("/", "_") + ".json")
    with open(path, "w", encoding="utf-8") as f:
        json.dump(answers, f, ensure_ascii=False, indent=2)

    tps = [r["tps"] for r in rows]
    walls = [r["wall"] for r in rows]
    return {
        "样本数": len(rows),
        "生成速度中位数": "%.1f token/s" % statistics.median(tps),
        "生成速度最低": "%.1f token/s" % min(tps),
        "单次耗时中位数": "%.1fs" % statistics.median(walls),
        # P95 用来看长尾:中位数好看、P95 很差的服务,用户照样骂
        "单次耗时 P95": "%.1fs" % sorted(walls)[int(len(walls) * 0.95) - 1],
        "答案存档": path,
    }


def bench_parallel(model, prompt, n):
    """并发压测:n 个线程同时发同一条请求。

    单人测着飞快、多人一起用就超时,差别就出在这里。
    并发数超过服务端 OLLAMA_NUM_PARALLEL 时,多出来的请求会排队,
    表现为单次耗时线性变长,而不是报错。
    """
    results, lock = [], threading.Lock()

    def worker():
        try:
            _ans, m = call_once(model, prompt)
        except Exception as exc:
            with lock:
                results.append({"error": str(exc)})
            return
        with lock:
            results.append(m)

    threads = [threading.Thread(target=worker) for _ in range(n)]
    t0 = time.time()
    for t in threads:
        t.start()
    for t in threads:
        t.join()
    total = time.time() - t0

    ok = [r for r in results if "error" not in r]
    failed = len(results) - len(ok)
    if not ok:
        return {"并发数": n, "全部失败": failed}
    return {
        "并发数": n,
        "成功": len(ok),
        "失败": failed,
        "墙钟总耗时": "%.1fs" % total,
        "单请求耗时中位数": "%.1fs" % statistics.median([r["wall"] for r in ok]),
        "单请求速度中位数": "%.1f token/s" % statistics.median([r["tps"] for r in ok]),
    }


# --------------------------------------------------------------------------
DEFAULT_SAMPLES = [
    "用一句话解释什么是私有化部署。",
    "把下面这句话翻译成英文:数据不出内网。",
    "列出三条本地部署大模型的注意事项。",
]


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--models", required=True,
                    help="逗号分隔的模型全名,例如 qwen2:1.5b,qwen2:7b")
    ap.add_argument("--samples", help="真实业务样本文件,一行一条;不给就用内置示例")
    ap.add_argument("--concurrency", type=int, default=0,
                    help="大于 0 时额外做一轮并发压测")
    ap.add_argument("--outdir", default="./bench_out", help="答案存档目录")
    args = ap.parse_args()

    if args.samples:
        with open(args.samples, encoding="utf-8") as f:
            samples = [ln.strip() for ln in f if ln.strip()]
    else:
        samples = DEFAULT_SAMPLES
        print("⚠️  用的是内置示例样本,结论只能参考。")
        print("    真正拍板前请换成你自己的三十条真实业务数据。\n")

    for model in [m.strip() for m in args.models.split(",") if m.strip()]:
        print("=" * 60)
        print("模型:%s" % model)
        print("预热中(首次加载可能要几十秒)…")
        if not warmup(model):
            continue

        print("串行跑 %d 条样本:" % len(samples))
        summary = bench_serial(model, samples, args.outdir)
        if summary:
            print("  —— 汇总 ——")
            for k, v in summary.items():
                print("  %-16s %s" % (k, v))

        if args.concurrency > 0:
            print("并发 %d 压测:" % args.concurrency)
            for k, v in bench_parallel(model, samples[0], args.concurrency).items():
                print("  %-16s %s" % (k, v))

    print("=" * 60)
    print("速度数据已打印,答案存档在 %s" % args.outdir)
    print("⚠️  质量必须人工逐条看,脚本不替你判断哪个模型答得好。")
    return 0


if __name__ == "__main__":
    sys.exit(main())
warmup() 先空跑一次就是为了这个。同理,temperature 固定为 0 是为了可复现——每次跑出不同的答案,横向对比就没意义了。
"""探活:确认本地 Ollama 服务真的活着,而不是「我以为它活着」。

只依赖标准库,装完 Ollama 立刻就能跑:
    python3 check_ollama.py
"""
import json
import os
import urllib.error
import urllib.request

# 服务地址走环境变量,方便在本机 / 虚拟机 / 同事机器之间切换,不写死
BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434")
TIMEOUT = 5


def get_json(path):
    """向 Ollama 发一个 GET 请求,把响应体解析成字典。"""
    url = BASE.rstrip("/") + path
    req = urllib.request.Request(url, headers={"Accept": "application/json"})
    with urllib.request.urlopen(req, timeout=TIMEOUT) as resp:
        return json.loads(resp.read().decode("utf-8"))


def main():
    print("目标服务:%s" % BASE)

    # 第一步:/api/version 是最轻的一个接口,它通了说明 HTTP 服务在监听
    try:
        version = get_json("/api/version")
    except urllib.error.URLError as exc:
        # 连不上的两种典型原因:服务没起;或者只监听了 127.0.0.1 而你在远程连
        print("连不上:%s" % exc.reason)
        print("排查顺序:systemctl status ollama → ss -lntp | grep 11434 → 防火墙")
        return 1
    print("服务版本:%s" % version.get("version", "未知"))

    # 第二步:/api/tags 列出本地已有的模型。空列表说明服务在跑但一个模型都没拉
    tags = get_json("/api/tags")
    models = tags.get("models", [])
    if not models:
        print("本地没有任何模型,先执行:ollama pull qwen2:1.5b")
        return 0

    print("本地模型共 %d 个:" % len(models))
    for m in models:
        # size 是字节数,换算成 GB 才有体感
        size_gb = m.get("size", 0) / 1024 ** 3
        print("  %-28s %6.2f GB" % (m.get("name", "?"), size_gb))

    # 第三步:/api/ps 看此刻真正占着内存/显存的模型
    running = get_json("/api/ps").get("models", [])
    if running:
        print("正在占用内存的模型:")
        for m in running:
            print("  %-28s %s" % (m.get("name", "?"), m.get("expires_at", "")))
    else:
        print("当前没有模型驻留内存(都已按 keep_alive 卸载)")
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
05骨架模板:把选型结论落成一份可复跑的探测脚本
同一台机器交给不同的人判断,结论应该一致——靠脚本,不靠经验
前面三个案例的判断过程,本质上是同一套流程:先看机器有什么,再算模型要多少,最后对一遍差额。把它固化成脚本,好处是任何人拿到任何一台机器,跑一次就能拿到同样的结论,不用再去问「我这机器能跑 7B 吗」。
"""骨架模板:私有化部署上线前的自检脚本。

复制这个文件到你的运维仓库,把 TODO 填成自己环境的值,
上线前跑一次,全绿再把地址发给同事。

用法:
    OLLAMA_BASE=http://10.0.0.20:11434 python3 deploy_probe_skeleton.py
"""
import json
import os
import urllib.error
import urllib.request

# TODO: 换成你自己的服务地址;口令/令牌一律走环境变量,不要写进源码
BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434")
# TODO: 如果前面挂了带鉴权的网关,把令牌放进环境变量再读出来
TOKEN = os.environ.get("OLLAMA_GATEWAY_TOKEN", "")

# TODO: 换成你们生产上真正要用的模型全名(必须带冒号版本)
REQUIRED_MODELS = [
    "qwen2:1.5b",
]

TIMEOUT = 10


def call(path, payload=None):
    """统一的请求封装:带上鉴权头,GET 与 POST 都走这里。"""
    url = BASE.rstrip("/") + path
    headers = {"Accept": "application/json"}
    if TOKEN:
        headers["Authorization"] = "Bearer " + TOKEN
    data = None
    if payload is not None:
        data = json.dumps(payload).encode("utf-8")
        headers["Content-Type"] = "application/json"
    req = urllib.request.Request(url, data=data, headers=headers)
    with urllib.request.urlopen(req, timeout=TIMEOUT) as resp:
        return json.loads(resp.read().decode("utf-8"))


def check_alive():
    """① 服务在不在。"""
    info = call("/api/version")
    return True, "版本 %s" % info.get("version", "未知")


def check_models():
    """② 生产要用的模型是不是都已经拉好。"""
    have = {m["name"] for m in call("/api/tags").get("models", [])}
    missing = [m for m in REQUIRED_MODELS if m not in have]
    if missing:
        return False, "缺模型:%s(先 ollama pull)" % "、".join(missing)
    return True, "模型齐全:%s" % "、".join(REQUIRED_MODELS)


def check_infer():
    """③ 真发一次推理,只有拿到非空回答才算通。"""
    payload = {
        "model": REQUIRED_MODELS[0],
        "messages": [{"role": "user", "content": "只回复两个字:正常"}],
        "stream": False,
        # TODO: 探活不需要长回答,按需要调小
        "options": {"num_predict": 16},
    }
    text = call("/api/chat", payload).get("message", {}).get("content", "")
    if not text.strip():
        return False, "模型返回空内容"
    return True, "推理正常,返回 %d 字" % len(text.strip())


# TODO: 按需要继续补自己的检查项,例如磁盘余量、显存占用、网关证书有效期
CHECKS = [
    ("服务存活", check_alive),
    ("模型就绪", check_models),
    ("推理可用", check_infer),
]


def main():
    print("探活目标:%s" % BASE)
    failed = 0
    for name, fn in CHECKS:
        try:
            ok, detail = fn()
        except urllib.error.HTTPError as exc:
            ok, detail = False, "HTTP %s" % exc.code
        except urllib.error.URLError as exc:
            ok, detail = False, "连不上:%s" % exc.reason
        print("[%s] %-8s %s" % ("通过" if ok else "失败", name, detail))
        if not ok:
            failed += 1
    print("\n结论:%s" % ("全部通过" if failed == 0 else "有 %d 项没过,别上线" % failed))
    return 1 if failed else 0


if __name__ == "__main__":
    raise SystemExit(main())
| 要改的地方 | 改成什么 |
|---|---|
CANDIDATES | 换成你们内部允许使用的模型清单;不在清单里的模型不参与推荐 |
RESERVE_GB | 留给系统和其他进程的显存;多任务机器要调大 |
TARGET_PARALLEL | 预期并发数,直接影响 KV 缓存的估算倍数 |
| 服务探测地址 | 已装 Ollama 的机器改成实际地址,脚本会顺带验一次接口连通性 |
5.2 立项前的八项检查清单
脚本只能回答技术问题。真正让私有化项目死掉的,往往是下面这几栏里的空白——每一条都要能写出具体答案,写不出来就是风险点。
| 检查项 | 及格标准 | 写不出来会怎样 |
|---|---|---|
| 立项理由 | 能说出具体是哪类数据不能出网 | 拿「省钱」当理由,第一轮评审就被算账算穿 |
| 调用量估计 | 每天多少次、峰值并发多少 | 选型全基于单人测试,上线就排队超时 |
| 真实样本 | 凑齐三十条,含边界情况 | 只能拿跑分榜凑数,模型上线后质量不达预期 |
| 授权协议 | 确认该尺寸允许商用 | 产品上线后才发现许可证不允许,返工成本极高 |
| 硬件到位时间 | 显卡采购周期写进排期 | 代码写完了卡还没到,项目干等 |
| 磁盘规划 | 模型目录指到数据盘并预留两倍空间 | 系统盘被几十 G 的模型撑爆,服务连日志都写不下 |
| 运维归属 | 有名有姓的值班人 | 几个月后变成一台没人敢重启的僵尸机器 |
| 降级预案 | 服务挂了走什么路 | 一次容量故障就把业务全线阻断 |
cost_compare.py 回答「该不该做」,deploy_probe_skeleton.py 回答「这台机器能做到什么程度」,bench_local.py 回答「选哪个模型」。三份输出加上这张清单,就是一份拿得出手的选型报告。
nvidia-smi,没装驱动或者是 AMD / 昇腾卡就取不到,脚本会降级成「未检测到 GPU」。取不到不等于没有,这种情况要人工确认,别直接照着「纯 CPU」的结论走。
06易错点汇总
按「认知 / 选型 / 显存 / 成本」四类归并,踩过一次就别再踩
⚠️ 一、认知层面
- 以为私有化部署会让模型变聪明。不会。私有化只改变数据流向,不改变模型能力。同等预算下本地能跑的模型,能力通常明显弱于顶级云端模型。
- 把私有化、微调、RAG 当成一条路上的三个台阶。三件事互相独立:私有化解决「跑在哪」,微调解决「会不会干这行的活」,RAG 解决「知不知道公司的资料」。
- 以为「租一台云 GPU 跑模型」不算私有化。关键在于推理发生在谁控制的机器上。机器是租的、但权限和模型文件归你,仍然算;调厂商的 API 则不算。
- 以为装完 Ollama 数据就绝对安全了。模型不出网,不代表服务不出网。默认配置下 Ollama 没有任何鉴权,一旦监听到
0.0.0.0且防火墙放行,谁都能调。这一点在《Linux 企业级部署》里会展开。
⚠️ 二、选型层面
- 按跑分榜选模型。榜单测的是通用能力,和你的业务样本关系有限。正确做法是拿三十条真实业务数据,把候选模型各跑一遍,人工看结果。
- 贪大。24GB 的卡硬塞 32B,结果并发只能是 1、上下文开不大,十个人一起用就排队超时。多人服务的场景下,14B 的体验通常好过 32B。
- 忽略模型的授权协议。商用之前必须确认许可证允许商用,不同模型、不同尺寸的条款可能不一样,别默认「开源就能随便用」。
- 只测单次问答,不测并发。单人测着挺快,上线就慢得没法用——因为并发时 KV 缓存成倍占显存。压测必须在选型阶段做,不是上线后补。
⚠️ 三、显存与量化
- 只算权重,不留余量。实际占用 = 权重 + KV 缓存 + 运行时开销。至少留 20%~30%,卡得刚好的配置一定会在并发上来时 OOM。
- 把估算值当精确值。脚本算出来的是数量级参考,真实占用以
ollama ps的输出为准。 - 没发现模型其实在跑 CPU。显存装不下时不会报错,只会悄悄变慢。务必看
ollama ps的PROCESSOR列,显示100% GPU才是全进显存。 - 为了省显存无脑选最低量化。量化越低损失越明显,尤其在数学、代码、长逻辑上。显存够就用 Q8,别为了省两个 G 牺牲质量。
- 忘了上下文长度也吃显存。
num_ctx从 4096 拉到 32768,KV 缓存能翻好几倍。改这个参数前先算一遍账。
⚠️ 四、成本与运维
- 只比 token 单价和电费。真实成本还包括显卡采购、机房托管、运维人力、升级时的回归测试。低频调用场景私有化几乎一定更贵。
- 没人负责运维就上私有化。这是一个需要长期值班的系统。没人管的私有化部署,几个月后就是一台没人敢重启的僵尸机器。
- 把模型存在系统盘。模型动辄几十 GB,系统盘很快撑爆。部署时就该把存放目录指到数据盘,别等满了再迁。
- 用「省钱」当私有化的立项理由。算不过账的时候这个理由会被推翻。真正站得住的理由只有一个:数据不能出网。
07自测题
点击题目展开答案;能把这 14 题说清楚,选型这一关就过了
什么是私有化部署?判断的关键条件是什么?
把大模型的权重文件放在自己控制的机器上,推理过程完全在这台机器内部完成。判断的关键不是「在不在本地」,而是「推理发生在谁控制的机器上」——自己租的云服务器,只要权限和模型文件归你,同样算私有化;调厂商 API 则不算。
企业选择私有化部署,最站得住的理由是什么?
数据不能出网。病历、合同、工资表、代码库这类数据一旦发到厂商机房就不可控。省钱不是好理由——低频调用场景下私有化几乎一定比调 API 更贵。
私有化部署、微调、RAG 三者是什么关系?
三件事互相独立,不是递进关系。私有化解决「模型跑在哪」,微调解决「模型会不会干你这行的活」,RAG 解决「模型知不知道你公司的资料」。私有化的模型照样可能不懂业务,云端模型照样能接 RAG。
哪些情况下不该选私有化?举三种。
① 处理的是公开数据,本来就不怕出网;② 任务需要很强的推理能力,本地小模型和顶级云端模型差距是数量级的;③ 调用量小且不稳定,租卡全天空转不划算;④ 没人负责长期运维。
模型名字里的 7B 指什么?怎么估算它占多少显存?
B 是 billion,7B 即七十亿个参数。估算口诀:参数量(B)× 每参数字节数 = 权重占用(GB)。FP16 每参数 2 字节、Q8 约 1 字节、Q4 约 0.5 字节。所以 7B 的 Q4 约 3.5~4.5 GB,32B 的 Q4 约 18 GB。
为什么按权重算出来的数字不能直接当作显存需求?
实际占用 = 权重 + KV 缓存 + 运行时开销。KV 缓存随上下文长度和并发数增长,最容易被忽略。所以要在权重之上留 20%~30% 余量,否则并发一上来就 OOM。
什么是量化?Q4 相比 FP16 牺牲了什么?
用更少的比特存每一个参数,把 16 位浮点压到 8 位或 4 位整数。像把精装菜谱缩印成便携本——菜和步骤都在,但一些细微的火候描述被四舍五入掉了。Q4 体积约为 FP16 的四分之一,代价是在数学、代码、长逻辑这些任务上有可感的质量损失。
同样的显存,该选大模型的 Q4 还是小模型的 Q8?
经验上优先选参数量更大的低量化版本:14B 的 Q4 通常好过 7B 的 Q8,虽然占的显存差不多。参数量带来的能力增益一般压得过量化的损失。但这条不绝对,上线前务必用自己的真实样本各测一遍。
显存装不下模型时会发生什么?怎么发现?
不会报错,只会悄悄变慢——部分权重溢到内存,变成 CPU/GPU 混合推理,速度掉几倍。发现的唯一可靠办法是看 ollama ps 的 PROCESSOR 列:显示 100% GPU 才是全部装进了显存,出现 CPU 字样就说明溢出了。
把 num_ctx 从 4096 调到 32768,有什么代价?
模型能记住更长的对话,但 KV 缓存会翻好几倍,显存占用同步上涨。并发场景下这个涨幅还要再乘以并发数。改这个参数之前必须重新算一遍显存账。
8GB 显存的开发机,推荐跑多大的模型?
7B 的 Q4 是甜点位,约占 5 GB,留得出上下文余量。1.5B 适合快速调通链路;14B 级别约需 10 GB,装不下会溢到内存,速度掉到难以接受。
24GB 的卡供十几个人用,为什么不推荐 32B?
32B 的 Q4 约占 22 GB,能装下但几乎没有余量:并发只能是 1,上下文也得压着。十几个人同时用会排队超时。选 14B(约 10 GB),把省下的显存用于提高并发和上下文,整体体验明显更好。先定并发数,再倒推模型尺寸。
没有显卡的老机器能跑吗?
能跑但要接受速度。1.5B 及以下可用,每秒十几个 token;7B 勉强能跑,每秒几个 token,用户会明显感觉到卡顿;14B 以上一次回答要几分钟,没有实用价值。纯 CPU 只适合离线批处理,不适合交互式问答。
为什么不能按跑分榜选模型?
榜单测的是通用能力,和你的业务样本关系有限。正确做法是拿三十条真实业务数据,把候选模型各跑一遍,人工看结果。模型质量必须用自己的数据测,跑分和参数量都替代不了这一步。
24GB 的卡跑 14B 占 10G,剩下的显存能再跑一个 14B 吗?有必要吗?
技术上可以,但没必要。模型权重是所有并发请求共用的一份,不会因为多一个人就加载多一份。想支持更多人,把 OLLAMA_NUM_PARALLEL 调上去就行,多出来的开销只是 KV 缓存,而不是再来一份 10G 的权重。加载两份同模型是纯浪费。
请求数超过 OLLAMA_NUM_PARALLEL 会报错吗?
不会。多出来的请求进队列等着,表现是单次耗时线性变长。直到队列也满(OLLAMA_MAX_QUEUE,默认 512),服务端才返回 503。所以排查「变慢」时要先看是不是在排队,而不是一上来就怀疑模型或显卡。
为什么拉模型时必须写全名带冒号版本?
只写 qwen2 会拉到仓库的默认标签,具体是哪一档取决于仓库当时的设置。团队里两个人各拉一次,很可能拿到不同的模型,后面对不上性能数据就会互相扯皮。写 qwen2:1.5b 这种完整标号才能复现。
压测时为什么必须先预热?temperature 为什么设 0?
不预热的话,第一条样本会把几十秒的模型加载时间算进成绩,整组数据就废了。temperature 设 0 是为了可复现——每次跑出不同的答案,模型之间的横向对比就没意义了。
为什么说「省钱」不是好的立项理由?
因为算得出来。按每天 500 次调用估:API 月账单约 72 元,而私有化一次性投入约 2.76 万、每月固定支出还要 1459 元(电费 + 运维工时)。月支出就已经是 API 的二十倍,永远不回本。只有调用量足够大时结论才会翻转。站得住的理由只有数据不能出网。
领导说「先拿一台游戏本试试」,这条路行吗?
试点行,上生产不行。笔记本显卡显存小、持续高负载会降频,而且没有服务器的散热和供电设计,跑一下演示可以,当成共享服务一定出问题。正确做法是先在它上面把链路跑通、把模型选型定下来,再拿着实测数据去申请真正的服务器。
同一个模型,为什么别人跑得比我快很多?
先查三件事,顺序别反:① 是不是溢出到 CPU 了(ollama ps 看 PROCESSOR 列,这是差距最大的一项,差十几倍);② 量化档位是不是同一个(q4 和 q8 不是一回事);③ 是不是把加载时间算进去了(没预热)。三项都一致还慢,再谈显卡本身的差距。
为什么说「模型越大越好」在企业里不成立?
因为成本和体验是一起涨的。模型大一档,显存需求、卡的价格、单次延迟、能支持的并发数全部变差。企业场景很多是分类、抽取、格式改写这类活,小模型完全胜任。正确顺序是先拿真实业务题测一批,找到恰好能过关的最小档位,而不是一上来就上最大的。
业务部门说「我们的数据不敏感」,还需要私有化吗?
先问一句:那些数据里有没有客户名、合同号、报价、员工信息?很多人说的「不敏感」指的是「不是国家机密」,但内部运营数据照样不能出网。确实都是公开信息的场景(比如改写对外宣传文案),走 API 反而更划算——效果更好、成本更低、不用运维。别为了私有化而私有化。
私有化之后,模型效果比不上云端,怎么跟领导说?
如实说,并把账算清楚:本地能跑的档位与云端旗舰模型存在真实差距,这是选这条路的已知代价,不是部署没做好。接下来给两个可行动作:用真实业务题测出「恰好能过关的最小档位」,或者走混合路线——涉密走内网、公开且要求高的走云端。
Ollama、vLLM、LM Studio 各适合什么场景?
Ollama:上手最简单,适合个人开发和中小规模内部服务;vLLM:高并发线上服务,吞吐量明显更好,配置也复杂得多;LM Studio:纯图形界面,适合完全不碰命令行的人。先用 Ollama 打通链路,因为它对外是 HTTP 接口,将来换 vLLM 只需改地址。
词术语表
| 术语 | 含义 |
|---|---|
| 私有化部署 | 模型权重放在自己控制的机器上,推理全程在内部完成,数据不出网 |
| 显存 / VRAM | 显卡上的内存,决定能装下多大的模型;比喻里的「灶台面积」 |
| 参数量(B) | 模型的参数个数,B 表示十亿;7B 即七十亿个参数 |
| 量化 | 用更少的比特存每个参数,体积变小、质量略降;常见档位 FP16 / Q8 / Q4 |
| FP16 | 半精度浮点,每参数 2 字节,本地部署里的高精度档 |
| Q4 | 四位量化,每参数约 0.5 字节,Ollama 的默认档位 |
| KV 缓存 | 推理时缓存的注意力键值,随上下文长度和并发数增长,是显存的隐藏开销 |
| OOM | Out Of Memory,显存或内存不足导致的失败 |
| Ollama | 把「下载权重、装推理引擎、起服务」打包成几条命令的本地部署工具 |
| vLLM | 面向高并发的推理框架,吞吐量优于 Ollama,配置复杂度也更高 |
num_ctx | 上下文长度,决定模型一次能看多少内容,直接影响 KV 缓存大小 |
ollama ps | 查看已加载模型及其占用位置的命令,PROCESSOR 列是判断是否溢出的唯一依据 |
OLLAMA_NUM_PARALLEL | 一个模型同时处理几个请求;调大只多吃 KV 缓存,不会多加载一份权重 |
OLLAMA_MAX_QUEUE | 排队上限,默认 512;超出后服务端直接返回 503 |
| 模型标号 | 形如 qwen2:1.5b 的全名;省略冒号部分会拿到仓库默认标签,不可复现 |
| 预热 | 压测前先空跑一次把模型加载进显存,避免加载时间污染成绩 |
| 回本点 | 私有化累计成本开始低于云端 API 的那一个月;超过显卡服役期就等于不成立 |
| 本讲产出的四个脚本 | 回答的问题 | 什么时候跑 |
|---|---|---|
cost_compare.py | 该不该做私有化 | 立项评估阶段,写报告之前 |
check_ollama.py | 这台机器现在什么状态 | 拿到陆生机器的第一步 |
vram_plan.py / deploy_probe_skeleton.py | 这块卡能跑多大的模型 | 拉模型之前 |
bench_local.py | 候选模型选哪个 | 模型拉下来之后、拍板之前 |