Ollama API 与客户端接入
命令行只是接口的一层壳。看懂 /api/chat 的请求体,ChatBox、LangChain、你自己的后端就都通了。
30″30 秒看懂 Ollama 的 API
前两讲敲的 ollama run,其实不是它自己在跑模型——它只是把你输入的话打包成一个 HTTP 请求,发给后台那个常驻服务。命令行是壳,接口才是芯。
这件事想通了,后面全通了:ChatBox、Dify、LangChain、你自己写的后端,用的都是同一套接口。它们之间的区别只是外壳长得不一样。所以这一讲不讲某个客户端怎么配,而是讲那个所有客户端共用的芯。
| 你敲的命令 | 它实际发的请求 | 说明 |
|---|---|---|
ollama run 模型 "问题" | POST /api/chat | 最核心的接口,多轮对话都走它 |
ollama list | GET /api/tags | 磁盘上有哪些模型 |
ollama ps | GET /api/ps | 显存里跑着哪些 |
ollama pull 模型 | POST /api/pull | 下载模型 |
ollama rm 模型 | DELETE /api/delete | 网关上必须拦掉的那个 |
ollama show 模型 | POST /api/show | 看参数量、量化、模板 |
01概念:一套接口,所有客户端共用
先把接口分组记住,再去背具体字段
1.1 命令行只是接口的壳
上一讲说过,ollama 命令是客户端,它把命令变成 HTTP 请求发给 127.0.0.1:11434。这个结构带来两个很实用的推论:
- 命令行能做的,代码全都能做。不需要在 Python 里
subprocess调ollama命令——那是绕远路,直接发 HTTP 请求更快也更稳。 - 换客户端不用换后端。今天用 ChatBox,明天换成自研前端,Ollama 侧一个字都不用改。
| 接入方式 | 本质是什么 | 适合谁 |
|---|---|---|
| 命令行 | 官方写的一个 HTTP 客户端 | 调试、脚本、一次性问答 |
| 图形客户端(ChatBox 等) | 带界面的 HTTP 客户端 | 不写代码的业务同事 |
官方 ollama Python 库 | 把 URL 和 JSON 包掉了 | 写 Python 的日常开发 |
OpenAI SDK 指向 /v1 | 走兼容层 | 已有代码要切到本地模型 |
| 直接发 HTTP | 就是接口本身 | 任何语言、任何环境,零依赖 |
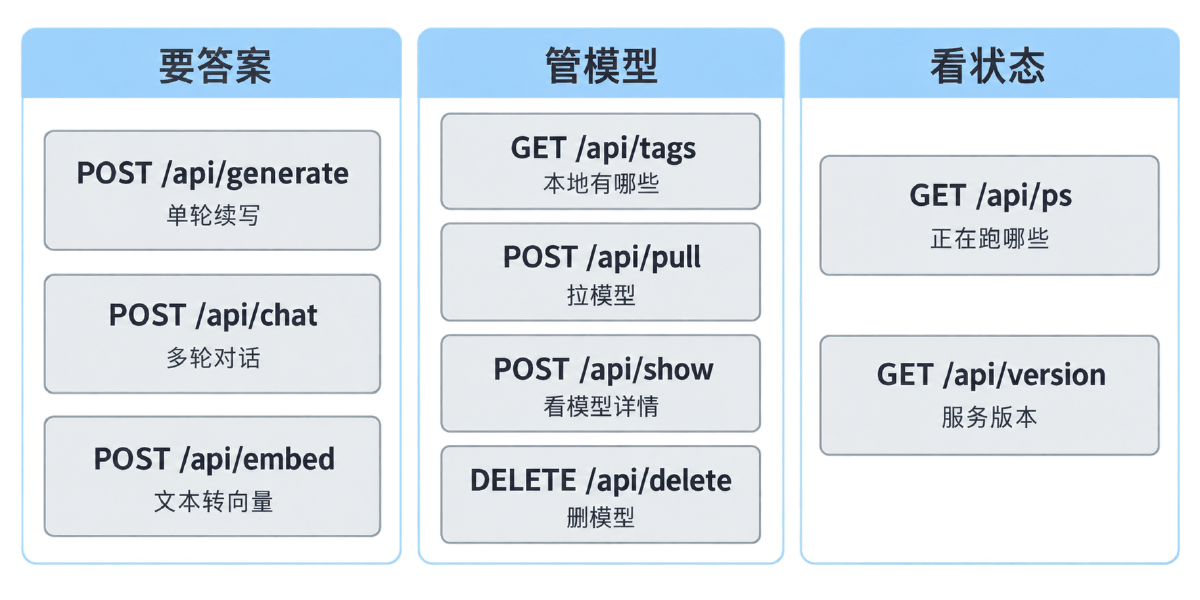
1.2 接口按用途分三组
接口不用一个个背,按用途分成三组就清楚了:
| 分组 | 接口 | 说明 |
|---|---|---|
| 要答案 | POST /api/generate | 单轮续写,给一段提示词,返回一段文本 |
POST /api/chat | 多轮对话,日常用它 | |
POST /api/embed | 文本转向量,做检索和相似度用 | |
| 管模型 | GET /api/tags | 本地有哪些模型 |
POST /api/pull | 拉模型 | |
POST /api/show | 看模型详情、参数、模板 | |
DELETE /api/delete | 删模型;网关必须拦 | |
| 看状态 | GET /api/ps | 正在占显存的模型 |
GET /api/version | 服务版本;探活首选,最轻 |
/api/embeddings 是旧写法
早期版本用的是 /api/embeddings(复数),现在官方文档里的接口是 /api/embed。老教程和老代码里还能看到旧的那个。碰到时以你这台机器的实际版本为准——GET /api/version 查清版本号再去对文档,别照着过期教程硬套。
1.3 generate 与 chat 的区别
两个都能拿到答案,差别在输入结构:
| 对比项 | /api/generate | /api/chat |
|---|---|---|
| 输入字段 | prompt,一段纯文本 | messages,一个消息列表 |
| 有没有角色 | 没有 | 有 system / user / assistant |
| 多轮对话 | 要自己把历史拼成一段文本 | 天然支持,按条追加即可 |
| 输出位置 | response 字段 | message.content 字段 |
| 推荐场景 | 单轮续写、completion 形式的文本生成 | 绝大多数场景,默认用它 |
/api/chat
它能覆盖 generate 的所有场景——单轮问答就只放一条 user 消息。而且它的结构和 OpenAI 那套是对齐的,将来要切换到别的模型服务,迁移成本最低。
02原理:一个 JSON 撑起所有客户端
五个字段、一条铁律、两种响应模式
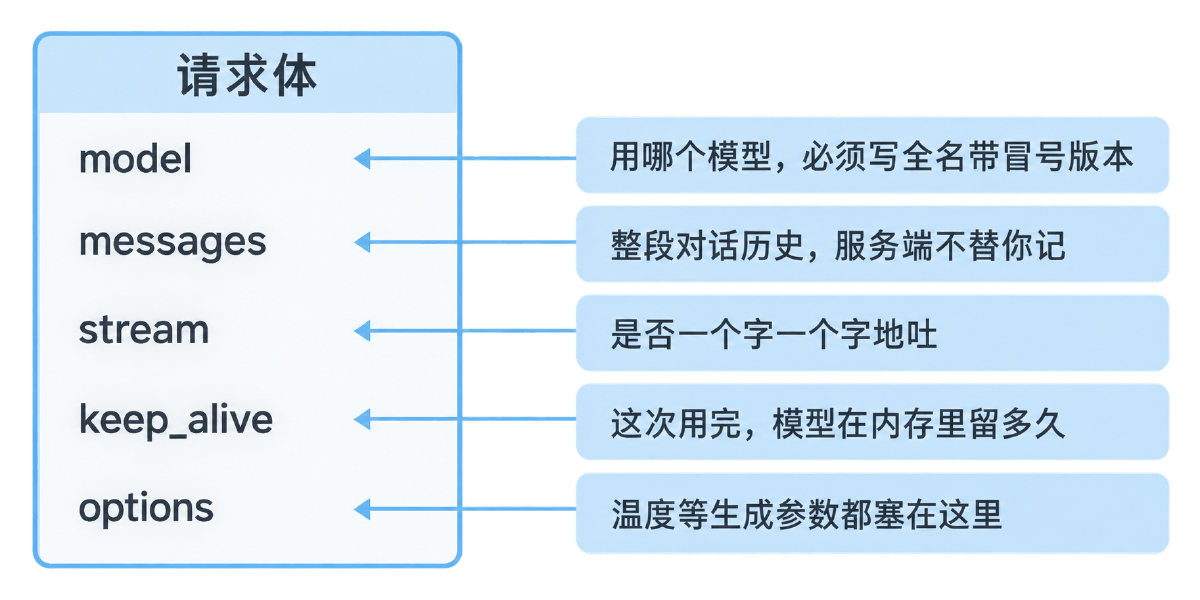
2.1 请求体五个关键字段
POST /api/chat 的请求体就是一个 JSON。绝大多数时候你只需要关心这五个字段:
| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
model | 字符串 | 是 | 必须写全名带冒号版本,例如 qwen2:1.5b |
messages | 数组 | 是 | 整段对话历史;服务端不替你记 |
stream | 布尔 | 否 | 是否一个字一个字地吐;不传默认是 true |
keep_alive | 字符串/数字 | 否 | 这次用完模型在内存里留多久;传 0 立刻卸载 |
options | 对象 | 否 | temperature、num_ctx 等生成参数都塞这里 |
messages 里每一条消息有两个字段:role 和 content。角色一共三种:
| role | 谁说的 | 放什么 |
|---|---|---|
system | 你给模型定的规矩 | 人设、边界、输出格式;放在最前面,整轮都受它约束 |
user | 用户 | 用户的每一句话 |
assistant | 模型自己 | 模型之前说过的话,要由你回填进去 |
options 里的字段名和 /set parameter 完全一致
对话里敲 /set parameter temperature 0.3,和请求体里写 "options": {"temperature": 0.3} 是同一件事。区别只是前者退出即失效,后者每次请求都带。别把参数写到 options 外面——写错位置不会报错,它会被静默忽略,你还以为参数生效了。
2.2 服务端不记历史
这是整讲最重要的一点,也是新手写聊天机器人踩的第一个大坑。Ollama 服务端是无状态的:每个请求都是孤立的,答完就忘,它不知道你上一次问了什么。
(问、答、再问)
所以多轮对话的实现方式是:每问一次,就把之前所有的问和答连同新问题一起发过去。模型的回答也必须由你手动追加回 messages——漏了这一步,模型就永远不记得自己说过什么。
| 做法 | 模型表现 | 原因 |
|---|---|---|
| 只传当前这一句 | 「我不知道你叫什么」 | 模型每次都从零开始 |
| 传了历史但漏了 assistant | 重复回答、自相矛盾 | 它看不到自己上一轮说了什么 |
| 传完整历史 | 正常多轮 | 上下文靠你自己带上 |
num_ctx 后被静默截断(模型突然「忘了」最早的内容,却不报错)。所以必须裁剪——保留最近 N 条,但 system 那条要单独保住,不能被裁掉。
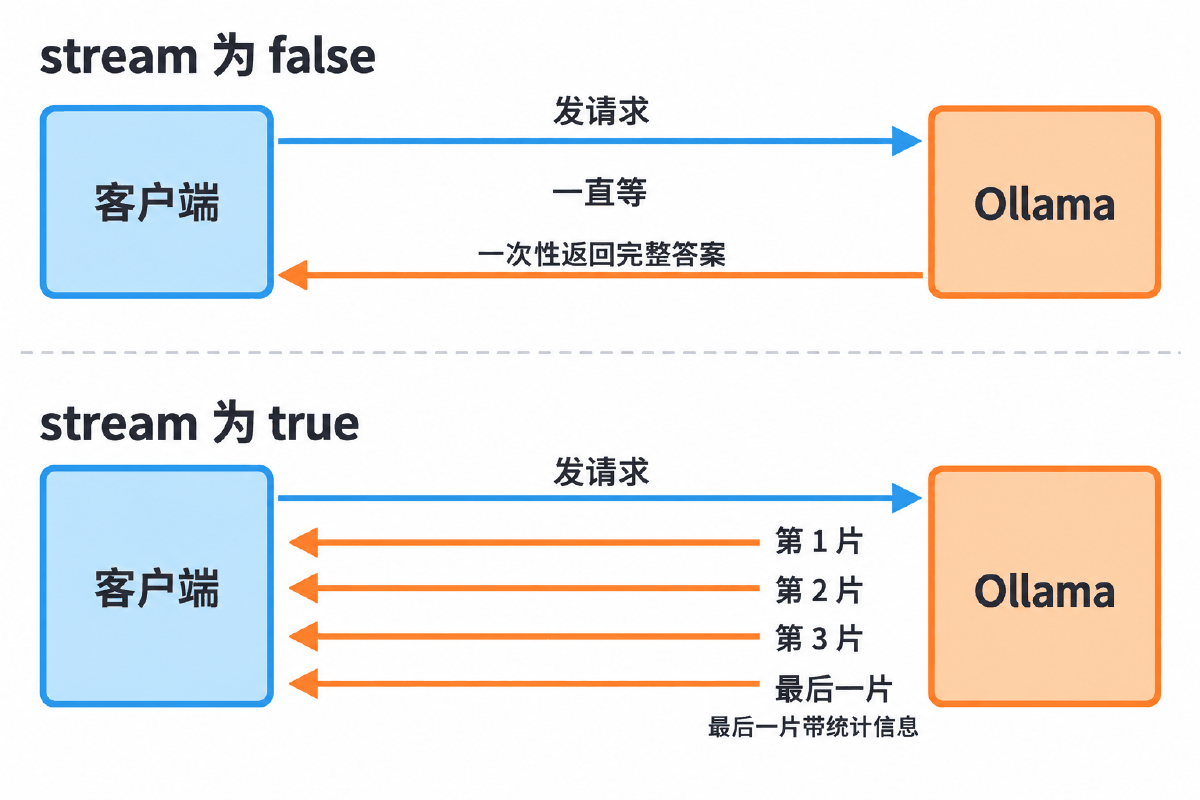
2.3 stream 的两种响应
同一个接口,stream 取值不同,响应结构完全不一样。这是接入时最容易写错的地方。
| 对比项 | stream: false | stream: true |
|---|---|---|
| 响应形态 | 一个完整的 JSON | 一行一个 JSON,多行 |
| 怎么解析 | json.loads(整个响应) | 逐行读、逐行 json.loads |
| 文本在哪 | message.content 是完整答案 | 每片的 message.content 是一小段增量 |
| 怎么判断结束 | 响应结束就是结束 | 某一片的 done 为 true |
| 统计信息 | 就在这个 JSON 里 | 在最后一片里,那片通常没有文本 |
| 用户体验 | 等几十秒,然后整段出现 | 字一个个冒出来,等待感弱很多 |
json.loads。它不是一个 JSON 数组,是「一行一个 JSON」,整体解析必然报错。② 不传 stream 就按非流式解析。/api/chat 不传这个字段时默认是流式的,要一次性结果必须显式写 "stream": false。
2.4 响应里的耗时统计
响应里带了一组性能数字,排查「为什么慢」时非常有用。注意单位是纳秒,要除以 10 的 9 次方才是秒。
| 字段 | 含义 | 怎么用 |
|---|---|---|
total_duration | 整次请求耗时 | 端到端体感时间 |
load_duration | 加载模型耗时 | 模型已在内存里时接近 0;很大说明刚被卸载过 |
prompt_eval_count | 读题消耗的 token | 历史越长它越大,是「越聊越慢」的直接证据 |
eval_count | 生成的 token 数 | 配合下一行算速度 |
eval_duration | 生成阶段耗时 | eval_count ÷ eval_duration = token/s |
load_duration:它很大就说明模型被卸载后重新加载了,该调 OLLAMA_KEEP_ALIVE,而不是换模型。load_duration 接近 0 而 token/s 很低,才是算力或溢出的问题。
03最小代码:三十行跑通第一个接口调用
不装任何第三方库,理解这段,后面全是包装
下面这段代码只用标准库,不需要 pip install 任何东西。它把 2.1 节讲的五个字段全用上了,流程就三步:拼请求体 → 发 POST → 取 message.content。
"""最小代码:不装任何第三方库,直接用 HTTP 调本地模型对话。

理解这 30 行,后面所有客户端(ChatBox、LangChain、你自己的后端)
都只是在这套请求上加包装。

    python3 min_chat.py
"""
import json
import os
import urllib.request

BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434")
MODEL = os.environ.get("OLLAMA_MODEL", "qwen2:1.5b")

# ① 请求体:model 用哪个模型,messages 是整段对话历史
payload = {
    "model": MODEL,
    "messages": [
        # system 定人设,放在最前面,整轮对话都受它约束
        {"role": "system", "content": "你是一个简洁的中文助手,回答不超过两句话。"},
        {"role": "user", "content": "什么是私有化部署?"},
    ],
    # stream 为 False:等模型全部生成完,一次性返回一个 JSON
    "stream": False,
    # options 里放生成参数,字段名和 /set parameter 里的一模一样
    "options": {"temperature": 0.3, "num_predict": 128},
}

# ② 发请求:路径固定是 /api/chat,方法是 POST,body 是 JSON
req = urllib.request.Request(
    BASE.rstrip("/") + "/api/chat",
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json"},
)

with urllib.request.urlopen(req, timeout=120) as resp:
    result = json.loads(resp.read().decode("utf-8"))

# ③ 取答案:模型说的话在 message.content 里
print("模型回答:", result["message"]["content"])

# ④ 顺带看一眼性能,耗时字段单位是纳秒,除以 1e9 才是秒
total_s = result.get("total_duration", 0) / 1e9
eval_count = result.get("eval_count", 0)
eval_s = result.get("eval_duration", 1) / 1e9
print("总耗时 %.2f 秒,生成 %d 个 token,速度 %.1f token/s"
      % (total_s, eval_count, eval_count / eval_s if eval_s else 0))
| 这一行 | 为什么这么写 |
|---|---|
"stream": False | 必须显式写——不写默认是流式的,响应结构完全不同 |
system 放在最前面 | 它约束整轮对话;放中间或末尾效果会打折 |
Content-Type: application/json | 不带这个头,服务端可能拒收 |
result["message"]["content"] | /api/chat 的答案在这里;/api/generate 则是 response |
/ 1e9 | 耗时字段单位是纳秒,不换算会得出「耗时 30 亿秒」 |
curl http://127.0.0.1:11434/api/chat -d '{"model":"qwen2:1.5b","messages":[{"role":"user","content":"你好"}],"stream":false}'3.2 写业务代码之前,先跟一遍接口自检
curl 适合验单条接口。真要接入一个新环境,要问的不止一件事:服务在不在、模型在不在、流式通不通、统计字段对不对、危险接口拦没拦。一条一条手敲很容易漏,写成脚本跑一遍更稳。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""api_probe.py —— Ollama HTTP 接口自检脚本

用途:接入之前先跑一遍,把「服务能不能用、模型在不在、流式通不通、
耗时统计对不对」一次性问清楚,避免带着环境问题去调业务代码。

用法:
    python3 api_probe.py                      # 用默认地址和模型
    OLLAMA_BASE=http://10.0.0.8:11434 python3 api_probe.py
    OLLAMA_MODEL=qwen2:7b python3 api_probe.py

说明:
  * 只读接口 + 一次极短的对话请求,不会改动服务端任何状态。
  * 令牌走环境变量 OLLAMA_GATEWAY_TOKEN,不接受命令行参数,
    避免凭据留在 shell history 和进程列表里。
  * 退出码 0 = 全部通过,1 = 有检查项失败,便于接进 CI 或巡检。
"""

import json
import os
import sys
import time
import urllib.error
import urllib.request

BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434").rstrip("/")
MODEL = os.environ.get("OLLAMA_MODEL", "qwen2:1.5b")
TOKEN = os.environ.get("OLLAMA_GATEWAY_TOKEN", "")
TIMEOUT = float(os.environ.get("OLLAMA_TIMEOUT", "30"))

OK = "[ OK ]"
NG = "[FAIL]"

results = []


def record(name, passed, detail=""):
    """记录一项检查结果,并立刻打印,方便边跑边看。"""
    results.append((name, passed))
    flag = OK if passed else NG
    line = "%s %s" % (flag, name)
    if detail:
        line += " —— " + detail
    print(line)


def headers():
    h = {"Content-Type": "application/json"}
    if TOKEN:
        h["Authorization"] = "Bearer " + TOKEN
    return h


def http_get(path):
    req = urllib.request.Request(BASE + path, headers=headers(), method="GET")
    with urllib.request.urlopen(req, timeout=TIMEOUT) as resp:
        return json.loads(resp.read().decode("utf-8"))


def http_post(path, payload, stream=False):
    body = json.dumps(payload).encode("utf-8")
    req = urllib.request.Request(BASE + path, data=body,
                                 headers=headers(), method="POST")
    resp = urllib.request.urlopen(req, timeout=TIMEOUT)
    if stream:
        return resp
    with resp:
        return json.loads(resp.read().decode("utf-8"))


def check_version():
    """最轻的探活方式:能拿到版本号,说明服务在、网络通、鉴权过。"""
    try:
        data = http_get("/api/version")
        ver = data.get("version", "?")
        record("服务探活 GET /api/version", True, "版本 " + str(ver))
        return True
    except urllib.error.HTTPError as exc:
        hint = "鉴权失败,检查 OLLAMA_GATEWAY_TOKEN" if exc.code in (401, 403) else ""
        record("服务探活 GET /api/version", False, "HTTP %s %s" % (exc.code, hint))
    except Exception as exc:  # 连接被拒、超时、DNS 等
        record("服务探活 GET /api/version", False,
               "%s(先确认服务在跑、监听地址和防火墙)" % exc.__class__.__name__)
    return False


def check_model_present():
    """确认目标模型真的在磁盘上,避免把「模型没下载」误判成「接口不通」。"""
    try:
        data = http_get("/api/tags")
    except Exception as exc:
        record("模型列表 GET /api/tags", False, str(exc))
        return False
    names = [m.get("name", "") for m in data.get("models", [])]
    record("模型列表 GET /api/tags", True, "共 %d 个" % len(names))
    if MODEL in names:
        record("目标模型存在:" + MODEL, True)
        return True
    # 给出最接近的候选,多数情况是版本号写漏了
    near = [n for n in names if n.split(":")[0] == MODEL.split(":")[0]]
    detail = "本地没有;同名不同版本:%s" % (", ".join(near) if near else "无")
    record("目标模型存在:" + MODEL, False, detail)
    return False


def check_chat_nostream():
    """非流式:必须显式 stream=False,否则拿到的是多行流式响应。"""
    payload = {
        "model": MODEL,
        "messages": [{"role": "user", "content": "只回答两个字:收到"}],
        "stream": False,
        "options": {"temperature": 0},
    }
    started = time.time()
    try:
        data = http_post("/api/chat", payload)
    except Exception as exc:
        record("非流式对话 POST /api/chat", False, str(exc))
        return None
    text = data.get("message", {}).get("content", "")
    if not text:
        record("非流式对话 POST /api/chat", False, "响应里没有 message.content")
        return None
    record("非流式对话 POST /api/chat", True,
           "耗时 %.1fs,回答 %r" % (time.time() - started, text[:20]))
    return data


def check_stats(data):
    """耗时字段单位是纳秒;load_duration 很大说明模型刚被重新加载。"""
    if not data:
        return
    eval_count = data.get("eval_count") or 0
    eval_ns = data.get("eval_duration") or 0
    load_ns = data.get("load_duration") or 0
    if eval_count and eval_ns:
        speed = eval_count / (eval_ns / 1e9)
        record("生成速度统计", True, "%.1f token/s" % speed)
    else:
        record("生成速度统计", False, "响应里缺 eval_count / eval_duration")
    load_s = load_ns / 1e9
    if load_s > 1.0:
        record("模型常驻情况", True,
               "本次加载耗时 %.1fs,模型此前不在内存,可调大 OLLAMA_KEEP_ALIVE" % load_s)
    else:
        record("模型常驻情况", True, "模型已常驻,加载耗时 %.2fs" % load_s)


def check_chat_stream():
    """流式:一行一个 JSON,逐行解析;done 那片带统计、通常没有文本。"""
    payload = {
        "model": MODEL,
        "messages": [{"role": "user", "content": "从 1 数到 5,只输出数字"}],
        "stream": True,
        "options": {"temperature": 0},
    }
    started = time.time()
    first_chunk_at = None
    chunks = 0
    text = ""
    try:
        resp = http_post("/api/chat", payload, stream=True)
    except Exception as exc:
        record("流式对话 stream=true", False, str(exc))
        return
    with resp:
        for raw in resp:
            line = raw.decode("utf-8").strip()
            if not line:
                continue
            try:
                piece = json.loads(line)
            except json.JSONDecodeError:
                record("流式对话 stream=true", False,
                       "有一行不是合法 JSON,不要对整个响应做 json.loads")
                return
            seg = piece.get("message", {}).get("content", "")
            if seg:
                chunks += 1
                text += seg
                if first_chunk_at is None:
                    first_chunk_at = time.time() - started
            if piece.get("done"):
                break
    if chunks <= 1:
        record("流式对话 stream=true", False,
               "只收到 %d 片,检查网关是否开了缓冲(proxy_buffering)" % chunks)
        return
    record("流式对话 stream=true", True,
           "%d 片,首字 %.2fs,全文 %r" % (chunks, first_chunk_at or 0, text[:20]))


def check_delete_blocked():
    """网关应当拦掉模型管理类接口;直连时不拦是正常的,只提示。"""
    payload = {"model": "__probe_not_exist__"}
    body = json.dumps(payload).encode("utf-8")
    req = urllib.request.Request(BASE + "/api/delete", data=body,
                                 headers=headers(), method="DELETE")
    try:
        urllib.request.urlopen(req, timeout=TIMEOUT)
        record("危险接口 DELETE /api/delete 被拦截", False,
               "未被拦截;若这是对外网关,必须按路径拦掉管理类接口")
    except urllib.error.HTTPError as exc:
        if exc.code in (401, 403, 404, 405):
            record("危险接口 DELETE /api/delete 被拦截", True, "HTTP %s" % exc.code)
        else:
            record("危险接口 DELETE /api/delete 被拦截", True,
                   "HTTP %s(非 2xx 即未放行)" % exc.code)
    except Exception as exc:
        record("危险接口 DELETE /api/delete 被拦截", True, exc.__class__.__name__)


def main():
    print("目标服务:%s" % BASE)
    print("目标模型:%s" % MODEL)
    print("鉴权令牌:%s" % ("已注入" if TOKEN else "未设置"))
    print("-" * 56)

    if not check_version():
        print("-" * 56)
        print("服务都没探通,后面的检查没有意义,先解决连通性。")
        return 1

    has_model = check_model_present()
    data = check_chat_nostream() if has_model else None
    check_stats(data)
    if has_model:
        check_chat_stream()
    check_delete_blocked()

    print("-" * 56)
    failed = [name for name, passed in results if not passed]
    print("通过 %d/%d" % (len(results) - len(failed), len(results)))
    if failed:
        for name in failed:
            print("  未通过:%s" % name)
        return 1
    print("全部通过,可以开始接业务代码。")
    return 0


if __name__ == "__main__":
    sys.exit(main())
| 检查项 | 不通时说明什么 | 下一步查哪 |
|---|---|---|
/api/version | 服务、网络或鉴权有问题 | 401/403 查令牌;连不上查监听地址与防火墙 |
/api/tags 里有目标模型 | 模型没下载,或版本号写漏了 | 脚本会把同名不同版本列出来对照 |
| 非流式对话 | 请求体或模型本身有问题 | 先用 curl 打一发比对 |
| 流式只收到 1 片 | 网关把流缓冲住了 | 查 proxy_buffering |
load_duration 很大 | 模型刚被卸载过 | 调 OLLAMA_KEEP_ALIVE,而不是换模型 |
DELETE /api/delete 未被拦 | 这个地址如果对外,谁能问问题谁就能删模型 | 回上一讲按路径放行那节 |
0,有失败项返回 1。既可以手动跑,也可以放进上一讲的巡检体系里当一个深度探活项——端口通不代表能答题,这个脚本才真的发了一次请求。注意它会真实占用一次推理,巡检频率别调得太密。
os.environ.get("OLLAMA_BASE", ...) 读地址,是为了同一份代码能在开发机和服务器上都跑。硬编码 127.0.0.1 的代码,部署到要连远程模型服务的环境时就得改源码——改源码就会漏改,漏改就是事故。
04完整案例:三种接入方式
流式多轮、零改动切换、图形客户端
4.1 案例一 · 流式多轮对话
把 2.2 和 2.3 两节合起来就是这个案例:边收边打印,并且自己维护历史。它是所有聊天机器人的内核。
"""完整案例:带上下文的流式命令行对话。

两个要点:
  1. stream 为 True 时,服务端按行返回一串 JSON,每行一小片文本,
     必须逐行解析、逐行打印,用户才会看到「一个字一个字冒出来」的效果。
  2. 模型服务端不保存任何历史。想让它记住上一句,就得把整段 messages
     每次都重新发过去——这正是私有化部署里最常被误解的一点。

    python3 stream_chat.py
"""
import json
import os
import sys
import urllib.request

BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434")
MODEL = os.environ.get("OLLAMA_MODEL", "qwen2:1.5b")

# 上下文窗口有限,历史无限增长会越来越慢、最后超出 num_ctx 被截断,
# 所以只保留最近 N 轮。system 那条要单独保住,不能被裁掉。
MAX_TURNS = 20

SYSTEM = {"role": "system", "content": "你是中文助手,回答简洁,不确定就直说。"}


def chat_stream(messages):
    """发一次流式请求,边收边打印,返回模型这一轮说的完整内容。"""
    payload = {
        "model": MODEL,
        "messages": messages,
        "stream": True,
        "options": {"temperature": 0.3},
    }
    req = urllib.request.Request(
        BASE.rstrip("/") + "/api/chat",
        data=json.dumps(payload).encode("utf-8"),
        headers={"Content-Type": "application/json"},
    )

    pieces = []
    with urllib.request.urlopen(req, timeout=600) as resp:
        # 响应是「一行一个 JSON」,不是一个大 JSON 数组,不能整体 json.loads
        for raw in resp:
            line = raw.decode("utf-8").strip()
            if not line:
                continue
            chunk = json.loads(line)

            # 每一片的文本增量在 message.content 里
            part = chunk.get("message", {}).get("content", "")
            if part:
                pieces.append(part)
                sys.stdout.write(part)
                sys.stdout.flush()

            # done 为 True 的那一片是最后一片,带统计信息,本身通常没有文本
            if chunk.get("done"):
                dur = chunk.get("total_duration", 0) / 1e9
                cnt = chunk.get("eval_count", 0)
                print("\n[本轮 %d token,耗时 %.1f 秒]" % (cnt, dur))
    return "".join(pieces)


def main():
    print("私有模型对话(输入 exit 退出)  模型:%s" % MODEL)
    messages = [SYSTEM]

    while True:
        try:
            user = input("\n你:").strip()
        except (EOFError, KeyboardInterrupt):
            print()
            break
        if not user:
            continue
        if user.lower() in ("exit", "quit", "/bye"):
            break

        # 把用户这句追加进历史
        messages.append({"role": "user", "content": user})

        print("模型:", end="")
        answer = chat_stream(messages)

        # 关键一步:把模型的回答也追加回历史,下一轮它才「记得」自己说过什么
        messages.append({"role": "assistant", "content": answer})

        # 裁剪历史:保留 system + 最近 MAX_TURNS 条
        if len(messages) > MAX_TURNS + 1:
            messages = [SYSTEM] + messages[-MAX_TURNS:]

    print("已退出。")


if __name__ == "__main__":
    main()
| 关键处理 | 代码里怎么做的 | 漏了会怎样 |
|---|---|---|
| 逐行解析 | for raw in resp 一行行读 | 整体 json.loads 必然报错 |
| 实时输出 | sys.stdout.flush() | 缓冲住了,还是等到最后一次性出现 |
| 判断结束 | 看某片的 done | 不知道什么时候该停 |
| 回填 assistant | 把完整答案追加进 messages | 模型不记得自己说过什么 |
| 裁剪历史 | 保留 system + 最近 N 条 | 越聊越慢,最后被静默截断 |
system 必须单独保住
简单粗暴地 messages[-20:] 会把最前面那条 system 一起裁掉,人设突然消失,模型行为在聊到第二十轮时莫名其妙变了。正确写法是 [SYSTEM] + messages[-N:]——代码里就是这么做的。
4.2 案例二 · OpenAI 兼容层零改动切换
场景:已有一套调 OpenAI 的代码,现在要求数据不出网,得切到本地模型。不用重写业务逻辑——Ollama 在 /v1 下实现了一部分 OpenAI 接口。
"""OpenAI 兼容层:让已有的代码不改业务逻辑就切到私有模型。

Ollama 在 /v1 下实现了一部分 OpenAI 接口,所以用 openai 官方 SDK 时,
只需要换掉 base_url,剩下的调用写法一个字都不用动。

    pip install openai
    python3 openai_compat.py
"""
import os

from openai import OpenAI

# base_url 指向本地 Ollama 的 /v1,注意结尾这个斜杠要带上
BASE_URL = os.environ.get("OLLAMA_OPENAI_BASE", "http://127.0.0.1:11434/v1/")
MODEL = os.environ.get("OLLAMA_MODEL", "qwen2:1.5b")

# 本地 Ollama 不校验 key,但 SDK 要求这个参数必须有值,随便填一个占位串。
# 如果前面挂了带鉴权的网关,就把真实令牌放进环境变量再读出来,别写进源码。
API_KEY = os.environ.get("OLLAMA_API_KEY", "ollama")

client = OpenAI(base_url=BASE_URL, api_key=API_KEY)


def ask_once(question):
    """一次性返回:和调云端 OpenAI 的写法完全一致。"""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "你是中文助手,回答简洁。"},
            {"role": "user", "content": question},
        ],
        temperature=0.3,
    )
    return resp.choices[0].message.content


def ask_stream(question):
    """流式返回:逐片打印。"""
    stream = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": question}],
        stream=True,
    )
    for chunk in stream:
        # 最后一片的 delta.content 可能是 None,要判空
        part = chunk.choices[0].delta.content
        if part:
            print(part, end="", flush=True)
    print()


if __name__ == "__main__":
    print("一次性返回:")
    print(ask_once("用一句话说明 Ollama 是什么"))

    print("\n流式返回:")
    ask_stream("再用一句话说明为什么企业要私有化部署")
| 要改的 | 改成什么 | 说明 |
|---|---|---|
base_url | http://127.0.0.1:11434/v1/ | 只改这一处,注意结尾的 /v1/ |
api_key | 任意占位字符串 | 本地不校验,但 SDK 要求这个参数有值 |
model | 本地模型全名 | gpt-4 这种名字本地没有,必须换 |
| 其余调用代码 | 一个字都不用改 | chat.completions.create 结构完全一致 |
keep_alive、num_ctx 等字段在 OpenAI 那套结构里没有对应位置;云端模型的某些高级能力本地小模型也不具备。切过去之后必须重新跑一遍业务回归,别假设「接口通了就等于功能一样」。
4.3 案例三 · 接入图形客户端
不写代码的同事需要一个界面。ChatBox 这类客户端本质就是带界面的 HTTP 客户端,配置项只有两个:服务地址和模型名。
| 配置项 | 填什么 | 常见错误 |
|---|---|---|
| API 类型 / 提供方 | 选 Ollama(或 OpenAI 兼容) | 选错类型,请求路径对不上 |
| 服务地址 | 本机 http://127.0.0.1:11434;远程填服务器地址 | 填了服务器地址,但服务端只监听回环 |
| 模型 | 下拉里选,或手填全名 | 下拉是空的——说明地址没通,不是客户端的问题 |
OLLAMA_ORIGINS
浏览器里跑的客户端受跨域策略约束。控制台报 CORS 错误时,问题在 OLLAMA_ORIGINS 上,不在 OLLAMA_HOST。这两个变量管的是完全不同的两件事,很多人在错误的地方查半天。桌面版客户端不走浏览器,没有这个问题。
4.4 案例四 · 用 /api/embed 做一个最小检索
前三个案例都在用「要答案」里的对话接口。还有一个接口在企业场景里出镜率极高:/api/embed。它不生成文字,只把一段话变成一串数字(向量),用来比「两句话意思像不像」。
打个比方:对话接口是师傅炒菜,嵌入接口是给每道菜贴个味道标签——客人说「来点酸辣的」,你不用把菜全炒一遍,按标签挑最近的那道就行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""embed_search.py —— 用 /api/embed 做一个最小的语义检索

用途:演示「文本转向量 → 算相似度 → 找最接近的一条」这条链路,
把接口分组里「要答案」的第三个接口 /api/embed 用起来。

用法:
    python3 embed_search.py "公司年假怎么休"
    OLLAMA_EMBED_MODEL=bge-m3 python3 embed_search.py "报销流程"

说明:
  * 只用标准库,余弦相似度手写,不依赖 numpy。
  * 嵌入模型和对话模型是两类模型,不能混用:
    用 qwen2 这类对话模型去调 /api/embed,要么报错要么质量很差。
  * 老版本的接口路径是 /api/embeddings(复数),本脚本会在
    /api/embed 返回 404 时自动回退,并把实际用的路径打印出来。
"""

import json
import math
import os
import sys
import urllib.error
import urllib.request

BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434").rstrip("/")
EMBED_MODEL = os.environ.get("OLLAMA_EMBED_MODEL", "bge-m3")
TOKEN = os.environ.get("OLLAMA_GATEWAY_TOKEN", "")
TIMEOUT = float(os.environ.get("OLLAMA_TIMEOUT", "60"))

# 假装这是知识库里已经切好的片段。真实项目里它来自数据库或文件。
DOCS = [
    "年假按入职年限计算,满一年五天,此后每满一年增加一天,上限十五天。",
    "差旅报销需在回程后十个工作日内提交,超期需部门负责人签字说明。",
    "公司内网只允许通过堡垒机访问生产服务器,禁止在办公机上保存生产密钥。",
    "病假需提供二级以上医院证明,三天以内可由直属主管直接批准。",
    "试用期为三个月,期间双方可提前三日书面通知解除劳动合同。",
]


def headers():
    h = {"Content-Type": "application/json"}
    if TOKEN:
        h["Authorization"] = "Bearer " + TOKEN
    return h


def post(path, payload):
    body = json.dumps(payload).encode("utf-8")
    req = urllib.request.Request(BASE + path, data=body,
                                 headers=headers(), method="POST")
    with urllib.request.urlopen(req, timeout=TIMEOUT) as resp:
        return json.loads(resp.read().decode("utf-8"))


def embed(texts):
    """返回每段文本对应的向量。优先新接口,404 时回退到旧接口。"""
    try:
        data = post("/api/embed", {"model": EMBED_MODEL, "input": texts})
        # 新接口统一返回 embeddings 列表
        vectors = data.get("embeddings")
        if vectors:
            return vectors, "/api/embed"
    except urllib.error.HTTPError as exc:
        if exc.code != 404:
            raise
    # 旧接口一次只能处理一段文本,字段名也不一样
    vectors = []
    for text in texts:
        data = post("/api/embeddings", {"model": EMBED_MODEL, "prompt": text})
        vectors.append(data["embedding"])
    return vectors, "/api/embeddings"


def cosine(a, b):
    """余弦相似度:两个向量夹角越小,值越接近 1。"""
    dot = sum(x * y for x, y in zip(a, b))
    na = math.sqrt(sum(x * x for x in a))
    nb = math.sqrt(sum(y * y for y in b))
    if na == 0 or nb == 0:
        return 0.0
    return dot / (na * nb)


def main():
    query = sys.argv[1] if len(sys.argv) > 1 else "年假有几天"
    print("嵌入模型:%s" % EMBED_MODEL)
    print("查询:%s" % query)

    try:
        vectors, used_path = embed(DOCS + [query])
    except urllib.error.HTTPError as exc:
        print("请求失败 HTTP %s" % exc.code)
        if exc.code == 404:
            print("两个接口路径都不通,先 GET /api/version 确认版本再对照文档。")
        return 1
    except Exception as exc:
        print("请求失败:%s(先确认嵌入模型已经 pull 下来)" % exc)
        return 1

    print("实际使用的接口:%s" % used_path)
    print("向量维度:%d" % len(vectors[0]))
    print("-" * 56)

    q_vec = vectors[-1]
    scored = []
    for doc, vec in zip(DOCS, vectors[:-1]):
        scored.append((cosine(q_vec, vec), doc))
    scored.sort(key=lambda item: item[0], reverse=True)

    for rank, (score, doc) in enumerate(scored, 1):
        mark = "  ←最接近" if rank == 1 else ""
        print("%d. %.4f  %s%s" % (rank, score, doc[:34], mark))

    print("-" * 56)
    print("把排第一的片段塞进 /api/chat 的 system 或 user 消息里,")
    print("就是最朴素的一套检索增强问答。")
    return 0


if __name__ == "__main__":
    sys.exit(main())
| 要点 | 说明 |
|---|---|
| 模型不能混用 | 嵌入模型和对话模型是两类模型。拿 qwen2 这种对话模型去调 /api/embed,要么报错要么质量很差 |
| 路径回退 | 新接口 /api/embed 返回 404 时自动试旧的 /api/embeddings,并把实际用的路径打印出来 |
| 字段不一样 | 新接口收 input、返回 embeddings;旧接口收 prompt、返回 embedding,而且一次只能处理一段 |
| 余弦相似度 | 手写三行,不依赖 numpy;值越接近 1 意思越接近 |
| 下一步 | 把排第一的片段塞进 /api/chat 的消息里,就是最朴素的检索增强问答 |
05骨架模板:封装成能给同事用的客户端
超时、重试、上下文裁剪,这三样不做就别上线
前面的案例都是「跑通」级别的代码。真要给同事 import,还得把三件事固化下来——它们不做,上线后必然被「偶发超时」和「越聊越慢」找上门。
"""骨架模板:把私有模型封装成一个可以给同事直接 import 的客户端。

复制这个文件到你的项目里,按 TODO 改完就能用。
它把三件事固化下来:超时、重试、上下文裁剪——这三样不做,
上线后必然被「偶发超时」和「越聊越慢」找上门。

    from client_skeleton import OllamaClient
    bot = OllamaClient()
    print(bot.ask("你好"))
"""
import json
import os
import time
import urllib.error
import urllib.request


class OllamaClient:
    def __init__(self, base=None, model=None, system=None):
        # TODO: 换成你自己的服务地址;生产环境走网关域名,不要直连 11434
        self.base = (base or os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434")).rstrip("/")
        # TODO: 换成你们确定要用的模型全名,必须带冒号版本
        self.model = model or os.environ.get("OLLAMA_MODEL", "qwen2:1.5b")
        # TODO: 写你自己的人设
        self.system = system or "你是中文助手,回答简洁准确,不确定就直说。"
        # 令牌一律走环境变量,不准硬编码
        self.token = os.environ.get("OLLAMA_GATEWAY_TOKEN", "")

        # TODO: 按业务调整
        self.timeout = 120        # 单次请求超时(秒);长文本生成要调大
        self.retries = 2          # 失败重试次数
        self.max_history = 20     # 保留最近多少条消息,防止上下文无限膨胀

        self.history = []

    # ---------- 内部:发一次请求 ----------
    def _post(self, path, payload):
        url = self.base + path
        headers = {"Content-Type": "application/json"}
        if self.token:
            headers["Authorization"] = "Bearer " + self.token
        body = json.dumps(payload).encode("utf-8")

        last = None
        for attempt in range(self.retries + 1):
            try:
                req = urllib.request.Request(url, data=body, headers=headers)
                with urllib.request.urlopen(req, timeout=self.timeout) as resp:
                    return json.loads(resp.read().decode("utf-8"))
            except (urllib.error.URLError, TimeoutError) as exc:
                last = exc
                if attempt < self.retries:
                    # 退避重试:模型正在加载时第一次请求很容易超时
                    time.sleep(2 ** attempt)
        raise RuntimeError("调用 %s 失败:%s" % (url, last))

    # ---------- 对外:单轮问答,不带历史 ----------
    def ask(self, question, **options):
        payload = {
            "model": self.model,
            "messages": [
                {"role": "system", "content": self.system},
                {"role": "user", "content": question},
            ],
            "stream": False,
            # TODO: 确定性任务把 temperature 调到 0.1~0.3
            "options": {"temperature": 0.3, **options},
        }
        return self._post("/api/chat", payload)["message"]["content"]

    # ---------- 对外:多轮对话,自己维护历史 ----------
    def chat(self, question, **options):
        self.history.append({"role": "user", "content": question})
        payload = {
            "model": self.model,
            "messages": [{"role": "system", "content": self.system}] + self.history,
            "stream": False,
            "options": {"temperature": 0.3, **options},
        }
        answer = self._post("/api/chat", payload)["message"]["content"]

        # 模型的回答必须也存进历史,否则下一轮它不知道自己说过什么
        self.history.append({"role": "assistant", "content": answer})
        if len(self.history) > self.max_history:
            self.history = self.history[-self.max_history:]
        return answer

    def reset(self):
        """清空上下文,相当于对话里的 /clear。"""
        self.history = []


if __name__ == "__main__":
    bot = OllamaClient()
    print(bot.ask("用一句话介绍你自己"))
| 机制 | 代码里怎么做的 | 不做会怎样 |
|---|---|---|
| 超时 | urlopen(timeout=...) | 服务卡住时调用方一起挂死,没有任何反馈 |
| 退避重试 | time.sleep(2 ** attempt) | 模型正在加载时第一次请求很容易超时,一次失败就放弃太脆弱 |
| 上下文裁剪 | 保留 system + 最近 N 条 | 越聊越慢,最后被静默截断 |
| 令牌注入 | 从环境变量读,有才加 Authorization | 硬编码令牌,或者连不上带鉴权的网关 |
| 单轮/多轮分开 | ask() 不带历史,chat() 带 | 分类抽取这类任务被无关历史干扰 |
5.2 复制之后要改哪几处
| 位置 | 改成什么 |
|---|---|
self.base | 生产走网关域名,不要直连 11434 |
self.model | 你们确定要用的模型全名,必须带冒号版本 |
self.system | 你自己的业务人设 |
self.timeout | 长文本生成要调大;探活类调用可以很小 |
self.max_history | 按 num_ctx 和单条消息长度定 |
5.3 max_history 到底该填多少
骨架里那个 max_history 不能拍脑袋。它和 num_ctx、人设长度、单条消息平均长度都有关。算一下比猜靠谱:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""history_budget.py —— 上下文预算计算器

用途:回答「我的 num_ctx 够撑几轮对话」「历史该保留几条」这两个问题。
不去猜,按字数估 token,把预算算出来再定裁剪策略。

用法:
    python3 history_budget.py
    NUM_CTX=8192 AVG_USER_CHARS=120 python3 history_budget.py

估算口径(够用即可,不追求精确):
  * 中文约 1.5 字/token,英文约 4 字符/token;本脚本按中文为主估。
  * 一轮对话 = 一条 user + 一条 assistant。
  * 生成也要占窗口,所以必须预留输出空间,不能把窗口全给历史。
"""

import os

NUM_CTX = int(os.environ.get("NUM_CTX", "4096"))
SYSTEM_CHARS = int(os.environ.get("SYSTEM_CHARS", "200"))
AVG_USER_CHARS = int(os.environ.get("AVG_USER_CHARS", "60"))
AVG_ASSIST_CHARS = int(os.environ.get("AVG_ASSIST_CHARS", "300"))
RESERVE_OUTPUT = int(os.environ.get("RESERVE_OUTPUT", "512"))

CHARS_PER_TOKEN = 1.5


def to_tokens(chars):
    """按中文口径把字数折成 token 数,向上取整。"""
    return int(chars / CHARS_PER_TOKEN + 0.999)


def main():
    sys_tokens = to_tokens(SYSTEM_CHARS)
    turn_tokens = to_tokens(AVG_USER_CHARS) + to_tokens(AVG_ASSIST_CHARS)
    usable = NUM_CTX - RESERVE_OUTPUT - sys_tokens

    print("上下文窗口 num_ctx      : %d token" % NUM_CTX)
    print("预留给生成的输出空间    : %d token" % RESERVE_OUTPUT)
    print("system 人设占用         : %d token(%d 字)" % (sys_tokens, SYSTEM_CHARS))
    print("可用于历史的额度        : %d token" % usable)
    print("单轮对话平均占用        : %d token(问 %d 字 + 答 %d 字)"
          % (turn_tokens, AVG_USER_CHARS, AVG_ASSIST_CHARS))
    print("-" * 56)

    if usable <= 0:
        print("窗口已被 system 和输出预留吃满,必须调大 num_ctx 或精简人设。")
        return 1

    max_turns = usable // turn_tokens
    print("理论可承载轮数          : %d 轮" % max_turns)

    # 留三成余量:真实对话里总有几轮特别长,卡着上限跑必然被截断。
    safe_turns = int(max_turns * 0.7)
    safe_msgs = max(safe_turns * 2, 2)
    print("建议保留最近            : %d 轮(即 messages 里 %d 条,不含 system)"
          % (safe_turns, safe_msgs))
    print("-" * 56)

    print("写进代码就是这一行:")
    print("    messages = [SYSTEM] + history[-%d:]" % safe_msgs)
    print()
    print("注意 system 要单独拼在前面,不能让它进入被裁剪的那一段。")
    print()

    print("不同窗口下的对照(按当前平均长度估):")
    print("%-12s %-12s %-12s" % ("num_ctx", "可用额度", "建议保留条数"))
    for ctx in (2048, 4096, 8192, 16384, 32768):
        avail = ctx - RESERVE_OUTPUT - sys_tokens
        if avail <= 0:
            print("%-12d %-12s %-12s" % (ctx, "不足", "-"))
            continue
        turns = avail // turn_tokens
        msgs = max(int(turns * 0.7) * 2, 2)
        print("%-12d %-12d %-12d" % (ctx, avail, msgs))

    print("-" * 56)
    print("提醒:num_ctx 调大会同时抬高显存占用,")
    print("显存不够时模型会溢出到 CPU,速度断崖式下跌——")
    print("窗口不是越大越好,够用就行。")
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
| 输入项 | 从哪拿 | 说明 |
|---|---|---|
NUM_CTX | ollama show 或 options.num_ctx | 模型实际生效的窗口 |
SYSTEM_CHARS | 数你自己的人设字数 | 人设也占窗口,而且每轮都占 |
AVG_ASSIST_CHARS | 看几条真实回答的长度 | 回答通常比提问长得多,别拿提问长度代替 |
RESERVE_OUTPUT | 按最长一次回答留 | 生成也占窗口,不预留就会写到一半被截 |
脚本直接输出一行可以拄进代码的结论,并附上不同 num_ctx 下的对照表。它留了三成余量——真实对话里总有几轮特别长,卡着理论上限跑必然被截断。
num_ctx 是本能反应,但 num_ctx 调大会同时抬高显存占用。显存不够时模型溢出到 CPU,速度断崖式下跌——你以为在优化体验,实际把服务搞卡了。先裁剪历史、再调窗口,顺序别反。
os.environ.get("OLLAMA_GATEWAY_TOKEN", "") 读令牌,不要改成硬编码。硬编码的凭据会跟着代码进 Git、进镜像、进日志,删都删不干净。这条规矩对所有凭据都适用,不只是这一个。
min_chat.py 用来理解协议,出问题时照着它抓包比对;stream_chat.py 用来理解流式和历史;client_skeleton.py 才是拿去用的那一份。三者的业务逻辑完全一样,区别只在工程化程度。
06易错点汇总
按「请求体 / 上下文 / 流式 / 兼容层 / 客户端」五类归并
⚠️ 一、请求体写错
model不写版本号。qwen2和qwen2:1.5b不是同一个东西,接口层面同样适用这条。- 把生成参数写在
options外面。例如把temperature直接放在请求体顶层。不会报错,会被静默忽略——你还以为参数生效了,实际一直在用默认值。 - 忘了
Content-Type: application/json。服务端可能直接拒收,报的错又跟 JSON 内容无关,容易查偏。 - 用
/api/generate却去取message.content。generate的答案在response字段里,chat才是message.content。 - 照着老教程用
/api/embeddings。官方文档里现在的接口是 /api/embed。先GET /api/version查清版本再对文档,别硬套过期教程。 - 硬编码服务地址。部署到要连远程模型的环境时得改源码,改源码就会漏改。用环境变量读。
⚠️ 二、上下文(最容易犯的一类)
- 以为服务端会记住历史。Ollama 是无状态的,每个请求都是孤立的。多轮对话是你每次把整段历史重新发过去装出来的。
- 只把模型的回答打印出来,没追加回
messages。结果是模型不记得自己上一轮说过什么,重复回答、自相矛盾。 - 历史无限追加。三个后果:请求越来越慢、显存占用上涨、超出
num_ctx后被静默截断——模型突然「忘了」最早的内容,却不报错。 - 裁剪时把
system一起裁掉。messages[-20:]这种写法会让人设在聊到第二十轮时突然消失。正确写法是[SYSTEM] + messages[-N:]。 - 单轮任务也带上历史。分类、抽取这类任务被无关历史干扰,结果不稳定。骨架里
ask()和chat()分开就是为了这个。
⚠️ 三、流式
- 对流式响应整体
json.loads。它不是一个 JSON 数组,是「一行一个 JSON」,整体解析必然报错。要逐行读、逐行解析。 - 不传
stream就按非流式解析。/api/chat不传这个字段时默认是流式的。要一次性结果必须显式写"stream": false。 - 忘了
flush()。输出被缓冲住,还是等到最后一次性出现,流式效果白做了。 - 去最后一片里找文本。
done为true的那片带的是统计信息,通常没有文本内容。 - 忘了把各片拼起来就当成完整答案回填历史。回填的必须是拼接后的完整文本。
- 经过 Nginx 时没关
proxy_buffering。代码没问题,但网关把流缓冲住了,前端仍然要等全部生成完。
⚠️ 四、OpenAI 兼容层
base_url漏了/v1。路径对不上,报 404。api_key留空。本地虽然不校验,但 SDK 要求这个参数有值,不给会在客户端侧直接抛异常。- 忘了换
model。代码里还写着gpt-4,本地根本没有这个模型。 - 以为兼容就是等价。兼容层只实现了一部分接口,
keep_alive、num_ctx这些 Ollama 特有字段没有对应位置。切过去必须重跑业务回归。 - 流式时不判空。最后一片的
delta.content可能是None,直接拼接会抛异常。
⚠️ 五、客户端与工程化
- 网页客户端连不上就去改
OLLAMA_HOST。控制台报 CORS 就是OLLAMA_ORIGINS的事,两个变量管的是完全不同的两件事。 - 排查顺序反了。正确顺序是:① 服务器本机 curl → ② 客户端机器 curl → ③ 才查客户端配置。反过来会在设置界面里白折腾很久。
- 不设超时。服务卡住时调用方跟着挂死,没有任何反馈。
- 一次失败就放弃。模型正在加载时第一次请求很容易超时,要退避重试。
- 把耗时字段当成秒。单位是纳秒,不除以 10 的 9 次方会得出「耗时 30 亿秒」。
- 令牌硬编码进源码。会跟着代码进 Git、进镜像、进日志,删都删不干净。一律走环境变量。
- 在 Python 里用
subprocess调ollama命令。绕远路——命令本身也只是个 HTTP 客户端,直接发请求更快也更稳。
07自测题
先自己答一遍,再点开对照
为什么说「命令行只是接口的壳」?这个结论有什么实际用处?
ollama run 本身不跑模型,它把你的输入打包成 POST /api/chat 发给后台常驻服务。两个推论:① 命令行能做的代码全能做,不必在 Python 里 subprocess 调命令绕远路;② 换客户端不用换后端,ChatBox、LangChain、自研前端用的都是同一套接口。
日常该用 /api/generate 还是 /api/chat?
默认用 /api/chat。它输入的是 messages 消息列表、带 system/user/assistant 角色,天然支持多轮;generate 只收一段 prompt,多轮要自己拼文本。而且 chat 的结构和 OpenAI 那套对齐,将来迁移成本最低。注意取值位置不同:chat 是 message.content,generate 是 response。
为什么模型「不记得上一句」?该怎么修?
因为服务端完全无状态——每个请求都是孤立的,答完就忘。多轮对话是你每次把整段历史重新发过去装出来的。修法:把模型的回答追加回 messages,下一轮连同历史一起发。只打印不回填,是新手最高频的那个错。
历史无限追加会出什么问题?裁剪时要注意什么?
三个后果:请求越来越慢(读题 token 变多)、显存占用上涨(KV 缓存变大)、超出 num_ctx 后被静默截断——模型突然忘了最早的内容却不报错。裁剪时system 必须单独保住,写成 [SYSTEM] + messages[-N:];直接 messages[-20:] 会把人设一起裁掉。
不传 stream 字段,默认是流式还是非流式?
默认是流式(true)。要一次性拿完整结果,必须显式写 "stream": false。很多人不传就按非流式去 json.loads,直接报错——因为流式响应不是一个 JSON 数组,而是「一行一个 JSON」,只能逐行读、逐行解析。
流式响应里,完整答案和统计信息分别在哪?
每一片的 message.content 是一小段增量,完整答案要你自己把各片拼起来(回填历史时回填的必须是拼接后的全文)。统计信息在 done 为 true 的最后一片里,那一片通常没有文本内容——去它里面找答案会拿到空字符串。
代码里明明写了流式,前端还是要等全部生成完才显示,查哪?
两个地方:本机是不是漏了 sys.stdout.flush()(输出被缓冲);经过 Nginx 就查 proxy_buffering 有没有关——代码没问题,是网关把流缓冲住了。这是上一讲网关配置里那条 proxy_buffering off 的直接对应。
用户抱怨慢,怎么用响应里的统计字段分清原因?
先看 load_duration:它很大说明模型被卸载后重新加载了,该调 OLLAMA_KEEP_ALIVE,而不是换模型。load_duration 接近 0 而 eval_count ÷ eval_duration(即 token/s)很低,才是算力或显存溢出的问题。prompt_eval_count 一路涨,就是历史没裁剪的证据。注意所有耗时单位是纳秒,要除以 10 的 9 次方。
已有一套 OpenAI 代码要切到本地模型,最少改几处?
三处:base_url 改成 http://127.0.0.1:11434/v1/(别漏 /v1)、api_key 给个占位字符串(本地不校验但 SDK 要求有值)、model 换成本地模型全名。其余业务代码一个字不用改。
「接口通了」是不是就等于「功能一样」?
不是。兼容层只实现了一部分接口,keep_alive、num_ctx 这些 Ollama 特有字段在 OpenAI 结构里没有对应位置;云端大模型的某些能力本地小模型也不具备。切过去之后必须重跑一遍业务回归,别拿「不报错」当验收标准。
网页版客户端控制台报 CORS,该改哪个变量?
改 OLLAMA_ORIGINS,不是 OLLAMA_HOST。前者管浏览器跨域策略,后者管监听地址,两件完全不同的事。桌面版客户端不走浏览器,没有这个问题。
客户端连不上,正确的排查顺序是什么?
① 在服务器本机 curl——不通说明服务侧问题,与客户端无关;② 在客户端所在机器 curl——不通说明监听地址或防火墙;③ 都通才去查客户端配置。顺序反过来,会在设置界面里白折腾很久。写代码前也建议先用 curl 打通接口,能省掉一大半排查时间。
把 temperature 写在请求体顶层会怎样?
不报错,被静默忽略——你以为参数生效了,实际一直在用默认值。生成参数必须放进 options 对象里。options 的字段名和对话中 /set parameter 的完全一致,区别只是前者每次请求都带、后者退出即失效。
给同事用的客户端,哪三件事不做就别上线?
超时(不设的话服务卡住时调用方一起挂死)、退避重试(模型正在加载时第一次请求很容易超时,一次失败就放弃太脆弱)、上下文裁剪(否则越聊越慢最后被静默截断)。另外令牌一律走环境变量读,不能硬编码进源码。
网关上为什么要专门拦 DELETE /api/delete?
因为模型管理类接口和问答接口在同一个端口上,谁能问问题,谁就能删模型。上一讲网关配置里按路径放行就是为此:只放行 /api/chat 这类要答案的接口,删除、拉取等管理接口一律拦在外面。
查接口速查表
要答案的接口
| 接口 | 作用 | 要点 |
|---|---|---|
POST /api/chat | 多轮对话 | 默认用它;答案在 message.content |
POST /api/generate | 单轮续写 | 输入是 prompt;答案在 response |
POST /api/embed | 文本转向量 | 旧写法是 /api/embeddings,以本机版本为准 |
管模型的接口
| 接口 | 对应命令 | 要点 |
|---|---|---|
GET /api/tags | ollama list | 磁盘上有哪些 |
POST /api/pull | ollama pull | 响应是流式进度 |
POST /api/show | ollama show | 看参数量、量化、模板 |
DELETE /api/delete | ollama rm | 网关必须拦掉 |
看状态的接口
| 接口 | 对应命令 | 要点 |
|---|---|---|
GET /api/ps | ollama ps | 显存里跑着哪些 |
GET /api/version | ollama -v | 探活首选,最轻;也用来对文档版本 |
请求体字段
| 字段 | 含义 | 要点 |
|---|---|---|
model | 模型全名 | 必须带冒号版本号 |
messages | 对话历史 | 服务端不替你记 |
stream | 是否流式 | 不传默认 true |
keep_alive | 用完在内存留多久 | 传 0 立刻卸载 |
options.temperature | 随机度 | 必须放 options 里,放外面被静默忽略 |
options.num_ctx | 上下文窗口 | 调大吃显存 |
响应字段
| 字段 | 含义 | 怎么用 |
|---|---|---|
message.content | 答案文本 | 流式时是增量片段,要自己拼 |
done | 是否结束 | 流式判断结束的唯一依据 |
load_duration | 加载模型耗时 | 很大 → 调 OLLAMA_KEEP_ALIVE |
prompt_eval_count | 读题 token 数 | 一路涨 = 历史没裁剪 |
eval_count / eval_duration | 生成量 / 生成耗时 | 相除得 token/s;耗时单位是纳秒 |
三份示例代码怎么选
| 文件 | 用途 | 什么时候看 |
|---|---|---|
min_chat.py | 理解协议 | 接口出问题,照着它比对请求 |
stream_chat.py | 理解流式与历史 | 写聊天功能之前 |
openai_compat.py | 已有代码切本地 | 手上有 OpenAI 代码时 |
client_skeleton.py | 拿去用的那一份 | 要给同事 import 时 |
/api/chat 的请求体和两种响应模式,图形客户端、SDK、自研后端就都只是它的不同包装——出问题时抓包一看就知道错在哪一层。