向量化与切分:决定天花板的两步
库里如果没有一个「自身就能答全」的块,后面调什么都是白费——切分是天花板,检索只在天花板底下取值。
30″30 秒看懂向量化与切分
上一讲里那位资料员,是怎么在几万张活页里「一眼」挑出相关的三五张的?他不读内容——他看坐标。
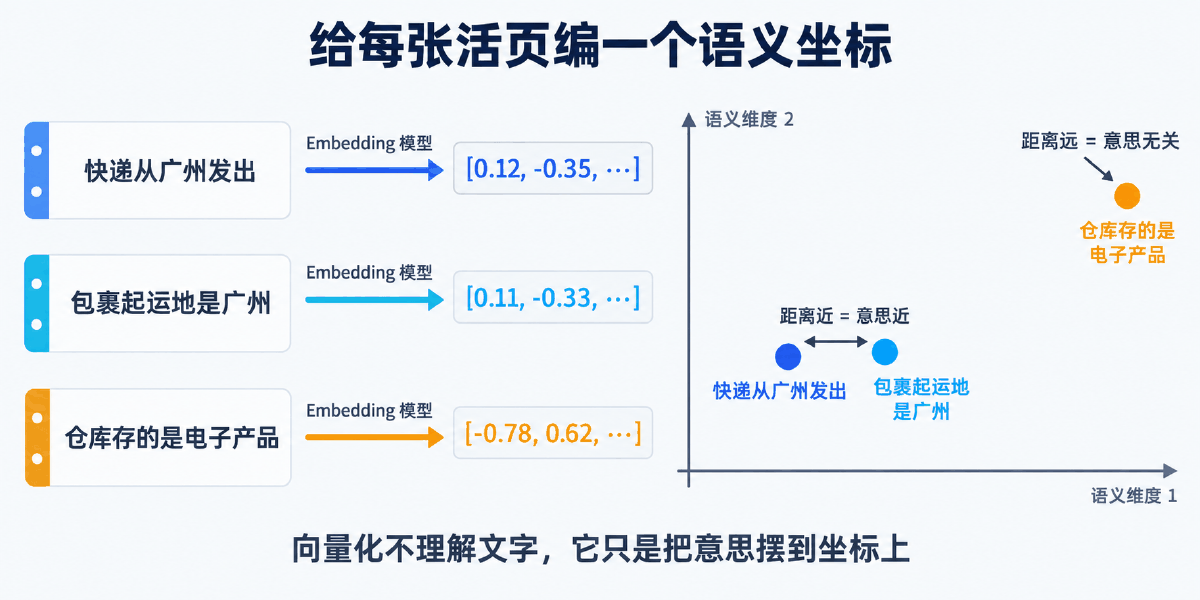
每张活页在入库时都被编了一个坐标:不是「第 3 排第 7 格」这种位置编号,而是按意思编的坐标。讲广州发货的活页挤在一块,讲仓储费用的挤在另一块。提问时,资料员把题目也换算成一个坐标,然后量一下谁离得近,近的就抽出来。
这个「把文字换算成坐标」的动作叫 Embedding,「量谁离得近」用的尺子叫 余弦相似度。而在编坐标之前,还有一件更要命的事:那张活页本身是怎么裁出来的。
| 这一讲的四个动作 | 技术名 | 做砸了会怎样 |
|---|---|---|
| 把长文档裁成活页 | 切分(chunking) | 一句话被拦腰剪断,取回来的块读不通,后面全废 |
| 相邻两张留一段重复 | 重叠(overlap) | 刀口正好落在关键句上,两边都只剩半句 |
| 给每张活页编坐标 | Embedding | 选错模型,中文语义压根对不上 |
| 量两个坐标的远近 | 余弦相似度 | 用错尺子,长文档系统性地排在前面 |
01概念:坐标、尺子、活页
Embedding 到底编了什么,余弦为什么是默认选择
1.1 Embedding:把意思换算成坐标
Embedding 模型的输入是一段文字,输出是一串定长的浮点数。定长这一点很关键:不管你喂的是 5 个字还是 500 个字,bge-large-zh-v1.5 都还你 1024 个数。这串数就是这段文字在「语义空间」里的坐标。
它编的是意思,不是字面。「快递从广州发出」和「包裹起运地是广州」没有一个共同的词组,但两串坐标挨得很近;「仓库存的是电子产品」用了「是」「的」这些高频字,坐标却离得很远。这正是它比关键词搜索强的全部原因。
| 对比 | 关键词检索 | 向量检索 |
|---|---|---|
| 匹配依据 | 字面重合 | 意思接近 |
| 「起运地」能匹配到「从哪发出」吗 | 不能 | 能 |
| 「ABC123456」这种单号 | 非常准 | 常常找不准 |
| 是否需要建库时算模型 | 不需要 | 需要,每块都要过一遍 |
注意第三行:向量检索在精确串(单号、型号、人名、编号)上是弱项。这不是模型不行,是它天生在做模糊匹配。第 06 节的混合检索就是为这件事准备的。
1.2 维度:坐标有几个轴
512 维就是 512 个轴,3072 维就是 3072 个轴。轴越多,能表达的细微差别越多,代价是内存、磁盘、计算三样一起变贵,而且是线性地贵。
这些数字不能猜,只能查。下面是逐个读官方 config.json 与模型卡确认的(核证情况见术语表后的来源说明):
| 模型 | 维度 | 最大输入 | 适用场景 |
|---|---|---|---|
| bge-small-zh-v1.5 | 512 | 512 | 中文,资源紧张时的首选 |
| m3e-base | 768 | 512 | 中文常用基线 |
| nomic-embed-text-v1.5 | 768 | 2048 | 长文本友好 |
| bge-large-zh-v1.5 | 1024 | 512 | 中文效果优先 |
| mxbai-embed-large-v1 | 1024 | 512 | 英文强,中文一般 |
| bge-m3 | 1024 | 8194 | 多语言 + 超长输入 |
| text-embedding-3-small | 1536 | 8191 | 闭源 API,按 token 计费 |
| text-embedding-3-large | 3072 | 8191 | 闭源 API,维度最高 |
1.3 余弦相似度:量夹角,不量长短
有了坐标就要量远近。向量库里常见的有三把尺子:
| 尺子 | 量的是 | 值越大越相似? | 要注意 |
|---|---|---|---|
| 余弦(cosine) | 两个向量的夹角 | 是,范围 −1~1 | 默认选它,不受向量长度影响 |
| 内积(dot / IP) | 点积 | 是 | 向量未归一化时会偏向长向量 |
| L2 距离 | 直线距离 | 否,越小越相似 | 阈值方向和前两个相反,最容易写反 |
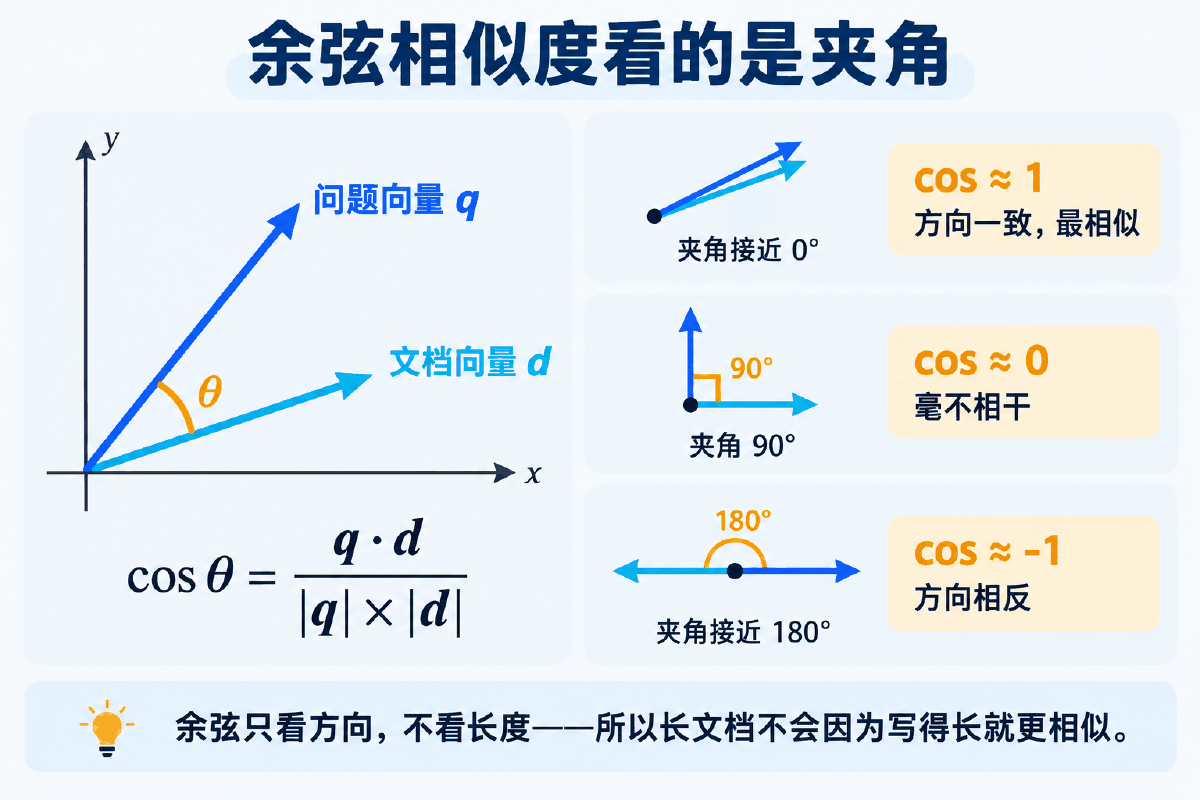
为什么默认是余弦?因为一段文字的向量长度会受文本长短影响,而我们要比的是「说的是不是一回事」,不是「谁写得长」。夹角剔掉了长度这个干扰项。
1.4 活页:一块装一个完整的意思
切分没有标准答案,但有一条判据,而且这条判据可以逐块检查:
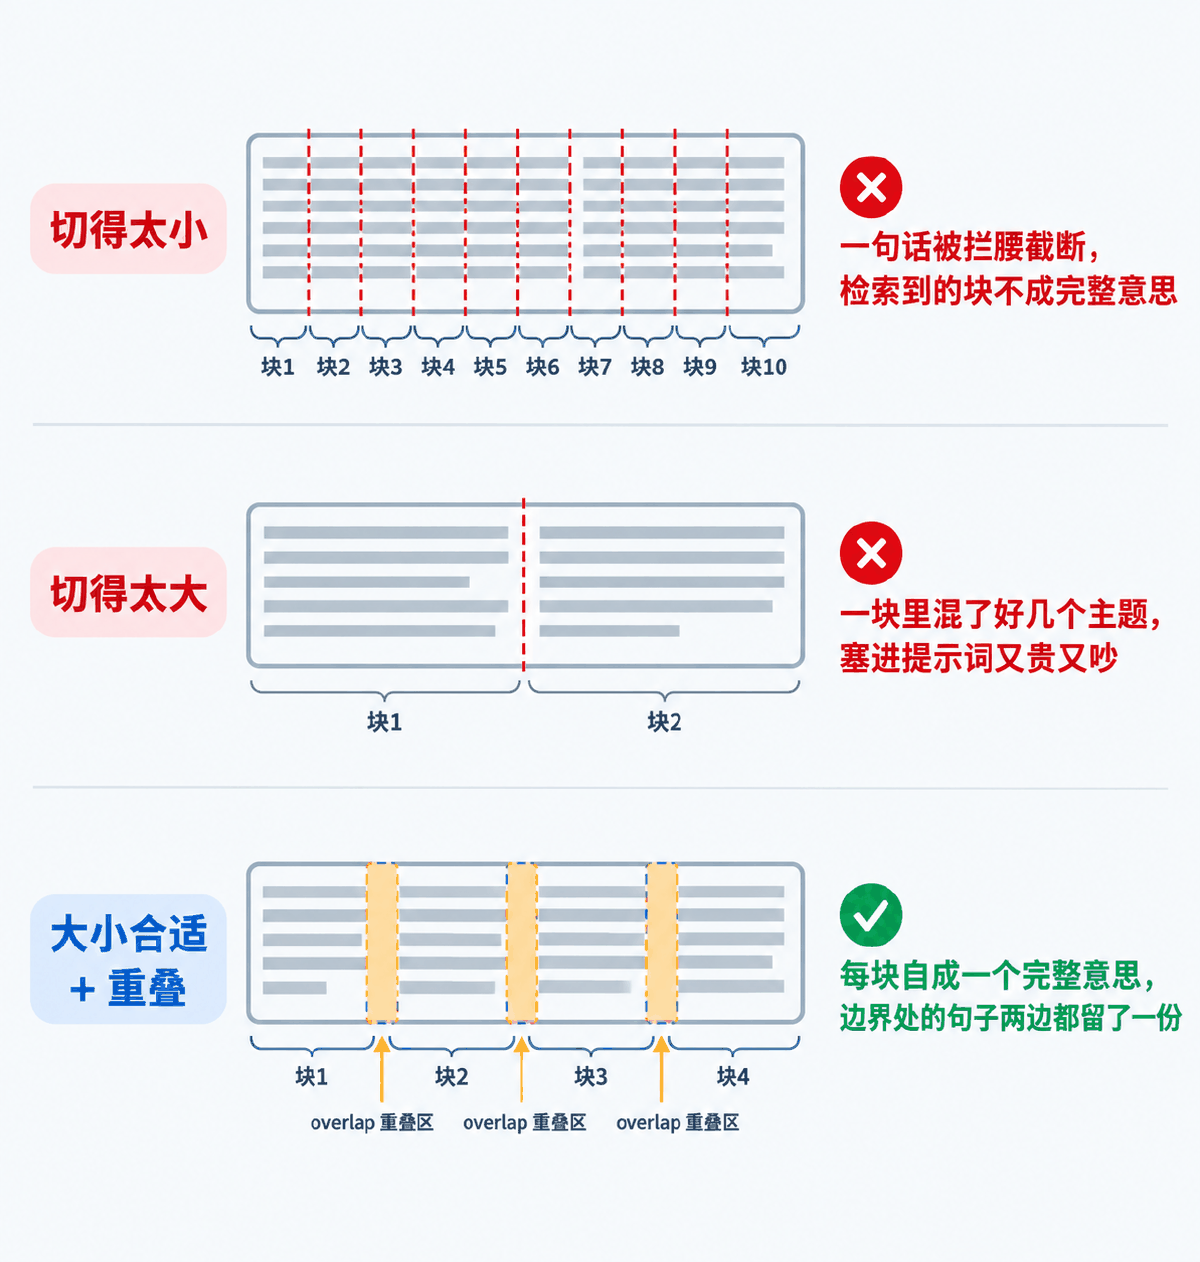
切块只有两个旋钮,但它们的含义常被搞混:
| 参数 | 含义 | 常见取值 | 调大会怎样 |
|---|---|---|---|
chunk_size | 一块最多多长 | 中文 200~500 字符 | 块更完整,但混进无关内容、更费 token |
chunk_overlap | 相邻两块重复多少 | chunk_size 的 10%~20% | 刀口容错更好,但块数和存储变多 |
两条硬性约束:overlap 必须小于 chunk_size(否则窗口挪不动,切分器会直接报错或死循环);chunk_size 不能超过 Embedding 模型的最大输入(否则静默截断)。
02原理:把余弦手算一遍
三个三维向量,六行公式,把「选 L2 还是内积」这件事彻底讲死
2.1 公式与它的三个取值
余弦相似度的定义只有一行:
| 公式 | 读法 |
|---|---|
cos(q,d) = q·d / (|q| × |d|) | 点积除以两个模长之积 |
q·d = Σ qᵢ·dᵢ | 逐位相乘再求和 |
|q| = √(Σ qᵢ²) | 各位平方和再开根 |
结果落在 −1 到 1 之间:1 是同向,0 是垂直(毫不相干),−1 是完全相反。实际的文本 Embedding 很少出现负值,中文语料里两段无关文字通常落在 0.1~0.3,这也是后面设阈值时的经验起点。
2.2 用三个向量把它跑出来
下面这段代码不装任何库,只用 math。它挑了三个精心设计的向量:A 和 B 方向完全一致但长度差一倍,C 和它们垂直。
"""手算余弦相似度,把「相似」这件事拆到只剩加减乘除。

三件事一次说清:
  1. cos = 点积 ÷ 两个模长,几何意义是夹角
  2. 向量归一化之后,点积就等于 cos —— 向量库常说的「内积 = 余弦」是这个意思
  3. 归一化之后,L2 距离与 cos 单调对应,排序结果完全一致

纯标准库,直接运行可看到全部中间量。
"""
import math

# 三个手写的三维向量,假装它们是三段话的 embedding
A = [0.60, 0.80, 0.00]   # 「快递从广州发出」
B = [0.30, 0.40, 0.00]   # 「包裹起运地是广州」——和 A 方向完全相同,只是长度一半
C = [0.00, 0.00, 1.00]   # 「仓库存的是电子产品」——和 A 完全正交


def dot(u, v):
    return sum(x * y for x, y in zip(u, v))


def norm(u):
    return math.sqrt(dot(u, u))


def cosine(u, v):
    return dot(u, v) / (norm(u) * norm(v))


def l2(u, v):
    return math.sqrt(sum((x - y) ** 2 for x, y in zip(u, v)))


def normalize(u):
    n = norm(u)
    return [x / n for x in u]


def show(name, u):
    print("%s = [%s]   模长 |%s| = %.4f"
          % (name, ", ".join("%.4f" % x for x in u), name, norm(u)))


def main():
    print("=== 三个向量 ===")
    show("A", A)
    show("B", B)
    show("C", C)

    print("\n=== 逐步手算 cos(A, B) ===")
    print("点积 A·B = %.2f×%.2f + %.2f×%.2f + %.2f×%.2f = %.4f"
          % (A[0], B[0], A[1], B[1], A[2], B[2], dot(A, B)))
    print("模长 |A| = %.4f,|B| = %.4f" % (norm(A), norm(B)))
    print("cos = %.4f ÷ (%.4f × %.4f) = %.6f"
          % (dot(A, B), norm(A), norm(B), cosine(A, B)))
    print("→ A 和 B 方向完全一致,cos = 1,尽管 B 的长度只有 A 的一半。")

    print("\n=== 三组两两比较 ===")
    print("%-8s %10s %10s %10s" % ("组合", "点积", "余弦", "L2 距离"))
    for n1, v1, n2, v2 in [("A", A, "B", B), ("A", A, "C", C), ("B", B, "C", C)]:
        print("%-8s %10.4f %10.4f %10.4f"
              % ("%s-%s" % (n1, n2), dot(v1, v2), cosine(v1, v2), l2(v1, v2)))
    print("→ 点积把 A-B 算成 0.50,比 A 自己跟自己的 1.00 小,但它们明明是同一个方向。")
    print("  原始点积会被向量长度带偏,余弦不会。")

    print("\n=== 归一化之后,点积 == 余弦 ===")
    na, nb, nc = normalize(A), normalize(B), normalize(C)
    show("A'", na)
    show("B'", nb)
    for n1, v1, n2, v2 in [("A'", na, "B'", nb), ("A'", na, "C'", nc)]:
        d, c = dot(v1, v2), cosine(v1, v2)
        print("%s·%s = %.6f,cos = %.6f,相差 %.1e" % (n1, n2, d, c, abs(d - c)))
    assert abs(dot(na, nb) - cosine(A, B)) < 1e-12
    print("断言通过:归一化后用最快的点积算子,拿到的就是余弦。")

    print("\n=== 归一化之后,L2 和余弦排序一致 ===")
    print("恒等式:|u−v|² = 2 − 2·cos(u,v)   (u、v 都是单位向量)")
    for n1, v1, n2, v2 in [("A'", na, "B'", nb), ("A'", na, "C'", nc)]:
        left = l2(v1, v2) ** 2
        right = 2 - 2 * cosine(v1, v2)
        print("  %s vs %s:左 %.6f  右 %.6f  相差 %.1e" % (n1, n2, left, right, abs(left - right)))
        assert abs(left - right) < 1e-12
    print("断言通过:所以向量库里选 L2 还是内积,前提是向量有没有归一化。")
    print("没归一化就选内积,长文档会因为向量更长而系统性地排在前面——这是一类很隐蔽的召回偏差。")


if __name__ == "__main__":
    main()
跑出来的核心一段是:
| 组合 | 点积 | 余弦 | L2 距离 |
|---|---|---|---|
| A-B(同向,长度差一倍) | 0.5000 | 1.0000 | 0.5000 |
| A-C(垂直) | 0.0000 | 0.0000 | 1.4142 |
| B-C(垂直) | 0.0000 | 0.0000 | 1.1180 |
第一行就是全部要点:A 和 B 明明是同一个方向,点积只给 0.50,余弦给 1.00。点积被长度带偏了,余弦没有。把这件事翻译成 RAG 的语言——长文档的向量往往更长,用未归一化的点积检索,长文档会系统性地排在前面,哪怕它跟问题没那么相关。
2.3 归一化之后,三把尺子合成一把
把向量除以自己的模长,变成长度为 1 的单位向量,这个动作叫归一化。做完之后代码里两条断言都成立:
| 恒等式 | 实测误差 | 意味着 |
|---|---|---|
归一化后 u·v == cos(u,v) | 0.0e+00 | 可以放心用最快的点积算子,拿到的就是余弦 |
|u−v|² == 2 − 2·cos(u,v) | 最大 4.4e−16 | L2 排序与余弦排序完全一致 |
4.4e−16 是浮点精度的量级,等于严格相等。所以那个反复被问的问题——「向量库的 metric 该选 L2、内积还是余弦」——有一个干净的答案:
向量未归一化 → 必须选余弦。唯一会出事的组合是「未归一化 + 内积」:不报错,只是长文档悄悄往前排。入库前先确认你的 Embedding 输出有没有归一化——很多中文模型(如 BGE 系列)默认输出的就是单位向量,但不要假设。
2.4 L2 阈值的方向是反的
还有一个每期都有人踩的低级坑:余弦和内积是越大越相似,L2 是越小越相似。写阈值过滤时,条件从 score >= 0.3 变成 dist <= 0.8,方向要跟着翻。写反了会发生什么?它会把最相关的结果全部过滤掉,只留最不相关的——而且不报错。
更麻烦的是,有些向量库的 Python 接口返回的字段名就叫 score,里面装的却是 L2 距离。所以有一条纪律值得养成:
03切分实验:八组参数,一张对照表
同一段物流文本,chunk_size 从 15 试到 300,看天花板在哪一档抬起来
3.1 实验怎么设计的
光说「切太小不好、切太大也不好」没用,得能量。这个实验拿一段 198 字的物流说明,固定问题「这批货从哪里发出,大概几天能到?」,然后做两件事:
- 逐块检查库里有没有「自身就能答全」的块——即同时含有出发地和运输时长的块。这一列量的是切分。
- 看检索排第一的那块能不能答全。这一列量的是检索。
两列分开,是这个实验最值钱的地方:它让「该改切分」和「该调检索」变成一个可以看的判断,而不是靠猜。
"""切块实验:同一份资料,chunk_size 与 overlap 一变,能不能答全就变。

脚本用同一个问题、同一套相似度算法,只改切块参数,量两件事:
  A 库里到底存不存在一个「自身就能答全」的块   —— 这是切分决定的
  B 排在第一的那个块是不是这种块               —— 这是检索决定的
两件事必须分开量,否则召回不准时根本说不清该去调哪一边。

纯标准库,直接运行。
"""
import math
import re
from collections import Counter

DOC = (
    "速达物流公司总部设在北京市,主要业务范围包括国际快递和仓储管理两大板块。"
    "本次运单的货物编号为 ABC123456,发货日期是 2023 年 1 月 15 日,"
    "当前货物已经抵达上海分拨中心,预计到达日期为 2023 年 1 月 20 日。"
    "承运方为快运通,采用陆运方式,出发地是广州,目的地是重庆,预计运输时间三天。"
    "仓储方面,东方仓储中心位于深圳市,主要存储电子产品,采用常温仓储,当前库存量一千件。"
)

QUESTION = "这批货从哪里发出,大概几天能到?"


def fixed_split(text, size, overlap):
    """按固定字数硬切,块之间保留 overlap 个字符的重叠。"""
    if overlap >= size:
        raise ValueError("overlap 必须小于 chunk_size,否则窗口挪不动会死循环")
    out, start = [], 0
    while start < len(text):
        out.append(text[start:start + size])
        if start + size >= len(text):
            break
        start += size - overlap
    return out


def tokenize(t):
    return re.findall(r"[a-z0-9]+", t.lower()) + re.findall(r"[\u4e00-\u9fff]", t)


def embed(t):
    return Counter(tokenize(t))


def cosine(a, b):
    common = set(a) & set(b)
    dot = sum(a[k] * b[k] for k in common)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return dot / (na * nb) if na and nb else 0.0


def answers_fully(text):
    """一个块能不能独立答完这个问题:出发地 + 时长,缺一不可。"""
    return ("出发地是广州" in text) and ("运输时间三天" in text)


def rank(chunks, question):
    qv = embed(question)
    scored = [(cosine(qv, embed(c)), c) for c in chunks]
    scored.sort(key=lambda x: x[0], reverse=True)
    return scored


def main():
    print("原文 %d 字,问题:%s\n" % (len(DOC), QUESTION))
    print("%-11s %-8s %-6s %-12s %-12s %-10s"
          % ("chunk_size", "overlap", "块数", "库里有完整块", "Top1 答得全", "Top1 分数"))
    print("-" * 66)

    for size, overlap in [(15, 0), (20, 5), (35, 0), (35, 7),
                          (50, 10), (80, 16), (120, 24), (300, 30)]:
        chunks = fixed_split(DOC, size, overlap)
        ranked = rank(chunks, QUESTION)
        exists = any(answers_fully(c) for c in chunks)
        top_ok = answers_fully(ranked[0][1])
        print("%-11d %-8d %-6d %-12s %-12s %-10.4f"
              % (size, overlap, len(chunks),
                 "有" if exists else "没有",
                 "答得全" if top_ok else "答不全",
                 ranked[0][0]))

    print()
    print("第一列到第四列是切分的锅,第五列是检索的锅。分开看:")
    print("  · 「库里有完整块 = 没有」 → 再怎么调 k、调阈值都没用,必须回去改切分。")
    print("  · 「有完整块但 Top1 答不全」 → 切分没问题,是检索排序的问题,该调 k 或换算法。")

    print()
    print("=" * 66)
    print("细看两组")
    for size, overlap in [(15, 0), (50, 10)]:
        chunks = fixed_split(DOC, size, overlap)
        ranked = rank(chunks, QUESTION)
        print("-" * 66)
        print("chunk_size=%d overlap=%d → %d 块" % (size, overlap, len(chunks)))
        full = [c for c in chunks if answers_fully(c)]
        print("  自身能答全的块:%d 个" % len(full))
        for score, text in ranked[:2]:
            mark = "✔" if answers_fully(text) else "✘"
            print("  %s %.4f 「%s」" % (mark, score, text))

    print("=" * 66)
    print("重叠到底救了什么:看刀口落在哪")
    for overlap in (0, 7):
        chunks = fixed_split(DOC, 35, overlap)
        # 找到「出发地是广州」这句话被切在哪两块之间
        idx = [i for i, c in enumerate(chunks) if "出发地" in c]
        print("  overlap=%-2d  含「出发地」的块共 %d 个:%s"
              % (overlap, len(idx), "、".join("第%d块" % (i + 1) for i in idx)))
        for i in idx:
            print("           第%d块:「%s」" % (i + 1, chunks[i]))
    print()
    print("结论:overlap 不是为了多存几份,是让被刀口切开的那句话")
    print("      在相邻两块里各留一份完整的,取到哪一块都读得通。")


if __name__ == "__main__":
    main()
3.2 实测结果
| chunk_size | overlap | 块数 | 库里有完整块 | Top1 答得全 | Top1 分数 |
|---|---|---|---|---|---|
| 15 | 0 | 14 | 没有 | 答不全 | 0.2390 |
| 20 | 5 | 13 | 没有 | 答不全 | 0.1890 |
| 35 | 0 | 6 | 没有 | 答不全 | 0.1793 |
| 35 | 7 | 7 | 没有 | 答不全 | 0.2138 |
| 50 | 10 | 5 | 有 | 答不全 | 0.1712 |
| 80 | 16 | 3 | 有 | 答不全 | 0.1347 |
| 120 | 24 | 2 | 有 | 答不全 | 0.1412 |
| 300 | 30 | 1 | 有 | 答得全 | 0.1386 |
这张表要横着读,分成三段:
| 档位 | 症状 | 该怎么办 |
|---|---|---|
| 15 ~ 35 | 库里根本没有能答全的块 | 这时候调 k、调阈值、上 Rerank、改提示词,全部无效。只能回去改切分。 |
| 50 ~ 120 | 库里有了,但 Top1 不是它 | 切分已经不是瓶颈,该去调 k / 换相似度算法 / 加 Rerank |
| 300 | 整段成了一块,自然答得全 | 本例文本太短才成立;真实长文档这么切会把无关内容一起拖进来 |
3.3 分数为什么不随块变大而变高
留意最后一列:chunk_size=15 时分数最高(0.2390),300 时反而只有 0.1386。这不矛盾——块越小,块里的字越少,问题里的字在其中的占比就越高,相似度自然被抬上去。但这个高分毫无意义,因为那一块内容是「为 ABC123456,发货日」,读都读不通。
3.4 重叠到底救了什么
实验最后一段专门看刀口。同一段文字,overlap=0 和 overlap=7 时,含「出发地」的那一块分别是:
| 配置 | 那一块的内容 |
|---|---|
| overlap=0 | 「3 年 1 月 20 日。承运方为快运通,采用陆运方式,出发地是广州,」 |
| overlap=7 | 「 20 日。承运方为快运通,采用陆运方式,出发地是广州,目的地是重庆,」 |
overlap=0 那块的结尾正好断在「出发地是广州,」——目的地被切到下一块去了。加了 7 个字的重叠,这句话就完整了。
04中文切分的三个坑
照抄英文教程的参数,在中文语料上会静默地失效
切分这一步的示例代码几乎全来自英文教程,而中英文在分隔符、断句方式、长度单位三件事上都不一样。这三个差异一个都不会报错,只会让效果莫名其妙地差。
"""中文切分的三个坑,每个都当场复现一遍。

坑一:默认分隔符是空行或空格,中文正文里根本没有 → 切不动
坑二:按字数切会把一句话拦腰斩断 → 块不成意思
坑三:chunk_size 的单位是字符还是 token,中英文不是一回事 → 估算失真

纯标准库,直接运行。
"""
import re

CN = (
    "速达物流公司总部设在北京市。本次运单货物编号为 ABC123456。"
    "当前货物已抵达上海分拨中心,预计到达日期为 2023 年 1 月 20 日。"
    "承运方为快运通,出发地是广州,目的地是重庆,预计运输时间三天。"
)

EN = ("Sudar Logistics is headquartered in Beijing. "
      "The shipment ABC123456 has arrived at the Shanghai hub. "
      "It departs from Guangzhou and arrives in Chongqing in three days.")


def split_by_separator(text, separator, size):
    """模拟「先按分隔符切,再按 size 聚合」这一类切分器的行为。"""
    pieces = text.split(separator) if separator else [text]
    out, buf = [], ""
    for p in pieces:
        candidate = (buf + separator + p) if buf else p
        if len(candidate) <= size:
            buf = candidate
        else:
            if buf:
                out.append(buf)
            buf = p
    if buf:
        out.append(buf)
    return out


def recursive_split(text, seps, size):
    """递归切分:按分隔符优先级依次尝试,切不动就降级到下一级。

    这正是 RecursiveCharacterTextSplitter 的思路,
    关键在于分隔符列表要为中文准备句号、分号、逗号这几级。
    """
    if len(text) <= size:
        return [text]
    for i, sep in enumerate(seps):
        if sep and sep in text:
            parts, out, buf = text.split(sep), [], ""
            for p in parts:
                cand = (buf + sep + p) if buf else p
                if len(cand) <= size:
                    buf = cand
                else:
                    if buf:
                        out.append(buf)
                    buf = p if len(p) <= size else ""
                    if not buf:
                        out += recursive_split(p, seps[i + 1:], size)
            if buf:
                out.append(buf)
            return out
    return [text[i:i + size] for i in range(0, len(text), size)]


def rough_tokens(text):
    """粗估 token 数:汉字按 1 个 token,英文按 4 个字符 1 个 token。

    只为说明量级差异,不是任何具体分词器的精确结果。
    """
    cjk = len(re.findall(r"[\u4e00-\u9fff]", text))
    rest = len(re.sub(r"[\u4e00-\u9fff]", "", text))
    return cjk + rest / 4


def main():
    print("=" * 62)
    print("坑一:默认按空行/空格切,中文切不动")
    print("=" * 62)
    print("原文 %d 字,里面有 %d 个空格、%d 个空行"
          % (len(CN), CN.count(" "), CN.count("\n\n")))
    for sep, name in [("\n\n", "空行"), (" ", "空格")]:
        got = split_by_separator(CN, sep, 50)
        print("  用「%s」切,size=50 → %d 块,最长一块 %d 字" % (name, len(got), max(len(g) for g in got)))
    print("  ↑ 用空行切:文本里一个空行都没有,整篇原样返回,远超 size。")
    print("    用空格切:确实切出了几块,但那 7 个空格全在英文单号和阿拉伯数字旁边,")
    print("    切点落在哪里完全是碰运气,跟句子边界没任何关系。")
    print("  英文对照:")
    got = split_by_separator(EN, " ", 50)
    print("    用「空格」切英文,size=50 → %d 块,最长 %d 字符" % (len(got), max(len(g) for g in got)))
    print("  ↑ 同一套默认参数,英文正常、中文失效。这就是照抄英文教程最容易踩的一脚。")

    print()
    print("=" * 62)
    print("坑二:按字数硬切,句子被拦腰斩断")
    print("=" * 62)
    hard = [CN[i:i + 30] for i in range(0, len(CN), 30)]
    for i, c in enumerate(hard[:4], 1):
        broken = not c.rstrip().endswith(("。", ",", ";"))
        print("  第%d块%s「%s」" % (i, "(断在半句)" if broken else "(收在标点)", c))
    print()
    print("  换成中文分隔符递归切,size=30:")
    good = recursive_split(CN, ["。", ";", ",", ""], 30)
    for i, c in enumerate(good[:5], 1):
        print("  第%d块「%s」" % (i, c))
    print("  ↑ 每块都收在标点上,块自身读得通。分隔符列表里必须有中文标点。")

    print()
    print("=" * 62)
    print("坑三:chunk_size 的单位,中英文差一倍还多")
    print("=" * 62)
    print("%-6s %-10s %-14s %-10s" % ("语言", "字符数", "粗估 token", "字符/token"))
    for name, text in [("中文", CN), ("英文", EN)]:
        ch, tk = len(text), rough_tokens(text)
        print("%-6s %-10d %-14.1f %-10.2f" % (name, ch, tk, ch / tk))
    print()
    print("  同样写 chunk_size=500:")
    print("    按字符算,中文一块约 500 token,英文一块约 125 token —— 差 4 倍。")
    print("    模型上下文与 Embedding 输入上限都是按 token 卡的,")
    print("    所以要先确认自己用的切分器数的是字符还是 token,再去定这个数。")


if __name__ == "__main__":
    main()
4.1 坑一:默认分隔符在中文上切不动
很多切分器的默认分隔符是 ["\n\n", "\n", " ", ""]——空行、换行、空格。这套顺序在英文里很合理,在中文里几乎失效。实测一段 103 字的中文(含 7 个空格、0 个空行):
| 切法 | 块数 | 最长一块 | 结果 |
|---|---|---|---|
| 按空行切,size=50 | 1 | 103 字 | 整篇原样返回,远超 size |
| 按空格切,size=50 | 3 | 45 字 | 切点全落在英文单号和数字旁,跟句子边界无关 |
| 同一套参数切英文,size=50 | 4 | 48 字符 | 完全正常 |
最后一行是关键对照:同一套参数,英文正常、中文失效。中文正文里通常一个空行都没有,空格只出现在英文单词和阿拉伯数字旁边——按空格切等于按「哪里混了英文」切,切点落在哪里完全是碰运气。
4.2 坑二:按字数硬切,句子被拦腰斩断
知道默认分隔符没用之后,第二个本能反应是「那就按字数硬切」。实测 size=30 的结果:
| 纯按字数硬切 | 改用中文分隔符递归切 |
|---|---|
| 「速达物流公司总部设在北京市。本次运单货物编号为 ABC123」 | 「速达物流公司总部设在北京市」 |
| 「456。当前货物已抵达上海分拨中心,预计到达日期为 2023」 | 「本次运单货物编号为 ABC123456」 |
| 「 年 1 月 20 日。承运方为快运通,出发地是广州,目的地」 | 「当前货物已抵达上海分拨中心」 |
| 「是重庆,预计运输时间三天。」 | 「预计到达日期为 2023 年 1 月 20 日」 |
左边那一列,单号 ABC123456 被从中间劈成了 ABC123 和 456,日期 2023 年 被切成两块。这种块入了库,就永远检索不到完整单号了。右边每一块都收在标点上,单独拿出来都读得通。
["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]递归切分器会先试最粗的,切不下去再退到下一级,最后才落到「硬切」。把中文句号放在列表里,就是这一整节唯一必须记住的动作。
4.3 坑三:chunk_size 的单位,中英文差四倍
chunk_size=500 里的 500,数的是字符还是 token?这两个在英文里差不多,在中文里差四倍。实测同一段内容的中英文版本:
| 语言 | 字符数 | 粗估 token | 字符/token |
|---|---|---|---|
| 中文 | 103 | 79.8 | 1.29 |
| 英文 | 166 | 41.5 | 4.00 |
换算过来:同样写 chunk_size=500,按字符算的话,中文一块约 500 token,英文一块只有约 125 token——差 4 倍。而模型上下文窗口、Embedding 的最大输入,卡的都是 token,不是字符。
② 成本估算翻车:照英文经验估的 token 数,在中文上要乘以三到四倍。
所以定这个数之前,先确认你用的切分器数的是字符还是 token。
05选型:维度要花多少钱,向量库选哪个
两段可运行的算账脚本,把「凭感觉选」换成「按数字选」
5.1 维度的代价,算出来就不纠结了
「维度越高越好」是个很自然的直觉,但代价是线性的,而且三样一起涨。下面这段脚本把八个常用模型的账一次算清:
"""维度决定的三笔账:内存、磁盘、单次检索的计算量。

选 Embedding 模型时,「效果好不好」之外还有一个必须一起看的量:维度。
维度直接乘进内存、磁盘和检索耗时里,选之前先把账算出来。

表里的维度是各模型公开配置里的隐藏层宽度,不是估的。
纯标准库,直接运行。
"""

# (模型名, 维度, 单次可编码的最大长度, 说明)
MODELS = [
    ("bge-small-zh-v1.5", 512, 512, "中文小模型,维度最省"),
    ("m3e-base", 768, 512, "中文常用基线"),
    ("nomic-embed-text-v1.5", 768, 2048, "长文本友好"),
    ("bge-large-zh-v1.5", 1024, 512, "中文大模型"),
    ("mxbai-embed-large-v1", 1024, 512, "英文强,中文一般"),
    ("bge-m3", 1024, 8194, "多语言 + 超长输入"),
    ("text-embedding-3-small", 1536, 8191, "闭源 API,按 token 计费"),
    ("text-embedding-3-large", 3072, 8191, "闭源 API,维度最高"),
]

BYTES_PER_FLOAT32 = 4
BYTES_PER_INT8 = 1


def gib(n_bytes):
    return n_bytes / (1024 ** 3)


def mib(n_bytes):
    return n_bytes / (1024 ** 2)


def main():
    for n_chunks in (10_000, 1_000_000):
        print("=" * 74)
        print("库里有 %s 个 chunk 时,光是向量本身要占多少" % f"{n_chunks:,}")
        print("=" * 74)
        print("%-26s %-6s %-12s %-12s %-10s"
              % ("模型", "维度", "float32", "int8 量化", "省下"))
        print("-" * 74)
        for name, dim, _maxlen, _note in MODELS:
            f32 = n_chunks * dim * BYTES_PER_FLOAT32
            i8 = n_chunks * dim * BYTES_PER_INT8
            fmt = (lambda b: "%8.2f MB" % mib(b)) if n_chunks < 100_000 else (lambda b: "%8.2f GB" % gib(b))
            print("%-26s %-6d %-12s %-12s %-10s"
                  % (name, dim, fmt(f32), fmt(i8), "%.0f%%" % ((1 - i8 / f32) * 100)))
        print()

    print("=" * 74)
    print("检索一次要做多少次乘加:暴力扫描 = chunk 数 × 维度")
    print("=" * 74)
    print("%-26s %-6s %-18s %-18s" % ("模型", "维度", "1 万块", "100 万块"))
    print("-" * 74)
    for name, dim, _maxlen, _note in MODELS:
        print("%-26s %-6d %-18s %-18s"
              % (name, dim, f"{10_000 * dim:,} 次", f"{1_000_000 * dim:,} 次"))
    print()
    print("3072 维比 512 维贵 6 倍,内存、磁盘、计算三样一起贵 6 倍。")
    print("百万级别上暴力扫描已经不现实,所以向量库才要建近似索引")
    print("(HNSW、IVF 这类),用一点点召回率换回几十倍的速度。")

    print()
    print("=" * 74)
    print("还有一个容易忽略的上限:单块文本的最大长度")
    print("=" * 74)
    print("%-26s %-10s %-12s %s" % ("模型", "最大长度", "维度", "说明"))
    print("-" * 74)
    for name, dim, maxlen, note in MODELS:
        print("%-26s %-10d %-12d %s" % (name, maxlen, dim, note))
    print()
    print("chunk 超过这个长度不会报错,只会被悄悄截断——")
    print("后半段内容压根没进向量,检索自然找不回来,而且没有任何提示。")
    print("所以 chunk_size 的上限不只由模型上下文决定,也由 Embedding 的输入上限决定。")

    # 维度不是越高越好的反证:维度翻倍,成本确定翻倍,效果提升不保证
    print()
    print("选型顺序建议:先按语种和最大长度筛掉不合用的,")
    print("再在剩下的里面按维度挑最省的那个,最后才用自己的问题集实测效果。")


if __name__ == "__main__":
    main()
库里 100 万个 chunk 时,光是向量本身要占的磁盘(不含原文和索引结构):
| 模型 | 维度 | float32 | int8 量化 | 检索一次的乘加次数 |
|---|---|---|---|---|
| bge-small-zh-v1.5 | 512 | 1.91 GB | 0.48 GB | 5.12 亿 |
| m3e-base / nomic-v1.5 | 768 | 2.86 GB | 0.72 GB | 7.68 亿 |
| bge-large-zh-v1.5 / bge-m3 | 1024 | 3.81 GB | 0.95 GB | 10.24 亿 |
| text-embedding-3-small | 1536 | 5.72 GB | 1.43 GB | 15.36 亿 |
| text-embedding-3-large | 3072 | 11.44 GB | 2.86 GB | 30.72 亿 |
3072 维比 512 维贵 6 倍,内存、磁盘、计算三样一起贵 6 倍。而效果并不会跟着贵 6 倍——中文场景下 bge-large-zh-v1.5(1024 维)往往就够用了。
② 百万级别上暴力扫描已经不现实(每次检索十亿次乘加),所以向量库才要建近似索引(HNSW、IVF 这类),用一点点召回率换回几十倍速度。但几千条以内,暴力扫描反而更简单也更准。
5.2 Embedding 模型怎么挑
抛开榜单,落到项目上只有四个问题:
| 问题 | 怎么答 |
|---|---|
| 中文为主还是英文为主? | 中文选 BGE 系列或 m3e;mxbai-embed-large-v1 英文强但中文一般 |
| 块会不会超过 512 token? | 会就选 bge-m3(8194)或 nomic-v1.5(2048),别硬塞给 512 的模型 |
| 能不能把数据发到外部 API? | 不能就只剩本地开源模型这一条路 |
| 库有多大? | 百万级以上,维度每高一档都要多付真金白银,优先 512/768 |
闭源 API 侧的价格也要算进来:text-embedding-3-small 每百万 token $0.02、1536 维;3-large 每百万 token $0.13、3072 维。建库是一次性支出(10 万个 500 字的块约 5000 万 token),但每次提问都要给问题算一次向量,这笔是长期支出。
5.3 向量库怎么挑
选型不该靠「听说 XX 好」,而该先写死约束再排序。下面这段脚本把六个主流向量库的形态列清楚,再按三个真实场景各跑一次打分:
"""向量库选型:按自己的约束打分,而不是背一张「谁最好」的榜单。

六个候选都开源免费,差别不在功能多少,而在它们各自假设了什么部署形态。
把约束写成信号,让分数自己排出来;换了项目只改 need 字典。

star 数是排序的参考量之一,取自各仓库公开的星标数,
写死在这里只为可复现,真实选型时应当自己重新拉一次。
纯标准库,直接运行。
"""

# (名称, 星标数, 形态, 是否需要独立服务, 是否支持磁盘持久化, 是否支持元数据过滤, 是否支持分布式)
CANDIDATES = [
    ("FAISS",    40929, "库(进程内)",   False, True,  False, False),
    ("Chroma",   29325, "库 / 单机服务",  False, True,  True,  False),
    ("pgvector", 23062, "Postgres 扩展",  True,  True,  True,  False),
    ("Qdrant",   34660, "独立服务",       True,  True,  True,  True),
    ("Milvus",   46152, "独立服务",       True,  True,  True,  True),
    ("Weaviate", 16819, "独立服务",       True,  True,  True,  True),
]

FIELDS = ["name", "stars", "shape", "needs_server", "persist", "filter", "distributed"]


def to_dict(row):
    return dict(zip(FIELDS, row))


def score(cand, need):
    """按项目约束打分。每条约束要么加分要么直接出局。"""
    s, reasons = 0, []

    if need["no_extra_service"] and cand["needs_server"]:
        return None, ["要额外起服务,不满足「不加运维负担」"]
    if need["metadata_filter"] and not cand["filter"]:
        return None, ["不支持按元数据过滤,不满足「要按部门/时间筛」"]
    if need["distributed"] and not cand["distributed"]:
        return None, ["不支持分布式,撑不住目标数据量"]

    if not cand["needs_server"]:
        s += 3
        reasons.append("进程内即可,无额外运维 +3")
    if cand["filter"]:
        s += 2
        reasons.append("支持元数据过滤 +2")
    if cand["distributed"]:
        s += 2
        reasons.append("可水平扩展 +2")
    if need["reuse_existing_db"] and "Postgres" in cand["shape"]:
        s += 4
        reasons.append("直接复用现有 Postgres,数据与向量同库同事务 +4")

    # 使用量作为并列时的次级排序依据,权重刻意压低:
    # 星多只说明生态活跃,不代表更适合你这个项目。
    s += cand["stars"] / 20000
    reasons.append("生态活跃度 +%.2f" % (cand["stars"] / 20000))
    return s, reasons


SCENES = [
    ("单机小项目:几千个块,不想多起任何服务",
     {"no_extra_service": True, "metadata_filter": False,
      "distributed": False, "reuse_existing_db": False}),
    ("已有 Postgres 的业务系统,要按部门和时间过滤",
     {"no_extra_service": False, "metadata_filter": True,
      "distributed": False, "reuse_existing_db": True}),
    ("千万级向量,要水平扩展和在线扩容",
     {"no_extra_service": False, "metadata_filter": True,
      "distributed": True, "reuse_existing_db": False}),
]


def main():
    print("%-10s %-8s %-16s %-8s %-8s %-8s %-8s"
          % ("名称", "星标", "形态", "需起服务", "可持久化", "元数据过滤", "分布式"))
    print("-" * 74)
    for row in CANDIDATES:
        c = to_dict(row)
        print("%-10s %-8s %-16s %-8s %-8s %-8s %-8s"
              % (c["name"], f"{c['stars']:,}", c["shape"],
                 "是" if c["needs_server"] else "否",
                 "是" if c["persist"] else "否",
                 "是" if c["filter"] else "否",
                 "是" if c["distributed"] else "否"))

    for title, need in SCENES:
        print()
        print("=" * 74)
        print("场景:%s" % title)
        print("=" * 74)
        ranked, out = [], []
        for row in CANDIDATES:
            c = to_dict(row)
            s, reasons = score(c, need)
            (out if s is None else ranked).append((c["name"], s, reasons))
        ranked.sort(key=lambda x: x[1], reverse=True)

        for name, s, reasons in ranked:
            print("  %-10s %6.2f   %s" % (name, s, ";".join(reasons)))
        for name, _s, reasons in out:
            print("  %-10s %6s   出局:%s" % (name, "—", reasons[0]))
        if ranked:
            print("  → 首选:%s" % ranked[0][0])


if __name__ == "__main__":
    main()
| 名称 | 星标 | 形态 | 需起服务 | 元数据过滤 | 分布式 |
|---|---|---|---|---|---|
| Milvus | 46,152 | 独立服务 | 是 | 是 | 是 |
| FAISS | 40,929 | 库(进程内) | 否 | 否 | 否 |
| Qdrant | 34,660 | 独立服务 | 是 | 是 | 是 |
| Chroma | 29,325 | 库 / 单机服务 | 否 | 是 | 否 |
| pgvector | 23,062 | Postgres 扩展 | 是 | 是 | 否 |
| Weaviate | 16,819 | 独立服务 | 是 | 是 | 是 |
星标数通过 GitHub API 实时读取,会随时间变化,作量级参考而非精确指标。
三个场景跑出来的首选各不相同,而且理由是可复述的:
| 场景 | 首选 | 为什么其他的出局 |
|---|---|---|
| 单机小项目,几千块,不想多起服务 | Chroma(6.47) | pgvector / Qdrant / Milvus / Weaviate 都要额外起服务;FAISS 能进程内但不支持元数据过滤 |
| 已有 Postgres,要按部门和时间过滤 | pgvector(7.15) | 复用现有库、向量与业务数据同库同事务,加分最高;FAISS 因不支持过滤直接出局 |
| 千万级向量,要水平扩展 | Milvus(6.31) | Chroma 与 pgvector 不支持分布式,撑不住目标数据量 |
模板骨架:离线建库五步
加载 → 体检 → 切分 → 向量化 → 入库,把 TODO 填掉就是生产版本
这一讲的所有结论,落到代码里就是下面这一份。它纯标准库可跑(用词袋顶替真实 Embedding),每一个会变的东西都被隔离在一个函数或一个常量里:
"""离线建库骨架:加载 → 体检 → 切分 → 向量化 → 入库。

纯标准库即可跑通(用词袋顶替真实 Embedding),把 TODO 换成真实组件就是生产版本。
运行:
    python3 chunk_pipeline_skeleton.py
"""
import os
import re
import json
import math

# ---------------------------------------------------------------- 配置区
# TODO: 资料目录,先只放三五份做验证,别一上来全量灌
DOC_DIR = os.environ.get("KB_DOC_DIR", "./docs")

# TODO: 索引落盘位置
INDEX_PATH = os.environ.get("KB_INDEX", "./kb_index.json")

# TODO: 块大小。中文按字符算时 200~500 是常见区间,
#       且必须小于 Embedding 模型的最大输入(bge-large-zh-v1.5 是 512 token)
CHUNK_SIZE = int(os.environ.get("KB_CHUNK_SIZE", "300"))

# TODO: 重叠。一般取 chunk_size 的 10%~20%,必须小于 chunk_size
CHUNK_OVERLAP = int(os.environ.get("KB_CHUNK_OVERLAP", "50"))

# 中文标点必须在列表里,否则递归切分会一路降级到按字数硬切
SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]

# TODO: 换真实模型时改这里,建库与提问必须用同一个
EMBED_MODEL = os.environ.get("KB_EMBED_MODEL", "bag-of-words")


# ---------------------------------------------------------------- ① 加载
def load_docs(doc_dir):
    """返回 [(text, source)]。

    TODO: 换成真实加载器(PDF/Word/HTML)时,务必保住来源与页码——
    来源在这一步丢了,后面就再也标不出出处。
    """
    items = []
    if not os.path.isdir(doc_dir):
        # 没有目录时用一段内置样例,保证骨架能直接跑起来
        demo = ("速达物流公司总部设在北京市,业务范围包括国际快递与仓储管理。\n\n"
                "本次运单货物编号为 ABC123456,当前已抵达上海分拨中心,"
                "预计到达日期为 2023 年 1 月 20 日。\n\n"
                "承运方为快运通,采用陆运方式,出发地是广州,目的地是重庆,"
                "预计运输时间三天。\n\n"
                "东方仓储中心位于深圳市,存储电子产品,常温仓储,当前库存一千件。\n\n"
                "国际件报关所需材料包括商业发票、装箱单与贸易合同,"
                "缺任一项都会被海关退回重新申报。\n\n"
                "冷链货物需全程温控,交接时须记录温度并由双方签字确认。\n\n"
                "所有分拨中心均在每日 22:00 前完成当日件的装车发运。\n\n"
                "超重货物需提前一个工作日报备,并由发运网点安排专车,"
                "未报备的超重件不予插单。\n\n"
                "货物破损理赔按声明价值或实际损失较低者计算,"
                "理赔申请须在签收后七日内提出。")
        return [(demo, "内置样例")]
    for name in sorted(os.listdir(doc_dir)):
        path = os.path.join(doc_dir, name)
        if os.path.isfile(path) and name.endswith((".txt", ".md")):
            with open(path, encoding="utf-8") as f:
                items.append((f.read(), name))
    return items


# ---------------------------------------------------------------- ② 体检
def health_check(text, source):
    """入库前拦一道。返回 (是否通过, 问题列表)。"""
    problems = []
    if len(text.strip()) == 0:
        problems.append("抽出 0 个字,多半是扫描件,要先过 OCR")
    if text.count("\ufffd") > 0:
        problems.append("含 %d 个替换字符,编码有问题" % text.count("\ufffd"))
    longest = max((len(line) for line in text.splitlines()), default=0)
    if longest > CHUNK_SIZE * 4:
        problems.append("最长一行 %d 字,疑似表格被拍平" % longest)
    if "\n\n" not in text and not re.search(r"[。!?]", text):
        problems.append("既无空行也无中文句末标点,缺切分锚点")
    return (len(problems) == 0, problems)


# ---------------------------------------------------------------- ③ 切分
def split(text, size=CHUNK_SIZE, overlap=CHUNK_OVERLAP, seps=SEPARATORS):
    """递归切分:按分隔符从粗到细尝试,最后才按字数硬切。"""
    if overlap >= size:
        raise ValueError("overlap 必须小于 chunk_size,否则窗口挪不动")
    if len(text) <= size:
        return [text] if text.strip() else []

    for sep in seps:
        if sep == "":
            break
        if sep not in text:
            continue
        parts, buf, out = text.split(sep), "", []
        for i, p in enumerate(parts):
            piece = p + (sep if i < len(parts) - 1 else "")
            if len(buf) + len(piece) <= size:
                buf += piece
            else:
                if buf.strip():
                    out.append(buf)
                buf = (buf[-overlap:] if overlap and buf else "") + piece
        if buf.strip():
            out.append(buf)
        if all(len(c) <= size for c in out):
            return out

    # 所有分隔符都切不动,退到硬切
    step = size - overlap
    return [text[i:i + size] for i in range(0, len(text), step) if text[i:i + size].strip()]


# ---------------------------------------------------------------- ④ 向量化
def tokenize(s):
    """中文逐字拆,英文数字整词保留。"""
    return re.findall(r"[a-zA-Z0-9]+|[\u4e00-\u9fff]", s.lower())


def embed(text):
    """TODO: 换成真实 Embedding 模型,返回定长浮点列表。

    换模型后 similarity() 必须成对修改,否则分数毫无意义却照样能跑。
    """
    vec = {}
    for t in tokenize(text):
        vec[t] = vec.get(t, 0) + 1
    return vec


def similarity(a, b):
    """TODO: 换成标准余弦(点积 / 模长积),与 embed() 成对修改。"""
    common = set(a) & set(b)
    dot = sum(a[t] * b[t] for t in common)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return dot / (na * nb) if na and nb else 0.0


# ---------------------------------------------------------------- ⑤ 入库
def build_index(doc_dir=DOC_DIR, index_path=INDEX_PATH):
    """TODO: 换成真实向量库(FAISS / Chroma / pgvector)时只换这个函数。

    注意:向量用来找、原文用来读、来源用来核对,三样必须一起存。
    """
    records, skipped = [], []
    for text, source in load_docs(doc_dir):
        ok, problems = health_check(text, source)
        if not ok:
            skipped.append((source, problems))
            continue
        for i, chunk in enumerate(split(text)):
            records.append({
                "id": "%s#%d" % (source, i),
                "text": chunk,
                "source": source,
                "vector": embed(chunk),     # 真实向量库里这里是浮点列表
            })

    with open(index_path, "w", encoding="utf-8") as f:
        json.dump({"model": EMBED_MODEL, "records": records},
                  f, ensure_ascii=False)

    print("入库 %d 块,落盘 %s(Embedding:%s)"
          % (len(records), index_path, EMBED_MODEL))
    for source, problems in skipped:
        print("  跳过 %s:%s" % (source, ";".join(problems)))
    return records


def self_check(records, probe="出发地是哪里"):
    """建完立刻问一句已知答案,确认库建对了再往下做问答。"""
    if not records:
        print("库是空的,别往下做问答了。")
        return
    qv = embed(probe)
    ranked = sorted(records, key=lambda r: similarity(qv, r["vector"]), reverse=True)
    print("-" * 56)
    print("建库自检,问「%s」取回前 2 块:" % probe)
    for i, r in enumerate(ranked[:2], 1):
        print("  [%d] %.4f  %s" % (i, similarity(qv, r["vector"]),
                                   r["text"].replace("\n", " ")[:46]))
    print("逐条读一遍:取回的内容对不上题,就说明切分或模型有问题,先回去查这两处。")


if __name__ == "__main__":
    self_check(build_index())
| TODO | 默认值 | 怎么定 |
|---|---|---|
DOC_DIR | ./docs | 先只放三五份做验证,别一上来全量灌 |
CHUNK_SIZE | 300 | 中文 200~500 字符;必须小于 Embedding 的最大输入 |
CHUNK_OVERLAP | 50 | chunk_size 的 10%~20%,且必须小于 chunk_size |
SEPARATORS | 带中文标点 | 这一项不用改,但不要删掉中文标点 |
EMBED_MODEL | 词袋 | 换真实模型;提问时必须原样再用一次 |
embed() + similarity() | 词袋 + 余弦 | 成对修改,只改一个照样能跑但分数无意义 |
build_index() | JSON 落盘 | 换 FAISS / Chroma / pgvector 时只换这个函数 |
四处刻意的设计
| 位置 | 做法 | 为什么 |
|---|---|---|
load_docs() | 返回 (text, source) 二元组 | 来源在第一步丢了,后面就再也标不出出处 |
health_check() | 入库前拦一道 | 空文本、乱码、拍平表格、缺锚点,切完之后就很难发现了 |
split() | 第一行校验 overlap < size | 写反了会让窗口挪不动,直接报错好过死循环 |
build_index() | 同时存 text、source、vector | 向量用来找、原文用来读、来源用来核对 |
直接跑一次(没有 ./docs 目录时会用内置样例),输出是:
| 输出 | 说明 |
|---|---|
| 入库 2 块 | 265 字以上的样例按空行切成两块 |
| 建库自检,取回前 2 块 | 0.1639 / 0.0959,逐条读一遍对不对得上题 |
self_check() 只做一件事:用一个你已经知道答案的问题查一次,把取回的原文打出来。对不上题,说明切分或 Embedding 有问题——这时候回头改,成本比写完整套问答之后再查低一个数量级。把验证放在最靠近出错点的地方。
embed() + similarity()(成对改),重跑自检看取回的块有没有变好;② 再换 build_index() 里的存储。一次只换一个变量,否则效果变了也不知道是谁的功劳。几千块以内,JSON + 线性扫描其实完全够用。
06易错点汇总
按「切分 / 向量化 / 相似度 / 选型 / 入库」五类归并
⚠️ 一、切分
- 块切得太小,库里根本没有能答全的块。 第 03 节实测:chunk_size 从 15 到 35 的四档里,「库里有完整块」全是「没有」。这时候调 k、调阈值、上 Rerank、改提示词统统无效。切分是天花板,检索只是在天花板底下取值。
- 块切得太大,一块混了好几个主题。 检索回来的内容里真正相关的只占一小部分,既费 token 又把模型带偏,还会顶破 Embedding 的最大输入。
- 用默认分隔符切中文。
["\n\n","\n"," ",""]这套在中文上几乎失效:实测按空行切,103 字的文本返回 1 块、原样不动;按空格切,切点全落在英文单号和数字旁边。分隔符列表里必须加中文标点。 - 纯按字数硬切。 单号
ABC123456被劈成ABC123和456,日期被切成两半。这样的块入库后,完整单号永远检索不到。 - overlap 设成 0。 刀口正好落在关键句上时,两边都只剩半句。overlap 的作用不是多存几份,是让被切开的那句话在相邻两块里各留一份完整的。
- overlap ≥ chunk_size。 窗口挪不动,切分器要么报错要么死循环。一般取 chunk_size 的 10%~20%。
- 不管什么资料都套同一个 chunk_size。 属性表按行切就对了(第 01 页案例),长篇制度文档要按条款切。切分规则应当顺着资料的结构走。
⚠️ 二、向量化
- 块长度超过 Embedding 模型的最大输入。 这是本讲最隐蔽的坑:不报错,只是超出部分被静默截断,后半截从来没被编进坐标。bge-large-zh-v1.5 卡在 512 token,配 chunk_size=500 字符的中文块已经贴着上限。定 chunk_size 之前先查模型的最大输入。
- 把 chunk_size 的单位搞错。 中文约 1.29 字符/token,英文约 4.00——同样写 500,中英文差近 4 倍。而模型窗口和 Embedding 上限卡的都是 token。
- 建库和提问用了不同的模型。 两套坐标系不通用;维度相同时连异常都不会抛,只是结果全是噪声。
- 换了模型不重建库。 换模型 = 换坐标系 = 整库作废,必须全部重算,没有增量这条路。
- 用英文强的模型跑中文语料。 mxbai-embed-large-v1 在英文上很好,中文一般。选模型先看语言,再看维度。
⚠️ 三、相似度与阈值
- 未归一化却选了内积。 实测 A、B 两个方向完全一致的向量,点积只给 0.5000、余弦给 1.0000——点积被长度带偏了。翻译成 RAG:长文档会系统性地排在前面,而且不报错。
- L2 的阈值方向写反。 余弦和内积越大越相似,L2 越小越相似。写成
dist >= 0.8会把最相关的全部过滤掉,只留最不相关的。 - 把返回字段名叫
score就当成相似度。 有些库的score里装的是 L2 距离。接新库时先拿一条相关、一条无关各查一次,看哪个数值更大。 - 跨配置比较相似度分数。 换了 chunk_size、换了模型、换了 metric,分数就不在同一刻度上了。实测同一段文本,chunk_size=15 时 Top1 分数 0.2390、=300 时只有 0.1386,而后者才是对的那块。别抄别人的阈值经验值。
⚠️ 四、选型
- 无脑选最高维度。 3072 维比 512 维贵 6 倍,内存、磁盘、计算一起贵;效果不会跟着贵 6 倍。百万级库上,这是实打实的服务器账单。
- 学习阶段就上 Milvus、Weaviate。 装两天、调一天连接,效果不好时分不清是切分、模型还是索引参数的锅。学习阶段 FAISS 或 Chroma 二选一。
- 先看榜单再找理由。 正确顺序是:先写死硬性约束(要不要元数据过滤、要不要分布式、能不能起服务),用约束砍掉选项,剩下的再比。FAISS 星标 40,929 很高,但只要需求里有「按部门过滤」,它第一个出局。
- 忽略「要不要额外起服务」这条约束。 对小项目来说,多一个常驻服务就是多一份运维和故障面。
⚠️ 五、入库与维护
- 只存向量,不存原文和来源。 检索回来一堆数字,既拼不进提示词,也标不出出处。
- 不存元数据。 部门、生效日期、文档版本这些字段,入库时不写,后面想按条件过滤就只能整库重建。元数据宁可多存,存了不用的代价远小于没存。
- 资料更新时整库重建。 小库无所谓,大库很痛。入库时给每块留一个稳定 ID(文件路径 + 块序号),更新时按文档删旧增新。
- 把量化当成免费的。 int8 省 75% 空间,但确实有精度损失。小库不必量化,大库量化前先用测试集量一次命中率变化。
07自测题
点击题目展开答案;这 12 题全说得清,切分和向量化就过关了
判断一个块切得好不好,只看一件事,是哪件?
把这一块单独拿出来给一个陌生人看,他读不读得懂。开头是「……的货物编号为」、结尾是「出发地是广」这种块,无论被检索排在第几都答不出问题。块的自足性是整个 RAG 的地基。
chunk_size 从 15 调到 300 的实验里,哪一列说明「该回去改切分」而不是「该调检索」?
「库里有完整块」那一列。它是「没有」时(15/20/35 这几档),调 k、调阈值、上 Rerank、改提示词全部无效,只能改切分;它是「有」但 Top1 答不全时,才轮到检索侧调参。这两件事必须分开量。
overlap 存在的意义是什么?设成 0 会出什么事?
让被刀口切开的那句话,在相邻两块里各留一份完整的,取到哪块都读得通。实测 overlap=0 时那一块的结尾正好断在「出发地是广州,」——目的地被切到下一块;加 7 个字重叠后句子就完整了。它不是「多存几份」。
为什么 chunk_size=15 时的 Top1 分数(0.2390)反而比 300 时(0.1386)高?
块越小字越少,问题里的字在其中占比就越高,相似度被抬上去了。但这个高分毫无意义——那块内容是「为 ABC123456,发货日」,读都读不通。推论:相似度分数不能跨配置比较,别抄别人的阈值经验值。
为什么默认分隔符 ["\n\n","\n"," ",""] 在中文上会失效?
中文正文里通常一个空行都没有,空格只出现在英文单词和阿拉伯数字旁边。实测:按空行切,103 字的文本返回 1 块、原样不动;按空格切,切点全落在英文单号旁,跟句子边界毫无关系。同一套参数切英文却完全正常——这就是照抄英文教程最容易踩的一脚。
中文切分的分隔符列表应该怎么写?
按语义强弱从粗到细:["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]。递归切分器先试最粗的,切不下去再退一级,最后才硬切。把中文句号放进列表,是这一节唯一必须记住的动作。
chunk_size=500,中文和英文分别约等于多少 token?
中文约 1.29 字符/token → 约 500 token;英文约 4.00 字符/token → 约 125 token。差近 4 倍。而模型窗口和 Embedding 输入上限卡的都是 token,所以按英文经验估中文成本会少算三到四倍。
块长度超过 Embedding 模型的最大输入,会发生什么?
静默截断——不报错,超出部分从来没被编进坐标,检索永远找不到它。bge-large-zh-v1.5 和 bge-small-zh-v1.5 都卡在 512,bge-m3 是 8194,nomic-embed-text-v1.5 是 2048。定 chunk_size 之前先查这个数。
余弦、内积、L2,什么时候可以随便选,什么时候必须选余弦?
向量已归一化 → 三个排序完全一样,挑最快的(通常是内积);未归一化 → 必须选余弦。实测归一化后 u·v == cos(u,v) 误差 0.0e+00,|u−v|² == 2−2cos 误差最大 4.4e−16(浮点精度量级)。唯一会出事的组合是「未归一化 + 内积」。
接一个陌生向量库时,怎么三十秒判断返回的是相似度还是距离?
拿一条肯定相关和一条肯定无关的文本各查一次,打印分数。相关的那条数值更大就是相似度,更小就是距离。有些库的字段名叫 score,装的却是 L2 距离——阈值方向写反会把最相关的全过滤掉,而且不报错。
100 万个 chunk,3072 维比 512 维要多花多少?
向量本身 11.44 GB vs 1.91 GB,约 6 倍;暴力检索一次的乘加 30.72 亿 vs 5.12 亿,同样 6 倍。内存、磁盘、计算三样一起贵,而效果不会跟着贵 6 倍。int8 量化可以再省 75%。
向量库选型的正确顺序是什么?举一个「星标高却出局」的例子。
先写死硬性约束,用约束砍选项,剩下的再比分。FAISS 星标 40,929 排第二,但只要需求里有「按部门/时间过滤」,它第一个出局——它不支持元数据过滤。同理 Chroma 和 pgvector 在千万级分布式场景直接出局。先看榜单再找理由,一定会选错。
词术语表
| 术语 | 含义 |
|---|---|
| Embedding | 把一段文字换算成一串定长浮点数的模型;输出长度固定,与输入长短无关 |
| 维度 | Embedding 输出的浮点数个数,即语义空间的轴数;512、768、1024、1536、3072 是常见档位 |
| 最大输入 | Embedding 模型单次能接受的最大 token 数,超出部分被静默截断 |
| 归一化 | 把向量除以自身模长,变成长度为 1 的单位向量 |
| 余弦相似度 | q·d / (|q|×|d|),量的是夹角,不受向量长度影响;范围 −1~1,越大越相似 |
| 内积 / 点积 | 逐位相乘再求和;向量归一化后等于余弦,未归一化时会偏向长向量 |
| L2 距离 | 两点间直线距离,越小越相似;阈值方向与余弦相反 |
| chunk_size | 一个切块的最大长度;要先确认单位是字符还是 token |
| chunk_overlap | 相邻两块的重复长度,让被刀口切开的句子在两块里各留一份完整的 |
| 递归切分 | 按分隔符列表从粗到细依次尝试,切不下去才退到下一级,最后才硬切 |
| 元数据 | 与块一起存的结构化字段(来源、部门、日期、版本),用于检索时过滤 |
| 量化 | 把 float32 向量压成 int8 等低精度表示,省约 75% 空间,换取少量精度损失 |
| 近似索引 | HNSW、IVF 这类结构,用一点点召回率换几十倍检索速度,百万级库的必需品 |