【案例】新零售评价决策系统 · PET 数据侧
不给 BERT 换答题卡,而是把选择题改写成它练了几百万遍的填空题——模板、标签映射与一条评论的完整编码链路。
30″30 秒看懂 PET
把 BERT 想成一位只会做填空题的老师傅:他被训练了几百万道「把句子里挖掉的字补回来」的题,闭着眼都能填。可你现在要他做的是选择题——给一条用户评价,从「水果 / 酒店 / 衣服 / 平板……」十个选项里挑一个。
常规做法是给他发一张新的答题卡(一个随机初始化的分类头),让他从零学怎么涂卡。PET 的做法完全相反:不换答题卡,把选择题改写成填空题。把评价套进一句话——「这是一条__评论:苹果有点小,不过好吃。」——老师傅立刻就会了,因为这正是他练了几百万遍的题型。他在空格里填出「水果」两个字,你再把「水果」翻译回类别编号。
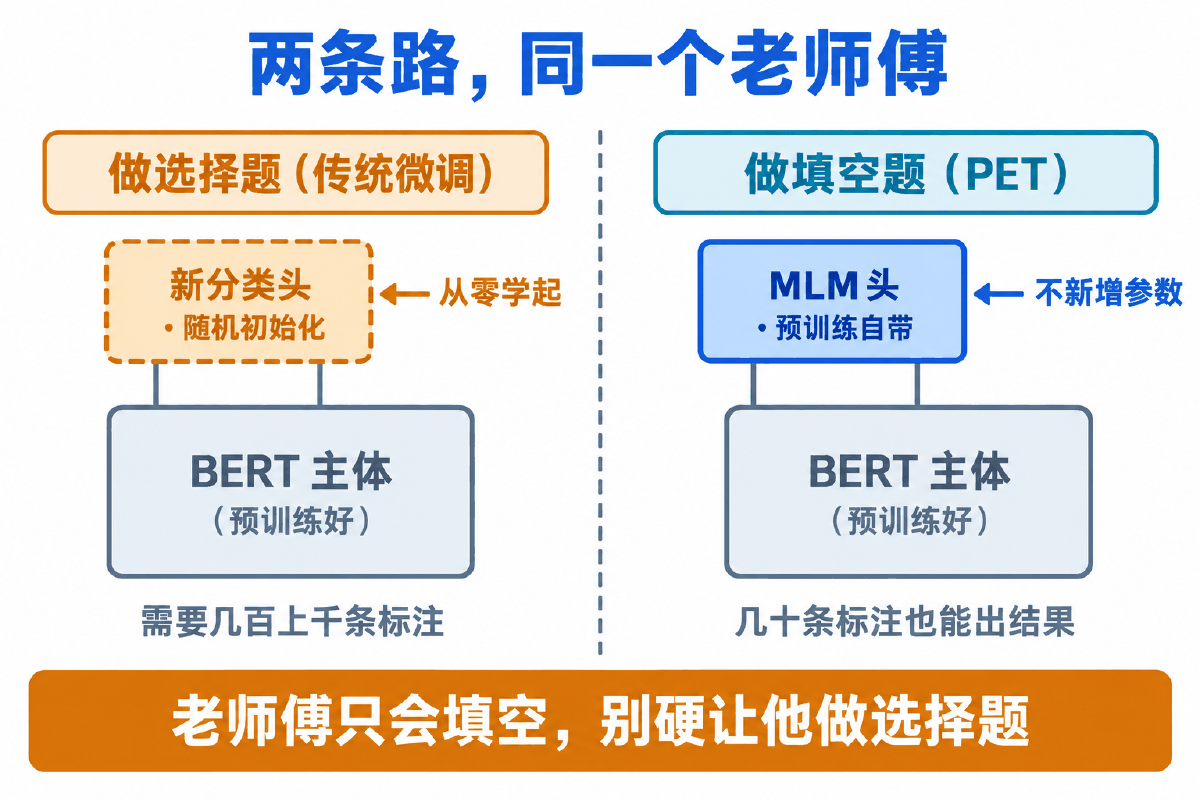
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 只会填空的老师傅 | BERT + MLM 头 | 预训练阶段练的就是MaskedLM,这个头是现成的,不是新加的 |
| 把选择题改写成填空题 | Pattern(模板) | 一句带 {MASK} 占位符的话,把原始评论包进去 |
| 空格 | [MASK] token | 模型在这个位置输出整个词表上的概率分布 |
| 把「水果」翻译回类别 | Verbalizer(标签映射) | 标签词 ↔ 类别的双向词典,两个方向都要用 |
| 新发的答题卡 | 随机初始化的分类头 | 传统微调的做法,PET 里压根没有这个东西 |
01概念
PET 是什么、为什么样本少的时候它更管用、它和你熟悉的几种做法差在哪
定义与由来
PET 是 Pattern-Exploiting Training 的缩写,中文常译作「模式利用训练」。它的核心主张只有一句话:不要改造模型去适配任务,而是改造任务去适配模型。
具体到实现,一个 PET 任务由两样东西定义:
- Pattern(模板)——一个把原始输入包装成完形填空题的句式。本讲用的是
这是一条{MASK}评论:{textA}。 - Verbalizer(标签映射)——把类别标签与自然语言词绑定的词典。类别「水果」绑定标签词「水果、苹果、香蕉、葡萄……」。
两者合称 PVP(Pattern-Verbalizer Pair)。换任务时改的是这两个文件,训练代码一行不动——这一点在后面的骨架模板里会反复用到。
为什么样本少的时候它更管用
传统微调要在 BERT 顶上接一个 (hidden_size, num_labels) 的线性层。以 bert-base-chinese 为例,hidden_size=768,十分类就是 768×10+10 = 7690 个随机初始化的参数。这些参数对任务一无所知,要靠标注数据从零教。几十条样本喂给它,学到的基本是噪声。
PET 用的 MLM 头不是新的。它在预训练阶段就和整个 BERT 一起被优化过,输出层直接连着 21128 个词的词表,而且「这是一条 __ 评论」这种句式本身就在预训练语料里大量出现过。模型不是在学一个新任务,而是在一个它已经很熟的任务上做微小的偏好调整。
和邻近概念的区别
| 做法 | 新增可训练参数 | 要不要标注数据 | 适用场景 |
|---|---|---|---|
| 传统微调 (分类头) | 一个线性层,随机初始化 | 要,且越多越好 | 标注充足(几千条起),类别语义抽象、写不出好模板 |
| PET | 无 | 要,但几十条就能起步 | 标注稀缺,类别有直白的自然语言名字 |
| P-Tuning | 几个伪 token 的 embedding | 要,几十条起步 | 模板不好写、类别抽象时替代 PET |
| Zero-shot 提示 | 无 | 不要 | 快速验证想法;准确率通常低于有监督方案 |
| In-Context Learning | 无 | 要几条做示例 | 大模型场景;BERT 这类小模型用不了 |
再强调一条容易混的边界:PET 不是 prompt engineering。 提示工程是在推理时调措辞,模型权重不变;PET 会真刀真枪地反向传播、更新 BERT 的全部参数。模板只是输入的组织方式,不是替代训练的手段。
这套方案在业务里解决什么问题
新零售场景下,用户评价按商品大类分流后要走不同的处理链路:生鲜类评价里的「不新鲜」要触发供应链预警,酒店类评价里的「隔音差」要进物业工单,电器类评价里的「发烫」要进质量追溯。分流第一步就是把评价打上类别标签。
难点在于:新开一个品类时,人工标注最多能给出几十条。等攒够几千条再上模型,业务早就跑过去了。PET 让这套分流器能在几十条标注上先跑起来,随着数据积累再迭代——这才是它在工程上真正的价值。
02原理:一条评论怎么变成一个类别
五个环节,每一个环节都有一个具体的数据形态,盯着形状看就不会晕
老师傅要答题,题目得先送到他手上。从原始评论到最终类别,中间要过五道手。这一节只讲数据怎么流动,不涉及训练——训练是下一页的事。
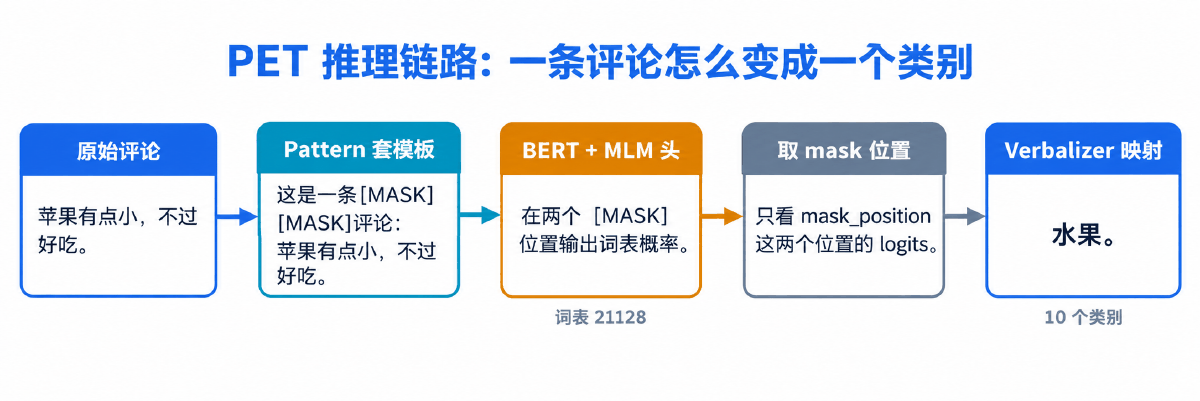
① 原始数据长什么样
训练文件是纯文本,一行一条,标签在前、制表符分隔、正文在后:
电脑	(1)这款笔记本外观感觉挺漂亮的,分量吗,对我来说不算沉。 (2)安装了WindowsXP系统后,运行的速度挺快。发热量没有想象中那么大。可能尚未运行很耗资源的程序,没有感到内存的弊病。不过,1G的内存确实有点小。 (3)附赠的包很不错,挺有手感的。但是附赠的鼠标实在是太小了,幸好同时订了一个双飞燕的鼠标哟。
水果	什么苹果啊,都没有苹果味,怪怪的味道,而且一点都不甜,超级难吃!
平板	价格便宜送货快,质量挺好的
书籍	当时是因为要写读书报告 所以上网到处抄 就发现这本书感觉以前自己没看过中文版的骆驼祥子就看过电影所以决定买个英文的看看本来以为 是中文翻译过来的 不会太地道结果 令我惊讶翻译的非常好!忠实了原著!很多很多复杂的复合句 而且 用词也很得体觉得 是个 非常不错的拓宽知识面的一本小说推荐!
水果	很差的果,表面色泽就已经看到不新鲜啦,跟图片相比,简直一个天一个地,还有烂果,果大细不一致,小到哭。
衣服	垃圾 垃圾垃圾
衣服	外表跟图片不太像,而且号码偏大一些,穿着宽松而且裤腿不是很长,除了穿着暖和外还凑合吧,可能我个人试着不太合适
衣服	不好看,不值这个价钱
酒店	房间超级小,根本就不值688元的价格,特别是在广州这样一个酒店业十分发达的城市,酒店服务差,入住登记时强调要安静的房间,结果还是给安排在了电梯口。两百米范围内的芸莱斯堡,房价比这便宜,房间也比这大,环境也强很多。打算住两晚的,只住一晚凑合下。下次再也不会选择这家了。
水果	脆脆的,甜味可以,可能时间有点长了,水分不是很足。
平板	华为机器肯定不错,但第一次碰上京东最糟糕的服务,以后不想到京东购物了。
书籍	为什么不认真的检查一下, 发这么一本脏脏的书给顾客呢!
衣服	手感不错,用料也很好,不知道水洗后怎样,相信大品牌,质量过关,五星好评!!!
蒙牛	蒙牛除了会造假和抄袭,还会别的不?你妈还纯甄来。
水果	苹果有点小,不过好吃,还有几个烂的。估计是故意的放的。差评。
酒店	房间很宽敞,大床实在是很大,两个大人带个小孩睡着一点儿也不挤,打扫也很干净。站在海景房的阳台上任海风拂面真是很惬意。早餐内容也很丰富,不过性价比不高。但除此之外,就不能要求更多。送餐的食物实在是有失水准,晚上的露天烧烤除了暴贵之外,没留下其它印象。
平板	靠,才到就降价很不爽啊啊啊啊啊啊啊啊啊啊啊啊啊啊啊啊啊啊啊啊啊啊啊!!!!!!!
衣服	帮自己的亲亲老公买的 衣裤子摸起来很舒服 老公穿起来帅帅哒 他很喜欢 很满意 我心里也感觉很高兴?? 喜欢的帅哥美女们 快快下手咯
酒店	是华苑产业园区唯一的酒店,虽说有3星,但总体感觉也就比快捷酒店好一点。
衣服	京东快递很快,就快递可以,其他就很普通。
这套格式的三个硬性要求:
- 分隔符是制表符
\t,不是空格也不是逗号。正文里出现空格和逗号是常事,用它们分隔必然出错。 - 标签在前。正文里可能含制表符残留,用
split('\t', 1)只切第一刀,正文里的制表符就不会把行切碎。 - 一行一条,正文里不能有换行。多行评论要先把换行替换成空格或特殊符号。
本讲的数据集:训练集 63 条、验证集 590 条、共 10 个类别。验证集反而比训练集大十倍——这在小样本场景里很正常:标注预算优先花在「能把模型测准」上,而不是「多喂几条」。
② 模板:把评论套进填空题
模板存在一个单独的文件里,整个项目只有一行:
这是一条{MASK}评论:{textA}。
两个占位符各有分工:{MASK} 是要模型填的空,{textA} 是原始评论的落位。解析器扫一遍这个字符串,把它拆成一个有序的片段列表:
# -*- coding:utf-8 -*-
"""模板解析器的最小验证:不依赖 torch / transformers,直接跑就能看结果。

为什么要单独写这个脚本:HardTemplate.prompt_analysis() 是纯字符串处理,
它出错时的表现往往是「模型训练不收敛」,隔了好几层才暴露。
把它单独拎出来用断言钉死,模板一改就能立刻验证。
"""


def parse_prompt(prompt: str):
    """与 HardTemplate.prompt_analysis() 完全相同的逻辑,去掉了类的外壳。"""
    inputs_list, custom_tokens = [], set()
    idx = 0
    while idx < len(prompt):
        str_part = ''
        if prompt[idx] not in ['{', '}']:
            inputs_list.append(prompt[idx])
        if prompt[idx] == '{':
            idx += 1
            while prompt[idx] != '}':
                str_part += prompt[idx]
                idx += 1
        elif prompt[idx] == '}':
            raise ValueError("模板里有不成对的 '}'")
        if str_part:
            inputs_list.append(str_part)
            custom_tokens.add(str_part)
        idx += 1
    return inputs_list, custom_tokens


def fill(prompt: str, values: dict, mask_length: int):
    """把占位符替换成真值,返回送进 tokenizer 之前的那句话。"""
    inputs_list, custom_tokens = parse_prompt(prompt)
    out = ''
    for value in inputs_list:
        if value in custom_tokens:
            out += values['MASK'] * mask_length if value == 'MASK' else values[value]
        else:
            out += value
    return out


if __name__ == '__main__':
    p = '这是一条{MASK}评论:{textA}。'
    inputs_list, custom_tokens = parse_prompt(p)
    print('拆开结果:', inputs_list)
    print('占位符  :', sorted(custom_tokens))

    # 断言一:占位符必须被整体识别,不能被拆成单个字符
    assert 'MASK' in inputs_list and 'textA' in inputs_list
    assert 'M' not in inputs_list, '占位符被逐字符拆开了,说明大括号没吃干净'

    # 断言二:mask_length=2 时必须出现两个连续的 [MASK]
    s = fill(p, {'textA': '苹果有点小,不过好吃。', 'MASK': '[MASK]'}, mask_length=2)
    print('填好的句子:', s)
    assert s.count('[MASK]') == 2
    assert '[MASK][MASK]' in s, '两个 [MASK] 必须连续,中间不能插字'

    # 断言三:换模板只影响这句话的长相,占位符语义不变
    p2 = '评论:{textA} 它属于{MASK}类。'
    s2 = fill(p2, {'textA': '掉色掉得厉害', 'MASK': '[MASK]'}, mask_length=2)
    print('换个模板  :', s2)
    assert s2.startswith('评论:') and s2.count('[MASK]') == 2

    # 断言四:模板写坏了要当场报错,而不是默默产出怪句子
    try:
        parse_prompt('这是一条 MASK}评论')
        raise SystemExit('应该报错却没有报错')
    except ValueError as e:
        print('坏模板被拦下:', e)

    print('全部断言通过')
解析的结果不是一句话,而是一份「每个位置放什么」的施工图:哪几个位置是固定文字、哪几个位置留给 mask、哪几个位置塞正文。真正编码时按图施工。
{MASK} 在第几个字符,编码后 [MASK] 就在第几个 token——这个对应关系只在「模板前缀全是单字符 token」时才成立。稳妥做法是在拼接过程中记录下标,而不是事后用 index() 去搜。评论正文里真出现「[MASK]」四个字时,index() 会找到错的位置。
③ Verbalizer:标签词与类别的双向词典
模型在 mask 位置吐出的是词,不是类别编号。这中间需要一张映射表:
电脑	电脑
水果	水果,苹果,香蕉,榴莲,西瓜
平板	平板
衣服	衣服
酒店	酒店
洗浴	洗浴
书籍	书籍
蒙牛	蒙牛
手机	手机
电器	电器
格式是「主标签 \t 子标签1,子标签2,...」。主标签是最终输出的类别名,子标签是这个类别下所有可以接受的词。两个方向都要用到:
| 方向 | 什么时候用 | 做什么 |
|---|---|---|
| 主 → 子 | 训练时 | 标签「水果」展开成所有子标签的 token id,算损失时每个子标签都算一遍 |
| 子 → 主 | 推理时 | 模型填出「苹果」,翻回主标签「水果」作为最终答案 |
子标签机制解决的是「同一个类别有多种说法」。用户说「这个苹果不错」,模型在 mask 位置更可能填「苹果」而不是「水果」——如果只认「水果」两个字,这条就判错了。多准备几个同义词,命中率立刻上去。
# -*- coding:utf-8 -*-
"""标签词映射表的解析与使用:纯标准库,可直接运行。

verbalizer.txt 每行是「主标签 <TAB> 子标签1,子标签2,...」。
一对多映射的意义:模型在 [MASK] 位置更容易吐出「苹果」而不是抽象的「水果」,
那就把「苹果」挂到「水果」名下,预测到任一子标签都算命中主标签。
"""
import io


DEMO_FILE = """电脑\t电脑,笔记本
水果\t水果,苹果,香蕉,榴莲
平板\t平板
衣服\t衣服,外套,裤子
酒店\t酒店,宾馆
"""


def load_label_dict(fp) -> dict:
    """读成 {主标签: [子标签...]} 。用 dict.fromkeys 去重而不是 set,保持顺序稳定。"""
    label_dict = {}
    for line in fp:
        line = line.strip()
        if not line:
            continue
        label, sub_labels = line.split('\t')
        label_dict[label] = list(dict.fromkeys(sub_labels.split(',')))
    return label_dict


def find_main_label(label_dict: dict, sub_label: str):
    """由子标签反查主标签;查不到返回 None,交给调用方决定怎么兜底。"""
    for main, subs in label_dict.items():
        if sub_label in subs:
            return main
    return None


def longest_common_substring(a: str, b: str):
    """最长公共子串长度。子标签没命中时用它做「最像哪个主标签」的兜底匹配。"""
    best = 0
    table = [[0] * (len(b) + 1) for _ in range(len(a) + 1)]
    for i, ca in enumerate(a):
        for j, cb in enumerate(b):
            if ca == cb:
                table[i + 1][j + 1] = table[i][j] + 1
                best = max(best, table[i + 1][j + 1])
    return best


def hard_mapping(label_dict: dict, sub_label: str):
    """模型吐了个词表里有、映射表里没有的词时,挑重合度最高的主标签。"""
    best_label, best_score = None, -1
    for main in label_dict:
        score = longest_common_substring(sub_label, main)
        if score > best_score:
            best_label, best_score = main, score
    return best_label


if __name__ == '__main__':
    label_dict = load_label_dict(io.StringIO(DEMO_FILE))
    print('主标签数量:', len(label_dict))
    for k, v in label_dict.items():
        print('  %-4s -> %s' % (k, v))

    # 一对多映射:命中任一子标签都归到同一个主标签
    assert find_main_label(label_dict, '苹果') == '水果'
    assert find_main_label(label_dict, '香蕉') == '水果'
    assert find_main_label(label_dict, '宾馆') == '酒店'
    print('一对多映射校验通过')

    # 没收录的词走兜底
    assert find_main_label(label_dict, '手机') is None
    print('未收录词 手机 -> 兜底到:', hard_mapping(label_dict, '手机'))
    print('未收录词 笔记 -> 兜底到:', hard_mapping(label_dict, '笔记'))

    # 一条硬性前提:子标签的字数要和 [MASK] 个数配得上。
    # max_label_len=2 时,「笔记本」会被截成「笔记」,映射表里就别指望它原样命中。
    max_label_len = 2
    too_long = [s for subs in label_dict.values() for s in subs if len(s) > max_label_len]
    print('超过 %d 个字、会被截断的子标签: %s' % (max_label_len, too_long))
    assert '笔记本' in too_long
    print('全部断言通过')
④ 编码:从字符串到张量
这一步把施工图变成模型能吃的四个数组。以模板 这是一条{MASK}评论:{textA}。、max_label_len=2 为例,一条评论编码后是这样:
| 字段 | 形状 | 内容 |
|---|---|---|
input_ids | (batch, max_seq_len) | 套完模板的完整序列,mask 位置放 tokenizer.mask_token_id |
token_type_ids | (batch, max_seq_len) | 单句任务全 0 |
attention_mask | (batch, max_seq_len) | 真实 token 为 1,padding 为 0 |
mask_positions | (batch, max_label_len) | 每个 [MASK] 在序列里的下标,算损失时只看这几个位置 |
mask_labels | (batch, max_label_len) | 标签的 token id,不足补 pad,超长截断 |
下面这个脚本把「一条评论 → 五个数组」的全过程摊开,每一步都带断言,形状不对当场就炸:
# -*- coding:utf-8 -*-
"""mask 位置是怎么算出来的:纯标准库复刻,可直接运行。

真实代码里这一步是 np.where(input_ids == 103)。这里用普通列表复刻同样的逻辑,
重点验证三件事:位置随模板长度变化、两个 mask 必须相邻、截断会把 mask 挤掉。
"""

MASK_ID = 103   # 中文 BERT 词表里 [MASK] 的 id
CLS_ID = 101
SEP_ID = 102
PAD_ID = 0


def fake_encode(template_prefix_len: int, mask_num: int,
                tail_len: int, content_len: int, max_seq_len: int):
    """模拟 "这是一条[MASK][MASK]评论:<正文>。" 这类模板编码后的 input_ids。

    参数:
        template_prefix_len: [MASK] 之前的模板字数("这是一条" = 4)
        mask_num:            [MASK] 个数
        tail_len:            [MASK] 之后、正文之前的模板字数("评论:" = 3)
        content_len:         正文字数
    """
    ids = [CLS_ID]
    ids += [1000 + i for i in range(template_prefix_len)]   # 模板前半段
    ids += [MASK_ID] * mask_num
    ids += [2000 + i for i in range(tail_len)]              # 模板后半段
    ids += [3000 + i for i in range(content_len)]           # 正文
    ids += [SEP_ID]
    ids = ids[:max_seq_len]                                 # 超长截断,和 truncation=True 一致
    ids += [PAD_ID] * (max_seq_len - len(ids))              # 不足补齐
    return ids


def find_mask_positions(ids):
    """等价于 np.where(np.array(ids) == MASK_ID)[0].tolist()。"""
    return [i for i, t in enumerate(ids) if t == MASK_ID]


if __name__ == '__main__':
    # 模板 "这是一条{MASK}评论:{textA}。",mask_length=2
    ids = fake_encode(template_prefix_len=4, mask_num=2, tail_len=3,
                      content_len=10, max_seq_len=64)
    pos = find_mask_positions(ids)
    print('模板「这是一条[MASK][MASK]评论:…」的 mask 位置:', pos)
    # [CLS] 占 0,"这是一条" 占 1~4,所以两个 mask 落在 5 和 6
    assert pos == [5, 6]
    assert pos[1] - pos[0] == 1, '两个 mask 必须相邻'

    # 换个模板:mask 挪到最前面,位置立刻变成 1 和 2
    ids2 = fake_encode(template_prefix_len=0, mask_num=2, tail_len=3,
                       content_len=10, max_seq_len=64)
    print('模板「[MASK][MASK]评论:…」的 mask 位置:', find_mask_positions(ids2))
    assert find_mask_positions(ids2) == [1, 2]

    # 危险场景:正文很长 + max_seq_len 很小,模板被截断
    ids3 = fake_encode(template_prefix_len=4, mask_num=2, tail_len=3,
                       content_len=200, max_seq_len=16)
    pos3 = find_mask_positions(ids3)
    print('max_seq_len=16 且正文很长时的 mask 位置:', pos3)
    assert pos3 == [5, 6], '这个模板把 mask 放在句首附近,截断的是尾巴,mask 活下来了'

    # 真正会出事的模板:把 {MASK} 放在正文后面
    ids4 = [CLS_ID] + [3000 + i for i in range(200)] + [MASK_ID, MASK_ID] + [SEP_ID]
    ids4 = ids4[:16] + [PAD_ID] * max(0, 16 - len(ids4[:16]))
    pos4 = find_mask_positions(ids4)
    print('模板把 mask 放在长正文之后,截断后的 mask 位置:', pos4)
    assert pos4 == [], 'mask 被截没了——后面取 logits 时会直接报越界或算错'

    print('全部断言通过')
⑤ 标签编码:两个字的硬约束
max_label_len=2 这个配置项看着不起眼,它其实规定了「所有类别名必须能压进两个 token」。十个类别里有「笔记本」这种三字词时,它会被安静地截成「笔记」——不报错、不警告,只是准确率莫名其妙地差一截。
# -*- coding:utf-8 -*-
"""标签怎么变成 mask_labels:截断、补齐与长度一致性。纯标准库,可直接运行。

mask_labels 的长度必须恒等于 mask 个数,否则一个 batch 里形状对不齐,
default_data_collator 拼张量时会当场报错。
"""

PAD_ID = 0

# 手写一份「字 -> id」的小词表,模拟 tokenizer 的行为
FAKE_VOCAB = {
    '水': 3717, '果': 3362, '手': 2797, '机': 3322, '平': 2398, '板': 3352,
    '衣': 6132, '服': 6302, '酒': 6983, '店': 2421, '笔': 5011, '记': 6381, '本': 3315,
}


def fake_tokenize(text: str):
    """模拟 tokenizer(text)['input_ids']:首尾各加一个特殊 token。"""
    return [101] + [FAKE_VOCAB[c] for c in text] + [102]


def encode_label(label: str, mask_length: int):
    """与 data_preprocess.py 里那三行完全一致的逻辑。"""
    ids = fake_tokenize(label)[1:-1]                      # 掐头去尾
    ids = ids[:mask_length]                               # 长了截断
    ids = ids + [PAD_ID] * (mask_length - len(ids))       # 短了补齐
    return ids


if __name__ == '__main__':
    mask_length = 2

    # 正常情况:两个字正好两个 id
    assert encode_label('水果', 2) == [3717, 3362]
    assert encode_label('酒店', 2) == [6983, 2421]
    print('两字标签:', encode_label('水果', 2), encode_label('酒店', 2))

    # 三个字的标签被截成两个字——「笔记本」变成「笔记」
    cut = encode_label('笔记本', 2)
    print('三字标签被截断:', cut, '(丢掉了「本」的 id 3315)')
    assert cut == [5011, 6381]

    # 一个字的标签被 pad 补齐;pad 位置在算损失时要先剔除
    FAKE_VOCAB['书'] = 741
    one = encode_label('书', 2)
    print('单字标签被补齐:', one)
    assert one == [741, PAD_ID]

    # 不管标签几个字,出来的长度恒等于 mask 个数——这是能拼 batch 的前提
    for label in ['水果', '笔记本', '书']:
        assert len(encode_label(label, mask_length)) == mask_length
    print('长度一致性校验通过:全部为', mask_length)

    # 反过来:改 mask 个数就要重新审一遍标签表
    print('mask_length=3 时:', encode_label('笔记本', 3))
    assert encode_label('笔记本', 3) == [5011, 6381, 3315]
    print('全部断言通过')
03最小代码:把一条评论编码出来
剥掉配置、日志、异常处理,只剩最短的一条路
先把最短的路走通再去看全套工程代码。下面这段不训练、不加载数据集,只做一件事:拿一条评论,套上模板,编码成模型能吃的张量,并把 mask 位置打印出来。跑通它,PET 的数据侧就懂了一半。
# -*- coding:utf-8 -*-
"""硬模板类:把一句评论套进人工写好的模板,并算出 [MASK] 落在第几个位置。

这个类做两件事,缺一不可:
  1. 解析模板字符串,把 "{MASK}" "{textA}" 这类占位符拆出来;
  2. 填好占位符、交给 tokenizer 编码,再把 [MASK] 的下标找出来。
第 2 步的 mask_position 是整条 PET 链路的关键——损失只在这几个位置上算。
"""
import numpy as np


class HardTemplate(object):
    """人工定义句子与 [MASK] 之间位置关系的模板。"""

    def __init__(self, prompt: str):
        """
        参数:
            prompt: 模板字符串,例如 "这是一条{MASK}评论:{textA}。"
        """
        self.prompt = prompt
        self.inputs_list = []        # 模板拆开后的逐项列表
        self.custom_tokens = set()   # 模板里出现过的占位符名字
        self.prompt_analysis()

    def prompt_analysis(self):
        """把模板字符串拆成「普通字符」与「占位符」两类。

        "这是一条{MASK}评论:{textA}。"
          -> inputs_list = ['这','是','一','条','MASK','评','论',':','textA','。']
          -> custom_tokens = {'MASK', 'textA'}
        拆成逐字符的列表是为了后面能按原顺序拼回去,同时把占位符整体替换掉。
        """
        idx = 0
        while idx < len(self.prompt):
            str_part = ''
            # 普通字符:原样收进列表
            if self.prompt[idx] not in ['{', '}']:
                self.inputs_list.append(self.prompt[idx])
            # 遇到左括号:一路吃到右括号,中间的内容就是占位符名
            if self.prompt[idx] == '{':
                idx += 1
                while self.prompt[idx] != '}':
                    str_part += self.prompt[idx]
                    idx += 1
            # 单独出现的右括号说明模板写错了,直接报错比默默跑出怪结果强
            elif self.prompt[idx] == '}':
                raise ValueError("模板里有不成对的 '}',检查 prompt 写法。")
            if str_part:
                self.inputs_list.append(str_part)
                self.custom_tokens.add(str_part)
            idx += 1

    def __call__(self, inputs_dict: dict, tokenizer, mask_length, max_seq_len=512):
        """把一条样本套进模板并编码。

        参数:
            inputs_dict: 占位符取值,例如 {"textA": "这个手机也太卡了", "MASK": "[MASK]"}
            tokenizer:   BERT 的分词器
            mask_length: [MASK] 要重复几个,等于标签字数
        返回:
            dict,含 text / input_ids / token_type_ids / attention_mask / mask_position
        """
        outputs = {
            'text': '',
            'input_ids': [],
            'token_type_ids': [],
            'attention_mask': [],
            'mask_position': [],
        }

        # 按 inputs_list 的顺序拼回一整句:占位符换成真值,普通字符原样接上
        str_formated = ''
        for value in self.inputs_list:
            if value in self.custom_tokens:
                if value == 'MASK':
                    # 标签有几个字,就放几个 [MASK],位置必须连续
                    str_formated += inputs_dict['MASK'] * mask_length
                else:
                    str_formated += inputs_dict[value]
            else:
                str_formated += value

        # padding='max_length' 让一个 batch 里所有样本等长,truncation 防止超过 512 报错
        encoded = tokenizer(text=str_formated,
                            padding='max_length',
                            max_length=max_seq_len,
                            truncation=True)

        outputs['input_ids'] = encoded['input_ids']
        outputs['token_type_ids'] = encoded['token_type_ids']
        outputs['attention_mask'] = encoded['attention_mask']
        outputs['text'] = ''.join(tokenizer.convert_ids_to_tokens(encoded['input_ids']))

        # 找 [MASK] 的下标:先拿到 [MASK] 的 token id(中文 BERT 里是 103),
        # 再在 input_ids 里搜它出现的所有位置。不要用模板字符串的字符下标去数,
        # 因为 tokenizer 会插入 [CLS],中英文混排时切词结果也不是一字一 token。
        mask_token_id = tokenizer.convert_tokens_to_ids(['[MASK]'])[0]
        mask_position = np.where(np.array(outputs['input_ids']) == mask_token_id)[0].tolist()
        outputs['mask_position'] = mask_position
        return outputs


if __name__ == '__main__':
    from transformers import AutoTokenizer

    from pet_config import ProjectConfig

    pc = ProjectConfig()
    tokenizer = AutoTokenizer.from_pretrained(pc.pre_model)
    hard_template = HardTemplate(prompt='这是一条{MASK}评论:{textA}。')
    print('拆开的模板:', hard_template.inputs_list)
    print('占位符    :', hard_template.custom_tokens)

    out = hard_template(
        inputs_dict={'textA': '包装不错,苹果挺甜的,个头也大。', 'MASK': '[MASK]'},
        tokenizer=tokenizer,
        mask_length=2,
        max_seq_len=30,
    )
    print('拼好的文本:', out['text'])
    print('mask 位置 :', out['mask_position'])
这个类只有两个方法值得细看:
get_template_result()把模板字符串扫成片段列表。扫描是一次性的,构造时做完,之后每条样本都复用这份施工图,不必重复解析。__call__()按施工图拼出最终的 token 列表,同时返回 mask 的下标。下标和序列是一起产出的,从根上避免了「事后去找 mask 在哪」这个隐患。
这是一条{MASK}评论:{textA}。 写进代码里当然也能跑。单独存文件的收益在于:训练脚本和推理脚本读的是同一份文件。模板改了一个字,两边同时生效。写死在代码里,迟早出现「训练用 A 模板、推理用 B 模板」的事故,而这种事故不报错,只掉准确率。
把模板类接上 tokenizer,就得到完整的编码函数:
# -*- coding:utf-8 -*-
"""把「标签\t评论」的一行文本,变成模型能吃的一组张量。

一条样本要产出五样东西:
  input_ids / token_type_ids / attention_mask  —— 套好模板后的编码
  mask_positions                               —— [MASK] 落在第几个位置
  mask_labels                                  —— 标签字的 token id,用来算损失
推理阶段没有标签,mask_labels 就不产出,其余四样完全一致。
"""
from functools import partial

import numpy as np
import torch

from hard_template import HardTemplate


def convert_example(examples: dict,
                    tokenizer,
                    max_seq_len: int,
                    mask_length: int,
                    hard_template: HardTemplate,
                    train_mode: bool = True,
                    return_tensor: bool = False) -> dict:
    """批量转换。

    参数:
        examples: {"text": ['水果\t脆脆的,甜味可以', '平板\t价格便宜送货快', ...]}
        mask_length: [MASK] 的个数,等于配置里的 max_label_len
        train_mode: True 时按 \t 切出标签;False 时整行都是待预测正文
    返回:
        dict,每个值是 np.ndarray(或 return_tensor=True 时的 LongTensor)
    """
    tokenized_output = {
        'input_ids': [],
        'token_type_ids': [],
        'attention_mask': [],
        'mask_positions': [],
        'mask_labels': [],
    }

    for example in examples['text']:
        label = ''
        if train_mode:
            # 只按第一个制表符切,评论正文里再出现制表符也不会被切坏
            label, content = example.strip().split('\t', 1)
        else:
            content = example.strip()

        # 交给模板:占位符填值 + 编码 + 定位 [MASK]
        encoded_inputs = hard_template(
            inputs_dict={'textA': content, 'MASK': '[MASK]'},
            tokenizer=tokenizer,
            max_seq_len=max_seq_len,
            mask_length=mask_length,
        )
        tokenized_output['input_ids'].append(encoded_inputs['input_ids'])
        tokenized_output['token_type_ids'].append(encoded_inputs['token_type_ids'])
        tokenized_output['attention_mask'].append(encoded_inputs['attention_mask'])
        tokenized_output['mask_positions'].append(encoded_inputs['mask_position'])

        if train_mode:
            # 标签「水果」-> [101, 3717, 3362, 102],掐头去尾只留正文两个 id
            label_encoded = tokenizer(text=[label])['input_ids'][0][1:-1]
            # 比 mask 个数长就截断(「笔记本」只留「笔记」)
            label_encoded = label_encoded[:mask_length]
            # 比 mask 个数短就用 pad 补齐,保证同一批里形状一致
            label_encoded = label_encoded + [tokenizer.pad_token_id] * (mask_length - len(label_encoded))
            tokenized_output['mask_labels'].append(label_encoded)

    # 推理阶段没有 mask_labels,留着空列表会让 np.array 产出 shape (0,),干脆删掉
    if not train_mode:
        tokenized_output.pop('mask_labels')

    for k, v in tokenized_output.items():
        tokenized_output[k] = torch.LongTensor(v) if return_tensor else np.array(v)
    return tokenized_output


if __name__ == '__main__':
    from datasets import load_dataset
    from transformers import AutoTokenizer

    from pet_config import ProjectConfig

    pc = ProjectConfig()
    tokenizer = AutoTokenizer.from_pretrained(pc.pre_model)
    hard_template = HardTemplate(prompt='这是一条{MASK}评论:{textA}。')

    # 先用手写的两条样本试,形状对了再上整个数据集
    examples = {'text': ['手机\t这个手机也太卡了。', '水果\t苹果有点小,不过好吃。']}
    out = convert_example(examples, tokenizer,
                          max_seq_len=30, mask_length=2, hard_template=hard_template)
    for k, v in out.items():
        print('%-15s %s' % (k, v.shape))
    print('mask_positions:', out['mask_positions'])
    print('mask_labels   :', out['mask_labels'])

    # partial 把不变的参数固定住,剩下的签名正好符合 datasets.map 的要求
    convert_func = partial(convert_example,
                           tokenizer=tokenizer,
                           hard_template=hard_template,
                           max_seq_len=pc.max_seq_len,
                           mask_length=pc.max_label_len)
    dataset = load_dataset('text', data_files=pc.train_path)
    dataset = dataset.map(convert_func, batched=True)
    print(dataset['train'])
这里有三个细节,每一个都对应后面易错点里的一条:
| 细节 | 代码 | 不这么写会怎样 |
|---|---|---|
| 正文长度先扣掉模板 | max_seq_len - 模板长度 - mask 长度 | 正文占满长度,mask 被 truncation 截掉,模型没地方填答案 |
| 标签先截断再补齐 | label_ids[:max_label_len] 后补 pad | 长短不一的标签没法堆成张量,default_data_collator 直接报错 |
| 推理时不切标签 | train_mode=False 分支 | 推理数据没有标签列,用 split('\t') 会抛 ValueError |
04完整案例:新零售评价分流器的数据管线
从一个目录的原始文件,到可以直接喂给训练循环的 DataLoader
场景与目录结构
业务目标:把用户评价按商品大类分流,十个类别,标注只有 63 条。工程上要交付的是一条能重跑、能换数据、能换模板的数据管线。
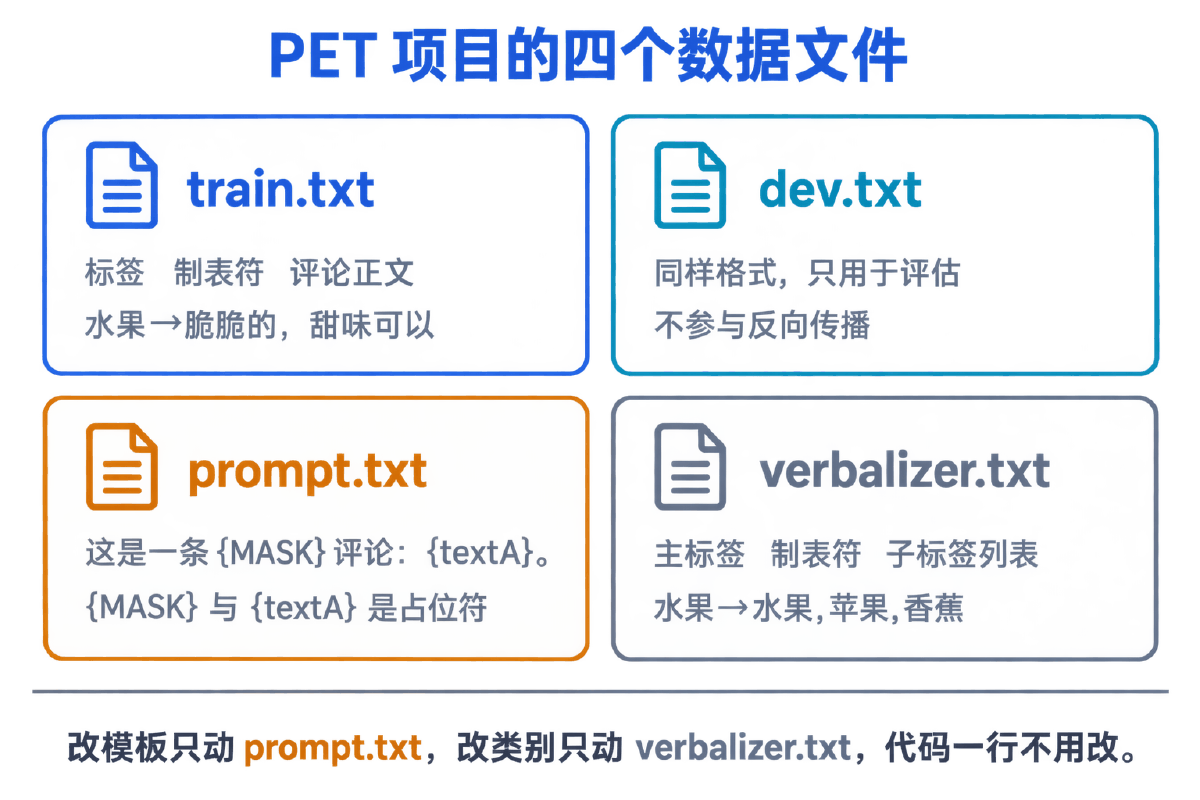
项目目录是这样组织的:
| 路径 | 角色 | 换任务时要不要改 |
|---|---|---|
data/train.txt | 训练集 | 要换 |
data/dev.txt | 验证集 | 要换 |
data/prompt.txt | 模板 | 要改 |
data/verbalizer.txt | 标签映射 | 要改 |
pet_config.py | 全部超参数 | 调几个数 |
data_handle/ | 编码与 DataLoader | 不改 |
utils/ | 损失、评估、映射 | 不改 |
train.py / inference.py | 训练与推理入口 | 不改 |
这个划分不是审美问题。「要改的」全是数据文件和几个数字,「不改的」全是代码——做到这一点,换一个业务线只需要重新标注和重写两个 txt。
第一步:配置集中管理
所有路径和超参数收在一个类里,别的模块只 import 它。这样改参数只有一个地方要动:
# coding:utf-8
"""PET 路线的项目配置:所有「不常改」的量集中在一处。

写配置类而不是把常量散落在各文件里,好处是换一次数据集、换一次底座模型,
只需要改这一个文件;train.py / inference.py / data_handle 全部从这里取值。
路径一律走环境变量 + 相对路径,换机器不用改代码。
"""
import os

import torch


class ProjectConfig(object):
    def __init__(self):
        # 训练设备:有 CUDA 就用第 0 号卡,否则退回 CPU。
        # Apple Silicon 可改成 'mps:0';写死 'cuda:0' 会让没有卡的同学直接报错。
        self.device = 'cuda:0' if torch.cuda.is_available() else 'cpu'

        # 项目根目录。默认取当前文件的上级目录,也允许用环境变量覆盖,
        # 这样同一份代码在本地和云端算力平台上都能跑,不需要改源码。
        self.root = os.environ.get(
            'PET_PROJECT_ROOT',
            os.path.dirname(os.path.abspath(__file__)),
        )

        # 底座模型:中文 BERT。它的 config 里 hidden_size=768、num_hidden_layers=12、
        # vocab_size=21128,后面算 logits 形状时要用到这几个数。
        self.pre_model = os.path.join(self.root, 'bert-base-chinese')

        # 四个数据文件。train/dev 是「标签\t正文」,prompt 是模板,verbalizer 是标签词映射。
        self.train_path = os.path.join(self.root, 'data', 'train.txt')
        self.dev_path = os.path.join(self.root, 'data', 'dev.txt')
        self.prompt_file = os.path.join(self.root, 'data', 'prompt.txt')
        self.verbalizer = os.path.join(self.root, 'data', 'verbalizer.txt')

        # ---- 训练超参数 ----
        self.max_seq_len = 512      # BERT 的 max_position_embeddings 就是 512,不能再大
        self.batch_size = 8         # 小样本任务,8 已经够;显存紧张就降到 4
        self.learning_rate = 5e-5   # BERT 微调的常用区间 2e-5 ~ 5e-5
        self.weight_decay = 0       # 权重衰减;样本极少时置 0,避免把本来就弱的信号压没
        self.warmup_ratio = 0.06    # 前 6% 的步数用来把学习率从 0 线性拉到设定值

        # 标签最大长度 = [MASK] 的个数。中文类别词基本是两个字,所以取 2。
        # 改成 3 的话,模板里就会出现三个 [MASK],verbalizer 里的词也要按 3 截断补齐。
        self.max_label_len = 2

        self.epochs = 10            # 63 条样本、batch=8,一轮 8 步,10 轮也就 80 步
        self.logging_steps = 5      # 每 5 步打一次日志
        self.valid_steps = 20       # 每 20 步在 dev 上评估一次,F1 变好才存盘

        self.save_dir = os.path.join(self.root, 'checkpoints')


if __name__ == '__main__':
    pc = ProjectConfig()
    print('device      :', pc.device)
    print('prompt_file :', pc.prompt_file)
    print('verbalizer  :', pc.verbalizer)
    print('mask 个数   :', pc.max_label_len)
几个关键数字的来历:
| 参数 | 取值 | 为什么是这个值 |
|---|---|---|
max_seq_len | 512 | BERT 的位置编码上限就是 512,再大要改模型结构 |
batch_size | 8 | 训练集只有 63 条,batch 太大一轮就没几步,梯度更新次数不够 |
learning_rate | 5e-5 | BERT 系全参微调的常用区间 2e-5 ~ 5e-5;样本少取上限,学快一点 |
max_label_len | 2 | 十个类别名都是两字词;有三字词必须调大 |
epochs | 10 | 63 条数据一轮只有 8 步,10 轮才 80 步,不多 |
valid_steps | 20 | 每 20 步验证一次,全程验证 4 次,能看出趋势又不至于太慢 |
第二步:数据体检
拿到数据先别急着训练。这个脚本统计类别分布、长度分布、标签长度,三分钟就能发现「某个类别只有 2 条」这种会毁掉整次训练的问题:
# -*- coding:utf-8 -*-
"""数据集体检:行数、类别分布、脏数据。纯标准库,训练之前先跑一遍。

小样本任务最怕两件事:类别严重不均衡、标签和正文对不上。
这两件事都不会报错,只会让指标莫名其妙地低,所以要在训练前主动查。
"""
import collections
import sys


def scan(path: str):
    """逐行检查一个「标签\t正文」格式的数据文件。"""
    counter = collections.Counter()
    bad_lines, lengths = [], []
    with open(path, 'r', encoding='utf8') as f:
        for lineno, line in enumerate(f, 1):
            line = line.rstrip('\n')
            if not line.strip():
                continue
            if '\t' not in line:
                bad_lines.append((lineno, '缺少制表符', line[:30]))
                continue
            label, content = line.split('\t', 1)
            if not content.strip():
                bad_lines.append((lineno, '正文为空', label))
                continue
            counter[label] += 1
            lengths.append(len(content))
    return counter, bad_lines, lengths


def report(path: str):
    counter, bad_lines, lengths = scan(path)
    total = sum(counter.values())
    print('文件:', path)
    print('有效样本:', total, ' 类别数:', len(counter))
    if total:
        print('类别分布(条数 / 占比):')
        for label, n in counter.most_common():
            print('  %-6s %4d  %5.1f%%' % (label, n, n * 100.0 / total))
        most, least = counter.most_common()[0][1], counter.most_common()[-1][1]
        print('最多/最少 比值: %.1f' % (most / least))
        if most / least >= 3:
            print('  警告: 类别不均衡,少数类的召回会被压低')
    if lengths:
        lengths.sort()
        print('正文长度 最短/中位/最长: %d / %d / %d'
              % (lengths[0], lengths[len(lengths) // 2], lengths[-1]))
    if bad_lines:
        print('异常行:')
        for lineno, why, sample in bad_lines[:10]:
            print('  第 %d 行 %s: %s' % (lineno, why, sample))
    else:
        print('未发现格式异常行')


if __name__ == '__main__':
    # 不给参数时跑内置的一小份样例,保证这个脚本任何时候都能直接运行
    if len(sys.argv) > 1:
        report(sys.argv[1])
    else:
        import io
        demo = ("水果\t脆脆的,甜味可以,可能时间有点长了,水分不是很足。\n"
                "平板\t华为机器肯定不错,但第一次碰上京东最糟糕的服务。\n"
                "书籍\t为什么不认真的检查一下,发这么一本脏脏的书给顾客呢!\n"
                "衣服\t手感不错,用料也很好,相信大品牌,五星好评!!!\n"
                "水果\t苹果有点小,不过好吃,还有几个烂的。\n"
                "水果\t这个苹果感觉是长熟的,没有打蜡,又甜又脆\n"
                "衣服\t掉色掉的厉害,洗一次就花了\n"
                "平板\t手机很好,就是客服垃圾\n")
        path = '/tmp/_pet_demo_train.txt'
        with io.open(path, 'w', encoding='utf8') as f:
            f.write(demo)
        report(path)
        print('\n注意最后一行:标签写的是「平板」,正文说的是「手机很好」。')
        print('这类标签与正文不符的脏数据,脚本查不出来,只能人工过一遍验证集。')
体检要看的四件事:
- 类别是不是极度不均衡。 63 条分 10 类,平均每类 6 条。某一类只有 1 条时,它在验证集上的指标毫无意义。
- 正文长度分布。 最长的那条加上模板长度有没有超
max_seq_len。超了就要么调大长度,要么接受截断。 - 标签长度。 有没有超过
max_label_len的类别名。 - 训练集与验证集的类别集合是否一致。 验证集里出现训练集没有的类别,那个类别的指标永远是 0。
第三步:编码与 DataLoader
编码函数已经在上一节写好了,这里把它接到 datasets 和 DataLoader 上:
# coding:utf-8
"""数据加载器:把 map 之后的数据集包成 DataLoader。

default_data_collator 负责把 list 拼成 tensor 并对齐一个 batch,
因为前面已经 padding 到定长,这里不需要再写自定义 collate 函数。
"""
from functools import partial

from datasets import load_dataset
from torch.utils.data import DataLoader
from transformers import AutoTokenizer, default_data_collator

from data_preprocess import convert_example
from hard_template import HardTemplate
from pet_config import ProjectConfig

pc = ProjectConfig()
tokenizer = AutoTokenizer.from_pretrained(pc.pre_model)


def get_data():
    """返回 (train_dataloader, dev_dataloader)。"""
    # 模板从文件读,不写死在代码里——换模板是调参行为,不该改源码
    with open(pc.prompt_file, 'r', encoding='utf8') as f:
        prompt = f.readlines()[0].strip()
    hard_template = HardTemplate(prompt=prompt)

    dataset = load_dataset('text', data_files={'train': pc.train_path, 'dev': pc.dev_path})
    new_func = partial(convert_example,
                       tokenizer=tokenizer,
                       hard_template=hard_template,
                       max_seq_len=pc.max_seq_len,
                       mask_length=pc.max_label_len)
    dataset = dataset.map(new_func, batched=True)

    train_dataloader = DataLoader(dataset['train'],
                                  shuffle=True,                      # 训练集必须打乱
                                  collate_fn=default_data_collator,
                                  batch_size=pc.batch_size)
    dev_dataloader = DataLoader(dataset['dev'],
                                collate_fn=default_data_collator,     # 验证集不打乱,结果可复现
                                batch_size=pc.batch_size)
    return train_dataloader, dev_dataloader


if __name__ == '__main__':
    train_dataloader, dev_dataloader = get_data()
    print('训练集批数:', len(train_dataloader))
    print('验证集批数:', len(dev_dataloader))
    for batch in train_dataloader:
        for k, v in batch.items():
            print('%-15s %-18s %s' % (k, tuple(v.shape), v.dtype))
        break
三个容易被跳过的点:
load_dataset('text', ...)把每一行读成一条{'text': '...'},标签还没切开。切分是编码函数的事。partial()把 tokenizer、模板、长度这些固定参数先绑上去,map()只传样本。不用partial就得写全局变量或者 lambda 闭包,都不如它清晰。default_data_collator负责把一批样本堆成张量。前提是每条样本的每个字段长度都一致——这就是编码阶段必须补齐的原因。
跑一遍,看输出长什么样
管线接好之后,第一件事是打印一个 batch 的形状,确认每个字段都对:
# -*- coding:utf-8 -*-
"""把「标签\t评论」的一行文本,变成模型能吃的一组张量。

一条样本要产出五样东西:
  input_ids / token_type_ids / attention_mask  —— 套好模板后的编码
  mask_positions                               —— [MASK] 落在第几个位置
  mask_labels                                  —— 标签字的 token id,用来算损失
推理阶段没有标签,mask_labels 就不产出,其余四样完全一致。
"""
from functools import partial

import numpy as np
import torch

from hard_template import HardTemplate


def convert_example(examples: dict,
                    tokenizer,
                    max_seq_len: int,
                    mask_length: int,
                    hard_template: HardTemplate,
                    train_mode: bool = True,
                    return_tensor: bool = False) -> dict:
    """批量转换。

    参数:
        examples: {"text": ['水果\t脆脆的,甜味可以', '平板\t价格便宜送货快', ...]}
        mask_length: [MASK] 的个数,等于配置里的 max_label_len
        train_mode: True 时按 \t 切出标签;False 时整行都是待预测正文
    返回:
        dict,每个值是 np.ndarray(或 return_tensor=True 时的 LongTensor)
    """
    tokenized_output = {
        'input_ids': [],
        'token_type_ids': [],
        'attention_mask': [],
        'mask_positions': [],
        'mask_labels': [],
    }

    for example in examples['text']:
        label = ''
        if train_mode:
            # 只按第一个制表符切,评论正文里再出现制表符也不会被切坏
            label, content = example.strip().split('\t', 1)
        else:
            content = example.strip()

        # 交给模板:占位符填值 + 编码 + 定位 [MASK]
        encoded_inputs = hard_template(
            inputs_dict={'textA': content, 'MASK': '[MASK]'},
            tokenizer=tokenizer,
            max_seq_len=max_seq_len,
            mask_length=mask_length,
        )
        tokenized_output['input_ids'].append(encoded_inputs['input_ids'])
        tokenized_output['token_type_ids'].append(encoded_inputs['token_type_ids'])
        tokenized_output['attention_mask'].append(encoded_inputs['attention_mask'])
        tokenized_output['mask_positions'].append(encoded_inputs['mask_position'])

        if train_mode:
            # 标签「水果」-> [101, 3717, 3362, 102],掐头去尾只留正文两个 id
            label_encoded = tokenizer(text=[label])['input_ids'][0][1:-1]
            # 比 mask 个数长就截断(「笔记本」只留「笔记」)
            label_encoded = label_encoded[:mask_length]
            # 比 mask 个数短就用 pad 补齐,保证同一批里形状一致
            label_encoded = label_encoded + [tokenizer.pad_token_id] * (mask_length - len(label_encoded))
            tokenized_output['mask_labels'].append(label_encoded)

    # 推理阶段没有 mask_labels,留着空列表会让 np.array 产出 shape (0,),干脆删掉
    if not train_mode:
        tokenized_output.pop('mask_labels')

    for k, v in tokenized_output.items():
        tokenized_output[k] = torch.LongTensor(v) if return_tensor else np.array(v)
    return tokenized_output


if __name__ == '__main__':
    from datasets import load_dataset
    from transformers import AutoTokenizer

    from pet_config import ProjectConfig

    pc = ProjectConfig()
    tokenizer = AutoTokenizer.from_pretrained(pc.pre_model)
    hard_template = HardTemplate(prompt='这是一条{MASK}评论:{textA}。')

    # 先用手写的两条样本试,形状对了再上整个数据集
    examples = {'text': ['手机\t这个手机也太卡了。', '水果\t苹果有点小,不过好吃。']}
    out = convert_example(examples, tokenizer,
                          max_seq_len=30, mask_length=2, hard_template=hard_template)
    for k, v in out.items():
        print('%-15s %s' % (k, v.shape))
    print('mask_positions:', out['mask_positions'])
    print('mask_labels   :', out['mask_labels'])

    # partial 把不变的参数固定住,剩下的签名正好符合 datasets.map 的要求
    convert_func = partial(convert_example,
                           tokenizer=tokenizer,
                           hard_template=hard_template,
                           max_seq_len=pc.max_seq_len,
                           mask_length=pc.max_label_len)
    dataset = load_dataset('text', data_files=pc.train_path)
    dataset = dataset.map(convert_func, batched=True)
    print(dataset['train'])
正常输出应当是这样的结构:input_ids 与 attention_mask 形状相同、都是 (batch, max_seq_len);mask_positions 是 (batch, max_label_len);mask_labels 同形。把 input_ids 解码回文字看一眼,能直接看出模板有没有套对、mask 有没有被截掉——这一眼比读十行日志管用。
这是一条{MASK}评论:{textA}。,正文如果本身以句号结尾,拼出来就是「……好吃。。」。这不会报错,模型也能学,但它让训练和推理的输入分布多了一处无意义的差异。要么模板去掉尾号,要么正文入库时统一去掉末尾标点——选一个,两边一致就行。
05骨架模板
换一个业务线时,复制这一份,填掉 TODO 就能开跑
前面的代码是围绕「新零售评价十分类」写的。把业务相关的部分抽掉,剩下的就是一份可以直接套到任何 PET 分类任务上的骨架。它比完整代码短,因为把一定要改的和基本不用改的分开标了出来。
# -*- coding:utf-8 -*-
"""PET 数据侧骨架模板:换一个业务场景时,改 TODO 的四处即可。

用法:
  1. 按 TODO-1 准备 train.txt / dev.txt(标签\t正文)
  2. 按 TODO-2 写 prompt.txt(一行,含 {MASK} 与 {textA})
  3. 按 TODO-3 写 verbalizer.txt(主标签\t子标签1,子标签2)
  4. 按 TODO-4 定 mask 个数,必须与标签字数对得上
  跑通这个文件 = 数据侧全部就绪,可以直接接训练脚本。
"""
import os
from functools import partial

from datasets import load_dataset
from torch.utils.data import DataLoader
from transformers import AutoTokenizer, default_data_collator

from data_preprocess import convert_example
from hard_template import HardTemplate

# TODO-1: 换成你自己的数据目录
DATA_DIR = os.environ.get('PET_DATA_DIR', './data')
PRE_MODEL = os.environ.get('PET_PRE_MODEL', './bert-base-chinese')

# TODO-2: 换成你自己的模板。{textA} 是正文位,{MASK} 是答案位。
#         答案位尽量靠前,避免长正文把它挤出截断窗口。
PROMPT = '这是一条{MASK}评论:{textA}'

# TODO-3: 换成你自己的标签词映射。左边是业务标签,右边是模型更容易吐出来的词。
VERBALIZER = {
    '正面': ['好', '赞'],
    '负面': ['差', '烂'],
}

# TODO-4: mask 个数。VERBALIZER 右侧的词有几个字,这里就填几,别混用不同字数。
MASK_LENGTH = 1

BATCH_SIZE = 8
MAX_SEQ_LEN = 256


def build_loaders():
    tokenizer = AutoTokenizer.from_pretrained(PRE_MODEL)
    hard_template = HardTemplate(prompt=PROMPT)

    dataset = load_dataset('text', data_files={
        'train': os.path.join(DATA_DIR, 'train.txt'),
        'dev': os.path.join(DATA_DIR, 'dev.txt'),
    })
    func = partial(convert_example,
                   tokenizer=tokenizer,
                   hard_template=hard_template,
                   max_seq_len=MAX_SEQ_LEN,
                   mask_length=MASK_LENGTH)
    dataset = dataset.map(func, batched=True)

    train_loader = DataLoader(dataset['train'], shuffle=True,
                              collate_fn=default_data_collator, batch_size=BATCH_SIZE)
    dev_loader = DataLoader(dataset['dev'],
                            collate_fn=default_data_collator, batch_size=BATCH_SIZE)
    return train_loader, dev_loader


def self_check():
    """上训练之前的三条硬检查,任何一条不过都别急着跑 train。"""
    # 检查一:模板必须同时含有两个占位符
    assert '{MASK}' in PROMPT and '{textA}' in PROMPT, '模板缺占位符'
    # 检查二:同一类别下的标签词字数要一致,否则截断补齐会把语义弄丢
    for label, words in VERBALIZER.items():
        lens = {len(w) for w in words}
        assert lens == {MASK_LENGTH}, '类别 %s 的标签词字数 %s 与 MASK_LENGTH=%d 不符' % (
            label, sorted(lens), MASK_LENGTH)
    # 检查三:类别之间别有重复词,否则一个词映射到两个类,评估直接失真
    seen = {}
    for label, words in VERBALIZER.items():
        for w in words:
            assert w not in seen, '标签词 %s 同时属于 %s 和 %s' % (w, seen[w], label)
            seen[w] = label
    print('模板与标签词自检通过:%d 个类别,%d 个标签词,mask 个数 %d'
          % (len(VERBALIZER), len(seen), MASK_LENGTH))


if __name__ == '__main__':
    self_check()
    # 数据文件就绪后,把下面两行取消注释即可打通数据侧
    # train_loader, dev_loader = build_loaders()
    # print(len(train_loader), len(dev_loader))
四个 TODO 的填法:
| TODO | 填什么 | 填错的典型后果 |
|---|---|---|
| TODO-1 模板 | 一句含 {MASK} 与 {textA} 的话 | 占位符拼错(比如写成 {mask})会被当成普通文字,模型没有空可填 |
| TODO-2 标签表 | 主标签与子标签 | 子标签给太少,模型填的同义词全部落到「无法解析」 |
| TODO-3 标签长度 | 最长类别名的字数 | 比实际短就静默截断;比实际长则每条样本多算几个 pad 位置的损失 |
| TODO-4 序列长度 | 按正文长度分布定 | 给小了正文被截,给大了显存白烧、训练变慢 |
check_before_train() 把前面讲的四类体检串成一个函数:标签超长、截断撞车、正文可用长度不足、类别数量极不均衡。任何一项不过就不要开始训练。这几秒钟能省下的是几小时的无效训练加一轮返工。
怎么改成二分类或多标签
| 变体 | 要改的地方 | 注意 |
|---|---|---|
| 二分类 (好评/差评) | verbalizer 写两行;模板改成这是一条{MASK}的评论:{textA} | 标签词选「好 / 差」这种模型天然会填的字,比「正面 / 负面」更容易命中 |
| 类别名是三字词 | max_label_len=3 | 所有类别的 mask 数量必须一致,短标签靠 pad 补齐 |
| 句对任务 | 模板加 {textB},编码时传两段 | token_type_ids 不再全 0,要按句子分段 |
| 多标签 | 不适合直接套 PET | 单个 mask 只能填一个答案;多标签要改成多个模板分别判断,或换回分类头 |
06易错点汇总
按「模板 / 标签 / 编码 / 数据」四类归并,全是不报错但掉指标的坑
⚠️ 一、模板
- 模板尾部的句号与正文句号撞成「。。」。 模板是
……{textA}。,正文本身多半也以句号结尾。不报错,但训练和推理的输入多了一处无意义噪声。模板去掉尾号,或正文入库时统一剥掉末尾标点,二选一。 - 把 mask 放在长正文之后。 写成
{textA},这是一条{MASK}评论看着更通顺,但正文一长,truncation 从尾部截,把 mask 整个截没了。模型在一个没有[MASK]的序列上取 mask 位置,取到的是 padding。mask 要放在正文之前。 - 训练和推理用了不同的模板。 模板写死在两个脚本里,改了一个忘了另一个。指标会莫名其妙地掉一大截,查半天查不出来。模板必须从同一个文件读。
- 占位符拼错。
{mask}、{MASK }、{ MASK}都不会被解析器识别,会被当成普通文字编码进去。解析完打印一遍片段列表,一眼就能看见。
⚠️ 二、标签与 Verbalizer
- 三字类别名被
max_label_len=2安静截断。 「笔记本」变成「笔记」,不报错。截断后还可能与别的类别撞车,两个类别退化成同一个答案。开训前跑撞车检测。 - 子标签给得太少。 只写主标签「水果」,模型填出「苹果」时映射不回去,落进「无法解析」。每个类别多准备几个模型自然会填的同义词。
- 用
set()去重子标签。 集合的遍历顺序在不同进程里可能不同,会让「按子标签复制」那一步的张量顺序抖动,复现不了。用dict.fromkeys()去重,顺序稳定。 - 忘了去掉
[CLS]和[SEP]。tokenizer('水果')['input_ids']返回的是[101, 3717, 3362, 102],直接当标签用,模型会被要求在 mask 位置填出[CLS]。必须[1:-1]。 hard_mapping兜底结果没记日志。 兜底是按最长公共子串挑一个最像的主标签,本质是猜。线上开着它没问题,但要把兜底的比例统计出来——这个比例高到 10%,说明子标签表该扩充了。
⚠️ 三、编码与张量
- 用
input_ids.index(mask_token_id)去找 mask 位置。 正文里真出现「[MASK]」这几个字时会找错。下标应当在拼接过程中记录,不要事后搜索。 - 正文截断时没扣掉模板长度。 直接
tokenizer(text, max_length=512, truncation=True),套上模板后总长超 512,mask 被挤出去。可用长度 =max_seq_len - 模板 token 数 - mask 数。 - 标签没补齐就堆 batch。 「水果」两个 token、「笔记本」三个 token,
default_data_collator堆不成矩形张量,直接抛错。所有标签都要补到max_label_len。 - 推理时还去切标签。
train_mode忘了传False,推理数据没有\t,split('\t')抛ValueError。 attention_mask用错 padding 判据。 这套代码用id > 0判可见性,前提是pad_token_id == 0。换一个 pad id 不为 0 的分词器就要改成与pad_token_id比较。
⚠️ 四、数据本身
- 分隔符用了空格或逗号。 评论正文里空格和逗号遍地都是,行会被切碎。只能用制表符,而且
split('\t', 1)只切第一刀。 - 验证集里有训练集没见过的类别。 那个类别的 recall 永远是 0,还会把 macro 平均整体拉低,让你误判模型不行。
- 某个类别只有一两条。 它在 macro 平均里和有二十条的类别权重一样大,指标波动会非常剧烈。要么合并类别,要么补标注,要么报指标时把它单列。
- 正文里含换行。 一条评论被读成两行,第二行没有
\t,直接报错或被静默跳过。入库时把换行替换掉。 - 训练集和验证集有重复样本。 63 条训练、590 条验证的场景下,验证集里混进训练样本,指标会虚高。做一次交集检查,成本极低。
07自测题
点击题目展开答案;这 9 题能说清楚,PET 的数据侧就过关了
PET 的全称是什么?它和传统微调最本质的差别在哪一句话上?
Pattern-Exploiting Training,模式利用训练。本质差别:传统微调改造模型去适配任务(接一个随机初始化的分类头),PET 改造任务去适配模型(把分类题改写成模型最熟的完形填空题),因此不新增任何从零学起的参数。
为什么说 PET 在样本极少时更有优势?给出一个具体的数字论据。
传统微调在 bert-base-chinese 上做十分类,要从零学 768×10+10 = 7690 个随机初始化的参数;几十条样本学到的基本是噪声。PET 复用预训练就带的 MLM 头,输出空间是模型最熟的 21128 词词表,模型只需做微小的偏好调整。本讲的训练集只有 63 条。
PET 和 prompt engineering 是一回事吗?
不是。提示工程只在推理时调措辞,模型权重不变;PET 会真实反向传播、更新 BERT 的全部参数。模板在 PET 里只是输入的组织方式,不是替代训练的手段。
PVP 指什么?它由哪两个文件承载?
Pattern-Verbalizer Pair。模板由 prompt.txt 承载(本讲内容是 这是一条{MASK}评论:{textA}。),标签映射由 verbalizer.txt 承载(每行「主标签 \t 子标签1,子标签2,...」)。换任务改这两个文件,训练代码一行不动。
Verbalizer 的两个使用方向分别在什么时候用?
主 → 子用在训练:标签「水果」展开成所有子标签的 token id,每个子标签都参与损失。子 → 主用在推理:模型在 mask 位置填出「苹果」,翻回主标签「水果」作为最终输出。
为什么一个类别要配多个子标签?只写主标签会怎样?
同一个类别有多种自然说法。用户评论里出现「这个苹果不错」,模型在 mask 位置更倾向填「苹果」而不是「水果」。只认主标签时,这条会落进「无法解析」或被 hard_mapping 猜一个。多准备几个模型自然会填的同义词,命中率显著上升。
mask_positions 为什么不能用 index() 去找?
评论正文里真出现「[MASK]」这几个字时,index() 会返回正文里那个位置,损失就算到了正文的字上——不报错,只掉指标。正确做法是在拼接序列的过程中记录下标,序列和下标一起产出。
模板写成 {textA},这是一条{MASK}评论 有什么风险?
truncation 从尾部截断。正文一长,mask 会被整个截掉,模型在一个没有 [MASK] 的序列上取 mask 位置,取到的是 padding。mask 必须放在正文之前。
max_label_len=2 时,类别名「笔记本」会发生什么?要怎么在开训前发现?
被安静截成「笔记」,不报错不警告。更糟的是如果类别表里本来就有「笔记」,两个类别会退化成同一个答案,模型永远分不开。开训前跑一遍标签长度检查 + 截断撞车检测:把所有类别名截到 max_label_len,看有没有两个类别映射到同一个串。
附术语表
| 术语 | 英文原形 | 含义 |
|---|---|---|
| 模式利用训练 | PET Pattern-Exploiting Training | 把下游任务改写成预训练时的完形填空形态,复用 MLM 头,不新增随机初始化参数 |
| 模板 | Pattern | 含 {MASK} 与 {textA} 占位符的句式,负责把原始输入包装成填空题 |
| 标签映射 | Verbalizer | 类别与自然语言标签词之间的双向词典,含主标签与子标签两层 |
| 模板-映射对 | PVP Pattern-Verbalizer Pair | 一个 PET 任务的完整定义,由模板与标签映射共同构成 |
| 掩码语言模型 | MLM Masked Language Model | BERT 的预训练任务之一:遮住部分 token 让模型预测;PET 直接复用它的输出头 |
| 主标签 | main label | 最终对外输出的类别名,如「水果」 |
| 子标签 | sub label | 同一类别下模型可能填出的多个同义词,如「苹果、香蕉、葡萄」 |
| 硬模板 | hard template | 由人写的、有字面意义的自然语言模板;与之相对的是 P-Tuning 的软模板 |
| 兜底映射 | hard mapping | 模型填出的词不在映射表里时,按最长公共子串挑一个最像的主标签 |
| 截断 | truncation | 序列超过 max_seq_len 时从尾部丢弃多余 token;会静默丢掉排在后面的 mask |
| 补齐 | padding | 把不等长的序列补到相同长度,补的是 pad_token_id,由 attention_mask 屏蔽 |