大模型主要微调方法总览
提示词到头了才改权重:先把显存和参数量算成一笔账,再决定走全量、LoRA 还是 QLoRA。
30″30 秒看懂微调
把大模型想成一位刚毕业的通才:该读的书都读过了,什么都懂一点,但没在任何一个岗位上待过——所以他答得出「胃胀是怎么回事」,却答不出你们医院导诊台那套固定话术。
让他胜任这个岗位,有三条路。第一条是送回学校重读四年,把脑子里每一个知识点都按新岗位重写一遍——效果好,但学费和时间都贵得离谱。第二条是让他脑子原封不动,只在腰上别一本随身手册,遇事先翻手册再开口——手册薄薄一本,练的也只是这本手册。第三条更省:先把他的记忆压缩存放,腾出地方,再照样别上那本手册。
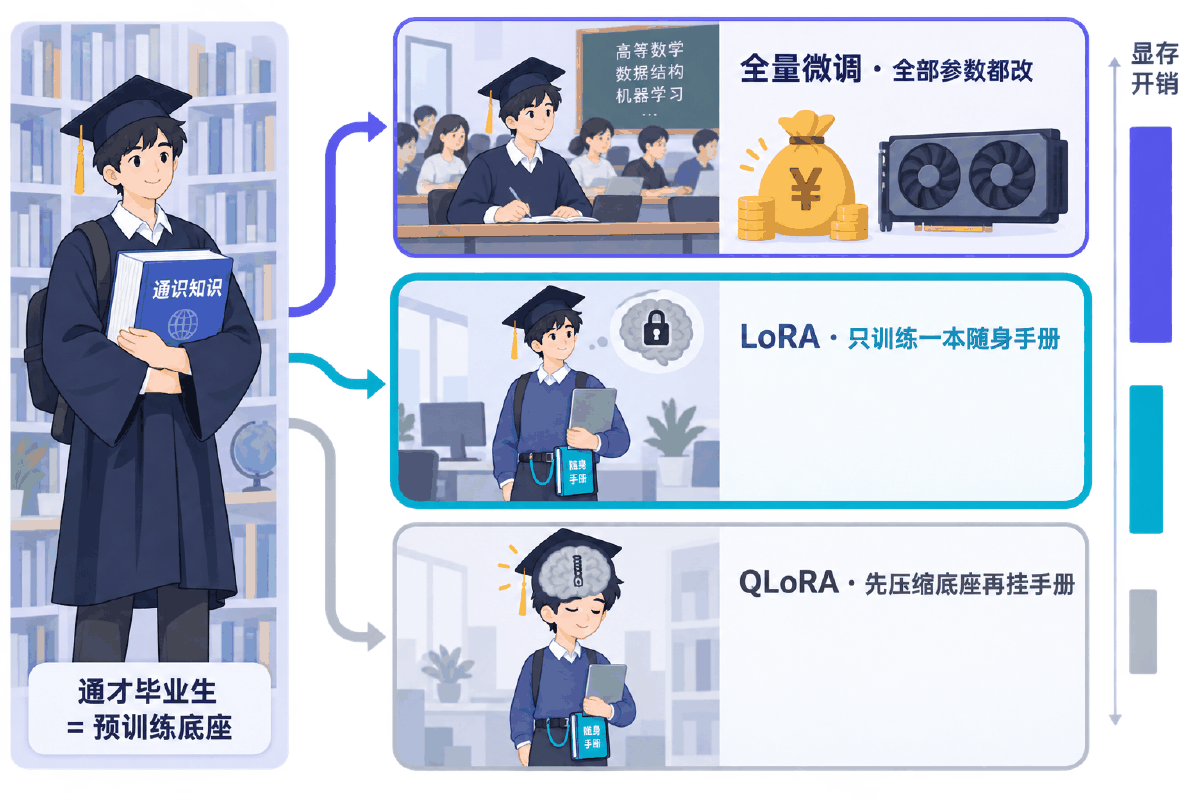
| 比喻里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 通才毕业生 | 预训练底座 | 已经学会语言规律和通用知识的模型权重,一切微调都从它出发 |
| 回炉重读四年 | 全量微调 | 模型里每一个参数都参与更新,效果上限最高,显存开销也最高 |
| 随身手册 | LoRA 的旁支矩阵 | 在原权重旁边挂两个小矩阵,只训练它们,主干全程冻结 |
| 先压缩记忆再别手册 | QLoRA | 底座按 4-bit 量化存放,旁支仍用高精度训练,显存再降一截 |
| 岗前培训教材 | 指令数据集 | 成百上千条「这样问、该那样答」的样例,是微调真正的原料 |
| 培训预算 | 显存与算力 | 决定你能不能选某条路的硬约束,通常比效果更早卡住你 |
后面所有内容都绕着这条铁律转:先把「一次微调到底要花多少显存」算成一笔明账,再看 LoRA 到底省在账单的哪一行,最后给一条能照着走的选型路径。
01概念:微调改的是什么
先把「微调」这个词的边界划清楚,再区分它与检索、提示词的分工
1.1 微调改的是权重,不是知识库
预训练把模型的参数调成了「懂语言、懂常识」的状态。微调(fine-tune)就是拿你自己的数据,在这个状态上继续做梯度下降,把参数往你的任务上再推一段。推完之后模型文件变了,行为也变了,而且这个变化是固化在权重里的——下次加载不需要再喂任何示例。
这里有一个非常容易想歪的地方。既然参数变了,是不是意味着「我把公司的资料喂进去,模型就记住了」?不能这么指望。梯度下降调整的是「在某个上下文下,下一个 token 该给多高的概率」,它擅长把反复出现的表达模式压进参数;而一条只出现一两次的具体事实,既学不牢,也无法保证在需要时被准确取出。想让模型可靠地用上某份资料,正确做法是把资料检索出来放进上下文,让模型读着答。
1.2 提示词、检索、微调的分工
m3 那一讲已经把提示词这条路走到了尽头——包括 Prefix-Tuning、P-Tuning 这类「把提示词本身变成可训练向量」的过渡技术。到了这里,我们讨论的是更彻底的一步:直接改模型权重。三条路的取舍关系如下。
| 手段 | 改什么 | 要几条数据 | 什么时候它是对的选择 |
|---|---|---|---|
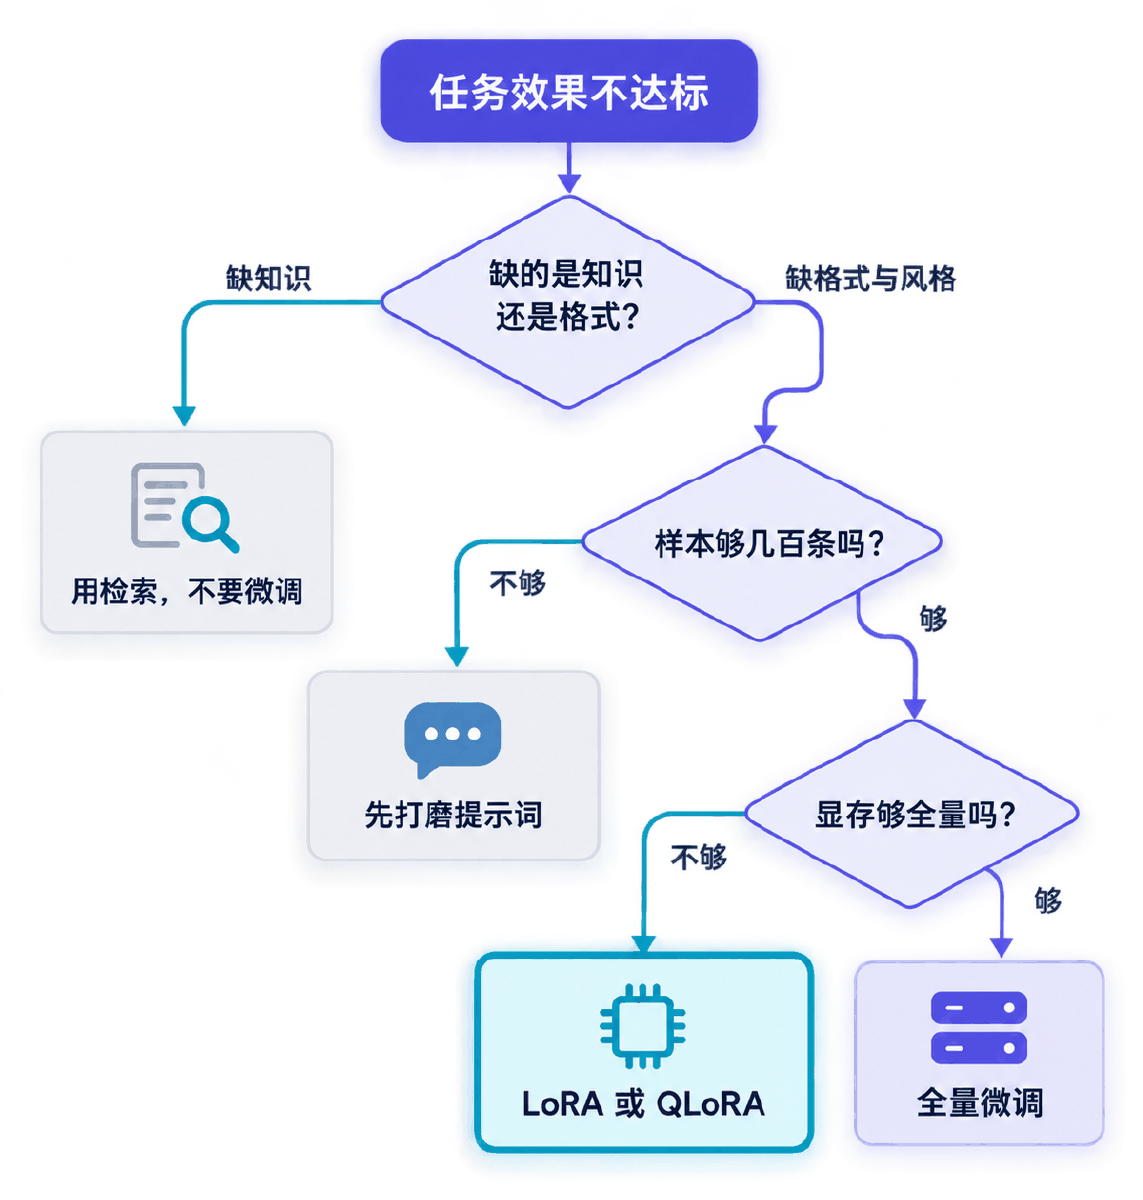
| 提示词工程 | 只改输入 | 0 ~ 几十条 | 任务能用几句话说清、几个示例就能带对;永远先试这一条,它成本最低、改起来最快 |
| 检索增强 | 只改输入 | 文档任意多 | 缺的是事实:内部文档、实时数据、法规条款。资料更新只需重建索引,不用重训 |
| 微调 | 改权重 | 几百 ~ 几万条 | 缺的是格式、语气、任务套路;或提示词已经长到拖慢推理、还是不稳定 |
三者可以叠加,而且叠加的顺序有讲究:先把提示词打磨到位,再决定要不要微调。因为提示词能解决的问题,微调也能解决,但反过来不成立,而且微调的每一次迭代都要重训一遍。用微调去解决一个改提示词就能解决的问题,是在用最贵的手段办最便宜的事。
1.3 全量微调与高效微调
确定要改权重之后,还有第二个岔路:改全部参数,还是只改一小撮。
| 对比项 | 全量微调 | 高效微调(PEFT) |
|---|---|---|
| 参与更新的参数 | 全部 | 通常不到总量的 1%,其余冻结 |
| 显存开销 | 最高,梯度与优化器状态都按全量算 | 显著降低,省的主要是优化器状态那一项 |
| 产物大小 | 一份完整模型,动辄几个 GB | 一份旁支权重,常在几 MB 量级 |
| 多任务部署 | 每个任务存一整份模型 | 一个底座挂多份旁支,按需切换 |
| 效果上限 | 最高 | 多数任务能逼近,但不保证等同,要用你自己的验证集判断 |
| 灾难性遗忘风险 | 较高,原有能力可能被覆盖 | 较低,主干参数没动过 |
PEFT(Parameter-Efficient Fine-Tuning)是这一类方法的统称,LoRA 是其中落地最广的一种。它们的原理在 m3 的 2.7、2.8 两节已经拆过——Adapter 串在层间、Prefix 与 P-Tuning 动的是输入侧的虚拟 token、LoRA 走的是低秩旁路。这一讲不重复那些推导,只回答工程上真正要拍板的三个问题:这笔显存账怎么算、秩该取多少、什么时候该换全量。
02原理:把显存和参数算成一笔明账
四项开销、LoRA 省在哪一行、秩怎么换算成参数量、QLoRA 多做的一步、指令数据长什么样
2.1 显存账本的四项开销
「这个模型我的卡能不能训」不是玄学,是一道加法题。训练时占显存的东西只有四类,逐项算清楚就有答案。
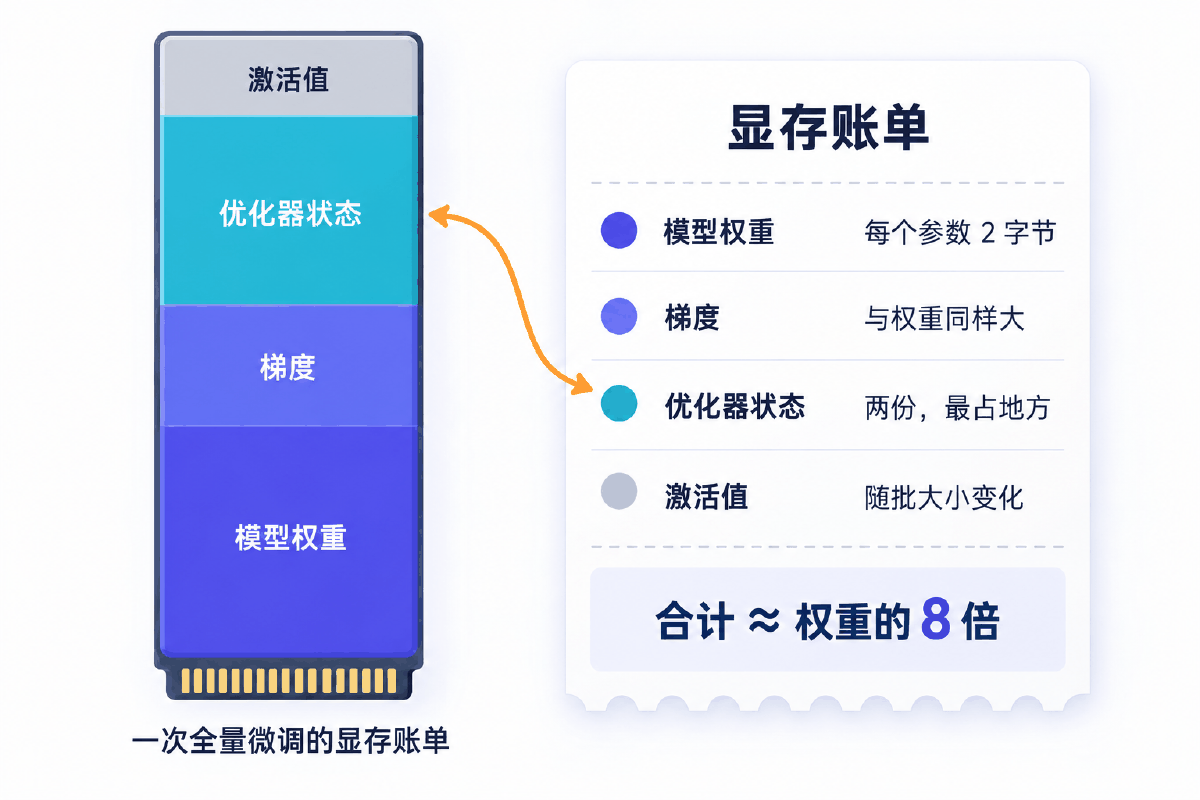
| 项目 | 每个参数占多少 | 为什么是这个数 |
|---|---|---|
| 模型权重 | 2 字节 | 以 bf16 / fp16 存放,一个参数两字节。这是最容易估的一项 |
| 梯度 | 2 字节 | 反向传播时每个可训练参数都要挂一个同形状的梯度,所以与权重同样大 |
| 优化器状态 | 8 字节 | Adam 系要为每个参数存一阶动量和二阶动量两份,而且通常用 fp32,4+4=8。这是账单上最大的一项 |
| 激活值 | 不固定 | 前向留下来、反向要用的中间结果,随批大小与序列长度变化,可用梯度检查点换算力来压 |
把前三项加起来:每个可训练参数约 12 字节。所以一个 7B 模型做全量微调,光这三项就是 7×10⁹ × 12 ≈ 84 GB,再加激活值,实测估算落在 104.3 GB——一张 80G 的卡装不下。这就是为什么全量微调在多数团队根本不是一个可选项。
2.2 LoRA 省在哪一行
LoRA 的做法是:原权重矩阵 W 整个冻住,在它旁边并联一条低秩通路。输入同时走主干和旁支,两条输出相加。
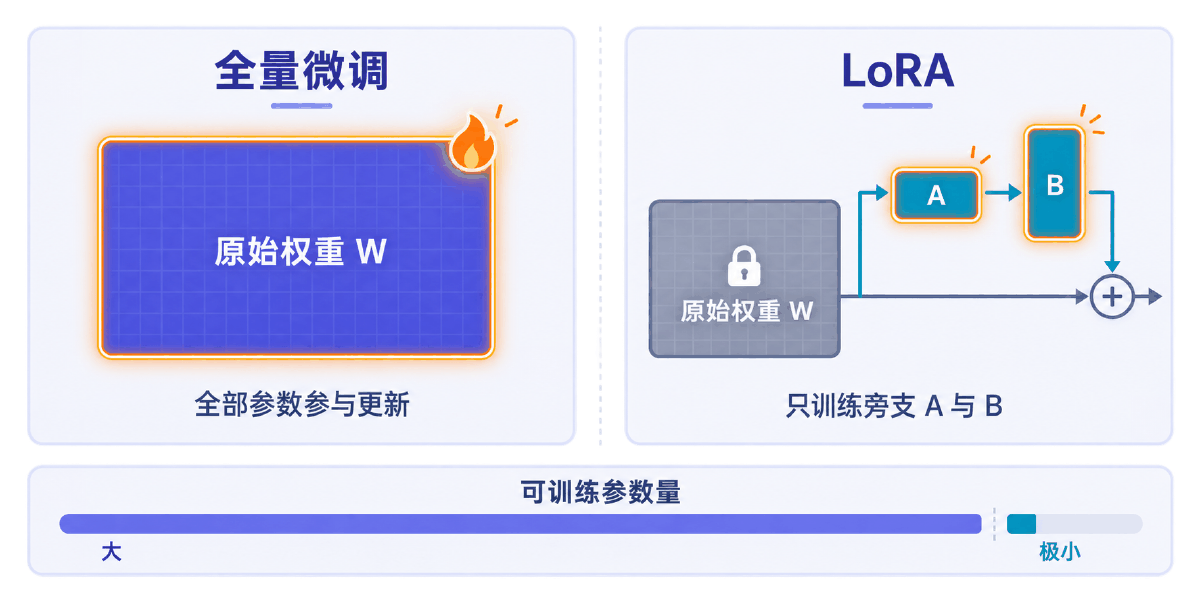
写成式子就是 h = Wx + BAx。其中 A 把维度从 d 压到 r,B 再从 r 还原到 d,r 远小于 d,所以 A 和 B 加起来的参数量比 W 小两三个数量级。训练时只有 A、B 需要梯度,于是账单变成这样:
| 账单项 | 全量微调 | LoRA |
|---|---|---|
| 模型权重 | 全量 × 2 字节 | 全量 × 2 字节(一分没省,底座还得放着) |
| 梯度 | 全量 × 2 字节 | 只有旁支 × 2 字节 |
| 优化器状态 | 全量 × 8 字节 | 只有旁支 × 8 字节 |
| 7B 实测估算 | 104.3 GB | 13.1 GB |
看清楚这张表最重要的一行:权重那一项没有省。LoRA 不会让底座变小,它只是让「为训练额外付的钱」几乎归零。所以 LoRA 之后仍然装不下,唯一的出路就是把权重那一项也压下去——这正是 QLoRA 干的事。
2.3 秩取多少,等于多少参数
挂在一个形状为 d_in × d_out 的权重上,LoRA 新增的参数量是:
r × d_in + r × d_out = r × (d_in + d_out)
关键结论:参数量与 r 成正比。r 从 8 翻到 16,旁支参数就翻一倍。以 GPT-2 为例,注意力的 c_attn 形状是 768 × 2304(Q、K、V 三份合并在一起),取 r=8 时新增 8 × (768+2304) = 24,576 个参数;12 层全挂上去就是 294,912 个,占总量 102,068,736 的 0.289%。
| 参数 | 典型取值 | 怎么定 |
|---|---|---|
r(秩) | 8 ~ 32 | 任务越接近底座已有能力,r 可以越小。先从 8 起步,效果不够再往上加,别一上来就拉满 |
lora_alpha | 通常取 2r | 旁支输出会乘上 alpha / r 这个缩放系数。按 2r 取值时缩放恒为 2,调 r 时不必重调学习率 |
target_modules | 注意力的投影层 | 写的是模块名,不同架构名字不同:GPT-2 是 c_attn,LLaMA / Qwen 系是 q_proj、k_proj、v_proj、o_proj |
lora_dropout | 0 ~ 0.1 | 样本少时给一点,防止旁支把训练集背下来 |
target_modules 写错不会报错
名字对不上时,PEFT 只是一个旁支都没挂上,可训练参数占比会异常(接近 0 或接近 100%),训练照样跑完,效果却不对。挂完必须打印一次占比,落在零点几个百分点才算对。
2.4 QLoRA 多做的那一步
QLoRA 的思路直白:既然权重那一项省不掉,就把它换个存法。底座权重用 4-bit 量化存放,每个参数从 2 字节降到约 0.5 字节,权重那一项直接砍掉四分之三;旁支仍然用高精度训练,保证梯度质量。前向计算时再把用到的那部分权重临时还原成高精度。
| 方案 | 底座权重 | 可训练部分 | 7B 实测估算 |
|---|---|---|---|
| 全量微调 | 16-bit | 全部参数 | 104.3 GB |
| LoRA | 16-bit | 旁支 | 13.1 GB |
| QLoRA | 4-bit | 旁支(高精度) | 3.4 GB |
代价是速度:量化和反量化都要花时间,同样的数据跑一轮通常更慢。所以顺序是——能上 LoRA 就别上 QLoRA,显存真不够了再上。它是用时间换空间,不是免费的升级。
2.5 指令数据长什么样
微调的原料是成对的「输入—期望输出」。业界事实标准是三个字段:
| 字段 | 放什么 | 说明 |
|---|---|---|
instruction | 这次要模型干的事 | 任务描述本身,例如「根据患者描述给出初步分诊建议」 |
input | 这一条的具体素材 | 可以为空。为空时表示任务描述里已经包含全部信息 |
output | 期望模型说出来的话 | 只有这一段参与计算损失,前两段是条件,不是学习目标 |
最后一行是整个数据侧最关键的一句。把提示词部分也算进损失,模型会花力气去学「怎么复述问题」,而那件事根本不需要它学。具体怎么用 -100 把提示词屏蔽掉,下一讲的数据流水线里会逐字节拆开看。
03最小代码:三十行挂上 LoRA
能跑通的最短版本,先把「旁支到底挂没挂上」这件事验证掉
不谈数据、不谈训练循环,先把最核心的那一步单独拎出来:加载底座 → 描述一个 LoRA 配置 → 套上去 → 数一数有多少参数真的在训。这四步如果打印出来的占比不对,后面训多久都是白训。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""用 peft 给一个因果语言模型挂上 LoRA 的最短完整写法。

三步:加载底座 → 描述一个 LoraConfig → get_peft_model 包起来。
包完立刻打印可训练参数占比,这个数字是判断「LoRA 有没有真的挂上去」
最直接的证据:如果打出来是 100%,说明底座压根没被冻结。
"""
import os

import torch
from peft import LoraConfig, TaskType, get_peft_model
from transformers import AutoModelForCausalLM, AutoTokenizer

# 底座路径走环境变量,方便在本地目录和 Hub 名字之间切换,也避免写死别人的路径
BASE_MODEL = os.environ.get("BASE_MODEL", "uer/gpt2-chinese-cluecorpussmall")


def load_base():
    """加载底座与分词器。

    dtype 用 bfloat16:数值范围和 fp32 一样宽,比 fp16 不容易溢出;
    没有 GPU 时退回 fp32,否则 CPU 上跑 bf16 会非常慢。
    """
    use_gpu = torch.cuda.is_available()
    model = AutoModelForCausalLM.from_pretrained(
        BASE_MODEL,
        dtype=torch.bfloat16 if use_gpu else torch.float32,
    )
    tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)
    return model, tokenizer


def build_lora_config(r=8, alpha=16, dropout=0.05):
    """LoRA 的全部选择都集中在这一个对象里。

    r           旁支的秩。小任务 4~8 够用,风格迁移类任务可以到 16~32。
    lora_alpha  缩放系数,旁支输出会乘 alpha/r。惯例是设成 r 的两倍。
    target_modules 往哪些线性层挂旁支——影响比 r 更大。
                GPT-2 系的注意力投影层叫 c_attn;
                LLaMA / Qwen 系叫 q_proj / k_proj / v_proj / o_proj。
                写错名字不会报错,只会挂不上去,所以下面要打印占比核对。
    lora_dropout 只作用在旁支上,小数据集时开一点防过拟合。
    task_type   决定 peft 怎么包装前向和标签,因果语言建模填 CAUSAL_LM。
    """
    return LoraConfig(
        task_type=TaskType.CAUSAL_LM,
        r=r,
        lora_alpha=alpha,
        lora_dropout=dropout,
        bias="none",              # 不训练 bias,这是最常用的档位
        target_modules=["c_attn"],
    )


def attach_lora(model, config):
    """挂上旁支并打印可训练参数占比。"""
    model = get_peft_model(model, config)

    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
    total = sum(p.numel() for p in model.parameters())
    print("可训练参数 %d / 全部参数 %d  →  %.4f%%"
          % (trainable, total, 100.0 * trainable / total))

    # 占比接近 100% 说明冻结没生效,继续训下去就是在做全量微调
    if trainable / total > 0.5:
        raise RuntimeError(
            "可训练占比过高,底座没有被冻结——检查 target_modules 是否写对")
    return model


if __name__ == "__main__":
    model, tokenizer = load_base()

    before = sum(p.numel() for p in model.parameters() if p.requires_grad)
    print("挂 LoRA 之前的可训练参数:%d(等于全部参数)" % before)

    model = attach_lora(model, build_lora_config())

    # peft 自带的报告,和上面手算的应当一致
    model.print_trainable_parameters()

    # 训练结束后只需要保存旁支,几百 KB 到几 MB,不是几百 MB 的整模型
    # model.save_pretrained("checkpoints/lora-adapter")
    #
    # 推理时两种用法:
    #   ① 保持旁支挂着:加载底座后 PeftModel.from_pretrained(base, "lora-adapter")
    #   ② 合并回权重:merged = model.merge_and_unload(),之后按普通模型部署,
    #      推理不再有额外开销,代价是这份权重只对应这一个任务。
逐行说几个容易忽略的点。
| 代码位置 | 它在干什么、为什么必须这么写 |
|---|---|
task_type=TaskType.CAUSAL_LM | 告诉 PEFT 这是自回归生成任务。写错类型会导致包装出来的模型在计算损失时对不上,换成分类任务要改成 SEQ_CLS |
target_modules=["c_attn"] | 要挂旁支的模块名。这是最容易写错的一行——它是模型内部的模块名,不是层的序号,不同架构完全不同 |
lora_alpha=16 | 配合 r=8,缩放系数 alpha/r 恰好是 2。按 2r 取值的好处是调 r 时不用重调学习率 |
get_peft_model(...) | 真正动手的一步:遍历模型,凡是名字匹配 target_modules 的层,冻结原权重并挂上 A、B 两个小矩阵 |
| 最后的断言 | 把「占比应当很小」写成可执行的检查。不写这一句,挂错了你只会在几小时后从效果上察觉 |
在没有 GPU 的机器上,这段代码同样能跑完——挂旁支和数参数都是纯 CPU 的事。它的输出长这样:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""LoRA 的秩 r 到底换来多少可训练参数,以及 alpha 怎么影响更新幅度。

一条被反复问错的问题:「r 调大一倍,训练是不是慢一倍?」
不是。算一遍就知道:r 只影响旁支,旁支相对主干小两个数量级,
真正决定训练速度的是前向传播要过的那个冻结主干。
纯标准库,可直接运行。
"""


def lora_params_for_linear(d_in, d_out, r):
    """一条 LoRA 旁支的参数量。

    原始线性层是 d_in × d_out。LoRA 不动它,在旁边并两个小矩阵:
      A: d_in × r    把输入降到 r 维
      B: r × d_out   再升回 d_out 维
    所以旁支参数量是 r × (d_in + d_out),与 r 成正比。
    """
    return r * (d_in + d_out)


def gpt2_lora_budget(n_embd, n_layer, r, targets=("c_attn",)):
    """算整个 GPT-2 上挂 LoRA 之后的可训练参数量。

    targets 决定往哪些线性层挂旁支,这是 LoRA 最关键的选择之一。
    """
    # GPT-2 里各个线性层的形状(输入维, 输出维)
    shapes = {
        "c_attn": (n_embd, 3 * n_embd),   # Q/K/V 合并投影
        "c_proj": (n_embd, n_embd),       # 注意力输出投影
        "c_fc": (n_embd, 4 * n_embd),     # MLP 升维
        "mlp_proj": (4 * n_embd, n_embd),  # MLP 降维
    }
    per_layer = sum(lora_params_for_linear(*shapes[t], r=r) for t in targets)
    return per_layer * n_layer


def effective_scaling(alpha, r, use_rslora=False):
    """LoRA 旁支输出乘的那个系数。

    默认 scaling = alpha / r。这意味着固定 alpha 去调大 r,
    每条旁支的贡献反而被压小了——这是调参时最容易踩反的一脚。
    use_rslora 改成 alpha / sqrt(r),让不同 r 之间更可比。
    """
    if use_rslora:
        return alpha / (r ** 0.5)
    return alpha / r


if __name__ == "__main__":
    N_EMBD, N_LAYER = 768, 12
    BASE_TOTAL = 102_068_736

    print("一、秩 r 与可训练参数量(只挂在 c_attn 上)")
    print("  %-6s %14s %12s" % ("r", "可训练参数", "占全模型"))
    for r in (1, 2, 4, 8, 16, 32, 64):
        p = gpt2_lora_budget(N_EMBD, N_LAYER, r)
        print("  %-6d %14d %11.3f%%" % (r, p, 100.0 * p / BASE_TOTAL))

    # 手算核对:r=8 时,c_attn 是 768→2304
    #   每层 8 * (768 + 2304) = 24576,12 层 = 294912
    assert gpt2_lora_budget(N_EMBD, N_LAYER, 8) == 294912, "r=8 的账对不上"
    print("\n  断言通过:r=8 时可训练参数 294,912")

    print("\n二、挂在哪些层上,比 r 调多大影响更大")
    combos = [
        ("仅 c_attn(Q/K/V)", ("c_attn",)),
        ("c_attn + c_proj", ("c_attn", "c_proj")),
        ("注意力 + MLP 全挂", ("c_attn", "c_proj", "c_fc", "mlp_proj")),
    ]
    for name, targets in combos:
        p = gpt2_lora_budget(N_EMBD, N_LAYER, 8, targets)
        print("  %-22s r=8  %9d  (%.3f%%)" % (name, p, 100.0 * p / BASE_TOTAL))
    print("  对比:仅 c_attn 但 r=64        %9d  (%.3f%%)"
          % (gpt2_lora_budget(N_EMBD, N_LAYER, 64),
             100.0 * gpt2_lora_budget(N_EMBD, N_LAYER, 64) / BASE_TOTAL))

    print("\n三、alpha / r 的缩放系数")
    print("  %-8s %-8s %-12s %-12s" % ("alpha", "r", "alpha/r", "alpha/√r"))
    for alpha, r in ((16, 8), (16, 16), (16, 32), (32, 16), (8, 8)):
        print("  %-8d %-8d %-12.4f %-12.4f"
              % (alpha, r, effective_scaling(alpha, r),
                 effective_scaling(alpha, r, use_rslora=True)))
    print("\n  注意第 1、2、3 行:alpha 不动、r 翻倍,旁支的贡献被砍半。")
    print("  想让「加大 r」真的等于「学得更多」,要么同步放大 alpha,")
    print("  要么改用 alpha/√r 的缩放方式。")
这份脚本把 2.3 那条公式做成了可复算的表:给定秩和要挂的模块,直接算出新增多少参数、占总量多少。把 r 从 8 改成 16 再跑一遍,你会看到参数量精确地翻倍——这比记住「r 越大参数越多」有用得多。
04完整案例:把选型算成五个数字
参数量、显存、旁支占比、训练步数、决策路径——每一步都落成一个能当场复算的脚本
选型不该靠感觉。这一节把决策拆成五个问题,每个问题配一份可以直接运行的脚本,跑出来的数字就是拍板依据。全部脚本只用标准库或已装好的库,在没有 GPU 的机器上也能跑完。
4.1 这个模型到底有多少参数
一切估算都从参数量开始。但「多少 B」这个说法太粗——真正要知道的是参数分布在哪里,因为不同部位的可优化空间完全不同。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""逐层手算一个 GPT-2 规模模型的参数量。

为什么要手算:显存、训练时长、能不能上全量微调,全都由参数量推出来。
把参数量当成一个黑盒数字去查,遇到改 n_layer / n_embd 就再也算不清了。
这里只用标准库,任何机器都能跑,跑出来的数要和 from_pretrained 之后
sum(p.numel() for p in model.parameters()) 对得上。
"""


def gpt2_param_count(vocab_size, n_embd, n_positions, n_layer, tie_embeddings=True):
    """按 GPT-2 的模块构成逐项累加。

    返回 (总参数量, 明细字典)。明细按「一次性的」和「每层重复的」分开,
    因为改层数只影响后者,改词表只影响前者。
    """
    detail = {}

    # ---- 一次性部分:两张嵌入表 ----
    # wte 词嵌入:每个 token 一行 n_embd 维向量
    detail["wte 词嵌入"] = vocab_size * n_embd
    # wpe 位置嵌入:每个位置一行,最大长度决定行数
    detail["wpe 位置嵌入"] = n_positions * n_embd

    # ---- 每层重复部分 ----
    # ln_1 / ln_2 两个 LayerNorm,各有 weight 和 bias,所以是 2 * n_embd
    ln = 2 * n_embd
    # c_attn 把输入一次投影成 Q、K、V 三份,所以输出维度是 3 * n_embd
    c_attn = n_embd * (3 * n_embd) + 3 * n_embd
    # c_proj 注意力输出再投影回 n_embd
    c_proj = n_embd * n_embd + n_embd
    # MLP 的中间层按惯例是 4 倍宽
    n_inner = 4 * n_embd
    c_fc = n_embd * n_inner + n_inner
    mlp_proj = n_inner * n_embd + n_embd

    per_layer = ln + c_attn + c_proj + ln + c_fc + mlp_proj
    detail["每层小计"] = per_layer
    detail["%d 层合计" % n_layer] = per_layer * n_layer

    # ---- 收尾的 LayerNorm ----
    detail["ln_f 末层归一化"] = 2 * n_embd

    total = (detail["wte 词嵌入"] + detail["wpe 位置嵌入"]
             + per_layer * n_layer + detail["ln_f 末层归一化"])

    # lm_head 与 wte 共享权重时不额外计参数,这是 GPT-2 的默认做法
    if not tie_embeddings:
        detail["lm_head 独立输出层"] = n_embd * vocab_size
        total += n_embd * vocab_size

    return total, detail


def human(n):
    """把参数量写成人看得懂的量级。"""
    for unit, base in (("B", 1e9), ("M", 1e6), ("K", 1e3)):
        if n >= base:
            return "%.2f%s" % (n / base, unit)
    return str(n)


if __name__ == "__main__":
    # 这组数字取自本项目实际使用的中文 GPT-2 配置
    total, detail = gpt2_param_count(
        vocab_size=21128, n_embd=768, n_positions=1024, n_layer=12)

    width = max(len(k) for k in detail)
    for k, v in detail.items():
        print("%-*s %12d  (%s)" % (width, k, v, human(v)))
    print("-" * (width + 26))
    print("%-*s %12d  (%s)" % (width, "总参数量", total, human(total)))

    # 嵌入表在小模型里占比高得惊人,这是中文模型的常态:词表大、层数少
    emb = detail["wte 词嵌入"] + detail["wpe 位置嵌入"]
    print("\n嵌入表占比:%.1f%%" % (100.0 * emb / total))
    print("Transformer 主体占比:%.1f%%"
          % (100.0 * detail["12 层合计"] / total))

    # 换个配置立刻能看出哪个超参最贵
    print("\n改配置的边际代价:")
    for name, kw in (
        ("层数 12 → 24", dict(vocab_size=21128, n_embd=768, n_positions=1024, n_layer=24)),
        ("隐层 768 → 1024", dict(vocab_size=21128, n_embd=1024, n_positions=1024, n_layer=12)),
        ("词表 21128 → 151936", dict(vocab_size=151936, n_embd=768, n_positions=1024, n_layer=12)),
    ):
        t, _ = gpt2_param_count(**kw)
        print("  %-22s %s  (%+.1f%%)" % (name, human(t), 100.0 * (t - total) / total))

    # 断言:手算结果必须稳定,改动上面的公式时这行会第一时间报错
    assert total == 102068736, "参数量对不上,检查逐项公式"
    print("\n断言通过:总参数量 102,068,736")
拿中文 GPT-2 底座实跑,结果是 102,068,736 个参数。拆开看:
| 部位 | 占比 | 意味着什么 |
|---|---|---|
| 词嵌入 | 约 16.7% | 词表 21128 × 隐层 768。词表越大这块越重,中文模型尤其明显 |
| Transformer 各层 | 其余大部分 | 12 层 × 12 头,注意力与前馈各占一部分,LoRA 通常就挂在这里面的注意力投影上 |
这个数字一定要自己跑出来。uer/gpt2-chinese-cluecorpussmall 的实际配置是 vocab 21128、n_embd 768、12 层 12 头,而网上流传的估算常按更小的词表写,两者差出来的正好是嵌入层那一块。以配置文件为准,不要照抄任何二手数字——词表规模直接影响嵌入层大小,抄错会让后面整条显存估算都偏。
4.2 我的卡能不能训
有了参数量,套 2.1 的四项开销就能给出答案。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""训练显存估算:把「这张卡到底能不能训」算成一个可复核的数字。

显存分四块,只有前三块能靠参数量精确推算:
  ① 权重     —— 参数量 × 每个参数的字节数
  ② 梯度     —— 每个「要训练」的参数配一份梯度
  ③ 优化器态 —— Adam 系列每个可训练参数要存 m 和 v 两份
  ④ 激活值   —— 和 batch、序列长度、层数有关,不是参数量的函数

④ 没法用一个公式算准,所以下面只算 ①②③ 的下界,并把 ④ 留成一个
经验系数。得到的数字是「至少要这么多」,不是「这么多就够」。
"""

BYTES = {"fp32": 4, "fp16": 2, "bf16": 2, "int8": 1, "nf4": 0.5}


def train_memory(n_params, trainable_params, weight_dtype="bf16",
                 optimizer="adamw", master_weights=True):
    """返回各部分显存占用(单位:字节)。

    master_weights: 混合精度训练时,优化器另存一份 fp32 的权重副本用于累加更新,
                    只对「可训练」的那部分参数存,冻结参数不需要。
    """
    parts = {}
    parts["权重"] = n_params * BYTES[weight_dtype]

    # 梯度只为可训练参数分配;冻结的参数 requires_grad=False,不产生梯度
    parts["梯度"] = trainable_params * BYTES[weight_dtype]

    # AdamW 每个可训练参数存一阶矩 m 和二阶矩 v,各 4 字节
    slots = {"adamw": 2, "adam": 2, "sgd_momentum": 1, "sgd": 0}[optimizer]
    parts["优化器状态"] = trainable_params * 4 * slots

    if master_weights and weight_dtype in ("fp16", "bf16"):
        parts["fp32 权重副本"] = trainable_params * 4

    return parts


def gb(n_bytes):
    return n_bytes / (1024 ** 3)


def report(title, n_params, trainable, **kw):
    parts = train_memory(n_params, trainable, **kw)
    total = sum(parts.values())
    print("\n%s" % title)
    print("  可训练参数 %s / %s  (%.4f%%)"
          % (fmt(trainable), fmt(n_params), 100.0 * trainable / n_params))
    for k, v in parts.items():
        print("    %-14s %8.2f GB" % (k, gb(v)))
    print("    %-14s %8.2f GB  ← 不含激活值" % ("小计", gb(total)))
    return total


def fmt(n):
    for unit, base in (("B", 1e9), ("M", 1e6)):
        if n >= base:
            return "%.2f%s" % (n / base, unit)
    return str(int(n))


# 常见消费级/数据中心卡的显存,用来把抽象数字翻译成「哪张卡跑得动」
CARDS = ((24, "单张 24G 卡"), (48, "单张 48G 卡"), (80, "单张 80G 卡"))


def verdict(need_gb):
    """给出最小可行的那张卡;都装不下就报需要几张 80G。"""
    for size, name in CARDS:
        # 留 20% 余量给激活值和碎片,这是经验值不是定理
        if need_gb * 1.2 <= size:
            return "→ %s 可行" % name
    return "→ 单卡装不下,至少需要 %d 张 80G 卡做切分" % (int(need_gb * 1.2 // 80) + 1)


if __name__ == "__main__":
    # ---- 场景一:1 亿参数的中文 GPT-2,全量微调 ----
    small = 102_068_736
    report("① GPT-2 (102M) 全量微调 · bf16 混合精度 + AdamW",
           small, small)

    # ---- 场景二:7B 底座,全量微调 ----
    seven_b = 7_000_000_000
    full_7b = report("② 7B 底座 全量微调 · bf16 + AdamW", seven_b, seven_b)

    # ---- 场景三:7B 底座 + LoRA,只训 0.1% ----
    lora_trainable = int(seven_b * 0.001)
    lora_7b = report("③ 7B 底座 + LoRA(仅 0.1% 可训) · bf16 + AdamW",
                     seven_b, lora_trainable)

    # ---- 场景四:7B 底座 4-bit 量化 + LoRA ----
    # 量化只压缩「权重」这一块,梯度和优化器态仍按可训练参数的高精度算
    q_parts = train_memory(seven_b, lora_trainable, weight_dtype="bf16")
    q_parts["权重"] = int(seven_b * BYTES["nf4"])
    qlora_7b = sum(q_parts.values())
    print("\n④ 7B 底座 4-bit 量化 + LoRA")
    for k, v in q_parts.items():
        print("    %-14s %8.2f GB" % (k, gb(v)))
    print("    %-14s %8.2f GB  ← 不含激活值" % ("小计", gb(qlora_7b)))

    print("\n" + "=" * 52)
    print("同一个 7B 底座,三条路线的显存下界:")
    print("  全量微调        %6.1f GB   %s" % (gb(full_7b), verdict(gb(full_7b))))
    print("  LoRA            %6.1f GB   %s" % (gb(lora_7b), verdict(gb(lora_7b))))
    print("  4-bit + LoRA    %6.1f GB   %s" % (gb(qlora_7b), verdict(gb(qlora_7b))))
    print("\n关键结论:LoRA 省掉的是梯度和优化器状态,权重那一块一分没省;")
    print("      要动权重那一块,只能靠量化。两件事互相独立,可以叠加。")
脚本对同一个 7B 模型给出三个数,这三个数基本决定了绝大多数团队的技术路线:
| 方案 | 估算显存 | 能跑在什么卡上 |
|---|---|---|
| 全量微调 | 104.3 GB | 单卡放不下,要多卡切分 |
| LoRA | 13.1 GB | 一张 16G 卡就能开工 |
| 4-bit + LoRA | 3.4 GB | 消费级显卡也能跑 |
同一份脚本换成本讲用的 102M 小模型,全量微调只要 1.52 GB——这正是教学项目敢用全量微调的原因:模型小到账单可以忽略。方法的选择从来不是「哪个先进」,而是「哪个装得下」。
4.3 旁支到底挂上了没有
挂 LoRA 最怕的不是报错,是静默地什么都没挂上。用一个数字把它钉死:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""QLoRA:把底座压成 4-bit 再挂 LoRA,让大底座塞进小显存。

和上一份的区别只有一处——加载底座时多传一个量化配置。
LoRA 那部分一个字都不用改,这正是 QLoRA 好用的原因:
量化管「权重那一块占多大」,LoRA 管「梯度和优化器态那几块占多大」,
两件事互不干扰,可以直接叠。
"""
import os

import torch
from peft import LoraConfig, TaskType, get_peft_model, prepare_model_for_kbit_training
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

BASE_MODEL = os.environ.get("BASE_MODEL", "Qwen/Qwen2.5-7B-Instruct")


def build_quant_config():
    """4-bit 量化的四个参数,逐个说明它们各自换来什么。"""
    return BitsAndBytesConfig(
        # 开启 4-bit 加载。权重从 2 字节压到 0.5 字节,直接省掉约 3/4
        load_in_4bit=True,
        # NF4 是为「近似正态分布」的权重设计的 4-bit 数据类型,
        # 同样 4 bit,它比普通 int4 更贴合权重的实际分布
        bnb_4bit_quant_type="nf4",
        # 双重量化:把量化过程本身产生的缩放常数再量化一次,
        # 省下的是每个块的元数据开销,量不大但基本没有代价
        bnb_4bit_use_double_quant=True,
        # 计算时反量化到哪种精度。权重存 4-bit,但真正做矩阵乘法时
        # 会临时还原成 bf16——存储省了,计算精度没丢太多
        bnb_4bit_compute_dtype=torch.bfloat16,
    )


def load_quantized_base():
    """加载 4-bit 底座。

    这一步之后模型里的线性层已经不是普通 nn.Linear 了,
    所以下一步必须调用 prepare_model_for_kbit_training。
    """
    model = AutoModelForCausalLM.from_pretrained(
        BASE_MODEL,
        quantization_config=build_quant_config(),
        device_map="auto",     # 让 accelerate 自动决定每层放哪张卡
    )
    tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)
    return model, tokenizer


def build_lora_config():
    """注意 target_modules 换了一批名字。

    Qwen / LLaMA 这类架构把 Q、K、V 拆成了三个独立的投影层,
    名字和 GPT-2 的 c_attn 完全不同。照抄上一份的 ["c_attn"] 会挂不上去。
    """
    return LoraConfig(
        task_type=TaskType.CAUSAL_LM,
        r=16,
        lora_alpha=32,
        lora_dropout=0.05,
        bias="none",
        target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],
    )


def main():
    model, tokenizer = load_quantized_base()

    # 这一步做三件事:把 LayerNorm 提回 fp32 保证数值稳定、
    # 打开输入梯度、配合梯度检查点。少了它,反向传播会在量化层断掉。
    model = prepare_model_for_kbit_training(model)

    # 梯度检查点:用时间换显存,前向不存中间激活,反向时重算一遍。
    # 激活值那一块是显存估算里唯一算不准的部分,这是压它最有效的手段。
    model.gradient_checkpointing_enable()

    model = get_peft_model(model, build_lora_config())
    model.print_trainable_parameters()

    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
    total = sum(p.numel() for p in model.parameters())
    print("手算核对:%.4f%% 可训练" % (100.0 * trainable / total))

    # ⚠ 量化后的底座不能直接 merge_and_unload():
    # 旁支是 bf16,底座是 4-bit,合并会把量化误差固化进权重。
    # 要导出单一模型,得先用 fp16/bf16 重新加载一遍底座再合并。
    return model, tokenizer


if __name__ == "__main__":
    main()
在 GPT-2 上取 r=8、只挂 c_attn,实测得到 294,912 个可训练参数,占总量 0.289%。这个数字的用法是:
| 打印出来的占比 | 说明什么 |
|---|---|
| 零点几个百分点 | 正常,旁支挂上了 |
| 接近 0 或恰好 0 | target_modules 名字没匹配上,一个旁支都没挂 |
| 接近 100% | 主干没被冻住,这一轮训的其实是全量微调,显存会立刻爆 |
4.4 这一轮要跑多少步
「训 3 轮」这句话落到调度器上,要换算成参数更新次数,而不是批次数。两者差一个梯度累积倍数,算错就会让学习率曲线整条跑偏。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""训练超参之间的换算:一轮到底走多少步,warmup 该设多少。

这些数字在配置文件里各写各的,但它们之间是硬绑定的。
最常见的事故是:设了梯度累积却忘了它会把「参数更新次数」除以累积步数,
于是 warmup 步数占了整个训练的一大半,学习率还没升上去训练就结束了。

纯标准库,可直接运行。
"""
import math


def steps_per_epoch(n_samples, batch_size, drop_last=False):
    """一轮里 dataloader 会吐出多少个 batch。"""
    if drop_last:
        return n_samples // batch_size
    return math.ceil(n_samples / batch_size)


def optimizer_steps(n_samples, batch_size, epochs,
                    grad_accum=1, drop_last=False):
    """真正调用 optimizer.step() 的次数——学习率调度器认的是这个数。

    注意这里对每轮的 batch 数先整除累积步数:
    一轮结束时不满一个累积周期的那几个 batch,梯度会被带进下一轮或被丢掉,
    所以按轮取整比「总 batch 数除以累积步数」更贴近实际。
    """
    per_epoch = steps_per_epoch(n_samples, batch_size, drop_last)
    return (per_epoch // grad_accum) * epochs


def effective_batch(batch_size, grad_accum, n_devices=1):
    """等效批大小:一次参数更新实际看过多少条样本。

    调 batch_size 调到显存爆掉时,用梯度累积换等效批大小,
    数学上与直接开大 batch 近似等价(BatchNorm 之类的除外)。
    """
    return batch_size * grad_accum * n_devices


def warmup_steps(total_steps, ratio=0.03, minimum=10):
    """按比例算预热步数,并守住一个下限。

    比例通常取 1%~10%。总步数很小时按比例算会算出 2、3 步,
    预热等于没做,所以设一个下限。
    """
    return max(minimum, int(total_steps * ratio))


def lr_at(step, total_steps, base_lr, warm):
    """线性预热 + 线性衰减的学习率曲线,用来画出「现在学多快」。"""
    if step < warm:
        return base_lr * step / max(1, warm)
    progress = (step - warm) / max(1, total_steps - warm)
    return base_lr * max(0.0, 1.0 - progress)


if __name__ == "__main__":
    N = 20000          # 训练样本条数
    BS = 4             # 单卡批大小(受显存限制)
    ACCUM = 8          # 梯度累积步数
    EPOCHS = 3
    LR = 2e-4

    per_epoch = steps_per_epoch(N, BS)
    total = optimizer_steps(N, BS, EPOCHS, ACCUM)
    warm = warmup_steps(total)

    print("一、一组典型配置的换算")
    print("  样本数              %d" % N)
    print("  单卡批大小          %d" % BS)
    print("  梯度累积步数        %d" % ACCUM)
    print("  等效批大小          %d   ← 模型「感觉到」的批大小"
          % effective_batch(BS, ACCUM))
    print("  每轮 batch 数       %d" % per_epoch)
    print("  每轮参数更新次数    %d   ← 被累积步数除掉了" % (per_epoch // ACCUM))
    print("  训练轮数            %d" % EPOCHS)
    print("  总参数更新次数      %d   ← 调度器认的就是这个数" % total)
    print("  预热步数(3%%)        %d" % warm)

    assert per_epoch == 5000
    assert total == 1875
    print("\n  断言通过:每轮 5000 个 batch,总更新 1875 次")

    print("\n二、忘了除累积步数会怎样")
    wrong_total = per_epoch * EPOCHS       # 把 batch 数当成了更新次数
    wrong_warm = warmup_steps(wrong_total)
    print("  按 batch 数算的总步数    %d" % wrong_total)
    print("  据此算出的预热步数        %d" % wrong_warm)
    print("  而真实总更新次数只有      %d" % total)
    print("  → 预热步数 %d 已经超过真实总步数 %d 的 %.0f%%,"
          % (wrong_warm, total, 100.0 * wrong_warm / total))
    print("    学习率全程都在往上爬,从没进入衰减阶段,训练等于没调度。")

    print("\n三、学习率曲线抽样(正确配置)")
    print("  %-10s %-14s" % ("step", "lr"))
    for s in (0, warm // 2, warm, total // 4, total // 2, total - 1):
        print("  %-10d %-14.3e" % (s, lr_at(s, total, LR, warm)))

    print("\n四、同样 20000 条样本,换几组配置看总步数")
    print("  %-8s %-8s %-10s %-12s %-10s" % ("batch", "accum", "等效批", "每轮更新", "总更新"))
    for bs, acc in ((4, 1), (4, 8), (8, 4), (16, 2), (32, 1)):
        pe = steps_per_epoch(N, bs)
        print("  %-8d %-8d %-10d %-12d %-10d"
              % (bs, acc, effective_batch(bs, acc), pe // acc,
                 optimizer_steps(N, bs, EPOCHS, acc)))
    print("\n  等效批一样(都是 32)的几行,总更新次数也一样——")
    print("  显存不够时用累积步数换批大小,训练轨迹基本可比。")
这份脚本把四个量串成一条链:样本数 ÷ 批大小 = 批次数;批次数 ÷ 累积步数 = 每轮更新次数;再 × 轮数 = 总更新次数。预热步数按总更新次数的百分比取,所以链条上任何一环算错,预热比例都会跟着错。脚本还顺带算出等效批大小 = 批大小 × 累积步数——这是显存吃紧时唯一能同时兼顾「批次要大」和「显存要小」的办法。
4.5 让决策本身可复算
最后把前面四个数字汇总成一条可执行的路径。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""该走提示工程、RAG,还是微调?把这个判断写成可复核的规则。

这三条路线经常被当成「谁更高级」的排序题,其实它们解决的是不同的缺口:
  缺规矩(输出格式、语气、行业术语的说法)   → 提示工程,不行再微调
  缺知识(内部文档、会变的事实、要引用出处) → RAG,微调解决不了
  缺习惯(大量重复的固定任务,要压推理成本) → 微调

下面这个打分器不替你做决定,它的作用是把「我觉得该微调」拆成
几个必须逐条回答的事实问题。纯标准库,可直接运行。
"""

# 每条判据:(问题, 命中时给哪条路线加分, 权重, 解释)
RULES = [
    ("答案依赖会变化的事实(价格、库存、政策、今天的数据)",
     "rag", 3, "权重被冻结在训练那一刻,事实一变就得重训,这条路不划算"),
    ("答案必须能追溯到具体文档、要给出处",
     "rag", 3, "微调把知识揉进权重里,没法指着说「这句出自第几页」"),
    ("知识库会持续新增内容",
     "rag", 2, "新增一次就重训一次,运维成本压不住"),
    ("要改的是输出格式 / 语气 / 固定话术",
     "finetune", 2, "这类「怎么说」的习惯正是微调最擅长的"),
    ("手上有 1000 条以上标注一致的样本",
     "finetune", 3, "没有足够标注,微调只会把噪声学进去"),
    ("同一类请求每天调用量很大,推理成本是痛点",
     "finetune", 2, "示例和说明写在提示词里,每次调用都要为它付费"),
    ("提示词已经长到影响延迟或经常被截断",
     "finetune", 2, "把提示词里的规矩固化进权重,输入就能瘦下来"),
    ("任务边界还在反复变,需求没定下来",
     "prompt", 3, "需求一天一变时,改文字几分钟,重训几小时"),
    ("没有 GPU 或没有训练环境",
     "prompt", 3, "微调这条路的门票就是能跑反向传播"),
    ("只是想让模型「更聪明一点」,说不清具体差在哪",
     "prompt", 2, "说不清差在哪,就没有验收标准,训完也无法判断有没有变好"),
]

ROUTE_NAME = {
    "prompt": "提示工程(含 In-Context Learning / CoT)",
    "rag": "RAG 外挂知识库",
    "finetune": "微调(优先 PEFT)",
}
SHORT_NAME = {"prompt": "提示工程", "rag": "RAG", "finetune": "微调"}


def decide(answers):
    """answers: 与 RULES 等长的布尔列表。返回 (得分表, 命中理由)。"""
    score = {"prompt": 0, "rag": 0, "finetune": 0}
    reasons = {"prompt": [], "rag": [], "finetune": []}
    for (question, route, weight, why), hit in zip(RULES, answers):
        if hit:
            score[route] += weight
            reasons[route].append((question, why))
    return score, reasons


def explain(answers):
    score, reasons = decide(answers)
    ranked = sorted(score.items(), key=lambda kv: -kv[1])
    print("  得分:" + "  ".join("%s=%d" % (SHORT_NAME[k], v) for k, v in ranked))
    top, top_score = ranked[0]
    second_score = ranked[1][1]
    if top_score == 0:
        print("  → 判据一条都没命中,说明需求还没描述清楚,先别动手")
        return
    print("  → 推荐:%s" % ROUTE_NAME[top])
    if top_score - second_score <= 1:
        print("  ⚠ 与第二名只差 %d 分,属于可以叠着用的场景,别二选一"
              % (top_score - second_score))
    for q, why in reasons[top]:
        print("     · %s\n       %s" % (q, why))


if __name__ == "__main__":
    print("判据清单:")
    for i, (q, route, w, _why) in enumerate(RULES, 1):
        print("  %2d. [%s +%d] %s" % (i, route, w, q))

    print("\n" + "=" * 60)
    print("\n场景 A:把公司内部制度文档做成问答")
    explain([True, True, True, False, False, False, False, False, False, False])

    print("\n场景 B:让模型按固定模板输出分诊引导,日调用十万级")
    explain([False, False, False, True, True, True, True, False, False, False])

    print("\n场景 C:老板说「让它变聪明点」,没有数据也没有卡")
    explain([False, False, False, False, False, False, False, True, True, True])

    print("\n场景 D:既要引用文档,又要固定输出格式")
    explain([False, True, True, True, True, False, False, False, False, False])

    print("\n" + "=" * 60)
    print("最后一句:这三条路线不是互斥的。真实项目里最常见的组合是")
    print("「RAG 供知识 + 微调定格式」——检索负责说得对,微调负责说得像。")
脚本接受「样本条数、可用显存、任务类型」几个输入,输出推荐方案和理由。它的价值不在于代替你判断,而在于把判断依据写成了文字——三个月后回头看,你能确切知道当初为什么选了 LoRA 而不是全量。
还有一项常被跳过的准备工作:把原始数据整理成统一的指令格式。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""指令数据集的三元组格式:instruction / input / output 到底怎么拼。

微调数据不是「一堆问答」就完事了。模型看到的是一整条被拼接好的字符串,
标签则决定这条字符串里哪几个字要算损失。拼错、标错,训练照跑不误,
但学出来的东西完全不是你想要的——这类错误不会报错,只会让效果莫名其妙地差。

纯标准库,可直接运行。
"""
import json

# 三元组的语义分工:
#   instruction 这次要模型干什么(任务指令,每条都要有)
#   input       这次的具体材料(可以为空,为空就是纯指令任务)
#   output      标准答复(训练时的监督信号)
SAMPLES = [
    {
        "instruction": "根据患者描述的症状,给出可能涉及的科室和就医建议。",
        "input": "最近一周总是饭后上腹胀痛,夜里加重,偶尔反酸。",
        "output": "这些表现常见于上消化道问题,建议挂消化内科就诊,"
                  "由医生安排胃镜或幽门螺杆菌检测进一步判断。"
    },
    {
        "instruction": "提取下面这句话里的检查项目名称,用顿号分隔。",
        "input": "医生开了血常规、腹部超声和幽门螺杆菌呼气试验。",
        "output": "血常规、腹部超声、幽门螺杆菌呼气试验"
    },
    {
        "instruction": "用一句话解释什么是空腹血糖。",
        "input": "",
        "output": "空腹血糖指至少 8 小时未进食后测得的静脉血糖值,"
                  "是筛查糖代谢异常的基础指标。"
    },
]

# 提示词模板:训练和推理必须用同一套,差一个换行都会掉效果
TEMPLATE_WITH_INPUT = (
    "### 指令:\n{instruction}\n\n"
    "### 输入:\n{input}\n\n"
    "### 回复:\n"
)
TEMPLATE_NO_INPUT = (
    "### 指令:\n{instruction}\n\n"
    "### 回复:\n"
)


def build_prompt(sample):
    """把三元组拼成模型真正看到的那段提示词(不含答案)。"""
    if sample.get("input", "").strip():
        return TEMPLATE_WITH_INPUT.format(**sample)
    return TEMPLATE_NO_INPUT.format(instruction=sample["instruction"])


def build_example(sample, eos="</s>"):
    """拼出完整训练样本,并标出答案从第几个字符开始。

    返回 (完整文本, 答案起始下标)。这个下标就是后面做标签屏蔽的依据:
    下标之前的部分是提示词,不该算损失;之后的才是要学的答案。
    """
    prompt = build_prompt(sample)
    full = prompt + sample["output"] + eos
    return full, len(prompt)


def mask_labels(token_ids, prompt_len, ignore_index=-100):
    """把提示词部分的标签置成 ignore_index,让损失只落在答案上。

    prompt_len 这里用 token 个数(不是字符数)。
    真实代码里由 tokenizer 分别编码 prompt 和 full 再取长度差。
    """
    labels = list(token_ids)
    for i in range(min(prompt_len, len(labels))):
        labels[i] = ignore_index
    return labels


def validate(sample):
    """上训练之前先把脏数据挡掉,返回问题清单。"""
    problems = []
    if not sample.get("instruction", "").strip():
        problems.append("instruction 为空:模型不知道这条要它干什么")
    if not sample.get("output", "").strip():
        problems.append("output 为空:这条没有监督信号,白占一个样本位")
    if sample.get("output", "").strip() == sample.get("input", "").strip():
        problems.append("output 与 input 完全相同:多半是数据清洗时串行了")
    if len(sample.get("output", "")) > 2000:
        problems.append("output 过长:会被 max_length 截断成半句话")
    return problems


if __name__ == "__main__":
    print("一、三元组拼成的完整训练样本\n")
    for i, s in enumerate(SAMPLES, 1):
        full, prompt_len = build_example(s)
        print("--- 样本 %d(input %s) ---" % (i, "有值" if s["input"] else "为空"))
        print(full)
        print("   提示词占前 %d 个字符,答案从第 %d 个字符开始\n"
              % (prompt_len, prompt_len))

    print("二、标签屏蔽的效果(用字符下标示意)\n")
    # 假装每个字符就是一个 token,只为把屏蔽这件事看清楚
    demo = SAMPLES[2]
    full, prompt_len = build_example(demo)
    ids = list(range(len(full)))
    labels = mask_labels(ids, prompt_len)
    n_ignored = sum(1 for x in labels if x == -100)
    print("  全长 %d,被置为 -100 的有 %d 个,真正参与损失的有 %d 个"
          % (len(labels), n_ignored, len(labels) - n_ignored))
    print("  参与损失的正是这一段:%r" % full[prompt_len:])
    assert n_ignored == prompt_len
    print("  断言通过:屏蔽长度与提示词长度一致")

    print("\n三、脏数据校验")
    dirty = [
        {"instruction": "", "input": "头疼", "output": "建议就诊"},
        {"instruction": "总结这段话", "input": "血压偏高", "output": "血压偏高"},
        {"instruction": "解释高血压", "input": "", "output": ""},
    ]
    for i, s in enumerate(dirty, 1):
        print("  脏样本 %d:" % i)
        for p in validate(s):
            print("    ✗ " + p)

    print("\n四、落盘成 jsonl(每行一条,训练脚本按行读)")
    for s in SAMPLES[:2]:
        print("  " + json.dumps(s, ensure_ascii=False))
它做三件事:拼接三个字段、检查必填项、统计长度分布。最后一项直接决定 max_length 取多少,而这个值又反过来影响显存里的激活值那一项——账本上的四项开销,到这里终于全部连起来了。
05骨架模板
两份可复制改造的文件:一份高效微调,一份全量微调,把 TODO 填完就能开跑
前面四节算清楚了该走哪条路,这一节给出对应的起手文件。两份模板刻意保持同样的结构、同样的变量名,方便你并排对照——它们真正的差别只有三处:加载后多不多一步包装、学习率差几个数量级、保存的是整模型还是旁支。
模板一:PEFT 路线
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""可复制改造的 PEFT 指令微调骨架。

把 TODO 填完就是一份能跑的训练脚本。刻意保留了每一步的检查点,
因为微调最难受的地方在于:写错了也不报错,只是效果差,
所以每一步都要有一个能当场看到的证据。

用法:
    export BASE_MODEL=<底座路径或 Hub 名字>
    export DATA_PATH=<jsonl 数据路径>
    python3 skeleton_peft_sft.py
"""
import json
import os

import torch
from datasets import Dataset
from peft import LoraConfig, TaskType, get_peft_model
from transformers import (AutoModelForCausalLM, AutoTokenizer, Trainer,
                          TrainingArguments)

BASE_MODEL = os.environ.get("BASE_MODEL", "TODO-填底座名字")
DATA_PATH = os.environ.get("DATA_PATH", "TODO-填数据路径.jsonl")
OUT_DIR = os.environ.get("OUT_DIR", "checkpoints/adapter")
MAX_LEN = int(os.environ.get("MAX_LEN", "512"))

# TODO: 换成你自己任务的模板。训练和推理必须用同一套,差一个换行都会掉效果
PROMPT_TEMPLATE = (
    "### 指令:\n{instruction}\n\n"
    "### 输入:\n{input}\n\n"
    "### 回复:\n"
)


def load_jsonl(path):
    """读 jsonl,每行一个 {instruction, input, output}。"""
    rows = []
    with open(path, "r", encoding="utf-8") as f:
        for line_no, line in enumerate(f, 1):
            line = line.strip()
            if not line:
                continue
            try:
                rows.append(json.loads(line))
            except json.JSONDecodeError as e:
                raise ValueError("第 %d 行不是合法 JSON:%s" % (line_no, e))
    if not rows:
        raise ValueError("数据集是空的,检查 DATA_PATH")
    print("✅ 读到 %d 条样本,第一条的键:%s" % (len(rows), sorted(rows[0])))
    return rows


def make_tokenize_fn(tokenizer):
    """把三元组编码成 input_ids / labels。

    关键在标签屏蔽:提示词部分置 -100,损失只落在答案上。
    不做这一步,模型会把「### 指令:」这种模板字样也当成要学的内容。
    """
    def fn(sample):
        prompt = PROMPT_TEMPLATE.format(
            instruction=sample["instruction"],
            input=sample.get("input", ""))
        answer = sample["output"] + tokenizer.eos_token

        prompt_ids = tokenizer(prompt, add_special_tokens=False)["input_ids"]
        answer_ids = tokenizer(answer, add_special_tokens=False)["input_ids"]

        input_ids = (prompt_ids + answer_ids)[:MAX_LEN]
        # 提示词那一段全部屏蔽掉
        labels = ([-100] * len(prompt_ids) + answer_ids)[:MAX_LEN]

        return {"input_ids": input_ids,
                "labels": labels,
                "attention_mask": [1] * len(input_ids)}
    return fn


def collate(batch, pad_id):
    """按批内最长长度补齐;标签用 -100 补,输入用 pad_id 补。"""
    max_len = max(len(x["input_ids"]) for x in batch)
    out = {"input_ids": [], "labels": [], "attention_mask": []}
    for x in batch:
        gap = max_len - len(x["input_ids"])
        out["input_ids"].append(x["input_ids"] + [pad_id] * gap)
        out["labels"].append(x["labels"] + [-100] * gap)
        out["attention_mask"].append(x["attention_mask"] + [0] * gap)
    return {k: torch.tensor(v) for k, v in out.items()}


def main():
    tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)
    if tokenizer.pad_token is None:
        # 很多因果模型没有 pad_token,拿 eos 顶上即可
        tokenizer.pad_token = tokenizer.eos_token

    rows = load_jsonl(DATA_PATH)
    ds = Dataset.from_list(rows).map(
        make_tokenize_fn(tokenizer), remove_columns=list(rows[0]))

    # 检查点一:随便挑一条,把屏蔽后还剩下什么打印出来看
    sample = ds[0]
    kept = [i for i, l in enumerate(sample["labels"]) if l != -100]
    print("✅ 第一条样本长度 %d,参与损失的 token 有 %d 个"
          % (len(sample["input_ids"]), len(kept)))
    print("   参与损失的内容:%r"
          % tokenizer.decode([sample["input_ids"][i] for i in kept]))

    split = ds.train_test_split(test_size=0.05, seed=42)

    model = AutoModelForCausalLM.from_pretrained(
        BASE_MODEL,
        dtype=torch.bfloat16 if torch.cuda.is_available() else torch.float32)

    lora = LoraConfig(
        task_type=TaskType.CAUSAL_LM,
        r=8,
        lora_alpha=16,
        lora_dropout=0.05,
        bias="none",
        # TODO: 按底座架构填。GPT-2 系填 ["c_attn"];
        #       Qwen / LLaMA 系填 ["q_proj","k_proj","v_proj","o_proj"]
        target_modules=["TODO-填目标模块名"],
    )
    model = get_peft_model(model, lora)

    # 检查点二:占比必须是零点几个百分点。是 100% 说明模块名写错了
    model.print_trainable_parameters()

    args = TrainingArguments(
        output_dir=OUT_DIR,
        per_device_train_batch_size=4,
        gradient_accumulation_steps=8,
        num_train_epochs=3,
        learning_rate=2e-4,          # LoRA 的学习率可以比全量微调大得多
        warmup_step=0.03,
        lr_scheduler_type="cosine",
        max_grad_norm=1.0,
        bf16=torch.cuda.is_available(),
        logging_steps=20,
        eval_strategy="epoch",
        save_strategy="epoch",
        load_best_model_at_end=True,
        metric_for_best_model="eval_loss",
        greater_is_better=False,
        report_to="none",
    )

    trainer = Trainer(
        model=model,
        args=args,
        train_dataset=split["train"],
        eval_dataset=split["test"],
        data_collator=lambda b: collate(b, tokenizer.pad_token_id),
        processing_class=tokenizer,
    )

    trainer.train()

    # 只存旁支,几百 KB 到几 MB
    model.save_pretrained(OUT_DIR)
    tokenizer.save_pretrained(OUT_DIR)
    print("✅ 旁支已保存到 %s" % OUT_DIR)

    # 检查点三:训完立刻拿训练集里的一条去问,答不上来说明根本没学进去
    print("最终评估:%s" % trainer.evaluate())


if __name__ == "__main__":
    main()
填之前先看清楚这几个 TODO 的填法:
| TODO 位置 | 怎么填 |
|---|---|
| 底座名或路径 | 走环境变量 BASE_MODEL,本地目录和 Hub 名字都能用。不要硬编码进源码 |
target_modules | 照你的架构填:GPT-2 系填 c_attn;LLaMA / Qwen 系填 q_proj 等。填完必须看一眼打印出来的可训练参数占比 |
| 学习率 | LoRA 用 1e-4 ~ 3e-4。照搬全量微调的 2e-5 是 LoRA 效果差的头号原因——只训旁支,步子必须迈得更大 |
| 数据加载 | 接上你自己的 dataset。格式统一走 instruction / input / output 三段式 |
模板二:全量微调路线
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""全量微调的标准写法,用来和 LoRA 那一份逐行对照。

放在这里不是推荐你这么干,而是为了让「PEFT 到底省了什么」有个参照物:
把这份和 peft_lora_setup.py 并排看,会发现模型定义部分几乎一样,
差别只在「有没有冻结底座」这一件事上——而显存差了一个数量级。
"""
import os

import torch
from transformers import (AutoModelForCausalLM, AutoTokenizer,
                          DataCollatorForLanguageModeling, Trainer,
                          TrainingArguments)

BASE_MODEL = os.environ.get("BASE_MODEL", "uer/gpt2-chinese-cluecorpussmall")
OUT_DIR = os.environ.get("OUT_DIR", "checkpoints/full-finetune")


def build_training_args():
    """训练参数。注释里标出的是容易和旧写法搞混的字段。"""
    return TrainingArguments(
        output_dir=OUT_DIR,
        # 单卡批大小。显存不够就调小它,再用累积步数把等效批大小补回来
        per_device_train_batch_size=4,
        per_device_eval_batch_size=4,
        gradient_accumulation_steps=8,      # 等效批大小 = 4 × 8 = 32
        num_train_epochs=3,
        # 全量微调的学习率要比 LoRA 小一到两个数量级:
        # 动的是预训练好的权重本身,步子迈大了直接把原有能力冲掉
        learning_rate=2e-5,
        weight_decay=0.01,
        # 预热:按总更新次数的比例给,传小数表示比例
        warmup_step=0.03,
        lr_scheduler_type="linear",
        # 梯度裁剪,防止个别异常样本把权重一把带飞
        max_grad_norm=1.0,
        bf16=torch.cuda.is_available(),
        logging_steps=50,
        eval_strategy="epoch",              # 每轮评估一次
        save_strategy="epoch",
        load_best_model_at_end=True,        # 训完自动回滚到最好的那一轮
        metric_for_best_model="eval_loss",
        greater_is_better=False,
        report_to="none",                   # 不往任何实验跟踪平台发数据
    )


def main(train_dataset, eval_dataset):
    tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)
    model = AutoModelForCausalLM.from_pretrained(
        BASE_MODEL,
        dtype=torch.bfloat16 if torch.cuda.is_available() else torch.float32,
    )

    # 因果语言建模的 collator:mlm=False 表示不做掩码语言建模,
    # 它会自动把 input_ids 复制一份当 labels,并把 padding 位置置成 -100
    collator = DataCollatorForLanguageModeling(tokenizer=tokenizer, mlm=False)

    trainer = Trainer(
        model=model,
        args=build_training_args(),
        train_dataset=train_dataset,
        eval_dataset=eval_dataset,
        data_collator=collator,
        # 分词器要通过 processing_class 传,不再是过去的 tokenizer=
        processing_class=tokenizer,
    )

    trainer.train()
    trainer.save_model(OUT_DIR)       # 存的是完整权重,和底座一样大
    tokenizer.save_pretrained(OUT_DIR)

    metrics = trainer.evaluate()
    print("最终评估:%s" % metrics)
    return trainer


if __name__ == "__main__":
    raise SystemExit(
        "这份脚本需要传入已经 tokenize 好的数据集才能跑,\n"
        "请在自己的训练入口里 import main() 并把 Dataset 传进来。")
这份模板用的是官方 Trainer,它把训练循环、评估、保存都包好了,适合模型小到显存放得下的场景。但它有一批参数名在 transformers v5 里改过,照着老教程抄必然报错:
| 老写法(v4) | 现在的写法(v5) | 说明 |
|---|---|---|
tokenizer= | processing_class= | Trainer 的构造参数改名,传老名字会报未知参数 |
evaluation_strategy= | eval_strategy= | 同上,少了 evaluation_ 前缀 |
warmup_ratio= | warmup_step= | 合并成一个参数,传小数时按比例解释 |
torch_dtype= | dtype= | from_pretrained 的参数改名 |
report_to 默认上报 | 默认 "none" | 不再默认往实验跟踪平台发数据,要上报得显式写 |
06易错点汇总
按「选型 / 显存 / LoRA 配置 / 数据 / 版本」五类归并,每条都给现象和修法
⚠️ 一、选型层面
- 拿微调去补知识。 现象:喂了几百条公司资料,模型该不知道还是不知道,甚至开始一本正经地编。修法:缺事实走检索,微调只负责把话说成你要的样子。两件事都要就两样都上。
- 提示词还没打磨就上微调。 现象:训完发现效果和改两句提示词差不多,但多花了几天。修法:永远先把提示词试到头,它成本最低、迭代最快。
- 为了「先进」而选 QLoRA。 现象:显存明明够,却用量化把速度拖慢一截。修法:能上 LoRA 就别上 QLoRA——它是用时间换空间,显存不紧张时这笔交易不划算。
- 默认「高效微调效果一定不如全量」。 修法:多数任务能逼近,但不保证等同。别照搬结论,用你自己的验证集测一次再下判断。
⚠️ 二、显存估算
- 只按权重算显存。 现象:算出来 14 GB,实际一跑就 OOM。修法:加上梯度和优化器状态,每个可训练参数约 12 字节,再留激活值的余量。
- 以为 LoRA 能让底座变小。 现象:LoRA 之后仍然装不下,百思不得其解。修法:权重那一项一分没省,省的是梯度和优化器状态。底座要压只能靠量化。
- 忘了优化器状态是两份。 Adam 系要存一阶和二阶动量,通常还是
fp32,合计 8 字节——这是账单上最大的一项,不是权重。 - 把优化器状态算在了冻结参数头上。 修法:梯度和优化器状态只为需要梯度的参数分配。这正是 PEFT 省钱的全部原理。
⚠️ 三、LoRA 配置
target_modules名字写错。 现象:不报错,训练照常跑完,效果却不对。修法:挂完立刻打印可训练参数占比,落在零点几个百分点才算对;接近 0 是没挂上,接近 100% 是主干没冻住。- 把全量微调的学习率照搬给 LoRA。 现象:loss 几乎不动,训了几轮和没训一样。修法:LoRA 用
1e-4 ~ 3e-4,比全量高近十倍——只训旁支,步子必须迈大。 - 把全部参数都传给优化器。 现象:不报错,但显存和全量微调差不多,LoRA 白挂了。修法:只把
requires_grad为真的参数传进去,否则优化器会为冻结参数也分配状态。 - 一上来就把 r 拉满。 修法:从 r=8 起步,参数量与 r 成正比,翻倍前先确认小的确实不够用。
- 调 r 时忘了
lora_alpha。 修法:按alpha = 2r取值,缩放系数恒为 2,改 r 时不必重调学习率。
⚠️ 四、数据与步数
- 把提示词部分也算进损失。 现象:模型学会了复述问题,答案部分反而没学好。修法:提示词位置的标签置为
-100,只让output参与计分。 - 把总步数按批次数算。 现象:学习率曲线提前跑完,后半程一直贴着 0。修法:总步数 = 批次数 ÷ 累积步数 × 轮数,调度器推进的是参数更新次数。
max_length拍脑袋定。 现象:定小了长答案被砍,定大了补位白烧显存。修法:先统计长度分布,按分位数取值。- 照抄二手的模型规格。 现象:按错误的词表大小估算,整条显存账都偏。修法:以配置文件为准——本讲用的中文 GPT-2 实际是 vocab 21128、n_embd 768、12 层 12 头。
⚠️ 五、版本与参数名
- 照着老教程写 Trainer 参数。 现象:报未知参数,或者行为和预期不一致。修法:对照 v5 的新名字——
tokenizer=→processing_class=、evaluation_strategy=→eval_strategy=、torch_dtype=→dtype=、warmup_ratio并入warmup_step。 - 以为训练日志会自动上报。 修法:
report_to现在默认是"none",要上报得显式写。 - 把密钥硬编码进脚本。 修法:一律走
os.environ.get(...),模型路径同理。
07自测题
点击题目展开答案;能把这 10 题说清楚,选型这一关就过了
微调擅长解决什么问题,不擅长解决什么问题?
擅长改「怎么答」——输出的格式、语气、任务套路,因为这些是反复出现的表达模式,容易被梯度下降压进参数。不擅长往模型里塞进大量新事实:一条只出现一两次的具体事实既学不牢,也无法保证在需要时被准确取出。缺事实应当走检索,把资料放进上下文让模型读着答。
提示词、检索、微调三者的先后顺序应该怎么排?为什么?
先提示词,再判断缺的是知识还是格式。缺知识上检索,缺格式才微调。原因是提示词能解决的问题微调也能解决,反过来不成立;而微调的每次迭代都要重训一遍。用微调去办一件改提示词就能办的事,是用最贵的手段办最便宜的事。
全量微调和高效微调,除了显存,还有哪些实际差别?
①产物大小:全量是一份完整模型(GB 级),PEFT 是一份旁支(MB 级)。②多任务部署:PEFT 可以一个底座挂多份旁支按需切换,全量要每个任务存一整份。③灾难性遗忘:全量风险更高,PEFT 主干没动过。④效果上限:全量最高,PEFT 多数任务能逼近但不保证等同。
训练时占显存的有哪四项?每项每个参数大约多少字节?
模型权重 2 字节(bf16/fp16)、梯度 2 字节(与权重同形状)、优化器状态 8 字节(Adam 系存一阶和二阶动量,通常 fp32,4+4)、激活值不固定(随批大小与序列长度变化)。前三项合计每个可训练参数约 12 字节。
为什么说 LoRA 并没有让底座变小?它到底省了什么?
因为权重那一项一分没省——底座还得完整放在显存里。LoRA 冻结了 99% 以上的参数,而梯度和优化器状态只为需要梯度的参数分配,所以省掉的是这两项。实测同一个 7B 模型:全量 104.3 GB → LoRA 13.1 GB。要把权重那一项也压下去,只能靠量化,那就是 QLoRA。
本讲用的中文 GPT-2 底座,参数量是多少?词嵌入占多大比例?
实测 102,068,736 个参数,词嵌入约占 16.7%(词表 21128 × 隐层 768)。注意这个词表大小要以配置文件为准,不要照抄二手数字——词表规模直接影响嵌入层大小,抄错会让整条显存估算跟着偏。
挂完 LoRA 后必须检查哪个数字?它异常时分别说明什么?
检查可训练参数占总量的比例。落在零点几个百分点才正常;接近 0 说明 target_modules 名字没匹配上,一个旁支都没挂;接近 100% 说明主干没被冻住,这一轮训的其实是全量微调。必须打印这个数,因为挂错不会报错。
秩 r 与新增参数量是什么关系?GPT-2 上 r=8 只挂 c_attn 是多少个参数?
挂在形状 d_in × d_out 的权重上,新增 r × (d_in + d_out) 个参数,与 r 成正比,r 翻倍参数翻倍。GPT-2 的 c_attn 是 768×2304,r=8 时单层 8×(768+2304)=24,576;12 层合计 294,912 个,占总量 0.289%。
LoRA 的学习率该怎么取?为什么和全量微调不一样?
LoRA 取 1e-4 ~ 3e-4,全量微调取 1e-5 ~ 5e-5,差近十倍。因为只有旁支在训、主干全程冻结,可调空间小得多,步子必须迈得更大。照搬全量微调的学习率是 LoRA 效果差的头号原因。另外 lora_alpha 按 2r 取值,缩放系数恒为 2,调 r 时不必重调学习率。
三段式指令数据里,哪一段参与计算损失?写错会怎样?
只有 output 参与。instruction 和 input 是条件不是学习目标,对应位置的标签要置为 -100。写错的后果是模型花力气去学「怎么复述问题」,而答案部分反而没学好。
「训 3 轮」怎么换算成调度器要的总步数?算错会有什么现象?
总更新次数 = 批次数 ÷ 累积步数 × 轮数,调度器推进的是参数更新次数而不是批次数。直接拿批次数当总步数,学习率曲线会提前跑完,后半程一直贴着 0,模型等于后面几轮白训。另外等效批大小 = 批大小 × 累积步数,这是显存吃紧时唯一能兼顾大批次的办法。
附版本与字段对照
本讲代码实跑时的依赖版本,以及几个改过名字的参数
依赖版本
下面是本讲全部脚本实跑时所在环境的版本。微调这条链上的库迭代很快,参数名改动频繁,看教程时先对一眼版本,能省掉大半的报错排查。
| 库 | 版本 | 在这条链上负责什么 |
|---|---|---|
transformers | 5.17.0 | 模型加载、分词器、Trainer、学习率调度 |
peft | 0.21.0 | LoRA 等高效微调方法的实现,get_peft_model 就来自这里 |
trl | 1.13.0 | 面向指令微调与偏好对齐的上层封装 |
datasets | 5.0.1 | 数据集加载与批处理 |
accelerate | 1.15.0 | 设备调度与分布式训练的底层支撑 |
bitsandbytes | 0.50.2 | 4-bit / 8-bit 量化,QLoRA 依赖它 |
transformers v5 改过名字的参数
网上大量教程停留在 v4,直接照抄会报未知参数,或者行为与预期不一致。这几个是本讲会碰到的:
| v4 写法 | v5 写法 | 说明 |
|---|---|---|
Trainer(tokenizer=...) | processing_class= | 不只接分词器,也接图像、音频的处理器,所以改成了更通用的名字 |
evaluation_strategy= | eval_strategy= | 纯粹的改名,取值不变 |
warmup_ratio= | warmup_step= | 两个参数合并成一个,传小数时按比例解释,传整数时按步数解释 |
from_pretrained(torch_dtype=...) | dtype= | 加载精度的参数改名 |
report_to 默认上报 | 默认 "none" | 不再默认往实验跟踪平台发数据,需要上报要显式写 |
术语表
| 术语 | 含义 |
|---|---|
fine-tune | 微调。拿自己的数据在预训练权重上继续做梯度下降,把参数往任务上推一段 |
PEFT | 参数高效微调的统称。只训练极小一部分参数,其余冻结 |
LoRA | 低秩适配。冻结原权重,在旁边并联 A、B 两个低秩矩阵,只训练它们 |
QLoRA | 底座按 4-bit 量化存放的 LoRA,用速度换显存 |
r(秩) | LoRA 旁支的中间维度。新增参数量与它成正比 |
lora_alpha | 旁支输出的缩放分子,实际缩放系数是 alpha / r |
target_modules | 要挂旁支的模块名列表,按架构填写 |
| 梯度累积 | 攒够若干个批次的梯度再更新一次参数,用来在小显存上获得大的等效批大小 |
| 等效批大小 | 批大小 × 累积步数,模型实际感受到的批次规模 |
| 灾难性遗忘 | 微调后原有的通用能力被覆盖、明显退化的现象 |