DreamBooth / LoRA 微调与出图服务化
微调不是把画师换掉,而是给他挂一个可拆卸的挂件;挂件要生效,prompt 里必须喊出它的专属 token。
30″30 秒看懂微调与服务化
通用的 Stable Diffusion 底模,是一位什么都画得来的通才画师。他画得出「一只狗」,但画不出你家那只狗——因为他从没见过。微调要解决的就是这件事。
让他记住一个新形象,有两条路。第一条是送他去封闭集训:关起门来反复看你那几十张照片,出来时他整个人都变了,画什么都带点你家狗的味道——这是 DreamBooth,产物是一位全新的画师,几个 GB。第二条是给他配一个可拆卸的挂件:画师本人一个字没改,挂上就换风格,摘下还是原来的他——这是 LoRA,产物只有几十 MB。
不管走哪条路,都得先给这个新形象起一个专属代号,比如 [V]。以后想让画师画它,prompt 里必须把这个代号喊出来,不喊他就当没这回事。
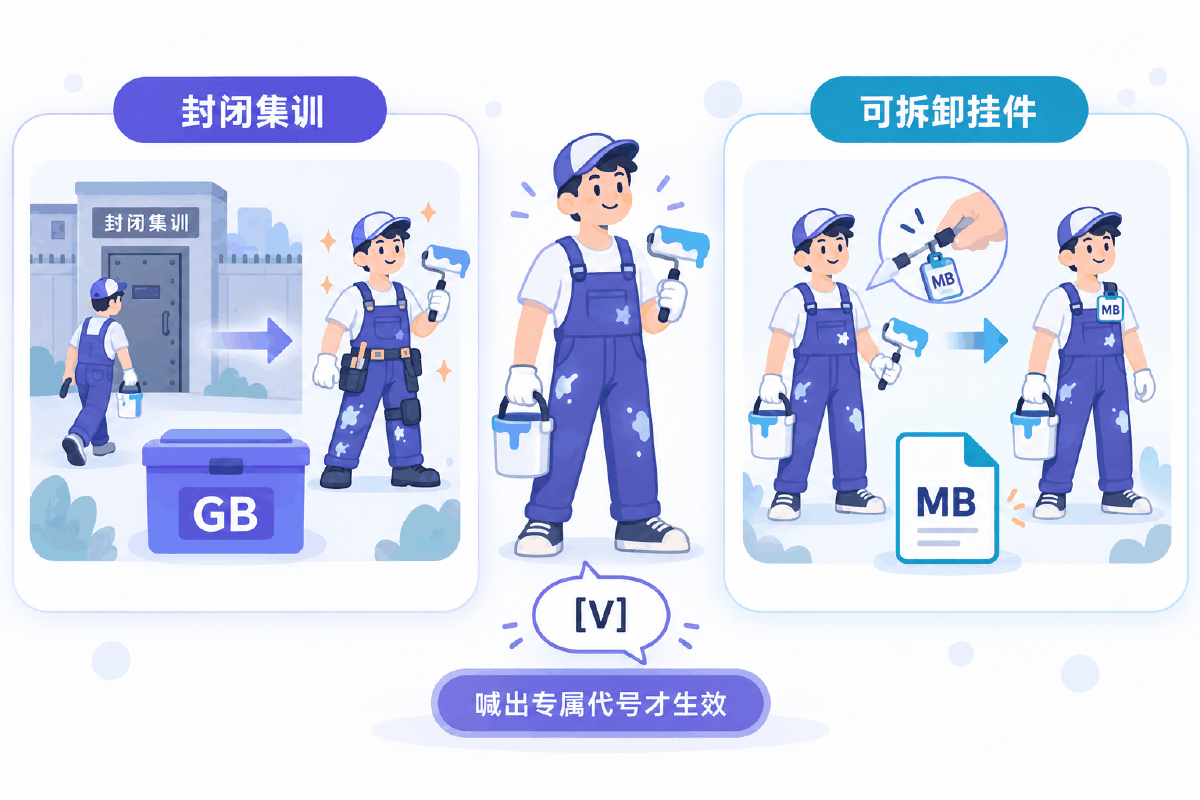
| 比喻里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 通才画师 | base model / checkpoint | 预训练好的 SD 底模,2~7 GB,画风由它决定 |
| 封闭集训 | DreamBooth | 用少量图片微调整个模型,产物是一个完整的新模型 |
| 可拆卸挂件 | LoRA | 底模冻结不动,旁边挂一对低秩矩阵,随挂随摘 |
| 新加的词条 | Textual Inversion | 只往词表里塞一个新词的向量,几 KB |
| 旁边的小助手 | Hypernetwork | 额外挂一个小网络去改 U-Net 的中间结果,常用来学画风 |
专属代号 [V] | 专属 token / instance prompt | 一个没有含义的罕见词,用来指代你要教的那个新形象 |
| 复习「普通的狗长什么样」 | 类别先验 / class prompt | 防止画师学完之后把所有狗都画成你家那只 |
| 画店的取件号 | task_id 与异步任务队列 | 出一张图要几十秒,客人先拿号、回头凭号取件 |
这一讲的后半段跳到服务化。逻辑是连着的:挂件训好了,总要让别人用上。而出一张图要几十秒,同步的 HTTP 请求必然超时——所以画店不能让客人站在柜台前干等,只能发一张取件号,让他回头再来问。这就是异步任务队列存在的全部理由。
01概念:四条路通向同一个目标
为什么底模不够用、四种训练方法的分工、跑得起来需要什么硬件、模型从哪里下
1.1 底模已经很强了,为什么还要微调
通用底模的能力边界很清楚:它学过的概念都画得出来,没学过的一个也画不出来。而实际项目里要的往往恰恰是后者:
一位真实人物、一只自家宠物、一件具体的产品。底模没见过,prompt 写得再细也只能得到「一个长得有点像的陌生人」。
品牌视觉规范、某位插画师的笔触、一整套 IP 的配色。这类需求靠堆形容词描述不出来,只能拿图训。
今天画海报、明天画头像,都要保持同一套形象。微调的产物是一份权重,换机器、换同事都能复用。
微调的成本比想象中低。DreamBooth 就是对文本生成图片模型进行微调,它使用户可以用几张个性化的图片(比如个人照片、自家宠物照片),以很少的训练成本就训练一个专属的模型。这也是开源底模最大的价值——底模要靠 4000 卡 A100 规模的集群才训得出来,而在它之上做一次微调,一张消费级显卡跑几十分钟就够了。
1.2 四种训练方法:各改各的那一层
Stable Diffusion 有四种训练模型的方法。它们的差别不在「效果好坏」,而在改的是模型的哪一部分——这直接决定了产物多大、训练多久、适合什么任务。
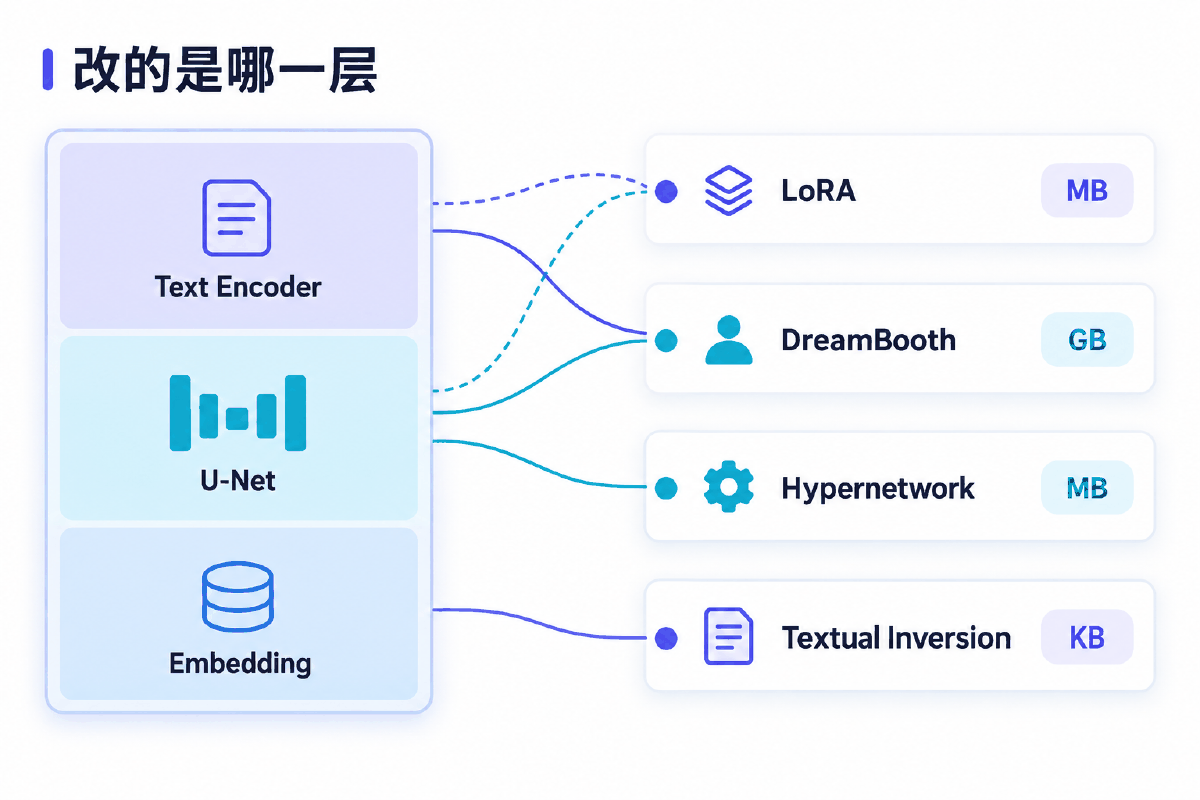
| 训练方法 | 作用 | 特点 |
|---|---|---|
Textual Inversion | 使用文本提示来训练模型,根据模型引用给定的图像并选择最匹配的图像 | 对计算资源要求较低,适用于需要快速生成大量高质量图像的场景 |
Hypernetwork | 从模型内部找到更多相似的东西,使得生成为近似内容图像 | 通常训练艺术风格,推荐训练画风 |
DreamBooth | 使用少量图像来训练模型的方法,是一种基于深度学习的图像风格转换技术 | 可以将一张图片的风格应用到另一张图片上,以生成新的图像 |
LoRA | 使用少量图像来训练模型的方法,只修改网络中部分参数 | 训练速度更快,模型大小适中 |
把「改哪一层」这件事摊开,四者的关系就一目了然了:
| 方法 | 动了哪一部分 | 产物体积 | 显存门槛 | 最适合 |
|---|---|---|---|---|
Textual Inversion | 只在 embedding 词表里新增一个词的向量,模型本体一个参数没动 | 几十 KB | 低 | 教会模型一个新概念的名字 |
Hypernetwork | 额外挂一个小网络,去改 U-Net 注意力层的中间结果 | 几十~几百 MB | 中 | 画风、笔触 |
DreamBooth | 整个 U-Net(可选连同 text encoder)全量更新 | 2~7 GB | 高(24 G) | 把一个具体主体刻进模型 |
LoRA | U-Net 与 text encoder 的部分层旁路挂一对低秩矩阵,原权重冻结 | 几十 MB | 低(8 G) | 人物、画风、配饰,日常首选 |
体积差了五个数量级(KB → GB),正是因为它们动的层级完全不同。
1.3 硬件要求与云 GPU
先看 Stable Diffusion 模型本身的配置要求。注意最后一列的重要程度——这张表真正想说的是:除了显卡,其他都不太重要。
| 硬件 | 推荐配置 | 最低配置 | 重要程度 |
|---|---|---|---|
| 操作系统 | Windows 10 或 11 / macOS / Linux | 无要求 | ☆ |
| CPU | 64 位多核处理器 | 无要求 | ☆ |
| 显卡 | NVIDIA 显卡,RTX 3060 以上算力,显存 8 GB 以上 | GTX 1660 以上性能显卡,显存 6 GB 以上 | ☆☆☆☆☆ |
| 内存 | 16 GB 以上 | 8 GB | ☆☆☆ |
| 硬盘空间 | 100 GB 以上 | 20 GB 以上 | ☆☆☆ |
| 出图效果 | 10~30 秒,可绘制 1024×1024 的图像 | 1~3 分钟,可绘制 512×512 的图像 | / |
两条配套的建议:推荐使用搭载 N 卡的 Windows 系统,macOS 在默认配置下仅支持 CPU 运算,图形性能较差、插件支持有限,且训练模型困难;推荐使用云端部署 Stable Diffusion,将其部署在云服务器上使用。
为什么训练这一步几乎一定要上云
注意上表说的是出图的门槛。训练的门槛还要高一截:DreamBooth 基于开源代码 diffusers,显存需要 24 GB 以上;LoRA 基于开源代码 kohya_ss,显存需要 8 GB 以上。消费级显卡里能凑够 24 GB 的本来就不多,所以 DreamBooth 这条路基本只能租卡。
云 GPU 平台解决的正是这三个痛点:GPU 卡型多样,算力、显存差异大,选型困难;环境配置复杂、模型安装和调试门槛高;各类插件迭代频繁,难以进行环境管理。对应的产品能力是:
根据应用匹配推选 GPU 算力资源,实现最高性价比;同时打通必备云服务组件,大幅简化云服务配置流程。
分钟级自动构建 LLM、AI 作画等应用环境,提供多种预装模型环境,包含 Stable Diffusion、ChatGLM 等热门模型。
提供开发者友好的图形界面,支持 JupyterLab、WebUI 等多种算力连接方式,AI 研究调试门槛很低。
实际使用的路径是一条直线,中间不需要自己配环境:
另外建议在使用前先安装 Python、Git 和 CUDA 等主要前置应用,以减少报错的可能性并提高下载速度。
1.4 预训练模型从哪里来
微调必须站在一个底模之上,而底模不用自己训。三个主要来源:
| 站点 | 定位 | 特点 |
|---|---|---|
| Hugging Face(抱脸网) huggingface.co/models | 开源机器学习模型总站 | 专注于构建、训练和部署先进开源机器学习模型,包含的内容非常广泛,不仅仅包括 AI 绘画,还包括很多其他 AI 领域的东西。diffusers 代码里的仓库名直接指向这里。 |
| Civitai(C 站) civitai.com | 专业的 AI 绘画模型分享平台 | 无需注册即可访问和下载模型,包含模型的详细介绍、使用教程、参考图等丰富内容。找 LoRA 和画风模型主要靠它。 |
| 哩布哩布 AI liblibai.com | 国内的 AI 绘画原创模型网站 | 包含大量模型和绘图作品,还支持在线 Stable Diffusion 绘图。国内访问速度有优势。 |
② 看清授权范围:模型页上通常写明能否商用、能否二次分发。拿去做交付物之前先确认这一条,出了事没法补救。
02原理:两条路各自动了什么
专属 token 与类别先验、低秩分解、rank 的取舍、每个超参数改了什么
2.1 DreamBooth 的三件事
DreamBooth 主要是对文本生成图片模型进行微调,它使用户可以用几张个性化的图片,以很少的训练成本就训练一个专属的模型。它的训练过程可以拆成一句话:
a [V] dog,[V] 是一个罕见、没有什么含义的符号组合。在训练过程中,首先用文本编码器提取这个专属 prompt 的文本特征,然后用图像编码器提取图片的特征,以文本特征、图像特征作为扩散模型的输入,进行模型训练。预测时输入关键词即可生成对应风格的图片。
这段话里藏着三个必须讲透的设计。
① 为什么专属 token 必须是一个「没有含义的词」
训练在做的事,本质是把「这个词」和「这组图」强行绑在一起。如果你挑的词模型本来就认识,那这个绑定就变成了「覆盖」——模型原本对这个词的理解会被你这几十张图冲掉。
| 挑的 token | 后果 | 为什么 |
|---|---|---|
dog | 灾难 | 模型里所有的狗都会被拽向你这几张图,从此再也画不出普通的狗 |
mydog | 较差 | 会被切成 my + dog 两个有含义的碎片,照样污染 dog |
Tom | 较差 | 常见人名,模型有很强的既有印象,两股力量互相打架 |
sks / [V] | 好 | 罕见组合,切出来的碎片几乎没有语义,是一块干净的画布 |
Plaidshirtprogrammer | 好 | 拼出来的「不存在的词」,同样干净;可读性还比 sks 好 |
所以配置里那两条注意事项是这么来的:INSTANCE_PROMPT 中填入专属关键词,可以指定任意关键词,但是需要找一个「不存在的词」。
② 类别先验 prompt 是干什么的
另一条配置说:CLASS_PROMPT 是让 AI 自动生成 image 用的 prompt,不要有专属关键词即可。这句话背后是 DreamBooth 论文里最重要的一个机制。
训练时只喂「你家那只狗」的照片,模型会得出一个过头的结论:「原来狗就长这样」。于是它画什么狗都画成你家那只,甚至连「狼」「狐狸」都开始跑偏——这个现象叫语言漂移。
类别先验的做法是:让底模自己生成一批普通的狗(用不含专属 token 的 a photo of dog),训练时把这批图和你的图一起喂进去,损失函数里额外加一项「普通的狗要画得和以前一样」。相当于一边教他认识你家的狗,一边让他复习普通的狗长什么样。
| 参数 | 作用 | 调它会怎样 |
|---|---|---|
--with_prior_preservation | 开启类别先验保留 | 不开就没有复习环节,语言漂移风险大增 |
--class_prompt | 复习用的 prompt,不含专属 token | 写错成含专属 token,复习和学习就变成同一件事,机制失效 |
--num_class_images | 复习图的数量,一般 100~200 | 太少压不住漂移;太多训练变慢、新形象学得不牢 |
--prior_loss_weight | 复习这一项在损失里的权重 | 调大越保守(不容易过拟合但也不太像);调小越激进 |
③ 数据为什么必须多样
数据准备那一步的要求是:把图像统一处理成 512×512 格式,为了使 DreamBooth 模型更加多样化,尽量使用不同的环境、灯光、发型、表情、姿势、角度等。
原因在于模型分不清「哪些特征属于主体、哪些属于场景」。如果你的 103 张照片全是同一个背景、同一个角度拍的,模型会把那个背景也一并算进「这个专属 token 的含义」里——以后不管你写什么 prompt,背景都甩不掉。
| 数据集问题 | 训练后的症状 | 修法 |
|---|---|---|
| 背景全一样 | 背景甩不掉,换 prompt 也没用 | 补充不同环境拍的图 |
| 角度全是正面 | 一写侧面就崩,或者硬掰成正面 | 补侧面、背面、俯仰角 |
| 光线全是白天自然光 | 夜景、逆光出图质量骤降 | 补不同光线条件的图 |
| 张数太少(< 10) | 严重过拟合,几乎只会复刻训练图 | 补到 20 张以上;实在没有就降步数、调大先验权重 |
| 尺寸不统一 | 训练时自动裁切,主体被裁掉一半 | 统一裁成 512×512 并人工过一遍裁切结果 |
2.2 LoRA:用两个瘦矩阵代替一个胖矩阵
LoRA 的全称是 Low-Rank Adaptation of Large Language Models,即大语言模型的低阶适应。它最早是给语言模型设计的,后来被原样搬到了扩散模型上。
它的定位是:在不修改 SD 模型的前提下,利用少量数据训练出一种画风 / IP / 人物,实现定制化需求,所需的训练资源比较小,非常适合社区使用者和个人开发者。用数据公式表达如下:
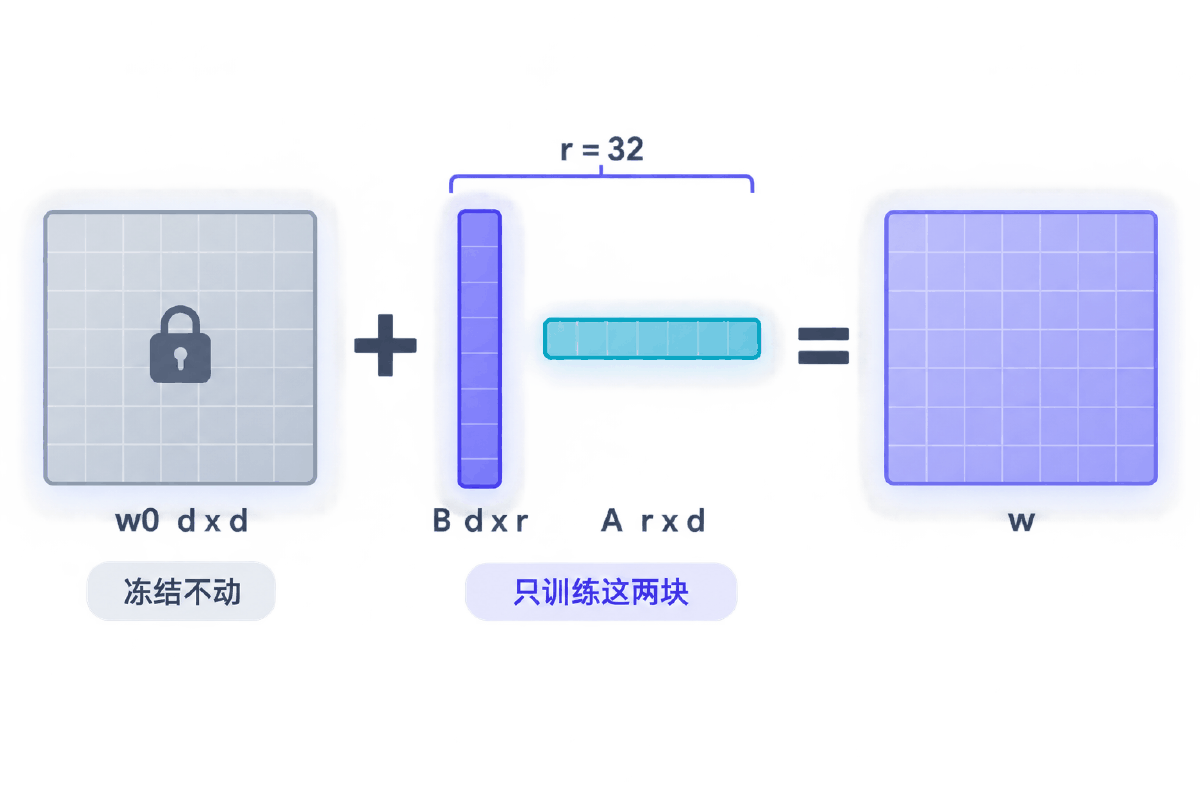
其中 w₀ 是预训练 SD 模型的参数(Weights),BA 为低秩矩阵也就是 LoRA 模型的参数,w 代表被 LoRA 模型影响后的最终 SD 模型参数。整个过程是一个简单的线性关系:原 SD 模型叠加 LoRA 模型后,得到一个全新效果的模型。
为什么这能省掉那么多参数
关键在 B 和 A 的形状。假设原来那层权重 w₀ 是一个 d × d 的方阵:
| 矩阵 | 形状 | 参数量(d = 1024,r = 32) | 训不训 |
|---|---|---|---|
| w₀ | d × d | 1024 × 1024 = 1048576 | 冻结,一个字节都不改 |
| B | d × r(高瘦) | 1024 × 32 = 32768 | 训练 |
| A | r × d(矮胖) | 32 × 1024 = 32768 | 训练 |
| B 与 A 合计 | — | 65536 | 占 w₀ 的 6.25% |
B 乘 A 之后得到的仍然是一个 d × d 的矩阵,形状和 w₀ 严丝合缝,可以直接相加——但它是由两个瘦矩阵「撑」出来的,自由度被限制在 r 这个很小的数上。这就是「低秩」的含义。
三个直接后果
磁盘上存的只有 B 和 A,不含 w₀。底模 2~7 GB,LoRA 几十 MB,差了两个数量级。分享、下载、同时挂好几个都毫无压力。
底模全程冻结,不需要为它保存梯度和优化器状态。训练时显存的大头(优化器状态通常是参数量的两倍)在这里基本不存在,只多出 rank 那一小撮可训练参数。
因为是加法,挂上就是 w₀ + BA,摘下就是 w₀,底模文件从未被改写。还能乘个系数 w₀ + α·BA 调强度,甚至同时挂多个 LoRA。
「挂件强度」就是那个 α——
set_adapters(["glasses"], adapter_weights=[0.8]) 里的 0.8。画风过冲就往下调到 0.6~0.8,这是 DreamBooth 做不到的事:集训回来的人,你没法让他「只发挥 80% 的新本事」。
2.3 rank 怎么选
rank(也写作 network_dim)就是公式里那个 r,是 LoRA 唯一的结构性超参数。它决定挂件的「容量」——能记住多少新东西。
| rank | 产物体积(SD 1.5 参考) | 容量 | 适合 |
|---|---|---|---|
| 4~8 | 约 10~20 MB | 小 | 单一画风、笔触、色调,学的东西很「薄」 |
| 16~32 | 约 40~80 MB | 中 | 日常首选。具体人物、宠物、产品、服饰 |
| 64~128 | 约 150~300 MB | 大 | 多个概念、复杂 IP 体系;需要配足够多的数据 |
| > 128 | 300 MB 以上 | 过剩 | 几十张图的小数据集基本必过拟合,且失去了 LoRA 轻量的意义 |
选 rank 的直觉是「容量要和数据量匹配」:20 张图配 rank 128,等于给小学生一本厚词典,他只会把这 20 张图原样背下来——出图时一写别的场景就崩。反过来,rank 4 想学一个复杂人物的多角度特征,容量不够,怎么训都只学个大概。
② 加上这个 LoRA 之后,不相关的词也变形了——写「一辆车」结果车上也带着训练主体的纹理;
③ 挂件强度调到 0.5 以下才勉强能用。
遇到这三条,先降 rank,再降步数,最后才考虑补数据。
2.4 训练超参数:每一个都改了什么
LoRA 训练的配置分四组:训练规模、学习率、优化器、输出。逐个说清它们的影响。
第一组:图像分辨率、批次大小、最大训练轮数、保存频率
| 参数 | 常用值 | 它到底在控制什么 |
|---|---|---|
resolution | 512 | 训练分辨率,要和数据集裁切尺寸一致。拉到 768 显存开销按面积翻倍,而 SD v1 底模本身在 512 附近训练,收益有限 |
train_batch_size | 1~2(8 G 显存) | 一次同时看几张图。显存的主要开销之一;调不上去就用梯度累积 |
gradient_accumulation_steps | 1~4 | 累积几次梯度再更新一次。等效批次 = batch × 累积步数,显存不涨,代价是慢 |
max_train_steps或 max epochs | 1600 左右起步 | 训多久。最容易调错的一个:太少学不到,太多就过拟合。经验起点是「图片数 × 10~15」 |
checkpointing_steps | 200 | 每隔多少步存一版。这个参数的价值被严重低估——它让你训完能横向挑最好的那一版,而不是只能信最后一版 |
train_text_encoder | 看任务 | 是否仅训练 U-Net,还是连文本编码器一起训。打开后专属 token 学得更牢,但画风容易外溢到别的词上 |
第二组:学习率与调度器
配置里要设置的是整体模型学习率 lr、U-Net 部分的学习率 unet_lr,以及文本编码器的学习率 text_encoder_lr;调度器选择余弦退火重启模式 lr_scheduler,并设置相应的预热步数 lr_warmup_steps 和余弦退火的重启周期数 lr_restart_cycles。
| 参数 | LoRA 常用值 | 调它的后果 |
|---|---|---|
unet_lr | 1e-4 | 主力学习率。调大到 1e-3 学得快但容易崩;调小到 1e-5 训半天没变化 |
text_encoder_lr | 5e-5(比 unet 小) | 必须比 unet_lr 小。文本编码器是所有词共用的,学快了会把整个词表带偏 |
lr_warmup_steps | 总步数的 5%~10% | 预热:开头先用很小的 lr 爬坡。省掉它,前几十步的大梯度可能直接把挂件打废 |
lr_scheduler | cosine_with_restarts | 余弦退火重启:lr 按余弦曲线降到底,然后跳回高位重来,帮模型跳出局部最优 |
lr_restart_cycles | 2~4 | 重启几次。周期太多,每个周期都没降到底就重启,等于一直在高 lr 上晃 |
把这两个数字记混,是新手训练翻车最常见的原因之一。
第三组:优化器
优化器类型 optimizer_type 默认选择 AdamW8bit。这个选择不是随便定的,它是「8 GB 显存能跑起来」的关键一环:
| 优化器 | 每个可训练参数额外占的显存 | 取舍 |
|---|---|---|
AdamW(fp32 状态) | 约 8 字节(一阶矩 + 二阶矩) | 最稳,但显存开销是参数本身的两倍 |
AdamW8bit | 约 2 字节 | 省下约 3/4 的优化器显存,精度损失在微调场景几乎察觉不到 |
SGD | 最省 | 省显存但收敛差,扩散模型微调基本不用 |
配合 mixed_precision=fp16 和 gradient_checkpointing(用重算换显存),这三件套凑齐,才有「LoRA 8 GB 显存可训」这个结论。
第四组:输出
最后要配置的是输出模型的名称和保存格式,是否保存训练状态,以及其他与数据处理相关的设置。保存格式建议一律用 safetensors——它不像 .ckpt 那样基于 pickle,加载别人的模型时不会执行任意代码,这是实打实的安全差别。
2.5 两者怎么选
| 维度 | DreamBooth | LoRA |
|---|---|---|
| 改什么 | 整个 U-Net(可选含 text encoder) | 旁路的低秩矩阵,底模冻结 |
| 显存门槛 | 24 GB 以上 | 8 GB 以上 |
| 产物体积 | 2~7 GB | 几十 MB |
| 训练速度 | 慢 | 更快 |
| 学习率 | 2e-6 量级 | 1e-4 量级 |
| 强度可调 | 不可以 | 可以,乘 α 即可 |
| 能否叠加多个 | 不能 | 能,同时挂多个 |
| 还原成底模 | 不能,只能换回原文件 | 卸下即还原 |
| 放哪个目录 | models/Stable-diffusion | models/Lora |
| 适合 | 要把一个主体刻进底模、后续所有出图都基于它 | 绝大多数场景:人物、画风、配饰、产品 |
实操上的默认答案是:先用 LoRA。它更快、更省、可调强度、可叠加、可还原,训坏了删掉重来的代价接近于零。只有当你确实需要一个「所有出图都自带这个风格」的专用底模时,才值得为 DreamBooth 付出 24 GB 显存和几个 GB 的存储代价。
两者也不冲突——完全可以先用 DreamBooth 训一个主体底模,再在它之上训 LoRA 叠加配饰或画风。这正是下一节两个案例的关系:格子衫模型是底,眼镜挂件是面。
03最小代码:挂上一个 LoRA 出图
先把「用」跑通,再回头看「怎么训出来的」
训练要几十分钟,使用只要三行。所以从使用这一端切入最省事——先看清楚挂件是怎么挂上去的,训练那一章的每个参数才有落点。
# -*- coding: utf-8 -*-
"""最小 LoRA 推理:给一个通用模型挂上训好的挂件,出图。

环境:
    pip install diffusers transformers accelerate peft torch safetensors
要点:
    load_lora_weights 只是在运行时把 BA 叠加到对应层上,
    磁盘上的 base model 权重一个字节都不会被改写。
"""
import torch
from diffusers import StableDiffusionPipeline

DEVICE = "cuda" if torch.cuda.is_available() else "cpu"
DTYPE = torch.float16 if DEVICE == "cuda" else torch.float32

# ① 先装底模(base model / checkpoint),也就是那位通才画师
pipe = StableDiffusionPipeline.from_pretrained(
    "runwayml/stable-diffusion-v1-5", torch_dtype=DTYPE).to(DEVICE)

# ② 挂上 LoRA 权重。几十 MB 的 .safetensors,秒级加载。
pipe.load_lora_weights(
    "./lora_out",                     # 目录,或直接给 .safetensors 文件路径
    weight_name="glasses_lora.safetensors",
    adapter_name="glasses",
)

# ③ 挂件强度:1.0 是训练时的原始强度,画风过冲就往下调到 0.6~0.8
pipe.set_adapters(["glasses"], adapter_weights=[0.8])

generator = torch.Generator(device="cpu").manual_seed(1024)

# ④ prompt 里必须喊出训练时用的专属 token,否则挂件挂了也等于没挂
image = pipe(
    prompt="a portrait of sks_glasses man, front view, soft studio light",
    negative_prompt="lowres, blurry, distorted face",
    num_inference_steps=25,
    guidance_scale=7.5,
    generator=generator,
).images[0]

image.save("lora_out.png")

# ⑤ 卸下挂件,pipe 立刻恢复成原来的通才画师
pipe.unload_lora_weights()
print("saved lora_out.png")
| 这一行 | 它对应原理里的什么 |
|---|---|
from_pretrained(...) | 装入 w₀。磁盘上那 2~7 GB 的底模,全程只读 |
load_lora_weights(...) | 装入 B 和 A。它只是在运行时把 BA 叠加到对应层上,底模文件一个字节都不会被改写 |
set_adapters([...], adapter_weights=[0.8]) | 公式里的 α:w = w₀ + α·BA。1.0 是训练时的原始强度 |
prompt="... sks_glasses man ..." | 铁律落地的地方。不喊专属 token,挂件挂了等于没挂 |
unload_lora_weights() | 摘下挂件,pipe 立刻恢复成原来的通才画师 |
unload_lora_weights() 后用同样的 prompt 跑。两张图差异明显,说明挂件生效了;两张图几乎一样,说明白训了——要么权重没加载上,要么 prompt 里的 token 拼错了。这个对照法比盯着一张图猜可靠得多,也是上一讲「固定 seed、一次只改一个变量」的直接应用。
weight_name 要和实际文件名完全一致,包括大小写和 .safetensors 后缀;② LoRA 的底模版本必须和这里加载的底模对得上(SD 1.5 的 LoRA 不能挂到 SDXL 上),不报错但出图一团糟;
③ 挂件强度不是越高越好。训练轮数偏多的 LoRA,α = 1.0 时往往已经过冲,0.6~0.8 反而更自然。
04完整案例:从训练到线上出图
DreamBooth 训格子衫、LoRA 训眼镜、权重转换进 WebUI,再接成异步出图服务
4.1 DreamBooth 训练:格子衫程序员
目标是让模型记住一种格子衫的样子。实验基于开源代码 diffusers,显存需要 24 GB 以上,在云 GPU 平台的 JupyterLab 中实现。
第一步:数据准备
收集一些格子衫的图片,将图像统一处理成 512×512 格式。该数据集中包含 103 张格子衫图片;为了使 DreamBooth 模型更加多样化,尽量使用不同的环境、灯光、发型、表情、姿势、角度等,将这些数据放入文件夹 train_images 中。
| 目录 | 放什么 | 要点 |
|---|---|---|
train_images/ | 你的 103 张格子衫图 | 统一 512×512,裁切结果要人工过一遍,别把主体裁掉 |
class_images/ | 类别先验图 | 留空即可,训练脚本会用底模自己生成填满 |
dreambooth_out/ | 训练产物 | diffusers 格式目录,含 unet/ vae/ text_encoder/ 等子目录 |
第二步:确定两个 prompt
格子衫任务训练的 prompt 是 Plaidshirtprogrammer。配置时的三条规则:
INSTANCE_PROMPT中填入 Plaidshirtprogrammer。可以指定任意关键词,但是需要找一个「不存在的词」。CLASS_PROMPT是让 AI 自动生成 image 用的 prompt,不要有专属关键词即可。- 预览图设置需要修改成你想生成的图片的 prompt。
Plaidshirtprogrammer 是个好选择
它是 plaid + shirt + programmer 拼起来的一个不存在的单词,tokenizer 会把它切成几个没什么独立语义的碎片,等于一块干净的画布。对比一下:如果写成 plaid shirt,模型里所有的格子衫都会被拽向你这 103 张图,从此再也画不出普通格子衫——这正是 2.1 节说的语言漂移。
第三步:转换源模型并启动训练
训练前需要先实现源模型到 diffusers 模型的转换:手里如果只有一个 .ckpt / .safetensors 单文件,要先转成 diffusers 目录格式,训练脚本才读得进去。之后配置加速器——该配置文件包含了一些与加速相关的默认配置,如计算环境、分布式训练设置、混合精度等。
下面这份启动器把所有参数集中在文件顶部,拼出 accelerate launch 命令:
# -*- coding: utf-8 -*-
"""DreamBooth 训练启动器:把参数集中在一处,拼出 accelerate 命令并执行。

依赖 diffusers 官方示例脚本 train_dreambooth.py:
    git clone https://github.com/huggingface/diffusers
    pip install -r diffusers/examples/dreambooth/requirements.txt
    accelerate config default

显存:fp16 + 8bit Adam 下约 16~24 GB;24 GB 以上才建议同时训 text_encoder。
"""
import os
import subprocess
import sys

# ======================================================================
# 一、路径
# ======================================================================
# 底模。可以是 HuggingFace 仓库名,也可以是本地 diffusers 格式目录。
# 如果手里只有一个 .ckpt/.safetensors 单文件,先用
# convert_original_stable_diffusion_to_diffusers.py 转成 diffusers 目录。
PRETRAINED = os.environ.get("SD_BASE", "runwayml/stable-diffusion-v1-5")

# 你的主体图片目录。103 张格子衫照片就放这里,统一裁成 512x512。
INSTANCE_DIR = "./train_images"

# 类别先验图片目录。留空目录即可,脚本会自己用底模生成填满。
CLASS_DIR = "./class_images"

# 训练产物目录
OUTPUT_DIR = "./dreambooth_out"

# ======================================================================
# 二、两个 prompt:DreamBooth 的灵魂
# ======================================================================
# 专属 token + 类别词。Plaidshirtprogrammer 是刻意挑的「不存在的词」,
# 它在 tokenizer 里会被切成几个没什么语义的碎片,不会和已有概念打架。
# 反例:写 "a photo of a dog" 会把模型里所有的狗都拽向你这几张图。
INSTANCE_PROMPT = "a photo of Plaidshirtprogrammer shirt"

# 类别先验 prompt:不含专属 token,只有类别词。
# 它的作用是让模型一边学新主体、一边被「普通衬衫长什么样」拽住,
# 避免语言漂移(learned prior preservation)。
CLASS_PROMPT = "a photo of shirt"

# 训练中途的预览图 prompt,用来肉眼判断学到第几步最像
VALIDATION_PROMPT = "a photo of Plaidshirtprogrammer shirt, on a wooden hanger"

# ======================================================================
# 三、超参数
# ======================================================================
RESOLUTION = 512            # 与数据集裁切尺寸一致;改大显存暴涨
TRAIN_BATCH_SIZE = 1        # 单卡基本只能 1,用梯度累积换等效 batch
GRAD_ACCUM = 1
LEARNING_RATE = 2e-6        # DreamBooth 改的是全量 U-Net,lr 必须极小
LR_SCHEDULER = "constant"
LR_WARMUP_STEPS = 0
MAX_TRAIN_STEPS = 1200      # 经验值:实例图片数 x 10~15
NUM_CLASS_IMAGES = 200      # 类别先验图数量,一般 100~200
PRIOR_LOSS_WEIGHT = 1.0     # 先验损失权重,调大越保守、越不容易过拟合
CHECKPOINT_STEPS = 400      # 每隔多少步存一次中间权重,便于回退挑点
SEED = 1337


def build_cmd():
    """拼 accelerate launch 命令。改参数只需要动上面的常量。"""
    cmd = [
        "accelerate", "launch",
        "diffusers/examples/dreambooth/train_dreambooth.py",
        "--pretrained_model_name_or_path=%s" % PRETRAINED,
        "--instance_data_dir=%s" % INSTANCE_DIR,
        "--output_dir=%s" % OUTPUT_DIR,
        '--instance_prompt=%s' % INSTANCE_PROMPT,
        # 开启类别先验保留,下面三个参数必须成组出现
        "--with_prior_preservation",
        "--prior_loss_weight=%s" % PRIOR_LOSS_WEIGHT,
        "--class_data_dir=%s" % CLASS_DIR,
        '--class_prompt=%s' % CLASS_PROMPT,
        "--num_class_images=%d" % NUM_CLASS_IMAGES,
        # 训练规模
        "--resolution=%d" % RESOLUTION,
        "--train_batch_size=%d" % TRAIN_BATCH_SIZE,
        "--gradient_accumulation_steps=%d" % GRAD_ACCUM,
        "--learning_rate=%s" % LEARNING_RATE,
        "--lr_scheduler=%s" % LR_SCHEDULER,
        "--lr_warmup_steps=%d" % LR_WARMUP_STEPS,
        "--max_train_steps=%d" % MAX_TRAIN_STEPS,
        "--checkpointing_steps=%d" % CHECKPOINT_STEPS,
        "--seed=%d" % SEED,
        # 省显存三件套
        "--mixed_precision=fp16",
        "--gradient_checkpointing",
        "--use_8bit_adam",
        # 中途预览
        '--validation_prompt=%s' % VALIDATION_PROMPT,
        "--num_validation_images=2",
        "--validation_steps=200",
    ]
    # 显存 24 GB 以上再打开:同时微调文本编码器,专属 token 学得更牢,
    # 但也更容易把整个词表带偏。
    if os.environ.get("TRAIN_TEXT_ENCODER") == "1":
        cmd.append("--train_text_encoder")
    return cmd


def main():
    os.makedirs(INSTANCE_DIR, exist_ok=True)
    os.makedirs(CLASS_DIR, exist_ok=True)
    os.makedirs(OUTPUT_DIR, exist_ok=True)

    imgs = [f for f in os.listdir(INSTANCE_DIR)
            if f.lower().endswith((".png", ".jpg", ".jpeg", ".webp"))]
    if not imgs:
        print("实例图片目录是空的:%s" % INSTANCE_DIR)
        return 1
    print("实例图片 %d 张,建议步数 %d~%d,当前设置 %d"
          % (len(imgs), len(imgs) * 10, len(imgs) * 15, MAX_TRAIN_STEPS))

    cmd = build_cmd()
    print("\n".join(cmd))
    return subprocess.call(cmd)


if __name__ == "__main__":
    sys.exit(main())
| 参数组 | 关键项 | 为什么是这个值 |
|---|---|---|
| 两个 prompt | instance_prompt / class_prompt | 一个带专属 token,一个绝对不能带。写反了先验保留机制就失效了 |
| 类别先验 | --with_prior_preservation + --prior_loss_weight + --class_data_dir + --class_prompt + --num_class_images | 这五个必须成组出现,少一个脚本就会报参数缺失 |
| 学习率 | 2e-6 | 改的是底模全量参数,必须极小。用 LoRA 那个 1e-4 会直接毁掉底模 |
| 步数 | 1200 | 经验值「实例图片数 × 10~15」。103 张图对应 1000~1500 |
| 省显存三件套 | fp16 + gradient_checkpointing + use_8bit_adam | 缺一个,24 GB 都未必够 |
| 中途预览 | validation_prompt + validation_steps | 每 200 步出两张预览图,肉眼判断学到第几步最像 |
| 存盘频率 | checkpointing_steps=400 | 训完能横向挑最好的一版,而不是只能信最后一版 |
4.2 LoRA 训练:给人物加上眼镜
第二个任务是给我们的人物带上眼镜。LoRA 训练基于开源代码 kohya_ss 来实现,显存需要 8 GB 以上,同样在 JupyterLab 中完成。
数据:20 张图 + 20 个同名 txt
该数据集包含 20 张图片,每张图片对应着一个 txt 文件,文本文件中记录着对应图片的文本描述。数据放入文件夹 train 中。
| 文件 | 内容 |
|---|---|
train/001.png | 一张 512×512 的人物图 |
train/001.txt | 这张图的文本描述,例如 sks_glasses man, front view, indoor, soft light |
| … | 20 组,文件名必须严格同名,只有后缀不同 |
所以想让 LoRA 学「眼镜」,就要在描述里写清除了眼镜之外的一切(角度、背景、光线、服装),把眼镜留给专属 token。反过来,如果每张图的描述都写了
glasses,模型会认为眼镜只是个普通可替换属性,专属 token 反而学不到东西。
训练配置的四组参数
配置过程分四步:首先配置 LoRA 训练的预训练模型路径、模型类型、参数化、训练数据集路径以及指定网络结构和超参数——这里需要将前面训练的格子衫模型放入指定文件夹中,并放置好训练图片的位置。然后依次配置训练规模、学习率、输出三组参数,详见 2.4 节。
下面这份启动器读一份 JSON 配置,训练前先把最容易翻车的三件事拦下来:
# -*- coding: utf-8 -*-
"""LoRA 训练启动器:读一份 JSON 配置,拼出训练命令。

依赖 diffusers 官方 LoRA 示例:
    diffusers/examples/dreambooth/train_dreambooth_lora.py
显存:fp16 + 8bit Adam 下 8 GB 即可跑 512 分辨率。
为什么只要 8 GB:底模全程冻结、不需要为它保存优化器状态和梯度,
显存里只多出 rank 那一小撮可训练参数。
"""
import json
import os
import subprocess
import sys

CONFIG_PATH = os.environ.get("LORA_CONFIG", "lora_config.json")

DEFAULTS = {
    "pretrained_model": "runwayml/stable-diffusion-v1-5",
    "instance_data_dir": "./train",
    "output_dir": "./lora_out",
    "instance_prompt": "a photo of sks_glasses man",
    "resolution": 512,
    "train_batch_size": 2,
    "gradient_accumulation_steps": 1,
    "max_train_steps": 1600,
    "checkpointing_steps": 200,
    "rank": 32,
    "learning_rate": 1e-4,
    "text_encoder_lr": 5e-5,
    "lr_scheduler": "cosine_with_restarts",
    "lr_warmup_steps": 100,
    "lr_num_cycles": 3,
    "seed": 1337,
    "train_text_encoder": True,
    "mixed_precision": "fp16",
    "use_8bit_adam": True,
}


def load_config(path):
    """文件不存在就用默认值,并顺手写一份出来供修改。"""
    if not os.path.exists(path):
        with open(path, "w", encoding="utf-8") as f:
            json.dump(DEFAULTS, f, ensure_ascii=False, indent=2)
        print("已生成默认配置:%s" % path)
        return dict(DEFAULTS)
    with open(path, encoding="utf-8") as f:
        cfg = dict(DEFAULTS)
        cfg.update(json.load(f))
        return cfg


def check(cfg):
    """训练前先把最容易翻车的三件事拦下来。"""
    problems = []
    d = cfg["instance_data_dir"]
    if not os.path.isdir(d):
        problems.append("训练图目录不存在:%s" % d)
    else:
        imgs = [f for f in os.listdir(d)
                if f.lower().endswith((".png", ".jpg", ".jpeg", ".webp"))]
        txts = [f for f in os.listdir(d) if f.lower().endswith(".txt")]
        if not imgs:
            problems.append("训练图目录里没有图片")
        # kohya 风格的数据集要求每张图配一个同名 txt 描述文件
        missing = [f for f in imgs
                   if os.path.splitext(f)[0] + ".txt" not in txts]
        if txts and missing:
            problems.append("缺少同名 txt 描述:%s" % ", ".join(missing[:5]))
    if cfg["rank"] > 128:
        problems.append("rank=%d 偏大,几十张图的小数据集基本必过拟合"
                        % cfg["rank"])
    if cfg["resolution"] % 8 != 0:
        problems.append("resolution 必须是 8 的倍数")
    return problems


def build_cmd(cfg):
    cmd = [
        "accelerate", "launch",
        "diffusers/examples/dreambooth/train_dreambooth_lora.py",
        "--pretrained_model_name_or_path=%s" % cfg["pretrained_model"],
        "--instance_data_dir=%s" % cfg["instance_data_dir"],
        "--output_dir=%s" % cfg["output_dir"],
        '--instance_prompt=%s' % cfg["instance_prompt"],
        "--resolution=%d" % cfg["resolution"],
        "--train_batch_size=%d" % cfg["train_batch_size"],
        "--gradient_accumulation_steps=%d" % cfg["gradient_accumulation_steps"],
        "--max_train_steps=%d" % cfg["max_train_steps"],
        "--checkpointing_steps=%d" % cfg["checkpointing_steps"],
        # 低秩分解的秩:w = w0 + BA 里 B 是 d x r、A 是 r x d
        "--rank=%d" % cfg["rank"],
        "--learning_rate=%s" % cfg["learning_rate"],
        "--text_encoder_lr=%s" % cfg["text_encoder_lr"],
        # 余弦退火重启:学习率周期性跳回高位,帮模型跳出局部最优
        "--lr_scheduler=%s" % cfg["lr_scheduler"],
        "--lr_warmup_steps=%d" % cfg["lr_warmup_steps"],
        "--lr_num_cycles=%d" % cfg["lr_num_cycles"],
        "--seed=%d" % cfg["seed"],
        "--mixed_precision=%s" % cfg["mixed_precision"],
        "--gradient_checkpointing",
    ]
    if cfg["use_8bit_adam"]:
        # AdamW8bit:把优化器状态从 fp32 压到 8bit,省下约 2/3 的优化器显存
        cmd.append("--use_8bit_adam")
    if cfg["train_text_encoder"]:
        cmd.append("--train_text_encoder")
    return cmd


def main():
    cfg = load_config(CONFIG_PATH)
    problems = check(cfg)
    if problems:
        for p in problems:
            print("[检查未通过] %s" % p)
        return 1
    cmd = build_cmd(cfg)
    print("\n".join(cmd))
    return subprocess.call(cmd)


if __name__ == "__main__":
    sys.exit(main())
注意 check() 拦的三件事,每一件都对应一类真实事故:
| 检查项 | 不拦的话会怎样 | 根因 |
|---|---|---|
| 图片目录不存在或为空 | 训练跑起来了,几分钟后才报错退出 | 路径写错、数据没上传完 |
| 缺少同名 txt 描述 | 训完才发现效果不对,白烧一小时 GPU | 漏传了几个描述文件,kohya 会按空描述处理 |
| rank 过大 | 训完严重过拟合,出图复刻训练集 | 容量和数据量不匹配,见 2.3 节 |
| resolution 不是 8 的倍数 | 潜空间尺寸对不上,直接报错 | 8 倍下采样的硬性约束 |
回到比喻——先送画师去集训学会画格子衫,再给这位新画师配一副眼镜挂件。这也是 2.5 节说的「两者不冲突」的实际长相。
4.3 权重转换与 WebUI 加载
训练完成后会保存训练权重,但这种模型权重无法直接在 WebUI 中使用,需要将其转换为 ckpt 的形式。两种产物的处理方式完全不同,别混:
| 产物 | 原始格式 | 要不要转换 | 放进哪个目录 |
|---|---|---|---|
| DreamBooth | diffusers 目录(unet/ vae/ …) | 要,合并成单文件 | stable-diffusion-webui/models/Stable-diffusion |
| LoRA | 单个 .safetensors | 不用,直接复制 | stable-diffusion-webui/models/Lora |
# -*- coding: utf-8 -*-
"""把训练产物转成 WebUI 能加载的格式,并放进正确的目录。

两条路完全不同,别混:
    DreamBooth 产物  是一个 diffusers 目录(unet/ vae/ text_encoder/ ...)
                     → 合并成单文件 .safetensors → models/Stable-diffusion/
    LoRA 产物        本来就是单个 .safetensors
                     → 直接复制 → models/Lora/

转换脚本来自 diffusers 仓库:
    diffusers/scripts/convert_diffusers_to_original_stable_diffusion.py
"""
import argparse
import os
import shutil
import subprocess
import sys

CONVERT_SCRIPT = ("diffusers/scripts/"
                  "convert_diffusers_to_original_stable_diffusion.py")


def convert_dreambooth(model_dir, webui_root, name, half=True):
    """diffusers 目录 → 单文件 .safetensors → models/Stable-diffusion/"""
    if not os.path.isdir(os.path.join(model_dir, "unet")):
        raise SystemExit("不像 diffusers 目录,缺 unet/ 子目录:%s" % model_dir)

    dst_dir = os.path.join(webui_root, "models", "Stable-diffusion")
    os.makedirs(dst_dir, exist_ok=True)
    dst = os.path.join(dst_dir, name + ".safetensors")

    cmd = [sys.executable, CONVERT_SCRIPT,
           "--model_path", model_dir,
           "--checkpoint_path", dst,
           "--use_safetensors"]
    if half:
        # fp16 存盘,2 GB 出头;不加这个参数是 4 GB 起步
        cmd.append("--half")
    print(" ".join(cmd))
    rc = subprocess.call(cmd)
    if rc != 0:
        raise SystemExit("转换失败,退出码 %d" % rc)
    print("已写入 %s(%.1f MB)" % (dst, os.path.getsize(dst) / 1e6))
    return dst


def install_lora(lora_file, webui_root, name=None):
    """LoRA 不需要转换,复制到 models/Lora/ 即可。"""
    if not os.path.isfile(lora_file):
        raise SystemExit("找不到 LoRA 权重:%s" % lora_file)
    dst_dir = os.path.join(webui_root, "models", "Lora")
    os.makedirs(dst_dir, exist_ok=True)
    fname = (name + ".safetensors") if name else os.path.basename(lora_file)
    dst = os.path.join(dst_dir, fname)
    shutil.copyfile(lora_file, dst)
    print("已写入 %s(%.1f MB)" % (dst, os.path.getsize(dst) / 1e6))
    return dst


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--webui", required=True,
                    help="stable-diffusion-webui 根目录")
    ap.add_argument("--dreambooth", help="DreamBooth 输出的 diffusers 目录")
    ap.add_argument("--lora", help="LoRA 输出的 .safetensors 文件")
    ap.add_argument("--name", default="my_model", help="落盘后的文件名(不含后缀)")
    ap.add_argument("--fp32", action="store_true", help="不压 fp16")
    args = ap.parse_args()

    if not args.dreambooth and not args.lora:
        raise SystemExit("--dreambooth 与 --lora 至少给一个")

    if args.dreambooth:
        convert_dreambooth(args.dreambooth, args.webui, args.name,
                           half=not args.fp32)
    if args.lora:
        install_lora(args.lora, args.webui, args.name)

    print("\n放好之后回到 WebUI:左上角模型下拉框点刷新,"
          "LoRA 在生成页的 Lora 标签页里;\n"
          "出图时 prompt 里必须带上训练时的专属 token。")


if __name__ == "__main__":
    main()
在 WebUI 里预测
模型预测在 WebUI 中完成。两种模型的操作流程是类似的:
models/Stable-diffusionmodels/Lora「模型放对目录了、下拉框也选了,出图却和没训一样」——先回头检查这一步,而不是怀疑训练失败。这是整个微调链路上最高频的一个坑。
4.4 服务化的两条路:自建还是调 API
挂件训好了,接下来要让别人用上。选型只有两条路,取舍很清楚:
| 维度 | 自建 WebUI / diffusers 服务 | 调云厂商文生图 API |
|---|---|---|
| 能用自己训的模型 | 能,这是它存在的唯一硬理由 | 不能,只能用平台提供的风格 |
| 起步成本 | 要买/租 GPU,要配环境 | 几乎为零,注册即用 |
| 单张成本 | 固定的机器月租,量大时更便宜 | 按次计费,量大时更贵 |
| 空闲时 | 照样烧钱 | 不调用不花钱 |
| 并发与扩容 | 自己扛,要做队列和多机 | 平台扛,但有频率限制 |
| 数据安全 | 本地闭环 | 图片与提示词上传第三方 |
| 内容合规 | 自己负责,要自己接审核 | 平台内置审核 |
| 中文理解 | 取决于底模,SD v1 对中文很弱 | 中文理解能力强,支持古诗词、水墨剪纸等中国元素 |
云厂商的 AI 绘画能力通常提供 API 和 SaaS 两种服务形态:API 需要调用接口来使用,适用于有代码编写基础、对 HTTP 请求和 API 调用有一定了解的开发者;SaaS 是在线创作工具,直接通过网页端输入文本或图像即可完成图像生成任务,不需编程基础。两个典型接口是:
| 接口 | 功能 | 输入 | 输出 |
|---|---|---|---|
TextToImage | 智能文生图 | 256 个字符以内的描述性文本,推荐使用中文 | 对应风格及分辨率的 AI 生成图 |
ImageToImage | 智能图生图 | 单边分辨率小于 2000、转成 Base64 字符串后小于 5 MB 的图片,建议同时输入描述文本 | 对应风格及分辨率的 AI 生成图 |
len(prompt) > 256 就是干这个的。
4.5 异步出图服务:为什么必须异步
不管走哪条路,出一张图都要几十秒。这个数字决定了服务的形态:
| 如果做成同步 | 会发生什么 |
|---|---|
| HTTP 连接一直挂着 | 网关、CDN、小程序端的默认超时多在 30~60 秒,出图还没完连接就断了 |
| 用户切后台或断网 | 请求丢失,图白画了,服务端也不知道该给谁 |
| 并发上来 | 每个请求占一个连接干等,连接池瞬间打满,新用户连提交都提交不了 |
| 重试 | 客户端超时重试 = 又排一次队,雪上加霜 |
所以正确的形态是取号等叫号:提交接口只负责登记任务、立刻返回一个 task_id;真正出图在后台慢慢跑;客户端凭号轮询查询接口,拿到图片地址。
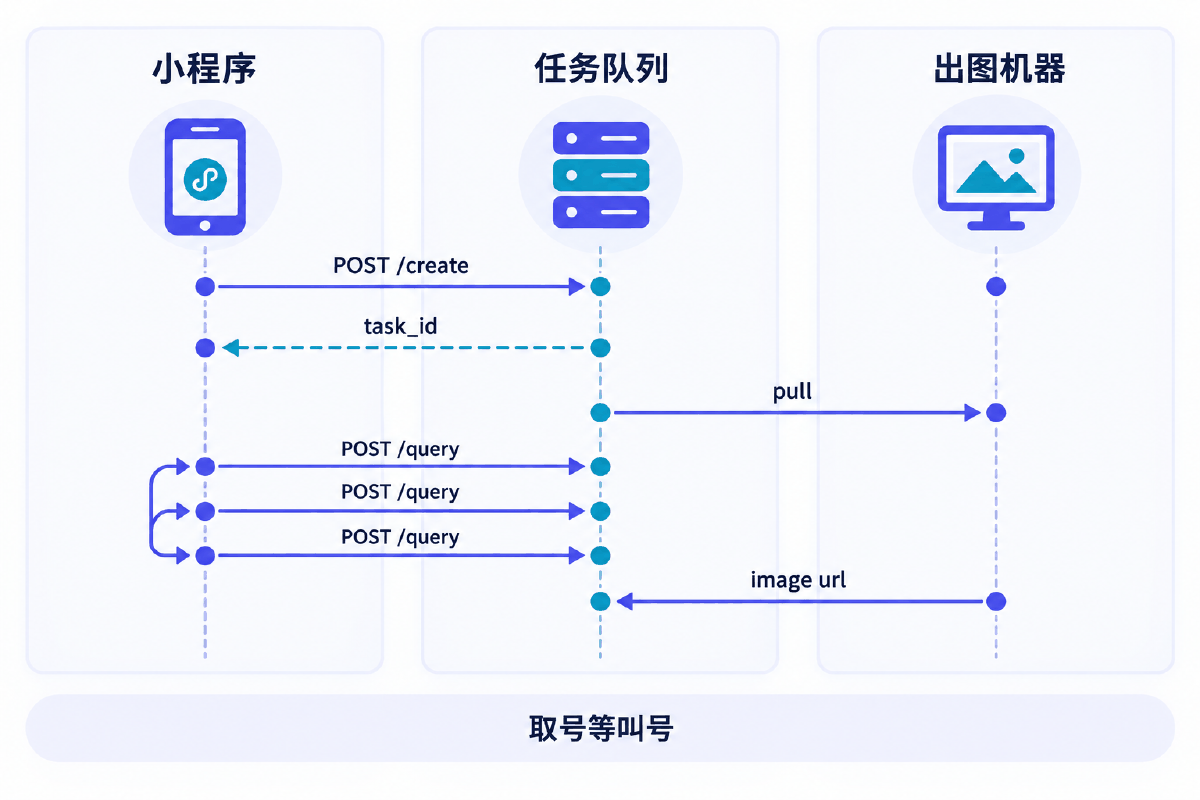
下面这份服务只用标准库实现,不引第三方 Web 框架,便于直接阅读。它把演示工程里 Go 服务端的逻辑改写成了 Python——这是一套通用的异步长任务模式,和「出图」本身无关:凡是单次耗时超过十几秒的活儿(转码、导出、批量分析),都应该走提交/查询两个接口。
# -*- coding: utf-8 -*-
"""异步出图服务:提交任务拿号 → 后台画 → 凭号查结果。

这是一套通用的异步长任务模式,和「出图」本身无关:
凡是单次耗时超过十几秒的活儿(转码、导出、批量分析),
都应该走 提交/查询 两个接口,而不是让 HTTP 连接干等。

只用标准库跑起来,不引第三方 Web 框架,便于直接阅读:
    python3 async_draw_service.py
    curl -X POST localhost:8000/frontend/create -d '{"prompt":"一只柯基"}'
    curl -X POST localhost:8000/frontend/query  -d '{"job_id":"..."}'

生产环境把 QUEUE/RESULT 两个字典换成 Redis 或对象存储即可横向扩机器。
"""
import json
import os
import random
import string
import threading
import time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

LISTEN = ("0.0.0.0", int(os.environ.get("PORT", "8000")))

# 任务队列与结果表。单机内存版,重启即丢;生产环境换 Redis/COS。
QUEUE = []                 # 待处理任务,元素是 dict
RESULT = {}                # job_id -> 结果 dict
LOCK = threading.Lock()

# 一次出图的经验耗时,用来给前端估算剩余时间
AVG_COST_SEC = 40

ALPHABET = string.ascii_letters + string.digits


def gen_job_id(n=32):
    """任务号要足够长、足够随机:它同时充当「凭号取件」的凭证。
    用自增 ID 的话,别人改个数字就能看到你的图。"""
    return "".join(random.choice(ALPHABET) for _ in range(n))


# ====================================================================
# 出图后端:这里替换成你自己的实现
# ====================================================================
def render_image(prompt, negative_prompt, seed):
    """真正干活的地方。三选一:

    1) 本地 diffusers:pipe(prompt=...).images[0].save(path)
    2) 本机 WebUI 的 /sdapi/v1/txt2img 接口
    3) 云厂商文生图 API(返回 base64 或临时 URL)

    这里用 sleep 占位,保证这份代码不依赖 GPU 也能跑通整条链路。
    """
    time.sleep(AVG_COST_SEC * 0.1)
    return {"prompt": prompt, "negative_prompt": negative_prompt, "seed": seed}


def upload_to_object_storage(job_id, payload):
    """把成品图传到对象存储,返回带签名、会过期的临时 URL。

    两个要点:
    ① 不要把图片 base64 塞进查询接口的响应里——几 MB 的 JSON 会拖垮客户端;
    ② 一律用预签名 URL 并设过期时间,桶本身保持私有读。
    """
    path = "aidraw/%s.png" % job_id
    expire = int(time.time()) + 3600
    sign = os.environ.get("COS_SECRET_ID", "")[:6] or "unsigned"
    return "https://example-bucket.cos.example.com/%s?e=%d&s=%s" % (
        path, expire, sign)


# ====================================================================
# 后台 worker:单线程逐个消费,天然就是限流
# ====================================================================
def worker_loop():
    while True:
        job = None
        with LOCK:
            if QUEUE:
                job = QUEUE.pop(0)
        if job is None:
            time.sleep(1)
            continue

        job_id = job["job_id"]
        begin = time.time()
        with LOCK:
            RESULT[job_id] = {"job_id": job_id, "job_status": "RUNNING"}
        try:
            payload = render_image(job.get("prompt", ""),
                                   job.get("negative_prompt", ""),
                                   job.get("seed"))
            url = upload_to_object_storage(job_id, payload)
            done = {
                "job_id": job_id,
                "session_id": job.get("session_id", ""),
                "job_status": "FINISHED",
                "result_url": url,
                "cost_time": int((time.time() - begin) * 1000),
            }
        except Exception as exc:                       # noqa: BLE001
            # 失败也必须写进结果表,否则客户端会永远轮询下去
            done = {
                "job_id": job_id,
                "job_status": "FAILED",
                "error": "%s: %s" % (type(exc).__name__, exc),
                "cost_time": int((time.time() - begin) * 1000),
            }
        with LOCK:
            RESULT[job_id] = done


# ====================================================================
# HTTP 接口
# ====================================================================
class Handler(BaseHTTPRequestHandler):
    def _read_json(self):
        length = int(self.headers.get("Content-Length") or 0)
        raw = self.rfile.read(length) if length else b"{}"
        try:
            return json.loads(raw.decode("utf-8") or "{}")
        except json.JSONDecodeError:
            return {}

    def _send(self, obj, code=200):
        body = json.dumps(obj, ensure_ascii=False).encode("utf-8")
        self.send_response(code)
        self.send_header("Content-Type", "application/json; charset=utf-8")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

    def do_POST(self):                                  # noqa: N802
        req = self._read_json()

        # 接口一:提交任务,立刻返回任务号。这一步绝不能等图画完。
        if self.path == "/frontend/create":
            prompt = (req.get("prompt") or "").strip()
            if not prompt:
                return self._send({"error": "prompt 不能为空"}, 400)
            if len(prompt) > 256:
                # 云厂商文生图接口普遍限制 256 字符,前置校验省一次失败调用
                return self._send({"error": "prompt 超过 256 字符"}, 400)

            job = {
                "job_id": gen_job_id(),
                "session_id": req.get("session_id", ""),
                "prompt": prompt,
                "negative_prompt": req.get("negative_prompt", ""),
                "seed": req.get("seed"),
            }
            with LOCK:
                QUEUE.append(job)
                queue_len = len(QUEUE)
            return self._send({
                "job_id": job["job_id"],
                "session_id": job["session_id"],
                "job_status": "PENDING",
                "queue_len": queue_len,
                # 把估算的等待时间一起返回,前端才能画进度条
                "remain_time": queue_len * AVG_COST_SEC,
            })

        # 接口二:凭号查结果。查不到就说明还在队列里。
        if self.path == "/frontend/query":
            job_id = req.get("job_id") or ""
            with LOCK:
                ret = RESULT.get(job_id)
                pending = any(j["job_id"] == job_id for j in QUEUE)
            if ret:
                return self._send(ret)
            if pending:
                return self._send({"job_id": job_id, "job_status": "PENDING"})
            return self._send({"job_id": job_id, "job_status": "NOT_FOUND"}, 404)

        return self._send({"error": "no such route"}, 404)

    def log_message(self, fmt, *args):
        print("[%s] %s" % (time.strftime("%H:%M:%S"), fmt % args))


def main():
    threading.Thread(target=worker_loop, daemon=True).start()
    print("listening on %s:%d" % LISTEN)
    ThreadingHTTPServer(LISTEN, Handler).serve_forever()


if __name__ == "__main__":
    main()
| 接口 / 组件 | 职责 | 关键设计 |
|---|---|---|
POST /frontend/create | 提交任务 | 绝不等图画完,登记后立刻返回 task_id、队列长度、预估剩余时间 |
POST /frontend/query | 凭号查结果 | 返回 PENDING / RUNNING / FINISHED / FAILED,失败也必须写进结果表 |
gen_job_id() | 生成任务号 | 32 位随机串。不能用自增 ID——别人改个数字就能看到你的图 |
worker_loop() | 后台消费 | 单线程逐个消费,天然就是限流,不会把显存挤爆 |
render_image() | 真正出图 | 三选一:本地 diffusers、本机 WebUI 的 /sdapi/v1/txt2img、云厂商 API |
upload_to_object_storage() | 结果落对象存储 | 返回带签名、会过期的临时 URL,桶保持私有读 |
FAILED,客户端会永远轮询下去,既耗流量又占连接。② 不要把图片 base64 塞进查询接口的响应里。几 MB 的 JSON 会拖垮客户端解析,还让轮询变得极其昂贵。一律返回预签名 URL,让客户端直接去对象存储取。
为什么结果要落对象存储
把生成好的图片上传到对象存储、再通过预签名地址分发,解决了三件事:出图机器可以随时销毁而图片还在;多台出图机器共用一个结果池,查询接口不必知道是哪台机器画的;图片走对象存储的 CDN 分发,不占出图机器的带宽。演示工程里连任务队列本身都放在对象存储上(提交任务写一个对象、出图机器轮询目录取任务),代价是延迟略高,好处是完全无状态、加机器就能扩容。
4.6 小程序端的完整链路
小程序要通过中转服务来异步处理消息,该服务主要做两件事:一、转发请求到 AI 绘画;二、查询 AI 绘画的结果。页面上用户可以输入创意提示,点击按钮后后台会生成图像,并能查看任务状态、完成数量以及处理和剩余时间,生成的图像最后展示在页面上。
| 环节 | 谁来做 | 要点 |
|---|---|---|
| ① 输入创意提示 | 小程序页面 | 前端先做 256 字符校验,别把必然失败的请求发出去 |
| ② 提交任务 | 小程序 → 中转服务 | 拿到 task_id 立刻落地到本地缓存,用户切后台再回来还能接着查 |
| ③ 展示排队信息 | 小程序页面 | 用返回的队列长度和预估剩余时间画进度条,几十秒的等待必须有反馈 |
| ④ 轮询查询 | 小程序 → 中转服务 | 首次等待给足、间隔退避;离开页面时务必 clearInterval |
| ⑤ 展示结果 | 小程序页面 | 拿预签名 URL 直接渲染;URL 会过期,要保存就得及时下载 |
| ⑥ 鉴权与密钥 | 中转服务 | 云厂商的密钥只能放在服务端,绝不能出现在小程序包里 |
# -*- coding: utf-8 -*-
"""异步出图服务的客户端调用模板:提交 → 轮询 → 取图。

小程序端 wx.request、Web 端 fetch、Go 端 http.Post,逻辑完全一样,
只是语法不同。这份 Python 版可以直接拿来做联调和压测。
"""
import json
import os
import time
import urllib.error
import urllib.request

# ======================================================================
# 参数区
# ======================================================================
# TODO 1:服务端地址
BASE_URL = os.environ.get("DRAW_API", "http://127.0.0.1:8000")

# TODO 2:鉴权。凭证一律走环境变量,绝不写进源码或前端包里。
TOKEN = os.environ.get("DRAW_API_TOKEN", "")

# TODO 3:出图参数
PROMPT = "一只戴墨镜的柯基,工作室灯光,高细节"
NEGATIVE_PROMPT = "低分辨率, 模糊, 水印"

# TODO 4:轮询策略。
# 首次等待要给足(出图本来就要几十秒),间隔用退避而不是死等 1 秒,
# 否则 100 个用户在线就是每秒 100 次无效查询。
FIRST_WAIT = 8          # 提交后先睡多久再开始问
POLL_INTERVAL = 3       # 初始轮询间隔(秒)
POLL_BACKOFF = 1.4      # 每次乘这个系数,上限 POLL_MAX
POLL_MAX = 15
TIMEOUT_SEC = 180       # 总超时,超了就报错退出,不能无限等
# ======================================================================


def post(path, payload):
    data = json.dumps(payload, ensure_ascii=False).encode("utf-8")
    req = urllib.request.Request(
        BASE_URL + path, data=data,
        headers={"Content-Type": "application/json"})
    if TOKEN:
        req.add_header("Authorization", "Bearer " + TOKEN)
    try:
        with urllib.request.urlopen(req, timeout=20) as resp:
            return json.loads(resp.read().decode("utf-8"))
    except urllib.error.HTTPError as err:
        body = err.read().decode("utf-8", "replace")
        return {"job_status": "HTTP_%d" % err.code, "error": body}


def submit():
    """第一步:提交任务,只拿号,不等图。"""
    ret = post("/frontend/create", {
        "prompt": PROMPT,
        "negative_prompt": NEGATIVE_PROMPT,
        "session_id": "demo-session",
    })
    if not ret.get("job_id"):
        raise SystemExit("提交失败:%s" % ret)
    print("已取号 job_id=%s 队列长度=%s 预计 %ss"
          % (ret["job_id"], ret.get("queue_len"), ret.get("remain_time")))
    return ret["job_id"]


def poll(job_id):
    """第二步:凭号轮询,直到 FINISHED / FAILED / 超时。"""
    deadline = time.time() + TIMEOUT_SEC
    interval = POLL_INTERVAL
    time.sleep(FIRST_WAIT)

    while time.time() < deadline:
        ret = post("/frontend/query", {"job_id": job_id})
        status = ret.get("job_status")
        print("  status=%s" % status)

        if status == "FINISHED":
            return ret
        if status in ("FAILED", "NOT_FOUND"):
            raise SystemExit("任务失败:%s" % ret)

        time.sleep(interval)
        interval = min(interval * POLL_BACKOFF, POLL_MAX)

    raise SystemExit("超过 %ds 仍未完成,job_id=%s" % (TIMEOUT_SEC, job_id))


def download(url, out_path):
    """第三步:结果是一个会过期的临时 URL,要落盘就趁早。"""
    with urllib.request.urlopen(url, timeout=60) as resp:
        body = resp.read()
    with open(out_path, "wb") as f:
        f.write(body)
    print("已保存 %s(%d 字节)" % (out_path, len(body)))


def main():
    job_id = submit()
    ret = poll(job_id)
    print("耗时 %s ms" % ret.get("cost_time"))
    print("图片地址 %s" % ret.get("result_url"))
    # TODO 5:真实环境打开这一行把图拉下来
    # download(ret["result_url"], "%s.png" % job_id)


if __name__ == "__main__":
    main()
正确做法是模板里那三个参数:首次等待给足(
FIRST_WAIT=8)、间隔按系数退避(×1.4,上限 15 秒)、设总超时(180 秒后报错退出,不能无限等)。
05骨架模板:拿去改就能用
一份训练参数配置,一份服务端调用模板
5.1 LoRA 训练参数配置模板
训练脚本本身不用改,要改的永远是参数。这份 JSON 把 2.4 节讲过的四组参数全写进去,每一组前面挂一条以下划线开头的说明键——它不参与解析,只是让你改的时候不用回来翻讲义。
复制成 lora_config.json,改完带 TODO 的四项,直接喂给 4.2 的 train_lora.py。
{
  "_说明": "LoRA 训练参数模板。复制成 lora_config.json,改完 TODO 再跑 train_lora.py。",

  "pretrained_model": "TODO 底模路径。想让 LoRA 和某个画风底模配套,就填那个底模",
  "instance_data_dir": "TODO 训练图目录。每张图配一个同名 .txt 描述文件",
  "output_dir": "./lora_out",
  "instance_prompt": "TODO 专属 token + 类别词,例如 a photo of sks_glasses man",

  "_分辨率": "训练分辨率要和数据集裁切尺寸一致。拉到 768 显存翻倍,SD v1 底模收益有限",
  "resolution": 512,

  "_批次": "8G 显存填 1~2;等效批次靠 gradient_accumulation_steps 放大,显存不涨",
  "train_batch_size": 2,
  "gradient_accumulation_steps": 1,

  "_步数": "经验值 = 图片数 x repeat x epoch。20 张图跑 1600 步是常见起点;过拟合就往下砍",
  "max_train_steps": 1600,

  "_存盘频率": "每 200 步存一版,训完横向挑最好的那一版,而不是只信最后一版",
  "checkpointing_steps": 200,

  "_rank": "低秩分解的秩 r。8~16 学画风,32~64 学具体人物/物体,>128 小数据集必过拟合",
  "rank": 32,

  "_学习率": "LoRA 的 lr 比全量微调大两个量级。unet 用 1e-4,文本编码器要更小,否则词表被带偏",
  "learning_rate": 1e-4,
  "text_encoder_lr": 5e-5,

  "_调度器": "余弦退火重启:lr 周期性跳回高位,帮模型跳出局部最优。cycles 一般 2~4",
  "lr_scheduler": "cosine_with_restarts",
  "lr_warmup_steps": 100,
  "lr_num_cycles": 3,

  "_优化器": "AdamW8bit 把优化器状态压到 8bit,是 8G 显存能跑起来的关键一环",
  "use_8bit_adam": true,
  "mixed_precision": "fp16",

  "_文本编码器": "true 时专属 token 学得更牢,但画风容易外溢到别的词;只学画风可以关掉",
  "train_text_encoder": true,

  "_种子": "固定住才能做参数对比实验:只改一个参数、seed 不变,差异才归因得清",
  "seed": 1337
}
| 必改的四项 | 填什么 |
|---|---|
pretrained_model | 底模路径。想让 LoRA 和某个画风底模配套,就填那个底模——4.2 里填的正是 DreamBooth 训出来的格子衫模型 |
instance_data_dir | 训练图目录,每张图配一个同名 .txt 描述文件 |
instance_prompt | 专属 token + 类别词,例如 a photo of sks_glasses man。token 必须是「不存在的词」 |
rank | 画风 8~16,具体人物/物体 32~64。数据只有几十张时不要超过 64 |
② 生效但不像 → 加步数或加 rank,先加步数;
③ 太像了、甩不掉训练集背景 → 降 rank、降步数,或挑一个更早的 checkpoint;
④ 主体对了但别的词也被带偏 → 关掉
train_text_encoder,或把 text_encoder_lr 再调小一档。每次只动一个参数,seed 保持不变——否则你分不清是哪一下起的作用。
5.2 出图服务调用模板
这份模板对应 4.5 那个异步服务的客户端一侧。小程序的 wx.request、Web 端的 fetch、Go 端的 http.Post,逻辑完全一样,只是语法不同;这份 Python 版可以直接拿来做联调和压测。
# -*- coding: utf-8 -*-
"""异步出图服务的客户端调用模板:提交 → 轮询 → 取图。

小程序端 wx.request、Web 端 fetch、Go 端 http.Post,逻辑完全一样,
只是语法不同。这份 Python 版可以直接拿来做联调和压测。
"""
import json
import os
import time
import urllib.error
import urllib.request

# ======================================================================
# 参数区
# ======================================================================
# TODO 1:服务端地址
BASE_URL = os.environ.get("DRAW_API", "http://127.0.0.1:8000")

# TODO 2:鉴权。凭证一律走环境变量,绝不写进源码或前端包里。
TOKEN = os.environ.get("DRAW_API_TOKEN", "")

# TODO 3:出图参数
PROMPT = "一只戴墨镜的柯基,工作室灯光,高细节"
NEGATIVE_PROMPT = "低分辨率, 模糊, 水印"

# TODO 4:轮询策略。
# 首次等待要给足(出图本来就要几十秒),间隔用退避而不是死等 1 秒,
# 否则 100 个用户在线就是每秒 100 次无效查询。
FIRST_WAIT = 8          # 提交后先睡多久再开始问
POLL_INTERVAL = 3       # 初始轮询间隔(秒)
POLL_BACKOFF = 1.4      # 每次乘这个系数,上限 POLL_MAX
POLL_MAX = 15
TIMEOUT_SEC = 180       # 总超时,超了就报错退出,不能无限等
# ======================================================================


def post(path, payload):
    data = json.dumps(payload, ensure_ascii=False).encode("utf-8")
    req = urllib.request.Request(
        BASE_URL + path, data=data,
        headers={"Content-Type": "application/json"})
    if TOKEN:
        req.add_header("Authorization", "Bearer " + TOKEN)
    try:
        with urllib.request.urlopen(req, timeout=20) as resp:
            return json.loads(resp.read().decode("utf-8"))
    except urllib.error.HTTPError as err:
        body = err.read().decode("utf-8", "replace")
        return {"job_status": "HTTP_%d" % err.code, "error": body}


def submit():
    """第一步:提交任务,只拿号,不等图。"""
    ret = post("/frontend/create", {
        "prompt": PROMPT,
        "negative_prompt": NEGATIVE_PROMPT,
        "session_id": "demo-session",
    })
    if not ret.get("job_id"):
        raise SystemExit("提交失败:%s" % ret)
    print("已取号 job_id=%s 队列长度=%s 预计 %ss"
          % (ret["job_id"], ret.get("queue_len"), ret.get("remain_time")))
    return ret["job_id"]


def poll(job_id):
    """第二步:凭号轮询,直到 FINISHED / FAILED / 超时。"""
    deadline = time.time() + TIMEOUT_SEC
    interval = POLL_INTERVAL
    time.sleep(FIRST_WAIT)

    while time.time() < deadline:
        ret = post("/frontend/query", {"job_id": job_id})
        status = ret.get("job_status")
        print("  status=%s" % status)

        if status == "FINISHED":
            return ret
        if status in ("FAILED", "NOT_FOUND"):
            raise SystemExit("任务失败:%s" % ret)

        time.sleep(interval)
        interval = min(interval * POLL_BACKOFF, POLL_MAX)

    raise SystemExit("超过 %ds 仍未完成,job_id=%s" % (TIMEOUT_SEC, job_id))


def download(url, out_path):
    """第三步:结果是一个会过期的临时 URL,要落盘就趁早。"""
    with urllib.request.urlopen(url, timeout=60) as resp:
        body = resp.read()
    with open(out_path, "wb") as f:
        f.write(body)
    print("已保存 %s(%d 字节)" % (out_path, len(body)))


def main():
    job_id = submit()
    ret = poll(job_id)
    print("耗时 %s ms" % ret.get("cost_time"))
    print("图片地址 %s" % ret.get("result_url"))
    # TODO 5:真实环境打开这一行把图拉下来
    # download(ret["result_url"], "%s.png" % job_id)


if __name__ == "__main__":
    main()
| TODO | 改什么 | 注意 |
|---|---|---|
| TODO 1 | 服务端地址 | 走环境变量,本地联调与线上共用一份代码 |
| TODO 2 | 鉴权 token | 一律 os.environ.get,绝不写进源码或前端包 |
| TODO 3 | 出图参数 | 提交前先在本地校验 256 字符上限 |
| TODO 4 | 轮询策略 | 首次等待、退避系数、上限、总超时,四个都要设 |
| TODO 5 | 下载结果 | 预签名 URL 会过期,要长期保存就得及时落盘 |
lora_config_template.json 管「训出一个挂件」,draw_client_template.py 管「把挂件的产能卖出去」。中间的接力棒是 4.3 那一步:把权重转换好、放进 models/Lora、并在服务端的默认 prompt 里写上专属 token。漏了最后半句,线上出的图就和没训一样。
06易错点汇总
按「方法选型 / 数据与 token / 超参数 / 权重与加载 / 服务化」五类归并,踩过一次就别再踩
⚠️ 一、方法选型
- 以为 LoRA 会改底模文件。
w = w₀ + BA是运行时的加法,磁盘上的底模一个字节都不会被改写。卸下挂件立刻还原,训坏了删掉重来的代价接近于零。 - 为了一个小需求上 DreamBooth。 它要 24 GB 以上显存、产物 2~7 GB、强度不可调、不能叠加。绝大多数场景 LoRA(8 GB 以上)就够了,默认答案是先用 LoRA。
- 把四种方法当成「效果好坏」的排序。 它们的差别在改的是哪一层:Textual Inversion 改 embedding 词表(几十 KB),Hypernetwork 挂小网络改 U-Net 中间结果,DreamBooth 全量更新 U-Net,LoRA 旁路低秩矩阵。体积差五个数量级就是这么来的。
- 用 Textual Inversion 去学复杂人物。 它只往词表里加一个向量,容量极小,适合教一个新概念的名字;想记住多角度的具体主体,容量根本不够。
- 拿 SD 1.5 的 LoRA 去挂 SDXL 底模。 不报错,但出图一团糟——两者的层结构和潜空间尺寸都不同。下模型时第一件事就是核对底模版本。
⚠️ 二、数据与专属 token
- 专属 token 挑了一个模型认识的词。 写
dog、plaid shirt这类常见词,模型里所有的狗/格子衫都会被拽向你这几十张图,从此再也画不出普通的。必须找一个「不存在的词」,如sks、Plaidshirtprogrammer。 CLASS_PROMPT里写了专属关键词。 类别先验 prompt 是让 AI 自动生成 image 用的,不要有专属关键词。写进去之后「学习」和「复习」变成同一件事,先验保留机制彻底失效。- 不开类别先验就训 DreamBooth。 少了复习环节,语言漂移风险大增——画什么狗都画成你家那只。
--with_prior_preservation那五个参数必须成组出现,少一个脚本直接报参数缺失。 - 训练图全是同一个背景/角度/光线。 模型分不清哪些特征属于主体,会把背景也算进专属 token 的含义里,以后怎么写 prompt 都甩不掉那个背景。要尽量使用不同的环境、灯光、发型、表情、姿势、角度。
- 图片尺寸没统一成 512×512。 训练时自动裁切,主体可能被裁掉一半。统一裁完要人工过一遍裁切结果。
- LoRA 数据集缺了同名 txt 描述。 kohya 会按空描述处理,训完才发现效果不对,白烧一小时 GPU。训练前脚本就该拦下来。
- 描述文件里把要学的东西也写进去了。 规则是反的:写进描述的模型认为「可变」,没写的才被吸收进专属 token。想学眼镜,就要写清除了眼镜之外的一切。
- 训练图少于 10 张还用大 rank。 严重过拟合,出图几乎复刻训练集。补数据到 20 张以上,或降 rank、降步数、调大先验权重。
⚠️ 三、超参数
- 把 DreamBooth 和 LoRA 的学习率记混。 DreamBooth 是 2e-6 量级(改底模全量参数,迈大一步就毁掉原有能力),LoRA 是 1e-4 量级(改从零初始化的旁路)。用错方向,要么毁模型,要么训半天没变化。
text_encoder_lr设得和unet_lr一样大。 文本编码器是所有词共用的,学快了整个词表被带偏——出图时不相关的词也跟着变形。它必须比 unet_lr 小一档。- rank 越大越好。 容量要和数据量匹配。20 张图配 rank 128,模型只会把这 20 张原样背下来。> 128 在小数据集上基本必过拟合。
- 省掉
lr_warmup_steps。 开头的大梯度可能直接把挂件打废。预热步数取总步数的 5%~10%。 - 只信最后一版权重。
checkpointing_steps的价值被严重低估——每 200 步存一版,训完横向挑,往往中间某一版才是最好的。 - 为了出大图把
resolution拉到 768 甚至 1024。 显存开销按面积涨,而 SD v1 底模本身在 512 附近训练,收益有限。 - 爆显存就换小 batch 一条路走到黑。 先凑齐省显存三件套:
fp16+gradient_checkpointing+use_8bit_adam;等效批次用梯度累积放大,显存不涨。 - 训练和对比实验时不固定 seed。 参数改了、图变了,你分不清是参数起的作用还是抽到了好牌。一次只动一个参数,seed 保持不变。
⚠️ 四、权重转换与加载
- 把 DreamBooth 的产物直接丢进 WebUI。 它是一个 diffusers 目录,无法直接在 WebUI 中使用,需要转换为 ckpt 的形式(单文件
.safetensors)。 - 把 LoRA 也拿去转换。 LoRA 本来就是单个
.safetensors,直接复制即可,不需要任何转换。 - 两种产物放错目录。 DreamBooth 进
models/Stable-diffusion,LoRA 进models/Lora。放错了下拉框里根本看不到。 - 出图时 prompt 里没写专属 token。 这是整条微调链路上最高频的坑。模型放对了、下拉框也选了,出图却和没训一样——先查这一条,别怀疑训练失败。
- 挂件强度一律给 1.0。 训练轮数偏多的 LoRA 在 1.0 时往往已经过冲,0.6~0.8 反而更自然。
weight_name写得和实际文件名对不上。 包括大小写和.safetensors后缀,差一个字符就加载不到,而且未必报明显的错。- 随手加载来路不明的
.ckpt。 它基于 pickle,加载时可能执行任意代码。一律优先用safetensors格式。 - 训练完不销毁云 GPU 实例。 按时长计费,训练产物先下载或传到对象存储,再销毁实例——把这一步写进流程清单。
⚠️ 五、服务化
- 把出图做成同步接口。 出一张图几十秒,而网关、CDN、小程序端默认超时多在 30~60 秒,连接必断。并发一上来连接池瞬间打满,新用户连提交都提交不了。
- 任务号用自增 ID。 别人改个数字就能看到你的图。必须是足够长的随机串——它同时充当凭号取件的凭证。
- 失败时不写结果表。 客户端会永远轮询下去,既耗流量又占连接。
FAILED也是一种结果,必须落表。 - 把图片 base64 塞进查询接口的响应。 几 MB 的 JSON 拖垮客户端解析,还让轮询变得极其昂贵。一律返回预签名 URL。
- 对象存储的桶设成公有读。 任务号再随机也没用,别人可以直接遍历。桶保持私有读,靠带签名、会过期的临时 URL 分发。
- 轮询间隔写死 1 秒。 100 个用户在线就是每秒 100 次无效查询,查询接口自己先被打垮。要首次等待给足 + 间隔退避 + 设总超时。
- 离开页面不清轮询定时器。 小程序里
clearInterval漏了,用户切走之后请求还在发。 - 把云厂商密钥放进小程序包里。 前端包可以被解出来,密钥只能放在服务端;代码里一律
os.environ.get(...),不硬编码。 - 不做输入前置校验。 256 字符、单边 2000、Base64 后 5 MB 这三条限制,等调用失败再处理,用户已经白等了一轮。
- 后台开多线程并发出图。 显存是共享的,并发出图很容易直接 OOM。单线程逐个消费天然就是限流;要提吞吐应该加机器,不是加线程。
07自测题
点击题目展开答案;能把这 12 题说清楚,这一讲就通了
四种训练方法各自的作用和特点是什么?
Textual Inversion:使用文本提示来训练模型,根据模型引用给定的图像并选择最匹配的图像;对计算资源要求较低,适用于需要快速生成大量高质量图像的场景。
Hypernetwork:从模型内部找到更多相似的东西,使得生成为近似内容图像;通常训练艺术风格,推荐训练画风。
DreamBooth:使用少量图像来训练模型的方法,是一种基于深度学习的图像风格转换技术;可以将一张图片的风格应用到另一张图片上,以生成新的图像。
LoRA:使用少量图像来训练模型的方法,只修改网络中部分参数;训练速度更快,模型大小适中。
为什么这四种方法的产物体积能差到五个数量级(KB 到 GB)?
因为它们改的层级不同。Textual Inversion 只在 embedding 词表里新增一个词的向量,模型本体一个参数没动,所以只有几十 KB;Hypernetwork 额外挂一个小网络改 U-Net 注意力层的中间结果,几十到几百 MB;LoRA 在部分层旁路挂一对低秩矩阵、原权重冻结,几十 MB;DreamBooth 整个 U-Net(可选连同 text encoder)全量更新,所以产物是 2~7 GB 的完整模型。
DreamBooth 和 LoRA 的显存门槛分别是多少?为什么差这么多?
DreamBooth 基于 diffusers,显存需要 24 GB 以上;LoRA 基于 kohya_ss,显存需要 8 GB 以上。差别在于 LoRA 把底模全程冻结,不需要为底模保存梯度和优化器状态——而优化器状态通常是参数量的两倍,是训练显存的大头。LoRA 显存里只多出 rank 那一小撮可训练参数。
完整复述 DreamBooth 的训练过程。
对于一组个性化的图片,首先需要定义一个专属的 prompt,比如 a [V] dog,[V] 是一个罕见没有什么含义的符号组合。训练过程中,首先用文本编码器提取这个专属 prompt 的文本特征,然后用图像编码器提取图片的特征,以文本特征、图像特征作为扩散模型的输入进行模型训练。预测时输入关键词即可生成对应风格的图片。
专属 token 为什么必须挑一个「不存在的词」?挑成 dog 会怎样?
训练本质是把「这个词」和「这组图」强行绑定。如果挑的词模型本来就认识,绑定就变成了覆盖:写 dog,模型里所有的狗都会被拽向你这几张图,从此再也画不出普通的狗。mydog 同样不行——会被切成 my + dog 两个有含义的碎片。要挑 sks、Plaidshirtprogrammer 这类罕见组合,切出来的碎片几乎没有语义,是一块干净的画布。
类别先验 prompt 是干什么的?它里面能不能写专属 token?
绝对不能写。CLASS_PROMPT 是让 AI 自动生成 image 用的 prompt,不要有专属关键词即可。它的作用是让底模自己生成一批普通的同类图,训练时和你的图一起喂进去,损失里加一项「普通的同类要画得和以前一样」,防止语言漂移(模型学完之后把所有同类都画成你这一个)。写进专属 token 之后,「学习」和「复习」变成同一件事,机制彻底失效。
为什么训练数据要尽量多样?数据全是同一个背景会怎样?
因为模型分不清「哪些特征属于主体、哪些属于场景」。要尽量使用不同的环境、灯光、发型、表情、姿势、角度,否则模型会把共有的背景也算进专属 token 的含义里——以后不管写什么 prompt,那个背景都甩不掉。同理,角度全是正面会导致一写侧面就崩。
写出 LoRA 的公式并解释每一项。
w = w₀ + BA。其中 w₀ 是预训练 SD 模型的参数(Weights),BA 为低秩矩阵也就是 LoRA 模型的参数,w 代表被 LoRA 模型影响后的最终 SD 模型参数。整个过程是一个简单的线性关系:原 SD 模型叠加 LoRA 模型后,得到一个全新效果的模型。LoRA 全称是 Low-Rank Adaptation of Large Language Models。
B 和 A 的形状分别是什么?为什么参数量能省下来?
设原层权重 w₀ 是 d × d,则 B 是 d × r(高瘦),A 是 r × d(矮胖),r 就是 rank。以 d = 1024、r = 32 为例:w₀ 有 1048576 个参数,B 与 A 合计只有 65536 个,约占 6.25%。B 乘 A 得到的仍是 d × d,形状和 w₀ 严丝合缝可以直接相加,但自由度被限制在很小的 r 上,这就是「低秩」。
rank 该怎么选?设成 256 会发生什么?
容量要和数据量匹配:4~8 学画风,16~32 是日常首选(具体人物、宠物、产品),64~128 用于多概念且要配足够多的数据。超过 128 在几十张图的小数据集上基本必过拟合:出图几乎复刻训练图、甩不掉训练集背景,甚至不相关的词也跟着变形,而且失去了 LoRA 轻量的意义。遇到过拟合,先降 rank、再降步数,最后才考虑补数据。
为什么 LoRA 能调强度、能叠加、能一键还原,而 DreamBooth 不能?
因为 LoRA 是加法:挂上是 w₀ + α·BA,摘下就是 w₀,底模文件从未被改写,所以能乘系数调强度(过冲就调到 0.6~0.8)、能同时挂多个、能卸下即还原。DreamBooth 是把底模本身的参数改掉了,产物就是一个新模型——你没法让一个集训回来的人「只发挥 80% 的新本事」。
为什么 DreamBooth 的学习率要比 LoRA 小两个量级?
DreamBooth 常用 2e-6,LoRA 常用 1e-4,差约 50 倍。DreamBooth 直接改底模的全量参数,那是巨额算力训出来的东西,稍微迈大一步就会毁掉原有能力;LoRA 改的是一个从零初始化的旁路,本来就是空白,可以放开步子学。另外 text_encoder_lr 必须比 unet_lr 更小,因为文本编码器是所有词共用的,学快了会把整个词表带偏。
训练产物怎么放进 WebUI?出图时还要做什么?
DreamBooth 的产物是 diffusers 目录,无法直接在 WebUI 中使用,需要转换为 ckpt 的形式,然后放进 stable-diffusion-webui/models/Stable-diffusion;LoRA 本来就是单个 .safetensors,不用转换,直接复制到 models/Lora。
出图时必须在正向 prompt 中添加训练时用的专属 token——这是整条微调链路上最高频的坑,「模型放对了出图却没变化」九成是这一条。
出图服务为什么必须异步?同步会死在哪里?
出一张图要几十秒,而网关、CDN、小程序端的默认超时多在 30~60 秒:连接会先断;用户切后台或断网则请求丢失、图白画了;并发上来后每个请求占一个连接干等,连接池瞬间打满,新用户连提交都提交不了;客户端超时重试又会再排一次队。正确形态是取号等叫号:提交接口登记任务并立刻返回 task_id,后台慢慢出图,客户端凭号轮询查询接口拿图片地址。
异步服务里,任务号、失败结果、图片返回方式各有什么要求?
任务号要足够长的随机串,不能用自增 ID——它同时充当凭号取件的凭证,自增的话改个数字就能看别人的图。失败也必须写进结果表(FAILED),否则客户端会永远轮询下去。图片一律返回预签名、会过期的 URL,不要把 base64 塞进查询响应里——几 MB 的 JSON 会拖垮客户端,还让轮询变得极其昂贵;对象存储的桶要保持私有读。另外轮询要首次等待给足 + 间隔退避 + 设总超时。
词术语表
| 术语 | 含义 |
|---|---|
| base model / checkpoint | 预训练好的 SD 底模,2~7 GB,画风由它决定;所有微调都站在它之上 |
| fine-tune | 微调,用少量数据在底模之上调整参数,使其学会新主体或新画风 |
| Textual Inversion | 只在 embedding 词表里新增一个词的向量,产物几十 KB,对计算资源要求较低 |
| Hypernetwork | 额外挂一个小网络去改 U-Net 中间结果,通常训练艺术风格,推荐训练画风 |
| DreamBooth | 用少量图像全量微调模型的方法,产物是一个完整的新模型,显存需 24 GB 以上 |
| LoRA | Low-Rank Adaptation,底模冻结、旁路挂低秩矩阵;只修改网络中部分参数,训练更快、模型大小适中,显存需 8 GB 以上 |
| w = w₀ + BA | LoRA 的核心公式。w₀ 是预训练参数,BA 是低秩矩阵即 LoRA 参数,w 是叠加后的最终参数 |
| rank / network_dim | 低秩分解的秩 r,决定挂件容量。画风 4~8,人物 16~32,超过 128 小数据集必过拟合 |
| 专属 token | 指代新主体的罕见符号组合,如 [V]、sks;必须是一个「不存在的词」,出图时 prompt 里必须喊出来 |
| instance prompt | 含专属 token 的训练 prompt,例如 a [V] dog |
| class prompt | 类别先验 prompt,不含专属 token,用于让底模生成复习用的同类图 |
| prior preservation | 类别先验保留,防止语言漂移——避免模型把所有同类都画成你训练的那一个 |
| AdamW8bit | 把优化器状态压到 8bit 的优化器,是 8 GB 显存能跑 LoRA 的关键一环 |
| cosine_with_restarts | 余弦退火重启调度器,学习率降到底后跳回高位,帮模型跳出局部最优 |
| gradient_checkpointing | 用重算换显存的技巧:前向不存中间激活,反向时再算一遍 |
| safetensors | 模型存储格式,不基于 pickle,加载时不会执行任意代码,优于 .ckpt |
| task_id | 异步任务号,足够长的随机串,同时充当凭号取件的凭证 |
| 预签名 URL | 对象存储生成的带签名、会过期的临时地址;桶保持私有读,靠它分发结果图 |
| 退避轮询 | 查询间隔按系数递增并设上限与总超时,避免每秒一次的无效查询打垮接口 |