主流大模型全景与选型
不存在「最好的模型」,只存在「在你的约束下最合适的模型」——换一组约束,冠军就换人。
30″30 秒看懂大模型选型
挑模型这件事,本质上和给团队招人一模一样。
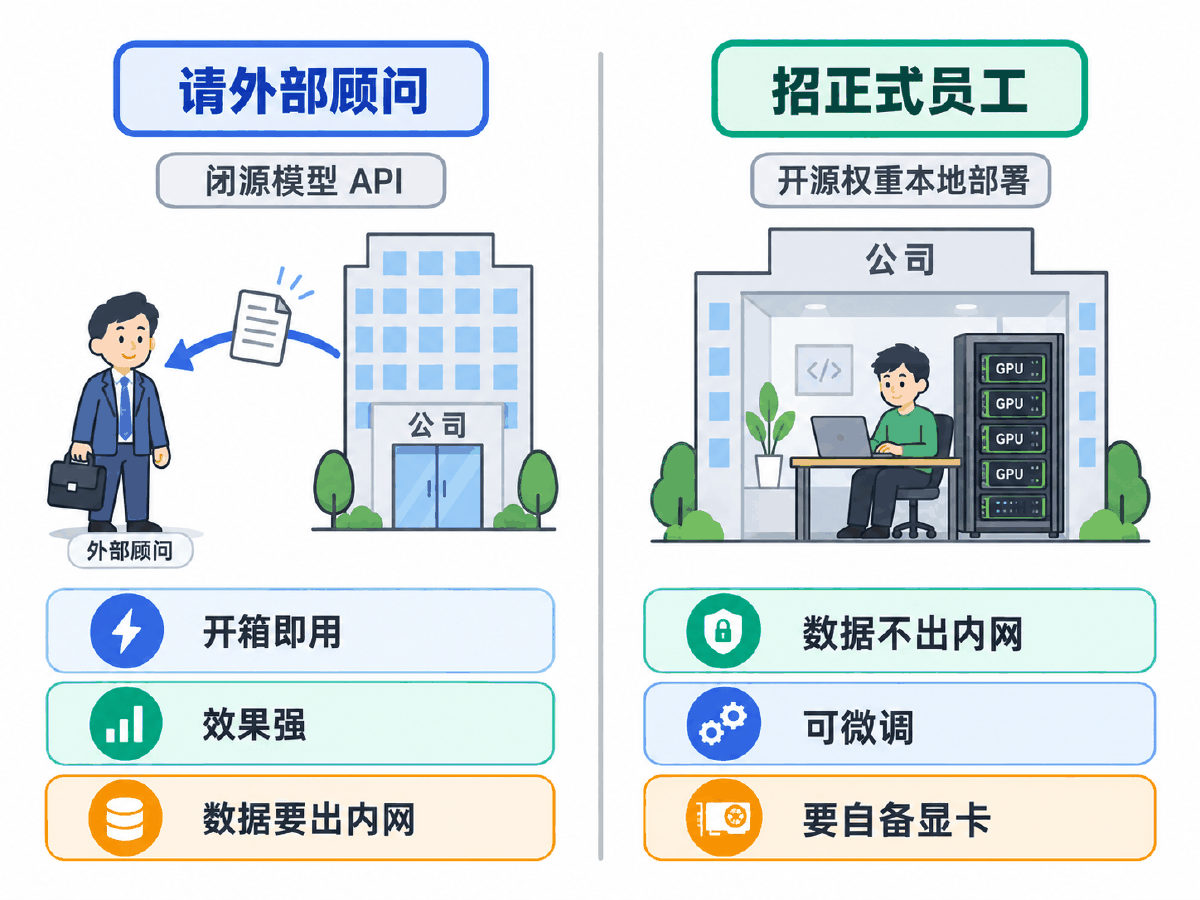
你可以请外部顾问——能力最强、来了就能干活、按小时计费,但公司的资料得发给他看;也可以招个正式员工坐进办公室——资料一步不出内网,你还能送他去进修(微调),代价是要给他配工位和显卡。前者是闭源 API,后者是开源权重本地部署。
招人时你会看学历、看专业方向、看一次能读完多厚的材料。对应到模型,就是参数量、架构、上下文长度。而最关键的一点两边也一样:简历漂亮不等于干得好,得让他做一套你自己的题。
| 招聘里的概念 | 对应的技术概念 | 你该关心什么 |
|---|---|---|
| 请外部顾问 | 闭源模型 API | 开箱即用、效果强;但数据要出内网,按 token 付费,版本由对方说了算 |
| 招正式员工入职 | 开源权重本地部署 | 数据不出内网、版本可锁定、可微调;但要自备显卡和运维 |
| 学历 | 参数量(7B / 70B / 235B) | 相关但不决定一切,训练数据量与后训练质量同样关键 |
| 专业方向 | 架构(Encoder / Decoder / Encoder-Decoder) | 决定它擅长理解还是擅长生成 |
| 一次能读完多厚的材料 | 上下文长度(context length) | 直接决定能不能把整份文档塞进去问 |
| 全公司统一的入职手续 | OpenAI 兼容协议 | 换人不用改流程——换模型不用改业务代码 |
| 让他做一套你的题 | 用自己的测试集实测 | 唯一能拍板的依据,榜单只能用来圈候选 |
01概念:三大架构分野
同一个 Transformer,拆开用还是整个用,决定了模型擅长什么
1.1 一切从 Transformer 开始
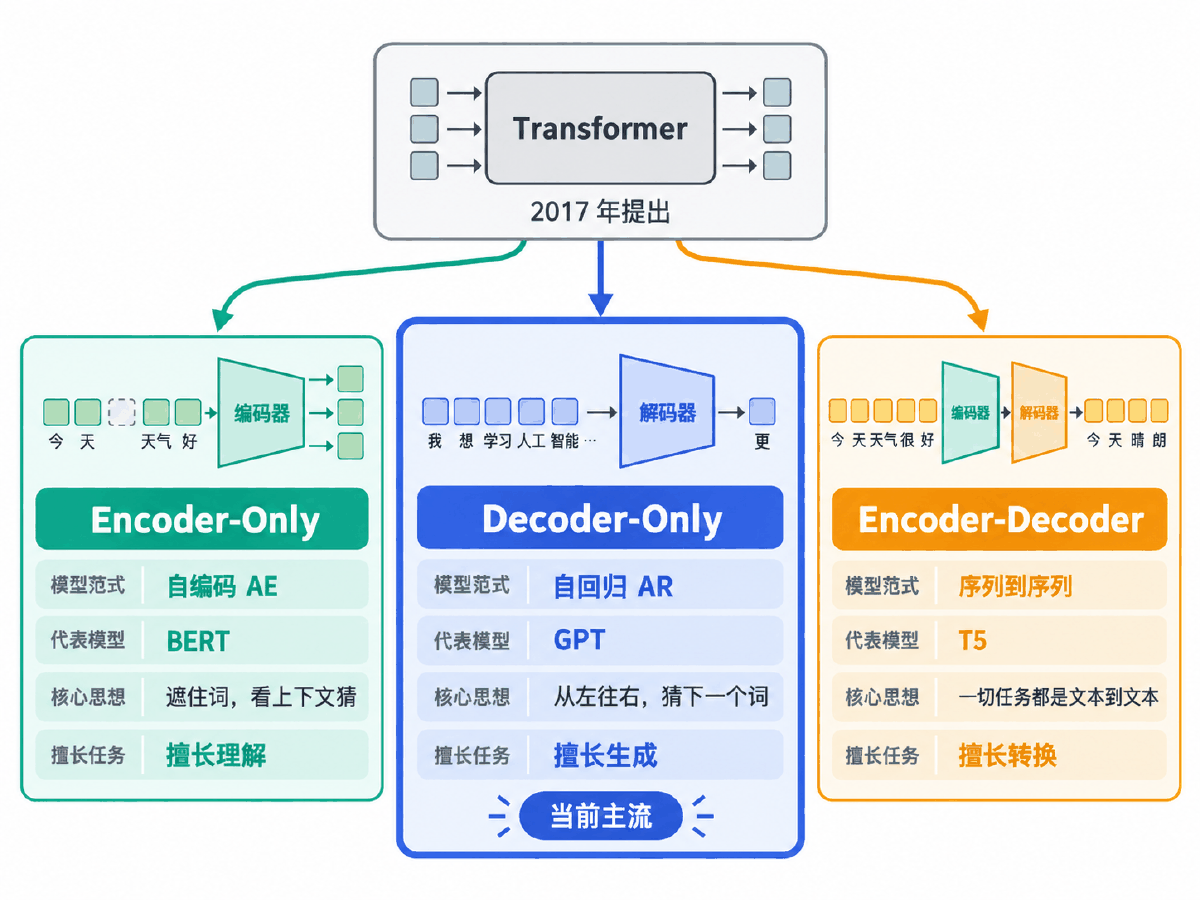
大模型本身基于 Transformer 架构。自 2017 年 Attention is all you need 诞生起,原始的 Transformer 模型为不同领域提供了灵感和启发。基于这个框架衍生出了一系列模型:有些只使用 encoder,有些只使用 decoder,有些同时使用 encoder + decoder。
于是大模型的分类就有了三种:自编码模型(encoder)、自回归模型(decoder)和序列到序列模型(encoder-decoder)。
| 类别 | 代表 | 用了什么 | 基本原理 | 擅长 |
|---|---|---|---|---|
| 自编码 AE AutoEncoder | BERT | Encoder-Only | 在输入中随机 MASK 掉一部分单词,根据上下文预测这个词 | 内容理解类任务(NLU):情感分析、提取式问答、分类 |
| 自回归 AR Autoregressive | GPT | Decoder-Only | 从左往右学习,只能利用上文信息 | 生成式任务(NLG):摘要、翻译、抽象问答,长文本生成能力强 |
| 序列到序列 Seq2Seq | T5 | Encoder-Decoder | 把每个 task 都视作序列到序列的转换 | 既要理解又要生成的任务,如机器翻译 |
1.2 BERT:双向编码,擅长「读懂」
BERT 是 2018 年 10 月由 Google AI 研究院提出的预训练模型,全称 Bidirectional Encoder Representation from Transformers。它在机器阅读理解顶级水平测试 SQuAD1.1 中两个衡量指标上全面超越人类,并在 11 种不同 NLP 测试中创出 SOTA,包括将 GLUE 基准推高至 80.4%(绝对改进 7.6%)、MultiNLI 准确度达到 86.7%(绝对改进 5.6%)。
宏观上 BERT 分三个模块:最底层的 Embedding 模块、中间层的 Transformer 模块、最上层的预微调模块。
| 模块 | 内容 |
|---|---|
| Embedding | 三种 Embedding 直接加和:Token Embeddings(词嵌入,首个单词是 CLS 标志)、Segment Embeddings(句子分段嵌入)、Position Embeddings(位置编码) |
| 双向 Transformer | 只使用经典 Transformer 的 Encoder 部分,完全舍弃 Decoder |
| 预微调 | 最后一层按任务调整。如句子级分类任务,直接取第一个 [CLS] token 的 final hidden state,加一层全连接后 softmax 预测标签 |
它的两大预训练任务也很有代表性:
随机抽取 15% 的 token 参与 MASK 任务。其中 80% 用 [MASK] 替换,10% 用随机单词替换,10% 保持不变。
输入句子对 (A, B),预测 B 是不是 A 的真实下一句。其中 50% 是真实的下一句(IsNext,正样本),50% 是随机抽取的句子(NotNext,负样本)。
BERT 的关键参数:transformer 层数 12、特征维度 768、head 数 12、总参数量 1.15 亿。数据集为 BooksCorpus(800M words)+ English Wikipedia(2,500M words)。
缺点也很明确:存在预训练与微调之间的输入噪声差异(训练时有 [MASK],实际使用时没有),而且更适合 NLU 任务,不适合 NLG。
1.3 GPT:单向生成,擅长「往下写」
2018 年 6 月,OpenAI 发表论文《用生成式预训练提高模型的语言理解力》,推出了具有 1.17 亿参数的 GPT(Generative Pre-training)模型。
GPT 采用单向 Transformer:给定句子 [u1, u2, …, un],GPT 在预测单词 ui 时只会利用 [u1, …, u(i-1)] 的信息,而 BERT 会同时利用上下文 [u1,…,u(i-1), u(i+1),…,un]。
Masked Multi-Head Attention 层和 Feed Forward 层。另外,经典 Transformer 解码器用了 6 个 Decoder Block,GPT 用了 12 个。
GPT 的训练分两阶段:① 无监督的预训练语言模型;② 有监督的下游任务 fine-tuning。预训练阶段最大化似然函数,本质是基于前 k 个词预测当前词,k 是上文窗口大小——理论上 k 取得越大,模型能获取的上文信息越充足,能力越强。
关键参数与 BERT 惊人地接近:层数 12、特征维度 768、head 数 12、总参数量 1.17 亿。数据集是 BooksCorpus,约 5 GB、7400w+ 句子、7000 本不同风格的书。选它的理由很实在:书籍文本包含大量高质量长句,保证模型学习长距离信息依赖;而且这些书未开源公布,下游数据集里很难见到,更能验证模型的泛化能力。
缺点是:语言模型是单向的,且针对不同任务需要不同数据集分别微调,比较麻烦。
1.4 T5:把所有任务都变成 Text-to-Text
T5 由谷歌提出,目的是构建任务统一框架:将所有 NLP 任务都视为文本转换任务。这样就能用同样的模型、同样的损失函数、同样的训练过程、同样的解码过程完成所有 NLP 任务。
结构与原始 Transformer 基本一致,改动有两处:① 简化版 Layer Normalization,去除了 bias,并把 Layer Norm 放在残差连接外面;② 简化版相对位置编码——每个位置编码是一个标量,被加到 logits 上用于计算注意力权重,各层共享位置编码,但同一层内不同注意力头的位置编码独立学习。
预训练任务包括两种类型:Causal Language Modeling(因果语言建模)和填空任务(Masked Language Modeling)。数据集是对 Common Crawl 过滤后得到的 C4(the Colossal Clean Crawled Corpus),去掉重复的、低质量的、看着像代码的文本,只保留英文。
关键参数:层数 24、特征维度 768、head 数 12、总参数量 2.2 亿。
1.5 为什么最后是 Decoder-only 赢了
今天你能叫得出名字的大模型,几乎清一色是 Decoder-only。原因有两层:
Encoder 的双向注意力会存在低秩问题,这可能会削弱模型表达能力。就生成任务而言,引入双向注意力并无实质好处。
Encoder-Decoder 架构在某些场景下表现更好,大概只是因为它多了一倍参数。所以在同等参数量、同等推理成本下,Decoder-only 架构就是最优选择。
所以下一节看各家模型时,你会发现它们的训练目标完全一样,差别全在「零件选型」上——用哪种归一化、哪种激活函数、哪种位置编码。
02原理:主流开源模型差在哪
训练目标全都一样,差别在四个零件的选型上
2.1 先记住这张零件表
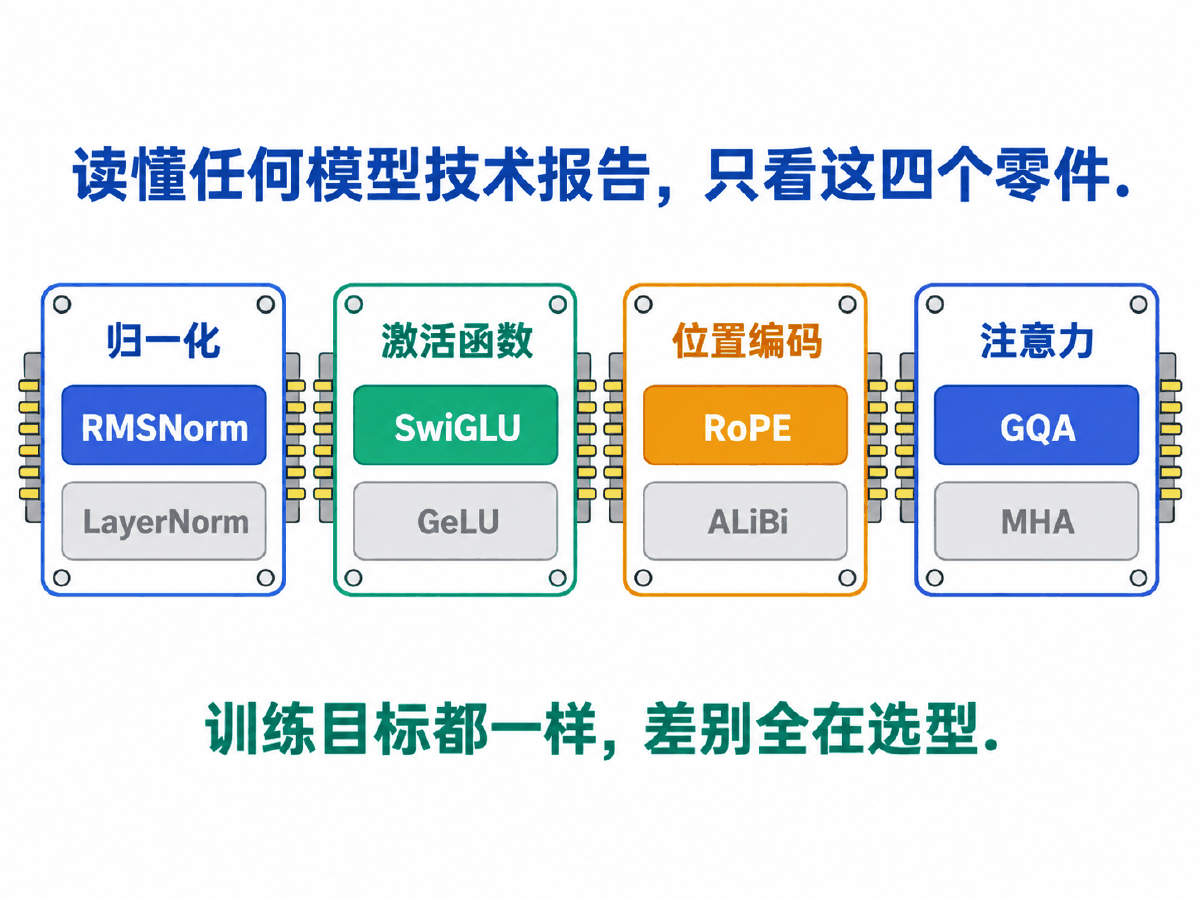
看模型不要从名字看,要从四个零件看。几乎每一份模型技术报告的「模型结构」一节,讲的都是这四件事怎么选:
| 零件 | 它解决什么 | 常见选项 |
|---|---|---|
| 归一化 normalization | 让深层网络训练稳定、不发散 | Post-LN / Pre-LN;LayerNorm / RMSNorm / DeepNorm |
| 激活函数 activation | 提供非线性表达能力 | ReLU / GeLU / GeGLU / SwiGLU |
| 位置编码 position | 告诉模型词的先后顺序,并决定能不能外推到更长序列 | 绝对位置编码 / RoPE(旋转) / ALiBi(相对) |
| 注意力 attention | 决定推理速度与显存占用 | MHA / MQA(Multi-Query) / GQA(分组查询) |
其中 RMSNorm 与 LayerNorm 的主要区别在于去掉了减去均值的部分,简化了计算,可以减少约 7%~64% 的计算时间。而 GQA 则是通过减少键值(KV)缓存的使用来提升推理效率。
2.2 五个代表模型的零件矩阵
把主流开源模型按这四个零件横向摆开,规律立刻显形:
| 模型 | 架构 | 归一化 | 激活函数 | 位置编码 | 其他改动 |
|---|---|---|---|---|---|
| ChatGLM-6B | Prefix-Decoder | Post-LN + DeepNorm | GeGLU | RoPE | embedding 层梯度缩减(相当于缩小 10 倍),提升训练稳定性 |
| LLaMA | Decoder-only | Pre-LN + RMSNorm | SwiGLU | RoPE | BPE tokenizer,词表仅 32000 |
| BLOOM | Decoder-only | Pre-LN + embedding LN | GeLU | ALiBi | embedding 层后加 LN 使训练更稳定;ALiBi 外推性更好 |
| Baichuan-7B | Decoder-only | Pre-LN + RMSNorm | SwiGLU | RoPE | 与 LLaMA 一致的模型设计 |
| Qwen | Decoder-only | RMSNorm | SwiGLU | RoPE | GQA 分组查询注意力,提升推理效率 |
Pre-LN + RMSNorm + SwiGLU + RoPE 几乎成了事实标准,BLOOM 的 ALiBi 与 ChatGLM 的 GeGLU 是少数派。所以读一个新模型的技术报告时,先定位这四个零件,十分钟就能判断它和你熟悉的模型差多远。
2.3 ChatGLM:中文友好的 Prefix-Decoder
ChatGLM-6B 是清华大学提出的开源、支持中英双语的对话语言模型,基于 General Language Model (GLM) 架构,具有 62 亿参数。它使用了和 ChatGPT 相似的技术,经过约 1T 标识符的中英双语训练(中英文比例 1:1),辅以监督微调、反馈自助、人类反馈强化学习。
它的训练目标与别家不同,是基于自回归空白填充的:在输入文本中随机挖去一些连续的文本片段,然后训练模型按照任意顺序重建这些片段。GLM 把 NLU 任务转化为包含任务描述的完形填空问题,再通过自回归生成的方式来回答。
被称为 Prefix-Decoder 而不是纯 Decoder 的原因:Decoder 是单向的,但 GLM 某些位置可以看到双向——Part A 的词可以互相看到,但看不到 Part B;Part B 的词可以看到 Part A 和 Part B 中前面的词。
| 配置 | 数值 | 量化等级 | 推理最低显存 | 高效参数微调最低显存 |
|---|---|---|---|---|
| 参数 | 6.2B | FP16(无量化) | 13GB | 14GB |
| 隐藏层维度 | 4096 | INT8 | 10GB | 9GB |
| 层数 / 注意力头数 | 28 / 32 | INT4 | 6GB | 7GB |
| 词表大小 / 最大长度 | 130528 / 2048 | — | — | — |
优点是部署门槛低——INT4 精度下只需 6GB 显存,可以部署在消费级显卡上推理;缺点是模型容量小,记忆和语言能力相对较弱、多轮对话能力较弱。
迭代也很典型:ChatGLM2-6B 采用 FlashAttention 把上下文从 2K 提到 32K,引入 Multi-Query Attention 使推理提速 42%,数学任务性能提升 571%;ChatGLM3-6B 再加上多模态理解、代码增强模块与网络搜索增强。
2.4 LLaMA:英文世界的地基
LLaMA(Large Language Model Meta AI)由 Meta AI 于 2023 年发布,共有 7B、13B、33B、65B 四种版本。训练数据以英语为主的拉丁语系,外加来自 GitHub 的代码数据,不包含中韩日文,所有训练数据都是开源的。其中 65B 和 33B 在 1.4 万亿 token 上训练,7B 和 13B 在 1 万亿 token 上训练。
它最出名的结论是:130 亿参数的 LLaMA 在大多数基准上可以胜过 GPT-3(1750 亿参数),并且可以在单块 V100 GPU 上运行;最大的 650 亿参数版本可以媲美 Chinchilla-70B 和 PaLM-540B。
社区的标准解法是扩充中文词表:在中文语料上用 Sentence Piece 训练一个中文 tokenizer(如 20000 个中文词汇),再与原始 LLaMA tokenizer 合并,得到词表大小 49953 的 Chinese LLaMA tokenizer。
迭代路线同样值得记:LLaMA 2 训练语料比 LLaMA 多 40%,上下文从 2048 升级到 4096,并训练出 chat 版本(SFT + RLHF);LLaMA 3 词表扩大到 128k,8B 和 70B 都采用 GQA 提升推理速度,预训练数据超过 15T token,比 LLaMA 2 大了 7 倍。
2.5 BLOOM 与 Baichuan:多语言路线与中文路线
由 Hugging Face 训练。训练数据包含英语、中文、法语等共 46 种语言和 13 种编程语言,1.5TB 去重清洗后的文本,中文语料占比 16.2%。参数规模有 560M、1.1B、1.7B、3B、7.1B 和 176B。词表大小 250880。
176B 版本在 384 张 A100 80GB 上训练,2022 年 3 月至 7 月耗时约 3.5 个月,算力成本超过 300 万欧元。
优点是多语言适应性好,可在多种语言间切换而无需重新训练。
由百川智能于 2023 年 6 月发布,开放且可商用,支持中英双语,在约 1.2 万亿 token 上训练的 70 亿参数模型。词表大小 64000,最大长度 4096。模型设计与 LLaMA 一致。
在标准的中文和英文权威 benchmark(C-EVAL / MMLU)上均取得了同参数规模下的最好效果。
Baichuan-13B 参数达 130 亿、训练 1.4 万亿 token,改用 ALiBi 位置编码,并开源了 int8 和 int4 量化版本,可部署在 Nvidia 3090 这样的消费级显卡上。
2.6 Qwen:把后训练做厚
Qwen 由阿里巴巴训练并开源,最早于 2023 年 8 月开源 70 亿参数规模,随后陆续开源多个版本,参数从 18 亿到 720 亿。结构上是 GQA + RMSNorm + SwiGLU + RoPE 的组合。
以 Qwen2.5-7B-Instruct 为例:参数 7B、隐藏层维度 3584、层数 28、注意力头 28 个 query + 4 个 key-value(这就是 GQA:query 头多、KV 头少)、词表大小 151936、最大长度 32768。
它的核心改进不在结构而在训练:预训练使用了高达 18 万亿 token 的数据(Qwen2 是 7 万亿),后训练阶段引入复杂的监督微调和多阶段强化学习,显著提升了长文本生成、结构化数据分析和指令遵循能力。
② 词表大小是中文能力的先行指标:32000(LLaMA)→ 64000(Baichuan)→ 151936(Qwen)。词表越大,中文编码效率越高、越省 token。
③ 训练数据量的增长快过参数量:1T → 1.4T → 15T → 18T。近几代的能力提升,更多来自数据与后训练,而不是单纯堆参数。
2.7 MoE:让参数「大而不贵」
近几年还多了一个必须知道的概念:MoE(Mixture-of-Experts,混合专家)。它把前馈层拆成许多「专家」,每次推理只激活其中一小部分。
所以 MoE 模型有两个参数量:总参数量决定显存占用,激活参数量决定推理计算量。以官方公布的 Qwen3 开源权重为例——Qwen3-235B-A22B 总参数 235B、激活参数 22B;Qwen3-30B-A3B 总参数 30B、激活参数 3B。
反过来,看到「激活 3B」就以为能力等同于 3B 稠密模型也错了。选型时这两个数字都要问清楚:一个决定你的显存账单,一个决定你的延迟。
2.8 显存账本:自建路线的第一道硬门槛
前面所有参数、架构、词表的讨论,到了自建部署这一步都要换算成同一件事:这张卡装不装得下。下面的算法十分粗糙,但足够在选型阶段筛掉一大半候选。
第一块:权重
显存占用的大头是权重,算法就一行:参数量 × 每个参数的字节数。精度决定后一个因子:FP32=4、FP16/BF16=2、INT8=1、INT4=0.5。
同一个 7B 模型(实测输出见 3.2 节,已含 1.2 倍开销系数):
| 精度 | 权重 | 含开销 | 24GB 消费级显卡 |
|---|---|---|---|
| FP32 | 26.08 GB | 31.29 GB | ❌ 装不下 |
| FP16 | 13.04 GB | 15.65 GB | ✅ 装得下 |
| INT8 | 6.52 GB | 7.82 GB | ✅ 宽裕 |
| INT4 | 3.26 GB | 3.91 GB | ✅ 宽裕 |
这就是 2.3 节 ChatGLM-6B 那张表里「INT4 只需 6GB」的来源——量化是把大模型塞进小卡的第一手段,FP16 到 INT4 直接降到四分之一。代价是精度损失,具体损多少必须在你自己的任务上实测。
第二块:KV cache——长上下文的隐形成本
权重是固定的,KV cache 却随上下文长度线性增长。它缓存的是已生成 token 的 Key 和 Value,避免每生成一个词就重算一遍前文。
实测一下(28 层、head_dim=128、FP16、batch=1),对比 MHA(28 个 KV 头)与 GQA(4 个 KV 头):
| 上下文长度 | MHA(28 头) | GQA(4 头) | GQA 省了 |
|---|---|---|---|
| 2K | 0.77 GB | 0.11 GB | 86% |
| 8K | 3.06 GB | 0.44 GB | 86% |
| 32K | 12.25 GB | 1.75 GB | 86% |
| 128K | 49.00 GB | 7.00 GB | 86% |
② 为什么并发一高就 OOM:KV cache 还要再乘 batch。单路 32K 只要 1.75GB,十路并发就是 17.5GB。压测时显存爆掉,十有八九是这里。
拆到多卡上:不是加卡就线性变快
FP16 下算一遍需要几张 80GB 卡:
| 规模 | 权重 | 含开销 | 80GB 卡数 |
|---|---|---|---|
| 7B | 13.04 GB | 15.65 GB | 1 张 |
| 13B | 24.21 GB | 29.06 GB | 1 张 |
| 32B | 59.60 GB | 71.53 GB | 1 张(已经很满) |
| 70B | 130.39 GB | 156.46 GB | 2 张 |
| 235B(MoE 总参数) | 437.72 GB | 525.27 GB | 7 张 |
MoE 省的是计算量(延迟、吐吐量),不是显存。 把「激活 22B」当成「22B 的显存需求」去报硬件预算,是自建路线上最昂贵的误判之一。
还有一件事要提前想:单卡装不下就要张量并行,而张量并行靠卡间通信。没有 NVLink 的机器上走 PCIe,通信开销可能把多卡的收益吞掉一大截——两张卡不等于两倍速度。所以实际选型时,能单卡装下的方案优先级往往高于参数更大但必须拆卡的方案。
03最小代码:先问服务「你到底有哪些模型」
列表里有 ≠ 你这一刻调得动
3.1 探测服务真实可用的模型
选型的第一步不是看榜单,是连上你要用的那个服务,把它真实支持的模型列出来,再逐个发一次最小请求。这两步缺一不可:
"""探测一个 OpenAI 兼容服务:它到底有哪些模型、哪个真能调通。

为什么要探测:模型列表里有,不代表你的账号这一刻调得动。
只有真发一次请求、看响应里的 model 字段,才算「调得通」。

运行前配置:
    export LLM_API_KEY="你的key"
    export LLM_BASE_URL="https://api.deepseek.com"
依赖:pip install "openai>=1.0"
"""
import os
import sys

from openai import OpenAI

BASE_URL = os.environ.get("LLM_BASE_URL", "https://api.deepseek.com")
client = OpenAI(api_key=os.environ["LLM_API_KEY"], base_url=BASE_URL, timeout=30.0)


def list_models():
    """第一步:把服务端声明支持的模型列出来。"""
    try:
        models = client.models.list()
    except Exception as err:
        print("[x] 列举模型失败:", type(err).__name__, err)
        return []
    names = sorted(m.id for m in models.data)
    print("服务 %s 声明了 %d 个模型:" % (BASE_URL, len(names)))
    for name in names:
        print("   ", name)
    return names


def probe(model):
    """第二步:真发一次最小请求,看它是否返回、返回的 model 是哪个。

    只要 1 个 token 的输出,成本可以忽略不计。
    """
    try:
        response = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": "hi"}],
            max_tokens=1,
        )
    except Exception as err:
        return False, "%s: %s" % (type(err).__name__, str(err)[:80])

    # 注意:响应里的 model 可能与你请求的名字不同(别名、灰度、降级都会改写它)
    served = response.model
    note = "实际服务模型 %s" % served
    if served != model:
        note += "(与请求名 %s 不一致)" % model
    return True, note


def main():
    names = sys.argv[1:] or list_models()
    if not names:
        print("没有可探测的模型名,可在命令行直接传入,如:")
        print("   python3 probe_endpoint.py deepseek-flash")
        return

    print("\n逐个实测(每个只花 1 个输出 token):")
    print("%-34s %-6s %s" % ("模型", "可用", "说明"))
    print("-" * 78)
    for name in names:
        ok, note = probe(name)
        print("%-34s %-6s %s" % (name, "✓" if ok else "✗", note))


if __name__ == "__main__":
    main()
/v1/models 返回的是服务端声明支持的清单,不代表你的账号、你的余额、你的地域在这一刻调得动它。常见情况:清单里有这个模型,但你的账号没开通权限、或后端没有可用容量,一调就报错。只有真发一次请求、看到响应,才算「调得通」。 每个模型只花 1 个输出 token,成本可以忽略不计。
response.model 可能与你请求的名字不同。别名、灰度发布、自动降级都会改写它——你以为在用旗舰版,实际被路由到了轻量版,效果对不上却查不出原因。所以做模型对比实验时,务必记录响应里的实际 model 字段,而不是记录你请求时写的那个字符串。
运行方式:
$ export LLM_API_KEY="你的key"
$ export LLM_BASE_URL="https://api.deepseek.com"

# 用法一:不带参数 —— 先列举服务声明支持的模型,再逐个实测
$ python3 probe_endpoint.py

服务 https://api.deepseek.com 声明了 N 个模型:
    <模型名 1>
    <模型名 2>

逐个实测(每个只花 1 个输出 token):
模型                               可用   说明
------------------------------------------------------------------------------
<模型名 1>                         ✓     实际服务模型 <响应里的 model 字段>
<模型名 2>                         ✗     NotFoundError: ...

# 用法二:只测你关心的那几个,跳过列举
$ python3 probe_endpoint.py deepseek-flash deepseek-v4-pro

# 换一家服务,只改 base_url,脚本一个字都不用动
$ export LLM_BASE_URL="https://open.bigmodel.cn/api/paas/v4/"
$ python3 probe_endpoint.py
3.2 自建路线:先算显存,再谈效果
走 API 路线只需要探测模型列表;一旦要自建部署,第一个要算的不是效果而是显存。算不过来,后面的所有评测都是白做。把 2.8 节的两个公式写成脚本:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""显存估算——选型时最先要回答的问题:这张卡装不装得下。

只用标准库,直接 python3 vram_estimate.py 就能跑。
算的是量级,不是精确值;真实占用还受推理框架、批大小、显存碎片影响,
但用它筛掉明显装不下的候选,足够了。
"""

# 每个参数在不同精度下占多少字节
BYTES_PER_PARAM = {
    "FP32": 4,
    "FP16": 2,
    "BF16": 2,
    "INT8": 1,
    "INT4": 0.5,
}

# 推理时除权重外的额外开销系数(激活值、框架常驻、显存碎片)
# 经验值:按权重的 1.2 倍留余量
OVERHEAD = 1.2


def weight_gb(params_b, dtype):
    """权重占用(GB)。params_b 单位是十亿(B)。"""
    return params_b * 1e9 * BYTES_PER_PARAM[dtype] / (1024 ** 3)


def kv_cache_gb(layers, kv_heads, head_dim, seq_len, batch, dtype="FP16"):
    """KV cache 占用(GB)。

    每层要为 K 和 V 各存一份,所以乘 2。
    GQA 的关键就在 kv_heads——它比 query 头少,KV cache 直接按比例缩小。
    """
    per_token = 2 * layers * kv_heads * head_dim * BYTES_PER_PARAM[dtype]
    return per_token * seq_len * batch / (1024 ** 3)


def fits(need_gb, card_gb):
    return "✅ 装得下" if need_gb <= card_gb else "❌ 装不下"


def main():
    print("=" * 68)
    print("一、同一个 7B 模型,不同精度下的权重占用")
    print("=" * 68)
    print("%-8s %-12s %-14s %s" % ("精度", "权重(GB)", "含开销(GB)", "24GB 卡"))
    print("-" * 68)
    for dtype in ["FP32", "FP16", "INT8", "INT4"]:
        w = weight_gb(7, dtype)
        total = w * OVERHEAD
        print("%-8s %-12.2f %-14.2f %s" % (dtype, w, total, fits(total, 24)))
    print()
    print("结论:量化是把大模型塞进小卡的第一手段。")
    print("      FP16 到 INT4,显存直接降到四分之一。")
    print()

    print("=" * 68)
    print("二、不同规模模型在 FP16 下要几张 80GB 卡")
    print("=" * 68)
    print("%-16s %-14s %-12s %s" % ("模型规模", "权重(GB)", "含开销(GB)", "80GB 卡数"))
    print("-" * 68)
    for params in [7, 13, 32, 70, 235]:
        w = weight_gb(params, "FP16")
        total = w * OVERHEAD
        cards = int(total // 80) + (1 if total % 80 else 0)
        print("%-16s %-14.2f %-12.2f %d 张" % ("%dB" % params, w, total, cards))
    print()
    print("注意:235B 这一行对 MoE 模型同样成立——")
    print("      权重要全部加载,省的是计算量,不是显存。")
    print()

    print("=" * 68)
    print("三、KV cache:长上下文的隐形成本")
    print("=" * 68)
    # 参数取自公开的 7B 级模型常见配置
    layers, head_dim = 28, 128
    print("配置:28 层,head_dim=128,FP16,batch=1")
    print("%-14s %-12s %-14s %s" % ("上下文长度", "MHA(28头)", "GQA(4头)", "GQA 省了"))
    print("-" * 68)
    for seq in [2048, 8192, 32768, 131072]:
        mha = kv_cache_gb(layers, 28, head_dim, seq, 1)
        gqa = kv_cache_gb(layers, 4, head_dim, seq, 1)
        save = (1 - gqa / mha) * 100
        print("%-14s %-12.2f %-14.2f %.0f%%" % ("%d" % seq, mha, gqa, save))
    print()
    print("这就是 GQA 被所有新模型采用的原因:")
    print("  KV 头从 28 降到 4,KV cache 直接降到 1/7,长上下文才跑得起。")
    print()

    print("=" * 68)
    print("四、一个完整的选型判断示例")
    print("=" * 68)
    scenarios = [
        ("单张 4090 24GB 跑 7B", 7, "INT4", 24, 28, 4, 8192),
        ("单张 A100 80GB 跑 32B", 32, "FP16", 80, 64, 8, 8192),
        ("单张 A100 80GB 跑 70B", 70, "FP16", 80, 80, 8, 8192),
    ]
    for name, params, dtype, card, layers_n, kv_h, seq in scenarios:
        w = weight_gb(params, dtype) * OVERHEAD
        kv = kv_cache_gb(layers_n, kv_h, 128, seq, 1)
        total = w + kv
        print("%s:" % name)
        print("   权重+开销 %.1f GB + KV cache %.1f GB = %.1f GB  ->  %s"
              % (w, kv, total, fits(total, card)))
    print()
    print("70B FP16 单卡装不下,只有三条路:上多卡、上量化、换小模型。")
    print("选型阶段就要算清楚,不要等部署时才发现。")


if __name__ == "__main__":
    main()
运行输出
====================================================================
一、同一个 7B 模型,不同精度下的权重占用
====================================================================
精度       权重(GB)       含开销(GB)        24GB 卡
--------------------------------------------------------------------
FP32     26.08        31.29          ❌ 装不下
FP16     13.04        15.65          ✅ 装得下
INT8     6.52         7.82           ✅ 装得下
INT4     3.26         3.91           ✅ 装得下

结论:量化是把大模型塞进小卡的第一手段。
      FP16 到 INT4,显存直接降到四分之一。

====================================================================
二、不同规模模型在 FP16 下要几张 80GB 卡
====================================================================
模型规模             权重(GB)         含开销(GB)      80GB 卡数
--------------------------------------------------------------------
7B               13.04          15.65        1 张
13B              24.21          29.06        1 张
32B              59.60          71.53        1 张
70B              130.39         156.46       2 张
235B             437.72         525.27       7 张

注意:235B 这一行对 MoE 模型同样成立——
      权重要全部加载,省的是计算量,不是显存。

====================================================================
三、KV cache:长上下文的隐形成本
====================================================================
配置:28 层,head_dim=128,FP16,batch=1
上下文长度          MHA(28头)     GQA(4头)        GQA 省了
--------------------------------------------------------------------
2048           0.77         0.11           86%
8192           3.06         0.44           86%
32768          12.25        1.75           86%
131072         49.00        7.00           86%

这就是 GQA 被所有新模型采用的原因:
  KV 头从 28 降到 4,KV cache 直接降到 1/7,长上下文才跑得起。

====================================================================
四、一个完整的选型判断示例
====================================================================
单张 4090 24GB 跑 7B:
   权重+开销 3.9 GB + KV cache 0.4 GB = 4.3 GB  ->  ✅ 装得下
单张 A100 80GB 跑 32B:
   权重+开销 71.5 GB + KV cache 2.0 GB = 73.5 GB  ->  ✅ 装得下
单张 A100 80GB 跑 70B:
   权重+开销 156.5 GB + KV cache 2.5 GB = 159.0 GB  ->  ❌ 装不下

70B FP16 单卡装不下,只有三条路:上多卡、上量化、换小模型。
选型阶段就要算清楚,不要等部署时才发现。
② 32B FP16 要 71.5GB——在 80GB 卡上看似能进,但只剩 8GB 给 KV cache,并发稍高就爆。「刚好装得下」在生产环境里等于装不下。
③ 128K 上下文的 MHA KV cache 要 49GB——比 7B 模型权重本身还大。选型时只看「支持 128K」而不算这笔账,上线必爆。
它的用法是在选型阶段筛掉明显装不下的候选,而不是拿来写进采购单。真要定硬件,必须在目标框架上实测一轮。
04完整案例:把选型做成一张可复算的表
硬门槛先淘汰,加权排序再定名次
4.1 选型的两步法
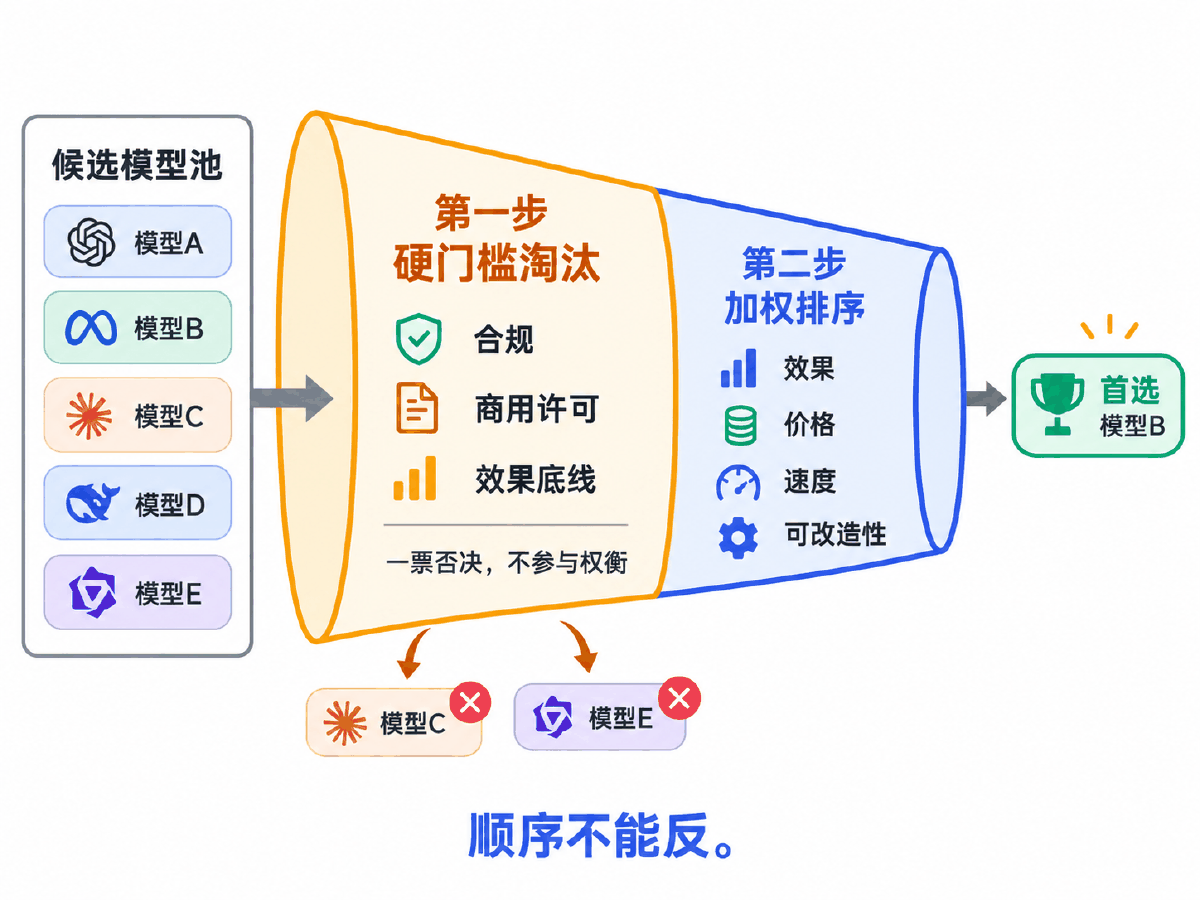
「哪个模型更好」之所以答不了,是因为它把两类完全不同的条件混在了一起:
| 条件类型 | 例子 | 怎么处理 |
|---|---|---|
| 硬门槛 | 数据不能出内网、必须支持 Function Call、必须能商用 | 一票否决,不参与权衡。不满足就出局,再便宜也不要 |
| 软权重 | 效果、价格、速度、可改造性 | 按业务重要性给权重,加权求和排序 |
顺序不能反。只做加权排序是典型错误:一个效果不及格但极便宜的模型,会靠价格分把总分刷上去,排到第一名。
"""选型打分:把「哪个模型更合适」从拍脑袋变成一张可复算的表。

两步走,顺序不能反:
  第一步 硬门槛淘汰——不满足业务底线的直接出局,多便宜都不要;
  第二步 加权排序——在活下来的候选里,按业务权重算总分。

只做第二步是典型错误:一个效果不及格但极便宜的模型会把总分刷上去。
纯标准库,直接 python3 select_model.py 就能跑。
"""
# 候选模型的属性。分数一律 0~10,含义见 CRITERIA。
# ⚠️ 这些数字必须由你自己的实测填入,不要抄榜单。
CANDIDATES = [
    {"name": "闭源旗舰 API",   "quality": 10, "cost": 3, "latency": 6, "privacy": 2, "controllable": 3},
    {"name": "闭源轻量 API",   "quality": 7,  "cost": 8, "latency": 9, "privacy": 2, "controllable": 3},
    {"name": "开源权重 · 云端", "quality": 8,  "cost": 6, "latency": 7, "privacy": 5, "controllable": 8},
    {"name": "开源权重 · 内网", "quality": 7,  "cost": 5, "latency": 5, "privacy": 10, "controllable": 10},
    {"name": "小参数本地部署",  "quality": 4,  "cost": 10, "latency": 8, "privacy": 10, "controllable": 10},
]

CRITERIA = {
    "quality":      "任务效果:用你自己的测试集测出来的准确率/通过率",
    "cost":         "性价比:同样一批请求花多少钱,分越高越便宜",
    "latency":      "响应速度:首 token 延迟与整体吞吐",
    "privacy":      "数据可控:数据是否离开内网",
    "controllable": "可改造性:能不能微调、能不能锁版本",
}

# 每个场景两部分:gates 是一票否决的硬门槛,weights 是排序权重。
SCENARIOS = {
    "对外客服(量大、要便宜、要快)": {
        "gates": {"quality": 6},                 # 答错了要赔钱,效果有底线
        "weights": {"quality": 3, "cost": 5, "latency": 5, "privacy": 1, "controllable": 1},
    },
    "内部知识库(数据不能出内网)": {
        "gates": {"privacy": 8, "quality": 6},   # 合规是红线,不参与权衡
        "weights": {"quality": 3, "cost": 2, "latency": 2, "privacy": 5, "controllable": 4},
    },
    "复杂推理(效果压倒一切)": {
        "gates": {"quality": 8},
        "weights": {"quality": 8, "cost": 1, "latency": 1, "privacy": 1, "controllable": 1},
    },
}


def passes(candidate, gates):
    """硬门槛检查:返回 (是否通过, 被哪一项卡住)。"""
    for key, floor in gates.items():
        if candidate[key] < floor:
            return False, "%s=%d < %d" % (key, candidate[key], floor)
    return True, ""


def score(candidate, weights):
    """加权求和后归一化到 0~10,方便横向比较。"""
    total = sum(candidate[k] * w for k, w in weights.items())
    return total / sum(weights.values())


def main():
    print("评分维度:")
    for key, desc in CRITERIA.items():
        print("  %-13s %s" % (key, desc))

    for scenario, conf in SCENARIOS.items():
        gates, weights = conf["gates"], conf["weights"]
        print("\n" + "=" * 64)
        print("场景:%s" % scenario)
        print("硬门槛:%s" % "  ".join("%s>=%d" % (k, v) for k, v in gates.items()))
        print("权重:  %s" % "  ".join("%s=%d" % (k, v) for k, v in weights.items()))
        print("-" * 64)

        survivors, rejected = [], []
        for candidate in CANDIDATES:
            ok, reason = passes(candidate, gates)
            (survivors if ok else rejected).append((candidate, reason))

        for candidate, reason in rejected:
            print("  ✗ %-16s 出局(%s)" % (candidate["name"], reason))

        ranked = sorted(survivors, key=lambda pair: -score(pair[0], weights))
        for rank, (candidate, _) in enumerate(ranked, 1):
            print("  %d. %-16s 得分 %.2f" % (rank, candidate["name"],
                                            score(candidate, weights)))
        if ranked:
            print("  => 首选:%s" % ranked[0][0]["name"])
        else:
            print("  => 无人通过门槛,说明门槛定得过高或候选池太小")

    print("\n" + "=" * 64)
    print("同一批候选,换一组门槛和权重,冠军就换人——")
    print("所以「哪个模型最好」这个问题不成立,成立的是「在我的约束下哪个最好」。")


if __name__ == "__main__":
    main()
4.2 运行结果:换一组约束,冠军就换人
直接 python3 select_model.py,三个场景用的是同一批候选:
评分维度:
  quality       任务效果:用你自己的测试集测出来的准确率/通过率
  cost          性价比:同样一批请求花多少钱,分越高越便宜
  latency       响应速度:首 token 延迟与整体吞吐
  privacy       数据可控:数据是否离开内网
  controllable  可改造性:能不能微调、能不能锁版本

================================================================
场景:对外客服(量大、要便宜、要快)
硬门槛:quality>=6
权重:  quality=3  cost=5  latency=5  privacy=1  controllable=1
----------------------------------------------------------------
  ✗ 小参数本地部署          出局(quality=4 < 6)
  1. 闭源轻量 API         得分 7.40
  2. 开源权重 · 云端        得分 6.80
  3. 开源权重 · 内网        得分 6.07
  4. 闭源旗舰 API         得分 5.33
  => 首选:闭源轻量 API

================================================================
场景:内部知识库(数据不能出内网)
硬门槛:privacy>=8  quality>=6
权重:  quality=3  cost=2  latency=2  privacy=5  controllable=4
----------------------------------------------------------------
  ✗ 闭源旗舰 API         出局(privacy=2 < 8)
  ✗ 闭源轻量 API         出局(privacy=2 < 8)
  ✗ 开源权重 · 云端        出局(privacy=5 < 8)
  ✗ 小参数本地部署          出局(quality=4 < 6)
  1. 开源权重 · 内网        得分 8.19
  => 首选:开源权重 · 内网

================================================================
场景:复杂推理(效果压倒一切)
硬门槛:quality>=8
权重:  quality=8  cost=1  latency=1  privacy=1  controllable=1
----------------------------------------------------------------
  ✗ 闭源轻量 API         出局(quality=7 < 8)
  ✗ 开源权重 · 内网        出局(quality=7 < 8)
  ✗ 小参数本地部署          出局(quality=4 < 8)
  1. 闭源旗舰 API         得分 7.83
  2. 开源权重 · 云端        得分 7.50
  => 首选:闭源旗舰 API

================================================================
同一批候选,换一组门槛和权重,冠军就换人——
所以「哪个模型最好」这个问题不成立,成立的是「在我的约束下哪个最好」。
| 场景 | 硬门槛 | 首选 | 为什么 |
|---|---|---|---|
| 对外客服 | quality≥6 | 闭源轻量 API | 小参数本地部署虽然最便宜,但效果分 4 分没过门槛直接出局 |
| 内部知识库 | privacy≥8, quality≥6 | 开源权重 · 内网 | 合规是红线,三个候选因数据要出内网被淘汰,只剩一个 |
| 复杂推理 | quality≥8 | 闭源旗舰 API | 效果权重压倒一切时,贵和慢都可以忍 |
⚠️ 但有一条必须说清:表里的分数必须来自你自己的实测。抄榜单填进去,得到的只是一个包装得很专业的拍脑袋。
4.3 参数量、上下文、价格:会变的数字怎么用
模型版本、价格、上下文长度这三类数字变化极快,任何写死在文档里的具体数值都有保质期。正确的用法是:记住量级和趋势,用到具体数字时现查官方页面。
下面这组是从各家官方文档实际取回的样例,用来说明「一张选型表该记录哪些字段」,而不是让你背数字:
| 该记录的字段 | 取自官方文档的样例 | 为什么要记它 |
|---|---|---|
| base_url | DeepSeek:https://api.deepseek.com;智谱:https://open.bigmodel.cn/api/paas/v4/ | 决定你的客户端连到哪,换供应商只改这一处 |
| 模型名 | DeepSeek 文档当前列出 deepseek-flash 与 deepseek-v4-pro;智谱文档示例中出现 glm-5.3、glm-5.3-flash | 模型名会改、会下线、会被别名转发,必须以官方页面为准 |
| 上下文长度 / 最大输出 | DeepSeek 两个模型均标注上下文 1M、最大输出 384K | 决定能不能把整份文档塞进去;最大输出常被忽略,长文生成会被它卡住 |
| 计价方式 | DeepSeek 按每百万 token 计价,且区分缓存命中 / 未命中与高峰 / 低谷时段(低谷价为高峰价的一半) | 只比「单价」会算错账,缓存和时段能差出数倍 |
| 并发限制 | DeepSeek 文档为两个模型分别标注了并发上限 | 压测前不看这个,上线必被限流打脸 |
| 开源许可 | Qwen3 六个 dense 模型以 Apache 2.0 开放权重 | 能不能商用是硬门槛,不是软权重 |
Incorrect API key provided、错误码 invalid_api_key。这个报错看起来像「Key 失效了」,实际是地域不匹配。不知道这件事的话,能查一整天。类似的坑各家都有,接入前先读一遍官方的「常见错误」章节,比事后 debug 便宜得多。
看懂计价结构,比比单价重要
选型时人人都会问「多少钱一百万 token」,但单一报价几乎不能用来估算真实账单。以 DeepSeek 官方定价页的结构为例,一份完整报价至少分四个维度:
| 维度 | 含义 | 对账单的影响 |
|---|---|---|
| 输入 vs 输出 | 两者分开计价,输出通常明显贵于输入 | 多轮对话把历史反复重传,吃的是输入配额;让模型少废话,省的是输出配额 |
| 缓存命中 vs 未命中 | 相同前缀命中缓存时,输入价格大幅下降 | 把固定的 system 提示词放在最前面且保持不变,就能持续命中缓存 |
| 高峰 vs 低谷时段 | 不同时段适用不同单价 | 批量、离线、可延迟的任务挪到低谷时段跑,成本差异可观 |
| 并发上限 | 账号级别的速率限制 | 不在报价表里,却直接决定你能不能撑住业务峰值 |
② 同一家的不同型号价差很大。 各家都同时提供旗舰型与轻量型(如 DeepSeek 文档里列出的
deepseek-v4-pro 与 deepseek-flash)。先用轻量型跑你的测试集,过不了再升级,而不是一上来就用旗舰型。
选型方法论的保质期是几年,具体的模型名和价格,保质期可能只有几周。
05骨架模板:用自己的题去考候选模型
榜单只能圈候选,拍板必须靠你自己的测试集
4.2 节那张选型表里的分数从哪来?只有一个正当来源:拿你自己的题,让每个候选都做一遍。这份骨架把「跑一批题 → 记录耗时与 token → 判对错 → 出对比表 → 存档」串起来。
"""选型实测骨架:拿自己的题目去考候选模型,出一张可复算的对比表。

榜单只能用来圈定候选,最终拍板必须靠你自己的测试集。
这份骨架把「跑一批题 → 记录耗时与 token → 判对错 → 出表」串起来。
复制后改 5 处 TODO。

运行前配置各家的 key,例如:
    export DEEPSEEK_API_KEY=...
依赖:pip install "openai>=1.0"
"""
import json
import os
import time

from openai import OpenAI

# TODO 1:登记参与对比的候选。base_url 与模型名以各家官方文档为准。
CANDIDATES = [
    {"label": "A 家轻量", "base_url": "https://api.deepseek.com",
     "key_env": "DEEPSEEK_API_KEY", "model": "deepseek-flash"},
    # {"label": "B 家旗舰", "base_url": "...", "key_env": "...", "model": "..."},
]

# TODO 2:换成你自己的题目。20~50 道覆盖真实业务分布,比 1000 道通用题有用。
TASKS = [
    {"id": "cls-1", "prompt": "判断这句话的情感,只回答 正面 或 负面:这家店服务真差。",
     "expect": "负面"},
    {"id": "cls-2", "prompt": "判断这句话的情感,只回答 正面 或 负面:物流很快,包装完好。",
     "expect": "正面"},
]

# TODO 3:换成你的判分逻辑。分类看精确匹配,生成类可换成 ROUGE 或人工抽检。
def judge(output, expect):
    return expect in output


def ask(candidate, prompt):
    """发一次请求,返回 (文本, 耗时秒, 输出token数)。失败返回文本 None。"""
    api_key = os.environ.get(candidate["key_env"])
    if not api_key:
        return None, 0.0, 0
    client = OpenAI(api_key=api_key, base_url=candidate["base_url"], timeout=60.0)

    start = time.time()
    try:
        response = client.chat.completions.create(
            model=candidate["model"],
            messages=[{"role": "user", "content": prompt}],
            # TODO 4:判定类任务把 temperature 压到 0,让结果可复现
            temperature=0,
            max_tokens=64,
        )
    except Exception as err:
        print("   [x] %s: %s" % (candidate["label"], type(err).__name__))
        return None, time.time() - start, 0

    elapsed = time.time() - start
    return (response.choices[0].message.content.strip(),
            elapsed,
            response.usage.completion_tokens)


def main():
    report = []
    for candidate in CANDIDATES:
        print("测试 %s(%s)" % (candidate["label"], candidate["model"]))
        correct, total_time, total_tokens, done = 0, 0.0, 0, 0

        for task in TASKS:
            output, elapsed, tokens = ask(candidate, task["prompt"])
            total_time += elapsed
            total_tokens += tokens
            if output is None:
                continue
            done += 1
            ok = judge(output, task["expect"])
            correct += int(ok)
            print("   %-8s %s  %.2fs  %s" % (task["id"], "✓" if ok else "✗",
                                             elapsed, output[:24]))

        row = {
            "模型": candidate["label"],
            "完成数": done,
            "正确率": round(correct / done, 4) if done else None,
            "平均耗时秒": round(total_time / done, 3) if done else None,
            "输出token合计": total_tokens,
        }
        report.append(row)

    print("\n对比表:")
    if report:
        cols = list(report[0].keys())
        print("  " + "  ".join("%-12s" % c for c in cols))
        for row in report:
            print("  " + "  ".join("%-12s" % row[c] for c in cols))

    # TODO 5:落盘存档,下次换版本时直接对比,避免「感觉变差了」这种无证据判断
    with open("bench_report.json", "w", encoding="utf-8") as f:
        json.dump(report, f, ensure_ascii=False, indent=2)
    print("\n已写入 bench_report.json")


if __name__ == "__main__":
    main()
temperature 压到 0 · TODO 5 结果落盘存档。其余代码不用动。
5.1 出题比写代码更重要
这个脚本的技术含量很低,难的是 TASKS 里放什么。三条经验:
| 原则 | 说明 |
|---|---|
| 数量取 20~50 道 | 覆盖真实业务分布的 20 道,比通用榜单的 1000 道有用得多。太少则噪声大,太多则迭代一次太慢 |
| 必须含难例和边界 | 把线上真实出过错的 case 收集进来。全是简单题的话,所有候选都满分,测了等于没测 |
| 答案要能机器判分 | 分类、抽取、判断类任务天然可判;生成类任务先定好判分方式(ROUGE 或人工抽检比例),别测完了才发现没法打分 |
5.2 除了正确率,这三个数也要记
平均耗时决定用户体感。有的模型正确率高 2 个点,但慢 3 倍,交互式场景直接出局。
同样答对,一个用 50 token、一个用 500 token,账单差 10 倍。啰嗦是要花钱的。
报错、超时、限流的比例。实验室里差别不大,上量之后它比正确率更能决定成败。
temperature 没压到 0:判定类任务每次结果都不一样,你会误以为是模型不稳,其实是自己没锁随机性。② 只跑一次就下结论:网络抖动、服务端负载都会影响耗时。耗时至少跑三轮取中位数。
③ 换了模型却没换提示词:不同模型对提示词的敏感度不同,用 A 调优过的提示词去测 B,对 B 不公平。要么都用中性提示词,要么各自调优后再比。
bench_report.json 一定要存。云端模型会在你不知情的情况下更新版本,某天用户反馈「最近答得不如以前」时,有存档你就能跑同一套题直接对比,没存档就只能靠感觉争论。
5.3 许可证:真正的一票否决项
4.1 节把「商用许可」列为硬门槛,这里把它展开。许可证不参与加权打分——不满足就直接出局,再好的效果也没用。而它又恰恰是技术选型里最容易被跳过的一项。
| 许可类型 | 典型约束 | 实际影响 |
|---|---|---|
| 宽松开源许可 (如 Apache 2.0) | 保留版权声明即可自由使用、修改、分发、商用 | 限制最少。Qwen3 的开源权重就采用 Apache 2.0 |
| 自定义社区许可 | 厂商自拟条款,常附带用户规模上限、场景禁止项、品牌使用要求 | 必须逐条读。「开源」两个字不等于可以随便商用 |
| 仅学术 / 需申请 | 默认不开放商用,需邮件申请并获得官方书面授权 | 审批周期不可控,不能排进紧急项目的关键路径 |
| 闭源 API | 只有使用权,受服务条款约束 | 关注数据是否被用于训练、是否允许转售、是否允许蒸馏输出 |
② 模型许可 ≠ 数据许可。 微调用的数据集可能有自己的许可约束,有些明确禁止商用,也禁止用于训练商用模型。
③ 许可会随版本变。 同一系列的不同尺寸、不同代次可能适用不同许可。以你要用的那个具体权重仓库里的 LICENSE 文件为准,不要拿系列印象代替。
落到操作上就一句话:把你要用的那个权重仓库的 LICENSE 和使用条款当场打开读一遍,截图存档,连同日期一起写进选型报告。这件事花不了十分钟,但漏了它,前面所有实测工作都可能作废。
06易错点汇总
按「架构 / 模型事实 / 选型 / 实测 / 部署」五类归并
⚠️ 一、架构概念
- 把 BERT 当成能聊天的模型。 BERT 是 Encoder-Only 的自编码模型,靠 MASK 预测被遮住的词,适合理解类任务(分类、提取式问答),不适合 NLG。它不会「续写」。
- 以为 GPT 的 Decoder 和经典 Transformer 的 Decoder 一样。 GPT 取消了第二个 encoder-decoder attention 子层,只保留 Masked Multi-Head Attention 和 Feed Forward。而且经典 Transformer 用 6 个 Decoder Block,GPT 用 12 个。
- 把 ChatGLM 说成纯 Decoder-only。 它是 Prefix-Decoder:Part A 内部可以双向看到,Part B 只能看到 Part A 和自己前面的词。纯 Decoder 是完全单向的。
- 把「Decoder-only 赢了」理解成「Encoder 没用」。 原因是双向注意力存在低秩问题可能削弱表达能力,且就生成任务而言双向注意力无实质好处;Encoder-Decoder 表现好往往只是因为多了一倍参数。在理解类任务上 Encoder 架构依然有价值。
- 混淆 MLM 的 15% 与 80/10/10。 是随机抽 15% 的 token 参与 MASK 任务,在这 15% 里再按 80% 换
[MASK]、10% 换随机词、10% 保持不变 分配。
⚠️ 二、模型事实记混
- 把参数量和训练数据量搞混。 ChatGLM-6B 是 62 亿参数、约 1T 训练数据;LLaMA-65B 和 33B 训练于 1.4T token,7B/13B 是 1T。两个数字不是一回事。
- 以为参数越大中文越好。 LLaMA 的中文短板是词表结构性问题:词表仅 32000、中文 token 只有几百个,编码效率低。参数量再大也补不了这个,得扩充词表重训。
- 忘了 BLOOM 用的是 ALiBi 而非 RoPE。 主流是 RoPE,BLOOM 是少数派,选它正是看中 ALiBi 外推性更好。ChatGLM 的激活函数是 GeGLU 而不是大多数模型的 SwiGLU,也是同类少数派。
- 把 MoE 的总参数当成激活参数。 Qwen3-235B-A22B 是总参数 235B、激活 22B。总参数决定显存,激活参数决定计算量,两个都要问。
- 直接引用会过期的数字。 模型名、价格、上下文长度变化极快,写进方案前必须打开官方文档当场核对,不要从二手资料复制。
⚠️ 三、选型方法
- 只做加权排序,不设硬门槛。 效果不及格但极便宜的模型会靠价格分刷到第一名。合规、商用许可、必备能力都是一票否决项,不参与权衡。
- 拿榜单分数当选型依据。 榜单只能用来圈定候选。榜单题目与你的业务分布不同,还存在针对性优化的可能。
- 问「哪个模型最好」。 这个问题不成立。成立的问法是「在我的任务、预算、合规要求下,哪个最合适」。
- 把开源理解成免费。 开源省的是 API 费,但要付显卡、电费、运维、工程师时间。小规模用量下,闭源 API 往往更便宜。
- 忽略最大输出长度。 上下文长度和最大输出是两个数。上下文 1M 不代表能一次吐出 1M,长文生成会被 max output 卡住。
- 只比单价不看计价规则。 缓存命中与未命中、高峰与低谷时段的价格能差数倍,还要看并发上限。
⚠️ 四、实测环节
- 只看模型列表就认为可用。
/v1/models里有,不代表你的账号这一刻调得动。必须真发一次请求。 - 不核对响应里的
model字段。 别名、灰度、降级都会改写它,你以为在测旗舰版,实际被路由到轻量版。对比实验要记录响应里的实际 model。 temperature没压到 0 就做判定类评测。 每次结果都不同,误判成模型不稳定。- 只跑一次就比耗时。 网络抖动和服务端负载影响很大,至少三轮取中位数。
- 用为 A 调优过的提示词去测 B。 对 B 不公平,结论不可信。
- 不存档实测结果。 云端模型会悄悄更新版本,没有存档就只能靠感觉争论「是不是变差了」。
⚠️ 五、接入与部署
- API Key 与 endpoint 地域不匹配。 阿里云百炼的 Key 按地域绑定,跨地域调用返回 401
Incorrect API key provided、错误码invalid_api_key——看着像 Key 失效,实际是地域错了。 - 把显存需求算少了。 ChatGLM-6B 推理 FP16 需 13GB、INT8 需 10GB、INT4 只需 6GB。量化能大幅降低门槛,但要评估效果损失。
- 忘了确认商用许可。 学术开放 ≠ 可商用。有的模型需要邮件申请并获得官方商用许可后才能免费商用。
- 把 API-KEY 硬编码进源码。 一律走环境变量,且不要连同配置文件提交到 Git。
- 把「学术开放」当成「可商用」。 权重能下载、能跑通,和能不能用在收费产品里是两件事。以你要用的那个具体权重仓库里的
LICENSE为准,不要拿系列印象代替——同系列不同尺寸、不同代次可能适用不同许可。 - 只看模型许可,忽略数据许可。 微调用的数据集有自己的许可约束,有些明确禁止商用、也禁止用于训练商用模型。
- 把上下文长度当成最大输出长度。 两者是两个独立的数。能塞进去一百万 token,不代表能一口气吐出一百万——写长文被截断,十有八九是撞上了最大输出。
⚠️ 六、显存与容量测算
- 只算权重,不算 KV cache。 权重是固定的,KV cache 随上下文长度和并发数线性增长。实测:28 层 MHA 模型在 128K 上下文下 KV cache 就要 49GB,比 7B 权重本身还大。
- 把「刚好装得下」当成可以上线。 32B FP16 占 71.5GB,在 80GB 卡上只剩 8GB 给 KV cache,并发稍高就 OOM。生产环境要留出 KV cache 和并发的余量。
- 默认用 FP32 加载。 7B 模型 FP32 要 31GB,24GB 卡直接 OOM;换 FP16 只要 15.65GB 就进去了。很多「显卡不够」其实是精度选错。
- 以为加卡就线性变快。 单卡装不下就要张量并行,而张量并行靠卡间通信。没有 NVLink 时走 PCIe,通信开销会吞掉很大一截收益——两张卡不等于两倍速度。
- 拿粗算结果当采购依据。 估算只用来筛掉明显装不下的候选。真要定硬件,必须在目标推理框架(vLLM 等)上实测一轮,框架的显存管理策略差别很大。
07自测题
点击题目展开答案;能把这 14 题说清楚,这一讲就通了
大模型的三种架构类别是什么?各自的代表模型与基本原理?
自编码模型 AE(Encoder-Only,代表 BERT):在输入中随机 MASK 掉一部分单词,根据上下文预测这个词,适合 NLU 理解类任务。
自回归模型 AR(Decoder-Only,代表 GPT):从左往右学习,只能利用上文信息,适合 NLG 生成类任务。
序列到序列模型(Encoder-Decoder,代表 T5):同时使用编码器和解码器,把每个 task 视作序列到序列的转换,适合机器翻译这类既要理解又要生成的任务。
BERT 的两大预训练任务是什么?MLM 的比例怎么分配?
MLM(Masked LM)与 NSP(Next Sentence Prediction)。
MLM:随机抽取 15% 的 token 参与 MASK 任务,在这部分里 80% 用 [MASK] 替换、10% 用随机单词替换、10% 保持不变。
NSP:输入句子对 (A,B) 预测 B 是否为 A 的真实下一句,50% 是真实下一句(IsNext 正样本),50% 是随机抽取的句子(NotNext 负样本)。
GPT 的 Decoder Block 与经典 Transformer 的 Decoder Block 有什么不同?
GPT 取消了第二个 encoder-decoder attention 子层,只保留 Masked Multi-Head Attention 层和 Feed Forward 层。另外经典 Transformer 解码器采用 6 个 Decoder Block,GPT 采用 12 个。GPT 总参数量 1.17 亿,BERT 是 1.15 亿。
为什么现在的大模型几乎都用 Decoder-only?
两个原因。理论上:Encoder 的双向注意力会存在低秩问题,可能削弱模型表达能力,而就生成任务而言引入双向注意力并无实质好处。工程上:Encoder-Decoder 在某些场景表现更好,大概只是因为多了一倍参数;在同等参数量、同等推理成本下,Decoder-only 就是最优选择。此外还有训练效率与工程实现上的优势。
看一个新模型的结构,应该重点看哪四个零件?
归一化(Pre-LN/Post-LN,LayerNorm/RMSNorm/DeepNorm)、激活函数(ReLU/GeLU/GeGLU/SwiGLU)、位置编码(绝对/RoPE/ALiBi)、注意力机制(MHA/MQA/GQA)。
当前的事实标准是 Pre-LN + RMSNorm + SwiGLU + RoPE;BLOOM 用 ALiBi、ChatGLM 用 GeGLU 是少数派。RMSNorm 相比 LayerNorm 去掉了减去均值的部分,可减少约 7%~64% 的计算时间。
ChatGLM-6B 为什么被称为 Prefix-Decoder 而不是 Decoder-only?训练目标是什么?
因为 Decoder 是完全单向的,而 GLM 某些位置可以看到双向:Part A 的词可以互相看到但看不到 Part B,Part B 的词可以看到 Part A 和 Part B 中前面的词。
训练目标是基于自回归空白填充:在输入文本中随机挖去一些连续的文本片段,训练模型按照任意顺序重建这些片段。
LLaMA 在中文上效果差的根本原因是什么?社区怎么解决?
根本原因是训练语料以英文为主、不包含中文,且 tokenizer 词表只有 32000,其中中文 token 只有几百个——一个汉字常被切成多个 token,编码效率低、模型学习难度大。
标准解法是扩充中文词表:在中文语料上用 Sentence Piece 训练中文 tokenizer(如 20000 个中文词汇),与原始 tokenizer 合并,得到词表大小 49953 的 Chinese LLaMA tokenizer。
从 ChatGLM、LLaMA、Qwen 的迭代里能看出哪三条通用规律?
① 上下文长度一路暴涨:2048 → 4096 → 32K → 128K;② 词表大小是中文能力的先行指标:32000(LLaMA)→ 64000(Baichuan)→ 151936(Qwen);③ 训练数据量的增长快过参数量:1T → 1.4T → 15T → 18T,近几代能力提升更多来自数据与后训练而非堆参数。
选型为什么必须「硬门槛先淘汰、加权排序再定名次」?顺序反了会怎样?
因为合规、商用许可、必备能力这类条件是一票否决的,不能拿来和价格做权衡。顺序反了的典型后果是:一个效果不及格但极便宜的模型,靠价格分把总分刷上去排到第一名。
运行 select_model.py 能看到:同一批候选,客服场景首选闭源轻量 API,内网知识库场景首选开源权重内网部署,复杂推理场景首选闭源旗舰 API——换一组约束,冠军就换人。
为什么模型列表里有某个模型,还必须真发一次请求?响应里哪个字段最该核对?
因为 /v1/models 返回的只是服务端声明支持的清单,不代表你的账号、余额、地域在这一刻调得动它——可能没开通权限或后端无可用容量。
最该核对的是响应里的 model 字段:它可能与你请求的名字不同(别名、灰度发布、自动降级都会改写它)。做对比实验时要记录响应里的实际 model,而不是请求时写的字符串。
一个 7B 模型在 FP16 下大概要多少显存?怎么算?
算法就一行:参数量 × 每参数字节数。FP16 每参数 2 字节,所以 7e9 × 2 / 1024³ ≈ 13.04 GB;再乘上约 1.2 倍的激活值与框架开销,约 15.65 GB。
对比一下:FP32 要 31.29 GB(这就是 24GB 卡常见的 OOM 原因),INT8 要 7.82 GB,INT4 只要 3.91 GB。
为什么所有新模型都换成了 GQA?用数字说。
因为 KV cache 随上下文长度线性增长,而 KV 头数直接决定它的大小。实测(28 层、head_dim=128、FP16、batch=1):128K 上下文下,MHA(28 个 KV 头)要 49 GB,GQA(4 个 KV 头)只要 7 GB,省 86%。
49GB 比 7B 模型权重本身还大——不换 GQA,长上下文根本跑不起来。
Qwen3-235B-A22B 要按 235B 还是 22B 准备显存?为什么?
按 235B 准备显存。MoE 每次推理只激活一部分专家,但全部权重都要加载进显存——你不知道下一个 token 会路由到哪个专家。
FP16 下 235B 的权重约 437.72 GB,含开销约 525 GB,需要 7 张 80GB 卡。
MoE 省的是计算量(延迟、吞吐),不是显存。把激活参数当显存需求去报硬件预算,是自建路线上最昂贵的误判之一。
32B FP16 算出来占 71.5GB,80GB 卡「装得下」——可以上线了吗?
不能。只剩 8GB 给 KV cache,单路 32K 上下文就要 1.75GB,十路并发直接 17.5GB——压测必 OOM。
「刚好装得下」在生产环境里等于装不下。还要注意:估算只用来筛掉明显装不下的候选,真要定硬件必须在目标推理框架(如 vLLM)上实测。
词术语表
| 术语 | 含义 |
|---|---|
| AE / AutoEncoder | 自编码模型,Encoder-Only,代表 BERT;靠 MASK 预测被遮住的词,擅长理解类任务 |
| AR / Autoregressive | 自回归模型,Decoder-Only,代表 GPT;从左往右预测下一个词,擅长生成类任务 |
| Seq2Seq | 序列到序列模型,Encoder-Decoder,代表 T5;把所有任务视作文本到文本的转换 |
| Prefix-Decoder | 前缀解码器;前缀部分可双向可见、生成部分单向,ChatGLM 采用 |
| MLM | Masked Language Modeling,带 mask 的语言模型训练任务 |
| NSP | Next Sentence Prediction,预测句子 B 是否为句子 A 的真实下一句 |
| RMSNorm | 归一化方式,相比 LayerNorm 去掉了减去均值的部分,计算更省 |
| DeepNorm | 用于超深网络的归一化方案,ChatGLM 采用 post layer norm 形式 |
| SwiGLU / GeGLU / GeLU | 三种激活函数;SwiGLU 是当前主流选择 |
| RoPE | 旋转位置编码,当前主流;提升模型对长序列的处理能力 |
| ALiBi | 相对位置编码,外推性更好,BLOOM 与 Baichuan-13B 采用 |
| GQA | Grouped-Query Attention,分组查询注意力;通过减少 KV 缓存提升推理效率 |
| MQA | Multi-Query Attention,多查询注意力,ChatGLM2 用它提速 42% |
| MoE | Mixture-of-Experts 混合专家;有总参数量与激活参数量两个数,前者定显存、后者定算力 |
| BPE | Byte Pair Encoding,一种子词切分算法,用于训练 tokenizer |
| context length | 上下文长度,一次能处理的最大 token 数;与最大输出长度是两个不同的数 |
| 量化 / INT4 / INT8 | 用更低精度存权重以降低显存门槛,代价是可能的效果损失 |
| KV cache | 缓存已生成 token 的 Key/Value,避免重算前文;占用随上下文长度与并发数线性增长 |
| FP32 / FP16 / BF16 | 权重精度;每参数分别占 4 / 2 / 2 字节,直接决定显存占用 |
| head_dim | 每个注意力头的维度;与层数、KV 头数一起决定 KV cache 大小 |
| 张量并行 | 把单层权重切到多卡上并行计算;依赖卡间通信,无 NVLink 时收益明显打折 |
| vLLM | 常用推理框架,以 PagedAttention 降低 KV cache 碎片、提升并发吞吐 |
| 激活参数量 | MoE 模型单次推理实际参与计算的参数量;它决定延迟,不决定显存(显存按总参数算) |
| 权重开销系数 | 估算显存时在权重之外预留的倍数(激活值、框架常驻、显存碎片),经验值约 1.2 |
| C-EVAL / MMLU | 常用的中文 / 英文权威评测基准;只能用来圈定候选,不能代替自己的测试集 |
| 硬门槛 | 选型第一步的一票否决项(合规、商用许可、效果底线),不参与加权打分 |
| 加权排序 | 选型第二步,对通过硬门槛的候选按效果/价格/速度/可改造性打分排序 |
| OpenAI 兼容协议 | 以 OpenAI 的接口格式为事实标准,换供应商只需改 base_url 和模型名 |
| 最大输出长度 | 单次响应能生成的最大 token 数;与上下文长度是两个独立的数,长文被截断通常撞的是它 |
| 前缀缓存 | 相同请求前缀命中缓存时输入价格大幅下降;把固定 system 放最前面且保持不变就能持续命中 |
| Apache 2.0 | 宽松的开源许可,保留版权声明即可自由使用、修改、分发与商用;Qwen3 开源权重采用它 |
| 社区许可 | 厂商自拟的许可条款,常附带用户规模上限与场景禁止项;开源 ≠ 可随意商用 |
知道选哪个之后,下一讲解决怎么把它接进代码里。