Ollama 命令行与对话指令全解
两套命令、一条生命周期:系统终端里管模型,对话框里调模型,弄混了就会一直报「command not found」。
30″30 秒看懂 Ollama 的两套命令
Ollama 像一台傻瓜料理机:以前要自己买食材、调火候、洗锅,现在插上电、选好菜谱,按一个键就开做。但它有两套完全不同的按钮——机器外壳上的旋钮,和打开盖子之后里面的调节钮。
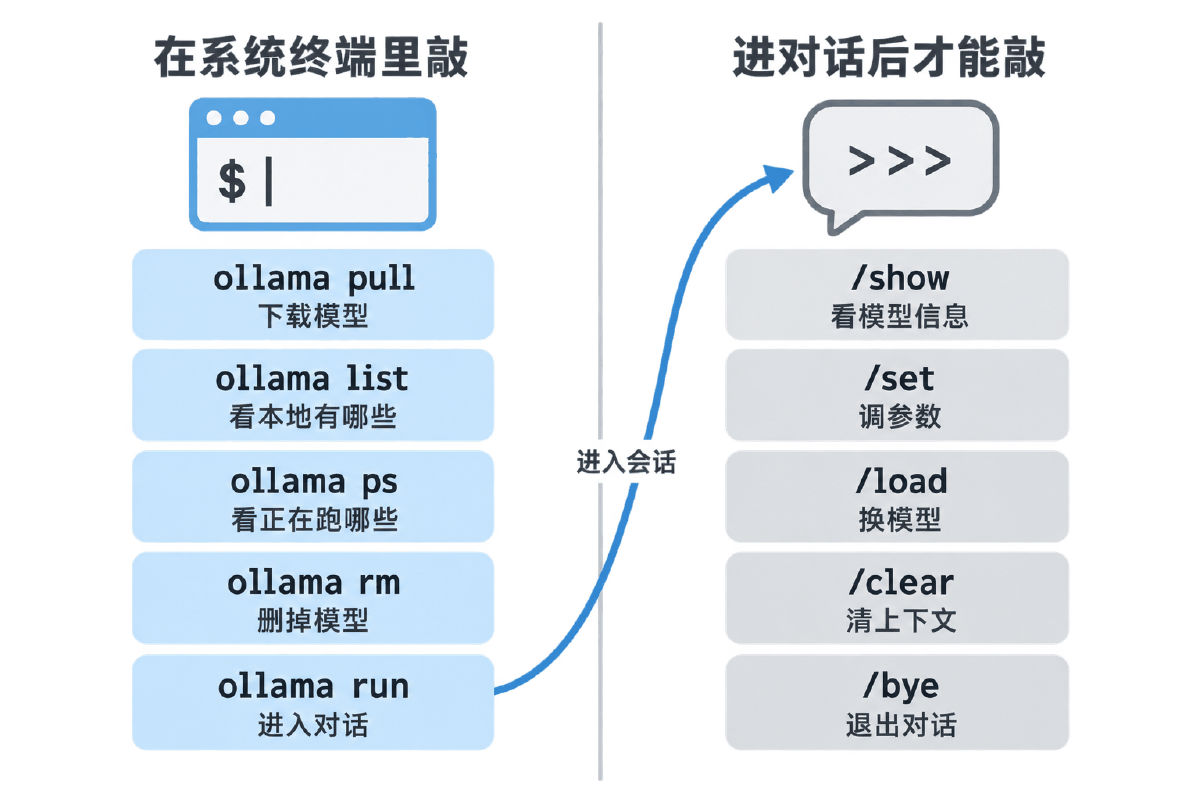
外壳上的旋钮是系统终端里敲的命令:ollama pull 下载菜谱、ollama list 看有哪些菜谱、ollama rm 扔掉不要的。盖子里面的调节钮是进入对话之后才能敲的斜杠指令:/set 调火候、/clear 倒掉锅里的、/bye 关盖子。
把这两套弄混,是新手最常见的第一个坑。在系统终端里敲 /show,shell 会告诉你「没有这个命令」;在对话框里敲 ollama list,模型会一本正经地给你编一段解释。
| 比喻里的动作 | 对应的命令 | 在哪里敲 |
|---|---|---|
| 从菜谱网站下载菜谱 | ollama pull qwen2:1.5b | 系统终端 |
| 看看家里有哪些菜谱 | ollama list | 系统终端 |
| 看看现在灶上炖着什么 | ollama ps | 系统终端 |
| 打开料理机开始做 | ollama run qwen2:1.5b | 系统终端(敲完就进对话了) |
| 调小火候 | /set parameter temperature 0.3 | 对话里 |
| 倒掉锅里的、重新开始 | /clear | 对话里 |
| 关盖子走人 | /bye | 对话里 |
ollama 前缀的在系统终端敲,带 / 前缀的在对话里敲。看到提示符是 $ 还是 >>>,就知道自己现在站在哪一边。这条分不清,后面所有命令都会时灵时不灵。
01概念:装完之后,机器上多了什么
先搞清楚 Ollama 到底是个什么东西,命令才不会瞎敲
1.1 两套命令,别弄混
Ollama 装完之后,你手上其实有两样东西:一个叫 ollama 的命令行工具,和一个在后台常驻的服务进程。它们的关系是:
这个结构解释了两件常让人困惑的事:
- 为什么有时候敲命令会报「connection refused」。因为客户端在,服务没起来。命令本身没问题,是后面那半截断了。
- 为什么关掉终端窗口,模型还占着显存。因为模型是加载在服务进程里的,和你那个终端窗口没关系。要卸载得靠
keep_alive到期,或者重启服务。
| 对比项 | 系统终端命令 | 对话内斜杠指令 |
|---|---|---|
| 提示符长什么样 | $ 或 # | >>> |
| 前缀 | 都以 ollama 开头 | 都以 / 开头 |
| 管什么 | 模型文件、服务状态 | 当前这次对话的行为 |
| 作用范围 | 全局,重启后仍然有效 | 只在本次会话内,退出就没了 |
| 敲错了会怎样 | shell 报 command not found | 模型把它当成普通问题,一本正经地瞎答 |
/show,shell 直接报错,你立刻就知道错了。但在对话框里敲 ollama list,模型不会报错——它会当成一个普通问题,给你编一段像模像样的「本地模型列表」。那个列表是假的。看到输出是自然语言而不是表格,就说明敲错地方了。
1.2 装完之后发生了什么
不同系统的安装方式不一样,但装完之后的结果是一致的:
| 系统 | 常见安装方式 | 装完之后 |
|---|---|---|
| Windows / macOS | 下载安装包,双击安装 | 后台服务自动起来,托盘里有图标,开机自启 |
| Linux | 官方一键脚本,或下载压缩包解压 | 一键脚本会顺带装好 systemd 服务;手动解压的不会,得自己配 |
装完立刻验证,别急着拉模型:
ollama --version        # 能打印版本号,说明命令装好了
ollama list # 能返回列表(哪怕是空的),说明服务通了这两条都通过,才算装成功。只有第一条通过,说明命令有了但服务没起来——这是 Linux 手动解压安装最常见的状态。
课堂和内网机房都不通外网,走的是离线包。离线装比一键脚本多出三件事,每一件被漏掉都会表现成「装好了但用不了」:
| 要做的事 | 一键脚本会替你做吗 | 漏了会怎样 |
|---|---|---|
| 二进制放进 PATH | 会 | ollama -v 报 command not found |
| 写 systemd 服务 | 会;解压包不会 | 得手动 serve,关终端服务就没了 |
| 把模型文件也搬过来 | 都不会 | 服务起来了,list 是空的,又拉不了 |
#!/bin/bash
# 离线安装:机器不通外网(课堂环境、内网机房)时怎么把 Ollama 装起来。
#
# 联网机器上一条 curl 就完事,离线环境要自己做三件事:
#   ① 把二进制放进 PATH
#   ② 手写 systemd 服务(一键脚本才会替你写,解压包不会)
#   ③ 把模型文件也搬过来 —— 这一步最容易被忘,装好了却拉不到模型
#
# 用法:把 ollama-linux-amd64.tgz 和模型目录拷到本机后执行
#   sudo bash ollama_offline_install.sh
set -euo pipefail

PKG="${PKG:-./ollama-linux-amd64.tgz}"      # 离线安装包路径
MODELS_DIR="${MODELS_DIR:-/data/ollama/models}"   # 模型存放目录,指到数据盘
MODELS_SRC="${MODELS_SRC:-}"                # 别的机器拷来的模型目录,可以为空

echo "===== ① 解压二进制 ====="
if [ ! -f "$PKG" ]; then
  echo "找不到安装包 $PKG,先把它拷到当前目录"
  exit 1
fi
tar -xzf "$PKG" -C /usr
# 验证:打得出版本号才算装上。报 command not found 就是解压路径不对
ollama -v

echo
echo "===== ② 准备模型目录 ====="
# 模型动辄几十 G,一定要放数据盘,不能留在系统盘
mkdir -p "$MODELS_DIR"

if [ -n "$MODELS_SRC" ] && [ -d "$MODELS_SRC" ]; then
  echo "从 $MODELS_SRC 拷模型过来(这一步可能很久)"
  # -a 保留权限和时间戳,模型目录里的 blobs 和 manifests 结构必须原样保留
  cp -a "$MODELS_SRC"/. "$MODELS_DIR"/
else
  echo "没指定 MODELS_SRC,跳过;稍后需要联网 pull 或再手动拷贝"
fi

# 服务以哪个用户跑,目录就得属于谁;不然服务起来了却读不到模型
chown -R root:root "$MODELS_DIR"

echo
echo "===== ③ 写 systemd 服务 ====="
# 注意:这里是新建一个服务文件。如果机器上已经有 /etc/systemd/system/ollama.service,
# 先备份再改,不要直接覆盖别人配好的参数。
if [ -f /etc/systemd/system/ollama.service ]; then
  cp -a /etc/systemd/system/ollama.service \
        "/etc/systemd/system/ollama.service.bak.$(date +%Y%m%d%H%M%S)"
  echo "已备份原有服务文件"
fi

cat > /etc/systemd/system/ollama.service <<EOF
[Unit]
Description=Ollama Service
After=network-online.target
Wants=network-online.target

[Service]
ExecStart=/usr/bin/ollama serve
User=root
Group=root
Restart=always
RestartSec=3
Environment="OLLAMA_MODELS=${MODELS_DIR}"
Environment="OLLAMA_HOST=127.0.0.1:11434"
Environment="OLLAMA_KEEP_ALIVE=30m"

[Install]
WantedBy=default.target
EOF

echo
echo "===== ④ 启动并设开机自启 ====="
# 改完服务文件必须 daemon-reload,否则 systemd 还在用旧的那份
systemctl daemon-reload
systemctl enable ollama
systemctl restart ollama
sleep 2
systemctl status ollama --no-pager | head -6

echo
echo "===== ⑤ 验证 ====="
ss -lntp | grep 11434 || echo "11434 没在监听,看 journalctl -u ollama -n 30"
# 环境变量有没有真的吃进去,看进程实际拿到的环境最可靠
PID=$(systemctl show -p MainPID --value ollama)
[ "$PID" != "0" ] && tr '\0' '\n' < "/proc/$PID/environ" | grep '^OLLAMA_' || true
ollama list
cp -a
模型目录里的 blobs 和 manifests 结构必须原样保留,权限和时间戳也要带上。拷完还要确认目录属主和服务运行用户一致——服务起来了却读不到模型,十有八九是这里出的问题。
~/.ollama/models)。模型动辄几个到几十 GB,拉上三五个系统盘就满了。生产机器务必在启动服务前把 OLLAMA_MODELS 指到数据盘。改路径之后已经拉过的模型不会自动搬家,要么手动移过去,要么重新拉。
1.3 serve 到底要不要手动敲
ollama serve 是启动服务的命令,但大多数情况下你不需要敲它。判断标准很简单:
| 情况 | 要不要手动 serve | 怎么确认 |
|---|---|---|
| Windows / macOS 安装包装的 | 不用 | 托盘有图标,ollama list 能返回 |
| Linux 一键脚本装的 | 不用 | systemctl is-active ollama 返回 active |
| Linux 手动解压装的 | 要 | 敲了才有服务;但这种起法关掉终端就没了 |
| 生产服务器 | 不该手动敲 | 必须做成 systemd 服务,见《Linux 企业级部署》 |
address already in use,指的是 11434 端口已经被现有的服务占着。这不是故障——恰恰说明服务是好的。此时应该直接用,而不是去杀掉重起。真要重启,用 systemctl restart ollama,别用「敲一遍 serve」这种方式。
02原理:模型从哪里来,到哪里去
搞清这条生命周期,命令就不用背了
2.1 模型的三个落脚点
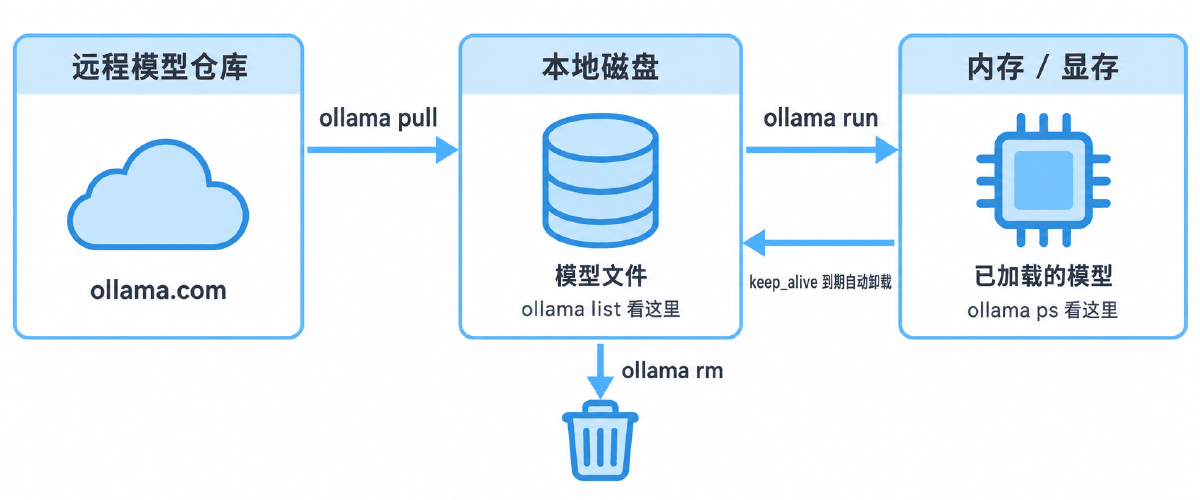
一个模型在你机器上只会处在三种状态之一,所有命令都是在这三者之间搬东西:
| 落脚点 | 谁能看见它 | 说明 |
|---|---|---|
| 远程模型仓库 | 浏览器 / ollama pull | 模型还没下载,在 ollama.com 上放着 |
| 本地磁盘 | ollama list | 已经下载好的模型文件,占磁盘不占显存 |
| 内存 / 显存 | ollama ps | 正在运行的模型,占显存;用完一段时间后自动卸载 |
ollama list 查磁盘上有什么,ollama ps 查显存里正跑着什么。「模型明明 list 里有,为什么 ps 里没有」——因为它还没被加载,正常现象。反过来,排查显存占用只能看 ps,看 list 没有任何意义。
2.2 pull 和 run 的区别
两条命令都能把模型弄到本地,区别在于「下载完之后做什么」:
| 命令 | 没下载过时 | 已经下载过时 | 用在什么场景 |
|---|---|---|---|
ollama pull 模型 | 下载,然后停 | 检查更新,通常很快结束 | 提前备料、批量准备、写进部署脚本 |
ollama run 模型 | 先下载,再直接进对话 | 加载进显存,直接进对话 | 手动测试、交互式使用 |
所以在部署脚本里应该用 pull——用 run 的话,脚本会停在对话界面上等你输入,整个自动化流程就卡死在那儿了。
run 后面直接跟上问题,它就只回答一次然后退出:ollama run qwen2:1.5b "用一句话介绍你自己"。这个用法很适合写进脚本做健康检查,或者和管道配合,例如 cat 文件 | ollama run 模型 "总结这段内容"。
2.3 keep_alive 与自动卸载
模型加载进显存要花几秒到几十秒,所以 Ollama 用完之后不会立刻卸载,而是先留着,等一段时间没人用再释放。这个时长默认是 5 分钟。
| 场景 | 建议设置 | 理由 |
|---|---|---|
| 高频线上服务 | 设长,例如 30m 或 -1(永不卸载) | 省掉反复加载的几十秒,响应稳定 |
| 显存紧张、多模型轮换 | 设短,例如 1m | 让不用的模型尽快腾出显存 |
| 开发机偶尔用 | 默认 5 分钟就行 | 不用操心 |
设置方式有两种:全局设 OLLAMA_KEEP_ALIVE 环境变量,或者在单次 API 请求里带 keep_alive 字段。要立刻卸载某个模型,把它的 keep_alive 设成 0 再发一次请求即可。
keep_alive 还没到期。这是设计行为,不是内存泄漏。确认方法是 ollama ps,输出里会显示这个模型还有多久过期。等着、或者手动卸载,都可以;但不要因此去重装 Ollama。
2.4 对话里的斜杠指令
ollama run 之后,提示符变成 >>>,这时候能用的是另一套指令:
| 指令 | 作用 | 什么时候用 |
|---|---|---|
/? | 列出所有可用指令 | 忘了有哪些指令时,第一个敲它 |
/show info | 看当前模型的参数量、量化、上下文长度 | 确认自己用的到底是哪一档 |
/set parameter 名 值 | 临时调生成参数 | 试火候,比如把 temperature 调低 |
/set system "..." | 临时设人设 | 试提示词效果,不用改代码 |
/load 模型 | 在对话里切换模型 | 对比两个模型的回答 |
/clear | 清空上下文 | 模型被之前的对话带偏了,或者要换话题 |
/bye | 退出对话 | 回到系统终端 |
/set 改的东西退出就没了
斜杠指令的作用范围只有当前这次会话。/bye 之后再 run 一次,所有设置都回到默认值。想让设置长期生效,有两条路:写进 Modelfile 固化成一个新模型(见 4.3),或者在每次 API 请求里传 options(见《Ollama API 与客户端接入》)。别指望 /set 能存住。
2.5 四个生成参数
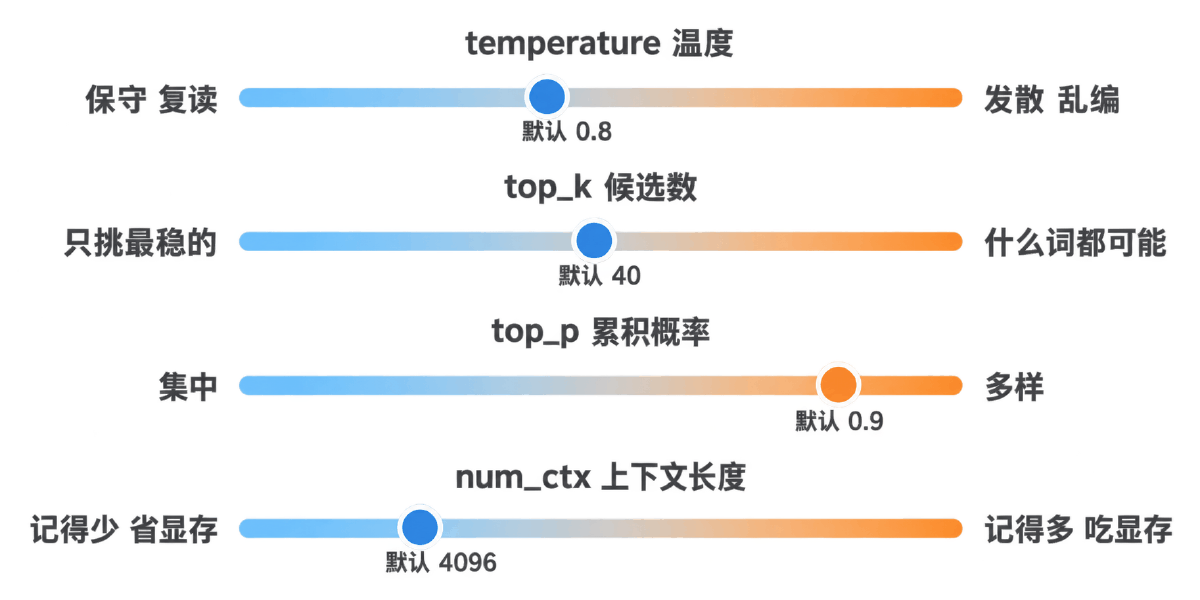
调参本质上是在几个滑块之间找平衡,每个滑块往两端拨各有代价:
| 参数 | 默认值 | 调低会怎样 | 调高会怎样 |
|---|---|---|---|
temperature | 0.8 | 保守、稳定,但容易重复 | 发散、有创意,但容易胡编 |
top_k | 40 | 每步只从最稳的几个词里挑 | 候选词变多,表达更多样也更容易跑偏 |
top_p | 0.9 | 只在高概率词里选,输出更集中 | 纳入更多低概率词,输出更多样 |
num_ctx | 4096 | 记得少,省显存 | 记得多,显存占用同步上涨 |
上面这张表记不住也没关系——自己跑一遍十秒钟就懂了。对话里的 /set parameter 一次只能试一个值、退出还会丢,下面这个脚本把整条梯度一次跑完,并把几轮回答的相似度量化出来:
"""调参实验台:同一个问题,在不同参数下各跑几遍,把差异摆到眼前。

为什么需要它:
    「temperature 调低会更稳定」这句话,看文档记不住,
    自己跑一遍、看着同一个问题在 0.0 下三次回答一模一样、
    在 1.2 下三次各说各话,十秒钟就理解了。

对话里的 /set parameter 一次只能试一个值,退出还会丢。
这个脚本一次把整条梯度跑完,并把结果并排打印出来。

用法:
    python3 param_explore.py --model qwen2:1.5b
    python3 param_explore.py --model qwen2:1.5b --param top_p --values 0.1,0.5,0.9
    python3 param_explore.py --model qwen2:1.5b --prompt "给这段日志写一句故障摘要"

依赖:只用标准库。
"""
import argparse
import difflib
import json
import os
import sys
import urllib.request

BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434").rstrip("/")

# 默认问一个「有标准答案但允许不同表述」的问题:
# 太开放(写首诗)看不出稳定性,太封闭(1+1)所有参数都一样。
DEFAULT_PROMPT = "用一句话说明什么是私有化部署。"


def ask(model, prompt, options, timeout=180):
    payload = {
        "model": model,
        "messages": [{"role": "user", "content": prompt}],
        "stream": False,
        "options": options,
    }
    req = urllib.request.Request(
        BASE + "/api/chat",
        data=json.dumps(payload).encode("utf-8"),
        headers={"Content-Type": "application/json"},
    )
    with urllib.request.urlopen(req, timeout=timeout) as resp:
        return json.loads(resp.read().decode("utf-8"))["message"]["content"].strip()


def similarity(answers):
    """两两比对答案的相似度,用来量化「稳不稳定」。

    用标准库的 difflib 做字符级比对就够了:
    这里要的不是语义相似度,而是「是不是几乎逐字一样」。
    返回 0~1,越接近 1 表示几轮回答越像。
    """
    if len(answers) < 2:
        return 1.0
    scores = []
    for i in range(len(answers)):
        for j in range(i + 1, len(answers)):
            scores.append(difflib.SequenceMatcher(None, answers[i], answers[j]).ratio())
    return sum(scores) / len(scores)


def run_sweep(model, prompt, param, values, repeat):
    print("模型:%s" % model)
    print("问题:%s" % prompt)
    print("扫描参数:%s    每档重复 %d 次\n" % (param, repeat))

    summary = []
    for v in values:
        # 注意这里每一档都是独立的一次次请求,互相之间没有上下文,
        # 所以差异完全来自参数本身,不会被前面的对话影响。
        options = {param: v}
        print("=" * 60)
        print("%s = %s" % (param, v))
        print("-" * 60)

        answers = []
        for k in range(repeat):
            try:
                a = ask(model, prompt, options)
            except Exception as exc:
                print("  第 %d 次失败:%s" % (k + 1, exc))
                continue
            answers.append(a)
            print("  [%d] %s" % (k + 1, a))

        if answers:
            sim = similarity(answers)
            avg_len = sum(len(a) for a in answers) / len(answers)
            summary.append((v, sim, avg_len))
            print("  —— 几次回答的平均相似度 %.2f,平均长度 %.0f 字" % (sim, avg_len))
        print()

    if summary:
        print("=" * 60)
        print("汇总(相似度越高=越稳定、越可复现)")
        print("-" * 60)
        print("%-12s %-12s %s" % (param, "相似度", "平均长度"))
        for v, sim, ln in summary:
            bar = "█" * int(sim * 20)
            print("%-12s %-12.2f %-6.0f %s" % (v, sim, ln, bar))
        print()
        print("解读:")
        print("  · 相似度接近 1.00 —— 几乎每次都给同样的话,适合分类、抽取这类任务")
        print("  · 相似度明显下降 —— 表达开始发散,适合创作,但也更容易跑偏")
        print("  · 注意看平均长度:有些参数不改变稳定性,只改变啰嗦程度")


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--model", required=True, help="模型全名,例如 qwen2:1.5b")
    ap.add_argument("--prompt", default=DEFAULT_PROMPT)
    ap.add_argument("--param", default="temperature",
                    help="要扫描的参数名:temperature / top_p / top_k")
    ap.add_argument("--values", default="",
                    help="逗号分隔的取值;不给就按参数名用内置梯度")
    ap.add_argument("--repeat", type=int, default=3,
                    help="每档重复几次;至少 2 次才看得出稳定性")
    args = ap.parse_args()

    # 不同参数的取值范围不一样,内置梯度按参数名分别给
    presets = {
        "temperature": [0.0, 0.3, 0.8, 1.2],
        "top_p": [0.1, 0.5, 0.9, 1.0],
        "top_k": [1, 10, 40, 100],
    }
    if args.values:
        raw = [x.strip() for x in args.values.split(",") if x.strip()]
        values = [int(x) if args.param == "top_k" else float(x) for x in raw]
    else:
        values = presets.get(args.param)
        if values is None:
            print("参数 %s 没有内置梯度,请用 --values 指定" % args.param)
            return 1

    run_sweep(args.model, args.prompt, args.param, values, args.repeat)
    return 0


if __name__ == "__main__":
    sys.exit(main())
| 看到的现象 | 说明什么 |
|---|---|
| 相似度接近 1.00 | 几乎每次都给同样的话,适合分类、抽取这类要求可复现的任务 |
| 相似度明显下降 | 表达开始发散,适合创作,但也更容易跑偏 |
| 相似度没变、长度变了 | 这个参数对当前任务只改变啰嗦程度,不改变稳定性 |
temperature 调到 0.1~0.3,创作类任务保持默认或往上调。top_k 和 top_p 一般不用动——先把 temperature 调对,绝大多数问题就解决了。num_ctx 只在确实需要处理长文档时才调大,而且调之前先算显存账。
03最小代码:从一台干净机器到第一次对话
五步,每步都带一个验证动作
整个上手过程只有五步。关键不在于命令本身,而在于每一步后面那条验证命令——上一步没验证通过就往下走,最后出了问题根本不知道断在哪一层。
ollama -v 打得出版本号ss -lntp 看到 11434 在监听ollama list 里能看到它ollama ps 看跑的是 GPU 还是 CPU#!/bin/bash
# 最小可复现路径:从一台干净的 Linux 机器,到能跟模型说上话。
# 每一步都带验证动作,上一步没验证通过就别走下一步。
set -euo pipefail
# ---------- ① 安装 ----------
# 方式 A:离线包(课堂环境用这个,安装包已经在本地)
# tar -xzf ollama-linux-amd64.tgz -C /usr
# 方式 B:联网一键脚本(工作中常用,会顺带把 systemd 服务也装好)
# curl -fsSL https://ollama.com/install.sh | sh
ollama -v # 打得出版本号才算装上;报 command not found 就是 PATH 没生效
# ---------- ② 起服务 ----------
# 前台起(调试用,关掉终端服务就没了):ollama serve
# 后台托管(生产用,开机自启):
systemctl start ollama
systemctl status ollama --no-pager | head -5 # 要看到 active (running)
# 端口真的在监听吗?这一步最容易被跳过
ss -lntp | grep 11434 || echo "11434 没在监听,先看 journalctl -u ollama"
# ---------- ③ 拉模型 ----------
# 模型名必须写全「名字:版本」;不写版本默认拉 latest,体积可能大得多
ollama pull qwen2:1.5b
ollama list # 拉下来的模型在这里,看 NAME 和 SIZE 两列
# ---------- ④ 对话 ----------
# 交互式:进去后用 /bye 退出
# ollama run qwen2:1.5b
# 一次性问答:带上提示词,答完自动退出,适合写进脚本
ollama run qwen2:1.5b "用一句话说明什么是私有化部署"
# ---------- ⑤ 收尾确认 ----------
ollama ps # 看模型是不是还占着内存;PROCESSOR 列显示 GPU 还是 CPU
| 这一步失败了 | 说明断在哪 | 先查什么 |
|---|---|---|
ollama -v 报 command not found | 命令没装上或 PATH 没生效 | 确认解压目录、重开一个终端 |
| 11434 没在监听 | 服务没起来 | journalctl -u ollama -n 30 |
pull 卡住或很慢 | 网络问题 | 换网络或用离线包;模型几个 G,慢是正常的 |
| 对话能进去但答得极慢 | 在用 CPU 跑 | ollama ps 看 PROCESSOR 列 |
ollama pull qwen2 和 ollama pull qwen2:1.5b 拉到的不是同一个东西。前者拉的是仓库默认标签,体积可能大得多,而且不同时间拉到的可能不一样。凡是写进脚本和文档的模型名,一律带上冒号版本号,否则同事照着你的文档跑出来的结果和你对不上。
ollama run 模型 会进入交互式对话,用 /bye 退出;ollama run 模型 "问题" 则是答完就退出。写进脚本的一律用后者——前者会让脚本停在对话界面上等输入,整个自动化流程就卡死了。
04完整案例:三件真会遇到的事
上手、运维、固化人设——这三件做完,命令行这一关就过了
4.1 案例一 · 从零到第一次对话
就是上一节那个脚本。这里补充一遍各步骤的正常输出长什么样,好让你知道自己是不是走对了。
| 命令 | 正常输出的特征 | 不正常的样子 |
|---|---|---|
ollama -v | 一行版本号 | command not found:PATH 没生效 |
ollama list | 表头 NAME SIZE MODIFIED,可以没有内容 | 报连接错误:服务没起 |
ollama pull | 进度条走到 success | 长时间不动:网络问题 |
ollama run | 提示符变成 >>> | 卡在加载:模型太大、显存不够 |
ollama ps | PROCESSOR 列显示 100% GPU | 显示 CPU 或混合:溢出了 |
ollama list 只打印一行表头、没有任何模型,这是正确的。它证明客户端和服务之间通了。很多人看到「什么都没有」以为装失败了,又去重装一遍——白折腾。
4.2 案例二 · 日常模型运维
场景:机器磁盘快满了,要在不影响线上服务的前提下腾空间。顺序是盘点 → 体检 → 看底细 → 清理 → 复核,一步都不能跳。
#!/bin/bash
# 模型仓库的日常运维:盘点 → 体检 → 清理 → 复核。
# 场景:机器磁盘快满了,要在不影响线上服务的前提下腾空间。
set -euo pipefail

KEEP_MODEL="${KEEP_MODEL:-qwen2:1.5b}"   # 线上正在用的,绝对不能删

echo "===== ① 盘点:本地一共有哪些模型 ====="
ollama list

echo
echo "===== ② 体检:谁正占着内存/显存 ====="
# PROCESSOR 列是关键:100% GPU 才是全进显存;出现 CPU 说明显存不够溢出了
# UNTIL 列是 keep_alive 到期时间,到点模型自动卸载
ollama ps

echo
echo "===== ③ 看清楚线上这个模型的底细 ====="
# 不用把模型跑起来就能看信息
ollama show "$KEEP_MODEL"                  # 参数量、量化等级、上下文长度
ollama show "$KEEP_MODEL" --parameters     # 内置的停止词等参数
ollama show "$KEEP_MODEL" --template       # 提示词模板,排查「答非所问」时要看它

echo
echo "===== ④ 清理:删掉不再需要的模型 ====="
# 注意:ollama rm 只认模型全名,不能像 docker 那样用 ID 前缀
for m in $(ollama list | awk 'NR>1 {print $1}'); do
  if [ "$m" = "$KEEP_MODEL" ]; then
    echo "跳过线上模型:$m"
    continue
  fi
  echo "待删除:$m"
  # 真要删就去掉下面这行的注释;保持注释状态时这个脚本是只读的
  # ollama rm "$m"
done

echo
echo "===== ⑤ 复核:确认线上模型还在、还能答 ====="
ollama list | grep -q "^${KEEP_MODEL}" && echo "线上模型仍在:$KEEP_MODEL"
# 让它立刻卸载,把显存还回来(keep_alive 传 0)
curl -s http://127.0.0.1:11434/api/generate \
  -d "{\"model\":\"${KEEP_MODEL}\",\"keep_alive\":0}" > /dev/null
echo "已请求卸载模型,再看一次 ps:"
ollama ps
| 步骤 | 命令 | 为什么不能跳 |
|---|---|---|
| 盘点 | ollama list | 先知道有什么,才知道能删什么 |
| 体检 | ollama ps | 正在跑的模型不能删,这一步就是防止误删 |
| 看底细 | ollama show | 确认线上那个到底是哪一档,别删错了同名不同版本的 |
| 清理 | ollama rm | 真正腾空间的一步 |
| 复核 | 再 list + 发一次请求 | 确认线上模型还在、还能答,才算收工 |
ollama rm 只认全名,而且删了就没了
不能像 Docker 那样用 ID 前缀。更要紧的是:删掉之后要重新下载才能恢复,几个 G 的模型可能要拉很久。所以脚本里那行 ollama rm 是注释掉的——先跑一遍看清楚要删哪些,确认无误再放开注释。这个习惯值得保留到所有批量删除脚本里。
机器上模型一多,人要在脑子里把 list 和 ps 两边的信息拼起来,这个拼接开始出错——删掉了正在用的,或者留着一个半年没人碰的 20G 模型占着数据盘。把两边合成一张表就清楚了:
"""模型盘点:磁盘上有什么、显存里跑着什么、哪些可以删。

`ollama list` 和 `ollama ps` 各给一半信息,人要自己在脑子里拼。
机器上模型一多,这个拼接就开始出错 —— 删掉了正在用的,
或者留着一个半年没人碰的 20G 模型占着数据盘。

这个脚本把两边的信息合到一张表里,并给出清理建议。
它**只读**,不会删任何东西:删除命令打印出来,由你自己复制执行。

用法:
    python3 model_inventory.py
    python3 model_inventory.py --keep qwen2:1.5b,deepseek-r1:7b

依赖:只用标准库,走 HTTP 接口,不依赖 ollama 命令是否在 PATH 里。
"""
import argparse
import json
import os
import sys
import urllib.error
import urllib.request

BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434").rstrip("/")


def get(path):
    """GET 一个接口,拿不到就抛出带说明的错误。"""
    try:
        with urllib.request.urlopen(BASE + path, timeout=15) as resp:
            return json.loads(resp.read().decode("utf-8"))
    except urllib.error.URLError as exc:
        raise RuntimeError(
            "连不上 %s%s —— 先确认服务在跑:systemctl is-active ollama" % (BASE, path)
        ) from exc


def human(n):
    """字节数转成人看得懂的单位。"""
    for unit in ("B", "KB", "MB", "GB", "TB"):
        if n < 1024 or unit == "TB":
            return "%.1f%s" % (n, unit)
        n /= 1024


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--keep", default="",
                    help="逗号分隔的保留清单,这些模型不会出现在清理建议里")
    args = ap.parse_args()
    keep = set(x.strip() for x in args.keep.split(",") if x.strip())

    # /api/tags 对应 ollama list:磁盘上有哪些
    disk = get("/api/tags").get("models", [])
    # /api/ps 对应 ollama ps:显存里跑着哪些
    loaded = {m["name"]: m for m in get("/api/ps").get("models", [])}

    if not disk:
        print("磁盘上一个模型都没有。先 ollama pull 一个。")
        return 0

    total = sum(m.get("size", 0) for m in disk)
    print("=" * 74)
    print("本地模型盘点   共 %d 个,合计占用 %s" % (len(disk), human(total)))
    print("=" * 74)
    print("%-28s %-10s %-12s %-10s %s"
          % ("模型", "大小", "量化", "参数量", "状态"))
    print("-" * 74)

    # 按体积从大到小排:要腾空间时,先看最上面几行就够了
    for m in sorted(disk, key=lambda x: -x.get("size", 0)):
        name = m["name"]
        det = m.get("details", {}) or {}
        state = "显存中" if name in loaded else "仅磁盘"
        if name in keep:
            state += " · 保留"
        print("%-28s %-10s %-12s %-10s %s"
              % (name,
                 human(m.get("size", 0)),
                 det.get("quantization_level", "-"),
                 det.get("parameter_size", "-"),
                 state))

    # 正在显存里的单独列一遍,带上到期时间
    if loaded:
        print()
        print("当前占着内存/显存的模型:")
        for name, m in loaded.items():
            # expires_at 就是 keep_alive 到期的时刻,到点自动卸载
            print("  · %-26s 占用 %-10s 到期 %s"
                  % (name, human(m.get("size", 0)), m.get("expires_at", "未知")))
    else:
        print()
        print("当前没有模型占用内存/显存。")

    # 清理建议:只挑「不在保留清单、且当前没在跑」的
    candidates = [m for m in disk
                  if m["name"] not in keep and m["name"] not in loaded]
    print()
    if candidates:
        freeable = sum(m.get("size", 0) for m in candidates)
        print("可清理候选(不在保留清单、且当前没在跑),共可腾出 %s:" % human(freeable))
        for m in sorted(candidates, key=lambda x: -x.get("size", 0)):
            print("  ollama rm %s        # %s" % (m["name"], human(m.get("size", 0))))
        print()
        print("⚠️  上面只是打印,脚本不会替你删。")
        print("    删之前再确认一遍:这个模型有没有被别的服务或定时任务用着。")
    else:
        print("没有可清理的候选:要么都在保留清单里,要么都正在跑。")

    return 0


if __name__ == "__main__":
    try:
        sys.exit(main())
    except RuntimeError as exc:
        print(exc)
        sys.exit(1)
ollama rm 命令打印出来让你自己复制执行,而不是直接跑。这不是偼懒——模型删了要重新下载,几个 G 拉很久,而「这个模型有没有被别的服务或定时任务用着」脚本判断不了。所有批量删除工具都应该守这个规矩。
keep_alive 到期,就发一次 keep_alive 为 0 的请求:
curl -s http://127.0.0.1:11434/api/generate -d '{"model":"qwen2:1.5b","keep_alive":0}'ollama ps,这个模型就从列表里消失了。这是唯一不用重启服务就能卸载单个模型的办法。
4.3 案例三 · 用 Modelfile 固化人设
前面说过,/set 改的东西一退出就没了。要让「人设 + 参数」长期生效,正确做法是写一个 Modelfile,把它烤成一个新模型。
# 骨架模板:把一个通用模型固化成「带人设、带默认参数」的私有模型。
#
# 用法:
#   1. 复制成 Modelfile,按 TODO 改
#   2. ollama create 你的模型名 -f Modelfile
#   3. ollama run 你的模型名
#   4. ollama list 里会多出这一条,像普通模型一样使用
#
# 为什么要做这个:把「人设 + 参数」写死在模型里,业务代码就不必每次都传一长串
# system 提示词和 options,换模型时也只改这一个文件。

# TODO: 换成本地已经拉好的基座模型全名(ollama list 里能查到的那个)
FROM qwen2:1.5b

# ---------- 人设 ----------
# TODO: 改成你自己的业务角色设定。写得越具体,跑偏的概率越低。
SYSTEM """
你是某公司内部的运维助手。
回答只依据用户提供的信息,不确定就直接说不确定,不要编造命令和参数。
回答用中文,先给结论,再给步骤。
"""

# ---------- 默认生成参数 ----------
# 这些值等价于对话里敲 /set parameter,区别是这里写死、重启也在

# TODO: 确定性任务(分类、抽取)调低到 0.1~0.3;创作类才往上调
PARAMETER temperature 0.3

# TODO: 上下文长度。调大更能记事,但显存占用同步上涨,并发时成倍放大
PARAMETER num_ctx 4096

# TODO: 单次回答最多生成多少 token,防止模型长篇大论刷屏
PARAMETER num_predict 512

# TODO: 遇到这些串就停止生成,按你的输出格式来定;不需要就整行删掉
# PARAMETER stop "###"

# ---------- 提示词模板 ----------
# 一般不用动:模板由基座模型自带,改错会导致模型答非所问。
# 确实要改时,先用 `ollama show 基座模型 --template` 把原版抄出来再改。
三步走:
ollama create 新名字 -f Modelfileollama run 新名字,list 里也能看到| 指令 | 作用 | 要不要改 |
|---|---|---|
FROM | 基于哪个已有模型 | 必改,写本地已拉好的全名 |
SYSTEM | 固化的人设提示词 | 必改,写得越具体跑偏越少 |
PARAMETER | 默认生成参数 | 按任务类型调 temperature 和 num_ctx |
TEMPLATE | 提示词模板 | 一般不要动,改错会导致答非所问 |
骨架看完还是不知道「写多具体算具体」,对照一份填好的就清楚了。下面这份是一个制造企业内部知识库助手,人设里身份、边界、输出格式三件事都写死了——缺任何一条,模型都会自由发挥:
# 填好的实例:一个内部知识库问答助手。
# 对照 Modelfile.skeleton 看,能直观看出「该写多具体」。
#
# 落地:
#   ollama create kb-assistant -f Modelfile.kb-assistant
#   ollama run kb-assistant
#   ollama list      # 它会像普通模型一样出现在列表里

FROM qwen2:1.5b

# 人设写得越具体,跑偏概率越低。
# 注意三件事都写死了:身份、边界、输出格式 —— 缺任何一条模型都会自由发挥。
SYSTEM """
你是某制造企业的内部知识库助手,服务对象是一线生产和质检人员。

回答规则:
1. 只依据用户在问题中提供的信息回答。用户没给的内容,直接说「资料里没有,需要人工确认」,不要推测。
2. 涉及安全操作、设备参数、质量判定标准时,必须提醒对方以现行作业指导书为准。
3. 回答用中文,先给结论,再给依据,最后给下一步动作。总长度控制在五句话以内。
4. 不回答与生产业务无关的问题,礼貌拒绝即可。
"""

# 知识库问答属于确定性任务:同一个问题应该每次给同样的答案。
# 温度压到 0.2,配合上面的「不要推测」,能显著减少编造。
PARAMETER temperature 0.2

# top_p 一起收紧,进一步压住发散。
PARAMETER top_p 0.7

# 用户会把整段作业指导书贴进来,上下文要够。
# 但注意:这个值直接决定 KV 缓存大小,并发场景下要重新算显存账。
PARAMETER num_ctx 8192

# 回答限制在五句话以内,生成上限给 400 就够,防止模型长篇大论。
PARAMETER num_predict 400
| 这份实例里的选择 | 为什么这么定 |
|---|---|
temperature 0.2 | 知识库问答是确定性任务,同一个问题应该每次给同样的答案 |
top_p 0.7 | 和低温度配合,进一步压住发散;这是少数值得动 top_p 的场景 |
num_ctx 8192 | 用户会把整段作业指导书贴进来,4096 不够装 |
num_predict 400 | 人设要求五句话以内,给上限防止模型啰嗦 |
| 「资料里没有,需要人工确认」 | 把「不知道」给出固定说法,比写「不要编造」有效得多 |
create 出来的不是副本,是引用
它不会把基座模型再复制一份,所以几乎不额外占磁盘。但反过来说,基座模型被 rm 掉之后,你这个自定义模型也会跟着不能用。清理磁盘时要留意这层依赖关系。
05骨架模板:三份脚本怎么配合用
一份管上手,一份管日常,一份管固化
前面三个案例各自对应一份可复用的文件。它们的分工是这样的:
| 文件 | 什么时候跑 | 核心价值 |
|---|---|---|
ollama_first_run.sh | 拿到新机器的第一天 | 每步带验证,断在哪一层一目了然 |
model_ops.sh | 磁盘告警、显存告急时 | 默认只读(删除命令是注释的),先看清再动手 |
Modelfile.skeleton | 业务人设定下来之后 | 把人设和参数固化,保证团队行为一致 |
5.2 把命令行用成生产力:离线批处理
上一讲的结论是「纯 CPU 机器只适合离线批处理」——这就是那个场景的落地形式。机器慢没关系,晚上挂着跑,第二天来看结果;而且几百条数据全要出网的话,调云端 API 反而又贵又不合规。
"""批量跑:把一个文件里的几百条问题喂给本地模型,结果存成 CSV。

私有化部署最划算的用法之一就是离线批处理 ——
机器慢没关系,晚上挂着跑,第二天来看结果。
这类活儿交给云端 API 反而贵,而且几百条数据全要出网。

这个脚本负责把这件事做稳:
    · 断点续跑:中途挂了重跑,已完成的不再重复调用
    · 逐条落盘:跑一条写一条,进程被杀也不丢前面的结果
    · 失败隔离:单条失败记下错误继续跑,不让一条脏数据毁掉整批

用法:
    python3 batch_ask.py --model qwen2:1.5b --input questions.txt --output result.csv
    python3 batch_ask.py --model qwen2:1.5b --input questions.txt \
        --system "你是质检助手,只回答是或否。"

依赖:只用标准库。
"""
import argparse
import csv
import json
import os
import sys
import time
import urllib.error
import urllib.request

BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434").rstrip("/")


def ask(model, system, question, timeout, retries=2):
    """问一条。失败重试,重试仍失败就抛出去由上层记录。"""
    messages = []
    if system:
        messages.append({"role": "system", "content": system})
    messages.append({"role": "user", "content": question})

    payload = {
        "model": model,
        "messages": messages,
        "stream": False,
        # 批处理要可复现:同一批数据重跑,结果应该一致
        "options": {"temperature": 0},
    }
    body = json.dumps(payload).encode("utf-8")

    last = None
    for attempt in range(retries + 1):
        try:
            req = urllib.request.Request(
                BASE + "/api/chat", data=body,
                headers={"Content-Type": "application/json"})
            with urllib.request.urlopen(req, timeout=timeout) as resp:
                data = json.loads(resp.read().decode("utf-8"))
            return data["message"]["content"].strip(), data.get("eval_count", 0)
        except (urllib.error.URLError, TimeoutError, KeyError) as exc:
            last = exc
            if attempt < retries:
                # 退避重试:服务在加载模型或正忙时,等一下往往就好了
                time.sleep(2 ** attempt)
    raise RuntimeError(str(last))


def load_done(path):
    """读已有的输出文件,拿到已经跑完的行号,用于断点续跑。

    几百条跑到一半断了,从头再来既费时间又浪费电。
    """
    done = set()
    if not os.path.exists(path):
        return done
    with open(path, encoding="utf-8", newline="") as f:
        for row in csv.DictReader(f):
            if row.get("index"):
                done.add(int(row["index"]))
    return done


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--model", required=True)
    ap.add_argument("--input", required=True, help="问题文件,一行一条")
    ap.add_argument("--output", default="batch_result.csv")
    ap.add_argument("--system", default="", help="统一人设,可留空")
    ap.add_argument("--timeout", type=int, default=300)
    args = ap.parse_args()

    with open(args.input, encoding="utf-8") as f:
        questions = [ln.strip() for ln in f if ln.strip()]
    if not questions:
        print("输入文件里没有问题")
        return 1

    done = load_done(args.output)
    if done:
        print("检测到已有结果 %d 条,将跳过这些继续跑。" % len(done))

    # 追加模式打开;文件不存在时先写表头
    new_file = not os.path.exists(args.output)
    fout = open(args.output, "a", encoding="utf-8", newline="")
    writer = csv.writer(fout)
    if new_file:
        writer.writerow(["index", "question", "answer", "tokens", "seconds", "error"])
        fout.flush()

    ok = fail = 0
    t_start = time.time()
    for i, q in enumerate(questions, 1):
        if i in done:
            continue
        t0 = time.time()
        try:
            answer, tokens = ask(args.model, args.system, q, args.timeout)
            err = ""
            ok += 1
        except RuntimeError as exc:
            # 单条失败不中断整批:把错误写进结果文件,人工再看
            answer, tokens, err = "", 0, str(exc)
            fail += 1

        writer.writerow([i, q, answer, tokens, "%.1f" % (time.time() - t0), err])
        # 每条都 flush:进程被杀也不会丢掉前面已经跑出来的结果
        fout.flush()

        status = "OK " if not err else "FAIL"
        print("[%s] %d/%d  %.1fs  %s"
              % (status, i, len(questions), time.time() - t0, q[:30]))

    fout.close()
    elapsed = time.time() - t_start
    print("-" * 56)
    print("完成 %d 条,失败 %d 条,总耗时 %.1f 分钟" % (ok, fail, elapsed / 60))
    print("结果已写入 %s" % args.output)
    if fail:
        print("⚠️  有失败记录,在 CSV 的 error 列里;修好之后重跑同一条命令即可续跑。")
    return 0


if __name__ == "__main__":
    sys.exit(main())
跑几百条的脚本和跑一条的脚本,差别全在下面这三件事上:
| 机制 | 怎么实现的 | 不做会怎样 |
|---|---|---|
| 断点续跑 | 先读输出 CSV,已完成的行号跳过 | 跑到一半断了只能从头来,一晚白跑 |
| 逐条落盘 | 每写一行就 flush() | 进程被杀,内存里的结果全丢 |
| 失败隔离 | 单条失败写进 error 列,继续跑 | 一条脏数据抛异常,整批停在第 37 条 |
5.3 把这几份接进真实流程
单独跑没问题,接进团队流程时还要注意几件事:
- 首次部署脚本要幂等。它可能被跑很多遍。
ollama pull本身是幂等的(已存在就只检查更新),但systemctl start在服务已跑时会静默成功——这没问题,别画蛇添足去先stop。 - 运维脚本永远保持「默认只读」。删除类命令一律注释掉,让使用者主动放开。这条习惯能挡住绝大多数误删事故。
- Modelfile 要进版本库。它是一份配置,不是一次性命令。进了 Git,人设改了哪一版、谁改的才查得到。
ollama serve 起的服务关掉终端就没了,不能用于生产。怎么写 service 文件、怎么开远程访问、怎么控并发,是下一讲《Linux 企业级部署》的内容。
06易错点汇总
按「命令位置 / 安装启动 / 模型管理 / 对话与调参」四类归并
⚠️ 一、命令敲错了地方
- 在系统终端敲斜杠指令。比如直接敲
/show,shell 报 command not found。斜杠指令必须先ollama run进对话。 - 在对话里敲
ollama list。这个更坑——模型不会报错,它会当成普通问题,给你编一段像模像样的「本地模型列表」。那个列表是假的。看到输出是自然语言而不是表格,就说明敲错地方了。 - 看不出自己在哪一边。看提示符:
$/#是系统终端,>>>是对话里。这一眼能省掉大量瞎猜。 /bye之后以为还在对话里。退出之后再敲斜杠指令就会报 command not found,白排查半天。
⚠️ 二、安装与启动
- 只验证了
ollama -v就认为装好了。命令装上不等于服务起来了。必须再跑一次ollama list,能返回(哪怕是空的)才算通。 - 服务已经在跑还去敲
ollama serve。会报address already in use。这不是故障,恰恰说明服务是好的。要重启用systemctl restart ollama。 - 手动
serve起的服务当成生产可用。关掉终端就没了。生产必须 systemd 托管。 - 刚装完
list是空的就以为失败。空列表是正确的,它恰好证明客户端和服务通了。别重装。 - 没改
OLLAMA_MODELS就开始拉模型。默认落在系统盘,拉几个就满。改路径之后已拉的模型不会自动搬家,所以这件事要在拉模型之前做。
⚠️ 三、模型管理
- 模型名不写版本号。
qwen2和qwen2:1.5b拉到的不是同一个东西。凡是写进脚本和文档的一律带冒号版本,否则同事跑出来的结果和你对不上。 - 把
list和ps搞混。list查磁盘上有什么,ps查显存里跑着什么。排查显存占用只能看ps。 - 「list 里有但 ps 里没有」以为出故障了。正常——模型还没被加载而已。
- 用 ID 前缀删模型。
ollama rm只认全名,不像 Docker 那样支持前缀。 - 删之前没确认哪个在线上用。删掉要重新下载才能恢复,几个 G 拉很久。运维脚本里的删除命令默认注释掉,先看清单再放开。
- 删了基座模型,自定义模型跟着废了。
ollama create出来的是引用不是副本,存在依赖关系。 - 部署脚本里用
ollama run拉模型。它会进对话界面等输入,脚本卡死在那儿。脚本里一律用pull,或者run 模型 "问题"这种一次性形式。
⚠️ 四、对话与调参
- 以为
/set能存住。斜杠指令只在当前会话有效,/bye之后全部回到默认。要长期生效就写Modelfile,或在 API 请求里传options。 - 「我没在用,显存怎么还占着」。十有八九是
keep_alive还没到期(默认 5 分钟)。这是设计行为,不是内存泄漏,别因此重装。 - 不知道怎么立刻释放显存。发一次
keep_alive为0的请求即可,这是唯一不用重启服务就能卸载单个模型的办法。 - 一上来就调
top_k/top_p。先把temperature调对,绝大多数问题就解决了。确定性任务调到 0.1~0.3。 - 随手把
num_ctx拉到很大。它直接决定 KV 缓存大小,显存占用同步上涨,并发场景下还要再乘并发数。调之前先算账。 - 改了
Modelfile的TEMPLATE。模板由基座模型自带,改错会导致模型答非所问。确实要改,先用ollama show 模型 --template把原版抄出来。
07自测题
点击题目展开答案;能把这 18 题说清楚,命令行这一关就过了
怎么一眼看出自己现在该敲哪套命令?
看提示符。$ 或 # 是系统终端,敲带 ollama 前缀的命令;>>> 是模型对话里,敲带 / 前缀的指令。
在对话框里敲 ollama list 会发生什么?为什么这比在终端敲斜杠指令更危险?
模型会把它当成一个普通问题,编一段像模像样的「本地模型列表」。危险在于它不报错——而在系统终端敲 /show,shell 会直接报 command not found,你立刻知道错了。判断办法:输出是自然语言而不是表格,就说明敲错地方了。
ollama 命令和 Ollama 服务是什么关系?
ollama 是客户端,它把你的命令变成 HTTP 请求发给 127.0.0.1:11434 上常驻的服务进程,服务才是真正加载模型、跑推理的那个。所以「命令装上了」和「服务起来了」是两件事。
关掉终端窗口,为什么模型还占着显存?
因为模型是加载在后台服务进程里的,和你那个终端窗口没有关系。要释放得等 keep_alive 到期,或者发一次 keep_alive 为 0 的请求,或者重启服务。
装完之后用哪两条命令验证?只过第一条说明什么?
ollama --version 验证命令装上了;ollama list 验证服务通了。只过第一条说明命令有了但服务没起来——这是 Linux 手动解压安装最常见的状态,一键脚本才会顺带装好 systemd 服务。
刚装完 ollama list 什么都没有,是不是装失败了?
不是。空列表(只有表头)是正确的,它恰恰证明客户端和服务之间通了。很多人看到「什么都没有」就去重装,白折腾。
敲 ollama serve 报 address already in use,该怎么处理?
说明 11434 端口已经被现有服务占着——这不是故障,恰恰说明服务是好的,直接用就行。真要重启用 systemctl restart ollama,不要用「再敲一遍 serve」这种方式。
什么情况下才需要手动敲 ollama serve?
只有 Linux 手动解压安装的情况需要。Windows/macOS 安装包和 Linux 一键脚本都会自动起服务。而且手动 serve 起的服务关掉终端就没了,不能用于生产——生产必须 systemd 托管。
OLLAMA_MODELS 为什么要在拉模型之前就改好?
默认路径在系统盘,模型动辄几个到几十 GB,拉几个就满。而改路径之后已经拉过的模型不会自动搬家,要么手动移过去,要么重新拉——所以这件事必须在拉模型之前做。
ollama list 和 ollama ps 分别查什么?
list 查磁盘上下载了哪些模型,ps 查内存/显存里正跑着哪些。「list 里有但 ps 里没有」是正常的,只说明模型还没被加载。排查显存占用只能看 ps。
pull 和 run 有什么区别?部署脚本里该用哪个?
pull 下载完就停;run 下载完直接进入对话界面。脚本里必须用 pull——用 run 会让脚本停在对话界面上等输入,整个自动化流程卡死。要在脚本里问一句话,用 ollama run 模型 "问题" 这种一次性形式。
为什么模型名一定要写成 qwen2:1.5b 而不是 qwen2?
只写名字会拉到仓库的默认标签,体积可能大得多,而且不同时间拉到的可能不一样。团队里两个人各拉一次很可能拿到不同的模型,后面对不上性能数据就会互相扯皮。
ollama rm 能用 ID 前缀吗?删了能恢复吗?
不能用前缀,只认模型全名(不像 Docker)。删掉之后只能重新下载,几个 G 可能要拉很久。所以运维脚本里的删除命令应该默认注释掉,先跑一遍看清单,确认无误再放开。
ollama create 出来的自定义模型会额外占多少磁盘?
几乎不额外占——它是对基座模型的引用,不是副本。但反过来说,基座模型被删掉之后,自定义模型也跟着不能用了。清理磁盘时要留意这层依赖。
/set parameter temperature 0.3 改的设置能存住吗?
存不住。斜杠指令只在当前这次会话有效,/bye 之后再 run,所有设置回到默认。要长期生效有两条路:写进 Modelfile 固化成新模型,或者在每次 API 请求里传 options。
模型被前面的对话带偏了,怎么办?
敲 /clear 清空上下文,相当于重新开一局。不需要退出再进。
「我没在用,显存怎么还占着」——怎么解释、怎么立刻释放?
是 keep_alive 还没到期(默认 5 分钟),设计行为,不是内存泄漏。ollama ps 能看到还有多久过期。要立刻释放就发一次 keep_alive 为 0 的请求,这是唯一不用重启服务就能卸载单个模型的办法。
四个生成参数里,日常最该调哪一个?
temperature。确定性任务(分类、抽取、改写)调到 0.1~0.3,创作类保持默认 0.8 或往上。top_k(默认 40)和 top_p(默认 0.9)一般不用动;num_ctx(默认 4096)只在处理长文档时才调大,而且要先算显存账。
Modelfile 里哪一条指令最好不要动?为什么?
TEMPLATE。提示词模板由基座模型自带,改错会导致模型答非所问。确实要改,先用 ollama show 模型 --template 把原版抄出来再改。
查命令速查表
系统终端里敲(前缀 ollama)
| 命令 | 作用 | 要点 |
|---|---|---|
ollama -v | 看版本 | 验证命令装上了;不验证服务 |
ollama serve | 前台启动服务 | 关掉终端就没了,生产别用 |
ollama pull 模型 | 下载模型 | 脚本里用它,不要用 run |
ollama list | 看磁盘上有哪些模型 | 空列表也算正常 |
ollama ps | 看显存里跑着哪些 | PROCESSOR 列是判断溢出的唯一依据 |
ollama show 模型 | 看模型底细 | 不用跑起来就能看;加 --template 看模板 |
ollama run 模型 | 进入交互对话 | 提示符变成 >>> |
ollama run 模型 "问题" | 问一次就退出 | 适合写进脚本、配管道 |
ollama create 名 -f Modelfile | 固化人设成新模型 | 是引用不是副本,依赖基座模型 |
ollama rm 模型 | 删除模型 | 只认全名;删了要重新下载 |
对话里敲(前缀 /)
| 指令 | 作用 | 要点 |
|---|---|---|
/? | 列出所有指令 | 忘了就敲它 |
/show info | 看当前模型信息 | 确认自己用的是哪一档 |
/set parameter 名 值 | 临时调参数 | 退出即失效 |
/set system "..." | 临时设人设 | 试提示词用,不用改代码 |
/load 模型 | 切换模型 | 方便横向对比回答 |
/clear | 清空上下文 | 被带偏了就敲它,不用退出 |
/bye | 退出对话 | 回到系统终端 |
关键环境变量
| 变量 | 默认 | 说明 |
|---|---|---|
OLLAMA_MODELS | 系统盘下的用户目录 | 拉模型之前就要改,改后已有模型不会自动搬家 |
OLLAMA_KEEP_ALIVE | 5m | 模型用完在内存里留多久;-1 永不卸载,0 立刻卸载 |
OLLAMA_HOST | 127.0.0.1:11434 | 监听地址,改远程访问用;下一讲展开 |
list 看中间一段,ps 看最后一段,rm 往回删。再加上一条分界线——带 ollama 的在终端敲,带 / 的在对话里敲,这一讲就通了。