【案例】新零售评价决策系统 · PET 训练与评估
512 个格子只批两个——mlm_loss 的四步形状变换、训练循环的固定顺序,以及一套能复现指标的评估与存盘策略。
30″30 秒看懂 PET 的训练
上一页老师傅已经拿到了填空题。这一页讲怎么批改。
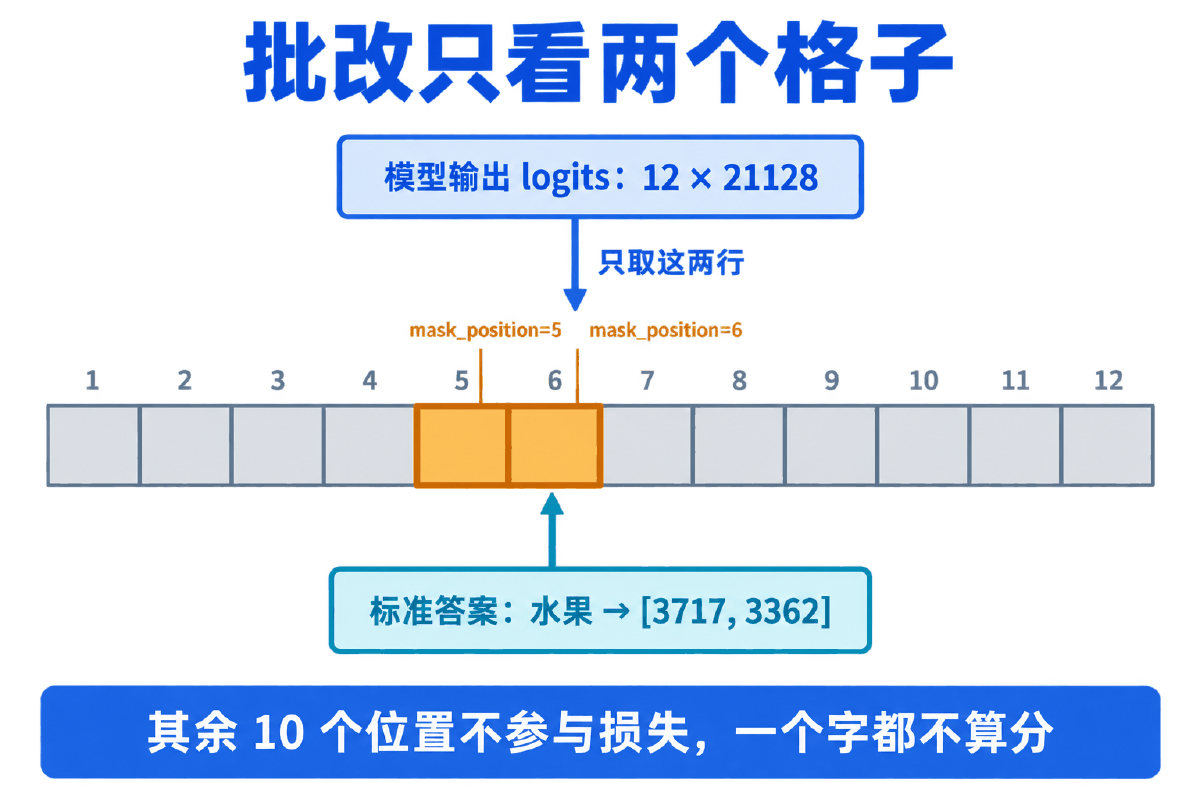
一张答题卡上有 512 个格子,可真正要批的只有两个——就是那两个 [MASK]。其余 510 个格子写的是题干本身,模型照抄一遍不算本事,批它没有意义。所以 PET 的损失函数干的第一件事,就是从一大张卷子里把那两个格子抠出来,其余全部不计分。
抠出来之后还有一层:标准答案不止一个。类别「水果」下面挂着「水果、苹果、香蕉、葡萄」四个子标签,填中任意一个都算对。所以要把这两个格子的答案复制四份,分别和四个标准答案比对。
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 整张答题卡 | logits,形状 (batch, seq_len, 21128) | 模型对序列里每个位置、每个词的打分 |
| 要批的那两个格子 | mask_positions | 只取这两行,其余位置一个字都不算分 |
| 多份标准答案 | 子标签的 token id | 一个类别挂多个可接受答案,逐一比对 |
| 批改打分 | CrossEntropyLoss | 算模型填的词与标准答案的差距 |
| 改完卷子调整教法 | 反向传播 + optimizer.step() | 更新 BERT 的全部参数,不只是某一层 |
| 阶段小测 | 每 valid_steps 步跑一次验证集 | F1 变好才存盘,防止后期过拟合覆盖好模型 |
01概念
PET 的损失和普通分类损失差在哪、指标为什么要用 macro 平均
mlm_loss 不是一个新损失函数
名字听着像是 PET 专用的东西,其实内核就是最普通的 CrossEntropyLoss。特别之处全在喂给它什么:
| 对比项 | 普通分类微调 | PET 的 mlm_loss |
|---|---|---|
| 参与损失的位置 | [CLS] 一个位置 | mask 位置,max_label_len 个 |
| 输出维度 | 类别数(本讲是 10) | 词表大小 21128 |
| 标准答案 | 一个类别 id | 若干个子标签,每个都是 token id 序列 |
| 这一层的参数 | 新加的线性层,随机初始化 | 预训练带来的 MLM 头,没有新参数 |
输出维度从 10 变成 21128,听起来像是把任务变难了。实际不然——模型在这 21128 个词上的判别能力是预训练练出来的,早就在那儿了。类别数只有 10 的分类头才是真正的从零开始。
为什么要「复制子标签」
一个类别挂多个子标签,意味着标准答案不唯一。实现上有两条路:
- 取最大值——四个子标签里模型打分最高的那个算对。逻辑直观,但梯度只回流到一个子标签上,其余三个学不到东西。
- 逐个都算——把 mask 位置的 logits 复制四份,分别和四个子标签算损失再求和。本讲用的是这一条:每个子标签都往上推一把。
代价是张量要膨胀。原本一个样本的 mask logits 是 (2, 21128),复制四份变成 (4, 2, 21128),再摊平成 (8, 21128) 去算交叉熵。形状怎么变、为什么这么变,是这一页最值得盯的地方。
指标:为什么用 macro 平均
本讲的验证集 590 条、10 个类别,分布并不均匀。三种平均方式给出的数字差别很大:
| 平均方式 | 怎么算 | 什么时候用 |
|---|---|---|
| micro | 把所有样本的 TP/FP/FN 加总后再算一次 | 只关心整体正确率;多数类会主导结果 |
| macro | 每个类别各算一遍,再对类别取算术平均 | 每个类别同等重要,少数类不能被淹没 |
| weighted | 按各类样本数加权平均 | 介于两者之间;样本数多的类别权重大 |
业务上选 macro 的理由很直接:新开的品类样本最少,恰恰是最需要盯住的那个。用 micro,它判全错也看不出来。
02原理:mlm_loss 的四步与训练循环
盯着张量形状看,四步走完就懂了
从 logits 到损失,一个样本走一遍
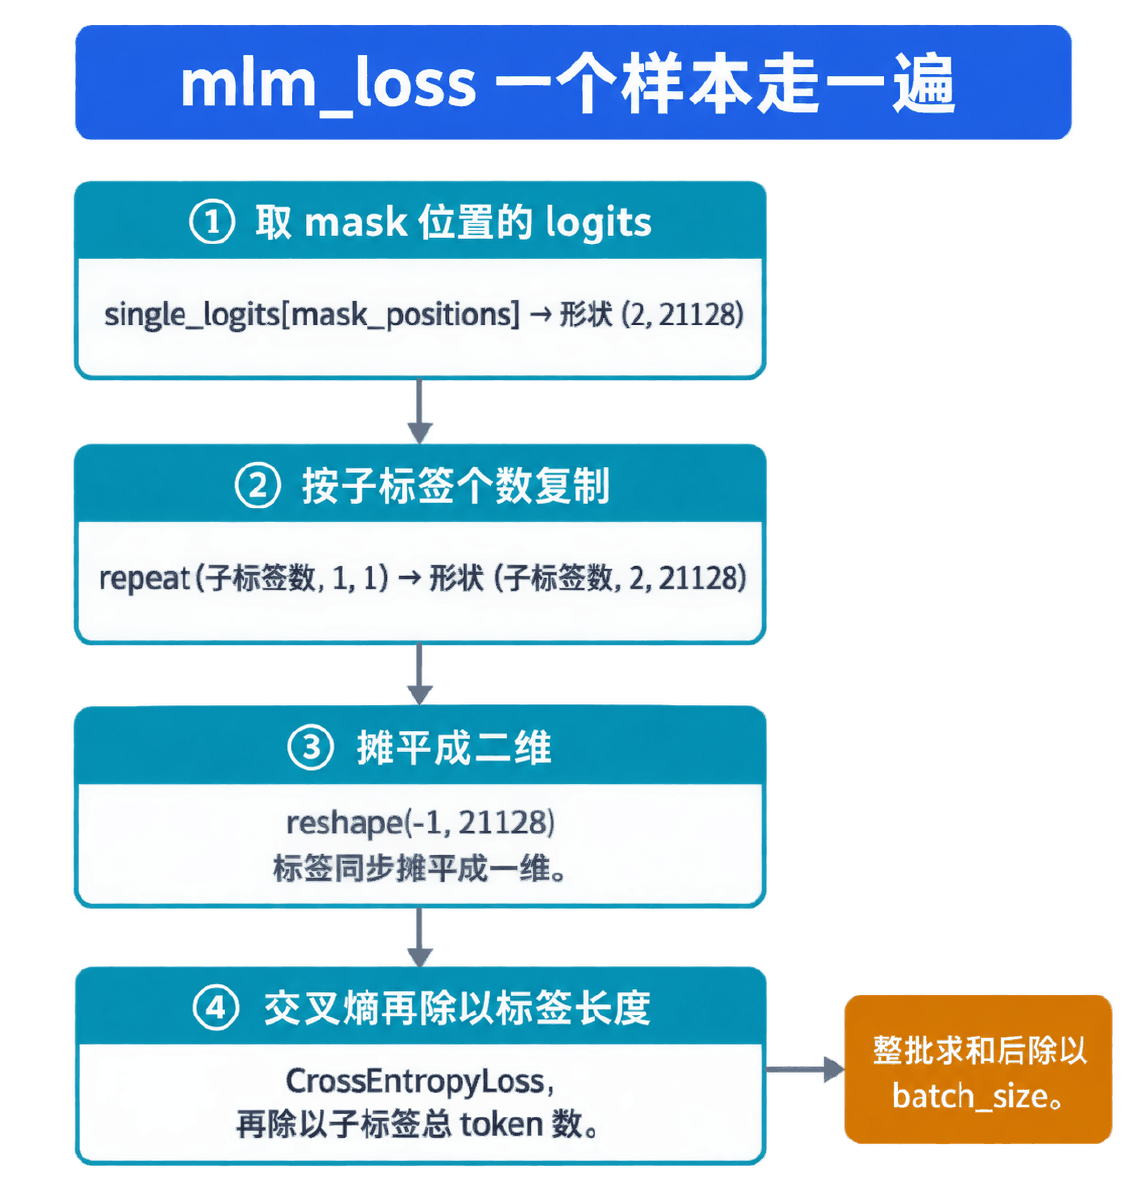
模型前向之后拿到的 logits 形状是 (batch, seq_len, vocab_size)。以 batch=8、seq_len=512、vocab=21128 计算,这是一个上亿元素的张量。真正有用的只有 batch × 2 行。
| 步骤 | 操作 | 形状变化 |
|---|---|---|
| ① | 取 mask 位置的 logits | (512, 21128) → (2, 21128) |
| ② | 按子标签个数复制 | (2, 21128) → (4, 2, 21128) |
| ③ | 摊平成二维 | (4, 2, 21128) → (8, 21128),标签同步摊成 (8,) |
| ④ | 交叉熵再除以标签总长 | (8, 21128) → 标量 |
第 ④ 步那个除法值得单独说。CrossEntropyLoss 默认 reduction='mean',已经对 8 个位置取了平均。这里再除以子标签的总 token 数,是为了让子标签多的类别不会因为「答案多」而在损失里占更大权重。不除的话,挂了 8 个子标签的类别,损失天然是挂 2 个子标签的类别的四倍,梯度会被它带偏。
# coding:utf-8
"""PET 训练要用的两个核心函数:算损失、把 logits 翻回 token id。

这两个函数是整条链路上最容易写错、也最难从报错信息里看出来的地方,
所以每一步都把张量形状写在注释里,改代码时对着形状核一遍。
"""
import torch


def mlm_loss(logits, mask_positions, sub_mask_labels, cross_entropy_criterion, device):
    """只在 [MASK] 位置上计算交叉熵。

    参数:
        logits:           模型原始输出 (batch, seq_len, vocab_size)
        mask_positions:   mask 的下标   (batch, mask_label_num)
        sub_mask_labels:  每个样本的子标签 token id,变长嵌套列表,例如
                          [[[2398, 3352]],
                           [[2398, 3352], [3819, 3861]]]
                          第一个样本只有 1 个子标签,第二个有 2 个
        cross_entropy_criterion: torch.nn.CrossEntropyLoss()
    返回:
        标量 loss
    """
    batch_size, seq_len, vocab_size = logits.size()
    loss = None

    # 逐样本算:因为每个样本的子标签个数不同,没法直接向量化成一个大张量
    for single_logits, single_sub_mask_labels, single_mask_positions in zip(
            logits, sub_mask_labels, mask_positions):
        # 只取 mask 那几行 -> (mask_label_num, vocab_size),例如 (2, 21128)
        single_mask_logits = single_logits[single_mask_positions]

        # 一个主标签挂了 N 个子标签,就把这份 logits 复制 N 份,
        # 让「水果/苹果/香蕉」每个候选都和同一份预测分布比一次
        single_mask_logits = single_mask_logits.repeat(len(single_sub_mask_labels), 1, 1)
        # -> (sub_label_num, mask_label_num, vocab_size)

        # 摊平成二维,CrossEntropyLoss 要求输入 (N, C)
        single_mask_logits = single_mask_logits.reshape(-1, vocab_size)

        # 标签同步摊平成一维 (sub_label_num * mask_label_num,)
        single_sub_mask_labels = torch.LongTensor(single_sub_mask_labels).to(device)
        single_sub_mask_labels = single_sub_mask_labels.reshape(-1, 1).squeeze()

        cur_loss = cross_entropy_criterion(single_mask_logits, single_sub_mask_labels)
        # 除以参与比较的 token 总数:子标签多的类别不会因为「候选多」而天然吃更大的损失
        cur_loss = cur_loss / len(single_sub_mask_labels)

        loss = cur_loss if loss is None else loss + cur_loss

    # 再除以 batch_size,保证换 batch_size 时损失数值可比
    return loss / batch_size


def convert_logits_to_ids(logits: torch.Tensor, mask_positions: torch.Tensor):
    """把 mask 位置上概率最高的 token 取出来。

    参数:
        logits:         (batch, seq_len, vocab_size)
        mask_positions: (batch, mask_label_num)
    返回:
        (batch, mask_label_num) 的 token id
    """
    label_length = mask_positions.size()[1]
    batch_size, seq_len, vocab_size = logits.size()

    # 把 (batch, seq_len) 的二维下标压成一维下标:第 b 个样本第 p 个位置 -> b*seq_len+p
    mask_positions_after_reshaped = []
    for batch, mask_pos in enumerate(mask_positions.detach().cpu().numpy().tolist()):
        for pos in mask_pos:
            mask_positions_after_reshaped.append(batch * seq_len + pos)

    logits = logits.reshape(batch_size * seq_len, -1)      # (batch*seq_len, vocab_size)
    mask_logits = logits[mask_positions_after_reshaped]    # (batch*label_num, vocab_size)

    # 注意:这里是在整个词表上取 argmax,可能吐出「的」「很」这类虚词,
    # 所以必须再过一道 Verbalizer 才能得到类别,不能直接拿它当预测结果用
    predict_tokens = mask_logits.argmax(dim=-1)
    return predict_tokens.reshape(-1, label_length)


if __name__ == '__main__':
    logits = torch.randn(2, 20, 21128)
    mask_positions = torch.LongTensor([[5, 6], [5, 6]])
    print('取出的 token id:', convert_logits_to_ids(logits, mask_positions))
形状变换的实证
上面四步光看代码容易晕。这个脚本用纯标准库把每一步的形状算出来并断言,跑一遍比读十遍强:
# -*- coding:utf-8 -*-
"""mlm_loss 的形状推导:纯标准库,不装 torch 也能跑通全部断言。

这个脚本不算真实数值,只把每一步的形状按公式推一遍。
形状对不上是这段代码最常见的故障,先在这里把账算清楚,再去跑 GPU。
"""

VOCAB_SIZE = 21128     # 中文 BERT 词表大小
SEQ_LEN = 512
BATCH = 8
MASK_NUM = 2           # 等于 max_label_len


def shapes_for_one_sample(sub_label_num: int):
    """返回 mlm_loss 内部四步的形状。"""
    step1 = (MASK_NUM, VOCAB_SIZE)                       # 取 mask 位置的 logits
    step2 = (sub_label_num, MASK_NUM, VOCAB_SIZE)        # 按子标签个数复制
    step3 = (sub_label_num * MASK_NUM, VOCAB_SIZE)       # 摊平成 (N, C)
    step4 = (sub_label_num * MASK_NUM,)                  # 标签摊平成 (N,)
    return step1, step2, step3, step4


if __name__ == '__main__':
    print('模型输出 logits 形状:', (BATCH, SEQ_LEN, VOCAB_SIZE))
    print('元素个数: %d —— 这就是显存吃紧的来源' % (BATCH * SEQ_LEN * VOCAB_SIZE))

    for n in (1, 4):
        s1, s2, s3, s4 = shapes_for_one_sample(n)
        print('\n子标签个数 =', n)
        print('  ① 取 mask 位置   ', s1)
        print('  ② 复制           ', s2)
        print('  ③ 摊平 logits    ', s3)
        print('  ④ 摊平 labels    ', s4)
        # CrossEntropyLoss 的硬性要求:输入 (N, C),标签 (N,),两个 N 必须相等
        assert s3[0] == s4[0], 'logits 与 labels 的第一维必须相等'
        assert s3[1] == VOCAB_SIZE

    # 一个容易忽略的事实:子标签越多,单样本进 CE 的样本数越多,
    # 所以代码里要除以 len(single_sub_mask_labels) 把它归一化掉
    s_one = shapes_for_one_sample(1)[2][0]
    s_four = shapes_for_one_sample(4)[2][0]
    print('\n1 个子标签进 CE 的行数:', s_one)
    print('4 个子标签进 CE 的行数:', s_four)
    assert s_four == s_one * 4
    print('不做归一化的话,子标签多的类别损失会天然大 4 倍')

    # 整批的显存账:logits 按 fp32 算
    bytes_fp32 = BATCH * SEQ_LEN * VOCAB_SIZE * 4
    print('\n单个 logits 张量 fp32 占用: %.2f GB' % (bytes_fp32 / 1024 ** 3))
    print('把 max_seq_len 从 512 降到 128,占用变成: %.2f GB'
          % (BATCH * 128 * VOCAB_SIZE * 4 / 1024 ** 3))
    assert bytes_fp32 // (BATCH * 128 * VOCAB_SIZE * 4) == 4
    print('结论:序列长度减半,这个张量线性减半——显存不够时先动它')
    print('全部断言通过')
推理侧:下标摊平的坑
convert_logits_to_ids 做的是反方向的事:从 logits 里把 mask 位置的预测 token 取出来。它的实现把 (batch, seq_len) 的二维下标压成一维再索引,公式是 b × seq_len + p。
这个换算写错不会报错,只会安静地取到别的样本的位置。指标莫名其妙地低,日志里什么异常都没有。下面这个脚本把正确写法和「忘乘 seq_len」的错误写法并排跑,用断言把差异钉死:
# -*- coding:utf-8 -*-
"""convert_logits_to_ids 的下标换算:纯标准库复刻,可直接运行。

真实代码把 (batch, seq_len) 的二维下标压成一维再去索引,
这一步写错不会报错,只会安静地取到别的样本的位置,指标莫名其妙地低。
用断言把换算关系钉死。
"""

BATCH = 3
SEQ_LEN = 10
VOCAB = 7


def flatten_positions(mask_positions, seq_len):
    """(batch, mask_num) 的二维下标 -> 摊平后的一维下标。"""
    flat = []
    for b, positions in enumerate(mask_positions):
        for p in positions:
            flat.append(b * seq_len + p)
    return flat


def fake_logits():
    """构造一份可预测的 logits:第 b 个样本第 s 个位置,最大值落在 (b+s) % VOCAB 上。"""
    out = []
    for b in range(BATCH):
        rows = []
        for s in range(SEQ_LEN):
            row = [0.0] * VOCAB
            row[(b + s) % VOCAB] = 9.0
            rows.append(row)
        out.append(rows)
    return out


def argmax(row):
    return max(range(len(row)), key=lambda i: row[i])


if __name__ == '__main__':
    logits = fake_logits()
    mask_positions = [[5, 6], [5, 6], [2, 3]]

    flat = flatten_positions(mask_positions, SEQ_LEN)
    print('二维下标:', mask_positions)
    print('摊平后的一维下标:', flat)
    assert flat == [5, 6, 15, 16, 22, 23]

    # 摊平 logits:(batch, seq_len, vocab) -> (batch*seq_len, vocab)
    flat_logits = [row for sample in logits for row in sample]
    assert len(flat_logits) == BATCH * SEQ_LEN

    picked = [argmax(flat_logits[i]) for i in flat]
    # 再 reshape 回 (batch, mask_num)
    label_length = len(mask_positions[0])
    predict = [picked[i:i + label_length] for i in range(0, len(picked), label_length)]
    print('取出的 token id:', predict)

    # 逐个核对:第 b 个样本第 p 个位置的答案应当是 (b+p) % VOCAB
    for b, positions in enumerate(mask_positions):
        for k, p in enumerate(positions):
            assert predict[b][k] == (b + p) % VOCAB, '第 %d 个样本取错了位置' % b
    print('下标换算校验通过')

    # 常见写错法:忘了乘 seq_len,直接拿 p 当一维下标
    wrong = [argmax(flat_logits[p]) for positions in mask_positions for p in positions]
    wrong = [wrong[i:i + label_length] for i in range(0, len(wrong), label_length)]
    print('忘乘 seq_len 的错误结果:', wrong)
    assert wrong[1] != predict[1], '第 2 个样本会取到第 1 个样本的位置——而且不报错'
    print('全部断言通过')
训练循环:一步训练与一轮验证
训练主循环的结构和任何一个 PyTorch 项目都一样,PET 特有的部分只有「查子标签」和「算 mlm_loss」两行。
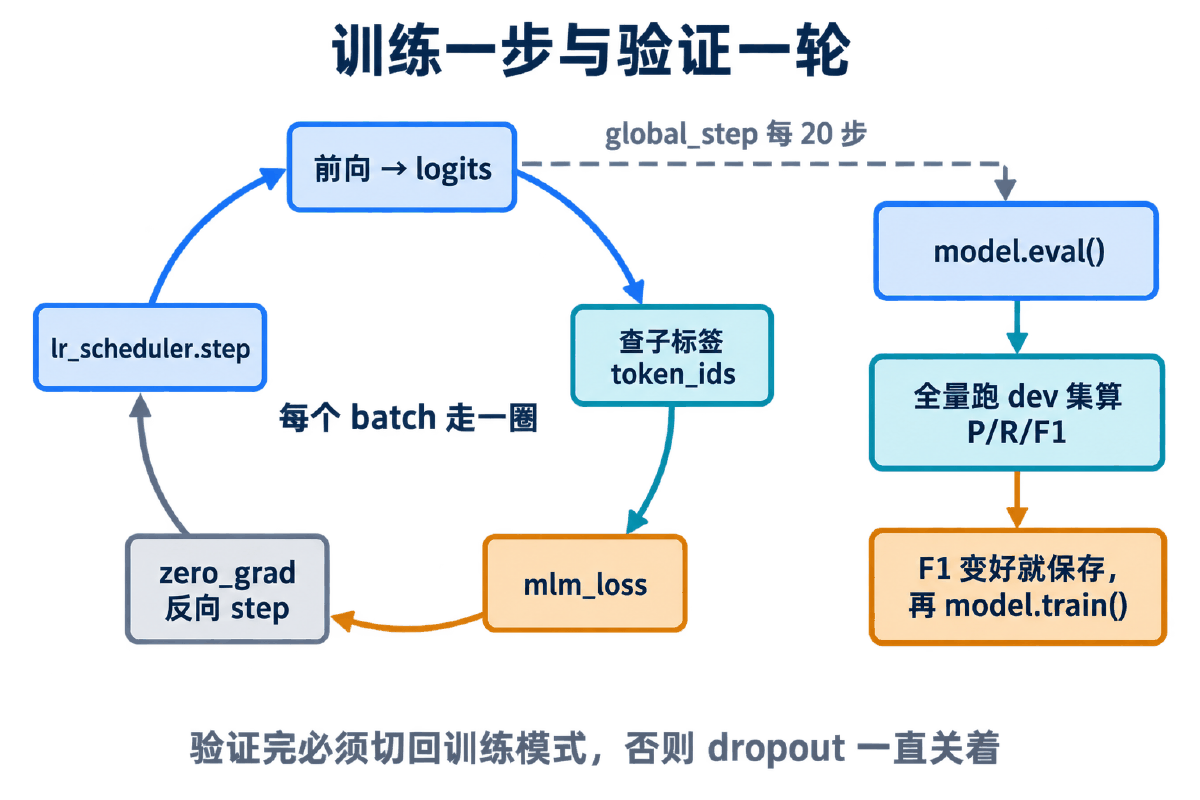
循环里有四处顺序不能颠倒:
| 顺序 | 代码 | 颠倒了会怎样 |
|---|---|---|
| 1 | optimizer.zero_grad() | 不清零,上一步的梯度会累加进来,等效学习率被放大 |
| 2 | loss.backward() | — |
| 3 | optimizer.step() | — |
| 4 | lr_scheduler.step() | 放在 optimizer.step() 之前,第一步就用了衰减后的学习率 |
学习率预热:一个被照抄的三行
训练脚本里这三行几乎每个项目都有:
max_train_steps = epochs × len(train_dataloader)warm_steps = int(warmup_ratio × max_train_steps)get_scheduler('linear', optimizer, warm_steps, max_train_steps)
问题在于 warmup_ratio=0.06 这个比例是从大数据集场景抄来的。本讲训练集 63 条、batch 8,一轮 8 步,10 轮 80 步——预热只有 4 步,基本等于没预热。同样的比例放到 6000 条数据上是 450 步,效果完全不同。
# -*- coding:utf-8 -*-
"""学习率预热与线性衰减:把 get_scheduler('linear') 的曲线手算出来。

训练脚本里这三行最容易被当成模板照抄:
    max_train_steps = epochs * len(train_dataloader)
    warm_steps = int(warmup_ratio * max_train_steps)
    lr_scheduler = get_scheduler('linear', optimizer, warm_steps, max_train_steps)
数据量一小,max_train_steps 就小,预热步数可能小到 4 步——等于没预热。
"""
import math


def steps_per_epoch(num_samples: int, batch_size: int):
    """DataLoader 默认 drop_last=False,所以是向上取整。"""
    return math.ceil(num_samples / batch_size)


def lr_factor(step: int, warm_steps: int, max_train_steps: int):
    """transformers 的 linear schedule:先线性升到 1,再线性降到 0。"""
    if step < warm_steps:
        return step / max(1, warm_steps)
    return max(0.0, (max_train_steps - step) / max(1, max_train_steps - warm_steps))


if __name__ == '__main__':
    num_train, batch_size, epochs, warmup_ratio, base_lr = 63, 8, 10, 0.06, 5e-5

    per_epoch = steps_per_epoch(num_train, batch_size)
    max_train_steps = epochs * per_epoch
    warm_steps = int(warmup_ratio * max_train_steps)

    print('训练样本 %d 条,batch_size=%d -> 每轮 %d 步' % (num_train, batch_size, per_epoch))
    assert per_epoch == 8, '63 / 8 = 7.875,向上取整是 8'
    print('训练 %d 轮 -> 总步数 %d' % (epochs, max_train_steps))
    assert max_train_steps == 80
    print('warmup_ratio=%.2f -> 预热 %d 步' % (warmup_ratio, warm_steps))
    assert warm_steps == 4, 'int(0.06*80)=4,只有 4 步预热'

    print('\nstep   lr')
    for step in [0, 1, 2, 4, 8, 20, 40, 60, 79, 80]:
        print('%4d   %.3e' % (step, base_lr * lr_factor(step, warm_steps, max_train_steps)))

    # 预热结束那一步正好是峰值
    assert abs(lr_factor(warm_steps, warm_steps, max_train_steps) - 1.0) < 1e-9
    # 最后一步降到 0
    assert lr_factor(max_train_steps, warm_steps, max_train_steps) == 0.0

    print('\n换个数据量再看一遍:')
    for n in (63, 600, 6000):
        p = steps_per_epoch(n, batch_size)
        m = epochs * p
        w = int(warmup_ratio * m)
        print('  %5d 条 -> 每轮 %4d 步,总 %5d 步,预热 %3d 步' % (n, p, m, w))
    assert int(warmup_ratio * epochs * steps_per_epoch(6000, batch_size)) == 450
    print('样本从 63 条涨到 6000 条,预热步数从 4 步涨到 450 步——同一个比例,效果完全不同')
    print('全部断言通过')
warmup_ratio 调大,要么直接指定 num_warmup_steps。
03最小代码:把损失算出来
不加载模型、不读数据,只把四步形状变换跑通
训练脚本跑起来要显卡、要模型权重、要数据集,验证一个形状问题成本太高。最短的路是:用假的 logits 把 mlm_loss 的四步走一遍,形状对了再上真数据。
# -*- coding:utf-8 -*-
"""mlm_loss 的形状推导:纯标准库,不装 torch 也能跑通全部断言。

这个脚本不算真实数值,只把每一步的形状按公式推一遍。
形状对不上是这段代码最常见的故障,先在这里把账算清楚,再去跑 GPU。
"""

VOCAB_SIZE = 21128     # 中文 BERT 词表大小
SEQ_LEN = 512
BATCH = 8
MASK_NUM = 2           # 等于 max_label_len


def shapes_for_one_sample(sub_label_num: int):
    """返回 mlm_loss 内部四步的形状。"""
    step1 = (MASK_NUM, VOCAB_SIZE)                       # 取 mask 位置的 logits
    step2 = (sub_label_num, MASK_NUM, VOCAB_SIZE)        # 按子标签个数复制
    step3 = (sub_label_num * MASK_NUM, VOCAB_SIZE)       # 摊平成 (N, C)
    step4 = (sub_label_num * MASK_NUM,)                  # 标签摊平成 (N,)
    return step1, step2, step3, step4


if __name__ == '__main__':
    print('模型输出 logits 形状:', (BATCH, SEQ_LEN, VOCAB_SIZE))
    print('元素个数: %d —— 这就是显存吃紧的来源' % (BATCH * SEQ_LEN * VOCAB_SIZE))

    for n in (1, 4):
        s1, s2, s3, s4 = shapes_for_one_sample(n)
        print('\n子标签个数 =', n)
        print('  ① 取 mask 位置   ', s1)
        print('  ② 复制           ', s2)
        print('  ③ 摊平 logits    ', s3)
        print('  ④ 摊平 labels    ', s4)
        # CrossEntropyLoss 的硬性要求:输入 (N, C),标签 (N,),两个 N 必须相等
        assert s3[0] == s4[0], 'logits 与 labels 的第一维必须相等'
        assert s3[1] == VOCAB_SIZE

    # 一个容易忽略的事实:子标签越多,单样本进 CE 的样本数越多,
    # 所以代码里要除以 len(single_sub_mask_labels) 把它归一化掉
    s_one = shapes_for_one_sample(1)[2][0]
    s_four = shapes_for_one_sample(4)[2][0]
    print('\n1 个子标签进 CE 的行数:', s_one)
    print('4 个子标签进 CE 的行数:', s_four)
    assert s_four == s_one * 4
    print('不做归一化的话,子标签多的类别损失会天然大 4 倍')

    # 整批的显存账:logits 按 fp32 算
    bytes_fp32 = BATCH * SEQ_LEN * VOCAB_SIZE * 4
    print('\n单个 logits 张量 fp32 占用: %.2f GB' % (bytes_fp32 / 1024 ** 3))
    print('把 max_seq_len 从 512 降到 128,占用变成: %.2f GB'
          % (BATCH * 128 * VOCAB_SIZE * 4 / 1024 ** 3))
    assert bytes_fp32 // (BATCH * 128 * VOCAB_SIZE * 4) == 4
    print('结论:序列长度减半,这个张量线性减半——显存不够时先动它')
    print('全部断言通过')
损失算通之后,把 Verbalizer 接上,训练侧的两个核心组件就齐了:
# -*- coding:utf-8 -*-
"""Verbalizer:主标签与子标签之间的双向翻译器。

训练时要「主标签 -> 子标签 token id」去算损失;
推理时要「预测出的 token -> 主标签」去出结果。两个方向都在这个类里。
"""
from typing import List, Union


class Verbalizer(object):

    def __init__(self, verbalizer_file: str, tokenizer, max_label_len: int):
        self.tokenizer = tokenizer
        self.max_label_len = max_label_len
        self.label_dict = self.load_label_dict(verbalizer_file)

    def load_label_dict(self, verbalizer_file: str):
        """读成 {主标签: [子标签...]}。"""
        label_dict = {}
        with open(verbalizer_file, 'r', encoding='utf8') as f:
            for line in f.readlines():
                if not line.strip():
                    continue
                label, sub_labels = line.strip().split('\t')
                # 用 dict.fromkeys 去重并保持书写顺序;换成 set 会让每次运行的顺序不同,
                # 进而让「子标签复制」那一步的张量顺序抖动,不利于复现
                label_dict[label] = list(dict.fromkeys(sub_labels.split(',')))
        return label_dict

    def find_sub_labels(self, label: Union[list, str]):
        """主标签 -> 所有子标签及其 token id。

        label 可以是字符串「体育」,也可以是 id 列表 [860, 5509, 0]。
        """
        if isinstance(label, list):
            # 先把 pad 去掉,再转回文字,否则会翻出一个带 [PAD] 的怪词
            while self.tokenizer.pad_token_id in label:
                label.remove(self.tokenizer.pad_token_id)
            label = ''.join(self.tokenizer.convert_ids_to_tokens(label))
        if label not in self.label_dict:
            raise ValueError('标签 "%s" 不在映射表 %s 里' % (label, list(self.label_dict)))

        sub_labels = self.label_dict[label]
        # [1:-1] 掐掉 [CLS] 与 [SEP]
        token_ids = [_id[1:-1] for _id in self.tokenizer(sub_labels)['input_ids']]
        for i in range(len(token_ids)):
            token_ids[i] = token_ids[i][:self.max_label_len]
            if len(token_ids[i]) < self.max_label_len:
                token_ids[i] += [self.tokenizer.pad_token_id] * (self.max_label_len - len(token_ids[i]))
        return {'sub_labels': sub_labels, 'token_ids': token_ids}

    def batch_find_sub_labels(self, label: List[Union[list, str]]):
        return [self.find_sub_labels(l) for l in label]

    @staticmethod
    def get_common_sub_str(str1: str, str2: str):
        """最长公共子串,返回 (子串, 长度)。"""
        lstr1, lstr2 = len(str1), len(str2)
        record = [[0] * (lstr2 + 1) for _ in range(lstr1 + 1)]
        p, max_num = 0, 0
        for i in range(lstr1):
            for j in range(lstr2):
                if str1[i] == str2[j]:
                    record[i + 1][j + 1] = record[i][j] + 1
                    if record[i + 1][j + 1] > max_num:
                        max_num = record[i + 1][j + 1]
                        p = i + 1
        return str1[p - max_num:p], max_num

    def hard_mapping(self, sub_label: str):
        """模型吐出的词不在映射表里时,挑重合度最高的主标签兜底。"""
        label, max_overlap_str = '', 0
        for main_label, sub_labels in self.label_dict.items():
            overlap_num = 0
            for s_label in sub_labels:
                overlap_num += self.get_common_sub_str(sub_label, s_label)[1]
            if overlap_num >= max_overlap_str:
                max_overlap_str = overlap_num
                label = main_label
        return label

    def find_main_label(self, sub_label: Union[list, str], hard_mapping=True):
        """子标签 -> 主标签。找不到且 hard_mapping=True 时走兜底。"""
        if isinstance(sub_label, list):
            while self.tokenizer.pad_token_id in sub_label:
                sub_label.remove(self.tokenizer.pad_token_id)
            sub_label = ''.join(self.tokenizer.convert_ids_to_tokens(sub_label))

        main_label = '无法解析'
        for label, sub_labels in self.label_dict.items():
            if sub_label in sub_labels:
                main_label = label
                break
        if main_label == '无法解析' and hard_mapping:
            main_label = self.hard_mapping(sub_label)
        return {'label': main_label, 'token_ids': [
            self.tokenizer.convert_tokens_to_ids(list(main_label))]}

    def batch_find_main_label(self, sub_label: List[Union[list, str]], hard_mapping=True):
        return [self.find_main_label(l, hard_mapping) for l in sub_label]


if __name__ == '__main__':
    from transformers import AutoTokenizer

    tokenizer = AutoTokenizer.from_pretrained('./bert-base-chinese')
    verbalizer = Verbalizer(verbalizer_file='./data/verbalizer.txt',
                            tokenizer=tokenizer, max_label_len=2)
    print(verbalizer.label_dict)
    print(verbalizer.batch_find_sub_labels(['水果', '酒店']))
    print(verbalizer.batch_find_main_label([[3717, 3362], [6983, 2421]]))
04完整案例:把评价分流器训起来
从 DataLoader 到一个能存盘、能复现指标的训练脚本
训练主脚本
上一页的数据管线已经能吐出 batch,这一页把它接上模型、损失和优化器。整个 train.py 分五块:加载、优化器、调度器、训练循环、定期验证存盘。
# -*- coding:utf-8 -*-
"""PET 训练主脚本:加载 MLM 头模型 -> 逐 batch 算 mask 位置损失 -> 定期验证存盘。

和普通 BERT 分类微调相比,这里只有两处不同:
  1. 用 AutoModelForMaskedLM 而不是 AutoModelForSequenceClassification;
  2. 损失只在 [MASK] 位置上算,且答案要先过 Verbalizer 翻成子标签。
其余(AdamW 分组衰减、warmup、best 存盘)与常规微调完全一致。
"""
import os
import time

import torch
from tqdm import tqdm
from transformers import AutoModelForMaskedLM, AutoTokenizer, get_scheduler

from common_utils import convert_logits_to_ids, mlm_loss
from data_loader import get_data
from metric_utils import ClassEvaluator
from pet_config import ProjectConfig
from verbalizer import Verbalizer

pc = ProjectConfig()


def evaluate_model(model, metric, data_loader, tokenizer, verbalizer):
    """在验证集上跑一遍,返回 acc / precision / recall / f1 / 逐类指标。"""
    model.eval()          # 关掉 dropout,BN 走推理统计
    metric.reset()        # 不清空的话,这一轮会把上一轮的样本也算进去

    with torch.no_grad():  # 验证不需要梯度,省显存也更快
        for batch in tqdm(data_loader, desc='eval'):
            logits = model(input_ids=batch['input_ids'].to(pc.device),
                           token_type_ids=batch['token_type_ids'].to(pc.device),
                           attention_mask=batch['attention_mask'].to(pc.device)).logits

            # 真值:把 pad 去掉再转回文字,得到「水果」这样的主标签
            mask_labels = batch['mask_labels'].numpy().tolist()
            for i in range(len(mask_labels)):
                while tokenizer.pad_token_id in mask_labels[i]:
                    mask_labels[i].remove(tokenizer.pad_token_id)
            mask_labels = [''.join(tokenizer.convert_ids_to_tokens(t)) for t in mask_labels]

            # 预测:mask 位置取 argmax -> 子标签 -> 主标签
            predictions = convert_logits_to_ids(
                logits, batch['mask_positions']).cpu().numpy().tolist()
            predictions = verbalizer.batch_find_main_label(predictions)
            predictions = [ele['label'] for ele in predictions]

            metric.add_batch(pred_batch=predictions, gold_batch=mask_labels)

    eval_metric = metric.compute()
    model.train()         # 一定要切回训练模式,否则 dropout 后面一直是关的
    return (eval_metric['accuracy'], eval_metric['precision'],
            eval_metric['recall'], eval_metric['f1'], eval_metric['class_metrics'])


def model2train():
    train_dataloader, dev_dataloader = get_data()

    # 关键一行:带 MLM 头的模型。这个头是预训练好的,不是随机初始化的新层
    model = AutoModelForMaskedLM.from_pretrained(pc.pre_model)
    tokenizer = AutoTokenizer.from_pretrained(pc.pre_model)
    verbalizer = Verbalizer(verbalizer_file=pc.verbalizer,
                            tokenizer=tokenizer,
                            max_label_len=pc.max_label_len)

    criterion = torch.nn.CrossEntropyLoss()
    metric = ClassEvaluator()
    loss_list = []

    # bias 与 LayerNorm 的权重不做衰减,这是 BERT 系微调的通行做法:
    # 这两类参数本来就该自由漂移,压它们只会拖慢收敛
    no_decay = ['bias', 'LayerNorm.weight']
    optimizer_grouped_parameters = [
        {'params': [p for n, p in model.named_parameters() if not any(nd in n for nd in no_decay)],
         'weight_decay': pc.weight_decay},
        {'params': [p for n, p in model.named_parameters() if any(nd in n for nd in no_decay)],
         'weight_decay': 0.0},
    ]
    optimizer = torch.optim.AdamW(optimizer_grouped_parameters, lr=pc.learning_rate)
    model.to(pc.device)

    max_train_steps = pc.epochs * len(train_dataloader)
    warm_steps = int(pc.warmup_ratio * max_train_steps)
    lr_scheduler = get_scheduler(name='linear',
                                 optimizer=optimizer,
                                 num_warmup_steps=warm_steps,
                                 num_training_steps=max_train_steps)

    print('总步数 %d,预热 %d 步' % (max_train_steps, warm_steps))
    tic_train = time.time()
    global_step, best_f1 = 0, 0

    for epoch in range(pc.epochs):
        for batch in tqdm(train_dataloader, desc='epoch %d' % epoch):
            logits = model(input_ids=batch['input_ids'].to(pc.device),
                           token_type_ids=batch['token_type_ids'].to(pc.device),
                           attention_mask=batch['attention_mask'].to(pc.device)).logits

            # 主标签 -> 该标签下所有子标签的 token id
            mask_labels = batch['mask_labels'].numpy().tolist()
            sub_labels = verbalizer.batch_find_sub_labels(mask_labels)
            sub_labels = [ele['token_ids'] for ele in sub_labels]

            loss = mlm_loss(logits,
                            batch['mask_positions'].to(pc.device),
                            sub_labels,
                            criterion,
                            pc.device)

            loss_list.append(float(loss.cpu().detach()))
            global_step += 1

            optimizer.zero_grad()   # 不清零会把上一步的梯度累加进来
            loss.backward()
            optimizer.step()
            lr_scheduler.step()     # 顺序固定:先 optimizer 再 scheduler

            if global_step % pc.logging_steps == 0:
                time_diff = time.time() - tic_train
                print('global step %d, epoch: %d, loss: %.5f, speed: %.2f step/s'
                      % (global_step, epoch, sum(loss_list) / len(loss_list),
                         pc.logging_steps / time_diff))
                tic_train = time.time()

            if global_step % pc.valid_steps == 0:
                acc, precision, recall, f1, class_metrics = evaluate_model(
                    model, metric, dev_dataloader, tokenizer, verbalizer)
                print('Evaluation precision: %.5f, recall: %.5f, F1: %.5f'
                      % (precision, recall, f1))
                # 只有 F1 变好才存盘,避免后期过拟合把好模型覆盖掉
                if f1 > best_f1:
                    print('best F1 updated: %.5f --> %.5f' % (best_f1, f1))
                    print('逐类指标:', class_metrics)
                    best_f1 = f1
                    cur_save_dir = os.path.join(pc.save_dir, 'model_best')
                    os.makedirs(cur_save_dir, exist_ok=True)
                    model.save_pretrained(cur_save_dir)
                    tokenizer.save_pretrained(cur_save_dir)   # 分词器要一起存,推理时才对得上
                tic_train = time.time()

    print('训练结束,最好 F1: %.5f' % best_f1)


if __name__ == '__main__':
    model2train()
只有两行是 PET 独有的,其余和任何 BERT 微调项目一模一样:
| 行 | 代码 | 作用 |
|---|---|---|
| 加载模型 | AutoModelForMaskedLM | 带 MLM 头,不是 AutoModelForSequenceClassification |
| 算损失前 | verbalizer.batch_find_sub_labels(...) | 主标签展开成所有子标签的 token id |
优化器的分组衰减
代码里这一段几乎所有 BERT 系项目都会照抄,值得知道它在干什么:
no_decay = ['bias', 'LayerNorm.weight']——这两类参数不做 weight decay。- 其余参数按
pc.weight_decay衰减。
理由:weight decay 的本意是防止权重过大导致过拟合。但 bias 是平移项、LayerNorm.weight 是缩放项,它们本来就该自由取值,压着它们只会拖慢收敛。本讲的配置里 weight_decay=0,这段分组实际上没起作用——但换到大数据集要开衰减时,这段结构直接可用。
评估:每 20 步跑一次全量验证
# -*- coding:utf-8 -*-
"""多分类评估器:累积一批批的预测,最后一次性算 acc / precision / recall / f1。

写成「add_batch 累积 + compute 汇总」的形式,是因为验证集要分批过,
不能每个 batch 算一次指标再取平均——那样算出来的数和整体指标对不上。
"""
from typing import List

import numpy as np
from sklearn.metrics import (accuracy_score, confusion_matrix, f1_score,
                             precision_score, recall_score)


class ClassEvaluator(object):

    def __init__(self):
        self.goldens = []
        self.predictions = []

    def add_batch(self, pred_batch: List[List], gold_batch: List[List]):
        """把一个 batch 的预测与真值追加进来。"""
        assert len(pred_batch) == len(gold_batch), '预测与真值条数不一致'
        # 多字标签可能以列表形式传进来,拼成字符串再比,避免逐字对齐的麻烦
        if isinstance(gold_batch[0], list):
            pred_batch = [','.join([str(e) for e in ele]) for ele in pred_batch]
            gold_batch = [','.join([str(e) for e in ele]) for ele in gold_batch]
        self.goldens.extend(gold_batch)
        self.predictions.extend(pred_batch)

    def compute(self, round_num=2):
        """汇总指标。average='macro' 让每个类别等权,少数类不会被多数类淹没。"""
        classes, class_metrics, res = sorted(list(set(self.goldens) | set(self.predictions))), {}, {}
        res['accuracy'] = round(accuracy_score(self.goldens, self.predictions), round_num)
        res['precision'] = round(precision_score(self.goldens, self.predictions,
                                                 average='macro', zero_division=0), round_num)
        res['recall'] = round(recall_score(self.goldens, self.predictions,
                                           average='macro', zero_division=0), round_num)
        res['f1'] = round(f1_score(self.goldens, self.predictions,
                                   average='macro', zero_division=0), round_num)

        # 再算一遍逐类指标:整体 F1 掉了要知道是哪个类拖的后腿
        try:
            conf_matrix = np.array(confusion_matrix(self.goldens, self.predictions))
            assert conf_matrix.shape[0] == len(classes)
            for i in range(len(classes)):
                precision = 0 if sum(conf_matrix[:, i]) == 0 else conf_matrix[i, i] / sum(conf_matrix[:, i])
                recall = 0 if sum(conf_matrix[i, :]) == 0 else conf_matrix[i, i] / sum(conf_matrix[i, :])
                f1 = 0 if (precision + recall) == 0 else 2 * precision * recall / (precision + recall)
                class_metrics[classes[i]] = {
                    'precision': round(precision, round_num),
                    'recall': round(recall, round_num),
                    'f1': round(f1, round_num),
                }
            res['class_metrics'] = class_metrics
        except Exception as e:
            print('[警告] 逐类指标计算失败:', e)
            res['class_metrics'] = {}
        return res

    def reset(self):
        """每次评估前必须清空,否则这一轮会把上一轮的样本也算进去。"""
        self.goldens = []
        self.predictions = []


if __name__ == '__main__':
    evaluator = ClassEvaluator()
    evaluator.add_batch(pred_batch=['水果', '酒店', '水果', '衣服'],
                        gold_batch=['水果', '酒店', '衣服', '衣服'])
    print(evaluator.compute())
评估器写成「add_batch 累积 + compute 汇总」而不是每个 batch 算一次再平均,原因是:每批算一次再取平均,和整体算一次,结果不一样。类别在各 batch 里分布不均时,差得更多。
它同时给出整体指标和逐类指标。整体 F1 掉了,先看逐类——通常是某一个类别塌了,而不是全面下滑。
# -*- coding:utf-8 -*-
"""指标是怎么算出来的:手算一遍 macro 平均,纯标准库,可直接运行。

评估脚本给出的 precision / recall / f1 用的是 macro 平均——每个类别先各算各的,
再对类别取算术平均。它和「按样本数加权」的结果差别很大,报指标时必须说清用了哪种。
"""
import collections


def confusion(goldens, predictions, classes):
    """返回 {类别: (TP, FP, FN)}。"""
    stat = {c: [0, 0, 0] for c in classes}
    for g, p in zip(goldens, predictions):
        if g == p:
            stat[g][0] += 1          # 预测对了,算这个类的 TP
        else:
            stat[p][1] += 1          # 预测成了 p,但真值不是 p -> p 的 FP
            stat[g][2] += 1          # 真值是 g 却没预测出来 -> g 的 FN
    return stat


def per_class(stat):
    out = {}
    for c, (tp, fp, fn) in stat.items():
        precision = 0.0 if tp + fp == 0 else tp / (tp + fp)
        recall = 0.0 if tp + fn == 0 else tp / (tp + fn)
        f1 = 0.0 if precision + recall == 0 else 2 * precision * recall / (precision + recall)
        out[c] = (precision, recall, f1)
    return out


def macro(metrics):
    n = len(metrics)
    return tuple(sum(m[i] for m in metrics.values()) / n for i in range(3))


if __name__ == '__main__':
    goldens = ['水果', '水果', '水果', '水果', '酒店', '酒店', '衣服', '衣服', '衣服', '衣服']
    predictions = ['水果', '水果', '水果', '衣服', '酒店', '水果', '衣服', '衣服', '衣服', '酒店']

    classes = sorted(set(goldens) | set(predictions))
    print('类别:', classes)
    print('真值分布:', dict(collections.Counter(goldens)))

    stat = confusion(goldens, predictions, classes)
    print('\n类别  TP  FP  FN')
    for c in classes:
        print('%-4s %3d %3d %3d' % (c, *stat[c]))

    metrics = per_class(stat)
    print('\n类别  precision  recall   f1')
    for c in classes:
        print('%-4s   %.3f     %.3f   %.3f' % (c, *metrics[c]))

    # 逐个核对手算值:水果 TP=3, FP=1(酒店被判成水果), FN=1(一条水果被判成衣服)
    assert stat['水果'] == [3, 1, 1]
    assert abs(metrics['水果'][0] - 0.75) < 1e-9
    assert abs(metrics['水果'][1] - 0.75) < 1e-9

    mp, mr, mf = macro(metrics)
    acc = sum(1 for g, p in zip(goldens, predictions) if g == p) / len(goldens)
    print('\naccuracy = %.3f' % acc)
    print('macro precision / recall / f1 = %.3f / %.3f / %.3f' % (mp, mr, mf))
    assert abs(acc - 0.7) < 1e-9

    # 关键对照:只有 2 条样本的「酒店」和有 4 条的「水果」在 macro 里权重一样大
    print('\n酒店只有 2 条样本,却和水果、衣服各占 1/3 的权重')
    print('把酒店的 2 条全判错,macro f1 会掉得比 accuracy 明显得多')
    bad = ['水果' if g == '酒店' else p for g, p in zip(goldens, predictions)]
    bad_metrics = per_class(confusion(goldens, bad, classes))
    bad_acc = sum(1 for g, p in zip(goldens, bad) if g == p) / len(goldens)
    print('全判错后 accuracy = %.3f, macro f1 = %.3f' % (bad_acc, macro(bad_metrics)[2]))
    assert macro(bad_metrics)[2] < mf
    print('全部断言通过')
验证时的三个开关
| 开关 | 代码 | 漏了会怎样 |
|---|---|---|
| 切推理模式 | model.eval() | dropout 还开着,同一份数据两次评估结果不同 |
| 关梯度 | torch.no_grad() | 显存暴涨,验证集大一点直接 OOM |
| 清空累积 | metric.reset() | 这一轮把上一轮的样本也算进去,指标越算越平 |
还有第四件事:验证完必须 model.train() 切回去。漏了它,后续训练全程 dropout 是关着的,表现是训练损失降得特别快而验证指标不动——典型的过拟合信号,但根因不是数据,是这一行。
存盘策略
脚本只在 F1 变好时存盘,存到 model_best。这个策略有两个隐含前提:
- 验证集足够可信。 本讲验证集 590 条、比训练集大十倍,这个前提成立。验证集只有几十条时,F1 的抖动可能纯属噪声,「best」存的是一次运气。
- 分词器要和模型一起存。
tokenizer.save_pretrained()不能省。推理时从model_best加载分词器,才能保证 token id 与训练时一致。
推理:和训练共用同一套模板
# -*- coding:utf-8 -*-
"""加载训练好的 PET 模型做预测。

推理与训练走的是同一套模板与 Verbalizer,唯一的差别是 train_mode=False:
不切标签、不产出 mask_labels,其余编码步骤一模一样。
模板与训练时不一致,等于换了一场考试,指标会毫无征兆地崩掉。
"""
import os
import time
from typing import List

import torch
from transformers import AutoModelForMaskedLM, AutoTokenizer

from common_utils import convert_logits_to_ids
from data_preprocess import convert_example
from hard_template import HardTemplate
from pet_config import ProjectConfig
from verbalizer import Verbalizer

pc = ProjectConfig()
device = pc.device
model_path = os.path.join(pc.save_dir, 'model_best')

tokenizer = AutoTokenizer.from_pretrained(model_path)
model = AutoModelForMaskedLM.from_pretrained(model_path)
model.to(device).eval()

# 模板必须从同一个文件读,不要在推理脚本里另手写一份
with open(pc.prompt_file, 'r', encoding='utf8') as f:
    prompt = f.readlines()[0].strip()
hard_template = HardTemplate(prompt=prompt)
verbalizer = Verbalizer(verbalizer_file=pc.verbalizer,
                        tokenizer=tokenizer,
                        max_label_len=pc.max_label_len)


def inference(contents: List[str]):
    """输入若干条评论,返回每条的类别。"""
    with torch.no_grad():
        start_time = time.time()
        tokenized_output = convert_example(
            {'text': contents},
            tokenizer,
            hard_template=hard_template,
            max_seq_len=128,          # 推理可以比训练短,只要别把 mask 截掉
            mask_length=pc.max_label_len,
            train_mode=False,         # 关键:没有标签可切
            return_tensor=True,
        )
        logits = model(input_ids=tokenized_output['input_ids'].to(device),
                       token_type_ids=tokenized_output['token_type_ids'].to(device),
                       attention_mask=tokenized_output['attention_mask'].to(device)).logits

        predictions = convert_logits_to_ids(
            logits, tokenized_output['mask_positions']).cpu().numpy().tolist()
        # hard_mapping 打开:模型吐出映射表里没有的词时,找最像的主标签兜底,
        # 而不是返回「无法解析」。上线时建议把兜底结果单独记一份日志。
        predictions = verbalizer.batch_find_main_label(predictions, hard_mapping=True)
        predictions = [ele['label'] for ele in predictions]
        print('用时 %.3fs,%d 条' % (time.time() - start_time, len(contents)))
        return predictions


if __name__ == '__main__':
    contents = [
        '天台很好看,躺在躺椅上很悠闲,适合一家出行,下次有机会肯定还会再来的,值得推荐',
        '环境、设施很棒,周边配套齐全,早餐不错,服务态度很好,性价比超高的一家',
        '物流超快,隔天就到了,还没用,屯着出游的时候用的,挺方便的,占地小',
        '这个榴莲虽然闻着臭、长得难看,但是味道很棒,很容易上瘾,下次还买',
        '上衣太小了,穿上很紧,而且颜色也不正',
    ]
    for content, label in zip(contents, inference(contents)):
        print('%s  ->  %s' % (label, content[:24]))
推理脚本里唯一容易写错的是 train_mode=False。推理数据没有标签列,忘了传就会在 split('\t') 上抛 ValueError。除此之外,模板、Verbalizer、编码长度全部复用训练时的那一份。
hard_mapping=True 时,模型填出映射表里没有的词会按最长公共子串猜一个最像的类别;关掉则返回「无法解析」。线上建议打开,但要把兜底比例记进日志。这个比例持续高于 10%,说明子标签表覆盖不够,该补词了——这是个很好的数据质量信号。
05骨架模板
训练侧的通用骨架:把「必改的」和「照抄的」分开
train.py 有一百多行,但真正要跟着任务变的只有五处。把它们标成 TODO,其余部分固化下来,就得到这份骨架:
# -*- coding:utf-8 -*-
"""PET 训练侧骨架模板:把 TODO 填掉就能跑自己的任务。

它比 train.py 短,是因为把「一定要改的」和「基本不用改的」分开了:
TODO 标出来的五处是换任务必改项,其余部分原样复制即可。
"""
import os

import torch
from transformers import AutoModelForMaskedLM, AutoTokenizer, get_scheduler

# TODO-1: 底座模型。中文任务用 bert-base-chinese;换英文底座时模板与标签词都要重写
PRE_MODEL = os.environ.get('PET_PRE_MODEL', './bert-base-chinese')
# TODO-2: 存盘目录
SAVE_DIR = os.environ.get('PET_SAVE_DIR', './checkpoints')
# TODO-3: 超参数。样本少就把 epochs 调大、batch 调小
EPOCHS, BATCH_SIZE, LR, WARMUP_RATIO = 10, 8, 5e-5, 0.06
# TODO-4: 评估与存盘节奏
LOGGING_STEPS, VALID_STEPS = 5, 20
DEVICE = 'cuda:0' if torch.cuda.is_available() else 'cpu'


def build_optimizer(model, weight_decay=0.0):
    """AdamW + 分组权重衰减。这段几乎不用改,照抄即可。"""
    no_decay = ['bias', 'LayerNorm.weight']
    grouped = [
        {'params': [p for n, p in model.named_parameters()
                    if not any(nd in n for nd in no_decay)], 'weight_decay': weight_decay},
        {'params': [p for n, p in model.named_parameters()
                    if any(nd in n for nd in no_decay)], 'weight_decay': 0.0},
    ]
    return torch.optim.AdamW(grouped, lr=LR)


def build_scheduler(optimizer, steps_per_epoch):
    max_train_steps = EPOCHS * steps_per_epoch
    warm_steps = int(WARMUP_RATIO * max_train_steps)
    if warm_steps < 10:
        print('[提醒] 预热只有 %d 步,数据量太小时预热基本不起作用' % warm_steps)
    return get_scheduler('linear', optimizer,
                         num_warmup_steps=warm_steps,
                         num_training_steps=max_train_steps), max_train_steps


def train(train_loader, dev_loader, loss_fn, eval_fn):
    """
    参数:
        loss_fn(model, batch) -> loss        TODO-5: 换任务时只要重写这一个函数
        eval_fn(model, dev_loader) -> float  返回一个越大越好的指标
    """
    model = AutoModelForMaskedLM.from_pretrained(PRE_MODEL).to(DEVICE)
    tokenizer = AutoTokenizer.from_pretrained(PRE_MODEL)
    optimizer = build_optimizer(model)
    scheduler, max_train_steps = build_scheduler(optimizer, len(train_loader))

    global_step, best_score = 0, -1.0
    for epoch in range(EPOCHS):
        for batch in train_loader:
            loss = loss_fn(model, batch)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
            scheduler.step()
            global_step += 1

            if global_step % LOGGING_STEPS == 0:
                print('step %d/%d loss %.5f' % (global_step, max_train_steps, float(loss)))
            if global_step % VALID_STEPS == 0:
                score = eval_fn(model, dev_loader)
                print('step %d 验证指标 %.5f' % (global_step, score))
                if score > best_score:
                    best_score = score
                    cur = os.path.join(SAVE_DIR, 'model_best')
                    os.makedirs(cur, exist_ok=True)
                    model.save_pretrained(cur)
                    tokenizer.save_pretrained(cur)
                    print('已存盘 ->', cur)
    return best_score


if __name__ == '__main__':
    print('设备:', DEVICE)
    print('把 loss_fn 与 eval_fn 接上 data_loader 即可开跑')
| TODO | 填什么 | 怎么定这个值 |
|---|---|---|
| TODO-1 底座 | 预训练模型路径 | 中文任务用 bert-base-chinese;换英文底座时模板与标签词都要重写 |
| TODO-2 存盘目录 | checkpoints 路径 | 按业务分目录,别和别的任务混在一起 |
| TODO-3 超参数 | epochs / batch / lr / warmup | 样本少就把 epochs 调大、batch 调小,保证梯度更新次数够 |
| TODO-4 节奏 | logging_steps / valid_steps | 总步数少时调小,否则全程验证不了几次,看不出趋势 |
| TODO-5 损失 | loss_fn(model, batch) | 换任务只重写这一个函数,训练循环不动 |
骨架里 build_scheduler() 内置了一条提醒:预热步数小于 10 时打印警告。这条提醒是前面那个「63 条数据只预热 4 步」的坑固化下来的产物——把踩过的坑写成代码里的断言或警告,比写进文档更可靠。
迁移到别的任务要动哪些
| 场景 | 改动 | 注意 |
|---|---|---|
| 换一个分类业务 | 数据文件 + 模板 + 标签表 | 训练代码一行不动 |
| 数据量涨到几千条 | epochs 调小、batch 调大 | 预热步数会自然变充足,可以恢复 0.06 的比例 |
| 类别名变成三字词 | max_label_len=3 | 必须重新生成数据,缓存的旧特征 mask 数量不对 |
| 要用 F1 以外的指标选模型 | 改 eval_fn 的返回值 | 骨架约定「越大越好」,用 loss 选模型要取负号 |
06易错点汇总
按「损失 / 训练循环 / 评估 / 存盘推理」四类归并
⚠️ 一、损失函数
- 把整个序列都算进损失。 直接把
logits和完整的input_ids喂给CrossEntropyLoss,模型的任务变成「把题干背下来」。512 个位置里只有 2 个有用,训练信号被稀释 250 倍。必须先按mask_positions取行。 - 下标摊平忘了乘
seq_len。 二维下标压成一维的公式是b × seq_len + p。漏了乘法,第 2 个及以后的样本全部取到第 1 个样本的位置——不报错,只是指标低得莫名其妙。 - 忘了除以标签总 token 数。 挂 8 个子标签的类别损失天然是挂 2 个子标签类别的 4 倍,梯度被它带偏,子标签多的类别会被过度优化。
- 把
batch_size写死在损失函数里。 最后一个 batch 往往不满(63 条 / batch 8,最后一批只有 7 条)。用logits.size(0)取实际批大小,别用配置里的数。 - 子标签复制后标签没同步摊平。 logits 变成
(8, 21128)而标签还是(4, 2),CrossEntropyLoss会报维度不匹配——这个倒是会报错,属于好坑。
⚠️ 二、训练循环
optimizer.zero_grad()漏了或位置不对。 梯度会跨步累加,等效学习率被放大到失控,损失直接发散成nan。lr_scheduler.step()放在optimizer.step()之前。 第一步就用上了衰减后的学习率,预热等于白设。顺序固定:zero_grad → backward → optimizer.step → scheduler.step。- 预热比例照抄大数据集的 0.06。 63 条数据总共 80 步,预热只有 4 步。小数据集要看步数不是比例,直接指定
num_warmup_steps更稳。 logging_steps比总步数还大。 总共 80 步,logging_steps=100,全程一条日志都不打,看着像卡死了。- 把
loss_list一直累加却从不清空。 打印的「平均损失」是从第一步到现在的全局平均,越到后面越迟钝,看不出最近的变化趋势。
⚠️ 三、评估
- 验证完忘了
model.train()切回去。 后续训练全程 dropout 关闭。现象是训练损失降得异常快、验证指标不动,看起来像过拟合,实际是这一行的锅。 metric.reset()漏了。 第二轮验证把第一轮的样本也算进去,指标被历史数据平滑,永远看不出真实变化。- 忘了
torch.no_grad()。 验证时构建计算图,显存占用翻倍,验证集稍大就 OOM。 - 每个 batch 算一次指标再求平均。 和整体算一次的结果不同,类别分布不均时差得更多。正确做法是累积预测与真值,最后统一算。
- 报指标不说平均方式。 macro 与 micro 差十几个点是常事。本讲用的是 macro,少数类和多数类等权。
- 验证集里有训练集没出现过的类别。 该类 recall 恒为 0,还把 macro 平均整体拉低,容易误判模型不行。
⚠️ 四、存盘与推理
- 只存模型不存分词器。 推理时从别处加载分词器,token id 可能对不上,输出全乱。
tokenizer.save_pretrained()和model.save_pretrained()要成对出现。 - 每次验证都无条件覆盖存盘。 后期过拟合的模型会把中期的好模型覆盖掉。只在指标变好时存。
- 验证集太小还用「best 存盘」策略。 几十条验证集上的 F1 抖动可能纯是噪声,存下来的「best」是一次运气。
- 推理忘了传
train_mode=False。 推理数据没有\t,split('\t')抛ValueError。 - 推理用了和训练不同的模板。 两边必须读同一个文件。模板差一个字,指标就断崖,而且没有任何报错。
hard_mapping的兜底比例不做统计。 兜底本质是猜。比例高说明子标签表覆盖不足,这是个很有价值的数据质量信号,别浪费。
07自测题
点击题目展开答案;这 9 题过了,PET 的训练侧就通了
mlm_loss 和普通的 CrossEntropyLoss 是什么关系?
内核就是 CrossEntropyLoss,没有新东西。特别之处全在喂给它什么:只取 mask 位置的 logits(不是整个序列),输出维度是词表 21128(不是类别数),标准答案是若干个子标签的 token id(不是一个类别 id)。
把 (2, 21128) 复制成 (4, 2, 21128) 是在干什么?为什么要这么做?
这个类别挂了 4 个子标签,标准答案不唯一。复制 4 份分别与 4 个子标签算损失再求和,等于每个子标签都往上推一把。另一条路是只取打分最高的那个,但那样梯度只回流到一个子标签,其余三个学不到。
算完交叉熵为什么还要除以子标签的总 token 数?
防止「子标签多的类别」在损失里占更大权重。挂 8 个子标签的类别,损失天然是挂 2 个子标签类别的 4 倍,不做归一化梯度会被它带偏,这个类别被过度优化。
写出训练一步里四个调用的正确顺序,并说明颠倒后果。
optimizer.zero_grad() → loss.backward() → optimizer.step() → lr_scheduler.step()。漏了第一步,梯度跨步累加、等效学习率失控;把第四步提到第三步之前,第一步就用上了衰减后的学习率,预热白设。
训练集 63 条、batch 8、epochs 10、warmup_ratio 0.06,预热多少步?这个数合理吗?
每轮 ceil(63/8) = 8 步,总共 80 步,预热 int(0.06×80) = 4 步。不合理——预热需要的是一定数量的步数(经验上几十步起),不是固定比例。同样 0.06 放到 6000 条数据上是 450 步。小数据集应当直接指定 num_warmup_steps。
为什么 bias 和 LayerNorm.weight 不做 weight decay?
weight decay 的本意是压制过大的权重以防过拟合。但 bias 是平移项、LayerNorm.weight 是缩放项,本来就该自由取值,压着它们只会拖慢收敛,对泛化没有帮助。
验证函数里 model.eval()、torch.no_grad()、metric.reset() 各自漏掉会怎样?
model.eval() 漏了:dropout 还开着,同一份数据两次评估结果不同。torch.no_grad() 漏了:构建计算图,显存翻倍容易 OOM。metric.reset() 漏了:这一轮把上一轮样本也算进去,指标被历史平滑。还有第四件:验证完必须 model.train() 切回去,否则后续训练 dropout 一直关着。
为什么用 macro 平均而不是 micro?
macro 让每个类别等权。业务上新开的品类样本最少、最需要盯住,用 micro 它判全错也看不出来——多数类会主导整体数字。代价是少数类的指标抖动会放大到整体上。汇报时必须写清用的是哪一种。
只在 F1 变好时存盘,这个策略的前提是什么?
两个前提:① 验证集足够可信——本讲验证集 590 条、是训练集的十倍,前提成立;验证集只有几十条时 F1 抖动可能纯是噪声,存下的 best 是运气。② 分词器要一起存,否则推理时 token id 可能与训练时对不上。
附术语表
| 术语 | 英文原形 | 含义 |
|---|---|---|
| 掩码位置损失 | mlm loss | 只在 [MASK] 位置上计算的交叉熵;内核是普通的 CrossEntropyLoss |
| 对数几率 | logits | 模型输出的未归一化打分,形状 (batch, seq_len, vocab_size) |
| 交叉熵损失 | CrossEntropyLoss | 分类任务的标准损失,默认 reduction='mean' |
| 宏平均 | macro average | 每个类别各算一遍指标再取算术平均,少数类与多数类等权 |
| 微平均 | micro average | 所有样本的 TP/FP/FN 加总后算一次,多数类主导结果 |
| 混淆矩阵 | confusion matrix | 真值与预测的交叉计数表,用来算逐类指标 |
| 学习率预热 | warmup | 训练初期让学习率从 0 线性升到设定值,避免参数还乱时迈大步 |
| 线性衰减 | linear schedule | 预热结束后学习率线性降到 0 |
| 权重衰减 | weight decay | 在损失里加入权重的 L2 惩罚;bias 与 LayerNorm.weight 通常排除 |
| 梯度清零 | zero_grad | 每步更新前清空累积梯度,漏了会导致等效学习率失控 |
| 推理模式 | eval mode | model.eval() 关闭 dropout 等训练期行为,验证完要切回 train() |
| 兜底映射 | hard mapping | 模型填出的词不在映射表里时,按最长公共子串挑最像的主标签 |