CLIP 跨模态对齐与扩散模型原理
CLIP 把图和话放进同一个向量空间,量出「像不像」;扩散模型把「从噪声到图像」拆成几十上百次简单回归。前者指方向,后者动凿子。
30″30 秒看懂 CLIP 与扩散模型
文生图不是「模型读懂句子后把图画出来」,而是一间石雕工作室:桌上先摆一整块满是噪点的石料,一位雕刻师抡着凿子,一凿一凿地把多余的石屑敲掉,几十刀之后,石料里就露出了那只猫。
雕刻师并不认字。他只会干一件事:看一眼眼下这块石头,判断「这一刀该敲掉哪儿」。真正读懂订单上那句「戴帽子的猫」的,是站在旁边的监理——他手里有一本特殊的词典,能把一张图和一句话翻译成同一种坐标,于是他能一眼看出「现在这块半成品,离订单上写的那句话还差多远」,并把方向告诉雕刻师。
监理全程不碰凿子。他不会雕,一刀都不会。他只负责量距离、指方向。这就是 CLIP 与 diffusion 的分工。
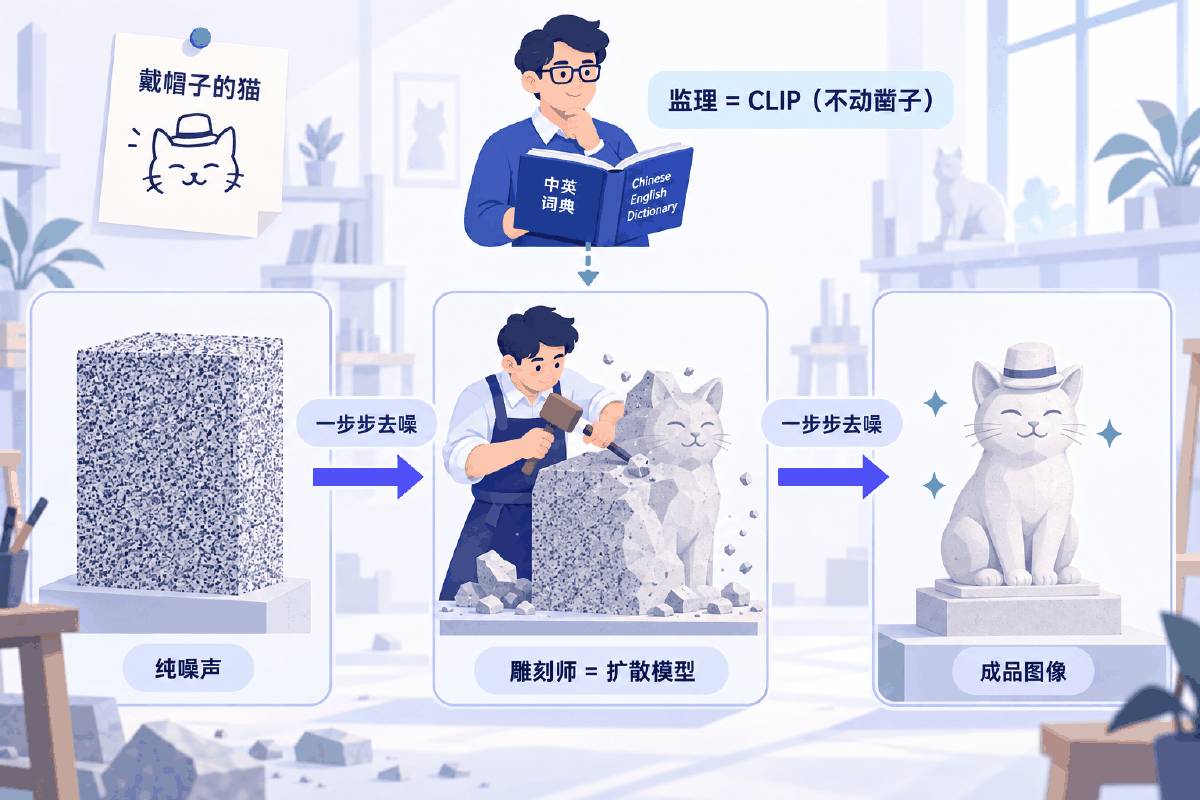
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 订单便签「戴帽子的猫」 | prompt | 用户给的那句文本,整个流程唯一的人类输入 |
| 满是噪点的石料 | 纯高斯噪声 x_T | 每次出图的起点,随机采样得来;换个随机种子就换一块石料 |
| 雕刻师 | 扩散模型的噪声预测网络(U-Net) | 看当前这块石头,预测「这一步里混进去的噪声长什么样」 |
| 一凿 | 一个去噪 timestep | 减掉预测出的那一点噪声,石头就干净一点点 |
| 敲掉的石屑 | 预测出的噪声 ε | 网络的输出,形状和输入图像完全一样 |
| 监理 | CLIP | 把图和话放进同一个向量空间,量出「像不像」,从不动手雕 |
| 监理那本词典 | 图文共享的向量空间 | 4 亿对图文用 contrastive learning 练出来的那把统一尺子 |
| 监理说话的嗓门 | guidance scale | 调大:更贴订单但更僵硬;调小:更自由但容易跑题 |
把这条铁律记牢,后面所有内容就都有了归位:02 节的前半段在讲监理那本词典是怎么练出来的,后半段在讲雕刻师的凿法,最后一段讲两人怎么配合到一块儿。
01概念:两个模型,两件不同的事
为什么图和话要住进同一个空间,以及生成模型的三条技术路线各自长什么样
1.1 图像与文本,本来是两套互不相通的坐标
一张 512×512 的 RGB 图片,在计算机里是 786432 个数字;一句「戴帽子的猫」,是几个 token 的编号。两者的数值空间毫无可比性——你没法把像素值和 token id 放一块儿做减法,也没法问「这张图和这句话差多少」。
可文生图这件事,从根上就要求能回答这个问题。你要让机器判断「当前生成到一半的这张图,是不是越来越像用户要的那句话」,就必须先有一把两边都能量的尺子。
CLIP(Contrastive Language-Image Pre-training)解决的就是这件事:训练两个编码器,让它们把图和话都投影到同一个高维向量空间里,语义相近的图文落在相近的位置。有了它,「这张图像不像这句话」就退化成一个再简单不过的运算——两个向量的 cosine 相似度。
1.2 CLIP 是什么,不是什么
2021 年,OpenAI 发布跨模态预训练大模型 CLIP,采用双塔模型与对比学习的训练方式,从互联网收集了 4 亿对图文对。它要达到的目的很直白:给定一句文本,匹配到与文本内容相符的图片;给定一张图片,匹配到与图片相符的文本。
紧接着一句话必须记死:CLIP 不能用来进行图像生成,却是图像生成的基础。这两句不矛盾——它是尺子不是刻刀。
| 常见误解 | 实际情况 |
|---|---|
| CLIP 能根据文字画图 | 它没有任何解码器,输出只有向量。画图的是扩散模型。 |
| CLIP 是个图像分类模型 | 它没有固定类别表。分类是被改写出来的用法:把类别写成句子,比谁更像。 |
| CLIP 输出的是一个分数 | 它输出两个向量。分数是你自己拿这两个向量算 cosine 得来的。 |
| 文生图时 CLIP 也在训练 | 参数冻结。训练 LoRA 或微调 U-Net 时,文本塔通常整个不动。 |
| CLIP 和普通词向量差不多 | 普通 embedding 只在文本内部对齐;CLIP 的核心价值是跨模态对齐。 |
1.3 生成模型的三条路线
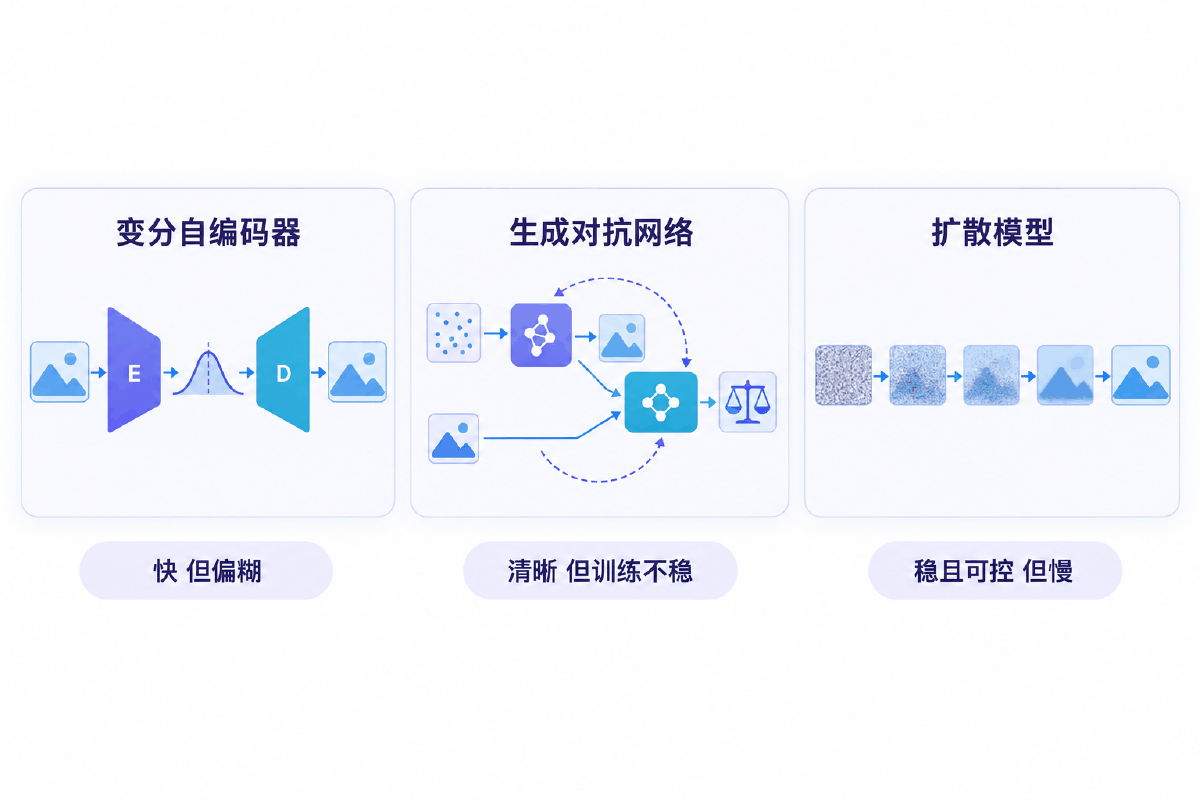
在扩散模型成为主流之前,图像生成走过两条路。三者的设计出发点完全不同:
由 Kingma 等人提出。与传统自编码器用数值方式描述潜空间不同,它以概率方式对潜在空间进行观察。编码器把高维数据转换为潜在空间的概率分布,解码器从采样数据重建生成新数据。
由 Ian Goodfellow 提出,最著名的生成模型。用零和博弈策略学习:生成器负责造出合理数据当作负样本,判别器负责分辨输入是生成的还是真实的,输出越接近 0 越可能是生成数据。衍生出 DCGAN、StyleGAN、CycleGAN 等变体。
受非平衡热力学启发,定义一条扩散步骤的马尔可夫链,逐渐向数据中添加噪声,然后学习逆扩散过程,从噪声中构建出所需样本。最初的设计目标只是去除图像中的噪声。
1.4 为什么最后是扩散模型胜出
把三条路线摆到同一张表上比,胜负的原因就清楚了:
| 维度 | VAE | GAN | Diffusion |
|---|---|---|---|
| 训练稳定性 | 高,就是一个重建 + KL 的优化问题 | 低,两个网络互相对抗,容易崩塌或震荡 | 高,本质是一个普通的回归任务,loss 单调可看 |
| 采样速度 | 快,一次前向出图 | 快,一次前向出图 | 慢,要循环几十到上千步 |
| 样本多样性 | 好,但细节偏糊 | 容易 mode collapse,只会画少数几种 | 好,覆盖分布完整,同一句话能出很多种结果 |
| 可控性 | 潜空间可插值,但语义不易对齐 | 条件注入需要专门改结构 | 强,每一步都能接受条件,天然适合分步干预 |
| 画质上限 | 中等,重建损失导致平均化 | 高,清晰锐利 | 高,并且能靠增加步数继续换质量 |
| 失败的样子 | 图糊 | 训练直接不收敛,或反复画同一张脸 | 步数不够时噪点残留,但不会崩 |
结论一句话:扩散模型用「慢」换来了「稳、全、可控」。它把一个极难的问题(一步从噪声跳到清晰图像)拆成了几十上百个极简单的问题(每一步只去掉一点点噪声),而每个小问题都是一个规规矩矩的回归任务。工程上,慢是可以靠采样器优化和算力堆缓解的;训练崩溃和多样性丧失却没法靠堆算力解决。
Stable Diffusion 里三者同堂:VAE 负责把图像压进潜空间再解码回像素,扩散模型 在潜空间里干活,而 GAN 的思路仍然活在各种超分辨率与人脸修复模块里。说「扩散赢了」,赢的是生成主干这一个位置。
1.5 CLIP 与扩散模型在文生图里的分工
| 问题 | CLIP | Diffusion |
|---|---|---|
| 它的输入 | 一张图 / 一句话 | 一张带噪的图 + 时间步 + 文本条件 |
| 它的输出 | 一个向量 | 一张与输入同形状的噪声图 |
| 回答的问题 | 这张图和这句话有多像 | 这一步该减掉哪些噪声 |
| 推理时参数 | 冻结 | 冻结(微调时被改的主要是它) |
| 缺了它会怎样 | 能出图,但完全不受文字控制 | 根本出不了图 |
| 比喻里的角色 | 监理 | 雕刻师 |
02原理:监理的词典,与雕刻师的凿法
对比学习怎么练出跨模态空间、扩散模型怎么一步步去噪、两者在文生图里怎么合流
2.1 双塔结构:两座塔,一个出口
CLIP 的结构简单到有点朴素:两个各自独立的编码器,各自把自己那一侧的数据压成一个向量。
| 塔 | 缩写 | 常用结构 | 输入 → 输出 |
|---|---|---|---|
| 图像编码器 | IE | CNN(ResNet)或 ViT | (3, 224, 224) 的图像 → 一个 512 或 768 维向量 |
| 文本编码器 | TE | Transformer | 一串 token → 一个同维度的向量 |
两座塔不共享任何参数,中间也没有交叉注意力。它们唯一的联系是最后那个出口:输出向量的维度必须一样,否则没法算相似度。整个训练过程做的事,就是拧这两座塔的参数,让它们的出口对齐到同一套坐标上。
2.2 对比学习:一个 batch 里的 N×N 相似度矩阵
训练的核心步骤,一句话能说完:给定一个 batch 的 N 个(图片,文本)对,图片输入给 Image Encoder 得到表征 I₁, I₂, …, IN,文本输入给 Text Encoder 得到表征 T₁, T₂, …, TN,其中 (Ij, Tj) 属于正样本,(Ij, Tk) 属于负样本。最大化 N 个正样本的 cosine 相似度,最小化 N²−N 个负样本的 cosine 相似度。
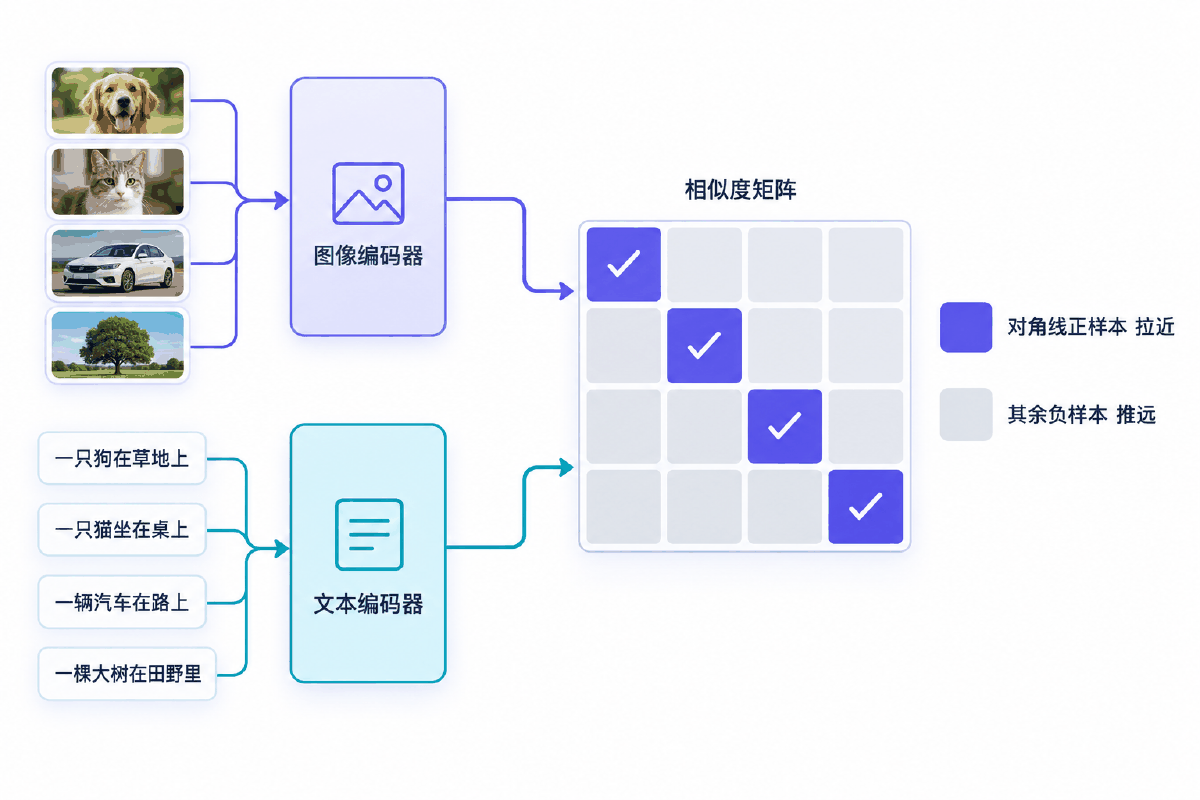
把这句话摊开成可以动手实现的四步:
一个 batch 取 N 对图文。N 张图过图像塔得到 N 个向量,N 句话过文本塔得到 N 个向量。两组向量都做 L2 归一化,归一化之后点积就等于 cosine 相似度。
N 个图像向量与 N 个文本向量两两配对,算出一个 N×N 的相似度矩阵,一共 N² 个数。矩阵第 j 行第 k 列,就是第 j 张图与第 k 句话的相似度。
矩阵的对角线上那 N 个格子是正样本——它们本来就是从同一个网页上扒下来的图文对。其余 N²−N 个格子全是负样本。
把对角线拉高、其余压低。工程实现上就是对每一行做一次交叉熵、对每一列再做一次,标签是 0..N-1,两个方向的 loss 取平均。
之所以要行、列各算一次,是因为这两个方向对应两个不同的任务:按行是「给定这张图,从 N 句话里挑对的那句」;按列是「给定这句话,从 N 张图里挑对的那张」。CLIP 两个方向都要会,所以两个方向都要练。
2.3 温度系数:一个常被忽略的可学习参数
算完 cosine 相似度之后不能直接丢进 softmax,因为 cosine 的取值范围只有 [−1, 1],softmax 出来的分布会非常平,梯度推不动。所以要先除以一个温度系数 τ(实现上通常写成乘以 logit_scale)。
| τ 的取值 | 效果 | 后果 |
|---|---|---|
| 偏大(分布平) | 正负样本的概率差距小 | 模型学得慢,区分度不够 |
| 偏小(分布尖) | 概率几乎全压在最相似的那个上 | 对困难负样本过度敏感,训练不稳 |
| CLIP 的做法 | 让它作为可学习参数一起训,并做数值裁剪防止炸掉 | 省掉一个难调的超参 |
这直接解释了一个实践现象:用 transformers 调 CLIP 时,logits_per_image 的数值经常在 20~30 这个量级,而不是 0.2~0.3——那是 cosine 相似度已经乘过 logit_scale 的结果。想拿原始 cosine,得自己用归一化后的向量做点积。
2.4 4 亿对图文意味着什么
CLIP 从互联网收集了 4 亿对图文。这个数字带来三个直接后果,理解它们比记住数字本身重要:
| 后果 | 解释 |
|---|---|
| 监督信号免费 | 传统视觉数据集是劳动密集型的,创建成本很高,需要人一张张标注类别。而图文对是网页本来就有的——图片和它的 alt 文本、图注天然成对,不需要额外雇人标。数据规模因此能大两三个数量级。 |
| 语义覆盖面极宽 | 标准视觉数据集只擅长一项任务,适应新任务并不容易。而网页图文覆盖了品牌、人名、艺术风格、抽象概念、罕见物种,几乎是人类视觉词汇的一次快照。这是 zero-shot 能成立的前提。 |
| 噪声也被一起学了 | 网页文本大量是营销话术、文件名、水印说明。CLIP 学到的是「互联网上人们怎么描述图片」,不是「客观事实」。所以它会把「专业摄影」「4K」这类词和某种画面质感绑定——文生图 prompt 里堆质量词能起作用,根子就在这里。 |
2.5 Zero-Shot Transfer:把分类改写成「哪句话最像」
训练完成后,输入文本可以预测匹配图片,输入图片可以预测匹配文本。Zero-Shot Transfer 这个阶段,就是直接使用 CLIP 预训练好的 Image Encoder 和 Text Encoder 去完成一个它从没专门训练过的任务。比如拿一张 ImageNet-1K 验证集的图片,CLIP 预训练好的模型能完成这个分类任务。
关键在于那个改写动作。传统分类模型的最后一层是一个固定的 Linear(d, 1000),输出 1000 个类别的分数——类别表焊死在权重里,想加一类就得重训。CLIP 把这件事换了个问法:
这个改写带来三件以前做不到的事:
- 类别可以随时增删。想加「柯基」这一类,写一句
a photo of a corgi就完事,不碰任何权重。 - 类别可以是一句描述而不只是一个词。
a blurry photo taken at night也能当类别,传统分类器没法表达这种粒度。 - 同一个模型能当检索引擎用。把矩阵的方向转过来——一句话对 N 张图取 top-k,就是跨模态检索。分类与检索在 CLIP 眼里是同一个矩阵的两种读法。
cat 的效果明显差于 a photo of a cat。因为训练语料是网页图文,句子形态的描述在分布上更常见,裸词更像是标签系统的产物。进一步的做法是一个类别写多条模板,编码后取平均作为这一类的原型向量——04 节的 zero-shot 案例就是这么做的。
2.6 前向过程:一条只会加噪的马尔可夫链
说完监理,换雕刻师。扩散模型包括前向过程和反向过程两段。
前向扩散过程将图像逐步引入噪声,直到成为完全随机噪声,这一过程把噪声逐步扩散到图像的每个像素,最终使得图像无法辨识。它的三个性质要记牢:
| 性质 | 含义 |
|---|---|
| 马尔可夫链 | 第 t 步只依赖第 t−1 步,跟更早的历史无关。x_t = √(1−β_t)·x_{t−1} + √β_t·ε |
| 不含任何可学习参数 | 加多少噪声由一张预先定好的 β 调度表决定,从头到尾没有网络参与。这一段是纯数学,不训练。 |
| 终点是标准高斯 | T 步之后,x_T 近似服从标准高斯分布 N(0, I),原图的信息被彻底洗掉。 |
β 调度表通常从 1e-4 线性涨到 0.02:早期每步只掺一点点噪声,后期掺得多。这样安排是因为图像早期还有清晰结构,掺猛了信息一下就没了;后期本来就剩噪声,多掺点无妨。
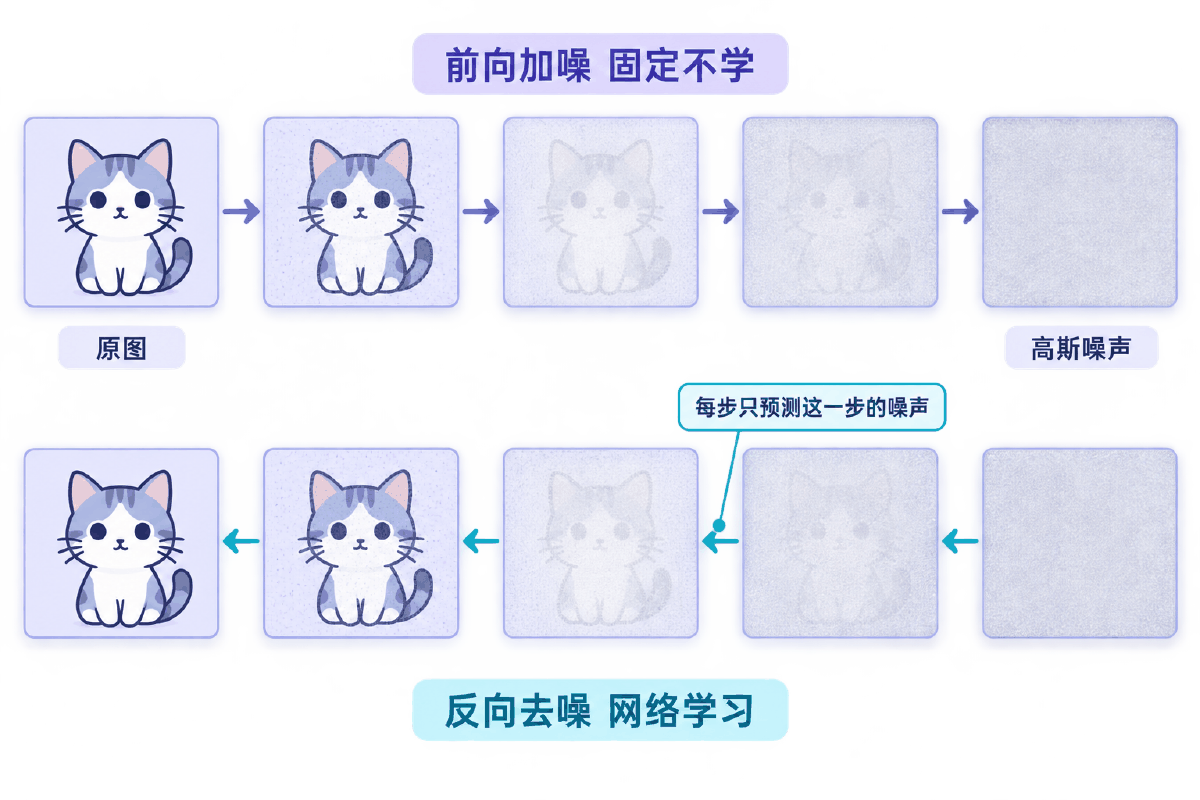
前向过程还有一个对训练至关重要的便利:连续加多次高斯噪声,结果仍是一个高斯分布。于是可以推出闭式解,从 x_0 一步跳到任意第 t 步:
| 符号 | 定义 | 作用 |
|---|---|---|
β_t | 第 t 步加噪强度 | 调度表给定,不学 |
α_t | 1 − β_t | 这一步保留下来的比例 |
ᾱ_t | α_1 · α_2 · … · α_t 累乘 | 从第 0 步到第 t 步总共保留的比例 |
| 闭式解 | x_t = √ᾱ_t · x_0 + √(1−ᾱ_t) · ε | 训练时不必真的循环 T 次,随机抽一个 t 直接跳过去 |
这条公式是训练能跑得动的根本原因。没有它,每训一个样本都要循环上千次加噪,训练成本要涨三个数量级。
2.7 反向过程:网络到底在学什么
反向降噪过程通过从高斯噪声中逐步去除噪声,还原出源数据的清晰信号。在反向过程中,利用马尔可夫链在每个时间步逐步去除预测噪声,从高斯噪声中恢复图像。
这里最容易误解的一点是:网络学的不是「下一张图长什么样」,而是「这一步里混进去的噪声长什么样」。它的输出形状和输入图像完全一致,内容是一张噪声图,减掉它,石头就干净一点点。
| 环节 | 输入 | 输出 | 损失函数 |
|---|---|---|---|
| 训练一步 | 加噪图 x_t + 时间步 t(+ 文本条件) | 预测噪声 ε̂ | MSE(ε̂, ε)——就是个普通的回归 |
| 采样一步 | 当前 x_t + 时间步 t | 更干净的 x_{t−1} | 无,纯推理 |
时间步 t 必须作为输入送进网络,否则网络不知道现在噪声有多重,也就无从判断该减多少。实现上把整数 t 编码成一个向量(正弦位置编码)再和特征相加,这一点在 04 节的极简扩散实现里逐行可见。
扩散模型把这一跳拆成 T 次小跳。每一小跳里,
x_t 和 x_{t−1} 只差一点点噪声,两者的分布差异小到可以用一个高斯近似,于是「预测这一步的噪声」就变成了一个简单、良定义、梯度稳定的回归任务。难度被时间维度摊平了。代价是采样要循环 T 次,这就是扩散模型慢的全部原因。
顺着这条逻辑,很多工程现象都能解释:
- 步数调低出图就有噪点——凿子没敲够,石屑还留在上面。
- DDIM 等采样器能跳步——它改用确定性的更新公式,允许几步并作一步,用一点点质量换速度。
- 同一个 prompt 换种子就换图——起点那块石料不一样,雕出来自然不同。
- 采样时每步要再注入一点随机噪声(最后一步除外)——否则所有样本会朝同一个方向塌缩,多样性消失。
2.8 合流:文本条件与 classifier-free guidance
到这里两条线可以接上了。要让雕刻师听懂订单,只需在噪声预测网络上开一个口子,把 CLIP 文本塔输出的向量作为条件送进去(Stable Diffusion 里通过 cross-attention 注入)。网络于是从 ε̂ = f(x_t, t) 变成 ε̂ = f(x_t, t, c)。
但仅仅送进去还不够——网络可能敷衍地忽略这个条件。classifier-free guidance 解决的就是「怎么逼它认真听」:
ε_c − ε_u 就是「有文本」相对「没文本」多出来的那部分方向。把它乘上 guidance_scale(记作 s)再加回去,等价于把监理的嗓门调大。
| guidance_scale | 效果 | 典型现象 |
|---|---|---|
| s = 1 | 等价于不做 guidance | 图很自然,但经常跑题,prompt 里的细节丢一半 |
| s ≈ 7~8 | 常用区间 | 贴题与自然度的平衡点,多数模型的默认值在这一带 |
| s = 15+ | 条件被过度放大 | 构图僵硬、颜色过饱和、出现油画感伪影,细节反而丢失 |
| 代价 | 每步要跑两次网络 | 开启 CFG 的采样耗时约为不开的两倍 |
classifier guidance:额外训练一个分类器,用它对图像求梯度来引导生成方向。缺点是要多训一个模型,而且这个分类器还得能处理各种噪声程度的图。classifier-free guidance 用「同一个网络的有条件 / 无条件两次输出之差」替代了那个外部分类器——省掉的是分类器,不是引导。
2.9 三家代表产品
在扩散模型的基础上,各大公司与研究机构研发出了自己的代表产品。三家的骨架都是「文本编码器 + 扩散」,差别在开源程度与可得性:
| 产品 | 出品方 | 开源程度 | 可得性与特点 |
|---|---|---|---|
DALL-E 2 | OpenAI | 闭源 | 在 OpenAI 网站向公众开放,提供数量有限的免费图像和额外的购买图像服务。走「CLIP 图像向量 → prior → 解码」的路线。 |
Imagen | 闭源 | 2022 年 5 月发布的文本到图像扩散模型,该模型目前不对外开放。用户可通过输入描述性文本,生成图文匹配的图像。它的一个重要发现是:放大纯文本语言模型比放大图像部分更能提升图文一致性。 | |
Stable Diffusion | Stability AI、CompVis 团队、RunwayML | 开源 | 免费且开源,是 AI 图像生成发展的里程碑。在 Stability 那座 4000 卡 A100 集群上训练(模型本身约用 256 张 A100、15 万 GPU 小时)。因为开源,社区得以在它之上做微调与插件生态——这也是后面能自己训画风的前提。 |
03最小代码:让监理开口打一次分
一张本地图片 + 几条候选文本 → softmax 概率,30 行看懂 CLIP 的全部输入输出
理解 CLIP 最短的路径不是读论文,是跑一次打分。整条链路只有五步,和监理的工作顺序完全一致:
"""最小可运行示例:用 CLIP 给「一张图 + 多条候选文本」打分。

依赖:pip install torch transformers pillow
首次运行会自动下载 openai/clip-vit-base-patch32(约 600MB)。

整条链路只有五步,和讲义里监理的工作顺序完全一致:
    ① 读图  ② 读候选文本  ③ 双塔各自编码  ④ 算 cosine 相似度  ⑤ softmax 成概率
"""

import os

import torch
from PIL import Image
from transformers import CLIPModel, CLIPProcessor

# ① 模型名可以用环境变量覆盖,方便换成本地已下载好的路径
MODEL_NAME = os.environ.get("CLIP_MODEL", "openai/clip-vit-base-patch32")
IMAGE_PATH = os.environ.get("CLIP_IMAGE", "./demo.jpg")

# processor 负责「把图片缩放归一化 + 把文本切成 token」,model 负责两座塔的前向
processor = CLIPProcessor.from_pretrained(MODEL_NAME)
model = CLIPModel.from_pretrained(MODEL_NAME)
model.eval()  # 推理模式:CLIP 在这里参数冻结,不训练

# ② 候选文本。写成一句完整的话,比只写一个词效果好得多
candidates = [
    "a photo of a cat",
    "a photo of a dog",
    "a photo of a car",
    "a photo of a plate of noodles",
]

# ③ 图和文一起交给 processor,padding=True 把长短不一的句子补齐
image = Image.open(IMAGE_PATH).convert("RGB")
inputs = processor(text=candidates, images=image, return_tensors="pt", padding=True)

with torch.no_grad():
    outputs = model(**inputs)

# ④ logits_per_image 形状是 (图片数, 文本数),值 = cosine 相似度 × 可学习的温度系数
logits = outputs.logits_per_image  # (1, 4)

# ⑤ 在「文本」这一维做 softmax,得到「这张图最像哪句话」的概率分布
probs = logits.softmax(dim=-1)[0]

print("图片:", IMAGE_PATH)
for text, p, raw in zip(candidates, probs.tolist(), logits[0].tolist()):
    print("  %-40s  概率 %6.2f%%   原始分 %7.3f" % (text, p * 100, raw))

best = int(torch.argmax(probs))
print("\n最匹配:%s(%.2f%%)" % (candidates[best], probs[best] * 100))

# 单独拿两座塔的输出向量看一眼:它们维度相同,因为住在同一个向量空间里
img_vec = model.get_image_features(pixel_values=inputs["pixel_values"])
txt_vec = model.get_text_features(input_ids=inputs["input_ids"],
                                  attention_mask=inputs["attention_mask"])
print("图像向量 shape:", tuple(img_vec.shape), " 文本向量 shape:", tuple(txt_vec.shape))
3.1 输出长什么样
拿一张普通的家猫照片跑,控制台会打出类似这样的结果:
| 候选文本 | 原始分(已乘 logit_scale) | softmax 概率 |
|---|---|---|
| a photo of a cat | 约 27 | 绝大部分概率落在这一条 |
| a photo of a dog | 约 21 | 少量 |
| a photo of a car | 约 17 | 接近 0 |
| a photo of a plate of noodles | 约 16 | 接近 0 |
最后两行 get_image_features 与 get_text_features 打印的 shape 会是 (1, 512) 和 (4, 512)——维度相同,这就是「住在同一个空间」最直观的证据。
pip install torch transformers pillow。首次运行会自动从 Hugging Face 下载 openai/clip-vit-base-patch32(约 600MB),下载慢可以先手动拉到本地,再把 CLIP_MODEL 环境变量指到本地目录。全程不需要任何 API key,CLIP 是本地模型。
04完整案例:zero-shot 分类 · 跨模态检索 · 从零写扩散
前两个案例把同一个相似度矩阵按两个方向读,第三个案例把雕刻师的凿法从头写一遍
4.1 CLIP zero-shot 图像分类
目标:不训练任何分类头,只靠一组类别名就把图片分好类。换一批类别 = 换一个分类器。
它与最小代码的三处不同
| 改动 | 为什么 |
|---|---|
| 类别写成多条模板句再取平均 | 单条模板对措辞敏感。a photo of a cat、a blurry photo of a cat、a close-up photo of a cat 三条编码后平均,得到更稳的「类别原型向量」,抗噪能力明显更好。 |
| 文本向量只算一次,存成矩阵复用 | 类别是固定的,图片是流水来的。先把 N 个类别编码成 (N, D) 的矩阵,之后每张图只需一次图像编码 + 一次矩阵乘法。 |
| 手动做 L2 归一化再点积 | 归一化之后点积就是纯 cosine,数值含义清楚。logits_per_image 乘过 logit_scale,不适合跨图片横向比较。 |
"""案例一:CLIP zero-shot 图像分类。

不训练任何分类头,只把「分类」改写成「哪句描述跟这张图最像」。
换一批类别标签 = 换一个分类器,这就是 zero-shot transfer 的全部秘密。

用法:
    python3 clip_zero_shot.py ./photos            # 批量跑一个目录
    python3 clip_zero_shot.py ./photos/cat.jpg    # 跑单张

依赖:pip install torch transformers pillow
"""

import os
import sys

import torch
from PIL import Image
from transformers import CLIPModel, CLIPProcessor

MODEL_NAME = os.environ.get("CLIP_MODEL", "openai/clip-vit-base-patch32")

# 类别列表:改这里就等于换一个分类器,不需要任何再训练
LABELS = ["猫", "狗", "汽车", "飞机", "蛋糕", "键盘", "盆栽", "自行车"]

# prompt 模板。CLIP 的训练语料是网页图文,句子形态的描述比裸词命中率高,
# 这个技巧在原论文里叫 prompt engineering / prompt ensembling。
TEMPLATES = [
    "a photo of a {}.",
    "a blurry photo of a {}.",
    "a close-up photo of a {}.",
]

# 中文类别转成英文提示词。base 版 CLIP 的文本塔主要吃英文,
# 直接用中文做提示词会明显掉点——想用中文要换 Chinese-CLIP 系列权重。
ZH2EN = {
    "猫": "cat", "狗": "dog", "汽车": "car", "飞机": "airplane",
    "蛋糕": "cake", "键盘": "keyboard", "盆栽": "potted plant", "自行车": "bicycle",
}


def build_text_bank(model, processor, device):
    """把每个类别的多条模板句编码后取平均,作为这一类的「文本原型」。"""
    protos = []
    for zh in LABELS:
        en = ZH2EN[zh]
        sentences = [t.format(en) for t in TEMPLATES]
        batch = processor(text=sentences, return_tensors="pt", padding=True).to(device)
        with torch.no_grad():
            feats = model.get_text_features(**batch)
        # 先做 L2 归一化再平均,避免长句因为向量模长大而被放大
        feats = feats / feats.norm(dim=-1, keepdim=True)
        proto = feats.mean(dim=0)
        proto = proto / proto.norm()
        protos.append(proto)
    return torch.stack(protos)  # (类别数, 向量维度)


def collect_images(path):
    exts = (".jpg", ".jpeg", ".png", ".webp", ".bmp")
    if os.path.isfile(path):
        return [path]
    files = []
    for name in sorted(os.listdir(path)):
        if name.lower().endswith(exts):
            files.append(os.path.join(path, name))
    return files


def main():
    target = sys.argv[1] if len(sys.argv) > 1 else "./photos"
    files = collect_images(target)
    if not files:
        print("没有找到图片:", target)
        return

    device = "cuda" if torch.cuda.is_available() else "cpu"
    processor = CLIPProcessor.from_pretrained(MODEL_NAME)
    model = CLIPModel.from_pretrained(MODEL_NAME).to(device).eval()

    text_bank = build_text_bank(model, processor, device)  # 只算一次,可复用

    for path in files:
        image = Image.open(path).convert("RGB")
        batch = processor(images=image, return_tensors="pt").to(device)
        with torch.no_grad():
            img_feat = model.get_image_features(**batch)
        img_feat = img_feat / img_feat.norm(dim=-1, keepdim=True)

        # 归一化之后的点积就是 cosine 相似度;乘 100 只是把差距拉开便于 softmax
        sims = (img_feat @ text_bank.T)[0]
        probs = (sims * 100).softmax(dim=-1)

        top = torch.topk(probs, k=3)
        head = "  ".join("%s %.1f%%" % (LABELS[i], p * 100)
                         for p, i in zip(top.values.tolist(), top.indices.tolist()))
        print("%-28s -> %s" % (os.path.basename(path), head))


if __name__ == "__main__":
    main()
输出长什么样
把一个装着若干照片的目录丢给它,每行打印一张图的 top-3:
| 文件 | top-3 结果 |
|---|---|
| cat_on_desk.jpg | 猫 96.4% 狗 1.8% 键盘 0.7% |
| street.jpg | 汽车 88.1% 自行车 6.2% 飞机 2.0% |
| dessert.jpg | 蛋糕 91.7% 盆栽 2.4% 猫 1.1% |
openai/clip-vit-base-patch32 的文本塔训练语料以英文为主,直接拿中文当 prompt 会明显掉点——不是报错,是安静地变差,最容易误判成「CLIP 不行」。真要用中文,换 Chinese-CLIP 系列权重,代码其余部分一个字不用改。代码里 ZH2EN 那张映射表就是干这件事的。
4.2 CLIP 跨模态检索
把相似度矩阵转个方向读就成了检索:一句话对 N 张图,取 top-k。
| 任务 | 矩阵怎么读 | 输出 |
|---|---|---|
| zero-shot 分类 | 一张图 对 N 句话 | 取最大 → 类别 |
| 跨模态检索 | 一句话 对 N 张图 | 取前 k → 图片列表 |
工程上真正的关键点只有一个:图库向量只算一次并落盘。这正是 2.1 节说的双塔结构红利——图库编码是离线的,在线只有「1 次文本编码 + 1 次矩阵乘法」,万级图库的检索是毫秒级。
"""案例二:CLIP 跨模态检索 —— 一批图 + 一句话,取 top-k。

思路和 zero-shot 分类是同一套,只是把矩阵转了个方向:
    分类 = 一张图 对 N 句话   取最大
    检索 = 一句话 对 N 张图   取前 k

工程上的关键点是「图库向量只算一次」:把 N 张图编码成一个矩阵存下来,
之后每来一句查询只需要编码 1 条文本 + 做一次矩阵乘法,毫秒级返回。

用法:
    python3 clip_retrieval.py ./photos "一只趴在键盘上的猫"
依赖:pip install torch transformers pillow
"""

import json
import os
import sys

import torch
from PIL import Image
from transformers import CLIPModel, CLIPProcessor

MODEL_NAME = os.environ.get("CLIP_MODEL", "openai/clip-vit-base-patch32")
INDEX_FILE = os.environ.get("CLIP_INDEX", "./clip_index.pt")
TOP_K = int(os.environ.get("TOP_K", "5"))


def list_images(folder):
    exts = (".jpg", ".jpeg", ".png", ".webp", ".bmp")
    return [os.path.join(folder, n) for n in sorted(os.listdir(folder))
            if n.lower().endswith(exts)]


def build_index(folder, model, processor, device, batch_size=16):
    """把整个图库编码成 (N, D) 的归一化矩阵,落盘复用。"""
    paths = list_images(folder)
    if not paths:
        raise SystemExit("图库为空:" + folder)

    vectors = []
    for i in range(0, len(paths), batch_size):
        chunk = paths[i:i + batch_size]
        images = [Image.open(p).convert("RGB") for p in chunk]
        batch = processor(images=images, return_tensors="pt").to(device)
        with torch.no_grad():
            feats = model.get_image_features(**batch)
        # 归一化:之后点积 == cosine 相似度,省掉每次算模长
        feats = feats / feats.norm(dim=-1, keepdim=True)
        vectors.append(feats.cpu())
        print("已编码 %d / %d" % (min(i + batch_size, len(paths)), len(paths)))

    matrix = torch.cat(vectors, dim=0)
    torch.save({"paths": paths, "matrix": matrix}, INDEX_FILE)
    print("索引已写入", INDEX_FILE, "shape =", tuple(matrix.shape))
    return paths, matrix


def load_or_build(folder, model, processor, device):
    if os.path.exists(INDEX_FILE):
        data = torch.load(INDEX_FILE, map_location="cpu")
        # 图库增删过就重建,避免路径与向量对不上号
        if data["paths"] == list_images(folder):
            print("复用已有索引", INDEX_FILE)
            return data["paths"], data["matrix"]
        print("图库有变化,重建索引")
    return build_index(folder, model, processor, device)


def search(query, paths, matrix, model, processor, device, k=TOP_K):
    batch = processor(text=[query], return_tensors="pt", padding=True).to(device)
    with torch.no_grad():
        txt = model.get_text_features(**batch)
    txt = (txt / txt.norm(dim=-1, keepdim=True)).cpu()

    sims = (matrix @ txt.T)[:, 0]          # (N,) 每张图与这句话的 cosine
    k = min(k, sims.shape[0])
    top = torch.topk(sims, k=k)
    return [(paths[i], float(s)) for s, i in zip(top.values, top.indices)]


def main():
    folder = sys.argv[1] if len(sys.argv) > 1 else "./photos"
    query = sys.argv[2] if len(sys.argv) > 2 else "a cat sitting on a keyboard"

    device = "cuda" if torch.cuda.is_available() else "cpu"
    processor = CLIPProcessor.from_pretrained(MODEL_NAME)
    model = CLIPModel.from_pretrained(MODEL_NAME).to(device).eval()

    paths, matrix = load_or_build(folder, model, processor, device)
    hits = search(query, paths, matrix, model, processor, device)

    print("\n查询:", query)
    for rank, (path, score) in enumerate(hits, 1):
        print("  #%d  %.4f  %s" % (rank, score, path))

    # cosine 相似度是「相对排序」用的,绝对值没有统一阈值含义:
    # 同一句话在不同图库里的最高分可能差很多,别拿 0.3 之类的数字当硬门槛。
    print("\n结果 JSON:")
    print(json.dumps([{"path": p, "score": round(s, 4)} for p, s in hits],
                     ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
每一步在干什么
build_index分批读图 → 图像塔编码 → L2 归一化 → 拼成 (N, D) 矩阵 → torch.save 落盘。批大小 16 是为了控制显存,图多就调小。
load_or_build复用前先比对文件列表是否变化。图库增删过却继续用旧索引,会出现「搜出来的图和路径对不上号」这种极难排查的错。
search一句话编码成 (1, D),矩阵乘法得到 (N,) 的相似度,topk 取前 k。全程没有再碰任何图片文件。
打印排名 + 分数 + 路径,并额外给一份 JSON,方便直接接进后端接口。
4.3 从零实现一个极简扩散模型
前两个案例都在用别人训好的模型。这一个反过来:把加噪、噪声预测、反向采样三段逻辑亲手写一遍,看着点云从一团高斯噪声里长出双月牙形状。
MLP,不是 U-Net;总共 3000 次迭代,CPU 上一两分钟跑完。它生成的是二维坐标,不是图片,也不具备任何实用价值。存在的唯一理由是:把加噪 / 去噪循环放到能在自己机器上跑完、能逐行打断点的尺度上。但三段逻辑与真正的图像扩散模型逐行同构——把维度从 2 换成
(3, 512, 512)、把 MLP 换成 U-Net、把 T 从 200 调到 1000,就是 DDPM 的主干。
"""案例三:从零实现一个极简扩散模型(DDPM 的最小骨架)。

规模很小:数据是 2D 平面上的一个双月牙点云,网络只有三层 MLP,CPU 上一两分钟能跑完。
它不生成图片,只生成「二维坐标」——但前向加噪、噪声预测、反向采样三段逻辑
与真正的图像扩散模型逐行同构,把维度从 2 换成 (3, 512, 512)、把 MLP 换成 U-Net 即可。
目的只有一个:让加噪 / 去噪循环真正跑在眼前,而不是停留在公式上。

依赖:pip install torch numpy(画图可选 matplotlib)
用法:python3 tiny_diffusion.py
"""

import math
import os

import numpy as np
import torch
import torch.nn as nn

torch.manual_seed(0)
np.random.seed(0)

T = 200            # 扩散总步数:步数越多每步要预测的噪声越少,学起来越容易
BATCH = 256
STEPS = 3000       # 训练迭代次数
DEVICE = "cuda" if torch.cuda.is_available() else "cpu"


# ---------------------------------------------------------------- 数据
def make_moons(n):
    """手写一个双月牙点云,省掉 sklearn 依赖。"""
    t = np.random.rand(n // 2) * math.pi
    outer = np.stack([np.cos(t), np.sin(t)], axis=1)
    inner = np.stack([1 - np.cos(t), 0.5 - np.sin(t)], axis=1)
    pts = np.concatenate([outer, inner], axis=0)
    pts += np.random.randn(*pts.shape) * 0.06        # 一点点抖动
    pts = (pts - pts.mean(0)) / pts.std(0)           # 标准化到 0 均值 1 方差
    return torch.tensor(pts, dtype=torch.float32)


DATA = make_moons(8192)


# ------------------------------------------------------- 噪声调度表
# beta 从小到大线性增长:早期每步只掺一点噪声,后期掺得多,
# 这样 x_T 才能稳稳落到标准高斯上。
betas = torch.linspace(1e-4, 0.02, T)
alphas = 1.0 - betas
abar = torch.cumprod(alphas, dim=0)                  # \bar{alpha}_t,累乘
sqrt_abar = torch.sqrt(abar)
sqrt_one_minus_abar = torch.sqrt(1.0 - abar)


def q_sample(x0, t, noise):
    """前向过程一步到位:x_t = sqrt(abar_t) * x0 + sqrt(1-abar_t) * eps

    马尔可夫链本来要一步步加,但连续加高斯噪声仍是高斯,
    所以可以用闭式公式从 x0 直接跳到任意第 t 步 —— 训练因此不必真的循环 T 次。
    """
    a = sqrt_abar[t].unsqueeze(-1)
    b = sqrt_one_minus_abar[t].unsqueeze(-1)
    return a * x0 + b * noise


# ---------------------------------------------------------------- 网络
class TimeEmbedding(nn.Module):
    """把整数时间步 t 编码成向量,网络才知道「现在噪声有多重」。"""

    def __init__(self, dim=64):
        super().__init__()
        self.dim = dim

    def forward(self, t):
        half = self.dim // 2
        freqs = torch.exp(-math.log(10000) * torch.arange(half, device=t.device) / half)
        args = t.float().unsqueeze(-1) * freqs.unsqueeze(0)
        return torch.cat([torch.sin(args), torch.cos(args)], dim=-1)


class EpsNet(nn.Module):
    """噪声预测网络:输入 (x_t, t),输出「这一步里混进去的噪声」。

    注意它的输出维度和输入 x 完全一样 —— 图像扩散里 U-Net 也是这个形状约定。
    """

    def __init__(self, dim=2, hidden=128, tdim=64):
        super().__init__()
        self.temb = TimeEmbedding(tdim)
        self.net = nn.Sequential(
            nn.Linear(dim + tdim, hidden), nn.SiLU(),
            nn.Linear(hidden, hidden), nn.SiLU(),
            nn.Linear(hidden, hidden), nn.SiLU(),
            nn.Linear(hidden, dim),
        )

    def forward(self, x, t):
        return self.net(torch.cat([x, self.temb(t)], dim=-1))


# ---------------------------------------------------------------- 训练
def train():
    model = EpsNet().to(DEVICE)
    opt = torch.optim.Adam(model.parameters(), lr=2e-3)
    data = DATA.to(DEVICE)

    for step in range(1, STEPS + 1):
        idx = torch.randint(0, data.shape[0], (BATCH,), device=DEVICE)
        x0 = data[idx]

        # 每个样本随机抽一个时间步,等价于「所有步数一起练」
        t = torch.randint(0, T, (BATCH,), device=DEVICE)
        noise = torch.randn_like(x0)
        xt = q_sample(x0, t.cpu(), noise.cpu()).to(DEVICE)

        pred = model(xt, t)
        # 训练目标就是一个普通的回归 loss:预测的噪声要贴近真实撒进去的噪声
        loss = ((pred - noise) ** 2).mean()

        opt.zero_grad()
        loss.backward()
        opt.step()

        if step % 500 == 0:
            print("step %4d   loss %.4f" % (step, loss.item()))
    return model


# ---------------------------------------------------------------- 采样
@torch.no_grad()
def sample(model, n=1000):
    """反向过程:从纯噪声出发,循环 T 次,每次减掉网络预测的那一点噪声。"""
    x = torch.randn(n, 2, device=DEVICE)          # x_T ~ N(0, I)
    traj = []
    for i in reversed(range(T)):
        t = torch.full((n,), i, device=DEVICE, dtype=torch.long)
        eps = model(x, t)

        a_t = alphas[i]
        abar_t = abar[i]
        # DDPM 的后验均值:把预测出来的噪声按系数扣掉
        mean = (x - (1 - a_t) / torch.sqrt(1 - abar_t) * eps) / torch.sqrt(a_t)

        if i > 0:
            # 除最后一步外都要再注入一点随机性,否则样本会塌到同一个点上
            x = mean + torch.sqrt(betas[i]) * torch.randn_like(x)
        else:
            x = mean
        if i % 50 == 0:
            traj.append((i, x.cpu().clone()))
    return x.cpu(), traj


def describe(name, pts):
    print("%-10s 均值 (%6.3f, %6.3f)  标准差 (%5.3f, %5.3f)"
          % (name, pts[:, 0].mean(), pts[:, 1].mean(), pts[:, 0].std(), pts[:, 1].std()))


def main():
    model = train()
    out, traj = sample(model)

    print("\n反向采样过程中点云的统计量变化:")
    for i, pts in traj:
        describe("t=%03d" % i, pts)
    describe("真实数据", DATA)
    describe("生成结果", out)

    np.savetxt("tiny_diffusion_samples.csv", out.numpy(), delimiter=",", fmt="%.5f")
    print("\n已写出 tiny_diffusion_samples.csv,可用任意绘图工具画散点看双月牙形状")

    if os.environ.get("PLOT") == "1":
        import matplotlib.pyplot as plt
        fig, ax = plt.subplots(1, 2, figsize=(9, 4))
        ax[0].scatter(DATA[:, 0], DATA[:, 1], s=3)
        ax[0].set_title("real")
        ax[1].scatter(out[:, 0], out[:, 1], s=3, color="crimson")
        ax[1].set_title("sampled")
        plt.tight_layout()
        plt.savefig("tiny_diffusion.png", dpi=120)
        print("已保存 tiny_diffusion.png")


if __name__ == "__main__":
    main()
四个零件逐个对照
| 代码里的零件 | 对应原理 | 换成真实图像模型时怎么变 |
|---|---|---|
betas / alphas / abar | 噪声调度表(2.6 节) | 几乎不用变,最多把 linear 换成 cosine 调度 |
q_sample | 前向加噪闭式解 | 只需把广播形状从 (-1, 1) 改成 (-1, 1, 1, 1) |
TimeEmbedding | 把 t 告诉网络(2.7 节) | 不变,U-Net 内部同样用正弦编码 |
EpsNet | 噪声预测网络 | 整个换成 U-Net,这是唯一需要大改的地方 |
sample 里的循环 | 反向去噪 | 不变;想加速就换 DDIM 之类的跳步采样器 |
训练循环里三行最关键的代码
| 代码 | 它在干什么 |
|---|---|
t = torch.randint(0, T, (BATCH,)) | 每个样本随机抽一个时间步。等价于「所有步数一起练」——不必按顺序从 0 训到 T。 |
xt = q_sample(x0, t, noise) | 用闭式解一步跳到第 t 步,省掉 t 次循环。这就是 2.6 节那条公式的价值。 |
loss = ((pred - noise) ** 2).mean() | 训练目标的全部:预测的噪声要贴近真实撒进去的噪声。一个普通的 MSE 回归,没有对抗、没有 KL。 |
跑起来能看到什么
训练时 loss 从 1.0 上下稳步降到 0.3~0.4 区间并趋平。采样阶段脚本会按 50 步一档打印点云的统计量,你会看到标准差从 1.0 附近逐步收敛到接近真实数据的水平——这就是「从一团标准高斯里长出结构」的量化证据:
| 采样进度 | 点云标准差 | 含义 |
|---|---|---|
| t=199(刚开始) | 接近 1.00, 1.00 | 还是标准高斯,没有任何结构 |
| t=100 | 开始偏离 1.0 | 轮廓在浮现 |
| t=000(结束) | 向真实数据的统计量靠拢 | 双月牙成形 |
脚本会写出 tiny_diffusion_samples.csv,用任意绘图工具画散点就能看到形状;装了 matplotlib 的话加 PLOT=1 环境变量,直接出一张真实与生成的对照图。
if i > 0: x = mean + √β_i · 噪声,最后一步则直接取 mean。去噪过程中每一步都要再注入一点随机性——听起来反直觉,但少了它,所有样本会沿着同一条路径滑向同一个点,生成结果彻底失去多样性。把这一行注释掉重跑一次,是理解这件事最快的方式。
4.4 三个案例的关系
| 案例 | 用到的角色 | 核心运算 | 回答了什么问题 |
|---|---|---|---|
| zero-shot 分类 | 监理 | 1 图 × N 文,取 max | 监理怎么判断「像不像」 |
| 跨模态检索 | 监理 | 1 文 × N 图,取 top-k | 同一把尺子还能怎么用 |
| 极简扩散 | 雕刻师 | 加噪 → 回归 → 循环去噪 | 雕刻师那一凿到底怎么落下去 |
把三个案例连起来,文生图的全貌就完整了:前两个是监理的两种用法,第三个是雕刻师的完整工艺,而 2.8 节的 classifier-free guidance 是把两人接到一起的那根线。
05骨架模板:拿去改就能用
一份 CLIP 打分模板,一份扩散训练循环模板,TODO 处就是全部需要你动的地方
5.1 CLIP 打分模板
把 04 节两个案例的共性抽出来:「给一张图和若干候选描述,问哪句最像」。素材打标、内容初筛、出图质检全是它的特例。与 03 节的最小代码相比,模板多做了三件事:
| 改进 | 为什么 |
|---|---|
| 模型与 processor 模块级只加载一次 | 最小代码每次运行重新加载权重,批量处理时开销全在加载上。模板把它们提到模块级,导入一次、复用到底。 |
| 打分与判定拆成两个函数 | score() 只管算,decide() 管业务规则。换阈值策略不用碰模型代码。 |
| 显式的低置信度分支 | softmax 一定会给出一个最大值,哪怕全都不像。MIN_PROB 这道闸门就是给「转人工 / 归入其他」留的口子。 |
"""CLIP 打分骨架模板 —— 复制后只改 5 处 TODO。

用途:任何「给一张图和若干候选描述,问哪句最像」的任务都能套。
    图片审核:候选文本写成合规/违规的若干种描述
    素材标注:候选文本写成你的标签体系
    出图质检:候选文本写成 prompt 本身,用得分判断生成结果贴不贴题

依赖:pip install torch transformers pillow
"""

import os

import torch
from PIL import Image
from transformers import CLIPModel, CLIPProcessor

# ---------------------------------------------------------------- TODO 1
# 换模型权重。英文场景用 openai/clip-vit-base-patch32;
# 中文场景换成 OFA-Sys/chinese-clip-vit-base-patch16 一类的中文权重。
MODEL_NAME = os.environ.get("CLIP_MODEL", "openai/clip-vit-base-patch32")

# ---------------------------------------------------------------- TODO 2
# 换候选文本。写成完整句子,不要只写单个名词。
CANDIDATES = [
    "a photo of a cat",
    "a photo of a dog",
]

# ---------------------------------------------------------------- TODO 3
# 换判定阈值。softmax 概率是「候选之间的相对排序」,
# 想做「都不像就拒绝」要额外设一个最低概率或最低 cosine 门槛。
MIN_PROB = 0.5

_device = "cuda" if torch.cuda.is_available() else "cpu"
_processor = CLIPProcessor.from_pretrained(MODEL_NAME)
_model = CLIPModel.from_pretrained(MODEL_NAME).to(_device).eval()


def score(image_path, candidates=None):
    """返回 [(候选文本, 概率), ...],按概率从高到低排序。"""
    texts = candidates or CANDIDATES
    image = Image.open(image_path).convert("RGB")
    batch = _processor(text=texts, images=image,
                       return_tensors="pt", padding=True).to(_device)
    with torch.no_grad():
        logits = _model(**batch).logits_per_image[0]
    probs = logits.softmax(dim=-1).tolist()
    pairs = list(zip(texts, probs))
    pairs.sort(key=lambda kv: kv[1], reverse=True)
    return pairs


def decide(image_path):
    """在打分之上加一层业务判定。"""
    pairs = score(image_path)
    best_text, best_prob = pairs[0]
    if best_prob < MIN_PROB:
        # ------------------------------------------------------ TODO 4
        # 低置信度时的兜底策略:转人工、落到「其他」类、或者换一套候选重试。
        return {"label": "uncertain", "prob": best_prob, "detail": pairs}
    return {"label": best_text, "prob": best_prob, "detail": pairs}


if __name__ == "__main__":
    # ---------------------------------------------------------- TODO 5
    # 换成你的图片路径或目录遍历。
    result = decide(os.environ.get("CLIP_IMAGE", "./demo.jpg"))
    print(result["label"], "%.2f%%" % (result["prob"] * 100))
    for text, prob in result["detail"]:
        print("   %-40s %6.2f%%" % (text, prob * 100))
openai/clip-vit-base-patch32,中文换 Chinese-CLIP)· TODO 2 换候选文本,写成完整句子 · TODO 3 定阈值 · TODO 4 写低置信度兜底策略 · TODO 5 换图片路径或目录遍历。中间的双塔编码与相似度计算一行都不用动。
5.2 扩散训练循环模板
把 tiny_diffusion.py 拆成四个可替换的零件:数据集、噪声调度表、噪声预测网络、训练循环。换数据换网络互不影响,而训练循环那段几乎不用动——这正是扩散模型工程上好用的地方。
| 零件 | 对应 TODO | 换成图像任务时 |
|---|---|---|
build_dataset | TODO 2 | 换成 ImageFolder + transforms,归一化到 [-1, 1] |
make_schedule | — | 已内置 linear 与 cosine 两种,小分辨率上 cosine 通常更稳 |
EpsNet | TODO 3 | 整个换成 U-Net,输出形状必须与输入一致 |
| 训练循环 | TODO 4 | 想做条件生成,就在这里把文本 embedding 传进网络并随机置空 |
"""扩散模型训练循环骨架模板 —— 复制后只改 5 处 TODO。

这份骨架把 DDPM 的训练拆成四个可替换的零件:
    数据集 / 噪声调度表 / 噪声预测网络 / 训练循环
换数据换网络都不影响另外两块,训练循环那段几乎不用动。

依赖:pip install torch
"""

import math

import torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset

DEVICE = "cuda" if torch.cuda.is_available() else "cpu"

# ---------------------------------------------------------------- TODO 1
# 扩散步数与训练超参。步数越大单步越好学、采样越慢;
# 玩具数据 200 步够用,图像任务常见 1000 步。
T = 1000
EPOCHS = 20
BATCH = 64
LR = 2e-4


# ---------------------------------------------------------------- TODO 2
def build_dataset():
    """换成你的数据。要求:已归一化到大致 [-1, 1],形状 (N, ...) 任意。

    图像任务典型做法:
        transforms.Compose([Resize(64), CenterCrop(64), ToTensor(),
                            Normalize([0.5]*3, [0.5]*3)])
    """
    x = torch.randn(4096, 2)          # 占位:换成真实张量
    return TensorDataset(x)


# ------------------------------------------------------- 噪声调度表
def make_schedule(kind="linear"):
    """beta 调度。linear 是原始 DDPM 的做法,cosine 在小分辨率上更稳。"""
    if kind == "cosine":
        s = 0.008
        steps = torch.arange(T + 1, dtype=torch.float32) / T
        f = torch.cos((steps + s) / (1 + s) * math.pi / 2) ** 2
        abar = f / f[0]
        betas = torch.clip(1 - abar[1:] / abar[:-1], 0, 0.999)
    else:
        betas = torch.linspace(1e-4, 0.02, T)
    alphas = 1.0 - betas
    abar = torch.cumprod(alphas, dim=0)
    return betas, alphas, abar


BETAS, ALPHAS, ABAR = make_schedule("linear")
SQRT_ABAR = torch.sqrt(ABAR)
SQRT_1M_ABAR = torch.sqrt(1.0 - ABAR)


def q_sample(x0, t, noise):
    """前向加噪闭式解,一步跳到第 t 步。形状广播按 x0 的维度数自动补齐。"""
    shape = (-1,) + (1,) * (x0.dim() - 1)
    a = SQRT_ABAR.to(x0.device)[t].view(shape)
    b = SQRT_1M_ABAR.to(x0.device)[t].view(shape)
    return a * x0 + b * noise


# ---------------------------------------------------------------- TODO 3
class EpsNet(nn.Module):
    """噪声预测网络。输出形状必须与输入 x 完全一致。

    2D 玩具数据用 MLP 即可;图像任务把这里整个换成 U-Net
    (例如 diffusers 的 UNet2DModel),时间步走它自带的 timestep 入参。
    """

    def __init__(self, dim=2, hidden=128, tdim=64):
        super().__init__()
        self.tdim = tdim
        self.net = nn.Sequential(
            nn.Linear(dim + tdim, hidden), nn.SiLU(),
            nn.Linear(hidden, hidden), nn.SiLU(),
            nn.Linear(hidden, dim),
        )

    def time_embed(self, t):
        half = self.tdim // 2
        freqs = torch.exp(-math.log(10000) * torch.arange(half, device=t.device) / half)
        args = t.float().unsqueeze(-1) * freqs.unsqueeze(0)
        return torch.cat([torch.sin(args), torch.cos(args)], dim=-1)

    def forward(self, x, t):
        return self.net(torch.cat([x, self.time_embed(t)], dim=-1))


# ---------------------------------------------------------------- 训练循环
def train():
    loader = DataLoader(build_dataset(), batch_size=BATCH, shuffle=True, drop_last=True)
    model = EpsNet().to(DEVICE)
    opt = torch.optim.AdamW(model.parameters(), lr=LR)

    for epoch in range(1, EPOCHS + 1):
        total, seen = 0.0, 0
        for (x0,) in loader:
            x0 = x0.to(DEVICE)
            t = torch.randint(0, T, (x0.shape[0],), device=DEVICE)
            noise = torch.randn_like(x0)
            xt = q_sample(x0, t, noise)

            # ------------------------------------------------ TODO 4
            # 想做条件生成(文生图)就在这里把文本 embedding 传进网络:
            #     pred = model(xt, t, text_emb)
            # 并按 10% 概率把 text_emb 置空,训练出 classifier-free guidance 需要的无条件分支。
            pred = model(xt, t)
            loss = ((pred - noise) ** 2).mean()

            opt.zero_grad()
            loss.backward()
            torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
            opt.step()

            total += loss.item() * x0.shape[0]
            seen += x0.shape[0]
        print("epoch %3d   loss %.4f" % (epoch, total / max(seen, 1)))

    # ------------------------------------------------------------ TODO 5
    # 换成你的保存路径;真实训练还要存 optimizer 状态和 EMA 权重以便断点续训。
    torch.save(model.state_dict(), "eps_net.pt")
    return model


@torch.no_grad()
def sample(model, n=256, shape=(2,), guidance=None):
    """反向采样。guidance 传入 (cond, uncond, scale) 时启用 classifier-free guidance。"""
    x = torch.randn((n,) + shape, device=DEVICE)
    for i in reversed(range(T)):
        t = torch.full((n,), i, device=DEVICE, dtype=torch.long)
        if guidance is None:
            eps = model(x, t)
        else:
            cond, uncond, scale = guidance
            e_c, e_u = model(x, t, cond), model(x, t, uncond)
            # 把「有文本」相对「无文本」多出来的那部分放大 scale 倍
            eps = e_u + scale * (e_c - e_u)

        a_t, abar_t = ALPHAS[i].to(DEVICE), ABAR[i].to(DEVICE)
        mean = (x - (1 - a_t) / torch.sqrt(1 - abar_t) * eps) / torch.sqrt(a_t)
        x = mean if i == 0 else mean + torch.sqrt(BETAS[i].to(DEVICE)) * torch.randn_like(x)
    return x.cpu()


if __name__ == "__main__":
    net = train()
    out = sample(net)
    print("采样结果 shape:", tuple(out.shape))
q_sample 用 x0.dim() 自动推断广播形状,2D 点云和 4D 图像张量都能直接用,不用改代码;②
sample() 里留了 guidance 参数,传入 (cond, uncond, scale) 就启用 classifier-free guidance,公式正是 2.8 节那条 ε = ε_u + s·(ε_c − ε_u)。
amp 显存吃不消)。这三样在 TODO 5 附近补,不影响主干逻辑。
5.3 两份模板怎么选
| 模板 | 什么时候用 | 不需要什么 |
|---|---|---|
clip_score_template.py | 用现成 CLIP 做打分、分类、检索、质检 | 不需要 GPU 训练,不需要标注数据 |
diffusion_train_template.py | 要自己训一个扩散模型,或改造现有训练流程 | 不需要 CLIP,除非要做条件生成 |
绝大多数应用场景只会用到第一份。第二份的价值在于:当你之后去读 Stable Diffusion 的训练脚本时,能一眼认出哪几行是主干、哪几行是工程加固。
06易错点汇总
按「概念 / CLIP 用法 / 扩散原理 / 训练与采样 / 文生图工程」五类归并
⚠️ 一、概念层面
- 以为 CLIP 能画图。 它没有解码器,输出只有向量。把「CLIP 生成了图片」这句话说出口,就是把监理和雕刻师搞混了。铁律:CLIP 不生成图像,它是生成的基础。
- 以为文生图时 CLIP 在学习。 推理阶段参数是冻结的,训练
LoRA/ 微调时被改的主要是 U-Net。监理连自己那本词典都不改一个字。 - 把 CLIP 当成图像分类模型。 它没有固定类别表。分类是被改写出来的用法——把类别写成句子,比谁更像。
- 把扩散模型的「加噪」当成要训练的部分。 前向过程没有任何可学习参数,全部由 β 调度表决定。要训练的只有反向那个噪声预测网络。
- 记混时间线。 VAE 与 GAN 都是 2014 年,扩散模型是 2015 年提出,CLIP 是 2021 年由 OpenAI 发布,Imagen 是 2022 年 5 月 由 Google 发布。
- 以为扩散模型取代了 VAE 和 GAN。 Stable Diffusion 里 VAE 仍然负责潜空间的压缩与解码;GAN 的思路活在超分与人脸修复模块里。被替换的只是「生成主干」这一个位置。
⚠️ 二、CLIP 用法
- 把 softmax 概率当置信度。 它只在你给的候选之间归一化。图里是挖掘机、候选里没有挖掘机时,照样有一条拿走 90%。要做拒识必须另外看原始 cosine 并设门槛,或者在候选里加一条兜底描述。
- 拿 cosine 分数抄一个固定阈值。 不同图库、不同 prompt 下最高分能差出一倍。它是排序用的,不是判定用的;要定门槛就在自己的数据上统计分位数。
- 候选文本只写单个词。
cat明显差于a photo of a cat,因为训练语料是网页图文,句子形态更贴近训练分布。更稳的做法是一类写多条模板、编码后取平均。 - 用英文权重跑中文 prompt。 不会报错,只会安静地变差,最容易被误判成「CLIP 效果不行」。中文场景换
Chinese-CLIP系列权重,其余代码不动。 - 把
logits_per_image当 cosine 值。 它已经乘过可学习的logit_scale,所以数值常在 20~30。要纯 cosine 就自己把向量 L2 归一化后做点积。 - 向量忘了归一化就直接点积。 这时点积会被向量模长带偏,长句、复杂图会无端得高分。先归一化,再点积。
- 图库变了还在用旧索引。 会出现「搜出来的分数是对的,路径却对不上号」这种极难排查的错。检索案例里那段文件列表比对就是防它的。
- 对比学习训练时用小 batch。 batch size 在这里就是负样本数量,N=64 意味着每个正样本只有 63 个负样本作陪。而且梯度累积不能等价替代——累积起来的样本之间不会互为负样本。
⚠️ 三、扩散原理
- 以为网络预测的是「下一张图」。 它预测的是这一步里混进去的噪声,输出形状与输入图像一致。减掉它才得到下一张图。
- 忘了把时间步 t 送进网络。 不给 t,网络就不知道现在噪声有多重,也无从判断该减多少,训练会收敛到一个「平均噪声」的糊结果。
- 训练时真的循环 T 次加噪。 有闭式解
x_t = √ᾱ_t·x_0 + √(1−ᾱ_t)·ε,随机抽一个 t 一步跳过去就行。真循环会让训练成本涨三个数量级。 - 把 α 和 ᾱ 用混。
α_t = 1 − β_t是单步保留比例,ᾱ_t是从 0 到 t 的累乘。闭式解用 ᾱ,采样公式里两个都要用,混了出来的图必然是纯噪声或纯灰。 - 采样时每一步都不注入随机噪声。 少了它,所有样本沿同一路径塌向同一点,多样性彻底消失。注意最后一步是例外,那一步直接取均值。
- 问「为什么不一步到位」。 一步到位就是 GAN 在做的事,也是它训练不稳的根源。扩散把难度摊到时间维度上,每一小步都退化成简单回归。慢是代价,稳是收益。
- 把步数当成质量旋钮无脑调大。 步数不足会留噪点,但超过采样器的有效区间后几乎不再变好,只是线性变慢。
⚠️ 四、训练与采样工程
- 数据没归一化到 [-1, 1]。 调度表是按这个量级设计的。喂 [0, 1] 或原始像素值进去,加噪强度与数据尺度不匹配,loss 降得下去但采样出来是灰片。
- 广播形状写死。
sqrt_abar[t]取出来是一维的,必须 reshape 成(-1, 1)(点云)或(-1, 1, 1, 1)(图像)才能与数据相乘。模板里用x0.dim()自动推断,就是为了避开这个坑。 - 不做梯度裁剪。 扩散训练偶发的梯度尖峰会把权重打飞,之后 loss 再也降不下来。
clip_grad_norm_(params, 1.0)成本极低。 - 不存 EMA 权重。 直接拿最后一步的权重采样,质量明显差于 EMA 版本。这是扩散模型里投入产出比最高的一条工程加固。
- 只存了模型权重没存 optimizer 状态。 断点续训时优化器动量从零开始,loss 会先反弹一段。
- 拿 loss 绝对值判断好坏。 扩散的 loss 是所有时间步上的平均,数值受调度表和数据尺度影响很大,跨实验不可比。要比就固定种子看采样结果。
⚠️ 五、文生图应用
- guidance_scale 无脑拉满。 15 以上会出现构图僵硬、颜色过饱和、油画感伪影,细节反而丢失。常用区间是 7~8。监理嗓门太大,雕刻师就只会照本宣科。
- 忘了 CFG 让耗时翻倍。 开启后每一步要跑两次网络(有条件 + 无条件)。做延迟预算时按两倍算。
- 以为 classifier-free 是「不需要引导」。 省掉的是那个外部分类器,不是引导本身。引导仍在,只是改用同一个网络的两次输出之差来实现。
- 训练条件模型时不随机置空文本。 不置空,网络就学不会无条件分支,采样时
ε_u无从谈起,CFG 直接失效。常用置空概率约 10%。 - 换了种子还期望出同一张图。 种子决定起点那块石料。要复现一张图,种子、步数、采样器、guidance、模型版本全部要一致,缺一个都对不上。
- 把 prompt 里的质量词当玄学。 它有效的根子在 2.4 节:CLIP 学的是「互联网上人们怎么描述图片」,质量词在训练语料里与某种画面质感强绑定。理解了来源,就知道它什么时候会失效——换一个训练语料分布不同的模型,同一套咒语就不灵了。
07自测题
点击题目展开答案;能把这 14 题说清楚,这一讲就通了
CLIP 是哪一年由谁发布的?它用什么结构、什么训练方式、多少数据?
2021 年由 OpenAI 发布的跨模态预训练大模型。采用双塔模型与对比学习的训练方式,从互联网收集了 4 亿对图文对。
CLIP 能用来生成图像吗?它在文生图里扮演什么角色?
不能。它没有解码器,输出只有向量。它是图像生成的基础:把图像和文本压进同一个向量空间,提供「这张图像不像这句话」的度量,在文生图里为扩散模型提供文本条件。用比喻说,它是监理不是雕刻师,从不动凿子,而且推理时参数冻结。
一个 batch 有 N 对图文,正样本和负样本各有多少个?训练目标是什么?
N 个图像表征与 N 个文本表征两两组合得到 N×N 相似度矩阵。对角线上的 (I_j, T_j) 是正样本,共 N 个;其余 (I_j, T_k) 是负样本,共 N²−N 个。训练目标:最大化 N 个正样本的 cosine 相似度,最小化 N²−N 个负样本的 cosine 相似度。
为什么损失要按行和按列各算一次?
两个方向对应两个不同任务:按行是「给定这张图,从 N 句话里挑对的那句」(图搜文);按列是「给定这句话,从 N 张图里挑对的那张」(文搜图)。CLIP 两个方向都要会用,所以两个方向都要练,两个 loss 取平均。
为什么 CLIP 这类模型的训练 batch size 特别大?用梯度累积能替代吗?
因为 batch size 就是负样本数量:N=64 时每个正样本只有 63 个负样本作陪,N 上万时区分难度才够,模型才被迫学出细粒度的语义。梯度累积不能等价替代——累积只是把多个小矩阵串起来,跨累积步的样本之间不会互相成为负样本,N×N 矩阵并没有变大。
为什么用 transformers 跑 CLIP 时,logits_per_image 的值是 20~30 而不是 0.2~0.3?
因为它已经乘过可学习的温度系数(logit_scale)。cosine 本身只在 [−1, 1],直接 softmax 分布太平、梯度推不动,所以要先除以温度 τ 放大差距。想拿原始 cosine,得自己把两边向量做 L2 归一化后点积。
4 亿对图文这个规模,除了「数据多」还意味着什么?
三件事:①监督信号免费——图文对是网页本来就有的(图 + alt 文本 / 图注),不像传统视觉数据集那样劳动密集、成本高;②语义覆盖面极宽——涵盖品牌、人名、艺术风格、抽象概念,这是 zero-shot 能成立的前提;③噪声也被一起学了——CLIP 学到的是「互联网上人们怎么描述图片」而非客观事实,这正是 prompt 里堆质量词能起作用的根源。
Zero-Shot Transfer 是怎么把「分类」改写成 CLIP 能做的事的?
用预训练好的 Image Encoder 与 Text Encoder,把每个类别名填进模板写成句子(a photo of a {cat}),编码成 N 个文本向量;图片编码成 1 个图像向量;算 1×N 的 cosine,取最大的那句话对应的类别就是预测结果。换一批类别句 = 换一个分类器,不训练任何权重。
zero-shot 分类和跨模态检索,在实现上的差别是什么?
是同一个相似度矩阵的两种读法:分类是「1 图 × N 文,取 max」,检索是「1 文 × N 图,取 top-k」。工程上检索多一步——把图库向量离线算好落盘,在线只剩一次文本编码加一次矩阵乘法。
候选文本只写 cat 而不写 a photo of a cat,会怎样?为什么?
效果明显变差。因为训练语料是网页图文,句子形态的描述在分布上更常见,裸词更像标签系统的产物、离训练分布远。更稳的做法是一个类别写多条模板句,编码后取平均作为该类的原型向量。
softmax 给出 95% 的概率,能说明模型很确定吗?
不能。softmax 只在你给的这几条候选之间归一化。图里是挖掘机而候选里没有挖掘机时,照样会有一条拿走 90% 以上。要做拒识,必须另外看原始 cosine 的绝对值并设门槛,或在候选里加一条兜底描述。而且 cosine 阈值不能抄,要在自己数据上统计分位数。
扩散模型的前向过程有哪三个性质?它需要训练吗?
①是一条马尔可夫链,第 t 步只依赖第 t−1 步;②不含任何可学习参数,加多少噪声由预先定好的 β 调度表决定,完全不需要训练;③终点 x_T 近似标准高斯 N(0, I),原图信息被彻底洗掉。需要训练的只有反向过程的噪声预测网络。
反向过程里,网络到底在预测什么?训练目标是什么?
预测的不是「下一张图」,而是这一步里混进去的噪声 ε,输出形状与输入图像完全一致。训练目标是一个普通的 MSE 回归:loss = MSE(ε̂, ε),没有对抗、没有 KL。采样时把预测出的噪声按系数减掉,就得到更干净的 x_{t−1}。
为什么要分成很多小步,不能一步从噪声跳到图像?
因为「一步到位」要求网络一次性拟合整个数据分布,是个极复杂的映射——那正是 GAN 在做的事,也是它训练不稳的根源。拆成 T 小步后,x_t 与 x_{t−1} 只差一点点噪声,分布差异小到可用高斯近似,每一步都退化成简单、良定义、梯度稳定的回归。难度被摊到了时间维度上,代价是采样要循环 T 次——这就是扩散慢的全部原因。
训练时如果真的循环 T 次加噪,会有什么问题?正确做法是什么?
成本会涨三个数量级。正确做法是用闭式解:连续加高斯噪声仍是高斯,所以 x_t = √ᾱ_t·x_0 + √(1−ᾱ_t)·ε,随机抽一个 t 就能一步跳到第 t 步。其中 α_t = 1 − β_t 是单步保留比例,ᾱ_t 是累乘,两者不能混用。
反向采样时,为什么每一步还要再注入一点随机噪声?哪一步例外?
因为不注入的话,所有样本会沿同一条路径滑向同一个点,生成结果彻底失去多样性。最后一步(i=0)例外,那一步直接取均值,不再加噪。把这行注释掉重跑一次,是理解这件事最快的方式。
classifier-free guidance 是怎么工作的?名字里的 classifier-free 相对什么而言?
训练时以约 10% 的概率把文本条件置空,让同一个网络顺带学会无条件生成;采样时每步跑两次得到 ε_c 与 ε_u,再按 ε = ε_u + s·(ε_c − ε_u) 把「有文本相对没文本多出来的方向」放大 s 倍。
它相对的是早期的 classifier guidance——那种做法要额外训练一个分类器来求梯度引导。省掉的是分类器,不是引导。代价是每步跑两次网络,耗时翻倍。
guidance_scale 调到 20 会发生什么?常用值是多少?
条件被过度放大,出现构图僵硬、颜色过饱和、油画感伪影,细节反而丢失。常用区间是 7~8;s=1 等价于不做 guidance,图很自然但经常跑题。用比喻说:监理嗓门太大,雕刻师就只会照本宣科。
VAE、GAN、Diffusion 三条路线各自的短板是什么?为什么最后是扩散模型成为文生图主干?
VAE:训练稳、采样快,但重建损失导致结果偏糊。GAN:画质锐利、采样快,但两网络对抗导致训练不稳,且容易 mode collapse 只会画少数几种。Diffusion:训练稳(本质是回归)、多样性好、可控性强,短板是采样慢。
扩散胜出的原因是:慢可以靠采样器优化和算力缓解,训练崩溃与多样性丧失却没法靠堆算力解决。三者并非互相取代——Stable Diffusion 里 VAE 仍负责潜空间压缩与解码。
DALL-E 2、Imagen、Stable Diffusion 三家的骨架相同吗?最大的差别在哪?
骨架都是「文本编码器 + 扩散」。最大差别在开源程度与可得性:DALL-E 2(OpenAI)闭源,在官网向公众开放、提供有限免费额度与付费购买;Imagen(Google,2022 年 5 月)闭源且目前不对外开放;Stable Diffusion(Stability AI、CompVis、RunwayML)免费且开源,最初在 4000 卡 A100 集群上 训练,正因为开源才长出了后来的微调与插件生态。
同一个 prompt、同样的参数,两次出图不一样,最可能是什么原因?要复现一张图需要固定哪些东西?
最可能是随机种子不同——种子决定起点那块石料(初始噪声 x_T)。要复现一张图,必须种子、步数、采样器、guidance_scale、模型版本全部一致,缺一个都对不上。
词术语表
| 术语 | 含义 |
|---|---|
| CLIP | Contrastive Language-Image Pre-training。2021 年 OpenAI 发布的跨模态预训练模型,双塔结构 + 对比学习,4 亿对图文。只产出向量,不生成图像 |
| 双塔模型 | 图像编码器与文本编码器各自独立、不共享参数,唯一约束是输出向量维度相同。好处是图库向量可离线预计算 |
| Image Encoder | 图像塔,常用 CNN(ResNet)或 ViT |
| Text Encoder | 文本塔,用 Transformer |
| contrastive learning | 对比学习。一个 batch 的 N 对图文构成 N×N 相似度矩阵,拉近对角线 N 个正样本、推远 N²−N 个负样本 |
| cosine 相似度 | 两个向量夹角的余弦。向量做 L2 归一化后,点积即等于它 |
| logit_scale | 可学习的温度系数。cosine 乘上它再做 softmax,用来把过平的分布拉尖 |
| zero-shot transfer | 直接用预训练好的两座塔完成没专门训练过的任务;分类被改写成「哪句描述跟这张图最像」 |
| prompt 模板 | 把类别名填进 a photo of a {} 这类句式;多条模板编码后取平均得到类别原型向量 |
| 跨模态检索 | 文搜图或图搜文。与 zero-shot 分类是同一个相似度矩阵的两种读法 |
| VAE | 变分自编码器,2014 年 Kingma 等人提出。以概率方式描述潜在空间;在 Stable Diffusion 里负责像素空间与潜空间的压缩解码 |
| GAN | 生成对抗网络,2014 年 Ian Goodfellow 提出。生成器与判别器零和博弈;变体有 DCGAN、StyleGAN、CycleGAN |
| mode collapse | GAN 的典型失败:生成器只会输出少数几种样本,多样性丧失 |
| diffusion model | 扩散模型,2015 年提出,受非平衡热力学启发。定义一条加噪的马尔可夫链,再学习逆扩散过程从噪声中构建样本 |
| 前向过程 | 逐步向图像加高斯噪声直到成为完全随机噪声。无可学习参数,由 β 调度表决定 |
| 反向过程 | 从高斯噪声出发,每个时间步去除预测出的噪声,逐步还原清晰信号 |
| β 调度表 | 每一步的加噪强度,常从 1e-4 线性涨到 0.02。早期少掺、后期多掺 |
| αt / ᾱt | α_t = 1 − β_t 是单步保留比例;ᾱ_t 是从 0 到 t 的累乘。闭式解用 ᾱ |
| 闭式解 | x_t = √ᾱ_t·x_0 + √(1−ᾱ_t)·ε。让训练可以随机抽一个 t 一步跳过去,不必循环加噪 |
| timestep | 时间步。必须作为输入送进网络,否则网络不知道当前噪声有多重 |
| 噪声预测网络 | 输入带噪图与时间步,输出同形状的预测噪声。图像任务里通常是 U-Net |
| U-Net | 原本用于生物医学图像分割的 U 型网络,在扩散模型里承担噪声预测,能在较少样本下提取并解构图像特征 |
| Scheduler | 采样器。定义用哪种算法运行降噪:步数、是否具备随机性、查找去噪后样本的算法 |
| classifier-free guidance | 训练时随机置空文本条件学出无条件分支,采样时按 ε = ε_u + s·(ε_c − ε_u) 放大文本方向。省掉的是外部分类器,不是引导 |
| guidance scale | 上式中的 s,控制文本条件的分量。常用 7~8;过大导致构图僵硬、颜色过饱和 |
| EMA | 权重的指数滑动平均。采样质量明显优于最后一步的裸权重,是扩散训练里性价比最高的加固 |
| DALL-E 2 | OpenAI 的文生图产品,闭源,官网开放有限免费额度与付费购买 |
| Imagen | Google 2022 年 5 月发布的文本到图像扩散模型,目前不对外开放 |
| Stable Diffusion | Stability AI、CompVis 团队与 RunwayML 共同开源的文生图模型,免费开源,在 Stability 的 4000 卡 A100 集群上训练 |
CLIP)用 4 亿对图文练出一把能同时量图和话的尺子,雕刻师(diffusion)把「从噪声到图像」拆成几十上百刀的简单回归;监理指方向,雕刻师动凿子,两人从不换位。