【案例】新媒体评论分类与信息抽取 · 数据工程
会写文章的大模型也要按表格交差——Instruction 三段式工单、input_ids 与 labels 的错位对齐,以及开训前必做的截断体检。
30″30 秒看懂生成式微调的数据
前三页那位老师傅只会填空,格子就两个。这一页换人:来的是一位会写文章的大模型,什么都能说,问题恰恰是想说什么说什么。
你要的不是文章,是一张能直接入库的表格:主语属于哪个类别、这句话里有哪些主谓宾三元组。所以工作方式变成派工单——先递一张工单过去:「你现在是阅读理解器,严格按指令回答。任务是找三元组,输出 json。句子在这儿。Answer:」——最后那个冒号后面故意空着,那是留给他写的位置。他写完,你按格式收走。
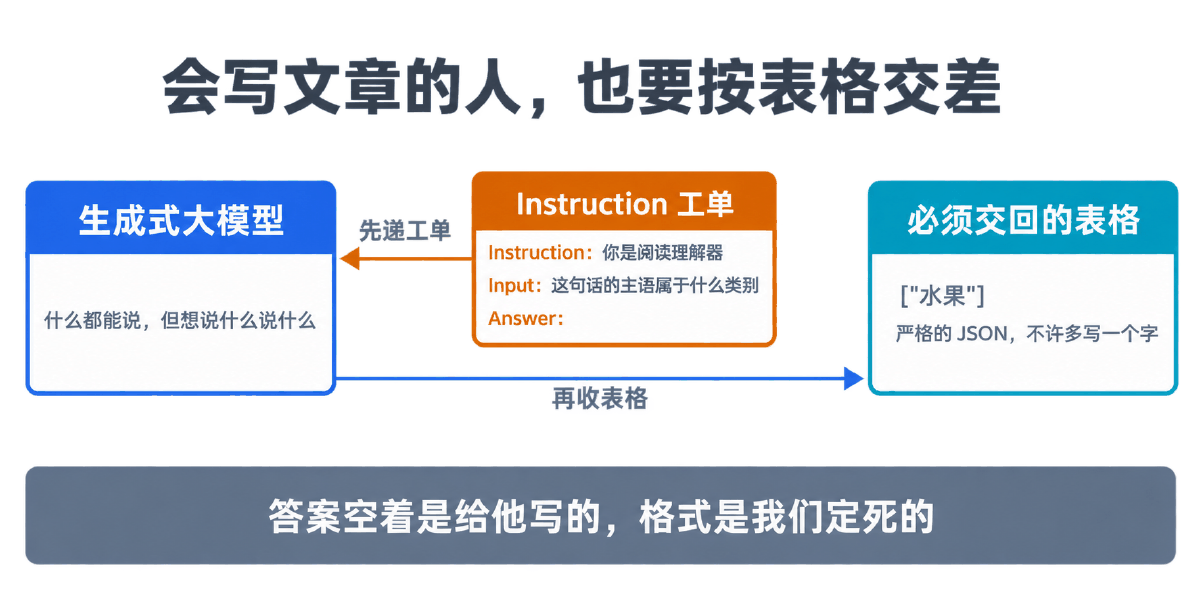
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 会写文章的人 | ChatGLM-6B | 62 亿参数的生成式模型,输出是一段文本而不是一个类别 |
| 工单 | context | Instruction + Input + Answer: 三段式,训练推理逐字一致 |
| 必须交回的表格 | target | 严格的 JSON 字符串,多写一个字都解析不了 |
| 空着的答案栏 | <sop> 之后的位置 | 损失只算这一段,前面的工单内容一个字都不计分 |
| 工单上不计分的部分 | labels 里的 -100 | 把提示部分涂成 -100,模型就不会去背题干 |
| 换一种活 | 换 Instruction 文本 | 分类与抽取共用一套字段结构,训练代码一行不动 |
-100。这一点想不通,后面所有的形状和报错都看不懂。
01概念
从「判别」到「生成」,数据形态变了什么
两类任务的根本差别
| 对比项 | BERT 判别式(前三页) | ChatGLM 生成式(这一页) |
|---|---|---|
| 模型输出 | mask 位置上的词概率 | 一段自由长度的文本 |
| 类别数 | 必须事先定死 | 没有这个概念,任务靠文字说清 |
| 标签形态 | 类别名的 token id,长度固定 | 一段字符串,通常是 JSON |
| 损失位置 | mask_positions 那几个位置 | <sop> 之后的全部位置 |
| 换任务的成本 | 改模板 + 改标签表 | 只改 Instruction 文本 |
| 输出可靠性 | 一定落在类别集合内 | 可能写出解析不了的东西,必须设校验闸 |
最后一行是工程上最大的变化。判别式模型的输出天然受限于类别集合,不会给你一个不存在的类别;生成式模型可以写出任何东西——包括把你的 Instruction 复读一遍、在 JSON 外面裹一层客套话、写到一半停笔。所以生成式方案的下游一定要有解析与字段校验,这不是可选项。
Instruction 三段式
本讲的数据格式固定为两个字段:context 与 target。context 内部是三段:
| 段 | 内容 | 作用 |
|---|---|---|
| Instruction | 「你现在是一个很厉害的阅读理解器,严格按照人类指令进行回答。」 | 设定角色与总体约束,所有任务共用一句 |
| Input | 具体任务描述 + 空行 + 待处理的句子 | 换任务只换这一段 |
| Answer: | 固定以 Answer: 收尾,后面留空 | 既是模型开始作答的信号,也是推理时切结果的锚点 |
三段式不是唯一写法,但一旦定下来就不能再改一个字——包括空格和换行的数量。训练时模型学的是「见到这个特定的前缀就按这个格式作答」,推理时前缀差一个空格,对模型来说就是另一场考试。
一套格式服务两个任务
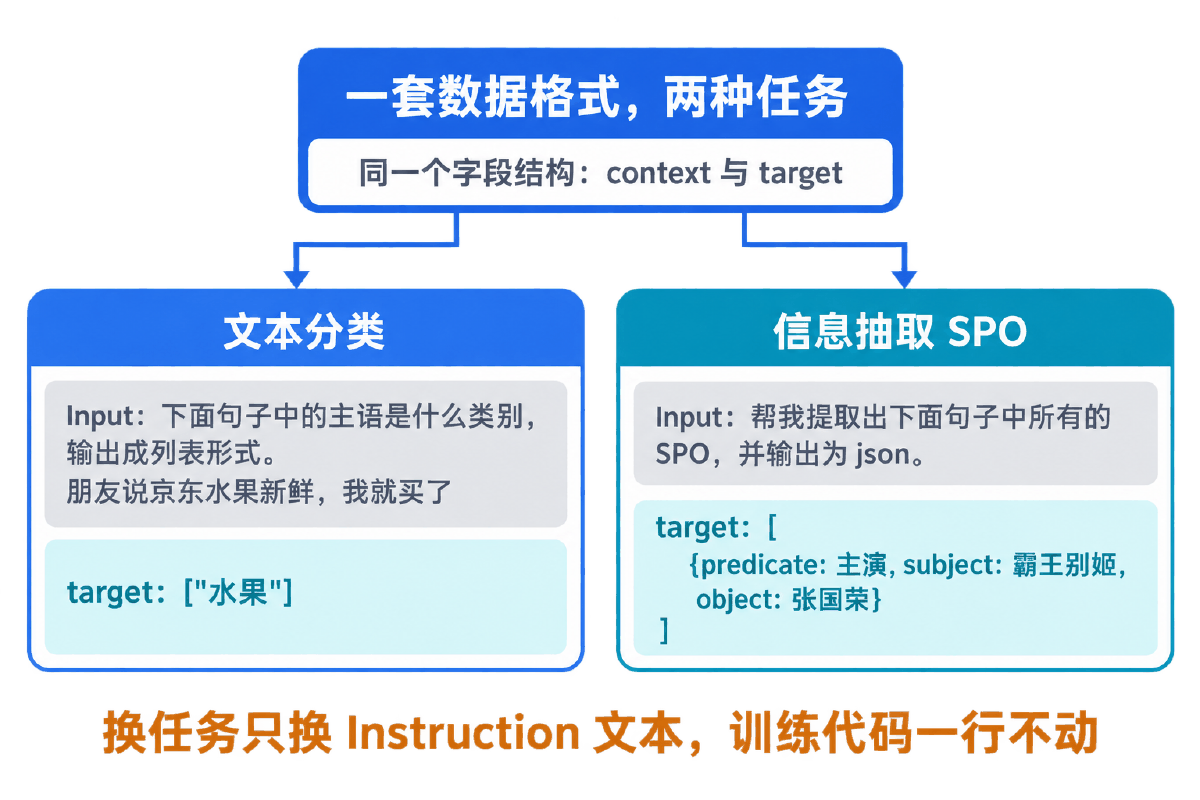
本案例要做两件事:评论分类、SPO 信息抽取。它们共用同一套字段结构:
{"context": "Instruction: 现在你是一个非常厉害的SPO抽取器。\nInput: 下面这句中包含了哪些三元组,用json列表的形式回答,不要输出除json外的其他答案。\n\n73获奖记录人物评价:黄磊是一个特别幸运的演员,拍第一部戏就碰到了导演陈凯歌,而且在他的下一部电影《夜半歌声》中演对手戏的张国荣、吴倩莲、黎明等都是著名的港台演员。\nAnswer: ", "target": "```json\n[{\"subject\": \"夜半歌声\",\"subject_type\": \"影视作品\",\"predicate\": \"主演\",\"object\": \"黄磊\",\"object_type\": \"人物\"}]\n```"}
{"context": "Instruction: 现在你是一个非常厉害的SPO抽取器。\nInput: 抽取下面这句话中的SPO,只返回json的答案。\n\n马红宝 男 汉族,1949年8月生,浙江省长兴县人,1978年8月加入中国共产党,1967年9月参加工作,大普文化\nAnswer: ", "target": "```json\n[{\"predicate\": \"民族\", \"object_type\": \"Text\", \"subject_type\": \"人物\", \"object\": \"汉族\", \"subject\": \"马红宝\"}, {\"predicate\": \"国籍\", \"object_type\": \"国家\", \"subject_type\": \"人物\", \"object\": \"中国\", \"subject\": \"马红宝\"}, {\"predicate\": \"出生地\", \"object_type\": \"地点\", \"subject_type\": \"人物\", \"object\": \"浙江省长兴\", \"subject\": \"马红宝\"}, {\"predicate\": \"出生日期\", \"object_type\": \"Date\", \"subject_type\": \"人物\", \"object\": \"1949年8月\", \"subject\": \"马红宝\"}]\n```"}
{"context": "Instruction: 现在你是一个非常厉害的SPO抽取器。\nInput: 前秦世祖宣昭皇帝苻坚(338年-385年10月16日),字永固,又字文玉,小名坚头,氐族,略阳临渭(今甘肃秦安)人,十六国时期前秦的君主,公元357-385年在位。\n\n上面这句话中包含了哪些三元组信息?。\nAnswer: ", "target": "这句话中包含了前秦世祖宣昭皇帝苻坚的生日、字、小名、出生地、民族等信息,以上信息用json可以表示为:\n```json\n[{\"predicate\": \"出生日期\", \"object_type\": \"Date\", \"subject_type\": \"人物\", \"object\": \"338年\", \"subject\": \"苻坚\"}, {\"predicate\": \"字\", \"object_type\": \"Text\", \"subject_type\": \"历史人物\", \"object\": \"文玉\", \"subject\": \"苻坚\"}, {\"predicate\": \"出生地\", \"object_type\": \"地点\", \"subject_type\": \"人物\", \"object\": \"略阳临渭\", \"subject\": \"苻坚\"}, {\"predicate\": \"民族\", \"object_type\": \"Text\", \"subject_type\": \"人物\", \"object\": \"氐族\", \"subject\": \"苻坚\"}]\n```"}
{"context": "Instruction: 现在你是一个非常厉害的SPO抽取器。\nInput: “《大明按察使》该剧由黄海涛,申积军,阙云霞,沈剑波,王江红担任策划、黄克敏执导,姚橹,丁勇岱,杨旸,高鑫,李芯逸等主演的悬疑断案电视剧。”中包含了哪些SPO信息?用json的格式回答,不要说多余的话。\nAnswer: ", "target": "```json\n[{\"predicate\": \"导演\", \"object_type\": \"人物\", \"subject_type\": \"影视作品\", \"object\": \"黄克敏\", \"subject\": \"大明按察使\"}, {\"predicate\": \"主演\", \"object_type\": \"人物\", \"subject_type\": \"影视作品\", \"object\": \"丁勇岱\", \"subject\": \"大明按察使\"}, {\"predicate\": \"主演\", \"object_type\": \"人物\", \"subject_type\": \"影视作品\", \"object\": \"姚橹\", \"subject\": \"大明按察使\"}, {\"predicate\": \"主演\", \"object_type\": \"人物\", \"subject_type\": \"影视作品\", \"object\": \"杨旸\", \"subject\": \"大明按察使\"}]\n```"}
{"context": "Instruction: 现在你是一个非常厉害的SPO抽取器。\nInput: 《中国姓氏大辞典》是在国家自然科学基金的支持下,于2010年由江西人民出版社正式编纂出版的图书,作者是袁义达、邱家儒。\n\n抽取出这句话中包含了哪些关系,并用json的形式回答,不要输出多余信息。\nAnswer: ", "target": "```json\n[{\"predicate\": \"出版社\", \"object_type\": \"出版社\", \"subject_type\": \"书籍\", \"object\": \"江西人民出版社\", \"subject\": \"中国姓氏大辞典\"}, {\"predicate\": \"作者\", \"object_type\": \"人物\", \"subject_type\": \"图书作品\", \"object\": \"袁义达\", \"subject\": \"中国姓氏大辞典\"}, {\"predicate\": \"作者\", \"object_type\": \"人物\", \"subject_type\": \"图书作品\", \"object\": \"邱家儒\", \"subject\": \"中国姓氏大辞典\"}]\n```"}
混在一个文件里一起训练,模型会根据 Instruction 的措辞自动切换行为。这带来两个好处:一次训练服务两个业务;两个任务的数据互相当作正则化,单任务数据少时反而更稳。
为什么是 ChatGLM-6B
本讲用的底座是 ChatGLM-6B:62 亿参数,GLM 架构,hidden_size=4096、num_layers=28,权重以 float16 存储。选它的工程理由是它在单张消费级显卡上能跑起来,而且中文语料占比高。
它的 GLM 架构和常见的 GPT 系有一处差别直接影响数据处理:序列里有 [gMASK]、<sop>、<eop> 这几个特殊 token,标记「从这里开始生成」和「生成结束」。这几个标记不用自己拼,分词器的 build_inputs_with_special_tokens() 会补上——但你必须知道它们在哪,因为 labels 的分界线就是 <sop> 的位置。
02原理:一条 jsonl 怎么变成 input_ids 与 labels
五步,盯住那条 -100 的分界线
先看数据长什么样
一条样本就是一行 JSON,两个字段。换行在 jsonl 里是转义的 \n,所以一条样本永远占一行,可以流式按行读:
# -*- coding:utf-8 -*-
"""数据长什么样:一条 jsonl 拆开看,纯标准库,可直接运行。

两个任务(文本分类、SPO 抽取)共用同一套字段:context 与 target。
context 里塞的是「Instruction + Input + Answer:」三段式,
Answer: 后面故意留空——那是留给模型写的位置。
"""
import json

CLS_SAMPLE = {
    "context": "Instruction: 你现在是一个很厉害的阅读理解器,严格按照人类指令进行回答。\n"
               "Input: 下面句子中的主语是什么类别,输出成列表形式。\n\n"
               "朋友说京东上买的水果很新鲜,我就也下单了一箱\nAnswer: ",
    "target": "[\"水果\"]"
}

SPO_SAMPLE = {
    "context": "Instruction: 你现在是一个很厉害的阅读理解器,严格按照人类指令进行回答。\n"
               "Input: 找到句子中的三元组信息并输出成json给我:\n\n"
               "《霸王别姬》是由张国荣主演的一部电影\nAnswer: ",
    "target": "```json\n[{\"predicate\": \"主演\", \"object_type\": \"人物\", "
              "\"subject_type\": \"影视作品\", \"object\": \"张国荣\", \"subject\": \"霸王别姬\"}]\n```"
}


def show(name, sample):
    print('=' * 60)
    print(name)
    print('=' * 60)
    context, target = sample['context'], sample['target']
    for i, seg in enumerate(context.split('\n')):
        print('  ctx[%d] %s' % (i, seg if seg else '(空行)'))
    print('  target: %s' % target)
    print('  context %d 字 / target %d 字' % (len(context), len(target)))


if __name__ == '__main__':
    show('任务一:文本分类', CLS_SAMPLE)
    show('任务二:SPO 信息抽取', SPO_SAMPLE)

    # 两条样本的字段名完全一样——这是「换任务不改代码」的前提
    assert set(CLS_SAMPLE) == set(SPO_SAMPLE) == {'context', 'target'}
    print('\n两个任务的字段结构完全一致:', sorted(CLS_SAMPLE))

    # context 一定以 'Answer: ' 收尾,推理时按这个标记切结果
    for s in (CLS_SAMPLE, SPO_SAMPLE):
        assert s['context'].rstrip(' ').endswith('Answer:'), 'Answer: 是切分锚点,不能省'
    print("context 都以 'Answer: ' 结尾,推理时按它切出模型写的部分")

    # target 必须是合法 JSON(SPO 的要先剥掉代码围栏)
    print('\n分类 target 解析:', json.loads(CLS_SAMPLE['target']))
    spo = SPO_SAMPLE['target'].strip().removeprefix('```json').removesuffix('```').strip()
    parsed = json.loads(spo)
    print('抽取 target 解析:', parsed[0]['subject'], '-', parsed[0]['predicate'], '-', parsed[0]['object'])
    assert parsed[0]['subject'] == '霸王别姬'

    # 写回一行 jsonl 看看真实存储形态
    line = json.dumps(CLS_SAMPLE, ensure_ascii=False)
    print('\n存盘时就是这么一行:')
    print(' ', line[:100] + ' ...')
    assert '\\n' in line, 'jsonl 里换行是转义的 \\n,一条样本永远占一行'
    print('\n一条样本 = 一行 JSON,换行被转义,所以可以按行流式读')
工单是拼出来的,不是手写的
context 里那三段有严格的空格和换行约定:Input 与正文之间是两个换行,Answer: 后面有一个空格,结尾不加换行。手写字符串迟早会在这几个地方出入,而训练与推理只要差一个字符,模型的行为就会变。把它固化成一个函数,两边都调它:
# -*- coding:utf-8 -*-
"""Instruction 是怎么拼出来的:把三段式做成函数,纯标准库,可直接运行。

手写 context 字符串很容易在空格、换行、冒号上出入,
而训练与推理只要有一个字不一致,模型就像换了一场考试。
所以把它固化成一个函数,两边都调它。
"""
import json

SYSTEM = '你现在是一个很厉害的阅读理解器,严格按照人类指令进行回答。'

TASK_PROMPT = {
    'classify': '下面句子中的主语是什么类别,输出成列表形式。',
    'spo': '找到句子中的三元组信息并输出成json给我:',
    'ner': '找到文章中所有【{entity_type}】类型的实体,并按照JSON格式输出。',
}


def build_context(task: str, sentence: str, **kwargs) -> str:
    """拼出 context。注意三个细节,缺一个就和训练数据对不上:
    1) Input 与正文之间是两个换行;
    2) Answer 后面有一个空格;
    3) 结尾不加换行。
    """
    if task not in TASK_PROMPT:
        raise ValueError('未知任务 %s,可选: %s' % (task, list(TASK_PROMPT)))
    instruction = TASK_PROMPT[task].format(**kwargs) if kwargs else TASK_PROMPT[task]
    return ('Instruction: %s\nInput: %s\n\n%s\nAnswer: '
            % (SYSTEM, instruction, sentence))


def build_sample(task: str, sentence: str, target, **kwargs) -> dict:
    """训练样本 = context + target。target 是对象时序列化成紧凑 JSON。"""
    if not isinstance(target, str):
        target = json.dumps(target, ensure_ascii=False)
    return {'context': build_context(task, sentence, **kwargs), 'target': target}


if __name__ == '__main__':
    ctx = build_context('classify', '朋友说京东上买的水果很新鲜,我就也下单了一箱')
    print(repr(ctx))

    # 训练与推理必须走同一个函数,结果逐字相同
    assert build_context('classify', 'x') == build_context('classify', 'x')
    assert ctx.endswith('Answer: '), 'Answer: 后面那个空格不能丢'
    assert '\n\n' in ctx, 'Input 与正文之间是两个换行'

    print('\n三个任务各生成一条:')
    samples = [
        build_sample('classify', '这款平板续航很顶', ['平板']),
        build_sample('spo', '《霸王别姬》是由张国荣主演的一部电影',
                     [{'predicate': '主演', 'subject': '霸王别姬', 'object': '张国荣'}]),
        build_sample('ner', '北京冬奥会在张家口设了赛区', ['北京', '张家口'], entity_type='地点'),
    ]
    for s in samples:
        print(' ', json.dumps(s, ensure_ascii=False)[:96], '...')

    # 换任务只换 instruction 文本,格式骨架一模一样
    heads = [s['context'].split('\n')[0] for s in samples]
    assert len(set(heads)) == 1, '三个任务的第一行完全相同'
    print('\n三条样本的 Instruction 行完全相同,差别只在 Input 行')

    # 带占位符的任务能格式化进去
    assert '【地点】' in samples[2]['context']
    print('ner 任务的实体类型被填进了模板:',
          samples[2]['context'].split('\n')[1])
特殊 token 与序列拼接
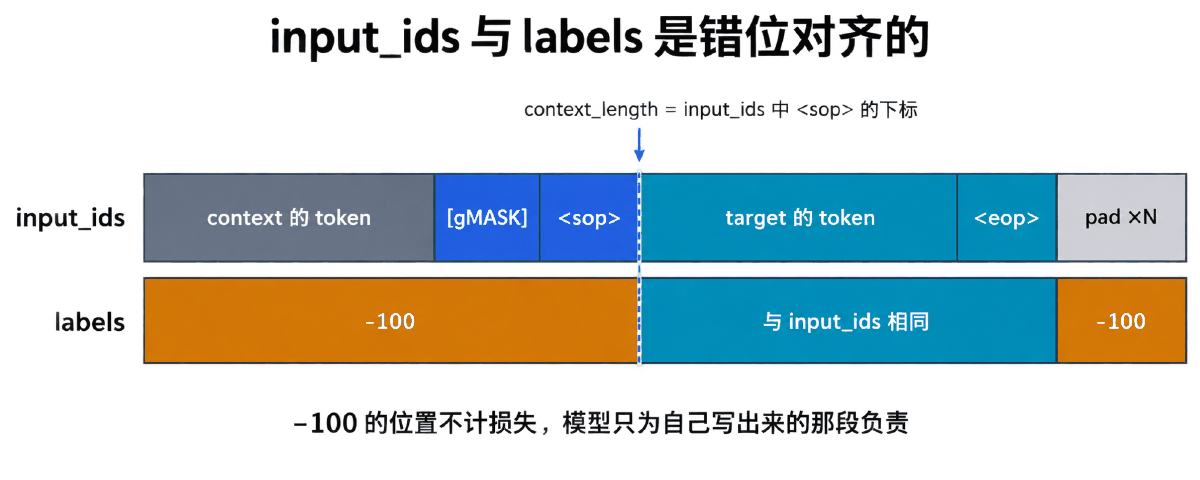
tokenizer.build_inputs_with_special_tokens(prompts_ids, target_ids) 会把两段拼起来并补上 GLM 的特殊标记,结果是这样一条序列:
| 位置 | 内容 | 含义 |
|---|---|---|
| 开头 | context 的 token | 工单正文 |
| 中间 | [gMASK] <sop> | 「从这里开始生成」的分界标记 |
| 之后 | target 的 token | 标准答案 |
| 结尾 | <eop> | 生成结束标记 |
| 尾部 | pad × N | 补齐到固定长度 |
不要自己手拼这几个标记。不同版本的 GLM 在标记数量和顺序上有差异,调分词器的方法才不会错。
labels:把工单涂成 -100
这是整个生成式微调最容易写错、错了又不报错的一步。规则只有两句:
<sop>及之前的位置全部填-100,不计损失。- 之后的位置照抄
input_ids,包括结尾的<eop>。
-100 是 PyTorch 交叉熵的默认 ignore_index,落在这个值上的位置会被完全跳过。代码里对应两行:
context_length = input_ids.index(tokenizer.bos_token_id)—— 找到<sop>的下标。labels = [-100] * context_length + input_ids[mask_position + 1:]
# -*- coding:utf-8 -*-
"""labels 是怎么涂成 -100 的:纯标准库复刻,可直接运行。

这一段是整个生成式微调最容易写错的地方。
写错了不会报错,只会让模型把「提示词」也当成要背下来的内容,
表现是:推理时它把你的 Instruction 一字不差地复读一遍。
"""

GMASK, SOP, EOP, PAD = 150001, 150004, 150005, 3
IGNORE = -100


def build_inputs(prompt_ids, target_ids):
    """复刻 ChatGLM 的 build_inputs_with_special_tokens。"""
    return prompt_ids + [GMASK, SOP] + target_ids + [EOP]


def make_labels(input_ids, bos_token_id=SOP):
    """提示部分涂 -100,答案部分照抄 input_ids。"""
    context_length = input_ids.index(bos_token_id)
    mask_position = context_length - 1
    return [IGNORE] * context_length + input_ids[mask_position + 1:]


def pad_to(input_ids, labels, max_len):
    pad_len = max_len - len(input_ids)
    return (input_ids + [PAD] * pad_len,
            labels + [IGNORE] * pad_len)   # 标签补 -100,不是补 PAD


if __name__ == '__main__':
    prompt_ids = [5001, 5002, 5003, 5004]      # "Instruction: ... Answer: "
    target_ids = [7001, 7002]                  # '["水果"]'

    input_ids = build_inputs(prompt_ids, target_ids)
    print('input_ids:', input_ids)
    assert input_ids == [5001, 5002, 5003, 5004, GMASK, SOP, 7001, 7002, EOP]

    labels = make_labels(input_ids)
    print('labels   :', labels)
    assert len(labels) == len(input_ids), 'labels 必须和 input_ids 等长'

    # 关键性质一:<sop> 及之前全部是 -100
    context_length = input_ids.index(SOP)
    print('\ncontext_length(<sop> 的下标):', context_length)
    assert labels[:context_length] == [IGNORE] * context_length
    print('前 %d 个位置不计损失' % context_length)

    # 关键性质二:答案段与 input_ids 逐元素相同
    assert labels[context_length:] == input_ids[context_length:]
    print('从下标 %d 起,labels 与 input_ids 完全一致:' % context_length,
          labels[context_length:])

    # 关键性质三:<eop> 要参与损失,模型才学得会「写完就停」
    assert labels[-1] == EOP, '结束符必须计损失,否则模型不知道何时停下'
    print('结束符 <eop> 参与损失 -> 模型学得会停笔')

    # padding 之后再验一次
    ids_p, labels_p = pad_to(input_ids, labels, 16)
    print('\npad 到 16:')
    print('  input_ids:', ids_p)
    print('  labels   :', labels_p)
    assert labels_p[len(input_ids):] == [IGNORE] * 7
    assert IGNORE not in ids_p, 'input_ids 里不能出现 -100'

    # 对照:labels 补 PAD 的错误写法
    wrong = labels + [PAD] * (16 - len(labels))
    diff = sum(1 for a, b in zip(labels_p, wrong) if a != b)
    print('\n标签补 PAD(错误)会让 %d 个位置变成「要模型学着输出 padding」' % diff)
    assert diff == 7

    # 统计参与损失的 token 占比 —— 数据质量的一个硬指标
    valid = sum(1 for t in labels_p if t != IGNORE)
    print('\n参与损失的 token: %d / %d = %.1f%%' % (valid, len(labels_p), 100 * valid / len(labels_p)))
    print('这个比例太低(比如 5%)说明提示太长、答案太短,训练信号被稀释')
三条必须成立的性质,脚本里都用断言钉住了:
| 性质 | 怎么验 | 不成立的后果 |
|---|---|---|
| 两者等长 | len(labels) == len(input_ids) | 形状不匹配,训练直接报错 |
| 前缀全是 -100 | 前 context_length 个都是 -100 | 模型去背工单,推理时把 Instruction 复读一遍 |
| 结束符计损失 | labels[-1] 是 <eop> | 模型学不会停笔,一直写到长度上限 |
padding 补什么
input_ids 补 pad_token_id,labels 补 -100。两边补的东西不一样,这是最容易顺手写错的地方——顺着上一行复制粘贴,就会把 labels 也补成 pad_token_id,于是模型开始努力学习「答案写完之后再输出一串 padding」。
还有一个有用的副产品:labels 里非 -100 的比例,就是真正参与损失的 token 占比。这个数太低(比如 5%)说明工单太长、答案太短,训练信号被稀释,要么精简 Instruction,要么把 max_source_seq_len 调小。开训前打印一个 batch 的这个比例,比看十行日志有用。
03最小代码:编码一条样本
不加载 6B 模型,只把 input_ids 与 labels 对齐关系验证清楚
加载 ChatGLM-6B 要十几 GB 显存,为了验证一个下标关系不值得。最短路径是用假的 token id 把拼接和涂色走一遍,形状与性质对了再上真模型。
# -*- coding:utf-8 -*-
"""labels 是怎么涂成 -100 的:纯标准库复刻,可直接运行。

这一段是整个生成式微调最容易写错的地方。
写错了不会报错,只会让模型把「提示词」也当成要背下来的内容,
表现是:推理时它把你的 Instruction 一字不差地复读一遍。
"""

GMASK, SOP, EOP, PAD = 150001, 150004, 150005, 3
IGNORE = -100


def build_inputs(prompt_ids, target_ids):
    """复刻 ChatGLM 的 build_inputs_with_special_tokens。"""
    return prompt_ids + [GMASK, SOP] + target_ids + [EOP]


def make_labels(input_ids, bos_token_id=SOP):
    """提示部分涂 -100,答案部分照抄 input_ids。"""
    context_length = input_ids.index(bos_token_id)
    mask_position = context_length - 1
    return [IGNORE] * context_length + input_ids[mask_position + 1:]


def pad_to(input_ids, labels, max_len):
    pad_len = max_len - len(input_ids)
    return (input_ids + [PAD] * pad_len,
            labels + [IGNORE] * pad_len)   # 标签补 -100,不是补 PAD


if __name__ == '__main__':
    prompt_ids = [5001, 5002, 5003, 5004]      # "Instruction: ... Answer: "
    target_ids = [7001, 7002]                  # '["水果"]'

    input_ids = build_inputs(prompt_ids, target_ids)
    print('input_ids:', input_ids)
    assert input_ids == [5001, 5002, 5003, 5004, GMASK, SOP, 7001, 7002, EOP]

    labels = make_labels(input_ids)
    print('labels   :', labels)
    assert len(labels) == len(input_ids), 'labels 必须和 input_ids 等长'

    # 关键性质一:<sop> 及之前全部是 -100
    context_length = input_ids.index(SOP)
    print('\ncontext_length(<sop> 的下标):', context_length)
    assert labels[:context_length] == [IGNORE] * context_length
    print('前 %d 个位置不计损失' % context_length)

    # 关键性质二:答案段与 input_ids 逐元素相同
    assert labels[context_length:] == input_ids[context_length:]
    print('从下标 %d 起,labels 与 input_ids 完全一致:' % context_length,
          labels[context_length:])

    # 关键性质三:<eop> 要参与损失,模型才学得会「写完就停」
    assert labels[-1] == EOP, '结束符必须计损失,否则模型不知道何时停下'
    print('结束符 <eop> 参与损失 -> 模型学得会停笔')

    # padding 之后再验一次
    ids_p, labels_p = pad_to(input_ids, labels, 16)
    print('\npad 到 16:')
    print('  input_ids:', ids_p)
    print('  labels   :', labels_p)
    assert labels_p[len(input_ids):] == [IGNORE] * 7
    assert IGNORE not in ids_p, 'input_ids 里不能出现 -100'

    # 对照:labels 补 PAD 的错误写法
    wrong = labels + [PAD] * (16 - len(labels))
    diff = sum(1 for a, b in zip(labels_p, wrong) if a != b)
    print('\n标签补 PAD(错误)会让 %d 个位置变成「要模型学着输出 padding」' % diff)
    assert diff == 7

    # 统计参与损失的 token 占比 —— 数据质量的一个硬指标
    valid = sum(1 for t in labels_p if t != IGNORE)
    print('\n参与损失的 token: %d / %d = %.1f%%' % (valid, len(labels_p), 100 * valid / len(labels_p)))
    print('这个比例太低(比如 5%)说明提示太长、答案太短,训练信号被稀释')
接上真实分词器之后,就是项目里的编码函数。它比 BERT 版简单:没有 token_type_ids,也没有 attention_mask——ChatGLM 的 forward 会根据 <sop> 的位置自己构造注意力掩码,我们只负责给对两个字段:
# -*- coding:utf-8 -*-
"""把一条 {context, target} 变成 ChatGLM 能吃的 input_ids / labels。

生成式微调与 BERT 分类最大的认知差:
输入和标签是**同一条序列**,只是标签把「提示部分」全部涂成 -100,
让损失只落在模型自己要写出来的那一段上。
"""
import numpy as np


def convert_example(examples: dict,
                    tokenizer,
                    max_source_seq_len: int,
                    max_target_seq_len: int):
    """
    参数:
        examples: {'text': ['{"context": "...", "target": "..."}', ...]},每行一条 jsonl
        max_source_seq_len: 提示部分最长 token 数
        max_target_seq_len: 回答部分最长 token 数
    返回:
        {'input_ids': [...], 'labels': [...]},两者等长
    """
    import json

    tokenized_output = {'input_ids': [], 'labels': []}
    max_seq_length = max_source_seq_len + max_target_seq_len

    for example in examples['text']:
        try:
            example = json.loads(example)
            context = example['context']
            target = example['target']

            # prompt 部分:不加特殊 token,后面手动拼
            prompts_ids = tokenizer.encode(text=context, add_special_tokens=False)
            target_ids = tokenizer.encode(text=target, add_special_tokens=False)

            # 超长就截断。截 prompt 会丢掉 Instruction 的尾部,
            # 截 target 会让模型学到「答案写一半就停」——两种都要在数据阶段先统计好
            if len(prompts_ids) >= max_source_seq_len:
                prompts_ids = prompts_ids[:max_source_seq_len - 1]
            if len(target_ids) >= max_target_seq_len - 1:
                target_ids = target_ids[:max_target_seq_len - 2]

            # build_inputs_with_special_tokens 会补上 [gMASK] 与 <sop>,
            # 并在结尾补 <eop>,这是 GLM 系列的生成格式,别自己手拼
            input_ids = tokenizer.build_inputs_with_special_tokens(prompts_ids, target_ids)

            # <sop> 的下标 = 提示部分的长度。labels 从这里开始才是真答案
            context_length = input_ids.index(tokenizer.bos_token_id)
            mask_position = context_length - 1

            labels = [-100] * context_length + input_ids[mask_position + 1:]

            pad_len = max_seq_length - len(input_ids)
            input_ids = input_ids + [tokenizer.pad_token_id] * pad_len
            # 标签这边补的是 -100 而不是 pad_token_id:
            # 补 pad_token_id 会让模型努力去学「输出一串 padding」
            labels = labels + [-100] * pad_len

            tokenized_output['input_ids'].append(input_ids)
            tokenized_output['labels'].append(labels)
        except Exception as e:
            print('[跳过] 解析失败:', e)
            continue

    for k, v in tokenized_output.items():
        tokenized_output[k] = np.array(v)
    return tokenized_output


if __name__ == '__main__':
    from transformers import AutoTokenizer

    tokenizer = AutoTokenizer.from_pretrained('./ChatGLM-6B', trust_remote_code=True)
    out = convert_example(
        {'text': ['{"context": "Instruction: 你是阅读理解器\\nAnswer: ", "target": "[\\"水果\\"]"}']},
        tokenizer, max_source_seq_len=100, max_target_seq_len=100)
    print('input_ids 形状:', out['input_ids'].shape)
    print('labels    形状:', out['labels'].shape)
    print('labels 里 -100 的个数:', int((out['labels'] == -100).sum()))
04完整案例:新媒体评论的两个任务
一套数据管线,同时喂饱分类和信息抽取
业务场景
新媒体运营每天要处理几万条评论,需求有两个:
- 分类——这条评论在说哪个品类,用来把评论分流到不同的运营组。
- 信息抽取——把评论里提到的实体关系抽成三元组(主语、谓语、宾语),沉淀成可查询的知识库。
用判别式方案要做两个模型:一个分类头、一套 NER/关系抽取的标注体系。用生成式方案,两件事共用一份数据格式、一次训练、一个模型。
配置
# -*- coding:utf-8 -*-
"""ChatGLM + LoRA 的工程配置。

和 BERT 路线最大的差别:这里不再有「类别数」这种概念。
任务是什么,全靠 instruction 文本说清楚;换任务不改代码,只改数据。
"""
import os

import torch


class ProjectConfig(object):
    def __init__(self):
        self.device = 'cuda:0' if torch.cuda.is_available() else 'cpu'
        self.root = os.environ.get(
            'GLM_PROJECT_ROOT',
            os.path.dirname(os.path.abspath(__file__)),
        )
        # 底座:ChatGLM-6B,62 亿参数,GLM 架构,28 层,hidden_size 4096
        self.pre_model = os.path.join(self.root, 'ChatGLM-6B')
        self.train_path = os.path.join(self.root, 'data', 'mixed_train_dataset.jsonl')
        self.dev_path = os.path.join(self.root, 'data', 'mixed_dev_dataset.jsonl')

        # LoRA 三件套
        self.use_lora = True
        self.lora_rank = 8          # 秩:A 是 (hidden, 8),B 是 (8, out)
        self.lora_alpha = 32        # 缩放系数,实际缩放 = alpha / rank = 4
        self.lora_dropout = 0.1

        self.use_ptuning = False    # 与 LoRA 二选一,不要同时开
        self.pre_seq_len = 128
        self.prefix_projection = False

        # 显存敏感项:batch 只能给到 2,靠梯度累积把等效 batch 撑起来
        self.batch_size = 2
        self.gradient_accumulation_steps = 8
        self.epochs = 2
        self.learning_rate = 1e-4   # 比全参微调的 5e-5 大一个量级:只训 0.06% 的参数,学慢了学不动
        self.weight_decay = 0
        self.warmup_ratio = 0.06

        # 输入输出各留 100 个 token。超了直接截断,不会报错
        self.max_source_seq_len = 100
        self.max_target_seq_len = 100

        self.logging_steps = 10
        self.save_freq = 1000
        self.save_dir = os.path.join(self.root, 'checkpoints', 'ptune')


if __name__ == '__main__':
    pc = ProjectConfig()
    print('设备          :', pc.device)
    print('等效 batch    :', pc.batch_size * pc.gradient_accumulation_steps)
    print('LoRA 缩放系数 :', pc.lora_alpha / pc.lora_rank)
    print('单条最长 token:', pc.max_source_seq_len + pc.max_target_seq_len)
与前三页的 BERT 配置对比,多出来和少掉的都值得注意:
| 配置项 | 取值 | 为什么 |
|---|---|---|
batch_size | 2 | 6B 模型半精度就要十几 GB,batch 只能给到个位数 |
gradient_accumulation_steps | 8 | 攒 8 步再更新,等效 batch 是 16,把显存换成时间 |
learning_rate | 1e-4 | 比 BERT 全参微调的 5e-5 大一个量级——只训 0.06% 的参数,学慢了学不动 |
epochs | 2 | 生成式微调很容易过拟合,轮数远少于 BERT 的 10 |
max_source_seq_len | 100 | 工单 + 正文的预算;固定 Instruction 头就吃掉一半 |
max_target_seq_len | 100 | 按最长的那个任务定,SPO 的 JSON 比分类长一个数量级 |
| 类别数 | 没有 | 任务靠 Instruction 文本说清,不靠结构写死 |
开训前必做:截断体检
max_source_seq_len=100 是配置里的默认值,不是普适真理。那句固定的 Instruction 头本身就占掉五十几个 token,正文只剩四十来个。评论类短文本勉强够,SPO 抽取的 target 是一串 JSON,两个三元组就能顶到 75 个 token。
# -*- coding:utf-8 -*-
"""开训前必做:统计有多少条样本会被 max_source/target_seq_len 截断。

max_source_seq_len=100 是配置里写死的默认值,不是普适真理。
新媒体评论普遍短,但 SPO 抽取任务的 target 是一串 JSON,
很容易超过 100 个 token —— 被截断的样本会教模型「写一半就交卷」。
"""
import json

MAX_SOURCE, MAX_TARGET = 100, 100


def rough_token_len(text: str) -> int:
    """粗估 token 数:中文按字算,ASCII 连续段按 4 个字符 1 token 估。

    真实统计请换成 tokenizer.encode(text, add_special_tokens=False) 的长度;
    这里用粗估是为了在没有模型权重的机器上也能先跑一遍体检。
    """
    n, ascii_run = 0, 0
    for ch in text:
        if ord(ch) < 128:
            ascii_run += 1
        else:
            n += 1 + (ascii_run + 3) // 4
            ascii_run = 0
    return n + (ascii_run + 3) // 4


def audit(samples):
    over_src = over_tgt = 0
    src_lens, tgt_lens = [], []
    for s in samples:
        sl, tl = rough_token_len(s['context']), rough_token_len(s['target'])
        src_lens.append(sl)
        tgt_lens.append(tl)
        over_src += sl >= MAX_SOURCE
        over_tgt += tl >= MAX_TARGET - 1
    return {
        'total': len(samples),
        'src_max': max(src_lens), 'src_avg': sum(src_lens) / len(src_lens),
        'tgt_max': max(tgt_lens), 'tgt_avg': sum(tgt_lens) / len(tgt_lens),
        'over_src': over_src, 'over_tgt': over_tgt,
    }


if __name__ == '__main__':
    head = ('Instruction: 你现在是一个很厉害的阅读理解器,严格按照人类指令进行回答。\n'
            'Input: 找到句子中的三元组信息并输出成json给我:\n\n')
    samples = [
        {'context': head + '这款平板续航很顶\nAnswer: ', 'target': '["平板"]'},
        {'context': head + '《霸王别姬》是由张国荣主演的一部电影\nAnswer: ',
         'target': '```json\n[{"predicate": "主演", "object_type": "人物", '
                   '"subject_type": "影视作品", "object": "张国荣", "subject": "霸王别姬"}]\n```'},
        {'context': head + '《活着》是余华在1992年发表的长篇小说,讲述了福贵一生的故事\nAnswer: ',
         'target': '```json\n[{"predicate": "作者", "object_type": "人物", '
                   '"subject_type": "图书作品", "object": "余华", "subject": "活着"}, '
                   '{"predicate": "出版时间", "object_type": "时间", '
                   '"subject_type": "图书作品", "object": "1992年", "subject": "活着"}]\n```'},
    ]

    stat = audit(samples)
    print('样本数        :', stat['total'])
    print('source 平均/最长: %.1f / %d  (上限 %d)' % (stat['src_avg'], stat['src_max'], MAX_SOURCE))
    print('target 平均/最长: %.1f / %d  (上限 %d)' % (stat['tgt_avg'], stat['tgt_max'], MAX_TARGET))
    print('会被截断的 source: %d 条' % stat['over_src'])
    print('会被截断的 target: %d 条' % stat['over_tgt'])

    # 光是这条固定的 Instruction 头就吃掉多少预算
    head_len = rough_token_len(head)
    print('\n固定 Instruction 头占 %d 个 token,正文只剩 %d 个'
          % (head_len, MAX_SOURCE - head_len))
    assert head_len > 40, 'Instruction 头本身就很长,这是新手最容易忽略的一笔开销'

    # 两条 SPO 的样本,target 比分类长一个数量级
    cls_t = rough_token_len(samples[0]['target'])
    spo_t = rough_token_len(samples[2]['target'])
    print('分类 target %d token vs 双三元组 target %d token,差 %.1f 倍'
          % (cls_t, spo_t, spo_t / cls_t))
    assert spo_t > cls_t * 5
    print('\n结论:同一份 max_target_seq_len 同时服务两个任务时,按长的那个任务定')
体检要看四个数:source 的平均与最长、target 的平均与最长、会被截断的条数、固定头占用的比例。任何一项超标,要么调长度上限,要么精简 Instruction,不要直接开训。
rough_token_len() 是粗估(中文按字算、ASCII 按 4 字符 1 token),目的是在没有模型权重的机器上也能先跑一遍体检。拿到模型后换成 tokenizer.encode(text, add_special_tokens=False) 的长度,结论更准。
DataLoader
# -*- coding:utf-8 -*-
"""生成式微调的 DataLoader。

比 BERT 路线简单:没有 token_type_ids,没有 attention_mask ——
ChatGLM 的 forward 会根据 input_ids 里的 <sop> 位置自己构造注意力掩码。
我们只负责给对 input_ids 与 labels。
"""
from functools import partial

from datasets import load_dataset
from torch.utils.data import DataLoader
from transformers import AutoTokenizer, default_data_collator

from data_handle import convert_example
from glm_config import ProjectConfig

pc = ProjectConfig()
# trust_remote_code=True:ChatGLM 的分词器实现放在模型仓库里,不在 transformers 本体
tokenizer = AutoTokenizer.from_pretrained(pc.pre_model, trust_remote_code=True)


def get_data():
    dataset = load_dataset('text', data_files={'train': pc.train_path,
                                               'dev': pc.dev_path})
    new_func = partial(convert_example,
                       tokenizer=tokenizer,
                       max_source_seq_len=pc.max_source_seq_len,
                       max_target_seq_len=pc.max_target_seq_len)

    # batched=True:一次处理一批,比逐条快很多。
    # 注意 convert_example 内部是按条循环的,这里的 batch 只是为了减少函数调用开销
    dataset = dataset.map(new_func, batched=True)

    train_dataloader = DataLoader(dataset['train'],
                                  shuffle=True,
                                  collate_fn=default_data_collator,
                                  batch_size=pc.batch_size)
    dev_dataloader = DataLoader(dataset['dev'],
                                collate_fn=default_data_collator,
                                batch_size=pc.batch_size)
    return train_dataloader, dev_dataloader


if __name__ == '__main__':
    train_dataloader, dev_dataloader = get_data()
    print('train batch 数:', len(train_dataloader))
    print('dev   batch 数:', len(dev_dataloader))
    for batch in train_dataloader:
        print('字段:', list(batch.keys()))
        print('形状:', {k: tuple(v.shape) for k, v in batch.items()})
        # 训练开始前最值得看的一眼:这一批里有多少 token 真的参与了损失
        valid = int((batch['labels'] != -100).sum())
        total = batch['labels'].numel()
        print('参与损失的 token: %d / %d = %.1f%%' % (valid, total, 100 * valid / total))
        break
三个要点:
trust_remote_code=True不能省。ChatGLM 的分词器和建模代码放在模型仓库里,不在transformers本体。- 只有
input_ids与labels两个字段。attention_mask由模型内部按<sop>位置构造。 - 拿到第一个 batch 先打印参与损失的 token 占比。这个数比 batch 形状更能说明数据质量。
从业务数据到 jsonl
真实项目里拿到的是 Excel 导出或标注平台的结果,离能开训还差一个转换脚本。它要做四件事:拼工单、序列化答案、固定种子打散、切分训练与验证集。
# -*- coding:utf-8 -*-
"""骨架模板:把你自己的标注数据转成这套 jsonl。

拿到一份业务数据(Excel 导出、爬虫结果、标注平台导出),
到能开训之间就差这一个脚本。四个 TODO 填完即可。
"""
import json
import random

# TODO-1: 系统角色描述。定了之后训练与推理都不能再改
SYSTEM = '你现在是一个很厉害的阅读理解器,严格按照人类指令进行回答。'
# TODO-2: 每个任务一句话指令
INSTRUCTIONS = {
    'classify': '下面句子中的主语是什么类别,输出成列表形式。',
    'spo': '找到句子中的三元组信息并输出成json给我:',
}
# TODO-3: 验证集比例
DEV_RATIO = 0.1
SEED = 42


def build_context(task: str, sentence: str) -> str:
    return ('Instruction: %s\nInput: %s\n\n%s\nAnswer: '
            % (SYSTEM, INSTRUCTIONS[task], sentence))


def build_target(task: str, answer) -> str:
    """分类返回裸 JSON 列表;抽取包一层 ```json 围栏,与原项目保持一致。"""
    body = json.dumps(answer, ensure_ascii=False)
    if task == 'spo':
        return '```json\n%s\n```' % body
    return body


def iter_raw():
    """TODO-4: 换成你自己的数据源,yield (task, sentence, answer)。"""
    yield 'classify', '朋友说京东上买的水果很新鲜,我就也下单了一箱', ['水果']
    yield 'classify', '这款平板的续航是真顶,出差两天没充电', ['平板']
    yield 'spo', '《霸王别姬》是由张国荣主演的一部电影', [
        {'predicate': '主演', 'subject': '霸王别姬', 'object': '张国荣'}]


def main(train_path='mixed_train_dataset.jsonl', dev_path='mixed_dev_dataset.jsonl'):
    samples = []
    for task, sentence, answer in iter_raw():
        if task not in INSTRUCTIONS:
            print('[跳过] 未知任务', task)
            continue
        samples.append({'context': build_context(task, sentence),
                        'target': build_target(task, answer)})

    # 固定随机种子再打散:两个任务混在一起训练时,顺序必须是乱的,
    # 否则前半程全是分类、后半程全是抽取,模型会在后半程「忘掉」前一个任务
    random.Random(SEED).shuffle(samples)

    n_dev = max(1, int(len(samples) * DEV_RATIO))
    dev, train = samples[:n_dev], samples[n_dev:]

    for path, rows in ((train_path, train), (dev_path, dev)):
        with open(path, 'w', encoding='utf8') as f:
            for r in rows:
                f.write(json.dumps(r, ensure_ascii=False) + '\n')
        print('写出 %s: %d 条' % (path, len(rows)))
    return len(train), len(dev)


if __name__ == '__main__':
    import os
    import tempfile

    tmp = tempfile.mkdtemp()
    n_train, n_dev = main(os.path.join(tmp, 'train.jsonl'), os.path.join(tmp, 'dev.jsonl'))
    assert n_train + n_dev == 3

    # 回读校验:每一行都必须是合法 JSON 且字段齐全
    with open(os.path.join(tmp, 'train.jsonl'), encoding='utf8') as f:
        for line in f:
            row = json.loads(line)
            assert set(row) == {'context', 'target'}
            assert row['context'].endswith('Answer: ')
    print('回读校验通过:每行都是合法 JSON,字段齐全,context 以 Answer: 收尾')
脚本最后带一段回读校验:写完再逐行读回来,确认每行都是合法 JSON、字段齐全、context 以 Answer: 收尾。写文件的脚本自己检查自己的产物,成本几乎为零,能挡掉的却是「训练跑了两小时才发现数据有问题」。
05骨架模板
换一个业务,改四个 TODO
# -*- coding:utf-8 -*-
"""骨架模板:把你自己的标注数据转成这套 jsonl。

拿到一份业务数据(Excel 导出、爬虫结果、标注平台导出),
到能开训之间就差这一个脚本。四个 TODO 填完即可。
"""
import json
import random

# TODO-1: 系统角色描述。定了之后训练与推理都不能再改
SYSTEM = '你现在是一个很厉害的阅读理解器,严格按照人类指令进行回答。'
# TODO-2: 每个任务一句话指令
INSTRUCTIONS = {
    'classify': '下面句子中的主语是什么类别,输出成列表形式。',
    'spo': '找到句子中的三元组信息并输出成json给我:',
}
# TODO-3: 验证集比例
DEV_RATIO = 0.1
SEED = 42


def build_context(task: str, sentence: str) -> str:
    return ('Instruction: %s\nInput: %s\n\n%s\nAnswer: '
            % (SYSTEM, INSTRUCTIONS[task], sentence))


def build_target(task: str, answer) -> str:
    """分类返回裸 JSON 列表;抽取包一层 ```json 围栏,与原项目保持一致。"""
    body = json.dumps(answer, ensure_ascii=False)
    if task == 'spo':
        return '```json\n%s\n```' % body
    return body


def iter_raw():
    """TODO-4: 换成你自己的数据源,yield (task, sentence, answer)。"""
    yield 'classify', '朋友说京东上买的水果很新鲜,我就也下单了一箱', ['水果']
    yield 'classify', '这款平板的续航是真顶,出差两天没充电', ['平板']
    yield 'spo', '《霸王别姬》是由张国荣主演的一部电影', [
        {'predicate': '主演', 'subject': '霸王别姬', 'object': '张国荣'}]


def main(train_path='mixed_train_dataset.jsonl', dev_path='mixed_dev_dataset.jsonl'):
    samples = []
    for task, sentence, answer in iter_raw():
        if task not in INSTRUCTIONS:
            print('[跳过] 未知任务', task)
            continue
        samples.append({'context': build_context(task, sentence),
                        'target': build_target(task, answer)})

    # 固定随机种子再打散:两个任务混在一起训练时,顺序必须是乱的,
    # 否则前半程全是分类、后半程全是抽取,模型会在后半程「忘掉」前一个任务
    random.Random(SEED).shuffle(samples)

    n_dev = max(1, int(len(samples) * DEV_RATIO))
    dev, train = samples[:n_dev], samples[n_dev:]

    for path, rows in ((train_path, train), (dev_path, dev)):
        with open(path, 'w', encoding='utf8') as f:
            for r in rows:
                f.write(json.dumps(r, ensure_ascii=False) + '\n')
        print('写出 %s: %d 条' % (path, len(rows)))
    return len(train), len(dev)


if __name__ == '__main__':
    import os
    import tempfile

    tmp = tempfile.mkdtemp()
    n_train, n_dev = main(os.path.join(tmp, 'train.jsonl'), os.path.join(tmp, 'dev.jsonl'))
    assert n_train + n_dev == 3

    # 回读校验:每一行都必须是合法 JSON 且字段齐全
    with open(os.path.join(tmp, 'train.jsonl'), encoding='utf8') as f:
        for line in f:
            row = json.loads(line)
            assert set(row) == {'context', 'target'}
            assert row['context'].endswith('Answer: ')
    print('回读校验通过:每行都是合法 JSON,字段齐全,context 以 Answer: 收尾')
| TODO | 填什么 | 注意 |
|---|---|---|
| TODO-1 角色描述 | Instruction 的第一句 | 定下来就不能改;改了必须重新训练 |
| TODO-2 任务指令 | 每个任务一句话 | 措辞要能区分开不同任务,别写成两句近义句 |
| TODO-3 验证集比例 | 通常 0.1 | 样本少时至少保证每个任务都有验证样本 |
| TODO-4 数据源 | iter_raw() 换成你的读取逻辑 | 用 yield 流式产出,大文件不必全部读进内存 |
答案格式要不要包代码围栏
本讲的原始数据里,SPO 抽取的 target 外面包了一层 ```json 围栏,分类任务的没有。这是两种风格,各有理由:
| 写法 | 好处 | 代价 |
|---|---|---|
| 裸 JSON | 解析直接 json.loads,少一步 | 模型偶尔会自己加围栏,下游还得兼容 |
| 包 ```json 围栏 | 和模型的自然倾向一致,边界清晰 | 解析前必须先剥围栏 |
选哪个都行,但一份数据集里必须统一。混着来,模型学到的是「有时候加有时候不加」,下游解析永远要兼容两种,还没法用「是否带围栏」当质量信号。
加第三个任务要动什么
| 步骤 | 动作 | 检查点 |
|---|---|---|
| 1 | INSTRUCTIONS 里加一条 | 措辞与已有两条有明显区分度 |
| 2 | iter_raw() 产出新任务的样本 | 答案格式与已有任务风格统一 |
| 3 | 重跑截断体检 | 新任务的 target 是不是更长 |
| 4 | 重新 shuffle 并切分 | 三个任务在训练集里交替出现 |
| 5 | 训练代码 | 不用改 |
06易错点汇总
按「提示一致性 / labels / 长度 / 数据构造」四类归并
⚠️ 一、提示一致性
- 训练与推理的工单差一个空格。
Answer:后面那个空格、Input与正文之间那两个换行,任何一处不一致,对模型来说就是另一场考试。指标掉得莫名其妙,日志里没有任何异常。唯一可靠的防法是把拼接固化成函数,两边都调它。 - Instruction 改了却没重新训练。 角色描述那一句是模型行为的锚点,改一个字就该重训。线上悄悄改文案是很常见的事故源。
Answer:这个锚点被去掉。 推理时要靠它切出模型写的部分。去掉之后只能靠猜边界,模型复读的工单内容会混进结果里。- 两个任务的 Instruction 写成近义句。 「找出三元组」和「抽取三元组信息」区分度太低,模型分不清该走哪套输出格式。措辞要有明显差异。
⚠️ 二、labels 对齐
- labels 直接等于 input_ids,没有涂 -100。 模型把整张工单一起背下来,推理时会把你的 Instruction 一字不差地复读一遍。这是生成式微调最典型的症状。
- padding 时给 labels 补了
pad_token_id。 顺着上一行复制粘贴就会这么写。后果是模型努力学习「答案写完再输出一串 padding」。labels 补的必须是-100。 - 把
<eop>也涂成 -100。 结束符不计损失,模型学不会停笔,推理时会一直写到max_new_tokens上限,后面全是重复内容。 - 手拼
[gMASK]、<sop>。 不同版本的 GLM 在标记数量和顺序上有差异。用build_inputs_with_special_tokens(),别自己拼。 context_length用len(prompts_ids)代替。 特殊 token 补进来之后,提示段的实际长度已经变了。必须用input_ids.index(bos_token_id)去定位。- 参与损失的 token 占比没看过。 这个数太低(比如 5%)说明工单太长、答案太短,训练信号被稀释。开训前打印一个 batch 的这个比例,几秒钟的事。
⚠️ 三、长度与截断
- 照抄
max_source_seq_len=100不做体检。 固定的 Instruction 头就吃掉五十几个 token,正文只剩四十来个。长一点的评论直接被腰斩。 - target 被截断。 比 source 被截更糟:模型学到的是「答案写一半就停」,上线后稳定输出残缺 JSON,而且训练日志里看不出任何异常。
- 两个任务共用一份
max_target_seq_len却按短的那个定。 分类的 target 只有几个 token,SPO 的 JSON 能到七八十个。必须按长的那个任务定。 - 用字符数当 token 数估。 中文大致一字一 token,英文和数字是几个字符一个 token。混排文本用字符数估会偏得很多,拿到分词器后要用真实编码长度重算。
⚠️ 四、数据构造
- 混合任务没打散顺序。 前半程全分类、后半程全抽取,模型在后半程会「忘掉」前一个任务。必须 shuffle,而且用固定种子以便复现。
- 答案格式不统一。 一部分包
```json围栏、一部分不包,模型学到的是「有时候加有时候不加」,下游解析永远要兼容两种。一份数据集里必须统一。 - jsonl 里出现真实换行。 一条样本被读成两行,后一行不是合法 JSON,要么报错要么被静默跳过。
json.dumps会自动转义,手写文件时才会踩到。 ensure_ascii用了默认的 True。 中文全被转成\uXXXX,文件能用但完全没法人工看,出问题时排查成本剧增。写中文数据一律ensure_ascii=False。- 写完不回读校验。 逐行读回来确认是合法 JSON、字段齐全、
context以Answer:收尾,几乎零成本,能挡掉「训练两小时才发现数据有问题」。 - 验证集里没有覆盖到某个任务。 切分时不分层,随机切可能把某个任务的样本全分到训练集,那个任务的验证指标完全空白。
07自测题
点击题目展开答案;这 9 题过了,生成式微调的数据侧就通了
生成式微调与判别式微调,在「类别」这件事上最大的差别是什么?
判别式必须事先把类别数定死,输出天然落在类别集合内;生成式没有类别这个概念,任务靠 Instruction 文本说清,换任务只改文字。代价是输出不再受结构约束,可能写出解析不了的东西——下游必须自己设解析与字段校验闸。
context 的三段分别是什么?哪一段是换任务时唯一要改的?
Instruction(角色与总体约束,所有任务共用一句)、Input(具体任务描述 + 空行 + 待处理句子)、Answer: (固定收尾,留空给模型写)。换任务只改 Input 段的任务描述。
为什么两个任务可以混在一个文件里一起训练?要注意什么?
因为它们共用同一套字段结构(context / target),模型按 Instruction 措辞自动切换行为。要注意必须用固定种子 shuffle 打散顺序——前半程全分类、后半程全抽取会让模型在后半程忘掉前一个任务。
labels 里的 -100 是什么?分界线在哪?
-100 是 PyTorch 交叉熵的默认 ignore_index,落在这个值的位置完全不计损失。分界线是 <sop> 的下标:之前全部涂 -100,之后照抄 input_ids(包括结尾的 <eop>)。
labels 没涂 -100 会出现什么现象?
模型把整张工单一起背下来,推理时把你的 Instruction 一字不差复读一遍再写答案。这是生成式微调最典型的症状,看到复读先查 labels。
padding 时 input_ids 和 labels 分别补什么?补错会怎样?
input_ids 补 pad_token_id,labels 补 -100。把 labels 也补成 pad_token_id,模型会努力学习「答案写完之后再输出一串 padding」。另外 <eop> 必须计损失,涂成 -100 会让模型学不会停笔。
max_source_seq_len=100 时,正文实际能用多少?
远不到 100。那句固定的 Instruction 头本身就占五十几个 token,正文只剩四十来个。所以这个默认值必须做截断体检之后再决定沿用还是调大,不能照抄。
source 被截断和 target 被截断,哪个后果更严重?
target 被截更严重。 截 source 丢的是 Instruction 尾部,模型可能不知道输出格式;截 target 让模型学到「答案写一半就停」,上线后稳定输出残缺 JSON,而训练日志里毫无异常。
为什么本讲的 DataLoader 里没有 attention_mask?
ChatGLM 的 forward 会根据 input_ids 里 <sop> 的位置自己构造注意力掩码,不需要外部传。我们只负责给对 input_ids 与 labels 两个字段。这和 BERT 路线必须手工重算掩码是相反的。
附术语表
| 术语 | 英文原形 | 含义 |
|---|---|---|
| 指令微调 | instruction tuning | 用「指令 + 输入 + 答案」的样本训练生成式模型,让它按指令产出结构化输出 |
| 工单 / 提示段 | context | Instruction + Input + Answer: 三段式;训练与推理必须逐字一致 |
| 目标段 | target | 标准答案,通常是一段严格 JSON |
| 忽略标记 | -100 | PyTorch 交叉熵的默认 ignore_index,该位置完全不计损失 |
| 生成起始符 | <sop> | GLM 的「从这里开始生成」标记;labels 的分界线就是它的下标 |
| 生成结束符 | <eop> | 生成结束标记,必须参与损失,否则模型学不会停笔 |
| 全局掩码符 | [gMASK] | GLM 架构的特殊标记,由分词器自动补上,不要手拼 |
| 三元组抽取 | SPO extraction | 从文本里抽出 subject / predicate / object 三元组 |
| 行式 JSON | jsonl | 一行一条 JSON 的文本格式,换行被转义,可流式按行读 |
| 梯度累积 | gradient accumulation | 攒若干步的梯度再更新一次,用时间换显存,撑起等效 batch |
| 远程代码信任 | trust_remote_code | 允许加载模型仓库里自带的建模与分词代码;ChatGLM 必需 |