Prompt-Tuning 入门:四范式与提示学习
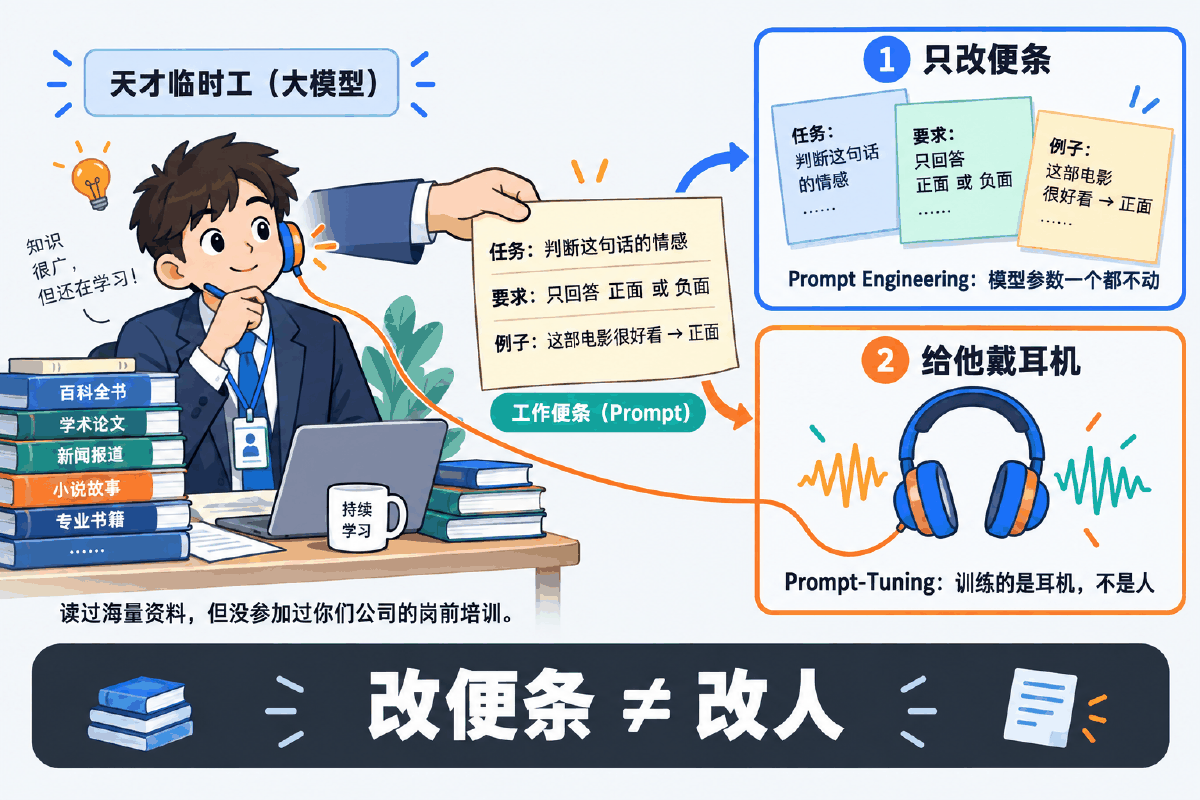
大模型是个读遍全世界资料却没参加过岗前培训的天才临时工;Prompt 就是递进去的那张工作便条——改便条,不改人。
30秒看懂
一个比喻,一张图,一条铁律——先把这一讲的骨架立起来
把大模型想象成一个读遍了全世界资料、却从没参加过你们公司岗前培训的天才临时工。他什么都懂一点,但不知道你们这儿「把工单标成红色」是什么意思。你有三种办法让他干活:
把任务、要求、例子写在一张纸条上递过去。人没变、脑子没变,变的只是那张纸条。这就是 Prompt Engineering(提示工程)。
耳机里循环播放一段只有他听得懂的「暗号」,你不停调这段暗号直到他干活最顺。训练的是耳机,不是人。这就是 Prompt-Tuning。
花几个月把人本身改造一遍。效果最好,但代价最大,而且每个岗位都要另外送一个人去培训。这就是 Fine-Tuning(微调)。
这一讲里出场的角色
| 角色 | 对应比喻 | 它到底是什么 |
|---|---|---|
| 预训练模型(PLM) | 天才临时工 | 在海量无标注文本上做完形填空练出来的模型,如 BERT、GPT。本讲以 BERT 为例 |
| Prompt | 递过去的工作便条 | 拼在原句前后的一段文本,把「请你分类」改写成「请你填空」 |
| Pattern / Template | 便条的固定格式 | 带 [MASK] 的短句模板,例如「整体感觉是 [MASK] 的。」 |
| Verbalizer | 暗号对照表 | 标签词与类别的映射,例如「好/棒/赞 → 正面」 |
| Hard Prompt | 手写的纸条 | 人能读懂的真实文字模板,不需要训练 |
| Soft Prompt | 定制耳机里的暗号 | 一串可训练的向量,词表里查不到对应汉字 |
| Fine-Tuning | 脱产培训 | 用下游标注数据更新模型全部参数 |
② 第三范式和第四范式的输入,差别只有一处——是哪一处?
③ 为什么说 Hard Prompt 「改一个字,结果可能大变」?
④ Soft Prompt 只训练几万个参数,凭什么能顶用?
01概念:NLP 的四种范式与提示学习
从「人给机器造特征」到「人给机器写便条」,NLP 一共翻了三次身
1.1 四种范式:谁去迁就谁
「范式(Paradigm)」听着玄,说穿了就是一个时代里大家默认的解题套路。NLP 到目前为止换过四套套路,每一次换,都是在回答同一个问题:是让数据去迁就模型,还是让模型去迁就数据?
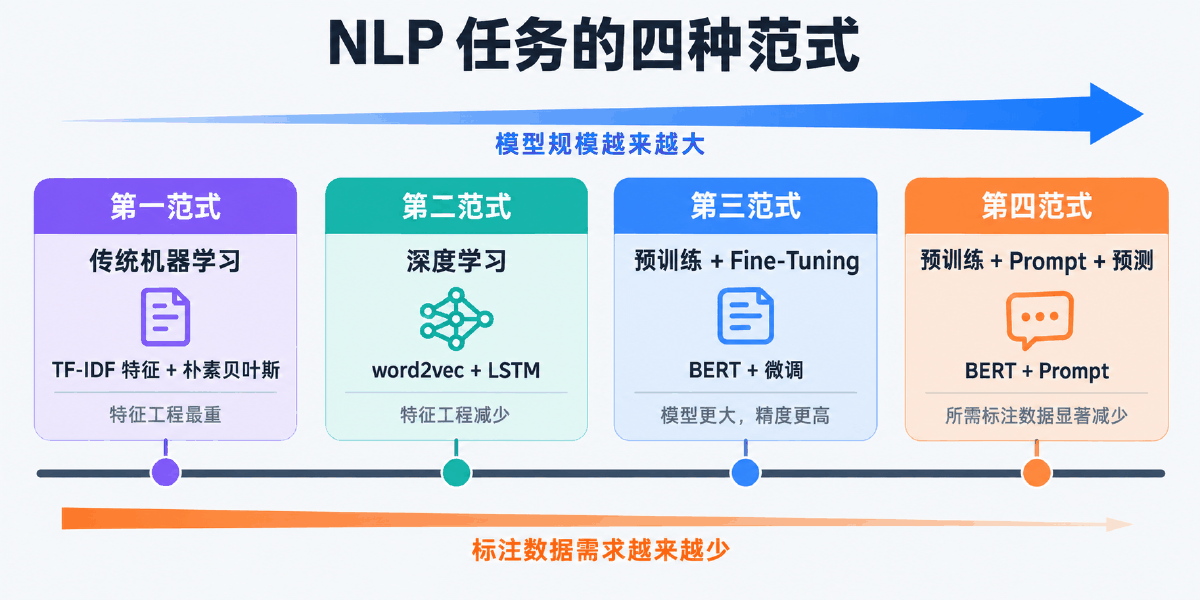
| 范式 | 代表技术 | 要人做的事 | 要的标注数据 |
|---|---|---|---|
| 第一范式 传统机器学习 | TF-IDF + 朴素贝叶斯 SVM、CRF | 设计特征 | 大量。特征工程占掉大半工作量,换个任务就要重做一遍 |
| 第二范式 深度学习 | word2vec + LSTM TextCNN | 设计网络结构 | 大量。不用手搓特征了,但网络从随机初始化学起,数据缺口没变小 |
| 第三范式 预训练 + Fine-Tuning | BERT + 分类头 | 设计下游任务与训练流程 | 中等。几百到几千条就能出效果 |
| 第四范式 预训练 + Prompt + 预测 | BERT + Pattern + Verbalizer | 设计提示(Prompt) | 少量,甚至零样本 |
1.2 第三范式的痛点:两个目标对不上
BERT 预训练时干的活是 MLM(Masked Language Model,掩码语言模型):把句子里的字随机盖住,让模型猜盖住的是什么字。这是一道完形填空题。
可是到了下游做情感分类,我们的做法是:在 BERT 顶上新接一个分类头(一层 hidden → num_labels 的线性层),拿 [CLS] 位置的向量去算二分类。这是一道选择题。
「这部电影很[MASK]看」→「好」
[CLS] 向量 → 0 或 1
两个目标不一致,带来三个实实在在的代价:
那个分类头是随机初始化的,预训练一点忙都帮不上。数据一少,它就学不稳。
为了把「从完形填空切到分类」这件事教会,几百上千条标注跑不掉。小样本场景直接失效。
全参微调意味着每个下游任务都要另存一份完整权重。十个任务,十份 BERT。
1.3 第四范式的想法:别改模型,改题面
既然模型最会做的是完形填空,那就把分类题改写成完形填空题——让下游任务去迁就预训练,而不是反过来。
| 做法 | 送进模型的输入 | 模型顶上用什么 |
|---|---|---|
| 第三范式 | [CLS] 这部电影很好看。[SEP] | 新增的分类头(随机初始化) |
| 第四范式 | [CLS] 这部电影很好看。[SEP] 整体感觉是[MASK]的。[SEP] | 复用预训练自带的 MLM 头 |
[MASK] 的模板。就凭这一处改动,下游任务和预训练任务的形式对上了,那个随机初始化的分类头也不需要了。第 03 节的代码会把这句话跑成断言。
1.4 Prompt 到底是什么
Prompt(提示)就是那段拼上去的模板文本。它的作用是唤醒预训练模型里已经存在的知识,而不是往里灌新知识。
回到比喻:临时工脑子里本来就知道「好看 → 正面」,你不需要重新教他,你只需要换一种他熟悉的问法。「请判断情感极性」他听不懂行话,「整体感觉是______的」他一听就会填。
1.5 Prompt Learning 的三种基本形态
| 形态 | 标注样本数 | 典型写法 |
|---|---|---|
| Zero-shot 零样本 | 0 | 只给任务描述和模板:这部电影很好看。整体感觉是[MASK]的。 |
| One-shot 单样本 | 1 | 模板前先给一个做好的例子,再问新句子 |
| Few-shot 少样本 | 通常 2~32 | 给若干例子,让模型照着例子的格式作答 |
这三种形态在 GPT-3 论文《Language Models are Few-Shot Learners》(arXiv:2005.14165)里被系统地提出并命名,也是「In-Context Learning」这个概念的源头。注意:这三种都不更新模型参数,例子只是写进输入里而已——这一点在下一讲会被反复用到。
02原理:Pattern、Verbalizer 与两种 Prompt
把一道分类题改写成完形填空,只需要三步;难的是这三步各自的取舍
2.1 三步走:Pattern → 填空 → Verbalizer
Prompt Learning 的整条推理链路只有三步,任何一份实现拆开都是这三步:
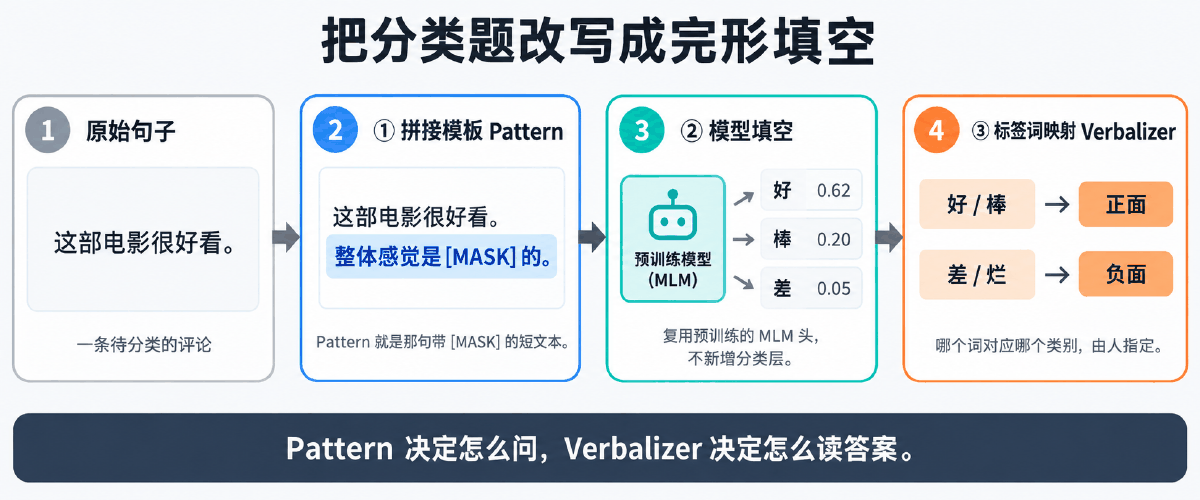
[MASK] 的模板[MASK] 位置输出整个词表的概率分布这三步的组合有个专有名字:PVP(Pattern-Verbalizer-Pair,模板-标签词对),出自 PET 论文《Exploiting Cloze Questions for Few Shot Text Classification and Natural Language Inference》(arXiv:2001.07676)。Pattern 决定怎么问,Verbalizer 决定怎么读答案,两者必须成对设计,单独换任何一边都会翻车。
2.2 Pattern:模板不是随便写的
Pattern(也叫 Template)是一段带 [MASK] 的短文本,里面用占位符标出原句插在哪。同一个情感分类任务,能写出无数个模板:
| 编号 | 模板 | 特点 |
|---|---|---|
| T1 | {x} 整体感觉是[MASK]的。 | 模板在后、留了空格分隔,最常见的写法 |
| T2 | {x} 这是一条[MASK]评。 | 标签词换成「好评/差评」的那个字,语感更自然 |
| T3 | 评论:{x} 情感:[MASK]。 | 结构化写法,模板把字段名也写进去了 |
| T4 | [MASK]。{x} | 危险:模型还没读到评论就要作答 |
| T5 | {x} It was [MASK]. | 危险:中文模型配英文模板,等于换了语言考试 |
| T6 | {x}[MASK] | 危险:没有分隔符,切词结果会变 |
[MASK] 的位置不同、标签词所在语言也不同——准确率差出十几个点是常事。人工挑模板成本高、方差大、换个数据集就要重挑,这正是后面 Soft Prompt 要解决的问题。第 04 节有一份脚本把这些差异逐项量化出来。
2.3 Verbalizer:标签词映射表
模型在 [MASK] 位置吐出的是整个词表上的概率分布,不是「正面/负面」。把词翻译成类别,靠的就是 Verbalizer:
| 类别 | 标签词(Label Words) | 说明 |
|---|---|---|
| 正面 | 好 / 棒 / 赞 | 一个类别可以挂多个词,推理时把它们的分数汇总 |
| 负面 | 差 / 烂 / 糟 | 词必须在词表里存在,且最好是单字,否则要处理多 token 对齐 |
[MASK] 位置概率最高的词,很可能是「的」「很」这类高频虚词,它们根本不是标签词。正确做法是先把候选范围收缩到标签词集合,再在集合内部比较。第 04 节的 verbalizer_decode.py 把这一步的数字全部算给你看。
两种汇总方式
| 方式 | 算法 | 注意 |
|---|---|---|
| max | 取该类别下最高的标签词 logit | 简单,对「一个好词就够」的场景友好 |
| sum | 先 softmax,再把该类别所有标签词的概率相加 | 类别下标签词数量不等时会偏向词多的一类,要注意平衡 |
两种都常见,但必须全程用同一种。混用会得到不可比的数字,报指标时要写清楚用了哪一种。
2.4 MLM 头为什么能省掉分类头
BERT 预训练时顶上那一层叫 MLM 头,它把 hidden 维向量映射回整个词表(中文 BERT 词表约 21128),并且这层权重通常与输入 embedding 共享。它是预训练好的,不是随机的。
这层是随机初始化的
再用 Verbalizer 收缩到 2 类
好处很直接:没有任何一层是从零学起的。零样本能出结果,就是因为整条链路上没有未经训练的参数。这也是「少量标注甚至零样本」这句话的技术来源。
2.5 Hard Prompt 与 Soft Prompt
上面讲的模板全是人写的真实文字,这类叫 Hard Prompt(离散提示)。它的软肋就是 2.2 节说的模板敏感性。有人于是提出:既然模板难挑,那就别挑了,让模型自己学。
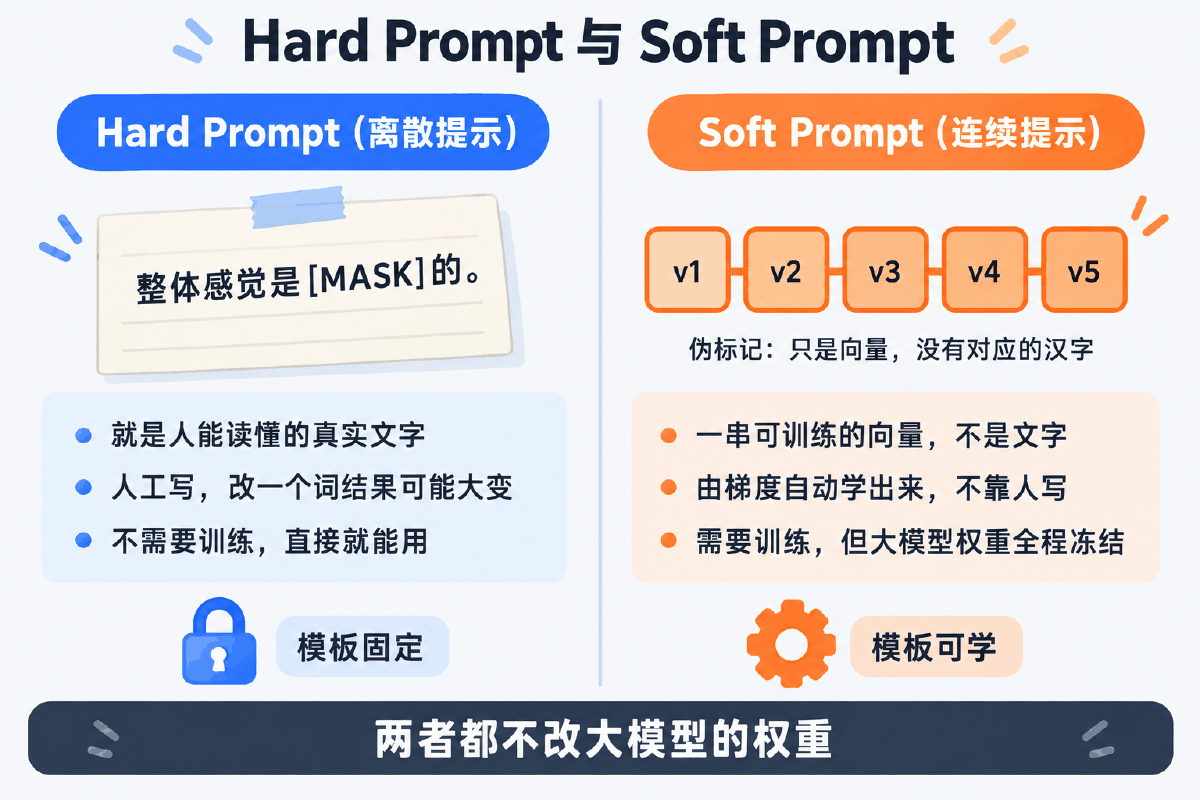
| 维度 | Hard Prompt(离散) | Soft Prompt(连续) |
|---|---|---|
| 长什么样 | 人能读懂的文字:整体感觉是[MASK]的。 | 一串向量 v1 v2 v3 v4 v5,词表里查不到对应汉字 |
| 从哪来 | 人工设计、反复试 | 随机初始化,由梯度自动学出来 |
| 要不要训练 | 不要,拿来就能用 | 要,但只训练这几个向量 |
| 大模型权重 | 冻结 | 同样冻结 |
| 可读性 | 好,出了问题能肉眼排查 | 差,只能看指标,无法直接解释 |
| 稳定性 | 差,改一个词结果可能大变 | 好,梯度会找到局部最优的那一段 |
Soft Prompt 改的是 embedding 之后的那几行向量:它们根本不过 tokenizer,直接作为可训练参数拼在句子向量前面。第 04 节的
hard_vs_soft_input.py 会把两条路的矩阵形状打出来对比。
2.6 参数账:为什么说代价小
以 BERT-base(hidden=768,12 层)为例,把三种做法的可训练参数量摆在一起:
| 方案 | 可训练参数量级 | 每多一个任务要另存什么 |
|---|---|---|
| 全参 Fine-Tuning | 约 1.0 亿(全部) | 一整份模型权重,数百 MB |
| 只训分类头 | 1538 个(768×2+2) | 一层线性,几 KB。但效果通常不够 |
| Soft Prompt(prompt_len=20) | 15360 个(20×768) | 一小段向量,几十 KB |
精确数字由 param_budget.py 按公式算出(第 04 节),你可以把 hidden、layers 换成自己的模型再算一遍。
2.7 四个容易混的名词,一次钉死
| 名词 | 改什么 | 要不要训练 | 要不要梯度 | 本模块在哪讲 |
|---|---|---|---|---|
| Prompt Engineering 提示工程 | 输入文本 | 不训练 | 不需要 | 第三讲、第四讲、第五讲 |
| In-Context Learning 上下文学习 | 输入文本(塞进示例) | 不训练 | 不需要 | 第二讲 2.1 |
| CoT 思维链 | 输入文本(要求分步推理) | 不训练 | 不需要 | 第二讲 2.3 |
| Prompt-Tuning 提示微调 | 伪标记向量,模型权重冻结 | 要训练 | 需要 | 本讲 + 第二讲 2.4 |
| Fine-Tuning 全参微调 | 模型全部权重 | 要训练 | 需要 | 模块 ⑧ 微调专题 |
这张表是整个模块 ③ 的坐标系。下一讲会在它上面补齐 Instruction-Tuning 与 PEFT 家族(Prefix-Tuning、P-Tuning v2、Adapter、LoRA),并给出完整的选型判据。
03最小代码:手搓一个 PVP
不装框架、不下模型,30 行看清「输入构造」到底做了什么
Prompt-Tuning 的第一步永远是把分类样本改写成完形填空样本。这一步既不需要 GPU,也不需要联网——本质就是字符串拼接加一张映射表。先把它跑通,再去看任何框架的实现都不会懵。
# -*- coding: utf-8 -*-
"""手搓一遍 Pattern-Verbalizer-Pair:把分类样本变成完形填空样本。

纯标准库可跑。跑完你会看到:所谓 Prompt-Tuning 的「输入构造」,
本质就是字符串拼接 + 一张标签词映射表,没有任何魔法。
"""

# Pattern:带 [MASK] 的短文本,{x} 是原句的占位
PATTERNS = {
    "p1": "{x} 整体感觉是[MASK]的。",
    "p2": "{x} 这是一条[MASK]评。",
    "p3": "评论:{x} 情感:[MASK]。",
}

# Verbalizer:标签词 -> 类别。一个类别可以挂多个标签词
VERBALIZER = {
    "正面": ["好", "棒", "赞"],
    "负面": ["差", "烂", "糟"],
}

SAMPLES = [
    ("这部电影很好看。", "正面"),
    ("剧情拖沓,看了半小时就想走。", "负面"),
    ("演员表演到位,节奏也舒服。", "正面"),
]


def build_input(sentence, pattern_key="p1"):
    """把原句套进 Pattern,得到送进 BERT 的那一串 token 文本。"""
    body = PATTERNS[pattern_key].format(x=sentence)
    return "[CLS] " + body + " [SEP]"


def label_to_words(label):
    """训练时要知道 [MASK] 位置的正确答案是哪些词。"""
    if label not in VERBALIZER:
        raise KeyError("Verbalizer 里没有类别 %r,模型无从学起" % label)
    return VERBALIZER[label]


def word_to_label(word):
    """推理时把 [MASK] 预测出来的词翻译回类别。"""
    for label, words in VERBALIZER.items():
        if word in words:
            return label
    # 落到映射表外面的词,必须显式暴露,不能悄悄当成某一类
    return None


def main():
    print("【一、Pattern 把分类题拼成了填空题】")
    for sent, label in SAMPLES:
        text = build_input(sent, "p1")
        print("  原句 : %s" % sent)
        print("  输入 : %s" % text)
        print("  标签 : %s -> [MASK] 的正确答案可以是 %s" % (label, label_to_words(label)))
        print()

    print("【二、同一句话换三个 Pattern,模型看到的东西完全不同】")
    sent = SAMPLES[0][0]
    for key in PATTERNS:
        print("  %s: %s" % (key, build_input(sent, key)))
    print()

    print("【三、Verbalizer 是双向的】")
    for word in ["好", "棒", "烂", "一般"]:
        label = word_to_label(word)
        shown = label if label else "映射表里没有 -> 必须当作无法判定,而不是硬塞给某一类"
        print("  [MASK] 预测出 %r -> %s" % (word, shown))
    print()

    # 断言:映射表不能有一个词同时指向两个类别,否则推理会自相矛盾
    seen = {}
    for label, words in VERBALIZER.items():
        for w in words:
            assert w not in seen, "标签词 %r 同时属于 %s 和 %s,映射必然出错" % (w, seen[w], label)
            seen[w] = label
    print("映射表自检通过:%d 个标签词,没有一个词跨类别。" % len(seen))


if __name__ == "__main__":
    main()
3.1 跑起来是什么样
直接 python3 pvp_build.py,输出分三段。第一段展示 Pattern 把分类题拼成了填空题:
| 原句 | 拼出来的输入 | 标签 → [MASK] 的正确答案 |
|---|---|---|
| 这部电影很好看。 | [CLS] 这部电影很好看。 整体感觉是[MASK]的。 [SEP] | 正面 → 好 / 棒 / 赞 |
| 剧情拖沓,看了半小时就想走。 | [CLS] 剧情拖沓,看了半小时就想走。 整体感觉是[MASK]的。 [SEP] | 负面 → 差 / 烂 / 糟 |
第二段把同一句话套三个模板,你会看到模型拿到的字符串完全不同——这就是 2.2 节说的模板敏感性,眼见为实:
| 模板 | 送进模型的文本 |
|---|---|
| p1 | [CLS] 这部电影很好看。 整体感觉是[MASK]的。 [SEP] |
| p2 | [CLS] 这部电影很好看。 这是一条[MASK]评。 [SEP] |
| p3 | [CLS] 评论:这部电影很好看。 情感:[MASK]。 [SEP] |
第三段演示 Verbalizer 是双向的:训练时「类别 → 标签词」告诉模型正确答案,推理时「标签词 → 类别」把预测翻译回去。
word_to_label 对映射表外的词返回 None,而不是默认塞给某一类。「判不了」必须显式暴露,悄悄归类是线上事故的常见源头。② 脚本末尾那段断言检查「同一个标签词不能同时属于两个类别」。映射表一旦交叉,推理结果必然自相矛盾,而这种错不会报错,只会悄悄降低准确率。
3.2 这 30 行对应真实框架的哪一部分
| 脚本里的东西 | 真实框架里的对应物 | 后面还要加什么 |
|---|---|---|
PATTERNS | OpenPrompt 的 ManualTemplate | 换成 token id、处理截断与最大长度 |
VERBALIZER | OpenPrompt 的 ManualVerbalizer | 标签词要转成词表 id,多 token 的词要做池化 |
build_input | 数据处理 collate_fn | 补 attention_mask、记录 [MASK] 的下标 |
label_to_words | 训练时构造 label | 把词 id 填到 [MASK] 位置算交叉熵 |
[MASK] 的下标一定要记下来
真实实现里,模型输出的是整个序列每个位置的词表分布,形状 (batch, seq_len, vocab)。你必须知道 [MASK] 在第几个位置,才能取出那一行。拼接模板时顺手把下标存下来,否则后面要重新扫一遍序列找,既慢又容易在截断后错位。
04完整案例:把四范式和两种 Prompt 全部跑一遍
五个纯标准库脚本,每一个都把一句结论变成可核对的数字
这一节的五个脚本不联网、不装依赖、不下模型,python3 文件名 直接跑。它们的共同点是:每个脚本最后都有断言——如果哪句结论站不住,脚本会当场报错,而不是让你盯着输出自己判断。
4.1 四范式对照:谁在动,动多少
同一件事(情感二分类),四种范式各自怎么做。重点看最后那段 check():它把 1.3 节「差别只有一处」那句话写成了三条断言。
# -*- coding: utf-8 -*-
"""四种范式的同一件事:都在做「情感二分类」,区别在于谁去迁就谁。

纯标准库,直接 python3 paradigm_compare.py 就能跑,用来把四范式从
「背四句话」变成「看得见的输入长什么样」。
"""

SENT = "这部电影很好看。"

# 每种范式:模型怎么拿到输入、谁的参数在动、需要多少标注数据
PARADIGMS = [
    {
        "no": "第一范式",
        "name": "传统机器学习",
        "stack": "TF-IDF 特征 + 朴素贝叶斯",
        "model_input": "['电影', '好看'] 这类稀疏特征向量",
        "trainable": "分类器全部参数(模型很小)",
        "data": "大量标注(几千到几万条)",
        "pain": "特征全靠人工设计,换个任务要重做特征工程",
    },
    {
        "no": "第二范式",
        "name": "深度学习",
        "stack": "word2vec + LSTM",
        "model_input": "词向量序列 [768 维 × 句长]",
        "trainable": "整个网络(随机初始化)",
        "data": "大量标注(上万条)",
        "pain": "特征工程少了,但网络从零学起,数据还是要得多",
    },
    {
        "no": "第三范式",
        "name": "预训练 + Fine-Tuning",
        "stack": "BERT + 新增分类头",
        "model_input": "[CLS] 这部电影很好看。[SEP]",
        "trainable": "BERT 全部参数 + 新分类头",
        "data": "中等标注(几百到几千条)",
        "pain": "预训练学的是完形填空,下游学的是分类,两个目标对不上",
    },
    {
        "no": "第四范式",
        "name": "预训练 + Prompt + 预测",
        "stack": "BERT + Pattern + Verbalizer",
        "model_input": "[CLS] 这部电影很好看。[SEP] 整体感觉是[MASK]的。[SEP]",
        "trainable": "复用预训练的 MLM 头,不新增分类层",
        "data": "少量标注,甚至零样本",
        "pain": "模板和标签词怎么选,成了新的难题",
    },
]


def show():
    for p in PARADIGMS:
        print("=" * 68)
        print("%s · %s" % (p["no"], p["name"]))
        print("  技术栈      : %s" % p["stack"])
        print("  模型看到的  : %s" % p["model_input"])
        print("  在动的参数  : %s" % p["trainable"])
        print("  标注数据    : %s" % p["data"])
        print("  代价        : %s" % p["pain"])
    print("=" * 68)


def check():
    """第三、第四范式的关键差别:输入里有没有 [MASK]。"""
    third = PARADIGMS[2]["model_input"]
    fourth = PARADIGMS[3]["model_input"]
    assert "[MASK]" not in third, "第三范式靠分类头,输入里不该有 [MASK]"
    assert "[MASK]" in fourth, "第四范式靠完形填空,输入里必须有 [MASK]"
    # 第四范式的输入 = 第三范式的输入 + 一段模板
    assert fourth.startswith(third), "第四范式只是在原输入后面又拼了一段模板"
    extra = fourth[len(third):]
    print("第四范式比第三范式多出来的那一段模板:%r" % extra)
    print("它没有改动原句一个字,只是把「分类」改写成了「填空」。")


if __name__ == "__main__":
    print("待处理的句子:%s\n" % SENT)
    show()
    print()
    check()
跑完你会看到这三行断言全部通过:
| 断言 | 它证明了什么 |
|---|---|
第三范式输入里没有 [MASK] | 它靠新增分类头拿 [CLS] 向量做分类,不需要填空 |
第四范式输入里必须有 [MASK] | 它靠 MLM 头填空,[MASK] 就是答案的落点 |
| 第四范式输入以第三范式输入开头 | 原句一个字没改,只是在后面又拼了一段模板 |
' 整体感觉是[MASK]的。[SEP]'。整个第四范式的全部改动,就是这十几个字符。
4.2 Verbalizer 解码:从词表分布到类别
2.3 节说「不能直接对词表取 argmax」,这个脚本把数字算给你看。它写死了一组演示 logits,让「MLM 头输出 → 类别概率」这条路径每一步都能手算核对。
# -*- coding: utf-8 -*-
"""从 [MASK] 的词表分布,到最终类别:Verbalizer 那一步到底算了什么。

纯标准库(只用 math),可以直接跑。这里的 logits 是写死的演示值,
目的是让「MLM 头输出 -> 类别概率」这条路径每一步都能手算核对。
"""
import math

# 模型在 [MASK] 位置对整个词表打的分(只列出我们关心的几个词)
MASK_LOGITS = {
    "好": 6.2,
    "棒": 5.1,
    "赞": 3.4,
    "差": 1.8,
    "烂": 1.2,
    "糟": 0.9,
    "的": 5.9,   # 高频虚词,分数很高,但它不在标签词里
    "很": 4.7,
}

VERBALIZER = {
    "正面": ["好", "棒", "赞"],
    "负面": ["差", "烂", "糟"],
}


def softmax(scores):
    m = max(scores.values())
    exp = {k: math.exp(v - m) for k, v in scores.items()}
    total = sum(exp.values())
    return {k: v / total for k, v in exp.items()}


def label_scores(logits, verbalizer, mode="max"):
    """把标签词的分数汇总成类别分数。

    mode='max' 取该类别下最高的标签词分数;
    mode='sum' 把该类别下所有标签词的概率加起来。
    两种都常见,但必须全程用同一种,混用会得到不可比的数字。
    """
    if mode == "max":
        return {lab: max(logits[w] for w in words if w in logits)
                for lab, words in verbalizer.items()}
    probs = softmax(logits)
    return {lab: sum(probs[w] for w in words if w in probs)
            for lab, words in verbalizer.items()}


def main():
    print("【一、词表上的完整分布(含无关词)】")
    full = softmax(MASK_LOGITS)
    for w, p in sorted(full.items(), key=lambda kv: -kv[1]):
        mark = "  <- 标签词" if any(w in ws for ws in VERBALIZER.values()) else ""
        print("  %-3s logit=%.1f  p=%.4f%s" % (w, MASK_LOGITS[w], p, mark))
    print("  注意:概率最高的是「的」,它根本不是标签词。")
    print("  所以不能直接取 argmax,必须先把范围收缩到标签词上。\n")

    print("【二、只在标签词之间比较(max 汇总)】")
    ls = label_scores(MASK_LOGITS, VERBALIZER, "max")
    for lab, s in ls.items():
        print("  %s : 最高标签词 logit = %.1f" % (lab, s))
    picked = max(ls, key=ls.get)
    print("  判定结果 -> %s\n" % picked)

    print("【三、换成 sum 汇总,结论是否一样】")
    ls2 = label_scores(MASK_LOGITS, VERBALIZER, "sum")
    for lab, s in ls2.items():
        print("  %s : 标签词概率之和 = %.4f" % (lab, s))
    picked2 = max(ls2, key=ls2.get)
    print("  判定结果 -> %s" % picked2)

    assert picked == picked2 == "正面", "两种汇总方式在本例中应给出相同结论"
    print("\n两种汇总方式结论一致,但数值不可互相比较——报指标时要说明用了哪一种。")

    # 这一步才是 Prompt-Tuning 训练时算 loss 的地方
    pos_p = ls2["正面"] / (ls2["正面"] + ls2["负面"])
    print("归一化到两类之后,正面的概率 = %.4f" % pos_p)
    print("交叉熵损失(真实标签为正面)= %.6f" % (-math.log(pos_p)))


if __name__ == "__main__":
    main()
| 词 | logit | softmax 概率 | 是不是标签词 |
|---|---|---|---|
| 好 | 6.2 | 最高的标签词 | 是(正面) |
| 的 | 5.9 | 仅次于「好」 | 不是,高频虚词 |
| 很 | 4.7 | — | 不是 |
| 差 | 1.8 | 最高的负面标签词 | 是(负面) |
4.3 模板敏感性:六个模板的差异在哪
2.2 节列了六个模板并标了三个「危险」。这个脚本不靠感觉,把差异量化出来:总长度、[MASK] 的绝对位置、标签词语言、模板在原句与 [MASK] 之间插了什么。
# -*- coding: utf-8 -*-
"""模板敏感性:同一个任务,六种写法,模型给的答案可能完全不同。

这是 Hard Prompt 最大的软肋,也是后面 Soft Prompt 出现的直接原因。
本脚本不联网、不调模型,它做的是另一件更有用的事:
把六个模板的结构差异量化出来,让你看清「差异到底出在哪」。
"""

SENT = "剧情拖沓,看了半小时就想走。"

TEMPLATES = [
    ("T1", "{x} 整体感觉是[MASK]的。", ["好", "差"]),
    ("T2", "{x} 这是一条[MASK]评。", ["好", "差"]),
    ("T3", "{x} 我的评价:[MASK]。", ["正面", "负面"]),
    ("T4", "[MASK]。{x}", ["好", "差"]),
    ("T5", "{x} It was [MASK].", ["good", "bad"]),
    ("T6", "{x}[MASK]", ["好", "差"]),
]


def render(tpl, sent):
    return tpl.format(x=sent)


def template_gap(tpl):
    """模板自己在 {x} 与 [MASK] 之间插了什么。

    只看渲染后的文本会被原句自带的句号干扰,所以要在模板层面判。
    若 [MASK] 在 {x} 前面(如 T4),返回 None 表示不适用。
    """
    xi, mi = tpl.find("{x}"), tpl.find("[MASK]")
    if xi < 0 or mi < 0 or mi < xi:
        return None
    return tpl[xi + len("{x}"):mi]


def describe(name, tpl, sent, words):
    text = render(tpl, sent)
    pos = text.index("[MASK]")
    gap = template_gap(tpl)
    return {
        "name": name,
        "tpl": tpl,
        "text": text,
        "len": len(text),
        "mask_at": pos,
        "mask_ratio": pos / len(text),
        "words": words,
        "word_lang": "英文" if any(w.isascii() for w in words) else "中文",
        "gap": gap,
        "gap_desc": "[MASK] 在句首" if gap is None else (repr(gap) if gap else "紧贴(空)"),
    }


def main():
    rows = [describe(n, t, SENT, w) for n, t, w in TEMPLATES]

    print("句子:%s\n" % SENT)
    print("%-4s %-6s %-10s %-6s %-14s %s"
          % ("模板", "总长", "[MASK]位置", "语言", "模板插入的间隔", "拼出来的输入"))
    for r in rows:
        print("%-4s %-6d %-10d %-6s %-14s %s"
              % (r["name"], r["len"], r["mask_at"], r["word_lang"],
                 r["gap_desc"], r["text"]))

    print("\n【差异出在哪】")
    print("· T4 把 [MASK] 放到了句首,模型还没读到评论就要作答,位置信息完全变了。")
    print("· T5 换成英文模板配英文标签词,中文预训练模型在这条路上几乎学不到东西。")
    print("· T6 没有任何分隔符,[MASK] 直接粘在句号后面,切词结果会变。")

    # 把可量化的部分做成断言,避免嘴上说说
    t1 = next(r for r in rows if r["name"] == "T1")
    t4 = next(r for r in rows if r["name"] == "T4")
    assert t1["mask_at"] > t4["mask_at"], "T4 的 [MASK] 必须比 T1 更靠前"
    t6 = next(r for r in rows if r["name"] == "T6")
    assert t6["gap"] == "", "T6 的模板在 {x} 与 [MASK] 之间不应插入任何字符"
    assert t1["gap"].startswith(" "), "T1 的模板靠一个空格把原句和模板隔开"
    assert t4["gap"] is None, "T4 的 [MASK] 在原句之前,间隔不适用"

    print("\n【结论】")
    print("六个模板表达的是同一个意思,但送进模型的 token 序列长度、")
    print("[MASK] 的位置、标签词所在语言全都不同——效果自然会差出一截。")
    print("人工挑模板成本高、方差大,这正是 Soft Prompt 要解决的问题。")


if __name__ == "__main__":
    main()
| 模板 | 问题 | 量化表现 |
|---|---|---|
T4 [MASK]。{x} | 位置颠倒 | [MASK] 下标远小于 T1,模型还没读到评论就要作答 |
T5 {x} It was [MASK]. | 语言错配 | 标签词被判为「英文」,中文预训练模型在这条路上几乎学不到东西 |
T6 {x}[MASK] | 没有分隔 | 模板插入的间隔为空串,[MASK] 直接粘在句号后面,切词结果会变 |
template_gap() 因此只看模板本身 {x} 与 [MASK] 之间的那一段。这类「看起来能用、实际会被数据污染」的判据,是自测脚本里最容易写错的地方。
4.4 Hard 与 Soft:差别在 embedding 的哪一边
2.5 节的关键句是「Hard Prompt 改的是 tokenizer 之前的字符串,Soft Prompt 改的是 embedding 之后的那几行向量」。这个脚本用 8 维的迷你隐层把两条路的矩阵形状打出来。
# -*- coding: utf-8 -*-
"""Hard Prompt 与 Soft Prompt 在「送进模型之前」到底差在哪一步。

结论先摆出来:差别不在模型,在 embedding 这一层之前还是之后。
Hard Prompt 是先有文字再查表;Soft Prompt 直接就是表里查不到的向量。
纯标准库可跑,用小维度把形状算清楚。
"""

HIDDEN = 8          # 真实模型是 768/4096,这里缩小成 8 方便打印
VOCAB = {"[CLS]": 0, "[SEP]": 1, "[MASK]": 2, "这": 3, "部": 4,
         "电": 5, "影": 6, "很": 7, "好": 8, "看": 9, "。": 10,
         "整": 11, "体": 12, "感": 13, "觉": 14, "是": 15, "的": 16}


def fake_embedding(token_id):
    """假装这是 embedding table 的一行,真实值由预训练得到。"""
    return [round((token_id * 0.37 + i * 0.11) % 1.0, 3) for i in range(HIDDEN)]


def tokenize(text):
    """按字切,未登录字一律记为 [UNK](这里用 -1 表示)。"""
    ids = []
    i = 0
    while i < len(text):
        for special in ("[CLS]", "[SEP]", "[MASK]"):
            if text.startswith(special, i):
                ids.append(VOCAB[special])
                i += len(special)
                break
        else:
            ch = text[i]
            ids.append(VOCAB.get(ch, -1))
            i += 1
    return ids


def hard_prompt_path(sentence):
    """Hard Prompt:模板是真实文字,和原句一起过 tokenizer、一起查 embedding。"""
    text = "[CLS]" + sentence + "整体感觉是[MASK]的。[SEP]"
    ids = tokenize(text)
    vectors = [fake_embedding(i) if i >= 0 else [0.0] * HIDDEN for i in ids]
    return text, ids, vectors


def soft_prompt_path(sentence, prompt_len=5):
    """Soft Prompt:伪标记没有文字,也不查 embedding table,直接是可训练参数。"""
    text = "[CLS]" + sentence + "[SEP]"
    ids = tokenize(text)
    sent_vecs = [fake_embedding(i) if i >= 0 else [0.0] * HIDDEN for i in ids]
    # 伪标记向量:训练开始时随机初始化,之后被梯度一路更新
    pseudo = [[round(0.01 * (k + 1) + 0.002 * j, 4) for j in range(HIDDEN)]
              for k in range(prompt_len)]
    return text, pseudo + sent_vecs, pseudo


def main():
    sent = "这部电影很好看。"

    print("【Hard Prompt 这条路】")
    text, ids, vecs = hard_prompt_path(sent)
    print("  拼出来的文字 : %s" % text)
    print("  token id     : %s" % ids)
    print("  向量矩阵形状 : (%d, %d)   <- 每一行都来自 embedding table" % (len(vecs), HIDDEN))
    print("  第一行向量   : %s\n" % vecs[0])

    print("【Soft Prompt 这条路】")
    p_len = 5
    text2, all_vecs, pseudo = soft_prompt_path(sent, p_len)
    print("  拼出来的文字 : %s   <- 模板一个字都没有" % text2)
    print("  伪标记个数   : %d" % p_len)
    print("  向量矩阵形状 : (%d, %d) = (%d 伪标记 + %d 原句 token, hidden)"
          % (len(all_vecs), HIDDEN, p_len, len(all_vecs) - p_len))
    print("  伪标记第一行 : %s" % pseudo[0])
    print("  这 %d 行在词表里查不到任何对应的汉字。\n" % p_len)

    print("【形状对账】")
    n_sent = len(tokenize("[CLS]" + sent + "[SEP]"))
    assert len(all_vecs) == p_len + n_sent, "拼接后长度必须是 p + n"
    print("  (p + n) × e = (%d + %d) × %d = %d 个数" % (p_len, n_sent, HIDDEN, len(all_vecs) * HIDDEN))
    print("  其中只有 %d × %d = %d 个数是可训练的,其余全部冻结。"
          % (p_len, HIDDEN, p_len * HIDDEN))

    print("\n【一句话记住】")
    print("Hard Prompt 改的是 tokenizer 之前的字符串;")
    print("Soft Prompt 改的是 embedding 之后的那几行向量。")


if __name__ == "__main__":
    main()
| 对比项 | Hard Prompt | Soft Prompt |
|---|---|---|
| 拼出来的文字 | [CLS]这部电影很好看。整体感觉是[MASK]的。[SEP] | [CLS]这部电影很好看。[SEP](模板一个字都没有) |
| 过不过 tokenizer | 过,模板和原句一起查 embedding table | 不过,伪标记直接就是向量 |
| 矩阵形状 | (原句+模板 token 数, hidden) | (p 个伪标记 + n 个原句 token, hidden) |
| 可训练的部分 | 没有 | 只有 p × hidden 那几行 |
脚本结尾的断言 len(all_vecs) == p_len + n_sent 钉死了拼接关系;再往下一行会告诉你:整个矩阵里只有 p × hidden 个数是可训练的,其余全部冻结。
4.5 参数账:Soft Prompt 到底省了多少
2.6 节那张表的数字不是抄来的经验值,是这个脚本按公式算出来的。你可以把 CFG 里的 hidden、layers 换成自己的模型再算一遍。
# -*- coding: utf-8 -*-
"""参数账:全参微调、加分类头、只训 Soft Prompt,各自要动多少参数。

纯标准库可跑。数字全部由公式算出,不是抄来的经验值——
你可以把 hidden、layers 换成自己的模型再算一遍。
"""

# BERT-base 的常见配置
CFG = {
    "vocab": 21128,      # 中文 BERT 词表大小
    "hidden": 768,       # d_model
    "layers": 12,
    "ff": 3072,          # FFN 中间层
    "max_pos": 512,
    "num_labels": 2,     # 下游二分类
    "prompt_len": 20,    # Soft Prompt 的伪标记个数
}


def encoder_params(cfg):
    """粗算 encoder 主体参数量:embedding + N 层 transformer。"""
    h = cfg["hidden"]
    emb = cfg["vocab"] * h + cfg["max_pos"] * h + 2 * h      # 词/位置/段
    attn = 4 * (h * h + h)                                    # Q K V O
    ffn = (h * cfg["ff"] + cfg["ff"]) + (cfg["ff"] * h + h)   # 两个线性层
    ln = 4 * h                                                # 两个 LayerNorm
    per_layer = attn + ffn + ln
    return emb + cfg["layers"] * per_layer


def head_params(cfg):
    """第三范式新增的分类头:hidden -> num_labels。"""
    return cfg["hidden"] * cfg["num_labels"] + cfg["num_labels"]


def soft_prompt_params(cfg):
    """第四范式里 Soft Prompt 的可训参数:prompt_len 个 hidden 维向量。"""
    return cfg["prompt_len"] * cfg["hidden"]


def pct(part, whole):
    return 100.0 * part / whole


def main():
    total = encoder_params(CFG)
    head = head_params(CFG)
    soft = soft_prompt_params(CFG)

    print("模型主体参数量(BERT-base 量级): %s" % "{:,}".format(total))
    print()

    rows = [
        ("全参 Fine-Tuning", total + head, "主体 + 分类头全部更新"),
        ("只训分类头", head, "主体冻结,只动最后那层线性"),
        ("Soft Prompt(prompt_len=%d)" % CFG["prompt_len"], soft, "主体冻结,只动伪标记向量"),
    ]
    print("%-28s %14s %10s  %s" % ("方案", "可训参数", "占比", "说明"))
    for name, n, note in rows:
        print("%-28s %14s %9.4f%%  %s" % (name, "{:,}".format(n), pct(n, total + head), note))

    print()
    print("【一句话读懂这张表】")
    print("Soft Prompt 只有 %s 个可训参数,是全参微调的 1/%d。"
          % ("{:,}".format(soft), round((total + head) / soft)))
    print("每多一个下游任务,全参微调要另存一整份模型,Soft Prompt 只多存一小段向量。")

    # 换算成磁盘占用(fp32,每参数 4 字节)
    print()
    print("按 fp32 存盘:全参微调一份 %.0f MB,Soft Prompt 一份 %.1f KB。"
          % ((total + head) * 4 / 1024 / 1024, soft * 4 / 1024))

    assert soft < head * 100, "Soft Prompt 的参数量应当与分类头同一量级,而非模型量级"
    assert pct(soft, total) < 0.1, "Soft Prompt 占比应当远低于 0.1%"
    print("\n自检通过:Soft Prompt 的开销确实停留在「小配件」量级。")


if __name__ == "__main__":
    main()
| 脚本里的函数 | 算的是什么 |
|---|---|
encoder_params | embedding(词/位置/段)+ 12 层 transformer(QKVO 四个投影 + FFN 两层 + LayerNorm) |
head_params | 第三范式新增的分类头:hidden × num_labels + num_labels |
soft_prompt_params | 第四范式的伪标记:prompt_len × hidden |
4.6 五个脚本的关系
前三个讲清「第四范式怎么跑」,后两个讲清「为什么值得这么跑」。五个脚本连起来,就是这一讲的全部技术内容。
05骨架模板:拿去改就能用
一份 PVP 骨架 + 一张模板设计检查表,套到自己的任务上
5.1 PVP 骨架
把第 03、04 节的东西收敛成一个类:模板、标签词、输入构造、双向映射、解码、自检全在里面。纯标准库,先在本地把「输入长什么样、映射对不对」验证通过,再接真实模型。
# -*- coding: utf-8 -*-
"""PVP 骨架:把任意文本分类任务改写成完形填空任务。

复制后只改五处 TODO 就能用在自己的数据上。纯标准库,先在本地把
「输入长什么样、标签词映射对不对」验证通过,再接真实模型。

用法:
    python3 pvp_skeleton.py            # 跑自检 + 打印样例
    from pvp_skeleton import PVP       # 当成模块导入
"""


class PVP(object):
    """Pattern-Verbalizer-Pair:一个任务一份实例。"""

    # TODO 1:换成你的任务模板。{x} 是原文占位,[MASK] 是答案落点。
    #         写 2~3 个备选,后面用 pick_pattern() 在验证集上选。
    PATTERNS = {
        "p1": "{x} 整体感觉是[MASK]的。",
        "p2": "{x} 这是一条[MASK]评。",
    }

    # TODO 2:换成你的类别与标签词。要求:
    #   · 标签词必须在预训练词表里存在,优先选单字;
    #   · 同一个词不能挂在两个类别下;
    #   · 各类别的标签词个数尽量持平,否则 sum 汇总会偏。
    VERBALIZER = {
        "正面": ["好", "棒", "赞"],
        "负面": ["差", "烂", "糟"],
    }

    # TODO 3:按你使用的模型改特殊标记(BERT 系用 [CLS]/[SEP]/[MASK])
    CLS, SEP, MASK = "[CLS]", "[SEP]", "[MASK]"

    def __init__(self, pattern_key="p1"):
        if pattern_key not in self.PATTERNS:
            raise KeyError("没有模板 %r,可选:%s"
                           % (pattern_key, list(self.PATTERNS)))
        self.pattern_key = pattern_key
        self._check_verbalizer()

    # ---------------- 构造输入 ----------------
    def build(self, text):
        """原文 -> 送进模型的字符串,以及 [MASK] 在字符串里的下标。

        真实实现里要把下标换成 token 下标(tokenize 之后再定位),
        这里先用字符下标把流程跑通。
        """
        body = self.PATTERNS[self.pattern_key].format(x=text)
        full = "%s %s %s" % (self.CLS, body, self.SEP)
        return full, full.index(self.MASK)

    # ---------------- 标签双向映射 ----------------
    def label_words(self, label):
        """训练时:类别 -> 该类别下所有标签词。"""
        if label not in self.VERBALIZER:
            raise KeyError("Verbalizer 里没有类别 %r" % label)
        return self.VERBALIZER[label]

    def word_label(self, word):
        """推理时:标签词 -> 类别。表外的词返回 None,不要默认归类。"""
        for label, words in self.VERBALIZER.items():
            if word in words:
                return label
        return None

    # ---------------- 解码 ----------------
    def decode(self, mask_scores, mode="max"):
        """把 [MASK] 位置的词表分数汇总成类别分数。

        mask_scores: dict[词] = 分数(真实场景是 logits 张量取对应词 id)
        mode: 'max' 取类别下最高分;'sum' 把该类别所有标签词的分数相加。
        两种都常见,但必须全程用同一种:数值不可互相比较。
        用 'sum' 时各类别的标签词个数要持平,否则词多的一类天然占便宜。
        返回 (类别, 类别分数字典)。全程只在标签词集合内比较。
        """
        if mode not in ("max", "sum"):
            raise ValueError("mode 只能是 max 或 sum")
        scores = {}
        for label, words in self.VERBALIZER.items():
            hit = [mask_scores[w] for w in words if w in mask_scores]
            if not hit:
                # 该类别一个标签词都没命中:必须暴露,不能当成 0 分默默参与比较
                raise ValueError("类别 %r 的标签词都不在打分结果里" % label)
            scores[label] = max(hit) if mode == "max" else sum(hit)
        best = max(scores, key=scores.get)
        return best, scores

    # ---------------- 自检 ----------------
    def _check_verbalizer(self):
        seen = {}
        for label, words in self.VERBALIZER.items():
            if not words:
                raise ValueError("类别 %r 没有标签词" % label)
            for w in words:
                if w in seen:
                    raise ValueError("标签词 %r 同时属于 %s 和 %s"
                                     % (w, seen[w], label))
                seen[w] = label


def pick_pattern(samples, score_fn):
    """在验证集上挑模板。

    samples: [(文本, 真实类别), ...]
    score_fn: 接收 (拼好的输入, mask_idx) 返回 dict[词]=分数 的函数,
              真实场景里就是「调模型拿 [MASK] 位置 logits」。
    TODO 4:接上你的模型推理函数,然后用这个函数选模板,别靠手感。
    """
    result = {}
    for key in PVP.PATTERNS:
        pvp = PVP(key)
        right = 0
        for text, gold in samples:
            full, idx = pvp.build(text)
            pred, _ = pvp.decode(score_fn(full, idx))
            right += int(pred == gold)
        result[key] = right / float(len(samples))
    return result


def _demo():
    pvp = PVP("p1")

    print("【一、输入构造】")
    for text in ["这部电影很好看。", "剧情拖沓,看了半小时就想走。"]:
        full, idx = pvp.build(text)
        print("  原文 : %s" % text)
        print("  输入 : %s" % full)
        print("  [MASK] 字符下标 : %d\n" % idx)

    print("【二、解码】")
    # TODO 5:换成真实模型在 [MASK] 位置的输出分数
    fake_scores = {"好": 6.2, "棒": 5.1, "赞": 3.4,
                   "差": 1.8, "烂": 1.2, "糟": 0.9,
                   "的": 5.9}
    for mode in ("max", "sum"):
        label, detail = pvp.decode(fake_scores, mode)
        print("  mode=%-4s -> %s   %s" % (mode, label, detail))
    print("  注意「的」分数 5.9 很高,但它不是标签词,不参与比较。")

    print("\n【三、映射表自检】")
    try:
        bad = type("Bad", (PVP,), {"VERBALIZER": {"A": ["好"], "B": ["好"]}})
        bad()
    except ValueError as e:
        print("  按预期拦下交叉标签词:%s" % e)

    assert pvp.word_label("棒") == "正面"
    assert pvp.word_label("一般") is None, "表外词必须返回 None"
    print("  双向映射自检通过。")


if __name__ == "__main__":
    _demo()
| TODO | 改什么 | 要注意 |
|---|---|---|
| TODO 1 | PATTERNS | 写 2~3 个备选模板,别只写一个;后面用 pick_pattern() 在验证集上选 |
| TODO 2 | VERBALIZER | 标签词要在词表里、优先单字、不能跨类、各类个数尽量持平 |
| TODO 3 | 特殊标记 | BERT 系是 [CLS]/[SEP]/[MASK],换模型要跟着换 |
| TODO 4 | score_fn | 接上真实模型推理,返回 [MASK] 位置各标签词的分数 |
| TODO 5 | 演示分数 | 换成真实输出后,_demo() 就是一个端到端冒烟测试 |
None:判不了就说判不了,不默默归类。② 某类别一个标签词都没命中时直接抛错:不拿 0 分顶上去参与比较,否则会稳定误判成另一类。
③ 构造时就返回
[MASK] 下标:不留到后面重新扫序列找,截断之后再找必错位。
build() 返回的是字符下标,只够把流程跑通。真实实现必须先 tokenize 再定位 [MASK] 的 token 下标——模型输出的形状是 (batch, seq_len, vocab),要取的是 token 维度上的那一行。中文一字一 token 时两者恰好接近,一旦出现英文、数字、标点合并,字符下标就会错。
5.2 模板设计检查表
写一个新模板时,照着这张表过一遍,能挡掉绝大多数低级错误:
| 检查项 | 判据 | 踩了会怎样 |
|---|---|---|
| 语序 | [MASK] 出现在原句之后 | 放句首等于让模型没读材料就答题 |
| 分隔 | 原句与模板之间有标点或空格 | 粘连会改变分词结果,行为不可预期 |
| 语言 | 模板语言 = 预训练语料语言 | 中文模型配英文模板,等于换了一门考试 |
| 语感 | 把标签词填进去,整句读得通 | 「这是一条好评」通顺,「感觉是好评的」别扭,模型也别扭 |
| 长度 | 模板尽量短,别挤占原句预算 | 长文本任务里,模板太长会把原句挤出最大长度 |
| 唯一性 | 整条输入里只有一个 [MASK] | 多个 [MASK] 要额外设计对齐逻辑,先别上 |
5.3 标签词挑选检查表
| 检查项 | 说明 |
|---|---|
| 在词表里 | 用 tokenizer.convert_tokens_to_ids 验一下,拿不到 id 的词直接换掉 |
| 单 token | 多 token 的词要做池化或取首 token,规则一变结果就变,能避则避 |
| 不跨类 | 同一个词挂两个类别,推理必然自相矛盾——骨架里已有断言拦截 |
| 个数持平 | 用 sum 汇总时,词多的类别天然占便宜 |
| 避开高频虚词 | 「的」「了」「是」这类词在任何上下文分数都高,选进来等于引入噪声 |
5.4 从骨架到真实训练,还差哪几步
[MASK] 位置 logitsrequires_grad 设为 False06易错点
八个坑,前四个关乎理解,后四个关乎实现
两者中文都带「微调」,但改的东西完全不在一个层面。Prompt-Tuning 训练的是几千到几万个伪标记参数,大模型权重全程冻结;Fine-Tuning 更新的是模型全部权重。面试里问「你用 Prompt-Tuning 做过什么」,回答成「我们微调了模型」是当场失分的。
✅ 判据只有一条:训练结束后模型主体的权重变了没有。变了是 Fine-Tuning,没变是 Prompt-Tuning。
写提示词、加示例、要求分步推理——这些一个梯度都不产生。效果是靠唤醒模型已有的能力,不是靠教它新东西。反过来说,提示词再怎么写,也补不上模型压根不具备的知识,这类问题要靠 RAG 或微调解决。
✅ 记住第 02 节 2.7 那张表:要不要梯度这一列,把五个名词干净地切成了两半。
[MASK] 位置分数最高的往往是「的」「了」「是」这类高频虚词。直接取最大值,你拿到的是一个与任务无关的词,然后要么报错要么被强行归到某一类。
✅ 先把候选收缩到标签词集合,再在集合内部比较。verbalizer_decode.py 里「的」的 logit 是 5.9,仅次于「好」的 6.2——差距只有 0.3,换一句话就可能翻转。
比如给「正面」挂了「好」,又给「好评」这个类挂了「好」。这种错不会抛异常,只会让准确率莫名其妙地低,排查起来非常费时间。
✅ 构造 Verbalizer 时就加一段唯一性断言(骨架里的 _check_verbalizer)。让它在启动时炸,而不是在指标里烂着。
拼好模板后用 text.index("[MASK]") 拿到的是字符位置,而模型输出的是 (batch, seq_len, vocab),要的是 token 位置。中文纯汉字时两者接近,一旦混入英文、数字、标点合并,就会取错行——而且取错的那一行也是合法的概率分布,不会报错。
✅ 先 tokenize,再在 token 序列里找 [MASK] 的下标,并且在截断之后再找。
BERT 最大长度 512。做长文本分类时,模板写得花里胡哨占掉几十个 token,截断时被砍掉的是原句的尾巴,而关键信息常常就在尾巴上。更糟的是:模板要是被截断,[MASK] 可能整个消失。
✅ 模板越短越好;截断策略优先砍原句中部,并在代码里断言 [MASK] 仍然存在。
[MASK] 是 BERT 系的写法。RoBERTa 用 <mask>,T5 用 sentinel token <extra_id_0>,GPT 这类自回归模型压根没有掩码填空这回事。照搬 [MASK] 的结果是它被当成普通字符串切成几个 token,模型完全不知道你要它填空。
✅ 一律用 tokenizer.mask_token 取,别硬编码字符串。换模型第一件事就是打印一遍特殊标记。
模板换一个词,准确率能差十几个点。凭感觉挑一个就上,等于把一个关键超参数交给了运气。同理,max 汇总和 sum 汇总的数值不可互相比较,报指标时不写清楚,等于报了个没法复现的数。
✅ 备选模板在验证集上逐个跑(骨架里的 pick_pattern()),用数字选;报指标时把模板、标签词、汇总方式三件事一起写进实验记录。
07自测题
点击题目展开答案;能把这 10 题说清楚,这一讲就通了
NLP 的四种范式分别是什么?每一次转变把人从哪件活里解放出来了?
① 传统机器学习(TF-IDF + 朴素贝叶斯):人替机器造特征。② 深度学习(word2vec + LSTM):人替机器搭结构,不用手搓特征了。③ 预训练 + Fine-Tuning(BERT + 分类头):人替机器定下游任务,网络不用从零学。④ 预训练 + Prompt + 预测(BERT + Pattern + Verbalizer):人替机器写便条。一条贯穿的线是:模型越来越大,需要的标注数据越来越少。
第三范式和第四范式送进模型的输入,差别只有一处,是哪一处?
第四范式在原输入后面又拼了一段带 [MASK] 的模板,原句一个字都没改。第三范式:[CLS] 这部电影很好看。[SEP];第四范式:[CLS] 这部电影很好看。[SEP] 整体感觉是[MASK]的。[SEP]。paradigm_compare.py 里用三条断言钉死了这件事,其中一条是「第四范式的输入必须以第三范式的输入开头」。
第三范式明明已经很好用了,它的痛点是什么?
预训练的目标是完形填空(MLM),下游微调的目标是分类,两个目标对不上,带来三个代价:① 分类头是随机初始化的,预训练帮不上忙,数据一少就学不稳;② 仍然需要几百到几千条标注,小样本场景失效;③ 每个下游任务要另存一整份模型权重。
PVP 是什么?Pattern 和 Verbalizer 各自管什么?
Pattern-Verbalizer-Pair(模板-标签词对),出自 PET 论文(arXiv:2001.07676)。Pattern 决定怎么问——带 [MASK] 的模板,把分类题改写成填空题;Verbalizer 决定怎么读答案——标签词与类别的映射,如「好/棒/赞 → 正面」。两者必须成对设计,单独换任何一边都会翻车。
为什么不能直接在 [MASK] 的词表分布上取 argmax?
因为概率最高的经常是「的」「了」「是」这类高频虚词,它们根本不是标签词。verbalizer_decode.py 的演示数据里,「的」的 logit 是 5.9,仅次于「好」的 6.2——差距只有 0.3,换一句话就可能翻转。正确做法是先把候选收缩到标签词集合,再在集合内部比较。
标签词汇总的 max 与 sum 两种方式,能不能混用?
不能。两种都常见,但必须全程用同一种,它们产出的数值不可互相比较。另外用 sum 时要注意各类别的标签词个数尽量持平,否则词多的那一类天然占便宜。报指标时要把模板、标签词、汇总方式三件事一起写清楚,否则实验无法复现。
第四范式省掉了随机初始化的分类头,靠的是什么?
靠复用 BERT 预训练自带的 MLM 头——那一层把 hidden 维向量映射回整个词表(中文 BERT 约 21128 个词),并且是预训练好的,不是随机的。于是整条链路上没有任何一层是从零学起,这就是「零样本也能出结果」的技术来源。
Hard Prompt 和 Soft Prompt 插入模型的位置有什么不同?
Hard Prompt 改的是 tokenizer 之前的字符串:模板是真实文字,和原句一起过分词、一起查 embedding table。Soft Prompt 改的是 embedding 之后的那几行向量:伪标记根本不过 tokenizer,词表里查不到对应汉字,它们直接作为可训练参数拼在句子向量前面。两者的共同点是:大模型权重都冻结。
为什么说「人工挑模板成本高、方差大」?举三个会翻车的模板。
因为模板表达同一个意思,但送进模型的 token 序列长度、[MASK] 位置、标签词语言全都不同,准确率差出十几个点是常事。三个典型:① [MASK]。{x}——模型还没读到评论就要作答;② {x} It was [MASK].——中文模型配英文模板,等于换了一门考试;③ {x}[MASK]——没有分隔符,[MASK] 粘在句号后面,切词结果会变。这正是 Soft Prompt 要解决的问题。
以 BERT-base、prompt_len=20 为例,Soft Prompt 要训练多少参数?这意味着什么?
20 × 768 = 15360 个,占模型主体不到 0.1%(param_budget.py 里有这条断言)。意味着:全参微调每多一个任务要另存一整份权重、数百 MB,而 Soft Prompt 只多存一小段向量、几十 KB。这就是「每多一个任务就多一整份模型」这个痛点的解法。
Prompt Engineering、In-Context Learning、CoT、Prompt-Tuning、Fine-Tuning,哪些要梯度?
前三个都不需要梯度,它们改的只是输入文本;后两个都需要梯度,区别在于 Prompt-Tuning 只更新伪标记向量、模型权重冻结,而 Fine-Tuning 更新模型全部权重。用本讲的比喻收束:写便条、递例子、要求分步推理都是改便条;Prompt-Tuning 是给他戴一副定制耳机;只有 Fine-Tuning 是送去脱产培训改造本人。改便条 ≠ 改人。
词术语表
| 术语 | 含义 |
|---|---|
| 范式(Paradigm) | 一个时代里解决 NLP 任务的默认套路;本讲讲了四种,每一种都在回答「让数据迁就模型,还是让模型迁就数据」 |
| PLM | Pre-trained Language Model,预训练语言模型,如 BERT、GPT |
| MLM | Masked Language Model,掩码语言模型;BERT 的预训练任务,本质是完形填空 |
| MLM 头 | 把 hidden 维向量映射回整个词表的那一层,预训练好的;第四范式复用它,因此不必新增分类头 |
| Prompt | 拼在原句前后的一段提示,作用是唤醒模型已有的知识,把「分类」改写成模型最擅长的「填空」 |
| Pattern / Template | 带 [MASK] 的模板短句,决定「怎么问」,如 {x} 整体感觉是[MASK]的。 |
| Verbalizer | 标签词与类别的映射表,决定「怎么读答案」,如「好/棒/赞 → 正面」 |
| PVP | Pattern-Verbalizer-Pair,模板与标签词成对设计的方法,出自 PET 论文 arXiv:2001.07676 |
| 标签词(Label Word) | Verbalizer 里代表某个类别的词;要求在词表中存在、优先单字、不跨类别 |
| Hard Prompt | 离散提示;人写的真实文字模板,不需要训练,但模板敏感性强 |
| Soft Prompt | 连续提示;一串可训练向量(伪标记),词表里查不到对应汉字,由梯度学出来 |
| 伪标记(Pseudo Token) | Soft Prompt 里的那几行向量;不过 tokenizer,直接拼在句子向量前面 |
| Prompt-Tuning | 只训练 Soft Prompt、冻结模型全部权重的方法;论文 arXiv:2104.08691 |
| Fine-Tuning | 用下游标注数据更新模型全部权重;效果好但每个任务要另存一份模型 |
| Zero-shot / One-shot / Few-shot | 输入里给 0 个 / 1 个 / 若干个示例;三者都不更新参数,概念源自 GPT-3 论文 arXiv:2005.14165 |
| 模板敏感性 | 同一意思的不同模板导致结果大幅波动的现象;Hard Prompt 最大的软肋 |