【案例】Python + Streamlit 搭建私有聊天机器人
把前四讲串成一个能交付的东西——页面、工具层、本地模型,数据一步不出内网。
30″30 秒看懂这个案例
前四讲分别讲清了为什么私有化、怎么装、怎么上生产、接口长什么样。这一讲把它们串成一个能给同事打开就用的东西:一个跑在内网的聊天机器人。
成品很简单——浏览器里一个聊天页面,输入问题,答案一个字一个字冒出来。但它背后是完整的一条链:页面 → 工具层 → 本地模型,全程数据不出这台机器。
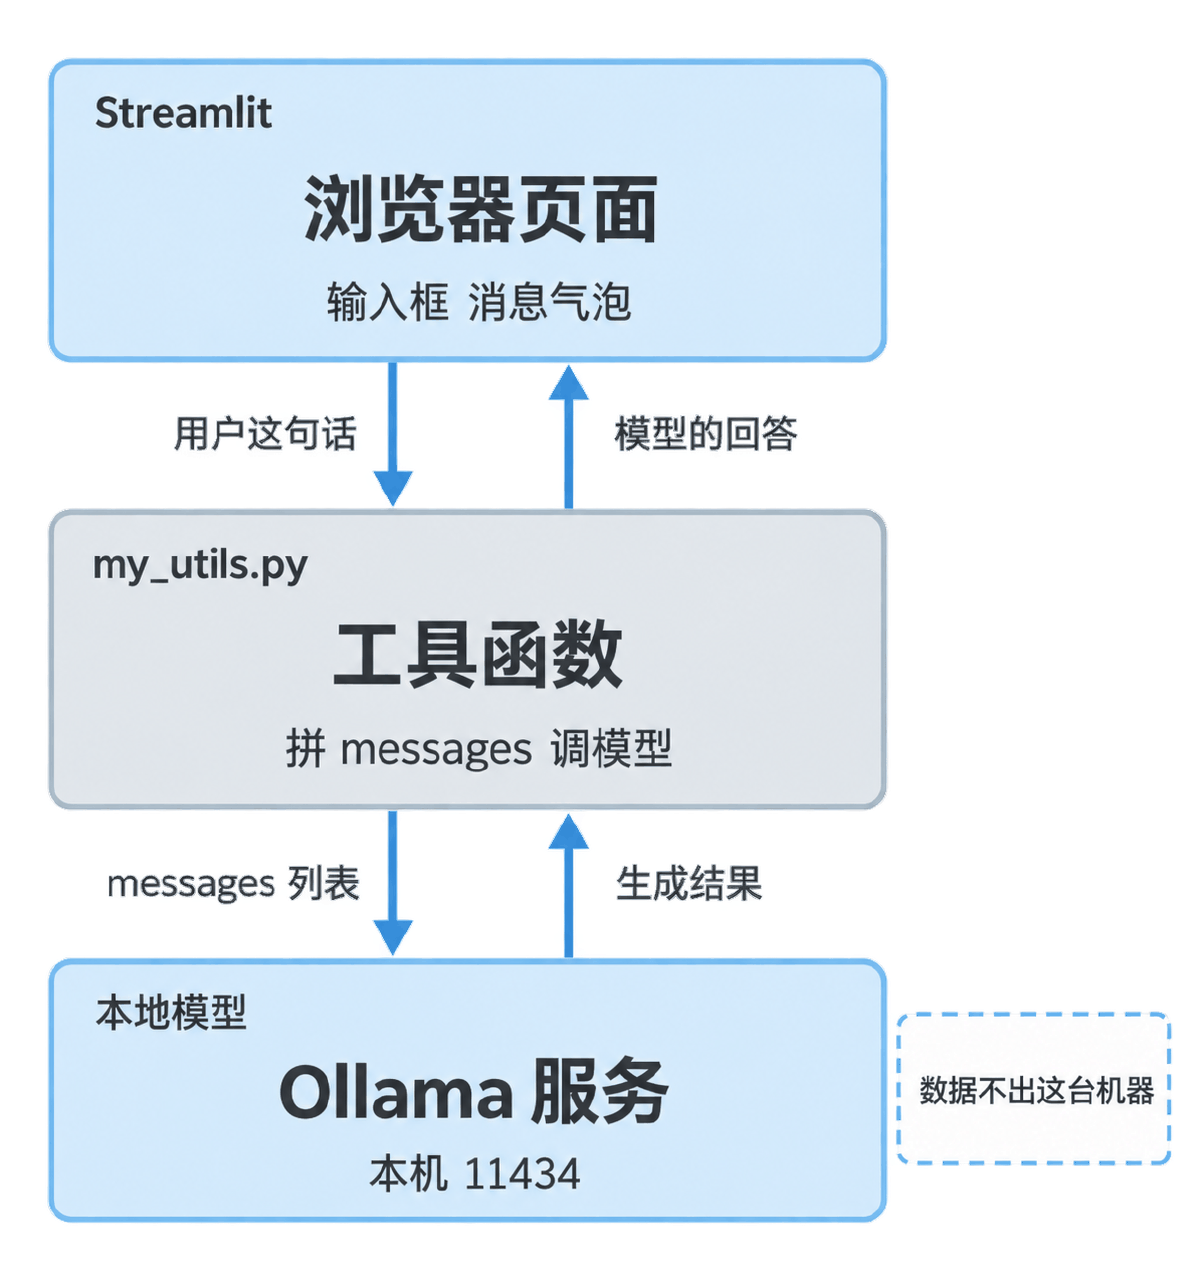
| 这一层 | 文件 | 只负责一件事 |
|---|---|---|
| 界面层 | my_chat.py | 显示气泡、收集输入,不碰模型 |
| 工具层 | my_utils.py | 拼 messages、调模型、返回文本,不碰界面 |
| 模型层 | Ollama 服务 | 真正算答案,跑在 11434 |
这一讲要解决的技术难点其实只有两个,而且都不在「调模型」上——调模型上一讲已经讲透了。难点在界面框架的运行机制和对话记忆:
- Streamlit 每次交互都会把整个脚本从第一行重跑一遍。所以普通变量存不住任何东西。
- Ollama 服务端不记历史。上一讲的铁律,在这里要真正落地成代码。
session_state 的东西。聊天记录、用户身份、任何需要跨轮次存在的状态,放普通变量就等于没存——页面一刷全归零,机器人就永远只记得你最后说的那一句。
chatbot_skeleton.py 是改几个 TODO 就能变成你自己业务助手的骨架:人设可配、历史可裁剪、流式输出、异常兜底四件事都替你处理好了。
01概念:三层分工与技术选型
先把边界划清楚,再动手写
1.1 三层分工
很多人写第一个聊天机器人时,把界面和调模型的代码全塞在一个文件里。跑得起来,但只要界面一换就得重写一遍。这个案例从一开始就分成两个文件,不是为了好看,是为了这三件事:
| 好处 | 具体表现 |
|---|---|
| 界面可替换 | 把 Streamlit 换成 Flask、命令行、企业微信机器人,my_utils.py 一个字不用动 |
| 故障可隔离 | 出问题时先单独跑 python3 my_utils.py——通了就说明是界面的锅,不通就是模型的锅 |
| 改动可收敛 | 换模型、加超时、加日志、加鉴权,全都只改工具层这一个文件 |
1.2 为什么选 Streamlit
这个案例用 Streamlit 写界面。它的定位很明确:给不写前端的人用的界面框架——纯 Python,没有 HTML、CSS、JavaScript。
| 方案 | 写界面要会什么 | 什么时候选它 |
|---|---|---|
| Streamlit | 只要 Python | 内部工具、demo、验证想法;本案例 |
| Gradio | 只要 Python | 模型演示、快速分享,组件更偏 AI 场景 |
| Flask + 前端 | Python + HTML/JS | 要自定义交互、要接进现有系统 |
| 现成客户端 | 什么都不用写 | 只是要个能聊天的窗口,别写代码 |
Streamlit 的核心 API 就四个,看懂这四个这个案例就没有别的门槛了:
| API | 作用 | 要点 |
|---|---|---|
st.chat_message(role) | 画一个消息气泡 | role 是 user 或 assistant,样式不同 |
st.chat_input(提示) | 底部输入框 | 没输入时返回 None,脚本执行到这就结束 |
st.session_state | 跨重跑保存数据 | 本讲的关键,下一节专门讲 |
st.write_stream(生成器) | 边收边渲染 | 顺便把完整文本作为返回值给你 |
python3
Streamlit 程序必须用 streamlit run my_chat.py 启动。直接 python3 my_chat.py 不会报错,但也不会出现页面,只会打印一堆看不懂的提示——很多人卡在这里,以为代码写错了。
02原理:两个机制决定了代码怎么写
脚本重跑、状态保存、记忆传递
2.1 整个脚本会重跑
这是 Streamlit 最反直觉、也是新手第一个撞墙的地方:用户每做一次交互(敲回车、点按钮),Streamlit 就把这个 .py 文件从第一行整个重新执行一遍。
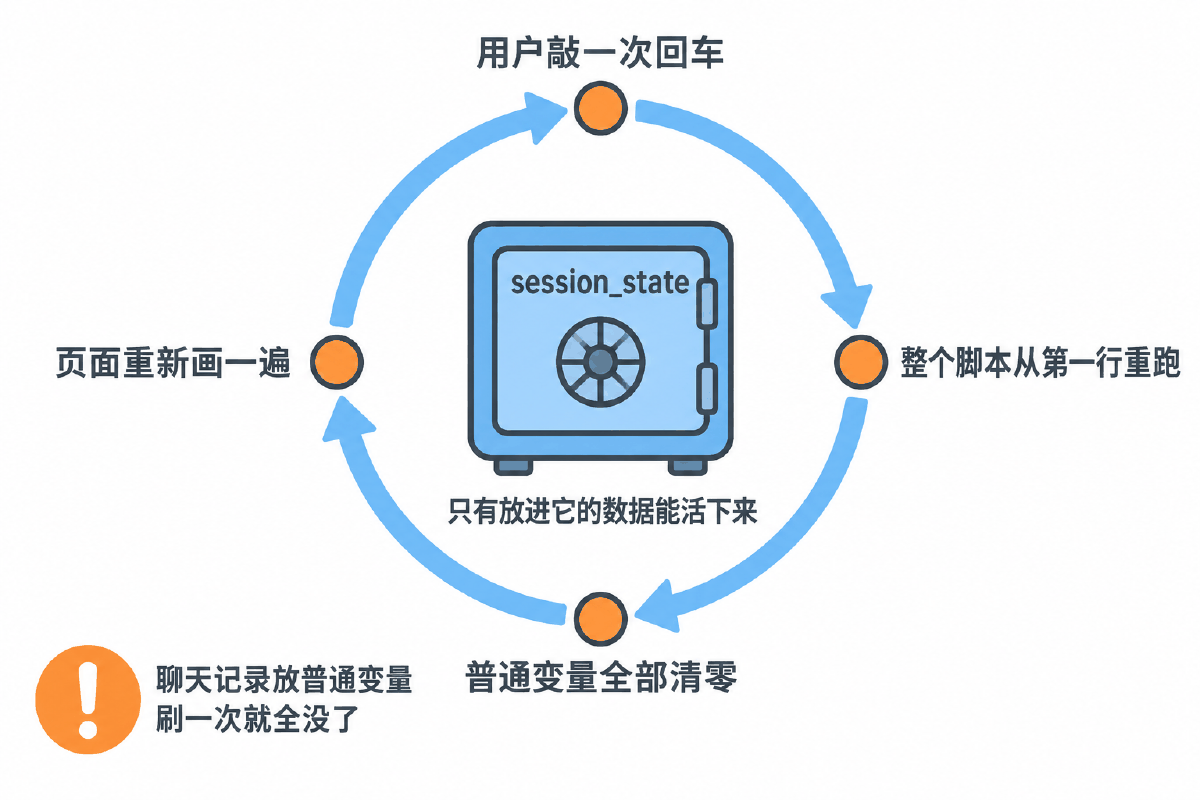
不是「只执行改变的部分」,是从头到尾全跑一遍。带来的后果很直接:
| 你写的东西 | 重跑之后 | 说明 |
|---|---|---|
普通变量 messages = [] | 被重新初始化成空 | 聊天记录放这里等于没存 |
| 已经画出来的气泡 | 消失 | 页面是重绘的,得自己再画一遍 |
| 全局计数器 | 永远是初始值 | 加一之后下一轮又归零 |
st.session_state 里的东西 | 活下来了 | 这是唯一的例外 |
session_state)里,第二天翻本子。写在手心里的,一洗手就没了。
2.2 session_state 是唯一的保险箱
它的用法就是个字典,但有一个固定写法必须记住:
if "messages" not in st.session_state:
    st.session_state["messages"] = [初始消息]
这个 if 是整个程序的关键。它的意思是「只在第一次进入时初始化,之后的每次重跑都跳过」。去掉这个 if,每次重跑都会把历史清空,机器人就永远只记得你最后说的那一句——这是本讲最高频的 bug,没有之一。
| 写法 | 结果 | 原因 |
|---|---|---|
messages = [](普通变量) | 每轮清空 | 重跑时被重新赋值 |
st.session_state["messages"] = [](无 if) | 每轮清空 | 放进保险箱了,但每次重跑都重新清一遍 |
if ... not in ... 再赋值 | 正常累积 | 只初始化一次 |
因为页面是整个重绘的,历史气泡也必须自己重新画出来。所以代码里固定有这一段循环:
for message in st.session_state["messages"]:
    with st.chat_message(message["role"]):
st.markdown(message["content"])它不是「多余的渲染」,它就是页面上那些历史气泡本身。漏了它,页面上只会剩下最新一条。
st.markdown() 只是画,画完这一轮就没了;session_state.append() 才是存。两件事都要做,而且顺序是先存再画——顺序反了,遇到中途异常就会出现「屏幕上有、历史里没有」的错位。
2.3 记忆靠自己带上
上一讲的铁律在这里落地:Ollama 服务端不保存任何历史。所谓「机器人记得我叫什么」,是你每次把整段对话重新发过去的结果。
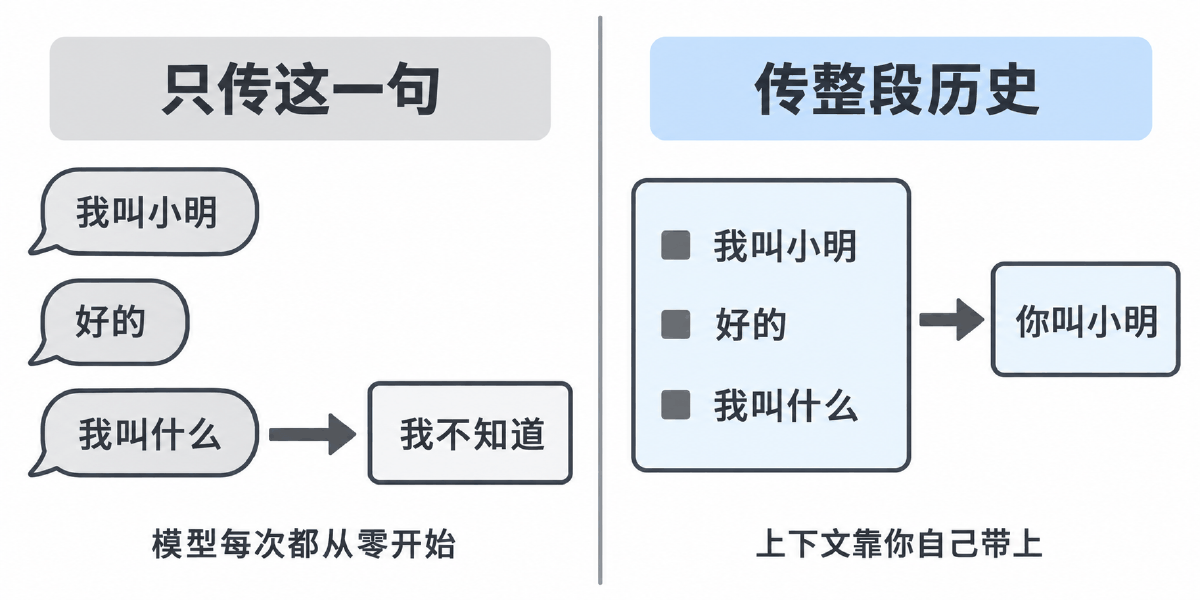
| 传给模型的内容 | 代码写法 | 用户看到的表现 |
|---|---|---|
| 只传当前这一句 | get_response(prompt) | 「我不知道你叫什么」 |
| 传整段历史 | get_response(st.session_state["messages"]) | 「你叫小明」 |
所以案例里调模型那一行传的是整个 messages 列表,不是那一句 prompt。而且模型答完之后,必须把回答也 append 回 messages——漏了这一步,模型下一轮就不记得自己刚说过什么,会出现重复回答、自相矛盾。
system 不能被裁
历史无限增长会越来越慢、显存涨、最后被 num_ctx 静默截断。my_utils.py 里用 MAX_MESSAGES 取最近 N 条,并且把 system 单独拼在最前面、不参与裁剪。直接切片会把人设一起切掉,聊到几十轮后机器人性格突变。
session_state 解决的是「页面记不记得」,messages 解决的是「模型记不记得」。两者缺一不可:只做前者,页面上气泡在但模型答非所问;只做后者,刷新一次全没了。这个案例的全部难点就这两条。
03最小代码:先用官方库说一句话
界面之前,先确认模型能调通
写界面之前,先把「Python 能不能调到模型」这件事单独验证掉。这一步不通就去写界面,后面分不清是界面问题还是模型问题,会白白浪费很多时间。
上一讲用的是裸 HTTP。这里换成官方的 ollama 库——它只是替你把 URL、JSON 序列化、响应解析包掉了,底下走的还是同一个 /api/chat 接口,字段名一个都没变。
"""最小代码:用官方 ollama 库跟本地模型说一句话。

    pip install ollama
    python3 min_ollama.py

和直接发 HTTP 相比,这个库只是替你把 URL、JSON 序列化、响应解析包掉了,
底下走的还是同一个 /api/chat 接口。
"""
import os

import ollama

MODEL = os.environ.get("OLLAMA_MODEL", "qwen2:1.5b")

# 情况一:Ollama 就在本机、端口也没改,直接用模块级函数
response = ollama.chat(
    model=MODEL,
    messages=[{"role": "user", "content": "从前有座山,山里有个庙,续写一下"}],
)
# 返回是个字典,模型说的话在 message.content 里
print(response["message"]["content"])

# 情况二:模型跑在别的机器上(或改过端口),就显式建一个 Client
host = os.environ.get("OLLAMA_HOST_ADDR", "127.0.0.1")
port = os.environ.get("OLLAMA_PORT", "11434")
client = ollama.Client(host="http://%s:%s" % (host, port))

response2 = client.chat(
    model=MODEL,
    messages=[{"role": "user", "content": "用一句话说明什么是私有化部署"}],
    # options 和 HTTP 接口里的完全一致
    options={"temperature": 0.3, "num_predict": 128},
)
print(response2["message"]["content"])
| 写法 | 什么时候用 | 说明 |
|---|---|---|
ollama.chat(...) | Ollama 就在本机、端口没改 | 模块级函数,最省事 |
ollama.Client(host=...) | 模型在别的机器上,或改过端口 | 显式建客户端,地址走环境变量读 |
| 这一处 | 和上一讲的对应关系 |
|---|---|
messages=[...] | 就是 /api/chat 请求体里的 messages,结构完全一致 |
options={...} | 字段名和 HTTP 接口里完全一致,temperature、num_predict 照搬 |
response["message"]["content"] | 答案的位置也没变 |
没写 stream | 库这一层默认是非流式,和裸 HTTP 的默认值相反,别记混 |
/api/chat 不传 stream 默认是流式;ollama 库的 chat() 不传 stream 默认是非流式,要流式得显式写 stream=True。这两个默认值方向相反,从一边切到另一边时最容易踩。
pip install ollama 装的是客户端库,不是 Ollama 本身。模型服务得先按第二讲装好、跑起来。库装了但服务没起,报的是连接被拒绝——别去重装库,去 curl /api/version 看服务。
04完整案例:三步做出私有聊天机器人
先工具层,再界面层,最后跑起来验收
4.1 第一步 · 工具层 my_utils.py
先写后端。它只负责一件事:把消息交给模型、把答案拿回来。不导入任何界面相关的东西——这样界面换掉时它能原样搬走。
"""后端工具箱:只负责「把消息交给模型、把答案拿回来」。

刻意和界面代码分开:
  - 界面换成 Flask、命令行、企业微信机器人,这个文件都不用动
  - 想换模型、加超时、加日志,也只改这一个文件

单独运行可以脱离界面自测:
    python3 my_utils.py
"""
import os

import ollama

MODEL = os.environ.get("OLLAMA_MODEL", "qwen2:1.5b")

# 上下文窗口有限,历史无限增长会越来越慢,最后被 num_ctx 截断。
# 只把最近 N 条发给模型;N 取多少取决于 num_ctx 和单条消息长度。
MAX_MESSAGES = 50

SYSTEM_PROMPT = "你是黑马智聊机器人,用中文回答,简洁准确,不确定就直说。"


def get_response(prompt):
    """prompt 既可能是一个字符串(单轮),也可能是 messages 列表(多轮)。

    之所以两种都收:界面早期版本传的是一句话,加上记忆之后传的是整段历史。
    与其改调用方,不如在这里判一下类型,接口保持向后兼容。
    """
    if isinstance(prompt, str):
        messages = [{"role": "user", "content": prompt}]
    else:
        # 取最近 MAX_MESSAGES 条,避免上下文无限膨胀
        messages = list(prompt)[-MAX_MESSAGES:]

    # system 始终放在最前面,而且不参与裁剪
    if not messages or messages[0].get("role") != "system":
        messages = [{"role": "system", "content": SYSTEM_PROMPT}] + messages

    response = ollama.chat(
        model=MODEL,
        messages=messages,
        options={"temperature": 0.3},
    )
    return response["message"]["content"]


def get_response_stream(prompt):
    """流式版本:返回一个生成器,界面拿去逐片渲染。"""
    messages = [{"role": "user", "content": prompt}] if isinstance(prompt, str) else list(prompt)[-MAX_MESSAGES:]
    if not messages or messages[0].get("role") != "system":
        messages = [{"role": "system", "content": SYSTEM_PROMPT}] + messages

    for chunk in ollama.chat(model=MODEL, messages=messages, stream=True):
        part = chunk.get("message", {}).get("content", "")
        if part:
            yield part


if __name__ == "__main__":
    # 脱离界面自测:这一步通了,再去调界面;否则分不清是界面问题还是模型问题
    print(get_response("一周有几天?"))
| 设计点 | 为什么这么写 |
|---|---|
| 同时接受字符串和列表 | 界面早期版本传的是一句话,加上记忆之后传的是整段历史。在这里判一下类型,调用方不用改 |
MAX_MESSAGES 裁剪 | 历史无限增长会越来越慢,最后被 num_ctx 静默截断 |
system 单独拼在最前 | 不参与裁剪,否则聊久了人设消失 |
| 模型名走环境变量 | 换模型不用改源码,改源码就会漏改 |
带 __main__ 自测块 | 能脱离界面单独跑,这一点在排查时值一百行日志 |
| 额外给了流式版本 | get_response_stream 返回生成器,界面想升级成流式时直接换函数 |
python3 my_utils.py 能打印出「一周有七天」,这一层就算过了。通了再去写界面——之后界面出任何问题,你都能确定模型这条链是好的。
4.2 第二步 · 界面层 my_chat.py
界面层只管显示和收集输入,调模型那一行直接 from my_utils import get_response。整个文件的执行顺序就是 2.1 节讲的:每次交互从第一行重跑一遍。
"""界面层:Streamlit 聊天页面,只管显示和收集输入。

    pip install streamlit ollama
    streamlit run my_chat.py

必须理解的机制:用户每敲一次回车,Streamlit 就把这个文件**从第一行整个重跑一遍**。
所以普通变量存不住东西,聊天记录只能放进 st.session_state。
"""
import streamlit as st

from my_utils import get_response

st.set_page_config(page_title="黑马智聊机器人", page_icon="💬")
st.title("黑马智聊机器人")
st.caption("模型跑在本机,数据不出内网")

# ---------- ① 初始化:只在首次进入时执行一次 ----------
# 这个 if 是整个程序的关键。没有它,每次重跑都会把历史清空,
# 机器人就永远只记得你最后说的那一句。
if "messages" not in st.session_state:
    st.session_state["messages"] = [
        {"role": "assistant", "content": "你好,我是黑马智聊机器人,有什么可以帮你的?"},
    ]

# ---------- ② 重放:把历史全部重新画一遍 ----------
# 因为页面是整个重绘的,之前的气泡不会自动留在屏幕上,必须自己循环画出来
for message in st.session_state["messages"]:
    with st.chat_message(message["role"]):
        st.markdown(message["content"])

# ---------- ③ 输入框 ----------
# chat_input 固定在页面底部;没输入时返回 None,脚本执行到这里就结束了
prompt = st.chat_input("请输入你要咨询的问题:")

if prompt:
    # 先把用户这句存进历史,再画出来——顺序反了会导致刷新后丢失
    st.session_state["messages"].append({"role": "user", "content": prompt})
    st.chat_message("user").markdown(prompt)

    # ---------- ④ 调模型 ----------
    with st.chat_message("assistant"):
        with st.spinner("正在思考…"):
            # 把整段历史都传过去,模型才有上下文
            content = get_response(st.session_state["messages"])
        st.markdown(content)

    # ---------- ⑤ 模型的回答也要存进历史 ----------
    # 漏掉这一步,下一轮模型就不记得自己刚才说过什么
    st.session_state["messages"].append({"role": "assistant", "content": content})

# ---------- ⑥ 侧边栏:清空对话 ----------
with st.sidebar:
    if st.button("清空对话"):
        st.session_state["messages"] = [
            {"role": "assistant", "content": "已清空,我们重新开始。"},
        ]
        # 手动触发一次重跑,页面立刻刷新
        st.rerun()
代码里六个编号段落,对应六件必须做的事:
| 段落 | 做什么 | 漏了会怎样 |
|---|---|---|
| ① 初始化 | if "messages" not in ... | 每轮清空,机器人永远只记得最后一句 |
| ② 重放历史 | 循环把气泡重新画一遍 | 页面上只剩最新一条 |
| ③ 输入框 | st.chat_input | —(没输入时返回 None,脚本到这就结束) |
| ④ 调模型 | 传整段历史而不是那一句 | 模型没有上下文,答非所问 |
| ⑤ 回填回答 | append assistant 消息 | 模型不记得自己说过什么 |
| ⑥ 清空按钮 | 重置 session_state + st.rerun() | 点了没反应,要等下次交互才刷新 |
append 进历史,再 markdown 画出来。反过来的话,中途调模型抛异常时,屏幕上有这句话但历史里没有——下一轮重跑,这句话凭空消失,用户会以为自己没发出去。
4.3 第三步 · 跑起来验收
| 步骤 | 命令 / 动作 | 通过标准 |
|---|---|---|
| ① 确认服务 | ollama ps | 目标模型在列表里,PROCESSOR 是 GPU |
| ② 自测工具层 | python3 my_utils.py | 终端打印出回答 |
| ③ 起界面 | streamlit run my_chat.py | 浏览器自动打开页面 |
| ④ 测记忆 | 先说「我叫小明」,再问「我叫什么」 | 答得出「小明」才算真通 |
| ⑤ 测刷新 | 按 F5 刷新页面 | 历史清空是正常的(新会话) |
| ⑥ 测清空 | 点侧边栏「清空对话」 | 立刻回到开场白 |
4.4 第四步 · 换一个界面,验证分层真的成立
1.1 节说分层的好处是「界面可替换」。这句话不验证一下就只是口号。下面这份把 Streamlit 换成纯命令行,my_utils.py 一个字都没改,直接 import 过来用。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""cli_chat.py —— 同一个工具层,换一个界面

用途:证明分层不是嘴上说说。这个文件把 Streamlit 界面换成纯命令行,
     而 my_utils.py 一个字都没改,直接 import 过来用。

用法:
    python3 cli_chat.py
    OLLAMA_MODEL=qwen2:7b python3 cli_chat.py

为什么值得写这一份:
  * 服务器上没有浏览器时,它就是最快的验收手段;
  * 页面出问题时,用它对照一下就知道是界面的锅还是模型的锅;
  * 接企业微信机器人、定时任务、批处理脚本时,起点也是这一份。

对话中可用的命令:
    /clear  清空历史,重新开始
    /save   把当前对话存成 JSON 文件
    /stat   看当前历史条数与大致字数
    /bye    退出
"""

import json
import os
import sys
import time

from my_utils import MAX_MESSAGES, SYSTEM_PROMPT, get_response_stream

SAVE_DIR = os.environ.get("CHAT_SAVE_DIR", ".")


def new_history():
    """每次开新对话都从这里开始:只有一条 system。"""
    return [{"role": "system", "content": SYSTEM_PROMPT}]


def show_stat(messages):
    """历史有多长,心里要有数——越长越慢是必然的。"""
    chars = sum(len(m["content"]) for m in messages)
    turns = len([m for m in messages if m["role"] == "user"])
    print("  历史消息 %d 条(含 system),完成 %d 轮问答,约 %d 字"
          % (len(messages), turns, chars))
    print("  工具层保留上限 MAX_MESSAGES = %d 条" % MAX_MESSAGES)
    if len(messages) > MAX_MESSAGES:
        print("  已超过上限,最早的消息不会再发给模型(system 除外)")


def save_history(messages):
    """存成 JSON,方便事后复盘模型到底看到了什么。"""
    name = time.strftime("chat-%Y%m%d-%H%M%S.json")
    path = os.path.join(SAVE_DIR, name)
    with open(path, "w", encoding="utf-8") as fp:
        json.dump(messages, fp, ensure_ascii=False, indent=2)
    print("  已保存到 %s" % path)


def ask(messages, question):
    """发一轮问答:流式打印,返回完整答案。

    这里不用 print(end="") 之后再统一 flush,是因为不 flush 的话
    输出会被缓冲住,流式效果白做了——看起来还是等到最后一次性出现。
    """
    messages.append({"role": "user", "content": question})
    print("助手:", end="")
    sys.stdout.flush()

    started = time.time()
    pieces = []
    try:
        for part in get_response_stream(messages):
            pieces.append(part)
            print(part, end="")
            sys.stdout.flush()
    except KeyboardInterrupt:
        print("\n  (已中断本轮生成)")
        messages.pop()  # 这一轮不完整,把问题也撤回,避免污染历史
        return None
    except Exception as exc:
        print("\n  调用模型失败:%s" % exc)
        print("  先确认服务在跑:ollama ps;再确认模型名写全了带冒号版本。")
        messages.pop()
        return None

    answer = "".join(pieces)
    elapsed = time.time() - started
    print("\n  (耗时 %.1fs,%d 字)" % (elapsed, len(answer)))

    # 关键一步:模型的回答必须回填进历史,否则下一轮它不记得自己说过什么
    messages.append({"role": "assistant", "content": answer})
    return answer


def main():
    print("=" * 56)
    print("命令行版聊天机器人(界面换了,工具层没动)")
    print("模型:%s" % os.environ.get("OLLAMA_MODEL", "qwen2:1.5b"))
    print("命令:/clear 清空  /save 保存  /stat 看历史  /bye 退出")
    print("=" * 56)

    messages = new_history()

    while True:
        try:
            question = input("\n你:").strip()
        except (EOFError, KeyboardInterrupt):
            print("\n再见。")
            return 0

        if not question:
            continue
        if question == "/bye":
            print("再见。")
            return 0
        if question == "/clear":
            messages = new_history()
            print("  已清空,我们重新开始。")
            continue
        if question == "/stat":
            show_stat(messages)
            continue
        if question == "/save":
            save_history(messages)
            continue
        if question.startswith("/"):
            print("  未知命令;可用:/clear /save /stat /bye")
            continue

        ask(messages, question)


if __name__ == "__main__":
    sys.exit(main())
| 它的实际用处 | 说明 |
|---|---|
| 服务器上没浏览器 | 这就是最快的验收手段,SSH 上去直接聊 |
| 页面出问题时分层定位 | 命令行能聊→界面的锅;也不能聊→模型的锅 |
| 接企业微信机器人、定时任务 | 起点就是这份,把 input() 换成消息回调即可 |
/stat 看历史长度 | 直观感受「越聊越长」到底长多快 |
/save 存成 JSON | 事后复盘模型到底看到了什么,比猜有用 |
KeyboardInterrupt 后做了一件事:messages.pop()。这一轮答案不完整,就把问题一起撤回,否则历史里会留下一个没有回答的提问,下一轮模型会被它带偏。界面版遇到异常也该同理处理。
4.5 第五步 · 把验收写成脚本
4.3 那张表是手工点一遍。改一次代码就重点一遍,早晚会偷懒。把它写成脚本,重点验的不是「有没有回答」,而是「多轮记忆通没通」:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""chat_smoke_test.py —— 交付之前的自动化验收

用途:把「肉眼点一遍页面」这件事写成脚本。重点验的不是「有没有回答」,
     而是这个案例真正的验收点——**多轮记忆到底通没通**。

用法:
    python3 chat_smoke_test.py
    OLLAMA_MODEL=qwen2:7b python3 chat_smoke_test.py

它验五件事:
    1. 工具层能不能调通模型(单轮)
    2. 传整段历史时,模型记不记得前面说过的名字
    3. 只传当前这一句时,模型确实不记得(反向验证)
    4. 流式接口能不能分多片返回
    5. 历史裁剪之后,system 人设还在不在

退出码 0 = 全通过,1 = 有失败项,可以接进发版流程。
"""

import sys
import time

import my_utils

PASS = "[ PASS ]"
FAIL = "[ FAIL ]"

results = []


def record(name, ok, detail=""):
    results.append((name, ok))
    line = "%s %s" % (PASS if ok else FAIL, name)
    if detail:
        line += " —— " + detail
    print(line)
    return ok


def t1_single_turn():
    """最基本的一步:工具层能不能拿到回答。"""
    try:
        answer = my_utils.get_response("一周有几天?只回答数字。")
    except Exception as exc:
        return record("1. 工具层单轮调用", False,
                      "%s(先确认 ollama ps 里有这个模型)" % exc)
    if not answer or not answer.strip():
        return record("1. 工具层单轮调用", False, "返回了空字符串")
    return record("1. 工具层单轮调用", True, "回答 %r" % answer.strip()[:20])


def t2_memory_with_history():
    """传整段历史,模型应该记得名字。这是本案例的核心验收点。"""
    messages = [
        {"role": "user", "content": "记住,我叫小明。"},
        {"role": "assistant", "content": "好的,小明。"},
        {"role": "user", "content": "我叫什么名字?只回答名字。"},
    ]
    try:
        answer = my_utils.get_response(messages)
    except Exception as exc:
        return record("2. 传整段历史时有记忆", False, str(exc))
    ok = "小明" in answer
    detail = "回答 %r" % answer.strip()[:24]
    if not ok:
        detail += ";检查界面层是否传了整个 messages 而不是单句"
    return record("2. 传整段历史时有记忆", ok, detail)


def t3_no_memory_without_history():
    """反向验证:只传当前这一句,模型不应该知道名字。

    这一项失败并不总是代码问题(小模型可能瞎猜一个名字),
    所以失败时给的是提示而不是断言,避免误导。
    """
    try:
        answer = my_utils.get_response("我叫什么名字?")
    except Exception as exc:
        return record("3. 不传历史时确实没有记忆", False, str(exc))
    ok = "小明" not in answer
    detail = "回答 %r" % answer.strip()[:24]
    if not ok:
        detail += ";模型凭空说出了名字,属于异常,检查是否误用了共享历史"
    return record("3. 不传历史时确实没有记忆", ok, detail)


def t4_stream_chunks():
    """流式应当分多片返回;只收到一片说明中间有人做了缓冲。"""
    started = time.time()
    chunks = 0
    text = ""
    try:
        for part in my_utils.get_response_stream("从 1 数到 10,只输出数字。"):
            chunks += 1
            text += part
    except Exception as exc:
        return record("4. 流式接口分片返回", False, str(exc))
    if chunks <= 1:
        return record("4. 流式接口分片返回", False,
                      "只收到 %d 片,检查网关 proxy_buffering" % chunks)
    return record("4. 流式接口分片返回", True,
                  "%d 片,耗时 %.1fs" % (chunks, time.time() - started))


def t5_system_survives_trim():
    """构造一段超长历史,确认裁剪之后 system 仍然在最前面。

    这里不发请求,只检查工具层的拼装逻辑——真正容易错的就是这一步。
    """
    long_history = []
    for i in range(my_utils.MAX_MESSAGES + 20):
        role = "user" if i % 2 == 0 else "assistant"
        long_history.append({"role": role, "content": "第 %d 条消息" % i})

    # 复刻 get_response 里的拼装逻辑,验证裁剪顺序
    trimmed = list(long_history)[-my_utils.MAX_MESSAGES:]
    if not trimmed or trimmed[0].get("role") != "system":
        trimmed = [{"role": "system", "content": my_utils.SYSTEM_PROMPT}] + trimmed

    ok = trimmed[0]["role"] == "system" and len(trimmed) <= my_utils.MAX_MESSAGES + 1
    detail = "裁剪后 %d 条,首条 role=%s" % (len(trimmed), trimmed[0]["role"])
    if not ok:
        detail += ";system 被裁掉会导致聊久了人设消失"
    return record("5. 裁剪后 system 仍在最前", ok, detail)


def main():
    print("模型:%s" % my_utils.MODEL)
    print("历史上限 MAX_MESSAGES:%d" % my_utils.MAX_MESSAGES)
    print("-" * 56)

    if not t1_single_turn():
        print("-" * 56)
        print("最基本的调用都没通,后面的用例没有意义。")
        print("排查顺序:ollama ps → curl /api/version → python3 my_utils.py")
        return 1

    t2_memory_with_history()
    t3_no_memory_without_history()
    t4_stream_chunks()
    t5_system_survives_trim()

    print("-" * 56)
    failed = [name for name, ok in results if not ok]
    print("通过 %d/%d" % (len(results) - len(failed), len(results)))
    if failed:
        for name in failed:
            print("  未通过:%s" % name)
        return 1
    print("全部通过,可以交付。")
    return 0


if __name__ == "__main__":
    sys.exit(main())
| 用例 | 验什么 | 失败说明什么 |
|---|---|---|
| 1 单轮调用 | 工具层能不能拿到回答 | 模型或服务的问题,后面用例没意义,直接停 |
| 2 传历史有记忆 | 说完名字后能不能答出来 | 界面层可能只传了单句,没传整个 messages |
| 3 不传历史无记忆 | 反向验证,确认记忆真是历史带来的 | 模型凭空说出名字,查是不是误用了共享历史 |
| 4 流式分片 | 能不能收到多片 | 只收到一片 → 网关把流缓冲住了 |
5 裁剪后 system 还在 | 拼装逻辑(不发请求) | 人设会在聊得够久后惄然消失 |
0/1 让它能直接接进发版流程。
05骨架模板:改 TODO 就能交付
人设可配、历史可裁剪、流式输出、异常兜底
案例版本是为了讲清机制,写得尽量直白。真要给同事用,还差四样东西。下面这份骨架把它们都补上了,配置区的 TODO 改完就是你自己的业务助手。
"""骨架模板:私有聊天机器人,复制改 TODO 就能变成你自己的业务助手。

    pip install streamlit ollama
    streamlit run chatbot_skeleton.py

已经替你处理好的四件事:人设可配、历史可裁剪、流式输出、异常兜底。
"""
import os

import ollama
import streamlit as st

# ---------- 配置区:改这里就够了 ----------
# TODO: 换成你要用的模型全名(ollama list 里查得到的那个)
MODEL = os.environ.get("OLLAMA_MODEL", "qwen2:1.5b")

# TODO: 模型服务地址;跑在别的机器上就改这里,或者设环境变量
HOST = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434")

# TODO: 换成你的业务人设,这一段直接决定机器人像不像样
SYSTEM_PROMPT = """
你是某公司的内部助手。
只依据用户提供的信息回答,不确定就说不确定,不要编造。
回答用中文,先结论后细节。
"""

# TODO: 页面标题与开场白
PAGE_TITLE = "内部智能助手"
WELCOME = "你好,我是内部助手,有什么可以帮你的?"

# TODO: 保留多少条历史。调大更能记事,但每轮请求都变长、变慢
MAX_MESSAGES = 40

client = ollama.Client(host=HOST)


def call_model(messages):
    """流式调用,返回一个生成器供 st.write_stream 渲染。"""
    payload = [{"role": "system", "content": SYSTEM_PROMPT}] + messages[-MAX_MESSAGES:]
    for chunk in client.chat(model=MODEL, messages=payload, stream=True,
                             options={"temperature": 0.3}):
        part = chunk.get("message", {}).get("content", "")
        if part:
            yield part


# ---------- 页面 ----------
st.set_page_config(page_title=PAGE_TITLE, page_icon="💬")
st.title(PAGE_TITLE)

if "messages" not in st.session_state:
    st.session_state["messages"] = [{"role": "assistant", "content": WELCOME}]

for m in st.session_state["messages"]:
    with st.chat_message(m["role"]):
        st.markdown(m["content"])

prompt = st.chat_input("请输入问题:")
if prompt:
    st.session_state["messages"].append({"role": "user", "content": prompt})
    st.chat_message("user").markdown(prompt)

    with st.chat_message("assistant"):
        try:
            # write_stream 会边收边渲染,并把完整文本作为返回值给你
            answer = st.write_stream(call_model(st.session_state["messages"]))
        except Exception as exc:  # 模型没起、端口不通、超时都会走到这里
            answer = "调用模型失败:%s" % exc
            st.error(answer)

    st.session_state["messages"].append({"role": "assistant", "content": answer})

with st.sidebar:
    st.write("当前模型:`%s`" % MODEL)
    st.write("服务地址:`%s`" % HOST)
    if st.button("清空对话"):
        st.session_state["messages"] = [{"role": "assistant", "content": WELCOME}]
        st.rerun()
| 补上的能力 | 代码里怎么做的 | 不做会怎样 |
|---|---|---|
| 人设可配 | 顶部 SYSTEM_PROMPT 常量 | 人设散在各处,改一次要翻好几个文件 |
| 历史裁剪 | messages[-MAX_MESSAGES:],system 单独拼 | 越聊越慢,最后被静默截断 |
| 流式输出 | 生成器 + st.write_stream | 用户盯着转圈等十几秒,体感极差 |
| 异常兜底 | try / except + st.error | 服务没起时整页报红崩掉,同事只会说「你这东西坏了」 |
| 配置可见 | 侧边栏显示当前模型与地址 | 出问题时问不清对方连的是哪台 |
st.write_stream 的便利之处
它边收边渲染,同时把拼好的完整文本作为返回值给你。所以流式和「回填完整回答进历史」这两件事,一行就都办了——不用自己再拼一次字符串。
5.2 改哪几处
| TODO 位置 | 改成什么 | 提示 |
|---|---|---|
MODEL | 你的模型全名 | 必须带冒号版本号,ollama list 里查 |
HOST | 模型服务地址 | 生产环境指向网关,不要直连 11434 |
SYSTEM_PROMPT | 你的业务人设 | 写清边界:「不确定就说不确定,不要编造」 |
PAGE_TITLE / WELCOME | 标题与开场白 | 开场白顺手告诉用户这机器人能干什么 |
MAX_MESSAGES | 保留多少条历史 | 用上一讲的 history_budget.py 算,别拍脑袋 |
5.3 还差什么才算真能交付
骨架解决的是「程序层面」的完整性。要真正放进公司内网给人用,还有几件事在这份代码之外:
| 缺口 | 怎么补 | 在哪一讲 |
|---|---|---|
| 谁都能打开页面 | 网关加鉴权,或接公司统一登录 | 第三讲 |
| 进程关掉就没了 | 写成 systemd 服务托管 | 第三讲 |
| 不知道有没有人在用 | 工具层加日志,记录耗时与失败 | 本讲,工具层是唯一入口 |
| 多人同时问会排队 | 按算力算并发,别直接调大 | 第三讲 |
| 答案不够准 | 接检索增强,把资料塞进提示词 | 第四讲的 embed_search.py 是起点 |
5.4 把「有没有人用」变成可观测的
上表里那一行「不知道有没有人在用」,是内部工具最常见的盲区。日志加在工具层,因为它是所有界面共用的唯一入口——加在界面层,换一个界面就要重加一次。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""chat_logger.py —— 给工具层加一层日志与统计

用途:回答「到底有没有人在用」「慢在哪」「失败率多少」这三个问题。
     日志加在工具层,因为它是所有界面共用的唯一入口——
     加在界面层的话,换一个界面就要重加一次。

用法(在 my_utils 里包一层):
    from chat_logger import log_call

    @log_call
    def get_response(prompt):
        ...

单独查看统计:
    python3 chat_logger.py            # 打印汇总
    python3 chat_logger.py --tail 20  # 看最近 20 条

日志落在 CHAT_LOG_PATH 指定的文件,默认 ./chat_calls.log,
每行一条 JSON,方便用 grep / jq 直接查,也方便后续接进日志系统。

刻意不记录用户问题的完整原文,只记长度和哈希——
内部助手的对话里经常有敏感信息,日志是最容易被忽略的泄漏口。
"""

import functools
import hashlib
import json
import os
import sys
import time

LOG_PATH = os.environ.get("CHAT_LOG_PATH", "chat_calls.log")


def _digest(text):
    """只留短哈希,用于判断「是不是同一个问题反复问」,但还原不出原文。"""
    return hashlib.sha256(text.encode("utf-8")).hexdigest()[:12]


def _write(record):
    """一行一条 JSON;失败不能影响主流程,所以整段包住。"""
    try:
        with open(LOG_PATH, "a", encoding="utf-8") as fp:
            fp.write(json.dumps(record, ensure_ascii=False) + "\n")
    except Exception:
        # 日志写不进去不该拖垮聊天功能,静默放过
        pass


def _summarize_prompt(prompt):
    """兼容工具层的两种入参:字符串或 messages 列表。"""
    if isinstance(prompt, str):
        return {"turns": 1, "chars": len(prompt), "hash": _digest(prompt)}
    messages = list(prompt)
    chars = sum(len(m.get("content", "")) for m in messages)
    last_user = ""
    for m in reversed(messages):
        if m.get("role") == "user":
            last_user = m.get("content", "")
            break
    return {
        "turns": len([m for m in messages if m.get("role") == "user"]),
        "chars": chars,
        "hash": _digest(last_user) if last_user else "",
    }


def log_call(func):
    """装饰器:记录每次模型调用的耗时、规模与成败。"""

    @functools.wraps(func)
    def wrapper(prompt, *args, **kwargs):
        info = _summarize_prompt(prompt)
        started = time.time()
        try:
            answer = func(prompt, *args, **kwargs)
        except Exception as exc:
            _write({
                "ts": time.strftime("%Y-%m-%d %H:%M:%S"),
                "ok": False,
                "elapsed": round(time.time() - started, 2),
                "in_turns": info["turns"],
                "in_chars": info["chars"],
                "q": info["hash"],
                "err": exc.__class__.__name__,
            })
            raise
        elapsed = time.time() - started
        out_chars = len(answer) if isinstance(answer, str) else 0
        _write({
            "ts": time.strftime("%Y-%m-%d %H:%M:%S"),
            "ok": True,
            "elapsed": round(elapsed, 2),
            "in_turns": info["turns"],
            "in_chars": info["chars"],
            "out_chars": out_chars,
            "q": info["hash"],
        })
        return answer

    return wrapper


def load_records(path=None):
    path = path or LOG_PATH
    if not os.path.exists(path):
        return []
    records = []
    with open(path, "r", encoding="utf-8") as fp:
        for line in fp:
            line = line.strip()
            if not line:
                continue
            try:
                records.append(json.loads(line))
            except json.JSONDecodeError:
                continue  # 半行写坏了就跳过,不因为一行毁掉整份统计
    return records


def summarize(records):
    if not records:
        print("还没有任何调用记录:%s" % LOG_PATH)
        return 0

    total = len(records)
    failed = [r for r in records if not r.get("ok")]
    ok_records = [r for r in records if r.get("ok")]
    elapsed_list = sorted(r.get("elapsed", 0) for r in ok_records)

    print("日志文件      : %s" % LOG_PATH)
    print("总调用        : %d 次" % total)
    print("失败          : %d 次(%.1f%%)"
          % (len(failed), 100.0 * len(failed) / total))

    if elapsed_list:
        avg = sum(elapsed_list) / len(elapsed_list)
        p50 = elapsed_list[len(elapsed_list) // 2]
        p95 = elapsed_list[min(len(elapsed_list) - 1,
                               int(len(elapsed_list) * 0.95))]
        print("耗时 平均/中位/P95 : %.1fs / %.1fs / %.1fs" % (avg, p50, p95))
        print("最慢一次      : %.1fs" % elapsed_list[-1])

    if ok_records:
        avg_turns = sum(r.get("in_turns", 0) for r in ok_records) / len(ok_records)
        avg_in = sum(r.get("in_chars", 0) for r in ok_records) / len(ok_records)
        print("平均轮数      : %.1f 轮" % avg_turns)
        print("平均送入字数  : %.0f 字" % avg_in)
        if avg_in > 4000:
            print("  提示:送入字数偏大,检查历史裁剪是否生效")

    if failed:
        kinds = {}
        for r in failed:
            kinds[r.get("err", "?")] = kinds.get(r.get("err", "?"), 0) + 1
        print("失败类型      : %s"
              % ", ".join("%s×%d" % (k, v) for k, v in kinds.items()))

    # 反复问同一个问题,通常说明答案没让人满意
    counter = {}
    for r in records:
        key = r.get("q") or ""
        if key:
            counter[key] = counter.get(key, 0) + 1
    repeated = [(k, v) for k, v in counter.items() if v >= 3]
    if repeated:
        repeated.sort(key=lambda x: x[1], reverse=True)
        print("高频重复提问  : %d 个(最高 %d 次)——答案可能没解决问题"
              % (len(repeated), repeated[0][1]))
    return 0


def main():
    args = sys.argv[1:]
    records = load_records()
    if "--tail" in args:
        idx = args.index("--tail")
        n = int(args[idx + 1]) if len(args) > idx + 1 else 10
        for r in records[-n:]:
            print(json.dumps(r, ensure_ascii=False))
        return 0
    return summarize(records)


if __name__ == "__main__":
    sys.exit(main())
| 记下来的东西 | 能回答的问题 |
|---|---|
| 调用次数、时间 | 到底有没有人用?什么时段用得多? |
| 耗时平均 / 中位 / P95 | 「慢」是普遍现象还是少数长尾,平均值单看会骗人 |
| 失败次数与异常类型 | 是服务挂了、超时了,还是参数写错 |
| 平均轮数与送入字数 | 历史裁剪到底生没生效(字数一直涨就是没生效) |
| 问题的短哈希 | 同一个问题反复问,通常说明答案没解决问题 |
_write() 里整段包了 try,写不进去就静默放过。监控手段把主流程搞挂了,是比没有监控更尴尬的事故。同理,读日志时某一行写坏了也只跳过那一行,不因为一行毁掉整份统计。
streamlit run 打开有页面,距离「同事随时能用、坏了有人知道」还差一整套运维。这五个缺口里任何一个不补,上线后都会以事故的形式提醒你。
min_ollama.py 验证能不能调通;my_utils.py + my_chat.py 讲清机制怎么回事;chatbot_skeleton.py 才是拿去改的那一份。业务逻辑一模一样,区别只在工程化程度。
06易错点汇总
按「启动 / 状态 / 记忆 / 体验 / 交付」五类归并
⚠️ 一、启动与环境
- 用
python3 my_chat.py启动。不会报错,但也不会出现页面,只打印一堆提示。必须用streamlit run my_chat.py。 - 以为
pip install ollama装的是 Ollama。装的是客户端库,模型服务得另外装、另外起。 - 库装了、服务没起就去重装库。报连接被拒绝时该查服务:
curl /api/version、ollama ps。 - 模型名写漏版本号。
qwen2和qwen2:1.5b不是一个东西,这条在命令行、接口、库里都成立。 - 把
my_utils.py和my_chat.py放在不同目录。from my_utils import ...直接报找不到模块,两个文件要同级。
⚠️ 二、状态与重跑(本讲最大的一类)
- 聊天记录放普通变量。每次交互整个脚本重跑,普通变量全部重新初始化,等于没存。
- 用了
session_state但漏了那个if。st.session_state["messages"] = []直接写,每次重跑都重新清一遍,和没用一样。必须if "messages" not in st.session_state:再赋值。 - 忘了重放历史气泡。页面是整个重绘的,不循环画一遍,屏幕上只会剩最新一条。
- 分不清「存了」和「画了」。
st.markdown()只是画,这一轮结束就没了;append才是存。两件都要做。 - 先画再存。中途调模型抛异常时,屏幕上有这句话但历史里没有,下一轮重跑这句话凭空消失。顺序是先存再画。
- 点了清空按钮没反应。改完
session_state要st.rerun()手动触发重跑,否则要等下一次交互才刷新。
⚠️ 三、记忆与上下文
- 只把当前这一句传给模型。页面上气泡都在,但模型每次都从零开始,问「我叫什么」就答不出来。要传整个
messages列表。 - 模型的回答只画不存。下一轮模型不记得自己刚说过什么,出现重复回答、自相矛盾。
- 历史无限增长。越聊越慢、显存上涨,超出
num_ctx后被静默截断且不报错。 - 裁剪时把
system一起切掉。直接messages[-40:],聊到几十轮后人设突然消失、性格突变。正确写法是[SYSTEM] + messages[-N:]。 MAX_MESSAGES拍脑袋定。它和num_ctx、人设长度、单条消息长度都有关,用上一讲的history_budget.py算。- 看到轮数不够就猛调
num_ctx。窗口调大会同时抬高显存占用,显存不够会溢出到 CPU,速度断崖下跌。先裁剪再调窗口。
⚠️ 四、体验与异常
- 不做流式。用户盯着转圈等十几秒,体感比实际慢得多。
- 把库的默认值和 HTTP 的记混。裸 HTTP
/api/chat不传stream默认流式;ollama库的chat()默认非流式。方向正好相反。 - 没有异常兜底。模型服务没起时整页报红崩掉,同事只会反馈「你这东西坏了」,你还得从头问起。
- 流式时不判空片段。最后一片通常没有文本,直接拼接可能出问题。
- 侧边栏不显示当前模型和地址。排查时问不清对方连的是哪台服务,来回好几轮。
⚠️ 五、交付与安全
- 把「本机跑起来了」当成「能交付了」。还差鉴权、服务托管、日志、并发规划四件事。
- 为了让同事访问,顺手把 11434 也对外开了。要暴露的是聊天页面,不是模型端口——模型端口仍然只对网关开放,否则谁都能删模型。
- 界面层直接调模型、不分层。换界面时整套重写;出问题时也没法用
python3 my_utils.py快速分层定位。 - 模型名、地址硬编码进源码。换环境就要改源码,改源码就会漏改。走环境变量。
- 人设里不写边界。没有「不确定就说不确定」这类约束,模型会一本正经地编——内部助手编出来的答案,比没有助手更危险。
- 忘了模型跑在哪数据就流到哪。把机器人接到公网模型上,前四讲的私有化前提就全废了。
07自测题
先自己答一遍,再点开对照
为什么要把 my_utils.py 和 my_chat.py 分开写?
三个好处:界面可替换——换成 Flask、命令行、企业微信机器人,工具层一个字不用动;故障可隔离——单独跑 python3 my_utils.py,通了就说明是界面的锅;改动可收敛——换模型、加超时、加日志只改一个文件。
Streamlit 最反直觉的机制是什么?
用户每做一次交互,整个 .py 文件从第一行重新执行一遍——不是只跑改变的部分。所以普通变量每轮被重新初始化、已画出的气泡会消失。唯一能活下来的是放进 st.session_state 的数据。
这两行的区别是什么?
st.session_state["messages"] = []
if "messages" not in st.session_state: st.session_state["messages"] = []
第一行每次重跑都重新清一遍,虽然放进了保险箱,效果和没存一样。第二行只在首次进入时初始化,之后的重跑全部跳过,历史才能累积。漏掉这个 if 是本讲最高频的 bug,表现就是机器人永远只记得最后一句。
页面上历史气泡为什么要自己循环画一遍?
因为页面是整个重绘的,之前画的气泡不会自动留在屏幕上。那段 for message in st.session_state["messages"] 循环就是页面上那些历史气泡本身,不是多余渲染。漏了它,屏幕上只剩最新一条。
「存进 session_state」和「用 st.markdown 画出来」是一回事吗?顺序有讲究吗?
不是一回事:markdown 只是画,这一轮结束就没了;append 才是存。两件都要做,而且先存再画。反过来的话,中途调模型抛异常时屏幕上有这句话但历史里没有,下一轮重跑这句话凭空消失,用户会以为自己没发出去。
机器人答不出「我叫什么」,问题在哪?
传给模型的是当前这一句而不是整个 messages 列表。Ollama 服务端不保存任何历史,所谓记忆是你每次把整段对话重新发过去的结果。另一种常见变体是:模型的回答只画了没 append 回历史,导致模型不记得自己说过什么。
session_state 和 messages 分别解决什么问题?
session_state 解决「页面记不记得」,messages 解决「模型记不记得」。只做前者,气泡都在但模型答非所问;只做后者,页面一刷全没了。这个案例的全部难点就这两条,缺一不可。
裁剪历史时最容易切掉什么?
system 那一条。直接 messages[-40:] 会把最前面的人设一起切掉,聊到几十轮后机器人性格突变,还很难查。正确写法是 [SYSTEM] + messages[-N:],让 system 单独拼在前面、不参与裁剪。
轮数不够用,是不是直接调大 num_ctx 就行?
不是。num_ctx 调大会同时抬高显存占用,显存不够时模型溢出到 CPU,速度断崖式下跌——你以为在优化体验,实际把服务搞卡了。先裁剪历史,再考虑调窗口,顺序别反。MAX_MESSAGES 用 history_budget.py 算,别拍脑袋。
官方 ollama 库和裸 HTTP 在 stream 上有什么坑?
默认值方向相反:裸 HTTP 调 /api/chat 不传 stream 默认是流式;ollama 库的 chat() 不传 stream 默认是非流式。从一边切到另一边时最容易踩。其余字段(messages、options、取值位置)完全一致,库只是把 URL 和 JSON 包掉了。
st.write_stream 比手写循环省在哪?
它边收边渲染,同时把拼好的完整文本作为返回值给你。所以「流式显示」和「把完整回答回填进历史」两件事一行就办了,不用自己再拼一次字符串。
为什么骨架里要包 try / except?
模型服务没起、端口不通、超时都会抛异常。没有兜底时整页报红崩掉,同事只会反馈「你这东西坏了」,你还得从头问起。兜底之后页面还在,错误信息也能直接看到,排查从一轮变成零轮。
这个案例的真正验收点是哪一步?
先说「我叫小明」,再问「我叫什么」,答得出才算真通。页面能显示、能出答案只说明「调通了」;记忆答对才是 session_state 和 messages 两个机制同时正确的唯一证据。很多人做到「页面能打开」就以为完成了,交付后才被同事发现机器人失忆。
要让同事访问这个页面,该开哪个端口?
只暴露聊天页面的端口,11434 仍然只对网关开放。为了方便顺手把模型端口也开出去,等于绕过了第三讲配的鉴权和限流——谁能问问题,谁就能删模型。另外别忘了页面侧也要走监听地址、防火墙、网关鉴权那一整套。
本机跑起来了,离「能交付」还差哪五件事?
鉴权(谁都能打开)、服务托管(进程关掉就没了,要写 systemd)、日志(不知道有没有人用、失败率多少,加在工具层这个唯一入口)、并发规划(多人同时问会排队,按算力算别直接调大)、答案质量(接检索增强,把资料塞进提示词)。每一个不补都会以事故的形式提醒你。
人设里为什么必须写边界?
没有「只依据用户提供的信息回答,不确定就说不确定,不要编造」这类约束,模型会一本正经地编。内部助手编出来的答案,比没有助手更危险——同事会当成公司口径去执行。
查模块速查与收束
本讲用到的 Streamlit API
| API | 作用 | 要点 |
|---|---|---|
st.set_page_config(...) | 标题、图标 | 要写在其他 st. 调用之前 |
st.chat_message(role) | 画一个消息气泡 | user / assistant 样式不同 |
st.chat_input(提示) | 底部输入框 | 没输入时返回 None |
st.session_state | 跨重跑保存数据 | 初始化必须包 if not in |
st.write_stream(生成器) | 边收边渲染 | 顺带返回拼好的完整文本 |
st.spinner(文字) | 转圈提示 | 非流式时用来缓解等待感 |
st.error(文字) | 红色错误条 | 异常兜底时给用户看 |
st.rerun() | 手动触发重跑 | 改完 session_state 要立刻刷新时用 |
本讲四份代码怎么选
| 文件 | 用途 | 什么时候看 |
|---|---|---|
min_ollama.py | 验证能不能调通 | 写界面之前第一步 |
my_utils.py | 工具层,只管调模型 | 理解分层与裁剪 |
my_chat.py | 界面层,只管显示 | 理解重跑与 session_state |
chatbot_skeleton.py | 拿去改的那一份 | 要交付给同事时 |
整个模块回头看
| 讲次 | 解决的问题 | 留下的铁律 |
|---|---|---|
| ① 为什么私有化 | 该不该走这条路,选多大的模型 | 模型跑在哪,数据就流到哪 |
| ② Ollama 命令行 | 怎么装、怎么跑、怎么固化人设 | 带 ollama 前缀在终端敲,带 / 前缀在对话里敲 |
| ③ Linux 企业级部署 | 怎么托管、怎么对外、怎么巡检 | 改 OLLAMA_HOST=0.0.0.0 只是开门,不带门卫 |
| ④ API 与客户端接入 | 接口长什么样,怎么接进代码 | 服务端不保存任何对话历史 |
| ⑤ 私有聊天机器人 | 把前四讲串成能交付的东西 | 能活过一次刷新的,只有 session_state |
一条命令清单(按顺序)
| 阶段 | 命令 | 确认什么 |
|---|---|---|
| 模型在跑 | ollama ps | PROCESSOR 是 GPU,没溢出到 CPU |
| 接口能用 | python3 api_probe.py | 探活、模型、流式、统计一次问清 |
| 工具层能用 | python3 my_utils.py | 脱离界面能拿到回答 |
| 页面能用 | streamlit run my_chat.py | 浏览器打开有页面 |
| 记忆能用 | 说「我叫小明」再问「我叫什么」 | 答对才算真通 |
| 服务常驻 | systemctl status ollama | enabled + active |