大模型 Agent 的原理
把「问一次答一次」改造成「想一想、做一步、看结果、再想一想」的循环——自主性就长在这个循环里,而循环的执行权仍在你的代码手上。
30″30 秒看懂 Agent
还是那间中央厨房。厨师(大模型)负责做菜,传送带(Chain)负责把工位串起来,外卖小哥(Tools)负责跑外面的世界。今天上场的是店长——他一道菜也不做,却是整间店里唯一一个会拐弯的人。
来了一张模糊的订单:「给这桌配一份适合今天天气的套餐」。传送带这时候是失灵的——它只会照着写死的工序一路走到底,没人告诉它今天该走哪条工序。店长的做法不一样:他先想一想「今天天气怎么样,我得先问一下」,再派人去做(叫外卖小哥去查),然后看结果(今天 32 度),再想一想「那就上凉菜」,再派人去取菜谱卡……一圈一圈地转,直到他认为这单可以出餐为止。
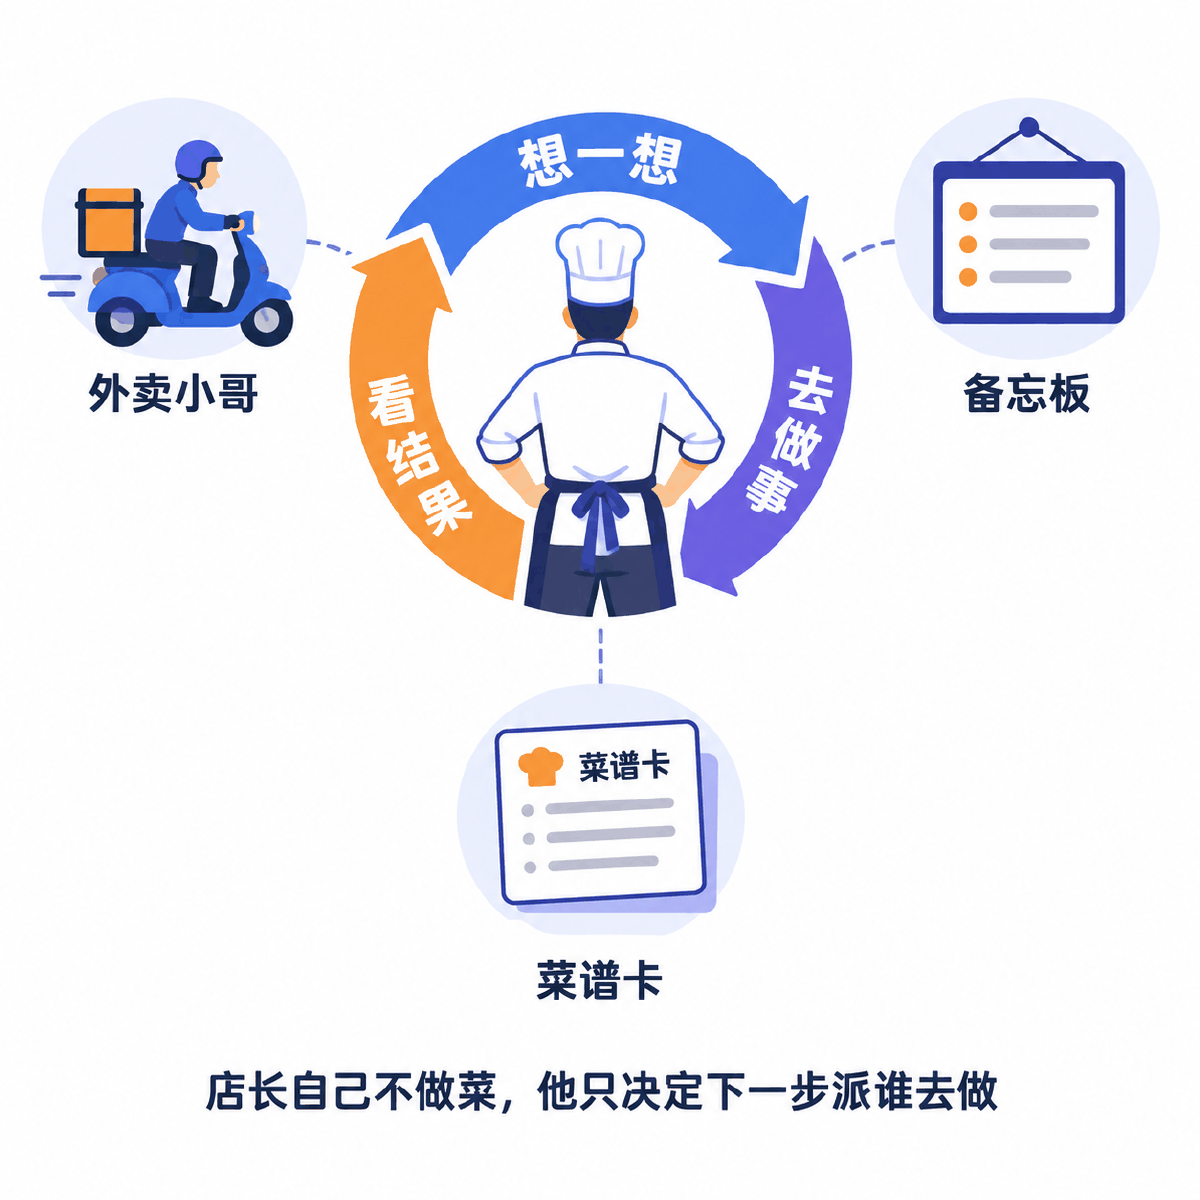
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 店长 | Agent | 不生产内容,只在每一轮里判断「下一步做什么、派谁去」,并判断「是不是可以收尾了」 |
| 店长脑子里那圈「想→做→看」 | 循环(loop) | Agent 的全部自主性就在这里;抽掉循环,店长就退化成一个普通工位 |
| 厨师 | 大模型 LLM | 每一轮真正做出判断的人;店长的「想」其实就是调一次模型 |
| 外卖小哥、送货司机 | Tools | 跑外部世界:查接口、读数据库、做计算 |
| 挂在墙上的备忘板 | Memory | 记住这一单转到第几圈、前几圈都看到了什么 |
| 「这单可以出餐了」 | 终止条件 | 模型这一轮不再要求调用工具,循环退出 |
| 「最多问三遍,问不出就照常规上」 | 最大步数 | 写在你代码里的刹车,防止店长原地打转一整晚 |
while 是你写的,什么时候停是你定的,每一轮的工具也是你执行的。模型只是在每一圈被问一次「接下来干什么」。
tools 怎么写、tool_calls 长什么样、回执怎么配 tool_call_id——都在 Function Call 那一讲讲透了。这一讲默认你已经会那一轮,重点只放在把那一轮套进循环之后,多出来的那些事:谁来决定还要不要转下一圈、转多少圈才算多、转不出来怎么办。
01概念:Agent 是什么,为什么需要它
一个定义、三件套、一张和链的差别表
1.1 一句话定义
Agent(智能体)是一个通过动态协调大语言模型与工具来完成复杂任务的系统。它让 LLM 充当「决策大脑」,根据当前状态自主选择下一步该调用什么工具,把中间结果重新喂回大脑,如此往复,最终生成答案。
关键词是「动态」。同样是查天气再推荐穿衣,写成链,你必须提前决定「先查天气、再生成建议」这个顺序;写成 Agent,顺序是模型在运行时一轮一轮定出来的——它甚至可能发现你根本没说城市,于是先反问你一句。
为什么非要多这一层?
因为大模型再强,也有三件事做不了:不知道此刻的事实、算不准复杂的数、动不了外部世界。Function Call 已经把「借助外部工具」这件事解决了一半——模型能写出委托单。但它只解决了一次。现实里的任务往往是这样的:
「杭州和南京哪个人均产值高」要查两次人口、两次产值、算两次除法;「南京有多少人」只要查一次。同一个入口,步数由问题决定,没法写死。
查到「资料库里没有拉萨的数据」,接下来该换个城市还是如实告知用户?这个判断只能在看到结果之后才做得出来。
第一步的结果可能直接推翻原计划。流水线不会改道,带回路的循环才会。
1.2 三件套:规划、记忆、工具
2023 年 6 月,Lilian Weng 在个人博客里首次系统性地描述了现代 AI Agent 架构,用一个式子概括:
大模型是大脑,规划负责拆任务、记忆负责记住已经发生过什么、工具负责伸手够到外部世界,行动是真的把事做了而不是纸上谈兵。
用「打车去西藏玩」这件事把三件套对上号:大脑中枢是规划行程的你;规划是「第一步定路线、第二步订酒店、第三步安排餐饮」;工具是打车软件和订房软件;记忆是聊到第三句还记得目的地是西藏,不会把酒店订到别的省去。
| 组件 | 在循环里的位置 | 它缺席会怎样 |
|---|---|---|
| 规划 Planning | 每一轮的「想」 | 任务拆不开,复杂问题只能一口吞下去,模型只好一次性瞎编一个完整答案 |
| 记忆 Memory | 轮与轮之间的连接 | 每轮都从零开始,第二轮不知道第一轮查到了什么,循环退化成反复空转 |
| 工具 Tools | 每一轮的「做」 | 循环里没有新信息进来,转多少圈都只是模型自说自话 |
| 行动 Action | 你的代码真正执行工具 | 只有意图没有执行,就退回成了「一份很详细的计划书」 |
记忆要分成两层看
| 层次 | 存什么 | 怎么实现 |
|---|---|---|
| 短期记忆 | 单次任务之内的上下文:每一轮的思考与观察结果 | 就是那个不断追加的消息列表,受限于模型的上下文窗口长度 |
| 长期记忆 | 跨任务、跨会话的知识与偏好 | 向量数据库(相似性检索)、知识图谱(结构化语义),或直接把知识固化进模型参数 |
拿人打比方:心算时临时记住几个数字是短期记忆;学会骑自行车后多年不骑仍然会,是长期记忆。Agent 循环真正倚重的是短期记忆——它就是循环的状态本体。多轮会话怎么裁剪、怎么摘要,在会话记忆那一讲已经讲过,这里不重复。
1.3 和链的本质差别
在 Chain 里,行动序列是硬编码的,像是一条线性流水线;而 Agent 采用语言模型作为推理引擎,由它来确定以什么样的顺序采取什么样的行动,像是「拥有大脑的机器工人」。
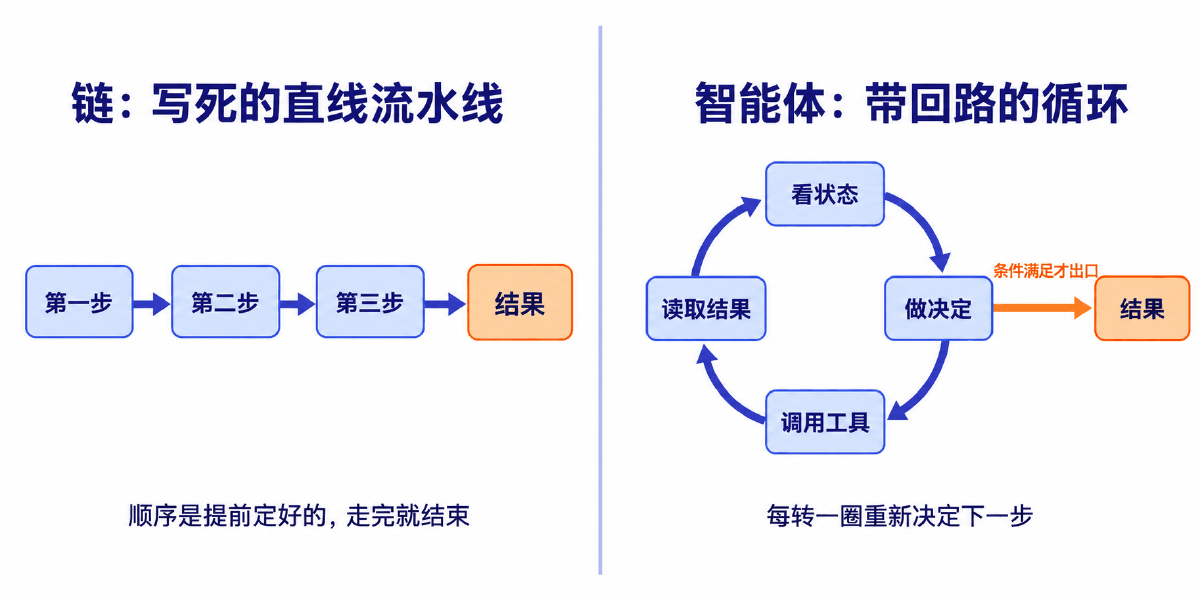
| 维度 | Chain(链) | Agent(智能体) |
|---|---|---|
| 步骤顺序 | 开发者写代码时就定死了 | 模型在运行时一轮一轮定 |
| 执行次数 | 固定,几步就是几步 | 不确定,同一份代码可能 2 轮也可能 8 轮 |
| 控制流 | 单向直线,走完即止 | 带回路,每转一圈重新决策 |
| 中间结果 | 作为下一格的输入往前传 | 回填进上下文,影响后续的判断本身 |
| 可预测性 | 高。成本、延迟、行为都能估准 | 低。成本是区间,行为要靠轨迹回溯 |
| 适合 | 流程稳定、边界清晰的批量加工 | 开放式、多步骤、事先不知道要几步的问题 |
02原理:循环是怎么转起来又停下来的
ReAct 的一圈、一轮里的三件事、与单次委托的边界、四种刹车
2.1 ReAct:把「想」和「做」交替起来
ReAct = Reasoning + Acting,推理与行动。它的主张只有一句:不要让模型一口气把计划全想完,而是每想一小步就去做一下,拿真实结果回来再想下一步。
为什么这么设计?因为纯推理的模型是在闭着眼睛规划。你让它一次性写出「查特斯拉股价 → 查去年股价 → 算涨幅」的完整方案,它写得出来,但方案里的每个数字都是它猜的。ReAct 的做法是每一步都睁眼看一次真实世界,用观察结果纠正下一步的推理——这就是它具备反思和自我纠错能力的来源。
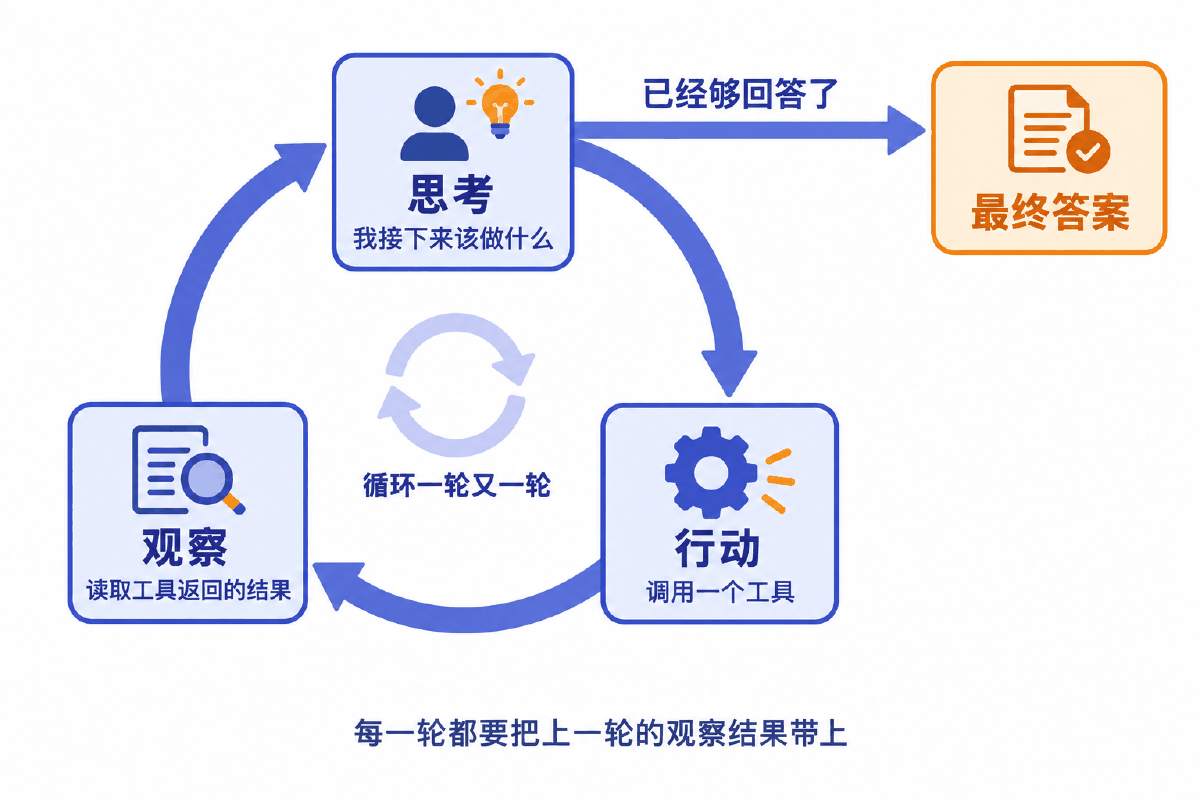
一圈里固定三个动作,缺一不可:
一段真实的循环长这样:问题:我想查某某 → 思考:我需要先搜索最新信息 → 行动:调用搜索工具 → 观察:获得 3 个结果 → 思考:需要抓取第一个链接 → 行动:调用抓取工具 → 观察:获得网页正文 → 思考:信息够了 → 最终答案。
Thought: / Action: / Action Input: 的格式写,程序用正则把动作抠出来执行,再把 Observation: 拼回提示词。后来有了结构化的工具调用协议,动作改用 tool_calls 表达,观察改用 role 为 tool 的消息回填,解析从「正则抠文本」变成「读字段」,稳定性大幅提升。两者的差别只在动作怎么表达,「想→做→看→再想」这个骨架一模一样。第 03 节两份代码分别是这两种写法。
| 对比维度 | 文本式 ReAct | 结构化工具调用 |
|---|---|---|
| 动作的表达 | 自然语言,靠约定格式 | JSON 字段,协议保证 |
| 解析方式 | 正则匹配,格式写歪就失败 | 直接读 tool_calls,不会歪 |
| 对模型的要求 | 通用模型即可 | 需要模型支持工具调用 |
| 延迟与开销 | 较高,要生成完整推理文本 | 较低,直接产出参数 |
| 决策过程可读性 | 好,推理过程直接可见 | 要看结构化轨迹 |
2.2 一轮里,你的代码到底做了什么
把循环体拆开,每一轮固定有五件事按序发生。这五件事里,只有第一件是模型干的:
| 顺序 | 谁来做 | 做什么 |
|---|---|---|
| ① | 模型 | 拿到「目前已知的一切」,输出这一轮的判断:要么是一张委托单,要么是最终答案 |
| ② | 你的代码 | 看有没有 tool_calls。没有就退出循环——这是最主要的终止条件 |
| ③ | 你的代码 | 执行护栏检查:工具在不在清单里、参数合不合法、是不是高风险动作 |
| ④ | 你的代码 | 真正调用函数,拿到返回值(这一步和单次委托完全一样) |
| ⑤ | 你的代码 | 把这一轮的判断与结果一起追加进消息列表,进入下一轮 |
第 ⑤ 步是循环能成立的全部秘密:下一轮的输入 = 这一轮的输入 + 这一轮发生的事。消息列表只追加不修改,越转越长——这既是它能「记住」的原因,也是成本按轮数快速上涨的原因。
2.3 和 Function Call 的边界:一次委托 vs 一个循环
这是本讲最容易含糊的地方,必须划清楚。
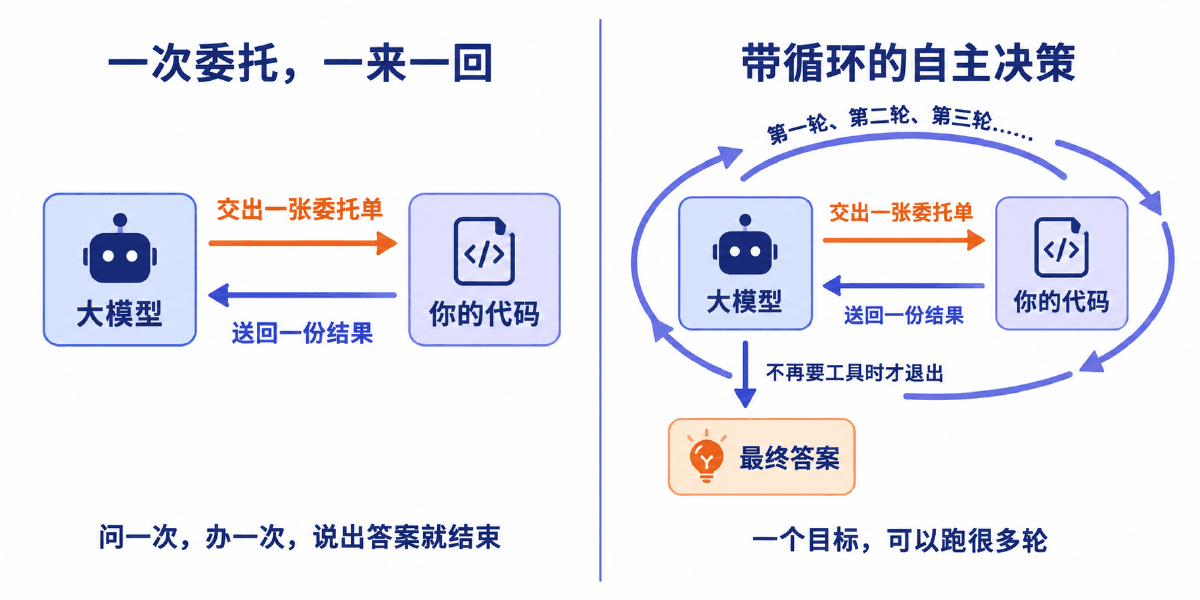
| 维度 | Function Call | Agent |
|---|---|---|
| 是什么 | 一种协议:模型如何表达「我想调这个函数、参数是这些」 | 一种控制流:反复使用这个协议,直到目标达成 |
| 形态 | 一次委托,一来一回 | 委托 → 看结果 → 再决定,可以很多轮 |
| 轮数 | 说完答案就结束 | 由模型在运行时决定,你只设上限 |
| 谁决定还要不要继续 | 不存在这个问题 | 模型给信号(还要不要工具),你的代码做裁决(要不要真的再转一圈) |
| 代码长相 | 顺序执行,一段直着写下来 | 一个 while 把那段直的包起来 |
① 单次委托里那些规矩——回填 assistant 消息、回执配
tool_call_id、description 决定模型选不选——在循环里一条都没变,只是每一轮都要遵守一遍;② 循环多出来的是三个新问题:什么时候停、转岔了怎么办、转太多轮的钱谁出。这三个问题全部由你的代码回答,模型一个都答不了。
while 是你写的。——这就是本讲铁律的另一种说法。
2.4 循环怎么停下来
写一个能转的循环只要五分钟,写一个肯停的循环才是工程活。四种刹车,一个都不能少:
模型这一轮不再返回 tool_calls,说明它认为信息够了。这是唯一的「正常出口」,其余三种都是兜底。
max_steps,通常 6~10。到顶必须明确返回「未能得出结论」,不能静默返回空字符串——那会让上游以为任务成功了。
token 累计上限 + 挂钟超时。只限步数挡不住成本:单轮塞进几万 token 的长观察结果,三轮就能烧穿预算。
同一个工具配同一组参数连续出现三次,基本可以判定原地打转。步数上限也能兜住,但那要白烧完所有步数。
把这四条做成一个可复用的控制器,比在 while 里塞一堆 if 干净得多——第 05 节给了实现。
03最小代码:一个 while 就是全部
六十行手写循环,看清「自主性」落到代码上是什么样子
不用任何框架。把单次委托的那段代码原样搬过来,外面套一个 for,Agent 就成立了。读的时候只盯三处:什么时候退出、观察结果怎么回填、刹车在哪。
"""极简 ReAct 循环:不依赖任何框架,60 行看懂 Agent 的自主性到底在哪。

运行前:
    pip install openai
    export OPENAI_API_KEY=...        # 兼容 OpenAI 协议的任意服务都行
    export OPENAI_BASE_URL=...       # 换供应商只改这一行
"""
import json
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),
    base_url=os.environ.get("OPENAI_BASE_URL"),
)
MODEL = os.environ.get("MODEL_NAME", "gpt-4o-mini")


# ① 两个最普通的 Python 函数,Agent 能做的事全靠它们
def search(keyword: str) -> str:
    fake = {"杭州人口": "杭州市常住人口约 1252 万人",
            "南京人口": "南京市常住人口约 954 万人"}
    return fake.get(keyword, "没有查到相关资料")


def calculate(expression: str) -> str:
    # 真实项目请换成受限求值器,这里为了聚焦主线用最短写法
    return str(eval(expression, {"__builtins__": {}}, {}))


TOOLS = [
    {"type": "function", "function": {
        "name": "search", "description": "按关键词检索资料,返回一句话事实",
        "parameters": {"type": "object", "properties": {
            "keyword": {"type": "string", "description": "检索关键词"}},
            "required": ["keyword"]}}},
    {"type": "function", "function": {
        "name": "calculate", "description": "计算一个纯数字算术表达式",
        "parameters": {"type": "object", "properties": {
            "expression": {"type": "string", "description": "例如 (12-9)/9*100"}},
            "required": ["expression"]}}},
]
REGISTRY = {"search": search, "calculate": calculate}

MAX_STEPS = 6          # ② 循环的刹车:没有它,Agent 可能一直转下去


def run(question: str) -> str:
    messages = [
        {"role": "system", "content": "你是一个严谨的助手。需要事实就去检索,"
                                      "需要算数就去计算,不要凭印象回答。"},
        {"role": "user", "content": question},
    ]
    for step in range(1, MAX_STEPS + 1):
        # ③ 思考:把「目前已知的一切」整个交给模型,让它决定下一步
        reply = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS, tool_choice="auto"
        ).choices[0].message
        messages.append(reply.model_dump(exclude_none=True))

        # ④ 终止条件:模型这一轮不再要工具,说明它认为可以收尾了
        if not reply.tool_calls:
            print("第 %d 轮收尾" % step)
            return reply.content

        # ⑤ 行动 + 观察:执行工具,把结果作为新事实追加回去,进入下一轮
        for call in reply.tool_calls:
            args = json.loads(call.function.arguments)
            result = REGISTRY[call.function.name](**args)
            print("第 %d 轮 → %s(%s) = %s" % (step, call.function.name, args, result))
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": str(result)})

    # ⑥ 步数用尽仍未收敛:必须给出明确结论,不能静默返回空
    return "已达到最大步数 %d,未能得出结论" % MAX_STEPS


if __name__ == "__main__":
    print(run("杭州比南京多多少人口?折算成百分比是多少?"))
MAX_STEPS 是刹车,永远不要省 · ③ 每轮把整个 messages 交给模型,它才知道前几轮发生过什么 · ④ if not reply.tool_calls 就是终止条件,这一行是循环与单次委托唯一的结构差别 · ⑤ 执行工具 + 回填结果,下一轮的输入因此变长 · ⑥ 步数耗尽要明确说没得出结论,不能默默返回空。
跑一下「杭州比南京多多少人口、折算成百分比」,你会看到它自己转了三轮:
把问题换成「南京有多少人」,同一份代码只转两轮。轮数不是你写的,是问题决定的——这就是第 01 节说的「动态」。
eval 做算术是为了让主线短,真实项目要换成受限求值器或白名单解析,eval 会执行任意表达式;②
REGISTRY[call.function.name] 直接下标取值,模型一旦幻觉出一个不存在的工具名就是 KeyError,循环当场断掉。正确做法是 .get() 之后把「没有这个工具」作为观察结果交回去,让模型自己改正。第 05 节的骨架已经这么写了。
纯文本版:模型不支持工具调用时怎么办
如果手上的模型不支持结构化工具调用,ReAct 照样能跑——这本来就是它最早的形态。约定一套文本格式,用正则把动作抠出来,把结果拼回提示词,循环一样成立。
"""纯文本版 ReAct:模型不支持结构化工具调用时,靠提示词 + 正则把循环跑起来。

ReAct 论文里的原始形态就是文本:模型输出
    Thought: ...
    Action: 工具名
    Action Input: 参数
程序解析出动作并执行,把结果作为
    Observation: ...
拼回提示词,再让模型续写下一轮。结构化工具调用是后来的工程化改良,
但两者的骨架一模一样:想 → 做 → 看 → 再想。
"""
import os
import re

from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),
    base_url=os.environ.get("OPENAI_BASE_URL"),
)
MODEL = os.environ.get("MODEL_NAME", "gpt-4o-mini")


def search(q: str) -> str:
    table = {"珠穆朗玛峰高度": "珠穆朗玛峰海拔 8848.86 米",
             "华山高度": "华山海拔 2154.9 米"}
    return table.get(q.strip(), "未检索到相关资料")


def calculate(expr: str) -> str:
    return str(round(eval(expr, {"__builtins__": {}}, {}), 4))


TOOLBOX = {"检索": search, "计算": calculate}

TEMPLATE = """你可以使用以下工具:
检索:输入一个关键词,返回一句事实
计算:输入一个算术表达式,返回数值

严格按以下格式逐轮输出,一次只输出一轮:
Thought: 你的推理
Action: 检索 或 计算
Action Input: 工具的输入

当信息已经足够时,改为输出:
Thought: 你的推理
Final Answer: 最终答案

问题:{question}
{scratchpad}"""

ACTION_RE = re.compile(r"Action:\s*(\S+)\s*\nAction Input:\s*(.+)")


def run(question: str, max_steps: int = 6) -> str:
    scratchpad = ""                       # 这就是 Agent 的短期记忆
    for step in range(1, max_steps + 1):
        prompt = TEMPLATE.format(question=question, scratchpad=scratchpad)
        text = client.chat.completions.create(
            model=MODEL, temperature=0, stop=["Observation:"],
            messages=[{"role": "user", "content": prompt}],
        ).choices[0].message.content.strip()
        print("── 第 %d 轮 ──\n%s" % (step, text))

        if "Final Answer:" in text:
            return text.split("Final Answer:", 1)[1].strip()

        m = ACTION_RE.search(text)
        if not m:
            # 模型没按格式写,把要求再说一遍,给它一次自我纠正的机会
            scratchpad += text + "\nObservation: 输出格式不正确,请严格按格式重写本轮。\n"
            continue

        name, arg = m.group(1).strip(), m.group(2).strip()
        observation = TOOLBOX.get(name, lambda _: "没有这个工具")(arg)
        # 关键一步:把「这一轮做了什么、看到了什么」原样接在提示词后面
        scratchpad += text + "\nObservation: " + observation + "\n"
    return "超过 %d 轮未得出结论" % max_steps


if __name__ == "__main__":
    print(run("珠穆朗玛峰比华山高多少米?高出的部分相当于华山的百分之多少?"))
stop=["Observation:"] 让模型写完动作就停笔,不许它自己编造观察结果——不加这一句,模型会一口气把整个循环都「演」完,包括本该由工具返回的数据;②
scratchpad 就是短期记忆的最朴素形态,一个不断变长的字符串;③ 模型格式写歪时,不要抛异常中断,把「格式不对,请重写」当成一条观察结果塞回去,给它一次自我纠正的机会。
04完整案例:四种形态,同一个循环
写死的链、自主的循环、先拆再做的规划、需要人点头的写操作
4.1 同一个需求的两种写法
需求就一句:「杭州比南京多多少人口?折算成百分比是多少?」 先用链实现,再用循环实现,两份代码放在一起,差别就不用解释了。
写法一:链——步骤与顺序都由你写死
"""链的写法:步骤与顺序都由开发者写死,模型只负责每一格里的那点活。

同一个需求「杭州比南京多多少人口、折算成百分比」,先用链实现一遍,
再看 agent_loop.py 用循环实现的版本,两份代码放在一起,差别一眼就出来。
"""
import os
import re

from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),
    base_url=os.environ.get("OPENAI_BASE_URL"),
)
MODEL = os.environ.get("MODEL_NAME", "gpt-4o-mini")

CITY_DB = {"杭州": 1252.0, "南京": 954.0}      # 单位:万人


def ask(prompt: str) -> str:
    """一次纯文本问答,没有工具,没有循环。"""
    resp = client.chat.completions.create(
        model=MODEL, messages=[{"role": "user", "content": prompt}], temperature=0
    )
    return resp.choices[0].message.content.strip()


def step1_extract(question: str) -> tuple:
    """第一步:让模型从原话里抽出两个城市名。位置固定,先后固定。"""
    raw = ask("从这句话里抽出两个城市名,只输出两个词、用逗号隔开,"
              "不要任何解释:\n" + question)
    names = [x.strip() for x in re.split(r"[,,]", raw) if x.strip()]
    return names[0], names[1]


def step2_lookup(a: str, b: str) -> tuple:
    """第二步:查数。这一步压根没模型什么事,是写死的字典查询。"""
    if a not in CITY_DB or b not in CITY_DB:
        raise KeyError("资料库里没有 %s 或 %s" % (a, b))
    return CITY_DB[a], CITY_DB[b]


def step3_compute(pa: float, pb: float) -> tuple:
    """第三步:算数。同样写死,模型碰都不碰。"""
    return pa - pb, (pa - pb) / pb * 100


def step4_phrase(a: str, b: str, diff: float, pct: float) -> str:
    """第四步:让模型把数字说成人话。它只做这一件事。"""
    return ask("用一句中文自然地陈述这个结论,不要加任何额外信息:%s 比 %s 多 "
               "%.0f 万人,相当于多出 %.2f%%。" % (a, b, diff, pct))


def run(question: str) -> str:
    """四步固定串行。谁先谁后、跑几步,全写在这里,和模型无关。"""
    a, b = step1_extract(question)
    pa, pb = step2_lookup(a, b)
    diff, pct = step3_compute(pa, pb)
    return step4_phrase(a, b, diff, pct)


if __name__ == "__main__":
    print(run("杭州比南京多多少人口?折算成百分比是多少?"))
    # 换个问法试试:「南京和苏州哪个人口多」——第二步直接抛 KeyError,
    # 因为这条流水线只会按「抽两个城市→查表→相减→润色」这一条路走。
    # 流水线不会改道,能力边界就是它被写死的那几格。
四个函数按序执行:抽城市名 → 查表 → 相减 → 润色。模型只在第一步和第四步出现,中间两步压根没它的事。这条流水线跑得又快又稳,成本可以精确到 token——但它只会走这一条路。
把问题换成「南京和苏州哪个人口多」,第二步直接抛 KeyError,因为资料库里没有苏州;换成「杭州有多少人」,它照样傻乎乎地去抽两个城市名。流水线不会改道,能力边界就是被写死的那几格。
写法二:循环——步骤与顺序由模型在运行时定
"""同一个需求的循环写法:步骤数和顺序都由模型在运行时决定。

和 chain_hardcoded.py 放在一起读:那边是四个写死的函数按序执行,
这边只有一个 while,工具怎么用、用几次、先用哪个,全在循环里现场决定。
"""
import json
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),
    base_url=os.environ.get("OPENAI_BASE_URL"),
)
MODEL = os.environ.get("MODEL_NAME", "gpt-4o-mini")

CITY_DB = {"杭州": 1252.0, "南京": 954.0, "苏州": 1296.0, "合肥": 985.0}


def lookup_population(city: str) -> str:
    """查一个城市的常住人口,单位万人。"""
    if city not in CITY_DB:
        return "资料库里没有 %s 的人口数据" % city
    return "%s 常住人口 %.0f 万人" % (city, CITY_DB[city])


def calculate(expression: str) -> str:
    """算一个纯数字表达式。"""
    try:
        return str(round(eval(expression, {"__builtins__": {}}, {}), 4))
    except Exception as exc:
        return "表达式无法计算:%s" % exc


TOOLS = [
    {"type": "function", "function": {
        "name": "lookup_population",
        "description": "查询指定城市的常住人口数量,单位为万人",
        "parameters": {"type": "object", "properties": {
            "city": {"type": "string", "description": "城市中文名,例如 杭州"}},
            "required": ["city"]}}},
    {"type": "function", "function": {
        "name": "calculate",
        "description": "计算一个纯数字的算术表达式,返回数值结果",
        "parameters": {"type": "object", "properties": {
            "expression": {"type": "string", "description": "例如 (1252-954)/954*100"}},
            "required": ["expression"]}}},
]
REGISTRY = {"lookup_population": lookup_population, "calculate": calculate}

SYSTEM = ("你是一个严谨的数据助手。凡是涉及具体数字的事实,一律通过工具获取,"
          "不许凭记忆作答;凡是涉及算术,一律交给计算工具。"
          "信息足够时直接给出最终结论,不要再调用工具。")


def run(question: str, max_steps: int = 8) -> str:
    messages = [{"role": "system", "content": SYSTEM},
                {"role": "user", "content": question}]
    for step in range(1, max_steps + 1):
        reply = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
            tool_choice="auto", temperature=0
        ).choices[0].message
        messages.append(reply.model_dump(exclude_none=True))

        if not reply.tool_calls:
            return reply.content

        for call in reply.tool_calls:
            args = json.loads(call.function.arguments)
            out = REGISTRY[call.function.name](**args)
            print("  第 %d 轮 · %s%s → %s" % (step, call.function.name, args, out))
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": str(out)})
    return "超过最大步数 %d 仍未收敛,请缩小问题范围" % max_steps


if __name__ == "__main__":
    # 同一份代码,三个问法所需的轮数完全不同:
    #   两城比较 → 查两次 + 算一次 + 收尾,约 3~4 轮
    #   单城查询 → 查一次 + 收尾,2 轮
    #   资料库里没有的城市 → 工具如实返回「没有数据」,模型据此改口而不是硬编
    for q in ["杭州比南京多多少人口?折算成百分比是多少?",
              "苏州有多少人?",
              "拉萨和合肥哪个人口多?"]:
        print("问题:", q)
        print("回答:", run(q), "\n")
没有 step1 到 step4,只有一个 for 和两个工具。同一份代码,三个问法的表现完全不同:
| 问法 | 实际轮数 | 循环里发生了什么 |
|---|---|---|
| 杭州比南京多多少人口,百分比 | 约 3~4 轮 | 查两次人口 → 算一次除法 → 收尾 |
| 苏州有多少人 | 2 轮 | 查一次 → 收尾,不会多此一举 |
| 拉萨和合肥哪个人口多 | 3 轮左右 | 工具如实返回「没有拉萨的数据」,模型据此改口说明,而不是硬编一个数 |
4.2 调研型 Agent:轮数随问题难度伸缩
把工具加到三个(查人口、查产值、算数),问题也换成需要交叉计算的那种,循环的价值会更明显。
"""完整案例一:调研型 Agent —— 轮数由问题难度决定,而不是由代码写死。

同一份代码,问「北京人口多少」两轮就收尾,问「长三角三城谁增速最快」
可能要转六七轮。这正是循环相对流水线的价值所在。
"""
import json
import os
import time

from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),
    base_url=os.environ.get("OPENAI_BASE_URL"),
)
MODEL = os.environ.get("MODEL_NAME", "gpt-4o-mini")

# ---------------- 工具区:三个互相独立的能力 ----------------
CITY = {
    "杭州": {"pop": 1252.0, "gdp": 20059.0},
    "南京": {"pop": 954.0, "gdp": 17421.0},
    "苏州": {"pop": 1296.0, "gdp": 24653.0},
}


def city_population(city: str) -> str:
    d = CITY.get(city)
    return "%s 常住人口 %.0f 万人" % (city, d["pop"]) if d else "没有 %s 的数据" % city


def city_gdp(city: str) -> str:
    d = CITY.get(city)
    return "%s 地区生产总值 %.0f 亿元" % (city, d["gdp"]) if d else "没有 %s 的数据" % city


def calculate(expression: str) -> str:
    try:
        return str(round(eval(expression, {"__builtins__": {}}, {}), 2))
    except Exception as exc:
        return "计算失败:%s" % exc


REGISTRY = {"city_population": city_population, "city_gdp": city_gdp,
            "calculate": calculate}

TOOLS = [
    {"type": "function", "function": {
        "name": "city_population", "description": "查询城市常住人口,单位万人",
        "parameters": {"type": "object",
                       "properties": {"city": {"type": "string", "description": "城市中文名"}},
                       "required": ["city"]}}},
    {"type": "function", "function": {
        "name": "city_gdp", "description": "查询城市地区生产总值,单位亿元",
        "parameters": {"type": "object",
                       "properties": {"city": {"type": "string", "description": "城市中文名"}},
                       "required": ["city"]}}},
    {"type": "function", "function": {
        "name": "calculate", "description": "计算纯数字算术表达式",
        "parameters": {"type": "object",
                       "properties": {"expression": {"type": "string",
                                                     "description": "例如 20059/1252"}},
                       "required": ["expression"]}}},
]

SYSTEM = ("你是一名数据调研助手。所有数字必须来自工具,禁止凭记忆作答;"
          "所有算术必须交给计算工具。每次只做一小步,拿到结果后再决定下一步。"
          "信息足够时直接给出结论并说明依据来自哪几次查询。")


def research(question: str, max_steps: int = 10, verbose: bool = True) -> dict:
    messages = [{"role": "system", "content": SYSTEM},
                {"role": "user", "content": question}]
    tool_calls_made, t0 = 0, time.time()

    for step in range(1, max_steps + 1):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
            tool_choice="auto", temperature=0)
        msg = resp.choices[0].message
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return {"answer": msg.content, "steps": step,
                    "tool_calls": tool_calls_made,
                    "seconds": round(time.time() - t0, 2)}

        for call in msg.tool_calls:
            name = call.function.name
            args = json.loads(call.function.arguments)
            result = REGISTRY.get(name, lambda **_: "没有这个工具")(**args)
            tool_calls_made += 1
            if verbose:
                print("  第%d轮 %s%s → %s" % (step, name, args, result))
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": str(result)})

    return {"answer": "超过 %d 轮仍未收敛" % max_steps, "steps": max_steps,
            "tool_calls": tool_calls_made, "seconds": round(time.time() - t0, 2)}


if __name__ == "__main__":
    for q in ["南京有多少人口?",
              "杭州和南京,哪个人均生产总值更高?高出百分之多少?"]:
        print("【问题】", q)
        out = research(q)
        print("【回答】", out["answer"])
        print("【统计】共 %d 轮,%d 次工具调用,用时 %.2f 秒\n"
              % (out["steps"], out["tool_calls"], out["seconds"]))
它返回的不只是答案,还有「转了几轮、调了几次工具、花了多少秒」。做 Agent 一定要把这三个数带出来:
| 问题 | 轮数 | 工具调用 | 说明 |
|---|---|---|---|
| 南京有多少人口 | 2 | 1 | 一次查询就够,模型不会强行凑步骤 |
| 杭州和南京人均产值谁高、高百分之多少 | 5~6 | 4~6 | 两次人口 + 两次产值 + 两次除法 + 一次比较 |
注意 system 提示词里那两句约束:「所有数字必须来自工具,禁止凭记忆作答」「每次只做一小步」。少了前一句,模型会直接背出一个看起来很像的数字,根本不调工具;少了后一句,它倾向于一轮里并发调五六个工具,轨迹会变得很难追。
4.3 先拆再做:另一种规划姿势
ReAct 是「边想边做」,每轮只决定下一步。还有一种做法是先把任务一次性拆成子任务清单,再逐条执行,通常叫 Plan-and-Execute。
"""规划:先拆再做,和边想边做,是两种不同的规划姿势。

ReAct 是「边想边做」——每一轮只决定下一步。
Plan-and-Execute 是「先拆再做」——一次性列出全部子任务,再逐条执行。
两者不是谁取代谁,长任务里常常混用:先拆出大纲,每条大纲内部再走 ReAct 循环。
"""
import json
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),
    base_url=os.environ.get("OPENAI_BASE_URL"),
)
MODEL = os.environ.get("MODEL_NAME", "gpt-4o-mini")

PLAN_PROMPT = """把下面这个目标拆成 2 到 5 个可以独立执行的子任务。
每个子任务必须是一句可以直接动手的指令,不要写「分析一下」这种空话。
只输出 JSON 数组,形如 ["子任务一", "子任务二"],不要任何解释。

目标:{goal}"""

REVIEW_PROMPT = """目标:{goal}

已经完成的子任务及其结果:
{done}

还没做的子任务:
{todo}

请判断:现有结果是否已经足够达成目标?
如果足够,输出 JSON:{{"finish": true, "answer": "最终答案"}}
如果不够,输出 JSON:{{"finish": false, "next": "下一步应该做什么,可以修改原计划"}}
只输出 JSON。"""


def ask_json(prompt: str):
    """要模型只吐 JSON,还得自己兜底:它很爱用 ```json 包一层。"""
    text = client.chat.completions.create(
        model=MODEL, temperature=0,
        messages=[{"role": "user", "content": prompt}],
    ).choices[0].message.content.strip()
    if text.startswith("```"):
        text = text.strip("`").lstrip("json").strip()
    return json.loads(text)


def make_plan(goal: str):
    """第一步:一次性拆出计划。计划是文本,不是承诺——后面随时可以改。"""
    return ask_json(PLAN_PROMPT.format(goal=goal))


def run(goal: str, executor, max_rounds: int = 6):
    """executor 是你自己的执行器:给它一句子任务,它跑一轮 ReAct 返回结果。

    注意 review 这一步:每执行完一条就回头看一次目标。
    少了它,Agent 会一根筋地把计划执行到底——哪怕第二条就已经能收尾,
    哪怕第一条的结果已经证明整个计划走错了方向。
    """
    todo = make_plan(goal)
    print("初始计划:", todo)
    done = []
    for rnd in range(1, max_rounds + 1):
        if not todo:
            break
        task = todo.pop(0)
        result = executor(task)
        done.append((task, result))
        print("第 %d 轮完成:%s → %s" % (rnd, task, result))

        verdict = ask_json(REVIEW_PROMPT.format(
            goal=goal,
            done="\n".join("- %s:%s" % (t, r) for t, r in done),
            todo="\n".join("- " + t for t in todo) or "(无)"))
        if verdict.get("finish"):
            return verdict["answer"]
        if verdict.get("next"):
            todo.insert(0, verdict["next"])      # 允许中途改计划
    return "计划执行完毕,但未能确认目标达成:%s" % done


if __name__ == "__main__":
    def fake_executor(task):
        return "(示例结果)已处理:" + task

    print(run("统计长三角三个城市的人口并找出最多的那个", fake_executor))
| 对比 | 边想边做(ReAct) | 先拆再做(Plan-and-Execute) |
|---|---|---|
| 规划时机 | 每一轮临时决定下一步 | 开头一次性列出全部子任务 |
| 长任务表现 | 容易走着走着忘了总目标 | 有清单兜着,方向更稳 |
| 应变能力 | 强,每轮都能改主意 | 弱,需要额外的复查步骤才能改计划 |
| 调用开销 | 轮数多,但每轮短 | 多一次规划调用,执行阶段更紧凑 |
代码里的 REVIEW_PROMPT 是这两者的缝合点:每执行完一条子任务就回头看一次总目标,够了就提前收尾,发现走错就当场改计划。少了这一步,Agent 会一根筋地把清单执行到底——哪怕第二条就已经能回答问题,哪怕第一条的结果已经证明整个计划跑偏了。
实际工程里两者常混用:外层用计划拆出大纲,每条大纲内部再走 ReAct 循环。
4.4 带人工确认的写操作
前面三个案例的工具全是「读」。一旦循环里出现「写」——发邮件、改数据、付钱——风险性质就完全变了:Agent 可以跑很多轮,而错一次就可能造成不可撤销的改动。
"""完整案例二:带人工确认的 Agent —— 循环可以自主,动作不必全自主。

读操作让它随便跑,写操作必须停下来等人点头。
实现方式很朴素:在执行工具之前插一个确认闸门,不通过就把「被拒绝」
作为一条观察结果交回循环,让模型换个做法,而不是让程序崩掉。
"""
import json
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),
    base_url=os.environ.get("OPENAI_BASE_URL"),
)
MODEL = os.environ.get("MODEL_NAME", "gpt-4o-mini")

INBOX = [{"id": 1, "from": "客户A", "subject": "报价单有误", "urgent": True},
         {"id": 2, "from": "同事B", "subject": "周会挪到周四", "urgent": False}]
SENT = []

READ_ONLY = {"list_mails", "read_mail"}
WRITE_OPS = {"send_reply"}


def list_mails() -> str:
    return json.dumps([{k: m[k] for k in ("id", "from", "subject", "urgent")}
                       for m in INBOX], ensure_ascii=False)


def read_mail(mail_id: int) -> str:
    for m in INBOX:
        if m["id"] == int(mail_id):
            return "来自 %s 的邮件:%s" % (m["from"], m["subject"])
    return "没有编号为 %s 的邮件" % mail_id


def send_reply(mail_id: int, content: str) -> str:
    SENT.append({"mail_id": int(mail_id), "content": content})
    return "已回复邮件 %s" % mail_id


REGISTRY = {"list_mails": list_mails, "read_mail": read_mail, "send_reply": send_reply}

TOOLS = [
    {"type": "function", "function": {
        "name": "list_mails", "description": "列出收件箱里所有邮件的摘要",
        "parameters": {"type": "object", "properties": {}, "required": []}}},
    {"type": "function", "function": {
        "name": "read_mail", "description": "按编号读取一封邮件的正文",
        "parameters": {"type": "object",
                       "properties": {"mail_id": {"type": "integer", "description": "邮件编号"}},
                       "required": ["mail_id"]}}},
    {"type": "function", "function": {
        "name": "send_reply", "description": "对指定邮件发送一条回复,这是对外可见的写操作",
        "parameters": {"type": "object", "properties": {
            "mail_id": {"type": "integer", "description": "邮件编号"},
            "content": {"type": "string", "description": "回复正文"}},
            "required": ["mail_id", "content"]}}},
]


def ask_human(name: str, args: dict) -> bool:
    """确认闸门。演示里走命令行,真实系统里换成工单、审批流或聊天机器人按钮。"""
    print("\n⚠ 需要确认:即将执行 %s" % name)
    print("  参数:%s" % json.dumps(args, ensure_ascii=False))
    return input("  批准执行?(y/N) ").strip().lower() == "y"


def run(goal: str, max_steps: int = 8, auto_approve: bool = False) -> str:
    messages = [
        {"role": "system", "content": "你是邮件助理。先查看收件箱,判断哪封最紧急,"
                                      "读完内容后再起草回复。回复属于写操作,"
                                      "若被拒绝,就把草稿念给用户听,不要反复重试。"},
        {"role": "user", "content": goal}]

    for step in range(1, max_steps + 1):
        msg = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
            tool_choice="auto", temperature=0).choices[0].message
        messages.append(msg.model_dump(exclude_none=True))
        if not msg.tool_calls:
            return msg.content

        for call in msg.tool_calls:
            name = call.function.name
            args = json.loads(call.function.arguments)
            if name in WRITE_OPS and not auto_approve and not ask_human(name, args):
                result = "用户拒绝了这次操作,请不要重复尝试,改为把内容告诉用户"
            else:
                result = REGISTRY[name](**args)
            print("  第%d轮 %s → %s" % (step, name, result))
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": str(result)})
    return "超过最大步数 %d" % max_steps


if __name__ == "__main__":
    print(run("看一下收件箱,挑最紧急的那封回一句「已收到,今天内处理」"))
    print("实际发出的回复:", SENT)
如果这里直接
raise,用户得到的就是一个崩掉的程序;如果什么都不回填,模型会以为没发出去,然后一遍遍重试——这正是死循环最常见的成因之一。
把风险动作单独列一张清单(代码里的 WRITE_OPS),闸门只卡这张清单,读操作完全不受影响。这样既保住了循环的自主性,又把不可逆的动作牢牢按在人手里。
四个案例放在一起
| 案例 | 控制流 | 轮数 | 它示范的要点 |
|---|---|---|---|
| 链版人口对比 | 直线 | 固定 4 步 | 顺序写死,快而稳,但不会改道 |
| 循环版人口对比 | 回路 | 2~4 轮 | 轮数由问题决定,能对中间结果做反应 |
| 调研型 Agent | 回路 | 2~6 轮 | 多工具选择 + 轮数与成本可观测 |
| 邮件助理 | 回路 + 闸门 | 3~5 轮 | 自主决策与人工授权并存 |
四个案例的循环体是同一段代码:调模型 → 看有没有 tool_calls → 执行 → 回填 → 再调模型。变的只是工具集、刹车参数和执行前的闸门。
05骨架模板:把循环做成能上生产的东西
一份即用骨架,加五个可单独拆用的零件
5.1 通用骨架(推荐直接拿这份改)
最小代码是用来理解的,这份是用来用的。它在那个 for 之外补齐了四件事:工具登记、四种刹车、逐轮轨迹、执行前兜底。
"""可复制的 Agent 循环骨架:只改 TODO 处,其余代码不用动。

它把前面拆开讲的四件事合成一份:工具注册、循环刹车、逐轮轨迹、执行前护栏。
从零写一个 Agent,从这份文件开始改是最快的。
"""
import json
import os
import time

from openai import OpenAI

# ---- TODO 1:换成你的模型服务(任何兼容 OpenAI 协议的服务都行) ----
client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY"),
    base_url=os.environ.get("OPENAI_BASE_URL"),
)
MODEL = os.environ.get("MODEL_NAME", "gpt-4o-mini")


# ---- TODO 2:换成你自己的工具函数,返回值一律是字符串 ----
def example_tool(keyword: str) -> str:
    """一个示例工具。真实实现可以是查库、调接口、读文件。"""
    return "关于「%s」的示例结果" % keyword


# ---- TODO 3:把函数登记进来,键名必须与下面 TOOLS 里的 name 完全一致 ----
REGISTRY = {"example_tool": example_tool}

# ---- TODO 4:把每个工具描述给模型。description 决定它选不选你这个工具 ----
TOOLS = [
    {"type": "function", "function": {
        "name": "example_tool",
        "description": "按关键词查询资料,返回一句话结果",
        "parameters": {"type": "object", "properties": {
            "keyword": {"type": "string", "description": "要查询的关键词"}},
            "required": ["keyword"]}}},
]

# ---- TODO 5:换成你的人设与任务约束 ----
SYSTEM = ("你是一个严谨的助手。需要外部事实时调用工具,不要凭记忆作答;"
          "信息足够时直接给出结论,不要再调用工具。")

# ---- 循环上限:三条刹车,按你的场景调 ----
MAX_STEPS = 8
MAX_SECONDS = 90
MAX_TOKENS = 30000
REPEAT_LIMIT = 3          # 同一动作连续几次就判定为原地打转


def run(question: str, verbose: bool = True) -> dict:
    messages = [{"role": "system", "content": SYSTEM},
                {"role": "user", "content": question}]
    trace, fingerprints = [], []
    tokens, t0 = 0, time.monotonic()

    for step in range(1, MAX_STEPS + 1):
        if time.monotonic() - t0 > MAX_SECONDS:
            return _stop("超过时间上限", trace, step, tokens, t0)
        if tokens > MAX_TOKENS:
            return _stop("超过 token 预算", trace, step, tokens, t0)
        if len(fingerprints) >= REPEAT_LIMIT and len(set(fingerprints[-REPEAT_LIMIT:])) == 1:
            return _stop("检测到重复动作", trace, step, tokens, t0)

        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
            tool_choice="auto", temperature=0)
        tokens += getattr(resp.usage, "total_tokens", 0) or 0
        msg = resp.choices[0].message
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            trace.append({"step": step, "phase": "finish"})
            return {"answer": msg.content, "stop": "模型给出最终答案",
                    "steps": step, "tokens": tokens,
                    "seconds": round(time.monotonic() - t0, 2), "trace": trace}

        for call in msg.tool_calls:
            name, raw = call.function.name, call.function.arguments
            fingerprints.append("%s|%s" % (name, raw))
            result = _safe_invoke(name, raw)
            trace.append({"step": step, "tool": name, "args": raw,
                          "result": str(result)[:200]})
            if verbose:
                print("  第%d轮 %s(%s) → %s" % (step, name, raw, result))
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": str(result)})

    return _stop("达到最大步数", trace, MAX_STEPS, tokens, t0)


def _safe_invoke(name: str, raw_args: str) -> str:
    """执行前的最后一道关:工具存在吗、参数是合法 JSON 吗、执行会抛异常吗。

    三种情况都不抛出,而是把原因作为观察结果交回去,让模型有机会自己改正。
    """
    fn = REGISTRY.get(name)
    if fn is None:
        return "没有名为 %s 的工具,可选:%s" % (name, "、".join(REGISTRY))
    try:
        args = json.loads(raw_args or "{}")
    except json.JSONDecodeError as exc:
        return "参数不是合法 JSON:%s" % exc
    try:
        return str(fn(**args))
    except Exception as exc:
        return "工具执行失败:%s: %s" % (type(exc).__name__, exc)


def _stop(reason: str, trace, step, tokens, t0) -> dict:
    return {"answer": "未得出结论(%s)" % reason, "stop": reason, "steps": step,
            "tokens": tokens, "seconds": round(time.monotonic() - t0, 2),
            "trace": trace}


if __name__ == "__main__":
    out = run("帮我查一下关键词「智能体」的资料")
    print("\n答案:", out["answer"])
    print("停止原因:%s;%d 轮,%d token,%.2f 秒"
          % (out["stop"], out["steps"], out["tokens"], out["seconds"]))
REGISTRY · TODO 4 照着写工具描述 · TODO 5 换人设与约束。四条上限按场景调,其余代码不用动。
answer 之外还带着 stop(为什么停)、steps、tokens、seconds 和 trace。上线之后你会天天看这几个字段:答案不对时,先看是「正常收尾」还是「撞了步数上限」,这两件事的修法完全不同。
5.2 工具注册表:让工具集不会对不上
循环里最容易长歪的地方,是每加一个工具要同时改三处:函数本体、JSON Schema、分发分支。漏改一处,模型就会调用一个「描述里有、代码里没有」的工具。用装饰器把三处收成一处:
"""工具注册表:把「函数本体」和「写给模型看的说明」绑在一起,只登记一次。

循环里最容易长歪的地方,是每加一个工具就要同时改三处:函数、schema、
分发的 if 分支。用一个装饰器把三处收成一处,Agent 的工具集就再也不会对不上。
"""
import inspect
import json


class ToolRegistry:
    def __init__(self):
        self._funcs = {}
        self._schemas = []

    def tool(self, description: str, **param_desc):
        """装饰器:登记一个函数,顺便根据签名生成 JSON Schema。

        param_desc 里写每个参数的中文说明——这句说明决定模型填不填、填什么,
        比函数名重要得多。
        """
        def deco(fn):
            sig = inspect.signature(fn)
            props, required = {}, []
            for name, p in sig.parameters.items():
                kind = {int: "integer", float: "number", bool: "boolean"}.get(
                    p.annotation, "string")
                props[name] = {"type": kind,
                               "description": param_desc.get(name, name)}
                if p.default is inspect.Parameter.empty:
                    required.append(name)
            self._funcs[fn.__name__] = fn
            self._schemas.append({"type": "function", "function": {
                "name": fn.__name__, "description": description,
                "parameters": {"type": "object", "properties": props,
                               "required": required}}})
            return fn
        return deco

    @property
    def schemas(self):
        """直接丢给模型的 tools 参数。"""
        return self._schemas

    def invoke(self, name: str, arguments: str) -> str:
        """按名字执行,并把任何异常翻译成模型看得懂的文字。

        这里是循环稳定性的关键:工具抛异常时如果让它冒泡,整个循环就断了;
        把错误变成一条 observation 交回去,模型才有机会换个参数重试。
        """
        fn = self._funcs.get(name)
        if fn is None:
            return "没有名为 %s 的工具,请从清单里重新选择" % name
        try:
            args = json.loads(arguments) if isinstance(arguments, str) else arguments
        except json.JSONDecodeError:
            return "参数不是合法 JSON,请重新生成:%s" % arguments
        try:
            return str(fn(**args))
        except TypeError as exc:
            return "参数不匹配:%s" % exc
        except Exception as exc:
            return "工具执行失败:%s: %s" % (type(exc).__name__, exc)


registry = ToolRegistry()


@registry.tool("查询指定城市今天的天气状况", city="城市中文名,例如 北京")
def get_weather(city: str) -> str:
    table = {"北京": "晴,18 到 28 度", "上海": "多云,21 到 27 度"}
    return table.get(city, "暂无 %s 的天气数据" % city)


@registry.tool("按关键词检索内部资料库", keyword="检索关键词", top_k="返回条数")
def search_docs(keyword: str, top_k: int = 3) -> str:
    return "关于「%s」检索到 %d 条资料(示例数据)" % (keyword, top_k)


@registry.tool("计算一个纯数字算术表达式", expression="例如 (28-18)/18*100")
def calculate(expression: str) -> str:
    return str(round(eval(expression, {"__builtins__": {}}, {}), 4))


if __name__ == "__main__":
    print(json.dumps(registry.schemas, ensure_ascii=False, indent=2))
    print(registry.invoke("get_weather", '{"city": "北京"}'))
    print(registry.invoke("get_weather", '{"城市": "北京"}'))   # 参数名写错
    print(registry.invoke("不存在的工具", "{}"))                 # 幻觉调用
invoke 里那三层 try 是重点:工具不存在、参数不是合法 JSON、函数执行抛异常——三种情况都不让它冒泡,而是翻译成一句模型看得懂的话交回循环。工具抛异常直接中断整个循环,是 Agent 最常见的脆断点。
5.3 循环控制器:四种刹车做成一个对象
"""循环控制器:Agent 真正的工程难点不在「怎么转起来」,而在「什么时候停」。

一个 while 很好写,难的是它会不会转到天荒地老、会不会把钱烧光。
这里把四种刹车做成一个可复用的对象,任何循环都能挂上去。
"""
import time


class StopReason:
    DONE = "模型给出最终答案"
    MAX_STEPS = "达到最大步数"
    TIMEOUT = "超过挂钟时间上限"
    BUDGET = "超过 token 预算"
    REPEAT = "检测到重复动作,判定为原地打转"


class LoopController:
    def __init__(self, max_steps=8, max_seconds=60.0, max_tokens=20000,
                 repeat_threshold=3):
        self.max_steps = max_steps
        self.max_seconds = max_seconds
        self.max_tokens = max_tokens
        self.repeat_threshold = repeat_threshold
        self.step = 0
        self.tokens = 0
        self.started = time.monotonic()
        self.history = []          # 每一轮实际执行的 (工具名, 参数) 指纹

    def elapsed(self) -> float:
        return time.monotonic() - self.started

    def check(self):
        """每轮开头调一次;返回停止原因,返回 None 表示可以继续。"""
        if self.step >= self.max_steps:
            return StopReason.MAX_STEPS
        if self.elapsed() > self.max_seconds:
            return StopReason.TIMEOUT
        if self.tokens > self.max_tokens:
            return StopReason.BUDGET
        if self._is_spinning():
            return StopReason.REPEAT
        return None

    def _is_spinning(self) -> bool:
        """同一个工具 + 同一组参数连续出现 N 次,就是死循环的典型指纹。

        模型卡住时的表现通常不是报错,而是一遍遍调同一个工具期待不同结果。
        步数上限能兜住,但那要烧满所有步数;这个检测能提前刹车。
        """
        n = self.repeat_threshold
        return len(self.history) >= n and len(set(self.history[-n:])) == 1

    def record(self, tool_name: str, arguments: str, usage=None):
        """每执行完一轮记一笔:动作指纹 + token 消耗。"""
        self.step += 1
        self.history.append("%s|%s" % (tool_name, arguments))
        if usage is not None:
            self.tokens += getattr(usage, "total_tokens", 0) or 0

    def summary(self, reason: str) -> str:
        return ("停止原因:%s;共 %d 轮,耗时 %.1f 秒,累计 %d token"
                % (reason, self.step, self.elapsed(), self.tokens))


def demo():
    """不联网也能看懂控制器的行为:模拟一个一直重复同一动作的模型。"""
    ctrl = LoopController(max_steps=10, repeat_threshold=3)
    while True:
        reason = ctrl.check()
        if reason:
            print(ctrl.summary(reason))
            break
        ctrl.record("search", '{"keyword": "同一个词"}')
        print("第 %d 轮:调用 search" % ctrl.step)


if __name__ == "__main__":
    demo()
_is_spinning 值得单独说:模型卡住时的表现往往不是报错,而是一遍遍调用同一个工具、填同一组参数,期待出现不同结果。步数上限当然也能兜住,但那要白白烧完所有步数和 token。连续三次相同指纹就提前刹车,省下来的是真金白银。
5.4 短期记忆与长期记忆
"""Agent 的记忆:循环之内的草稿纸,和循环之外的长期档案,是两回事。

短期记忆决定「这一轮能不能接上上一轮」,长期记忆决定「换个会话还记不记得你」。
把它们混在一个列表里,是新手最常见的设计事故。
"""
import json
import os
import time


class Scratchpad:
    """短期记忆:一次任务之内,把每轮的思考、动作、观察按序摊平。

    它就是循环的状态本体——没有它,每一轮模型都是从零开始,
    所谓「自主决策」也就无从谈起。
    """

    def __init__(self, system: str, question: str, max_chars=6000):
        self.messages = [{"role": "system", "content": system},
                         {"role": "user", "content": question}]
        self.max_chars = max_chars

    def add_assistant(self, message):
        self.messages.append(message)

    def add_observation(self, tool_call_id: str, text: str, limit=1200):
        """工具结果要截断再入库。

        一次网页检索可能返回几万字符,原样塞进去,两三轮就把上下文窗口撑满,
        后面的轮次会因为超长而报错或者被迫丢掉最早的指令。
        """
        if len(text) > limit:
            text = text[:limit] + "……(结果过长,已截断)"
        self.messages.append({"role": "tool", "tool_call_id": tool_call_id,
                              "content": text})

    def compact(self):
        """超长时的退让策略:保留 system 与最初的问题,压缩中间的轮次。

        中间轮次一旦丢弃就不可恢复,所以要留一条摘要占位,
        让模型知道「前面做过事,只是细节省略了」。
        """
        total = sum(len(str(m.get("content") or "")) for m in self.messages)
        if total <= self.max_chars:
            return False
        head, tail = self.messages[:2], self.messages[-4:]
        dropped = len(self.messages) - len(head) - len(tail)
        if dropped <= 0:
            return False
        note = {"role": "user",
                "content": "(此前已执行 %d 条中间步骤,结论已并入后续观察结果)" % dropped}
        self.messages = head + [note] + tail
        return True


class LongTermMemory:
    """长期记忆:跨任务、跨会话的事实档案,用最朴素的 JSON 文件演示。

    生产环境会换成向量库或数据库,但接口形态就是这两个方法:
    写入一条事实、按关键词召回若干条。
    """

    def __init__(self, path="agent_memory.json"):
        self.path = path
        self.items = []
        if os.path.exists(path):
            self.items = json.load(open(path, encoding="utf-8"))

    def remember(self, text: str, tags=()):
        self.items.append({"text": text, "tags": list(tags), "ts": time.time()})
        with open(self.path, "w", encoding="utf-8") as f:
            json.dump(self.items, f, ensure_ascii=False, indent=2)

    def recall(self, keyword: str, top_k=3):
        hit = [x for x in self.items if keyword in x["text"] or keyword in x["tags"]]
        return [x["text"] for x in hit[-top_k:]]


if __name__ == "__main__":
    pad = Scratchpad("你是一个助手", "帮我对比两个城市的人口")
    pad.add_assistant({"role": "assistant", "content": "我先查第一个城市"})
    pad.add_observation("call_1", "杭州常住人口 1252 万人")
    print("短期记忆条数:", len(pad.messages))

    mem = LongTermMemory("/tmp/agent_memory_demo.json")
    mem.remember("这位用户长期关注长三角城市数据", tags=["偏好"])
    print("长期记忆召回:", mem.recall("偏好"))
| 方法 | 解决的问题 |
|---|---|
add_observation(limit=1200) | 工具结果先截断再入库。一次检索可能返回几万字符,原样塞进去两三轮就撑满上下文窗口 |
compact() | 超长时保留 system 与原始问题,压缩中间轮次,并留一条占位说明,让模型知道前面做过事 |
LongTermMemory | 跨任务的事实档案。演示用 JSON 文件,生产换向量库或数据库,接口形态就是写入与召回两个方法 |
5.5 轨迹记录:出错时能回答「第几轮走偏的」
"""轨迹记录:Agent 出错时,你要能回答「它第几轮开始走偏的」。

链出问题,看一眼输入输出就知道;Agent 出问题,中间可能已经转了七八轮,
没有轨迹就只能靠猜。所以循环里每一轮都要落一条结构化记录。
"""
import json
import time


class Trace:
    def __init__(self, goal: str):
        self.goal = goal
        self.started = time.time()
        self.steps = []

    def log_think(self, step: int, content, tool_calls):
        """记一轮「想」:模型说了什么、打算调哪些工具。"""
        self.steps.append({
            "step": step, "phase": "think", "ts": round(time.time() - self.started, 3),
            "content": (content or "")[:200],
            "tools": [{"name": c.function.name, "args": c.function.arguments}
                      for c in (tool_calls or [])],
        })

    def log_act(self, step: int, name: str, args: str, result: str, cost_ms: int):
        """记一轮「做 + 看」:工具、入参、返回、耗时。"""
        self.steps.append({
            "step": step, "phase": "act", "ts": round(time.time() - self.started, 3),
            "tool": name, "args": args, "result": str(result)[:300],
            "cost_ms": cost_ms,
        })

    def log_stop(self, reason: str, answer: str = ""):
        self.steps.append({"phase": "stop", "reason": reason,
                           "answer": (answer or "")[:300],
                           "ts": round(time.time() - self.started, 3)})

    def to_json(self, path=None):
        data = {"goal": self.goal, "total_seconds": round(time.time() - self.started, 3),
                "steps": self.steps}
        text = json.dumps(data, ensure_ascii=False, indent=2)
        if path:
            with open(path, "w", encoding="utf-8") as f:
                f.write(text)
        return text

    def pretty(self) -> str:
        """人眼快速扫一遍用的紧凑视图。"""
        lines = ["目标:%s" % self.goal]
        for s in self.steps:
            if s["phase"] == "think":
                tools = "、".join(t["name"] for t in s["tools"]) or "(不再调用工具)"
                lines.append("  [%5.2fs] 第%s轮 想 → %s" % (s["ts"], s["step"], tools))
            elif s["phase"] == "act":
                lines.append("  [%5.2fs] 第%s轮 做 → %s(%s) 用时 %dms"
                             % (s["ts"], s["step"], s["tool"], s["args"], s["cost_ms"]))
                lines.append("           看 → %s" % s["result"])
            else:
                lines.append("  [%5.2fs] 结束:%s" % (s["ts"], s["reason"]))
        return "\n".join(lines)

    def diagnose(self) -> list:
        """从轨迹里自动挑出三种最常见的异常形态。"""
        problems = []
        acts = [s for s in self.steps if s["phase"] == "act"]
        seen = {}
        for a in acts:
            key = "%s|%s" % (a["tool"], a["args"])
            seen[key] = seen.get(key, 0) + 1
        for key, n in seen.items():
            if n >= 3:
                problems.append("同一动作重复 %d 次,疑似原地打转:%s" % (n, key))
        slow = [a for a in acts if a["cost_ms"] > 5000]
        if slow:
            problems.append("有 %d 次工具调用超过 5 秒,循环整体延迟会被放大" % len(slow))
        empty = [a for a in acts if not a["result"].strip()]
        if empty:
            problems.append("有 %d 次工具返回为空,模型很可能据此编造内容" % len(empty))
        return problems


if __name__ == "__main__":
    tr = Trace("对比两个城市人口")
    tr.log_act(1, "lookup", '{"city":"杭州"}', "1252 万", 120)
    tr.log_act(2, "lookup", '{"city":"杭州"}', "1252 万", 118)
    tr.log_act(3, "lookup", '{"city":"杭州"}', "1252 万", 130)
    tr.log_stop("检测到重复动作")
    print(tr.pretty())
    print("诊断:", tr.diagnose())
链出问题,看一眼输入输出就知道;Agent 出问题,中间可能已经转了七八轮,没有轨迹就只能靠猜。diagnose() 把三种最常见的异常形态自动挑出来:同一动作重复三次以上、工具调用超过 5 秒、工具返回为空(模型很可能据此开始编造)。
5.6 护栏:把四种失败模式堵在执行之前
"""护栏:把 Agent 的四种典型失败模式,一条条堵在执行工具之前。

这些检查都发生在「模型已经写好动作、你还没真正执行」的那个缝隙里。
铁律在这里体现得最直白:循环的执行权在你的代码手上,所以拦得住。
"""
import json
import re


class GuardError(Exception):
    """护栏拒绝执行;把它转成 observation 交回模型,而不是让循环崩掉。"""


ALLOWED_TOOLS = {"search_docs", "lookup_population", "calculate", "send_email"}
HIGH_RISK = {"send_email", "delete_record", "transfer_money"}
SQL_WRITE = re.compile(r"\b(delete|drop|update|insert|alter|truncate)\b", re.I)


def check_known_tool(name: str):
    """幻觉调用:模型会凭空发明一个不存在的工具名,还填得有模有样。"""
    if name not in ALLOWED_TOOLS:
        raise GuardError("工具 %s 不在清单内,可选:%s"
                         % (name, "、".join(sorted(ALLOWED_TOOLS))))


def check_args(name: str, arguments: str) -> dict:
    """参数幻觉:字段名拼错、该填数字填了整句话,都要在执行前拦下。"""
    try:
        args = json.loads(arguments)
    except json.JSONDecodeError as exc:
        raise GuardError("参数不是合法 JSON:%s" % exc)
    if not isinstance(args, dict):
        raise GuardError("参数必须是一个对象")
    if name == "calculate":
        expr = str(args.get("expression", ""))
        if not re.fullmatch(r"[\d\s\.\+\-\*/\(\)%]+", expr):
            raise GuardError("计算表达式只允许数字与运算符,收到:%s" % expr)
    if name == "search_docs" and SQL_WRITE.search(str(args.get("keyword", ""))):
        raise GuardError("检索关键词里出现写操作语句,已拒绝")
    return args


def check_budget(step: int, max_steps: int, tokens: int, max_tokens: int):
    """步数爆炸与成本失控:这两件事必须同时看。

    只限步数挡不住成本——一次塞进去几万 token 的长上下文,
    三轮就能把预算烧完。
    """
    if step > max_steps:
        raise GuardError("已达最大步数 %d" % max_steps)
    if tokens > max_tokens:
        raise GuardError("已超 token 预算 %d" % max_tokens)


def needs_human(name: str, args: dict) -> bool:
    """高风险动作不由模型拍板:发邮件、删数据、转账一律先问人。

    这不是保守,而是循环的必然要求:Agent 可以跑很多轮,
    错一次就可能对外部世界造成不可撤销的改动。
    """
    if name not in HIGH_RISK:
        return False
    if name == "send_email" and args.get("to", "").endswith("@example.com"):
        return False        # 内部测试地址可以放行
    return True


def guard(name: str, arguments: str, step: int, tokens: int,
          max_steps=8, max_tokens=20000, approver=None) -> dict:
    """统一入口:过了这一关才允许真正执行工具。"""
    check_budget(step, max_steps, tokens, max_tokens)
    check_known_tool(name)
    args = check_args(name, arguments)
    if needs_human(name, args):
        if approver is None or not approver(name, args):
            raise GuardError("高风险动作 %s 未获批准,已取消" % name)
    return args


if __name__ == "__main__":
    cases = [("查天气", "{}"),
             ("calculate", '{"expression": "import os"}'),
             ("send_email", '{"to": "[email protected]", "body": "涨薪申请"}'),
             ("calculate", '{"expression": "(1252-954)/954*100"}')]
    for n, a in cases:
        try:
            print("放行:", n, guard(n, a, step=1, tokens=10,
                                   approver=lambda *_: False))
        except GuardError as exc:
            print("拦下:", n, "→", exc)
5.7 成本推演:为什么 Agent 的账估不准
"""成本推演:为什么一条链的花费可以估准,而 Agent 只能估一个区间。

链的调用次数是常数,Agent 的调用次数是随机变量。更麻烦的是,
每一轮都要把之前所有轮次的消息重新发一遍,上下文是累加的——
所以总开销大致按轮数的平方增长,而不是线性。这段代码把这件事算给你看。
"""


def chain_cost(steps: int, prompt_tokens: int, output_tokens: int) -> int:
    """链:每一步各发各的提示词,互不叠加。"""
    return steps * (prompt_tokens + output_tokens)


def agent_cost(rounds: int, system_tokens: int, question_tokens: int,
               think_tokens: int, observation_tokens: int) -> int:
    """循环:第 n 轮要重发前 n-1 轮的全部内容。

    每轮的输入 = 系统提示 + 问题 + 已累积的(思考 + 观察)。
    """
    total = 0
    carried = system_tokens + question_tokens
    for _ in range(rounds):
        total += carried + think_tokens          # 这一轮的输入 + 输出
        carried += think_tokens + observation_tokens
    return total


def compare(max_rounds: int = 8):
    sys_t, q_t, think_t, obs_t = 300, 60, 120, 400
    print("轮数  累计 token   相对 2 轮的倍数")
    base = agent_cost(2, sys_t, q_t, think_t, obs_t)
    for r in range(2, max_rounds + 1):
        c = agent_cost(r, sys_t, q_t, think_t, obs_t)
        print("%3d   %9d   %6.1f 倍" % (r, c, c / base))
    print("\n同样办完这件事,写死的四步链:%d token"
          % chain_cost(4, sys_t + q_t, think_t))


def budget_rounds(max_tokens: int, system_tokens=300, question_tokens=60,
                  think_tokens=120, observation_tokens=400) -> int:
    """反过来问:给定预算,最多允许转几轮?把结果配成 max_steps。"""
    r = 0
    while agent_cost(r + 1, system_tokens, question_tokens,
                     think_tokens, observation_tokens) <= max_tokens:
        r += 1
    return r


if __name__ == "__main__":
    compare()
    for budget in (5000, 20000, 100000):
        print("预算 %6d token → 最多约 %d 轮" % (budget, budget_rounds(budget)))
    # 结论:观察结果的长度是成本的主要杠杆。
    # 把一次检索返回的几千字符截断到几百字符,往往比把 max_steps 从 8 调到 6
    # 省得多,而且不损失解决问题的能力。
链的调用次数是常数,Agent 的调用次数是随机变量。更麻烦的是每一轮都要把之前所有轮次重新发一遍,上下文是累加的——所以总开销大致按轮数的平方增长,而不是线性。跑一下 compare(),8 轮的花费大约是 2 轮的十几倍。
max_steps 从 8 调到 6 省得多,而且不损失解决问题的能力。budget_rounds() 可以反过来用:给定预算,算出最多允许转几轮,直接配成 max_steps。
5.8 零件怎么选
| 文件 | 什么时候用 | 作用 |
|---|---|---|
min_react_loop.py | 理解原理 | 60 行看清循环的骨架,见第 03 节 |
skeleton_agent_loop.py | 动手写第一个 | 四件事齐全的即用骨架,日常首选 |
tool_registry.py | 工具超过三个 | 一次登记,schema 与分发不会对不上 |
loop_controller.py | 循环开始不听话 | 四重刹车,尤其是重复动作检测 |
trace_logger.py | 开始排查线上问题 | 逐轮轨迹 + 自动诊断 |
guardrails.py | 工具里出现写操作 | 执行前的最后一道关 |
cost_estimate.py | 要给老板报预算 | 把轮数换算成 token,反推上限 |
06易错点汇总
按「概念 / 循环 / 失败模式 / 选型」四类归并,每条都给现象和修法
⚠️ 一、概念层面
- 以为 Agent 是「更聪明的模型」。 换成 Agent 用的还是同一个模型。多出来的只是一个
while、一份工具清单和一套刹车。模型能力没变,变的是你给它的机会次数。 - 以为 Agent 会自己执行工具。 和单次委托一样,模型只产出「要调哪个、参数是什么」,真正调用的永远是你的代码。循环也是你的代码在转。
- 把 Agent 当成链的升级版,见需求就上。 它是另一种控制流,不是更高的档位。流程固定的需求写成 Agent,只会把可预测的成本换成不可预测的账单。
- 以为 ReAct 必须用文本格式。 文本格式只是它最早的形态。用结构化工具调用表达动作,骨架完全一样,而且更稳。
- 把「规划」理解成一定要先列清单。 ReAct 的规划是分摊在每一轮里的,每次只规划下一步——这也是规划。
⚠️ 二、循环写法
- 没写最大步数。 最典型也最致命。模型一旦陷进「再查一次说不定就有了」的模式,循环能一直转到你发现账单为止。
max_steps是必写项,不是优化项。 - 步数耗尽时静默返回空字符串或
None。 上游会当成任务成功。必须明确返回「已达最大步数,未能得出结论」。 - 忘了把 assistant 那条消息回填。 只追加工具结果、不追加模型那轮的输出,回执就成了孤儿,接口直接报错。顺序也不能颠倒:先 assistant,后 tool。
- 第二轮以后不再传
tools。 每一轮都要传。不传的那一轮,模型就失去了继续调用工具的能力,会被迫用现有信息硬凑答案。 - 工具抛异常直接冒泡。 循环当场断掉,前面几轮的开销全部白费。正确做法是捕获后把错误信息当成观察结果回填,让模型换个参数重试。
REGISTRY[name]直接下标取值。 模型幻觉出一个不存在的工具名就是KeyError。用.get(),并把「没有这个工具,可选清单是……」交回去。- 把工具的原始返回整个塞进上下文。 一次网页检索几万字符,两三轮就撑满上下文窗口,后面的轮次要么报错要么丢掉最早的指令。先截断再入库。
- 一轮里并发调五六个工具还不做区分。 模型可以一次返回多个
tool_calls,你要逐个执行、逐条回填,一条都不能漏,否则tool_call_id配不上。
⚠️ 三、四种失败模式
- 死循环(原地打转)。 现象:同一个工具、同一组参数连续调用,结果每次都一样。成因通常是工具返回了空结果或错误,而模型不认为那是终局。修法:重复动作检测——连续三次相同指纹就刹车;同时确保工具返回的空结果带明确措辞(「没有查到」而不是空字符串)。
- 幻觉调用。 现象:调用一个描述里根本不存在的工具,参数还填得像模像样。成因:工具描述含糊,或清单太长。修法:执行前校验工具名,把「不在清单内,可选是……」作为观察结果回传;同时精简工具集,
description写清用途与边界。 - 步数爆炸。 现象:简单问题也转七八轮。成因:system 提示词没说「信息足够就直接收尾」,模型倾向于多做几步显得严谨。修法:提示词里明写收尾条件,并把
max_steps压到场景真正需要的量级。 - 成本失控。 现象:步数没超,账单超了。成因:每轮都要重发全部历史,开销按轮数平方增长,而长观察结果会把每一轮的基数抬高。修法:token 预算刹车 + 观察结果截断,后者杠杆更大。
- 不可撤销的误操作。 现象:模型在某一轮自作主张发了邮件、改了数据。修法:把写操作单列清单,执行前插人工确认闸门;被拒绝时把「已拒绝,请勿重试」回填进去,而不是抛异常。
⚠️ 四、选型:什么时候一条链就够了
- 步骤固定、次数已知的加工任务——翻译、摘要、格式转换、批量打标。写成链,成本可预估、延迟稳定、出错好查。上 Agent 纯属浪费。
- 只需要一次外部调用的问答——「北京今天天气」。一次 Function Call 就够了,不需要循环。判断标准很简单:会不会出现「要根据这次的结果决定下一步」?不会,就不需要回路。
- 对延迟敏感的在线场景。 Agent 的轮数不确定,尾延迟天然难控。要么退回链,要么把
max_steps压到 2~3 并接受降级答案。 - 真正该用 Agent 的样子:步数事先不知道、下一步依赖上一步的结果、中途可能要改主意、工具有多个且需要挑选。四条里占了两条以上,才值得付循环的代价。
| 需求特征 | 选择 | 理由 |
|---|---|---|
| 流程写得出流程图 | 链 | 能画成直线的就不要做成回路 |
| 只差一次外部数据 | 单次 Function Call | 一来一回,不需要循环 |
| 要查几次说不准 | Agent | 轮数交给模型,上限交给你 |
| 工具多且需要挑 | Agent | 挑工具正是推理引擎的强项 |
| 有写操作 | Agent + 闸门 | 自主决策可以有,自主动手不可以 |
@tool 把函数变成工具、用 create_agent 把这个循环一行建起来,并用中间件在循环的各个钩子上挂自己的逻辑——你会发现框架做的事,和这里手写的这些一一对应。
07自测题
点击题目展开答案;能把这 16 题说清楚,这一讲就通了
用一句话说清 Agent 是什么。
一个通过动态协调大语言模型与工具来完成复杂任务的系统:让 LLM 充当决策大脑,根据当前状态自主选择下一步调用什么工具,把中间结果喂回大脑,如此往复直到得出答案。关键词是「动态」——顺序是运行时定的,不是写代码时定的。
Lilian Weng 那个式子是什么?每一项在循环里对应什么?
Agent = LLM + Planning + Memory + Tools + Action。LLM 是大脑,Planning 是每一轮的「想」,Tools 是每一轮的「做」,Memory 是轮与轮之间的连接(没有它每轮都从零开始),Action 是你的代码真正把工具执行了——只有意图没有执行,就只是一份计划书。
Agent 的短期记忆和长期记忆分别是什么?循环主要倚重哪个?
短期记忆是单次任务之内的上下文,就是那个不断追加的消息列表,受限于上下文窗口长度;长期记忆跨任务跨会话,用向量数据库、知识图谱或微调固化实现。循环主要倚重短期记忆——它就是循环的状态本体。类比:心算时记住几个数字是短期,学会骑车多年后仍会是长期。
Chain 和 Agent 最本质的差别是哪一条?
控制流:Chain 里行动序列是硬编码的,是单向直线的流水线,走完即止;Agent 用语言模型作为推理引擎来决定以什么顺序采取什么行动,控制流带回路,每转一圈重新决策。由此派生出其余差别:步数固定 vs 不确定、成本可估 vs 只能估区间。
ReAct 的三个动作是什么?为什么不让模型一次性把计划想完?
Thought 思考 → Action 行动 → Observation 观察,然后回到思考。不一次想完,是因为纯推理等于闭着眼睛规划——模型能写出完整方案,但方案里每个数字都是猜的。每步都用真实观察结果纠正下一步推理,这才是它具备反思与自我纠错能力的来源。
文本式 ReAct 和结构化工具调用,差别在哪?骨架变了吗?
差别只在动作怎么表达:前者模型按 Thought:/Action:/Action Input: 写文本,程序用正则抠出来执行,结果拼成 Observation: 接回提示词;后者动作用 tool_calls 表达、观察用 role 为 tool 的消息回填,解析从「正则抠文本」变成「读字段」。「想→做→看→再想」的骨架完全一样。
文本式 ReAct 里为什么要设 stop=["Observation:"]?
让模型写完动作就停笔。不加这一句,模型会一口气把整个循环都「演」完,连本该由工具返回的观察结果都自己编出来——那些数据全是假的。停止符强制它把控制权交回你的代码。
循环里一轮固定发生五件事,其中几件是模型做的?
只有一件。模型做的是第①件:拿着目前已知的一切,输出这一轮的判断(一张委托单,或最终答案)。剩下四件——判断有没有 tool_calls、护栏校验、真正执行函数、把判断与结果一起追加回消息列表——全是你的代码做的。
为什么说「下一轮的输入 = 这一轮的输入 + 这一轮发生的事」?这带来什么代价?
因为消息列表只追加不修改,每一轮都要把全部历史重新发给模型。这既是它能「记住」前几轮的原因,也意味着开销大致按轮数的平方增长而不是线性——8 轮的花费大约是 2 轮的十几倍。
Function Call 和 Agent 的边界在哪?说清楚,别含糊。
Function Call 是一种协议——模型如何表达「我要调这个函数、参数是这些」,形态是一次委托、一来一回,说完答案就结束。Agent 是一种控制流——反复使用这个协议,形态是「委托 → 看结果 → 再决定」的循环,同一个目标可以跑很多轮。代码上的差别就是:Agent 用一个 while 把那段直着写的代码包了起来。
Agent 的「自主」究竟自主在哪?不自主在哪?
自主在路径:先查哪个、要不要再查一次、什么时候算够了,都是模型在运行时决定的。不自主在权限:它按不下执行键,也决定不了循环能跑多久——那个 while 是你写的,刹车也是你设的,每一轮的工具还是你的代码执行的。
循环的四种停止方式是什么?哪一种是「正常出口」?
① 正常收敛——模型这一轮不再返回 tool_calls,这是唯一的正常出口;② 达到 max_steps;③ 超过 token 预算或挂钟超时;④ 重复动作检测触发。后三种都是兜底。到达任何一种兜底出口,都必须明确返回「未得出结论」及原因,不能静默返回空。
只设 max_steps,能不能防住成本失控?
不能。步数没超、账单超了是很常见的情形:单轮塞进几万 token 的长观察结果,三轮就能烧穿预算。所以步数与 token 预算要同时设。省钱杠杆最大的其实是第三件事——把工具返回结果截断,通常比把 max_steps 从 8 调到 6 省得多,而且不损失解决问题的能力。
工具执行抛异常,应该让它冒泡吗?为什么?
不应该。冒泡会让循环当场中断,前面几轮的开销全部白费。正确做法是捕获后把错误信息当成一条观察结果回填(「参数不匹配:……」「没有这个工具,可选:……」),模型读到之后有机会自己换个参数或换个工具重试。同理,人工拒绝高风险动作时也要回填「已拒绝,请勿重试」,而不是 raise。
怎么识别并阻止死循环?为什么光靠 max_steps 不够好?
识别指纹是同一个工具 + 同一组参数连续出现三次——模型卡住时的表现通常不是报错,而是一遍遍调同一个工具期待不同结果。max_steps 确实能兜住,但那要白白烧完所有步数和 token 才停。重复动作检测能提前刹车。此外还要确保工具的空结果带明确措辞(「没有查到」而不是空字符串),否则模型不会认为那是终局。
什么时候一条链就够了,不必上 Agent?
判断标准只有一句:会不会出现「要根据这次的结果决定下一步」?不会,就不需要回路。具体地:步骤固定次数已知的加工任务(翻译、摘要、格式转换、批量打标)写成链;只需一次外部调用的问答(「北京今天天气」)一次 Function Call 就够;对延迟敏感的在线场景也应退回链。反过来,「步数事先不知道、下一步依赖上一步、中途可能改主意、工具多需要挑」四条占两条以上,才值得付循环的代价。
词术语表
| 术语 | 含义 |
|---|---|
| Agent | 通过动态协调 LLM 与 Tools 完成复杂任务的系统;自主性体现在「委托 → 看结果 → 再决定」的循环上 |
| ReAct | Reasoning + Acting,推理与行动交替进行:思考 → 行动 → 观察 → 再思考,直到给出最终答案 |
| Thought / Action / Observation | ReAct 一轮里的三个动作:决定下一步、调用工具、读取工具返回的真实结果 |
| Planning | 规划:任务分解与反思自省。ReAct 把它分摊在每一轮,Plan-and-Execute 把它集中在开头 |
| Memory | 记忆:短期指单次任务内的上下文(消息列表本体),长期指跨任务的知识档案 |
| Tools | 工具:封装好输入、输出与处理方法的外部能力单元,是循环里新信息的唯一来源 |
| scratchpad | 草稿纸:把每一轮的思考与观察按序摊平的短期记忆载体 |
| Chain | 链:行动序列硬编码的线性流水线,顺序在写代码时就定死 |
| Plan-and-Execute | 先把任务拆成子任务清单再逐条执行的规划姿势,常与 ReAct 混用 |
| max_steps | 最大步数:循环的必写刹车,到顶必须明确返回「未得出结论」 |
| 终止条件 | 模型这一轮不再返回 tool_calls,循环正常退出;其余停止方式都是兜底 |
| trace | 轨迹:逐轮记录的想 / 做 / 看,Agent 排障的唯一凭据 |
| 幻觉调用 | 模型调用一个清单里不存在的工具,参数还填得像模像样;要在执行前校验并把提示回填 |
while 里。模型多了「看完结果再决定下一步」的机会,而循环转几圈、什么时候停、每一轮的工具怎么执行,权力始终在你的代码手上。看懂一轮里哪一件事是模型做的、哪四件是你做的,这一讲就通了。