卷积神经网络 CNN
全连接层处理一张 224×224 的图片要一亿五千万个参数,而且把「相邻」这件事彻底丢掉了。卷积用一枚滑动的印章同时解决这两个问题——这一页把卷积核、步长、padding、池化和维度推导全部算到能自己手推。
30″30 秒看懂卷积神经网络
把卷积想成一枚印章:印章只有巴掌大,但它可以在整张图上一格一格地挪,每挪到一处就在下面盖一下,记下「这块地方和我这个花纹像不像」。盖满全图,就得到一张相似度地图——这就是特征图。
印章的花纹是学出来的,不是人设计的。有的印章学会了对横边敏感,有的对竖边敏感,有的对某种颜色块敏感。把几十枚这样的印章并排盖一遍,一张图就被翻译成了几十张「某种花纹在哪出现过」的地图。
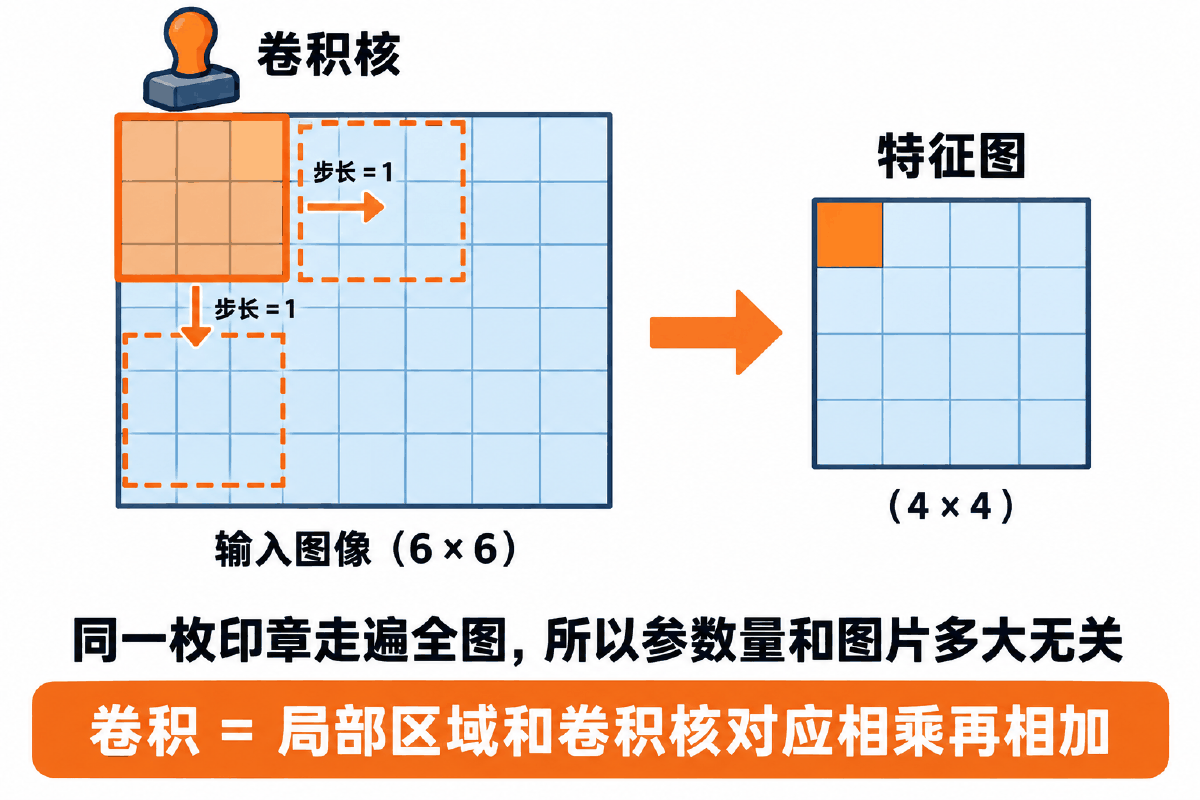
关键在图底那句话:同一枚印章走遍全图。整张图共用这一套花纹,所以参数量只和印章多大有关,和图片多大完全无关——一枚 3×3 的印章永远只有 9 个数加 1 个偏置,不管它盖的是 6×6 的小图还是 1024×1024 的大图。这正是全连接层做不到的事:全连接给每个像素配一个独立权重,图片一大参数就爆炸。
| 比喻里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 印章 | 卷积核 kernel / filter | 一小块权重矩阵,常见 3×3、5×5;它的数值是训练出来的 |
| 盖一下 | 卷积运算 | 把印章盖住的那块区域和印章对应相乘再相加,得到一个数 |
| 一次挪几格 | 步长 stride | 挪得越大,输出地图越小,计算量也越小 |
| 四周垫一圈白边 | padding | 补 0 把边缘垫出来,防止图越卷越小、边缘信息被卷丢 |
| 盖出来的相似度地图 | 特征图 feature map | 卷积层的输出;一枚印章产出一张 |
| 几十枚不同花纹的印章 | out_channels | 卷积核的个数,用几枚印章输出就有几个通道 |
| 地图缩印一份 | 池化 pooling | 每小块只留最大值或平均值,尺寸减半而一个参数都不带 |
| 看完地图下结论 | 全连接层 | 把所有特征图拉成一根长向量,最后判定这是猫还是狗 |
| 同一枚印章走遍全图 | 权值共享 | CNN 参数量小的根本原因,也是它能识别「猫在图片哪个角落都算猫」的原因 |
N = (W − F + 2P) / S + 1。 网络能不能跑通,不取决于你觉得它「应该差不多」,而取决于这个公式一层层算下来的数字对不对得上。拉平后送进全连接层的那个数必须是算出来的,不能拍脑袋写——本页案例里是 576,它等于 16 × 6 × 6,每一位都能推。写错了的现象是 mat1 and mat2 shapes cannot be multiplied。
01概念:为什么图像非要用卷积
图像在内存里的样子、全连接层的两宗罪,以及卷积用哪两条性质把它们一起解决
1.1 图像在计算机里长什么样
一张图片本质上就是一堆数字。每个像素(pixel)的取值范围是 [0, 255]:越接近 0 越暗,0 是纯黑;越接近 255 越亮,255 是纯白。
灰度图一个像素一个数就够了。彩色图靠 RGB 三个通道(channel)叠加出所有颜色,同一个位置要存红、绿、蓝三个数。所以一张彩色图片是三维的:高 × 宽 × 通道。
| 排列约定 | 形状写法 | 谁在用 | 说明 |
|---|---|---|---|
| HWC | (高, 宽, 通道) | matplotlib、OpenCV、PIL | 读图工具给出来的就是这个顺序,例如 (640, 640, 3) |
| NCHW | (批量, 通道, 高, 宽) | PyTorch | 卷积层只认这个,例如 (8, 3, 32, 32) |
两者差一次维度重排,这是图像任务里第一个必踩的坑。转换固定两步:permute(2, 0, 1) 把通道提到最前,unsqueeze(0) 补出批量维。另外 torchvision 的 ToTensor() 一次帮你做完两件事——HWC 转 CHW,并把像素从 0~255 归一到 0.0~1.0。
"""图像在内存里长什么样:像素、通道、HWC。"""
import numpy as np
import matplotlib.pyplot as plt

# 像素值 0 最暗(黑),255 最亮(白)
black = np.zeros([200, 200, 3])            # 全 0 -> 纯黑
white = np.full([200, 200, 3], 255)        # 全 255 -> 纯白
plt.imshow(black); plt.show()
plt.imshow(white); plt.show()

# 读一张真实图片:matplotlib 给出的顺序是 (高, 宽, 通道),简称 HWC
img = plt.imread('data/img.jpg')
print('图像形状 (H, W, C):', img.shape)     # 例如 (640, 640, 3)
print('取值范围:', img.min(), '~', img.max())

plt.imshow(img)
plt.axis('off')
plt.show()

# PyTorch 的卷积层要的是 (N, C, H, W),和这里差一次转置,别记混
1.2 全连接层处理图像的两宗罪
上一页那种全连接网络当然也能吃图像——把 (3, 32, 32) 拉平成 3072 长的向量就行。问题是它有两个无法回避的毛病。
第一宗罪:参数爆炸
全连接层的参数量 = 输入元素个数 × 输出神经元个数 + 偏置。第一个隐藏层就取 1000 个神经元,算一下:
| 图片尺寸 | 拉平后长度 | 全连接参数量 | 6 个 3×3 卷积核 | 倍数 |
|---|---|---|---|---|
| 32×32 | 3072 | 307.30 万 | 168 | 18292 倍 |
| 64×64 | 1.23 万 | 1228.90 万 | 168 | 73149 倍 |
| 224×224 | 15.05 万 | 1.51 亿 | 168 | 896006 倍 |
| 1024×1024 | 314.57 万 | 31.46 亿 | 168 | 18724577 倍 |
看第三列和第四列的对比:图片边长翻一倍,全连接参数量翻四倍;卷积那一列纹丝不动。224×224 是很常见的输入尺寸,光第一层就要一亿五千万个参数——这还只是一层。参数多不仅意味着显存和算力吃不消,更意味着极度容易过拟合:参数比样本还多,模型有充足的余量把训练集背下来。
第二宗罪:空间结构被丢掉
更致命的是这一条。把 3×3 的图拉平成 9 个数之后:
| 原图 | 拉平后 | 发生了什么 |
|---|---|---|
[[1,2,3],[4,5,6],[7,8,9]] | [1,2,3,4,5,6,7,8,9] | 像素 5 本来就在 2 的正下方,拉平后却隔了 2 个位置 |
对全连接层来说,输入向量的每一位都是彼此独立、地位平等的一个数字,它根本不知道第 2 位和第 5 位在原图上是紧挨着的。「相邻像素高度相关」这个图像最基本的性质,在拉平那一刻就被扔掉了,网络只能从海量数据里重新硬学一遍。
还有一个连带后果:平移不变性丢失。同一只猫出现在图片左上角和右下角,拉平后是两个完全不同的向量,全连接层得把两种情况分别学一遍。
"""全连接层处理图像为什么不可行:参数量对着算一遍就知道了。

不依赖任何第三方库,纯算术,可以直接跑出确定的数字。

两个公式:
    全连接层参数量 = 输入元素个数 × 输出神经元个数 + 输出神经元个数(偏置)
    卷积层参数量   = 卷积核个数 × (输入通道数 × 核高 × 核宽 + 1)

关键差别在于:全连接的参数量**随图片尺寸平方级增长**,
卷积的参数量**和图片多大完全无关**——同一枚印章走遍全图。
"""


def fc_params(in_elements, out_units):
    """一个全连接层的参数量。"""
    return in_elements * out_units + out_units


def conv_params(in_channels, out_channels, ksize):
    """一个卷积层的参数量。注意式子里没有 H 和 W。"""
    return out_channels * (in_channels * ksize * ksize + 1)


def human(n):
    """把参数量换算成更好理解的量级。"""
    if n >= 1e8:
        return '%.2f 亿' % (n / 1e8)
    if n >= 1e4:
        return '%.2f 万' % (n / 1e4)
    return '%d' % n


def compare(size, channels=3, hidden=1000, out_channels=6, ksize=3):
    in_elements = channels * size * size
    fc = fc_params(in_elements, hidden)
    conv = conv_params(channels, out_channels, ksize)
    return in_elements, fc, conv


if __name__ == '__main__':
    print('第一个隐藏层取 1000 个神经元,卷积层取 6 个 3×3 卷积核:\n')
    print('%-12s %-14s %-18s %-14s %s'
          % ('图片边长', '拉平后长度', '全连接参数量', '卷积参数量', '倍数'))
    for size in (32, 64, 224, 512, 1024):
        in_elements, fc, conv = compare(size)
        print('%-12s %-14s %-18s %-14s %.0f 倍'
              % ('%d×%d' % (size, size), human(in_elements),
                 human(fc), human(conv), fc / conv))

    print('\n看最后一列:图片边长翻一倍,全连接参数量翻四倍,卷积那一列纹丝不动。')

    # ------------------------------------------------------------ 第二个问题
    print('\n全连接的第二宗罪:把二维结构拍扁之后,「相邻」这件事就丢了。')
    img = [[1, 2, 3],
           [4, 5, 6],
           [7, 8, 9]]
    flat = [v for row in img for v in row]
    print('原图 3×3 :', img)
    print('拉平之后 :', flat)
    print('像素 2 在原图里上下左右分别是 %s;拉平后它的邻居只剩下 %s。'
          % ([img[1][1]], [flat[0], flat[2]]))
    print('也就是说:5 明明就在 2 的正下方,拉平后却隔了 2 个位置,')
    print('全连接层无从知道这层关系,只能从数据里硬学——这正是卷积要替它做的事。')

    # ------------------------------------------------------------ 真实网络对账
    print('\n本页 CIFAR-10 网络的卷积层参数量(和图片尺寸无关的那部分):')
    c1 = conv_params(3, 6, 3)
    c2 = conv_params(6, 16, 3)
    print('  卷积1  3 -> 6  通道,3×3 核:6 × (3×3×3 + 1) = %d' % c1)
    print('  卷积2  6 -> 16 通道,3×3 核:16 × (6×3×3 + 1) = %d' % c2)
    print('  两个卷积层合计 %d 个参数' % (c1 + c2))
    fc1 = fc_params(576, 120)
    print('  而紧随其后的一个全连接层 576 -> 120 就要 %d 个参数' % fc1)
    print('  比例:%.1f 倍。CNN 的参数大头一直在全连接层,不在卷积层。'
          % (fc1 / (c1 + c2)))
这份代码不依赖任何第三方库,直接跑就能看到上面两张表的数字。末尾还算了本页 CIFAR-10 网络的参数分布,结论有点反直觉:两个卷积层加起来只有 1048 个参数,而紧随其后的一个全连接层 576→120 就要 69240 个,是前者的 66 倍。CNN 的参数大头一直在全连接层,不在卷积层。
1.3 卷积靠哪两条性质破局
卷积对着上面两宗罪各下了一刀:
一个输出只看输入里一小块区域(印章盖住的那块),而不是全图。这既大幅削减了连接数,又天然保留了「相邻」关系——被同一次卷积盖住的像素,本来就是空间上挨着的。
同一枚印章走遍全图,所有位置共用同一套权重。参数量因此与图片尺寸脱钩;而且猫出现在哪个角落,都会被同一枚印章识别出来——平移不变性就这么来了。
| 维度 | 全连接层 | 卷积层 |
|---|---|---|
| 每个输出看多少输入 | 全部 | 只看一个局部窗口 |
| 参数量与图片尺寸 | 平方级增长 | 完全无关 |
| 空间结构 | 拉平即丢失 | 全程保持二维 |
| 物体换个位置 | 得重新学 | 同一枚核照样认得出 |
| 擅长的数据 | 结构化表格特征 | 图像等网格状、局部相关的数据 |
一个完整的 CNN 由三种层分工协作,图③画的就是这条流水线:卷积层提特征、池化层降维度、全连接层下结论。卷积和池化负责把原始像素一步步压缩成「有什么花纹」,最后交给全连接层做判定。
02原理:把每一格都算出来
卷积怎么算、尺寸怎么变、通道怎么接、池化干什么,最后串成一条完整流水线
2.1 卷积计算:对应相乘再相加
卷积运算本身极其朴素,一句话说完:把卷积核盖住的那块区域和卷积核对应位置相乘,再把所有乘积加起来,得到一个数。这个数就是输出特征图上的一格。然后印章往右挪一步,再算一格;这一行挪完,往下挪一步接着来。
以图①的情形为例:6×6 的输入、3×3 的卷积核、步长 1。印章在横向能放 4 个位置、纵向也是 4 个,所以输出是 4×4。注意输出比输入小了一圈——不补 padding 的卷积总会让图变小,这是 2.2 要处理的问题。
与其背,不如把双重循环自己写一遍。下面这份不依赖 torch,逐格打印中间结果,还顺便用循环次数反过来验证了尺寸公式:
"""手写卷积:不用 torch,把「对应相乘再相加」逐格算出来。

跑一遍这份代码,卷积就不再是黑箱了——它只是一个双重循环,
每一步取出一个和卷积核同样大小的窗口,对应位置相乘、全部加起来。

顺带把输出尺寸公式 N = (W - F + 2P) / S + 1 用实际循环次数验证一遍:
循环真正跑了多少行多少列,公式就必须给出同样的数。
"""


def conv2d(image, kernel, stride=1, padding=0, bias=0.0):
    """单通道二维卷积。image / kernel 都是二维嵌套列表。"""
    if padding > 0:
        image = pad_zeros(image, padding)

    in_h, in_w = len(image), len(image[0])
    k_h, k_w = len(kernel), len(kernel[0])

    out = []
    row = 0
    while row + k_h <= in_h:                 # 纵向滑动
        line = []
        col = 0
        while col + k_w <= in_w:             # 横向滑动
            total = 0.0
            for i in range(k_h):             # 窗口内逐格相乘再相加
                for j in range(k_w):
                    total += image[row + i][col + j] * kernel[i][j]
            line.append(total + bias)        # 每个卷积核配一个偏置
            col += stride
        out.append(line)
        row += stride
    return out


def pad_zeros(image, p):
    """四周补 p 圈 0。补完边长增加 2p,这就是公式里 +2P 的来历。"""
    width = len(image[0]) + 2 * p
    top = [[0] * width for _ in range(p)]
    middle = [[0] * p + list(r) + [0] * p for r in image]
    bottom = [[0] * width for _ in range(p)]
    return top + middle + bottom


def out_size(w, f, p, s):
    """输出尺寸公式;除不尽时向下取整(窗口伸出边界就不算这一步)。"""
    return (w - f + 2 * p) // s + 1


def show(name, mat):
    print('%s  (%d×%d)' % (name, len(mat), len(mat[0])))
    for row in mat:
        print('   ' + ' '.join('%6.1f' % v for v in row))


if __name__ == '__main__':
    # 6×6 的输入,格子里填 1..36 方便肉眼核对
    image = [[r * 6 + c + 1 for c in range(6)] for r in range(6)]
    show('输入图像', image)

    # 一枚 3×3 的「印章」:中间重、四周轻,作用是突出中心像素
    kernel = [[0, -1, 0],
              [-1, 5, -1],
              [0, -1, 0]]
    show('\n卷积核', kernel)

    # ---- 步长 1、不补零:6×6 -> 4×4,正是图①画的那个情形
    feat = conv2d(image, kernel, stride=1, padding=0)
    show('\n步长1 不补零 的特征图', feat)
    print('   公式预测边长 = (6 - 3 + 2×0) / 1 + 1 = %d,实测 %d ✔'
          % (out_size(6, 3, 0, 1), len(feat)))

    # 手算第一格验证:窗口是 [[1,2,3],[7,8,9],[13,14,15]]
    manual = (1 * 0 + 2 * (-1) + 3 * 0
              + 7 * (-1) + 8 * 5 + 9 * (-1)
              + 13 * 0 + 14 * (-1) + 15 * 0)
    print('   左上角那一格手算 = %d,代码算出 = %.0f' % (manual, feat[0][0]))

    # ---- 步长 2:窗口一次跨两格,输出边长直接减半
    feat2 = conv2d(image, kernel, stride=2, padding=0)
    show('\n步长2 不补零 的特征图', feat2)
    print('   公式预测 = (6 - 3 + 0) / 2 + 1 = %d,实测 %d ✔'
          % (out_size(6, 3, 0, 2), len(feat2)))

    # ---- 补一圈 0:尺寸被保住
    small = [[r * 5 + c + 1 for c in range(5)] for r in range(5)]
    feat3 = conv2d(small, kernel, stride=1, padding=1)
    print('\n5×5 输入,补一圈 0,步长 1 -> 输出 %d×%d' % (len(feat3), len(feat3[0])))
    print('   公式预测 = (5 - 3 + 2×1) / 1 + 1 = %d ✔' % out_size(5, 3, 1, 1))
    print('   这就是「四周补一圈 0 尺寸就保住」的由来:3×3 核配 padding=1。')

    # ---- 参数量:和图片多大没有关系
    print('\n这枚 3×3 卷积核的参数量 = 3×3 + 1 = 10 个,')
    print('无论输入是 6×6 还是 1024×1024,都是这 10 个数在反复使用。')
拿它跑一个 6×6 的输入(格子里依次填 1 到 36)和一枚 3×3 的锐化核 [[0,−1,0],[−1,5,−1],[0,−1,0]],左上角第一格的计算过程完全可以手推:印章盖住的是 [[1,2,3],[7,8,9],[13,14,15]],于是
1×0 + 2×(−1) + 3×0 + 7×(−1) + 8×5 + 9×(−1) + 13×0 + 14×(−1) + 15×0 = 8
代码算出来也是 8。整张输出是 4×4,与公式 (6−3+0)/1+1 = 4 一致。把步长改成 2,输出立刻变成 2×2,公式给的是 (6−3+0)/2+1 = 2——循环实际跑了几次,公式就必须给出几,这是本节最该建立的信心。
2.2 padding 与 stride
不补零的卷积有两个副作用:图越卷越小(每层都缩一圈,深网络卷几层就没了),以及边缘信息被冷落——角上的像素只被印章盖到一次,而中间的像素会被盖到很多次。
padding 的办法很直接:在原图四周补一圈 0 再卷。补一圈,边长增加 2(左右各一),这就是公式里 +2P 的来历。
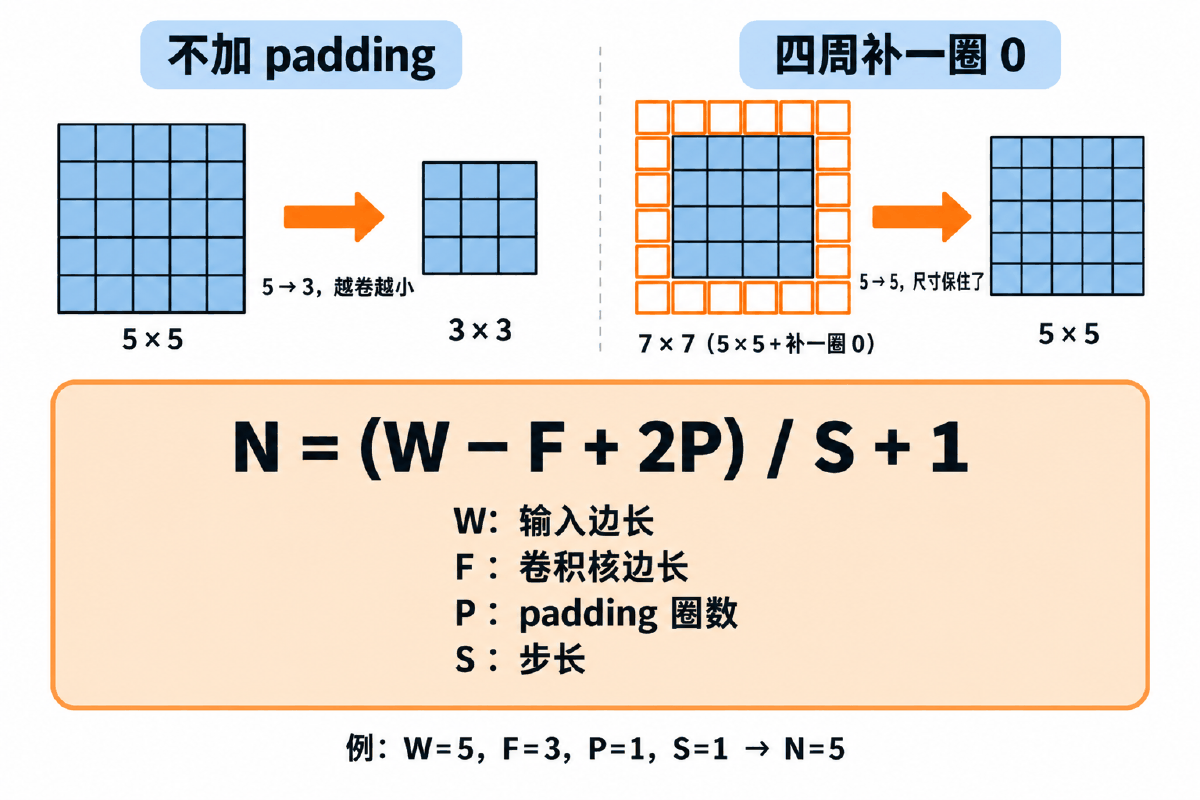
图里左右两半是同一个 5×5 输入、同一枚 3×3 核的对照:不补 padding 时 5 → 3,越卷越小;四周补一圈 0 变成 7×7 再卷,7 → 5,尺寸保住了。
stride(步长)则是印章一次挪几格。步长 1 逐格挪,输出最大;步长 2 隔一格挪,输出边长大致减半、计算量减到四分之一。它是主动降维的手段之一。
| 参数 | 调大的效果 | 典型取值 |
|---|---|---|
kernel_size F | 感受野更大,参数更多,输出更小 | 一般取奇数 3、5、7;3×3 最常用,因为它有中心点且参数少 |
stride S | 输出急剧变小,计算量下降,细节丢失 | 1 为主;要降维时用 2 |
padding P | 输出变大,边缘信息被保住 | 0 或 (F−1)/2 |
padding = (F−1)/2 配 stride = 1,输出尺寸和输入完全相同。 于是 3×3 配 padding=1、5×5 配 padding=2、7×7 配 padding=3。这也是卷积核偏爱奇数边长的原因之一——偶数核没法对称地补,还找不到中心点。想保持尺寸就用这个配比,想降维就交给池化或步长,两件事分开管,网络结构会清爽很多。
"""padding 与 stride 的组合实验:改一个参数,看特征图尺寸怎么变。

每组都先写出公式预测值,再让 PyTorch 实际算一遍,两边必须一致。
公式:N = (W - F + 2P) / S + 1,除不尽向下取整。
"""
import torch
import torch.nn as nn


def predict(w, f, p, s):
    """公式预测的输出边长。"""
    return (w - f + 2 * p) // s + 1


def check(in_size, ksize, padding, stride, in_ch=3, out_ch=8):
    """建一个卷积层实跑一次,和公式对账。"""
    conv = nn.Conv2d(in_ch, out_ch, kernel_size=ksize,
                     stride=stride, padding=padding)
    x = torch.randn(1, in_ch, in_size, in_size)
    out = conv(x)

    expect = predict(in_size, ksize, padding, stride)
    actual = out.shape[-1]
    flag = '一致' if expect == actual else '不一致'
    print('W=%-4d F=%d P=%d S=%d  公式 %-4d 实测 %-4d  %s  输出形状 %s'
          % (in_size, ksize, padding, stride, expect, actual, flag, tuple(out.shape)))
    return actual


if __name__ == '__main__':
    print('一、padding 的作用:把被卷掉的边缘补回来')
    check(5, 3, padding=0, stride=1)      # 5 -> 3,越卷越小
    check(5, 3, padding=1, stride=1)      # 5 -> 5,尺寸保住
    check(32, 3, padding=0, stride=1)     # 32 -> 30
    check(32, 3, padding=1, stride=1)     # 32 -> 32

    print('\n  规律:核边长 F 为奇数时,padding = (F-1)/2 正好让尺寸不变。')
    for f in (1, 3, 5, 7):
        p = (f - 1) // 2
        print('    F=%d -> padding=%d,此时 32×32 卷完还是 %d×%d'
              % (f, p, predict(32, f, p, 1), predict(32, f, p, 1)))

    print('\n二、stride 的作用:一步跨多远,直接决定降维速度')
    for s in (1, 2, 3):
        check(32, 3, padding=1, stride=s)
    print('  步长每翻一倍,输出边长大致减半,计算量减到四分之一。')

    print('\n三、除不尽的情况:向下取整,右下角那一条被丢掉')
    check(7, 3, padding=0, stride=2)      # (7-3)/2+1 = 3
    check(8, 3, padding=0, stride=2)      # (8-3)//2+1 = 3,和 7 一样
    print('  注意上面两行输出边长相同:边长 8 的那一列多出来的像素没人管,')
    print('  想一个不漏就得补 padding,或者让尺寸能被整除。')

    print('\n四、池化层用的是同一个公式')
    pool = nn.MaxPool2d(kernel_size=2, stride=2)
    x = torch.randn(1, 6, 30, 30)
    print('  6×30×30 经过 2×2 步长 2 的最大池化 ->', tuple(pool(x).shape))
    print('  公式:(30 - 2 + 0) / 2 + 1 = %d ' % predict(30, 2, 0, 2))
    print('  通道数 6 没变——池化对每个通道单独做。')

    print('\n五、参数量只和核大小、通道数有关,和输入尺寸无关')
    for size in (32, 224):
        conv = nn.Conv2d(3, 6, kernel_size=3)
        n = sum(p.numel() for p in conv.parameters())
        print('  输入 %d×%d 时,这个卷积层参数量 = %d' % (size, size, n))
    print('  6 × (3×3×3 + 1) = 168,两次都一样。')
2.3 输出尺寸公式
图②下半部分那个大公式,是整页最该背下来的一行:
N = (W − F + 2P) / S + 1
| 符号 | 含义 | 怎么理解 |
|---|---|---|
| W | 输入边长 | 方形输入时高宽同值;不同就分别代入算两次 |
| F | 卷积核边长 | 印章多大 |
| P | padding 圈数 | 补一圈边长加 2,所以是 2P |
| S | 步长 | 一次挪几格 |
| N | 输出边长 | 除不尽时向下取整 |
公式的来历其实就是数一数「印章能放几个位置」:去掉核自己占的 F−1 格,剩下的长度按步长切,再加上起始那一个位置。图②举的例子 W=5, F=3, P=1, S=1 代入得 (5−3+2)/1+1 = 5,尺寸保持。
「向下取整」这一条容易被忽略:W=7, F=3, P=0, S=2 算出 (7−3)/2+1 = 3;W=8 时是 (8−3)//2+1 = 3,两者输出一样大。也就是边长 8 那次多出来的一列像素根本没被算进去——窗口伸出边界的那一步直接丢弃。要一个不漏就得补 padding,或者让尺寸能被整除。
"""逐层推导特征图尺寸:把「576 是怎么来的」算给自己看。

不依赖 torch,纯算术。搭网络时先用它把每一层的形状过一遍,
比搭完跑起来再看报错快得多。

核心公式(卷积和池化共用同一个):
    N = (W - F + 2P) / S + 1     除不尽时向下取整
其中 W 输入边长、F 核边长、P padding 圈数、S 步长。
"""


def out_size(w, f, p=0, s=1):
    """算一层之后的边长。向下取整:窗口伸出边界的那一步不算数。"""
    return (w - f + 2 * p) // s + 1


class Shape:
    """记录 (通道数, 高, 宽) 并逐层推进。"""

    def __init__(self, c, h, w, name='输入'):
        self.c, self.h, self.w = c, h, w
        self.log = ['%-10s %d×%d×%d' % (name, c, h, w)]

    def conv(self, out_channels, ksize, stride=1, padding=0, name='卷积'):
        self.h = out_size(self.h, ksize, padding, stride)
        self.w = out_size(self.w, ksize, padding, stride)
        self.c = out_channels                    # 卷积核有几个,输出就有几个通道
        self.log.append('%-10s %d×%d×%d   (核 %d×%d,步长 %d,padding %d)'
                        % (name, self.c, self.h, self.w, ksize, ksize, stride, padding))
        return self

    def pool(self, ksize=2, stride=2, padding=0, name='池化'):
        self.h = out_size(self.h, ksize, padding, stride)
        self.w = out_size(self.w, ksize, padding, stride)
        # 通道数不变:池化对每个通道单独做,不像卷积会把通道加起来
        self.log.append('%-10s %d×%d×%d   (窗口 %d×%d,步长 %d)'
                        % (name, self.c, self.h, self.w, ksize, ksize, stride))
        return self

    def flatten(self):
        n = self.c * self.h * self.w
        self.log.append('%-10s %d   (= %d × %d × %d)'
                        % ('拉平', n, self.c, self.h, self.w))
        return n

    def show(self):
        for line in self.log:
            print('  ' + line)


def conv_params(in_c, out_c, k):
    return out_c * (in_c * k * k + 1)


def fc_params(in_f, out_f):
    return in_f * out_f + out_f


if __name__ == '__main__':
    print('一、公式自检(几组能手算的例子)')
    cases = [
        (5, 3, 1, 1, '补一圈 0,尺寸保住'),
        (5, 3, 0, 1, '不补零,越卷越小'),
        (6, 3, 0, 1, '印章图里的 6×6 -> 4×4'),
        (32, 3, 0, 1, 'CIFAR 第一层卷积'),
        (30, 2, 0, 2, 'CIFAR 第一层池化'),
        (7, 3, 0, 2, '步长 2,除不尽向下取整'),
    ]
    for w, f, p, s, note in cases:
        print('  W=%-4d F=%d P=%d S=%d -> N=%-4d %s'
              % (w, f, p, s, out_size(w, f, p, s), note))

    print('\n二、逐层推导 CIFAR-10 分类网络')
    shape = Shape(3, 32, 32)
    shape.conv(6, ksize=3, stride=1, padding=0, name='卷积1')
    shape.pool(2, 2, name='池化1')
    shape.conv(16, ksize=3, stride=1, padding=0, name='卷积2')
    shape.pool(2, 2, name='池化2')
    flat = shape.flatten()
    shape.show()

    print('\n  拉平后维度 = %d —— nn.Linear 的第一个参数必须写这个数' % flat)
    assert flat == 576, '和网络里写的 576 对不上,说明哪一层参数改了'
    print('  断言通过:与网络里写死的 576 一致。')

    print('\n三、这个网络的参数量分布')
    p_conv1 = conv_params(3, 6, 3)
    p_conv2 = conv_params(6, 16, 3)
    p_fc1 = fc_params(576, 120)
    p_fc2 = fc_params(120, 84)
    p_out = fc_params(84, 10)
    total = p_conv1 + p_conv2 + p_fc1 + p_fc2 + p_out
    for name, p in (('卷积1', p_conv1), ('卷积2', p_conv2), ('全连接 576→120', p_fc1),
                    ('全连接 120→84', p_fc2), ('输出 84→10', p_out)):
        print('  %-16s %7d 个  占比 %5.1f%%' % (name, p, 100.0 * p / total))
    print('  合计 %d 个参数' % total)
    print('  池化层 0 个参数——它只挑数不学东西。')

    print('\n四、改一个参数会连累后面所有层')
    print('  把两个卷积核都换成 5×5,其余不动:')
    alt = Shape(3, 32, 32)
    alt.conv(6, ksize=5, name='卷积1')
    alt.pool(2, 2, name='池化1')
    alt.conv(16, ksize=5, name='卷积2')
    alt.pool(2, 2, name='池化2')
    alt_flat = alt.flatten()
    alt.show()
    print('  拉平后变成 %d,全连接层第一个参数就得跟着改成 %d。' % (alt_flat, alt_flat))
    print('  忘了改的现象:mat1 and mat2 shapes cannot be multiplied。')
这份代码把公式包成了一个可以逐层推进的小工具,跑一遍就能看到 CIFAR-10 那条链路每一层的形状。它末尾还有一个断言:推导出来的拉平维度必须等于 576,对不上就说明哪一层参数被改过——把维度推导变成可执行的检查,比人肉套公式可靠得多。
2.4 多通道与多卷积核
前面都在讲单通道。真实图片有 3 个通道,这时候卷积核怎么办?规则只有两条,记住就不会算错:
一枚核要同时盖住所有通道:3 通道输入配的就是 3×3×3 的立体核。各通道分别相乘求和后再加到一起,所以一枚核只产出一张特征图,不管输入有几个通道。
用几枚核,输出就有几个通道。out_channels 这个参数名的字面意思就是它。每枚核学一种花纹,摞起来就是一叠特征图。
于是通道数的变化完全由 out_channels 决定,和输入通道数无关。参数量公式也随之确定:
卷积层参数量 = 核个数 × (输入通道数 × 核高 × 核宽 + 1)
括号里最后的 +1 是每枚核配的一个偏置。代入本页网络的第一层:6 × (3×3×3 + 1) = 168;第二层 16 × (6×3×3 + 1) = 880。式子里没有 H 和 W——这就是「参数量和图片多大无关」的数学表述。
"""多通道与多卷积核:通道数是怎么一步步变过去的。

两条规则,记住就不会算错:
  1. 一个卷积核的**深度必须等于输入通道数**——它要同时盖住所有通道,
     各通道分别相乘求和,最后加到一起,所以**一个核只产出一张特征图**。
  2. 用几个卷积核,输出就有几个通道。out_channels 就是卷积核的个数。

于是通道数的变化完全由 out_channels 决定,与输入通道数无关。
"""
import torch
import torch.nn as nn


def show(name, tensor):
    print('%-28s %s' % (name, tuple(tensor.shape)))


if __name__ == '__main__':
    torch.manual_seed(0)

    # ---------------------------------------------------------- 单通道 -> 单核
    print('一、最简单的情形:1 个通道,1 个卷积核')
    x1 = torch.randn(1, 1, 6, 6)          # (N, C, H, W)
    conv1 = nn.Conv2d(in_channels=1, out_channels=1, kernel_size=3)
    show('输入', x1)
    show('输出(一张特征图)', conv1(x1))
    print('  权重形状', tuple(conv1.weight.shape), '= (核个数, 输入通道, 核高, 核宽)')
    print('  参数量 = 1 × (1×3×3 + 1) =', sum(p.numel() for p in conv1.parameters()))

    # ---------------------------------------------------------- 多通道 -> 单核
    print('\n二、彩色图 3 通道,仍然只用 1 个卷积核')
    x3 = torch.randn(1, 3, 6, 6)
    conv2 = nn.Conv2d(in_channels=3, out_channels=1, kernel_size=3)
    show('输入', x3)
    show('输出(还是一张特征图)', conv2(x3))
    print('  权重形状', tuple(conv2.weight.shape), '—— 核的深度自动变成 3')
    print('  三个通道各自卷完之后**相加**成一张,所以输出通道数还是 1。')
    print('  参数量 = 1 × (3×3×3 + 1) =', sum(p.numel() for p in conv2.parameters()))

    # ---------------------------------------------------------- 多通道 -> 多核
    print('\n三、3 通道输入,6 个卷积核')
    conv3 = nn.Conv2d(in_channels=3, out_channels=6, kernel_size=3)
    show('输入', x3)
    show('输出(6 张特征图摞起来)', conv3(x3))
    print('  权重形状', tuple(conv3.weight.shape))
    print('  参数量 = 6 × (3×3×3 + 1) =', sum(p.numel() for p in conv3.parameters()))
    print('  每个核学一种花纹:有的对横边敏感,有的对竖边敏感,有的对颜色块敏感。')

    # ---------------------------------------------------------- 通道数错配
    print('\n四、in_channels 写错会怎样')
    wrong = nn.Conv2d(in_channels=1, out_channels=6, kernel_size=3)
    try:
        wrong(x3)                          # 输入 3 通道,层却声明 1 通道
    except RuntimeError as exc:
        print('  报错:', str(exc).split('\n')[0])
    print('  修法:in_channels 必须等于上一层的输出通道数,第一层等于图片通道数。')

    # ---------------------------------------------------------- 池化不改通道
    print('\n五、对比:池化层不会合并通道')
    feat = conv3(x3)
    pooled = nn.MaxPool2d(kernel_size=2, stride=2)(feat)
    show('卷积输出', feat)
    show('池化之后', pooled)
    print('  通道数 6 原封不动,只有高和宽减半——这是池化和卷积最本质的区别。')

    # ---------------------------------------------------------- 整条链路
    print('\n六、把两层串起来,看通道怎么一路变过去')
    net = nn.Sequential(
        nn.Conv2d(3, 6, kernel_size=3), nn.ReLU(),
        nn.MaxPool2d(2, 2),
        nn.Conv2d(6, 16, kernel_size=3), nn.ReLU(),
        nn.MaxPool2d(2, 2),
    )
    out = net(torch.randn(1, 3, 32, 32))
    show('3×32×32 走完两组卷积池化', out)
    print('  拉平长度 =', out.numel(), '= 16 × 6 × 6')
| 情形 | 输入 | 卷积核 | 输出 | 参数量 |
|---|---|---|---|---|
| 单通道单核 | 1×6×6 | 1 枚 1×3×3 | 1×4×4 | 1×(1×3×3+1) = 10 |
| 多通道单核 | 3×6×6 | 1 枚 3×3×3 | 1×4×4 | 1×(3×3×3+1) = 28 |
| 多通道多核 | 3×6×6 | 6 枚 3×3×3 | 6×4×4 | 6×(3×3×3+1) = 168 |
in_channels 和 out_channels 的关系理解反了。记住:in_channels 必须等于上一层的输出通道数(没得选),out_channels 是你自己定的(想要几张特征图就填几)。
2.5 池化层:只挑数,不学东西
卷积把图翻译成了特征图,但尺寸降得不够快,而且特征图里有大量冗余——某个花纹在这一小块区域出现过就行,具体在这块区域的哪一格并不重要。池化(pooling)就是把这个「大概在这一块」的信息保留下来,把精确位置扔掉。
| 类型 | API | 每个窗口取什么 | 什么时候用 |
|---|---|---|---|
| 最大池化 | nn.MaxPool2d(2, 2) | 最大值 | 默认选它;保留最显著的响应,边缘纹理类特征靠它 |
| 平均池化 | nn.AvgPool2d(2, 2) | 平均值 | 需要整体背景信息时;网络末尾的全局平均池化很常用 |
拿一个 3×3 的输入 [[0,1,2],[3,4,5],[6,7,8]] 配 2×2 窗口、步长 1 手算一遍:四个窗口的最大值分别是 4、5、7、8,平均值分别是 2、3、5、6。输出都是 2×2——池化用的是和卷积完全相同的那个尺寸公式。
"""池化层:只降维,不带参数,逐通道各池各的。"""
import torch
import torch.nn as nn

# ---------- 单通道 ----------
x = torch.tensor([[[0, 1, 2],
                   [3, 4, 5],
                   [6, 7, 8]]]).float()      # (1, 3, 3)

print('最大池化:\n', nn.MaxPool2d(kernel_size=2, stride=1, padding=0)(x))
# 每个 2×2 窗口取最大:[[4,5],[7,8]]

print('平均池化:\n', nn.AvgPool2d(kernel_size=2, stride=1, padding=0)(x))
# 每个 2×2 窗口取均值:[[2,3],[5,6]]

# ---------- 多通道 ----------
x3 = torch.tensor([[[0, 1, 2], [3, 4, 5], [6, 7, 8]],
                   [[10, 20, 30], [40, 50, 60], [70, 80, 90]],
                   [[11, 22, 33], [44, 55, 66], [77, 88, 99]]]).float()
out = nn.MaxPool2d(kernel_size=2, stride=1, padding=0)(x3)
print('多通道池化后形状', out.shape)          # (3, 2, 2)
# 通道数不变:池化对每个通道单独做,不像卷积会把通道加起来

# 池化层没有任何可学习参数
print('池化层参数量', sum(p.numel() for p in nn.MaxPool2d(2).parameters()))   # 0
池化有三条性质必须记牢,它们都和卷积相反:
| 性质 | 池化层 | 对比卷积层 |
|---|---|---|
| 参数量 | 0 个,没有任何可学习参数 | 卷积有权重和偏置要学 |
| 通道数 | 不变,每个通道单独池各的 | 卷积会把各通道加起来,通道数由核个数决定 |
| 作用 | 降维、减计算量、提升对微小位移的鲁棒性 | 提取特征 |
2.6 整条流水线
把前面所有零件按顺序串起来,就是一个完整的 CNN:
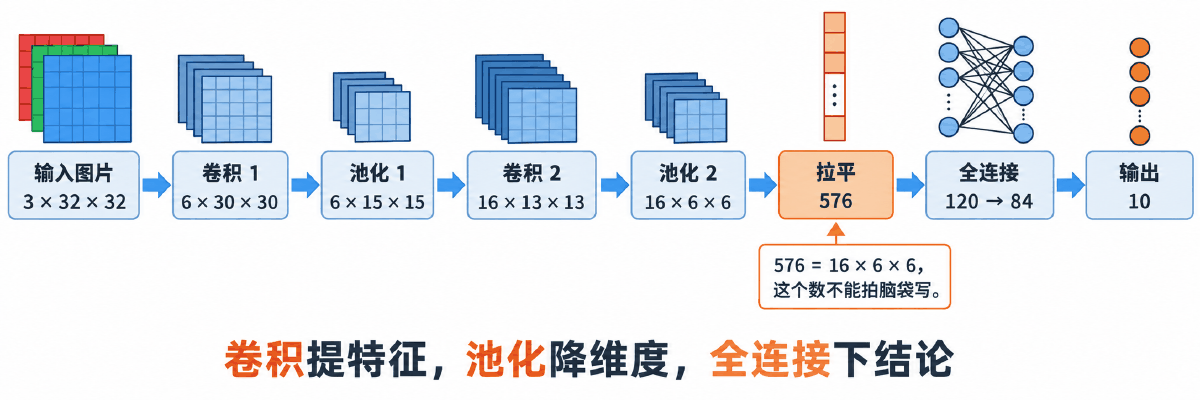
图里每一格的数字都能用 2.3 的公式推出来。逐层推导一遍(输入 3×32×32,两次卷积都是 3×3 核、步长 1、不补零,两次池化都是 2×2 窗口、步长 2):
| 层 | 输出形状 | 尺寸怎么算的 | 通道数怎么来的 |
|---|---|---|---|
| 输入 | 3×32×32 | — | RGB 三通道 |
| 卷积 1 | 6×30×30 | (32−3+0)/1+1 = 30 | 用了 6 枚核 |
| 池化 1 | 6×15×15 | (30−2+0)/2+1 = 15 | 池化不改通道 |
| 卷积 2 | 16×13×13 | (15−3+0)/1+1 = 13 | 用了 16 枚核 |
| 池化 2 | 16×6×6 | (13−2+0)/2+1 = 6 | 池化不改通道 |
| 拉平 | 576 | 16 × 6 × 6 = 576 | 三个维度全乘起来 |
| 全连接 1 | 120 | — | 自己定的宽度 |
| 全连接 2 | 84 | — | 自己定的宽度 |
| 输出 | 10 | — | 必须等于类别数 |
倒数第四行里有一处值得停一下:(13−2)/2+1 算出来是 6.5,向下取整得 6。13 是奇数,2×2 的窗口按步长 2 走到最后会剩一行一列盖不住,直接丢弃。这也是为什么 16×6×6 = 576 而不是很多人凭印象写的 16×7×7。
28 → 14 → 10 → 5,拉平维度变成 16×5×5 = 400。忘了同步改 nn.Linear 的第一个参数,报错是 mat1 and mat2 shapes cannot be multiplied。与其人肉推,不如用一次假前向量出来——cnn_skeleton.py 就是这么做的。
最后回到图底那句话:卷积提特征,池化降维度,全连接下结论。三种层各司其职,整条流水线做的事情是——把 3072 个原始像素,一步步压缩成 576 个有意义的特征,再交给全连接层判定它属于 10 个类别中的哪一个。
03最小代码:卷积层和池化层各跑一次
先把一张图送进一个卷积层,确认形状和公式对得上,再看池化
3.1 一张图进去,一叠特征图出来
这一段没有网络、没有训练,只做一件事:把一张真实图片整理成 (N, C, H, W),送进一个卷积层,打印输出形状。跑通它就说明环境和维度约定都理顺了。
"""卷积层最小例子:一张图进去,一叠特征图出来。"""
import torch
import torch.nn as nn
import matplotlib.pyplot as plt

img = plt.imread('data/img.jpg')            # (640, 640, 3),HWC

# HWC -> CHW,再在最前面补一个 batch 维,变成 (1, 3, 640, 640)
x = torch.tensor(img).permute(2, 0, 1).unsqueeze(0).to(torch.float32)
print('送进卷积层的形状', x.shape)

# in_channels 必须等于输入的通道数;out_channels 就是卷积核的个数
conv = nn.Conv2d(in_channels=3, out_channels=3,
                 kernel_size=3, stride=2, padding=0)

feature_map = conv(x)
print('特征图形状', feature_map.shape)
# 手算验证:N = (640 - 3 + 2*0) / 2 + 1 = 319(除不尽时向下取整)

# 卷积层的参数量 = 卷积核个数 × (通道数 × 核高 × 核宽 + 1 个偏置)
#               = 3 × (3 × 3 × 3 + 1) = 84,和图片多大完全无关
print('参数量', sum(p.numel() for p in conv.parameters()))
三个参数决定了这一层:in_channels 必须等于输入的通道数(彩色图是 3),out_channels 是你要用几枚卷积核,kernel_size 是印章多大。代码里 640×640 的输入配 3×3 核、步长 2、不补零,输出边长按公式是 (640−3+0)/2+1 = 319.5 → 319——向下取整,右下角那半格被丢掉。
最后一行打印参数量:3 × (3×3×3 + 1) = 84。把输入换成 1024×1024,这个数还是 84,可以自己改一行验证。
plt.imread 给出的是 HWC、0~255 的整数,而卷积层要 NCHW、float32。所以必须 permute(2,0,1) 换维、unsqueeze(0) 补批量维、.to(torch.float32) 转类型,一个都不能少。漏掉 unsqueeze 的现象是报维度不足,漏掉类型转换的现象是 expected scalar type Float。
3.2 池化:降一半尺寸,不带参数
"""池化层:只降维,不带参数,逐通道各池各的。"""
import torch
import torch.nn as nn

# ---------- 单通道 ----------
x = torch.tensor([[[0, 1, 2],
                   [3, 4, 5],
                   [6, 7, 8]]]).float()      # (1, 3, 3)

print('最大池化:\n', nn.MaxPool2d(kernel_size=2, stride=1, padding=0)(x))
# 每个 2×2 窗口取最大:[[4,5],[7,8]]

print('平均池化:\n', nn.AvgPool2d(kernel_size=2, stride=1, padding=0)(x))
# 每个 2×2 窗口取均值:[[2,3],[5,6]]

# ---------- 多通道 ----------
x3 = torch.tensor([[[0, 1, 2], [3, 4, 5], [6, 7, 8]],
                   [[10, 20, 30], [40, 50, 60], [70, 80, 90]],
                   [[11, 22, 33], [44, 55, 66], [77, 88, 99]]]).float()
out = nn.MaxPool2d(kernel_size=2, stride=1, padding=0)(x3)
print('多通道池化后形状', out.shape)          # (3, 2, 2)
# 通道数不变:池化对每个通道单独做,不像卷积会把通道加起来

# 池化层没有任何可学习参数
print('池化层参数量', sum(p.numel() for p in nn.MaxPool2d(2).parameters()))   # 0
拿 [[0,1,2],[3,4,5],[6,7,8]] 配 2×2 窗口、步长 1,四个窗口的最大值是 [[4,5],[7,8]]、平均值是 [[2,3],[5,6]],都能心算核对。多通道那一段的重点是输出通道数仍然是 3——池化对每个通道单独做,不像卷积会把通道加起来。最后一行打印池化层的参数量,结果是 0。
3.3 手算验证:不装 torch 也能跑
下面两份完全不依赖第三方库,装不了 torch 的机器上照样能跑,而且每个数字都能拿纸笔核对。第一份把卷积的双重循环写出来,逐格打印:
"""手写卷积:不用 torch,把「对应相乘再相加」逐格算出来。

跑一遍这份代码,卷积就不再是黑箱了——它只是一个双重循环,
每一步取出一个和卷积核同样大小的窗口,对应位置相乘、全部加起来。

顺带把输出尺寸公式 N = (W - F + 2P) / S + 1 用实际循环次数验证一遍:
循环真正跑了多少行多少列,公式就必须给出同样的数。
"""


def conv2d(image, kernel, stride=1, padding=0, bias=0.0):
    """单通道二维卷积。image / kernel 都是二维嵌套列表。"""
    if padding > 0:
        image = pad_zeros(image, padding)

    in_h, in_w = len(image), len(image[0])
    k_h, k_w = len(kernel), len(kernel[0])

    out = []
    row = 0
    while row + k_h <= in_h:                 # 纵向滑动
        line = []
        col = 0
        while col + k_w <= in_w:             # 横向滑动
            total = 0.0
            for i in range(k_h):             # 窗口内逐格相乘再相加
                for j in range(k_w):
                    total += image[row + i][col + j] * kernel[i][j]
            line.append(total + bias)        # 每个卷积核配一个偏置
            col += stride
        out.append(line)
        row += stride
    return out


def pad_zeros(image, p):
    """四周补 p 圈 0。补完边长增加 2p,这就是公式里 +2P 的来历。"""
    width = len(image[0]) + 2 * p
    top = [[0] * width for _ in range(p)]
    middle = [[0] * p + list(r) + [0] * p for r in image]
    bottom = [[0] * width for _ in range(p)]
    return top + middle + bottom


def out_size(w, f, p, s):
    """输出尺寸公式;除不尽时向下取整(窗口伸出边界就不算这一步)。"""
    return (w - f + 2 * p) // s + 1


def show(name, mat):
    print('%s  (%d×%d)' % (name, len(mat), len(mat[0])))
    for row in mat:
        print('   ' + ' '.join('%6.1f' % v for v in row))


if __name__ == '__main__':
    # 6×6 的输入,格子里填 1..36 方便肉眼核对
    image = [[r * 6 + c + 1 for c in range(6)] for r in range(6)]
    show('输入图像', image)

    # 一枚 3×3 的「印章」:中间重、四周轻,作用是突出中心像素
    kernel = [[0, -1, 0],
              [-1, 5, -1],
              [0, -1, 0]]
    show('\n卷积核', kernel)

    # ---- 步长 1、不补零:6×6 -> 4×4,正是图①画的那个情形
    feat = conv2d(image, kernel, stride=1, padding=0)
    show('\n步长1 不补零 的特征图', feat)
    print('   公式预测边长 = (6 - 3 + 2×0) / 1 + 1 = %d,实测 %d ✔'
          % (out_size(6, 3, 0, 1), len(feat)))

    # 手算第一格验证:窗口是 [[1,2,3],[7,8,9],[13,14,15]]
    manual = (1 * 0 + 2 * (-1) + 3 * 0
              + 7 * (-1) + 8 * 5 + 9 * (-1)
              + 13 * 0 + 14 * (-1) + 15 * 0)
    print('   左上角那一格手算 = %d,代码算出 = %.0f' % (manual, feat[0][0]))

    # ---- 步长 2:窗口一次跨两格,输出边长直接减半
    feat2 = conv2d(image, kernel, stride=2, padding=0)
    show('\n步长2 不补零 的特征图', feat2)
    print('   公式预测 = (6 - 3 + 0) / 2 + 1 = %d,实测 %d ✔'
          % (out_size(6, 3, 0, 2), len(feat2)))

    # ---- 补一圈 0:尺寸被保住
    small = [[r * 5 + c + 1 for c in range(5)] for r in range(5)]
    feat3 = conv2d(small, kernel, stride=1, padding=1)
    print('\n5×5 输入,补一圈 0,步长 1 -> 输出 %d×%d' % (len(feat3), len(feat3[0])))
    print('   公式预测 = (5 - 3 + 2×1) / 1 + 1 = %d ✔' % out_size(5, 3, 1, 1))
    print('   这就是「四周补一圈 0 尺寸就保住」的由来:3×3 核配 padding=1。')

    # ---- 参数量:和图片多大没有关系
    print('\n这枚 3×3 卷积核的参数量 = 3×3 + 1 = 10 个,')
    print('无论输入是 6×6 还是 1024×1024,都是这 10 个数在反复使用。')
第二份是维度推导器,搭网络之前先用它把每一层形状过一遍,比搭完跑起来再看报错快得多:
"""逐层推导特征图尺寸:把「576 是怎么来的」算给自己看。

不依赖 torch,纯算术。搭网络时先用它把每一层的形状过一遍,
比搭完跑起来再看报错快得多。

核心公式(卷积和池化共用同一个):
    N = (W - F + 2P) / S + 1     除不尽时向下取整
其中 W 输入边长、F 核边长、P padding 圈数、S 步长。
"""


def out_size(w, f, p=0, s=1):
    """算一层之后的边长。向下取整:窗口伸出边界的那一步不算数。"""
    return (w - f + 2 * p) // s + 1


class Shape:
    """记录 (通道数, 高, 宽) 并逐层推进。"""

    def __init__(self, c, h, w, name='输入'):
        self.c, self.h, self.w = c, h, w
        self.log = ['%-10s %d×%d×%d' % (name, c, h, w)]

    def conv(self, out_channels, ksize, stride=1, padding=0, name='卷积'):
        self.h = out_size(self.h, ksize, padding, stride)
        self.w = out_size(self.w, ksize, padding, stride)
        self.c = out_channels                    # 卷积核有几个,输出就有几个通道
        self.log.append('%-10s %d×%d×%d   (核 %d×%d,步长 %d,padding %d)'
                        % (name, self.c, self.h, self.w, ksize, ksize, stride, padding))
        return self

    def pool(self, ksize=2, stride=2, padding=0, name='池化'):
        self.h = out_size(self.h, ksize, padding, stride)
        self.w = out_size(self.w, ksize, padding, stride)
        # 通道数不变:池化对每个通道单独做,不像卷积会把通道加起来
        self.log.append('%-10s %d×%d×%d   (窗口 %d×%d,步长 %d)'
                        % (name, self.c, self.h, self.w, ksize, ksize, stride))
        return self

    def flatten(self):
        n = self.c * self.h * self.w
        self.log.append('%-10s %d   (= %d × %d × %d)'
                        % ('拉平', n, self.c, self.h, self.w))
        return n

    def show(self):
        for line in self.log:
            print('  ' + line)


def conv_params(in_c, out_c, k):
    return out_c * (in_c * k * k + 1)


def fc_params(in_f, out_f):
    return in_f * out_f + out_f


if __name__ == '__main__':
    print('一、公式自检(几组能手算的例子)')
    cases = [
        (5, 3, 1, 1, '补一圈 0,尺寸保住'),
        (5, 3, 0, 1, '不补零,越卷越小'),
        (6, 3, 0, 1, '印章图里的 6×6 -> 4×4'),
        (32, 3, 0, 1, 'CIFAR 第一层卷积'),
        (30, 2, 0, 2, 'CIFAR 第一层池化'),
        (7, 3, 0, 2, '步长 2,除不尽向下取整'),
    ]
    for w, f, p, s, note in cases:
        print('  W=%-4d F=%d P=%d S=%d -> N=%-4d %s'
              % (w, f, p, s, out_size(w, f, p, s), note))

    print('\n二、逐层推导 CIFAR-10 分类网络')
    shape = Shape(3, 32, 32)
    shape.conv(6, ksize=3, stride=1, padding=0, name='卷积1')
    shape.pool(2, 2, name='池化1')
    shape.conv(16, ksize=3, stride=1, padding=0, name='卷积2')
    shape.pool(2, 2, name='池化2')
    flat = shape.flatten()
    shape.show()

    print('\n  拉平后维度 = %d —— nn.Linear 的第一个参数必须写这个数' % flat)
    assert flat == 576, '和网络里写的 576 对不上,说明哪一层参数改了'
    print('  断言通过:与网络里写死的 576 一致。')

    print('\n三、这个网络的参数量分布')
    p_conv1 = conv_params(3, 6, 3)
    p_conv2 = conv_params(6, 16, 3)
    p_fc1 = fc_params(576, 120)
    p_fc2 = fc_params(120, 84)
    p_out = fc_params(84, 10)
    total = p_conv1 + p_conv2 + p_fc1 + p_fc2 + p_out
    for name, p in (('卷积1', p_conv1), ('卷积2', p_conv2), ('全连接 576→120', p_fc1),
                    ('全连接 120→84', p_fc2), ('输出 84→10', p_out)):
        print('  %-16s %7d 个  占比 %5.1f%%' % (name, p, 100.0 * p / total))
    print('  合计 %d 个参数' % total)
    print('  池化层 0 个参数——它只挑数不学东西。')

    print('\n四、改一个参数会连累后面所有层')
    print('  把两个卷积核都换成 5×5,其余不动:')
    alt = Shape(3, 32, 32)
    alt.conv(6, ksize=5, name='卷积1')
    alt.pool(2, 2, name='池化1')
    alt.conv(16, ksize=5, name='卷积2')
    alt.pool(2, 2, name='池化2')
    alt_flat = alt.flatten()
    alt.show()
    print('  拉平后变成 %d,全连接层第一个参数就得跟着改成 %d。' % (alt_flat, alt_flat))
    print('  忘了改的现象:mat1 and mat2 shapes cannot be multiplied。')
pip install torch torchvision;读图与显示需要 matplotlib。fc_vs_conv_params.py、conv_by_hand.py、output_size.py 三份只用标准库。CIFAR-10 案例首次运行会自动下载约 170MB 数据集,CPU 上训练一轮大约需要几十秒到几分钟,视机器而定。
04完整案例:CIFAR-10 图像十分类
从数据集到训练再到单张预测,每一层的维度都对着公式走一遍
4.1 CIFAR-10 数据集
CIFAR-10 是图像分类里最常用的入门数据集:5 万张训练图、1 万张测试图、10 个类别,每类 6000 张,图像尺寸统一是 32×32×3 的彩色小图。十个类别是飞机、汽车、鸟、猫、鹿、狗、青蛙、马、船、卡车。
torchvision.datasets 已经把它封装好了,一行就能拿到 Dataset 对象。要留意两件事:
| 要点 | 说明 |
|---|---|
transform=ToTensor() | 做两件事:HWC → CHW,并把像素从 0~255 归一到 0.0~1.0。少了它,形状和量级都不对 |
train=True / False | 分别取训练集和测试集;测试集只在最后评估用,不参与任何调参 |
.data.shape | 打印出来是 (50000, 32, 32, 3)——这是原始 HWC 形状,经 ToTensor 之后才变成 CHW |
.class_to_idx | 类别名到下标的映射,顺序由数据集固定,推理时对照它翻译预测结果,不能自己重排 |
4.2 搭网络与维度推导
网络结构就是图③那条流水线:卷积 → 池化 → 卷积 → 池化 → 拉平 → 三个全连接。每一层的参数都要和维度推导对上:
| 层 | 代码 | 输出形状 | 说明 |
|---|---|---|---|
| 卷积 1 | nn.Conv2d(3, 6, kernel_size=3, stride=1) | 6×30×30 | 输入 3 通道(没得选),输出 6 通道(自己定) |
| 池化 1 | nn.MaxPool2d(kernel_size=2, stride=2) | 6×15×15 | 通道不变,尺寸减半 |
| 卷积 2 | nn.Conv2d(6, 16, kernel_size=3, stride=1) | 16×13×13 | 输入必须写 6,等于上一层的输出通道数 |
| 池化 2 | nn.MaxPool2d(kernel_size=2, stride=2) | 16×6×6 | 13 是奇数,(13−2)/2+1 = 6.5 向下取整得 6 |
| 拉平 | x.reshape(x.size(0), -1) | 576 | 16×6×6 = 576;必须保留第 0 维 |
| 全连接 1 | nn.Linear(576, 120) | 120 | 第一个参数必须是 576 |
| 全连接 2 | nn.Linear(120, 84) | 84 | 宽度自己定 |
| 输出 | nn.Linear(84, 10) | 10 | 必须等于类别数;返回原始 logits,不加 softmax |
每个卷积之后都接一个 relu 激活,给网络加上非线性——没有激活函数的话,连着几层卷积在数学上等价于一层,深度就白搭了。
"""完整案例:CIFAR10 十分类。

5 万张 32×32 彩色训练图、1 万张测试图、10 个类别。
网络:卷积 -> 池化 -> 卷积 -> 池化 -> 拉平 -> 三个全连接。
"""
import time
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision.datasets import CIFAR10
from torchvision.transforms import ToTensor

BATCH_SIZE = 8


def create_dataset(root='data'):
    # ToTensor 做两件事:HWC -> CHW,并把像素从 0~255 归一到 0.0~1.0
    train = CIFAR10(root=root, train=True, transform=ToTensor(), download=True)
    valid = CIFAR10(root=root, train=False, transform=ToTensor(), download=True)
    return train, valid


class ImageClassification(nn.Module):
    def __init__(self):
        super().__init__()
        # 输入 3×32×32
        self.conv1 = nn.Conv2d(3, 6, kernel_size=3, stride=1)    # -> 6×30×30
        self.pool1 = nn.MaxPool2d(kernel_size=2, stride=2)       # -> 6×15×15
        self.conv2 = nn.Conv2d(6, 16, kernel_size=3, stride=1)   # -> 16×13×13
        self.pool2 = nn.MaxPool2d(kernel_size=2, stride=2)       # -> 16×6×6

        # 576 = 16 × 6 × 6,这个数是上面一路算下来的,不能拍脑袋写
        self.linear1 = nn.Linear(576, 120)
        self.linear2 = nn.Linear(120, 84)
        self.out = nn.Linear(84, 10)

    def forward(self, x):
        x = self.pool1(torch.relu(self.conv1(x)))
        x = self.pool2(torch.relu(self.conv2(x)))
        # 把 (batch, 16, 6, 6) 摊平成 (batch, 576) 才能进全连接层
        x = x.reshape(x.size(0), -1)
        x = torch.relu(self.linear1(x))
        x = torch.relu(self.linear2(x))
        return self.out(x)          # 原始 logits,softmax 交给损失函数


def train(model, train_dataset, epochs=10, lr=1e-3):
    criterion = nn.CrossEntropyLoss()
    optimizer = optim.Adam(model.parameters(), lr=lr)

    for epoch in range(epochs):
        dataloader = DataLoader(train_dataset, batch_size=BATCH_SIZE, shuffle=True)
        total_loss, sample_num, start = 0.0, 0, time.time()

        model.train()
        for x, y in dataloader:
            loss = criterion(model(x), y)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

            total_loss += loss.item() * len(y)
            sample_num += len(y)

        print('epoch %2d  loss %.5f  time %.2fs'
              % (epoch + 1, total_loss / sample_num, time.time() - start))

    torch.save(model.state_dict(), 'model/image_classification.pth')
    return model


def evaluate(valid_dataset, weight='model/image_classification.pth'):
    model = ImageClassification()
    model.load_state_dict(torch.load(weight))
    model.eval()

    dataloader = DataLoader(valid_dataset, batch_size=BATCH_SIZE, shuffle=False)
    correct, total = 0, 0
    with torch.no_grad():
        for x, y in dataloader:
            correct += (model(x).argmax(dim=-1) == y).sum().item()
            total += len(y)
    print('测试集准确率 %.4f' % (correct / total))


def main():
    train_dataset, valid_dataset = create_dataset()
    print('训练集', train_dataset.data.shape)     # (50000, 32, 32, 3)
    print('测试集', valid_dataset.data.shape)     # (10000, 32, 32, 3)
    print('类别表', train_dataset.class_to_idx)

    model = ImageClassification()
    train(model, train_dataset)
    evaluate(valid_dataset)


if __name__ == '__main__':
    main()
4.3 训练与评估
训练部分和上一页的五步骨架一模一样:前向 → 算损失 → 清零 → 反向 → 更新。换成图像任务之后,主循环一个字都没改,这正是值得注意的地方——CNN 换掉的只是 forward 里那串运算,训练逻辑是通用的。
| 配置 | 本例取值 | 为什么 |
|---|---|---|
| 损失函数 | nn.CrossEntropyLoss() | 多分类标准选择;内部含 log_softmax,所以网络输出层不加 softmax |
| 优化器 | optim.Adam(lr=1e-3) | 默认首选,省去手调学习率的功夫 |
| batch_size | 8 | 小 batch 在 CPU 上也跑得动;显存够可以调大,同时把学习率一起放大 |
| 损失统计 | loss.item() * len(y) | 按样本数加权,最后一个不满的 batch 才不会把均值带偏 |
| 保存 | model.state_dict() | 存权重字典而不是整个对象,换环境不会因类路径变化而加载失败 |
评估函数里有三句必写:model.eval() 切换模式、with torch.no_grad() 关掉梯度、argmax(dim=-1) 把 10 个分数里最大的那个下标取出来当预测类别。准确率就是「预测下标 == 真实标签」的比例。
拿什么判断训练是不是真的在进步
和上一页同一个道理:看的不是损失的绝对值,而是趋势和独立指标。损失在降但测试准确率不动,多半是过拟合开始了;损失降不动且准确率接近 10%(十个类别瞎猜的水平),那是根本没学起来,先去查数据和标签有没有对齐。
4.4 单张图片预测
训练脚本和推理脚本是两份东西。推理这一侧最容易漏的四件事,每一件漏了都不报错、只是结果错:
网络类的定义要和训练时一模一样,连层的属性名都不能改——load_state_dict 是按名字对号入座的,改了名字直接报 key 不匹配。
model.eval()否则 Dropout 还在随机失活、BN 还在用当前批的统计量,同一张图连问两次答案不同。
torch.no_grad()推理不需要梯度,关掉能省内存也更快。
训练时 ToTensor 做了 HWC→CHW 和除以 255,推理时必须做一模一样的两步,少一步就是静默出错。
"""用训练好的权重对单张图片做预测:推理阶段的完整姿势。

训练脚本和推理脚本是两份东西,推理这一侧最容易漏的四件事:
  1. 网络结构必须和训练时**完全一致**,否则 load_state_dict 直接报 key 不匹配;
  2. 必须 model.eval(),否则 Dropout 还在随机失活,同一张图连问两次答案不同;
  3. 必须 torch.no_grad(),推理不需要梯度,省内存也更快;
  4. 预处理必须和训练时**逐字一致**——训练时怎么归一化,这里就怎么归一化。
"""
import os

import torch
import torch.nn as nn

# CIFAR-10 的类别顺序由数据集固定,不能自己重排
CLASSES = ['airplane', 'automobile', 'bird', 'cat', 'deer',
           'dog', 'frog', 'horse', 'ship', 'truck']
CN = ['飞机', '汽车', '鸟', '猫', '鹿', '狗', '青蛙', '马', '船', '卡车']

WEIGHT = os.environ.get('CIFAR_WEIGHT', 'model/image_classification.pth')


class ImageClassification(nn.Module):
    """必须和训练脚本里的定义一模一样,连层的属性名都不能改。"""

    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(3, 6, kernel_size=3, stride=1)    # 3×32×32 -> 6×30×30
        self.pool1 = nn.MaxPool2d(kernel_size=2, stride=2)       # -> 6×15×15
        self.conv2 = nn.Conv2d(6, 16, kernel_size=3, stride=1)   # -> 16×13×13
        self.pool2 = nn.MaxPool2d(kernel_size=2, stride=2)       # -> 16×6×6
        self.linear1 = nn.Linear(576, 120)                       # 576 = 16×6×6
        self.linear2 = nn.Linear(120, 84)
        self.out = nn.Linear(84, 10)

    def forward(self, x):
        x = self.pool1(torch.relu(self.conv1(x)))
        x = self.pool2(torch.relu(self.conv2(x)))
        x = x.reshape(x.size(0), -1)
        x = torch.relu(self.linear1(x))
        x = torch.relu(self.linear2(x))
        return self.out(x)


def load_model(weight=WEIGHT):
    model = ImageClassification()
    state = torch.load(weight, map_location='cpu')
    model.load_state_dict(state)
    model.eval()                      # 第 2 件事:切到评估模式
    return model


def preprocess(img_hwc):
    """把 (H, W, C)、取值 0~255 的图片变成网络要的 (1, 3, 32, 32)、0.0~1.0。

    这两步必须和训练时的 ToTensor() 完全对齐:
      ToTensor 做的就是「HWC -> CHW」+「除以 255」。
    少做一步归一化,预测结果会错得莫名其妙而且不报错。
    """
    x = torch.as_tensor(img_hwc, dtype=torch.float32)
    if x.max() > 1.5:                 # 还是 0~255 的量纲就归一化
        x = x / 255.0
    x = x.permute(2, 0, 1)            # HWC -> CHW
    return x.unsqueeze(0)             # 补出 batch 维


@torch.no_grad()                      # 第 3 件事:整个函数都不追踪梯度
def predict(model, x, topk=3):
    logits = model(x)                            # 原始分数,不是概率
    probs = torch.softmax(logits, dim=1)[0]      # 推理阶段自己补 softmax
    values, indices = probs.topk(topk)
    return [(CLASSES[i], CN[i], v.item()) for v, i in zip(values, indices)]


def main():
    if not os.path.exists(WEIGHT):
        print('找不到权重文件 %s,先跑训练脚本,或用环境变量 CIFAR_WEIGHT 指定路径' % WEIGHT)
        return

    model = load_model()
    print('参数量', sum(p.numel() for p in model.parameters()))

    # 真实使用时把这里换成 plt.imread('xxx.jpg') 读进来的数组,
    # 尺寸不是 32×32 的要先缩放,否则拉平维度对不上。
    fake = torch.randint(0, 256, (32, 32, 3))
    x = preprocess(fake)
    print('送进网络的形状', tuple(x.shape))

    for name, cn, p in predict(model, x):
        print('  %-12s %-4s %.2f%%' % (name, cn, p * 100))

    # 验证 eval() 确实生效:同一张图连问两次,结果必须完全一致
    a = predict(model, x)
    b = predict(model, x)
    print('两次预测是否完全一致:', a == b)


if __name__ == '__main__':
    main()
代码里有两处值得单独说。一是 softmax 在推理阶段才补上:训练时交给 CrossEntropyLoss,网络输出的是原始 logits;要给人看「有多大把握」时,才自己调 torch.softmax 把分数转成概率。二是末尾那个自检——同一张图连续预测两次,结果必须完全一致,这是验证 eval() 确实生效的标准手法,三行代码就能确诊线上模型状态是否正确。
WEIGHT = os.environ.get('CIFAR_WEIGHT', 'model/image_classification.pth'),给了默认值又允许覆盖。路径、密钥、口令一律走环境变量,这样同一份脚本在本机和服务器上都不用改。
05骨架模板:换任务只改三处
一份把拉平维度交给代码自己量的 CNN 模板,改通道数和层数都不用重新手推
4.2 那份网络把 576 写死在了 nn.Linear 里。它没错,但只要动一下卷积核大小、层数或输入尺寸,这个数就得重算,忘了改就是一个 mat1 and mat2 shapes cannot be multiplied。下面这份模板换了个思路:用一次假前向把拉平维度问出来,从此再也不用手推。
"""CNN 骨架模板:改通道数和层数,拉平那一步用代码自动算,别手填。"""
import torch
import torch.nn as nn


class MyCNN(nn.Module):
    def __init__(self, in_channels=3, image_size=32, n_class=10):
        super().__init__()

        # TODO: 按需要增减「卷积 + 激活 + 池化」块;通道数一般逐层翻倍
        self.features = nn.Sequential(
            nn.Conv2d(in_channels, 16, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2),

            nn.Conv2d(16, 32, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2),
        )

        # 用一次假前向把拉平后的长度问出来,比人肉套公式可靠
        with torch.no_grad():
            dummy = torch.zeros(1, in_channels, image_size, image_size)
            flat_dim = self.features(dummy).flatten(1).shape[1]
        print('拉平后维度 =', flat_dim)

        # TODO: 分类头的宽度按任务调
        self.classifier = nn.Sequential(
            nn.Linear(flat_dim, 128),
            nn.ReLU(),
            nn.Dropout(p=0.3),
            nn.Linear(128, n_class),       # 不加 softmax,交给 CrossEntropyLoss
        )

    def forward(self, x):
        x = self.features(x)
        x = x.flatten(1)                   # 等价 x.reshape(x.size(0), -1)
        return self.classifier(x)


if __name__ == '__main__':
    net = MyCNN()
    print(net(torch.randn(4, 3, 32, 32)).shape)    # torch.Size([4, 10])
    print('参数量', sum(p.numel() for p in net.parameters()))
核心那三行
模板里最关键的是构造函数里的这一段:拿一个全 0 的假输入走一遍特征提取部分,量出它出来时有多长,再拿这个数去建全连接层。
| 这一行 | 在干什么 |
|---|---|
with torch.no_grad(): | 这只是一次测量,不需要梯度,也不该污染任何状态 |
dummy = torch.zeros(1, in_channels, image_size, image_size) | 造一条假样本;内容无所谓,形状才是关键,所以用全 0 最省事 |
flat_dim = self.features(dummy).flatten(1).shape[1] | 走一遍卷积池化,拉平,读出长度。这就是那个「不能拍脑袋写」的数 |
好处很实在:把两个卷积核从 3×3 改成 5×5,或者把输入从 32×32 换成 64×64,只改一个参数,后面全自动跟上。output_size.py 那份推导器是给人看的,这一段是给代码用的,两者互为验证。
换任务要改哪三处
| 位置 | 默认值 | 换任务时改成 |
|---|---|---|
in_channels | 3 | 灰度图改 1;多光谱等特殊数据按实际通道数填 |
image_size | 32 | 输入图片的边长;改了它拉平维度会自动跟着变,不用手算 |
n_class | 10 | 类别数。二分类可以填 2 配 CrossEntropyLoss |
features 里的块 | 两组卷积池化 | 要更强的特征提取就增加块数,通道数一般逐层翻倍(16→32→64) |
nn.Sequential 把「卷积 + 激活 + 池化」打包成块,加层就是复制一块 · ② 卷积配 padding=1 让尺寸只由池化决定,维度变化一眼看得清 · ③ 拉平维度由代码自己量,改结构不会漏改 · ④ 分类头末尾不加 softmax,交给 CrossEntropyLoss。
transform 里加。
搭完先做两个检查
网络写完、开跑之前,花十秒钟做这两件事,能挡掉绝大多数维度类问题:
| 检查 | 怎么做 | 期望看到 |
|---|---|---|
| 一、形状能过 | 拿一个随机 batch 前向一次:net(torch.randn(4, 3, 32, 32)).shape | torch.Size([4, 10])——第 0 维是 batch,第 1 维是类别数 |
| 二、参数量合理 | sum(p.numel() for p in net.parameters()) | 和预期量级一致;大得离谱通常意味着拉平维度或某层宽度写错了 |
模板文件末尾的 __main__ 就是这两句。先让形状跑通,再去接数据——拿真实数据调试维度问题,等于每次试错都要多等几十秒的数据加载。
06易错点汇总
按「维度约定 / 尺寸推导 / 通道接驳 / 层配置 / 训练与推理」五类归并,每条都给现象和修法
⚠️ 一、维度约定
- 把
(H, W, C)直接喂进卷积层。 现象:报输入维度不对。读图库给的是 HWC,PyTorch 要 NCHW。修法:permute(2, 0, 1)把通道提到最前。 - 忘了补 batch 维。 现象:单张图片前向时报维度不足。修法:
x.unsqueeze(0)——网络永远按「一批」处理数据,哪怕这一批只有一张。 - 忘了转
float32。 现象:expected scalar type Float but found Byte。图片读进来是 0~255 的整数。修法:.to(torch.float32),同时别忘了除以 255。 - 以为
.data.shape就是网络看到的形状。 CIFAR-10 打印出来是(50000, 32, 32, 3),那是原始 HWC;经ToTensor()之后才变成 CHW。两者别混。 - 推理时漏掉归一化。 现象:不报错,但预测结果毫无道理。训练时除了 255,推理时没除,量级差了两百多倍。修法:把预处理封装成一个函数,训练和推理共用同一个。
⚠️ 二、尺寸推导
- 拉平维度拍脑袋写。 现象:
mat1 and mat2 shapes cannot be multiplied (4x576 and 400x120)——报错信息里那两个数就是答案:实际是 576,你写了 400。修法:按公式逐层推,或用假前向量出来。 - 忘了向下取整。
(13−2)/2+1 = 6.5,实际是 6 不是 7。很多人凭印象写16×7×7。修法:奇数边长遇到步长 2 时特别留意,窗口伸出边界的那一步直接丢弃。 - 改了卷积核大小却没改全连接层。 3×3 换 5×5,同一条链路从
30→15→13→6变成28→14→10→5,拉平维度从 576 变 400。修法:用cnn_skeleton.py那种自动量取的写法。 - 换了输入尺寸就全盘崩。 32×32 的网络直接喂 64×64,拉平维度完全不同。修法:把
image_size做成参数,拉平维度由代码算。 - 以为 padding=1 总能保持尺寸。 只有 3×3 核配步长 1 时才成立。通式是
padding = (F−1)/2且stride=1。
⚠️ 三、通道接驳
- 后一层的
in_channels没跟上前一层的out_channels。 现象:expected input to have N channels, but got M channels。修法:in_channels没得选(必须等于上一层输出),out_channels才是你自己定的。 - 以为 3 通道输入配 1 枚核会出 3 个通道。 实际出 1 个——三个通道卷完之后相加成一张。输出通道数只由核的个数决定。
- 以为池化会改变通道数。 不会。池化对每个通道单独做,通道数进出一致;只有卷积会合并通道。
- 第一层的
in_channels写错。 彩色图是 3,灰度图是 1。拿灰度数据配in_channels=3会直接报错。
⚠️ 四、层配置
- 卷积之间忘了加激活函数。 现象:不报错,但深度白搭——连着几层线性运算在数学上等价于一层。修法:每个卷积后接
relu。 - 拉平时写成
reshape(-1)。 现象:batch 维被揉掉,(4,16,6,6)变成一根 2304 长的向量。修法:reshape(x.size(0), -1)或x.flatten(1),永远保留第 0 维。 - 输出层后面加了 softmax。 现象:损失降得极慢且查不出原因。
CrossEntropyLoss内部已含log_softmax。修法:训练时输出原始 logits,要概率时在推理阶段自己补。 - 输出层维度不等于类别数。 十分类却写
nn.Linear(84, 1)。修法:最后一层的输出维度必须等于类别数。 - 在卷积层上用普通 Dropout。 效果有限——特征图空间相关性强,随机丢单个像素作用不大。修法:要用就用
Dropout2d整通道丢,或者干脆只在全连接部分用。 - 核大小取偶数。 偶数核没有中心点,也没法对称补 padding。修法:取 3、5、7 这类奇数。
⚠️ 五、训练与推理
- 推理前忘了
model.eval()。 现象:同一张图连问两次答案不同,准确率虚低,不报任何错。修法:加载权重之后立刻切换,并用「连续预测两次结果是否相同」自检。 - 推理时没包
torch.no_grad()。 现象:内存占用远高于预期,速度也慢。修法:包上,或用@torch.no_grad()装饰器。 - 推理脚本里的网络结构和训练时不一致。 现象:
load_state_dict报 missing/unexpected keys。层的属性名也算结构的一部分,改名同样会报错。 - 保存了整个 model 对象而不是
state_dict()。 换环境时可能因为类路径变了而加载失败。修法:存state_dict(),加载前先把类定义好。 - 拿测试集反复调参。 调着调着测试集就变成训练集的一部分了。修法:另划验证集调参,测试集只在最后用一次。
- 准确率接近 10% 还在调网络。 十分类瞎猜就是 10%,说明根本没学起来。修法:先查数据——标签是否对齐、归一化是否做了、标签 dtype 是不是
int64。
把报错现场跑一遍
上面的条目读一遍记不住,自己触发一遍就记住了。下面这份把五种最常见的维度问题全部原地复现,用 try/except 抓住并打印报错原文,跑到底不会中断,每一种后面紧跟修法:
"""CNN 里五种形状报错的原地复现:每一种都先触发、再打印修法。

全部用 try/except 抓住,跑到底不会中断。读一遍不如自己触发一遍。
"""
import torch
import torch.nn as nn


def case(title):
    print('\n' + '=' * 60)
    print(title)


if __name__ == '__main__':
    torch.manual_seed(0)

    # ------------------------------------------------------------ 一
    case('一、把 (H, W, C) 直接喂进卷积层')
    hwc = torch.randn(32, 32, 3)          # 图像库给出的顺序
    conv = nn.Conv2d(3, 6, kernel_size=3)
    try:
        conv(hwc)
    except RuntimeError as exc:
        print('报错:', str(exc).split('\n')[0])
    fixed = hwc.permute(2, 0, 1).unsqueeze(0)     # HWC -> CHW -> 补 batch 维
    print('修法:permute(2,0,1).unsqueeze(0) ->', tuple(fixed.shape))
    print('输出:', tuple(conv(fixed).shape))

    # ------------------------------------------------------------ 二
    case('二、忘了补 batch 维,单张图片直接送进去')
    chw = torch.randn(3, 32, 32)
    try:
        conv(chw)
    except RuntimeError as exc:
        print('报错:', str(exc).split('\n')[0])
    print('修法:x.unsqueeze(0) ->', tuple(conv(chw.unsqueeze(0)).shape))
    print('说明:网络永远按「一批」处理数据,哪怕这一批只有一张。')

    # ------------------------------------------------------------ 三
    case('三、拉平后的维度写错(最高频的一种)')

    class WrongFlat(nn.Module):
        def __init__(self, flat_dim):
            super().__init__()
            self.conv1 = nn.Conv2d(3, 6, kernel_size=3)
            self.pool1 = nn.MaxPool2d(2, 2)
            self.conv2 = nn.Conv2d(6, 16, kernel_size=3)
            self.pool2 = nn.MaxPool2d(2, 2)
            self.fc = nn.Linear(flat_dim, 120)

        def forward(self, x):
            x = self.pool1(torch.relu(self.conv1(x)))
            x = self.pool2(torch.relu(self.conv2(x)))
            x = x.reshape(x.size(0), -1)
            return self.fc(x)

    x = torch.randn(4, 3, 32, 32)
    try:
        WrongFlat(400)(x)                 # 400 是 5×5 核网络的数,这里该是 576
    except RuntimeError as exc:
        print('报错:', str(exc).split('\n')[0])
    print('修法一:按公式推 16×6×6 = 576')
    print('输出:', tuple(WrongFlat(576)(x).shape))
    print('修法二(更稳):用一次假前向把这个数问出来,见下面 probe_flat_dim')

    # ------------------------------------------------------------ 四
    case('四、拉平时用了 reshape(-1) 而不是 reshape(batch, -1)')
    feat = torch.randn(4, 16, 6, 6)
    wrong = feat.reshape(-1)              # 把整个 batch 揉成一根长向量
    right = feat.reshape(feat.size(0), -1)
    print('reshape(-1)          ->', tuple(wrong.shape), ' batch 维没了')
    print('reshape(size(0), -1) ->', tuple(right.shape), ' 正确')
    fc = nn.Linear(576, 120)
    try:
        fc(wrong)
    except RuntimeError as exc:
        print('报错:', str(exc).split('\n')[0])
    print('修法:永远保留第 0 维,或者直接用 x.flatten(1)')

    # ------------------------------------------------------------ 五
    case('五、上一层输出通道和下一层输入通道接不上')
    bad = nn.Sequential(
        nn.Conv2d(3, 6, kernel_size=3),
        nn.Conv2d(8, 16, kernel_size=3),   # 上一层出 6 通道,这里却写 8
    )
    try:
        bad(torch.randn(1, 3, 32, 32))
    except RuntimeError as exc:
        print('报错:', str(exc).split('\n')[0])
    print('修法:后一层的 in_channels 必须等于前一层的 out_channels。')

    # ------------------------------------------------------------ 通用工具
    case('通用工具:与其手推,不如让代码自己量一遍')

    def probe_flat_dim(features, in_channels=3, image_size=32):
        """拿一个全 0 的假输入走一遍特征提取部分,量出拉平后的长度。"""
        with torch.no_grad():
            dummy = torch.zeros(1, in_channels, image_size, image_size)
            return features(dummy).flatten(1).shape[1]

    features = nn.Sequential(
        nn.Conv2d(3, 6, kernel_size=3), nn.ReLU(), nn.MaxPool2d(2, 2),
        nn.Conv2d(6, 16, kernel_size=3), nn.ReLU(), nn.MaxPool2d(2, 2),
    )
    print('3×32×32 输入下量出来的拉平维度 =', probe_flat_dim(features))
    print('换成 5×5 的核再量一次:')
    features5 = nn.Sequential(
        nn.Conv2d(3, 6, kernel_size=5), nn.ReLU(), nn.MaxPool2d(2, 2),
        nn.Conv2d(6, 16, kernel_size=5), nn.ReLU(), nn.MaxPool2d(2, 2),
    )
    print('拉平维度 =', probe_flat_dim(features5))
    print('这样改核大小、加层、换输入尺寸都不用重新手推。')

    # ------------------------------------------------------------ 逐层打印
    case('排错习惯:在 forward 里逐层打印形状')

    class Verbose(nn.Module):
        def __init__(self, verbose=True):
            super().__init__()
            self.verbose = verbose
            self.conv1 = nn.Conv2d(3, 6, kernel_size=3)
            self.pool1 = nn.MaxPool2d(2, 2)
            self.conv2 = nn.Conv2d(6, 16, kernel_size=3)
            self.pool2 = nn.MaxPool2d(2, 2)

        def forward(self, x):
            steps = [('输入', x)]
            x = torch.relu(self.conv1(x)); steps.append(('卷积1', x))
            x = self.pool1(x);             steps.append(('池化1', x))
            x = torch.relu(self.conv2(x)); steps.append(('卷积2', x))
            x = self.pool2(x);             steps.append(('池化2', x))
            x = x.flatten(1);              steps.append(('拉平', x))
            if self.verbose:
                for name, t in steps:
                    print('  %-8s %s' % (name, tuple(t.shape)))
            return x

    Verbose()(torch.randn(4, 3, 32, 32))
    print('把这段打印留在开发期,定稿前把 verbose 关掉即可。')
文件末尾还给了两个通用工具:probe_flat_dim() 用假前向量出拉平维度,以及一个带 verbose 开关的网络——在 forward 里逐层打印形状。维度对不上时,与其盯着报错信息猜,不如把每一层的实际形状打出来,一眼就能看到是在哪一层开始跑偏的。开发期留着,定稿前把开关关掉即可。
mat1 and mat2 shapes cannot be multiplied (4x576 and 400x120) 这一行里:4x576 是数据真实的样子,400x120 是你写的全连接层。576 就是正确答案,直接把 400 改成 576 即可。维度类报错几乎都自带答案,先逐字读完再动手改。
07自测题
点击题目展开答案;这 11 题都能说清楚,这一页就通了
全连接层处理图像有哪两个致命问题?
一是参数爆炸:参数量 = 输入元素个数 × 输出神经元个数,随图片边长平方级增长。224×224 的彩色图拉平是 150528 个数,配 1000 个神经元的第一层就要 1.51 亿个参数,而同样输入下 6 个 3×3 卷积核只要 168 个。二是空间结构被丢掉:拉平之后每一位都是彼此独立的数字,「像素 5 在像素 2 的正下方」这个关系消失了,连带平移不变性也没了——同一只猫换个位置就得重新学一遍。
卷积靠哪两条性质解决上面的问题?
局部连接:一个输出只看输入里一个小窗口,既削减连接数,又天然保留「相邻」关系。权值共享:同一枚卷积核走遍全图,所有位置共用同一套权重,于是参数量与图片尺寸完全脱钩,而且物体出现在哪个角落都会被同一枚核识别出来。
一个 CNN 里参数最多的通常是哪一类层?
全连接层,不是卷积层。本页网络里两个卷积层加起来只有 168 + 880 = 1048 个参数,而紧随其后的 nn.Linear(576, 120) 一层就有 576×120+120 = 69240 个,是前者的 66 倍,占全网参数的 85%。卷积层负责的是「提特征」,它省参数正是靠权值共享。
写出输出尺寸公式,并说明每个符号的含义和取整规则。
N = (W − F + 2P) / S + 1。W 输入边长、F 卷积核边长、P padding 圈数(补一圈边长加 2,所以是 2P)、S 步长、N 输出边长。除不尽时向下取整——窗口伸出边界的那一步直接丢弃。例:W=5, F=3, P=1, S=1 得 (5−3+2)/1+1 = 5,尺寸保持不变。
6×6 的输入配 3×3 卷积核、步长 1、不补零,输出多大?步长改成 2 呢?
步长 1 时 (6−3+0)/1+1 = 4,输出 4×4(就是图①画的情形)。步长 2 时 (6−3+0)/2+1 = 2.5 → 2,输出 2×2。步长每翻一倍,输出边长大致减半、计算量减到四分之一。
要让卷积后尺寸不变,padding 该配多少?为什么卷积核偏爱奇数边长?
核边长 F 为奇数时,padding = (F−1)/2 配 stride = 1 即可保持尺寸:3×3 配 1、5×5 配 2、7×7 配 3。偏爱奇数有两个原因:偶数核没有中心点,定位时会有半格偏移;也没法对称地补 padding(左右要补的圈数不等)。
3 通道输入配 1 枚卷积核,输出有几个通道?参数量是多少?
输出 1 个通道。核的深度会自动等于输入通道数(变成 3×3×3 的立体核),三个通道各自卷完之后相加成一张特征图,所以一枚核只产出一张。参数量 = 1 × (3×3×3 + 1) = 28。输出通道数只由核的个数决定,和输入通道数无关。
池化层有多少可学习参数?它会改变通道数吗?
0 个参数——它只是在每个窗口里挑最大值或算平均值,没有任何东西要学。通道数也不变:池化对每个通道单独做,进出通道数一致。这两点都和卷积相反:卷积有权重要学,而且会把各通道加起来、用核的个数决定输出通道数。
池化为什么能提升对微小位移的鲁棒性?代价是什么?
2×2 最大池化只关心「这四格里最大的是多少」。物体在图上挪动一两个像素,最大值往往还落在同一个窗口里,输出不变——这就是 CNN 对小幅平移、轻微形变不敏感的直接来源。代价是精确位置信息被丢弃,所以需要精确定位的任务(分割、检测)会谨慎使用池化。
输入 3×32×32,两次「3×3 卷积(步长1、不补零)+ 2×2 池化(步长2)」,第二次卷积用 16 个核。逐层推出拉平维度。
卷积1:(32−3)/1+1 = 30 → 6×30×30;池化1:(30−2)/2+1 = 15 → 6×15×15;卷积2:(15−3)/1+1 = 13 → 16×13×13;池化2:(13−2)/2+1 = 6.5 → 6 → 16×6×6。拉平 = 16 × 6 × 6 = 576。注意池化2那一步要向下取整,13 是奇数,最后一行一列盖不住直接丢弃,所以是 6 不是 7。
报错 mat1 and mat2 shapes cannot be multiplied (4x576 and 400x120),问题在哪、怎么改、怎么从根上避免?
拉平维度写错了:4x576 是数据真实的样子(batch=4,特征 576),400x120 是你写的全连接层。把 nn.Linear(400, 120) 改成 nn.Linear(576, 120) 即可。维度类报错几乎都自带答案。 从根上避免的办法是别手写这个数——用一次假前向量出来:self.features(torch.zeros(1,3,32,32)).flatten(1).shape[1],之后改核大小、加层、换输入尺寸都不用重推。
卷积层之间为什么必须加激活函数?CNN 的输出层要加 softmax 吗?
必须加激活(通常是 relu),否则连着几层线性运算在数学上等价于一层,加深度就白搭了,而且不会报任何错。输出层不加 softmax:CrossEntropyLoss 内部已经含了 log_softmax,重复加会把梯度压平,表现为损失降得极慢还查不出原因。要给人看概率时,在推理阶段自己调 torch.softmax。
词术语表
| 术语 | 含义 |
|---|---|
| 像素 pixel | 图像的最小单位,取值 [0, 255];0 最暗,255 最亮 |
| 通道 channel | 彩色图由 RGB 三个通道叠加;灰度图只有 1 个通道 |
| HWC | (高, 宽, 通道),matplotlib / OpenCV / PIL 读图给出的顺序 |
| NCHW | (批量, 通道, 高, 宽),PyTorch 卷积层唯一认的排列 |
| ToTensor() | 一次做两件事:HWC → CHW,并把像素归一到 0.0~1.0 |
| 卷积核 kernel / filter | 一小块权重矩阵,常见 3×3、5×5;数值由训练学出来 |
| 卷积运算 | 核盖住的区域与核对应相乘再相加,得到输出的一格 |
| 特征图 feature map | 卷积层的输出;一枚核产出一张 |
| 局部连接 | 每个输出只看输入的一个小窗口,保留空间相邻关系 |
| 权值共享 | 同一枚核走遍全图;参数量与图片尺寸无关的根本原因 |
| 平移不变性 | 物体出现在图片哪个位置都能被同一枚核识别出来 |
| 步长 stride | 核每次滑动几格;调大则输出变小、计算量下降 |
| padding | 四周补 0 圈数;防止图越卷越小、边缘信息被冷落 |
| 输出尺寸公式 | N = (W − F + 2P) / S + 1,除不尽向下取整 |
| in_channels | 输入通道数,必须等于上一层的输出通道数,没得选 |
| out_channels | 卷积核的个数,也就是输出通道数;由你自己定 |
| 卷积层参数量 | 核个数 × (输入通道数 × 核高 × 核宽 + 1);式子里没有 H 和 W |
| 池化 pooling | 每个窗口只留最大值或平均值;0 参数、不改通道数 |
| 最大池化 MaxPool2d | 取窗口最大值,保留最显著响应;默认选它 |
| 平均池化 AvgPool2d | 取窗口平均值,保留整体背景信息 |
| 拉平 flatten | 把 (C, H, W) 摊成一根向量交给全连接层;必须保留 batch 维 |
| 感受野 | 输出上一个点能「看到」的原图范围;层数越深、核越大,感受野越大 |
| CIFAR-10 | 5 万训练图 + 1 万测试图、10 类、尺寸 32×32×3 的经典图像分类数据集 |
| logits | 输出层给出的原始分数;训练时直接交给 CrossEntropyLoss,不加 softmax |
N = (W − F + 2P) / S + 1 唯一确定。拉平后的那个数必须算出来:本页是 576,等于 16 × 6 × 6,改了任何一处结构都得重算——或者干脆交给一次假前向去量。