AI 论文精读、复现与撰写
把一篇论文当成一套房子:先找房、再验房、然后自己盖房、最后交房验收——每一步都有可执行动作和硬性产出。
30″30 秒看懂论文这件事
把一篇论文当成一套房子:作者是开发商,你是买家。中介网站上那张照片和一句话简介,就是标题和摘要——它只负责把你骗进门,不负责对你的居住体验负责。
没经验的人进门就开始感慨装修真漂亮,出来说「这篇写得真好」。有经验的人掏出卷尺和验房清单:墙体承重够不够(实验设计站不站得住)、水管走向合不合理(方法框架通不通)、同小区还有哪几套在卖(baseline 是谁、比得公不公平)、拆掉一个房间还能不能住人(ablation study 说明了什么)。
读够了房,你要自己盖一套。盖房就是复现与撰写:先照着别人的图纸搭一个样板间,确认自己真的懂了,再画自己的图纸动土。最后交房——投稿前对着竣工验收单一条条打勾,答辩时带着验收方在房子里走一圈,回答他们能想到的每一个刁钻问题。
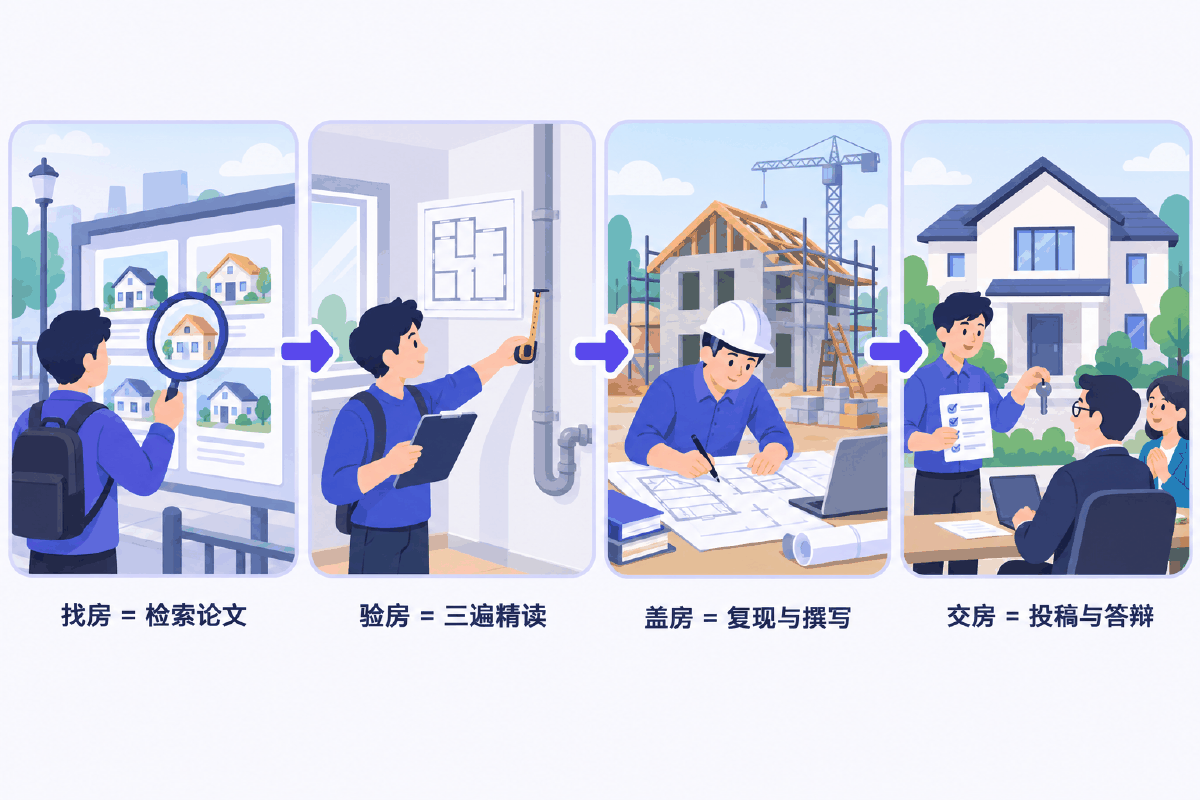
| 比喻里的角色 | 对应的环节 | 它到底是什么 |
|---|---|---|
| 一套房子 | 一篇论文 | 你要评估、要学习、最终要自己造一套的东西 |
| 中介网站的照片与简介 | 标题与摘要 | 第一遍筛选的全部依据,10 分钟决定「留还是弃」 |
| 户型图 | 方法框架图与关键图表 | 第二遍只看它,就能知道这篇干了什么、怎么干的、效果如何 |
| 卷尺 | 自己动手推公式、跑代码 | 第三遍的核心动作。不量过的尺寸不算数 |
| 验房清单 | 精读模板 | 把「读懂了没有」变成一张可以逐格填的表,空格就是没读懂的地方 |
| 同小区在售房源 | baseline | 没有它,「好」就没有参照系;条件不一致的对比等于没比 |
| 拆掉一个房间看还能不能住 | ablation study | 验证每个创新点是不是真的在承重 |
| 这片小区的历史与周边楼盘 | related work | 说明你这套房子填的是哪块空地 |
| 自己画的施工图纸 | 论文各章节骨架 | 动笔前先搭结构,而不是从第一个字开始写 |
| 竣工验收单 | 投稿前 checklist | 提交前逐条打勾,每一条都是审稿意见里真实出现过的扣分项 |
| 带验收方走一圈 | 项目答辩与路演 | 30 秒说清价值,一张图讲清架构,剩下时间接住追问 |
这条铁律也是学术规范的底线:引用要如实反映原文,数据与结果必须来自真实运行,署名、资助与工具使用按目标期刊要求如实声明。
后面的结构就按这条路走:02.1–02.2 找房、02.3–02.4 验房、02.5–02.6 翻译与复现、02.7 盖房、02.8 交房与答辩,05 节把验房清单、施工图纸、竣工验收单三份模板直接给你。
01概念:论文长什么样,去哪儿找
七章结构各自回答什么问题,以及中外文数据库分别适合哪个阶段
1.1 为什么绕不开论文
三类人绕不开:考研考博是必备,高薪岗位的技术深度要求你能读懂一手材料,而想把一个方向从入门做到精通,论文是唯一不失真的信息源。二手解读、公众号长文、视频讲解都经过了一次转述,转述必然丢信息、加私货。
更现实的理由是:工程上你迟早要复现一个别人的方法。到那天,博客里那句「效果很好」帮不了你,只有论文里的超参表、数据集划分和 ablation 表能帮你。
1.2 论文的七章结构
一篇规范的 AI 论文,骨架是固定的。每一章都在回答一个明确的问题,缺哪章读者就会在哪里卡住:
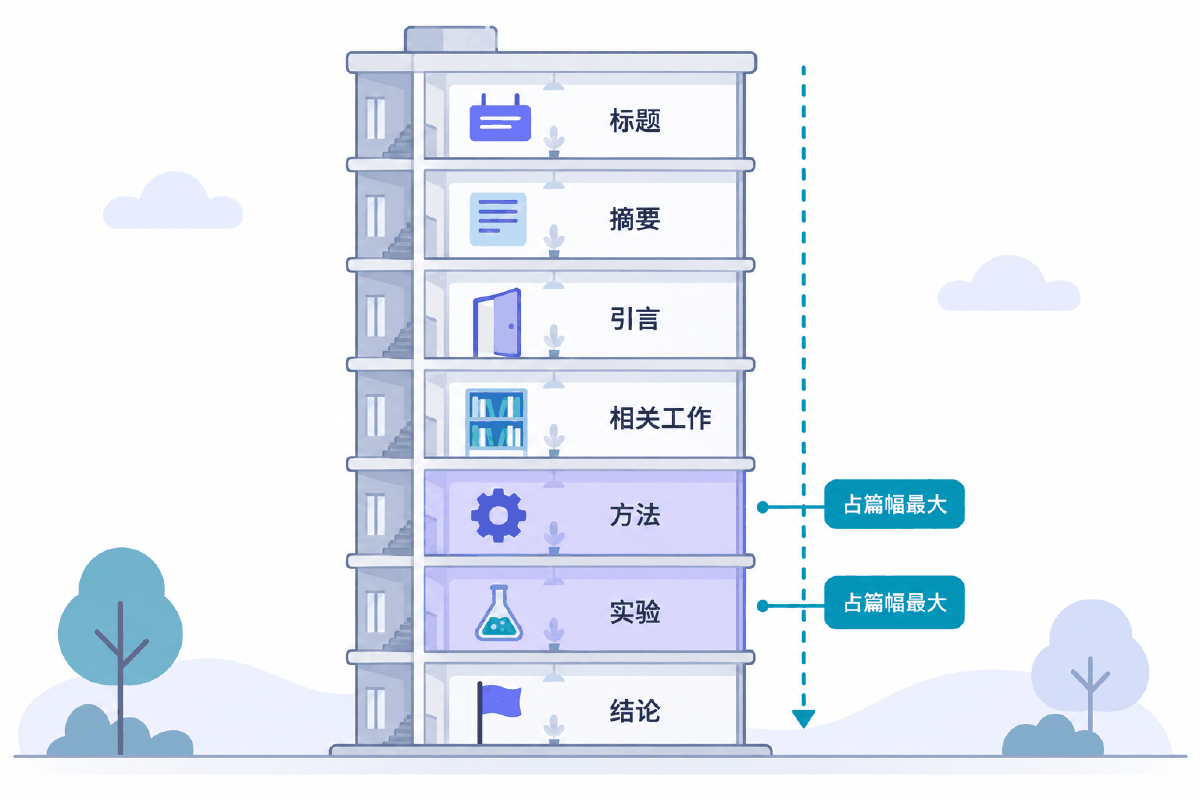
| 章节 | 回答的问题 | 写得好的标志 |
|---|---|---|
标题 title | 这篇是干什么的 | 「做了什么 + 用什么做的」两件事都出现,兼顾准确与吸引力 |
摘要 abstract | 目的、方法、结果 | 三段式齐全,结果里有具体数字而不是「显著提升」 |
引言 introduction | 为什么值得做 | 现状与问题 → 研究意义 → 方法概述 → 创新点与贡献,四层依次收窄 |
相关工作 related work | 前人做到哪一步了 | 按主题和方法论分类,指出不足,并说明自己怎么填补 |
方法 method | 具体怎么做的 | 整体框架图 → 每个模块的原理与公式推导 → 明确指出创新点 |
实验 experiments | 效果到底如何 | 数据集、指标、硬件、超参、轮数交代清楚;定量对比 + ablation study |
结论 conclusion | 学到了什么,还差什么 | 定性总结不重复罗列数字,主动交代局限与未来工作 |
方法与实验两章占篇幅最大,也是第三遍精读的主战场。用比喻说:前面几章是售楼处的宣传册,这两章才是承重墙和水电图。读论文时间不够,砍前面,别砍这两章。
1.3 去哪儿找论文
渠道分中文和外文两条线,各自的强项不同,用错阶段会浪费大量时间:
| 渠道 | 语言 | 最适合的阶段 | 特点与代价 |
|---|---|---|---|
| 知网 | 中文 | 入门期:快速建立术语体系 | 中文综述和学位论文质量参差但胜在好读;学位论文的「相关工作」一章往往是现成的入门地图。多数机构需要订阅 |
| 万方 | 中文 | 入门期补充 | 与知网收录范围有差异,一个找不到可以换另一个试 |
| Google Scholar | 中外文 | 全阶段:找线索、追被引 | 覆盖最广,被引数和「被引用次数」链接是它最大的价值;收录宽松,预印本和正式版混在一起,要自己辨别 |
| Web of Science | 外文 | 评估期:判断分量 | 收录 SCI/SSCI,期刊分区与影响因子可查,适合判断一篇工作的学术分量。需要机构订阅 |
| arXiv | 外文 | 追前沿:最新最快 | 完全免费、无门槛、有公开 API(03 节就用它)。代价是未经同行评审,质量自负;同一篇可能有多个版本,实验结果会变 |
| ACM 等出版社 | 外文 | 定稿期:拿正式版 | 会议与期刊的 camera-ready 版本,是引用时应该指向的版本 |
| 专用数据库 | 按领域 | 垂直领域深挖 | 医学、法律、材料等领域有各自的权威库,通用搜索引擎覆盖不到 |
2103.00020v1 和 v3 可能实验结果不同、方法描述也不同。复现不出来时,第一件要确认的事就是「我读的版本和作者放代码时的版本是不是同一个」。引用时也要写清读的是哪一版,或者优先引正式发表版。
1.4 一个常见的顺序错误
| 常见做法 | 更好的做法 |
|---|---|
| 一上来就在 arXiv 按关键词翻最新的 | 先用中文综述或学位论文建立术语体系,知道这个方向的标准说法是什么,再去外文库检索——否则关键词都写不对,搜出来全是不相关的 |
| 搜到一篇就开始逐字读 | 先攒出 20~30 篇的候选池,批量做第一遍筛选,留下 5 篇再深读。筛选的单位成本远低于精读 |
| 只看最新的 | 最新的往往在改进某个源头方法。不读源头,看不懂改进在改什么 |
| 只看引用数最高的 | 高引可能只是年头久。要结合时间窗看年均引用,一篇 2023 年的 300 引,分量重于 2015 年的 500 引 |
02方法:找 · 读 · 译 · 复现 · 写 · 答辩
每一步都拆成能立刻执行的动作,每一步都有明确的产出物
2.1 找:从一篇种子论文拉出一条线索链
关键词检索只能给你一堆散点,真正把一个方向理清楚的是线索链。做法是先拿到一篇种子论文——任意一篇方向对口、质量不差的工作——然后朝两个方向走:
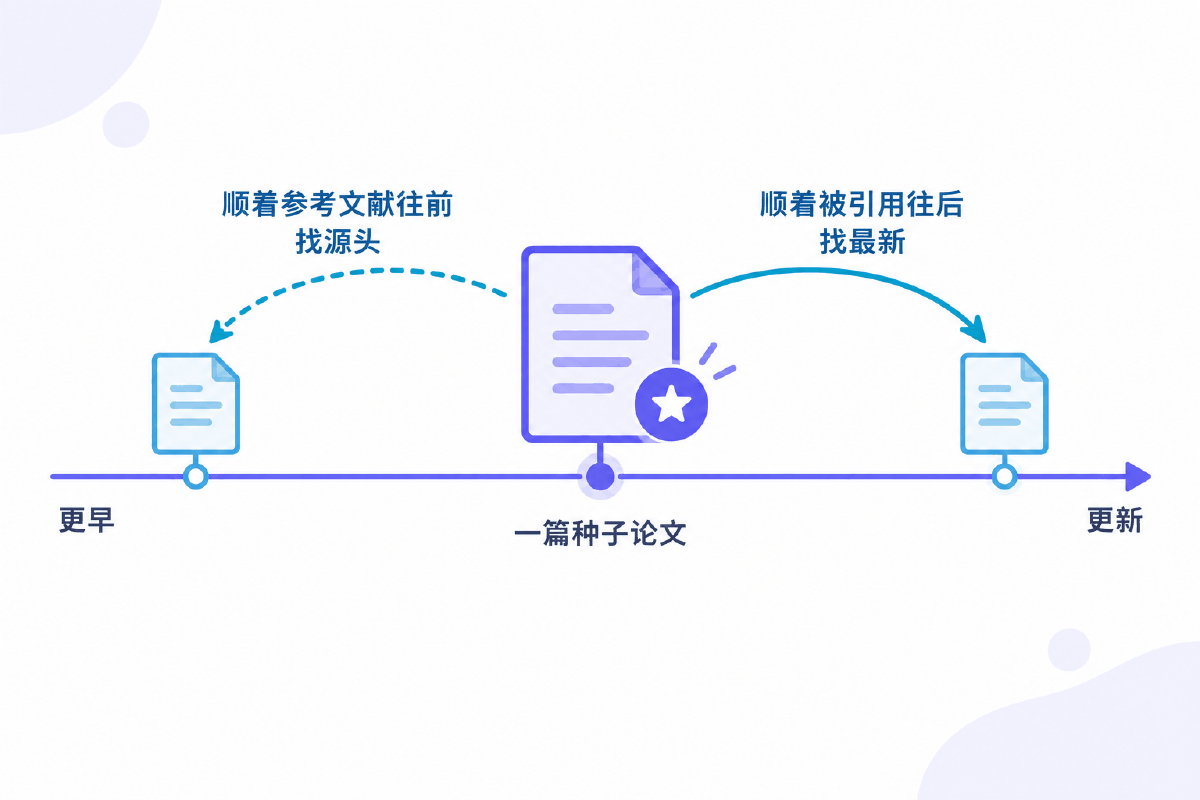
| 方向 | 顺着什么走 | 找到什么 | 停在哪里 |
|---|---|---|---|
| 往前(更早) | 种子论文的 related work 与参考文献 | 这条技术路线的源头方法 | 追到某篇被反复引用的奠基工作,它的 related work 开始讲另一个领域时就停 |
| 往后(更新) | Google Scholar 的「被引用次数」 | 在种子之上做改进的最新工作 | 追到最近半年,或者被引数明显断层时 |
两个方向合起来,就得到一条「源头 → 种子 → 最新」的链。读完这条链,你能说清楚这个方向为什么会演化成今天这样,而不只是知道几个模型名。
筛选:引用数 + 时间窗 + 关键词三者组合
| 筛选维度 | 怎么用 | 单独用会怎样 |
|---|---|---|
| 引用数 | 看年均引用,不看绝对值 | 只看绝对值会一路倒向老论文,看不到新方法 |
| 时间窗 | 分两段取:近 1 年看前沿,3~8 年前看奠基 | 只看近一年,读到的全是别人改进的改进,看不懂动机 |
| 关键词 | 拆成几组分别检索再合并去重 | 一条长查询把条件全 AND 上,命中数会掉到个位数 |
| 团队与实验室 | 锁定几个持续产出的作者,追他们的主页 | — |
这套筛选逻辑,04 节的 arxiv_survey.py 已经写成了脚本:多组关键词分别检索、合并去重、按时间窗过滤、导出一份带勾选框的候选清单。
2.2 读:三遍阅读法,每一遍都有硬性产出
「三遍阅读法」被讲烂了,但多数人执行不了,原因是没有规定每一遍的时间上限和产出物。没有产出物的阅读会不自觉地滑向逐字读,第一篇就耗光耐心。
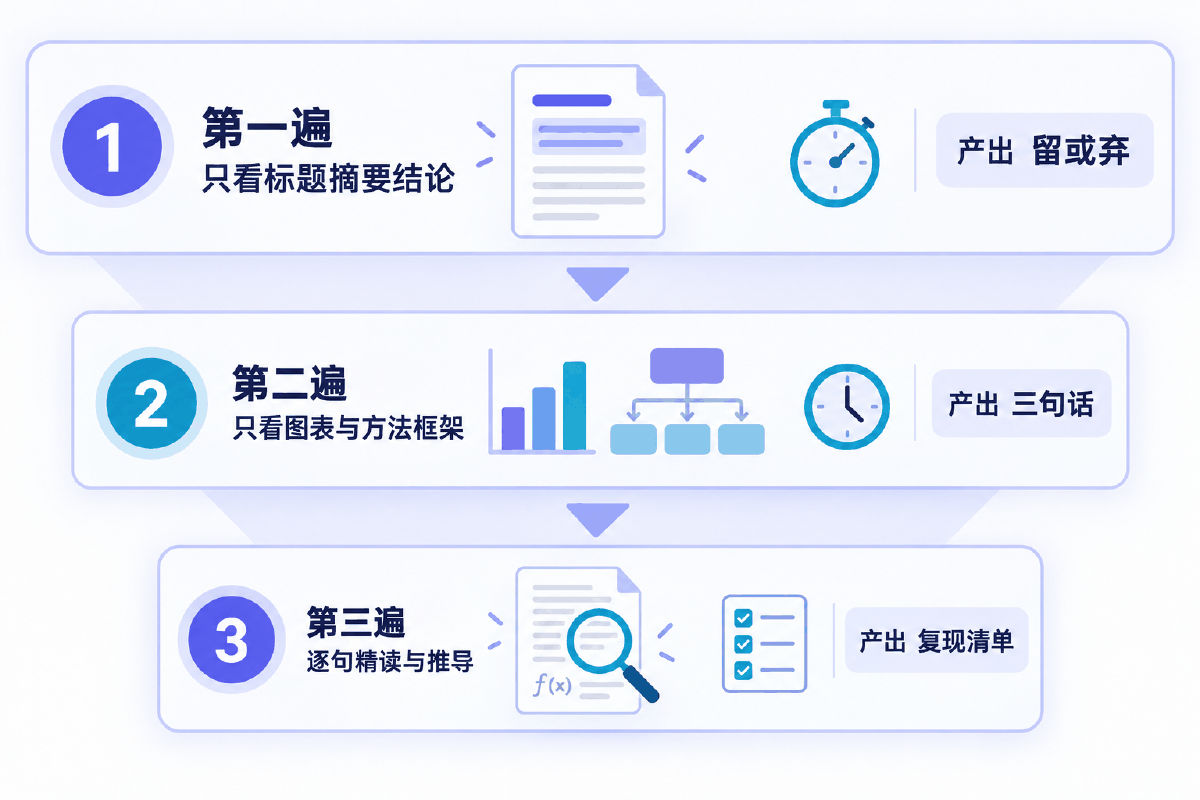
第一遍:泛读 —— 决定「留」还是「弃」
| 项目 | 内容 |
|---|---|
| 时间上限 | 10 分钟,超时直接判「弃」 |
| 只看 | 标题、摘要、结论;有图就扫一眼第一张框架图 |
| 动作 | 从标题到结论浏览每个章节的起始和结束,对文章布局建立基本认识;关注每部分的主题句和论点,捕捉核心观点和研究目的;不追求细节 |
| 顺手标记 | 作者提出的方法与其他研究方法之间的差异,这是理解其贡献与新颖性的入口 |
| 产出 | 「留」或「弃」一个字 + 一句话理由,写进候选清单 |
| 判弃的典型理由 | 问题设定与我不同 / 数据模态不同 / 是纯理论我要的是工程 / 已被后续工作取代 |
第二遍:略读 —— 图表与方法框架
| 项目 | 内容 |
|---|---|
| 时间上限 | 1 小时 |
| 只看 | 图和表,加上方法一节的框架描述 |
| 为什么盯图表 | 图表直观展示关键数据和研究发现,快速浏览图表能更快捕捉核心信息。一篇写得好的论文,框架图 + 主结果表就能讲完八成 |
| 同时做 | 圈出关键引文——这些参考文献包含理解本文所必需的背景或先前研究基础,它们就是 2.1 节往前追的线头 |
| 产出 | 三句话:①它干了什么 ②它怎么干的 ③干得怎么样 |
| 写不出三句话说明 | 要么这篇写得不清楚,要么你缺前置知识——两种情况都该先去读它引的那几篇,而不是硬啃 |
第三遍:精读 —— 逐句、推导、批判
| 动作 | 具体做什么 |
|---|---|
| 理解每句每段 | 深挖每个句子和段落的深层含义,尝试理解作者的表达意图,仿佛自己身临其境地撰写这篇论文 |
| 反思结构组织 | 设想如果由自己撰写,会如何优化内容布局。这一步能显著提高你自己的写作能力 |
| 复现推导 | 公式自己在纸上推一遍。推不动的那一步往往是全文真正的创新点,也常是后面复现失败的根源 |
| 批判实验设计 | 对实验描述进行批判性阅读:用的什么数据、什么指标、怎么做的实验、效果如何;再问「如果我来做,能不能改进」 |
| 产出 | 一份填满的精读模板 + 一份可执行的复现清单 |
2.3 批判性阅读要问的问题
第三遍最难的不是看懂,是看出哪里站不住。这几个问题按顺序问一遍,大部分问题都能暴露:
baseline 用的是它原论文的最优配置,还是作者随手跑的一版?训练数据量、backbone 规模、训练轮数是否一致?条件不齐的对比等于没比。
提升 0.3 个点,但只跑了一次、没有方差——这个提升可能完全落在随机波动里。有没有报告多次运行的均值与标准差?
宣称三个创新点,ablation 表只有两行,那第三个创新点就是没被证明的创新点。而且每行是不是只改了一个变量?
只在一个数据集上验证,结论却写成「适用于各类任务」。看它的结论句有没有超出实验能支撑的范围。
只放成功案例的定性分析,可信度打折。好论文会主动给失败样例并解释原因。
代码是否公开?超参是否给全?数据能否获取?可复现性声明的完整程度,本身就是质量信号。
2.4 译:三种工具,三个适用边界
读外文论文绕不开翻译,但三类工具的定位完全不同,用错场合就会出事:
| 工具 | 适用 | 优势 | 边界 |
|---|---|---|---|
| 网页沉浸式翻译插件 | 在线浏览 arXiv 网页版、博客、会议主页 | 双语对照、原文段落保留、随读随译 | 对 PDF 支持弱;公式和表格常被打乱 |
| 本地文献翻译工具 | 离线读 PDF,做第一遍筛选 | 保留 PDF 排版,划词即译,适合快速扫摘要 | 术语按通用词典译,专业术语经常译错 |
| 大模型精准翻译 + 理解 | 啃某一段读不懂的方法描述 | 能解释而不只是翻译,可以追问、可以要求保留术语原形 | 见下方铁律。会漏公式、会改术语、会补出原文没有的内容 |
① 术语漂移——同一个
embedding 在前后两段被译成「嵌入」「向量」「编码」,读者会以为是三个不同的东西;模型也可能把领域内有特定含义的词按日常义翻译。② 公式被吃掉——行间公式在转换中丢失、下标错位、求和上下限被吞。而公式恰恰是方法一节信息密度最高的地方。
③ 幻觉式脑补——原文含糊或排版断裂时,模型会顺着语感生成一段看起来非常合理、但原文根本没有的内容。这是最危险的一类,因为译文读起来比原文还流畅。
正确用法:把译文当成「导航」,把原文当成「地图」。用译文快速定位到关键段落,然后回到原文逐句核对;凡是要写进自己论文的结论,一律以原文为准。这就是铁律在翻译环节的落地。
2.5 复现:从论文到代码的三步落地顺序
复现最常见的失败方式,是一上来就想跑通主实验。正确顺序是由易到难,每一步都拿到一个确定的成功信号:
用作者给的权重和样例
最小数据集、最短轮数
此时才动结构和超参
| 步骤 | 成功信号 | 卡住时的含义 |
|---|---|---|
| ① 跑通 demo | 输出与 README 里的示例一致 | 纯环境问题,与论文方法无关 |
| ② 小配置复现 | 指标进入论文报告值的合理邻域 | 可能是超参、数据划分或随机性 |
| ③ 换自己的数据 | 流程跑通且指标可解释 | 方法的适用边界问题,属于正常研究内容 |
复现不出来时,怎么区分三种原因
| 原因 | 怎么判断 | 怎么处理 |
|---|---|---|
| 环境问题 | 报错在 import、CUDA、算子、版本不兼容上;连官方 demo 都跑不通 | 严格对齐 README 的框架版本与 CUDA 版本;优先用作者给的 Docker 或 requirements.txt 锁定版本。这一类占比最高,也最容易解决 |
| 超参 / 数据问题 | demo 能跑,训练能收敛,但指标差一截 | 逐项核对:数据集划分方式、预处理、batch size、学习率与调度、训练轮数、随机种子、评测脚本是官方的还是自己写的。差距常常出在评测实现上 |
| 论文没写全 | 按论文所有描述都对齐了,差距依然稳定存在;或论文里某个模块的细节根本没交代 | 查代码仓库的 issue 区,同样的问题往往已经有人问过;对比官方代码与论文描述,以代码为准;仍无解就在自己的工作里如实写明「按原文描述未能复现到报告值」,并给出你的复现配置 |
2.6 写:每一节的正例与反例
写作部分不讲抽象原则,直接给对照。左列是常见写法,右列是更好的写法——差别几乎都在「有没有把话说到可验证的程度」。
标题
| 常见写法 | 更好的写法 |
|---|---|
| 《一种基于深度学习的图像分类方法研究》 | 把做了什么 + 用什么做的都写出来,让同行一眼判断相不相关。标题是论文的门面,以最简洁的方式传达核心主题和研究方向 |
| 堆砌四五个定语,读完不知道重点 | 写三个候选,念给不做这个方向的人听,选他能复述出来的那个。技巧上也可以让导师或领域内的人帮着定 |
摘要
| 常见写法 | 更好的写法 |
|---|---|
| 「本文提出了一种新方法,实验表明效果良好」 | 严格走目的—方法—结果三段式:研究目的明确指出范围、目标和重要性;方法概述研究对象、工具技术与主要活动;结果分层次呈现数据与发现 |
| 结果写「性能显著提升」 | 给具体数字:在哪个数据集、哪个指标上、比谁提升了多少 |
| 摘要里堆公式和术语 | 语言精炼,核心机制用一句话说清,不堆术语不写公式。自检:不看正文只读摘要,读者能答出「做什么、怎么做、好多少」吗 |
引言
| 常见写法 | 更好的写法 |
|---|---|
| 从「人工智能近年来发展迅速」开头 | 可以看成详细版的摘要,四层依次收窄:交代研究现状与问题(数据不足、理论不完善、技术限制等具体挑战)→ 基于这些问题说明研究意义 → 说明具体研究方法 → 说明创新点与贡献 |
| 问题描述得很泛,没收窄到一句话 | 最后一段必须把问题收窄成一句可判定的话,后面所有内容都围绕它 |
| 贡献写成一段话 | 分条列出,条数与正文小节一一对应。审稿人会拿这几条去正文里逐条找证据 |
相关工作
| 常见写法 | 更好的写法 |
|---|---|
| 「A 做了…… B 做了…… C 做了……」流水账 | 按主题和方法论分类,这样不仅体现各研究流派的贡献,还能揭示领域内的发展趋势和潜在联系 |
| 只夸前人,不说不足 | 对比分析不同方法以发现其局限,明确说明自己的研究如何填补这些空白 |
| 贬低前人来抬高自己 | 建立在前人工作之上时,重点阐述原有研究的关键点与自己所做的具体改进,既体现连续性又突出创新价值 |
| 内容不多却硬凑一章 | 内容少可以并进引言;多到撑得起才单独成章 |
方法
| 常见写法 | 更好的写法 |
|---|---|
| 上来就给公式 | 首先交代整体框架,用一张框架图展现各组件的相互作用与数据流向,再逐个讲模块 |
| 框架图里有的框,正文没提 | 图里每个框都要在正文出现;正文提到的每个模块都要能在图上指出来 |
| 公式罗列,不解释符号 | 原理和公式详细推导,每个新符号首次出现处给定义,全文含义唯一 |
| 创新点藏在段落中间 | 明确指出创新点,并诚实写清「本节中哪些是新提出的、哪些沿用已有工作」。审稿人很看重这句的诚实 |
实验
| 常见写法 | 更好的写法 |
|---|---|
| 「在公开数据集上做了实验」 | 交代清楚实验过程:数据集的选择与处理、硬件设备、初始参数设定、训练周期数、训练过程中 loss 的变化趋势,这些细节共同构成实验的基础框架 |
| 只给一张总表 | 通过图表方式展示结果,图表既证明严谨性也反映工作量:性能曲线、混淆矩阵等都是评估模型优劣的视觉工具 |
| 表格数字复述一遍当分析 | 定量对比要解读:说明提升来自哪里、在什么条件下失效,把结论落到机制上 |
| ablation 只做一两行 | 每个创新点对应一行,一次只改一个变量,并解释每行掉点的原因 |
| 只放成功样例 | 补上失败样例与原因分析,可信度反而更高 |
结论
| 常见写法 | 更好的写法 |
|---|---|
| 把摘要复制一遍 | 对研究成果做准确专业的定性描述,强调关键数据但避免结果的重复罗列 |
| 「效果还有提升空间」 | 延伸出实验无法体现的信息:探讨工作的潜在和长期效应,比较与他人工作的异同,揭示结果存在的问题及局限,提出具体的未来改进方向 |
| 结论里冒出引言没提过的新结论 | 结论的每一句都应该能在实验里找到支撑 |
2.7 答辩与项目路演
交房环节。听众不是审稿人而是评委和客户,他们的注意力窗口比审稿人短得多。
组织顺序
| 环节 | 时长 | 要做到 |
|---|---|---|
| 问题与价值 | 30 秒 | 用一句话说清「谁、在什么场景下、因为什么痛点、损失了什么」,再用一句话说清你的方案带来什么改变。30 秒说不清,后面讲得再细也没人听 |
| 方案架构 | 1 张图 | 一张图讲完整体架构,数据从哪进、经过哪几个模块、从哪出。图上不超过 7 个框 |
| 关键指标与对比 | 1 张表 | 核心指标 + 对比对象 + 提升幅度。指标要选听众关心的那个,不是你最好看的那个 |
| demo 演示 | 2~3 分钟 | 只演示主链路,提前准备好输入样例 |
| 总结与后续 | 30 秒 | 当前边界 + 下一步计划 |
demo 的失败预案
| 风险 | 预案 |
|---|---|
| 现场断网、接口超时 | 提前录好一段完整的操作录屏,网一断立刻切视频,讲解词不变 |
| 模型返回慢,冷场 | 准备好缓存过的样例;等待时用这段时间讲架构,不要盯着进度条沉默 |
| 输入被临时改成刁钻样例 | 坦率说明当前适用边界,并当场演示它如何优雅失败——能承认边界比强行圆场加分 |
| 投影分辨率不对、字太小 | 提前到场试投;界面字号按最后一排能看清设计 |
| 依赖环境炸了 | 本地离线副本 + 云端各准备一份,两套入口都测过 |
高频追问与回答要点
| 问题 | 回答要点 |
|---|---|
| 为什么选这个模型? | 给对比过的备选和淘汰理由:效果、成本、延迟、可控性四个维度各是什么数字。「因为它效果好」是最差的回答 |
| 数据从哪来?合规吗? | 说清来源、规模、标注方式、授权情况与隐私处理。这一问在真实项目里权重极高 |
| 成本多少? | 把训练一次性成本与推理单次成本分开算,给出单位请求成本与月度估算 |
| 上线后怎么监控? | 指标监控(准确率、延迟、失败率)+ 数据漂移监控 + 人工抽检机制 + 回滚方案,四件缺一不可 |
| 和现有方案比优势在哪? | 给同条件对比表;同时说清你不如对方的地方,这会显著提高其余部分的可信度 |
| 效果不好的 case 长什么样? | 提前准备 2~3 个真实失败样例与原因分析。被问到才现想,会显得没做过评测 |
| 这套能推广到别的场景吗? | 明确说出迁移需要改什么、改动量多大,不要空泛地说「可以」 |
03最小代码:把 arXiv 变成命令行
只用标准库,按关键词检索并打印标题、日期、摘要
第一遍筛选是个批量动作,用浏览器一页页翻效率很低。arXiv 提供公开检索接口 http://export.arxiv.org/api/query,不需要申请任何 key,返回 Atom 格式的 XML,用 urllib 加 xml.etree 就能解析——一个第三方包都不装。
"""最小可运行示例:按关键词检索 arXiv,打印标题、日期、摘要。

只用标准库:urllib 发请求,xml.etree 解析 Atom 返回,不装任何第三方包。
arXiv 的公开检索接口地址是 http://export.arxiv.org/api/query,无需申请 key。

用法:
    python3 arxiv_search_min.py
    python3 arxiv_search_min.py "contrastive language image pretraining" 5
"""

import sys
import urllib.parse
import urllib.request
import xml.etree.ElementTree as ET

API = "http://export.arxiv.org/api/query"
NS = {"a": "http://www.w3.org/2005/Atom"}


def search(keyword, max_results=5):
    # all: 表示在标题/摘要/作者等所有字段里找;想只搜标题就换成 ti:
    params = {
        "search_query": 'all:"%s"' % keyword,
        "start": 0,
        "max_results": max_results,
        "sortBy": "submittedDate",      # 按提交时间倒序,先看最新的
        "sortOrder": "descending",
    }
    url = API + "?" + urllib.parse.urlencode(params)
    # 官方要求带一个可识别的 User-Agent,不带容易被限流
    req = urllib.request.Request(url, headers={"User-Agent": "heima-notes-demo/1.0"})
    with urllib.request.urlopen(req, timeout=30) as resp:
        raw = resp.read().decode("utf-8")
    return parse(raw)


def parse(xml_text):
    """Atom feed -> 字典列表。字段名照 arXiv 返回的原样取。"""
    root = ET.fromstring(xml_text)
    papers = []
    for entry in root.findall("a:entry", NS):
        def text(tag):
            node = entry.find("a:" + tag, NS)
            return (node.text or "").strip() if node is not None else ""

        papers.append({
            "title": " ".join(text("title").split()),          # 标题里带换行,压成一行
            "published": text("published")[:10],               # 2021-02-26T...  取前 10 位
            "updated": text("updated")[:10],
            "summary": " ".join(text("summary").split()),
            "authors": [a.find("a:name", NS).text
                        for a in entry.findall("a:author", NS)],
            "link": text("id"),
        })
    return papers


def main():
    keyword = sys.argv[1] if len(sys.argv) > 1 else "diffusion model"
    n = int(sys.argv[2]) if len(sys.argv) > 2 else 5

    papers = search(keyword, n)
    print("关键词:%s    命中 %d 篇\n" % (keyword, len(papers)))
    for i, p in enumerate(papers, 1):
        print("[%d] %s" % (i, p["title"]))
        print("    提交 %s   更新 %s" % (p["published"], p["updated"]))
        print("    作者 %s" % ", ".join(p["authors"][:4]))
        print("    链接 %s" % p["link"])
        # 摘要截断到 220 字,第一遍筛选本来就只需要看开头几句
        print("    摘要 %s...\n" % p["summary"][:220])


if __name__ == "__main__":
    main()
3.1 查询参数逐个说明
| 参数 | 取值 | 作用 |
|---|---|---|
search_query | all:"关键词" | all: 表示在标题、摘要、作者等所有字段里找。只搜标题换成 ti:,只搜摘要用 abs:,按作者用 au:。加引号是为了让短语整体匹配 |
max_results | 整数 | 单次返回条数。一次别要太多,分页取更稳 |
sortBy | submittedDate | 按提交时间排序。也可用 relevance 或 lastUpdatedDate |
sortOrder | descending | 倒序,先看最新的 |
start | 整数 | 翻页偏移量,配合 max_results 做分页 |
3.2 返回字段与解析要点
| 字段 | 取值与坑 |
|---|---|
title | 原始返回里带换行和多余空格,必须 " ".join(text.split()) 压成一行,否则后面写进 Markdown 表格会炸版 |
published / updated | 形如 2021-02-26T18:57:57Z,取前 10 位就是日期。两者不同说明这篇改过版本 |
summary | 摘要全文,同样要压空白。第一遍筛选只看前几句就够 |
author | 是多个同名节点,用 findall 取列表,每个节点里的 name 才是姓名 |
id | 论文链接,末段就是 arXiv 编号(含版本号) |
② 请求之间加间隔:官方建议不要高频连打,04 节的批量脚本里每组关键词之间
sleep(3);③ 解析用命名空间:Atom 的节点都在
http://www.w3.org/2005/Atom 命名空间下,find("title") 会返回 None,必须写成 find("a:title", NS)。这是这段代码最容易踩的坑。
04完整案例:候选清单 · 规范引用 · 批量建笔记
三个脚本串成一条流水线:检索导出 → 精读建档 → 写作时引用不出错
三个案例不是孤立的演示,它们首尾相接:
→ candidates.md
→ notes/*.md + INDEX.md
→ 正文引用与参考文献
4.1 批量检索并导出候选清单
把 2.1 节的筛选逻辑写成流水线:多组关键词分别检索 → 合并去重 → 时间窗过滤 → 必含词/排除词过滤 → 导出带勾选框的 Markdown。导出的 candidates.md 直接就是第一遍阅读的工作台。
"""案例一:批量检索 + 时间/关键词过滤,导出一份候选清单 Markdown。

它把「第一遍筛选」这件事做成流水线:
    多组关键词 -> 合并去重 -> 时间窗过滤 -> 必含词/排除词过滤 -> 导出带勾选框的清单

导出的 candidates.md 直接就是第一遍阅读的工作台:
每篇一个 checkbox,读完打勾并在「留/弃」一栏写一个字。

只用标准库。用法:
    python3 arxiv_survey.py
    python3 arxiv_survey.py --since 2024-01-01 --out /tmp/candidates.md
"""

import argparse
import re
import sys
import time
import urllib.parse
import urllib.request
import xml.etree.ElementTree as ET

API = "http://export.arxiv.org/api/query"
NS = {"a": "http://www.w3.org/2005/Atom"}

# ---- 检索配置:按主题拆成几组关键词,覆盖面比一条长查询好得多 ----
QUERIES = [
    "contrastive language image pretraining",
    "text to image diffusion",
    "classifier-free guidance",
]
MUST_INCLUDE = []                  # 标题或摘要必须命中其中之一,留空表示不限制
MUST_EXCLUDE = ["survey of surveys"]   # 命中即丢弃
PER_QUERY = 25


def fetch(keyword, max_results):
    params = {
        "search_query": 'all:"%s"' % keyword,
        "start": 0,
        "max_results": max_results,
        "sortBy": "submittedDate",
        "sortOrder": "descending",
    }
    url = API + "?" + urllib.parse.urlencode(params)
    req = urllib.request.Request(url, headers={"User-Agent": "heima-notes-survey/1.0"})
    with urllib.request.urlopen(req, timeout=40) as resp:
        return resp.read().decode("utf-8")


def parse(xml_text, source):
    root = ET.fromstring(xml_text)
    out = []
    for entry in root.findall("a:entry", NS):
        def text(tag):
            node = entry.find("a:" + tag, NS)
            return (node.text or "").strip() if node is not None else ""

        link = text("id")
        out.append({
            "id": link.rstrip("/").split("/")[-1],      # 2103.00020v1
            "title": " ".join(text("title").split()),
            "published": text("published")[:10],
            "summary": " ".join(text("summary").split()),
            "authors": [a.find("a:name", NS).text for a in entry.findall("a:author", NS)],
            "link": link,
            "source": source,
        })
    return out


def keep(paper, since, until):
    date = paper["published"]
    if since and date < since:
        return False
    if until and date > until:
        return False

    blob = (paper["title"] + " " + paper["summary"]).lower()
    if MUST_INCLUDE and not any(w.lower() in blob for w in MUST_INCLUDE):
        return False
    if any(w.lower() in blob for w in MUST_EXCLUDE):
        return False
    return True


def collect(since, until):
    seen, papers = set(), []
    for q in QUERIES:
        try:
            raw = fetch(q, PER_QUERY)
        except Exception as exc:                      # 网络波动不该让整轮白跑
            print("检索失败:%s(%s)" % (q, exc), file=sys.stderr)
            continue
        for p in parse(raw, q):
            base = re.sub(r"v\d+$", "", p["id"])      # 去掉版本号再去重
            if base in seen:
                continue
            seen.add(base)
            if keep(p, since, until):
                papers.append(p)
        time.sleep(3)                                 # 官方建议的请求间隔,别打太快
    papers.sort(key=lambda x: x["published"], reverse=True)
    return papers


def to_markdown(papers, since, until):
    lines = [
        "# 候选论文清单",
        "",
        "时间窗:%s ~ %s    共 %d 篇" % (since or "不限", until or "不限", len(papers)),
        "",
        "读法:一篇给 10 分钟,只看标题和摘要,决定「留」还是「弃」,在表格里写一个字。",
        "",
        "| 留/弃 | 日期 | 标题 | 一句话理由 |",
        "| :-: | :-: | --- | --- |",
    ]
    for p in papers:
        title = p["title"].replace("|", "/")
        lines.append("|  | %s | [%s](%s) |  |" % (p["published"], title, p["link"]))

    lines += ["", "---", "", "## 摘要速览", ""]
    for i, p in enumerate(papers, 1):
        lines += [
            "### %d. %s" % (i, p["title"]),
            "",
            "- 日期:%s | 命中关键词:`%s`" % (p["published"], p["source"]),
            "- 作者:%s" % ", ".join(p["authors"][:5]),
            "- 链接:%s" % p["link"],
            "",
            "> %s" % p["summary"][:600],
            "",
        ]
    return "\n".join(lines)


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--since", default="", help="起始日期 YYYY-MM-DD")
    ap.add_argument("--until", default="", help="截止日期 YYYY-MM-DD")
    ap.add_argument("--out", default="candidates.md")
    args = ap.parse_args()

    papers = collect(args.since, args.until)
    md = to_markdown(papers, args.since, args.until)
    with open(args.out, "w", encoding="utf-8") as f:
        f.write(md)
    print("命中 %d 篇,已写入 %s" % (len(papers), args.out))


if __name__ == "__main__":
    main()
四个设计决定,每个都对应一个真实问题
| 设计 | 代码位置 | 解决什么 |
|---|---|---|
| 关键词拆成几组分别查 | QUERIES | 一条长查询把条件全 AND 上,命中数会掉到个位数。分组查再合并,召回率高得多 |
| 去重时剥掉版本号 | re.sub(r"v\d+$", "", id) | 2103.00020v1 与 v3 是同一篇,不剥版本号会重复收录 |
| 单组失败不中断整轮 | try/except 后 continue | 网络抖动只该损失一组结果,不该让跑了一半的检索全白费 |
组间 sleep(3) | collect() | 官方建议的请求间隔。打太快会被限流,得不偿失 |
输出的 candidates.md 长什么样
文件分两部分。上半部分是一张可勾选的决策表,一篇一行:
| 留/弃 | 日期 | 标题 | 一句话理由 |
|---|---|---|---|
| 留 | 2021-02-26 | Learning Transferable Visual Models… | 对比学习源头,必读 |
| 弃 | 2024-07-11 | …… for Medical Imaging | 模态不同,问题设定对不上 |
下半部分是摘要速览,每篇给日期、命中的关键词组、作者、链接和摘要前 600 字——第一遍要看的东西全在这一屏里,不用来回切浏览器标签。
4.2 从 BibTeX 生成规范引用
写论文时最琐碎又最容易扣分的一步:同一批文献在中文期刊要 GB/T 7714 格式,英文投稿要 IEEE 或 ACM 格式,手排必然漏标点、丢页码、作者顺序颠倒。这个脚本把 .bib 解析成结构化数据,再按模板渲染。
"""案例二:从 BibTeX 条目生成规范引用文本。

写论文时最琐碎又最容易出错的一步:同一批文献要在正文里写成 GB/T 7714、
在英文投稿里写成 IEEE 或 ACM 风格,手动排版必然漏标点、丢页码、作者顺序颠倒。
这个脚本把 .bib 解析成结构化字典,再按模板渲染成几种常见格式。

只用标准库。用法:
    python3 bibtex_cite.py refs.bib
    python3 bibtex_cite.py refs.bib --style ieee
    python3 bibtex_cite.py refs.bib --check      # 只做字段完整性体检
"""

import argparse
import re
import sys

# 每种条目类型的必填字段。缺字段的引用在审稿人眼里等同于「没读过原文」。
REQUIRED = {
    "article": ["author", "title", "journal", "year"],
    "inproceedings": ["author", "title", "booktitle", "year"],
    "book": ["author", "title", "publisher", "year"],
    "misc": ["author", "title", "year"],
}


def parse_bib(text):
    """极简 BibTeX 解析:按 @type{key, ...} 切块,再按 field = {value} 取字段。

    只处理花括号包裹的值,够应付 Google Scholar / arXiv / DBLP 导出的条目。
    真项目里文献量大、格式杂,建议直接用 bibtexparser 库。
    """
    entries = []
    for m in re.finditer(r"@(\w+)\s*\{\s*([^,]+),(.*?)\n\}", text, re.S):
        etype, key, body = m.group(1).lower(), m.group(2).strip(), m.group(3)
        fields = {}
        for fm in re.finditer(r"(\w+)\s*=\s*\{(.*?)\}\s*,?\s*(?=\n\s*\w+\s*=|\s*$)",
                              body, re.S):
            name = fm.group(1).lower()
            value = " ".join(fm.group(2).split())
            fields[name] = value
        entries.append({"type": etype, "key": key, "fields": fields})
    return entries


def split_authors(raw):
    """BibTeX 作者用 and 分隔,姓名可能写成 "Last, First" 或 "First Last"。"""
    people = []
    for person in re.split(r"\s+and\s+", raw):
        person = person.strip()
        if not person:
            continue
        if "," in person:
            last, first = [x.strip() for x in person.split(",", 1)]
        else:
            parts = person.split()
            last, first = parts[-1], " ".join(parts[:-1])
        people.append((last, first))
    return people


def initials(first):
    return " ".join(p[0] + "." for p in first.split() if p)


def fmt_gbt(entry):
    """GB/T 7714 风格:作者用全大写姓 + 名首字母,三人以上加「等」。"""
    f = entry["fields"]
    people = split_authors(f.get("author", ""))
    names = ["%s %s" % (last.upper(), initials(first).replace(".", "").replace(" ", ""))
             for last, first in people[:3]]
    author = ", ".join(names) + (",等" if len(people) > 3 else "")
    venue = f.get("journal") or f.get("booktitle") or f.get("publisher", "")
    tail = ", ".join(x for x in [f.get("volume", ""), f.get("pages", "")] if x)
    return "%s. %s[J/OL]. %s, %s%s." % (
        author, f.get("title", ""), venue, f.get("year", ""),
        (", " + tail) if tail else "")


def fmt_ieee(entry):
    f = entry["fields"]
    people = split_authors(f.get("author", ""))
    names = ["%s %s" % (initials(first), last) for last, first in people]
    if len(names) > 6:
        author = names[0] + " et al."
    elif len(names) > 1:
        author = ", ".join(names[:-1]) + " and " + names[-1]
    else:
        author = names[0] if names else ""
    venue = f.get("journal") or f.get("booktitle") or f.get("publisher", "")
    bits = ['%s, "%s,"' % (author, f.get("title", "")), "%s," % venue]
    if f.get("volume"):
        bits.append("vol. %s," % f["volume"])
    if f.get("pages"):
        bits.append("pp. %s," % f["pages"].replace("--", "-"))
    bits.append("%s." % f.get("year", ""))
    return " ".join(bits)


def fmt_inline(entry):
    """正文里的作者-年份引用,用来快速检查「引了但没在正文出现」。"""
    people = split_authors(entry["fields"].get("author", ""))
    year = entry["fields"].get("year", "n.d.")
    if not people:
        return "(%s)" % year
    if len(people) == 1:
        return "(%s, %s)" % (people[0][0], year)
    if len(people) == 2:
        return "(%s & %s, %s)" % (people[0][0], people[1][0], year)
    return "(%s et al., %s)" % (people[0][0], year)


STYLES = {"gbt": fmt_gbt, "ieee": fmt_ieee, "inline": fmt_inline}


def check(entries):
    bad = 0
    for e in entries:
        need = REQUIRED.get(e["type"], REQUIRED["misc"])
        missing = [k for k in need if not e["fields"].get(k)]
        if missing:
            bad += 1
            print("缺字段  %-28s %s -> %s" % (e["key"], e["type"], ", ".join(missing)))
        if e["type"] == "misc" and "arxiv" in e["fields"].get("title", "").lower():
            print("提示    %-28s 正式发表版优先于 arXiv 预印本" % e["key"])
    print("\n体检完成:%d 条,其中 %d 条字段不全" % (len(entries), bad))
    return bad


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("bib")
    ap.add_argument("--style", default="gbt", choices=sorted(STYLES))
    ap.add_argument("--check", action="store_true")
    args = ap.parse_args()

    with open(args.bib, encoding="utf-8") as f:
        entries = parse_bib(f.read())
    if not entries:
        print("没解析到任何条目,检查一下 .bib 是不是花括号风格", file=sys.stderr)
        return

    if args.check:
        check(entries)
        return

    render = STYLES[args.style]
    for i, e in enumerate(entries, 1):
        print("[%d] %s" % (i, render(e)))


if __name__ == "__main__":
    main()
三种输出风格
| 风格 | 命令 | 用途 |
|---|---|---|
gbt | 默认 | GB/T 7714:作者姓全大写 + 名首字母,超过三人加「等」 |
ieee | --style ieee | 名首字母 + 姓,超过六人用 et al.,卷号页码按 vol./pp. 排 |
inline | --style inline | 正文里的作者-年份引用,用来快速核对「引了但正文没出现」 |
--check 才是最值钱的功能
它不渲染,只做字段完整性体检:按条目类型检查必填字段,缺哪个报哪个,并提示「正式发表版优先于 arXiv 预印本」。
| 条目类型 | 必填字段 |
|---|---|
article | author, title, journal, year |
inproceedings | author, title, booktitle, year |
book | author, title, publisher, year |
典型输出:缺字段 zhang2023clip article -> journal, year。参考文献字段不全,在审稿人眼里约等于「没认真读过原文」——这正是铁律的延伸。
bibtexparser 这类成熟库——代码里也写明了这一点。别拿它当生产级工具。
4.3 把精读模板批量实例化成文件
模板只有一份,论文有几十篇。这个工具读候选清单,按 templates/reading-note.md 逐篇生成 notes/<日期>-<短标题>.md,并额外生成一个 INDEX.md 汇总表记录进度。
"""案例三:把精读模板批量实例化成一人一篇的笔记文件。

读一份候选清单(arxiv_survey.py 导出的 candidates.md,或自己写的 papers.json),
按 templates/reading-note.md 逐篇生成 notes/<日期>-<短标题>.md,
并额外生成一个 INDEX.md 汇总表,记录每篇的读到第几遍。

顺手解决三个真实痛点:
    ① 不会覆盖已有笔记(改过的内容永远不丢,除非显式 --force)
    ② 文件名统一,按日期排序就是你的阅读时间线
    ③ 模板一改,新生成的笔记全部跟着改,老笔记不动

只用标准库。用法:
    python3 make_reading_notes.py --from candidates.md
    python3 make_reading_notes.py --from papers.json --out notes --force
"""

import argparse
import json
import os
import re
from datetime import date

HERE = os.path.dirname(os.path.abspath(__file__))
TEMPLATE = os.path.join(HERE, "templates", "reading-note.md")


def load_from_markdown(path):
    """从 candidates.md 的表格行里抓 | 日期 | [标题](链接) |。"""
    papers = []
    row = re.compile(r"^\|.*?\|\s*(\d{4}-\d{2}-\d{2})\s*\|\s*\[(.+?)\]\((\S+?)\)\s*\|")
    with open(path, encoding="utf-8") as f:
        for line in f:
            m = row.match(line.strip())
            if m:
                papers.append({"date": m.group(1), "title": m.group(2), "link": m.group(3)})
    return papers


def load_from_json(path):
    with open(path, encoding="utf-8") as f:
        data = json.load(f)
    out = []
    for item in data:
        out.append({
            "date": item.get("published") or item.get("date") or str(date.today()),
            "title": item["title"],
            "link": item.get("link", ""),
        })
    return out


def slugify(title, limit=48):
    """标题转文件名:去掉标点、空格换连字符、限长,避免路径过长与非法字符。"""
    s = re.sub(r"[^\w\u4e00-\u9fff]+", "-", title.lower())
    s = re.sub(r"-+", "-", s).strip("-")
    return s[:limit] or "untitled"


def render(template, paper):
    out = template.replace("__TITLE__", paper["title"])
    out = out.replace("__LINK__", paper["link"] or "TODO")
    return out


def write_index(outdir, records):
    lines = [
        "# 精读进度",
        "",
        "| 日期 | 标题 | 笔记 | 读到第几遍 | 结论 |",
        "| :-: | --- | :-: | :-: | --- |",
    ]
    for r in records:
        lines.append("| %s | %s | [笔记](%s) |  |  |"
                     % (r["date"], r["title"].replace("|", "/"), r["file"]))
    lines += ["", "说明:第一遍填「留/弃」,第二遍填三句话结论,第三遍填复现清单完成度。", ""]
    path = os.path.join(outdir, "INDEX.md")
    with open(path, "w", encoding="utf-8") as f:
        f.write("\n".join(lines))
    return path


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--from", dest="src", required=True, help="candidates.md 或 papers.json")
    ap.add_argument("--out", default="notes")
    ap.add_argument("--force", action="store_true", help="覆盖已存在的笔记")
    ap.add_argument("--template", default=TEMPLATE)
    args = ap.parse_args()

    if not os.path.exists(args.template):
        raise SystemExit("模板不存在:" + args.template)
    with open(args.template, encoding="utf-8") as f:
        template = f.read()

    papers = (load_from_json(args.src) if args.src.endswith(".json")
              else load_from_markdown(args.src))
    if not papers:
        raise SystemExit("没有从 %s 解析出任何论文" % args.src)

    os.makedirs(args.out, exist_ok=True)
    created, skipped, records = 0, 0, []

    for p in papers:
        fname = "%s-%s.md" % (p["date"], slugify(p["title"]))
        path = os.path.join(args.out, fname)
        records.append({"date": p["date"], "title": p["title"], "file": fname})

        if os.path.exists(path) and not args.force:
            skipped += 1
            continue
        with open(path, "w", encoding="utf-8") as f:
            f.write(render(template, p))
        created += 1

    index = write_index(args.out, records)
    print("共 %d 篇:新建 %d,跳过已存在 %d" % (len(papers), created, skipped))
    print("汇总表:", index)


if __name__ == "__main__":
    main()
它解决的三个真实痛点
文件已存在就跳过,除非显式加 --force。你填过的内容不会因为重跑脚本而消失——这是这类工具最容易伤人的地方。
2021-02-26-learning-transferable-visual-models.md。按文件名排序就是你的阅读时间线,slugify 会清掉非法字符并限长。
模板是外部文件而不是硬编码字符串,--template 还能指向自定义版本。老笔记不受影响。
两种输入都支持
| 输入 | 解析方式 | 来源 |
|---|---|---|
candidates.md | 正则抓表格行里的 | 日期 | [标题](链接) | | 4.1 的产物,直接串起来 |
papers.json | json.load,兼容 published 与 date 两种字段名 | 自己整理的,或别的检索工具导出的 |
生成的 INDEX.md
| 日期 | 标题 | 笔记 | 读到第几遍 | 结论 |
|---|---|---|---|---|
| 2021-02-26 | Learning Transferable… | 链接 | 3 | 已复现 demo,方法可用 |
| 2022-05-23 | Photorealistic Text-to-Image… | 链接 | 2 | 模型不开放,只取思路 |
第一遍填「留/弃」,第二遍填三句话结论,第三遍填复现清单完成度。这张表就是你对整个方向的掌握程度快照,也是写 related work 时最省力的素材来源。
arxiv_survey.py --since 2023-01-01 出候选清单 → 花几小时做完第一遍、把「弃」的行删掉 → make_reading_notes.py --from candidates.md 给留下的几篇建档 → 精读时逐格填表 → 写作时用 bibtex_cite.py --check 体检参考文献。全程只用标准库,不需要任何 key。
05骨架模板:验房清单 · 施工图纸 · 竣工验收单
三份可直接复制改造的 Markdown 模板,TODO 处就是全部需要你填的地方
三份模板对应比喻里的三个环节,也对应研究流程的三个阶段:
| 模板 | 比喻角色 | 什么时候用 | 产出 |
|---|---|---|---|
reading-note.md | 验房清单 | 第三遍精读时 | 一篇论文的完整档案 + 复现清单 |
paper-skeleton.md | 施工图纸 | 动笔写自己的论文时 | 七章齐全的骨架,按推荐顺序标注 |
submission-checklist.md | 竣工验收单 | 投稿前最后一道关 | 七大类逐条打勾 |
5.1 精读模板
它把「读懂了没有」变成一张可以逐格填的表——空着的格子就是你还没读懂的地方,这比「感觉读懂了」诚实得多。十个小节按第三遍的动作顺序排列:
| 小节 | 填的时候在检验什么 |
|---|---|
| 一句话贡献 | 不超过 40 字、不许抄摘要。写不出来就是没抓住主线 |
| 问题定义 | 输入是什么、输出是什么、它认为现有方法差在哪 |
| 方法框架 | 按数据流写 3~6 步,能对着它自己画出框架图才算过关;附带一张模块输入输出形状表 |
| 关键公式 | 每条公式标注「我推导过吗」。推不动的那一步往往是真正的创新点 |
| 数据集与指标 | 规模、划分方式、指标衡量什么 |
| baseline 与对比 | 单列一行「是否同等条件」,逼自己回答 2.3 节第一个问题 |
| ablation 说明了什么 | 额外一列「能不能换个解释」,防止照单全收作者的因果归因 |
| 局限与疑问 | 区分「作者自己承认的」和「作者没说但我觉得站不住的」 |
| 可复用的点 | 能拿走什么、用到我的哪个环节、需要改什么 |
| 复现清单 | 七个 checkbox,直接决定下一步动不动手 |
# 精读笔记 · __TITLE__

> 读完第三遍再回头把这张表填满。空着的格子就是你还没读懂的地方。

| 字段 | 内容 |
| :-- | :-- |
| 标题 | __TITLE__ |
| 作者 / 单位 | TODO |
| 发表于 | TODO(会议或期刊 + 年份 + 是否正式发表) |
| 链接 / DOI | __LINK__ |
| 代码仓库 | TODO(没有就写「未公开」,别留空) |
| 读的版本 | TODO(arXiv v2 / 会议 camera-ready,版本不同实验可能不同) |
| 我读它的目的 | TODO(找方法 / 找 baseline / 找数据集 / 补背景) |

---

## 1. 一句话贡献

TODO:不超过 40 字,写「它把什么做成了什么」,不要抄摘要。

## 2. 问题定义

- **输入是什么:** TODO
- **输出是什么:** TODO
- **它认为现有方法差在哪:** TODO
- **这个问题为什么值得做:** TODO

## 3. 方法框架

TODO:按数据流写 3~6 步,每步一行,能对着画出框架图为准。

1. TODO
2. TODO
3. TODO

**每一步的输入输出张量形状 / 数据格式:**

| 模块 | 输入 | 输出 | 作用 |
| :-- | :-- | :-- | :-- |
| TODO | TODO | TODO | TODO |

## 4. 关键公式

| 编号 | 公式在做什么 | 符号含义 | 我推导过吗 |
| :-: | :-- | :-- | :-: |
| 式(1) | TODO | TODO | 是 / 否 |
| 式(2) | TODO | TODO | 是 / 否 |

> 推不动的那一步单独记下来,它往往是全文真正的创新点,也常是后面复现失败的根源。

## 5. 数据集与指标

| 数据集 | 规模 | 划分方式 | 指标 | 这个指标衡量什么 |
| :-- | :-- | :-- | :-- | :-- |
| TODO | TODO | TODO | TODO | TODO |

## 6. baseline 与对比结果

| 方法 | 主指标 | 相对提升 | 参数量 / 算力 | 是否同等条件 |
| :-- | :-: | :-: | :-: | :-: |
| baseline A | TODO | — | TODO | — |
| 本文方法 | TODO | TODO | TODO | 是 / 否 |

**对比是否公平:** TODO(同数据集?同训练量?同 backbone?对手是否用了原论文最优配置?)

## 7. ablation study 说明了什么

| 去掉的部件 | 指标变化 | 能得出的结论 | 能不能换个解释 |
| :-- | :-: | :-- | :-- |
| TODO | TODO | TODO | TODO |

> 判定标准:每一个宣称的创新点,都应该有一行 ablation 对应。对不上的创新点就是没被证明的创新点。

## 8. 局限与我的疑问

- **作者自己承认的局限:** TODO
- **作者没说但我觉得站不住的地方:** TODO
- **我读不懂的地方(写清楚卡在哪一句):** TODO
- **需要回头查的引文:** TODO

## 9. 可复用的点

| 能拿走什么 | 用到我的哪个环节 | 需要改什么 |
| :-- | :-- | :-- |
| TODO | TODO | TODO |

## 10. 复现清单

- [ ] 官方仓库能否 clone,README 是否给了环境版本
- [ ] demo / inference 脚本能跑通
- [ ] 预训练权重是否公开(否 → 只能从头训)
- [ ] 主实验的最小配置需要多少显存、多少小时
- [ ] 数据集能否下载,是否需要申请
- [ ] 随机种子与评测脚本是否给出
- [ ] 复现结果与论文报告差多少,差距能否解释

---

**读完时间:** TODO  |  **三遍各花了:** TODO / TODO / TODO
5.2 论文各章节骨架
按 2.6 节的正例逐节写成带 TODO 的骨架,并在文件开头标注了推荐的写作顺序:方法 → 实验 → 引言 → 相关工作 → 结论 → 摘要 → 标题。
| 骨架里埋的强制动作 | 为什么 |
|---|---|
| 标题要写三个候选 | 逼自己跳出第一直觉;选那个外行也能复述出来的 |
| 摘要三段下面各挂一句自检 | 「不看正文只读摘要,能答出做什么、怎么做、好多少吗」 |
| 贡献必须分条编号 | 条数要与正文小节一一对应,审稿人会逐条去正文找证据 |
| 方法一节留了创新点小结 | 强制你写清「哪些是新提的、哪些沿用已有工作」,这句的诚实度很影响评审印象 |
| 实验一节的设置写成清单 | 数据集、指标、硬件、超参、训练细节,五项一个都不许空 |
| ablation 表预置了行结构 | 「完整模型」一行 + 每个创新点一行,一次只改一个变量 |
| 定性分析明确要求失败样例 | 只放成功样例一定会被追问 |
# __TITLE__

<!-- 骨架文件:每个 TODO 都是一句话提示,写完就把提示行删掉。
     写作顺序建议:方法 → 实验 → 引言 → 相关工作 → 结论 → 摘要 → 标题。
     摘要和标题最后写,因为那时你才真正知道自己做出了什么。 -->

## 标题

TODO:一行,兼顾准确与吸引力。让「做了什么 + 用什么做的」两件事都出现。
写三个候选,念给不做这个方向的人听,选他能复述出来的那个。

- 候选 A:TODO
- 候选 B:TODO
- 候选 C:TODO

## 摘要(Abstract)

TODO 目的:这个领域当前卡在什么地方,本文要解决哪个具体问题。(2~3 句)

TODO 方法:用一句话说清方法的核心机制,不堆术语,不写公式。(2~3 句)

TODO 结果:在哪个数据集、哪个指标上、比谁提升了多少,给具体数字。(2~3 句)

> 自检:不看正文,只读摘要,读者能答出「做什么、怎么做、好多少」三个问题吗?

## 1 引言(Introduction)

### 1.1 研究现状与问题

TODO:从大背景收到具体问题,三到四段,每段一个层次。最后一段要把问题收窄到一句话。

### 1.2 研究意义

TODO:解决这个问题之后,谁会受益、能带来什么变化。

### 1.3 方法概述

TODO:用三到五句话把方法讲一遍,让读者不看第 3 节也知道你干了什么。

### 1.4 创新点与贡献

TODO 用分条列出,与正文小节一一对应:

1. 我们提出了 TODO,解决了 TODO;
2. 我们设计了 TODO,使得 TODO;
3. 在 TODO 数据集上,本文方法相比 TODO 提升 TODO。

## 2 相关工作(Related Work)

### 2.1 TODO 主题一

TODO:这一类方法的代表工作、共同思路、共同的不足。

### 2.2 TODO 主题二

TODO:同上。

### 2.3 与本文的关系

TODO:明确写出「上述方法在 TODO 上受限,本文通过 TODO 填补这一空白」。

## 3 方法(Method)

### 3.1 问题定义与符号

TODO:先把输入输出形式化。给一张符号表,全文符号含义唯一。

### 3.2 整体框架

TODO:先放框架图(图 1),再用一段话按数据流向把图讲一遍,图里每个框都要在正文出现。

### 3.3 TODO 模块一

TODO:先说这个模块要解决什么,再给公式,再逐项解释符号,最后说它为什么比现有做法好。

$$ \text{TODO 公式 (1)} $$

### 3.4 TODO 模块二

TODO:同上。

### 3.5 创新点小结

TODO:一句话点明「本节中 TODO 与 TODO 是本文新提出的,其余沿用已有工作」。审稿人最看重这句的诚实。

## 4 实验(Experiments)

### 4.1 实验设置

- **数据集:** TODO(规模、划分、来源、许可)
- **评价指标:** TODO(指标定义、实现来源)
- **硬件:** TODO(显卡型号、数量)
- **超参数:** TODO(优化器、学习率、batch size、训练轮数)
- **训练细节:** TODO(收敛情况、loss 曲线见图 TODO)

### 4.2 定量对比

TODO:主结果表,本文方法与 baseline 同条件对比。最优值加粗,说明标记规则。

| 方法 | 指标 A | 指标 B | 参数量 |
| :-- | :-: | :-: | :-: |
| TODO | TODO | TODO | TODO |

TODO:一段文字解读表格,说明提升来自哪里,而不是复述数字。

### 4.3 ablation study

TODO:每个创新点对应一行,一次只去掉一个部件。

| 配置 | 指标 A | 相对完整模型 |
| :-- | :-: | :-: |
| 完整模型 | TODO | — |
| 去掉 TODO | TODO | TODO |

TODO:解释每一行掉点的原因,把结论落到机制上。

### 4.4 定性分析

TODO:给可视化样例,包括失败样例。只放成功样例会被追问。

## 5 结论(Conclusion)

TODO 定性总结:用文字概括本文做了什么、得到了什么结论,不重复罗列数字。

TODO 局限:诚实写出方法在什么条件下会退化。

TODO 未来工作:给出具体的下一步,不要写「进一步提升性能」这类空话。

## 参考文献

TODO:格式统一,逐条核对卷号页码年份。每一条都应是你真正读过的。

## 附录(可选)

- A. 完整超参数表
- B. 更多可视化结果
- C. 公式推导细节
5.3 投稿前 checklist
七大类、七十余条,每一条都是审稿意见里真实出现过的扣分项。全部打勾再点提交:
| 分类 | 抓什么 |
|---|---|
| 一、内容完整性 | 贡献条数与正文是否对齐、结论有没有超纲、局限是否单独成段 |
| 二、公式与符号 | 编号与引用一致、同一符号全文含义唯一、新符号首次出现有定义 |
| 三、图与表 | 脱离正文能否独立看懂、单栏宽度下字号是否可读、转灰度后能否区分 |
| 四、实验可信度 | baseline 是否公平、是否报方差、ablation 是否覆盖每个创新点、超参搜索范围是否交代 |
| 五、引用与诚信 | 每条引用都读过原文、引用如实反映原文、数据与结果均来自真实运行、署名与资助如实声明、辅助工具使用按政策披露 |
| 六、可复现性 | 数据与代码可得性声明、划分方式、随机种子与环境版本、他人能否跑出同量级结果 |
| 七、格式与提交 | 官方模板未私改版式、页数合规、双盲下无身份线索(含自引改第三人称、文件元数据)、留足提交时间 |
# 投稿前 checklist

> 全部打勾再点提交。每一条都是审稿意见里真实出现过的扣分项。

## 一、内容完整性

- [ ] 摘要严格覆盖「目的—方法—结果」三段,且结果里有具体数字
- [ ] 引言最后一段用分条列出了贡献,条数与正文实际做的事一一对应
- [ ] 每一个宣称的创新点,在方法一节都有对应小节,在实验一节都有对应验证
- [ ] related work 不只是罗列,每一类都写清了不足,并说明本文如何填补
- [ ] 结论没有出现引言里没提过的新结论
- [ ] 局限与未来工作单独成段,不是一句「效果还有提升空间」

## 二、公式与符号

- [ ] 所有公式连续编号,正文引用的编号与实际编号一致
- [ ] 同一个符号全文含义唯一,没有 N 一会儿是样本数一会儿是维度
- [ ] 所有新引入的符号在首次出现处有定义
- [ ] 向量、矩阵、标量的字体区分一致(粗体 / 斜体规则全文统一)
- [ ] 公式末尾的标点符合目标期刊要求

## 三、图与表

- [ ] 每张图表脱离正文也能看懂:坐标轴有单位、图例完整、caption 自足
- [ ] 图里的字号放到单栏宽度仍然可读(打印一页出来看一眼)
- [ ] 表格的最优值加粗,次优值有标记,标记规则写在 caption 里
- [ ] 折线图给出误差范围或多次运行的标准差,不是单次跑的结果
- [ ] 所有图表在正文中都被引用过,且引用顺序与出现顺序一致
- [ ] 彩色图转灰度后仍能区分(部分期刊黑白印刷)

## 四、实验可信度

- [ ] baseline 采用其原论文的最优配置,或说明了为何用别的配置
- [ ] 本文方法与 baseline 的训练数据、训练量、backbone 规模一致
- [ ] 主实验报告了多次运行的均值与方差,而不是挑最好的一次
- [ ] ablation study 覆盖了每一个创新点,且一次只改一个变量
- [ ] 超参搜索范围与选定值写清楚了,包括 baseline 的
- [ ] 硬件、训练时长、显存占用有交代
- [ ] 评测指标的实现来源写明(官方脚本 / 自己实现)

## 五、引用与诚信

- [ ] 每一条引用都读过原文,不存在只看摘要就引的条目
- [ ] 引用的事实与原文说法一致,没有断章取义
- [ ] 参考文献格式统一,卷号、页码、年份、出版方完整
- [ ] 预印本已正式发表的,引用正式版本
- [ ] 他人成果、图表、代码均已注明出处并符合其许可
- [ ] 所有数据与结果均来自真实运行,未经过任何修饰
- [ ] 合作者贡献、资助来源、利益冲突已按要求声明
- [ ] 使用辅助工具的情况已按目标会议或期刊的政策如实披露

## 六、可复现性

- [ ] 数据与代码的可得性有明确声明(公开 / 申请后可得 / 不可公开及原因)
- [ ] 数据集划分方式、预处理脚本写清楚了
- [ ] 随机种子与环境版本(框架版本、CUDA 版本)有记录
- [ ] 换一台机器、由另一个人照着论文能跑出同一量级的结果

## 七、格式与提交

- [ ] 使用目标会议或期刊的官方模板,未私自改行距、页边距、字号
- [ ] 页数、参考文献是否计入页数,均符合要求
- [ ] 双盲要求下,正文、致谢、图表、代码链接中无任何作者身份线索
- [ ] 自引改写为第三人称(「文献 [12] 提出」而非「我们之前提出」)
- [ ] 补充材料单独打包,正文不依赖补充材料才能读懂
- [ ] 文件名、投稿系统的元数据未泄漏身份(双盲时)
- [ ] 全文过一遍拼写检查,专有名词大小写统一
- [ ] 距离 deadline 至少留 24 小时,避开系统拥堵

---

**提交时间:** TODO  |  **投稿目标:** TODO  |  **最后自查人:** TODO
5.4 三份模板怎么配合
一篇一份,攒成 notes/
related work 直接取材于 notes/
逐条打勾
三份模板都是纯 Markdown,可以直接复制走。想批量生成一人一份的精读笔记,用 4.3 的 make_reading_notes.py——它会读第一份模板,按候选清单实例化成整个 notes/ 目录并附带进度汇总表。
06易错点汇总
按「找 / 读 / 译 / 复现 / 写 / 答辩」六类归并,踩过一次就别再踩
⚠️ 一、找论文
- 一上来就在 arXiv 按关键词翻最新的。 术语体系还没建立,关键词都写不对,搜出来全是不相关的。先用中文综述或学位论文摸清这个方向的标准说法,再去外文库检索。
- 只看引用数最高的。 高引可能只是年头久。要看年均引用——一篇 2023 年的 300 引,分量重于 2015 年的 500 引。
- 只读最新的,不读源头。 最新工作往往在改进某个源头方法,不读源头就看不懂改进在改什么,更看不出它避开了什么。
- 一条长查询把所有条件 AND 上。 命中数会掉到个位数,还会漏掉措辞不同的同类工作。拆成几组关键词分别检索再合并去重。
- 搜到一篇读一篇。 逐篇穿插着读,判断标准会随疲劳漂移。先攒 20~30 篇的候选池,一次性把第一遍做完。
- 忽略 arXiv 的版本号。
v1与v3可能实验结果不同、方法描述也不同。复现对不上时,这是第一个要排查的地方。 - 把预印本当成已发表工作引用。 已经正式发表的,引用正式版本;确实只有预印本的,如实标注。
⚠️ 二、读论文
- 第一遍就逐字读。 三遍法失效的头号原因。第一遍限时 10 分钟、只看标题摘要结论,超时直接判「弃」。
- 每一遍没有产出物。 没有产出就没有终止条件,读着读着必然滑向逐字读。三遍的产出分别是:留或弃、三句话、填满的精读模板 + 复现清单。
- 第二遍跳过图表直接读文字。 图表直观展示关键数据与发现,框架图 + 主结果表能讲完八成。跳过它们等于绕远路。
- 第二遍不圈关键引文。 那些引文就是往前追源头的线头,当时不圈,回头得重读一遍才能找到。
- 第三遍不动笔推公式。 看懂和推得出是两回事。推不动的那一步往往是全文真正的创新点,也常是后面复现失败的根源。
- 把作者的因果解释照单全收。 ablation 掉了 2 个点,作者说明是模块 A 的功劳——但换个解释行不行?精读模板里专门留了「能不能换个解释」这一列。
- 不检查对比是否公平。 baseline 用的是它原论文的最优配置吗?训练数据量、backbone 规模一致吗?条件不齐的对比等于没比。
- 把「提升 0.3 个点」当成有效结论。 只跑一次、没有方差的提升,可能完全落在随机波动里。
- 宣称三个创新点,ablation 只有两行也不追问。 第三个创新点就是没被证明的创新点。
⚠️ 三、翻译
- 把大模型译文直接当理解写进自己的论文。 违反铁律。三类具体风险:术语漂移(同一个
embedding前后被译成三个不同的词)、公式被吃掉(行间公式丢失、下标错位、求和上下限被吞)、幻觉式脑补(原文含糊时生成一段看着合理、原文根本没有的内容)。 - 被译文的流畅度骗了。 最危险的情况恰恰是译文读起来比原文还顺——那通常意味着模型把不确定的地方抹平了。
- 拿网页插件译 PDF。 沉浸式翻译对在线网页很好用,但对 PDF 支持弱,公式和表格常被打乱。读 PDF 换本地文献翻译工具。
- 指望翻译工具译对专业术语。 本地工具按通用词典译,专业术语经常错。术语保留英文原形,只译叙述部分。
- 只读译文不回原文。 正确姿势:译文当导航,原文当地图。用译文快速定位关键段落,再回原文逐句核对。
⚠️ 四、复现
- 一上来就跑主实验。 正确顺序是官方 demo → 主实验的一个小配置 → 换自己的数据,每步都要拿到确定的成功信号再往下走。
- 分不清三类失败。 连 demo 都跑不通=环境问题(对齐框架与 CUDA 版本,优先用作者的 Docker 或锁版本的
requirements.txt);能收敛但指标差一截=超参或数据问题(逐项核对划分、预处理、学习率、轮数、种子,尤其是评测脚本是官方的还是自己写的);全对齐了差距仍稳定存在=论文没写全(查仓库 issue、以代码为准)。 - 评测指标自己实现了一版。 同名指标的实现差异能造成好几个点的差距,这是「复现不出来」最隐蔽的来源之一。
- 没锁随机种子就下结论。 单次运行的差异可能比方法带来的差异还大。
- 复现不出来就默不作声或硬凑数字。 正确做法是如实写明「按原文描述未能复现到报告值」并给出自己的复现配置。如实报告是研究的一部分,修饰数据不是。
- 不记录复现过程。 环境版本、命令、耗时、结果当时不写,两周后自己都复现不了自己的复现。
⚠️ 五、写作
- 从第一个字开始顺着写。 推荐顺序是方法 → 实验 → 引言 → 相关工作 → 结论 → 摘要 → 标题。摘要和标题最后写,那时你才真正知道自己做出了什么。
- 摘要写「效果良好」。 结果必须给具体数字:哪个数据集、哪个指标、比谁提升多少。
- 引言从「人工智能近年来发展迅速」开头。 四层要依次收窄:现状与问题 → 研究意义 → 方法概述 → 创新点与贡献,最后一段把问题收窄成一句可判定的话。
- 贡献写成一段话而不分条。 审稿人会拿贡献条目去正文里逐条找证据,条数要与正文小节一一对应。
- 相关工作写成流水账。 要按主题和方法论分类,指出各自不足,并说明自己怎么填补。
- 贬低前人来抬高自己。 正确做法是阐述原有研究的关键点与自己的具体改进,体现连续性。
- 方法一节上来就给公式。 先给整体框架图讲清组件关系与数据流向,再逐模块推导。图里每个框都要在正文出现。
- 符号前后不一致。 同一个
N一会儿是样本数一会儿是维度,这是审稿意见里最常见的低级扣分项。 - 公式编号与正文引用对不上。 改稿时插入一条公式却没更新引用,全文编号就全错位了。投稿前必须整体过一遍。
- 图表脱离正文看不懂。 坐标轴要有单位、图例要完整、caption 要自足。还要检查单栏宽度下字号是否可读、转灰度后能否区分。
- 实验设置写得含糊。 数据集、指标、硬件、超参、训练轮数、loss 曲线,五项一个都不能空——这些细节共同构成实验的基础框架。
- 表格数字复述一遍当分析。 要解读:提升来自哪里、什么条件下失效,把结论落到机制上。
- 结论把摘要复制一遍。 结论要做定性总结、避免重复罗列数字,并主动交代局限与具体的未来工作。
- 结论里冒出引言没提过的新结论。 每一句都要能在实验里找到支撑。
- 参考文献字段不全。 缺卷号、页码、出版方,在审稿人眼里约等于「没认真读过原文」。用
bibtex_cite.py --check先体检一遍。 - 双盲投稿留下身份线索。 致谢、代码链接、自引的第一人称表述(要改成「文献 [12] 提出」)、甚至文件元数据,都会暴露身份。
⚠️ 六、答辩与路演
- 开场先讲技术架构。 前 30 秒必须说清问题与价值——谁、在什么场景、因为什么痛点、损失了什么。30 秒说不清,后面讲得再细也没人听。
- 架构图上塞二十个框。 一张图、不超过 7 个框,讲清数据从哪进、经过哪几个模块、从哪出。
- 挑自己最好看的指标讲。 要选听众关心的那个。挑好看的那个,第一个追问就会把你问穿。
- demo 没有失败预案。 至少准备:完整操作录屏(断网就切)、缓存好的样例(接口慢时用)、提前试投影。等待时讲架构,不要盯着进度条沉默。
- 被改成刁钻输入就慌。 坦率说明适用边界,当场演示它如何优雅失败。承认边界比强行圆场加分。
- 「为什么选这个模型」答「因为它效果好」。 要给对比过的备选和淘汰理由,效果、成本、延迟、可控性四个维度各有数字。
- 答不上数据来源与合规。 来源、规模、标注方式、授权情况、隐私处理——真实项目里这一问权重极高。
- 成本只报一个总数。 训练的一次性成本与推理的单次成本要分开算,给出单位请求成本与月度估算。
- 没想过上线后怎么监控。 指标监控 + 数据漂移监控 + 人工抽检 + 回滚方案,四件缺一不可。
- 被问失败 case 才现想。 提前准备 2~3 个真实失败样例与原因分析,否则会显得没做过评测。
07自测题
点击题目展开答案;能把这 14 题说清楚,这一讲就通了
中文库(知网、万方)和外文库(Google Scholar、Web of Science、arXiv、ACM)分别适合哪个阶段?
知网 / 万方:入门期用,靠中文综述与学位论文快速建立术语体系,学位论文的相关工作一章往往是现成的入门地图。
Google Scholar:全阶段,覆盖最广,「被引用次数」是它最大的价值,但预印本与正式版混在一起要自己辨别。
Web of Science:评估期,收录 SCI/SSCI,可查分区与影响因子,用来判断学术分量。
arXiv:追前沿,免费无门槛、有公开 API,代价是未经同行评审。
ACM 等出版社:定稿期拿 camera-ready 版本,引用应指向这一版。
怎么从一篇种子论文拉出一条线索链?两个方向各停在哪里?
往前:顺着种子论文的 related work 与参考文献追源头方法,追到某篇被反复引用的奠基工作、它的 related work 开始讲另一个领域时停。
往后:顺着 Google Scholar 的「被引用次数」追最新改进,追到最近半年或被引数明显断层时停。
合起来得到「源头 → 种子 → 最新」的链,读完能说清这个方向为什么演化成今天这样。
为什么不能只按引用数排序挑论文?关键词又该怎么组合?
引用绝对值会一路倒向老论文,要看年均引用——2023 年的 300 引重于 2015 年的 500 引。时间窗要分两段取:近 1 年看前沿,3~8 年前看奠基。关键词则要拆成几组分别检索再合并去重;一条长查询把条件全 AND 上,命中数会掉到个位数。
三遍阅读法每一遍的时间上限、只看什么、产出什么?
第一遍(泛读):≤10 分钟,只看标题、摘要、结论;产出「留」或「弃」一个字加一句理由。
第二遍(略读):≤1 小时,只看图表与方法框架,同时圈出关键引文;产出三句话——干了什么、怎么干的、干得怎么样。
第三遍(精读):逐句理解、自己推导公式、批判实验设计;产出填满的精读模板 + 可执行的复现清单。
为什么每一遍必须规定产出物?三遍法真正省时间的地方在哪?
没有产出物就没有终止条件,读着读着必然滑向逐字读,第一篇就耗光耐心。
真正省时间的地方不在读得快,而在绝大多数论文止步于第一遍:30 篇候选池筛掉 25 篇只花约 4 小时,剩 5 篇做第二遍,最终只有 1~2 篇值得第三遍。把精力集中到那 1~2 篇上,才是三遍法的意义。
第二遍写不出那三句话,说明什么?该怎么办?
要么这篇写得不清楚,要么你缺前置知识。两种情况都该先去读它引的那几篇(就是第二遍圈出来的关键引文),而不是硬啃。
第三遍批判性阅读,至少要问哪几个问题?
六个:①对比公平吗——baseline 是否用其原论文最优配置,数据量、backbone、轮数是否一致;②提升显著吗——有没有多次运行的均值与方差;③ablation 覆盖了吗——宣称几个创新点就该有几行,且一次只改一个变量;④结论超纲了吗;⑤有没有失败样例;⑥能复现吗——代码、超参、数据是否可得。
三类翻译工具各自的适用边界是什么?
网页沉浸式翻译插件:在线读 arXiv 网页版、博客,双语对照随读随译;对 PDF 支持弱,公式表格常被打乱。
本地文献翻译工具:离线读 PDF、做第一遍筛选,保留排版划词即译;专业术语常译错。
大模型精准翻译 + 理解:啃某一段读不懂的方法描述,能解释、能追问、能要求保留术语原形;但会漏公式、改术语、编内容。
为什么不能把大模型译文直接当成理解?
三类风险:①术语漂移——同一个 embedding 在前后两段被译成「嵌入」「向量」「编码」,读者以为是三个东西;②公式被吃掉——行间公式丢失、下标错位、求和上下限被吞,而公式恰恰是方法一节信息密度最高的地方;③幻觉式脑补——原文含糊时生成一段看着合理、原文根本没有的内容,且译文往往读起来比原文还流畅,最难察觉。
正确用法:译文当导航,原文当地图;要写进自己论文的结论一律以原文为准。
从论文到代码的落地顺序是什么?为什么不能直接跑主实验?
三步:①跑通官方 repo 的 demo / inference(用作者给的权重和样例)→ ②复现主实验的一个小配置(最小数据集、最短轮数)→ ③换成自己的数据(此时才动结构和超参)。
直接跑主实验的问题是:失败了你分不清是环境、超参还是方法本身的问题。每一步都要拿到一个确定的成功信号再往下走。
复现不出来,怎么区分「环境问题 / 超参问题 / 论文没写全」?
环境问题:报错在 import、CUDA、算子、版本上,连官方 demo 都跑不通。对齐 README 的框架与 CUDA 版本,优先用作者的 Docker 或锁版本的 requirements.txt。这一类占比最高也最好解决。
超参 / 数据问题:demo 能跑、训练能收敛,但指标差一截。逐项核对划分方式、预处理、batch size、学习率与调度、轮数、随机种子,尤其是评测脚本是官方的还是自己实现的。
论文没写全:所有描述都对齐了差距仍稳定存在,或某模块细节根本没交代。查仓库 issue,对比代码与论文描述以代码为准;仍无解就如实写明未能复现到报告值并给出自己的配置。
论文七章各回答什么问题?哪两章占篇幅最大?
标题:这篇干什么的;摘要:目的—方法—结果;引言:为什么值得做(现状与问题 → 研究意义 → 方法概述 → 创新点与贡献);相关工作:前人做到哪一步、不足在哪、我怎么填补;方法:怎么做的(框架图 → 模块原理与公式推导 → 明确创新点);实验:效果如何(数据集、指标、硬件、超参、轮数、loss 曲线 + 定量对比 + ablation);结论:定性总结 + 局限 + 未来工作。
方法与实验占篇幅最大,也是第三遍精读的主战场。
推荐的写作顺序是什么?为什么摘要和标题最后写?
方法 → 实验 → 引言 → 相关工作 → 结论 → 摘要 → 标题。先写你实际做过的事,最后写需要全局视角才能写准的部分——写完方法和实验,你才真正知道自己做出了什么,这时候写的摘要和标题才不会和正文对不上。
投稿前 checklist 里,公式、图表、实验三类各自最该检查什么?
公式:编号与正文引用一致、同一符号全文含义唯一、新符号首次出现有定义。
图表:脱离正文能独立看懂(坐标轴有单位、图例完整、caption 自足)、单栏宽度下字号可读、转灰度后仍可区分。
实验:baseline 是否公平(同配置、同数据量、同 backbone)、是否报多次运行的方差、ablation 是否覆盖每一个创新点且一次只改一个变量、超参搜索范围是否交代。
另外还有数据与代码的可得性声明,以及双盲要求下不留身份线索。
项目答辩该怎么组织?demo 的失败预案至少要准备哪几样?
组织顺序:30 秒说清问题与价值(谁、什么场景、什么痛点、损失什么)→ 一张图讲方案架构(不超过 7 个框)→ 一张表给关键指标与对比 → 2~3 分钟 demo → 30 秒总结与后续。
失败预案:完整操作录屏(断网就切)、缓存好的样例(接口慢时用,等待时讲架构别沉默)、提前试投影(字号按最后一排能看清)、本地与云端两套入口。被改成刁钻输入时,坦率说明边界并演示它如何优雅失败。
答辩常被追问的四个问题,回答要点是什么?
为什么选这个模型:给对比过的备选和淘汰理由,效果、成本、延迟、可控性四个维度各有数字,别答「因为效果好」。
数据从哪来:来源、规模、标注方式、授权与隐私处理。
成本多少:训练一次性成本与推理单次成本分开算,给单位请求成本与月度估算。
上线后怎么监控:指标监控 + 数据漂移监控 + 人工抽检 + 回滚方案,四件缺一不可。
这一讲的铁律是什么?它在翻译、复现、投稿三个环节分别对应什么要求?
铁律:没有自己量过的尺寸,不写进验房报告——要写进自己论文的结论,必须是你亲自读过原文、亲自跑过或推过得到的。
翻译环节:译文只能用来决定要不要读原文,结论一律以原文为准。
复现环节:复现不出来就如实写明,并给出自己的配置,不修饰数据。
投稿环节:每条引用都读过原文且如实反映原文、数据与结果均来自真实运行、署名与资助如实声明、辅助工具使用按目标会议或期刊政策披露。
词术语表
| 术语 | 含义 |
|---|---|
| abstract | 摘要。严格走目的—方法—结果三段式,结果要有具体数字 |
| introduction | 引言。可看作详细版摘要:现状与问题 → 研究意义 → 方法概述 → 创新点与贡献 |
| related work | 相关工作。按主题和方法论分类,指出前人不足,说明自己如何填补 |
| method | 方法。整体框架图 → 每个模块的原理与公式推导 → 明确指出创新点 |
| experiments | 实验。数据集、指标、硬件、超参、训练轮数、loss 曲线 + 定量对比 + ablation |
| conclusion | 结论。定性总结、局限、未来工作,避免重复罗列数字 |
| baseline | 对照方法。必须用其原论文的最优配置,且与本文方法同数据量、同规模,否则对比无效 |
| ablation study | 消融实验。逐个去掉部件看指标变化,验证每个创新点是否真的在起作用;一次只改一个变量 |
| camera-ready | 正式发表版。会议或期刊接收后的最终稿,引用应指向这一版 |
| 预印本 | 未经同行评审即公开的版本,如 arXiv。同一篇的 v1 与 v3 可能实验结果不同 |
| BibTeX | 文献条目的文本格式,形如 @article{key, author={...}, ...},可渲染成各种引用风格 |
| GB/T 7714 | 中文文献著录格式标准。作者姓全大写 + 名首字母,超过三人加「等」 |
| IEEE 风格 | 英文常用引用格式。名首字母 + 姓,超过六人用 et al.,卷号页码按 vol./pp. 排 |
| 双盲评审 | 作者与审稿人互不知晓身份。正文、致谢、图表、代码链接与文件元数据均不得留身份线索,自引改第三人称 |
| 可复现性声明 | 说明数据与代码是否公开、划分方式、随机种子与环境版本;其完整程度本身就是质量信号 |
| 三遍阅读法 | 泛读定留弃(≤10 分钟)→ 略读看图表出三句话(≤1 小时)→ 精读逐句推导出复现清单 |
| 线索链 | 以一篇种子论文为中心,顺参考文献往前找源头、顺被引往后找最新,理清方向的演化路径 |
| 年均引用 | 引用数除以发表年限。比引用绝对值更能反映近期工作的分量 |
| arXiv API | export.arxiv.org/api/query,返回 Atom 格式 XML,公开免费无需 key |
| Atom feed | arXiv 接口的返回格式。解析时所有节点都在 Atom 命名空间下,必须带命名空间查找 |
| 沉浸式翻译 | 网页双语对照翻译插件。适合在线网页,对 PDF 支持弱,公式表格易被打乱 |
| 术语漂移 | 翻译中同一术语在不同段落被译成不同词,导致读者误以为是不同概念 |