Transformer 架构与 self-attention
RNN 靠排队传话,传得越远越模糊,而且必须一个一个来。Transformer 换了个开法:让所有词坐到同一张圆桌上同时开会,任意两个词之间只隔一条线。这一页把 Q/K/V、多头、位置编码、残差与掩码全部拆到能自己写出来。
30″30 秒看懂 Transformer
上一页的 RNN 是排队传话:一句话的意思从第一个人嘴里出发,一个传一个往后递。传到第五个人时,第一个人说的话已经糊了;而且必须前一个人说完后一个人才能开口,队伍多长就要等多久。
Transformer 把队伍拆了,改成圆桌会议:一句话里的每个词都是一位与会者,所有人同时坐下、同时发言。任何一个词想了解另一个词,直接隔着桌子对话就行,中间不经过任何人转述——不管这两个词在原句里隔了 3 个位置还是 300 个位置,都只隔一条线。
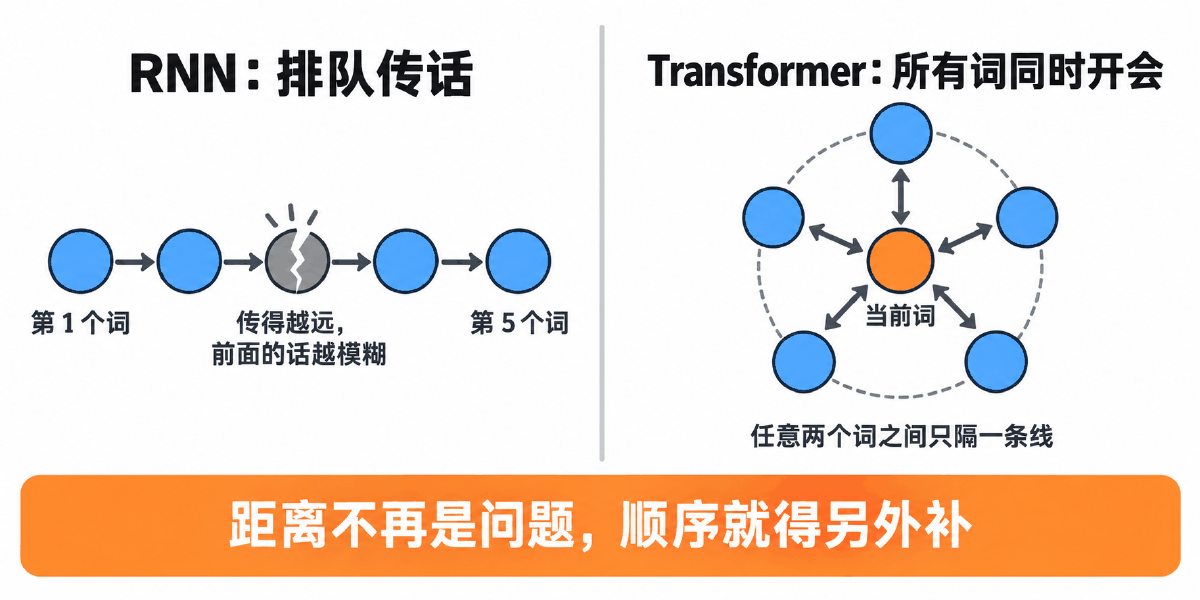
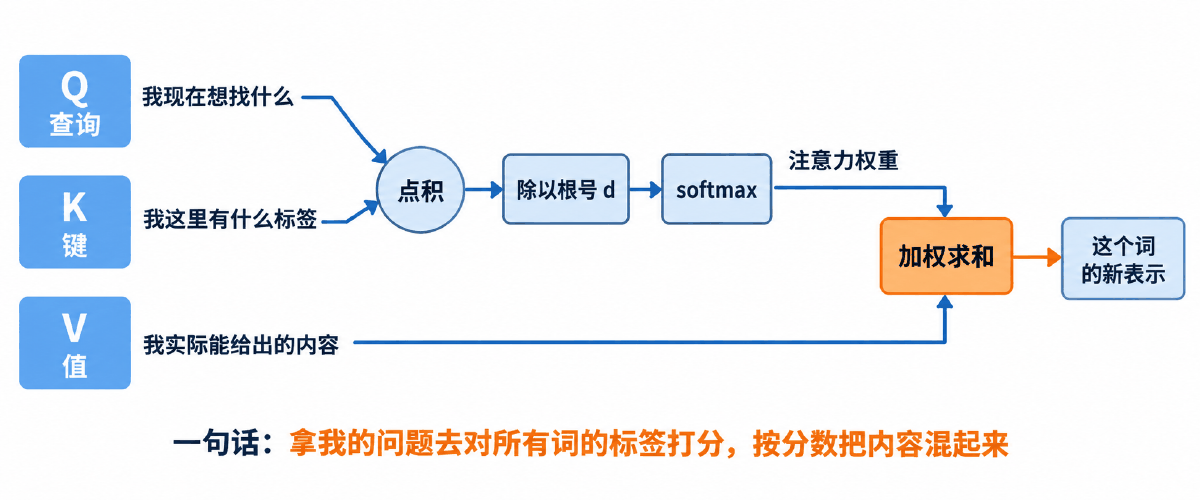
会议怎么开?每位与会者手里有三样东西:一张写着自己问题的纸条(Q)、一块挂在胸前的名牌(K)、还有一肚子真正能讲出来的内容(V)。轮到我发言时,我拿自己的纸条去比对全场每个人的名牌,谁的名牌和我的问题对得上,我就多听谁几分;最后按这个分数把大家的内容混成我的新笔记。这就是 self-attention 的全部。
但圆桌有个先天缺陷:围成一圈是没有先后顺序的。把与会者的座位打乱,每个人算出来的笔记一模一样——「我打你」和「你打我」会被当成同一句话。所以必须额外给每个人发一个座位号,这就是位置编码。
| 比喻里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 一位与会者 | 一个 token 的向量 | 句子里的一个词(或子词),经过 embedding 之后的表示 |
| 我手里的问题纸条 | Q(Query 查询) | 「我现在想找什么」;由这个词的向量乘 W_q 得到 |
| 胸前的名牌 | K(Key 键) | 「我这里挂着什么标签」;用来被别人的 Q 打分 |
| 真正讲出来的内容 | V(Value 值) | 「我实际能给出的信息」;被按分数加权混合的就是它 |
| 拿问题比名牌 | Q·Kᵀ 点积 | 算出「我该分给每个人多少注意力」的原始分数 |
| 把分数换算成百分比 | softmax | 归一化成一组和为 1 的权重,注意力总量守恒 |
| 按分数混内容 | 加权求和 权重 @ V | 得到这个词的新表示,形状和输入完全一样 |
| 同时开好几场分组会 | 多头注意力 multi-head | 把向量切成几段各算各的,每段关注一种关系,最后拼回来 |
| 发座位号 | 位置编码 positional encoding | 把位置信息加到词向量上,否则模型对语序完全无感 |
| 空座位 / 不许看后面的人 | padding mask / look-ahead mask | 把不该看的位置的分数设成负无穷,让 softmax 之后权重为 0 |
01概念:为什么要把队伍拆成圆桌
RNN 到底卡在哪两点、注意力换掉了什么、两者的正面对比
1.1 RNN 的两个硬伤
上一页结尾留了一个未解的问题:门控只是缓解,没有根治。RNN 真正的天花板是两条,而且两条都源于同一个设计——必须按顺序一步一步走:
第 t 步要用到第 t−1 步算出的 h,所以必须等前一步算完。句子有 500 个词就要串行 500 次。显卡有上万个计算核心,在这里几乎全程闲着——不是算力不够,是结构不让你用。
第 1 个词的信息要影响第 50 个词,得经过 49 次「整张重写」。反向传播时梯度要连乘 49 段,单段系数 0.9 就只剩 0.9⁴⁹ ≈ 0.006。信息不是被记错了,是压根没传到。
把这两条并排看,会发现它们指向同一个根源:任意两个词之间的「距离」等于它们在句子里的间隔。相隔 50 个词,信息就要走 50 步。于是步数既拖慢了速度(不能并行),又稀释了信息(衰减)。
那么改进的方向就只有一个:把任意两个词之间的距离压到 1 步。这正是图①右半边画的东西——所有词两两直连,任意两个词之间只隔一条线。
1.2 注意力换掉了什么
回到圆桌会议。会议要能开起来,每位与会者得先明确自己扮演的三个角色。这三个角色就是 Q / K / V,而它们全都来自同一个词向量,只是分别乘了三套不同的权重矩阵:
| 角色 | 怎么来的 | 回答的问题 | 在会议里做什么 |
|---|---|---|---|
Q 查询 | x @ W_q | 我现在想找什么 | 主动发起:拿着它去比对全场的名牌 |
K 键 | x @ W_k | 我这里挂着什么标签 | 被动展示:等着被别人的 Q 打分 |
V 值 | x @ W_v | 我实际能给出什么内容 | 真正被取走的东西:按分数被加权混合 |
「自」注意力的「自」,就落在「三者同源」这四个字上:Q、K、V 都是从同一句话的同一批词向量变出来的,所以是一句话内部的词在互相看。如果 Q 来自一句话、K 和 V 来自另一句话,那就是交叉注意力(cross-attention)——解码器读编码结果时用的正是它,4.1 节会再回来。
为什么非要分成三个角色?因为「用来被检索的特征」和「被检索到之后该交出的内容」不是一回事。举个例子:查字典时,你用拼音去检索(K 是拼音),但你要的是释义(V 是释义)。把 K 和 V 强行合成一个,等于要求「拿来排序的依据」和「最终有用的信息」必须是同一份数据,表达力会窄很多。
1.3 和 RNN 的正面对比
| 对比项 | RNN | Transformer |
|---|---|---|
| 任意两词的距离 | 等于它们在句中的间隔,最远 seq_len 步 | 恒为 1 步,直接连线 |
| 能否并行 | 不能,第 t 步依赖第 t−1 步 | 能,整句一次矩阵乘算完 |
| 顺序信息 | 由计算的先后天然承载 | 天然没有,必须靠位置编码显式补 |
| 计算量与句长 | 线性 O(n) | 平方 O(n²)——代价换来的 |
| 记忆容量 | 压进一个固定长度的 h,句子越长挤得越狠 | 每个词保留自己的表示,不存在统一的信息瓶颈 |
| 长文本表现 | 几十步之外基本失效 | 受限于显存与位置编码外推,而非结构衰减 |
| 参数量与句长 | 无关 | 同样无关(权重被所有位置共享) |
这张表里只有一行是 Transformer 更差的:计算量从线性变成了平方。这不是实现没优化好,是结构决定的——n 个词两两配对,就是 n² 条线。2.7 节会把这笔账算成具体数字,它直接解释了今天「上下文窗口」为什么是大模型最贵的参数。
02原理:把一次会议拆成五步
Q/K/V 怎么算、为什么要缩放、多头在分什么、座位号怎么发、残差与归一化各管什么
2.1 Q/K/V 三元组:三份数据,一个来源
一句话经过 embedding 之后是一个 (seq_len, d_model) 的矩阵——每行是一个词。接下来只做三次矩阵乘法:
| 运算 | 形状变化 | 说明 |
|---|---|---|
Q = x @ W_q | (n, d) @ (d, d) → (n, d) | 每个词都造出自己的一张问题纸条 |
K = x @ W_k | (n, d) @ (d, d) → (n, d) | 每个词都挂上自己的名牌 |
V = x @ W_v | (n, d) @ (d, d) → (n, d) | 每个词都准备好自己要交出的内容 |
W_q、W_k、W_v 是三套独立训练的权重,这一点很关键。因为它们不同,所以 Q 和 K 不同,进而「A 关注 B 的程度」不等于「B 关注 A 的程度」——注意力矩阵一般是不对称的。修饰词强烈关注它修饰的中心词,反过来则未必,这种非对称正是语言里真实存在的关系。
还有一件容易被忽略的事:这三套权重被句子里所有位置共享,和 RNN 共享 W_hh 是同一个道理。所以参数量只和 d_model 有关,和句子多长无关。
2.2 注意力的五步计算
有了 Q/K/V,剩下的就是图②那条流水线。整个 self-attention 只有五步,一步不多:
得到 n×n 分数表
设成 −inf(可选)
每行和为 1
得到新表示
可直接堆下一层
写成一行公式就是教科书上那条:Attention(Q, K, V) = softmax(Q Kᵀ / √d_k) V。逐步拆开看每一步的形状和含义:
| 步骤 | 输出形状 | 在圆桌会议里是什么 |
|---|---|---|
① Q @ Kᵀ | (n, n) | 一张全场打分表:第 i 行第 j 列 = 「第 i 个词对第 j 个词的关注分」 |
② / √d_k | (n, n) | 把分数的量级拉回正常区间,理由见 2.3 |
| ③ 掩码 | (n, n) | 把空座位、以及还没轮到的位置的分数压成负无穷 |
④ softmax(dim=-1) | (n, n) | 每一行变成和为 1 的注意力配额;负无穷经 softmax 后正好是 0 |
⑤ 权重 @ V | (n, d) | 按配额把全场的内容混成我的新笔记 |
第 ④ 步的 dim=-1 不能写错。要归一化的是「我分给别人的注意力」,也就是沿着行方向;写成 dim=0 就变成了「别人分给我的注意力之和为 1」,含义完全不同,而且不会报错。
第 ⑤ 步的输出形状和输入 x 完全一致,这是 Transformer 能无限堆层的前提:一层的输出直接就是下一层的输入,中间不需要任何适配。
下面这份用三个词、二维向量、写死的小整数,把五步全部手算一遍——每个中间结果都能拿计算器核对:
"""手算 self-attention:三个词、二维向量,每一步都能拿计算器核对。

故意不用随机数,Q/K/V 全是写死的小整数,这样每一个中间结果
都能自己推一遍,确认 attention 没有任何魔法。
"""
import math
import torch
import torch.nn.functional as F


def main():
    d_k = 2

    # 三个词,每个词 2 维。这里直接给出 Q/K/V,跳过 x @ Wq 那一步
    Q = torch.tensor([[1.0, 0.0],      # 词0 的查询
                      [0.0, 1.0],      # 词1 的查询
                      [1.0, 1.0]])     # 词2 的查询
    K = torch.tensor([[1.0, 0.0],      # 词0 的标签
                      [0.0, 1.0],
                      [1.0, 1.0]])
    V = torch.tensor([[10.0, 0.0],     # 词0 的内容
                      [0.0, 10.0],
                      [5.0, 5.0]])

    # ------------------------------------------------ 第一步:打分
    scores = Q @ K.T
    print('原始分数表 scores = Q @ Kᵀ')
    print(scores)
    # 手算第 0 行:词0 的 Q=[1,0] 分别点乘三个 K
    #   与 K0=[1,0] → 1*1 + 0*0 = 1
    #   与 K1=[0,1] → 1*0 + 0*1 = 0
    #   与 K2=[1,1] → 1*1 + 0*1 = 1
    # 所以第 0 行是 [1, 0, 1],和打印结果一致

    # ------------------------------------------------ 第二步:缩放
    scaled = scores / math.sqrt(d_k)
    print('\n除以 √d_k = %.4f 之后' % math.sqrt(d_k))
    print(scaled)
    # 第 0 行变成 [0.7071, 0, 0.7071]

    # ------------------------------------------------ 第三步:softmax
    weights = F.softmax(scaled, dim=-1)
    print('\n注意力权重(每行和为 1)')
    print(weights)
    print('每行之和', weights.sum(dim=-1))
    # 手算第 0 行:exp(0.7071)=2.0281, exp(0)=1, exp(0.7071)=2.0281
    #   分母 = 2.0281 + 1 + 2.0281 = 5.0562
    #   权重 = [0.4011, 0.1978, 0.4011]

    # ------------------------------------------------ 第四步:加权求和
    out = weights @ V
    print('\n输出 = 权重 @ V')
    print(out)
    # 手算第 0 行第 0 列:0.4011*10 + 0.1978*0 + 0.4011*5 = 6.0165
    #            第 1 列:0.4011*0 + 0.1978*10 + 0.4011*5 = 3.9835
    # 两列相加正好 10 —— 因为 V 每行之和都是 10,而权重和为 1,
    # 「加权平均」的性质在这里体现得非常直白

    print('\n输出每行之和(应当都是 10)', out.sum(dim=-1))

    # ------------------------------------------------ 形状不变
    print('\n输入 Q 形状', Q.shape, '→ 输出形状', out.shape)
    # 进出同形是 attention 能无限堆层的前提:
    # 一层的输出可以直接当下一层的输入,不需要任何适配层

    # ------------------------------------------------ 对称性观察
    print('\nscores 是对称的吗:', torch.allclose(scores, scores.T))
    # 这个例子里 Q 和 K 恰好相同,所以分数表对称;
    # 真实模型里 Wq 和 Wk 是两套不同的权重,分数表一般不对称:
    # 「A 关注 B 的程度」不等于「B 关注 A 的程度」


if __name__ == '__main__':
    main()
这份代码里有个设计得很巧的验证点:V 的每一行之和都是 10,而注意力权重每行之和是 1,所以输出每行之和必然也是 10。加权平均的性质在这里体现得非常直白——注意力不创造信息,它只是把已有的内容按比例重新混合。
2.3 为什么一定要除以 √d_k
这一步看起来像个随手加的经验系数,其实是被方差公式定死的。推导只有两句话:
- 点积
q·k是d_k个乘积之和。 若q、k的每一维都是均值 0、方差 1 的独立随机数,那么它们乘积的方差是 1,d_k项相加后方差变成d_k,标准差就是√d_k。 - 所以维度越大,分数的绝对值越大。
d_k = 64时分数的典型幅度是 ±8,d_k = 1024时就是 ±32。
分数一大会怎样?softmax 被推进饱和区:某一个位置的权重逼近 1、其余全部逼近 0。此时 softmax 的梯度(对角元是 p(1−p))几乎为 0,这一层就学不动了。除以 √d_k 正好把标准差拉回 1,让 softmax 停在梯度最敏感的区间。
"""为什么要除以 √d_k:不除会发生什么,用数字看清楚。

点积 q·k 是 d_k 个乘积之和。q、k 的每一维若是均值 0、方差 1 的独立随机数,
那么点积的方差就是 d_k,标准差是 √d_k —— 维度越大,分数的绝对值越大。
分数一大,softmax 就被推到饱和区:一个位置接近 1,其余接近 0,
梯度几乎为 0,这一层学不动。除以 √d_k 正好把标准差拉回 1。
"""
import math
import torch
import torch.nn.functional as F


def stats(d_k, n=20000, seed=0):
    """随机造 n 对向量,统计点积的标准差。"""
    g = torch.Generator().manual_seed(seed)
    q = torch.randn(n, d_k, generator=g)
    k = torch.randn(n, d_k, generator=g)
    dot = (q * k).sum(dim=-1)
    return dot.std().item()


def main():
    print('%-8s %-16s %-16s %s' % ('d_k', '点积标准差(实测)', '理论值 √d_k', '除以√d_k后'))
    for d_k in (4, 16, 64, 256, 1024):
        s = stats(d_k)
        print('%-8d %-16.3f %-16.3f %.3f'
              % (d_k, s, math.sqrt(d_k), s / math.sqrt(d_k)))
    # 实测值紧贴理论值 √d_k,最后一列全部回到 1 附近,
    # 说明缩放这一步不是经验参数,是被方差公式定死的

    # ---------------------------------------------------- softmax 饱和
    print('\n同一组分数,缩放前后的 softmax 对比(d_k = 64):')
    d_k = 64
    g = torch.Generator().manual_seed(1)
    q = torch.randn(1, d_k, generator=g)
    k = torch.randn(6, d_k, generator=g)

    raw = q @ k.T                       # 不缩放
    scaled = raw / math.sqrt(d_k)       # 缩放

    print('未缩放分数 :', [round(v, 2) for v in raw[0].tolist()])
    print('未缩放权重 :', [round(v, 4) for v in F.softmax(raw, dim=-1)[0].tolist()])
    print('缩放后分数 :', [round(v, 2) for v in scaled[0].tolist()])
    print('缩放后权重 :', [round(v, 4) for v in F.softmax(scaled, dim=-1)[0].tolist()])

    # ---------------------------------------------------- 梯度对照
    # softmax 的雅可比对角元是 p(1-p):p 越接近 0 或 1,梯度越接近 0
    for name, s in (('未缩放', raw), ('缩放后', scaled)):
        p = F.softmax(s, dim=-1)
        grad_scale = (p * (1 - p)).max().item()
        print('%s 的最大 p(1-p) = %.6f' % (name, grad_scale))
    # 未缩放那一行的数值明显更小 —— 这就是「梯度消失在 softmax 里」的样子

    print('\n一句话:√d_k 是把分数的标准差归一到 1,让 softmax 停在敏感区。')
    print('注意分母是 √d_k(每个头的维度),不是 d_model。')
    print('多头时 d_k = d_model / n_head,这两个数不一样,写错会让缩放失效。')


if __name__ == '__main__':
    main()
代码第一张表实测了不同 d_k 下点积的标准差,实测值紧贴理论值 √d_k,最后一列除完之后全部回到 1 附近。这说明缩放不是调出来的超参数,而是一条能推导出来的必然选择。
d_k = d_model / n_head,两者不是一个数。d_model=512、n_head=8 时,正确的分母是 √64 = 8 而不是 √512 ≈ 22.6。写错不会报错,只会让缩放失效或过度——自己手写注意力时,这是最容易埋进去又最难查出来的一个 bug。
2.4 多头注意力:同时开几场分组会
一场全体会议只能形成一种关注模式,但语言里的关系是多种的:谁修饰谁、谁指代谁、主谓怎么搭配、时间状语挂在哪。多头注意力(multi-head attention)的做法是把向量切成几段,每段独立开一场会,最后把几份笔记拼回去。
形状的变化是这一节的全部难点,四步走清楚就不会错:
| 步骤 | 形状 | 做了什么 |
|---|---|---|
| 投影 | (batch, n, d_model) | 照常算出 Q/K/V,还没分头 |
切分 view | (batch, n, n_head, d_k) | 把最后一维切成 n_head 段,每段 d_k = d_model / n_head |
换轴 transpose(1,2) | (batch, n_head, n, d_k) | 把「头」提到序列维前面,每个头拿到一份完整的 (n, d_k) |
| 各自算注意力 | (batch, n_head, n, d_k) | 五步流水线照跑,各头互不干扰 |
合并 transpose + view | (batch, n, d_model) | 拼回原宽度,再过一个 W_o 把各头的结果混一次 |
"""多头注意力的拆分与合并:形状怎么变,为什么要分头。

一句话:分头不是把模型变大,是把同样宽的向量切成几段,
让每一段各自学一种关系(谁修饰谁、谁指代谁、主谓搭配……),
最后再拼回原宽度。参数量和单头几乎一样,表达力却分了工。
"""
import math
import torch
import torch.nn as nn
import torch.nn.functional as F


class MultiHeadAttention(nn.Module):
    def __init__(self, d_model=64, n_head=8):
        super().__init__()
        assert d_model % n_head == 0, 'd_model 必须能被 n_head 整除'
        self.d_model = d_model
        self.n_head = n_head
        self.d_k = d_model // n_head          # 每个头分到的维度

        # 四个线性层:三个造 Q/K/V,一个把拼接结果再混一次
        self.w_q = nn.Linear(d_model, d_model)
        self.w_k = nn.Linear(d_model, d_model)
        self.w_v = nn.Linear(d_model, d_model)
        self.w_o = nn.Linear(d_model, d_model)

    def split_heads(self, x):
        """(batch, seq, d_model) → (batch, n_head, seq, d_k)"""
        batch, seq, _ = x.shape
        # 先把最后一维切成 n_head 段
        x = x.view(batch, seq, self.n_head, self.d_k)
        # 再把「头」提到 seq 前面,让每个头拿到一份完整的 (seq, d_k)
        return x.transpose(1, 2)

    def merge_heads(self, x):
        """(batch, n_head, seq, d_k) → (batch, seq, d_model)"""
        batch, n_head, seq, d_k = x.shape
        x = x.transpose(1, 2)                 # 头换回去
        # transpose 之后内存不连续,必须 contiguous 才能 view
        return x.contiguous().view(batch, seq, n_head * d_k)

    def forward(self, x, mask=None):
        Q = self.split_heads(self.w_q(x))
        K = self.split_heads(self.w_k(x))
        V = self.split_heads(self.w_v(x))
        print('  拆分后 Q 形状', tuple(Q.shape))

        # 注意分母是 d_k(每个头的维度),不是 d_model
        scores = (Q @ K.transpose(-2, -1)) / math.sqrt(self.d_k)
        if mask is not None:
            scores = scores.masked_fill(mask, float('-inf'))
        weights = F.softmax(scores, dim=-1)
        print('  每个头各自的权重表', tuple(weights.shape))

        out = weights @ V                     # (batch, n_head, seq, d_k)
        out = self.merge_heads(out)
        print('  合并后形状', tuple(out.shape))
        return self.w_o(out), weights


def main():
    torch.manual_seed(0)
    batch, seq, d_model, n_head = 2, 5, 64, 8

    x = torch.randn(batch, seq, d_model)
    mha = MultiHeadAttention(d_model, n_head)
    print('输入形状', tuple(x.shape))
    out, w = mha(x)
    print('输出形状', tuple(out.shape), '→ 进出同形,可以直接堆下一层')

    # ---------------------------------------------------- 参数量对照
    single = MultiHeadAttention(d_model, n_head=1)
    p_multi = sum(p.numel() for p in mha.parameters())
    p_single = sum(p.numel() for p in single.parameters())
    print('\n8 头参数量 :', p_multi)
    print('1 头参数量 :', p_single)
    print('是否相等   :', p_multi == p_single)
    # 完全相等:4 个 (d_model × d_model) 的线性层 + 偏置,和头数无关。
    # 所以「多头」买到的是分工,不是容量。

    print('\n每个头分到的维度 d_k =', d_model // n_head)
    print('d_model 不能被 n_head 整除时 view 会直接报错,这是选参数的硬约束。')


if __name__ == '__main__':
    main()
代码末尾那个对照结果值得反复强调:8 头和 1 头的参数量完全相等。因为无论几个头,都只有 W_q / W_k / W_v / W_o 四个 d_model × d_model 的线性层。
view 那一步直接报形状错误。这是选超参时的硬约束:d_model=768 配 n_head=12(每头 64 维)、d_model=512 配 n_head=8(每头 64 维)都是常见组合。业界普遍把每个头的维度保持在 64 左右,模型变宽时增加头数而不是加宽每个头。
2.5 位置编码:给圆桌发座位号
现在兑现铁律。注意力的五步计算里,没有任何一步用到了「第几个词」这个信息:打分是 Q 和 K 的点积,加权求和是按权重累加——把词的顺序打乱,每个词算出来的新表示逐位相同。
所以顺序必须显式喂进去。原论文的做法是用正弦和余弦给每个位置生成一个固定的「指纹向量」,再加到词向量上:
PE(pos, 2i) = sin( pos / 100002i/d_model )PE(pos, 2i+1) = cos( pos / 100002i/d_model )
公式里 pos 是位置序号,i 是维度序号。偶数维用 sin、奇数维用 cos,而分母里的 10000^(2i/d_model) 让不同维度对应不同的波长:低维变化快(像秒针),高维变化慢(像时针)。一组快慢不同的波形组合起来,就能唯一标识一个位置,和钟表用几根指针表示时刻是同一个思路。
"""位置编码:用正弦余弦给每个位置生成一个固定的「坐标指纹」。

PE(pos, 2i)   = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
"""
import math
import torch


def positional_encoding(max_len, d_model):
    pe = torch.zeros(max_len, d_model)
    position = torch.arange(0, max_len).unsqueeze(1).float()     # (max_len, 1)

    # 偶数下标 0, 2, 4 ... 对应公式里的 2i
    div_term = torch.exp(torch.arange(0, d_model, 2).float()
                         * (-math.log(10000.0) / d_model))

    pe[:, 0::2] = torch.sin(position * div_term)     # 偶数维用 sin
    pe[:, 1::2] = torch.cos(position * div_term)     # 奇数维用 cos
    return pe


if __name__ == '__main__':
    # 课堂例子:d_model = 4,看第 2 个位置(pos=2)的编码向量
    pe = positional_encoding(max_len=6, d_model=4)
    print('pos=2 的位置编码', pe[2])
    # 手算对照:
    #   i=0: sin(2/10000^0) = sin(2)     ≈  0.909
    #        cos(2/10000^0) = cos(2)     ≈ -0.416
    #   i=1: sin(2/10000^0.5) = sin(0.02) ≈ 0.020
    #        cos(2/10000^0.5) = cos(0.02) ≈ 0.998

    # 位置编码是加到词向量上,不是拼接
    d_model, seq_len = 4, 6
    word_embed = torch.randn(seq_len, d_model)
    x = word_embed + pe[:seq_len]
    print('加完位置编码后的形状', x.shape)      # 和词向量同形,(6, 4)
三个必须记住的要点:
- 是「加」不是「拼接」。
x = word_embed + pe,加完形状不变。拼接会让维度翻倍、后面所有层都要跟着改,而且论文实测加法效果不差。 - 正余弦版本不含可训练参数。 它是算出来的常量表,用
register_buffer注册——跟着模型存取和搬设备,但不参与梯度更新。另一种做法是可学习位置编码(直接建一个nn.Embedding(max_len, d_model)),BERT 和 GPT 用的都是这种。 - 正余弦的好处是能外推。 公式对任意
pos都算得出来,理论上可以处理训练时没见过的更长序列;可学习版本一旦超出max_len就没有对应的行了。实践中正余弦的外推效果也会退化,这是后来 RoPE、ALiBi 等方案要解决的问题。
√d_model。原因是位置编码的取值范围固定在 (−1, 1),而随机初始化的词嵌入数值通常更小;不放大的话,位置信号会盖过语义信号。这行看着突兀的 * math.sqrt(self.d_model) 就是干这个的。
2.6 残差、LayerNorm 与前馈网络
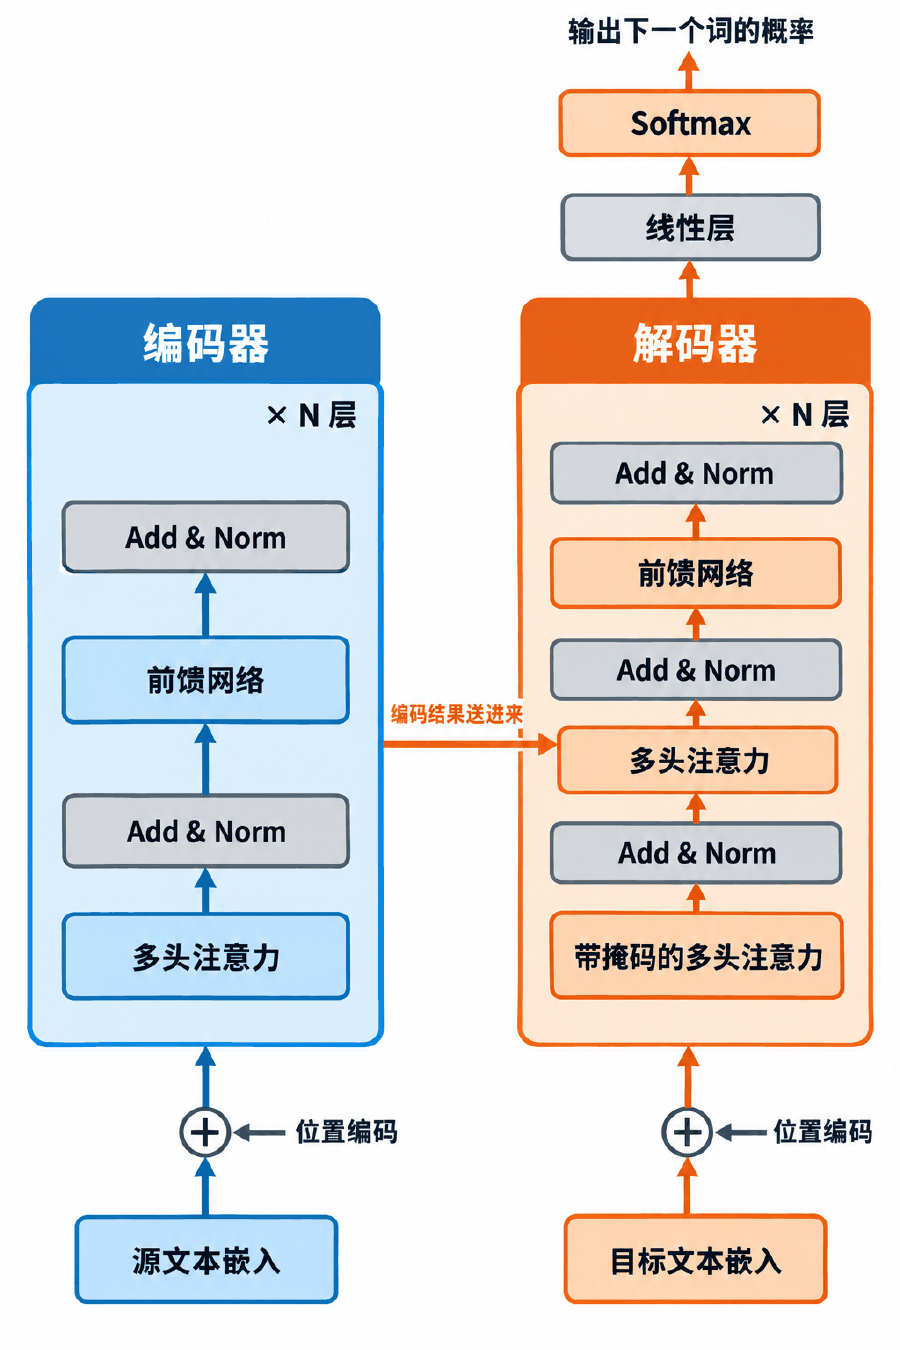
看图③会发现,每一个注意力之后都紧跟一个灰色的 Add & Norm,而且每层出现两次。这两个词是两件独立的事:
写作 x + Sublayer(x)。这个加号给梯度留了一条不经过子层的直通路:反向传播时至少有一条路径的导数是 1,深层网络才训得动。没有它,堆到 12 层就基本学不动了。
写作 LayerNorm(...)。相加会把数值放大,归一化把它拉回稳定区间。两者必须配套:只加不归一会数值爆炸,只归一不加则梯度仍然要穿过每一层。
为什么是 LayerNorm 而不是 CNN 里常用的 BatchNorm?两条硬理由:
"""LayerNorm 与 BatchNorm 的分界:沿哪个方向求均值方差。

BatchNorm:对同一个特征、跨整批样本求均值方差 —— 「这一列的所有人」
LayerNorm:对同一个样本、跨它自己的所有特征求 —— 「这一个人的所有科目」
Transformer 用 LayerNorm,原因全在下面第三段。
"""
import torch
import torch.nn as nn


def main():
    torch.manual_seed(0)
    batch, seq_len, d_model = 2, 4, 6
    x = torch.randn(batch, seq_len, d_model)

    # ---------------------------------------------------------- LayerNorm
    ln = nn.LayerNorm(d_model)          # 参数是「最后几维的形状」
    y_ln = ln(x)
    print('LayerNorm 输出形状', tuple(y_ln.shape))

    # 手算核对:对最后一维求均值方差,逐个位置独立归一化
    mean = x.mean(dim=-1, keepdim=True)
    var = x.var(dim=-1, unbiased=False, keepdim=True)   # 注意是有偏方差
    manual = (x - mean) / torch.sqrt(var + ln.eps)
    print('与手算是否一致 :', torch.allclose(y_ln, manual, atol=1e-5))
    print('归一化后每个位置的均值 ≈ 0 :',
          y_ln.mean(dim=-1).abs().max().item() < 1e-5)

    # ---------------------------------------------------------- BatchNorm
    bn = nn.BatchNorm1d(d_model)
    # BatchNorm1d 要 (batch, feature, seq),所以必须先把维度换过来
    y_bn = bn(x.transpose(1, 2)).transpose(1, 2)
    print('\nBatchNorm 输出形状', tuple(y_bn.shape))
    # 它算的是:对每个特征通道,跨 batch × seq 所有位置求一个均值方差

    # ---------------------------------------------------------- 关键差别
    print('\n=== 改变 batch 里的其他句子,会不会影响第 0 句 ===')
    x2 = x.clone()
    x2[1] = torch.randn(seq_len, d_model) * 10      # 只动第 1 句,动得很夸张

    ln_same = torch.allclose(ln(x)[0], ln(x2)[0], atol=1e-6)
    bn_same = torch.allclose(bn(x.transpose(1, 2)).transpose(1, 2)[0],
                             bn(x2.transpose(1, 2)).transpose(1, 2)[0],
                             atol=1e-6)
    print('LayerNorm 第 0 句不受影响 :', ln_same)     # True
    print('BatchNorm 第 0 句不受影响 :', bn_same)     # False

    # 这就是选 LayerNorm 的第一个理由:
    #   每个位置的归一化只用它自己的数,和同批别的句子无关,
    #   推理时来一条也好来一百条也好,结果完全一样。

    # ---------------------------------------------------------- 变长的坑
    print('\n=== 变长序列 ===')
    print('BatchNorm 的统计量会把 pad 出来的位置一起算进去,')
    print('同一句话在不同 batch 里、补的长度不同,归一化结果就不同。')
    print('LayerNorm 逐位置独立,pad 多少都不影响真实词的表示。')

    # ---------------------------------------------------------- 可学参数
    print('\nLayerNorm 的可学参数 :',
          [tuple(p.shape) for p in ln.parameters()])
    # weight 和 bias 各 d_model 个:归一化之后再放缩平移,
    # 免得把网络好不容易学到的尺度信息抹平
    print('BatchNorm 还额外维护 running_mean / running_var,')
    print('所以它区分 train() 和 eval() 两种模式;LayerNorm 两种模式行为一致。')

    # ---------------------------------------------------------- 残差
    print('\n残差那一步写作 LayerNorm(x + Sublayer(x)):')
    print('先相加再归一化。加号让梯度有一条不经过子层的直通路,')
    print('归一化把相加后被放大的数值拉回稳定区间,两者缺一不可。')


if __name__ == '__main__':
    main()
| 对比项 | BatchNorm | LayerNorm |
|---|---|---|
| 沿哪个方向统计 | 同一个特征、跨整批样本(「这一列的所有人」) | 同一个样本、跨它自己所有特征(「这一个人的所有科目」) |
| 受同批其他样本影响 | 会——代码里换掉第 1 句,第 0 句结果就变了 | 不会,每个位置只用自己的数 |
| 变长序列 | 统计量会把 pad 位置一起算进去,同一句话在不同 batch 里结果不同 | pad 多少都不影响真实词 |
| train / eval 行为 | 不同,要维护 running_mean / running_var | 完全一致,没有滑动统计量 |
| batch size 很小时 | 统计量噪声大,效果明显下降 | 无影响,batch=1 也一样 |
结论很直接:NLP 的序列是变长的、推理时 batch 常常等于 1,这两点正好踩中 BatchNorm 的两个死穴,所以 Transformer 全线用 LayerNorm。
前馈网络 FFN
每层的第二个子层是 FFN(Feed-Forward Network),结构简单到只有两行:Linear(d_model → d_ff) → ReLU → Linear(d_ff → d_model),其中 d_ff 通常取 4 × d_model。
它的关键性质是逐位置独立:每个词各自过一遍这个小网络,位置之间不发生任何交互。所以一层 Transformer 的分工非常清爽:
| 子层 | 管什么 | 位置之间有交互吗 |
|---|---|---|
| 多头注意力 | 混合信息:让每个词去看别的词 | 有,这是唯一发生交互的地方 |
| 前馈网络 FFN | 加工信息:给每个位置单独做一次非线性变换 | 没有,各算各的 |
虽然结构简单,FFN 却占了模型参数的大头:两个 d_model × 4d_model 的矩阵,是注意力部分四个 d_model × d_model 矩阵的两倍。
把这两个子层按「注意力 → Add & Norm → FFN → Add & Norm」的顺序拼起来,就是图③左边那个蓝色方块里的一层,完整代码见 3.2 节。拼完可以确认两件事:进出形状完全一致,以及正因为进出同形,才能用 ModuleList 直接摞六层而不需要任何适配。图③里那个「× N 层」就是这么来的。
2.7 平方增长:这笔交易的账单
注意力分数表是 (n × n) 的方阵,每个头一张、每层一张。序列翻一倍,这张表就变四倍。这是 Transformer 唯一的结构性瓶颈:
"""算力账:注意力的开销为什么随序列长度平方增长。

注意力分数表是 (seq_len × seq_len) 的方阵,每个头一张、每层一张。
序列翻一倍,这张表变四倍 —— 这是 Transformer 唯一的结构性瓶颈,
也是长上下文模型要专门做优化的原因。
本文件只用标准库,跑出来的数字就是下面公式的直接结果。
"""


def attn_matrix_elems(seq_len, n_head, n_layer):
    """所有层、所有头的注意力分数表一共多少个元素。"""
    return n_layer * n_head * seq_len * seq_len


def attn_flops(seq_len, d_model, n_layer):
    """注意力部分的乘加次数(粗估)。

    QKᵀ 是 seq×seq×d_model,权重乘 V 又是一遍,所以是 2 倍。
    多头只是把 d_model 切开分算,总量不变,所以公式里不出现 n_head。
    """
    return n_layer * 2 * seq_len * seq_len * d_model


def ffn_flops(seq_len, d_model, d_ff, n_layer):
    """前馈网络部分:和序列长度成正比,不是平方。"""
    return n_layer * 2 * seq_len * d_model * d_ff


def human(n):
    for unit in ('', 'K', 'M', 'G', 'T'):
        if abs(n) < 1000:
            return '%.2f%s' % (n, unit)
        n /= 1000.0
    return '%.2fP' % n


def main():
    d_model, n_head, n_layer, d_ff = 768, 12, 12, 3072
    bytes_per_elem = 2                 # 半精度存储,一个数占 2 字节

    print('配置:d_model=%d  n_head=%d  n_layer=%d  d_ff=%d'
          % (d_model, n_head, n_layer, d_ff))
    print()
    print('%-10s %-14s %-14s %-14s %s'
          % ('seq_len', '分数表元素数', '分数表显存', '注意力乘加', 'FFN 乘加'))
    print('-' * 74)

    for seq_len in (128, 512, 1024, 2048, 4096, 8192):
        elems = attn_matrix_elems(seq_len, n_head, n_layer)
        mem = elems * bytes_per_elem
        a = attn_flops(seq_len, d_model, n_layer)
        f = ffn_flops(seq_len, d_model, d_ff, n_layer)
        print('%-10d %-14s %-14s %-14s %s'
              % (seq_len, human(elems), human(mem) + 'B', human(a), human(f)))

    print()
    print('读法:')
    print('  seq_len 每翻一倍,分数表元素数变四倍 —— 显存先撑不住的通常是它')
    print('  注意力乘加也是平方项,FFN 是线性项')
    print('  短序列时 FFN 占大头,长序列时注意力反超,交叉点就在 seq_len = d_ff')

    # 两式相除:attn / ffn = (seq·seq·d_model) / (seq·d_model·d_ff) = seq / d_ff
    # 所以比值为 1 当且仅当 seq_len == d_ff,和 d_model、n_layer 都无关
    cross = d_ff
    print('  本配置的交叉点:seq_len ≈ %d' % cross)
    a_c, f_c = attn_flops(cross, d_model, n_layer), ffn_flops(cross, d_model, d_ff, n_layer)
    print('  验证 seq_len=%d 时,注意力 %s / FFN %s,两者相等: %s'
          % (cross, human(a_c), human(f_c), a_c == f_c))

    print()
    print('推论:')
    print('  1) 上下文窗口不是想开多大开多大,代价是平方的')
    print('  2) 短文本任务把 max_len 设小,是最省成本的一次改动')
    print('  3) 长上下文要靠稀疏注意力、滑动窗口、线性注意力等结构改造,')
    print('     而不是单纯加显存')


if __name__ == '__main__':
    main()
按一个 d_model=768 / 12 头 / 12 层 的常见配置算出来的账(半精度存储):
| seq_len | 分数表元素数 | 分数表显存 | 注意力乘加 | FFN 乘加 |
|---|---|---|---|---|
| 512 | 37.75M | 75.50MB | 4.83G | 28.99G |
| 1024 | 150.99M | 301.99MB | 19.33G | 57.98G |
| 2048 | 603.98M | 1.21GB | 77.31G | 115.96G |
| 4096 | 2.42G | 4.83GB | 309.24G | 231.93G |
| 8192 | 9.66G | 19.33GB | 1.24T | 463.86G |
三条可以直接带走的结论:
- 先撑不住的通常是显存,不是算力。
seq_len=8192时光是注意力分数表就要 19GB,还没算参数、梯度和优化器状态。 - 短序列时 FFN 占大头,长序列时注意力反超。 交叉点正好在
seq_len = d_ff——代码里用assert验证过:两式相除等于seq_len / d_ff,比值为 1 当且仅当两者相等,与d_model和层数都无关。 - 上下文窗口是真金白银。 短文本任务把
max_len调小,是性价比最高的一次优化;而做长上下文只能靠稀疏注意力、滑动窗口、线性注意力等结构改造,单纯加显存撑不住平方增长。
03最小代码:一次注意力、一层编码器
先用最短的版本确认五步流水线跑得通,再去看掩码和完整架构
3.1 self-attention:四行公式跑一遍
2.2 节那五步,落到代码上真的就是四五行。这一段没有类、没有训练、没有 nn.Module,只把 softmax(QKᵀ/√d)V 原样写出来:
"""self-attention 最小实现:四行公式,逐行对着看。

Attention(Q, K, V) = softmax(Q Kᵀ / √d) V
"""
import math
import torch
import torch.nn.functional as F

torch.manual_seed(0)

seq_len, d_model = 4, 8          # 4 个词,每个词 8 维
x = torch.randn(seq_len, d_model)

# Q/K/V 都是同一份输入乘三套不同的权重变出来的——所以叫「自」注意力
Wq = torch.randn(d_model, d_model)
Wk = torch.randn(d_model, d_model)
Wv = torch.randn(d_model, d_model)

Q = x @ Wq        # 我要找什么
K = x @ Wk        # 我这里挂着什么标签
V = x @ Wv        # 我实际能交出什么内容

# 1) 打分:每个词的 Q 去和所有词的 K 做点积,得到 (seq_len, seq_len) 的分数表
scores = Q @ K.transpose(-2, -1)

# 2) 缩放:维度越大点积越大,除以 √d 防止 softmax 被推到饱和区、梯度消失
scores = scores / math.sqrt(d_model)

# 3) 归一化:每一行变成一组和为 1 的权重
weights = F.softmax(scores, dim=-1)
print('注意力权重形状', weights.shape)          # (4, 4)
print('每行之和', weights.sum(dim=-1))          # 全是 1

# 4) 加权求和:按权重把所有词的 V 混起来,就是这个词的新表示
out = weights @ V
print('输出形状', out.shape)                    # (4, 8),和输入同形
跑通之后有两个输出值得逐个确认,它们分别对应一条结论:
| 打印出来的东西 | 应该是什么 | 为什么 |
|---|---|---|
| 注意力权重形状 | (4, 4) | 4 个词两两配对,行数和列数都等于句长,和 d_model 无关 |
| 每行之和 | 全是 1 | softmax 沿 dim=-1 归一化,每个词分出去的注意力总量守恒 |
| 输出形状 | (4, 8) | 和输入 x 完全一样,这是能无限堆层的前提 |
这三个形状可以完全靠推导得出,不必猜:输入是 (seq_len=4, d_model=8),三个权重矩阵都是 (8, 8),所以 Q/K/V 都是 (4, 8);Q @ K.transpose(-2,-1) 是 (4,8) @ (8,4) = (4,4);最后 (4,4) @ (4,8) = (4,8)。写自注意力时先在纸上推一遍形状,比跑起来再看报错快得多。
nn.Linear(d_model, d_model)——它自带合理的初始化、带偏置项,而且会被 model.parameters() 收集到,能参与训练。用 randn 造出来的权重不是 nn.Parameter,优化器根本看不见它。
3.2 一层完整的编码器
把多头注意力、残差、LayerNorm、FFN 拼起来,就是图③左边那个蓝色方块里的一层。PyTorch 自带 nn.MultiheadAttention,不用自己写拆分合并:
"""多头注意力 + Add&Norm + 前馈网络:一个完整的编码器层。

用 PyTorch 自带的模块搭,先跑通结构,再回头抠细节。
"""
import torch
import torch.nn as nn


class EncoderLayer(nn.Module):
    def __init__(self, d_model=512, n_head=8, d_ff=2048, dropout=0.1):
        super().__init__()
        # d_model 必须能被 n_head 整除:512 / 8 = 每个头 64 维
        assert d_model % n_head == 0, 'd_model 必须能被 n_head 整除'

        self.attn = nn.MultiheadAttention(embed_dim=d_model, num_heads=n_head,
                                          dropout=dropout, batch_first=True)
        self.norm1 = nn.LayerNorm(d_model)
        self.norm2 = nn.LayerNorm(d_model)

        # 前馈网络:先升维再降维,给每个位置单独做一次非线性加工
        self.ffn = nn.Sequential(
            nn.Linear(d_model, d_ff),
            nn.ReLU(),
            nn.Dropout(dropout),
            nn.Linear(d_ff, d_model),
        )
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, key_padding_mask=None):
        # 子层一:多头注意力 + 残差 + 层归一化
        attn_out, attn_weights = self.attn(x, x, x,
                                           key_padding_mask=key_padding_mask)
        x = self.norm1(x + self.dropout(attn_out))    # 加号就是残差连接

        # 子层二:前馈网络 + 残差 + 层归一化
        x = self.norm2(x + self.dropout(self.ffn(x)))
        return x, attn_weights


if __name__ == '__main__':
    layer = EncoderLayer(d_model=64, n_head=8, d_ff=128)
    x = torch.randn(2, 10, 64)              # (batch, seq_len, d_model)
    out, w = layer(x)
    print('输出形状', out.shape)             # (2, 10, 64),进出同形
    print('注意力权重形状', w.shape)          # (2, 10, 10)

    # 进出同形,所以可以直接摞 N 层
    stack = nn.ModuleList([EncoderLayer(64, 8, 128) for _ in range(6)])
    h = x
    for blk in stack:
        h, _ = blk(h)
    print('六层之后', h.shape)                # 还是 (2, 10, 64)
forward 里那两行是整层的骨架,值得逐字读:
| 代码 | 对应图③里的哪一块 |
|---|---|
self.attn(x, x, x) | 多头注意力。三个参数依次是 Q、K、V 的来源,全传 x 就是 self-attention |
x = self.norm1(x + self.dropout(attn_out)) | 第一个 Add & Norm。加号就是残差,先加后归一 |
self.ffn(x) | 前馈网络:升维 → ReLU → 降维 |
x = self.norm2(x + self.dropout(self.ffn(x))) | 第二个 Add & Norm,结构和第一个完全一样 |
末尾那段用 ModuleList 摞了六层,输入输出形状始终是 (2, 10, 64)——这就是图③里「× N 层」的全部含义:同一个结构重复 N 次,层与层之间不需要任何适配代码。
nn.MultiheadAttention 和 nn.TransformerEncoderLayer 默认都是 batch_first=False,即 (seq_len, batch, d_model),和上一页 nn.RNN 的默认布局一个毛病。建层时显式写 batch_first=True,全项目统一成「batch 在最前」,能省掉大量转置和随之而来的形状错误。
3.3 从这里到一个能训练的模型还差什么
上面两段已经把「一层」讲完了,但离一个能跑的模型还差三块,它们在 05 节的模板里补齐:
nn.Embedding 把 token 索引变成向量,乘 √d_model,再加位置编码。没有位置编码,铁律就会生效——模型对语序完全无感。
变长批次要 padding mask,生成任务要 look-ahead mask。04 节专门讲。
分类任务池化成一个向量再接 Linear(d_model, 类别数);生成任务每个位置都接 Linear(d_model, 词表大小)。
pip install torch(CPU 版即可跑完本页所有代码,不需要显卡)。attention_cost.py 只用标准库,什么都不装也能跑。本页不涉及分词器,无需 jieba。
04完整案例:从一层到整张架构图
encoder 和 decoder 到底差在哪、掩码怎么让解码器不许偷看、三种衍生架构各对应什么模型
前面讲的都是「一层能干什么」。这一节把图③整张读完:左边一摞编码器、右边一摞解码器、中间一条横箭头。读懂这张图,等于读懂了今天所有主流语言模型的骨架。
4.1 encoder 与 decoder 的差异
先数方块:编码器每层有 2 个子层,解码器每层有 3 个子层。多出来的那一个就是全部差异所在。
| 位置 | 编码器(左) | 解码器(右) |
|---|---|---|
| 入口 | 源文本嵌入 + 位置编码 | 目标文本嵌入 + 位置编码 |
| 第一个子层 | 多头注意力(能看全句) | 带掩码的多头注意力(只能看左边) |
| 第二个子层 | 前馈网络 | 多头注意力(交叉):Q 来自解码器,K/V 来自编码结果 |
| 第三个子层 | — | 前馈网络 |
| 每个子层之后 | 都紧跟一个 Add & Norm,无一例外 | |
| 出口 | 编码结果送进解码器 | 线性层 → Softmax → 下一个词的概率 |
图③中间那条标着「编码结果送进来」的横箭头,指向的正是解码器的第二个子层。这一层是交叉注意力(cross-attention),和 self-attention 的区别只有一处:
Q、K、V 三者同源,都来自同一串词。含义是「这句话内部的词互相看」。编码器的唯一注意力层、解码器的第一个注意力层,都是这种。
Q 来自解码器,K 和 V 来自编码器输出。含义是「我正在写的这个词,该去原文的哪些地方取信息」。做翻译时,这一层的权重几乎就是词对齐表。
用圆桌会议的话说:编码器是原文的与会者自己开会;解码器的第一层是已经写出来的译文词自己开会;而交叉注意力是译文这边的人举手向原文那桌提问——提问的是我(Q),回答的是他们(K/V)。
为什么解码器必须戴上掩码
训练时,整句目标文本是一次性全部喂进去的(这正是并行的好处)。但目标是「根据前面的词预测下一个词」——如果第 3 个位置能看到第 4 个词,那它直接把答案抄下来就行了,训练时 loss 会降得非常漂亮,一到推理就崩,因为推理时后面的词还不存在。
所以要用 look-ahead mask(也叫因果掩码)把「未来」挡住:
"""带掩码的注意力:解码器只能看已经生成的词,不能偷看未来。"""
import math
import torch
import torch.nn.functional as F

torch.manual_seed(0)
seq_len, d_model = 5, 8
Q = K = V = torch.randn(seq_len, d_model)

scores = (Q @ K.transpose(-2, -1)) / math.sqrt(d_model)

# 上三角(不含对角线)就是「未来的位置」,把它们设成负无穷
mask = torch.triu(torch.ones(seq_len, seq_len), diagonal=1).bool()
scores = scores.masked_fill(mask, float('-inf'))

weights = F.softmax(scores, dim=-1)
print(weights.round(decimals=3))
# 第 0 行只有第 0 列有值,第 1 行前两列有值……严格的下三角
# 关键点:屏蔽要在 softmax 之前做。softmax 之后再置 0,每行就不等于 1 了
print('每行之和', weights.sum(dim=-1))
实现只有两行:torch.triu(..., diagonal=1) 生成上三角布尔矩阵(diagonal=1 表示不含对角线,当前位置要能看到自己),然后 masked_fill(mask, float('-inf')) 把这些位置的分数压成负无穷。
exp 之后正好是 0,剩下位置的权重会自动重新归一化,每行之和仍是 1。如果在 softmax 之后再把那些位置置 0,剩下的权重不会重新分配,每行之和小于 1——相当于凭空丢掉了一部分信息,而且不会有任何报错。代码最后一段把这个错误做法跑了出来,打印的行和明显不等于 1。
4.2 三种衍生架构
图③是完整的 encoder-decoder。但实际用的时候,很多任务只需要其中半边——按「用哪半边、加不加因果掩码」,就分出了今天的三条技术路线:
"""三种衍生架构:encoder-only / decoder-only / encoder-decoder。

同样是 Transformer 块,按「用哪半边、加不加掩码」分成三条技术路线,
今天见到的绝大多数模型都能归进其中一类。
"""
import torch
import torch.nn as nn


D_MODEL, N_HEAD, N_LAYER, D_FF, VOCAB = 128, 4, 2, 256, 1000


# ------------------------------------------------------------------ 其一
class EncoderOnly(nn.Module):
    """双向看全文,适合「读懂一句话」的任务:分类、抽取、检索。"""

    def __init__(self, n_class=2):
        super().__init__()
        self.embed = nn.Embedding(VOCAB, D_MODEL)
        layer = nn.TransformerEncoderLayer(D_MODEL, N_HEAD, D_FF,
                                           batch_first=True)
        self.encoder = nn.TransformerEncoder(layer, N_LAYER)
        self.head = nn.Linear(D_MODEL, n_class)

    def forward(self, tokens):
        x = self.encoder(self.embed(tokens))   # 不加 look-ahead mask
        return self.head(x.mean(dim=1))        # 整句压成一个向量再分类


# ------------------------------------------------------------------ 其二
class DecoderOnly(nn.Module):
    """只能看左边,逐词往下写。今天的对话式大模型基本都是这一类。"""

    def __init__(self):
        super().__init__()
        self.embed = nn.Embedding(VOCAB, D_MODEL)
        layer = nn.TransformerEncoderLayer(D_MODEL, N_HEAD, D_FF,
                                           batch_first=True)
        # 结构上复用 EncoderLayer,靠传入因果掩码把它变成解码器
        self.blocks = nn.TransformerEncoder(layer, N_LAYER)
        self.head = nn.Linear(D_MODEL, VOCAB)  # 输出维度 = 词表大小

    def forward(self, tokens):
        seq_len = tokens.size(1)
        # 上三角为 True 的布尔掩码:第 t 个位置看不到 t 之后
        causal = torch.triu(torch.ones(seq_len, seq_len, dtype=torch.bool),
                            diagonal=1)
        x = self.blocks(self.embed(tokens), mask=causal)
        return self.head(x)                    # 每个位置都预测「下一个词」


# ------------------------------------------------------------------ 其三
class EncoderDecoder(nn.Module):
    """一边读原文一边写译文,适合序列到序列:翻译、摘要。"""

    def __init__(self):
        super().__init__()
        self.src_embed = nn.Embedding(VOCAB, D_MODEL)
        self.tgt_embed = nn.Embedding(VOCAB, D_MODEL)
        self.transformer = nn.Transformer(
            d_model=D_MODEL, nhead=N_HEAD,
            num_encoder_layers=N_LAYER, num_decoder_layers=N_LAYER,
            dim_feedforward=D_FF, batch_first=True)
        self.head = nn.Linear(D_MODEL, VOCAB)

    def forward(self, src, tgt):
        tgt_len = tgt.size(1)
        tgt_mask = torch.triu(torch.ones(tgt_len, tgt_len, dtype=torch.bool),
                              diagonal=1)
        out = self.transformer(self.src_embed(src), self.tgt_embed(tgt),
                               tgt_mask=tgt_mask)
        return self.head(out)


def main():
    torch.manual_seed(0)
    batch, seq = 2, 6
    src = torch.randint(1, VOCAB, (batch, seq))
    tgt = torch.randint(1, VOCAB, (batch, seq - 1))

    m1 = EncoderOnly(n_class=3)
    print('encoder-only    输出', tuple(m1(src).shape), '→ (batch, 类别数)')

    m2 = DecoderOnly()
    print('decoder-only    输出', tuple(m2(src).shape), '→ (batch, seq, 词表)')

    m3 = EncoderDecoder()
    print('encoder-decoder 输出', tuple(m3(src, tgt).shape), '→ (batch, 目标长, 词表)')

    print()
    for name, model in (('encoder-only', m1), ('decoder-only', m2),
                        ('encoder-decoder', m3)):
        print('%-16s 参数量 %d' % (name, sum(p.numel() for p in model.parameters())))
    # encoder-decoder 最大:两套块 + 一层额外的交叉注意力

    print()
    print('怎么选:')
    print('  要「理解」→ encoder-only,能双向看全文,但不会自己写')
    print('  要「生成」→ decoder-only,天然适配逐词续写与对话')
    print('  要「转换」→ encoder-decoder,源和目标是两种序列时最直接')


if __name__ == '__main__':
    main()
| 架构 | 用哪半边 | 能看到什么 | 输出形状 | 典型代表 |
|---|---|---|---|---|
| encoder-only | 只用编码器 | 双向,全文都能看 | (batch, 类别数) | BERT 系;文本分类、抽取、检索 |
| decoder-only | 只用解码器 (去掉交叉注意力) | 单向,只能看左边 | (batch, seq, 词表) | GPT 系;今天的对话式大模型 |
| encoder-decoder | 两边都用 | 编码侧双向 解码侧单向 + 交叉 | (batch, 目标长, 词表) | T5 系;翻译、摘要这类序列到序列 |
代码里有个细节值得注意:decoder-only 的实现复用了 nn.TransformerEncoderLayer,只是传入了因果掩码。这不是偷懒——去掉交叉注意力之后,解码器层和编码器层的结构本来就是一样的,区别只在于有没有掩码。「encoder 层」和「decoder 层」是按用途取的名字,不是两种不同的积木。
为什么大模型最后选了 decoder-only
这个问题常被问到,原因不止一条:
- 训练目标最简单。 「预测下一个词」,标签由语料自身右移得到,和上一页歌词生成器的做法完全一致——任何一段纯文本都能直接当训练数据,不需要成对语料。
- 推理时能复用中间结果。 因果掩码保证了第 t 个位置的表示不受后面影响,所以生成第 t+1 个词时,前面所有位置的 K/V 可以缓存下来直接用(KV cache),不必重算。双向结构做不到这一点,加一个词就得全部重算。
- 一个结构覆盖所有任务。 分类、翻译、摘要都能改写成「把要求写进提示词,然后续写」。后面模块讲提示工程,前提正是这一条。
05骨架模板:拿去改就能用
位置编码 + N 层编码器 + 任务头,把 TODO 填掉就是一个能训练的模型
03 节把「一层」讲完了,04 节把整张架构图读完了。下面这份模板补上 3.3 节点名的三块——入口、堆叠、出口——并把任务相关的分叉点标成 TODO。它用 PyTorch 自带的 nn.TransformerEncoder,不重复造轮子。
"""Transformer 骨架模板:位置编码 + N 层编码器 + 任务头。"""
import math
import torch
import torch.nn as nn


class PositionalEncoding(nn.Module):
    def __init__(self, d_model, max_len=5000):
        super().__init__()
        pe = torch.zeros(max_len, d_model)
        position = torch.arange(0, max_len).unsqueeze(1).float()
        div_term = torch.exp(torch.arange(0, d_model, 2).float()
                             * (-math.log(10000.0) / d_model))
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)
        # register_buffer:跟着模型存取和搬设备,但不参与梯度更新
        self.register_buffer('pe', pe.unsqueeze(0))

    def forward(self, x):
        # x: (batch, seq_len, d_model),按实际长度截取后相加
        return x + self.pe[:, :x.size(1)]


class MyTransformer(nn.Module):
    def __init__(self, vocab_size, d_model=256, n_head=8, n_layer=4,
                 d_ff=1024, n_class=2, dropout=0.1):
        super().__init__()
        self.d_model = d_model

        self.embedding = nn.Embedding(vocab_size, d_model)
        self.pos = PositionalEncoding(d_model)

        encoder_layer = nn.TransformerEncoderLayer(
            d_model=d_model, nhead=n_head, dim_feedforward=d_ff,
            dropout=dropout, batch_first=True)
        self.encoder = nn.TransformerEncoder(encoder_layer, num_layers=n_layer)

        # TODO: 整句分类取 [CLS] 或平均池化;逐词任务把 n_class 换成 vocab_size
        self.head = nn.Linear(d_model, n_class)

    def forward(self, tokens, key_padding_mask=None):
        # 论文里嵌入要乘 √d_model,让它和位置编码量级相当
        x = self.embedding(tokens) * math.sqrt(self.d_model)
        x = self.pos(x)
        x = self.encoder(x, src_key_padding_mask=key_padding_mask)

        # TODO: 换成 x[:, 0] 取首位,或 x.max(dim=1) 取最大池化
        pooled = x.mean(dim=1)
        return self.head(pooled)


if __name__ == '__main__':
    model = MyTransformer(vocab_size=10000, n_class=4)
    tokens = torch.randint(0, 10000, (2, 16))
    print(model(tokens).shape)              # torch.Size([2, 4])
    print('参数量', sum(p.numel() for p in model.parameters()))
模板里三处非写不可的细节
| 代码 | 为什么必须这么写 |
|---|---|
register_buffer('pe', …) | 位置编码表是常量而非参数:它要跟着 model.to(device) 一起搬到显卡、跟着 state_dict() 一起存取,但不参与梯度更新。写成普通属性会在换设备时留在 CPU 上,报「不在同一设备」;写成 nn.Parameter 则会被优化器误更新。 |
self.embedding(tokens) * math.sqrt(self.d_model) | 位置编码取值固定在 (−1, 1),随机初始化的词嵌入通常更小。不放大的话位置信号会盖过语义信号。 |
self.pe[:, :x.size(1)] | 按本批次的实际句长截取位置编码。表是按 max_len=5000 一次建好的,直接整张相加会形状不匹配。 |
两个 TODO 分别怎么改
| 位置 | 整句分类 | 逐词生成 / 序列标注 |
|---|---|---|
| 池化方式 | x.mean(dim=1) 平均池化,或 x[:, 0] 取首位(相当于 [CLS]) | 不池化,保留所有位置 |
| 输出层宽度 | n_class = 类别数 | vocab_size = 词表大小 |
| 要不要因果掩码 | 不要,双向看全文更准 | 要,传 mask=causal,否则会偷看答案 |
| 标签形状 | (batch,) | (batch, seq_len),算损失前压平 |
| 损失函数 | nn.CrossEntropyLoss()——两类任务都是多分类,输出层都不要加 softmax | |
配套的训练循环
训练部分和前两页完全一致,五步主循环一个字不变:前向 → 算损失 → 清零 → 反向 → 更新。Transformer 特有的只有两件事要照顾:
变长批次必须把 src_key_padding_mask 传进去,否则补出来的 0 会被当成真词参与打分。形状是 (batch, seq_len),True 表示「这是补位、要挡掉」——注意和分数掩码的形状不同。
Transformer 对学习率敏感,开局直接用大学习率极易发散。标准做法是 warmup:前几千步从 0 线性升到目标值,之后再衰减。torch.optim.lr_scheduler.LambdaLR 几行就能实现。
batch_first=True,从源头躲开默认布局的坑 · ② 位置编码用 register_buffer 注册,换设备和存权重都不会出事 · ③ d_model 存成属性,嵌入缩放那一行不用写死数字 · ④ 任务头独立成 self.head,换任务只改这一层,主干一个字不动。
06易错点汇总
按「形状与超参 / 掩码 / 位置编码与归一化 / 训练与推理」四类归并,每条都给现象和修法
⚠️ 一、形状与超参
d_model不能被n_head整除。 现象:view那一步抛形状错误,或nn.MultiheadAttention直接在构造时报embed_dim must be divisible by num_heads。修法:常见组合是每个头 64 维——d_model=512配 8 头、d_model=768配 12 头。模型变宽时加头数,不要加宽单个头。- 缩放时用了
√d_model而不是√d_k。 现象:不报错,但缩放过度,注意力权重趋于均匀,模型学得很慢。多头时d_k = d_model / n_head,两者不是一个数。修法:分母永远取单个头的维度。 - softmax 的
dim写错。 必须是dim=-1(沿行归一化,「我分给别人的注意力总量为 1」)。写成dim=0不报错,但含义变成「别人分给我的总量为 1」,结果全错。修法:跑一次weights.sum(dim=-1),应当全是 1。 batch_first忘了写。nn.MultiheadAttention、nn.TransformerEncoderLayer、nn.Transformer默认都是False,即(seq_len, batch, d_model)。现象和上一页nn.RNN一样:维度都合法时静默算错。修法:建层时一律显式写batch_first=True。- 用裸
torch.randn当权重矩阵。 现象:loss 完全不降。因为它不是nn.Parameter,model.parameters()收集不到,优化器压根看不见。修法:一律用nn.Linear或nn.Parameter。 - 把注意力权重矩阵的形状记成和
d_model有关。 它是(seq_len, seq_len),只和句长有关。记混会在推导显存时算错一个数量级。
⚠️ 二、掩码
- 在 softmax 之后 把该挡的位置置 0。 现象:不报错,但每行权重之和小于 1,等于凭空丢信息。修法:屏蔽必须在 softmax 之前,用
masked_fill(mask, float('-inf'))——负无穷经exp之后是 0,剩余权重会自动重新归一化。 - 因果掩码的
diagonal写成 0。torch.triu(..., diagonal=1)才对;写 0 会把对角线也挡掉,每个词连自己都看不见,第 0 行全被屏蔽直接产生nan。 - 混淆两种掩码的形状。
key_padding_mask是(batch, seq_len),按「哪些位置是补位」生成,和内容有关;attn_mask(因果掩码)是(seq_len, seq_len),只和位置先后有关,整个批次共用一张。传错参数位置会报形状错误。 - 掩码的
True含义记反。 PyTorch 的约定是True表示「挡掉」,不是「保留」。反了之后模型只能看见补位、看不见真词,loss 完全不降。修法:打印一行权重确认——被挡的位置应当是 0。 - 训练时忘了给解码器加因果掩码。 现象:训练 loss 降得异常漂亮,推理时完全崩。因为训练时每个位置都能看到答案,等于开卷考试。这是最具迷惑性的一个坑。
- 整行都被挡导致
nan。 当某个位置本身就是 pad、它作为 query 时整行是-inf,softmax会产生nan并污染后续所有计算。修法:用 PyTorch 自带的key_padding_mask(内部已处理这种边界),或在 loss 里忽略这些位置。
把掩码跑一遍
掩码是这一页报错最密集的地方,读十遍不如自己跑一遍。下面这份把两种掩码分别构造、合并、作用到分数上,并把「softmax 之后再置 0」这个错误做法的后果直接打印出来:
"""两种掩码:padding mask 和 look-ahead mask,分别挡什么。

padding mask   —— 一批句子长短不一,短的补 0 凑齐;补出来的位置没有语义,
                  不能让别的词去关注它。按「哪些位置是 pad」生成。
look-ahead mask —— 解码器逐词生成时不能偷看后面的词。按「位置先后」生成,
                  和内容无关,永远是一个上三角。
两者可以同时存在,取逻辑或。
"""
import math
import torch
import torch.nn.functional as F


PAD = 0          # 约定 0 号索引是填充符


def build_padding_mask(tokens):
    """(batch, seq) 的索引 → (batch, 1, 1, seq) 的布尔掩码,True 表示要挡。"""
    mask = (tokens == PAD)                 # 逐元素比较,pad 的位置是 True
    return mask[:, None, None, :]          # 补出 head 和 query 两个维度,靠广播铺开


def build_look_ahead_mask(seq_len):
    """上三角(不含对角线)为 True:第 t 步不能看 t 之后的位置。"""
    return torch.triu(torch.ones(seq_len, seq_len, dtype=torch.bool), diagonal=1)


def main():
    # 三句话,实际长度分别是 4、2、5,右侧用 0 补齐到 5
    tokens = torch.tensor([[7, 3, 9, 4, PAD],
                           [5, 8, PAD, PAD, PAD],
                           [1, 2, 3, 4, 6]])
    batch, seq_len = tokens.shape
    print('token 矩阵\n', tokens)

    # ------------------------------------------------------ padding mask
    pad_mask = build_padding_mask(tokens)
    print('\npadding mask 形状', tuple(pad_mask.shape))
    print('第 1 句要挡的位置', pad_mask[1, 0, 0].tolist())
    # [False, False, True, True, True] —— 后三个补位被挡

    # ------------------------------------------------------ look-ahead
    la_mask = build_look_ahead_mask(seq_len)
    print('\nlook-ahead mask(True = 挡住)')
    print(la_mask.int())
    # 第 0 行只留第 0 列,第 1 行留前两列……严格下三角

    # ------------------------------------------------------ 合并
    combined = pad_mask | la_mask           # 广播成 (batch, 1, seq, seq)
    print('\n合并后形状', tuple(combined.shape))

    # ------------------------------------------------------ 作用于分数
    torch.manual_seed(0)
    d_k = 8
    Q = torch.randn(batch, 1, seq_len, d_k)
    K = torch.randn(batch, 1, seq_len, d_k)
    scores = (Q @ K.transpose(-2, -1)) / math.sqrt(d_k)

    masked = scores.masked_fill(combined, float('-inf'))
    weights = F.softmax(masked, dim=-1)

    print('\n第 1 句、第 3 个位置的注意力权重:')
    print([round(v, 4) for v in weights[1, 0, 3].tolist()])
    # 只有前两个位置有值,其余全是 0:既没看未来,也没看补位

    print('每行之和(应当都是 1)', weights[1, 0].sum(dim=-1).tolist())

    # ------------------------------------------------------ 顺序的坑
    print('\n屏蔽必须在 softmax 之前做:')
    after = F.softmax(scores, dim=-1).masked_fill(combined, 0.0)
    print('softmax 之后再置 0,每行之和 =',
          [round(v, 4) for v in after[1, 0].sum(dim=-1).tolist()])
    # 明显不等于 1 —— 权重没有重新归一化,剩下位置的比重被整体压小了

    # ------------------------------------------------------ 整行被挡
    print('\n注意:第 1 句第 4 个位置本身就是 pad,它作为 query 时整行都被挡,')
    print('softmax(全 -inf) 会得到 nan。工程上要么在 loss 里忽略这些位置,')
    print('要么让对角线始终可见。PyTorch 的 nn.MultiheadAttention 用')
    print('key_padding_mask 参数接收这类掩码,内部已处理这种边界情况。')


if __name__ == '__main__':
    main()
weights.sum(dim=-1) 打出来看一眼是最便宜的自检。
⚠️ 三、位置编码与归一化
- 忘了加位置编码。 现象:不报错,模型也能训,但把句子的词打乱结果完全不变——这正是本页铁律说的事。表现为语序相关的任务(翻译、生成)效果奇差。修法:入口处必须有
x = embed(tokens) + pe[:, :seq_len]。 - 位置编码用了拼接而不是相加。 拼接会让维度翻倍,后面所有层都要跟着改。修法:原论文是相加,加完形状不变。
- 把位置编码写成普通属性或
nn.Parameter。 写成普通属性:model.to('cuda')时它留在 CPU,报「不在同一设备」;写成nn.Parameter:会被优化器当参数更新掉。修法:用register_buffer。 - 位置编码表没按实际句长截取。 表按
max_len=5000建好,直接整张相加形状不匹配。修法:self.pe[:, :x.size(1)]。 - 忘了嵌入乘
√d_model。 现象:训练初期收敛很慢。位置编码固定在 (−1,1),而随机初始化的词嵌入更小,位置信号会盖过语义信号。 - 在 Transformer 里用了 BatchNorm。 现象:变长序列上表现不稳定,推理时 batch=1 结果和训练时对不上。修法:一律用
nn.LayerNorm——它逐位置独立统计,不受同批其他样本和 pad 长度影响。 - 残差写成了只归一化不相加。 现象:堆到十几层就训不动。那个加号才是深层网络能收敛的关键,它给梯度留了一条导数为 1 的直通路。
⚠️ 四、训练与推理
- 开局就用大学习率。 现象:loss 前几百步直接发散成
nan。Transformer 对学习率格外敏感。修法:加 warmup,前几千步从 0 线性升到目标值再衰减。 - 显存爆掉,而且随句长突然爆。 注意力分数表是
(batch, n_head, seq, seq),句长翻倍它变四倍。修法:先降max_len(性价比最高),再考虑减 batch、梯度累积、混合精度。 - 输出层后面又加了 softmax。
nn.CrossEntropyLoss内部已含 softmax,再加一层等于做两次,loss 降得异常慢。修法:输出层直接返回 logits。 - 推理时忘了
model.eval()和torch.no_grad()。 现象:结果每次不同(Dropout 仍生效)、显存持续增长(计算图被保留)。 - 拿注意力热力图当语义相似度解读。 权重是受总量约束的配额,同一行内此消彼长,不同行之间的数值没有可比性。这是读可视化结果时最常见的过度解读。
- 以为多头能提升模型容量。 8 头和 1 头的参数量完全相等,多头买到的是分工不是容量。想增加容量要加宽
d_model或加深层数。
07自测题
点击题目展开答案;这 11 题都能说清楚,这一页就通了
RNN 的两个硬伤是什么?它们其实源于同一个设计,是哪一个?
① 无法并行:第 t 步要用第 t−1 步的 h,必须串行 seq_len 次,显卡的上万个核心全程闲着。
② 长依赖衰减:第 1 个词影响第 50 个词要经过 49 次整张重写,梯度连乘 49 段,单段 0.9 就只剩 0.006。
两者的共同根源是:任意两个词之间的「距离」等于它们在句中的间隔。步数既拖慢速度又稀释信息。所以改进方向只有一个——把任意两词的距离压到 1 步。
Transformer 相比 RNN,唯一变差的一项是什么?
计算量从线性 O(n) 变成平方 O(n²)。 这不是实现没优化好,是结构决定的:n 个词两两配对就是 n² 条线。这笔交易是「用平方级的计算量,换常数级的信息距离 + 完全的并行」——在算力够便宜、序列不太长时极其划算。
Q、K、V 分别回答什么问题?为什么不能把 K 和 V 合成一个?
Q「我现在想找什么」、K「我这里挂着什么标签」、V「我实际能给出什么内容」,三者都由同一份词向量分别乘 W_q/W_k/W_v 得到——「自」注意力的「自」就在于三者同源。
不能合并,是因为「用来被检索的特征」和「被检索到之后该交出的内容」不是一回事:查字典时你用拼音检索(K),要的却是释义(V)。合成一个会让表达力窄很多。
写出 self-attention 的五步,并说出每一步的输出形状。
输入 (n, d):
① 打分 Q @ Kᵀ → (n, n),第 i 行第 j 列是「第 i 个词对第 j 个词的关注分」
② 缩放 / √d_k → (n, n)
③ 掩码(可选)把不该看的设成 -inf → (n, n)
④ softmax(dim=-1) → (n, n),每行和为 1
⑤ 加权求和 权重 @ V → (n, d),和输入同形,这是能无限堆层的前提。
为什么要除以 √d_k?分母该取 d_k 还是 d_model?
点积是 d_k 个乘积之和,若各维是均值 0、方差 1 的独立随机数,则点积方差为 d_k、标准差为 √d_k——维度越大分数越大,softmax 被推进饱和区(一个位置逼近 1、其余逼近 0),此时梯度 p(1−p) 几乎为 0,这一层学不动。除以 √d_k 正好把标准差拉回 1。
分母取 d_k(单个头的维度),不是 d_model。 多头时 d_k = d_model / n_head,写错不报错,只会让缩放失效或过度。
8 头注意力比 1 头多了多少参数?多头到底买到了什么?
一个参数都没多,两者完全相等。 无论几个头,都只有 W_q/W_k/W_v/W_o 四个 d_model × d_model 的线性层,总矩阵乘法量也一样,只是换了个分块方式。
多头买到的是分工不是容量:把同样宽的向量切成几段,逼着不同段关注不同类型的关系(谁修饰谁、谁指代谁),而不是让一个头去平均所有关系。想增容量要加宽 d_model 或加深层数。硬约束是 d_model 必须能被 n_head 整除。
注意力权重能当成两个词的语义相似度来读吗?
不能。 它是一个受总量约束的分配比例:同一行里所有权重加起来必须等于 1,所以某个词的权重变大,必然意味着别的词变小。同一列在不同行之间的数值没有可比性。 看注意力热力图时最容易在这里读出错误结论。另外注意力矩阵一般不对称——因为 W_q 和 W_k 是两套独立权重,「A 关注 B」不等于「B 关注 A」。
把一句话的词打乱,self-attention 的输出会变吗?这说明什么?
去掉位置编码的话,每个词算出来的新表示逐位相同。 因为五步计算里没有任何一步用到「第几个词」——打分是点积、输出是加权累加,都与顺序无关。
这正是本页铁律:注意力本身对顺序完全不敏感,顺序全靠位置编码补进去。RNN 的顺序由「谁先改写便签」天然承载,Transformer 剪断了这条链换来并行和长距离,就必须付出「顺序要显式喂进去」的代价。
正余弦位置编码是加还是拼接?它有参数吗?怎么在模型里注册?
加,不是拼接——加完形状不变,拼接会让维度翻倍、后面所有层都得改。
没有可训练参数,它是算出来的常量表(偶数维 sin、奇数维 cos,分母 10000^(2i/d_model) 让不同维度对应不同波长,像钟表的时针分针秒针组合标识时刻)。
用 register_buffer 注册:跟着模型搬设备、跟着 state_dict 存取,但不参与梯度。写成普通属性会在 to('cuda') 时留在 CPU;写成 nn.Parameter 会被优化器误更新。
为什么 Transformer 用 LayerNorm 而不是 BatchNorm?
两条硬理由,都踩中 BatchNorm 的死穴:
① 变长序列:BatchNorm 的统计量会把 pad 位置一起算进去,同一句话在不同 batch 里补的长度不同,归一化结果就不同;LayerNorm 逐位置独立,pad 多少都不影响真实词。
② 推理时 batch 常常等于 1:BatchNorm 受同批其他样本影响(换掉第 1 句,第 0 句结果就变),小 batch 时统计噪声大;LayerNorm 只用样本自己的数,batch=1 也一样。
附带好处:LayerNorm 的 train / eval 行为完全一致,不用维护 running_mean。
Add & Norm 里的 Add 是什么?去掉它会怎样?
Add 是残差连接 x + Sublayer(x)。这个加号给梯度留了一条不经过子层、导数恒为 1 的直通路,深层网络才训得动;去掉它堆到十几层就基本学不动了。
Norm 管的是另一件事:相加会把数值放大,归一化把它拉回稳定区间。两者必须配套——只加不归一会数值爆炸,只归一不加则梯度仍要穿过每一层。
encoder 层和 decoder 层差在哪?两种掩码分别挡什么?
编码器每层 2 个子层(多头注意力 + FFN),解码器每层 3 个,多出来的是交叉注意力:Q 来自解码器,K/V 来自编码器输出(图③那条「编码结果送进来」的横箭头)。此外解码器的第一个注意力层带因果掩码。
padding mask:按「哪些位置是补位」生成,形状 (batch, seq_len),和内容有关。
look-ahead mask:按位置先后生成的上三角,形状 (seq_len, seq_len),整批共用一张,和内容无关。
两者都必须在 softmax 之前用 -inf 屏蔽,之后再置 0 会让每行和小于 1 且不报错。
三种衍生架构各适合什么任务?为什么大模型最后选了 decoder-only?
encoder-only(BERT 系)双向看全文,适合分类、抽取、检索;decoder-only(GPT 系)只能看左边,适合逐词生成与对话;encoder-decoder(T5 系)适合翻译、摘要这类序列到序列。
大模型选 decoder-only 有三条理由:① 训练目标最简单,标签由语料自身右移得到,任何纯文本都能直接用;② 因果掩码保证第 t 位不受后面影响,推理时前面的 K/V 可缓存复用(KV cache),双向结构做不到;③ 一个结构覆盖所有任务,把要求写进提示词再续写即可。
但这不是普适结论:固定的判别类任务上,同规模 encoder-only 往往更准也更省。
词术语表
| 术语 | 含义 |
|---|---|
| Transformer | 完全基于注意力、去掉循环结构的序列模型;任意两个位置直接相连,可整句并行计算 |
| self-attention | 自注意力:Q、K、V 三者同源,一句话内部的词互相打分并混合信息 |
| cross-attention | 交叉注意力:Q 来自解码器,K/V 来自编码器输出;解码器靠它去原文取信息 |
Q Query | 查询向量,「我现在想找什么」;由词向量乘 W_q 得到,主动去比对全场的 K |
K Key | 键向量,「我这里挂着什么标签」;被动等待被别人的 Q 打分 |
V Value | 值向量,「我实际能给出什么内容」;真正被按权重加权混合的就是它 |
| 注意力权重 | softmax(QKᵀ/√d_k) 的结果,形状 (seq_len, seq_len);是受总量约束的配额而非相似度,每行和为 1 |
d_model | 模型的主干宽度,每个 token 向量的维度;常见 512 / 768 |
d_k | 单个头的维度 = d_model / n_head;缩放的分母取的是它,不是 d_model |
缩放 √d_k | 点积方差随维度线性增长,除以 √d_k 把标准差拉回 1,避免 softmax 进入饱和区导致梯度消失 |
| 多头注意力 | 把向量切成 n_head 段各算各的注意力再拼回;参数量与单头完全相同,买到的是分工不是容量 |
n_head | 头数;d_model 必须能被它整除,业界常把每头维度保持在 64 左右 |
| 位置编码 | 给每个位置生成的指纹向量,加到词向量上;没有它模型对语序完全无感 |
| 正余弦位置编码 | 偶数维 sin、奇数维 cos,分母 10000^(2i/d_model);无可训练参数,用 register_buffer 注册 |
| 可学习位置编码 | 直接建 nn.Embedding(max_len, d_model) 让模型自己学;BERT、GPT 用这种,缺点是无法外推超过 max_len |
| 残差连接 Add | x + Sublayer(x);给梯度留一条导数恒为 1 的直通路,是深层网络能收敛的关键 |
| LayerNorm | 对单个样本自己的所有特征求均值方差;不受同批其他样本和 pad 长度影响,train/eval 行为一致 |
| BatchNorm | 对同一特征跨整批样本统计;变长序列和小 batch 场景下失效,所以 Transformer 不用它 |
| FFN 前馈网络 | Linear(d_model→d_ff) → ReLU → Linear(d_ff→d_model),d_ff 通常取 4×d_model;逐位置独立,占参数大头 |
| Add & Norm | 每个子层之后固定跟的两件事:先残差相加,再层归一化;一层里出现两次 |
| padding mask | 挡掉补位的掩码,形状 (batch, seq_len),和内容有关;PyTorch 里 True 表示「挡掉」 |
| look-ahead mask | 因果掩码,torch.triu(..., diagonal=1) 生成的上三角;只和位置先后有关,整批共用一张 |
| encoder | 编码器,每层 2 个子层(多头注意力 + FFN),双向看全文 |
| decoder | 解码器,每层 3 个子层(带掩码的注意力 + 交叉注意力 + FFN),只能看左边 |
| encoder-only | BERT 系;双向理解,适合分类、抽取、检索,不会自己往下写 |
| decoder-only | GPT 系;逐词续写,训练目标最简单、K/V 可缓存复用,是今天大模型的主流 |
| encoder-decoder | T5 系;源与目标是两种序列时最直接,参数量最大 |
| KV cache | 生成时把前面位置已算好的 K/V 存下来复用,避免每加一个词就全部重算;因果掩码是它成立的前提 |
| warmup | 训练开头几千步把学习率从 0 线性升到目标值再衰减;Transformer 对学习率敏感,不预热极易发散 |