LangChain Tools 与 Agent 实战
把一个普通 Python 函数变成模型认得出、挑得中、填得对的工具,再用 create_agent 把工具箱交给店长,让它自己决定先做哪件、后做哪件。
30″30 秒看懂 Tools 与 Agent 实战
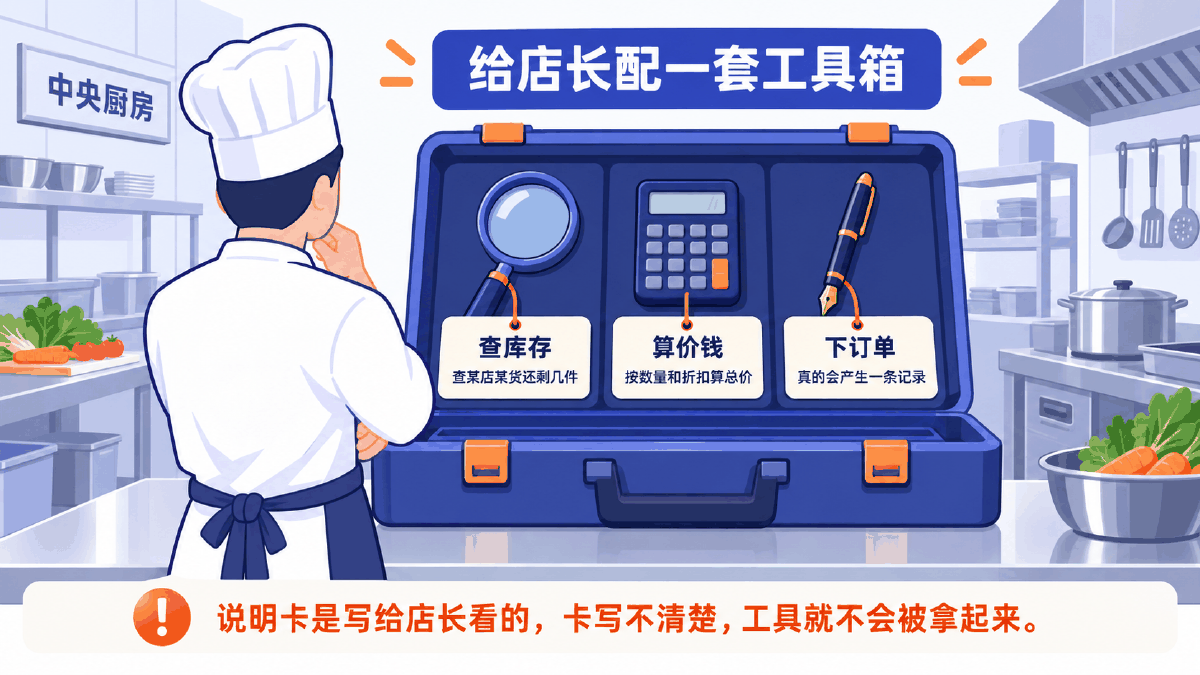
还是那间中央厨房。厨师(大模型)手艺再好也只会做菜——他跑不出去买货、算不了账、更下不了单。于是厨房里设了一个店长(Agent),店长自己也不做菜,他手上有一个工具箱:查库存的放大镜、算价钱的计算器、下订单的钢笔。
关键在工具箱的细节:每件工具上都挂着一张说明卡——这件家伙什叫什么、什么时候该拿起来、要填哪几个空。店长不会拆开工具研究内部构造,他只读说明卡。卡写得含糊,工具就一直躺在箱子里;卡写错了,他就会在该拿计算器的时候抓起钢笔。
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 厨师 | 大模型 | 真正产出内容的人;也是判断「该用哪件工具、参数填什么」的那个脑子 |
| 店长 | Agent | 拿着工具箱反复决策:还要不要再做一件事、做哪件,做完了就收工 |
| 工具箱 | tools=[...] | 交给 Agent 的工具列表,内置的和你自己写的混在一起,Agent 看不出区别 |
| 一件工具 | Tool | 一个被包装过的普通函数:有名字、有说明、有参数表、有真身 |
| 挂在工具上的说明卡 | description | 模型挑不挑这件工具,全看这张卡;它是这一讲的主角 |
| 卡上的填空格 | args_schema | 每个参数叫什么、什么类型、什么含义、有没有取值范围 |
| 工具的金属部分 | 被装饰的那个函数 | 真正跑起来的代码,由你的进程执行,模型碰不到 |
| 店长的工作循环 | create_agent 的执行循环 | 调模型 → 看要不要用工具 → 用 → 把结果塞回去 → 再调模型 |
| 墙上的备忘板 | checkpointer + thread_id | 让这一轮记得上一轮说过什么,不同会话各用各的板子 |
description 是写给模型看的,不是写给同事看的注释。模型选不选你这个工具,全看它。函数写得再漂亮、逻辑再严密,说明卡含糊,它就永远不会被拿起来。
01概念:Tool 到底是什么
一个被包装过的普通函数、它的四个要素、现成的与自己写的、以及和 Function Call 的分工
1.1 Tool 是一个「带说明书的函数」
只会生成文本的模型,能力是封闭的:它答不出今天的库存,也算不准一笔带折扣的总价,更不可能替你在数据库里插一条订单。Tool 就是为了把这堵墙凿开——它把外部系统、API 或者你自己的一段 Python 函数封装成一个可调用模块,让模型能够跟真实世界互动。
但要注意 Tool 的本体有多朴素:它就是一个普通函数,外面裹了一层说明书。裹上这层之后多了三样东西:
有了唯一的 name,模型点名的时候才知道点谁。同一个工具箱里名字不能重复。
有了 description 和参数表,这些会被送进模型的上下文,成为它选择的依据。
成了 Runnable:invoke / ainvoke 一视同仁,所以它能被塞进链,也能被塞进 Agent。
模块化是 Tool 的设计前提:一个工具只专注一件事,搜索工具、计算工具、天气工具各管一摊,需要谁就把谁放进列表。这也是为什么后面案例里的三个工具,一个只查库存、一个只算钱、一个只下单——把它们合成一个「万能工具」,模型反而不知道什么时候该用它。
1.2 四要素:模型看三样,你的程序跑一样
一件完整的 Tool 由四个要素组成,这是这一讲最该背下来的结构:
| 要素 | 对应的字段 | 谁在用它 |
|---|---|---|
| ① 名称 | name | 模型:用来点名。你:用来在日志里认出是哪件工具被调用了 |
| ② 功能描述 | description | 模型:唯一的选择依据。写不清楚,工具形同虚设 |
| ③ 参数结构 | args_schema(一个 Pydantic 模型) | 模型:照着填参数。框架:在执行前替你做一次校验 |
| ④ 要调用的函数 | 被装饰的那个函数本体 | 只有你的程序在跑它。模型自始至终没碰过这行代码 |
还有一个只对 Agent 生效的开关 return_direct:默认 False,工具结果会回到模型手里、让它决定下一步;设成 True 则执行完直接把结果甩给用户、循环当场中断。
1.3 现成的工具与自己写的工具
社区已经有大量现成工具:搜索引擎、维基百科、文件操作、Shell、SQL 查询、各种云服务 SDK,装上对应的集成包就能直接塞进 tools 列表。要不要自己写,判断标准很简单:
| 这件事的性质 | 怎么选 | 例子 |
|---|---|---|
| 任何人做都一样 | 用现成的 | 联网搜索、抓网页、读本地文件、跑一段计算 |
| 只有你们公司这么做 | 自己写 | 查你们的库存表、按你们的规则算价、走你们的审批下单 |
| 现成的能用但字段不对 | 包一层 | 用 StructuredTool 把已有函数裹起来,重写名称与描述 |
"""内置工具与自定义工具的分界线在哪。

社区里已经有大量现成工具(搜索、维基、文件操作、Shell、SQL……),
装上对应的集成包就能直接塞进 tools 列表,不用自己写。

判断标准很简单:
    这件事任何人做都一样      → 用现成的(搜索、爬网页、读文件)
    这件事只有你们公司这么做  → 自己写(查你们的库、算你们的价、下你们的单)
"""

import os

from langchain.tools import tool


def load_search_tool():
    """搜索类工具的典型接法:装包 → 配 key → 实例化 → 塞进 tools。

    pip install langchain-tavily
    export TAVILY_API_KEY=...
    """
    if not os.environ.get("TAVILY_API_KEY"):
        return None
    from langchain_tavily import TavilySearch

    return TavilySearch(max_results=3)


@tool
def get_internal_headcount(dept: str) -> str:
    """查询公司某个部门的在编人数。仅限内部部门名,例如 研发部、售后部。"""
    table = {"研发部": 128, "售后部": 46, "市场部": 31}
    if dept not in table:
        return f"没有 {dept} 这个部门"
    return f"{dept} 在编 {table[dept]} 人"


def build_toolbox() -> list:
    """把现成工具与自定义工具混在一个列表里——对 Agent 来说它们没有区别。"""
    box = [get_internal_headcount]
    search = load_search_tool()
    if search is not None:
        box.insert(0, search)
    else:
        print("未配置 TAVILY_API_KEY,这次只带自定义工具")
    return box


if __name__ == "__main__":
    tools = build_toolbox()
    for t in tools:
        print("-", t.name, "|", t.description.splitlines()[0][:50])

    # 工具箱不是越大越好:
    # 工具越多,每次调模型的上下文越长、选错的概率也越高。
    # 超过十来个就该按场景分组,或者用动态工具选择只挂当前用得上的那几个。
    print("当前工具数:", len(tools))
1.4 和 Function Call、和 Agent 原理的分工
这三件事很容易糊成一团,其实是三个层次:
| 层次 | 在哪一讲 | 关心什么 |
|---|---|---|
| 协议层 | Function Call | 模型怎么把「要办哪件事、参数填什么」写成一张结构化委托单,消息里怎么一来一回 |
| 机制层 | Agent 的原理 | 为什么加一层循环就有了自主性,ReAct 怎么想、怎么做、怎么看 |
| 工程层 | 这一讲 | 工具怎么定义才被选中,Agent 怎么装配、怎么观察、怎么限住、怎么记住 |
换句话说:Function Call 那一讲教你手写「调用—执行—回填」的整套循环;这一讲是把那套循环交给框架,你只负责把工具做好、把护栏立住。手写一遍是必要的——不然你不知道 create_agent 内部在替你做什么;但真做项目时,没人会再手写第二遍。
02原理:四要素怎么变成模型的选择依据
说明书是怎么送进上下文的、description 该怎么写、参数 schema 管什么、循环由谁在转、三代写法怎么搬
2.1 你写的四样东西,模型只收得到三样
把一个函数变成 Tool,写法上只是加一行装饰器;但发生的事情是:①②③ 被序列化后塞进了模型的请求,④ 留在你的进程里。
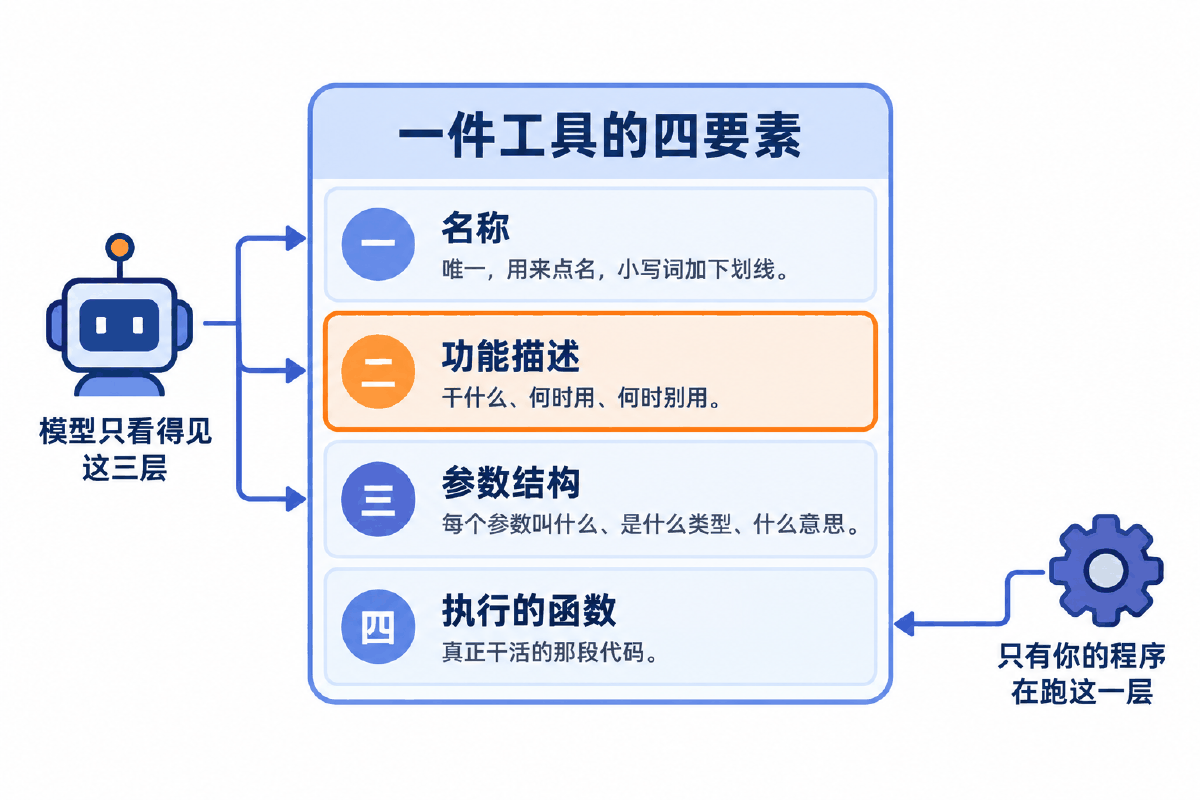
先把四要素亲手打印一遍,看清楚模型收到的到底长什么样:
"""Tool 的四要素:名称、功能描述、参数结构、要调用的函数。

用 @tool 装饰器把一个普通函数升级成 Tool,然后把这四样东西
逐个打印出来看——模型收到的就是这些信息,一个字都不多。

运行:python tool_basics.py
依赖:pip install "langchain>=1.0"
"""

import json

from langchain.tools import tool


@tool
def add_number(a: int, b: int) -> int:
    """两个整数相加,返回它们的和。"""
    return a + b


# name / description / return_direct 都可以在装饰器里改写。
# 注意第一个位置参数就是工具名,传字符串即可覆盖函数名。
@tool("add_two_number", description="计算两个整数的和", return_direct=True)
def add_number_v2(a: int, b: int) -> int:
    """两个整数相加。"""
    return a + b


def show(t) -> None:
    """把一个 Tool 的四要素摊开打印。"""
    print("① 名称      name         =", t.name)
    print("② 功能描述  description  =", t.description)
    print("③ 参数结构  args         =", json.dumps(t.args, ensure_ascii=False))
    print("   完整入参 schema        =",
          json.dumps(t.args_schema.model_json_schema(), ensure_ascii=False)
          if hasattr(t.args_schema, "model_json_schema") else t.args_schema)
    print("④ 要调用的函数            =", t.func.__name__ if t.func else "(异步实现)")
    print("   return_direct         =", t.return_direct)
    print("-" * 60)


if __name__ == "__main__":
    show(add_number)
    show(add_number_v2)

    # 工具自己也是 Runnable:invoke 传一个参数字典,键名即形参名。
    print("add_number.invoke        ->", add_number.invoke({"a": 10, "b": 20}))
    print("add_two_number.invoke    ->", add_number_v2.invoke({"a": 10, "b": 20}))

    # 类型注解不是装饰用的:它决定了 args 里每个参数的 type。
    # 去掉 a: int 之后,参数类型会退化,模型更容易填错。
三个细节值得停一下:
| 细节 | 说明 |
|---|---|
| 文档字符串就是描述 | 不传 description 时,装饰器拿函数的文档字符串当工具描述。所以用 @tool 时文档字符串是必需的,不是可选的礼貌。 |
| 类型注解决定参数类型 | a: int 里的 int 会变成参数表里的 integer。类型注解是必须写的——没有它,参数结构无从生成。 |
| 名称可以覆盖 | 装饰器第一个位置参数就是工具名,@tool("add_two_number") 即可改掉函数名。名称推荐用小写词加下划线,不要带空格或特殊字符,有些模型服务会直接拒绝。 |
2.2 description 怎么写,模型才挑得对
description 不是注释。注释写给三个月后的你看,描述写给此刻正在挑工具的模型看。前者可以写「查订单」,后者写「查订单」等于没写。
一句合格的描述要回答四个问题,缺一个就会以特定的方式出错:
| 要回答 | 缺了会怎样 | 写法示例 |
|---|---|---|
| 它干什么 | 模型完全不知道有什么用,永远不选它 | 按订单号查询一笔订单的状态、金额与物流单号 |
| 什么时候该用 | 该调的时候不调,直接瞎编一个答案 | 当用户提到订单号、问「我的单子到哪了」「发货没有」时使用 |
| 参数从哪儿取 | 参数填错,或者拿用户的原话整句塞进去 | order_id 是形如 SO20251208001 的订单编号 |
| 什么时候别用 | 多工具场景里抢活,把该给别人的任务接过来 | 用户只说了商品名而没给订单号时,先反问,不要猜 |
"""description 写得好不好,差别有多大?把两版工具摆在一起看。

同一个功能写两份描述:一份含糊、一份说清「什么时候用、输入是什么、
产出是什么、什么时候别用」。把两份分别交给同一个模型、问同一句话,
看它挑不挑得中。

运行前先配好模型访问信息(以 OpenAI 兼容网关为例):
    export OPENAI_API_KEY=...
    export OPENAI_BASE_URL=...
"""

import os

from langchain.chat_models import init_chat_model
from langchain.tools import tool


@tool("query_order", description="查订单")
def bad_version(order_id: str) -> str:
    """查订单。"""
    return "{\"order_id\": \"%s\", \"status\": \"已发货\"}" % order_id


@tool(
    "query_order",
    description=(
        "按订单号查询一笔订单的状态、金额与物流单号。"
        "当用户提到订单号、问「我的单子到哪了」「发货没有」时使用。"
        "入参 order_id 是形如 SO20251208001 的订单编号;"
        "用户只说了商品名而没给订单号时,先反问订单号,不要猜。"
    ),
)
def good_version(order_id: str) -> str:
    """按订单号查询订单状态。"""
    return "{\"order_id\": \"%s\", \"status\": \"已发货\"}" % order_id


QUESTION = "帮我看看 SO20251208001 这一单发货了吗"


def ask(tool_obj) -> None:
    """把单个工具绑定到模型上,看模型会不会主动选它。"""
    if not os.environ.get("OPENAI_API_KEY"):
        print("未配置 OPENAI_API_KEY,跳过实际请求")
        return
    model = init_chat_model("openai:gpt-4o-mini", temperature=0)
    msg = model.bind_tools([tool_obj]).invoke(QUESTION)
    if msg.tool_calls:
        print("选中工具:", msg.tool_calls[0]["name"], "参数:", msg.tool_calls[0]["args"])
    else:
        print("没有选工具,模型直接回了文本:", msg.text())


if __name__ == "__main__":
    print("【含糊版 description】", bad_version.description)
    ask(bad_version)
    print("-" * 60)
    print("【说清楚版 description】", good_version.description)
    ask(good_version)

    # 一句话记住:description 是给模型的选择依据,不是给同事的注释。
    # 它要回答四个问题:干什么、什么时候用、参数怎么填、什么时候别用。
2.3 参数结构:把校验挡在业务代码之前
函数签名能表达的信息很有限:参数叫什么、是什么类型,仅此而已。用 Pydantic 写一份 args_schema,你就能额外告诉模型:这个参数是什么意思、有哪些合法取值、默认值多少、上下界在哪。
"""用 Pydantic 给工具参数写一份正经的 schema。

函数签名只能表达「参数叫什么、是什么类型」,
args_schema 还能表达「这个参数是什么意思、有哪些合法取值、默认值是多少」。
这些信息会随工具一起送进模型的上下文,直接决定模型填参数的准确率。
"""

import json
from typing import Literal

from langchain.tools import tool
from pydantic import BaseModel, Field


class WeatherInput(BaseModel):
    """查询天气所需要的入参。"""

    city: str = Field(description="城市名称,使用中文,例如 北京、杭州")
    unit: Literal["摄氏度", "华氏度"] = Field(
        default="摄氏度",
        description="温度单位,默认摄氏度",
    )
    days: int = Field(
        default=1,
        ge=1,
        le=7,
        description="要查询的天数,1 表示只看今天,最多 7 天",
    )


@tool(args_schema=WeatherInput)
def get_weather(city: str, unit: str = "摄氏度", days: int = 1) -> str:
    """查询指定城市未来若干天的天气。需要实时天气、气温、下不下雨时使用。"""
    sample = {"北京": (18, 32, "晴"), "杭州": (21, 29, "多云")}
    low, high, text = sample.get(city, (20, 28, "晴"))
    if unit == "华氏度":
        low, high = round(low * 9 / 5 + 32), round(high * 9 / 5 + 32)
    return f"{city} 未来 {days} 天:{text},{low}~{high}{unit}"


if __name__ == "__main__":
    print("name        =", get_weather.name)
    print("description =", get_weather.description)
    print("args        =", json.dumps(get_weather.args, ensure_ascii=False, indent=2))

    print(get_weather.invoke({"city": "北京"}))
    print(get_weather.invoke({"city": "杭州", "unit": "华氏度", "days": 3}))

    # 越界的参数会被 Pydantic 直接拦下,轮不到你的业务代码处理。
    try:
        get_weather.invoke({"city": "北京", "days": 99})
    except Exception as exc:  # noqa: BLE001  演示校验失败的现象
        print("参数校验失败:", type(exc).__name__)
加了 schema 之后有两个立竿见影的好处:
Field(description=...) 里的每一句话都会随工具一起进上下文。「城市名称,使用中文」这几个字,能省掉一半「Beijing 还是 北京」的扯皮。
ge=1, le=7 这类约束由 Pydantic 在执行前校验。模型填了 99 天,异常在工具入口就抛出来了,轮不到你的业务代码处理。
另一条路是 StructuredTool.from_function:当函数来自别人的模块、来自 SDK,你不想也不该去改它,就在外面包一层。它比装饰器多给了几个位置——同步实现、异步实现可以一起挂上:
"""StructuredTool.from_function:把「已经存在的函数」包成 Tool。

@tool 适合新写的函数——你能直接在函数上加装饰器。
但很多时候函数来自别人的模块、来自 SDK,你不想(也不该)去改它,
这时候用 StructuredTool.from_function 在外面包一层。
它还能同时挂上同步实现 func 与异步实现 coroutine。
"""

import asyncio
import json

from langchain_core.tools import StructuredTool
from pydantic import BaseModel, Field


# ---- 假设下面两个函数来自已有业务模块,一个字都不想改 ----------------
def search_docs(query: str, top_k: int = 3) -> str:
    hits = [f"《{query}》相关文档 {i + 1}" for i in range(top_k)]
    return ";".join(hits)


async def asearch_docs(query: str, top_k: int = 3) -> str:
    await asyncio.sleep(0)
    return search_docs(query, top_k)


# ---- 在外面包一层,把四要素补齐 ------------------------------------
class SearchInput(BaseModel):
    query: str = Field(description="检索关键词,写用户真正想找的那个词")
    top_k: int = Field(default=3, ge=1, le=10, description="返回的文档条数")


search_tool = StructuredTool.from_function(
    func=search_docs,                 # ④ 要调用的函数(同步)
    coroutine=asearch_docs,           #    异步实现,ainvoke 时自动走这条
    name="search_internal_docs",      # ① 名称:小写加下划线,别带空格
    description=(                     # ② 功能描述:写给模型看的
        "在公司内部知识库里检索文档。"
        "当用户问到内部流程、规范、历史方案时使用;"
        "不要用它查实时新闻或计算数值。"
    ),
    args_schema=SearchInput,          # ③ 参数结构
    return_direct=False,
)


if __name__ == "__main__":
    print("name        =", search_tool.name)
    print("description =", search_tool.description)
    print("args        =", json.dumps(search_tool.args, ensure_ascii=False))

    print(search_tool.invoke({"query": "报销流程", "top_k": 2}))
    print(asyncio.run(search_tool.ainvoke({"query": "值班制度"})))
| 场景 | 用哪个 | 原因 |
|---|---|---|
| 函数是你新写的 | @tool | 最短,一行装饰器;描述直接写文档字符串 |
| 函数是别人的、不能改 | StructuredTool.from_function | 不侵入原函数,在外面补齐名称与描述 |
| 同一个能力要同步也要异步 | StructuredTool.from_function | func 与 coroutine 可以同时指定 |
| 要在运行时动态造工具 | StructuredTool.from_function | 它是普通调用,可以放进循环里按配置批量生成 |
2.4 执行循环:转几圈由模型决定,转的动作由框架做
工具备齐之后,create_agent 会把它们和模型装配成一个能自己转起来的循环。这个循环长这样:
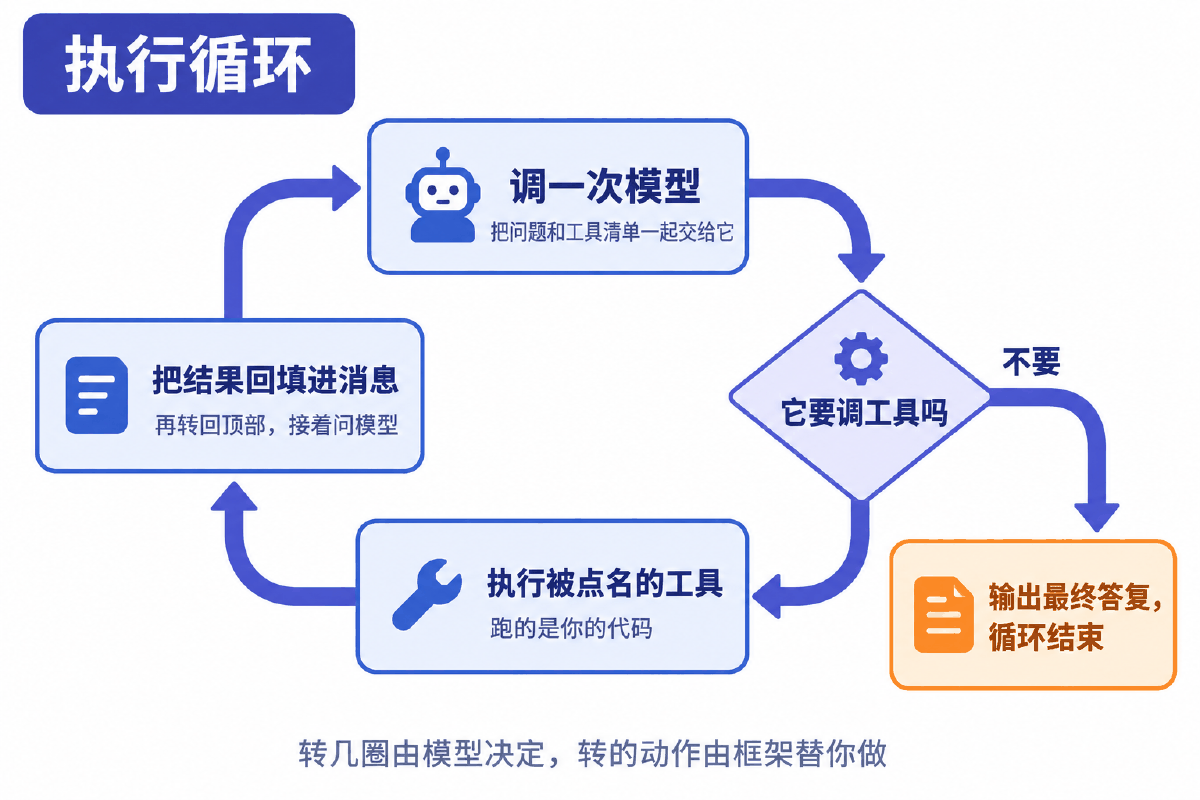
和手写版相比,变化的不是流程,而是流程写在谁的代码里。手写版里你要维护一个 while、要记得回填、要判断什么时候停;交给 create_agent 之后这些都在框架里了,你只在两端出现:定义工具(循环的输入)和读最终状态(循环的输出)。
2.5 三代写法的演进:认得出旧代码,搬得动新写法
同一件事在 LangChain 的不同阶段有三种长相。老项目里前两代还大量存在,你要认得出来,也要知道搬过来之后对应哪一行。
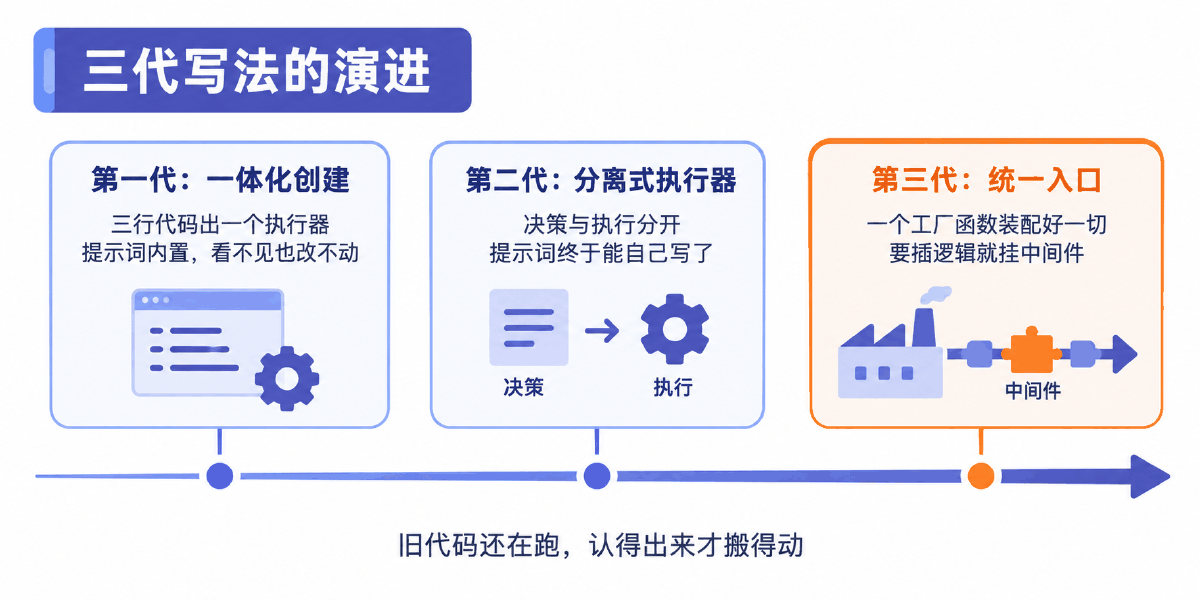
"""三代写法的演进:同一个需求,三种年代的代码长相。

同一件事——「给模型一个搜索工具,让它自己决定要不要用」——
在 LangChain 的不同阶段有三种写法。前两种在老项目里还大量存在,
你要认得出来,也要知道搬到当代写法之后对应哪一行。

本文件里只有第三代是可运行的;前两代以字符串形式保留长相,
避免导入已经不在 langchain 主包里的名字。
"""

ERA_1 = '''
# 第一代:一体化创建,三行出一个执行器
from langchain.agents import initialize_agent, AgentType

agent_executor = initialize_agent(
    tools=[search_tool],
    llm=llm,
    agent=AgentType.ZERO_SHOT_REACT_DESCRIPTION,   # 用枚举挑一套内置提示词
    verbose=True,
)
agent_executor.invoke("今天北京的天气怎么样?")

# 上手快,但提示词是内置的、看不见也改不动;
# 想换一句措辞就只能换一个 AgentType 碰运气。
'''

ERA_2 = '''
# 第二代:Agent 与运行时分离
from langchain.agents import AgentExecutor, create_react_agent
from langchain import hub

prompt = hub.pull("hwchase17/react")           # 提示词终于拿得到了
agent = create_react_agent(llm=llm, tools=tools, prompt=prompt)
agent_executor = AgentExecutor(agent=agent, tools=tools)
agent_executor.invoke({"input": "今天北京的天气怎么样?"})

# 决策逻辑(agent)与执行循环(AgentExecutor)分开了,提示词可自定义;
# 代价是代码变长,而且要在循环里插一段自己的逻辑仍然很别扭。
'''

ERA_3 = '''
# 第三代:统一入口 create_agent
from langchain.agents import create_agent

agent = create_agent(
    model="openai:gpt-4o-mini",
    tools=tools,
    system_prompt="今天北京的天气怎么样?这类实时问题必须调用工具。",
    middleware=[...],          # 想插东西就插 middleware,不用改循环
)
agent.invoke({"messages": [{"role": "user", "content": "今天北京的天气怎么样?"}]})
'''

# 逐项的搬迁关系,照着改即可
MIGRATION = [
    ("导入路径", "langgraph.prebuilt", "langchain.agents"),
    ("工厂函数", "create_react_agent", "create_agent"),
    ("提示词参数", "prompt=", "system_prompt=(传字符串)"),
    ("动态提示词", "自己拼 prompt", "@dynamic_prompt middleware"),
    ("调用前后插逻辑", "pre_model_hook / post_model_hook / state_modifier",
     "before_model / after_model / @wrap_model_call / @wrap_tool_call"),
    ("结构化输出", "response_format=(含 prompted 形式)",
     "response_format=ToolStrategy(...) 或 ProviderStrategy(...)"),
    ("流式节点名", '"agent"', '"model"'),
    ("运行时上下文", 'config["configurable"] 里塞', "invoke(context=...) + context_schema="),
    ("入参形态", '{"input": "..."}', '{"messages": [{"role": "user", "content": "..."}]}'),
]


if __name__ == "__main__":
    for title, block in (("第一代", ERA_1), ("第二代", ERA_2), ("第三代", ERA_3)):
        print("=" * 66)
        print(title, block)

    print("=" * 66)
    print("%-16s %-42s %s" % ("变化点", "旧写法", "当代写法"))
    for row in MIGRATION:
        print("%-16s %-42s %s" % row)
| 变化点 | 旧写法 | 当代写法 |
|---|---|---|
| 创建方式 | initialize_agent + AgentType 枚举 | create_agent 一个工厂函数装配好 |
| 分离式写法 | create_react_agent + AgentExecutor | 同样收敛到 create_agent |
| 导入路径 | langgraph.prebuilt | langchain.agents |
| 提示词参数 | prompt= | system_prompt=,传字符串,不要传消息对象 |
| 动态提示词 | 自己拼字符串 | @dynamic_prompt middleware |
| 循环里插逻辑 | pre_model_hook / post_model_hook / state_modifier | before_model / after_model / wrap_model_call / wrap_tool_call |
| 结构化输出 | response_format=(含提示词形式) | ToolStrategy / ProviderStrategy,提示词形式已移除 |
| 流式节点名 | "agent" | "model" |
| 入参形态 | {"input": "..."} | {"messages": [{"role": "user", "content": "..."}]} |
initialize_agent 与 AgentType 属于 legacy,已经搬到 langchain-classic,不再是推荐写法;②
from langchain_community.llms import Ollama 换成伙伴包 langchain-ollama;③
agent.run(...) 这种单字符串入口换成 agent.invoke({"messages": [...]})。看到
ZERO_SHOT_REACT_DESCRIPTION 这种枚举,基本可以判定这段代码来自 0.3 时代。
AgentType 里二选一:文本推理(模型把思考过程写成文字,系统再解析)还是结构化调用(模型直接返回结构化的调用意图)。当代写法不用你选了——create_agent 默认走结构化调用这条路,因为主流模型都已经原生支持。两者的机制差异属于 Agent 原理那一讲的内容。
03最小代码:四步跑通第一个 Agent
一个工具、一句人设、一次调用,先把最短的路走完
剥掉所有业务之后,用 create_agent 搭一个 Agent 只有四步。整个过程里你一行循环都不用写——「要不要再调一次工具」这件事,框架在替你判断。
@toolsystem_prompt{"messages": [...]}messages 的最后一条"""最小可跑的 Agent:一个工具 + 一句 system_prompt + 一次 invoke。
这是 LangChain 1.x 里构建 Agent 的当代写法:
from langchain.agents import create_agent
四步:定义工具 → 建 Agent → invoke → 取最后一条消息。
循环(要不要再调一次工具)由 create_agent 内部替你转,你不用手写 while。
环境:
pip install "langchain>=1.0" langchain-openai
export OPENAI_API_KEY=...
export OPENAI_BASE_URL=... # 用官方接口时可以不设
"""
import os
from langchain.agents import create_agent
from langchain.tools import tool
@tool
def get_city_population(city: str) -> str:
"""查询一个城市的常住人口数量(单位:万人)。需要人口数据时使用。"""
table = {"北京": 2183, "上海": 2487, "郑州": 1300, "杭州": 1252}
if city not in table:
return f"没有 {city} 的人口数据"
return f"{city} 常住人口约 {table[city]} 万人"
def build_agent():
"""把模型、工具、system_prompt 装配成一个 Agent。"""
return create_agent(
model="openai:gpt-4o-mini", # 也可以传已经实例化好的模型对象
tools=[get_city_population], # 工具列表,就是那个「工具箱」
system_prompt=( # 传字符串,不要传 SystemMessage 对象
"你是一个数据助手。需要具体数字时必须调用工具,"
"工具没有数据就如实说没有,不要自己编。"
),
)
def main() -> None:
if not os.environ.get("OPENAI_API_KEY"):
print("先配置 OPENAI_API_KEY 再运行")
return
agent = build_agent()
# 入参固定是一个字典,键 messages 装一个消息列表
result = agent.invoke(
{"messages": [{"role": "user", "content": "北京和杭州哪个人多?多多少万?"}]}
)
# 返回值也是状态字典,messages 里是这一轮跑出来的完整消息链
for m in result["messages"]:
print(f"[{m.type:9s}]", (m.text() or "").strip()[:80],
"| tool_calls:", getattr(m, "tool_calls", None))
print("\n最终答复:", result["messages"][-1].text())
if __name__ == "__main__":
main()
{"messages": [{"role": "user", "content": "..."}]},旧写法的 agent.run("问题") 和 {"input": "..."} 都不再是当代形态;② 人设参数叫
system_prompt,直接传字符串,不要传消息对象;③ 返回的也是状态字典:
result["messages"] 是这一轮跑出来的完整消息链,最后一条才是给用户看的答复,中间那些是模型的决策与工具回执。
把 result["messages"] 整个打印出来,你会看到一条典型的四段式链路:
| 序号 | 消息类型 | 内容 |
|---|---|---|
| ① | human | 北京和杭州哪个人多?多多少万? |
| ② | ai | 正文为空,带着两条工具调用意图:查北京、查杭州 |
| ③ | tool × 2 | 两条回执:常住人口约 2183 万人 / 约 1252 万人 |
| ④ | ai | 「北京比杭州多约 931 万人」——这次没有工具调用,循环到此结束 |
注意第 ② 步:模型一次就发出了两条调用意图,框架会并行执行、逐条回填。这是当代写法比手写循环省心的地方之一——并行调用的收集与配对不用你操心。
pip install "langchain>=1.0" langchain-openai,Python 需要 3.10 以上。密钥一律走环境变量 os.environ.get(...),不要硬编码进源码,更不要把 .env 提交进版本库。换成别家模型时,把 model= 的字符串换掉即可,其余代码不动。
04完整案例:一个会自己拿主意的门店助手
三件自定义工具串成一个 Agent,再依次接上流式观察、会话记忆、结构化输出与护栏
需求很具体:连锁咖啡店的店员想问一句「杭州西湖店的拿铁豆还有多少?按九折买 30 袋要多少钱?」,希望助手自己把这件事办完。这句话里其实藏着两件事——先查库存,再算价钱,而且第二件事要用到第一件的结果。
关键在于:你不会写「先调查询、再调计算」这行代码。你只把三件工具交出去,顺序由模型自己定。
4.1 工具箱:查询、计算、写入各一件
三件工具刚好覆盖三种典型形态,边界策略也完全不同:
| 工具 | 类型 | 边界策略 |
|---|---|---|
query_stock | 读操作 | 放开用;查不到时返回「查无记录」而不是抛异常,让模型如实转述 |
quote_price | 算操作 | 参数在 schema 层就卡死取值范围,脏数据进不了计算 |
create_order | 写操作 | 自己校验库存、自己限额;描述里写明「只有用户明确说下单才用」 |
"""门店助手的工具箱:三件真正能跑的工具。

- query_stock   查某个门店某个商品还有多少件(查询类)
- quote_price   按数量与折扣算总价(计算类)
- create_order  下一张订单(写操作,带安全边界)

工具的边界原则:
读操作放开;写操作必须自己校验参数、自己限额,
不要指望 system_prompt 能拦住一个填错参数的模型。
"""

from datetime import datetime

from langchain.tools import tool
from pydantic import BaseModel, Field

# 演示用的内存数据,真项目换成数据库查询即可
STOCK = {
    ("北京朝阳店", "拿铁豆"): 120,
    ("北京朝阳店", "冷萃瓶"): 8,
    ("杭州西湖店", "拿铁豆"): 40,
    ("杭州西湖店", "冷萃瓶"): 0,
}
PRICE = {"拿铁豆": 68.0, "冷萃瓶": 25.0}
ORDERS: list[dict] = []
MAX_QTY_PER_ORDER = 500


class StockInput(BaseModel):
    shop: str = Field(description="门店名称,例如 北京朝阳店、杭州西湖店")
    item: str = Field(description="商品名称,例如 拿铁豆、冷萃瓶")


@tool(args_schema=StockInput)
def query_stock(shop: str, item: str) -> str:
    """查询某个门店某个商品的当前库存件数。
    当用户问「还有没有货」「库存多少」「够不够」时使用。
    入参是门店名与商品名,两者都必须由用户给出,不要替用户猜门店。"""
    if (shop, item) not in STOCK:
        return f"查无记录:{shop} 没有登记过 {item}"
    return f"{shop} 的 {item} 当前库存 {STOCK[(shop, item)]} 件"


class QuoteInput(BaseModel):
    item: str = Field(description="商品名称")
    qty: int = Field(ge=1, le=MAX_QTY_PER_ORDER, description="购买数量,正整数")
    discount: float = Field(default=1.0, gt=0, le=1,
                            description="折扣系数,0.9 表示九折,默认不打折")


@tool(args_schema=QuoteInput)
def quote_price(item: str, qty: int, discount: float = 1.0) -> str:
    """按商品单价、数量和折扣计算订单总价。
    当用户问「多少钱」「一共几钱」「打完折是多少」时使用。
    这个工具只算钱,不查库存,也不会真的下单。"""
    if item not in PRICE:
        return f"没有 {item} 的价格"
    total = PRICE[item] * qty * discount
    return (f"{item} 单价 {PRICE[item]:.2f} 元 × {qty} 件 × 折扣 {discount} "
            f"= {total:.2f} 元")


class OrderInput(BaseModel):
    shop: str = Field(description="下单门店")
    item: str = Field(description="商品名称")
    qty: int = Field(ge=1, le=MAX_QTY_PER_ORDER, description="下单数量")


@tool(args_schema=OrderInput)
def create_order(shop: str, item: str, qty: int) -> str:
    """为指定门店创建一张采购订单。这是写操作,会真的产生一条订单记录。
    只有在用户明确说了「下单」「就要这些」之后才使用;
    库存不足时不要下单,先把缺口告诉用户。"""
    have = STOCK.get((shop, item))
    if have is None:
        return f"下单失败:{shop} 没有 {item} 这个商品"
    if qty > have:
        return f"下单失败:{shop} 的 {item} 只剩 {have} 件,不足 {qty} 件"
    STOCK[(shop, item)] = have - qty
    oid = f"SO{datetime.now():%Y%m%d}{len(ORDERS) + 1:03d}"
    ORDERS.append({"id": oid, "shop": shop, "item": item, "qty": qty})
    return f"下单成功,订单号 {oid},{shop} 的 {item} 剩余 {STOCK[(shop, item)]} 件"


SHOP_TOOLS = [query_stock, quote_price, create_order]


if __name__ == "__main__":
    print(query_stock.invoke({"shop": "北京朝阳店", "item": "冷萃瓶"}))
    print(quote_price.invoke({"item": "拿铁豆", "qty": 30, "discount": 0.9}))
    print(create_order.invoke({"shop": "北京朝阳店", "item": "冷萃瓶", "qty": 20}))
query_stock 那句「两者都必须由用户给出,不要替用户猜门店」,是在防模型随手挑一家店;quote_price 那句「只算钱,不查库存,也不会真的下单」,是在划清边界、防它抢别的工具的活;create_order 那句「这是写操作,会真的产生一条记录」,是在提高它动手的门槛。这些话都不是注释——它们会原样进入模型的上下文,是真正起作用的约束。
create_order 自己又查了一遍库存,不够就直接拒绝。凡是写操作,校验必须落在函数里,不能只落在 description 和 system_prompt 里。
4.2 装配与运行:顺序是模型定的
"""门店助手完整案例:三个自定义工具串成一个能自主决策的 Agent。

用户一句「杭州西湖店的拿铁豆还有多少?按九折买 30 袋要多少钱?」
里面藏着两件事:先查库存、再算价钱。
你不需要写「先调哪个再调哪个」——把工具交出去,顺序由模型自己定。

环境:
    pip install "langchain>=1.0" langchain-openai
    export OPENAI_API_KEY=...
    export OPENAI_BASE_URL=...
"""

import os

from langchain.agents import create_agent

from shop_tools import SHOP_TOOLS

SYSTEM_PROMPT = """你是一家连锁咖啡店的门店助手。

规则:
1. 涉及库存、价格、下单的问题一律调用工具,不要凭印象回答。
2. 用户没说门店时,先问清楚是哪家店,不要自己挑一家。
3. 下单前必须先查库存;库存不足就把缺口说明白,不要下单。
4. 工具返回「查无记录」时如实转述,不要编造数字。
"""


def build_agent():
    return create_agent(
        model="openai:gpt-4o-mini",
        tools=SHOP_TOOLS,
        system_prompt=SYSTEM_PROMPT,
    )


def run(agent, question: str) -> None:
    print("=" * 66)
    print("用户:", question)
    result = agent.invoke({"messages": [{"role": "user", "content": question}]})

    for m in result["messages"]:
        if m.type == "ai" and getattr(m, "tool_calls", None):
            for call in m.tool_calls:
                print(f"  → 决定调用 {call['name']},参数 {call['args']}")
        elif m.type == "tool":
            print(f"  ← {m.name} 返回:{m.content}")
    print("助手:", result["messages"][-1].text())


def main() -> None:
    if not os.environ.get("OPENAI_API_KEY"):
        print("先配置 OPENAI_API_KEY 再运行")
        return
    agent = build_agent()

    # 一轮里要连着用两个工具:查库存 → 算价钱
    run(agent, "杭州西湖店的拿铁豆还有多少?按九折买 30 袋要多少钱?")

    # 库存为 0 的情况,看它会不会老老实实说没货
    run(agent, "杭州西湖店的冷萃瓶帮我下 10 件")

    # 缺少门店信息,看它会不会反问而不是瞎选一家
    run(agent, "拿铁豆还有货吗")


if __name__ == "__main__":
    main()
三个问题各自测一种行为,输出大致是这样:
| 提问 | 它做了什么 | 说明 |
|---|---|---|
| 拿铁豆还有多少?九折 30 袋多少钱? | 先 query_stock,再 quote_price | 两件事的先后是它自己排的,你的代码里没有这个顺序 |
| 冷萃瓶帮我下 10 件 | 先查库存 → 发现为 0 → 不下单 | 工具返回的缺口被如实转述,没有编一个成功的订单号 |
| 拿铁豆还有货吗 | 不调工具,直接反问哪家门店 | 参数缺失时反问而不是瞎猜,靠的是描述与人设里的那两句话 |
第一个问题跑完,messages 里会留下六条记录:用户提问 → 工具调用意图(查库存)→ 回执 → 工具调用意图(算价钱)→ 回执 → 最终答复。两轮「调用—执行—回填」加一次收尾,和手写版的形状一模一样,只是这次循环写在框架里。
4.3 把循环看清楚:用 stream 逐节点观察
invoke 只给最终结果,出了问题两眼一抹黑。调试 Agent 的正确姿势是 stream:每个节点跑完就吐一块更新出来,你能看见它在第几步决定调什么、工具返回了什么。
"""把 Agent 的执行循环看清楚:用 stream 逐节点观察。

invoke 只给你最后的结果,出了问题两眼一抹黑。
stream 会在每个节点跑完后吐一块更新出来,你能看见
模型什么时候决定调工具、工具返回了什么、它又转回模型第几次。

节点名在 LangChain 1.x 里是 "model" 与 "tools"。
(旧版 langgraph.prebuilt.create_react_agent 里模型节点叫 "agent",
 迁移到 create_agent 之后这个名字变了,按 "agent" 取值会一直取到空。)
"""

import os

from langchain.agents import create_agent

from shop_tools import SHOP_TOOLS


def watch(agent, question: str) -> None:
    print("用户:", question)
    step = 0
    for chunk in agent.stream(
        {"messages": [{"role": "user", "content": question}]},
        stream_mode="updates",
    ):
        step += 1
        for node, update in chunk.items():
            msgs = update.get("messages", []) if isinstance(update, dict) else []
            for m in msgs:
                if node == "model":
                    calls = getattr(m, "tool_calls", None)
                    if calls:
                        names = "、".join(c["name"] for c in calls)
                        print(f"第 {step} 步 [model] 决定调用:{names}")
                    else:
                        print(f"第 {step} 步 [model] 给出最终答复:{m.text()[:60]}")
                elif node == "tools":
                    print(f"第 {step} 步 [tools] {m.name} → {m.content[:60]}")
    print("-" * 66)


def token_stream(agent, question: str) -> None:
    """只想看最终答复一个字一个字吐出来,用 stream_mode="messages"。"""
    for token, meta in agent.stream(
        {"messages": [{"role": "user", "content": question}]},
        stream_mode="messages",
    ):
        if meta.get("langgraph_node") == "model" and token.text():
            print(token.text(), end="", flush=True)
    print()


def main() -> None:
    if not os.environ.get("OPENAI_API_KEY"):
        print("先配置 OPENAI_API_KEY 再运行")
        return
    agent = create_agent(
        model="openai:gpt-4o-mini",
        tools=SHOP_TOOLS,
        system_prompt="你是门店助手,涉及库存与价格一律调用工具。",
    )
    watch(agent, "北京朝阳店的拿铁豆还有多少?买 20 袋原价多少钱?")
    token_stream(agent, "再帮我算一下 50 袋打八折多少钱")


if __name__ == "__main__":
    main()
| 流式模式 | 吐出来的是 | 什么时候用 |
|---|---|---|
stream_mode="updates" | 每个节点跑完后的状态更新 | 调试首选:看它调了哪些工具、转了几圈 |
stream_mode="messages" | 一个个 token | 做界面:让最终答复一个字一个字吐出来 |
stream_mode="values" | 每一步之后的完整状态 | 需要每步都拿到全量消息链时 |
"model",不是 "agent"
这是从旧写法搬过来最容易踩的坑:过去模型节点叫 "agent",create_agent 里它叫 "model"(工具节点叫 "tools")。按 "agent" 取值不会报错,只会一直取到空,让人误以为流式没生效。
4.4 让它记住上一轮:checkpointer + thread_id
上面的每次 invoke 都是独立的——问完「北京朝阳店的拿铁豆」,再问「那这家店的冷萃瓶呢」,它并不知道「这家店」是哪家。Agent 侧接记忆只要两样东西:给 create_agent 传一个 checkpointer,调用时带上 thread_id。
"""让 Agent 记住上一轮:checkpointer + thread_id。

Agent 的每一轮 invoke 默认是互相独立的——上一轮查过哪家门店,
这一轮它并不知道。给 create_agent 传一个 checkpointer,
再在调用时带上 thread_id,状态就会被持久化并按会话隔离。

记忆本身的原理(模型没有记忆、历史要一轮轮重新塞回去)在会话记忆那一讲,
这里只讲 Agent 侧这条路子怎么接。
"""

import os

from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver

from shop_tools import SHOP_TOOLS


def build_agent():
    return create_agent(
        model="openai:gpt-4o-mini",
        tools=SHOP_TOOLS,
        system_prompt="你是门店助手,涉及库存与价格一律调用工具。",
        # 演示用内存实现;进程一退就没了。
        # 要跨进程留存,换成 SQLite / Postgres 的 saver 实现。
        checkpointer=InMemorySaver(),
    )


def ask(agent, text: str, thread_id: str) -> str:
    cfg = {"configurable": {"thread_id": thread_id}}
    result = agent.invoke({"messages": [{"role": "user", "content": text}]}, cfg)
    answer = result["messages"][-1].text()
    print(f"[{thread_id}] 用户:{text}")
    print(f"[{thread_id}] 助手:{answer}\n")
    return answer


def main() -> None:
    if not os.environ.get("OPENAI_API_KEY"):
        print("先配置 OPENAI_API_KEY 再运行")
        return
    agent = build_agent()

    # 同一个 thread_id:第二句里的「这家店」指代第一句的门店
    ask(agent, "北京朝阳店的拿铁豆还有多少?", thread_id="shop-001")
    ask(agent, "那这家店的冷萃瓶呢?", thread_id="shop-001")

    # 换一个 thread_id:互不相通,它不知道刚才聊的是哪家店
    ask(agent, "那这家店的冷萃瓶呢?", thread_id="shop-999")

    # 想看某个会话当前存了什么,直接读状态
    state = agent.get_state({"configurable": {"thread_id": "shop-001"}})
    print("shop-001 累计消息条数:", len(state.values["messages"]))


if __name__ == "__main__":
    main()
| 概念 | 作用 |
|---|---|
checkpointer | 把状态持久化下来。每一步开始时读、关键步骤完成时写 |
thread_id | 会话的身份证。不同 thread 之间完全隔离,A 用户的上文不会串到 B 用户那里 |
InMemorySaver | 内存实现,进程一退就没了。要跨进程留存就换成数据库支撑的实现 |
agent.get_state(cfg) | 随时把某个会话当前存了什么捞出来看 |
checkpointer 负责存,thread_id 负责分。
4.5 结构化输出:让最终答复直接能入库
Agent 跑完循环通常吐一段人话,好看但没法直接用。传一个 response_format,结果里就会多出一个 structured_response——一个通过校验的 Pydantic 对象。
"""让 Agent 的最终答复是一个结构化对象,而不是一段人话。

Agent 跑完循环之后通常吐一段自然语言,好看但没法直接入库。
给 create_agent 传 response_format,最终结果里会多出 structured_response,
它是一个通过校验的 Pydantic 对象,字段名、类型都由你定。

ToolStrategy 的做法是把这个 schema 也当作一个「工具」交给模型,
让它在结束前按 schema 填一次——所以对支持工具调用的模型都能用。
"""

import os

from langchain.agents import create_agent
from langchain.agents.structured_output import ToolStrategy
from pydantic import BaseModel, Field

from shop_tools import SHOP_TOOLS


class StockAnswer(BaseModel):
    """一次库存问询的结构化结论。"""

    shop: str = Field(description="门店名称")
    item: str = Field(description="商品名称")
    qty: int = Field(description="当前库存件数,查不到写 -1")
    enough: bool = Field(description="是否满足用户要的数量")
    note: str = Field(description="一句话说明,写给人看")


def build_agent():
    return create_agent(
        model="openai:gpt-4o-mini",
        tools=SHOP_TOOLS,
        system_prompt="你是门店助手,涉及库存与价格一律调用工具。",
        response_format=ToolStrategy(StockAnswer),
    )


def main() -> None:
    if not os.environ.get("OPENAI_API_KEY"):
        print("先配置 OPENAI_API_KEY 再运行")
        return

    agent = build_agent()
    result = agent.invoke(
        {"messages": [{"role": "user", "content": "北京朝阳店的冷萃瓶够不够 20 件?"}]}
    )

    answer: StockAnswer = result["structured_response"]
    print("类型      :", type(answer).__name__)
    print("门店      :", answer.shop)
    print("商品      :", answer.item)
    print("库存      :", answer.qty)
    print("是否够用  :", answer.enough)
    print("说明      :", answer.note)

    # 拿到的是对象,直接进数据库或者拼下一段逻辑,不用再去正则抠数字
    print("入库用的字典:", answer.model_dump())


if __name__ == "__main__":
    main()
ToolStrategy 的做法是把你的 schema 也当成一件工具交给模型,让它在收尾前按 schema 填一次。所以它对任何支持工具调用的模型都能用,不挑服务商。另一个选项 ProviderStrategy 走的是模型服务商原生的结构化输出能力,支持的服务商上更稳,但不是所有家都有。
ToolStrategy,要么 ProviderStrategy。好处是校验不过会重来,而不是给你一段拼不出对象的字符串。
4.6 护栏:工具会报错、循环会失控、写操作要复核
上面的 Agent 拿去演示没问题,上生产还差三层护栏。这三层都通过 middleware 挂上去——它们插在循环的缝隙里,不用改循环本身。
| 钩子 | 插在哪 | 典型用途 |
|---|---|---|
before_agent | 整个任务开始前 | 加载用户档案、准备上下文 |
before_model | 每次调模型之前 | 步数刹车、裁剪历史 |
wrap_model_call | 把调模型整个包住 | 改请求、失败重试、动态换模型 |
wrap_tool_call | 把执行工具整个包住 | 异常兜底、超时、审计日志 |
after_model | 每次模型返回之后 | 敏感信息过滤、输出校验 |
after_agent | 整个任务结束后 | 落库、统计、清理 |
"""给 Agent 的循环加护栏:middleware 的四个常用钩子。

create_agent 内部的循环是「调模型 → 执行工具 → 回填 → 再调模型」,
middleware 就是在这条循环的缝隙里插自己的代码:

    before_agent      整个任务开始前跑一次
    before_model      每次调模型之前
    wrap_model_call   把调模型这一步整个包住,可以改请求、可以重试
    wrap_tool_call    把执行工具这一步整个包住,异常在这里兜住
    after_model       每次模型返回之后
    after_agent       整个任务结束后跑一次

下面三段分别解决三个真会踩到的问题:工具报错、步数失控、写操作没人复核。
"""

from collections.abc import Callable

from langchain.agents import create_agent
from langchain.agents.middleware import (
    HumanInTheLoopMiddleware,
    SummarizationMiddleware,
    before_model,
    wrap_tool_call,
)
from langchain.messages import ToolMessage
from langchain.tools.tool_node import ToolCallRequest

MAX_MODEL_CALLS = 8


@wrap_tool_call
def catch_tool_errors(
    request: ToolCallRequest,
    handler: Callable[[ToolCallRequest], ToolMessage],
) -> ToolMessage:
    """工具抛异常时,把异常转成一条 ToolMessage 还给模型。

    不加这一层,工具里一个 KeyError 就会把整个 Agent 打断;
    加了之后模型看得见错误内容,通常会改参数重试一次。
    """
    try:
        return handler(request)
    except Exception as exc:  # noqa: BLE001  这里就是要兜住所有异常
        return ToolMessage(
            content=f"工具执行失败:{exc}。请检查参数后重试,或者告诉用户查不到。",
            tool_call_id=request.tool_call["id"],
        )


@before_model
def limit_steps(state) -> dict | None:
    """步数刹车:模型被调用超过上限就强行收尾。

    模型偶尔会在两个工具之间来回打转。没有上限的循环
    既烧钱又不会自己停,生产环境必须有这一层。
    """
    used = sum(1 for m in state["messages"] if m.type == "ai")
    if used >= MAX_MODEL_CALLS:
        return {
            "messages": [{"role": "assistant",
                          "content": "这个问题我尝试了多轮仍未解决,先交给人工处理。"}],
            "jump_to": "end",
        }
    return None


def build_guarded_agent(tools):
    """把三层护栏一起装上。"""
    return create_agent(
        model="openai:gpt-4o-mini",
        tools=tools,
        system_prompt="你是门店助手,涉及库存与价格一律调用工具。",
        middleware=[
            limit_steps,            # 步数上限
            catch_tool_errors,      # 工具异常兜底
            # 写操作在执行前暂停,等人点头;把工具名列进 interrupt_on
            HumanInTheLoopMiddleware(
                interrupt_on={"create_order": True},
            ),
            # 历史太长时自动压缩,避免把上下文窗口撑爆
            SummarizationMiddleware(
                model="openai:gpt-4o-mini",
                max_tokens_before_summary=4000,
            ),
        ],
    )


if __name__ == "__main__":
    from shop_tools import SHOP_TOOLS

    agent = build_guarded_agent(SHOP_TOOLS)
    print("已装配的护栏:步数上限 / 工具异常兜底 / 写操作人工确认 / 历史摘要压缩")
    print("提示:装了 HumanInTheLoopMiddleware 之后必须配 checkpointer,")
    print("      否则中断之后没有地方存状态,恢复不回来。")
四层护栏各治一种病:
不加这层,工具里一个 KeyError 就会把整个任务打断。加了之后异常变成一条消息还给模型,它通常会改参数重试一次。
模型可能在两个工具之间来回打转。超过上限就强行收尾转人工,比烧完预算才发现要好。
HumanInTheLoopMiddleware 把指定工具拦在执行之前,把「打算调什么、参数填了什么」交给人看一眼。
SummarizationMiddleware 在历史撑爆上下文窗口之前先做摘要,长会话必备。
人工确认这条路子值得单独跑一遍,因为它涉及「中断—恢复」,写法和别的护栏不一样:
"""写操作前停一下:HumanInTheLoopMiddleware 的完整跑法。

查库存查错了最多是答案不准;下错单是真赔钱。
所以凡是写操作,正确的姿势是让 Agent 在执行工具之前停住,
把「它打算调哪个工具、参数填了什么」交给人看一眼。

中断要能恢复,就必须有 checkpointer 存状态,还要有 thread_id 找回来。
"""

import os

from langchain.agents import create_agent
from langchain.agents.middleware import HumanInTheLoopMiddleware
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.types import Command

from shop_tools import SHOP_TOOLS


def build_agent():
    return create_agent(
        model="openai:gpt-4o-mini",
        tools=SHOP_TOOLS,
        system_prompt="你是门店助手。下单前先查库存,库存不足不要下单。",
        middleware=[
            HumanInTheLoopMiddleware(
                # 只拦写操作;查询类工具照常自动执行
                interrupt_on={"create_order": True},
                description_prefix="以下写操作需要人工确认:",
            )
        ],
        checkpointer=InMemorySaver(),
    )


def main() -> None:
    if not os.environ.get("OPENAI_API_KEY"):
        print("先配置 OPENAI_API_KEY 再运行")
        return

    agent = build_agent()
    cfg = {"configurable": {"thread_id": "hitl-001"}}

    result = agent.invoke(
        {"messages": [{"role": "user",
                       "content": "北京朝阳店的拿铁豆下单 10 袋"}]},
        cfg,
    )

    # 被中断时,结果里会带上 __interrupt__,里面是等待确认的工具调用
    interrupts = result.get("__interrupt__")
    if not interrupts:
        print("这一轮没有触发确认:", result["messages"][-1].text())
        return

    print("等待确认的动作:", interrupts[0].value)

    # 人点头 → accept;也可以 edit 改参数,或者 reject 附上拒绝原因
    approved = agent.invoke(
        Command(resume={"decisions": [{"type": "accept"}]}),
        cfg,
    )
    print("确认之后:", approved["messages"][-1].text())

    # 拒绝的写法(换成这一段即可):
    # agent.invoke(
    #     Command(resume={"decisions": [
    #         {"type": "reject", "message": "本月采购额度已用完,先不要下单"}
    #     ]}),
    #     cfg,
    # )


if __name__ == "__main__":
    main()
HumanInTheLoopMiddleware 必须和 checkpointer 一起用,并且每次调用都带同一个 thread_id。少了任何一样,中断之后就接不回去了。恢复时的三种决定:
accept 照原样执行、edit 改完参数再执行、reject 拒绝并把原因告诉模型。
05骨架模板:拿去改就能用
一份 Agent 骨架、一份工具骨架,改 TODO 处即可
5.1 Agent 骨架:四块结构,五处 TODO
把案例里的共性抽出来就是它。结构固定成四块,改动只发生在工具区和装配区:
| 区块 | 要不要改 | 内容 |
|---|---|---|
| ① 工具区 | 必改 | 你的业务能力,一件工具做一件事,描述写清四个问题 |
| ② 护栏区 | 一般不改 | 工具异常兜底 + 步数上限,两段照抄即可 |
| ③ 装配区 | 改两处 | 换模型、换人设,其余不动 |
| ④ 调用区 | 不改 | ask 拿结果、watch 看过程,调试和上线各用一个 |
"""可复用骨架:一个带护栏的 Agent,改五处 TODO 就能上手。

结构固定为四块:
    ① 工具区    你的业务能力,一个工具做一件事
    ② 护栏区    工具异常兜底 + 步数上限 + 写操作确认
    ③ 装配区    create_agent 把模型、工具、提示词、护栏拼起来
    ④ 调用区    invoke 拿结果,stream 看过程

环境:
    pip install "langchain>=1.0" langchain-openai
    export OPENAI_API_KEY=...
    export OPENAI_BASE_URL=...
"""

import os
from collections.abc import Callable

from langchain.agents import create_agent
from langchain.agents.middleware import before_model, wrap_tool_call
from langchain.messages import ToolMessage
from langchain.tools import tool
from langchain.tools.tool_node import ToolCallRequest
from langgraph.checkpoint.memory import InMemorySaver
from pydantic import BaseModel, Field

MAX_MODEL_CALLS = 8


# ---------- ① 工具区:TODO 1 换成你自己的工具 ------------------------
class LookupInput(BaseModel):
    keyword: str = Field(description="TODO 2:说清这个参数是什么、怎么填、有什么格式要求")


@tool(args_schema=LookupInput)
def lookup_something(keyword: str) -> str:
    """TODO 3:这段描述是写给模型看的,决定它选不选这个工具。
    要回答四件事:这个工具干什么、用户说什么话时该用它、
    参数从哪里取、什么情况下不要用它。"""
    return f"这里返回 {keyword} 的查询结果"


TOOLS = [lookup_something]


# ---------- ② 护栏区:一般不用改 --------------------------------------
@wrap_tool_call
def catch_tool_errors(
    request: ToolCallRequest,
    handler: Callable[[ToolCallRequest], ToolMessage],
) -> ToolMessage:
    """工具抛异常时转成消息还给模型,别让整个任务直接崩掉。"""
    try:
        return handler(request)
    except Exception as exc:  # noqa: BLE001
        return ToolMessage(
            content=f"工具执行失败:{exc}。请检查参数后重试。",
            tool_call_id=request.tool_call["id"],
        )


@before_model
def limit_steps(state) -> dict | None:
    """步数刹车,避免模型在工具之间无限打转。"""
    used = sum(1 for m in state["messages"] if m.type == "ai")
    if used >= MAX_MODEL_CALLS:
        return {
            "messages": [{"role": "assistant", "content": "多轮尝试未果,转人工处理。"}],
            "jump_to": "end",
        }
    return None


# ---------- ③ 装配区:TODO 4 换模型、TODO 5 换人设 --------------------
def build_agent():
    return create_agent(
        model="openai:gpt-4o-mini",                      # TODO 4
        tools=TOOLS,
        system_prompt=(                                  # TODO 5
            "你是一个业务助手。需要具体数据时一律调用工具,"
            "工具查不到就如实说查不到,不要编造。"
        ),
        middleware=[limit_steps, catch_tool_errors],
        checkpointer=InMemorySaver(),
    )


# ---------- ④ 调用区 --------------------------------------------------
def ask(agent, text: str, thread_id: str = "default") -> str:
    cfg = {"configurable": {"thread_id": thread_id}}
    result = agent.invoke({"messages": [{"role": "user", "content": text}]}, cfg)
    return result["messages"][-1].text()


def watch(agent, text: str, thread_id: str = "default") -> None:
    cfg = {"configurable": {"thread_id": thread_id}}
    for chunk in agent.stream(
        {"messages": [{"role": "user", "content": text}]}, cfg, stream_mode="updates"
    ):
        for node, update in chunk.items():
            print("[%s]" % node, update)


if __name__ == "__main__":
    if not os.environ.get("OPENAI_API_KEY"):
        print("先配置 OPENAI_API_KEY 再运行")
    else:
        bot = build_agent()
        print(ask(bot, "帮我查一下 报销流程"))
Field(description=...) · TODO 3 把工具描述写全(干什么、何时用、参数怎么填、何时别用)· TODO 4 换模型 · TODO 5 换人设。护栏和调用区一个字都不用动。
5.2 工具骨架:三类工具,三种写法边界
工具不是都长一个样。读、算、写三类的安全边界完全不同,这份模板把三类摆在一起:
| 类型 | 必须做的事 | 为什么 |
|---|---|---|
| 读操作 | 返回值限长、限条数 | 超长结果会把上下文淹掉,模型反而抓不住重点 |
| 算操作 | 参数约束写进 schema | 校验在工具入口完成,脏数据进不了业务;绝不用 eval 跑模型给的表达式 |
| 写操作 | 限额 + 幂等 + 人工确认 | 模型会重试,重试就可能重复下单;额度必须在代码里卡死 |
"""可复用骨架:一个工具该长什么样。

三类工具各有各的写法边界,这份模板把三类都摆出来:
    读操作    放开用,返回值尽量短、尽量结构化
    算操作    参数在 schema 层就校验掉,别把脏数据放进计算
    写操作    自己限额、自己幂等,再配 HumanInTheLoopMiddleware 复核

改 TODO 的地方即可。
"""

from datetime import datetime

from langchain.tools import tool
from pydantic import BaseModel, Field

MAX_ROWS = 50              # TODO 1:读操作的返回上限
MAX_AMOUNT = 10000.0       # TODO 2:写操作的单次额度上限
_DONE: dict[str, str] = {}  # 幂等表:请求号 → 已产生的结果


# ---------- 读操作 ----------------------------------------------------
class SearchInput(BaseModel):
    keyword: str = Field(description="TODO 3:检索关键词,说明从用户的哪句话里取")
    limit: int = Field(default=10, ge=1, le=MAX_ROWS,
                       description=f"返回条数,最多 {MAX_ROWS} 条")


@tool(args_schema=SearchInput)
def search_records(keyword: str, limit: int = 10) -> str:
    """TODO 4:一句话说清这个工具查什么表、什么时候该用、什么时候不该用。"""
    rows = [f"{keyword}-记录{i + 1}" for i in range(min(limit, MAX_ROWS))]
    # 返回值越短,模型越不容易被淹没;超长结果先截断再给它。
    return ";".join(rows) if rows else "没有查到匹配的记录"


# ---------- 算操作 ----------------------------------------------------
class CalcInput(BaseModel):
    amount: float = Field(gt=0, description="金额,必须为正数")
    rate: float = Field(gt=0, le=1, description="折扣系数,0.85 表示八五折")


@tool(args_schema=CalcInput)
def calc_amount(amount: float, rate: float) -> str:
    """按折扣系数计算实付金额。只负责算钱,不查数据也不写库。"""
    # 校验交给 Pydantic,这里只写业务;
    # 千万别用 eval 跑模型给的表达式,那等于把执行权交出去。
    return f"{amount:.2f} × {rate} = {amount * rate:.2f}"


# ---------- 写操作 ----------------------------------------------------
class WriteInput(BaseModel):
    request_id: str = Field(description="业务请求号,同一笔业务重试时必须一致")
    amount: float = Field(gt=0, le=MAX_AMOUNT,
                          description=f"金额,单次不得超过 {MAX_AMOUNT}")
    memo: str = Field(default="", description="备注,可留空")


@tool(args_schema=WriteInput)
def submit_request(request_id: str, amount: float, memo: str = "") -> str:
    """提交一笔付款申请。这是写操作,会真的产生一条记录。
    只有在用户明确确认之后才使用;金额超限时不要拆单绕过上限。"""
    if request_id in _DONE:            # 幂等:同一个请求号只生效一次
        return f"该请求已处理过:{_DONE[request_id]}"
    if amount > MAX_AMOUNT:            # schema 之外再兜一层,防止绕过
        return f"金额 {amount} 超过单次上限 {MAX_AMOUNT},已拒绝"
    result = f"受理成功,单号 RQ{datetime.now():%Y%m%d%H%M%S},金额 {amount:.2f}"
    _DONE[request_id] = result
    return result


TOOLS = [search_records, calc_amount, submit_request]


if __name__ == "__main__":
    print(search_records.invoke({"keyword": "报销", "limit": 3}))
    print(calc_amount.invoke({"amount": 268, "rate": 0.85}))
    print(submit_request.invoke({"request_id": "R-001", "amount": 500}))
    print(submit_request.invoke({"request_id": "R-001", "amount": 500}))
5.3 两份模板怎么配合
tool_template.py 写你的工具agent_skeleton.py 的 TOOLSwatch 跑几个刁钻问题,看它选没选对第三步不能省。工具写完的第一件事是验描述,不是验功能——功能你自己单测就能验,而「模型会不会在该用的时候用它」只能真跑一遍才知道。发现它该调不调,先改 description,别急着改代码。
06易错点汇总
按「工具定义 / 参数 / 装配 / 循环与流式 / 安全」五类归并,踩过一次就别再踩
⚠️ 一、工具定义
- 把
description当注释写。 写成「查订单」三个字,模型就不知道什么时候该用它,该调时不调、直接编一个答案。描述要回答四件事:干什么、何时用、参数从哪取、何时别用。这是本讲铁律,也是排查「工具不被调用」的第一现场。 - 用
@tool却不写文档字符串。 装饰器默认拿文档字符串当描述,没有它就等于把工具的说明书撕了。 - 忘了写类型注解。
def add(a, b)生成不出像样的参数结构,模型只能瞎猜类型。类型注解是必须的,不是风格问题。 - 工具名带空格或特殊字符。 推荐小写词加下划线;有些模型服务会直接拒绝带空格的名字,报错信息还很难懂。
- 一个工具塞进五件事。 「查询并计算并下单」这种万能工具,模型反而不知道什么时候用。一件工具做一件事,这是模块化设计的前提。
- 工具箱无限膨胀。 工具越多、上下文越长、选错概率越高。超过十来件就分组或者动态挂载。
- 改函数体却忘了改描述。 函数已经支持按日期查了,描述里还写着「只查当天」——模型会照着描述办事,而不是照着代码。
⚠️ 二、参数与 schema
- 参数名和 schema 里的字段名对不上。
args_schema的字段必须和函数形参一一对应,否则调用时参数传不进去。 - 只写类型不写
description。city: str不告诉模型「用中文城市名」,它就可能填英文;一句话就能省掉的扯皮。 - 把取值范围写在提示词里而不是 schema 里。 写进
Field(ge=1, le=7)才是硬约束,由框架在执行前拦下;写在提示词里只是建议。 - 用了保留的参数名。
config和runtime是框架保留的,拿它们当业务参数名会在运行时报错。要访问运行时信息就用ToolRuntime。 - 期待 schema 能拦住业务错误。 它只校验类型和取值范围,「这家店有没有这个货」这种业务校验还得你自己写在函数里。
⚠️ 三、装配与旧写法迁移
- 照着旧资料写
initialize_agent+AgentType。 这套属于 legacy,已经搬到langchain-classic,不再是推荐写法。当代写法只有一个入口:from langchain.agents import create_agent。 - 从
langgraph.prebuilt导create_react_agent。 导入路径与函数名都变了,现在是langchain.agents的create_agent。 - 还在用
prompt=传人设。 参数名是system_prompt=,而且传字符串,不要传消息对象。 - 调用时传字符串或
{"input": ...}。 入参形态是{"messages": [{"role": "user", "content": "..."}]};agent.run("问题")也是旧写法。 - 拿
result["output"]取答案。 返回的是状态字典,答案在result["messages"][-1]。 - 还在找
pre_model_hook/post_model_hook。 这些钩子统一成了 middleware:before_model/after_model/wrap_model_call/wrap_tool_call。 - 沿用
langchain_community.llms.Ollama。 换成伙伴包langchain-ollama;langchain-community里的老入口不是当代推荐路径。
⚠️ 四、执行循环与流式
- 流式里按
"agent"取节点。 模型节点现在叫"model",工具节点叫"tools"。按旧名字取不会报错,只会一直取到空,很难排查。 - 循环没有上限。 模型可能在两个工具之间来回打转,烧钱且不会自己停。用
before_model做步数刹车。 - 工具抛异常直接崩掉整个任务。 用
wrap_tool_call把异常转成消息还给模型,它通常会改参数重试。 - 工具返回值过长。 一次返回几千行会把上下文淹掉,还可能直接撑爆窗口。返回前先截断、先聚合。
- 把
return_direct=True当加速开关乱用。 它会让循环当场结束、结果直接甩给用户,模型没有机会再加工。需要后续推理或串联别的工具时不能用。 - 用
invoke调试。 它只给最终结果,中间全是黑箱。调试一律用stream(stream_mode="updates")。 - 忘了并行调用。 模型可能一次返回多条调用意图,框架会并行执行;写日志、算计数时别假设「一步只有一条」。
⚠️ 五、记忆与安全
- 以为传了
checkpointer就有记忆。 还得在每次调用时带thread_id,否则状态存了也找不回来。 - 所有用户共用一个
thread_id。 会话之间本该互相隔离,共用就会串上下文,把 A 的订单说给 B 听。 - 拿
InMemorySaver上生产。 它只存在内存里,进程一退全没。要跨进程留存就换数据库支撑的实现。 - 用了人工确认却没配
checkpointer。 中断之后状态没地方存,恢复不回来。两者必须成对出现。 - 写操作只靠提示词约束。 「库存不足不要下单」写在人设里只是建议。限额、幂等、库存校验必须落在函数代码里。
- 把数据库口令、API 密钥硬编码进源码。 一律
os.environ.get(...),.env不进版本库。 - 给模型一个能执行任意代码的工具。 让它写表达式再
eval、或者直接开一个 Shell 工具,等于把执行权交出去。真要做,必须配沙箱、白名单与超时。 - 忘了超时。 工具里一个卡死的 HTTP 请求会把整个 Agent 挂住;对外请求一律设超时。
07自测题
点击题目展开答案;能把这 16 题说清楚,这一讲就通了
一件 Tool 由哪四个要素组成?其中哪些是模型看得见的?
名称(name)、功能描述(description)、参数结构(args_schema)、要调用的函数(函数本体)。前三样会被送进模型的上下文,第四样只在你的进程里执行——模型自始至终没碰过那段代码。
用 @tool 装饰一个函数时,工具的名称和描述默认从哪里来?怎么覆盖?
名称默认取函数名,描述默认取函数的文档字符串——所以用 @tool 时文档字符串是必需的。覆盖方式:@tool("add_two_number", description="计算两个整数的和"),第一个位置参数就是工具名。
为什么工具函数必须写类型注解?
因为类型注解决定参数结构:a: int 会变成参数表里的 integer。没有注解,模型就不知道该填什么类型,填错的概率大幅上升。这不是代码风格问题,是功能问题。
return_direct=True 是什么意思?什么时候不该用?
默认 False,工具结果会回到模型手里、由它决定下一步;设成 True 则执行完直接把结果返回给用户、循环当场中断。当结果还需要模型进一步推理、总结,或者还要串联别的工具时,不能用它——因为模型根本没机会看到这个结果。
本讲铁律是什么?把 description 写成「查订单」会有什么后果?
铁律:工具的 description 是写给模型看的,不是写给同事看的注释;模型选不选你这个工具,全看它。
写成「查订单」三个字,模型不知道什么时候该用它,典型后果是该调的时候不调、直接编一个答案,或者在多工具场景里选错工具。
一句合格的工具描述要回答哪四个问题?
① 它干什么(不写则永远不被选中)、② 什么时候该用(不写则该调不调)、③ 参数从哪儿取(不写则参数填错)、④ 什么时候别用(不写则在多工具场景里抢别人的活)。
@tool 和 StructuredTool.from_function 各适合什么场景?
@tool 适合你自己新写的函数,一行装饰器最省事。StructuredTool.from_function 适合函数来自别人的模块或 SDK、不方便改的情况,在外面包一层补齐名称与描述;它还能同时挂同步实现(func)与异步实现(coroutine),也便于在运行时按配置批量生成工具。
把参数的取值范围写在 system_prompt 里和写在 Field(ge=1, le=7) 里有什么区别?
写在提示词里只是建议,模型可以不遵守;写进 Field 是硬约束,由 Pydantic 在工具执行前校验,越界直接抛异常,轮不到你的业务代码处理脏数据。凡是能表达成约束的,都该写进 schema。
用 create_agent 搭一个 Agent 需要哪几步?入参和返回值各是什么形态?
四步:定义工具 → create_agent(model=..., tools=[...], system_prompt="...") → invoke → 读结果。
入参是字典 {"messages": [{"role": "user", "content": "..."}]};返回也是状态字典,完整消息链在 result["messages"],给用户看的答复是最后一条。
案例里用户一句话问了「还有多少货」和「多少钱」两件事,先查后算的顺序是谁定的?
模型定的。代码里只把三件工具交出去,没有任何一行写「先调查询再调计算」。模型看懂第二件事要用第一件的结果,于是自己排了顺序、分两轮委托。排序的判断权在模型,执行的动作在框架和你的代码里。
调试 Agent 时为什么不该用 invoke?流式的节点名要注意什么?
invoke 只给最终结果,中间调了哪些工具、转了几圈全是黑箱。调试用 stream(stream_mode="updates"),每个节点跑完就吐一块更新。
注意模型节点叫 "model",工具节点叫 "tools"。旧写法里模型节点叫 "agent",按旧名字取不会报错,只会一直取到空。
怎么让 Agent 记住上一轮说过的话?两个必需条件是什么?
给 create_agent 传一个 checkpointer(负责把状态持久化),调用时带上 thread_id(负责区分是哪一个会话)。两者缺一不可——只传 checkpointer 不带 thread_id,状态存了也找不回来。不同 thread 之间完全隔离。
三代写法各是什么?迁移时最容易漏的三个参数变化是什么?
第一代 initialize_agent + AgentType 枚举(提示词内置、改不动);第二代 create_react_agent + AgentExecutor(决策与执行分离、提示词可自定义);第三代 create_agent 统一入口。
最容易漏的三处:导入路径 langgraph.prebuilt → langchain.agents;prompt= → system_prompt=(传字符串);流式节点名 "agent" → "model"。
middleware 有哪几个常用钩子?异常兜底和步数刹车分别挂在哪个上?
before_agent / before_model / wrap_model_call / wrap_tool_call / after_model / after_agent。
工具异常兜底挂 wrap_tool_call:把异常转成一条消息还给模型,让它改参数重试,而不是让整个任务崩掉。步数刹车挂 before_model:统计已经调了多少次模型,超限就强行收尾。
要让「下单」这类写操作在执行前由人确认,需要配哪些东西?漏了会怎样?
用 HumanInTheLoopMiddleware,把要拦的工具名写进 interrupt_on;同时必须配 checkpointer,并且每次调用带同一个 thread_id。漏了 checkpointer,中断之后状态没地方存,恢复不回来。恢复时可以 accept(照原样执行)、edit(改参数再执行)或 reject(拒绝并说明原因)。
写操作类工具除了人工确认,代码里还必须做哪两件事?为什么?
限额和幂等。限额要在函数里卡死,不能只写在描述和人设里——提示词只是建议,模型可能填一个超量参数。幂等要靠「业务请求号 → 已产生的结果」这张表:模型失败后会重试,护栏里的异常兜底还鼓励它重试,没有幂等,一次网络抖动就可能变成两张订单。另外别忘了给对外请求设超时。
词术语表
| 术语 | 含义 |
|---|---|
| Tool | 被包装过的普通函数,带名称、描述、参数结构;是 Agent 与外部世界交互的接口 |
@tool | 把函数变成 Tool 的装饰器;默认取函数名作名称、取文档字符串作描述 |
StructuredTool | 另一种造工具的方式,from_function 把已有函数包成 Tool,可同时挂同步与异步实现 |
description | 写给模型看的功能描述,模型选不选这件工具的唯一依据 |
args_schema | 用 Pydantic 写的参数结构,描述每个参数的含义、类型与取值范围,并在执行前校验 |
return_direct | 仅对 Agent 生效;为 True 时工具执行完直接把结果返回用户、循环中断 |
create_agent | langchain.agents 里构建 Agent 的当代入口,装配模型、工具、人设与 middleware |
system_prompt | create_agent 的人设参数,传字符串;旧写法里叫 prompt |
| 执行循环 | 调模型 → 判断有无工具调用 → 执行工具 → 回填 → 再调模型,直到不再需要工具 |
| 节点名 | 流式输出里的节点标识:模型节点是 "model",工具节点是 "tools" |
| middleware | 插在执行循环缝隙里的钩子:before_model / wrap_model_call / wrap_tool_call / after_model 等 |
HumanInTheLoopMiddleware | 内置中间件,把指定工具拦在执行之前交给人确认;必须配 checkpointer |
SummarizationMiddleware | 内置中间件,历史过长时自动做摘要压缩,避免撑爆上下文窗口 |
checkpointer | 状态持久化组件,Agent 侧会话记忆靠它存;InMemorySaver 是内存实现 |
thread_id | 会话标识,放在 config["configurable"] 里;不同 thread 之间状态完全隔离 |
response_format | 让 Agent 产出结构化结果的参数,取值用 ToolStrategy 或 ProviderStrategy |
ToolStrategy | 把输出 schema 当成一件工具交给模型填,适用于任何支持工具调用的模型 |
langchain-classic | legacy 功能的新家,initialize_agent、LLMChain 这类旧写法搬到了这里 |