【案例】金融行业动态方向评估(二):信息抽取与文本匹配
同一个天才临时工,换两张工作便条:一张让他照表单填格子,一张让他核对两份单据是不是同一件事——模型没变,变的只有便条和验收标准。
30秒看懂
同一个人,两张不同的便条——难的不是让他干活,是让他交上来的东西能直接用
还是那个读遍了全世界资料、却没参加过你们公司岗前培训的天才临时工。上一讲你递给他的便条是「这段话属于哪一类」,他回一个词就完事。这一讲的两张便条难度陡增:
递过去一份印好格子的表单:日期、股票名称、开盘价、收盘价、成交量。他读完原文,把能对上的填进去,填不了的格子也不许空着,要写「原文中未提及」。这就是信息抽取(Information Extraction,IE)。
递过去两张单据,问他:这两张说的是不是同一件事?他只能回「是」或「不是」,不许写小作文。这就是文本匹配(Text Matching)。
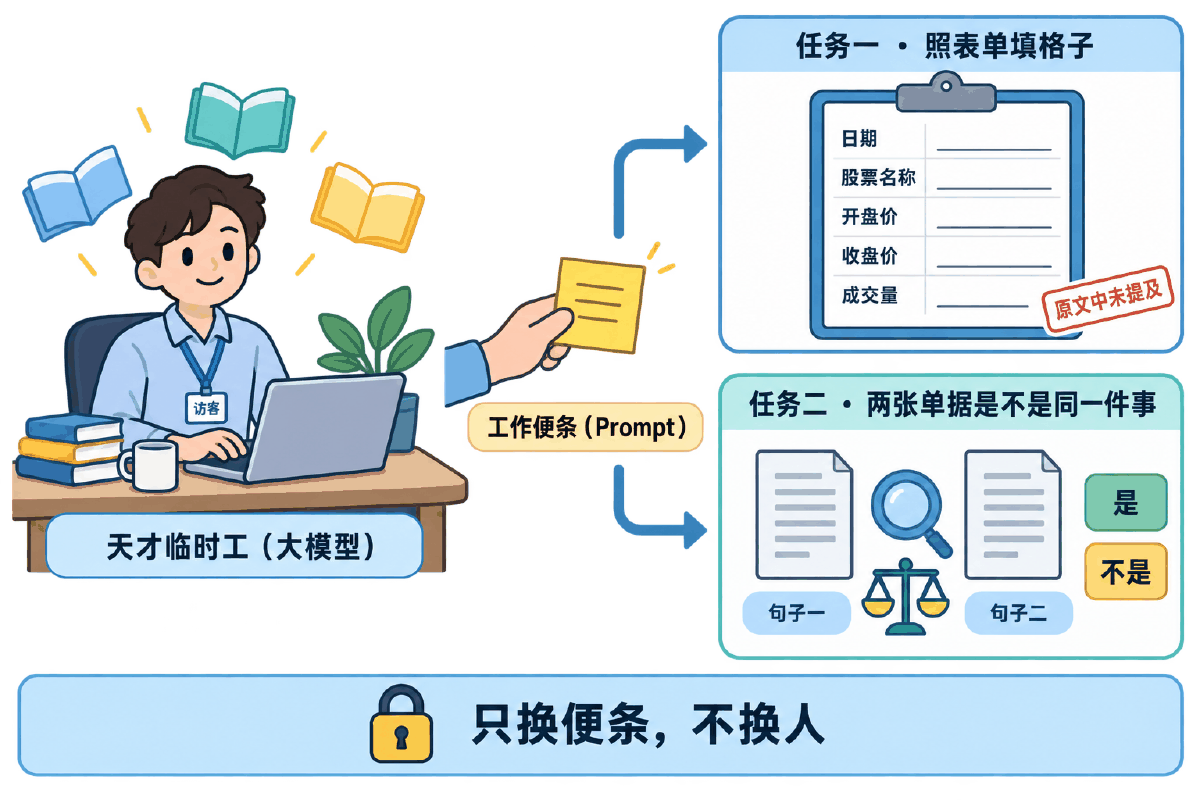
两张便条都不改这个人一根汗毛——模型权重全程冻结,你唯一能动的就是便条上的字。但比起分类,这两件事多了一道致命的关卡:他交回来的是一段话,不是一条数据。表单填得再对,只要格式散了、少了个引号、前面多了句「好的,结果如下」,你的程序就接不住。
dict,不是表格,不是数据库的一行。「解析成功」只证明它是个合法 JSON,不证明字段齐全、不证明值没被编出来。所以这一讲的每条链路末尾都挂着同一个东西:解析 → 规整 → 校验 → 再入库,四步缺一步,线上就会出现一条谁都查不出来的脏数据。模块 ③ 的总铁律依然成立:改便条 ≠ 改人。下面所有优化动作,全部发生在便条这一侧。
这一讲里出场的角色
| 角色 | 对应比喻 | 它到底是什么 |
|---|---|---|
| 大模型 | 天才临时工 | 本讲跑在本地 Ollama 上的 qwen3:8b,全程不训练、不微调 |
| Prompt | 递过去的工作便条 | system 消息 + few-shot 示例 + 这一次的提问,三段拼成一次请求 |
| schema | 表单上印好的格子 | 要抽哪几个字段,一次定死,全流程复用 |
原文中未提及 | 空格子上的红章 | 抽不到时的统一占位符;不许留空、不许漏键、不许写 null |
| 解析器 | 收表的人 | 把那段字符串变成 dict;救不回来就退回重填 |
| 校验器 | 验收的人 | 查字段齐不齐、值的形状对不对;不合格不许进下一环节 |
| 评测集 | 事先备好的标准答卷 | 人工标好的金标;模型改一版就重跑一次,用数字比高低 |
| 阈值 | 「算不算同一件事」的那条线 | 匹配任务里把分数切成是/不是的分界点,由评测集扫出来 |
② 模型答「原文中未提及」和模型漏了这个键,是不是一回事?
③ 匹配任务里,准确率 0.9 的模型为什么可能一条正例都没找出来?
④ 同一套四步方法论,哪两步能在两个任务之间直接复用,哪两步必须推倒重做?
01概念:两类任务与同一套四步方法论
先把与行业无关的部分讲干净,再谈金融文本——顺序反了,学到的就只是两段能抄的代码
1.1 信息抽取与文本匹配到底在做什么
这两件事的共同点是:输入是自由文本,输出必须是程序能直接消费的东西。区别在于输出的形状差得很远。
| 维度 | 信息抽取(IE) | 文本匹配 |
|---|---|---|
| 输入 | 一段文本 | 两段文本 |
| 输出 | 一个结构化对象,字段数 = schema 大小 | 一个二值判定:是 / 不是 |
| 输出空间 | 开放——值是原文里的任意片段 | 封闭——只有两个取值 |
| 错法 | 抽错、抽漏、多抽、编造、格式散架 | 只有两种:该判是的判成不是,该判不是的判成是 |
| 解析难度 | 高,要从字符串里还原出嵌套结构 | 低,把回答收敛成两个词就行 |
| 最容易翻车的地方 | 原文里没有的字段,模型会顺手编一个 | 话题相近但方向相反的一对,模型会判成「是」 |
1.2 四步方法论:任务定义 → 提示词设计 → 评测集 → 迭代优化
上一讲用这条链路做完了文本分类,它在这两个任务上一样成立。区别不在链路本身,而在每一步的验收判据。
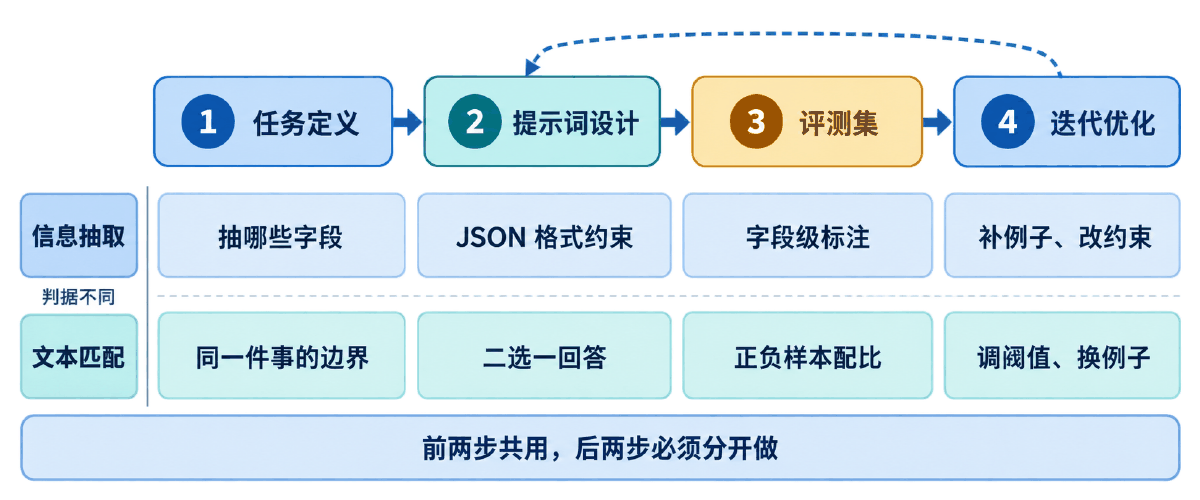
边界画在哪
钉死输出格式
加上打分口径
改完重跑一遍
| 步骤 | 这一步交付什么 | 做完的标志 |
|---|---|---|
| ① 任务定义 | 一句话说清输入输出,外加一份边界说明 | 拿两条有争议的样本给三个人标,标出来一致 |
| ② 提示词设计 | system 消息 + few-shot 示例 + 提问模板 | 随手拿一条没见过的样本,输出形状完全符合预期 |
| ③ 评测集 | 几十到几百条金标 + 一个打分脚本 | 脚本能直接吐出数字,不需要人再看一眼 |
| ④ 迭代优化 | 改过的提示词 + 前后两版的分数对比 | 分数涨了,且知道是哪一处改动带来的 |
1.3 抽取任务的判据:形状、覆盖、真假,三件事分开看
抽取的输出是一个对象,「对不对」这个问题要拆成三层,每一层的修法完全不同:
是不是合法 JSON、字段齐不齐、值是不是列表。这一层靠代码解决——解析容错 + 规整 + 校验,跟模型聪明不聪明无关。
原文里明明有的值,模型漏掉了。这一层靠提示词解决——补 few-shot 例子、把字段说明写细。
原文里没有,模型给了一个看着很合理的值。这一层最危险,因为形状完全正确,校验器一个字都挑不出来。
ie_field_score.py 里就有 hallucinated 和 missed 两个独立计数器。
1.4 匹配任务的判据:边界定义比模型更重要
匹配任务的分数低,十次有八次不是模型不行,而是「相似」这两个字你自己就没定义清楚。同一对句子,换个口径答案就反了:
| 口径 | 判据 | 「央行降息」vs「央行加息」 |
|---|---|---|
| 同一话题 | 在讲同一个领域的事 | 是——都在讲央行利率 |
| 同一事件 | 指向现实中同一件事 | 不是——两个相反的动作 |
| 同一方向 | 对市场的影响方向一致 | 不是——一个宽松一个收紧 |
| 可互相替代 | 检索时返回其中一条就够了 | 不是——替代了就丢信息 |
这四种口径没有对错,但你必须选一种,写进 system 消息,并且让标注员照着同一种标。口径不统一,评测集本身就自相矛盾,后面再怎么调提示词都是白费。
1.5 和分类任务的分界线
上一讲的分类任务,输出空间是一个封闭的类别列表;这一讲的两个任务,一个输出空间开放(抽取),一个输入变成了两段(匹配)。三者的工程差别落在这张表上:
| 任务 | 输出 | 主要风险 | 主指标 |
|---|---|---|---|
| 文本分类 | 一个类别名 | 答出类别表之外的词 | 准确率 / 各类 F1 |
| 信息抽取 | 一个结构化对象 | 格式散架、字段编造 | 字段级准确率 |
| 文本匹配 | 是 / 不是 | 边界定义不清、样本失衡 | 精确率 / 召回率 / F1 |
三者共用的那一半是:都不训练模型、都靠 few-shot 给例子、都要把输出格式钉死、都要有评测集。这也是为什么把它们放进同一个项目里讲——换任务时真正要重做的只有后两步。
1.6 运行环境
这一讲的代码跑在本地推理上,不调用任何云端 API,因此不需要任何密钥,也不产生调用费用。
| 组件 | 版本前提 | 作用 |
|---|---|---|
| Ollama | 已安装并处于运行状态 | 本地模型管理与推理服务,默认监听 11434 端口 |
| 模型 | qwen3:8b | 80 亿参数量级,先执行 ollama run qwen3:8b 拉到本地,约需 5.2 GB 以上磁盘空间 |
| Python | 3.8 及以上 | ollama 库对 Python 版本的下限要求 |
ollama | pip install ollama | 官方 Python 客户端,把本地 REST 接口包成 chat() 等函数 |
rich | pip install rich | 终端彩色输出与运行中状态条,只影响观感,不影响逻辑 |
调用写法就一行,消息列表的结构和 OpenAI 风格的 chat 接口一致:
qwen3 系列带 thinking 能力,输出里可能夹着思考段
Qwen3 在 Ollama 的模型库里从 0.6b 到 235b 都有,8b 只是其中一档,并且这一系列标注了 tools 与 thinking 两种能力。带 thinking 的模型在默认设置下可能先输出一段推理,再给结果——这正是第 02 节要做「先截出最外层大括号再解析」的现实原因。换模型规格时,第一件事是打印一次原始返回,看清楚它到底吐了什么,不要假设它只吐 JSON。
02原理:从 schema 到指标,两条链路拆开讲
抽取和匹配在前两步几乎一样,从第三步开始彻底分家
2.1 抽取第一步:schema 怎么定
schema 就是表单上印好的那几个格子。它是整条链路的锚点:提示词照它写、解析照它校验、评分照它逐项算。定 schema 时只有四条规矩:
| 规矩 | 怎么做 | 不这么做会怎样 |
|---|---|---|
| 字段名用业务里的原话 | 叫「开盘价」就不要写成 open_price | 模型要在中文原文和英文字段名之间多绕一道,抽漏率上升 |
| 一个字段只装一件事 | 「开盘价」和「收盘价」分开,不合并成「价格」 | 合并字段的值没法逐项比对,评分时只能整块判对错 |
| 字段数量克制 | 一次抽 5~8 个,多了拆成两轮 | 字段一多,模型容易顾此失彼,尾部字段准确率明显掉 |
| 值的形状统一 | 一律 list[str],哪怕只有一个值 | 时而字符串时而列表,下游每次用都要先判类型 |
落到金融文本上,这份 schema 长这样——一个实体类型,五个字段:
收盘价 · 成交量
['原文中未提及']SCHEMA 写成 {"金融": [...]} 而不是直接一个字段列表,是为了以后能横向扩展:加一个「公告」类型、一个「研报」类型,各自带自己的字段表,提示词拼装那段代码一行都不用改。不要写死成单一类型——这是从一开始就该留的口子。
2.2 抽取第二步:提示词四件套
这一段直接复用第三讲的六个技巧,不另起名字。抽取任务用到的是其中四个:
| 技巧 | 在这里怎么用 | 对应到提示词的哪一句 |
|---|---|---|
| 分隔符 | 原文和指令之间空两行,让模型分得清「哪段是材料、哪段是命令」 | {}\n\n提取上述句子中…… |
| 结构化输出 | 明确要 JSON,并把字段名逐个列出来 | 并按照JSON格式输出 |
| 条件检查 | 告诉模型「找不到时该怎么办」,而不是让它自由发挥 | 不存在的信息用['原文中未提及']来表示 |
| few-shot | 给一组完整的一问一答,让它看见答案的形状 | 前置消息里的 user / assistant 各一条 |
把四件套拼起来,最终发给模型的提问模板只有一行:
{原文}\n\n提取上述句子中“{实体类型}”({字段1, 字段2, …})的实体,并按照JSON格式输出,上述句子中不存在的信息用['原文中未提及']来表示,多个值之间用','分隔。
而 few-shot 那一组示例,是整个提示词里最值钱的部分。它同时传递了四层信息,每一层都是纯文字说明很难讲清楚的:
示例里的回答是一个大括号对象,模型照着仿写的概率远高于你用中文描述十遍。
示例写的是 "100美元" 而不是 100——单位跟着值走,这个约定靠例子传达最省事。
示例里哪怕只有一个值也写成 ["2023-01-10"],模型就不会时而给字符串时而给列表。
示例原文里有「飙升至105美元」「回落至98美元」,而答案里一个都没有——这就教会了模型:只要开盘和收盘,中间的波动价不是我们要的。
2.3 抽取第三步:把输出约束成可解析的结构
这是抽取任务和分类任务真正拉开差距的地方。分类任务答错了你一眼能看出来,抽取任务答对了也可能接不住。
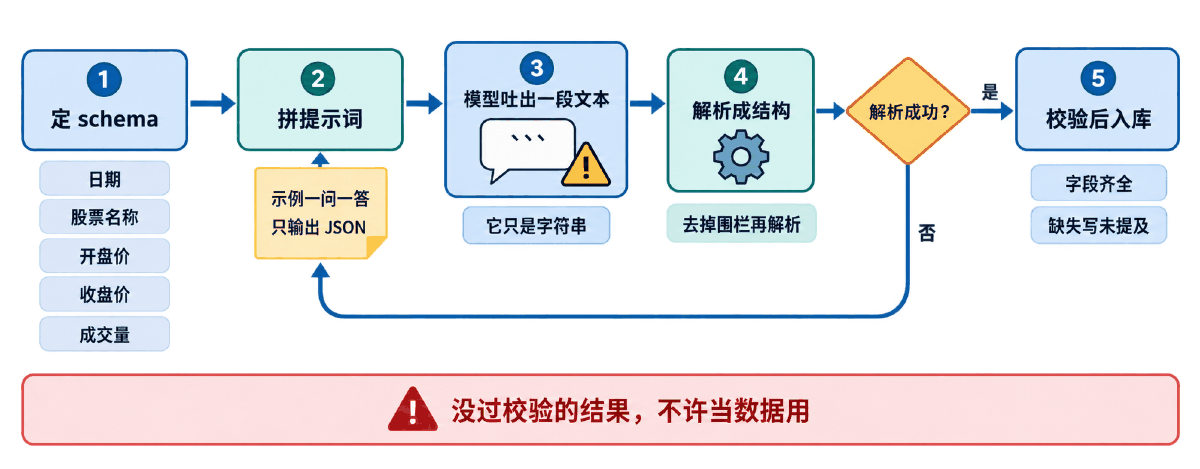
模型返回的字符串,常见形态有这么几种,全部都要接得住:
| 形态 | 样子 | 处理办法 |
|---|---|---|
| 干净 JSON | {"日期": ["2023-02-15"]} | 直接 json.loads |
| 套了代码围栏 | ```json … ``` | 正则取出围栏里那段再解析 |
| 前后有寒暄 | 好的,结果如下:{…} 希望有帮助。 | 正则截出最外层大括号那一段 |
| 中文标点 | {“日期”: [“2023-02-15”]} | 结构性标点做全角转半角 |
| Python 风格单引号 | {'日期': ['2023-02-15']} | 单引号换双引号(放最后试,值里带撇号会误伤) |
| 尾随逗号 | {"日期": ["2023-02-15"],} | 正则去掉 } 或 ] 前的逗号 |
| 压根不是 JSON | 这句话里没有股票信息。 | 判定失败,走重试;救不回来就退回人工 |
None,绝不返回原始字符串充数。一旦允许返回半成品,脏数据就会从这里漏进业务。
抽不到时返回什么
三种写法看着差不多,工程上差别极大:
| 写法 | 下游代码要写成 | 问题 |
|---|---|---|
| 漏掉这个键 | data.get("收盘价") 还要判 None | 最差。「没抽到」和「模型忘了这个字段」分不开 |
值为 null 或 "" | 每次用前判空 | 类型不统一,统计时要额外过滤 |
["原文中未提及"] | 直接当普通值读 | 最好。形状统一,且这个值本身就是一条可统计的信息 |
选第三种还有一个隐藏好处:「未提及」的比例本身就是个监控指标。某天它突然从 5% 涨到 40%,说明上游文本格式变了,或者模型版本换了——这比等业务报错早得多。
2.4 抽取第四步:解析失败怎么重试
重试不是把同一句话再发一遍——那样大概率还是同样的结果。重试要带上上一次的错误信息,把失败的输出作为上下文回喂给模型:
+「上一条不是合法 JSON,请只输出一个 JSON 对象」
不写进结果集
| 重试策略 | 适用情况 | 注意 |
|---|---|---|
| 原样重发 | 怀疑是偶发抖动 | 本地推理基本没有抖动,作用有限 |
| 带错误回喂 | 格式跑偏、多写了解释 | 首选。把坏输出放进 assistant 位,再补一句纠正 |
| 降低温度 | 输出发散、每次都不一样 | 格式任务本来就该用低随机性 |
| 拆小 schema | 字段太多、尾部字段总丢 | 分两轮抽,再合并结果 |
2.5 匹配任务的提示词:把回答空间压到最小
匹配的提示词比抽取简单,但有一个专门的难点:模型天生爱解释。你问「这两句话相似吗」,它很想回「这两句话都在讨论股市走势,因此是相似的」。所以 system 消息里必须有一句硬约束:
接着用 few-shot 把答案的形状钉死成两个字。这里的示例配比有讲究:
| 示例 | 标签 | 它在教什么 |
|---|---|---|
| 公司ABC发布季度财报,盈利增长。/ 财报披露,公司ABC利润上升。 | 是 | 同一件事换个说法,就该判「是」 |
| 黄金价格下跌,投资者抛售。/ 外汇市场交易额创下新高。 | 不是 | 都属金融,但不是同一件事——同领域不等于同事件 |
| 央行降息,刺激经济增长。/ 新能源技术的创新。 | 不是 | 完全不相干的一对,给出下界 |
2.6 阈值怎么定,正负样本怎么配
让模型直接回「是/不是」,你就没有阈值可调——它内部那条线在哪你不知道。想要能调,就得让它给分数:
| 做法 | 输出 | 能不能调阈值 | 代价 |
|---|---|---|---|
| 直接二选一 | 是 / 不是 | 不能 | 最省事,但精确率和召回率的取舍权不在你手上 |
| 让模型给 0~1 的分 | 0.82 | 能 | 要额外约束输出格式;分数的刻度不一定稳定 |
| 走向量余弦 | 0.76 | 能 | 要另外部署 embedding 模型,但分数刻度稳定得多 |
只要拿得到分数,「阈值定在哪」就不再是拍脑袋的事——扫一遍,挑 F1 最高的那个:
召回率高、精确率低
取 F1 峰值
精确率高、召回率低
正负样本怎么配
| 配比要求 | 判据 | 违反了会怎样 |
|---|---|---|
| 正负比例别太偏 | 正类占三到七成之间 | 1:9 时,闭眼全答「不是」也有 0.9 准确率 |
| 负样本要有难例 | 难负样本占负类四成以上 | 负样本全是风马牛不相及的,分数虚高,上线就打回原形 |
| 难例要覆盖两种 | ① 同话题反方向 ② 同主体不同事件 | 只准备一种,模型会学到另一种的捷径 |
| 正样本别只有改写 | 同一件事的不同角度也要有 | 否则模型学成了「换词检测器」,遇到换角度的表述就判不是 |
同主体不同事件:「公司ABC完成并购」vs「公司ABC发布季度财报」——主语一样,说的是两件事。
这两类样本决定了你的模型是真的在判「同一件事」,还是只在数有多少词重合。
2.7 两套打分方式
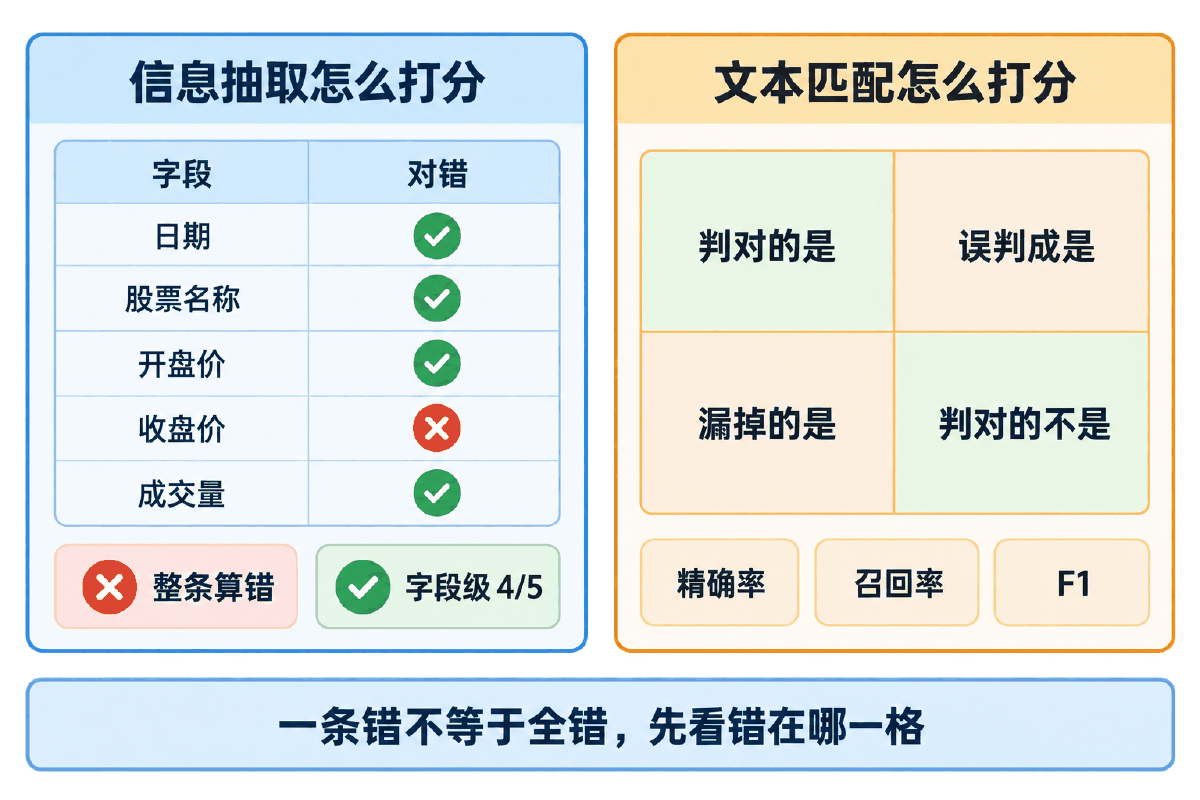
抽取:字段级准确率
整条准确率(exact match)要求五个字段全对才算一条对。它的问题是把信息压没了:一条只错了一个字段,和一条五个全错,得分完全一样,都是 0。
| 口径 | 怎么算 | 能告诉你什么 |
|---|---|---|
| 整条准确率 | 全对的条数 ÷ 总条数 | 「这条结果能不能直接用」——业务验收看这个 |
| 字段级准确率 | 对的字段数 ÷ 总字段数 | 「离能用还差多远」——改提示词时看这个 |
| 逐字段拆开 | 每个字段单独算一次 | 「哪个字段在拖后腿」——这才是可执行的信息 |
两个口径都要报,但迭代时盯的是逐字段那张表。它会直接告诉你:该补的是「成交量」的例子,还是「股票名称」的说明。
匹配:准确率之外还要看什么
匹配任务只报准确率等于没报。必须把混淆矩阵四格摊开:
| 格子 | 含义 | 业务代价 |
|---|---|---|
| TP 判对的「是」 | 真的是同一件事,也判成了是 | — |
| FP 误判成「是」 | 不是同一件事,却判成了是 | 去重时把两条不同的信息合并掉,丢信息 |
| FN 漏掉的「是」 | 是同一件事,却判成了不是 | 去重没生效,留冗余 |
| TN 判对的「不是」 | 真的不是,也判成了不是 | — |
| 指标 | 公式 | 回答的问题 |
|---|---|---|
| 准确率 Accuracy | (TP+TN) ÷ 全部 | 整体判对了多少——样本失衡时会骗人 |
| 精确率 Precision | TP ÷ (TP+FP) | 判成「是」的里面,真有多少是对的 |
| 召回率 Recall | TP ÷ (TP+FN) | 真正的「是」,被找回来多少 |
| F1 | 2PR ÷ (P+R) | 两者的调和平均,挑阈值时用它当目标 |
2.8 共性与差异:同一套方法论,哪些复用哪些重做
| 步骤 | 信息抽取 | 文本匹配 | 能不能复用 |
|---|---|---|---|
| ① 任务定义 | 定 schema:抽哪几个字段 | 定边界:怎样才算同一件事 | 结构复用,内容各写各的 |
| ② 提示词骨架 | system + few-shot + 提问模板 | system + few-shot + 提问模板 | 可以直接复用,连拼装代码都一样 |
| ② 输出约束 | JSON,字段齐全,占位符 | 两个词之一,不许解释 | 必须重写 |
| ② 后处理 | 去围栏、截对象、修标点、解析 | 否定词优先的关键词归一化 | 必须重写 |
| ③ 评测集形态 | 每条一个完整金标对象 | 每条一个句子对加一个标签 | 必须重做 |
| ③ 打分口径 | 字段级准确率 + 逐字段拆解 | 精确率 / 召回率 / F1 | 必须重做 |
| ③ 评测集体检 | 「未提及」要有覆盖 | 正负配比 + 难负样本占比 | 思路相同,判据不同 |
| ④ 迭代抓手 | 补字段说明、补 few-shot、拆 schema | 改边界定义、补难负样本、调阈值 | 思路相同,动作不同 |
| ④ 失败留痕 | 记原始输出,统计放弃条数 | 记判不了的对,统计未决条数 | 可以直接复用 |
03最小代码:先把「接得住」这一步跑通
不装 Ollama、不下模型,先解决抽取任务里 90% 的线上故障来源
写抽取程序的人,第一反应通常是先把模型调起来。但真正让程序在半夜挂掉的,几乎从来不是模型答得不好,而是它答得「不够整齐」——多了个围栏、前面加了句寒暄、引号用了中文的。这一段代码不需要任何依赖,python3 json_repair.py 直接跑,把这条防线先建起来。
# -*- coding: utf-8 -*-
"""把模型吐出来的那段文本尽量变成 dict。

模型返回的永远是字符串。它可能规规矩矩给 JSON,也可能:
  · 套一层 ```json ... ``` 围栏
  · 用中文引号、中文逗号
  · 用 Python 风格的单引号
  · 在 JSON 前后再写两句寒暄
  · 结尾多一个逗号
这个文件只做一件事:尽量救回来;救不回来就返回 None,绝不返回半成品。

纯标准库,`python3 json_repair.py` 直接跑自测。
"""
import json
import re

FENCE_RE = re.compile(r"```(?:json|JSON)?\s*(.*?)```", re.DOTALL)
OBJ_RE = re.compile(r"\{.*\}", re.DOTALL)
TRAILING_COMMA_RE = re.compile(r",\s*([}\]])")

# 全角标点 → 半角,只在结构层面替换,值里的中文不受影响(见下方 _protect)
PUNCT_MAP = {
    "“": '"', "”": '"', "‘": "'", "’": "'",
    ":": ":", ",": ",", "【": "[", "】": "]",
}


def strip_fence(text: str) -> str:
    """去掉 Markdown 代码围栏,只保留里面那段。"""
    found = FENCE_RE.findall(text)
    for block in found:
        if block.strip():
            return block.strip()
    return text.strip()


def slice_object(text: str) -> str:
    """把首尾的寒暄砍掉,只留最外层大括号那一段。"""
    match = OBJ_RE.search(text)
    return match.group(0) if match else text


def normalize_punct(text: str) -> str:
    """把结构性的全角标点换成半角。"""
    for src, dst in PUNCT_MAP.items():
        text = text.replace(src, dst)
    return text


def parse_model_json(text: str):
    """主入口:返回 dict,救不回来返回 None。

    逐级放宽,每一级都先试一次标准解析,能早退就早退。
    """
    if not isinstance(text, str) or not text.strip():
        return None

    candidates = []
    stage1 = strip_fence(text)
    candidates.append(stage1)
    stage2 = slice_object(stage1)
    candidates.append(stage2)
    stage3 = normalize_punct(stage2)
    candidates.append(stage3)
    candidates.append(TRAILING_COMMA_RE.sub(r"\1", stage3))
    # 最后一招:Python 风格单引号换成双引号(值里含撇号时会失败,所以放最后)
    candidates.append(TRAILING_COMMA_RE.sub(r"\1", stage3).replace("'", '"'))

    for candidate in candidates:
        try:
            data = json.loads(candidate)
        except (ValueError, TypeError):
            continue
        if isinstance(data, dict):
            return data
    return None


def _demo():
    cases = [
        ('{"日期": ["2023-02-15"]}', True, "标准 JSON"),
        ('```json\n{"日期": ["2023-02-15"]}\n```', True, "带围栏"),
        ("好的,结果如下:\n{\"日期\": [\"2023-02-15\"]}\n希望有帮助。", True, "前后有寒暄"),
        ("{'日期': ['2023-02-15']}", True, "单引号"),
        ('{"日期": ["2023-02-15"],}', True, "尾随逗号"),
        ('{“日期”: [“2023-02-15”]}', True, "全角引号"),
        ("原文中未提及", False, "根本不是 JSON"),
        ('{"日期": ["2023-02-15"', False, "截断了"),
        ("", False, "空字符串"),
    ]
    ok = 0
    for raw, should_parse, label in cases:
        data = parse_model_json(raw)
        got = data is not None
        flag = "通过" if got == should_parse else "不符"
        if got == should_parse:
            ok += 1
        print(f"[{flag}] {label:<12} 解析={'成功' if got else '失败'} -> {data}")
    print(f"\n{ok}/{len(cases)} 条符合预期")
    assert ok == len(cases), "容错解析行为与预期不符"

    # 关键断言:救不回来时必须是 None,不能是字符串、不能是空 dict
    assert parse_model_json("模型今天心情不好") is None
    assert parse_model_json("[1,2,3]") is None, "顶层不是对象时也要判失败"
    print("断言全部通过:解析失败一律返回 None,绝不返回半成品")


if __name__ == "__main__":
    _demo()
3.1 跑起来是什么样
脚本自带九条测试用例,覆盖了前面 2.3 节列出的全部形态。跑完输出是这样:
| 输入形态 | 期望 | 结果 |
|---|---|---|
| 标准 JSON | 解析成功 | {'日期': ['2023-02-15']} |
带 ```json 围栏 | 解析成功 | {'日期': ['2023-02-15']} |
| 前后有寒暄 | 解析成功 | {'日期': ['2023-02-15']} |
| Python 风格单引号 | 解析成功 | {'日期': ['2023-02-15']} |
| 尾随逗号 | 解析成功 | {'日期': ['2023-02-15']} |
| 全角引号 | 解析成功 | {'日期': ['2023-02-15']} |
| 根本不是 JSON | 解析失败 | None |
| 被截断了 | 解析失败 | None |
| 空字符串 | 解析失败 | None |
末尾打印 9/9 条符合预期,然后是两条断言:解析不出来时必须返回 None,并且顶层不是对象(比如返回了一个数组)时同样判失败。
3.2 这 100 行里,三个不肯将就的设计
五级候选串按「越来越激进」的顺序排,每一级都先试标准 json.loads。干净的输入在第一级就返回了,根本不会走到替换引号那种有副作用的步骤。
replace("'", '"') 看着万能,实际上值里只要有一个撇号就会把 JSON 打烂。它是最后一招,不是第一招。
所有候选都试完还不行,返回 None。不返回原始字符串,不返回空 dict——那两种「善意」的兜底,都会让脏数据静悄悄流进下游。
json.loads 对整段字符串是零容忍的:只要前面多一个字,它就整段报错。而模型很爱在 JSON 前后各写一句话——尤其是带 thinking 能力的模型,可能先输出一整段推理再给结果。用 \{.*\} 配合 re.DOTALL 贪婪匹配,截出从第一个左大括号到最后一个右大括号的那一段,是最省事且足够稳的做法。
PUNCT_MAP 里换的是引号、冒号、逗号、方括号——这些是 JSON 的语法符号。至于值里面的中文逗号、书名号,一个都不能动:"股票名称": ["古哥-D[EOOE]美股"] 这种值里本来就带方括号,粗暴全局替换反而会把它改坏。容错的边界,是「只修语法,不碰内容」。
04完整案例:两条链路各跑一遍
校验器、评分器、两个主程序、指标与阈值、评测集体检——七个文件连成一条完整流水线
这一节的脚本分两类:纯标准库的五个(ie_schema_check / ie_field_score / match_metrics / match_threshold_scan / eval_set_build)python3 文件名 直接跑,每个末尾都带断言;依赖 Ollama 的两个(finance_ie / finance_text_matching)需要本地模型服务起着才能跑。
4.1 抽取结果校验器:解析成功 ≠ 结果可用
上一节的 parse_model_json 只保证「它是个 dict」。而 dict 里可能缺字段、值的类型五花八门、还多出几个 schema 之外的字段——模型特别爱自己加一个「投资者情绪」。这个文件把「规整」和「校验」两件事分开:normalize 只修形状,check 只报问题,两者都不猜内容。
# -*- coding: utf-8 -*-
"""抽取结果校验器:解析成功 ≠ 结果可用。

parse_model_json 只保证「它是个 dict」。这个文件保证:
  · schema 里的字段一个不少(少的补成「原文中未提及」)
  · 没有 schema 之外的野字段(模型很爱自己加「涨跌幅」)
  · 每个值都是 list[str],单个字符串自动包成 list
  · 「原文中未提及」必须独占,不能和真值混在同一个 list 里

纯标准库,`python3 ie_schema_check.py` 直接跑自测。
"""
NOT_MENTIONED = "原文中未提及"


def normalize(data: dict, fields: list, placeholder: str = NOT_MENTIONED) -> dict:
    """把模型给的 dict 规整成「字段齐全、值都是 list[str]」的标准形状。

    只做形状上的修复,不猜内容:缺失字段一律补 placeholder。
    """
    fixed = {}
    for field in fields:
        value = data.get(field, None)
        if value is None or value == "" or value == []:
            fixed[field] = [placeholder]
            continue
        if isinstance(value, (str, int, float)):
            value = [str(value)]
        elif isinstance(value, list):
            value = [str(v) for v in value if str(v).strip() != ""]
            if not value:
                value = [placeholder]
        else:
            value = [str(value)]
        fixed[field] = value
    return fixed


def check(data: dict, fields: list, placeholder: str = NOT_MENTIONED) -> list:
    """返回问题清单;空列表表示这条结果可以进下一环节。"""
    problems = []
    if not isinstance(data, dict):
        return ["顶层不是对象"]

    for field in fields:
        if field not in data:
            problems.append(f"缺字段:{field}")
            continue
        value = data[field]
        if not isinstance(value, list):
            problems.append(f"{field} 的值不是列表:{type(value).__name__}")
            continue
        if not value:
            problems.append(f"{field} 是空列表,应写成 ['{placeholder}']")
            continue
        if any(not isinstance(v, str) for v in value):
            problems.append(f"{field} 里有非字符串元素")
        if placeholder in value and len(value) > 1:
            problems.append(f"{field} 把占位符和真值混在了一起:{value}")

    extra = [k for k in data.keys() if k not in fields]
    if extra:
        problems.append(f"多出 schema 之外的字段:{extra}")
    return problems


def _demo():
    fields = ["日期", "股票名称", "开盘价", "收盘价", "成交量"]

    # 一条典型的「模型自由发挥」结果:漏了收盘价、成交量写成了数字、还自己加了一个字段
    raw = {
        "日期": ["2023-02-15"],
        "股票名称": "佰笃[BD]美股",
        "开盘价": ["10美元"],
        "成交量": 460000,
        "投资者情绪": ["平稳"],
    }

    print("原始:", raw)
    problems = check(raw, fields)
    print("\n校验问题:")
    for p in problems:
        print("  ·", p)
    assert problems, "这条明显有问题,校验器却没报"

    fixed = normalize(raw, fields)
    print("\n规整后:")
    for k, v in fixed.items():
        print(f"  {k}: {v}")

    problems_after = check(fixed, fields)
    print("\n规整后的校验问题:", problems_after or "无")
    assert problems_after == [], "规整后仍不合格,说明 normalize 漏了情况"

    # normalize 只修形状,不编内容:收盘价原文里没有,就必须是占位符
    assert fixed["收盘价"] == [NOT_MENTIONED]
    # 野字段在 normalize 后被丢掉(schema 说了算)
    assert "投资者情绪" not in fixed
    # 数字被转成字符串,不做单位猜测
    assert fixed["成交量"] == ["460000"]

    # 占位符与真值混用必须被拦住
    bad = dict(fixed)
    bad["开盘价"] = ["10美元", NOT_MENTIONED]
    assert any("混在了一起" in p for p in check(bad, fields))

    print("\n断言全部通过:normalize 只修形状,check 只报问题,两者都不编内容")


if __name__ == "__main__":
    _demo()
拿一条典型的「模型自由发挥」结果喂进去,它会报出四个问题:
| 模型给的 | 校验器报的问题 | 规整后 |
|---|---|---|
"股票名称": "佰笃[BD]美股" | 值不是列表:str | ["佰笃[BD]美股"] |
压根没有 收盘价 这个键 | 缺字段:收盘价 | ["原文中未提及"] |
"成交量": 460000 | 值不是列表:int | ["460000"] |
"投资者情绪": ["平稳"] | 多出 schema 之外的字段 | 丢弃——schema 说了算 |
check(fixed, fields) == [] 钉死了这条关系:normalize 能修的,check 就不该再报。两者一旦对不上,说明 normalize 漏了某种情况——这个断言就是用来在开发期把那种情况逼出来的。
["10美元", "原文中未提及"] 这种返回形状完全合法,json.loads 和类型检查都挑不出毛病,但它在语义上自相矛盾——既抽到了又没抽到。下游做统计时会把它算成「已抽到」,于是「未提及」的比例被悄悄压低。脚本里专门有一条规则拦它。
4.2 字段级评分器:同一份结果,两种口径差出 0.333 和 0.867
2.7 节说「整条准确率会把信息压没」,这个脚本把数字算出来。评测集里三条金标,模型给的三条结果各有各的毛病:
| 条目 | 模型的问题 | 属于哪类错 |
|---|---|---|
| 第 1 条 | 成交量写成 460000,金标是 460,000 | 格式差异,归一化后应当判对 |
| 第 2 条 | 股票名称只给「盘古」,丢了 (0021) | 抽得不全 |
| 第 3 条 | 原文没有收盘价,模型给了「51元」 | 编造——最危险的一类 |
# -*- coding: utf-8 -*-
"""字段级评分器:整条对错会把信息压没,字段级才看得见问题在哪。

两种口径:
  · 整条准确率(exact match):五个字段全对才算一条对
  · 字段级准确率(field-level):逐字段比,一条错一个字段只扣一个字段的分
再按字段拆开,能直接指出「哪个字段在拖后腿」——这是改提示词的依据。

纯标准库,`python3 ie_field_score.py` 直接跑。
"""
NOT_MENTIONED = "原文中未提及"

# 评测集:人工标注的答案(gold)与模型给出的结果(pred)
GOLD = [
    {
        "日期": ["2023-02-15"], "股票名称": ["佰笃[BD]美股"],
        "开盘价": ["10美元"], "收盘价": ["13美元"], "成交量": ["460,000"],
    },
    {
        "日期": ["2023-04-05"], "股票名称": ["盘古(0021)"],
        "开盘价": ["23元"], "收盘价": ["26美元"], "成交量": ["310,000"],
    },
    {
        "日期": ["2023-05-20"], "股票名称": ["长虹科技"],
        "开盘价": ["48元"], "收盘价": [NOT_MENTIONED], "成交量": ["120,000"],
    },
]

PRED = [
    {   # 成交量丢了千分位
        "日期": ["2023-02-15"], "股票名称": ["佰笃[BD]美股"],
        "开盘价": ["10美元"], "收盘价": ["13美元"], "成交量": ["460000"],
    },
    {   # 股票名称把括号里的代码扔了,成交量同样丢千分位
        "日期": ["2023-04-05"], "股票名称": ["盘古"],
        "开盘价": ["23元"], "收盘价": ["26美元"], "成交量": ["310000"],
    },
    {   # 原文没有收盘价,模型自己编了一个——最危险的一类错
        "日期": ["2023-05-20"], "股票名称": ["长虹科技"],
        "开盘价": ["48元"], "收盘价": ["51元"], "成交量": ["120,000"],
    },
]

FIELDS = ["日期", "股票名称", "开盘价", "收盘价", "成交量"]


def norm_value(values: list) -> tuple:
    """比较前的归一化:去空白、去千分位逗号。顺序不敏感,所以排序成元组。"""
    cleaned = [str(v).strip().replace(",", "").replace(",", "") for v in values]
    return tuple(sorted(cleaned))


def score(gold_list: list, pred_list: list, fields: list) -> dict:
    assert len(gold_list) == len(pred_list), "评测集与预测条数必须一一对应"
    per_field = {f: {"right": 0, "total": 0} for f in fields}
    exact_right = 0
    hallucinated = 0     # 金标是「未提及」,模型却给了具体值
    missed = 0           # 金标有值,模型答「未提及」

    for gold, pred in zip(gold_list, pred_list):
        all_right = True
        for field in fields:
            g = norm_value(gold.get(field, [NOT_MENTIONED]))
            p = norm_value(pred.get(field, [NOT_MENTIONED]))
            per_field[field]["total"] += 1
            if g == p:
                per_field[field]["right"] += 1
            else:
                all_right = False
                if g == (NOT_MENTIONED,) and p != (NOT_MENTIONED,):
                    hallucinated += 1
                if g != (NOT_MENTIONED,) and p == (NOT_MENTIONED,):
                    missed += 1
        if all_right:
            exact_right += 1

    field_right = sum(v["right"] for v in per_field.values())
    field_total = sum(v["total"] for v in per_field.values())
    return {
        "exact": exact_right / len(gold_list),
        "field": field_right / field_total,
        "per_field": per_field,
        "hallucinated": hallucinated,
        "missed": missed,
    }


def _report(result: dict):
    print(f"整条准确率 exact match : {result['exact']:.3f}")
    print(f"字段级准确率 field-level: {result['field']:.3f}")
    print("\n逐字段:")
    for field, stat in result["per_field"].items():
        acc = stat["right"] / stat["total"]
        bar = "█" * int(acc * 20)
        print(f"  {field:<6} {stat['right']}/{stat['total']}  {acc:.2f} {bar}")
    print(f"\n凭空编出来的值:{result['hallucinated']} 个")
    print(f"该抽没抽到的值:{result['missed']} 个")


if __name__ == "__main__":
    result = score(GOLD, PRED, FIELDS)
    _report(result)

    # 三条里只有第一条全对(千分位归一化后成交量算对)→ exact = 1/3
    assert abs(result["exact"] - 1 / 3) < 1e-9
    # 错的只有两个字段:第二条的股票名称、第三条的收盘价 → 13/15
    assert abs(result["field"] - 13 / 15) < 1e-9
    # 只看 exact,这一版像是「三条错两条」;字段级立刻指出 86.7% 的字段是对的
    assert result["field"] > result["exact"]
    assert result["per_field"]["成交量"]["right"] == 3, "千分位已归一化,应判对"
    assert result["per_field"]["日期"]["right"] == 3
    assert result["per_field"]["股票名称"]["right"] == 2
    assert result["per_field"]["收盘价"]["right"] == 2
    # 第三条原文没有收盘价,模型编了个 51 元——这类错必须单独计数
    assert result["hallucinated"] == 1 and result["missed"] == 0
    print("\n断言全部通过:同一份结果,两种口径差出 0.333 与 0.867")
跑出来的数字:
| 指标 | 数值 | 它在说什么 |
|---|---|---|
| 整条准确率 exact match | 0.333 | 三条里只有第 1 条能直接用 |
| 字段级准确率 | 0.867 | 15 个字段里对了 13 个 |
| 日期 / 开盘价 / 成交量 | 3/3 | 这三个字段已经稳了,不用再管 |
| 股票名称 | 2/3 | 该补例子的是它 |
| 收盘价 | 2/3 | 错因是编造,不是抽漏,修法完全不同 |
| 凭空编出来的值 | 1 个 | 单独计数,不和别的错混在一起 |
| 该抽没抽到的值 | 0 个 | 这一版没有抽漏问题 |
norm_value 里已经把逗号去掉,归一化后两边完全相等,所以它是整条正确的。正确答案是 exact = 1/3、field = 13/15。写进讲义前先让机器算一遍,比反复读代码可靠得多。
460000 和 460,000 算不算对?这是个必须提前定死的口径。写进 norm_value,整个评测集就永远用同一把尺子;靠人看的时候「感觉差不多就算对」,两轮迭代之后你会发现分数不可比。同理,值的顺序不敏感,所以 norm_value 里要排序。
4.3 金融信息抽取完整程序
把 schema、提示词、few-shot、解析容错、校验、重试串成一个文件。注意它把解析和校验直接复用了前两个脚本,而不是各写一遍——这两件事在任何抽取任务里都一样,没有重复实现的必要。
# -*- coding: utf-8 -*-
"""金融文本信息抽取:把一句话抽成固定字段的 JSON。

运行前提:本机已装 Ollama 并拉好模型(ollama run qwen3:8b),
        以及 Python 包 ollama 与 rich。
环境变量:
    OLLAMA_MODEL  模型名,默认 qwen3:8b
    OLLAMA_HOST   服务地址,默认走 ollama 库自己的 http://127.0.0.1:11434
"""
import json
import os
import sys

import ollama
from rich import print
from rich.console import Console

# 1. schema:这张表单上有哪几个格子,一次定死,全流程复用
SCHEMA = {
    "金融": ["日期", "股票名称", "开盘价", "收盘价", "成交量"],
}

# 抽不到时统一填这个值,而不是留空、不是 null、不是漏键
NOT_MENTIONED = "原文中未提及"

# 2. 提示词骨架:句子在前,要求在后,最后一句把输出格式钉死
IE_PATTERN = (
    "{}\n\n提取上述句子中{}的实体,并按照JSON格式输出,"
    "上述句子中不存在的信息用['" + NOT_MENTIONED + "']来表示,多个值之间用','分隔。"
)

# 3. few-shot:给一问一答,让模型看见「答案长什么样」
IE_EXAMPLES = {
    "金融": [
        {
            "content": "2023-01-10,股市震荡。股票古哥-D[EOOE]美股今日开盘价100美元,"
                       "一度飙升至105美元,随后回落至98美元,最终以102美元收盘,成交量达到520000。",
            "answers": {
                "日期": ["2023-01-10"],
                "股票名称": ["古哥-D[EOOE]美股"],
                "开盘价": ["100美元"],
                "收盘价": ["102美元"],
                "成交量": ["520000"],
            },
        }
    ]
}


def build_prompt(sentence: str, entity_type: str) -> str:
    """把一句话套进 IE_PATTERN,得到最终发给模型的那段文本。"""
    fields = ", ".join(SCHEMA[entity_type])
    return IE_PATTERN.format(sentence, f"“{entity_type}”({fields})")


def init_prompts() -> list:
    """构造前置消息:system + 若干组 few-shot 问答。"""
    history = [{"role": "system", "content": "你是一个信息抽取助手。"}]
    for entity_type, examples in IE_EXAMPLES.items():
        for example in examples:
            history.append({
                "role": "user",
                "content": build_prompt(example["content"], entity_type),
            })
            history.append({
                "role": "assistant",
                "content": json.dumps(example["answers"], ensure_ascii=False),
            })
    return history


def call_model(messages: list, model: str) -> str:
    """调一次模型,只负责拿回字符串;任何异常都往上抛,由调用方决定重试。"""
    resp = ollama.chat(model=model, messages=messages)
    return resp["message"]["content"]


def extract_once(sentence: str, history: list, model: str) -> str:
    """单次抽取,返回模型的原始文本输出。"""
    messages = list(history) + [
        {"role": "user", "content": build_prompt(sentence, "金融")}
    ]
    return call_model(messages, model)


def extract(sentence: str, history: list, model: str, retries: int = 2) -> dict:
    """带重试的抽取:解析失败就重来,重来时把错误回喂给模型。

    返回值一定是 dict;连续失败则抛 ValueError,由上层决定是丢弃还是转人工。
    """
    from json_repair import parse_model_json  # 解析容错逻辑单独成文件,便于复用与单测
    from ie_schema_check import normalize, check

    last_raw = ""
    for attempt in range(retries + 1):
        messages = list(history)
        messages.append({"role": "user", "content": build_prompt(sentence, "金融")})
        if attempt > 0:
            messages.append({"role": "assistant", "content": last_raw})
            messages.append({
                "role": "user",
                "content": "上一条回复不是合法 JSON。请只输出一个 JSON 对象,"
                           "不要写解释、不要加代码围栏。",
            })
        last_raw = call_model(messages, model)
        data = parse_model_json(last_raw)
        if data is None:
            continue
        data = normalize(data, SCHEMA["金融"], NOT_MENTIONED)
        problems = check(data, SCHEMA["金融"])
        if not problems:
            return data
    raise ValueError(f"连续 {retries + 1} 次未拿到合法结果,最后一次原文:{last_raw[:200]}")


def main() -> int:
    console = Console()
    model = os.environ.get("OLLAMA_MODEL", "qwen3:8b")
    history = init_prompts()

    sentences = [
        "2023-02-15,寓意吉祥的节日,股票佰笃[BD]美股开盘价10美元,虽然经历了波动,"
        "但最终以13美元收盘,成交量微幅增加至460,000,投资者情绪较为平稳。",
        "2023-04-05,市场迎来轻松氛围,股票盘古(0021)开盘价23元,尽管经历了波动,"
        "但最终以26美元收盘,成交量缩小至310,000,投资者保持观望态度。",
    ]

    failed = 0
    for sentence in sentences:
        with console.status("[bold bright_green]正在抽取..."):
            try:
                result = extract(sentence, history, model)
            except ollama.ResponseError as exc:      # 模型没拉下来、服务没起
                print(f"[bold red]模型调用失败:{exc}")
                return 2
            except ValueError as exc:                # 输出始终解析不了
                print(f"[bold yellow]放弃这一条:{exc}")
                failed += 1
                continue
        print(f"[bold bright_red]原文:{sentence}")
        print(f"[bold bright_green]抽取:{json.dumps(result, ensure_ascii=False)}")

    print(f"[bold]共 {len(sentences)} 条,放弃 {failed} 条")
    return 0


if __name__ == "__main__":
    sys.exit(main())
| 函数 | 负责什么 | 关键点 |
|---|---|---|
build_prompt | 把一句话套进 IE_PATTERN | 字段列表从 SCHEMA 现取,改 schema 不用改这里 |
init_prompts | 构造 system + few-shot 前置消息 | 示例答案用 json.dumps(..., ensure_ascii=False),中文不转义 |
call_model | 只负责发一次请求、拿回字符串 | 不做任何解析,异常往上抛 |
extract | 解析 → 规整 → 校验 → 不合格就重试 | 返回值一定是 dict;连续失败抛 ValueError |
main | 遍历句子、打印、统计放弃条数 | 模型服务挂了直接退出,单条解析失败只跳过这一条 |
ollama.ResponseError 是服务级故障——模型没拉下来、Ollama 没启动。这种错继续跑下去毫无意义,应当直接退出。ValueError 是单条数据的问题——这一句话的输出反复解析不了。这种错只该跳过这一条,剩下的继续跑。写成一个
except Exception 全吞掉,结果就是:服务早就挂了,程序还在那儿老老实实跑完一千条,最后打印「共 1000 条,放弃 1000 条」。
输出长什么样
一条合格结果的标准形态是这样——它同时也是 few-shot 里那条示例的答案:
{'日期': ['2023-01-10'], '股票名称': ['古哥-D[EOOE]美股'], '开盘价': ['100美元'], '收盘价': ['102美元'], '成交量': ['520000']}
注意这条答案里没有「一度飙升至105美元」和「随后回落至98美元」。原文里明明写了这两个价格,但它们既不是开盘价也不是收盘价——schema 之外的信息一律不抽,这条规矩是靠示例传达的,不是靠文字说明。
4.4 金融文本匹配完整程序
# -*- coding: utf-8 -*-
"""金融文本匹配:判断两段文本是不是在说同一件事。

运行前提:本机已装 Ollama 并拉好模型(ollama run qwen3:8b),
        以及 Python 包 ollama 与 rich。
环境变量:
    OLLAMA_MODEL  模型名,默认 qwen3:8b
"""
import os
import sys

import ollama
from rich import print
from rich.console import Console

POSITIVE = "是"
NEGATIVE = "不是"

SYSTEM_PROMPT = (
    "现在你需要帮助我完成文本匹配任务,当我给你两个句子时,"
    "你需要回答我这两句话语义是否相似。只需要回答是否相似,不要做多余的回答。"
)

# few-shot:正负样本都要给,而且负样本要给「像但不是」的那种
EXAMPLES = {
    POSITIVE: [
        ("公司ABC发布了季度财报,显示盈利增长。", "财报披露,公司ABC利润上升。"),
    ],
    NEGATIVE: [
        ("黄金价格下跌,投资者抛售。", "外汇市场交易额创下新高。"),
        ("央行降息,刺激经济增长。", "新能源技术的创新。"),
    ],
}

PAIR_PATTERN = "句子一: {}\n句子二: {}\n上面两句话是相似的语义吗?"


def init_prompts() -> list:
    """system + few-shot 一问一答,构成前置消息。"""
    history = [{"role": "system", "content": SYSTEM_PROMPT}]
    for label, pairs in EXAMPLES.items():
        for s1, s2 in pairs:
            history.append({"role": "user", "content": PAIR_PATTERN.format(s1, s2)})
            history.append({"role": "assistant", "content": label})
    return history


def normalize_answer(text: str):
    """把模型的自由回答收敛成 是 / 不是 / None。

    「不是」必须先判,否则「不是」会被「是」的子串匹配吃掉——
    这是本任务最容易写反的一行。
    """
    if not isinstance(text, str):
        return None
    cleaned = text.strip().replace(" ", "").replace("\n", "")
    for marker in ("不是", "不相似", "否"):
        if marker in cleaned:
            return NEGATIVE
    for marker in ("是", "相似"):
        if marker in cleaned:
            return POSITIVE
    return None


def match_pair(s1: str, s2: str, history: list, model: str, retries: int = 1):
    """返回 是 / 不是;模型答非所问就重试,仍失败返回 None 交人工。"""
    for attempt in range(retries + 1):
        messages = list(history)
        messages.append({"role": "user", "content": PAIR_PATTERN.format(s1, s2)})
        if attempt > 0:
            messages.append({
                "role": "user",
                "content": f"请只回答「{POSITIVE}」或「{NEGATIVE}」两个词之一。",
            })
        raw = ollama.chat(model=model, messages=messages)["message"]["content"]
        answer = normalize_answer(raw)
        if answer is not None:
            return answer, raw
    return None, raw


def main() -> int:
    console = Console()
    model = os.environ.get("OLLAMA_MODEL", "qwen3:8b")
    history = init_prompts()

    sentence_pairs = [
        ("股票市场今日大涨,投资者乐观。", "持续上涨的市场让投资者感到满意。"),
        ("油价大幅下跌,能源公司面临挑战。", "未来智能城市的建设趋势愈发明显。"),
        ("利率上升,影响房地产市场。", "高利率对房地产有一定冲击。"),
    ]

    undecided = 0
    for s1, s2 in sentence_pairs:
        with console.status("[bold bright_green]正在判定..."):
            try:
                answer, raw = match_pair(s1, s2, history, model)
            except ollama.ResponseError as exc:
                print(f"[bold red]模型调用失败:{exc}")
                return 2
        print(f"[bold bright_red]句子一:{s1}")
        print(f"[bold bright_red]句子二:{s2}")
        if answer is None:
            undecided += 1
            print(f"[bold yellow]判不了,原始回复:{raw[:80]}")
        else:
            print(f"[bold bright_green]判定:{answer}")

    print(f"[bold]共 {len(sentence_pairs)} 对,判不了 {undecided} 对")
    return 0


if __name__ == "__main__":
    sys.exit(main())
结构和抽取程序是同一套,但后处理那一段完全不同:
| 抽取程序 | 匹配程序 |
|---|---|
parse_model_json + normalize + check,三段 | normalize_answer 一个函数,十行 |
| 失败时抛异常,转人工 | 失败时返回 None,打印原始回复 |
| 重试要把坏输出回喂进去 | 重试只需追加一句「请只回答是或不是」 |
normalize_answer 里否定词必须先扫
for marker in ("不是", "不相似", "否") 这一轮循环写在肯定词之前。理由很朴素:「不是」这个字符串里含着「是」。顺序反了,所有负例都会被判成正例,而程序一个错都不会报——分数会莫名其妙地偏,你还得从头查起。脚本 match_skeleton.py 的自检里专门有一条断言守着这件事。
三对句子的预期判定
| 句子一 | 句子二 | 预期 |
|---|---|---|
| 股票市场今日大涨,投资者乐观。 | 持续上涨的市场让投资者感到满意。 | 相似 |
| 油价大幅下跌,能源公司面临挑战。 | 未来智能城市的建设趋势愈发明显。 | 不相似 |
| 利率上升,影响房地产市场。 | 高利率对房地产有一定冲击。 | 相似 |
这三对是主程序里的验收样本,正确答案依次是['相似', '不相似', '相似']。它们分别测三件事:换个说法的同一件事、完全不相干的一对、因果方向一致的改写。第三对最值得留意——两句话的用词重合度并不高(「利率上升」对「高利率」、「影响」对「冲击」),靠数词重合是判不出来的。
4.5 指标与阈值:两个脚本把「准确率会骗人」证明给你看
先看指标。match_metrics.py 造了两份评测集,用同一批预测跑:
# -*- coding: utf-8 -*-
"""文本匹配的评测指标:准确率单独看会骗人。

同一批预测,在不同正负比例的评测集上算出来的准确率完全不同。
这个文件把混淆矩阵、精确率、召回率、F1 一次算清楚,并用一个
「全判不是」的退化模型证明:准确率 0.9 也可能一无是处。

纯标准库,`python3 match_metrics.py` 直接跑。
"""
POSITIVE = "是"
NEGATIVE = "不是"


def confusion(gold: list, pred: list) -> dict:
    """返回四格计数。约定:正类 = 「是」(两句话指向同一件事)。"""
    assert len(gold) == len(pred), "金标与预测条数必须一致"
    tp = fp = fn = tn = 0
    for g, p in zip(gold, pred):
        if g == POSITIVE and p == POSITIVE:
            tp += 1
        elif g == NEGATIVE and p == POSITIVE:
            fp += 1
        elif g == POSITIVE and p == NEGATIVE:
            fn += 1
        else:
            tn += 1
    return {"TP": tp, "FP": fp, "FN": fn, "TN": tn}


def metrics(cm: dict) -> dict:
    tp, fp, fn, tn = cm["TP"], cm["FP"], cm["FN"], cm["TN"]
    total = tp + fp + fn + tn
    acc = (tp + tn) / total if total else 0.0
    precision = tp / (tp + fp) if (tp + fp) else 0.0
    recall = tp / (tp + fn) if (tp + fn) else 0.0
    f1 = 2 * precision * recall / (precision + recall) if (precision + recall) else 0.0
    return {"准确率": acc, "精确率": precision, "召回率": recall, "F1": f1}


def show(title: str, gold: list, pred: list):
    cm = confusion(gold, pred)
    m = metrics(cm)
    print(f"\n{title}")
    print(f"  样本 {len(gold)} 条,其中正类 {gold.count(POSITIVE)} 条")
    print(f"  TP={cm['TP']}  FP={cm['FP']}  FN={cm['FN']}  TN={cm['TN']}")
    print("  " + "  ".join(f"{k}={v:.3f}" for k, v in m.items()))
    return cm, m


if __name__ == "__main__":
    # 评测集 A:正负各半,比较诚实的一份
    gold_a = [POSITIVE] * 5 + [NEGATIVE] * 5
    pred_a = [POSITIVE, POSITIVE, POSITIVE, NEGATIVE, POSITIVE,
              NEGATIVE, NEGATIVE, POSITIVE, NEGATIVE, NEGATIVE]
    cm_a, m_a = show("评测集 A:正负 5:5", gold_a, pred_a)

    # 评测集 B:只有 1 条正类,其余全是负类——真实语料里非常常见
    gold_b = [POSITIVE] + [NEGATIVE] * 9
    pred_b = [NEGATIVE] * 10          # 一个退化模型:闭着眼睛全答「不是」
    cm_b, m_b = show("评测集 B:正负 1:9,模型全答「不是」", gold_b, pred_b)

    print("\n" + "─" * 52)
    print(f"A 的准确率 {m_a['准确率']:.3f},F1 {m_a['F1']:.3f}")
    print(f"B 的准确率 {m_b['准确率']:.3f},F1 {m_b['F1']:.3f}")
    print("B 的准确率更高,但它一条正类都没找出来。")

    # 断言:退化模型的准确率高于真模型,F1 却是 0
    assert m_b["准确率"] > m_a["准确率"], "样本失衡下准确率会被负类抬上去"
    assert m_b["F1"] == 0.0 and m_b["召回率"] == 0.0
    assert m_a["F1"] > 0.6

    # 精确率与召回率的方向相反,必须一起看
    assert abs(m_a["精确率"] - 4 / 5) < 1e-9   # 判「是」5 次,对 4 次
    assert abs(m_a["召回率"] - 4 / 5) < 1e-9   # 5 条真正类,找回 4 条

    print("\n断言全部通过:只报准确率的匹配实验,等于没报")
| 评测集 | 配比 | 模型 | 准确率 | F1 |
|---|---|---|---|---|
| A | 正负 5:5 | 正常预测,错了两条 | 0.800 | 0.800 |
| B | 正负 1:9 | 闭着眼全答「不是」 | 0.900 | 0.000 |
TP=0 FP=0 FN=1 TN=9——这个「模型」什么都没做,只是重复输出同一个词。准确率 0.900 完全是被九条负样本抬上去的。脚本里的断言把这件事钉死:m_b["准确率"] > m_a["准确率"] 且 m_b["F1"] == 0.0。只报准确率的匹配实验,等于没报。
再看阈值。只要模型能给出 0~1 的分数,那条线就不该靠手感画:
# -*- coding: utf-8 -*-
"""阈值扫描:让模型给分而不是给结论,阈值由评测集定,不由手感定。

只要能拿到一个 0~1 的「相似度分数」,判「是」还是「不是」就是一条线的事。
这条线定在哪,直接决定精确率与召回率往哪边倒。
扫一遍所有候选阈值,挑 F1 最高的那个——这才是「阈值怎么定」的答案。

纯标准库,`python3 match_threshold_scan.py` 直接跑。
"""
from match_metrics import confusion, metrics, POSITIVE, NEGATIVE

# 评测集:(金标, 模型给的相似度分数)
# 分数可以来自「回答『是』时的自报置信度」,也可以来自两句话的向量余弦
SAMPLES = [
    ("是", 0.95), ("是", 0.88), ("是", 0.81), ("是", 0.72), ("是", 0.64),
    ("是", 0.58), ("不是", 0.61), ("不是", 0.55), ("不是", 0.42), ("不是", 0.33),
    ("不是", 0.21), ("不是", 0.12), ("是", 0.49), ("不是", 0.68), ("是", 0.77),
]


def predict(samples: list, threshold: float) -> list:
    """分数 >= 阈值判为正类。边界取闭区间,全流程必须统一。"""
    return [POSITIVE if score >= threshold else NEGATIVE for _, score in samples]


def scan(samples: list, thresholds: list) -> list:
    gold = [label for label, _ in samples]
    rows = []
    for th in thresholds:
        pred = predict(samples, th)
        m = metrics(confusion(gold, pred))
        rows.append((th, m))
    return rows


def _bar(value: float, width: int = 16) -> str:
    return "█" * int(round(value * width))


if __name__ == "__main__":
    thresholds = [round(0.30 + 0.05 * i, 2) for i in range(13)]   # 0.30 ~ 0.90
    rows = scan(SAMPLES, thresholds)

    print(f"{'阈值':<6}{'精确率':<8}{'召回率':<8}{'F1':<8}")
    print("─" * 44)
    best_th, best_f1 = None, -1.0
    for th, m in rows:
        print(f"{th:<8.2f}{m['精确率']:<10.3f}{m['召回率']:<10.3f}"
              f"{m['F1']:<8.3f}{_bar(m['F1'])}")
        if m["F1"] > best_f1:
            best_th, best_f1 = th, m["F1"]

    print("─" * 44)
    print(f"F1 最高的阈值:{best_th:.2f}(F1={best_f1:.3f})")

    low = dict(rows)[0.30]
    high = dict(rows)[0.90]
    print(f"\n阈值 0.30:召回率 {low['召回率']:.3f},精确率 {low['精确率']:.3f}"
          f"  —— 宁可错抓,不肯放过")
    print(f"阈值 0.90:召回率 {high['召回率']:.3f},精确率 {high['精确率']:.3f}"
          f"  —— 宁可放过,不肯错抓")

    # 阈值越高,召回率单调不增;精确率总体不减。这是这张表最该记住的形状
    recalls = [m["召回率"] for _, m in rows]
    assert all(recalls[i] >= recalls[i + 1] for i in range(len(recalls) - 1)), \
        "阈值升高时召回率不可能变大"
    assert low["召回率"] == 1.0, "阈值 0.30 低于所有正类分数,应当全部召回"
    assert high["精确率"] >= low["精确率"]
    assert best_f1 > max(low["F1"], high["F1"]), "最优阈值应当好过两个极端"
    print("\n断言全部通过:阈值是扫出来的,不是拍出来的")
| 阈值 | 精确率 | 召回率 | F1 |
|---|---|---|---|
| 0.30 | 0.615 | 1.000 | 0.762 |
| 0.45 | 0.727 | 1.000 | 0.842 ← 峰值 |
| 0.60 | 0.750 | 0.750 | 0.750 |
| 0.70 | 1.000 | 0.625 | 0.769 |
| 0.90 | 1.000 | 0.125 | 0.222 |
这张表的形状比具体数字更重要:阈值往上走,召回率单调不增,精确率总体不减,F1 在中间某处出现峰值。脚本里有一条断言专门守着召回率的单调性——如果哪天它不成立了,那一定是打分或者比较逻辑写错了。
0.45 是 F1 最高的点,但如果业务是信息去重(误判成「是」会把两条不同的消息合并掉),你应该往右挪到 0.70 那一档——精确率 1.000,代价是召回率掉到 0.625。F1 给的是默认答案,不是最终答案;最终答案要看哪种错更疼。
4.6 评测集体检:先查这份评测集本身合不合格
前面所有分数都建立在一个假设上:评测集是对的。这个脚本把两类评测集各查一遍,不合格就在断言处直接炸。
# -*- coding: utf-8 -*-
"""评测集体检:先看这份评测集本身合不合格,再看模型分数。

抽取任务与匹配任务的评测集判据不同,这个文件把两边都查一遍:
  · 抽取:每条都要有全部字段的金标;「未提及」的字段要有一定占比,
          否则「抽不到时返回什么」这条规则根本没被测到
  · 匹配:正负比例不能太偏;负样本里要有「话题相近但不是同一件事」的难例,
          全是「风马牛不相及」的负样本会把分数刷得虚高

纯标准库,`python3 eval_set_build.py` 直接跑。
"""
NOT_MENTIONED = "原文中未提及"
FIELDS = ["日期", "股票名称", "开盘价", "收盘价", "成交量"]


def audit_ie_set(gold_list: list, fields: list) -> dict:
    """抽取评测集体检。"""
    missing_field_rows = []
    placeholder_hits = {f: 0 for f in fields}
    for idx, gold in enumerate(gold_list):
        absent = [f for f in fields if f not in gold]
        if absent:
            missing_field_rows.append((idx, absent))
        for field in fields:
            if gold.get(field) == [NOT_MENTIONED]:
                placeholder_hits[field] += 1
    total = len(gold_list)
    covered = [f for f, n in placeholder_hits.items() if n > 0]
    return {
        "条数": total,
        "字段不全的条目": missing_field_rows,
        "出现过未提及的字段": covered,
        "未提及覆盖率": len(covered) / len(fields) if fields else 0.0,
    }


def audit_match_set(pairs: list) -> dict:
    """匹配评测集体检。pairs 里每项是 (句子一, 句子二, 金标, 是否难例)。"""
    pos = [p for p in pairs if p[2] == "是"]
    neg = [p for p in pairs if p[2] == "不是"]
    hard_neg = [p for p in neg if p[3]]
    total = len(pairs)
    return {
        "条数": total,
        "正类": len(pos),
        "负类": len(neg),
        "正类占比": len(pos) / total if total else 0.0,
        "难负样本": len(hard_neg),
        "难负占负类": len(hard_neg) / len(neg) if neg else 0.0,
    }


IE_GOLD = [
    {"日期": ["2023-02-15"], "股票名称": ["佰笃[BD]美股"], "开盘价": ["10美元"],
     "收盘价": ["13美元"], "成交量": ["460,000"]},
    {"日期": ["2023-04-05"], "股票名称": ["盘古(0021)"], "开盘价": ["23元"],
     "收盘价": ["26美元"], "成交量": ["310,000"]},
    {"日期": ["2023-05-20"], "股票名称": ["长虹科技"], "开盘价": ["48元"],
     "收盘价": [NOT_MENTIONED], "成交量": ["120,000"]},
    {"日期": ["2023-06-11"], "股票名称": ["华兴能源"], "开盘价": [NOT_MENTIONED],
     "收盘价": ["77元"], "成交量": [NOT_MENTIONED]},
]

MATCH_PAIRS = [
    ("股票市场今日大涨,投资者乐观。", "持续上涨的市场让投资者感到满意。", "是", False),
    ("利率上升,影响房地产市场。", "高利率对房地产有一定冲击。", "是", False),
    ("公司ABC发布季度财报,盈利增长。", "财报披露,公司ABC利润上升。", "是", False),
    ("油价大幅下跌,能源公司面临挑战。", "未来智能城市的建设趋势愈发明显。", "不是", False),
    ("央行降息,刺激经济增长。", "新能源技术的创新。", "不是", False),
    # 难负样本:同一个话题、同一批词,方向相反
    ("央行宣布降息,市场流动性宽松。", "央行宣布加息,市场流动性收紧。", "不是", True),
    # 难负样本:同一家公司,说的是两件事
    ("公司ABC完成对某科技企业的并购。", "公司ABC发布季度财报,盈利增长。", "不是", True),
]


if __name__ == "__main__":
    ie_report = audit_ie_set(IE_GOLD, FIELDS)
    print("【抽取评测集】")
    for k, v in ie_report.items():
        print(f"  {k}: {v}")

    match_report = audit_match_set(MATCH_PAIRS)
    print("\n【匹配评测集】")
    for k, v in match_report.items():
        print(f"  {k}: {v:.3f}" if isinstance(v, float) else f"  {k}: {v}")

    print("\n" + "─" * 46)
    assert ie_report["字段不全的条目"] == [], "金标必须字段齐全,否则字段级打分没法算"
    assert ie_report["未提及覆盖率"] >= 0.5, \
        "至少一半字段要出现过「未提及」,否则测不到抽不到时的行为"
    assert 0.3 <= match_report["正类占比"] <= 0.7, "正负比例过偏,准确率会失真"
    assert match_report["难负占负类"] >= 0.4, \
        "负样本全是风马牛不相及的,分数会虚高"
    print("两份评测集体检通过:它们能测出该测的东西")
| 评测集 | 体检项 | 实测 | 判据 |
|---|---|---|---|
| 抽取 | 金标字段是否齐全 | 无缺项 | 缺一个字段,字段级打分就没法算 |
| 抽取 | 「未提及」覆盖率 | 0.6 | 至少一半字段出现过,否则测不到抽不到时的行为 |
| 匹配 | 正类占比 | 0.429 | 落在 0.3~0.7 之间才不会被负类抬分 |
| 匹配 | 难负样本占负类 | 0.500 | 不足四成,分数会虚高 |
json_repair 接住字符串 → ie_schema_check 规整校验 → finance_ie 串成主程序 → ie_field_score 打分。匹配线:
finance_text_matching 跑判定 → match_metrics 算指标 → match_threshold_scan 挑阈值。两条线共用:
eval_set_build 在最前面把关——评测集不合格,后面所有数字都不用看。
05骨架模板:换个行业也能直接用
两份骨架 + 三张检查表,把这一讲的全部约定固化下来
5.1 信息抽取骨架
提示词拼装、解析容错、字段规整、校验、重试——五段全在一个文件里,改五处 TODO 就能换到别的行业。没接真实模型之前它也能跑:_demo() 走的是离线那条路,先把「提示词长什么样、校验拦不拦得住坏数据」验证通过,再去接模型。
# -*- coding: utf-8 -*-
"""信息抽取骨架:换 schema、换例子、换模型接口,其余不用动。

改完 5 处 TODO 就能用。没接真实模型之前,把 call_model 留成假的,
先用 _demo() 把「提示词长什么样、校验拦不拦得住坏数据」验证通过。

纯标准库,`python3 ie_skeleton.py` 直接跑(跑的是离线自检那条路)。
"""
import json
import re

# ── TODO 1:定义 schema —— 要抽哪些字段,一次定死 ───────────────────
SCHEMA = {
    "金融": ["日期", "股票名称", "开盘价", "收盘价", "成交量"],
}
NOT_MENTIONED = "原文中未提及"

# ── TODO 2:提示词骨架 —— 末尾那句格式约束不要删 ─────────────────────
IE_PATTERN = (
    "{}\n\n提取上述句子中{}的实体,并按照JSON格式输出,"
    "上述句子中不存在的信息用['" + NOT_MENTIONED + "']来表示,多个值之间用','分隔。"
)

# ── TODO 3:few-shot 例子 —— 至少一条,答案必须是你想要的那个形状 ─────
EXAMPLES = {
    "金融": [
        {
            "content": "2023-01-10,股市震荡。股票古哥-D[EOOE]美股今日开盘价100美元,"
                       "最终以102美元收盘,成交量达到520000。",
            "answers": {
                "日期": ["2023-01-10"],
                "股票名称": ["古哥-D[EOOE]美股"],
                "开盘价": ["100美元"],
                "收盘价": ["102美元"],
                "成交量": ["520000"],
            },
        }
    ]
}

FENCE_RE = re.compile(r"```(?:json|JSON)?\s*(.*?)```", re.DOTALL)
OBJ_RE = re.compile(r"\{.*\}", re.DOTALL)


def build_prompt(sentence: str, entity_type: str) -> str:
    fields = ", ".join(SCHEMA[entity_type])
    return IE_PATTERN.format(sentence, f"“{entity_type}”({fields})")


def init_prompts(entity_type: str) -> list:
    history = [{"role": "system", "content": "你是一个信息抽取助手。"}]
    for example in EXAMPLES[entity_type]:
        history.append({"role": "user",
                        "content": build_prompt(example["content"], entity_type)})
        history.append({"role": "assistant",
                        "content": json.dumps(example["answers"], ensure_ascii=False)})
    return history


def parse(text: str):
    """去围栏 → 截出对象 → 解析。失败返回 None,绝不返回半成品。"""
    if not isinstance(text, str) or not text.strip():
        return None
    blocks = FENCE_RE.findall(text)
    body = blocks[0].strip() if blocks and blocks[0].strip() else text.strip()
    match = OBJ_RE.search(body)
    if match:
        body = match.group(0)
    try:
        data = json.loads(body)
    except ValueError:
        return None
    return data if isinstance(data, dict) else None


def normalize(data: dict, fields: list) -> dict:
    """字段补齐、值统一成 list[str]、野字段丢掉。只修形状,不猜内容。"""
    fixed = {}
    for field in fields:
        value = data.get(field)
        if value in (None, "", []):
            fixed[field] = [NOT_MENTIONED]
        elif isinstance(value, list):
            items = [str(v) for v in value if str(v).strip()]
            fixed[field] = items or [NOT_MENTIONED]
        else:
            fixed[field] = [str(value)]
    return fixed


def check(data: dict, fields: list) -> list:
    problems = []
    for field in fields:
        value = data.get(field)
        if not isinstance(value, list) or not value:
            problems.append(f"{field} 不是非空列表")
        elif NOT_MENTIONED in value and len(value) > 1:
            problems.append(f"{field} 占位符与真值混用")
    return problems


def call_model(messages: list) -> str:
    """── TODO 4:接上真实模型 ───────────────────────────────────

    本地 Ollama 的写法(需要 pip install ollama,并先 ollama run <模型>):

        import ollama, os
        model = os.environ.get("OLLAMA_MODEL", "qwen3:8b")
        return ollama.chat(model=model, messages=messages)["message"]["content"]

    换成别的服务时,只需保证这个函数「收消息列表、返回一段字符串」。
    密钥一律走 os.environ.get(...),不要写进源码。
    """
    raise NotImplementedError("接上模型后删掉这一行")


def extract(sentence: str, entity_type: str, retries: int = 2) -> dict:
    history = init_prompts(entity_type)
    fields = SCHEMA[entity_type]
    raw = ""
    for attempt in range(retries + 1):
        messages = list(history) + [
            {"role": "user", "content": build_prompt(sentence, entity_type)}
        ]
        if attempt > 0:
            messages.append({"role": "assistant", "content": raw})
            messages.append({"role": "user",
                             "content": "上一条不是合法 JSON,请只输出一个 JSON 对象。"})
        raw = call_model(messages)
        data = parse(raw)
        if data is None:
            continue
        data = normalize(data, fields)
        if not check(data, fields):
            return data
    raise ValueError(f"重试 {retries} 次仍未拿到合法结果:{raw[:120]}")


def _demo():
    """── TODO 5:接上真实模型后,把这里换成一条真实句子的端到端冒烟测试 ──"""
    fields = SCHEMA["金融"]
    print("提示词长这样:\n")
    print(build_prompt("2023-02-15,股票佰笃[BD]美股开盘价10美元。", "金融"))

    fake = '```json\n{"日期": ["2023-02-15"], "股票名称": "佰笃[BD]美股", "开盘价": ["10美元"]}\n```'
    data = parse(fake)
    assert data is not None, "带围栏的输出应当能解析"
    fixed = normalize(data, fields)
    assert check(fixed, fields) == []
    assert fixed["收盘价"] == [NOT_MENTIONED], "缺的字段要补占位符,不能漏键"
    print("\n规整后:", json.dumps(fixed, ensure_ascii=False))
    assert parse("我不知道") is None, "解析不了必须是 None"
    print("离线自检通过:提示词、解析、规整、校验四段都在")


if __name__ == "__main__":
    _demo()
| TODO | 改什么 | 要注意 |
|---|---|---|
| TODO 1 | SCHEMA | 字段名用业务原话;一个字段只装一件事;一次别超过 8 个 |
| TODO 2 | IE_PATTERN | 末尾那句格式约束不要删,它同时管住了「输出 JSON」和「抽不到怎么办」 |
| TODO 3 | EXAMPLES | 答案必须人工写死;原文里要故意留几个不该抽的干扰值 |
| TODO 4 | call_model | 只需保证「收消息列表、返回一段字符串」;密钥走 os.environ.get |
| TODO 5 | _demo() | 接上模型后换成一条真实句子的端到端冒烟测试 |
None:不返回原始字符串充数,脏数据没有入口。②
normalize 只修形状,缺的字段一律补占位符:它绝不猜内容,「原文没有」和「模型忘了」由此永远可区分。③ schema 之外的字段直接丢掉:模型自己加的「投资者情绪」不会悄悄流进下游表结构。
5.2 文本匹配骨架
同样五处 TODO。多出来的那块是 pick_threshold——只在能拿到分数时才用得上,纯二选一的场景直接删掉。
# -*- coding: utf-8 -*-
"""文本匹配骨架:换判据、换例子、换模型接口,其余不用动。

改完 5 处 TODO 就能用。没接真实模型之前,_demo() 会把
「回答归一化」和「阈值选择」两段离线验证通过。

纯标准库,`python3 match_skeleton.py` 直接跑(跑的是离线自检那条路)。
"""
POSITIVE = "是"
NEGATIVE = "不是"

# ── TODO 1:写清楚「同一件事」的边界 —— 这句话决定了全部标注口径 ──────
SYSTEM_PROMPT = (
    "现在你需要帮助我完成文本匹配任务,当我给你两个句子时,"
    "你需要回答我这两句话语义是否相似。只需要回答是否相似,不要做多余的回答。"
)

# ── TODO 2:few-shot —— 正负都要给,负样本里要有「像但不是」的难例 ────
EXAMPLES = {
    POSITIVE: [
        ("公司ABC发布了季度财报,显示盈利增长。", "财报披露,公司ABC利润上升。"),
    ],
    NEGATIVE: [
        ("黄金价格下跌,投资者抛售。", "外汇市场交易额创下新高。"),
        ("央行宣布降息,市场流动性宽松。", "央行宣布加息,市场流动性收紧。"),
    ],
}

PAIR_PATTERN = "句子一: {}\n句子二: {}\n上面两句话是相似的语义吗?"


def init_prompts() -> list:
    history = [{"role": "system", "content": SYSTEM_PROMPT}]
    for label, pairs in EXAMPLES.items():
        for s1, s2 in pairs:
            history.append({"role": "user", "content": PAIR_PATTERN.format(s1, s2)})
            history.append({"role": "assistant", "content": label})
    return history


def normalize_answer(text: str):
    """── TODO 3:把模型的自由回答收敛成两个值之一 ───────────────────

    先判否定词,再判肯定词。顺序反了,「不是」会被「是」吃掉。
    收敛不了就返回 None —— 判不了要显式暴露,不许默认归到某一类。
    """
    if not isinstance(text, str):
        return None
    cleaned = text.strip().replace(" ", "").replace("\n", "")
    for marker in ("不是", "不相似", "不同", "否"):
        if marker in cleaned:
            return NEGATIVE
    for marker in ("是", "相似", "相同"):
        if marker in cleaned:
            return POSITIVE
    return None


def call_model(messages: list) -> str:
    """── TODO 4:接上真实模型 ───────────────────────────────────

    本地 Ollama 的写法(需要 pip install ollama,并先 ollama run <模型>):

        import ollama, os
        model = os.environ.get("OLLAMA_MODEL", "qwen3:8b")
        return ollama.chat(model=model, messages=messages)["message"]["content"]

    密钥一律走 os.environ.get(...),不要写进源码。
    """
    raise NotImplementedError("接上模型后删掉这一行")


def match_pair(s1: str, s2: str, history: list, retries: int = 1):
    raw = ""
    for attempt in range(retries + 1):
        messages = list(history) + [{"role": "user", "content": PAIR_PATTERN.format(s1, s2)}]
        if attempt > 0:
            messages.append({"role": "user",
                             "content": f"请只回答「{POSITIVE}」或「{NEGATIVE}」。"})
        raw = call_model(messages)
        answer = normalize_answer(raw)
        if answer is not None:
            return answer, raw
    return None, raw


def evaluate(gold: list, pred: list) -> dict:
    """精确率 / 召回率 / F1。准确率单独看会被样本比例带偏,所以不单独报。"""
    tp = sum(1 for g, p in zip(gold, pred) if g == POSITIVE and p == POSITIVE)
    fp = sum(1 for g, p in zip(gold, pred) if g == NEGATIVE and p == POSITIVE)
    fn = sum(1 for g, p in zip(gold, pred) if g == POSITIVE and p == NEGATIVE)
    precision = tp / (tp + fp) if (tp + fp) else 0.0
    recall = tp / (tp + fn) if (tp + fn) else 0.0
    f1 = 2 * precision * recall / (precision + recall) if (precision + recall) else 0.0
    return {"精确率": precision, "召回率": recall, "F1": f1}


def pick_threshold(scored: list, candidates: list) -> float:
    """── TODO 5:拿到分数时用这个挑线;只有二选一回答时删掉本函数 ─────

    scored 里每项是 (金标, 分数)。挑 F1 最高的阈值,并列时取更高的那个
    (更保守,宁可放过不肯错抓)。
    """
    gold = [label for label, _ in scored]
    best_th, best_f1 = candidates[0], -1.0
    for th in candidates:
        pred = [POSITIVE if score >= th else NEGATIVE for _, score in scored]
        f1 = evaluate(gold, pred)["F1"]
        if f1 >= best_f1:
            best_th, best_f1 = th, f1
    return best_th


def _demo():
    print("前置消息共", len(init_prompts()), "条")

    # 归一化:否定词优先,这是最容易写反的一处
    assert normalize_answer("不是") == NEGATIVE
    assert normalize_answer("是的,两句话语义相似") == POSITIVE
    assert normalize_answer("这两句话不相似。") == NEGATIVE
    assert normalize_answer("嗯……不好说") is None, "判不了要返回 None"
    print("回答归一化自检通过(含「不是」不会被「是」吃掉)")

    scored = [("是", 0.9), ("是", 0.7), ("不是", 0.6), ("不是", 0.2), ("是", 0.65)]
    th = pick_threshold(scored, [round(0.1 * i, 1) for i in range(1, 10)])
    pred = [POSITIVE if s >= th else NEGATIVE for _, s in scored]
    metric = evaluate([g for g, _ in scored], pred)
    print(f"选出的阈值 {th},此时 {metric}")
    assert metric["F1"] >= 0.8
    print("阈值选择自检通过:阈值来自评测集,不来自手感")


if __name__ == "__main__":
    _demo()
| TODO | 改什么 | 要注意 |
|---|---|---|
| TODO 1 | SYSTEM_PROMPT | 把「同一件事」的边界写进去,并且让标注员照同一句话标 |
| TODO 2 | EXAMPLES | 负样本里必须有难例;默认给的那条「降息 vs 加息」就是同话题反方向 |
| TODO 3 | normalize_answer | 否定词先扫;收敛不了返回 None,不许默认归到某一类 |
| TODO 4 | call_model | 同抽取骨架 |
| TODO 5 | pick_threshold | 并列时取更高的阈值(更保守);拿不到分数就删掉这个函数 |
evaluate() 里故意没有准确率
骨架的评估函数只返回精确率、召回率、F1。这不是漏写——匹配任务的准确率在样本失衡时会骗人,把它放进默认输出,就会有人顺手拿它当结论。要看准确率可以自己加,但默认不给,是为了逼你先看那三个。
5.3 抽取任务检查表
| 检查项 | 判据 | 踩了会怎样 |
|---|---|---|
| schema 锁定 | 字段表只有一处定义,全流程引用它 | 提示词写五个字段、校验查六个,永远对不上 |
| 值的形状 | 一律 list[str] | 下游每次取值都要先判类型 |
| 占位符 | 抽不到写 ['原文中未提及'] | 漏键会让「没抽到」和「模型忘了」混为一谈 |
| 占位符独占 | 不与真值同处一个列表 | 形状合法但语义矛盾,统计时被算成「已抽到」 |
| 解析兜底 | 失败返回 None | 返回半成品,脏数据从这里漏进业务 |
| 重试上限 | 2~3 次,超了抛异常 | 无限重试把一条脏样本变成死循环 |
| 失败留痕 | 记原始输出、统计放弃条数 | 没有素材可供下一轮改提示词 |
| 异常分层 | 服务级退出,数据级跳过 | 服务挂了还跑完一千条,最后全是放弃 |
5.4 匹配任务检查表
| 检查项 | 判据 | 踩了会怎样 |
|---|---|---|
| 边界定义 | 四种口径里明确选一种,写进 system | 标注员各标各的,评测集自相矛盾 |
| 标注一致性 | 10 条难例背对背标,不一致低于一成 | 人都分不清的事,指望模型分清是妄想 |
| 回答归一化 | 否定词先扫 | 负例全被判成正例,且不报任何错 |
| 未决出口 | 收敛不了返回 None | 默默归到某一类,指标被污染且查不出来 |
| 正负配比 | 正类占 0.3~0.7 | 1:9 时闭眼全答「不是」也有 0.9 准确率 |
| 难负样本 | 占负类四成以上,且覆盖两类 | 分数虚高,上线立刻打回原形 |
| 指标选择 | 报 P / R / F1,准确率不单独报 | 拿一个会骗人的数字当结论 |
| 阈值来源 | 扫描选出,并记录选它的理由 | 换个人接手,没人知道 0.7 是怎么来的 |
5.5 从骨架到上线,还差哪几步
离线自检全通过
call_model先打印一次原始返回
跑一遍体检脚本
不许边改边跑
三件事一起存档
06易错点
八个坑,前四个在抽取线上,中间两个在匹配线上,最后两个两边都会踩
json.loads 没报错,只证明这段字符串是合法 JSON。它不保证字段齐全、不保证值的类型统一、更不保证值是从原文里抽的。最典型的一条:模型返回 {"日期": ["2023-02-15"]},只有一个字段,解析完美通过,下游一取「收盘价」就是 KeyError。
✅ 解析之后必须接规整 + 校验两步:normalize 把字段补齐、形状统一,check 把剩下的问题列成清单。清单非空就不许进下一环节。
提示词里不写「找不到该怎么办」,模型就会自己想办法:有时漏掉这个键,有时给 null,有时给空字符串,有时干脆编一个看起来很合理的值。第三种最要命——形状完全正确,校验器一个字都挑不出来,脏数据一路流到报表里。
✅ 提示词里明确写死 不存在的信息用['原文中未提及']来表示;评分脚本里把编造和抽漏分成两个独立计数器(hallucinated / missed),它们的修法完全不同。
跑了一轮,挑一条看着不错的输出,复制进 EXAMPLES 当示例——这一步会把模型的错误固化进提示词,然后在后面每一次调用里被放大。示例里那个多抽的「涨跌幅」字段,从此会出现在每一条结果里。
✅ few-shot 的 assistant 消息一律人工写死。它的语义是「我希望你这样答」,不是「你上次是这样答的」。示例原文里还要故意留几个不该抽的干扰值(如「一度飙升至105美元」),用示例的答案告诉模型:这些不要。
解析失败了,把同一条消息再发一遍。本地推理几乎没有随机抖动,大概率还是同样的坏输出,白白多花一次推理时间。更糟的是有人写成 while True,一条脏样本就把整个批处理卡死。
✅ 重试要带着上一次的错误回喂:把坏输出放进 assistant 位,再补一句「上一条不是合法 JSON,请只输出一个 JSON 对象」。次数固定 2~3 次,超了抛异常并记下原始输出——那段文本是下一轮改提示词最好的素材。
把模型回答收敛成两个值时,先扫肯定词再扫否定词。而「不是」这个字符串里含着「是」——于是所有负例都被判成正例。这个错不会抛任何异常,程序跑得好好的,只是分数莫名其妙地偏,你还得从数据一路查回来。
✅ 否定词(不是 / 不相似 / 不同 / 否)必须先扫,肯定词放后面。骨架里的自检有一条断言专门守着:normalize_answer("这两句话不相似。") == "不是"。
真实语料里正例天然稀少,1:9 是常态。这时一个闭着眼全答「不是」的退化模型,准确率就有 0.900——比认真判的模型还高。拿这个数字去汇报,结论是「效果很好」,实际是一条正例都没找出来(match_metrics.py 里 TP=0 FP=0 FN=1 TN=9,F1 = 0.000)。
✅ 混淆矩阵四格摊开,报精确率 / 召回率 / F1。准确率可以列,但不能单独作为结论。评测集本身也要体检:正类占比落在 0.3~0.7 之间,否则先去补样本。
造负样本时图省事,随手配两条完全不相干的句子——「央行降息」对「新能源技术的创新」。这种样本模型闭着眼都能判对,分数刷得很漂亮,上线立刻打回原形。真实场景里难的从来是「话题相同、方向相反」和「主体相同、事件不同」这两类。
✅ 难负样本要占负类四成以上,并且两类都要有:① 同话题反方向(降息 vs 加息)② 同主体不同事件(同一家公司的并购 vs 财报)。eval_set_build.py 里的断言会在比例不够时直接炸。
同时改了 system 措辞、加了两个示例、又把阈值从 0.6 挪到 0.45——分数涨了三个点。你不知道是哪一处带来的,也说不清下次换个数据集还灵不灵。提示词这一层没有梯度、没有日志、没有报错,唯一的因果信息就来自「改一处、跑一遍、比一次」。
✅ 先跑一版基线把分数记下来,之后一次只改一处。定版时把提示词、示例、阈值三件事一起存档——少存一件,这个结果就复现不了。
07自测题
点击题目展开答案;这 10 题说清楚了,这一讲就通了
「任务定义 → 提示词设计 → 评测集 → 迭代优化」这四步,换到另一个任务时哪些能复用、哪些必须重做?
前两步的骨架能复用:system + few-shot + 提问模板这套拼装方式,抽取和匹配完全一样,连代码都不用改。后两步的判据必须重做:评测集的形态(一个金标对象 vs 一个句子对加标签)、打分口径(字段级准确率 vs 精确率/召回率/F1)、迭代抓手(补字段说明 vs 补难负样本、调阈值)全都不同。抄整套代码时最容易连评分脚本一起抄,结果拿「整条准确率」去评匹配任务——数字算得出来,但指导不了任何一次修改。
为什么说没有评测集,第 ④ 步就不成立?
因为提示词这一层没有梯度、没有报错、没有日志。没有评测集,迭代就退化成「改一版,拿两三条样本看看,感觉好像好点了」。改到第五版你已经分不清是真的变好了,还是这两三条恰好对了。唯一的因果信息来自「改一处、跑一遍、比一次」,而「比一次」需要一份固定的、事先标好的评测集。所以评测集必须先于迭代存在,而不是等效果不好了再补。
模型答「原文中未提及」和模型漏了这个键,是不是一回事?
完全不是。前者是模型明确表态「我读了,原文没有」;后者是模型压根没处理这个字段,可能是忘了、可能是被截断了。两者在下游的形状也不同:占位符是一个正常值,直接当普通数据读;漏键要额外判 None,而且「没抽到」和「模型忘了」永远分不开。所以提示词里要明确写死占位符,normalize 再兜一层底把缺的字段补上。附带的好处是:「未提及」的比例本身就是个监控指标——它突然从 5% 涨到 40%,说明上游文本或模型版本变了。
为什么抽取任务的分数要按字段算,而不是按整条算?举一组数字。
整条准确率(exact match)要求五个字段全对才算一条对,它把信息压没了:错一个字段和五个全错,得分完全一样。ie_field_score.py 的三条评测数据里,整条准确率是 0.333,字段级准确率是 0.867(15 个字段对了 13 个)。逐字段拆开更有用:日期、开盘价、成交量都是 3/3(已经稳了),股票名称和收盘价各 2/3——这才是可执行的信息:该补例子的是这两个字段。两个口径都要报,但迭代时盯的是逐字段那张表。
模型返回 ```json {...} ```,为什么不能直接 json.loads?完整的容错顺序是什么?
因为 json.loads 对整段字符串零容忍,前后多一个字就整段报错。容错要逐级放宽,每一级先试一次标准解析,能早退就早退:① 去掉 ```json 围栏 → ② 用 \{.*\} 配 re.DOTALL 截出最外层大括号(砍掉前后的寒暄和 thinking 段)→ ③ 结构性全角标点转半角 → ④ 去掉尾随逗号 → ⑤ 单引号换双引号。第 ⑤ 级放最后,因为值里只要有一个撇号就会把 JSON 打烂。全部失败必须返回 None,绝不返回原始字符串充数。
解析失败时正确的重试姿势是什么?为什么原样重发不行?
原样重发不行,因为本地推理几乎没有随机抖动,大概率还是同样的坏输出。正确做法是带着上一次的错误回喂:把坏输出放进 assistant 位,再补一句 user 消息「上一条不是合法 JSON,请只输出一个 JSON 对象,不要写解释、不要加代码围栏」。次数固定 2~3 次,超了抛异常并记下原始输出。另外两类异常要分开处理:ollama.ResponseError 是服务级故障(模型没拉下来、服务没起),应当直接退出;解析失败是单条数据的问题,只跳过这一条。写成一个 except Exception 全吞掉,结果就是服务早挂了程序还在跑完一千条。
「央行降息」和「央行加息」这一对,该判相似还是不相似?
取决于你选了哪种口径,而口径必须提前定死并写进 system 消息。按「同一话题」判是相似(都在讲央行利率);按「同一事件」「同一方向」「可互相替代」三种口径都判不相似(两个相反的动作)。这四种口径没有对错,但你必须选一种,并且让标注员照同一句话标。匹配任务分数低,十次有八次不是模型不行,而是「相似」这两个字自己就没定义清楚。检验办法:挑 10 对最难判的样本让两三个人背对背标,不一致比例超过一成就回去改定义。
准确率 0.900 的模型,为什么可能一条正例都没找出来?
因为评测集正负比是 1:9。一个闭着眼全答「不是」的退化模型,混淆矩阵是 TP=0 FP=0 FN=1 TN=9——准确率 (0+9)/10 = 0.900,完全靠九条负样本抬上去;而精确率、召回率、F1 全是 0.000。对照组正负 5:5、错了两条的正常模型,准确率只有 0.800,F1 却是 0.800。只报准确率的匹配实验等于没报:要么把混淆矩阵四格摊开报 P/R/F1,要么先去把评测集的正类占比补到 0.3~0.7 之间。
阈值怎么定?F1 最高的那个阈值是不是一定就该用?
先得拿得到分数——直接二选一的回答没有阈值可调,要让模型给 0~1 的分,或者走向量余弦。拿到分数后扫一遍(如 0.30 到 0.90 每 0.05 一档),算出每档的 P/R/F1。match_threshold_scan.py 的数据里 F1 峰值在 0.45(F1=0.842)。但 F1 峰值只是默认答案,不是最终答案:做信息去重时误判成「是」会把两条不同的消息合并掉(丢信息),应该往右挪到 0.70(精确率 1.000,召回率掉到 0.625);做线索召回时漏一条少一条,就该往左挪保召回。先问清楚哪种错更疼,再挑阈值。
normalize_answer 里为什么否定词必须先扫?写反了会发生什么?
因为「不是」这个字符串里含着「是」。如果先扫肯定词,模型回「不是」时会先命中「是」,被判成正例——所有负例全部翻转。而这个错不抛任何异常:程序跑得好好的,只是分数莫名其妙地偏,得从数据一路查回来。正确顺序是先扫 ("不是", "不相似", "不同", "否"),再扫 ("是", "相似", "相同"),两轮都没命中时返回 None——判不了要显式暴露,不许默认归到某一类。
这一讲做了这么多校验、重试、评分,模型本身被改动过吗?
一个参数都没动。schema、提示词、few-shot 示例、输出格式约束——全都写在「便条」上;解析、规整、校验、重试、打分——全都在便条之外的工程代码里。整条链路从头到尾,模型只做一件事:读一段文本,吐一段文本。这正是模块 ③ 的总铁律:改便条 ≠ 改人。
而这一讲自己的铁律是它的工程推论:模型吐出来的永远是字符串,没过校验的结果不许当数据用。「解析成功」只证明它是合法 JSON,不证明字段齐全、不证明值没被编出来——所以每条链路末尾都挂着解析 → 规整 → 校验 → 再入库,缺一步线上就会出现一条谁都查不出来的脏数据。
词术语表
| 术语 | 含义 |
|---|---|
| 信息抽取(IE) | Information Extraction,从自由文本里抽出预先定义好的字段,输出一个结构化对象;本讲的输出形态是 list[str] 组成的 JSON |
| 文本匹配 | 判定两段文本是否指向同一件事;输出是二值判定,本讲用「是 / 不是」两个词 |
| schema | 要抽哪几个字段的定义表;提示词照它写、校验照它查、评分照它逐项算,全流程只有一处定义 |
原文中未提及 | 抽不到时的统一占位符;它是一个正常值,不是 null、不是空串、更不是漏键 |
| 占位符独占 | 一个字段的值列表里出现占位符时,不允许同时存在真值;形状合法但语义自相矛盾,要单独拦 |
| 解析容错 | 把模型返回的字符串尽量变成 dict 的一组逐级放宽策略:去围栏 → 截对象 → 修标点 → 去尾逗号 → 换引号 |
| 规整(normalize) | 把 dict 修成「字段齐全、值都是 list[str]」的标准形状;只修形状,不猜内容 |
| 校验(check) | 列出这条结果还剩哪些问题;清单非空就不许进下一环节 |
| 错误回喂重试 | 解析失败时把坏输出放进 assistant 位、再补一句纠正指令重发;比原样重发有效得多 |
| 整条准确率 | exact match,所有字段全对才算一条对;回答「这条能不能直接用」 |
| 字段级准确率 | 对的字段数 ÷ 总字段数;回答「离能用还差多远」,迭代时主要看它的逐字段拆解 |
| 编造(hallucinated) | 原文没有的字段,模型给了一个看似合理的值;形状完全合法,校验器挑不出来,必须单独计数 |
| 抽漏(missed) | 原文有值但模型答「未提及」;和编造代价不同——抽漏是缺数据,编造是脏数据 |
| 边界定义 | 「怎样才算同一件事」的口径,有同话题 / 同事件 / 同方向 / 可互相替代四种,必须选一种写进 system 消息 |
| 难负样本 | 像但不是的负例,两类:同话题反方向(降息 vs 加息)、同主体不同事件;应占负类四成以上 |
| 混淆矩阵 | TP / FP / FN / TN 四格;FP 在去重场景下丢信息,FN 留冗余,代价不对称 |
| 精确率 Precision | TP ÷ (TP+FP),判成「是」的里面真对了多少 |
| 召回率 Recall | TP ÷ (TP+FN),真正的「是」被找回来多少 |
| F1 | 2PR ÷ (P+R),精确率与召回率的调和平均;挑阈值时当默认目标,但不是最终答案 |
| 阈值扫描 | 把候选阈值逐个算一遍 P/R/F1,取峰值;阈值越高召回率单调不增、精确率总体不减 |
| 评测集体检 | 在看模型分数之前先查评测集本身:抽取看「未提及」覆盖率,匹配看正负配比与难负样本占比 |
| Ollama | 本地模型管理与推理服务,默认监听 11434 端口;本讲的模型跑在它上面,不走云端 |
qwen3:8b | 本讲使用的 80 亿参数量级模型;Qwen3 在 Ollama 模型库里从 0.6b 到 235b 都有规格,并标注了 tools 与 thinking 两种能力 |
ollama.chat | 官方 Python 客户端的对话接口,收 model 与 messages,返回体里取 ["message"]["content"],拿到的是一段字符串 |
整个模块从头到尾没有训练过任何一个模型,没有更新过任何一个参数。能做到的事却从「判断一句话属于哪一类」,走到了「把一段非结构化文本变成能入库的结构化数据」。这就是这五讲唯一想说清的那件事:改便条 ≠ 改人——而便条能走多远,取决于你愿意为它配多少验收工序。
再往下走,便条就到头了:模型压根不具备的知识补不进来,靠提示词也压不出更高的上限。那时才轮到给他戴定制耳机,或者送去脱产培训——那是微调专题的事。