Function Call 的原理及实践
让大模型把「要办哪件事、参数填什么」写成一张结构化委托单,而真正执行的永远是你的代码。
30″30 秒看懂 Function Call
把大模型想成一位被锁在办公室里的博学顾问:他读过海量的书,但办公室里没有网线,门也锁着——所以他不知道今天的天气,也进不了你公司的数据库。
你问他“今天北京天气如何”,他不会硬编一个答案,而是写一张委托单递出来:“请帮我办这件事:get_current_weather,参数 location=北京。” 单子由门外的跑腿助理——也就是你写的代码——拿去真正执行:发 HTTP 请求、查数据库。办完把回执递回办公室,顾问看完回执,才写出那句人话答复。
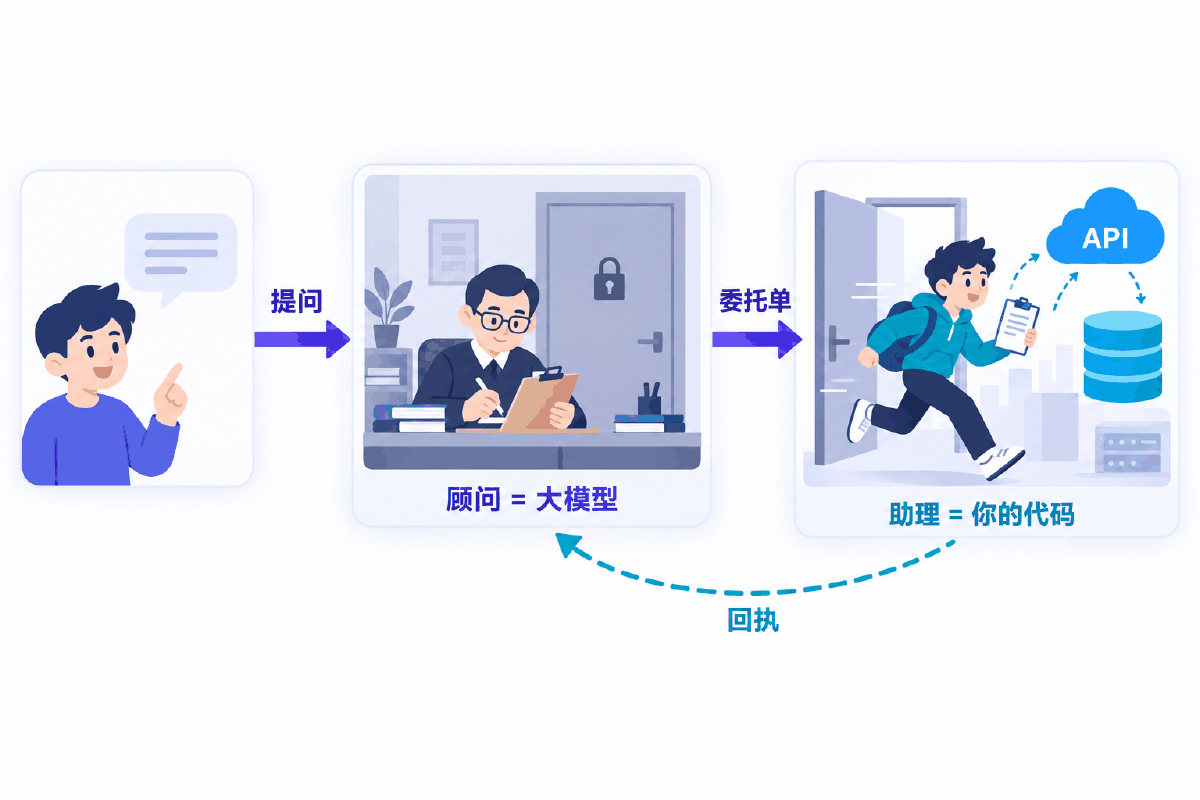
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 博学顾问 | 大模型(glm-4) | 只判断「要不要办事、办哪件、填什么参数」,从不亲自办事 |
| 可委托事项清单 | tools | 你提前告诉顾问:他能委托哪些事、每件事需要填哪些信息 |
| 委托单 | tool_calls | 顾问填好的单子:函数名 + 参数,是一段 JSON,不是执行结果 |
| 跑腿助理 | 你的 Python 代码 | 照着单子真正调用函数、请求接口、执行 SQL |
| 回执 | role 为 tool 的消息 | 把函数返回值贴回对话记录,让顾问看得见 |
| 顾问看回执后写的答复 | 第二次调用模型的输出 | 把冷冰冰的数据翻译成自然语言 |
01概念:什么是 Function Call
定义、由来,以及它到底替大模型补上了什么短板
1.1 定义与由来
2023 年 6 月 13 日,OpenAI 公布了 Function Call(函数调用) 功能。它指的是在语言模型中集成外部功能或 API 的调用能力——这意味着模型可以在生成文本的过程中调用外部函数或服务,获取额外的数据或执行特定的任务。
注意这句定义里的措辞:「集成调用能力」。能力是集成进来了,但按下执行键的手,始终在开发者这边。这一点在下一节会反复强调。
Function Call 的基本流程(简化版)
用比喻复述一遍:顾问先掂量这个问题靠自己的学问答不答得了;答得了就直接答(上面那条路),答不了就去翻「可委托事项清单」,挑一件、填好单子,等助理把回执送回来再答(下面那条路)。
1.2 Function Call 解决大模型的三类问题
大模型训练的数据集无法包含最新的信息,如最新的新闻、实时股价等。通过 Function Call,模型可以实时获取最新数据,提供更加时效的服务。
模型训练数据虽多但有限,无法覆盖所有领域,如医学、法律等领域的专业咨询。Function Call 允许模型调用外部数据库或 API,获取特定领域的详细信息。
大模型虽然功能强大,但不可能内置所有可能需要的功能。通过 Function Call,可以轻松扩展模型能力,如调用外部工具进行复杂计算、数据分析等。
本讲后面的三个案例,正好一一呼应这三类问题:天气对应信息实时性,数据库查询对应数据局限性,航班票价的两步串联对应功能扩展性。
1.3 和 RAG 的区别
这两者经常被混为一谈,但主动权归属完全不同:
| 维度 | RAG | Function Call |
|---|---|---|
| 谁发起 | 你的程序先检索,再把文档塞进提示词 | 模型自己判断要不要调、调哪个、传什么参数 |
| 拿到的是 | 一段相似文本 | 一次函数执行的真实结果 |
| 擅长 | 私有文档问答、长资料检索 | 实时数据、写操作、精确计算、系统集成 |
02原理:两次调用之间发生了什么
调用模式的变化、一条铁律、tools 的字段含义、messages 的增长过程
2.1 没有 Function Call 时,调用模式非常简单
当没有函数调用(function-call)的时候,我们调用大模型构建 AI 应用的模式非常简单,主要步骤只有两步、并重复执行:
- 用户(Client)发请求给我们的服务(Chat Server)
- 我们的服务(Chat Server)给模型提示词,拿到文本后返回
2.2 有 Function Call 时,模式复杂一些
当有函数调用(function-call)的时候,模式比之前要复杂一些,主要步骤是四步:
用户(Client)发请求 prompt 以及 functions 给我们的服务(Chat Server)。
模型根据用户的 prompt,判断是用普通文本还是函数调用的格式响应我们的服务(Chat Server)。
如果是函数调用格式,那么 Chat Server 就会执行这个函数,并且将结果返回给模型。
然后模型使用提供的数据,用连贯的文本响应并返回。
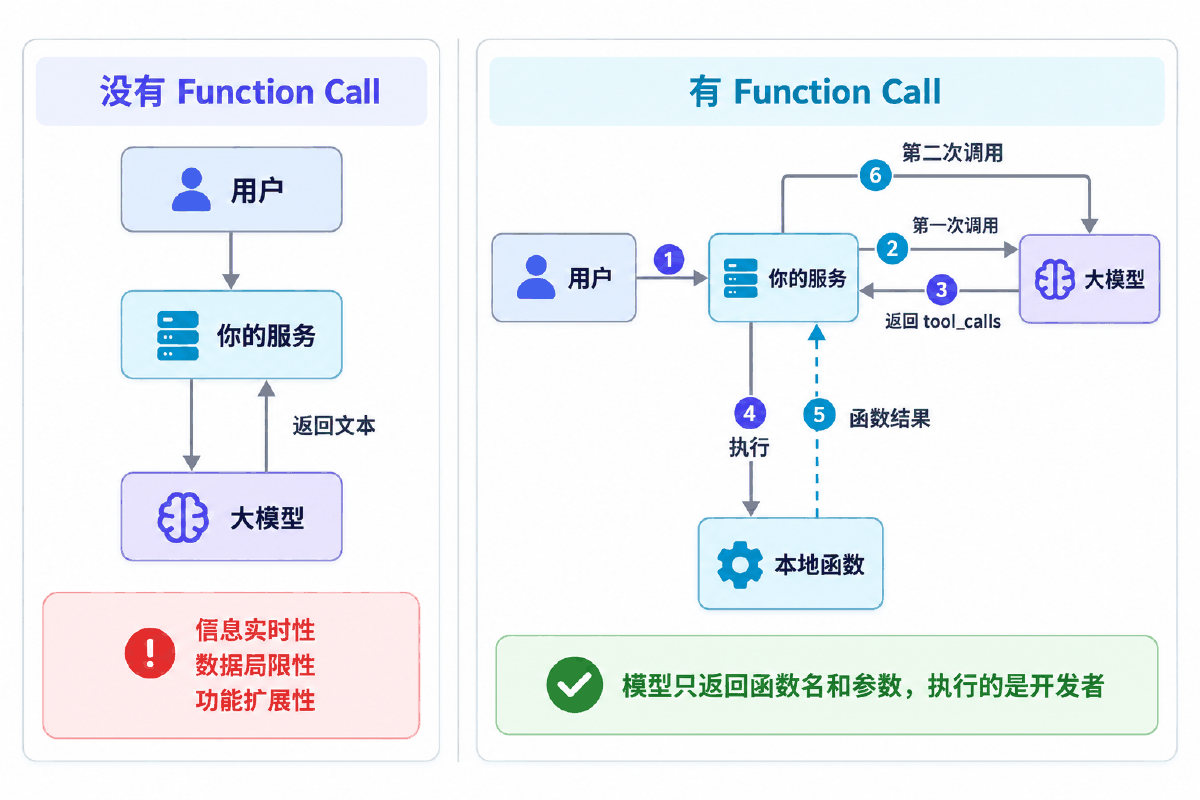
2.3 核心概念:模型不执行函数
这条规则决定了后面所有代码的长相。把它拆成三句话记:
| 环节 | 谁来做 | 产出什么 |
|---|---|---|
| 判断要不要调函数、调哪个 | 模型 | finish_reason='tool_calls' |
| 给出函数名和参数 | 模型 | tool_calls[0].function.name 与 .arguments(字符串形式的 JSON) |
| 真正执行函数 | 开发者 | 函数返回值,由你手动放回 messages |
所以「模型调用了天气接口」这句话是错的。准确说法是:模型请求你去调天气接口,你调完把结果告诉它。
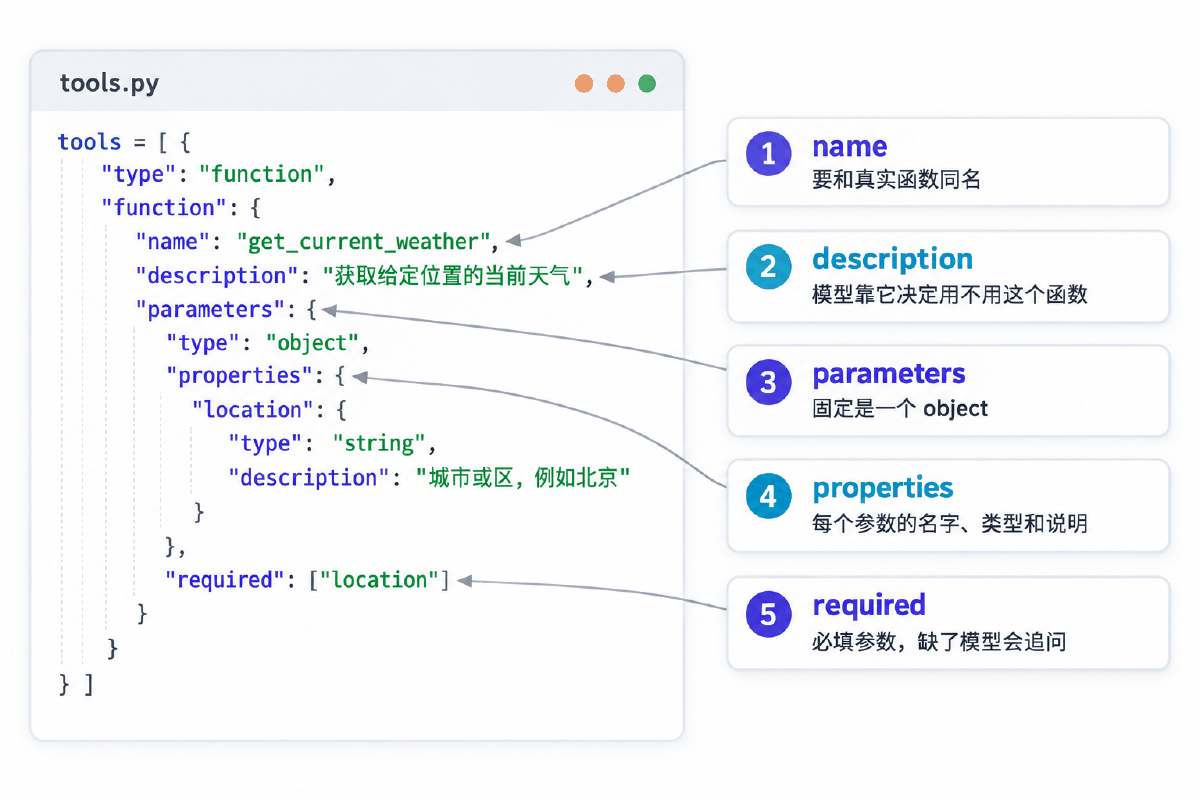
2.4 tools 的 JSON Schema:写给模型看的说明书
tools 是一个数组,数组里每个元素描述一个可被委托的函数。它不参与任何计算,唯一作用是让模型知道有什么可用、每个参数该填什么。
[
  {
    "type": "function",
    "function": {
      "name": "get_current_weather",
      "description": "获取给定位置的当前天气",
      "parameters": {
        "type": "object",
        "properties": {
          "location": {
            "type": "string",
            "description": "城市或区,例如北京、海淀"
          }
        },
        "required": ["location"]
      }
    }
  }
]
| 字段 | 取值 | 作用与注意 |
|---|---|---|
type | "function" | 工具类型,目前固定这一种,照写。 |
function.name | 函数名字符串 | 必须与真实 Python 函数同名。它是后面派发表 available_functions 的键,写错直接 KeyError。 |
function.description | 一句话说明 | 决定模型选不选这个函数。写给模型看,不是写给同事看的注释;含糊 → 该调时不调、或调错函数。 |
parameters.type | "object" | 参数整体是一个对象,固定写法。 |
properties | 参数字典 | 每个参数写清 type 和 description;参数名要与函数形参一致,模型据此从用户原话里抽值。 |
required | 字符串数组 | 必填参数清单。列进来的参数缺失时,模型会反问用户而不是瞎编——这正是航班案例里 system 提示词强调「不要假设或猜测参数值」的配套设计。 |
2.5 两次调用之间,messages 是怎么长大的
Function Call 没有任何隐藏状态,全部上下文都堆在 messages 这一个列表里,而且只追加、不修改。下面这张时序图把两次调用之间发生的事按时间轴排开:
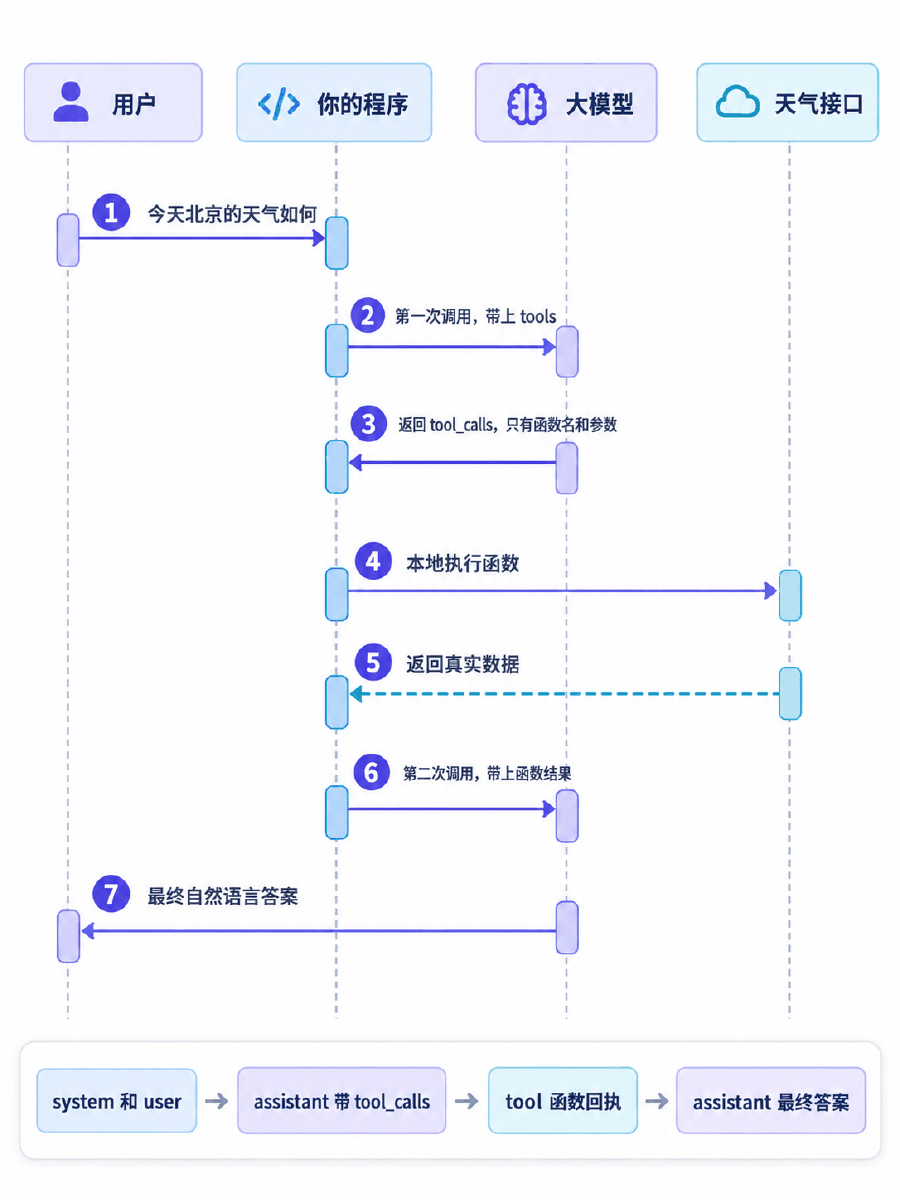
第一次调用前,messages 是 2 条:
[
  {
    "role": "system",
    "content": "你是一个天气播报小助手,你需要根据用户提供的地址来回答当地的天气情况,如果用户提供的问题具有不确定性,不要自己编造内容,提示用户明确输入"
  },
  {
    "role": "user",
    "content": "今天北京的天气如何"
  }
]
第一次调用返回的不是答案,而是一张委托单。把响应对象摊开看,关键的三处已标注:
Completion(
    model='glm-4',
    created=1765805092,
    choices=[CompletionChoice(
        index=0,
        finish_reason='tool_calls',          # ← 关键:模型因「要调工具」而结束,不是因为答完了
        message=CompletionMessage(
            content=None,                    # ← 没有文本内容,模型这一轮压根没打算回答
            role='assistant',
            reasoning_content=None,
            tool_calls=[                     # ← 这就是「委托单」
                CompletionMessageToolCall(
                    id='call_-8074878091637713008',   # 委托单编号,回执要靠它配对
                    function=Function(
                        arguments='{"location": "北京"}',   # 参数:字符串形式的 JSON
                        name='get_current_weather'         # 函数名:要调哪个函数
                    ),
                    type='function',
                    index=0
                )
            ]
        )
    )],
    request_id='2025121521245166e1ccfc510a4af9',
    id='2025121521245166e1ccfc510a4af9',
    usage=CompletionUsage(prompt_tokens=155, completion_tokens=11, total_tokens=166)
)
接着你把这条 assistant 消息原样回填,再把函数执行结果作为 role 为 tool 的消息追加进去。第二次调用前,messages 变成 4 条:
[
  { "role": "system", "content": "你是一个天气播报小助手……" },

  { "role": "user", "content": "今天北京的天气如何" },

  {
    "role": "assistant",
    "content": null,
    "tool_calls": [
      {
        "id": "call_-8074878091637713008",
        "type": "function",
        "function": {
          "name": "get_current_weather",
          "arguments": "{\"location\": \"北京\"}"
        },
        "index": 0
      }
    ]
  },

  {
    "role": "tool",
    "tool_call_id": "call_-8074878091637713008",
    "name": "get_current_weather",
    "content": "{\"location\": \"北京\", \"high_temperature\": \"高温 33℃\", \"low_temperature\": \"低温 17℃\", \"week\": \"星期一\", \"type\": \"晴\"}"
  }
]
role 为 tool 的消息靠 tool_call_id 认领「自己是哪张委托单的回执」。如果上一条 assistant(内含 tool_calls)没有回填,回执就成了孤儿,接口会直接报错。顺序也不能颠倒:先 assistant,后 tool。
03最小代码:跑通第一个 Function Call
先把最短的一条路走完,再去看三个完整案例
三个案例的代码看着不一样,剥掉业务之后剩下的只有 60 行——这是理解 Function Call 的最短路径。整个流程就五步,对着代码里的编号看:
# -*- coding: utf-8 -*-
"""
Function Call 最小骨架(单函数版)
==========================================
天气案例去掉「天气」之后,剩下的就是这 60 行。
只有一个工具、固定两轮对话,是理解 Function Call 的最短路径。
需要多个工具或函数间依赖,请用 fc_skeleton.py(带注册表 + while 多轮)。
"""

import json
import os

# TODO(拓展点 1):换 client / 换模型
from zhipuai import ZhipuAI

client = ZhipuAI(api_key=os.environ["ZHIPUAI_API_KEY"])
MODEL = "glm-4"
# openai 包写法(只差 import 和 base_url,下面代码一字不改):
# from openai import OpenAI
# client = OpenAI(api_key=os.environ["OPENAI_API_KEY"],
#                 base_url="https://open.bigmodel.cn/api/paas/v4/")


# TODO(拓展点 2):换成你的真实函数(模型不执行它,执行的是你)
def my_function(param1):
    """示例:查天气、查订单、算运费……换成你的业务逻辑。"""
    return {"param1": param1, "result": "这里换成真实结果"}


# TODO(拓展点 3):函数描述——name 必须和上面的函数名一致
tools = [{
    "type": "function",
    "function": {
        "name": "my_function",
        "description": "这个函数是干什么的、什么时候该调用它",
        "parameters": {
            "type": "object",
            "properties": {
                "param1": {"type": "string", "description": "参数含义,写清格式和示例"},
            },
            "required": ["param1"],
        },
    },
}]


def run(user_input):
    messages = [{"role": "user", "content": user_input}]

    # 第一次调用:模型决定要不要用工具
    first = client.chat.completions.create(
        model=MODEL, messages=messages, tools=tools, tool_choice="auto")
    msg = first.choices[0].message

    if not getattr(msg, "tool_calls", None):
        return msg.content                        # 模型觉得不用工具,直接回答

    tool_call = msg.tool_calls[0]
    args = json.loads(tool_call.function.arguments)   # arguments 是字符串 JSON
    result = my_function(**args)                      # 本地执行

    messages.append(msg.model_dump())             # 回填 assistant(带 tool_calls)
    messages.append({                             # 回填 tool(函数回执)
        "role": "tool",
        "tool_call_id": tool_call.id,
        "name": tool_call.function.name,
        "content": json.dumps(result, ensure_ascii=False),   # 必须是字符串
    })

    # 第二次调用:模型拿着真实结果,翻译成人话
    second = client.chat.completions.create(
        model=MODEL, messages=messages, tools=tools, tool_choice="auto")
    return second.choices[0].message.content


if __name__ == "__main__":
    # TODO(拓展点 4):换成你的提问
    print(run("这里换成用户的问题"))
ZhipuAI(api_key=...) 与 OpenAI(api_key=..., base_url=...)。下面的业务代码一个字都不用改——因为 client.chat.completions.create(tools=..., tool_choice="auto") 和返回的 tool_calls 结构是同一套 OpenAI 风格协议。换成 DeepSeek、Qwen 或本地 vLLM,也只是换 base_url。
.env 文件写 zhipu_api=你的KEY,代码里用 os.environ['zhipu_api'] 读取。不要把 KEY 硬编码进源码,更不要连同 .env 一起提交到 Git。环境要求:Python 3.10 以上,依赖 pip install zhipuai python-dotenv requests(注意包名是 zhipuai)。
04完整案例:天气 · 航班 · 数据库
单函数、多函数串联、参数本身是一条 SQL——三种典型形态
4.1 单一函数应用:实时天气查询
假设我们要创建一个具备查询实时天气的聊天机器人。基本流程分三步:准备工作 → 定义 Function Tools → 模型应用 Function Call。
| 项目 | 说明 |
|---|---|
| 支持的模型 | 国内外支持 Function Call 的模型,如 ChatGPT、百度文心一言、智谱 ChatGLM3、讯飞星火 3.0 等 |
| 本次选用 | 基于智谱 AI 的 ChatGLM 来实现,注册申请 API-KEY:open.bigmodel.cn/dev/howuse/functioncall |
| Python 版本 | 3.10 以上 |
| 依赖安装 | pip install zhipuai python-dotenv requests |
tools.py —— 定义 Function Tools
这个文件承担三件事:① 定义查询天气的外部函数;② 描述函数功能;③ 解析模型参数并调用函数。文件路径 ./ChatGLM3_FunctionCall/weather/tools.py,一共包含 2 个自定义函数和 1 个函数功能描述。
"""
单一函数应用(天气)—— 工具层:函数定义 + 函数描述 tools + 调用结果解析
文件路径:./ChatGLM3_FunctionCall/weather/tools.py
"""
import json                      # 解析模型返回的 arguments(字符串形式的 JSON)
import requests                  # 请求第三方天气接口

# ============ 1. 函数描述 tools:写给「模型」看的说明书 ============
# 注意:tools 不是代码逻辑,它只是一份 JSON Schema 清单,
#      模型读了它才知道「我手上有哪些函数可以委托、每个函数要填哪些参数」。
tools = [
    {
        "type": "function",                       # 工具类型,目前固定为 function
        "function": {
            # 函数名:必须与下方真实的 Python 函数同名,否则派发时会 KeyError
            "name": "get_current_weather",
            # 函数描述:模型「选不选这个函数」完全依据这句话,要写清楚用途
            "description": "获取给定位置的当前天气",
            "parameters": {                       # 参数定义,遵循 JSON Schema
                "type": "object",                 # 参数整体是一个对象,固定写法
                "properties": {                   # 对象里的各个字段
                    "location": {                 # 参数名,要与函数形参一致
                        "type": "string",         # 参数类型
                        # 参数描述:模型据此从用户原话里抽取出「北京」这个值
                        "description": "城市或区,例如北京、海淀",
                    },
                },
                "required": ["location"],         # 必填参数;缺失时模型会反问用户而不是瞎编
            },
        }
    }
]


# ============ 2. 真正干活的本地函数:查询天气 ============
def get_current_weather(location):
    """得到给定地址的当前天气信息(真正执行方是本函数,不是模型)"""
    # 2.1 读取「城市 -> 邮政编码」映射表,天气接口用编码而不是中文城市名
    with open('./cityCode_use.json', 'r', encoding='utf-8') as file:
        data = json.load(file)                    # json.load 直接把文件流解析成 Python 列表

    city_code = ""                                # 城市编码,默认空
    weather_info = {}                             # 查询结果,默认空字典

    # 2.2 遍历映射表,找到与 location 同名的城市,取出它的编码
    for loc in data:
        if location == loc["市名"]:
            city_code = loc["编码"]

    # 2.3 拿到编码才发起请求;没匹配到就直接返回空结果,避免拼出错误 URL
    if city_code:
        weather_url = "http://t.weather.itboy.net/api/weather/city/" + city_code
        response = requests.get(weather_url)      # 发起 HTTP GET 请求
        result1 = eval(response.text)             # 示例写法:把返回文本转成字典
        # 更稳的写法是 result1 = response.json(),eval 会执行任意表达式,生产环境不要用

        forecast = result1["data"]["forecast"][0]  # forecast[0] 就是「今天」的预报
        # 2.4 只挑模型需要的字段返回,喂给模型的内容越干净,最终回答越准
        weather_info = {
            "location": location,
            "high_temperature": forecast["high"],
            "low_temperature": forecast["low"],
            "week": forecast["week"],
            "type": forecast["type"],
        }

    # 2.5 必须返回字符串:messages 里 role 为 tool 的 content 只接受字符串
    #     ensure_ascii=False 保证中文不被转成 \uXXXX 乱码
    return json.dumps(weather_info, ensure_ascii=False)


# ============ 3. 解析模型回复:判断要不要调函数,并把函数调起来 ============
def parse_response(response):
    """根据模型回复决定是否调用工具函数;若调用,返回函数执行结果"""
    response_message = response.choices[0].message

    # 3.1 关键判断:模型回复里有 tool_calls,说明它填了「委托单」
    #     没有 tool_calls,说明模型认为直接用文本回答就够了
    if response_message.tool_calls:
        # 3.2 函数名 -> 函数对象 的派发表;多函数场景往这里继续加即可
        available_functions = {
            "get_current_weather": get_current_weather,
        }
        # 3.3 从模型回复中取出函数名(模型只告诉你「叫什么」)
        function_name = response_message.tool_calls[0].function.name
        fuction_to_call = available_functions[function_name]

        # 3.4 arguments 是「字符串形式的 JSON」,必须 json.loads 才能当参数用
        function_args = json.loads(response_message.tool_calls[0].function.arguments)

        # 3.5 真正执行函数 —— 这一行是整个 Function Call 里唯一「执行」的地方
        function_response = fuction_to_call(
            location=function_args.get("location"),
        )
        return function_response


if __name__ == '__main__':
    # 单独测试本地函数是否可用(不经过模型,先保证函数本身跑得通)
    function_name = get_current_weather
    response = function_name(location="北京")
    print(response)
get_current_weather 返回的是 json.dumps(..., ensure_ascii=False) 字符串,因为 role 为 tool 的 content 只接受字符串,ensure_ascii=False 保证中文不变成 \uXXXX。②
parse_response 里的 available_functions 是「函数名 → 函数对象」的派发表,多函数场景就是往这里加键值对。③ 示例里用
eval(response.text) 把接口返回转成字典,学习阶段可以,生产环境请换成 response.json()——eval 会执行任意表达式。
天气接口需要城市编码而不是中文城市名,所以要准备一份映射表(节选):
[
  {"市名": "北京", "编码": "101010100"},
  {"市名": "海淀", "编码": "101010200"},
  {"市名": "朝阳", "编码": "101010300"},
  {"市名": "上海", "编码": "101020100"},
  {"市名": "天津", "编码": "101030100"},
  {"市名": "郑州", "编码": "101180101"},
  {"市名": "深圳", "编码": "101280601"},
  {"市名": "广州", "编码": "101280101"},
  {"市名": "杭州", "编码": "101210101"},
  {"市名": "成都", "编码": "101270101"}
]
weather_zhipu.py —— 主逻辑:两次调用模型
文件路径 ./ChatGLM3_FunctionCall/weather/weather_zhipu.py,包含 2 个函数:调用模型的函数和主逻辑函数。
"""
单一函数应用(天气)—— 主逻辑:两次调用模型,中间夹一次本地函数执行
文件路径:./ChatGLM3_FunctionCall/weather/weather_zhipu.py

运行前准备:
    pip install zhipuai python-dotenv requests
    在同目录 .env 中写入: zhipu_api=你的APIKEY
"""
import os                                    # 读取环境变量,密钥不写死在代码里
from dotenv import load_dotenv, find_dotenv  # 从 .env 文件加载环境变量
from tools import *                          # 导入 tools 列表、get_current_weather、parse_response
from zhipuai import ZhipuAI                  # 智谱官方 SDK

_ = load_dotenv(find_dotenv())               # find_dotenv 自动向上查找 .env,load 进 os.environ
zhupu_ak = os.environ['zhipu_api']           # 从环境变量取 API-KEY(严禁硬编码进源码)
client = ZhipuAI(api_key=zhupu_ak)           # 创建客户端
ChatGLM = "glm-4"                            # 选用支持 Function Call 的模型


def chat_completion_request(messages, tools=None, tool_choice=None, model=ChatGLM):
    """
    统一的模型调用入口(两次调用复用同一个函数,只是传入的 messages 不同)

    参数:
        messages:    对话消息列表,Function Call 的全部状态都靠它承载
        tools:       函数描述清单;不传则模型无从得知有哪些函数可用
        tool_choice: "auto" 表示由模型自行决定用文本回答还是调用函数
        model:       模型名称
    返回:
        成功返回响应对象,失败返回异常对象
    """
    try:
        response = client.chat.completions.create(
            model=model,
            messages=messages,
            tools=tools,
            tool_choice=tool_choice,
        )
        return response
    except Exception as e:
        print("Unable to generate ChatCompletion response")
        print(f"Exception: {e}")
        return e


def main():
    # ---------- 第 1 步:构造初始 messages(此时 2 条:system + user)----------
    messages = []
    messages.append({
        "role": "system",
        "content": "你是一个天气播报小助手,你需要根据用户提供的地址来回答当地的天气情况,"
                   "如果用户提供的问题具有不确定性,不要自己编造内容,提示用户明确输入"
    })
    messages.append({"role": "user", "content": "今天北京的天气如何"})

    # ---------- 第 2 步:第一次调用模型(带上 tools)----------
    # 模型此时不会给出天气,而是返回 tool_calls:函数名 + 参数
    response = chat_completion_request(messages, tools=tools, tool_choice="auto")

    # ---------- 第 3 步:本地真正执行函数,拿到真实数据 ----------
    function_response = parse_response(response)

    # ---------- 第 4 步:把模型那条 assistant 消息原样回填进 messages ----------
    # 必须回填!否则下一条 role 为 tool 的消息会找不到它所对应的 tool_calls
    assistant_message = response.choices[0].message
    messages.append(assistant_message.model_dump())   # model_dump 把对象转成字典

    # 取出函数名与本次工具调用的 id(id 用来把「回执」和「委托单」配对)
    function_name = response.choices[0].message.tool_calls[0].function.name
    function_id = response.choices[0].message.tool_calls[0].id

    # ---------- 第 5 步:把函数执行结果作为 role 为 tool 的消息加入 messages ----------
    messages.append({
        "role": "tool",                 # 固定角色名,表示这是工具执行结果
        "tool_call_id": function_id,    # 必须与上一条 assistant 中的 tool_calls[0].id 一致
        "name": function_name,          # 函数名
        "content": function_response,   # 函数返回值,字符串
    })
    # 此刻 messages 共 4 条:system / user / assistant(tool_calls) / tool

    # ---------- 第 6 步:第二次调用模型,得到最终自然语言答案 ----------
    last_response = chat_completion_request(messages, tools=tools, tool_choice="auto")
    print(f'last_response--》{last_response.choices[0].message}')


if __name__ == '__main__':
    main()
运行结果
# ① 天气案例(单一函数)最终输出
last_response--》CompletionMessage(
    content='根据您的查询,我获取到了北京市当前的天气情况。今天是星期一,北京的天气情况是晴天,
             最高气温为33℃,最低气温为17℃。请注意天气变化,做好防晒和保暖措施。',
    role='assistant',
    tool_calls=None)          # ← tool_calls 变成 None,说明这次是真答案,循环结束

# ② 航班案例(多个函数)最终输出
last_response--》CompletionMessage(
    content='2024年4月2日,郑州到北京的航班号为1123,票价为668元。',
    role='assistant',
    tool_calls=None)

# ③ 数据库案例最终输出
last_response--》content='根据您的查询,我已经为您找到了工资最高的员工。这位员工的姓名是KING,他的工资是5000元。'
                 role='assistant' tool_calls=None
注意最后一行的 tool_calls=None——它是「循环该结束了」的信号:模型这次给的是真答案,不再是委托单。
4.2 多个函数应用:航班号 → 票价
假设我们要创建一个具备查询航班功能的聊天机器人。流程和环境同上一节一致,但是由于涉及多个函数,因此在代码设计结构上有所改动,完整代码包含三个文件:
| 文件 | 职责 |
|---|---|
muti_utils.py | 主要用来定义多个 Functions,以及函数的应用(解析分发) |
airplane_function_tools.py | 主要用来实现函数的功能描述 tools |
muti_function_zhipu.py | 主逻辑函数,实现模型 Function Call 的应用 |
第 1 轮委托
get_plane_number(郑州→北京,2024-04-02)拿到航班号 1123;第 2 轮拿着 1123 委托 get_ticket_price 拿到 668;第 3 轮才合成人话。对应比喻:顾问发现第二件事缺个关键信息,于是先派助理跑第一趟,拿到回执后再派第二趟。串联的判断是模型做的,串联的执行仍然是你的代码做的。
muti_utils.py —— 两个业务函数 + 统一分发
目的:① 定义查询飞机航班的函数;② 定义查询飞机票价的函数;③ 解析模型参数调用函数。文件路径 ./ChatGLM3_FunctionCall/airplane/muti_utils.py,一共包含 3 个自定义函数。
"""
多函数应用(航班)—— 函数层:定义多个可被委托的函数 + 统一的调用分发
文件路径:./ChatGLM3_FunctionCall/airplane/muti_utils.py
说明:可直接运行的完整脚本。
"""
import json


# ============ 函数 1:根据「出发地 + 目的地 + 日期」查航班号 ============
def get_plane_number(date, start, end):
    """
    用写死的字典模拟航班库;真实项目里把这里换成航司 API 或数据库查询即可,
    对模型而言接口形态不变 —— 它只负责填参数,不关心你内部怎么查。
    """
    plane_number = {
        "北京": {
            "深圳": "126",
            "广州": "356",
        },
        "郑州": {
            "北京": "1123",
            "天津": "3661",
        }
    }
    # 返回结构里带上 date,方便模型在下一轮把日期继续传给票价函数
    return {"date": date, "number": plane_number[start][end]}


# ============ 函数 2:根据「航班号 + 日期」查票价 ============
def get_ticket_price(date: str, number: str):
    """用固定票价模拟;重点在于它依赖上一个函数的输出(航班号)"""
    print(date)
    print(number)
    return {"ticket_price": "668"}


# ============ 统一分发:按模型给出的函数名,派发到对应的本地函数 ============
def parse_function_call(model_response):
    """
    与单函数版最大的不同:这里要用 if 判断函数名,
    因为模型可能选 get_plane_number,也可能选 get_ticket_price。
    """
    function_result = ''
    if model_response.choices[0].message.tool_calls:
        tool_call = model_response.choices[0].message.tool_calls[0]
        args = tool_call.function.arguments        # 字符串形式的 JSON

        function_result = {}
        if tool_call.function.name == "get_plane_number":
            # ** 解包:把 {"start":"郑州","end":"北京","date":"2024-04-02"} 展开成关键字参数
            function_result = get_plane_number(**json.loads(args))
        if tool_call.function.name == "get_ticket_price":
            function_result = get_ticket_price(**json.loads(args))

    return function_result
与单函数版相比,唯一的结构变化在 parse_function_call:它要按函数名分支,因为模型这次可能挑两个函数中的任意一个。另外注意 get_plane_number 的返回里带上了 date——这样模型在第二轮才能把日期一并传给票价函数。
airplane_function_tools.py —— 两个函数的 tools 描述
目的:定义函数描述功能,相当于给大模型应用的工具描述 tools。文件路径 ./ChatGLM3_FunctionCall/airplane/airplane_function_tools.py。
"""
多函数应用(航班)—— 工具描述层:一次性把两个函数都描述给模型
文件路径:./ChatGLM3_FunctionCall/airplane/airplane_function_tools.py

关键点:tools 是一个数组,里面放几个元素,模型手上就有几张「可委托事项」。
模型每一轮只会挑一个去填委托单,挑哪个取决于 description 写得准不准。
"""

tools = [
    {
        "type": "function",
        "function": {
            "name": "get_plane_number",
            # 描述里点明了三个输入和一个输出,模型才知道「先查航班号」这一步归它
            "description": "根据始发地、目的地和日期,查询对应日期的航班号",
            "parameters": {
                "type": "object",
                "properties": {
                    "start": {
                        "description": "出发地",
                        "type": "string"
                    },
                    "end": {
                        "description": "目的地",
                        "type": "string"
                    },
                    "date": {
                        "description": "日期",
                        "type": "string",
                    }
                },
                # 三个参数都必填:用户说不全时,模型会追问而不是编造
                "required": ["start", "end", "date"]
            },
        }
    },
    {
        "type": "function",
        "function": {
            "name": "get_ticket_price",
            # 这个函数需要「航班号」,而航班号只能由上一个函数产出 ——
            # 两个函数因此形成依赖链,模型会自动分成两轮来调
            "description": "查询某航班在某日的价格",
            "parameters": {
                "type": "object",
                "properties": {
                    "number": {
                        "description": "航班号",
                        "type": "string"
                    },
                    "date": {
                        "description": "日期",
                        "type": "string",
                    }
                },
                "required": ["number", "date"]
            },
        }
    },
]
tools 数组里放了两个元素,模型手上就有两张「可委托事项」。它靠 description 分辨:查航班号要「始发地、目的地、日期」,查票价要「航班号、日期」。
muti_function_zhipu.py —— 三次调用模型,两次本地执行
文件路径 ./ChatGLM3_FunctionCall/airplane/muti_function_zhipu.py。主逻辑是「调用—执行—回填」重复两遍,最后再调一次收尾。
"""
多函数应用(航班)—— 主逻辑:三次调用模型,中间夹两次本地函数执行
文件路径:./ChatGLM3_FunctionCall/airplane/muti_function_zhipu.py
说明:可直接运行的完整脚本。

一句话看懂本例的串联:
    用户只问「票价」,但票价函数要航班号 ——
    模型第 1 轮先委托 get_plane_number 拿到航班号 1123,
    第 2 轮才委托 get_ticket_price 拿到票价 668,
    第 3 轮把两段回执合成一句人话。

运行前准备:
    pip install zhipuai python-dotenv
    在同目录 .env 中写入: zhipu_api=你的APIKEY
"""
import os
import json
from zhipuai import ZhipuAI
from dotenv import load_dotenv, find_dotenv
from muti_utils import *                      # 三个自定义函数
from airplane_function_tools import *         # tools 描述清单

_ = load_dotenv(find_dotenv())
zhupu_ak = os.environ['zhipu_api']            # 从环境变量读取 API-KEY
client = ZhipuAI(api_key=zhupu_ak)
ChatGLM = "glm-4"


def chat_completion_request(messages, tools=None, tool_choice=None, model=ChatGLM):
    """模型调用入口,与单函数版完全一致 —— 多函数的复杂度不在调用,而在 messages 的累积"""
    try:
        response = client.chat.completions.create(
            model=model,
            messages=messages,
            tools=tools,
            tool_choice=tool_choice,
        )
        return response
    except Exception as e:
        print("Unable to generate ChatCompletion response")
        print(f"Exception: {e}")
        return e


def main():
    # ---------- 准备 messages ----------
    messages = []
    messages.append({
        "role": "system",
        "content": "现在你是一个航班查询助手,将根据用户问题提供答案,"
                   "但是不要假设或猜测传入函数的参数值。如果用户的描述不明确,请要求用户提供必要信息"
    })
    messages.append({
        "role": "user",
        "content": "帮我查询2024年4月2日,郑州到北京的航班的票价"
    })

    # ========== 第一轮:查航班号 ==========
    # 1. 第一次调用模型 —— 模型判断出要先拿航班号
    first_response = chat_completion_request(messages, tools=tools, tool_choice="auto")
    assistant_message1 = first_response.choices[0].message
    print(f'assistant_message1-->{assistant_message1}')

    # 2. 把模型这条 assistant 回复(内含 tool_calls)原样加入 messages
    messages.append(first_response.choices[0].message.model_dump())

    # 3. 按模型给的函数名和参数,在本地真正执行 get_plane_number
    first_function = parse_function_call(model_response=first_response)

    # 4. 把第一次的函数结果作为 role 为 tool 的消息加入 messages
    tool_call = first_response.choices[0].message.tool_calls[0]
    messages.append({
        "role": "tool",
        "tool_call_id": tool_call.id,                       # 与第一张委托单配对
        "content": str(json.dumps(first_function)),         # content 必须是字符串
    })

    # ========== 第二轮:用航班号查票价 ==========
    # 5. 第二次调用模型 —— 模型看到航班号 1123,于是委托第二个函数
    second_response = chat_completion_request(messages, tools=tools, tool_choice="auto")

    # 6. 第二条 assistant 回复同样要回填
    messages.append(second_response.choices[0].message.model_dump())

    # 7. 本地执行 get_ticket_price
    second_function = parse_function_call(model_response=second_response)
    tool2_call = second_response.choices[0].message.tool_calls[0]

    # 8. 第二次的函数结果继续追加为 role 为 tool 的消息
    messages.append({
        "role": "tool",
        "tool_call_id": tool2_call.id,                      # 与第二张委托单配对
        "content": str(json.dumps(second_function)),
    })
    # 此刻 messages 共 6 条:
    # system / user / assistant(委托1) / tool(回执1) / assistant(委托2) / tool(回执2)

    # ========== 第三轮:合成最终答案 ==========
    # 9. 最后一次调用,模型不再返回 tool_calls,而是给出自然语言结果
    last_response = chat_completion_request(messages, tools=tools, tool_choice="auto")
    print(f'last_response--》{last_response.choices[0].message}')


if __name__ == '__main__':
    main()
messages 在这个案例里长到 6 条
| 序号 | role | 内容 |
|---|---|---|
| ① | system | 航班查询助手人设,强调「不要假设或猜测传入函数的参数值」 |
| ② | user | 帮我查询 2024 年 4 月 2 日,郑州到北京的航班的票价 |
| ③ | assistant | 第一张委托单:get_plane_number,参数 start/end/date |
| ④ | tool | 第一份回执:{"date": "2024-04-02", "number": "1123"} |
| ⑤ | assistant | 第二张委托单:get_ticket_price,参数 number=1123、date |
| ⑥ | tool | 第二份回执:{"ticket_price": "668"} |
最终输出:content='2024年4月2日,郑州到北京的航班号为1123,票价为668元。' role='assistant' tool_calls=None
4.3 数据库查询应用
假设我们要创建一个可以连接数据库查询的聊天机器人。流程和环境同上一节一致,但是在代码设计结构上有所改动,完整代码包含两个部分:
| 文件 | 职责 |
|---|---|
sql_function_tools.py | 主要用来定义查询数据库函数、函数功能描述 tools,以及函数的应用(解析分发) |
sql_zhipu.py | 主逻辑函数,实现模型 Function Call 的应用 |
ask_database,它的唯一参数 query 是一整条 SQL 语句——也就是说,SQL 由模型写,执行由 pymysql 做。模型凭什么写得出正确的 SQL?因为我们把建表语句连同中文字段注释一起塞进了参数的
description。对应比喻:顾问手上多了一份「库房清单」,他照着清单开取货单,取货的仍然是助理。
sql_function_tools.py —— 表结构 + 执行 SQL + tools + 解析
目的:① 定义查询数据库的函数;② 描述函数功能 tools;③ 解析模型参数调用函数。文件路径 ./ChatGLM3_FunctionCall/sql/sql_function_tools.py。
"""
数据库查询应用 —— 工具层:表结构描述 + 执行 SQL 的函数 + tools 描述 + 解析分发
文件路径:./ChatGLM3_FunctionCall/sql/sql_function_tools.py
说明:可直接运行的完整脚本。

本例的精髓:函数只有一个(ask_database),但它的参数是一条 SQL 语句。
把「建表语句」塞进参数的 description 里,模型就知道有哪些表、哪些字段,
从而自己写出正确的 SQL —— 模型负责写 SQL,pymysql 负责执行 SQL。
"""
import os
import json
import pymysql

# ============ 1. 把数据库表结构写成字符串(单表版本)============
database_schema_string = """
CREATE TABLE `emp` (
  `empno` int DEFAULT NULL, --员工编号, 默认为空
  `ename` varchar(50) DEFAULT NULL, --员工姓名, 默认为空
  `job` varchar(50) DEFAULT NULL,--员工工作, 默认为空
  `mgr` int DEFAULT NULL,--员工领导, 默认为空
  `hiredate` date DEFAULT NULL,--员工入职日期, 默认为空
  `sal` int DEFAULT NULL,--员工的月薪, 默认为空
  `comm` int DEFAULT NULL,--员工年终奖, 默认为空
  `deptno` int DEFAULT NULL,--员工部分编号, 默认为空
)"""

# ============ 2. 多表版本:表之间的关系也一并交代清楚 ============
# 注意每个字段后面的中文注释 —— 它们同样是给模型看的,
# 模型靠这些注释把「工资」对应到 sal、把「部门」对应到 deptno。
database_schema_string1 = """
CREATE TABLE `emp` (
  `empno` int DEFAULT NULL, --员工编号, 默认为空
  `ename` varchar(50) DEFAULT NULL, --员工姓名, 默认为空
  `job` varchar(50) DEFAULT NULL,--员工工作, 默认为空
  `mgr` int DEFAULT NULL,--员工领导, 默认为空
  `hiredate` date DEFAULT NULL,--员工入职日期, 默认为空
  `sal` int DEFAULT NULL,--员工的月薪, 默认为空
  `comm` int DEFAULT NULL,--员工年终奖, 默认为空
  `deptno` int DEFAULT NULL,--员工部分编号, 默认为空
);
CREATE TABLE `DEPT` (
  `DEPTNO` int NOT NULL, -- 部门编码, 默认为空
  `DNAME` varchar(14) DEFAULT NULL,--部门名称, 默认为空
  `LOC` varchar(13) DEFAULT NULL,--地点, 默认为空
  PRIMARY KEY (`DEPTNO`)
);
"""


# ============ 3. 真正执行 SQL 的本地函数 ============
def ask_database(query):
    """连接数据库,执行模型生成的 SQL 并返回结果"""
    print("进入函数内部")
    # 3.1 连接 MySQL(账号口令一律走环境变量,不要硬编码在源码里)
    conn = pymysql.connect(
        host=os.environ.get("MYSQL_HOST", "localhost"),
        port=int(os.environ.get("MYSQL_PORT", 3306)),
        user=os.environ.get("MYSQL_USER", "root"),
        password=os.environ["MYSQL_PASSWORD"],          # 从环境变量读取,缺失即报错
        database=os.environ.get("MYSQL_DATABASE", "it_heima"),
        charset='utf8mb4',
    )
    cursor = conn.cursor()      # 3.2 创建游标
    print('开始测试')
    cursor.execute(query)       # 3.3 执行模型写好的 SQL
    result = cursor.fetchall()  # 3.4 取回全部查询结果
    cursor.close()              # 3.5 关闭游标
    conn.close()                # 3.6 关闭连接
    return result


# ============ 4. tools:把表结构塞进参数描述里 ============
tools = [
    {
        "type": "function",
        "function": {
            "name": "ask_database",
            "description": "使用此函数回答业务问题,要求输出是一个SQL查询语句",
            "parameters": {
                "type": "object",
                "properties": {
                    "query": {
                        "type": "string",
                        # 这段 f-string 就是本例的核心:
                        # 把建表语句拼进 description,模型才能写出字段正确的 SQL
                        "description": f"SQL查询提取信息以回答用户的问题。"
                                       f"SQL应该使用以下数据库模式编写:{database_schema_string1}"
                                       f"查询应该以纯文本返回,而不是JSON。"
                                       f"查询应该只包含MySQL支持的语法。",
                    }
                },
                "required": ["query"],
            },
        }
    }
]


# ============ 5. 解析模型回复并执行函数 ============
def parse_response(response):
    response_message = response.choices[0].message
    if response_message.tool_calls:
        available_functions = {
            "ask_database": ask_database
        }
        function_name = response_message.tool_calls[0].function.name
        fuction_to_call = available_functions[function_name]
        function_args = json.loads(response_message.tool_calls[0].function.arguments)
        # 这里的 query 参数,内容就是模型自己写出来的那条 SQL 语句
        function_response = fuction_to_call(
            query=function_args.get("query"),
        )
        return function_response
pymysql.connect(),改为从环境变量读取,避免口令进版本库;②
tools 里引用的是多表版 database_schema_string1,单表版 database_schema_string 保留作对比——表越多,描述越要写清表间关系,否则模型不会写 JOIN。
sql_zhipu.py —— 主逻辑:两次调用模型
文件路径 ./ChatGLM3_FunctionCall/sql/sql_zhipu.py。主逻辑与天气案例完全同构:两次调用模型,中间夹一次本地执行。
"""
数据库查询应用 —— 主逻辑:两次调用模型,中间夹一次 SQL 执行
文件路径:./ChatGLM3_FunctionCall/sql/sql_zhipu.py
说明:可直接运行的完整脚本。

运行前准备:
    pip install zhipuai python-dotenv pymysql
    在同目录 .env 中写入:
        zhipu_api=你的APIKEY
        MYSQL_PASSWORD=你的数据库密码
"""
import os
import json
from zhipuai import ZhipuAI
from dotenv import load_dotenv, find_dotenv
from sql_function_tools import *      # tools、ask_database、parse_response

_ = load_dotenv(find_dotenv())
zhupu_ak = os.environ['zhipu_api']    # 从环境变量读取 API-KEY
client = ZhipuAI(api_key=zhupu_ak)
ChatGLM = "glm-4"


def chat_completion_request(messages, tools=None, tool_choice=None, model=ChatGLM):
    """模型调用入口:三个案例共用同一套写法"""
    try:
        response = client.chat.completions.create(
            model=model,
            messages=messages,
            tools=tools,
            tool_choice=tool_choice,
        )
        return response
    except Exception as e:
        print("Unable to generate ChatCompletion response")
        print(f"Exception: {e}")
        return e


def main():
    # ---------- 第 1 步:准备 messages ----------
    messages = []
    messages.append({
        "role": "system",
        "content": "通过针对业务数据库生成 SQL 查询来回答用户的问题"
    })
    messages.append({
        "role": "user",
        "content": "查询一下最高工资的员工姓名及对应的工资"
    })

    # ---------- 第 2 步:第一次调用模型 ----------
    # 模型不会去查库,它返回的 arguments 里是一条它写好的 SQL,例如:
    # SELECT ename, sal FROM emp ORDER BY sal DESC LIMIT 1;
    response = chat_completion_request(messages, tools=tools, tool_choice="auto")

    # ---------- 第 3 步:本地用 pymysql 执行这条 SQL ----------
    function_response = parse_response(response)

    # ---------- 第 4 步:回填 assistant 消息 ----------
    assistant_message = response.choices[0].message
    print(f'assistant_message-->{assistant_message}')
    messages.append(assistant_message.model_dump())

    function_name = response.choices[0].message.tool_calls[0].function.name
    function_id = response.choices[0].message.tool_calls[0].id

    # ---------- 第 5 步:把查询结果作为 role 为 tool 的消息加入 ----------
    # 注意:fetchall() 返回的是元组,必须转成字符串才能放进 content
    messages.append({
        "role": "tool",
        "tool_call_id": function_id,
        "name": function_name,
        "content": str(function_response),
    })

    # ---------- 第 6 步:第二次调用模型,把查询结果翻译成人话 ----------
    last_response = chat_completion_request(messages, tools=tools, tool_choice="auto")
    print(f'last_response--》{last_response.choices[0].message}')


if __name__ == '__main__':
    main()
这一轮模型实际写出来的 SQL
-- 用户原话:查询一下最高工资的员工姓名及对应的工资
-- 模型据此写出的 SQL(放在 tool_calls[0].function.arguments 的 query 字段里)
SELECT ename, sal
FROM emp
ORDER BY sal DESC
LIMIT 1;

-- pymysql 执行后 cursor.fetchall() 返回:(('KING', 5000),)
-- 这份结果转成字符串,作为 role 为 tool 的消息回填进 messages
执行后 fetchall() 返回 (('KING', 5000),),转成字符串放进 role 为 tool 的消息,第二次调用模型得到:
content='根据您的查询,我已经为您找到了工资最高的员工。这位员工的姓名是KING,他的工资是5000元。' role='assistant' tool_calls=None
4.4 三个案例的结构对比
| 案例 | 函数个数 | 调用模型次数 | 参数里装的是什么 |
|---|---|---|---|
| 天气 | 1 | 2 次 | 一个城市名 location |
| 航班 | 2(有依赖) | 3 次 | 出发地/目的地/日期,第二轮是航班号 |
| 数据库 | 1 | 2 次 | 一整条 SQL 语句 |
三个案例的骨架完全一样:调模型 → 看有没有 tool_calls → 本地执行 → 回填 assistant 和 tool → 再调模型。变化的只是函数个数、参数形态和轮数。
05骨架模板:拿去改就能用
通用版(注册表 + 自动多轮)与数据库版(含只读安全校验)
5.1 通用骨架(推荐拿这份)
把天气、航班、数据库三个案例的共性抽出来,就是它;三个案例都只是它的特例。与前面逐个写死的实现相比,它做了三件事:
| 改进 | 为什么 |
|---|---|
available_functions 注册表 | 加新工具只动一个字典 + 一段 tools,不再写 if name == "xxx" 的硬编码分发 |
while 自动多轮 | 前面的实现把「两轮/三轮」写死了;模板循环到模型不再返回 tool_calls 为止,函数依赖再深也能跑完 |
| 循环内批量执行 | 模型一次返回多个 tool_calls 时(并行调用)逐个执行并逐条回填,不会漏掉 |
# -*- coding: utf-8 -*-
"""
Function Call 可复用骨架模板(通用版)
==========================================
把这个文件整个复制到你自己的项目里,只改 TODO(拓展点) 标注的地方就能跑。
三个案例(天气 / 航班 / 数据库)都是这个骨架的特例。

设计要点:
  1. available_functions 是「函数注册表」——加新工具只动这一个字典和 tools 列表;
  2. run_conversation 用 while 循环自动多轮,直到模型不再返回 tool_calls;
     (天气案例是 2 轮,航班案例是 3 轮,这里不写死轮数)
  3. 与 OpenAI 风格 SDK 完全兼容:client.chat.completions.create(tools=..., tool_choice="auto")。
"""

import json
import os

# ============================================================
# 一、client 初始化:两种写法二选一,只差 import 和 base_url
# ============================================================
# TODO(拓展点 1):换模型 / 换厂商,只改这一段

# 写法 A —— 智谱官方 SDK(本讲示例用的就是这个)
from zhipuai import ZhipuAI

client = ZhipuAI(api_key=os.environ["ZHIPUAI_API_KEY"])
MODEL = "glm-4"

# 写法 B —— openai 包(同一套代码可对接 OpenAI / DeepSeek / Qwen / 本地 vLLM)
# from openai import OpenAI
# client = OpenAI(
#     api_key=os.environ["OPENAI_API_KEY"],
#     base_url="https://open.bigmodel.cn/api/paas/v4/",   # 换成你的厂商地址即可
# )
# MODEL = "glm-4"
#
# 常见 base_url 参考:
#   OpenAI      https://api.openai.com/v1
#   智谱         https://open.bigmodel.cn/api/paas/v4/
#   DeepSeek    https://api.deepseek.com
#   本地 vLLM    http://127.0.0.1:8000/v1
# 两种写法下面的业务代码一个字都不用改——tool_calls 的字段结构是一样的。


# ============================================================
# 二、你的真实函数:模型永远不执行它们,执行的是这里
# ============================================================
# TODO(拓展点 2):把下面两个示例函数换成你自己的业务函数
#   规则:参数名要和 tools 描述里的 properties 完全一致;
#         返回值建议是 str / dict,方便统一 json.dumps。

def my_function_a(param1, param2="默认值"):
    """示例函数 A:换成你的——查数据库、调接口、读文件、发消息都行。"""
    # ... 你的业务逻辑 ...
    return {"param1": param1, "param2": param2, "result": "这里换成真实结果"}


def my_function_b(param1):
    """示例函数 B:用来演示「多函数」和「函数间依赖」。"""
    return {"input": param1, "result": "第二个函数的结果"}


# ============================================================
# 三、函数注册表:加新工具时,这里加一行
# ============================================================
# TODO(拓展点 3):注册你的函数(键必须与 tools 里的 name 一致)
available_functions = {
    "my_function_a": my_function_a,
    "my_function_b": my_function_b,
}


# ============================================================
# 四、tools 描述:告诉模型有什么可用、参数怎么填
# ============================================================
# TODO(拓展点 4):照着抄一份就是一个新工具
#   description 写清楚「什么时候该用它」,模型靠它决定用不用;
#   required 里的参数是必填,模型缺了会反问用户。
tools = [
    {
        "type": "function",
        "function": {
            "name": "my_function_a",                      # 必须与 available_functions 的键一致
            "description": "这个函数是干什么的、什么情况下调用它",
            "parameters": {
                "type": "object",
                "properties": {
                    "param1": {
                        "type": "string",
                        "description": "参数含义,写清楚格式和示例,例如:城市名,如 北京",
                    },
                    "param2": {
                        "type": "string",
                        "description": "可选参数的含义",
                    },
                },
                "required": ["param1"],                   # 必填参数
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "my_function_b",
            "description": "第二个函数的用途说明",
            "parameters": {
                "type": "object",
                "properties": {
                    "param1": {"type": "string", "description": "参数含义"},
                },
                "required": ["param1"],
            },
        },
    },
]


# ============================================================
# 五、解析分发:把模型给的「函数名 + 参数」真正执行掉
# ============================================================
def parse_response(tool_call):
    """执行一次 tool_call,返回字符串形式的结果。

    注意两个坑:
      1. arguments 是【字符串形式的 JSON】,必须 json.loads 才能取值;
      2. 回填给模型的 content 必须是【字符串】,元组/字典要先 dumps 或 str。
    """
    name = tool_call.function.name
    args = json.loads(tool_call.function.arguments or "{}")

    func = available_functions.get(name)
    if func is None:
        return f"错误:未注册的函数 {name}"

    try:
        result = func(**args)
    except Exception as exc:                      # 函数报错也要如实回给模型,别让它瞎猜
        return f"函数 {name} 执行失败:{exc}"

    if isinstance(result, str):
        return result
    return json.dumps(result, ensure_ascii=False)


# ============================================================
# 六、主循环:自动多轮,直到模型不再要求调用工具
# ============================================================
def run_conversation(user_input, system_prompt=None, max_rounds=5):
    """前面的实现是固定两轮/三轮,这里做成 while 循环,函数依赖再深也能跑完。"""
    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": user_input})

    rounds = 0
    while True:                                   # 自动多轮,直到模型不再要求调用工具
        rounds += 1
        if rounds > max_rounds:                   # max_rounds 是保险丝,防止死循环
            return "已达到最大轮数上限,请检查函数是否陷入循环调用。"

        response = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            tools=tools,                          # 每一轮都要继续传 tools
            tool_choice="auto",                   # auto = 由模型自己决定用不用工具
        )
        msg = response.choices[0].message

        # 没有 tool_calls,说明模型已经能直接回答,收工
        if not getattr(msg, "tool_calls", None):
            return msg.content

        # 1) 先把带 tool_calls 的 assistant 消息原样回填(漏了这步,下一条 tool 消息会成孤儿)
        messages.append(msg.model_dump())

        # 2) 逐个执行,每个 tool_call 回填一条 role="tool" 的消息
        for tool_call in msg.tool_calls:
            messages.append({
                "role": "tool",
                "tool_call_id": tool_call.id,     # 靠它和上面的调用配对,不能省
                "name": tool_call.function.name,
                "content": parse_response(tool_call),
            })
        # 3) 回到循环顶部,带着函数结果再问一次模型


# ============================================================
# 七、跑起来
# ============================================================
if __name__ == "__main__":
    # TODO(拓展点 5):换成你自己的提问和 system 提示词
    answer = run_conversation(
        user_input="这里换成用户的问题",
        system_prompt="你是一个助手,需要时请调用提供的工具,不要编造数据。",
    )
    print(answer)
available_functions · TODO 4 照着写一段 tools 描述 · TODO 5 换提问和 system 提示词。其余代码不用动。
5.2 数据库问答骨架(含只读安全校验)
把 emp/dept 两张表拿掉后的通用版。结构与 4.3 一致,但多了一层必须有的安全校验:只放行 SELECT、禁多语句、拦写操作关键字、没写 LIMIT 就替它补上。演示代码为了简洁没写这一段,拿去做真项目一定要加。
# -*- coding: utf-8 -*-
"""
Function Call 数据库问答骨架(参数即 SQL 版)
==========================================
SQL 案例去掉 emp/dept 表之后的通用版本。
特点:只有一个工具 ask_database,它的唯一参数就是【一整条 SQL】——
      SQL 由模型写,执行仍然由你的代码做。

⚠️ 安全红线:模型写的 SQL 绝不能直接执行。
   本模板内置只读校验(只允许 SELECT、禁止多语句、强制 LIMIT),
   生产环境还必须配一个【只读数据库账号】兜底。
"""

import json
import os
import re

import pymysql

# TODO(拓展点 1):换 client / 换模型
from zhipuai import ZhipuAI

client = ZhipuAI(api_key=os.environ["ZHIPUAI_API_KEY"])
MODEL = "glm-4"
# openai 包写法:
# from openai import OpenAI
# client = OpenAI(api_key=os.environ["OPENAI_API_KEY"],
#                 base_url="https://open.bigmodel.cn/api/paas/v4/")


# ============================================================
# 一、表结构描述:模型全靠它写 SQL
# ============================================================
# TODO(拓展点 2):把这里换成你自己的建表语句
#   两个要点:① 字段一定要带中文注释,模型靠注释把「工资」对应到 sal;
#            ② 多表时必须写明表间关系,否则模型写不出正确的 JOIN。
database_schema_string = """
CREATE TABLE your_table (
    id      INT PRIMARY KEY,        -- 主键
    name    VARCHAR(50),            -- 名称,例如 员工姓名
    amount  DECIMAL(10,2),          -- 金额,例如 月薪
    dept_id INT                     -- 部门编号,关联 dept.id
);

CREATE TABLE dept (
    id    INT PRIMARY KEY,          -- 部门编号
    dname VARCHAR(50)               -- 部门名称
);
-- 表间关系:your_table.dept_id = dept.id
"""


# ============================================================
# 二、执行 SQL 的函数(带安全校验)
# ============================================================
# TODO(拓展点 3):换成你的数据库连接信息(一律走环境变量,别写死口令)
DB_CONF = dict(
    host=os.environ.get("DB_HOST", "127.0.0.1"),
    port=int(os.environ.get("DB_PORT", 3306)),
    user=os.environ["DB_USER"],            # 建议:只读账号
    password=os.environ["DB_PASSWORD"],
    database=os.environ.get("DB_NAME", "your_db"),
    charset="utf8mb4",
)

MAX_ROWS = 200


def _guard(sql):
    """把模型写的 SQL 关进笼子里。缺了这一步,一句 DELETE 就能删库。"""
    s = sql.strip().rstrip(";").strip()
    if ";" in s:
        raise ValueError("拒绝执行:不允许多语句")
    if not re.match(r"(?is)^\s*(select|with)\b", s):
        raise ValueError("拒绝执行:只允许 SELECT 查询")
    if re.search(r"(?i)\b(insert|update|delete|drop|alter|truncate|grant|create)\b", s):
        raise ValueError("拒绝执行:检测到写操作关键字")
    if not re.search(r"(?i)\blimit\b", s):
        s += f" LIMIT {MAX_ROWS}"             # 没写 LIMIT 就替它加上,防止拉全表
    return s


def ask_database(query):
    """执行模型生成的查询,返回字符串形式的结果。"""
    safe_sql = _guard(query)
    conn = pymysql.connect(**DB_CONF)
    try:
        with conn.cursor() as cursor:
            cursor.execute(safe_sql)
            rows = cursor.fetchall()
    finally:
        conn.close()                          # 异常路径也要关,别泄漏连接
    return str(rows)


available_functions = {"ask_database": ask_database}


# ============================================================
# 三、tools 描述:把表结构塞进参数说明里
# ============================================================
tools = [{
    "type": "function",
    "function": {
        "name": "ask_database",
        "description": "用 SQL 查询数据库来回答用户关于业务数据的问题。",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {
                    "type": "string",
                    "description": (
                        "一条合法的 MySQL SELECT 语句,用于回答用户问题。"
                        "必须依据下面的表结构书写,只返回 SQL 本身,不要加解释:\n"
                        f"{database_schema_string}"
                    ),
                },
            },
            "required": ["query"],
        },
    },
}]


# ============================================================
# 四、主流程:两次调用
# ============================================================
def run(user_input):
    messages = [
        {"role": "system", "content": "你是数据分析助手,只依据数据库查询结果回答,不要编造数字。"},
        {"role": "user", "content": user_input},
    ]

    first = client.chat.completions.create(
        model=MODEL, messages=messages, tools=tools, tool_choice="auto")
    msg = first.choices[0].message

    if not getattr(msg, "tool_calls", None):
        return msg.content

    messages.append(msg.model_dump())
    for tool_call in msg.tool_calls:
        args = json.loads(tool_call.function.arguments)
        try:
            content = available_functions[tool_call.function.name](**args)
        except Exception as exc:
            content = f"查询失败:{exc}"       # 把拒绝原因如实告诉模型,它会换一种问法
        messages.append({
            "role": "tool",
            "tool_call_id": tool_call.id,
            "name": tool_call.function.name,
            "content": content,
        })

    second = client.chat.completions.create(
        model=MODEL, messages=messages, tools=tools, tool_choice="auto")
    return second.choices[0].message.content


if __name__ == "__main__":
    # TODO(拓展点 4):换成你的提问
    print(run("这里换成用户的问题,例如:金额最高的是谁"))
_guard() 拦的是文本层面的写操作,绕过的花样总比规则多。真正的兜底是数据库只读账号:即使校验被绕过,数据库这一层也执行不了 DELETE。两层都要有。
5.3 三份模板怎么选
| 模板 | 适用 | 特点 |
|---|---|---|
fc_skeleton_min.py | 一个函数、一轮就够 | 60 行,用来理解流程,见第 03 节 |
fc_skeleton.py | 多个函数、可能有依赖 | 注册表 + while 自动多轮,日常首选 |
fc_skeleton_db.py | 让模型写 SQL 查库 | 在通用版基础上加只读校验与 LIMIT 兜底 |
06易错点汇总
按「概念 / 流程 / 单函数 / 多函数 / 数据库」五类归并,踩过一次就别再踩
⚠️ 一、概念层面
- 把 Function Call 当成「模型会自己上网」。 它既不会上网,也不会执行代码;它只会写一张单子。联网的是你的 requests,查库的是你的 pymysql。
- 把它和 RAG 混为一谈。 RAG 是先检索再把文档塞进提示词;Function Call 是模型自己决定「要不要调、调哪个、传什么参数」,主动权在模型的判断上。
- 记错时间点。 是 2023 年 6 月 13 日 由 OpenAI 公布,不是 2022 年,也不是随 GPT-4 首发一起发布的。
⚠️ 二、调用流程与 messages
- 只调一次模型就想拿到答案。 第一次调用的
content是None,里面没有天气。必须有第二次调用,模型才会把回执翻译成人话。 - 直接把
arguments当字典用。 它是字符串形式的 JSON,必须json.loads()之后才能取值。 - 忘了回填 assistant 消息,或颠倒了它和 tool 消息的顺序。 二者必须成对、按序出现:先 assistant,后 tool。
role为tool的content传了字典或元组。 只能传字符串,所以天气案例用json.dumps(),数据库案例用str()。- 第二次调用忘了继续传
tools。 两次都要传——因为模型可能还需要再发起一轮调用(航班案例就真的发生了)。 - 把
description写成「天气」两个字。 模型据此决定调不调、调哪个;描述含糊会导致该调时不调,或多函数场景下选错函数。
⚠️ 三、单函数案例(天气)
cityCode_use.json找不到。 代码里写的是相对路径./cityCode_use.json,必须在该文件所在目录下启动脚本,否则FileNotFoundError。- 读 JSON 没带
encoding='utf-8'。 Windows 默认 GBK,中文城市名会直接报解码错误。 - 城市名对不上。 用户说「海淀」而映射表里只有「北京」,会导致
city_code为空、返回空字典。模型拿到空回执就只能含糊其辞——空结果也要回传,别让程序静默失败。 - 把
zhipu_api写死在代码里,或者.env里的变量名与os.environ['zhipu_api']不一致,会抛KeyError。 - 误以为
parse_response里就完成了对话。 它只负责「执行函数拿结果」,把结果送回模型是主逻辑的事。
⚠️ 四、多函数案例(航班)
- 只写了一轮就想拿票价。 少一轮,模型手里就没有航班号,要么反问你,要么编一个号码。有几层函数依赖,就有几轮「调用—执行—回填」。
- 两次的
tool_call_id用混。 第二份回执必须配second_response里的tool_calls[0].id,复制粘贴第一份的 id 会直接报错。 parse_function_call用了两个独立if而不是字典派发。 函数名互斥时逻辑没问题,但多函数扩展时建议改成注册表,避免漏判。plane_number[start][end]直接下标取值。 用户问「郑州到深圳」时字典里没有这条线路,会抛KeyError。真实项目要用.get()并返回「查无此航线」,让模型把这个结果如实转述给用户。- 忘了把
date透传。 第一个函数若不返回date,模型第二轮就得靠猜——这正是 system 提示词禁止的行为。
⚠️ 五、数据库案例
- 把模型生成的 SQL 直接执行而不做任何限制。 模型可能写出
DELETE、DROP,或拉取整表。生产环境务必:只读账号 + 白名单校验(只允许 SELECT)+ 强制 LIMIT + 超时。这是本案例最大的安全坑。 - 表结构描述里漏了中文注释。 模型靠
--员工的月薪这类注释把「工资」对应到sal;漏了注释,字段选错概率显著上升。 - 多表时不说明关系。
emp.deptno与DEPT.DEPTNO的关联若没写明,模型写不出正确的JOIN。 content传了元组。cursor.fetchall()返回元组,必须str()或json.dumps()成字符串。- 连接没关。
cursor.close()与conn.close()不能省;异常路径建议用try/finally或上下文管理器,否则连接泄漏。 - 把数据库口令写死在源码里。 与 API-KEY 同理,一律走环境变量。
07自测题
点击题目展开答案;能把这 15 题说清楚,这一讲就通了
什么是 Function Call?是哪一天由谁公布的?
在语言模型中集成外部功能或 API 的调用能力,使模型可以在生成文本的过程中调用外部函数或服务,以获取额外数据或执行特定任务。由 OpenAI 于 2023 年 6 月 13 日 公布。
Function Call 主要解决大模型的哪三类问题?各举一例。
信息实时性(最新新闻、实时股价)、数据局限性(医学、法律等专业领域,或公司内部数据库)、功能扩展性(复杂计算、数据分析等模型没有内置的能力)。
用户问「你好」,模型也会触发 Function Call 吗?
不会。流程第一步就是模型判断「是否需要调用外部信息」,判断为「否」时直接生成文本回复并结束,不会产生 tool_calls。用比喻说:顾问自己就能答的问题,不必写委托单。
Function Call 和 RAG 的本质区别在哪?
发起方不同。RAG 由你的程序先检索、再把文档塞进提示词;Function Call 由模型自己判断要不要调、调哪个、传什么参数,拿回的是函数执行的真实结果而不是相似文本。
大模型能够直接运行 function 吗?
不会调用函数,仅返回函数的参数。开发者利用模型输出的参数在应用中调用函数。
第一次调用模型后,怎么判断该不该执行本地函数?
检查 response.choices[0].message.tool_calls 是否存在。有值说明模型要求调用函数(此时 finish_reason 为 'tool_calls'、content 为 None);为空则说明模型直接用文本回答了。
tool_call_id 有什么用?漏了会怎样?
它把「函数执行结果」与「模型发出的那次工具调用」配对,取自 tool_calls[0].id。漏了或对不上,模型无法确定这份回执属于哪次调用,接口会报错。
把 description 写成「天气」两个字,会有什么后果?
模型据此判断该不该用这个函数。描述过于含糊时,模型可能在该调用时不调用(直接瞎编天气),也可能在多函数场景下调错函数。描述要写清用途、输入、产出,例如「获取给定位置的当前天气」。
tool_choice="auto" 是什么意思?
把「要不要调用工具」的决定权交给模型:它可以选择直接用文本回答,也可以选择返回 tool_calls。这与流程图第一个判断框「是否需要调用外部信息」是同一件事。
Function Call 单一函数应用的完整流程是怎样的?
定义函数:函数可以是真实的外部 API 或工具,也可以是模拟函数。
提供函数定义给模型:将定义好的函数作为参数(tools)提供给模型。
模型生成函数调用 JSON:包含要调用的函数名称和参数值。
后端系统执行函数:后端系统根据 JSON 中的内容,调用相应的函数得到结果。
将函数结果返回给模型:函数返回结果给模型,作为模型的额外上下文信息。
模型生成最终响应:模型综合原始查询、函数调用结果等信息,生成最终输出。
天气函数为什么要返回字符串而不是字典?
因为这个返回值要放进 messages 里 role 为 tool 的 content 字段,该字段只接受字符串。所以用 json.dumps(weather_info, ensure_ascii=False) 序列化,并保留中文原文。
如果用户问「今天天气怎么样」却没说城市,会发生什么?
location 在 required 里,而 system 提示词又要求「问题具有不确定性时,不要自己编造内容,提示用户明确输入」。因此模型通常不会返回 tool_calls,而是直接用文本反问用户是哪个城市。
为什么航班案例调用了三次模型,而天气、数据库案例只调两次?
因为航班案例存在函数依赖:get_ticket_price 需要 get_plane_number 的输出。每解决一层依赖就要「调模型 → 执行函数 → 回填结果」一轮,两层依赖两轮,最后再调一次把结果合成自然语言,共三次。天气和数据库只有一个不依赖别人的函数,一轮就够。
如果把航班的两个函数合并成一个「查票价(含航班号查询)」,还需要多轮吗?
不需要,模型一轮就能委托完,内部两步由你的函数自己串。这是工程取舍:函数粒度细则模型编排灵活、可复用,但轮次多、token 成本高;函数粒度粗则调用次数少、更快,但灵活性差。
数据库案例里,SQL 是谁写的?又是谁执行的?用户说「把张三的工资改成 9999」该怎么防?
SQL 由模型写(出现在 tool_calls[0].function.arguments 的 query 字段里),由开发者的 ask_database 函数用 pymysql 执行——铁律在这里依然成立。防护要做在你的函数里,不能指望提示词:使用只读数据库账号、校验语句必须以 SELECT 开头、拒绝多语句、追加 LIMIT 上限、设置查询超时。
词术语表
| 术语 | 含义 |
|---|---|
| Function Call | 在语言模型中集成外部功能或 API 的调用能力;模型只产出调用意图,不执行 |
| tools | 函数描述清单(JSON Schema 数组),告诉模型有哪些函数可用、参数是什么 |
| tool_calls | 模型返回的调用意图,含 id、函数 name 和字符串形式的 arguments |
| tool_choice | 调用策略;"auto" 表示由模型自行决定是否调用工具 |
| messages | 对话消息列表,Function Call 的全部状态都在这里,只追加不修改 |
| role | 消息角色:system / user / assistant / tool |
| tool_call_id | 把函数执行结果与对应的那次工具调用配对的标识 |
| JSON Schema | 描述 JSON 数据结构的规范,tools 的 parameters 就用它书写 |
| finish_reason | 本次生成的结束原因;'tool_calls' 表示模型因要调用工具而停下 |
messages 怎么一条条长大,这一讲就通了。