DeepSeek 实战:思维链数据生产线
把一个强模型的输出,变成一批能训练的语料——生成问题、生成答案、组织语料集,三步走;大数据系统、数据切块、生产者消费者,三方法。
30″30 秒看懂思维链数据生产线
把这件事想成开一家中央厨房:城里有位米其林大厨,手艺一流,但他一天只能做几百道菜,请不起也带不走。你想让自家连锁店的小厨也做出接近的味道,唯一可行的办法是——把大厨做菜的全过程,变成一盒盒标准化的备料,运回自家后厨反复练。
于是你搭了一条流水线:先列点菜单(要练哪些菜、每种练多少道),把单子递给大厨;大厨一边做菜一边把心里的琢磨也念出来——「这个食材偏酸,所以糖要减三克」;上料工把菜单一张张放上传送带,一排分拣工从传送带上取单、催大厨出菜,把成品和那段念白一起装进配菜盒;盒子过一道质检员,不合格的挑出去;合格的贴标入冷库,等着小厨来取。
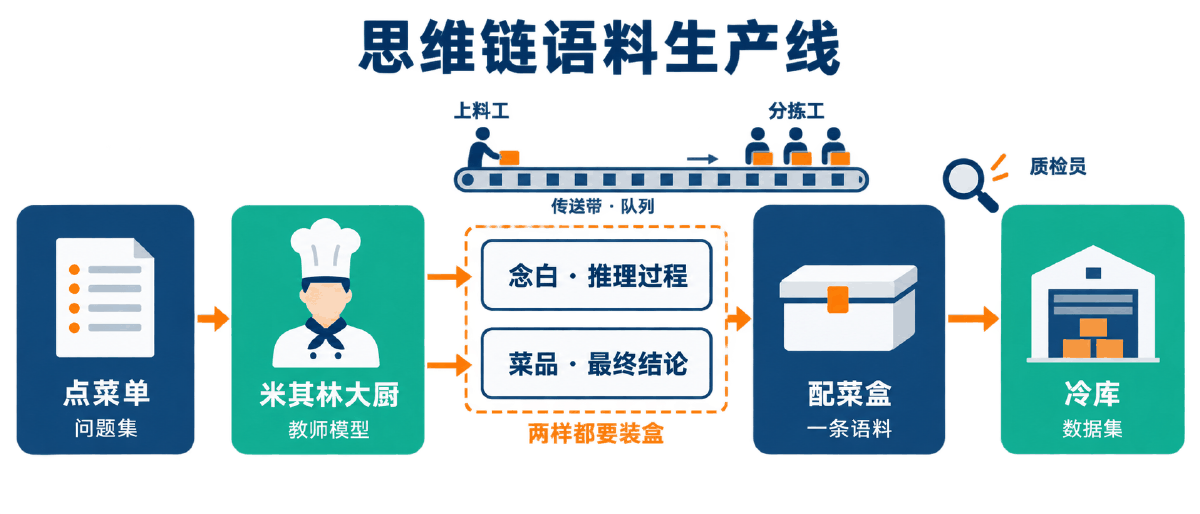
| 厨房里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 米其林大厨 | 教师模型 DeepSeek-R1 | 唯一的知识来源。你买的是他的输出,不是他本人 |
| 点菜单 | 问题集(instruction) | 决定学生模型将来会做哪些菜。单子偏了,后面全白干 |
| 大厨的念白 | reasoning_content | 推理过程。这才是「思维链」三个字的本体 |
| 端上桌的菜 | content | 最终结论。只有它,学生学到的是结果不是思路 |
| 配菜盒 | 一条 jsonl 样本 | {"instruction":…, "input":"", "output":…},念白包在 <think> 里 |
| 上料工 / 传送带 / 分拣工 | 生产者 / 队列 / 消费者 | 批量跑数的三件套。传送带限长、分拣工多开、崩了能接着跑 |
| 质检员 | 打分模型 Qwen2.5-72B-Instruct | 换一双眼睛挑次品。不能让大厨自己验自己的菜 |
| 冷库 | train.jsonl + dataset_info.json | 训练工具认的是这套目录约定,摆错位置就取不到货 |
reasoning_content 和 content 是两个独立字段,少取一个,学生模型就只学到了「答案长什么样」,学不到「答案是怎么想出来的」——那条生产线就白建了。后面所有代码,都是在实现「怎么把念白和菜一起装好、装得又快又不丢」。
01概念:语料生产线是什么
两个「三」撑起全页骨架;问题从哪来决定了这条线值不值得建
1.1 两个「三」
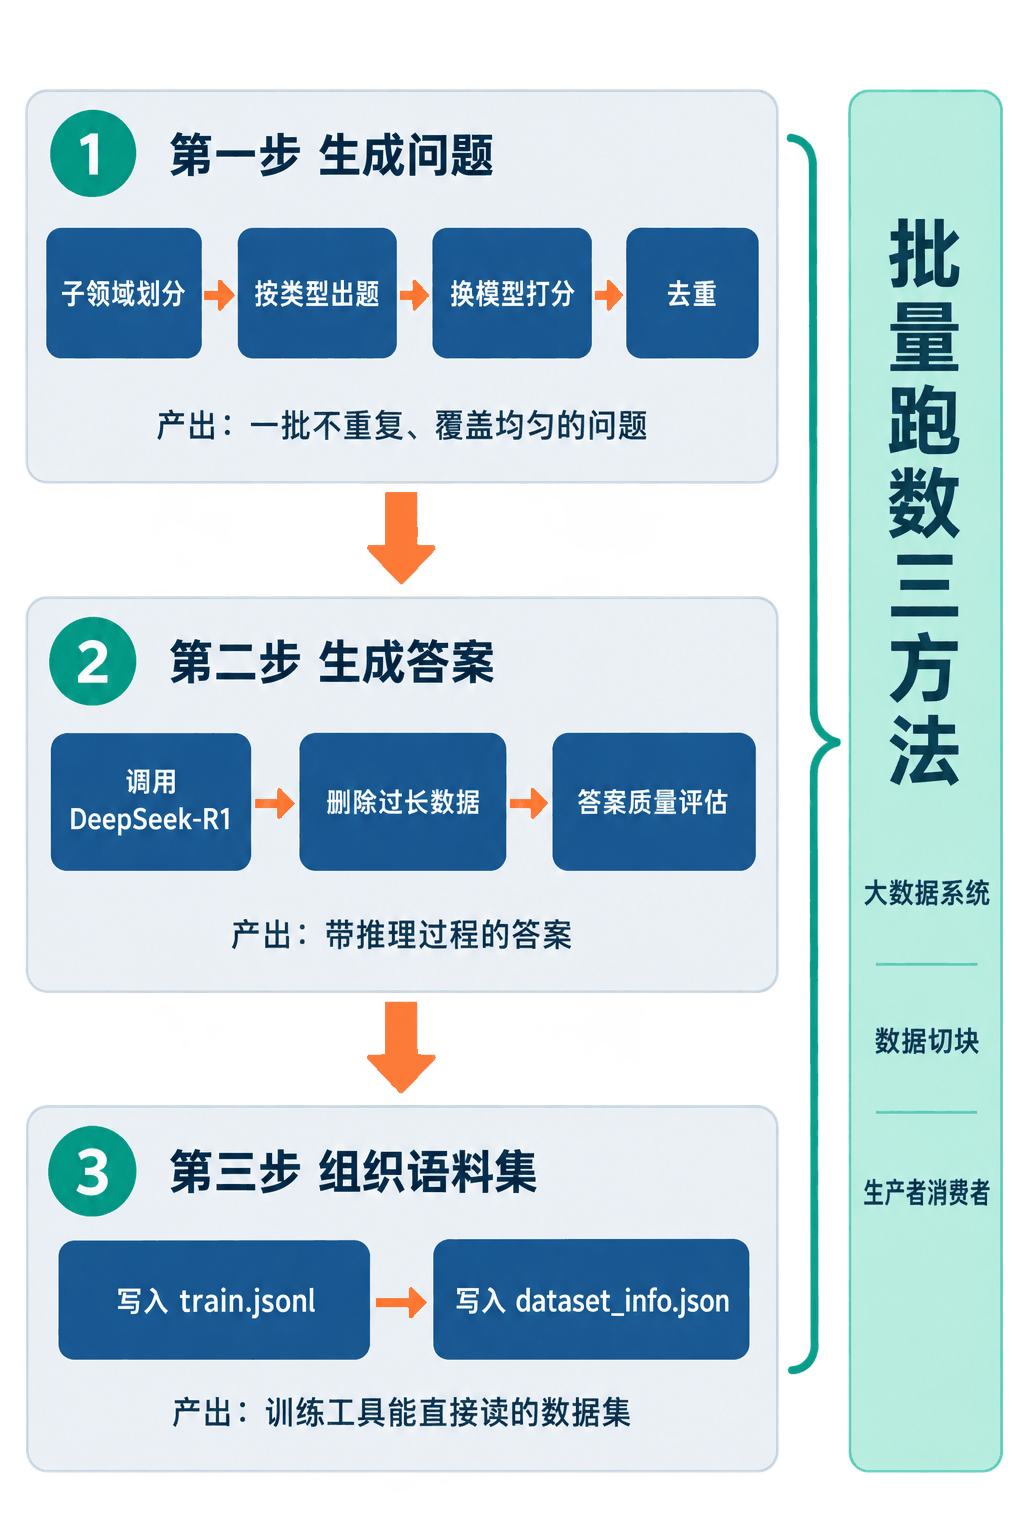
整条生产线只有两句话要背。第一句管流程,第二句管规模:
生成问题 → 生成答案 → 组织语料集
顺序不能调。问题定下来之前,你连该花多少钱调 API 都算不出来。
大数据系统 / 数据切块 / 生产者消费者
三步走是「做什么」,三方法是「怎么把几万条一次跑完」,两者正交。
用厨房的话说:三步走是列单 → 做菜 → 装盒;三方法是后厨怎么排班。排班方式换了,菜谱不变;菜谱换了,排班照样能用。这也是为什么这一页把它们分开讲——把两件事搅在一起,是新手最常见的返工原因。
1.2 问题从哪来:公共语料 vs 自己造
先问自己一句:要学的是「通用特性」还是「特定领域知识」?答案不同,路径完全不同。
| 要学的东西 | 问题来源 | 典型例子与判断依据 |
|---|---|---|
| 通用特性、泛领域知识 | 公共语料里选 | 思维链本身就属于这一类——「会一步步推理」不挑领域。公开问答数据集里随便捞一批问题,覆盖面够广就行,成本近乎为零。 |
| 特殊特性、特定领域知识 | 必须自己组织 | 模型写某种小众语言的代码、医药机电化工的领域知识、某部法律的适用判断。公共语料里根本没有这些题,捞不到就只能自己出。 |
1.3 和另外两种造数方式比
「让强模型批量产语料」不是唯一选择。放在一起比,才知道它的适用边界在哪:
| 方式 | 成本 | 速度 | 质量与风险 |
|---|---|---|---|
| 人工标注 | 最高 | 最慢 | 质量上限最高,专业领域尤其靠得住。但一条带完整推理过程的思维链样本,人写下来要几分钟,五千条就是几百个工时。 |
| 爬现成数据 | 低 | 快 | 拿到的是结果而非推理过程,格式五花八门,版权与合规还得单独评。练思维链基本用不上。 |
| 强模型批量产出 (本页做法) | 中 | 快 | 推理过程原生自带,格式完全可控,量想要多少有多少。代价是质量天花板就是教师模型,而且教师偶尔会错——所以必须配一道打分筛选。 |
结论很直白:要的是「过程」而不只是「答案」时,强模型批量产出几乎是唯一划算的路。它不追求质量最高,追求的是在可接受的质量下,把规模和速度同时拿到手。
02原理:一条样本是怎么被造出来的
出题 → 筛题 → 取答案 → 截长 → 评分 → 落盘,六道工序,每一道都有它非做不可的理由
2.1 第一步:生成问题
点菜单决定了小厨将来会做什么菜。这一步产出的是一批彼此不重复、覆盖均匀、确实属于目标领域的问题。拿「中国现行婚姻法」举例,目标 5000 条,四道小工序:
① 让大模型先做子领域划分
别上来就说「给我出 5000 道婚姻法的题」——模型会疯狂输出「离婚怎么分财产」的各种变体,五千条里有四千条在说同一件事。先让它把领域切开、把配额定死:
| prompt 里的成分 | 为什么必须有 |
|---|---|
身份限定你是一位中国婚姻法方面的专家 | 把模型的输出分布拉到专业语域,别用大白话糊弄。 |
总量共5000条 | 让它直接给出每个子领域该出多少条,省掉你自己按比例分配。 |
表格三列名称 / 数量 / 详细说明 | 第三列是这一步真正的产出物——它会被原样塞进下一步的 prompt。 |
格式收口不允许输出其他字符 | 没有这句,模型会在表格前后各写一段客套话,切分脚本直接崩。 |
实际拿到的配额表长这样(5000 条的分配):
| 子领域名称 | 语料数量 | 详细说明 |
|---|---|---|
| 结婚登记与条件 | 500 | 涉及结婚年龄、自愿原则、禁止近亲结婚、疾病限制、登记程序及法律效力等。 |
| 夫妻权利义务 | 400 | 涵盖共同财产管理、相互扶养义务、姓名权、生育权及日常家事代理权等。 |
| 离婚程序与条件 | 600 | 包括协议离婚冷静期、诉讼离婚标准、分居认定、感情破裂证明及调解程序等。 |
| 财产分割 | 800 | 涉及共同财产界定、个人财产保护、债务承担、房产分割规则及隐匿财产追责等。 |
| 子女抚养与监护权 | 800 | 包含抚养费计算标准、探视权实施、非婚生子女权益、抚养关系变更及教育责任等。 |
| 家庭暴力与保护令 | 500 | 涵盖暴力行为认定、人身保护令申请、证据收集、紧急庇护措施及刑事责任关联等。 |
| 继承权与婚姻关系 | 300 | 涉及配偶继承顺位、遗嘱效力、遗产分割冲突、再婚继承权及代位继承问题等。 |
| 无效婚姻与可撤销婚姻 | 200 | 包括重婚无效、胁迫婚姻撤销、隐瞒疾病撤销的程序及法律后果等。 |
| 涉外婚姻 | 300 | 涉及跨国婚姻登记、域外结婚效力认定、财产跨境分割及国际子女抚养公约适用等。 |
| 法律责任与救济措施 | 200 | 包含虚假登记处罚、拒不执行判决后果、损害赔偿计算及强制执行程序等。 |
② 按类型批量生成问题
拿到配额表之后,一个子领域一个子领域地灌。这一步 prompt 的要害是:把类别清单和每个类别的详细说明整段塞进去,再指定本次只针对其中哪一类出题。
为什么要把所有类别的说明都塞进去,而不是只给当前这一类?因为模型需要知道边界在哪——「财产分割」和「继承权与婚姻关系」都会碰到房子,只给一类的定义,出的题会大面积滑到隔壁类去,最后配额全乱。
格式要求同样写死:每个问题单独一行,只允许输出问题本身,不允许输出任何其他字符。这样脚本按 \n 一切就是一条样本。「夫妻权利义务」这一类实际产出的题,随手抽几条:
- 夫妻共同财产的范围在法律中有哪些明确列举?
- 一方擅自将婚后共同存款赠与他人的行为是否有效?
- 日常家事代理权是否涵盖为子女报名私立学校的决定?
- 夫妻一方因个人投资失败产生的债务是否属于共同债务?
- 夫妻一方婚前持有的股票婚后增值部分如何界定归属?
注意这些题的共同点:每一条都能给出确定的法律判断,而且都要讲理由——这正是思维链语料需要的题型。如果出出来的是「婚姻法是哪一年颁布的」这种纯记忆题,教师模型的念白会短到没有价值。
③ 问题检查:换一个模型打分
出题的模型自己判断「这题是不是属于夫妻权利义务」,跟考生自己批卷没区别。换一个公认的高质量模型来打这个分,评分区间 0~9,0 表示完全错误,9 表示非常准确。
prompt 的关键设计:【输入文本】中的每一行是一条独立数据,需要单独判定。输出时每条数据的结果单独输出一行,只允许输出准确性评分。这么写有两个好处——一次请求批量判多条,以及输出只有几个数字,token 成本几乎为零。得分低的题直接删掉。
④ 去重
批量生成的题,重复是必然的:同一个子领域灌 20 轮,「婚后买房算谁的」会以十几种说法反复出现。短文本去重的标准做法是 simhash——把每条文本压成一个定长指纹,指纹之间的汉明距离小于阈值就判为重复。
量再大一些(几十万条以上),两两比对的 O(n²) 扛不住,改用分桶的 simhash:把指纹切成若干段,只有落在同一个桶里的候选才真正去算距离,复杂度大幅下降。
2.2 第二步:调 DeepSeek-R1 拿答案
问题清单就绪,接下来把它们一条条送给教师模型。接口是标准的 OpenAI 兼容格式:
| 项 | 取值 |
|---|---|
| 接口地址 | https://api.siliconflow.cn/v1/chat/completions |
| model | deepseek-ai/DeepSeek-R1 |
| 鉴权 | Authorization: Bearer <key>,key 从环境变量读,不准写进源码 |
| temperature | 0.6 |
| max_tokens | 15000,思维链很长,给小了会被硬截断 |
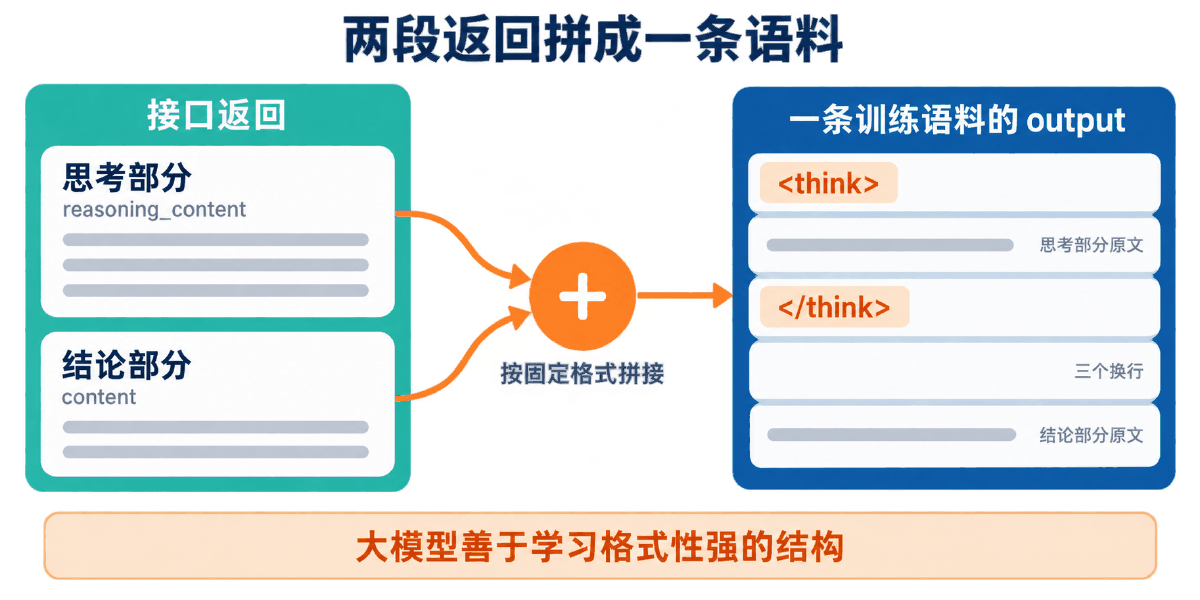
返回值分两段,这是全页最关键的一点
普通模型的返回里只有一个 content。R1 不一样,它把推理过程和结论拆成了两个字段:
| 字段 | 内容 | 丢了会怎样 |
|---|---|---|
message['reasoning_content'] | 思考部分 | 思维链没了。学生模型只会背答案,遇到没见过的题立刻露馅 |
message['content'] | 结论部分 | 只有推理没有结论,样本不完整,训练时模型学不会收口 |
两段都拿到之后,按固定格式拼成一条 output:
# 拿到的两段文本
think  = response.json()['choices'][0]['message']['reasoning_content']   # 念白
result = response.json()['choices'][0]['message']['content']             # 菜品

# 拼成一条 output:标记 + 念白 + 标记 + 三个换行 + 结论
data["output"] = "<think>\n" + think + "\n</think>\n\n\n" + result

# 拼出来的实际长相(省略号处是真实的推理文字)
<think>
好的,用户让我给出“wander”这个词的三个近义词。首先,我需要回忆一下这个词的中文释义……
总结下来,三个近义词应该是“游荡”、“闲逛”和“徘徊”。
</think>


“wander”(漫游、闲逛、徘徊)的三个近义词包括:
1. 游荡:指不规则地走动,多用于形容人在空闲时随意游走。
2. 闲逛:指随意地在某个场所走动,多指在不特定的目的下漫无目的地走动。
3. 徘徊:指在某个地方来回走动,常用于描述在某一地点停留或思考。
<think> 是一个极其醒目的分隔标记,训练几百条之后,学生模型就会稳定地「先在 <think> 里想,再在外面答」。这不是审美问题——格式越规整,学生学得越快、越稳。反过来,如果你把念白和结论用换行随便一拼,学生根本分不清哪段是思考、哪段是给用户看的答案。
温度参数:这一步唯一要反复权衡的旋钮
答案多样性好,同一类问题不会千篇一律;但也越容易出问题——跑题、编造、逻辑断裂的概率同步上升。
答案稳定,事实错误少;但很相似,比较死板——五千条语料像一个模子刻出来的,学生模型学到的是模板不是能力。
取 0.6,是「有变化但不放飞」的经验点。造语料和线上问答的取值逻辑完全不同:线上求稳,造语料要的是在可控范围内的多样性。
重试机制
一批几万条的任务要跑十几个小时,网络抖动、网关 5xx 是必然事件,不是意外。最多重试 3 次是经验值:三次还不成,多半不是抖动而是这条请求本身有问题(比如 prompt 超长),继续重试只是浪费时间,记下失败原因跳过即可,最后单独捞一遍。
2.3 删除过长的数据
为什么要删
训练时的显存占用和序列长度直接相关,几条三万字的样本就能把 cutoff_len 顶上去,全批次跟着吃亏。
长尾样本数量极少。真去数一遍就会发现,砍掉超长的那一截,丢掉的样本连 2% 都不到。
怎么删
| 场景 | 截取依据 |
|---|---|
| 小数据集 | 按计算资源截。显存能吃多长就设多长,反正样本总量不大,多丢几条也伤不到结构。 |
| 大数据集 | 按长度累计数量的拐点截。先统计长度分布,找到「再往后放宽也收不到多少样本」的那一档,就在那里切。 |
拐点怎么从分布表里读出来,第 04 节用真实数据算一遍。
2.4 答案质量评估
打分模型的选择
Qwen2.5-72B-Instruct。它和 R1 不同源、训练数据不同、犯错的模式也不同——两个模型同时在同一条样本上犯同一个错,概率才够低。
打分 prompt 的四要素
| 要素 | 写法 | 缺了会怎样 |
|---|---|---|
| ① 身份限定 | 你是一位问答对的质量评估专家 | 模型会顺手去回答那个问题,而不是评价它 |
| ② 任务说明清晰 | 0 表示答案和问题无关,9 表示非常好地回答了问题 | 不给锚点,分数在不同批次之间完全不可比 |
| ③ 输出格式限定 | 只允许输出分数,不允许输出其他任何字符 | 模型写一大段点评,既贵又得额外解析 |
| ④ 强格式包裹 | 【问题】…【答案】… | 问答两段糊在一起,模型读串行,评的可能是问题本身 |
另外两个参数:temperature 要比较小(取 0.2,打分要的是可复现而不是创意),max_tokens 压到 10——输出长度对吞吐量的影响极大,这里只需要吐一个数字,压到极限就是省钱省时间。
可靠程度估算
一条错答案想混进最终数据集,得同时闯过两关:教师模型答错了,并且打分模型没看出来。两个环节各给一个假设值:
| 环节 | 任务难度 | 假设正确率 | 依据 |
|---|---|---|---|
| 生成答案 | 较为复杂 | 80% | 要推理、要组织长文,出错空间大 |
| 打分 | 较为简单 | 90% | 只需判断「答没答到点上」,比自己答一遍容易得多 |
只取打分最高的那一批样本,整体准确率估算为:
1 − (1 − 80%) × (1 − 90%) = 1 − 0.2 × 0.1 = 98%
2.5 第三步:组织语料集
最后一步是把合格的盒子码进冷库。格式是 jsonl,一行一条,不是一个大 JSON 数组——几十万条的文件,逐行读才不会撑爆内存。
{"instruction": "夫妻共同财产的范围在法律中有哪些明确列举?", "input": "", "output": "<think>\n用户问的是夫妻共同财产的范围……需要先区分法定共同财产与约定财产制,再逐项列举……\n</think>\n\n\n夫妻共同财产主要包括:一、工资、奖金、劳务报酬;二、生产、经营、投资的收益……"}
{"instruction": "一方擅自将婚后共同存款赠与他人的行为是否有效?", "input": "", "output": "<think>\n这条要落到无权处分与善意取得上……共同共有意味着单方处分需要另一方同意……\n</think>\n\n\n原则上无效。婚后存款属于夫妻共同财产,一方未经另一方同意的大额无偿赠与……"}
{"instruction": "请给出“wander”这个词的三个近义词?", "input": "", "output": "<think>\n好的,用户让我给出“wander”这个词的三个近义词。首先,我需要回忆一下这个词的中文释义……\n</think>\n\n\n“wander”的三个近义词包括:1. 游荡;2. 闲逛;3. 徘徊。"}
| 字段 | 含义 |
|---|---|
instruction | 问题本身。生产线第一步产出的那一条 |
input | 补充输入。这类问答语料通常留空字符串,但字段不能省 |
output | <think> 包住的念白 + 三个换行 + 结论 |
光有 jsonl 还不够。数据集所在目录下必须有一个 dataset_info.json,它负责把「数据集名字」映射到「文件名」——训练工具读的是这个名字,不是文件路径:
{
  "chat-train": {
    "file_name": "train.jsonl"
  }
}
--dataset chat-train,工具去 --dataset_dir 指定的目录里翻 dataset_info.json,查到 chat-train 对应 train.jsonl,才去读那个文件。少了这个映射,报的错是「找不到数据集 chat-train」,而不是「找不到文件」——照着文件路径排查半天都查不出来。
03最小代码:把一条样本造出来
去掉批量、去掉队列、去掉打分,只保留「问一句 → 拿两段 → 拼成一条」的最短路径
整条生产线看着长,核心其实只有三十行。先把最小版本跑通,确认三件事:key 能用、reasoning_content 确实有内容、拼出来的 output 格式对。这三件确认了,剩下的全是工程量。
# -*- coding: utf-8 -*-
"""调用 DeepSeek-R1 拿「思考 + 结论」两段文本,拼成可训练的 output。

要点只有三条:
  1. R1 的返回里 reasoning_content 与 content 是两个独立字段,少取一个就丢掉思维链;
  2. 两段用 <think>...</think> 包起来再接结论,格式固定,学生模型最吃这一套;
  3. key 只从环境变量读,绝不写进源码。

运行前:export SILICONFLOW_API_KEY=你的key
"""
import json
import os
import time

import requests

URL = "https://api.siliconflow.cn/v1/chat/completions"
MODEL = "deepseek-ai/DeepSeek-R1"

# 温度是这一步唯一需要反复权衡的参数:
#   高 -> 答案多样,但跑偏、胡说的概率同步上升
#   低 -> 答案稳定,但成千上万条语料彼此雷同,学生模型学不到泛化
# 0.6 是「有变化但不放飞」的经验取值。
TEMPERATURE = 0.6
MAX_TOKENS = 15000
RETRY = 3          # 网络抖动、网关 5xx 都靠它兜底
RETRY_SLEEP = 2    # 秒,指数退避的基数


def _api_key() -> str:
    key = os.environ.get("SILICONFLOW_API_KEY")
    if not key:
        raise RuntimeError("环境变量 SILICONFLOW_API_KEY 没设置")
    return key


def call_server(prompt, model=MODEL, temperature=TEMPERATURE):
    """返回 (success, msg, think, result)。

    think   -> reasoning_content,模型的推理过程
    result  -> content,模型给用户看的结论
    """
    headers = {
        "Authorization": "Bearer " + _api_key(),
        "Content-Type": "application/json",
    }
    payload = {
        "model": model,
        "messages": [{"role": "user", "content": prompt}],
        "temperature": temperature,
        "max_tokens": MAX_TOKENS,
    }

    msg = "OK"
    for attempt in range(1, RETRY + 1):
        try:
            resp = requests.post(URL, json=payload, headers=headers, timeout=600)
            resp.raise_for_status()
            message = resp.json()["choices"][0]["message"]
            # 关键:两个字段都要取。只取 content 等于把老师的解题过程扔了。
            think = message.get("reasoning_content") or ""
            result = message.get("content") or ""
            if not result:
                raise ValueError("content 为空")
            return True, "OK", think, result
        except Exception as exc:                      # noqa: BLE001
            msg = "第 %d 次调用异常: %s" % (attempt, exc)
            if attempt < RETRY:
                time.sleep(RETRY_SLEEP * attempt)
    return False, msg, "", ""


def build_output(think, result):
    """把思考和结论拼成训练语料的 output 字段。

    格式写死成 <think>\\n…\\n</think> 空两行再接结论:
    大模型对格式性强的结构学得又快又稳,推理时也会照着这个壳子吐。
    """
    return "<think>\n" + think + "\n</think>\n\n\n" + result


def ask_batch(src_path, dst_path):
    """把 jsonl 里每条 instruction 送给 R1,回填 output 后写回 jsonl。"""
    ok = fail = 0
    with open(src_path, "r", encoding="utf-8") as src, \
            open(dst_path, "a", encoding="utf-8") as dst:
        for line in src:
            line = line.strip()
            if not line:
                continue
            data = json.loads(line)
            success, msg, think, result = call_server(data["instruction"])
            if not success:
                fail += 1
                print("失败", data.get("id"), msg)
                continue
            data["output"] = build_output(think, result)
            dst.write(json.dumps(data, ensure_ascii=False) + "\n")
            dst.flush()          # 跑几小时的任务,不 flush 一崩就全没了
            ok += 1
            print("入库", data.get("id"), "思考%d字 结论%d字" % (len(think), len(result)))
    print("完成 成功 %d 条,失败 %d 条" % (ok, fail))


if __name__ == "__main__":
    question = "请给出“wander”这个词的三个近义词?"
    success, msg, think, result = call_server(question)
    print(success, msg)
    print("思考部分:" + think)
    print("结论部分:" + result)
    print("拼好的 output 前 80 字:" + build_output(think, result)[:80])
逐段说明
| 代码位置 | 在干什么 / 为什么这么写 |
|---|---|
_api_key() | key 只从 os.environ.get("SILICONFLOW_API_KEY") 读,取不到就立刻抛错而不是带着空 key 去请求——否则你会拿到一个 401,然后花二十分钟怀疑接口地址写错了。 |
TEMPERATURE = 0.6 | 造语料的取值。线上问答场景要稳,会往 0.1~0.3 走;这里要的是可控的多样性。 |
MAX_TOKENS = 15000 | 思维链动辄几千字,给小了会被硬截断——被截断的样本比没有样本更糟,它教会学生模型「说到一半停下」。 |
for attempt in range(1, RETRY + 1) | 最多 3 次。每次失败后 sleep(RETRY_SLEEP * attempt) 退避,避免在服务端过载时反复捶它。 |
message.get("reasoning_content") or "" | 用 .get() 而不是 [...]:换成不带推理的模型时,这个字段压根不存在,直接下标会 KeyError 炸在半夜。 |
if not result: raise | 空 content 也算失败,要走重试。接口返回 200 不等于拿到了东西。 |
build_output() | 唯一一处格式约定。"<think>\n" + think + "\n</think>\n\n\n" + result,三个换行不是手滑,是让结论和推理在视觉和 token 上都彻底分开。 |
dst.flush() | 写一条落一条。跑十几个小时的任务,进程被 OOM 杀掉是常事,不 flush 就等着重跑。 |
跑起来长什么样
直接 python3 call_deepseek.py,它会用「请给出“wander”这个词的三个近义词?」试一发。真实返回的两段文本差异非常明显——念白是啰嗦的、自我推翻的、带「不过」和「再想想」的;结论是干净的、分条的、给用户看的:
True OK

思考部分:
好的,用户让我给出“wander”这个词的三个近义词。首先,我需要回忆一下这个词的中文释义。
Wander 通常指的是漫游、闲逛,或者不规则地走动。接下来,我需要想三个相关的中文词,
可能需要考虑不同的侧重点。

首先想到的是“漫游”,因为“漫游”和“走动”相关,但可能不够精确。然后是“游荡”,这个词更强调
不规律地走动,符合“wander”的意思。第三个可能需要更正式一点,比如“徘徊”,用来形容在某个
地方来回走动,可能更符合“wander”的场景,比如游园或者散步。

不过,用户可能需要的是更自然的词汇,所以“游荡”可能更贴近。但需要确认是否有其他更常见的
词。比如“闲逛”也可以,但“游荡”更强调不规则的走动,可能更准确。另外,“徘徊”也可以,但
“游荡”可能更常用。

再想想有没有其他可能性。比如“流连忘返”,但这个词更多是形容时间上的停留,不如“游荡”贴切。
所以可能“游荡”和“闲逛”是合适的。但用户可能需要三个不同的词,所以可能需要调整。

总结下来,三个近义词应该是“游荡”、“闲逛”和“徘徊”。这样既涵盖了不规则走动的方面,
也包括随意走动的情况,可能满足用户的需求。

结论部分:
“wander”(漫游、闲逛、徘徊)的三个近义词包括:
1. 游荡:指不规则地走动,多用于形容人在空闲时随意游走。
2. 闲逛:指随意地在某个场所走动,多指在不特定的目的下漫无目的地走动。
3. 徘徊:指在某个地方来回走动,常用于描述在某一地点停留或思考。

这三个词都表达了“wander”中的“不规则走动”这一核心含义。
len(think) 是 0,说明你调的模型没有推理字段(比如把 model 写成了普通的对话模型),这时候整条生产线在造无效数据,而且不会报任何错。这是最贵的一种错——跑完两万条才发现全是废料。批量开跑前,先看一眼第一条样本的 think 长度。
headers = {"Authorization": f"Bearer ****"}。这种写法一旦进了 git,撤不回来。 全页所有代码统一走环境变量:export SILICONFLOW_API_KEY=...,源码里只有变量名。同理,后面访问本地 api server 时素材里写的 api_key="0" 也要改成从环境变量取,虽然本地服务不校验,但这个习惯一旦破例就会带到线上。
04完整案例
一条五千条规模的婚姻法语料线,从配额表到落盘;再把长度拐点和批量跑数各算一遍
4.1 婚姻法 5000 条:把三步走走一遍
目标:给一个只懂通用知识的小模型,喂出中国现行婚姻法方面的判断能力。总量 5000 条,教师模型 DeepSeek-R1,质检模型 Qwen2.5-72B-Instruct。
| 工序 | 动作 | 产出 | 规模变化 |
|---|---|---|---|
| ① 划分 | 大模型出配额表 | 10 个子领域 + 配额 + 说明 | 0 → 一张表 |
| ② 出题 | 按类别循环灌 prompt | 纯文本,每行一题 | 0 → 约 6500 条(故意超产) |
| ③ 筛题 | 换模型打 0~9 分 | 带分数的题 | 6500 → 约 5800 条 |
| ④ 去重 | simhash 指纹比对 | 去重后的题 | 5800 → 约 5000 条 |
| ⑤ 取答案 | 调 R1,拼 <think> | answerData.jsonl | 5000 →(失败重捞后)约 5000 条 |
| ⑥ 截长 | 按拐点删超长样本 | 长度可控的 jsonl | 约 −1.5% |
| ⑦ 评分 | 问答对整体再打一次分 | 高分样本 | 只留 ≥7 分 |
| ⑧ 落盘 | 写 train.jsonl + dataset_info.json | 可训练的数据集 | 终稿 |
取答案这一步的钱怎么算
出题和打分都是短输出,几乎不花钱;真正的成本全在第 ⑤ 步。一条思维链样本的输出常在 2000~3000 字,5000 条就是一千多万字的输出。开跑前先拿 20 条试算单价,再决定要不要把总量从 5000 压到 3000——这个账要在第 ① 步定配额时就算,不是跑到一半才发现超预算。
打分脚本
# -*- coding: utf-8 -*-
"""用 Qwen2.5-72B-Instruct 给「问答对」打 0~9 分,低分样本直接淘汰。

三个必须守住的设定:
  1. 换一个模型打分。让 R1 给自己的答案打分,等于让考生自己批卷。
  2. temperature 调到 0.2。打分要的是可复现,不是创意。
  3. max_tokens 压到 10。输出长度对吞吐量的影响极大,这里只需要一个数字。

运行前:export SILICONFLOW_API_KEY=你的key
"""
import json
import os
import re

import requests

URL = "https://api.siliconflow.cn/v1/chat/completions"
JUDGE_MODEL = "Qwen/Qwen2.5-72B-Instruct"

# 打分 prompt 的四要素,缺一条分数就开始飘:
#   ① 身份限定:把模型摆到「质量评估专家」的位置上
#   ② 任务说明:0 分什么样、9 分什么样,说死
#   ③ 输出格式限定:只允许输出分数,不许写理由
#   ④ 强格式包裹:【问题】【答案】把两段料分开,模型不会读串
PROMPT_TMPL = (
    "你是一位问答对的质量评估专家,请对以下问答对的质量作出评估,"
    "分数从0到9,0表示答案和问题无关,9表示【答案】非常好地回答了【问题】,"
    "只允许输出分数,不允许输出其他任何字符。\n"
    "【问题】\n{question}\n\n"
    "【答案】\n{answer}\n"
)

KEEP_THRESHOLD = 7   # 只留高分样本


def _api_key() -> str:
    key = os.environ.get("SILICONFLOW_API_KEY")
    if not key:
        raise RuntimeError("环境变量 SILICONFLOW_API_KEY 没设置")
    return key


def score_one(question, answer):
    """返回 (success, msg, score),score 为 -1 表示没拿到有效分数。"""
    payload = {
        "model": JUDGE_MODEL,
        "messages": [{
            "role": "user",
            "content": PROMPT_TMPL.format(question=question, answer=answer),
        }],
        "temperature": 0.2,
        "max_tokens": 10,
    }
    headers = {
        "Authorization": "Bearer " + _api_key(),
        "Content-Type": "application/json",
    }
    try:
        resp = requests.post(URL, json=payload, headers=headers, timeout=120)
        resp.raise_for_status()
        text = resp.json()["choices"][0]["message"]["content"]
        # 即使限定了输出格式,也要防一手模型多吐一个句号或换行
        m = re.search(r"\d", text)
        if not m:
            return False, "未解析到分数: %r" % text, -1
        return True, "OK", int(m.group())
    except Exception as exc:                          # noqa: BLE001
        return False, "API调用异常: %s" % exc, -1


def filter_by_score(src_path, keep_path, drop_path, threshold=KEEP_THRESHOLD):
    """逐条打分,高分写 keep_path,低分写 drop_path 留档备查。"""
    kept = dropped = broken = 0
    with open(src_path, "r", encoding="utf-8") as src, \
            open(keep_path, "w", encoding="utf-8") as keep, \
            open(drop_path, "w", encoding="utf-8") as drop:
        for line in src:
            line = line.strip()
            if not line:
                continue
            data = json.loads(line)
            success, msg, score = score_one(data["instruction"], data["output"])
            if not success:
                broken += 1
                print("打分失败", data.get("id"), msg)
                continue
            data["score"] = score
            target, counter = (keep, "kept") if score >= threshold else (drop, "dropped")
            target.write(json.dumps(data, ensure_ascii=False) + "\n")
            if counter == "kept":
                kept += 1
            else:
                dropped += 1
    print("保留 %d 条,淘汰 %d 条,打分失败 %d 条" % (kept, dropped, broken))


def reliability(gen_acc=0.80, judge_acc=0.90):
    """两道关口串起来之后的整体准确率估算。

    生成答案是复杂任务,假设 80% 正确;打分是简单任务,假设 90% 正确。
    一条错答案要混进最终数据集,必须「生成错了」且「打分也没看出来」,
    所以留下来的样本估算准确率 = 1 - (1-0.80) x (1-0.90) = 98%。
    这是建立在两个假设之上的估算值,不是实测结果。
    """
    return 1 - (1 - gen_acc) * (1 - judge_acc)


if __name__ == "__main__":
    print("可靠性估算:%.2f%%" % (reliability() * 100))
三个设定值得单独点出来:JUDGE_MODEL 与教师模型不同源;temperature=0.2 让同一条样本重复打分基本稳定;max_tokens=10 把输出压到只够吐一个数字。最后那个 reliability() 就是 98% 的来源,函数注释里写明了它是估算——代码里也别让这个数字装成实测值。
本机跑一下这个估算:
可靠性估算:98.00%
4.2 长度分布:拐点到底怎么读出来
一批 15320 条思维链语料,按 1000 字一档统计长度分布。表很长,但要看的只有两列:每一档的占比,和累计占比。
# -*- coding: utf-8 -*-
"""统计语料长度分布,按累计数量的拐点决定截断阈值。

纯标准库,可直接跑。不带参数时用内置的真实分布做演示。

思路:
  1. 按 1000 字一档统计样本数量;
  2. 算出每一档的累计占比;
  3. 找「再往后放宽一档,只能多收不到 delta 比例样本」的那一档 —— 就是拐点;
  4. 阈值定在拐点,超长样本直接丢。
"""
import json
import sys

BUCKET = 1000

# 一批 15000 余条思维链语料的真实长度分布(区间上界 -> 样本数)
SAMPLE_DIST = [
    (1000, 616), (2000, 4817), (3000, 6660), (4000, 1703), (5000, 439),
    (6000, 228), (7000, 237), (8000, 154), (9000, 118), (10000, 83),
    (11000, 42), (12000, 42), (13000, 33), (14000, 23), (15000, 27),
    (16000, 16), (17000, 13), (18000, 13), (19000, 10), (20000, 7),
    (21000, 10), (22000, 5), (23000, 6), (24000, 3), (25000, 1),
    (26000, 3), (27000, 0), (28000, 6), (29000, 0), (30000, 1),
    (31000, 2), (32000, 0), (33000, 0), (34000, 0), (35000, 1), (36000, 1),
]


def build_dist(path, field="output"):
    """从 jsonl 里统计长度分布,返回 [(区间上界, 数量), ...]。"""
    counter = {}
    with open(path, "r", encoding="utf-8") as f:
        for line in f:
            line = line.strip()
            if not line:
                continue
            data = json.loads(line)
            n = len(data.get(field, ""))
            upper = (n // BUCKET + 1) * BUCKET
            counter[upper] = counter.get(upper, 0) + 1
    return sorted(counter.items())


def find_knee(dist, delta=0.005):
    """拐点:某一档之后,每档新增样本占比都低于 delta,就在这里切。"""
    total = sum(c for _u, c in dist)
    acc = 0
    for upper, count in dist:
        acc += count
        if count / total < delta:
            return upper, acc / total
    return dist[-1][0], 1.0


def report(dist, delta=0.005):
    total = sum(c for _u, c in dist)
    knee, knee_ratio = find_knee(dist, delta)
    acc = 0
    print("%-14s %8s %8s %10s" % ("长度区间", "样本数", "占比", "累计占比"))
    for upper, count in dist:
        acc += count
        mark = "  <== 拐点" if upper == knee else ""
        print("%-14s %8d %7.2f%% %9.2f%%%s"
              % ("%d~%d" % (upper - BUCKET, upper), count,
                 count / total * 100, acc / total * 100, mark))
    print()
    print("样本总量:%d" % total)
    print("建议截断阈值:%d 字" % knee)
    print("保留样本占比:%.2f%%,丢弃 %d 条"
          % (knee_ratio * 100, total - round(knee_ratio * total)))
    return knee


def cut(src_path, dst_path, threshold, field="output"):
    kept = dropped = 0
    with open(src_path, "r", encoding="utf-8") as src, \
            open(dst_path, "w", encoding="utf-8") as dst:
        for line in src:
            line = line.strip()
            if not line:
                continue
            data = json.loads(line)
            if len(data.get(field, "")) <= threshold:
                dst.write(json.dumps(data, ensure_ascii=False) + "\n")
                kept += 1
            else:
                dropped += 1
    print("保留 %d 条,丢弃 %d 条" % (kept, dropped))


if __name__ == "__main__":
    if len(sys.argv) > 1:
        report(build_dist(sys.argv[1]))
    else:
        report(SAMPLE_DIST)
不带参数直接跑,它用内置的这份真实分布做演示。完整输出:
长度区间                样本数       占比       累计占比
0~1000              616    4.02%      4.02%
1000~2000          4817   31.44%     35.46%
2000~3000          6660   43.47%     78.94%
3000~4000          1703   11.12%     90.05%
4000~5000           439    2.87%     92.92%
5000~6000           228    1.49%     94.41%
6000~7000           237    1.55%     95.95%
7000~8000           154    1.01%     96.96%
8000~9000           118    0.77%     97.73%
9000~10000           83    0.54%     98.27%
10000~11000          42    0.27%     98.54%  <== 拐点
11000~12000          42    0.27%     98.82%
12000~13000          33    0.22%     99.03%
13000~14000          23    0.15%     99.18%
14000~15000          27    0.18%     99.36%
15000~16000          16    0.10%     99.46%
16000~17000          13    0.08%     99.55%
17000~18000          13    0.08%     99.63%
18000~19000          10    0.07%     99.70%
19000~20000           7    0.05%     99.75%
20000~21000          10    0.07%     99.81%
21000~22000           5    0.03%     99.84%
22000~23000           6    0.04%     99.88%
23000~24000           3    0.02%     99.90%
24000~25000           1    0.01%     99.91%
25000~26000           3    0.02%     99.93%
26000~27000           0    0.00%     99.93%
27000~28000           6    0.04%     99.97%
28000~29000           0    0.00%     99.97%
29000~30000           1    0.01%     99.97%
30000~31000           2    0.01%     99.99%
31000~32000           0    0.00%     99.99%
32000~33000           0    0.00%     99.99%
33000~34000           0    0.00%     99.99%
34000~35000           1    0.01%     99.99%
35000~36000           1    0.01%    100.00%

样本总量:15320
建议截断阈值:11000 字
保留样本占比:98.54%,丢弃 223 条
这张表在说什么
0~4000 字四档就吃掉了 90.05% 的样本,其中 2000~3000 一档独占 43.47%。这说明教师模型的输出长度高度集中——典型的思维链就是两三千字。
从 10000 字往后,三十多档加起来只有 1.46%,中间还夹着好几个 0 样本的空档。为这 1.46% 的样本把 cutoff_len 抬到 36000,整批训练都得陪着吃显存。
脚本里判拐点的规则很朴素:从前往后扫,第一个「本档样本占比低于 0.5%」的档位就是拐点。扫到 10000~11000 这一档时,它只有 42 条、占 0.27%,第一次跌破阈值——拐点就在这里。
| 读出来的结论 | 数值 |
|---|---|
| 样本总量 | 15320 条 |
| 拐点档位 | 10000~11000 字 |
| 建议截断阈值 | 11000 字 |
| 保留占比 | 98.54% |
| 丢弃数量 | 223 条 |
换句话说:把最长的那 223 条扔掉,换来序列长度上限从 36000 降到 11000——省下来的显存足够把批处理大小往上提一档。这就是「对数据集影响不大」这句话的量化版本。
delta 是可调的:显存特别紧就调大(拐点前移、砍得更狠),样本特别宝贵就调小。真正要守的是另一件事——砍完之后回头统计各子领域的剩余条数,确认没有哪一类被砍掉两成以上。脚本不会替你做这个检查,它只认长度,不认内容。
4.3 生产环境跑海量数据:三方案对比
五千条还能单机慢慢跑,几十万条就必须挑一种批量作业方式。三条路各有各的死穴:
| 方案 | 优点 | 缺点 | 什么时候选它 |
|---|---|---|---|
| 大数据系统 | 方便快捷,能充分利用集群算力 | 环境冲突;不一定支持 GPU;时间和任务冲突 | 公司已有成熟集群、任务是纯 IO 且依赖简单时。依赖复杂的环境别往集群上塞,装不上就是装不上。 |
| 数据切块 | 方便,各进程/各机器互不影响 | 要等最晚的那个进程完成;不方便扩展 | 样本数量不多、任务简单、一次性跑完就不再跑的场合。切十块,九块十分钟跑完,第十块跑两小时,你还是得等两小时。 |
| 生产者消费者 | 几乎同时完成(最早和最晚的消费者最多差一条数据);进度随时可见;可动态增减消费者;单机多机都能跑 | 需要自己组织协调软硬件 | 资源充足时的默认选择。灵活性换来的那点开发量,第二次用就赚回来了。 |
用厨房的话说:大数据系统是把菜单外包给中央食堂——快,但人家的灶台未必合你的锅;数据切块是把菜单平均分给十个厨子各干各的——简单,但手慢的那个拖住所有人;生产者消费者是上一条传送带——谁空了谁取单,全员同时收工。
4.4 生产者消费者:工程细节与实跑
这套模式以队列为核心。队列可以是语言自带的数据结构(Python 的 multiprocessing.Queue、queue.Queue,单机用),也可以换成中间件的消息队列(kafka、RabbitMQ、RocketMQ),单机多机都能跑。角色只有两个:
读数据、拆成任务、放进输入队列。可以一个也可以多个,一般是 IO 密集型,用线程就够。
从输入队列领任务,干完把结果放进输出队列。一般是多个,数量由任务性质决定。
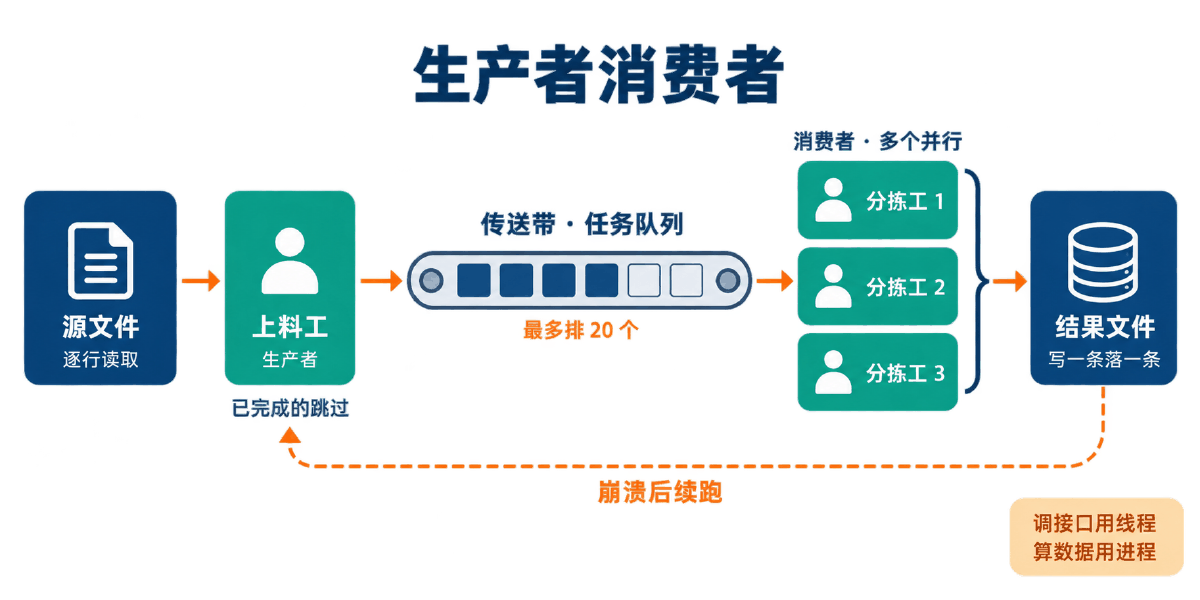
五个必须写进代码的细节
| 细节 | 代码里的样子 | 不写会怎样 |
|---|---|---|
| ① 崩溃可续跑 | 先读结果文件,把已完成 id 收进 finishedSet,命中就跳过 |
跑了十个小时崩在 80%,重启从第 1 条开始——前面那 80% 的钱白花了。 |
| ② 队列限长 | while task_queue.qsize() >= 20: time.sleep(1) |
生产者读文件比消费者调 API 快几个数量级,几秒钟就把几十万条全塞进内存,OOM。 |
| ③ 大文件逐行读 | for line in file:,不用 readlines() |
几个 GB 的 jsonl 一次性读进列表,同样是 OOM,而且崩在最开头,连一条都没跑。 |
| ④ 线程还是进程 | 调 API 用 threading;纯计算必须 multiprocessing |
Python 的 GIL 决定了计算密集型任务开再多线程也只用得上一个核。造语料是 IO 密集型(时间全花在等服务器),线程是对的;换成本地跑推理或做分词统计,就必须换进程。 |
| ⑤ 写盘后 flush | target.write(...) 紧跟 target.flush() |
缓冲区里攒着几十条没落盘,进程被杀就全没了;更糟的是 ① 的 finishedSet 也跟着读不到,续跑时会重复花钱。 |
完整可跑的骨架
# -*- coding: utf-8 -*-
"""生产者消费者模式:批量跑数的骨架,可直接在本机跑通。

这里用一个会 sleep、偶尔抛异常的模拟任务代替真实 API 调用,
换成 call_deepseek.call_server 就是生产版本。

四个工程细节都在代码里:
  1. 崩溃可续跑   —— 先读结果文件,把已完成的 id 收进 finishedSet
  2. 队列限长     —— qsize() 超过上限就让生产者歇一秒,内存不是无限的
  3. 大文件逐行读 —— 不用 readlines(),几十 GB 也不会撑爆内存
  4. 写一条 flush 一条 —— 进程被杀也只丢最后一条

用法:python3 producer_consumer.py            # 自带演示数据,跑完自动退出
"""
import json
import os
import queue
import random
import threading
import time

TASK_QUEUE_LIMIT = 20    # 内存里的队列,放多了没意义
CONSUMER_COUNT = 10      # 调 API 是 IO 密集型,用线程;数量看服务端吞吐
RETRY = 3

task_queue = queue.Queue()
result_queue = queue.Queue()
DONE = object()          # 毒丸:生产者放完任务后塞进去,通知消费者收工


def call_server_simulate(prompt):
    """模拟远程调用:随机耗时,遇到以「能」开头的 prompt 触发异常走重试。"""
    time.sleep(random.uniform(0.05, 0.2))
    msg = "OK"
    for attempt in range(1, RETRY + 1):
        try:
            if prompt.startswith("能"):
                1 / 0                       # 故意造一个异常,检验重试分支
            return True, "OK", "reasoning_content of " + prompt, "content of " + prompt
        except Exception as exc:            # noqa: BLE001
            msg = "第 %d 次调用异常: %s" % (attempt, exc)
    return False, msg, "", ""


def produce_task(src_path, dst_path):
    """读源文件,跳过已完成样本,把任务塞进队列。"""
    finished = set()
    if os.path.exists(dst_path):
        with open(dst_path, "r", encoding="utf-8") as done_file:
            for line in done_file:
                line = line.strip()
                if not line:
                    continue
                data = json.loads(line)
                if "id" in data:
                    finished.add(data["id"])
    if finished:
        print("检测到已完成 %d 条,本轮跳过" % len(finished))

    with open(src_path, "r", encoding="utf-8") as src:
        for line in src:                     # 逐行读,内存友好
            line = line.strip()
            if not line:
                continue
            data = json.loads(line)
            if data["id"] in finished:
                continue
            while task_queue.qsize() >= TASK_QUEUE_LIMIT:
                time.sleep(1)                # 队列满了就等,别把内存撑爆
            task_queue.put(data)

    for _ in range(CONSUMER_COUNT):
        task_queue.put(DONE)


def consume_task(index):
    """从任务队列领任务,把结果丢进结果队列。"""
    while True:
        data = task_queue.get(block=True)
        if data is DONE:
            result_queue.put(DONE)
            return
        success, msg, think, result = call_server_simulate(data["instruction"])
        result_queue.put((data, success, msg, think, result))


def collect(dst_path):
    """唯一的写盘口,顺带充当进度条。"""
    ok = fail = 0
    finished_consumers = 0
    with open(dst_path, "a", encoding="utf-8") as target:
        while finished_consumers < CONSUMER_COUNT:
            item = result_queue.get(block=True)
            if item is DONE:
                finished_consumers += 1
                continue
            data, success, msg, think, result = item
            if success:
                data["output"] = "<think>\n" + think + "\n</think>\n\n\n" + result
                target.write(json.dumps(data, ensure_ascii=False) + "\n")
                target.flush()               # 写一条落一条
                ok += 1
            else:
                fail += 1
                print("结果错误 id=%s %s" % (data["id"], msg))
    print("入库 %d 条,丢弃 %d 条" % (ok, fail))


def ask_batch_mt(src_path, dst_path, consumer_count=CONSUMER_COUNT):
    producer = threading.Thread(target=produce_task, args=(src_path, dst_path))
    producer.start()
    for i in range(consumer_count):
        threading.Thread(target=consume_task, args=(i,), daemon=True).start()
    collect(dst_path)
    producer.join()


def _make_demo(src_path):
    """造 30 条演示数据,其中 5 条以「能」开头,用来触发失败分支。"""
    with open(src_path, "w", encoding="utf-8") as f:
        for i in range(30):
            head = "能否" if i % 6 == 0 else "请说明"
            f.write(json.dumps(
                {"id": i, "instruction": "%s第 %d 个问题" % (head, i), "input": ""},
                ensure_ascii=False) + "\n")


if __name__ == "__main__":
    src = "/tmp/cot_demo_query.jsonl"
    dst = "/tmp/cot_demo_answer.jsonl"
    _make_demo(src)
    if os.path.exists(dst):
        os.remove(dst)
    start = time.time()
    ask_batch_mt(src, dst)
    print("耗时 %.2f 秒" % (time.time() - start))
    print("---- 断点续跑:原样再跑一次 ----")
    ask_batch_mt(src, dst)
为了让它在没有 key 的机器上也能跑通,真实 API 调用被换成了 call_server_simulate():随机 sleep 模拟网络等待,凡是以「能」开头的 prompt 触发一次除零异常,用来检验重试分支和失败分支确实走到了。换成生产版本只要把这一个函数替换成 call_deepseek.call_server。
另外补了一个素材里没有的收口设计:毒丸(DONE 哨兵对象)。生产者放完任务后往队列里塞 CONSUMER_COUNT 个 DONE,消费者取到就退出,收集线程数够了就停。没有它,while True 的消费者会永远阻塞在 get() 上,脚本跑完也退不出来——演示代码可以按 Ctrl+C,放进定时任务就是个挂死的进程。
实跑输出
本机 python3 producer_consumer.py,30 条演示数据、10 个消费者,跑完接着原样再跑一次验证续跑:
结果错误 id=6 第 3 次调用异常: division by zero
结果错误 id=0 第 3 次调用异常: division by zero
结果错误 id=12 第 3 次调用异常: division by zero
结果错误 id=18 第 3 次调用异常: division by zero
结果错误 id=24 第 3 次调用异常: division by zero
入库 25 条,丢弃 5 条
耗时 1.20 秒
---- 断点续跑:原样再跑一次 ----
检测到已完成 25 条,本轮跳过
结果错误 id=18 第 3 次调用异常: division by zero
结果错误 id=0 第 3 次调用异常: division by zero
结果错误 id=12 第 3 次调用异常: division by zero
结果错误 id=24 第 3 次调用异常: division by zero
结果错误 id=6 第 3 次调用异常: division by zero
入库 0 条,丢弃 5 条
三处要看:
- 5 条失败、25 条入库。30 条里
id能被 6 整除的 5 条以「能否」开头,三次重试全部失败后被丢弃——失败样本没有静默消失,而是打印了 id 和原因,事后可以单独捞。 - 1.19 秒跑完 30 条。10 个消费者并行,总耗时约等于单条耗时 ×3,而不是 ×30。
- 第二轮打印「检测到已完成 25 条,本轮跳过」,入库 0 条。这就是
finishedSet在干活:成功的 25 条一条都没重跑,只有那 5 条失败的又试了一遍(因为它们从来没进过结果文件)——这个行为正是你想要的。
05骨架模板
换个领域就能直接用的三段 prompt,以及五个文件各自的定位
5.1 问题生产三段式 prompt
出题这一环没法写成通用代码——每个领域的类别、配额、题型都不一样。能复用的是prompt 的结构:把 {领域} 换成自己的领域内容即可。三段的顺序不能调换:先划分子领域定配额,再按类型批量出题,最后换模型打分筛选。
===============================================================================
问题生产三段式 prompt 模板
把 {{...}} 换成你自己的领域内容即可复用。
三段的顺序不能调换:先划分子领域定配额,再按类型批量出题,最后换模型打分筛选。
===============================================================================


-------------------------------------------------------------------------------
【第一段】子领域划分 —— 先把配额表定下来
产出:一张三列表格(子领域名称 / 语料数量 / 详细说明)
用途:第二段的 prompt 直接吃这张表;同时它就是数据集的结构比例,去重和截断时
      都要照着它保持比例。
-------------------------------------------------------------------------------
你是一位 {领域,例如「中国现行婚姻法」} 方面的专家,我需要整理一份
{领域} 方面的训练语料,共 {总条数,例如 5000} 条,需要考虑
{领域} 的哪几个子领域,各自语料的数量是多少?用一个表格输出结果,
每一行是一个子领域,第一列是子领域的名称,第二列是语料的数量,
第三列是对这个子领域的详细说明。不允许输出其他字符。


-------------------------------------------------------------------------------
【第二段】按类型批量生成问题
产出:每行一道题的纯文本,可直接按行切成 jsonl
关键:把上一段拿到的「类别清单 + 各类别详细说明」整段塞进来,模型才知道
      「夫妻权利义务」到底该出哪些题;不塞说明,出的题会大面积跑到别的类别去。
      循环这一段,每次只换【本次类别】,就能把配额一格一格填满。
-------------------------------------------------------------------------------
你是一位 {领域} 方面的专家,根据【特定类别】的定义,针对其中
{本次类别,例如「夫妻权利义务」} 方面的规定,向学生提供
{每批题量,例如 20} 道练习题,你能提出哪些问题?
每个问题单独一行,只允许输出问题本身,不允许输出任何其他字符。

【特定类别】
{第一段产出的类别名称数组,例如
["结婚登记与条件","夫妻权利义务","离婚程序与条件","财产分割"]}

各类别详细说明如下:
{逐行贴第一段表格的第三列,格式为「类别名称:详细说明」}


-------------------------------------------------------------------------------
【第三段】问题检查 —— 换一个高质量模型打分
产出:每行一个 0~9 的整数,与输入文本逐行对应
关键:换模型。出题的模型来判自己出的题是否切题,等于考生自己批卷。
      输出格式限死成纯数字,把 max_tokens 压到个位数,吞吐立刻上去。
      低分的题直接删掉,删的时候注意各子领域之间的比例不要被删失衡。
-------------------------------------------------------------------------------
你是一位 {领域} 方面的专家,如果要把【输入文本】分类到【特定类别】中,
那么输入文本属于 {本次类别} 是否准确?给出一个准确性评分,
该评分是 0 到 9 之间的正整数,其中 0 表示完全错误,9 表示非常准确。
【输入文本】中的每一行是一条独立数据,需要单独判定。
输出时每条数据的结果单独输出一行,只允许输出准确性评分,不允许输出其他任何字符。

【特定类别】
{同第二段的类别数组}

各类别详细说明如下:
{同第二段的类别说明}

【输入文本】
{第二段生成的问题,每行一条,一次别塞太多,20~50 行为宜}


===============================================================================
接下来的三件事(都不在 prompt 里,靠代码做)
  1. 去重:simhash 算指纹,指纹汉明距离小于阈值判为重复;量大时先分桶再比对。
     删重复样本时同样要保持各子领域的比例。
  2. 取答案:把筛过的问题送教师模型,见 call_deepseek.py。
  3. 打分筛选:把「问答对」整体再评一次,见 score_answers.py。
===============================================================================
5.2 五个文件的分工
| 文件 | 对应工序 | 换领域时要改什么 |
|---|---|---|
gen_questions.template.txt | ① 出题 ② 筛题 | 把三处 {领域}、类别数组、类别说明整段替换。类别说明必须逐条重写,这是模型判断边界的唯一依据。 |
call_deepseek.py | ③ 取答案 | 通常一行都不用改。换教师模型改 MODEL;教师模型不带推理字段时,build_output() 的 <think> 包装要一并去掉。 |
length_filter.py | ④ 截长 | 把 SAMPLE_DIST 换成自己的数据:python3 length_filter.py your.jsonl 直接从文件统计。delta 按显存松紧调。 |
score_answers.py | ⑤ 评分 | 改 PROMPT_TMPL 里的身份限定(「问答对的质量评估专家」→ 你的领域专家),KEEP_THRESHOLD 按实际分数分布定。 |
producer_consumer.py | 贯穿 ③⑤ | 把 call_server_simulate() 换成真实调用;CONSUMER_COUNT 按服务端吞吐调。其余四个细节(续跑、限长、逐行读、flush)原样保留。 |
5.3 目录摆法
训练工具认的是目录约定,不是你的文件名品味。最终交给训练环节的应该是这样一棵树:
data/
└── chatData/                     <- 训练命令里的 --dataset_dir 指向这里
    ├── dataset_info.json         <- 必须有,把数据集名映射到文件名
    ├── train.jsonl               <- 终稿:一行一条 {"instruction","input","output"}
    ├── queryData.jsonl           <- 中间产物:只有题,没有答案
    ├── answerData.jsonl          <- 中间产物:题 + 未过滤的答案
    └── dropped.jsonl             <- 中间产物:被打分淘汰的样本,留档备查

dataset_info.json 的内容:
{
  "chat-train": {                 <- 训练命令里的 --dataset 用这个名字
    "file_name": "train.jsonl"    <- 实际读的文件
  }
}
dataset_info.json 必须和 jsonl 躺在同一个目录里。训练命令写 --dataset_dir 指向这个目录、--dataset chat-train 指向映射表里的键名。
queryData.jsonl(题)、answerData.jsonl(带答案)、dropped.jsonl(被打分淘汰的)三个中间文件都留着。调参阶段要反复回看「到底是题出得不好,还是答案生成得不好」——只留终稿,出了问题就只能从头再跑一遍,而重跑的钱全花在取答案这一步。
06易错点汇总
按「出题 / 取答案 / 截长与评分 / 批量跑数 / 落盘与安全」五类归并
⚠️ 一、出题阶段
- 上来就让模型出 5000 道题。 不先划分子领域、不定配额,产出会疯狂集中在领域里最热的那两三个话题上,五千条里有四千条是同一件事的变体。先出配额表,再一格一格填。
- 第二段 prompt 里只给当前类别的定义。 模型不知道边界在哪,出的题会大面积滑到隔壁类别去。所有类别的名称和详细说明都要整段塞进去,再指定本次只针对其中一类。
- 忘了写「不允许输出其他任何字符」。 模型会在前后各加一段客套话、给题目编上序号、甚至补一段「以上题目供参考」。按行切分的脚本直接把这些当成题目收进去了。
- 让出题的模型自己给题打分。 考生自己批卷。问题检查必须换一个高质量模型。
- 去重和筛题删完就完事。 各子领域被删的比例差别很大——越套路化的类别重复率越高,一轮去重能砍掉它 40%。删完必须回头对配额表,缺口要补生成。
- 出的全是记忆型问题。「婚姻法哪一年颁布的」这种题,教师模型的念白只有一两句,样本没有思维链价值。要出需要判断、需要讲理由的题。
⚠️ 二、调 DeepSeek-R1 取答案
- 只取了
content。 这是本页最贵的错误,而且不报任何错——你会得到一批格式完全正确、但没有思维链的语料,跑完两万条才发现全是废料。批量开跑前先看一眼第一条样本的len(think)。 - 用下标取
message['reasoning_content']。 换成不带推理的模型时这个字段压根不存在,半夜抛KeyError。用.get()并判空。 - 把接口返回 200 当成成功。
content可能是空字符串。空结果也要算失败走重试,否则数据集里混进一堆output只有<think>壳子的废样本。 max_tokens给小了。 思维链动辄几千字,给 2000 会被硬截断。被截断的样本比没有样本更糟——它在教学生模型「说到一半停下」。- 拼
output时换行数量对不上。"<think>\n" + think + "\n</think>\n\n\n" + result,结尾是三个换行。格式是训练信号的一部分,同一批数据里不能一半这样拼一半那样拼。 - 温度照抄线上问答的取值。 线上求稳会用 0.1~0.3,造语料用这个值会得到五千条高度雷同的样本。造语料要的是可控的多样性,取 0.6。
- 无限重试。 三次不成多半是这条请求本身有问题(prompt 超长、内容触发拦截),继续重试只是烧钱。记下失败原因跳过,最后单独捞一遍。
⚠️ 三、截长与评分
- 凭感觉定截断阈值。「就按 4000 吧」——这一刀可能砍掉 10% 的样本。先统计分布,从累计占比里读拐点,再决定砍哪里。
- 砍完不看结构。 长度和内容类型强相关,需要长篇论证的那类题天然更长,一刀切下去被砍光的往往是同一个子领域。脚本只认长度,不认内容,这个检查得你自己做。
- 打分模型和教师模型同源。 同一家的模型犯错模式相似,两道关口实际只顶一道用。
- 打分 prompt 没限定输出格式。 模型写一大段点评,既贵又得额外写解析。加上「只允许输出分数」,并把
max_tokens压到 10。 - 打分 prompt 没限定身份。 模型会顺手去回答那个问题,而不是评价它——你会拿到一篇答案,然后
int()解析崩掉。 - 打分时温度没调小。 同一条样本两次打分差三分,阈值就成了掷骰子。取 0.2。
- 把 98% 当成实测准确率对外说。 它是基于两个假设值的估算,还默认了两个环节的错误相互独立。要给对外数字,抽 200 条人工标一遍。
⚠️ 四、批量跑数
- 不做断点续跑。 跑十小时崩在 80%,重启从头开始。先读结果文件把已完成 id 收进
finishedSet,这二十行代码能救回一整夜的钱。 - 队列不限长。 生产者读文件比消费者调 API 快几个数量级,几秒钟就把几十万条塞进内存。
qsize()超过上限就 sleep。 - 用
readlines()读大文件。 几个 GB 的 jsonl 一次性进列表,崩在最开头,一条都没跑。 - 计算密集型任务开一堆线程。 Python 的 GIL 决定了它们只能轮流用一个核。IO 密集用线程、计算密集必须用进程,这条没有例外。
- 写盘不
flush()。 缓冲区攒着几十条没落盘,进程被杀就全丢;更糟的是续跑时finishedSet也读不到这几十条,会重复花钱。 - 消费者
while True没有退出条件。 演示时按 Ctrl+C 没事,放进定时任务就是个永远挂着的进程。用毒丸(哨兵对象)让消费者正常收工。 - 失败样本静默丢弃。
pass一写,你永远不知道少了多少条、为什么少。失败也要打印 id 和原因,事后单独捞。 - 样本量不大也上生产者消费者。 几百条数据用数据切块甚至单线程就够了,别为了用模式而用模式。
⚠️ 五、落盘与安全
- 忘了
dataset_info.json。 训练时报的错是「找不到数据集 chat-train」而不是「找不到文件」,照着文件路径能排查半天。它必须和 jsonl 在同一个目录里。 - 写成一个大 JSON 数组而不是 jsonl。 几十万条的文件没法逐行读、没法断点续写、崩一次整个文件就是坏的。一行一条。
input字段直接省掉。 值可以是空字符串,但键不能少。- 中间产物跑完就删。 调参阶段要反复回看「是题的问题还是答案的问题」,只留终稿就只能从头重跑——而重跑的钱全花在取答案这一步。
- key 硬编码在源码里。
headers = {"Authorization": f"Bearer ****"}这种写法一旦进了 git 就撤不回来。一律os.environ.get(...),取不到就立刻抛错,别带着空 key 去请求然后对着 401 发呆。 - 访问本地服务时图省事写
api_key="0"。 本地服务确实不校验,但这个习惯一旦破例就会带到线上。统一从环境变量取,本地给个占位值也从环境变量给。
07自测题
点击题目展开答案;这 12 题都能讲清楚,这条生产线你就能自己搭一遍
「两个三」分别是什么?它们之间是什么关系?
组织语料三步走:生成问题 → 生成答案 → 组织语料集。批量跑数三方法:大数据系统 / 数据切块 / 生产者消费者。
两者正交:三步走是「做什么」,三方法是「怎么把几万条一次跑完」。排班方式换了菜谱不变,菜谱换了排班照样能用。把这两件事搅在一起是最常见的返工原因。
什么情况下问题可以从公共语料里选,什么情况下必须自己造?
要学的是通用特性或泛领域知识(比如思维链本身——「会一步步推理」不挑领域),从公共语料里选就行,成本近乎为零。
要学的是特殊特性或特定领域知识(写某种小众语言的代码、医药机电化工的领域知识、某部法律的适用判断),公共语料里根本没有这些题,必须自己组织。
为什么出题时要故意超产 1.2~1.4 倍?
因为后面有四道关口层层扣:筛题删、去重删、截长删、评分再删。按 5000 出题最后只剩三千多。
超产是为了让每一道筛都能放心地严。出题很便宜(短输出),取答案才贵(长输出),宁可多花一点出题的钱,也别让「量不够」倒逼你放松质量标准。
子领域划分那个 prompt,为什么一定要让模型输出「详细说明」这一列?
因为第三列会被原样塞进下一步的出题 prompt,它是模型判断类别边界的唯一依据。
而且这张表还有第二个身份:它就是整个数据集的结构比例。后面去重删样本、截长删样本,删完都要回头对这张表,看哪个子领域被删狠了要补回来。
按类型出题时,为什么要把所有类别的说明都塞进 prompt,而不只给当前这一类?
因为模型需要知道边界在哪。「财产分割」和「继承权与婚姻关系」都会碰到房子,只给一类的定义,出的题会大面积滑到隔壁类去,最后配额全乱。给全套定义,模型才能把当前这一类和相邻类别区分开。
删重复样本时唯一的硬规矩是什么?为什么?
保持样本库的比例。
去重删掉的样本在各子领域之间分布极不均匀——越套路化的类别重复率越高,一轮去重可能砍掉它 40%。不回头补,数据集结构就失衡了,学生模型会在某几类问题上明显变笨。截长时同理。
R1 的返回里有哪两个字段?只取其中一个会怎样?
reasoning_content(思考部分)和 content(结论部分)。
只取 content:思维链没了,学生模型只会背答案,遇到没见过的题立刻露馅——而且整个过程不报任何错,这是本页最贵的错误。只取 reasoning_content:样本没有收口,模型学不会给出最终结论。
为什么要用 <think>...</think> 把思考部分包起来?
因为大模型非常善于学习各种格式性强的结构。<think> 是一个极其醒目的分隔标记,训练几百条之后学生模型就会稳定地「先在标记里想,再在外面答」。
如果用换行随便一拼,学生根本分不清哪段是思考、哪段是给用户看的答案。完整拼法:"<think>\n" + think + "\n</think>\n\n\n" + result。
造语料的温度为什么取 0.6,而不是照抄线上问答的 0.2?
温度高则答案多样性好,但也越容易出问题;温度低则答案稳定,但很相似、比较死板。
线上问答求稳,所以低;造语料要的是在可控范围内的多样性——五千条像一个模子刻出来的,学生学到的是模板不是能力。0.6 是「有变化但不放飞」的经验点。
为什么要删除过长的数据?小数据集和大数据集分别怎么删?
两个理由:节省资源(显存占用和序列长度直接相关,几条超长样本就把 cutoff_len 顶上去,全批次陪着吃亏);对数据集影响不大(长尾样本数量极少)。
小数据集按计算资源截——显存吃得下多长就设多长;大数据集按长度累计数量的拐点截——先统计分布,找到「再放宽也收不到多少样本」的那一档。
给你那张 15320 条的长度分布表,拐点怎么读出来?截断后保留多少?
从前往后扫累计占比,找第一个本档样本占比低于阈值(脚本里取 0.5%)的档位。10000~11000 这一档只有 42 条、占 0.27%,第一次跌破——拐点在这里。
阈值定在 11000 字,保留 98.54%,丢弃 223 条。代价是砍掉 223 条,换来序列长度上限从 36000 降到 11000,省下的显存够把批处理大小提一档。
98% 这个数字是怎么算的?能不能对外说「我们的数据集准确率 98%」?
算法:生成答案是复杂任务假设 80% 正确,打分是简单任务假设 90% 正确,一条错答案要混进来必须两关都失手,所以 1-(1-80%)×(1-90%) = 98%。
不能对外这么说。 80% 和 90% 都是拍出来的假设值,公式还默认了两个环节的错误相互独立——而现实里教师答得云山雾罩的难题,打分模型往往也判不准。这个数字只能用来论证「两道关口比一道强很多」的量级判断。要给对外数字,抽 200 条人工标。
生产环境跑海量数据有哪三种方法?资源充足时选哪种,为什么?
大数据系统:方便快捷、能用集群算力;缺点是环境冲突、不一定支持 GPU、时间和任务冲突。
数据切块:方便、互不影响;缺点是要等最晚的进程完成、不方便扩展。
生产者消费者:几乎同时完成(最早和最晚的消费者最多差一条数据)、进度随时可见、可动态增减消费者、单机多机都能跑;缺点是要自己组织协调软硬件。
资源充足选生产者消费者,它最灵活;那点开发量第二次用就赚回来了。
消费者该用线程还是进程?数量怎么定?
看任务性质:IO 密集型用线程(调 API 时间全花在等服务器),数量受限于 IO 性能——服务端 QPS、磁盘读写、网络延迟;计算密集型在 Python 里必须用进程,因为 GIL 让多线程只能轮流用一个核,数量受限于算力和内存。
数量没有通用答案,从 10 开始试,看吞吐曲线什么时候不再涨;服务端开始返 429 或响应时间明显变长就是上限。
一个跑几十小时的任务,代码里必须写进哪几个细节?
① 断点续跑:先读结果文件把已完成 id 收进 finishedSet,命中就跳过。
② 队列限长:qsize() 超上限就 sleep,内存不是无限的。
③ 大文件逐行读,不用 readlines()。
④ IO 密集用线程、计算密集用进程。
⑤ 写一条 flush() 一条——不然进程被杀不但丢数据,续跑时 finishedSet 也读不到,会重复花钱。
再补一条:消费者要有退出条件(毒丸),否则脚本跑完也退不出来。
安装环境非常复杂的计算密集型任务,最好用哪种方式跑?样本量很小的简单任务呢?
环境复杂的计算密集型任务:不要往大数据集群上塞——环境冲突正是它最大的短板,装不上就是装不上。用生产者消费者,自己搭好环境后随意部署消费者,想用多进程就用多进程。
样本量不多的简单任务:数据切块甚至单线程跑就够了,别为了用模式而用模式。
附术语表
本页出现的关键术语,按首次出现顺序
| 术语 | 含义 |
|---|---|
| 教师模型 | 被学习的那个强模型。本页是 DeepSeek-R1,它的输出就是语料的唯一来源。 |
| 思维链 | 模型给出结论之前的推理过程。它是这条生产线要留住的东西,也是 <think> 标记里包的内容。 |
reasoning_content | R1 返回里存放推理过程的字段,与 content 并列、独立。 |
content | R1 返回里存放最终结论的字段,即给用户看的那段答案。 |
instruction / input / output | 训练语料三字段。instruction 是问题,input 是补充输入(通常留空字符串但键不能省),output 是 <think> 包住的推理加结论。 |
| jsonl | 一行一个 JSON 对象的文本格式。相对大 JSON 数组的好处:逐行读不吃内存、能断点续写、崩一次也只坏最后一行。 |
dataset_info.json | 数据集目录里的映射表,把数据集名(如 chat-train)映射到实际文件名(如 train.jsonl)。训练命令认的是名字。 |
| temperature | 采样温度。高则多样但易出问题,低则稳定但死板。造语料取 0.6,打分取 0.2。 |
max_tokens | 单次输出的 token 上限。取答案给 15000 防截断,打分压到 10 以省钱提速。 |
| simhash | 短文本去重算法:把文本压成定长指纹,指纹汉明距离小于阈值即判为重复。量大时先分桶再比对,避免两两比较。 |
| 拐点 | 长度分布里「再往后放宽也收不到多少样本」的那一档。大数据集的截断阈值按它定。 |
| 生产者 / 消费者 / 队列 | 批量作业的三件套。生产者拆任务入队,消费者出队执行并把结果入结果队列,队列是整个体系的核心。 |
finishedSet | 启动时从结果文件里重建的已完成 id 集合,断点续跑靠它跳过已处理样本。 |
| 毒丸(哨兵) | 放进队列用来通知消费者收工的特殊对象。没有它,while True 的消费者会永远阻塞在 get() 上。 |
| GIL | Python 的全局解释器锁。它导致计算密集型任务多开线程也只用得上一个核,所以这类任务必须用进程。 |