【案例】Streamlit + LangChain 智能聊天机器人
界面只是点单台:会话记忆、链路编排、流式输出全在后厨——换一个前端,后厨一行都不用改。
30″30 秒看懂这个案例
前五讲把中央厨房的每个工位都拆开讲过了:菜谱卡怎么填变量、传送带怎么把工位串起来、墙上那块备忘板怎么记住客人说过什么、店长怎么派外卖小哥跑腿。这一讲把它们装在一起,开门营业。
营业之后,多出来的只有一个东西:前厅的点单台。顾客站在点单台前说「我要一份番茄炒蛋,不要放葱」,点单台把这句话递进后厨,后厨照着流水线做完,再从传菜口一勺一勺端出来。顾客看不见备忘板,也看不见传送带——他只知道自己说了一句话,然后菜来了。
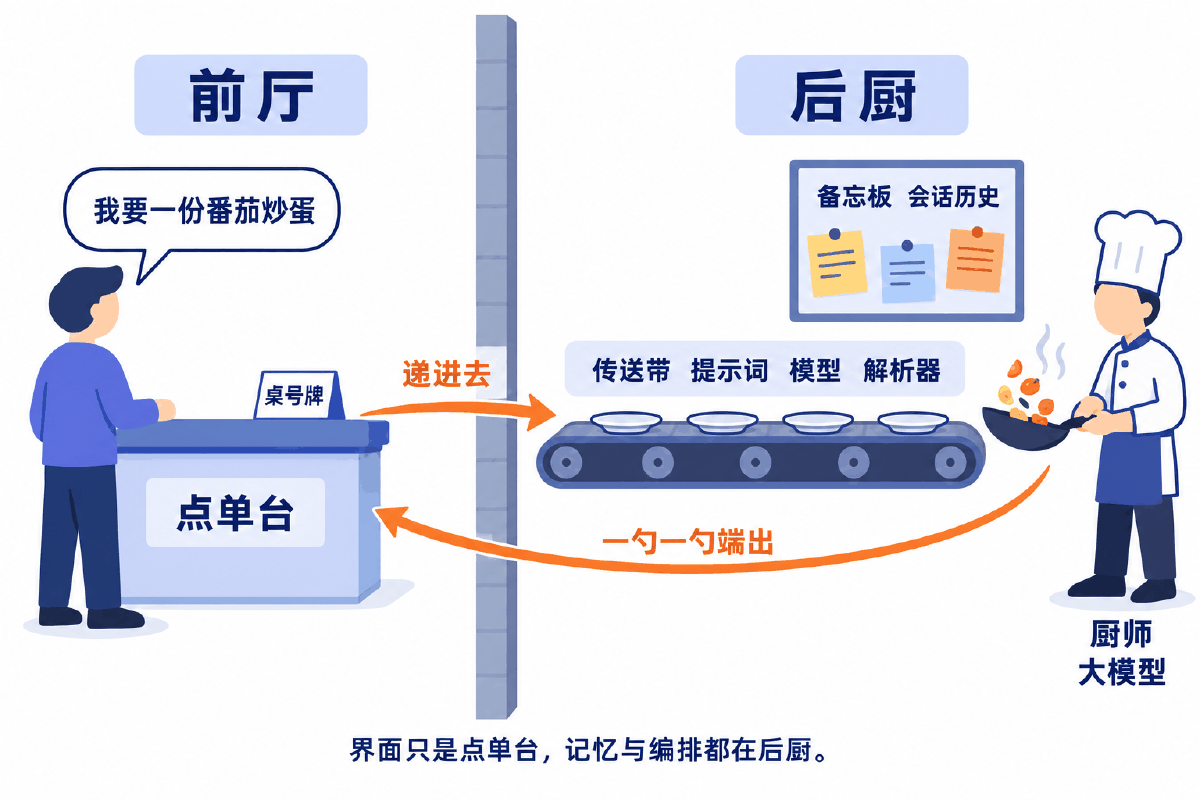
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 前厅点单台 | Streamlit 页面 | 收一句话、画气泡,不碰模型、不碰历史 |
| 点单台上的桌号牌 | session_id | 决定这一单归哪块备忘板,写错就串桌 |
| 后厨的传送带 | LCEL 链(prompt | model | parser) | 把人设、历史、这一问排好序送进模型 |
| 墙上那块备忘板 | BaseChatMessageHistory | 存这一桌说过的每一句,下一轮原样贴回菜谱卡 |
| 备忘板的限高线 | 历史修剪与 Token 预算 | 贴满了就撕掉最早的,人设那张永不撕 |
| 传菜口一勺一勺端 | 流式输出(stream) | 不等整盘做完,先让顾客尝到第一口 |
| 厨师 | 大模型 | 真正产出内容的人,云端或本地都行 |
chat_core.py 一个字没动。
st.chat_input 怎么用、为什么每次交互整个脚本会重跑一遍、session_state 为什么是唯一能跨重跑活下来的地方、Ollama 本地模型怎么接——在那一讲已经讲透,这里直接用结论,不重讲。本讲的新东西只有一件:把 LangChain 的链与记忆接进来。接进来之后,历史不再是你手工维护的一个列表,而是链自己会读、会写的一块备忘板;模型换云端还是换本地,也不再牵动界面。
01概念:先选路,再分层
三种搭建方式怎么选、三层架构为什么必须分开、引入 LangChain 换来了什么
1.1 搭一个聊天机器人,有三条路
聊天机器人是一种基于自然语言处理技术的软件程序,能通过文本或语音与用户交互:理解意图、维持多轮对话的连贯性、按用户偏好给出定制回答,必要时还能执行任务——查信息、下预订、控制设备。这些能力今天已经不需要从零造,问题只剩下一个:从哪条路开始。
| 路线 | 代表做法 | 要会什么 | 什么时候选它 |
|---|---|---|---|
| 无代码平台 | 可视化配置智能体,选模型、挂插件、写开场白,再接到公众号 | 不用写代码 | 需求简单、要快速上线;不追求私有化 |
| 开源框架开发 | 用对话库加 Web 框架自己搭 | 有编程基础 | 需求复杂、要高度定制;纯规则库的对话质量有限 |
| 大模型集成 | 本讲这条:本地或云端部署模型,用框架编排,自己写界面 | 编程 + 部署 | 要高质量对话且要掌控数据与链路 |
实际项目里这三条路并不互斥,常见的是结合其中一两种。本讲选的是「开源框架 + 大模型集成」的综合方案:后端用大模型提供对话能力,中间用 LangChain 编排链路与记忆,前端用 Streamlit 承载界面。这样既保住了数据与链路的掌控权,又不必为了一个输入框去写前端。
项目要达到的目标
理解并生成自然语言,中英文都能聊;能处理用户输入并给出准确、流畅的回复,而不是关键词匹配出来的模板话。
用户在页面输入文本,机器人实时响应并展示回复,对话过程流畅、延迟可控——这条要求直接决定了必须做流式。
输入框、对话展示区一目了然,回复实时展示在对话区域,不需要用户学怎么用。
1.2 三层架构:界面层 / 编排层 / 模型层
很多人写第一个版本时,把页面和调模型的代码全塞进一个文件。跑得起来,但只要界面一换、模型一换、记忆策略一改,就要整个重写。这个案例从第一行代码就分成三层:
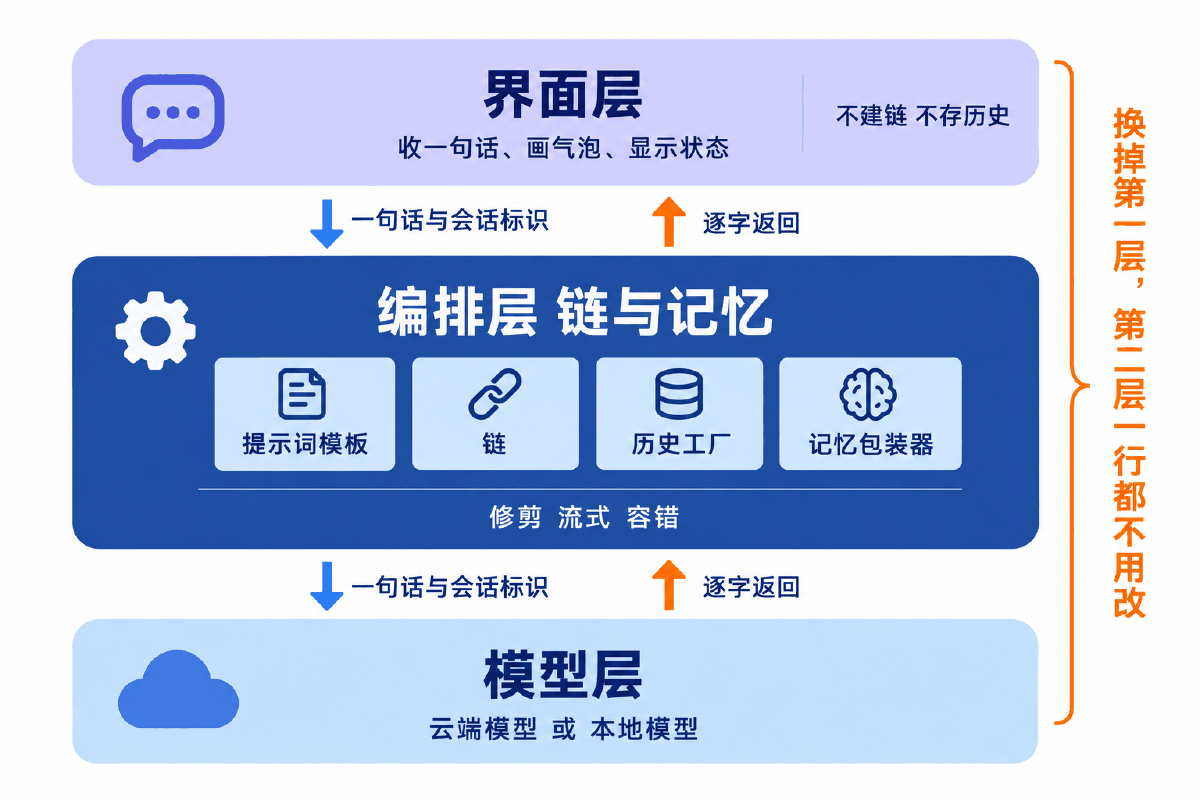
| 层 | 文件 | 只负责 | 绝不做 |
|---|---|---|---|
| 界面层 | chat_app.py | 收一句话、画气泡、显示状态 | 不建链、不存历史、不认识任何模型 |
| 编排层 | chat_core.py 及其依赖 | 建链、读写记忆、修剪、流式、兜底 | 不导入 streamlit,不打印任何东西 |
| 模型层 | 云端 API 或本地服务 | 真正算答案 | 不知道有没有界面这回事 |
分开写不是为了好看,是为了这四件具体的事:
| 好处 | 具体表现 |
|---|---|
| 界面可替换 | 换成命令行、Flask、企业微信回调,chat_core.py 一个字不用动(4.9 节实测) |
| 故障可隔离 | 出问题先单独跑 python3 chat_core.py——通了就是界面的锅,不通就是后厨的锅 |
| 改动可收敛 | 换模型、改人设、加重试、加日志、改修剪策略,全都只改编排层 |
| 记忆只有一份 | 历史只存在备忘板上,界面不再自己备一份——两边各存一份迟早对不上 |
1.3 引入 LangChain 换来了什么
不用框架也能做聊天机器人:自己拼 messages 列表、自己发请求、自己切历史。上一讲就是这么做的,而且做得通。那为什么还要多一层?
| 这件事 | 手工写法 | 接入 LangChain 之后 |
|---|---|---|
| 历史怎么进请求 | 自己维护列表,自己拼进请求体 | MessagesPlaceholder 是模板里的一个插槽,链自己会填 |
| 历史什么时候写回 | 手工 append,漏一次模型就失忆 | RunnableWithMessageHistory 调用前读、拿到回复后写 |
| 多会话隔离 | 自己维护「会话 ID → 列表」的字典 | 工厂函数按 session_id 取容器,隔离逻辑收在一处 |
| 换存储 | 调用处到处都要改 | 只换工厂函数,链上其余代码不动 |
| 换模型 | 请求体、字段名、流式格式各家不同 | init_chat_model("provider:model"),换一个字符串 |
| 流式 | 自己解析分片协议 | chain.stream(...) 直接给生成器 |
| 升级成 Agent | 从零实现「调用—执行—回填」循环 | 链换成 create_agent,界面层无感(4.10 节) |
换来的是统一的接口和可替换的零件;代价是多一层依赖、多一套概念要学。对一次性 demo 来说不划算,对一个要长期改、要换模型、要上多用户的应用来说,省下的是后面每一次改动的成本。
02原理:一句话在三层之间怎么走
调用链路、编排层的四个零件、会话隔离、修剪预算、流式传递
2.1 一次提问走过的完整路线
用户在页面敲下「我刚才说我叫什么」,回车。这一句话接下来要走七步,其中只有第 4 步在模型那边:
session_idsession_id 找到这一桌的历史容器| 步骤 | 谁干的 | 关键点 |
|---|---|---|
| ① | 界面层 | 桌号牌必须是服务端认过的,不能由前端随便传一个 |
| ② ③ ⑥ | RunnableWithMessageHistory | 读在调用前,写在拿到回复后,中间出异常这一轮就不会被写进去 |
| ④ | 模型 | 它不知道有历史这回事——历史对它来说就是这次请求里的普通消息 |
| ⑤ ⑦ | 链 + 界面 | 流式是一节一节往下传的,中间任何一节要攒齐才动,流就断在那里 |
2.2 编排层的四个零件
后厨看着复杂,拆开只有四个零件,缺一不可,多一个都算冗余:
ChatPromptTemplate 三段式:人设在最前、MessagesPlaceholder 在中间、本轮输入在最后。插槽就是「把备忘板整块贴进来」的位置。
prompt | model | parser。它本身完全不知道「记忆」这回事——链只管把输入变成输出,这正是它能被复用的原因。
给一个 session_id,返回这个会话的历史容器。换存储只换这一个函数,内存、文件、Redis 对链来说没有区别。
RunnableWithMessageHistory 把前三者接起来,负责调用前读、拿到回复后写。包完之后它仍然是一个 Runnable,invoke / stream 照常用。
| 参数 | 填什么 | 填错的现象 |
|---|---|---|
input_messages_key | 本轮输入在入参字典里的键名 | 抛键名相关的错,或历史写进去的是整个字典 |
history_messages_key | 模板里插槽的 variable_name | 历史填不进模板,表现为「完全没记忆」 |
| 工厂函数的入参 | 默认只有 session_id 一个 | 想按「用户 + 会话」两级隔离要另行声明字段 |
版本说明:这一套写法的来历
早期资料里常见的是 ConversationChain 配 ConversationBufferMemory,一行就能建出带记忆的对话。那一套现在已搬到 langchain-classic,不再是推荐写法;当代写法是「普通链 + RunnableWithMessageHistory」,也就是本讲用的这一套。
| 要做的事 | 早期写法 | 当代写法 |
|---|---|---|
| 建带记忆的对话 | ConversationChain + ConversationBufferMemory | prompt | model | parser 外包一层 RunnableWithMessageHistory |
| 建模型 | 各家伙伴包各自的类 | init_chat_model("provider:model") 统一入口 |
| Agent 带记忆 | memory 对象挂在执行器上 | create_agent(..., checkpointer=...) + thread_id |
| 导入旧链 | from langchain.chains import ... | from langchain_classic.chains import ... |
2.3 会话隔离:桌号牌决定你看到哪块板
线上不会只有一个人在聊天。谁看到哪块备忘板,完全由 session_id 决定——它是这个应用最敏感的一个字符串。
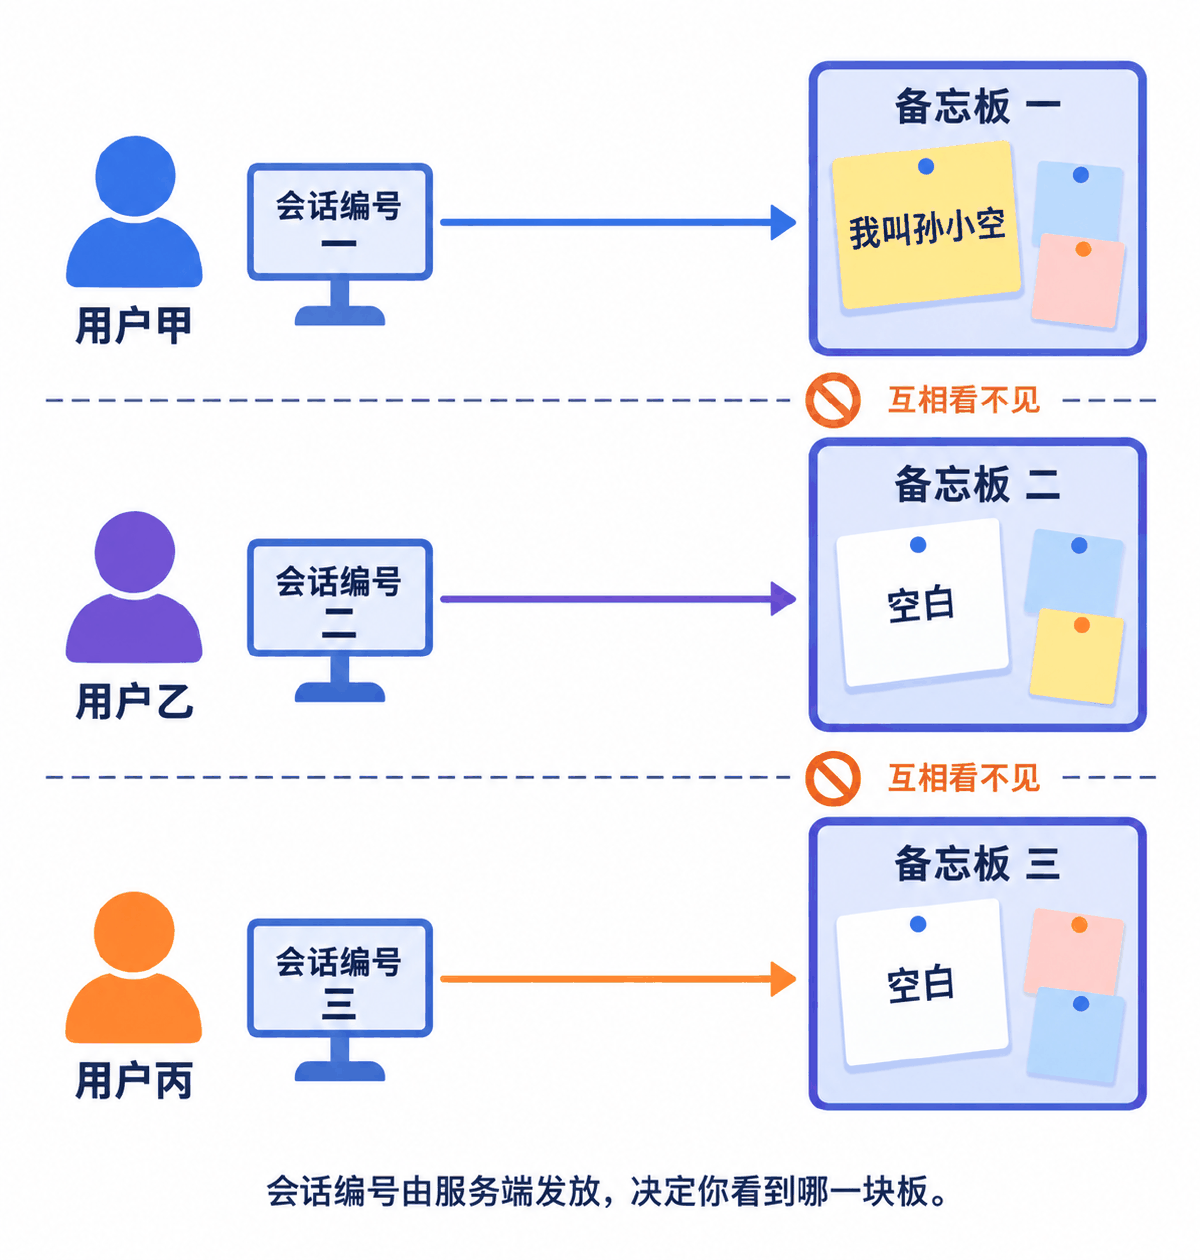
| 场景 | 会话 ID | 看到的历史 |
|---|---|---|
| 同一个人,同一段对话 | 一样 | 完整的上下文,记得住名字和订单号 |
| 同一个人,点了「新建对话」 | 换一个 | 空白——这正是「新建对话」该有的表现 |
| 两个人同时在用 | 各自不同 | 互相看不见,这是底线 |
| 会话 ID 由前端传、服务端不校验 | 可被篡改 | 改一个参数就能读到别人的会话 |
session_id 必须由服务端生成,或者由已验证的登录态派生。鉴权要在进入链之前做完,工厂函数里只做「按 key 取容器」这一件事。另外,会话 ID 不要拿手机号、邮箱这类可枚举的东西直接拼——那等于把别人的备忘板编号写在门口。多用户多会话的隔离机制本身在「会话记忆与多轮上下文」那一讲有完整拆解,这里只落地成应用里的一个模块。
2.4 修剪与 Token 预算:备忘板有限高线
一块板子贴不下无限张便签。对话越长,每轮送进模型的历史越长,后果依次发生:
| 尺子 | 怎么量 | 优点 | 缺点 |
|---|---|---|---|
| 按条数 | 只保留最近 N 条 | 算得快、好理解 | 消息长短不均时很不准,一条长文就顶穿 |
| 按 Token 预算 | trim_messages 按估算值从后往前留 | 与真实成本对齐 | 要一个计数函数,略慢 |
| 摘要压缩 | 把早期对话压成一段摘要 | 长对话也能保住要点 | 多一次模型调用,摘要本身可能丢细节 |
② 裁完不要以一句孤立的回答开头。历史第一条是助手的回答而没有对应的提问,模型会试图为它补一个语境,容易跑偏。
2.5 流式:从模型一路传到界面
同样一段两百字的回答,一次性返回要等模型全部生成完才给你,用户盯着空白等好几秒;流式是生成一点吐一点,首字延迟通常是前者的几分之一。内容总量没变,变的是等待体感——而项目需求里「对话过程流畅、延迟可控」这条,靠的就是它。
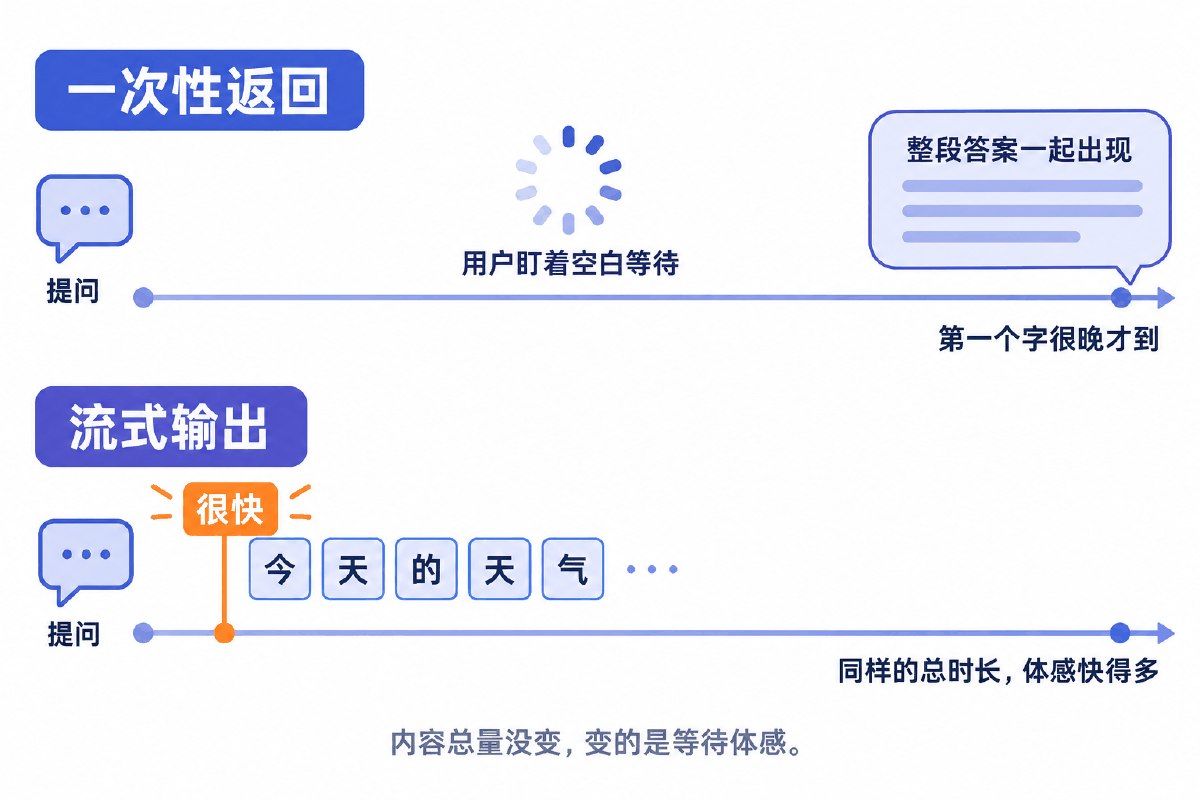
流式没有任何魔法,它就是一条逐节传递的管道:
| 入口 | 拿到的是 | 用在哪 |
|---|---|---|
invoke | 完整结果 | 后台任务、批处理、要拿整段做后处理时 |
stream | 最终输出的增量片段 | 聊天界面逐字显示,本讲主用 |
astream_events | 链上每一步的事件 | 要在界面显示「正在检索…/正在生成…」 |
现象是:代码里明明写了
stream,界面却卡半天然后整段蹦出来。排查方法是把可疑的那一节摘掉再试一次。链本身的流式机制在「LCEL 与链的组合」那一讲有更细的拆解。
session_id 决定「看到哪块板」,备忘板决定「模型记不记得」,流式决定「用户等多久看到第一个字」。这三件事都在后厨,界面一件也不参与——这就是本讲铁律的具体含义。
03最小代码:八十行跑通一个带记忆的聊天页
先把最短的一条路走完,再去拆完整案例
完整案例有十来个文件,但剥掉持久化、修剪、重试、模型切换之后,真正让它成立的只有八十行。先把这八十行跑通,后面每一节都只是在往上加一件事。
RunnableWithMessageHistory 负责读与写stream 交给界面渲染# -*- coding: utf-8 -*-
"""
最小可跑:Streamlit 点单台 + LangChain 后厨
============================================
全文只有三件事:
1. 建一条带记忆的链(编排层,不认识 Streamlit)
2. 页面把会话 ID 和这一轮问题递进去
3. 把返回的文本画成气泡
启动:streamlit run min_app.py
依赖:pip install streamlit langchain langchain-openai
"""
import os
import uuid
import streamlit as st
from langchain.chat_models import init_chat_model
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory
# ---------------------------------------------------------------- 后厨
_store = {}
def get_history(session_id: str) -> InMemoryChatMessageHistory:
"""一个会话 ID 对应一块独立的备忘板。"""
if session_id not in _store:
_store[session_id] = InMemoryChatMessageHistory()
return _store[session_id]
@st.cache_resource(show_spinner=False)
def build_chain():
"""@st.cache_resource 让这条链只建一次,不随页面重跑反复创建。"""
model = init_chat_model(
os.environ.get("CHAT_MODEL", "openai:gpt-4o-mini"),
temperature=0.3,
api_key=os.environ.get("OPENAI_API_KEY"),
)
prompt = ChatPromptTemplate.from_messages([
("system", "你是一个中文智能助手,回答简洁、准确。"),
MessagesPlaceholder(variable_name="history"),
("human", "{question}"),
])
chain = prompt | model | StrOutputParser()
return RunnableWithMessageHistory(
chain,
get_history,
input_messages_key="question",
history_messages_key="history",
)
# ---------------------------------------------------------------- 前厅
st.title("智能聊天机器人")
# 会话 ID 由服务端生成,存进 session_state,一个浏览器标签一份
if "sid" not in st.session_state:
st.session_state["sid"] = str(uuid.uuid4())
if "bubbles" not in st.session_state:
st.session_state["bubbles"] = []
for role, text in st.session_state["bubbles"]:
with st.chat_message(role):
st.markdown(text)
question = st.chat_input("说点什么")
if question:
st.session_state["bubbles"].append(("user", question))
with st.chat_message("user"):
st.markdown(question)
conversation = build_chain()
cfg = {"configurable": {"session_id": st.session_state["sid"]}}
with st.chat_message("assistant"):
# 链的 stream 直接就是生成器,交给界面边收边渲染
answer = st.write_stream(
conversation.stream({"question": question}, config=cfg))
st.session_state["bubbles"].append(("assistant", answer))
| 这一处 | 作用 | 去掉会怎样 |
|---|---|---|
get_history 里的 if | 同一个会话 ID 复用同一块板 | 每轮新建一块空板,永远没有记忆 |
MessagesPlaceholder | 历史贴进模板的位置 | 历史读出来了也填不进去,等于没读 |
history_messages_key="history" | 告诉包装器往哪个插槽填 | 键名对不上,表现同样是「完全没记忆」 |
@st.cache_resource | 链只建一次 | 每次交互重建链与客户端,变慢且白白占连接 |
config={"configurable": {"session_id": ...}} | 这一单归哪块板 | 不传会直接报错,随手写死则所有人共用一块板 |
st.write_stream(...) | 边收边画,并返回完整文本 | 改成一次性返回,用户要盯着空白等完 |
bubbles 列表
最小版本图省事,界面自己存了一份气泡用于重绘。完整案例会把它删掉,改成直接从备忘板读——因为两边各存一份,迟早会出现「屏幕上有、模型没看见」的错位。这一处正是最小版和可交付版的第一个分水岭。
os.environ.get(...),不出现任何密钥字面量,也不把密钥打进日志或页面。换模型、换环境时改环境变量即可——改源码就一定会漏改。启动前先把 CHAT_MODEL 与凭据配好,再 streamlit run min_app.py。
04完整案例:从最小版长成可交付的应用
先把后厨拆成能替换的零件,再装上前厅,最后逐项补齐交付要求
最小版有四个说不过去的地方:历史存在进程里重启就没、无限增长、会话 ID 随手生成没人校验、模型一抖整页崩。下面按顺序把它们补上。每一节只解决一个问题,代码文件也一一对应——这正是分层的另一个好处:每个问题都有明确的归属文件。
| 文件 | 层 | 解决的问题 |
|---|---|---|
chat_core.py | 编排层 | 建链、装记忆,对外只暴露四个函数 |
history_store.py | 编排层 | 历史存在哪:内存 / 文件 / 可换 Redis |
trim_policy.py | 编排层 | 按条数或 Token 预算修剪,人设不裁 |
session_keys.py | 编排层 | 会话 ID 的生成、派生与校验 |
stream_bridge.py | 编排层 | 流式的三种消费方式与首字延迟度量 |
resilience.py | 编排层 | 失败分类、退避重试、超时兜底 |
model_switch.py | 编排层 | 云端与本地模型共用同一套编排 |
agent_mode.py | 编排层 | 把链换成 Agent,界面层无感 |
chat_app.py | 界面层 | Streamlit 页面,只收单只画气泡 |
cli_probe.py | 界面层 | 同一个后厨换成命令行,验证分层成立 |
4.1 编排层:整个后厨收在一个文件里
它对外只暴露四个函数——reply、reply_stream、history_of、reset。界面层只认这四个,其余全是内部实现。这个文件不导入界面库,也不打印任何东西。
# -*- coding: utf-8 -*-
"""
编排层:chat_core.py —— 整个后厨都在这一个文件里
==================================================
它对外只暴露四个函数,界面层只认这四个:

  reply(session_id, question)          一次性拿完整答案
  reply_stream(session_id, question)   生成器,边算边吐
  history_of(session_id)               取这块备忘板上的消息,用来重放气泡
  reset(session_id)                    清空这块备忘板

这个文件不导入 streamlit,也不打印任何东西。
换 Flask、换命令行、换企业微信回调,都能原样搬走。
"""

import os
from typing import Iterator, List

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import BaseChatMessageHistory
from langchain_core.messages import BaseMessage
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory

from history_store import get_history
from trim_policy import trim_history

SYSTEM_PROMPT = os.environ.get(
    "SYSTEM_PROMPT",
    "你是一个中文智能助手。回答简洁、准确、有条理。\n"
    "只依据用户提供的信息和你确知的常识回答;不确定就直说不确定,不要编造。",
)

MODEL_NAME = os.environ.get("CHAT_MODEL", "openai:gpt-4o-mini")
TEMPERATURE = float(os.environ.get("CHAT_TEMPERATURE", "0.3"))


def _build_prompt() -> ChatPromptTemplate:
    """三段式:人设在最前、历史插槽在中间、本轮输入在最后。

    MessagesPlaceholder 就是「把备忘板整块贴进来」的那个插槽,
    顺序写错(历史放到本轮输入之后)会让模型把旧话当成最新指令。
    """
    return ChatPromptTemplate.from_messages([
        ("system", SYSTEM_PROMPT),
        MessagesPlaceholder(variable_name="history"),
        ("human", "{question}"),
    ])


def _build_model():
    """密钥与模型名全部走环境变量,源码里不出现任何凭据。"""
    return init_chat_model(
        MODEL_NAME,
        temperature=TEMPERATURE,
        api_key=os.environ.get("OPENAI_API_KEY"),
        timeout=float(os.environ.get("CHAT_TIMEOUT", "60")),
        max_retries=int(os.environ.get("CHAT_MAX_RETRIES", "2")),
    )


def _history_with_trim(session_id: str) -> BaseChatMessageHistory:
    """工厂函数:取出这个会话的备忘板,顺手按预算修剪一次。

    修剪放在这里而不是放在界面层,是因为「一块板子最多贴多少张便签」
    属于后厨的规矩,前厅不该知道。
    """
    history = get_history(session_id)
    trim_history(history)
    return history


_chain = _build_prompt() | _build_model() | StrOutputParser()

conversation = RunnableWithMessageHistory(
    _chain,
    _history_with_trim,
    input_messages_key="question",
    history_messages_key="history",
)


def _cfg(session_id: str) -> dict:
    return {"configurable": {"session_id": session_id}}


def reply(session_id: str, question: str) -> str:
    return conversation.invoke({"question": question}, config=_cfg(session_id))


def reply_stream(session_id: str, question: str) -> Iterator[str]:
    """把链的增量片段原样透出去;写历史由 RunnableWithMessageHistory 负责。"""
    for chunk in conversation.stream({"question": question},
                                     config=_cfg(session_id)):
        if chunk:
            yield chunk


def history_of(session_id: str) -> List[BaseMessage]:
    return list(get_history(session_id).messages)


def reset(session_id: str) -> None:
    get_history(session_id).clear()


if __name__ == "__main__":
    # 脱离界面自测:通了说明后厨没问题,之后页面出错就是前厅的事
    sid = "selftest"
    print(reply(sid, "我叫孙小空,请记住"))
    print(reply(sid, "我叫什么名字?"))
    print("这块备忘板上有 %d 条消息" % len(history_of(sid)))
| 设计点 | 为什么这么写 |
|---|---|
| 修剪放在工厂函数里 | 「一块板最多贴多少张便签」是后厨的规矩,前厅不该知道;放这里还能保证每次取板都顺手修一次 |
| 人设、模型名、温度全走环境变量 | 换环境不改源码;密钥更是只能走环境变量 |
timeout 与 max_retries 交给模型客户端 | 能在客户端解决的就别自己造轮子,外层只做兜底与文案翻译(4.7 节) |
reply_stream 跳过空片段 | 末片经常是空字符串,直接往界面上灌会多出无意义的渲染 |
带 __main__ 自测块 | 能脱离界面单独跑,排查时这一点值一百行日志 |
python3 chat_core.py 能打印出「你叫孙小空」,后厨就算过了。通了再写界面——之后页面出任何问题,你都能确定后厨这条链是好的。
4.2 历史存在哪:换存储只换一个函数
进程内字典有三个致命问题:重启即丢、多副本各存各的、内存只涨不降。前两个在单机开发时看不出来,一上线就集中爆发:用户刷新页面发现对话没了,或者同样的问题在两台机器上得到完全不同的上下文。
# -*- coding: utf-8 -*-
"""
备忘板的容器:history_store.py
================================
会话历史要存在哪,是整个应用最容易被低估的一个决定。

  进程内字典   开发够用;重启即丢、多副本各存各的、内存只涨不降
  本地文件     单机部署可用,重启还在;并发写要加锁
  Redis / 库   多副本、要过期、要审计时的正解

换存储只要换掉 get_history 的实现,链上其余代码一个字不用改——
这正是把工厂函数单独拿出来的价值。
"""

import json
import os
import threading
from typing import Dict, List

from langchain_core.chat_history import BaseChatMessageHistory
from langchain_core.messages import BaseMessage, messages_from_dict, messages_to_dict

BACKEND = os.environ.get("HISTORY_BACKEND", "memory")   # memory | file
DATA_DIR = os.environ.get("HISTORY_DIR", "./chat_history")

_lock = threading.Lock()
_mem: Dict[str, BaseChatMessageHistory] = {}


class FileChatMessageHistory(BaseChatMessageHistory):
    """把一个会话的消息落成一个 JSON 文件。

    只需要实现三个成员,LangChain 就认它:
      messages      属性,返回 List[BaseMessage]
      add_messages  追加若干条,传空列表要能安全返回
      clear         清空本会话,对应界面上的「新建对话」
    """

    def __init__(self, session_id: str, directory: str = DATA_DIR):
        # 会话 ID 直接当文件名会被 ../ 穿越,只留安全字符
        safe = "".join(c for c in session_id if c.isalnum() or c in "-_")[:64]
        os.makedirs(directory, exist_ok=True)
        self.path = os.path.join(directory, "%s.json" % (safe or "anonymous"))

    @property
    def messages(self) -> List[BaseMessage]:
        if not os.path.exists(self.path):
            return []
        try:
            with open(self.path, encoding="utf-8") as f:
                return messages_from_dict(json.load(f))
        except (ValueError, OSError):
            # 单个会话文件写坏,不应该让整个应用起不来
            return []

    def add_messages(self, messages: List[BaseMessage]) -> None:
        if not messages:
            return
        with _lock:
            merged = self.messages + list(messages)
            tmp = self.path + ".tmp"
            with open(tmp, "w", encoding="utf-8") as f:
                json.dump(messages_to_dict(merged), f, ensure_ascii=False)
            os.replace(tmp, self.path)     # 原子替换,进程被杀也不会留半个文件

    def clear(self) -> None:
        with _lock:
            if os.path.exists(self.path):
                os.remove(self.path)


def get_history(session_id: str) -> BaseChatMessageHistory:
    """工厂函数:给一个会话 ID,返回它专属的那块备忘板。"""
    if BACKEND == "file":
        return FileChatMessageHistory(session_id)

    from langchain_core.chat_history import InMemoryChatMessageHistory
    with _lock:
        if session_id not in _mem:
            _mem[session_id] = InMemoryChatMessageHistory()
        return _mem[session_id]


def known_sessions() -> List[str]:
    """运维用:当前有哪些会话。内存版看字典,文件版看目录。"""
    if BACKEND == "file":
        if not os.path.isdir(DATA_DIR):
            return []
        return sorted(f[:-5] for f in os.listdir(DATA_DIR)
                      if f.endswith(".json"))
    return sorted(_mem)


if __name__ == "__main__":
    from langchain_core.messages import AIMessage, HumanMessage

    h = get_history("demo-001")
    h.add_messages([HumanMessage(content="我叫孙小空"),
                    AIMessage(content="记住了")])
    print("demo-001:", len(h.messages), "条")
    print("demo-002:", len(get_history("demo-002").messages), "条")   # 0
    print("当前会话:", known_sessions())
| 要实现的成员 | 约定 |
|---|---|
messages | 属性,返回消息列表;读不出来时返回空列表而不是抛异常 |
add_messages(msgs) | 追加若干条;传空列表要能安全返回 |
clear() | 清空本会话,对应界面上的「新建对话」 |
| 存储 | 重启还在 | 多副本共享 | 适用 |
|---|---|---|---|
| 进程内字典 | 否 | 否 | 开发与调试 |
| 本地文件 | 是 | 否(除非共享盘) | 单机部署、内部小范围使用 |
| Redis / 数据库 | 是 | 是 | 多副本、要过期、要审计 |
../ 的 ID 就能写到任意目录,所以只保留安全字符并截断长度。② 先写临时文件再原子替换。直接覆盖写,进程在中途被杀就会留下半个 JSON,下次启动整个会话读不出来。
4.3 修剪策略:两把尺子,一条底线
原理在 2.4 节讲过了,这里落地成一个可以单独跑的模块。两把尺子按需要选,底线只有一条:人设不能被裁掉。
# -*- coding: utf-8 -*-
"""
历史修剪与 Token 预算:trim_policy.py
=======================================
一块备忘板贴不下无限张便签。对话越长,每一轮送进模型的历史越长,
后果依次是:变慢 → 变贵 → 超出上下文窗口后被静默截断。

这里提供两把尺子,按需要选一把:

  按条数   trim_by_count   算得快,长短不均时不准
  按 Token trim_by_tokens  贵一点但准,生产建议用它

两把尺子都必须保证一件事:**system 那一条不能被裁掉**,
否则聊到几十轮后人设突然消失,表现为机器人「性格突变」。
"""

import os
from typing import List

from langchain_core.chat_history import BaseChatMessageHistory
from langchain_core.messages import BaseMessage, trim_messages

MAX_MESSAGES = int(os.environ.get("MAX_MESSAGES", "20"))
MAX_TOKENS = int(os.environ.get("MAX_TOKENS", "3000"))
STRATEGY = os.environ.get("TRIM_STRATEGY", "count")     # count | tokens


def _approx_tokens(messages: List[BaseMessage]) -> int:
    """粗略估算:中文按 1 字 ≈ 1 token 上限估,宁可高估也不要低估。

    真实计费以模型侧 tokenizer 为准,这里只用来做预算控制。
    """
    total = 0
    for m in messages:
        text = m.content if isinstance(m.content, str) else str(m.content)
        total += len(text) + 4          # 每条消息本身的角色与分隔开销
    return total


def trim_by_count(messages: List[BaseMessage],
                  limit: int = MAX_MESSAGES) -> List[BaseMessage]:
    """保留最近 limit 条,并且从一条用户消息开始,避免以孤立回答开头。"""
    if len(messages) <= limit:
        return list(messages)
    kept = list(messages[-limit:])
    while kept and kept[0].type == "ai":
        kept.pop(0)
    return kept


def trim_by_tokens(messages: List[BaseMessage],
                   limit: int = MAX_TOKENS) -> List[BaseMessage]:
    """用 langchain_core 的 trim_messages 按预算从后往前保留。

    start_on="human" 保证裁剪后第一条是用户消息;
    include_system=True 保证 system 不参与裁剪。
    """
    return trim_messages(
        messages,
        max_tokens=limit,
        strategy="last",
        token_counter=_approx_tokens,
        start_on="human",
        include_system=True,
        allow_partial=False,
    )


def trim_history(history: BaseChatMessageHistory) -> int:
    """就地修剪一块备忘板,返回裁掉的条数。

    实现方式是「清空再写回保留部分」,因为 BaseChatMessageHistory
    的公共约定里只有 add_messages 和 clear,没有「删掉前 N 条」。
    """
    messages = list(history.messages)
    if not messages:
        return 0

    kept = (trim_by_tokens(messages) if STRATEGY == "tokens"
            else trim_by_count(messages))
    dropped = len(messages) - len(kept)
    if dropped > 0:
        history.clear()
        history.add_messages(kept)
    return dropped


if __name__ == "__main__":
    from langchain_core.messages import AIMessage, HumanMessage, SystemMessage

    demo = [SystemMessage(content="你是客服助手")]
    for i in range(1, 16):
        demo.append(HumanMessage(content="第 %d 个问题" % i))
        demo.append(AIMessage(content="第 %d 个回答" % i))

    by_count = trim_by_count(demo, 8)
    by_token = trim_by_tokens(demo, 120)
    print("原始 %d 条,估算 %d token" % (len(demo), _approx_tokens(demo)))
    print("按条数保留 %d 条,首条是 %s" % (len(by_count), by_count[0].type))
    print("按预算保留 %d 条,system 还在:%s"
          % (len(by_token), any(m.type == "system" for m in by_token)))
| 参数 | 作用 | 怎么定 |
|---|---|---|
strategy="last" | 从后往前保留 | 对话场景固定这个;"first" 用在要保住开头的场景 |
start_on="human" | 裁完第一条必须是用户消息 | 避免以孤立回答开头 |
include_system=True | 人设不参与裁剪 | 这一条就是底线本身 |
token_counter | 怎么算长度 | 示例用字符数粗估,宁可高估;生产可换成模型侧的计数 |
add_messages 和 clear,没有「删掉前 N 条」这种方法。所以就地修剪的通用做法是:读出来、算出要保留的部分、清空、再写回去。换成 Redis 实现时同理,只是这三步都发生在服务端。
4.4 会话标识:这个应用最敏感的字符串
匿名访客用随机 ID,登录用户由已验证的身份派生。不管哪种,都要经过一次校验再进链。
# -*- coding: utf-8 -*-
"""
会话标识:session_keys.py
==========================
一个线上的聊天应用永远不止一个人在用。谁看到哪块备忘板,
全靠一个 session_id 决定——**它是这个应用最敏感的一个字符串**。

三条规矩:

  1. 会话 ID 由服务端生成或校验,绝不直接采信前端传来的值
  2. 一个人可以有多段会话(新建对话 = 换一块空白备忘板)
  3. 会话 ID 不要拿用户手机号、邮箱这类可枚举的东西直接拼

这里给出两种生成方式:匿名随机 ID,和登录态派生 ID。
"""

import hashlib
import hmac
import os
import re
import uuid

SECRET = os.environ.get("SESSION_SECRET", "")
SAFE = re.compile(r"^[A-Za-z0-9_-]{8,64}$")


def new_anonymous_id() -> str:
    """匿名访客:随机一个,够长、不可猜。"""
    return "anon-" + uuid.uuid4().hex


def derive_id(user_id: str, conversation_id: str) -> str:
    """登录用户:由服务端已验证的身份派生,前端改不动。

    用 HMAC 而不是直接拼接,是为了让 ID 既稳定(同一个人同一段会话
    每次算出来都一样)又不可反推(拿到 ID 也猜不出用户是谁)。
    """
    if not SECRET:
        raise RuntimeError("未配置 SESSION_SECRET,拒绝派生会话 ID")
    raw = "%s|%s" % (user_id, conversation_id)
    digest = hmac.new(SECRET.encode("utf-8"), raw.encode("utf-8"),
                      hashlib.sha256).hexdigest()
    return "u-" + digest[:40]


def validate(session_id: str) -> str:
    """任何从外部进来的会话 ID 都要先过这一关。

    不合格就抛异常,而不是「兜底给一个默认值」——
    默认值意味着所有非法请求共用同一块备忘板,那是最糟的串话方式。
    """
    if not session_id or not SAFE.match(session_id):
        raise ValueError("非法的会话标识")
    return session_id


def fingerprint(session_id: str) -> str:
    """写日志时用这个短指纹,不要把完整会话 ID 落进日志文件。"""
    return hashlib.sha256(session_id.encode("utf-8")).hexdigest()[:8]


if __name__ == "__main__":
    a = new_anonymous_id()
    print("匿名会话:", a, "→ 校验通过:", validate(a) == a)
    print("日志指纹:", fingerprint(a))

    os.environ["SESSION_SECRET"] = "demo-secret-do-not-use-in-production"
    SECRET = os.environ["SESSION_SECRET"]
    s1 = derive_id("u1001", "c1")
    s2 = derive_id("u1001", "c2")
    s3 = derive_id("u2002", "c1")
    print("同人不同会话是否相同:", s1 == s2)      # False
    print("不同人同会话号是否相同:", s1 == s3)    # False
    print("同一入参两次是否稳定:", s1 == derive_id("u1001", "c1"))   # True

    for bad in ["", "../../etc/passwd", "abc"]:
        try:
            validate(bad)
        except ValueError as e:
            print("拒绝 %r:%s" % (bad, e))
| 做法 | 得到的 ID | 为什么 |
|---|---|---|
| 匿名随机 | 一段随机十六进制 | 够长、不可猜;浏览器标签关掉就作废 |
| 登录态派生 | 身份的 HMAC 摘要前缀 | 既稳定又不可反推:同一人同一段会话每次算出来一样,拿到 ID 也猜不出是谁 |
| 校验不合格直接抛异常 | — | 不要兜底给默认值——那意味着所有非法请求共用一块板,是最糟的串话方式 |
| 日志只记短指纹 | 八位哈希 | 能判重复、还原不出会话,也就读不到别人的历史 |
用户ID + 会话号 拼成字符串当 key,看着也能隔离,但规律太明显:知道同事的工号就能算出他的会话 key。用 HMAC 派生的成本只有几行,换来的是「拿到一个 ID 也推不出下一个」。
4.5 界面层:删掉那份多余的气泡列表
和最小版最大的差别在这里:界面不再自己存消息。气泡的数据源就是备忘板,页面重绘时从后厨读一遍画出来。两边只留一份,就不会对不上。
# -*- coding: utf-8 -*-
"""
界面层:chat_app.py —— 只负责点单,不进后厨
==============================================
这个文件里没有一行 LangChain 代码。它只做四件事:

  1. 拿到这次会话的 session_id
  2. 把备忘板上的历史重放成气泡
  3. 收一句话,交给 chat_core
  4. 把返回的字流画出来

Streamlit 控件本身的机制(每次交互整脚本重跑、session_state 为什么必须用)
在「私有聊天机器人」那一讲已经讲透,这里只用结论。

启动:streamlit run chat_app.py
"""

import streamlit as st

import chat_core
import session_keys

st.set_page_config(page_title="智能聊天机器人", page_icon="💬")

# ① 会话标识:服务端生成一次,之后这一个浏览器标签一直用它
if "sid" not in st.session_state:
    st.session_state["sid"] = session_keys.new_anonymous_id()
sid = st.session_state["sid"]

# ② 侧边栏:把「当前连的是哪个模型、这块板上有多少条」摆出来
with st.sidebar:
    st.caption("会话指纹:%s" % session_keys.fingerprint(sid))
    st.caption("模型:%s" % chat_core.MODEL_NAME)
    st.caption("历史消息:%d 条" % len(chat_core.history_of(sid)))
    if st.button("新建对话"):
        chat_core.reset(sid)
        st.session_state["sid"] = session_keys.new_anonymous_id()
        st.rerun()

st.title("智能聊天机器人")

# ③ 重放历史:气泡的数据源是后厨的备忘板,界面自己不再存一份
#    两边各存一份迟早会对不上:界面上有、模型看不见,是最难查的那类 bug
ROLE = {"human": "user", "ai": "assistant"}
for message in chat_core.history_of(sid):
    role = ROLE.get(message.type)
    if role:
        with st.chat_message(role):
            st.markdown(message.content)

# ④ 收一句话,交给后厨
question = st.chat_input("输入你的问题")
if question:
    with st.chat_message("user"):
        st.markdown(question)

    with st.chat_message("assistant"):
        try:
            # write_stream 边收边画,返回值是拼好的完整文本
            st.write_stream(chat_core.reply_stream(sid, question))
        except Exception as exc:                      # noqa: BLE001
            # 后厨出故障时,页面要还在、错误要看得见,不能整页崩掉
            st.error("这次没能回答:%s" % exc)
            st.caption("稍后重试;若持续失败,检查模型服务与网络。")
| 段落 | 做什么 | 漏了会怎样 |
|---|---|---|
| ① 会话标识 | 首次打开生成一个,存进页面状态 | 每次交互换一个 ID,永远没有记忆 |
| ② 侧边栏 | 显示会话指纹、模型、历史条数 | 排查时问不清对方连的是哪台、聊了多久 |
| ③ 重放历史 | 从备忘板读出来画气泡 | 页面上只剩最新一条 |
| ④ 收单与流式 | 交给后厨,边收边画 | — |
| 异常兜底 | try 包住调用,出错时给红条 | 模型服务没起时整页崩掉,用户只会说「你这东西坏了」 |
| 新建对话 | 清空旧板 + 换新 ID + 触发重绘 | 点了没反应,或者换了 ID 旧板却留在内存里不释放 |
human / ai / system,而界面的气泡角色是 user / assistant。代码里用一个字典做映射,并且顺手把 system 过滤掉——人设是给模型看的,不该出现在用户屏幕上。
4.6 流式与度量:盯住首字延迟
流式做没做对,看一个数字就够了:首字延迟。它是用户按下回车到看见第一个字的时间,也是「这东西反应快不快」的全部主观来源。
# -*- coding: utf-8 -*-
"""
流式怎么一路从模型传到界面:stream_bridge.py
==============================================
链的 stream() 本身就是一个生成器,中间没有任何魔法:
模型每吐一小块,链上每一节把它加工一下往下传,最后到你手里。

这个文件演示三件事:

  1. 最朴素的消费:for chunk in chain.stream(...)
  2. 把生成器包一层,顺带统计首字延迟、片数、总字数
  3. 用 astream_events 观察「现在流的是链上哪一节」

界面侧只需要拿到一个生成器,Streamlit 的 st.write_stream 会边收边画,
并把拼好的完整文本作为返回值给你——所以「流式显示」和
「把完整回答写回历史」两件事一行就办完了。
"""

import os
import time
from typing import Iterable, Iterator

from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个中文助手,回答控制在 200 字以内。"),
    ("human", "{question}"),
])
model = init_chat_model(os.environ.get("CHAT_MODEL", "openai:gpt-4o-mini"),
                        temperature=0.3,
                        api_key=os.environ.get("OPENAI_API_KEY"))
chain = prompt | model | StrOutputParser()


def measured(chunks: Iterable[str]) -> Iterator[str]:
    """包一层做度量:首字延迟是聊天体验里最该盯的那个数字。

    注意它仍然是生成器——包装不能把流攒起来,否则就退化成一次性返回。
    """
    started = time.time()
    first_at = None
    pieces = 0
    chars = 0
    for chunk in chunks:
        if not chunk:
            continue                      # 末片常常是空的,跳过
        if first_at is None:
            first_at = time.time() - started
        pieces += 1
        chars += len(chunk)
        yield chunk
    total = time.time() - started
    print("首字 %.2fs | 共 %d 片 %d 字 | 总耗时 %.2fs"
          % (first_at or total, pieces, chars, total))


def stream_text(question: str) -> Iterator[str]:
    return measured(chain.stream({"question": question}))


async def watch_events(question: str) -> None:
    """想在界面上显示「正在检索…」「正在生成…」时用它。

    astream_events 给的是链上每一步的事件,而不只是最终文本:
    on_chat_model_stream 才是模型吐字,其余是节点的开始与结束。
    """
    async for ev in chain.astream_events({"question": question}):
        kind = ev["event"]
        if kind == "on_chat_model_stream":
            piece = ev["data"]["chunk"].content
            if piece:
                print(piece, end="", flush=True)
        elif kind in ("on_chain_start", "on_chain_end"):
            print("\n[%s] %s" % (kind, ev.get("name")))


if __name__ == "__main__":
    for piece in stream_text("用三句话解释什么是流式输出"):
        print(piece, end="", flush=True)
    print()

    # 事件版需要异步环境:
    # import asyncio; asyncio.run(watch_events("同上"))
| 观察到的现象 | 多半是什么原因 |
|---|---|
| 只收到一片,且很晚才到 | 链上有一节要攒齐才动,或反向代理把流缓冲住了 |
| 片数正常但首字很慢 | 输入太长(历史没修剪)、模型排队、或本地模型算力不足 |
| 片数正常但界面一次性蹦出来 | 包装函数把生成器攒成了列表,包装不能破坏流 |
| 末尾多出一个空气泡 | 没跳过空片段 |
4.7 重试与超时:失败要分类
模型调用是一次跨网络的远程请求,它一定会失败,只是频率问题。把失败分成三类,处理方式完全不同:
| 类别 | 典型 | 该怎么做 | 给用户看什么 |
|---|---|---|---|
| 可重试 | 限流、5xx、连接超时 | 退避后再试,多半能成 | 「访问的人有点多,稍等几秒」 |
| 不可重试 | 凭据无效、参数错误 | 立刻失败,再试一百次也一样 | 「服务配置有问题,请联系管理员」 |
| 超时 | 总耗时超过时限 | 主动掐断 | 「这次等待超时了,换个更短的问法」 |
# -*- coding: utf-8 -*-
"""
错误处理、重试与超时:resilience.py
=====================================
模型调用是一次跨网络的远程请求,它一定会失败,只是频率问题。
把失败分成三类,处理方式完全不同:

  可重试   429 限流、5xx、连接超时 —— 退避后再试,多半能成
  不可重试 401 密钥错、400 参数错  —— 再试一百次也一样,直接报错
  超时     用户已经等太久          —— 主动掐断,给一句人话

重试次数与超时时间最好交给模型客户端自己做(init_chat_model 的
max_retries / timeout),这里再包一层是为了:统一兜底文案、
把技术异常翻译成用户看得懂的话、给运维留一条可统计的记录。
"""

import os
import random
import time
from typing import Callable, Iterator

MAX_ATTEMPTS = int(os.environ.get("CHAT_MAX_ATTEMPTS", "3"))
BASE_DELAY = float(os.environ.get("CHAT_BASE_DELAY", "1.0"))
DEADLINE = float(os.environ.get("CHAT_DEADLINE", "45"))

RETRYABLE_HINTS = ("timeout", "timed out", "rate limit", "429",
                   "500", "502", "503", "504", "connection", "temporarily")

FRIENDLY = {
    "auth": "服务配置有问题,请联系管理员(凭据未通过校验)。",
    "rate": "当前访问的人有点多,请稍等几秒再试。",
    "timeout": "这次等待超时了,换个更短的问法试试。",
    "other": "这次没能回答,请稍后重试。",
}


def classify(exc: Exception) -> str:
    text = ("%s %s" % (type(exc).__name__, exc)).lower()
    if "401" in text or "api key" in text or "unauthor" in text:
        return "auth"
    if "429" in text or "rate limit" in text:
        return "rate"
    if "timeout" in text or "timed out" in text:
        return "timeout"
    return "other"


def is_retryable(exc: Exception) -> bool:
    text = ("%s %s" % (type(exc).__name__, exc)).lower()
    if classify(exc) == "auth":
        return False
    return any(h in text for h in RETRYABLE_HINTS)


def call_with_retry(fn: Callable[[], str]) -> str:
    """指数退避 + 抖动。抖动很关键:没有它,一批用户会在同一毫秒齐刷刷重试。"""
    started = time.time()
    last = None
    for attempt in range(1, MAX_ATTEMPTS + 1):
        if time.time() - started > DEADLINE:
            raise TimeoutError("超过整体时限 %.0fs" % DEADLINE)
        try:
            return fn()
        except Exception as exc:                      # noqa: BLE001
            last = exc
            if attempt == MAX_ATTEMPTS or not is_retryable(exc):
                break
            delay = BASE_DELAY * (2 ** (attempt - 1)) * (1 + random.random() * 0.3)
            time.sleep(delay)
    raise last


def safe_stream(make_stream: Callable[[], Iterator[str]]) -> Iterator[str]:
    """流式版本:**只在第一片之前重试**。

    已经吐了半句话再重试,用户会看到同一段话说两遍。
    所以首片之后出错只能收尾,把残句留在屏幕上并追加一句提示。
    """
    for attempt in range(1, MAX_ATTEMPTS + 1):
        produced = False
        try:
            for chunk in make_stream():
                produced = True
                yield chunk
            return
        except Exception as exc:                      # noqa: BLE001
            if produced:
                yield "\n\n(回答被中断:%s)" % FRIENDLY[classify(exc)]
                return
            if attempt == MAX_ATTEMPTS or not is_retryable(exc):
                yield FRIENDLY[classify(exc)]
                return
            time.sleep(BASE_DELAY * (2 ** (attempt - 1)))


if __name__ == "__main__":
    calls = {"n": 0}

    def flaky():
        calls["n"] += 1
        if calls["n"] < 3:
            raise RuntimeError("503 service temporarily unavailable")
        return "第 %d 次成功" % calls["n"]

    print(call_with_retry(flaky))

    def bad_key():
        raise RuntimeError("401 invalid api key")

    try:
        call_with_retry(bad_key)
    except Exception as e:                            # noqa: BLE001
        print("不重试,直接失败:", classify(e), "→", FRIENDLY[classify(e)])
produced 标记:首片之前失败可以重试;首片之后失败只能收尾,把残句留在屏幕上并追加一句说明。
4.8 换模型不换厨房
编排层里唯一和「具体哪家模型」有关的,就是建模型那一行。把它抽成一个函数,云端模型和本地模型就能共用同一套链、同一套记忆、同一套界面。
# -*- coding: utf-8 -*-
"""
换厨师不换厨房:model_switch.py
=================================
编排层里唯一和「具体哪家模型」有关的,就是建模型那一行。
把它抽成一个函数,云端模型和本地 Ollama 就能共用同一套链、
同一套记忆、同一套界面——这正是分层的兑现时刻。

  云端     init_chat_model("openai:gpt-4o-mini")
  本地     init_chat_model("ollama:qwen2:7b")

init_chat_model 接受 "<provider>:<model>" 这种写法,
provider 对应装好的伙伴包(langchain-openai / langchain-ollama)。
本地模型不需要密钥,但需要 Ollama 服务已经起着。
"""

import os

from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate

PRESETS = {
    "cloud": {
        "spec": os.environ.get("CLOUD_MODEL", "openai:gpt-4o-mini"),
        "needs_key": True,
        "note": "效果稳定、开箱即用;数据要出公网,按 token 计费",
    },
    "local": {
        "spec": os.environ.get("LOCAL_MODEL", "ollama:qwen2:7b"),
        "needs_key": False,
        "note": "数据不出内网、无调用费;要自备显卡,效果取决于模型大小",
    },
}


def make_model(profile: str = None, **overrides):
    """按档位建模型。除了这个函数,其余代码不该出现任何厂商名字。"""
    profile = profile or os.environ.get("MODEL_PROFILE", "cloud")
    if profile not in PRESETS:
        raise ValueError("未知档位 %r,可选:%s" % (profile, list(PRESETS)))

    preset = PRESETS[profile]
    kwargs = {
        "temperature": float(os.environ.get("CHAT_TEMPERATURE", "0.3")),
        "timeout": float(os.environ.get("CHAT_TIMEOUT", "60")),
    }
    if preset["needs_key"]:
        key = os.environ.get("OPENAI_API_KEY")
        if not key:
            raise RuntimeError("档位 %s 需要 OPENAI_API_KEY,未配置则改用 local"
                               % profile)
        kwargs["api_key"] = key
    else:
        # 本地模型服务地址也走环境变量,换机器不改源码
        kwargs["base_url"] = os.environ.get("OLLAMA_HOST",
                                            "http://127.0.0.1:11434")
    kwargs.update(overrides)
    return init_chat_model(preset["spec"], **kwargs)


def make_chain(profile: str = None):
    """链的结构与档位完全无关,换档位只换中间那一节。"""
    prompt = ChatPromptTemplate.from_messages([
        ("system", "你是一个中文助手,回答简洁。"),
        ("human", "{question}"),
    ])
    return prompt | make_model(profile) | StrOutputParser()


def available_profiles():
    """给界面用:哪些档位现在真的能选。缺密钥的档位不该出现在下拉框里。"""
    usable = []
    for name, preset in PRESETS.items():
        if preset["needs_key"] and not os.environ.get("OPENAI_API_KEY"):
            continue
        usable.append(name)
    return usable or ["local"]


if __name__ == "__main__":
    for name, preset in PRESETS.items():
        print("%-6s %-24s %s" % (name, preset["spec"], preset["note"]))
    print("当前可选档位:", available_profiles())

    # 同一个问题跑两个档位,比较回答风格与耗时;没配密钥的档位会跳过
    for name in available_profiles():
        try:
            print("[%s] %s" % (name, make_chain(name).invoke(
                {"question": "一句话介绍你自己"})))
        except Exception as exc:                      # noqa: BLE001
            print("[%s] 不可用:%s" % (name, exc))
| 档位 | 优点 | 代价 |
|---|---|---|
| 云端 | 效果稳定、开箱即用、不占本地算力 | 数据要出公网,按用量计费 |
| 本地 | 数据不出内网、无调用费用 | 要自备显卡,效果取决于模型大小 |
本地模型的安装、显存占用、常驻托管在私有化部署那一个模块里已经讲过,这里只关心一件事:它进入这套编排的方式和云端模型完全一样——换一个模型标识字符串,链的结构一个字不变。
available_profiles() 会把没配好凭据的档位过滤掉。让用户选一个注定报错的选项,是最没必要的一类差评——能在界面上避免的错误,就不要留到调用时再抛。
4.9 换一个前端,验证铁律真的成立
「界面只是点单台」这句话,不验证一下就只是口号。下面这份把 Streamlit 换成纯命令行,chat_core.py 一个字都没改,直接导入过来用。
# -*- coding: utf-8 -*-
"""
不开界面也能聊:cli_probe.py
==============================
同一个 chat_core,换一个前端。这份脚本的价值有三个:

  1. 证明「界面只是点单台」这句话不是口号——后厨一行没改
  2. 排障时分层定位:命令行能聊 → 界面的锅;也不能聊 → 后厨的锅
  3. 服务器上没浏览器时,这是最快的验收手段

内置几个斜杠命令,用来观察后厨的状态:
  /new    换一块空白备忘板
  /hist   打印这块板上的全部消息
  /stat   看条数与估算 token
  /quit   退出
"""

import sys

import chat_core
import session_keys
from trim_policy import _approx_tokens


def show_history(sid: str) -> None:
    role = {"human": "我", "ai": "助手", "system": "人设"}
    for i, m in enumerate(chat_core.history_of(sid), 1):
        text = m.content if isinstance(m.content, str) else str(m.content)
        head = text.replace("\n", " ")[:60]
        print("  %2d. %-4s %s" % (i, role.get(m.type, m.type), head))


def main() -> int:
    sid = session_keys.new_anonymous_id()
    print("会话指纹 %s | 模型 %s | /quit 退出"
          % (session_keys.fingerprint(sid), chat_core.MODEL_NAME))

    while True:
        try:
            question = input("\n我> ").strip()
        except (EOFError, KeyboardInterrupt):
            print()
            return 0

        if not question:
            continue
        if question == "/quit":
            return 0
        if question == "/new":
            chat_core.reset(sid)
            sid = session_keys.new_anonymous_id()
            print("已换一块空白备忘板:%s" % session_keys.fingerprint(sid))
            continue
        if question == "/hist":
            show_history(sid)
            continue
        if question == "/stat":
            msgs = chat_core.history_of(sid)
            print("共 %d 条,估算 %d token" % (len(msgs), _approx_tokens(msgs)))
            continue

        print("助手> ", end="", flush=True)
        try:
            for piece in chat_core.reply_stream(sid, question):
                print(piece, end="", flush=True)
            print()
        except KeyboardInterrupt:
            # 这一轮答案不完整,把这一问一答从历史里撤掉,别让残句污染下一轮
            print("\n(已中断)")
            chat_core.reset(sid)
        except Exception as exc:                      # noqa: BLE001
            print("\n调用失败:%s" % exc)


if __name__ == "__main__":
    sys.exit(main())
| 它的实际用处 | 说明 |
|---|---|
| 服务器上没浏览器 | 这就是最快的验收手段,连上去直接聊 |
| 分层定位故障 | 命令行能聊 → 界面的锅;也不能聊 → 后厨的锅 |
| 接企业微信、定时任务 | 起点就是这份,把 input() 换成消息回调即可 |
/stat 看条数与估算 token | 直观感受「越聊越长」到底长多快,也验证修剪有没有生效 |
/hist 打印备忘板 | 事后复盘模型到底看到了什么,比猜有用 |
chat_core、同一套记忆、同一套修剪与容错。这就是「换一个前端,后厨一行都不用改」的字面意思。
4.10 把链换成 Agent:界面层无感
前面的后厨是一条固定流水线。如果业务需要它自己决定「先查订单还是先查物流」,就把链换成 Agent——店长上岗,工具箱交给他。对界面层来说这个替换是无感的:它照样只调 reply 和 reply_stream。
# -*- coding: utf-8 -*-
"""
把后厨从「链」换成「店长」:agent_mode.py
==========================================
前面的应用是一条固定流水线:提示词 → 模型 → 解析器。
如果要让它自己决定「先查订单还是先查物流」,就把链换成 Agent。

对界面层来说,这个替换是无感的:它照样只调 reply / reply_stream。
后厨里换的东西有两处——

  记忆    RunnableWithMessageHistory → checkpointer + thread_id
  执行体  prompt | model | parser     → create_agent(...)

工具的协议层细节(模型怎么填参数、回执怎么贴回去)在 Function Call
那一讲;工具怎么写、description 怎么措辞在 Tools 与 Agent 实战那一讲。
这里只关心它怎么接进一个已有的聊天应用。
"""

import os
from typing import Iterator

from langchain.agents import create_agent
from langchain.tools import tool
from langgraph.checkpoint.memory import InMemorySaver

SYSTEM_PROMPT = (
    "你是电商平台的客服助手。需要订单信息时调用工具,"
    "不要凭空猜测订单号或物流状态。"
)

_ORDERS = {
    "12345": {"status": "已发货", "amount": 299.0},
    "12346": {"status": "待付款", "amount": 158.0},
}


@tool
def query_order(order_id: str) -> str:
    """按订单号查询订单状态与金额。order_id 是纯数字的订单编号。"""
    row = _ORDERS.get(order_id.strip())
    if not row:
        return "未查到订单 %s" % order_id
    return "订单 %s:%s,金额 %.2f 元" % (order_id, row["status"], row["amount"])


@tool
def refund_policy(keyword: str) -> str:
    """查询退换货政策。keyword 是要查的关键词,如「七天」「运费」。"""
    table = {
        "七天": "签收后七天内无理由退货,商品需不影响二次销售。",
        "运费": "质量问题运费由平台承担,非质量问题由买家承担。",
    }
    for k, v in table.items():
        if k in keyword:
            return v
    return "未找到相关条款,请转人工客服。"


# checkpointer 就是 Agent 这条路线上的备忘板;thread_id 相当于会话 ID
agent = create_agent(
    model=os.environ.get("CHAT_MODEL", "openai:gpt-4o-mini"),
    tools=[query_order, refund_policy],
    system_prompt=SYSTEM_PROMPT,
    checkpointer=InMemorySaver(),
)


def _cfg(session_id: str) -> dict:
    return {"configurable": {"thread_id": session_id}}


def reply(session_id: str, question: str) -> str:
    """和 chat_core.reply 同签名,界面层不用改一个字。"""
    result = agent.invoke(
        {"messages": [{"role": "user", "content": question}]},
        _cfg(session_id))
    return result["messages"][-1].content


def reply_stream(session_id: str, question: str) -> Iterator[str]:
    """流式:只把模型节点吐的字透给界面,工具执行过程不往界面上倒。

    v1 里模型节点名是 "model"(旧版叫 "agent"),流式过滤时别记错。
    """
    for chunk, meta in agent.stream(
            {"messages": [{"role": "user", "content": question}]},
            _cfg(session_id), stream_mode="messages"):
        if meta.get("langgraph_node") == "model" and chunk.content:
            yield chunk.content


if __name__ == "__main__":
    sid = "agent-demo"
    print(reply(sid, "帮我看下订单 12345 什么状态"))
    print(reply(sid, "那它多少钱来着?"))      # 考察 checkpointer 有没有生效
    print(reply(sid, "退货运费谁出?"))
| 换掉的东西 | 链的写法 | Agent 的写法 |
|---|---|---|
| 执行体 | prompt | model | parser | create_agent(model=..., tools=[...], system_prompt=...) |
| 记忆 | RunnableWithMessageHistory + session_id | checkpointer + thread_id |
| 流式过滤 | 片段就是最终文本 | 按节点名过滤,模型节点叫 model(旧版叫 agent) |
| 界面层 | 调四个函数 | 一个字不用改 |
工具的协议层细节——模型怎么把「要办哪件事、参数填什么」写成一张结构化委托单、回执怎么贴回对话——在 Function Call 那一讲;工具四要素怎么写、description 怎么措辞才会被选中,在 Tools 与 Agent 实战那一讲。这里只关心它怎么接进一个已有的应用。
05骨架模板:拿去改就能交付
单文件骨架、验收脚本、上线前自检清单
5.1 单文件骨架
完整案例拆成十个文件,是为了讲清每个零件的边界。真要开一个新项目,先从这份单文件骨架起步更快:三层边界仍然在文件内部保持着,配置区的 TODO 改完就是你自己的业务助手;等到要拆的时候,把「后厨」整段剪进 chat_core.py 即可,前厅代码不用动。
# -*- coding: utf-8 -*-
"""
骨架模板:chatbot_skeleton.py —— 改 TODO 就是你自己的业务助手
================================================================
这一份把前面拆开讲的零件装在一起,并且刻意写成**单文件**,
方便直接复制到新项目里跑起来。文件内部仍然保持三层边界:

  配置区(TODO 全在这里) → 后厨(建链、记忆、修剪) → 前厅(Streamlit)

要拆成多文件时,把「后厨」整段剪进 chat_core.py 即可,前厅代码不用改。

启动:streamlit run chatbot_skeleton.py
依赖:pip install streamlit langchain langchain-openai
"""

import os
import uuid

import streamlit as st
from langchain.chat_models import init_chat_model
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory

# ================================ 配置区 ================================
# TODO 1:换成你的模型。云端 "openai:gpt-4o-mini",本地 "ollama:qwen2:7b"
MODEL_SPEC = os.environ.get("CHAT_MODEL", "openai:gpt-4o-mini")

# TODO 2:写你的业务人设。务必写清边界,否则模型会一本正经地编
SYSTEM_PROMPT = (
    "你是某公司的智能助手。回答简洁、准确。\n"
    "只依据用户提供的信息和你确知的常识回答;不确定就说不确定,不要编造。"
)

# TODO 3:页面标题与开场提示
PAGE_TITLE = "智能助手"
INPUT_HINT = "输入你的问题"

# TODO 4:一块备忘板最多留多少条消息。太长会变慢、变贵,最后被静默截断
MAX_MESSAGES = int(os.environ.get("MAX_MESSAGES", "20"))

# TODO 5:需要持久化时,把 _store 换成文件或 Redis 实现
_store = {}

# ================================ 后厨 ==================================


def get_history(session_id: str) -> InMemoryChatMessageHistory:
    """工厂函数:一个会话 ID 一块备忘板,顺手修剪。"""
    if session_id not in _store:
        _store[session_id] = InMemoryChatMessageHistory()
    history = _store[session_id]

    messages = history.messages
    if len(messages) > MAX_MESSAGES:
        kept = list(messages[-MAX_MESSAGES:])
        while kept and kept[0].type == "ai":
            kept.pop(0)                 # 别让历史以一句孤立的回答开头
        history.clear()
        history.add_messages(kept)
    return history


@st.cache_resource(show_spinner=False)
def build_conversation():
    """只建一次。少了这个装饰器,页面每次重跑都会重新建链和客户端。"""
    model = init_chat_model(
        MODEL_SPEC,
        temperature=float(os.environ.get("CHAT_TEMPERATURE", "0.3")),
        api_key=os.environ.get("OPENAI_API_KEY"),
        timeout=float(os.environ.get("CHAT_TIMEOUT", "60")),
    )
    prompt = ChatPromptTemplate.from_messages([
        ("system", SYSTEM_PROMPT),
        MessagesPlaceholder(variable_name="history"),
        ("human", "{question}"),
    ])
    chain = prompt | model | StrOutputParser()
    return RunnableWithMessageHistory(
        chain,
        get_history,
        input_messages_key="question",
        history_messages_key="history",
    )


# ================================ 前厅 ==================================
st.set_page_config(page_title=PAGE_TITLE, page_icon="💬")

if "sid" not in st.session_state:
    st.session_state["sid"] = uuid.uuid4().hex
sid = st.session_state["sid"]

with st.sidebar:
    st.caption("模型:%s" % MODEL_SPEC)
    st.caption("历史:%d 条(上限 %d)"
               % (len(get_history(sid).messages), MAX_MESSAGES))
    if st.button("新建对话"):
        get_history(sid).clear()
        st.session_state["sid"] = uuid.uuid4().hex
        st.rerun()

st.title(PAGE_TITLE)

ROLE = {"human": "user", "ai": "assistant"}
for message in get_history(sid).messages:
    role = ROLE.get(message.type)
    if role:
        with st.chat_message(role):
            st.markdown(message.content)

question = st.chat_input(INPUT_HINT)
if question:
    with st.chat_message("user"):
        st.markdown(question)
    with st.chat_message("assistant"):
        try:
            st.write_stream(build_conversation().stream(
                {"question": question},
                config={"configurable": {"session_id": sid}}))
        except Exception as exc:                      # noqa: BLE001
            st.error("这次没能回答:%s" % exc)
| TODO | 改成什么 | 提示 |
|---|---|---|
MODEL_SPEC | 你的模型标识 | 形如 provider:model;本地模型要先把服务起起来 |
SYSTEM_PROMPT | 你的业务人设 | 务必写清边界:「不确定就说不确定,不要编造」 |
PAGE_TITLE / INPUT_HINT | 标题与输入提示 | 顺手告诉用户这个助手能干什么 |
MAX_MESSAGES | 备忘板的限高线 | 先按平均消息长度估一个,再用 /stat 观察着调 |
_store | 历史容器 | 要重启不丢就换成文件或 Redis 实现,其余代码不动 |
| 骨架已经替你处理好的 | 在哪一段 | 不做会怎样 |
|---|---|---|
| 历史自动修剪 | 工厂函数里 | 越聊越慢、越贵,最后被静默截断 |
| 人设不被裁掉 | 修剪时只动最近 N 条 | 聊久了机器人性格突变 |
| 链只建一次 | @st.cache_resource | 每次交互重建链与客户端 |
| 气泡只有一份数据源 | 从备忘板重放 | 屏幕上有、模型没看见 |
| 异常兜底 | 调用外面的 try | 后厨一抖整页报红崩掉 |
| 新建对话 | 清空旧板 + 换 ID + 重绘 | 点了没反应,或旧板残留占内存 |
5.2 验收脚本:把手工点击变成可重复的检查
手工点一遍页面,改一次代码就要再点一遍,早晚会偷懒。把验收写成脚本,重点验的不是「有没有回答」,而是记忆、隔离、流式、修剪这四条链路。
# -*- coding: utf-8 -*-
"""
交付前验收:smoke_test.py
===========================
手工点一遍页面,改一次代码就要再点一遍,早晚会偷懒。把验收写成脚本,
重点验的不是「有没有回答」,而是**记忆、隔离、流式、修剪**这四条链路。

退出码 0 表示全过,1 表示有失败,可以直接接进发版流程。
运行:python3 smoke_test.py
"""

import sys
import time

import chat_core
import session_keys
from trim_policy import trim_by_count

RESULTS = []


def check(name: str, ok: bool, detail: str = "") -> bool:
    RESULTS.append((name, ok, detail))
    print("%s %s %s" % ("[通过]" if ok else "[失败]", name, detail))
    return ok


def case_single_turn() -> bool:
    """1. 后厨能不能出菜。不通则后面的用例没有意义。"""
    text = chat_core.reply(session_keys.new_anonymous_id(), "回答一个字:好")
    return check("单轮调用", bool(text and text.strip()), "返回 %d 字" % len(text or ""))


def case_memory() -> bool:
    """2. 同一个会话 ID 里,第二轮能不能记得第一轮说的名字。"""
    sid = session_keys.new_anonymous_id()
    chat_core.reply(sid, "我叫孙小空,请记住这个名字")
    answer = chat_core.reply(sid, "我刚才说我叫什么?")
    return check("多轮记忆", "孙小空" in answer, answer.strip()[:40])


def case_isolation() -> bool:
    """3. 反向用例:换一个会话 ID 就不该记得。只验正向可能是模型蒙对的。"""
    sid_a, sid_b = (session_keys.new_anonymous_id() for _ in range(2))
    chat_core.reply(sid_a, "我叫孙小空,请记住这个名字")
    answer = chat_core.reply(sid_b, "我刚才说我叫什么?")
    return check("会话隔离", "孙小空" not in answer, answer.strip()[:40])


def case_stream() -> bool:
    """4. 流式要能收到多片;只收到一片说明流被谁缓冲住了。"""
    sid = session_keys.new_anonymous_id()
    started = time.time()
    first_at = None
    pieces = 0
    for chunk in chat_core.reply_stream(sid, "用三句话介绍中央厨房的分工"):
        if first_at is None:
            first_at = time.time() - started
        pieces += 1
    return check("流式分片", pieces > 1,
                 "%d 片,首字 %.2fs" % (pieces, first_at or -1))


def case_trim_keeps_system() -> bool:
    """5. 纯本地逻辑,不发请求:修剪之后人设必须还在。"""
    from langchain_core.messages import AIMessage, HumanMessage, SystemMessage

    msgs = [SystemMessage(content="你是客服助手")]
    for i in range(20):
        msgs += [HumanMessage(content="问%d" % i), AIMessage(content="答%d" % i)]
    kept = trim_by_count(msgs, 6)
    return check("修剪不裁人设", kept[0].type != "ai",
                 "保留 %d 条,首条 %s" % (len(kept), kept[0].type))


def main() -> int:
    if not case_single_turn():
        print("\n后厨不通,后续用例跳过。先查模型服务、密钥与网络。")
        return 1
    case_memory()
    case_isolation()
    case_stream()
    case_trim_keeps_system()

    failed = [n for n, ok, _ in RESULTS if not ok]
    print("\n共 %d 项,失败 %d 项" % (len(RESULTS), len(failed)))
    for name in failed:
        print("  · %s" % name)
    return 1 if failed else 0


if __name__ == "__main__":
    sys.exit(main())
| 用例 | 验什么 | 失败说明什么 |
|---|---|---|
| 1 单轮调用 | 后厨能不能出菜 | 模型服务、凭据或网络的问题,后面用例没意义,直接停 |
| 2 多轮记忆 | 同一会话里第二轮记不记得名字 | 插槽键名写错,或历史没写回 |
| 3 会话隔离 | 反向用例:换会话 ID 就不该记得 | 工厂函数把所有人指向了同一块板,这是最严重的一类事故 |
| 4 流式分片 | 能不能收到多片 | 只收到一片 → 链上有一节不支持流,或被代理缓冲 |
| 5 修剪不裁人设 | 纯本地逻辑,不发请求 | 人设会在聊得够久之后悄悄消失 |
5.3 上线前自检:本机跑通 ≠ 能交付
「本机打得开页面」离「同事随时能用、坏了有人知道」还差一整套。把清单写成可执行的检查项,缺什么一眼看得见——它不发任何模型请求,所以可以随时跑、也能进流水线。
# -*- coding: utf-8 -*-
"""
上线前自检:deploy_check.py
============================
「本机 streamlit run 打得开」离「同事随时能用、坏了有人知道」还差一整套。
这份脚本把交付清单写成可执行的检查项,缺什么一眼看得见。

它不发任何模型请求,只看配置与环境,所以可以随时跑、也能进 CI。
运行:python3 deploy_check.py
"""

import os
import shutil
import socket
import sys

CHECKS = []


def record(name, ok, detail, blocking=True):
    CHECKS.append((name, ok, detail, blocking))


def check_secrets():
    """密钥必须来自环境变量,源码里出现字面量是最常见的事故。"""
    key = os.environ.get("OPENAI_API_KEY", "")
    profile = os.environ.get("MODEL_PROFILE", "cloud")
    if profile == "local":
        record("模型凭据", True, "本地档位不需要密钥")
    else:
        record("模型凭据", bool(key),
               "已配置(长度 %d)" % len(key) if key else "未配置 OPENAI_API_KEY")


def check_session_secret():
    secret = os.environ.get("SESSION_SECRET", "")
    record("会话派生密钥", len(secret) >= 16,
           "已配置" if len(secret) >= 16 else "未配置或过短,登录态会话无法派生 ID")


def check_history_backend():
    backend = os.environ.get("HISTORY_BACKEND", "memory")
    if backend == "memory":
        record("历史存储", False,
               "进程内字典:重启即丢、多副本各存各的,仅适合开发", blocking=False)
    else:
        directory = os.environ.get("HISTORY_DIR", "./chat_history")
        writable = os.access(os.path.dirname(os.path.abspath(directory)) or ".",
                             os.W_OK)
        record("历史存储", writable, "%s(目录可写:%s)" % (backend, writable))


def check_trim():
    limit = int(os.environ.get("MAX_MESSAGES", "20"))
    record("历史上限", 2 <= limit <= 200,
           "MAX_MESSAGES=%d" % limit)


def check_timeout():
    timeout = float(os.environ.get("CHAT_TIMEOUT", "60"))
    record("超时设置", 5 <= timeout <= 180, "CHAT_TIMEOUT=%.0fs" % timeout)


def check_port(port=8501):
    """页面端口是否已被占用;同时提醒模型端口不应对外。"""
    with socket.socket() as s:
        s.settimeout(0.5)
        busy = s.connect_ex(("127.0.0.1", port)) == 0
    record("页面端口 %d" % port, True,
           "已有服务在监听" if busy else "空闲", blocking=False)


def check_process_manager():
    record("进程托管", shutil.which("systemctl") is not None,
           "有 systemctl,可写 service 常驻" if shutil.which("systemctl")
           else "未发现 systemctl,需另行托管进程", blocking=False)


def main():
    check_secrets()
    check_session_secret()
    check_history_backend()
    check_trim()
    check_timeout()
    check_port()
    check_process_manager()

    blocking_failed = 0
    for name, ok, detail, blocking in CHECKS:
        mark = "[通过]" if ok else ("[必修]" if blocking else "[提醒]")
        print("%s %-14s %s" % (mark, name, detail))
        if not ok and blocking:
            blocking_failed += 1

    print("\n还需人工确认:页面前置鉴权、模型端口只对网关开放、"
          "调用日志只记长度与短哈希。")
    print("必修项未通过 %d 条" % blocking_failed)
    return 1 if blocking_failed else 0


if __name__ == "__main__":
    sys.exit(main())
| 缺口 | 怎么补 | 脚本能不能自动查 |
|---|---|---|
| 凭据硬编码在源码里 | 一律走环境变量 | 能查是否配置,查不出源码里有没有字面量 |
| 历史重启就丢 | 换文件或 Redis 存储 | 能 |
| 没有超时与上限 | 配 CHAT_TIMEOUT 与 MAX_MESSAGES | 能 |
| 进程关掉就没了 | 写成常驻服务托管 | 只能提示环境是否具备 |
| 谁都能打开页面 | 页面前置鉴权或接统一登录 | 不能,人工确认 |
| 模型端口对外暴露 | 只对网关开放 | 不能,人工确认 |
| 日志把对话原文写进去 | 只记长度与短哈希 | 不能,人工确认 |
三份产物怎么选
| 产物 | 用途 | 什么时候用 |
|---|---|---|
min_app.py | 理解机制的最短路径 | 第一次接链与记忆时 |
chat_core.py 等十个文件 | 讲清每个零件的边界 | 要改记忆策略、换存储、加容错时按文件找 |
chatbot_skeleton.py | 拿去改的那一份 | 开新项目、要交付给同事时 |
06易错点汇总
按「分层 / 记忆 / 会话 / 流式 / 容错 / 交付」六类归并,踩过一次就别再踩
⚠️ 一、分层与架构
- 界面层直接建链、直接调模型。换前端时整套重写,出问题时也没法用
python3 chat_core.py快速分层定位。编排层不许导入界面库,这条是分层是否成立的唯一硬标准。 - 界面自己再存一份聊天记录。接入记忆之后,历史的唯一归属是备忘板。两边各存一份,迟早出现「屏幕上有、模型没看见」,而且这类错位极难查。气泡的数据源就该是备忘板本身。
- 把修剪、重试、人设这些规矩写进界面层。它们是后厨的规矩,换一个前端就要重写一遍。
- 没做「换前端」验证就宣称分层了。写一份几十行的命令行前端跑一遍,是最便宜的证明方式。
- 模型名、服务地址、人设硬编码进源码。换环境就要改源码,改源码就会漏改。
⚠️ 二、记忆与上下文(本讲最大的一类)
- 工厂函数每次都新建一个容器。少了「已存在就复用」那个判断,每轮都是一块空白板,表现为完全没有记忆。
history_messages_key与模板插槽的名字对不上。历史读出来了却填不进模板,现象和「根本没读」一模一样,查的时候容易往错误方向走。- 模板三段顺序写错。历史放到本轮输入之后,模型会把旧话当成最新指令;人设放到历史之后,约束力会随历史变长而稀释。
- 历史无限增长。先变慢,再变贵,最后超出上下文窗口被静默截断且不报错——最难受的是它不报错。
- 裁剪时把人设一起切掉。直接留最后 N 条,聊到几十轮后机器人性格突变。人设必须不参与裁剪。
- 裁完以一句孤立的回答开头。没有对应的提问,模型会自行脑补语境,答案开始跑偏。
- 以为修剪能「删掉前 N 条」。历史容器只有追加和清空两种操作,就地修剪的做法是「读出、算出保留部分、清空、写回」。
- 用条数当唯一尺子。消息长短不均时,一条长文就能顶穿窗口。要准就按 Token 预算量。
⚠️ 三、会话标识与隔离
- 会话 ID 写死成一个常量。开发时看不出问题,一上线所有人共用一块备忘板,互相看得见对方说过什么。这是本讲最严重的事故形态。
- 直接采信前端传来的会话 ID。改一个参数就能读到别人的历史。鉴权必须在进入链之前做完,工厂函数只做「按 key 取容器」。
- 校验不通过时兜底给一个默认 ID。等于把所有非法请求塞进同一块板,比直接报错更糟。
- 用手机号、工号直接拼会话 key。规律太明显,知道同事工号就能算出他的 key。要派生就用带密钥的摘要。
- 会话 ID 当文件名直接用。带
../的 ID 能写到任意目录,落盘前必须过滤字符并限长。 - 「新建对话」只换了 ID,没清旧板。旧历史留在内存里只涨不降,长时间运行后内存被一堆没人再用的会话占满。
- 把完整会话 ID 写进日志。日志一旦外泄,等于泄露了访问别人历史的钥匙。写短指纹就够用。
⚠️ 四、流式输出
- 链上有一节要攒齐才动。流就断在那里,现象是「明明写了流式,界面还是卡半天然后整段蹦出来」。排查方法:把可疑的那一节摘掉再试。
- 给流加统计时把生成器攒成了列表。包装必须仍然是生成器,边透传边计数,否则流式悄悄退化成一次性返回。
- 不跳过空片段。末片经常是空的,直接渲染会多出无意义的空白。
- 已经吐了半句话还去重试。用户会看到同一段话说两遍。流式重试只能发生在第一片之前。
- 把工具执行的中间输出原样推到聊天框。既暴露内部实现,用户也看不懂。要显示进度就用事件流做成一行状态提示。
- Agent 模式下按旧节点名过滤。当前版本模型节点叫
model,按旧名字过滤会一个字都收不到。 - 反向代理缓冲了响应。本机好好的,上了网关就退化成一次性返回——这类问题查代码永远查不出来,要去看代理配置。
⚠️ 五、容错与稳定性
- 没有异常兜底。模型服务没起、端口不通、超时都会抛异常,整页报红崩掉,用户只会反馈「你这东西坏了」。
- 所有失败一律重试。凭据无效、参数错误再试一百次也一样,白白拖长用户等待。失败要先分类。
- 重试不加抖动。一批同时失败的用户会在同一毫秒齐刷刷再来一次,把刚喘过气的服务再次压垮。
- 只设单次超时,不设整体时限。三次重试各等一分钟,用户实际等了三分多钟还没结果。
- 把技术异常原文直接甩给用户。一串英文堆栈既没用又吓人,更可能把内部地址、模型名甚至凭据片段暴露出去。翻译成一句人话,细节留给日志。
- 中断的那一轮留在历史里。残缺的问答会污染下一轮上下文,该撤就撤掉。
- 每次页面重跑都重建链与客户端。不加缓存时页面每交互一次就新建一遍,变慢还白占连接。
⚠️ 六、交付与安全
- 把「本机跑起来了」当成「能交付了」。还差鉴权、常驻托管、持久化、日志、并发规划。
- 为了让同事访问,顺手把模型端口也对外开了。要暴露的是聊天页面,模型端口仍然只对网关开放。
- 把对话原文全写进日志。内部助手的对话里常夹着客户名、合同号、报价,等于给隔离开了一个后门。只记长度与短哈希。
- 凭据写死在源码里,或跟着代码一起提交。一律走环境变量,且不要打进日志和页面。
- 人设里不写边界。没有「不确定就说不确定」这类约束,模型会一本正经地编,而同事会把它当成公司口径去执行。
- 把缺凭据的模型档位摆在下拉框里。让用户选一个注定报错的选项,是最没必要的一类差评。
- 只验「能记住」,不验「不该记住的没记住」。少了反向用例,串会话这种事故要等用户来报。
- 用旧写法起新项目。早期的一体化对话链已搬到
langchain-classic、不再是推荐写法;新项目直接用「普通链 + 记忆包装器」。
07自测题
点击题目展开答案;这 19 题说得清,这个案例就真的做得出来
搭一个聊天机器人有哪三条路?本讲为什么选第三条?
无代码平台(可视化配置,不写代码,需求简单时最快)、开源框架开发(自己搭,定制性强,但纯规则库的对话质量有限)、大模型集成(部署模型 + 框架编排 + 自写界面)。本讲走的是「开源框架 + 大模型集成」的综合路线:既保住数据与链路的掌控权,又能拿到高质量对话。三条路在实际项目里并不互斥,常见的是结合其中一两种。
三层架构分别是什么?各自绝对不做什么?
界面层只收一句话、画气泡、显示状态,不建链不存历史不认识模型;编排层建链、读写记忆、修剪、流式、兜底,不导入界面库、不打印任何东西;模型层只负责算答案,不知道有没有界面。判断分层是否成立的硬标准就一条:编排层有没有导入界面库。
本讲的铁律是什么?怎么证明它成立?
界面只是点单台。会话记忆、链路编排、流式输出都在后厨;换一个前端,后厨一行都不用改。证明方式是 4.9 节:把 Streamlit 换成命令行前端,chat_core.py 一个字没动,两个前端共用同一套记忆、修剪与容错。
不用 LangChain 也能做聊天机器人,多这一层换来了什么?
换来统一接口与可替换零件:历史进出请求由记忆包装器负责(不用手工 append)、换存储只换工厂函数、换模型只换一个标识字符串、流式直接给生成器、要升级成 Agent 时界面层无感。代价是多一层依赖和一套概念。一次性 demo 不划算;要长期改、换模型、上多用户的应用很划算。
编排层的四个零件是哪四个?
① 带插槽的提示词模板(人设 → MessagesPlaceholder → 本轮输入);② 一条普通的 LCEL 链(prompt | model | parser,它本身不知道记忆这回事);③ 历史工厂函数(会话 ID → 历史容器);④ 记忆包装器 RunnableWithMessageHistory(调用前读、拿到回复后写)。缺一不可。
模型到底记不记得上一轮说过的话?
不记得。模型每一轮都是从零开始读你这次发过去的消息。所谓「它记得我叫孙小空」,是因为填菜谱卡那一步把上一轮的问答又原样塞了一遍进去。把备忘板拿掉,模型立刻失忆。
页面明明接了记忆,机器人却完全不记得,最可能的三个原因是什么?
① 工厂函数每次都新建容器(少了「已存在就复用」的判断);② history_messages_key 与模板插槽名字对不上,历史读出来了填不进去;③ 会话 ID 每次交互都换一个(没存进页面状态)。三种现象一模一样,都表现为「毫无记忆」,所以要逐个排除。
模板三段的顺序能不能调?
不能。必须是人设 → 历史 → 本轮输入。历史放到本轮输入之后,模型会把旧话当成最新指令;人设放到历史之后,它会被越堆越长的历史往后推,约束力显著下降。
早期资料里的一体化对话链现在还能用吗?该怎么表述?
那套(一体化对话链配缓冲记忆对象)已搬到 langchain-classic,不再是推荐写法,导入路径要相应改成从 langchain_classic 取。当代写法是「普通链 + RunnableWithMessageHistory」;Agent 那条路线则用 checkpointer + thread_id。
为什么说 session_id 是这个应用最敏感的字符串?
因为谁看到哪块备忘板,完全由它决定。写死成常量 → 所有人共用一块板,互相看得见对方说过什么;直接采信前端传值 → 改一个参数就能读别人的历史。所以它必须由服务端生成或由已验证的登录态派生,鉴权要在进入链之前做完。
校验不通过时,给一个默认会话 ID 兜底行不行?
不行,那比直接报错更糟:所有非法请求都会被塞进同一块备忘板,互相看到对方的内容。正确做法是抛异常拒绝。另外会话 ID 落盘当文件名前必须过滤字符并限长,否则带 ../ 的 ID 能写到任意目录。
历史无限增长会依次发生什么?
先变慢(输入越长首字延迟越高)→ 再变贵(历史每轮重发一遍,费用随轮数累积)→ 最后被静默截断(超出上下文窗口,最早的内容被丢掉且不报错)。最难受的是第三步不报错,只能靠观察发现。
修剪历史时有哪两条不能破的底线?
① 人设那一条不参与裁剪——直接留最后 N 条会把人设一起切掉,聊到几十轮后机器人性格突变,还极难查;② 裁完不要以一句孤立的回答开头——没有对应提问,模型会自行脑补语境,答案开始跑偏。
为什么就地修剪要写成「清空再写回」?
因为历史容器的公共约定里只有 add_messages 和 clear,没有「删掉前 N 条」这种方法。所以通用做法是:读出来 → 算出要保留的部分 → 清空 → 写回去。换成 Redis 实现时同理,只是三步都发生在服务端。
代码里写了流式,界面却卡半天然后整段蹦出来,怎么查?
典型原因是链上有一节必须拿到完整输入才能工作(普通后处理函数、要求完整结构的解析器),流断在那里。排查方法是把可疑的那一节摘掉再试一次。另外两种常见原因:给流加统计时把生成器攒成了列表;反向代理把响应缓冲住了(本机正常、上网关就退化,查代码永远查不出来)。
流式调用失败了能不能重试?
只能在第一片之前重试。已经吐了半句话再重试,用户会看到同一段话说两遍,比报错还难堪。首片之后失败只能收尾:把残句留在屏幕上,追加一句说明。实现上用一个「是否已产出」的标记来区分这两种情况。
模型调用失败该怎么分类处理?
可重试(限流、5xx、连接超时)→ 退避后再试,退避要加抖动,否则一批用户会在同一毫秒齐刷刷重试把服务再压垮;不可重试(凭据无效、参数错误)→ 立刻失败;超时 → 主动掐断。另外要设整体时限,否则三次重试各等一分钟,用户实际等了三分多钟。给用户看的永远是一句人话,技术细节留给日志。
验收脚本里为什么必须有「会话隔离」这个反向用例?
只验「能记住」不够——万一是模型蒙对的呢?一正一反都符合预期,才能证明记忆真是那块备忘板带来的。而且串会话是本讲最严重的事故形态,少了这个用例,只能等用户来报。
本机跑通之后,离真正交付还差哪几件事?
鉴权(页面前置登录,谁都能打开不行)、常驻托管(进程关掉就没了)、持久化(进程内字典重启即丢、多副本各存各的)、日志(不知道有没有人用、失败率多少;只记长度与短哈希,不记原文)、并发规划。还有一条容易忘:要暴露的是聊天页面,模型端口仍然只对网关开放。
词术语表与模块收束
本讲术语
| 术语 | 含义 |
|---|---|
| Streamlit | 纯 Python 的界面框架,本讲里只承担点单台的角色 |
| LCEL | 用管道符把 Runnable 串成链的写法,prompt | model | parser |
| Runnable | LangChain 的统一执行协议,invoke / batch / stream 都由它约定 |
| Memory | 会话历史;本讲里就是墙上那块备忘板 |
MessagesPlaceholder | 提示词模板里的历史插槽,链自己往里填 |
RunnableWithMessageHistory | 记忆包装器:调用前读历史、拿到回复后写回 |
BaseChatMessageHistory | 历史容器的接口,只需实现 messages / add_messages / clear |
session_id | 桌号牌,决定这一单落在哪块备忘板上 |
trim_messages | 按预算修剪历史的工具函数,能保住人设、能从用户消息开头 |
init_chat_model | 按 provider:model 建模型的统一入口 |
create_agent | 当前版本构建 Agent 的标准方式 |
| checkpointer | Agent 路线上的状态持久化组件,配 thread_id 区分会话 |
| 首字延迟 | 按下回车到看见第一个字的时间,流式做没做对就看它 |
langchain-classic | 早期链与弃用功能的新家,旧写法的导入路径落在这里 |
这一讲用到的入口速查
| 要做的事 | 入口 | 要点 |
|---|---|---|
| 建模型 | init_chat_model("provider:model") | 凭据走环境变量,超时与重试交给它 |
| 建链 | prompt | model | parser | 链本身不知道记忆这回事 |
| 装记忆 | RunnableWithMessageHistory(...) | 两个 key 名必须与模板对上 |
| 指定会话 | config={"configurable": {"session_id": ...}} | 服务端生成或校验,绝不采信前端 |
| 一次性拿答案 | invoke | 后台任务、要整段做后处理时用 |
| 逐字输出 | stream | 聊天界面主用;包装它时别破坏生成器 |
| 看链上每一步 | astream_events | 要在界面显示进度提示时用 |
| 修剪历史 | trim_messages(...) | 保住人设、从用户消息开头 |
| 换成 Agent | create_agent(..., checkpointer=...) | 会话键变成 thread_id,流式节点名是 model |
交付前最后一遍检查
| 阶段 | 怎么验 | 通过标准 |
|---|---|---|
| 后厨通不通 | python3 chat_core.py | 脱离界面能拿到回答 |
| 记忆通不通 | 先说名字,再问名字 | 答得出才算真通 |
| 隔离通不通 | 换一个会话 ID 再问一次 | 答不出才算对 |
| 流式通不通 | 数收到几片、首字多久 | 多片且首字明显早于总耗时 |
| 修剪通不通 | 命令行里 /stat 连看几轮 | 条数到达上限后不再增长,人设还在 |
| 一次跑完 | python3 smoke_test.py | 退出码为 0 |
| 配置齐不齐 | python3 deploy_check.py | 必修项 0 条未通过 |
整个模块回头看
| 讲次 | 厨房里的哪一块 | 留下的铁律 |
|---|---|---|
| LangChain 入门与 Model I/O | 菜谱卡、配菜台、摆盘工位 | LangChain ≠ 大模型,它一个 token 也不生成 |
| LCEL 与链的组合 | 传送带 | 管道符不执行任何计算,只把上一节的输出接到下一节 |
| 会话记忆与多轮上下文 | 墙上的备忘板 | 模型本身没有记忆,全靠每轮把历史重新塞进去 |
| Function Call | 委托单 | 模型只填单子,执行的永远是你的代码 |
| Agent 的原理 | 店长的循环 | 自主性长在循环里,循环的执行权仍在你手上 |
| Tools 与 Agent 实战 | 工具箱与名牌 | 工具的 description 是写给模型看的 |
| 本讲 | 前厅点单台 + 后厨 | 界面只是点单台,换一个前端后厨一行都不用改 |