【案例】金融行业动态方向评估(一):方法论与文本分类
临时工还是那个临时工,这一讲把工作便条从「能问出答案」写到「能上生产」——先有考卷,再改便条,一次只改一处。
30秒看懂
同一个临时工,同一张便条——这一讲把便条写到能上生产
还是那个读遍了全世界资料、却从没参加过你们公司岗前培训的天才临时工。前三讲你已经学会怎么把便条递进去,也学会了写便条的两大原则和六个技巧。但把它交到业务手上之前,还差最后一段路:你怎么知道这张便条真的够用?
「帮我看看这段金融文字」不是任务,「把这段文字判定到四个固定类别之一,只回类别名」才是。任务定义的判据:能写成一句话,且这句话里含输入、输出、可选范围。
攒一批已经有标准答案的题目,在你动第一版便条之前就把它锁死。没有考卷,你改便条全凭手感,改好改坏都不知道。
加了格式约束、又换了措辞、又补了示例,分数涨了三个点——你不知道是哪一处起的作用,下一轮也就无从下手。
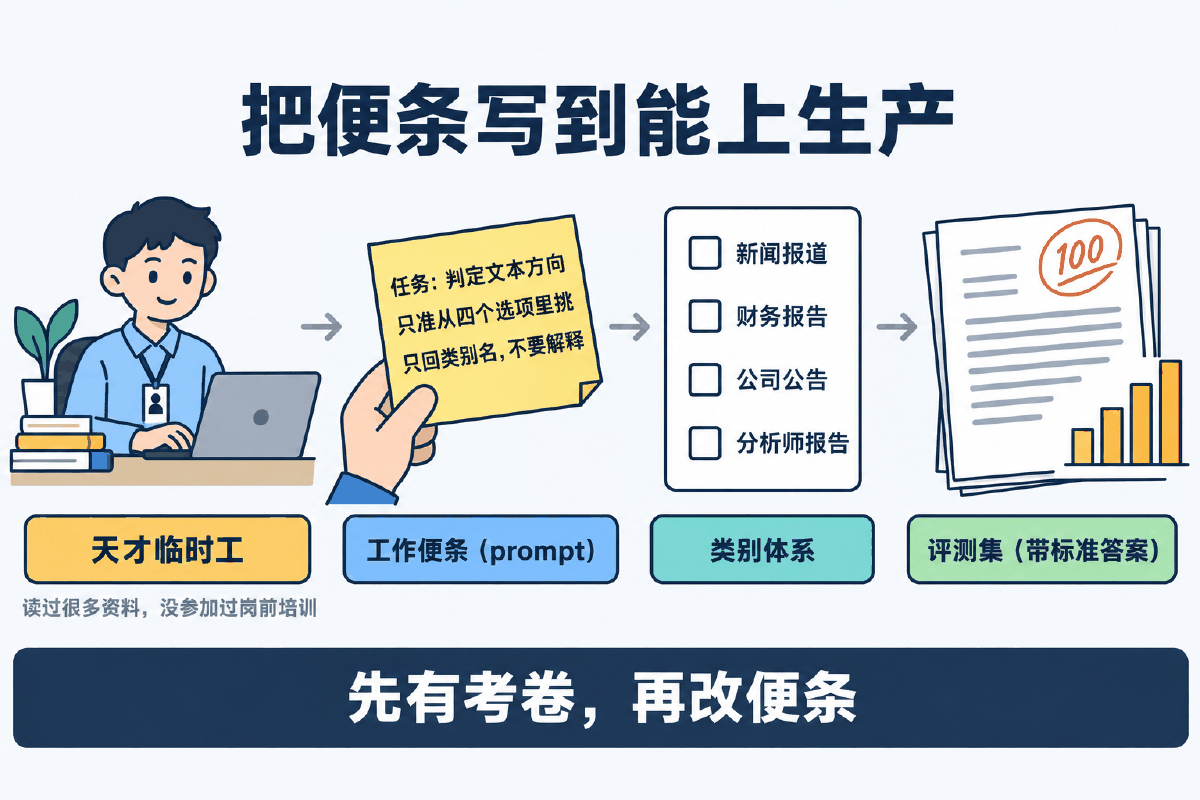
这一讲里出场的角色
| 角色 | 对应比喻 | 它到底是什么 |
|---|---|---|
| 大模型 | 天才临时工 | 已经具备语言理解能力的通用模型,本讲用它直接做判别,不训练 |
| Prompt | 递过去的工作便条 | 写进 messages 的那几段文字:角色、任务、类别、格式、示例 |
| 类别体系 | 便条上那几个勾选框 | 一组互斥且穷尽的枚举值,模型只准从里面挑一个 |
| few-shot 示例 | 便条背面附的样卡 | 几组「问题 + 标准答案」,教的是格式与口径,不是新知识 |
| 评测集 | 事先出好的岗前考卷 | 一批带标准答案的样本,先于提示词存在,改提示词期间不许动 |
| 准确率 | 考卷得分 | 判对的条数除以总条数;配一个误差区间才有意义 |
| 越界输出 | 他自己发明了框外的答案 | 返回了类别体系里没有的说法,必须显式记成「判不了」 |
| 迭代 | 改一处,再考一遍 | 改动 → 重跑评测集 → 看分数动没动,循环 |
② 评测集要多大、怎么标,才能看出两版提示词的差别?
③ 模型回了一句「这段文字属于财务报告类别,因为……」,你的程序该怎么办?
④ 准确率从 75% 涨到 79%,这 4 个点算不算数?
01概念:把提示词做成工程,而不是手艺
四步链路,每一步都有判据;判据过不了,就不许往下走
1.1 「能问出答案」和「能上生产」差在哪
在对话框里试提示词,成功的标准很松:它答对了一次,你就觉得行了。但真要把这件事接进业务流程,标准立刻变成四条:
| 要求 | 对话框里试 | 接进生产 |
|---|---|---|
| 答得对不对 | 看一眼,觉得对 | 在一批带标准答案的样本上算出一个数 |
| 答案能不能用 | 人眼能读懂就行 | 程序要能直接取出字段,多一句解释都算故障 |
| 稳不稳 | 试了三条都对 | 同一版提示词跑整批,波动要在可接受范围内 |
| 改得动改不动 | 随手改,越改越顺手 | 每一次改动都要能说清带来了什么变化 |
这四条要求逼出一条固定的工作链路。它与行业无关——做金融文本判定、做工单分类、做客服意图识别,走的都是同一条路。
1.2 四步链路:任务定义 → 提示词设计 → 评测集 → 迭代优化
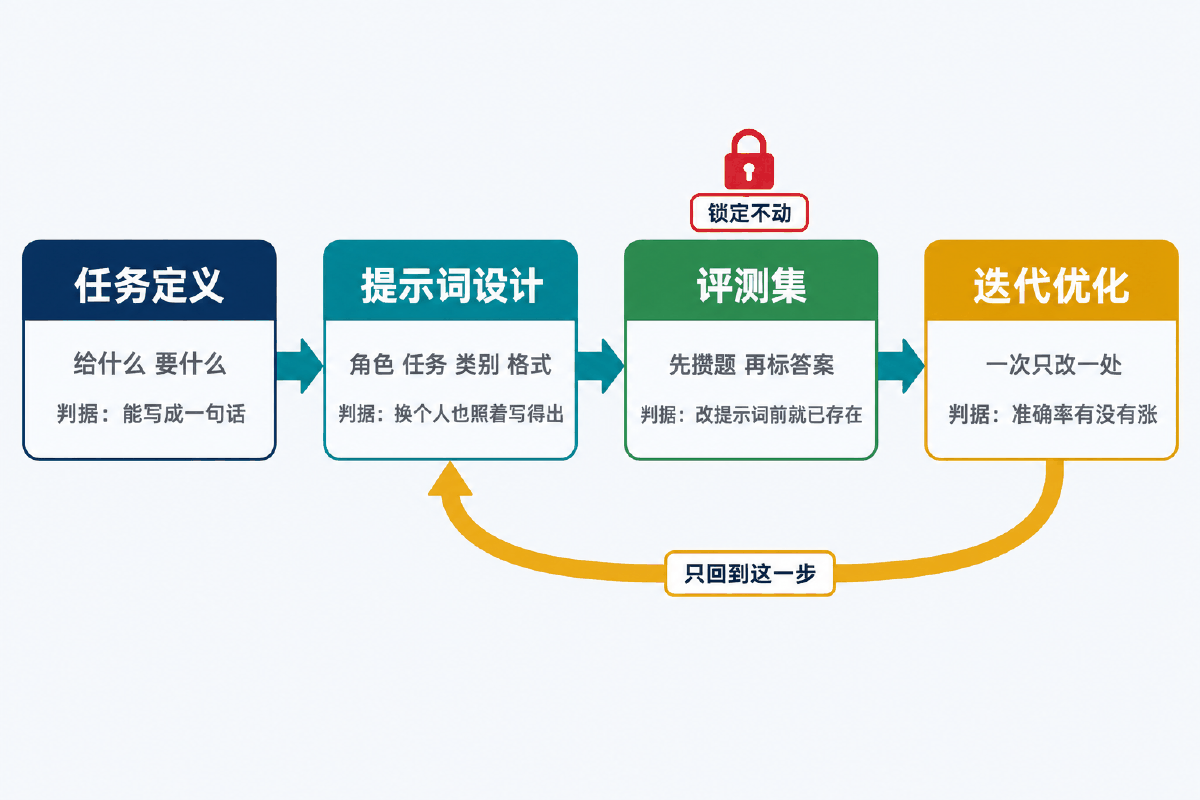
| 步骤 | 这一步在干什么 | 过关判据(做不到就别往下走) |
|---|---|---|
| ① 任务定义 | 把业务诉求翻译成一个有确定输入输出的问题 | 能写成一句话,且这句话里含「给什么、要什么、可选范围」 |
| ② 提示词设计 | 把这句话展开成模型看得懂的指令 | 换个人照着这份定义也写得出同样的提示词 |
| ③ 评测集 | 攒一批带标准答案的样本并锁死 | 在第一版提示词写出来之前它就已经存在 |
| ④ 迭代优化 | 改一处、重跑、看分数 | 每一版只比上一版改一处,且差值超出噪声才算数 |
1.3 第一步:任务定义
任务定义是整条链路上唯一一件纯粹靠人想清楚的事,模型帮不上忙。它要回答三个问题:
输入是一段文本?一对文本?还是一段文本加一张表?长度上限是多少,超了怎么办,这些现在就要定。
要一个标签、一组字段,还是一段话?要的东西是不是可枚举,直接决定了后面能不能算准确率。
答案只能从哪几个里挑?范围之外的情况存不存在?「都不是」要不要单列一类?
这三问决定了任务属于哪一类,而任务类型又决定了后面怎么评测:
| 任务类型 | 输出形态 | 能不能直接算准确率 | 典型评测指标 |
|---|---|---|---|
| 判别式 · 分类 | 一个枚举值 | 能,直接比对 | 准确率、每类 precision / recall / F1、混淆矩阵 |
| 判别式 · 抽取 | 一组字段 | 能,但要逐字段比 | 字段级 precision / recall,整条全对率 |
| 判别式 · 匹配 | 是 / 否 | 能 | 准确率、F1 |
| 生成式 · 摘要改写 | 一段自由文本 | 不能,没有唯一正确答案 | 人工打分、成对比较、规则检查 |
1.4 第二步:提示词设计
第三讲讲过两大原则(写清晰具体的指令、给模型充足的思考时间)和六个技巧。到了生产任务里,这些技巧不是挑着用,而是按固定顺序拼成一份结构化的提示词:
| 组成部分 | 回答什么问题 | 用到第三讲的哪个技巧 |
|---|---|---|
| 角色 | 你现在是谁 | 指定角色,把模型的输出分布往这个领域收 |
| 任务 | 你要干的这件事叫什么 | 清晰具体的指令 |
| 可选范围 | 答案只能从哪几个里挑 | 结构化输出的前置条件 |
| 输出格式 | 答案长什么样 | 结构化输出——这一条决定程序能不能解析 |
| 示例 | 照着这个样子答 | few-shot,教格式与口径 |
| 边界说明 | 拿不准的时候按什么判 | 条件检查 / 指定步骤 |
| 分隔 | 哪一段是待处理的原文 | 分隔符,防止原文里的句子被当成指令 |
1.5 第三步:评测集
评测集是一批带标准答案的样本。它的作用只有一个:把「我觉得变好了」换成一个数。四件事要在动提示词之前定下来:
| 要定的事 | 通用判据 | 踩坑代价 |
|---|---|---|
| 从哪来 | 抽真实数据,不要拿写提示词时用过的那几条 | 用调试样本当考题,分数虚高,上线现原形 |
| 多大 | 每类不少于 25 条,且各类条数持平 | 太小的话,几个点的差别全被噪声淹没 |
| 怎么标 | 先写标注手册,两人独标,不一致的进仲裁 | 标注口径不统一,等于用一把会变形的尺子量 |
| 怎么锁 | 落盘进仓库,调提示词期间一条都不许改 | 边调边改考题,分数只会越来越好看 |
1.6 第四步:迭代优化
有了前三步,迭代就变成一个机械的循环,不再需要灵感:
这里有个反直觉但极其重要的判据:分数涨了,不等于这次改动有用。评测集只有 24 条时,准确率的 95% 误差区间半宽能到 ±16 个百分点——涨 4 个点完全可能只是换了个随机数。第 04 节的脚本会把这个数算给你看。
1.7 这一讲改的仍然只是便条
四步链路走下来,你会写很多东西:类别定义、示例、格式约束、边界说明。但要清楚这些东西全部都写进了输入:
| 这一讲做的事 | 改了什么 | 要不要梯度 | 属于哪一类 |
|---|---|---|---|
| 写角色、任务、格式约束 | 输入文本 | 不要 | Prompt Engineering |
| 加 few-shot 示例 | 输入文本 | 不要 | In-Context Learning |
| 补边界说明、要求分步判断 | 输入文本 | 不要 | Prompt Engineering |
| (本讲不做)训练伪标记向量 | 一小段可训练向量 | 要 | Prompt-Tuning |
| (本讲不做)更新模型权重 | 模型全部权重 | 要 | Fine-Tuning |
02原理:把四步链路落到金融文本方向判定
同一条链路,换成金融语料走一遍;每一步都给出可以照抄的判据
2.1 任务定义:判定文本方向,不是预测涨跌
业务侧的原始诉求通常是一句很模糊的话:「金融数据太多了,帮我们从里面挑出有用的」。按 1.3 节的三问把它收一收:
| 三问 | 这个任务的答案 |
|---|---|
| 给什么 | 一段中文金融行业动态文本,通常是一到三句话,几十到两百字 |
| 要什么 | 一个类别名,表示这段文字属于哪一种材料形态 |
| 可选范围 | 新闻报道 / 财务报告 / 公司公告 / 分析师报告,四选一 |
收敛成一句话就是:给定一段中文金融文本,从四个固定类别中选出它所属的那一个,只返回类别名。这句话通过了任务定义的判据——含输入、含输出、含可选范围。
2.2 类别定义与边界:先把「靠什么判」写下来
四个类别名单独看都很好懂,但真拿几十条样本去标,分歧立刻出现:一份年报里也会提到并购,一篇新闻里也会引用财务数据。光有类别名不够,必须写出判据。
这个任务的判据可以收敛成两个维度:谁在说(企业自己,还是第三方)和说的是什么形式的话(陈述已发生的事,还是给出判断与预期):
| 类别 | 谁在说 | 说什么形式的话 | 典型信号词 |
|---|---|---|---|
| 新闻报道 | 第三方 | 陈述已经发生的事 | 今日、据报道、发布公告宣布、市场 |
| 财务报告 | 企业自己 | 披露经营与财务数据 | 资产负债表、报告期内、营业收入、现金流 |
| 公司公告 | 企业自己 | 宣布一件具体事项 | 本公司宣布、董事会决议、拟于、聘任 |
| 分析师报告 | 第三方 | 给出判断与预期 | 我们认为、维持评级、预计、投资者应关注 |
但 2×2 拆出来必然有摩擦点,这些就是要单独标记的边界样本:
| 边界情形 | 为什么难判 | 按判据该落哪一类 |
|---|---|---|
| 监管部门答记者问 | 发言方是机构自己,但形态像新闻 | 第三方在陈述已发生的事 → 新闻报道 |
| 年报里对下一年度目标的说明 | 既是企业自述,又带前瞻判断 | 企业自己在披露经营情况 → 财务报告 |
| 回购进展说明 | 既像公告,又带数据披露 | 企业自己在宣布具体事项 → 公司公告 |
| 引用了经营数据的研究结论 | 数据来自财报,结论来自第三方 | 第三方在给判断 → 分析师报告 |
财务公告、而示例答案里写的是财务报告——模型会照着示例答财务报告,而你的程序拿着财务公告去比对,这一类样本会全部判错,且错得毫无规律。第 03 节的代码把这种情况明确处理掉了。
2.3 提示词怎么写:七块落到这个任务上
按 1.4 节那张表逐块填:
| 组成部分 | 这个任务里写成什么 | 缺席时会出现的现象 |
|---|---|---|
| 角色 | 「现在你是一个文本分类器」 | 模型容易转成聊天口吻,开头加寒暄 |
| 任务 | 「把我给你的句子分类到以下类别中」 | 模型可能去做摘要或点评,而不是判定 |
| 可选范围 | 四个类别名,原样列出 | 模型会自己发明类别,比如「行业研究」「监管动态」 |
| 输出格式 | 「只输出类别名本身,不要任何解释」 | 返回里带解释,程序取不出标签 |
| 示例 | 每类一条典型文本 + 对应类别名 | 口径靠模型自己猜,边界样本摇摆 |
| 边界说明 | 2.2 节那两个判断轴 | 边界样本的判定随机,重跑结果会变 |
| 分隔 | 待判文本用引号或 ``` 包起来 | 原文里的句子可能被当成新指令 |
示例(few-shot)在对话式接口里的正确写法,是拆成一问一答的多轮消息,而不是堆在一段话里:
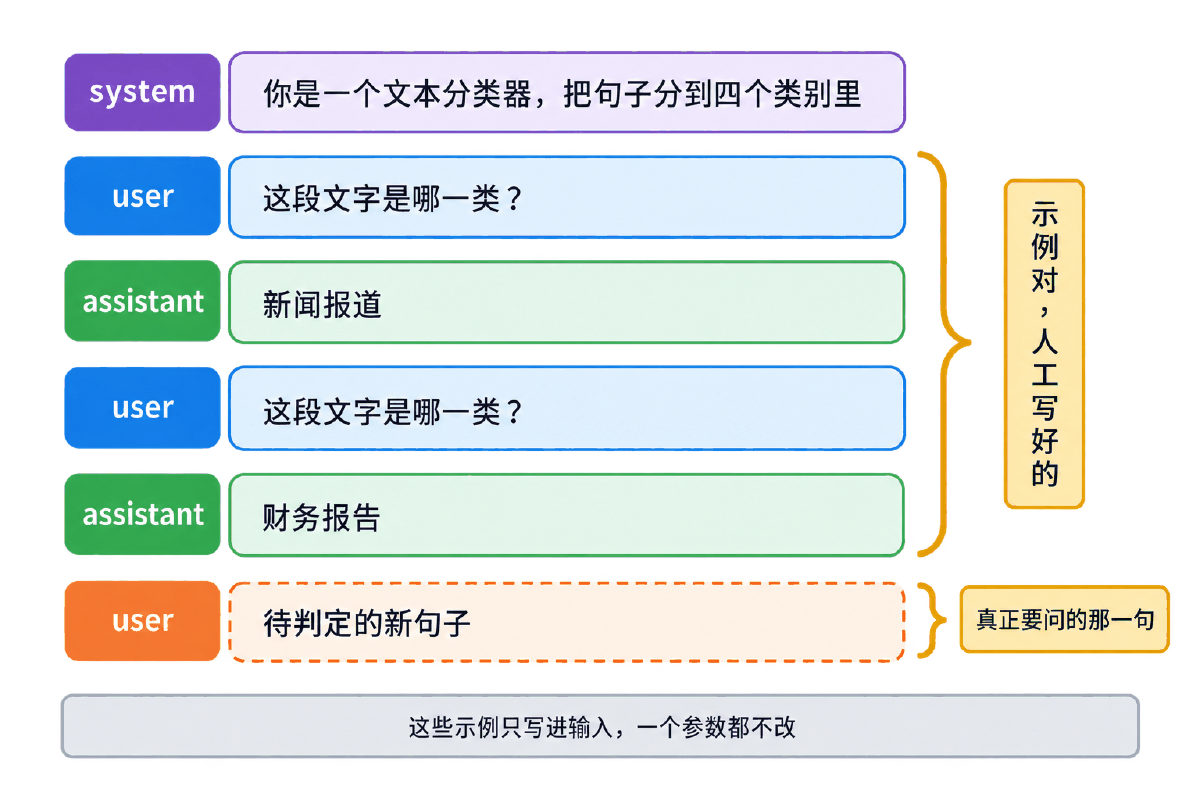
user 问、assistant 答的真实轮次,等于让模型看到它自己上一次是怎么回答的,它会照着那个形态继续;堆在一段 system 里则只是「读到过这些文字」,模仿强度明显更弱。注意图③底部那句话:这些示例只写进输入,一个参数都不改——它仍然是便条,不是培训。
2.4 输出怎么约束:从自由文本收敛到枚举值
模型返回的永远是字符串,不是枚举。约束输出本质上是把「可能的返回形态」尽量压窄,压不掉的部分再交给代码兜底。三层手段,从前到后:
在提示词里写死「只输出类别名本身,不要输出任何解释、理由或标点」。这一句是性价比最高的一处改动。
few-shot 里 assistant 的回答就是光秃秃四个字。示例的形态比指令的措辞更有约束力。
解析函数负责剥壳:去思考块、去代码围栏、去引号标点,再判断能不能落进枚举。
当输出不止一个字段时(比如既要类别又要置信度),指令层就该升级成结构化输出——要求返回 JSON,并把字段名、取值范围写进提示词。判别式单标签任务不需要 JSON,一个裸类别名是最容易解析、最不容易出错的形态。
| 输出约定 | 适用场景 | 解析成本 |
|---|---|---|
| 裸枚举值 | 单标签分类 | 最低。字符串比对即可 |
| JSON 单字段 | 要带置信度或理由 | 中。要处理代码围栏、单双引号、尾逗号 |
| JSON 多字段 | 信息抽取类任务 | 高。要逐字段校验类型与取值 |
2.5 越界输出怎么处理:判不了就说判不了
不管指令写得多死,总有返回落在枚举之外。把它们分成四种,处理方式各不相同:
| 形态 | 例子 | 该怎么处理 | 为什么 |
|---|---|---|---|
| 带包装 | “财务报告”、代码围栏、<think> 块 | 剥掉后接受 | 模型的判断是对的,只是外面裹了一层 |
| 同义写法 | 财报、研报 | 查同义表后接受 | 含义唯一,可以安全收敛 |
| 带解释 | 「属于财务报告类别,因为……」 | 只出现一个类别名时才接受 | 出现两个就说明模型在比较,不能替它挑 |
| 真越界 | 董事会决议、空返回 | 记成「判不了」 | 猜一个进去,等于把故障藏进准确率里 |
2.6 评测集怎么攒、多大、怎么标
按 1.5 节的四件事逐条落地:
| 环节 | 这个任务里的具体做法 |
|---|---|
| 从哪来 | 从真实语料里分层抽样:四个类别各自抽,保证每类条数相等。写提示词时用过的示例文本一条都不许进评测集 |
| 多大 | 起步每类 25 条、共 100 条;本讲的演示评测集是每类 6 条共 24 条,这个规模只够看出大问题,看不出几个点的差别,2.7 节会把这句话算成数字 |
| 怎么标 | 先把 2.2 节那张判据表当作标注手册,两人独立标同一批,不一致的条目进第三人仲裁;仲裁时如果发现判据本身说不清,回头改判据并重标全部样本 |
| 标什么 | 每条至少四个字段:sid(能定位)、文本、标准答案、是不是边界样本 |
| 怎么锁 | 落盘成代码仓库里的一个文件,进版本管理;调提示词期间只读不写 |
2.7 准确率怎么算,以及「涨了几个点」算不算数
单标签分类的准确率就是最朴素的那个定义:
三个数缺一不可,而且要一起看:
| 现象 | 说明什么 | 该改哪里 |
|---|---|---|
| 可解析率低 | 格式约束没生效 | 指令层加一句「只输出类别名」,或在示例里演示形态 |
| 可解析率满分,准确率低,错误分散 | 模型确实判不准 | 补示例、补边界说明 |
| 错误集中在某两类互换 | 这两类的边界没划清 | 回 2.2 节改判据,并重标评测集 |
| 错的永远是那几条边界样本 | 类别体系本身有问题 | 回任务定义,考虑合并类别或增设「都不是」 |
至于「涨了几个点算不算数」,用准确率的 95% 误差区间来判。按正态近似,半宽 = 1.96 × √(p(1−p)/n):
| 评测集规模 n | 准确率 p=0.8 时的半宽 | 能分辨的最小差别 |
|---|---|---|
| 24 | 约 ±16.0 个百分点 | 只能看出「大不一样」,几个点全是噪声 |
| 100 | 约 ±7.8 个百分点 | 能看出十个点以上的差别 |
| 240 | 约 ±5.1 个百分点 | 能看出十个点左右的差别 |
eval_scorer.py 里的 ci95() 实算,第 04 节会把它跑出来。
2.8 运行环境
本讲的代码按本地推理组织:用 Ollama 把模型跑在自己机器上,Python 侧通过 ollama 库的 ollama.chat 发起对话式调用,终端展示用 rich 美化。
| 依赖 | 作用 | 前提 |
|---|---|---|
| Python | 运行环境 | 3.8 及以上 |
| Ollama | 本地模型管理与推理服务 | 需先安装并启动服务,默认监听 127.0.0.1:11434 |
ollama(Python 库) | 发请求,提供 chat / generate 两种调用 | pip install ollama |
rich | 终端彩色输出与状态条 | pip install rich,只影响观感不影响结果 |
模型 qwen3:8b | 实际做判定的那个模型 | ollama run qwen3:8b 先拉到本地,约 5.2 GB 磁盘空间 |
qwen3 这一系列在 Ollama 模型库里从 0.6b 一直排到 235b,标注具备 tools 与 thinking 两项能力。选 8b 是因为它在单机可跑与判别质量之间比较平衡;机器吃力就往下换更小的规格,判别类任务对参数量的敏感度低于生成类任务。
thinking 能力会直接影响解析
带 thinking 的模型可能先吐一段推理再给结论,返回里就会出现 <think>…</think> 这样的包装。这不是模型不听话,是它的正常形态。所以 2.5 节那张表里第一行「带包装 → 剥掉后接受」不是可选项而是必需项:解析函数必须先去掉思考块,再判断类别。第 03 节的最小代码第一件事就是干这个。
03最小代码:把自由文本收成一个枚举值
不装依赖、不连模型,先把最容易出事的那一段跑通
整条链路上最先该写、也最容易被跳过的,不是调模型那一步,而是「拿到一串字符串之后怎么办」。原因很实在:调模型那一步依赖环境,而这一步不依赖任何东西,纯字符串处理,本机直接跑。把它先写好,后面接上任何模型都不会在解析上翻车。
# -*- coding: utf-8 -*-
"""把模型吐出来的自由文本收敛成一个枚举值,越界的显式报出来。

大模型返回的是字符串,不是枚举。它可能回「财务报告」,也可能回
「这段文字属于财务报告类别,因为……」,还可能回一个你压根没定义过的
「财报」。程序如果直接拿这串东西当标签,准确率会被格式噪声吃掉一大截。

这份文件只做一件事:**文本 → 枚举值 或者 明确的「判不了」**。
纯标准库可跑。
"""
import re

LABELS = ["新闻报道", "财务报告", "公司公告", "分析师报告"]

# 常见的同义/简写写法,收敛到正式类别名。
# 注意:这张表是「容错」不是「猜」——只收录含义唯一的写法。
ALIAS = {
    "财报": "财务报告",
    "财务公告": "财务报告",
    "年报": "财务报告",
    "季报": "财务报告",
    "新闻": "新闻报道",
    "报道": "新闻报道",
    "公告": "公司公告",
    "研报": "分析师报告",
    "分析报告": "分析师报告",
    "研究报告": "分析师报告",
}

# 模型爱加的包装:思考块、代码围栏、引号、句末标点
_THINK = re.compile(r"<think>.*?</think>", re.S)
_FENCE = re.compile(r"```[a-zA-Z]*\s*(.*?)\s*```", re.S)
_TRIM = "\"'“”‘’ 。..,,::;;!!??\n\t "


def normalize(raw):
    """清掉包装,返回一串干净文本。不做任何类别判断。"""
    if raw is None:
        return ""
    text = str(raw)
    text = _THINK.sub("", text)          # 带 thinking 能力的模型会先吐一段推理
    m = _FENCE.search(text)
    if m:
        text = m.group(1)                # 代码围栏里才是正文
    return text.strip(_TRIM)


def parse_label(raw, labels=None, allow_alias=True):
    """返回 (类别 或 None, 判定依据)。

    判定顺序是有讲究的,从严到松:
      1. exact  —— 清洗后正好等于某个类别名,这是唯一「干净」的情况;
      2. alias  —— 命中同义表;
      3. unique —— 文本里只出现了一个类别名(模型加了解释但没改口);
      4. 其余一律返回 None,绝不猜。
    """
    labels = list(labels or LABELS)
    text = normalize(raw)
    if not text:
        return None, "empty"

    if text in labels:
        return text, "exact"

    if allow_alias and text in ALIAS and ALIAS[text] in labels:
        return ALIAS[text], "alias"

    # 模型没忍住加了解释:只有当文本里**恰好只出现一个**类别名时才接受
    hit = [lab for lab in labels if lab in text]
    if len(hit) == 1:
        return hit[0], "unique"
    if len(hit) > 1:
        # 出现多个类别名,说明模型在比较或者在犹豫,这种绝不能挑一个用
        return None, "ambiguous"

    if allow_alias:
        ahit = {ALIAS[k] for k in ALIAS if k in text and ALIAS[k] in labels}
        if len(ahit) == 1:
            return ahit.pop(), "alias_in_text"

    return None, "out_of_scope"


def _demo():
    cases = [
        ("财务报告", "干净的枚举值"),
        ("  财务报告。 ", "带空白和句号"),
        ("“财务报告”", "带引号"),
        ("```\n财务报告\n```", "被代码围栏包住"),
        ("<think>先看有没有资产负债表</think>财务报告", "带思考块"),
        ("财报", "同义写法"),
        ("财务公告", "选项和示例用词不一致时的典型产物"),
        ("这段文字属于财务报告类别,因为它描述了资产负债表", "多了解释,但只提到一个类别"),
        ("可能是财务报告,也可能是公司公告", "两个类别都提到了"),
        ("董事会决议", "压根不在类别体系里"),
        ("", "空返回"),
    ]
    print("%-46s %-12s %s" % ("模型返回(截断显示)", "解析结果", "依据"))
    print("-" * 78)
    ok = 0
    for raw, _note in cases:
        lab, why = parse_label(raw)
        shown = (raw[:20] + "…") if len(raw) > 21 else raw
        print("%-46s %-12s %s" % (repr(shown), lab if lab else "判不了", why))
        ok += int(lab is not None)
    print("-" * 78)
    print("%d/%d 条能收敛到枚举值,其余显式判不了。" % (ok, len(cases)))

    # 断言:这几条是安全底线,改代码把它们改坏了要当场炸
    assert parse_label("财务报告")[0] == "财务报告"
    assert parse_label("可能是财务报告,也可能是公司公告") == (None, "ambiguous")
    assert parse_label("董事会决议") == (None, "out_of_scope")
    assert parse_label("")[0] is None
    assert parse_label("财报", allow_alias=False)[0] is None, \
        "关掉同义表后就不该再认简写"
    print("越界处理自检通过:模糊与越界都返回 None,没有一条被硬塞进某一类。")


if __name__ == "__main__":
    _demo()
3.1 跑起来是什么样
直接 python3 output_guard.py。脚本里内置了十一条构造出来的待解析字符串,涵盖了实际会遇到的各种返回形态;它逐条过一遍,打印解析结果和判定依据:
| 待解析的字符串 | 解析结果 | 依据 | 说明 |
|---|---|---|---|
财务报告 | 财务报告 | exact | 理想形态,字符串比对即可 |
财务报告。 | 财务报告 | exact | 首尾空白与句号被剥掉 |
“财务报告” | 财务报告 | exact | 中文引号也在剥除字符集里 |
| 代码围栏包住的类别名 | 财务报告 | exact | 先取围栏内部,再判断 |
<think>…</think>财务报告 | 财务报告 | exact | 思考块整段去掉 |
财报 | 财务报告 | alias | 命中同义表 |
财务公告 | 财务报告 | alias | 类别名写法不一致时的典型产物 |
| 「属于财务报告类别,因为……」 | 财务报告 | unique | 带解释,但只提到一个类别 |
| 「可能是财务报告,也可能是公司公告」 | 判不了 | ambiguous | 提到两个类别,不许替它挑 |
董事会决议 | 判不了 | out_of_scope | 压根不在类别体系里 |
| 空返回 | 判不了 | empty | 调用成功但内容为空 |
末尾那行统计是 8/11 条能收敛到枚举值,其余显式判不了。——这个「其余」才是重点。
exact,再 alias,最后才是「文本里只出现一个类别名」。顺序反了会让带解释的返回抢在干净返回前面被匹配,依据就不准了。②
ambiguous 和 out_of_scope 分开记。前者说明模型在犹豫,该补边界说明;后者说明它没接住类别体系,该把可选范围写得更醒目。合并成一个「失败」,就丢掉了区分这两种修法的信息。③ 同义表是「容错」不是「猜」。只收录含义唯一的写法;
公告 可以收敛到「公司公告」,但报告 就不行——它同时沾着三个类别。
3.2 结尾那几行断言在守什么
| 断言 | 它拦住的事故 |
|---|---|
| 干净类别名必须解析成功 | 改正则时把正常路径改坏——最基本的回归保护 |
两个类别名同时出现 → ambiguous | 有人为了「提高可解析率」把它改成取第一个,那等于在指标里注水 |
表外词 → out_of_scope | 有人用模糊匹配去硬套最相近的类别 |
| 关掉同义表后不该再认简写 | 同义表失效了却没人发现,因为主路径仍然通 |
ambiguous 改成返回第一个命中的类别,程序照样跑完,可解析率还会上升,看起来一切都变好了——实际上你只是把一批「模型没想清楚」的样本随机分配给了某个类别。所以这一节的代码里断言比逻辑还多,目的就是把这种不会报错的错变成会报错的。
3.3 这 100 行对应真实系统的哪一部分
| 脚本里的东西 | 真实系统里的位置 | 接上去还要加什么 |
|---|---|---|
LABELS | 类别体系的唯一事实来源 | 提示词、评测集、数据库枚举都从这里取,不各写一份 |
normalize() | 返回预处理 | 按实际遇到的包装形态往里加规则,每加一条补一条断言 |
parse_label() | 解析层 | 把判定依据一并落库,方便事后统计哪种形态最多 |
返回 None 的分支 | 故障通道 | 接告警:「判不了」的比例突然上升,往往是模型或提示词被人动过 |
04完整案例:六个脚本把四步链路接起来
前四个不需要任何推理环境就能跑,后两个负责接上真实模型
这一节的脚本按链路顺序排:评测集先落盘 → 提示词渲染成数据 → 打分与混淆矩阵 → 迭代记录,这四个纯标准库、python3 文件名 直接跑;最后两个把模型接进来。这个切法不是为了好看——它对应 2.8 节那句话:整条链路上只有一个函数碰模型。
4.1 评测集先落盘
按 2.6 节的做法攒出来的 24 条样本,四个类别各 6 条,边界样本单独打标记。它是仓库里的一个普通文件,改提示词期间只读不写。
# -*- coding: utf-8 -*-
"""金融文本方向判定的评测集:24 条带标准答案的样本。

这份文件是整条链路上唯一「先于提示词存在」的东西。改提示词之前它必须
已经躺在仓库里,否则后面所有的准确率都没有参照物。

设计约定:
  · 四个类别每类 6 条,人为保证类别均衡,算总准确率时不会被大类带偏;
  · 每条都带 sid,出了问题能一眼定位到是哪一条;
  · hard=True 标记边界样本(两个类别都沾边的那种),单独统计;
  · 纯标准库,import 进来就能用,不依赖任何模型。
"""

# 类别体系:全流程只认这四个字符串,多一个字少一个字都算越界
LABELS = ["新闻报道", "财务报告", "公司公告", "分析师报告"]

# 每条样本:(sid, 文本, 标准答案, 是否边界样本)
SAMPLES = [
    # ---------- 新闻报道:第三方视角在陈述已经发生的事 ----------
    ("N01", "今日,央行发布公告宣布降低利率,以刺激经济增长。这一降息举措将影响贷款利率,并在未来几个季度内对金融市场产生影响。", "新闻报道", False),
    ("N02", "今日,股市经历了一轮震荡,受到宏观经济数据和全球贸易紧张局势的影响。投资者密切关注美联储可能的政策调整,以适应市场的不确定性。", "新闻报道", False),
    ("N03", "受隔夜外围市场影响,今日开盘三大股指集体低开,随后震荡回升,尾盘收复大部分失地。", "新闻报道", False),
    ("N04", "据多家媒体报道,某大型券商昨日下午召开临时会议,讨论调整旗下多只产品的费率结构。", "新闻报道", False),
    ("N05", "监管部门今日就近期市场波动答记者问,表示将继续维护市场平稳运行。", "新闻报道", True),
    ("N06", "本周大宗商品市场普遍回落,铜、铝价格分别下跌,相关板块个股跟随走弱。", "新闻报道", False),

    # ---------- 财务报告:企业自己在披露经营与财务数据 ----------
    ("F01", "本公司年度财务报告显示,去年公司实现了稳步增长的盈利,同时资产负债表呈现强劲的状况。经济环境的稳定和管理层的有效战略执行为公司的健康发展奠定了基础。", "财务报告", False),
    ("F02", "公司资产负债表显示,公司偿债能力强劲,现金流充足,为未来投资和扩张提供了坚实的财务基础。", "财务报告", False),
    ("F03", "报告期内,公司实现营业收入同比增长,归属于母公司股东的净利润同步提升,毛利率较上年同期略有改善。", "财务报告", False),
    ("F04", "本季度经营活动产生的现金流量净额为正,存货周转天数较上季度缩短,应收账款账龄结构保持稳定。", "财务报告", False),
    ("F05", "截至报告期末,公司资产总额较年初增长,负债率维持在行业平均水平以下。", "财务报告", False),
    ("F06", "公司管理层在年报中对下一年度的经营目标作出说明,并披露了主要财务指标的完成情况。", "财务报告", True),

    # ---------- 公司公告:企业在宣布一件具体的事项 ----------
    ("A01", "本公司高兴地宣布成功完成最新一轮并购交易,收购了一家在人工智能领域领先的公司。这一战略举措将有助于扩大我们的业务领域,提高市场竞争力", "公司公告", False),
    ("A02", "本公司宣布成功收购一家在创新科技领域领先的公司,这一战略性收购将有助于公司拓展技术能力和加速产品研发。", "公司公告", False),
    ("A03", "本公司董事会决议通过,聘任新任首席财务官,自决议之日起生效,相关手续正在办理中。", "公司公告", False),
    ("A04", "本公司拟于下月召开临时股东大会,审议关于变更募集资金用途的议案,现将会议相关事项通知如下。", "公司公告", False),
    ("A05", "本公司控股子公司近日取得一项发明专利授权,该专利的取得不会对公司当期经营业绩产生重大影响。", "公司公告", False),
    ("A06", "本公司发布关于回购股份进展的说明,截至目前已累计回购股份若干股。", "公司公告", True),

    # ---------- 分析师报告:第三方在给判断与建议 ----------
    ("R01", "最新的行业分析报告指出,科技公司的创新将成为未来增长的主要推动力。云计算、人工智能和数字化转型被认为是引领行业发展的关键因素,投资者应关注这些趋势", "分析师报告", False),
    ("R02", "最新的分析报告指出,可再生能源行业预计将在未来几年经历持续增长,投资者应该关注这一领域的投资机会", "分析师报告", False),
    ("R03", "我们维持对该板块的中性评级,认为当前估值已部分反映了行业景气度的改善预期。", "分析师报告", False),
    ("R04", "研究团队认为,随着渗透率提升放缓,该细分赛道的竞争格局将在未来两年内逐步明朗。", "分析师报告", False),
    ("R05", "本报告基于公开资料整理,测算结果显示该行业未来三年复合增速有望维持在两位数区间。", "分析师报告", False),
    ("R06", "综合公司披露的经营数据与行业景气度,我们上调了对其盈利能力的判断。", "分析师报告", True),
]


def labels():
    """返回类别体系的副本,避免调用方误改全局常量。"""
    return list(LABELS)


def samples(only_hard=None):
    """取样本。only_hard=True 只取边界样本,False 只取普通样本,None 全取。"""
    if only_hard is None:
        return list(SAMPLES)
    return [s for s in SAMPLES if s[3] is bool(only_hard)]


def self_check():
    """评测集自身的体检。数据有毛病要在跑模型之前就炸出来。"""
    sids = [s[0] for s in SAMPLES]
    assert len(sids) == len(set(sids)), "sid 重复,定位样本时会串"

    texts = [s[1] for s in SAMPLES]
    assert len(texts) == len(set(texts)), "有完全重复的文本,会让准确率虚高"

    for sid, text, gold, hard in SAMPLES:
        assert gold in LABELS, "%s 的标准答案 %r 不在类别体系里" % (sid, gold)
        assert text.strip(), "%s 的文本是空的" % sid
        assert isinstance(hard, bool), "%s 的 hard 标记不是布尔值" % sid

    # 类别必须均衡,否则「总准确率」这个数会被样本多的类别绑架
    per = {}
    for _sid, _t, gold, _h in SAMPLES:
        per[gold] = per.get(gold, 0) + 1
    assert len(set(per.values())) == 1, "各类别样本数不相等:%s" % per
    return per


if __name__ == "__main__":
    per = self_check()
    print("评测集自检通过")
    print("  样本总数 : %d" % len(SAMPLES))
    print("  类别数   : %d" % len(LABELS))
    for lab in LABELS:
        print("    %-6s %d 条" % (lab, per[lab]))
    print("  边界样本 : %d 条(%s)"
          % (len(samples(True)), " ".join(s[0] for s in samples(True))))
跑 python3 evalset.py,它先体检再报数:
| 自检项 | 拦住的问题 |
|---|---|
sid 不重复 | 定位样本时串号,错误分析全乱 |
| 文本不重复 | 同一条被抽进来两次,准确率被它单独影响两倍 |
| 标准答案都在类别体系里 | 标注时写了同义词,这条样本永远判错 |
| 各类别条数相等 | 总准确率被样本多的类别绑架 |
边界样本 : 4 条(N05 F06 A06 R06)。这四条的编号被显式记下来,后面算分时能把它们单独拎出来算——2.6 节说过,普通样本在错和只有边界样本在错,修法完全不同。
4.2 提示词渲染成数据,而不是手写字符串
把提示词当字符串手写,改三版就会乱;把它当配置渲染出来,改了哪一处、改了几处,程序自己能查。
# -*- coding: utf-8 -*-
"""提示词渲染器:把「角色 + 任务 + 类别 + 格式 + 示例」拼成 messages。

把提示词当字符串手写,改三次就会乱;把它当**数据结构渲染出来**,
改哪一处、改了几处,都能被程序检查。这份文件不调任何模型,
它只负责把配置渲染成 messages 列表并打印出来。纯标准库可跑。
"""
import json

import evalset

# 每个类别一条示例。示例文本直接取自评测集之外的那几条典型样本,
# 目的是让模型看到「什么样的文字算这一类」,而不是靠类别名猜。
CLASS_EXAMPLES = {
    "新闻报道": "今日,股市经历了一轮震荡,受到宏观经济数据和全球贸易紧张局势的影响。投资者密切关注美联储可能的政策调整,以适应市场的不确定性。",
    "财务报告": "本公司年度财务报告显示,去年公司实现了稳步增长的盈利,同时资产负债表呈现强劲的状况。经济环境的稳定和管理层的有效战略执行为公司的健康发展奠定了基础。",
    "公司公告": "本公司高兴地宣布成功完成最新一轮并购交易,收购了一家在人工智能领域领先的公司。这一战略举措将有助于扩大我们的业务领域,提高市场竞争力",
    "分析师报告": "最新的行业分析报告指出,科技公司的创新将成为未来增长的主要推动力。云计算、人工智能和数字化转型被认为是引领行业发展的关键因素,投资者应关注这些趋势",
}

ASK = "“{text}”是 {labels} 里的什么类别?"


def build_system(labels, with_format_rule=True, with_boundary=False):
    """角色 + 任务 + 类别体系(+ 输出格式约束)(+ 边界说明)。"""
    parts = ["现在你是一个文本分类器,你需要按照要求将我给你的句子分类到:%s类别中。" % labels]
    if with_format_rule:
        parts.append("只输出类别名本身,不要输出任何解释、理由或标点。")
    if with_boundary:
        parts.append(
            "判定依据是这段文字的**体裁**,不是它提到的内容:"
            "第三方在陈述已经发生的事是新闻报道;"
            "企业自己在披露经营与财务数据是财务报告;"
            "企业自己在宣布一件具体事项是公司公告;"
            "第三方在给出判断与预期是分析师报告。")
    return "".join(parts)


def build_messages(text, labels, shots=None,
                   with_format_rule=True, with_boundary=False):
    """渲染出完整 messages。shots 为 None 时就是 zero-shot。"""
    msgs = [{"role": "system",
             "content": build_system(labels, with_format_rule, with_boundary)}]
    for label, example in (shots or {}).items():
        msgs.append({"role": "user", "content": ASK.format(text=example, labels=labels)})
        msgs.append({"role": "assistant", "content": label})
    msgs.append({"role": "user", "content": ASK.format(text=text, labels=labels)})
    return msgs


def describe(msgs):
    """粗略统计规模。字符数不是 token 数,但足够看出量级变化。"""
    chars = sum(len(m["content"]) for m in msgs)
    roles = {}
    for m in msgs:
        roles[m["role"]] = roles.get(m["role"], 0) + 1
    return {"messages": len(msgs), "chars": chars, "roles": roles}


def _demo():
    labels = evalset.labels()
    target = "公司资产负债表显示,公司偿债能力强劲,现金流充足,为未来投资和扩张提供了坚实的财务基础。"

    variants = [
        ("v1 只有角色和类别", dict(shots=None, with_format_rule=False, with_boundary=False)),
        ("v2 加一句格式约束", dict(shots=None, with_format_rule=True, with_boundary=False)),
        ("v3 再加四条示例", dict(shots=CLASS_EXAMPLES, with_format_rule=True, with_boundary=False)),
        ("v4 再补边界说明", dict(shots=CLASS_EXAMPLES, with_format_rule=True, with_boundary=True)),
    ]

    print("【一、四版提示词的规模】")
    print("  %-18s %8s %8s  %s" % ("版本", "消息条数", "字符数", "角色分布"))
    prev = None
    for name, kw in variants:
        msgs = build_messages(target, labels, **kw)
        d = describe(msgs)
        delta = "" if prev is None else "  (+%d 字符)" % (d["chars"] - prev)
        print("  %-18s %8d %8d  %s%s"
              % (name, d["messages"], d["chars"],
                 " ".join("%s×%d" % (k, v) for k, v in sorted(d["roles"].items())),
                 delta))
        prev = d["chars"]

    print("\n【二、v3 渲染出来长什么样】")
    msgs = build_messages(target, labels, shots=CLASS_EXAMPLES)
    for i, m in enumerate(msgs):
        body = m["content"]
        body = body if len(body) <= 52 else body[:52] + "…"
        print("  [%02d] %-9s %s" % (i, m["role"], body))

    print("\n【三、示例对的方向不能反】")
    pairs = [(msgs[i], msgs[i + 1]) for i in range(1, len(msgs) - 1, 2)]
    for u, a in pairs:
        assert u["role"] == "user" and a["role"] == "assistant", \
            "示例必须是 user 问、assistant 答,反了模型就学成了反向映射"
        assert a["content"] in labels, "示例答案 %r 不在类别体系里" % a["content"]
    print("  %d 组示例对方向正确,答案全部落在类别体系内。" % len(pairs))

    # 断言:v1→v2 只能差那一句格式约束,别的一个字都不许动
    m1 = build_messages(target, labels, shots=None, with_format_rule=False)
    m2 = build_messages(target, labels, shots=None, with_format_rule=True)
    assert len(m1) == len(m2), "v1 与 v2 的消息条数必须一致"
    assert m1[-1] == m2[-1], "待判句这一条不许跟着变"
    added = m2[0]["content"].replace(m1[0]["content"], "")
    assert added == "只输出类别名本身,不要输出任何解释、理由或标点。", \
        "v1→v2 改动不止一处:%r" % added
    print("\n  v1→v2 的全部差异:%r" % added)
    print("  就这一句,别的一个字没动——这才叫「一次只改一处」。")

    print("\n【四、messages 原样(v2,可直接贴进请求体)】")
    print(json.dumps(m2, ensure_ascii=False, indent=2)[:600] + "\n  …")


if __name__ == "__main__":
    _demo()
跑起来第一段是四版提示词的规模对照,数字由脚本实算:
| 版本 | 消息条数 | 字符数 | 相比上一版 |
|---|---|---|---|
| v1 只有角色和类别 | 2 | 156 | — |
| v2 加一句格式约束 | 2 | 180 | +24 字符 |
| v3 再加四条示例 | 10 | 653 | +473 字符 |
| v4 再补边界说明 | 10 | 754 | +101 字符 |
这张表顺带回答了一个常被忽略的成本问题:加四条示例让输入涨了三倍多。few-shot 不是免费的,每一次调用都要把这些示例重新发一遍。
user 问、assistant 答,反了模型就学成了反向映射;再检查示例答案全部落在类别体系内。最后一条最关键:它把 v1 与 v2 的差异算出来,断言差异恰好只有那一句格式约束,并把它原样打印出来。「一次只改一处」从一句口号变成了一条会失败的断言。
4.3 打分:准确率、每类指标、混淆矩阵
打分器只认「标准答案 + 预测」两列,跟模型、跟接口、跟哪一版提示词都无关,所以它在没有任何推理环境的机器上也能跑。
# -*- coding: utf-8 -*-
"""评测集打分器:准确率、每类 P/R/F1、混淆矩阵、误差区间。

输入是「标准答案 + 预测」两列,跟模型、跟接口、跟哪一版提示词都无关,
所以它可以在没有任何推理环境的机器上跑。纯标准库。

用法:
    python3 eval_scorer.py              # 用内置的一组演示预测跑一遍
    from eval_scorer import score       # 当成模块用
"""
import math

import evalset


def score(pairs, labels):
    """pairs: [(sid, 标准答案, 预测 或 None), ...]

    预测为 None 表示模型没给出合法枚举值(越界/模糊/空),
    它**算错,但单独计数**——这两种错的修法完全不同。
    """
    total = len(pairs)
    right = sum(1 for _s, g, p in pairs if p is not None and p == g)
    invalid = sum(1 for _s, _g, p in pairs if p is None)

    # 混淆矩阵:cm[真实][预测],预测列多一个 "判不了"
    cols = list(labels) + ["判不了"]
    cm = {g: {c: 0 for c in cols} for g in labels}
    for _sid, gold, pred in pairs:
        cm[gold][pred if pred is not None else "判不了"] += 1

    per = {}
    for lab in labels:
        tp = cm[lab][lab]
        fn = sum(cm[lab][c] for c in cols) - tp
        fp = sum(cm[g][lab] for g in labels if g != lab)
        prec = tp / float(tp + fp) if (tp + fp) else 0.0
        rec = tp / float(tp + fn) if (tp + fn) else 0.0
        f1 = 2 * prec * rec / (prec + rec) if (prec + rec) else 0.0
        per[lab] = {"tp": tp, "fp": fp, "fn": fn,
                    "precision": prec, "recall": rec, "f1": f1}

    acc = right / float(total) if total else 0.0
    return {"total": total, "right": right, "invalid": invalid,
            "accuracy": acc, "per_label": per, "cm": cm, "cols": cols}


def ci95(acc, n):
    """准确率的 95% 置信区间半宽(正态近似)。

    用途只有一个:判断两版提示词的差距是不是噪声。
    n 很小的时候这个半宽会大得吓人——那说明评测集该扩了,不是提示词不行。
    """
    if n <= 0:
        return 0.0
    return 1.96 * math.sqrt(acc * (1 - acc) / float(n))


def report(res, labels, title="评测结果"):
    lines = []
    half = ci95(res["accuracy"], res["total"])
    lines.append("【%s】" % title)
    lines.append("  样本数     : %d" % res["total"])
    lines.append("  判对       : %d" % res["right"])
    lines.append("  判不了     : %d(越界/模糊/空返回,计入错误)" % res["invalid"])
    lines.append("  准确率     : %.1f%%   95%% 区间约 ±%.1f 个百分点"
                 % (res["accuracy"] * 100, half * 100))
    lines.append("")
    lines.append("  %-8s %8s %8s %8s   (TP/FP/FN)" % ("类别", "精确率", "召回率", "F1"))
    for lab in labels:
        d = res["per_label"][lab]
        lines.append("  %-8s %7.1f%% %7.1f%% %7.1f%%   (%d/%d/%d)"
                     % (lab, d["precision"] * 100, d["recall"] * 100,
                        d["f1"] * 100, d["tp"], d["fp"], d["fn"]))
    lines.append("")
    lines.append("  混淆矩阵(行=标准答案,列=预测)")
    head = "  %-10s" % "" + "".join("%-9s" % c for c in res["cols"])
    lines.append(head)
    for g in labels:
        row = "  %-10s" % g + "".join("%-9d" % res["cm"][g][c] for c in res["cols"])
        lines.append(row)
    return "\n".join(lines)


# 一组演示预测:把「加了解释导致取不出标签」和「相邻类别混淆」两种典型
# 错误都放进来,好让混淆矩阵真的有东西可看。
DEMO_PRED = {
    "N05": "公司公告",      # 监管答记者问被当成了公告
    "F06": "分析师报告",    # 年报里的目标说明被当成了判断
    "A06": None,            # 越界:模型回了个类别体系外的说法
    "R06": "财务报告",      # 引用了经营数据就被拉去财务报告
    "N03": None,            # 模糊:模型同时提到两个类别
}


def _demo():
    labels = evalset.labels()
    evalset.self_check()

    pairs = []
    for sid, _text, gold, _hard in evalset.samples():
        pred = DEMO_PRED[sid] if sid in DEMO_PRED else gold
        pairs.append((sid, gold, pred))

    res = score(pairs, labels)
    print(report(res, labels, "演示预测"))

    print("")
    print("  边界样本单独看:")
    hard_sids = {s[0] for s in evalset.samples(True)}
    hard_pairs = [p for p in pairs if p[0] in hard_sids]
    hres = score(hard_pairs, labels)
    print("    边界 %d 条,判对 %d 条,准确率 %.1f%%"
          % (hres["total"], hres["right"], hres["accuracy"] * 100))
    easy_pairs = [p for p in pairs if p[0] not in hard_sids]
    eres = score(easy_pairs, labels)
    print("    普通 %d 条,判对 %d 条,准确率 %.1f%%"
          % (eres["total"], eres["right"], eres["accuracy"] * 100))
    print("    总准确率被边界样本拉低了 %.1f 个百分点。"
          % ((eres["accuracy"] - res["accuracy"]) * 100))

    # 断言:打分器自己不能算错
    assert res["total"] == 24
    assert res["right"] + sum(1 for _s, g, p in pairs if p != g) == 24
    assert res["invalid"] == 2, "两条 None 必须被单独数出来"
    for lab in labels:
        s = sum(res["cm"][lab][c] for c in res["cols"])
        assert s == 6, "%s 行的样本数应为 6,实得 %d" % (lab, s)
    perfect = score([(s, g, g) for s, g, _p in pairs], labels)
    assert abs(perfect["accuracy"] - 1.0) < 1e-9, "全对时准确率必须是 100%"
    assert abs(ci95(1.0, 24)) < 1e-9, "准确率 100% 时正态近似区间退化为 0"
    print("\n  打分器自检通过。")


if __name__ == "__main__":
    _demo()
脚本内置了一组演示预测,故意把 2.7 节那张表里的几种典型错误都放进去:两条解析失败、三条相邻类别互换。跑出来的结果是:
| 指标 | 值 |
|---|---|
| 样本数 | 24 |
| 判对 | 19 |
| 判不了 | 2(越界/模糊,计入错误但单独计数) |
| 准确率 | 79.2%,95% 区间约 ±16.2 个百分点 |
| 边界样本 | 4 条判对 0 条,准确率 0.0% |
| 普通样本 | 20 条判对 19 条,准确率 95.0% |
混淆矩阵那一段把「错到哪儿去了」摊开。它比准确率多给一条信息:错误是分散的,还是集中在某两类互换。演示数据里可以看到新闻报道那一行有 1 条跑去了公司公告、1 条判不了,而其余三类各错一条——分散型错误,说明不是某一对类别的边界塌了。
ci95() 那几行断言,是「什么时候该停手」的判据
脚本断言 ci95(0.8, 24) > ci95(0.8, 240):样本越多,区间越窄。实算出来 n=24 时半宽 ±16.0 个百分点,n=240 时收窄到 ±5.1。所以当你想分辨的差别小于当前噪声尺度时,正确动作是扩评测集,不是接着改便条。
4.4 迭代记录:逼自己一次只改一处
调提示词最常见的失败不是改错了,是一次改了三处。这个脚本把提示词拆成可比较的字段,相邻两版之间改动超过一处直接抛错。
先看最关键的那一步——v1 → v2。第一版提示词只写了角色与类别范围,没有任何输出格式约束。没有这一句的时候,模型把判定写成一句带理由的话是完全合理的——你并没有告诉它不要这么做,这是提示词的缺口,不是模型不听话。改动只有一处:在 system 里追加「只输出类别名本身,不要输出任何解释、理由或标点」。
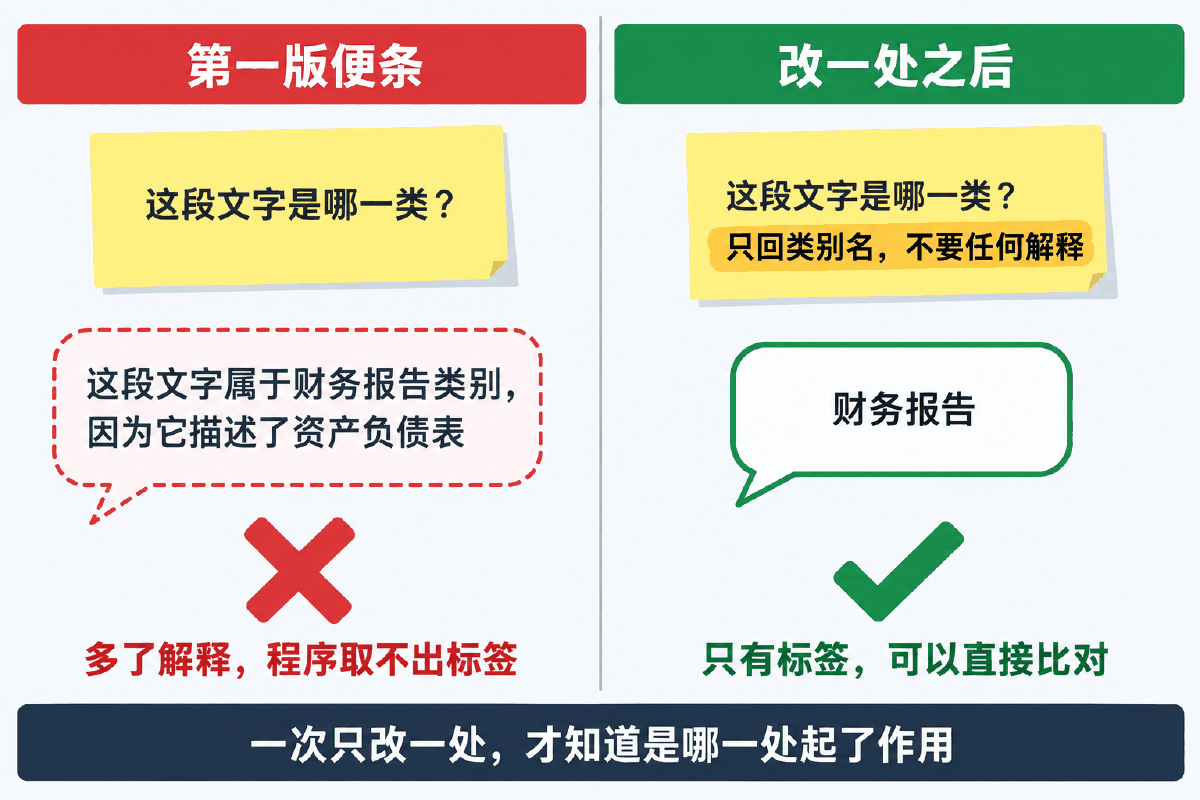
| 第一版的问题 | 改了哪一处 | 效果变化 |
|---|---|---|
| 返回里带解释与理由,程序取不出干净标签 | format_rule:追加一句格式约束 | 返回从要靠 unique 兼容的长句,变成能直接 exact 比对的裸类别名 |
| 口径靠模型自己猜,边界样本摇摆 | shots:每类补一条示例 | 输入从 180 字符涨到 653 字符,成本三倍以上,效果要在你自己的评测集上实测 |
| 拿不准时没有可依据的判断轴 | boundary_rule:补两个判断轴 | 再涨 101 字符;它直接针对的是边界样本那一组 |
unique 分支勉强接住,而一旦解释里提到第二个类别名就会直接变成 ambiguous——这一点 output_guard.py 已经把两种形态都跑给你看了。但具体涨了多少个百分点,必须由 run_eval.py 在你自己的推理环境里跑出来,不能照抄任何地方的数字——换个模型、换批语料,这个数就变了。
# -*- coding: utf-8 -*-
"""迭代记录器:逼着自己「一次只改一处」,并把效果变化算成数字。

调提示词最常见的失败不是改错了,是**一次改了三处**:加了格式约束、
换了措辞、又补了两个示例,然后准确率涨了 8 个点,你不知道是哪一处起的作用,
下一轮也就无从下手。

这份文件做两件事:
  1. 记录每一版改了哪些字段,改动超过一处直接抛错;
  2. 把相邻两版的指标差算出来,并用置信区间判断这个差是不是噪声。
纯标准库可跑。
"""
from eval_scorer import ci95

# 提示词被拆成可比较的字段。改提示词 = 改这张表里的某一个键。
BASE = {
    "role": "文本分类器",
    "labels": "['新闻报道', '财务报告', '公司公告', '分析师报告']",
    "format_rule": "",
    "shots": 0,
    "boundary_rule": "",
}


class Iteration(object):
    def __init__(self, name, fields, note=""):
        self.name = name
        self.fields = dict(fields)
        self.note = note
        self.metrics = {}

    def diff(self, other):
        """返回两版之间所有不同的字段名。"""
        keys = set(self.fields) | set(other.fields)
        return sorted(k for k in keys
                      if self.fields.get(k) != other.fields.get(k))


def chain(*iterations):
    """检查整条迭代链:相邻两版之间**只准差一个字段**。"""
    for prev, cur in zip(iterations, iterations[1:]):
        changed = prev.diff(cur)
        if len(changed) != 1:
            raise AssertionError(
                "%s → %s 一次改了 %d 处(%s),拆开重做"
                % (prev.name, cur.name, len(changed), "、".join(changed)))
    return True


def compare(prev, cur, n):
    """相邻两版的指标差,附一句「这个差算不算数」的判断。"""
    out = []
    for key in ("parse_rate", "accuracy"):
        a = prev.metrics.get(key)
        b = cur.metrics.get(key)
        if a is None or b is None:
            continue
        delta = b - a
        # 两个比例之差的粗略噪声尺度:各自区间半宽的和
        noise = ci95(a, n) + ci95(b, n)
        verdict = "超出噪声,算数" if abs(delta) > noise else "落在噪声里,不算数"
        out.append((key, a, b, delta, noise, verdict))
    return out


def _demo():
    n = 24  # 评测集大小

    v1 = Iteration("v1", BASE, "只有角色和类别体系")
    v2 = Iteration("v2", dict(BASE, format_rule="只输出类别名本身,不要输出任何解释、理由或标点。"),
                   "加一句输出格式约束")
    v3 = Iteration("v3", dict(v2.fields, shots=4), "每个类别补一条示例")
    v4 = Iteration("v4", dict(v3.fields, boundary_rule="按体裁判定,不按提到的内容判定"),
                   "补类别边界说明")

    print("【一、改动链路检查】")
    chain(v1, v2, v3, v4)
    for prev, cur in ((v1, v2), (v2, v3), (v3, v4)):
        print("  %s → %s  改动字段:%s   %s"
              % (prev.name, cur.name, "、".join(prev.diff(cur)), cur.note))
    print("  四版全部满足「一次只改一处」。")

    print("\n【二、一次改两处会怎样】")
    bad = Iteration("v3x", dict(v2.fields, shots=4,
                                boundary_rule="按体裁判定"), "同时加示例和边界说明")
    try:
        chain(v2, bad)
    except AssertionError as e:
        print("  被拦下:%s" % e)

    print("\n【三、把指标填进去再比(以下为举例用的假想值)】")
    # 下面这组数字是**举例用的假想值**,只用来演示「差多少才算数」
    # 这个判据,它不是任何模型的成绩。真实数字要由 run_eval.py 在你自己的
    # 推理环境里跑出来再回填;在那之前,不要拿这里的值对外报指标。
    v1.metrics = {"parse_rate": 0.50, "accuracy": 0.50}
    v2.metrics = {"parse_rate": 1.00, "accuracy": 0.75}
    v3.metrics = {"parse_rate": 1.00, "accuracy": 0.79}

    for prev, cur in ((v1, v2), (v2, v3)):
        print("  %s → %s" % (prev.name, cur.name))
        for key, a, b, delta, noise, verdict in compare(prev, cur, n):
            print("    %-10s %.0f%% → %.0f%%   差 %+.0f 个百分点,"
                  "噪声尺度 ±%.0f —— %s"
                  % (key, a * 100, b * 100, delta * 100, noise * 100, verdict))

    print("\n【四、这条链路给出的结论】")
    print("  · 格式约束这一处,把「取不出标签」整类问题一次清掉;")
    print("  · 示例这一处,带来的准确率变化落在噪声里,n=24 的评测集判不出来;")
    print("  · 想判出几个点的差别,评测集得先扩大——不是再去改提示词。")

    # 断言:评测集越小,噪声尺度越大,这是扩评测集的硬理由
    assert ci95(0.8, 24) > ci95(0.8, 240), "样本越多,区间应越窄"
    assert ci95(0.8, 24) > 0.15, "n=24 时半宽超过 15 个百分点"
    print("\n  n=24 时半宽 ±%.1f 个百分点;n=240 时收窄到 ±%.1f 个百分点。"
          % (ci95(0.8, 24) * 100, ci95(0.8, 240) * 100))


if __name__ == "__main__":
    _demo()
四版的改动链路是这样的,每一步只动一个字段:
| 步骤 | 改动字段 | 这一处在解决什么 |
|---|---|---|
| v1 → v2 | format_rule | 返回里带解释,程序取不出标签 |
| v2 → v3 | shots | 口径靠模型自己猜,边界样本摇摆 |
| v3 → v4 | boundary_rule | 拿不准时没有可依据的判断轴 |
如果有人想一次同时加示例和边界说明,脚本会当场拦下来,打印:v2 → v3x 一次改了 2 处(boundary_rule、shots),拆开重做。
compare() 演示的那组 50% / 75% / 79% 是为了说明「差多少才算数」这个判据而虚构的数字,脚本注释里也写死了这一点。真实数字必须由 run_eval.py 在你自己的推理环境里跑出来再填进去。在那之前,不要拿这里的值对外报任何指标——这是这一整讲最不能含糊的一条。
而这个判据本身是可靠的,它给出的结论是:n=24 时,+25 个百分点的准确率变化都还落在噪声尺度里(噪声 ±37),只有可解析率那种 +50 个百分点的整类改善才稳稳超出噪声。这正是 2.7 节那张表要表达的意思。
4.5 接上真实推理
前面四个脚本把「输入构造、输出校验、打分、迭代」全部验证完了,剩下的就是那一个碰模型的函数。这一版比随手写的脚本多了四件事:配置走环境变量、异常处理、重试退避、输出校验。
# -*- coding: utf-8 -*-
"""金融文本方向判定:可以上生产的那一版。

跟随手写的脚本比,这一版多了四件事,每一件都是线上真会出问题的地方:
  1. 模型名、地址、超时、重试全部走环境变量,不写死在代码里;
  2. 每一次调用都包了异常处理,单条失败不拖垮整批;
  3. 模型返回先过 output_guard,收不进枚举值就记成「判不了」,不硬塞;
  4. 结果带上原始返回,出了问题能回看模型到底说了什么。

运行前置:
    pip install ollama rich
    ollama run qwen3:8b          # 先把模型拉到本地
可选环境变量:
    FIN_MODEL       模型名,默认 qwen3:8b
    OLLAMA_HOST     Ollama 服务地址,默认 http://127.0.0.1:11434
    FIN_TIMEOUT     单次调用超时秒数,默认 60
    FIN_RETRY       单条最多重试次数,默认 2
"""
import os
import sys
import time

from rich import print
from rich.console import Console

import evalset
from output_guard import parse_label
from prompt_render import CLASS_EXAMPLES, build_messages

console = Console()

MODEL = os.environ.get("FIN_MODEL", "qwen3:8b")
HOST = os.environ.get("OLLAMA_HOST", "http://127.0.0.1:11434")
TIMEOUT = float(os.environ.get("FIN_TIMEOUT", "60"))
RETRY = int(os.environ.get("FIN_RETRY", "2"))


def _client():
    """延迟导入 ollama:没装依赖时给一句人话,而不是一屏 traceback。"""
    try:
        import ollama
    except ImportError:
        print("[bold red]没有找到 ollama 库,先执行 pip install ollama[/bold red]")
        sys.exit(1)
    # 指定 host 才能连远端的推理机;不指定就是本机默认端口
    return ollama.Client(host=HOST, timeout=TIMEOUT)


def classify_one(client, text, labels, shots=None):
    """判定一条文本。返回 (类别 或 None, 依据, 原始返回)。"""
    messages = build_messages(text, labels, shots=shots)
    last_err = ""
    for attempt in range(RETRY + 1):
        try:
            resp = client.chat(model=MODEL, messages=messages)
            raw = resp["message"]["content"]
        except Exception as exc:                      # 网络/超时/服务没起来
            last_err = "%s: %s" % (type(exc).__name__, exc)
            if attempt < RETRY:
                time.sleep(2 ** attempt)              # 指数退避,别原地猛打
                continue
            return None, "call_failed", last_err

        label, why = parse_label(raw, labels)
        if label is not None:
            return label, why, raw
        # 解析不出来也值得再试一次:温度不为 0 时下一次可能就规矩了
        if attempt < RETRY:
            continue
        return None, why, raw
    return None, "call_failed", last_err


def classify_many(texts, labels=None, shots=None):
    labels = labels or evalset.labels()
    client = _client()
    results = []
    for i, text in enumerate(texts, 1):
        with console.status("[bold bright_green]判定第 %d/%d 条…" % (i, len(texts))):
            label, why, raw = classify_one(client, text, labels, shots)
        results.append({"text": text, "label": label, "why": why, "raw": raw})
    return results


def main():
    labels = evalset.labels()
    texts = [
        "今日,央行发布公告宣布降低利率,以刺激经济增长。这一降息举措将影响贷款利率,并在未来几个季度内对金融市场产生影响。",
        "本公司宣布成功收购一家在创新科技领域领先的公司,这一战略性收购将有助于公司拓展技术能力和加速产品研发。",
        "公司资产负债表显示,公司偿债能力强劲,现金流充足,为未来投资和扩张提供了坚实的财务基础。",
        "最新的分析报告指出,可再生能源行业预计将在未来几年经历持续增长,投资者应该关注这一领域的投资机会",
    ]

    print("[bold]模型[/bold] %s   [bold]地址[/bold] %s" % (MODEL, HOST))
    results = classify_many(texts, labels, shots=CLASS_EXAMPLES)

    bad = 0
    for r in results:
        head = r["text"][:28] + "…"
        if r["label"] is None:
            bad += 1
            print(">>> [bold bright_red]判不了[/bold bright_red](%s) %s" % (r["why"], head))
            print("    原始返回:%r" % (str(r["raw"])[:120],))
        else:
            print(">>> [bold bright_green]%s[/bold bright_green](%s) %s"
                  % (r["label"], r["why"], head))
    print("\n共 %d 条,%d 条收敛到类别体系内,%d 条判不了。"
          % (len(results), len(results) - bad, bad))


if __name__ == "__main__":
    main()
| 改进点 | 随手写的版本 | 这一版 |
|---|---|---|
| 模型名 / 地址 | 写死在调用里 | os.environ.get 取,默认值兜底,换机器不改代码 |
| 调用失败 | 直接抛,整批中断 | 捕获后指数退避重试,单条失败不拖垮整批 |
| 返回处理 | 直接当标签用 | 过 parse_label,收不进枚举就记「判不了」 |
| 排查手段 | 只打印结论 | 把原始返回一并带出来,判错了能回看模型到底说了什么 |
| 缺依赖 | 一屏 traceback | 提示一句 pip install ollama 然后退出 |
parse_label 返回 None 时会再调一次模型。理由是:温度不为 0 时,同一份输入的下一次返回可能就规矩了。但重试次数必须有上限(默认 2 次),否则遇到系统性的格式问题,你会把同一条样本无限重试下去——那不是容错,是把故障拖成超时。
4.6 端到端跑一版
最后一个脚本把所有零件接起来:读评测集 → 渲染 messages → 调模型 → 校验输出 → 算分 → 写 CSV。
# -*- coding: utf-8 -*-
"""在评测集上跑一版提示词,把准确率算出来。

这是把前面几个零件接起来的那一步:
    evalset(标准答案) → prompt_render(渲染 messages)
        → finance_classify(调模型 + 输出校验) → eval_scorer(算分)

用法:
    python3 run_eval.py v1        # 只有角色和类别
    python3 run_eval.py v2        # 加一句输出格式约束
    python3 run_eval.py v3        # 再补四条示例
    python3 run_eval.py v4        # 再补类别边界说明

跑完会把 (sid, 标准答案, 预测) 三列写进 CSV,方便回看是哪几条错了。
依赖 ollama 与本地已拉好的模型;没有推理环境时先跑 eval_scorer.py,
它用同样的打分逻辑,不需要模型。
"""
import csv
import os
import sys

import evalset
from eval_scorer import report, score
from output_guard import parse_label
from prompt_render import CLASS_EXAMPLES, build_messages

OUT_DIR = os.environ.get("FIN_EVAL_OUT", ".")

# 四版提示词的差异全部收敛在这张表里,一版只比上一版多一个键
VARIANTS = {
    "v1": dict(shots=None, with_format_rule=False, with_boundary=False),
    "v2": dict(shots=None, with_format_rule=True, with_boundary=False),
    "v3": dict(shots=CLASS_EXAMPLES, with_format_rule=True, with_boundary=False),
    "v4": dict(shots=CLASS_EXAMPLES, with_format_rule=True, with_boundary=True),
}


def run(version):
    from finance_classify import MODEL, _client, RETRY  # 复用同一套调用与重试

    if version not in VARIANTS:
        raise SystemExit("没有这一版:%s,可选 %s" % (version, list(VARIANTS)))

    labels = evalset.labels()
    evalset.self_check()
    client = _client()
    kw = VARIANTS[version]

    pairs, rows = [], []
    parsed = 0
    samples = evalset.samples()
    for i, (sid, text, gold, hard) in enumerate(samples, 1):
        messages = build_messages(text, labels, **kw)
        raw, pred, why = "", None, "call_failed"
        for attempt in range(RETRY + 1):
            try:
                raw = client.chat(model=MODEL, messages=messages)["message"]["content"]
            except Exception as exc:
                why = "%s: %s" % (type(exc).__name__, exc)
                continue
            pred, why = parse_label(raw, labels)
            break
        parsed += int(pred is not None)
        pairs.append((sid, gold, pred))
        rows.append({"sid": sid, "hard": int(hard), "gold": gold,
                     "pred": pred or "", "why": why,
                     "raw": str(raw).replace("\n", " ")[:200]})
        print("  [%2d/%2d] %s 标准=%-6s 预测=%-6s (%s)"
              % (i, len(samples), sid, gold, pred or "判不了", why))

    res = score(pairs, labels)
    parse_rate = parsed / float(len(samples))

    path = os.path.join(OUT_DIR, "eval_%s.csv" % version)
    with open(path, "w", encoding="utf-8-sig", newline="") as f:
        w = csv.DictWriter(f, fieldnames=["sid", "hard", "gold", "pred", "why", "raw"])
        w.writeheader()
        w.writerows(rows)

    print("")
    print(report(res, labels, "%s / %s" % (version, MODEL)))
    print("\n  可解析率   : %.1f%%(模型返回能收敛成枚举值的比例)" % (parse_rate * 100))
    print("  明细已写入 : %s" % path)
    print("\n  把准确率与可解析率填进 iterate_log.py,再跟上一版比。"
          "两版之间只许差一处,否则涨跌无法归因。")
    return res, parse_rate


if __name__ == "__main__":
    run(sys.argv[1] if len(sys.argv) > 1 else "v2")
| 命令 | 跑的是哪一版 |
|---|---|
python3 run_eval.py v1 | 只有角色和类别体系 |
python3 run_eval.py v2 | 加一句输出格式约束 |
python3 run_eval.py v3 | 再补四条示例 |
python3 run_eval.py v4 | 再补类别边界说明 |
它除了打印报告,还会把 (sid, hard, gold, pred, why, raw) 六列写进 eval_<版本>.csv。raw 这一列是排查的命根子:准确率掉了要回看模型原话,没有它就只能靠猜。
05骨架模板:换个行业也能照着做
一份分类骨架 + 三张检查表,套到自己的任务上
5.1 分类骨架
把第 03、04 节的东西收敛成一个文件:类别体系、边界说明、示例、提示词渲染、输出校验、评测、迭代检查全在里面,五处 TODO 标出要改的地方。纯标准库,不接模型也能跑完整条链路——它自带一个假的 predict_fn,先证明输入构造、输出校验、打分三段都是对的,再去接真实推理。
# -*- coding: utf-8 -*-
"""大模型文本分类骨架:换个行业、换个类别体系,改五处 TODO 就能用。

这份骨架把「任务定义 → 提示词设计 → 评测集 → 迭代优化」四步固化成了代码结构:
    LABELS / DESCRIPTIONS   任务定义与类别边界
    build_messages()        提示词设计
    EVALSET + evaluate()    评测集与打分
    VERSIONS + diff_once()  迭代优化,一次只改一处

纯标准库,不接模型也能跑:它会用一个假的 predict_fn 把整条链路走通,
证明「输入构造、输出校验、打分」三段都是对的,再去接真实推理。

用法:
    python3 llm_classify_skeleton.py       # 跑自检 + 演示
"""
import re

# ---------------------------------------------------------------- 任务定义
# TODO 1:换成你的类别体系。三条硬要求:
#   · 类别之间互斥,一条文本只应落进一个类别;
#   · 类别名在提示词、示例、评测集、代码里**逐字一致**,不许出现同义写法;
#   · 类别数先控制在 10 个以内,超了先考虑分层判定。
LABELS = ["新闻报道", "财务报告", "公司公告", "分析师报告"]

# TODO 2:写清每个类别的边界。这段会拼进提示词,也是标注员的标注手册。
#         判据:两个标注员照着它标同一批数据,结论应当一致。
DESCRIPTIONS = {
    "新闻报道": "第三方在陈述已经发生的事",
    "财务报告": "企业自己在披露经营与财务数据",
    "公司公告": "企业自己在宣布一件具体事项",
    "分析师报告": "第三方在给出判断与预期",
}

# TODO 3:每个类别给一条示例。示例要挑典型的,不要挑边界样本。
SHOTS = {
    "新闻报道": "今日,股市经历了一轮震荡,受到宏观经济数据和全球贸易紧张局势的影响。",
    "财务报告": "本公司年度财务报告显示,去年公司实现了稳步增长的盈利。",
    "公司公告": "本公司宣布成功完成最新一轮并购交易,收购了一家人工智能公司。",
    "分析师报告": "最新的行业分析报告指出,科技创新将成为未来增长的主要推动力。",
}

ASK = "“{text}”是 {labels} 里的什么类别?"


# ------------------------------------------------------------ 提示词设计
def build_messages(text, shots=None, with_format_rule=True, with_boundary=False):
    """渲染 messages。每个开关对应一处可独立开合的改动。"""
    sys_parts = ["现在你是一个文本分类器,你需要按照要求将我给你的句子分类到:%s类别中。" % LABELS]
    if with_format_rule:
        sys_parts.append("只输出类别名本身,不要输出任何解释、理由或标点。")
    if with_boundary:
        sys_parts.append("判定依据是文字的体裁:" +
                         ";".join("%s是%s" % (k, v) for k, v in DESCRIPTIONS.items()) + "。")
    msgs = [{"role": "system", "content": "".join(sys_parts)}]
    for label, example in (shots or {}).items():
        msgs.append({"role": "user", "content": ASK.format(text=example, labels=LABELS)})
        msgs.append({"role": "assistant", "content": label})
    msgs.append({"role": "user", "content": ASK.format(text=text, labels=LABELS)})
    return msgs


# ------------------------------------------------------------ 输出校验
_THINK = re.compile(r"<think>.*?</think>", re.S)
_FENCE = re.compile(r"```[a-zA-Z]*\s*(.*?)\s*```", re.S)
_TRIM = "\"'“”‘’ 。..,,::;;!!??\n\t "


def parse_label(raw):
    """自由文本 → 枚举值 或 None。表外、模糊一律 None,绝不猜。"""
    text = _THINK.sub("", str(raw or ""))
    m = _FENCE.search(text)
    if m:
        text = m.group(1)
    text = text.strip(_TRIM)
    if text in LABELS:
        return text, "exact"
    hit = [lab for lab in LABELS if lab in text]
    if len(hit) == 1:
        return hit[0], "unique"
    if len(hit) > 1:
        return None, "ambiguous"
    return None, "out_of_scope"


# ------------------------------------------------------------ 评测集
# TODO 4:换成你自己的评测集,并且**在动提示词之前就把它标好**。
#         每类不少于 25 条、类别均衡、边界样本单独标记,是能看出差别的起点。
EVALSET = [
    ("S01", "今日,央行发布公告宣布降低利率,以刺激经济增长。", "新闻报道"),
    ("S02", "公司资产负债表显示,公司偿债能力强劲,现金流充足。", "财务报告"),
    ("S03", "本公司董事会决议通过,聘任新任首席财务官。", "公司公告"),
    ("S04", "我们维持对该板块的中性评级,认为估值已部分反映预期。", "分析师报告"),
]


def evaluate(predict_fn, **kw):
    """predict_fn(messages) -> 模型返回的原始字符串。"""
    right = parsed = 0
    detail = []
    for sid, text, gold in EVALSET:
        raw = predict_fn(build_messages(text, **kw))
        pred, why = parse_label(raw)
        parsed += int(pred is not None)
        right += int(pred == gold)
        detail.append((sid, gold, pred, why))
    n = float(len(EVALSET))
    return {"accuracy": right / n, "parse_rate": parsed / n, "detail": detail}


# ------------------------------------------------------------ 迭代优化
# TODO 5:每加一版,只准比上一版多改一个键。
VERSIONS = {
    "v1": dict(shots=None, with_format_rule=False, with_boundary=False),
    "v2": dict(shots=None, with_format_rule=True, with_boundary=False),
    "v3": dict(shots=SHOTS, with_format_rule=True, with_boundary=False),
    "v4": dict(shots=SHOTS, with_format_rule=True, with_boundary=True),
}


def diff_once(a, b):
    """相邻两版必须只差一个键,差多了当场抛错。"""
    keys = set(a) | set(b)
    changed = sorted(k for k in keys if a.get(k) != b.get(k))
    if len(changed) != 1:
        raise AssertionError("一次改了 %d 处:%s" % (len(changed), "、".join(changed)))
    return changed[0]


def _self_check():
    assert len(LABELS) == len(set(LABELS)), "类别名重复"
    assert set(DESCRIPTIONS) == set(LABELS), "边界说明与类别体系对不上"
    assert set(SHOTS) <= set(LABELS), "示例答案跑到类别体系外面去了"
    for _sid, _t, gold in EVALSET:
        assert gold in LABELS, "评测集里的标准答案 %r 不在类别体系里" % gold
    order = ["v1", "v2", "v3", "v4"]
    steps = [diff_once(VERSIONS[a], VERSIONS[b]) for a, b in zip(order, order[1:])]
    assert steps == ["with_format_rule", "shots", "with_boundary"], steps
    return steps


def _demo():
    steps = _self_check()
    print("【骨架自检通过】每一版只改一处:%s" % " → ".join(steps))

    # 一个假模型:v1 那样没有格式约束时啰嗦,加了约束就只回类别名。
    # 它的作用是把链路走通,不是模拟真实模型的判断力。
    def fake_predict(messages):
        rule_on = "只输出类别名本身" in messages[0]["content"]
        target = messages[-1]["content"]
        guess = next((lab for lab in LABELS if lab[:2] in target), LABELS[0])
        for sid, text, gold in EVALSET:
            if text in target:
                guess = gold
                break
        return guess if rule_on else "这段文字属于%s类别,因为它的表述方式符合该体裁。" % guess

    print("\n【假模型跑两版,看链路通不通】")
    for name in ("v1", "v2"):
        r = evaluate(fake_predict, **VERSIONS[name])
        print("  %s  可解析率 %.0f%%   准确率 %.0f%%"
              % (name, r["parse_rate"] * 100, r["accuracy"] * 100))
        for sid, gold, pred, why in r["detail"]:
            print("      %s 标准=%-6s 预测=%-6s (%s)" % (sid, gold, pred or "判不了", why))

    print("\n  接真实模型时,把 fake_predict 换成一次真实调用即可,"
          "其余三段(渲染、校验、打分)一行都不用动。")

    try:
        diff_once(VERSIONS["v2"], dict(VERSIONS["v4"]))
    except AssertionError as e:
        print("\n【跨版直接跳会被拦下】%s" % e)


if __name__ == "__main__":
    _demo()
| TODO | 改什么 | 要注意 |
|---|---|---|
| TODO 1 | LABELS | 类别互斥、全流程逐字一致、先控制在 10 个以内 |
| TODO 2 | DESCRIPTIONS | 它既拼进提示词,也是标注手册;判据是两个人照着它标结论一致 |
| TODO 3 | SHOTS | 挑典型样本,别拿边界样本当示例——那会把摇摆教给模型 |
| TODO 4 | EVALSET | 在动提示词之前就标好;每类不少于 25 条、类别均衡 |
| TODO 5 | VERSIONS | 每加一版只准比上一版多改一个键,diff_once() 会验 |
None:判不了就说判不了,绝不猜。②
_self_check() 检查四张表的一致性:边界说明的键要和类别体系完全相同,示例答案与评测集标准答案都不许跑到体系外。③
diff_once() 把「一次只改一处」写成断言,跨版直接跳会被当场拦下。④ 自带假模型走通全链路:接真实推理之前,先证明不是你的代码有问题。
fake_predict 是照着评测集答案回答的,它的准确率必然是 100%,这个数字没有任何评价意义。它证明的只有一件事:渲染、校验、打分三段接得上,不会在管道上丢东西。真正的判别质量,要等你把它换成一次真实调用之后才知道。别把冒烟测试的满分当成效果。
5.2 类别体系检查表
定义一套新类别时,照这张表过一遍:
| 检查项 | 判据 | 踩了会怎样 |
|---|---|---|
| 互斥 | 任一条样本只应落进一个类别 | 标注员各标各的,准确率天花板被压死 |
| 穷尽 | 真实语料里没有「哪个都不像」的大类遗漏 | 模型被迫硬塞,错误集中在某一类 |
| 可判据化 | 能降维成两三个判断轴 | 只能背定义,边界样本全靠感觉 |
| 逐字一致 | 提示词、示例、评测集、代码里写法完全相同 | 模型答对了却被判错,且错得没有规律 |
| 粒度合适 | 每类在真实语料里都有足够样本 | 稀有类别凑不齐评测样本,指标不可信 |
| 兜底类别 | 明确「都不是」要不要单列 | 不列则强判,列了则要定义它的边界 |
5.3 提示词检查表
| 检查项 | 说明 |
|---|---|
| 四块刚需齐了没 | 角色、任务、可选范围、输出格式。判别式任务缺一块就会出问题 |
| 可选范围原样列出 | 把类别名逐个写进去,别用「以上几类」这种指代 |
| 格式约束是否具体 | 「只输出类别名本身,不要输出任何解释、理由或标点」比「简洁回答」有效得多 |
| 示例方向对不对 | user 问、assistant 答;答案是光秃秃的类别名 |
| 示例是否泄题 | 示例文本不许出现在评测集里,否则分数虚高 |
| 待判文本有没有包起来 | 用引号或 ``` 分隔,防止原文里的句子被当成指令 |
| 长度成本算过没有 | few-shot 每次调用都要重发一遍,示例越多单次成本越高 |
5.4 从骨架到上线,还差哪几步
fake_predict 换成一次真实调用06易错点
八个坑,前四个出在方法论上,后四个出在代码里
这是最普遍也代价最大的一个。等提示词调得差不多了再去攒评测集,你会不自觉地拿着已经调好的提示词去挑样本——挑出来的题目天然偏向当前这一版,分数虚高。更要命的是,在此之前所有「我觉得改好了」的判断都没有任何证据,其中可能有一半是改坏的。
✅ 判据只有一条:第一版提示词写出来之前,评测集文件已经在仓库里了。做不到就别往下走,这一步省下的两小时,后面要用两天还。
加了格式约束、顺手换了措辞、又补了两条示例,准确率涨了 5 个点。你不知道是哪一处起的作用——可能是格式约束带来了 8 个点,而那两条示例反而拖了 3 个点。下一轮你继续往这个方向加示例,只会越走越偏。
✅ 把提示词拆成可独立开合的字段,相邻两版只准差一个字段,并且写成断言(iterate_log.py 的 chain()、骨架里的 diff_once())。想同时验两处,那是两轮实验,不是一轮。
评测集 24 条,准确率从 75% 涨到 79%——正好一条样本的差别。这个「涨了 4 个点」在 n=24 时完全落在噪声里(噪声尺度约 ±34 个百分点)。拿它当成改动有效的证据,等于把随机数写进了实验记录。
✅ 每次报准确率都带上 95% 区间半宽 1.96×√(p(1−p)/n)。差值没超出噪声就当作「没看出差别」,然后去扩评测集——不是接着改便条。n 从 24 提到 240,半宽从 ±16.0 收到 ±5.1。
连改三版分数都不动,错的还是同样那三条边界样本。这时候继续补示例、换措辞都是徒劳——问题不在便条上,在类别体系本身:这几条样本人都判不一致,模型凭什么判得准。
✅ 标注阶段就算一下两人独标的不一致率:人都有 20% 对不上,模型准确率的天花板大概也就在 80%。错误集中在边界样本时,回到类别定义那一步——重划判据、合并类别,或者增设一个「都不是」。人分不清的界限,别指望模型分得清。
最省事的写法是解析不出来就返回第一个类别。这样做之后可解析率永远是 100%,准确率里却混进了一批其实是格式故障的错误,而指标上完全看不出来。你会以为是模型判断力不行,于是去补边界说明、去加示例——改一整天,因为根本没改在点子上。
✅ 「判不了」必须是显式结果并单独计数。这个数大 → 格式约束有问题;这个数是 0 而准确率低 → 才轮到去改判据。output_guard.py 里还把它细分成 ambiguous(模型在犹豫,补边界说明)和 out_of_scope(没接住类别体系,把可选范围写醒目),两种修法不一样,合并记录就丢了这个信息。
类别名会同时出现在提示词的可选范围、few-shot 示例的答案、评测集的标准答案、代码里的枚举常量。只要有一处写成同义词,比如可选范围里是财务公告而示例答案里是财务报告,模型会照着示例答,你的程序却拿另一个写法去比对,这一类样本会全部判错,而且错得毫无规律——最难排查的一种。
✅ 让类别体系只有一个事实来源(本讲是 evalset.LABELS),提示词、评测、枚举全部从它取,不各写一份。骨架里的 _self_check() 会断言边界说明的键、示例答案、评测集标准答案三者都落在 LABELS 里。
带 thinking 能力的模型可能先返回 <think>…</think> 再给结论,有的还会裹一层代码围栏。这不是模型不听话,是它的正常形态。解析函数如果直接拿整串去比对枚举值,会把一大批判断完全正确的返回记成「判不了」,然后你去改提示词——改错了地方。
✅ 解析的第一件事是剥壳:去思考块 → 取代码围栏内部 → 去引号与首尾标点 → 再判断类别。顺序不能反。剥完之后仍然要保留原始返回,run_eval.py 把它写进 CSV 的 raw 列,准确率掉了要回看模型原话。
骨架里的假模型是照着评测集答案回答的,准确率必然 100%;示例文本如果混进了评测集,真实模型的分数也会异常好看。这两种满分都没有评价意义,但它们长得和真成绩一模一样,很容易被直接写进汇报。
✅ 两条纪律:示例文本一条都不许进评测集;假模型只用来证明管道接得上,它的分数不写进任何记录。同理,iterate_log.py 演示段里那组假想值也不能对外报——真实数字只能来自 run_eval.py 在真实推理环境里跑出来的那一次。
07自测题
点击题目展开答案;能把这 10 题说清楚,这一讲就通了
把提示词做成生产任务,固定链路是哪四步?每一步的过关判据是什么?
① 任务定义——判据是能写成一句话,且这句话里含「给什么、要什么、可选范围」。② 提示词设计——判据是换个人照着这份定义也写得出同样的提示词。③ 评测集——判据是在第一版提示词写出来之前它就已经存在。④ 迭代优化——判据是每一版只比上一版改一处,且差值超出噪声才算数。判据过不了就不许往下走。
为什么说「能在对话框里问出答案」离「能上生产」还差很远?
标准变了四条:答得对不对要在一批带标准答案的样本上算出一个数,而不是看一眼觉得对;答案要程序能直接取出字段,多一句解释都算故障;要整批跑完看波动,不是试三条;每一次改动都要能说清带来了什么变化。这四条要求直接逼出了那条四步链路。
同一个业务诉求,什么时候该把它收成判别式任务?为什么?
只要能收成枚举值,就收成枚举值。因为判别式任务(分类、抽取、匹配)的评测是自动的、可重复的、不需要人天天看结果;而生成式任务(摘要、改写)没有唯一正确答案,只能靠人工打分或成对比较。这是提示工程能不能真正上生产的第一道分水岭。本讲的金融文本方向判定就是被刻意收成了四选一。
本讲的四个类别是什么?靠哪两个判断轴区分?
四个类别是 新闻报道 / 财务报告 / 公司公告 / 分析师报告。两个判断轴是:谁在说(企业自己 vs 第三方)和说的是什么形式的话(陈述已发生的事 vs 给出判断与预期)。交叉成 2×2:第三方陈述事实=新闻报道,企业披露经营财务数据=财务报告,企业宣布具体事项=公司公告,第三方给判断=分析师报告。把类别体系降维成少数几个判断轴,换任何行业都适用——标注手册从「背四条定义」变成「回答两个问题」。
判别式任务的提示词里,哪四块是刚需?各自缺席会出现什么现象?
角色(缺了模型转成聊天口吻、加寒暄)、任务(缺了模型可能去做摘要或点评)、可选范围(缺了模型会自己发明类别)、输出格式(缺了返回带解释,程序取不出标签)。示例与边界说明按需要往上加;待判文本可能含指令性语句时,分隔也必须有。
few-shot 示例为什么要拆成 user / assistant 交替的多轮,而不是堆在一段 system 里?
对话模型按「角色 + 轮次」组织输入。写成真实轮次等于让模型看到它自己上一次是怎么回答的,它会照着那个形态继续;堆在一段 system 里只是「读到过这些文字」,模仿强度明显更弱。另外注意方向不能反——必须 user 问、assistant 答,反了模型就学成了反向映射。但无论怎么写,示例只进输入,一个参数都不改。
评测集要多大?n=24 和 n=240 分别能分辨多大的差别?
起步每类不少于 25 条、各类条数持平。按正态近似,95% 区间半宽 = 1.96×√(p(1−p)/n)。p=0.8 时:n=24 半宽约 ±16.0 个百分点(只能看出「大不一样」);n=100 约 ±7.8;n=240 约 ±5.1。这张表的用法不是去追某个 n,而是给「该不该继续改提示词」一个停止条件:想分辨的差别小于当前噪声尺度时,正确动作是扩评测集,不是接着改便条。
准确率 79.2%,但拆开看普通样本 95%、边界样本 0%。该改哪里?
不该改提示词。普通样本 95% 说明模型判断力没问题、格式也没问题;错误全部集中在边界样本,说明类别边界本身没划清楚。该回到类别定义那一步:重划判据、合并类别,或增设「都不是」。如果连着改三版分数都不动、错的还是同样那几条,更要确认这一点。不拆开看,你会一直在错误的地方使劲。
准确率从 75% 涨到 79%,这 4 个点算不算数?
在 n=24 的评测集上不算数。4 个点正好是一条样本的差别,而此时两版之间的噪声尺度约 ±34 个百分点(两版各自区间半宽之和),这个差完全落在噪声里。拿它当成改动有效的证据,等于把随机数写进实验记录。相比之下,可解析率那种从 50% 到 100% 的整类改善才稳稳超出噪声——iterate_log.py 的 compare() 就是干这个判断的。
模型返回「这段文字属于财务报告类别,因为它描述了资产负债表」,程序该怎么办?如果返回的是「可能是财务报告,也可能是公司公告」呢?
第一种:文本里只出现了一个类别名,按 unique 接受,判为「财务报告」——模型判断是对的,只是多了解释。第二种:出现了两个类别名,说明模型在比较或犹豫,必须返回 None 记成「判不了」(ambiguous),绝不能替它挑一个。两者都要记下判定依据:ambiguous 多说明该补边界说明,out_of_scope 多说明该把可选范围写得更醒目。
为什么「判不了」必须单独计数,而不能默默归到某一类?
因为默默归类之后,准确率里混进了一批其实是格式故障的错误,而指标上完全看不出来。你会以为是模型判断力不行,于是去补边界说明、加示例,改一整天也改不在点子上。正确读法是:「判不了」的数大 → 格式约束有问题;这个数是 0 而准确率低 → 才轮到去改判据。上线后它还是最灵敏的监控指标——不需要标准答案就能算。
这一整讲做完,模型被改变了吗?用本模块的比喻说一遍。
一点都没变。类别定义、示例、格式约束、边界说明——这些全部写进了输入,整条链路没有任何一步产生梯度,模型权重一个都没动。用比喻说:我们始终只是在反复改那张递进去的工作便条,既没有给他戴定制耳机(Prompt-Tuning),更没有送他去脱产培训(Fine-Tuning)。改便条 ≠ 改人。这也意味着:提示词写得再好,也补不上模型压根不具备的能力——真到那一步,要动的是另外两条路。
词术语表
| 术语 | 含义 |
|---|---|
| 任务定义 | 四步链路的第一步;把业务诉求收成一句含「给什么、要什么、可选范围」的话 |
| 判别式任务 | 输出可枚举或可逐字段比对的任务(分类、抽取、匹配),评测可自动化 |
| 生成式任务 | 输出自由文本的任务(摘要、改写),没有唯一正确答案,只能人工打分或成对比较 |
| 类别体系 | 一组互斥且穷尽的枚举值;要求全流程逐字一致,只有一个事实来源 |
| 判断轴 | 把类别体系降维成的少数几个提问维度;本讲用「谁在说」与「说什么形式的话」两轴 |
| 边界样本 | 两个类别都沾边的样本;要单独标记、单独统计,它反映的是类别定义而非模型能力 |
| 评测集 | 一批带标准答案的样本;必须先于提示词存在,调提示词期间只读不写 |
| 分层抽样 | 按类别分别抽样,保证各类条数持平,避免总准确率被大类绑架 |
| 标注手册 | 写明每个类别判据的文档;判据是两个标注员照着它标同一批数据结论一致 |
| 标注不一致率 | 两人独立标注对不上的比例;它大致框定了模型准确率的天花板 |
| 准确率 | 判对条数 ÷ 总条数;单独报没有意义,要配误差区间一起看 |
| 可解析率 | 模型返回能收敛成枚举值的比例;格式约束是否生效的直接指标,也是上线后最灵敏的监控项 |
| 混淆矩阵 | 行是标准答案、列是预测的计数表;用来看错误是分散的还是集中在某两类互换 |
| precision / recall / F1 | 每个类别各自的精确率、召回率与调和平均;总准确率掩盖的问题要靠它们拆出来 |
| 95% 误差区间 | 准确率的噪声尺度,半宽 1.96×√(p(1−p)/n);差值没超出它就当作没看出差别 |
| 结构化输出 | 要求模型按固定格式(枚举值、JSON)作答,使程序能直接解析;单标签任务里裸枚举值最稳 |
| 越界输出 | 返回了类别体系之外的内容;必须显式记成「判不了」,不许默默归类 |
| ambiguous / out_of_scope | 两种「判不了」:前者模型同时提到多个类别(补边界说明),后者压根没接住类别体系(把可选范围写醒目) |
| 剥壳 | 解析前去掉思考块、代码围栏、引号与首尾标点的预处理步骤,顺序不能反 |
| few-shot | 在输入里给若干「问题 + 标准答案」示例;教的是格式与口径,不更新任何参数 |
| Ollama | 本地模型管理与推理服务,默认监听 127.0.0.1:11434;Python 侧用 ollama.chat 发起对话式调用 |
| thinking 能力 | 模型先输出一段推理再给结论的能力;会让返回带 <think> 包装,解析必须先剥掉 |
| rich | 终端彩色输出与状态条的 Python 库;只影响观感,不影响判定结果 |