会话记忆与多轮上下文
模型每一轮都是从零开始读你发过去的消息;所谓「它记住了」,全靠你把历史重新塞进请求里。
30″30 秒看懂会话记忆
回到那间中央厨房。厨师手艺一流,但他有个毛病:每做完一道菜就把刚才的事忘得干干净净。上一单谁点的、忌口是什么、加没加辣,他一概不记得。
厨房的应对办法不是给厨师换脑子,而是在墙上挂一块备忘板:每来一单,服务员先把这桌之前点过什么、说过什么全都抄到板上,然后连同新的单子一起递给厨师。厨师看着这一整块板做菜,做完再把这一轮的问答添回板上。下一轮,重复一遍。
所以「这家店记性真好」是个错觉。记性好的是那块板,和每轮都肯把板重新抄一遍的服务员——也就是你写的代码。
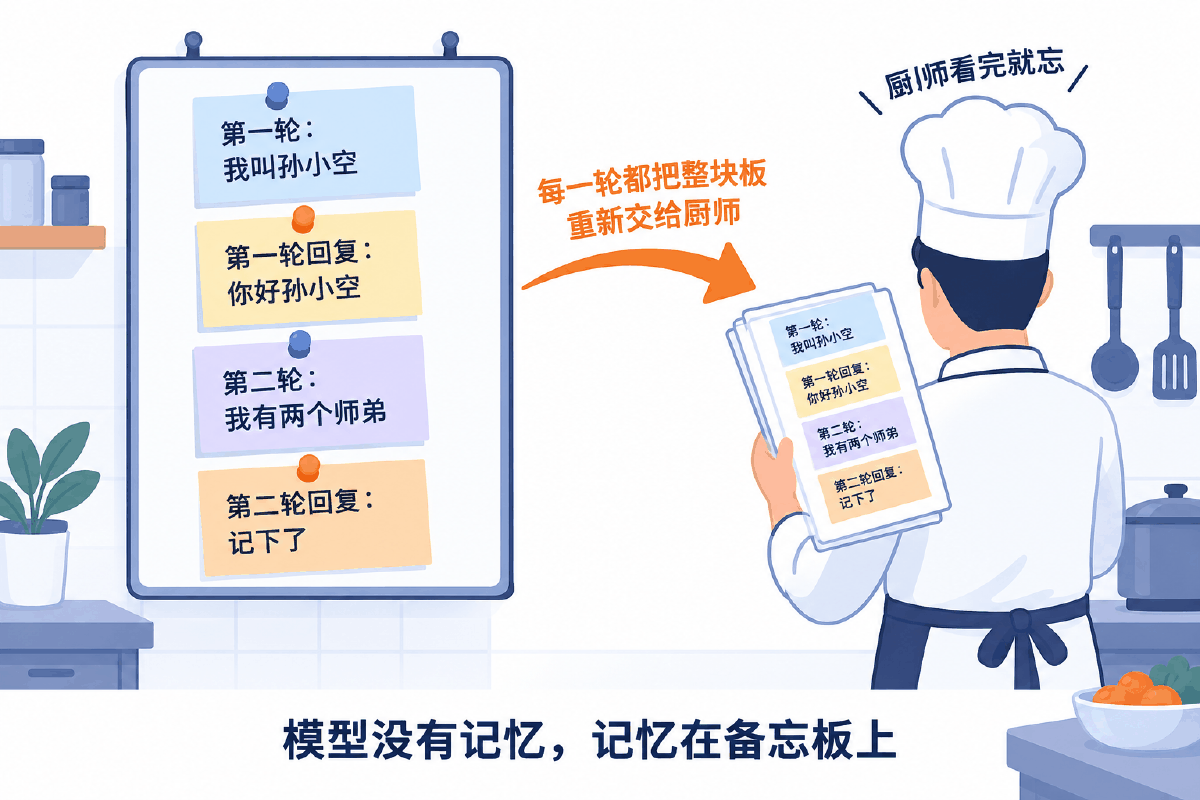
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 转头就忘的厨师 | 大模型 | 每次请求都是从零开始读消息,两次请求之间不保留任何状态 |
| 墙上的备忘板 | 会话历史 ChatMessageHistory | 按顺序存住这段对话的每一条消息,本身不做任何裁剪 |
| 板上的一张便签 | 一条消息 HumanMessage / AIMessage | 带着「谁说的」和「说了什么」两部分,不是一段裸字符串 |
| 每桌一块板 | session_id | 不同用户、不同会话各自一块,互相看不见 |
| 抄板子的服务员 | RunnableWithMessageHistory | 调用前读历史填进提示词,拿到回复后把这一问一答写回去 |
| 板子太满,只抄最近几条 | 窗口 / 修剪 / 摘要策略 | 历史不能无限长,得在「记全」和「省钱」之间做取舍 |
| 备忘板从白板换成账本 | 持久化实现(如 Redis) | 换存储不改业务代码,重启和多机部署才不会丢会话 |
前两讲已经把厨房的工位讲清楚了:菜谱卡怎么填变量、传送带怎么用 | 把工位串起来。这一讲只加一件东西——那块墙上的备忘板,以及它和传送带怎么接。
01概念:记忆到底存在哪里
模型无状态的由来、Memory 组件的职责边界、一次调用里的两次交互
1.1 模型为什么天生没有记忆
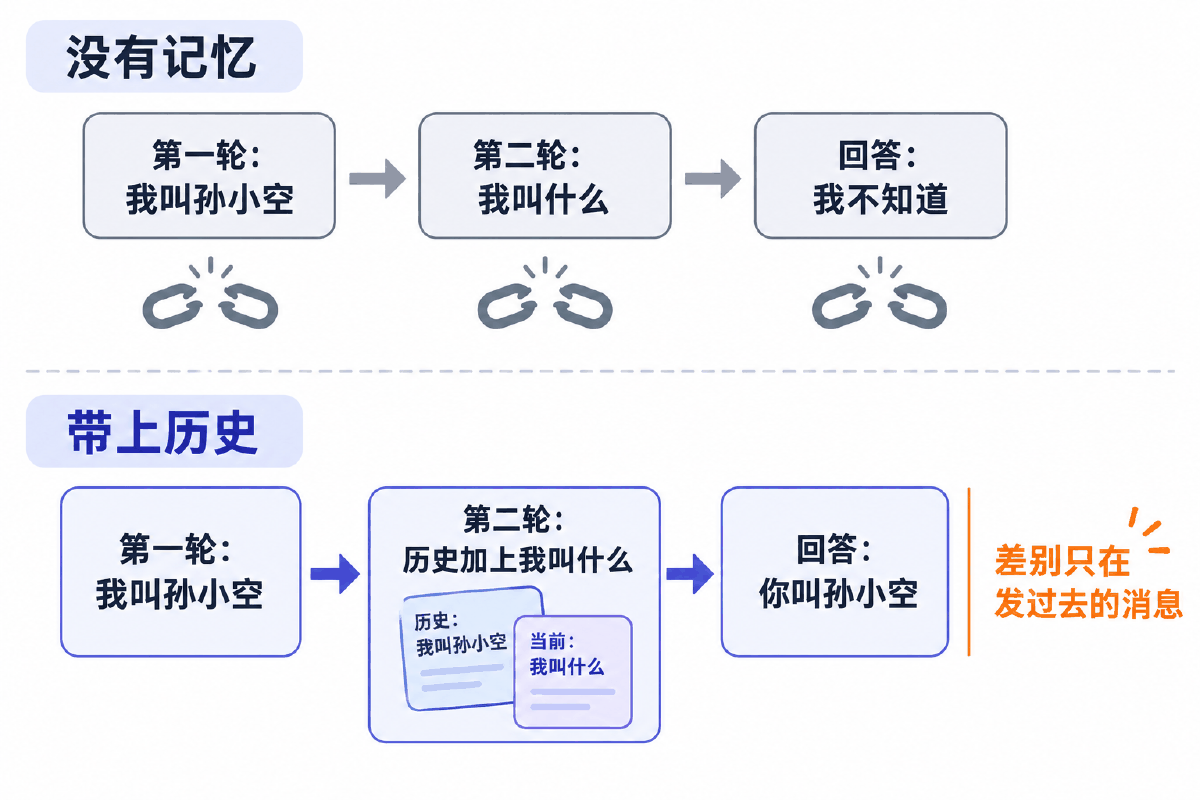
大多数大模型应用都有一个会话界面,允许多轮对话,并且看起来「有上下文记忆能力」。但底层的事实是:模型本身不会记忆任何上下文,它只能依靠这一次请求里收到的输入去产生输出。
这不是某个模型的缺陷,而是接口设计上的选择。一次推理请求进来,模型读完 messages、算出下一段文字、返回,然后这次请求相关的一切就被丢弃了。下一次请求到达时,它是一张白纸。这种「两次请求之间不保留状态」的性质叫无状态。
无状态带来三个直接后果,后面的所有设计都是围着它们转的:
想让模型知道三轮前说过什么,只能在这一轮的请求里把那三轮原样再发一遍。历史不在服务端,在你手里。
每轮都重发全部历史,意味着输入 token 一轮比一轮多。第 20 轮的那次请求,前 19 轮的内容都要再付一次钱。
上下文窗口是有限的。历史涨到把窗口撑满,请求会直接失败——不是模型忘了,是根本发不进去。
把这三点连起来,「记忆」这件事的本质就清楚了:它不是让模型变得能记事,而是在每一轮里挑一批历史重新发过去,并且要挑得起、发得下、付得起。
1.2 Memory 是什么
既然上下文得自带,就需要一个额外的模块去保存对话过程,并在下一次请求时把历史交出来。在 LangChain 里,承担这件事的一类组件统称 Memory(记忆)。
它的职责边界要划清楚,否则很容易把不属于它的事塞进来:
| Memory 负责 | Memory 不负责 |
|---|---|
| 按顺序存住这段会话的消息 | 让模型「学会」这些内容——模型的权重一个都没变 |
| 在调用前把历史交出来 | 决定历史怎么摆进提示词——那是提示词模板的事 |
| 在拿到回复后把这一轮存回去 | 跨会话的长期知识——那是检索增强要解决的问题 |
| 按会话标识隔离不同用户 | 鉴权与权限校验——那应该在进入链之前做完 |
再回到比喻:备忘板只负责记和给,不负责做菜,也不负责决定这块板该怎么念给厨师听。 这与整个模块的铁律是同一句话——LangChain 不做菜,它只是厨房。
与「模型自己带的上下文」的区别
有些接口支持传一个会话标识、由服务端保存历史。这看起来省事,但要分清差别:
| 维度 | 自己维护历史 | 依赖服务端会话 |
|---|---|---|
| 历史在哪 | 在你的存储里,随时可读可改可导出 | 在对方服务器上,你只有一个标识 |
| 换模型 | 换一行 provider 字符串,历史照用 | 历史跟着旧 provider 走,基本要重来 |
| 裁剪与摘要 | 完全可控,想怎么裁怎么裁 | 按对方的规则来,通常不可见 |
| 合规与审计 | 能落库、能脱敏、能删除 | 取决于对方的策略 |
所以除非只是做个玩具,历史应该攥在自己手里。这也是 Memory 这类组件存在的意义。
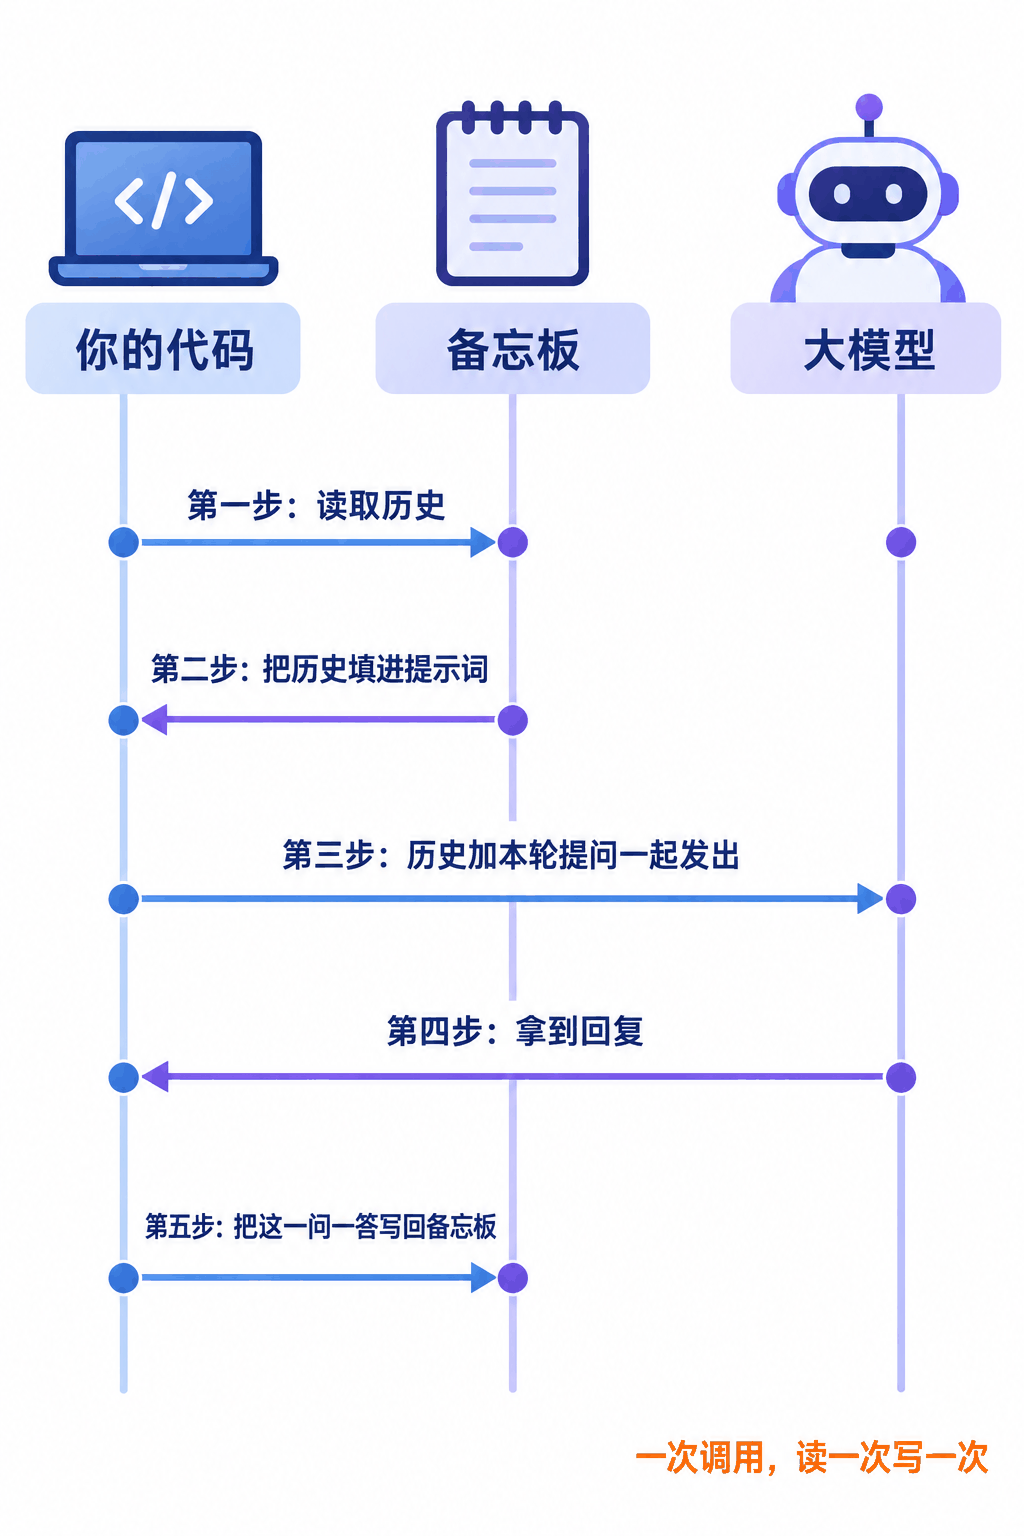
1.3 一个链接入记忆后,与记忆交互几次
答案是两次:一次读、一次写。这两次的位置是固定的,记住它,后面看任何一份带记忆的代码都不会晕:
第 ② 步和第 ⑥ 步就是那两次交互。读发生在调用模型之前,写发生在拿到回复之后——顺序反了,模型就会看到自己还没说出口的话。
02原理:历史长什么样、怎么挑、怎么送
消息的数据结构、四种策略的取舍、当代写法的运转方式、Token 预算
2.1 消息与历史的数据结构
会话历史的最小单位不是字符串,而是消息对象。一条消息至少带两部分信息:谁说的(角色)和说了什么(内容)。丢掉角色,多轮之后模型就分不清哪句是用户的要求、哪句是自己的承诺。
| 消息类 | type 值 | 放什么,什么时候用 |
|---|---|---|
SystemMessage | system | 人设与全局规则。它不属于会话历史,每轮由提示词模板固定拼在最前面 |
HumanMessage | human | 用户说的每一句,是历史的一半 |
AIMessage | ai | 模型回的每一句,是历史的另一半 |
ToolMessage | tool | 工具执行结果。它也会进历史,协议层的细节在 Function Call 那一讲 |
装这些消息的容器是 ChatMessageHistory 这一类对象,最基础的实现叫 InMemoryChatMessageHistory。它的职责窄得出奇——只有存、取、清三件事,不做格式化、不做裁剪、不做摘要。裁剪和摘要是「读的时候怎么挑」,跟容器无关。
# -*- coding: utf-8 -*-
"""
消息与历史容器:三类消息 + InMemoryChatMessageHistory
=========================================================
会话历史的最小单位是「消息对象」,不是字符串。
把消息拼成一段纯文本很容易丢角色信息,多轮之后模型就分不清谁说了什么。

InMemoryChatMessageHistory 是最基础的历史容器:
只负责存消息、取消息、清空,不做任何裁剪、摘要或格式化。
"""

from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.messages import AIMessage, HumanMessage, SystemMessage


def build_history():
    """手工塞入一段三轮对话,观察它在内存里长什么样。"""
    history = InMemoryChatMessageHistory()

    # 方式一:便捷方法,内部帮你包成对应的消息类
    history.add_user_message("你好,我叫小张")
    history.add_ai_message("你好小张,很高兴认识你")

    # 方式二:直接追加消息对象,能一次加多条、也能加 SystemMessage
    history.add_messages([
        HumanMessage(content="帮我记一下:我的项目叫「中央厨房」"),
        AIMessage(content="好的,已经记住你的项目名是「中央厨房」"),
    ])
    return history


def inspect(history):
    """messages 属性返回 List[BaseMessage],可以按下标、按类型访问。"""
    for i, msg in enumerate(history.messages, 1):
        # type 是 'human' / 'ai' / 'system' / 'tool'
        print("%d. [%s] %s" % (i, msg.type, msg.content))

    print("总条数:", len(history.messages))
    print("只看用户说过的话:",
          [m.content for m in history.messages if isinstance(m, HumanMessage)])


def system_message_is_not_history():
    """SystemMessage 是人设,不属于会话历史,每轮由提示词模板重新拼上。

    把它存进历史容器,一旦历史被裁剪,人设就可能被一起裁掉。
    正确做法是让它固定待在提示词模板的第一条。
    """
    persona = SystemMessage(content="你是一个耐心的中文助教,回答控制在三句话以内。")
    history = build_history()
    return [persona] + history.messages


if __name__ == "__main__":
    h = build_history()
    inspect(h)

    # 清空整段会话:用户点「新建对话」时就是调它
    h.clear()
    print("清空后:", h.messages)          # []

    print("拼上人设后共 %d 条" % len(system_message_is_not_history()))
SystemMessage 就可能被一起裁掉,模型的人设会莫名其妙地消失。正确做法是让人设待在提示词模板的第一条,每轮重新拼上,永远不参与裁剪。
消息与 dict 的互转:让会话活过进程重启
内存里的容器一退出进程就空了。要把会话存下来,得先把消息对象转成能序列化的结构。core 提供了一对函数:
| 函数 | 方向 | 产出 |
|---|---|---|
messages_to_dict | 消息对象 → list[dict] | 每项形如 {"type": "human", "data": {"content": "...", ...}},可直接 json.dumps |
messages_from_dict | list[dict] → 消息对象 | 还原成 HumanMessage / AIMessage,能继续往容器里追加 |
# -*- coding: utf-8 -*-
"""
消息与 dict 的互转,以及把会话落盘
===================================
进程一退出,内存里的历史就没了。想让「昨天聊到一半」明天还能接上,
就得把消息对象转成可序列化的结构存起来,下次再转回来。

core 提供了一对函数:
    messages_to_dict(msgs)    消息对象 -> 可 json.dumps 的 list[dict]
    messages_from_dict(dicts) list[dict] -> 消息对象
"""

import json
import os

from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.messages import messages_from_dict, messages_to_dict

STORE_DIR = os.environ.get("CHAT_STORE_DIR", "./chat_sessions")


def dump_session(session_id, history):
    """把一段会话写成 JSON 文件。"""
    os.makedirs(STORE_DIR, exist_ok=True)
    path = os.path.join(STORE_DIR, "%s.json" % session_id)

    payload = messages_to_dict(history.messages)
    # payload 形如:
    # [{"type": "human", "data": {"content": "在吗", "additional_kwargs": {}, ...}},
    #  {"type": "ai",    "data": {"content": "有什么事?", ...}}]

    with open(path, "w", encoding="utf-8") as f:
        # ensure_ascii=False:中文按原样写入,文件打开就能读
        json.dump(payload, f, ensure_ascii=False, indent=2)
    return path


def load_session(session_id):
    """把 JSON 文件读回成一个可继续追加的历史容器。"""
    path = os.path.join(STORE_DIR, "%s.json" % session_id)
    history = InMemoryChatMessageHistory()
    if not os.path.exists(path):
        return history            # 新会话,返回空容器

    with open(path, encoding="utf-8") as f:
        payload = json.load(f)

    # 转回来的是 HumanMessage / AIMessage 对象,不是 dict
    history.add_messages(messages_from_dict(payload))
    return history


if __name__ == "__main__":
    h = InMemoryChatMessageHistory()
    h.add_user_message("在吗")
    h.add_ai_message("有什么事?")

    p = dump_session("u1001", h)
    print("已写入", p)

    back = load_session("u1001")
    print("读回 %d 条" % len(back.messages))
    print("第一条类型:", type(back.messages[0]).__name__)   # HumanMessage
    print("内容一致:", back.messages[0].content == "在吗")   # True

    # 接着聊,新消息追加在后面,再 dump 一次即可
    back.add_user_message("帮我查下订单")
    dump_session("u1001", back)
写 JSON 时记得带 ensure_ascii=False,否则中文会变成一串 \uXXXX,人工排查的时候根本读不动。
2.2 四种记忆策略,以及各自的代价
历史不能无限长,所以「读的时候挑哪些」就成了核心问题。业界的做法归起来只有四种,它们是一条清晰的演进线:全都要 → 只要近的 → 旧的压缩 → 两者混合。
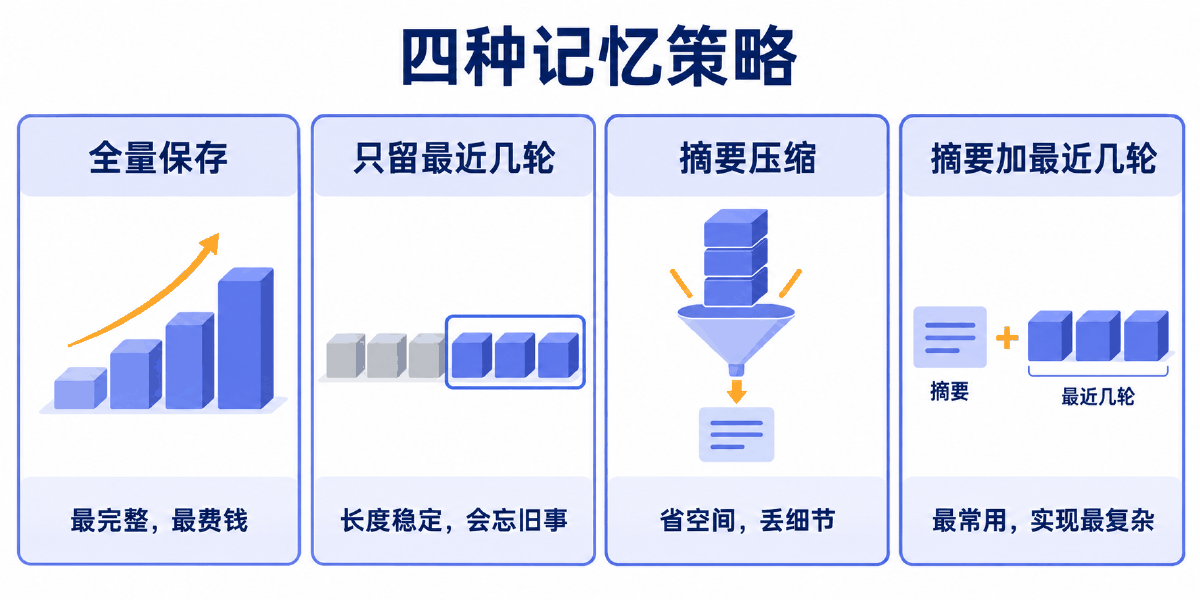
| 策略 | 读的时候给什么 | 输入长度 | 代价 |
|---|---|---|---|
| 全量保存 | 一条不落,全部历史 | 随轮数线性增长 | 最贵,且迟早顶穿上下文窗口 |
| 只留最近 K 轮 | 最后 K 轮原始消息 | 有上限,稳定 | 窗口外的信息是真的丢了,第 1 轮说的名字再也找不回来 |
| 摘要压缩 | 一段滚动摘要,不带原始消息 | 基本恒定 | 每轮多调一次模型;细节与原话被抹掉;摘要之上再摘要会累积误差 |
| 摘要 + 最近 K 轮 | 摘要 + 最后 K 轮原始消息 | 有上限 | 实现最复杂,仍要付摘要那次调用的钱,但综合表现最好 |
第三种策略里最容易写错的一步
摘要不是「每轮把全部历史重新总结一遍」——那样做,成本比全量保存还高。正确的做法是增量滚动:
而且摘要不该每轮都算。设一个触发阈值,只有历史长度超过它、真有内容溢出时才算一次,否则等于把每轮的模型调用次数翻倍。
2.3 当代写法:RunnableWithMessageHistory 怎么运转
知道了「读什么、写什么」,剩下的问题是「谁来在合适的时机读和写」。当代写法把这件事交给 RunnableWithMessageHistory:它包在一条普通的 LCEL 链外面,链本身完全不知道记忆的存在。
它需要四个零件,缺一不可:
提示词模板里放一个 MessagesPlaceholder,它是一整段消息列表的插槽,不是一个字符串变量。历史会原样铺开填进这个位置。
prompt | model,甚至可以再接输出解析器。这条链是可以单独跑的,只是跑的时候历史插槽得你自己填。
签名是「给一个 session_id,返回这个会话的历史容器」。隔离就是在这里发生的:不同的 id 返回不同的容器。
input_messages_key 说明本轮输入在入参里叫什么;history_messages_key 说明历史要填进模板的哪个插槽。写错就填不进去。
接起来之后,一次 invoke 内部发生的事,正是第 1.3 节那六步:
注意第 ⑥ 步:写回是它替你做的,你不用手动 add_messages。这也解释了一个常见现象——第一次调用时历史是空的,但调用结束后容器里已经有两条了。
2.4 Token 预算:一次请求的额度怎么分
「留最近几轮」这个说法其实不严谨。模型的硬限制是按 token 算的,而一条 500 字的长消息和一条「嗯」差着两个量级。真正的账应该这么算:
| 占用项 | 说明 |
|---|---|
| 人设 | 每轮固定开销,通常几十到几百 token |
| 本轮提问 | 用户这一次输入的长度,不可裁剪 |
| 工具描述 | 如果这条链带工具,tools 的 JSON Schema 也占额度 |
| 历史 | 唯一可以压缩的那一项,预算是减出来的 |
| 回复预留 | 必须留够,留少了回复会被截断在半句话上 |
换成一行式子:历史预算 = 上下文窗口 − 回复预留 − 人设 − 本轮提问 − 工具描述 − 安全缓冲。缓冲是给不同 provider 的计费口径差异留的,两三百 token 足够。
按这个预算去裁的工具是 trim_messages,第 04 节会逐参数拆开讲。真正超长、裁到没法再裁的对话,处理手段按代价从低到高有三种:
按预算只留最近若干条。最便宜,代价是远期信息直接丢。
把溢出的那段压成摘要。多一次模型调用,换回关键事实。
全文写进外部存储,需要时按当前问题检索回来。最贵也最完整。
2.5 版本变化:那些记忆类去哪了
很多资料里的写法是这样的:ConversationBufferMemory、ConversationBufferWindowMemory、ConversationTokenBufferMemory、ConversationSummaryMemory、ConversationSummaryBufferMemory,再配一个 ConversationChain 或 LLMChain。
在 LangChain 1.x 里,这些 legacy 组件连同 LLMChain 一起搬到了 langchain-classic 包,不再是推荐写法。原因也很实在:它们接不进 LCEL 管道——带 Memory 的 LLMChain 没法用 | 往后接一个输出解析器,而这正是第 2 讲反复强调的组合能力。
| 旧写法 | 当代做法 |
|---|---|
ConversationBufferMemory | RunnableWithMessageHistory + 工厂函数,读历史时不做任何裁剪 |
ConversationBufferWindowMemory(k=n) | 读历史时切片 messages[-2*n:] |
ConversationTokenBufferMemory | trim_messages(..., token_counter=model),口径与计费一致 |
ConversationSummaryMemory | 自己维护一段滚动摘要,拼进人设 |
ConversationSummaryBufferMemory | 摘要 + 最近 K 轮,超过阈值才压缩 |
ConversationChain(llm=llm) | prompt | model | parser 外面包一层 RunnableWithMessageHistory |
# -*- coding: utf-8 -*-
"""
旧写法与当代写法的迁移
========================
LangChain 0.3 时代的 Memory 是一组「记忆类」:ConversationBufferMemory、
ConversationBufferWindowMemory、ConversationSummaryMemory、
ConversationSummaryBufferMemory,以及把它们和 LLMChain 封装到一起的
ConversationChain。

在 1.x 里,这些类连同 LLMChain 一起搬到了 langchain-classic 包,
不再是推荐写法:它们接不进 LCEL 管道,也没法用 | 往后接输出解析器。
当代做法是「链 + RunnableWithMessageHistory」,策略由你在读历史那一步决定。

本文件把旧写法注释在上、新写法写在下,一行对一行地看。
"""

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.messages import trim_messages
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables import RunnablePassthrough
from langchain_core.runnables.history import RunnableWithMessageHistory

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

# ---------------------------------------------------------------------------
# 旧:memory = ConversationBufferMemory(return_messages=True)
#     chain  = LLMChain(llm=llm, prompt=prompt, memory=memory)
#     chain.invoke({"question": "..."})
# 新:
prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个与人类对话的机器人。"),
    MessagesPlaceholder(variable_name="history"),
    ("human", "问题:{question}"),
])

_store = {}


def get_history(session_id):
    return _store.setdefault(session_id, InMemoryChatMessageHistory())


# 新写法能接输出解析器,旧的 LLMChain 接不了
buffer_chain = RunnableWithMessageHistory(
    prompt | model | StrOutputParser(),
    get_history,
    input_messages_key="question",
    history_messages_key="history",
)

# ---------------------------------------------------------------------------
# 旧:ConversationBufferWindowMemory(k=2)
# 新:读历史时切片,或用 trim_messages 按 token 裁
window_chain = RunnableWithMessageHistory(
    RunnablePassthrough.assign(history=lambda x: x["history"][-4:])
    | prompt | model | StrOutputParser(),
    get_history, input_messages_key="question", history_messages_key="history",
)

# ---------------------------------------------------------------------------
# 旧:ConversationTokenBufferMemory(llm=llm, max_token_limit=50)
# 新:trim_messages,token_counter 传模型,口径和计费一致
token_chain = RunnableWithMessageHistory(
    RunnablePassthrough.assign(
        history=lambda x: trim_messages(x["history"], max_tokens=200,
                                        strategy="last", token_counter=model,
                                        include_system=True, start_on="human"))
    | prompt | model | StrOutputParser(),
    get_history, input_messages_key="question", history_messages_key="history",
)

# ---------------------------------------------------------------------------
# 旧:ConversationSummaryMemory / ConversationSummaryBufferMemory
# 新:自己维护一句摘要,见 strategy_summary.py 与 strategy_summary_window.py
#
# 旧:ConversationChain(llm=llm)(内置 input / history 两个变量)
# 新:上面的 buffer_chain 就是它的等价物,而且提示词完全由你掌握
# ---------------------------------------------------------------------------

if __name__ == "__main__":
    cfg = {"configurable": {"session_id": "migrate-demo"}}
    print(buffer_chain.invoke({"question": "小明有 1 只猫"}, config=cfg))
    print(buffer_chain.invoke({"question": "小刚有 2 只狗"}, config=cfg))
    print(buffer_chain.invoke({"question": "他们一共有几只宠物?"}, config=cfg))
return_messages=False),当代写法一律走消息对象列表,提示词里要用 MessagesPlaceholder 而不是一个 {history} 字符串变量。② 旧写法里的
memory_key 对应现在的 history_messages_key,而且必须与模板里 MessagesPlaceholder 的 variable_name 一致,三处名字要对齐。
Agent 那一侧是另一套
上面讲的都是「链 + 记忆」这条路线。如果你用的是 Agent,短期记忆走的是另一套接口:给 create_agent 传一个 checkpointer,再用 thread_id 区分会话;状态存在 graph state 里由 checkpointer 持久化,thread 之间互相隔离。形态长这样:
# -*- coding: utf-8 -*-
"""
Agent 那一侧的短期记忆:checkpointer + thread_id
==================================================
链路上用 RunnableWithMessageHistory 按 session_id 取历史;
Agent 上则是另一套:给 create_agent 传一个 checkpointer,
再用 thread_id 区分会话。

状态存在 graph state 里,由 checkpointer 负责持久化;
thread 之间互相隔离,每一步开始时读、某一步完成时写。

这里只演示形态,Agent 的构建、工具与中间件在 Agent 实战那一讲展开。
"""

from langchain.agents import create_agent
from langchain.tools import tool
from langgraph.checkpoint.memory import InMemorySaver


@tool
def get_order_status(order_id: str) -> str:
    """根据订单号查询订单的当前状态。"""
    return "订单 %s 已发货,预计明天送达。" % order_id


# checkpointer 就是 Agent 的备忘板;换成持久化实现即可跨进程保留
agent = create_agent(
    model="openai:gpt-4o-mini",
    tools=[get_order_status],
    system_prompt="你是电商客服助手,用中文作答。",
    checkpointer=InMemorySaver(),
)

if __name__ == "__main__":
    cfg = {"configurable": {"thread_id": "u1001-c1"}}

    r1 = agent.invoke(
        {"messages": [{"role": "user", "content": "帮我查一下订单 12346"}]}, cfg)
    print(r1["messages"][-1].content)

    # 同一个 thread_id:不用再说一遍订单号
    r2 = agent.invoke(
        {"messages": [{"role": "user", "content": "它什么时候到?"}]}, cfg)
    print(r2["messages"][-1].content)

    # 换 thread_id 等于换一块空白备忘板
    other = {"configurable": {"thread_id": "u1001-c2"}}
    r3 = agent.invoke(
        {"messages": [{"role": "user", "content": "它什么时候到?"}]}, other)
    print(r3["messages"][-1].content)
两条路线解决的是同一个问题、结论也一致:状态永远在你这边,模型那边什么都不留。 Agent 的构建、工具与中间件不在这一讲展开,留到 Agent 实战那一讲。
03最小代码:先证伪,再跑通
用两个实验确认模型确实没有记忆,再写出最短的一条带记忆链路
3.1 先把「模型没有记忆」证给自己看
直接背结论没用,跑一遍才记得住。下面这个文件做两次实验,用同一个模型、问同一句追问,唯一的差别是发过去的消息列表:
| 实验 | 这一轮发了什么 | 模型的回答 |
|---|---|---|
| A | 只有「我叫什么名字?」一句 | 答不出来,通常反问你是谁 |
| B | 前两轮原样 + 「我叫什么名字?」 | 答得出来:你叫孙小空 |
# -*- coding: utf-8 -*-
"""
证明模型没有记忆:同一个问题,带历史与不带历史的两种结果
=============================================================
跑完这一个文件,「模型本身没有记忆」就不再是一句口号。

两次实验用同一个模型、同一句追问:
  实验 A:每次只发当前这一句 —— 模型答不出名字
  实验 B:把前几轮原样重新发一遍 —— 模型答得出名字

差别不在模型,在你发过去的 messages 列表。
"""

import os

from langchain.chat_models import init_chat_model

# 模型通过统一入口创建;换 provider 只改这一行的字符串
# 需要密钥的 provider 一律从环境变量读,不要写进源码
os.environ.setdefault("OPENAI_API_KEY", os.environ.get("OPENAI_API_KEY", ""))
model = init_chat_model("openai:gpt-4o-mini", temperature=0)

FIRST = "你好,我叫孙小空,今年考上了一本。"
FOLLOW = "我叫什么名字?"


def without_memory():
    """实验 A:每一轮都是一次全新的请求,模型手上只有当前这一句。"""
    model.invoke([{"role": "user", "content": FIRST}])
    # 注意:上面那次调用的内容没有被任何人保存下来
    reply = model.invoke([{"role": "user", "content": FOLLOW}])
    return reply.content


def with_memory():
    """实验 B:自己维护一个 messages 列表,每轮把全部历史重新发过去。"""
    history = []

    history.append({"role": "user", "content": FIRST})
    first_reply = model.invoke(history)
    # 模型的回答也要追加进去,否则下一轮它看不到自己说过什么
    history.append({"role": "assistant", "content": first_reply.content})

    history.append({"role": "user", "content": FOLLOW})
    second_reply = model.invoke(history)
    history.append({"role": "assistant", "content": second_reply.content})

    print("第二次请求实际发送了 %d 条消息" % (len(history) - 1))
    return second_reply.content


if __name__ == "__main__":
    print("A 无历史:", without_memory())
    # 典型输出:抱歉,我不知道你的名字,你可以告诉我。

    print("B 带历史:", with_memory())
    # 典型输出:你叫孙小空。

    # 结论:模型两次都是同一个模型,能力没变。
    # 变的只是「这次请求里有没有把之前说过的话再带上」。
实验 B 里有两行特别关键,新手最容易漏掉第二行:
history.append({"role": "user", ...})——不追加,模型下一轮不知道你问过什么。
history.append({"role": "assistant", ...})——不追加,模型会忘记自己答应过什么,很容易前后矛盾。
所以那句铁律不是修辞:模型两次都是同一个模型,能力一点没变;变的只是这次请求里有没有把之前说过的话再带上。
3.2 最短的一条带记忆链路
手动维护 history 列表当然能用,但会话一多就得自己管字典、自己控读写时机。把这件事交出去,就是下面这份最小代码。四个零件,三十行:
# -*- coding: utf-8 -*-
"""
最小可跑的带记忆链:RunnableWithMessageHistory + MessagesPlaceholder
=====================================================================
四个零件,缺一不可:

  1. ChatPromptTemplate 里留一个 MessagesPlaceholder,它是历史消息的插槽
  2. 一条普通的 LCEL 链:prompt | model
  3. 一个工厂函数:给 session_id,返回这个会话的历史容器
  4. RunnableWithMessageHistory 把上面三者接起来

调用时用 config={"configurable": {"session_id": "..."}} 指定是谁在说话。
"""

import os

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

# 1. 提示词模板:人设固定在最前,历史插槽在中间,本轮输入在最后
prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个中文助手,回答简洁明了。"),
    MessagesPlaceholder(variable_name="history"),
    ("human", "{question}"),
])

# 2. 普通的 LCEL 链,本身完全不知道「记忆」这回事
chain = prompt | model

# 3. 工厂函数:一个 session_id 对应一块独立的历史
_store = {}


def get_history(session_id: str) -> InMemoryChatMessageHistory:
    if session_id not in _store:
        _store[session_id] = InMemoryChatMessageHistory()
    return _store[session_id]


# 4. 包一层,链就有了记忆
#    input_messages_key  :本轮输入在 invoke 的入参里叫什么
#    history_messages_key:历史要填进模板里哪个插槽
conversation = RunnableWithMessageHistory(
    chain,
    get_history,
    input_messages_key="question",
    history_messages_key="history",
)

if __name__ == "__main__":
    cfg = {"configurable": {"session_id": "demo-001"}}

    r1 = conversation.invoke({"question": "我叫孙小空"}, config=cfg)
    print(r1.content)

    r2 = conversation.invoke({"question": "我叫什么名字?"}, config=cfg)
    print(r2.content)          # 你叫孙小空

    # 换一个 session_id,等于换了一块空白备忘板
    other = {"configurable": {"session_id": "demo-002"}}
    r3 = conversation.invoke({"question": "我叫什么名字?"}, config=other)
    print(r3.content)          # 不知道

    # 读写各发生一次:invoke 前读历史填模板,拿到回复后把这一问一答写回去
    print("demo-001 共 %d 条" % len(get_history("demo-001").messages))   # 4
    print("demo-002 共 %d 条" % len(get_history("demo-002").messages))   # 2
② 换成
demo-002 这个 session_id 再问同一句,答不出来——那是另一块空白备忘板。③ 两次调用之后,
demo-001 的容器里有 4 条消息而不是 2 条:每轮写回的是一问一答两条。
MessagesPlaceholder(variable_name="history")、history_messages_key="history"、以及你在链内部引用 x["history"] 时用的键,是同一个名字。改了一处忘了另外两处,表现是历史永远填不进去、模型每轮都像第一次见你,而且不报错——这种静默失败最难查。
pip install langchain langchain-openai;用本地模型就换成 langchain-ollama,模型字符串写 ollama:qwen3:8b 之类。密钥一律从环境变量读,不要写进源码,更不要提交到 Git。
04完整案例:四种策略、修剪、隔离、持久化
每种策略各跑一遍,看清它在什么时候开始「忘事」,最后装成一个能用的客服机器人
4.1 四种策略逐个跑
四个文件用的是同一段四轮对话,只换记忆策略。请重点看最后一问「我叫什么?」——它是一把尺子,量出每种策略的记忆边界在哪。
策略一:全量保存
工厂函数什么都不做,有多少历史就给多少。这是最容易写对、也最容易在生产上出事的一种。
# -*- coding: utf-8 -*-
"""
策略一:全量保存 —— 一条不落地把历史全发回去
================================================
最简单,也最贵。

优点:上下文最完整,模型不会「忘记」任何细节
代价:每一轮的输入 token 都比上一轮更多,费用与延迟随轮数线性上涨;
      聊到一定长度会直接顶穿模型的上下文窗口,请求报错

适用:客服工单、问题诊断这类轮数可控(十几轮以内)且细节不能丢的场景。
"""

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个乐于助人的中文助手。"),
    MessagesPlaceholder(variable_name="history"),
    ("human", "{question}"),
])

_store = {}


def get_history(session_id):
    """全量策略的工厂函数什么都不做 —— 有多少存多少。"""
    return _store.setdefault(session_id, InMemoryChatMessageHistory())


chat = RunnableWithMessageHistory(
    prompt | model, get_history,
    input_messages_key="question", history_messages_key="history",
)


def run_dialogue(session_id, questions):
    cfg = {"configurable": {"session_id": session_id}}
    for q in questions:
        reply = chat.invoke({"question": q}, config=cfg)
        history_len = len(get_history(session_id).messages)
        # 观察点:每问一句,历史就长 2 条,下一轮的输入也跟着变长
        print("[历史 %2d 条] 用户:%s" % (history_len, q))
        print("             助手:%s\n" % reply.content)


if __name__ == "__main__":
    run_dialogue("buffer-demo", [
        "你好,我是孙小空",
        "我还有两个师弟,猪小戒和沙小僧",
        "我今年考上了一本",
        "我叫什么?我有几个师弟?",     # 全量保存:三条信息都答得出来
    ])

    msgs = get_history("buffer-demo").messages
    print("最终历史 %d 条,字符总数 %d"
          % (len(msgs), sum(len(m.content) for m in msgs)))
运行时留意每轮打印的历史条数:1 → 3 → 5 → 7,一轮长 2 条。四个问题全答得上来,代价是第 4 轮的请求里装着前 3 轮的全文。把这条曲线延长到第 50 轮,账单和延迟都不会好看。
| 轮次 | 读到的历史 | 这一轮的输入规模 |
|---|---|---|
| 第 1 轮 | 空 | 人设 + 本轮提问 |
| 第 2 轮 | 2 条 | 人设 + 第 1 轮全文 + 本轮提问 |
| 第 4 轮 | 6 条 | 人设 + 前 3 轮全文 + 本轮提问 |
| 第 N 轮 | 2(N−1) 条 | 线性增长,没有上限 |
策略二:只留最近 K 轮
在读历史那一步加一次切片,就得到了滑动窗口。裁剪发生在读的时候,容器里仍然存着全量——这一点在代码末尾打印出来了。
# -*- coding: utf-8 -*-
"""
策略二:只留最近 K 轮 —— 滑动窗口
====================================
观察发现,太久远的对话对当前这一问往往没有帮助,
于是只把最近 K 轮塞回去,更早的直接丢掉。

优点:每轮输入长度有上限,费用与延迟稳定,永远不会顶穿上下文窗口
代价:窗口外的信息是真的丢了。第 1 轮说的名字,K=1 时到第 3 轮就再也答不出来

实现要点:裁剪发生在「读历史」这一步,不要去改历史容器本身 ——
容器留全量,读的时候只取一段,这样想换策略随时能换。
"""

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import BaseChatMessageHistory, InMemoryChatMessageHistory
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables import RunnablePassthrough
from langchain_core.runnables.history import RunnableWithMessageHistory

K = 2                 # 保留最近 K 轮,一轮 = 一问一答 = 2 条消息

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个乐于助人的中文助手。"),
    MessagesPlaceholder(variable_name="history"),
    ("human", "{question}"),
])

_store: dict[str, BaseChatMessageHistory] = {}


def get_history(session_id) -> BaseChatMessageHistory:
    return _store.setdefault(session_id, InMemoryChatMessageHistory())


def window(payload):
    """在进入提示词模板之前,把 history 截成最近 K 轮。"""
    msgs = payload["history"]
    payload["history"] = msgs[-2 * K:] if len(msgs) > 2 * K else msgs
    return payload


# RunnablePassthrough.assign 之后再接模板,裁剪就成了链上的一个普通环节
chain = RunnablePassthrough.assign(history=lambda x: window(x)["history"]) | prompt | model

chat = RunnableWithMessageHistory(
    chain, get_history,
    input_messages_key="question", history_messages_key="history",
)

if __name__ == "__main__":
    cfg = {"configurable": {"session_id": "window-demo"}}
    for q in ["你好,我是孙小空",
              "我还有两个师弟,猪小戒和沙小僧",
              "我今年考上了一本",
              "我叫什么?"]:
        print("用户:", q)
        print("助手:", chat.invoke({"question": q}, config=cfg).content, "\n")

    # K=2 时,最后一问看到的只有第 2、3 轮,第 1 轮的名字已经滑出窗口
    print("容器里仍然存着 %d 条(裁剪只发生在读的时候)"
          % len(get_history("window-demo").messages))
策略三:摘要压缩
不丢内容、只压体积:让模型把旧对话缩写成一段话。关键在 update() 这个方法——新摘要 = 旧摘要 + 新增对话,而不是每轮从头重写整段历史。
# -*- coding: utf-8 -*-
"""
策略三:摘要压缩 —— 把旧对话交给模型缩写成一段话
====================================================
按条数或 token 硬截断,总会切掉一些仍然有用的信息。
摘要的思路是:不丢内容,只压缩体积 —— 让模型把旧对话缩写成几句话。

优点:几十轮之后输入长度依然可控,关键事实(姓名、订单号、偏好)能保住
代价:① 每次更新摘要都要额外调一次模型,多一份钱、多一份延迟
      ② 摘要是有损的,细节和原话会被抹掉
      ③ 摘要之上再做摘要,误差会一层层累积

实现要点:新摘要 = 旧摘要 + 新增对话,不是每次都从头重写整段历史。
"""

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.messages import AIMessage, HumanMessage
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

SUMMARY_PROMPT = ChatPromptTemplate.from_messages([
    ("system",
     "你在维护一段对话的滚动摘要。把已有摘要和新增对话合并成一段新的中文摘要,"
     "保留姓名、编号、时间、明确的偏好与承诺;不要编造原文没有的内容;不超过 120 字。"),
    ("human", "已有摘要:\n{summary}\n\n新增对话:\n{new_lines}\n\n新摘要:"),
])

CHAT_PROMPT = ChatPromptTemplate.from_messages([
    ("system", "你是一个中文助手。以下是你和用户之前对话的摘要:\n{summary}"),
    MessagesPlaceholder(variable_name="recent"),
    ("human", "{question}"),
])

summary_chain = SUMMARY_PROMPT | model


class SummaryMemory:
    """一段会话 = 一句摘要 + 一个原始历史容器。"""

    def __init__(self):
        self.summary = "(暂无)"
        self.history = InMemoryChatMessageHistory()

    def _render(self, msgs):
        role = {"human": "用户", "ai": "助手"}
        return "\n".join("%s:%s" % (role.get(m.type, m.type), m.content) for m in msgs)

    def update(self, question, answer):
        """把这一轮写进历史,并据此刷新摘要。"""
        new_lines = self._render([HumanMessage(content=question),
                                  AIMessage(content=answer)])
        self.history.add_messages([HumanMessage(content=question),
                                   AIMessage(content=answer)])
        self.summary = summary_chain.invoke(
            {"summary": self.summary, "new_lines": new_lines}).content


def ask(mem: SummaryMemory, question: str) -> str:
    # 纯摘要策略:不带任何原始消息,recent 永远是空列表
    reply = (CHAT_PROMPT | model).invoke(
        {"summary": mem.summary, "recent": [], "question": question})
    mem.update(question, reply.content)
    return reply.content


if __name__ == "__main__":
    mem = SummaryMemory()
    for q in ["你好,我想咨询数据分析课程",
              "我有 Python 基础,但没做过项目",
              "课程时长和学费是多少?",
              "我刚才说我有什么基础来着?"]:
        print("用户:", q)
        print("助手:", ask(mem, q))
        print("当前摘要:", mem.summary, "\n")

    # 原始对话一条没少,只是没有全部发给模型
    print("原始历史 %d 条,摘要 %d 字"
          % (len(mem.history.messages), len(mem.summary)))
摘要提示词里有三句约束,每一句都是踩出来的:
| 约束 | 不写会怎样 |
|---|---|
| 保留姓名、编号、时间、偏好与承诺 | 模型倾向于写「用户咨询了课程」这种空话,具体信息全丢 |
| 不要编造原文没有的内容 | 摘要里会冒出用户从没说过的需求,而且下一轮会被当成事实继续用 |
| 限定字数 | 摘要本身越滚越长,最后和全量保存一样贵 |
策略四:摘要 + 最近 K 轮(混合)
纯摘要丢细节,纯窗口丢远期记忆,把两者接起来就是生产里最常用的那一种。发出去的消息结构固定是:
# -*- coding: utf-8 -*-
"""
策略四:摘要 + 最近若干轮 —— 混合型,生产里最常用
====================================================
纯摘要丢细节,纯窗口丢远期记忆。混合策略把两者接起来:

    [人设] + [旧对话的摘要] + [最近 K 轮原始消息] + [本轮提问]

最近几轮保持原话,模型答起来精确;再往前的只留摘要,体积可控。
代价是实现比前两种复杂,而且摘要仍然要额外调模型。

触发时机:历史长度超过阈值时,才把「溢出的那一段」并进摘要。
不要每轮都重算摘要,那等于把成本翻倍。
"""

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.messages import AIMessage, HumanMessage
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder

KEEP_ROUNDS = 2          # 最近保留几轮原始消息
TRIGGER = 6              # 原始消息超过几条才触发摘要

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

SUMMARY_PROMPT = ChatPromptTemplate.from_messages([
    ("system", "把已有摘要和新增对话合并成一段不超过 120 字的中文摘要,"
               "保留姓名、编号、金额、明确偏好;不要编造。"),
    ("human", "已有摘要:\n{summary}\n\n新增对话:\n{new_lines}\n\n新摘要:"),
])

CHAT_PROMPT = ChatPromptTemplate.from_messages([
    ("system", "你是一个中文客服助手。较早对话的摘要:\n{summary}"),
    MessagesPlaceholder(variable_name="recent"),
    ("human", "{question}"),
])

summary_chain = SUMMARY_PROMPT | model
chat_chain = CHAT_PROMPT | model


class SummaryBufferMemory:
    def __init__(self, keep_rounds=KEEP_ROUNDS, trigger=TRIGGER):
        self.summary = "(暂无)"
        self.history = InMemoryChatMessageHistory()
        self.keep = keep_rounds * 2
        self.trigger = trigger

    @staticmethod
    def _render(msgs):
        role = {"human": "用户", "ai": "助手"}
        return "\n".join("%s:%s" % (role.get(m.type, m.type), m.content) for m in msgs)

    def recent(self):
        """读:只取最近 keep 条原始消息。"""
        return self.history.messages[-self.keep:]

    def save(self, question, answer):
        """写:追加本轮,必要时把溢出的旧消息压进摘要。"""
        self.history.add_messages([HumanMessage(content=question),
                                   AIMessage(content=answer)])
        msgs = self.history.messages
        if len(msgs) <= self.trigger:
            return

        overflow = msgs[:-self.keep]          # 这一段即将被摘要吸收
        self.summary = summary_chain.invoke({
            "summary": self.summary,
            "new_lines": self._render(overflow),
        }).content

        # 吸收完就从容器里移除,避免下次重复摘要同一段
        kept = msgs[-self.keep:]
        self.history.clear()
        self.history.add_messages(kept)


def ask(mem, question):
    reply = chat_chain.invoke({"summary": mem.summary,
                               "recent": mem.recent(),
                               "question": question})
    mem.save(question, reply.content)
    return reply.content


if __name__ == "__main__":
    mem = SummaryBufferMemory()
    for q in ["你好,我想查订单 12345 的状态",
              "这个订单是上周五下的",
              "我现在急着用,能加急吗",
              "等等,我记错了,应该是 12346",
              "你们的退货政策是怎样的",
              "我最后确认的订单号是多少?"]:
        print("用户:", q)
        print("助手:", ask(mem, q), "\n")

    print("摘要:", mem.summary)
    print("保留原始消息 %d 条" % len(mem.history.messages))
注意 save() 里的两个阈值分工不同,别混用:trigger 决定「什么时候才压缩」,keep 决定「压缩后留几条原文」。压缩完要把被吸收的旧消息从容器里移除,否则下次会把同一段重复摘要一遍,摘要里就出现车轱辘话。
4.2 按 Token 预算修剪:trim_messages
按条数切只是权宜之计,模型的限制是按 token 算的。trim_messages 直接按预算裁,而且会照顾消息的配对关系。
# -*- coding: utf-8 -*-
"""
trim_messages:按 token 预算修剪历史
======================================
手写切片只能按「条数」切,而模型的限制是按 token 算的 ——
一条 500 字的长消息和一条「嗯」占的 token 差了两个量级。
trim_messages 直接按 token 预算裁,并且能保住人设和消息配对。

几个关键参数:
  max_tokens     预算上限
  strategy       "last" 保留最后若干条(多轮对话用它);"first" 保留开头
  token_counter  怎么数 token;传模型对象就用该模型的分词口径
  include_system 保留开头的 SystemMessage,人设不会被裁掉
  start_on       裁完后第一条从什么角色开始,"human" 可避免以 AI 回复开头
  allow_partial  允许把一条消息截一半,默认 False
"""

from langchain.chat_models import init_chat_model
from langchain_core.messages import (AIMessage, HumanMessage, SystemMessage,
                                     trim_messages)
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables import RunnablePassthrough

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

MESSAGES = [
    SystemMessage(content="你是一个中文助手,回答简洁。"),
    HumanMessage(content="你好,我叫孙小空"),
    AIMessage(content="你好孙小空,很高兴认识你。"),
    HumanMessage(content="我有两个师弟,猪小戒和沙小僧"),
    AIMessage(content="听起来是个热闹的团队。"),
    HumanMessage(content="我今年考上了一本"),
    AIMessage(content="恭喜你,这是很了不起的成绩。"),
    HumanMessage(content="我叫什么名字?"),
]


def trim_by_tokens(budget=80):
    """按 token 预算裁,人设保留,从用户消息开始。"""
    return trim_messages(
        MESSAGES,
        max_tokens=budget,
        strategy="last",
        token_counter=model,
        include_system=True,
        start_on="human",
        allow_partial=False,
    )


def trim_by_count(n=4):
    """临时想按条数裁:token_counter 传 len,一条就算一个单位。"""
    return trim_messages(MESSAGES, max_tokens=n, strategy="last",
                         token_counter=len, include_system=True,
                         start_on="human")


# 修剪是链上的一个普通环节,可以直接串进 LCEL
prompt = ChatPromptTemplate.from_messages([
    MessagesPlaceholder(variable_name="history"),
    ("human", "{question}"),
])
trimmer = trim_messages(max_tokens=200, strategy="last", token_counter=model,
                        include_system=True, start_on="human")
chain = RunnablePassthrough.assign(history=lambda x: trimmer.invoke(x["history"])) \
    | prompt | model

if __name__ == "__main__":
    for m in trim_by_tokens(80):
        print("[%s] %s" % (m.type, m.content))
    print("---")
    print("按条数裁剩 %d 条" % len(trim_by_count(4)))

    # 裁到只剩人设 + 最后一问时,模型就答不出名字了 —— 预算给小了
    print(chain.invoke({"history": MESSAGES[:-1],
                        "question": "我叫什么名字?"}).content)
| 参数 | 常用取值 | 作用 |
|---|---|---|
max_tokens | 算出来的预算 | 裁剪后的上限,不是建议值 |
strategy | "last" | 保留末尾若干条。多轮对话几乎总是用它;"first" 用于要保开头的场景 |
token_counter | 模型对象 | 用该模型的分词口径来数,最准。传 len 就退化成按条数裁 |
include_system | True | 保住开头的人设,不让它被裁掉 |
start_on | "human" | 裁完第一条从用户消息开始,避免历史以一句没头没尾的 AI 回复开头 |
allow_partial | False | 不把单条消息截一半。开成 True 会出现半句话的历史 |
它本身也是一个 Runnable,可以直接串进管道,跟第 2 讲讲的组合方式完全一致。
预算是减出来的,不是猜的
# -*- coding: utf-8 -*-
"""
Token 预算:一次请求的额度到底怎么分
=======================================
上下文窗口是一个硬上限,它同时装下这些东西:

    人设 + 历史 + 本轮提问 + 工具描述  ≤  窗口 - 预留给回复的额度

所以「历史能带多少」不是拍脑袋定的,而是减出来的。
这个文件把减法写成代码:先算固定开销,剩下的才是历史的预算。
"""

from langchain.chat_models import init_chat_model
from langchain_core.messages import (AIMessage, HumanMessage, SystemMessage,
                                     trim_messages)

CONTEXT_WINDOW = 8192      # 模型的上下文窗口,按你实际用的模型填
RESERVE_FOR_REPLY = 1024   # 给回复留出的额度,不留就可能被截断
SAFETY = 256               # 缓冲:不同 provider 计费口径略有差异

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

SYSTEM = SystemMessage(content="你是一个中文客服助手,回答控制在五句话以内。")


def count(messages):
    """用模型自己的口径数 token,比按字数估准得多。"""
    return model.get_num_tokens_from_messages(messages)


def history_budget(question: str) -> int:
    """算出这一轮历史最多能占多少 token。"""
    fixed = count([SYSTEM, HumanMessage(content=question)])
    budget = CONTEXT_WINDOW - RESERVE_FOR_REPLY - SAFETY - fixed
    return max(budget, 0)


def build_request(history, question):
    """按预算裁历史,拼出这一轮真正发出去的消息列表。"""
    budget = history_budget(question)
    kept = trim_messages(
        [SYSTEM] + list(history),
        max_tokens=budget,
        strategy="last",
        token_counter=model,
        include_system=True,
        start_on="human",
    )
    payload = kept + [HumanMessage(content=question)]

    used = count(payload)
    if used > CONTEXT_WINDOW - RESERVE_FOR_REPLY:
        # 裁完还超,说明单条消息本身就过长:该走摘要或分段,而不是继续裁
        raise ValueError("单轮输入 %d token 仍超预算,请改用摘要策略" % used)

    return payload, {"budget": budget, "used": used,
                     "dropped": len(history) + 1 - len(kept)}


if __name__ == "__main__":
    history = []
    for i in range(1, 21):
        history.append(HumanMessage(content="第 %d 个问题,内容比较长" % i * 3))
        history.append(AIMessage(content="第 %d 个回答,同样写得比较详细" % i * 3))

    payload, stat = build_request(history, "把我前面问过的第一个问题复述一遍")
    print("历史预算 %(budget)d token,本次实际使用 %(used)d token,丢弃 %(dropped)d 条" % stat)
    print("发出去的消息共 %d 条" % len(payload))

    # 超长对话的三种处理,按代价从低到高:
    #   1. 裁:trim_messages 按预算留最近若干条,最便宜,丢远期信息
    #   2. 摘:把溢出的一段压成摘要,多一次模型调用,保住关键事实
    #   3. 存:把全文写进外部存储,需要时再按问题检索回来,最贵也最完整
这份代码里有一个值得注意的分支:裁完仍然超预算时直接抛错,而不是继续裁。因为这种情况通常意味着单条消息本身就过长(用户粘了一整篇文档),继续裁只会把有用的上下文全切光,该走的是摘要或分段处理。
4.3 多用户多会话隔离
线上不会只有一个人在聊天。隔离的唯一入口就是那个工厂函数,写歪一行就会串会话,而且是最严重的那类事故:A 用户看到 B 用户的订单号。
# -*- coding: utf-8 -*-
"""
多用户多会话隔离:session_id 的工厂函数怎么写
================================================
线上不是只有一个人在聊天。工厂函数是隔离的唯一入口,写歪了就会串会话。

三条规则:
  1. key 必须能唯一定位到「谁的哪一段对话」,通常是 用户ID + 会话ID
  2. 工厂函数只负责「给 key 返回容器」,不要在里面做裁剪、摘要、鉴权
  3. 进程内字典只适合本机单进程;多副本部署必须换成外部存储
"""

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import BaseChatMessageHistory, InMemoryChatMessageHistory
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.runnables.utils import ConfigurableFieldSpec

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个电商客服助手,用中文友好作答。"),
    MessagesPlaceholder(variable_name="history"),
    ("human", "{question}"),
])

_store: dict[tuple[str, str], BaseChatMessageHistory] = {}


def get_history(user_id: str, conversation_id: str) -> BaseChatMessageHistory:
    """两个维度共同决定一块备忘板:同一个人的不同会话也要互相隔离。"""
    key = (user_id, conversation_id)
    if key not in _store:
        _store[key] = InMemoryChatMessageHistory()
    return _store[key]


# 默认只认 session_id 一个字段。想用多个字段,就把它们声明出来
conversation = RunnableWithMessageHistory(
    prompt | model,
    get_history,
    input_messages_key="question",
    history_messages_key="history",
    history_factory_config=[
        ConfigurableFieldSpec(
            id="user_id", annotation=str, name="用户 ID",
            description="登录后的稳定用户标识", default="", is_shared=True,
        ),
        ConfigurableFieldSpec(
            id="conversation_id", annotation=str, name="会话 ID",
            description="同一用户的第几段对话", default="", is_shared=True,
        ),
    ],
)


def ask(user_id, conversation_id, question):
    cfg = {"configurable": {"user_id": user_id, "conversation_id": conversation_id}}
    return conversation.invoke({"question": question}, config=cfg).content


if __name__ == "__main__":
    print(ask("u1001", "c1", "我的订单号是 12345"))
    print(ask("u1001", "c1", "我刚说的订单号是多少?"))     # 记得 12345

    # 同一个人换一段会话:查不到上一段的订单号
    print(ask("u1001", "c2", "我刚说的订单号是多少?"))

    # 另一个人:更不可能看到别人的订单号
    print(ask("u2002", "c1", "我刚说的订单号是多少?"))

    print("当前共 %d 块独立历史" % len(_store))            # 3
默认只认 session_id 一个字段。想按「用户 + 会话」两个维度隔离,就用 history_factory_config 把字段声明出来,调用时在 configurable 里一并传。代码末尾的四次提问验证了三件事:
| 提问 | 会话 | 预期 |
|---|---|---|
| 「我的订单号是 12345」 | u1001 / c1 | 写进这块备忘板 |
| 「我刚说的订单号是多少?」 | u1001 / c1 | 记得 12345 |
| 同一句 | u1001 / c2 | 同一个人的另一段会话,查不到 |
| 同一句 | u2002 / c1 | 另一个人,更查不到 |
session_id 必须由服务端根据登录态生成或校验。如果直接把前端传来的字符串当 key,改一个参数就能读到别人的会话历史。鉴权要在进入链之前做完,工厂函数里只做「按 key 取容器」这一件事。
4.4 换成持久化存储
进程内字典有三个致命问题:重启即丢、多副本各存各的、内存只涨不降。前两个在单机开发时看不出来,一上线就会集中爆发:用户刷新页面发现对话没了,或者同样的问题在两台机器上得到完全不同的上下文。
换存储只需要实现三个成员,链上其它代码一个字都不用改——这正是把工厂函数独立出来的价值。
| 要实现的成员 | 约定 |
|---|---|
messages | 属性,返回 List[BaseMessage] |
add_messages(msgs) | 追加若干条;传空列表要能安全返回 |
clear() | 清空本会话,对应用户点「新建对话」 |
# -*- coding: utf-8 -*-
"""
生产环境的持久化历史:自己实现一个 BaseChatMessageHistory
============================================================
进程内字典有三个致命问题:重启即丢、多副本各存各的、内存只涨不降。
换成外部存储只需要实现三个成员,链上的其它代码一个字都不用改。

要实现的接口:
    messages          属性,返回 List[BaseMessage]
    add_messages(x)   追加若干条
    clear()           清空本会话

社区也提供了现成的 RedisChatMessageHistory,思路与这份实现一致;
自己写一份的好处是能控制 key 规则、过期时间和序列化格式。
"""

import json
import os

import redis
from langchain_core.chat_history import BaseChatMessageHistory
from langchain_core.messages import (BaseMessage, messages_from_dict,
                                     messages_to_dict)

# 连接信息一律走环境变量,口令不进源码、不进版本库
_client = redis.Redis.from_url(
    os.environ.get("REDIS_URL", "redis://127.0.0.1:6379/0"),
    decode_responses=True,
)

TTL_SECONDS = 60 * 60 * 24 * 7        # 七天没人说话就自动回收


class RedisMessageHistory(BaseChatMessageHistory):
    """用一个 Redis List 存一段会话,每个元素是一条序列化后的消息。"""

    def __init__(self, session_id: str, client=None, ttl: int = TTL_SECONDS):
        self.session_id = session_id
        self.client = client or _client
        self.ttl = ttl

    @property
    def key(self) -> str:
        # 加业务前缀,避免和别的数据撞键
        return "chat:history:%s" % self.session_id

    @property
    def messages(self) -> list[BaseMessage]:
        raw = self.client.lrange(self.key, 0, -1)
        return messages_from_dict([json.loads(item) for item in raw])

    def add_messages(self, messages: list[BaseMessage]) -> None:
        if not messages:
            return
        payload = [json.dumps(d, ensure_ascii=False)
                   for d in messages_to_dict(messages)]
        pipe = self.client.pipeline()
        pipe.rpush(self.key, *payload)
        pipe.expire(self.key, self.ttl)      # 每次写入都续期
        pipe.execute()

    def clear(self) -> None:
        self.client.delete(self.key)

    def tail(self, n: int) -> list[BaseMessage]:
        """只取最近 n 条:窗口策略在存储层就能完成,不用把全量读回内存。"""
        raw = self.client.lrange(self.key, -n, -1)
        return messages_from_dict([json.loads(item) for item in raw])


def get_history(session_id: str) -> BaseChatMessageHistory:
    """把它交给 RunnableWithMessageHistory,唯一的改动就是这一个函数。"""
    return RedisMessageHistory(session_id)


if __name__ == "__main__":
    h = get_history("u1001-c1")
    h.clear()
    h.add_messages([])                       # 空列表要安全返回
    from langchain_core.messages import AIMessage, HumanMessage

    h.add_messages([HumanMessage(content="我的订单号是 12346"),
                    AIMessage(content="已记录订单号 12346。")])

    print("读回 %d 条" % len(h.messages))
    print("最近 1 条:", h.tail(1)[0].content)
    print("剩余存活时间:%s 秒" % _client.ttl(h.key))
三个工程细节值得停一下:
chat:history:<id>,避免和别的数据撞键,也方便按前缀批量清理和统计。
每次 add_messages 都重设过期时间,活跃会话不会被回收,沉寂的会话自动释放空间。
lrange(key, -n, -1) 让窗口策略在存储层就完成,不必把几百条历史全读进内存再切片。
社区也提供了现成的 RedisChatMessageHistory,思路与这份实现一致;自己写一份的好处是能控制 key 规则、过期时间和序列化格式。连接信息一律走环境变量,口令不进源码。
4.5 装起来:带记忆的客服机器人
把前面拆开讲的零件装成一个能跑的东西:混合记忆、两级隔离、可换存储,外加一张事实卡片。
# -*- coding: utf-8 -*-
"""
完整案例:带记忆的电商客服机器人
==================================
把前面拆开讲的零件装成一个能跑的东西:

  · 混合记忆:摘要 + 最近 K 轮,长对话也不会顶穿窗口
  · 多用户隔离:user_id + conversation_id 两级 key
  · 可换存储:把 HISTORY_FACTORY 换成 Redis 版本即可上生产
  · 事实卡片:订单号这类关键信息单独记一份,不让摘要把它抹掉

运行后模拟一段六轮对话,最后一问考察它记不记得改过的订单号。
"""

import os

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.messages import AIMessage, HumanMessage
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder

KEEP = 4                 # 最近保留几条原始消息
TRIGGER = 8              # 超过几条才触发摘要

model = init_chat_model(
    os.environ.get("CHAT_MODEL", "openai:gpt-4o-mini"), temperature=0.3)

CHAT_PROMPT = ChatPromptTemplate.from_messages([
    ("system",
     "你是电商平台的客服助手,用中文友好、专业地回答。\n"
     "已确认的事实:{facts}\n"
     "较早对话的摘要:{summary}"),
    MessagesPlaceholder(variable_name="recent"),
    ("human", "{question}"),
])

SUMMARY_PROMPT = ChatPromptTemplate.from_messages([
    ("system", "把已有摘要与新增对话合并成不超过 120 字的中文摘要,"
               "保留订单号、金额、时间与承诺;不要编造。"),
    ("human", "已有摘要:\n{summary}\n\n新增对话:\n{lines}\n\n新摘要:"),
])

chat_chain = CHAT_PROMPT | model | StrOutputParser()
summary_chain = SUMMARY_PROMPT | model | StrOutputParser()


def HISTORY_FACTORY(key):
    """换成 redis_history.get_history 就是生产版本,其余代码不动。"""
    return _mem.setdefault(key, InMemoryChatMessageHistory())


_mem = {}
_summary = {}
_facts = {}


def _render(msgs):
    role = {"human": "用户", "ai": "客服"}
    return "\n".join("%s:%s" % (role.get(m.type, m.type), m.content) for m in msgs)


def remember_fact(key, name, value):
    """关键事实单独存一份,它不参与裁剪也不进摘要,因此永远不会丢。"""
    _facts.setdefault(key, {})[name] = value


def ask(user_id, conversation_id, question):
    key = (user_id, conversation_id)
    history = HISTORY_FACTORY(key)

    answer = chat_chain.invoke({
        "facts": _facts.get(key) or "(暂无)",
        "summary": _summary.get(key, "(暂无)"),
        "recent": history.messages[-KEEP:],
        "question": question,
    })

    history.add_messages([HumanMessage(content=question),
                          AIMessage(content=answer)])

    msgs = history.messages
    if len(msgs) > TRIGGER:
        overflow = msgs[:-KEEP]
        _summary[key] = summary_chain.invoke({
            "summary": _summary.get(key, "(暂无)"),
            "lines": _render(overflow),
        })
        kept = msgs[-KEEP:]
        history.clear()
        history.add_messages(kept)

    return answer


if __name__ == "__main__":
    U, C = "u1001", "c1"
    dialogue = [
        "你好,我想查订单 12345 的状态",
        "这个订单是上周五下的",
        "我现在急着用,能加急处理吗",
        "等等,我记错了,应该是 12346",
        "你们的退货政策是怎样的",
        "我最终确认的订单号是多少?",
    ]

    for i, q in enumerate(dialogue, 1):
        if "12346" in q:
            remember_fact((U, C), "订单号", "12346")
        print("第 %d 轮 用户:%s" % (i, q))
        print("        客服:%s\n" % ask(U, C, q))

    print("摘要:", _summary.get((U, C), "(未触发)"))
    print("事实卡片:", _facts.get((U, C)))
    print("保留原始消息 %d 条" % len(HISTORY_FACTORY((U, C)).messages))
模拟的六轮对话里藏着一个专门设计的考点:用户在第 4 轮改了订单号(12345 → 12346),最后一轮问「我最终确认的订单号是多少?」。这一问同时考三件事:
| 考点 | 如果做错会怎样 |
|---|---|
| 记得住改过的值 | 答成 12345——摘要把「改了」这个动作压没了 |
| 分得清新旧 | 两个号都报出来,让用户自己挑 |
| 经得起压缩 | 触发摘要之后答成「你的订单」,具体号码消失 |
对策就是 remember_fact() 那张事实卡片:订单号这类关键标识单独存一份,不参与裁剪、不进摘要,每轮固定拼进人设。这是摘要策略最实用的一个补丁——比把摘要提示词写得更长有效得多。
HISTORY_FACTORY 换成 redis_history.get_history,其余代码一个字不动,就从「重启即丢」变成了「多机共享」。这就是把读写历史收敛到一个函数里的回报。
界面层怎么把这套东西接到聊天窗口上——输入框、消息气泡、会话切换——不在这一讲的范围里。链路编排、记忆与流式输出的完整落地,放在 Streamlit 智能聊天机器人那一讲。
05骨架模板:拿去改就能用
四种策略写在同一份骨架里,切策略只改一个常量
5.1 通用骨架
把第 04 节四个案例的共性抽出来,就是这一份。它做了三件前面没做的事:
| 改进 | 为什么 |
|---|---|
| 策略收敛成一个常量 | 前面每种策略各是一个文件,切换要改结构;这里改 STRATEGY 一行即可,四种策略共用同一套读写流程 |
| 读与写各自独立成函数 | read_recent() 管「这轮给多少」,write_back() 管「怎么存回去」。加新策略只动这两处,不碰调用链 |
| 存储实现单点可换 | get_history() 是唯一和存储打交道的地方,从内存换 Redis 只改这一个函数 |
# -*- coding: utf-8 -*-
"""
带记忆的对话骨架 —— 复制后只改 TODO 处
==========================================
四种策略写在同一份骨架里,改一个常量就能切换:

    STRATEGY = "buffer"   全量保存
             = "window"   只留最近 K 轮
             = "trim"     按 token 预算修剪
             = "summary"  摘要 + 最近 K 轮

存储实现、模型、人设各自只有一个改动点,其余代码不用动。
"""

import os

from langchain.chat_models import init_chat_model
from langchain_core.chat_history import BaseChatMessageHistory, InMemoryChatMessageHistory
from langchain_core.messages import AIMessage, HumanMessage, trim_messages
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder

# TODO(1):选策略与参数
STRATEGY = "window"
KEEP_MESSAGES = 6          # window / summary 保留的原始消息条数
TOKEN_BUDGET = 1500        # trim 策略的 token 预算
SUMMARY_TRIGGER = 12       # summary 策略:超过多少条才压缩

# TODO(2):换模型。需要密钥的 provider 一律读环境变量
model = init_chat_model(
    os.environ.get("CHAT_MODEL", "openai:gpt-4o-mini"), temperature=0)

# TODO(3):换人设。历史插槽的名字要和下面 recent 保持一致
PROMPT = ChatPromptTemplate.from_messages([
    ("system", "你是一个中文助手。较早对话的摘要:{summary}"),
    MessagesPlaceholder(variable_name="recent"),
    ("human", "{question}"),
])

SUMMARY_PROMPT = ChatPromptTemplate.from_messages([
    ("system", "把已有摘要与新增对话合并成不超过 120 字的中文摘要,保留关键事实,不要编造。"),
    ("human", "已有摘要:\n{summary}\n\n新增对话:\n{lines}\n\n新摘要:"),
])

chat_chain = PROMPT | model | StrOutputParser()
summary_chain = SUMMARY_PROMPT | model | StrOutputParser()

_store: dict[str, BaseChatMessageHistory] = {}
_summary: dict[str, str] = {}


# TODO(4):换存储。上生产时改成 Redis / 数据库实现即可,其余代码不动
def get_history(session_key: str) -> BaseChatMessageHistory:
    return _store.setdefault(session_key, InMemoryChatMessageHistory())


def _render(msgs):
    role = {"human": "用户", "ai": "助手"}
    return "\n".join("%s:%s" % (role.get(m.type, m.type), m.content) for m in msgs)


def read_recent(session_key):
    """读:按策略决定这一轮把哪些历史发回去。"""
    msgs = get_history(session_key).messages
    if STRATEGY == "buffer":
        return msgs
    if STRATEGY in ("window", "summary"):
        return msgs[-KEEP_MESSAGES:]
    if STRATEGY == "trim":
        return trim_messages(msgs, max_tokens=TOKEN_BUDGET, strategy="last",
                             token_counter=model, include_system=True,
                             start_on="human")
    raise ValueError("未知策略:%s" % STRATEGY)


def write_back(session_key, question, answer):
    """写:把这一轮追加进去;summary 策略下顺便压缩溢出的部分。"""
    history = get_history(session_key)
    history.add_messages([HumanMessage(content=question),
                          AIMessage(content=answer)])

    if STRATEGY != "summary":
        return
    msgs = history.messages
    if len(msgs) <= SUMMARY_TRIGGER:
        return

    overflow = msgs[:-KEEP_MESSAGES]
    _summary[session_key] = summary_chain.invoke({
        "summary": _summary.get(session_key, "(暂无)"),
        "lines": _render(overflow),
    })
    kept = msgs[-KEEP_MESSAGES:]
    history.clear()
    history.add_messages(kept)


def ask(session_key: str, question: str) -> str:
    answer = chat_chain.invoke({
        "summary": _summary.get(session_key, "(暂无)"),
        "recent": read_recent(session_key),
        "question": question,
    })
    write_back(session_key, question, answer)
    return answer


if __name__ == "__main__":
    # TODO(5):换成你的会话标识,通常是 用户ID:会话ID
    key = "u1001:c1"
    print(ask(key, "你好,我叫孙小空"))
    print(ask(key, "我叫什么名字?"))
    print("历史 %d 条" % len(get_history(key).messages))
ollama:模型名)· TODO 3 换人设,注意插槽名要和 recent 一致 · TODO 4 换存储实现 · TODO 5 换会话标识,通常是 用户ID:会话ID。其余代码不用动。
5.2 持久化历史骨架
第 4.4 节那份 Redis 实现本身就是模板。换成 MySQL、MongoDB 或任何存储,要改的只有三处:key 怎么拼、消息怎么序列化、怎么按会话删。接口的三个成员签名不变,上层链路就感觉不到差别。
# -*- coding: utf-8 -*-
"""
生产环境的持久化历史:自己实现一个 BaseChatMessageHistory
============================================================
进程内字典有三个致命问题:重启即丢、多副本各存各的、内存只涨不降。
换成外部存储只需要实现三个成员,链上的其它代码一个字都不用改。

要实现的接口:
    messages          属性,返回 List[BaseMessage]
    add_messages(x)   追加若干条
    clear()           清空本会话

社区也提供了现成的 RedisChatMessageHistory,思路与这份实现一致;
自己写一份的好处是能控制 key 规则、过期时间和序列化格式。
"""

import json
import os

import redis
from langchain_core.chat_history import BaseChatMessageHistory
from langchain_core.messages import (BaseMessage, messages_from_dict,
                                     messages_to_dict)

# 连接信息一律走环境变量,口令不进源码、不进版本库
_client = redis.Redis.from_url(
    os.environ.get("REDIS_URL", "redis://127.0.0.1:6379/0"),
    decode_responses=True,
)

TTL_SECONDS = 60 * 60 * 24 * 7        # 七天没人说话就自动回收


class RedisMessageHistory(BaseChatMessageHistory):
    """用一个 Redis List 存一段会话,每个元素是一条序列化后的消息。"""

    def __init__(self, session_id: str, client=None, ttl: int = TTL_SECONDS):
        self.session_id = session_id
        self.client = client or _client
        self.ttl = ttl

    @property
    def key(self) -> str:
        # 加业务前缀,避免和别的数据撞键
        return "chat:history:%s" % self.session_id

    @property
    def messages(self) -> list[BaseMessage]:
        raw = self.client.lrange(self.key, 0, -1)
        return messages_from_dict([json.loads(item) for item in raw])

    def add_messages(self, messages: list[BaseMessage]) -> None:
        if not messages:
            return
        payload = [json.dumps(d, ensure_ascii=False)
                   for d in messages_to_dict(messages)]
        pipe = self.client.pipeline()
        pipe.rpush(self.key, *payload)
        pipe.expire(self.key, self.ttl)      # 每次写入都续期
        pipe.execute()

    def clear(self) -> None:
        self.client.delete(self.key)

    def tail(self, n: int) -> list[BaseMessage]:
        """只取最近 n 条:窗口策略在存储层就能完成,不用把全量读回内存。"""
        raw = self.client.lrange(self.key, -n, -1)
        return messages_from_dict([json.loads(item) for item in raw])


def get_history(session_id: str) -> BaseChatMessageHistory:
    """把它交给 RunnableWithMessageHistory,唯一的改动就是这一个函数。"""
    return RedisMessageHistory(session_id)


if __name__ == "__main__":
    h = get_history("u1001-c1")
    h.clear()
    h.add_messages([])                       # 空列表要安全返回
    from langchain_core.messages import AIMessage, HumanMessage

    h.add_messages([HumanMessage(content="我的订单号是 12346"),
                    AIMessage(content="已记录订单号 12346。")])

    print("读回 %d 条" % len(h.messages))
    print("最近 1 条:", h.tail(1)[0].content)
    print("剩余存活时间:%s 秒" % _client.ttl(h.key))
② 单会话上限——有人能把一段会话聊到上万条,读全量会拖垮服务,存储层就要能只取末尾若干条。
③ 敏感信息——手机号、地址会原样躺在历史里,落库前该脱敏就脱敏,该加密就加密。
5.3 三份模板怎么选
| 模板 | 适用 | 特点 |
|---|---|---|
min_memory_chain.py | 学习、验证环境 | 三十行,四个零件看得清清楚楚,见第 03 节 |
memory_skeleton.py | 日常首选 | 四种策略一份代码,读写分离,改常量就能切 |
customer_service_bot.py | 长对话业务场景 | 混合记忆 + 两级隔离 + 事实卡片,见第 4.5 节 |
5.4 策略选型的几条经验
对话天然在十轮以内结束(表单填写、一次性问答),直接全量保存,别把简单问题做复杂。
客服、陪伴、助理这类轮数不可控的场景,一步到位上「摘要 + 最近 K 轮」,后面不用返工。
订单号、工单号、金额、收货地址走事实卡片,不要指望摘要能把它们保住。
K 和 max_tokens 不要拍脑袋。按第 2.4 节那条式子减一遍,留够回复额度。
06易错点汇总
按「概念 / 数据结构 / 读写时机 / 策略 / 隔离与存储 / 版本迁移」六类归并
⚠️ 一、概念层面
- 以为模型「学会」了这段对话。 权重一个都没变。它只是这一次请求里读到了你发过去的历史,请求结束就什么都不剩。下次不发,它照样不知道。
- 以为 Memory 是个服务端会话。 历史存在你的进程或你的存储里。换句话说,你的程序崩了,会话就没了——除非你自己做了持久化。
- 把会话记忆和知识库混为一谈。 记忆解决的是「这段对话里说过什么」,跨会话的长期知识该走检索增强,两者的存储、检索方式和失效策略都不一样。
- 觉得「多轮上下文」是模型的高级能力。 它是工程能力。同一个模型,会不会多轮,全看调用方肯不肯把历史重新带上。
⚠️ 二、消息与数据结构
- 把历史拼成一段纯文本塞进提示词。 角色信息丢了,多轮之后模型分不清哪句是用户要求、哪句是自己承诺过的话。用
MessagesPlaceholder铺消息列表,不要用{history}这样的字符串变量。 - 把
SystemMessage存进历史容器。 一旦触发裁剪或滑窗,人设可能被一起裁掉,模型会突然「变了个人」。人设固定在模板第一条,永不参与裁剪。 - 直接把消息对象
json.dumps。 会抛序列化错误。要先messages_to_dict(),读回来再messages_from_dict()。 - 落盘时忘了
ensure_ascii=False。 中文全变成\uXXXX,排查问题时文件根本读不动。 - 手动拼 dict 时漏了字段。
messages_from_dict期望的是{"type": ..., "data": {...}}这个结构,自己拍脑袋造的字典转不回来。要转就用配套的那个函数。
⚠️ 三、读写时机
- 只把模型的回复写回历史,忘了写用户那一句。 下一轮历史里全是助手的自言自语。一轮等于两条消息,成对写入。
- 先写后读。 把本轮提问先追加进历史,再读历史填模板,结果本轮提问在消息列表里出现两次,模型经常会把问题复述一遍再回答。读在调用前,写在拿到回复后。
- 用了
RunnableWithMessageHistory还手动add_messages。 写回是它替你做的,再手动写一次就重复了,历史里全是成对的重复消息。 - 三处名字没对齐。
MessagesPlaceholder的variable_name、history_messages_key、链内部引用的键必须同名。不一致时不报错,只是历史永远填不进去,模型每轮都像第一次见你——最难查的一类问题。 input_messages_key与invoke的入参键不一致。 会直接报找不到输入键;相比上一条,这个反而算好事。- 调用时忘了传
config。 没有session_id,要么报错,要么所有人共用一块备忘板——后者更危险。
⚠️ 四、策略与裁剪
- 直接把容器里的旧消息删掉来实现窗口。 数据就真没了,想换策略也回不去。容器存全量,裁剪只发生在读的时候。
- 把 K 当成消息条数。 一轮是两条。想留最近 3 轮,切片要写
[-6:]而不是[-3:],否则历史会从一句 AI 回复开始。 - 按条数裁却以为控住了成本。 一条粘贴进来的长文档能顶几十条短消息。要控成本就按 token 裁,
token_counter传模型对象。 - 每轮都重算摘要。 成本直接翻倍。设触发阈值,只有真有内容溢出时才算一次。
- 摘要时把全部历史重新总结一遍。 那比全量保存还贵。正确做法是旧摘要 + 新增对话 → 新摘要。
- 压缩完没把被吸收的旧消息移除。 下轮会把同一段再摘一次,摘要里开始出现车轱辘话,而且越滚越离谱。
- 指望摘要保住订单号。 压几轮就变成「用户的订单」了。关键标识走事实卡片,单独存、不裁剪、不进摘要。
- 摘要提示词没写「不要编造」。 摘要里会冒出用户从没说过的需求,而且下一轮会被当成既定事实继续用下去。
trim_messages忘了include_system=True。 人设被裁掉,模型的语气和边界突然全变。- 没设
start_on="human"。 裁完的历史以一句没头没尾的 AI 回复开头,模型容易顺着那句往下接。
⚠️ 五、隔离与存储
- 直接拿前端传来的字符串当
session_id。 改一个参数就能读到别人的会话历史。会话标识必须由服务端按登录态生成或校验,鉴权在进入链之前做完。 - 只按用户隔离,不按会话隔离。 同一个人的两段不相干的对话会串在一起,模型拿着 A 话题的上下文回答 B 话题。
- 工厂函数里塞业务逻辑。 裁剪、摘要、鉴权都不该写在这里。它只负责「给 key 返回容器」,混进别的逻辑后换存储就得重写。
- 生产环境还在用进程内字典。 重启即丢、多副本各存各的、内存只涨不降。单机开发时完全看不出来,上线当天集中爆发。
- 存储不设过期。 历史只进不出,迟早把存储撑满。写入时续期是个省事又有效的做法。
- 把数据库口令写死在源码里。 与 API-KEY 同理,一律走环境变量,不进版本库。
- 历史原样落库不做处理。 手机号、地址、身份证号会明文躺在里面,该脱敏脱敏、该加密加密。
⚠️ 六、版本与迁移
- 照着 0.3 时代的写法直接敲。
ConversationBufferMemory、ConversationChain、LLMChain这些在 1.x 已经搬到langchain-classic,不再是推荐写法;继续用,就享受不到 LCEL 的组合能力。 - 以为
from langchain.memory import ...还能照旧。 1.x 的langchain命名空间收窄了,只保留 agents / messages / tools / chat_models / embeddings 这几块。导入路径要跟着改。 - 迁移时忘了
return_messages的差别。 旧记忆类默认返回拼接好的纯文本,当代写法一律走消息对象列表,提示词那一侧要同步改成MessagesPlaceholder。 - 把
memory_key和history_messages_key当成两回事。 它们是同一个角色,迁移时对齐成一个名字即可。 - 在 Agent 上找
RunnableWithMessageHistory。 Agent 那一侧走的是checkpointer+thread_id,两套接口解决同一个问题,别硬套。
07自测题
点击题目展开答案;能把这 18 题说清楚,这一讲就通了
模型本身有没有记忆?「它记住了我的名字」这句话该怎么纠正?
没有。模型是无状态的:一次请求读完消息、算出输出就结束,两次请求之间不保留任何状态。准确说法是——你的代码把之前的对话重新塞进了这一次请求里,模型是现场读到的,不是记住的。
模型无状态带来哪三个直接后果?
① 上下文必须自带:想让它知道三轮前的事,就得把那三轮再发一遍;② 成本随轮数增长:每轮重发历史,输入 token 越来越多;③ 存在硬上限:历史涨到撑满上下文窗口,请求会直接失败。
Memory 组件负责什么、不负责什么?
负责:按顺序存消息、调用前把历史交出来、拿到回复后存回去、按会话标识隔离。
不负责:让模型「学会」内容(权重没变)、决定历史怎么摆进提示词(那是模板的事)、跨会话的长期知识(那是检索增强)、鉴权(应该在进链之前做完)。
一个链接入记忆后,会与记忆模块交互几次?分别在什么时候?
两次:一次读、一次写。收到用户输入时,从记忆组件查询历史,拼进提示词传给模型;返回响应之前,把这一轮的内容写回记忆组件,供下次查询。读在调用模型之前,写在拿到回复之后,顺序不能颠倒。
为什么历史要存消息对象,而不是拼成一段纯文本?
因为消息对象带着角色信息(human / ai / system / tool)。拼成纯文本后角色就糊在一起了,多轮之后模型分不清哪句是用户的要求、哪句是自己做过的承诺,容易前后矛盾。
SystemMessage 该不该存进历史容器?为什么?
不该。它是人设,不属于会话历史。存进容器后,一旦触发裁剪或滑动窗口,人设可能被一起裁掉,模型会突然变了个语气和边界。正确做法是让它固定待在提示词模板的第一条,每轮重新拼上,永不参与裁剪。
要把会话存到文件或数据库,需要哪一对函数?各自的方向是什么?
messages_to_dict(msgs) 把消息对象转成可 json.dumps 的 list[dict],每项形如 {"type": "human", "data": {...}};messages_from_dict(dicts) 转回消息对象。写 JSON 时记得 ensure_ascii=False,否则中文会变成 \uXXXX。
四种记忆策略分别是什么?各自的代价是什么?
全量保存:一条不落全发回去。上下文最完整,但输入长度随轮数线性增长,最贵,迟早顶穿窗口。
只留最近 K 轮:输入长度有上限、稳定,但窗口外的信息是真的丢了。
摘要压缩:把旧对话缩写成一段话,长度基本恒定;代价是每次更新摘要要额外调一次模型、细节被抹掉、摘要之上再摘要会累积误差。
摘要 + 最近 K 轮:综合表现最好,最近几轮保原话、更早的只留摘要;代价是实现最复杂,且仍要付摘要那次调用的钱。
窗口策略里,K=1 和 K=3 在「我叫什么?」这一问上表现为什么不同?
名字是第 1 轮说的。K=1 时窗口里只剩最近一轮,第 1 轮已经滑出去,模型答不出来;K=3 时第 1 轮还在窗口内,模型答得出来。这正是窗口策略的边界:它不是「忘了」,是你根本没把那段发过去。
更新摘要时,正确的做法是什么?为什么不能每轮把全部历史重新总结一遍?
正确做法是增量滚动:新摘要 = 旧摘要 + 新增对话,只调一次模型。每轮重新总结全部历史,处理的内容量和全量保存一样多,还额外多付一次模型调用,比不做摘要还贵。另外摘要不该每轮都算,要设触发阈值,真有内容溢出时才算。
摘要策略下,订单号这类关键信息老是丢,怎么办?
不要靠把摘要提示词写得更长。正确对策是事实卡片:把订单号、金额、工单号这类关键标识单独存一份,不参与裁剪、不进摘要,每轮固定拼进人设里。摘要只用来承载「聊过什么」,精确值交给卡片。
用 RunnableWithMessageHistory 做一条带记忆的链,需要哪四个零件?
① 提示词模板里的 MessagesPlaceholder(历史插槽);② 一条普通的 LCEL 链,如 prompt | model;③ 一个工厂函数,给 session_id 返回该会话的历史容器;④ 两个键名 input_messages_key 与 history_messages_key。调用时用 config={"configurable": {"session_id": "..."}} 指定是谁在说话。
历史填不进提示词、模型每轮都像第一次见你,最可能是什么原因?
三处名字没对齐:MessagesPlaceholder(variable_name=...)、history_messages_key、以及链内部引用的那个键,必须是同一个名字。这种情况不会报错,只是历史静默地填不进去,属于最难查的一类问题。
为什么裁剪要放在「读出来之后」,而不是直接删容器里的旧消息?
因为容器一旦删了就回不去了。容器存全量、读的时候再挑,好处是想从窗口换成摘要、或把 K 调大,只改挑的那一段代码,历史数据一条都不用动;还能随时导出完整会话做审计和排查。
历史的 token 预算该怎么算?为什么按条数裁不靠谱?
历史预算 = 上下文窗口 − 回复预留 − 人设 − 本轮提问 − 工具描述 − 安全缓冲。按条数裁不靠谱,是因为一条粘贴进来的长文档能顶几十条短消息,条数相同而 token 差两个量级。要控成本就用 trim_messages,token_counter 传模型对象,口径和计费一致。
trim_messages 里 include_system 和 start_on 各解决什么问题?
include_system=True 保住开头的人设,不让它被裁掉,否则模型的语气和边界会突然全变;start_on="human" 让裁完的历史从用户消息开始,避免以一句没头没尾的 AI 回复开头、模型顺着那句往下接。
要把内存历史换成 Redis,需要改哪些地方?换存储前要先想清楚什么?
只需实现三个成员:messages 属性、add_messages()、clear(),再把工厂函数指向新实现,链上其它代码一个字都不用改。换之前要想清楚三件事:会话什么时候过期、单会话条数上限(有人能聊到上万条)、敏感信息要不要脱敏或加密。连接口令一律走环境变量。
Agent 那一侧的短期记忆是怎么做的?和链上的写法是什么关系?
给 create_agent 传一个 checkpointer,再用 thread_id 区分会话;状态存在 graph state 里由 checkpointer 持久化,thread 之间互相隔离。它和链上的 RunnableWithMessageHistory 是两套接口、同一个结论:状态永远在你这边,模型那边什么都不留。
词术语表
| 术语 | 含义 |
|---|---|
| 无状态 | 模型两次请求之间不保留任何上下文;每次推理只依赖本次请求里的消息 |
| Memory | 保存与管理多轮对话上下文的一类组件;只负责存与取,不改变模型本身 |
| 会话历史 | 一段对话里按顺序排列的消息列表,是「记忆」真正存放的地方 |
HumanMessage | 用户说的一条消息,type 为 human |
AIMessage | 模型回的一条消息,type 为 ai |
SystemMessage | 人设与全局规则;不属于会话历史,每轮由提示词模板固定拼在最前 |
InMemoryChatMessageHistory | 最基础的历史容器,只有存、取、清三件事,不做裁剪与摘要 |
BaseChatMessageHistory | 历史容器的接口;实现 messages / add_messages / clear 即可换任意存储 |
MessagesPlaceholder | 提示词模板里的历史插槽,填入的是一整段消息列表而非字符串 |
RunnableWithMessageHistory | 包在链外面的一层;按 session_id 读历史、调用后把这一问一答写回去 |
session_id | 会话标识,决定这次调用读写哪一块历史;必须由服务端生成或校验 |
trim_messages | 按 token 预算修剪历史的工具,可保住人设、控制起始角色 |
| 上下文窗口 | 一次请求能装下的 token 上限;人设、历史、本轮提问与回复预留都挤在里面 |
| 滚动摘要 | 旧摘要与新增对话合并成的新摘要,用增量方式维护而非每轮重算 |
| 事实卡片 | 订单号等关键标识单独存的一份数据,不参与裁剪也不进摘要 |
checkpointer | Agent 侧的状态持久化组件,配合 thread_id 区分并隔离会话 |
langchain-classic | legacy 功能的新家;LLMChain、ConversationChain 等搬到了这里,不再是推荐写法 |