【案例】新媒体评论分类与信息抽取 · LoRA 训练与上线
原件封存,旁边挂一张 14 MB 的小抄——0.06% 的可训练参数、梯度累积的两处配套改动,以及一个底座挂几十个业务的部署方式。
30″30 秒看懂 LoRA
前面三条路线都是把整个模型的参数全改一遍。BERT 一亿参数,改得动。ChatGLM-6B 有 62 亿,全参微调要几十 GB 显存,一张消费级显卡连门都进不去。
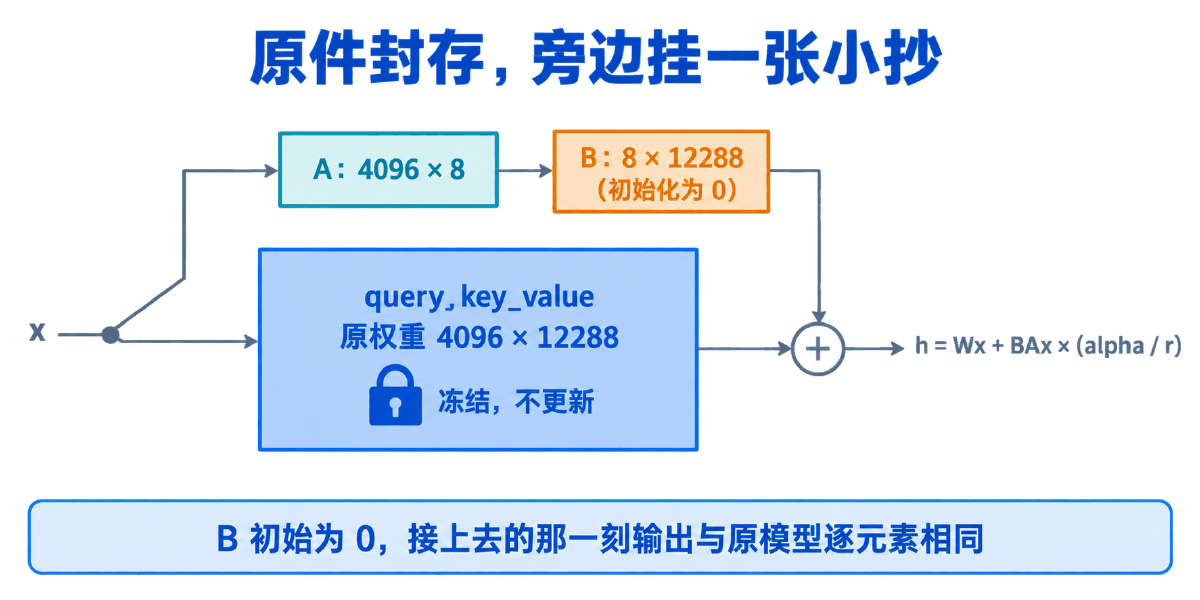
LoRA 的做法是:原件封存,旁边挂一张小抄。模型原来的权重矩阵锁死不动,在它旁边并联两个又瘦又小的矩阵 A 和 B。数据进来时兵分两路——一路走原权重,一路走小抄——两路结果相加就是最终输出。训练时只更新小抄,原件一个数都不碰。
小抄有多小?ChatGLM-6B 的注意力权重是 4096 × 12288,五千万个数。LoRA 把它拆成 4096 × 8 和 8 × 12288 两块,加起来 13 万个数。28 层全加起来 367 万,占整个模型的 0.06%。
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 封存的原件 | 冻结的原权重 W | requires_grad=False,不算梯度也不更新 |
| 小抄的两页 | 低秩矩阵 A 与 B | A 把 4096 维压到 8 维,B 再放回 12288 维 |
| 小抄一开始是空白的 | B 初始化为 0 | 接上去那一刻输出与原模型逐元素相同,不会一上来把模型带偏 |
| 小抄的字写多大 | alpha / r 缩放系数 | 本讲 32/8 = 4,控制小抄对最终输出的影响力 |
| 一个业务一份小抄 | 一个适配器 adapter | 14 MB 一份,一个底座能同时挂几十份 |
| 把小抄誊回原件 | merge_and_unload() | 推理延迟回到底座水平,代价是从此换不了适配器 |
h = Wx + (alpha/r)·BAx —— 这一个公式把这一页的原理全讲完了,剩下的都是工程。
01概念
低秩是什么意思、为什么 0.06% 的参数就够用、和前面几种方法怎么排
「低秩」这两个字
一个 4096 × 12288 的矩阵有五千万个自由度,但微调时它真正发生的变化未必需要那么多自由度。LoRA 的假设是:微调带来的权重增量 ΔW 是「低秩」的——它可以用两个瘦长矩阵的乘积很好地近似。
所以不去直接学 ΔW,而是学 A 和 B,让 ΔW ≈ B·A。秩 r=8 意味着这个增量被限制在一个 8 维的子空间里。参数量从 4096×12288 降到 4096×8 + 8×12288,降了 384 倍。
r,或者干脆做全参微调。
为什么 B 要初始化为 0
A 用高斯随机初始化,B 全部初始化为 0。于是训练第 0 步时 BAx = 0,模型输出与原底座逐元素相同。
这个设计解决的是「接上适配器那一刻别把模型弄坏」。如果 A、B 都随机初始化,一上来就往输出里注入一堆噪声,模型得先花很多步把这些噪声消掉。从 0 开始,训练是「在原模型基础上逐步叠加修正」,而不是「先破坏再修复」。
缩放系数 alpha/r
完整的前向是 h = Wx + (alpha/r)·BAx。本讲 alpha=32, r=8,缩放系数是 4。
这个系数最容易被误解成「LoRA 的强度旋钮」。它确实是,但它和 r 绑在一起:
| r | alpha | scale = alpha/r |
|---|---|---|
| 8 | 32 | 4.0 |
| 16 | 32 | 2.0 |
| 32 | 32 | 1.0 |
想「学得更多」而把 r 从 8 调到 32,缩放系数却从 4 掉到 1,两个方向互相抵消。所以调 r 时通常让 alpha 跟着一起调,保持 alpha/r 不变——常见配比是 alpha = 2r 或 alpha = 4r。
# -*- coding:utf-8 -*-
"""alpha/r 这个缩放系数到底在缩放什么:纯标准库数值实验,可直接运行。

h = W·x + (alpha/r)·B·A·x
很多人以为调 alpha 就是调「LoRA 的强度」——对,但它和 rank 绑在一起:
rank 调大时如果 alpha 不动,等效强度会掉。
"""


def matvec(mat, vec):
    return [sum(m * v for m, v in zip(row, vec)) for row in mat]


def lora_delta(A, B, x, alpha, r):
    """(alpha/r) * B(A x)。A: (r, in),B: (out, r)。"""
    ax = matvec(A, x)
    bax = matvec(B, ax)
    scale = alpha / r
    return [scale * v for v in bax], scale


if __name__ == '__main__':
    x = [1.0, 2.0, 3.0, 4.0]

    # r=2 的一组权重
    A2 = [[0.1, 0.0, 0.0, 0.0], [0.0, 0.1, 0.0, 0.0]]
    B2 = [[1.0, 0.0], [0.0, 1.0], [1.0, 1.0]]

    for alpha in (2, 8, 32):
        delta, scale = lora_delta(A2, B2, x, alpha, r=2)
        print('r=2 alpha=%-3d scale=%-5.1f delta=%s' % (alpha, scale, [round(v, 3) for v in delta]))

    # 性质一:delta 与 alpha 成正比
    d1, _ = lora_delta(A2, B2, x, 2, 2)
    d2, _ = lora_delta(A2, B2, x, 8, 2)
    assert all(abs(b - 4 * a) < 1e-9 for a, b in zip(d1, d2)), 'alpha 翻 4 倍,增量翻 4 倍'
    print('\nalpha 从 2 到 8,增量正好放大 4 倍')

    # 性质二:B 初始化为 0,接上去的那一刻输出完全不变
    B_zero = [[0.0, 0.0], [0.0, 0.0], [0.0, 0.0]]
    delta0, _ = lora_delta(A2, B_zero, x, 32, 2)
    assert delta0 == [0.0, 0.0, 0.0]
    print('B 初始化为 0 -> 训练第 0 步的输出与原模型逐元素相同,不会一上来就把模型带偏')

    # 性质三:rank 翻倍而 alpha 不动,缩放系数减半
    print('\nrank   alpha   scale')
    for r in (2, 4, 8, 16, 32):
        print('%-6d %-7d %.2f' % (r, 32, 32 / r))
    assert 32 / 8 == 4.0 and 32 / 32 == 1.0
    print('\n把 rank 从 8 调到 32 想「学得更多」,scale 却从 4 掉到 1 —— ')
    print('两个方向互相抵消,所以调 rank 时通常让 alpha 跟着一起调,保持 alpha/r 不变')

    # 常见配比
    print('\n常见配比: alpha = 2r(scale=2)或 alpha = 4r(scale=4)')
    for r in (8, 16, 32):
        print('  r=%-3d alpha=%-3d scale=%.1f' % (r, 4 * r, 4 * r / r))
四种方法横向排
| 方法 | 底座是否冻结 | 新增可训练参数 | 存盘体积 |
|---|---|---|---|
| 全参微调 | 不冻结 | 0(改的是原参数) | 完整模型,11.5 GB |
| PET | 不冻结 | 0 | 完整模型 |
| P-Tuning(本课实现) | 不冻结 | 6 个 embedding | 完整模型 |
| LoRA | 冻结 | 367 万,占 0.06% | 适配器 14 MB |
前三种的共同点是「底座参数都要动」,所以存盘存的是整个模型,一个任务一份 11.5 GB。LoRA 是这张表里唯一真正的参数高效微调:底座冻结,存盘只存那 367 万个数。这个差别在上线时会变成一条完全不同的部署路径。
02原理:一条支路是怎么接上去的
从一个矩阵到 28 层,把参数量一层一层数清楚
接在哪一层
LoRA 不是给整个模型都加支路,而是挑几个矩阵下手。LoraConfig 里的 target_modules 就是这张名单,本讲填的是 ['query_key_value']。
为什么只写一个名字?因为 ChatGLM 把注意力的 Q、K、V 三个投影合并成了一个大矩阵,形状 4096 × 12288(12288 = 3 × 4096)。写一个 query_key_value 等于同时改了 Q、K、V 三处。换成 LLaMA 系模型,它们是分开的三个模块,名单就要写成 ['q_proj', 'k_proj', 'v_proj']。
target_modules 里的名字匹配不上任何一层时,peft 不会抛异常,只是一个 LoRA 层都没插进去。表现是 print_trainable_parameters() 打出 0 或者接近 100%,训练照跑但什么也没学到。这一行输出必须看。
参数量一层一层数
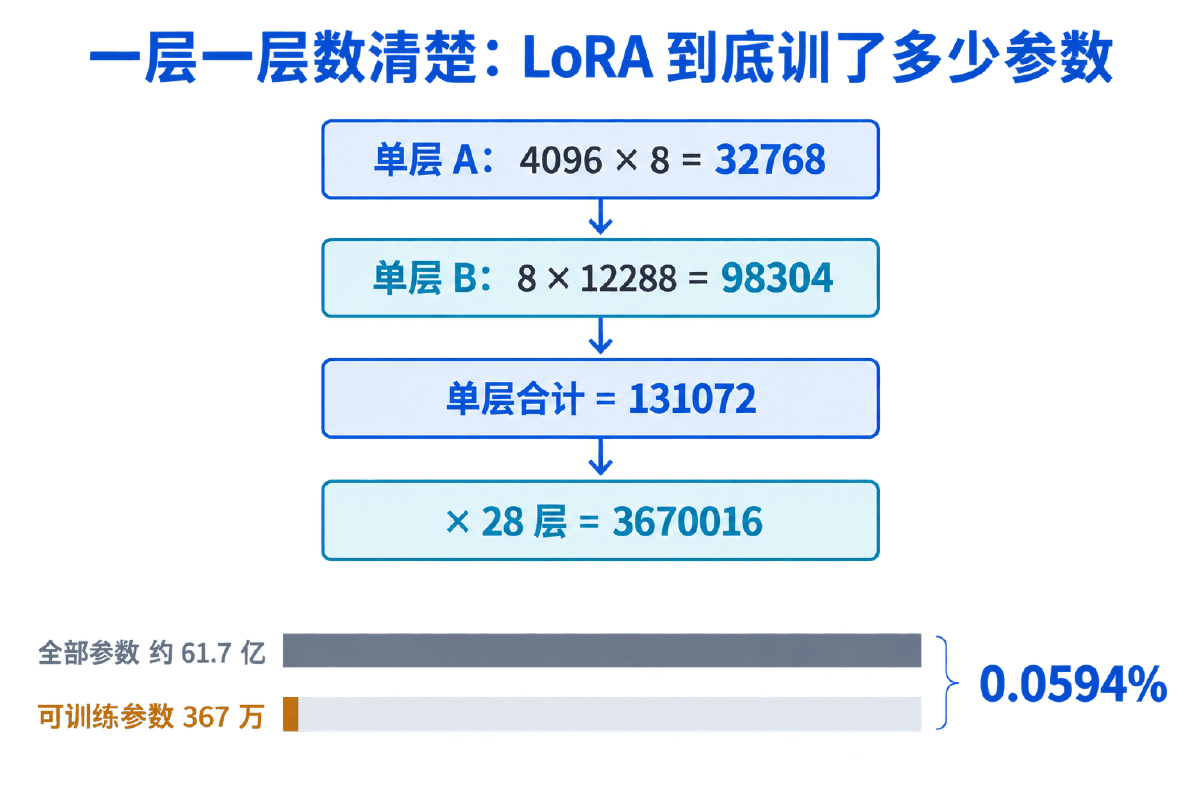
| 项 | 计算 | 结果 |
|---|---|---|
| 原权重 | 4096 × 12288 | 50,331,648 |
| A 矩阵 | 4096 × 8 | 32,768 |
| B 矩阵 | 8 × 12288 | 98,304 |
| 单层合计 | 32768 + 98304 | 131,072 |
| 28 层 | 131072 × 28 | 3,670,016 |
| 占全模型 | 3670016 / 61.7 亿 | 0.0594% |
这些数字不是背来的,是从 ChatGLM-6B 的配置里算出来的:hidden_size=4096、num_layers=28。换底座就换数,算法一样:
# -*- coding:utf-8 -*-
"""LoRA 到底省了多少:把可训练参数一层一层算出来,纯标准库,可直接运行。

这些数字不是背来的,是从 ChatGLM-6B 的 config 里算出来的:
hidden_size=4096,num_layers=28,query_key_value 把 Q/K/V 合成一个
(4096, 3*4096) 的矩阵。
"""

HIDDEN = 4096
LAYERS = 28
TOTAL_PARAMS = 6_173_286_400   # ChatGLM-6B 约 62 亿


def lora_params_per_layer(in_dim, out_dim, rank):
    """A: (in, r),B: (r, out)。"""
    return in_dim * rank + rank * out_dim


def full_params_per_layer(in_dim, out_dim):
    return in_dim * out_dim


if __name__ == '__main__':
    qkv_out = 3 * HIDDEN
    print('query_key_value 原权重: %d x %d = %d' % (HIDDEN, qkv_out, HIDDEN * qkv_out))

    rank = 8
    a = HIDDEN * rank
    b = rank * qkv_out
    per_layer = lora_params_per_layer(HIDDEN, qkv_out, rank)
    print('\nrank=%d 时:' % rank)
    print('  A: %d x %d = %d' % (HIDDEN, rank, a))
    print('  B: %d x %d = %d' % (rank, qkv_out, b))
    print('  单层合计 = %d' % per_layer)
    assert a == 32768 and b == 98304 and per_layer == 131072

    total_lora = per_layer * LAYERS
    print('  x %d 层 = %d' % (LAYERS, total_lora))
    assert total_lora == 3_670_016

    pct = 100 * total_lora / TOTAL_PARAMS
    print('\n可训练占比 = %d / %d = %.4f%%' % (total_lora, TOTAL_PARAMS, pct))
    assert pct < 0.1

    # 对照:只改这 28 层的 qkv 做全参微调,也要 14 亿参数
    full_qkv = full_params_per_layer(HIDDEN, qkv_out) * LAYERS
    print('\n只全参微调这 28 层 qkv: %d 个参数,是 LoRA 的 %.0f 倍'
          % (full_qkv, full_qkv / total_lora))
    assert full_qkv / total_lora == 384.0

    # rank 翻倍,参数就翻倍——线性关系,不是指数
    print('\nrank   可训练参数   占比')
    prev = None
    for r in (1, 2, 4, 8, 16, 32, 64):
        n = lora_params_per_layer(HIDDEN, qkv_out, r) * LAYERS
        print('%-6d %-12d %.4f%%' % (r, n, 100 * n / TOTAL_PARAMS))
        if prev:
            assert n == prev * 2, 'rank 翻倍参数正好翻倍'
        prev = n

    # 存盘体积:float32 每个参数 4 字节
    print('\n适配器存盘体积(float32): %.1f MB' % (total_lora * 4 / 1024 / 1024))
    print('完整模型存盘体积(float16): %.1f GB' % (TOTAL_PARAMS * 2 / 1024 ** 3))
    assert total_lora * 4 / 1024 / 1024 < 20
    print('\n一个任务一个适配器,14 MB 一份 —— 这就是能同时上线几十个业务的原因')
脚本最后两行算的是存盘体积:适配器 float32 存下来 14 MB,完整模型 float16 是 11.5 GB。差了八百倍——这就是下一节那套多业务部署方案的全部底气。
rank 与参数量是线性关系
| r | 可训练参数 | 占比 |
|---|---|---|
| 4 | 1,835,008 | 0.0297% |
| 8 | 3,670,016 | 0.0594% |
| 16 | 7,340,032 | 0.1189% |
| 32 | 14,680,064 | 0.2378% |
rank 翻倍参数正好翻倍,不是指数增长。所以调 rank 的成本很可控——真正的约束不是显存,是小数据集上调大 rank 容易过拟合。本讲两个任务的数据量不大,r=8 是个稳妥起点。
半精度与 LoRA 层的精度
6B 模型用 float32 存要 24 GB,必须半精度上卡。但代码里有一行反向操作:把 LoRA 层单独拉回 float32。
理由是低秩矩阵的数值本来就小,B 又从 0 开始,梯度更小。float16 的最小正规数在 6e-5 量级,再小就下溢成 0——梯度变成 0,这一层就彻底不学了,而且没有任何报错。底座冻结不需要梯度,半精度无所谓;LoRA 层是唯一要学的东西,精度不能省。
梯度累积
batch_size=2、gradient_accumulation_steps=8,等效 batch 是 16。实现上是三件事:
- 每一步照常前向、反向,但不调
optimizer.step(),梯度自然累加在.grad里。 - 反向前把损失除以累积步数:
(loss / 8).backward()。不除的话累加起来的梯度是 8 倍,等效学习率被放大 8 倍。 - 攒够 8 步才
optimizer.step()+scheduler.step()+zero_grad()。
max_train_steps 如果还写成 epochs × len(dataloader),就把它算成了 8 倍。学习率会在训练才走到八分之一时就衰减到 0,后面七分之八的训练等于白跑。正确写法是先除以 gradient_accumulation_steps。
03最小代码:给模型套上 LoRA
五行配置加一行包装,参数占比打印出来就算成功
LoRA 的接入代码非常短。短到容易让人以为没做什么事,所以更要盯住那一行参数占比的输出——它是唯一能证明 LoRA 真的生效了的证据。
# -*- coding:utf-8 -*-
"""给 ChatGLM 套上 LoRA:从加载底座到打印可训练参数占比。

整个「参数高效微调」的落地就这么几行。难点不在写,在于
看懂每一行改变了什么,出问题时知道去哪儿查。
"""
import torch
from peft import LoraConfig, TaskType, get_peft_model
from transformers import AutoModel, AutoTokenizer


def build_lora_model(pre_model: str,
                     rank: int = 8,
                     alpha: int = 32,
                     dropout: float = 0.1,
                     target_modules=None):
    """加载底座并挂上 LoRA 适配器。"""
    # trust_remote_code=True:ChatGLM 的建模代码在模型仓库里
    model = AutoModel.from_pretrained(pre_model, trust_remote_code=True)
    tokenizer = AutoTokenizer.from_pretrained(pre_model, trust_remote_code=True)

    config = LoraConfig(
        task_type=TaskType.CAUSAL_LM,   # 生成任务;分类任务要换成 SEQ_CLS
        inference_mode=False,           # 训练阶段必须 False,True 会把 dropout 关掉
        r=rank,
        lora_alpha=alpha,
        lora_dropout=dropout,
        # ChatGLM 把 Q/K/V 合成了一个 query_key_value 大矩阵,
        # 所以这里只写一个名字就等于同时改了 Q、K、V 三处
        target_modules=target_modules or ['query_key_value'],
    )

    model = get_peft_model(model, config)
    # 这行必看:可训练参数占比应当在 0.1% 以下。
    # 如果打出来是 100%,说明 target_modules 没匹配上任何层,LoRA 等于没生效
    model.print_trainable_parameters()
    return model, tokenizer


def count_trainable(model):
    """手动数一遍,别只信 print_trainable_parameters。"""
    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
    total = sum(p.numel() for p in model.parameters())
    return trainable, total, 100 * trainable / total


def prepare_for_training(model, device: str):
    """训练前的三个开关,少一个都可能出问题。"""
    # ① 半精度:6B 模型用 float32 存不下,float16 在 24G 卡上才够
    model = model.half().to(device)
    # ② 有些底座默认关掉了 cache,训练时开着会和梯度检查点冲突
    model.config.use_cache = False
    # ③ LoRA 层本身用 float32 更稳:低秩矩阵数值小,半精度容易下溢成 0
    for name, param in model.named_parameters():
        if 'lora' in name.lower():
            param.data = param.data.to(torch.float32)
    return model


if __name__ == '__main__':
    model, tokenizer = build_lora_model('./ChatGLM-6B', rank=8, alpha=32, dropout=0.1)
    trainable, total, pct = count_trainable(model)
    print('可训练 %d / 总计 %d = %.4f%%' % (trainable, total, pct))
    print('缩放系数 alpha/r =', 32 / 8)
LoraConfig 的字段逐个说清楚:
| 字段 | 本讲取值 | 作用与注意 |
|---|---|---|
task_type | CAUSAL_LM | 生成任务;做分类要换 SEQ_CLS,写错会让 peft 包错输出头 |
inference_mode | False | 训练必须 False;True 会把 LoRA 的 dropout 关掉 |
r | 8 | 秩。参数量与它成正比 |
lora_alpha | 32 | 缩放分子,实际缩放是 alpha/r = 4 |
lora_dropout | 0.1 | 只作用在支路上,底座不受影响 |
target_modules | ['query_key_value'] | 名单。匹配不上不会报错,只是一层都没插 |
print_trainable_parameters() 正常应当打出 0.06% 左右。打出 100% 说明底座没冻结;打出 0 或者报「没有可训练参数」说明 target_modules 一个都没匹配上。这一行不对就不要往下走,训练跑完也是白跑。
04完整案例:训起来,再把它接到线上
训练脚本、输出解析闸、一个底座挂多份适配器
训练主脚本
数据管线上一页已经建好,这一页把它接上 LoRA 和梯度累积。整个训练循环与 BERT 那两页的结构一致,多出来的只有累积计数和半精度处理:
# -*- coding:utf-8 -*-
"""ChatGLM + LoRA 训练主脚本。

和 BERT 那两页的训练循环比,这里多了两样东西:
① 梯度累积——显存塞不下大 batch,就攒几步再更新一次;
② 半精度与 use_cache 开关——6B 模型的工程约束。
损失不用自己算:把 labels 一起喂进去,模型内部就把 -100 的位置跳过了。
"""
import os
import time

import torch
from tqdm import tqdm
from transformers import AutoModel, AutoTokenizer, default_data_collator, get_scheduler
from peft import LoraConfig, TaskType, get_peft_model

from data_loader import get_data
from glm_config import ProjectConfig

pc = ProjectConfig()


def save_model(model, cur_save_dir: str):
    """LoRA 存的是适配器,不是整个模型——十几 MB,不是十几 GB。"""
    os.makedirs(cur_save_dir, exist_ok=True)
    if pc.use_lora:
        merged_model = {}
        lora_state = model.state_dict()
        for k, v in lora_state.items():
            if 'lora' in k:      # 只挑带 lora 的权重
                merged_model[k] = v
        torch.save(merged_model, os.path.join(cur_save_dir, 'adapter_model.bin'))
    else:
        model.save_pretrained(cur_save_dir)


def evaluate_model(model, dev_dataloader):
    """验证集平均损失。生成任务没有现成的 F1,先用 loss 看趋势。"""
    model.eval()
    total_loss, n = 0.0, 0
    with torch.no_grad():
        for batch in dev_dataloader:
            loss = model(input_ids=batch['input_ids'].to(dtype=torch.long, device=pc.device),
                         labels=batch['labels'].to(dtype=torch.long, device=pc.device)).loss
            total_loss += float(loss)
            n += 1
    model.train()
    return total_loss / max(1, n)


def model2train():
    model = AutoModel.from_pretrained(pc.pre_model, trust_remote_code=True)
    tokenizer = AutoTokenizer.from_pretrained(pc.pre_model, trust_remote_code=True)

    if pc.use_lora:
        config = LoraConfig(task_type=TaskType.CAUSAL_LM,
                            inference_mode=False,
                            r=pc.lora_rank,
                            lora_alpha=pc.lora_alpha,
                            lora_dropout=pc.lora_dropout,
                            target_modules=['query_key_value'])
        model = get_peft_model(model, config)
        model.print_trainable_parameters()   # 占比应当远小于 1%

    # 半精度上卡;LoRA 层单独拉回 float32,低秩矩阵数值小,fp16 容易下溢
    model = model.half().to(pc.device)
    model.config.use_cache = False
    if pc.use_lora:
        for name, param in model.named_parameters():
            if 'lora' in name.lower():
                param.data = param.data.to(torch.float32)

    no_decay = ['bias', 'LayerNorm.weight']
    optimizer_grouped_parameters = [
        {'params': [p for n, p in model.named_parameters()
                    if not any(nd in n for nd in no_decay) and p.requires_grad],
         'weight_decay': pc.weight_decay},
        {'params': [p for n, p in model.named_parameters()
                    if any(nd in n for nd in no_decay) and p.requires_grad],
         'weight_decay': 0.0},
    ]
    optimizer = torch.optim.AdamW(optimizer_grouped_parameters, lr=pc.learning_rate)

    train_dataloader, dev_dataloader = get_data()
    # 有梯度累积时,「多少步更新一次」才是调度器该看的步数
    num_update_steps_per_epoch = max(
        1, len(train_dataloader) // pc.gradient_accumulation_steps)
    max_train_steps = pc.epochs * num_update_steps_per_epoch
    warm_steps = int(pc.warmup_ratio * max_train_steps)
    lr_scheduler = get_scheduler(name='linear',
                                 optimizer=optimizer,
                                 num_warmup_steps=warm_steps,
                                 num_training_steps=max_train_steps)

    print('每轮更新 %d 次,共 %d 次,预热 %d 次'
          % (num_update_steps_per_epoch, max_train_steps, warm_steps))

    loss_list, global_step, tic_train = [], 0, time.time()
    for epoch in range(1, pc.epochs + 1):
        for batch_idx, batch in enumerate(tqdm(train_dataloader, desc='epoch %d' % epoch)):
            # labels 一起传进去,损失由模型内部算,-100 的位置自动跳过
            loss = model(
                input_ids=batch['input_ids'].to(dtype=torch.long, device=pc.device),
                labels=batch['labels'].to(dtype=torch.long, device=pc.device)).loss
            loss_list.append(float(loss.detach()))

            # 除以累积步数:不除的话等效学习率会被放大 8 倍
            (loss / pc.gradient_accumulation_steps).backward()

            if (batch_idx + 1) % pc.gradient_accumulation_steps == 0:
                optimizer.step()
                lr_scheduler.step()
                optimizer.zero_grad()
                global_step += 1

                if global_step % pc.logging_steps == 0:
                    time_diff = time.time() - tic_train
                    print('step %d, epoch %d, loss %.5f, speed %.2f step/s'
                          % (global_step, epoch, sum(loss_list) / len(loss_list),
                             pc.logging_steps / time_diff))
                    tic_train = time.time()

                if global_step % pc.save_freq == 0:
                    save_model(model, os.path.join(pc.save_dir, 'model_%d' % global_step))

        dev_loss = evaluate_model(model, dev_dataloader)
        print('epoch %d 结束,dev loss = %.5f' % (epoch, dev_loss))
        save_model(model, os.path.join(pc.save_dir, 'model_epoch_%d' % epoch))

    print('训练结束')


if __name__ == '__main__':
    model2train()
有一处和前面三页完全不同:损失不用自己算。把 labels 一起传给模型,它内部就把 -100 的位置跳过了,返回的 .loss 直接可以 backward。前面 PET 那套 mlm_loss 是因为损失只在 mask 位置上算,标准接口做不到,才要手写。
存盘只存那 367 万个数
save_model() 里遍历 state_dict(),只挑名字里带 lora 的权重存下来。存盘文件十几 MB,不是十几 GB。
这带来一个容易忽略的约束:适配器和底座是绑定的。用 ChatGLM-6B 训出来的适配器,接到别的模型上形状对不上;就算形状凑巧对得上,学到的修正也是针对那个底座的权重分布的,接过去只会添乱。存适配器时务必把底座的名称和版本一起记下来。
输出必须过一道闸
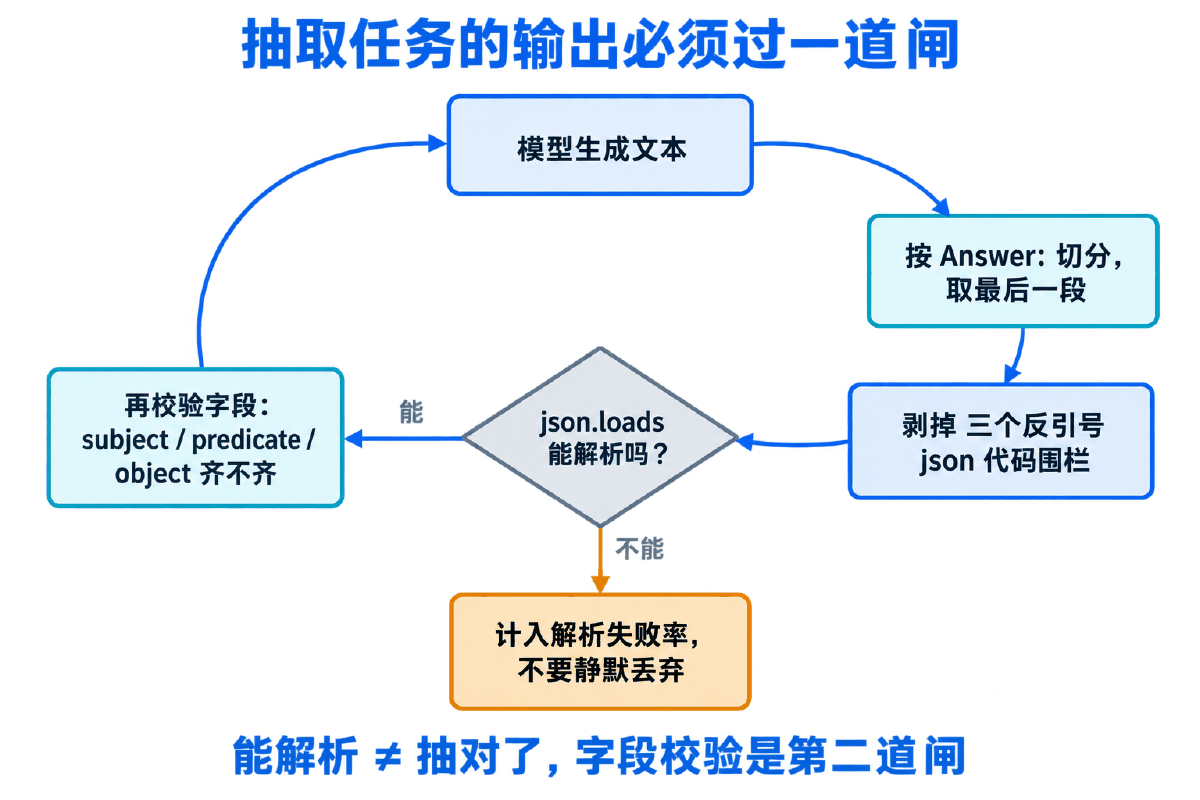
生成式模型返回的是文本。「能解析」和「抽对了」是两件事,所以设两道闸:
| 闸 | 检查什么 | 拦不住会怎样 |
|---|---|---|
| 第一道 | json.loads 能不能过 | 下游拿到一段自然语言,类型错误直接抛到调用方 |
| 第二道 | 结构与字段是否齐全 | JSON 合法但缺 object 字段,入库时才发现 |
两道闸之前还有两步预处理:按 Answer: 切出模型写的那段(模型常把整个工单复读一遍),剥掉 ```json 代码围栏。
# -*- coding:utf-8 -*-
"""加载 LoRA 适配器做推理,并把输出过一道解析闸。

生成式模型返回的是一段文本,不是一个类别。
「能解析」和「抽对了」是两件事,所以这里设两道闸:
① json.loads 能不能过;② 字段齐不齐。两道都记失败率,不要静默丢弃。
"""
import json
import os
import re
from typing import List

CODE_FENCE = re.compile(r'^```(?:json)?\s*|\s*```$', re.MULTILINE)
REQUIRED_SPO_KEYS = {'subject', 'predicate', 'object'}


def load_model(adapter_dir: str):
    """底座 + 适配器。底座只加载一次,适配器可以随时换成另一个业务的。

    torch / transformers / peft 都在函数内部导入:这样没装深度学习环境的机器
    也能直接跑本文件底部的解析闸自检。
    """
    from peft import PeftModel
    from transformers import AutoModel, AutoTokenizer

    from glm_config import ProjectConfig

    pc = ProjectConfig()
    tokenizer = AutoTokenizer.from_pretrained(pc.pre_model, trust_remote_code=True)
    model = AutoModel.from_pretrained(pc.pre_model, trust_remote_code=True)
    model = PeftModel.from_pretrained(model, adapter_dir)
    # merge_and_unload 把 BA 合并回原权重,推理不再多走一条支路,延迟回到底座水平。
    # 代价:合并后就换不了适配器了,要多任务共存就别合并
    model = model.merge_and_unload()
    return model.half().to(pc.device).eval(), tokenizer


def _device():
    from glm_config import ProjectConfig

    return ProjectConfig().device


def strip_fence(text: str) -> str:
    return CODE_FENCE.sub('', text.strip()).strip()


def parse_answer(raw: str, task: str = 'spo'):
    """把模型输出解析成结构化结果,返回 (ok, 结果或失败原因)。"""
    # ① 只要 Answer: 之后那一段。模型常把整个提示复读一遍
    if 'Answer:' in raw:
        raw = raw.split('Answer:')[-1]
    body = strip_fence(raw)

    # ② 第一道闸:能不能解析成 JSON
    try:
        data = json.loads(body)
    except json.JSONDecodeError as e:
        return False, 'JSON 解析失败: %s | 原文前 60 字: %s' % (e.msg, body[:60])

    # ③ 第二道闸:结构与字段
    if task == 'spo':
        if not isinstance(data, list):
            return False, '期望 list,实际 %s' % type(data).__name__
        for item in data:
            if not isinstance(item, dict):
                return False, '列表元素不是 dict'
            missing = REQUIRED_SPO_KEYS - set(item)
            if missing:
                return False, '缺字段 %s' % sorted(missing)
    elif task == 'classify':
        if not isinstance(data, list) or not all(isinstance(x, str) for x in data):
            return False, '分类任务期望字符串列表'
    return True, data


def inference(model, tokenizer, contexts: List[str], task='spo', max_new_tokens=300):
    import torch

    device = _device()
    results, fail_parse, fail_field = [], 0, 0
    with torch.no_grad():
        for context in contexts:
            ids = tokenizer.encode(context, return_tensors='pt').to(device)
            out = model.generate(input_ids=ids,
                                 max_new_tokens=max_new_tokens,
                                 do_sample=False)   # 抽取任务别采样,要可复现
            raw = tokenizer.decode(out[0], skip_special_tokens=True)
            ok, data = parse_answer(raw, task)
            if not ok:
                if 'JSON 解析失败' in str(data):
                    fail_parse += 1
                else:
                    fail_field += 1
            results.append({'ok': ok, 'result': data, 'raw': raw})
    total = max(1, len(contexts))
    print('解析失败率 %.1f%%,字段校验失败率 %.1f%%'
          % (100 * fail_parse / total, 100 * fail_field / total))
    return results


if __name__ == '__main__':
    # 不依赖模型也能验证解析闸本身是对的
    cases = [
        ('```json\n[{"predicate": "主演", "subject": "霸王别姬", "object": "张国荣"}]\n```', True),
        ('Answer: [{"predicate": "主演", "subject": "霸王别姬", "object": "张国荣"}]', True),
        ('[{"predicate": "主演", "subject": "霸王别姬"}]', False),      # 缺 object
        ('[{"predicate": "主演", "subject": "霸王别姬",', False),        # 被截断
        ('好的,我来帮你抽取:主演是张国荣', False),                      # 根本没输出 JSON
    ]
    for raw, expect in cases:
        ok, data = parse_answer(raw, 'spo')
        assert ok == expect, raw
        print('%s  %s' % ('通过' if ok else '拦下', data if ok else data))
    print('\n解析闸自检通过:5 条样例的判定与预期一致')
这个文件把重依赖都放进了函数内部,所以不装 torch 也能直接跑它的解析闸自检:五条样例分别覆盖「正常带围栏」「带 Answer 前缀」「缺字段」「被截断」「根本没输出 JSON」,判定与预期一致才算过。
max_target_seq_len 太小把答案截了,后者是模型没学会输出完整结构。混在一起记成「失败」,就丢掉了定位信息。两个比例分开打日志,并且把失败样本的原文留下来。
一个底座挂多份适配器
适配器 14 MB 一份,底座 11.5 GB 一份。于是部署方式变了:底座只装一份,每个业务各自一个适配器,按请求切换。
# -*- coding:utf-8 -*-
"""一个底座挂多个适配器:显存账与切换策略,纯标准库,可直接运行。

LoRA 真正改变上线方式的地方在这里:
底座只装一份,每个业务各自一个十几 MB 的适配器,按请求切。
前提是**不要 merge_and_unload**——合并了就换不回来了。
"""

BASE_GB = 11.5          # ChatGLM-6B float16 权重约 11.5 GB
ADAPTER_MB = 14.0       # rank=8 时适配器约 14 MB


class AdapterRegistry:
    """把「哪个业务用哪个适配器」这件事管起来,不要散在 if-else 里。"""

    def __init__(self):
        self._adapters = {}
        self._active = None

    def register(self, name: str, path: str, note: str = ''):
        if name in self._adapters:
            raise ValueError('适配器 %s 已注册,换个名字或先 unregister' % name)
        self._adapters[name] = {'path': path, 'note': note}

    def unregister(self, name: str):
        self._adapters.pop(name, None)
        if self._active == name:
            self._active = None

    def activate(self, name: str):
        """真实代码里对应 model.set_adapter(name)。"""
        if name not in self._adapters:
            raise KeyError('未注册的适配器: %s' % name)
        self._active = name
        return self._adapters[name]['path']

    @property
    def active(self):
        return self._active

    def memory_gb(self):
        """底座一份 + 每个适配器一份。"""
        return BASE_GB + len(self._adapters) * ADAPTER_MB / 1024

    def table(self):
        rows = [('业务', '适配器路径', '备注')]
        for name, info in self._adapters.items():
            rows.append((name, info['path'], info['note']))
        return rows


if __name__ == '__main__':
    reg = AdapterRegistry()
    reg.register('comment_cls', './checkpoints/cls/model_epoch_2', '评论分类')
    reg.register('spo_extract', './checkpoints/spo/model_epoch_2', '三元组抽取')
    reg.register('title_gen', './checkpoints/title/model_epoch_3', '标题生成')

    for row in reg.table():
        print('%-14s %-40s %s' % row)

    print('\n当前激活:', reg.active)
    path = reg.activate('spo_extract')
    print('切到 spo_extract ->', path)
    assert reg.active == 'spo_extract'

    # 重名直接拦住,不要覆盖别人的适配器
    try:
        reg.register('spo_extract', './other')
    except ValueError as e:
        print('\n重名被拦住:', e)

    # 显存账
    print('\n适配器数   显存占用')
    for n in (1, 3, 10, 50):
        r = AdapterRegistry()
        for i in range(n):
            r.register('task_%d' % i, './ckpt/%d' % i)
        print('%-10d %.3f GB' % (n, r.memory_gb()))

    r50 = AdapterRegistry()
    for i in range(50):
        r50.register('t%d' % i, './c/%d' % i)
    assert r50.memory_gb() < BASE_GB + 1
    print('\n50 个业务共存,比单独部署 50 份 6B 模型省了 %.0f GB' % (50 * BASE_GB - r50.memory_gb()))

    # 合并与不合并的取舍
    print('\n%-22s %-16s %s' % ('策略', '推理延迟', '能否切换适配器'))
    print('%-22s %-16s %s' % ('merge_and_unload', '与底座相同', '不能,已经焊死'))
    print('%-22s %-16s %s' % ('保留适配器', '略高(多一条支路)', '能,set_adapter 即可'))
    print('\n单业务高并发选合并;多业务共用一张卡选保留。')
| 适配器数 | 显存占用 | 对照:独立部署 |
|---|---|---|
| 1 | 11.51 GB | 11.5 GB |
| 10 | 11.64 GB | 115 GB |
| 50 | 12.18 GB | 575 GB |
50 个业务共存,比独立部署省下五百多 GB 显存。前提是不要调 merge_and_unload()——合并之后适配器就焊进原权重了,换不回来。
合并还是不合并
| 策略 | 推理延迟 | 能否切换适配器 | 适用 |
|---|---|---|---|
merge_and_unload() | 与底座相同 | 不能 | 单业务、高并发、延迟敏感 |
| 保留适配器 | 略高(多一条支路) | 能 | 多业务共用一张卡 |
合并的数学基础是 W' = W + (alpha/r)·B·A——把支路的贡献直接加进原权重,前向就只剩一次矩阵乘法。这一步是等价变换,不损失精度(半精度下会有极小的舍入差异)。
上线前的三项检查
- 适配器目录存在且能加载。 路径写错时 peft 的报错不够直白,先自己判一次。
- 提示模板与训练时逐字一致。 调的是同一个
build_context()函数,不是另抄一份。 - 兜底值类型正确。 生成失败、解析失败时返回空列表而不是抛异常,别让上游崩在一条脏数据上。
05骨架模板
从适配器目录到一个可调用的函数
# -*- coding:utf-8 -*-
"""上线骨架:从适配器目录到一个可调用的函数,四个 TODO 填完即可。

把「加载 -> 拼提示 -> 生成 -> 解析 -> 兜底」串成一条链,
每一环都留了失败出口,不让异常直接抛到调用方。
"""
import json
import os

# TODO-1: 底座路径
BASE_MODEL = os.environ.get('GLM_BASE', './ChatGLM-6B')
# TODO-2: 适配器目录
ADAPTER_DIR = os.environ.get('GLM_ADAPTER', './checkpoints/ptune/model_epoch_2')
# TODO-3: 与训练时逐字一致的提示模板
SYSTEM = '你现在是一个很厉害的阅读理解器,严格按照人类指令进行回答。'
INSTRUCTION = '找到句子中的三元组信息并输出成json给我:'
# TODO-4: 兜底返回值。宁可返回空结果,也不要把异常抛给上游
FALLBACK = []


def build_context(sentence: str) -> str:
    return ('Instruction: %s\nInput: %s\n\n%s\nAnswer: '
            % (SYSTEM, INSTRUCTION, sentence))


def load(base=BASE_MODEL, adapter=ADAPTER_DIR, merge=True):
    """返回 (model, tokenizer)。merge=True 延迟更低但不能再换适配器。"""
    from peft import PeftModel
    from transformers import AutoModel, AutoTokenizer

    tokenizer = AutoTokenizer.from_pretrained(base, trust_remote_code=True)
    model = AutoModel.from_pretrained(base, trust_remote_code=True)
    model = PeftModel.from_pretrained(model, adapter)
    if merge:
        model = model.merge_and_unload()
    return model.half().cuda().eval(), tokenizer


def extract(model, tokenizer, sentence: str, max_new_tokens=300):
    """一条句子进,结构化结果出。任何一环失败都返回 FALLBACK 并记日志。"""
    import torch

    context = build_context(sentence)
    try:
        with torch.no_grad():
            ids = tokenizer.encode(context, return_tensors='pt').cuda()
            out = model.generate(input_ids=ids,
                                 max_new_tokens=max_new_tokens,
                                 do_sample=False)
            raw = tokenizer.decode(out[0], skip_special_tokens=True)
    except Exception as e:
        print('[generate 失败] %s | 句子: %s' % (e, sentence[:30]))
        return FALLBACK

    body = raw.split('Answer:')[-1].strip()
    if body.startswith('```'):
        body = body.strip('`')
        body = body[4:] if body.lower().startswith('json') else body
    try:
        data = json.loads(body.strip())
    except json.JSONDecodeError as e:
        # 记原文,不要只记「解析失败」——排查时全靠这一行
        print('[解析失败] %s | 原文: %s' % (e.msg, body[:80]))
        return FALLBACK
    return data


def health_check():
    """上线前的三项检查,任何一项不过就别放量。"""
    problems = []
    if not os.path.isdir(ADAPTER_DIR):
        problems.append('适配器目录不存在: %s' % ADAPTER_DIR)
    if 'Answer: ' not in build_context('测试'):
        problems.append('提示模板与训练时不一致')
    if not isinstance(FALLBACK, (list, dict)):
        problems.append('兜底值类型不对,上游会崩')
    return problems


if __name__ == '__main__':
    print('提示模板:')
    print(repr(build_context('《霸王别姬》是由张国荣主演的一部电影')))
    problems = health_check()
    if problems:
        print('\n上线前检查未通过:')
        for p in problems:
            print('  -', p)
    else:
        print('\n上线前检查通过')
| TODO | 填什么 | 注意 |
|---|---|---|
| TODO-1 底座 | 与训练时完全相同的模型路径 | 底座换了,适配器学到的修正就不对了 |
| TODO-2 适配器 | checkpoint 目录 | 存盘时把底座名称和版本一起记下来 |
| TODO-3 提示模板 | 与训练逐字一致的三段式 | 直接复用数据构造脚本里的那个函数最稳 |
| TODO-4 兜底值 | 空列表或空字典 | 宁可返回空结果,也不要把异常抛给上游 |
骨架把「加载 → 拼提示 → 生成 → 解析 → 兜底」串成一条链,每一环都留了失败出口:
generate抛异常(显存不足、输入超长)→ 记日志,返回兜底值。- 解析失败 → 把原文记进日志,返回兜底值。只记「解析失败」四个字,事后什么也查不了。
health_check()在放量前跑一遍,三项不过就别上。
几个值该怎么定
| 参数 | 建议 | 理由 |
|---|---|---|
do_sample | False | 抽取和分类要可复现。采样会让同一条输入两次结果不同,没法排查也没法回归测试 |
max_new_tokens | 按 target 长度分布定 | 给小了答案被截,给大了模型话痨时白烧算力 |
r / alpha | 与训练时完全一致 | 从适配器目录加载时 peft 会读配置文件,但手动构造 LoraConfig 时容易写错 |
| 是否 merge | 单业务合并,多业务保留 | 见上一节的对照表 |
从这一讲带走的四条
- 底座冻结、只训支路,是 62 亿参数模型能在单卡上微调的前提。
- 可训练参数占比那一行输出必须看,它是 LoRA 真正生效的唯一证据。
- 生成式模型的输出必须过校验闸,而且解析失败与字段失败要分开统计。
- 一个底座挂多份适配器,让「一个业务一个模型」的部署成本从几十 GB 降到十几 MB。
06易错点汇总
按「配置 / 精度显存 / 训练循环 / 上线」四类归并
⚠️ 一、LoRA 配置
target_modules写的名字匹配不上任何一层。 peft 不会报错,只是一个 LoRA 层都没插进去。训练照跑、损失照降(因为底座没冻结时是全参在动),但存出来的适配器是空的。print_trainable_parameters()那一行必须看,正常是 0.06% 左右。- 换底座没换名单。 ChatGLM 把 Q/K/V 合成了
query_key_value,LLaMA 系是分开的q_proj/k_proj/v_proj。照抄别人的配置会静默失效。 task_type写错。 生成任务要CAUSAL_LM,分类任务要SEQ_CLS。写错会让 peft 包上错误的输出头。- 训练时
inference_mode=True。 LoRA 的 dropout 被关掉,小数据集上更容易过拟合。 - 调大
r却不动alpha。 缩放系数alpha/r会同步变小,两个方向互相抵消。想真正加大容量就让alpha跟着调,保持比值不变。 - 推理时手写的
LoraConfig与训练时不一致。 从适配器目录加载时 peft 会读配置文件,但手动构造时r/alpha写错,缩放就错了。
⚠️ 二、精度与显存
- LoRA 层留在 float16。 低秩矩阵数值小、B 又从 0 起步,梯度很容易下溢成 0——这一层彻底不学了,而且没有任何报错。底座半精度没问题,LoRA 层要单独拉回 float32。
- 忘了
model.config.use_cache = False。 训练时开着 cache 会和梯度检查点冲突,报错信息很难对应到根因。 - 以为 LoRA 能让显存降到零头。 它省的是优化器状态和梯度的显存,底座的 11.5 GB 权重照样要装进去。单卡装不下底座时,LoRA 也救不了。
- 把
batch_size往大了调。 6B 模型半精度加上激活值,batch 给到个位数就顶天了。要更大的等效 batch 就用梯度累积。
⚠️ 三、训练循环
- 梯度累积时损失没除以累积步数。 累加起来的梯度是 8 倍,等效学习率被放大 8 倍,损失容易发散。反向前写
(loss / accum).backward()。 - 调度器的总步数按 batch 数算。 有梯度累积时,
max_train_steps要先除以gradient_accumulation_steps。不除就多算了 8 倍,学习率在训练走到八分之一时就衰减到 0,后面全白跑。 - 累积没攒满就
zero_grad()。 清零的位置必须在optimizer.step()之后,而不是每个 batch 开头。放错地方,累积等于没做。 - 把
labels自己算损失。 生成式模型把labels一起传进去就行,内部会跳过-100。自己动手反而容易把偏移算错。 - epochs 照抄 BERT 的 10。 生成式微调很容易过拟合,本讲配置是 2。轮数给多了,模型会开始背训练集里的具体答案。
- 学习率照抄 5e-5。 只训 0.06% 的参数,学习率要比全参微调大一个量级,本讲用 1e-4。太小会表现为「损失几乎不动」。
⚠️ 四、上线
- 适配器与底座对不上。 适配器是绑定底座训出来的,换个模型就算形状凑巧匹配,学到的修正也不对。存盘时把底座名称与版本一起记下来。
- 多业务部署还调了
merge_and_unload()。 合并之后适配器焊进原权重,再也换不回来,多适配器共存的方案直接作废。单业务高并发才合并。 - 推理用了和训练不同的提示模板。 差一个空格就是另一场考试。直接复用数据构造脚本里的那个函数,不要另抄。
- 解析失败静默丢弃。 失败样本的原文必须留下来。只记「失败」两个字,事后完全无法定位是截断问题还是格式问题。
- 解析失败与字段校验失败混在一起统计。 前者多半是
max_target_seq_len太小,后者是模型没学会完整结构。两个比例分开记才有定位价值。 - 推理开着
do_sample=True。 抽取任务同一条输入两次结果不同,没法回归测试也没法排查。 - 忘了模型会复读工单。 不按
Answer:切,整段提示会混进解析结果里。
07自测题
点击题目展开答案;这 10 题过了,LoRA 从原理到上线就通了
用一个公式概括 LoRA 的前向过程,并说明每一项。
h = Wx + (alpha/r)·B·A·x。W 是冻结的原权重;A 把输入从 4096 维压到 r=8 维;B 再放回 12288 维;alpha/r 是缩放系数(本讲 32/8 = 4)。模型结构没变,只是旁边并联了一条支路。
为什么 B 初始化为 0,A 用随机初始化?
B 为 0 时 BAx = 0,接上适配器那一刻输出与原底座逐元素相同,训练是在原模型基础上逐步叠加修正,而不是先注入噪声再花很多步消掉。两个都随机初始化会一上来把模型带偏。A 必须随机,否则 A、B 都是 0 就永远没有梯度。
算一遍:ChatGLM-6B 上 r=8 时可训练参数是多少?占比多少?
query_key_value 是 4096 × 12288。A 是 4096×8 = 32768,B 是 8×12288 = 98304,单层 131072;28 层共 3,670,016。占 61.7 亿的 0.0594%。适配器 float32 存盘约 14 MB。
把 r 从 8 调到 32 而 alpha 保持 32,会发生什么?
参数量翻 4 倍,但缩放系数从 32/8 = 4 掉到 32/32 = 1,两个方向互相抵消。想真正加大容量要让 alpha 跟着调,保持 alpha/r 不变,常见配比是 alpha = 2r 或 4r。
target_modules 写成 ['q_proj'] 去训 ChatGLM,会怎样?
匹配不上任何一层,peft 不会报错,一个 LoRA 层都没插进去。ChatGLM 把 Q/K/V 合成了 query_key_value。判断依据是 print_trainable_parameters() 的输出——正常应当是 0.06% 左右,打出 0 或 100% 都说明配置有问题。
底座已经 half() 了,为什么还要把 LoRA 层拉回 float32?
低秩矩阵数值小、B 从 0 起步、梯度更小,float16 的最小正规数在 6e-5 量级,再小就下溢成 0——这一层彻底不学了,而且没有任何报错。底座冻结不需要梯度,半精度无所谓;LoRA 层是唯一要学的东西,精度不能省。
梯度累积有两处必须配套改,是哪两处?
① 反向前把损失除以累积步数:(loss / accum).backward(),否则梯度是 8 倍、等效学习率被放大 8 倍。② 调度器的 max_train_steps 要按更新次数算(先除以 gradient_accumulation_steps),否则学习率在训练走到八分之一时就衰减到 0。
为什么这一页的学习率是 1e-4,而 BERT 那几页是 5e-5?
只训练 0.06% 的参数,可调整的自由度少得多,学习率要比全参微调大一个量级才学得动。学习率照抄 5e-5 的典型表现是损失几乎不动。同理 epochs 也从 10 降到 2,生成式微调更容易过拟合。
merge_and_unload() 做了什么?什么时候不该用?
把 (alpha/r)·B·A 加进原权重(W' = W + ΔW),前向只剩一次矩阵乘法,推理延迟回到底座水平。多业务共用一张卡时不该用——合并后适配器焊死,再也换不回来,多适配器共存方案作废。单业务高并发、延迟敏感才合并。
生成式模型的输出为什么要过两道闸?两道分别查什么?
因为「能解析」和「抽对了」是两件事。第一道 json.loads 查能不能解析;第二道查结构与字段是否齐全(subject/predicate/object)。两道之前还要先按 Answer: 切出模型写的那段、剥掉代码围栏。两个失败率要分开统计:解析失败多半是长度截断,字段失败是模型没学会完整结构。
附术语表
| 术语 | 英文原形 | 含义 |
|---|---|---|
| 低秩适配 | LoRA Low-Rank Adaptation | 冻结原权重,并联两个低秩矩阵承载微调增量,只训这一小部分参数 |
| 参数高效微调 | PEFT Parameter-Efficient Fine-Tuning | 只训练极小一部分参数的微调方法族;LoRA 是其中最常用的一种 |
| 秩 | rank,r | 低秩矩阵的中间维度,本讲取 8;参数量与它成正比 |
| 缩放分子 | lora_alpha | 与 r 一起决定缩放系数 alpha/r,本讲 32/8 = 4 |
| 目标模块 | target_modules | 要挂支路的层名单;匹配不上不会报错,只是一层都没插 |
| 适配器 | adapter | 训练产出的 LoRA 权重包,r=8 时约 14 MB,与底座绑定 |
| 权重合并 | merge_and_unload | 把支路贡献加回原权重;延迟回到底座水平,但从此换不了适配器 |
| 梯度累积 | gradient accumulation | 攒若干步梯度再更新一次,用时间换显存;损失要先除以累积步数 |
| 半精度 | float16 / half | 用 16 位浮点存权重;LoRA 层需单独保留 float32 以防梯度下溢 |
| 缓存开关 | use_cache | 生成时的 KV 缓存;训练阶段要关掉,否则与梯度检查点冲突 |
| 贪心解码 | do_sample=False | 每步取概率最高的 token;抽取类任务必须用它以保证可复现 |
| 解析闸 | output validation | 对生成文本做 JSON 解析与字段校验的两道检查,失败率要分开统计 |