损失函数与反向传播
损失函数把「这次错得多离谱」压成一个数字,反向传播把这个数字沿着网络倒着摊回每一个参数,算出各自该负多少责任。两件事合起来只回答一个问题:下一步该往哪边调、调多少。注意它们都不改参数。
30″30 秒看懂损失与反向传播
接着上一页的公司比喻往下走:老板拍完板,结果送到客户手里,客户退回来一张批改过的卷子。卷子上圈着一个刺眼的数字——这次总共扣了 12 分。接下来公司要做的,不是马上换人,而是先把这 12 分摊回到每一级:老板担 6 分、总监担 4 分、主管担 2 分。
把一整张卷子的对错概括成一个数字,这件事叫损失函数(loss function)。把这个数字沿着汇报链条倒着摊回每个人头上,这件事叫反向传播(back propagation)。摊到某个人头上的那份责任,就是他的梯度。
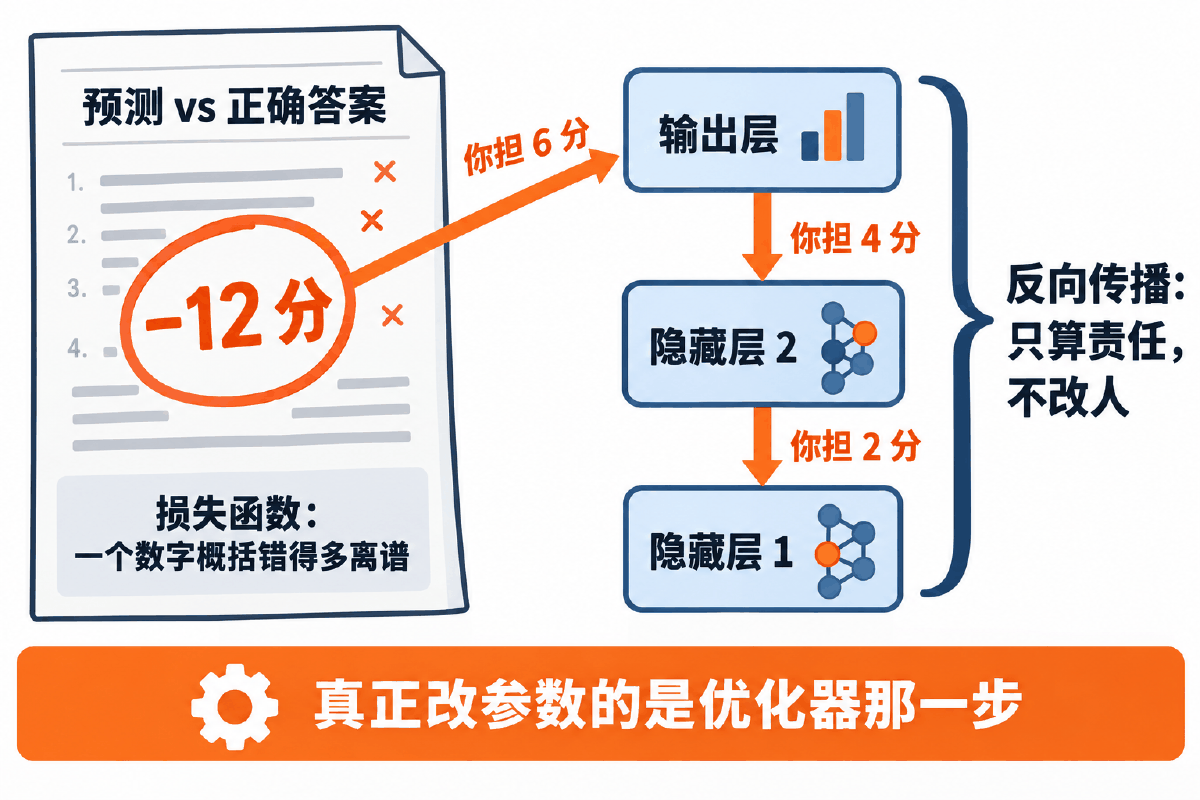
图里右侧那个大括号写着一句必须记死的话:反向传播只算责任,不改人。它算完 6 分 / 4 分 / 2 分就收工了,谁都没被调岗。真正按责任大小去调整每个人的,是紧随其后的优化器那一步。这条分工贯穿整页。
| 比喻里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 客户退回的卷子 | 预测值 vs 真实值 | 网络输出 y_pred 和标签 y_true 摆在一起比对 |
| 卷面总扣分 | 损失 loss | 一个标量;越大说明这次错得越离谱 |
| 扣分怎么算 | 损失函数 | 分类用交叉熵,回归用 MSE / MAE / SmoothL1,选错了整个训练方向就偏了 |
| 「你担 6 分」 | 梯度 .grad | 损失对某个参数的偏导数,即「这个参数该为当前误差负多少责任」 |
| 逐级往回摊 | 反向传播 / 链式法则 | 从输出层往输入层,把各段导数连乘着传回去 |
| 按责任调整每个人 | optimizer.step() | 唯一真正改参数的一步 |
| 清掉上次的账 | optimizer.zero_grad() | 梯度默认累加,不清零这次就会带着上次的旧账算 |
| 一批卷子批一次 | 一次 iteration | 一个 batch 走完「前向 → 算损失 → 清零 → 反向 → 更新」 |
| 全班卷子批完一轮 | 一个 epoch | 全部样本完整过一遍 |
loss.backward() 做完之后,模型里每个参数的 .grad 被填上了,而参数本身一个数都没变;真正动手的是 optimizer.step()。所以训练循环的五步顺序是死的:前向 → 算损失 → 清零 → 反向 → 更新,少一步或换一次顺序,都会得到一个不报错但永远学不好的模型。
backward() 只能对标量调用,因为梯度回答的是「这个数变化一点点,各参数各负多少责任」,而「这个数」必须先是一个数。所以任何损失函数的最后一步,都是把一批样本的误差汇总成一个标量。
01概念:给分、摊责任,以及训练的三个计量单位
损失函数的定位与别名、前向与反向的分工,还有 epoch / batch / iteration 到底怎么换算
1.1 损失函数是什么
损失函数用来衡量模型当前这套参数的质量,衡量方式很朴素:拿网络输出和真实答案比,把差异折算成一个数。这个数越小,说明这套参数越好。整个训练过程要做的事,就是把这个数变小。
同一个东西在不同资料里有四个名字,看到别慌,说的都是它:
| 叫法 | 英文 | 侧重点 |
|---|---|---|
| 损失函数 | loss function | 单个样本的预测与真实值之间的差异 |
| 代价函数 | cost function | 整个训练集(或一批)损失的平均,规模更大 |
| 目标函数 | objective function | 优化过程要最小化的那个东西,可能还包含正则项 |
| 误差函数 | error function | 强调「和正确答案的偏差」这层含义 |
工程实践中这四个词基本混用。真正要区分清楚的不是名字,而是「这个任务该用哪一个具体的损失函数」——分类和回归的选法完全不同,这是 02 节的主线。
1.2 前向传播与反向传播的分工
| 对比项 | 前向传播 forward | 反向传播 backward |
|---|---|---|
| 方向 | 输入层 → 隐藏层 → 输出层 | 输出层 → 隐藏层 → 输入层 |
| 在算什么 | 用当前参数算出预测值 | 用链式法则算出每个参数的偏导数 |
| 产出 | 预测值,进而得到 loss | 每个参数的 .grad |
| 改参数吗 | 不改 | 不改 |
| 比喻里是什么 | 一线往上逐级汇报,最后老板拍板 | 卷子扣的分逐级往回摊,算出各自担几分 |
把这两件事和「更新」摆在一起,就是那条五步主循环。其中只有第 ⑤ 步碰了参数:
更新那一步的公式仍然是梯度下降:w ← w − lr × ∂loss/∂w。学习率 lr 太小则每轮挪一点点、训练时间成本高;太大则可能一步跨过最优解,在两侧来回震荡甚至发散。所以学习率往往还要随训练过程动态调整——那是优化器那一页的主题。
1.3 epoch、batch_size、iteration
这三个词天天出现在训练日志里,定义其实极简单:
| 术语 | 定义 | 在比喻里 |
|---|---|---|
| epoch | 全部训练样本完整过一遍,即训练轮次 | 全班的卷子批完一整轮 |
| batch_size | 一次参数更新用多少条样本 | 一次抱多少份卷子上来批 |
| iteration | 用一个 batch 完成一次参数更新的过程 | 批完这一摞,调整一次做法 |
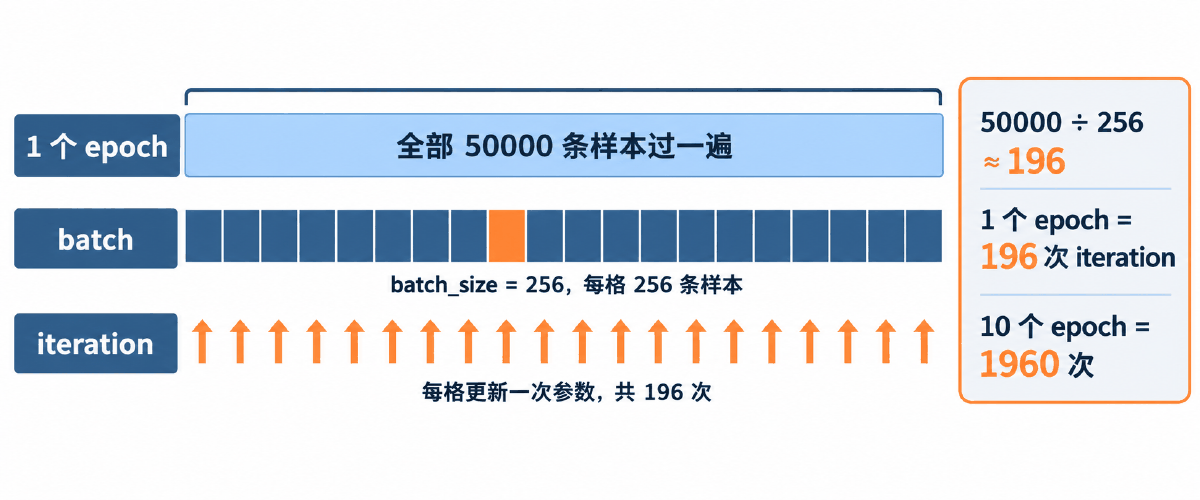
换算只有一条:一个 epoch 的 iteration 数 = 样本总数 ÷ batch_size(除不尽则向上取整,把最后不满的一批也算上)。以图里的数为例:
| 问题 | 算式 | 结果 |
|---|---|---|
| 一个 epoch 要过多少条样本 | — | 50000 条,全部 |
| 训练集能切成几个 batch | 50000 ÷ 256 = 195 余 80 | 196 个(最后一批只有 80 条) |
| 一个 epoch 有几次 iteration | 每个 batch 更新一次 | 196 次 |
| 10 个 epoch 一共更新几次 | 196 × 10 | 1960 次 |
按 batch_size 的取法,梯度下降分成三种,区别只在这一个数上:
| 名称 | batch_size | 一个 epoch 更新几次 | 特点 |
|---|---|---|---|
| 全批量 BGD | 全部样本 | 1 次 | 梯度方向最准,但一个 epoch 才走一步,显存也扛不住 |
| 小批量 Mini-Batch | 通常 16~512 | N/B 向上取整 | 工程上唯一实用的选择,在方向准确度和更新频率之间折中 |
| 随机 SGD | 1 | N 次 | 更新最频繁,但单条样本的梯度方向抖动极大,训练很慢 |
02原理:怎么给分,责任怎么摊回去
分类与回归两条选型路线,链式法则逐步手推,以及梯度消失与爆炸的成因
2.1 分类任务的损失函数
分类任务的输出是「属于每一类的概率」,衡量方式是交叉熵(cross entropy)。它的思想一句话说得完:只盯着正确答案那一格的预测概率,概率越低惩罚越重。
单条样本的损失 = −log( p[正确类别] )
为什么是 −log?看几个数就懂了:
| 正确类别的预测概率 | −log(p) | 含义 |
|---|---|---|
| 1.0(完全确信且答对) | 0 | 不扣分 |
| 0.5 | 约 0.69 | 半信半疑,扣一点 |
| 0.1 | 约 2.30 | 基本答错,重扣 |
| 趋近 0(完全确信但答错) | 趋向 +∞ | 自信地答错,扣分无上限 |
最后一行才是交叉熵的精髓:它对「又错又自信」的惩罚是爆炸式的,这会逼着网络在没把握时把概率摊平,而不是乱赌。
多分类:nn.CrossEntropyLoss
多分类的完整路径是 logits → softmax → 取正确类那一格 → 取负对数 → 一批取平均。PyTorch 把这四步全部打包进了 nn.CrossEntropyLoss(),所以它也常被叫作 softmax 损失。由此推出两条硬规矩:
② 标签必须是
int64 的类别下标,形状 (batch,),取值 0 到 类别数−1。不是 one-hot,也不是 float。
下面这段用纯 Python 把那四步手写一遍,再和官方实现对账,顺便演示「多加一次 softmax」之后损失变成了什么样:
"""CrossEntropyLoss 自带 softmax 的证明,以及手动再加一次 softmax 的后果。

手算路径:
    1) 对 logits 做 softmax,得到每一类的概率 p
    2) 取出真实类别那一格的概率 p[label]
    3) 这一条样本的损失 = -log(p[label])
    4) 一批样本取平均
把这四步写出来,和 nn.CrossEntropyLoss() 的结果对账。
"""
import math

import torch
import torch.nn as nn


def manual_cross_entropy(logits, labels):
    """纯 Python 版交叉熵,只用 math,不借助任何 torch 的损失函数。"""
    losses = []
    for row, label in zip(logits.tolist(), labels.tolist()):
        m = max(row)                                  # 减最大值,防指数溢出
        exps = [math.exp(v - m) for v in row]
        total = sum(exps)
        p_true = exps[label] / total
        losses.append(-math.log(p_true))
    return sum(losses) / len(losses)


def main():
    # 真实值必须是 int64 的类别下标,不是 one-hot,也不是浮点
    y_true = torch.tensor([1, 2], dtype=torch.int64)
    # 预测值是没过任何激活函数的原始分数 logits
    y_pred = torch.tensor([[0.2, 0.6, 0.2],
                           [0.1, 0.8, 0.1]], requires_grad=True)

    official = nn.CrossEntropyLoss()(y_pred, y_true)
    manual = manual_cross_entropy(y_pred.detach(), y_true)

    print('nn.CrossEntropyLoss = %.10f' % official.item())
    print('手算四步          = %.10f' % manual)
    print('两者之差 = %.12f —— 说明这个损失函数内部确实做了 softmax'
          % abs(official.item() - manual))

    # ---------------------------------------------------------- 错误示范
    # 如果模型最后一层已经加了 softmax,再交给 CrossEntropyLoss,
    # 等于把概率当 logits 又压了一次。
    probs = torch.softmax(y_pred.detach(), dim=-1)
    wrong = nn.CrossEntropyLoss()(probs, y_true)
    print('\n先手动 softmax 再进 CrossEntropyLoss = %.10f' % wrong.item())
    print('正确写法 = %.10f' % official.item())
    print('两次 softmax 之后概率被压平,损失数值失真,梯度也被削弱')
    print('压平前的概率分布:', [round(v, 4) for v in probs[0].tolist()])
    print('再压一次之后    :',
          [round(v, 4) for v in torch.softmax(probs, dim=-1)[0].tolist()])

    # ---------------------------------------------------------- 取出预测类别
    # 推理时才需要 softmax,而且只是为了把分数变成好看的概率;
    # 只想知道预测哪一类的话,直接对 logits 取 argmax 就够了。
    print('\nargmax(logits) =', y_pred.argmax(dim=-1).tolist())
    print('argmax(softmax) =', probs.argmax(dim=-1).tolist(),
          '—— softmax 不改变大小顺序')

    # ---------------------------------------------------------- 二分类的对照
    # 二分类换成 sigmoid + BCELoss:预测值必须已经落在 (0,1)
    p = torch.tensor([0.6901, 0.5459, 0.2469], requires_grad=True)
    t = torch.tensor([0., 1., 0.])
    bce = nn.BCELoss()(p, t)
    hand = -sum(ti * math.log(pi) + (1 - ti) * math.log(1 - pi)
                for pi, ti in zip(p.tolist(), t.tolist())) / 3
    print('\nnn.BCELoss = %.10f   手算 = %.10f' % (bce.item(), hand))
    # 若模型最后一层没加 sigmoid,就该用 BCEWithLogitsLoss,它内部会补上


if __name__ == '__main__':
    main()
二分类:nn.BCELoss
只有两类时不需要 softmax,用 sigmoid 把输出压成一个 (0,1) 的概率 ŷ 就够了,损失换成二分类交叉熵:
L = −[ y·log(ŷ) + (1−y)·log(1−ŷ) ]
这个式子是个开关:标签 y=1 时只剩前半截 −log(ŷ),y=0 时只剩后半截 −log(1−ŷ)。两种情况都在说同一件事——正确那一侧的概率越低,扣分越多。
| 场景 | 损失函数 | 网络最后一层 | 标签类型 | 标签形状 |
|---|---|---|---|---|
| 多分类 | nn.CrossEntropyLoss() | 什么都不加 | int64 类别下标 | (batch,) |
| 二分类 | nn.BCELoss() | 必须加 sigmoid | float32 的 0./1. | 与预测值一致 |
| 二分类(推荐) | nn.BCEWithLogitsLoss() | 什么都不加 | float32 的 0./1. | 与预测值一致 |
log(0) 会得到 inf,损失直接变 nan。合起来算能避开这个坑。同理,多分类也不要自己写 log(softmax(x))。
2.2 回归任务的损失函数
回归的输出是一个连续数值,衡量方式就是「差多少」。三个常用选项的区别,不在损失值本身,而在误差变大时惩罚涨得多快:
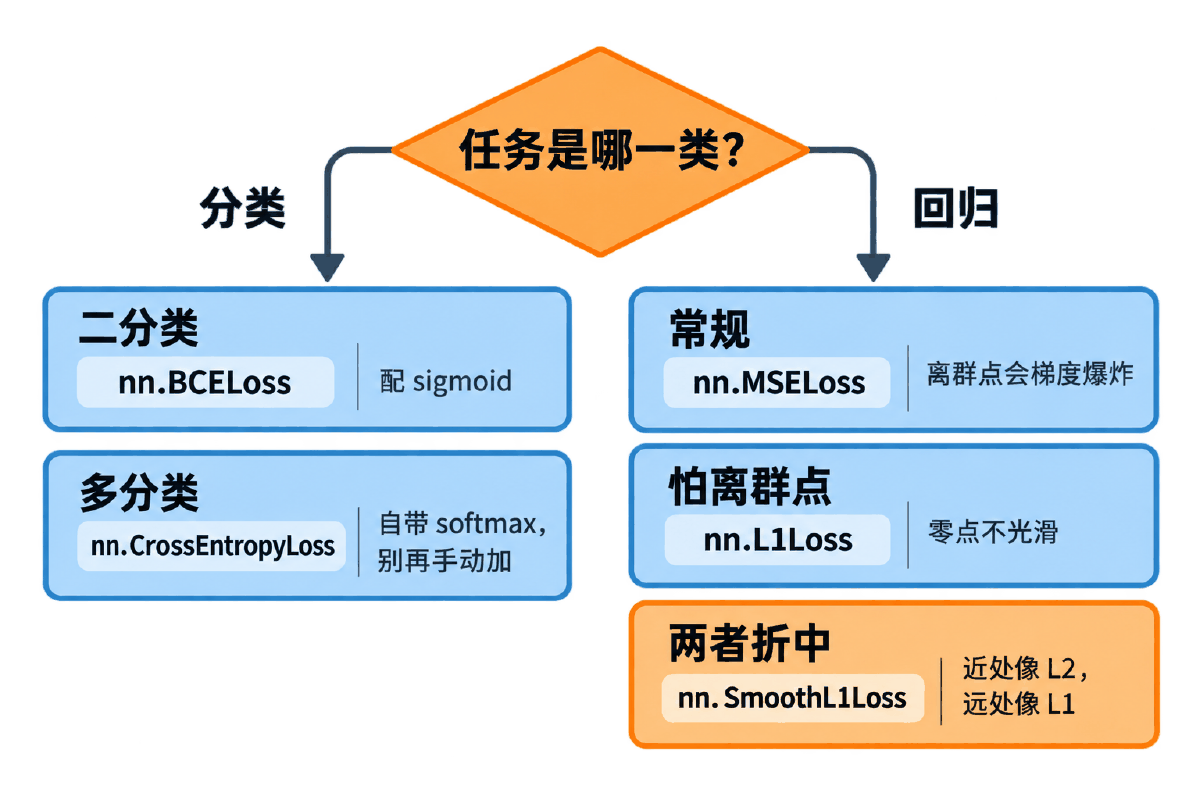
| 损失 | 公式 | 梯度 | PyTorch | 优缺点 |
|---|---|---|---|---|
| MAE(L1) | |ŷ − y| 取均值 | 恒为 ±1 | nn.L1Loss() | 对离群点不敏感,稳;零点不光滑,逼近最优解时会跨过极小值 |
| MSE(L2) | (ŷ − y)² 取均值 | 2×误差,随误差线性增长 | nn.MSELoss() | 处处光滑、收敛快;误差大时梯度容易爆炸,一条标错的样本就能主导整批梯度 |
| Smooth L1 | |误差|<1 时按 L2 算,否则按 L1 算 | 近处随误差变小,远处封顶在 ±1 | nn.SmoothL1Loss() | 两头的好处都要:零点光滑、离群点不炸 |
拿 y_pred = [1.0, 1.0, 1.9]、y_true = [2.0, 2.0, 2.0] 这组数手算一遍(三个误差是 −1、−1、−0.1):
| 损失 | 手算式 | 结果 |
|---|---|---|
| MAE | (1 + 1 + 0.1) ÷ 3 | 约 0.7 |
| MSE | (1 + 1 + 0.01) ÷ 3 | 约 0.67 |
| Smooth L1 | (0.5 + 0.5 + 0.5×0.1²) ÷ 3 | 约 0.335 —— 三个误差都在 ±1 以内,全部走 L2 分支 |
光看这三个数分不出优劣。把误差拉大到 100 再看梯度,差距就出来了:MSE 的梯度是 200,MAE 和 SmoothL1 都只有 1。这就是「离群点会梯度爆炸」的确切含义——不是损失值大,是梯度大到能把整批更新带偏。
"""MSE / MAE / SmoothL1 三条曲线:比损失值更该看的是它们的梯度。

选损失函数其实是在选「误差变大时,惩罚涨得多快」:
    MSE      惩罚按误差平方涨,梯度 = 2·误差,离群点能把梯度顶上天
    MAE      惩罚按误差线性涨,梯度恒为 ±1,稳,但零点处不可导
    SmoothL1 误差小于 1 时像 MSE,大于 1 时像 MAE,两头的好处都要
"""
import torch
import torch.nn as nn


def loss_and_grad(criterion, err):
    """给定一个误差值,返回该损失函数的损失值与对预测值的梯度。"""
    pred = torch.tensor([err], requires_grad=True)
    target = torch.tensor([0.0])
    loss = criterion(pred, target)
    loss.backward()
    return loss.item(), pred.grad.item()


def table():
    mse, mae, smooth = nn.MSELoss(), nn.L1Loss(), nn.SmoothL1Loss()

    print('%8s | %10s %10s | %10s %10s | %10s %10s'
          % ('误差', 'MSE 值', 'MSE 梯度', 'MAE 值', 'MAE 梯度',
             'SL1 值', 'SL1 梯度'))
    for err in (0.1, 0.5, 1.0, 2.0, 5.0, 20.0, 100.0):
        lm, gm = loss_and_grad(mse, err)
        la, ga = loss_and_grad(mae, err)
        ls, gs = loss_and_grad(smooth, err)
        print('%8.1f | %10.2f %10.2f | %10.2f %10.2f | %10.2f %10.2f'
              % (err, lm, gm, la, ga, ls, gs))

    # 看最后一行:误差 100 时 MSE 的梯度是 200,MAE 和 SmoothL1 都只有 1。
    # 一条标错的样本就能让 MSE 主导整批梯度,这就是「离群点梯度爆炸」。


def outlier_effect():
    """同一批数据,只把一条改成离群点,看三种损失各自变化多少。"""
    pred = torch.tensor([1.0, 2.0, 3.0, 4.0])
    clean = torch.tensor([1.1, 2.1, 2.9, 3.9])
    dirty = clean.clone()
    dirty[3] = 100.0                       # 第四条标注错了

    for name, criterion in (('MSE', nn.MSELoss()),
                            ('MAE', nn.L1Loss()),
                            ('SmoothL1', nn.SmoothL1Loss())):
        a = criterion(pred, clean).item()
        b = criterion(pred, dirty).item()
        print('%-9s 干净数据 %8.3f -> 含一条离群点 %10.3f   放大 %8.1f 倍'
              % (name, a, b, b / a))


def zero_point():
    """MAE 在零点不光滑:左右两侧的导数是 -1 和 +1,跳变。"""
    for err in (-0.001, -1e-8, 0.0, 1e-8, 0.001):
        _, g = loss_and_grad(nn.L1Loss(), err)
        print('误差 %12.1e 时 MAE 的梯度 = %+.1f' % (err, g))
    print('梯度不随误差变小而变小,逼近最优解时会在极小值附近来回跨步')

    print()
    for err in (-0.001, -1e-8, 0.0, 1e-8, 0.001):
        _, g = loss_and_grad(nn.SmoothL1Loss(), err)
        print('误差 %12.1e 时 SmoothL1 的梯度 = %+.1e' % (err, g))
    print('SmoothL1 在零点附近梯度跟着误差一起变小,能稳稳停住')


if __name__ == '__main__':
    table()
    print('-' * 60)
    outlier_effect()
    print('-' * 60)
    zero_point()
2.3 反向传播:链式法则一步步摊回去
有了损失这个标量,接下来的问题是:它对每一个参数的偏导数是多少。答案由链式法则给出——复合函数求导,等于把路径上每一段的导数连乘起来。
以一条最短的路径为例。输出层某个权重 w₅ 影响损失的路径是三段:
| 第几段 | 这一段在问什么 | 对应的偏导 |
|---|---|---|
| 第 1 段 | 输出变一点,损失变多少 | ∂E/∂out —— 由损失函数的形式决定 |
| 第 2 段 | 内部状态值变一点,输出变多少 | ∂out/∂net —— 激活函数的导数,sigmoid 是 out(1−out) |
| 第 3 段 | 权重变一点,内部状态值变多少 | ∂net/∂w₅ —— 就是这条连线上游传来的激活值 |
| 合起来 | — | ∂E/∂w₅ = ∂E/∂out × ∂out/∂net × ∂net/∂w₅,三段相乘 |
靠近输入的权重要复杂一点,但只多一条规则:一个中间节点如果同时喂给了多个下游节点,它的责任要把各条路径的贡献加起来。比喻里就是——一个主管同时给两位总监供料,两边的扣分都得算他一份。
路径再长也是这两条规则的重复。4.1 节会拿一个带具体数字的两层网络,把每一步手算出来再和 PyTorch 对账;这里先看它在张量层面的样子:
"""手推一次反向传播,再让 PyTorch 算一遍,两个结果必须对得上。

网络:x(2,5) -> z = x @ w + b -> (2,3),损失用 MSE,真实值全 0。
把链式法则一步步写出来,就知道 autograd 没有魔法。
"""
import torch

torch.manual_seed(42)

x = torch.ones(2, 5)                       # 2 个样本、5 个特征,全设成 1 方便手算
y = torch.zeros(2, 3)                      # 真实值全 0
w = torch.randn(5, 3, requires_grad=True)  # 5 个输入 -> 3 个输出
b = torch.randn(3, requires_grad=True)

# ---------- 前向 ----------
z = x @ w + b
loss = torch.nn.MSELoss()(z, y)
print('loss =', loss.item())

# ---------- 反向(交给 autograd)----------
loss.backward()
print('autograd 给的 w.grad:\n', w.grad)
print('autograd 给的 b.grad:\n', b.grad)

# ---------- 反向(自己推)----------
# MSE: loss = (1/N) * Σ (z - y)^2,这里 N = 2*3 = 6,且 y = 0
#   ∂loss/∂z = (2/N) * (z - y) = z / 3
#   z = x·w + b,所以 ∂z/∂w = x,∂z/∂b = 1
#   链式相乘并对样本维求和:
#      ∇w = xᵀ @ (z/3)
#      ∇b = (z/3) 按样本维求和
grad_z = (2.0 / y.numel()) * (z - y)
manual_w = x.t() @ grad_z
manual_b = grad_z.sum(dim=0)

print('手推 w 的最大误差 = %.10f' % (w.grad - manual_w).abs().max().item())
print('手推 b 的最大误差 = %.10f' % (b.grad - manual_b).abs().max().item())
.grad 是累加的:不清零的话,第 100 次反向拿到的是前 100 次梯度之和,参数会被推到离谱的地方,表现为 loss 先降后暴涨、最后变 nan。这不是缺陷——梯度累加正是显存不够时模拟大 batch 的手段(见 4.3)。既然累加有用,就必须由你显式声明「这一轮重新开始」。3.2 节会把这个累加过程逐次打印出来,数字可以手算核对。
2.4 梯度消失与梯度爆炸
既然反向传播是连乘,那么整条链的命运就由「每一段的倍率」决定:
每段倍率小于 1,连乘之后趋近 0。sigmoid 的导数上限是 0.25,0.25⁵ ≈ 0.00098、0.25¹⁰ ≈ 9.5×10⁻⁷——靠近输入的几层几乎收不到梯度,参数原地不动,表现为 loss 降一点就停住。
每段倍率大于 1,连乘之后放大到溢出。权重初始化过大或学习率过高时,十层连乘就是十次方,1.5¹⁰ ≈ 57.7、1.5²⁰ ≈ 3325,很快超出 float32 的表示范围,loss 直接变 nan。
| 问题 | 典型现象 | 处理手段 |
|---|---|---|
| 梯度消失 | loss 早早停在高位;打印各层梯度范数,前几层比后几层小几个数量级 | 隐藏层换 ReLU;用 He 初始化;加 BatchNorm;结构上用残差连接 |
| 梯度爆炸 | loss 突然飙升或变 nan,往往在训练前几十步就出现 | 梯度裁剪 clip_grad_norm_;降学习率;换更保守的初始化 |
"""梯度消失与梯度爆炸:把每一层收到的梯度大小逐层打出来。

链式法则是连乘。每一段的倍率小于 1,乘到前面就趋近 0(梯度消失);
每一段大于 1,乘到前面就炸上天(梯度爆炸)。
这份代码把「倍率」这件事直接做成实验。
"""
import torch
import torch.nn as nn


def deep_net(depth, activation, weight_std=None):
    """搭一个 depth 层的窄网络,每层都是 16 -> 16。"""
    layers = []
    for _ in range(depth):
        linear = nn.Linear(16, 16)
        if weight_std is not None:
            nn.init.normal_(linear.weight, mean=0.0, std=weight_std)
            nn.init.zeros_(linear.bias)
        layers.append(linear)
        layers.append(activation())
    layers.append(nn.Linear(16, 1))
    return nn.Sequential(*layers)


def layer_grad_norms(model, x, y):
    """反向一次,返回每个线性层权重梯度的范数(从输入侧数到输出侧)。"""
    loss = ((model(x) - y) ** 2).mean()
    model.zero_grad()
    loss.backward()
    return [m.weight.grad.norm().item()
            for m in model if isinstance(m, nn.Linear)]


def compare_activation():
    torch.manual_seed(0)
    x = torch.randn(64, 16)
    y = torch.randn(64, 1)

    for name, act in (('Sigmoid', nn.Sigmoid), ('Tanh', nn.Tanh), ('ReLU', nn.ReLU)):
        torch.manual_seed(0)
        model = deep_net(10, act)
        norms = layer_grad_norms(model, x, y)
        print('%-8s 第 1 层 %.3e   第 5 层 %.3e   最后一层 %.3e   首尾比 %.2e'
              % (name, norms[0], norms[4], norms[-1],
                 norms[0] / max(norms[-1], 1e-30)))

    print('sigmoid 的导数上限是 0.25,十层连乘最好情形也只有 0.25^10 ≈ 9.5e-07,')
    print('所以靠近输入的那几层几乎收不到梯度,等于没在训练。')


def explode():
    """把权重初始化放大,制造梯度爆炸。"""
    torch.manual_seed(0)
    x = torch.randn(64, 16)
    y = torch.randn(64, 1)

    for std in (0.1, 0.5, 1.0, 2.0):
        torch.manual_seed(0)
        model = deep_net(10, nn.ReLU, weight_std=std)
        norms = layer_grad_norms(model, x, y)
        first = norms[0]
        flag = ' <- 已经溢出成 nan/inf' if not torch.isfinite(
            torch.tensor(first)) else ''
        print('权重 std=%-4s  第 1 层梯度范数 = %.3e%s' % (std, first, flag))

    print('std 每放大一档,连乘十层就放大十次方,很快超出 float32 能表示的范围。')


def clip_demo():
    """梯度裁剪:把整体梯度范数按比例压回阈值以内,方向不变、长度变短。"""
    torch.manual_seed(0)
    model = deep_net(6, nn.ReLU, weight_std=1.5)
    x, y = torch.randn(64, 16), torch.randn(64, 1)

    loss = ((model(x) - y) ** 2).mean()
    model.zero_grad()
    loss.backward()

    before = torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
    after = torch.sqrt(sum((p.grad ** 2).sum() for p in model.parameters()))
    print('裁剪前的总梯度范数 = %.4f' % before.item())
    print('裁剪后的总梯度范数 = %.4f(阈值 1.0)' % after.item())
    print('clip_grad_norm_ 必须放在 backward() 之后、step() 之前')


if __name__ == '__main__':
    compare_activation()
    print('-' * 60)
    explode()
    print('-' * 60)
    clip_demo()
clip_grad_norm_ 改的是已经算好的 .grad:把整体梯度的长度按比例压回阈值以内,方向不变、只变短。放在 backward() 之前等于裁上一轮的旧梯度,放在 step() 之后则完全没起作用——两种写法都不报错。
03最小代码:五个损失函数各调一次
先把「谁吃什么形状、什么类型」跑一遍,再谈训练
3.1 五个损失函数的最小调用
损失函数的用法都是两步:先实例化,再把预测值和真实值传进去。真正会卡住人的从来不是这两步,而是每个损失函数对输入的类型和形状要求不一样。下面这段把五个常用损失各调一次,重点看注释里标的要求:
"""五个损失函数的最小调用:先看清各自吃什么形状、什么类型。"""
import torch
import torch.nn as nn

# ---------- 多分类:CrossEntropyLoss ----------
# 真实值是类别下标,必须 int64;不用自己做 one-hot
y_true = torch.tensor([1, 2], dtype=torch.int64)
# 预测值是每一类的原始分数 logits,不要提前过 softmax
y_pred = torch.tensor([[0.2, 0.6, 0.2],
                       [0.1, 0.8, 0.1]], requires_grad=True)
print('CrossEntropy:', nn.CrossEntropyLoss()(y_pred, y_true).item())

# ---------- 二分类:BCELoss ----------
# 预测值必须已经过 sigmoid,落在 (0,1);真实值是 0/1 的 float
y_pred = torch.tensor([0.6901, 0.5459, 0.2469], requires_grad=True)
y_true = torch.tensor([0, 1, 0], dtype=torch.float32)
print('BCE:', nn.BCELoss()(y_pred, y_true).item())

# ---------- 回归三兄弟 ----------
y_pred = torch.tensor([1.0, 1.0, 1.9], requires_grad=True)
y_true = torch.tensor([2.0, 2.0, 2.0])
print('L1  (MAE):', nn.L1Loss()(y_pred, y_true).item())        # (1+1+0.1)/3
print('MSE (L2) :', nn.MSELoss()(y_pred, y_true).item())       # (1+1+0.01)/3
print('SmoothL1 :', nn.SmoothL1Loss()(y_pred, y_true).item())  # 近处像 L2,远处像 L1
| 损失函数 | 预测值要求 | 真实值要求 | 最常见的报错 |
|---|---|---|---|
CrossEntropyLoss | 原始分数 logits,(batch, 类别数) | int64 类别下标,(batch,) | expected scalar type Long but found Float |
BCELoss | 已过 sigmoid,落在 (0,1) | float32 的 0./1. | all elements of input should be between 0 and 1 |
L1Loss | 预测值与真实值形状必须一致,都是浮点 | 不报错但被广播,损失静默算错 | |
MSELoss | 同上 | 同上 | |
SmoothL1Loss | 同上 | 同上 | |
手算核对一下多分类那一段:第一条样本的分数是 [0.2, 0.6, 0.2]、正确类别是 1。softmax 之后正确类的概率约 0.427,−log(0.427) ≈ 0.85;第二条样本的分数是 [0.1, 0.8, 0.1] 而正确类别是 2,正确类的概率只有约 0.249,−log(0.249) ≈ 1.39。两条取平均约 1.12。第二条明明分数最高的是第 1 类,正确答案却是第 2 类,所以它的扣分接近第一条的两倍——交叉熵的惩罚逻辑在这两个数上看得清清楚楚。
MSELoss 接受任意两个能广播的形状。预测值 (batch, 1) 配标签 (batch,) 时它不报错,而是广播成 (batch, batch),算出 batch² 个差值的均值。这个损失数值看起来完全正常,模型却永远学不好。算损失之前打印一次两边的 .shape,是最划算的习惯。
3.2 反向传播的最小三步
损失算出来之后,拿到梯度只要一行 loss.backward()。把它和清零、更新连起来,就是训练循环的后三步。下面这段用一个单参数的例子,演示「不清零」和「清零」的差别——这是整页最该亲手跑一遍的代码:
"""梯度累加实验:证明「不清零」到底会错成什么样。"""
import torch

# 同一个前向算三次反向,梯度会一路叠加
x = torch.tensor(3.0, requires_grad=True)
for i in range(1, 4):
    y = x ** 2                 # dy/dx = 2x = 6
    y.backward()
    print('第 %d 次反向后 x.grad = %.1f(正确值应当是 6.0)' % (i, x.grad.item()))
# 输出 6.0 / 12.0 / 18.0 —— 第二次起就已经错了

print('---- 每次反向前清零 ----')
x = torch.tensor(3.0, requires_grad=True)
for i in range(1, 4):
    y = x ** 2
    if x.grad is not None:
        x.grad.zero_()         # 训练循环里 optimizer.zero_grad() 干的就是这件事
    y.backward()
    print('第 %d 次反向后 x.grad = %.1f' % (i, x.grad.item()))
# 三次都是 6.0
这段完全可以手算验证:y = x² 的导数是 2x,x = 3 时梯度应当是 6。不清零时连续三次反向会得到 6、12、18(一路累加,全程零报错零警告);每次反向前清零则三次都是 6。能解释清楚 12 和 18 是怎么来的,就理解了为什么训练循环必须有 zero_grad() 这一步。
pip install torch(CPU 版足够)。本页所有网络都只有几十到几千个参数,是否有 GPU 不影响任何结论。grad_check.py 用到双精度,也只在 CPU 上跑。
04完整案例
先把一个两层网络的反向传播手算到底,再跑通一个 epoch,然后是梯度累加与数值校验
4.1 两层网络:手推一遍,再让 PyTorch 算一遍
这是整页最值得花时间的一段。网络小到能用计算器算完,全程没有随机数,每一个中间值都可以自己复算:
| 部件 | 取值 | 说明 |
|---|---|---|
| 输入 | i₁ = 0.05,i₂ = 0.10 | 一条样本,两个特征 |
| 隐藏层权重 | w₁=0.15, w₂=0.20, w₃=0.25, w₄=0.30 | 两个神经元 h₁、h₂,各两个权重 |
| 隐藏层偏置 | b₁ = 0.35 | 这个例子里两个神经元共用一个偏置值 |
| 输出层权重 | w₅=0.40, w₆=0.45, w₇=0.50, w₈=0.55 | 两个输出神经元 o₁、o₂ |
| 输出层偏置 | b₂ = 0.60 | — |
| 激活函数 | 全部用 sigmoid | 选它是因为导数形式简单:out × (1 − out) |
| 目标值 | t₁ = 0.01,t₂ = 0.99 | 损失用 E = Σ ½(t − out)²,系数 ½ 是为了求导后正好抵消 |
第一步:前向,把每个中间值算出来
| 量 | 算式 | 结果 |
|---|---|---|
net_h1 | 0.15×0.05 + 0.20×0.10 + 0.35 | 0.3775 |
out_h1 | sigmoid(0.3775) | 0.593269992 |
net_h2 | 0.25×0.05 + 0.30×0.10 + 0.35 | 0.3925 |
out_h2 | sigmoid(0.3925) | 0.596884378 |
net_o1 | 0.40×out_h1 + 0.45×out_h2 + 0.60 | 1.105905967 |
out_o1 | sigmoid(net_o1) | 0.751365070 |
out_o2 | sigmoid(1.224921404) | 0.772928465 |
| E_total | ½(0.01−out_o1)² + ½(0.99−out_o2)² | 0.298371109 |
第二步:反向求 w₅,三段相乘
| 段 | 算式 | 结果 |
|---|---|---|
∂E/∂out_o1 | −(t₁ − out_o1) = out_o1 − 0.01 | 0.741365070 |
∂out_o1/∂net_o1 | out_o1 × (1 − out_o1) | 0.186815602 |
∂net_o1/∂w₅ | 上游传来的激活值 out_h1 | 0.593269992 |
| ∂E/∂w₅ | 三者相乘 | 0.082167041 |
| 更新后的 w₅ | 0.40 − 0.5 × 0.082167041(学习率取 0.5) | 0.358916480 |
第三步:反向求 w₁,多一步「两条路径求和」
w₁ 在第一层,它先影响 out_h1,而 out_h1 同时喂给了 o₁ 和 o₂ 两个输出神经元,所以两边的责任都得算它一份:
| 段 | 算式 | 结果 |
|---|---|---|
∂E/∂out_h1 | 经 o₁ 的那一份 + 经 o₂ 的那一份 | 0.036350306 |
∂out_h1/∂net_h1 | out_h1 × (1 − out_h1) | 0.241300709 |
∂net_h1/∂w₁ | 输入 i₁ | 0.05 |
| ∂E/∂w₁ | 三者相乘 | 0.000438568 |
| 更新后的 w₁ | 0.15 − 0.5 × 0.000438568 | 0.149780716 |
把 ∂E/∂w₅ ≈ 0.0822 和 ∂E/∂w₁ ≈ 0.000439 摆在一起看,两者差了约 187 倍。同一次反向,越往输入侧走梯度越小——这正是 2.4 节梯度消失的具体数字版:sigmoid 的导数(这里是 0.1868 和 0.2413)每经一层就乘一次,再乘上小于 1 的权重,链条越长衰减越狠。
"""两层小网络的反向传播:先纯手算,再让 PyTorch 算,两边逐个参数对账。

网络结构(激活函数全用 sigmoid,损失用 0.5·Σ(target − out)²):
    输入 i1=0.05, i2=0.10
    隐藏层 h1, h2    权重 w1..w4,共享偏置 b1=0.35
    输出层 o1, o2    权重 w5..w8,共享偏置 b2=0.60
    目标 t1=0.01, t2=0.99

全程没有随机数,每个中间值都能用计算器复算。
"""
import math

import torch


def sigmoid(z):
    return 1.0 / (1.0 + math.exp(-z))


def manual():
    i1, i2 = 0.05, 0.10
    w1, w2, w3, w4, b1 = 0.15, 0.20, 0.25, 0.30, 0.35
    w5, w6, w7, w8, b2 = 0.40, 0.45, 0.50, 0.55, 0.60
    t1, t2 = 0.01, 0.99

    # ---------------- 前向 ----------------
    net_h1 = w1 * i1 + w2 * i2 + b1
    out_h1 = sigmoid(net_h1)
    net_h2 = w3 * i1 + w4 * i2 + b1
    out_h2 = sigmoid(net_h2)

    net_o1 = w5 * out_h1 + w6 * out_h2 + b2
    out_o1 = sigmoid(net_o1)
    net_o2 = w7 * out_h1 + w8 * out_h2 + b2
    out_o2 = sigmoid(net_o2)

    e1 = 0.5 * (t1 - out_o1) ** 2
    e2 = 0.5 * (t2 - out_o2) ** 2

    print('前向:net_h1=%.6f out_h1=%.9f' % (net_h1, out_h1))
    print('      net_h2=%.6f out_h2=%.9f' % (net_h2, out_h2))
    print('      net_o1=%.9f out_o1=%.9f' % (net_o1, out_o1))
    print('      net_o2=%.9f out_o2=%.9f' % (net_o2, out_o2))
    print('      E1=%.9f  E2=%.9f  E_total=%.9f' % (e1, e2, e1 + e2))

    # ---------------- 反向:先求 w5 ----------------
    # 链条三段:E 对 out_o1 → out_o1 对 net_o1 → net_o1 对 w5
    dE_dout_o1 = -(t1 - out_o1)                  # = out_o1 - t1
    dout_o1_dnet_o1 = out_o1 * (1 - out_o1)      # sigmoid 的导数形式
    dnet_o1_dw5 = out_h1                         # net_o1 = w5·out_h1 + ...
    dE_dw5 = dE_dout_o1 * dout_o1_dnet_o1 * dnet_o1_dw5

    print('\n反向 w5:%.9f × %.9f × %.9f = %.9f'
          % (dE_dout_o1, dout_o1_dnet_o1, dnet_o1_dw5, dE_dw5))
    print('学习率 0.5 时 w5 更新为 %.9f' % (w5 - 0.5 * dE_dw5))

    # ---------------- 反向:再求 w1 ----------------
    # w1 藏在第一层,它影响 out_h1,而 out_h1 同时喂给 o1 和 o2,
    # 所以「责任」要从两条路径加起来。
    dE1_dnet_o1 = dE_dout_o1 * dout_o1_dnet_o1
    dE2_dnet_o2 = -(t2 - out_o2) * out_o2 * (1 - out_o2)
    dE_dout_h1 = dE1_dnet_o1 * w5 + dE2_dnet_o2 * w7      # 两条路径求和
    dout_h1_dnet_h1 = out_h1 * (1 - out_h1)
    dE_dw1 = dE_dout_h1 * dout_h1_dnet_h1 * i1

    print('\n反向 w1:两条路径相加得 dE/dout_h1 = %.9f' % dE_dout_h1)
    print('        × %.9f × %.2f = %.9f'
          % (dout_h1_dnet_h1, i1, dE_dw1))
    print('学习率 0.5 时 w1 更新为 %.9f' % (w1 - 0.5 * dE_dw1))

    return dE_dw5, dE_dw1


def by_autograd():
    """同一个网络交给 PyTorch,看它算出来是不是同一组数。"""
    i = torch.tensor([0.05, 0.10])
    w_h = torch.tensor([[0.15, 0.20],       # h1 的权重 w1, w2
                        [0.25, 0.30]], requires_grad=True)   # h2 的 w3, w4
    b_h = torch.tensor([0.35, 0.35], requires_grad=True)
    w_o = torch.tensor([[0.40, 0.45],       # o1 的权重 w5, w6
                        [0.50, 0.55]], requires_grad=True)   # o2 的 w7, w8
    b_o = torch.tensor([0.60, 0.60], requires_grad=True)
    t = torch.tensor([0.01, 0.99])

    out_h = torch.sigmoid(w_h @ i + b_h)
    out_o = torch.sigmoid(w_o @ out_h + b_o)
    loss = (0.5 * (t - out_o) ** 2).sum()    # 注意是求和不是求平均

    loss.backward()
    print('\nautograd:loss = %.9f' % loss.item())
    print('autograd:dE/dw5 = %.9f' % w_o.grad[0, 0].item())
    print('autograd:dE/dw1 = %.9f' % w_h.grad[0, 0].item())
    return w_o.grad[0, 0].item(), w_h.grad[0, 0].item()


if __name__ == '__main__':
    m5, m1 = manual()
    a5, a1 = by_autograd()
    print('\nw5 两边之差 = %.12f' % abs(m5 - a5))
    print('w1 两边之差 = %.12f' % abs(m1 - a1))
    print('对得上,说明 autograd 做的就是这套链式法则,没有别的魔法')
backward() 里没有任何魔法,它做的就是你刚才用计算器做的事——按计算图倒着走,每段乘一次导数,分叉处求和。以后遇到梯度异常,你可以像查算术题一样一段段查,而不是把它当黑箱。
4.2 跑通一个完整的 epoch
把损失、反向、更新串起来,加上 DataLoader 的分批,就是一个真正能训练的循环。这段代码故意造了一批线性可分的假数据(标签由一组固定权重生成),这样「学得动」是有保证的——损失不降就一定是代码写错了,而不是数据太难:
"""把损失、反向、更新串成一个完整的 epoch,并打印损失是否真的在降。"""
import torch
from torch import nn, optim
from torch.utils.data import TensorDataset, DataLoader


def make_data(n=512, in_features=8, n_class=3, seed=0):
    """造一批线性可分的假数据:标签由一组固定权重决定,保证学得动。"""
    torch.manual_seed(seed)
    x = torch.randn(n, in_features)
    true_w = torch.randn(in_features, n_class)
    y = (x @ true_w).argmax(dim=1)          # 类别下标,int64
    return TensorDataset(x, y), in_features, n_class


class Net(nn.Module):
    def __init__(self, in_features, n_class):
        super().__init__()
        self.fc = nn.Linear(in_features, 32)
        self.out = nn.Linear(32, n_class)

    def forward(self, x):
        # 输出原始 logits,softmax 由 CrossEntropyLoss 内部完成
        return self.out(torch.relu(self.fc(x)))


def main():
    dataset, in_features, n_class = make_data()
    loader = DataLoader(dataset, batch_size=32, shuffle=True)

    model = Net(in_features, n_class)
    criterion = nn.CrossEntropyLoss()
    optimizer = optim.Adam(model.parameters(), lr=1e-3)

    for epoch in range(10):
        total_loss, total_num, correct = 0.0, 0, 0
        for bx, by in loader:
            logits = model(bx)                 # 前向
            loss = criterion(logits, by)       # 算损失

            optimizer.zero_grad()              # 清零:否则梯度累加
            loss.backward()                    # 反向:只算梯度,参数没动
            optimizer.step()                   # 更新:这一步才真的改参数

            # loss 是这一批的平均值,乘回样本数才能跨批次累加
            total_loss += loss.item() * len(by)
            total_num += len(by)
            correct += (logits.argmax(dim=1) == by).sum().item()

        print('epoch %2d  loss %.5f  acc %.4f'
              % (epoch + 1, total_loss / total_num, correct / total_num))


if __name__ == '__main__':
    main()
| 代码位置 | 为什么这么写 |
|---|---|
y = (x @ true_w).argmax(dim=1) | 用 argmax 生成类别下标,天然就是 int64,正好满足 CrossEntropyLoss 的要求 |
return self.out(torch.relu(self.fc(x))) | 输出原始 logits,不加 softmax——损失函数内部已经含了 |
zero_grad() → backward() → step() | 三步顺序不可调换。清零必须在反向之前,更新必须在反向之后 |
total_loss += loss.item() * len(by) | 两件事:① .item() 取出 Python 浮点数,否则整张计算图被挂住不释放,长训练必爆内存;② 乘回样本数,因为 loss 是这一批的平均值,最后一批往往不满,直接按批次平均会把结果带偏 |
(logits.argmax(dim=1) == by).sum() | 算准确率不需要 softmax——它不改变大小顺序,直接对 logits 取 argmax 即可 |
4.3 梯度累加:显存不够时怎么模拟大 batch
「梯度默认累加」这件事在 2.3 节是个坑,这里它是个功能。想用 batch_size=128 但显存只装得下 32 时,做法是:连跑 4 个小批只反向不更新,让梯度自然叠加,第 4 批之后再更新一次。
| 环节 | 常规训练 | 梯度累加(累加 4 步) |
|---|---|---|
| 前向 + 算损失 | 每批一次 | 每批一次 |
| 损失缩放 | 不用 | loss ÷ 4,否则等效学习率被放大 4 倍 |
backward() | 每批一次 | 每批一次(梯度自动叠加) |
step() / zero_grad() | 每批一次 | 每 4 批一次 |
| 显存占用 | 按大 batch 算 | 只按小 batch 算,这就是全部收益 |
| 耗时 | — | 不省时间,前向反向的次数一次没少 |
这么做真的等效吗?下面这段把两条路径放在同一组初始权重、同一批数据上跑,直接比最后的梯度:「batch_size=8 累加 4 步」与「batch_size=32 直接算」的梯度应当完全相同。最后一段还故意不除以累加步数,把「梯度被放大几倍」这件事量化出来:
"""梯度累加模拟大 batch:小批跑 4 次只反向不更新,第 4 次之后才更新一次。

要证明的事:
    「batch_size=8 累加 4 步」得到的梯度,和「batch_size=32 直接算」完全相同。
证明方式:两条路径都从同一份初始权重、同一批数据出发,最后比梯度。
"""
import torch
from torch import nn


def build_model(seed=0):
    """每次都从同一组初始权重出发,两条路径才有可比性。"""
    torch.manual_seed(seed)
    return nn.Sequential(nn.Linear(6, 12), nn.ReLU(), nn.Linear(12, 1))


def big_batch_grad(x, y):
    """常规做法:一次性把 32 条样本喂进去。"""
    model = build_model()
    criterion = nn.MSELoss()

    loss = criterion(model(x), y)
    model.zero_grad()
    loss.backward()
    return [p.grad.clone() for p in model.parameters()], loss.item()


def accumulated_grad(x, y, micro=8, accum_steps=4):
    """省显存做法:每次只喂 8 条,连做 4 次反向,梯度自然叠加。"""
    model = build_model()
    criterion = nn.MSELoss()

    model.zero_grad()                       # 整轮开始前清一次,之后中途不清
    total = 0.0
    for step in range(accum_steps):
        bx = x[step * micro:(step + 1) * micro]
        by = y[step * micro:(step + 1) * micro]

        loss = criterion(model(bx), by)
        # 关键的一除:每个小批的 loss 是它自己那 8 条的均值,
        # 直接叠 4 次相当于把梯度放大 4 倍,等于偷偷把学习率调大了 4 倍。
        loss = loss / accum_steps
        loss.backward()                     # 只反向,不 step、不 zero_grad
        total += loss.item()

    return [p.grad.clone() for p in model.parameters()], total


def main():
    torch.manual_seed(42)
    x = torch.randn(32, 6)
    y = torch.randn(32, 1)

    big, big_loss = big_batch_grad(x, y)
    acc, acc_loss = accumulated_grad(x, y)

    print('一次性大 batch 的 loss = %.8f' % big_loss)
    print('累加四步得到的 loss     = %.8f' % acc_loss)

    worst = max((a - b).abs().max().item() for a, b in zip(big, acc))
    print('两条路径的梯度最大差异 = %.10f' % worst)
    print('差异为 0(或仅剩浮点误差),说明累加确实等效于大 batch')

    # ------------------------------------------------------------ 忘了除会怎样
    model = build_model()
    criterion = nn.MSELoss()
    model.zero_grad()
    for step in range(4):
        bx = x[step * 8:(step + 1) * 8]
        by = y[step * 8:(step + 1) * 8]
        criterion(model(bx), by).backward()     # 故意不除以 4
    no_div = [p.grad.clone() for p in model.parameters()]
    ratio = no_div[0].norm().item() / max(big[0].norm().item(), 1e-12)
    print('\n忘记除以累加步数时,梯度范数是正确值的 %.2f 倍' % ratio)
    print('等效学习率被放大同样的倍数,训练很容易发散')


def train_loop_sketch(model, loader, criterion, optimizer, accum_steps=4):
    """真实训练里的写法,重点在 step / zero_grad 的位置和收尾。"""
    model.train()
    optimizer.zero_grad()
    pending = False                          # 有没有还没生效的累计梯度

    for i, (bx, by) in enumerate(loader, start=1):
        loss = criterion(model(bx), by) / accum_steps
        loss.backward()
        pending = True

        if i % accum_steps == 0:
            optimizer.step()                 # 每 accum_steps 批才更新一次
            optimizer.zero_grad()
            pending = False

    # 收尾:样本数不能被整除时,最后剩下的几批也要补一次更新,
    # 否则这部分梯度算了却从未生效。
    if pending:
        optimizer.step()
        optimizer.zero_grad()


if __name__ == '__main__':
    main()
step(),否则这部分梯度算了却从未生效。
4.4 数值梯度校验:怎么确认反向传播没写错
自己实现一个层或一个自定义损失时,怎么知道梯度算对了?用梯度的定义去验它:把某个参数挪动一个极小量 ε,看损失变了多少。
∂loss/∂w ≈ [ loss(w + ε) − loss(w − ε) ] ÷ (2ε)
这叫中心差分。它慢得离谱——每个参数要做两次完整前向,百万参数的模型根本不可能——但正因为它只依赖损失函数本身、完全不碰反向传播的代码,所以能当独立裁判。
"""数值梯度校验:不信 autograd?用「挪一点点看损失变多少」验它一遍。

梯度的定义就是变化率:
    ∂loss/∂w ≈ [ loss(w + ε) − loss(w − ε) ] / (2ε)
这叫中心差分。它慢得没法用来训练,但用来核对反向传播写得对不对,
是自己实现层或自定义损失时最可靠的一招。
"""
import torch
import torch.nn as nn


def numeric_grad(model, params, x, y, criterion, eps=1e-3):
    """对每个参数逐个元素做一次中心差分,返回同形状的数值梯度。"""
    grads = []
    for p in params:
        g = torch.zeros_like(p)
        flat_p, flat_g = p.data.view(-1), g.view(-1)
        for i in range(flat_p.numel()):
            original = flat_p[i].item()

            flat_p[i] = original + eps
            loss_plus = criterion(model(x), y).item()

            flat_p[i] = original - eps
            loss_minus = criterion(model(x), y).item()

            flat_p[i] = original                    # 用完立刻还原,不能留痕
            flat_g[i] = (loss_plus - loss_minus) / (2 * eps)
        grads.append(g)
    return grads


def main():
    torch.manual_seed(0)

    # 小网络 + 小数据:数值梯度是 O(参数量) 次前向,规模一大就跑不动
    model = nn.Sequential(
        nn.Linear(3, 4),
        nn.Tanh(),          # 用 tanh 而不是 relu:relu 在 0 点不可导,差分会失真
        nn.Linear(4, 1),
    ).double()              # 双精度能把差分的舍入误差压下去

    x = torch.randn(8, 3, dtype=torch.float64)
    y = torch.randn(8, 1, dtype=torch.float64)
    criterion = nn.MSELoss()

    params = list(model.parameters())

    # ---------------------------------------------------------- autograd
    model.zero_grad()
    criterion(model(x), y).backward()
    auto = [p.grad.clone() for p in params]

    # ---------------------------------------------------------- 中心差分
    with torch.no_grad():
        numeric = numeric_grad(model, params, x, y, criterion)

    print('%-14s %-14s %-14s %s' % ('参数', 'autograd 范数', '数值梯度范数', '相对误差'))
    for (name, _), a, n in zip(model.named_parameters(), auto, numeric):
        rel = (a - n).norm() / (a.norm() + n.norm() + 1e-12)
        print('%-14s %-14.8f %-14.8f %.3e'
              % (name, a.norm().item(), n.norm().item(), rel.item()))

    print('\n相对误差在 1e-6 量级以内就说明反向传播是对的。')
    print('误差偏大时先查三件事:')
    print('  1) eps 太小被浮点舍入吃掉,或太大导致差分不准,先试 1e-3 ~ 1e-5')
    print('  2) 网络里有 relu 这类折点函数,正好踩在不可导点上')
    print('  3) 模型里有 dropout / BatchNorm 这类每次前向结果都变的层,')
    print('     校验前必须先 model.eval()')

    # ---------------------------------------------------------- 代价有多大
    n_param = sum(p.numel() for p in params)
    print('\n本例参数量 %d,数值校验做了 %d 次前向;' % (n_param, 2 * n_param))
    print('参数上百万时这个做法完全不可行——这正是反向传播的价值:')
    print('一次反向就拿到全部参数的梯度,代价约等于一次前向。')


if __name__ == '__main__':
    main()
| 校验时的讲究 | 为什么 |
|---|---|
网络转成 .double() | float32 的舍入误差和差分本身的量级接近,会淹没结果 |
| 用 tanh 而不是 relu | relu 在 0 点不可导,差分正好跨过折点时结果会失真 |
| ε 取 1e-3 到 1e-5 | 太大差分不准,太小被浮点舍入吃掉,两头都不行 |
先 model.eval() | Dropout 这类层每次前向结果都不同,两次前向就没有可比性了 |
| 改完参数立刻还原 | 差分是「试探」,试探完必须把参数放回原位,否则后续全错 |
相对误差在 1e-6 量级以内就可以认为反向传播是对的。代码最后一段还顺手算了笔账:数值校验要做 2×参数量 次前向,而反向传播一次就能拿到全部参数的梯度,代价约等于一次前向——这正是反向传播这个算法的全部价值所在。
05骨架模板:拿去改就能用
一份按任务类型分支的损失选型模板,外加一份上手前的形状自检
选损失函数这件事,出错基本集中在两处:选错了类型(回归任务用了交叉熵),或者类型选对了但输入不合规(标签是 float、预测值没过 sigmoid、两边形状不一致)。下面这份模板把两处都固化下来——先按任务挑分支,再让 check_shapes 把类型和形状卡一遍:
"""损失函数选型骨架:按任务类型挑一条分支,其余删掉。"""
import torch
import torch.nn as nn

TASK = 'multiclass'     # TODO: 'multiclass' / 'binary' / 'regression'


def build_criterion(task=TASK):
    if task == 'multiclass':
        # 网络最后一层不加 softmax;标签是 int64 的类别下标
        return nn.CrossEntropyLoss()
    if task == 'binary':
        # 网络最后一层要加 sigmoid;标签是 0./1. 的 float
        return nn.BCELoss()
    if task == 'regression':
        # TODO: 数据干净用 MSELoss,离群点多用 L1Loss,折中用 SmoothL1Loss
        return nn.SmoothL1Loss()
    raise ValueError('未知任务类型:%s' % task)


def check_shapes(logits, target, task=TASK):
    """上手前先自检一遍形状和类型,能挡掉八成的 RuntimeError。"""
    if task == 'multiclass':
        assert logits.dim() == 2, 'logits 应为 (batch, 类别数)'
        assert target.dtype == torch.int64, '多分类标签必须是 int64'
        assert target.dim() == 1, '多分类标签应为 (batch,) 的类别下标'
    elif task == 'binary':
        assert target.dtype == torch.float32, '二分类标签必须是 float32'
        assert logits.shape == target.shape, '二分类预测与标签形状要一致'
    else:
        assert logits.shape == target.shape, '回归预测与标签形状要一致'


if __name__ == '__main__':
    criterion = build_criterion()
    logits = torch.randn(4, 3, requires_grad=True)   # TODO: 换成模型输出
    target = torch.tensor([0, 2, 1, 1])              # TODO: 换成真实标签
    check_shapes(logits, target)
    print(criterion(logits, target).item())
改哪几处
| 位置 | 多分类 | 二分类 | 回归 |
|---|---|---|---|
TASK | 'multiclass' | 'binary' | 'regression' |
| 网络最后一层 | 什么都不加 | 加 torch.sigmoid | 什么都不加 |
| 标签 dtype | int64 类别下标 | float32 的 0./1. | float32 |
| 标签形状 | (batch,) | 与预测值一致 | 与预测值一致 |
| 具体损失 | CrossEntropyLoss | BCELoss(或不加 sigmoid 改用 BCEWithLogitsLoss) | 干净数据 MSELoss;离群点多 L1Loss;拿不准 SmoothL1Loss |
assert,挡掉的是本页 06 节里绝大多数报错,其中包括唯一那条不报错的——预测值 (batch, 1) 配标签 (batch,) 被静默广播。断言失败时抛出的是你自己写的中文提示,比框架那句 expected scalar type Long but found Float 好懂得多。训练脚本第一次跑通之后可以留着它,几乎不耗时间。
配套的训练循环骨架
损失函数选好之后,把它塞进五步循环就能训练。循环部分沿用 4.2 那份脚本的结构,四个位置是必须照抄的:
| 必须照抄的写法 | 漏了会怎样 |
|---|---|
每个 epoch 开头 model.train() | Dropout / BatchNorm 停在推理模式,训练行为不对;验证前则要切 model.eval() |
zero_grad() → backward() → step() 三连 | 漏清零则梯度累加、loss 先降后飙成 nan;顺序错则静默学不动 |
total_loss += loss.item() * len(by) | 不用 .item() 会挂住计算图直至 OOM;不乘样本数则最后一个不满的批会把平均值带偏 |
开头 torch.manual_seed(n) | 两次结果不一样,无法判断某个改动到底有没有效 |
backward() 之后、step() 之前。
06易错点汇总
按「损失选型 / 输入类型与形状 / 反向传播 / 训练循环」四类归并,每条都给现象和修法
⚠️ 一、损失函数选型
- 多分类时网络最后一层加了 softmax,损失又用
CrossEntropyLoss。 现象:不报错,但等于连做两次 softmax,概率被压平、损失失真、梯度变钝,训练明显比别人慢。修法:用CrossEntropyLoss时输出层直接返回原始分数。 - 二分类忘了加 sigmoid 就用
BCELoss。 现象:all elements of input should be between 0 and 1。修法:要么前面补torch.sigmoid,要么直接换nn.BCEWithLogitsLoss()(推荐,数值更稳)。 - 回归任务的输出层套了激活函数。 现象:预测值被硬压进 (0,1) 或 [0,+∞),标签一旦超出这个范围就永远学不到。修法:回归输出层什么都不加。
- 数据里有离群点还在用 MSE。 现象:loss 突然飙升,甚至变
nan。因为 MSE 的梯度是2×误差,误差 100 时梯度就有 200,一条标错的样本能主导整批更新。修法:换SmoothL1Loss,或先清洗数据。 - 自己写
log(softmax(x))。 现象:偶发nan。softmax 输出被浮点舍入成 0 时log(0)就是-inf。修法:用框架提供的合并实现,它内部做了数值稳定处理。 - 拿损失的绝对值横向比模型。 交叉熵的 0.69 和 MSE 的 0.69 之间没有任何关系;换个单位 MSE 能差几个数量级。损失只用于纵向比较同一任务的不同轮次。
⚠️ 二、输入的类型与形状
- 多分类标签传成了 float。 现象:
expected scalar type Long but found Float。修法:标签必须是int64的类别下标,用torch.tensor(labels, dtype=torch.int64)。 - 多分类标签做成了 one-hot。 现象:维度不符而报错。修法:
CrossEntropyLoss要的是(batch,)的下标,不是(batch, 类别数)的 one-hot——它内部自己会取正确类那一格。 - 类别下标越界。 3 类的任务里出现了下标 3。现象:报越界错误,有时还伴随难懂的 assert 信息。修法:合法取值是 0 到 类别数−1;标签从 1 开始编号的数据集要整体减 1。
- 预测值
(batch, 1)与标签(batch,)直接算 MSE。 现象:不报错,广播成(batch, batch),损失数值看着正常、实际完全错误,模型永远学不好。这是本页最危险的一条。 修法:统一reshape(-1, 1),或算损失前assert两边形状一致。 - 回归标签是
float64。 现象:expected scalar type Float but found Double。NumPy / pandas 给的默认是float64,网络权重是float32。修法:建张量时显式dtype=torch.float32。 - 把带梯度的 loss 直接
.numpy()。 现象:Can't call numpy() on Tensor that requires grad。修法:loss.item(),或loss.detach().numpy()。
⚠️ 三、反向传播
- 对非标量调用
backward()。 现象:grad can be implicitly created only for scalar outputs。修法:先.sum()或.mean()。真实训练里这件事由损失函数自动完成——所以损失永远是一个数。 - 同一张计算图
backward()两次。 现象:Trying to backward through the graph a second time。反向一次之后中间结果就被释放了。修法:重新前向一次;确有需要才用retain_graph=True,它会显著增加显存占用。 - 以为
backward()会更新参数。 它只把.grad填上,参数一个都没动。不写step()的训练循环 loss 会一直不降,而且不报任何错——最折磨人的静默失败。 - 去找中间结果的
.grad。 现象:打印出None并附带一条警告。只有叶子节点默认保留梯度。确实需要时用.retain_grad()。 - 在
torch.no_grad()里算损失又想反向。 现象:element 0 of tensors does not require grad。no_grad是给推理和参数更新用的,训练的前向不能包在里面。 - 梯度裁剪放错位置。 放在
backward()之前裁的是上一轮的旧梯度,放在step()之后完全不起作用,两种都不报错。修法:固定放在backward()和step()之间。
⚠️ 四、训练循环
- 忘了
zero_grad()。 现象:loss 先下降后突然飙升,最后变nan,因为梯度一轮轮累加、步子越迈越大。修法:把「清零 → 反向 → 更新」当成不可拆的三连。 - 三步顺序放错。 清零放在
backward()之后等于把刚算出的梯度抹掉,参数永远不变;step()放在backward()之前用的是上一轮的旧梯度。两种都不报错,只是学不动。 - 累加 loss 时忘了
.item()。 现象:内存/显存持续增长直到 OOM,因为每个 loss 张量都挂着一整张计算图。修法:total_loss += loss.item() * len(by)。 - 按批次数求平均而不是按样本数。 最后一个 batch 往往不满,直接除以批数会把平均损失算偏。修法:乘回
len(by)再除以总样本数。 - 梯度累加时忘了把损失除以累加步数。 现象:等效学习率被放大数倍,训练发散。修法:
loss = loss / accum_steps;同时注意收尾时剩余的批次要补一次step()。 - 验证前忘了
model.eval()和torch.no_grad()。 现象:Dropout 仍在随机丢弃,验证指标偏低且每次不同;不加no_grad还会白白占显存。 - epoch 和 iteration 搞混。 日志里「step 1000」指的是第 1000 次参数更新,不是第 1000 轮。50000 条样本、
batch_size=256时,一个 epoch 只有 196 次 iteration。
把报错现场跑一遍
上面的条目读一遍记不住,自己触发一遍就记住了。下面这份把六种最常见的损失函数报错原地复现,用 try/except 抓住并打印报错原文,跑到底不会中断:
"""损失函数最常见的六种报错,原地复现一遍,看清报错原文和修法。

每一段都用 try/except 抓住异常,跑到底不中断。
自己触发一次,比读十条注意事项记得牢。
"""
import torch
import torch.nn as nn


def case(title, fn):
    print('=' * 58)
    print(title)
    try:
        fn()
        print('  -> 没有报错')
    except Exception as exc:                     # noqa: BLE001 演示用,要看原文
        print('  -> %s: %s' % (type(exc).__name__, str(exc).split('\n')[0]))


def wrong_label_dtype():
    """多分类标签写成了 float。"""
    logits = torch.randn(4, 3)
    labels = torch.tensor([0., 2., 1., 1.])      # 应该是 int64
    nn.CrossEntropyLoss()(logits, labels)


def right_label_dtype():
    logits = torch.randn(4, 3)
    labels = torch.tensor([0, 2, 1, 1], dtype=torch.int64)
    print('  修法:标签用 int64 的类别下标,损失 = %.6f'
          % nn.CrossEntropyLoss()(logits, labels).item())


def one_hot_label():
    """把标签做成了 one-hot 又当类别下标传。"""
    logits = torch.randn(2, 3)
    labels = torch.tensor([[0, 1, 0], [0, 0, 1]], dtype=torch.int64)
    nn.CrossEntropyLoss()(logits, labels)


def label_out_of_range():
    """类别下标越界:3 类的任务里出现了下标 3。"""
    logits = torch.randn(2, 3)
    labels = torch.tensor([1, 3], dtype=torch.int64)     # 合法范围是 0..2
    nn.CrossEntropyLoss()(logits, labels).backward()


def bce_without_sigmoid():
    """BCELoss 要求预测值落在 (0,1),直接喂原始分数会报错。"""
    logits = torch.tensor([2.5, -1.2, 0.3])
    target = torch.tensor([1., 0., 1.])
    nn.BCELoss()(logits, target)


def bce_fixed():
    logits = torch.tensor([2.5, -1.2, 0.3])
    target = torch.tensor([1., 0., 1.])
    a = nn.BCELoss()(torch.sigmoid(logits), target).item()
    b = nn.BCEWithLogitsLoss()(logits, target).item()
    print('  修法一 sigmoid + BCELoss   = %.8f' % a)
    print('  修法二 BCEWithLogitsLoss   = %.8f(数值更稳,推荐)' % b)


def silent_broadcast():
    """最危险的一种:不报错,但算出来的损失是错的。"""
    pred = torch.randn(8, 1)          # 模型输出
    target = torch.randn(8)           # 标签少了一维
    loss = nn.MSELoss()(pred, target)
    print('  形状 %s 与 %s 被广播成 %s'
          % (tuple(pred.shape), tuple(target.shape),
             tuple((pred - target).shape)))
    print('  损失值 %.6f 看起来完全正常,实际是 64 个差值的均值' % loss.item())
    fixed = nn.MSELoss()(pred, target.reshape(-1, 1))
    print('  修正后 = %.6f,两个数完全不同' % fixed.item())


def backward_twice():
    """同一张计算图反向两次。"""
    w = torch.tensor(2.0, requires_grad=True)
    loss = (w * 3) ** 2
    loss.backward()
    loss.backward()                   # 图已被释放


if __name__ == '__main__':
    case('一、多分类标签是 float', wrong_label_dtype)
    right_label_dtype()
    case('二、多分类标签做成了 one-hot', one_hot_label)
    case('三、类别下标越界', label_out_of_range)
    case('四、BCELoss 收到未过 sigmoid 的原始分数', bce_without_sigmoid)
    bce_fixed()
    case('五、预测与标签形状不一致(不报错,最危险)', silent_broadcast)
    case('六、同一张计算图 backward 两次', backward_twice)
    print('=' * 58)
    print('第五条是唯一不抛异常的一条:算损失前先 assert 两边形状一致。')
(8,1) 和 (8,) 广播成 (8,8),算出 64 个差值的均值当损失。这个数字看起来完全正常,模型却永远学不好。养成「算损失前先 assert 两边形状」的习惯,这一条就再也不会发生。
按现象反查原因
| 你看到的现象 | 最可能的原因 | 怎么确认 |
|---|---|---|
| loss 一直不降,纹丝不动 | 漏了 step(),或参数没进优化器 | 训练前后各打印一次某个权重,看有没有变化 |
loss 先降后暴涨成 nan | 忘了 zero_grad(),或学习率过大 | 先把 lr 降一个数量级;仍然如此就查清零那一行 |
头几步就 nan | 梯度爆炸,或 log(0) | 打印总梯度范数;把手写的 log/softmax 换成框架合并实现 |
| loss 降得很慢,前几层梯度接近 0 | 梯度消失 | 逐层打印 weight.grad.norm(),看首尾相差几个数量级 |
| loss 在降但准确率不动 | 标签或形状接错了,损失被静默算错 | 打印 y_pred.shape、y.shape、y.dtype 三个值 |
| 显存一路涨到 OOM | 累加 loss 时漏了 .item() | 搜一遍代码里所有 += loss |
| 同样的代码两次结果不同 | 没固定随机种子 | 脚本开头加 torch.manual_seed(n) |
07自测题
点击题目展开答案;这些题都能说清楚,这一页就通了
损失函数、代价函数、目标函数、误差函数有什么区别?
侧重点不同,工程里基本混用:损失函数强调单个样本的差异;代价函数是整个训练集(或一批)损失的平均;目标函数是优化过程要最小化的东西,可能还含正则项;误差函数强调与正确答案的偏差。真正要分清的不是名字,而是「这个任务该用哪一个具体损失」。
交叉熵为什么用 −log(p) 而不是 1 − p?
因为 −log 对「又错又自信」的惩罚是爆炸式的:正确类概率趋近 0 时损失趋向 +∞,而 1−p 最多只能扣 1 分。这会逼着网络在没把握时把概率摊平而不是乱赌。对照几个数:p=1 时损失 0,p=0.5 时约 0.69,p=0.1 时约 2.30。
用 nn.CrossEntropyLoss 时,网络最后一层要不要加 softmax?为什么?
不要加。 这个损失函数内部已经包含了完整四步:softmax → 取正确类那一格 → 取负对数 → 一批取平均。自己再加一次等于连做两次 softmax,概率被压平、损失失真、梯度变钝,而且完全不报错。所以输出层直接返回原始分数 logits。
多分类的标签应该是什么类型和形状?one-hot 行不行?
必须是 int64 的类别下标,形状 (batch,),取值 0 到 类别数−1。不能传 one-hot,也不能是 float——损失函数内部会自己去取正确类那一格。标签从 1 开始编号的数据集要整体减 1,否则会越界报错。
MSE、MAE、SmoothL1 各自的梯度有什么特点?数据里有离群点该选哪个?
MSE 的梯度是 2×误差,随误差线性增长,误差 100 时梯度就有 200 —— 一条标错的样本能主导整批更新,这就是「离群点梯度爆炸」。MAE 的梯度恒为 ±1,对离群点不敏感,但零点不光滑,逼近最优解时会跨过极小值。SmoothL1 在 ±1 以内像 L2、以外像 L1,两头好处都要。有离群点就选 SmoothL1(或先清洗数据)。
反向传播会改变参数吗?真正改参数的是哪一步?
不会。 loss.backward() 只把每个参数的 .grad 填上,参数本身一个数都没变。真正改参数的是 optimizer.step()。这就是本页铁律:损失函数负责给分,反向传播负责摊责任,两者都不改参数。
写出训练循环的五步,并说明哪两步的顺序绝对不能换。
① 前向 → ② 算损失 → ③ 梯度清零 → ④ 反向 → ⑤ 更新。 清零必须在反向之前(放后面等于把刚算出的梯度抹掉,参数永远不变),更新必须在反向之后(放前面用的是上一轮的旧梯度)。两种顺序错误都不报错,只是静默学不动。
求某个输出层权重的梯度,链条分几段?靠近输入的权重多了什么规则?
输出层权重分三段连乘:∂E/∂out(由损失函数决定)× ∂out/∂net(激活函数的导数,sigmoid 是 out(1−out))× ∂net/∂w(上游传来的激活值)。靠近输入的权重多一条规则:一个节点同时喂给多个下游时,各条路径的贡献要相加——比喻里就是一个主管给两位总监供料,两边的扣分都算他一份。
在 4.1 的例子里,∂E/∂w₅ ≈ 0.0822 而 ∂E/∂w₁ ≈ 0.000439,差了约 187 倍。这说明什么?
说明越靠近输入的层,梯度越小。因为每往回传一层就要多乘一次激活函数的导数(这里是 0.1868 和 0.2413,都远小于 1),再乘上小于 1 的权重,连乘越多衰减越狠。这就是梯度消失在具体数字上的样子:链条再长几层,前面的参数基本就不动了。
为什么 PyTorch 的 .grad 默认累加而不是自动清零?
因为梯度累加本身是有用的功能:显存装不下大 batch 时,可以连跑几个小 batch 只反向不更新,让梯度自然叠加,等效于一个大 batch。既然累加有用,框架就不能替你决定什么时候「重新开始」,必须由你显式调 zero_grad()。代价是忘了这一步会让 loss 先降后飙成 nan,且全程零报错。
同一张计算图连续 backward() 两次会发生什么?
报 Trying to backward through the graph a second time:第一次反向之后中间结果就被释放了。正常做法是重新前向一次。确有需要才传 retain_graph=True,但它会显著增加显存占用,不要当默认写法。
梯度消失和梯度爆炸的共同成因是什么?各自怎么处理?
共同成因是链式法则的连乘:每段倍率小于 1 就逐层衰减到 0(消失),大于 1 就逐层放大到溢出(爆炸)。消失:隐藏层换 ReLU、用 He 初始化、加 BatchNorm、上残差连接。爆炸:梯度裁剪 clip_grad_norm_、降学习率、换更保守的初始化。
sigmoid 的导数上限是多少?十层连乘之后还剩多少?
上限 0.25(出现在 x=0 处)。最好的情形连乘十层是 0.25¹⁰ ≈ 9.5×10⁻⁷,五层是 0.25⁵ ≈ 0.00098。所以 sigmoid 网络五层之内就会出现梯度消失,靠近输入的层几乎收不到梯度。ReLU 正半轴导数恒为 1,连乘多少次都是 1。
梯度裁剪该放在训练循环的哪个位置?放错了会怎样?
固定放在 backward() 之后、step() 之前,因为它改的是已经算好的 .grad——把整体梯度长度按比例压回阈值以内,方向不变、只变短。放在 backward() 之前裁的是上一轮旧梯度,放在 step() 之后完全不起作用,两种都不报错。
50000 条样本、batch_size=256,一个 epoch 有几次 iteration?10 个 epoch 呢?
50000 ÷ 256 = 195 余 80,保留最后不满的那一批就是 196 次 iteration;10 个 epoch 就是 1960 次参数更新。最后一批只有 80 条样本——这也是为什么累加损失时要乘回样本数再除以总数,按批次数求平均会把结果带偏。
梯度累加模拟大 batch 时,为什么要把损失除以累加步数?它能省时间吗?
不除的话,累加 4 步得到的梯度是常规大 batch 的 4 倍,等效于偷偷把学习率调大 4 倍,很容易发散。它只省显存,不省时间——前向和反向的次数一次都没少。另外收尾时剩余的批次要补一次 step(),否则这部分梯度算了却从未生效。
怎么独立验证自己实现的反向传播是对的?为什么这招不能用来训练?
用中心差分:∂loss/∂w ≈ [loss(w+ε) − loss(w−ε)] ÷ (2ε),和 autograd 的结果比,相对误差在 1e-6 量级以内就算对。它只依赖损失函数本身、完全不碰反向传播的代码,所以能当独立裁判。不能用来训练是因为每个参数都要做两次完整前向,代价是 2×参数量 次前向;而反向传播一次就拿到全部梯度,代价约等于一次前向——这正是这个算法的全部价值。
词术语表
| 术语 | 含义 |
|---|---|
| 损失函数 loss function | 衡量当前参数质量的函数,把预测与真实值的差异汇总成一个标量 |
| 代价函数 / 目标函数 / 误差函数 | 同一件事的不同叫法;代价函数指整批的平均,目标函数可能还含正则项 |
| logits | 网络输出层未经任何激活的原始分数;CrossEntropyLoss 要的就是它 |
| 交叉熵 cross entropy | 分类损失;单条样本的值是 −log(正确类的预测概率),对「又错又自信」惩罚极重 |
| nn.CrossEntropyLoss | 多分类损失,内部已含 softmax;标签必须是 int64 的类别下标 |
| nn.BCELoss | 二分类交叉熵;预测值必须已过 sigmoid,标签是 float32 的 0./1. |
| nn.BCEWithLogitsLoss | sigmoid 与 BCE 的合并实现,数值更稳,网络最后一层不用加 sigmoid |
| MAE / L1 Loss | 绝对误差均值;梯度恒为 ±1,抗离群点,但零点不光滑 |
| MSE / L2 Loss | 平方误差均值;梯度是 2×误差,处处光滑,离群点会梯度爆炸 |
| Smooth L1 Loss | 分段函数:误差在 ±1 内按 L2 算、外按 L1 算,兼顾光滑与抗离群点 |
| 前向传播 forward | 数据从输入层逐层算到输出层,得到预测值与损失;不改参数 |
| 反向传播 back propagation | 从损失出发、沿计算图倒推,用链式法则算出每个参数的梯度;不改参数 |
| 链式法则 | 复合函数求导:把路径上各段导数连乘;一个节点喂多个下游时,各路径求和 |
| 梯度 gradient | 损失对某参数的偏导数,含义是「这个参数该为当前误差负多少责任」 |
| 叶子节点 | 自己创建、无 grad_fn 的张量,即模型参数;只有它默认保留 .grad |
| zero_grad() | 把 .grad 清零;梯度默认累加,所以每轮必须显式清一次 |
| optimizer.step() | 按 w ← w − lr × ∂loss/∂w 更新参数,唯一真正改参数的一步 |
| 学习率 lr | 每步迈多大;太小训练慢,太大会跨过最优解甚至发散 |
| epoch | 全部训练样本完整过一遍 |
| batch_size | 一次参数更新用多少条样本;常取 2 的幂次 |
| iteration | 用一个 batch 完成一次参数更新;一个 epoch 的次数 = 向上取整(样本数 ÷ batch_size) |
| BGD / Mini-Batch / SGD | 按 batch_size 取全部 / 一小批 / 一条区分的三种梯度下降,区别只在这一个数 |
| 梯度累加 | 连跑几个小批只反向不更新,让梯度叠加后再更新一次;省显存不省时间,损失要除以累加步数 |
| 梯度消失 vanishing | 各段倍率小于 1,连乘后趋近 0,靠近输入的层收不到梯度 |
| 梯度爆炸 exploding | 各段倍率大于 1,连乘后溢出,loss 突然飙升或变 nan |
| 梯度裁剪 clip_grad_norm_ | 把整体梯度长度压回阈值内,方向不变;位置固定在 backward() 与 step() 之间 |
| 中心差分 / 数值梯度 | [loss(w+ε) − loss(w−ε)] ÷ (2ε);用来独立校验反向传播,慢到无法用于训练 |