【案例】Qwen 微调实战 · 合并、GPTQ 量化与 vLLM 上线
训练收敛只是拿到一张配方修改单。从 checkpoint 到能扛住并发的线上服务,还隔着合并、量化、部署这三道工序。
30″30 秒看懂这一讲
把微调训练想成一位主厨在试菜:他试了几百次,终于把口味调对了,但他手里攥着的不是一本菜谱,而是一沓写满修改意见的便签——「盐减半」「先煸后煮」「起锅前淋香油」。便签本身没法用,厨房里其他人拿到它不知道从哪下手。
要把这道菜变成每天出几千份、还不能翻车的中央厨房产品,得走三道工序:先把便签誊写进正式菜谱(合并),再把「3.1416 克盐」这种精确到离谱的刻度改成半小勺(量化),最后把「一个厨师从头炒到尾」改成流水线(部署)。这一讲讲的就是这三道工序,一道都不能跳。
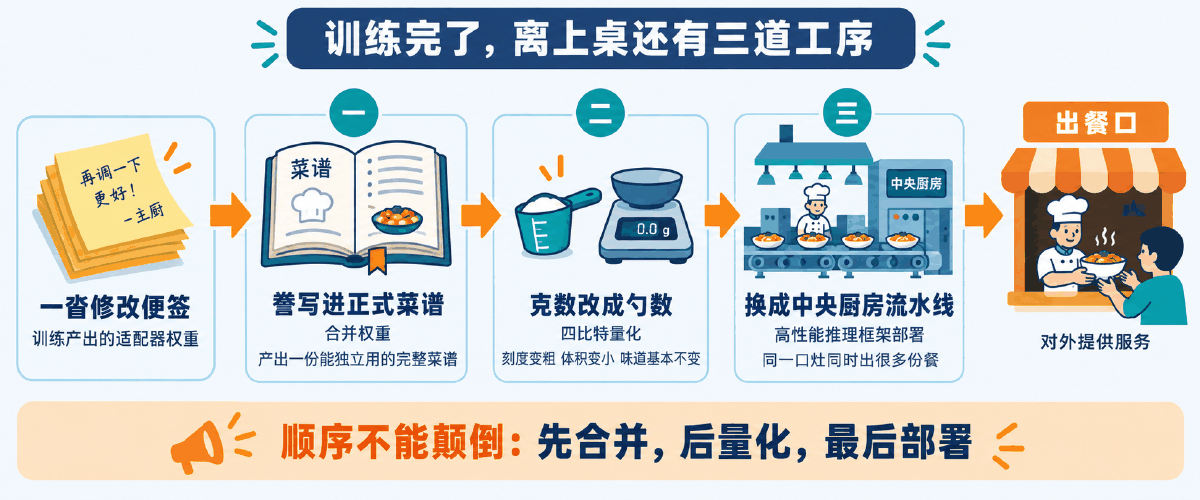
| 中央厨房里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 原版菜谱 | 基座模型(Qwen2-7B-Instruct) | 预训练权重,几十亿参数,谁都能照着做但做不出你要的味道 |
| 一沓修改便签 | LoRA adapter(checkpoint-xxx) | 训练只存了低秩增量,几十 MB,离开原版菜谱就没有意义 |
| 誊写成正式菜谱 | 权重合并(llamafactory-cli export) | 把增量算回主干权重,产出一份能独立加载的完整模型 |
| 把克数改成勺数 | GPTQ 4-bit 量化 | 用更粗的刻度记录同一个数,体积和显存大幅下降,味道基本不变 |
| 试做几道招牌菜校味 | 校准数据(calibration data) | 一小批真实样本,用来确认「换刻度之后味道有没有跑偏」 |
| 哪味料最敏感的敏感度表 | Hessian 逆矩阵 | 告诉算法哪些权重动一点点就毁掉输出,得留更精细的刻度 |
| 中央厨房流水线 | vLLM | 推理框架,负责让同一套灶台同时出很多份餐 |
| 备料 / 出餐 | prefill / decode | 前者一次性处理整段 prompt,后者一个 token 一个 token 往外吐 |
| 熬好的高汤 | KV cache | 已经算过的 K、V 存起来,下一个 token 不必从头再算 |
| 16 格标准餐盒 + 取餐号码牌 | PagedAttention 的 block 与 block table | 显存按固定小块按需发放,用多少取多少,不再整桌预留 |
| 同一条流水线挂多本菜谱 | 多 LoRA(--enable-lora) | 一个服务同时挂多个 adapter,调用时点名用哪一本 |
finetuning_type 一律写 lora(哪怕你训的是 QLoRA),不要指定量化模型,也不要写 quantization_bit。量化是合并完成之后单独跑的一道工序,用的是 GPTQ,跟训练时那个 4-bit 完全是两件事。
llamafactory-cli export merge_lora.yaml → python run_gptq.py → python -m vllm.entrypoints.openai.api_server --model ...。后面每一节都是在拆这三条命令背后发生了什么。
01概念:训练收敛之后,路才走了一半
三道工序各解决什么问题,以及它们和上一讲的 QLoRA 是什么关系
1.1 训练完之后还缺三步
训练脚本跑完、loss 曲线平了,目录里躺着一个 checkpoint-1250,这时候很容易产生一个错觉:模型已经好了,剩下的只是「部署一下」。实际上从这里到线上服务,中间隔着三个性质完全不同的问题。
| 工序 | 解决的问题 | 输入 | 产出 |
|---|---|---|---|
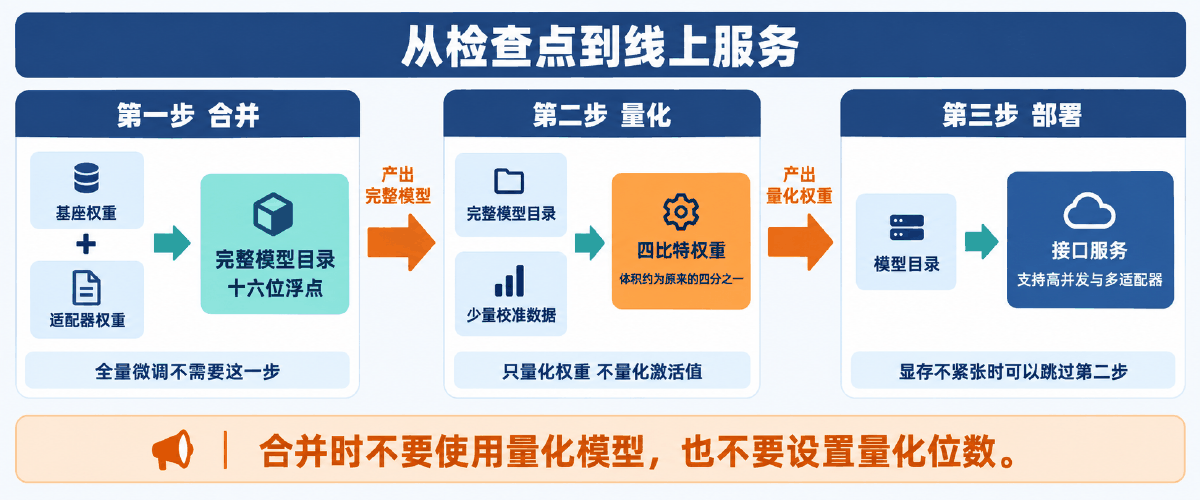
| ① 合并 merge | 产物不完整,没法独立加载 | 基座权重 + adapter | 一份完整的 FP16 模型目录,可直接被任何推理框架加载 |
| ② 量化 GPTQ | 体积大、显存吃紧、单卡装不下 | 合并后的完整模型 + 校准数据 | 4-bit 权重(safetensors),体积约为 FP16 的四分之一 |
| ③ 部署 vLLM | 能跑但太慢、并发一上来就崩 | 量化或未量化的模型目录 | 一个 OpenAI 风格的 HTTP 服务,支持高并发与多 adapter |
三件事互相独立:全量微调不需要第 ① 步;显存宽裕可以跳过第 ② 步;只做离线批量推理可以不起服务、直接用 vLLM 的离线接口。但只要走的是 LoRA / QLoRA 路线并且要对外提供服务,三步就一步都少不了。
1.2 为什么必须合并权重
回到中央厨房的比喻:便签上写的是「减半」「多加两勺」,是相对量,不是绝对量。 便签离开原版菜谱就毫无意义——「盐减半」,减的是谁的一半?
LoRA 的产物就是这样一沓相对量。训练时冻结基座、只更新两个低秩矩阵,脚本保存时也只把这两个矩阵存下来,几十 MB 而已。所以:
- 要推理,必须同时提供基座和 adapter,让框架在加载时现场把增量叠加回去;
- 或者提前合并一次,把增量永久算进主干权重,产出一份完整模型。之后无论谁来加载,都不需要知道 LoRA 的存在。
生产上选后者:少一个依赖、少一次加载期计算,而且量化、转格式这些后续工序基本都只接受完整模型。采用 LoRA 或 QLoRA 训练时,脚本只保存对应的 LoRA 权重,需要合并权重才能进行推理;全量参数训练无需执行此步骤。
1.3 PTQ 与 QAT:两种量化路线的分野
量化方法主要有两大类,上一讲的 QLoRA 与这一讲的 GPTQ 正好各占一边:
| 对比项 | PTQ(Post-Training Quantization) | QAT(Quantization Aware Training) |
|---|---|---|
| 中文 | 训练后量化 | 量化感知训练 |
| 代表 | GPTQ | QLoRA |
| 什么时候量化 | 训练全部结束之后,单独跑一遍 | 训练 / 微调过程中同时进行 |
| 要不要重训 | 不需要,只要一小批校准数据 | 本身就是训练流程的一部分 |
| 目的 | 压缩推理阶段的体积与显存 | 压缩训练阶段的显存,让大模型塞进小卡 |
| 量化谁 | 只量化权重 | 量化基座权重,adapter 仍是高精度 |
| 这一讲的位置 | 合并之后的第 ② 道工序 | 属于上一讲的训练环节 |
用厨房的话说:QAT 是主厨在试菜阶段就只用「勺」这种粗刻度去调味,调出来的配方天然适配粗刻度;PTQ 是菜谱已经定稿,再回头把克数翻译成勺数,翻译时要拿几道招牌菜试吃,确认味道没跑。
quantization_bit: 4 与 GPTQ 的 bits=4 都是 4-bit,但它们作用在完全不同的阶段,产物也不通用。QLoRA 训完拿到的仍是一个高精度 adapter,必须先按 1.2 节合并成 FP16 完整模型,再交给 GPTQ 重新量化。
1.4 为什么要换掉训练框架自带的推理服务
LLaMA-Factory 自带的 api server 能起服务,训练完顺手验证一下很方便。问题是它为「能跑」设计,不是为「扛住并发」设计。同一个问题、同一块卡,实测下来差距是这样的:
| 部署方式 | 输出速度 | 说明 |
|---|---|---|
| LLaMA-Factory api server | 5.05 字/秒 | 训练框架自带的推理服务,逐 token 朴素生成 |
| LLaMA-Factory api server | 7.26 字/秒 | 另一次测量记录到的数值,量级与上一行一致 |
| vLLM api server | 111.92 字/秒 | 输出 1794 字耗时 16.03 秒,同一块卡、同一个 3B 模型 |
vLLM 由加州大学伯克利分校团队开发,通过显存管理和调度策略上的改造,解决了传统推理框架显存利用率低、吞吐量不足、并发处理效率低的问题。它的对外特性清单里,对这个项目最要紧的是三条:
合并后的目录、GPTQ 量化产物都能直接 --model 指过去,不需要转格式。
起服务之后用 openai 客户端换个 base_url 就能调,上层应用代码一个字不用改。
一个服务同时挂多个 adapter,请求时用 model 参数点名,省服务器也方便对比。
其余特性还有并行采样与波束搜索等多种解码算法、张量并行与流水线并行、流式输出、前缀缓存,以及对 NVIDIA GPU、AMD、Intel CPU、TPU 等多种硬件的支持。环境要求很朴素:Linux、Python 3.9–3.12、一块 GPU(V100 / T4 / RTX20xx / A100 / L4 / H100 均可),安装就是 pip install vllm。
02原理:三道工序各自在做什么
合并的算术、GPTQ 的逐层逼近、KV cache 与 PagedAttention 的显存账
2.1 合并在做什么运算
LoRA 训练时,被冻结的原权重矩阵记作 W,训练出来的两个小矩阵记作 A 和 B。推理时模型实际用的是 W + BA 这个组合——基座出大头,增量出微调带来的那部分差异。
不合并时,这个加法每次加载模型都要现场做一遍,而且框架必须同时知道基座在哪、adapter 在哪。合并做的事情就一句话:把 W + BA 算出来,把结果写回权重文件,从此不再有 A 和 B。
所以合并有三个直接后果,对应后面易错点里最常见的几个坑:
| 后果 | 意味着什么 |
|---|---|
| 参数量不变 | 合并后的模型大小等于基座大小。7B 模型 FP16 约 14 GB,合并前后都是这个量级 |
| 基座必须完全对得上 | 增量是相对某一份具体权重训出来的。换一个基座版本再合并,等于把「盐减半」贴到另一本菜谱上,结果不可预期 |
| 合并后 adapter 失效 | 合并产物已经含有增量,再叠一次 adapter 就是加了两遍,输出会明显走样 |
quantization_bit,等于在「刻度已经被压粗」的菜谱上誊写便签——增量精度会被量化误差吃掉一大块。正确顺序是先用 FP16 基座合并,再单独量化。
2.2 GPTQ:把菜谱的克数改成勺数,还要保证味道不跑
GPTQ(Gradient-based Post-training Quantization)是一种针对大规模预训练模型的高效后量化算法。它的目标很明确:在不重新训练的前提下,把权重压到 4-bit 甚至更低,同时尽可能保住性能。它采用非对称量化,并且逐层处理——每一层独立量化完,再继续下一层。
难点在于:把「3.1416 克」写成「半小勺」,误差是必然的。GPTQ 的聪明之处在于它不平均对待每一味料。
Hessian 逆矩阵:哪一味料动不得
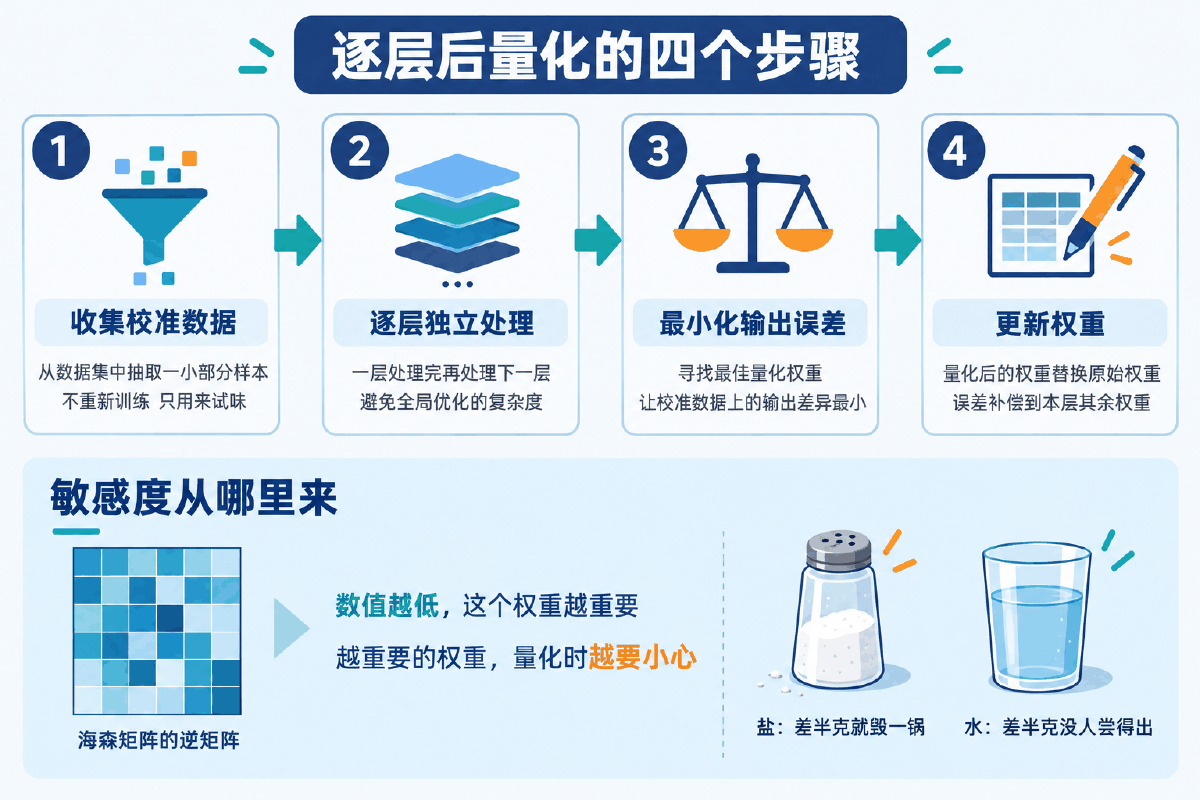
在逐层量化时,算法首先把这一层的权重转换为 Hessian 矩阵的逆矩阵。Hessian 告诉我们模型输出对每个权重变化的敏感程度,也就是每个权重的重要性(影响程度)。
拿到敏感度信息后,GPTQ 对权重矩阵逐列操作:量化这一列的权重 → 计算由此引入的误差 → 把这份误差补偿到该层其余还没量化的权重上。处理完一列再处理下一列,一层处理完再更新所有其余权重。这就是它比「直接四舍五入」精度高得多的原因——误差不是被忽略,而是被后面的权重接住了。
算法的四个步骤
GPTQ 的核心思想是通过最小化量化引入的输出误差,实现高精度低比特量化。具体到每一层的权重矩阵,它利用一小部分校准数据,最小化量化前后模型输出的差异。基本步骤如下:
从训练数据或相关数据集中抽取一小部分样本作为校准数据。对应厨房里的「先试做几道招牌菜」——不是全量重训,只是取样试吃。
对模型的每一层独立量化,避免全局优化的复杂度。一层一道工序,做完封存,不回头。
对于每一层,寻找最佳的量化权重,使得在校准数据上的输出误差最小。日志里那个 avg loss 就是这一步的度量。
把量化后的权重替换原始权重,同时把量化误差补偿进同层剩余权重。
2.3 分组量化:group_size 到底在分什么组
如果整个权重矩阵共用一组量化参数(缩放系数与零点),那么一个极端值就会把整个矩阵的刻度拉粗。分组量化把多个权重组合在一起进行量化:每 group_size 个权重共享一组参数,组内刻度自适应。
group_size | 效果 | 代价 |
|---|---|---|
| 越小(如 32) | 刻度更贴合局部分布,精度更好 | 要存的量化参数更多,模型体积变大 |
| 128(常用默认) | 精度与体积的平衡点 | — |
| 越大 / 不分组 | 额外参数最少,体积最小 | 一个离群权重就能把整组刻度带偏 |
用勺子打比方:group_size=128 相当于每 128 味配料共用一套量勺。分得太细,厨房要摆满各种规格的量勺;分得太粗,一套量勺量不准所有东西。
2.4 推理的两个阶段与 KV cache
LLM 推理过程通常分为两个阶段,vLLM 的全部优化都围绕这两个阶段展开:
对应厨房:prefill 是备料——把整张订单的食材一次性处理好;decode 是出餐——一份一份端出去,前一份端出去了才知道下一份怎么配。
为什么只缓存 K 和 V,不缓存 Q
大模型计算复杂度最高的就是自注意力 QKV 的计算。如果每输出一个字符都要从头计算,成本太高,所以把中间阶段的 K 和 V 值存入缓存,这就是 KV cache。在 prefill 阶段,prompt 过一遍模型后得到的 K、V 就保存进 cache。
厨房版本:高汤(K、V)熬一次能反复取用,点单的那句话(Q)用完就作废。
传统 KV cache 的三个问题
传统做法是直接分配一段连续的物理显存给 KV cache。随着 prompt 变长、输出序列变长,这段显存不断增长,于是问题接踵而至:
| 问题 | 后果 |
|---|---|
| 输出序列长度无法预先知道 | 没法为 KV cache 量身定制存储空间,只能拍脑袋预留 |
| 预留多了 | 大量显存被占着不用,能并发的请求数被硬生生压低 |
| 预留少了 | 生成到一半空间不够,请求失败或被迫中断 |
还有一个批处理上的两难:业务数据是流式到达的,推理动作却是批量的。凑不满一批就开始推理,要拿 0 去填充、浪费算力;等着凑满,又不知道要等到什么时候、浪费时间。如何优化 KV cache、节省显存、提高推理吞吐量,就成了 LLM 推理框架要解决的重点问题。
2.5 PagedAttention:把显存改成「按块发放」
vLLM 通过一种名为 PagedAttention 的技术,动态地为请求分配 KV cache 显存,提升显存利用率。它的设计灵感来自操作系统中虚拟内存的分页管理技术。
先回忆一下分页管理的三条基本原理:
- 把物理内存划分为固定大小的块,每一块叫一页(page);从物理内存模拟出来的虚拟内存也按相同方式划分。
- 对于一个进程,不需要静态加载它的全部代码和数据。用到哪部分就动态加载哪部分到虚拟内存,再由虚拟内存做物理内存的映射。
- 一个进程在物理内存上的存储可以不连续,但在它自己的虚拟内存里是连续的。通过模拟连续内存,既解决了物理内存的碎片问题,也方便了进程的开发和运行。
把两个进程看成两本书,代码分布在书的不同页上:想读哪一页就加载哪一页,而不是把两本书整个搬进来;不想读某些页时,也能按页码把它清空。
PagedAttention 把这套机制原样搬到了 KV cache 上,四个概念一一对应:
| PagedAttention | 操作系统里的对应物 | 说明 |
|---|---|---|
| 请求(request) | 进程 | 一次会话就是一个「进程」 |
| 逻辑内存 (logical KV blocks) | 虚拟内存 | 每个 block 类比一个 page,大小固定,vLLM 中默认为 16,即可装 16 个 token 的 K/V 值 |
| 块表(block table) | 虚拟内存到物理内存的映射表 | 记录每个逻辑 block 实际落在哪个物理 block 上 |
| 物理内存 (physical KV blocks) | 物理内存 | 真正的 GPU 显存,物理块之间不要求连续 |
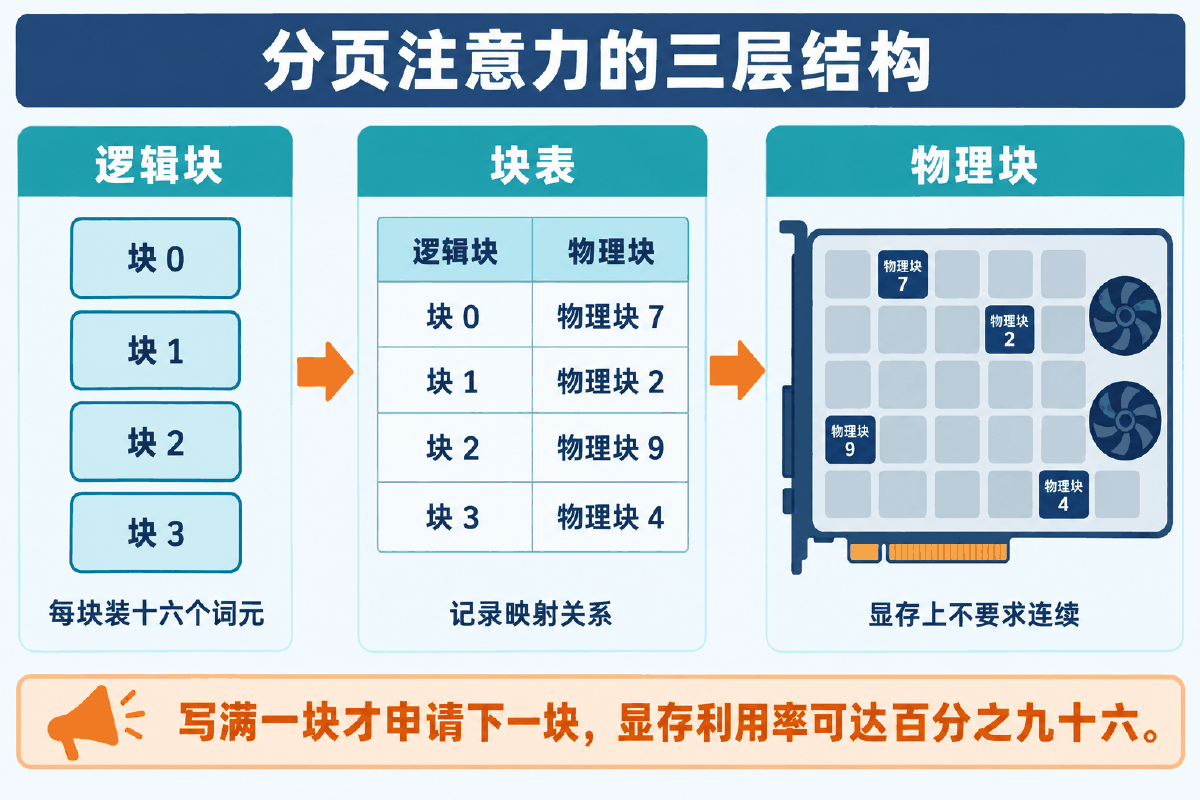
于是 2.4 节那三个问题一起消失了:只有在当前块写满时才申请下一块,每次只增加一块,最坏的结果不过是最后一个块没写满。这种方式下显存的利用率能达到 96%。
批量任务调度:不必等同一批
显存利用率提高之后,能并行的推理任务数量随之增加,调度策略也跟着变了:
vLLM 不再要求所有并行任务处于同一阶段。别的任务正在 decode 时,只要资源充足,新任务可以随时开始 prefill,减少了任务批次之间的等待。
如果超出并行量,最后的请求会被抢占(preemption),退出所有占用资源,等待运行中的任务完成后再继续。
厨房版本:流水线上不必等「全部菜都备完料」才统一开火,哪个灶台空出来就先做哪单;灶台全占满时,最后来的单子先退回等位区,而不是把所有人的菜都拖慢。
03最小代码:三条命令走完全程
先把最短的一条路跑通,再回头看每个参数为什么这么填
三道工序剥掉所有可选项之后,只剩三次调用。把它们串起来,就是从 checkpoint 到线上服务的最短路径:
第一步:合并,一个 YAML 一条命令
合并没有 Python 代码,全部配置写在 YAML 里,命令只负责把它读进去:
### LoRA / QLoRA 权重合并模板
### 用法:llamafactory-cli export merge_lora.template.yaml
### 合并时不要使用量化模型,也不要写 quantization_bit

### model
# TODO 1: 基座模型路径或 HuggingFace 模型 ID,必须与训练时用的基座完全一致
model_name_or_path: TODO-PATH-TO-BASE-MODEL
# TODO 2: 训练产出的 adapter 目录(checkpoint-xxx 那一层)
adapter_name_or_path: TODO-PATH-TO-LORA-CHECKPOINT
# 合并 Qwen2 系列时必须为 qwen
template: qwen
# 无论训练时用的是 LoRA 还是 QLoRA,这里一律填 lora
finetuning_type: lora

### export
# TODO 3: 合并后完整权重的落盘目录
export_dir: models/qwen2-7b-sft-lora-merged
# 单个权重分片的最大体积,单位 GB
export_size: 2
# 合并在 CPU 上做,显存不够也能完成;有充裕显存可改 cuda
export_device: cpu
# 是否导出为旧版 .bin 格式,false 表示使用 safetensors
export_legacy_format: false
然后执行:
llamafactory-cli export merge_lora.template.yaml跑完 export_dir 指向的目录里就是一份完整模型:权重分片、config.json、tokenizer 文件一应俱全,可以像任何 HuggingFace 模型一样被加载。
第二步:量化,一条命令三个路径
量化脚本要三样东西:待量化的模型、一份校准数据、一个输出目录。
python run_gptq.py \
  --model_name_or_path models/qwen2-7b-sft-lora-merged \
  --data_path data/calibration.json \
  --out_path models/qwen2-7b-sft-gptq-int4
校准数据是普通的对话 JSON,每条形如 {"conversations": [{"from": "user", "value": "..."}, {"from": "assistant", "value": "..."}]}。几百条真实业务样本就够,不需要训练集那个量级——它只用来「试吃」,不用来学习。
依赖装一次即可:
pip install auto-gptq optimum -i https://mirrors.aliyun.com/pypi/simple/第三步:起服务,一行命令
vLLM 提供了一个 OpenAI 风格的 HTTP API 服务器,启动之后就可以让客户端通过 REST API 调用模型做文本生成:
python -m vllm.entrypoints.openai.api_server \
  --model models/qwen2-7b-sft-gptq-int4 \
  --host 0.0.0.0 \
  --port 8000 \
--trust_remote_code True| 参数 | 作用 |
|---|---|
--model | 模型目录。合并后的 FP16 目录、GPTQ 量化产物都可以,vLLM 会自己识别量化格式 |
--host 0.0.0.0 | 监听所有网卡。只写 127.0.0.1 的话容器外、局域网内都访问不到 |
--port 8000 | 服务端口。云平台上还要在控制台做一次端口映射,才能拿到对外 URL |
--trust_remote_code True | Qwen 这类带自定义建模代码的模型需要它,否则加载直接报错 |
日志刷到服务启动完毕的提示,就可以用 OpenAI 客户端去调了:
"""用 OpenAI 客户端访问 vLLM 起的 api server,并顺手量一下输出速度。

服务端地址与凭据全部来自环境变量,脚本里不写死任何 key:
    export VLLM_BASE_URL="http://127.0.0.1:8000/v1"
    export VLLM_API_KEY="本地服务随便填一个占位串"
    export VLLM_MODEL="add1"      # 指定走哪个 LoRA;留空则走基座模型

依赖:pip install openai
运行:python vllm_client.py
"""

import os
import time

from openai import OpenAI


def build_client() -> OpenAI:
    base_url = os.environ.get("VLLM_BASE_URL", "http://127.0.0.1:8000/v1")
    # vLLM 本地服务不校验 key,但 openai SDK 要求这个字段非空,
    # 所以仍然从环境变量取,绝不在源码里写死真实凭据
    api_key = os.environ.get("VLLM_API_KEY")
    if not api_key:
        raise RuntimeError("未找到 VLLM_API_KEY,请先在环境变量里配置")
    return OpenAI(api_key=api_key, base_url=base_url)


def call_server(client: OpenAI, prompt: str) -> str:
    # model 传 LoRA 的挂载名就走那个 LoRA,传空字符串则走基座模型
    model = os.environ.get("VLLM_MODEL", "")
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2048,
    )
    return result.choices[0].message.content


def main() -> None:
    client = build_client()
    prompt = "用一段话说明 PagedAttention 解决了什么问题。"

    start = time.time()
    answer = call_server(client, prompt)
    cost = time.time() - start

    print(answer)
    print("-" * 60)
    print(f"输出长度:{len(answer)} 字")
    print(f"耗时:{cost:.2f} 秒")
    print(f"输出速度:{len(answer) / cost:.2f} 字/秒")


if __name__ == "__main__":
    main()
openai SDK 要求 api_key 字段非空。不要因此就在源码里写一个字面量顶上——这个习惯一旦养成,换到需要真实凭据的服务时就会原样把 key 写进去。统一用 os.environ.get(...) 读,取不到就报错退出。
LLM 类一次投喂整批 prompt,内部照样享受 PagedAttention 与连续批处理的好处。
"""vLLM 离线批量推理:一次把整批 prompt 喂进去,拿回全部结果。

离线模式不起 HTTP 服务,适合跑评测、批量刷数据。
依赖:pip install vllm
运行:python vllm_offline_infer.py --model <模型目录>
"""

import argparse

from vllm import LLM, SamplingParams


def build_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser("vLLM offline batch inference")
    parser.add_argument("--model", type=str, required=True,
                        help="模型目录,合并后的全量权重或 GPTQ 量化产物都行")
    parser.add_argument("--temperature", type=float, default=0.8,
                        help="采样温度,越大越发散")
    parser.add_argument("--top_p", type=float, default=0.95,
                        help="核采样阈值")
    parser.add_argument("--max_tokens", type=int, default=100,
                        help="单条输出的最大 token 数")
    return parser.parse_args()


def main() -> None:
    args = build_args()

    # 一次投喂多条,vLLM 内部会自己做连续批处理,不必等凑满一批
    prompts = [
        "总结下面这段文本的摘要:随着科技的飞速发展,我们的生活方式也在悄然改变。"
        "智能手机、人工智能、物联网等科技产品的出现,为我们的日常生活带来了更多便利和舒适。",
        "用三句话说明什么是 KV cache。",
    ]

    sampling_params = SamplingParams(
        temperature=args.temperature,
        top_p=args.top_p,
        max_tokens=args.max_tokens,
    )

    # trust_remote_code=True:Qwen 等带自定义建模代码的模型需要它
    llm = LLM(model=args.model, trust_remote_code=True)

    outputs = llm.generate(prompts, sampling_params)

    for output in outputs:
        print("=" * 60)
        print("Prompt:", output.prompt)
        print("Output:", output.outputs[0].text)


if __name__ == "__main__":
    main()
04完整案例:把 Qwen 的 checkpoint 送上线
三道工序逐段拆开,每一步的配置、代码、日志和产物长什么样
前面讲的是通用方法:任何一个走 LoRA 路线的模型,都要经过合并、量化、部署。这一节落到具体项目上——把上一讲训练出来的 Qwen adapter,一路送到能对外提供服务的状态。
4.1 第一道工序:把便签誊写进菜谱
配置文件全貌如下,逐行都有注释;下面再逐个参数讲它的取值逻辑。
### LoRA / QLoRA 权重合并模板
### 用法:llamafactory-cli export merge_lora.template.yaml
### 合并时不要使用量化模型,也不要写 quantization_bit

### model
# TODO 1: 基座模型路径或 HuggingFace 模型 ID,必须与训练时用的基座完全一致
model_name_or_path: TODO-PATH-TO-BASE-MODEL
# TODO 2: 训练产出的 adapter 目录(checkpoint-xxx 那一层)
adapter_name_or_path: TODO-PATH-TO-LORA-CHECKPOINT
# 合并 Qwen2 系列时必须为 qwen
template: qwen
# 无论训练时用的是 LoRA 还是 QLoRA,这里一律填 lora
finetuning_type: lora

### export
# TODO 3: 合并后完整权重的落盘目录
export_dir: models/qwen2-7b-sft-lora-merged
# 单个权重分片的最大体积,单位 GB
export_size: 2
# 合并在 CPU 上做,显存不够也能完成;有充裕显存可改 cuda
export_device: cpu
# 是否导出为旧版 .bin 格式,false 表示使用 safetensors
export_legacy_format: false
| 参数 | 说明 | 怎么填 |
|---|---|---|
model_name_or_path | 预训练模型的名称或路径 | 必须与训练时用的基座完全一致,包括版本。填错不会报错,只会输出走样 |
adapter_name_or_path | adapter 路径 | 指到 checkpoint-xxx 那一层目录,里面有 adapter_model.safetensors |
template | 模型模板 | 合并 Qwen2 模型权重,务必将 template 设为 qwen |
finetuning_type | 微调类型 | 无论 LoRA 还是 QLoRA 训练,合并权重时 finetuning_type 均为 lora |
export_dir | 导出路径 | 合并产物落盘目录,建议名字里带上基座名与训练方式,便于追溯 |
export_size | 最大导出模型文件大小 | 单位 GB,控制分片粒度。填 2 就是每个分片不超过 2 GB |
export_device | 导出设备 | cpu 慢但稳,显存不够也能完成;显存充裕可改 cuda 提速 |
export_legacy_format | 是否使用旧格式导出 | false 表示用 safetensors;除非下游工具只认 .bin,否则保持 false |
执行合并:
llamafactory-cli export merge_lora.template.yamltemplate 设为 qwen。② 无论 LoRA 还是 QLoRA 训练,合并权重时
finetuning_type 均为 lora。另外,合并时不要使用量化模型,也不要写
quantization_bit——这一条在配置文件顶部就用注释标出来了。
export_dir 目录:应该有若干 model-0000x-of-0000y.safetensors 分片、一个 model.safetensors.index.json、config.json,以及 tokenizer 相关文件。总体积应当与基座相当(7B 的 FP16 约 14 GB)。如果只有几十 MB,说明导出的还是 adapter,配置没生效。
4.2 第二道工序:GPTQ 4-bit 量化
量化脚本实现了对 Qwen 系列大语言模型的 GPTQ 量化(4-bit)全流程,主要包含三个关键阶段:数据预处理 → 模型量化 → 结果保存。
"""用 AutoGPTQ 把合并后的 Qwen 模型量化到 4-bit。

三个阶段:把对话数据拼成 ChatML 校准样本 -> 逐层量化 -> 存成 safetensors。
所有路径都走命令行参数,脚本里不写死任何目录。

依赖:pip install auto-gptq optimum transformers torch
运行:python run_gptq.py --model_name_or_path <合并后的模型目录> \
                        --data_path <校准数据.json> \
                        --out_path <量化产物目录>
"""

import argparse
import json
import logging
from typing import Any, Dict, List

import torch
import transformers
from transformers import AutoTokenizer
from transformers.trainer_pt_utils import LabelSmoother
from auto_gptq import AutoGPTQForCausalLM, BaseQuantizeConfig

# 这个常量标记「不参与 loss 计算」的位置,值为 -100
IGNORE_TOKEN_ID = LabelSmoother.ignore_index


def preprocess(
    sources: List[Dict[str, Any]],
    tokenizer: transformers.PreTrainedTokenizer,
    max_len: int,
    system_message: str = "You are a helpful assistant.",
) -> List[Dict[str, torch.Tensor]]:
    """把原始对话拼成 Qwen 的 ChatML 格式,并切成 input_ids / attention_mask。

    拼出来的文本形如:
        <|im_start|>system\n你是一个助手<|im_end|>\n
        <|im_start|>user\n什么是 AI<|im_end|>\n
        <|im_start|>assistant\nAI 是……<|im_end|>\n
    """
    # 角色前缀:ChatML 用 <|im_start|>角色 开头,<|im_end|> 收尾
    roles = {"user": "<|im_start|>user", "assistant": "<|im_start|>assistant"}

    im_start = tokenizer.im_start_id          # <|im_start|> 的 token id
    im_end = tokenizer.im_end_id              # <|im_end|> 的 token id
    nl_tokens = tokenizer("\n").input_ids     # 换行符的 token id
    _system = tokenizer("system").input_ids + nl_tokens

    data: List[Dict[str, torch.Tensor]] = []

    for source in sources:
        source = source["conversations"]
        # 首句若不是用户发言就丢掉,保证对话从 user 开始
        if roles[source[0]["from"]] != roles["user"]:
            source = source[1:]

        input_id: List[int] = []
        target: List[int] = []

        # 先铺系统消息:input 里保留全文,target 里整段屏蔽掉
        system = [im_start] + _system + tokenizer(system_message).input_ids \
            + [im_end] + nl_tokens
        input_id += system
        target += [im_start] + [IGNORE_TOKEN_ID] * (len(system) - 3) \
            + [im_end] + nl_tokens
        assert len(input_id) == len(target)

        for sentence in source:
            role = roles[sentence["from"]]
            _input_id = tokenizer(role).input_ids + nl_tokens \
                + tokenizer(sentence["value"]).input_ids + [im_end] + nl_tokens
            input_id += _input_id

            if role == "<|im_start|>user":
                # 用户说的话不参与 loss,整段填 IGNORE_TOKEN_ID
                _target = [im_start] + [IGNORE_TOKEN_ID] * (len(_input_id) - 3) \
                    + [im_end] + nl_tokens
            elif role == "<|im_start|>assistant":
                # 助手回答要学,只屏蔽掉角色前缀那几个 token
                prefix_len = len(tokenizer(role).input_ids)
                _target = [im_start] + [IGNORE_TOKEN_ID] * prefix_len \
                    + _input_id[prefix_len + 1:-2] + [im_end] + nl_tokens
            else:
                raise NotImplementedError(f"未知角色:{role}")
            target += _target

        assert len(input_id) == len(target)

        # 超长直接截断到 max_len
        ids = torch.tensor(input_id[:max_len], dtype=torch.int)
        # 非 padding 位置为 1,让注意力跳过填充位
        attention_mask = ids.ne(tokenizer.pad_token_id)
        data.append(dict(input_ids=ids, attention_mask=attention_mask))

    return data


def build_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser("Model Quantization using AutoGPTQ")
    parser.add_argument("--model_name_or_path", type=str, required=True,
                        help="待量化的模型目录(LoRA 请先合并权重)")
    parser.add_argument("--data_path", type=str, required=True,
                        help="校准数据 JSON,几百条真实对话即可")
    parser.add_argument("--out_path", type=str, required=True,
                        help="量化产物输出目录")
    parser.add_argument("--max_len", type=int, default=8192,
                        help="单条校准样本的最大 token 数")
    parser.add_argument("--bits", type=int, default=4,
                        help="量化位宽,4 表示 int4")
    parser.add_argument("--group_size", type=int, default=128,
                        help="分组量化的组大小,每 128 个权重共享一组量化参数")
    return parser.parse_args()


def main() -> None:
    args = build_args()

    logging.basicConfig(
        format="%(asctime)s %(levelname)s [%(name)s] %(message)s",
        level=logging.INFO,
        datefmt="%Y-%m-%d %H:%M:%S",
    )

    quantize_config = BaseQuantizeConfig(
        bits=args.bits,
        group_size=args.group_size,   # 分组量化:组内共享缩放系数,组越小精度越好、体积越大
        damp_percent=0.01,            # 阻尼系数,调大可抑制量化带来的数值抖动
        desc_act=False,               # False 明显提速,困惑度会略微变差
        static_groups=False,          # False 表示分组在量化过程中可动态调整
        sym=True,                     # 对称量化,零点固定在 0,误差更小
        true_sequential=True,         # 按权重顺序逐个处理,精度更高
        model_name_or_path=None,
        model_file_base_name="model",
    )

    tokenizer = AutoTokenizer.from_pretrained(
        args.model_name_or_path, trust_remote_code=True)
    # Qwen 没有单独的 pad token,用结束符顶上
    tokenizer.pad_token_id = tokenizer.eod_id

    with open(args.data_path, encoding="utf-8") as f:
        raw = json.load(f)
    data = preprocess(raw, tokenizer, args.max_len)
    logging.info("校准样本数:%d", len(data))

    model = AutoGPTQForCausalLM.from_pretrained(
        args.model_name_or_path,
        quantize_config,
        device_map="auto",
        trust_remote_code=True,
    )

    # 真正的量化在这一行发生,日志会逐层打印 avg loss
    # cache_examples_on_gpu=False:校准中间结果放 CPU,省显存
    model.quantize(data, cache_examples_on_gpu=False)

    # use_safetensors=True:存成 safetensors,加载时不执行任意代码
    model.save_quantized(args.out_path, use_safetensors=True)
    tokenizer.save_pretrained(args.out_path)
    logging.info("量化完成,产物已写入:%s", args.out_path)


if __name__ == "__main__":
    main()
阶段一:preprocess() 把对话拼成 ChatML
校准数据是普通的对话 JSON,但模型只认自己的对话格式。preprocess() 做的事就是把原始对话转换为符合 Qwen 模型输入格式的 token 序列,拼出来的文本长这样:
<|im_start|>system
You are a helpful assistant.<|im_end|>
<|im_start|>user
What is AI?<|im_end|>
<|im_start|>assistant
AI is...<|im_end|>
具体做了四件事:
| 动作 | 细节 |
|---|---|
| 添加特殊标记 | 每段以 <|im_start|>角色 开头、<|im_end|> 收尾,这套记法就是 ChatML。代码里用 tokenizer.im_start_id / im_end_id 取它们的 token id |
| 构建系统消息上下文 | 开头固定铺一段 system 消息,默认是 You are a helpful assistant. |
| 区分用户 / 助手角色段落 | 首句若不是 user 就丢掉,保证对话从用户发言开始 |
生成 input_ids 与 attention_mask | 前者是截断到 max_len 的 token 序列,后者标出哪些位置不是 padding |
IGNORE_TOKEN_ID 在屏蔽什么
IGNORE_TOKEN_ID = LabelSmoother.ignore_index,值是 -100。它标记「这个位置不参与 loss 计算」:system 段整段屏蔽,user 段整段屏蔽,只有 assistant 的回答内容保留下来。放在校准场景里理解:试吃时只尝主厨要求改的那几味,客人点单的原话不算在评分里。
tokenizer.pad_token_id = tokenizer.eod_id 不能省
Qwen 没有单独的 pad token。不补这一行,后面 input_id.ne(tokenizer.pad_token_id) 会拿 None 去比较,直接抛错。
阶段二:BaseQuantizeConfig 逐参数
量化配置决定了「刻度怎么划」。七个参数逐个看:
| 参数 | 取值 | 作用 |
|---|---|---|
bits | 4 | 量化位宽,4 表示 int4 模型。这是体积压缩的主要来源 |
group_size | 128 | 指定量化时使用的组大小。组量化把模型中的多个权重组合在一起进行量化,以减少模型大小并提高计算效率 |
damp_percent | 0.01 | 用于在量化过程中控制权重的调整程度。较高的值可以减少量化带来的影响 |
desc_act | False | 设置为 False 可以显著加快推理速度,但困惑度可能会略有下降 |
static_groups | False | 是否在量化过程中使用静态量化。设为 True 则量化过程中组不会被动态调整 |
sym | True | 对称性。控制量化是否是对称的,可以减少量化误差 |
true_sequential | True | 控制量化过程中是否考虑权重的顺序。设为 True 时量化过程会考虑权重顺序,可能提高量化后模型的精度 |
真正触发量化的只有一行:
model.quantize(data, cache_examples_on_gpu=False)cache_examples_on_gpu=False 把校准过程的中间结果放在 CPU 而不是显存里。量化本身就是为了省显存,这里再省一道——代价是多一些 CPU 与 GPU 之间的搬运时间。
阶段三:保存为可部署格式
model.save_quantized(args.out_path, use_safetensors=True)
tokenizer.save_pretrained(args.out_path)
use_safetensors=True 让权重以 safetensors 格式落盘——这是一种安全序列化格式,加载时不会执行任意代码,也就不会因为拿到一个来路不明的权重文件而被注入。同时要记得把 tokenizer 一起存到同一个目录,否则部署时模型加载得起来、分词器找不到。
4.3 读懂量化日志:avg loss 是什么,为什么越往后越大
量化跑起来后,日志会逐层、逐个模块地刷。截取第 1 层的片段:
INFO - Start quantizing layer 1/24
INFO - Quantizing attn.c_attn in layer 1/24...
[auto_gptq.quantization.gptq] duration: 1.5492913722991943
[auto_gptq.quantization.gptq] avg loss: 0.30306549643755853
INFO - Quantizing attn.c_proj in layer 1/24...
[auto_gptq.quantization.gptq] duration: 0.5725982189178467
[auto_gptq.quantization.gptq] avg loss: 9.118557701843061e-05
INFO - Quantizing mlp.w1 in layer 1/24...
[auto_gptq.quantization.gptq] avg loss: 0.605090880661868
INFO - Quantizing mlp.w2 in layer 1/24...
[auto_gptq.quantization.gptq] avg loss: 0.5784293756949321
INFO - Quantizing mlp.c_proj in layer 1/24...
[auto_gptq.quantization.gptq] avg loss: 0.018937584166223192
再看第 23、24 层同样位置的数字:
| 模块 | layer 1/24 | layer 22/24 | layer 23/24 | layer 24/24 |
|---|---|---|---|---|
attn.c_attn | 0.3031 | 13.3245 | 11.9609 | 11.1491 |
attn.c_proj | 0.0000912 | 0.4531 | 0.5182 | 0.8637 |
mlp.w1 | 0.6051 | 7.9842 | 8.3594 | 8.1233 |
mlp.w2 | 0.5784 | 6.7273 | 7.1481 | 7.1085 |
mlp.c_proj | 0.0189 | 2.6601 | 2.8796 | 5.5982 |
avg loss 就是 2.2 节第 ③ 步的度量:这个模块量化前后,在校准数据上的平均输出误差。duration 是这个模块量化耗时,单位秒。
这份日志里,靠后的层数值明显高于第 1 层。一个合理的解释是:GPTQ 是逐层独立处理的,后面的层拿到的输入已经是前面所有层量化之后的输出,误差在层间累积,所以越靠后的层要拟合的目标本身就带着前面的偏差。
attn.c_attn 反而在下降(13.32 → 11.96 → 11.15)。不同模型、不同校准数据,曲线形状会变。avg loss 的绝对值也没有统一及格线,不同模块的量级本来就差着好几个数量级(同一层里
attn.c_proj 是 9.1e-05,mlp.w1 是 0.605)。真正该看的是量化完之后跑一遍业务评测,用任务指标判断能不能上线,而不是盯着日志数字猜。
量化跑完会进入 Packing model... 阶段,把逐层结果打包写盘,日志逐个打印 transformer.h.0.attn.c_attn 这样的模块名,直到 Model packed. 出现,整个过程结束。
4.4 第三道工序:vLLM 上线
先用离线接口确认模型能正常出字,再起服务——这样出问题时能立刻分清是模型的事还是服务的事。
"""vLLM 离线批量推理:一次把整批 prompt 喂进去,拿回全部结果。

离线模式不起 HTTP 服务,适合跑评测、批量刷数据。
依赖:pip install vllm
运行:python vllm_offline_infer.py --model <模型目录>
"""

import argparse

from vllm import LLM, SamplingParams


def build_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser("vLLM offline batch inference")
    parser.add_argument("--model", type=str, required=True,
                        help="模型目录,合并后的全量权重或 GPTQ 量化产物都行")
    parser.add_argument("--temperature", type=float, default=0.8,
                        help="采样温度,越大越发散")
    parser.add_argument("--top_p", type=float, default=0.95,
                        help="核采样阈值")
    parser.add_argument("--max_tokens", type=int, default=100,
                        help="单条输出的最大 token 数")
    return parser.parse_args()


def main() -> None:
    args = build_args()

    # 一次投喂多条,vLLM 内部会自己做连续批处理,不必等凑满一批
    prompts = [
        "总结下面这段文本的摘要:随着科技的飞速发展,我们的生活方式也在悄然改变。"
        "智能手机、人工智能、物联网等科技产品的出现,为我们的日常生活带来了更多便利和舒适。",
        "用三句话说明什么是 KV cache。",
    ]

    sampling_params = SamplingParams(
        temperature=args.temperature,
        top_p=args.top_p,
        max_tokens=args.max_tokens,
    )

    # trust_remote_code=True:Qwen 等带自定义建模代码的模型需要它
    llm = LLM(model=args.model, trust_remote_code=True)

    outputs = llm.generate(prompts, sampling_params)

    for output in outputs:
        print("=" * 60)
        print("Prompt:", output.prompt)
        print("Output:", output.outputs[0].text)


if __name__ == "__main__":
    main()
启动日志里有几行值得停一下:
| 日志 | 含义 |
|---|---|
Available KV cache memory: 16.56 GiB | 模型权重装完之后,剩给 KV cache 的显存。这个数字直接决定能并发多少 |
GPU KV cache size: 90,400 tokens | 把上面的显存换算成能缓存多少个 token 的 K/V |
Maximum concurrency for 8,192 tokens per request: 11.04x | 按每请求 8192 token 估算,大约能并发 11 路。这就是 2.5 节说的「并行量」 |
Chunked prefill is enabled | 长 prompt 的 prefill 会被切块执行,避免一次占满调度窗口 |
est. speed input: 424.53 toks/s, output: 176.47 toks/s | 这一批请求的实测输入 / 输出吞吐 |
确认没问题就起 HTTP 服务:
python -m vllm.entrypoints.openai.api_server \
  --model /path/to/your-model \
  --host 0.0.0.0 \
  --port 8000 \
--trust_remote_code True如果跑在云平台的容器里,本机端口还要在控制台做一次端口映射,才能拿到一个对外可访问的 URL。拿到之后,客户端只需要把 base_url 指过去:
"""用 OpenAI 客户端访问 vLLM 起的 api server,并顺手量一下输出速度。

服务端地址与凭据全部来自环境变量,脚本里不写死任何 key:
    export VLLM_BASE_URL="http://127.0.0.1:8000/v1"
    export VLLM_API_KEY="本地服务随便填一个占位串"
    export VLLM_MODEL="add1"      # 指定走哪个 LoRA;留空则走基座模型

依赖:pip install openai
运行:python vllm_client.py
"""

import os
import time

from openai import OpenAI


def build_client() -> OpenAI:
    base_url = os.environ.get("VLLM_BASE_URL", "http://127.0.0.1:8000/v1")
    # vLLM 本地服务不校验 key,但 openai SDK 要求这个字段非空,
    # 所以仍然从环境变量取,绝不在源码里写死真实凭据
    api_key = os.environ.get("VLLM_API_KEY")
    if not api_key:
        raise RuntimeError("未找到 VLLM_API_KEY,请先在环境变量里配置")
    return OpenAI(api_key=api_key, base_url=base_url)


def call_server(client: OpenAI, prompt: str) -> str:
    # model 传 LoRA 的挂载名就走那个 LoRA,传空字符串则走基座模型
    model = os.environ.get("VLLM_MODEL", "")
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2048,
    )
    return result.choices[0].message.content


def main() -> None:
    client = build_client()
    prompt = "用一段话说明 PagedAttention 解决了什么问题。"

    start = time.time()
    answer = call_server(client, prompt)
    cost = time.time() - start

    print(answer)
    print("-" * 60)
    print(f"输出长度:{len(answer)} 字")
    print(f"耗时:{cost:.2f} 秒")
    print(f"输出速度:{len(answer) / cost:.2f} 字/秒")


if __name__ == "__main__":
    main()
model 参数填什么
没挂 LoRA 时,model 填启动时 --model 给的那个路径字符串(服务端会把它作为 served model name)。挂了 LoRA 时填 adapter 的挂载名。传空串则直接使用基座模型推理。
4.5 多 LoRA 同时挂载
vLLM 能够同时加载多个 LoRA,随时可以指定使用其中的任意一个。启动命令换成 vllm serve 形式,加上 --enable-lora 与 --lora-modules:
#!/usr/bin/env bash
# vLLM api server 启动骨架,改完 TODO 直接 bash serve_vllm.template.sh
set -euo pipefail

# TODO 1: 基座模型或量化产物目录
MODEL_PATH="TODO-PATH-TO-MODEL"
# TODO 2: 对外端口,容器/云平台上还要在控制台做端口映射
PORT="${PORT:-8000}"
# TODO 3: 用哪块卡
export CUDA_VISIBLE_DEVICES="${CUDA_VISIBLE_DEVICES:-0}"

# ---------- 写法一:模块入口,最通用 ----------
python -m vllm.entrypoints.openai.api_server \
  --model "${MODEL_PATH}" \
  --host 0.0.0.0 \
  --port "${PORT}" \
  --trust_remote_code True

# ---------- 写法二:同时挂多个 LoRA ----------
# 挂上去之后,客户端用 model 参数点名走哪个 LoRA,传空串则走基座模型。
# 去掉下面的注释并补上 TODO 路径即可启用(注意与写法一二选一)。
#
# vllm serve "${MODEL_PATH}" \
#   --host 0.0.0.0 \
#   --port "${PORT}" \
#   --enable-lora \
#   --lora-modules \
#     cot=TODO-PATH-TO-LORA-A/checkpoint-1250/ \
#     cat=TODO-PATH-TO-LORA-B/checkpoint-120/ \
#     spo=TODO-PATH-TO-LORA-C/checkpoint-375/
--lora-modules 后面是一串 名字=路径,名字由你自己取(上面用了 cot、cat、spo),路径指到 checkpoint-xxx 目录。挂上去之后,请求里 model="cot" 就走第一个 adapter,model="" 就走基座。
这个特性在实际生产中非常方便,好处有三条:
可以同时加载对比测试的 N 个 LoRA,无缝切换使用任意一个,随时对比它们在不同输入下的表现。省掉了「改配置、重启服务、再测一遍」的来回。
如果有多个低频使用的 LoRA,可以把它们加载到少数几台服务器上,节省部署服务的硬件资源——基座只装一份,adapter 才几十 MB。
多个 LoRA 分开部署时,每个 LoRA 需要做自己的服务器组,组内资源共享,但组间无法共享;统一部署则可以共享所有资源,峰谷互相填补。
还是中央厨房:同一条流水线上挂着好几本菜谱,点单时报菜谱名。要是每本菜谱都单开一间厨房,中午川菜排长队时,隔壁粤菜厨房的灶台只能空着。
4.6 速度实测:换框架换来了什么
同一个 3B 量级的 GPTQ-Int4 模型,同一块卡,同一个测试问题:
测试问题:对于「初三女生在搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元」的新闻事件,你有什么看法?
输出长度:1794 字 耗时:16.03 秒 输出速度:111.92 字/秒| 部署方式 | 实测输出速度 | 倍数 |
|---|---|---|
| LLaMA-Factory api server | 5.05 字/秒 | 基准 |
| LLaMA-Factory api server(另一次记录) | 7.26 字/秒 | 约 1.4× |
| vLLM api server | 111.92 字/秒 | 约 15–22× |
05骨架模板:五个文件覆盖全流程
改完 TODO 就能跑,凭据全部走环境变量
这一讲的产物是五个文件,按三道工序排开。每个文件都只留了必须由你决定的 TODO,其余参数已经按 4.x 节的取值逻辑填好。
| 文件 | 工序 | 改哪里 |
|---|---|---|
merge_lora.template.yaml | ① 合并 | 3 处 TODO:基座路径、adapter 路径、导出目录 |
run_gptq.py | ② 量化 | 不用改,三个路径全部走命令行参数 |
serve_vllm.template.sh | ③ 部署 | 3 处 TODO:模型路径、端口、显卡;多 LoRA 段按需解注释 |
vllm_offline_infer.py | ③ 验证 | 把 prompts 换成你的业务样例 |
vllm_client.py | ③ 调用 | 不用改,三个环境变量控制行为 |
5.1 合并配置模板
顶部那行注释是提醒自己的:合并时不要使用量化模型,也不要写 quantization_bit。
### LoRA / QLoRA 权重合并模板
### 用法:llamafactory-cli export merge_lora.template.yaml
### 合并时不要使用量化模型,也不要写 quantization_bit

### model
# TODO 1: 基座模型路径或 HuggingFace 模型 ID,必须与训练时用的基座完全一致
model_name_or_path: TODO-PATH-TO-BASE-MODEL
# TODO 2: 训练产出的 adapter 目录(checkpoint-xxx 那一层)
adapter_name_or_path: TODO-PATH-TO-LORA-CHECKPOINT
# 合并 Qwen2 系列时必须为 qwen
template: qwen
# 无论训练时用的是 LoRA 还是 QLoRA,这里一律填 lora
finetuning_type: lora

### export
# TODO 3: 合并后完整权重的落盘目录
export_dir: models/qwen2-7b-sft-lora-merged
# 单个权重分片的最大体积,单位 GB
export_size: 2
# 合并在 CPU 上做,显存不够也能完成;有充裕显存可改 cuda
export_device: cpu
# 是否导出为旧版 .bin 格式,false 表示使用 safetensors
export_legacy_format: false
5.2 起服务脚本模板
两种写法都留在里面:默认启用的是模块入口写法(最通用),下面注释掉的是多 LoRA 写法。两者二选一,不要同时放开,否则第二条命令永远等不到执行。
#!/usr/bin/env bash
# vLLM api server 启动骨架,改完 TODO 直接 bash serve_vllm.template.sh
set -euo pipefail

# TODO 1: 基座模型或量化产物目录
MODEL_PATH="TODO-PATH-TO-MODEL"
# TODO 2: 对外端口,容器/云平台上还要在控制台做端口映射
PORT="${PORT:-8000}"
# TODO 3: 用哪块卡
export CUDA_VISIBLE_DEVICES="${CUDA_VISIBLE_DEVICES:-0}"

# ---------- 写法一:模块入口,最通用 ----------
python -m vllm.entrypoints.openai.api_server \
  --model "${MODEL_PATH}" \
  --host 0.0.0.0 \
  --port "${PORT}" \
  --trust_remote_code True

# ---------- 写法二:同时挂多个 LoRA ----------
# 挂上去之后,客户端用 model 参数点名走哪个 LoRA,传空串则走基座模型。
# 去掉下面的注释并补上 TODO 路径即可启用(注意与写法一二选一)。
#
# vllm serve "${MODEL_PATH}" \
#   --host 0.0.0.0 \
#   --port "${PORT}" \
#   --enable-lora \
#   --lora-modules \
#     cot=TODO-PATH-TO-LORA-A/checkpoint-1250/ \
#     cat=TODO-PATH-TO-LORA-B/checkpoint-120/ \
#     spo=TODO-PATH-TO-LORA-C/checkpoint-375/
5.3 调用端模板
三个环境变量决定它的行为,一个都不写死:
| 环境变量 | 默认值 | 作用 |
|---|---|---|
VLLM_BASE_URL | http://127.0.0.1:8000/v1 | 服务地址,注意结尾的 /v1 不能少 |
VLLM_API_KEY | 无默认,缺失直接报错 | 本地服务不校验,但仍从环境变量取,绝不写死 |
VLLM_MODEL | 空串 | 挂了多 LoRA 时点名用哪个;空串走基座模型 |
"""用 OpenAI 客户端访问 vLLM 起的 api server,并顺手量一下输出速度。

服务端地址与凭据全部来自环境变量,脚本里不写死任何 key:
    export VLLM_BASE_URL="http://127.0.0.1:8000/v1"
    export VLLM_API_KEY="本地服务随便填一个占位串"
    export VLLM_MODEL="add1"      # 指定走哪个 LoRA;留空则走基座模型

依赖:pip install openai
运行:python vllm_client.py
"""

import os
import time

from openai import OpenAI


def build_client() -> OpenAI:
    base_url = os.environ.get("VLLM_BASE_URL", "http://127.0.0.1:8000/v1")
    # vLLM 本地服务不校验 key,但 openai SDK 要求这个字段非空,
    # 所以仍然从环境变量取,绝不在源码里写死真实凭据
    api_key = os.environ.get("VLLM_API_KEY")
    if not api_key:
        raise RuntimeError("未找到 VLLM_API_KEY,请先在环境变量里配置")
    return OpenAI(api_key=api_key, base_url=base_url)


def call_server(client: OpenAI, prompt: str) -> str:
    # model 传 LoRA 的挂载名就走那个 LoRA,传空字符串则走基座模型
    model = os.environ.get("VLLM_MODEL", "")
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2048,
    )
    return result.choices[0].message.content


def main() -> None:
    client = build_client()
    prompt = "用一段话说明 PagedAttention 解决了什么问题。"

    start = time.time()
    answer = call_server(client, prompt)
    cost = time.time() - start

    print(answer)
    print("-" * 60)
    print(f"输出长度:{len(answer)} 字")
    print(f"耗时:{cost:.2f} 秒")
    print(f"输出速度:{len(answer) / cost:.2f} 字/秒")


if __name__ == "__main__":
    main()
llamafactory-cli export merge_lora.template.yaml → python run_gptq.py --model_name_or_path <合并产物> --data_path <校准数据> --out_path <量化产物> → bash serve_vllm.template.sh → python vllm_client.py。中间任何一步失败,先回到 06 节对照现象。
06易错点汇总
按三道工序归类,每条都写清「现象 → 原因 → 修法」
⚠️ 一、合并阶段
- 压根没合并就去加载 adapter 目录。 现象:模型加载报错,或者加载成功但输出完全是基座的味道。原因:
checkpoint-xxx里只有 LoRA 权重,几十 MB,不是一个完整模型。修法:先跑llamafactory-cli export,确认导出目录体积与基座相当。 template没设成qwen。 现象:合并能完成,但推理时对话格式错乱、模型不停自问自答。原因:模板决定了对话怎么拼装。修法:合并 Qwen2 模型权重,务必将template设为qwen。- 训的是 QLoRA,就把
finetuning_type写成qlora。 现象:配置解析失败或合并结果不对。修法:无论 LoRA 还是 QLoRA 训练,合并权重时finetuning_type均为lora。QLoRA 只是训练时对基座做了量化,产出的 adapter 本身仍然是 LoRA。 - 合并时带上了量化模型或
quantization_bit。 现象:合并出来的模型质量明显低于训练时的评测结果。原因:在被压粗刻度的权重上叠加增量,精度被吃掉。修法:用 FP16 基座合并,量化放到合并之后单独做。 - 基座版本对不上。 现象:不报错,但输出莫名其妙。原因:LoRA 增量是相对某一份具体权重训出来的。修法:把训练时的
model_name_or_path原样抄进合并配置,包括版本号和本地路径。 - 合并之后又挂了一次同一个 adapter。 现象:输出风格夸张、重复、明显跑偏。原因:增量被加了两遍。修法:合并产物当普通模型用,不要再传
adapter_name_or_path。 export_device: cuda但显存不够。 现象:合并过程 OOM。修法:改成cpu,慢一些但不吃显存。
⚠️ 二、量化阶段
- 忘了
tokenizer.pad_token_id = tokenizer.eod_id。 现象:preprocess()里input_id.ne(tokenizer.pad_token_id)抛异常。原因:Qwen 没有独立的 pad token,默认是None。修法:照代码补上这一行。 - 把校准数据当训练数据准备。 现象:量化跑几个小时还没完,或者内存爆掉。原因:校准只需要一小部分样本,几百条真实对话即可。修法:抽样,不要全量。
- 校准数据和业务场景不搭。 现象:量化后通用能力还在,但业务任务上明显退化。原因:GPTQ 是在校准数据上最小化输出误差,校准数据决定了「保住哪部分能力」。修法:用真实业务样本做校准,别拿一份无关的公开数据集凑数。
- 把
avg loss当成模型质量的唯一判据。 现象:看到后面几层 loss 上到 10 以上就慌了,或者看到都小于 1 就直接上线。原因:不同模块的量级天然差好几个数量级(同一层里attn.c_proj是 9.1e-05、mlp.w1是 0.605),而且它没有统一及格线。修法:量化完跑一遍业务评测,用任务指标决定能不能上线。 - 把「层数越深 avg loss 越大」当成定律记。 现象:换个模型发现曲线不是这样,怀疑自己跑错了。原因:那只是某一次运行的观察,同一份日志里
attn.c_attn从 22 层到 24 层反而在下降。修法:当成「误差会在层间累积」这个机制的一个例子看,别当公式。 - 只存了权重、忘了存 tokenizer。 现象:部署时模型能加载,分词器找不到。修法:
save_quantized之后紧跟tokenizer.save_pretrained(out_path),两者必须落在同一个目录。 - 显存不够但
cache_examples_on_gpu开着。 现象:量化中途 OOM。修法:设成False,中间结果放 CPU。 - 期待 4-bit 之后显存正好降到四分之一。 现象:实测没降那么多。原因:GPTQ 只量化权重,激活值和 KV cache 都还是高精度。修法:按「权重那部分降到约四分之一」估算,KV cache 单独算。
- 把
desc_act=True当默认好选项。 现象:推理速度明显变慢。原因:desc_act=False可以显著加快推理速度,代价只是困惑度略有下降。修法:没有明确精度诉求就保持False。
⚠️ 三、部署阶段
- 漏了
--trust_remote_code True。 现象:加载 Qwen 直接报错,提示需要执行远程代码。修法:补上。同理,离线接口里LLM(model=..., trust_remote_code=True)也要带。 --host用了默认的本地回环。 现象:本机 curl 通,容器外 / 局域网内连不上。修法:--host 0.0.0.0;云平台上还要在控制台做一次端口映射才能拿到对外 URL。base_url漏了/v1。 现象:404 或者返回一段 HTML。修法:地址写成http://host:8000/v1。model参数随便填。 现象:报模型不存在。原因:没挂 LoRA 时它是启动时--model那个路径字符串;挂了 LoRA 时是 adapter 的挂载名。修法:不确定就先GET /v1/models看服务端报了哪些名字。传空串则走基座模型。- 把
api_key写死成一个字面量。 现象:代码本身能跑,但这个习惯迁到需要真实凭据的服务上就会泄漏。修法:一律os.environ.get(...),取不到就报错退出——模板里就是这么写的。 - 并发一上去首字延迟突然抬头。 现象:压测长尾延迟飙升。原因:超出并行量时最后的请求会被抢占(preemption),退出占用资源、排队等待。修法:看启动日志里的
Maximum concurrency估算上限,超了就加卡或限流,不是调采样参数能解决的。 - 多 LoRA 启动时两种写法同时放开。 现象:第二条命令永远不执行。原因:前一条
api_server是前台阻塞进程。修法:模板里两段二选一。 - 拿单请求速度去承诺并发吞吐。 现象:上线后实际表现和汇报数字对不上。修法:单请求 111.92 字/秒 是单请求口径;并发能力要另跑压测,没测就别报数。
⚠️ 四、跨阶段的顺序问题
- 先量化后合并。 这是本讲最贵的一个坑:量化产物不是 FP16,再拿它当基座合并,增量精度被量化误差吞掉。修法记死顺序:合并 → 量化 → 部署。
- 把 QLoRA 的 4-bit 当成「已经量化过了,可以直接上线」。 QLoRA 训完拿到的仍是高精度 adapter,基座的量化是训练期的显存手段,不是部署产物。修法:照样走合并,再决定要不要 GPTQ。
- 全量微调也去跑一遍合并。 现象:找不到 adapter 报错。原因:全量参数训练无需执行合并这一步,训练产物本身就是完整模型。修法:直接进量化或部署。
07自测题
点击题目展开答案;这 12 题答得上来,三道工序就通了
LoRA 训练完为什么不能直接拿 checkpoint 去推理?全量微调也要合并吗?
采用 LoRA 或 QLoRA 训练时,脚本只保存对应的 LoRA 权重(低秩增量,几十 MB),它是相对基座的「增量」,离开基座没有意义,需要合并权重才能进行推理。全量参数训练无需执行此步骤——它的产物本身就是一份完整模型。
合并 Qwen2 时,template 和 finetuning_type 分别填什么?
template 必须设为 qwen;finetuning_type 无论训练时用的是 LoRA 还是 QLoRA,一律填 lora。另外合并时不要使用量化模型,也不要写 quantization_bit。
合并之后模型体积会变大吗?为什么?
不会。合并是把低秩增量 加进 原有权重矩阵(W + BA → W'),参数量与基座完全一致,所以合并产物的体积等于基座体积,而不是「基座 + adapter」。如果导出目录只有几十 MB,说明导出的还是 adapter,配置没生效。
PTQ 和 QAT 有什么区别?各自的代表是什么?
PTQ(Post-Training Quantization,训练后量化)——训练完成后进行量化,代表是 GPTQ;QAT(Quantization Aware Training,量化感知训练)——训练/微调过程中同时进行量化,代表是 QLoRA。前者压的是推理阶段的体积与显存,不需要重训;后者压的是训练阶段的显存。
GPTQ 的四个基本步骤是什么?
① 收集校准数据:从训练数据或相关数据集中抽取一小部分样本;② 逐层处理:对每一层独立量化,避免全局优化的复杂度;③ 最小化输出误差:对每一层寻找最佳量化权重,使校准数据上的输出误差最小;④ 更新权重:用量化后的权重替换原始权重。
Hessian 逆矩阵在 GPTQ 里起什么作用?数值高的权重重要还是数值低的重要?
Hessian 告诉我们模型输出对每个权重变化的敏感程度,也就是权重的重要性。与 Hessian 矩阵中较小值相关的权重更为重要,因为这些权重的微小变化可能对模型性能产生重大影响。在 Hessian 矩阵的逆矩阵中,数值越低,权重越「重要」。 对权重的每一列,算法量化权重、计算误差,并相应更新其中的权重,处理完后再更新所有其余权重。
group_size=128 是什么意思?调大调小各有什么代价?
组量化把多个权重组合在一起进行量化,每 128 个权重共享一组量化参数(缩放系数与零点),以减少模型大小并提高计算效率。调小(如 32)刻度更贴合局部分布、精度更好,但要存的量化参数更多、体积变大;调大则额外参数少、体积小,但一个离群权重就能把整组刻度带偏。
量化日志里的 avg loss 是什么?为什么这次运行里靠后的层数值更大?能当成普适定律吗?
avg loss 是该模块量化前后在校准数据上的平均输出误差。这次运行里靠后的层数值更大,合理的解释是 GPTQ 逐层独立处理,后面的层拿到的输入已经是前面各层量化之后的输出,误差在层间累积。
但它不是普适定律:同一份日志里 attn.c_attn 从 22 层到 24 层反而在下降(13.32 → 11.96 → 11.15);不同模块的量级也天然差好几个数量级。判断能否上线要跑业务评测,不能盯日志数字猜。
为什么 4-bit 量化后显存占用不会精确降到四分之一?
因为 GPTQ 只对权重进行量化,激活值和 KV cache 仍然是高精度。省下的是「显存里放权重」的那部分和加载体积,计算过程并没有整体变成 4-bit 整数运算。
LLM 推理的两个阶段分别是什么?KV cache 在哪个阶段被写入?
prefill(预填充):把整段 prompt 喂给模型做 forward 计算,采用 KV cache 技术时,prompt 过后得到的 K、V 就保存进 cache;decode(生成):根据 prefill 的结果,一个 token 一个 token 地生成 response。
为什么是 KV cache 而不是 QKV cache?
decode 阶段每一步只有当前这一个新 token 需要 Query,去和前面所有 token 的 K、V 做注意力;历史 token 的 Q 再也不会被用到,缓存它没有意义。而历史 token 的 K、V 每一步都会被重新用到,缓存它们才省算力。
传统 KV cache 直接分配连续显存有哪三个问题?
① 输出序列长度无法预先知道,很难提前为 KV cache 量身定制存储空间;② 预留多了,大量显存被占着不用,能并发的请求数被压低;③ 预留少了,生成到一半空间不够。随着 prompt 变多变长,KV cache 不断变大,对显存造成压力。
PagedAttention 的四个概念分别对应操作系统里的什么?vLLM 默认一个 block 装多少 token?显存利用率能到多少?
请求(request)↔ 进程;逻辑内存(logical KV blocks)↔ 虚拟内存,每个 block 类比一个 page;块表(block table)↔ 虚拟内存到物理内存的映射表;物理内存(physical KV blocks)↔ 物理内存,块在 GPU 显存上。vLLM 中 block 默认大小为 16,即可装 16 个 token 的 K/V 值;这种方式下显存利用率能达到 96%。
vLLM 中一批任务正在推理,又来了一条新请求,会怎么处理?超出并行量呢?
vLLM 不再要求所有并行任务处于同一阶段:其他推理任务进行时,只要资源充足,新请求可以随时开始,减少了任务批次间的等待。如果超出并行量,最后的请求会被抢占(preemption),退出所有占用资源,等待运行中的任务完成后再继续——表现为这条请求的首字延迟明显变长。
同时加载多个 LoRA 有哪三个好处?客户端怎么指定用哪一个?
① 方便对比测试:同时加载 N 个 LoRA,无缝切换,随时对比不同输入下的表现;② 节约服务器资源:多个低频 LoRA 可以加载到少数几台服务器上;③ 方便负载均衡:分开部署时组内资源共享、组间无法共享,统一部署则可共享所有资源。
启动时用 --enable-lora --lora-modules 名字=路径 挂载,调用时用 model 参数点名;model 传空串则直接使用基座模型推理。
实测速度对比里那三个数字分别是什么口径?能不能说「vLLM 快 20 倍」?
LLaMA-Factory 起的 api server 实测有 5.05 字/秒 与 7.26 字/秒 两个记录,来自不同次运行;vLLM api server 部署后为 111.92 字/秒(输出 1794 字、耗时 16.03 秒)。
三个数字都是单请求口径,且训练框架侧两次测量条件不完全一致,所以只能说量级差异约 15–22 倍,不能报一个确定倍数。并发吞吐的差距要另跑压测,没测就不报数。
附术语表
这一讲出现过的英文原形,按工序排
| 术语 | 中文 | 一句话解释 |
|---|---|---|
adapter | 适配器 | LoRA 训练保存下来的低秩增量权重,几十 MB,离开基座无法独立推理 |
checkpoint | 检查点 | 训练过程中定期落盘的产物目录,LoRA 路线下里面只有 adapter |
merge / export | 权重合并 / 导出 | 把增量算回主干权重,产出一份能独立加载的完整模型 |
PTQ | 训练后量化 | Post-Training Quantization,训练完成后单独量化,代表是 GPTQ |
QAT | 量化感知训练 | Quantization Aware Training,训练过程中同时量化,代表是 QLoRA |
GPTQ | — | 只量化权重的高效后量化算法,逐层独立处理,能压到 4-bit 并保住精度 |
| Hessian | 海森矩阵 | 描述模型输出对权重变化的敏感程度;其逆矩阵中数值越低,权重越重要 |
| calibration data | 校准数据 | 一小批样本,用来衡量量化前后的输出差异,不参与训练 |
group_size | 分组大小 | 多少个权重共享一组量化参数,默认 128,是精度与体积的平衡点 |
avg loss | 平均误差 | 量化日志里每个模块量化前后在校准数据上的平均输出误差 |
| ChatML | — | Qwen 使用的对话标记格式,以 <|im_start|>角色 开头、<|im_end|> 收尾 |
| safetensors | — | 安全序列化的权重格式,加载时不执行任意代码 |
| prefill | 预填充阶段 | 把整段 prompt 一次性喂给模型做 forward 计算 |
| decode | 生成阶段 | 基于 prefill 结果,一个 token 一个 token 地产出 response |
KV cache | KV 缓存 | 把注意力的 K、V 中间结果存下来,避免每输出一个字符都从头算 |
| PagedAttention | 分页注意力 | 借鉴操作系统虚拟内存分页,把 KV cache 按固定块按需发放 |
| block table | 块表 | 逻辑 KV blocks 到物理 KV blocks 的映射表 |
| preemption | 抢占 | 超出并行量时,最后的请求退出占用资源、排队等待 |
| vLLM | — | 伯克利团队开发的高性能推理框架,靠显存管理与调度策略提升吞吐 |
| api server | 接口服务 | vLLM 提供的 OpenAI 风格 HTTP 服务,换个 base_url 就能调 |