优化器、学习率与正则化
同一个网络、同一批数据,换个优化器可能从学不动变成十几轮收敛。这一页把「梯度算出来之后该怎么迈这一步」讲透:四种优化器各解决什么问题、学习率该怎么衰减、模型开始背答案时用哪几招按住它。
30″30 秒看懂优化器与正则化
训练一个模型,就像蒙着眼睛下山:看不见全局地形,只能用脚尖探一探当前位置的坡度,然后朝着下坡方向挪一步,再探一次,再挪一步。山谷最低处就是损失最小的那组参数。
上一页已经把「怎么探坡度」讲完了——那就是反向传播算出来的梯度。这一页只回答后半句:探到坡度之后,这一步到底该怎么迈。迈法不同,有人十几轮走到谷底,有人在半山腰原地踏步一整天。
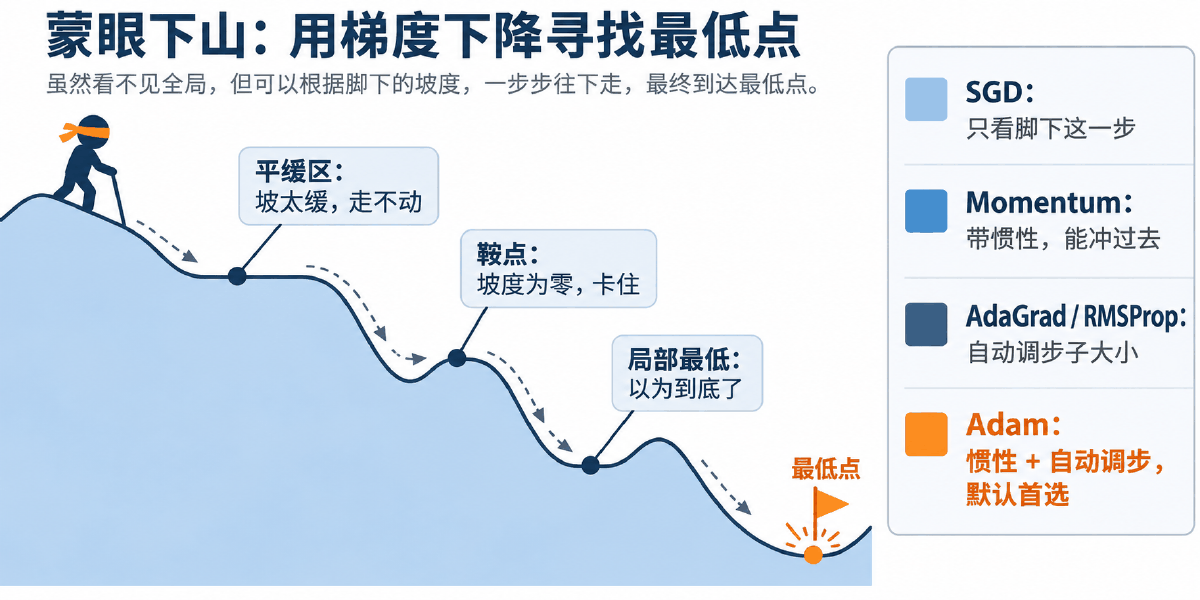
图里标出来的三处,正是只会「看脚下这一步」的走法必然会栽的地方:平缓区坡太缓,一步挪不了多少,走到天黑还在半山腰;鞍点坡度正好是零,脚尖探不出方向,人就定住了;局部最低四周都是上坡,以为到底了,其实真正的谷底还在更远处。
四种优化器就是四种应对办法:带上惯性冲过平缓区和鞍点(Momentum),让步子自动变大变小(AdaGrad / RMSProp),两样都要(Adam)。而正则化管的是另一件事——防止这个人把这一条下山路线的每块石头都背下来,换一座山就不会走了。
| 比喻里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 蒙眼下山的人 | 模型参数 | 要被调整的那一堆 w 和 b;「走到哪」就是「参数取什么值」 |
| 脚下的坡度 | 梯度 .grad | 反向传播算出来的偏导数,指出「往哪个方向损失会变大」 |
| 一步迈多大 | 学习率 lr | 步子太大会一脚跨过谷底来回横跳,太小则天黑也到不了 |
| 走路带的惯性 | Momentum 动量 | 把历史梯度攒起来,遇到平缓区和鞍点能靠惯性冲过去 |
| 自动调步子大小 | AdaGrad / RMSProp | 某个方向老是猛冲就把这个方向的步子收小,反之放大 |
| 惯性 + 自动调步 | Adam | 两者合一,默认首选;不知道选什么的时候就用它 |
| 越走越小心 | 学习率衰减 scheduler | 前期迈大步找方向,后期迈小步精调,别踩过头 |
| 背下了每块石头 | 过拟合 overfitting | 训练集分数很高、验证集分数掉下来,模型在背答案而不是学规律 |
| 蒙上一只眼再走 | Dropout | 训练时随机让一部分神经元休息,逼着剩下的也学会独立判断 |
| 每批出发前重新校准 | BatchNorm | 把每一批数据的分布拉回统一基准,让后面的层不用反复适应 |
01概念:这一步为什么不好迈
朴素梯度下降会卡在哪、训练日志里那三个数怎么换算、模型学歪了有哪两种歪法
1.1 朴素 SGD 为什么不够用
最朴素的更新公式只有一行:w ← w − lr × g。它的全部信息量就是「当前这一点的坡度」,既不记得上一步从哪来,也不知道别的方向是什么情况。三种地形能把它治住:
坡度很小,lr × g 这一步几乎等于原地不动。损失曲线表现为长时间几乎水平,看着像收敛了,其实只是走得太慢。跑一夜发现损失只降了 0.01,多半在这里。
某些方向是上坡、另一些是下坡,合起来梯度正好为 0。更新量是 0,参数彻底不动。高维空间里鞍点比局部最低点常见得多,这是深度网络的主要卡点。
小批量算出来的梯度带噪声,每一批都把参数往稍微不同的方向拽。表现为损失上下抖动、整体下降很慢,像在峡谷两壁之间来回撞。
三种毛病的共同点是:只看当下这一瞬间的梯度,信息太少。后面四种优化器全部在做同一件事——把历史信息利用起来。Momentum 用历史梯度的方向,AdaGrad 与 RMSProp 用历史梯度的幅度,Adam 两样都用。
optim.SGD 只是「按梯度更新」这个动作的实现,喂给它多大的 batch 由 DataLoader 决定。所以说「用 SGD 训练」时,实际几乎都是小批量梯度下降。
1.2 epoch / batch_size / iteration
训练日志里天天出现这三个数,它们之间是死的换算关系,不是三个独立旋钮:
| 概念 | 定义 | 调它会影响什么 |
|---|---|---|
| epoch | 把全部训练数据完整过一遍 | 轮数不够会欠拟合,轮数过多会过拟合;配早停用最省心 |
| batch_size | 一次参数更新用多少条样本 | 调大更稳但更新次数少、更吃显存;调小噪声大但泛化常常更好 |
| iteration | 一次参数更新的过程 | 不是自己设的,由前两个数算出来 |
换算只有一条:每个 epoch 的 iteration 数 = ⌈样本总数 ÷ batch_size⌉,向上取整——最后那个不满的批次也要算一次更新。50000 条样本、batch_size=256,一轮就是 ⌈50000/256⌉ = 196 次更新,跑 10 轮共 1960 次。
"""Epoch / Batch size / Iteration 三个数到底谁决定谁。

这三个词天天出现在训练日志里,但很多人说不清它们的换算关系。
本文件不依赖 torch,纯标准库,可以直接跑出确定的数字自己核对。

换算关系只有一条:
    每个 epoch 的 iteration 数 = ceil(样本总数 / batch_size)
「ceil」是向上取整——最后一个不满的批次也要算一次参数更新。
"""
import math


def plan(sample_num, batch_size, epochs):
    """算出一次训练总共要做多少次参数更新。"""
    iter_per_epoch = math.ceil(sample_num / batch_size)
    last_batch = sample_num - (iter_per_epoch - 1) * batch_size
    return {
        'sample_num': sample_num,
        'batch_size': batch_size,
        'epochs': epochs,
        'iter_per_epoch': iter_per_epoch,
        'last_batch_size': last_batch,        # 最后一批可能不满
        'total_iter': iter_per_epoch * epochs,
    }


def show(info):
    print('样本 %d 条,batch_size=%d,共 %d 轮'
          % (info['sample_num'], info['batch_size'], info['epochs']))
    print('  每轮 iteration 数 = ceil(%d / %d) = %d'
          % (info['sample_num'], info['batch_size'], info['iter_per_epoch']))
    print('  最后一批只有 %d 条样本' % info['last_batch_size'])
    print('  全程参数更新次数 = %d × %d = %d'
          % (info['iter_per_epoch'], info['epochs'], info['total_iter']))
    print()


# ---------------------------------------------------------------- 三种梯度下降
# 区别只在 batch_size 取多少,公式本身一个字没变
VARIANTS = [
    # 名称,           batch_size 取法,        一轮更新几次,        特点
    ('全批量 BGD', '等于全部样本数', '1 次', '方向最准,但一步要算完所有样本,慢且吃内存'),
    ('随机 SGD', '1', '样本数那么多次', '更新快、噪声大,损失曲线剧烈抖动'),
    ('小批量 Mini-Batch', '8 / 16 / 32 / 64…', 'ceil(N/B) 次', '实际训练唯一在用的方案,噪声与效率的折中'),
]


def compare_variants(sample_num=50000):
    print('样本总数 %d 时,三种梯度下降一轮各更新几次:' % sample_num)
    print('  全批量  : 1 次')
    print('  随机    : %d 次' % sample_num)
    for b in (8, 256):
        print('  小批量 B=%-4d: %d 次' % (b, math.ceil(sample_num / b)))
    print()


if __name__ == '__main__':
    compare_variants()

    # 一个能手算核对的例子:50000 张图,batch_size=256
    # 50000 / 256 = 195.3125 -> 向上取整 196
    show(plan(sample_num=50000, batch_size=256, epochs=10))

    # 不整除的小例子,方便一眼看清「最后一批不满」
    show(plan(sample_num=2000, batch_size=8, epochs=50))

    for name, how, times, note in VARIANTS:
        print('%-18s batch_size %-16s 一轮 %-14s %s' % (name, how, times, note))
这段代码不依赖任何第三方库,直接跑就能看到数字。它最后一段把三种梯度下降摆在一起,可以看出它们公式完全相同,区别只在 batch_size 取多少:
| 名称 | batch_size | 一轮更新几次 | 代价与收益 |
|---|---|---|---|
| 全批量 BGD | 全部样本 | 1 次 | 梯度方向最准,但一步要算完所有样本,慢且吃内存,数据大了根本装不下 |
| 随机 SGD | 1 | 和样本数一样多 | 更新极快但噪声极大,损失曲线剧烈抖动,也用不上矩阵并行 |
| 小批量 Mini-Batch | 8 / 16 / 32 / 64… | ⌈N/B⌉ 次 | 实际训练唯一在用的方案;噪声适中反而有助于跳出局部最低 |
1.3 过拟合与欠拟合:两种截然相反的病
回到下山的比喻。欠拟合是这个人还在半山腰就停了——连训练集都没学明白;过拟合是他把这条路线的每块石头都背了下来,闭着眼能走完这一条,换一座山立刻摔跤。
| 现象 | 训练损失 | 验证损失 | 该动哪一边 |
|---|---|---|---|
| 欠拟合 | 高,还在降 | 高,跟着降 | 优化不够:加深加宽网络、换 Adam、调大学习率、多训几轮 |
| 过拟合 | 很低,继续降 | 先降后升 | 泛化不够:Dropout、weight_decay、早停、加数据、减小模型 |
| 拟合良好 | 低,趋于平台 | 低,贴着训练曲线 | 可以收工,或者试着再压一点点 |
| 数据/标签有问题 | 降不下去 | 乱跳 | 先查数据:标签错位、特征没标准化、类别极度不均衡 |
关键在第二列和第三列要一起看。只盯着训练损失,过拟合发生时你看到的是「损失一路走低」,感觉一切正常,实际模型已经在退步了。所以训练脚本从第一版起就该同时记录验证集指标,这不是可选的调试手段。
"""过拟合 / 欠拟合的判别器:只看训练与验证两条损失曲线的关系。

不依赖 torch,把训练过程中记录下来的两条曲线喂进来就能出诊断结论。
真实项目里把 train_loss / valid_loss 每轮 append 进列表,训练完直接调用。

判别规则(三种典型形态):
    1. 两条都高、都还在降        -> 欠拟合:模型太小或训练轮数不够
    2. 训练一直降、验证先降后升  -> 过拟合:该上正则化了
    3. 两条都低且贴在一起        -> 拟合良好
"""


def diagnose(train_loss, valid_loss, gap_ratio=0.3, patience=5):
    """返回 (结论, 解释)。

    gap_ratio: 验证损失比训练损失高出多少比例算「差距过大」
    patience : 验证损失连续多少轮不再下降算「已经转折」
    """
    assert len(train_loss) == len(valid_loss), '两条曲线长度必须一致'
    assert len(train_loss) >= patience + 1, '轮数太少,看不出趋势'

    last_train = train_loss[-1]
    last_valid = valid_loss[-1]
    best_valid = min(valid_loss)
    best_epoch = valid_loss.index(best_valid)

    # 训练损失还在明显下降吗(拿最后 patience 轮和之前对比)
    train_still_falling = train_loss[-patience - 1] - last_train > 1e-4

    # 验证损失从最低点之后又涨回去了多少
    valid_rebound = last_valid - best_valid

    if last_train > 0.6 * train_loss[0] and train_still_falling:
        return ('欠拟合',
                '训练损失本身还很高且仍在下降,说明模型连训练集都没学明白:'
                '加深网络、加宽隐藏层、延长训练轮数、或者把学习率调大一点。')

    if valid_rebound > 1e-4 and best_epoch < len(valid_loss) - patience:
        return ('过拟合',
                '验证损失在第 %d 轮触底 %.4f,之后反弹到 %.4f,而训练损失还在降——'
                '模型开始背答案了:上 Dropout / weight_decay,或直接早停到第 %d 轮。'
                % (best_epoch + 1, best_valid, last_valid, best_epoch + 1))

    if last_valid - last_train > gap_ratio * max(last_train, 1e-8):
        return ('轻度过拟合',
                '验证损失 %.4f 明显高于训练损失 %.4f,差距已经拉开,'
                '虽然还没反弹,但正则化可以先加上了。' % (last_valid, last_train))

    return ('拟合良好',
            '两条曲线都降到低位且贴得很近,训练 %.4f / 验证 %.4f。' % (last_train, last_valid))


# ---------------------------------------------------------------- 三组造出来的曲线
# 这些数字是手工编排的典型形态,用来验证判别逻辑本身,不是某次真实训练的结果
UNDERFIT_TRAIN = [1.38, 1.35, 1.33, 1.31, 1.29, 1.27, 1.25, 1.23]
UNDERFIT_VALID = [1.39, 1.36, 1.34, 1.32, 1.30, 1.28, 1.26, 1.24]

OVERFIT_TRAIN = [1.40, 0.95, 0.62, 0.40, 0.25, 0.15, 0.09, 0.05, 0.03, 0.02]
OVERFIT_VALID = [1.42, 1.00, 0.72, 0.61, 0.58, 0.60, 0.66, 0.74, 0.83, 0.91]

GOOD_TRAIN = [1.40, 0.90, 0.60, 0.45, 0.38, 0.34, 0.32, 0.31, 0.30, 0.30]
GOOD_VALID = [1.43, 0.94, 0.64, 0.48, 0.41, 0.36, 0.34, 0.33, 0.32, 0.32]


def ascii_curve(train, valid, width=48):
    """不装 matplotlib 也能看走势:把两条曲线画成字符图。"""
    hi = max(max(train), max(valid))
    lo = min(min(train), min(valid))
    span = (hi - lo) or 1.0
    for i, (t, v) in enumerate(zip(train, valid)):
        tp = int((t - lo) / span * (width - 1))
        vp = int((v - lo) / span * (width - 1))
        row = [' '] * width
        row[tp] = 'T'                       # T = 训练损失
        row[vp] = 'V' if vp != tp else '*'  # V = 验证损失,重合画 *
        print('  epoch %2d |%s|  train %.3f  valid %.3f'
              % (i + 1, ''.join(row), t, v))


if __name__ == '__main__':
    for name, tr, va in (('一、欠拟合', UNDERFIT_TRAIN, UNDERFIT_VALID),
                         ('二、过拟合', OVERFIT_TRAIN, OVERFIT_VALID),
                         ('三、拟合良好', GOOD_TRAIN, GOOD_VALID)):
        print(name)
        ascii_curve(tr, va)
        verdict, why = diagnose(tr, va)
        print('  诊断结论:%s —— %s\n' % (verdict, why))
这段同样不依赖第三方库,末尾还用字符画把曲线打印出来,没装 matplotlib 也能看走势。它的判别逻辑就是上表三行的代码化:T 和 V 一起往下走且都还高 → 欠拟合;V 触底之后掉头、T 继续降 → 过拟合;两个记号贴到一起变成 * → 拟合良好。
train_loss 和 valid_loss 两个数,训练结束把两个列表丢进 diagnose() 就有结论。真正要养成的习惯是记录,不是画图。
02原理:四种走法与三招约束
先把动量的数学零件拆开,再逐个搭出四种优化器,最后是学习率衰减与三种正则化
2.1 指数加权平均:所有优化器的公共零件
Momentum、RMSProp、Adam 三者的公式看着各不相同,但拆开来都用同一个零件——指数加权平均(EWA,exponentially weighted average)。它回答的是:怎么把一串历史数值压缩成一个「近期平均」,而且不用把历史全存下来。
公式就一行:St = β · St−1 + (1 − β) · Yt。用人话讲:新的平均值 = 上一次的平均值占 β 份,当前这个新值占 (1−β) 份。
为什么叫「指数」加权:把公式往前代一层就看出来了。S₃ = βS₂ + (1−β)Y₃ = β²S₁ + β(1−β)Y₂ + (1−β)Y₃——越久远的值,前面的 β 次方越多,权重指数级衰减。距离越远贡献越小,但从不彻底消失。
| β 取值 | 大致相当于平均最近几个值 | 曲线形态 |
|---|---|---|
| 0.5 | 约 2 个 | 几乎跟着原始值抖,平滑作用有限 |
| 0.9 | 约 10 个 | 默认值;明显平滑,又不至于反应迟钝 |
| 0.99 | 约 100 个 | 非常平缓,但对新变化反应很慢,容易「跟不上」 |
把它想成天气:明天的气温和昨天关系很大,和一个月前关系就小得多,但也不是完全没关系。β 越大,你越相信历史、越不理会今天这一下的抖动。
"""指数加权平均:Momentum、RMSProp、Adam 的共同零件。

一句话:新值 = 上一次的平均 × β + 当前值 × (1-β)。
β 越大,曲线越平滑,越不理会当前这一下的抖动。
"""
import torch
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

N = 30


def ewa(beta):
    torch.manual_seed(0)
    temperature = torch.randn(size=[N]) * 10     # 造 30 天的随机气温
    avg = []
    for idx, temp in enumerate(temperature, 1):
        if idx == 1:
            avg.append(temp)                      # 第一天没有历史,等于自身
            continue
        avg.append(avg[idx - 2] * beta + (1 - beta) * temp)
    return temperature, avg


if __name__ == '__main__':
    days = torch.arange(1, N + 1)
    for beta in (0.5, 0.9):
        temperature, avg = ewa(beta)
        plt.scatter(days, temperature)            # 散点是原始值
        plt.plot(days, avg, color='r')            # 折线是加权平均
        plt.title('β = %.1f' % beta)
        plt.show()

    # 把同一批数据的两条曲线打印出来对比末值
    print('β=0.5 末值 %.4f' % ewa(0.5)[1][-1])
    print('β=0.9 末值 %.4f  ← 更平缓,更依赖历史' % ewa(0.9)[1][-1])
idx == 1 时直接 append(temp)。如果按公式从 S₀ = 0 起步,前几个值会被 0 严重拉低——这个偏差是真实存在的,Adam 专门用偏差修正处理它,见 2.4。
2.2 Momentum:给下山的人加上惯性
把 EWA 套到梯度上,就得到动量法。更新分两步:
差别只有一处:更新用的不再是当前这一瞬的梯度 gt,而是历史梯度的加权平均 st。这一处改动同时治好了前面三种毛病:
- 鞍点:当前梯度为 0,但
s里还攒着前面一路下坡积累的量,参数照样往前挪——靠惯性冲过去。 - 平缓区:单步梯度小,但同方向的小梯度会一轮轮累加,越攒越大,速度反而起来了。
- 震荡:来回抖动的梯度方向相反,在加权平均里相互抵消,留下的是真正一致的那个方向,路线被抚平。
s = βs + (1−β)g,而 optim.SGD(momentum=0.9) 内部是 buf = β·buf + g,没有乘 (1−β)。两者只差一个常数倍,这个倍数会被学习率吸收,收敛行为一致。但手推数字和框架输出对账时必须用框架那一版,否则怎么算都差十倍。
2.3 AdaGrad 与 RMSProp:让步子自己调大小
动量改的是「往哪走」,这两位改的是「迈多大」。核心想法:某个方向上历史梯度一直很大,说明这个方向太陡,步子该收小;一直很小说明平坦,步子可以放大。做法是拿历史梯度的平方去除学习率。
AdaGrad 的四步:
- 初始化学习率 η、参数 w、极小常数 σ(防止除零,取 1e-10 量级)
- 初始化梯度累积变量
s = 0 - 取一个 mini-batch 算出梯度 gt,累积平方:st = st−1 + gt ⊙ gt(⊙ 是逐分量相乘)
- 按缩放后的学习率更新:wt = wt−1 − (η / (√st + σ)) · gt
注意第 3 步是纯粹的求和,s 只增不减,所以分母越来越大、有效学习率单调下降。这既是它的优点(自动衰减,不用手配 scheduler),也是它的致命伤:训练后期学习率被压得过小,模型还没到谷底就走不动了。
RMSProp 只改了一个字:把第 3 步的求和换成指数加权平均——
st = β · st−1 + (1 − β) · gt ⊙ gt
分母不再单调变大,久远的梯度会被逐渐遗忘,学习率能降也能回升,过早熄火的问题就解决了。PyTorch 里这个系数的参数名叫 alpha,就是公式里的 β。
2.4 Adam:惯性和自动调步都要
Momentum 管方向、RMSProp 管幅度,两者管的根本不是一回事,所以可以直接合并——这就是 Adam(Adaptive Moment Estimation,自适应矩估计),它同时维护两个 EWA:
| 变量 | 叫法 | 公式 | 作用 |
|---|---|---|---|
| mt | 一阶矩 | β₁·mt−1 + (1−β₁)·gt | 梯度的方向,就是 Momentum 那一份惯性 |
| vt | 二阶矩 | β₂·vt−1 + (1−β₂)·gt² | 梯度的幅度,就是 RMSProp 那个分母 |
| m̂ / v̂ | 偏差修正 | mt/(1−β₁t)、vt/(1−β₂t) | 抵消「从 0 起步导致前几步被严重低估」 |
最终更新:wt = wt−1 − η · m̂t / (√v̂t + σ)。
偏差修正那两下除法不是装饰。m 和 v 都从 0 开始,第一步算出来的 m₁ = 0.1·g₁,只有真实梯度的十分之一,如果直接拿去更新,前十几步几乎原地不动。除以 (1 − β₁ᵗ) 正好把它拉回真实量级:第一步时 1 − 0.9¹ = 0.1,m̂₁ = 0.1g/0.1 = g,分毫不差。随着 t 变大,β₁ᵗ 趋近 0,修正项自动退场。
四种方法的公式说到底都是几行算术,与其背,不如逐字翻译成 Python 跑一遍。下面这份不依赖 torch,每一步的中间量(惯性 buf、累积量 s、一阶矩 m、二阶矩 v)全都打印出来:
"""把四种优化器的更新公式逐字翻译成 Python,不依赖任何第三方库。

为什么要手写一遍:`torch.optim.Adam(...)` 这一行把公式全藏起来了,
手写版每一步的中间量都打印出来,能和纸上推导逐位对账。

统一实验条件(四种方法完全可比):
    损失  loss = w² / 2      ->  梯度 g = w
    起点  w = 1.0            ->  第一次的梯度必定是 1.0
    lr    = 0.01
"""
import math

LR = 0.01


def sgd(w, steps):
    """最朴素的梯度下降:w <- w - lr * g,没有任何记忆。"""
    for i in range(1, steps + 1):
        g = w                                  # loss = w²/2 的导数就是 w
        w = w - LR * g
        yield i, g, w, {}


def momentum(w, steps, beta=0.9):
    """动量法。注意这里用的是 PyTorch 的实现口径:

        buf <- beta * buf + g          (不乘 (1-beta))
        w   <- w - lr * buf

    教材里常写成指数加权平均 s <- beta*s + (1-beta)*g,
    两者只差一个常数倍,把它并进学习率即可,收敛行为一致。
    """
    buf = 0.0
    for i in range(1, steps + 1):
        g = w
        buf = beta * buf + g                   # 历史梯度攒下来的「惯性」
        w = w - LR * buf
        yield i, g, w, {'buf': buf}


def adagrad(w, steps, eps=1e-10):
    """AdaGrad:把历史梯度的平方**求和**,用它给学习率做分母。

    分母只增不减 -> 学习率单调下降 -> 后期可能过早走不动。
    """
    s = 0.0
    for i in range(1, steps + 1):
        g = w
        s = s + g * g                          # 平方和,永远在变大
        w = w - LR * g / (math.sqrt(s) + eps)
        yield i, g, w, {'s': s, 'lr_eff': LR / (math.sqrt(s) + eps)}


def rmsprop(w, steps, alpha=0.9, eps=1e-8):
    """RMSProp:把 AdaGrad 的「求和」换成「指数加权平均」。

    分母不再单调变大,久远的梯度会被逐渐遗忘,解决过早熄火。
    PyTorch 里这个系数叫 alpha,就是公式里的 beta。
    """
    s = 0.0
    for i in range(1, steps + 1):
        g = w
        s = alpha * s + (1 - alpha) * g * g    # 指数加权平均,会遗忘
        w = w - LR * g / (math.sqrt(s) + eps)
        yield i, g, w, {'s': s, 'lr_eff': LR / (math.sqrt(s) + eps)}


def adam(w, steps, beta1=0.9, beta2=0.99, eps=1e-8):
    """Adam = Momentum(一阶矩 m)+ RMSProp(二阶矩 v)+ 偏差修正。

    偏差修正那两下除法是必需的:m 和 v 都从 0 起步,
    前几步会被严重低估,除以 (1 - beta^t) 正好把它拉回真实量级。
    """
    m = v = 0.0
    for i in range(1, steps + 1):
        g = w
        m = beta1 * m + (1 - beta1) * g        # 一阶矩:梯度的方向
        v = beta2 * v + (1 - beta2) * g * g    # 二阶矩:梯度的幅度
        m_hat = m / (1 - beta1 ** i)           # 偏差修正
        v_hat = v / (1 - beta2 ** i)
        w = w - LR * m_hat / (math.sqrt(v_hat) + eps)
        yield i, g, w, {'m': m, 'v': v, 'm_hat': m_hat, 'v_hat': v_hat}


def run(name, gen):
    print('== %s ==' % name)
    for i, g, w, extra in gen:
        detail = '  '.join('%s=%.6f' % kv for kv in extra.items())
        print('  第%d次  梯度 %.6f  更新后 w %.6f   %s' % (i, g, w, detail))
    print()


if __name__ == '__main__':
    run('SGD', sgd(1.0, 2))
    run('Momentum', momentum(1.0, 2))
    run('AdaGrad', adagrad(1.0, 2))
    run('RMSProp', rmsprop(1.0, 2))
    run('Adam', adam(1.0, 2))

    # 跑长一点,看四种方法 30 步之后各自走到哪里
    print('== 30 步之后的 w(越接近 0 越好)==')
    for name, fn in (('SGD', sgd), ('Momentum', momentum),
                     ('AdaGrad', adagrad), ('RMSProp', rmsprop), ('Adam', adam)):
        last = 1.0
        for _, _, last, _ in fn(1.0, 30):
            pass
        print('  %-10s w = %.6f' % (name, last))
统一实验条件是 loss = w²/2(导数正好等于 w 本身)、起点 w = 1.0、lr = 0.01,所以第一次的梯度必定是 1.0,四种方法完全可比。跑出来的前两步是这样:
| 方法 | 第 1 步后的 w | 第 2 步后的 w | 为什么是这个数 |
|---|---|---|---|
| SGD | 0.990000 | 0.980100 | 每步就挪 0.01 × 当前梯度,梯度随 w 一起变小,步子越来越小 |
| Momentum | 0.990000 | 0.971100 | 第 2 步的惯性 buf = 0.9×1 + 0.99 = 1.89,位移几乎是 SGD 的两倍 |
| AdaGrad | 0.990000 | 0.982965 | 累积量 s 从 1 涨到 1.9801,有效学习率从 0.0100 掉到 0.0071 |
| RMSProp | 0.968377 | 0.945788 | 第一步分母只有 √0.1≈0.316,有效学习率被放大到 0.0316 |
| Adam | 0.990000 | 0.980003 | 偏差修正后 m̂/√v̂ 首步正好等于 1,所以第一步和 SGD 一模一样 |
三处值得盯住看:Momentum 第二步位移翻倍,惯性肉眼可见;RMSProp 第一步反而比 SGD 走得更远——自适应学习率既能压小也能放大,不要以为它只会衰减;Adam 第一步与 SGD 相同,这正是偏差修正干的活,它让 Adam 一开始就以正常步幅启动,而不是前十几步慢吞吞热身。
脚本最后还跑了 30 步,四种方法从 1.0 出发各自走到:SGD 0.7397、Momentum −0.1281、AdaGrad 0.9060、RMSProp 0.6347、Adam 0.7095(目标是 0)。Momentum 已经冲过了 0 点走到负半轴,这就是惯性的两面性——冲得过去,也可能冲过头;AdaGrad 几乎没动,正是那个「学习率过早降到走不动」的毛病。
手写版看清了机制,实际项目里当然还是用框架的实现。下面这份用同一个损失函数调 torch.optim 的四种优化器,输出可以和上面的手写版逐位对上:
"""四种优化器在同一个损失函数上各走两步,看更新幅度的差别。

损失统一取 loss = w² / 2,它对 w 的导数就是 w 本身,
所以起点 w=1.0 时第一次的梯度必定是 1.0,四种方法完全可比。
"""
import torch


def run(name, make_optimizer):
    w = torch.tensor([1.0], requires_grad=True)
    optimizer = make_optimizer(w)

    for step in (1, 2):
        loss = ((w ** 2) / 2.0).sum()      # 每步都要重新前向,w 变了
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        print('%-10s 第%d次  梯度 %.6f  更新后 w %.6f'
              % (name, step, w.grad.item(), w.item()))
    print()


if __name__ == '__main__':
    # SGD + momentum:带惯性,第二步的位移明显比纯 SGD 大
    run('Momentum', lambda w: torch.optim.SGD([w], lr=0.01, momentum=0.9))

    # AdaGrad:累积平方梯度,学习率只降不升,后期容易走不动
    run('AdaGrad', lambda w: torch.optim.Adagrad([w], lr=0.01))

    # RMSProp:把 AdaGrad 的「求和」换成「指数加权平均」,解决过早熄火
    #          alpha 就是公式里的 β
    run('RMSProp', lambda w: torch.optim.RMSprop([w], lr=0.01, alpha=0.9))

    # Adam:Momentum(一阶矩)+ RMSProp(二阶矩),默认首选
    run('Adam', lambda w: torch.optim.Adam([w], lr=0.01, betas=(0.9, 0.99)))
| 优化器 | 解决什么问题 | 关键参数 | 什么时候选它 |
|---|---|---|---|
SGD | — | lr | 需要精细控制、或者论文要求复现时;配好 scheduler 后期精度常常最高 |
SGD(momentum=0.9) | 鞍点、平缓区、震荡 | momentum | 图像任务的经典搭配,几乎没有理由用不带动量的纯 SGD |
Adagrad | 不同参数需要不同步长 | lr | 稀疏特征场景;一般任务上容易过早熄火,用得少 |
RMSprop | AdaGrad 的过早熄火 | alpha(即 β) | RNN 上表现不错 |
Adam | 方向 + 幅度一起管 | lr、betas | 默认首选;lr=1e-3 起步,不行再调 |
Adam(lr=1e-3) 把流程跑通,这是绝大多数任务的合理起点。要再榨精度时换 SGD(momentum=0.9) + 学习率衰减,慢慢调。把时间花在数据和网络结构上,收益远大于在优化器之间反复横跳。
2.5 学习率衰减:前期迈大步,后期迈小步
学习率是整个训练里最该调、也最值得调的一个数。它太大太小各有一套典型症状:
| 症状 | 损失曲线长什么样 | 多半是 |
|---|---|---|
损失变成 nan 或直接飙升 | 前几轮就炸 | 学习率太大,一步跨过谷底还越跨越远 |
| 损失上下横跳不下降 | 锯齿状,整体平 | 学习率偏大,在谷底两壁之间来回弹 |
| 损失降得极慢 | 近乎水平的缓降 | 学习率太小(也可能是卡在平缓区) |
| 先降得挺好,后期原地踏步 | 降到某处就平了 | 该衰减学习率了——步子对前期合适,对精调太大 |
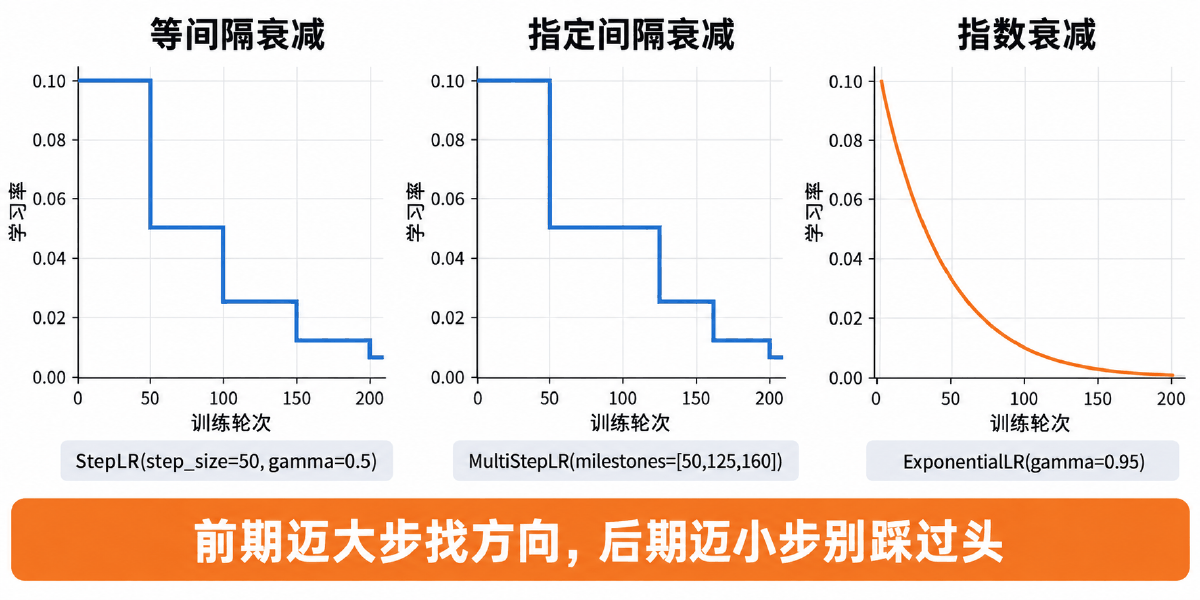
最后一行就是衰减存在的理由:同一个学习率不可能同时适合前期和后期。前期离谷底远,大步快走;后期已经在谷底附近,大步只会一脚跨过去。
| 策略 | API | 调整方式 | 适用场景 |
|---|---|---|---|
| 等间隔衰减 | StepLR(step_size=50, gamma=0.5) | 每 50 轮 lr ← lr × 0.5 | 最常用;不清楚该在哪降就用它 |
| 指定间隔衰减 | MultiStepLR(milestones=[50,125,160]) | 只在这几个轮次上乘 gamma | 已经跑过一轮、知道曲线在哪压平时 |
| 指数衰减 | ExponentialLR(gamma=0.95) | 每轮都乘 0.95 | 要求平滑下降;gamma 稍大一点就衰减很快,注意别把 lr 压成 0 |
"""三种学习率衰减策略:调度器每个 epoch 走一步,不是每个 batch。"""
import torch
from torch import optim
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

LR, ITERATION, MAX_EPOCH = 0.1, 10, 200


def collect(make_scheduler, title):
    w = torch.tensor([1.0], requires_grad=True)
    x = torch.tensor([1.0])
    y_true = torch.tensor([0.0])

    optimizer = optim.SGD([w], lr=LR, momentum=0.9)
    scheduler = make_scheduler(optimizer)

    lr_list, epoch_list = [], []
    for epoch in range(MAX_EPOCH):
        lr_list.append(scheduler.get_last_lr()[0])
        epoch_list.append(epoch)

        for _ in range(ITERATION):                 # 一个 epoch 里的每个 batch
            loss = ((w * x - y_true) ** 2) / 2.0
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

        scheduler.step()      # 关键:放在 epoch 循环里,不要放进 batch 循环

    plt.plot(epoch_list, lr_list, label=title)
    plt.xlabel('Epoch')
    plt.ylabel('Learning rate')
    plt.legend()
    plt.show()
    print('%s:起始 %.4f -> 结束 %.6f' % (title, lr_list[0], lr_list[-1]))


if __name__ == '__main__':
    # 等间隔:每 50 个 epoch 砍一半
    collect(lambda o: optim.lr_scheduler.StepLR(o, step_size=50, gamma=0.5),
            '等间隔衰减 StepLR')

    # 指定间隔:只在这几个点上砍
    collect(lambda o: optim.lr_scheduler.MultiStepLR(o, milestones=[50, 125, 160],
                                                     gamma=0.5),
            '指定间隔衰减 MultiStepLR')

    # 指数:每个 epoch 都乘 gamma,平滑下降
    collect(lambda o: optim.lr_scheduler.ExponentialLR(o, gamma=0.95),
            '指数衰减 ExponentialLR')
ExponentialLR(gamma=0.95) 一轮就把学习率乘了 0.95²⁰⁰ ≈ 0.000035,第二轮开始模型就彻底不动了。现象是「损失前一轮降得好好的,之后再也不变」。另外 optimizer.step() 要在 scheduler.step() 之前调用,顺序反了 PyTorch 会给出警告。
2.6 Dropout:让神经元轮流休息
过拟合的本质是某几条通路被过度依赖——就像下山时总走同一条小径,某块石头松了整个人就摔。Dropout 的办法很直接:训练时每一轮随机让一部分神经元罢工,逼着剩下的神经元也得学会独立判断,不能把宝全押在某个同伴身上。
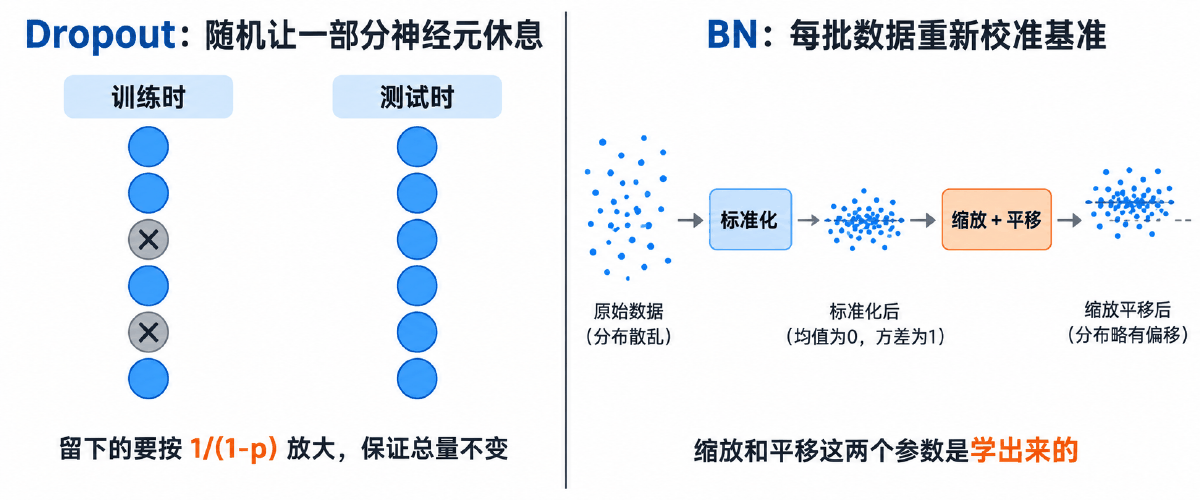
图左半边画的就是这件事,但要注意底注那一行——它是 Dropout 最容易被忽略的一半:
为什么必须放大:假设 p=0.5,一半神经元被关掉,这一层输出的总量直接腰斩。测试时不失活、总量满血,后面那一层看到的数值量级会突然翻倍,等于换了一个模型。把存活的乘上 1/(1−0.5) = 2,训练时的期望输出就和测试时对齐了,这样测试阶段才可以什么都不做。
"""Dropout 与 BatchNorm 的行为:注意训练模式和测试模式不一样。"""
import torch
import torch.nn as nn

torch.manual_seed(0)

# ---------------- Dropout ----------------
dropout = nn.Dropout(p=0.4)
inputs = torch.randint(0, 10, size=[1, 4]).float()
layer = nn.Linear(4, 5)
y = torch.relu(layer(inputs))
print('未失活:', y)

dropout.train()                 # 训练模式:随机置 0,剩下的按 1/(1-p) 放大
print('训练时失活:', dropout(y))

dropout.eval()                  # 测试模式:Dropout 直接变成恒等映射
print('测试时不失活:', dropout(y))

# ---------------- BatchNorm ----------------
# 参数 2 = 通道数;affine=True 表示缩放 γ 和平移 β 是可学习的
bn = nn.BatchNorm2d(2, eps=1e-05, momentum=0.1, affine=True)
x = torch.randn(1, 2, 3, 4)     # (batch, channel, height, width)
out = bn(x)
print('BN 输出形状', out.shape)  # 形状不变,只是把每个通道的分布拉正
print('可学习的缩放 γ', bn.weight.data)   # 初始全 1
print('可学习的平移 β', bn.bias.data)     # 初始全 0
| 该怎么用 | 说明 |
|---|---|
| p 取多少 | 隐藏层常用 0.2 ~ 0.5。过拟合越严重取越大,但取到 0.7 以上往往连训练集都学不动了 |
| 插在哪 | 插在隐藏层之间(通常在激活函数之后)。不要插在输出层之前——随机丢掉最终结论没有任何道理 |
| 和 BN 的顺序 | 习惯写法是 Linear → BN → ReLU → Dropout;两者叠加使用时效果有时会互相干扰,拿不准就先只用一个 |
| 卷积层上 | 卷积层一般不用普通 Dropout(空间相关性强,随机丢单个像素作用有限),要用就用 Dropout2d 整通道丢 |
2.7 BatchNorm:每批数据出发前重新校准
换个角度看训练:第 5 层看到的输入,是第 4 层的输出;而第 4 层的参数每轮都在变,它的输出分布也就跟着一直漂移。于是第 5 层刚适应了上一轮的分布,下一轮又得重新适应——大量算力浪费在追着分布跑上。
BatchNorm 的做法是在层与层之间插一个校准站:不管上一层送来什么分布,一律先掰回统一基准,再交给下一层。图③右半边画的四步:
第 ③ 步常被问:既然费劲把分布拉成标准正态,为什么又要缩放平移一下把它推偏?因为「均值 0、方差 1」未必是这一层最好的分布。强行固定等于给网络加了一条它没要求的约束。加上两个可学习参数 γ(缩放)和 β(平移),网络就能自己决定要不要偏、偏多少——极端情况下它甚至可以学出「原样还回去」。这两个参数是学出来的,不是超参数。
第 ④ 步则解释了训练和测试为什么行为不同:测试时可能只有一条样本,算不出「这一批」的均值方差,所以只能用训练期间累计下来的 running_mean / running_var。这就是 model.eval() 非切不可的第二个理由。
| 参数 | 含义 | 要点 |
|---|---|---|
num_features | 通道数 | 第一个位置参数;图像用 BatchNorm2d(C),全连接用 BatchNorm1d(特征数) |
eps | 防止除零 | 默认 1e-5,基本不用动 |
momentum | running 统计量的更新速度 | 默认 0.1;和优化器里的 momentum 毫无关系,只是重名 |
affine | 是否启用 γ 与 β | 默认 True;设 False 就只做标准化,不再缩放平移 |
drop_last=True 即可。确实必须用小 batch 的场景改用 LayerNorm(Transformer 用的就是它)。
model.train() 和 model.eval() 究竟切换了什么,值得单独跑一遍看清楚。这两个方法不改任何权重、不算任何梯度,只是把所有子模块的 self.training 标志位翻一下,而真正因此改变行为的只有 Dropout 和 BatchNorm 两类层:
"""model.train() 与 model.eval() 到底切换了什么。

这两个方法不改任何权重、不算任何梯度,它们只做一件事:
把网络里所有子模块的 self.training 标志位设成 True / False。
真正因此改变行为的只有两类层:

    Dropout    训练时随机置 0 并按 1/(1-p) 放大;测试时完全不动
    BatchNorm  训练时用**当前这批**的均值方差,同时更新全局running统计量;
               测试时改用累计下来的 running_mean / running_var

忘了切换的后果:
    忘了 eval()  -> 预测结果每次都不一样,且准确率虚低
    忘了 train() -> Dropout 永远不生效,正则化等于没加
"""
import torch
import torch.nn as nn

torch.manual_seed(0)


def show_dropout_behavior():
    print('===== Dropout =====')
    dropout = nn.Dropout(p=0.5)
    x = torch.ones(1, 8)                     # 全 1,方便看出哪些被置 0、哪些被放大

    dropout.train()
    print('训练模式连打三次(每次都不同):')
    for _ in range(3):
        print('  ', dropout(x))
    # 存活的元素值是 1/(1-0.5) = 2.0,不是 1.0
    # 放大的目的:让这一层输出的**期望总量**和不失活时一致,
    # 否则测试时不失活,数值量级会突然翻倍。

    dropout.eval()
    print('测试模式连打三次(完全相同,就是恒等映射):')
    for _ in range(3):
        print('  ', dropout(x))


def show_bn_behavior():
    print('\n===== BatchNorm =====')
    bn = nn.BatchNorm1d(4)
    x = torch.tensor([[1.0, 2.0, 3.0, 4.0],
                      [5.0, 6.0, 7.0, 8.0]])

    print('初始 running_mean =', bn.running_mean)   # 全 0
    print('初始 running_var  =', bn.running_var)    # 全 1

    bn.train()
    out_train = bn(x)
    print('训练模式输出(用这一批自己的均值方差标准化):\n', out_train)
    # 每列两个数标准化后必然是 -1 和 +1(两样本情形),与列的绝对大小无关
    print('更新后的 running_mean =', bn.running_mean)
    # running_mean = (1 - momentum) * 旧值 + momentum * 本批均值
    #              = 0.9 * 0 + 0.1 * 本批均值

    bn.eval()
    out_eval = bn(x)
    print('测试模式输出(改用 running 统计量,数值完全不同):\n', out_eval)

    print('可学习的缩放 γ =', bn.weight.data)        # 初始全 1
    print('可学习的平移 β =', bn.bias.data)          # 初始全 0


def show_batch_size_one_trap():
    print('\n===== BN 的 batch_size=1 陷阱 =====')
    bn = nn.BatchNorm1d(4)
    bn.train()
    one_sample = torch.randn(1, 4)
    try:
        bn(one_sample)
    except Exception as exc:
        print('训练模式下喂 1 条样本:', type(exc).__name__, exc)
    # 原因:一条样本算不出方差(分母为 0),BatchNorm1d 直接拒绝。
    # 现实中触发场景:最后一个 batch 恰好只剩 1 条 ->
    # DataLoader 加 drop_last=True 即可绕开。

    bn.eval()
    print('测试模式下喂 1 条样本没问题:', bn(one_sample).shape)


class Net(nn.Module):
    """一个同时含 Dropout 和 BN 的网络,用来演示整网切换。"""

    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(8, 16)
        self.bn = nn.BatchNorm1d(16)
        self.drop = nn.Dropout(p=0.3)
        self.fc2 = nn.Linear(16, 2)

    def forward(self, x):
        x = torch.relu(self.bn(self.fc1(x)))
        x = self.drop(x)
        return self.fc2(x)


def show_whole_net_switch():
    print('\n===== 整网一次性切换 =====')
    net = Net()
    x = torch.randn(4, 8)

    net.train()
    a, b = net(x), net(x)
    print('train() 下两次前向是否相同:', torch.equal(a, b))   # False

    net.eval()
    with torch.no_grad():
        c, d = net(x), net(x)
    print('eval() 下两次前向是否相同:', torch.equal(c, d))    # True
    # 结论:预测阶段必须 eval(),否则同一张图连问两次会给出两个答案。


if __name__ == '__main__':
    show_dropout_behavior()
    show_bn_behavior()
    show_batch_size_one_trap()
    show_whole_net_switch()
| 层 | model.train() 下 | model.eval() 下 |
|---|---|---|
| Dropout | 随机置 0,存活的按 1/(1−p) 放大 | 完全不动,恒等映射 |
| BatchNorm | 用当前这批的均值方差,并更新 running 统计量 | 改用累计的 running_mean / running_var,不再更新 |
| Linear / Conv / 激活 | 没有区别 | 没有区别 |
eval():同一张图连问两次给出两个不同答案,测试准确率虚低,而且不报任何错。忘了 train()(比如验证完没切回来):Dropout 永远不生效,正则化等于没加,下一轮起模型开始安心背答案。标准写法是每个 epoch 开头写 model.train(),进验证函数第一行写 model.eval(),把它当模板固化下来。
2.8 权重衰减与早停:另外两招
Dropout 和 BN 改的是网络结构,还有两招不碰结构:
在损失里加一条惩罚:L2 罚所有参数的平方和,倾向于把权重整体压小;L1 罚绝对值之和,会把不重要的权重压成正好 0(稀疏)。道理是:权重数值越大,模型对个别特征越敏感,越容易记住噪声。
验证指标连续若干轮不再改善就停训,并回滚到最好的那一轮。不改网络、不加超参数,是最便宜的正则化。
L2 在 PyTorch 里不用自己写进损失函数——优化器的 weight_decay 参数就是它,optim.Adam(params, lr=1e-3, weight_decay=1e-4) 一句搞定。L1 没有现成开关,必须手写进损失。
"""L1 / L2 惩罚项:给损失函数加一条「别把权重养太大」的约束。

两种写法:
  1. 手写进损失里     —— 看得见公式,L1 只能这么写
  2. 交给 weight_decay —— 一个参数搞定,等价于 L2,实际项目里用这个

注意 weight_decay 同时作用在 weight 和 bias 上;严格做法是把 bias
和 BatchNorm 的参数排除在外,见文件末尾的分组写法。
"""
import torch
from torch import nn, optim


def l1_penalty(model):
    """L1:所有参数绝对值之和。倾向于把不重要的权重压成正好 0(稀疏)。"""
    return sum(p.abs().sum() for p in model.parameters())


def l2_penalty(model):
    """L2:所有参数平方和。倾向于把权重整体压小,但不会压到 0。"""
    return sum((p ** 2).sum() for p in model.parameters())


def train_with_manual_penalty(model, dataloader, kind='l2',
                              lam=1e-4, lr=1e-3, epochs=5):
    """手写惩罚项版本:损失 = 原始损失 + lam × 惩罚。"""
    criterion = nn.CrossEntropyLoss()
    optimizer = optim.Adam(model.parameters(), lr=lr)   # 注意不填 weight_decay

    for epoch in range(epochs):
        model.train()
        for bx, by in dataloader:
            base_loss = criterion(model(bx), by)
            penalty = l1_penalty(model) if kind == 'l1' else l2_penalty(model)
            loss = base_loss + lam * penalty        # lam 就是惩罚的力度

            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
        print('epoch %d  原始损失 %.5f  惩罚项 %.5f'
              % (epoch + 1, base_loss.item(), penalty.item()))
    return model


def build_optimizer_with_weight_decay(model, lr=1e-3, wd=1e-4):
    """框架版:weight_decay 就是 L2,写一个参数即可,不用改损失函数。"""
    return optim.Adam(model.parameters(), lr=lr, weight_decay=wd)


def build_optimizer_no_decay_on_bias(model, lr=1e-3, wd=1e-4):
    """更严谨的分组:bias 和 BatchNorm 的参数不做衰减。

    这两类参数本来就该自由取值,压小它们只会拖慢收敛,
    对准确率没有好处。参数量大的模型上这个差别很明显。
    """
    decay, no_decay = [], []
    for name, param in model.named_parameters():
        if not param.requires_grad:
            continue
        # bias 与 BN 的 weight/bias 都是一维的,据此区分最省事
        if param.ndim <= 1 or name.endswith('.bias'):
            no_decay.append(param)
        else:
            decay.append(param)

    print('参与衰减的参数张量 %d 个,豁免的 %d 个' % (len(decay), len(no_decay)))
    return optim.Adam([
        {'params': decay, 'weight_decay': wd},
        {'params': no_decay, 'weight_decay': 0.0},
    ], lr=lr)


if __name__ == '__main__':
    net = nn.Sequential(
        nn.Linear(20, 128), nn.ReLU(),
        nn.BatchNorm1d(128),
        nn.Linear(128, 4),
    )

    # 两种惩罚在同一组参数上的数值差别:L2 对大权重罚得更狠(平方)
    print('L1 惩罚 =', l1_penalty(net).item())
    print('L2 惩罚 =', l2_penalty(net).item())

    build_optimizer_with_weight_decay(net)
    build_optimizer_no_decay_on_bias(net)
weight_decay 默认作用在所有参数上,包括 bias 和 BatchNorm 的 γ、β。这几类参数本来就该自由取值,压小它们只会拖慢收敛、对精度没好处。代码里 build_optimizer_no_decay_on_bias 用参数分组把它们豁免掉——判据是「维度 ≤ 1 的参数张量」,一行搞定。参数量大的模型上这个差别很明显。
早停的两个细节新手常漏:判据必须用验证集(拿训练损失判早停等于没判,训练损失几乎总在降),以及停下来要回滚——最后一轮的权重已经是开始变差的那一版了,真正该保存的是验证指标最低的那一轮。
"""早停(Early Stopping):验证损失不再下降就收手,并回滚到最好的那一版。

早停是最便宜的正则化手段——不改网络、不改损失函数、不加超参数,
只是「别再练了」。但它有两个新手常漏的细节:

  1. 判据必须是**验证集**指标,拿训练损失判早停等于没判;
  2. 停下来之后要把权重**回滚到最佳轮次**,而不是留着最后一轮的权重——
     最后一轮已经是开始变差的那一版了。

这个类不依赖 torch,可以直接跑;save/restore 两个钩子留给调用方注入。
"""


class EarlyStopping:
    def __init__(self, patience=5, min_delta=1e-4, mode='min'):
        """patience : 连续多少轮没有改善就停
        min_delta: 改善多少才算数,防止在噪声里反复横跳
        mode     : 'min' 盯损失越小越好,'max' 盯准确率越大越好
        """
        self.patience = patience
        self.min_delta = min_delta
        self.mode = mode
        self.best = None
        self.best_epoch = -1
        self.bad_epochs = 0
        self.should_stop = False

    def _is_better(self, value):
        if self.best is None:
            return True
        if self.mode == 'min':
            return value < self.best - self.min_delta
        return value > self.best + self.min_delta

    def step(self, value, epoch, on_improve=None):
        """每个 epoch 算完验证指标后调用一次。返回是否应当停止。"""
        if self._is_better(value):
            self.best = value
            self.best_epoch = epoch
            self.bad_epochs = 0
            if on_improve is not None:
                on_improve()               # 这里把当前权重存下来
        else:
            self.bad_epochs += 1
            if self.bad_epochs >= self.patience:
                self.should_stop = True
        return self.should_stop


def train_with_early_stopping(model, train_loader, valid_loader,
                              criterion, optimizer, max_epochs=200,
                              patience=5, ckpt='model/best.pt'):
    """接进真实训练循环的样子。"""
    import copy
    import torch

    stopper = EarlyStopping(patience=patience, mode='min')
    best_state = None

    for epoch in range(max_epochs):
        # ---- 训练一轮
        model.train()                       # 打开 Dropout / BN 的训练行为
        for bx, by in train_loader:
            loss = criterion(model(bx), by)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

        # ---- 在验证集上评估
        model.eval()                        # 关掉 Dropout,BN 改用全局统计量
        total, num = 0.0, 0
        with torch.no_grad():               # 评估不需要梯度
            for bx, by in valid_loader:
                total += criterion(model(bx), by).item() * len(by)
                num += len(by)
        valid_loss = total / num
        print('epoch %3d  valid_loss %.5f' % (epoch + 1, valid_loss))

        def keep():
            nonlocal best_state
            best_state = copy.deepcopy(model.state_dict())

        if stopper.step(valid_loss, epoch, on_improve=keep):
            print('验证损失连续 %d 轮没有改善,停在第 %d 轮' % (patience, epoch + 1))
            break

    # ---- 回滚到最好的那一版,这一步不能省
    if best_state is not None:
        model.load_state_dict(best_state)
        torch.save(best_state, ckpt)
        print('已回滚到第 %d 轮的权重,验证损失 %.5f'
              % (stopper.best_epoch + 1, stopper.best))
    return model


if __name__ == '__main__':
    # 用 overfit_diagnose.py 里那条过拟合曲线走一遍,看早停停在哪
    valid_curve = [1.42, 1.00, 0.72, 0.61, 0.58, 0.60, 0.66, 0.74, 0.83, 0.91]
    stopper = EarlyStopping(patience=3, mode='min')
    for epoch, v in enumerate(valid_curve):
        stopped = stopper.step(v, epoch)
        print('epoch %2d  valid %.2f  best %.2f(第%d轮)  连续变差 %d 轮  %s'
              % (epoch + 1, v, stopper.best, stopper.best_epoch + 1,
                 stopper.bad_epochs, '-> 停止' if stopped else ''))
        if stopped:
            break
拿 1.3 里那条过拟合曲线(验证损失 1.42 → 0.58 触底 → 一路涨到 0.91)喂给 patience=3 的早停器,它会在第 5 轮记下最优、第 6/7/8 轮连续三次变差后停止,并把权重回滚到第 5 轮。对照 1.3 的判别结论「早停到第 5 轮」,两者是一致的——一个负责诊断,一个负责执行。
五种手段怎么配合
| 手段 | 代价 | 推荐顺序 | 备注 |
|---|---|---|---|
| 早停 | 几乎为零 | 第一个上 | 不改任何结构,还顺带省训练时间 |
| 加数据 / 数据增强 | 看场景 | 第二个考虑 | 治过拟合最根本的办法,只是往往最贵 |
| weight_decay | 一个参数 | 第三 | 1e-4 量级起步,配合早停基本够用 |
| Dropout | 改网络结构 | 第四 | 全连接层上效果明显;注意训练/测试模式切换 |
| 减小模型 | 可能欠拟合 | 最后 | 前面几招都压不住,说明模型对这点数据确实太大了 |
03最小代码:把优化器和调度器各接一次
三个插槽就能把上一页那份朴素训练循环升级成带调优的版本
3.1 五步骨架不动,只动三个插槽
先说结论:前向 → 算损失 → 清零 → 反向 → 更新这五步一个字都不用改。优化器、调度器、正则化全是插件式的,各自插在固定位置上。三个插槽分别是:
| 插槽 | 改在哪 | 怎么改 |
|---|---|---|
| 一、优化器 | 实例化那一行 | optim.SGD(...) 换成 optim.Adam(...);想要 L2 正则就再填一个 weight_decay=1e-4 |
| 二、调度器 | epoch 循环末尾 | 建一个 scheduler,每轮结束调一次 scheduler.step() |
| 三、正则化层 | 网络定义里 | 在线性层后插 BatchNorm1d,在激活后插 Dropout |
"""训练循环上的三个插槽:换优化器、接调度器、插正则化层。

五步主循环(前向 -> 算损失 -> 清零 -> 反向 -> 更新)一个字都不用改,
调优要动的只有这三处。把这份文件当成「改哪里」的对照表。
"""
import torch
from torch import nn, optim
from torch.utils.data import DataLoader, TensorDataset


# ---------------------------------------------------------------- 插槽一:优化器
def build_optimizer(model, kind='adam', lr=1e-3, weight_decay=0.0):
    """换优化器只改这一行,训练循环本身不动。"""
    if kind == 'sgd':
        return optim.SGD(model.parameters(), lr=lr,
                         weight_decay=weight_decay)
    if kind == 'momentum':
        # 加惯性:几乎没有理由用不带动量的纯 SGD
        return optim.SGD(model.parameters(), lr=lr, momentum=0.9,
                         weight_decay=weight_decay)
    if kind == 'rmsprop':
        return optim.RMSprop(model.parameters(), lr=lr, alpha=0.9,
                             weight_decay=weight_decay)
    # 默认首选;weight_decay 就是 L2 正则,填上即可,不用改损失函数
    return optim.Adam(model.parameters(), lr=lr, betas=(0.9, 0.999),
                      weight_decay=weight_decay)


# ---------------------------------------------------------------- 插槽二:调度器
def build_scheduler(optimizer, kind='step'):
    """三种衰减策略,返回 None 表示不衰减。"""
    if kind == 'step':                 # 每 20 轮砍一半
        return optim.lr_scheduler.StepLR(optimizer, step_size=20, gamma=0.5)
    if kind == 'multistep':            # 只在指定轮次砍
        return optim.lr_scheduler.MultiStepLR(
            optimizer, milestones=[50, 125, 160], gamma=0.5)
    if kind == 'exp':                  # 每轮都乘 gamma
        return optim.lr_scheduler.ExponentialLR(optimizer, gamma=0.95)
    return None


# ---------------------------------------------------------------- 插槽三:正则化层
class RegularizedNet(nn.Module):
    """Linear -> BN -> ReLU -> Dropout 是常用的堆叠顺序。"""

    def __init__(self, in_features, n_class, p=0.2):
        super().__init__()
        self.linear1 = nn.Linear(in_features, 128)
        self.bn1 = nn.BatchNorm1d(128)        # 校准站,插在线性层之后
        self.linear2 = nn.Linear(128, 256)
        self.bn2 = nn.BatchNorm1d(256)
        self.dropout = nn.Dropout(p=p)        # 随机休息,插在激活之后
        self.output = nn.Linear(256, n_class)

    def forward(self, x):
        x = torch.relu(self.bn1(self.linear1(x)))
        x = self.dropout(x)
        x = torch.relu(self.bn2(self.linear2(x)))
        x = self.dropout(x)
        # 输出层之前不插 Dropout:随机丢掉最终结论没有任何道理
        return self.output(x)                 # 不加 softmax,交给损失函数


# ---------------------------------------------------------------- 主循环
def train(model, dataset, epochs=5, batch_size=16, lr=1e-3):
    loader = DataLoader(dataset, batch_size=batch_size, shuffle=True,
                        drop_last=True)       # 防止最后一批只剩 1 条把 BN 打崩
    criterion = nn.CrossEntropyLoss()
    optimizer = build_optimizer(model, 'adam', lr=lr, weight_decay=1e-4)
    scheduler = build_scheduler(optimizer, 'step')

    for epoch in range(epochs):
        model.train()                         # 打开 Dropout / BN 的训练行为
        total_loss, total_num = 0.0, 0
        for bx, by in loader:
            loss = criterion(model(bx), by)

            optimizer.zero_grad()             # 五步骨架,一个字都没变
            loss.backward()
            optimizer.step()                  # 参数更新:每个 batch 一次

            total_loss += loss.item() * len(by)
            total_num += len(by)

        if scheduler is not None:
            scheduler.step()                  # 学习率衰减:每个 epoch 一次

        # 学习率是否真在按预期衰减,只有打印出来才知道
        print('epoch %3d  loss %.5f  lr %.6f'
              % (epoch + 1, total_loss / total_num,
                 optimizer.param_groups[0]['lr']))
    return model


if __name__ == '__main__':
    torch.manual_seed(0)
    x = torch.randn(200, 20)
    y = torch.randint(0, 4, (200,))
    net = RegularizedNet(in_features=20, n_class=4)
    train(net, TensorDataset(x, y))
这份代码里有三处细节值得单独拎出来:
- 两个
step()名字一样、层级不同。optimizer.step()在内层 batch 循环里,scheduler.step()在外层 epoch 循环里。缩进错一级就是一个隐蔽 bug,且不报任何错。 - 当前学习率从
optimizer.param_groups[0]['lr']读。 这一行建议固定写进日志——学习率是否真的在按预期衰减,只有打印出来才知道。 - DataLoader 加了
drop_last=True。 网络里有 BatchNorm 时这个参数近乎必需:最后一批若恰好只剩 1 条样本,训练模式下的 BN 会直接报错。
3.2 三个观察实验
下面三份都是最小实验,各自只看一件事,跑完就能对上原理部分的结论。第一份看 β 怎么控制平滑程度——散点是原始气温,折线是加权平均,β=0.9 明显比 β=0.5 平缓:
"""指数加权平均:Momentum、RMSProp、Adam 的共同零件。

一句话:新值 = 上一次的平均 × β + 当前值 × (1-β)。
β 越大,曲线越平滑,越不理会当前这一下的抖动。
"""
import torch
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

N = 30


def ewa(beta):
    torch.manual_seed(0)
    temperature = torch.randn(size=[N]) * 10     # 造 30 天的随机气温
    avg = []
    for idx, temp in enumerate(temperature, 1):
        if idx == 1:
            avg.append(temp)                      # 第一天没有历史,等于自身
            continue
        avg.append(avg[idx - 2] * beta + (1 - beta) * temp)
    return temperature, avg


if __name__ == '__main__':
    days = torch.arange(1, N + 1)
    for beta in (0.5, 0.9):
        temperature, avg = ewa(beta)
        plt.scatter(days, temperature)            # 散点是原始值
        plt.plot(days, avg, color='r')            # 折线是加权平均
        plt.title('β = %.1f' % beta)
        plt.show()

    # 把同一批数据的两条曲线打印出来对比末值
    print('β=0.5 末值 %.4f' % ewa(0.5)[1][-1])
    print('β=0.9 末值 %.4f  ← 更平缓,更依赖历史' % ewa(0.9)[1][-1])
第二份把四种优化器在同一个损失函数上各走两步。因为 loss = w²/2 的导数正好是 w 本身、起点固定为 1.0,第一次的梯度必定是 1.0,四种方法完全可比,输出可以和 2.4 那张表逐位对照:
"""四种优化器在同一个损失函数上各走两步,看更新幅度的差别。

损失统一取 loss = w² / 2,它对 w 的导数就是 w 本身,
所以起点 w=1.0 时第一次的梯度必定是 1.0,四种方法完全可比。
"""
import torch


def run(name, make_optimizer):
    w = torch.tensor([1.0], requires_grad=True)
    optimizer = make_optimizer(w)

    for step in (1, 2):
        loss = ((w ** 2) / 2.0).sum()      # 每步都要重新前向,w 变了
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        print('%-10s 第%d次  梯度 %.6f  更新后 w %.6f'
              % (name, step, w.grad.item(), w.item()))
    print()


if __name__ == '__main__':
    # SGD + momentum:带惯性,第二步的位移明显比纯 SGD 大
    run('Momentum', lambda w: torch.optim.SGD([w], lr=0.01, momentum=0.9))

    # AdaGrad:累积平方梯度,学习率只降不升,后期容易走不动
    run('AdaGrad', lambda w: torch.optim.Adagrad([w], lr=0.01))

    # RMSProp:把 AdaGrad 的「求和」换成「指数加权平均」,解决过早熄火
    #          alpha 就是公式里的 β
    run('RMSProp', lambda w: torch.optim.RMSprop([w], lr=0.01, alpha=0.9))

    # Adam:Momentum(一阶矩)+ RMSProp(二阶矩),默认首选
    run('Adam', lambda w: torch.optim.Adam([w], lr=0.01, betas=(0.9, 0.99)))
第三份画出三条学习率衰减曲线,和图②是同一组参数(StepLR(50, 0.5)、MultiStepLR([50,125,160])、ExponentialLR(0.95),起始学习率 0.1,跑 200 轮):
"""三种学习率衰减策略:调度器每个 epoch 走一步,不是每个 batch。"""
import torch
from torch import optim
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

LR, ITERATION, MAX_EPOCH = 0.1, 10, 200


def collect(make_scheduler, title):
    w = torch.tensor([1.0], requires_grad=True)
    x = torch.tensor([1.0])
    y_true = torch.tensor([0.0])

    optimizer = optim.SGD([w], lr=LR, momentum=0.9)
    scheduler = make_scheduler(optimizer)

    lr_list, epoch_list = [], []
    for epoch in range(MAX_EPOCH):
        lr_list.append(scheduler.get_last_lr()[0])
        epoch_list.append(epoch)

        for _ in range(ITERATION):                 # 一个 epoch 里的每个 batch
            loss = ((w * x - y_true) ** 2) / 2.0
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

        scheduler.step()      # 关键:放在 epoch 循环里,不要放进 batch 循环

    plt.plot(epoch_list, lr_list, label=title)
    plt.xlabel('Epoch')
    plt.ylabel('Learning rate')
    plt.legend()
    plt.show()
    print('%s:起始 %.4f -> 结束 %.6f' % (title, lr_list[0], lr_list[-1]))


if __name__ == '__main__':
    # 等间隔:每 50 个 epoch 砍一半
    collect(lambda o: optim.lr_scheduler.StepLR(o, step_size=50, gamma=0.5),
            '等间隔衰减 StepLR')

    # 指定间隔:只在这几个点上砍
    collect(lambda o: optim.lr_scheduler.MultiStepLR(o, milestones=[50, 125, 160],
                                                     gamma=0.5),
            '指定间隔衰减 MultiStepLR')

    # 指数:每个 epoch 都乘 gamma,平滑下降
    collect(lambda o: optim.lr_scheduler.ExponentialLR(o, gamma=0.95),
            '指数衰减 ExponentialLR')
pip install torch;画曲线的两份另需 matplotlib,手机价格案例还需要 pandas 和 scikit-learn。batch_epoch_iter.py、optimizer_math.py、overfit_diagnose.py、early_stopping.py 四份只用标准库,装不了 torch 也能跑。是否有 GPU 不影响本页任何结论。
04完整案例:手机价格区间分类
同一份数据、同一个任务,把本页的手段逐个加上去,看每一处改动各自解决什么
任务是这样的:手里有一批二手手机的硬件参数——电池容量、内存大小、主频、屏幕尺寸、摄像头像素等共 20 个特征,标签是它们最终的成交价格区间,用 0、1、2、3 表示从低到高四档。要做的不是预测具体价格,而是判断落在哪一档,所以这是一个四分类问题,不是回归。数据共 2000 条,八成拿来训练、两成留作验证。
4.1 基线版为什么只有六成
先按最朴素的配置搭一版:三个全连接层(20 → 128 → 256 → 4)、ReLU 激活、CrossEntropyLoss、optim.SGD(lr=1e-3)、训练 50 轮。这一版能跑通,但验证集准确率大约只有六成出头。四个类别瞎猜是 25%,所以它确实学到了东西,只是远不够用。
问题不在网络太小,而在五处配置全都停在默认值上:
| 基线的做法 | 症结 | 本页对应的手段 |
|---|---|---|
| 特征直接喂进网络 | ram 是几千、clock_speed 是个位数,量纲差三个数量级 | 标准化 StandardScaler |
SGD,无动量 | 只看当下梯度,平缓区寸步难行 | 换 Adam |
lr=1e-3 从头到尾不变 | 后期在谷底附近来回跨 | 学习率衰减 |
| 没有任何正则化 | 训练损失一路走低,验证掉头 | Dropout / weight_decay |
| 固定训练 50 轮 | 轮数拍脑袋定,多了过拟合、少了欠拟合 | 早停 |
ram 这种数值大的特征会主导梯度——损失对它的偏导天然大几个数量级,网络前期几乎只在调与它相关的权重,其余 19 个特征的信息被淹没。表现是「损失降得动但准确率上不去」。做特征标准化的收益,通常比换任何优化器都大。
4.2 五处改动逐个上
把上表右列全部落实,就是下面这份完整脚本:
"""完整案例:手机价格区间四分类。

数据:手机价格预测.csv,20 个硬件参数 -> 4 个价格区间(0/1/2/3)。
这一版把本讲的四个优化手段全用上:标准化、Adam、Dropout、更深的网络。
"""
import numpy as np
import pandas as pd
import torch
import torch.nn as nn
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from torch.utils.data import TensorDataset, DataLoader

CSV = 'data/手机价格预测.csv'


def create_dataset(csv_path=CSV):
    data = pd.read_csv(csv_path, encoding='UTF-8')

    x = data.iloc[:, :-1]        # 前 20 列是特征
    y = data.iloc[:, -1]         # 最后一列 price_range 是标签

    x_train, x_test, y_train, y_test = train_test_split(
        x, y, test_size=0.2, random_state=10, shuffle=True)

    # 标准化:ram 是几千、clock_speed 是个位数,不消量纲差异,梯度会被大特征带偏
    # 注意 fit 只在训练集上做,测试集只能 transform,否则就是信息泄漏
    transformer = StandardScaler()
    x_train = transformer.fit_transform(x_train)
    x_test = transformer.transform(x_test)

    # 特征必须 float32,分类标签必须 int64,这两个类型错了直接抛 RuntimeError
    train_dataset = TensorDataset(torch.tensor(x_train, dtype=torch.float32),
                                  torch.tensor(y_train.values, dtype=torch.int64))
    test_dataset = TensorDataset(torch.tensor(x_test, dtype=torch.float32),
                                 torch.tensor(y_test.values, dtype=torch.int64))

    return train_dataset, test_dataset, x_train.shape[1], len(np.unique(y_train))


class PhoneANN(nn.Module):
    def __init__(self, features, targets, p=0.2):
        super().__init__()
        self.linear1 = nn.Linear(features, 128)
        self.linear2 = nn.Linear(128, 256)
        self.dropout = nn.Dropout(p=p)        # 只在隐藏层之间插,不要插在输出层前
        self.output = nn.Linear(256, targets)

    def forward(self, x):
        x = torch.relu(self.linear1(x))
        x = self.dropout(x)
        x = torch.relu(self.linear2(x))
        x = self.dropout(x)
        # 这里不写 softmax:CrossEntropyLoss 自带,重复加会把梯度压平
        return self.output(x)


def train_model(train_dataset, features, targets,
                epochs=50, lr=1e-3, batch_size=8, seed=815):
    torch.manual_seed(seed)
    dataloader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)

    model = PhoneANN(features, targets)
    criterion = nn.CrossEntropyLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=lr, betas=(0.9, 0.99))

    for epoch in range(epochs):
        model.train()                       # 打开 Dropout
        total_loss, total_num = 0.0, 0
        for bx, by in dataloader:
            logits = model(bx)
            loss = criterion(logits, by)

            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

            total_loss += loss.item() * len(by)
            total_num += len(by)
        print('epoch %3d  loss %.5f' % (epoch + 1, total_loss / total_num))

    torch.save(model.state_dict(), 'model/phone_ann.pt')
    return model


def evaluate(model, test_dataset, batch_size=8):
    model.eval()                            # 关闭 Dropout,否则每次预测结果都不同
    dataloader = DataLoader(test_dataset, batch_size=batch_size, shuffle=False)

    correct = 0
    with torch.no_grad():                   # 预测不需要梯度,省显存也更快
        for bx, by in dataloader:
            y_pred = model(bx).argmax(dim=1)
            correct += (y_pred == by).sum().item()

    acc = correct / len(test_dataset)
    print('测试集准确率 %.5f' % acc)
    return acc


def main():
    train_dataset, test_dataset, features, targets = create_dataset()
    print('特征数 %d,类别数 %d' % (features, targets))
    model = train_model(train_dataset, features, targets)
    evaluate(model, test_dataset)


if __name__ == '__main__':
    main()
逐段拆解
| 代码位置 | 在干什么 / 为什么这么写 |
|---|---|
transformer.fit_transform(x_train)transformer.transform(x_test) | 标准化把每个特征压成均值 0、方差 1,量纲差异消失。fit 只能在训练集上做,测试集只能 transform——用测试集的统计量去拟合就是信息泄漏,评出来的分数虚高,上线立刻打回原形。 |
dtype=torch.float32 / torch.int64 | 特征必须是 float32,分类标签必须是 int64 的类别下标(不是 one-hot、不是浮点)。这两个类型写错直接抛 RuntimeError。 |
nn.Dropout(p=0.2) | 插在两个隐藏层之后、输出层之前。输出层前不插——随机丢掉最终结论没有任何道理。 |
return self.output(x) | 直接返回 logits,不加 softmax。CrossEntropyLoss 内部已经含了 log_softmax,重复加会把梯度压平,表现为「损失降得极慢还查不出原因」。 |
optim.Adam(..., betas=(0.9, 0.99)) | 一阶矩系数 0.9、二阶矩系数 0.99,就是 2.4 里的 β₁ 和 β₂。lr=1e-3 是 Adam 的常规起点。 |
model.train() 在每个 epoch 开头 | 打开 Dropout。漏了这一句,正则化等于没加。 |
model.eval() 在评估函数第一行 | 关闭 Dropout。漏了这一句,同一条样本连预测两次会给出两个答案,准确率虚低。 |
with torch.no_grad(): | 评估阶段不需要梯度,关掉能省内存也更快。 |
total_loss += loss.item() * len(by) | 按样本数加权,最后除以总样本数。若按 batch 数平均,最后一个不满的 batch 会把均值带偏。 |
torch.save(model.state_dict(), ...) | 存权重字典而不是整个 model 对象,换环境不会因为类路径变了而加载失败。 |
怎么判断改动到底有没有用
这是本案例最该学会的一件事。一次只动一处,每次都固定随机种子——代码里 torch.manual_seed(seed) 就是为此存在的。种子不固定时,两次结果本来就会差几个百分点,你根本分不清是改动起了作用,还是纯粹运气。
| 实验 | 动了什么 | 期望看到的变化 |
|---|---|---|
| 基线 | SGD + 无标准化 + 无正则 | 验证准确率作为对照起点 |
| 实验一 | 只加标准化 | 提升通常最明显;若几乎不动,说明原始特征量纲本来就接近 |
| 实验二 | 在一的基础上换 Adam | 收敛更快,相同轮数下损失更低 |
| 实验三 | 在二的基础上加 Dropout | 训练损失反而变高,但验证准确率上升——这才是正则化生效的样子 |
| 实验四 | 在三的基础上加学习率衰减 | 后期曲线更平稳,末轮成绩波动变小 |
4.3 早停与最优权重回滚
上面的脚本固定训练 50 轮,这个数是拍脑袋定的。换成早停,轮数就不用猜了:设一个足够大的上限,让验证指标自己决定什么时候停。
"""早停(Early Stopping):验证损失不再下降就收手,并回滚到最好的那一版。

早停是最便宜的正则化手段——不改网络、不改损失函数、不加超参数,
只是「别再练了」。但它有两个新手常漏的细节:

  1. 判据必须是**验证集**指标,拿训练损失判早停等于没判;
  2. 停下来之后要把权重**回滚到最佳轮次**,而不是留着最后一轮的权重——
     最后一轮已经是开始变差的那一版了。

这个类不依赖 torch,可以直接跑;save/restore 两个钩子留给调用方注入。
"""


class EarlyStopping:
    def __init__(self, patience=5, min_delta=1e-4, mode='min'):
        """patience : 连续多少轮没有改善就停
        min_delta: 改善多少才算数,防止在噪声里反复横跳
        mode     : 'min' 盯损失越小越好,'max' 盯准确率越大越好
        """
        self.patience = patience
        self.min_delta = min_delta
        self.mode = mode
        self.best = None
        self.best_epoch = -1
        self.bad_epochs = 0
        self.should_stop = False

    def _is_better(self, value):
        if self.best is None:
            return True
        if self.mode == 'min':
            return value < self.best - self.min_delta
        return value > self.best + self.min_delta

    def step(self, value, epoch, on_improve=None):
        """每个 epoch 算完验证指标后调用一次。返回是否应当停止。"""
        if self._is_better(value):
            self.best = value
            self.best_epoch = epoch
            self.bad_epochs = 0
            if on_improve is not None:
                on_improve()               # 这里把当前权重存下来
        else:
            self.bad_epochs += 1
            if self.bad_epochs >= self.patience:
                self.should_stop = True
        return self.should_stop


def train_with_early_stopping(model, train_loader, valid_loader,
                              criterion, optimizer, max_epochs=200,
                              patience=5, ckpt='model/best.pt'):
    """接进真实训练循环的样子。"""
    import copy
    import torch

    stopper = EarlyStopping(patience=patience, mode='min')
    best_state = None

    for epoch in range(max_epochs):
        # ---- 训练一轮
        model.train()                       # 打开 Dropout / BN 的训练行为
        for bx, by in train_loader:
            loss = criterion(model(bx), by)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

        # ---- 在验证集上评估
        model.eval()                        # 关掉 Dropout,BN 改用全局统计量
        total, num = 0.0, 0
        with torch.no_grad():               # 评估不需要梯度
            for bx, by in valid_loader:
                total += criterion(model(bx), by).item() * len(by)
                num += len(by)
        valid_loss = total / num
        print('epoch %3d  valid_loss %.5f' % (epoch + 1, valid_loss))

        def keep():
            nonlocal best_state
            best_state = copy.deepcopy(model.state_dict())

        if stopper.step(valid_loss, epoch, on_improve=keep):
            print('验证损失连续 %d 轮没有改善,停在第 %d 轮' % (patience, epoch + 1))
            break

    # ---- 回滚到最好的那一版,这一步不能省
    if best_state is not None:
        model.load_state_dict(best_state)
        torch.save(best_state, ckpt)
        print('已回滚到第 %d 轮的权重,验证损失 %.5f'
              % (stopper.best_epoch + 1, stopper.best))
    return model


if __name__ == '__main__':
    # 用 overfit_diagnose.py 里那条过拟合曲线走一遍,看早停停在哪
    valid_curve = [1.42, 1.00, 0.72, 0.61, 0.58, 0.60, 0.66, 0.74, 0.83, 0.91]
    stopper = EarlyStopping(patience=3, mode='min')
    for epoch, v in enumerate(valid_curve):
        stopped = stopper.step(v, epoch)
        print('epoch %2d  valid %.2f  best %.2f(第%d轮)  连续变差 %d 轮  %s'
              % (epoch + 1, v, stopper.best, stopper.best_epoch + 1,
                 stopper.bad_epochs, '-> 停止' if stopped else ''))
        if stopped:
            break
文件里 train_with_early_stopping() 就是把 4.2 的训练循环加了三件事:每轮结束在验证集上算一次损失、把这个数交给 EarlyStopping.step()、指标创新低时用 copy.deepcopy(model.state_dict()) 把当前权重留一份。停训后 load_state_dict(best_state) 回滚。
末尾的 __main__ 用 1.3 里那条过拟合曲线(验证损失 1.42 → 第 5 轮触底 0.58 → 一路涨到 0.91)走了一遍,patience=3 的早停器在第 5 轮记下最优,第 6、7、8 轮连续三次变差后停止,权重回滚到第 5 轮。这和 1.3 的判别结论「早停到第 5 轮」完全一致——一个负责诊断,一个负责执行。
min_delta——改善幅度小于 min_delta 的不算改善,能挡掉大部分噪声导致的假性「创新低」。05骨架模板:把旋钮集中到一处
一份把所有可调项收进 CONFIG 字典的训练脚本,调优时只改字典不改逻辑
调优最容易失控的地方,是可调项散落在代码各处:学习率写在优化器那行,dropout 写在网络定义里,轮数写在循环里,batch_size 写在 DataLoader 里。改了三处、忘了记录,几轮之后就说不清当前这一版到底是什么配置了。
下面这份模板把它们全部提到文件顶部的一个字典里。调优时只改字典、不碰下面的逻辑,每次实验把字典整个打印下来存档,实验就是可复现的。
"""调优骨架模板:把可调的旋钮集中到一处,一次只动一个。"""
import torch
from torch import nn, optim
from torch.utils.data import DataLoader

CONFIG = {
    'lr': 1e-3,            # TODO: 学不动就调大,损失来回震荡就调小
    'batch_size': 8,       # TODO: 显存够就调大,大 batch 更稳但更新次数少
    'epochs': 50,          # TODO: 看损失曲线,压平了就可以停
    'dropout': 0.2,        # TODO: 训练集好测试集差(过拟合)就调大
    'weight_decay': 0.0,   # TODO: 需要 L2 正则时填 1e-4 量级
    'optimizer': 'adam',   # TODO: 'adam' / 'sgd'
    'scheduler': 'step',   # TODO: 'none' / 'step' / 'exp'
    'seed': 0,
}


def build_optimizer(model, cfg=CONFIG):
    if cfg['optimizer'] == 'adam':
        return optim.Adam(model.parameters(), lr=cfg['lr'],
                          weight_decay=cfg['weight_decay'])
    return optim.SGD(model.parameters(), lr=cfg['lr'], momentum=0.9,
                     weight_decay=cfg['weight_decay'])


def build_scheduler(optimizer, cfg=CONFIG):
    if cfg['scheduler'] == 'step':
        return optim.lr_scheduler.StepLR(optimizer, step_size=20, gamma=0.5)
    if cfg['scheduler'] == 'exp':
        return optim.lr_scheduler.ExponentialLR(optimizer, gamma=0.95)
    return None


def train(model, dataset, cfg=CONFIG):
    torch.manual_seed(cfg['seed'])
    loader = DataLoader(dataset, batch_size=cfg['batch_size'], shuffle=True)

    criterion = nn.CrossEntropyLoss()      # TODO: 回归换成 MSELoss / SmoothL1Loss
    optimizer = build_optimizer(model, cfg)
    scheduler = build_scheduler(optimizer, cfg)

    for epoch in range(cfg['epochs']):
        model.train()
        total_loss, total_num = 0.0, 0
        for bx, by in loader:
            loss = criterion(model(bx), by)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
            total_loss += loss.item() * len(by)
            total_num += len(by)

        if scheduler is not None:
            scheduler.step()               # 每个 epoch 一次,别放进内层循环

        print('epoch %3d  loss %.5f  lr %.6f'
              % (epoch + 1, total_loss / total_num,
                 optimizer.param_groups[0]['lr']))
    return model
每个旋钮什么时候动
| 配置项 | 默认值 | 看到什么现象才动它 |
|---|---|---|
lr | 1e-3 | 损失变 nan 或剧烈震荡 → 调小十倍;损失几乎不降 → 调大十倍。按十倍量级试,别微调 |
batch_size | 8 | 显存够就调大,训练更稳更快;调大之后学习率通常要跟着放大 |
epochs | 50 | 损失还在明显下降就加轮数;配上早停之后这个数设大一点无所谓 |
dropout | 0.2 | 训练好、验证差 → 往 0.3/0.5 调;训练集本身都学不好就该调小甚至关掉 |
weight_decay | 0.0 | 轻度过拟合时填 1e-4 量级;和 Dropout 一起用时两个都别给太狠 |
optimizer | 'adam' | 先用 Adam 把流程跑通;要榨最后一点精度再换 'sgd' + 动量 + 衰减慢慢调 |
scheduler | 'step' | 损失降到某处就平了 → 开衰减;训练轮数很少(10 轮以内)则没必要 |
seed | 0 | 永远不要为了「换个结果看看」而改它。种子不固定,任何对比都失去意义 |
CONFIG,一眼看得到当前配置 · ② 开头 torch.manual_seed,结果可复现 · ③ 每轮开头 model.train(),Dropout / BN 处于正确模式 · ④ scheduler.step() 在 epoch 循环里,不在 batch 循环里 · ⑤ 日志同时打印 loss 和当前学习率,衰减有没有生效一目了然。
配合使用的两个组件
模板本身不含验证逻辑和早停,因为它们各自有取舍。要补上的话,把前面两份直接接进去即可:
| 组件 | 来自 | 怎么接 |
|---|---|---|
| 过拟合诊断 | overfit_diagnose.py | 每轮把 train_loss / valid_loss 各 append 进一个列表,训练结束整体丢进 diagnose() |
| 早停 + 回滚 | early_stopping.py | epoch 循环末尾调 stopper.step(valid_loss, epoch, on_improve=keep),返回 True 就 break |
| 参数分组衰减 | weight_decay.py | 把 build_optimizer 换成 build_optimizer_no_decay_on_bias,让 bias 与 BN 参数免于衰减 |
model.state_dict()、optimizer.state_dict() 和 scheduler.state_dict()——只存模型权重的话,Adam 攒的一阶矩二阶矩、调度器走到第几轮全部丢失,续训头几轮会明显抖一下。
06易错点汇总
按「优化器 / 学习率 / 正则化 / 训练模式 / 实验方法」五类归并,每条都给现象和修法
⚠️ 一、优化器
- 优化器实例化在了模型搬到 GPU 之前。 现象:训练时报参数不在同一设备,或者更新压根不生效。原因是优化器记的是建它那一刻的参数对象。修法:顺序固定为
model.to(device)→optim.Adam(model.parameters(), ...)。 - 手推的数字和 PyTorch 对不上。
optim.SGD(momentum=0.9)内部是buf = β·buf + g,没有乘 (1−β),和教材的 EWA 写法差一个常数倍。修法:对账时用框架那一版公式,见optimizer_math.py。 - 换成 Adam 之后沿用了 SGD 的学习率。 现象:loss 直接飙到
nan。SGD 常用1e-2量级,Adam 常用1e-3甚至更小,两者不通用。修法:换优化器就重新找学习率,按十倍量级试。 - 以为 AdaGrad 自带衰减就不用管学习率了。 现象:训练后期损失彻底不动。它的分母只增不减,学习率会被压到过小。修法:一般任务直接用 RMSProp 或 Adam。
- 断点续训只保存了模型权重。 现象:接着训练时头几轮损失明显抖一下。Adam 攒的一阶矩、二阶矩和调度器进度全丢了。修法:
model/optimizer/scheduler三个state_dict()一起存。
⚠️ 二、学习率与调度器
scheduler.step()写进了 batch 循环。 现象:第一轮还正常,之后损失再也不变。一轮 200 个 batch 时,gamma=0.95一轮就把学习率乘了0.95²⁰⁰ ≈ 0.000035。修法:它只属于 epoch 循环。scheduler.step()调在了optimizer.step()之前。 PyTorch 会给出顺序警告,且第一轮的学习率不是你设的初值。修法:先更新参数,再走调度器。- 学习率衰减了但没打印。 现象:调了半天不知道到底生效没有。修法:日志固定加
optimizer.param_groups[0]['lr']。 - 用
ExponentialLR时 gamma 取得太小。gamma=0.8跑 50 轮,学习率只剩初值的0.8⁵⁰ ≈ 1.4e-5。修法:指数衰减的 gamma 常取 0.95~0.99,先按轮数算一下终值再用。 - 把
batch_size调大而学习率不动。 现象:「突然学不动了」。batch 从 8 改到 64,每轮更新次数只剩八分之一,步子却没变大。修法:batch 调大时同步放大学习率。
⚠️ 三、正则化
- Dropout 插在了输出层之前。 现象:预测结果无规律波动,准确率上不去。随机丢掉最终结论没有任何道理。修法:只插在隐藏层之间。
- 用 Dropout 治欠拟合。 现象:训练损失本来就降不下去,加了 Dropout 之后更差。修法:先看两条曲线的关系——训练损失本身就高时,要做的是加大模型/多训几轮,正则化只会火上浇油。
- batch_size 很小却用了 BatchNorm。 现象:效果明显变差,或者最后一批报「一条样本算不出方差」。修法:DataLoader 加
drop_last=True;确实必须小 batch 就换LayerNorm。 - 把 BN 的
momentum当成优化器的动量。 两者只是重名,前者控制 running 统计量的更新速度,默认 0.1,基本不用动。 - 以为 BN 的 γ、β 是超参数。 它们是可学习参数,由反向传播自己调,不需要你设。
weight_decay给得过大。 现象:训练损失和验证损失一起变差。权重被压得太狠,模型表达能力被砍没了。修法:从1e-4起步,最多试到1e-2。- 拿训练损失判断正则化有没有用。 加了 Dropout 后训练损失本来就该变高。修法:只看验证指标。
- 早停用训练损失做判据。 训练损失几乎总在降,这样的早停永远不会触发。修法:判据必须是验证集指标。
- 早停停了但没回滚权重。 现象:早停之后成绩还不如中途某一版。最后一轮已经是变差的那一版了。修法:指标创新低时
deepcopy(state_dict()),停训后加载回来。
⚠️ 四、训练模式切换
- 预测前忘了
model.eval()。 现象:同一条样本连问两次给出两个答案,测试准确率虚低,而且不报任何错——最折磨人的静默失败。修法:评估函数第一行固定写它。 - 验证完忘了切回
model.train()。 现象:从第二轮起 Dropout 永远不生效,正则化等于没加。修法:每个 epoch 开头固定写model.train()。 - 以为
eval()会关掉梯度计算。 它只翻标志位,梯度照算。修法:评估还要额外包一层with torch.no_grad():,两件事各管各的。 - 以为
eval()会冻结参数。 它不冻结任何东西。要冻结得设param.requires_grad = False。
⚠️ 五、实验方法
- 没固定随机种子就下结论。 现象:同样的代码两次差好几个百分点,分不清是改动起了作用还是运气。修法:脚本开头
torch.manual_seed(n),做对比实验时尤其必要。 - 一次改了三处。 成绩涨了也说不清是哪一处的功劳,跌了更没法回退。修法:一次只动一个旋钮,记下数字再动下一个。
- 在测试集上反复调参。 调着调着测试集就变成了训练集的一部分,评出来的分数不可信。修法:划出独立的验证集调参,测试集只在最后用一次。
- 标准化的
fit在全量数据上做。 现象:本地分数很好、上线明显变差。这是信息泄漏:测试集的统计量泄进了预处理。修法:fit_transform只用训练集,测试集只transform。 - 只看损失不看业务指标。 数据自带噪声时损失有下限,降到平台不等于没学好。修法:分类看准确率等独立指标,回归看系数与真值的差距。
把行为差异跑一遍
第四类里那几条最值得亲手触发一次。下面这份把 Dropout 的训练/测试差异、BN 的两套统计量、batch_size=1 的报错、整网切换的效果全部原地复现:
"""model.train() 与 model.eval() 到底切换了什么。

这两个方法不改任何权重、不算任何梯度,它们只做一件事:
把网络里所有子模块的 self.training 标志位设成 True / False。
真正因此改变行为的只有两类层:

    Dropout    训练时随机置 0 并按 1/(1-p) 放大;测试时完全不动
    BatchNorm  训练时用**当前这批**的均值方差,同时更新全局running统计量;
               测试时改用累计下来的 running_mean / running_var

忘了切换的后果:
    忘了 eval()  -> 预测结果每次都不一样,且准确率虚低
    忘了 train() -> Dropout 永远不生效,正则化等于没加
"""
import torch
import torch.nn as nn

torch.manual_seed(0)


def show_dropout_behavior():
    print('===== Dropout =====')
    dropout = nn.Dropout(p=0.5)
    x = torch.ones(1, 8)                     # 全 1,方便看出哪些被置 0、哪些被放大

    dropout.train()
    print('训练模式连打三次(每次都不同):')
    for _ in range(3):
        print('  ', dropout(x))
    # 存活的元素值是 1/(1-0.5) = 2.0,不是 1.0
    # 放大的目的:让这一层输出的**期望总量**和不失活时一致,
    # 否则测试时不失活,数值量级会突然翻倍。

    dropout.eval()
    print('测试模式连打三次(完全相同,就是恒等映射):')
    for _ in range(3):
        print('  ', dropout(x))


def show_bn_behavior():
    print('\n===== BatchNorm =====')
    bn = nn.BatchNorm1d(4)
    x = torch.tensor([[1.0, 2.0, 3.0, 4.0],
                      [5.0, 6.0, 7.0, 8.0]])

    print('初始 running_mean =', bn.running_mean)   # 全 0
    print('初始 running_var  =', bn.running_var)    # 全 1

    bn.train()
    out_train = bn(x)
    print('训练模式输出(用这一批自己的均值方差标准化):\n', out_train)
    # 每列两个数标准化后必然是 -1 和 +1(两样本情形),与列的绝对大小无关
    print('更新后的 running_mean =', bn.running_mean)
    # running_mean = (1 - momentum) * 旧值 + momentum * 本批均值
    #              = 0.9 * 0 + 0.1 * 本批均值

    bn.eval()
    out_eval = bn(x)
    print('测试模式输出(改用 running 统计量,数值完全不同):\n', out_eval)

    print('可学习的缩放 γ =', bn.weight.data)        # 初始全 1
    print('可学习的平移 β =', bn.bias.data)          # 初始全 0


def show_batch_size_one_trap():
    print('\n===== BN 的 batch_size=1 陷阱 =====')
    bn = nn.BatchNorm1d(4)
    bn.train()
    one_sample = torch.randn(1, 4)
    try:
        bn(one_sample)
    except Exception as exc:
        print('训练模式下喂 1 条样本:', type(exc).__name__, exc)
    # 原因:一条样本算不出方差(分母为 0),BatchNorm1d 直接拒绝。
    # 现实中触发场景:最后一个 batch 恰好只剩 1 条 ->
    # DataLoader 加 drop_last=True 即可绕开。

    bn.eval()
    print('测试模式下喂 1 条样本没问题:', bn(one_sample).shape)


class Net(nn.Module):
    """一个同时含 Dropout 和 BN 的网络,用来演示整网切换。"""

    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(8, 16)
        self.bn = nn.BatchNorm1d(16)
        self.drop = nn.Dropout(p=0.3)
        self.fc2 = nn.Linear(16, 2)

    def forward(self, x):
        x = torch.relu(self.bn(self.fc1(x)))
        x = self.drop(x)
        return self.fc2(x)


def show_whole_net_switch():
    print('\n===== 整网一次性切换 =====')
    net = Net()
    x = torch.randn(4, 8)

    net.train()
    a, b = net(x), net(x)
    print('train() 下两次前向是否相同:', torch.equal(a, b))   # False

    net.eval()
    with torch.no_grad():
        c, d = net(x), net(x)
    print('eval() 下两次前向是否相同:', torch.equal(c, d))    # True
    # 结论:预测阶段必须 eval(),否则同一张图连问两次会给出两个答案。


if __name__ == '__main__':
    show_dropout_behavior()
    show_bn_behavior()
    show_batch_size_one_trap()
    show_whole_net_switch()
train() 下两次结果不同(Dropout 在随机失活),eval() 下两次结果完全相同。线上服务怀疑模型状态不对时,用这一招三行代码就能确诊,不用去翻整个训练脚本。
再跑一遍诊断
第五类的核心是「先诊断再动手」。把两条曲线喂进诊断器,结论会直接告诉你该去调优化还是调正则化:
"""过拟合 / 欠拟合的判别器:只看训练与验证两条损失曲线的关系。

不依赖 torch,把训练过程中记录下来的两条曲线喂进来就能出诊断结论。
真实项目里把 train_loss / valid_loss 每轮 append 进列表,训练完直接调用。

判别规则(三种典型形态):
    1. 两条都高、都还在降        -> 欠拟合:模型太小或训练轮数不够
    2. 训练一直降、验证先降后升  -> 过拟合:该上正则化了
    3. 两条都低且贴在一起        -> 拟合良好
"""


def diagnose(train_loss, valid_loss, gap_ratio=0.3, patience=5):
    """返回 (结论, 解释)。

    gap_ratio: 验证损失比训练损失高出多少比例算「差距过大」
    patience : 验证损失连续多少轮不再下降算「已经转折」
    """
    assert len(train_loss) == len(valid_loss), '两条曲线长度必须一致'
    assert len(train_loss) >= patience + 1, '轮数太少,看不出趋势'

    last_train = train_loss[-1]
    last_valid = valid_loss[-1]
    best_valid = min(valid_loss)
    best_epoch = valid_loss.index(best_valid)

    # 训练损失还在明显下降吗(拿最后 patience 轮和之前对比)
    train_still_falling = train_loss[-patience - 1] - last_train > 1e-4

    # 验证损失从最低点之后又涨回去了多少
    valid_rebound = last_valid - best_valid

    if last_train > 0.6 * train_loss[0] and train_still_falling:
        return ('欠拟合',
                '训练损失本身还很高且仍在下降,说明模型连训练集都没学明白:'
                '加深网络、加宽隐藏层、延长训练轮数、或者把学习率调大一点。')

    if valid_rebound > 1e-4 and best_epoch < len(valid_loss) - patience:
        return ('过拟合',
                '验证损失在第 %d 轮触底 %.4f,之后反弹到 %.4f,而训练损失还在降——'
                '模型开始背答案了:上 Dropout / weight_decay,或直接早停到第 %d 轮。'
                % (best_epoch + 1, best_valid, last_valid, best_epoch + 1))

    if last_valid - last_train > gap_ratio * max(last_train, 1e-8):
        return ('轻度过拟合',
                '验证损失 %.4f 明显高于训练损失 %.4f,差距已经拉开,'
                '虽然还没反弹,但正则化可以先加上了。' % (last_valid, last_train))

    return ('拟合良好',
            '两条曲线都降到低位且贴得很近,训练 %.4f / 验证 %.4f。' % (last_train, last_valid))


# ---------------------------------------------------------------- 三组造出来的曲线
# 这些数字是手工编排的典型形态,用来验证判别逻辑本身,不是某次真实训练的结果
UNDERFIT_TRAIN = [1.38, 1.35, 1.33, 1.31, 1.29, 1.27, 1.25, 1.23]
UNDERFIT_VALID = [1.39, 1.36, 1.34, 1.32, 1.30, 1.28, 1.26, 1.24]

OVERFIT_TRAIN = [1.40, 0.95, 0.62, 0.40, 0.25, 0.15, 0.09, 0.05, 0.03, 0.02]
OVERFIT_VALID = [1.42, 1.00, 0.72, 0.61, 0.58, 0.60, 0.66, 0.74, 0.83, 0.91]

GOOD_TRAIN = [1.40, 0.90, 0.60, 0.45, 0.38, 0.34, 0.32, 0.31, 0.30, 0.30]
GOOD_VALID = [1.43, 0.94, 0.64, 0.48, 0.41, 0.36, 0.34, 0.33, 0.32, 0.32]


def ascii_curve(train, valid, width=48):
    """不装 matplotlib 也能看走势:把两条曲线画成字符图。"""
    hi = max(max(train), max(valid))
    lo = min(min(train), min(valid))
    span = (hi - lo) or 1.0
    for i, (t, v) in enumerate(zip(train, valid)):
        tp = int((t - lo) / span * (width - 1))
        vp = int((v - lo) / span * (width - 1))
        row = [' '] * width
        row[tp] = 'T'                       # T = 训练损失
        row[vp] = 'V' if vp != tp else '*'  # V = 验证损失,重合画 *
        print('  epoch %2d |%s|  train %.3f  valid %.3f'
              % (i + 1, ''.join(row), t, v))


if __name__ == '__main__':
    for name, tr, va in (('一、欠拟合', UNDERFIT_TRAIN, UNDERFIT_VALID),
                         ('二、过拟合', OVERFIT_TRAIN, OVERFIT_VALID),
                         ('三、拟合良好', GOOD_TRAIN, GOOD_VALID)):
        print(name)
        ascii_curve(tr, va)
        verdict, why = diagnose(tr, va)
        print('  诊断结论:%s —— %s\n' % (verdict, why))
07自测题
点击题目展开答案;这 11 题都能说清楚,这一页就通了
朴素梯度下降会在哪三种地形上出问题?各自的表现是什么?
平缓区:坡度小,一步几乎挪不动,损失曲线长时间近乎水平。鞍点:梯度正好为 0,参数彻底不动——高维空间里鞍点比局部最低点常见得多。震荡:小批量梯度带噪声,参数来回被拽,损失上下抖动而整体下降很慢。三者的共同根源是只用当前这一瞬的梯度,信息太少。
指数加权平均的公式是什么?β 越大意味着什么?
St = β·St−1 + (1−β)·Yt,也就是「新平均 = 上次平均占 β 份 + 当前值占 (1−β) 份」。往前代一层会看到越久远的值权重按 β 的次方指数衰减。β 越大越相信历史、曲线越平滑,但对新变化反应越慢:0.5 约等于平均最近 2 个值,0.9 约 10 个,0.99 约 100 个。默认取 0.9。
Momentum 是怎么同时治好鞍点、平缓区和震荡这三件事的?
它把更新用的梯度换成了历史梯度的指数加权平均。鞍点处当前梯度为 0,但累积量里还攒着之前的惯性,照样往前挪;平缓区里同方向的小梯度一轮轮累加,越攒越大;震荡时方向相反的梯度在加权平均里相互抵消,留下真正一致的那个方向。一处改动,三个问题。
AdaGrad 和 RMSProp 只差一个字,是哪个字?为什么这一改如此关键?
AdaGrad 把历史梯度平方求和(s = s + g²),RMSProp 改成指数加权平均(s = βs + (1−β)g²)。求和意味着分母只增不减,有效学习率单调下降,训练后期会被压到走不动——这正是 AdaGrad 的致命伤。换成加权平均后久远的梯度会被遗忘,分母能降能升,过早熄火的问题就解决了。
Adam 里的偏差修正在修什么?不修会怎样?
一阶矩 m 和二阶矩 v 都从 0 起步,前几步会被这个 0 严重拉低:第一步 m₁ = 0.1·g₁,只有真实梯度的十分之一。不修正的话前十几步几乎原地热身。除以 (1 − β₁ᵗ) 正好抵消:第一步 1 − 0.9¹ = 0.1,m̂₁ = 0.1g/0.1 = g,分毫不差。t 变大后修正项自动退场。这也是为什么 Adam 的第一步和 SGD 完全一样。
损失变成 nan、损失上下横跳、损失降得极慢,各自最可能是什么原因?
nan 或飙升:学习率太大,一步跨过谷底而且越跨越远。横跳不降:学习率偏大,在谷底两壁之间来回弹。降得极慢:学习率太小,也可能是卡在平缓区。还有第四种——前期降得挺好、后期原地踏步,那不是学习率设错了,而是该衰减了:同一个学习率不可能同时适合前期和后期。
scheduler.step() 该放在哪一层循环?放错会出现什么现象?
放在 epoch 循环里,每轮一次;optimizer.step() 才在 batch 循环里。放进 batch 循环,衰减速度会被放大 iteration 倍——一轮 200 个 batch 时 ExponentialLR(gamma=0.95) 一轮就把学习率乘了 0.95²⁰⁰ ≈ 0.000035,现象是「第一轮还正常,之后损失再也不变」。另外顺序上 optimizer.step() 要在 scheduler.step() 之前。
Dropout 训练时为什么要把存活的神经元乘以 1/(1−p)?
为了让训练时的期望输出总量和测试时一致。p=0.5 时一半神经元被置零,这一层输出总量腰斩;测试时不失活、总量满血,后面那层看到的数值量级会突然翻倍,等于换了个模型。把存活的乘上 1/(1−0.5) = 2 补回来,测试阶段才可以什么都不做。
BatchNorm 既然已经把数据标准化成均值 0 方差 1,为什么又要缩放平移一下?
因为「均值 0、方差 1」未必是这一层最好的分布,强行固定等于给网络加了一条它没要求的约束。加上可学习的 γ(缩放)和 β(平移),网络能自己决定要不要偏、偏多少,极端情况下甚至能学出「原样还回去」。这两个是学出来的参数,不是超参数。
加了 Dropout 之后训练损失反而变高了,是加错了吗?
不是,这正是预期现象——你亲手往训练过程里加了噪声。判断有没有加对,唯一标准是验证指标是否变好。训练损失变高、验证准确率上升,就是正则化生效的样子。拿训练损失判断正则化,结论必然是反的。
model.train() 和 model.eval() 到底切换了什么?漏掉各会怎样?
它们不改权重、不算梯度,只是把所有子模块的 self.training 标志位翻一下,真正因此改变行为的只有两类层:Dropout(训练时随机置零并放大,测试时恒等映射)和 BatchNorm(训练时用当前这批的均值方差并更新 running 统计量,测试时改用累计的 running 值)。漏了 eval():同一条样本连问两次答案不同、准确率虚低,且不报任何错。漏了 train():Dropout 永远不生效,正则化等于没加。另外 eval() 不会关掉梯度计算,评估还要额外包 torch.no_grad()。
词术语表
| 术语 | 含义 |
|---|---|
| 梯度下降 | 沿梯度反方向挪一小步:w ← w − lr × g;本页所有优化器都是它的改良版 |
| 鞍点 saddle point | 某些方向上坡、另一些下坡,合起来梯度为 0 的位置;高维空间里比局部最低点常见得多 |
| 平缓区 | 坡度极小的区域,朴素更新在这里几乎原地不动 |
| epoch | 把全部训练数据完整过一遍 |
| batch_size | 一次参数更新用多少条样本 |
| iteration | 一次参数更新的过程;每轮 iteration 数 = ⌈样本数 ÷ batch_size⌉,由前两者算出 |
| EWA 指数加权平均 | St = β·St−1 + (1−β)·Yt;Momentum、RMSProp、Adam 的公共零件 |
| Momentum 动量 | 用历史梯度的加权平均代替当前梯度,靠惯性冲过鞍点与平缓区,并抚平震荡 |
| AdaGrad | 用历史梯度平方和缩放学习率;分母只增不减,后期容易过早熄火 |
| RMSProp | 把 AdaGrad 的求和换成指数加权平均,学习率能降也能回升;PyTorch 里系数参数名叫 alpha |
| Adam | 一阶矩(方向)+ 二阶矩(幅度)+ 偏差修正;默认首选,lr=1e-3 起步 |
| 一阶矩 / 二阶矩 | 分别是梯度的指数加权平均、梯度平方的指数加权平均 |
| 偏差修正 | 除以 1 − βᵗ,抵消一阶/二阶矩从 0 起步导致的前期低估 |
| 学习率 lr | 每步迈多大;调参里最该调也最值得调的一个数,按十倍量级试 |
| 学习率衰减 scheduler | 前期大步找方向、后期小步精调;StepLR / MultiStepLR / ExponentialLR |
| 过拟合 overfitting | 训练损失很低、验证损失掉头往上;模型在背答案而不是学规律 |
| 欠拟合 underfitting | 训练损失本身就高且还在降;模型连训练集都没学明白 |
| 正则化 regularization | 一切以牺牲训练集表现换取泛化能力的手段的总称 |
| Dropout | 训练时以概率 p 随机置零神经元,存活的按 1/(1−p) 放大;测试时恒等映射 |
| BatchNorm | 逐通道把每批数据标准化再缩放平移;γ 与 β 是可学习参数,测试时改用 running 统计量 |
| running_mean / running_var | 训练期间累计的全局均值方差,供测试阶段使用 |
| L1 / L2 惩罚 | 在损失里加参数绝对值和 / 平方和;L1 产生稀疏,L2 整体压小权重 |
| weight_decay | 优化器参数,等价于 L2 正则;1e-4 量级起步 |
| 早停 Early Stopping | 验证指标连续若干轮不改善就停训,并回滚到最优轮次的权重 |
| patience | 早停容忍多少轮没有改善,常规取 5~10 |
| 标准化 StandardScaler | 把特征压成均值 0 方差 1;fit 只能在训练集上做,否则是信息泄漏 |
| model.train() / model.eval() | 翻转 self.training 标志位;只影响 Dropout 与 BatchNorm,不关梯度也不冻参数 |