检索与问答链:把该用的那块拿准
复核员变不出新卡片——召回没抱回来的那张纸,Rerank 再强也救不回来。
30″30 秒看懂检索与问答链
资料室里的活页已经切好、编好坐标了。现在轮到资料员干活:拿着题目跑进去,抱几张回来。
他要当场做三个决定——抱几张?太远的要不要?谁摆最上面?抱少了,该用的那张没拿到;抱多了,一堆无关的纸塞进活页夹,考生反而被带偏。而且他抱回来的顺序不等于有用的顺序:真正能答题的那张,常常排在第三。
所以正经的做法是两道工序:资料员先粗抱一摞(快,宁可多拿),再让一位复核员把这摞重新排一遍、只留最上面几张(慢,但排得准)。
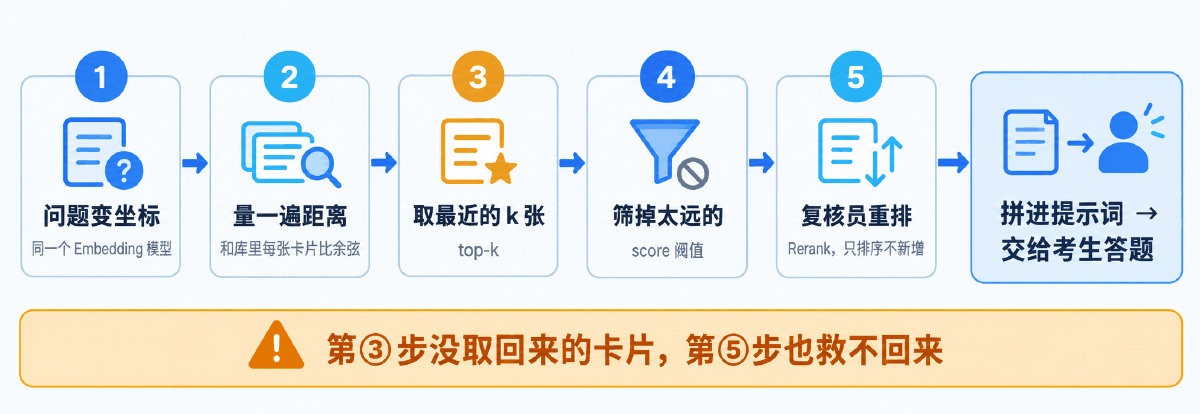
| 资料员的动作 | 技术名 | 做砸了会怎样 |
|---|---|---|
| 抱几张回来 | top-k | k 太小漏掉答案,k 太大全是噪声,还更贵更慢 |
| 太远的扔掉 | score 阈值 | 不设,库里没有的问题也会硬塞三张纸给考生 |
| 复核员重排 | Rerank | 不上,该用的那张常年排第三,进不了前二 |
| 按单号精确找 | 关键词 / 混合检索 | 只用向量,单号型号这类精确串找不准 |
| 摞好交给考生 | 提示词拼装 | 不编号就标不出出处,不圈范围模型就会混用先验知识 |
01概念:召回、排序、过滤是三件事
三个常被混着说的词,各自负责什么
1.1 召回、排序、过滤
「检索效果不好」这句话在工程上其实至少指三件不同的事,对应三个不同的旋钮:
| 环节 | 回答的问题 | 旋钮 | 量它的指标 |
|---|---|---|---|
| 召回(recall) | 该用的那块在不在返回结果里 | k、检索路数 | 命中率 |
| 排序(rank) | 它排第几 | 相似度算法、Rerank | MRR、Top1 准确率 |
| 过滤(filter) | 不相关的有没有被挡住 | score 阈值、元数据条件 | 误答率、拒答率 |
把它们分开,调参才有意义:命中率不达标就加大 k 或加一路检索,排名不对就上 Rerank,该拒答却没拒就调阈值。混在一起调,改完效果变了也说不清是谁的功劳。
1.2 top-k:抱几张
k 是整个 RAG 里最常被调的一个数,它的取舍非常直白:
| k 太小 | k 太大 |
|---|---|
| 该用的那块没取回来,答案缺内容 | 无关内容挤进提示词,把模型带偏 |
| 拒答率异常高 | token 变多,更贵更慢 |
| 改提示词救不回来 | 关键句夹在中间更容易被漏读 |
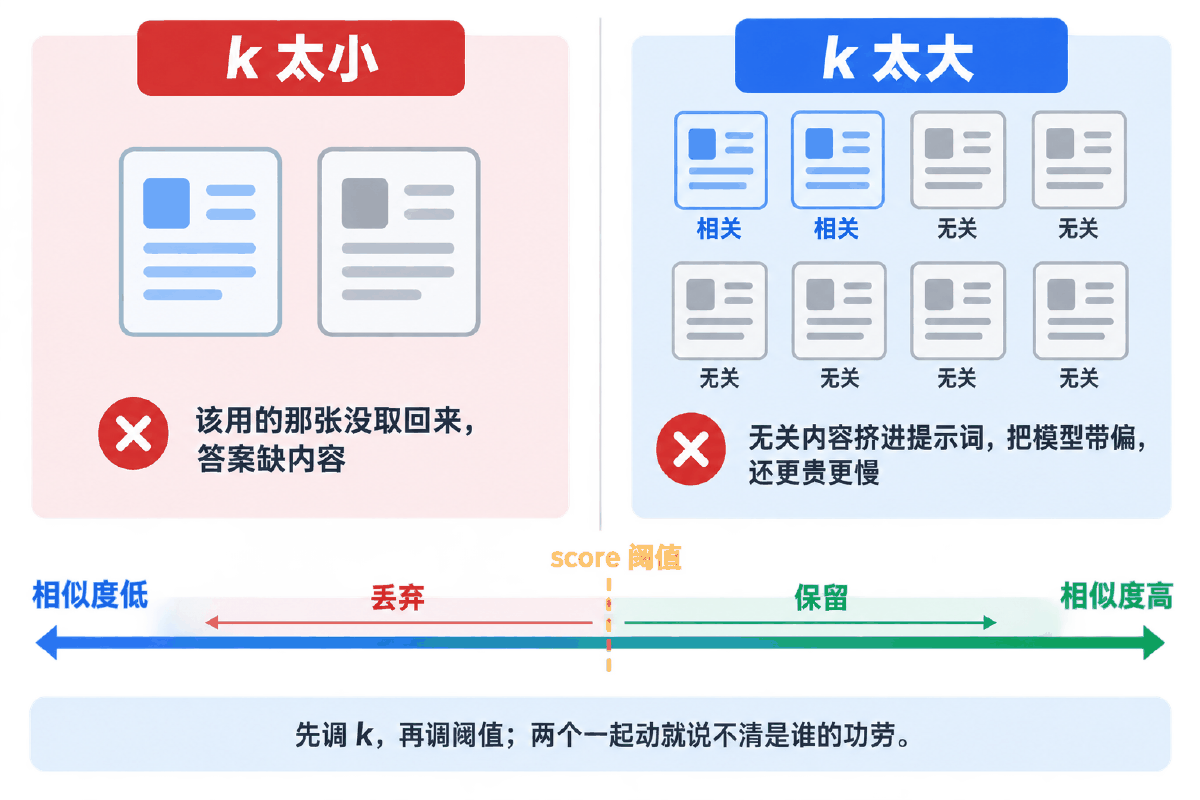
但「k 越大越保险」是个错觉。第 03 节的实测里,命中率在 k=3 时就到顶了(1.00),k 从 3 加到 8,命中率一点没涨,噪声比却从 0.67 涨到 0.88。再往上加的每一条,都只是在往活页夹里塞废纸。
1.3 score 阈值:太远的扔掉
top-k 有个天生的毛病——它永远返回 k 条,哪怕库里一条相关的都没有。挡住这种情况的是分数阈值:低于它的结果一律丢弃,全丢光就直接回复「资料中未提及」。
阈值带来一对此消彼长的错误,必须按业务偏一边:
| 阈值调高 | 阈值调低 | 该怎么偏 |
|---|---|---|
| 该答的漏答变多 | 该挡的放过变多 | 对外客服 / 法务 / 医疗:宁可漏答,阈值往高调 |
| 拒答率上升 | 编造风险上升 | 内部检索助手:宁可多给几条让人自己挑,往低调 |
1.4 召回与重排:两道工序,不是两个方案
这是新手最容易误解的一处:Rerank 不是「更好的检索」,它是接在检索后面的第二道工序。两者的目标函数完全不同:
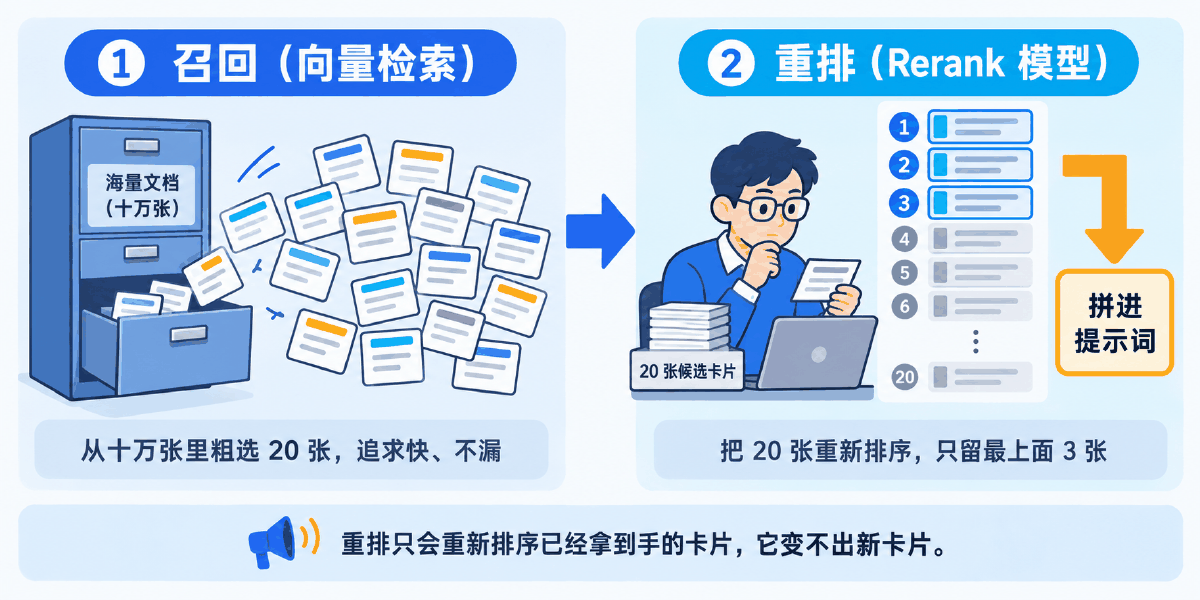
| 对比 | ① 召回(向量检索) | ② 重排(Rerank 模型) |
|---|---|---|
| 输入 | 问题 + 整个库(十万级) | 问题 + 召回回来的 20~50 条 |
| 怎么算 | 问题和文档各自编码,再比向量 | 问题和文档拼在一起过一遍模型 |
| 快慢 | 很快,可预先建索引 | 慢,每条都要过一次模型 |
| 追求 | 不漏 | 排得准 |
| 能不能新增结果 | 能 | 不能 |
最后一行就是本讲的铁律。Rerank 之所以排得更准,是因为它让问题和文档在同一次前向里互相看见(交叉编码),而向量检索为了能预先建索引,只能分开编码——这是速度换来的精度损失,也正是需要第二道工序的原因。
1.5 混合检索:语义找不准精确串
还有一类问题向量检索天生做不好:单号、型号、人名、条款编号。因为这些串的「意思」几乎为零,真正区分它们的是字符本身。
实测问「ABC123789 这单现在在哪」,向量检索把三条句式雷同的运单排在一起,正确那条只排第二;关键词检索一击即中。反过来问「货从哪个城市发出」,关键词检索返回空。
02原理:一次提问在管线里走完的五步
从问题文本到一段拼好的提示词,中间每一步改了什么
2.1 五步管线
| 步骤 | 输入 | 输出 | 要留意 |
|---|---|---|---|
| ① 问题向量化 | 问题文本 | 一个向量 | 必须用建库那个模型 |
| ② 量距离 | 问题向量 + 库 | 每块一个分数 | metric 要和建库时一致 |
| ③ 取 top-k | 全部分数 | k 条候选 | 召回阶段的 k 要放宽 |
| ④ 过阈值 | k 条候选 | ≤ k 条 | 可能一条都不剩,这是正常路径 |
| ⑤ 重排 + 拼装 | 剩下的候选 | 最终提示词 | 去重、编号、带来源、卡预算 |
注意第 ④ 步的「一条都不剩」:这不是异常,是系统在正确工作——库里真的没有答案时,就该什么都不返回。代码里必须把这条路径当成一等公民处理,而不是让它掉进「拿空 context 去问模型」的分支。
2.2 一个问题最多只算一次向量
在线阶段的耗时构成大致是这样的(本机不跑真实向量库,以下为典型量级参考):
| 环节 | 量级 | 能不能省 |
|---|---|---|
| 问题向量化 | 毫秒级(本地)/ 百毫秒级(API) | 高频重复问题可以缓存 |
| 向量检索 | 毫秒级(有索引) | 已经很快 |
| Rerank | 百毫秒级,随候选数线性增长 | 候选数是主要成本,别放 200 条 |
| 模型生成 | 秒级 | 占大头,和 context 长度正相关 |
结论很实用:省 token 就是省时间。k 从 3 调到 8,context 从 86 字涨到 217 字,生成这一步的耗时和费用跟着涨,而命中率一点没变。
2.3 提示词是怎么被拼出来的
第 ⑤ 步不只是把原文接起来,它有四个必须做的动作,顺序不能乱:
- 去重:同一段话可能在两份文档里都有,正文相同就合并,把来源并在一起。
- 编号:给每块加
[1] [2],模型才有东西可引用。 - 带来源:把文件名和页码写进 context,让答案能被回头核对。
- 卡预算:按字数或 token 数截断,装不下的整条丢掉,不要截半条。
2.4 拼装的三条规则各自挡掉什么
| system 里的规则 | 不写会怎样 | 挡掉的事故 |
|---|---|---|
| 只使用【已知信息】里出现过的内容 | 模型混用自己的先验知识 | 答案里有一半说不清依据 |
| 不足以回答时回复「资料中未提及」 | 检索为空时开始编 | 一本正经的假答案 |
| 每个结论后标出所依据的编号 | 想标也无从标起 | 无法验收、无法追责 |
第三条再强调一次:它是否生效,取决于 context 里有没有编号。规则和拼装必须成对存在,只写规则不编号,模型只能瞎编页码。
03把 k 和阈值量出来
两段可运行的实验:k 加到几就到顶,阈值该卡在哪
3.1 k 从 1 试到 8
实验用一个 8 块的小知识库和 4 条带标准答案的测试题,把 k 从 1 扫到 8,同时量三件事:命中率(该用的那块在不在返回结果里)、噪声比(返回结果里无关的占多少)、平均上下文长度(要付的 token)。
"""k 取多少:把「取几张卡片」这件事量出来,而不是拍脑袋。

三个指标一起看才有意义:
  命中率   —— 该用的那块在不在取回来的 k 张里(k 越大越高)
  噪声比   —— 取回来的 k 张里有多少是无关的(k 越大越差)
  上下文量 —— 拼进提示词的字数(k 越大越贵)
k 的取值就是在这三条曲线上找一个拐点。

纯标准库,直接运行。
"""
import math
import re
from collections import Counter

CHUNKS = [
    "货物编号 ABC123456,发货日期 2023-01-15,当前位置上海分拨中心。",
    "该批货物预计到达日期为 2023-01-20。",
    "承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天。",
    "东方仓储中心位于深圳市,存储电子产品,常温仓储,库存一千件。",
    "速达物流总部在北京市,业务范围为国际快递与仓储管理。",
    "客服热线工作时间为每日 9:00 至 21:00。",
    "国际件报关所需材料包括发票、装箱单与合同。",
    "冷链货物需全程温控,交接时须记录温度。",
]

# 测试集:问题 → 必须命中的块下标(人工标注,这一步没有捷径)
TESTSET = [
    ("这批货从哪发出,几天能到?", {2}),
    ("货现在到哪了?", {0}),
    ("深圳仓库存的是什么?", {3}),
    ("预计什么时候送到?", {1}),
]


def tokenize(t):
    return re.findall(r"[a-z0-9]+", t.lower()) + re.findall(r"[\u4e00-\u9fff]", t)


def embed(t):
    return Counter(tokenize(t))


def cosine(a, b):
    common = set(a) & set(b)
    dot = sum(a[k] * b[k] for k in common)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return dot / (na * nb) if na and nb else 0.0


INDEX = [(i, c, embed(c)) for i, c in enumerate(CHUNKS)]


def search(question, k):
    qv = embed(question)
    scored = [(cosine(qv, v), i, c) for i, c, v in INDEX]
    scored.sort(key=lambda x: x[0], reverse=True)
    return scored[:k]


def main():
    print("知识库 %d 块,测试集 %d 条\n" % (len(CHUNKS), len(TESTSET)))
    print("%-4s %-10s %-10s %-14s %s" % ("k", "命中率", "噪声比", "平均上下文", "说明"))
    print("-" * 64)

    rows = []
    for k in range(1, len(CHUNKS) + 1):
        hit = 0
        noise_num = noise_den = 0
        ctx_chars = 0
        for question, gold in TESTSET:
            got = search(question, k)
            idxs = {i for _s, i, _c in got}
            if gold & idxs:
                hit += 1
            noise_num += len(idxs - gold)
            noise_den += len(idxs)
            ctx_chars += sum(len(c) for _s, _i, c in got)
        rate = hit / len(TESTSET)
        noise = noise_num / noise_den
        avg_ctx = ctx_chars / len(TESTSET)
        rows.append((k, rate, noise, avg_ctx))
        note = ""
        if k > 1 and rows[-2][1] == rate:
            note = "命中率没涨,只是在加噪声"
        print("%-4d %-10.2f %-10.2f %-14.1f %s" % (k, rate, noise, avg_ctx, note))

    print()
    # 找到第一个命中率达到最高的 k:再往上加只剩坏处
    best = max(r[1] for r in rows)
    knee = next(k for k, rate, _n, _c in rows if rate >= best)
    print("命中率在 k=%d 时已经到顶(%.2f),再往上加 k:" % (knee, best))
    after = rows[knee - 1]
    last = rows[-1]
    print("  噪声比 %.2f → %.2f,平均上下文 %.0f 字 → %.0f 字,命中率一点没涨。"
          % (after[2], last[2], after[3], last[3]))
    print("  所以这个库上 k 取 %d 就够,不是越大越好。" % knee)

    print()
    print("=" * 64)
    print("单看一条问题,k 从 1 加到 4 都取回了什么")
    print("=" * 64)
    question, gold = TESTSET[0]
    print("问题:%s(标准答案是第 %s 块)\n" % (question, "、".join(str(i) for i in sorted(gold))))
    for score, i, c in search(question, 4):
        mark = "✔ 该用的" if i in gold else "✘ 噪声  "
        print("  %s  %.4f  [%d] %s" % (mark, score, i, c))
    print()
    print("注意第一条:分数最高的不一定是该用的那一条。")
    print("命中率要看的是「在不在这 k 条里」,而不是「是不是排第一」——")
    print("这也正是后面要上 Rerank 的理由。")


if __name__ == "__main__":
    main()
| k | 命中率 | 噪声比 | 平均上下文 | 判断 |
|---|---|---|---|---|
| 1 | 0.50 | 0.50 | 24.8 | 一半问题答不了 |
| 2 | 0.75 | 0.62 | 60.0 | 还在涨 |
| 3 | 1.00 | 0.67 | 86.5 | 到顶 |
| 4 | 1.00 | 0.75 | 113.5 | 只在加噪声 |
| 5 | 1.00 | 0.80 | 142.2 | 只在加噪声 |
| 8 | 1.00 | 0.88 | 217.0 | 只在加噪声 |
从 k=3 到 k=8:命中率一点没涨,噪声比从 0.67 涨到 0.88,上下文从 86 字涨到 217 字。多付的每一分钱都花在往活页夹里塞废纸上,还顺带增加了模型漏读关键句的风险。
3.2 分数最高的不一定是该用的
同一段实验还打印了单条问题的取回明细。问「这批货从哪发出,几天能到?」(标准答案是第 2 块):
| 判定 | 分数 | 内容 |
|---|---|---|
| ✘ 噪声 | 0.2417 | 该批货物预计到达日期为 2023-01-20。 |
| ✘ 噪声 | 0.1846 | 货物编号 ABC123456,发货日期 2023-01-15,当前位置上海分拨中心。 |
| ✔ 该用的 | 0.1430 | 承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天。 |
| ✘ 噪声 | 0.0692 | 国际件报关所需材料包括发票、装箱单与合同。 |
该用的那块排第三。所以命中率量的是「在不在这 k 条里」,而不是「是不是排第一」——这两个指标要分开看,前者不达标就加 k,后者不达标才上 Rerank。
3.3 阈值:先看分布,再定数
定阈值有一个很容易出错的顺序:直接拍一个 0.3 然后上线。正确做法是先拿两类问题各问一遍,把分数分布打出来——库里有答案的和库里没答案的。
"""分数阈值:怎么让系统学会说「资料里没有」。

top-k 有个天生的毛病——它永远返回 k 条,哪怕库里一条相关的都没有。
问一个知识库根本覆盖不到的问题,照样会拿回 k 条最不相干的东西,
模型看到这些东西,就很容易顺着它们编。

阈值就是补这个洞的:低于某个相似度,宁可空手回来。
但阈值不能拍脑袋定,要看分数分布。

纯标准库,直接运行。
"""
import math
import re
from collections import Counter

CHUNKS = [
    "货物编号 ABC123456,发货日期 2023-01-15,当前位置上海分拨中心。",
    "该批货物预计到达日期为 2023-01-20。",
    "承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天。",
    "东方仓储中心位于深圳市,存储电子产品,常温仓储,库存一千件。",
    "速达物流总部在北京市,业务范围为国际快递与仓储管理。",
    "客服热线工作时间为每日 9:00 至 21:00。",
]

# 库里答得出来的问题
IN_SCOPE = [
    "货现在到哪了?",
    "这批货几天能到?",
    "深圳仓库存的是什么?",
    "客服几点下班?",
]
# 库里根本没有的问题——这些必须被挡下来
OUT_SCOPE = [
    "公司年假怎么休?",
    "报销流程是什么?",
    "今天上海天气如何?",
]


def tokenize(t):
    return re.findall(r"[a-z0-9]+", t.lower()) + re.findall(r"[\u4e00-\u9fff]", t)


def embed(t):
    return Counter(tokenize(t))


def cosine(a, b):
    common = set(a) & set(b)
    dot = sum(a[k] * b[k] for k in common)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return dot / (na * nb) if na and nb else 0.0


INDEX = [(c, embed(c)) for c in CHUNKS]


def top_score(question):
    qv = embed(question)
    return max(cosine(qv, v) for _c, v in INDEX)


def main():
    print("=== 第一步:先看分数分布,别急着定阈值 ===\n")
    print("%-22s %-10s %s" % ("问题", "最高分", "类别"))
    print("-" * 52)
    in_scores, out_scores = [], []
    for q in IN_SCOPE:
        s = top_score(q)
        in_scores.append(s)
        print("%-22s %-10.4f %s" % (q, s, "库里有"))
    for q in OUT_SCOPE:
        s = top_score(q)
        out_scores.append(s)
        print("%-22s %-10.4f %s" % (q, s, "库里没有"))

    print()
    print("库里有   的最低分:%.4f" % min(in_scores))
    print("库里没有 的最高分:%.4f" % max(out_scores))
    gap = min(in_scores) - max(out_scores)
    if gap > 0:
        print("两类之间还有 %.4f 的空隙 → 阈值可以卡在这个空隙里。" % gap)
    else:
        print("两类分数重叠了 %.4f → 单靠阈值分不开," % -gap)
        print("要么先改进切分和向量化,要么加一层判断,不要指望一个数字解决问题。")

    print()
    print("=== 第二步:扫一遍阈值,看两类错误怎么此消彼长 ===\n")
    print("%-8s %-14s %-14s %s" % ("阈值", "该答的漏答", "该挡的放过", "总错误"))
    print("-" * 52)
    best = None
    for i in range(0, 41):
        th = i / 100
        miss = sum(1 for s in in_scores if s < th)      # 该答的被挡了
        leak = sum(1 for s in out_scores if s >= th)    # 该挡的放过去了
        total = miss + leak
        if best is None or total < best[1]:
            best = (th, total, miss, leak)
        if i % 4 == 0:
            print("%-8.2f %-14d %-14d %d" % (th, miss, leak, total))

    print()
    print("总错误最少的阈值:%.2f(漏答 %d,放过 %d)" % (best[0], best[2], best[3]))
    print()
    print("两类错误的代价并不对等,要按业务来偏:")
    print("  · 对外客服、法务、医疗 → 宁可漏答也不能瞎答,阈值往高调。")
    print("  · 内部检索助手         → 宁可多给几条让人自己挑,阈值往低调。")
    print()
    print("⚠️ 阈值是跟着 Embedding 模型走的。换了模型,分数分布整个平移,")
    print("   旧阈值会瞬间失效——所以换模型之后这张表必须重跑一遍。")


if __name__ == "__main__":
    main()
| 问题 | 最高分 | 类别 |
|---|---|---|
| 深圳仓库存的是什么? | 0.3889 | 库里有 |
| 这批货几天能到? | 0.3030 | 库里有 |
| 货现在到哪了? | 0.2182 | 库里有 |
| 客服几点下班? | 0.1925 | 库里有(最低) |
| 今天上海天气如何? | 0.1291 | 库里没有(最高) |
| 报销流程是什么? | 0.0772 | 库里没有 |
| 公司年假怎么休? | 0.0000 | 库里没有 |
两类之间留出了 0.1291 ~ 0.1925 的空隙,宽 0.0634。阈值就卡在这个空隙里,两类错误同时为零。扫描验证:
| 阈值 | 该答的漏答 | 该挡的放过 | 总错误 |
|---|---|---|---|
| 0.00 | 0 | 3 | 3 |
| 0.08 | 0 | 1 | 1 |
| 0.16 | 0 | 0 | 0 |
| 0.20 | 1 | 0 | 1 |
| 0.32 | 3 | 0 | 3 |
04完整案例:两道工序 + 两路检索 + 一次拼装
把「排第三」的那块救到第一,把单号查询救回来,再把结果拼成提示词
4.1 重排:把该用的那块提上来
接着第 03 节那个例子——该用的第 2 块排在第三名。加一道重排工序试试:
"""召回与重排是两件事:一个负责别漏,一个负责排对。

向量检索是「拿问题的向量去跟每块的向量比一次」,两边各自编码、互不照面,
所以它快得能扫百万条,但也粗。重排是「把问题和这一块拼在一起再读一遍」,
读得细,但慢得多,只能用在已经缩小到几十条的候选上。

这里用一个可解释的打分函数代替真正的 Rerank 模型:
它会看问题里的关键词在这一块里是否成对出现、位置是否接近。
真实项目换成 Rerank 模型,主流程一行都不用改。

纯标准库,直接运行。
"""
import math
import re
from collections import Counter

CHUNKS = [
    "货物编号 ABC123456,发货日期 2023-01-15,当前位置上海分拨中心。",
    "该批货物预计到达日期为 2023-01-20。",
    "承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天。",
    "东方仓储中心位于深圳市,存储电子产品,常温仓储,库存一千件。",
    "速达物流总部在北京市,业务范围为国际快递与仓储管理。",
    "客服热线工作时间为每日 9:00 至 21:00。",
    "国际件报关所需材料包括发票、装箱单与合同。",
    "冷链货物需全程温控,交接时须记录温度。",
]

QUESTION = "这批货从哪发出,几天能到?"
GOLD = 2  # 人工标注:只有第 2 块能答全


def tokenize(t):
    return re.findall(r"[a-z0-9]+", t.lower()) + re.findall(r"[\u4e00-\u9fff]", t)


def embed(t):
    return Counter(tokenize(t))


def cosine(a, b):
    common = set(a) & set(b)
    dot = sum(a[k] * b[k] for k in common)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return dot / (na * nb) if na and nb else 0.0


INDEX = [(i, c, embed(c)) for i, c in enumerate(CHUNKS)]

# 问题里真正承载意图的词组。真实 Rerank 模型是学出来的,
# 这里手写出来是为了让「重排凭什么改排序」看得见。
INTENT_GROUPS = [
    ["出发", "发出", "起运", "出发地", "从哪"],
    ["几天", "时长", "运输时间", "多久"],
]


def recall(question, k):
    """第一段:向量召回,粗选 k 条。"""
    qv = embed(question)
    scored = [(cosine(qv, v), i, c) for i, c, v in INDEX]
    scored.sort(key=lambda x: x[0], reverse=True)
    return scored[:k]


def rerank_score(question, chunk):
    """第二段:把问题和这一块放在一起读,按「意图组覆盖数」打分。

    关键差别:召回是逐词比对,一块里凑够几个高频字就能拿分;
    重排要求每一组意图都在这一块里落地,凑字数没用。
    """
    covered = 0
    for group in INTENT_GROUPS:
        if any(w in chunk for w in group):
            covered += 1
    # 覆盖到的意图组越多越好;全覆盖时额外奖励,因为它能独立答全
    score = covered / len(INTENT_GROUPS)
    if covered == len(INTENT_GROUPS):
        score += 0.5
    return score


def main():
    print("问题:%s" % QUESTION)
    print("标准答案:第 %d 块「%s」\n" % (GOLD, CHUNKS[GOLD]))

    k = 5
    cands = recall(QUESTION, k)
    print("=" * 66)
    print("① 召回:向量检索粗选 %d 条(快,但排序粗)" % k)
    print("=" * 66)
    for rank, (score, i, c) in enumerate(cands, 1):
        mark = "← 该用的" if i == GOLD else ""
        print("  第%d名  %.4f  [%d] %s %s" % (rank, score, i, c[:30], mark))
    gold_rank = next(r for r, (_s, i, _c) in enumerate(cands, 1) if i == GOLD)
    print("\n  该用的那一块排在第 %d 名。如果直接取 top-2,它根本进不了提示词。" % gold_rank)

    print()
    print("=" * 66)
    print("② 重排:只对这 %d 条重新打分排序(慢,但排得准)" % k)
    print("=" * 66)
    reranked = [(rerank_score(QUESTION, c), old_score, i, c) for old_score, i, c in cands]
    reranked.sort(key=lambda x: x[0], reverse=True)
    print("  %-6s %-10s %-10s %s" % ("新名次", "重排分", "原召回分", "内容"))
    for rank, (rs, os_, i, c) in enumerate(reranked, 1):
        mark = "← 该用的" if i == GOLD else ""
        print("  %-6d %-10.3f %-10.4f [%d] %s %s" % (rank, rs, os_, i, c[:26], mark))
    new_rank = next(r for r, (_rs, _os, i, _c) in enumerate(reranked, 1) if i == GOLD)
    print("\n  该用的那一块从第 %d 名升到第 %d 名。现在取 top-2 就能拿到它。"
          % (gold_rank, new_rank))

    print()
    print("=" * 66)
    print("③ 重排救不回来的情况:召回阶段就没取到它")
    print("=" * 66)
    tight = recall(QUESTION, 2)
    print("  召回只取 2 条时,候选是:")
    for score, i, c in tight:
        print("    %.4f  [%d] %s" % (score, i, c[:30]))
    got = {i for _s, i, _c in tight}
    print("  该用的第 %d 块%s在候选里。" % (GOLD, "" if GOLD in got else "不"))
    if GOLD not in got:
        print("  重排只能对这 2 条重新排序,第 %d 块压根没进来 —— 它变不出新卡片。" % GOLD)
        print("  所以工程上的固定配比是:召回放宽(20~50 条),重排收紧(留 3~5 条)。")


if __name__ == "__main__":
    main()
| 召回名次 | 召回分 | 重排后名次 | 重排分 | 内容 |
|---|---|---|---|---|
| 1 | 0.2417 | 2 | 0.000 | 该批货物预计到达日期为 2023-01-20。 |
| 2 | 0.1846 | 3 | 0.000 | 货物编号 ABC123456,发货日期 2023-01-15… |
| 3 | 0.1430 | 1 | 1.500 | 承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天 |
| 4 | 0.0692 | 4 | 0.000 | 国际件报关所需材料包括发票、装箱单与合同。 |
第 3 名升到第 1 名。现在取 top-2 就能拿到它,而重排之前取 top-2 会完全错过。
脚本里的重排打分是一个教学用的简化实现(按问题里的关键意图逐项核对,命中就加分),真实项目用的是 cross-encoder 类的 Rerank 模型——但两者的机制是同一件事:让问题和文档在同一次打分里互相看见,而不是各自编码后比坐标。
4.2 重排救不回来的那种情况
脚本第三段故意把召回收紧到 2 条:
| 召回 2 条的候选 | 结果 |
|---|---|
| 0.2417 该批货物预计到达日期为 2023-01-20。 | 不是该用的 |
| 0.1846 货物编号 ABC123456,发货日期 2023-01-15… | 不是该用的 |
该用的第 2 块压根不在候选里。重排只能对进来的这 2 条重新排序——它变不出新卡片。
4.3 混合检索:把单号查询救回来
问「ABC123789 这单现在在哪?」——库里有三条句式几乎一模一样的运单,只有单号不同。
"""混合检索:向量找得到意思,关键词找得到编号。

向量检索有一类天生的短板:单号、型号、法条编号、人名这种
「字面必须一模一样」的东西,它给不出可靠的区分度——
因为这些字符串在语义空间里彼此非常接近。

解法不是换更大的 Embedding,而是再加一路关键词检索,
两路结果按名次融合。这就是工程上说的 hybrid search。

融合用 RRF(Reciprocal Rank Fusion):只看名次不看分数,
因为两路的分数量纲根本不可比。

纯标准库,直接运行。
"""
import math
import re
from collections import Counter

CHUNKS = [
    "货物编号 ABC123456,发货日期 2023-01-15,当前位置上海分拨中心。",
    "货物编号 ABC123789,发货日期 2023-01-16,当前位置广州分拨中心。",
    "货物编号 XYZ987654,发货日期 2023-01-17,当前位置成都分拨中心。",
    "承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天。",
    "东方仓储中心位于深圳市,存储电子产品,常温仓储,库存一千件。",
    "所有分拨中心均在每日 22:00 前完成当日件的装车发运。",
]

QUESTION = "ABC123789 这单现在在哪?"
GOLD = 1


def tokenize(t):
    return re.findall(r"[a-z0-9]+", t.lower()) + re.findall(r"[\u4e00-\u9fff]", t)


def embed(t):
    return Counter(tokenize(t))


def cosine(a, b):
    common = set(a) & set(b)
    dot = sum(a[k] * b[k] for k in common)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return dot / (na * nb) if na and nb else 0.0


INDEX = [(i, c, embed(c)) for i, c in enumerate(CHUNKS)]


def vector_search(q, k):
    qv = embed(q)
    scored = [(cosine(qv, v), i) for i, _c, v in INDEX]
    scored.sort(key=lambda x: x[0], reverse=True)
    return [i for _s, i in scored[:k]]


def keyword_search(q, k):
    """关键词检索:只看「问题里的实词有没有原样出现在这一块里」。

    这里刻意只取长度 ≥ 2 的字母数字串和二字以上中文串,
    单个汉字区分度太低,放进来会把关键词检索也变成词频游戏。
    """
    terms = [t for t in re.findall(r"[a-z0-9]{2,}", q.lower())]
    terms += re.findall(r"[\u4e00-\u9fff]{2,}", q)
    scored = []
    for i, c, _v in INDEX:
        low = c.lower()
        hit = sum(1 for t in terms if t in low)
        if hit:
            scored.append((hit, i))
    scored.sort(key=lambda x: x[0], reverse=True)
    return [i for _s, i in scored[:k]]


def rrf(rank_lists, k_const=60):
    """RRF 融合:每条结果的得分 = Σ 1/(k_const + 名次)。

    只吃名次,不吃分数——所以余弦分和关键词命中数不需要归一化,
    这正是它在工程上被广泛采用的原因。
    """
    score = {}
    for lst in rank_lists:
        for rank, idx in enumerate(lst, 1):
            score[idx] = score.get(idx, 0.0) + 1.0 / (k_const + rank)
    return sorted(score.items(), key=lambda kv: kv[1], reverse=True)


def show(name, idxs):
    print("%s:" % name)
    if not idxs:
        print("    (空)")
    for rank, i in enumerate(idxs, 1):
        mark = " ← 该用的" if i == GOLD else ""
        print("    第%d名 [%d] %s%s" % (rank, i, CHUNKS[i][:32], mark))


def main():
    print("问题:%s" % QUESTION)
    print("标准答案:第 %d 块\n" % GOLD)

    v = vector_search(QUESTION, 3)
    k = keyword_search(QUESTION, 3)
    show("① 只用向量检索", v)
    print()
    show("② 只用关键词检索", k)

    print()
    print("向量检索把三条运单排在一起,因为它们的句式几乎一模一样——")
    print("真正区分它们的是单号那串字符,而单号恰恰是语义模型最不擅长的东西。")
    print("关键词检索正好相反:它对单号一击即中,但换个说法就全线扑空。")

    print()
    print("③ RRF 融合两路结果:")
    fused = rrf([v, k])
    for rank, (i, s) in enumerate(fused, 1):
        mark = " ← 该用的" if i == GOLD else ""
        print("    第%d名 %.5f [%d] %s%s" % (rank, s, i, CHUNKS[i][:32], mark))
    top1 = fused[0][0]
    print()
    print("融合后排第一的是第 %d 块,%s" % (top1, "正确。" if top1 == GOLD else "仍需调权重。"))

    print()
    print("=" * 62)
    print("反过来验一次:换一个纯语义的问题,关键词检索会失灵")
    print("=" * 62)
    q2 = "货从哪个城市发出,路上要多久?"
    v2, k2 = vector_search(q2, 3), keyword_search(q2, 3)
    print("问题:%s" % q2)
    show("  向量检索", v2)
    show("  关键词检索", k2)
    print()
    print("结论:两路各有各的盲区,所以工程上默认两路都开、用名次融合,")
    print("      而不是二选一。")


if __name__ == "__main__":
    main()
| 检索方式 | 该用的那块排第几 | 问题出在哪 |
|---|---|---|
| 只用向量 | 第 2 | 三条运单句式雷同,区分它们的是单号字符,而这正是语义模型的弱项 |
| 只用关键词 | 第 1(一击即中) | 换个说法就全线扑空 |
| RRF 融合 | 第 1(0.03252) | — |
反过来验一次,问「货从哪个城市发出,路上要多久?」这种纯语义问题:关键词检索返回空,向量检索照常工作。两路各有各的盲区——
1/(k+rank) 再相加,绕开了刻度问题,参数只有一个常数,工程上省心得多。这也是它成为默认融合方式的原因。
4.4 拼装:去重、编号、带来源、卡预算
检索结果拿到之后,还不能直接丢给模型。下面这段把四个动作都做了:
"""把检索结果拼成提示词:五条必须做到的事,逐条演示。

1. 每块带编号和来源,答案才能标出处
2. 明确圈定「只用已知信息」,并给出兜底话术
3. 控制总长度,超了要截断而不是硬塞
4. 去重,同一段话被切进两块时不要重复两遍
5. 空结果要走另一条分支,不能拿空 context 去问模型

纯标准库,直接运行。
"""

# 检索回来的结果:(分数, 来源, 正文)
HITS = [
    (0.81, "物流信息.pdf#p1", "承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天。"),
    (0.74, "物流信息.pdf#p1", "货物编号 ABC123456,发货日期 2023-01-15,当前位置上海分拨中心。"),
    (0.71, "线路手册.docx#p3", "承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天。"),
    (0.42, "仓储制度.md#p2", "东方仓储中心位于深圳市,存储电子产品,常温仓储,库存一千件。"),
]

QUESTION = "这批货从哪发出,几天能到?"

SYSTEM = """你是物流信息查询助手。

规则:
1. 只使用【已知信息】里出现过的内容作答,不得补充任何外部知识。
2. 【已知信息】不足以回答时,回复「资料中未提及」,不要推测。
3. 每个结论后面用方括号标出所依据的编号,例如 [1]。
4. 用户问的是多个问题时,逐条作答。"""

USER = """【已知信息】
{context}

【问题】
{question}"""


def dedup(hits):
    """按正文去重,保留分数最高的那条,并把其它来源并进去。

    同一段话出现在两份文档里是很常见的(制度被复制到多个手册)。
    不去重的后果:提示词里同一句话出现两遍,既浪费 token,
    又会让模型误以为这件事被「反复强调」,从而过度加权。
    """
    seen = {}
    for score, source, text in sorted(hits, key=lambda x: x[0], reverse=True):
        key = text.strip()
        if key in seen:
            seen[key]["sources"].append(source)
        else:
            seen[key] = {"score": score, "text": key, "sources": [source]}
    return list(seen.values())


def build_context(items, budget_chars):
    """按分数从高到低装,装不下就停,不截断句子中间。"""
    lines, used, dropped = [], 0, 0
    for i, item in enumerate(items, 1):
        line = "[%d] (来源:%s)%s" % (i, "、".join(item["sources"]), item["text"])
        if used + len(line) > budget_chars:
            dropped += 1
            continue
        lines.append(line)
        used += len(line)
    return "\n".join(lines), used, dropped


def build_messages(question, hits, budget_chars=200):
    items = dedup(hits)
    context, used, dropped = build_context(items, budget_chars)
    if not context:
        # 空结果必须走另一条分支:拿空 context 去问模型,等于请它自由发挥
        return None, {"reason": "no_hit", "used": 0, "dropped": dropped}
    messages = [
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": USER.format(context=context, question=question)},
    ]
    return messages, {"reason": "ok", "used": used, "dropped": dropped,
                      "kept": len(items) - dropped}


def main():
    print("=== 原始检索结果 %d 条 ===" % len(HITS))
    for score, source, text in HITS:
        print("  %.2f  %-20s %s" % (score, source, text))

    print()
    print("=== 去重后 ===")
    items = dedup(HITS)
    for i, it in enumerate(items, 1):
        print("  [%d] %.2f  来源 %s" % (i, it["score"], "、".join(it["sources"])))
    print("  %d 条 → %d 条,第 1 条和第 3 条正文完全相同,来源已合并。"
          % (len(HITS), len(items)))

    print()
    print("=== 预算充足时拼出来的提示词 ===")
    messages, info = build_messages(QUESTION, HITS, budget_chars=500)
    for m in messages:
        print("-" * 60)
        print("role = %s" % m["role"])
        print(m["content"])
    print("-" * 60)
    print("context 用掉 %d 字,丢弃 %d 条" % (info["used"], info["dropped"]))

    print()
    print("=== 预算很紧时会发生什么 ===")
    for budget in (500, 120, 60, 10):
        _msgs, info = build_messages(QUESTION, HITS, budget_chars=budget)
        print("  预算 %3d 字 → 用掉 %3d 字,丢弃 %d 条,结果:%s"
              % (budget, info["used"], info["dropped"], info["reason"]))
    print("  预算被压到装不下任何一条时,返回的是 no_hit 而不是一个空 context —— ")
    print("  这两种情况在代码里必须分开处理。")

    print()
    print("=== 检索什么都没找到时 ===")
    msgs, info = build_messages("公司年假怎么休?", [], budget_chars=500)
    print("  messages = %s,reason = %s" % (msgs, info["reason"]))
    print("  这一步直接回复用户「资料中未提及」,连模型都不用调:")
    print("  省一次调用,也断掉了空 context 触发编造的那条路。")


if __name__ == "__main__":
    main()
输入的 4 条里有两条正文完全相同(来自两份不同文档),去重后变成 3 条,来源合并成「物流信息.pdf#p1、线路手册.docx#p3」。拼出来的 user 消息是:
| 拼好的【已知信息】 |
|---|
| [1] (来源:物流信息.pdf#p1、线路手册.docx#p3)承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天。 |
| [2] (来源:物流信息.pdf#p1)货物编号 ABC123456,发货日期 2023-01-15,当前位置上海分拨中心。 |
| [3] (来源:仓储制度.md#p2)东方仓储中心位于深圳市,存储电子产品,常温仓储,库存一千件。 |
预算被压低时的行为也测了一遍,注意最后一行:
| 预算 | 实际用掉 | 丢弃条数 | 返回 |
|---|---|---|---|
| 500 字 | 175 | 0 | ok |
| 120 字 | 113 | 1 | ok |
| 60 字 | 49 | 2 | ok |
| 10 字 | 0 | 3 | no_hit |
no_hit 而不是一个空 context。这两种情况在代码里必须分开:前者直接回复用户「资料中未提及」,连模型都不用调——省一次调用,也断掉了空 context 触发编造的那条路;后者说明预算配错了,该去查配置而不是去查资料。
05骨架模板与六层排查表
一份可改造的问答链骨架,一张能当场定位问题的检查表
5.1 问答链骨架
下面这份把在线阶段的五步拆成五个互不纠缠的函数,每个可变点都留了 TODO:
"""问答链骨架:召回 → 阈值 → 重排 → 拼词 → 生成 → 带出处返回。

把 TODO 填掉就是一条可用的问答链。六个环节各自独立,
每个都能单独打开日志、单独换实现,不互相纠缠。

用法
    python3 qa_chain_skeleton.py "你的问题"
"""
import math
import os
import re
import sys
from collections import Counter

# ----------------------------------------------------------- 可调参数
RECALL_K = 20      # 召回放宽:宁可多拿,别漏
RERANK_K = 4       # 重排收紧:真正进提示词的条数
SCORE_MIN = 0.10   # TODO: 先跑一遍分数分布再定这个值
CTX_BUDGET = 1500  # context 的字数预算


# ----------------------------------------------------------- ① 索引
class Store:
    """TODO: 换成真正的向量库,保持 add / search 两个方法签名不变。"""

    def __init__(self):
        self.rows = []

    def add(self, text, source):
        self.rows.append({"text": text, "source": source, "vec": embed(text)})

    def search(self, query, k):
        qv = embed(query)
        scored = [(cosine(qv, r["vec"]), r) for r in self.rows]
        scored.sort(key=lambda x: x[0], reverse=True)
        return scored[:k]


def embed(text):
    """TODO: 换成 Embedding 模型。建库与提问必须用同一个。"""
    return Counter(re.findall(r"[a-z0-9]+", text.lower())
                   + re.findall(r"[\u4e00-\u9fff]", text))


def cosine(a, b):
    common = set(a) & set(b)
    dot = sum(a[k] * b[k] for k in common)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return dot / (na * nb) if na and nb else 0.0


# ----------------------------------------------------------- ② 阈值
def apply_threshold(hits, score_min=SCORE_MIN):
    """低于阈值的一律丢掉,宁可空手回来也不要把噪声塞给模型。"""
    return [(s, r) for s, r in hits if s >= score_min]


# ----------------------------------------------------------- ③ 重排
def rerank(question, hits, keep=RERANK_K):
    """TODO: 换成 Rerank 模型;它只重排,不新增候选。

    没有 Rerank 模型时,原样返回前 keep 条即可,
    这一层是可插拔的,不接也能跑。
    """
    return hits[:keep]


# ----------------------------------------------------------- ④ 拼词
SYSTEM = """你是知识库问答助手。

规则:
1. 只使用【已知信息】里的内容作答,不得补充外部知识。
2. 信息不足时回复「资料中未提及」,不要推测。
3. 每个结论后用方括号标出依据的编号。"""

USER = "【已知信息】\n{context}\n\n【问题】\n{question}"


def build_messages(question, hits, budget=CTX_BUDGET):
    seen, items = set(), []
    for _s, r in hits:                       # 去重:同一段话只留一份
        if r["text"] in seen:
            continue
        seen.add(r["text"])
        items.append(r)

    lines, used = [], 0
    for i, r in enumerate(items, 1):
        line = "[%d] (来源:%s)%s" % (i, r["source"], r["text"])
        if used + len(line) > budget:
            break
        lines.append(line)
        used += len(line)

    if not lines:
        return None, []
    return ([{"role": "system", "content": SYSTEM},
             {"role": "user", "content": USER.format(context="\n".join(lines),
                                                     question=question)}],
            items[:len(lines)])


# ----------------------------------------------------------- ⑤ 生成
def call_llm(messages):
    """TODO: 换成真实模型调用,密钥走环境变量:

        api_key = os.environ.get("LLM_API_KEY")
    """
    if os.environ.get("LLM_API_KEY"):
        return "[TODO: 在这里发起真实请求]"
    return "[未接入模型] 本应发出的 messages 共 %d 条" % len(messages)


# ----------------------------------------------------------- ⑥ 出口
def answer(store, question):
    hits = store.search(question, RECALL_K)
    hits = apply_threshold(hits)
    if not hits:
        return {"answer": "资料中未提及。", "sources": [], "stage": "threshold"}

    hits = rerank(question, hits)
    messages, used = build_messages(question, hits)
    if messages is None:
        return {"answer": "资料中未提及。", "sources": [], "stage": "budget"}

    text = call_llm(messages)
    return {"answer": text,
            "sources": [r["source"] for r in used],
            "stage": "ok"}


DEMO_DOCS = [
    ("承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天。", "线路手册#p3"),
    ("货物编号 ABC123456,当前位置上海分拨中心。", "运单#p1"),
    ("东方仓储中心位于深圳市,存储电子产品。", "仓储制度#p2"),
]


def main():
    question = sys.argv[1] if len(sys.argv) > 1 else "这批货从哪发出,几天能到?"
    store = Store()
    for text, source in DEMO_DOCS:      # TODO: 换成自己的建库流程
        store.add(text, source)

    result = answer(store, question)
    print("问题:%s" % question)
    print("阶段:%s" % result["stage"])
    print("出处:%s" % ("、".join(result["sources"]) or "无"))
    print("答案:%s" % result["answer"])


if __name__ == "__main__":
    main()
| TODO | 默认值 | 怎么定 |
|---|---|---|
RECALL_K | 20 | 召回放宽;向量检索快,多取几条几乎没代价 |
FINAL_K | 4 | 重排后留 3~5 条,这是真正进提示词的数量 |
SCORE_MIN | 0.15 | 必须在自己的库上量,见第 03 节的分布法 |
CTX_BUDGET | 2000 | 按模型窗口和成本定;装不下整条丢,不截半条 |
USE_RERANK | False | 先不开,量出排名确实靠后再开 |
USE_KEYWORD | True | 库里有单号/型号就开着,几乎没有副作用 |
embed() / search() | 词袋 / 线性扫描 | 换真实模型与向量库;两处要成对改 |
call_llm() | 打印 | 密钥走 os.environ.get(),不写进源码 |
USE_RERANK 默认关掉
Rerank 要多一次模型调用、多几百毫秒,而它只解决排名问题。先量再开:如果命中率不达标,该加的是 k,不是 Rerank;只有「在 top-k 里但排得靠后」这一种情况,开它才有收益。默认开着会让人误以为效果的提升来自它。
5.2 六层排查表:答不对时按顺序往下查
这是本讲最实用的一张表。RAG 答不对时,问题可能落在六层里的任意一层,每一层有自己该动的旋钮,而且顺序不能乱——因为每层都以下一层成立为前提。
"""召回不准怎么查:按固定顺序逐层排除,不要一上来就改提示词。

排查顺序是有讲究的——每一层都建立在下一层成立的前提上。
顺序颠倒的典型后果:切分根本没把答案留在任何一块里,
却花两天时间在调提示词措辞,怎么调都没用。

这个脚本把排查过程做成可执行的检查表:给它一个问题和期望答案,
它会逐层告诉你问题出在哪一层、下一步该动哪个旋钮。

纯标准库,直接运行。
"""
import math
import re
from collections import Counter

CHUNKS = [
    "货物编号 ABC123456,发货日期 2023-01-15,当前位置上海分拨中心。",
    "该批货物预计到达日期为 2023-01-20。",
    "承运方快运通,陆运,出发地广州,目的地重庆,预计运输时间三天。",
    "东方仓储中心位于深圳市,存储电子产品,常温仓储,库存一千件。",
    "速达物流总部在北京市,业务范围为国际快递与仓储管理。",
]


def tokenize(t):
    return re.findall(r"[a-z0-9]+", t.lower()) + re.findall(r"[\u4e00-\u9fff]", t)


def embed(t):
    return Counter(tokenize(t))


def cosine(a, b):
    common = set(a) & set(b)
    dot = sum(a[k] * b[k] for k in common)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return dot / (na * nb) if na and nb else 0.0


INDEX = [(i, c, embed(c)) for i, c in enumerate(CHUNKS)]


def search(q, k, score_min=0.0):
    qv = embed(q)
    scored = [(cosine(qv, v), i, c) for i, c, v in INDEX]
    scored.sort(key=lambda x: x[0], reverse=True)
    return [(s, i, c) for s, i, c in scored[:k] if s >= score_min]


def diagnose(question, must_words, k=3, score_min=0.0):
    """按固定顺序逐层检查,返回 (出问题的层, 该动哪个旋钮)。"""
    steps = []

    # 第 1 层:库里到底有没有这句话
    in_corpus = [i for i, c in enumerate(CHUNKS) if all(w in c for w in must_words)]
    steps.append(("① 资料里有没有", bool(in_corpus),
                  "资料本身缺这条 → 去补文档,别调任何参数"))
    if not in_corpus:
        return steps

    # 第 2 层:这句话是不是完整地落在某一块里
    steps.append(("② 有没有落在同一块里", True,
                  "被切散了 → 调大 chunk_size 或改分隔符"))

    # 第 3 层:这一块在不在 top-k 里
    got = search(question, k, 0.0)
    idxs = [i for _s, i, _c in got]
    in_topk = any(i in idxs for i in in_corpus)
    steps.append(("③ 在不在 top-%d 里" % k, in_topk,
                  "召回没取到 → 调大 k、开混合检索、或换 Embedding 模型"))
    if not in_topk:
        return steps

    # 第 4 层:会不会被阈值挡掉
    kept = search(question, k, score_min)
    kept_idx = [i for _s, i, _c in kept]
    pass_th = any(i in kept_idx for i in in_corpus)
    steps.append(("④ 过不过阈值 %.2f" % score_min, pass_th,
                  "被阈值挡了 → 调低阈值,或先确认分数分布再定"))
    if not pass_th:
        return steps

    # 第 5 层:排名靠不靠前
    rank = next(r for r, (_s, i, _c) in enumerate(kept, 1) if i in in_corpus)
    steps.append(("⑤ 排名第 %d" % rank, rank <= 2,
                  "排太后 → 上 Rerank,这一层才轮得到重排出场"))
    if rank > 2:
        return steps

    steps.append(("⑥ 前五层都过了", True,
                  "到这里还答不对,才轮到改提示词模板"))
    return steps


CASES = [
    ("这批货从哪发出,几天能到?", ["出发地", "运输时间"]),
    ("货物现在到哪了?", ["当前位置"]),
    ("公司年假怎么休?", ["年假"]),
]


def main():
    for question, must in CASES:
        print("=" * 66)
        print("问题:%s" % question)
        print("期望命中含有这些字样的块:%s" % "、".join(must))
        print("=" * 66)
        steps = diagnose(question, must, k=3, score_min=0.10)
        for name, ok, advice in steps:
            flag = "通过" if ok else "卡住"
            print("  %-22s %s" % (name, flag))
            if not ok:
                print("      → %s" % advice)
        if all(ok for _n, ok, _a in steps):
            print("      → %s" % steps[-1][2])
        print()

    print("=" * 66)
    print("这张检查表的意义:每一层都有自己该动的旋钮,且顺序不能乱。")
    print("常见的错误做法是跳过 ①②,直接在 ③④⑤ 上反复调参——")
    print("资料里压根没有的东西,调到天亮也召不回来。")


if __name__ == "__main__":
    main()
| 层 | 检查什么 | 卡在这层时该动什么 |
|---|---|---|
| ① | 资料里有没有 | 去补文档,别调任何参数 |
| ② | 有没有落在同一块里 | 改切分(chunk_size / overlap / 分隔符) |
| ③ | 在不在 top-k 里 | 加大 k,或加一路关键词检索 |
| ④ | 过不过阈值 | 重量一次分数分布,调阈值 |
| ⑤ | 排名靠不靠前 | 这一层才轮得到 Rerank 出场 |
| ⑥ | 前五层都过了 | 才轮到改提示词模板 |
脚本对三个问题各跑了一遍,结论分别落在不同层:
| 问题 | 卡在第几层 | 给出的动作 |
|---|---|---|
| 这批货从哪发出,几天能到? | ⑤ 排名第 3 | 排太后 → 上 Rerank |
| 货物现在到哪了? | ⑥ 六层全过 | 还答不对才改提示词模板 |
| 公司年假怎么休? | ① 资料里就没有 | 去补文档,别调参数 |
06易错点汇总
按「k / 阈值 / 重排 / 检索方式 / 拼装 / 验收」六类归并
⚠️ 一、top-k
- 以为 k 越大越保险。 实测命中率在 k=3 就到顶(1.00),k 从 3 加到 8 命中率一点没涨,噪声比从 0.67 涨到 0.88、上下文从 86 字涨到 217 字。多付的每一分钱都花在塞废纸上,还增加了模型漏读关键句的风险。
- 抄别人的 k。 「k=3 就够」是这个库上的结论。库变了、切分变了都要重扫一次,真实项目的拐点通常在 3~5 之间。
- 把命中率和 Top1 准确率混为一谈。 命中率量的是「在不在这 k 条里」。实测有一条问题,该用的那块分数 0.1430 排第三,而噪声排第一(0.2417)——命中率是 1,Top1 却是错的。前者不达标加 k,后者不达标才上 Rerank。
- 召回阶段就把 k 收得很紧。 召回的 k 大几乎没有代价(毫秒级),重排的条数才是成本。该省的是重排的条数。
⚠️ 二、阈值
- 不设阈值。 top-k 永远返回 k 条,库里一条相关的都没有时照样返回。不设阈值,系统就永远没有说「资料中未提及」的能力。
- 直接拍一个 0.3。 正确顺序是先量分布:拿「库里有答案」和「库里没答案」两类问题各问一遍。实测两类之间空隙是 0.1291~0.1925,阈值卡在 0.16 时两类错误同时为零。
- 两类分数重叠还在硬调阈值。 找不出空隙说明前面出了问题——切分太碎导致块自身读不通,或者 Embedding 选错了语言。回去改前面。
- 换了 Embedding 模型不重量阈值。 分布整条平移,旧阈值静默失效:要么大面积拒答,要么大面积放过。把量分布的脚本留在项目里。
- 不分业务地追求「总错误最少」。 两类错误代价不对等:对外客服、法务、医疗宁可漏答也不能瞎答,阈值往高调;内部检索助手往低调。
- L2 距离的阈值方向写反。 余弦越大越相似,L2 越小越相似。写反会把最相关的全过滤掉,只留最不相关的,而且不报错。
⚠️ 三、重排
- 指望 Rerank 救回召回阶段漏掉的块。 实测把召回收到 2 条时,该用的那块压根不在候选里,重排只是把两张错的重新排了一遍。复核员变不出新卡片。
- 默认就把 Rerank 打开。 它多一次模型调用、多几百毫秒,且只解决排名问题。先量再开——否则会误以为效果提升来自它。
- 重排的候选给太多。 每条都要过一次模型,耗时随候选数线性增长。固定配比:召回 20~50 条,重排后留 3~5 条。
- 把 Rerank 当成「更好的检索」。 它是第二道工序,不是替代品。向量检索为了能预先建索引只能把问题和文档分开编码,Rerank 让两者在同一次打分里互相看见——这是速度换精度的必然补偿。
⚠️ 四、检索方式
- 只用向量检索查单号、型号、条款编号。 实测问「ABC123789 这单在哪」,三条句式雷同的运单被排在一起,正确那条只排第二;关键词检索一击即中。这些串的「意思」几乎为零,区分它们的是字符本身。
- 反过来只用关键词检索。 同一个库上问「货从哪个城市发出」,关键词检索返回空。两路各有盲区,所以默认两路都开。
- 融合时把两路分数加权相加。 向量分和关键词分不在同一刻度,归一化参数还随数据漂移。用 RRF 只按名次算
1/(k+rank),绕开刻度问题。 - 忘了元数据过滤。 「只查 2025 年之后的制度」这类条件,靠语义是筛不掉的,必须在向量库里按字段过滤——前提是入库时存了这些字段。
⚠️ 五、拼装
- 不去重。 同一段话在两份文档里都有时,会占掉两个位置,等于白白浪费一条 k。正文相同就合并,来源并在一起。
- 不给每块编号。 然后在提示词里要求模型标出处——它只能瞎编页码。规则和编号必须成对存在。
- 预算不够时截半条。 模型读不出这是被截断的,只会当成完整信息理解。装不下就整条丢,并记下丢了几条,这样日志里查得到。
- 把「没检索到」和「检索到但装不下」混成一种。 前者直接回复用户,连模型都不用调;后者是预算配错了,该去查配置。实测预算压到 10 字时返回的是
no_hit而不是空 context,这两条路径在代码里必须分开。 - 拿空 context 去调模型。 这是编造最高发的场景,而且每次都要付钱。
⚠️ 六、排查与验收
- 跳过前两层直接调参。 六层检查表里,① 资料里有没有、② 有没有落在同一块里,是最容易被跳过的两层——因为「调参」看起来像在干活。资料里压根没有的东西,调到天亮也召不回来。
- k 和阈值一起调。 效果变了说不清是谁的功劳。固定一个调另一个。
- 没有测试集。 改完问两句觉得「好像好点了」就上线。准备 20~50 条带标准答案的题,把「卡在第几层」的分布打出来,改动有没有用就是一个数字。
- 只看最终答案,不看检索回了什么。 界面上不显示命中的原文,出错时没人能判断是检索错了还是模型答错了,排查只能靠猜。
07自测题
点击题目展开答案;这 12 题答得上,检索侧的调参就不用靠猜了
k 越大越保险吗?用实测数字说明。
不是。实测命中率在 k=3 时就到顶(1.00),k 从 3 加到 8:命中率一点没涨,噪声比 0.67 → 0.88,平均上下文 86 字 → 217 字。多出来的每一条都只是往活页夹里塞废纸,还增加模型漏读关键句的风险。定法:从小往大扫,找命中率第一次到顶的那个 k 就停。
命中率和 Top1 准确率有什么区别?各自不达标时该动什么?
命中率量「该用的那块在不在这 k 条里」,Top1 量「它是不是排第一」。实测有一条问题,该用的块分数 0.1430 排第三,噪声排第一(0.2417)——命中率是 1,Top1 却错。命中率不达标 → 加 k 或加一路检索;Top1 不达标 → 上 Rerank。
阈值该怎么定?为什么不能直接拍 0.3?
先量分布:拿「库里有答案」和「库里没答案」两类问题各问一遍。实测库里有的最低 0.1925,库里没有的最高 0.1291,中间空隙 0.0634——阈值卡进这个空隙(如 0.16),两类错误同时为零。分数分布跟着模型、切分、metric 一起走,别人的数在你的库上没有意义。
两类问题的分数完全重叠、找不出空隙,说明什么?
说明问题不在阈值这一层——多半是切分太碎(块自身读不通)或 Embedding 选错了语言。回去改前面,别在阈值上硬凑;硬凑的结果只能是在「大面积漏答」和「大面积放过」之间二选一。
对外客服和内部检索助手,阈值该往哪边偏?
两类错误代价不对等。对外客服、法务、医疗:宁可漏答也不能瞎答,阈值往高调;内部检索助手:宁可多给几条让人自己挑,往低调。所以「总错误最少」不一定是最优点,要按业务偏。
Rerank 能救回召回阶段漏掉的块吗?
不能,复核员变不出新卡片。实测把召回收到 2 条时,该用的那块压根不在候选里,重排只是把两张错的重新排了一遍。所以固定配比是:召回放宽 20~50 条,重排收紧留 3~5 条。
Rerank 为什么比向量检索排得准?代价是什么?
向量检索为了能预先建索引,必须把问题和文档各自编码后再比坐标;Rerank 把两者拼在一起过一遍模型,让它们在同一次打分里互相看见。代价是慢——每条候选都要过一次模型,耗时随候选数线性增长,所以只能用在小批候选上。
实测里,重排把该用的那块从第几名提到了第几名?
从第 3 名提到第 1 名(重排分 1.500,其余为 0.000)。重排前取 top-2 会完全错过它,重排后取 top-2 就能拿到。
为什么查单号要加一路关键词检索?
单号、型号、条款编号的「意思」几乎为零,真正区分它们的是字符本身,而这正是语义模型的弱项。实测问「ABC123789 这单在哪」,向量检索把三条句式雷同的运单排在一起、正确那条排第二;关键词检索一击即中。反过来问「货从哪个城市发出」,关键词检索返回空——两路各有盲区,所以默认两路都开。
融合两路结果时,为什么用 RRF 而不是把分数加权相加?
向量分和关键词分不在同一个刻度上,加权相加要先归一化,而归一化参数会随数据漂移。RRF 只用名次算 1/(k+rank) 再相加,绕开刻度问题,参数只有一个常数。
context 预算不够时,该截半条还是丢整条?为什么?
丢整条,并记下丢了几条。截半条时模型读不出这是被截断的,只会当成完整信息去理解,而且这个错误在日志里完全不可见。另外要区分两种结果:预算压到装不下任何一条时返回 no_hit,而不是一个空 context——前者直接回复用户,后者说明预算配错了。
RAG 答不对时的六层排查顺序是什么?最容易被跳过的是哪两层?
① 资料里有没有 → ② 有没有落在同一块里 → ③ 在不在 top-k 里 → ④ 过不过阈值 → ⑤ 排名靠不靠前 → ⑥ 才是提示词。最容易被跳过的是 ① 和 ②,因为「调参」看起来像在干活,「去补文档」看起来像在推责任。资料里压根没有的东西,调到天亮也召不回来。
词术语表
| 术语 | 含义 |
|---|---|
| 召回(recall) | 检索阶段把可能相关的块取回来;追求「不漏」,对应指标是命中率 |
| 命中率 | 该用的那块出现在返回的 k 条里的比例;量的是「在不在」,不是「排第几」 |
| MRR | Mean Reciprocal Rank,正确块名次倒数的平均值;排第 1 记 1,第 2 记 0.5,越接近 1 越好 |
| 噪声比 | 返回结果里无关块所占的比例;k 越大它越高 |
| top-k | 取相似度最高的 k 条;召回阶段放宽、最终进提示词时收紧 |
| score 阈值 | 低于该分数的结果一律丢弃,让系统有能力回答「资料中未提及」 |
| Rerank | 重排;把召回的少量候选重新打分排序,只排序不新增 |
| cross-encoder | 把问题和文档拼在一起过一遍模型的打分方式,准但慢,Rerank 模型的典型形态 |
| 关键词检索 | 按字面匹配,对单号、型号这类精确串很准,换个说法就失效 |
| 混合检索 | 向量与关键词两路同时检索,再融合结果 |
| RRF | Reciprocal Rank Fusion,按名次算 1/(k+rank) 相加来融合多路结果,绕开分数刻度不一致的问题 |
| 元数据过滤 | 按部门、日期、版本等字段先筛再检索;前提是入库时存了这些字段 |
| context 预算 | 允许拼进提示词的最大长度;装不下的整条丢弃,不截半条 |
| 拒答 | 检索结果为空或全部低于阈值时,直接回复「资料中未提及」,不调模型 |