大语言模型是什么:从语言模型到 LLM
从 N-gram 到 GPT,语言模型做的永远只有一件事:给「下一个词」算概率。
30″30 秒看懂大语言模型
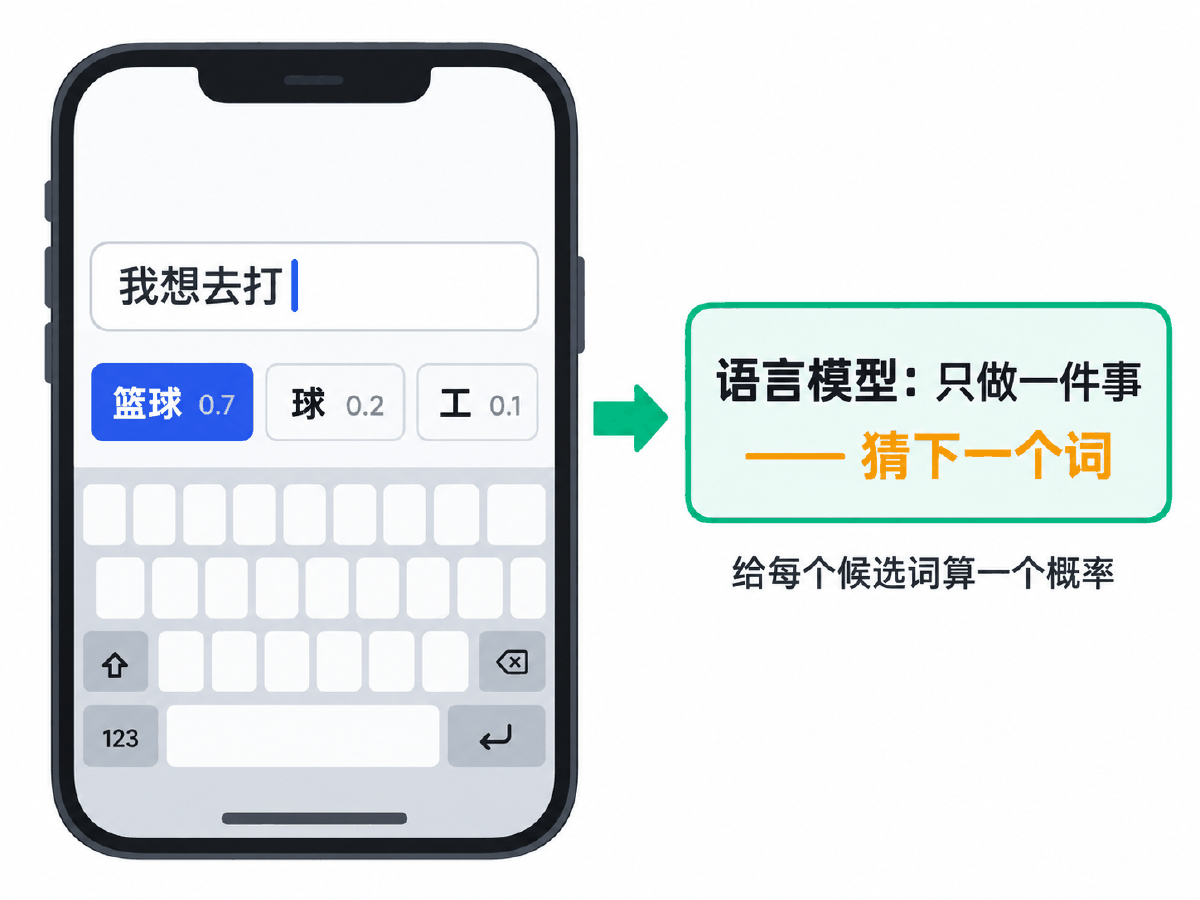
把语言模型想成手机输入法上面那条联想栏:你打了「我想去打」,它立刻在上面列出「篮球」「球」「工」,还按可能性从高到低排好。它做的事只有一件——猜下一个词,并给每个候选一个概率。
老输入法只记得你刚敲的那一两个词,所以经常联想得驴唇不对马嘴;新输入法能看懂整句话的意思,联想就准多了。而 大语言模型(LLM)就是一个读完了半个互联网的超级联想栏——它猜的不只是下一个词,而是一路猜下去,把整段回答「接龙」出来。
你和 ChatGPT 聊天时看到的那种「一个字一个字往外蹦」,就是这条联想栏在疯狂工作:猜一个词、填上去、把新句子重新读一遍、再猜下一个词,如此往复。
| 比喻里的角色 | 对应的技术概念 | 它到底在干什么 |
|---|---|---|
| 联想栏 | 语言模型(Language Model) | 给定上文,输出下一个词的概率分布,仅此而已 |
| 候选词的排序 | P(w | 上文) | 每个候选词配一个概率,越像人话的概率越高 |
| 只记得前一两个词的老输入法 | N-gram 语言模型 | 靠数数统计词的共现次数,没见过的组合直接判 0 |
| 能看懂意思的新输入法 | 神经网络语言模型 | 把词变成向量,意思相近的词离得近,没见过也能猜 |
| 读完半个互联网的联想栏 | 大语言模型(LLM) | 同样是猜下一个词,但参数与语料大到「涌现」出推理、写代码的能力 |
| 给输入法打分的尺子 | BLEU / ROUGE / PPL | 三个角度衡量「猜得准不准」:像不像、全不全、纠不纠结 |
01概念:语言模型与大语言模型
一句话的概率、四个发展阶段,以及「大」到底大在哪
1.1 语言模型的标准定义
通俗地说,语言模型是用来计算一个句子的概率的模型——判断一句话「是不是人话」的概率。
标准一点:对于某个词序列 S = {W1, W2, W3, …, Wn},语言模型就是计算该序列发生的概率 P(S)。如果给定的词序列符合语言习惯,就给出高概率,否则给出低概率。
举个具体的:假设词典 V = {黑马, 程序, 员, 来, 学习},语言模型要能算出任意一串词构成的句子的概率。最笨的办法是数数——数据集里共有 N 个句子,某个句子出现了 n 次,就说 P(S) = n/N。
这个模型的预测能力几乎为 0。因为只要一个句子没在数据集里出现过,概率就是 0,而世界上绝大多数合理的句子你都没见过。显然不合理。
P(W1,W2,…,Wn) = P(W1) · P(W2|W1) · P(W3|W1,W2) · … · P(Wn|W1,…,Wn-1)所以只要能算出
P(Wn | W1,…,Wn-1),就能得到整句的概率。这也引出了语言模型的另一种定义:能够计算 P(W1,W2,…,Wn) 的模型就是语言模型。换个角度看,这个式子还等价于:给定一个词组或一句话,预测接下来的那个词。这正是 30 秒看懂里那条联想栏干的事。
1.2 语言模型技术的四个阶段
这四个阶段不是「新的取代旧的」,而是每一代都在解决上一代的具体缺陷。带着「它治了什么病」去看,比背名字有用得多:
| 阶段 | 代表 | 核心思路 | 它治好了什么 / 又留下什么病 |
|---|---|---|---|
| ① 基于规则和统计 | N-gram | 人工设计特征,对固定长度的文本窗口做统计 | 简单能用;但参数空间爆炸、数据稀疏,没见过就是 0 |
| ② 神经语言模型 | NNLM | 把词映射成低维稠密向量,用神经网络算条件概率 | 治好了数据稀疏;但对长序列建模能力有限 |
| ③ 预训练语言模型 | BERT、GPT、T5 | 大规模语料上预训练,再到下游任务微调 | 泛化能力和语义表示都强了;但算力需求大、可解释性差 |
| ④ 大语言模型 | GPT-3 及其后 | 参数与语料继续指数级放大,走向对话式、生成式、多模态 | 能像人一样沟通;但算力要求高、可能生成有害或有偏见的内容 |
1.3 「大」语言模型,大在哪
大语言模型(Large Language Model,缩写 LLM)是一种旨在理解和生成人类语言的人工智能模型,可以处理文本分类、问答、翻译、对话等多种自然语言任务。
通常 LLM 指包含数千亿(或更多)参数的语言模型,这些参数是在大量文本数据上训练得到的。工程上还有一条更宽松的经验线:参数量超过 10B 的模型即可称为大语言模型。
2020 年 OpenAI 发布参数量高达 1750 亿的 GPT-3,首次展示了大语言模型的性能:相较于 BERT、GPT-2,GPT-3 可以在不调整权重的情况下,仅依据用户给出的任务示例完成具体任务。这件事的冲击力在于——以前想让模型做新任务必须重新训练,现在只要把例子写进提示词里。
1.4 三个容易混作一谈的概念
「语言模型」「预训练模型」「大语言模型」在日常交流里经常被混用,但它们回答的不是同一个问题:
| 概念 | 它描述的是 | 判定标准 |
|---|---|---|
| 语言模型 | 一类任务目标:给词序列算概率 | 只要能算 P(下一个词 | 上文),哪怕是查表统计,就算 |
| 预训练模型 | 一种训练范式:先在通用语料上学,再迁移到下游任务 | 看它是否经历了「预训练 → 微调」两段式 |
| 大语言模型 | 一个规模量级:参数与语料大到出现新能力 | 看参数量级(常用 10B 以上)与是否具备指令遵循、上下文学习能力 |
所以一个模型完全可以同时是这三者:GPT-3 是语言模型(算下一个词的概率),是预训练模型(先预训练后适配),也是大语言模型(1750 亿参数)。而一个 bigram 统计模型只是语言模型,两项都不沾。
1.5 一个可用的 LLM 是怎么炼出来的
说「LLM 就是猜下一个词」没错,但光猜下一个词的模型并不能直接拿来聊天——它只会接写。你问它「中国的首都是哪里?」,纯预训练模型很可能接一句「美国的首都是哪里?」,因为语料里问题常常成组出现。从「会接写」到「能干活」,中间隔着三个阶段:
| 阶段 | 学什么 | 数据形态 | 产出的能力 |
|---|---|---|---|
| ① 预训练 Pre-training | 猜下一个词 | 海量无标注文本(网页、书、代码) | 语言能力与世界知识。成本的 90% 以上花在这里 |
| ② 监督微调 SFT | 按指令回答 | 人工写的「指令 → 优质回答」对,量级在万到百万 | 听得懂人话,不再只会接写 |
| ③ 偏好对齐 RLHF / DPO | 哪个回答更受欢迎 | 人工对多个候选回答排序 | 回答更有用、更安全、语气更得体 |
• 想让模型多知道一个领域的事实——那是预训练层的事,个人和中小团队基本动不起,实际该走 RAG;
• 想让模型按固定格式、固定口吻干一件事——那是 SFT 层的事,几千条高质量样本就能看到效果;
• 只是想调整语气或加几条规则——连微调都不用,写进
system 提示词就行。分不清这三层,就会拿微调去解决本该用提示词解决的问题,花十倍的钱办一半的事。
涌现能力:为什么非要把模型做那么大
如果只是猜下一个词,为什么不能用小模型?因为有一类能力在参数量跨过某个阈值前几乎为零,跨过后突然出现,这被称为涌现能力(emergent abilities)。最典型的两个:
| 能力 | 表现 | 对开发者意味着什么 |
|---|---|---|
| 上下文学习 In-context Learning | 不改权重,只在提示词里给几个例子,模型就能仓照办理新任务 | 「换个任务就要重新训练一次」的时代结束了,提示词成了新的编程接口 |
| 思维链 Chain-of-Thought | 让它「一步一步想」,多步推理题的正确率显著上升 | 提示词的写法本身就能换来准确率,不花一分钱 |
实用的态度是:把它当作「大模型与小模型在某些任务上差距极大」的经验观察,而不是某种神秘的质变。选型时还是得实测,不能靠传说。
02原理:概率是怎么算出来的
从数数到向量,再到三把评分尺子
2.1 N-gram:用马尔可夫假设把链式法则截断
链式法则虽然正确,但 P(Wn | W1,…,Wn-1) 这个条件概率没法估——上文越长,这种组合在语料里出现的次数越接近 0。于是引入马尔可夫假设:
按「往前看几个词」分类,就有了 N 元模型:
| 名称 | 往前看 | 含义 |
|---|---|---|
| unigram(一元) | 0 个词 | 认为每个词的出现与周围词相互独立 |
| bigram(二元) | 1 个词 | 一个词的出现仅依赖它前面的那一个词 |
| trigram(三元) | 2 个词 | 一个词的出现仅依赖它前面的两个词 |
一般来说,N 元模型假设当前词的出现概率只与它前面的 N-1 个词有关。实践中用得最多的是 bigram 和 trigram。
bigram 的参数就两个计数
以 bigram 为例,要计算 P(Wi | Wi-1),只需要两个计数,然后做一次除法:
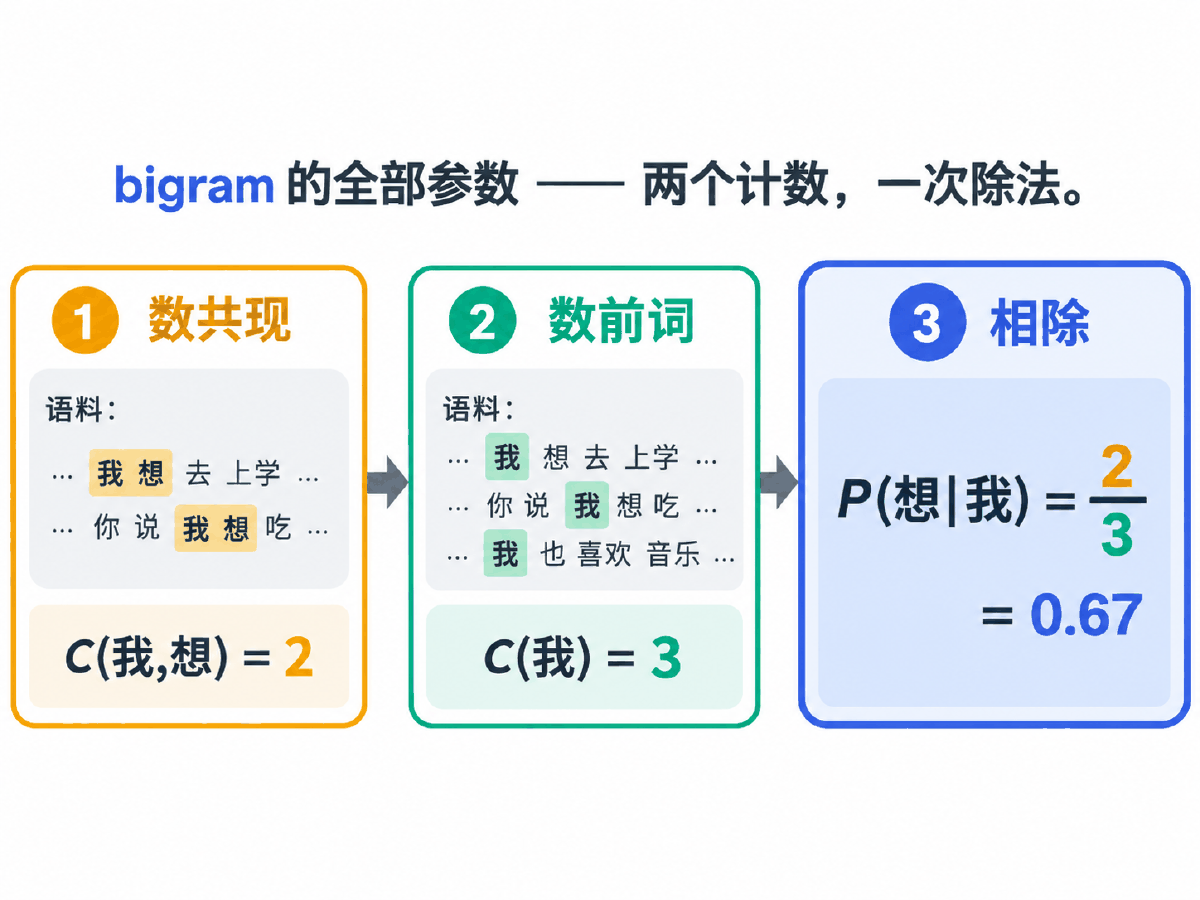
有了这张概率表,两件事立刻能做:
| 能做的事 | 怎么做 | 例子 |
|---|---|---|
| 算一句话的概率 | 把每一步的条件概率连乘起来 | 比较 P(我想去打篮球) 与 P(我想去学习),谁大谁更像人话 |
| 预测下一个词 | 固定上文,把所有候选词的概率排序取最大 | 「我想去打【?】」→ 篮球的概率远高于晚饭 |
N-gram 的优缺点
采用极大似然估计,参数易训练;完整包含了前 n-1 个词的信息;每个概率都能手算验证,出了问题能一眼看出是哪个计数不对。
只能建模到前 n-1 个词;随着 n 增大参数空间呈指数增长;数据稀疏难免出现 OOV(未登录词)问题;泛化能力差——换个说法就不认识了。
最致命的是数据稀疏:语料里没出现过的词对,概率直接是 0,连乘之后整句概率也是 0。而「没出现过」不等于「不合理」,这正是下一代模型要治的病。
2.2 平滑:在换模型之前,先给零概率打个补丁
数据稀疏有两条治法。换模型(下一节的 NNLM)是根治,但在 N-gram 时代人们先用了一条更便宜的:平滑(smoothing)——既然 0 概率是因为「没数到」,那就让每个组合都先白送一次计数。
最简单的版本叫加一平滑,也叫拉普拉斯平滑(Laplace smoothing):
P(Wi | Wi-1) = ( C(Wi-1, Wi) + 1 ) / ( C(Wi-1) + |V| )分子加 1,分母加的是整个词表的大小 |V|,不是加 1。
分母为什么必须加 |V|?因为每个候选词的分子都白送了 1,一共送出去 |V| 个计数,分母必须把这些补回来,所有候选词的概率之和才仍然等于 1。少加一点或多加一点,算出来的就不是概率分布,后面连乘、算 PPL 全都会错。
代价:高频搭配被稀释
平滑不是白来的。它把概率从「见过很多次」的搭配身上匀了一部分,分给「一次都没见过」的组合。用 2.1 节那份五句话语料实测(代码见 3.2 节),词表 |V| = 10:
| 查询 | 无平滑 | 加一平滑 | 发生了什么 |
|---|---|---|---|
| P(想|我) | 0.6667 | 0.2308 | 高频搭配,置信度掉了 65.4% |
| P(想|他) | 0.5000 | 0.1667 | 同上,掉了 66.7% |
| P(编程|我) | 0.0000 | 0.0769 | 零概率被救活了 |
| P(学|爱) | 0.0000 | 0.0833 | 同上 |
两列一对照,平滑的本质就清楚了:它用「削峰」换「填谷」。语料越小、词表越大,|V| 在分母里的占比就越大,削峰削得越狠——五句话的语料里 |V| 已经足以把 0.67 压到 0.23。
|V| 一加,所有真实统计量都被淹没,模型等于退化成了均匀分布。工程上用的是更精细的方案:Good-Turing(用出现 1 次的事件估计没出现的事件)、插值法(把 trigram、bigram、unigram 按权重混合)、以及效果最好的 Kneser-Ney(还额外考虑一个词能接在多少种不同上文后面)。
但它们的思路和加一平滑是同一条:不让任何合理组合的概率变成 0。
理解这一点,也就理解了 N-gram 为什么最终被淘汰:平滑只是不让概率为 0,它没法让模型知道「排球」和「篮球」是相近的东西。要做到那一步,得让词本身带上语义——这就是下一节。
2.3 神经网络语言模型:把词变成向量
神经网络语言模型(NNLM)的输入是 w(t-n+1), …, w(t-2), w(t-1),也就是前 n-1 个词,任务仍然是预测下一个词 w(t)。C(w) 表示单词 w 对应的词向量。整个网络只有三层:
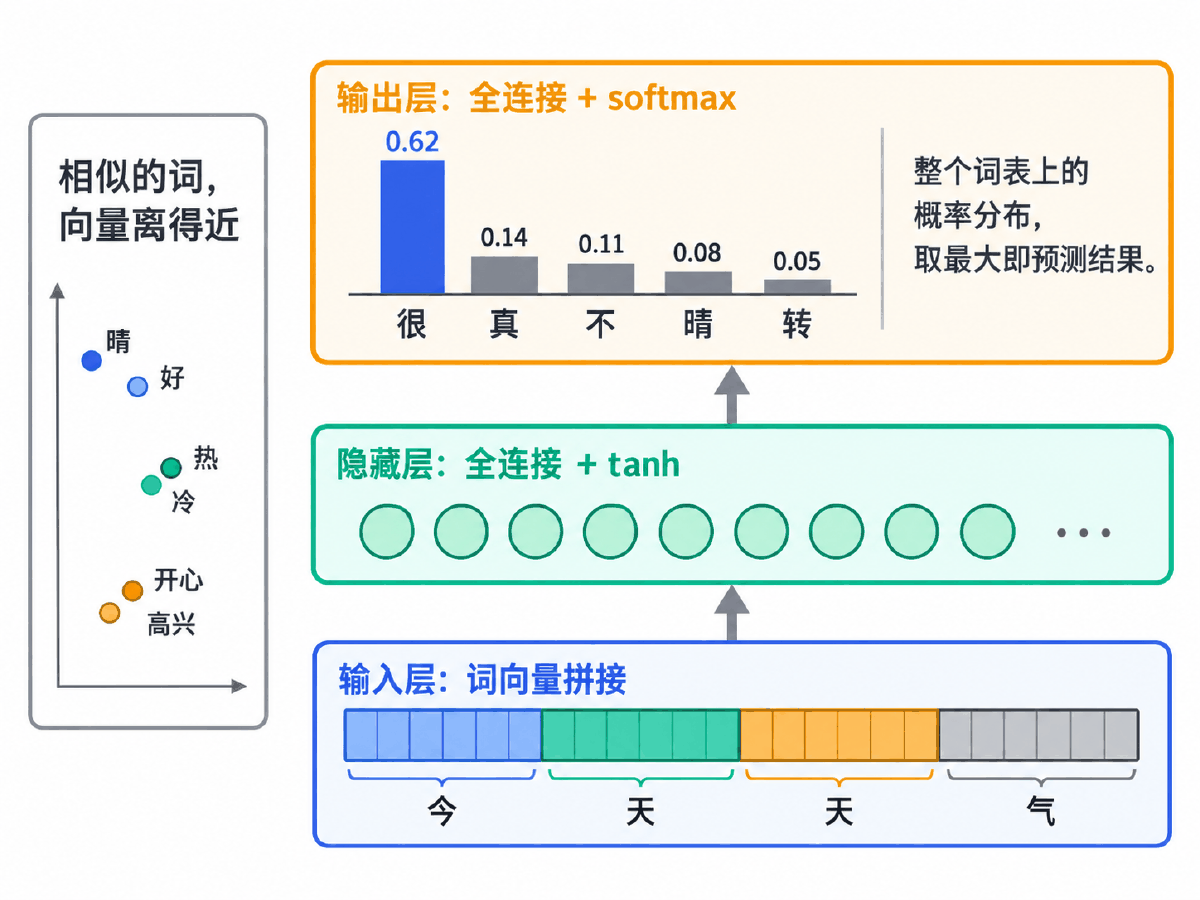
| 层 | 做什么 | 产出 |
|---|---|---|
| 第一层(输入) | 把 C(wt-n+1),…,C(wt-1) 这 n-1 个词向量首尾拼接起来 | 一个 (n-1)×m 大小的向量 x |
| 第二层(隐藏) | 一个全连接层,输出 Hx + d,再过 tanh 激活函数 | 上下文的非线性表示 |
| 第三层(输出) | 全连接层输出 V 个节点(V 为词汇总数),每个节点是未归一化的 logits,再过 softmax | 整个词表上的概率分布,取最大即预测结果 |
这一步把 N-gram「没见过就是 0」的死结解开了,也是后来所有大模型
embedding 层的雏形。
代价是:对长序列的建模能力仍然有限,而且深层网络可能出现梯度消失。真正把「长距离依赖」解决掉的是后来的 Transformer 与 attention。
2.4 预训练范式:先读书,再上岗
基于 Transformer 的预训练模型(GPT、BERT、T5 等)能从大规模通用文本中学到语言表示,再把这些知识用到下游任务上。使用方式固定为两段:
优点是泛化能力更强、语义表示更丰富、能有效防止过拟合;缺点是计算资源需求大、可解释性差。
再往后,随着预训练模型参数的指数级提升,语言模型性能也随之上升,直到 GPT-3 这一量级出现了不改权重、只给示例就能完成新任务的能力——从这里开始,「微调」不再是使用模型的唯一方式,提示词成了新的接口。
2.5 Token:模型真正读到的不是字,也不是词
前面所有讨论都假装模型的输入单位是「词」。到了 LLM 这里,这个假设要改了——模型读到的单位叫 token,它既不是汉字,也不是英文单词。
原因是两头都走不通:按单词切,词表会爆炸,而且遇到没见过的词(OOV)只能整个丢掉;按字符切,词表是小了,但一句话被拆成几百个单位,模型要跨很远才能拼出一个意思。折中方案是 subword(子词)——常用词整个保留,生僻词拆成有意义的片段。
BPE:数频次,合并最高频的那一对
最主流的 subword 算法是 BPE(Byte Pair Encoding,字节对编码)。它的训练过程只有三步,循环执行:
拿 low×5, lower×2, newest×6, widest×3 这份小语料实跑(代码见 3.3 节),前几步合并是这样的:
| 步 | 合并的对 | 频次 | 产生的新 token |
|---|---|---|---|
| 1 | e + s | 9 | es——newest 和 widest 共有 |
| 2 | es + t | 9 | est,英语最高频后缀之一被学出来了 |
| 3 | est + </w> | 9 | est</w>,带词尾的完整后缀 |
| 4~5 | l+o,lo+w | 7 | low |
| 8 | new + est</w> | 6 | newest</w>,高频词被整个收进词表 |
注意第 2 步:没有人告诉它「est 是英语的最高级后缀」,它是纯靠数频次数出来的。这正是 BPE 好用的地方——不需要任何语言学知识,换成中文、代码、DNA 序列,同一套算法照跑。
•
lowest → ['low', 'est</w>'],2 个 token——两个片段都是学过的,拼起来就行•
slow → ['s', 'low</w>'],2 个 token——训练时压根没见过 slow,照样切得出来•
newer → ['new', 'e', 'r', '</w>'],4 个 token——后缀 er 没学到,只能退回字符这就是 subword 消灭 OOV 的方式:实在不认识,就一路退到单个字符,但绝不会报错。
三条直接影响你花钱的推论
| 现象 | 原因 | 工程后果 |
|---|---|---|
| 中文比英文更费 token | 训练语料以英文为主,英文常用词多被合并成 1 个 token;中文常见的是 1~2 个汉字一个 token | 同样字数的中文提示词,token 数通常明显高于英文,账单也更高 |
| 生僻词、长数字串特别费 | 没进词表,被拆成很多碎片 | 批量处理 ID、哈希、序列号时成本会意外暴涨 |
| 换个模型,token 数就变了 | 每家的 tokenizer 和词表都不一样 | 跨模型比较价格必须用各自的 tokenizer 实测,不能拿字数折算 |
要准确数,只有两个办法:用该模型官方的 tokenizer 库离线算,或者发一次请求、读响应里的
usage 字段(见「大模型 API 开发入门」一讲)。
2.6 三把尺子:BLEU、ROUGE、PPL
模型生成了一段话,怎么判断好坏?除了 Accuracy(预测正确的样本占比)、Precision(被判为正类中真正为正类的比例)、Recall(所有正类中被正确识别的比例)这些分类指标,生成任务还有三把专用尺子:
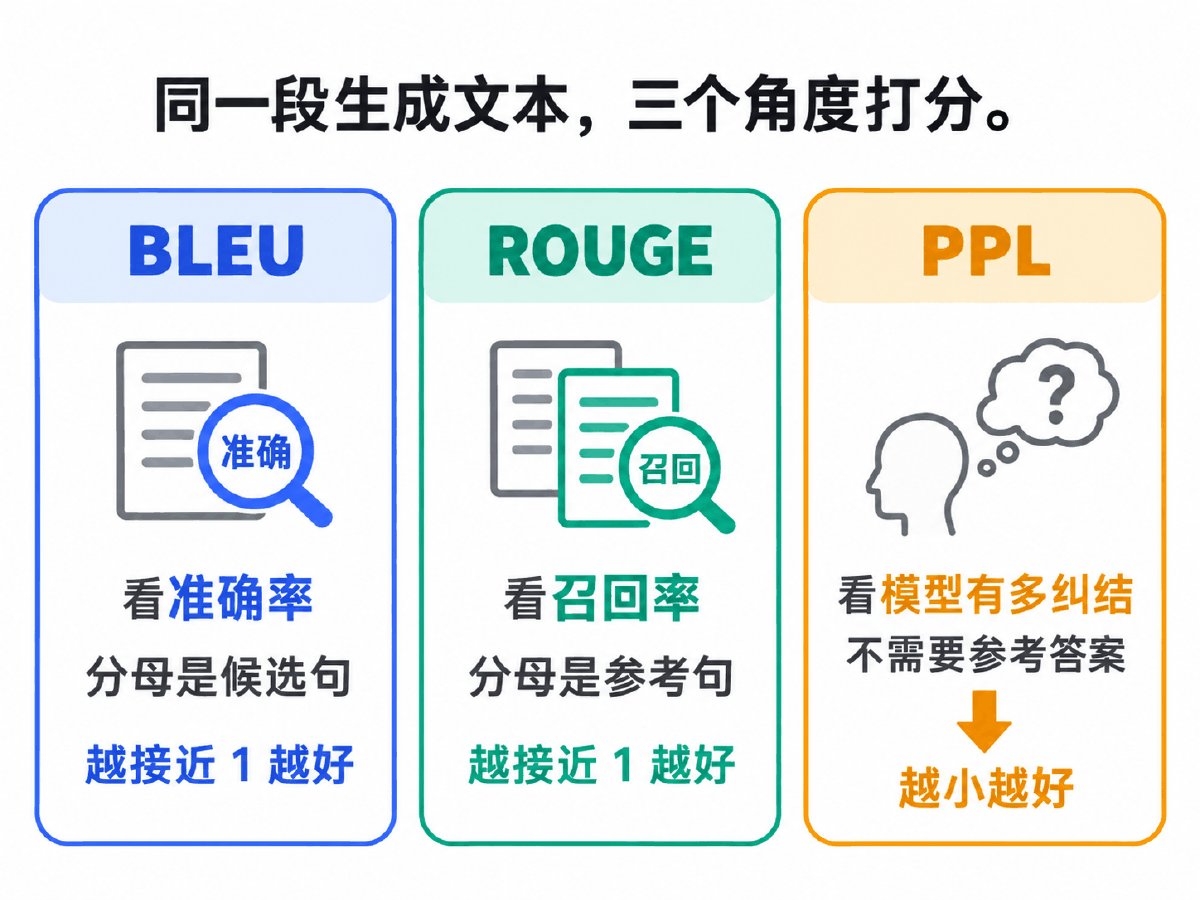
| 指标 | 看什么 | 取值 | 典型场景 |
|---|---|---|---|
| BLEU | 准确率 | [0, 1],越接近 1 越好 | 机器翻译:我生成的词,有多少在参考答案里 |
| ROUGE | 召回率 | [0, 1],越接近 1 越好 | 自动摘要、问答生成:参考答案里的词,我覆盖了多少 |
| PPL(困惑度) | 模型的纠结程度 | [0, +∞),越小越好 | 语言模型本身:面对真实句子,模型有多意外 |
BLEU:按 n-gram 分阶匹配
BLEU 根据 n-gram 划分成多种评价指标,实践中通常取 N=1~4 再加权平均。计算方式是:候选句与参考句的 n-gram 匹配个数 ÷ 候选句的 n-gram 总数。
拿一组具体的句子走一遍:
| 阶 | 候选句 candidate 的 n-gram | 匹配情况 | 匹配度 |
|---|---|---|---|
| 1-gram | {it, is, a, nice, day, today} | {today, is, a, nice, day} 命中 | 5/6 |
| 2-gram | {it is, is a, a nice, nice day, day today} | {is a, a nice, nice day} 命中 | 3/5 |
| 3-gram | {it is a, is a nice, a nice day, nice day today} | {is a nice, a nice day} 命中 | 2/4 |
| 4-gram | {it is a nice, is a nice day, a nice day today} | {is a nice day} 命中 | 1/3 |
其中 candidate 是 It is a nice day today,reference 是 today is a nice day。
the the the the,reference 是 The cat is standing on the ground。按朴素的 1-gram 匹配,四个 the 全都能在参考句里找到,匹配度 = 4/4 = 1,显然荒谬。解法是截断(clipping):先统计一个词在参考句中出现的最大次数,再用它来修剪该词在候选句中的计数。上例中 the 在参考句里出现 2 次,所以分子最多记 2,匹配度降为 2/4 = 0.5。
工程实现里通常还会叠一个长度惩罚(brevity penalty):候选句比参考句短就打折,防止模型只吐出最有把握的几个词骗高分。
ROUGE:把分母换成参考答案
ROUGE 与 BLEU 非常类似,都在衡量生成结果和标准结果的匹配程度,区别在于 ROUGE 基于召回率,BLEU 更看重准确率。ROUGE 分为 ROUGE-N、ROUGE-L、ROUGE-W、ROUGE-S 几种,其中 ROUGE-N 就是把两边按 N-gram 拆开后计算召回率。
还是上面那对句子,用 ROUGE-1 匹配:参考句的 5 个词 {today, is, a, nice, day} 全部被候选句覆盖,所以匹配度 5/5 = 1——说明生成内容完全覆盖了参考文本中的所有单词。
对比着看就很清楚:同一对句子,BLEU 的 1-gram 是 5/6,ROUGE-1 是 5/5。分子相同,分母一个是候选句、一个是参考句。这就是「准确率」与「召回率」的全部差别。
ROUGE-L 则不要求词连续,只要求顺序一致(最长公共子序列),比 ROUGE-N 宽松,更适合评价句式灵活的摘要。
PPL:模型有多「意外」
PPL(perplexity)用来度量一个概率分布或概率模型预测样本的好坏程度。基本思想很朴素:给测试集的句子赋予较高概率值的语言模型更好。测试集里的句子都是正常的人话,训练好的模型在它们上面给出的概率越高越好。
公式上,PPL 是平均负对数概率的指数:先把整句概率取以 2 为底的对数、除以词数取平均、取负,再作为 2 的指数。所以——
直观理解:PPL = 8 意味着模型每预测一个词时,平均在 8 个候选之间摇摆不定。PPL 越接近 1,说明它几乎每次都胸有成竹。
03最小代码:手写一个 bigram 语言模型
不装任何依赖,用计数和除法把「猜下一个词」跑出来
3.1 手写 bigram:两个计数一次除法
理解语言模型最快的路径,是自己实现一个最小的。下面这份代码只用标准库,语料只有 5 句话——小到每一个概率都能用手算复核。整个模型就三个函数:
"""bigram 语言模型:用计数和除法算出「哪句话更像人话」。

只用标准库,直接 python3 bigram_lm.py 就能跑。
语料很小,目的是让每一个数字都能用手算复核。
"""
from collections import defaultdict

# 语料:每个句子前后补上 <s> 和 </s>,让「句首第一个词」也有上文可依
CORPUS = [
    "我 想 去 打 篮球",
    "我 想 去 学习",
    "我 喜欢 打 篮球",
    "黑马 程序员 想 去 学习",
    "黑马 程序员 喜欢 学习",
]

BOS, EOS = "<s>", "</s>"


def tokenize(sentence):
    """把一行中文按空格切成词,并补上句首句尾标记。"""
    return [BOS] + sentence.split() + [EOS]


def train(corpus):
    """统计 C(w_{i-1}, w_i) 与 C(w_{i-1}),这就是 bigram 的全部参数。"""
    bigram = defaultdict(int)   # C(前一个词, 当前词)
    unigram = defaultdict(int)  # C(前一个词)
    for sentence in corpus:
        words = tokenize(sentence)
        for prev, cur in zip(words, words[1:]):
            bigram[(prev, cur)] += 1
            unigram[prev] += 1
    return bigram, unigram


def prob(bigram, unigram, prev, cur):
    """P(cur | prev) = C(prev, cur) / C(prev),即最大似然估计。"""
    if unigram[prev] == 0:
        return 0.0
    return bigram[(prev, cur)] / unigram[prev]


def sentence_prob(bigram, unigram, sentence):
    """链式法则 + 马尔可夫假设:整句概率 = 每一步条件概率连乘。"""
    words = tokenize(sentence)
    total = 1.0
    for prev, cur in zip(words, words[1:]):
        p = prob(bigram, unigram, prev, cur)
        print("    P(%-6s| %-6s) = %.4f" % (cur, prev, p))
        total *= p
    return total


def predict_next(bigram, unigram, prev):
    """给定上文一个词,把所有候选按概率从高到低排出来。"""
    candidates = [(cur, prob(bigram, unigram, prev, cur))
                  for (p, cur) in bigram if p == prev]
    return sorted(candidates, key=lambda x: -x[1])


if __name__ == "__main__":
    bigram, unigram = train(CORPUS)

    print("一、单步条件概率")
    print("  P(想 | 我)   =", round(prob(bigram, unigram, "我", "想"), 4))
    print("  P(喜欢 | 我) =", round(prob(bigram, unigram, "我", "喜欢"), 4))

    print("\n二、整句概率(越大越像人话)")
    for s in ["我 想 去 打 篮球", "我 想 去 学习"]:
        print("  句子:", s)
        p = sentence_prob(bigram, unigram, s)
        print("  => P(S) = %.6f\n" % p)

    print("三、预测下一个词:上文是「打」")
    for word, p in predict_next(bigram, unigram, "打"):
        print("  %-8s %.4f" % (word, p))

    print("\n四、数据稀疏:没见过的组合概率直接归零")
    print("  P(游泳 | 打) =", prob(bigram, unigram, "打", "游泳"))
运行输出
直接 python3 bigram_lm.py,得到的是真实输出,不是示意:
一、单步条件概率
  P(想 | 我)   = 0.6667
  P(喜欢 | 我) = 0.3333

二、整句概率(越大越像人话)
  句子: 我 想 去 打 篮球
    P(我     | <s>   ) = 0.6000
    P(想     | 我     ) = 0.6667
    P(去     | 想     ) = 1.0000
    P(打     | 去     ) = 0.3333
    P(篮球    | 打     ) = 1.0000
    P(</s>  | 篮球    ) = 1.0000
  => P(S) = 0.133333

  句子: 我 想 去 学习
    P(我     | <s>   ) = 0.6000
    P(想     | 我     ) = 0.6667
    P(去     | 想     ) = 1.0000
    P(学习    | 去     ) = 0.6667
    P(</s>  | 学习    ) = 1.0000
  => P(S) = 0.266667

三、预测下一个词:上文是「打」
  篮球       1.0000

四、数据稀疏:没见过的组合概率直接归零
  P(游泳 | 打) = 0.0
<s> 和 </s>:句首第一个词也需要「上文」,否则 P(我) 无从算起;句尾标记则让模型学会「话该结束了」。②
P(想|我)=0.6667 怎么来的:语料里「我」出现 3 次,其中「我 想」出现 2 次,2/3 = 0.6667。可以逐条数一遍语料验证。③
P(游泳|打)=0.0:语料里「打」后面只跟过「篮球」,所以「打游泳」概率归零。这就是数据稀疏——真实工程里必须靠平滑(smoothing)给未见组合分配一点概率,否则整句连乘全是 0。
后面所有的技术——词向量、attention、更大的参数量——都是在治这两个病。把这段代码跑明白,再看 Transformer 就有了参照物。
3.2 加一平滑:把上面那个 0 救回来
上一节最后那个 P(游泳|打)=0.0 不是 bug,是 N-gram 的先天缺陷。用 2.2 节的加一平滑改一版,同一份语料、同一个查询,两种算法并排打印,差别一眼就看到了:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""加一平滑(Laplace smoothing)——治 bigram 的「没见过就是 0」。

只用标准库,直接 python3 smoothing.py 就能跑。
对照组是 bigram_lm.py 的无平滑版本,同一份语料、同一个查询,
把「概率 0」和「概率很小但不是 0」的差别打印出来。
"""
from collections import defaultdict

# 和 bigram_lm.py 完全相同的五句话语料,便于逐行对照
CORPUS = [
    "我 想 学 人工 智能",
    "我 想 学 编程",
    "我 爱 人工 智能",
    "他 想 学 编程",
    "他 爱 编程",
]


def build_counts(corpus):
    """统计 bigram 共现次数与前词次数,并收集词表。"""
    bigram = defaultdict(int)
    unigram = defaultdict(int)
    vocab = set()
    for line in corpus:
        words = ["<s>"] + line.split() + ["</s>"]
        vocab.update(words)
        for i in range(len(words) - 1):
            bigram[(words[i], words[i + 1])] += 1
            unigram[words[i]] += 1
    return bigram, unigram, vocab


def p_mle(bigram, unigram, prev, word):
    """极大似然估计:C(prev, word) / C(prev),没见过直接是 0。"""
    if unigram[prev] == 0:
        return 0.0
    return bigram[(prev, word)] / unigram[prev]


def p_laplace(bigram, unigram, vocab, prev, word):
    """加一平滑:分子 +1,分母 + |V|。

    分母必须加整个词表大小,不是加 1——
    否则所有候选词的概率加起来不等于 1,就不是概率分布了。
    """
    v = len(vocab)
    return (bigram[(prev, word)] + 1) / (unigram[prev] + v)


def main():
    bigram, unigram, vocab = build_counts(CORPUS)
    v = len(vocab)
    print("语料 %d 句,词表 |V| = %d" % (len(CORPUS), v))
    print("词表:", " ".join(sorted(vocab)))
    print()

    # 三个查询:见过的、没见过的、前词也没见过的
    queries = [
        ("我", "想", "语料里出现过 2 次"),
        ("我", "编程", "两个词都在词表里,但从未相邻"),
        ("爱", "学", "同上,典型的数据稀疏"),
    ]
    print("%-14s %-12s %-12s %s" % ("查询", "无平滑", "加一平滑", "说明"))
    print("-" * 66)
    for prev, word, note in queries:
        a = p_mle(bigram, unigram, prev, word)
        b = p_laplace(bigram, unigram, vocab, prev, word)
        print("P(%s|%s)%s %-12.4f %-12.4f %s"
              % (word, prev, " " * (6 - len(word) - len(prev)), a, b, note))
    print()

    # 验证平滑后仍是合法概率分布:对固定前词,所有候选词概率之和应为 1
    prev = "我"
    total_mle = sum(p_mle(bigram, unigram, prev, w) for w in vocab)
    total_lap = sum(p_laplace(bigram, unigram, vocab, prev, w) for w in vocab)
    print("对前词「%s」,全词表概率求和:" % prev)
    print("  无平滑   = %.6f" % total_mle)
    print("  加一平滑 = %.6f" % total_lap)
    print()

    # 代价:把概率从高频词身上匀给了没见过的词
    print("平滑的代价——高频搭配被稀释:")
    for prev, word in [("我", "想"), ("他", "想")]:
        a = p_mle(bigram, unigram, prev, word)
        b = p_laplace(bigram, unigram, vocab, prev, word)
        drop = (a - b) / a * 100 if a else 0.0
        print("  P(%s|%s): %.4f -> %.4f  下降 %.1f%%" % (word, prev, a, b, drop))
    print()
    print("结论:平滑消灭了 0 概率,代价是牺牲了高频搭配的置信度。")
    print("词表越大,|V| 越大,稀释越狠——所以真实场景用的是 Kneser-Ney 等更精细的方案。")


if __name__ == "__main__":
    main()
运行输出
语料 5 句,词表 |V| = 10
词表: </s> <s> 人工 他 学 想 我 智能 爱 编程

查询             无平滑          加一平滑         说明
------------------------------------------------------------------
P(想|我)     0.6667       0.2308       语料里出现过 2 次
P(编程|我)    0.0000       0.0769       两个词都在词表里,但从未相邻
P(学|爱)     0.0000       0.0833       同上,典型的数据稀疏

对前词「我」,全词表概率求和:
  无平滑   = 1.000000
  加一平滑 = 1.000000

平滑的代价——高频搭配被稀释:
  P(想|我): 0.6667 -> 0.2308  下降 65.4%
  P(想|他): 0.5000 -> 0.1667  下降 66.7%

结论:平滑消灭了 0 概率,代价是牺牲了高频搭配的置信度。
词表越大,|V| 越大,稀释越狠——所以真实场景用的是 Kneser-Ney 等更精细的方案。
|V|,这一行就不是 1,后面所有算出来的东西全废。写完平滑先跑这一行。② P(想|我) 从 0.6667 掉到 0.2308,下降 65.4%——代价大得惊人。因为语料只有 5 句,
C(我)=3 而 |V|=10,分母一下子从 3 变成 13。
所以平滑的适用边界很清楚:语料越少、词表越大,加一平滑的副作用越大。它适合用来理解原理,真实项目请直接上 Kneser-Ney,或者干脆换神经网络。
3.3 BPE 分词器:看清楚一个 token 到底是什么
2.5 节说 token 是“数频次合并出来的片段”。口说无凭,把 BPE 训练过程整个写出来——核心就是 count_pairs() 和 merge_pair() 两个函数:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""极简 BPE 分词器——看清楚「一个 token 到底是什么」。

只用标准库,直接 python3 tokenizer_demo.py 就能跑。
真实的 tokenizer(tiktoken、SentencePiece)在工程细节上复杂得多,
但合并规则的核心就是下面这十几行:数相邻对、合并最高频的那一对、重复。
"""
from collections import Counter

# 训练语料:故意让 low/lower/newest/widest 共享后缀,看 BPE 怎么把后缀学出来
CORPUS = {
    "low": 5,
    "lower": 2,
    "newest": 6,
    "widest": 3,
}

NUM_MERGES = 10


def init_vocab(corpus):
    """把每个词切成字符序列,词尾加 </w> 标记,避免跨词合并。"""
    vocab = {}
    for word, freq in corpus.items():
        vocab[" ".join(list(word)) + " </w>"] = freq
    return vocab


def count_pairs(vocab):
    """统计所有相邻符号对的出现频次(按词频加权)。"""
    pairs = Counter()
    for word, freq in vocab.items():
        symbols = word.split()
        for i in range(len(symbols) - 1):
            pairs[(symbols[i], symbols[i + 1])] += freq
    return pairs


def merge_pair(pair, vocab):
    """把选中的符号对合并成一个新符号。"""
    merged = "".join(pair)
    old = " ".join(pair)
    out = {}
    for word, freq in vocab.items():
        # 用空格做边界,确保只替换完整的符号对,不会切断更长的符号
        out[(" " + word + " ").replace(" " + old + " ", " " + merged + " ").strip()] = freq
    return out


def train(corpus, num_merges):
    """跑 BPE 训练,返回合并规则表和最终词表。"""
    vocab = init_vocab(corpus)
    merges = []
    print("初始状态(每个字符都是一个 token):")
    for word, freq in vocab.items():
        print("   %-24s x%d" % (word, freq))
    print()
    for step in range(1, num_merges + 1):
        pairs = count_pairs(vocab)
        if not pairs:
            print("没有可合并的对了,提前停止。")
            break
        best, freq = pairs.most_common(1)[0]
        if freq < 2:
            print("第 %d 步:最高频对只出现 %d 次,停止合并。" % (step, freq))
            break
        vocab = merge_pair(best, vocab)
        merges.append(best)
        print("第 %2d 步:合并 %-12s 频次 %d  ->  新 token 「%s」"
              % (step, str(best), freq, "".join(best)))
    return merges, vocab


def encode(word, merges):
    """用学到的合并规则给新词分词,顺序必须和训练时一致。"""
    symbols = list(word) + ["</w>"]
    for pair in merges:
        i = 0
        while i < len(symbols) - 1:
            if (symbols[i], symbols[i + 1]) == pair:
                symbols[i:i + 2] = ["".join(pair)]
            else:
                i += 1
    return symbols


def main():
    merges, vocab = train(CORPUS, NUM_MERGES)
    print()
    print("最终切分结果:")
    for word, freq in vocab.items():
        print("   %-24s x%d" % (word, freq))
    print()

    print("拿学到的规则去切新词(训练时没见过的):")
    for word in ["lowest", "newer", "wide", "slow"]:
        toks = encode(word, merges)
        print("   %-8s -> %-30s 共 %d 个 token" % (word, str(toks), len(toks)))
    print()

    print("同一句话,不同语言的 token 数差别:")
    samples = [
        ("英文", "hello world"),
        ("中文", "你好世界"),
    ]
    for lang, text in samples:
        # 这里只按最朴素的规则估算:英文按空格切词再按字符兜底,中文按字
        rough = len(text.split()) if lang == "英文" else len(text)
        print("   %s「%s」字符数 %d,朴素切分约 %d 个单位"
              % (lang, text, len(text), rough))
    print()
    print("要记住的三件事:")
    print("  1. token 不是词也不是字,是 BPE 按频次合并出来的片段;")
    print("  2. 高频片段会变成一个 token,生僻词会被拆成好几个;")
    print("  3. 计费和上下文长度都按 token 算,所以换个 tokenizer,同一句话的成本就变了。")


if __name__ == "__main__":
    main()
运行输出
初始状态(每个字符都是一个 token):
   l o w </w>               x5
   l o w e r </w>           x2
   n e w e s t </w>         x6
   w i d e s t </w>         x3

第  1 步:合并 ('e', 's')   频次 9  ->  新 token 「es」
第  2 步:合并 ('es', 't')  频次 9  ->  新 token 「est」
第  3 步:合并 ('est', '</w>') 频次 9  ->  新 token 「est</w>」
第  4 步:合并 ('l', 'o')   频次 7  ->  新 token 「lo」
第  5 步:合并 ('lo', 'w')  频次 7  ->  新 token 「low」
第  6 步:合并 ('n', 'e')   频次 6  ->  新 token 「ne」
第  7 步:合并 ('ne', 'w')  频次 6  ->  新 token 「new」
第  8 步:合并 ('new', 'est</w>') 频次 6  ->  新 token 「newest</w>」
第  9 步:合并 ('low', '</w>') 频次 5  ->  新 token 「low</w>」
第 10 步:合并 ('w', 'i')   频次 3  ->  新 token 「wi」

最终切分结果:
   low</w>                  x5
   low e r </w>             x2
   newest</w>               x6
   wi d est</w>             x3

拿学到的规则去切新词(训练时没见过的):
   lowest   -> ['low', 'est</w>']             共 2 个 token
   newer    -> ['new', 'e', 'r', '</w>']      共 4 个 token
   wide     -> ['wi', 'd', 'e', '</w>']       共 4 个 token
   slow     -> ['s', 'low</w>']               共 2 个 token

同一句话,不同语言的 token 数差别:
   英文「hello world」字符数 11,朴素切分约 2 个单位
   中文「你好世界」字符数 4,朴素切分约 4 个单位

要记住的三件事:
  1. token 不是词也不是字,是 BPE 按频次合并出来的片段;
  2. 高频片段会变成一个 token,生僻词会被拆成好几个;
  3. 计费和上下文长度都按 token 算,所以换个 tokenizer,同一句话的成本就变了。
</w>:不加边界标记,合并会跨过词边界,把两个词的尾头粘成一个 token。② 频次要按词频加权:
newest 出现 6 次,它里面的 e+s 就要计 6 次,不是 1 次。③ 编码时必须按训练时的顺序重放合并规则:顺序一变,切出来的 token 就不一样。这也是为什么 tokenizer 文件必须跟模型权重配套分发,换一个就对不上。
tiktoken、SentencePiece)还要处理字节级回退、特殊 token、正则预切分、多语言归一化,并且用 Rust/C++ 写以保证速度。但合并规则的核心就是上面这十几行。看懂它,就看懂了为什么你的账单按 token 计而不按字数计。
04完整案例:把三把尺子写成可复算的代码
不装 nltk、不装 rouge,公式一行行写出来,每个中间量都能打印
评估指标最容易学成「背定义」。治这个病的办法是自己实现一遍——公式写进代码,中间量全部打印,再拿手算结果去对。下面这份实现只用标准库,包含 BLEU(含截断与长度惩罚)、ROUGE-N、ROUGE-L、PPL 四部分。
4.1 完整实现
"""BLEU / ROUGE-N / PPL 三个指标的纯标准库实现。

不装 nltk、不装 rouge,把公式一行行写出来,
这样每个中间量都能打印、能跟手算对上。
直接 python3 eval_metrics.py 运行。
"""
import math
from collections import Counter


# --------------------------------------------------------------------------
# 公共工具
# --------------------------------------------------------------------------
def ngrams(tokens, n):
    """把 token 序列切成 n-gram 列表;长度不够时返回空列表。"""
    return [tuple(tokens[i:i + n]) for i in range(len(tokens) - n + 1)]


# --------------------------------------------------------------------------
# BLEU:看准确率——候选句里的 n-gram 有多少能在参考句里找到
# --------------------------------------------------------------------------
def modified_precision(candidate, references, n):
    """截断精确率:候选的每个 n-gram 最多只能按参考里出现的最大次数计数。

    这一步专门治「the the the the」刷分:
    分子被参考句里 the 的真实出现次数封顶。
    """
    cand_counts = Counter(ngrams(candidate, n))
    if not cand_counts:
        return 0.0, 0, 0

    # 同一个 n-gram 在多条参考里取最大出现次数作为上限
    max_ref_counts = Counter()
    for ref in references:
        ref_counts = Counter(ngrams(ref, n))
        for gram, cnt in ref_counts.items():
            max_ref_counts[gram] = max(max_ref_counts[gram], cnt)

    clipped = sum(min(cnt, max_ref_counts[gram])
                  for gram, cnt in cand_counts.items())
    total = sum(cand_counts.values())
    return clipped / total, clipped, total


def brevity_penalty(candidate, references):
    """长度惩罚:候选句比参考句短就扣分,防止只输出最有把握的几个词。"""
    c = len(candidate)
    if c == 0:
        return 0.0
    # 取长度最接近候选句的那条参考作为有效长度 r
    r = min((abs(len(ref) - c), len(ref)) for ref in references)[1]
    if c > r:
        return 1.0
    return math.exp(1 - r / c)


def bleu(candidate, references, max_n=4, verbose=False):
    """BLEU = BP × exp(Σ w_n · log p_n),权重取均匀的 1/max_n。"""
    weights = [1 / max_n] * max_n
    log_sum = 0.0
    for n in range(1, max_n + 1):
        p_n, clipped, total = modified_precision(candidate, references, n)
        if verbose:
            print("  %d-gram 匹配 %d/%d = %.4f" % (n, clipped, total, p_n))
        if p_n == 0:
            # 任意一阶为 0,整体连乘就是 0;这也是短句 BLEU 常年偏低的原因
            return 0.0
        log_sum += weights[n - 1] * math.log(p_n)
    bp = brevity_penalty(candidate, references)
    if verbose:
        print("  长度惩罚 BP = %.4f" % bp)
    return bp * math.exp(log_sum)


# --------------------------------------------------------------------------
# ROUGE-N:看召回率——参考句里的 n-gram 有多少被候选句覆盖到
# --------------------------------------------------------------------------
def rouge_n(candidate, reference, n=1):
    """返回 (precision, recall, f1)。ROUGE 的主指标是 recall。"""
    cand_counts = Counter(ngrams(candidate, n))
    ref_counts = Counter(ngrams(reference, n))
    overlap = sum(min(cnt, cand_counts[gram]) for gram, cnt in ref_counts.items())

    cand_total = sum(cand_counts.values())
    ref_total = sum(ref_counts.values())
    precision = overlap / cand_total if cand_total else 0.0
    recall = overlap / ref_total if ref_total else 0.0
    if precision + recall == 0:
        return precision, recall, 0.0
    f1 = 2 * precision * recall / (precision + recall)
    return precision, recall, f1


def lcs_length(a, b):
    """最长公共子序列长度,ROUGE-L 用它衡量「顺序上的重合」。"""
    dp = [[0] * (len(b) + 1) for _ in range(len(a) + 1)]
    for i in range(1, len(a) + 1):
        for j in range(1, len(b) + 1):
            if a[i - 1] == b[j - 1]:
                dp[i][j] = dp[i - 1][j - 1] + 1
            else:
                dp[i][j] = max(dp[i - 1][j], dp[i][j - 1])
    return dp[len(a)][len(b)]


def rouge_l(candidate, reference):
    """ROUGE-L:不要求连续,只要求词序一致,比 ROUGE-N 宽松。"""
    lcs = lcs_length(candidate, reference)
    precision = lcs / len(candidate) if candidate else 0.0
    recall = lcs / len(reference) if reference else 0.0
    if precision + recall == 0:
        return precision, recall, 0.0
    f1 = 2 * precision * recall / (precision + recall)
    return precision, recall, f1


# --------------------------------------------------------------------------
# PPL:困惑度——模型面对真实句子时平均「纠结」在多少个候选词之间
# --------------------------------------------------------------------------
def perplexity(sentence, unigram):
    """PPL = 2^(-1/N · Σ log2 P(w)),等价于几何平均概率的倒数。"""
    log_prob = 0.0
    for word in sentence:
        p = unigram.get(word, 0.0)
        if p <= 0:
            # 概率为 0 时 log 无定义,真实工程里靠平滑兜底
            return float("inf")
        log_prob += math.log(p, 2)
    avg_neg_log = -log_prob / len(sentence)
    return 2 ** avg_neg_log


if __name__ == "__main__":
    cand = "It is a nice day today".lower().split()
    ref = "today is a nice day".lower().split()

    print("一、BLEU(准确率视角)")
    score = bleu(cand, [ref], max_n=4, verbose=True)
    print("  BLEU-4 = %.4f\n" % score)

    print("二、截断精确率治刷分")
    spam = "the the the the".split()
    spam_ref = "The cat is standing on the ground".lower().split()
    p1, clipped, total = modified_precision(spam, [spam_ref], 1)
    print("  候选 'the the the the' 的 1-gram 截断精确率 = %d/%d = %.4f\n"
          % (clipped, total, p1))

    print("三、ROUGE(召回率视角)")
    for n in (1, 2):
        p, r, f = rouge_n(cand, ref, n)
        print("  ROUGE-%d  P=%.4f  R=%.4f  F1=%.4f" % (n, p, r, f))
    p, r, f = rouge_l(cand, ref)
    print("  ROUGE-L  P=%.4f  R=%.4f  F1=%.4f\n" % (p, r, f))

    print("四、PPL(困惑度)")
    unigram = {"i": 1 / 12, "have": 1 / 12, "a": 3 / 12, "pen": 1 / 12,
               "he": 1 / 12, "has": 2 / 12, "book": 1 / 12,
               "she": 1 / 12, "cat": 1 / 12}
    corpus = [["i", "have", "a", "pen"],
              ["he", "has", "a", "book"],
              ["she", "has", "a", "cat"]]
    total = 0.0
    for s in corpus:
        ppl = perplexity(s, unigram)
        print("  %-22s PPL = %.4f" % (" ".join(s), ppl))
        total += ppl
    print("  平均 PPL = %.4f" % (total / len(corpus)))
4.2 运行结果与手算核对
直接 python3 eval_metrics.py:
一、BLEU(准确率视角)
  1-gram 匹配 5/6 = 0.8333
  2-gram 匹配 3/5 = 0.6000
  3-gram 匹配 2/4 = 0.5000
  4-gram 匹配 1/3 = 0.3333
  长度惩罚 BP = 1.0000
  BLEU-4 = 0.5373

二、截断精确率治刷分
  候选 'the the the the' 的 1-gram 截断精确率 = 2/4 = 0.5000

三、ROUGE(召回率视角)
  ROUGE-1  P=0.8333  R=1.0000  F1=0.9091
  ROUGE-2  P=0.6000  R=0.7500  F1=0.6667
  ROUGE-L  P=0.6667  R=0.8000  F1=0.7273

四、PPL(困惑度)
  i have a pen           PPL = 9.1180
  he has a book          PPL = 7.6673
  she has a cat          PPL = 7.6673
  平均 PPL = 8.1509
把输出和 2.4 节手算的数字并排放,四阶 BLEU 匹配度完全一致:
| 阶 | 手算 | 代码输出 | 是否一致 |
|---|---|---|---|
| 1-gram | 5/6 = 0.8333 | 0.8333 | ✅ |
| 2-gram | 3/5 = 0.6000 | 0.6000 | ✅ |
| 3-gram | 2/4 = 0.5000 | 0.5000 | ✅ |
| 4-gram | 1/3 = 0.3333 | 0.3333 | ✅ |
| ROUGE-1 召回 | 5/5 = 1.0000 | R=1.0000 | ✅ |
② 刷分被截住了:
the the the the 的 1-gram 截断精确率是 2/4 = 0.5,不是 1。③ 同一对句子,ROUGE-1 的 P=0.8333、R=1.0000——precision 与 BLEU 的 1-gram 完全相同,recall 才是 ROUGE 的主指标。这一行把两个指标的关系钉死了。
④ 平均 PPL = 8.1509:一元模型面对这三句话,平均在 8 个词之间摇摆。词表一共 9 个词,说明这个模型几乎没学到东西——PPL 接近词表大小,等于瞎猜。
4.3 三把尺子各自的盲区
三个指标都能被「骗」,知道怎么骗,才知道什么时候不能信它们:
| 指标 | 怎么被骗 | 后果 |
|---|---|---|
| BLEU | 换个同义说法,一个 n-gram 都不匹配 | 「今天天气很好」vs「今日天气不错」得分接近 0,但翻译质量一样 |
| ROUGE | 把参考答案的词全抄一遍再多写一堆废话 | 召回率拉满,但生成内容又臭又长;所以要同时看 precision |
| PPL | 换个分词方式或换个词表 | PPL 数值直接变样,跨模型比较 PPL 必须统一 tokenizer,否则没有可比性 |
共同的盲区是:它们都只在比对字面,不理解语义。所以这三个数字适合做回归监控(改了代码,分数掉了就报警),不适合当作「模型好不好」的最终判据。真要下结论,还得靠人工抽检或更强的模型来当裁判。
05骨架模板:批量评估脚本
改 5 处 TODO,就能给自己的一批生成结果打分出表
单条算指标是教学,真实工作里要的是一批样本跑完出一张表,而且能存档、能和上一版比。这份骨架把「读数据 → 分词 → 逐条打分 → 汇总平均 → 落盘」串好了,依赖只有标准库和同目录的 eval_metrics.py。
"""评估脚本骨架:把一批生成结果按 BLEU / ROUGE / PPL 打分并出报表。

复制后只改 5 处 TODO 即可用在自己的任务上。
依赖:只用标准库 + 同目录的 eval_metrics.py。
"""
import json
import os

from eval_metrics import bleu, rouge_n, rouge_l, perplexity

# TODO 1:换成你自己的数据文件。每行一个 JSON 对象,形如
#   {"prompt": "...", "prediction": "模型输出", "reference": "人工标准答案"}
DATA_PATH = os.environ.get("EVAL_DATA", "samples.jsonl")

# TODO 2:换成你的分词方式。中文建议用 jieba,英文按空格即可。
def tokenize(text):
    return text.lower().split()


# TODO 3:按任务类型挑指标。翻译看 BLEU,摘要看 ROUGE,语言模型看 PPL。
METRICS = ("bleu4", "rouge1_r", "rouge2_r", "rougeL_f")


def load(path):
    """读 jsonl;文件不存在时退回内置样例,保证脚本永远能跑起来。"""
    if not os.path.exists(path):
        return [
            {"prediction": "It is a nice day today", "reference": "today is a nice day"},
            {"prediction": "the the the the", "reference": "the cat is on the ground"},
        ]
    rows = []
    with open(path, encoding="utf-8") as f:
        for line in f:
            line = line.strip()
            if line:
                rows.append(json.loads(line))
    return rows


def score_one(prediction, reference):
    """对单条样本算出全部指标,返回字典。"""
    cand, ref = tokenize(prediction), tokenize(reference)
    r1_p, r1_r, r1_f = rouge_n(cand, ref, 1)
    r2_p, r2_r, r2_f = rouge_n(cand, ref, 2)
    rl_p, rl_r, rl_f = rouge_l(cand, ref)
    return {
        "bleu4": bleu(cand, [ref], max_n=4),
        "rouge1_r": r1_r,
        "rouge2_r": r2_r,
        "rougeL_f": rl_f,
    }


def main():
    rows = load(DATA_PATH)
    totals = dict.fromkeys(METRICS, 0.0)

    print("%-34s %s" % ("样本", "  ".join("%-9s" % m for m in METRICS)))
    print("-" * 80)
    for row in rows:
        scores = score_one(row["prediction"], row["reference"])
        for m in METRICS:
            totals[m] += scores[m]
        preview = row["prediction"][:30]
        print("%-34s %s" % (preview,
                            "  ".join("%-9.4f" % scores[m] for m in METRICS)))

    print("-" * 80)
    n = len(rows) or 1
    print("%-34s %s" % ("平均(共 %d 条)" % len(rows),
                        "  ".join("%-9.4f" % (totals[m] / n) for m in METRICS)))

    # TODO 4:需要 PPL 时,换成你自己的词表概率分布(真实项目里由模型给出)
    # print(perplexity(tokenize("i have a pen"), {"i": 1/12, ...}))

    # TODO 5:把结果落盘,接进 CI 做回归对比
    # json.dump(totals, open("eval_report.json", "w"), ensure_ascii=False, indent=2)


if __name__ == "__main__":
    main()
prediction 与 reference)· TODO 2 换分词方式,中文建议接 jieba · TODO 3 按任务类型挑指标,翻译看 BLEU、摘要看 ROUGE · TODO 4 需要 PPL 时传入模型给出的词表概率 · TODO 5 把结果落盘接进 CI。其余代码不用动。
文件不存在时它会退回内置样例,所以拿到手直接 python3 eval_skeleton.py 就有输出,不用先准备数据:
| 样本 | bleu4 | rouge1_r | rouge2_r | rougeL_f |
|---|---|---|---|---|
| It is a nice day today | 0.5373 | 1.0000 | 0.7500 | 0.7273 |
| the the the the | 0.0000 | 0.3333 | 0.0000 | 0.4000 |
| 平均(共 2 条) | 0.2686 | 0.6667 | 0.3750 | 0.5636 |
bleu4 = 0 把平均值狠狠拉低了。真实评估里只要有几条样本高阶完全不匹配,整批的平均 BLEU 就会失真。所以报告指标时至少同时给出中位数和分布,或者先剔除
finish_reason 异常的样本。只报一个平均分,是评估里最常见的自欺。
06易错点汇总
按「概念 / N-gram / 神经网络 / 指标 / 工程」五类归并
⚠️ 一、概念层面
- 以为大模型在「理解问题然后回答」。 它在做的仍然是逐词预测概率。理解、推理都是这件事做到极致后表现出来的行为,不是另一套独立机制。记住铁律,很多「为什么模型会胡说」的困惑自然就解开了。
- 把「语言模型」等同于「大语言模型」。 bigram 也是语言模型。区别只在规模与由此涌现的能力,不在任务目标。
- 把参数量当成唯一的「大」。 参数量、训练数据量、上下文长度是三个独立维度,一个 7B 但训练数据 18T 的模型,可能比 13B 但数据 1T 的更强。
- 记错 GPT-3 的量级。 是 1750 亿参数、2020 年由 OpenAI 发布。它的标志性能力是不调整权重、仅凭示例完成新任务。
⚠️ 二、N-gram 与马尔可夫假设
- 把 N 数错一位。 N 元模型是「当前词只依赖前 N-1 个词」。bigram 往前看 1 个,trigram 往前看 2 个。写代码时切 n-gram 切错长度,所有概率都会错。
- 忘了补句首句尾标记。 不补
<s>,第一个词没有上文,P(W1)无从计算;不补</s>,模型学不会「话说完了」,生成时会停不下来。 - 分母用错。
P(Wi|Wi-1) = C(Wi-1,Wi) / C(Wi-1),分母是前一个词的出现次数,不是语料总词数,也不是共现总数。 - 不做平滑就上真实数据。 只要有一个词对没见过,整句概率连乘后就是 0,所有句子都一样「不可能」,模型直接失效。
- 以为 N 越大越好。 N 增大时参数空间呈指数增长,数据稀疏更严重。实践中 bigram 和 trigram 用得最多,不是因为懒,是因为再大就估不准了。
- 平滑时分母只加 1。 加一平滑的分母必须加整个词表大小
|V|,因为每个候选词都白送了 1 个计数。分母加错,概率就不求和为 1,往后所有计算全废。验证办法只有一个:固定前词,把全词表的概率加起来看是不是 1。 - 把加一平滑当成生产方案。 真实词表几万起步,
|V|一加就把真实统计量淹没了。它只适合教学演示,生产请用 Good-Turing、插值法或 Kneser-Ney。
⚠️ 二之二、Token 与分词
- 把 token 当成字或词。 token 是 BPE 按频次合并出来的片段:高频词可能整个是 1 个 token,生僻词会被拆成好几个。「1 汉字 = 1 token」只是粗略经验值,不能用来算钱或判断是否超上下文。
- 拿 A 模型的 tokenizer 去估 B 模型的费用。 每家词表不同,同一句话 token 数不一样。跨模型比价格,要么用各自官方 tokenizer 离线算,要么发一次真实请求读
usage。 - BPE 训练时不加词尾边界标记。 不加
</w>,合并会跨过词边界,把上一个词的尾巴和下一个词的开头粘成一个 token。 - 编码时不按训练顺序重放合并规则。 合并规则是有序的,顺序一乱,切出来的 token 就与模型预期不一致。这也是 tokenizer 文件必须跟权重配套分发的原因。
- 忽略中文的 token 成本。 主流 tokenizer 的训练语料以英文为主,同等字数的中文提示词 token 数通常更高。预算估算别拿英文经验直接套。
⚠️ 三、神经网络语言模型
- 把词向量当成「模型的输出」。 词向量是中间表示,是随机初始化后跟着任务一起学出来的,输出层给的才是词表上的概率分布。
- 漏掉 softmax。 输出层 V 个节点给的是未归一化的
logits,必须经 softmax 才是概率,否则数值不在 [0,1]、也不求和为 1。 - 以为 NNLM 解决了长依赖。 它治的是数据稀疏,输入仍然是固定的前 n-1 个词。长序列问题要等 RNN、attention 才有像样的解法。
⚠️ 四、评估指标
- 把 PPL 的方向记反。 三把尺子里只有它越小越好。BLEU、ROUGE 是越接近 1 越好。
- 跨模型直接比 PPL。 分词方式或词表一变,PPL 数值就不可比。比较前必须统一 tokenizer。
- 算 BLEU 不做截断。 不截断的话
the the the the能拿满分。必须用参考句中该词的最大出现次数去修剪候选句的计数。 - 只看 ROUGE 的召回率。 把参考答案全抄一遍再灌一堆废话,召回率能拉满。要同时看 precision 或 F1。
- 拿 BLEU 判断中文生成质量。 中文需要先分词,且同义表达完全不匹配字面。字面指标只适合做回归监控,不适合当最终判据。
- 只报平均分。 几条 0 分样本就能把整批平均值拖垮。至少同时给中位数或分布。
⚠️ 五、工程实现
- 整句概率连乘导致数值下溢。 句子一长,几十个小于 1 的数连乘会小到浮点数表示不了,直接变成 0。真实实现一律在对数空间累加,最后再取指数。
- PPL 里对 0 概率取对数。
log(0)无定义,程序会崩或得到inf。要么平滑,要么显式判零。 - 读中文语料没带
encoding='utf-8'。 Windows 默认 GBK,中文直接报解码错误。 - 比较指标时改了分词却没说。 分词变了,所有 n-gram 都变了,两次结果不可比。评估配置要跟结果一起存档。
07自测题
点击题目展开答案;能把这 16 题说清楚,这一讲就通了
什么是语言模型?用一句话给出标准定义。
对于词序列 S = {W1, W2, …, Wn},语言模型就是计算该序列发生的概率 P(S) 的模型:符合语言习惯的序列给高概率,否则给低概率。等价的说法是——给定上文,预测下一个词。
什么是大语言模型?参数量的常用判定线是多少?
旨在理解和生成人类语言的人工智能模型,能处理文本分类、问答、翻译、对话等任务。通常指包含数千亿(或更多)参数的语言模型;工程上还有一条更宽松的经验线:参数量超过 10B 即可称为大语言模型。
语言模型技术发展的四个阶段分别是什么?每一阶段治了上一阶段的什么病?
① 基于规则和统计(N-gram)——起点,但参数空间过大、数据稀疏;② 神经语言模型——用词向量治好了数据稀疏,但长序列建模能力有限;③ 预训练语言模型(BERT/GPT/T5)——预训练+微调带来强泛化,但算力需求大、可解释性差;④ 大语言模型——参数与语料继续放大,能像人一样沟通,但算力要求高、可能生成有害或有偏见的内容。
GPT-3 最具标志性的能力是什么?为什么它很重要?
2020 年发布、1750 亿参数。标志性能力是可以在不调整权重的情况下,仅依据用户给出的任务示例完成具体任务。重要性在于:以前让模型做新任务必须重新训练,从此提示词成了使用模型的新接口,直接催生了后来的提示工程。
一个只做完预训练的模型,直接拿来聊天会怎样?后面还要加哪两段?
它只会接写——你问「中国的首都是哪里?」,它很可能接一句「美国的首都是哪里?」,因为语料里问题常成组出现。
后面要加两段:② SFT 监督微调,用「指令 → 优质回答」样本对让它听懂指令;③ RLHF / DPO 偏好对齐,用人工对候选回答的排序让回答更有用、更安全。
要让模型多掌握一个领域的事实知识,应该微调吗?
通常不该。事实知识主要在预训练层形成,那一层个人和中小团队基本动不起,实际该走 RAG(把资料检索出来放进提示词)。
微调适合解决的是固定格式、固定口吻、固定任务套路;只是调语气或加几条规则,连微调都不用,写进 system 提示词就行。分不清这三层,就会花十倍的钱办一半的事。
为什么不能直接用链式法则算整句概率?马尔可夫假设怎么救场?
链式法则里的 P(Wn|W1,…,Wn-1) 条件太长,这种组合在语料里几乎不出现,参数空间过大、数据稀疏,估不出来。马尔可夫假设规定:一个词出现的概率只与它前面有限的一个或几个词有关,把长条件截断成短条件,就能靠计数估计了。
bigram 的参数怎么算?写出 P(Wi|Wi-1) 的公式。
P(Wi|Wi-1) = C(Wi-1, Wi) / C(Wi-1)。分子是两词共现次数,分母是前一个词自身的出现次数(不是语料总词数)。只需要两个计数加一次除法,这就是 bigram 的全部参数。
N-gram 最致命的缺陷是什么?为什么 N 不是越大越好?
最致命的是数据稀疏:语料里没出现过的词对概率直接为 0,连乘后整句概率也是 0,而「没见过」不等于「不合理」。N 越大,参数空间呈指数增长,稀疏更严重,估计更不准,所以实践中 bigram 和 trigram 用得最多。
神经网络语言模型靠什么解决数据稀疏?说清机制。
靠词向量:每个词表示成低维连续向量,语义或语法相似的词,向量在空间中距离更近。于是模型见过「打篮球」,就能对没见过的「打排球」给出合理概率,不再依赖某个具体词序列是否在训练数据中出现过。网络三层:拼接词向量 → 全连接+tanh → 全连接+softmax 输出词表概率分布。
写出加一平滑的公式。分母为什么必须加 |V| 而不是加 1?
P(Wi|Wi-1) = ( C(Wi-1,Wi) + 1 ) / ( C(Wi-1) + |V| )。
因为每个候选词的分子都白送了 1,一共送出去 |V| 个计数,分母必须把这些全补回来,所有候选词的概率之和才仍然等于 1。验证办法就一个:固定前词,把全词表的概率加起来看是不是 1.000000。
平滑的代价是什么?为什么真实项目不用加一平滑?
代价是削峰填谷:把概率从高频搭配身上匀给没见过的组合。实测五句话语料(|V|=10),P(想|我) 从 0.6667 掉到 0.2308,下降 65.4%。
真实词表动辄几万几十万,分母被 |V| 一加,真实统计量完全被淹没,模型退化成均匀分布。生产上用 Good-Turing、插值法或效果最好的 Kneser-Ney。
一个 token 到底是什么?「1 个汉字 = 1 个 token」对吗?
token 是 BPE 按频次合并出来的片段,既不是字也不是词:高频词可能整个是 1 个 token(实测中 newest 被合并成一个),生僻词则被拆成好几个(newer → new / e / r / </w>)。
「1 汉字 = 1 token」不对,只是粗略经验值。要准确数字,要么用该模型官方 tokenizer 离线算,要么发一次请求读响应的 usage 字段。
BPE 训练的三步循环是什么?为什么说它不需要语言学知识?
① 把每个词拆成字符并加词尾标记;② 按词频加权统计所有相邻符号对的频次;③ 把最高频的那一对合并成新符号,回到 ②。
实测里第 2 步就把 est 合并了出来——没有人告诉它这是英语最高级后缀,纯靠数频次数出来的。所以同一套算法换成中文、代码、DNA 序列照样能跑。
BLEU、ROUGE、PPL 各看什么?哪个越小越好?
BLEU 看准确率(候选句的 n-gram 有多少在参考句里),取值 [0,1] 越大越好,主用于机器翻译;ROUGE 看召回率(参考句的 n-gram 被覆盖了多少),取值 [0,1] 越大越好,主用于摘要与问答生成;PPL 度量模型预测样本的好坏程度,越小越好——句子概率越大,模型越好,困惑度越小。
同一对句子,BLEU 的 1-gram 是 5/6,ROUGE-1 是 5/5。分子一样,差别在哪?截断又是治什么的?
差别只在分母:BLEU 的分母是候选句的 n-gram 总数(6 个),ROUGE 的分母是参考句的 n-gram 总数(5 个)。这就是准确率与召回率的全部区别。
截断治的是刷分:candidate 为 the the the the、reference 为 The cat is standing on the ground 时,朴素 1-gram 匹配度是 1,显然荒谬。先统计每个词在参考句中出现的最大次数(the 出现 2 次),再用它修剪候选句中的计数,匹配度降为 2/4 = 0.5。
词术语表
| 术语 | 含义 |
|---|---|
| Language Model(LM) | 计算词序列概率的模型;等价说法是「给定上文预测下一个词」 |
| LLM | Large Language Model,大语言模型;通常指参数量达数千亿、工程上常以 10B 为线的语言模型 |
| 链式法则 | 把整句概率拆成逐词条件概率连乘:P(S)=P(W1)·P(W2|W1)·… |
| 马尔可夫假设 | 一个词的出现概率只与它前面有限的几个词有关,用来把过长的条件截断 |
| N-gram | N 元语言模型;当前词只依赖前 N-1 个词,常用 bigram、trigram |
| OOV | Out-Of-Vocabulary,未登录词;词表里没有的词,是数据稀疏的典型表现 |
| smoothing | 平滑;给未出现过的组合分配少量概率,避免整句概率连乘归零 |
| Laplace smoothing | 加一平滑;分子 +1、分母 +|V|,最简单的平滑方案,代价是稀释高频搭配 |
| Kneser-Ney | 效果最好的经典 N-gram 平滑法,额外考虑一个词能接在多少种不同上文后面 |
| token | 模型实际读写的最小单位,既不是字也不是词,而是按频次合并出来的片段;计费与上下文长度都按它算 |
| subword | 子词;介于字符与单词之间的切分粒度,常用词整个保留、生僻词拆成片段 |
| BPE | Byte Pair Encoding,字节对编码;反复合并最高频相邻符号对来建词表的 subword 算法 |
| tokenizer | 分词器;把文本转成 token 序列的组件,必须与模型权重配套使用 |
| NNLM | 神经网络语言模型;用词向量与全连接网络替代计数统计 |
| embedding | 词向量;把词映射成低维稠密向量,语义相近的词距离更近 |
| logits | 输出层未归一化的分数,需经 softmax 才变成概率分布 |
| Pre-training | 预训练;在大规模通用语料上学习通用特征表示与知识 |
| Fine-tuning | 微调;在具体下游任务上迁移学习,获取更好的泛化效果 |
| SFT | Supervised Fine-Tuning,监督微调;用「指令 → 优质回答」样本对让模型从「会接写」变成「听得懂指令」 |
| RLHF | 基于人类反馈的强化学习;用人工对候选回答的排序来对齐模型偏好 |
| 涌现能力 | emergent abilities;参数规模跨过阈值后才明显出现的能力,如上下文学习、思维链;学界对其“突变性”有争议 |
| In-context Learning | 上下文学习;不改权重,只在提示词里给示例就能完成新任务 |
| Chain-of-Thought | 思维链;让模型分步推理再给答案,可显著提升多步推理任务的准确率 |
| BLEU | 基于 n-gram 准确率的生成质量指标,取值 [0,1],越接近 1 越好 |
| ROUGE | 基于召回率的生成质量指标,分 ROUGE-N / L / W / S 几种 |
| PPL | Perplexity 困惑度,度量模型预测样本的好坏程度,越小越好 |
| brevity penalty | 长度惩罚;候选句比参考句短时对 BLEU 打折,防止只吐几个词骗高分 |