LangChain 入门与 Model I/O
把大模型当成一位只管做菜的厨师,LangChain 是围着他盖起来的中央厨房:菜谱卡填变量、配菜台排消息、摆盘工位装数据,菜始终是厨师炒的。
30″30 秒看懂 LangChain
把大模型想象成一位手艺极好、但脾气古怪的厨师:他什么菜都会做,可你得亲自把食材洗好切好、按他习惯的摆法端到他面前,他才肯下锅。更麻烦的是,换一位厨师,摆法又得重学一遍。
LangChain 就是围着这位厨师盖起来的一间中央厨房。厨房里有照着填空的菜谱卡、有把原料理好分格的配菜台、有把成品装进标准餐盒的摆盘工位。你要做的从「伺候厨师」变成了「填菜谱卡、取餐盒」——中间那些琐碎的规矩,厨房替你立好了。
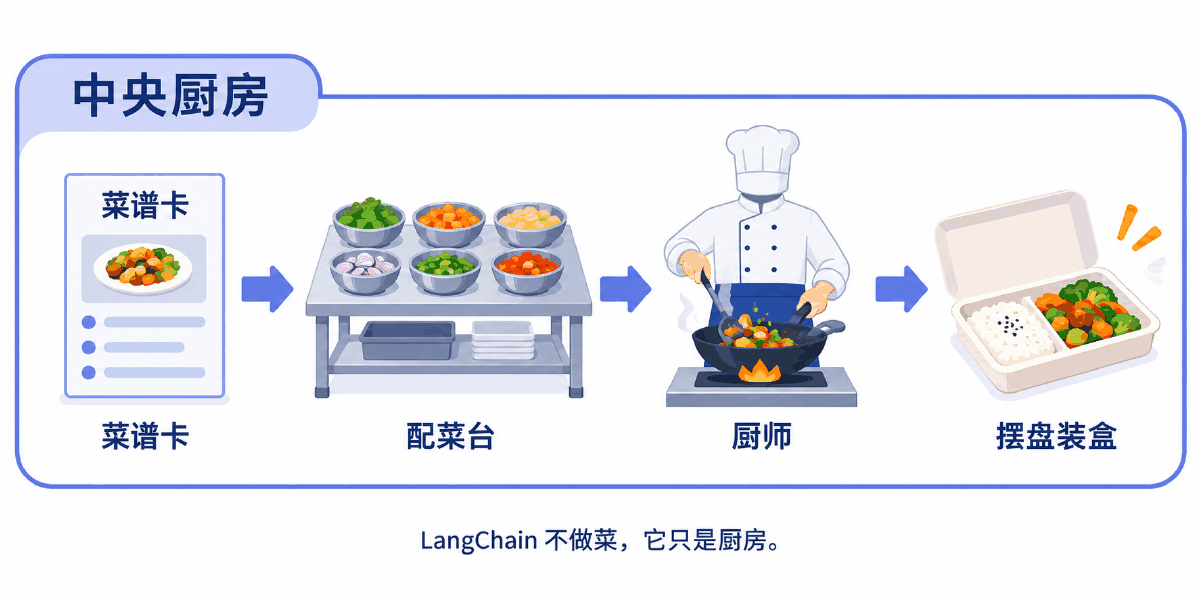
| 厨房里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 中央厨房(整间) | LangChain 框架 | 定标准、排工位、管流程,本身不产出任何内容 |
| 厨师 | 大模型 | 唯一真正「做菜」的人,所有文字都由它生成 |
| 菜谱卡(照着填变量) | PromptTemplate | 把写死的提示词挖出占位符,运行时填进去 |
| 配菜台 | Model I/O 的格式化环节 | 把变量拼成模型认的消息结构,端到厨师面前 |
| 摆盘装盒 | OutputParser | 把厨师端出来的一盘菜,装进程序能直接用的餐盒 |
| 传送带 | Chain 与管道符 | | 把上面几个工位接成一条线,下一讲的正题 |
| 墙上的备忘板 | Memory | 记着这桌客人之前点过什么,后面的讲次会展开 |
这套比喻会贯穿整个模块:下一讲的传送带、再往后的备忘板、外卖小哥和店长,用的都是这间厨房里的角色。先把四个工位认准,后面的内容都是往这条线上挂东西。
01概念:LangChain 是什么,又不是什么
由来、它替你挡掉了哪些麻烦,以及那些常见的误解
1.1 定义与由来
LangChain 发布于 2022 年 10 月,由 Harrison Chase 发起,是一个用于开发由大语言模型驱动的应用程序的开源框架。它比 ChatGPT 的问世还早一个月——这个时间点本身就说明,作者赌的不是某一个模型火起来,而是「以后会有很多模型,它们需要一套共同的用法」。
名字本身就是说明书:Lang 指 language,也就是大语言模型;Chain 指「链」,把模型与外部数据、各种组件连成链,以此构建 AI 应用。
还有一个流传很广的类比,理解它的定位很有用:
类似 Spring 之于 Java:Spring 自己不执行业务,它统一了依赖注入、事务、配置的写法。
Django 不发明 HTTP,它把路由、模板、ORM 的用法固定下来,让你少写胶水代码。
它是应用层框架,不是模型、不是算法、也不是推理引擎。定位错了,后面全是误会。
1.2 为什么需要它
最常见的质疑是:「我直接用某家模型的 API 也能做聊天机器人、问答系统,为什么要多套一层?」这话没错——不用 LangChain 完全做得出来。真正的问题是,做第二个、第三个应用的时候会发生什么。
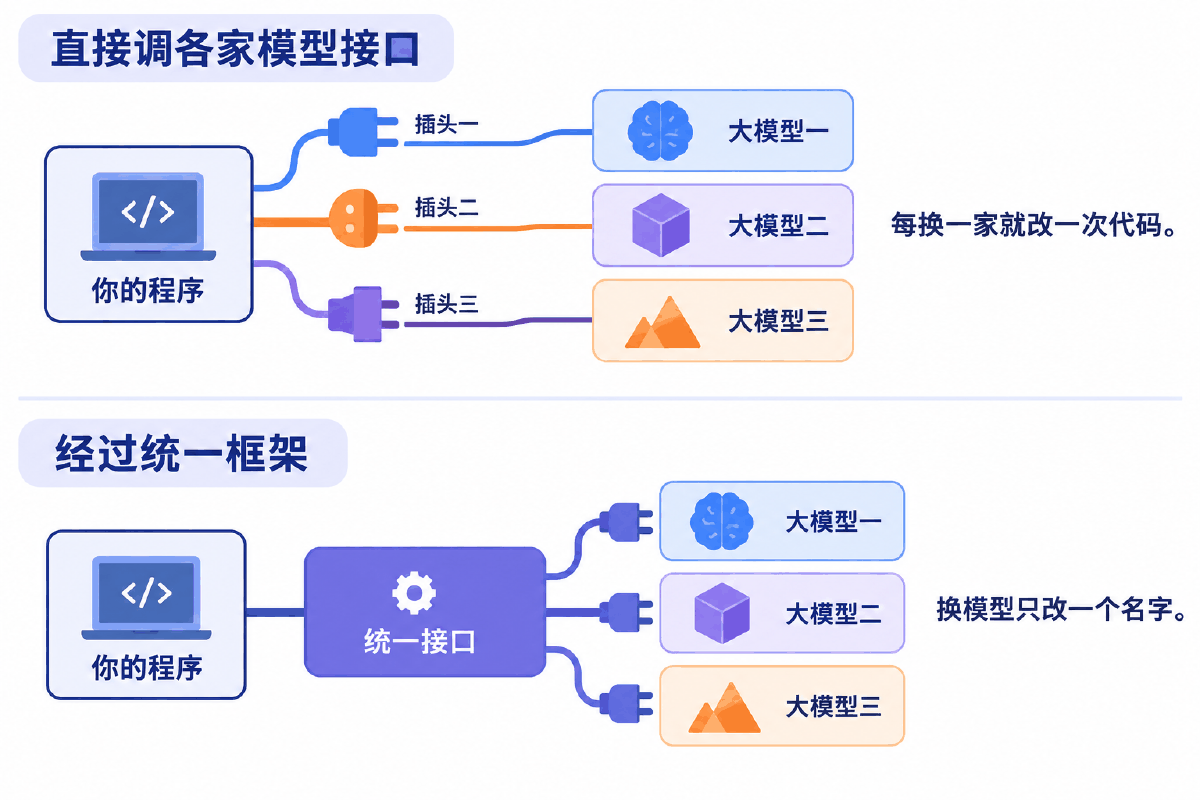
| 你会撞上的麻烦 | 直接调各家接口 | 经过统一框架 |
|---|---|---|
| 换模型 | 参数名、返回结构、消息格式各家不同,业务代码跟着改一遍 | 换一个模型名字符串,下游一行不动 |
| 提示词管理 | 字符串拼接满天飞,改一处漏一处 | 模板对象,变量缺失当场报错 |
| 输出处理 | 每个项目自己写一套正则抠 JSON | 解析器统一产出字典、列表、对象 |
| 多轮对话 | 自己攒消息列表、自己裁剪历史 | 有现成的记忆组件与占位符机制 |
| 接外部能力 | 联网、查库、算数都要自己搭一套调用协议 | 工具与智能体是框架内的一等公民 |
一句话总结它的价值:把「这家模型怎么用」的知识,换成「这类组件怎么用」的知识。前者随模型作废,后者能一直用下去。代价也很实在——多一层抽象,出问题时排查链路更长,这一点在易错点那一节会具体说。
1.3 三个必须先澄清的误解
pip install langchain 不会给你任何模型。它不提供 LLM,全靠第三方集成——要么接云端接口(需要密钥、按 token 计费),要么接本地部署(需要显卡和硬盘)。
回答质量由模型决定。框架能做的是把提示词组织得更好、把结构约束得更严——喂得更规整,不等于厨师厨艺变高。模型答不出的题,换个框架照样答不出。
同类框架不少:LlamaIndex 专注索引与检索,适合 RAG;SemanticKernel 在 C# 生态里更顺手;LangChain4j 是 Java 版本。LangChain 胜在出现最早、生态最全。
1.4 学完这条线能做什么
本模块六讲走完,下面这些应用形态就都在射程内了。这张表也顺带说明了各讲之间的依赖关系:
| 应用形态 | 主要用到 | 难度 |
|---|---|---|
| 文案生成、翻译、分类抽取 | 提示词模板 + 模型 + 输出解析器 | 本讲讲完就能写 |
| 多步处理流水线 | LCEL 管道组合 | ⭐⭐ |
| 上下文感知的对话机器人 | 会话记忆 + 消息占位符 | ⭐⭐⭐ |
| 能查天气、查库、算数的助手 | Tools + Function Call | ⭐⭐⭐⭐ |
| 自主拆解任务的智能助理 | Agent + 工具 + 记忆 | ⭐⭐⭐⭐⭐ |
| 企业知识库问答 | Embedding + 向量库 + 检索 | ⭐⭐⭐⭐⭐ |
注意最后一行的 Embedding:它也属于本讲要认的三类模型之一,但完整的检索链路是另一条主线,这里只把模型这一侧讲清楚。
02原理:厨房是怎么搭起来的
分层与拆包、六大组件、Model I/O 三段、三类模型、消息与参数、四种调用方式
2.1 架构分层:为什么是一堆包,而不是一个包
新手最容易卡住的第一步,不是写代码,而是搞不清该从哪个包里导入哪个类。原因是 LangChain 早就不是单个包了,它按「稳定程度」拆成了一组包。
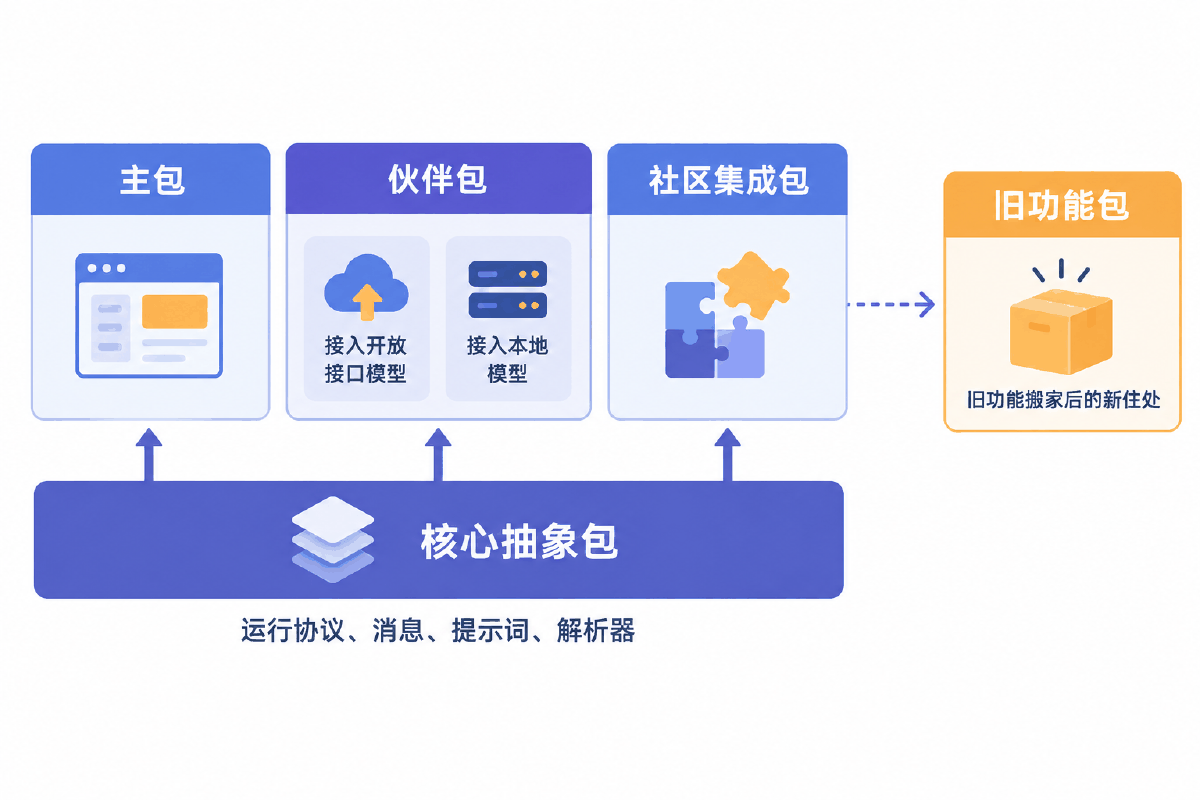
| 包 | 当前版本 | 装的是什么 |
|---|---|---|
langchain-core | 1.6.3 | 基础抽象:Runnable 协议、消息、提示词模板、工具定义、输出解析器。不依赖任何具体模型提供方,最稳定 |
langchain | 1.4.1 | 主包,管「搭认知架构」:智能体、统一的模型入口。1.x 之后命名空间大幅收窄 |
| 伙伴包 | langchain-openai 1.6.2langchain-ollama 1.1.0 | 某一家提供方的官方集成,单独发版,跟进最快 |
langchain-community | 0.4.2 | 第三方集成的大仓库,还没有官方伙伴包的接入都在这里 |
langchain-classic | 1.0.8 | 1.x 新增的包,是 legacy 功能搬家后的新住处 |
运行环境要求 Python 3.10 及以上。
from langchain.prompts import ...、from langchain.chains import LLMChain 都是标准写法,现在照抄会直接报导入错误。这不是示例写错了,是命名空间搬过家。
1.x 的主包只保留五个命名空间:
langchain.agents(create_agent)、langchain.messages、langchain.tools、langchain.chat_models(init_chat_model)、langchain.embeddings(init_embeddings)。
而
LLMChain、ConversationChain、ConversationBufferMemory、各类检索器、hub 模块等搬到了 langchain-classic,不再是推荐写法——它们能用,只是不该再作为新项目的起点。换算表见第 05 节。
2.2 六大组件:厨房里的六个区域
不管应用做到多复杂,拆开看都是这六块在组合。先建立地图,再逐个攻破:
标准化模型的输入与输出,含提示词模板、模型本身、输出解析。用得最多,也最简单,本讲的正题。
把多个组件串成完整流程。最重要的模块,也是下一讲的正题。
保存对话历史与上下文,让多轮对话接得上话。
工具是模型伸向外部世界的手;智能体负责自主决定用哪只手。
检索外部数据再交给模型,也就是 RAG 那条线:加载、切分、嵌入、存储、检索。
挂在各阶段的钩子,用于日志、监控、流式推送。
六块之外还有两个常被一并提起的名字:LangGraph 是在这套 API 之上做的进一步封装,用来编排更复杂的多步流程,也是当前智能体的底座;LangSmith 负责链路追踪、调试与监控,相当于这套体系的运维面板。
2.3 Model I/O 三段:格式化 → 预测 → 解析
这是整讲的骨架。任何一次与模型的交互,剥到底都是这三段:
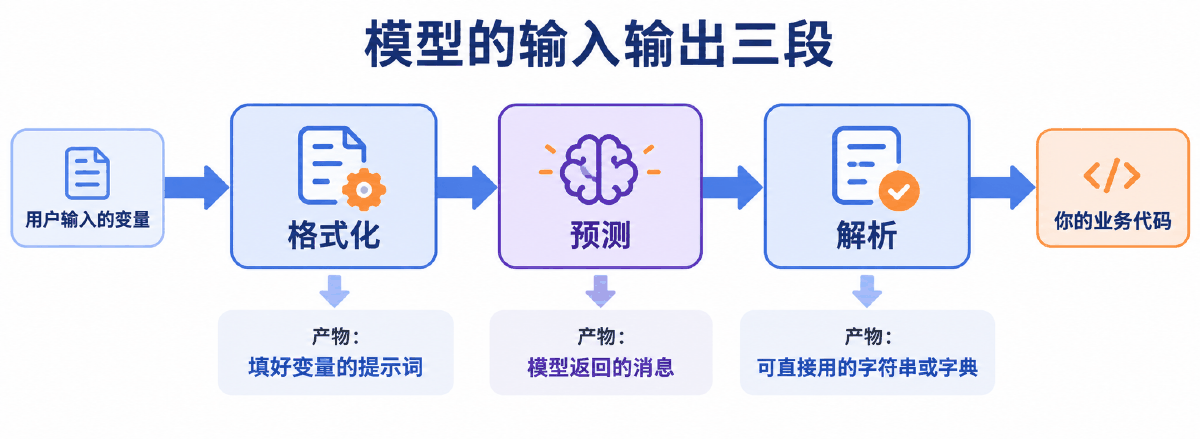
| 环节 | 谁在干活 | 进去的是 | 出来的是 |
|---|---|---|---|
| 格式化 | 你的模板 | 一个变量字典 | 填好的提示词 / 消息列表 |
| 预测 | 大模型 | 消息列表 | AIMessage 对象 |
| 解析 | 你的解析器 | AIMessage | 字符串 / 字典 / 列表 / 对象 |
把这张表和铁律放在一起看就清楚了:三段里只有中间那一段会生成内容,另外两段都是在搬运和整形。配菜台和摆盘工位再精致,菜还是厨师炒的。
2.4 三类模型:分清了才不会用错工位
LangChain 支持的模型分三大类。它们的区别不在聪明程度,而在输入输出的形状:
| 类型 | 输入 | 输出 | 什么时候用 |
|---|---|---|---|
| 对话模型 ChatModel | 带角色的消息列表 | 消息对象 (通常是 AIMessage) | 绝对主力。原生支持多轮、支持角色分工、支持工具调用,新项目一律用它 |
| 文本续写模型 LLM / Text Model | 一个字符串 | 一个字符串 | 只做单次续写。没有角色概念,无法处理复杂对话逻辑,如今基本退场 |
| 嵌入模型 Embedding Model | 文本 | 一串浮点数(向量) | 不生成任何自然语言。做相似度计算、检索、聚类时用 |
# -*- coding: utf-8 -*-
"""
三类模型:对话模型、文本续写模型、嵌入模型
==========================================
它们的差别不在「聪不聪明」,而在输入输出的形状不同,
因此在流水线里站的工位也不同。
"""

import os

from langchain.chat_models import init_chat_model
from langchain.embeddings import init_embeddings
from langchain_core.messages import HumanMessage, SystemMessage

if not os.environ.get("OPENAI_API_KEY"):
    raise SystemExit("请先设置环境变量 OPENAI_API_KEY")

# ---------------------------------------------------------------------------
# 一、对话模型(ChatModel):进消息列表,出消息对象
# 日常开发的绝对主力,本讲后面所有例子都用它。
# ---------------------------------------------------------------------------
chat = init_chat_model("openai:gpt-4o-mini")

messages = [
    SystemMessage(content="你是一位擅长人工智能学科的专家,回答尽量简短"),
    HumanMessage(content="请解释一下什么是机器学习"),
]
reply = chat.invoke(messages)

print(type(reply))        # AIMessage
print(reply.content)      # 文本正文
print(reply.response_metadata.get("finish_reason"))   # 结束原因

# 多轮的本质:把上一轮的 AIMessage 接回列表,再追加新的 HumanMessage。
messages.append(reply)
messages.append(HumanMessage(content="用一个比喻再讲一遍"))
print(chat.invoke(messages).content)

# ---------------------------------------------------------------------------
# 二、文本续写模型(LLM / Text Model):进字符串,出字符串
# 没有角色概念,也不维护对话结构,只做「续写」。
# 现在只在少数老接口上还能见到,新项目一律用对话模型。
# ---------------------------------------------------------------------------
#   from langchain_openai import OpenAI
#   completion = OpenAI()                      # 需要提供方仍然开放这类老接口
#   text = completion.invoke("写一首关于春天的诗")
#   print(type(text))                          # <class 'str'>
#
# 判断标准很简单:
#   需要设定角色、需要多轮、需要工具调用 —— 对话模型;
#   只要单次续写一段文字      —— 续写模型也够用,但没必要。

# ---------------------------------------------------------------------------
# 三、嵌入模型(Embedding Model):进文本,出一串浮点数
# 它不生成任何自然语言,产出的是可以做相似度计算的向量。
# 检索、聚类、去重、推荐都靠它,属于另一条技术线。
# ---------------------------------------------------------------------------
emb = init_embeddings("openai:text-embedding-3-small")

one = emb.embed_query("这是第一个测试文档")
print(len(one), one[:5])          # 向量维度,以及前五个分量

many = emb.embed_documents(["这是第一个测试文档", "这是第二个测试文档"])
print(len(many), len(many[0]))    # 两条文本,各自一个等长向量

# embed_query 与 embed_documents 的区别不只是参数个数:
# 部分提供方会对「查询」和「被检索的文档」用不同的处理方式,
# 所以别用一个方法硬顶两种场景。
2.5 消息:对话模型真正吃进去的东西
对话模型的输入不是一段文本,而是一串带角色的消息。角色决定模型怎么理解这句话:
| 消息类型 | 角色字符串 | 作用 |
|---|---|---|
SystemMessage | system | 定规矩:人设、语气、输出格式要求。通常是列表第一条,整轮不变 |
HumanMessage | human / user | 用户说的话 |
AIMessage | ai / assistant | 模型说过的话。多轮时由你把它接回列表 |
ToolMessage | tool | 工具执行结果的回执,协议层细节在 Function Call 那一讲 |
ChatMessage | 自定义 | 可自定义角色的通用消息,少见 |
# -*- coding: utf-8 -*-
"""
消息类型:对话模型真正吃进去的东西
====================================
对话模型的输入不是一段文本,而是一串带角色的消息。
角色决定了模型怎么理解这句话:是规矩、是提问,还是它自己说过的话。
"""

from langchain.chat_models import init_chat_model
from langchain_core.messages import AIMessage, HumanMessage, SystemMessage

model = init_chat_model("openai:gpt-4o-mini")

# ---------------------------------------------------------------------------
# 三种最常用的消息
# ---------------------------------------------------------------------------
# SystemMessage:定规矩。人设、语气、输出格式要求都写这里,
#                通常放在列表第一条,且整轮对话保持不变。
# HumanMessage :用户说的话。
# AIMessage    :模型说过的话。多轮对话时由你把它接回列表。
messages = [
    SystemMessage(content="你是一位著名的诗人,回答只写诗,不写解释"),
    HumanMessage(content="给我写一首唐诗"),
]

first = model.invoke(messages)
print(first.content)

# 把模型这一轮的回答接回去,再追加新问题,就是第二轮。
messages.append(first)
messages.append(HumanMessage(content="再写一首宋词"))
second = model.invoke(messages)
print(second.content)

# 此时 messages 已经有 4 条。模型能接上第二个问题,
# 不是因为它「记住了」,而是因为整段历史又被完整发了一遍。

# ---------------------------------------------------------------------------
# 另外两种消息,用到时再认
# ---------------------------------------------------------------------------
# ChatMessage:自定义角色,少见。
# ToolMessage:工具执行结果的回执,出现在工具调用场景里,
#              协议层的细节在 Function Call 那一讲。

# ---------------------------------------------------------------------------
# 简写形式:元组或字典
# ---------------------------------------------------------------------------
# 下面三种写法等价,选一种团队内统一即可。
model.invoke([SystemMessage(content="你是翻译助手"), HumanMessage(content="今天天气不错")])
model.invoke([("system", "你是翻译助手"), ("human", "今天天气不错")])
model.invoke([{"role": "system", "content": "你是翻译助手"},
              {"role": "user", "content": "今天天气不错"}])

# ---------------------------------------------------------------------------
# 标准内容块:跨提供方读同一份结构
# ---------------------------------------------------------------------------
# 不同家的响应体字段五花八门,1.x 用 content_blocks 把它们统一成一种结构,
# 推理过程、正文、工具调用请求都能用同一套代码取出来。
resp = model.invoke("简单算一下 1 加 2")
for block in resp.content_blocks:
    print(block["type"])          # 例如 "text"

# content 仍然可以直接当字符串用,简单场景不必动 content_blocks。
print(resp.content)
1.x 还引入了标准内容块 content_blocks:不同提供方的响应字段五花八门,它把推理过程、正文、工具调用请求统一成一种结构,跨模型取值时用同一套代码就够了。简单场景直接用 content 仍然没问题。
2.6 两个参数与一个单位
| 参数 | 管什么 | 怎么定 |
|---|---|---|
temperature | 随机性 | 取值 0 到 1。抽取、分类、写 SQL 这类要求可复现的任务压到 0;起名、写文案才调高到 0.7 以上 |
max_tokens | 这次最多生成多少 | 截的是输出不是输入。设小了句子会被拦腰砍断,finish_reason 会显示 length |
Token 是模型处理文本的最小单位,生成时一个接一个往外吐,每个新 token 都基于前面所有 token 预测——这也是流式输出能一个字一个字显示的原因。粗略换算:1 个中文 token 约 1 到 1.8 个汉字,1 个英文 token 约 3 到 4 个字母。计费和上下文窗口都按它算,所以历史越长,每一轮越贵。
# -*- coding: utf-8 -*-
"""
模型参数与 Token:控制成本与稳定性的两个旋钮
==============================================
参数调不好,表现出来就是「一会儿答得挺好,一会儿胡说八道」,
或者「答到一半突然断了」。这两种现象各有各的原因。
"""

from langchain.chat_models import init_chat_model

# ---------------------------------------------------------------------------
# temperature:随机性。取值越大越发散,越小越稳定。
# ---------------------------------------------------------------------------
# 需要结果可复现、能被下游程序解析(抽字段、写 SQL、做分类)时压到 0;
# 写文案、起名字、头脑风暴这类要多样性的场景才调高。
strict = init_chat_model("openai:gpt-4o-mini", temperature=0)
creative = init_chat_model("openai:gpt-4o-mini", temperature=0.9)

question = "给一家卖手冲咖啡的小店起个名字"
print("稳定档:", strict.invoke(question).content)
print("发散档:", creative.invoke(question).content)

# 同一个问题连问两次,temperature=0 的结果基本一致,0.9 的每次都不一样。

# ---------------------------------------------------------------------------
# max_tokens:这次最多生成多少 token。它截的是「输出」,不是「输入」。
# ---------------------------------------------------------------------------
short = init_chat_model("openai:gpt-4o-mini", max_tokens=20)
reply = short.invoke("详细介绍一下什么是大模型")
print(reply.content)
# 输出会在第 20 个 token 处硬生生断掉,句子可能只说了一半。
print(reply.response_metadata.get("finish_reason"))   # length 表示被截断

# 结论:句子莫名其妙断掉,先看 finish_reason 是不是 length,
# 而不是去怀疑模型「变笨了」。

# ---------------------------------------------------------------------------
# Token 是什么
# ---------------------------------------------------------------------------
# 模型处理文本的最小单位,生成时一个接一个往外吐,
# 每个新 token 都基于前面全部 token 预测出来——这也是流式输出能逐字显示的原因。
#
# 粗略换算:1 个中文 token 约等于 1 到 1.8 个汉字,
#          1 个英文 token 约等于 3 到 4 个字母。
#
# 计费与上下文窗口都按 token 算,所以历史越长、单次越贵。

usage = strict.invoke("你好").usage_metadata
print(usage["input_tokens"], usage["output_tokens"], usage["total_tokens"])

# 想在发请求前就估算长度,可以直接问模型对象:
print(strict.get_num_tokens("这是一句用来数 token 的中文"))
2.7 四种调用方式
LangChain 里的每个组件——模板、模型、解析器——都实现了同一套 Runnable 协议,所以这四个方法在任何组件上用法都一样。这也是下一讲能用一个管道符把它们串起来的前提。
| 方法 | 行为 | 典型场景 |
|---|---|---|
invoke | 单条输入,推理完一次性返回 | 后台任务、抽字段、分类 |
stream | 逐个 token 往外吐 | 面向用户的界面必须用它,否则用户盯着空白等十几秒 |
batch | 多条互不相关的输入并发跑 | 批量处理,返回顺序与输入严格一致 |
ainvoke / astream / abatch | 上面三个的异步版本 | 服务端高并发 |
# -*- coding: utf-8 -*-
"""
四种调用方式:invoke / batch / stream / 异步
=============================================
LangChain 里的每个组件——提示词模板、模型、解析器——都实现了同一套
Runnable 协议,所以这四个方法在任何组件上的用法完全一样。
这也是下一讲能用一个管道符把它们串起来的前提。
"""

import asyncio

from langchain.chat_models import init_chat_model
from langchain_core.messages import HumanMessage, SystemMessage

model = init_chat_model("openai:gpt-4o-mini")

# ---------------------------------------------------------------------------
# 一、invoke:处理单条输入,等模型全部推理完再一次性返回
# ---------------------------------------------------------------------------
reply = model.invoke("请介绍一下你自己")
print(reply.content)
# 体验上像「提交请求,等待结果」:安静几秒,然后整段文字突然出现。
# 做摘要、抽字段、分类这类后台任务,这种方式最简单也最稳。

# ---------------------------------------------------------------------------
# 二、stream:流式,一个 token 一个 token 地往外吐
# ---------------------------------------------------------------------------
print("开始流式输出:")
for chunk in model.stream("写一首关于春天的短诗"):
    print(chunk.content, end="", flush=True)   # flush 保证立刻显示,不进缓冲区
print("\n流式输出结束")
# 每个 chunk 是一小块增量,不是完整答案。
# 聊天界面必须用它,否则用户会盯着空白等十几秒。

# 需要把流式结果同时展示并留存时,一边打印一边拼:
full = ""
for chunk in model.stream("用两句话解释什么是提示词"):
    full += chunk.content
    print(chunk.content, end="", flush=True)
print()
print("完整文本长度:", len(full))

# ---------------------------------------------------------------------------
# 三、batch:一次提交多条互不相关的输入,并发跑
# ---------------------------------------------------------------------------
tasks = [
    [SystemMessage(content="你是一位乐于助人的小助手"), HumanMessage(content="什么是机器学习")],
    [SystemMessage(content="你是一位乐于助人的小助手"), HumanMessage(content="什么是深度学习")],
    [SystemMessage(content="你是一位乐于助人的小助手"), HumanMessage(content="什么是强化学习")],
]
results = model.batch(tasks)
for item in results:
    print(item.content[:40], "...")

# 返回结果的顺序与输入顺序严格一致,可以直接按下标取。
# 注意:batch 是并发不是排队,三条同时打出去,小心提供方的频率限制。
# 需要限制并发数时传配置:
results = model.batch(tasks, config={"max_concurrency": 2})

# ---------------------------------------------------------------------------
# 四、异步版本:ainvoke / abatch / astream
# ---------------------------------------------------------------------------
async def main():
    one = await model.ainvoke("一句话介绍长城")
    print(one.content)

    async for chunk in model.astream("一句话介绍黄河"):
        print(chunk.content, end="", flush=True)
    print()

asyncio.run(main())

# 选择很直白:
#   后台批处理     -> batch
#   面向用户的界面 -> stream
#   服务端高并发   -> 异步版本
#   其余           -> invoke
03最小代码:先把第一条路走通
十几行跑出第一个回答,再看统一入口到底统一了什么
3.1 环境与密钥
| 项目 | 说明 |
|---|---|
| Python 版本 | 3.10 及以上 |
| 最小依赖 | pip install langchain langchain-openai;接本地模型再加 langchain-ollama |
| 密钥 | 放环境变量 OPENAI_API_KEY;走代理网关时再加 OPENAI_BASE_URL |
| 虚拟环境 | 一个项目一个环境,避免不同项目的依赖互相顶撞 |
export OPENAI_API_KEY="sk-...",代码里 os.environ.get("OPENAI_API_KEY")。不要硬编码进源码,更不要把写着密钥的 .env 提交进版本库——这是排在第一位的事故来源,而且泄露之后是按别人花掉的 token 收费。
3.2 第一段代码
整段代码只做三件事:取密钥、拿模型、调一次。注意最后打印出来的不是字符串而是一个消息对象——这是后面所有解析工作的起点。
# -*- coding: utf-8 -*-
"""
LangChain 1.x 的第一段代码:一次最短的问答
==========================================
这段代码做的事只有三件:
  1. 从环境变量里取密钥;
  2. 用统一入口 init_chat_model 拿到一个对话模型;
  3. invoke 一次,把模型返回的消息打印出来。

整段代码里没有任何一处在「生成文本」——生成是模型那一侧的事,
LangChain 只负责把请求组织好、把响应包成统一的消息对象。
"""

import os

from langchain.chat_models import init_chat_model

# 密钥一律走环境变量,不要写进源码,更不要提交进版本库。
# 终端里先执行:export OPENAI_API_KEY="sk-..."
if not os.environ.get("OPENAI_API_KEY"):
    raise SystemExit("请先设置环境变量 OPENAI_API_KEY")

# 如果走的是代理网关或第三方兼容端点,再额外设置 OPENAI_BASE_URL。
# init_chat_model 会把这两个环境变量透传给底层的 langchain-openai。
BASE_URL = os.environ.get("OPENAI_BASE_URL")

# "openai:gpt-4o-mini" 是 "提供方:模型名" 的写法。
# 换成 "ollama:qwen3:8b" 就切到本地模型,下面的代码一行都不用改。
model = init_chat_model(
    "openai:gpt-4o-mini",
    temperature=0.7,     # 随机性,0 最稳定,越大越发散
    max_tokens=512,      # 限制这次最多生成多少 token,防止跑飞
)

# invoke 接受字符串,也接受消息列表;这里给最简单的字符串。
response = model.invoke("用一句话解释什么是大模型")

# 返回的是一个 AIMessage 对象,而不是裸字符串。
print(type(response))          # <class 'langchain_core.messages.ai.AIMessage'>
print(response.content)        # 真正的文本内容

# 除了正文,响应里还带着用量信息,做成本核算时很有用。
print(response.usage_metadata)  # {'input_tokens': 12, 'output_tokens': 37, ...}

# 一个容易被忽略的事实:上面这次调用是无状态的。
# 再问一次「刚才我问了什么」,模型答不上来——它没有记忆,
# 所谓的多轮对话全靠你每轮把历史一起发过去。
3.3 统一入口 init_chat_model
1.x 把「拿到一个对话模型」这件事收敛到了 langchain.chat_models 的 init_chat_model。它的价值不在少写几行,而在于把「用哪家模型」从代码问题降级成配置问题:
| 写法 | 形态 | 什么时候用 |
|---|---|---|
| 一个字符串 | init_chat_model("openai:gpt-4o-mini") | 日常首选。换本地模型改成 "ollama:qwen3:8b" 即可 |
| 分开传 | init_chat_model(name, model_provider=...) | 模型名来自配置文件或环境变量 |
| 运行时可切 | configurable_fields + with_config | 同一份代码里比较多个模型,或让用户自己选 |
| 直接构造类 | ChatOpenAI(...) / ChatOllama(...) | 要用某家独有的参数时更直白 |
# -*- coding: utf-8 -*-
"""
统一入口 init_chat_model:换模型只改一个字符串
================================================
LangChain 1.x 把「拿到一个对话模型」这件事收敛到了 langchain.chat_models
里的 init_chat_model。它的价值不在于少写几行,而在于:
把「用哪家模型」从代码问题降级成配置问题。
"""

import os

from langchain.chat_models import init_chat_model

# ---------------------------------------------------------------------------
# 写法一:一个字符串同时指定提供方与模型名,格式是 "提供方:模型名"
# ---------------------------------------------------------------------------
gpt = init_chat_model("openai:gpt-4o-mini", temperature=0)

# 换成本地 Ollama 拉起来的模型,只改这一个字符串。
# 前提是装了伙伴包 langchain-ollama,并且 ollama 服务已经在跑。
local = init_chat_model("ollama:qwen3:8b", temperature=0)

# ---------------------------------------------------------------------------
# 写法二:提供方与模型名分开传,适合模型名来自配置文件的场景
# ---------------------------------------------------------------------------
model_name = os.environ.get("CHAT_MODEL", "gpt-4o-mini")
provider = os.environ.get("CHAT_PROVIDER", "openai")

chat = init_chat_model(model_name, model_provider=provider, temperature=0.3)

# ---------------------------------------------------------------------------
# 写法三:运行时才决定用哪个模型
# configurable_fields 声明哪些字段允许在调用时改写,
# 之后用 with_config 就能在同一份代码里切换模型,不用重新构造对象。
# ---------------------------------------------------------------------------
switchable = init_chat_model(
    temperature=0,
    configurable_fields=("model", "model_provider"),
)

answer_a = switchable.with_config(
    configurable={"model": "gpt-4o-mini", "model_provider": "openai"}
).invoke("一句话介绍你自己")

answer_b = switchable.with_config(
    configurable={"model": "qwen3:8b", "model_provider": "ollama"}
).invoke("一句话介绍你自己")

print("云端模型:", answer_a.content)
print("本地模型:", answer_b.content)

# ---------------------------------------------------------------------------
# 为什么能统一?因为 init_chat_model 返回的对象都实现了同一套 Runnable 协议:
# invoke / batch / stream 以及对应的异步方法。
# 上层代码只依赖这套协议,不依赖某一家的 SDK 细节。
# ---------------------------------------------------------------------------
for chunk in gpt.stream("数三个数"):
    print(chunk.content, end="", flush=True)
print()

# 直接构造伙伴包里的类也完全可以,只是把提供方写死在了代码里:
#   from langchain_openai import ChatOpenAI
#   gpt = ChatOpenAI(model="gpt-4o-mini", temperature=0)
#   from langchain_ollama import ChatOllama
#   local = ChatOllama(model="qwen3:8b")
# 需要用到某家独有的参数时,直接构造更直白;其余情况优先用统一入口。
invoke / batch / stream 及其异步版本。上层代码只依赖这套协议,不依赖任何一家的 SDK 细节。后厨换了灶台,前面的工序不用重排——这就是整间中央厨房存在的意义。
04完整案例:把三段真正用起来
菜谱卡怎么写、餐盒怎么装、一条真实需求怎么落地、换成本地厨师怎么办
4.1 菜谱卡:提示词模板
提示词一旦写死,应用就只能回答一个问题。模板的作用是把变化的部分挖成占位符,运行时再填。这一步对应流水线上的配菜台。
4.1.1 PromptTemplate:产出一整段字符串
两种实例化方式效果完全一样:构造方法显式声明变量名,适合模板来自配置、需要校验的场景;from_template() 自动扫出占位符,是日常写法。
# -*- coding: utf-8 -*-
"""
PromptTemplate:把写死的提示词变成可填空的模板
================================================
提示词一旦写死,应用就只能回答一个问题。
模板的作用是把变化的部分挖成占位符,运行时再填进去。
"""

from langchain_core.prompts import PromptTemplate

# ---------------------------------------------------------------------------
# 两种实例化方式,效果完全一样
# ---------------------------------------------------------------------------
# 方式一:构造方法,显式声明变量名,适合模板来自配置、需要校验的场景
template_a = PromptTemplate(
    template="请简要描述{topic}的应用。",
    input_variables=["topic"],
)

# 方式二:from_template,自动从字符串里扫出 {} 占位符,日常写法
template_b = PromptTemplate.from_template("请简要描述{topic}的应用。")

print(template_a.input_variables)   # ['topic']
print(template_b.input_variables)   # ['topic']

# ---------------------------------------------------------------------------
# 填值:format 与 invoke 的区别
# ---------------------------------------------------------------------------
# format 返回字符串,人看着直观,调试时常用。
text = template_b.format(topic="机器学习")
print(type(text), text)             # <class 'str'> 请简要描述机器学习的应用。

# invoke 返回 PromptValue 对象,它能再转成字符串或消息列表,
# 所以能直接接到模型后面组成一条流水线。
value = template_b.invoke({"topic": "机器学习"})
print(type(value))                  # StringPromptValue
print(value.to_string())

# 记一个原则:自己看用 format,往下游传用 invoke。

# ---------------------------------------------------------------------------
# 多变量模板
# ---------------------------------------------------------------------------
review = PromptTemplate.from_template(
    "请评价{product}的优缺点,重点说{aspect1}和{aspect2}。"
)
print(review.format(product="笔记本电脑", aspect1="续航", aspect2="便携性"))

# 漏填任何一个变量都会直接报错,而不是把 {aspect2} 原样发给模型——
# 这正是模板相比字符串拼接的价值:错误在本地暴露,不会浪费一次调用。

# ---------------------------------------------------------------------------
# 部分变量:先固定一半,剩下的运行时再填
# ---------------------------------------------------------------------------
# 适合「角色、语气、输出格式」这类整轮不变的内容。
full = PromptTemplate.from_template(
    "你是一个{role},请用{style}的风格回答:\n问题:{question}\n答案:"
)

fixed = full.partial(role="资深厨师", style="专业但幽默")
print(fixed.format(question="如何煎牛排?"))     # 只需要再传 question

# 也可以在构造时就声明:
fixed2 = PromptTemplate(
    template="请评价{product}的优缺点,重点说{aspect1}和{aspect2}。",
    input_variables=["product"],
    partial_variables={"aspect1": "电池", "aspect2": "屏幕"},
)
print(fixed2.format(product="笔记本电脑"))

# ---------------------------------------------------------------------------
# 从文件加载模板
# ---------------------------------------------------------------------------
# 模板长到几十行时写在代码里很难维护,可以放进 yaml 或 json 单独管理,
# 好处是能单独做版本控制、能让非开发同事参与修改。
#   from langchain_core.prompts import load_prompt
#   prompt = load_prompt("asset/prompt.yaml", encoding="utf-8")
#   print(prompt.format(name="年轻人", what="滑稽"))
| 方法 | 返回类型 | 什么时候用 |
|---|---|---|
format() | str | 自己肉眼检查、打日志 |
invoke() | PromptValue | 往下游传。能再转字符串或消息列表,也能接进流水线 |
{aspect2} 原样发给模型,白白烧掉一次调用还拿回一段莫名其妙的回答。错误在本地暴露,永远好过在账单上暴露。
部分变量是个很实用的机制:角色、语气、输出格式说明这些整轮不变的内容,可以先用 partial() 固定下来,调用处只传真正变化的那一个。后面输出解析器那一节会再用到它。
4.1.2 ChatPromptTemplate:产出带角色的消息列表
对话模型吃的是消息列表,所以日常用得最多的是这个。列表里每个元素是 (角色, 内容) 的元组:
# -*- coding: utf-8 -*-
"""
ChatPromptTemplate:给多角色对话用的模板
=========================================
PromptTemplate 产出的是一整段字符串,ChatPromptTemplate 产出的是
一串带角色的消息。对话模型用后者,日常开发用得最多的也是后者。
"""

from langchain.chat_models import init_chat_model
from langchain_core.prompts import ChatPromptTemplate

# ---------------------------------------------------------------------------
# 两种实例化方式
# ---------------------------------------------------------------------------
# 列表里每个元素是 (角色, 内容) 的元组,角色写 "system" / "human" / "ai"。
chat_template = ChatPromptTemplate([
    ("system", "你是一个AI开发工程师,你的名字是{name}。"),
    ("human", "你能开发哪些AI应用?"),
    ("ai", "我能开发聊天机器人、图像识别、自然语言处理等应用。"),
    ("human", "{user_input}"),
])

# from_messages 的效果完全一样,只是写法更常见:
chat_template = ChatPromptTemplate.from_messages([
    ("system", "你是一个AI开发工程师,你的名字是{name}。"),
    ("human", "你能开发哪些AI应用?"),
    ("ai", "我能开发聊天机器人、图像识别、自然语言处理等应用。"),
    ("human", "{user_input}"),
])

# 注意中间那两条 human / ai:它们不是真实发生过的对话,
# 而是写死在模板里的样例,用来给模型示范该怎么答。

# ---------------------------------------------------------------------------
# 三种填值方式,返回类型各不相同
# ---------------------------------------------------------------------------
# format:返回一整段字符串,各角色被拼成 "System: ... Human: ..." 的形式。
#         只适合肉眼检查,不要拿去喂对话模型。
as_text = chat_template.format(name="小智", user_input="你能帮我做什么?")
print(type(as_text))            # <class 'str'>
print(as_text)

# format_messages:返回消息对象列表,可以直接交给模型。
as_messages = chat_template.format_messages(name="小智", user_input="你能帮我做什么?")
print(type(as_messages), len(as_messages))    # <class 'list'> 4
print(as_messages[0])                          # SystemMessage(...)

# invoke:返回 ChatPromptValue,能再转字符串或消息列表,
#         也是能接进流水线的那一种。
as_value = chat_template.invoke({"name": "小智", "user_input": "你能帮我做什么?"})
print(type(as_value))                          # ChatPromptValue
print(len(as_value.messages))                  # 4

# 日常取舍:要拿去调模型就用 format_messages 或 invoke,
#           要打印出来看就用 format。

# ---------------------------------------------------------------------------
# 接上模型
# ---------------------------------------------------------------------------
model = init_chat_model("openai:gpt-4o-mini")

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是{product}的客服助手,你的名字叫{name},回答不超过两句话"),
    ("human", "{query}"),
])

messages = prompt.format_messages(product="一家咖啡店", name="小豆", query="你是谁")
print(model.invoke(messages).content)

# 这两步——格式化、调用——就是模型输入输出的前两段。
# 第三段解析在 output_parser_str_json.py 里;
# 至于怎么把三段接成一条流水线,是下一讲的事。

# ---------------------------------------------------------------------------
# 一个必须绕开的坑:花括号
# ---------------------------------------------------------------------------
# 模板里的 {} 一律被当成占位符。想在提示词里写出真正的花括号,要写两个。
literal = ChatPromptTemplate.from_messages([
    ("system", "请严格按这个结构返回:{{\"姓名\": \"\", \"年龄\": 0}}"),
    ("human", "{query}"),
])
print(literal.format_messages(query="介绍一下李雷"))
| 方法 | 返回类型 | 说明 |
|---|---|---|
format() | str | 各角色被拼成一整段文本,只适合肉眼检查,别拿去喂对话模型 |
format_messages() | list | 推荐。返回消息对象列表,直接交给模型 |
invoke() | ChatPromptValue | 能接进流水线,也能再转成消息列表 |
模板里写死的那几条 human / ai 消息值得留意:它们不是真实发生过的对话,而是给模型看的示范——这正好引出下面的少样本。
4.1.3 MessagesPlaceholder:给消息列表留一个坑
普通占位符填的是一段文字,数量固定;但对话历史有几条是运行时才知道的,可能 0 条也可能 20 条。MessagesPlaceholder 就是为「填进来的是一串消息」准备的。
# -*- coding: utf-8 -*-
"""
MessagesPlaceholder:在模板中间留一个放消息列表的坑
=====================================================
模板里的普通占位符填的是一段文字,数量固定。
但对话历史的条数是运行时才知道的——可能 0 条,也可能 20 条。
MessagesPlaceholder 就是为这种「填进来的是一串消息」而准备的。
"""

from langchain.chat_models import init_chat_model
from langchain_core.messages import AIMessage, HumanMessage
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder

# ---------------------------------------------------------------------------
# 基本用法
# ---------------------------------------------------------------------------
prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一位乐于助人的助手"),
    MessagesPlaceholder("history"),     # 这里会被展开成任意多条消息
    ("human", "{question}"),
])

# 传空历史:结果是 2 条消息(系统 + 当前提问)
print(len(prompt.format_messages(history=[], question="你好")))

# 传两条历史:结果是 4 条
history = [
    HumanMessage(content="1+2*3 等于几?"),
    AIMessage(content="等于 7"),
]
messages = prompt.format_messages(history=history, question="我刚才问的是什么?")
for m in messages:
    print(type(m).__name__, "|", m.content)

# 输出顺序是:系统消息 → 历史两条 → 当前提问。
# 位置由 MessagesPlaceholder 在模板里的位置决定,不会乱序。

# ---------------------------------------------------------------------------
# 接上模型:这就是「多轮对话」最朴素的实现
# ---------------------------------------------------------------------------
model = init_chat_model("openai:gpt-4o-mini")

chat_history = []          # 自己维护的一个列表

def ask(question):
    """问一轮,并把这一轮的问答塞回历史。"""
    msgs = prompt.format_messages(history=chat_history, question=question)
    answer = model.invoke(msgs)
    chat_history.append(HumanMessage(content=question))
    chat_history.append(answer)
    return answer.content

print(ask("我叫李雷,今年 18 岁"))
print(ask("我多大了?"))     # 模型答得上来,因为上一轮被重新发过去了

# 请注意这里发生了什么:模型没有任何记忆,
# 它能答出年龄,纯粹是因为 chat_history 里的两条消息又被完整发了一遍。
# 历史越长,每轮请求越贵——怎么裁剪、怎么摘要、怎么按会话隔离,
# 是后面「会话记忆」那一讲的正题。

# ---------------------------------------------------------------------------
# 可选占位:允许这一项不传
# ---------------------------------------------------------------------------
optional = ChatPromptTemplate.from_messages([
    ("system", "你是一位乐于助人的助手"),
    MessagesPlaceholder("history", optional=True),
    ("human", "{question}"),
])
print(len(optional.format_messages(question="你好")))   # 不传 history 也不报错
chat_history 里的两条消息又被完整发了一遍。历史越长每轮越贵——怎么裁剪、怎么摘要、怎么按会话隔离,是「会话记忆」那一讲的正题,这里只把「坑留在哪」讲清楚。
4.1.4 少样本:不给规则,只给例子
直接提要求叫零样本,先给几个示范再提要求叫少样本。当你发现「怎么说它都不按格式来」的时候,少样本往往比把规则写得更长更管用。
# -*- coding: utf-8 -*-
"""
少样本提示:不给规则,只给例子
================================
直接提要求叫零样本(zero-shot),先给几个示范再提要求叫少样本(few-shot)。
当你发现「怎么说它都不按格式来」的时候,少样本往往比把规则写得更长更管用。
"""

from langchain.chat_models import init_chat_model
from langchain_core.prompts import (ChatPromptTemplate,
                                    FewShotChatMessagePromptTemplate,
                                    FewShotPromptTemplate, PromptTemplate)

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

# ---------------------------------------------------------------------------
# 先看零样本会怎么翻车
# ---------------------------------------------------------------------------
print(model.invoke("北京天气怎么样").content)
# 模型会长篇大论地解释它查不到实时天气。
# 但假设我们只想从这句话里抽出城市名,上面这个回答毫无用处。

# ---------------------------------------------------------------------------
# 一、FewShotPromptTemplate:拼一整段字符串提示词
# ---------------------------------------------------------------------------
# 第一步:写清楚「单个示例长什么样」
example_prompt = PromptTemplate.from_template("输入:{input}\n输出:{output}")

# 第二步:准备示例集合,每个示例是一个字典,键与上面的变量名一一对应
examples = [
    {"input": "北京天气怎么样", "output": "北京市"},
    {"input": "南京下雨吗", "output": "南京市"},
    {"input": "武汉热吗", "output": "武汉市"},
]

# 第三步:组装。prefix 放在所有示例前面,suffix 放在最后,留出真正的提问
few_shot = FewShotPromptTemplate(
    examples=examples,
    example_prompt=example_prompt,
    prefix="从下面这句话里提取城市名,只回答城市名。",
    suffix="输入:{input}\n输出:",
    input_variables=["input"],
)

prompt_text = few_shot.format(input="长沙多少度")
print(prompt_text)
# 渲染出来是:说明 + 三组示范 + 待回答的那一条,末尾停在「输出:」等着模型接话。

print(model.invoke(prompt_text).content)     # 长沙市

# 三个例子就把输出格式钉死了,而且一个字的规则都没写。

# ---------------------------------------------------------------------------
# 二、FewShotChatMessagePromptTemplate:把示例摊成多轮消息
# ---------------------------------------------------------------------------
# 对话模型更吃这一套:示例被展开成一问一答的消息对,像是真的聊过。
example_messages = ChatPromptTemplate.from_messages([
    ("human", "{input}"),
    ("ai", "{output}"),
])

few_shot_chat = FewShotChatMessagePromptTemplate(
    examples=examples,
    example_prompt=example_messages,
)

final = ChatPromptTemplate.from_messages([
    ("system", "你负责从用户的话里提取城市名,只回答城市名。"),
    few_shot_chat,                  # 三组示范会在这里展开成 6 条消息
    ("human", "{input}"),
])

msgs = final.format_messages(input="长沙多少度")
print(len(msgs))                    # 1 条系统 + 6 条示范 + 1 条提问 = 8
print(model.invoke(msgs).content)

# ---------------------------------------------------------------------------
# 用几个例子合适
# ---------------------------------------------------------------------------
# 2 到 5 个通常就够。例子太多有两个副作用:
#   一是每轮都要把它们重新发一遍,token 成本线性上涨;
#   二是例子覆盖面不均时,模型会被带偏到某一类上去。
# 例子的质量比数量重要:优先挑边界情况,别全是最典型的那种。
| 模板 | 示例呈现方式 | 适用 |
|---|---|---|
FewShotPromptTemplate | 拼成一整段文字 | 文本续写模型,或需要精确控制排版时 |
FewShotChatMessagePromptTemplate | 展开成一问一答的消息对 | 对话模型首选,示例看起来像真聊过 |
用几个例子合适?2 到 5 个通常就够。例子太多有两个副作用:每轮都要重发一遍,token 成本线性上涨;覆盖面不均时模型会被带偏到某一类上去。例子的质量比数量重要,优先挑边界情况,别全是最典型的那种。
4.2 摆盘装盒:输出解析器
模型返回的是消息对象,正文是一段自然语言;但下游代码要的往往是一个字符串、一个字典、一个列表。解析器干的就是这步转换,顺带还能反过来约束模型该怎么输出。
# -*- coding: utf-8 -*-
"""
输出解析器:把模型的话变成程序能用的数据
==========================================
模型返回的是消息对象,正文是一段自然语言。
但下游代码要的往往是一个字符串、一个字典、一个列表。
解析器干的就是这一步转换,顺带还能反过来约束模型该怎么输出。
"""

from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import (CommaSeparatedListOutputParser,
                                           JsonOutputParser, StrOutputParser)
from langchain_core.prompts import ChatPromptTemplate, PromptTemplate

model = init_chat_model("openai:gpt-4o-mini", temperature=0)

# ---------------------------------------------------------------------------
# 一、StrOutputParser:只把正文抠出来
# ---------------------------------------------------------------------------
raw = model.invoke("把这句话翻译成中文:It's a nice day today")
print(type(raw))            # AIMessage,带一堆用量与元信息

parser = StrOutputParser()
text = parser.invoke(raw)
print(type(text), text)     # <class 'str'> 今天天气不错。

# 它做的事等价于 raw.content,价值在于「它也是一个 Runnable」——
# 能作为流水线的最后一节挂上去,让整条链的输出类型稳定是字符串。

# ---------------------------------------------------------------------------
# 二、JsonOutputParser:要结构化数据
# ---------------------------------------------------------------------------
json_parser = JsonOutputParser()

# 关键在 get_format_instructions():它生成一段说明书,告诉模型该怎么排版输出。
# 把这段说明塞进提示词,模型才会乖乖返回 JSON。
print(json_parser.get_format_instructions())

prompt = PromptTemplate(
    template="回答用户的问题。\n{format_instructions}\n{query}\n",
    input_variables=["query"],
    partial_variables={"format_instructions": json_parser.get_format_instructions()},
)

resp = model.invoke(prompt.format(query="讲一个笑话,问题用 q 表示,答案用 a 表示"))
data = json_parser.invoke(resp)
print(type(data), data)     # <class 'dict'> {'q': '...', 'a': '...'}
print(data["a"])            # 可以直接按键取值

# 解析器还顺手擦了屁股:模型常常把 JSON 包在代码块标记里,
# 直接 json.loads 会报错,JsonOutputParser 会先把这层壳剥掉。

# ---------------------------------------------------------------------------
# 三、CommaSeparatedListOutputParser:要一个列表
# ---------------------------------------------------------------------------
list_parser = CommaSeparatedListOutputParser()

chat_prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一位心理学助手"),
    ("human", "{request}\n{format_instructions}"),
])

msgs = chat_prompt.format_messages(
    request="给我 5 种情绪",
    format_instructions=list_parser.get_format_instructions(),
)
moods = list_parser.invoke(model.invoke(msgs))
print(type(moods), moods)   # <class 'list'> ['快乐', '忧伤', '愤怒', '兴奋', '宁静']

# ---------------------------------------------------------------------------
# 还有哪些解析器
# ---------------------------------------------------------------------------
# XMLOutputParser              要 XML 结构
# DatetimeOutputParser         把回答解析成 datetime 对象
# EnumOutputParser             限定在若干枚举值里选一个
# PydanticOutputParser         解析成 Pydantic 模型实例,带字段校验
# OutputFixingParser           解析失败时,再调一次模型把格式修好
#
# 共同点是它们都实现了 Runnable 协议,所以用法一致,
# 都可以挂在模型后面当流水线的最后一节。
| 解析器 | 产出 | 要点 |
|---|---|---|
StrOutputParser | str | 等价于取 .content,价值在于它也是个 Runnable,能当流水线的最后一节 |
JsonOutputParser | dict | 会先剥掉模型习惯套上的代码块外壳,再解析 |
CommaSeparatedListOutputParser | list | 逗号分隔转列表 |
DatetimeOutputParser | datetime | 把回答解析成日期时间对象 |
PydanticOutputParser | 模型类实例 | 带字段类型校验,见下 |
EnumOutputParser | 枚举值 | 限定只能在若干取值里选一个 |
get_format_instructions()
解析器不是靠猜的。这个方法会生成一段说明书,你把它塞进提示词,模型才知道该按什么格式排版输出。所以解析器实际上管了两头:先约束模型怎么写,再把写出来的东西转成数据。用 partial() 把它固定进模板,是最顺手的写法。
4.2.1 再往前一步:结构化输出
JsonOutputParser 只保证「是一个 JSON」,不保证字段齐、类型对。真要把模型输出接进业务逻辑,得先把「我要什么」用一个类声明清楚:
# -*- coding: utf-8 -*-
"""
结构化输出:让模型的回答带字段校验
====================================
JsonOutputParser 只保证「是一个 JSON」,不保证字段齐、类型对。
真要把模型输出接进业务逻辑,得再往前走一步。
"""

from typing import List

from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import PydanticOutputParser
from langchain_core.prompts import ChatPromptTemplate
from pydantic import BaseModel, Field

model = init_chat_model("openai:gpt-4o-mini", temperature=0)


# ---------------------------------------------------------------------------
# 先把「我要什么」用一个类声明清楚
# ---------------------------------------------------------------------------
class Book(BaseModel):
    """一本书的基本信息。"""

    title: str = Field(description="书名")
    author: str = Field(description="作者姓名")
    year: int = Field(description="出版年份,四位数字")
    tags: List[str] = Field(description="三个主题标签")


# description 不是写给同事看的注释,模型会读它来决定每个字段填什么,
# 写含糊了,字段就容易填错或者空着。

# ---------------------------------------------------------------------------
# 方式一:PydanticOutputParser
# ---------------------------------------------------------------------------
parser = PydanticOutputParser(pydantic_object=Book)

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个图书信息助手。\n{format_instructions}"),
    ("human", "介绍一下《三体》"),
]).partial(format_instructions=parser.get_format_instructions())

book = parser.invoke(model.invoke(prompt.format_messages()))
print(type(book))          # <class '__main__.Book'>
print(book.title, book.year, book.tags)

# 拿到的是一个真正的对象,可以点出字段,类型也已经被校验过:
# year 如果模型返回了 "一九九一年" 这种字符串,这一步就会直接报错,
# 而不是等到下游做减法时才炸。

# ---------------------------------------------------------------------------
# 方式二:with_structured_output,把约束下沉到模型层
# ---------------------------------------------------------------------------
structured = model.with_structured_output(Book)
book2 = structured.invoke("介绍一下《活着》")
print(book2.author, book2.tags)

# 两者的差别值得记一下:
#   PydanticOutputParser  靠提示词说服模型排版,任何模型都能用,
#                         但模型不听话时就得靠 OutputFixingParser 兜底。
#   with_structured_output 由提供方在协议层保证结构,可靠得多,
#                         前提是这家模型支持结构化输出或工具调用。
# 能用后者就用后者;接的是本地小模型或老接口,再退回前者。

# ---------------------------------------------------------------------------
# 解析失败怎么办
# ---------------------------------------------------------------------------
# 不要直接把 parser.invoke 裸放在生产路径上,至少包一层:
try:
    result = parser.invoke(model.invoke(prompt.format_messages()))
except Exception as exc:
    print("解析失败,走降级路径:", exc)
    result = None

# 需要自动修复时用 OutputFixingParser,它会把出错的原文连同报错一起
# 再发给模型,让模型自己改对——代价是多一次调用:
#   from langchain_classic.output_parsers import OutputFixingParser
#   safe = OutputFixingParser.from_llm(parser=parser, llm=model)
| 路线 | 靠什么保证结构 | 取舍 |
|---|---|---|
PydanticOutputParser | 提示词里的格式说明 | 任何模型都能用;模型不听话时要靠 OutputFixingParser 兜底(它在 langchain-classic 里) |
with_structured_output | 提供方在协议层保证 | 可靠得多,前提是这家模型支持结构化输出或工具调用 |
选择很直白:能用后者就用后者;接的是本地小模型或老接口,再退回前者。注意字段的 description 是写给模型读的,不是写给同事看的注释——写含糊了,字段就容易填错或者空着。
4.3 落地案例:把一条商品评论拆成结构化字段
场景:电商后台每天收上来几万条评论,运营要的不是原文,而是情感倾向、涉及哪些方面、要不要人工跟进这三样能进报表的字段。这条路径把三段完整走了一遍。
# -*- coding: utf-8 -*-
"""
完整案例:把一条商品评论拆成结构化字段
========================================
场景:电商后台每天收上来几万条评论,运营要的不是原文,
而是「情感倾向、涉及哪些方面、要不要人工跟进」这三样能进报表的字段。

这条路径把模型输入输出的三段走了一遍:
  格式化(把评论塞进模板) → 预测(调模型) → 解析(转成对象)
"""

import os
from typing import List, Literal

from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import PydanticOutputParser
from langchain_core.prompts import ChatPromptTemplate
from pydantic import BaseModel, Field

if not os.environ.get("OPENAI_API_KEY"):
    raise SystemExit("请先设置环境变量 OPENAI_API_KEY")


# ---------------------------------------------------------------------------
# 第一步:把「要什么」声明清楚
# ---------------------------------------------------------------------------
class ReviewInsight(BaseModel):
    """一条评论的结构化结论。"""

    sentiment: Literal["正面", "负面", "中性"] = Field(description="整体情感倾向")
    aspects: List[str] = Field(description="评论涉及的方面,如 物流、包装、续航、客服")
    complaint: str = Field(description="用户抱怨的核心问题,没有抱怨则填写 无")
    need_followup: bool = Field(description="是否需要人工跟进,涉及退换货或投诉时为真")


parser = PydanticOutputParser(pydantic_object=ReviewInsight)

# ---------------------------------------------------------------------------
# 第二步:格式化。系统消息定规矩,少量示范钉死口径
# ---------------------------------------------------------------------------
prompt = ChatPromptTemplate.from_messages([
    ("system",
     "你是电商评论分析助手。只依据评论原文判断,不要脑补没写的内容。\n"
     "{format_instructions}"),
    ("human", "评论:手机很好用,就是快递等了五天,包装也压扁了。"),
    ("ai",
     '{{"sentiment": "中性", "aspects": ["物流", "包装"], '
     '"complaint": "快递慢且包装破损", "need_followup": false}}'),
    ("human", "评论:{review}"),
]).partial(format_instructions=parser.get_format_instructions())

# 注意示范那条 ai 消息里的双花括号:模板会把 {} 当占位符,
# 想输出真正的花括号必须写两个。

# ---------------------------------------------------------------------------
# 第三步:预测 + 解析
# ---------------------------------------------------------------------------
model = init_chat_model("openai:gpt-4o-mini", temperature=0)


def analyze(review: str) -> ReviewInsight:
    """把一条评论转成结构化结论。"""
    messages = prompt.format_messages(review=review)
    response = model.invoke(messages)          # 预测:拿回 AIMessage
    return parser.invoke(response)             # 解析:转成 ReviewInsight 对象


one = analyze("用了两周电池掉得飞快,申请换货客服一直不回,太失望了。")
print(one.sentiment)        # 负面
print(one.aspects)          # ['续航', '客服']
print(one.need_followup)    # True

# ---------------------------------------------------------------------------
# 批量处理:一次提交多条,并发跑
# ---------------------------------------------------------------------------
reviews = [
    "屏幕清晰,手感也好,价格算是同级里厚道的。",
    "发货倒是快,可是收到就是划痕机,要求退货。",
    "还行吧,没什么特别的感觉。",
]

batch_messages = [prompt.format_messages(review=r) for r in reviews]
responses = model.batch(batch_messages, config={"max_concurrency": 3})

for text, resp in zip(reviews, responses):
    try:
        item = parser.invoke(resp)
    except Exception as exc:                   # 模型偶尔会输出不合规的结构
        print("解析失败,转人工:", text[:12], exc)
        continue
    flag = "需跟进" if item.need_followup else "无需跟进"
    print(f"{item.sentiment} | {'、'.join(item.aspects)} | {flag}")

# ---------------------------------------------------------------------------
# 几个让这段代码能上生产的细节
# ---------------------------------------------------------------------------
# 1. temperature 必须压到 0。这是抽取任务,同一条评论每次都该得到同样的结论。
# 2. 解析一定要包 try:模型不是接口,它没有义务保证结构合法。
# 3. 失败的那条要能落到人工队列,别静默丢掉。
# 4. 字段的 description 是给模型读的,「涉及的方面」写得越具体,分类越稳。
输出长这样:负面 | 续航、客服 | 需跟进——每个字段都能直接进数据库、直接做聚合,不需要任何后处理。
temperature 必须压到 0,同一条评论每次都该得到同样的结论;② 解析一定要包 try——模型不是接口,它没有义务保证结构合法;
③ 失败的那条要能落到人工队列,别静默丢掉;
④ 示范那条
ai 消息里的花括号要写两个,否则会被当成占位符。
4.4 换成本地厨师:接 Ollama
数据不能出内网、想省掉按 token 计费、需要离线演示——这三种情况下都会把模型换成本地部署。对上层代码来说,换的只是一个名字。
# -*- coding: utf-8 -*-
"""
接本地私有模型:Ollama
========================
数据不能出内网、想省掉按 token 计费、需要离线演示——这三种情况下
都会把模型换成本地部署。对上层代码来说,换的只是一个名字。

准备工作(一次性):
  1. 装 Ollama:Linux 执行 curl -fsSL https://ollama.com/install.sh | sh
  2. 拉模型并跑起来:ollama run qwen3:8b
  3. 装伙伴包:pip install langchain-ollama
"""

from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_ollama import ChatOllama, OllamaEmbeddings

# ---------------------------------------------------------------------------
# 写法一:还是统一入口,只换提供方
# ---------------------------------------------------------------------------
model = init_chat_model("ollama:qwen3:8b", temperature=0)
print(model.invoke("你好,请介绍一下你自己").content)

# ---------------------------------------------------------------------------
# 写法二:直接构造伙伴包里的类,需要用 Ollama 特有参数时用它
# ---------------------------------------------------------------------------
local = ChatOllama(
    model="qwen3:8b",
    temperature=0,
    base_url="http://127.0.0.1:11434",   # 服务不在本机默认端口时才需要指定
)

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个翻译助手,把{input_language}翻译成{output_language},只输出译文"),
    ("human", "{text}"),
])

messages = prompt.format_messages(input_language="中文", output_language="英语", text="我爱编程")
print(local.invoke(messages).content)

# 注意:整个提示词模板、消息结构、解析器一个字都没改。
# 这正是统一接口的意义——后厨换了灶台,前面的工序不用重排。

# ---------------------------------------------------------------------------
# 本地嵌入模型
# ---------------------------------------------------------------------------
emb = OllamaEmbeddings(model="bge-m3")
vector = emb.embed_query("这是第一个测试文档")
print(len(vector))          # 向量维度,由模型决定

# ---------------------------------------------------------------------------
# 三个实际会踩到的差异
# ---------------------------------------------------------------------------
# 1. 带思考过程的模型(例如 deepseek-r1)会先吐一段推理再给答案,
#    直接拿 content 会把推理也带上。1.x 里可以按内容块类型挑出正文:
resp = local.invoke("1 加 1 等于几")
for block in resp.content_blocks:
    if block["type"] == "text":
        print(block["text"])

# 2. 本地小模型对格式要求的遵从度明显低于云端大模型,
#    JSON 解析失败的概率更高,少样本示例和解析失败兜底更有必要。
#
# 3. 首次调用要把模型权重读进显存,会慢十几秒,别误判成程序卡死。

# ---------------------------------------------------------------------------
# 旧写法提示
# ---------------------------------------------------------------------------
# 早期资料里的 from langchain_community.llms import Ollama 与
# from langchain_community.chat_models import ChatOllama 仍能跑,
# 但官方伙伴包 langchain-ollama 才是现在的推荐入口,功能跟进也更快。

chain_style_output = StrOutputParser().invoke(local.invoke("说一句话"))
print(chain_style_output)
整个提示词模板、消息结构、解析器一个字都没改。这就是统一接口的意义,也是第 01 节那张两条路对比图讲的事。
| 实际会踩到的差异 | 现象与应对 |
|---|---|
| 带思考过程的模型 | 会先吐一段推理再给答案,直接取 content 会把推理带上。按 content_blocks 的类型挑出正文 |
| 格式遵从度低 | 本地小模型解析失败的概率明显更高,少样本示例和失败兜底更有必要 |
| 首次调用很慢 | 要把权重读进显存,慢十几秒是正常的,别误判成程序卡死 |
| 界面怎么搭 | 用 Streamlit 把它包成可交互的对话界面,控件用法在 m4 的本地模型聊天机器人那一讲 |
至于怎么把这一节里的模板、模型、解析器接成一条真正的流水线,而不是像现在这样一步步手动传——那是下一讲 LCEL 的正题。
05骨架模板:拿去改就能用
一份三段式骨架,一份新旧写法换算表
5.1 三段式骨架
把本讲所有例子的共性抽出来,就是这一份:格式化 → 预测 → 解析,外加一层失败兜底。改动点只有五处,都标了 TODO,其余代码不用动。
# -*- coding: utf-8 -*-
"""
骨架模板:模型输入输出三段式,复制改 TODO 即可
===============================================
把本讲所有例子的共性抽出来就是这一份:
  格式化 -> 预测 -> 解析,外加一层失败兜底。

改动点只有五处,都标了 TODO;其余代码不用动。
"""

import os
from typing import List

from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import PydanticOutputParser, StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from pydantic import BaseModel, Field

# ---------------------------------------------------------------------------
# TODO 1:换模型。
#   云端: "openai:gpt-4o-mini"   本地: "ollama:qwen3:8b"
#   抽取、分类这类任务 temperature 一律 0;写文案才调高。
# ---------------------------------------------------------------------------
MODEL_NAME = os.environ.get("CHAT_MODEL", "openai:gpt-4o-mini")
model = init_chat_model(MODEL_NAME, temperature=0)


# ---------------------------------------------------------------------------
# TODO 2:声明你要的结构。
#   每个字段的 description 是写给模型看的,写清楚含义、格式和取值范围。
#   只要一段纯文本的话,把这个类连同下面的 parser 一起删掉,
#   换成 parser = StrOutputParser() 即可。
# ---------------------------------------------------------------------------
class Result(BaseModel):
    """这里写清楚这个结构整体代表什么。"""

    field_a: str = Field(description="字段含义,写明格式与示例")
    field_b: List[str] = Field(description="列表字段,说明元素是什么")
    field_c: bool = Field(description="布尔字段,说明什么情况下为真")


parser = PydanticOutputParser(pydantic_object=Result)
text_parser = StrOutputParser()      # 只要纯文本时改用这个

# ---------------------------------------------------------------------------
# TODO 3:写提示词。
#   system 定身份、定规矩、放格式说明;
#   中间可以插入若干组 human / ai 示范(少样本),不需要就删掉;
#   最后一条 human 留占位符,运行时填真实输入。
# ---------------------------------------------------------------------------
prompt = ChatPromptTemplate.from_messages([
    ("system",
     "你是一个TODO角色。只依据输入内容作答,不要编造没有的信息。\n"
     "{format_instructions}"),
    ("human", "TODO:一条示范输入"),
    ("ai", '{{"field_a": "示范值", "field_b": ["示范"], "field_c": false}}'),
    ("human", "{user_input}"),
]).partial(format_instructions=parser.get_format_instructions())


# ---------------------------------------------------------------------------
# 三段式主流程:格式化 -> 预测 -> 解析
# ---------------------------------------------------------------------------
def run(user_input: str):
    """处理单条输入,解析失败时返回 None 由调用方决定怎么降级。"""
    messages = prompt.format_messages(user_input=user_input)   # 一、格式化
    response = model.invoke(messages)                          # 二、预测
    try:
        return parser.invoke(response)                         # 三、解析
    except Exception as exc:
        print("解析失败:", exc)
        print("模型原文:", response.content[:200])
        return None


def run_many(inputs: List[str]):
    """批量处理。并发数按提供方的频率限制调,别一次打太多。"""
    batch = [prompt.format_messages(user_input=x) for x in inputs]
    responses = model.batch(batch, config={"max_concurrency": 5})
    out = []
    for raw, response in zip(inputs, responses):
        try:
            out.append(parser.invoke(response))
        except Exception:
            out.append(None)                # 失败的位置留空,方便回查是哪一条
    return out


if __name__ == "__main__":
    # TODO 4:换成你的真实输入
    print(run("TODO:这里换成真实的用户输入"))

    # TODO 5:需要流式展示时,把上面的 invoke 换成 stream。
    #   注意:流式与结构化解析不能同时要——没收全的 JSON 解析不了。
    #   界面上要边打字边显示,就只能用纯文本解析器。
    for chunk in model.stream("说一句话"):
        print(chunk.content, end="", flush=True)
    print()
| 改动点 | 怎么改 |
|---|---|
| TODO 1 换模型 | 云端 "openai:gpt-4o-mini",本地 "ollama:qwen3:8b"。抽取分类类任务 temperature 一律 0 |
| TODO 2 声明结构 | 按需要的字段改 Result 类;只要纯文本就删掉它,换 StrOutputParser() |
| TODO 3 写提示词 | system 定身份与规矩并放格式说明,中间插少样本示范(不需要就删),最后一条留占位符 |
| TODO 4 换输入 | 把示例输入换成真实数据 |
| TODO 5 要不要流式 | 界面场景把 invoke 换成 stream |
5.2 新旧写法换算
网上大量示例停留在 0.3 时代,思路依然成立,但导入路径和类名已经变了。照着这张表换算,能省掉大半排错时间:
| 要做的事 | 旧写法 | 现写法 |
|---|---|---|
| 导入提示词模板 | from langchain.prompts import ... | from langchain_core.prompts import ... |
| 导入输出解析器 | from langchain.output_parsers import ... | from langchain_core.output_parsers import ... |
| 拿对话模型 | from langchain_community.chat_models import ChatOllama | init_chat_model("ollama:qwen3:8b") 或伙伴包 langchain_ollama |
| 拿嵌入模型 | from langchain_community.embeddings import OllamaEmbeddings | init_embeddings(...) 或伙伴包 |
| 基础链 | LLMChain(llm=..., prompt=...) | 管道组合 prompt | model | parser(下一讲展开) |
| legacy 链与记忆 | from langchain.chains import LLMChain | from langchain_classic.chains import LLMChain |
| 提示词仓库 | from langchain import hub | from langchain_classic import hub |
| 调模型 | model(messages) | model.invoke(messages) |
# -*- coding: utf-8 -*-
"""
旧写法与现写法:读老资料时怎么换算
====================================
网上大量示例停留在 0.3 时代。它们的思路依然成立,但导入路径和类名
已经变了。这份文件把你最容易撞上的几处放在一起,方便照着改。
"""

# ---------------------------------------------------------------------------
# 一、导入路径:提示词与解析器都在 langchain-core 里
# ---------------------------------------------------------------------------
# 旧:from langchain.prompts import PromptTemplate, ChatPromptTemplate
# 旧:from langchain.prompts.few_shot import FewShotPromptTemplate
# 现:
from langchain_core.output_parsers import JsonOutputParser, StrOutputParser
from langchain_core.prompts import (ChatPromptTemplate, FewShotPromptTemplate,
                                    MessagesPlaceholder, PromptTemplate)

# 判断标准:凡是「不依赖任何具体模型提供方」的基础抽象——
# 运行协议、消息、提示词、工具定义、输出解析器——都归 langchain-core。

# ---------------------------------------------------------------------------
# 二、获取模型:主包给了统一入口
# ---------------------------------------------------------------------------
# 旧:from langchain_community.llms import Ollama
#     model = Ollama(model="qwen3:8b")
# 旧:from langchain_community.chat_models import ChatOllama
# 现:官方伙伴包,或者直接用统一入口
from langchain.chat_models import init_chat_model
from langchain.embeddings import init_embeddings

model = init_chat_model("ollama:qwen3:8b", temperature=0)
emb = init_embeddings("ollama:bge-m3")

# langchain-community 没有消失,它仍然是第三方集成的大仓库;
# 只是常用的那几家已经各自有了官方伙伴包,优先用伙伴包。

# ---------------------------------------------------------------------------
# 三、legacy 链:搬到了 langchain-classic
# ---------------------------------------------------------------------------
# 旧:from langchain.chains import LLMChain
#     chain = LLMChain(llm=model, prompt=prompt)
#     chain.run(topic="春天")
#
# 这些类没有从世界上消失,它们搬到了 langchain-classic:
#     from langchain_classic.chains import LLMChain
#
# 但它们不再是推荐写法。现在组合组件靠的是管道符——
# 怎么串、串出来是什么、为什么这么设计,是下一讲的正题。
prompt = PromptTemplate.from_template("写一句关于{topic}的话")
chain = prompt | model | StrOutputParser()
print(chain.invoke({"topic": "春天"}))

# 同样搬进 langchain-classic 的还有:
#   ConversationChain、ConversationBufferMemory 等会话记忆相关的类
#   MultiQueryRetriever 等检索器
#   indexing API、hub 模块、缓存嵌入辅助类
#   from langchain import hub  ->  from langchain_classic import hub

# ---------------------------------------------------------------------------
# 四、主包 1.x 还留着什么
# ---------------------------------------------------------------------------
# langchain.agents      create_agent、AgentState
# langchain.messages    消息类型、内容块、trim_messages
# langchain.tools       tool 装饰器、BaseTool
# langchain.chat_models init_chat_model、BaseChatModel
# langchain.embeddings  init_embeddings、Embeddings
#
# 换句话说:主包现在只管「搭认知架构」这一件事,其余都下沉或外移了。

# ---------------------------------------------------------------------------
# 五、还有一处小陷阱
# ---------------------------------------------------------------------------
# 老代码里能见到 model(messages) 这种把模型对象当函数调的写法,
# 它走的是内部的兼容入口,最终还是转到 invoke。新代码一律写 invoke。
resp = model.invoke("你好")
print(resp.content)

# 版本查验永远比猜测靠谱:
#   import langchain, langchain_core
#   print(langchain.__version__, langchain_core.__version__)
不依赖(运行协议、消息、提示词、工具定义、输出解析器)→
langchain-core;依赖某一家 → 伙伴包或
langchain-community;是搭认知架构用的(智能体、统一入口)→ 主包
langchain;是几年前流行、现在不推荐的 →
langchain-classic。
版本查验永远比猜测靠谱:import langchain, langchain_core 之后打印 __version__,比对着文档看当前这套 API 长什么样,比在搜索结果里翻哪一篇最新要快得多。
06易错点汇总
按「认知 / 环境与版本 / 模板 / 模型调用 / 解析 / 本地模型」六类归并
⚠️ 一、认知层面
- 把框架当成模型。
pip install langchain不会给你任何模型,它一个 token 也不生成。装完还得接云端接口或本地部署,前者要密钥要花钱,后者要显卡要硬盘。 - 指望换个框架让回答变好。 回答质量由模型决定。框架能把提示词组织得更好、把结构约束得更严,喂得更规整不等于厨师厨艺变高。
- 以为模型有记忆。 每次调用都是无状态的。多轮对话能接上话,全靠你把历史重新发一遍——这也意味着历史越长,每轮越贵。
- 以为模型能联网、能查库。 它默认做不到这两件事。LangChain 没有改变这一点,真正跑外部世界的是你的代码。
⚠️ 二、环境与版本
- 照抄老示例导致
ImportError。 这是新手撞得最多的一堵墙。from langchain.prompts import ...是 0.3 时代的写法,现在提示词与解析器都在langchain-core。换算表见第 05 节。 - 把 legacy 类理解成「已经被删了」。
LLMChain、ConversationChain、ConversationBufferMemory都还在,只是搬到了langchain-classic,不再是推荐写法。老项目照常跑,新项目别从它们起步。 - 只装了
langchain就想调模型。 主包不含任何提供方的集成,接哪家就得装哪家的伙伴包,例如langchain-openai、langchain-ollama。 - Python 版本过低。 要求 3.10 及以上,低版本会在安装依赖时就失败。
- 密钥硬编码进源码或提交进版本库。 一律
os.environ.get(...),.env写进忽略清单。泄露之后是按别人花掉的 token 收费。
⚠️ 三、提示词模板
- 模板里想写真正的花括号,只写了一个。
{}一律被当占位符,要输出花括号必须写两个。写少样本示范里的 JSON 时最容易中招。 - 给
ChatPromptTemplate用了format()然后直接喂模型。 它返回的是把各角色拼在一起的一整段字符串,角色信息就此丢失。要喂模型用format_messages()或invoke()。 - 变量名对不上。 模板里写
{topic},调用时传subject=,会直接报缺少变量——这其实是好事,错误提前暴露了。 - 把整轮不变的内容也每次传一遍。 角色、语气、格式说明用
partial()固定住,调用处只传真正变化的那一个,少一处写错的机会。 - 少样本例子堆太多。 2 到 5 个通常够用。例子每轮都要重发,token 成本线性上涨;覆盖面不均还会把模型带偏。质量优先于数量。
- 把模板里写死的
ai消息当成真实历史。 那是给模型看的示范,和运行时插进来的对话历史是两码事。
⚠️ 四、模型调用
- 句子莫名其妙断掉,去怀疑模型变笨了。 先看
finish_reason是不是length——那是max_tokens设小了截断的,不是模型的问题。 - 抽取、分类任务没把
temperature压到 0。 同一条输入每次结果不一样,下游报表就没法对账。反过来,写文案调成 0 会千篇一律。 - 以为
max_tokens能限制输入长度。 它截的是输出。输入太长要靠裁剪历史或换上下文窗口更大的模型。 - 把
AIMessage当字符串用。model.invoke(...)返回的是消息对象,取正文要.content,或者挂一个StrOutputParser。 - 面向用户的界面用了
invoke。 用户会盯着空白等十几秒。界面场景必须用stream。 batch一次打太多。 它是并发不是排队,容易撞上提供方的频率限制。用config={"max_concurrency": N}控制。- 流式输出不刷新缓冲区。 打印时带上
flush=True,否则内容会攒在缓冲区里一次性蹦出来,白做了流式。
⚠️ 五、输出解析
- 只挂了解析器,没把格式说明放进提示词。 解析器不会读心术。要调
get_format_instructions()把说明塞进模板,模型才知道该怎么排版。 - 自己用
json.loads硬解。 模型习惯把 JSON 包在代码块标记里,直接解会报错。JsonOutputParser会先剥壳。 - 把
parser.invoke裸放在生产路径上。 模型没有义务保证结构合法,解析必须包 try,失败的要能落到人工队列,不能静默丢掉。 - 字段
description写得太随意。 它是写给模型读的,模型靠它决定每个字段填什么。写成「名字」这种两个字,填错概率显著上升。 - 模型支持结构化输出却还在用提示词硬约束。 能用
with_structured_output就用它,可靠性不是一个量级。 - 同时要流式和结构化。 没收全的 JSON 解析不了,二选一,或者拆成两次调用。
⚠️ 六、本地模型
- 首次调用慢十几秒就以为卡死了。 那是在把权重读进显存,属于正常现象。
- 忘了先把服务跑起来。 得先
ollama run <模型名>;服务不在本机默认端口时要显式指定base_url。 - 带思考过程的模型,正文里混进了推理段。 按
content_blocks的类型挑出正文,别直接拿content往下游传。 - 拿云端那套提示词直接套本地小模型。 小模型对格式要求的遵从度明显更低,少样本示例和失败兜底都要加厚。
07自测题
点击题目展开答案;能把这 14 题说清楚,这一讲就通了
LangChain 是什么?用一句话说清它和大模型的关系。
一个用于开发由大语言模型驱动的应用程序的开源框架,2022 年 10 月由 Harrison Chase 发起。关系是:LangChain ≠ 大模型,它一个 token 也不生成,只统一「怎么进、怎么出」。用比喻说,它是中央厨房,大模型才是那位厨师。
既然直接调各家模型的接口也能做应用,为什么还要多套一层?
做第一个应用时确实看不出差别,差别出现在第二个之后:换模型要改一遍业务代码、提示词靠字符串拼接、每个项目自己写一套抠 JSON 的正则、多轮对话自己攒消息列表。框架的价值是把「这家模型怎么用」的知识换成「这类组件怎么用」的知识——前者随模型作废,后者能一直用。代价是多一层抽象,排查链路更长。
装完 LangChain 就能直接问问题了吗?
不能。它不提供任何 LLM,全靠第三方集成。要么接云端接口(需要密钥、按 token 计费),要么接本地部署(需要显卡和硬盘)。而且主包不含提供方集成,接哪家还得装哪家的伙伴包。
langchain-core、langchain、伙伴包、langchain-community、langchain-classic 各装什么?
core:不依赖任何提供方的基础抽象——Runnable 协议、消息、提示词模板、工具定义、输出解析器,最稳定。主包:搭认知架构,1.x 只保留 agents / messages / tools / chat_models / embeddings 五个命名空间。伙伴包:某一家的官方集成,单独发版。community:第三方集成大仓库。classic:1.x 新增,legacy 功能搬家后的新住处。
照着网上教程写 from langchain.prompts import PromptTemplate 报导入错误,怎么回事?
那是 0.3 时代的写法。1.x 之后命名空间收窄,提示词模板与输出解析器都归 langchain_core:from langchain_core.prompts import PromptTemplate。判断标准是问一句「这东西依赖某一家模型提供方吗」——不依赖就在 core 里找。
LLMChain 和 ConversationBufferMemory 现在还能用吗?
能用。它们搬到了 langchain-classic,不再是推荐写法,导入路径改成 from langchain_classic.chains import LLMChain。老项目照常跑,新项目不该从它们起步——现在组合组件靠的是管道符。
Model I/O 是哪三段?每一段的产物是什么?谁在真正干活?
格式化(提示词模板填变量,产出填好的提示词或消息列表)→ 预测(模型生成,产出 AIMessage)→ 解析(解析器转换,产出字符串、字典、列表或对象)。只有中间那一段会生成内容,另外两段都是搬运和整形。
对话模型、文本续写模型、嵌入模型的区别在哪?新项目该用哪个?
区别在输入输出的形状。对话模型进消息列表出消息对象,原生支持多轮和角色分工,新项目一律用它;文本续写模型进字符串出字符串,没有角色概念,基本退场;嵌入模型进文本出一串浮点数,不生成任何自然语言,用于相似度计算与检索。
三种常用消息各是什么角色?为什么多轮时要把 AIMessage 接回列表?
SystemMessage 定规矩(人设、语气、格式要求,通常第一条且整轮不变);HumanMessage 是用户说的话;AIMessage 是模型说过的话。接回列表是因为模型没有记忆,每次调用都是无状态的——它能接上话,纯粹是整段历史又被完整发了一遍。
回答老是说到一半就断,是模型变笨了吗?
不是。先看 finish_reason:如果是 length,说明被 max_tokens 截断了,调大即可。注意 max_tokens 截的是输出,输入太长要靠裁剪历史或换上下文窗口更大的模型。
做评论情感抽取,temperature 该设多少?为什么?
设 0。这是抽取任务,同一条输入每次都该得到同样的结论,否则下游报表没法对账。反过来,起名字、写文案这类要多样性的场景才调高到 0.7 以上。
format()、format_messages()、invoke() 三者怎么选?
format() 返回字符串,只适合肉眼检查和打日志;给 ChatPromptTemplate 用它会把各角色拼成一整段文本,角色信息丢失,不能直接喂对话模型。要喂模型用 format_messages()(返回消息列表,推荐)或 invoke()(返回 PromptValue,能接进流水线)。
普通占位符和 MessagesPlaceholder 有什么不同?后者解决什么问题?
普通占位符填的是一段文字,数量固定;MessagesPlaceholder 填进来的是一串消息,条数运行时才知道,可能 0 条也可能 20 条。它就是为插入对话历史(以及智能体的中间步骤)准备的,插入位置由它在模板里的位置决定。
挂了 JsonOutputParser,模型却还是返回大段自然语言,为什么?
因为没把格式说明放进提示词。解析器不会读心术,要调 get_format_instructions() 生成说明书并塞进模板(常用 partial() 固定进去),模型才知道该按什么格式排版。解析器实际上管两头:先约束模型怎么写,再把写出来的转成数据。
PydanticOutputParser 与 with_structured_output 怎么选?为什么字段的 description 很重要?
前者靠提示词里的格式说明来说服模型,任何模型都能用,但模型不听话时要靠 OutputFixingParser(在 langchain-classic 里)兜底;后者由提供方在协议层保证结构,可靠得多,前提是这家模型支持结构化输出或工具调用。能用后者就用后者。description 是写给模型读的,它靠这段话决定每个字段填什么,写含糊了字段就容易填错或空着。
词术语表
| 术语 | 含义 |
|---|---|
| LangChain | 开发大模型应用的开源框架;统一输入输出与组件用法,本身不生成任何内容 |
| Model I/O | 与模型交互的三段:格式化(Format)、预测(Predict)、解析(Parse) |
| Runnable | 贯穿全框架的统一调用协议,约定了 invoke / batch / stream 及其异步版本 |
| LCEL | 基于 Runnable 的管道式组合写法,用 | 把组件串成链,下一讲展开 |
| ChatModel | 对话模型。进带角色的消息列表,出消息对象,是日常开发的主力 |
| LLM / Text Model | 文本续写模型。进字符串出字符串,没有角色概念 |
| embedding | 文本嵌入。把文本转成一串浮点数(向量),用于相似度计算与检索 |
| Token | 模型处理文本的最小单位,逐个生成;计费与上下文窗口都按它算 |
| temperature | 随机性参数。抽取分类类任务设 0,创作类才调高 |
| max_tokens | 单次生成的长度上限,截的是输出;触发时 finish_reason 为 length |
| SystemMessage | 设定人设、语气与输出格式要求的消息,通常是列表第一条 |
| HumanMessage | 用户输入的消息 |
| AIMessage | 模型回复的消息对象,正文在 .content,用量在 .usage_metadata |
| content_blocks | 1.x 的标准内容块,跨提供方统一访问推理过程、正文与工具调用请求 |
| PromptTemplate | 产出一整段字符串的提示词模板 |
| ChatPromptTemplate | 产出带角色消息列表的提示词模板,对话模型用它 |
| MessagesPlaceholder | 模板中预留的位置,运行时填进来的是一串消息而不是一段文字 |
| zero-shot / few-shot | 零样本只提要求;少样本先给几组示范再提要求,用于钉死输出格式 |
| OutputParser | 输出解析器。把模型回复转成字符串、字典、列表或对象,并反过来约束模型的输出格式 |
| get_format_instructions | 解析器生成的格式说明书,要塞进提示词,模型才知道该怎么排版 |
| init_chat_model | 主包提供的对话模型统一入口,用 "提供方:模型名" 一个字符串切换模型 |
| init_embeddings | 嵌入模型的统一入口 |
| langchain-core | 基础抽象包:Runnable、消息、提示词、工具定义、输出解析器 |
| langchain-classic | 1.x 新增的包,LLMChain 等 legacy 功能搬家后的新住处 |
| Ollama | 本地运行大模型的集成框架,配合伙伴包 langchain-ollama 接入 |