Coze 实战:从工作流到可发布的智能体
把一家定制旅行社开起来:资源库备地接与攻略、工作流当行程线路、智能体当门市顾问,最后上架开卖、接同业分销接口——用自己的程序调用它。
30″30 秒看懂 Coze 这套东西
把整个平台想成一家定制旅行社。客人不进后台,只对着门市顾问说一句话;顾问听懂了,决定这一单走哪条行程线路;线路上每一站各办一件小事,需要什么支援,就去共用资源库调。
资源库里放三样东西:别人已经谈好的当地地接(plugin,比如文档解析、语音识别、联网搜索)、一柜子攻略手册(知识库,按语义找相近的段落)、一本客户订单台账(数据库,按字段精确增删改查)。线路排完要上架开卖——这叫发布,等于把它挂进门店橱窗,外面的人才订得到。再往外一步,把同业分销接口接上(API / SDK),自己写的程序就能绕过门市直接下单,一次订一百单。
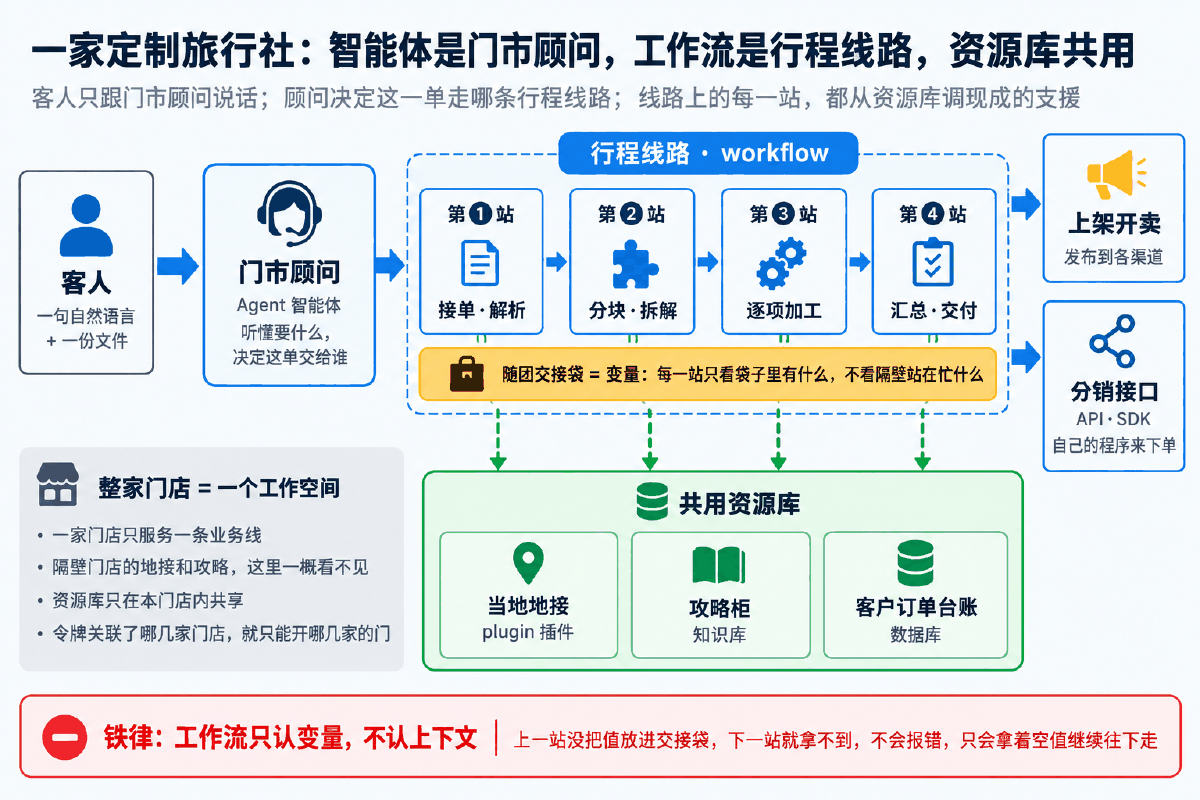
| 旅行社里的角色 | 对应的平台概念 | 它到底管什么 |
|---|---|---|
| 整家旅行社门店 | 工作空间 | 资源隔离的最小单位。隔壁业务线的地接和攻略,这里一概看不见,也用不了 |
| 门市顾问 | 智能体 Agent | 听懂客人说什么,决定这一单交给哪条行程线路;他自己不带团 |
| 一条行程线路 | workflow 工作流 | 把一件复杂的事拆成固定顺序的若干步;平台上几乎所有功能最终都落在这里 |
| 线路上的一站 | 节点 | 一站只办一件小事:调模型、取数据、判分支、跑循环 |
| 随团交接袋 | 变量 | 站与站之间唯一的传递通道。袋子里没有的东西,下一站就拿不到 |
| 当地地接 | plugin 插件 | 别人谈好的现成能力,拿来就用,不必自己造 |
| 攻略柜 | 知识库 | 存文档,按语义检索相近段落,解决"专业知识不够" |
| 客户订单台账 | 数据库 | 存结构化记录,按字段精确查改,解决"业务数据要落地" |
| 上架开卖 | 发布 | 不发布,外面谁也订不到——工作流、智能体都要各自发布 |
| 同业分销接口 | API / SDK | 让自己的程序来下单:批量跑、接进自家系统、当后端用 |
这条铁律会以三种面孔反复出现:提示词里的
{{变量名}} 和输入面板对不上、并行分支互相引用、循环体内部去够袋子外面的值。所有"结果很怪但不报错"的故障,先往这里查。
01概念:这套平台由哪几个东西拼起来
智能体和应用差在哪、空间与资源库怎么分层、知识库和数据库怎么选、在线版和开源版能不能互换
1.1 智能体与应用:差的不是能力,是交互形态
传统大模型像一本百科全书:知识渊博,有问必答,但它不会主动去"做"什么。智能体(Agent)则像一个全能助理——告诉它"我下周三去杭州出差,帮我安排行程",它会自己去查航班、订酒店、规划市内交通、提醒天气。它不只"有脑"能思考,还"有手有脚"能调工具。用一个常被引用的拆法记:
需要说清楚的是,现阶段的 Agent 还处在过渡形态:多数情况下我们事先把业务流程规定成一条固定线路,串联多个模型分别处理不同环节,从而解决一个复杂场景。而 Agent 的终极形态是不需要人去排这条线路,它自己就能把需求完成。这依赖模型能力的进一步提升,目前还需要时间。所以这一讲教的是"怎么把线路排好",而不是"怎么许愿"。
平台上有两种项目形态,很多人第一次进来会分不清:
| 对比维度 | 智能体 Agent | AI 应用 Application |
|---|---|---|
| 核心交互形态 | 对话驱动,以自然语言多轮对话为主 | 界面驱动,提供表单、按钮这类图形化界面 |
| 设计心智 | "跟我聊",像一个专家或助手,灵活响应 | "帮我做",像一个标准化工具,走固定流程 |
| 功能复杂度 | 相对轻量,适合单一或特定任务 | 相对复杂,整合多个智能体、工具和流程,形成完整解决方案 |
| 典型发布渠道 | 对话框、商店、集成到即时通讯工具 | 独立的 Web App、H5 页面、小程序,或通过 SDK/API 集成 |
| 底层区别 | 几乎没有。两者都靠工作流承载业务逻辑,区别主要在呈现与交互方式 | |
两者也不互斥。一个常见组合是:AI 应用负责收集结构化的用户输入并呈现最终结果,处理过程中再去调用一个或多个智能体完成分析、推理或创意生成。用旅行社打比方:应用是官网的预订表单——出发地、日期、预算选项都摆好了;智能体是门市顾问——你随便说,他来理解。两者背后接的是同一批行程线路。
本讲全程走"智能体"这一条,因为它把"模型自己做判断"这件事暴露得最清楚,也最能看出编排的门道。
1.2 空间、项目、资源库:三层关系一次理清
这三个词在文档里出现频率极高,关系其实很简单:
资源组织的基础单元,不同空间之间的资源与数据相互隔离。一个空间里可以有多个智能体和 AI 应用,并配一个资源库。
分智能体和 AI 应用两种类型。AI 应用内部可以创建自己的专属资源,也可以共享空间资源库里的资源。
创建、发布、管理共享资源的地方:插件、工作流、对话流、知识库、数据库、提示词。同一空间内的项目都能引用。
空间存在的意义是隔离业务。假设一家公司买了企业版,里面既有打车业务团队又有金融业务团队,两边只应该看得见自己开发的东西。这不是权限细节,这是架构约束:它决定了"某条工作流能不能被另一条引用"这类问题的答案——同一空间内可以,跨空间不行。
资源还分两处存放,容易踩坑:
| 存放位置 | 可见范围 | 什么时候用 |
|---|---|---|
| 空间资源库 | 本空间内所有智能体与 AI 应用 | 多个项目要共用的东西:违禁词表、面试题库、公共工具工作流 |
| AI 应用项目内 | 仅该项目自己 | 只服务这一个应用的私有资源;需要共享时再转移或复制到空间资源库 |
1.3 知识库还是数据库:这道选型题每个项目都要答一次
两者都是"让 Agent 访问私有数据"的手段,但它们是两种完全不同的东西:
| 维度 | 知识库 | 数据库 |
|---|---|---|
| 类比 | 一个支持快速检索的文件夹,里面是文档 | 一张巨大的表格,里面是结构化记录 |
| 装什么 | 专业书籍、说明书、产品文档、面试宝典 | 订单、流水、操作记录、违禁词、真题 |
| 怎么查 | 按语义找相近的段落,返回若干条候选 | 按字段精确匹配,条件命中就返回 |
| 结果确定吗 | 不确定。同一个问题换个说法,召回可能不同 | 确定。同样的条件永远返回同样的行 |
| 写入频率 | 低。写进去要经过解析、切分、处理 | 高。增删改查是它的日常 |
| 典型用法 | 问答、查重、找参考答案 | 记录、统计、按条件取数 |
判断口诀:问"像不像"用知识库,问"是不是"用数据库。"这段项目描述和模板库里的内容有多雷同"是像不像,用知识库;"工号 1050 的绩效等级是什么"是是不是,用数据库。
反过来把大段文档塞进数据库的某个字段:想按语义找相关段落时无从下手,只能整段取出来丢给模型,上下文瞬间被撑爆。
为什么违禁词这类数据值得单独进数据库,而不是写进提示词?三条现实理由:
- 便于管理。词库会一直增补,数据库天生擅长增删改查;写进提示词则每改一个词都要重新发布工作流、再发布智能体。
- 支持接口操作。将来要把这个功能接进自家系统,"前端操作 → 调接口改数据"是必然路径,数据库天然支持。
- 多处复用。一份数据被多条工作流引用,改一次全线生效,不用维护 N 份副本。
1.4 在线版与开源版:能不能互换,取决于你缺的是什么
这套平台有两条线:托管的在线版(订阅制,开箱即用),和可以自己部署的开源版。Coze Studio 于 2025 年 7 月 26 日开源,许可证为 Apache-2.0,允许免费商用和本地化部署。但"开源版"不等于"在线版的本地副本",两边的能力边界差得相当远:
| 功能模块 | 在线版 | 开源版 |
|---|---|---|
| 协作 | 团队空间、多人协作、权限管理 | 以个人空间为主,缺乏原生团队协作 |
| 插件生态 | 丰富的官方与第三方插件市场 | 仅内置少量官方插件,不支持插件市场,部分高级节点被移除 |
| 项目类型 | 对话型智能体 + 应用型智能体(有界面) | 主要支持对话型智能体 |
| 发布渠道 | 一键发布到多种外部平台 | 渠道有限,主要是 Web SDK 与接口集成 |
| 多模态 | 语音交互、图像生成等 | 缺少官方支持的语音、图像生成能力 |
| 运维与分析 | 开箱即用的运营面板 | 需要自行构建监控体系 |
所以这道选型题的正确问法不是"要不要私有化",而是:你缺的到底是数据不出网,还是插件生态?如果是前者,自部署是刚需;如果是后者,自部署反而是把自己最依赖的东西砍掉。这也是为什么私有化场景里另一套方案更常被选中——它开源更早、社区更成熟、功能面更宽。
这两条直接决定了"能不能拿它对外卖服务"。看仓库首页的许可证标签不够,要打开仓库根目录的 LICENSE 原文逐条读。
怎么判断一个平台"还活着、值得押注"?别看宣传稿,看三个可复核的硬指标——这套方法换任何开源项目都能用:
| 指标 | 怎么取 | 怎么读 |
|---|---|---|
| 最后一次提交 | 仓库接口的 pushed_at | 最硬的一条。几个月无提交的项目,自建前先确认还有没有人维护 |
| 星标数 | stargazers_count | 生态规模的粗略代理。只看量级,别抠零头;数字每天都在变 |
| 许可证 | license.spdx_id | 取值为 NOASSERTION 时,说明不是标准协议原文,必须去读 LICENSE 全文 |
这三个字段全部来自仓库的公共接口,不需要任何令牌:一条 curl https://api.github.com/repos/<owner>/<repo> 就能拿到,读 pushed_at、stargazers_count、license.spdx_id 三个键即可。取到的每个数字都只是某一时刻的快照——照着同样的方法自己再跑一次就能复核,这比记住任何一个具体数字都有价值。本讲之后凡是涉及“这个平台现在怎么样”的问题,答案都是这句话:自己去取一次这三个字段。
coze_settings.py 那样从环境变量读),而不是硬编码的字面量。
02原理:一条工作流跑起来的时候发生了什么
有向无环图、节点家族、变量契约、分支、循环、检索参数、日志,以及两种编排形态
2.1 工作流的本质:一张有向无环图
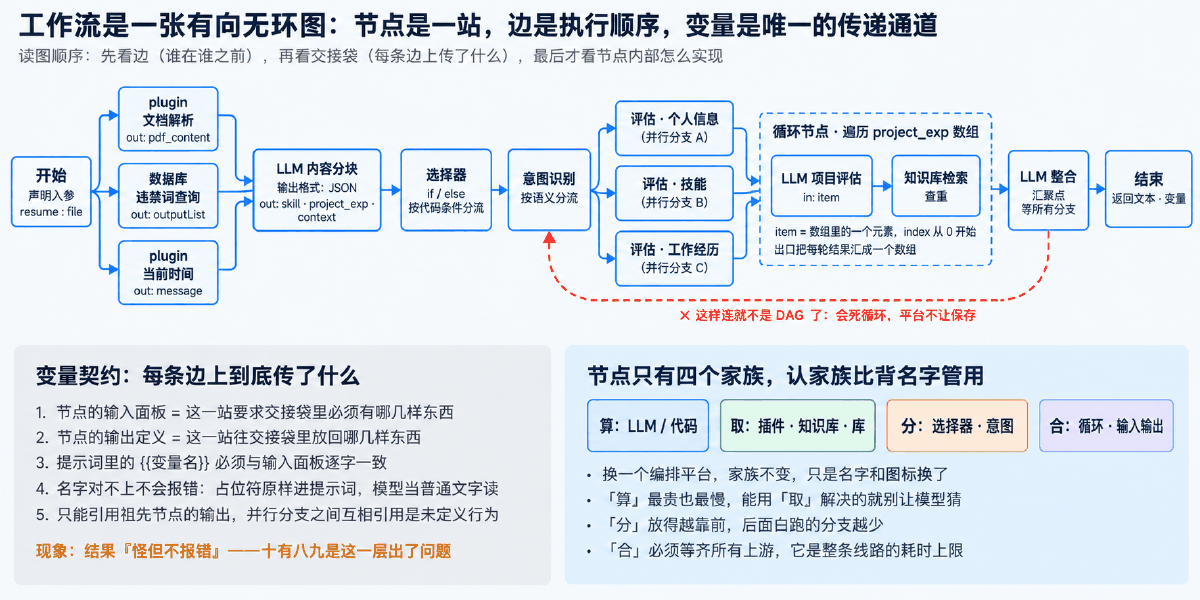
抛开界面上的拖拽和连线,工作流本质是一个有向无环图(DAG),由边和节点构成——边代表执行顺序,节点表示一个具体的执行步骤。这句定义里三个词都要抠:
| 词 | 含义 | 违反了会怎样 |
|---|---|---|
| 有向 | 边有方向,A→B 表示 A 先执行 | 没有方向就没有先后,"上游输出"这个概念不成立 |
| 无环 | 任何一条边都不能指回自己的祖先 | 会死循环。平台会直接拦住不让保存——这是硬约束,不是建议 |
| 图 | 不是一条链,可以分叉、可以汇聚 | 误以为只能一条直线串到底,就想不到用并行去省时间 |
两个特殊节点是这张图的边界:
- 开始节点:工作流的入口,相当于一段程序的主函数。它接收变量并传递给后面的节点,支持 String、Number 等多种类型;其中 Object 类型最多支持三层嵌套。它声明的参数名,就是外部调用这条工作流时必须传的键名——这一点在第 03 节直连调用时会再次出现。
- 结束节点:工作流的出口,相当于最后一行
return。它有两种返回方式:返回变量输出 JSON,适合绑定卡片或者被别的工作流、被程序调用;返回文本直接给出一段回复内容,支持用{{变量名}}引用输出参数,也可以勾选流式输出让它边生成边返回。
2.2 节点只有四个家族,认家族比背名字管用
平台的节点列表会越来越长,但把它们按"干什么"归类,只有四类。记住家族,换一个编排平台也能对号入座:
LLM 节点、代码节点。LLM 节点调模型按提示词生成内容;代码节点用 Python 或 JavaScript 写确定性逻辑。算是最贵也最慢的一类——能用规则算清楚的事,别交给模型去猜。
插件节点、知识库检索节点、数据库节点。插件是一系列工具的集合,每个工具都是一个可调用的接口;知识库按语义取;数据库按字段取。
选择器(if-else,按条件判断)、意图识别(按语义分类)。分支节点放得越靠前,后面白跑的路径越少。
循环节点、输入节点(中途向用户要信息)、输出节点(中途给用户发一句"正在处理")。汇聚点必须等齐所有上游才开始执行。
关于代码节点补充两句,因为它常被误当成"万能逃生舱":平台的运行环境是受限的。以 Python 为例,内置的第三方依赖很少,其中做网络请求的那个是异步版本,用的时候要配 await;阻塞式的 time.sleep() 会拖垮执行性能,推荐换成 asyncio.sleep()。把代码节点当成"做一点格式整理、拼一下字符串、算个时间差"的工具是对的;当成"在这里面把整个业务写完"就跑偏了——真要写那么多代码,说明这个需求本来就不该用低代码平台做。
2.3 变量契约:铁律在工程上的三种表现
这条铁律落到具体操作上,是一份三方都要对齐的契约:
| 契约的三方 | 在界面上的位置 | 对不上会怎样 |
|---|---|---|
| 上游节点的输出定义 | 该节点的输出区 | 没定义就取不到,下游连引用都引用不到 |
| 本节点的输入面板 | 该节点的输入区,写明变量名与来源 | 少填一个,提示词里对应的占位符就永远是空的 |
提示词里的 {{变量名}} | 系统提示词 / 用户提示词正文 | 名字写错不报错:占位符原样进提示词,模型当普通文字读 |
第三行是这套体系里最阴险的故障模式。把 {{context}} 写成 {{contex}},工作流照跑不误,节点也"有输出",只是模型看到的用户提示词里赫然写着一行 {{contex}}。结果就是怪,但不报错:评估结论莫名其妙、字段莫名其妙为空、同样的输入两次结果天差地别。
还有两种同源的坑:
- 并行分支之间互相引用变量。并行的两个分支没有先后关系,此刻读到的值是什么没有定义。要共享的数据,必须来自它们共同的祖先节点。
- 循环体内部去够外面的临时值。循环体是一个独立的小上下文,外面的东西要用就得显式传进去;循环体的产出也要在出口处显式汇总,不会自动漏到外面。
这份契约在本地怎么先验一遍?把节点的提示词和输入变量搬到本地跑:
"""单节点隔离调试:把工作流里的一个 LLM 节点搬到本地跑。

工作流跑错时最忌讳「改一处、整条重跑一遍」:含循环的工作流跑一次要几分钟。
更快的做法:节点提示词是纯文本、输入就是几个变量,都能搬到本地,
本地跑一次只花几秒,定稿后再贴回平台。只需一个 OpenAI 风格的兼容端点。
"""
from __future__ import annotations

import json
import os
import sys
import urllib.request
from pathlib import Path

# 任何 OpenAI 风格的兼容端点都可以;调提示词时用哪个模型不重要,能快速对比就行。
BASE_URL = os.environ.get("LLM_BASE_URL", "http://127.0.0.1:8000/v1")
MODEL = os.environ.get("LLM_MODEL", "qwen2.5-7b-instruct")


def load_prompt(path: str) -> str:
    """从文件读系统提示词。

    把提示词放进文件而不是写在代码字符串里,有三个好处:
    能进版本管理、能 diff 两版差异、能直接复制回平台节点。
    """
    return Path(path).read_text(encoding="utf-8")


def render(template: str, variables: dict) -> str:
    """把 {{变量名}} 占位符替换成真实值,和平台节点里的写法保持一致。

    刻意用最笨的字符串替换而不是模板引擎:
    目的是让本地渲染结果与平台完全一致,多一层语法糖就多一层不一致的风险。
    """
    rendered = template
    for key, value in variables.items():
        rendered = rendered.replace("{{%s}}" % key, str(value))

    # 渲染完还剩 {{ 说明有变量没喂,必须当场报错——线上最常见的故障就是
    # 占位符原样进提示词被当字面量,结果「怪但不报错」。
    if "{{" in rendered:
        leftover = rendered[rendered.index("{{"): rendered.index("{{") + 40]
        raise ValueError("仍有未替换的占位符:%s…… 检查变量名是否逐字一致" % leftover)
    return rendered


def call_llm(system_prompt: str, user_prompt: str, *, temperature: float = 0.1) -> str:
    """最小的 chat completions 调用。

    temperature 默认压到很低:调试提示词时要的是可复现,
    每次结果都不一样就没法判断「是提示词改好了还是这次运气好」。
    """
    payload = {
        "model": MODEL,
        "messages": [
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt},
        ],
        "temperature": temperature,
    }
    headers = {"Content-Type": "application/json"}
    api_key = os.environ.get("LLM_API_KEY", "")
    if api_key:
        headers["Authorization"] = "Bearer %s" % api_key

    request = urllib.request.Request(
        BASE_URL.rstrip("/") + "/chat/completions",
        data=json.dumps(payload, ensure_ascii=False).encode("utf-8"),
        headers=headers,
        method="POST",
    )
    with urllib.request.urlopen(request, timeout=120) as resp:
        data = json.loads(resp.read().decode("utf-8"))
    return data["choices"][0]["message"]["content"]


def check_json_output(text: str, required_keys: list) -> dict:
    """节点声明输出 JSON 时,本地先把这份契约验一遍。

    平台上的 LLM 节点选了 JSON 输出格式,仍然可能返回带 ```json 包裹的文本。
    下游节点按对象取值就会拿到空值,而且不报错——这是最难查的一类问题。
    """
    cleaned = text.strip()
    if cleaned.startswith("```"):
        # 去掉代码围栏:首行可能是 ```json,末行是 ```
        lines = [line for line in cleaned.splitlines() if not line.strip().startswith("```")]
        cleaned = "\n".join(lines)

    parsed = json.loads(cleaned)
    missing = [key for key in required_keys if key not in parsed]
    if missing:
        raise ValueError("输出缺少字段:%s;把字段名写进提示词并给一个示例" % missing)
    return parsed


def main() -> int:
    if len(sys.argv) < 3:
        print("用法:python coze_node_debug.py <提示词文件> <变量JSON> [必需字段,逗号分隔]")
        print("例:python coze_node_debug.py ./split.txt '{\"input\":\"张三 …\"}' skill,project_exp")
        return 2

    system_prompt = load_prompt(sys.argv[1])
    variables = json.loads(sys.argv[2])
    required = sys.argv[3].split(",") if len(sys.argv) > 3 else []

    user_prompt = render("输入的内容为:\n{{input}}", variables) if "input" in variables else ""
    print("===== 系统提示词(%d 字)=====" % len(system_prompt))
    print("===== 用户提示词 =====")
    print(user_prompt)

    output = call_llm(system_prompt, user_prompt)
    print("===== 模型输出 =====")
    print(output)

    if required:
        parsed = check_json_output(output, required)
        print("===== 字段校验通过 =====")
        print(json.dumps(parsed, ensure_ascii=False, indent=2)[:800])
    return 0


if __name__ == "__main__":
    sys.exit(main())
注意 render() 里那段"渲染完还剩 {{ 就当场报错"的逻辑。这正是平台不会替我们做的那次检查,也是把它搬到本地跑的最大收益:平台上要跑三分钟才能发现的错,本地一秒钟就红了。
2.4 两种分支:一个按代码判,一个按语义判
选择器和意图识别都是分支节点,但决策依据完全不同,选错会直接影响成本和稳定性:
| 维度 | 选择器(if-else) | 意图识别 |
|---|---|---|
| 判断依据 | 代码层面的逻辑判断:等于、包含、为空 | 让模型理解用户用自然语言表达的目的 |
| 结果确定吗 | 完全确定,同样输入永远同一条路 | 概率性的,同义不同说法可能走岔 |
| 成本 | 几乎为零 | 要调一次模型,算 token |
| 典型用途 | 入参为空就直接结束、按文件类型分流 | 客服分类、把不同咨询转给不同分支、非目标问题直接拒答 |
意图识别节点通常提供两种运行模式:极速模式速度优先,适合关注运行效率的场景,一般不支持设置系统提示词;完整模式效果优先,响应可能更慢,适合需要复杂逻辑判断的场景,往往要配一个意图识别能力更强的模型和一段细致严谨的提示词。
2.5 循环、并行与分治:为什么要把大任务拆小
循环节点有三种类型,对应编程里的三种结构:
| 循环类型 | 对应 | 典型场景 |
|---|---|---|
| 使用数组循环 | for item in list | 最常用。遍历一个已知序列,对每个元素做同样的处理:逐段生成长文、逐个项目评估、逐题判分 |
| 指定循环次数 | 固定次数的 for | 批量、顺序处理;次数也可以引用上游节点输出的数值 |
| 无限循环 | while | 要靠终止循环节点跳出。适合"失败就停""满足条件就停"这类场景,通常配合条件判断节点使用 |
数组循环里有两个变量:item 是数组中的单个元素,index 是元素的位置,从 0 开始计数。循环体里要用哪一个,在循环体的输入面板里显式选——又是一次变量契约。
真正的问题是:为什么不让模型一次把三个主题、五个项目全处理完,非要循环一条一条来?
所以把"一次处理 5 个项目"拆成"5 次各处理 1 个项目",不是为了并行省时间,而是为了让每一次的上下文都短而干净。省时间只是顺带的好处。
这套思路有个更老的名字:分治策略——分解、解决、合并。它在本讲里出现了两次:
| 步骤 | 在简历评估中的体现 | 在项目评估中的体现 |
|---|---|---|
| 分解 | 把一份简历拆成个人信息、技能、学历、工作经历、项目、自我评价六块 | 把"项目经历"这一块再拆成一个个独立的项目 |
| 解决 | 每块配一段专门的提示词,独立评估,六块并行 | 循环体内每次只评估一个项目 |
| 合并 | 汇总各块结论,整合成一份报告 | 循环出口把每轮结果汇成数组 |
并行带来的时间差很直观:六块串行,每块 n 秒,总共 6n;六块并行,总时间取决于最慢的那一块,约等于 n。前提是这六块之间互相独立、互不依赖——这正是 2.3 里"并行分支之间不得互相引用变量"的另一面。
2.6 检索参数的取舍:同一个知识库,参数不同结果天差地别
知识库检索节点的输入只有一个 query(字符串),输出是一个数组——匹配到几条就返回几条。但检索策略下面那一堆参数,才是决定效果的关键:
| 参数 | 含义 | 怎么调 |
|---|---|---|
| 检索策略 | 混合:全文 + 语义综合排序 语义:理解词与句之间的关系 全文:基于关键词 | 查专有名词、缩写、ID 这类字面要精确的内容用全文;问"意思相近"用语义;拿不准用混合 |
| 最大召回数量 | 最多返回几个段落 | 看下游要干什么:做查重要"宁可多召回再筛",调大;找标准答案要"少而准",调小 |
| 最小匹配度 | 低于这个分数的段落不返回 | 抬高会漏,压低会脏。下游是模型判断时,脏比漏更可怕 |
| 查询改写 | 根据对话历史重写 query | 多轮场景必开。用户第二句问"怎么用",不改写就查不到任何东西 |
| 结果重排 | 按相关性重新排序召回结果 | 追求高精度时开。未开启时输出的是向量检索结果,按匹配度从大到小排 |
查询改写解决的是指代问题。上一轮问"知识库检索节点可以用来做什么",这一轮只问"怎么用"——脱离上下文,这三个字什么也查不到。开启查询改写后,它会被重写成"知识库检索节点怎么用"。
结果重排解决的是顺序问题。问"如何制作意大利面",召回四个切片:A 讲历史、B 讲种类搭配、C 详细描述制作步骤、D 提供食谱。未重排时可能按 A、B、C、D 排;重排会分析真实意图,把 C、D 提到前面。为什么顺序重要:下游模型的注意力本来就偏向靠前的内容,把最相关的排在后面等于白召回。
找标准答案:召回数量压到很小(多了会互相干扰),匹配度阈值同样抬高(错的参考答案比没有参考答案更糟)。
两种都建议开查询改写与结果重排。参数是跟着"下游拿它干什么"走的,不是跟着知识库走的。
还有一件事容易被忽略:检索效果的上限,在文档切分那一步就定了。切得太碎,一个完整的论述被拦腰砍断,召回的片段读不懂;切得太整,一个片段里混了三个主题,匹配度被稀释。常见的切分策略有三类——按标点自动分段、按自定义标识符与长度分段(可设置重叠度保留上下文)、按文档的标题层级分段(适合技术手册、法律条文这类结构分明的材料)。分段策略选错,后面调再多参数也救不回来。
2.7 调试与看日志:这是这行的基本功
这一节看起来最不起眼,实际决定了搭一个应用要花一天还是一周。
平台提供的可观测能力分三层,要会分别使用:
给开始节点的所有输入赋值后执行一次。每个节点的执行结果都能单独展开看,还会给出整体耗时与 token 消耗。这是最快的一层反馈。
更细的信息:每个节点各自的耗时、输入输出各消耗多少 token、LLM 节点内部分了几个阶段、哪一步调用了插件、插件返回了什么。
改完之后效果不如之前,就去历史记录里对比。日志里保存的不只是输入输出,还有当时那一版的提示词长什么样——这是排查"到底改坏了哪一句"的唯一依据。
{{;④ 最后才怀疑模型。八成的问题在前三步就结了。一上来就改提示词、换模型,是最费时间的路径。
再加一条代码侧的习惯:凡是通过接口调用的,第一时间把日志 ID 打出来。它在建立请求的那一刻就有了,卡住、超时、返回怪结果时,拿着它回平台后台能直接定位到那一次执行。第 03 节的每段代码都会打印它,不是凑字数。
2.8 两种编排形态:谁来决定这一单交给谁
工作流搭好之后,还有最后一层:多条工作流之间,谁来分派?
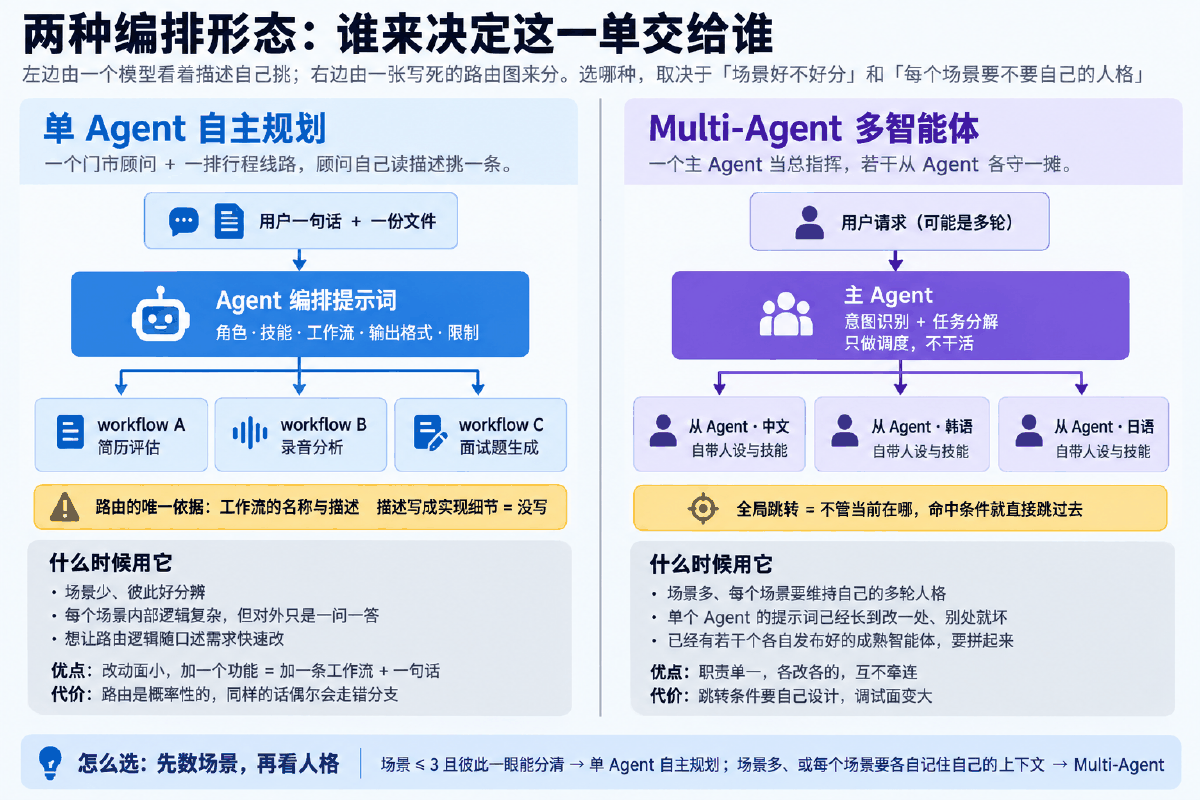
Multi-Agent 解决的是"单个 Agent 提示词太长"的问题。在单 Agent 模式下处理复杂任务时,必须写非常详细冗长的提示词,还要挂各种插件和工作流,调试复杂度很高——任何一处细节改动都可能影响整体功能。多 Agent 模式允许添加多个 Agent 节点,通过分工协作来拆解复杂任务。经典结构是主从模式:主 Agent 作为协调者,负责接收初始任务、做意图识别和任务分解;从 Agent 职责单一明确,各守一摊。
多 Agent 模式下有三类节点:
| 节点类型 | 是什么 | 什么时候用 |
|---|---|---|
| Agent 节点 | 可独立执行任务的智能实体,仅支持提示词和技能两项配置 | 功能相对简单,难以承载复杂业务流程,更适合对话类场景 |
| 工作空间智能体 | 把一个已发布的单 Agent 智能体整个挂进来当节点 | 实际项目里更常见的做法:把几个已经集成了插件和复杂工作流的成熟智能体,用一个父 Agent 做路由串起来 |
| 全局跳转条件 | 适用于所有 Agent 的全局条件,命中即跳转 | 实现复杂流程控制,比如任何时候用户说"转人工"都立刻跳走 |
而 单 Agent 自主规划模式是另一条路:让模型自主决定调用哪条工作流。这时候可以把每条工作流理解成一个"只干一件固定事的下属",当前智能体作为总管——尽管平台把它归类为单 Agent,它实际达成的是同一件事。
场景多、或每个场景要维持自己的多轮人格 → Multi-Agent。典型例子是语音助手控制一堆家电:每种设备的操作和交互方式都不一样、彼此独立互不干扰,按设备拆成多个 Agent 就很自然。
场景只有两三个还上 Multi-Agent,是拿复杂度换了个寂寞。
最后要说清一件事:单 Agent 自主规划的路由是概率性的。模型靠什么挑工作流?靠工作流的名称和描述。所以描述这段话不是注释,是路由规则本身——它要写"什么时候该调它",而不是"它内部怎么实现"。写成实现细节,等于没写。
03最小代码:把分销接口接通
四步自检、一次完整调用、两种入口的差别
编排做得再漂亮,只要还只能在平台的对话框里点,它就只是个玩具。接上接口,它才变成能被自己的系统调用的一个服务。这一节把这条路走通,只写最短的版本,完整案例留到第 04 节。
鉴权方式:三选一,别选错
所有接口请求都要在请求头的 Authorization 里带上访问令牌,格式是 Bearer <令牌>。令牌有三种:
| 方式 | 特点 | 用在哪 |
|---|---|---|
| 个人访问令牌 Personal Access Token | 生成和使用都便捷,可关联多个空间、开通指定接口权限。但本质是一种预授权的明文令牌 | 只用于测试和调试,并严格限制使用范围和有效期。保管不当极易泄露被盗用 |
| 服务访问令牌 Service Access Token | 以服务身份创建的凭证,有效期可以很长,操作简单,能简化授权流程 | 服务端程序的身份验证与授权 |
| OAuth 访问令牌 | 通过 OAuth 2.0 生成,有效期短、安全性更高,支持授权码、JWT 等多种授权类型 | 线上生产环境优先选它 |
os.environ.get(...) 读令牌,源码里不出现任何明文。三条不能破的线:不写进源码、不提交进 Git、不下发到浏览器。第三条最容易被破:前端直接调平台接口最省事,但前端拿得到的东西等于公开——那就是把自己的额度挂到公网上。正确形状见第 05 节的后端封装。
环境准备
先建一个干净的虚拟环境,再装官方 SDK,避免和别的项目互相污染:
conda create -n coze python=3.12 → conda activate coze → pip install cozepy
所有脚本共用同一份配置,集中在这里,别到处散落字面量:
"""集中式配置:所有凭证、ID、端点都从环境变量读入,源码里不出现任何明文。

用法(bash):
    export COZE_API_TOKEN='...'          # 访问令牌,调试用 PAT,线上换 SAT / OAuth
    export COZE_API_BASE='https://api.coze.cn'
    export COZE_BOT_ID='...'             # 已发布到 API/SDK 渠道的智能体 ID
    export COZE_WORKFLOW_ID='...'        # 已发布的工作流 ID
    export COZE_USER_ID='heima-demo'     # 业务侧自定义的用户标识

设计要点:缺必填项立刻抛错并点名(不等 HTTP 401);token 只在内存里、打印必掩码;
端点路径也做成可配置项,平台改版时只改一处。
"""
from __future__ import annotations

import os
from dataclasses import dataclass, field

# 国际站与国内站是两套独立环境,域名、模型与插件生态都不同;换环境只改这一个变量。
DEFAULT_API_BASE = "https://api.coze.cn"

# 三条最常用的 OpenAPI 路径,以平台文档为准,集中定义便于替换。
PATH_WORKFLOW_RUN = os.environ.get("COZE_PATH_WORKFLOW_RUN", "/v1/workflow/run")
PATH_WORKFLOW_STREAM = os.environ.get("COZE_PATH_WORKFLOW_STREAM", "/v1/workflow/stream_run")
PATH_FILE_UPLOAD = os.environ.get("COZE_PATH_FILE_UPLOAD", "/v1/files/upload")


class MissingConfig(RuntimeError):
    """配置缺失。单独定义,便于上层区分「没配好」和「调用失败」。"""


def _require(name: str) -> str:
    value = os.environ.get(name, "").strip()
    if not value:
        raise MissingConfig(
            "环境变量 %s 未设置。先 export %s='...' 再运行,"
            "不要把令牌写进源码或提交进 Git。" % (name, name)
        )
    return value


def mask(secret: str) -> str:
    """把令牌掩码成可以安全打印的形式:保留头 4 尾 4,中间一律星号。"""
    if len(secret) <= 8:
        return "*" * len(secret)
    return "%s%s%s" % (secret[:4], "*" * (len(secret) - 8), secret[-4:])


@dataclass
class CozeSettings:
    """一份运行期配置。所有脚本都从 CozeSettings.from_env() 起步。"""

    api_token: str = field(repr=False)
    api_base: str = DEFAULT_API_BASE
    bot_id: str = ""
    workflow_id: str = ""
    user_id: str = "heima-demo-user"
    timeout: float = 600.0          # 录音分析这类长任务单次可能跑几分钟
    connect_timeout: float = 10.0

    @classmethod
    def from_env(cls, *, need_bot: bool = False, need_workflow: bool = False) -> "CozeSettings":
        """从环境变量装配配置。need_bot / need_workflow 控制哪些 ID 是这次必须的。"""
        settings = cls(
            api_token=_require("COZE_API_TOKEN"),
            api_base=os.environ.get("COZE_API_BASE", DEFAULT_API_BASE).rstrip("/"),
            bot_id=os.environ.get("COZE_BOT_ID", "").strip(),
            workflow_id=os.environ.get("COZE_WORKFLOW_ID", "").strip(),
            user_id=os.environ.get("COZE_USER_ID", "heima-demo-user").strip(),
        )
        if need_bot and not settings.bot_id:
            raise MissingConfig("环境变量 COZE_BOT_ID 未设置:需要一个已发布到 API/SDK 渠道的智能体 ID。")
        if need_workflow and not settings.workflow_id:
            raise MissingConfig("环境变量 COZE_WORKFLOW_ID 未设置:需要一个已发布的工作流 ID。")
        return settings

    @property
    def auth_header(self) -> dict:
        return {"Authorization": "Bearer %s" % self.api_token}

    def describe(self) -> str:
        """启动自检打印这一行:确认读到了配置,且不泄漏令牌。"""
        return (
            "api_base=%s  token=%s  bot_id=%s  workflow_id=%s  user_id=%s"
            % (
                self.api_base,
                mask(self.api_token),
                self.bot_id or "(未设置)",
                self.workflow_id or "(未设置)",
                self.user_id,
            )
        )


if __name__ == "__main__":
    # 直接运行本文件,用来验证环境变量配好了没有。
    print(CozeSettings.from_env().describe())
三个设计点值得留意:缺配置时立刻抛错并说清缺了哪一个(而不是等到 401 才发现);打印时一律掩码(mask() 保留头四尾四);端点路径也做成配置项(平台的接口路径会随版本调整,集中定义改一处即可)。
第一个脚本:连通性自检
在写任何业务之前先确认四件事:令牌读到了、端点通、令牌有权限、拿得到日志 ID。这四件事任一不成立,后面写多少代码都是白写。
"""第一个要跑的脚本:连通性自检。

在搭任何业务之前先确认四件事:
1. 令牌读到了(而且没有写死在源码里);
2. 端点通(网络、域名、代理都没挡);
3. 令牌有权限(能列出工作空间说明鉴权通过);
4. 拿得到 logid(后面排查任何问题都靠它回平台后台定位)。

任一不成立,后面写多少业务代码都是白写。先跑通它,再动工作流。
"""
from __future__ import annotations

import sys

from coze_client import CozeError, build_sdk_client
from coze_settings import CozeSettings, MissingConfig


def ping_with_sdk(settings: CozeSettings) -> int:
    """用 SDK 列出当前令牌能看见的工作空间。

    工作空间是资源隔离的基础单元:不同空间里的智能体、工作流、知识库、
    数据库互不可见。能列出空间,说明令牌关联的空间范围是对的;
    列出来是空的,多半是令牌建的时候没有勾选这个空间。
    """
    coze = build_sdk_client(settings)
    if coze is None:
        print("未安装 SDK(pip install cozepy),改用 HTTP 路径自检。")
        return 2

    workspaces = coze.workspaces.list()
    count = 0
    for workspace in workspaces:
        count += 1
        # 迭代器会自动翻页,不用自己拼 page_num / page_size。
        print("  - %s" % workspace.model_dump_json(indent=2))

    # logid 是这次请求的唯一标识。失败时把它贴给平台,比截图有用得多。
    logid = getattr(getattr(workspaces, "response", None), "logid", "")
    print("共 %d 个工作空间,logid=%s" % (count, logid))
    if count == 0:
        print("提示:令牌没有关联任何空间,去令牌管理里补上空间与接口权限。")
    return 0 if count else 1


def main() -> int:
    try:
        settings = CozeSettings.from_env()
    except MissingConfig as exc:
        print("配置缺失:%s" % exc)
        return 3

    print("配置就绪:%s" % settings.describe())
    try:
        return ping_with_sdk(settings)
    except CozeError as exc:
        print("调用失败:%s" % exc)
        return 4
    except Exception as exc:  # noqa: BLE001 - 自检脚本要把任何异常都讲清楚
        print("未预期的异常:%s: %s" % (type(exc).__name__, exc))
        print("排查顺序:令牌是否过期 → 端点域名是否用错环境 → 出网是否被代理拦截。")
        return 5


if __name__ == "__main__":
    sys.exit(main())
为什么用"列工作空间"作为自检动作?因为工作空间是资源隔离的基础单元:能列出来,说明令牌关联的空间范围是对的;列出来是空的,多半是生成令牌时没勾上这个空间。这比直接去调业务接口、拿到一个含糊的错误码要好判断得多。
完整的一次调用:上传 + 多模态流式对话
注意时序图里的两件事:文件和问题是分两步送进去的——上传只是把文件换成一个 file_id,真正让智能体"看到"它,是在消息里带上这个 ID;回来的不是一段文本而是一串事件——正文一片一片地吐,结束和失败各有专门的事件。
"""上传文件 + 多模态流式对话:从自己的程序里调用一个已发布的智能体。

链路:本地文件 → 上传得到 file_id → 组装多模态消息 → 流式发起对话 → 按事件消费。

关键认知:上传和对话是两步(上传只换到 file_id,要在消息体里带上它);
流式返回的是一串事件而不是一段文本,正文要自己拼;
智能体必须已发布到 API/SDK 渠道,否则 bot_id 调不通。
"""
from __future__ import annotations

import os
import sys
from pathlib import Path
from typing import Optional

from coze_client import build_sdk_client
from coze_settings import CozeSettings, MissingConfig

# 平台对单个上传文件有大小上限,具体数值以平台文档为准。
# 这里读环境变量,给一个保守默认值,避免把会变的数字写死在代码里。
MAX_UPLOAD_BYTES = int(os.environ.get("COZE_MAX_UPLOAD_BYTES", str(64 * 1024 * 1024)))

# 文本类与音频类走不同的消息构造方法,靠扩展名分流。
AUDIO_EXT = {".mp3", ".wav", ".ogg"}
DOC_EXT = {".pdf", ".doc", ".docx", ".txt", ".md"}


def upload_file(coze, file_path: str):
    """上传本地文件,返回文件对象(含 id)。

    先本地校验再发请求:不存在、超限这两类错本地就能判,没必要浪费一次往返。
    """
    path = Path(file_path)
    if not path.exists():
        raise FileNotFoundError("文件不存在:%s" % file_path)
    size = path.stat().st_size
    if size == 0:
        raise ValueError("文件是空的:%s" % file_path)
    if size > MAX_UPLOAD_BYTES:
        raise ValueError(
            "文件 %d 字节,超过本地设定的上限 %d 字节。"
            "平台真实上限以官方文档为准,调大 COZE_MAX_UPLOAD_BYTES 即可放行。"
            % (size, MAX_UPLOAD_BYTES)
        )

    uploaded = coze.files.upload(file=path)
    print("上传成功:%s → file_id=%s(%d 字节)" % (path.name, uploaded.id, size))
    return uploaded


def build_message(file_id: str, file_path: str, instruction: str):
    """组装一条多模态用户消息:一个文件 + 一句指令。

    指令不能省:编排提示词靠它判断该走哪条工作流——只丢文件过去,
    等于把行李交给门市顾问却不说要去哪儿。
    """
    from cozepy import Message, MessageObjectString  # type: ignore

    ext = Path(file_path).suffix.lower()
    if ext in AUDIO_EXT:
        file_part = MessageObjectString.build_audio(file_id=file_id)
    elif ext in DOC_EXT:
        file_part = MessageObjectString.build_file(file_id=file_id)
    else:
        raise ValueError("不支持的扩展名 %s;音频用 %s,文档用 %s" % (ext, AUDIO_EXT, DOC_EXT))

    return Message.build_user_question_objects([file_part, MessageObjectString.build_text(instruction)])


def chat_stream(coze, settings: CozeSettings, messages, *, show_reasoning: bool = False) -> str:
    """发起流式对话,按事件消费,返回拼好的正文。

    四类事件必须分开处理:增量正文(追加)、增量思考过程(默认不展示)、
    对话完成(拿 token 统计并退出)、对话失败(别当成「结果为空」)。
    """
    from cozepy import ChatEventType  # type: ignore

    answer_parts: list[str] = []
    reasoning_started = False

    stream = coze.chat.stream(
        bot_id=settings.bot_id,
        user_id=settings.user_id,
        additional_messages=messages,
        parameters={},
    )
    # 日志 ID 在建立流的那一刻就有了,先打出来:
    # 万一后面卡住或超时,至少手上有一个能回后台查的凭据。
    print("logid=%s" % getattr(stream.response, "logid", ""))

    for event in stream:
        if event.event == ChatEventType.CONVERSATION_MESSAGE_DELTA:
            reasoning = getattr(event.message, "reasoning_content", None)
            if reasoning:
                if show_reasoning:
                    if not reasoning_started:
                        reasoning_started = True
                        print("\n----- 思考过程 -----")
                    print(reasoning, end="", flush=True)
                continue
            piece = event.message.content or ""
            answer_parts.append(piece)
            print(piece, end="", flush=True)

        elif event.event == ChatEventType.CONVERSATION_CHAT_COMPLETED:
            print("\n----- 完成,token 用量:%s -----" % event.chat.usage.token_count)
            break

        elif event.event == ChatEventType.CONVERSATION_CHAT_FAILED:
            print("\n----- 失败:%s -----" % event.chat.last_error)
            break

    return "".join(answer_parts)


def run(file_path: str, instruction: str, out_path: Optional[str] = None) -> str:
    settings = CozeSettings.from_env(need_bot=True)
    coze = build_sdk_client(settings)
    if coze is None:
        raise RuntimeError("未安装 SDK,先执行 pip install cozepy")

    uploaded = upload_file(coze, file_path)
    messages = [build_message(uploaded.id, file_path, instruction)]
    answer = chat_stream(coze, settings, messages)

    if out_path:
        Path(out_path).parent.mkdir(parents=True, exist_ok=True)
        Path(out_path).write_text(answer, encoding="utf-8")
        print("结果已写入 %s(%d 字)" % (out_path, len(answer)))
    return answer


if __name__ == "__main__":
    if len(sys.argv) < 3:
        print("用法:python coze_chat_stream.py <文件路径> <指令> [输出md路径]")
        print("例:python coze_chat_stream.py ./resume.pdf '帮我看看简历' ./out/resume.md")
        sys.exit(2)
    try:
        run(sys.argv[1], sys.argv[2], sys.argv[3] if len(sys.argv) > 3 else None)
    except MissingConfig as exc:
        print("配置缺失:%s" % exc)
        sys.exit(3)
四类事件必须分开处理,漏掉哪一类都会出问题:
| 事件 | 拿到什么 | 漏了会怎样 |
|---|---|---|
| 增量正文 | 一小片文本,要自己追加拼接 | 只取最后一片,结果残缺 |
| 增量思考过程 | 深度思考模型才有 | 不加区分地拼进正文,交付物里混进模型的自言自语 |
| 对话完成 | token 用量统计 | 循环不退出,一直挂着 |
| 对话失败 | 错误详情 | 把失败当成"结果为空"——这是批处理里最坑的一种,失败的文件被当成处理成功,不会被重跑 |
代码里还有几处刻意的写法:上传前先在本地校验文件存在与大小(这两类错在本地就能判,没必要浪费一次网络往返);音频和文档走不同的消息构造方法,靠扩展名分流;那句自然语言指令不能省——只丢一个文件过去,等于把材料塞给门市顾问却不说想去哪儿,编排提示词无从判断该走哪条工作流。
另一个入口:直连工作流
如果输入输出本来就是结构化的、分支也由自己的程序决定,那就不必绕智能体——直接把一条工作流当成一个远程函数调用。
"""工作流直连调用:绕过智能体,直接把一条工作流当成一个远程函数用。

何时直连工作流:输入输出结构化、分支由自己的程序决定,等价于调一个远程函数;
何时走智能体:输入是自然语言、由模型决定走哪条工作流、需要多轮上下文。

直连的两个前提:
1. 工作流必须已经发布(草稿状态调不通);
2. 开始节点声明的参数名,就是 parameters 里的键名——多一个少一个都不行。
   这正是「只认变量不认上下文」在 API 这一层的体现。
"""
from __future__ import annotations

import json
import sys
from typing import Any, Iterator

from coze_client import CozeError, HttpClient
from coze_settings import PATH_WORKFLOW_RUN, PATH_WORKFLOW_STREAM, CozeSettings, MissingConfig


def run_workflow(http: HttpClient, workflow_id: str, parameters: dict) -> dict:
    """非流式运行:一次请求拿到结束节点的全部返回。

    只适合总耗时可控的工作流;像整段录音分析那类长任务容易顶到网关超时,
    应该改用流式或异步。
    """
    payload = {"workflow_id": workflow_id, "parameters": parameters}
    data = http.post_json(PATH_WORKFLOW_RUN, payload)

    # 结束节点「返回变量」模式下业务结果是一段 JSON 字符串,要再解析一层;
    # 忽略这一层就会拿着字符串当字典用。
    raw = data.get("data")
    if isinstance(raw, str):
        try:
            data["parsed"] = json.loads(raw)
        except json.JSONDecodeError:
            # 结束节点选的是「返回文本」模式,本来就不是 JSON,原样保留。
            data["parsed"] = raw
    else:
        data["parsed"] = raw
    return data


def stream_workflow(http: HttpClient, workflow_id: str, parameters: dict) -> Iterator[tuple]:
    """流式运行:边跑边拿中间输出。工作流里输出节点的文字会先于最终结果到达。"""
    payload = {"workflow_id": workflow_id, "parameters": parameters}
    yield from http.post_stream(PATH_WORKFLOW_STREAM, payload)


def pretty(value: Any) -> str:
    return json.dumps(value, ensure_ascii=False, indent=2)


def main() -> int:
    if len(sys.argv) < 2:
        print("用法:python coze_workflow_run.py '<开始节点参数的 JSON>' [--stream]")
        print("例:python coze_workflow_run.py '{\"input\":\"成都\"}'")
        return 2

    try:
        settings = CozeSettings.from_env(need_workflow=True)
    except MissingConfig as exc:
        print("配置缺失:%s" % exc)
        return 3

    try:
        parameters = json.loads(sys.argv[1])
    except json.JSONDecodeError as exc:
        print("第一个参数必须是合法 JSON:%s" % exc)
        return 2
    if not isinstance(parameters, dict):
        print("参数必须是一个对象,键名要和开始节点声明的变量名逐字一致。")
        return 2

    http = HttpClient(settings)
    try:
        if "--stream" in sys.argv:
            for event_name, chunk in stream_workflow(http, settings.workflow_id, parameters):
                print("[%s] %s" % (event_name or "message", pretty(chunk)))
        else:
            result = run_workflow(http, settings.workflow_id, parameters)
            print("logid=%s" % result.get("_logid", ""))
            print(pretty(result.get("parsed")))
    except CozeError as exc:
        print("调用失败:%s" % exc)
        print("先自查:工作流发布了吗?参数名和开始节点一致吗?令牌有这个空间的权限吗?")
        return 4
    return 0


if __name__ == "__main__":
    sys.exit(main())
这段代码里,铁律以最赤裸的形式出现了一次:parameters 里的键名,必须和开始节点声明的变量名逐字一致。多一个、少一个、大小写不同,都不行。第 02 节说"工作流只认变量",在接口这一层就是这个样子。
| 对比 | 走智能体 | 直连工作流 |
|---|---|---|
| 传什么 | bot_id + 一句自然语言(可带文件) | workflow_id + 一个参数对象 |
| 谁决定走哪条路 | 模型,按编排提示词和工作流描述挑 | 你的代码,写死的 |
| 有对话历史吗 | 有,可以挂到一个会话上做多轮 | 没有,一次一结算 |
| 结果确定吗 | 路由是概率性的,可能挑错 | 确定 |
| 什么时候选它 | 面向人、输入是自然语言、需要多轮 | 面向系统、输入结构化、要可预测 |
② 不要背 SDK:每个平台设计接口的方式都不一样,参数多的时候全部记住是不可能的。记住思路,然后去官方示例目录里按文件名找到最接近的那个,改成自己的业务——这才是可持续的用法。
③ 日志 ID 是排查的起点:建立请求那一刻就有,第一时间打出来。
04完整案例:一个面试助手,三条工作流
从立项取舍到编排发布,一条完整链路每一步在干什么
4.1 项目背景与选型:为什么是低代码平台
场景是真实的:某职业教育机构的人工智能学科报名数激增,学生数量增长太快,就业环节出现了效率痛点。梳理下来有四个:
学生写简历的能力参差不齐,要注意的细节又多,初版质量很难把控,老师一份份看不过来。
一场面试 30~60 分钟。高峰期一个学生平均 3 场,就是两小时录音;3 个学生同时在面,就是 6 小时。逐个听,时间成本巨大;不听,就会漏掉重要信息。
面试宝典收录的题量庞大,部分学生抓不到重点,全背下来也不现实,结果在真实面试里栽在和简历强相关的常见问题上。
未工作过或性格内向的同学练习次数不够,真面试时因练习不足浪费机会。
四个痛点,一期只做三个半——模拟面试被砍掉了。理由写得很清楚:模拟面试要实现出题、模仿面试官语气、根据回答追问、判断答案对错、把控节奏,实现复杂度高;而对大部分学生来说,问题主要是知识掌握不足而非表达,有了面试题生成功能就能先解决大头。这就是真实项目里最常见的动作:按需求紧急程度、现有人力、预算做取舍,而不是把想到的全做完。
技术选型摆了三条路:
| 技术栈 | 优势 | 劣势 |
|---|---|---|
| 在线版低代码平台 | 快速实现需求,低代码 | 限制较多,无法实现比较定制化的功能 |
| 自部署的开源编排平台 | 快速实现需求,低代码,能对接本地模型和服务 | 本地版插件太少,很多功能要重新造轮子 |
| 代码版工作流框架 | 扩展性极强,基本不受限制,可对接本地模型、实现复杂自定义逻辑,支持高并发 | 上手成本高,开发周期长 |
结论是用在线版低代码平台先落地:一期投入约 40 人天、1~2 人、3 个月。等线上有一定规模之后,再考虑用代码版框架重构并集成到教学系统。选型没有标准答案,只有"在这个人力和周期下,哪个方案能把东西交出来"。
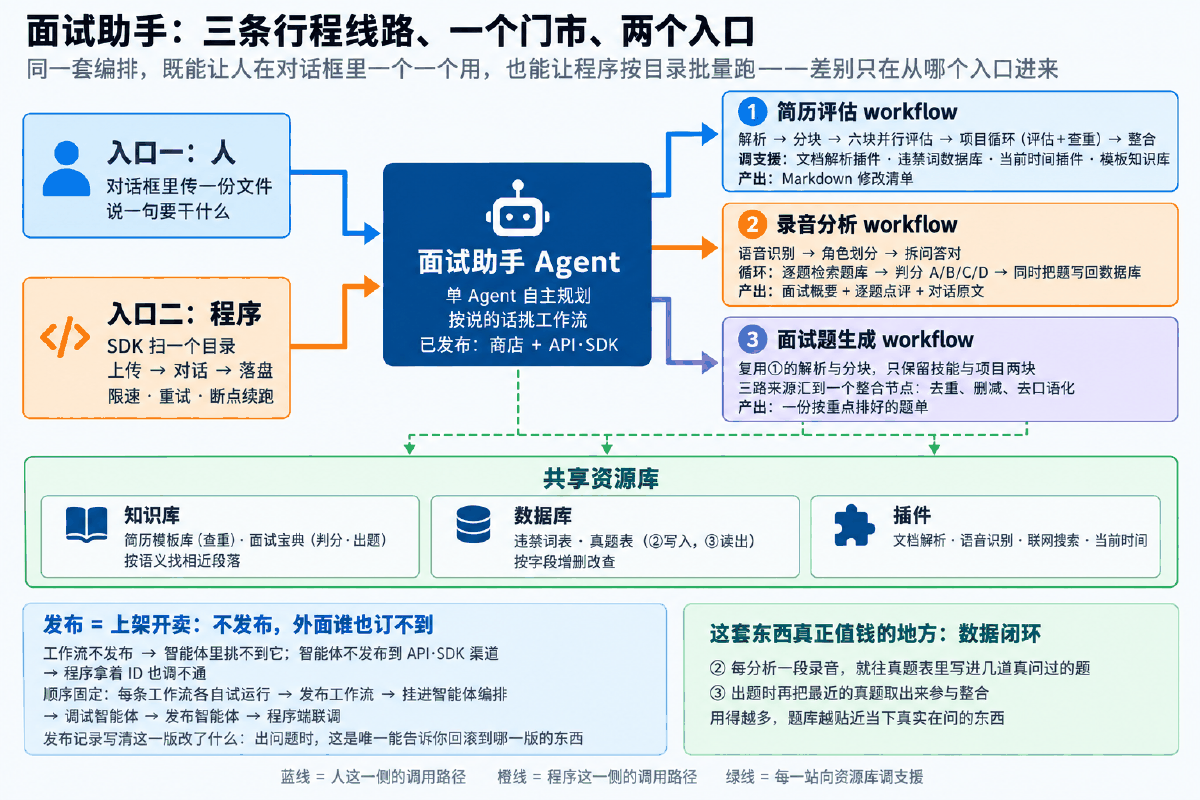
整体形状:三条工作流 + 一个智能体 + 两个入口。三条工作流互相独立、各自发布;智能体负责把用户那句话路由到正确的工作流;人从对话框进,程序从接口进。真正需要写代码的地方只有最后那个批量入口,其余全在编排里。
4.2 简历评估工作流:分治策略的标准示范
输入一份简历(pdf 或 doc),输出一份 Markdown 格式的修改建议。流程分四段:
整条工作流的结构,写成"节点 + 边 + 变量契约"三件事是这样的:
{
  "workflow": "ai_resume_handler",
  "description": "接收一份简历文件,分块后并行评估各部分,最后整合成一份可读的修改建议",
  "note": "讲结构用的骨架描述,不是平台导入格式。价值在于:把工作流写成「节点 + 边 + 变量契约」三件事,换任何编排平台都成立。",
  "start": { "outputs": [ { "name": "resume", "type": "file", "required": true } ] },
  "nodes": [
    { "id": "extract_text", "type": "plugin", "title": "简历文字提取",
      "inputs": { "url": "{{start.resume}}" },
      "outputs": ["pdf_content", "data", "content"] },

    { "id": "forbid_words", "type": "database", "title": "违禁词查询",
      "op": "select", "table": "forbidden_words", "fields": ["word"],
      "outputs": ["outputList"] },

    { "id": "now", "type": "plugin", "title": "当前时间", "outputs": ["message"] },

    { "id": "split", "type": "llm", "title": "简历内容分块", "model_hint": "长上下文模型",
      "inputs": { "input": "{{extract_text.pdf_content}}", "content": "{{extract_text.content}}" },
      "output_format": "json",
      "prompt_ref": "node_prompts.yaml#split_resume",
      "outputs": ["name", "base_info", "skill", "education", "work_exp", "project_exp", "self", "context"] },

    { "id": "eval_base_info", "type": "llm", "parallel_group": "sections",
      "inputs": { "base_info": "{{split.base_info}}", "context": "{{split.context}}", "date": "{{now.message}}" } },
    { "id": "eval_skill", "type": "llm", "parallel_group": "sections", "model_hint": "推理模型",
      "inputs": { "skill": "{{split.skill}}", "project_exp": "{{split.project_exp}}" } },
    { "id": "eval_education", "type": "llm", "parallel_group": "sections", "skills": ["联网搜索"],
      "inputs": { "education": "{{split.education}}", "date": "{{now.message}}" } },
    { "id": "eval_work", "type": "llm", "parallel_group": "sections", "model_hint": "推理模型",
      "inputs": { "work_exp": "{{split.work_exp}}", "context": "{{split.context}}", "date": "{{now.message}}" } },
    { "id": "eval_self", "type": "llm", "parallel_group": "sections",
      "inputs": { "self": "{{split.self}}", "context": "{{split.context}}" } },

    { "id": "loop_projects", "type": "loop", "loop_type": "array", "array": "{{split.project_exp}}",
      "body": [
        { "id": "eval_project", "type": "llm", "model_hint": "推理模型",
          "inputs": { "project_exp": "{{loop.item}}", "context": "{{split.context}}",
                      "date": "{{now.message}}", "forbid_list": "{{forbid_words.outputList}}" } },
        { "id": "query_rewrite", "type": "llm", "title": "检索 query 优化",
          "inputs": { "project_exp": "{{loop.item}}" }, "outputs": ["query"] },
        { "id": "template_search", "type": "knowledge", "dataset": "resume_templates",
          "inputs": { "query": "{{query_rewrite.query}}" },
          "params": { "top_k": 20, "min_score": 0.85, "rewrite": true, "rerank": true } },
        { "id": "dup_check", "type": "llm", "title": "重复度评估",
          "inputs": { "query": "{{query_rewrite.query}}", "context": "{{template_search.outputList}}" } }
      ],
      "outputs": ["project_results"] },

    { "id": "merge", "type": "llm", "title": "评估结果整合", "model_hint": "推理模型",
      "inputs": { "sections": "以上五个并行分支的 output", "projects": "{{loop_projects.project_results}}" },
      "outputs": ["report"] }
  ],
  "end": { "mode": "text", "answer": "{{merge.report}}", "stream": true },
  "edges": [
    ["start", "extract_text"], ["start", "forbid_words"], ["start", "now"],
    ["extract_text", "split"],
    ["split", "eval_base_info"], ["split", "eval_skill"], ["split", "eval_education"],
    ["split", "eval_work"], ["split", "eval_self"], ["split", "loop_projects"],
    ["forbid_words", "loop_projects"], ["now", "loop_projects"],
    ["eval_base_info", "merge"], ["eval_skill", "merge"], ["eval_education", "merge"],
    ["eval_work", "merge"], ["eval_self", "merge"], ["loop_projects", "merge"],
    ["merge", "end"]
  ],
  "design_notes": [
    "extract_text:传文档时内容落在 pdf_content,传网页地址时落在 data,同一时刻只有一个有值,下游必须同时接住。",
    "forbid_words 用数据库而不是写进提示词:违禁词会持续增补,改一行即生效,不必重新发布工作流和智能体。",
    "now 节点不可省:判断工作年限与毕业时间是否自洽,必须有一个可信的「今天」,模型自己并不知道今天几号。",
    "split 用长上下文模型:原文加分块结果同时占窗口,短窗口会截断,表现为后半段字段莫名为空。",
    "loop_projects:一次把 5 个项目全塞给模型,评估质量明显下滑;拆成 5 次单项目评估,每次上下文短而干净。",
    "query_rewrite:整段原文拿去检索噪声太大,先压成结构化摘要,召回相关性明显提升。",
    "template_search 参数:查重要「宁可多召回再筛」,top_k 放大,同时抬高阈值,避免只沾边的片段也算雷同。",
    "end 用返回文本适合直接展示;若要被别的工作流或程序调用,改成返回变量、输出结构化 JSON。"
  ],
  "invariants": [
    "所有边合起来必须是有向无环图:任何边都不能指回祖先,否则死循环。",
    "每个节点的 inputs 只能引用祖先节点的 outputs;引用不到就说明这条边没连。",
    "并行分支之间不得互相引用变量:它们没有先后关系,读到的值不确定。",
    "整合节点是所有并行分支的汇聚点,必须等所有分支完成才开始执行。"
  ]
}
这份文件不是平台的导入格式,它的价值在于:任何一条工作流都能被写成这三件事,换编排平台也成立。评审一条工作流时,看这个比看画布截图有效得多。
数据准备:三件东西必须在同一层准备好
| 要准备什么 | 用哪个节点 | 为什么必须有 |
|---|---|---|
| 简历正文 | 文档解析插件 | 后面所有评估的原料 |
| 违禁词清单 | 数据库查询 | 判断项目描述里有没有不该出现的词;查询条件写成"系统字段不为空",等价于取全表 |
| 当前时间 | 时间插件 | 模型自己并不知道今天几号。判断"2023 年毕业却写 5 年工作经验"这类矛盾,必须有一个可信的"今天" |
正确做法是两个字段都往下传,在分块节点的用户提示词里写成"输入的内容为 A;如果为空,则 B"。
内容分块:这一步的提示词质量决定后面全部
一个 LLM 节点,把简历原文拆成七项:姓名、基本信息、技能、教育经历、工作经历、项目经验(数组,每个项目一个元素)、个人爱好与评价,外加一段 context 概括供后续各块交叉校验时参考。
# 节点提示词模板:每个 LLM 节点一段,带变量契约
#
# 三条约定:
# 1. {{变量名}} 必须与节点输入面板里声明的名字逐字一致。不一致时平台不报错,
#    占位符原样进提示词被当成普通文字——最常见也最难发现的故障。
# 2. 要输出多个字段时,字段名必须在提示词里显式点名。
# 3. 规则型提示词把「规则」和「注意」分开写:规则是硬约束,注意是边界情况。

split_resume:
  purpose: "把一份简历原文拆成结构化的若干块,供后续各评估节点并行使用"
  model_hint: "长上下文模型;简历原文 + 拆分结果会同时占用窗口"
  output_format: json
  inputs:
    input: "文档解析插件的 pdf_content 字段"
    content: "文档解析插件的 content 字段,两者只有一个有值"
  outputs: [name, base_info, skill, education, work_exp, project_exp, self, context]
  system: |
    你是一个大模型和算法工程师简历内容提取助手,能够根据简历中的内容提取出来对应的实体。
    你将接受简历内容作为输入,并按照下列要求进行拆分,并输出为 json 格式:

    姓名:字段名 {{name}}
    基本信息:字段名 {{base_info}},包含姓名、求职岗位、期望薪资、工作年限、手机号、邮箱等,不含学历与技能
    个人技能:字段名 {{skill}},个人掌握的 IT 相关技能
    教育经历:字段名 {{education}},包含学历、在校时间、专业,以及位于简历第几部分
    工作经历:字段名 {{work_exp}},包含公司、时间、角色、从事内容,以及位于简历第几部分
    项目经验:字段名 {{project_exp}},每个项目作为数组中的一个元素,数组长度与项目数一致
    个人爱好与评价:字段名 {{self}}
    上下文:字段名 {{context}},以上所有内容的概括,供后续分块校验时作为参考

    注意:以上要求需要严格遵循。除上下文以外,其他内容不要省略和总结,
    直接拆出原文即可,不要出现错误的划分。
  user: |
    输入的内容为:
    {{input}}
    如果为空,则:
    {{content}}

eval_project:
  purpose: "循环体内部,每次只评估一个项目"
  model_hint: "推理模型"
  output_format: json
  inputs:
    project_exp: "循环变量 item,一个项目的全文"
    context: "简历概括"
    date: "当前时间"
    forbid_list: "违禁词数据库查询结果"
  system: |
    你是一个大模型和算法工程师简历审核大师,专门负责项目经历部分。

    规则:
    1. 项目数量要与工作年限匹配
    2. 工作经历和项目经历要分开写
    3. 每个项目至少包含项目介绍(背景)、个人负责部分、成果数据,分开写
    4. 建议在每个项目前加上技术栈
    5. 项目背景需要合理,要让人觉得这个项目是真实需求驱动的
    6. 实习阶段避免出现过重的措辞
    7. 项目周期需要合理
    8. 禁止出现:{{forbid_list}} 中的词
    9. 成果数据中不好解释的指标,需要提醒用户准备说法
    10. 项目经历不得与上下文冲突

    如果违反规则,列出需要修改的部分,并说明违反了哪一条。
  user: |
    项目经历:
    {{project_exp}}
    上下文:
    {{context}}
    当前时间:
    {{date}}

dedup_check:
  purpose: "拿检索回来的模板片段和本人项目做雷同比对"
  inputs: { query: "优化后的项目摘要", context: "知识库检索结果" }
  system: |
    你是一个大模型和算法工程师简历审核大师,专门负责项目经历部分,
    能够根据用户输入的项目内容和知识库中检索出来的内容进行对比,提示用户重合情况。

    需要严格执行:
    1. 技术点、业务流程、个人职责、优化点、成果数据一致或基本相似的,认为是雷同
    2. 输出时需要指出具体哪些部分雷同,并给出两边的原文对照
  user: |
    项目内容:
    {{query}}
    检索出来的内容:
    {{context}}

split_role:
  purpose: "把一段面试录音转出的文字划分成面试官与应试者两方,并做非面试内容拦截"
  model_hint: "推理模型;文字里已经没有声纹和语气,只能靠语义判断"
  inputs: { input: "语音识别节点的输出文本" }
  system: |
    你是一个语音转文字内容总结助手,专门负责面试内容的整理。
    1. 提取对话内容,以面试官和应试者进行区分,存放到字段 {{result}},
       按原内容整理,不要省略,每次说话换行。

    需要注意:
    1. 中间有卡顿或表现异常的地方,用方括号括起来并注明情况
    2. 在每句开头注明是面试官还是应试者
    3. 如果判断本次内容不是面试对话,直接输出空字符
  user: |
    语音转文字内容:
    {{input}}
  guard_note: "第 3 条是入口拦截:没有它,任何一段录音都会跑完全部循环与检索,白烧算力。"

qa_extract:
  purpose: "把整段面试对话拆成一个个问答对,供后续循环逐条评估"
  inputs: { qa: "角色划分后的对话原文" }
  system: |
    你是一个面试内容提取助手,能够根据面试官和面试者的对话提取出问题和回答两部分内容,
    格式:"问题:" + 换行 + "回答",并以数组形式返回。

    需要注意:
    1. 每个问答只保留问题和对应回答,省略无关的连接词
    2. 保留回答中的停顿等标注信息,以便后续评估
    3. 不需要提取自我介绍和项目介绍
    4. 问题需要结合上文还原指代。例如先问了编码器,接着问"解码器呢",
       要把第二个问题改写成完整的问句
  pitfall: "第 4 条必需:指代不还原,检索就会拿着'解码器呢'三个字去查,什么也查不到。"

answer_grade:
  purpose: "逐条评估回答质量,知识库查不到时回落到联网检索"
  model_hint: "推理模型;要判断两段表述是不是同一个意思"
  inputs: { input: "知识库检索结果", query: "问题", answer: "面试者的回答" }
  system: |
    你是一个大模型算法工程师的面试官,能够根据面试问题、用户回答、题库检索结果,
    以及互联网上的答案对回答进行综合评估。

    步骤:
    1. 先判断检索出来的内容是不是这个问题的答案;不是则转为联网检索;是则以它为准
    2. 对比问题和回答,判断回答质量

    需要注意:
    1. 给出 A/B/C/D 四级评价,并说明理由
    2. 回答不好的问题,要告诉用户正确答案
    3. 表达混乱的,要指出表达方式的问题
    4. 回答跑题的,要指出需要先理解问题再回答
  user: |
    问题:
    {{query}}
    用户回答:
    {{answer}}
    题库检索结果:
    {{input}}
这段提示词里有三个刻意的写法,都是可迁移的:
- 字段名在提示词里显式点名,并用符号包起来强调。不加符号分割,模型容易把字段名当成正文的一部分。要输出多个字段时这一步是必需的。
- 反复强调"直接拆出原文即可,不要省略和总结"。模型的默认倾向是概括,而这里要的是原样搬运——不强调,后面的评估会基于一段被压缩过的简历做判断,原文引用也就无从谈起。
- 单独产出一段
context。因为六块是并行评估的,彼此看不见对方。要做"技能和项目对不对得上""学历和工作经历有没有冲突"这类交叉判断,就得有一份共同的参照——这正是 2.3 里"并行分支要共享数据,必须来自共同祖先"的具体用法。
但也别一律用最大的:窗口越大通常越慢越贵,而且上下文腐烂的问题依然存在——窗口大小解决的是"装不装得下",不解决"装满了还准不准"。
并行评估:六块各评各的
六块的提示词结构高度一致,都是"角色 + 规则清单 + 输出格式",差别只在规则内容和输入变量。三个值得注意的设计:
| 评估块 | 特殊配置 | 为什么 |
|---|---|---|
| 技能 | 额外接收 project_exp;用推理能力更强的模型 | 要做交叉比对:项目里用到的技术点,技能里要有对应关键词;技能里写了却在项目中没体现的,也要指出来 |
| 学历 | 给节点挂上联网搜索技能 | 减少幻觉。学校信息模型未必准确,让它自己去查 |
| 工作经历 / 项目 | 用推理模型 | 判断逻辑复杂,且要结合大量文本做一致性比对 |
输出格式全部统一成两段:需要修改(必须附带简历原文)和参考建议(限制条数,且不得超过需要修改的部分)。后一条限制很关键:不加,模型会滔滔不绝地给一堆"建议",把真正的硬问题淹没掉。
项目评估:循环 + 查重,本条工作流最复杂的一段
项目是简历里最能体现区分度、也最难处理的部分:内容多(有的人写五个以上项目)、容易雷同(参考的模板类似,有人甚至连项目名都没改)、校验项多。所以这一块单独走一个循环,循环体内每次只处理一个项目,内部又分两条线:
LLM + 一份很长的规则清单:项目数量与工作年限是否匹配、结构是否包含背景/职责/成果、背景是否合理可信、技术点是否合理、成果指标里有没有不好解释的数字、有没有踩中违禁词。输出 JSON,便于循环出口汇总时省掉格式字符。
三个节点串联:query 优化(把项目原文压成结构化摘要)→ 模板库检索→ 重复度判定(把检索结果和本人项目原文做对照,指出具体哪些部分雷同)。
B 线里的 query 优化那一步,是很多人会漏掉的:整段项目原文直接拿去检索,噪声太大——里面既有技术栈又有业务背景还有一堆数字,向量化之后什么都像、又什么都不像。先用一个 LLM 节点把它压成"背景、技术点、业务流程、个人职责、优化点、成果数据"这样排好序的摘要,召回相关性会明显提升。提示词里同时严格要求"不可以添加不存在、杜撰的内容"——摘要环节一旦开始发挥,后面查出来的雷同就是假的。
检索参数按"查重"这个用途调:召回数量放大(宁可多召回再筛,提高重复内容的召回率)、匹配度阈值抬高(防止只沾了个边的文档也被算成雷同),查询改写和结果重排都打开。对照第 02 节那张参数表,这是"下游拿它干什么"决定参数的典型例子。
4.3 录音分析工作流:入口拦截与循环判分
输入一段面试录音,输出面试概要、逐题点评、对话原文。四段:
第一段:语音识别的三个配置决定成败
- 选参数量更大的识别模型:能结合上下文,识别准确率更高。代价是更贵——这是一次明确的成本换效果。
- 把节点超时时间调到最大:面试录音通常几分钟起步,用默认超时必然中途失败。
- 类型自动兼容:节点声明要字符串链接,而上游传过来的是音频类型,平台会自动做转换。界面上可能标红,但能正常执行——这类"标红但能跑"的情况,判断依据是试运行的实际结果,不是那个红框。
第二段:角色划分,以及一次极其划算的入口拦截
角色划分要把一段连续的文字分成"面试官:……"和"应试者:……"。这一步对推理能力要求不低——文字里已经没有声纹、语气这些信息了,只能靠语义判断谁在问、谁在答。所以要选能力更强的模型。
在入口处拦一次,比在出口处补救便宜一个数量级。这条经验适用于所有含循环和检索的长工作流。
第三段:拆问答对,以及指代还原
接下来把整段对话拆成一个个问答对,格式是"问题:换行回答",以数组返回,供后面的循环逐条处理。提示词里有一条看起来很琐碎、实际非常关键的要求:问题需要结合上文还原指代——面试官先问"Transformer 的编码器是什么",接着问"解码器呢",第二个问题必须被改写成完整的问句。
为什么?因为问答对被拆开以后,各自独立进入循环,循环体里看不见上下文(铁律的又一次现身)。指代不还原,后续的知识库检索就会拿着"解码器呢"三个字去查题库,什么也查不到,这道题就白判了。
还有一条约定要注意:LLM 节点能稳定产出的是字符串数组,对象数组实测不稳定。所以这里先产出字符串数组,在循环体内部再用一个 LLM 节点把每个问答对拆成"问题"和"回答"两个变量。这是个务实的妥协:与其和不稳定的结构较劲,不如多加一个节点。
第四段:并行的两条线——判分与入库
循环体内,每个问答对分出两条并行支路:
| 支路 | 做什么 | 关键配置 |
|---|---|---|
| 判分 | 拿问题去面试题库检索参考答案,再让推理模型对比"参考答案"和"本人回答",给出 A/B/C/D 四级评价 | 召回数量压到很小、匹配度阈值抬高。检索不到时回落到联网搜索——这是必须有的兜底 |
| 入库 | 把这道真实被问到的题写进数据库 | 公司字段先留空。后续迭代再补"这题是哪家公司问的" |
判分提示词里定义了四级标准:D 是完全不会;C 是只能答一小部分或卡壳太厉害;B 是能答对大部分但不够深入;A 是回答得非常好。同时要求:答得不好的要给出正确答案;表达混乱的要指出表达方式问题;跑题的要指出"先理解问题再回答"。
插件会换、界面会改、平台可能都会换,沉在自己数据库和知识库里的东西不会。做低代码项目时,有意识地设计这样一条数据闭环,价值远高于多搭两个节点。
4.4 面试题生成工作流:三路来源汇成一张题单
输入简历,输出一份按重点排好的题单。它的数据来源有三路:
把技能拆到最细,逐个去面试宝典里检索,再润色补齐。检索不到的走联网兜底。
项目内容不属于通用知识,检索不到,纯靠提示词质量。每次循环处理一个项目,用推理模型。
从录音分析工作流写入的数据库里取最近的一批真题,按写入时间倒序。
复用:不要抄第二遍
这条工作流开头的"文档解析 + 内容分块"和简历评估几乎一样。正确做法是在画布上框选复制、粘贴到新画布,再按需要做减法——只保留技能和项目两块。抄第二遍的代价不是多花十分钟,是从此以后同一段逻辑有两份、改一份忘一份。
技能点为什么要拆到最细
一行技能描述往往包含好几个技术点,比如"熟悉深度学习原理,对 RNN、LSTM、Transformer 的原理有深入研究,熟练使用 PyTorch 搭建神经网络"。直接拿这一整句去出题很难出得好。
换位思考一下:面试官拿到简历,是结合岗位需求针对每个点分别提问的,不会照着一整句问。所以这一步要把技能拆到"一个技术点一个元素"的粒度,后面每个技术点各自去检索、各自出题。拆的粒度,本质上是在模仿使用者的行为方式。
抽样策略:为什么选了最笨的那个
"最近的真题"怎么取?可选方案不少:取最近 N 条、随机无放回抽样、按分布抽样(比如大模型类一半、其他一半)。实现难度由易到难,效果理论上也由差到好。最终选了取最近 N 条,理由很实在:
- 项目初期题库积累不多,最好的抽样方式和最简单的效果差不了多少;
- 在编排平台里实现无放回抽样或按分布抽样会把问题复杂化,投入更多人力成本。
数据库查询这里有个细节:除了题目本身,还要把系统自带的创建时间字段一起查出来,因为要拿它做倒序排序。查询条件写成"题目不为空",等价于取全表。
整合:一个节点要干四件事
三路来源汇到一个整合节点,它要完成:去重、按与岗位的关联程度删减(基础技术点每个保留少量,核心技术点多保留几个)、去口语化(把"那你们是怎么做的"这类口水话还原成规范问句)、补充几道人事问题。输出字符串数组,一题一个元素。
4.5 编排与发布:把三条工作流装进一个门市
三条工作流做好了,还需要一个统一入口。场景不多、彼此容易分辨,所以选单 Agent 自主规划:把每条工作流当成一个只完成固定任务的下属,由一个父 Agent 统一管理。
人设与回复逻辑的结构固定为六段,少任何一段模型的行为都会开始飘:
# 智能体编排模板:把「人设 + 工作流路由 + 兜底话术」写成一份可评审的文件
#
# 为什么落成文件:平台的编排框改了就覆盖、没有历史;放进版本管理才能回答
# 「上周还好好的,谁改了什么」。定稿后原样贴回人设与回复逻辑面板即可。
#
# 用法:把所有 TODO 换成自己的业务内容;标注 KEEP 的结构不要动。

agent:
  name: "TODO:智能体名称"
  intro: "TODO:一句话说明它能干什么,会显示在列表和商店里"

  # KEEP:单 Agent 自主规划 与 Multi-Agent 的取舍写在这里,评审时一眼能看到理由
  mode: single_agent_planning
  mode_rationale: >
    场景少、彼此容易分辨,但每个场景内部的数据处理很复杂——这种形状用单 Agent
    自主规划最合适:每条工作流是一个只干一件事的下属,模型只负责「这一单交给谁」。
    场景多、且每个场景要维持自己的多轮人格时,才值得上 Multi-Agent。

  # KEEP:长期记忆按需开启。开了会记住用户偏好,也意味着上次会话会影响这次,调试时先想到它。
  long_term_memory: false

# ---------------------------------------------------------------------------
# 人设与回复逻辑:贴进平台的提示词框
# 结构固定为六段。少任何一段,模型的行为都会开始飘。
# ---------------------------------------------------------------------------
persona: |
  # 角色:
  TODO:一句话定义身份,例如「大模型算法工程师面试助手」

  ## 目标:
  TODO:说明它要替用户解决什么问题

  ## 技能:
  1. TODO:技能一,对应一条工作流
  2. TODO:技能二,对应一条工作流
  3. TODO:技能三,对应一条工作流
  4. 如果不属于以上场景,不要发挥。返回固定话术:
     TODO:兜底话术,告诉用户支持什么、该怎么做

  ## 工作流:
  1. 如果 TODO(触发条件一),执行 TODO(工作流英文名一)
  2. 如果 TODO(触发条件二),执行 TODO(工作流英文名二)
  3. 如果 TODO(触发条件三);若缺少必要输入,不要执行任何工作流,
     直接提示用户补齐再来

  ## 输出格式:
  TODO:无特定格式 / Markdown / 固定小节

  ## 限制:
  - 多给用户鼓励而不是打击
  - 对用户屏蔽调用工作流等内部细节
  - TODO:本业务特有的限制

# ---------------------------------------------------------------------------
# 工作流清单:名称与描述是路由的唯一依据
# ---------------------------------------------------------------------------
workflows:
  - name: "TODO_workflow_one"          # 英文 + 数字 + 下划线;这个名字会出现在提示词里
    description: >
      TODO:写清「什么时候该调它」,而不是「它内部怎么实现」。
      这段描述是模型选择工作流的依据,写成实现细节等于没写。
    inputs:
      - { name: "TODO_param", type: "string", required: true }
    published: true                     # KEEP:只有发布过的工作流才能被智能体调用

  - name: "TODO_workflow_two"
    description: "TODO"
    inputs:
      - { name: "TODO_param", type: "file", required: true }
    published: true

# ---------------------------------------------------------------------------
# 开场白与预置问题:降低用户的启动成本
# ---------------------------------------------------------------------------
opening:
  greeting: |
    TODO:一句自我介绍 + 支持哪几件事 + 操作三步走
    操作流程:
    1. TODO
    2. TODO
    3. 等待结果返回
  suggestions:
    - "TODO:预置问题一(上传文件后点击)"
    - "TODO:预置问题二(上传文件后点击)"
    - "TODO:预置问题三(上传文件后点击)"

# ---------------------------------------------------------------------------
# 发布:渠道决定了它能被谁用、怎么用
# ---------------------------------------------------------------------------
publish:
  channels:
    - store                # 平台内的商店,给人直接聊
    - api_sdk              # KEEP:要在自己的程序里调用,这一项必须勾上,否则 bot_id 调不通
  checklist:
    - "所有引用的工作流都已单独试运行通过"
    - "所有引用的工作流都已发布,不是草稿状态"
    - "数据库的线上环境数据已导入,不能只有测试环境有数据"
    - "知识库内容已完成处理,不是还在解析中"
    - "兜底话术实测过一次:随便说句闲聊,看它是不是老老实实拒绝"
    - "发布记录写清这一版改了什么,出问题时才知道回滚到哪一版"

# ---------------------------------------------------------------------------
# 上线后的观测项:不看这些,出了问题只能靠用户投诉才知道
# ---------------------------------------------------------------------------
observability:
  - "调用量与失败率:失败率突然抬头,先查是不是某条工作流发布了新版本"
  - "单次耗时分布:含循环的工作流耗时长尾很长,要给前端配合适的等待提示"
  - "token 消耗趋势:循环 + 长上下文模型是消耗大户,突增往往意味着有人传了超长输入"
  - "兜底话术触发率:太高说明路由描述写得不好,用户的正常请求被挡在门外了"
提示词的核心逻辑只有两件事:什么情况下调用什么工作流,以及处理不了的场景怎么回复。后者就是兜底话术——把它写死成一句固定回复(告诉用户支持哪几件事、该怎么做、有问题找谁),而不是让模型自由发挥。没有兜底话术的智能体,遇到闲聊就会开始编。
编排面板上要配三样:模型(选理解能力好一些的,它要负责听懂用户的意思)、三条工作流(必须全部加进来,否则模型挑不到)、开场白与预置问题。开场白要言简意赅地说清"我能干什么、你该怎么操作";预置问题直接写成可点击的引导语,降低用户的启动成本。
发布工作流时如果出现"没试运行过"的提醒,不要抱侥幸心理直接发。把风险前置:越早发现问题,整个工程的质量越容易把控。
还有一件容易漏的事:数据库分测试环境和线上环境,两套数据互相隔离。调试时写入的是测试环境,发布之后从商店、接口等渠道调用时读的是线上环境。所以上线前,同样的数据导入操作,线上环境也要做一遍——否则会出现"调试时好好的,一发布违禁词全查不到"。
4.6 批处理入口:把智能体当成一个命令行工具
老师要批量处理一沓简历或一堆录音,不可能一个个在对话框里传。这时候把已发布的智能体当成一个远程服务,用代码循环调用:
"""批处理:把已发布的智能体当成一个命令行工具,扫一个目录跑完。

交互逻辑留在平台上(工作流、提示词、知识库随时改),调度逻辑留在代码里
(遍历、限速、重试、落盘、断点续跑)。三类任务共用同一套骨架,区别只有
收哪些扩展名、发哪句指令,所以用一张表集中差异,不复制三份函数。
"""
from __future__ import annotations

import argparse
import sys
import time
from pathlib import Path

from coze_chat_stream import build_message, chat_stream, upload_file
from coze_client import build_sdk_client
from coze_retry import RateLimiter, call_with_retry
from coze_settings import CozeSettings, MissingConfig

# 任务名 → (可处理的扩展名, 发给智能体的指令, 输出子目录)
TASKS = {
    "resume": ({".pdf", ".doc", ".docx"}, "帮我看看简历", "resume_evaluated"),
    "audio": ({".mp3", ".wav", ".ogg"}, "帮我分析一下面试录音", "audio_evaluated"),
    "question": ({".pdf", ".doc", ".docx"}, "帮我生成一下面试题", "question_generated"),
}


def collect_files(root: Path, extensions: set) -> list:
    """递归收集待处理文件;顺序稳定,续跑才接得上。"""
    return [p for p in sorted(root.rglob("*")) if p.is_file() and p.suffix.lower() in extensions]


def handle_one(coze, settings: CozeSettings, path: Path, instruction: str, out_dir: Path) -> Path:
    """单文件:上传 → 对话 → 落盘,返回结果路径。"""
    uploaded = upload_file(coze, str(path))
    messages = [build_message(uploaded.id, str(path), instruction)]
    answer = chat_stream(coze, settings, messages)

    if not answer.strip():
        # 空结果不能当成功:多半是编排提示词没命中这个场景,或工作流中途失败。
        raise RuntimeError("返回内容为空,检查智能体编排提示词是否覆盖了这个指令")

    out_dir.mkdir(parents=True, exist_ok=True)
    out_file = out_dir / (path.stem + ".md")
    out_file.write_text(answer, encoding="utf-8")
    return out_file


def run_batch(task: str, directory: str, *, interval: float, attempts: int, resume: bool) -> int:
    if task not in TASKS:
        print("未知任务 %s,可选:%s" % (task, "、".join(TASKS)))
        return 2
    extensions, instruction, out_name = TASKS[task]

    root = Path(directory)
    if not root.is_dir():
        print("不是一个目录:%s" % directory)
        return 2

    try:
        settings = CozeSettings.from_env(need_bot=True)
    except MissingConfig as exc:
        print("配置缺失:%s" % exc)
        return 3
    coze = build_sdk_client(settings)
    if coze is None:
        print("未安装 SDK,先执行 pip install cozepy")
        return 3

    files = collect_files(root, extensions)
    out_dir = root / out_name
    if resume:
        done = {p.stem for p in out_dir.glob("*.md")} if out_dir.exists() else set()
        skipped = [f for f in files if f.stem in done]
        files = [f for f in files if f.stem not in done]
        print("续跑:跳过已完成 %d 个" % len(skipped))

    print("任务=%s  待处理 %d 个文件  输出到 %s" % (task, len(files), out_dir))
    limiter = RateLimiter(interval)
    started = time.time()
    ok, failed = 0, []

    for index, path in enumerate(files, start=1):
        print("\n[%d/%d] %s" % (index, len(files), path))
        limiter.wait()
        try:
            out_file = call_with_retry(
                lambda p=path: handle_one(coze, settings, p, instruction, out_dir),
                attempts=attempts,
            )
            ok += 1
            print("完成 → %s" % out_file)
        except Exception as exc:  # noqa: BLE001 - 单个文件失败不能中断整批
            failed.append((str(path), "%s: %s" % (type(exc).__name__, exc)))
            print("失败:%s" % exc)

    elapsed = time.time() - started
    print("\n" + "=" * 52)
    print("总计 %d 成功 %d 失败 %d 耗时 %.1fs" % (len(files), ok, len(failed), elapsed))
    for name, reason in failed:
        print("  失败:%s —— %s" % (name, reason))
    print("=" * 52)
    # 失败清单单独落盘,方便只重跑这一批
    if failed:
        report = out_dir / "_failed.txt"
        out_dir.mkdir(parents=True, exist_ok=True)
        report.write_text("\n".join("%s\t%s" % item for item in failed), encoding="utf-8")
        print("失败清单:%s" % report)
    return 0 if not failed else 1


def main() -> int:
    parser = argparse.ArgumentParser(description="批量调用智能体处理一个目录")
    parser.add_argument("task", choices=sorted(TASKS), help="任务")
    parser.add_argument("directory", help="待处理目录")
    parser.add_argument("--interval", type=float, default=1.0, help="最小间隔秒")
    parser.add_argument("--attempts", type=int, default=3, help="最多尝试次数")
    parser.add_argument("--no-resume", action="store_true", help="重跑")
    args = parser.parse_args()
    return run_batch(
        args.task,
        args.directory,
        interval=args.interval,
        attempts=args.attempts,
        resume=not args.no_resume,
    )


if __name__ == "__main__":
    sys.exit(main())
三类任务(简历、录音、出题)共用同一套骨架,差别只有两处:收哪些扩展名和发哪句指令。所以用一张表把差异集中起来,而不是复制三份几乎一样的函数——这是代码侧的"不要抄第二遍"。
批处理真正的难点不是跑不通,而是跑了四十份挂了。所以这份代码里有四个非功能性设计:
| 设计 | 解决什么 | 怎么做的 |
|---|---|---|
| 限速 | 主动限速比被限流后再退避划算 | 两次调用之间保证最小间隔;具体设多少去平台用量页面查自己账号的限制 |
| 分类重试 | 可重试的错和写错了的错,处理方式相反 | 见下一段的 coze_retry.py |
| 断点续跑 | 中途挂了不用从头再来 | 按输出目录里已有的结果跳过;文件顺序固定,保证每次接得上 |
| 空结果算失败 | 最容易被忽略的一条 | 返回内容为空说明编排提示词没命中或工作流中途失败,记成失败才会被重跑 |
"""错误处理与重试:把「偶发抖动」和「配置写错了」分开对待。

批量跑 100 份简历时,最耗人的不是跑不通,而是「跑了 40 份挂了」。原因分两类,
处理方式完全相反:可重试(网络抖动、5xx、限流、超时)等一会儿再来一次大概率就好;
不可重试(令牌过期、工作流没发布、参数名写错、格式不支持)重试一万次还是错,
只会烧额度、刷日志。核心不是「重试几次」,而是「哪些错该重试」。
"""
from __future__ import annotations

import random
import time
from typing import Callable, Iterable, TypeVar

from coze_client import CozeError

T = TypeVar("T")

# 这些 HTTP 状态码代表服务端侧的临时问题,值得退避后重来。
RETRIABLE_HTTP = {408, 425, 429, 500, 502, 503, 504}

# 这些异常类型代表本地环境或调用方式的问题,重试没有意义。
FATAL_EXC = (FileNotFoundError, ValueError, TypeError, KeyError)


def is_retriable(exc: BaseException) -> bool:
    """判断一个异常值不值得重试。"""
    if isinstance(exc, FATAL_EXC):
        return False
    if isinstance(exc, CozeError):
        code = exc.code
        if isinstance(code, int):
            # 4xx 里只有限流和请求超时值得重试,其余都是「你写错了」。
            if code in RETRIABLE_HTTP:
                return True
            if 400 <= code < 500:
                return False
        # 业务错误码拿不准时,保守地不重试:宁可报错让人看一眼,
        # 也不要闷头重试把配额烧掉。
        return False
    if isinstance(exc, TimeoutError):
        return True
    # 网络层异常(连接重置、DNS 抖动)通常是 OSError 的子类。
    return isinstance(exc, OSError)


def backoff_delays(attempts: int, base: float = 1.0, cap: float = 30.0) -> Iterable[float]:
    """指数退避 + 抖动。

    指数退避:1s、2s、4s、8s……给下游一个恢复的窗口。
    抖动:如果 100 个并发任务同时失败、又同时在第 1 秒重试,
    就会形成一波整齐的二次冲击。加一点随机偏移把它们打散。
    """
    for i in range(attempts):
        delay = min(cap, base * (2 ** i))
        yield delay * (0.5 + random.random() * 0.5)


def call_with_retry(
    func: Callable[[], T],
    *,
    attempts: int = 3,
    base: float = 1.0,
    on_retry: Callable[[int, BaseException, float], None] | None = None,
) -> T:
    """执行 func,失败时按策略重试。成功返回结果,最终失败抛出最后一个异常。

    attempts 是总次数不是额外次数:attempts=3 表示最多跑 3 次。
    """
    last_exc: BaseException | None = None
    delays = list(backoff_delays(attempts, base=base))

    for attempt in range(1, attempts + 1):
        try:
            return func()
        except BaseException as exc:  # noqa: BLE001 - 这里就是要统一分类
            last_exc = exc
            if attempt >= attempts or not is_retriable(exc):
                raise
            delay = delays[attempt - 1]
            if on_retry:
                on_retry(attempt, exc, delay)
            else:
                print("第 %d 次失败(%s),%.1fs 后重试" % (attempt, exc, delay))
            time.sleep(delay)

    assert last_exc is not None
    raise last_exc


class RateLimiter:
    """最简单的令牌间隔限速器:保证两次调用之间至少隔 interval 秒。

    批处理时主动限速,比被平台限流后再退避更划算:
    被限流会浪费一次请求、一次等待,还可能影响同空间的其他任务。
    具体该设多少,取决于账号的并发与调用限制——去平台的用量页面查,
    别照抄别人的数字。
    """

    def __init__(self, interval: float = 0.0):
        self.interval = interval
        self._last = 0.0

    def wait(self) -> None:
        if self.interval <= 0:
            return
        now = time.monotonic()
        gap = now - self._last
        if gap < self.interval:
            time.sleep(self.interval - gap)
        self._last = time.monotonic()


if __name__ == "__main__":
    # 一个自包含的演示:前两次抛可重试错误,第三次成功。
    state = {"n": 0}

    def flaky() -> str:
        state["n"] += 1
        if state["n"] < 3:
            raise CozeError("网关抖动", code=502)
        return "第 %d 次成功" % state["n"]

    print(call_with_retry(flaky, attempts=4, base=0.05))

    def broken() -> str:
        raise CozeError("工作流未发布", code=400)

    try:
        call_with_retry(broken, attempts=4, base=0.05)
    except CozeError as exc:
        print("不可重试,立即失败:%s" % exc)
重试策略的核心不是"重试几次",而是"哪些错该重试"。网络抖动、网关 5xx、限流、超时——等一会儿再来大概率就好了;令牌过期、工作流没发布、参数名写错、文件格式不支持——重试一万次也还是错,只会把额度烧光、把日志刷满。
退避里那个抖动值得单说:如果一百个任务同时失败、又同时在第 1 秒重试,就会形成一波整齐的二次冲击。加一点随机偏移把它们打散,是分布式调用里的标准动作。
项目收益怎么算
最后一步是很多人会跳过、但在真实工作里绕不开的:这个项目到底值不值。衡量口径必须回到立项时的需求——这个项目是为了解决人效问题,那就只能用人效来衡量:
| 指标 | 怎么算 | 说明 |
|---|---|---|
| 调用量 | 试点范围内的使用比例与人均调用次数 | 没人用的功能,效果再好也等于零 |
| 问题召回数 | 累计发现的问题数 / 人均发现数 | 证明它确实在干活,而不只是在跑 |
| 人力节省比 | 单次人工耗时 × 调用次数 → 折算成人天 | 这才是立项时承诺的那个收益 |
例外是纯技术类项目——比如客户明确要求分类准确率达到某个数才付款,那时准确率就等价于业务收益。判断标准是:立项时承诺的是什么。
同样要写下来的是没做的部分:软件工程永远是在时间、成本、质量之间取舍,投入越多质量越好,但成本和时间不是无限的。这个项目明确留了几个优化方向到下一期——换效果更好的模型、把查重扩展到学生之间互相比对、记录调用过程中的各类信息以便分析岗位需求分布、替换识别效果更好的解析插件。把"知道但这一期不做"写清楚,和把做了的写清楚一样重要。
05骨架模板:拿去改就能用
工作流结构、智能体编排、后端封装、本地 mock、多轮会话——五份可复制的底座
前面四节的东西,抽掉业务之后剩下的就是这几份模板。每一份都标了 TODO,只改标记处,其余不用动。
5.1 工作流结构骨架
见第 04 节的 workflow_resume_review.json。它不是平台的导入文件,而是把一条工作流写成可评审的三件事:节点、边、变量契约。文件末尾那四条 invariants 是通用的,任何一条工作流都该过一遍:
| 约束 | 怎么自查 |
|---|---|
| 必须是有向无环图 | 顺着每条边走一遍,看有没有绕回祖先。绕回去了平台会拦,但先自己发现更省事 |
| 只能引用祖先的输出 | 逐个节点看输入面板的来源。引用不到,说明这条边没连 |
| 并行分支之间不得互引 | 要共享的数据,往上提到它们共同的祖先节点产出 |
| 汇聚点等齐所有上游 | 整合节点是整条线路的耗时上限,优化时先看它等的是谁 |
5.2 智能体编排模板
见第 04 节的 agent_orchestration.yaml。为什么值得单独落成文件:平台上的编排框是一个输入框,改了就覆盖,没有历史。放进版本管理,才能回答"上周还好好的,谁改了什么"。定稿后原样贴回平台即可。
文件里有两处被标成 KEEP 的结构不要动:
- 模式选择要连理由一起写(
mode_rationale)。半年后有人问"为什么不用 Multi-Agent",这段话就是答案。 - 发布前的检查清单。六条里有四条是靠踩坑换来的:工作流是不是草稿、线上环境数据导了没、知识库处理完了没、兜底话术实测过没有。
反例:「本工作流通过文档解析插件提取文本后分六块并行评估」——全是实现细节,模型读完还是不知道什么时候该用它。
正例:「用户上传了简历文件,想知道简历有哪些问题、该怎么改时调用」。
5.3 把平台当后端:最小 Web 服务封装
第 03 节说过,令牌绝不能下发到浏览器。正确的形状是:浏览器 → 自己的后端(带自己的登录态)→ 平台接口。
"""把平台当后端:一个最小的 FastAPI 封装,前端只认自己的域名。

不让前端直连平台:令牌会暴露、没法鉴权与配额、没法换供应商。
正确形状:浏览器 → 自己的后端(带登录态)→ 平台 OpenAPI。

运行:
    pip install fastapi uvicorn cozepy
    uvicorn coze_backend:app --host 127.0.0.1 --port 8000
"""
from __future__ import annotations

import json
import tempfile
from pathlib import Path
from typing import Iterator

from fastapi import Depends, FastAPI, File, Form, Header, HTTPException, UploadFile
from fastapi.responses import StreamingResponse

from coze_chat_stream import build_message, upload_file
from coze_client import build_sdk_client
from coze_settings import CozeSettings

app = FastAPI(title="面试助手网关", version="1.0")

# 进程启动时装配一次,失败就直接起不来——比运行到一半才发现配置错要好。
SETTINGS = CozeSettings.from_env(need_bot=True)
COZE = build_sdk_client(SETTINGS)

# 允许的上传类型。白名单而不是黑名单:没想到的格式默认拒绝。
ALLOWED_SUFFIX = {".pdf", ".doc", ".docx", ".mp3", ".wav", ".ogg"}
MAX_BYTES = 32 * 1024 * 1024


def current_user(authorization: str = Header(default="")) -> str:
    """登录态 → 用户标识。平台侧 user_id 用自己的业务 ID,日志、配额、审计才对得上。"""
    if not authorization.startswith("Bearer "):
        raise HTTPException(status_code=401, detail="未登录")
    token = authorization[len("Bearer "):].strip()
    if not token:
        raise HTTPException(status_code=401, detail="未登录")
    # TODO: 换成真实的会话校验,返回业务用户 ID
    return "user-" + token[:8]


def save_upload(upload: UploadFile) -> Path:
    """把上传流落到临时文件,顺便做大小与类型校验。"""
    suffix = Path(upload.filename or "").suffix.lower()
    if suffix not in ALLOWED_SUFFIX:
        raise HTTPException(status_code=415, detail="不支持的文件类型 %s" % suffix)

    tmp = Path(tempfile.mkdtemp()) / (Path(upload.filename or "upload").name)
    size = 0
    with tmp.open("wb") as fh:
        while True:
            chunk = upload.file.read(1024 * 256)
            if not chunk:
                break
            size += len(chunk)
            if size > MAX_BYTES:
                raise HTTPException(status_code=413, detail="文件过大")
            fh.write(chunk)
    return tmp


def sse(payload: dict) -> str:
    """按 SSE 格式打包一条消息。"""
    return "data: %s\n\n" % json.dumps(payload, ensure_ascii=False)


def relay(file_path: Path, instruction: str, user_id: str) -> Iterator[str]:
    """把平台的事件流翻译成自己的事件流,中间加一层自己的协议。"""
    from cozepy import ChatEventType  # type: ignore

    try:
        uploaded = upload_file(COZE, str(file_path))
        messages = [build_message(uploaded.id, str(file_path), instruction)]
        stream = COZE.chat.stream(
            bot_id=SETTINGS.bot_id,
            user_id=user_id,
            additional_messages=messages,
            parameters={},
        )
        yield sse({"type": "start", "logid": getattr(stream.response, "logid", "")})

        for event in stream:
            if event.event == ChatEventType.CONVERSATION_MESSAGE_DELTA:
                if getattr(event.message, "reasoning_content", None):
                    continue          # 思考过程不外发给终端用户
                yield sse({"type": "delta", "text": event.message.content or ""})
            elif event.event == ChatEventType.CONVERSATION_CHAT_COMPLETED:
                yield sse({"type": "done", "tokens": event.chat.usage.token_count})
                break
            elif event.event == ChatEventType.CONVERSATION_CHAT_FAILED:
                yield sse({"type": "error", "message": str(event.chat.last_error)})
                break
    except Exception as exc:  # noqa: BLE001 - 流里不能抛异常,只能作为事件发出
        yield sse({"type": "error", "message": "%s: %s" % (type(exc).__name__, exc)})
    finally:
        # 临时文件用完即删,避免隐私数据堆在磁盘上。
        try:
            file_path.unlink(missing_ok=True)
        except OSError:
            pass


@app.post("/api/analyze")
def analyze(
    file: UploadFile = File(...),
    instruction: str = Form("帮我看看简历"),
    user_id: str = Depends(current_user),
):
    """上传一个文件并流式拿回分析结果。"""
    saved = save_upload(file)
    return StreamingResponse(
        relay(saved, instruction, user_id),
        media_type="text/event-stream",
        headers={"Cache-Control": "no-cache", "X-Accel-Buffering": "no"},
    )


@app.get("/api/health")
def health() -> dict:
    """健康检查。只暴露「配好了没有」,绝不回显令牌本身。"""
    return {"ok": COZE is not None, "bot_configured": bool(SETTINGS.bot_id)}
这一层解决四个问题,缺一个都会在上线后变成事故:
| 问题 | 不做这一层会怎样 | 这份模板怎么做的 |
|---|---|---|
| 令牌暴露 | 前端拿得到的东西等于公开,额度被人白嫖 | 令牌只存在于服务端进程的环境变量 |
| 没有鉴权与配额 | 谁都能调,调多少次都行 | current_user() 挂自己的登录态,平台侧的 user_id 用自己的业务 ID,日志和审计才对得上 |
| 锁死在一家供应商 | 想迁走就得改前端 | 不把平台的事件结构原样透出去,中间加一层自己的协议 |
| 上传没有边界 | 随便传什么、传多大都行 | 扩展名白名单(不是黑名单)+ 大小上限 + 用完即删 |
relay() 里把所有异常都转成一条 error 事件发出去,并在 finally 里删掉临时文件——简历、录音都是隐私数据,不能堆在磁盘上。
5.4 多轮会话:不要自己拼历史
做成对话式产品就会需要多轮。这里有一个常见的错误做法:在本地把历史消息攒起来,每次请求都整个塞进去。既容易漏,也会把上下文撑爆(第 02 节的上下文腐烂在这里同样成立)。
正确做法是把 conversation_id 传过去,让平台去管:
"""会话、消息、对话、上下文段落:四个对象的关系,以及多轮怎么接。

平台把一次交互拆成四个对象,名字很像,职责完全不同:

- 会话 Conversation:一段问答交互的容器,装着消息,自动处理截断。
- 消息 Message:用户或智能体创建的一条内容,可以是文本、图片或文件。
- 对话 Chat:在某个会话里对智能体的一次调用,会往会话里追加消息。
- 上下文段落 Section:会话内部的独立段落。用户点「清除上下文」时系统开一个
  新 Section,新对话不再受之前消息影响。

一句话记:会话是账本,消息是流水,对话是一次记账动作,段落是账本里的分页。

多轮对话怎么接:不要自己在本地拼历史消息塞进请求里——
把 conversation_id 传过去,平台会把这个会话的历史当上下文送给模型;自己拼既容易漏,也容易撑爆。
"""
from __future__ import annotations

import sys

from coze_client import build_sdk_client
from coze_settings import CozeSettings, MissingConfig


def create_conversation(coze):
    """新建会话。一个用户的一个业务场景对应一个会话。"""
    conversation = coze.conversations.create()
    print("会话已创建:conversation_id=%s" % conversation.id)
    return conversation


def ask_in_conversation(coze, settings: CozeSettings, conversation_id: str, text: str) -> str:
    """在指定会话里发起一次流式对话,返回拼好的正文。

    与 coze_chat_stream.py 的区别只有一个参数:多传了 conversation_id。
    多了这个参数,模型就看得见这个会话里之前说过的话。
    """
    from cozepy import ChatEventType, Message  # type: ignore

    parts: list[str] = []
    stream = coze.chat.stream(
        bot_id=settings.bot_id,
        user_id=settings.user_id,
        conversation_id=conversation_id,
        additional_messages=[Message.build_user_question_text(text)],
    )
    for event in stream:
        if event.event == ChatEventType.CONVERSATION_MESSAGE_DELTA:
            if getattr(event.message, "reasoning_content", None):
                continue
            piece = event.message.content or ""
            parts.append(piece)
            print(piece, end="", flush=True)
        elif event.event == ChatEventType.CONVERSATION_CHAT_COMPLETED:
            print("\n[token 用量 %s]" % event.chat.usage.token_count)
            break
        elif event.event == ChatEventType.CONVERSATION_CHAT_FAILED:
            print("\n[失败 %s]" % event.chat.last_error)
            break
    return "".join(parts)


def demo_multi_turn() -> int:
    """两轮对话的最小演示:第二轮只说「那它呢」,靠会话上下文还原指代。"""
    try:
        settings = CozeSettings.from_env(need_bot=True)
    except MissingConfig as exc:
        print("配置缺失:%s" % exc)
        return 3

    coze = build_sdk_client(settings)
    if coze is None:
        print("未安装 SDK,先执行 pip install cozepy")
        return 3

    conversation = create_conversation(coze)

    print("\n第一轮 >>> 帮我生成面试题需要准备什么?")
    ask_in_conversation(coze, settings, conversation.id, "帮我生成面试题需要准备什么?")

    # 第二轮故意说得很省略。如果不传 conversation_id,模型无从知道「它」指什么;
    # 传了,平台会把第一轮的问答一起送进去,指代就能解析。
    print("\n第二轮 >>> 那录音分析呢?")
    ask_in_conversation(coze, settings, conversation.id, "那录音分析呢?")
    return 0


if __name__ == "__main__":
    sys.exit(demo_multi_turn())
四个对象名字很像,职责完全不同,一张表分清:
| 对象 | 是什么 | 比喻 |
|---|---|---|
| 会话 Conversation | 一段问答交互的容器,装着一条条消息,能自动处理截断 | 一本账本 |
| 消息 Message | 用户或智能体创建的一条内容,可以是文本、图片或文件 | 账本里的一笔流水 |
| 对话 Chat | 在某个会话里对智能体的一次调用;产生的消息会被追加进这个会话 | 一次记账动作 |
| 上下文段落 Section | 会话内部的独立段落。用户清除上下文时系统开一个新段落,新对话不再受历史影响 | 账本里的分页 |
代码里的两轮演示刻意把第二句说得很省略("那录音分析呢?")。不传 conversation_id,模型无从知道"那"指什么;传了,平台会把第一轮的问答一起送进去,指代就能解析。
5.5 本地 mock:把平台换成一个行为可控的假对象
调试自己这一侧的遍历、重试、落盘逻辑时,每改一行就真跑一次既慢又贵。更重要的是,出问题时要能回答一个问题:是我的代码错了,还是平台那边变了?
"""本地 mock:没有令牌、没有网络,也能把自己这一侧的链路调通。

为什么要 mock:调试遍历、重试、落盘逻辑时,每改一行就真跑一次既慢又贵;
出问题时还要能回答「是我错了还是平台变了」——换成行为可控的假对象,答案立刻清楚。

用法:直接 python coze_mock.py 看假事件流;或在 coze_batch.py 里把
    build_sdk_client(...) 换成 MockCoze(),即可全程离线跑批。
"""
from __future__ import annotations

import random
import time
from dataclasses import dataclass, field
from pathlib import Path
from typing import Iterator, List


# ---- 事件类型常量:与 SDK 的枚举同名,便于替换时业务代码一行不改 ----
class ChatEventType:
    CONVERSATION_MESSAGE_DELTA = "conversation.message.delta"
    CONVERSATION_CHAT_COMPLETED = "conversation.chat.completed"
    CONVERSATION_CHAT_FAILED = "conversation.chat.failed"


@dataclass
class _Message:
    content: str = ""
    reasoning_content: str = ""


@dataclass
class _Usage:
    token_count: int = 0


@dataclass
class _Chat:
    usage: _Usage = field(default_factory=_Usage)
    last_error: str = ""


@dataclass
class _Event:
    event: str
    message: _Message = field(default_factory=_Message)
    chat: _Chat = field(default_factory=_Chat)


@dataclass
class _Response:
    logid: str = "mock-logid-0000"


@dataclass
class _File:
    id: str


class _MockStream:
    """把一段文字切成若干片,模拟流式返回;按概率注入一次失败。"""

    def __init__(self, text: str, *, fail_rate: float, delay: float):
        self.text = text
        self.fail_rate = fail_rate
        self.delay = delay
        self.response = _Response()

    def __iter__(self) -> Iterator[_Event]:
        if random.random() < self.fail_rate:
            # 故意造一次失败,用来验证上层的重试与失败清单是否真的生效。
            yield _Event(ChatEventType.CONVERSATION_CHAT_FAILED,
                         chat=_Chat(last_error="mock: 上游超时"))
            return

        step = max(8, len(self.text) // 12)
        for i in range(0, len(self.text), step):
            time.sleep(self.delay)
            yield _Event(ChatEventType.CONVERSATION_MESSAGE_DELTA,
                         message=_Message(content=self.text[i:i + step]))
        yield _Event(ChatEventType.CONVERSATION_CHAT_COMPLETED,
                     chat=_Chat(usage=_Usage(token_count=len(self.text) * 2)))


class _MockFiles:
    def __init__(self):
        self.uploaded: List[str] = []

    def upload(self, file):
        path = Path(str(file))
        if not path.exists():
            raise FileNotFoundError("文件不存在:%s" % path)
        self.uploaded.append(str(path))
        return _File(id="mock-file-%04d" % len(self.uploaded))


class _MockChat:
    def __init__(self, fail_rate: float, delay: float):
        self.fail_rate = fail_rate
        self.delay = delay
        self.calls = 0

    def stream(self, **kwargs):
        self.calls += 1
        # 回显调用参数,方便确认业务代码真的把 bot_id / user_id 传对了。
        preview = "bot_id=%s user_id=%s" % (kwargs.get("bot_id"), kwargs.get("user_id"))
        text = (
            "## 评估结果(mock)\n\n"
            "本地 mock 生成的假结果,用来验证链路而不消耗额度。\n\n"
            "- 调用参数:%s\n- 消息条数:%d\n" % (preview, len(kwargs.get("additional_messages") or []))
        )
        return _MockStream(text, fail_rate=self.fail_rate, delay=self.delay)


class MockCoze:
    """行为与真实客户端同形的假客户端。

    fail_rate 调高可以专门演练失败路径;delay 调 0 可以让整批秒跑完。
    """

    def __init__(self, *, fail_rate: float = 0.0, delay: float = 0.01):
        self.files = _MockFiles()
        self.chat = _MockChat(fail_rate, delay)


def build_mock_message(file_id: str, file_path: str, instruction: str) -> dict:
    """与真实 build_message 同形的替身:返回一个普通 dict 即可。"""
    return {"file_id": file_id, "path": file_path, "text": instruction}


if __name__ == "__main__":
    coze = MockCoze(fail_rate=0.0, delay=0.0)
    here = Path(__file__)
    uploaded = coze.files.upload(file=here)
    print("mock 上传:", uploaded.id)

    stream = coze.chat.stream(
        bot_id="mock-bot",
        user_id="mock-user",
        additional_messages=[build_mock_message(uploaded.id, str(here), "帮我看看简历")],
    )
    print("logid:", stream.response.logid)
    buffer = []
    for event in stream:
        if event.event == ChatEventType.CONVERSATION_MESSAGE_DELTA:
            buffer.append(event.message.content)
        elif event.event == ChatEventType.CONVERSATION_CHAT_COMPLETED:
            print("".join(buffer))
            print("token:", event.chat.usage.token_count)
        elif event.event == ChatEventType.CONVERSATION_CHAT_FAILED:
            print("失败:", event.chat.last_error)
它和真实客户端同形:同样的 files.upload()、同样的 chat.stream()、同样的事件类型常量名。所以在批处理脚本里把构造客户端那一行换掉,其余代码一个字都不用改。
fail_rate调高 → 专门演练失败路径,验证重试和失败清单是不是真的生效;delay调成 0 → 整批秒跑完,专心调遍历和落盘逻辑;- 假的返回里会回显收到的调用参数,顺手确认
bot_id/user_id真的传对了。
没有这一刀,排查时永远在"改一行、真跑一次、猜一猜"的循环里打转。
5.6 五份模板怎么选
| 模板 | 什么时候用 | 它替你省掉的事 |
|---|---|---|
workflow_resume_review.json | 设计或评审一条工作流 | 把"看画布截图猜逻辑"变成"读三件事" |
agent_orchestration.yaml | 配置一个智能体 | 编排提示词有版本、有理由、有发布清单 |
coze_backend.py | 要接进自家产品 | 令牌不泄漏、能换供应商、上传有边界 |
coze_conversation.py | 要做多轮对话 | 不用自己攒历史、不用自己处理截断 |
coze_mock.py | 调试自己这一侧的逻辑 | 不烧额度、不等几十秒、能把问题一分为二 |
再加上第 03、04 节的 coze_settings.py、coze_client.py、coze_ping.py、coze_chat_stream.py、coze_workflow_run.py、coze_retry.py、coze_batch.py、coze_node_debug.py,就是一套完整的、从跑通到上线的工具箱。
"""统一客户端封装:SDK 优先,HTTP 兜底。

为什么要这一层:SDK 签名会随版本变,散着调就升级一次改一片;新接口 SDK 未必
跟上,只能走 HTTP;鉴权、超时、日志 ID、错误翻译这些横切逻辑只写一遍。

SDK 本质就是 HTTP 的封装:同一动作,SDK 里是一行方法调用,
HTTP 里是「拼一个鉴权头 + POST 一段 JSON」。
"""
from __future__ import annotations

import json
import urllib.error
import urllib.request
from typing import Any, Optional

from coze_settings import CozeSettings


class CozeError(RuntimeError):
    """平台返回的业务错误。带 code 与 logid,便于回后台查日志。"""

    def __init__(self, message: str, *, code: Any = None, logid: str = ""):
        super().__init__(message)
        self.code = code
        self.logid = logid

    def __str__(self) -> str:  # pragma: no cover - 仅用于打印
        parts = [super().__str__()]
        if self.code is not None:
            parts.append("code=%s" % self.code)
        if self.logid:
            parts.append("logid=%s" % self.logid)
        return "  ".join(parts)


def build_sdk_client(settings: CozeSettings):
    """官方 SDK 同步客户端(pip install cozepy)。未安装时返回 None,让调用方回退到 HTTP。"""
    try:
        from cozepy import Coze, TokenAuth  # type: ignore
    except ImportError:
        return None
    return Coze(auth=TokenAuth(token=settings.api_token), base_url=settings.api_base)


class HttpClient:
    """只依赖标准库的最小 HTTP 客户端,丢到哪台机器都能跑。"""

    def __init__(self, settings: CozeSettings):
        self.settings = settings

    def post_json(self, path: str, payload: dict, *, timeout: Optional[float] = None) -> dict:
        """POST 一段 JSON,返回解析后的 dict。path 与 api_base 拼成完整 URL。"""
        url = self.settings.api_base + path
        body = json.dumps(payload, ensure_ascii=False).encode("utf-8")
        headers = dict(self.settings.auth_header)
        headers["Content-Type"] = "application/json"

        request = urllib.request.Request(url, data=body, headers=headers, method="POST")
        try:
            with urllib.request.urlopen(request, timeout=timeout or self.settings.timeout) as resp:
                raw = resp.read().decode("utf-8")
                logid = resp.headers.get("x-tt-logid", "") or resp.headers.get("X-Tt-Logid", "")
        except urllib.error.HTTPError as exc:
            detail = exc.read().decode("utf-8", errors="replace")
            raise CozeError("HTTP %s:%s" % (exc.code, detail[:500]), code=exc.code) from exc
        except urllib.error.URLError as exc:
            raise CozeError("网络不可达:%s" % exc.reason) from exc

        try:
            data = json.loads(raw)
        except json.JSONDecodeError as exc:
            raise CozeError("响应不是合法 JSON:%s" % raw[:300]) from exc

        # 平台风格的响应里,HTTP 200 不代表业务成功,还要看 body 里的 code。
        # 这一步不做,错误会以「空结果」的形式一路渗到业务里,非常难排查。
        code = data.get("code")
        if code not in (None, 0):
            raise CozeError(data.get("msg") or "业务失败", code=code, logid=logid)
        if logid:
            data.setdefault("_logid", logid)
        return data

    def post_stream(self, path: str, payload: dict, *, timeout: Optional[float] = None):
        """POST 后按行读取 SSE 流,逐条 yield (event, data)。"""
        url = self.settings.api_base + path
        body = json.dumps(payload, ensure_ascii=False).encode("utf-8")
        headers = dict(self.settings.auth_header)
        headers["Content-Type"] = "application/json"
        headers["Accept"] = "text/event-stream"

        request = urllib.request.Request(url, data=body, headers=headers, method="POST")
        event_name = ""
        with urllib.request.urlopen(request, timeout=timeout or self.settings.timeout) as resp:
            for raw_line in resp:
                line = raw_line.decode("utf-8").rstrip("\r\n")
                if not line:
                    event_name = ""
                    continue
                if line.startswith("event:"):
                    event_name = line[len("event:"):].strip()
                elif line.startswith("data:"):
                    chunk = line[len("data:"):].strip()
                    if chunk in ("", "[DONE]"):
                        continue
                    try:
                        yield event_name, json.loads(chunk)
                    except json.JSONDecodeError:
                        yield event_name, {"raw": chunk}


def get_clients(settings: CozeSettings):
    """一次拿到 (sdk, http)。sdk 可能为 None,业务代码要判空。"""
    return build_sdk_client(settings), HttpClient(settings)


if __name__ == "__main__":
    cfg = CozeSettings.from_env()
    sdk, http = get_clients(cfg)
    print("配置:", cfg.describe())
    print("SDK 可用:", sdk is not None)
    print("HTTP 客户端就绪:", isinstance(http, HttpClient))
最后解释一下为什么要有 coze_client.py 这一层。三条理由:SDK 方法签名会随版本变化,业务代码直接散着调,升级一次改一片;有些新接口 SDK 还没跟上,只能走 HTTP,有这一层就不用在业务里混两套写法;鉴权、超时、日志 ID、错误翻译这些横切逻辑只写一遍。
code 字段里。只判 HTTP 状态码不判它,错误会以"结果为空"的形式一路渗进业务——而"空"在批处理里往往被当成成功。post_json() 里那几行判断不是可选项。
06易错点汇总
按「变量 / 节点 / 资源 / 编排与发布 / 接口调用 / 选型」六类归并,踩过一次就别再踩
⚠️ 一、变量与契约(铁律的六种现身方式)
- 提示词里的
{{变量名}}和输入面板对不上。不会报错,占位符原样进提示词,模型当普通文字读。现象是「怪但不报错」:字段莫名其妙为空、结论跑偏、同样输入两次结果差很多。所有排查从这里开始。 - 并行分支之间互相引用变量。并行分支没有先后关系,此刻读到的值是未定义的。要共享的数据,必须来自它们共同的祖先节点——比如分块节点单独产出的那段
context。 - 循环体内部去够外面的临时值。循环体是独立的小上下文。外面的东西要用就显式传进去,循环的产出也要在出口处显式汇总,不会自动漏出来。
- 解析插件的双字段只接了一个。传文档时内容落在一个字段,传网页地址时落在另一个字段,同一时刻只有一个有值。只接一个,遇到另一种输入就静默拿到空值。两个都往下传,在用户提示词里写「输入为 A;如果为空,则 B」。
- 接口调用时
parameters的键名和开始节点对不上。多一个、少一个、大小写不同都不行。这是铁律在接口层的样子。 - LLM 节点声明输出 JSON,实际返回带代码围栏的文本。下游按对象取值会拿到空,而且不报错。本地先用
coze_node_debug.py的check_json_output()把这份契约验一遍。
⚠️ 二、节点使用
- 把该用选择器的判断交给了意图识别。「输入为空」「扩展名不对」「必填项缺失」这类用代码就能判的,用选择器一次模型调用都不用花。顺序反过来,就是在给垃圾输入付模型的钱。
- 分支节点放得太靠后。分支越靠前,后面白跑的路径越少。含循环和检索的长工作流尤其明显——录音分析那条如果不在角色划分处拦截非面试录音,一段无关音频会跑完全部循环。
- 让一个 LLM 节点干太多活。结果飘、幻觉多时,第一反应不该是换更强的模型,而是先问能不能拆。工作流可以加无数个 LLM 节点,分治的成本很低。
- 一次把整个数组丢给模型处理。「一次评 5 个项目」的质量一定低于「5 次各评 1 个」。这是上下文腐烂,不是模型不行。
- 把代码节点当成万能逃生舱。平台运行环境受限:可用的第三方依赖很少、做网络请求的那个是异步版本要配
await、阻塞式 sleep 会拖垮性能。要在里面写完整个业务,说明这个需求本来就不该用低代码做。 - 语音识别节点用默认超时。面试录音动辄几分钟,默认超时必然中途失败。把超时调到最大。
- 被「标红但能跑」的类型提示吓住。上游传音频/图片、节点声明要字符串链接时,平台会自动转换。判断依据是试运行的实际结果,不是那个红框。
- 指望识别节点直接给出带标点的文本。它不负责这个。后面追加一个 LLM 节点润色即可——一个节点解决不了的,加一个节点,而不是换更贵的插件。
⚠️ 三、知识库与数据库
- 选反了。问「像不像」用知识库,问「是不是」用数据库。把违禁词塞知识库会漏判(语义检索找的是意思相近的段落,不是确切出现的词);把长文档塞数据库字段则只能整段取出丢给模型,上下文瞬间撑爆。
- 一套检索参数走天下。参数跟着「下游拿它干什么」走:查重要召回数量放大、阈值抬高;找标准答案要召回数量压小、阈值同样抬高。两者都该开查询改写与结果重排。
- 多轮场景忘了开查询改写。用户第二句只问「怎么用」,不改写就什么也查不到。
- 拿整段原文直接去检索。噪声太大,什么都像又什么都不像。先用一个 LLM 节点压成结构化摘要再检索——同时严格要求「不得添加杜撰内容」,否则查出来的雷同是假的。
- 忽略了切分策略。检索效果的上限在文档切分那一步就定了。切太碎,片段读不懂;切太整,一个片段混三个主题匹配度被稀释。分段选错,后面调再多参数也救不回来。
- 把会被多处引用的资源建在项目内部。事后要共享就得转移或复制,而复制出去的两份从此各走各的。真实事故:违禁词表被复制三份,改了一份,另外两条工作流照旧放行。
- 只导了测试环境数据。测试数据和线上数据互相隔离。调试时好好的,一发布违禁词全查不到,就是漏了线上这一份。
- 跨空间引用资源。空间之间资源与数据完全隔离。同一空间内能引用,跨空间不行——这是架构约束,不是权限开关。
⚠️ 四、编排与发布
- 工作流没发布就挂进智能体。只有发布过的工作流才能被使用。同理,智能体不发布到 API/SDK 渠道,程序端拿着 ID 也调不通。平台界面上看得见 ≠ 接口调得到。
- 没试运行就直接发布。会把 BUG 隐患带进智能体。把风险前置:越早发现问题,整个工程的质量越容易把控。
- 工作流描述写成了实现细节。单 Agent 自主规划模式下,描述就是路由规则本身。写「本流程通过解析插件提取文本后六块并行评估」等于没写;要写「用户上传简历、想知道有哪些问题该怎么改时调用」。
- 没有兜底话术。没有它,遇到闲聊模型就开始编。把它写死成一句固定回复,而不是让模型自由发挥。
- 场景只有两三个就上 Multi-Agent。拿复杂度换了个寂寞。场景少且好分辨,单 Agent 自主规划就够;场景多、或每个场景要维持自己的多轮人格,才值得上。
- 忘了路由是概率性的。单 Agent 自主规划下,同一句话偶尔会走错分支。对确定性有要求的链路,走直连工作流,别让模型来分派。
- 发布记录写成「更新」两个字。出问题时,发布记录是唯一能告诉你「回滚到哪一版」的东西。
- 改完提示词直接覆盖,没有留版本。平台的编排框改了就覆盖,没有历史。落成文件进版本管理,才能回答「上周还好好的,谁改了什么」。
⚠️ 五、接口调用与批处理
- 把令牌写死在源码里,或下发到浏览器。三条线不能破:不写进源码、不提交进 Git、不下发到前端。前端拿得到的东西等于公开。正确形状是浏览器 → 自己的后端 → 平台接口。
- 生产环境用个人访问令牌。它本质是预授权的明文令牌,保管不当极易泄露被盗用。只用于测试与调试,并限制范围和有效期;生产优先 OAuth。
- 只判 HTTP 状态码,不判响应体里的业务码。HTTP 200 不代表业务成功。不判它,错误会以「结果为空」的形式渗进业务,而空在批处理里常被当成成功。
- 把失败当成「结果为空」。流式返回里失败是一个专门的事件。不单独处理,失败的文件会被记成成功,永远不会被重跑。空结果也要按失败记。
- 把思考过程拼进了正文。深度思考模型会吐出推理内容,不加区分地追加,交付物里就混进模型的自言自语。
- 收到完成事件不退出循环。拿到 token 统计就该 break,否则一直挂着。
- 只传文件不说话。等于把材料塞给门市顾问却不说想去哪儿,编排提示词无从判断走哪条工作流。那句自然语言指令不能省。
- 无差别重试。令牌过期、工作流没发布、参数名写错,重试一万次也还是错,只会烧光额度、刷满日志。先分类,再决定重不重试。
- 退避不加抖动。一百个任务同时失败又同时在第 1 秒重试,会形成整齐的二次冲击。加随机偏移把它们打散。
- 批处理不做断点续跑。跑了四十份挂了就得从头再来。按输出目录里已有的结果跳过,并保证文件顺序稳定。
- 流式响应里抛异常。响应头发出去之后再抛,前端只看到连接莫名其妙断了。把异常转成一条 error 事件发出去。
- 临时文件不删。简历、录音都是隐私数据,用完即删,别堆在磁盘上。
- 硬背 SDK。每家设计接口的方式都不一样,参数多时全记住不可能。记住思路,去官方示例目录按文件名找最接近的那个改——这才是可持续的用法。
⚠️ 六、选型与判断
- 以为「开源版 = 在线版的本地副本」。两边能力边界差很远:插件生态、应用型项目、多模态、发布渠道、运营面板,开源版都有明显缩水。先问清楚自己缺的到底是「数据不出网」还是「插件生态」。
- 只看仓库首页的许可证标签。同样标着宽松协议,有的是原文照搬,有的是改过的版本外加附加条款——常见的两条是未经书面授权不得用其源码运营多租户环境,以及使用其前端时不得移除或修改控制台与应用中的 LOGO 和版权信息。这直接决定能不能对外卖服务。必须打开仓库根目录的 LICENSE 原文逐条读。
- 照抄别人记下来的星标数、价格、免费额度、并发上限。这些数字随时会变,写下来那一刻就开始失真。记方法不记数字:活跃度看最后一次提交时间,许可证看
license.spdx_id,价格和额度去平台的用量与计费页面查当下的值。 - 一上来就追求最优方案。抽样策略那一段是最好的例子:项目初期题库积累不多,最好的抽样和最简单的效果差不了多少,而复杂方案要多花人力。选边际收益最高的,不是选理论最好的。
- 把技术指标当项目收益。准确率、召回率是技术收益,只是中间过程指标。业务收益要落在立项时承诺的那个口径上——这个项目承诺的是人效,就只能用人效衡量。
- 不写「知道但这一期不做」。把砍掉的需求和优化方向写清楚,和把做了的写清楚一样重要。
07自测题
点击题目展开答案;能把这 10 题说清楚,这一讲就通了
智能体和 AI 应用的本质差别是什么?为什么说它们不互斥?
差别不在能力,在交互形态。智能体是对话驱动,心智是「跟我聊」,像个灵活响应的助手;AI 应用是界面驱动(表单、按钮),心智是「帮我做」,像个走固定流程的标准化工具。底层两者都靠工作流承载业务逻辑,原理层面区别不大。
不互斥是因为它们可以组合:应用负责收集结构化输入并呈现结果,处理过程中调用一个或多个智能体完成分析与生成。用本讲的比喻:应用是官网的预订表单,智能体是门市顾问,背后接的是同一批行程线路。
知识库和数据库怎么选?举一个选反了就会出事的例子。
口诀:问「像不像」用知识库,问「是不是」用数据库。知识库存文档、按语义找相近段落、结果不确定;数据库存结构化记录、按字段精确匹配、结果确定且擅长高频增删改查。
选反的例子:把违禁词表塞进知识库,查「这段话里有没有违禁词」会变成语义检索,召回的是意思相近的段落而不是确切出现的词,漏判必然发生。反过来把大段文档塞进数据库某个字段,想按语义找相关段落时无从下手,只能整段取出丢给模型,上下文瞬间撑爆。
要判断一个开源编排平台「还活着、值不值得押注」,该看哪三个指标?为什么不记具体数字?
三个可复核的硬指标:最后一次提交时间(pushed_at,最硬的一条)、星标数(stargazers_count,只看量级不抠零头)、许可证(license.spdx_id)。
不记数字是因为它们每天都在变,记下来那一刻就开始失真。记方法不记数字——这三个字段都在仓库的公共接口里,不需要任何令牌,一条 curl 就能取到,谁都能自己复核一遍。
特别提醒:spdx_id 取值为 NOASSERTION 时,说明不是标准协议原文,必须打开仓库根目录的 LICENSE 逐条读附加条款——比如「未经书面授权不得用其源码运营多租户环境」「使用其前端时不得移除或修改 LOGO 与版权信息」,这两条直接决定能不能拿它对外卖服务。
「工作流是一张有向无环图」这句话里,三个词各自意味着什么工程约束?
有向:边有方向,A→B 表示 A 先执行。没有方向就没有先后,「上游输出」这个概念不成立。
无环:任何边都不能指回祖先,否则死循环。这是硬约束,平台会直接拦住不让保存。
图:不是一条链,可以分叉也可以汇聚。意识不到这一点,就想不到用并行去省时间。
本讲的铁律是什么?它在实际操作中有哪几种现身方式?
铁律:工作流只认变量,不认上下文。每个节点是无状态的,只看得见自己输入面板里声明的那几个变量,不知道上游思考过什么,也不知道隔壁分支跑到哪了。而且拿不到值时不会报错,只会拿着空值继续往下做。
常见现身方式:① 提示词里的 {{变量名}} 和输入面板对不上,占位符原样进提示词;② 并行分支之间互相引用变量(此刻的值是未定义的);③ 循环体内部去够外面的临时值;④ 解析插件的双字段只接了一个;⑤ 接口调用时 parameters 的键名和开始节点不一致。
统一现象:怪,但不报错。所有这类故障,排查都从变量契约开始。
选择器和意图识别都是分支节点,凭什么决定用哪个?把顺序搞反会付出什么代价?
选择器是代码层面的逻辑判断(等于、包含、为空),结果完全确定、成本几乎为零;意图识别是让模型理解自然语言表达的目的,结果是概率性的、要花一次模型调用的 token。它通常有极速与完整两种模式:前者速度优先、一般不支持系统提示词,后者效果优先、适合复杂逻辑判断。
顺序搞反的代价:「输入是不是空的」「扩展名对不对」这类用选择器一次模型调用都不用花;先让意图识别去处理垃圾输入,等于在给垃圾输入付模型的钱。正确做法是用选择器先挡掉明显不合法的,再让意图识别处理真正需要理解的部分。
为什么要用循环一条一条处理,而不是把整个数组一次丢给模型?这个道理还能推出什么做法?
因为上下文腐烂(Context Rot):给模型的上下文不是越多越好,输入超过某个限度后理解和回答质量反而下降。好比让一个人写两万字的文章,质量一定比写两百字时差——不是他不会写,是注意力被摊薄了。
所以拆成 N 次单元素处理,首要目的是让每次的上下文短而干净,并行省时间只是顺带的好处。
推出的做法就是分治策略:分解 → 解决 → 合并。本讲里出现两次——把一份简历拆成六块并行评估,再把项目那块拆成一个个项目循环评估。由此还得到一个判断习惯:结果飘、幻觉多时,先问「这个节点是不是被塞了太多活、能不能拆」,而不是先换更强的模型。
同一个知识库,做「简历查重」和「找标准答案」,检索参数该怎么调?为什么不一样?
查重:召回数量放大(宁可多召回再筛,提高重复内容的召回率),最小匹配度抬高(防止只沾了个边的片段也被算成雷同)。
找标准答案:召回数量压到很小(多了会互相干扰),最小匹配度同样抬高(错的参考答案比没有参考答案更糟)。
两者都建议开查询改写(多轮里还原指代)和结果重排(把最相关的排到前面,因为模型的注意力本就偏向靠前内容)。
根本原因:参数是跟着「下游拿它干什么」走的,不是跟着知识库走的。另外要记住,检索效果的上限在文档切分那一步就定了,分段策略选错,后面调再多参数也救不回来。
单 Agent 自主规划和 Multi-Agent 怎么选?前者的路由依据是什么?
判断顺序是先数场景,再看人格:场景少且彼此容易分辨、但每个场景内部数据处理复杂 → 单 Agent 自主规划(绝大多数开发用这一种就够,加功能 = 加一条工作流 + 提示词里加一句话);场景多、或每个场景要维持自己的多轮人格 → Multi-Agent(典型例子是语音助手控制一堆彼此独立的家电)。场景只有两三个就上 Multi-Agent,是拿复杂度换了个寂寞。
单 Agent 自主规划的路由依据是工作流的名称和描述,而且是概率性的。所以描述这一段不是注释,它就是路由规则本身:要写「什么时候该调它」,不写「它内部怎么实现」。对确定性有要求的链路,别让模型分派,走直连工作流。
一个在平台上试运行得好好的智能体,程序端调用却报错,按什么顺序排查?
按前提条件从硬到软排:
① 工作流发布了吗——只有发布过的工作流才能被智能体使用,草稿状态对外不存在。
② 智能体发布了吗、勾了 API/SDK 渠道吗——不勾,拿着 ID 也调不通。界面上看得见 ≠ 接口调得到。
③ 令牌关联了这个工作空间、开通了对应接口权限吗——先跑连通性自检,能列出工作空间说明鉴权范围没错,列出来是空的多半是生成令牌时没勾上空间。
④ 参数对不对——直连工作流时,parameters 的键名必须和开始节点声明的变量名逐字一致。
⑤ 线上环境数据导了吗——数据库的测试与线上数据互相隔离,只导测试环境会出现「调试时好好的,一发布全查不到」。
⑥ 还是不行,就拿日志 ID 回平台后台查那一次执行。它在建立请求那一刻就有,所以要第一时间打出来。
为什么不能让前端直接调平台接口?中间那一层后端到底解决了哪几个问题?
最直接的原因:令牌会暴露。前端拿得到的东西等于公开,等于把自己的额度挂到公网上。正确形状是浏览器 → 自己的后端(带自己的登录态)→ 平台接口,令牌只存在于服务端进程的环境变量里。
这一层还解决另外三件事:鉴权与配额(谁能用、能用几次,只能在自己的服务里落规则;而且平台侧的 user_id 要用自己的业务 ID,日志和审计才对得上);可迁移性(不把平台的事件结构原样透出去,中间加一层自己的协议,换供应商时前端一行不改);上传边界(扩展名白名单而非黑名单、大小上限、用完即删——简历和录音都是隐私数据)。
补充一个流式场景的坑:响应头发出去之后不能再抛异常,否则前端只看到连接莫名其妙断了。要把异常转成一条 error 事件发出去。
批处理跑到一半失败了,哪些错该重试、哪些不该?除了重试还需要哪几样东西?
该重试:网络抖动、网关 5xx、限流、请求超时——等一会儿再来大概率就好。
不该重试:令牌过期、工作流没发布、参数名写错、文件格式不支持——重试一万次也还是错,只会烧光额度、刷满日志。
所以重试策略的核心不是「重试几次」,而是「哪些错该重试」。退避要用指数退避加抖动,否则一百个任务同时失败又同时在第 1 秒重试,会形成整齐的二次冲击。
另外三样:主动限速(比被限流后再退避划算,具体间隔去平台用量页面查自己账号的限制)、断点续跑(按输出目录里已有结果跳过,前提是文件遍历顺序稳定)、把空结果按失败记(返回为空说明编排提示词没命中或工作流中途失败,记成成功它就永远不会被重跑——这是最容易被忽略的一条)。
面试助手案例里,「把面试题写回数据库」这一步看起来只是顺手存一下,为什么说它是整个项目最值钱的地方?
因为它构成了一条数据闭环:录音分析工作流每处理一段录音,就往真题表里写进几道真实被问过的题;面试题生成工作流再把最近的一批真题取出来参与整合。用得越多,题库越贴近当下真实在问的内容,而这是任何公开资料都替代不了的。
更重要的是资产归属:插件会换、界面会改、平台都可能换掉,但沉在自己数据库和知识库里的东西带得走。做低代码项目时有意识地设计这样一条闭环,价值远高于多搭两个节点。
顺带一提,这一步在实现上还留了余地:公司字段先写空,等后续迭代再补「这题是哪家公司问的」——先把数据存下来,字段可以慢慢长。
词术语表
| 术语 | 含义 |
|---|---|
| Agent 智能体 | 能感知环境、分析信息、自主决策并采取行动的软件实体;常用拆法 Agent = LLM + 记忆 + 任务规划 + 工具使用 |
| AI 应用 | 具备完整业务逻辑和可视化界面的独立项目;界面驱动,输入输出明确 |
| 工作空间 | 资源组织与隔离的基础单元;不同空间之间的资源与数据互不可见 |
| 资源库 | 创建、发布、管理共享资源的地方:插件、工作流、对话流、知识库、数据库、提示词 |
| workflow 工作流 | 一张有向无环图,由边和节点构成:边代表执行顺序,节点表示一个具体的执行步骤 |
| 对话流 | 面向对话场景的特殊工作流,适合在响应请求时做复杂逻辑处理的对话式应用 |
| DAG 有向无环图 | 边有方向、且任何边都不能指回祖先的图结构;无环是硬约束,成环会死循环 |
| 节点 | 工作流的执行单元,按职责分四个家族:算(LLM / 代码)、取(插件 / 知识库 / 数据库)、分(选择器 / 意图识别)、合(循环 / 输入 / 输出) |
| 开始节点 | 工作流入口,相当于主函数;它声明的参数名就是外部调用时必须传的键名 |
| 结束节点 | 工作流出口;返回变量输出 JSON 供下游处理,返回文本直接给出回复内容、可流式输出 |
| 变量 | 节点之间唯一的传递通道。提示词里用 {{变量名}} 引用,名字必须与输入面板逐字一致 |
| plugin 插件 | 一系列工具的集合,每个工具都是一个可调用的接口;以节点形式集成进工作流 |
| 知识库 | 存文档、按语义检索相近段落;解决专业知识不足与幻觉问题 |
| 数据库 | 存结构化记录、按字段精确增删改查;分测试环境与线上环境,两者数据隔离 |
| 选择器 | if-else 分支节点,按代码层面的条件判断分流,结果确定、成本极低 |
| 意图识别 | 按语义把用户表达归类到不同分支;有极速与完整两种模式 |
| 循环节点 | 三种类型:使用数组循环(for)、指定循环次数、无限循环(while,需终止循环节点跳出) |
| item / index | 数组循环里的两个变量:item 是当前元素,index 是位置,从 0 开始 |
| 上下文腐烂 Context Rot | 输入长度超过某个限度后,模型的理解与回答质量反而下降的现象;是拆任务、用循环、上 RAG 的根本理由 |
| 分治策略 | 分解 → 解决 → 合并。把一个大任务拆成互相独立、结构相同的子任务分别求解再汇总 |
| 检索策略 | 混合 / 语义 / 全文三种。专有名词、缩写、ID 用全文,问"意思相近"用语义 |
| 最大召回数量 | 知识库一次最多返回几个段落;查重调大,找标准答案调小 |
| 最小匹配度 | 低于该分数的段落不返回;抬高会漏,压低会脏 |
| 查询改写 | 结合对话历史重写 query,还原指代;多轮场景必开 |
| 结果重排 | 按相关性重新排序召回结果,把最相关的放到前面 |
| 命名实体识别 | 从自然语言里抽取人名、工号等实体;在工作流里通常用一个 LLM 节点加提示词实现 |
| 单 Agent 自主规划 | 由一个模型按工作流的名称与描述自主挑选调用哪条工作流;路由是概率性的 |
| Multi-Agent | 主从结构的多智能体:主 Agent 做意图识别与任务分解,从 Agent 职责单一;节点分 Agent、工作空间智能体、全局跳转条件三类 |
| 发布 | 让外部可用的前提。工作流不发布则智能体挑不到;智能体不发布到 API/SDK 渠道则程序调不通 |
| PAT 个人访问令牌 | 生成便捷但本质是预授权的明文令牌;只用于测试调试,并限制范围与有效期 |
| SAT 服务访问令牌 | 以服务身份创建的凭证,有效期可长,用于服务端程序的身份验证与授权 |
| OAuth 访问令牌 | 通过 OAuth 2.0 生成,有效期短、安全性更高;线上生产环境优先选用 |
| 会话 Conversation | 一段问答交互的容器,装着一条条消息,能自动处理截断 |
| 消息 Message | 用户或智能体创建的一条内容,可以是文本、图片或文件 |
| 对话 Chat | 在某个会话里对智能体的一次调用;产生的消息会被追加进该会话 |
| 上下文段落 Section | 会话内部的独立段落;用户清除上下文时系统开一个新段落,新对话不受历史影响 |
| logid 日志 ID | 一次请求的唯一标识,建立请求时即可拿到;排查任何问题的起点 |
| SPDX 标识 | 许可证的标准代号。取值为 NOASSERTION 时说明不是标准协议原文,必须读 LICENSE 全文 |
界面会改、插件会换、平台都可能被替换掉,但有向无环图这套编排心智、变量契约、知识库与数据库的选型判断、以及会读日志这项基本功,换到哪个平台都成立。剩下的,去把
coze_ping.py 跑通,然后搭第一条只有三个节点的工作流。