神经网络与激活函数
一个神经元只做两件事:把上级送来的数字加权求和,再把结果掰弯一次。把这两步叠成层、把层叠成网,就是深度学习的全部结构。这一页把神经元、全连接层、四个激活函数和参数初始化拆到能自己手算参数量。
30″30 秒看懂神经网络
把一个神经网络想成一家汇报层级极其严格的公司:一线业务员把原始情况报上去,部门主管挑着听、加上自己的判断再报给总监,总监再报给老板,最后由老板拍板给出一个结论。整家公司只有一条铁规矩——同级之间不说话,每个人只向上一级汇报。
公司里的每个人就是一个神经元(neuron)。每个人做的事只有两步:先把下属送来的信息按信任度加权,凑成一个总分;再按自己的表态风格把这个总分转成一句话报上去。第一步的结果叫内部状态值 z,第二步的结果叫激活值 a。
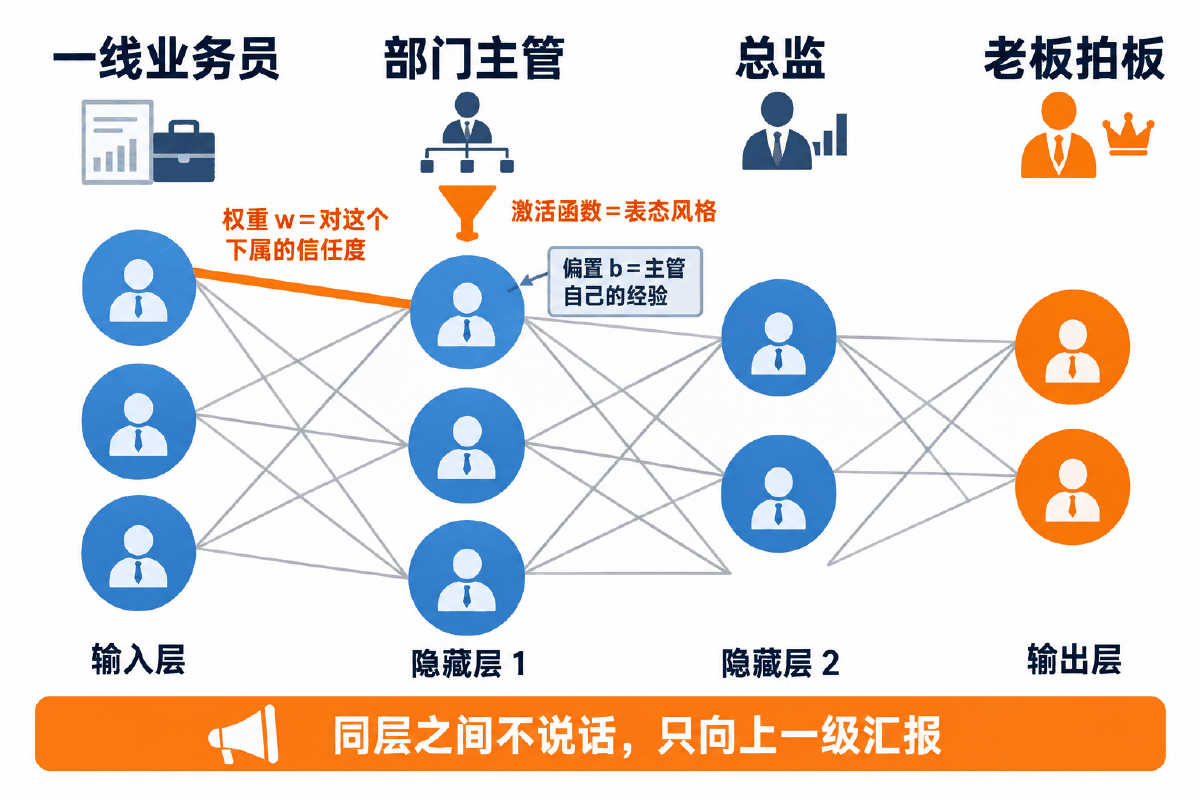
这张图里有四样东西要一次认清:权重 w 是「我对这个下属说的话信几分」,偏置 b 是「我自己本来就有的一个基础判断」,激活函数 f 是「我的表态风格」,而层 就是公司的一级级职级。整页后面所有内容,都是在讲这四样东西怎么设、怎么算、怎么初始化。
| 比喻里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 一线业务员 | 输入层 input layer | 数据的入口,一个特征对应一个神经元;它不做任何计算,也不含任何参数 |
| 部门主管、总监 | 隐藏层 hidden layer | 真正做加工的层;隐藏层的数量就是网络的「深度」 |
| 老板拍板 | 输出层 output layer | 给出最终结果;神经元个数由任务决定——回归 1 个,N 分类 N 个 |
| 对某个下属的信任度 | 权重 w | 每条连线一个数;训练要调的主要就是它 |
| 主管自己的经验 | 偏置 b | 每个神经元一个数,和输入无关,决定这个神经元「多容易被激活」 |
| 凑成一个总分 | 内部状态值 z = w·x + b | 加权求和,纯线性运算 |
| 表态风格 | 激活函数 f | 把 z 掰弯的非线性变换,网络能拟合曲线全靠它 |
| 报上去的那句话 | 激活值 a = f(z) | 这才是交给下一层的东西,z 只是中间产物 |
| 同层之间不说话 | 全连接 fully connected | 第 N 层每个神经元连到第 N−1 层的全部神经元,同层之间零连线 |
Linear 串起来,总能找到一个矩阵一步算完,深度带来的表达能力是零。激活函数是整个深度学习里唯一把「深」变成有意义的东西。这条铁律在 2.2 节会用代码逐位验证。
01概念:神经元、层,以及「全连接」到底连了什么
从一个神经元讲到一整张网,把术语和图里的角色一一对上
1.1 一个神经元的两步运算
人工神经网络(Artificial Neural Network,简称 ANN 或 NN)模仿的是生物神经元:树突接收若干路电信号,细胞体把电荷累积起来,达到一定电位才通过轴突发出信号。人工神经元把这件事简化成了两步,一步线性、一步非线性。
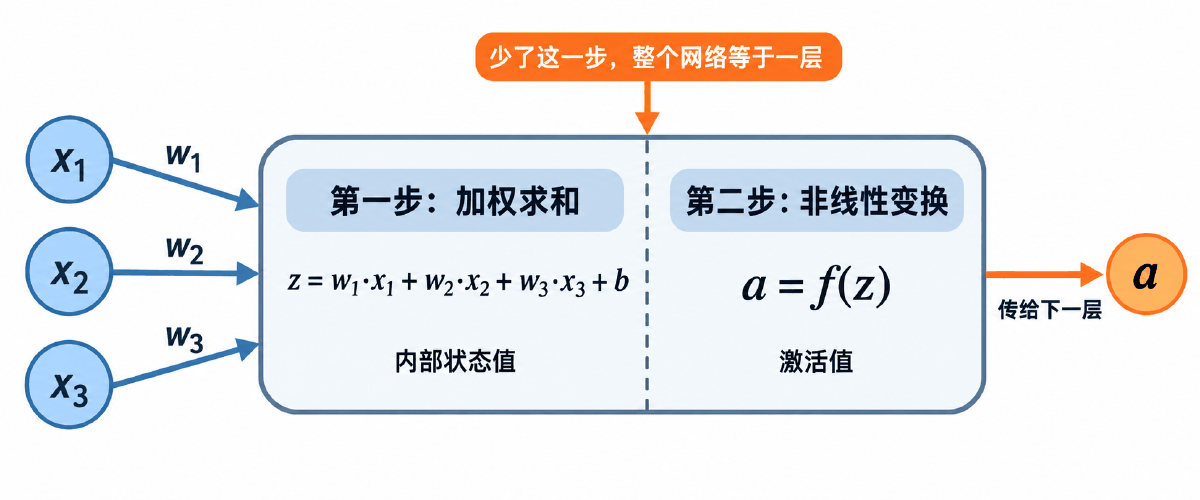
| 步骤 | 公式 | 叫法 | 它在比喻里是什么 |
|---|---|---|---|
| 第一步 | z = w₁x₁ + w₂x₂ + w₃x₃ + b | 内部状态值(加权求和值) | 主管按信任度把下属的话折算成一个总分,再加上自己的经验分 |
| 第二步 | a = f(z) | 激活值 | 按自己的表态风格,把总分转成实际报上去的那句话 |
两个细节要立刻钉死:
- 权重
w一条连线一个,偏置b一个神经元一个。 三个输入连进来就有三个w,但b始终只有一个。这条规则是后面手算参数量的唯一依据。 - 往下一层传的是
a,不是z。z只是中间产物。把它们混为一谈,后面推反向传播时链条会断——反向传播恰恰要分别对z和a求梯度。
b 的话,z = w·x 这条直线被钉死在原点上:输入全 0 时输出必然是 0。加上 b 才能整体上下平移,也就是让这个神经元「更容易」或「更难」被激活。对照比喻:一个天生乐观的主管,下属没说什么好消息他也会报个正面结论——这就是偏置。
1.2 全连接:层与层之间到底怎么连
把多个神经元并排放成一层,把多层前后接起来,就是一张网络。全连接神经网络(fully connected,也叫 FC 层、稠密层)的连接规则只有一句:第 N 层的每个神经元,都和第 N−1 层的所有神经元相连。由此推出四条必须记住的性质:
同一层的神经元互不通气,各算各的。它们之间唯一的联系是共用同一批输入。
从输入层往前走,穿过隐藏层,到输出层为止,不回头。这个过程就叫前向传播。
第 N−1 层输出 3 个激活值,第 N 层每个神经元就有 3 个权重。维度必须首尾相接,接不上直接报错。
全连接网络吃的张量形状固定是 (batch_size, in_features),出来是 (batch_size, out_features)。第 0 维永远是这一批有几条样本。
三种层的分工,以及各自有几个神经元,是搭网络时第一个要定的事:
| 层 | 神经元个数由谁决定 | 有没有参数 | 说明 |
|---|---|---|---|
| 输入层 | 特征个数,没得选 | 没有 | 只是数据入口。20 个特征就是 20 个神经元,改不了 |
| 隐藏层 | 自己定,是超参数 | 有 | 层数决定「深度」,每层宽度决定「容量」;这是调参的主战场 |
| 输出层 | 任务决定,没得选 | 有 | 回归 1 个;二分类 1 个(配 sigmoid)或 2 个;N 分类 N 个 |
1.3 神经网络强在哪、弱在哪
它不是万灵药。清楚地知道它的代价,才知道什么时候不该用它:
| 维度 | 优点 | 代价 |
|---|---|---|
| 精度 | 在图像、文本、语音这类高维数据上大幅领先传统方法 | 结构化小表格上常常打不过梯度提升树 |
| 表达能力 | 可以逼近任意非线性函数,前提是有激活函数、层够宽 | 容量越大越容易把噪声也背下来,过拟合风险随之上升 |
| 可解释性 | — | 黑箱。参数以百万计,说不清某个结论是怎么来的 |
| 成本 | 框架与预训练模型生态成熟,起步快 | 训练时间长、依赖算力,超参数多且需要反复调 |
| 数据量 | 数据越多优势越明显 | 小数据集上表现不佳,几百条样本时优先考虑传统模型 |
把这张表和上一页的张量放一起看,本页在整个体系里的位置就清楚了:张量解决「数据怎么装」,自动微分解决「梯度怎么来」,而神经网络解决「中间到底算什么」。三者凑齐,才能开始训练。
02原理:一层怎么算、为什么必须掰弯、参数从哪来
矩阵形式的全连接层、非线性的必要性、四个激活函数的取舍,以及初始化与参数量
2.1 一层到底在算什么
一个神经元是一次点积加一个偏置。一层有多个神经元时,把每个神经元的权重排成矩阵的一行,整层就能一次算完:
Z = X @ Wᵀ + B
| 符号 | 形状 | 含义 |
|---|---|---|
X | (batch, in_features) | 这一批数据,一行一条样本 |
W | (out_features, in_features) | 权重矩阵,一行是一个神经元的全部权重——这个顺序最容易记反 |
B | (out_features,) | 每个神经元一个偏置,靠广播加到每一行上 |
Z | (batch, out_features) | 整层的内部状态值,再逐元素过一次激活函数就是 A |
PyTorch 里这一整套封装成了 nn.Linear(in_features, out_features)。它内部做的就是上面这一行,连转置都替你写好了。下面这段把两种算法摆在一起对账,误差为 0 才说明真的理解了它在算什么:
"""全连接层:手写矩阵版与 nn.Linear 版算出来必须一模一样。

一层全连接做的事只有一句:把上一层送来的一排数字,
用一个权重矩阵乘过去,再加一排偏置。
这份代码把 nn.Linear 内部那一行摊开写,两边结果对账。
"""
import torch
import torch.nn as nn


def main():
    torch.manual_seed(0)

    batch, in_features, out_features = 4, 3, 2

    # 一批数据:4 条样本,每条 3 个特征。第 0 维永远是 batch
    x = torch.randn(batch, in_features)

    layer = nn.Linear(in_features, out_features)

    # ---------------------------------------------------------- 权重的形状
    # 这里最容易记反:weight 的形状是 (out_features, in_features),
    # 也就是「每一行是一个神经元的全部权重」,有几个神经元就有几行。
    print('weight 形状', tuple(layer.weight.shape))   # (2, 3)
    print('bias   形状', tuple(layer.bias.shape))     # (2,)

    # ---------------------------------------------------------- 官方版
    out_official = layer(x)

    # ---------------------------------------------------------- 手写版
    # 因为 weight 是 (out, in),要和 (batch, in) 相乘就得先转置成 (in, out)
    out_manual = x @ layer.weight.t() + layer.bias

    print('输出形状', tuple(out_official.shape))      # (4, 2)
    print('两种算法最大误差 = %.10f'
          % (out_official - out_manual).abs().max().item())

    # ---------------------------------------------------------- 逐个神经元拆开
    # 第 0 号神经元对第 0 条样本的内部状态值,就是一次点积加偏置
    z00 = torch.dot(layer.weight[0], x[0]) + layer.bias[0]
    print('第 0 条样本在第 0 号神经元上的 z:拆开算 = %.6f,整层算 = %.6f'
          % (z00.item(), out_official[0, 0].item()))

    # ---------------------------------------------------------- 全连接的含义
    # 第 N 层的每个神经元都连到第 N-1 层的全部神经元上,
    # 所以连线条数 = in_features × out_features,再加上每个神经元一个偏置。
    print('本层连线条数 =', in_features * out_features)
    print('本层参数总量 =', in_features * out_features + out_features,
          '实测 =', sum(p.numel() for p in layer.parameters()))

    # ---------------------------------------------------------- 不带偏置的层
    no_bias = nn.Linear(in_features, out_features, bias=False)
    print('去掉偏置后的参数量 =', sum(p.numel() for p in no_bias.parameters()))
    print('去掉偏置后 bias 属性 =', no_bias.bias)      # None

    # ---------------------------------------------------------- 输入必须是二维
    # 全连接网络吃的是 (batch_size, in_features)。单条样本要先补出 batch 维,
    # 否则矩阵乘法的维度对不上。
    single = torch.randn(in_features)
    print('单条样本补维前', tuple(single.shape),
          '补维后', tuple(single.unsqueeze(0).shape))
    print('单条样本的输出', tuple(layer(single.unsqueeze(0)).shape))


if __name__ == '__main__':
    main()
nn.Linear(3, 2) 的 weight.shape 是 (2, 3)。按「有几个神经元就有几行」去记,而不是按参数书写顺序去记。手写矩阵乘法时必须转置:x @ w.t()。这个点几乎每个人都会记反一次。
2.2 为什么激活函数必须是非线性的
回到铁律。假设去掉激活函数,两层网络就是:
| 推导 | 式子 |
|---|---|
| 第一层 | z₁ = x · W₁ + b₁ |
| 第二层 | z₂ = z₁ · W₂ + b₂ = (x · W₁ + b₁) · W₂ + b₂ |
| 展开合并 | z₂ = x · (W₁W₂) + (b₁W₂ + b₂) |
| 结论 | 令 W = W₁W₂、b = b₁W₂ + b₂,则 z₂ = x·W + b —— 又是一层线性层 |
叠一百层也一样:一串矩阵连乘的结果还是一个矩阵。换句话说,没有激活函数的深层网络,表达能力和一条直线完全相同,永远拟合不了弯曲的边界。下面这段代码把等效矩阵直接算出来,和两层网络的输出逐位比对:
"""没有激活函数,堆多少层都等于一层——这份代码把它算给你看。

两层线性层串起来:
    z1 = x @ W1ᵀ + b1
    z2 = z1 @ W2ᵀ + b2
       = x @ (W2 @ W1)ᵀ + (b1 @ W2ᵀ + b2)
等号右边仍然是「x 乘一个矩阵再加一个向量」,也就是一层线性层。
所以不加激活函数时,深度带来的表达能力是零。
"""
import torch
import torch.nn as nn


def main():
    torch.manual_seed(7)

    x = torch.randn(5, 4)            # 5 条样本,4 个特征

    l1 = nn.Linear(4, 6)             # 第一层:4 -> 6
    l2 = nn.Linear(6, 3)             # 第二层:6 -> 3

    # ---------------------------------------------------------- 不加激活函数
    two_layers = l2(l1(x))

    # 把两层合并成等效的单层:W = W2 @ W1,b = b1 @ W2ᵀ + b2
    W = l2.weight @ l1.weight                       # (3,6) @ (6,4) -> (3,4)
    b = l1.bias @ l2.weight.t() + l2.bias           # (6,) @ (6,3) -> (3,)
    one_layer = x @ W.t() + b

    print('两层线性 与 等效单层 的最大误差 = %.8f'
          % (two_layers - one_layer).abs().max().item())
    print('等效单层权重形状', tuple(W.shape), '—— 和直接写 nn.Linear(4, 3) 一样')

    # ---------------------------------------------------------- 加上激活函数
    # 中间插一个 ReLU 之后,就再也找不到一个矩阵能等效替代它了
    with_act = l2(torch.relu(l1(x)))
    print('插入 ReLU 后 与 等效单层 的最大差距 = %.6f'
          % (with_act - one_layer).abs().max().item())
    print('这个差距不为 0,说明非线性确实带来了单层做不到的表达能力')

    # ---------------------------------------------------------- 再直观一点
    # 线性函数的图像永远是直线/平面,无论叠多少层;
    # 要拟合一条弯曲的曲线,必须让每层的输出先被掰弯一次。
    t = torch.tensor([-2.0, -1.0, 0.0, 1.0, 2.0])
    print('原始输入          ', t.tolist())
    print('线性变换 3t+1     ', (3 * t + 1).tolist(), '  —— 等距点仍然等距')
    print('ReLU(3t+1)        ', torch.relu(3 * t + 1).tolist(),
          '  —— 负半边被压平,等距被打破')


if __name__ == '__main__':
    main()
插进一个 ReLU 之后,同一份对比立刻出现差距——这个差距就是「深度」值钱的地方。用比喻说:如果每级主管都只会按固定比例转述下属的话,那么中间设多少层管理岗都没有意义,老板直接听一线汇报是一样的;只有当主管会「这个不重要,不往上报」(ReLU 把负数压成 0)这类判断时,层级才产生了价值。
2.3 四个激活函数各自什么脾气
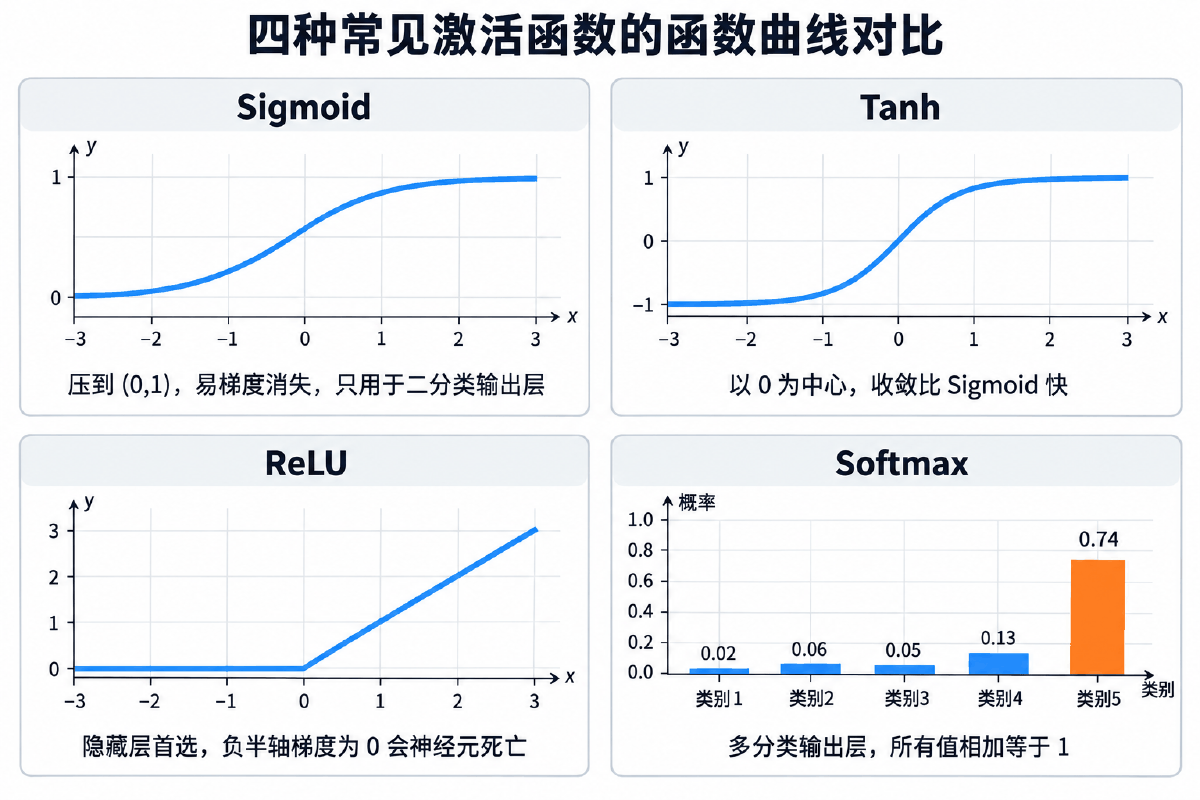
| 激活函数 | 把值压到 | 导数范围 | 该用在哪 | 要命的毛病 |
|---|---|---|---|---|
Sigmoid | (0, 1) | (0, 0.25] | 只用于二分类的输出层 | 导数最大才 0.25,连乘几层就归零;输入超出 ±6 后几乎不变,信息被抹平;不以 0 为中心 |
Tanh | (−1, 1) | (0, 1] | 隐藏层的备选 | 以 0 为中心、梯度比 sigmoid 大,收敛更快;但两侧导数同样趋 0,照样会梯度消失 |
ReLU | [0, +∞) | 0 或 1 | 隐藏层首选 | 正半轴导数恒为 1,不衰减、计算还快;但负半轴导数恒为 0,落进去的神经元再也醒不过来 |
Softmax | 一组和为 1 的概率 | — | 只用于多分类的输出层 | 不是逐点函数,作用在一整行上;用了 CrossEntropyLoss 就不要再手动加它 |
把「导数范围」这一列单独拎出来看,就能自己推出后面那一页要讲的梯度消失:反向传播是把各层的导数连乘,sigmoid 最好的情形也只有 0.25,0.25⁵ ≈ 0.00098、0.25¹⁰ ≈ 9.5×10⁻⁷——五层之内就基本没梯度了。ReLU 正半轴恒为 1,连乘多少次都是 1,这才是它成为默认选择的根本原因。
"""四个激活函数的数值对照:函数值、导数值,以及导数连乘之后还剩多少。

不画图,只打数字。看数字比看曲线更能说清「为什么 sigmoid 会梯度消失」。
"""
import torch


def value_table():
    """同一批输入,四个函数各自压成什么样。"""
    x = torch.tensor([-20.0, -6.0, -3.0, -1.0, 0.0, 1.0, 3.0, 6.0, 20.0])

    print('%8s %10s %10s %10s' % ('x', 'sigmoid', 'tanh', 'relu'))
    for i in range(len(x)):
        print('%8.1f %10.6f %10.6f %10.3f'
              % (x[i].item(),
                 torch.sigmoid(x[i]).item(),
                 torch.tanh(x[i]).item(),
                 torch.relu(x[i]).item()))

    # 看首尾两行:输入从 -20 变到 -6,sigmoid 的输出几乎没变化,
    # 输入差 14 的信息在这一步被抹平了,这就是「饱和区丢信息」。


def grad_table():
    """导数才是反向传播真正要连乘的东西。"""
    x = torch.linspace(-10, 10, 2001, requires_grad=True)

    # 对一批点求和后反向,x.grad 里就是逐点导数
    torch.sigmoid(x).sum().backward()
    sig_grad = x.grad.clone()

    x.grad.zero_()
    torch.tanh(x).sum().backward()
    tanh_grad = x.grad.clone()

    x.grad.zero_()
    torch.relu(x).sum().backward()
    relu_grad = x.grad.clone()

    print('sigmoid 导数最大值 = %.4f(出现在 x=0 处)' % sig_grad.max().item())
    print('tanh    导数最大值 = %.4f(出现在 x=0 处)' % tanh_grad.max().item())
    print('relu    导数最大值 = %.4f(正半轴恒为 1)' % relu_grad.max().item())
    print('relu    导数为 0 的点占比 = %.2f%%'
          % (100.0 * (relu_grad == 0).float().mean().item()))


def chain_product():
    """把导数连乘 n 次,看还剩多少——这就是层数一深就学不动的原因。"""
    print('%6s %16s %16s' % ('层数', 'sigmoid 最好情形', 'relu 正半轴'))
    for n in (1, 3, 5, 10, 20):
        # sigmoid 导数的上限是 0.25,取最好的情形连乘都是这个数
        print('%6d %16.10f %16.1f' % (n, 0.25 ** n, 1.0 ** n))
    # 0.25 的 5 次方不到千分之一,10 次方约百万分之一:
    # 传到前几层的梯度基本等于 0,参数根本不动。


def softmax_demo():
    """softmax 不是逐点函数,它把一组分数整体压成概率。"""
    scores = torch.tensor([0.2, 0.02, 0.15, 0.15, 1.3,
                           0.5, 0.06, 1.1, 0.05, 3.75])
    prob = torch.softmax(scores, dim=0)
    print('概率之和 = %.6f' % prob.sum().item())      # 恒等于 1
    print('最大概率的下标 =', torch.argmax(prob).item(),
          ',与分数最大的下标一致')

    # softmax 只关心分数之间的「差」,整体加减同一个常数结果不变
    shifted = torch.softmax(scores + 100.0, dim=0)
    print('全部加 100 之后的最大差异 = %.8f'
          % (prob - shifted).abs().max().item())
    # 这条性质也是各框架内部做数值稳定处理(减去最大值)的依据


if __name__ == '__main__':
    value_table()
    print('-' * 46)
    grad_table()
    print('-' * 46)
    chain_product()
    print('-' * 46)
    softmax_demo()
argmax 就够了,softmax 不改变大小顺序。
2.4 选激活函数:一张表就够
| 位置 | 任务 | 选谁 | 理由 |
|---|---|---|---|
| 隐藏层 | 任何 | ReLU | 不衰减梯度、计算量小、还能让一部分输出为 0 带来稀疏性 |
| 隐藏层 | ReLU 效果不好 | Leaky ReLU / Tanh | 先怀疑神经元死亡,用 Leaky ReLU 给负半轴留条缝;tanh 也可以试,但深了仍会梯度消失 |
| 输出层 | 二分类 | Sigmoid | 输出一个 (0,1) 的概率,配 nn.BCELoss |
| 输出层 | 多分类 | Softmax | 输出一组和为 1 的概率;配 nn.CrossEntropyLoss 时不要自己写 |
| 输出层 | 回归 | 什么都不加 | 预测值可正可负、范围不限,套任何激活函数都是在人为设限 |
2.5 参数初始化:起点决定能不能学得动
权重的初始值不是随便给的。两个极端各有各的死法:
同一层所有神经元收到的梯度完全相同,更新之后仍然完全相同,永远是彼此的复制品。隐藏层开再宽也等于只有一个神经元,这叫对称性没被打破。
内部状态值 z 的方差随层数逐层放大,sigmoid / tanh 被顶进两端的饱和区,导数趋 0;ReLU 则大批神经元直接死掉。
所以初始化的目标很明确:打破对称,同时让每一层输出的方差保持稳定。Xavier 和 He 就是按这个目标算出来的两个公式:
| 方法 | 正态版的标准差 | 均匀版的边界 | 配哪种激活 | PyTorch 写法 |
|---|---|---|---|---|
| Xavier(Glorot) | √(2 / (fan_in + fan_out)) | ±√(6 / (fan_in + fan_out)) | Sigmoid / Tanh | nn.init.xavier_normal_(w) / xavier_uniform_ |
| He(Kaiming) | √(2 / fan_in) | ±√(6 / fan_in) | ReLU 系 | nn.init.kaiming_normal_(w, nonlinearity='relu') |
| 正态 / 均匀随机 | 自己给 | 自己给 | 浅层网络够用 | nn.init.normal_(w, 0, 0.01) |
| 全 0 / 全 1 / 固定值 | — | — | 权重一律不用 | nn.init.zeros_(b) —— 偏置用全 0 没问题 |
fan_in 是这一层的输入神经元个数,fan_out 是输出神经元个数。两个公式的差别只在分母:ReLU 会把一半的输出砍成 0,方差平白少一半,所以 He 用 2/fan_in 把它补回来。
"""全 0 初始化为什么不行:同一层的神经元会拿到一模一样的梯度。

结论不靠背,靠跑:把一层的权重全设成 0,反向一次,
打印每个神经元拿到的梯度,会发现所有行完全相同——
它们从此永远是同一个神经元的复制品,隐藏层再宽也没用。
"""
import torch
import torch.nn as nn


def all_zero():
    torch.manual_seed(0)

    layer = nn.Linear(4, 3)
    nn.init.zeros_(layer.weight)
    nn.init.zeros_(layer.bias)

    out = nn.Linear(3, 1)
    nn.init.constant_(out.weight, 0.5)     # 输出层给个非 0 值,保证梯度能传回来
    nn.init.zeros_(out.bias)

    x = torch.randn(8, 4)
    y = torch.randn(8, 1)

    loss = ((out(torch.sigmoid(layer(x))) - y) ** 2).mean()
    loss.backward()

    print('全 0 初始化,隐藏层三个神经元各自拿到的梯度:')
    for i, row in enumerate(layer.weight.grad):
        print('  神经元 %d : %s' % (i, [round(v, 8) for v in row.tolist()]))

    first = layer.weight.grad[0]
    same = all(torch.allclose(first, r) for r in layer.weight.grad)
    print('三行是否完全相同 ->', same)
    print('相同意味着:更新之后它们的权重还是相同的,永远学不出差异')


def random_init():
    torch.manual_seed(0)

    layer = nn.Linear(4, 3)
    nn.init.normal_(layer.weight, mean=0.0, std=0.1)
    nn.init.zeros_(layer.bias)             # 偏置给 0 没问题,对称已被权重打破

    out = nn.Linear(3, 1)
    nn.init.constant_(out.weight, 0.5)
    nn.init.zeros_(out.bias)

    x = torch.randn(8, 4)
    y = torch.randn(8, 1)

    loss = ((out(torch.sigmoid(layer(x))) - y) ** 2).mean()
    loss.backward()

    print('随机初始化,隐藏层三个神经元各自拿到的梯度:')
    for i, row in enumerate(layer.weight.grad):
        print('  神经元 %d : %s' % (i, [round(v, 8) for v in row.tolist()]))

    first = layer.weight.grad[0]
    same = all(torch.allclose(first, r) for r in layer.weight.grad)
    print('三行是否完全相同 ->', same, '(各走各的,才谈得上分工)')


def scale_matters():
    """初始化的大小同样要紧:太大直接把 sigmoid 顶进饱和区。"""
    x = torch.randn(256, 128)

    for std in (0.01, 0.1, 1.0, 5.0):
        w = torch.randn(64, 128) * std
        z = x @ w.t()
        a = torch.sigmoid(z)
        # 激活值挤在 0 或 1 附近的比例越高,导数越接近 0,越学不动
        saturated = ((a < 0.01) | (a > 0.99)).float().mean().item()
        print('std=%-5s  z 的标准差 %7.3f   激活值落入饱和区的比例 %6.2f%%'
              % (std, z.std().item(), saturated * 100))

    print('这就是 xavier / kaiming 存在的理由:它们按扇入扇出算出一个')
    print('刚好让各层输出方差稳定的 std,不用手工试。')


if __name__ == '__main__':
    all_zero()
    print('-' * 56)
    random_init()
    print('-' * 56)
    scale_matters()
"""参数初始化:七种写法,以及该挑哪一种。"""
import torch.nn as nn

linear = nn.Linear(5, 3)     # 5 个输入、3 个输出,w 的形状是 (3, 5)

# 1) 均匀分布:默认从 (0, 1) 取值
nn.init.uniform_(linear.weight)

# 2) 固定值:调试时好用,正式训练别用,全一样等于只有一个神经元
nn.init.constant_(linear.weight, 5)

# 3) 全 0:同一层所有神经元收到的梯度完全相同,永远学不出差异
nn.init.zeros_(linear.weight)

# 4) 全 1:同样对称,同样学不动
nn.init.ones_(linear.weight)

# 5) 正态分布
nn.init.normal_(linear.weight, mean=0, std=1)

# 6) kaiming(HE)初始化:方差按 2/fan_in 算,配 ReLU 系
nn.init.kaiming_normal_(linear.weight, nonlinearity='relu')
nn.init.kaiming_uniform_(linear.weight, nonlinearity='relu')

# 7) xavier(Glorot)初始化:方差按 2/(fan_in+fan_out) 算,配 sigmoid / tanh
nn.init.xavier_normal_(linear.weight)
nn.init.xavier_uniform_(linear.weight)

print(linear.weight.data)

# 选法只有一句话:
#   隐藏层用 ReLU  -> kaiming
#   隐藏层用 sigmoid / tanh -> xavier
#   偏置 b 一律 zeros_,不需要打破对称
nn.Linear 本身已有一套默认初始化,浅层网络不写也能跑,写是为了在深层网络里可控。
2.6 参数量:一条公式手算到底
公式只有一条,来自 1.1 节的两个事实(一条连线一个 w,一个神经元一个 b):
某层参数量 = 该层神经元个数 × (上一层神经元个数 + 1)
以 3 → 3 → 2 → 2 这个结构为例:
| 层 | 算式 | 参数量 | 拆开看 |
|---|---|---|---|
| 隐藏层 1 | 3 × (3 + 1) | 12 | 9 个权重 + 3 个偏置 |
| 隐藏层 2 | 2 × (3 + 1) | 8 | 6 个权重 + 2 个偏置 |
| 输出层 | 2 × (2 + 1) | 6 | 4 个权重 + 2 个偏置 |
| 合计 | — | 26 | 输入层不贡献任何参数 |
"""参数量:先手算,再让代码数一遍,两个数必须相同。

手算规则只有一条:
    某一层的参数量 = 该层神经元个数 × (上一层神经元个数 + 1)
括号里的 +1 是每个神经元自带的那一个偏置 b。
输入层不算参数——它只是数据入口,没有权重。
"""
import torch
import torch.nn as nn


def hand_count(sizes):
    """按 [输入, 隐藏1, 隐藏2, ..., 输出] 的神经元个数手算总参数量。"""
    total = 0
    for i in range(1, len(sizes)):
        fan_in, fan_out = sizes[i - 1], sizes[i]
        layer = fan_out * (fan_in + 1)
        print('  第 %d 层:%d 个神经元 × (%d + 1) = %d'
              % (i, fan_out, fan_in, layer))
        total += layer
    return total


def build(sizes):
    """按同一组神经元个数建出真实网络。"""
    layers = []
    for i in range(1, len(sizes)):
        layers.append(nn.Linear(sizes[i - 1], sizes[i]))
        if i < len(sizes) - 1:
            layers.append(nn.ReLU())
    return nn.Sequential(*layers)


def report(model):
    """逐层列出形状与参数量,相当于自己写的一份模型摘要。"""
    print('%-10s %-16s %10s' % ('参数名', '形状', '个数'))
    total, trainable = 0, 0
    for name, p in model.named_parameters():
        print('%-10s %-16s %10d' % (name, str(tuple(p.shape)), p.numel()))
        total += p.numel()
        if p.requires_grad:
            trainable += p.numel()
    print('合计 %d,其中可训练 %d' % (total, trainable))
    # 一个 float32 参数占 4 字节,换算成显存占用
    print('权重本身约占 %.2f KB(float32,每个参数 4 字节)' % (total * 4 / 1024))
    return total


if __name__ == '__main__':
    sizes = [3, 3, 2, 2]        # 输入 3,隐藏层 3 和 2,输出 2

    print('手算:')
    manual = hand_count(sizes)
    print('  手算合计 =', manual)

    print('\n实测:')
    model = build(sizes)
    real = report(model)

    print('\n手算 %d,实测 %d,一致 -> %s' % (manual, real, manual == real))

    # ---------------------------------------------------------- 常见误解
    # 输入数据的条数(batch_size)跟参数量毫无关系:
    # 一次喂 5 条还是 500 条,网络的权重个数一模一样。
    for batch in (5, 500):
        x = torch.randn(batch, sizes[0])
        print('batch=%3d  输出形状 %s  参数量 %d'
              % (batch, tuple(model(x).shape), sum(p.numel() for p in model.parameters())))

    # ---------------------------------------------------------- 冻结参数
    # 迁移学习里常把前面几层冻住:requires_grad=False 之后它们不再出现在
    # 可训练参数里,优化器也就不会更新它们。
    for p in model[0].parameters():
        p.requires_grad = False
    print('\n冻结第一层之后:')
    report(model)
batch_size 只影响这一次前向要算多少遍,不影响权重的数量。初学时把这两件事搅在一起,是理解参数量时最大的绊脚石——代码最后一段专门把它跑出来了。
03最小代码:先把一个神经元跑出来
不用任何封装,手写一次两步运算,再看四个激活函数怎么调
3.1 一个神经元:z 和 a 各打印一次
这段代码里没有 nn.Linear、没有模型类,只有三个张量和两行运算。它的唯一目的是:让 w、b、z、a 四个符号在屏幕上各出现一次,从此不再混淆。
"""一个神经元的两步计算:加权求和,再过激活函数。

不用 nn.Linear,全手写一遍,看清楚 w、b、z、a 到底是谁。
"""
import torch

# 一条样本,3 个特征
x = torch.tensor([1.0, 2.0, 3.0])

# 这个神经元自己的参数:每个输入一个权重,外加一个偏置
w = torch.tensor([0.2, -0.5, 0.1])
b = torch.tensor(0.4)

# 第一步:加权求和,得到内部状态值 z
z = (w * x).sum() + b          # 等价于 torch.dot(w, x) + b
print('内部状态值 z =', z.item())      # 0.2*1 + (-0.5)*2 + 0.1*3 + 0.4 = -0.1

# 第二步:非线性变换,得到激活值 a,这才是交给下一层的东西
a = torch.sigmoid(z)
print('激活值 a =', a.item())

# 一层有多个神经元时,就把每个神经元的 w 排成矩阵,一次算完
W = torch.tensor([[0.2, -0.5, 0.1],     # 神经元 1 的三个权重
                  [0.7, 0.3, -0.2]])    # 神经元 2 的三个权重
B = torch.tensor([0.4, -0.1])
Z = W @ x + B                  # (2,3) @ (3,) -> (2,)
print('整层的 z =', Z)
print('整层的 a =', torch.sigmoid(Z))
这段可以完全手算核对:w = [0.2, −0.5, 0.1]、x = [1, 2, 3]、b = 0.4,那么
z = 0.2×1 + (−0.5)×2 + 0.1×3 + 0.4 = 0.2 − 1.0 + 0.3 + 0.4 = −0.1
再过 sigmoid 得到一个略小于 0.5 的数(因为 z 是负的,而 sigmoid(0) = 0.5)。能自己算出 −0.1 这个数,这一页的第一步就过了。
代码最后一段把两个神经元的权重排成一个 (2, 3) 的矩阵,一次算出整层的 Z。这正是 2.1 节那条矩阵公式的手写版——一层无非就是把多个神经元的点积并起来算。
3.2 四个激活函数:函数图像与导数图像
激活函数要同时看两张图:函数图像决定它把值压成什么样,导数图像决定梯度还剩多少。后者才是判断能不能用在隐藏层的依据。
"""四个激活函数:既画函数值,也画导数,导数才是梯度消失的证据。"""
import torch
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False


def draw(name, fn):
    """左边画函数图像,右边画导数图像。"""
    _, axes = plt.subplots(1, 2, figsize=(8, 3))

    x = torch.linspace(-20, 20, 1000)
    axes[0].plot(x, fn(x))
    axes[0].grid()
    axes[0].set_title('%s 函数图像' % name)

    # 导数图像的取法:对同一批点求和后反向传播,x.grad 里就是逐点导数
    x = torch.linspace(-20, 20, 1000, requires_grad=True)
    fn(x).sum().backward()
    axes[1].plot(x.detach(), x.grad)      # x 带梯度,画图前要 detach
    axes[1].grid()
    axes[1].set_title('%s 导数图像' % name)
    plt.show()


if __name__ == '__main__':
    draw('Sigmoid', torch.sigmoid)   # 导数最大只有 0.25,层数一深就消失
    draw('Tanh', torch.tanh)         # 导数范围 (0,1),以 0 为中心,比 sigmoid 快
    draw('ReLU', torch.relu)         # 正半轴导数恒为 1,负半轴恒为 0

    # Softmax 不是逐点函数,单独看:把一组分数压成和为 1 的概率
    scores = torch.tensor([0.2, 0.02, 0.15, 0.15, 1.3, 0.5, 0.06, 1.1, 0.05, 3.75])
    prob = torch.softmax(scores, dim=0)
    print(prob)
    print('概率之和 =', prob.sum().item())        # 1.0
    print('预测类别 =', torch.argmax(prob).item())  # 9,分数最高那一个
求导数图像的写法值得单独记一下,它用到了上一页的自动微分:
| 代码 | 在干什么 |
|---|---|
x = torch.linspace(-20, 20, 1000, requires_grad=True) | 在 −20 到 20 之间均匀取 1000 个点,并打开梯度开关 |
fn(x).sum().backward() | .sum() 是关键:backward() 只接受标量。求和之后每个点的偏导互不干扰,仍是各自的导数 |
x.grad | 这一千个点各自的导数值,直接就是导数曲线的纵坐标 |
x.detach() | 画图要的是数值本身。带梯度的张量不能直接交给绘图库,必须先脱离计算图 |
plt.rcParams['font.sans-serif'] = ['SimHei'] 和 plt.rcParams['axes.unicode_minus'] = False 就是解决这件事的:前者换成有中文的字体,后者防止负号也跟着变方块。
3.3 环境要求
pip install torch(CPU 版足够)。画激活函数图像另需 matplotlib。是否有 GPU 不影响本页任何结论——本页所有网络都只有几十个参数。
04完整案例
搭一个三层网络、跟踪一条数据穿过全网、对比三种等价写法,再把神经元死亡复现一次
4.1 搭一个三层网络并数清参数
目标结构:3 个输入特征 → 隐藏层 1(3 个神经元,sigmoid)→ 隐藏层 2(2 个神经元,ReLU)→ 输出层(2 个神经元,softmax)。按 2.5 节的配对规则,第一层配 xavier,第二层配 kaiming。
用 nn.Module 搭网络,固定只写两个方法:
__init__定义有哪些层、各层多宽、权重怎么初始化。第一行必须是 super().__init__(),否则层注册不进去,model.parameters() 会是空的。
forward定义数据怎么流:先过哪层、在哪里插激活函数。写 model(x) 就会自动走到这里,不要手动调 model.forward(x)。
"""搭一个三层网络并数清参数量。

结构:3 -> 3(sigmoid)-> 2(relu)-> 2(softmax)
每层的初始化方法按激活函数配对:sigmoid 配 xavier,relu 配 kaiming。
"""
import torch
import torch.nn as nn


class Model(nn.Module):
    def __init__(self):
        super().__init__()

        # 第 1 个隐藏层:3 个输入特征 -> 3 个神经元
        self.linear1 = nn.Linear(3, 3)
        nn.init.xavier_normal_(self.linear1.weight)   # 后面接 sigmoid
        nn.init.zeros_(self.linear1.bias)

        # 第 2 个隐藏层:上一层的 3 个输出 -> 2 个神经元
        self.linear2 = nn.Linear(3, 2)
        nn.init.kaiming_normal_(self.linear2.weight, nonlinearity='relu')
        nn.init.zeros_(self.linear2.bias)

        # 输出层:2 -> 2
        self.out = nn.Linear(2, 2)

    def forward(self, x):
        # 实例化后直接 model(x) 就会走到这里,不要手动调 forward
        x = torch.sigmoid(self.linear1(x))
        x = torch.relu(self.linear2(x))
        x = torch.softmax(self.out(x), dim=-1)   # dim=-1:每一行加起来为 1
        return x


if __name__ == '__main__':
    model = Model()

    # 输入是二维的 (batch_size, in_features),输出是 (batch_size, out_features)
    data = torch.randn(5, 3)
    output = model(data)
    print('输入形状', data.shape)      # torch.Size([5, 3])
    print('输出形状', output.shape)    # torch.Size([5, 2])

    # 参数量手算:每个神经元的参数 = 输入个数 + 1 个偏置
    #   linear1: 3 个神经元 × (3 + 1) = 12
    #   linear2: 2 个神经元 × (3 + 1) = 8
    #   out    : 2 个神经元 × (2 + 1) = 6
    #   合计 26
    total = sum(p.numel() for p in model.parameters())
    print('参数总量', total)           # 26

    for name, p in model.named_parameters():
        print(name, tuple(p.shape), p.numel())
这段代码的四个检查点
| 代码位置 | 为什么这么写 |
|---|---|
super().__init__() | 让父类把层登记到模块表里。漏了它,后面 model.parameters() 拿不到任何参数,优化器等于空转,而且不报错 |
nn.init.xavier_normal_(self.linear1.weight) | 第一层后面接 sigmoid,按配对规则选 xavier;注意初始化的是 .weight,偏置单独用 zeros_ |
nn.init.kaiming_normal_(..., nonlinearity='relu') | 第二层后面接 ReLU,改用 kaiming;nonlinearity 参数告诉它按哪种激活的增益系数来算 |
torch.softmax(self.out(x), dim=-1) | dim=-1 表示在最后一维上求和为 1,也就是每一行(每条样本)各自成为一组概率。写成 dim=0 会变成按列归一,跨样本混算,结果毫无意义 |
输出是什么形状,参数量是多少
喂进去 (5, 3),出来 (5, 2):批量大小原样保留,特征维被换成输出层的神经元个数。参数量按 2.6 节的公式手算是 3×4 + 2×4 + 2×3 = 26,代码里 sum(p.numel() for p in model.parameters()) 数出来的也必须是 26。
| 参数名 | 形状 | 个数 | 它是谁 |
|---|---|---|---|
linear1.weight | (3, 3) | 9 | 隐藏层 1 的三个神经元,每个 3 个权重 |
linear1.bias | (3,) | 3 | 隐藏层 1 每个神经元一个偏置 |
linear2.weight | (2, 3) | 6 | 隐藏层 2 的两个神经元,每个 3 个权重 |
linear2.bias | (2,) | 2 | — |
out.weight | (2, 2) | 4 | 输出层两个神经元,每个 2 个权重 |
out.bias | (2,) | 2 | — |
pip install torchsummary 之后 summary(model, input_size=(3,), batch_size=5) 能打出逐层的输出形状和 Param #,以及汇总的 Total params。它的数值和上面这张手算表必须一致——对不上就是结构没按预期搭出来,比如漏了一层或宽度写错。
4.2 一条数据穿过整张网络
上一段只看了首尾形状,中间发生了什么还是黑箱。这一段把每一层的 z 和 a 全部打出来——前向传播不该是玄学,它就是六次矩阵运算。
"""一条数据穿过整个网络:每一层的 z 和 a 全部打出来。

网络:3 -> 3(sigmoid)-> 2(relu)-> 2(softmax)
把每一步的形状和数值摊在眼前,前向传播就不再是黑箱。
"""
import torch
import torch.nn as nn


class TracedNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.linear1 = nn.Linear(3, 3)
        nn.init.xavier_normal_(self.linear1.weight)   # 后接 sigmoid,配 xavier
        nn.init.zeros_(self.linear1.bias)

        self.linear2 = nn.Linear(3, 2)
        nn.init.kaiming_normal_(self.linear2.weight, nonlinearity='relu')
        nn.init.zeros_(self.linear2.bias)

        self.out = nn.Linear(2, 2)

    def forward(self, x, trace=False):
        z1 = self.linear1(x)          # 内部状态值
        a1 = torch.sigmoid(z1)        # 激活值
        z2 = self.linear2(a1)
        a2 = torch.relu(z2)
        z3 = self.out(a2)
        a3 = torch.softmax(z3, dim=-1)

        if trace:
            for name, t in (('输入 x', x), ('z1', z1), ('a1=sigmoid(z1)', a1),
                            ('z2', z2), ('a2=relu(z2)', a2),
                            ('z3 原始分数', z3), ('a3=softmax(z3)', a3)):
                print('%-16s 形状 %-10s %s'
                      % (name, str(tuple(t.shape)),
                         [round(v, 4) for v in t.detach().flatten().tolist()]))
        return a3


def main():
    torch.manual_seed(3)
    net = TracedNet()

    # 一条样本也要补出 batch 维:全连接网络只吃二维数据
    one = torch.randn(1, 3)
    print('== 单条样本穿过网络 ==')
    prob = net(one, trace=True)
    print('概率之和 = %.6f,预测类别 = %d'
          % (prob.sum().item(), prob.argmax(dim=-1).item()))

    print('\n== 一批 5 条样本 ==')
    batch = torch.randn(5, 3)
    out = net(batch)
    print('输入形状', tuple(batch.shape), '-> 输出形状', tuple(out.shape))
    print('每一行各自加起来为 1:',
          [round(v, 6) for v in out.sum(dim=-1).tolist()])

    # 同层神经元之间没有任何连线:把 a1 的某一维改掉,
    # 只会影响下一层,不会影响 a1 的其他维度。
    print('\n== 逐层看形状变化 ==')
    print('3 个输入特征 -> 隐藏层 1 的 3 个神经元 -> 隐藏层 2 的 2 个神经元 -> 2 个输出')
    print('参数量 =', sum(p.numel() for p in net.parameters()),
          '(手算 3×4 + 2×4 + 2×3 = 26)')


if __name__ == '__main__':
    main()
跑起来能观察到三件事,正好对应比喻里的三条规矩:
| 观察到的现象 | 对应的规矩 |
|---|---|
形状按 (1,3) → (1,3) → (1,2) → (1,2) 一路变换 | 上一层的输出个数必须等于下一层的输入个数,层与层首尾相接 |
a1 的每个值都落在 0 到 1 之间 | sigmoid 把主管的表态压在 (0,1) 这个尺度上 |
a2 里出现了 0 | ReLU 把负的内部状态值砍成 0,也就是「这条不重要,不往上报」 |
| 最后一行的概率加起来是 1 | softmax 的定义如此,它是一整行一起算的 |
把单条样本换成一批 5 条之后,输出的每一行各自加起来仍然是 1,而不是整个矩阵加起来是 1——这就是 dim=-1 的实际含义。
4.3 三种写法,同一个网络
同一个结构有三种写法,参数量完全相同,区别只在可读性和灵活度:
| 写法 | 怎么写 | 什么时候用 | 代价 |
|---|---|---|---|
| 逐层定义 | __init__ 里一层层列,forward 里手写流程 | 需要分支、拼接、取中间结果时只能用它 | 层多了 forward 会很长 |
nn.Sequential | 把层和激活按顺序塞进去 | 纯粹一条直线堆下去 | 拿不到中间层输出,做不了分支 |
Sequential + OrderedDict | 给每层起名字 | 层多、需要按名字取层或冻结某几层 | 写起来略啰嗦 |
"""用 nn.Module 搭网络的三种写法,结构完全等价,挑顺手的用。

同一个结构:4 -> 8(relu)-> 8(relu)-> 3
三种写法建出来的参数量必须相同,最后一段验证这一点。
"""
from collections import OrderedDict

import torch
import torch.nn as nn


# ------------------------------------------------------------ 写法一:最常用
class NetA(nn.Module):
    """__init__ 里定义层,forward 里写数据怎么流。

    层数不多、但中间要做拼接/分支/取中间结果时,只能用这种写法。
    """

    def __init__(self):
        super().__init__()                  # 必须先调父类初始化,否则层注册不上
        self.fc1 = nn.Linear(4, 8)
        self.fc2 = nn.Linear(8, 8)
        self.out = nn.Linear(8, 3)

    def forward(self, x):
        # 实例化后写 model(x) 就会走到这里,不要手动写 model.forward(x)
        x = torch.relu(self.fc1(x))
        x = torch.relu(self.fc2(x))
        return self.out(x)                  # 多分类到此为止,softmax 交给损失函数


# ------------------------------------------------------------ 写法二:Sequential
class NetB(nn.Module):
    """纯粹一条直线堆下去时,用 Sequential 省掉整个 forward 的手写。"""

    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(4, 8), nn.ReLU(),
            nn.Linear(8, 8), nn.ReLU(),
            nn.Linear(8, 3),
        )

    def forward(self, x):
        return self.net(x)


# ------------------------------------------------------------ 写法三:带名字
class NetC(nn.Module):
    """给每层起名字,打印模型和按名字取层时都方便。"""

    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(OrderedDict([
            ('fc1', nn.Linear(4, 8)),
            ('act1', nn.ReLU()),
            ('fc2', nn.Linear(8, 8)),
            ('act2', nn.ReLU()),
            ('out', nn.Linear(8, 3)),
        ]))

    def forward(self, x):
        return self.net(x)


def count(model):
    return sum(p.numel() for p in model.parameters())


if __name__ == '__main__':
    a, b, c = NetA(), NetB(), NetC()

    x = torch.randn(6, 4)
    for name, m in (('NetA', a), ('NetB', b), ('NetC', c)):
        print('%s 输出形状 %s  参数量 %d'
              % (name, tuple(m(x).shape), count(m)))

    # 手算核对:8×(4+1) + 8×(8+1) + 3×(8+1) = 40 + 72 + 27 = 139
    print('手算参数量 =', 8 * (4 + 1) + 8 * (8 + 1) + 3 * (8 + 1))

    print('\n直接打印模型,能看到层的嵌套结构:')
    print(c)

    print('\n按名字取出某一层:', c.net.fc1)
    print('遍历全部可训练参数:')
    for name, p in a.named_parameters():
        print('  %-12s %-10s %d' % (name, tuple(p.shape), p.numel()))
nn.Sequential 收的是模块对象,torch.relu 是个函数,塞进去会直接报错。反过来,在 forward 里写 torch.relu(x) 完全正确,因为那里是在调用函数。同一个激活函数有「模块版」和「函数版」两副面孔,放对地方就行。
4.4 把神经元死亡复现一遍
ReLU 的缺点不是纸上谈兵。只要某个神经元对所有样本的 z 都小于 0,它的激活值恒为 0、梯度恒为 0、权重永远不再更新——这个神经元就废了,而且训练日志上看不出任何异常。
制造一个必死的神经元很简单:把它的偏置调到极负。下面这段就是这么干的,并打印出每个神经元收到的梯度:
"""神经元死亡:ReLU 的负半轴梯度为 0,一旦掉进去就再也出不来。

复现路径很简单——把某个神经元的偏置调得很负,
它对所有样本的内部状态值 z 都小于 0,
于是激活值恒为 0、梯度恒为 0、权重永远不更新,这个神经元就废了。
"""
import torch
import torch.nn as nn


def dead_neuron():
    torch.manual_seed(0)

    layer = nn.Linear(4, 3)
    with torch.no_grad():
        # 让 1 号神经元的偏置极负,制造一个必死的神经元
        layer.bias[1] = -50.0

    x = torch.randn(32, 4)
    z = layer(x)
    a = torch.relu(z)

    print('每个神经元的 z 最大值:', [round(v, 3) for v in z.max(dim=0).values.tolist()])
    print('每个神经元被激活的样本比例:',
          [round(v, 3) for v in (a > 0).float().mean(dim=0).tolist()])

    a.sum().backward()
    print('每个神经元收到的权重梯度绝对值之和:',
          [round(v, 8) for v in layer.weight.grad.abs().sum(dim=1).tolist()])
    print('1 号神经元的梯度是 0,它的权重从此纹丝不动——这就是神经元死亡')


def leaky_fix():
    """LeakyReLU 给负半轴留一个很小的斜率,梯度不再是 0。"""
    x = torch.tensor([-3.0, -1.0, 0.0, 1.0, 3.0], requires_grad=True)

    torch.relu(x).sum().backward()
    relu_grad = x.grad.clone().tolist()

    x.grad.zero_()
    nn.LeakyReLU(negative_slope=0.01)(x).sum().backward()
    leaky_grad = x.grad.clone().tolist()

    print('%8s %12s %12s' % ('x', 'ReLU 导数', 'LeakyReLU 导数'))
    for i, v in enumerate([-3.0, -1.0, 0.0, 1.0, 3.0]):
        print('%8.1f %12.2f %12.2f' % (v, relu_grad[i], leaky_grad[i]))
    print('负半轴 ReLU 是 0、LeakyReLU 是 0.01:小是小,但不为 0,还能爬回来')


def how_to_avoid():
    """真正的预防手段不是换激活函数,而是别让 z 一开始就跑偏。"""
    x = torch.randn(512, 128)

    for std in (0.01, 0.05, 0.2, 1.0):
        w = torch.randn(64, 128) * std
        b = torch.zeros(64)
        a = torch.relu(x @ w.t() + b)
        dead = (a.sum(dim=0) == 0).float().mean().item()
        print('权重 std=%-5s  整批样本都没激活过的神经元占比 %5.1f%%'
              % (std, dead * 100))

    print('把学习率压下来、用 kaiming 初始化,都是同一个目的:')
    print('别让某一步更新把 z 整体推到负半轴去。')


if __name__ == '__main__':
    dead_neuron()
    print('-' * 52)
    leaky_fix()
    print('-' * 52)
    how_to_avoid()
代码第三段更有实战价值:它扫了几档初始化尺度,统计「整批样本里一次都没被激活过的神经元占比」。这个比例才是判断网络是否健康的可观测指标——比例高,说明学习率或初始化把 z 整体推到了负半轴。
z 分布居中 · ③ 还不行再换 nn.LeakyReLU(0.01),给负半轴留一个小斜率,梯度不为 0 就还有机会爬回来。顺序反过来做,等于用换零件掩盖装配问题。
05骨架模板:拿去改就能用
一份只管网络结构的模板,把 TODO 填掉就能接上训练循环
4.1 的网络是为了讲清参数量而写死的三层。真实项目里层宽会反复调,所以模板把层的宽度做成参数,并且把初始化和激活函数的配对规则固化进去——这两件事一旦手工写,就一定会有一天忘记改。
"""网络结构骨架模板:只管定义模型,训练循环见训练骨架。"""
import torch
import torch.nn as nn


class MyNet(nn.Module):
    """把 TODO 填掉即可。层与层之间的维度必须首尾相接。"""

    def __init__(self, in_features, out_features, hidden=(128, 256)):
        super().__init__()                       # 必须先调父类初始化

        # TODO: 按需要增减隐藏层;hidden 里写每层的神经元个数
        self.fc1 = nn.Linear(in_features, hidden[0])
        self.fc2 = nn.Linear(hidden[0], hidden[1])
        self.out = nn.Linear(hidden[1], out_features)

        # TODO: 隐藏层用 ReLU 就配 kaiming,用 sigmoid/tanh 就配 xavier
        for layer in (self.fc1, self.fc2):
            nn.init.kaiming_normal_(layer.weight, nonlinearity='relu')
            nn.init.zeros_(layer.bias)

    def forward(self, x):
        x = torch.relu(self.fc1(x))
        x = torch.relu(self.fc2(x))
        # TODO: 多分类到此为止,softmax 交给 CrossEntropyLoss;
        #       二分类才在这里补 torch.sigmoid;回归直接返回。
        return self.out(x)


if __name__ == '__main__':
    net = MyNet(in_features=20, out_features=4)
    print(net)
    print('参数量', sum(p.numel() for p in net.parameters()))
    print(net(torch.randn(8, 20)).shape)        # torch.Size([8, 4])
要改的四处
| 位置 | 回归任务 | 二分类 | 多分类 |
|---|---|---|---|
out_features | 1 | 1 | 类别数 |
forward 的最后一步 | 直接返回,不加任何激活 | 补一个 torch.sigmoid | 仍然直接返回,softmax 交给损失函数 |
hidden | 先从 (128, 256) 这个量级起步 | 特征少就往小调;层宽不是越大越好,大了容易过拟合 | |
| 初始化 | 隐藏层用 ReLU 就保留 kaiming | 改用 sigmoid/tanh 时换成 xavier_normal_ | |
super().__init__() 写在第一行,层才注册得进去 · ② 权重按激活函数配对初始化,偏置统一 zeros_ · ③ 层宽用参数传入而不是写死,改结构不用翻代码 · ④ 末尾用 print(net) 和一次随机前向自检形状,结构错了当场就能发现,而不是等训练跑了半小时才报维度错误。
自检清单:新网络跑起来之前先过一遍
| 检查项 | 怎么查 | 不查会怎样 |
|---|---|---|
| 层与层维度接得上 | 随机造一批数据跑一次前向 | 训练启动后才报矩阵维度错误,白等 |
| 输出形状对得上标签 | 打印 model(x).shape 和 y.shape | 形状不一致时损失函数可能不报错,广播出一个错误的损失 |
| 参数量在预期量级 | sum(p.numel() for p in model.parameters()) | 层宽写错一位数,参数量差百倍,显存和时间全跑偏 |
| 输出层没有多余激活 | 回看 forward 最后一行 | 多分类时多加一次 softmax,损失失真、梯度变钝 |
| 初始化和激活配对 | 看 __init__ 里用的是 kaiming 还是 xavier | 深层网络训练初期损失不动或直接 nan |
06易错点汇总
按「搭建 / 激活函数 / 初始化 / 形状与参数量」四类归并,每条都给现象和修法
⚠️ 一、搭建网络
- 忘写
super().__init__()。 现象:model.parameters()是空的,优化器创建时报optimizer got an empty parameter list;即使侥幸跑起来,参数也一个都不更新。修法:__init__的第一行永远是super().__init__()。 - 手动调
model.forward(x)。 现象:一般能算出结果,但绕过了nn.Module的 hook 机制,日后加 Dropout/BatchNorm 或用可视化工具时行为异常。修法:一律写model(x)。 - 把层建在
forward里。 现象:每次前向都新建一层,权重每次都是随机的,loss 永远不降。修法:层在__init__里建一次,forward里只调用。 - 层与层维度接不上。 现象:
mat1 and mat2 shapes cannot be multiplied (5x3 and 2x2)。修法:上一层的out_features必须等于下一层的in_features,改宽度时两处一起改。 nn.Sequential里写了torch.relu。 现象:报错说收到的不是 Module。修法:Sequential里用模块版nn.ReLU(),forward里用函数版torch.relu(x)。- 把层放进普通 Python 列表。 现象:
self.layers = [nn.Linear(...), ...]里的层不会被注册,参数拿不到、也不会跟着.to(device)搬走。修法:用nn.ModuleList或nn.Sequential。
⚠️ 二、激活函数
- 隐藏层全用 sigmoid。 现象:网络一深,前几层的梯度接近 0,损失下降到某个值就再也不动。原因是 sigmoid 导数上限只有 0.25,五层之内就会梯度消失。修法:隐藏层默认 ReLU。
- 输出层多加了一次 softmax。 现象:不报错,但配
nn.CrossEntropyLoss时等于做了两次 softmax,概率被压平、梯度变钝,训练明显变慢。修法:用CrossEntropyLoss时输出层直接返回原始分数。 - 回归任务的输出层套了激活函数。 现象:预测值被硬压进 (0,1) 或 [0,+∞),真实标签一旦超出这个范围就永远学不到。修法:回归任务输出层什么都不加。
softmax的dim写错。 现象:不报错,但dim=0是按列归一,把不同样本混在一起算概率,结果毫无意义。修法:用dim=-1,含义是「每一行各自加起来为 1」。- 训练中大批神经元死亡。 现象:损失早早停住,检查发现某些神经元对所有样本的激活值恒为 0。修法:先降学习率,再换 kaiming 初始化,最后才考虑
nn.LeakyReLU。 - 把
z当成要传给下一层的东西。 现象:代码里写成x = self.fc1(x); x = self.fc2(x),中间漏了激活——整个网络退化成一层线性模型,不报任何错,只是永远拟合不了非线性关系。
⚠️ 三、参数初始化
- 权重全 0 初始化。 现象:不报错,但同一层所有神经元的梯度完全相同,隐藏层再宽也等价于一个神经元,模型表现远低于预期。修法:权重必须随机;偏置全 0 没问题。
- 初始化写在层之外。 现象:
nn.init.kaiming_normal_(linear.weight)写完之后又把linear重新赋值,初始化白做。修法:建层和初始化紧挨着写,中间不插别的逻辑。 - 初始化方法和激活函数配错。 ReLU 配 xavier、sigmoid 配 kaiming 都会让各层输出的方差逐层偏移,深层网络训练初期损失不动或直接
nan。修法:ReLU 系用 kaiming,sigmoid/tanh 用 xavier。 - 把
nn.init.constant_用在权重上。 调试时打印方便,正式训练时和全 0 是同一种病——所有神经元完全对称。 - 以为不写初始化就没有初始化。
nn.Linear自带一套默认初始化,浅层网络不写也能训。显式写是为了在深层网络里把方差控制住,不是必须,但深了必须。
⚠️ 四、形状与参数量
weight的形状记反。nn.Linear(3, 2)的weight.shape是(2, 3),按「几个神经元就几行」记。手写矩阵乘法时必须x @ w.t()。- 单条样本直接喂进网络。 现象:维度少一维,矩阵乘法报错。修法:
x.unsqueeze(0)补出 batch 维——全连接网络只吃(batch, features)的二维张量。 - 把
batch_size算进参数量。 一次喂 5 条还是 500 条,参数个数完全一样。输入数据和网络权重是两回事。 - 数层数时把输入层数进去。 输入层没有任何参数,不计入层数。按「有权重的层有几个」来数。
- 手算参数量时漏掉偏置。 公式是
神经元数 × (上一层神经元数 + 1),括号里的 +1 就是偏置。漏了它,三层小网络就会从 26 算成 19。 - 冻结参数只改了
requires_grad,却仍把它传给了优化器。 现象:不报错,但优化器里挂着一堆不更新的参数,某些优化器还会为它们维护状态、白占显存。修法:optim.Adam(filter(lambda p: p.requires_grad, model.parameters()), lr)。
把现象和原因对起来
上面这些坑里,最难办的不是报错的那些,而是不报错的那些。下面这张表按「你看到的现象」反查原因,训练不对劲时从这里开始找:
| 你看到的现象 | 最可能的原因 | 怎么确认 |
|---|---|---|
| loss 完全不动,一轮和一百轮一样 | 参数没进优化器 | 打印 len(list(model.parameters())),为 0 就是漏了 super().__init__() |
| loss 降一点就停,远不到预期 | 梯度消失,或神经元大批死亡 | 打印各层 weight.grad.norm(),看是不是前几层接近 0 |
| 拟合能力像线性模型 | 漏写激活函数 | 把 forward 逐行读一遍,每个隐藏层后面都该有一次非线性 |
| 加宽隐藏层完全没效果 | 权重全 0 或全同值初始化 | 打印 model.fc1.weight[:3],看几行是不是一模一样 |
训练初期就变 nan | 初始化尺度过大,或学习率过大 | 先把 lr 降一个数量级;仍然 nan 就查初始化 |
| 多分类准确率卡在随机水平 | 输出层多加了 softmax,或标签类型不对 | 看 forward 最后一行,以及标签是不是 int64 的类别下标 |
07自测题
点击题目展开答案;这些题都能说清楚,这一页就通了
一个神经元前向时产生哪两个值?哪一个才会传给下一层?
内部状态值 z = w·x + b(加权求和的结果)和激活值 a = f(z)。传给下一层的是 a,z 只是中间产物。这两个名字必须分清——反向传播时要分别对 z 和 a 求梯度,混为一谈链条就推不下去。
一个有 3 个输入的神经元,有几个权重、几个偏置?
3 个权重、1 个偏置。 规则是「一条连线一个 w,一个神经元一个 b」。这条规则就是参数量公式 神经元数 × (上一层神经元数 + 1) 里那个 +1 的来源。
「全连接」到底连了什么?同一层的神经元之间有连线吗?
第 N 层的每个神经元都连到第 N−1 层的全部神经元上,所以连线条数是 in_features × out_features。同一层的神经元之间没有任何连线,它们各算各的,唯一的联系是共用同一批输入。信息也只向前流动,不回头、不跨级。
三种层各自的神经元个数由谁决定?哪一层没有参数?
输入层由特征个数决定,没得选,而且不含任何参数——它只是数据入口。隐藏层的层数和宽度由你自己定,是超参数。输出层由任务决定:回归 1 个,二分类 1 个(配 sigmoid)或 2 个,N 分类 N 个。说「三层网络」时不把输入层数进去。
nn.Linear(5, 3) 的 weight 形状是什么?为什么手写矩阵乘法要转置?
形状是 (3, 5),也就是 (out_features, in_features),一行是一个神经元的全部权重。数据的形状是 (batch, 5),要和 (3, 5) 相乘就得先把它转成 (5, 3),所以写 x @ w.t() + b。
为什么激活函数必须是非线性的?用公式说明。
两层线性层串起来:z₂ = (x·W₁ + b₁)·W₂ + b₂ = x·(W₁W₂) + (b₁W₂ + b₂),令 W = W₁W₂、b = b₁W₂ + b₂,结果仍然是 x·W + b——一层线性层。叠多少层都一样,矩阵连乘的结果还是矩阵。所以没有非线性时,深度带来的表达能力是零,永远拟合不了弯曲的边界。
sigmoid 的导数最大是多少?由此推出它在隐藏层的什么问题?
导数范围是 (0, 0.25],最大 0.25,出现在 x=0 处。反向传播要把各层的导数连乘,0.25⁵ ≈ 0.00098、0.25¹⁰ ≈ 9.5×10⁻⁷,所以 sigmoid 网络五层之内就会梯度消失,靠近输入的层几乎收不到梯度。它在二分类输出层仍然好用,因为那里只做一次变换,不存在连乘。
ReLU 的优点和它的「神经元死亡」分别来自同一个性质吗?
是的,来自同一条定义:负半轴输出 0、正半轴原样输出。正半轴导数恒为 1 → 连乘不衰减,这是优点;负半轴导数恒为 0 → 一旦某神经元对所有样本的 z 都小于 0,它的梯度永远是 0、权重永远不更新,这就是神经元死亡。处理顺序是:先降学习率,再换 kaiming 初始化,最后才换 LeakyReLU。
隐藏层、二分类输出层、多分类输出层、回归输出层分别该用什么激活函数?
隐藏层 ReLU;二分类输出层 sigmoid;多分类输出层 softmax(但配 nn.CrossEntropyLoss 时不要自己写,它内部已经含了);回归输出层 什么都不加——预测值可正可负、范围不限,套激活函数就是人为设限。
给一行分数整体加上 100,softmax 的结果会变吗?这说明什么?
不变。 softmax 只关心分数之间的差,不关心绝对大小。两个推论:一是各框架内部会先减去最大值做数值稳定处理,不影响结果;二是只想知道预测哪一类时不必算 softmax,直接对原始分数取 argmax 即可,因为 softmax 不改变大小顺序。
为什么权重不能全 0 初始化?偏置全 0 行不行?
权重全 0 时,同一层所有神经元收到的梯度完全相同,更新之后仍然相同,永远是彼此的复制品,隐藏层再宽也等价于一个神经元——这叫对称性没被打破。偏置全 0 完全没问题,因为权重已经随机,对称早就打破了。全 1、固定值初始化和全 0 是同一种病。
Xavier 和 He 分别配哪种激活函数?它们的公式差在哪?
Xavier(Glorot)配 sigmoid / tanh,正态版标准差 √(2/(fan_in+fan_out));He(Kaiming)配 ReLU 系,正态版标准差 √(2/fan_in)。差别只在分母:ReLU 会把约一半的输出砍成 0,方差平白少一半,He 用 2/fan_in 把它补回来。两者的目标是同一个——让每层输出的方差保持稳定,不逐层放大或缩小。
结构 3 → 3 → 2 → 2 一共有多少个参数?手算过程写出来。
26 个。 按 神经元数 × (上一层神经元数 + 1):隐藏层 1 是 3×(3+1)=12,隐藏层 2 是 2×(3+1)=8,输出层是 2×(2+1)=6,合计 26。输入层不贡献参数。拆开看是 19 个权重加 7 个偏置。
把 batch_size 从 5 改成 500,参数量会变吗?
完全不变。 batch_size 只决定这一次前向要算多少遍,和权重的个数毫无关系。输出形状会从 (5, 2) 变成 (500, 2),但参数仍然是那 26 个。把输入数据和网络权重分清楚,是理解参数量的前提。
创建优化器时报 optimizer got an empty parameter list,第一个要查什么?
查 __init__ 的第一行有没有写 super().__init__()。漏了它,层不会被注册进模块表,model.parameters() 就是空的。另一个同类原因是把层放进了普通 Python 列表——要用 nn.ModuleList 或 nn.Sequential。
网络有三个隐藏层,但表现和线性模型一样,最该怀疑哪里?
漏写了激活函数。 forward 里写成 x = self.fc1(x); x = self.fc2(x) 这种连着调用而中间没有非线性,整个网络就塌缩成一层线性模型——而且不报任何错。逐行读 forward,确认每个隐藏层后面都有一次非线性变换。
把隐藏层从 64 加宽到 512,效果完全没变化,可能是什么原因?
最可能是权重被全 0 或固定值初始化了:同层神经元完全对称,加宽只是复制了更多份相同的神经元,有效容量没变。确认方法是打印 model.fc1.weight[:3],看几行是不是一模一样。其次要怀疑是不是漏了激活函数,或者已经过拟合、瓶颈不在容量上。
词术语表
| 术语 | 含义 |
|---|---|
| 神经元 neuron | 网络的最小计算单元;只做两件事——加权求和得到 z,非线性变换得到 a |
| ANN / NN | 人工神经网络,由大量神经元按层连接而成的计算模型 |
| 权重 w | 每条连线一个数,表示「对这一路输入的重视程度」;训练主要在调它 |
| 偏置 b | 每个神经元一个数,与输入无关;决定这个神经元「多容易被激活」 |
| 内部状态值 z | 加权求和的结果 z = w·x + b,纯线性运算,是中间产物 |
| 激活值 a | a = f(z),真正传给下一层的东西 |
| 激活函数 f | 把 z 掰弯的非线性变换;没有它,多层塌缩成一层 |
| 输入层 | 数据入口,一个特征一个神经元;不做运算,不含任何参数 |
| 隐藏层 | 输入层与输出层之间的层;数量决定网络的「深度」,宽度决定容量 |
| 输出层 | 给出最终结果;神经元个数由任务决定——回归 1 个,N 分类 N 个 |
| 全连接 fully connected | 第 N 层每个神经元连到第 N−1 层全部神经元;同层之间零连线 |
| 前向传播 | 数据从输入层逐层向前算到输出层的过程,单向、不回头 |
| Sigmoid | 压到 (0,1),导数上限 0.25;只用于二分类输出层,隐藏层会梯度消失 |
| Tanh | 压到 (−1,1),以 0 为中心,收敛比 sigmoid 快;两侧导数仍趋 0 |
| ReLU | 负的取 0、正的原样;隐藏层首选,代价是负半轴梯度为 0 会造成神经元死亡 |
| Leaky ReLU | 给负半轴留一个小斜率(如 0.01),梯度不为 0,用来救死掉的神经元 |
| Softmax | 把一行分数变成和为 1 的概率;只用于多分类输出层,且只看分数之差 |
| 神经元死亡 dead ReLU | 某神经元对所有样本的 z 恒小于 0,激活值与梯度恒为 0,权重永不更新 |
| 梯度消失 | 各层导数连乘后趋近 0,靠近输入的层几乎收不到梯度,等于没在训练 |
| fan_in / fan_out | 一层的输入神经元个数 / 输出神经元个数,是初始化公式里的分母 |
| Xavier(Glorot)初始化 | 标准差按 √(2/(fan_in+fan_out)) 取;配 sigmoid / tanh |
| He(Kaiming)初始化 | 标准差按 √(2/fan_in) 取;配 ReLU 系,补上 ReLU 砍掉的那一半方差 |
| 对称性没被打破 | 权重全 0 或全同值导致同层神经元梯度相同、永远相同,加宽也无效 |
| nn.Module | 所有网络的基类;__init__ 里定义层,forward 里定义数据怎么流 |
| nn.Linear(in, out) | 一个全连接层,内部算 x @ Wᵀ + b;weight 形状是 (out, in) |
| nn.Sequential | 把层按顺序串起来,省掉手写 forward;只适合无分支的直线结构 |
| 参数量 | 神经元数 × (上一层神经元数 + 1) 逐层相加;与 batch_size 无关 |