大模型蒸馏实战
把大模型的本事搬进小模型:裁剪、量化、蒸馏三条路里,蒸馏是唯一能换架构的一条;软标签、中间层特征、硬标签三种学法里,闭源教师只剩最后一种。
30″30 秒看懂模型蒸馏
把一个大模型想成一间老字号后厨:几十号伙计、几百样家什、一整面墙的电子秤,出品无可挑剔,但养这套班子一天的开销顶得上一家小店一个月。你现在要在商场里开个小档口,出品要接近,班底必须小。
三条路可走:辞掉不怎么干活的伙计(模型裁剪)、让每个伙计的工具箱变轻——精密电子秤换成粗刻度的量勺(模型量化)、或者另起一个小班子,把老师傅请来带徒弟(模型蒸馏)。前两条是在原班人马身上做减法,第三条是重新招人、重新学一遍——也只有第三条能把手艺搬到一个完全不同的班底上去。
而徒弟能学到什么程度,取决于师傅肯让他看到多少:师傅边做边报心里的把握——「这道菜我七分当它是文学、两分像军事」(软标签);徒弟贴身站在灶台边,把每一道工序的手法都记下来(中间层特征);或者师傅闭门谢客,徒弟只能买到他做好的成品,照着复刻(硬标签)。
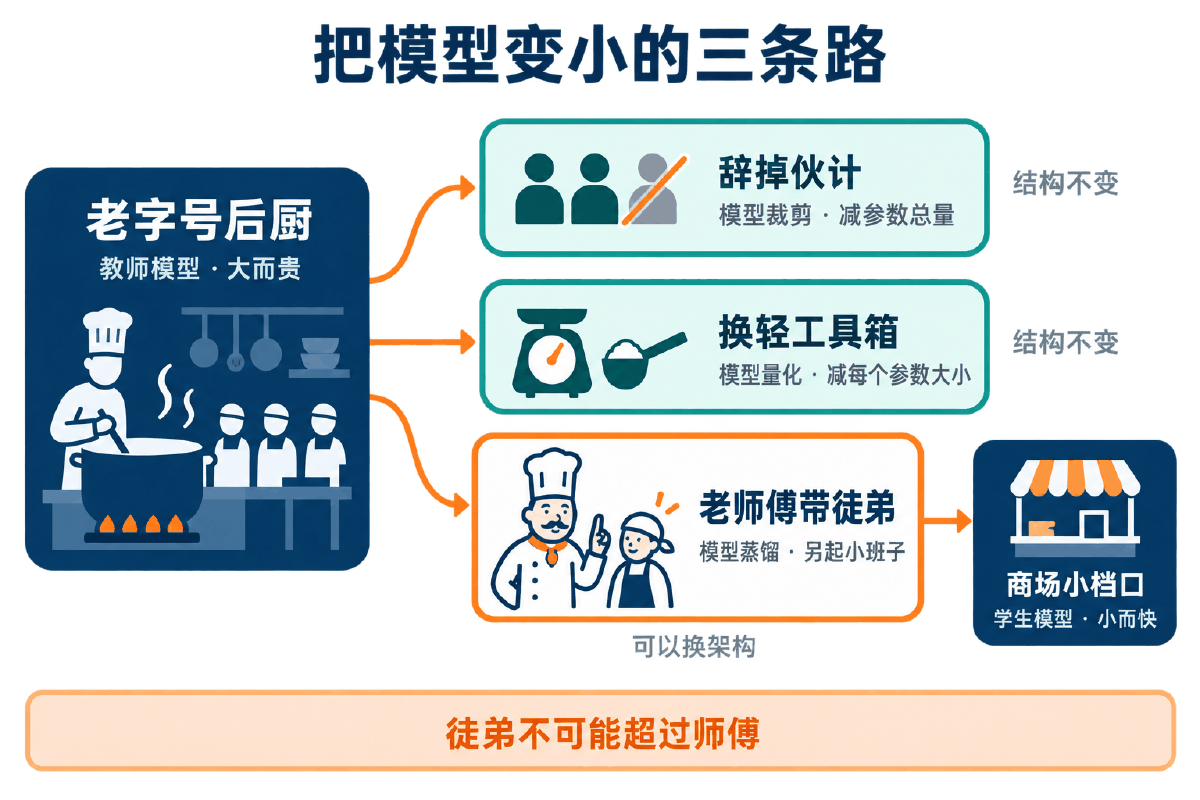
| 后厨里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 老字号后厨 | 教师模型 | 参数量大、效果好、养不起。本页的例子是 DeepSeek-R1 |
| 商场小档口 | 学生模型 | 参数量小、能上线。本页的例子是 Qwen2.5-3B-Instruct-GPTQ-Int4 |
| 辞伙计 | 模型裁剪 | 减少参数总量:按权重置 0,或整块结构切掉 |
| 换轻工具箱 | 模型量化 | 减少每个参数的大小:高精度数字换成低精度 |
| 带徒弟 | 模型蒸馏 | 另起一个小班子,从教师的输出里学手艺 |
| 师傅报的把握 | 软标签 | softmax 输出的概率分布,含类别间的隐含关系 |
| 贴身看工序 | 中间层特征 | 隐藏层输出向量、注意力向量 |
| 照着成品复刻 | 硬标签 | 只有最终结果。教师闭源时的唯一选择 |
| 徒弟的练习册 | 蒸馏数据集 | 教师推理产出的可训练数据。上一页那条生产线造的就是它 |
DeepSeek-R1 是闭源的、拿不到它的中间层和软标签,只能买它的最终输出,组织成数据集来教学生。那一页管「备料」,这一页管「原理 + 怎么把徒弟练出来、练完怎么上线」。
01概念:把模型变小的三条路
裁剪减数量、量化减精度、蒸馏换班底;三条路能叠加使用,但解决的是不同的问题
1.1 三条路的分工
| 思路 | 减的是什么 | 原模型还在吗 | 能换架构吗 |
|---|---|---|---|
| 模型裁剪 | 参数总量 | 在,被挖空了 | 不能。结构是原来那套 |
| 模型量化 | 每个参数的大小 | 在,数字变粗糙了 | 不能。结构一模一样 |
| 模型蒸馏 | 整个班底重来 | 不在,学生是另一个模型 | 能。可以跨架构蒸馏 |
这张表的最后一列是三者最本质的区别。裁剪和量化都是在同一具身体上做手术——辞几个伙计、换轻一点的工具,人还是那批人;蒸馏是另外找一批人,从头学,所以学生模型的结构可以和教师完全不同,甚至是另一个系列、另一个参数量级。
1.2 裁剪与量化:各自的代价
模型裁剪分两类
基于模型权重:训练后的权重整体符合正态分布,把接近 0 的那些「不重要的参数置 0」。
好处是精度损失小、想裁多少裁多少;代价是需要专用库支持——权重矩阵变成了稀疏矩阵,普通的稠密矩阵乘法根本享受不到这个稀疏性,不换推理库等于白裁。
基于模型的特定结构:整个注意力头、整层、整个通道地切。
好处是切完还是稠密矩阵,任何硬件都能直接跑、剪枝后可以适配轻量化设备;代价是可控性较差——切掉一整块,谁也说不准伤到了哪些能力,而且需要重训或调优。
| 裁剪的优点 | 裁剪的缺点 |
|---|---|
| 显著减少参数量和计算量,加快推理速度;结构化剪枝后可以适配轻量化设备 | 结构化裁剪的可控性较差;需要重训或调优;非结构化裁剪需要专用库支持 |
模型量化:减的是每个数字的精度
自然界中的数字可以拥有无限精度,计算机里的数字必须指定精度。把高精度数字转化为低精度数字,模型体积和算力需求同步下降——这就是量化。用后厨的话说:裁剪是辞人,量化是把每个人的精密电子秤换成粗刻度的量勺,人数没变,家什轻了。
| 分类维度 | 两种做法 | 差别 |
|---|---|---|
| 按时间点 | 训练后量化 / 量化感知训练 | 前者训完再压,快但掉点多;后者训练时就让模型「知道自己将来会被压」,效果好但要重训。QLoRA 训练属于后者 |
| 按粒度 | 统一精度量化 / 混合量化 | 前者全模型一个精度;后者对敏感层保留高精度,其余压到底。ViT 上常见混合量化 |
| 按对称性 | 对称量化 / 非对称量化 | 前者零点固定在 0,实现简单;后者带零点偏移,对分布不居中的权重更友好 |
减小模型体积和显存占用;加快推理速度。
有损压缩,必然会有精度损失(可以用混合精度和量化感知训练缓解);并非所有硬件都支持;模型泛化能力下降,对噪声的敏感度提升。
NF4 的 16 个分位点怎么来的、双重量化省了多少、GPTQ 怎么用 Hessian 逐列补偿误差——在 QLoRA 和 GPTQ 两页里。这里只需要记住它在三条路里的位置:量化不改结构、不改参数个数,只改每个数字占几个 bit。本页后面用的学生模型基座 Qwen2.5-3B-Instruct-GPTQ-Int4,名字里的 GPTQ-Int4 就是说它已经被量化过了——量化和蒸馏是叠加的,不是二选一。
1.3 模型蒸馏是什么
模型蒸馏是一种将复杂模型(教师模型)的知识迁移到更简单、更高效的模型(学生模型)中的技术。核心思想是通过模仿教师模型的输出来训练学生模型,使其在保持较小规模的同时,尽可能接近教师模型的性能。
典型的三个步骤
在大规模数据上训练一个高性能但复杂的教师模型。很多时候这一步不用你做——直接用一个现成的强模型当师傅。
用教师模型对训练数据进行推理,生成可训练的数据。数据的输出可以是中间层特征、软标签或者硬标签——三种学法的分岔口就在这里。
通过学习教师模型生成的数据,使学生模型的预测结果接近教师模型的预测结果。
蒸馏的优点:有具体数字的那种
| 收益 | 实例 |
|---|---|
| 参数量显著压缩 | BERT-base(110M 参数)→ DistilBERT(66M 参数),体积减少 40%;TinyBERT(14.5M 参数)仅保留 BERT-base 13% 的参数量 |
| 推理加速 | 学生模型推理速度提升 2~5 倍(如 DistilGPT-2 提速 3 倍);TinyBERT 在手机 CPU 上延迟从 500ms 降至 120ms |
| 泛化能力 | 如果学习了中间特征和软标签,可以提升小模型的泛化能力 |
| 跨架构 | 可以跨架构蒸馏——三条路里独一份 |
蒸馏的缺点
- 不可能超过教师模型。 这是铁律,也是所有蒸馏方案的天花板。
- 对温度非常敏感。 温度这一个超参就能让蒸馏从有效变成无效,第 02 节用实跑数字说明。
- 学习中间层特征和软标签,成本较高。 你得能拿到教师模型的内部状态——闭源模型直接出局。
02原理:三种蒸馏方式
师傅报把握、徒弟看工序、照着成品复刻——能学到哪一层,决定了徒弟能有多像
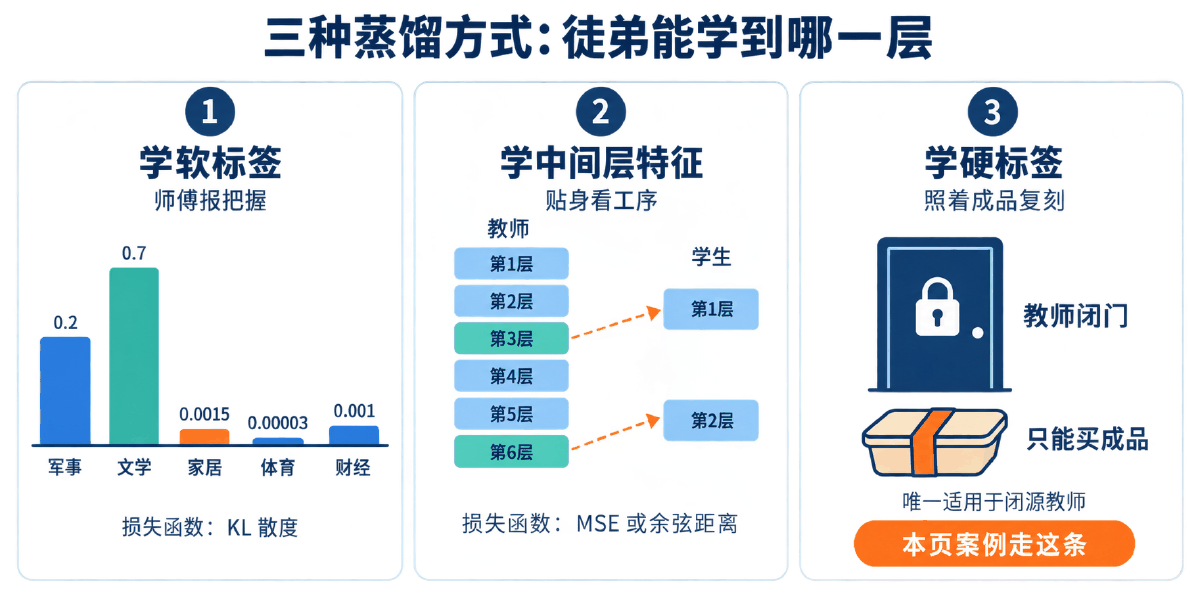
2.1 学软标签:师傅边做边报把握
什么是软标签
有一篇文章,是诗人艾青的自传,其中涉及到战争年代与王震将军的往事。拿去做分类,模型内部得到的是这样一组数:
| 军事 | 文学 | 家居 | 体育 | 财经 | 其他 | |
|---|---|---|---|---|---|---|
| 软标签 | 0.2 | 0.7 | 0.0015 | 0.00003 | 0.001 | …… |
| 硬标签 | 0 | 1 | 0 | 0 | 0 | …… |
在得到硬标签之前,通常会有一个 softmax 层,它作为多分类或归一化函数使用,把一组任意实数压成一组都大于 0、总和为 1 的数;由于指数函数的作用,这些值的大小差距会被拉开。这些值就是软标签。
为什么学软标签
硬标签只说了一件事:「这是文学」。软标签还多说了两件事:「它有两成像军事」,以及「像军事的程度远远高于像体育」——那段与王震将军的往事,痕迹就落在 0.2 这个数上。
正式表述:学习软标签的核心是通过教师模型的输出概率分布传递知识,使学生模型不仅能学习最终结果,还能捕捉类别间的隐含关系,内容比硬标签更丰富,很适合作为学生模型学习的目标。
损失函数:为什么是 KL 散度
软标签是一个概率分布,学生的输出也是一个概率分布。计算两个分布之间的差异,应该使用 KL 散度,而不是 MSE——MSE 比的是「每个数字差多少」,KL 散度比的是「用学生这个分布去近似教师那个分布,损失了多少信息」。对概率分布来说,后者才是有意义的度量。
温度在这里出场:教师的原始分布往往过于尖锐(0.7 和 0.00003 差了四个数量级),学生根本看不见那些小概率携带的信息。带温度的 softmax 把分布「抹平」,小概率被放大到可学的量级。第 03 节的最小代码把这个过程逐档打印出来。
2.2 学中间层特征:徒弟贴身看工序
什么是中间层特征
中间层特征指的是模型特定步骤输出的向量。在 NLP 领域主要有两种:
如多层 biLSTM 模型中第 n 层输出的向量,BERT 模型中第 k 层 encoder 或 decoder 输出的向量。
注意力机制输出的、对全局或局部的注意力向量。
为什么学中间层特征
因为中间层特征隐含了大量的词法、句法、语法信息:
BERT逐层抽象出的向量,包含了上下文敏感的词汇表征——同一个「苹果」,在「吃苹果」和「苹果发布会」里的向量是不一样的。Transformer的注意力向量,捕获了词与词之间复杂的依赖关系——「它」指向的到底是前面哪个名词,这个信息就在注意力矩阵里。
如果能有效学习这些特征,可以大幅度改善学生模型的效果。回到后厨:只看成品,徒弟学到的是「这道菜最后长这样」;站在灶台边看工序,他学到的是「什么时候下盐、油温到几成才下锅」——这是手艺本身,不是手艺的结果。
怎么对齐:学生层数不够怎么办
麻烦在于层数对不上:学生模型的层数只有教师模型的 1/k。两种对齐策略:
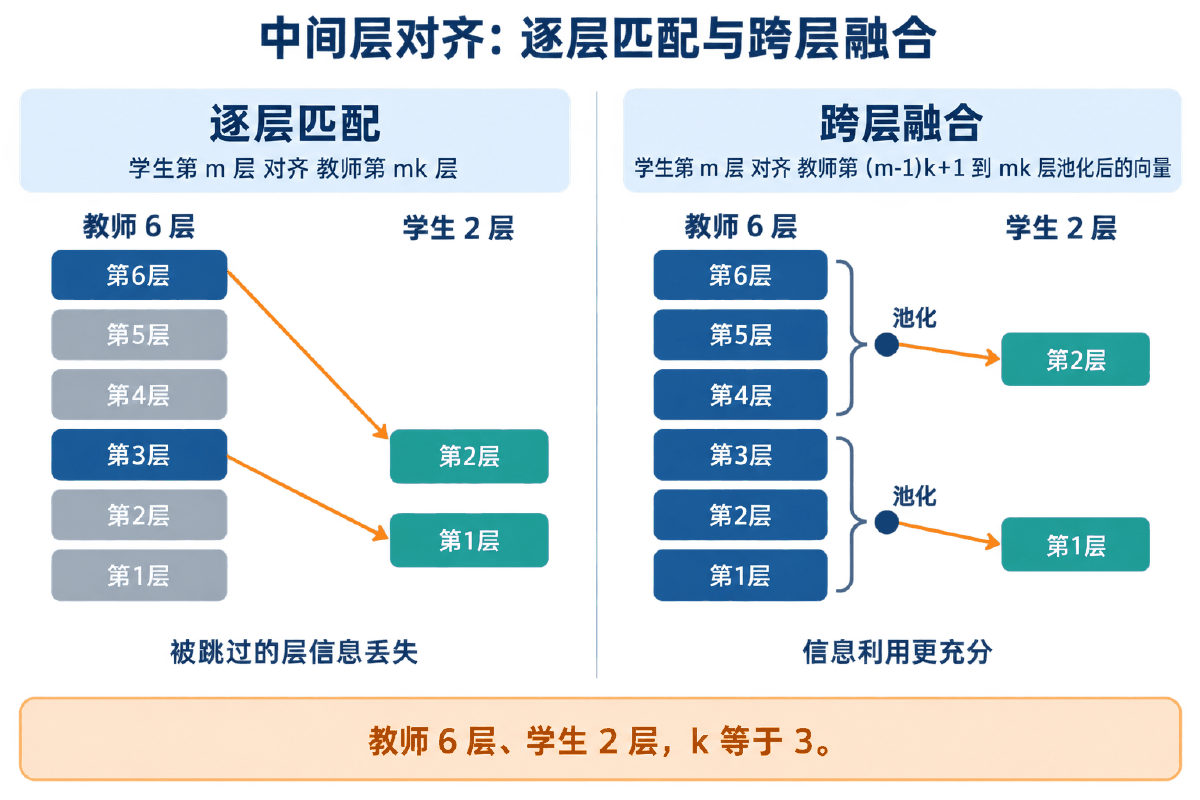
学生模型的第 m 层,对齐教师模型的第 mk 层向量。
也就是隔 k 层挑一层来学。实现简单,但被跳过的那些层里的信息直接丢了。
学生模型的第 m 层,对齐教师模型第 (m−1)k+1 层到第 mk 层池化后的向量。
把这一段所有层揉成一个向量再学,信息利用更充分,代价是要多做一次池化。
举个数:教师 12 层、学生 4 层,k=3。逐层匹配下,学生第 2 层去对齐教师第 6 层;跨层融合下,学生第 2 层去对齐教师第 4、5、6 层池化后的结果。
损失怎么算
| 学的是什么 | 损失函数 | 为什么 |
|---|---|---|
| 特征向量对齐 | MSE 或余弦距离 | 这是两个向量在比,比的是方向和大小,不是概率 |
| 注意力特征 | 可以考虑 KL 散度 | 注意力权重经过 softmax,本身就是一个概率分布,回到了 2.1 的情形 |
2.3 学硬标签:师傅闭门,只能买成品
什么是硬标签
就是上面那张表的第二行:只有一个 1,其余全是 0。放到生成式任务上,硬标签就是教师模型吐出来的那段文本本身——没有概率分布,没有中间状态,只有最终结果。
什么时候只能学硬标签
如果有条件,应该尽量学中间特征和软标签。那为什么还要学硬标签?五种情况:
| 情况 | 说明 |
|---|---|
| ① 教师模型不可用或是闭源模型 | 你只有一个 API,拿不到任何内部状态。这是最常见的情况。 |
| ② 获取中间特征或软标签成本过高 | DeepSeek-R1 正是这种情况——即使能拿到,逐 token 的 logits 数据量也大到存不下、传不动。 |
| ③ 训练资源受限 | 学中间层要同时跑教师和学生、对齐多层输出,显存和算力都得翻番。 |
| ④ 要学的领域或特性不是非常复杂 | 教一个固定格式的抽取任务,硬标签完全够用。 |
| ⑤ 学生模型已经有相当好的基础 | 基座本身够强,只需要把它「掰」到某个方向上,不需要从头教。 |
怎么学硬标签
组织符合某个领域或者特性的数据集——上一页整页都在讲这一步。
把问题批量送给教师模型,收集它的输出。
用这批数据做有监督微调,使学生学到领域知识或特性。第 04 节做这一步。
无需获取中间层特征或软标签;训练成本低;迭代速度快。
信息受损(那些概率分布里的隐含关系全丢了);效果的上限不高;易于过拟合(样本量不大时,学生容易背下答案而不是学会方法)。
DeepSeek-R1 闭源、中间特征拿不到 —— 命中上表的 ① 和 ②。所以那一页做的事是:组织问题 → 调 API 取输出 → 落成 jsonl。把 <think> 里的推理过程也留下来,正是在硬标签这条路上,把「信息受损」这个缺点尽可能补回来——虽然拿不到概率分布,但至少把教师的思考过程作为文本保住了。这是硬标签路线能做到的极限。
2.4 三条路横向比
| 对比项 | 学软标签 | 学中间层特征 | 学硬标签 |
|---|---|---|---|
| 学到什么 | 教师的概率分布 | 教师的内部表征与注意力 | 教师的最终输出 |
| 信息量 | 中 | 最高 | 最低 |
| 损失函数 | KL 散度 | MSE / 余弦距离(注意力可用 KL) | 普通的语言建模损失 |
| 需要教师开放到什么程度 | 要能拿到 logits | 要能拿到每一层的内部状态 | 只要能调用 |
| 成本 | 中 | 高 | 低 |
| 对温度敏感 | 非常敏感 | 部分敏感(注意力项) | 不涉及 |
| 闭源教师能用吗 | 不能 | 不能 | 能 |
| 后厨里的对应 | 师傅报把握 | 贴身看工序 | 照着成品复刻 |
选择逻辑很短:教师开放到哪一层,你就只能学到哪一层。能拿到内部状态就学中间层,只能拿到 logits 就学软标签,只有 API 就学硬标签——并且在硬标签这条路上,尽可能把教师输出里的结构(比如推理过程)保住。
03最小代码:把软标签蒸馏算一遍
温度缩放的 softmax 加 KL 散度,二十行讲完;只用标准库,任何机器都能直接跑
软标签蒸馏听着抽象,算一遍就通了。下面这份代码刻意不依赖 numpy 和 torch——公式本身只有指数、求和、取对数三样东西,框架只是帮你把它们批量化了而已。真实工程里把 softmax_t 和 kl_divergence 换成框架自带算子,逻辑一个字都不用改。
# -*- coding: utf-8 -*-
"""软标签蒸馏损失:温度缩放 softmax + KL 散度,逐步拆开算给你看。

刻意只用标准库(math),不依赖 numpy / torch,任何机器上都能直接跑。
真实工程里把下面的 softmax_t / kl_divergence 换成框架自带算子即可,
公式和温度的作用完全一样。

跑法:python3 kd_soft_label_loss.py
"""
import math

# 艾青自传那篇文章的分类 logits(教师模型 softmax 之前的原始输出)。
# 类别顺序固定,后面所有列表都按这个顺序。
LABELS = ["军事", "文学", "家居", "体育", "财经"]
TEACHER_LOGITS = [3.20, 4.45, -2.90, -6.85, -3.30]
STUDENT_LOGITS = [2.10, 3.00, -1.20, -3.40, -1.80]

# 硬标签:只有「文学」是 1,其余全是 0。信息量到此为止。
HARD_LABEL = [0, 1, 0, 0, 0]


def softmax_t(logits, temperature=1.0):
    """带温度的 softmax。

    T = 1   原始分布,差距被指数函数拉得很开
    T > 1   分布被「抹平」,小概率类别的信息被放大 —— 蒸馏就靠这个
    T < 1   分布更尖锐,趋近硬标签
    """
    scaled = [x / temperature for x in logits]
    m = max(scaled)                       # 减最大值,防指数溢出
    exps = [math.exp(x - m) for x in scaled]
    total = sum(exps)
    return [e / total for e in exps]


def kl_divergence(p, q, eps=1e-12):
    """KL(p || q):用 q 去近似 p 时损失了多少信息。

    p 是教师分布(目标),q 是学生分布(被优化的一方)。
    两个分布的差异要用 KL 散度度量,不是 MSE —— 概率分布之间比的是信息量。
    """
    return sum(pi * math.log((pi + eps) / (qi + eps)) for pi, qi in zip(p, q))


def distill_loss(student_logits, teacher_logits, temperature=4.0):
    """软标签蒸馏损失。

    注意乘 T^2:温度把 logits 缩小了 T 倍,梯度跟着小 T^2 倍,
    乘回来才能让软标签项和硬标签项的梯度在一个量级上。
    """
    p = softmax_t(teacher_logits, temperature)
    q = softmax_t(student_logits, temperature)
    return kl_divergence(p, q) * temperature * temperature


def show(title, dist):
    print(title)
    for name, v in zip(LABELS, dist):
        bar = "#" * max(1, int(v * 60))
        print("  %-4s %10.6f  %s" % (name, v, bar))


if __name__ == "__main__":
    print("=" * 62)
    print("一、硬标签 vs 软标签:同一篇文章,信息量差多少")
    print("=" * 62)
    print("硬标签:", dict(zip(LABELS, HARD_LABEL)))
    show("教师软标签(T=1):", softmax_t(TEACHER_LOGITS, 1.0))
    print("""
  硬标签只说了「这是文学」。
  软标签还说了「它有两成像军事,而且像军事的程度
  远高于像体育」—— 这正是艾青自传里那段与王震将军
  的往事留下的痕迹。类别之间的隐含关系,就藏在这些
  小数里。""")

    print()
    print("=" * 62)
    print("二、温度怎么影响分布")
    print("=" * 62)
    for t in (1.0, 2.0, 4.0, 8.0):
        d = softmax_t(TEACHER_LOGITS, t)
        print("T=%-4.1f  " % t + "  ".join(
            "%s=%.5f" % (n, v) for n, v in zip(LABELS, d)))
    print("""
  T 越大,分布越平,「家居 / 体育 / 财经」这些极小概率
  被放大到学生看得见的量级。蒸馏对温度非常敏感:
  T 太小等于在学硬标签,T 太大则噪声盖过信号。""")

    print()
    print("=" * 62)
    print("三、蒸馏损失")
    print("=" * 62)
    for t in (1.0, 2.0, 4.0, 8.0):
        print("T=%-4.1f  KL=%.6f  loss(KL x T^2)=%.6f"
              % (t,
                 kl_divergence(softmax_t(TEACHER_LOGITS, t),
                               softmax_t(STUDENT_LOGITS, t)),
                 distill_loss(STUDENT_LOGITS, TEACHER_LOGITS, t)))
三个函数各管什么
| 函数 | 在干什么 |
|---|---|
softmax_t(logits, T) |
先把每个 logit 除以温度 T,再做标准 softmax。T=1 是原始分布;T>1 把分布抹平,小概率被放大;T<1 让分布更尖锐、趋近硬标签。减最大值那一行不是可选项:不减的话 math.exp 在 logit 稍大时就溢出。 |
kl_divergence(p, q) |
KL(p‖q),p 是教师分布(目标),q 是学生分布(被优化的一方)。两个参数的顺序不能换——KL 散度不对称,换了就成了另一个目标。eps 防止 log(0)。 |
distill_loss(...) |
KL 再乘 T²。温度把 logits 缩小了 T 倍,回传的梯度跟着小 T² 倍;乘回来,软标签项才能和硬标签项在同一个量级上相加。这一步最容易被漏掉,漏了的现象是「调大温度后蒸馏几乎没效果」。 |
实跑输出
python3 kd_soft_label_loss.py,本机真实输出:
==============================================================
一、硬标签 vs 软标签:同一篇文章,信息量差多少
==============================================================
硬标签: {'军事': 0, '文学': 1, '家居': 0, '体育': 0, '财经': 0}
教师软标签(T=1):
  军事     0.222512  #############
  文学     0.776644  ##############################################
  家居     0.000499  #
  体育     0.000010  #
  财经     0.000335  #

  硬标签只说了「这是文学」。
  软标签还说了「它有两成像军事,而且像军事的程度
  远高于像体育」—— 这正是艾青自传里那段与王震将军
  的往事留下的痕迹。类别之间的隐含关系,就藏在这些
  小数里。

==============================================================
二、温度怎么影响分布
==============================================================
T=1.0   军事=0.22251  文学=0.77664  家居=0.00050  体育=0.00001  财经=0.00033
T=2.0   军事=0.33773  文学=0.63096  家居=0.01599  体育=0.00222  财经=0.01310
T=4.0   军事=0.34935  文学=0.47751  家居=0.07603  体育=0.02832  财经=0.06879
T=8.0   军事=0.29726  文学=0.34753  家居=0.13867  体育=0.08464  财经=0.13191

  T 越大,分布越平,「家居 / 体育 / 财经」这些极小概率
  被放大到学生看得见的量级。蒸馏对温度非常敏感:
  T 太小等于在学硬标签,T 太大则噪声盖过信号。

==============================================================
三、蒸馏损失
==============================================================
T=1.0   KL=0.025434  loss(KL x T^2)=0.025434
T=2.0   KL=0.067847  loss(KL x T^2)=0.271388
T=4.0   KL=0.060104  loss(KL x T^2)=0.961661
T=8.0   KL=0.022986  loss(KL x T^2)=1.471111
从这份输出里能读出三件事
硬标签是 {文学:1},一句话说完。软标签是 军事 0.2225 / 文学 0.7766 / 家居 0.0005 / 体育 0.00001 / 财经 0.0003——军事比体育高了四个数量级,那段与王震将军的往事就藏在这里。
T=1 时体育只有 0.00001,学生梯度里约等于不存在;T=8 时它变成 0.0846,被放大了八千多倍。这就是温度的全部作用。
看第三段:T=1 到 T=2,KL 从 0.0254 涨到 0.0678(差异被放大,学生学得到东西);再往上到 T=8,KL 反而跌回 0.0230——分布被抹得太平,教师和学生看起来都差不多了,信号被自己抹没了。
T 从 2 调到 8,KL 散度先涨后跌,回到了和 T=1 差不多的水平。温度太小等于在学硬标签,太大则噪声盖过信号——中间那段才有效。这个最优区间没有通用答案,必须在自己的任务上扫一遍,常见起点是 2~5。
DeepSeek-R1——用不上它,因为教师闭源,只能走硬标签。放在这里是为了让你看清三条路的差别到底体现在哪一行代码上:软标签路线的损失函数是自己写的,硬标签路线的损失函数就是普通的语言建模损失,训练工具直接给你算好。
04完整案例
把徒弟练出来、验收、上线提速,最后用一个真实项目算清「什么时候该少用大模型」
4.1 学生模型训练:从基座到 LoRA
第一步:选基座、把它拉到本地
徒弟得先是个识字的人,才谈得上跟师傅学手艺。基座模型的两个来源:能科学上网的去 huggingface 模型库;不能的走魔搭社区(modelscope)。在模型页点「模型文件」tab,下载页会直接给出命令,加 --local_dir 指定本地位置:
# 魔搭社区(modelscope)下载基座模型,--local_dir 指定落点
modelscope download --model Qwen/Qwen2.5-3B-Instruct-GPTQ-Int4 \
  --local_dir /workspace/deepseekDistllation/models/Qwen/Qwen2.5-3B-Instruct-GPTQ-Int4

# 能科学上网的可以直接用 huggingface 的模型库。
# 下载完先确认目录里有权重文件、tokenizer 和 config,缺一个都起不来。
这里选 Qwen2.5-3B-Instruct-GPTQ-Int4:3B 的体量能在单卡消费级显卡上跑起来,Instruct 说明它已经做过指令微调(有相当好的基础,命中 2.3 节的情况 ⑤),GPTQ-Int4 说明它已经被量化过——量化和蒸馏在这里是叠加的。
第二步:为什么用 LoRA 而不是全参数微调
全参数微调有三个绕不过去的缺陷:训练成本高(更新千亿级参数,还得配相当规模的数据集才不跑偏)、训练时间长(跟不上业务迭代节奏)、灾难性遗忘(重构所有参数,原有知识表征被破坏,新任务表现好了、旧任务急剧下降)。
LoRA(Low-Rank Adaptation)的做法是:不动原始矩阵,另训一个同样大小的增量矩阵 ΔW,推理时用 W + ΔW 代替 W。不动原始权重,灾难性遗忘自然就避免了。
但 ΔW 和 W 一样大,参数量没省。于是借用矩阵分解的思路(PCA、潜在语义分析 LSA、推荐系统的协同过滤都用过同一招):不训那个巨大的 ΔW,而是训两个小矩阵 A 和 B,让 A×B ≈ ΔW。只要够近似,工程上就可行。
| 矩阵 | 形状 | 参数量 |
|---|---|---|
ΔW(不分解) | M×N = 300000×500000 | 1500 亿 |
| A(取 r=16) | M×r | 480 万 |
| B(取 r=16) | r×N | 800 万 |
| 合计 | — | 1280 万,是原来的 0.000085,不到万分之一 |
实际做法:每个 transformer 都添加低秩旁路;矩阵 A 高斯初始化,矩阵 B 初始化为全 0。B 全 0 保证训练开始那一刻 A×B = 0,模型输出和基座完全一致——不会一上来就把基座打乱;而 A 不能也初始化为 0,否则梯度恒为 0,两个矩阵永远学不动。
第三步:用 LLaMA-Factory 训练
LLaMA-Factory 是一个封装比较完善的 LLM 微调工具,命令行和 webui 两种用法都支持:100+ 种模型、(增量)预训练与(多模态)指令监督微调、奖励模型训练、PPO / DPO / KTO / ORPO 训练;精度上覆盖 16 比特全参数微调、冻结微调、LoRA 微调,以及基于 AQLM/AWQ/GPTQ/LLM.int8/HQQ/EETQ 的 2/3/4/5/6/8 比特 QLoRA 微调。
llamafactory-cli webui 起服务,浏览器开 http://localhost:7860,把模型路径、数据路径、参数在界面上填好点开始。适合第一次跑通、适合调参时快速试错。
llamafactory-cli train 加一长串参数。适合固化成脚本、适合复现——webui 点出来的那次训练,日志里会打印等价的命令行,抄回脚本即可。
第四步:参数按重要程度分三档
参数非常多,但真正要理解的只有这三档。第一档决定这次训练指向哪里,第二档决定这次训练的性质,第三档决定效果好坏:
| 档位 | 参数 | 说明 |
|---|---|---|
| ① 极重要 路径与数据 | 模型名称 / 模型路径 / 检查点路径 / 数据路径 / 数据集 / 输出目录 / 训练参数目录 / 对话模板 | 改一个字就指向另一次实验。「数据集」填的是 dataset_info.json 里记录的那个键名;「对话模板」必须和使用的基座模型一致;「检查点路径」是接着哪个 checkpoint 继续训,不需要就留空。 |
| ② 极重要 训练性质 | 微调方法 / 训练阶段 / 量化等级 | 微调方法:full 全参数、freeze 冻结一部分、LoRA。 训练阶段:Supervised Fine-Tuning(本次选它)、Reward Modeling、PPO、DPO、KTO、Pre-Training。 量化等级:none / 8 位 / 4 位。 |
| ③ 重要 整体效果 | 学习率 / 截断长度 / 训练轮数 / 批处理大小 / 梯度累计 / 预热步数 / LoRA 秩 / LoRA 缩放系数 / LoRA 随机丢弃 | 反复调的就是这一组,逐项见下表。 |
第三档逐项拆开,配上本次实际取值:
| 参数 | 本次取值 | 怎么理解 |
|---|---|---|
| 学习率 | 1e-4 或 5e-5 | 量级本身就是语义:0.1 只用于探索、没人真用;0.01 从头训练的标准初始值;0.001 接近优化目标时的细致调整;0.0001 模型接近收敛时做微调;0.00005 预训练阶段的最后微调。 |
| 截断长度 | 6000 | 超过就截断。这个值要和上一页算出来的长度分布拐点对上——数据集里 98% 的样本都在 11000 字以内,而这里取 6000 是拿显存换来的折中。 |
| 训练轮数 | 1.0 | 学的特性较简单,1 轮即可。数据集太小时不应选太多轮数,会过拟合,可以考虑数据增强。 |
| 批处理大小 | 1 | 根据显存情况调。CUDA out of memory 首先动它。 |
| 梯度累计 | 2 | 批处理大小 × 梯度累计 决定了梯度更新的频率。显存不够又想要大等效批次,就压前者、抬后者。 |
| 预热步数 | 10 | 建议使用,防止参数剧烈震荡。 |
| LoRA 的秩 | 8 | 学到信息的丰富程度。就是前面推导里的 r。 |
| LoRA 缩放系数 | 16 | LoRA 的重要程度——旁路结果在合并时占多大权重。 |
| LoRA 随机丢弃 | 0.1 | 随机丢弃 LoRA 层权重的概率,一种正则化方法,防止模型过度依赖 LoRA。 |
4.2 验证效果:起服务、调接口、看差异
训练完拿到的是一个 checkpoint 目录,不是一个能直接用的模型文件。验证的办法是起一个 api server,然后用代码去调。
关键在于同一个基座可以挂不同的 LoRA——起服务时加不加 --adapter_name_or_path,就是对照组和实验组的区别:
# ---------------------------------------------------------------------------
# 一、只起基座(对照组)
# ---------------------------------------------------------------------------
CUDA_VISIBLE_DEVICES=0 API_PORT=8000 llamafactory-cli api \
  --model_name_or_path /workspace/models/Qwen/Qwen2.5-3B-Instruct-GPTQ-Int4

# ---------------------------------------------------------------------------
# 二、基座 + 一个 LoRA(实验组)
#     同一个基座换不同的 --adapter_name_or_path,就能切换到不同能力的模型
# ---------------------------------------------------------------------------
CUDA_VISIBLE_DEVICES=0 API_PORT=8000 llamafactory-cli api \
  --model_name_or_path /workspace/models/Qwen/Qwen2.5-3B-Instruct-GPTQ-Int4 \
  --adapter_name_or_path /workspace/saves/lora/cot/checkpoint-1250 \
  --finetuning_type lora

# ---------------------------------------------------------------------------
# 三、换 vLLM 部署,并同时挂载多个 LoRA
#     调用时用 model 参数点名要哪一个;model 给基座名或空串就是纯基座推理
# ---------------------------------------------------------------------------
CUDA_VISIBLE_DEVICES=0 API_PORT=8000 vllm serve \
  /workspace/models/Qwen/Qwen2.5-3B-Instruct-GPTQ-Int4 \
  --enable-lora \
  --lora-modules \
    cot=/workspace/saves/lora/cot/checkpoint-1250 \
    cat=/workspace/saves/lora/classify/checkpoint-120 \
    spo=/workspace/saves/lora/triple/checkpoint-375

# 服务起来后观察显卡:linux 用 watch -n 1 nvidia-smi
然后用标准的 OpenAI 客户端去调它:
# -*- coding: utf-8 -*-
"""访问 LLaMA-Factory 或 vLLM 的 api server,并测输出速度。

两者都是 OpenAI 兼容接口,代码完全一样,区别只在 model 参数:
  LLaMA-Factory 的 api server  -> model 随便填(通常写 "test")
  vLLM 且 --enable-lora        -> model 填 --lora-modules 里定义的名字,
                                  填空串或基座名就是用基座模型推理

运行前:
  export LLM_BASE_URL=http://localhost:8000/v1
  export LLM_API_KEY=local            # 本地服务不校验,但也别在源码里写字面量
  export LLM_MODEL=cot                # 想测基座就换成基座模型名
"""
import os
import time

from openai import OpenAI

# 同一道题跑基座和蒸馏后模型,差异最容易看出来:
# 基座会给一段四平八稳的议论,蒸馏过的会先在 <think> 里推一遍再作答。
DEFAULT_QUESTION = (
    "对于「初三女生在搀扶跌倒老奶奶后反被冤枉,但仍选择资助她千元」的新闻事件,"
    "你有什么看法?"
)


def make_client():
    base_url = os.environ.get("LLM_BASE_URL", "http://localhost:8000/v1")
    api_key = os.environ.get("LLM_API_KEY")
    if not api_key:
        raise RuntimeError("环境变量 LLM_API_KEY 没设置(本地服务可随便给一个占位值)")
    return OpenAI(api_key=api_key, base_url=base_url)


def call_server(question, model=None, max_tokens=20000):
    client = make_client()
    model = model or os.environ.get("LLM_MODEL", "test")
    result = client.chat.completions.create(
        messages=[{"role": "user", "content": question}],
        model=model,
        max_tokens=max_tokens,
    )
    return result.choices[0].message.content


def bench(question=DEFAULT_QUESTION, model=None):
    """打印输出长度、耗时、速度三个数,这就是部署优化的验收指标。"""
    start = time.time()
    text = call_server(question, model=model)
    cost = time.time() - start
    print("输出长度:%d 字  耗时:%.2f 秒  输出速度:%.2f 字/秒"
          % (len(text), cost, len(text) / cost))
    return text, cost


def compare(models, question=DEFAULT_QUESTION):
    """依次测多个 model(多个 LoRA 或基座),横向比速度。

    vLLM 能同时挂载多个 LoRA,切换只是换一个 model 名字,
    不用重启服务、不用再占一份显存 —— 对比测试因此变得很便宜。
    """
    rows = []
    for name in models:
        print("---- model = %s ----" % name)
        text, cost = bench(question, model=name)
        rows.append((name, len(text), cost, len(text) / cost))
        print(text[:200] + " ……")
        print()
    print("%-12s %10s %10s %12s" % ("model", "输出字数", "耗时(秒)", "速度(字/秒)"))
    for name, n, cost, speed in rows:
        print("%-12s %10d %10.2f %12.2f" % (name, n, cost, speed))


if __name__ == "__main__":
    bench()
api_key
本地起的 api server 不校验 key,常见写法是直接写 api_key="0"。这里改成从 LLM_API_KEY 读——本地服务给个占位值也从环境变量给。理由很简单:这份代码大概率会被复制去调线上服务,那时候破的例就成了泄露。base_url 同理,走 LLM_BASE_URL,换机器不用改代码。
测的问题固定一道,跑基座和蒸馏后模型各一遍。基座给的是一段四平八稳的议论;挂上思维链 LoRA 之后,模型会先在 <think> 里把事情推一遍,再给结论——这就是上一页那条生产线的成果,格式性强的结构确实被学进去了。
速度实测:同一个模型,换个部署方式差 22 倍
同一道测试问题,两种部署方式的实测数字:
| 部署方式 | 输出长度 | 耗时 | 输出速度 | 倍数 |
|---|---|---|---|---|
| LLaMA-Factory api server | 1902 字 | 376.63 秒 | 5.05 字/秒 | 1× |
vLLM api server | 1794 字 | 16.03 秒 | 111.92 字/秒 | 约 22× |
模型没变、LoRA 没变、硬件没变,只换了推理框架。 这个数字的意义是:如果你在为效果发愁的同时还在为速度发愁,先把部署方式换掉,很可能比继续调模型划算得多。
vLLM 快在哪
三件事:KV cache 把自注意力的中间 K、V 存下来,避免每输出一个字符都从头算;PagedAttention 把显存切成固定大小的块(默认 16)用块表关联,像内存分页那样按需申请,最坏只浪费最后一块,显存利用率能到 96%;批量任务优化——不再要求所有并行任务处于同一阶段,只要资源够就能随时插入新推理任务,超出并行量的请求会被抢占(preemption)、退出占用资源等待重试。细节在 vLLM 部署那一页。
vLLM 能同时加载多个 LoRA,随时指定用哪一个。三个好处:方便对比测试(同时挂 N 个 LoRA 无缝切换,随时比不同输入下的表现);节约服务器资源(多个低频 LoRA 塞进少数几台机器);方便负载均衡(分开部署则组间资源无法共享,统一部署可以共享全部资源)。call_api_server.py 里的 compare() 就是为这个场景写的。
4.3 收口:性能优化的四条路
蒸馏只是其中一条。真到了「这玩意儿太慢太贵」的时候,按下面四条依次找:
| 方向 | 手段 | 什么时候用 |
|---|---|---|
| ① 模型 | 裁剪 / 量化 / 蒸馏 | 模型本身就太大。见本页第 01 节。见效最大但周期最长,要重训要验收。 |
| ② 工具 | vLLM / HuggingFace TGI / FasterTransformer / DeepSpeed-Inference | 模型不动,换推理框架。性价比最高的一条——上面那个 5.05 → 111.92 就是证据。 |
| ③ prompt | 结构化 / 批处理 / 缩短输出 | 模型和框架都定了,从输入输出上抠。见下。 |
| ④ 业务 | 该不该用大模型 | 最容易被跳过、却往往收益最大的一条。见 4.4。 |
prompt 优化的三招
用【简历】【入职标准】这类强格式标记把各段输入分开,模型不会读串行,你也省掉了一堆解释性的话。
要抽取多个字段时,一次把所有字段和输出格式都说清,一个请求拿回一个完整 JSON,而不是一个字段发一次。
输出长度对大模型效率影响极大,应该尽力压缩,必要时压缩到一个 token。上一页的打分 prompt「只允许输出分数」、max_tokens=10,就是这一招的极致版本。
业务优化:哪些任务不该给大模型
| 类别 | 典型任务 | 原因 |
|---|---|---|
| 大模型无法处理 慎用 | 统计性任务:文本聚类、信息检索 | 这类任务要的是对全量数据做统计,大模型一次只看得到上下文窗口里的那点东西 |
| 低延迟任务:高频交易、舆情监控 | 逐 token 解码的延迟摆在那,再快也快不过一个规则引擎 | |
| 大模型无明显优势 慎用 | 较简单的分类任务 | 一个小分类模型又快又准又便宜 |
| 一般性的序列标注:分词、词性标注、常见实体识别 | 成熟方案遍地都是,精度不输大模型 | |
| 特别专业的领域:医药、化工 | 非常依赖专业词典,而词典匹配这件事本来就不需要模型 |
4.4 压轴案例:车系识别的混合策略
背景
某汽车领域互联网企业,需要短期内识别某时间段内所有文本中的车系,挖掘浏览者的购买意向形成商业价值。这批数据有 2.86 亿篇文章,要求速度快、时间短、资源消耗少。
两条常规路都走不通:用大模型实验,效果非常好,但时间来不及,也没有这么多资源可用;考虑过序列标注模型,但没有语料、没有标注人员支持,即使有现成的模型,现有资源下 2.86 亿篇文章全跑一遍时间仍然来不及。
深入挖掘任务的特性
转机来自两张表。先看车系本身:
| 类型 | 数量 | 例子 |
|---|---|---|
| 无歧义车系 | 3129 | 帕萨特、传祺、马自达、凯迪拉克 |
| 常用词歧义 | 116 | 几何、哪吒、指挥官 |
| 英文数字字符串歧义 | 513 | XC60、SL350 |
| 总数 | 3758 | 其中 83% 压根不会有歧义 |
再看文章:
| 类型 | 占比 | 该怎么处理 |
|---|---|---|
| 没有出现车系 | 84.3% | 直接丢弃,一个字都不用送模型 |
| 仅出现无歧义车系 | 13.16% | 字典命中即事实,直接记录 |
| 有潜在歧义车系 | 2.54% | 只有这一小撮需要大模型 |
最终方案:层层拦截
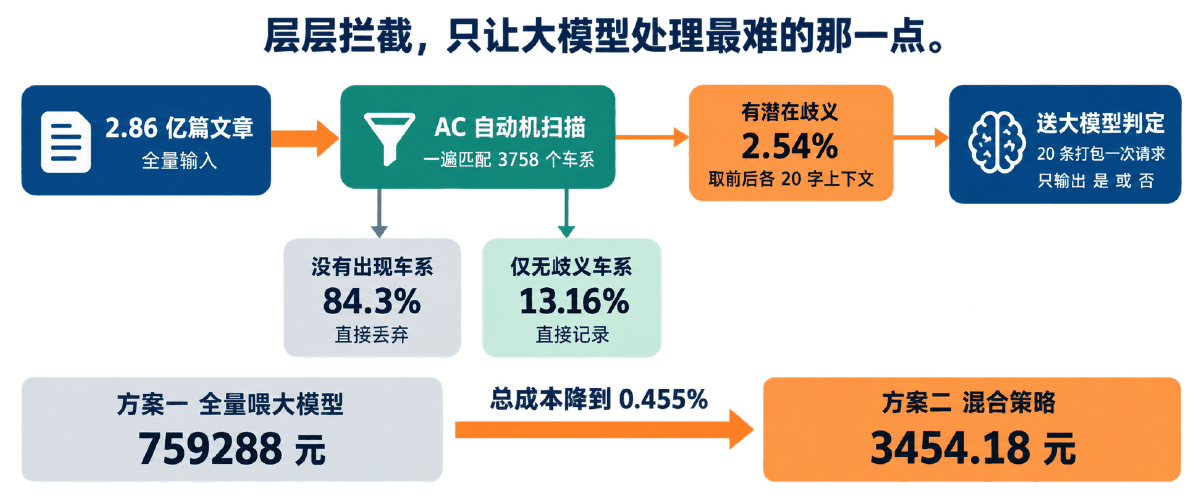
- 用 AC 自动机在所有文章中扫描所有车系字符串——一遍扫描同时匹配 3758 个关键词,复杂度和关键词数量无关。
- 无车系的,丢弃(84.3% 在这里被拦掉)。
- 所有无歧义车系,记录文章 ID、车系、出现位置(13.16% 在这里被拦掉)。
- 所有潜在歧义车系,取固定长度上下文(前后各 20 个字)送大模型判定——只剩 2.54%。
- 判定 prompt 里先给一个例子(「XC360 安全充电」判否、「XC360 就是其中的佼佼者」判是),再给真实输入;输出只允许「是」或「否」。
- 每 20 条数据打包进一条 prompt,请求数直接除以 20。
骨架代码
# -*- coding: utf-8 -*-
"""大模型 + 传统方法混合策略:AC 自动机全量扫描,只把歧义片段送大模型。

场景:2.86 亿篇文章里识别车系。全量喂大模型算得起吗?算不起。
做法:先用 AC 自动机把所有车系字符串一次扫出来,
      没出现车系的直接丢,无歧义的直接记账,
      只有「常用词歧义」和「英文数字串歧义」的片段才取上下文送大模型判定。

AC 自动机用标准库手写(无第三方依赖),本地可直接跑:
  python3 hybrid_pipeline_demo.py
"""
from collections import deque

# ---------------------------------------------------------------------------
# 一、AC 自动机(Aho-Corasick):一次扫描同时匹配上万个关键词
# ---------------------------------------------------------------------------


class AhoCorasick:
    def __init__(self):
        self.next = [{}]          # next[state][char] -> state
        self.fail = [0]
        self.out = [[]]           # 该状态命中的关键词列表

    def add(self, word):
        state = 0
        for ch in word:
            nxt = self.next[state].get(ch)
            if nxt is None:
                self.next.append({})
                self.fail.append(0)
                self.out.append([])
                nxt = len(self.next) - 1
                self.next[state][ch] = nxt
            state = nxt
        self.out[state].append(word)

    def build(self):
        """BFS 构造 fail 指针:匹配失败时跳到「最长的、也是某个模式前缀的后缀」。"""
        q = deque()
        for ch, s in self.next[0].items():
            self.fail[s] = 0
            q.append(s)
        while q:
            r = q.popleft()
            for ch, s in self.next[r].items():
                q.append(s)
                f = self.fail[r]
                while f and ch not in self.next[f]:
                    f = self.fail[f]
                f = self.next[f].get(ch, 0)
                self.fail[s] = 0 if f == s else f
                # 把 fail 指向状态的命中词并进来,一次匹配能报出所有重叠关键词
                self.out[s] += self.out[self.fail[s]]

    def search(self, text):
        """返回 [(起点, 终点, 关键词), ...],一遍扫描,复杂度与关键词数量无关。"""
        hits = []
        state = 0
        for i, ch in enumerate(text):
            while state and ch not in self.next[state]:
                state = self.fail[state]
            state = self.next[state].get(ch, 0)
            for word in self.out[state]:
                hits.append((i - len(word) + 1, i + 1, word))
        return hits


# ---------------------------------------------------------------------------
# 二、车系词典:三类,只有后两类需要大模型
# ---------------------------------------------------------------------------

UNAMBIGUOUS = ["帕萨特", "传祺", "马自达", "凯迪拉克"]   # 无歧义,直接记账
COMMON_WORD = ["几何", "哪吒", "指挥官"]                 # 常用词歧义
ALNUM_STR = ["XC60", "SL350", "XC360"]                   # 英文数字串歧义
AMBIGUOUS = set(COMMON_WORD + ALNUM_STR)

CONTEXT = 20          # 歧义片段前后各取 20 个字
BATCH = 20            # 20 条数据打包进一条 prompt

JUDGE_PROMPT_HEAD = (
    "你是一位汽车行业的专家,需要你确定一组文本片段的特定字符串是不是代表一个车系,"
    "如果是车系,输出是;否则输出否。不允许输出其他任何字符。"
)


def build_automaton():
    ac = AhoCorasick()
    for w in UNAMBIGUOUS + COMMON_WORD + ALNUM_STR:
        ac.add(w)
    ac.build()
    return ac


def scan_article(ac, doc_id, text):
    """返回 (直接记账的命中, 需要送大模型的片段)。"""
    direct, pending = [], []
    for start, end, word in ac.search(text):
        if word in AMBIGUOUS:
            left = max(0, start - CONTEXT)
            right = min(len(text), end + CONTEXT)
            pending.append([text[left:right], word])
        else:
            direct.append((doc_id, word, start))
    return direct, pending


def make_batches(pending, batch=BATCH):
    """每 batch 条打包成一条 prompt,这一步直接把请求数除以 20。"""
    for i in range(0, len(pending), batch):
        chunk = pending[i:i + batch]
        yield JUDGE_PROMPT_HEAD + "\n现在真实的输入是:\n" + repr(chunk), chunk


# ---------------------------------------------------------------------------
# 三、成本估算:把账算给人看
# ---------------------------------------------------------------------------

TOTAL_DOCS = 2.86e8           # 文章总量
AVG_CHARS = 1000              # 平均字数
RATIO_AMBIGUOUS = 0.0254      # 有潜在歧义车系的文章占比
AVG_AMB_PER_DOC = 2.5         # 这类文章里平均每篇的潜在歧义车系个数
PER_RECORD_CHARS = 60         # 一条歧义记录(4.6 字车系 + 前后 20 字 + 结构符号)
TMPL_CHARS = 305              # 提示词模板长度
OUT_CHARS_PER_REQ = 20        # 每次请求输出 20 个「是/否」

PLAN1_PROMPT_CHARS = 91       # 方案一每篇文章附带的提示词长度
CHARS_PER_TOKEN = 0.6         # 中文字数换算成 token 的经验系数
PRICE_IN = 4 / 1e6            # 元 / token
PRICE_OUT = 16 / 1e6


def cost(chars_in, chars_out):
    return (chars_in * CHARS_PER_TOKEN * PRICE_IN,
            chars_out * CHARS_PER_TOKEN * PRICE_OUT)


def estimate():
    # 方案一:所有文章全量喂大模型
    in1 = TOTAL_DOCS * (AVG_CHARS + PLAN1_PROMPT_CHARS)
    out1 = TOTAL_DOCS * (2 + (2 + 3.8) * 0.31)
    c1_in, c1_out = cost(in1, out1)

    # 方案二:只送 2.54% 文章里的歧义片段,且 20 条打一包
    amb_docs = TOTAL_DOCS * RATIO_AMBIGUOUS
    amb_items = amb_docs * AVG_AMB_PER_DOC
    requests = amb_items / BATCH
    in2 = requests * (TMPL_CHARS + PER_RECORD_CHARS * BATCH)
    out2 = requests * OUT_CHARS_PER_REQ
    c2_in, c2_out = cost(in2, out2)

    print("%-12s %14s %14s %14s" % ("", "输入字数(亿)", "输出字数(亿)", "总成本(元)"))
    print("%-12s %14.2f %14.4f %14.2f"
          % ("方案一", in1 / 1e8, out1 / 1e8, c1_in + c1_out))
    print("%-12s %14.2f %14.4f %14.2f"
          % ("方案二", in2 / 1e8, out2 / 1e8, c2_in + c2_out))
    print("%-12s %13.3f%% %13.3f%% %13.3f%%"
          % ("方案二/方案一", in2 / in1 * 100, out2 / out1 * 100,
             (c2_in + c2_out) / (c1_in + c1_out) * 100))
    print()
    print("需要大模型判定的文章:%.2f 万篇" % (amb_docs / 1e4))
    print("潜在歧义车系总数:    %.2f 万个" % (amb_items / 1e4))
    print("打包后的请求次数:    %.0f 次" % requests)


if __name__ == "__main__":
    ac = build_automaton()
    docs = [
        (1, "今天天气不错,和朋友去公园散步,没聊车。"),
        (2, "这款帕萨特的后备箱空间很大,传祺也不差。"),
        (3, "今年哪吒大火,票房达到了惊人的120亿美元,很多人都去看了。"),
        (4, "大部分朋友对此有一个误解,其实哪吒的目标从来都不是商务用车,"
            "而更偏向于表达用户的个性,XC60 的车主也有类似看法。"),
    ]

    print("=" * 62)
    print("一、AC 自动机扫描结果")
    print("=" * 62)
    all_pending = []
    for doc_id, text in docs:
        direct, pending = scan_article(ac, doc_id, text)
        if not direct and not pending:
            print("文章 %d:无车系,丢弃" % doc_id)
            continue
        for d in direct:
            print("文章 %d:无歧义命中 %s(位置 %d),直接记录" % d)
        for frag, word in pending:
            print("文章 %d:潜在歧义 %s,取上下文送大模型 -> %r" % (doc_id, word, frag))
        all_pending += pending

    print()
    print("=" * 62)
    print("二、打包后的 prompt(20 条一批,这里只有 %d 条)" % len(all_pending))
    print("=" * 62)
    for prompt, chunk in make_batches(all_pending):
        print(prompt[:300] + (" ……" if len(prompt) > 300 else ""))
        print("本批 %d 条,期望输出 %d 个字" % (len(chunk), len(chunk)))

    print()
    print("=" * 62)
    print("三、2.86 亿篇文章的成本估算")
    print("=" * 62)
    estimate()
AC 自动机用标准库手写,无第三方依赖,本机可直接跑。实跑输出:
==============================================================
一、AC 自动机扫描结果
==============================================================
文章 1:无车系,丢弃
文章 2:无歧义命中 帕萨特(位置 2),直接记录
文章 2:无歧义命中 传祺(位置 14),直接记录
文章 3:潜在歧义 哪吒,取上下文送大模型 -> '今年哪吒大火,票房达到了惊人的120亿美元,很多'
文章 4:潜在歧义 哪吒,取上下文送大模型 -> '大部分朋友对此有一个误解,其实哪吒的目标从来都不是商务用车,而更偏向于表达'
文章 4:潜在歧义 XC60,取上下文送大模型 -> '不是商务用车,而更偏向于表达用户的个性,XC60 的车主也有类似看法。'

==============================================================
二、打包后的 prompt(20 条一批,这里只有 3 条)
==============================================================
你是一位汽车行业的专家,需要你确定一组文本片段的特定字符串是不是代表一个车系,如果是车系,输出是;否则输出否。不允许输出其他任何字符。
现在真实的输入是:
[['今年哪吒大火,票房达到了惊人的120亿美元,很多', '哪吒'], ['大部分朋友对此有一个误解,其实哪吒的目标从来都不是商务用车,而更偏向于表达', '哪吒'], ['不是商务用车,而更偏向于表达用户的个性,XC60 的车主也有类似看法。', 'XC60']]
本批 3 条,期望输出 3 个字

==============================================================
三、2.86 亿篇文章的成本估算
==============================================================
                    输入字数(亿)        输出字数(亿)         总成本(元)
方案一                 3120.26        10.8623      759290.19
方案二                   13.67         0.1816        3454.22
方案二/方案一              0.438%         1.672%         0.455%

需要大模型判定的文章:726.44 万篇
潜在歧义车系总数:    1816.10 万个
打包后的请求次数:    908050 次
看第一段:文章 1 无车系被丢弃;文章 2 命中「帕萨特」「传祺」直接记录,一个字都没送模型;文章 3、4 命中「哪吒」「XC60」,各取前后 20 字上下文进待判队列。第二段把三条打包成一条 prompt,期望输出只有 3 个字。
把账算给读者看
估算前提:文章总量 2.86 亿、平均字数 1000 左右;所有文章中平均每篇含车系 0.31 个、平均每个车系名称长度 3.8;含潜在歧义车系的文章里平均每篇含 2.5 个、平均长度 4.6;硅基流动上 DeepSeek-R1 输入 4 元/M token、输出 16 元/M token。
每篇文章都带上 91 字的提示词送进去。
总输入:2.86亿 × (1000+91) = 3120.26 亿字
总输出:2.86亿 × (2+(2+3.8)×0.31) = 10.86 亿字
成本:759288 元
需判定文章 2.86亿 × 2.54% = 726.44 万篇,潜在歧义车系 1816.1 万个。
每条 60 字(4.6 字车系 + 前后各 20 字 + 结构符号),20 条一包、模板 305 字,共发 908050 次请求。
成本:3454.18 元
| 输入字数 | 输出字数 | 总成本 | |
|---|---|---|---|
| 方案一 | 3120.26 亿 | 10.86 亿 | 759288 元 |
| 方案二 | 13.7 亿 | 0.1816 亿 | 3454.18 元 |
| 方案二 / 方案一 | 0.439% | 1.672% | 0.455% |
两百二十倍的差价,来自三个动作:把 84.3% 的无关文章挡在门外(AC 自动机)、把 13.16% 的确定情况直接判掉(字典即事实)、把剩下那点送模型的内容压到只剩上下文片段并打包(prompt 优化的三招全用上了)。
05骨架模板
训练脚本、验证脚本、混合策略骨架,把 TODO 换成自己的路径就能用
5.1 学生模型训练脚本
webui 适合第一次跑通和快速试错,但复现要靠脚本。下面这份把第 04 节那三档参数按注释分了块:路径块改一个字就指向另一次实验,性质块决定这次训练到底在干什么,效果块是你会反复调的那一组。
#!/bin/bash
# =============================================================================
# 学生模型 LoRA 训练骨架(LLaMA-Factory 命令行)
# 把 TODO 换成自己的路径和参数即可。webui 上点出来的那一次训练,
# 日志里会打印等价的命令行,可以直接抄回这里做成可复现的脚本。
# =============================================================================

set -euo pipefail

# ---- TODO: 三个路径,改这里 -------------------------------------------------
BASE_MODEL="TODO/models/Qwen/Qwen2.5-3B-Instruct-GPTQ-Int4"   # 基座模型目录
DATA_DIR="TODO/data/chatData"                                  # 放 dataset_info.json 的目录
OUTPUT_DIR="TODO/models/lora/qwen2.5-3b-cot"                   # 训练产物落点
DATASET_NAME="chat-train"                                      # dataset_info.json 里的键名

export CUDA_VISIBLE_DEVICES=0

llamafactory-cli train \
  `# ---- 决定路径:改一个字都会指向另一次实验 ----` \
  --model_name_or_path "$BASE_MODEL" \
  --dataset_dir "$DATA_DIR" \
  --dataset "$DATASET_NAME" \
  --output_dir "$OUTPUT_DIR" \
  --template qwen \
  `# ---- 决定性质:这几项定了这次训练到底在干什么 ----` \
  --stage sft \
  --do_train True \
  --finetuning_type lora \
  --quantization_bit 4 \
  --quantization_method bitsandbytes \
  --double_quantization True \
  `# ---- 决定效果:反复调的就是这一组 ----` \
  --learning_rate 1e-4 \
  --cutoff_len 6000 \
  --num_train_epochs 1.0 \
  --per_device_train_batch_size 1 \
  --gradient_accumulation_steps 2 \
  --warmup_steps 10 \
  --lr_scheduler_type cosine \
  --lora_rank 8 \
  --lora_alpha 16 \
  --lora_dropout 0.1 \
  --lora_target all \
  `# ---- 工程项:一般照抄 ----` \
  --preprocessing_num_workers 16 \
  --max_samples 100000 \
  --max_grad_norm 1.0 \
  --logging_steps 5 \
  --save_steps 100 \
  --packing False \
  --report_to none \
  --bf16 True \
  --plot_loss True \
  --trust_remote_code True \
  --optim adamw_torch \
  --ddp_timeout 180000000 \
  --include_num_input_tokens_seen True

# =============================================================================
# 训练完拿 checkpoint 起服务验证:
#
#   基座(对照组)
#     API_PORT=8000 llamafactory-cli api --model_name_or_path "$BASE_MODEL"
#
#   基座 + LoRA(实验组)
#     API_PORT=8000 llamafactory-cli api \
#       --model_name_or_path "$BASE_MODEL" \
#       --adapter_name_or_path "$OUTPUT_DIR/checkpoint-TODO" \
#       --finetuning_type lora
#
#   换 vLLM 提速,并同时挂多个 LoRA
#     CUDA_VISIBLE_DEVICES=0 API_PORT=8000 vllm serve "$BASE_MODEL" \
#       --enable-lora \
#       --lora-modules cot="$OUTPUT_DIR/checkpoint-TODO"
#
# 然后 python3 call_api_server.py 测速度、看输出差异。
# =============================================================================
| 要改的 TODO | 填什么 |
|---|---|
BASE_MODEL | 基座模型目录,就是 modelscope download --local_dir 指定的那个路径。 |
DATA_DIR | 放 dataset_info.json 的目录。不是 jsonl 的路径,是它所在的目录。 |
DATASET_NAME | dataset_info.json 里的键名,默认 chat-train。 |
OUTPUT_DIR | 训练产物落点。建议按「基座名 + 任务名」命名,否则跑三个实验之后你会分不清哪个 checkpoint 是哪个。 |
文件末尾的 checkpoint-TODO | 训练结束后看 OUTPUT_DIR 里实际生成的 checkpoint 编号,填进去起服务。 |
5.2 验证脚本
call_api_server.py 已在第 04 节全文列出。它有两个入口:
bench()跑一道题,打印输出长度 / 耗时 / 速度三个数。这就是部署优化的验收指标,5.05 和 111.92 都是这么量出来的。
compare(models)传一组 model 名字(多个 LoRA 或基座),依次测完打一张横向对比表。配合 vLLM 的多 LoRA 挂载,切模型只是换个字符串,不重启、不多占显存。
三个环境变量:LLM_BASE_URL(换机器改这个)、LLM_API_KEY(本地给占位值也从环境变量给)、LLM_MODEL(点名用哪个 LoRA)。
5.3 混合策略骨架
hybrid_pipeline_demo.py 也在第 04 节全文列出,改造成生产版本要动三处:
| 位置 | 改成什么 |
|---|---|
UNAMBIGUOUS / COMMON_WORD / ALNUM_STR | 换成你自己的词典,并按「是否有歧义」分好类——这一步的分类质量直接决定了有多少数据能绕开大模型。 |
make_batches() 之后 | 接上真实的模型调用,并把返回的「是否」串按顺序对回每一条。返回条数和输入条数对不上时必须整批重试,别去猜对应关系。 |
estimate() 里的常量 | 把 TOTAL_DOCS、AVG_CHARS、RATIO_AMBIGUOUS 这些换成你自己抽样统计出来的值,再算你自己的账。 |
5.4 三份产物的关系
| 文件 | 在哪一步用 | 依赖什么 |
|---|---|---|
kd_soft_label_loss.py | 理解软标签蒸馏 | 只依赖标准库。教师闭源时用不上,它是为能拿到 logits 的场景准备的。 |
train_student.template.sh | 训练学生模型 | 需要上一页产出的 train.jsonl + dataset_info.json,以及一张能跑的显卡。 |
call_api_server.py | 验证与测速 | 需要一个已经起来的 api server(LLaMA-Factory 或 vLLM 都行)。 |
hybrid_pipeline_demo.py | 业务优化 | 只依赖标准库,随时可跑。和蒸馏并行,不是蒸馏的后继步骤。 |
06易错点汇总
按「概念 / 三种方式 / 训练 / 部署 / 业务与安全」五类归并
⚠️ 一、概念层面
- 指望学生超过教师。 不可能。学生学的是教师的输出,教师错的地方学生照单全收,教师不会的东西学生无从学起。动手之前先问:教师模型在这个任务上的表现,你接受吗?不接受就换教师,别在学生身上找补。
- 把裁剪和量化搞混。 裁剪减的是参数总量(辞伙计),量化减的是每个参数的大小(换轻工具箱)。两者都不改变模型架构,只有蒸馏能跨架构。
- 以为三条路只能选一条。 本页的学生基座
Qwen2.5-3B-Instruct-GPTQ-Int4本身就是量化过的,再往上做蒸馏——量化和蒸馏是叠加的。 - 非结构化裁剪完直接上线,然后发现没变快。 权重置 0 得到的是稀疏矩阵,普通稠密矩阵乘法享受不到稀疏性,必须有专用库支持,否则白裁。
- 忘了量化是有损压缩。 精度损失是必然的(可用混合精度和量化感知训练缓解),泛化能力下降、对噪声更敏感也是真实代价。还要确认目标硬件支持你选的量化方式——并非所有硬件都支持。
⚠️ 二、三种蒸馏方式
- 教师闭源却想学软标签。 软标签要 logits、中间层要每层内部状态,闭源 API 一样都给不了。只有 API 就只能学硬标签,这不是水平问题,是条件问题。
- 软标签的损失用 MSE。 两个概率分布之间比的是信息量,该用 KL 散度。MSE 是给特征向量对齐用的(或者余弦距离);注意力特征因为经过 softmax,可以考虑 KL 散度。
- KL 的两个参数写反。 KL 散度不对称,
KL(教师‖学生)和KL(学生‖教师)是两个不同的优化目标。 - 忘了乘
T²。 温度把 logits 缩小 T 倍,梯度跟着小T²倍。漏乘的现象很隐蔽:调大温度后蒸馏几乎没效果,你会以为是温度选错了。 - 温度随便拍一个。 「对温度非常敏感」是写在缺点里的。太小等于在学硬标签,太大则分布被抹平到教师和学生看起来差不多——信号被自己抹没了。必须在自己的任务上扫一遍,常见起点 2~5。
- 中间层对齐时层号算错。 逐层匹配是学生第 m 层对教师第 mk 层;跨层融合是学生第 m 层对教师第 (m−1)k+1 到 mk 层池化后的向量。教师 12 层、学生 4 层时
k=3,别把 k 当成层数差。 - 用硬标签蒸馏,样本量还很小。 硬标签本来就信息受损、上限不高、易于过拟合,样本再少,学生会直接把答案背下来。
⚠️ 三、训练学生模型
- 「数据集」参数填成了文件路径。 它填的是
dataset_info.json里的键名(如chat-train),--dataset_dir才是目录。报错会是「找不到数据集」,照着文件路径能查半天。 - 对话模板和基座模型不一致。 训练时拼出来的对话格式和模型预期的对不上,loss 看着在降,实际学歪了。模板必须和基座一致。
- 学习率按感觉给。 量级本身就是语义:
0.1只用于探索没人真用,0.01是从头训练的标准初始值,0.0001才是接近收敛时做微调的量级。1500 条数据、0.01 学习率、10 轮——这个组合几乎必然过拟合加震荡,效果不好是正常的。 - 数据集小还堆轮数。 学的特性较简单时 1 轮即可;数据集太小时更不该多轮,应该考虑数据增强而不是反复刷同一批样本。
CUDA out of memory后到处乱改。 按顺序动三个:先降批处理大小,再降截断长度,再抬梯度累计把等效批次补回来。量化等级从 none 换 4 也能救。- 把 LoRA 的 A、B 矩阵都初始化成 0。 梯度恒为 0,两个矩阵永远学不动。A 高斯初始化、B 全 0:B 全 0 保证训练起点与基座输出完全一致,A 非 0 保证梯度能流动。反过来也不行。
- 把 LoRA 的秩和缩放系数当成同一个东西。 秩决定学到信息的丰富程度,缩放系数决定 LoRA 的重要程度(旁路结果占多大权重)。
- 训练完找不到自己的 checkpoint。 三个实验都往同一个
output_dir里写,事后分不清哪个是哪个。按「基座名 + 任务名」建目录。
⚠️ 四、验证与部署
- 没有对照组就下结论。 说「蒸馏之后效果变好了」必须有基座跑同一道题的输出摆在旁边。同一个基座挂不挂
--adapter_name_or_path,就是实验组和对照组。 - 把框架的慢算到模型头上。 同一个模型、同一个 LoRA、同一块卡,LLaMA-Factory 的 api server 5.05 字/秒,换 vLLM 是 111.92 字/秒。效果和速度是两件事,先确认你在解决哪一件。
api_key="0"写死在代码里。 本地服务确实不校验,但这份代码迟早被复制去调线上服务。本地给占位值也从环境变量给。- vLLM 调用时 model 参数填错。 挂了 LoRA 就要填
--lora-modules里定义的名字;填空串或基座名走的是纯基座——测出来「蒸馏没效果」,其实压根没加载 LoRA。 - 多个低频 LoRA 各起一套服务。 分开部署则组间资源无法共享。vLLM 能同时挂多个,统一部署可以共享全部资源,还方便对比测试和负载均衡。
- 只看输出长度不看耗时。 验收指标是三个数一起看:输出长度、耗时、速度。只报速度容易被一个特别短的回答骗过去。
⚠️ 五、业务优化与成本
- 什么任务都往大模型上怼。 统计性任务(文本聚类、信息检索)和低延迟任务(高频交易、舆情监控)大模型无法处理;简单分类、一般序列标注、高度依赖专业词典的领域大模型没有优势。
- 先优化模型,最后才想业务。 顺序反了。四条路里业务优化往往收益最大——车系识别那个案例,模型一个字没改,成本降到 0.455%。
- 忘了压输出长度。 输入长度影响一次前向,输出长度影响逐 token 的解码次数。「只允许输出分数」「只允许输出是或否」这类限定,必要时压缩到一个 token。
- 一条数据发一次请求。 20 条打包成一条 prompt,请求数直接除以 20,模板开销也被摊薄。
- 把示例里的成本数字直接搬去做预算。 759288 元和 3454.18 元建立在几条平均值假设上(每篇 1000 字、每篇 0.31 个车系、歧义文章每篇 2.5 个)。先在自己的数据上抽样统计,再算自己的账。
- 打包后不校验返回条数。 模型返回的「是否」串和输入条数对不上时必须整批重试,千万别按位置猜对应关系——错位会污染整批结果,而且事后查不出来。
07自测题
点击题目展开答案;这 12 题讲得清楚,从原理到上线你就打通了
模型压缩有哪三种思路?它们各自减的是什么?
裁剪减的是参数总量(辞伙计);量化减的是每个参数的大小(把精密电子秤换成粗刻度量勺);蒸馏是另起一个班底,让小模型从教师的输出里学手艺。
最关键的区别在最后一列:裁剪和量化都不改变模型架构,只有蒸馏能跨架构。
非结构化裁剪和结构化裁剪各有什么代价?
非结构化基于模型权重,把不重要的参数置 0,精度损失小,但得到的是稀疏矩阵——需要专用库支持,否则普通稠密矩阵乘法根本享受不到稀疏性,裁了也不快。
结构化基于特定结构整块切,切完还是稠密矩阵、任何硬件都能跑、可以适配轻量化设备;但可控性较差(说不准伤到了哪些能力),而且需要重训或调优。
模型量化一定会损失信息吗?如何缓解?量化按哪三个维度分类?
一定会。量化是一种有损压缩,必然会有精度损失,可以用混合精度和量化感知训练缓解。另外两个代价常被忽略:并非所有硬件都支持,以及泛化能力下降、对噪声的敏感度提升。
三个分类维度:按时间点分训练后量化与量化感知训练(QLoRA 训练属后者);按粒度分统一精度量化与混合量化(ViT 上常见);按对称性分对称量化与非对称量化。
一个典型的蒸馏过程包含哪三个步骤?
①训练教师模型:在大规模数据上训练一个高性能但复杂的模型(很多时候直接拿现成强模型即可)。②知识迁移:用教师模型对训练数据做推理,生成可训练的数据,输出可以是中间层特征、软标签或硬标签。③训练学生模型:让学生的预测结果接近教师。
三种学法的分岔口就在第 ② 步。
什么是软标签?为什么它比硬标签更适合作为学习目标?
硬标签在 softmax 之后取最大值得到,只有一个 1 其余全 0;softmax 输出的那组概率分布就是软标签(都大于 0、总和为 1,且指数函数把差距拉开)。
艾青自传那个例子:硬标签只说「这是文学」;软标签说军事 0.2 / 文学 0.7 / 家居 0.0015 / 体育 0.00003——它还传递了类别间的隐含关系:像军事的程度远高于像体育,那段与王震将军的往事就藏在 0.2 里。信息比硬标签丰富得多。
学习概率分布应该用什么损失函数?特征向量和注意力特征呢?
两个概率分布之间的差异用 KL 散度——它衡量的是「用学生这个分布近似教师那个分布,损失了多少信息」,这才是概率分布之间有意义的度量。注意 KL 不对称,两个参数顺序不能换。
特征向量对齐用 MSE 或余弦距离(比的是向量的方向和大小,不是概率);注意力特征可以考虑 KL 散度,因为注意力权重经过 softmax,本身就是概率分布。
学生层数只有教师的 1/k,两种对齐策略分别怎么算?
逐层匹配:学生第 m 层对齐教师第 mk 层向量。实现简单,但被跳过的层信息直接丢了。
跨层融合:学生第 m 层对齐教师第 (m−1)k+1 到第 mk 层池化后的向量。信息利用更充分,代价是多做一次池化。
举例:教师 12 层、学生 4 层,k=3。逐层匹配下学生第 2 层对教师第 6 层;跨层融合下对教师第 4、5、6 层池化后的结果。
什么情况下只能学硬标签?这种方式有什么优缺点?
五种情况:①教师模型不可用或是闭源模型;②获取中间特征或软标签成本过高(DeepSeek-R1 就是这种);③训练资源受限;④要学的领域或特性不是非常复杂;⑤学生模型已经有相当好的基础。
优点:无需获取中间层特征或软标签、训练成本低、迭代速度快。缺点:信息受损、效果上限不高、易于过拟合。
温度调大一定更好吗?用实跑数字说明。
不是。同一对模型,KL 散度随温度先涨后跌:T=1 → 0.0254、T=2 → 0.0678、T=4 → 0.0601、T=8 → 0.0230。
T 太小等于在学硬标签;T 太大把分布抹得太平,教师和学生看起来都差不多,信号被自己抹没了。这正是「蒸馏对温度非常敏感」的含义。另外别忘了损失要乘 T²——温度把 logits 缩小 T 倍,梯度小 T² 倍,不乘回来软标签项就压不过硬标签项。
LoRA 为什么能同时避免灾难性遗忘、又能减小训练参数量?A、B 矩阵怎么初始化?
避免遗忘:不调整原始矩阵 W,而是另训一个增量 ΔW,推理时用 W+ΔW,原有知识表征没被破坏。
减参数:不直接训巨大的 ΔW,而是训两个小矩阵 A(M×r)、B(r×N),使 A×B ≈ ΔW。M=300000、N=500000 时 ΔW 是 1500 亿参数,取 r=16 后 A 是 480 万、B 是 800 万,合计 1280 万——0.000085,不到万分之一。
初始化:A 高斯初始化、B 全 0。B 全 0 保证训练起点输出与基座完全一致;A 不能也是 0,否则梯度恒为 0,两个矩阵永远学不动。两个都高斯初始化则训练一开始就把基座输出打乱了。
「我想学电气自动化的数据集,共 1500 条,用了 0.01 的学习率,做了 10 轮训练,为什么效果不好?」
两个参数都错了一个量级。0.01 是从头训练的标准初始学习率,在已有基座上微调应该用 1e-4 或 5e-5——0.01 会让参数剧烈震荡,把基座能力冲掉。1500 条属于小数据集,10 轮几乎必然过拟合:学的特性简单时 1 轮即可,数据集太小时更该考虑数据增强而不是反复刷同一批样本。
另外检查预热步数是否设了(建议 10,防止参数剧烈震荡)。
训练刚启动就报 CUDA out of memory: Tried to allocate 7.26G, GPU 0 has a total capacity of 23.64GB which 16.56MB is free,怎么办?
显存不够。按顺序动这几项:①降批处理大小(最直接,调到 1);②降截断长度(6000 往下调,代价是长样本被截);③抬梯度累计把等效批次补回来(批处理大小 × 梯度累计 决定梯度更新频率);④把量化等级从 none 换成 4,走 QLoRA;⑤确认微调方法是 LoRA 而不是 full。
另外这条日志说「总共 23.64GB 只剩 16.56MB 空闲」——先确认卡上没有别的进程在占,nvidia-smi 看一眼。
同一个模型,LLaMA-Factory 的 api server 和 vLLM 实测差多少?vLLM 快在哪?
同一道测试问题:LLaMA-Factory 输出 1902 字、耗时 376.63 秒、5.05 字/秒;vLLM 输出 1794 字、耗时 16.03 秒、111.92 字/秒,约 22 倍。模型、LoRA、硬件都没变。
快在三处:KV cache 把自注意力的 K、V 存下来避免重复计算;PagedAttention 把显存切成固定大小的块(默认 16)用块表关联、按需申请,最坏只浪费最后一块,显存利用率可达 96%;批量任务优化——不要求并行任务处于同一阶段,资源够就随时插入新任务,超出并行量的请求被抢占后退出资源等待。
优化大模型性能有哪四条路?哪条性价比最高、哪条最容易被跳过?
①模型(裁剪/量化/蒸馏)、②工具(vLLM / TGI / FasterTransformer / DeepSpeed-Inference)、③prompt(结构化/批处理/缩短输出)、④业务(该不该用大模型)。
性价比最高的是 ②——模型不动,5.05 变 111.92。最容易被跳过、收益却往往最大的是 ④——车系识别案例里模型一个字没改,成本降到 0.455%。
prompt 优化三招里,为什么「缩短输出」最值钱?
因为输入长度只影响一次前向(prefill),而输出长度影响的是逐 token 的解码次数——输出 1000 字就是 1000 次解码。所以「输出长度对大模型效率影响极大,应该尽力压缩,必要时压缩到一个 token」。
典型写法:「只允许输出分数,不允许输出其他任何字符」并把 max_tokens 压到 10;车系判定里「如果是车系,输出是;否则输出否」,20 条一批也只输出 20 个字。
哪些任务大模型没有优势?为什么?
无法处理:统计性任务(文本聚类、信息检索)——要对全量数据做统计,而大模型一次只看得到上下文窗口;低延迟任务(高频交易、舆情监控)——逐 token 解码的延迟快不过规则引擎。
没有优势:较简单的分类任务、一般性的序列标注(分词、词性标注、常见实体识别)、特别专业的领域(医药化工等非常依赖专业词典,而词典匹配本就不需要模型)。
车系识别案例里,2.86 亿篇文章怎么做到只花 3454.18 元?
靠层层拦截。先用 AC 自动机一遍扫描匹配全部 3758 个车系字符串;84.3% 没出现车系的文章直接丢弃;13.16% 仅出现无歧义车系的直接记录文章 ID、车系、位置;只有 2.54% 有潜在歧义的,取前后各 20 字上下文送大模型判定,且每 20 条打包进一条 prompt、只允许输出「是/否」。
结果:方案一全量喂大模型 759288 元,方案二 3454.18 元;输入字数降到 0.439%,总成本 0.455%。教益是:用简单快速的方法处理大部分容易处理的数据,用大模型处理少量困难的数据。
附术语表
本页出现的关键术语,按首次出现顺序
| 术语 | 含义 |
|---|---|
| 模型裁剪 | 减少参数总量。分非结构化(按权重置 0,需专用库支持)与结构化(按结构整块切,可控性差、需重训或调优)。 |
| 模型量化 | 减少每个参数的大小,把高精度数字转成低精度。按时间点、粒度、对称性三个维度分类。有损压缩,必然掉精度。 |
| 模型蒸馏 | 把教师模型的知识迁移到更小的学生模型。三条路里唯一能跨架构的。 |
| 教师模型 / 学生模型 | 被学的大模型 / 学的小模型。本页例子是 DeepSeek-R1 与 Qwen2.5-3B-Instruct-GPTQ-Int4。 |
| softmax | 把一组任意实数压成都大于 0、总和为 1 的分布;指数函数会把差距拉开。它的输出就是软标签。 |
| 软标签 / 硬标签 | 前者是概率分布,含类别间的隐含关系;后者只有一个 1、其余全 0,只给结论。 |
| KL 散度 | 衡量「用一个分布近似另一个分布损失了多少信息」。不对称,两个参数顺序不能换。学软标签用它,注意力特征也可以用它。 |
温度 T | softmax 前的缩放系数。T>1 抹平分布、放大小概率;蒸馏损失要乘 T² 把梯度量级补回来。蒸馏对它非常敏感。 |
| 中间层特征 | 模型特定步骤输出的向量:隐藏层输出(biLSTM 第 n 层、BERT 第 k 层 encoder/decoder)与注意力向量。 |
| 逐层匹配 / 跨层融合 | 学生层数为教师 1/k 时的两种对齐:前者学生第 m 层对教师第 mk 层;后者对教师第 (m−1)k+1 到 mk 层池化后的向量。 |
| LoRA | Low-Rank Adaptation。不动原始权重,另训两个小矩阵 A×B 近似增量 ΔW。A 高斯初始化、B 全 0。 |
| LoRA 的秩 / 缩放系数 / 随机丢弃 | 秩决定学到信息的丰富程度;缩放系数决定 LoRA 的重要程度;随机丢弃是正则化,防止模型过度依赖 LoRA。 |
| 灾难性遗忘 | 全参数微调重构所有参数导致原有知识表征被破坏,新任务好了、旧任务急剧下降。LoRA 不动原始矩阵,因此能避免。 |
LLaMA-Factory | 封装完善的 LLM 微调工具,webui 与命令行两种用法,支持 100+ 模型与多种训练阶段、多种精度。 |
modelscope | 魔搭社区。无法访问 huggingface 时用它拉基座模型,--local_dir 指定落点。 |
checkpoint / adapter | 训练产物目录。起服务时用 --adapter_name_or_path 把它挂到基座上,挂与不挂就是实验组与对照组。 |
| KV cache | 把自注意力的 K、V 中间结果缓存下来,避免每输出一个字符都从头计算。典型的空间换时间。 |
| PagedAttention | vLLM 的显存管理方式:切成固定大小的块(默认 16)用块表关联、按需申请,最坏只浪费最后一块,显存利用率可达 96%。 |
| AC 自动机 | Aho-Corasick。一遍扫描同时匹配成千上万个关键词,复杂度与关键词数量无关。混合策略里负责全量拦截。 |
| 混合策略 | 用简单快速的方法处理大部分容易处理的数据,用大模型处理少量困难的数据,层层拦截减轻大模型负担。 |