Prompt-Tuning 进阶:ICL、CoT 与 PEFT 全景
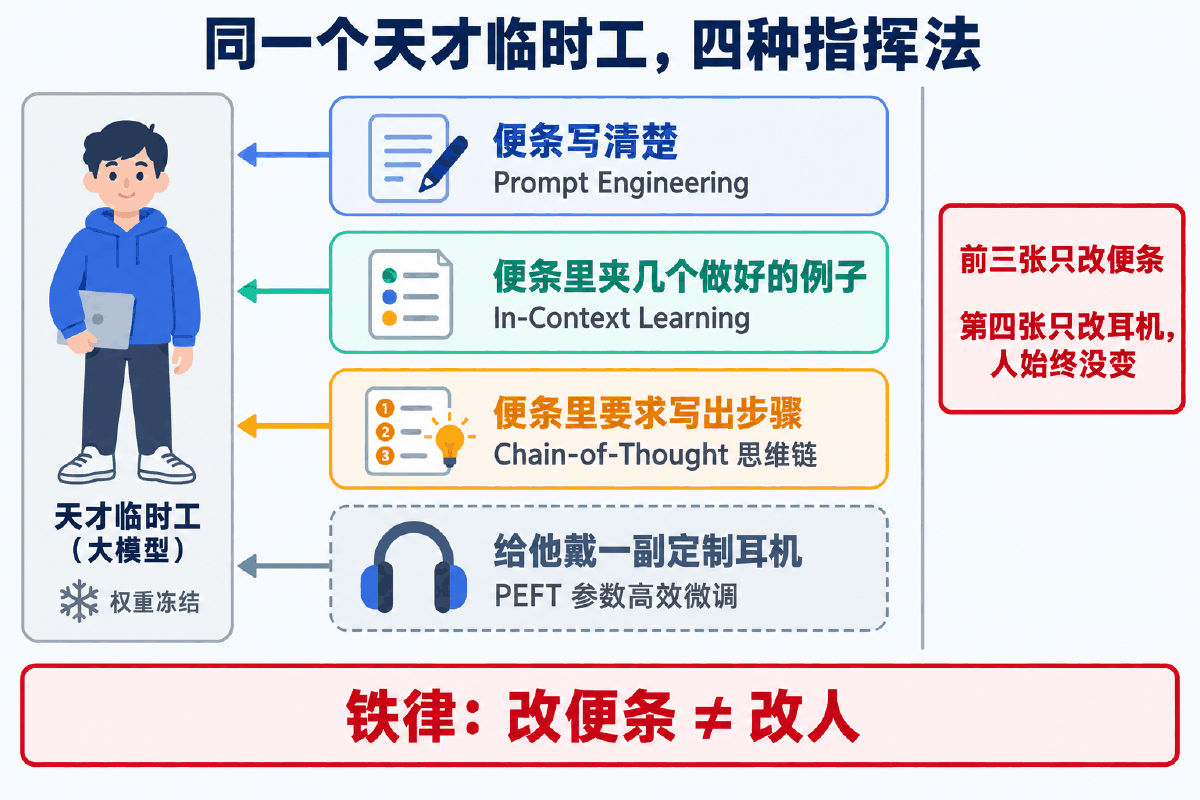
同一个天才临时工,四种指挥法:写清便条、便条里夹例子、便条里要求写步骤、给他戴一副定制耳机——前三种连耳机都不用戴。
30秒看懂
同一个临时工,四种指挥法——三种只动便条,一种才动耳机
上一讲已经把人和便条分开了:大模型是那个读遍全世界资料、却没参加过岗前培训的天才临时工,Prompt 是递进去的工作便条。这一讲要回答的是下一个问题——便条还能怎么写,耳机还能怎么做。四种办法,按「动不动梯度」分成两侧:
不解释规则,直接把几份填好的样张附上去,让他照着格式往下填。这就是 In-Context Learning(上下文学习)。
加一句「把过程写出来再给结论」。答案没变,但他被迫一步步算,错得少多了。这就是 CoT(思维链)。
不再让他猜,而是写明「判断情感,从 A/B/C 里选一个」。这就是 Instruction(指令)的写法。
前三种有个共同点:人没碰,耳机也没碰,动的全是那张纸。第四种才越过这条线——
耳机不止一种做法:可以只在他进门时播一段暗号,可以每个房间都播一段,可以在他工作流程里插一个小转换器,也可以在他的判断旁边并一条低秩捷径。这一族做法叫 PEFT(参数高效微调)。
把人送去脱产培训、改造本人——那是 Fine-Tuning,代价最大,放在模块 ⑧ 专门讲。这一讲从头到尾,临时工本人的权重一个都没动过。
这一讲里出场的角色
| 角色 | 对应比喻 | 它到底是什么 |
|---|---|---|
| In-Context Learning | 便条里夹的样张 | 把若干「输入 + 答案」的示例写进输入,让模型照格式作答,不更新任何参数 |
| Zero / One / Few-shot | 夹 0 张 / 1 张 / N 张 | 示例数量的三档叫法,三者都不训练 |
| Instruction 指令 | 写清任务的正式工单 | 把「做什么、选哪些」明写出来,模型做判别而不是续写 |
| CoT 思维链 | 「把过程写出来」 | 在示例或提示里加入中间推理步骤,把一步作答变成多步推导 |
| PEFT | 定制耳机这一整族 | 只训练少量额外参数、冻结主体的一整类方法的统称 |
| Prompt Tuning | 进门时播一段暗号 | 只在输入层拼一段可训练向量,与层数无关 |
| Prefix-Tuning / P-Tuning v2 | 每个房间都播一段 | 每一层都挂一段前缀向量,深度介入 |
| Adapter | 工作流程里插的小转换器 | 在每层内部插入「降维—非线性—升维」的小模块 |
| LoRA | 判断旁边并的低秩捷径 | 在权重矩阵旁并一条 A×B 支路,训练完可合并回原权重 |
② 为什么说 Instruction 教的是「听话」,Prompt 教的是「接话」?
③
Let's think step by step 只是一句话,为什么它需要两次调用才算用对?④ 同一个 7B 底座,Prompt Tuning 和 Adapter 的可训参数差了多少倍?
⑤ LoRA 刚接上去的那一刻,模型的输出会变吗?为什么?
01概念:规模变大之后,玩法全变了
模型小的时候只能靠训练;模型大到一定程度,写好输入本身就成了一种方法
1.1 一个转折:增益开始反超
上一讲的 Soft Prompt 是在 BERT 这种量级上讨论的——几千万到一亿参数,不训练基本不出活。但当模型参数量迈过十亿量级之后,出现了一件反直觉的事:对这些超大模型来说,精心设计模板或指令带来的增益,能超过按部就班地做标准 Fine-Tuning。GPT-3 这类模型只要把模板写对,就能做到免参数训练的零样本学习。
为什么会这样?三个条件同时成立才行:
模型有足够的容量把各种任务的解法都「顺带」学进去了,它缺的不是能力而是被唤醒的方式。
预训练读过的文本里本来就包含大量「问—答」「题—解」的天然格式,模型见过这种排版。
目标函数逼着它真的去建模语言规律,而不是死记硬背。这是前两条能兑现的前提。
1.2 In-Context Learning:把例子写进输入里
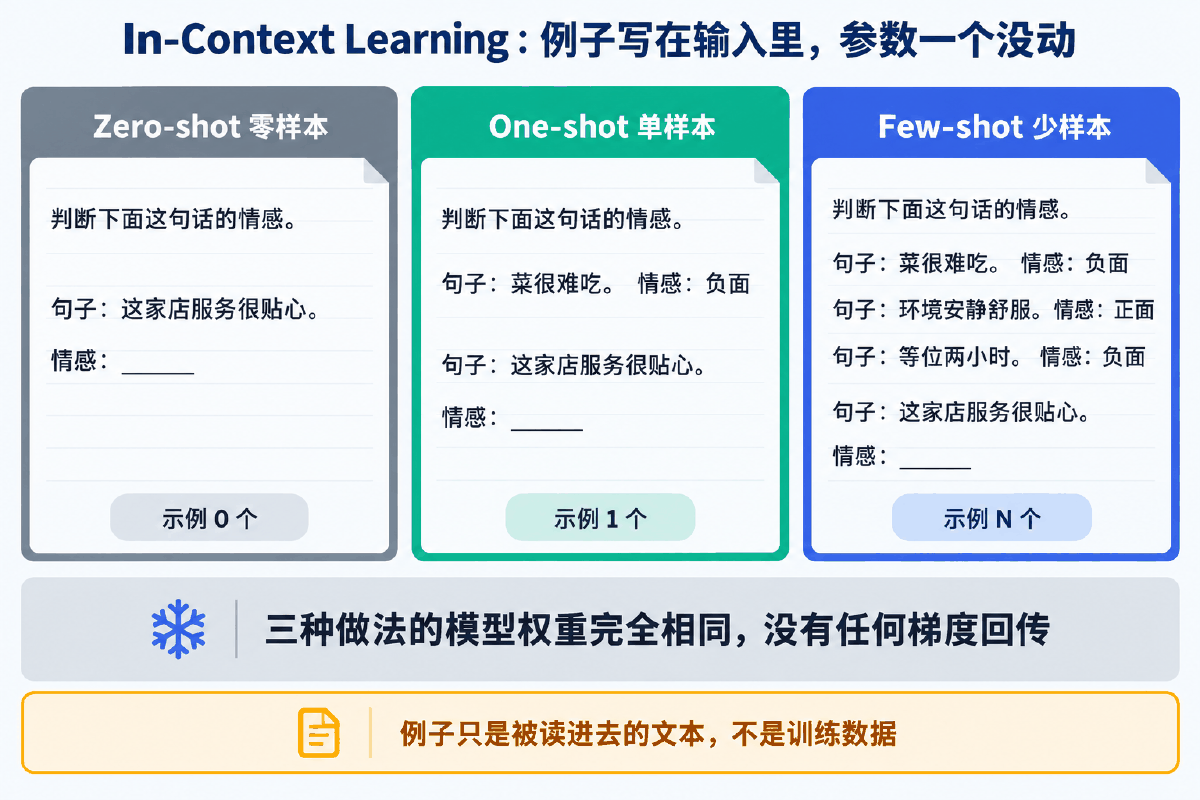
In-Context Learning(ICL,上下文学习)最早在 GPT-3 论文《Language Models are Few-Shot Learners》(arXiv:2005.14165)里被系统提出。做法极其朴素:从训练集里挑少量已标注的样本,连同任务指令一起拼成提示模板,用来指导模型对测试样本作答。
注意这个词里的两个部分:In-Context(在上下文里)说的是这些例子只存在于这一次的输入中;Learning(学习)打了引号——它看起来像学习,但没有任何参数被更新。这一次调用结束,模型对这些例子就再无记忆。
1.3 零样本、单样本、少样本
按附上去的示例个数,ICL 分成三档。三者的任务描述都一样,差别只在示例的数量:
| 形态 | 示例个数 | 做法 | 什么时候用 |
|---|---|---|---|
| Zero-shot 零样本 | 0 | 只给任务描述,直接让预训练模型上场预测 | 任务简单、输出格式天然;或者手头压根没有标注样本 |
| One-shot 单样本 | 1 | 预测前先插一个做好的样本做指导 | 主要用来示范输出格式,让模型知道该吐什么形状 |
| Few-shot 少样本 | N(常见 2~32) | 插 N 个样本,让模型理解任务再作答 | 任务有细微判定边界,需要靠例子把边界划出来 |
1.4 Instruction-Tuning:从「接话」到「听话」
Prompt 本质上也是对下游任务的一种指令——告诉模型要做什么、输出什么。那能不能把这件事做得更彻底:为各种类型的任务都定义好指令,拿这些指令去训练模型,让它学会「听指令」这件事本身?这就是 Instruction-Tuning(指令学习)。
看同一个句子的两种问法,差别一眼就出来:
| 问法 | 送进模型的文本 | 模型要做什么 |
|---|---|---|
| Prompt 式 | 带女朋友去了一家餐厅,她吃的很开心,这家餐厅太__了! | 续写——在空位上接一个词,接完还要用 Verbalizer 翻译成类别 |
| Instruction 式 | 判断这句话的情感:带女朋友去了一家餐厅,她吃的很开心。选项:A=好,B=一般,C=差 | 判别——读懂要求,从给定选项里选一个 |
Instruction 是去激发语言模型的理解能力——通过更明显的指令,让模型理解并做出正确的 action。
而且很明显:做判别比做生成容易。选项摆在那儿,模型不用自己憋一个词出来。
换句话说:会不会写指令是你的事,认不认识指令是模型的事——后者要靠训练喂出来。所以严格讲,Instruction-Tuning 属于「改人」那一侧,不属于「改便条」。
1.5 思维链:多给的不是答案,是过程
CoT(Chain-of-Thought,思维链)的概念首次提出于 Google 的论文《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》(arXiv:2201.11903)。它是一种改进的提示策略,专门用来提高大模型在复杂推理任务上的表现——算术推理、常识推理、符号推理。
它属于离散式提示学习,更准确地说是大模型下的上下文学习。和传统 ICL 的差别只有一处:
让模型补出 ytest
让模型先补推理,再补 ytest
就是中间多插了一段推导提示。示例从二元组 <input, output> 变成了三元组 <input, CoT, output>——这就是 CoT 的全部结构性改动。
1.6 PEFT:参数高效微调这一整族
PEFT(Parameter-Efficient Fine-Tuning,参数高效微调)是目前大模型在工业界落地的主流方式之一。它的定义很干脆:只微调少量或额外的模型参数,固定住大部分预训练参数,从而大幅降低计算与存储成本,同时最先进的 PEFT 技术能达到与全量微调相当的性能。
| PEFT 的三大类 | 改造位置 | 代表方法 |
|---|---|---|
| Prefix / Prompt 类 | 在输入或隐层添加 k 个额外可训练的前缀伪 token,只训练这些前缀参数 | Prefix-Tuning、P-Tuning、P-Tuning v2、Prompt Tuning |
| Adapter 类 | 把较小的神经网络层或模块插入预训练模型的每一层,下游微调时只训练这些适配器 | Adapter |
| 重参数化类 | 学习小参数的低秩矩阵来近似权重矩阵的参数更新,训练时只优化低秩矩阵 | LoRA |
02原理:示例、指令、推理链与四种耳机
每一种做法都有自己的失效边界,把边界讲清楚比把定义背下来有用得多
2.1 示例怎么写:三条硬要求
ICL 看着就是「把例子粘进去」,但粘法不对,效果会比零样本还差。示例必须同时满足三条:
| 要求 | 具体做法 | 违反了会怎样 |
|---|---|---|
| 格式同构 | 示例的输入行、答案行,和最后那条提问行用完全一样的字段名和分隔符 | 模型不知道该往哪儿填,可能把字段名也一起续写出来 |
| 答案位留空 | 提问块写到 情感: 就停住,不要把冒号后面也填上 | 答案位已经有内容,模型会当成又一个示例继续往下编 |
| 标签均衡 | 各类别的示例个数尽量持平,别一边倒 | 触发多数标签偏置,模型倾向于直接答那个出现最多的标签 |
把这三条写成代码就是第 03 节的 icl_builder.py。它用四条断言把「格式同构」「答案位留空」钉死,跑一遍就知道自己的拼装函数有没有偷偷破坏这些前提。
2.2 放几个、怎么排:两个真实存在的偏置
「示例放几个、按什么顺序放」听着像玄学,其实有两个可以量化的机制在起作用:
示例里哪个标签出现得多,模型就更倾向于答哪个。4 个示例全是正面,模型对负面样本的召回会掉。
离提问最近的那个示例影响最大。同一批示例顺序一反,最后一眼看到的标签就变了,结论可能跟着翻。
每加一个示例都要占上下文窗口、按 token 计费。示例不是免费的,效果打平就该停。
正确做法:把示例数当成超参数,在验证集上从 0、1、2、4、8 逐档试,选拐点那一档,而不是凭手感定一个数。第 04 节的
shot_order_effect.py 把这三件事全部量化成了可核对的数字。
2.3 接话与听话:Prompt 和 Instruction 的分工
1.4 节给了结论,这里补上机制。两种问法逼着模型走的是两条不同的输出路径:
→ 在词表上找一个最合适的词
→ 再用 Verbalizer 翻译成类别
→ 在三个选项里挑一个
→ 直接就是类别,不需要翻译
Instruction 少了一步翻译,输出空间也从整个词表收缩到了三个选项——这就是「判别比生成容易」的技术含义。
Instruction-Tuning 和 Prompt-Tuning 的核心是一样的:都是去发掘语言模型本身已经具备的知识。区别在于怎么问、以及问之前要不要先教。以电影评论二分类为例,最简单的模板是 {x} It was [mask].,它并没有突出该任务的具体特性;给它加上任务说明,写成 The movie review is {x}. It was [mask].,这种带任务特性的模板就可以称为指令(Instruction),再把 mask 位置的输出通过 Verbalizer 映射到标签上。
| 维度 | Prompt-Tuning | Instruction-Tuning |
|---|---|---|
| 激发的能力 | 续写能力:给上半句接下半句、做完形填空 | 理解能力:读懂指令并做出正确的 action |
| 模型要输出什么 | 一个词,还要过 Verbalizer | 一个选项,直接就是答案 |
| 要不要先精调模型 | 不要,没精调过的模型也能有一定效果 | 必须精调,让模型先认识这种指令模式 |
| 泛化的来源 | 模板挑得好 | 训练时见过足够多类型的任务指令 |
| 落在哪一侧 | 改便条(或改耳机) | 改人——它是一种 Fine-Tuning |
2.4 Few-shot CoT:示例从二元组变三元组
Few-shot CoT 是 ICL 的一种特殊情况:它通过融合 CoT 推理步骤,把每个演示从 <input, output> 扩充为 <input, CoT, output>。
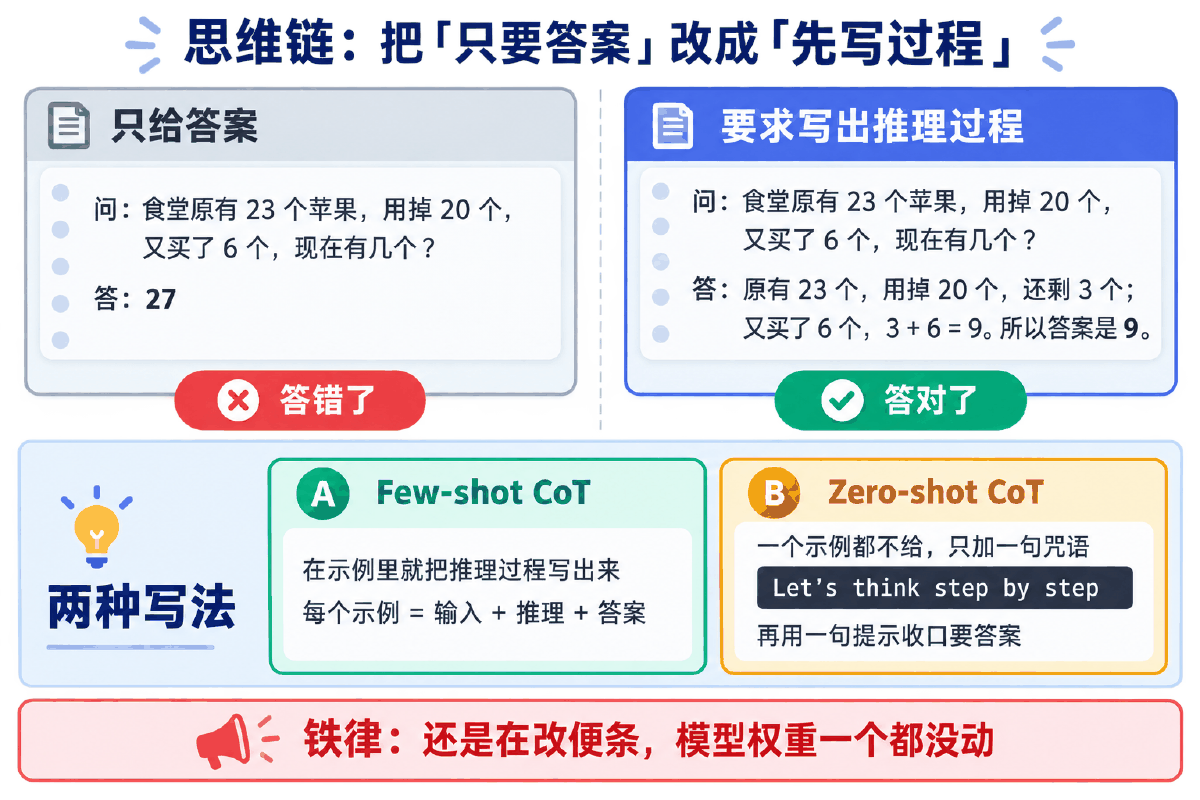
一个合格的 CoT 示例块长这样,三段缺一不可:
| 段 | 内容 | 作用 |
|---|---|---|
| 输入 | 问:食堂原有 23 个苹果,用掉 20 个,又买了 6 个,现在有几个? | 题面,和提问行同构 |
| 推理 | 推理:原有 23 个,用掉 20 个,还剩 23 - 20 = 3 个;又买了 6 个,3 + 6 = 9 个。 | 这一段是 CoT 的全部增量,示范「过程要写成什么样」 |
| 答案 | 答:9 | 最终结论,必须是上一段算出来的那个数 |
答:,模型会顺着格式直接吐一个数,把推理整段跳过——你写的那些示例推理就白写了。停在推理段,才能把模型逼进「先写过程」的轨道。cot_parser.py 用一条断言专门守这件事。
23 - 20 = 4),模型会照着错的范式学,而且错得很自信。写 CoT 示例时,每条算式都要自己核一遍;cot_parser.py 里有一条断言检查「答案必须在推理过程中真的出现过」,防的就是答案和过程对不上这种错。
2.5 Zero-shot CoT:两句咒语,两次调用
Few-shot CoT 要手写带推理的示例,成本不低。有没有一个示例都不写的办法?有——直接生成推理步骤,再用生成的 CoT 导出答案。论文《Large Language Models are Zero-Shot Reasoners》(arXiv:2205.11916)给出的做法是两句固定提示:
Let's think step by step模型顺着往下写出推导过程
+
Therefore, the answer is这篇论文报告的效果是实打实的:在 text-davinci-002 上,MultiArith 从 17.7% 提升到 78.7%,GSM8K 从 10.4% 提升到 40.7%,而且没有用任何手工编写的少样本示例;在 540B 参数的 PaLM 上也有相近幅度的提升。
第二阶段的输入必须是:问题 + 触发语 + 第一阶段的完整输出 + 抽取语。少拼任何一段,模型就看不到自己刚写的推理,只能重新猜一个。
cot_zero_shot.py 把这个拼接关系写成了断言。
Let's think step by step 和 Therefore, the answer is 是论文里实测过的那两句。换成中文、换个措辞、加个「请」字,就不再是被验证过的那个提示了,效果必须重新实测。这不是迷信——提示词的效果本来就对措辞敏感,换了措辞就是换了一个实验条件。
2.6 CoT 什么时候失效
CoT 不是万金油。它有四个明确的失效场景,踩中任何一个都是在白花 token:
| 失效场景 | 现象 | 怎么办 |
|---|---|---|
| 模型规模不够 | 小模型加了 CoT 反而更差,产出一段像模像样但完全错的推理 | CoT 的收益呈现明显的涌现特征:模型规模超过一定量级才出现。小模型别指望它 |
| 任务本身不需要多步推导 | 单跳事实问答加了 CoT,绕一大圈还更容易跑偏 | 只在算术、逻辑、多跳问答这类确实要分步的任务上用 |
| 只做了第一阶段 | 拿到长篇推理,没有结构化答案 | 补上第二阶段抽取,或改用 Few-shot CoT 一次拿到格式化输出 |
| 推理对了,答案抄错 | 过程算出 9,最后一行写了别的数 | 抽取阶段加校验:答案必须在推理文本里出现过 |
那篇提出 CoT 的论文本身就说明了规模这件事:用 8 个思维链示例提示一个 540B 参数的模型,就在 GSM8K 数学应用题上达到了当时的最佳准确率,甚至超过了带验证器的微调版 GPT-3。注意这句话里的两个关键词——540B 和 8 个示例:能力来自规模,触发只要几个例子。
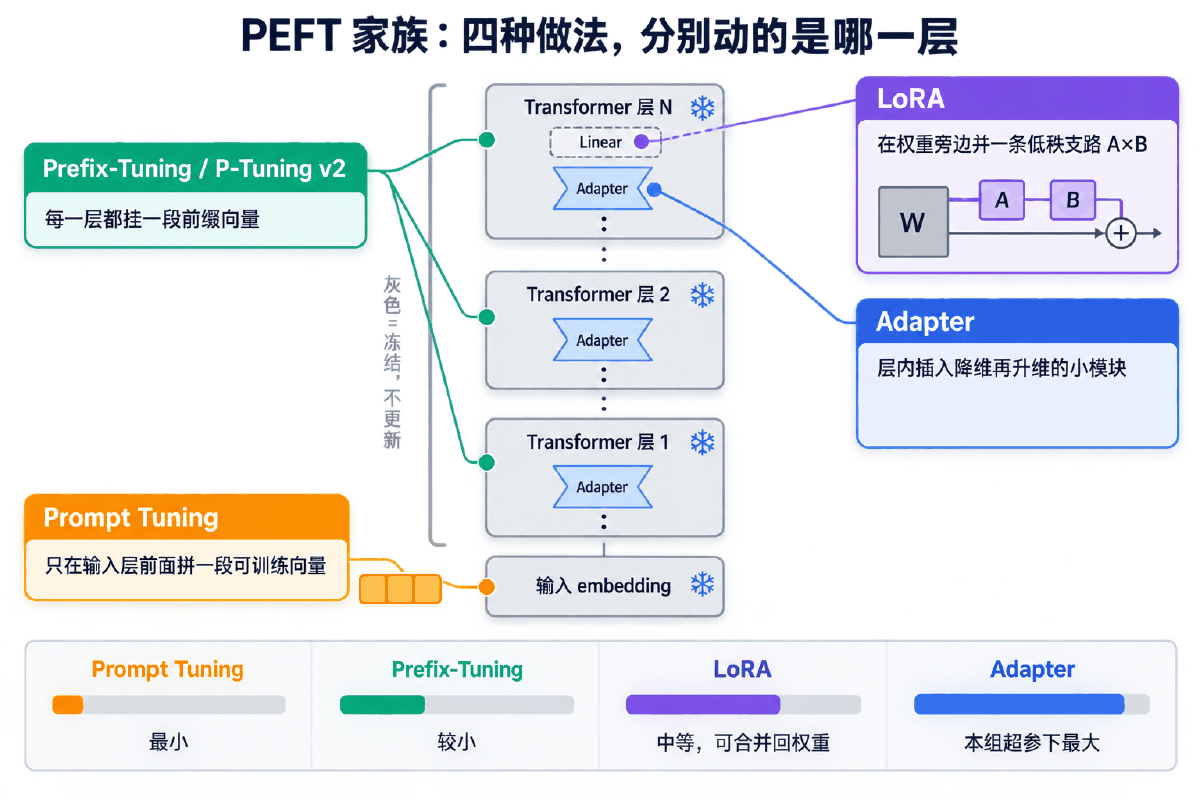
2.7 PEFT 家族全景:各自改哪一层
过了「要不要梯度」这条线,才轮到 PEFT 内部的选型。四种主流做法的差别,全在它们把可训练参数塞进了模型的哪个位置:
Prefix-Tuning:每一层都挂前缀
论文《Prefix-Tuning: Optimizing Continuous Prompts for Generation》(arXiv:2101.00190)提出:在输入 token 之前构造一段任务相关的 virtual tokens 作为 Prefix,训练时只更新 Prefix 部分的参数,Transformer 中的其他参数全部固定。形式上写作 z = [Prefix, x, y],前缀索引对应一个由 θ 参数化的向量矩阵 Pθ,维度是 |Pidx| × dim(hi)。
这篇论文实测只训练 0.1% 的参数,在全量数据下就能取得与 Fine-Tuning 相当的表现,在低数据场景下甚至更好,对训练时没见过的主题也外推得更好。
P-Tuning 与 P-Tuning v2
P-Tuning(《GPT Understands, Too》,arXiv:2103.10385)和 Prefix-Tuning 是同一时期的两条路子,差别有两处:
| 对比项 | Prefix-Tuning | P-Tuning |
|---|---|---|
| 插入位置 | 加在开头,看起来更像模仿 Instruction 指令 | 位置不固定,可以插在句中 |
| 插入深度 | 每一层都添加可训练参数 | 只在输入的时候加入 embedding |
| 初始化方式 | 通过 MLP 初始化 | 通过 LSTM + MLP 初始化 |
P-Tuning v2(arXiv:2110.07602)则是把 Deep Prompt Tuning 针对 NLU 任务做了优化和适配。它要解决的正是前代的两个短板:普通规模的预训练模型上 Prompt Tuning 表现不好,以及在硬序列标注任务上不管用。它的结论很硬:经过恰当优化的 Prompt Tuning 可以在各种模型规模和 NLU 任务上普遍有效,用 0.1%~3% 的可训参数就能匹配全量微调的表现。
Adapter:在层内插一个小模块
2019 年谷歌的《Parameter-Efficient Transfer Learning for NLP》(arXiv:1902.00751)拉开了 PEFT 研究的序幕。它和 Prefix 系那种「在输入前加参数」的思路不同:Adapter 是在预训练模型内部的网络层之间添加新的网络层或模块。训练时固定住原预训练模型的参数,只微调新增的 Adapter 结构。
Adapter 模块内部是三段式:
同时它设计了 skip-connection 结构(类似残差),确保最差情况下能退化为 identity——也就是说这个模块学不到东西时,至少不会把原模型搞坏。这篇论文在 GLUE 上每个任务只增加 3.6% 的参数,性能落在全量微调的 0.4% 以内,而全量微调每个任务要训练 100% 的参数。
LoRA:在权重旁边并一条低秩捷径
Adapter 有个副作用:在模型里加层会引入额外计算,带来推理延迟;Prefix-Tuning 则难以优化,性能随可训练参数规模呈非单调变化,而且为前缀保留一段序列长度,必然会挤掉下游任务可用的序列长度。这两个痛点催生了 LoRA。
LoRA(Low-Rank Adaptation,低秩适应)的核心思想是对权重矩阵做隐式的低秩转换——用一个较低维度的表示去近似一个高维矩阵。具体做法是:冻结预训练模型的权重,在每个 Transformer 块的 Linear 层旁边增加一个「旁支」A 和 B。A 把数据从 d 维降到 r 维(r 就是 LoRA 的秩,一个关键超参数),B 再把数据从 r 维升回 d 维,B 部分的参数初始化为 0。模型训练结束后,把 A、B 的贡献与原权重合并在一起使用。
B = 0 意味着旁支输出 x @ A @ B 恒为零向量。接上 LoRA 的那一刻,模型输出与原模型逐元素完全一致——不会有任何扰动。训练开始后 B 才逐渐偏离零,旁支才开始起作用。第 04 节的 lora_bypass_math.py 用手写矩阵乘法把这件事跑成了断言。
LoRA 论文(arXiv:2106.09685)给出的数字是这一族里最有说服力的:以 GPT-3 175B 为例,相比用 Adam 做全量微调,LoRA 能把可训练参数量减少 10000 倍,GPU 显存需求降低到三分之一;在 RoBERTa、DeBERTa、GPT-2、GPT-3 上的模型质量与微调持平或更好,训练吞吐更高,而且与 adapter 不同,它没有额外的推理延迟——因为旁支可以合并回权重。
四种做法横向对比
| 方法 | 改哪一层 | 可训参数量级 | 优点 | 缺点与适用场景 |
|---|---|---|---|---|
| Prompt Tuning arXiv:2104.08691 | 只在输入层拼一段可训练向量 | 最小,与层数无关 | 实现最简单;可以看作 Prefix-Tuning 的简化,不需要加 MLP 来解决难训练的问题 | 小模型上效果不稳;模型越大越顶用——随规模增长它会「补上差距」,在十亿参数以上匹配全量微调的表现。适合超大底座 + 极多任务 |
| Prefix-Tuning arXiv:2101.00190 | 每一层都挂一段前缀向量 | 较小(论文报 0.1%) | 深度介入,低数据场景比 Fine-Tuning 还好;对未见主题外推好 | 难优化,性能随参数规模非单调;前缀会占掉序列长度。适合生成类任务 |
| P-Tuning v2 arXiv:2110.07602 | 每一层加前缀,针对 NLU 优化 | 0.1%~3% | 跨模型规模和任务普遍有效;能处理硬序列标注任务 | 实现比 Prompt Tuning 复杂。适合 NLU 全家桶、序列标注 |
| Adapter arXiv:1902.00751 | 层内插入降维—非线性—升维模块 | 中等(论文报 3.6%) | 有 skip-connection,最差退化为 identity;新任务可随时加,不影响旧任务 | 引入额外计算,有推理延迟;参数量在这几种里偏大。适合任务差异大、需要强表达力的场景 |
| LoRA arXiv:2106.09685 | 在 Linear 权重旁并一条 A×B 低秩支路 | 由秩 r 决定,线性可调 | 可合并回权重,推理零额外延迟;零初始化保证无损接入;效果与全量微调持平或更好 | 秩 r 要调;合并后想换任务得拆回来。目前最通用、效果也最好的方法之一,单任务默认首选 |
2.8 四者一次钉死:改什么、要不要梯度、要不要数据
上一讲末尾那张坐标表,到这里就能画完整了。这是整个模块 ③ 最该背下来的一张表:
| 对比项 | Prompt Engineering 提示工程 | In-Context Learning 上下文学习 | CoT 思维链 | Prompt-Tuning (P-Tuning) 提示微调 |
|---|---|---|---|---|
| 改的是什么 | 输入文本的措辞与结构 | 输入文本里塞进的示例 | 输入文本里塞进的推理步骤 | 伪标记向量(Soft Prompt),模型权重冻结 |
| 要不要梯度 | ❌ 不需要 | ❌ 不需要 | ❌ 不需要 | ✅ 需要 |
| 要不要标注数据 | 不需要 | 需要少量(几条到几十条)当示例 | Few-shot CoT 需要几条带推理的示例;Zero-shot CoT 不需要 | 需要成百上千条训练样本 |
| 要不要 GPU | 不要 | 不要 | 不要 | 要,得能跑反向传播 |
| 成本结构 | 人力写提示;推理按 token 计费 | 输入变长 → 每次调用都更贵 | 输出也变长 → 比 ICL 还贵,且更慢 | 一次性训练成本;推理时输入不变长 |
| 产物是什么 | 一段提示词文本 | 一组精选示例 | 一组带推理的示例或两句触发语 | 一个几十 KB 到几 MB 的权重文件 |
| 换任务的代价 | 改文字,几分钟 | 换示例,几分钟 | 重写推理示例,几小时 | 重新训练一次 |
| 什么时候用它 | 任何时候的第一手段;没数据、没 GPU 时的唯一选择 | 任务有格式要求或判定边界,且手上有少量样本 | 任务要多步推理,且底座够大 | 有成百上千条标注、有训练环境,且要压低推理成本 |
| 在比喻里是 | 把便条写清楚 | 便条里夹样张 | 便条里要求写步骤 | 给他戴定制耳机 |
工程上的判断法子最简单:问一句「这次改动有没有产生一个需要存盘的新文件」。没有,你在改便条;有,你在改耳机。
最后一步能省下的正是前三步的持续成本:示例和推理链都写在输入里,每一次调用都要为它们付费;训练好的耳机不占输入长度。
03最小代码:手搓一个 few-shot 拼装器
不装框架、不调接口,40 行看清 zero / one / few-shot 到底差在哪
ICL 听着高级,但它的全部实现就是一个字符串拼装函数:把任务描述、若干示例、待预测句子按同一种格式串起来。既不需要 GPU,也不需要联网——先把这一步跑通,再去看任何框架的 few-shot 封装都不会懵。
# -*- coding: utf-8 -*-
"""In-Context Learning 输入拼装器:zero-shot / one-shot / few-shot 一次看全。

纯标准库可跑。跑完你会看到一件事:三种做法的差别**只在送进去的那串文本**,
模型权重、优化器、梯度全都不存在。所谓「学习」,学的是当前这一次输入。
"""

TASK_DESC = "判断下面这句话的情感,只回答「正面」或「负面」。"

# 候选示例池:真实项目里这些来自训练集
POOL = [
    ("菜很难吃,等位还等了两小时。", "负面"),
    ("环境安静舒服,适合聊天。", "正面"),
    ("服务员态度差,叫了三次都没人理。", "负面"),
    ("分量足,价格也实在。", "正面"),
]

QUERY = "这家店服务很贴心。"


def render_demo(sent, label):
    """一个示例渲染成两行:输入行 + 答案行。格式必须与提问行完全一致。"""
    return "句子:%s\n情感:%s" % (sent, label)


def build_prompt(query, demos):
    """把任务描述、若干示例、待预测句子拼成最终输入。

    demos 传空列表就是 zero-shot,传 1 个就是 one-shot,传 N 个就是 few-shot。
    """
    blocks = [TASK_DESC]
    for sent, label in demos:
        blocks.append(render_demo(sent, label))
    # 提问行故意留空,让模型顺着这个格式往下补
    blocks.append("句子:%s\n情感:" % query)
    return "\n\n".join(blocks)


def stat(prompt):
    """粗略统计:字符数、示例块数。真实项目里换成 tokenizer 的 token 数。"""
    return len(prompt), prompt.count("句子:") - 1


def main():
    modes = [
        ("zero-shot 零样本", []),
        ("one-shot  单样本", POOL[:1]),
        ("few-shot  少样本", POOL[:4]),
    ]

    lens = {}
    for name, demos in modes:
        p = build_prompt(QUERY, demos)
        n_char, n_demo = stat(p)
        lens[name] = n_char
        print("=" * 60)
        print("【%s】示例 %d 个 · 输入长度 %d 字符" % (name, n_demo, n_char))
        print("-" * 60)
        print(p)
        print()

    print("=" * 60)
    print("【三种做法的唯一差别】")
    print("  模型权重      : 完全相同,一个字节都没改")
    print("  梯度 / 优化器 : 不存在")
    print("  变的是什么    : 送进去的那串文本的长度和内容")
    print()
    for name in lens:
        print("  %s 输入 %d 字符" % (name, lens[name]))

    # 断言一:示例越多,输入越长——这正是 ICL 的全部成本所在
    assert lens["zero-shot 零样本"] < lens["one-shot  单样本"] < lens["few-shot  少样本"], \
        "示例增加必然带来输入变长,这是 ICL 唯一实打实的代价"

    # 断言二:zero-shot 的输入里不能出现任何已知答案,否则就是泄题
    zero = build_prompt(QUERY, [])
    for _, label in POOL:
        assert ("情感:%s" % label) not in zero, "zero-shot 的输入里不该出现任何带答案的示例"

    # 断言三:示例的渲染格式必须和提问行同构,否则模型不知道该补什么
    demo_line = render_demo(*POOL[0]).split("\n")[0]
    assert demo_line.startswith("句子:") and "句子:%s" % QUERY in zero, \
        "示例的输入行与提问行必须用同一个前缀,格式对不齐模型就不会照着填"

    print()
    print("自检通过:三种形态只是同一条输入的不同长度,没有任何参数被更新。")


if __name__ == "__main__":
    main()
3.1 跑起来是什么样
直接 python3 icl_builder.py,三种形态各打印一遍完整输入。同一个待预测句子、同一段任务描述,只有示例块数在变:
| 形态 | 示例个数 | 输入长度 | 相对零样本 |
|---|---|---|---|
| zero-shot | 0 | 42 字符 | 基准 |
| one-shot | 1 | 67 字符 | 多了一个示例块,长了 25 字符 |
| few-shot | 4 | 138 字符 | 三倍多——这就是 ICL 唯一实打实的代价 |
few-shot 那一版拼出来的完整输入长这样,注意最后两行故意停在冒号后面:
只回答「正面」或「负面」。
情感:负面
(重复 N 次)
情感:←停在这里
① 示例越多输入越长——这条成立,说明「ICL 的成本是线性增长的」不是空话。
② zero-shot 的输入里不许出现任何带答案的示例——防的是拼装函数写错时把答案漏进零样本分支,那样测出来的零样本成绩是假的。
③ 示例的输入行与提问行必须用同一个前缀——格式对不齐,模型就不知道该往哪儿填。
3.2 这 40 行对应真实项目的哪一部分
| 脚本里的东西 | 真实项目里的对应物 | 后面还要加什么 |
|---|---|---|
TASK_DESC | system prompt 或提示词模板的头部 | 加输出格式约束、边界情况说明 |
POOL | 示例检索库 | 换成向量检索,按与待预测样本的相似度动态挑 |
render_demo | 示例渲染模板 | 多字段任务要处理字段顺序、缺失值 |
build_prompt | 最终 prompt 组装 | 加 token 数统计与截断,别撑爆上下文窗口 |
stat | 成本监控 | 换成真实 tokenizer 的 token 数,字符数只能估个量级 |
len(prompt) 数字符,只够在本地看个趋势。真实计费和上下文窗口都按 token 算,中文一个字常常是 1 个 token,但英文、数字、标点会被合并或拆开,同样 138 个字符的中英混排输入,token 数可能差出一倍。上线前必须换成模型自带的 tokenizer 重新数一遍。
04完整案例:七个脚本,把每句结论跑成数字
不联网、不装依赖、不下模型,python3 文件名 直接跑;每个脚本结尾都有断言
这一节的七个脚本有个共同点:每个结论都配一条断言。哪句话站不住,脚本会当场抛 AssertionError,而不是让你盯着输出自己判断。Prompt 这一层本来就没有报错机制——模板写歪了、示例排错了、参数算少了,程序照样跑完,只是结果变差。这些断言的作用就是把「本来不会报错的错」变成会报错的。
4.1 示例的顺序与数量:把玄学量化
2.2 节说示例顺序和数量会影响结果。这个脚本不预测情感,它统计的是模型看到的输入本身——标签分布、末位标签、输入长度。三样都是可以直接数出来的。
# -*- coding: utf-8 -*-
"""示例的顺序和数量到底改变了什么:把「玄学」量化成可核对的数字。

纯标准库可跑。这个脚本不预测情感,它统计的是**模型看到的输入本身**——
标签分布、最后一个示例的标签、输入长度。这三样是 ICL 里最常被忽略的变量。
"""

POOL = [
    ("菜很难吃,等位还等了两小时。", "负面"),
    ("环境安静舒服,适合聊天。", "正面"),
    ("服务员态度差,叫了三次都没人理。", "负面"),
    ("分量足,价格也实在。", "正面"),
    ("上菜快,味道也稳定。", "正面"),
    ("包间隔音差,隔壁说话听得一清二楚。", "负面"),
]


def label_hist(demos):
    """统计示例里各标签出现了几次。"""
    h = {}
    for _, label in demos:
        h[label] = h.get(label, 0) + 1
    return h


def majority_ratio(demos):
    """占比最高的那个标签占了多少。越接近 1,多数标签偏置越强。"""
    h = label_hist(demos)
    return max(h.values()) / float(len(demos))


def describe(name, demos):
    h = label_hist(demos)
    last = demos[-1][1] if demos else "(无示例)"
    hist_s = " / ".join("%s×%d" % (k, v) for k, v in sorted(h.items()))
    print("%-14s 示例%d个  分布[%s]  末位标签=%s  多数占比=%.2f"
          % (name, len(demos), hist_s, last, majority_ratio(demos)))
    return majority_ratio(demos), last


def main():
    balanced = [POOL[0], POOL[1], POOL[2], POOL[3]]          # 负正负正
    skewed = [POOL[1], POOL[3], POOL[4], POOL[0]]            # 正正正负
    reversed_order = list(reversed(balanced))                # 正负正负

    print("【一、同样 4 个示例,排法不同,模型看到的统计特征就不同】")
    r_bal, last_bal = describe("交替排列", balanced)
    r_skew, last_skew = describe("同类扎堆", skewed)
    r_rev, last_rev = describe("逆序排列", reversed_order)
    print()

    print("【二、两个真实存在的偏置】")
    print("  多数标签偏置:示例里哪个标签多,模型就更爱答哪个。")
    print("    交替排列多数占比 %.2f,同类扎堆多数占比 %.2f —— 后者把模型往「正面」推。"
          % (r_bal, r_skew))
    print("  近因偏置:离提问最近的那个示例影响最大。")
    print("    交替排列末位=%s,逆序排列末位=%s —— 同一批示例,最后一眼看到的标签反了。"
          % (last_bal, last_rev))
    print()

    print("【三、示例数量的代价:长度是线性涨的】")
    print("%-8s %-10s %-10s" % ("示例数", "输入字符", "相对 zero-shot"))
    base = None
    for k in [0, 1, 2, 4, 6]:
        demos = POOL[:k]
        text = "\n\n".join(["句子:%s\n情感:%s" % (s, l) for s, l in demos])
        text += "\n\n句子:这家店服务很贴心。\n情感:"
        n = len(text)
        if base is None:
            base = n
        print("%-8d %-10d %-10s" % (k, n, "%.1f×" % (n / float(base))))
    print()
    print("  示例不是免费的:每加一个都要占掉上下文窗口,并按 token 计费。")
    print("  一旦发现 4 个和 8 个效果差不多,就该停在 4 个。")

    # 断言一:同类扎堆确实抬高了多数标签占比
    assert r_skew > r_bal, "同类扎堆应当产生更强的多数标签偏置"

    # 断言二:逆序确实换掉了末位标签——这就是「顺序敏感」的可测量来源
    assert last_rev != last_bal, "顺序一反,离提问最近的那个标签就变了"

    # 断言三:交替排列的标签分布是均衡的(各占一半)
    assert abs(r_bal - 0.5) < 1e-9, "交替排列应当做到标签分布完全均衡"

    # 断言四:示例集合完全相同,只是顺序不同
    assert sorted(balanced) == sorted(reversed_order), \
        "逆序只改顺序不改内容,因此差异只可能来自顺序本身"

    print()
    print("自检通过:顺序与数量都是**可测量的超参数**,不是玄学。")


if __name__ == "__main__":
    main()
同样 4 个示例,三种排法,模型看到的统计特征完全不同:
| 排法 | 标签分布 | 末位标签 | 多数占比 | 这意味着什么 |
|---|---|---|---|---|
| 交替排列 | 正面×2 / 负面×2 | 正面 | 0.50 | 分布完全均衡,没有多数标签偏置 |
| 同类扎堆 | 正面×3 / 负面×1 | 负面 | 0.75 | 四分之三是正面,模型被往「正面」推 |
| 逆序排列 | 正面×2 / 负面×2 | 负面 | 0.50 | 示例集合与交替排列完全相同,只是顺序反了,末位标签就反了 |
sorted(balanced) == sorted(reversed_order):两组示例的内容一模一样。既然内容相同、分布相同,那么两者之间任何效果差异,就只可能来自顺序本身。这条断言把「顺序敏感」从一句传闻变成了一个受控对照。
第三段把长度成本摆出来。示例从 0 加到 6,输入字符数几乎线性上涨:
| 示例数 | 0 | 1 | 2 | 4 | 6 |
|---|---|---|---|---|---|
| 输入字符 | 18 | 41 | 64 | 112 | 161 |
| 相对零样本 | 1.0× | 2.3× | 3.6× | 6.2× | 8.9× |
6 个示例把输入撑到了将近 9 倍。而效果通常在 4 个左右就打平了——这就是「示例数是超参数,要在验证集上选拐点」的由来。
4.2 CoT 结构解析:三段齐不齐
2.4 节说 Few-shot CoT 的示例是三元组。这个脚本把示例块解析成 (输入, 推理, 答案),并检查两件最容易出错的事:推理段在不在、答案是不是真从推理里算出来的。
# -*- coding: utf-8 -*-
"""CoT 提示结构解析器:把 Few-shot CoT 的示例拆成 <输入, 推理, 答案> 三段。

纯标准库可跑。普通 ICL 的示例是二元组 <input, output>;
Few-shot CoT 把它扩成三元组 <input, CoT, output>——多出来的中间那段就是全部秘密。
这个脚本负责检查:三段齐不齐、顺序对不对、答案是不是真从推理里长出来的。
"""

import re

# 一个写好的 Few-shot CoT 示例块。三行标记必须严格对齐,缺一行就不成立
DEMO = """问:食堂原有 23 个苹果,用掉 20 个,又买了 6 个,现在有几个?
推理:原有 23 个,用掉 20 个,还剩 23 - 20 = 3 个;又买了 6 个,3 + 6 = 9 个。
答:9"""

# 一个只有问答、没有推理的普通 ICL 示例块,用来做对照
DEMO_PLAIN = """问:食堂原有 23 个苹果,用掉 20 个,又买了 6 个,现在有几个?
答:9"""


def parse_demo(block):
    """把一个示例块解析成 (输入, 推理, 答案)。没有推理段就返回 None。"""
    q = re.search(r"^问:(.*)$", block, re.M)
    r = re.search(r"^推理:(.*)$", block, re.M)
    a = re.search(r"^答:(.*)$", block, re.M)
    if not q or not a:
        raise ValueError("示例块必须同时有「问:」和「答:」两行")
    return q.group(1).strip(), (r.group(1).strip() if r else None), a.group(1).strip()


def numbers_in(text):
    """抽出文本里所有整数,用来检查答案有没有凭空冒出来。"""
    return [int(x) for x in re.findall(r"\d+", text)]


def audit(block, name):
    """审一个示例块:三段齐不齐、答案是否出现在推理里。"""
    q, cot, a = parse_demo(block)
    print("【%s】" % name)
    print("  输入 : %s" % q)
    print("  推理 : %s" % (cot if cot else "(没有推理段)"))
    print("  答案 : %s" % a)
    has_cot = cot is not None
    grounded = has_cot and int(a) in numbers_in(cot)
    print("  三段齐全 : %s" % ("是" if has_cot else "否,这是普通 ICL 示例,不是 CoT 示例"))
    print("  答案有据 : %s" % ("是,%s 在推理里算出来过" % a if grounded
                              else "否,答案没有在推理过程中出现"))
    print()
    return has_cot, grounded


def build_fewshot_cot(demos, query):
    """把若干 CoT 示例和待解题拼成最终输入。提问块只到「推理:」为止。"""
    return "\n\n".join(demos + ["问:%s\n推理:" % query])


def main():
    print("【一、解析两种示例,看差在哪一段】")
    has_cot, grounded = audit(DEMO, "Few-shot CoT 示例")
    plain_cot, _ = audit(DEMO_PLAIN, "普通 ICL 示例")

    print("【二、拼出最终输入】")
    query = "书架上有 15 本书,搬走 7 本,又放上 4 本,现在有几本?"
    prompt = build_fewshot_cot([DEMO], query)
    print(prompt)
    print()

    print("【三、这个结构为什么重要】")
    print("  提问块停在「推理:」而不是「答:」——这是在逼模型先写过程再给结论。")
    print("  如果提问块直接给到「答:」,模型会跳过推理直接猜一个数,CoT 就白写了。")
    print()

    # 断言一:CoT 示例必须有推理段,普通示例必须没有
    assert has_cot is True, "CoT 示例必须含推理段"
    assert plain_cot is False, "普通 ICL 示例不应含推理段"

    # 断言二:答案必须能在推理里找到,不能凭空出现
    assert grounded is True, "CoT 示例的答案必须是推理过程算出来的数"

    # 断言三:最终输入必须以「推理:」结尾,把模型逼进先推理的轨道
    assert prompt.rstrip().endswith("推理:"), \
        "提问块要停在推理段,直接给到答案段会让模型跳过推理"

    # 断言四:示例里的推理链条本身要算得对
    q, cot, a = parse_demo(DEMO)
    assert 23 - 20 + 6 == int(a), "示例里的算式必须和答案自洽,否则教坏模型"

    print("自检通过:Few-shot CoT = 普通示例 + 中间那段推理,且答案必须由推理产生。")


if __name__ == "__main__":
    main()
| 被审的示例 | 三段齐全 | 答案有据 | 判定 |
|---|---|---|---|
| 带推理段的示例 | 是 | 是,9 在推理里算出来过 | 合格的 CoT 示例 |
| 只有问答的示例 | 否 | — | 这是普通 ICL 示例,不是 CoT 示例 |
numbers_in() 把推理段里出现过的整数全抽出来,再看答案在不在里面。推理写得漂漂亮亮、最后一行答案却是另一个数——这是 CoT 输出里非常常见的一种错,而且肉眼扫过去很容易漏掉。把它写成断言,示例质量才有下限。
脚本最后还有一条 prompt.rstrip().endswith("推理:"):它守的是 2.4 节那条铁律——提问块必须停在推理段,停在「答:」就等于请模型跳过推理。
4.3 Zero-shot CoT:两阶段拼接关系
2.5 节说 Zero-shot CoT 是两次调用。这个脚本把两个阶段的输入都拼出来,并用断言锁死它们之间的包含关系。
# -*- coding: utf-8 -*-
"""Zero-shot CoT 的两阶段提示:一个示例都不给,靠两句固定咒语把推理逼出来。

纯标准库可跑。Zero-shot CoT 不是「加一句话」,是**两次调用**:
第一次让模型写推理,第二次让它从推理里把答案抽出来。
少了第二次,你拿到的是一大段话,不是一个能入库的答案。
"""

TRIGGER = "Let's think step by step"          # 第一阶段:触发推理
EXTRACT = "Therefore, the answer is"          # 第二阶段:抽取答案

QUESTION = "食堂原有 23 个苹果,用掉 20 个,又买了 6 个,现在有几个?"


def stage1(question):
    """第一阶段输入:问题 + 触发语。此时不要求模型给答案。"""
    return "问:%s\n答:%s" % (question, TRIGGER)


def stage2(question, reasoning):
    """第二阶段输入:把第一阶段的原文接回去,再追加抽取语。"""
    return "问:%s\n答:%s%s\n%s" % (question, TRIGGER, reasoning, EXTRACT)


def main():
    print("【第一阶段:触发推理】")
    p1 = stage1(QUESTION)
    print(p1)
    print()
    print("  这一步模型会顺着 %r 往下写出推导过程。" % TRIGGER)
    print("  注意:此时**不要**追问答案,一追问它就会跳过推理。")
    print()

    # 这里用一段占位推理来演示第二阶段怎么拼,真实使用时换成模型第一阶段的输出
    reasoning_placeholder = "(模型在这里写出的推导过程)"

    print("【第二阶段:抽取答案】")
    p2 = stage2(QUESTION, reasoning_placeholder)
    print(p2)
    print()
    print("  第二阶段的输入 = 问题 + 触发语 + 第一阶段输出 + 抽取语。")
    print("  少拼任何一段,模型就失去了上下文,只能重新猜。")
    print()

    print("【和 Few-shot CoT 的分工】")
    rows = [
        ("Few-shot CoT", "要手写带推理的示例", "1 次调用", "示例写得好就稳,但每个任务都要重写示例"),
        ("Zero-shot CoT", "一个示例都不用写", "2 次调用", "省事,但精度通常不如写好的 Few-shot CoT"),
    ]
    print("%-16s %-20s %-10s %s" % ("方法", "要准备什么", "调用次数", "取舍"))
    for a, b, c, d in rows:
        print("%-16s %-20s %-10s %s" % (a, b, c, d))
    print()

    print("【什么时候它会不灵】")
    for line in [
        "模型太小:推理能力本身不存在,加咒语只会多产出一段像模像样的错话。",
        "题目不需要多步推导:单跳的事实问答加了 CoT 反而绕远、更容易跑偏。",
        "只做了第一阶段:拿到一大段推理却没有结构化答案,没法入库也没法评测。",
        "触发语被翻译或改写:换成别的措辞就不再是论文验证过的那句话,效果要重新实测。",
    ]:
        print("  · %s" % line)

    # 断言一:第一阶段必须以触发语收尾,不能带上抽取语
    assert p1.rstrip().endswith(TRIGGER), "第一阶段要停在触发语,别提前索要答案"
    assert EXTRACT not in p1, "抽取语不能出现在第一阶段"

    # 断言二:第二阶段必须完整包含第一阶段的内容
    assert p1 in p2.replace(reasoning_placeholder, ""), \
        "第二阶段必须把第一阶段原样接回去,否则模型看不到自己刚写的推理"

    # 断言三:第二阶段以抽取语收尾
    assert p2.rstrip().endswith(EXTRACT), "第二阶段要停在抽取语上,逼出一个短答案"

    # 断言四:两句咒语一字不改
    assert TRIGGER == "Let's think step by step"
    assert EXTRACT == "Therefore, the answer is"

    print()
    print("自检通过:Zero-shot CoT 是两阶段流程,不是一句咒语。")


if __name__ == "__main__":
    main()
| 阶段 | 输入构成 | 收尾于 | 断言守的是什么 |
|---|---|---|---|
| 第一阶段 | 问题 + Let's think step by step | 触发语 | 抽取语不许出现在第一阶段,一出现模型就会跳过推理 |
| 第二阶段 | 问题 + 触发语 + 第一阶段输出 + Therefore, the answer is | 抽取语 | 第二阶段必须完整包含第一阶段,否则模型看不到自己刚写的推理 |
Zero-shot CoT:一个示例都不用写,2 次调用,省事,但精度通常不如写好的 Few-shot CoT。
选哪个取决于你更缺什么:缺人力就用 Zero-shot,缺精度就用 Few-shot。
4.4 Prompt 与 Instruction:结构特征逐项对比
2.3 节讲了「接话与听话」,这个脚本把两种问法的结构特征抽成三个可判定的布尔值,让差别变得能核对。
# -*- coding: utf-8 -*-
"""Prompt 与 Instruction:同一个任务的两种问法,差别在「续写」还是「听指令」。

纯标准库可跑。这个脚本把两种问法渲染出来并逐项对比结构特征:
有没有任务说明、有没有给定选项、模型要做的是续写还是选择。
"""

SENT = "带女朋友去了一家餐厅,她吃的很开心。"

# 第一种问法:靠模型的续写能力,把句子往下接完
PROMPT_STYLE = "{x}这家餐厅太____了!"

# 第二种问法:明确写出要做什么、有哪些选项
INSTRUCTION_STYLE = "判断这句话的情感:{x}选项:A=好,B=一般,C=差"

LABEL_WORDS = ["好", "一般", "差"]
OPTIONS = ["A", "B", "C"]


def render(tpl, sent):
    return tpl.format(x=sent)


def features(text):
    """抽出三个可判定的结构特征。"""
    return {
        "含任务说明": any(k in text for k in ["判断", "请", "任务"]),
        "含候选选项": any(("%s=" % o) in text for o in OPTIONS),
        "含待补空位": "____" in text,
    }


def main():
    p = render(PROMPT_STYLE, SENT)
    ins = render(INSTRUCTION_STYLE, SENT)

    print("【一、同一句话,两种问法】")
    print("  Prompt 式      : %s" % p)
    print("  Instruction 式 : %s" % ins)
    print()

    print("【二、结构特征逐项对比】")
    fp, fi = features(p), features(ins)
    keys = ["含任务说明", "含候选选项", "含待补空位"]
    print("  %-12s %-12s %s" % ("特征", "Prompt 式", "Instruction 式"))
    for k in keys:
        print("  %-12s %-14s %s" % (k, "是" if fp[k] else "否", "是" if fi[k] else "否"))
    print()

    print("【三、模型被要求做的事不一样】")
    rows = [
        ("Prompt-Tuning", "激发续写能力", "把空位填上一个词", "填出的词还要过 Verbalizer 才变成类别"),
        ("Instruction-Tuning", "激发理解能力", "读懂指令并选一个选项", "直接吐选项,判别比生成容易"),
    ]
    print("  %-20s %-14s %-18s %s" % ("方法", "激发什么", "模型要做什么", "备注"))
    for a, b, c, d in rows:
        print("  %-20s %-14s %-18s %s" % (a, b, c, d))
    print()

    print("【四、最要紧的一条区别】")
    print("  Prompt-Tuning 在没有额外训练的模型上也能有一定效果。")
    print("  Instruction-Tuning 必须先用大量指令数据训练过,模型才认识这种问法。")
    print("  换句话说:前者是会不会问,后者是模型有没有被教过「听指令」这件事。")
    print()

    print("【五、为什么要为一个任务准备多个指令模板】")
    variants = [
        "判断这句话的情感:{x}选项:A=好,B=一般,C=差",
        "请阅读下面这句话,并从 A/B/C 中选出它的情感:{x}",
        "下面这句话表达的情感是?{x}A=好 B=一般 C=差",
    ]
    for i, v in enumerate(variants, 1):
        print("  指令%d: %s" % (i, render(v, SENT)))
    print("  单个模板的成绩会被措辞运气带偏,所以评测时看的是**一组模板的平均表现**。")

    # 断言一:Instruction 式必须同时含任务说明与候选选项
    assert fi["含任务说明"] and fi["含候选选项"], "Instruction 必须写明要做什么、可选哪些"
    # 断言二:Prompt 式靠的是空位续写,不给选项
    assert fp["含待补空位"] and not fp["含候选选项"], "Prompt 式靠续写,不提供候选选项"
    # 断言三:两种问法的原句必须一字不差,差异只能来自问法本身
    assert SENT in p and SENT in ins, "对比的前提是原句完全相同"
    # 断言四:多模板必须真的互不相同
    assert len(set(variants)) == len(variants), "指令模板不能重复,否则平均表现没有意义"

    print()
    print("自检通过:Prompt 教模型接话,Instruction 教模型听话。")


if __name__ == "__main__":
    main()
| 结构特征 | Prompt 式 | Instruction 式 |
|---|---|---|
| 含任务说明 | 否 | 是 |
| 含候选选项 | 否 | 是 |
| 含待补空位 | 是 | 否 |
三行一对照,两种问法的性质就清楚了:Prompt 式给的是一个待填的空,Instruction 式给的是一道带选项的题。脚本里那条 SENT in p and SENT in ins 的断言保证了对比的公平性——原句一字未改,差异只可能来自问法。
脚本第五段演示了 2.3 节说的「一个任务要准备多个指令模板」,给出三个措辞不同但意思相同的指令,并断言它们互不重复。评测时报的是这一组的平均分,不是挑最好看的那一个。
4.5 PEFT 参数账:本讲最该记住的一组数字
2.7 节把四种方法的改造位置讲清楚了,但「参数高效」到底效到什么程度,得靠算。这个脚本用一个 7B 量级的 decoder-only 底座(hidden=4096、layers=32、ff=11008、vocab=32000),把四种做法的可训参数、占比、fp16 存盘体积全部算出来。
# -*- coding: utf-8 -*-
"""PEFT 参数量计算器:同一个 base model,四种做法各要训练多少参数、存盘多大。

纯标准库可跑。数字全部由公式算出,不是抄来的经验值——
把 CFG 换成自己的模型再跑一遍,就是你自己的选型依据。
"""

# 一个 7B 量级 decoder-only 模型的常见配置
CFG = {
    "name": "7B decoder-only",
    "hidden": 4096,       # d_model
    "layers": 32,
    "ff": 11008,          # FFN 中间层
    "vocab": 32000,
    "heads": 32,
}

# 四种 PEFT 的超参数
HP = {
    "soft_prompt_len": 20,     # Prompt Tuning:只在输入层拼的伪标记个数
    "prefix_len": 10,          # Prefix-Tuning:每层前缀长度
    "adapter_bottleneck": 64,  # Adapter:降维后的维度
    "lora_rank": 8,            # LoRA:低秩支路的秩 r
    "lora_targets": 2,         # LoRA 挂在每层的几个投影上(常见做法:q_proj 与 v_proj)
}


def base_params(cfg):
    """base model 主体参数量(embedding + N 层 transformer),用于算占比。"""
    h, ff, L = cfg["hidden"], cfg["ff"], cfg["layers"]
    emb = cfg["vocab"] * h
    attn = 4 * h * h                       # Q K V O 四个投影
    mlp = 3 * h * ff                       # 门控 MLP 的三个矩阵
    per_layer = attn + mlp
    return emb + L * per_layer


def p_prompt_tuning(cfg, hp):
    """Prompt Tuning:只在输入 embedding 前拼一段向量,与层数无关。"""
    return hp["soft_prompt_len"] * cfg["hidden"]


def p_prefix_tuning(cfg, hp):
    """Prefix-Tuning:每一层的 key 和 value 各挂一段前缀,所以要乘 2 再乘层数。"""
    return 2 * hp["prefix_len"] * cfg["hidden"] * cfg["layers"]


def p_adapter(cfg, hp):
    """Adapter:降维 + 升维两个线性层(含偏置),每层插 2 个(attn 后与 FFN 后)。"""
    h, b = cfg["hidden"], hp["adapter_bottleneck"]
    one = (h * b + b) + (b * h + h)
    return one * 2 * cfg["layers"]


def p_lora(cfg, hp):
    """LoRA:每个目标矩阵旁边并一条 A(h×r) + B(r×h) 的支路,无偏置。"""
    h, r = cfg["hidden"], hp["lora_rank"]
    one = 2 * h * r
    return one * hp["lora_targets"] * cfg["layers"]


def mb(n_params, bytes_per=2):
    """按 fp16(每参数 2 字节)估存盘体积,单位 MB。"""
    return n_params * bytes_per / 1024.0 / 1024.0


def main():
    total = base_params(CFG)
    print("base model: %s  主体参数量 %s" % (CFG["name"], "{:,}".format(total)))
    print("(fp16 全量存盘约 %.0f MB)" % mb(total))
    print()

    rows = [
        ("Prompt Tuning", p_prompt_tuning(CFG, HP), "只改输入层", "soft_prompt_len=%d" % HP["soft_prompt_len"]),
        ("Prefix-Tuning", p_prefix_tuning(CFG, HP), "每层前缀", "prefix_len=%d" % HP["prefix_len"]),
        ("LoRA", p_lora(CFG, HP), "权重旁支", "r=%d, 目标%d个/层" % (HP["lora_rank"], HP["lora_targets"])),
        ("Adapter", p_adapter(CFG, HP), "层内插模块", "bottleneck=%d" % HP["adapter_bottleneck"]),
    ]
    rows.sort(key=lambda x: x[1])

    print("%-16s %14s %9s %11s  %-12s %s" % ("方法", "可训参数", "占比", "存盘(fp16)", "改哪一层", "超参"))
    for name, n, where, hp_s in rows:
        print("%-16s %14s %8.4f%% %10.2f MB  %-12s %s"
              % (name, "{:,}".format(n), 100.0 * n / total, mb(n), where, hp_s))
    print()

    print("【同一方法内部,超参怎么影响参数量】")
    print("  LoRA 的 r 翻倍,可训参数就翻倍(线性):")
    for r in [4, 8, 16, 32, 64]:
        hp = dict(HP); hp["lora_rank"] = r
        n = p_lora(CFG, hp)
        print("    r=%-3d -> %12s 个 (%.4f%%, %.2f MB)" % (r, "{:,}".format(n), 100.0 * n / total, mb(n)))
    print()
    print("  Adapter 的 bottleneck 翻倍,可训参数也基本翻倍:")
    for b in [8, 16, 32, 64, 128]:
        hp = dict(HP); hp["adapter_bottleneck"] = b
        n = p_adapter(CFG, hp)
        print("    b=%-3d -> %12s 个 (%.4f%%, %.2f MB)" % (b, "{:,}".format(n), 100.0 * n / total, mb(n)))
    print()
    print("  Prompt Tuning 的长度翻倍也只是线性涨,但基数极小:")
    for k in [10, 20, 50, 100]:
        hp = dict(HP); hp["soft_prompt_len"] = k
        n = p_prompt_tuning(CFG, hp)
        print("    len=%-4d -> %12s 个 (%.6f%%, %.4f MB)" % (k, "{:,}".format(n), 100.0 * n / total, mb(n)))
    print()

    print("【一句话读懂这张表】")
    print("  四种做法的可训参数都落在主体的 1% 以内,但彼此差着两个数量级:")
    print("  Prompt Tuning 最省(只碰输入层),Adapter 最贵(每层插两个模块)。")
    print("  省不等于好——参数越少,能表达的下游变化越有限,小模型上尤其明显。")

    # 断言一:四种方法都必须远低于全参微调
    for name, n, _, _ in rows:
        assert n < total * 0.01, "%s 的可训参数应当低于主体的 1%%,否则不配叫参数高效" % name

    # 断言二:与层数的关系——Prompt Tuning 是唯一不随层数增长的
    cfg2 = dict(CFG); cfg2["layers"] = CFG["layers"] * 2
    assert p_prompt_tuning(cfg2, HP) == p_prompt_tuning(CFG, HP), \
        "Prompt Tuning 只改输入层,层数翻倍不应改变它的参数量"
    for fn in (p_prefix_tuning, p_adapter, p_lora):
        assert fn(cfg2, HP) == 2 * fn(CFG, HP), \
            "%s 是逐层挂的,层数翻倍参数量必须翻倍" % fn.__name__

    # 断言三:量级排序(本组超参下)
    assert p_prompt_tuning(CFG, HP) < p_prefix_tuning(CFG, HP) < p_lora(CFG, HP) < p_adapter(CFG, HP), \
        "本组超参下的量级排序:Prompt Tuning < Prefix < LoRA < Adapter"

    # 断言四:LoRA 对 r 是严格线性的
    hp_a = dict(HP); hp_a["lora_rank"] = 8
    hp_b = dict(HP); hp_b["lora_rank"] = 16
    assert p_lora(CFG, hp_b) == 2 * p_lora(CFG, hp_a), "LoRA 参数量对 r 线性"

    print()
    print("自检通过:四种 PEFT 的参数量全部由公式确定,量级差异可复算。")


if __name__ == "__main__":
    main()
主体参数量 6,607,077,376(约 66 亿),fp16 全量存盘约 12,602 MB。四种 PEFT 的账单:
| 方法 | 超参 | 可训参数 | 占主体比例 | fp16 存盘 |
|---|---|---|---|---|
| Prompt Tuning | soft_prompt_len=20 | 81,920 | 0.0012% | 0.16 MB |
| Prefix-Tuning | prefix_len=10 | 2,621,440 | 0.0397% | 5.00 MB |
| LoRA | r=8,每层 2 个目标 | 4,194,304 | 0.0635% | 8.00 MB |
| Adapter | bottleneck=64 | 33,820,672 | 0.5119% | 64.51 MB |
② 彼此差着两个数量级——Adapter 的可训参数是 Prompt Tuning 的 413 倍。同样叫 PEFT,代价完全不在一个层级。
③ 存盘体积决定了多任务部署的可行性——12,602 MB 的底座只存一份,每个任务再存 0.16 MB 到 64.51 MB。一百个任务,Prompt Tuning 只多占 16 MB。
超参怎么影响参数量
脚本第二段扫了三组超参,规律很干净——全是线性的:
| LoRA 的 r | 4 | 8 | 16 | 32 | 64 |
|---|---|---|---|---|---|
| 可训参数 | 2,097,152 | 4,194,304 | 8,388,608 | 16,777,216 | 33,554,432 |
| 存盘 | 4.00 MB | 8.00 MB | 16.00 MB | 32.00 MB | 64.00 MB |
| Adapter 的 bottleneck | 8 | 16 | 32 | 64 | 128 |
|---|---|---|---|---|---|
| 可训参数 | 4,456,960 | 8,651,776 | 17,041,408 | 33,820,672 | 67,379,200 |
| 占比 | 0.0675% | 0.1309% | 0.2579% | 0.5119% | 1.0198% |
注意最后一格:bottleneck 加到 128,Adapter 就突破 1% 了。PEFT 的「高效」不是无条件的,超参开得太大一样会失去意义。
layers 从 32 翻倍到 64,Prompt Tuning 的参数量一个都不变,而 Prefix-Tuning、Adapter、LoRA 全部精确翻倍。原因就是 2.7 节那张图:Prompt Tuning 只碰输入层,其余三种都是逐层挂的。所以底座越深,这三种的成本涨得越快,而 Prompt Tuning 纹丝不动。选超大底座时,这条差异会变得非常显眼。
4.6 LoRA 旁支手算:为什么接上去输出不变
2.7 节说「B 初始化为 0,所以接上 LoRA 的那一刻模型输出完全不变」。这个脚本把维度缩到 6×6、秩缩到 2,用嵌套 list 手写矩阵乘法,把这句话算给你看。
# -*- coding: utf-8 -*-
"""LoRA 的旁支是怎么算的:手算一遍 W + A@B,看清「为什么训练开始时输出不变」。

纯标准库可跑,矩阵用嵌套 list 手写,维度缩到 6×6 方便肉眼核对。
三件事跑成断言:① B 初始化为 0 时旁支输出恒为 0;
② 旁支的参数量是 2·d·r,远小于 d·d;③ 训练完可以合并回 W,推理不多一次矩阵乘。
"""

import random

D = 6      # 演示用的隐层维度(真实模型是 4096 这种量级)
R = 2      # LoRA 的秩 r


def zeros(rows, cols):
    return [[0.0] * cols for _ in range(rows)]


def randmat(rows, cols, seed):
    rnd = random.Random(seed)
    return [[round(rnd.uniform(-1, 1), 3) for _ in range(cols)] for _ in range(rows)]


def matmul(X, Y):
    n, k, m = len(X), len(Y), len(Y[0])
    out = zeros(n, m)
    for i in range(n):
        for j in range(m):
            s = 0.0
            for t in range(k):
                s += X[i][t] * Y[t][j]
            out[i][j] = s
    return out


def matadd(X, Y):
    return [[X[i][j] + Y[i][j] for j in range(len(X[0]))] for i in range(len(X))]


def allclose(X, Y, tol=1e-9):
    for i in range(len(X)):
        for j in range(len(X[0])):
            if abs(X[i][j] - Y[i][j]) > tol:
                return False
    return True


def show(name, M):
    print("  %s  (%d×%d)" % (name, len(M), len(M[0])))
    for row in M[:3]:
        print("    [" + ", ".join("%7.3f" % v for v in row) + (" ...]" if len(row) > 3 else "]"))
    if len(M) > 3:
        print("    ...")


def main():
    # 预训练权重,冻结不动
    W = randmat(D, D, seed=7)
    # LoRA 旁支:A 随机初始化,B 全零初始化(论文里的做法)
    A = randmat(D, R, seed=11)
    B = zeros(R, D)
    x = [[round(random.Random(3).uniform(-1, 1), 3) for _ in range(D)]]   # 一条输入,1×D

    print("【一、三个矩阵的形状】")
    show("W(冻结)", W)
    show("A(可训练,d×r)", A)
    show("B(可训练,r×d,初始化为 0)", B)
    print()

    print("【二、训练刚开始时:旁支输出恒为 0】")
    base = matmul(x, W)                 # 原始通路
    delta = matmul(matmul(x, A), B)     # 旁支通路 x@A@B
    merged = matadd(base, delta)
    show("x @ W", base)
    show("x @ A @ B", delta)
    show("两者相加", merged)
    print("  B 是零矩阵,所以 x@A@B 必然是零向量 —— 加上它等于什么都没加。")
    print("  这就是 LoRA 能安全接到任何预训练模型上的原因:**接上去的那一刻,模型行为完全不变**。")
    print()

    print("【三、训练之后:B 不再是 0,旁支开始起作用】")
    B_trained = randmat(R, D, seed=13)
    delta2 = matmul(matmul(x, A), B_trained)
    out2 = matadd(base, delta2)
    show("训练后的 x @ A @ B", delta2)
    show("最终输出", out2)
    print()

    print("【四、合并:把旁支折进权重,推理时不多算一次】")
    W_merged = matadd(W, matmul(A, B_trained))      # W' = W + A@B
    out_merged = matmul(x, W_merged)
    show("W' = W + A@B", W_merged)
    print("  用 W' 直接算 x@W',结果应当与「原通路 + 旁支」逐元素相同。")
    print()

    print("【五、参数账】")
    full = D * D
    lora = D * R + R * D
    print("  原权重 W      : %d × %d = %d 个参数(冻结,不训练)" % (D, D, full))
    print("  LoRA 支路 A+B : %d×%d + %d×%d = %d 个参数(训练这些)" % (D, R, R, D, lora))
    print("  比例          : %.1f%%" % (100.0 * lora / full))
    print("  维度放大到 d=4096、r=8:%d 个 vs %d 个,比例 %.3f%%"
          % (2 * 4096 * 8, 4096 * 4096, 100.0 * (2 * 4096 * 8) / (4096 * 4096)))
    print("  秩 r 越小越省,但能表达的更新方向也越少 —— r 是效果与成本的旋钮。")

    # 断言一:B 为零时旁支输出必须是零向量
    assert allclose(delta, zeros(1, D)), "B 初始化为 0 时,旁支输出必须恒为 0"
    # 断言二:因此接上 LoRA 的初始输出与原模型完全一致
    assert allclose(merged, base), "刚接上 LoRA 时,模型输出不允许发生任何变化"
    # 断言三:合并回权重后结果等价,推理不需要额外的矩阵乘
    assert allclose(out_merged, out2), "W+A@B 合并后必须与分开算的结果一致"
    # 断言四:旁支参数量是 2·d·r,且在 r < d/2 时严格小于原权重
    assert lora == 2 * D * R and lora < full, "LoRA 参数量应为 2·d·r 且小于 d·d"

    print()
    print("自检通过:零初始化保证无损接入,低秩保证省,合并保证推理不变慢。")


if __name__ == "__main__":
    main()
| 脚本里的断言 | 它证明了什么 |
|---|---|
allclose(delta, zeros) | B 是零矩阵时,旁支输出 x@A@B 恒为零向量 |
allclose(merged, base) | 因此刚接上 LoRA 时,模型输出与原模型逐元素完全一致,零扰动接入 |
allclose(out_merged, out2) | 训练后把 W' = W + A@B 合并,结果与「原通路 + 旁支」分开算完全等价 |
lora == 2*D*R and lora < full | 旁支参数量就是 2·d·r,在 r < d/2 时严格小于原权重 |
x@W + x@A@B 与 x@(W + A@B) 完全相等,那就可以在部署前把旁支一次性折进权重。合并之后模型结构和原来一模一样,推理时不多算任何一次矩阵乘。这正是 LoRA 相比 Adapter 的关键优势——Adapter 的模块是实打实插在计算图里的,拆不掉。
参数账部分脚本给了两组数:演示维度下 6×6=36 个权重对应 2×6×2=24 个旁支参数(66.7%,因为 r=2 相对 d=6 一点都不低秩);放大到真实维度 d=4096, r=8,就是 65,536 个 vs 16,777,216 个,比例 0.391%。低秩这件事只有在 d 远大于 r 时才有意义。
4.7 选型判据:四个问题定一条路
前面六个脚本讲清了每种方法「是什么、多贵」,最后这个回答「我该用哪个」。它把选型压缩成四个能直接回答的问题。
# -*- coding: utf-8 -*-
"""选型判据:手头这个任务,到底该用 Prompt Engineering、ICL、CoT 还是 PEFT。

纯标准库可跑。把四个问题答成 True / False,脚本给出建议路线并说明理由。
判据不是拍脑袋来的:每一条都对应「要不要梯度、要不要标注数据、要不要多步推理」。
"""

# 四个决定性问题
QUESTIONS = [
    ("has_labeled_data", "手上有没有成百上千条标注数据?"),
    ("can_train", "有没有 GPU 和训练环境,能不能跑梯度回传?"),
    ("needs_reasoning", "任务要不要多步推理(算术、逻辑、多跳问答)?"),
    ("many_tasks", "同一个 base model 要不要同时服务很多个任务?"),
]


def decide(has_labeled_data, can_train, needs_reasoning, many_tasks):
    """返回 (推荐方法, 理由)。顺序就是判断优先级。"""
    if not can_train:
        # 没法训练,一切落在「改便条」这一侧
        if needs_reasoning:
            return ("CoT(Few-shot CoT 优先)",
                    "不能训练就只能改输入;任务要多步推理,普通示例不够,示例里必须带推理过程")
        if has_labeled_data:
            return ("In-Context Learning(few-shot)",
                    "不能训练但有现成的标注,挑几条当示例塞进输入,零成本拿到任务格式")
        return ("Prompt Engineering",
                "不能训练、也没有可用示例,只剩把任务描述写清楚这一条路")

    # 能训练,进入 PEFT 侧
    if not has_labeled_data:
        return ("先用 ICL / CoT 攒数据,再谈训练",
                "能训练但没有标注数据,梯度无从算起;先用改便条的办法跑起来并积累样本")
    if many_tasks:
        return ("PEFT(LoRA 优先,任务极多时看 Prompt Tuning)",
                "多任务共用一个冻结底座,每个任务只存一小份增量;LoRA 还能合并回权重不增推理延迟")
    return ("PEFT(LoRA)",
            "有数据也能训练,单任务下 LoRA 是效果与成本最平衡的默认选项")


CASES = [
    ("线上客服意图分类,标注 5000 条,有 GPU,只此一个任务", True, True, False, False),
    ("同一底座要服务 20 个部门的不同任务", True, True, False, True),
    ("只有 API 调用权限,拿不到权重,要做财报数字核算", False, False, True, False),
    ("只有 API 权限,有 200 条历史工单可当示例", True, False, False, False),
    ("只有 API 权限,任务是把一段话改写得更礼貌", False, False, False, False),
    ("有 GPU,但一条标注都没有", False, True, False, False),
]


def main():
    print("【四个决定性问题】")
    for key, q in QUESTIONS:
        print("  · %s" % q)
    print()

    print("【六个场景走一遍】")
    for name, a, b, c, d in CASES:
        method, why = decide(a, b, c, d)
        print("-" * 68)
        print("场景:%s" % name)
        print("  有标注=%s 能训练=%s 需推理=%s 多任务=%s" % (a, b, c, d))
        print("  建议 → %s" % method)
        print("  理由   %s" % why)
    print("-" * 68)
    print()

    print("【这棵树的骨架其实只有一句话】")
    print("  能不能跑梯度,决定你在「改便条」还是「改耳机」这一侧;")
    print("  跨过这条线之后,才轮到比较 LoRA、Prefix、Adapter 谁更合适。")

    # 断言一:不能训练时,绝不会推荐任何需要梯度的方案
    for a in (True, False):
        for c in (True, False):
            for d in (True, False):
                m, _ = decide(a, False, c, d)
                assert "PEFT" not in m, "不能训练时不允许推荐 PEFT"
    # 断言二:需要多步推理且不能训练时,必须走 CoT
    m, _ = decide(False, False, True, False)
    assert m.startswith("CoT"), "不能训练 + 要推理,答案只能是 CoT"
    # 断言三:能训练但没数据时,不能直接上 PEFT
    m, _ = decide(False, True, False, False)
    assert "PEFT" not in m, "没有标注数据就没有梯度可算,不该推荐 PEFT"
    # 断言四:有数据 + 能训练,一定落到 PEFT 侧
    m, _ = decide(True, True, False, False)
    assert "PEFT" in m, "有数据且能训练时,PEFT 是默认选项"

    print()
    print("自检通过:四个问题把方法空间切干净了,没有互相重叠的分支。")


if __name__ == "__main__":
    main()
| 场景 | 有标注 / 能训练 / 需推理 / 多任务 | 推荐 |
|---|---|---|
| 客服意图分类,5000 条标注,有 GPU,单任务 | 是 / 是 / 否 / 否 | PEFT(LoRA) |
| 同一底座服务 20 个部门 | 是 / 是 / 否 / 是 | PEFT(LoRA 优先,任务极多时看 Prompt Tuning) |
| 只有 API 权限,要做财报数字核算 | 否 / 否 / 是 / 否 | CoT(Few-shot CoT 优先) |
| 只有 API 权限,有 200 条历史工单 | 是 / 否 / 否 / 否 | In-Context Learning(few-shot) |
| 只有 API 权限,把一段话改写得更礼貌 | 否 / 否 / 否 / 否 | Prompt Engineering |
| 有 GPU,但一条标注都没有 | 否 / 是 / 否 / 否 | 先用 ICL / CoT 攒数据,再谈训练 |
脚本用一组穷举断言守住了这件事:只要
can_train=False,无论其余三个问题怎么答,推荐结果里都不会出现 PEFT。这条断言防的是决策逻辑在后续修改中被改乱——推荐一个跑不了的方案,比不推荐更糟。
4.8 七个脚本的关系
前四个全在「改便条」这一侧,第五个是两侧的分界,后两个在「改耳机」这一侧,最后一个把整条线收成一棵决策树。七个脚本连起来,就是这一讲的全部技术内容。
05骨架模板:拿去改就能用
一份 ICL + CoT 骨架 + 两张检查表,套到自己的任务上
5.1 ICL + CoT 骨架
把第 03、04 节的东西收敛成一个类:任务描述、示例池、字段名、选例策略、Few-shot 拼装、Zero-shot CoT 两阶段全在里面。纯标准库,先在本地把「示例选得对不对、格式对不对齐、推理段在不在」验证通过,再接真实模型。
# -*- coding: utf-8 -*-
"""ICL + CoT 提示骨架:改五处 TODO 就能套到自己的任务上。

纯标准库,先在本地把「示例选得对不对、格式对不对齐、推理段在不在」验证通过,
再接真实模型。骨架自带的检查会在启动时就把常见错误炸出来。
"""


class PromptBuilder:
    # TODO 1:换成你的任务说明。写清楚做什么、输出什么格式,不要写成寒暄
    TASK_DESC = "判断下面这句话的情感,只回答「正面」或「负面」。"

    # TODO 2:换成你的示例池。注意标签要均衡,别一边倒
    POOL = [
        ("菜很难吃,等位还等了两小时。", "负面"),
        ("环境安静舒服,适合聊天。", "正面"),
        ("服务员态度差,叫了三次都没人理。", "负面"),
        ("分量足,价格也实在。", "正面"),
    ]

    # TODO 3:字段名要和示例、提问完全一致,改一个字就得全改
    IN_FIELD = "句子"
    OUT_FIELD = "情感"
    COT_FIELD = "推理"

    # TODO 4:需要多步推理时设为 True,示例里必须带推理过程
    USE_COT = False

    # Zero-shot CoT 的两句咒语,原样使用,改写就不再是论文验证过的那句
    TRIGGER = "Let's think step by step"
    EXTRACT = "Therefore, the answer is"

    def __init__(self, n_shot=2):
        self.n_shot = n_shot
        self._check_pool()

    def _check_pool(self):
        """启动即检查,别把错误留到指标里。"""
        assert self.POOL, "示例池不能为空"
        hist = {}
        for _, label in self.POOL:
            hist[label] = hist.get(label, 0) + 1
        assert len(hist) >= 2, "示例池里至少要有两个不同的标签,否则模型只会复读多数类"
        most, least = max(hist.values()), min(hist.values())
        assert most <= 2 * least, "标签分布过于失衡(%s),模型会被多数标签偏置带走" % hist
        assert self.n_shot <= len(self.POOL), "要的示例数超过了示例池的大小"

    def pick_demos(self):
        """TODO 5:换成你的选例策略。

        这里用的是最朴素的「按标签轮流取」,保证送进去的示例标签均衡。
        进阶做法是按与待预测句子的相似度检索,但先把均衡这条守住。
        """
        by_label = {}
        for item in self.POOL:
            by_label.setdefault(item[1], []).append(item)
        picked, labels = [], sorted(by_label)
        i = 0
        while len(picked) < self.n_shot:
            bucket = by_label[labels[i % len(labels)]]
            idx = i // len(labels)
            if idx < len(bucket):
                picked.append(bucket[idx])
            i += 1
            if i > 1000:
                break
        return picked[:self.n_shot]

    def render_demo(self, sent, label, cot=None):
        lines = ["%s:%s" % (self.IN_FIELD, sent)]
        if self.USE_COT:
            assert cot, "开了 USE_COT 就必须给每个示例写出推理过程,否则退化成普通 ICL"
            lines.append("%s:%s" % (self.COT_FIELD, cot))
        lines.append("%s:%s" % (self.OUT_FIELD, label))
        return "\n".join(lines)

    def build(self, query, cots=None):
        """拼出最终输入。提问块故意留空,让模型顺着格式往下写。"""
        blocks = [self.TASK_DESC]
        demos = self.pick_demos()
        for i, (sent, label) in enumerate(demos):
            cot = cots[i] if (self.USE_COT and cots) else None
            blocks.append(self.render_demo(sent, label, cot))
        tail_field = self.COT_FIELD if self.USE_COT else self.OUT_FIELD
        blocks.append("%s:%s\n%s:" % (self.IN_FIELD, query, tail_field))
        text = "\n\n".join(blocks)
        self._check_prompt(text, query)
        return text

    def _check_prompt(self, text, query):
        """三条只要踩中就一定出问题的检查。"""
        assert text.rstrip().endswith(":"), "提问块要停在字段名后面,别把答案位也填上"
        assert query in text, "待预测句子必须出现在最终输入里"
        assert text.count("%s:" % self.IN_FIELD) == self.n_shot + 1, \
            "输入行数对不上示例数,多半是字段名写岔了"

    def build_zero_shot_cot(self, query):
        """不给任何示例,靠两阶段咒语逼出推理。返回第一阶段输入。"""
        return "%s\n%s:%s\n%s:%s" % (
            self.TASK_DESC, self.IN_FIELD, query, self.OUT_FIELD, self.TRIGGER)

    def build_extract(self, stage1_text, reasoning):
        """第二阶段:把第一阶段原文接回去再要答案。少拼一段模型就失去上下文。"""
        return "%s%s\n%s" % (stage1_text, reasoning, self.EXTRACT)


def _demo():
    q = "这家店服务很贴心。"

    b = PromptBuilder(n_shot=2)
    print("【Few-shot(无推理段)】")
    print(b.build(q))
    print()

    print("【Zero-shot CoT 第一阶段】")
    s1 = b.build_zero_shot_cot(q)
    print(s1)
    print()
    print("【Zero-shot CoT 第二阶段】")
    print(b.build_extract(s1, "(这里放模型第一阶段写出的推理)"))
    print()

    demos = b.pick_demos()
    labels = [l for _, l in demos]
    assert len(set(labels)) == len(set(l for _, l in PromptBuilder.POOL)), \
        "选例策略要保证每个标签都被覆盖到"
    print("骨架自检通过:选出的 %d 个示例标签为 %s,覆盖均衡。" % (len(demos), labels))


if __name__ == "__main__":
    _demo()
| TODO | 改什么 | 要注意 |
|---|---|---|
| TODO 1 | TASK_DESC | 写清做什么、输出什么格式。别写成寒暄,模型不吃客套话 |
| TODO 2 | POOL | 示例池标签要均衡;_check_pool() 会在启动时拦截严重失衡 |
| TODO 3 | 字段名 | IN_FIELD / OUT_FIELD / COT_FIELD 改一个就得全改,示例与提问必须同构 |
| TODO 4 | USE_COT | 需要多步推理才开。开了就必须给每个示例写推理,否则断言会拦下来 |
| TODO 5 | pick_demos | 默认是「按标签轮流取」保证均衡;进阶换成按相似度检索,但别丢掉均衡 |
② 开了 CoT 却没给推理就抛错:否则会悄悄退化成普通 ICL,而你以为自己在用 CoT。
③ 提问块必须停在字段名后的冒号上:
_check_prompt 里那条 endswith(":") 守的就是「别把答案位也填上」。④ 输入行数必须等于示例数 + 1:对不上就说明字段名写岔了,这种错不检查根本发现不了。
build_extract(stage1_text, reasoning) 要求你把第一阶段的原始输入传回来,而不是重新拼一遍。看着啰嗦,但这是有意的:重拼极容易漏掉触发语或改动空格,模型就看不到自己刚写的那段推理,第二阶段等于从头猜。把第一阶段的字符串原样存下来传回去,是唯一稳妥的做法。
5.2 示例设计检查表
准备 few-shot 示例时,照这张表过一遍:
| 检查项 | 判据 | 踩了会怎样 |
|---|---|---|
| 格式同构 | 示例行与提问行用同一套字段名和分隔符 | 模型不知道往哪填,可能把字段名一起续写出来 |
| 答案位留空 | 提问块停在 字段: | 模型把它当成又一个示例,继续往下编新题 |
| 标签均衡 | 各类别示例数尽量持平 | 多数标签偏置,少数类召回下降 |
| 末位可控 | 明确知道最后一个示例是什么标签 | 近因偏置,末位标签对结果影响最大 |
| 同域取样 | 示例与待判样本来自同一个业务域 | 拿电影评论教餐厅评论,边界对不上 |
| 数量选拐点 | 在验证集上试 0/1/2/4/8,选性价比拐点 | 凭手感定数,要么欠拟合要么白烧 token |
| 长度预算 | 示例总 token 数留出待判样本的余量 | 长文本任务里真正要判的那句被挤出窗口 |
5.3 CoT 写作检查表
| 检查项 | 说明 |
|---|---|
| 推理段真的存在 | 三元组少了中间那段就是普通 ICL,不是 CoT |
| 每步算式算得对 | 示例里的推理错了,模型会照着错的范式学,而且错得很自信 |
| 答案由推理产生 | 答案必须在推理文本里出现过;cot_parser.py 有现成的检查 |
| 提问块停在推理段 | 停在答案段等于请模型跳过推理 |
| 咒语一字不改 | Let's think step by step 与 Therefore, the answer is 原样使用 |
| 底座够大 | 小模型上 CoT 不但不涨,还会产出更自信的错推理 |
| 任务真的要分步 | 单跳事实问答别硬套 CoT,绕远还更容易跑偏 |
5.4 从改便条走到改耳机,还差哪几步
什么时候该从 ICL / CoT 切换到 PEFT?信号有三个,出现任意一个就该算账了:
示例占掉大半上下文,真正要判的内容反而放不下。耳机不占输入长度。
每次调用都要为那几百个示例 token 付费,量一上来就是持续出血。
手上已经有成百上千条样本,梯度有东西可算了,ICL 只用得上其中几条。
method_pick.py定在 LoRA / Prefix / Adapter
peft_param_calc.py确认可训参数与存盘体积
requires_grad 置 Falsepeft_param_calc.py 算出来的数字对一下,对不上立刻停——这比训练三小时后发现底座被整个改掉便宜得多。改便条 ≠ 改人,改耳机也 ≠ 改人。
06易错点
八个坑,前四个关乎理解,后四个关乎实现
名字里有「Learning」,于是很多人以为模型「学会」了那几个例子。它没有——ICL 不产生梯度、不更新任何权重、不留下任何持久化的东西。这一次调用结束,模型对这些示例再无记忆。
这个误解会带来两个实际后果:一是以为「多喂几轮例子模型就越来越准」,其实每一次调用都是从零开始;二是以为示例是一次性成本,其实它写在输入里,每一次调用都要重新付费。
✅ 判据还是第 02 节那一条:这次改动有没有产生一个需要存盘的新文件。ICL 没有,所以它是运行时行为,不是训练。
写指令是你的事,认识指令是模型的事。Prompt-Tuning 在没有精调过的模型上也能有一定效果,但 Instruction-Tuning 必须对模型做精调,让模型先知道这种指令模式长什么样。
所以「我把提示词改写成了 判断情感:…选项:A/B/C,这就是 Instruction-Tuning」是错的——那只是用了指令风格的提示词,属于 Prompt Engineering。真正的 Instruction-Tuning 要拿成千上万条跨任务的指令数据去训练模型。
✅ 记住它落在哪一侧:Instruction-Tuning 是一种 Fine-Tuning,它改的是人,不是便条。完整内容在模块 ⑧。
两个偏置是实打实存在的。多数标签偏置:示例里哪个标签多,模型就更爱答哪个——shot_order_effect.py 里「同类扎堆」那组多数占比 0.75,直接把模型往正面推。近因偏置:同一批示例顺序一反,末位标签就从「正面」变成「负面」,而两组示例的内容完全相同。
数量上则是收益递减 + 成本线性上涨:示例从 0 加到 6,输入字符从 18 涨到 161,接近 9 倍,而效果通常在 4 个左右就打平了。
✅ 把示例数和排法都当成超参数:在验证集上试 0/1/2/4/8 选拐点;排法上保证标签均衡,并明确知道末位是哪个标签。
CoT 的收益有明显的涌现特征——模型规模超过一定量级才出现,对小规模模型无效。在小模型上加 Let's think step by step,你会拿到一段像模像样、逻辑通顺、结论却完全错的推理,比不加还更有迷惑性。
反过来也要注意:任务本身不需要多步推导时(单跳事实问答),加 CoT 会绕远路,更容易跑偏,还多烧一倍输出 token。
✅ CoT 只用在两个条件同时成立时:底座够大 + 任务确实要分步(算术、逻辑、多跳问答)。任一条不满足就别上。
示例里认认真真写了推理过程,最后那个提问块却直接给到 答:。结果是模型顺着格式直接吐一个数,把推理整段跳过——你写的那些示例推理全白费,而且这种情况下的准确率和普通 few-shot 几乎没差别,你会误以为「CoT 对我的任务没用」。
✅ 提问块必须停在推理段:问:…\n推理:。cot_parser.py 里那条 endswith("推理:") 就是专门守这件事的。
加了触发语,拿到一大段推理,然后就结束了。那段话没法入库、没法评测、没法对接下游系统——你需要的是一个结构化答案,不是一篇作文。
第二阶段还有个容易错的地方:重新拼输入而不是把第一阶段原文接回去。重拼很容易漏掉触发语或改动空格,模型看不到自己刚写的推理,只能重新猜一个,而且它猜出来的答案往往和刚才的推理对不上。
✅ 第二阶段的输入必须是:问题 + 触发语 + 第一阶段完整输出 + Therefore, the answer is。把第一阶段的字符串原样存下来传回去,别重拼。
看到 Prompt Tuning 只要 81,920 个参数、Adapter 要 33,820,672 个,就觉得前者完胜。省不等于好——参数越少,能表达的下游变化越有限。Prompt Tuning 在普通规模的模型上表现并不好,它是随着底座变大才逐渐补上差距的;P-Tuning v2 提出的动机之一,正是「普通规模模型上 Prompt Tuning 效果不行,且处理不了硬序列标注任务」。
还有个结构差异容易漏:层数翻倍时,Prompt Tuning 参数量纹丝不动,而 Prefix / Adapter / LoRA 全部精确翻倍——因为只有 Prompt Tuning 不是逐层挂的。
✅ 选型同时看三件事:底座多大、任务多难、要不要零推理延迟。跑一遍 method_pick.py 和 peft_param_calc.py,用数字定,别用直觉定。
这是 PEFT 最贵的一个坑:主体没冻结,或者优化器里把全部参数都放进去了。程序不会报错,训练照跑,loss 照降,你以为自己在做 LoRA,实际上在做全量微调——显存爆了算你运气好,没爆的话你会拿到一份几十 GB 的「LoRA 权重」。
反向的错也有:主体冻了,但 PEFT 那组参数忘了加进优化器,训练全程什么都没更新,loss 一动不动,容易被误判成「学习率太小」。
✅ 训练开始前必须打印一次可训练参数量,和 peft_param_calc.py 按公式算出来的数字对一下:对不上立刻停。7B 底座上 LoRA r=8 应该是 4,194,304 个,看到 66 亿就说明主体没冻。
而所有判断的起点仍然是那一条:改便条 ≠ 改人。搞不清自己动的是输入文本、外挂参数还是模型本体,上面八个坑迟早都会踩一遍。
07自测题
点击题目展开答案;能把这 10 题说清楚,这一讲就通了
Zero-shot、One-shot、Few-shot 分别是什么?三者的共同点是什么?
都先给任务描述,差别只在预测前插入的示例个数:Zero-shot 插 0 个,直接让预训练模型上场;One-shot 插 1 个,相当于给一个例子让模型理解;Few-shot 插 N 个(常见 2~32)。共同点是最要紧的一条:三者都不更新任何模型参数,示例只是被读进去的文本,不是训练数据。这套概念源自 GPT-3 论文(arXiv:2005.14165)。
示例的顺序会影响结果吗?用一个可测量的方式说明。
会。shot_order_effect.py 拿同一组 4 个示例做了受控对照:「交替排列」和「逆序排列」的示例内容完全相同(脚本里有断言 sorted(balanced) == sorted(reversed_order))、标签分布都是 0.50,但末位标签一个是「正面」一个是「负面」。由于离提问最近的示例影响最大(近因偏置),两者的表现就可能不同。既然内容和分布都一样,任何差异就只能来自顺序本身。另一个偏置是多数标签偏置:「同类扎堆」那组多数占比 0.75,会把模型往占多数的那一类推。
示例是不是越多越好?代价是什么?
不是。效果上收益递减——从 0 到 2 通常提升明显,从 4 到 8 往往就打平了。成本上却是线性上涨:shot_order_effect.py 实测示例从 0 加到 6,输入字符从 18 涨到 161,接近 9 倍。而且示例写在输入里,每一次调用都要重新付费,长文本任务里还可能把真正要判的内容挤出上下文窗口。正确做法是把示例数当超参数,在验证集上试 0/1/2/4/8 选拐点。
指令学习和提示学习的区别是什么?
三条:① Prompt 是去激发语言模型的续写能力,比如给出上半句生成下半句、或者做完形填空;② Instruction-Tuning 则是激发语言模型的理解能力,通过给出更明显的指令/指示,让模型去理解并做出正确的 action;③ 最关键的一条——Prompt-Tuning 在没有精调的模型上也能有一定效果,但 Instruction-Tuning 必须对模型精调,让模型知道这种指令模式。用同一句话举例:这家餐厅太__了! 是 Prompt 式(续写);判断这句话的情感:…选项:A=好,B=一般,C=差 是 Instruction 式(判别)。做判别比做生成更容易。
为什么工程上要为一个任务准备 10 个指令模板?
因为单个模板的成绩会被措辞运气带偏——同一个任务换个说法就可能差几个点,拿单模板的数字汇报等于在报运气。标准做法是为每个任务设计 10 个指令模版,测试时看这一组模板的平均表现,这个平均值才是该任务真实的泛化水平。instruction_vs_prompt.py 里演示了三个措辞不同、语义相同的指令,并用断言保证它们互不重复——模板重复了,平均就没有意义。
什么是思维链方法?它和传统上下文学习差在哪一处?
CoT 是一种改进的提示策略,用于提高大模型在复杂推理任务(算术、常识、符号推理)上的性能,首次提出于 arXiv:2201.11903。它本身是一种离散式提示学习,属于大模型下的上下文学习。相比传统上下文学习(用 x₁,y₁,x₂,y₂,…x_test 作为输入让模型续写出 y_test),思维链多了中间的推导提示。结构上就是把每个示例从二元组 <input, output> 扩充为三元组 <input, CoT, output>。
Few-shot CoT 和 Zero-shot CoT 各自怎么写?
Few-shot CoT:手写若干带推理过程的示例,每个示例三段齐全(问 / 推理 / 答),1 次调用。关键细节是最后那个提问块必须停在「推理:」,停在「答:」模型就会跳过推理直接给数。
Zero-shot CoT:一个示例都不给,靠两阶段完成——第一阶段用 Let's think step by step 触发模型生成推理步骤;第二阶段把第一阶段原文接回去,再用 Therefore, the answer is 导出最终答案,共 2 次调用。取舍是:Zero-shot 省人力,Few-shot 精度通常更好。
Zero-shot CoT 的效果有多大?它什么时候会失效?
论文 arXiv:2205.11916 在 text-davinci-002 上报告:MultiArith 从 17.7% 提升到 78.7%,GSM8K 从 10.4% 提升到 40.7%,没有用任何手工示例;在 540B 的 PaLM 上也有相近幅度的提升。
四个失效场景:① 模型规模不够——CoT 的收益有明显的涌现特征,对小规模模型无效,还会产出更自信的错推理;② 任务不需要多步推导,单跳事实问答加了反而绕偏;③ 只做了第一阶段,拿到长篇推理却没有结构化答案;④ 推理对了但答案抄错,要在抽取阶段校验「答案必须在推理文本里出现过」。
Prefix-Tuning 是什么?它和 P-Tuning、Prompt Tuning 分别差在哪?
Prefix-Tuning(arXiv:2101.00190)是在输入 token 之前构造一段任务相关的 virtual tokens 作为 Prefix,训练时只更新 Prefix 部分的参数,Transformer 其他部分固定;论文实测只训练 0.1% 的参数即可取得可比表现。注意它在 Prefix 层前面加了 MLP 来解决直接更新导致训练不稳定的问题,训练完只保留 Prefix。
对比 P-Tuning:① Prefix-Tuning 把额外 embedding 加在开头,更像模仿 Instruction 指令,而 P-Tuning 位置不固定;② Prefix-Tuning 每一层都添加可训练参数、通过 MLP 初始化,P-Tuning 只在输入时加 embedding、通过 LSTM+MLP 初始化。
对比 Prompt Tuning:Prompt Tuning 可以看作 Prefix-Tuning 的简化,只在输入层加 prompt tokens,不需要加 MLP 来解决难训练的问题。
Adapter 和 LoRA 各自改哪一层?LoRA 为什么没有推理延迟?
Adapter(arXiv:1902.00751)是在预训练模型内部的网络层之间插入新模块:down-project 降维 → 非线性 → up-project 升维,并带 skip-connection 确保最差情况退化为 identity。论文在 GLUE 上每任务只加 3.6% 参数,性能落在全量微调的 0.4% 以内。它的代价是引入额外计算,带来推理延迟。
LoRA(arXiv:2106.09685)则冻结预训练权重,在每个 Transformer 块的 Linear 层旁边增加旁支 A 和 B:A 把数据从 d 维降到 r 维,B 从 r 维升回 d 维,B 初始化为 0。训练结束后把 A、B 与原权重合并使用。因为 x@W + x@A@B 恒等于 x@(W + A@B),旁支可以一次性折进权重,合并后模型结构与原来完全一致,推理时不多算任何一次矩阵乘——这就是零推理延迟的来源。论文报告相比 GPT-3 175B 全量微调,可训参数减少 10000 倍,显存需求降到三分之一。
为什么说 LoRA 可以「无损接入」任何预训练模型?
因为 B 初始化为 0。旁支的输出是 x @ A @ B,B 是零矩阵时这个结果恒为零向量,加到原通路上等于什么都没加。所以接上 LoRA 的那一刻,模型输出与原模型逐元素完全一致,零扰动;训练开始后 B 才逐渐偏离零,旁支才起作用。lora_bypass_math.py 用手写矩阵乘法把这件事跑成了两条断言:allclose(delta, zeros) 和 allclose(merged, base)。
同一个 7B 底座,四种 PEFT 的可训参数差多少?哪一种不随层数增长?
peft_param_calc.py 在 hidden=4096、layers=32 的底座(主体 6,607,077,376 个参数)上算出:Prompt Tuning(len=20)81,920 个,0.0012%,0.16 MB;Prefix-Tuning(len=10)2,621,440 个,0.0397%,5.00 MB;LoRA(r=8)4,194,304 个,0.0635%,8.00 MB;Adapter(bottleneck=64)33,820,672 个,0.5119%,64.51 MB。全都低于 1%,但Adapter 是 Prompt Tuning 的 413 倍。
层数翻倍时,只有 Prompt Tuning 参数量一个都不变——因为它只在输入层拼向量;Prefix-Tuning、Adapter、LoRA 都是逐层挂的,全部精确翻倍。
Prompt Engineering、ICL、CoT、Prompt-Tuning 四者的根本分界线是什么?
是「要不要梯度」。前三者都不需要梯度,它们改的只是送进去的输入文本——分别是措辞结构、塞进的示例、塞进的推理步骤;Prompt-Tuning 需要梯度,它训练的是伪标记向量(模型权重仍然冻结)。
由此派生出一整串差异:前三者不需要 GPU、改完立刻生效、随时可回退、产物只是一段文本;Prompt-Tuning 需要成百上千条标注和训练环境,产物是一个需要存盘和版本管理的权重文件,但推理时输入不变长,能把 ICL/CoT 的持续 token 成本省掉。
工程上最快的判断法:问一句「这次改动有没有产生一个需要存盘的新文件」——没有就是改便条,有就是改耳机。至于真正更新模型全部权重的 Fine-Tuning(包括 Instruction-Tuning),落在这张表之外,在模块 ⑧ 展开。改便条 ≠ 改人。
词术语表
| 术语 | 含义 |
|---|---|
| In-Context Learning(ICL) | 上下文学习;从训练集挑少量标注样本,设计任务相关的指令形成提示模板,用来指导测试样本作答。不更新任何参数,概念源自 GPT-3 论文 arXiv:2005.14165 |
| Zero-shot / One-shot / Few-shot | 给出任务描述后,预测前分别插入 0 个 / 1 个 / N 个示例;三者都不训练,N 常见取 2~32 |
| 多数标签偏置 | 示例中占多数的标签会把模型的输出往那一类推;用各类别示例数持平来对冲 |
| 近因偏置 | 离提问最近的那个示例影响最大;同一批示例顺序一反,末位标签就变了 |
| Instruction 指令 | 具备任务特性的模板,把「做什么、可选哪些」明写出来,如 The movie review is {x}. It was [mask]. |
| Instruction-Tuning | 指令学习;为各类任务定义指令并训练模型,提高对不同任务的泛化能力。必须对模型精调,属于 Fine-Tuning 一侧 |
| CoT(Chain-of-Thought) | 思维链;在提示中加入中间推理步骤,提升复杂推理任务表现。首次提出于 arXiv:2201.11903 |
| Few-shot CoT | ICL 的特殊情况,把每个演示从 <input, output> 扩充为 <input, CoT, output>;1 次调用 |
| Zero-shot CoT | 不给示例,先用 Let's think step by step 生成推理步骤,再用 Therefore, the answer is 导出答案;2 次调用。论文 arXiv:2205.11916 |
| 涌现(Emergent) | 某种能力在模型规模超过一定量级后才出现的现象;CoT 的收益就呈现这种模式,对小模型无效 |
| PEFT | Parameter-Efficient Fine-Tuning,参数高效微调;仅微调少量或额外参数、固定大部分预训练参数的一整类方法的统称 |
| Prompt Tuning | 只在输入层拼一段可训练向量,可看作 Prefix-Tuning 的简化,不需要 MLP;参数量与层数无关。论文 arXiv:2104.08691 |
| Prefix-Tuning | 在输入 token 之前构造任务相关的 virtual tokens 作为 Prefix,每一层都加可训练参数,训练时前接 MLP 稳定优化。论文 arXiv:2101.00190 |
| P-Tuning | 与 Prefix-Tuning 同期的做法,位置不固定、只在输入层加 embedding,用 LSTM+MLP 初始化。论文 arXiv:2103.10385 |
| P-Tuning v2 | Deep Prompt Tuning 针对 NLU 的优化版,用 0.1%~3% 的可训参数匹配全量微调,可处理硬序列标注任务。论文 arXiv:2110.07602 |
| Adapter | 在预训练模型每层内部插入「降维—非线性—升维」小模块,带 skip-connection 保证最差退化为 identity;有推理延迟。论文 arXiv:1902.00751 |
| LoRA | Low-Rank Adaptation;在 Linear 权重旁并一条 A(d×r) → B(r×d) 低秩支路,B 初始化为 0,训练后可合并回权重、零推理延迟。论文 arXiv:2106.09685 |
| 秩 r | LoRA 的关键超参数;旁支参数量为 2·d·r,对 r 严格线性。r 越小越省,能表达的更新方向也越少 |
| bottleneck | Adapter 降维后的维度;参数量随它近似线性增长,开到 128 时在 7B 底座上会突破主体的 1% |
| virtual token / 伪标记 | 不过 tokenizer、直接作为可训练向量参与计算的「词」;Prefix、Prompt Tuning 训练的就是它们 |