Linux 企业级部署:systemd、远程访问与并发
把「在我机器上能跑」变成「全公司都能用」,中间隔着四件事:托管、监听、鉴权、并发。
30″30 秒看懂企业级部署
上一讲把后厨的灶点着了,能炒出一盘菜。但自家吃饭和开门做生意,完全是两回事:开门做生意要有总闸(跳闸了自己合上)、要有传菜窗(客人不能直接闯进后厨)、还要知道一个灶最多同时炒几个锅。
这一讲要补的就是这三样东西。它们对应三个具体动作:把服务交给 systemd 托管、在前面架一道 Nginx 网关、把并发参数调到和显存匹配。
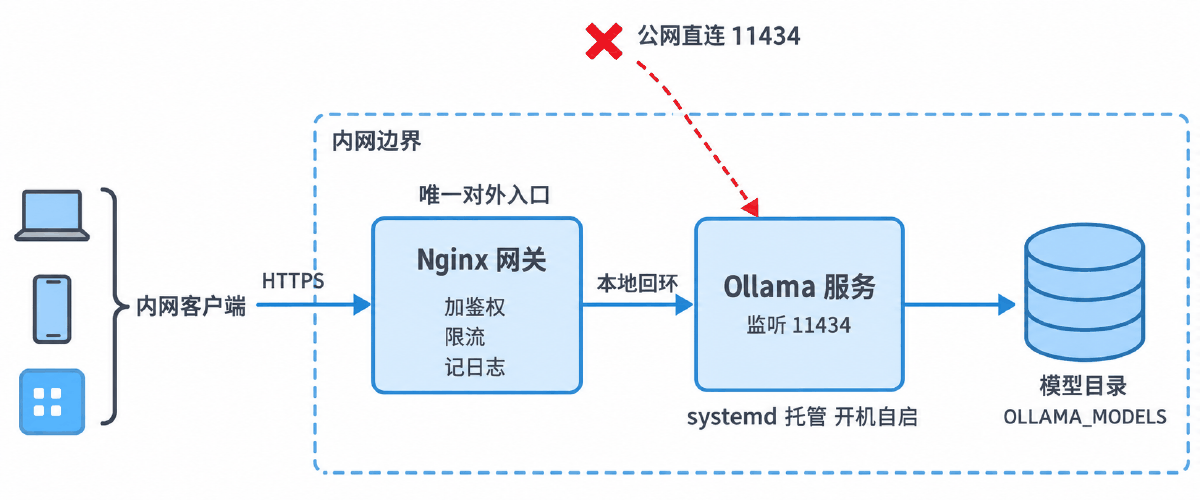
| 比喻里的东西 | 对应的技术 | 不做会怎样 |
|---|---|---|
| 总闸 | systemd 服务 | 关掉终端服务就没了;半夜挂了没人知道,也不会自己起来 |
| 后厨的门 | OLLAMA_HOST | 默认只听本机,别的机器根本连不上 |
| 传菜窗门卫 | Nginx 网关 + 鉴权 | 门一开谁都能进——Ollama 自己没有任何鉴权 |
| 一个灶炒几个锅 | OLLAMA_NUM_PARALLEL 等 | 要么排队超时,要么显存爆掉 |
| 菜谱存哪个柜子 | OLLAMA_MODELS | 几十 G 模型把系统盘撑爆,日志都写不下 |
OLLAMA_HOST 改成 0.0.0.0,只是「开门」,不带任何门卫。Ollama 默认没有任何鉴权机制——没有账号、没有密钥、没有访问控制。开了远程访问还不加网关,等于把一台能删模型、能跑任意推理的机器裸放在网络上。开门和设卡必须同一次做完。
01概念:从「能跑」到「能用」
差的不是技术难度,是四件必须做完的事
1.1 从能跑到能用,差哪四件事
开发机上 ollama run 跑通,只证明模型和显卡没问题。要变成全公司能用的服务,还差四步:
| 要补的东西 | 解决什么问题 | 做完的标志 |
|---|---|---|
| ① 进程托管 | 服务不能随终端关掉、挂了要自己起来 | systemctl is-active ollama 返回 active,重启机器后依然是 |
| ② 监听地址 | 别的机器要连得上 | 同事的机器 curl 你的 11434 能通 |
| ③ 访问控制 | 连得上的人不能为所欲为 | 不带口令的请求被网关挡掉 |
| ④ 并发与资源 | 多人同时用不会崩、不会无限排队 | 压测下单请求耗时可预期,显存不溢出 |
这四件事有严格的先后顺序。跳过 ① 直接做 ②,服务随时会消失;做了 ② 不做 ③,等于裸奔;③ 做完不调 ④,上线第一天就会被并发打爆。
OLLAMA_HOST=0.0.0.0,测通了就宣布「部署完成」。这是四步里风险最大的一步,却被当成了第一步。正确顺序是先 systemd 托管、再配网关、最后才开监听——开门之前先把门卫招好。
1.2 为什么必须交给 systemd
手动敲 ollama serve 起的服务有三个致命问题:
- 终端一关就没。SSH 断线、窗口关闭,进程跟着退出。
- 挂了不会自己起来。显存溢出、内核 OOM killer 干掉它,服务就此消失,直到有人发现。
- 机器重启后不会回来。机房断电恢复,所有服务都起来了,唯独你这个没有。
systemd 托管把这三件事一次解决:Restart=always 管自动拉起,WantedBy 管开机自启,journalctl 管日志留存。
| 配置项 | 作用 | 不写会怎样 |
|---|---|---|
Restart=always | 进程退出就重启 | 挂了一直挂着,没人值班就是全天故障 |
RestartSec=3 | 重启间隔 | 不写默认很短,异常时会疯狂重启刷日志 |
After=network-online.target | 等网络可用再启动 | 开机时抢跑,拉模型或绑定地址失败 |
Environment= | 给进程注入环境变量 | 所有调优参数都不生效 |
WantedBy=default.target | 开机自启 | 重启机器后服务不回来 |
1.3 环境变量写在哪才生效
这是新手最容易栽的地方。Ollama 的所有调优都靠环境变量,但环境变量写错地方等于没写。
| 写在哪 | 对 systemd 托管的服务生效吗 | 说明 |
|---|---|---|
~/.bashrc / /etc/profile | 不生效 | 那是登录 shell 的环境,systemd 启动服务时根本不读它 |
敲 export 后再 systemctl restart | 不生效 | 你导出的是当前终端的环境,不是服务的 |
service 文件里的 Environment= | 生效 | 标准做法 |
systemctl edit ollama 的覆盖片段 | 生效 | 不改原文件,升级时不会被覆盖,更推荐 |
PID=$(systemctl show -p MainPID --value ollama)
tr '\0' '\n' < /proc/$PID/environ | grep '^OLLAMA_'daemon-reload 或 restart。
推荐的写法是覆盖片段:只写你要加的那几行,不动官方原文件。用 systemctl edit ollama 生成,别自己手建目录:
# systemd 覆盖片段:只写你要加的几行,不动官方原文件。
#
# 生成方式(不要手动创建文件,让 systemd 自己建目录):
#   systemctl edit ollama
# 它会打开编辑器,把下面内容粘进去保存,实际落在:
#   /etc/systemd/system/ollama.service.d/override.conf
#
# 相比直接改 /etc/systemd/system/ollama.service 的好处:
#   升级 Ollama 时官方模板被覆盖,你的这几行仍然在。
#
# 保存之后照样要走完四步闭环:
#   systemctl daemon-reload && systemctl restart ollama
#   然后读 /proc/<PID>/environ 确认变量真的进去了

[Service]
# 模型放数据盘。注意:改这个值之后,已经拉过的模型不会自动搬家。
Environment="OLLAMA_MODELS=/data/ollama/models"

# 生产建议保持回环,对外由 Nginx 网关代理。
# 只有在没有网关、纯内网联调时才改成 0.0.0.0。
Environment="OLLAMA_HOST=127.0.0.1:11434"

# 工作时间基本一直有人用,留久一点,省掉反复加载的几十秒。
Environment="OLLAMA_KEEP_ALIVE=30m"

# 并发路数用 concurrency_plan.py 算出来,别拍脑袋。
# 显存够不代表能开很多路 —— 算力会先饱和。
Environment="OLLAMA_NUM_PARALLEL=4"

# 单模型服务设成 1,别让第二个模型来分显存。
Environment="OLLAMA_MAX_LOADED_MODELS=1"

# 队列不宜过长:排到的时候请求早该超时了,不如直接失败让客户端重试。
Environment="OLLAMA_MAX_QUEUE=256"

Environment="OLLAMA_CONTEXT_LENGTH=4096"
1.4 防火墙:连不上的另一半原因
服务起了、端口也在 0.0.0.0 上监听了,同事还是连不上——十有八九是防火墙。这两个层次很容易被混为一谈:
| 现象 | 真正的原因 | 怎么分辨 |
|---|---|---|
本机 curl 通,外机不通 | 监听地址还是回环 | ss -lntp 看到 127.0.0.1:11434 |
监听已是 0.0.0.0,外机仍不通 | 防火墙没放行 | firewall-cmd --list-ports 里没有该端口 |
| 内网通、跨网段不通 | 上层网络策略或安全组 | 本机两层都正常,得找网络管理员 |
/etc/systemd/system/ollama.service 属于官方模板,升级 Ollama 时可能被覆盖,你加的 Environment 行就没了。更稳的做法是用 systemctl edit ollama 生成一个 override.conf 片段,只写自己要加的几行。无论用哪种,动手之前先备份一份。
02原理:开门、设卡、控流量
三个环境变量族决定了服务的安全边界和承载能力
2.1 OLLAMA_HOST 与远程访问
默认值是 127.0.0.1:11434,意思是只接受本机的连接。别的机器 curl 过来会直接连接被拒——这不是防火墙拦的,是服务压根没在那个网卡上监听。
| 取值 | 谁能连上 | 适用场景 |
|---|---|---|
127.0.0.1:11434 | 只有本机 | 生产推荐:前面挂网关,网关走本地回环转发 |
0.0.0.0:11434 | 所有网卡上的所有人 | 临时联调;没网关时等于裸奔 |
192.168.1.10:11434 | 只在指定内网网卡上监听 | 比 0.0.0.0 收敛,机器多网卡时有用 |
还有一个常被漏掉的变量 OLLAMA_ORIGINS:它管的是浏览器跨域。用 ChatBox 这类网页客户端连不上、控制台报 CORS 错误时,问题在这个变量上,而不是 OLLAMA_HOST。
ss -lntp | grep 11434 看到的地址才是真相:显示 127.0.0.1:11434 就是只听本机,显示 *:11434 或 0.0.0.0:11434 才是对外开放。看这一行,不要看你以为自己改了什么。
2.2 默认没有任何鉴权
这一点必须说得非常清楚:Ollama 自己不提供账号、密钥或任何形式的访问控制。只要网络能到,任何人都能调用它的全部接口——包括这些:
| 接口 | 能干什么 | 被滥用的后果 |
|---|---|---|
/api/chat | 跑推理 | 白嫖你的算力,把显存占满,正常业务排队 |
/api/pull | 拉任意模型 | 把数据盘塞满 |
/api/delete | 删除模型 | 线上模型被删光,服务直接中断 |
/api/tags | 列出所有模型 | 泄露你部署了什么、业务方向是什么 |
所以正确结构是:Ollama 只监听 127.0.0.1,外部流量一律先过 Nginx 网关,鉴权、限流、接口白名单全部做在网关这一层。
/api/delete、/api/pull 这类管理接口一律拒绝)。第三条最容易被漏掉,但它挡住的是最严重的事故。
2.3 并发三参数
多人同时用的时候,决定服务表现的是三个变量:
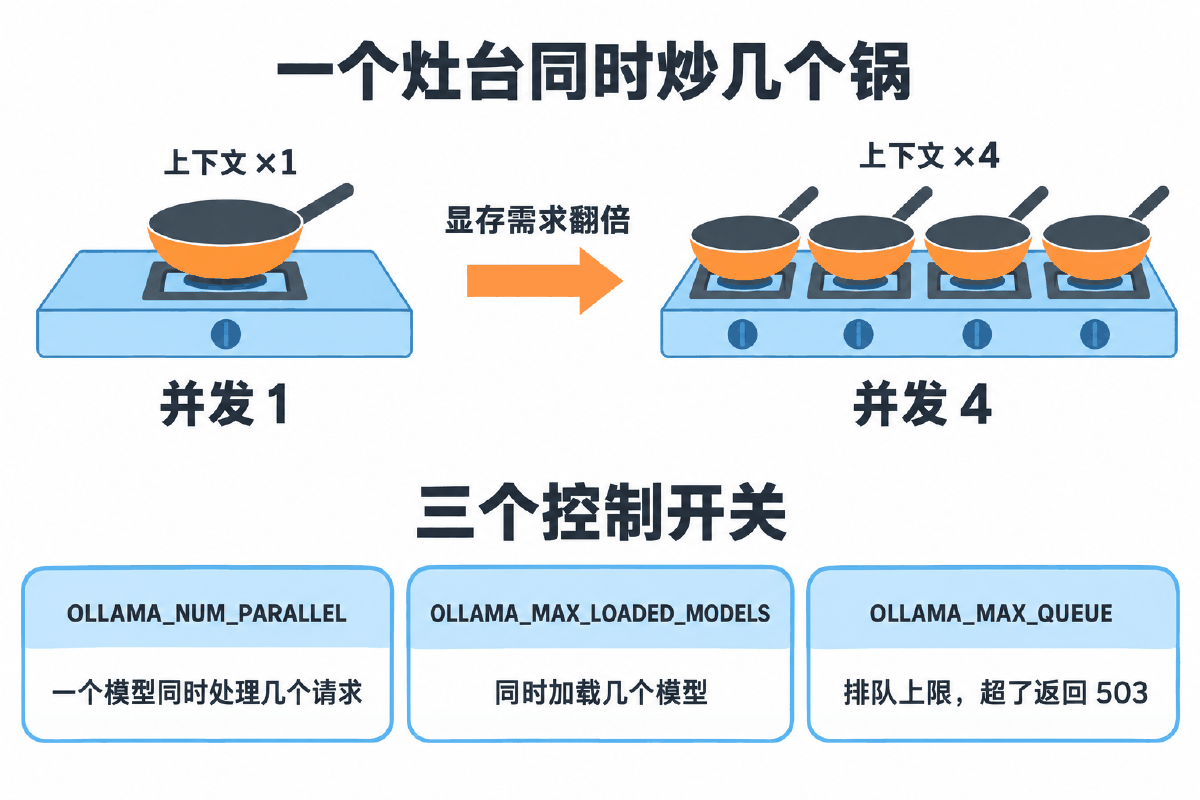
| 变量 | 默认值 | 管什么 | 调大的代价 |
|---|---|---|---|
OLLAMA_NUM_PARALLEL | 1 | 一个模型同时处理几个请求 | KV 缓存成倍上涨,显存吃紧 |
OLLAMA_MAX_LOADED_MODELS | 3×GPU 数 | 同时加载几个模型 | 每多一个就多一份完整权重,显存翻番 |
OLLAMA_MAX_QUEUE | 512 | 排队上限 | 队列越长,用户等待越久还不如直接失败 |
关键理解:模型权重是所有并发请求共用的一份,KV 缓存才是每个请求一份。所以要支持更多人,调 NUM_PARALLEL 就够了,不需要加载多个同名模型——那纯属浪费显存。
并发数具体该定多少,不要拍脑袋。下面这个脚本把两个约束都算了:
"""并发规划:这块卡、这个模型,最多能开几路并发。

上一讲讲过「先定并发数,再倒推模型尺寸」,这里给出具体算法。

估算口径:
    总占用 ≈ 模型权重 + 并发数 × 单路 KV 缓存 + 运行时开销
    权重是所有并发请求**共用的一份**,不随并发增长;
    KV 缓存是**每路一份**,且随上下文长度线性上涨 —— 这才是并发的真实代价。

单路 KV 缓存的粗略估法:
    KV ≈ 上下文长度 × 每 token 的 KV 字节数
    每 token 的 KV 字节数随模型层数和隐藏维度变化,
    这里按常见 7B~32B 稠密模型的经验值给区间,不做精确计算。

用法:
    python3 concurrency_plan.py --vram 24 --params 14
    python3 concurrency_plan.py --vram 24 --params 14 --ctx 8192
"""
import argparse
import sys

BYTES_PER_PARAM = {"FP16": 2.0, "Q8": 1.0, "Q4": 0.55}

# 每 token 的 KV 缓存字节数(经验区间,随参数量增大而增大)
# 取值偏保守,宁可估多不估少 —— 估少了上线就 OOM。
def kv_bytes_per_token(params_b):
    if params_b <= 2:
        return 60 * 1024        # 约 60KB
    if params_b <= 8:
        return 130 * 1024
    if params_b <= 16:
        return 200 * 1024
    return 320 * 1024


def plan(vram_gb, params_b, quant, ctx, reserve_ratio=0.2):
    gib = 1024 ** 3
    weights = params_b * 1e9 * BYTES_PER_PARAM[quant] / gib
    kv_one = kv_bytes_per_token(params_b) * ctx / gib
    # 运行时开销:激活值、中间结果等,按权重的一成估
    runtime = weights * 0.1
    # 留给系统和显存碎片的余量
    usable = vram_gb * (1 - reserve_ratio)

    budget = usable - weights - runtime
    max_parallel = int(budget // kv_one) if kv_one > 0 else 0

    return {
        "显存总量": vram_gb,
        "可用预算": usable,
        "模型权重": weights,
        "运行时开销": runtime,
        "单路 KV 缓存": kv_one,
        "理论最大并发": max_parallel,
    }


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--vram", type=float, required=True, help="显存大小,GB")
    ap.add_argument("--params", type=float, required=True, help="参数量,单位 B")
    ap.add_argument("--quant", default="Q4", choices=list(BYTES_PER_PARAM))
    ap.add_argument("--ctx", type=int, default=4096, help="上下文长度 num_ctx")
    ap.add_argument("--reserve", type=float, default=0.2, help="预留比例,默认两成")
    args = ap.parse_args()

    r = plan(args.vram, args.params, args.quant, args.ctx, args.reserve)

    print("=" * 56)
    print("配置:%.0fGB 显存 · %gB 模型 · %s 量化 · 上下文 %d"
          % (args.vram, args.params, args.quant, args.ctx))
    print("=" * 56)
    print("  显存总量        %6.1f GB" % r["显存总量"])
    print("  预留后可用      %6.1f GB   (留了 %.0f%%)"
          % (r["可用预算"], args.reserve * 100))
    print("  模型权重        %6.1f GB   (所有并发共用一份)" % r["模型权重"])
    print("  运行时开销      %6.1f GB" % r["运行时开销"])
    print("  单路 KV 缓存    %6.2f GB   (每路一份,随 ctx 线性上涨)"
          % r["单路 KV 缓存"])
    print("-" * 56)

    n = r["理论最大并发"]
    if n <= 0:
        print("结论:这块卡装不下这个配置。")
        print("      降量化档、换更小的模型,或者把 num_ctx 调小。")
        return 0

    # 关键:显存只是两个约束中的一个。
    # 即使显存还剩很多,并发路数一多,GPU 算力也会先饱和:
    # 总吞吐基本不再涨,而每一路的生成速度成比例变慢。
    # 对交互式问答来说,单路掍到 15 token/s 以下就已经憋得慌了,
    # 所以实际可用并发通常远低于显存算出来的那个数。
    COMPUTE_CAP = 4        # 单卡交互式服务的经验上限
    vram_safe = max(1, n - 1)          # 留一路给突发,避免跑满顶掉显存
    safe = min(vram_safe, COMPUTE_CAP)

    print("显存约束下的最大并发:%d 路" % n)
    print("算力约束下的经验上限:%d 路(交互式问答,单卡)" % COMPUTE_CAP)
    if vram_safe > COMPUTE_CAP:
        print("  → 显存不是瓶颈,算力是。再往上开只会让每一路都变慢。")
        print("  → 富余的显存更值得拿去调大 num_ctx,或者换更大的模型。")
    print("建议配置:OLLAMA_NUM_PARALLEL=%d" % safe)
    print()
    print("配套建议:")
    print("  OLLAMA_MAX_LOADED_MODELS=1   单模型服务,别让第二个模型分显存")
    print("  OLLAMA_CONTEXT_LENGTH=%d" % args.ctx)
    print()
    print("⚠️  这是估算,不是验收标准。")
    print("    配完必须压测验证:bench_local.py --concurrency %d" % safe)
    print("    压测时盯住 ollama ps 的 PROCESSOR 列,出现 CPU 就是溢出了。")
    return 0


if __name__ == "__main__":
    sys.exit(main())
拿 24GB 的卡跑 14B、上下文 4096 跑一遍,结果是这样的:
| 约束 | 算出来的上限 | 说明 |
|---|---|---|
| 显存 | 14 路 | 权重 7.2GB 共用,单路 KV 缓存约 0.78GB |
| 算力 | 4 路 | 单卡交互式服务的经验上限,真正的瓶颈 |
num_ctx,或者换更大的模型。
NUM_PARALLEL 时,多出来的进队列等着,表现是单次耗时线性变长而不是报错。直到队列也满了(MAX_QUEUE),服务端才返回 503。排查「变慢」时先确认是不是在排队,而不是一上来就怀疑模型或显卡。
2.4 改配置的四步闭环
改任何一个环境变量,都必须走完这四步。少一步等于没改,而且症状是「看起来改了,行为没变」,非常耗时间。
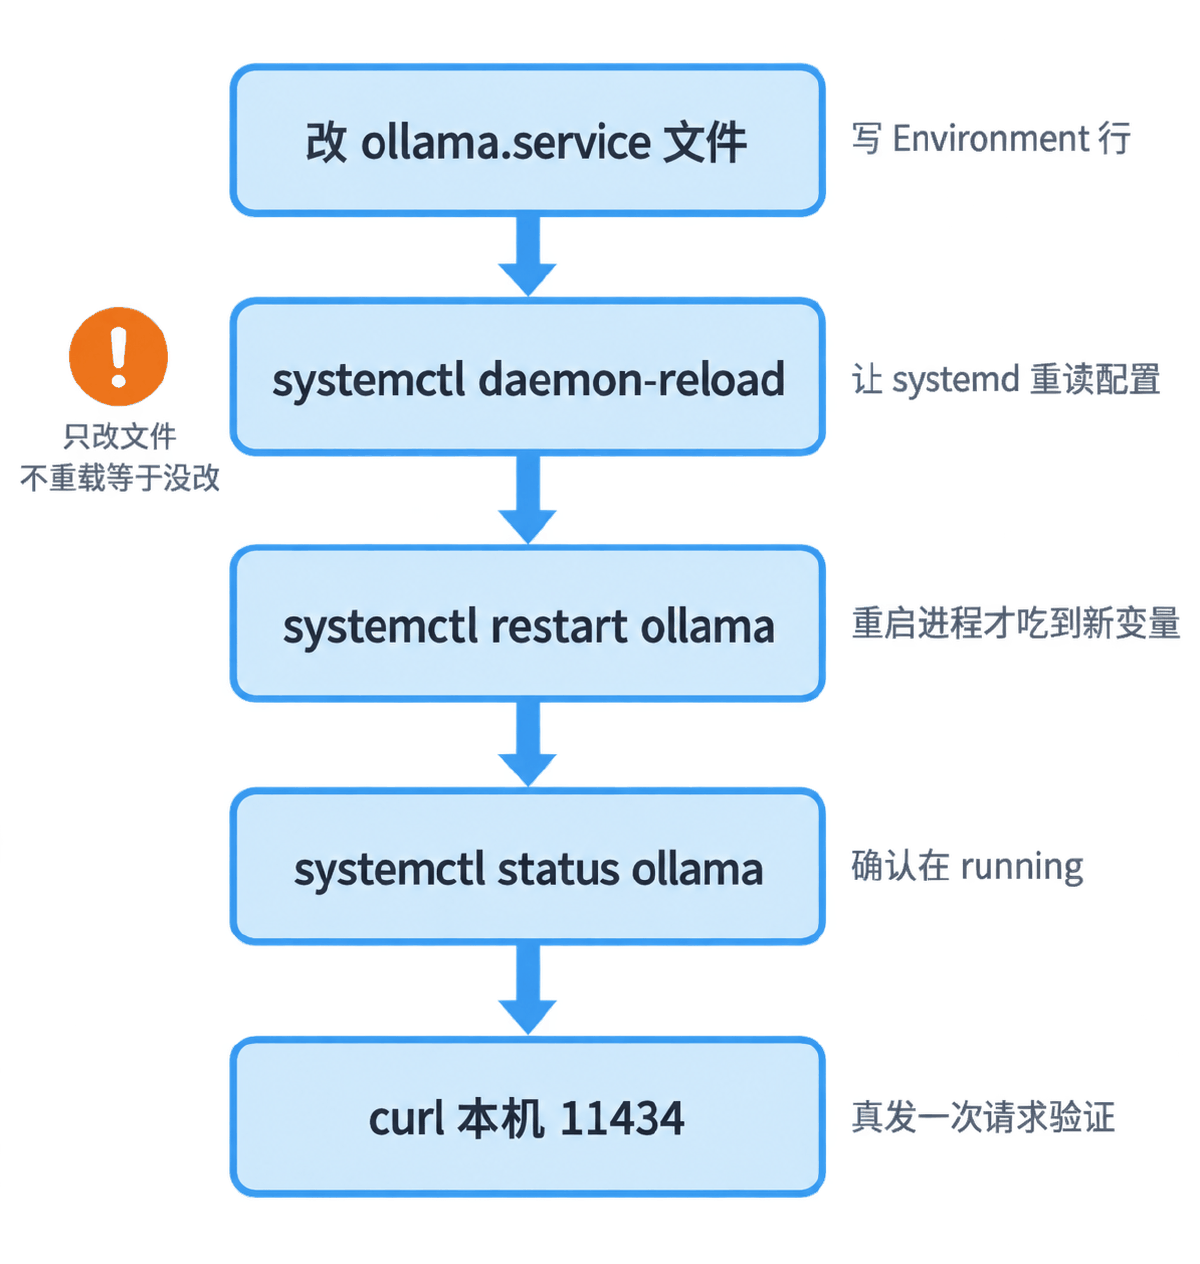
| 步骤 | 命令 | 漏掉会怎样 |
|---|---|---|
| ① 改文件 | 编辑 service 或 systemctl edit | — |
| ② 重读配置 | systemctl daemon-reload | systemd 还在用旧的那份,改了白改 |
| ③ 重启进程 | systemctl restart ollama | 进程里还是老环境变量 |
| ④ 验证 | 读 /proc/<PID>/environ + 发一次请求 | 不知道到底成没成,后面全靠猜 |
03最小代码:一份能上生产的 service 文件
所有调优参数都住在这个文件里
企业级部署的起点就是这个文件。它把前面讲的四件事里的三件(托管、监听、资源)都固化了下来——剩下的鉴权那一件,做在网关上。
[Unit]
Description=Ollama Service
# 等网络真正可用再启动,否则开机时拉模型会失败
After=network-online.target
Wants=network-online.target

[Service]
ExecStart=/usr/bin/ollama serve
User=root
Group=root
# 进程挂了自动拉起,3 秒后重试——私有化服务必须配,否则半夜挂了没人知道
Restart=always
RestartSec=3

# ---- 模型存放位置:默认在系统盘,模型动辄几十 GB,务必挪到数据盘 ----
Environment="OLLAMA_MODELS=/data/ollama/models"

# ---- 监听地址:默认只听 127.0.0.1,别的机器连不上 ----
# 改成 0.0.0.0 才能被内网访问。注意:这一步只是「开门」,不带任何鉴权
Environment="OLLAMA_HOST=0.0.0.0:11434"

# ---- 允许的浏览器来源,给 Web 客户端用 ----
Environment="OLLAMA_ORIGINS=*"

# ---- 内存驻留时长:默认 5m。高频服务设长一点,省掉反复加载的几十秒 ----
Environment="OLLAMA_KEEP_ALIVE=30m"

# ---- 并发控制:显存有限时这两个值决定服务会不会被打爆 ----
# 一个模型同时处理几个请求,默认 1;显存需求随它成倍上涨
Environment="OLLAMA_NUM_PARALLEL=2"
# 同时加载几个模型,默认是 3×GPU 数
Environment="OLLAMA_MAX_LOADED_MODELS=1"
# 忙不过来时的排队上限,默认 512;超出后服务端直接返回 503
Environment="OLLAMA_MAX_QUEUE=256"

# ---- 默认上下文长度,默认 4096 ----
Environment="OLLAMA_CONTEXT_LENGTH=4096"

[Install]
WantedBy=default.target
| 这一行 | 为什么要写 | 不写的后果 |
|---|---|---|
After/Wants=network-online.target | 等网络真正可用再启动 | 开机抢跑,绑定地址或拉模型失败 |
Restart=always + RestartSec=3 | 挂了自动拉起 | 半夜挂了没人知道,全天故障 |
OLLAMA_MODELS=/data/... | 模型放数据盘 | 几十 G 撑爆系统盘,日志都写不下 |
OLLAMA_HOST=0.0.0.0:11434 | 允许远程连接 | 别的机器连不上;但开了就必须配网关 |
OLLAMA_KEEP_ALIVE=30m | 模型常驻内存 | 默认 5 分钟,低频场景每次都要重新加载几十秒 |
OLLAMA_NUM_PARALLEL=2 | 支持并发 | 默认 1,第二个人来了只能排队 |
OLLAMA_MAX_LOADED_MODELS=1 | 限制同时加载的模型数 | 显存被多个模型分食,谁都跑不快 |
0.0.0.0 是有前提的
模板里写 0.0.0.0 是为了让你看到完整形态。生产上如果前面挂了 Nginx 网关,这里应该改回 127.0.0.1:11434——让网关走本地回环转发,Ollama 本身完全不对外暴露。这是最稳的结构。
systemctl edit ollama 生成覆盖片段,只写自己要加的 Environment 行。这样升级 Ollama 时你的配置不会被冲掉。真要直接改原文件,先 cp -a 备份一份带时间戳的。
04完整案例:上线、设卡、排障
三件事按顺序做完,服务才算真的交付
4.1 案例一 · 部门内网服务上线
场景:一台 24GB 显卡的服务器,供部门十几个人内网使用,模型选 14B。按 1.1 节那四步走:
这台机器的参数是这么定的:
| 参数 | 取值 | 怎么算出来的 |
|---|---|---|
| 模型 | 14B 的 Q4 | 约占 10GB,24GB 的卡留得出余量(见选型那一讲) |
OLLAMA_NUM_PARALLEL | 4 | 十几个人不会真的同时发;4 路并发 + 队列足够扛住峰值 |
OLLAMA_MAX_LOADED_MODELS | 1 | 只跑一个模型,不让第二个模型来分显存 |
OLLAMA_KEEP_ALIVE | 30m | 工作时间基本一直有人用,省掉反复加载的几十秒 |
OLLAMA_CONTEXT_LENGTH | 4096 | 并发 4 路时,上下文再往上调就要重算显存账 |
bench_local.py 加 --concurrency 4 就是干这个的。算完不压测,等于没定。
4.2 案例二 · Nginx 网关加鉴权
这是四步里最容易被跳过、后果也最严重的一步。结构很简单:Ollama 缩回 127.0.0.1,Nginx 成为唯一对外入口。
# Nginx 网关:Ollama 自己没有任何鉴权,所有访问控制都做在这一层。
#
# 落地方式:
#   1. 把这个文件放到 /etc/nginx/conf.d/ollama-gateway.conf
#   2. Ollama 只监听回环:OLLAMA_HOST=127.0.0.1:11434
#   3. nginx -t 语法检查通过后再 systemctl reload nginx
#
# 口令文件生成(不要把明文口令写进任何配置文件):
#   htpasswd -c /etc/nginx/ollama.htpasswd 你的用户名

# 按来源 IP 限速:每秒 5 个请求,突发 10 个
limit_req_zone $binary_remote_addr zone=ollama_rl:10m rate=5r/s;

upstream ollama_backend {
    # Ollama 只在本机回环监听,外部进不来,必须经过这个网关
    server 127.0.0.1:11434;
    keepalive 16;
}

server {
    listen 443 ssl;
    server_name ai.example.com;   # 改成你自己的内网域名

    ssl_certificate     /etc/nginx/ssl/ai.example.com.crt;
    ssl_certificate_key /etc/nginx/ssl/ai.example.com.key;

    # 单次请求体上限:多模态要传 base64 图片,默认 1m 会被截断
    client_max_body_size 32m;

    access_log /var/log/nginx/ollama-access.log;
    error_log  /var/log/nginx/ollama-error.log warn;

    location / {
        # ---- 第一道:账号口令 ----
        auth_basic           "Ollama Private";
        auth_basic_user_file /etc/nginx/ollama.htpasswd;

        # ---- 第二道:限速 ----
        limit_req zone=ollama_rl burst=10 nodelay;

        # ---- 第三道:只放行需要的接口,管理类接口一律拒绝 ----
        # 不加这一条的话,任何人都能调 /api/delete 把模型删光
        location ~ ^/api/(delete|pull|push|create|copy) {
            deny all;
        }

        proxy_pass http://ollama_backend;
        # Ollama 会校验 Host 头,必须改写成它自己认的值
        proxy_set_header Host localhost:11434;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_http_version 1.1;

        # ---- 流式返回必须关缓冲,否则前端要等全部生成完才看见字 ----
        proxy_buffering off;
        proxy_cache off;

        # ---- 大模型首个 token 可能等几十秒,超时要放宽 ----
        proxy_connect_timeout 10s;
        proxy_send_timeout    600s;
        proxy_read_timeout    600s;
    }
}
| 配置段 | 挡住什么 | 漏了会怎样 |
|---|---|---|
auth_basic | 没口令的请求 | 谁都能调用,算力被白嫖 |
limit_req | 单个来源的高频请求 | 一个客户端就能把服务打满 |
deny 管理接口 | /api/delete、/api/pull 等 | 模型被删光,服务直接中断 |
proxy_buffering off | — | 流式输出被缓冲,前端要等全部生成完才看见字 |
proxy_read_timeout 600s | — | 长回答被网关掐断,报 504 |
client_max_body_size 32m | — | 多模态传 base64 图片被截断 |
proxy_set_header Host 必须改写成 localhost:11434——Ollama 会校验 Host 头,不改写会被拒。② 流式场景必须关缓冲,否则「一个字一个字冒出来」的效果完全没了,用户会以为服务卡死。这两条不报错、只表现为「行为怪异」,最难排查。
htpasswd -c /etc/nginx/ollama.htpasswd 用户名 生成,它会把口令做成哈希存进去。任何情况下都不要把明文口令写进配置文件或提交进 Git。
4.3 案例三 · 服务挂了怎么逐层排障
「模型不回话了」这句话对应的可能是八种完全不同的故障。排障的价值不在于知道八个命令,而在于按顺序一层层往下走,不跳步——跳步会把「没起服务」误判成「模型坏了」。
#!/bin/bash
# 排障顺序:从「服务在不在」一路查到「模型答不答得出」,一层不通就停在那一层。
# 出问题时按顺序跑一遍,不要跳步——跳步会把「没起服务」误判成「模型坏了」。
set -uo pipefail

HOST="${OLLAMA_HOST_ADDR:-127.0.0.1}"
PORT="${OLLAMA_PORT:-11434}"
MODEL="${MODEL:-qwen2:1.5b}"

echo "===== ① 进程与服务状态 ====="
systemctl is-active ollama || echo "服务不是 active,先看第 ② 步日志"
systemctl status ollama --no-pager | head -8

echo
echo "===== ② 服务日志(最近 30 行) ====="
# 启动失败的真正原因几乎都在这里:端口被占、模型目录没权限、显卡驱动不认
journalctl -u ollama -n 30 --no-pager

echo
echo "===== ③ 端口有没有在监听 ====="
# 只看到 127.0.0.1:11434 说明没开远程;要被别的机器访问必须是 0.0.0.0
ss -lntp | grep "$PORT" || echo "端口没监听"

echo
echo "===== ④ 环境变量是否真的生效 ====="
# 注意:这里看的是进程实际拿到的环境,比看配置文件可靠
# 只改了 service 文件却没 daemon-reload + restart,这里就会露馅
PID=$(systemctl show -p MainPID --value ollama)
if [ "$PID" != "0" ] && [ -r "/proc/$PID/environ" ]; then
  tr '\0' '\n' < "/proc/$PID/environ" | grep '^OLLAMA_' || echo "没有任何 OLLAMA_ 变量"
else
  echo "拿不到主进程 PID,服务可能没起来"
fi

echo
echo "===== ⑤ 本机能不能连通 ====="
curl -s -m 5 "http://${HOST}:${PORT}/api/version" || echo "本机都连不上,问题在服务侧"

echo
echo "===== ⑥ 防火墙有没有放行 ====="
firewall-cmd --list-ports 2>/dev/null || echo "没装 firewalld 或没启用"

echo
echo "===== ⑦ 模型在不在、占的是 GPU 还是 CPU ====="
ollama list
ollama ps

echo
echo "===== ⑧ 真发一次推理 ====="
# 前七步全通但这步不通,才轮得到怀疑模型本身
curl -s -m 120 "http://${HOST}:${PORT}/api/chat" \
  -d "{\"model\":\"${MODEL}\",\"messages\":[{\"role\":\"user\",\"content\":\"只回复两个字:正常\"}],\"stream\":false}"
echo
| 层 | 查什么 | 这一层不通说明 |
|---|---|---|
| ① | 服务是不是 active | 进程根本没起来,后面都不用看 |
| ② | journalctl 最近 30 行 | 启动失败的真正原因几乎都在这里:端口占用、目录没权限、驱动不认 |
| ③ | 端口在不在监听 | 只看到 127.0.0.1 就是没开远程 |
| ④ | 进程实际拿到的环境变量 | 改了配置却没 daemon-reload,在这一层露馅 |
| ⑤ | 本机能不能连通 | 本机都不通,问题在服务侧,与网络无关 |
| ⑥ | 防火墙放行没有 | 服务好的、本机通的,别的机器连不上,就看这层 |
| ⑦ | 模型在不在、占 GPU 还是 CPU | 答得极慢通常是溢出到 CPU 了 |
| ⑧ | 真发一次推理 | 前七层全通这层才不通,才轮得到怀疑模型本身 |
05骨架模板:三份配置的分工
服务、网关、排障,各管一段,不要合并
| 文件 | 放在哪 | 管什么 |
|---|---|---|
ollama.service | /etc/systemd/system/ | 进程托管、模型目录、并发与常驻参数 |
ollama-gateway.conf | /etc/nginx/conf.d/ | 鉴权、限流、接口白名单、超时与缓冲 |
ops_check.sh | 运维目录,随手能跑的地方 | 出问题时逐层定位 |
5.2 落地顺序与验证点
三份配置不是同时生效的,落地要按顺序,每一步都有自己的验证动作:
| 顺序 | 动作 | 验证通过才往下走 |
|---|---|---|
| 1 | 部署 service,OLLAMA_HOST 先保持 127.0.0.1 | systemctl is-active 为 active,本机 curl /api/version 通 |
| 2 | 调并发与 KEEP_ALIVE,压测 | 压测下显存不溢出,ollama ps 显示 100% GPU |
| 3 | 部署 Nginx 网关 | nginx -t 通过;不带口令的请求被 401 挡掉 |
| 4 | 开放防火墙端口(只开网关的 443) | 同事机器能通过网关调通,直连 11434 不通 |
这四项验证不要手工敲,写成冒烟脚本。注意它必须在一台不是 Ollama 服务器的机器上跑——在本机跑,第一条永远是通的,测了等于没测:
#!/bin/bash
# 网关冒烟测试:验证「走网关能通」和「直连 11434 不通」两条同时成立。
#
# 为什么必须两条都测:
#   只测第一条,很可能网关配好了、11434 也还在内网裸奔,
#   任何人绕过网关直连就能删模型 —— 网关形同虚设。
#
# 用法(在一台**不是** Ollama 服务器的机器上跑,才有意义):
#   GATEWAY=https://ai.example.com OLLAMA_DIRECT=192.168.1.10:11434 \
#   AUTH_USER=alice bash gateway_smoke_test.sh
#
# 口令通过环境变量传入,不要写进命令行参数(会留在 history 里)。
set -uo pipefail

GATEWAY="${GATEWAY:-https://ai.example.com}"
OLLAMA_DIRECT="${OLLAMA_DIRECT:-192.168.1.10:11434}"
AUTH_USER="${AUTH_USER:-}"
# 口令从环境变量读;没给就走交互式输入,避免出现在进程列表里
if [ -z "${AUTH_PASS:-}" ] && [ -n "$AUTH_USER" ]; then
  read -rsp "输入 $AUTH_USER 的口令:" AUTH_PASS
  echo
fi

PASS=0
FAIL=0

check() {
  local name="$1" expect="$2" actual="$3"
  if [ "$expect" = "$actual" ]; then
    echo "  ✅ $name  (期望 $expect,实际 $actual)"
    PASS=$((PASS + 1))
  else
    echo "  ❌ $name  (期望 $expect,实际 $actual)"
    FAIL=$((FAIL + 1))
  fi
}

# 只取 HTTP 状态码,不打印响应体
code() {
  curl -s -o /dev/null -w '%{http_code}' -m 15 "$@" 2>/dev/null || echo "000"
}

echo "===== ① 直连 11434 应该连不上 ====="
# 这是最关键的一条。生产上 Ollama 应该只监听 127.0.0.1,
# 从别的机器直连必须失败(000 表示连接被拒或超时)。
DIRECT=$(code "http://${OLLAMA_DIRECT}/api/version")
check "直连 /api/version 被拒" "000" "$DIRECT"

echo
echo "===== ② 不带口令走网关应该被挡 ====="
NOAUTH=$(code "${GATEWAY}/api/version")
check "无口令请求返回 401" "401" "$NOAUTH"

echo
echo "===== ③ 带正确口令走网关应该通 ====="
if [ -n "$AUTH_USER" ]; then
  OK=$(code -u "${AUTH_USER}:${AUTH_PASS}" "${GATEWAY}/api/version")
  check "带口令请求返回 200" "200" "$OK"
else
  echo "  ⏭  没给 AUTH_USER,跳过"
fi

echo
echo "===== ④ 管理类接口即使带口令也应该被拒 ====="
# 网关的接口白名单是挡住最严重事故的那一层:
# /api/delete 能把线上模型删光。
if [ -n "$AUTH_USER" ]; then
  # 故意发一个不存在的模型名,就算白名单失效也删不掉真东西
  DEL=$(code -u "${AUTH_USER}:${AUTH_PASS}" -X DELETE \
        -H 'Content-Type: application/json' \
        -d '{"name":"__smoke_test_not_exist__"}' \
        "${GATEWAY}/api/delete")
  check "/api/delete 被网关拒绝(403)" "403" "$DEL"

  PULL=$(code -u "${AUTH_USER}:${AUTH_PASS}" -X POST \
         -H 'Content-Type: application/json' \
         -d '{"name":"__smoke_test_not_exist__"}' \
         "${GATEWAY}/api/pull")
  check "/api/pull 被网关拒绝(403)" "403" "$PULL"
else
  echo "  ⏭  没给 AUTH_USER,跳过"
fi

echo
echo "============================================"
echo "通过 $PASS 项,失败 $FAIL 项"
if [ "$FAIL" -gt 0 ]; then
  echo "⚠️  有失败项,网关还没配到位,不要对外放行。"
  exit 1
fi
echo "✅ 两条都成立:走网关能通、直连不通。"
| 检查项 | 期望状态码 | 不符合说明 |
|---|---|---|
直连 11434/api/version | 000(连不上) | Ollama 还在裸奔,OLLAMA_HOST 没收回回环 |
| 无口令走网关 | 401 | 鉴权没生效,谁都能调 |
| 带口令走网关 | 200 | 网关配错了,正常用户也用不了 |
/api/delete、/api/pull | 403 | 接口白名单漏了,模型可以被删光 |
ps 一下就看到了。脚本走环境变量或交互式输入,这个习惯对所有带凭据的脚本都适用。
5.3 上线之后:把「悄悄坏了」变成「有人知道」
Restart=always 只能解决「进程死了」这一种故障。更常见也更难发现的是进程活着、服务已经不可用:
| 隐形故障 | 端口还通吗 | 用户感受 |
|---|---|---|
| 模型溢出到 CPU | 通 | 速度掉到几 token/s,以为卡死 |
| 显存被别的进程占走 | 通 | 模型加载失败,请求报错 |
| 磁盘满了 | 通 | 日志写不进去,拉不了新模型 |
| 并发排队 | 通 | 响应时间越来越长,但不报错 |
"""健康巡检:周期性探活,把「服务悄悄坏了」变成「有人知道」。

systemd 的 Restart=always 只能解决「进程死了」这一种故障。
更常见也更难发现的是下面这几种 —— 进程活着,服务却已经不可用:

    · 模型溢出到 CPU,速度掉到几 token/s,用户以为卡死
    · 显存被别的进程占走,模型加载失败但服务端口还在
    · 磁盘满了,写不进日志和模型
    · 响应时间越来越长,其实是并发排队

这个脚本每隔一段时间做一次完整探测,把结果按行写进日志。
它**只观测、只告警,不自动重启** —— 自动重启在故障没定位前
往往只是把问题掩盖掉,变成周期性抖动。

用法:
    python3 health_watch.py                       # 前台跑,Ctrl-C 结束
    python3 health_watch.py --interval 300 --log /var/log/ollama-health.log
    # 想让它常驻,再写一个 systemd 服务托管它,别用 nohup

退出码:0 正常结束;1 启动参数有问题。
"""
import argparse
import json
import os
import sys
import time
import urllib.error
import urllib.request
from datetime import datetime

BASE = os.environ.get("OLLAMA_BASE", "http://127.0.0.1:11434").rstrip("/")


def now():
    return datetime.now().strftime("%Y-%m-%d %H:%M:%S")


def http_json(path, payload=None, timeout=20):
    url = BASE + path
    if payload is None:
        req = urllib.request.Request(url)
    else:
        req = urllib.request.Request(
            url, data=json.dumps(payload).encode("utf-8"),
            headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=timeout) as resp:
        return json.loads(resp.read().decode("utf-8"))


def probe(model, timeout):
    """做一轮完整探测,返回 (级别, 一行摘要)。

    级别:OK / WARN / CRIT
    分级依据是「用户感受得到吗」:
        CRIT  服务不可用,必须立刻处理
        WARN  还能用但已经不正常,会演变成故障
        OK    正常
    """
    # ---- ① 服务活着吗 ----
    try:
        ver = http_json("/api/version", timeout=10).get("version", "?")
    except (urllib.error.URLError, TimeoutError) as exc:
        return "CRIT", "服务不可达:%s" % exc

    # ---- ② 模型在显存里吗、占的是 GPU 还是 CPU ----
    processor = "未加载"
    try:
        running = http_json("/api/ps", timeout=10).get("models", [])
        for m in running:
            if m.get("name") == model:
                total = m.get("size", 0)
                vram = m.get("size_vram", 0)
                if total <= 0:
                    processor = "未知"
                elif vram >= total:
                    processor = "100% GPU"
                elif vram <= 0:
                    processor = "100% CPU"
                else:
                    processor = "%d%% GPU" % int(vram * 100 / total)
                break
    except Exception as exc:
        return "WARN", "版本 %s,但读 /api/ps 失败:%s" % (ver, exc)

    # ---- ③ 真发一次推理,测端到端延迟 ----
    # 前两步全通、这一步不通,才说明问题出在模型本身
    t0 = time.time()
    try:
        data = http_json("/api/chat", {
            "model": model,
            "messages": [{"role": "user", "content": "只回复两个字:正常"}],
            "stream": False,
            # 探活请求不要把模型顶进内存太久,也不要把别人的挤出去
            "keep_alive": "5m",
            "options": {"temperature": 0, "num_predict": 8},
        }, timeout=timeout)
    except (urllib.error.URLError, TimeoutError) as exc:
        return "CRIT", "版本 %s,推理失败:%s" % (ver, exc)

    wall = time.time() - t0
    tokens = data.get("eval_count", 0)
    eval_s = data.get("eval_duration", 0) / 1e9
    tps = tokens / eval_s if eval_s else 0

    summary = ("版本 %s | %s | 端到端 %.1fs | %.1f token/s"
               % (ver, processor, wall, tps))

    # ---- 分级 ----
    if "CPU" in processor and processor != "100% GPU":
        # 溢出到 CPU 是最典型的「进程活着但服务已经不可用」
        return "WARN", summary + " | 已溢出到 CPU,速度会明显下降"
    if tps and tps < 5:
        return "WARN", summary + " | 生成速度过低,检查是否在排队或溢出"
    if wall > 30:
        return "WARN", summary + " | 端到端延迟过高"
    return "OK", summary


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--model", default=os.environ.get("OLLAMA_MODEL", "qwen2:1.5b"))
    ap.add_argument("--interval", type=int, default=300, help="探测间隔秒数")
    ap.add_argument("--timeout", type=int, default=120, help="单次推理超时")
    ap.add_argument("--log", default="", help="日志文件;不给就打印到标准输出")
    ap.add_argument("--once", action="store_true", help="只探一次就退出,适合放 cron")
    args = ap.parse_args()

    out = open(args.log, "a", encoding="utf-8") if args.log else sys.stdout

    def emit(level, msg):
        line = "[%s] %-4s %s" % (now(), level, msg)
        print(line, file=out)
        out.flush()      # 每行都刷,进程被杀也不丢已经写的记录

    emit("INFO", "开始巡检 %s,模型 %s,间隔 %ds"
         % (BASE, args.model, args.interval))

    consecutive_bad = 0
    try:
        while True:
            level, msg = probe(args.model, args.timeout)
            emit(level, msg)

            if level == "OK":
                consecutive_bad = 0
            else:
                consecutive_bad += 1
                # 连续异常才升级告警:单次抖动不值得半夜叫醒人
                if consecutive_bad >= 3:
                    emit("ALERT", "连续 %d 次异常,需要人工介入" % consecutive_bad)

            if args.once:
                break
            time.sleep(args.interval)
    except KeyboardInterrupt:
        emit("INFO", "手动停止")
    finally:
        if args.log:
            out.close()
    return 0


if __name__ == "__main__":
    sys.exit(main())
ALERT 和普通 WARN 分开记。
nohup——巡检脚本自己悄悄死掉的话,你会在「没有告警」里获得虚假的安心感。或者用 --once 放进 cron,让 cron 去保证周期执行。
5.4 改动必须可回滚
生产机器上的每一次配置改动都要留后路。三条硬规矩:
- 改之前先备份。
cp -a 文件 文件.bak.$(date +%Y%m%d%H%M%S),带时间戳,一眼能看出改了几次。 - 优先用覆盖片段而不是改原文件。
systemctl edit ollama生成的override.conf只写你加的那几行,升级时不会被冲掉。 - Nginx 先
nginx -t再reload。语法错的配置一旦 reload 下去,整台机器上所有站点都受影响,不只是这一个服务。
06易错点汇总
按「托管 / 环境变量 / 安全 / 并发 / 排障」五类归并
⚠️ 一、进程托管
- 手动
ollama serve就当成部署完成。关掉终端服务就没了,SSH 一断也没了。生产必须 systemd 托管。 - 不写
Restart=always。服务挂了就一直挂着,没人值班就是全天故障。这一行是私有化服务的底线配置。 - 不写
WantedBy=default.target(或没enable)。机房断电恢复后,别的服务都回来了,唯独你这个没有。 - 不写
After=network-online.target。开机时抢跑,绑定地址或拉模型失败,表现为「重启后偶尔起不来」。 - 直接覆盖官方装的 service 文件。升级 Ollama 时你加的
Environment行会被冲掉。用 systemctl edit 生成覆盖片段更稳,无论如何改前先备份带时间戳的副本。
⚠️ 二、环境变量写错地方
- 写进
~/.bashrc或/etc/profile。对 systemd 服务完全不生效——那是登录 shell 的环境,systemd 启动服务时根本不读。 export之后直接systemctl restart。你导出的是当前终端的环境,不是服务的。同样不生效。- 改完文件忘了
daemon-reload。systemd 还在用旧的那份,改了白改。症状是「看起来改了,行为没变」。 daemon-reload了但没restart。配置读进去了,进程里还是老环境变量。这两步一个都不能少。- 不验证就宣布改好了。唯一可靠的验证是读
/proc/<PID>/environ,看进程实际拿到的环境,而不是看配置文件里写了什么。 - 改了
OLLAMA_MODELS以为模型会自动搬家。不会。已有模型要么手动移过去,要么重新拉。
⚠️ 三、安全(最严重的一类)
- 把
OLLAMA_HOST改成0.0.0.0就宣布部署完成。这只是「开门」,Ollama 自己没有任何鉴权——没有账号、没有密钥、没有访问控制。开门和设卡必须同一次做完。 - 网关只做了口令,没做接口白名单。
/api/delete能把线上模型删光,/api/pull能把数据盘塞满。管理类接口一律deny。 - 把明文口令写进配置文件或提交进 Git。用
htpasswd生成哈希文件,配置里只引用路径。 - 配了网关却没收回
OLLAMA_HOST。网关在 443 上做了鉴权,11434 还在内网裸奔,绕过网关直连照样进得去。必须同时验证「走网关能通」和「直连 11434 不通」。 - 忘了
OLLAMA_ORIGINS。网页客户端连不上、控制台报 CORS 错误时,问题在这个变量上,不在OLLAMA_HOST——很多人在错误的地方查半天。
⚠️ 四、并发与资源
- 为了支持更多人,加载多个同名模型。纯属浪费——模型权重是所有并发请求共用的一份,调
OLLAMA_NUM_PARALLEL就够了。 - 并发数拍脑袋定。要按「权重 + N 路 KV 缓存 + 运行时开销」算,落在显存内并留 20% 余量,算完还要压测验证。
- 把
OLLAMA_MAX_QUEUE调得很大来「解决超时」。队列越长用户等得越久,还不如直接失败让客户端重试。 - 并发上来变慢就怀疑显卡坏了。先确认是不是在排队——超过
NUM_PARALLEL不会报错,只会让单次耗时线性变长。 OLLAMA_KEEP_ALIVE默认 5 分钟不改。低频服务每次请求都要重新加载几十秒,用户以为服务挂了。
⚠️ 五、网关代理细节与排障
- 没改写
Host头。Ollama 会校验它,必须proxy_set_header Host localhost:11434,否则请求被拒。 - 没关
proxy_buffering。流式输出被缓冲,前端要等全部生成完才看见字,用户以为卡死。不报错,只表现为行为怪异,最难排查。 - 超时用默认值。大模型首个 token 可能等几十秒,长回答会被网关掐断报 504。
proxy_read_timeout要放宽到几百秒。 client_max_body_size用默认 1m。多模态传 base64 图片直接被截断。- 改完 Nginx 直接
reload。必须先nginx -t——语法错的配置 reload 下去,整台机器上所有站点都受影响。 - 排障跳步。直接从「模型不回话」跳到怀疑模型,会把「服务没起来」误判成「模型坏了」。按八层顺序走,前七层全通才轮得到怀疑模型本身。
⚠️ 六、运维习惯
- 直接在生产机上改配置、改完不留痕迹。下一个接手的人根本不知道为什么要这么配。改动前先
cp一份带日期的备份,并把原因写进注释——这两步合起来不到十秒,省下的是半天考古。 - 一次改三个参数然后重启。好了不知道是哪个起作用,坏了也不知道是哪个干的。一次只改一个,改完跑一遍验证。
- 把临时命令当成持久配置。终端里
export一下、手动ollama serve一下,当时都能跑,机器一重启全没。凡是要长期生效的,必须落到override.conf或 service 文件里。 - 只看
systemctl status就定义「服务正常」。它只能告诉你进程活着。显存被占、模型溢出、磁盘满、队列堆积时它一样是绿的。 - 磁盘不监控。模型文件动辄几十 GB,多拉几个模型就能把系统盘填满,表现却是五花八门的怪毛病,很少有人第一时间想到磁盘。
- 模型存储目录跟着默认值走。默认落在系统盘,而服务器的大容量盘往往另挂。装之前就把
OLLAMA_MODELS指到大盘,比存满了再搬容易得多。 - 升级挑在业务高峰做,而且不看发行说明。升级会重启服务,正在生成的请求全断;接口行为也可能变(比如嵌入接口改名那次)。
- 卸载时只删二进制。service 文件、
override.conf、专用用户、模型目录、Nginx 站点、防火墙规则都会留下来。残留的防火墙放行规则尤其危险——服务早没了,口子还开着。
07自测题
点击题目展开答案;能把这 18 题说清楚,这台服务就敢交给别人用
从「能跑」到「能用」差哪四件事?顺序能不能调?
① 进程托管 ② 监听地址 ③ 访问控制 ④ 并发与资源。顺序不能随便调,而且③ 必须在 ② 之前落地——先把门卫招好再开门。最常见的错误就是上来先改 OLLAMA_HOST=0.0.0.0,把风险最大的一步当成了第一步。
为什么手动 ollama serve 不能用于生产?
三个致命问题:终端一关就没(SSH 断线也没)、挂了不会自己起来、机器重启后不会回来。systemd 用 Restart=always、WantedBy、journalctl 一次解决这三件事。
After=network-online.target 不写会出什么问题?
开机时服务抢在网络可用之前启动,绑定地址或拉模型失败。症状是「重启后偶尔起不来」——偶发性让它特别难查。
一键脚本装的机器上要加环境变量,直接改官方 service 文件行不行?
能改但不推荐:升级 Ollama 时官方模板可能被覆盖,你加的 Environment 行就没了。更稳的是 systemctl edit ollama 生成 override.conf 覆盖片段,只写自己加的几行。无论用哪种,改前先 cp -a 备份一份带时间戳的。
把 OLLAMA_MODELS 写进 ~/.bashrc,对 systemd 托管的服务生效吗?
完全不生效。~/.bashrc 和 /etc/profile 是登录 shell 的环境,systemd 启动服务时根本不读它们。同理,敲 export 之后再 systemctl restart 也不生效——你导出的是当前终端的环境。只有 service 文件里的 Environment= 或 systemctl edit 的覆盖片段才有用。
改配置的四步闭环是什么?漏掉第二步会怎样?
① 改文件 ② systemctl daemon-reload ③ systemctl restart ollama ④ 验证。漏掉 ②,systemd 还在用旧的那份,改了白改,症状是「看起来改了,行为没变」。漏掉 ③ 则是配置读进去了、进程里还是老变量。
怎么确认环境变量真的进到进程里了?
看进程实际拿到的环境,不看配置文件:
PID=$(systemctl show -p MainPID --value ollama)
tr '\0' '\n' < /proc/$PID/environ | grep '^OLLAMA_'
文件里写着、这里没有,就说明漏了 daemon-reload 或 restart。
第 ④ 步为什么不能只看环境变量,还要发一次真实请求?
变量进去了只说明配置加载了,不代表服务可用。模型目录权限不对、显存不够加载失败,这些只有发一次真实推理才暴露得出来。「改完就宣布完成」是所有部署事故的共同起点。
把 OLLAMA_HOST 改成 0.0.0.0 之后,服务的安全状态是什么?
完全裸奔。Ollama 自己不提供账号、密钥或任何形式的访问控制。只要网络能到,任何人都能调用它的全部接口。改这个值只是「开门」,不带任何门卫——开门和设卡必须同一次做完。
不加网关最严重的后果是什么?
/api/delete 能删除模型——线上模型被删光,服务直接中断,还得重新下载几十 G。其次是 /api/pull 塞满数据盘、/api/chat 白嫖算力、/api/tags 泄露你部署了什么。
生产环境里 OLLAMA_HOST 推荐设成什么?
127.0.0.1:11434。前面挂 Nginx 网关,网关走本地回环转发,Ollama 本身完全不对外暴露。这是最稳的结构。设成 0.0.0.0 只适合临时联调。
网关至少要做哪三件事?哪件最容易被漏?
① 账号口令 ② 限速 ③ 接口白名单。第三条最容易被漏掉,但它挡住的是最严重的事故——管理类接口(delete / pull / push / create)必须一律 deny。
配好网关之后,要验证哪两件事才算设卡成功?
「走网关能通」和「直连 11434 不通」必须同时成立。只验证前一条,很可能 11434 也一起暴露在内网里,网关形同虚设。
网页客户端连不上、控制台报 CORS 错误,该改哪个变量?
OLLAMA_ORIGINS,它管的是浏览器跨域,和 OLLAMA_HOST 是两件事。很多人在 OLLAMA_HOST 上查半天,方向就错了。
要支持更多人同时用,该加载多个同名模型还是调并发参数?
调 OLLAMA_NUM_PARALLEL。模型权重是所有并发请求共用的一份,加载两份同名模型纯属浪费显存。多出来的开销只是 KV 缓存,而不是再来一份完整权重。
请求数超过 OLLAMA_NUM_PARALLEL 会发生什么?
不报错,多出来的请求进队列排着,表现为单次耗时线性变长。直到队列也满了(OLLAMA_MAX_QUEUE,默认 512),服务端才返回 503。所以排查「变慢」要先确认是不是在排队。
把 OLLAMA_MAX_QUEUE 调大能解决超时吗?
不能,只会让用户等得更久。队列越长,排到的时候请求早就该超时了,还不如直接失败让客户端重试。真正要调的是并发数和模型尺寸的匹配关系。
排障的八层顺序里,为什么第 ② 层(journalctl)这么关键?
因为启动失败的真正原因几乎都在那里:端口被占、模型目录没权限、显卡驱动不认。跳过它去猜,会浪费大量时间。
监听已经是 0.0.0.0 了,外机还是连不上,查哪里?
防火墙。ss -lntp 确认监听地址已经对外,就该看 firewall-cmd --list-ports 里有没有放行该端口。两者是两个层次:监听地址决定服务愿不愿意听,防火墙决定包能不能到。两层都正常而跨网段不通,就是上层网络策略或安全组的事了。
配了网关之后,防火墙应该放行哪些端口?
只开 443(网关),11434 一直不对外开放。很多人为了方便调试把 11434 也放行了,结果网关做的鉴权限流全能被绕过去。调试完必须收回去。
systemctl edit ollama 生成的覆盖片段好在哪?
它落在 /etc/systemd/system/ollama.service.d/override.conf,只写你要加的那几行,不动官方原文件。升级 Ollama 时官方模板被覆盖,你这几行仍然在。注意别自己手建目录,让 systemd 生成;保存后照样要走完四步闭环。
Restart=always 解决不了哪类故障?
解决不了进程活着、服务已不可用的隐形故障:模型溢出到 CPU、显存被别的进程占走、磁盘满了、并发排队。这几种情况下端口都还通,进程也不会退出,所以需要周期探活的巡检脚本。
巡检脚本发现异常,为什么不干脆自动重启?
故障没定位前自动重启,往往只是把问题掩盖成周期性抖动——显存溢出重启一次好一阵,过半小时又溢,监控上只看到「偶尔抖一下」。先如实记录、定位清楚,再谈自愈。另外它连续三次异常才升级 ALERT,单次抖动就告警,告警很快就没人看了。
网关冒烟测试为什么不能在 Ollama 服务器本机跑?
因为最关键的那一条是「直连 11434 应该连不上」。在本机跑,回环地址永远是通的,这一项测了等于没测。必须在一台不是服务器的机器上跑。
冒烟测试里口令为什么走环境变量而不是命令行参数?
命令行参数会留在 shell history 和进程列表里,同机器上别的用户 ps 一下就看到了。这个习惯对所有带凭据的脚本都适用。
巡检发现模型跑在 CPU 上,第一步查什么?
查显存被谁占了,而不是立刻换小模型。常见原因:另一个模型还没到 OLLAMA_KEEP_ALIVE 时间没卸载、别的进程占着卡、OLLAMA_NUM_PARALLEL 调得太大把 KV 缓存撑爆。三项都排除了再谈换档位。
为什么一次只改一个参数?
一次改三个然后重启,好了不知道是哪个起作用,坏了也不知道是哪个干的,下次遇到同类问题等于从头来。改一个、验证一遍、记一笔,慢十分钟,省下的是下一次的半天。配合备份与注释,改动才是可回滚的。
升级 Ollama 前要做哪三件事?
① 避开业务高峰——升级会重启服务,正在生成的请求全断;② 看发行说明——接口行为可能变(比如嵌入接口改名那次);③ 确认自定义参数写在 override.conf 而不是官方 service 文件里——后者会被升级覆盖,你的配置静悄悄消失。升完跑一遍冒烟测试再宣布完成。
不再用这台服务时,卸载要清哪些东西?
只删二进制远远不够:service 文件、override.conf、专用用户、模型目录(几十 GB)、Nginx 站点配置、证书、防火墙规则、巡检定时任务都要一并清。其中残留的防火墙放行规则最危险——服务早没了,口子还开着,下一个占用该端口的东西就被白白暴露了。
为什么要给服务建专用用户,而不是直接用 root 跑?
最小权限原则。这个服务对外监听端口、接受任意文本输入,万一出现漏洞,root 身份意味着整台机器直接沦陷;专用用户只能碰模型目录。另外也避免了模型文件属主混乱导致的权限怪问题。
改完 override.conf 后为什么光 restart 不够?
因为 systemd 把单元文件缓存在内存里,不 daemon-reload 它用的还是旧的。四步闭环是:systemctl edit → daemon-reload → restart → 验证(ss -lntp 或 systemctl show 看变量真的生效了)。最后一步最容易被省,也最容易出事。
模型目录为什么要装之前就指到大盘?
默认落在系统盘,而服务器的大容量盘往往另挂。模型文件动辄几十 GB,等系统盘快满了再搬,要停服务、改 OLLAMA_MODELS、搬数据、改属主,比一开始就指对麻烦得多。而且系统盘填满的表现是五花八门的怪毛病,很少有人第一时间想到磁盘。
机器重启后服务没起来,最先查什么?
systemctl is-enabled ollama。start 只是这一次启动,enable 才是开机自启。两个都要做,只做前者的表现就是「平时好好的,一重启就没了」。
同事说「我在终端里 export 过了,怎么不生效」?
因为 systemd 启动的服务读不到你终端里的环境变量。终端里 export 只对你手动跑的进程有效,而且关掉终端就没了。要长期生效,必须写进 service 文件或 override.conf 的 Environment=,再走 daemon-reload + restart。
为什么排障不能跳步?
跳步会把「没起服务」误判成「模型坏了」。前七层全通、第八层才不通,才轮得到怀疑模型本身。排障脚本的产出不是修好,而是准确的定位——交接时说「第 ④ 层不通」比说「模型有问题」有用一百倍。
查环境变量与命令速查表
Ollama 环境变量(全部写在 service 文件的 Environment= 里)
| 变量 | 默认值 | 说明 |
|---|---|---|
OLLAMA_MODELS | 用户目录下 | 模型存放目录,必须指到数据盘;改后已有模型不会自动搬家 |
OLLAMA_HOST | 127.0.0.1:11434 | 监听地址。生产建议保持回环,对外由网关代理 |
OLLAMA_ORIGINS | 受限 | 允许的浏览器来源;网页客户端报 CORS 就是它 |
OLLAMA_KEEP_ALIVE | 5m | 模型在内存里留多久;-1 永不卸载,0 立刻卸载 |
OLLAMA_NUM_PARALLEL | 1 | 一个模型同时处理几个请求;调它来支持更多人 |
OLLAMA_MAX_LOADED_MODELS | 3×GPU 数 | 同时加载几个模型;单模型服务设成 1,别让显存被分食 |
OLLAMA_MAX_QUEUE | 512 | 排队上限,超出返回 503;调大不解决超时 |
OLLAMA_CONTEXT_LENGTH | 4096 | 默认上下文长度;并发场景下调大要重算显存 |
systemd 常用命令
| 命令 | 什么时候用 |
|---|---|
systemctl daemon-reload | 改完 service 文件必须跑,否则改动不生效 |
systemctl restart ollama | 让进程吃到新的环境变量 |
systemctl enable ollama | 设置开机自启,机房断电恢复后服务能回来 |
systemctl is-active ollama | 脚本里判断服务状态,返回 active 才算好 |
systemctl edit ollama | 生成覆盖片段,升级时不会被冲掉,比改原文件稳 |
journalctl -u ollama -n 30 | 排障第二层,启动失败的真正原因几乎都在这里 |
systemctl show -p MainPID --value ollama | 拿主进程 PID,用来读 /proc/<PID>/environ |
验证类命令
| 命令 | 验证什么 |
|---|---|
ss -lntp | grep 11434 | 真实监听地址;127.0.0.1 是只听本机,0.0.0.0 才对外 |
tr '\0' '\n' < /proc/$PID/environ | 环境变量是否真的生效的唯一可靠依据 |
firewall-cmd --list-ports | 防火墙放行了哪些端口 |
curl -s localhost:11434/api/version | 本机连通性;不通说明问题在服务侧 |
ollama ps | 模型占的是 GPU 还是 CPU,以及 keep_alive 到期时间 |
nginx -t | reload 之前必跑;语法错的配置会影响整台机器所有站点 |
八层排障顺序速查
| 层 | 查什么 | 不通时的典型原因 |
|---|---|---|
| ① 进程 | systemctl status ollama | 没 enable、启动失败、被 OOM 杀掉 |
| ② 监听 | ss -lntp | grep 11434 | OLLAMA_HOST 没生效,仍是回环地址 |
| ③ 本机接口 | curl 127.0.0.1:11434/api/version | 服务起了但还在初始化 |
| ④ 防火墙 | firewall-cmd --list-ports | 端口没放行;或该关的 11434 反而开着 |
| ⑤ 跨机连通 | 在别的机器上 curl | 上层网络策略、安全组 |
| ⑥ 网关 | nginx -t + 访问日志 | Host 头没改写、证书、路径没放行 |
| ⑦ 鉴权 | 带令牌与不带令牌各打一次 | 令牌没注入,或压根没配鉴权 |
| ⑧ 模型 | ollama ps + 发一次真实请求 | 前七层全通才轮得到怀疑这一层 |
几个最容易混的环境变量
| 变量 | 管什么 | 写错的表现 |
|---|---|---|
OLLAMA_HOST | 服务监听哪个地址 | 外机连不上;或反过来裸奔对公网 |
OLLAMA_ORIGINS | 浏览器跨域放行 | 网页客户端报 CORS,改 HOST 没用 |
OLLAMA_MODELS | 模型存哪个目录 | 系统盘被几十 GB 模型填满 |
OLLAMA_KEEP_ALIVE | 用完在显存留多久 | 每次请求都重新加载,load_duration 很大 |
OLLAMA_NUM_PARALLEL | 同时处理几路请求 | 调太大导致显存溢出到 CPU,整体更慢 |
本讲产出的六份文件
| 文件 | 回答的问题 | 什么时候用 |
|---|---|---|
ollama.service | 服务怎么托管 | 首次部署 |
override.conf | 已有服务怎么加参数 | 一键脚本装过的机器,首选这份 |
concurrency_plan.py | 并发开几路 | 写 service 之前 |
ollama-gateway.conf | 怎么设卡 | 开监听之前 |
gateway_smoke_test.sh | 卡设住了没有 | 网关上线后,在别的机器上跑 |
ops_check.sh / health_watch.py | 现在到底怎么了 | 出问题时 / 常驻巡检 |