【案例】Qwen 微调实战 · 任务定义与数据工程
动手训练之前必须钉死四件事:任务边界、基座选型、数据格式、评价指标。钉不死就别点火——烧掉的算力不会退回来。
30″30 秒看懂这个项目
把一次大模型微调想成开一家餐厅。你不会一上来就点火炒菜——真正决定这家店活不活得下去的,是开炉之前那场立项会。
立项会上要钉死四件事:做哪一类菜(是不是非开这家店不可)、选哪口灶(铺面多大、灶多少火力)、菜谱怎么写(后厨每个人照着同一张卡出餐)、怎么算好吃(合格线画在哪,谁说了算)。四件事定不下来就开火,等于拿真金白银试错——而在微调里,试错烧的是显卡时间,烧完不会退回来。
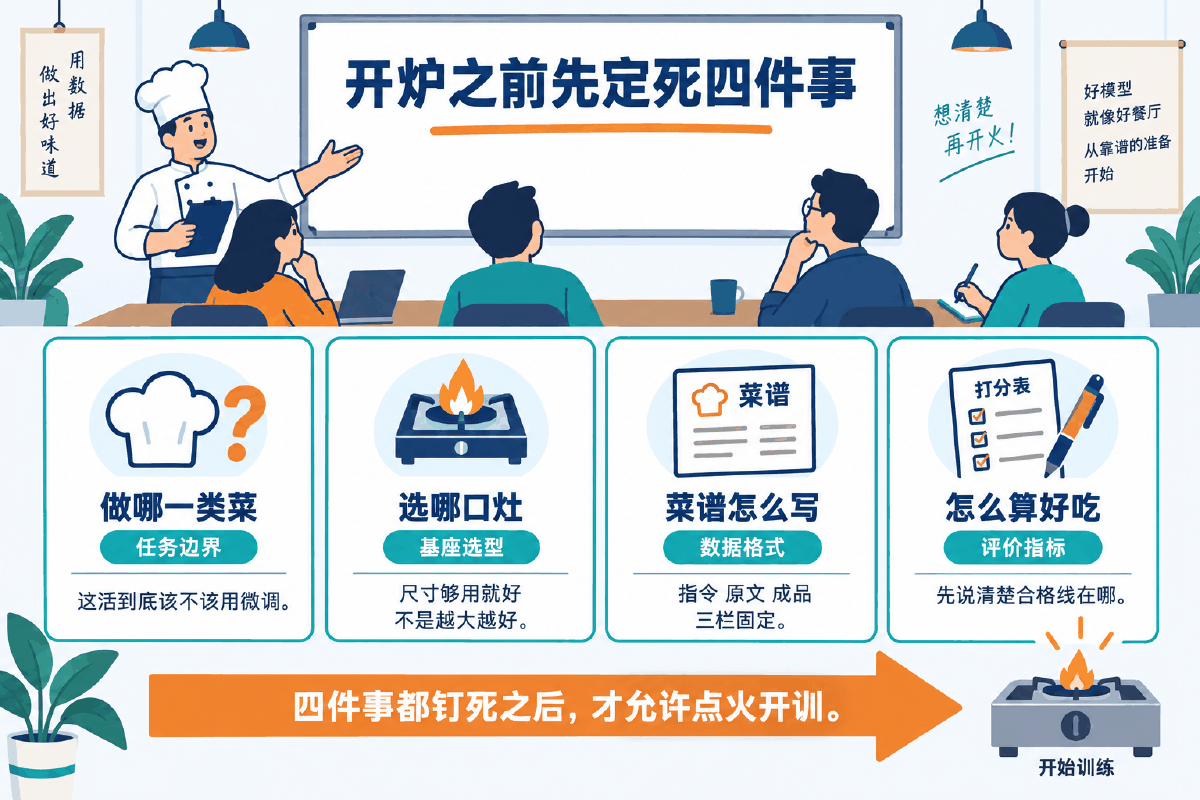
| 立项会上的事 | 对应的技术动作 | 定不下来会怎样 |
|---|---|---|
| 做哪一类菜 | 任务边界 | 把本该用提示词或检索解决的问题拿去微调,花几天训完,效果还不如改一句提示词 |
| 选哪口灶 | 基座选型(Qwen 的代次与参数量) | 灶太小做不动大席面,灶太大天天空烧——显存不够直接训不起来,显存过剩则白付成本 |
| 菜谱怎么写 | 数据格式(instruction / input / output) | 每个标注员写法不一样,模型学到的是「随便怎么答都行」 |
| 怎么算好吃 | 评价指标(F1、ROUGE-L) | 训完只能靠「我看着还行」拍脑袋,没法判断这版比上版好还是坏 |
| 后厨备料间 | 数据来源、清洗标注与增强 | 食材不新鲜,菜谱写得再好也白搭 |
| 菜单登记册 | data/dataset_info.json | 菜做好了但没上菜单,训练框架根本找不到你的数据 |
cutoff_len 决定了样本能有多长),不展开讲训练本身。
01概念:一个微调项目的立项会开什么
先判断该不该微调,再把微调和它的两个邻居分清楚,最后把四件事逐条钉死
1.1 第一个问题永远是:这活到底该不该用微调
微调不是万能钥匙,它只解决一类问题:让模型稳定地按照某种格式、某种风格、某种专业习惯去输出。它教的是「怎么做」,不是「知道什么」。
换回餐厅的说法:菜谱能教会厨师刀工、火候、摆盘顺序,让他每次出餐都长一个样;但菜谱教不会他今天菜市场的西红柿多少钱一斤——那是实时信息,得去问;也教不会他隔壁老板昨天新定的内部规矩——那是私有知识,得去查册子。
| 你的诉求 | 该用什么 | 为什么 |
|---|---|---|
| 输出格式总是飘,要求固定成某种结构 | 微调 | 格式是一种「行为习惯」,用几千条样本能压得很稳,提示词压不住 |
| 领域术语用不对、行话不地道 | 微调 | 行业语感要靠大量同领域语料喂出来 |
| 回答要基于公司内部几万份文档 | RAG(检索增强) | 文档会更新,靠训练把知识焊进权重,改一份文档就要重训一次 |
| 要最新股价、今天天气、库存数量 | Function Call / 工具调用 | 实时数据,任何训练方式都追不上 |
| 只是想让它说话客气点、分点作答 | 提示词工程 | 一句系统提示词就能解决,微调是杀鸡用牛刀 |
1.2 微调、提示词、RAG 的分工
三者不是竞争关系,在同一个项目里经常同时存在。本项目最终就是「微调出稳定的抽取格式」+「上线后靠提示词微调语气」的组合。
| 维度 | 提示词工程 | RAG | 微调 |
|---|---|---|---|
| 改的是什么 | 输入 | 输入(多塞了检索到的资料) | 模型权重本身 |
| 生效速度 | 立刻 | 建好索引即可 | 小时到天级,要算力 |
| 知识更新 | 改提示词 | 改文档即可,最灵活 | 要重训,最笨重 |
| 格式稳定性 | 弱,长对话后容易跑偏 | 弱 | 最强,这是它的主场 |
| 推理成本 | 提示词越长越贵 | 每次都要多塞检索结果,最贵 | 提示词可以写得极短,长期最省 |
| 对数据的要求 | 无 | 文档齐全即可 | 要成对的输入输出标注,最贵的一项 |
最后一行是很多项目低估的地方:微调真正的成本不在显卡,在标注。几千条高质量成对样本的整理工作量,通常远超训练本身。这也是为什么立项会要先把菜谱格式定死——格式定错了,标注返工的代价是成倍的。
1.3 立项四件事逐条钉死
写清楚模型输入什么、输出什么、不负责什么。本项目的边界是:输入一段中文原文,输出顿号分隔的核心短语;不负责判断真伪、不负责补充原文没有的信息、不负责翻译。边界越窄,样本越好标,效果越稳。
定下哪一代、哪个参数量,并且从此不再更换。换基座意味着模板(template)、显存预算、数据长度上限全部要重算,前面的训练成果一律作废。选型判断链见 2.1。
三个字段各自的写法约束要写成一页纸发给每个标注员:指令用哪一句、原文保留到什么程度、成品用什么分隔符、平均给几个短语。这一页纸就是后厨的菜谱卡。
在训练开始之前就把合格线画出来,并留出一份不参与训练的评测集。指标选型见 2.5。没有评测集的项目,最后只能靠「我看着还行」验收。
02原理:怎么挑灶、怎么写菜谱、怎么定合格线
选型的判断链、Qwen 三代的演进、参数量与显存的对应关系、三字段的写法约束、指标选型
2.1 基座选型的判断链
选型最容易犯的错,是看着一张「各尺寸模型对比表」从上往下挑,挑到一个「看起来不错」的。表是死的,判断链是活的——它是一串有先后顺序的问题,每回答一个就砍掉一半选项。
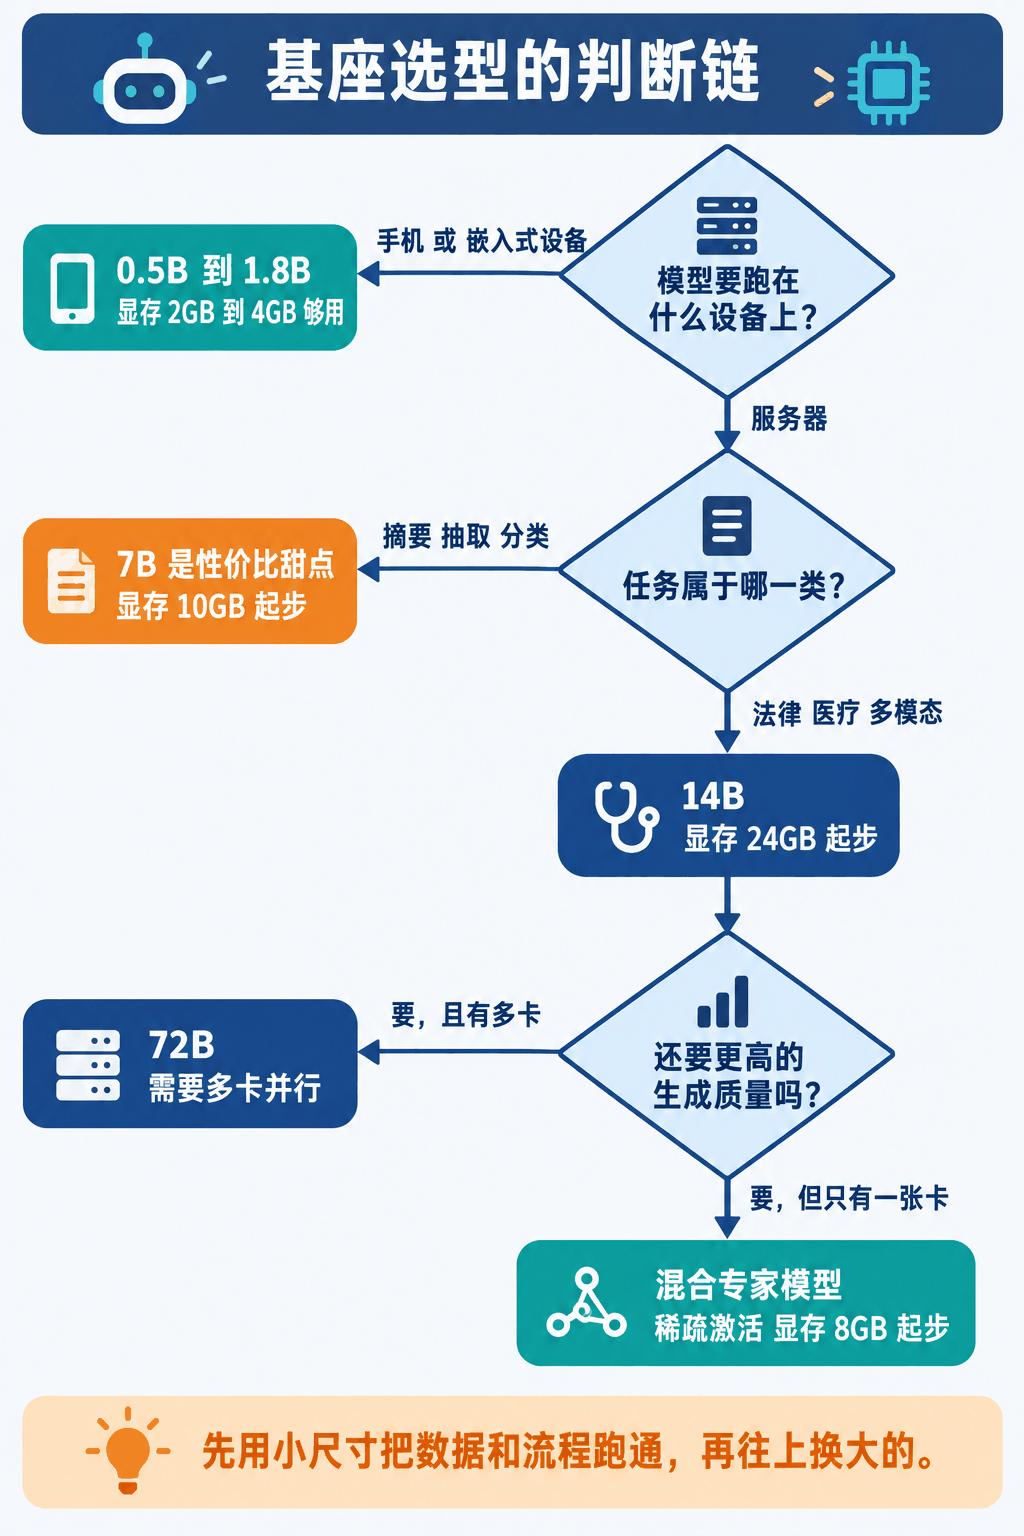
这条链一共三问,顺序不能换:
这一问决定上限,且是硬约束。要塞进手机或 IoT 设备,那就只能在 0.5B~1.8B 里选,后面两问都不用问了。跑在服务器上,才有往下挑的余地。
这一问决定下限。摘要、抽取、分类这类有明确输入输出的转换型任务,7B 就是性价比甜点;法律医疗这类需要长链条推理、术语密集的,才值得上 14B。
这一问决定要不要付多卡的钱。72B 的质量提升是真的,但代价是多卡并行;单卡又想要大模型的效果,路只有一条:MoE 稀疏激活。
本项目的走法:问 1 答「服务器」,问 2 答「摘要 + 抽取」,问 3 答「不需要」——落在 Qwen-7B 上。这个结论不是拍的,是这三问一路砍下来的唯一剩余项。
2.2 Qwen 三代的演进
选「哪一代」和选「多大」是两件事。代次决定了上下文长度、多模态能力、量化生态这些能力边界,参数量决定了算力账。
| 特性 | Qwen 1.0(2023) | Qwen 2.0(2024) | Qwen 3.0(2025 年中) |
|---|---|---|---|
| 参数量范围 | 1.8B~72B | 1.5B~72B | 0.5B~72B + MoE 架构 |
| 上下文长度 | 4k~32k tokens | 8k~128k tokens | 128k~1M tokens(实验版) |
| 多模态支持 | 基础图文问答(Qwen-VL) | 增强图文 / 音频理解 | 全模态(图 / 音 / 视频 / 3D) |
| 训练数据规模 | 3 万亿 tokens | 5 万亿 tokens | 8 万亿 tokens + 合成数据 |
| 推理效率优化 | GPTQ 4-bit 量化 | AWQ 4-bit + 动态量化 | 动态稀疏计算(MoE) |
| 垂直领域适配 | 通用场景 | 金融 / 医疗专用版 | 行业工具链深度集成 |
| 开源协议 | Apache 2.0 | Apache 2.0 | 商用友好 + 开发者激励计划 |
把这张表压成三句能用的判断:
- 看上下文长度这一行选代次。 本项目要处理法律文书、科研文献这类长文本,原文动辄数千字,
4k显然不够——这一行直接把 1.0 排除掉了。 - 看推理效率这一行选量化路线。 打算走 GPTQ 的,2.0 一代的生态最成熟;想吃 MoE 稀疏激活红利的,只能上 3.0。
- 看开源协议这一行做商用合规。 要交付给客户的项目,这一行是法务要问的第一个问题,不是技术细节。
2.3 参数量与场景的对照
这张表的正确读法是从右往左读:先看手上有什么卡,再倒推能上多大的模型。
| 模型 | 参数量 | 适用场景 | 硬件需求(FP16 推理) |
|---|---|---|---|
| Qwen3-0.5B | 0.5B | 边缘设备(手机 / IoT)、实时轻量任务 | 显存 ≥ 2GB(量化后支持 1GB) |
| Qwen-1.8B | 1.8B | 轻量级任务(如对话、文本分类)、边缘设备部署 | 显存 ≥ 4GB(如 RTX 3060) |
| Qwen-7B | 7B | 通用场景(摘要、信息抽取)、企业级服务 | 显存 ≥ 10GB(如 RTX 3090) |
| Qwen-14B | 14B | 复杂语义理解(法律 / 医疗文本)、多模态任务 | 显存 ≥ 24GB(如 A10/A100) |
| Qwen-72B | 72B | 高精度生成(创意写作、代码生成) | 多卡并行(如 8×A100 80GB) |
| Qwen3-MoE | 混合专家 | 超高效率推理(稀疏激活,激活参数量 1.8B,等效 14B) | 显存 ≥ 8GB(RTX 4080) |
≥10GB 指的是加载模型做推理。训练要贵得多——同一个 7B 模型,全量微调实测吃掉 42.18GB,LoRA 20.17GB,QLoRA 10.97GB。按推理显存去准备训练机器,一开训就会撞上 CUDA out of memory。这三个数字怎么来的、怎么压下去,是下一页的内容。
2.4 菜谱卡:三字段数据格式
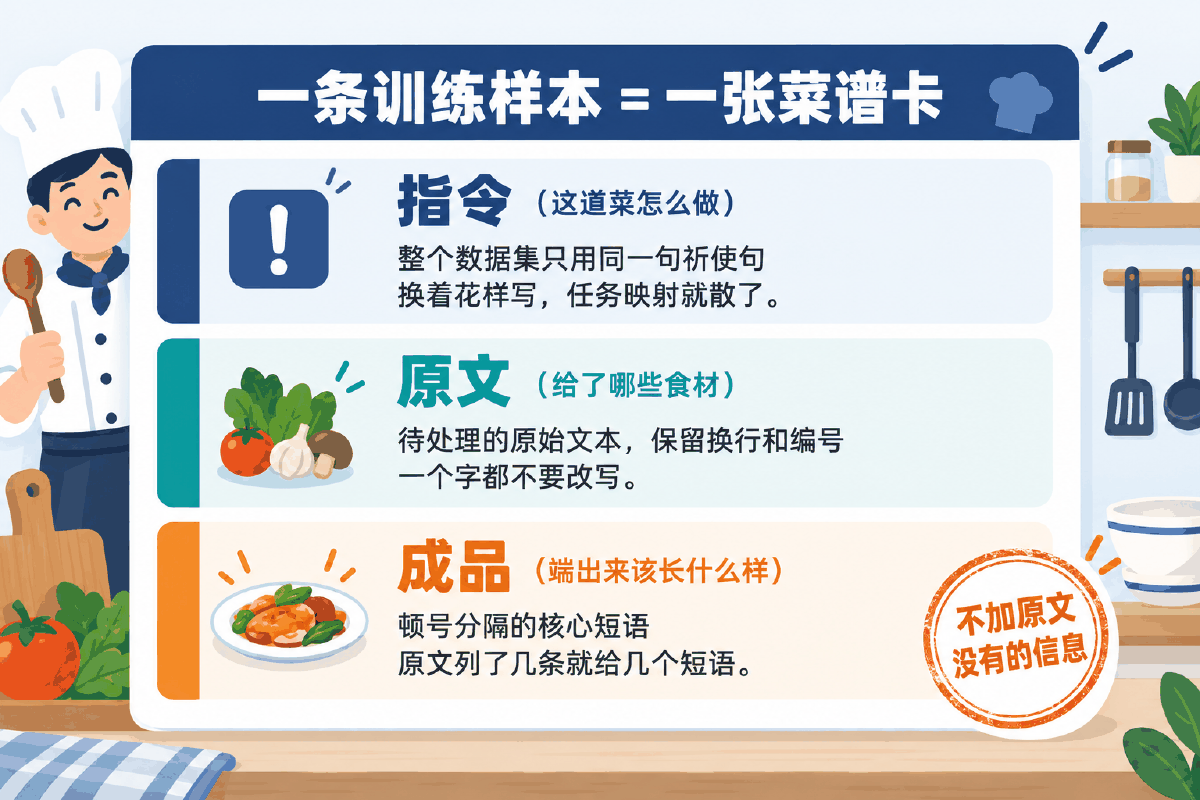
本项目采用标准的指令微调(Instruction Tuning)格式,每个样本就三个字段。别看只有三个,每一个都有自己的写法约束,任何一条松了,模型学到的东西就会跟着松。
[
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "保持身体健康的五个方法:\n\n1. 每天至少饮用8杯水,促进新陈代谢\n2. 每周进行150分钟中等强度运动,如快走或游泳\n3. 保证7-9小时高质量睡眠,避免熬夜\n4. 饮食中增加蔬菜水果比例,减少油炸食品\n5. 定期体检,监测血压、血糖等指标",
    "output": "多喝水、规律运动、充足睡眠、均衡饮食、定期体检"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "提高学习效率的三个技巧:\n\n1. 使用番茄工作法,每25分钟专注后休息5分钟\n2. 建立思维导图整理知识框架\n3. 睡前复习重点内容加强记忆",
    "output": "番茄工作法、思维导图、睡前复习"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "旅行必备物品清单:\n1. 护照/身份证原件及复印件\n2. 便携充电宝和转换插头\n3. 常用药品(退烧药、创可贴)\n4. 轻便折叠雨伞\n5. 分装洗漱用品",
    "output": "证件、充电设备、药品、雨具、洗漱包"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "职场沟通四大原则:\n① 明确沟通目标\n② 使用金字塔表达结构\n③ 注意非语言信号(眼神/姿态)\n④ 及时确认信息理解度",
    "output": "目标明确、结构化表达、非语言交流、信息确认"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "TODO 把待处理的原文贴到这里。要求:\n1. 保留原文的换行与编号,不要压成一行\n2. 每条内容是动宾短语,带细节描述\n3. 长度控制在 cutoff_len 之内,中文按 1 字 ≈ 1 token 估",
    "output": "TODO、顿号分隔的核心短语、必须 100% 覆盖 input 条目、不加原文没有的信息"
  }
]
字段一:instruction —— 这道菜怎么做
作用是明确告知模型需要执行的任务类型。本项目全程只用一句:
| 约束 | 为什么 |
|---|---|
| 固定句式,全数据集不变 | 帮模型建立稳定的任务映射关系。映射一旦建稳,实际应用时即使用户换了说法(「请总结以下要点」「帮我提炼一下」),模型仍能正确响应;反之,训练时指令写法就有十几种,模型学到的是「指令这个位置随便写什么都行」,映射反而散了。 |
| 使用祈使句明确任务目标 | 祈使句的信息密度最高、歧义最小。「请提取以下内容中的摘要信息」比「摘要」或者「下面这段话你看看」都好得多。 |
与后续 input 形成完整语义 | 指令以「以下内容」结尾,正好承接下一字段。读起来是一句完整的话,而不是两段拼在一起的碎片。 |
字段二:input —— 给了哪些食材
作用是提供待处理的原始文本内容。核心约束只有一条:它是原文,不是你改写过的原文。
- 保留换行和编号。 「1. 2. 3.」「① ② ③」这些结构信号是模型判断「原文列了几条」的依据,压成一行会直接削弱条目对齐能力。
- 每条内容是动宾短语(动词 + 名词),并包含细节描述。「每天至少饮用 8 杯水,促进新陈代谢」这种带数字、带目的的写法,比干巴巴的「喝水」更能训练模型的提炼能力——它要学的正是「把细节压掉、把动作留下」。
- 长度受
cutoff_len约束。 训练配置里cutoff_len: 1024,超出部分会被截断,而被截掉的往往正好是排在最后的output——样本看着在,其实已经废了。所以构造数据时就要做长度过滤,这一步写在build_dataset.py里。
字段三:output —— 端出来该长什么样
作用是给出符合指令要求的预期结果。这是三个字段里约束最多的一个,因为模型最终学的就是它。
| 约束 | 具体要求 | 违反了会怎样 |
|---|---|---|
| 内容形态 | 从 input 中提炼核心名词 / 动宾短语 | 写成整句话,模型就会学着输出长句,抽取任务变成了摘要任务 |
| 分隔符 | 中文顿号「、」 | 一半样本用顿号一半用逗号,上线后输出的分隔符就会随机漂移,下游解析全炸 |
| 顺序 | 无顺序要求(除非原文有优先级) | 强行要求顺序会逼模型学一个它无从判断的规则,反而增加噪声 |
| 数量 | 平均 3~5 个短语 | 数量分布过散,模型无法形成「该给几个」的稳定预期 |
| 覆盖率 | 100% 覆盖 input 条目 | 原文列了 5 条只标了 3 条,等于在教模型「漏掉两条也算对」 |
| 不编造 | 不添加原文未提及的信息 | 这是抽取类任务的底线。标注里出现一次编造,模型就学会了幻觉 |
input 条目」指的是原文列了几条,成品就要给几个短语,不是要求短语的字必须出现在原文里。原文写「每天至少饮用 8 杯水」,标成「多喝水」是正确的概括,尽管两者字面几乎不重合。把覆盖率理解成字面包含,做出来的校验脚本会把正确标注全判成错——这一点在 check_dataset.py 里踩过,见 4.5。
2.5 合格线画在哪:评价指标怎么定
指标必须贴着输出格式来定。本项目的输出是「顿号分隔的短语列表」,同时又归在「文本摘要」这个大类下,所以两套指标都要看。
| 指标 | 量什么 | 怎么算 | 本项目里的角色 |
|---|---|---|---|
| F1 | 关键信息抽取的准不准、全不全 | 把预测短语集合与标注短语集合求交集,精确率与召回率的调和平均 | 主指标。因为输出本来就是一个短语集合,天然适合用集合指标去量 |
| ROUGE-L | 生成摘要与参考摘要的最长公共子序列重合度 | 按 LCS 算召回与精确,再调和 | 辅指标。用来盯住「会不会越写越长、越写越飘」 |
| 人工抽检 | 有没有编造 | 随机抽 100 条,逐条看有没有原文没有的信息 | 兜底。编造在 F1 上可能只掉一两个点,但在业务上是致命的 |
val_size: 0.1 划出来的那 10% 是验证集,用来在训练过程中盯 loss、判断有没有过拟合,它每一轮都被看到。验收用的评测集要另外切一份,全程不进训练。拿验证集当评测集报出来的分,只能说明模型记住了这批数据,不能说明它在新数据上行。
03最小代码:把一条样本变成合法的训练数据
十几行看懂三字段是怎么落成文件的,以及为什么必须在这一步就做长度过滤
数据工程听起来很重,但剥掉清洗、增强、统计之后,最核心的动作只有一个:把「原文 + 标注」拼成一个三字段字典,攒成一个 JSON 数组落盘。下面这十几行就是全部:
import json

INSTRUCTION = "请提取以下内容中的摘要信息"   # 全数据集固定这一句

raw = [
    ("提高学习效率的三个技巧:\n1. 番茄工作法\n2. 思维导图\n3. 睡前复习",
     ["番茄工作法", "思维导图", "睡前复习"]),
]

samples = []
for text, phrases in raw:
    if not (20 <= len(text) <= 900):       # 长度过滤,挡住会被截断的样本
        continue
    samples.append({
        "instruction": INSTRUCTION,
        "input": text.strip(),              # 原文,保留换行与编号
        "output": "、".join(phrases),       # 顿号分隔,不是逗号
    })

with open("qwen_dataset.json", "w", encoding="utf-8") as f:
json.dump(samples, f, ensure_ascii=False, indent=2) # 必须关掉 ASCII 转义这段代码里有四处是写错了当时不报错、训完才发现的地方,逐个说清楚:
| 代码位置 | 写错的样子 | 后果 |
|---|---|---|
INSTRUCTION 提到循环外 | 在循环里根据内容拼不同的指令 | 任务映射被打散。模型学到「指令这一栏爱写什么写什么」,上线后换个说法就失效 |
| 长度过滤 | 不过滤,全都收 | 超长样本的尾部被 cutoff_len 截掉,截掉的正好是排在最后的 output。样本还在,但等于喂了一条没有答案的题 |
"、".join(...) | 用 ", ".join(...) | 分隔符不统一,模型输出的分隔符会随机漂移,下游按顿号切分的代码全部失效 |
ensure_ascii=False | 用默认值 True | 中文全部变成 \u5b66\u4e60 这样的转义串。训练框架能读,但人没法复查,标注错误从此无法用肉眼发现 |
[{...}, {...}])整体读入,适合几千到几万条;JSON Lines(一行一个对象)可以流式读、可以用 wc -l 直接数条数,适合更大的量。注册时 file_name 指向哪个后缀,框架就按哪种解析——文件内容是数组但文件名写成 .jsonl,会直接解析失败。
input 要 strip() 而不是整体清洗
strip() 只去掉首尾空白,属于「摆盘」;正文里的换行、编号、全角符号一个都不能动,因为它们是模型判断条目边界的依据。真正的清洗(去广告、去乱码、去重复段落)应该发生在更早的一步——原始语料入库的时候,而不是在构造训练样本的时候顺手做。两件事混在一起,出了问题你分不清是清洗规则错了还是构造逻辑错了。
04完整案例:这个项目的数据工程怎么落地
从任务定义到语料入库、增强、构造、体检、注册,最后串起整条技术路线
4.1 落地任务与应用场景
前面讲的四件事,到这里开始填具体内容。本项目的任务边界是两件事:文本摘要与关键信息抽取。它要解决的现实问题是信息过载——人每天面对大量文本,把关键信息自动提出来,能直接省掉阅读时间。
自动生成新闻要点,提升内容分发效率。特点是量大、时效强,对吞吐的要求高于对精度的要求。
从财报、研报中提取关键指标与风险事件。特点是不许编造,一个凭空多出来的数字就可能引出决策事故。
解析病历、文献,生成患者病情摘要。特点是术语密集,通用模型不微调几乎用不了。
快速抽取案件核心信息,辅助法律检索。特点是原文极长,这是选长上下文代次的直接理由。
自动化归档会议记录、技术文档。特点是私有数据,数据出不了内网,这是选开源模型私有化部署的直接理由。
五个场景形态各异,但输入输出的形状完全一样:给一段原文,要一串核心短语。这就是把它们合成一个任务来训的底气。
回到 1.1 的判断题:这五个场景为什么不用提示词或检索解决?因为它们要的不是「知道更多」,而是每一次都按同样的格式吐出同样颗粒度的短语——这是典型的行为型缺口,正是微调的主场。
4.2 数据来源与清洗标注
备料间分两条进货渠道,用途完全不同:
| 来源 | 具体 | 作用与注意 |
|---|---|---|
| 公开数据集 | CN-DBpedia(中文实体识别)、LCSTS(摘要生成)、领域定制语料(如金融 / 医疗文本) | 用来打底,把通用的中文语感和抽取习惯先喂上。量大、免费,但颗粒度不一定贴合你的业务 |
| 企业私有数据 | 脱敏后的内部文档、用户日志等 | 用来贴合业务,决定了模型上线后好不好用。必须脱敏——姓名、手机号、身份证、账号一律替换掉,否则这些信息会被写进权重,之后再也删不掉 |
清洗与标注的做法是人工 + 弱监督结合:
- 清洗去除噪声数据——广告尾巴、重复段落、编码乱码、空壳文档。这一步在语料入库时做,不要拖到构造样本时。
- 标注实体、关系及摘要标签。弱监督负责把量铺开(用规则或大模型先批量打一版),人工负责把质量兜住(抽检并修正,重点修「漏标」和「编造」这两类)。
4.3 数据增强的两把刀
标注贵,所以要用增强把有限的标注撑开。本项目用两种,它们撑的是不同的维度:
| 手法 | 怎么做 | 撑开了什么 | 要当心什么 |
|---|---|---|---|
| 回译 Back Translation | 中文原文 → 译成英文 → 再译回中文,得到一条说法不同、意思相同的新原文 | 句式与措辞的多样性。让模型明白「同一个意思换个说法,该抽的短语还是那几个」 | 回译会改写原文的用词。原文里的专有名词、数字、单位要锁住不译,否则「8 杯水」可能变成「八杯水」甚至「一些水」,标注就对不上了 |
| 实体替换 Entity Swapping | 把原文里的实体换成同类型的另一个(公司 A 换成公司 B,北京换成上海) | 实体的覆盖面。防止模型把某个具体实体名和某种输出模式绑死 | 标注要跟着一起换。原文换了实体而 output 里还留着旧实体,就制造了一条「编造」样本,比不增强还糟 |
4.4 构造数据集:build_dataset.py
把 03 节那十几行扩成能用的版本,它多做了四件事:字段规范化、长度与数量过滤、可选打乱、落盘统计。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""build_dataset.py —— 把原始文本构造成 instruction / input / output 三字段指令微调数据集。

输入:一份 JSON Lines 原始语料,每行至少包含正文字段(默认 `text`),
      可选地包含已标注好的关键短语字段(默认 `phrases`,列表或顿号分隔字符串)。
输出:LLaMA-Factory 可直接注册的 JSON 数组文件(一个 list,元素是三字段字典)。

运行(不需要 GPU,纯标准库):
    python3 build_dataset.py --raw raw.jsonl --out qwen_dataset.json
    python3 build_dataset.py --raw raw.jsonl --out qwen_dataset.json --demo

设计上只做三件事:规范化字段、按长度过滤、落盘并打印统计。
标注质量本身不是脚本能保证的,它只保证"格式是对的、长度是可训的"。
"""

import argparse
import json
import os
import random
import re
import sys
from collections import Counter

# ---------------------------------------------------------------------------
# 1. 固定指令:同一个任务只用同一句祈使句
# ---------------------------------------------------------------------------
# 指令固定不变,模型才能建立稳定的任务映射;换着花样写指令会让映射变松散。
INSTRUCTION = "请提取以下内容中的摘要信息"

# output 里多个短语之间的分隔符,全站统一为中文顿号
SEP = "、"

# 长度过滤阈值(按字符计,粗略对应 token 的 0.6~1.0 倍,中文偏 1.0)
MIN_INPUT_CHARS = 20
MAX_INPUT_CHARS = 900        # 与训练配置里的 cutoff_len: 1024 留出余量
MIN_OUTPUT_PHRASES = 2
MAX_OUTPUT_PHRASES = 12


# ---------------------------------------------------------------------------
# 2. 字段规范化
# ---------------------------------------------------------------------------
def normalize_input(text):
    """把正文规整成干净的多行文本。

    做三件事:统一换行、压掉连续空行、去掉首尾空白。
    不改写正文内容本身 —— input 就是"待处理的原文",改了它标注就对不上了。
    """
    if not isinstance(text, str):
        return ""
    text = text.replace("\r\n", "\n").replace("\r", "\n")
    text = re.sub(r"\n{3,}", "\n\n", text)
    text = re.sub(r"[ \t]+\n", "\n", text)
    return text.strip()


def normalize_output(phrases):
    """把关键短语规整成顿号分隔的一行字符串。

    接受三种输入形态:列表、顿号/逗号分隔的字符串、None。
    顺带去重并保持原顺序 —— 重复短语会让模型学到"可以啰嗦"。
    """
    if phrases is None:
        return ""
    if isinstance(phrases, str):
        parts = re.split(r"[、,,;;]", phrases)
    elif isinstance(phrases, (list, tuple)):
        parts = list(phrases)
    else:
        return ""

    seen, kept = set(), []
    for p in parts:
        p = str(p).strip().strip("。.,,、")
        if p and p not in seen:
            seen.add(p)
            kept.append(p)
    return SEP.join(kept)


# ---------------------------------------------------------------------------
# 3. 单条样本的构造与过滤
# ---------------------------------------------------------------------------
def build_sample(record, text_key="text", phrase_key="phrases"):
    """把一条原始记录变成三字段样本;不合格返回 (None, 原因)。"""
    raw_input = normalize_input(record.get(text_key))
    raw_output = normalize_output(record.get(phrase_key))

    if not raw_input:
        return None, "input 为空"
    if not raw_output:
        return None, "output 为空(未标注)"

    n = len(raw_input)
    if n < MIN_INPUT_CHARS:
        return None, "input 过短"
    if n > MAX_INPUT_CHARS:
        return None, "input 过长"

    phrases = raw_output.split(SEP)
    if len(phrases) < MIN_OUTPUT_PHRASES:
        return None, "短语数过少"
    if len(phrases) > MAX_OUTPUT_PHRASES:
        return None, "短语数过多"

    sample = {
        "instruction": INSTRUCTION,
        "input": raw_input,
        "output": raw_output,
    }
    return sample, None


# ---------------------------------------------------------------------------
# 4. 读入 / 写出
# ---------------------------------------------------------------------------
def read_jsonl(path):
    """逐行读 JSON Lines;坏行跳过并计数,不让一行脏数据毁掉整个构建。"""
    rows, bad = [], 0
    with open(path, "r", encoding="utf-8") as f:
        for line in f:
            line = line.strip()
            if not line:
                continue
            try:
                rows.append(json.loads(line))
            except json.JSONDecodeError:
                bad += 1
    if bad:
        print("[warn] 跳过无法解析的行:%d 行" % bad, file=sys.stderr)
    return rows


def demo_records():
    """内置样例,方便没有原始语料时先把流程跑通一遍。"""
    return [
        {
            "text": "保持身体健康的五个方法:\n"
                    "1. 每天至少饮用8杯水,促进新陈代谢\n"
                    "2. 每周进行150分钟中等强度运动,如快走或游泳\n"
                    "3. 保证7-9小时高质量睡眠,避免熬夜\n"
                    "4. 饮食中增加蔬菜水果比例,减少油炸食品\n"
                    "5. 定期体检,监测血压、血糖等指标",
            "phrases": ["多喝水", "规律运动", "充足睡眠", "均衡饮食", "定期体检"],
        },
        {
            "text": "提高学习效率的三个技巧:\n"
                    "1. 使用番茄工作法,每25分钟专注后休息5分钟\n"
                    "2. 建立思维导图整理知识框架\n"
                    "3. 睡前复习重点内容加强记忆",
            "phrases": "番茄工作法、思维导图、睡前复习",
        },
        {
            "text": "旅行必备物品清单:\n"
                    "1. 护照/身份证原件及复印件\n"
                    "2. 便携充电宝和转换插头\n"
                    "3. 常用药品(退烧药、创可贴)\n"
                    "4. 轻便折叠雨伞\n"
                    "5. 分装洗漱用品",
            "phrases": ["证件", "充电设备", "药品", "雨具", "洗漱包"],
        },
        {
            "text": "职场沟通四大原则:\n"
                    "① 明确沟通目标\n"
                    "② 使用金字塔表达结构\n"
                    "③ 注意非语言信号(眼神/姿态)\n"
                    "④ 及时确认信息理解度",
            "phrases": ["目标明确", "结构化表达", "非语言交流", "信息确认"],
        },
        {
            "text": "太短",   # 故意留一条会被长度过滤掉的
            "phrases": ["甲", "乙"],
        },
    ]


def summarize(samples):
    """打印一份可以贴进日志的统计,用来判断数据能不能开训。"""
    if not samples:
        print("没有产出任何样本。")
        return

    in_lens = sorted(len(s["input"]) for s in samples)
    out_cnt = sorted(len(s["output"].split(SEP)) for s in samples)

    def pct(arr, p):
        return arr[min(len(arr) - 1, int(len(arr) * p))]

    print("\n样本总数:%d" % len(samples))
    print("input  长度  min/中位/p95/max = %d / %d / %d / %d"
          % (in_lens[0], pct(in_lens, 0.5), pct(in_lens, 0.95), in_lens[-1]))
    print("output 短语数 min/中位/p95/max = %d / %d / %d / %d"
          % (out_cnt[0], pct(out_cnt, 0.5), pct(out_cnt, 0.95), out_cnt[-1]))

    dist = Counter(out_cnt)
    print("短语数分布:" + "  ".join("%d个:%d条" % (k, dist[k]) for k in sorted(dist)))

    inst = Counter(s["instruction"] for s in samples)
    print("instruction 种类数:%d(应为 1,多于 1 说明任务映射被写散了)" % len(inst))


def main():
    ap = argparse.ArgumentParser(description="构造 instruction/input/output 三字段微调数据集")
    ap.add_argument("--raw", help="原始语料 JSON Lines 路径")
    ap.add_argument("--out", default="qwen_dataset.json", help="输出的数据集 JSON 路径")
    ap.add_argument("--text-key", default="text", help="原始记录里正文字段名")
    ap.add_argument("--phrase-key", default="phrases", help="原始记录里关键短语字段名")
    ap.add_argument("--shuffle", action="store_true", help="落盘前打乱顺序")
    ap.add_argument("--seed", type=int, default=42, help="打乱用的随机种子")
    ap.add_argument("--demo", action="store_true", help="不读文件,用内置样例跑一遍")
    args = ap.parse_args()

    if args.demo:
        records = demo_records()
    elif args.raw:
        records = read_jsonl(args.raw)
    else:
        ap.error("要么给 --raw,要么加 --demo")
        return

    samples, rejects = [], Counter()
    for rec in records:
        sample, why = build_sample(rec, args.text_key, args.phrase_key)
        if sample is None:
            rejects[why] += 1
        else:
            samples.append(sample)

    if args.shuffle:
        random.Random(args.seed).shuffle(samples)

    out_dir = os.path.dirname(os.path.abspath(args.out))
    if out_dir:
        os.makedirs(out_dir, exist_ok=True)
    with open(args.out, "w", encoding="utf-8") as f:
        json.dump(samples, f, ensure_ascii=False, indent=2)

    print("已写出:%s" % args.out)
    if rejects:
        print("被过滤:" + "  ".join("%s=%d" % (k, v) for k, v in rejects.items()))
    summarize(samples)


if __name__ == "__main__":
    main()
不带原始语料也能先跑通一遍,用内置样例:
$ python3 build_dataset.py --demo --out qwen_dataset.json
已写出:qwen_dataset.json
被过滤:input 过短=1

样本总数:4
input  长度  min/中位/p95/max = 59 / 76 / 120 / 120
output 短语数 min/中位/p95/max = 3 / 5 / 5 / 5
短语数分布:3个:1条  4个:1条  5个:2条
instruction 种类数:1(应为 1,多于 1 说明任务映射被写散了)这份输出里,最后一行才是最该盯的。前面几行长度统计只是让你确认没人写出超长样本,而「instruction 种类数」只要不是 1,就说明有人在标注时自己改了指令句式——这件事在训练日志里看不出来,在这里一眼就能发现。
| 脚本里的关键决定 | 为什么这么定 |
|---|---|
MAX_INPUT_CHARS = 900 | 训练配置 cutoff_len: 1024,中文按 1 字符 ≈ 1 token 保守估,留出 100 多的余量给指令和输出。不是拍脑袋定的,是从训练参数倒推的 |
MIN_OUTPUT_PHRASES = 2 | 只给一个短语的样本没有「列表」的形态,训多了模型会倾向只答一个 |
normalize_output 里去重 | 重复短语会教模型「可以啰嗦」。顺序保持原样,因为标注规范里写明无顺序要求 |
--shuffle 带固定 --seed | 打乱是为了避免同类样本扎堆影响训练;固定种子是为了这次和下次构造出来的文件完全一致,方便定位问题 |
| 坏行跳过并计数 | 一行脏数据不该毁掉整次构建,但也不能静默吞掉——所以打到 stderr 上让人看见 |
4.5 开训前体检:check_dataset.py
构造完不等于能训。开炉前还要过一遍体检,四项检查各自对应一类真实会翻车的情况:
| 检查项 | 查什么 | 不查会怎样 |
|---|---|---|
| A 字段完整性 | 缺字段、类型不对、output 空串、instruction 不统一 | 空 output 是在直接教模型「可以什么都不答」 |
| B 条目级覆盖率 | 原文列了几条,成品给了几个短语 | 系统性漏标,模型学会「漏两条也算对」 |
| C 长度分布 | 三字段合计长度的直方图与超限条数 | 被 cutoff_len 截断的样本混在里面,看不出来 |
| D 重复与冲突 | 完全重复的样本、同一原文对应不同成品 | 重复导致局部过拟合;标注冲突让模型学得摇摆 |
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""check_dataset.py —— 开训之前把数据集体检一遍。

检查四件事,每一件都对应一个真实会翻车的点:
  A. 字段完整性     —— 缺字段 / 字段类型不对 / instruction 不统一
  B. output 覆盖率  —— input 里列了几条,output 就该给几个短语(条目级覆盖)
  C. 长度分布       —— input 会不会被 cutoff_len 截断
  D. 重复与泄漏     —— 完全重复的样本、input 相同 output 不同的冲突标注

运行(纯标准库,不需要 GPU):
    python3 check_dataset.py qwen_dataset.json
    python3 check_dataset.py qwen_dataset.json --cutoff 1024 --strict
退出码:0 = 通过;1 = 有致命问题(--strict 下警告也算不通过)。
"""

import argparse
import json
import re
import sys
from collections import Counter, defaultdict

SEP = "、"
REQUIRED_KEYS = ("instruction", "input", "output")


# ---------------------------------------------------------------------------
# A. 字段完整性
# ---------------------------------------------------------------------------
def check_fields(data):
    errors, warns = [], []

    if not isinstance(data, list):
        errors.append("顶层结构不是 list —— LLaMA-Factory 的 alpaca 风格数据集要求一个 JSON 数组")
        return errors, warns

    for i, item in enumerate(data):
        if not isinstance(item, dict):
            errors.append("第 %d 条不是对象" % i)
            continue
        for k in REQUIRED_KEYS:
            if k not in item:
                errors.append("第 %d 条缺字段 %s" % (i, k))
            elif not isinstance(item[k], str):
                errors.append("第 %d 条字段 %s 不是字符串(是 %s)" % (i, k, type(item[k]).__name__))
        if isinstance(item.get("input"), str) and not item["input"].strip():
            warns.append("第 %d 条 input 为空串" % i)
        if isinstance(item.get("output"), str) and not item["output"].strip():
            errors.append("第 %d 条 output 为空串 —— 空标注会直接教坏模型" % i)

    insts = Counter(x.get("instruction") for x in data if isinstance(x, dict))
    if len(insts) > 1:
        warns.append("instruction 有 %d 种写法,建议同一任务只用一句固定祈使句:%s"
                     % (len(insts), list(insts)[:3]))
    return errors, warns


# ---------------------------------------------------------------------------
# B. output 覆盖率
# ---------------------------------------------------------------------------
# input 里一个"条目"的开头长什么样:1. / 2、/ ① / - / • / (3)
ITEM_HEAD = re.compile(
    r"^\s*(?:\d+\s*[\.、)\)]|[((]\s*\d+\s*[))]|[①-⑳]|[-*•·])\s*\S"
)


def count_items(input_text):
    """数一数 input 里列了几个条目。

    标注规范要求 output 100% 覆盖 input 条目,所以"条目数"才是覆盖率的分母。
    注意不能用字面包含去判断 output 短语 —— 标注本来就是概括,
    「每天至少饮用8杯水」概括成「多喝水」,字面一个都对不上,那是正确标注。
    识别不出条目(整段散文)时返回 0,此时跳过覆盖率判断。
    """
    return sum(1 for line in input_text.split("\n") if ITEM_HEAD.match(line))


def _charset(s):
    """取中文字符与字母数字,用于"零交集"这一条最保守的编造信号。"""
    return set(re.findall(r"[\u4e00-\u9fff0-9A-Za-z]", s))


def check_coverage(data, sample_limit=20):
    warns, mismatched, orphan = [], [], []
    ratios = []

    for i, item in enumerate(data):
        if not isinstance(item, dict):
            continue
        inp = item.get("input") or ""
        out = item.get("output") or ""
        if not isinstance(inp, str) or not isinstance(out, str) or not out:
            continue

        phrases = [p for p in out.split(SEP) if p.strip()]
        if not phrases:
            continue

        # B-1 条目级覆盖:列了几条就该给几个短语
        n_items = count_items(inp)
        if n_items:
            ratio = min(1.0, len(phrases) / n_items)
            ratios.append(ratio)
            if len(phrases) != n_items and len(mismatched) < sample_limit:
                mismatched.append((i, n_items, len(phrases)))

        # B-2 最保守的编造信号:短语与原文一个字符都不沾
        inp_chars = _charset(inp)
        for p in phrases:
            cs = _charset(p)
            if cs and not (cs & inp_chars) and len(orphan) < sample_limit:
                orphan.append((i, p))

    if ratios:
        avg = sum(ratios) / len(ratios)
        full = sum(1 for r in ratios if r >= 0.999)
        print("条目级覆盖率:平均 %.1f%%,完全覆盖的样本 %d/%d(%.1f%%)"
              % (avg * 100, full, len(ratios), full / len(ratios) * 100))
        if avg < 0.95:
            warns.append("平均条目覆盖率 %.1f%% 偏低,说明有 input 条目在 output 里没被提到" % (avg * 100))
    else:
        print("条目级覆盖率:input 未使用编号/项目符号,跳过该项检查")

    if mismatched:
        warns.append("以下样本的条目数与短语数对不上(前 %d 条):" % len(mismatched))
        for i, a, b in mismatched:
            warns.append("    第 %d 条 → input %d 条目 / output %d 短语" % (i, a, b))
    if orphan:
        warns.append("以下短语与原文没有任何共同字符,疑似凭空添加(前 %d 条):" % len(orphan))
        for i, p in orphan:
            warns.append("    第 %d 条 → 「%s」" % (i, p))
    return warns


# ---------------------------------------------------------------------------
# C. 长度分布直方图
# ---------------------------------------------------------------------------
def histogram(values, bins=10, width=46, title="分布"):
    """纯文本直方图,方便直接贴进终端日志。"""
    if not values:
        return
    lo, hi = min(values), max(values)
    if lo == hi:
        print("%s:全部等于 %d" % (title, lo))
        return
    step = (hi - lo) / bins
    counts = [0] * bins
    for v in values:
        idx = min(bins - 1, int((v - lo) / step))
        counts[idx] += 1
    peak = max(counts) or 1
    print("\n%s(共 %d 条)" % (title, len(values)))
    for b in range(bins):
        left = lo + step * b
        right = lo + step * (b + 1)
        bar = "#" * int(counts[b] / peak * width)
        print("  %7.0f ~ %7.0f | %-*s %d" % (left, right, width, bar, counts[b]))


def check_length(data, cutoff):
    """按字符估算长度;中文场景下 1 字符 ≈ 1 token 是个偏保守的估计。"""
    warns = []
    lens = []
    over = 0
    for item in data:
        if not isinstance(item, dict):
            continue
        total = len(item.get("instruction") or "") + len(item.get("input") or "") \
            + len(item.get("output") or "")
        lens.append(total)
        if total > cutoff:
            over += 1
    if lens:
        lens_sorted = sorted(lens)
        p95 = lens_sorted[min(len(lens_sorted) - 1, int(len(lens_sorted) * 0.95))]
        print("\n三字段合计长度:中位 %d,p95 %d,最长 %d(字符)"
              % (lens_sorted[len(lens_sorted) // 2], p95, lens_sorted[-1]))
        histogram(lens, title="长度直方图")
        if over:
            warns.append("有 %d 条(%.1f%%)超过 cutoff_len=%d,训练时尾部会被截断,"
                         "被截掉的正好是 output —— 要么调大 cutoff_len,要么把长样本拆开"
                         % (over, over / len(lens) * 100, cutoff))
    return warns


# ---------------------------------------------------------------------------
# D. 重复与冲突
# ---------------------------------------------------------------------------
def check_duplicate(data):
    warns = []
    whole = Counter()
    by_input = defaultdict(set)
    for item in data:
        if not isinstance(item, dict):
            continue
        key = (item.get("instruction"), item.get("input"), item.get("output"))
        whole[key] += 1
        by_input[item.get("input")].add(item.get("output"))

    dup = sum(c - 1 for c in whole.values() if c > 1)
    if dup:
        warns.append("完全重复的样本 %d 条 —— 重复会让模型对这部分过拟合" % dup)

    conflict = [k for k, v in by_input.items() if len(v) > 1]
    if conflict:
        warns.append("同一 input 对应多个不同 output 的有 %d 组 —— 标注冲突,模型会学得摇摆" % len(conflict))
    return warns


def main():
    ap = argparse.ArgumentParser(description="指令微调数据集体检")
    ap.add_argument("path", help="数据集 JSON 路径")
    ap.add_argument("--cutoff", type=int, default=1024, help="训练配置里的 cutoff_len")
    ap.add_argument("--strict", action="store_true", help="把警告也当作不通过")
    args = ap.parse_args()

    with open(args.path, "r", encoding="utf-8") as f:
        data = json.load(f)

    print("=" * 62)
    print("数据集:%s" % args.path)
    print("=" * 62)

    errors, warns = check_fields(data)
    if not errors:
        warns += check_coverage(data)
        warns += check_length(data, args.cutoff)
        warns += check_duplicate(data)

    print("\n" + "-" * 62)
    if errors:
        print("致命问题 %d 项:" % len(errors))
        for e in errors[:40]:
            print("  [x] " + e)
    if warns:
        print("警告 %d 项:" % len(warns))
        for w in warns[:60]:
            print("  [!] " + w)
    if not errors and not warns:
        print("全部通过,可以开训。")

    bad = bool(errors) or (args.strict and bool(warns))
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
$ python3 check_dataset.py qwen_dataset.json --cutoff 1024
==============================================================
数据集:qwen_dataset.json
==============================================================
条目级覆盖率:平均 100.0%,完全覆盖的样本 4/4(100.0%)

三字段合计长度:中位 106,p95 156,最长 156(字符)

长度直方图(共 4 条)
       93 ~      99 | ############################################## 2
       99 ~     106 |                                                0
      106 ~     112 | #######################                        1
      ...
      150 ~     156 | #######################                        1

--------------------------------------------------------------
全部通过,可以开训。判据本身是错的。标注的本职就是概括,字面对不上恰恰说明概括做对了。改成条目级覆盖——数原文有几个编号条目,比对成品给了几个短语——同一批样本立刻变成 100%。
留下的教训:校验脚本误报比不报更危险,因为它会逼着标注员去迎合一个错的规则,把正确的概括改成机械的复制。
脚本里仍然保留了一条最保守的编造信号:短语与原文一个字符都不沾时才报出来。这条规则不会误伤概括(「多喝水」和原文共享「水」字),只会抓到真正凭空添加的内容。
4.6 把数据集登记到菜单上
菜做好了,还得上菜单,训练框架才找得到。LLaMA-Factory 靠 data/dataset_info.json 这个登记表定位数据集——在文件尾部追加一段键值对即可:
 "qwen_dataset": {
    "file_name": "qwen_dataset.json"
  },
两个字段各管一头:
| 位置 | 含义 | 谁来引用它 |
|---|---|---|
键名 "qwen_dataset" | 数据集名称 | 训练配置 yaml 里 dataset: 填的就是它。两边对不上,训练直接报找不到数据集 |
"file_name" | 数据集文件 | 框架去 data/ 目录下找这个文件。放在别处就要在训练时用 --dataset_dir 指定目录 |
如果数据落的是 JSON Lines,写法一样,只是 file_name 指向 .jsonl:
{
  "chat-train": {
    "file_name": "train.jsonl"
  }
}
对应的数据文件每行一个对象:
{"instruction": "提出问题1", "input": "", "output": "对应的答案1"}
{"instruction": "提出问题2", "input": "", "output": "对应的答案2"}dataset_info.json 里本来有上百个内置数据集条目,直接覆盖会把它们全删掉。要追加,不要覆盖。二、追加时漏了逗号。 在最后一个条目后面直接粘一段,JSON 立刻解析失败。粘完务必跑一次
python3 -c "import json;json.load(open('data/dataset_info.json',encoding='utf-8'))"。三、字段名与 alpaca 默认不一致却没写
columns 映射。 你的文件里叫 prompt/query/response,框架默认找 instruction/input/output,读出来全是空的——训练照常跑完,loss 也在降,但学到的是噪声。
4.7 技术路线全景与项目指标
数据备齐、菜单登记完,立项会的活就干完了。往后的路线全景长这样:
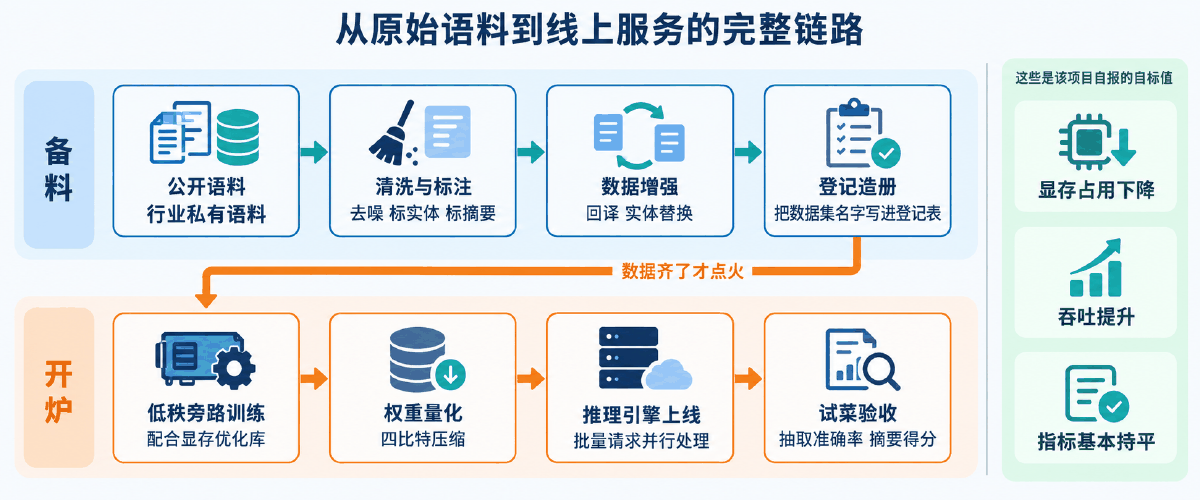
| 阶段 | 技术选择 | 这一步解决什么 |
|---|---|---|
| 训练 | LoRA + DeepSpeed | 冻结主干参数,只训低秩矩阵,显存降下来;配合 ZeRO 显存优化与梯度检查点,把训练塞进有限的卡里 |
| 压缩 | LoraQ + GPTQ | LoraQ 针对 LoRA 适配器做 4-bit 量化,压缩微调参数体积;GPTQ 对主干做 4-bit 权重量化,换来推理提速与显存下降 |
| 部署 | vLLM | 基于 PagedAttention 支持批量请求并行处理,把吞吐量顶上去 |
项目给出的性能指标如下。这是该项目在自己的数据和硬件上报出的目标 / 实测值,不是这条技术路线的普适结论——换一份数据、换一张卡、换一个 batch 配置,数字都会变:
| 指标 | Qwen-7B(原始) | Qwen-7B(量化+LoRA) | 怎么读这一行 |
|---|---|---|---|
| 显存占用(推理) | 16GB | 6GB | 降到原来的三分之一多一点,意味着从 A10 级别的卡下放到消费级显卡 |
| 吞吐量(tokens/s) | 120 | 320 | 快到约 2.7 倍。这里同时吃到了量化和推理引擎两份红利,不能全记在量化头上 |
| 实体识别 F1 | 92.1% | 91.5% | 掉了 0.6 个点。这就是为什么 2.5 节要求先画合格线——掉多少算可以接受,必须提前定 |
| 摘要 ROUGE-L | 78.3 | 77.8 | 掉了 0.5。与 F1 一起看,说明压缩的代价是均匀的,没有某一类任务被打崩 |
05骨架模板:拿去改就能用
一份样本模板、一份登记表模板,改完 TODO 就能接上训练
5.1 样本模板
发给标注员的那「一页纸」就是它。前四条是标好的范例,最后一条留着 TODO 占位,写清楚每一栏的约束——标注员照着填,不用再去读规范文档。
[
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "保持身体健康的五个方法:\n\n1. 每天至少饮用8杯水,促进新陈代谢\n2. 每周进行150分钟中等强度运动,如快走或游泳\n3. 保证7-9小时高质量睡眠,避免熬夜\n4. 饮食中增加蔬菜水果比例,减少油炸食品\n5. 定期体检,监测血压、血糖等指标",
    "output": "多喝水、规律运动、充足睡眠、均衡饮食、定期体检"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "提高学习效率的三个技巧:\n\n1. 使用番茄工作法,每25分钟专注后休息5分钟\n2. 建立思维导图整理知识框架\n3. 睡前复习重点内容加强记忆",
    "output": "番茄工作法、思维导图、睡前复习"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "旅行必备物品清单:\n1. 护照/身份证原件及复印件\n2. 便携充电宝和转换插头\n3. 常用药品(退烧药、创可贴)\n4. 轻便折叠雨伞\n5. 分装洗漱用品",
    "output": "证件、充电设备、药品、雨具、洗漱包"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "职场沟通四大原则:\n① 明确沟通目标\n② 使用金字塔表达结构\n③ 注意非语言信号(眼神/姿态)\n④ 及时确认信息理解度",
    "output": "目标明确、结构化表达、非语言交流、信息确认"
  },
  {
    "instruction": "请提取以下内容中的摘要信息",
    "input": "TODO 把待处理的原文贴到这里。要求:\n1. 保留原文的换行与编号,不要压成一行\n2. 每条内容是动宾短语,带细节描述\n3. 长度控制在 cutoff_len 之内,中文按 1 字 ≈ 1 token 估",
    "output": "TODO、顿号分隔的核心短语、必须 100% 覆盖 input 条目、不加原文没有的信息"
  }
]
| 改哪里 | 改成什么 |
|---|---|
| 前四条范例 | 换成你自己业务里的真实样本。范例的作用是定调,标注员会不自觉地模仿它们的颗粒度——范例给 5 个短语,后面标出来的普遍就是 5 个左右 |
instruction | 换成你任务的那一句祈使句,然后全文件统一。改了就得全部改,不能只改一条 |
最后一条 TODO | 正式使用时整条删掉。它只是给标注员看约束用的,留在训练数据里等于喂了一条垃圾样本 |
5.2 登记表模板
对应 LLaMA-Factory 的 data/dataset_info.json。它不是用来覆盖官方文件的,而是给你看清楚三种写法分别长什么样,然后把需要的那段追加过去。
{
  "_说明": [
    "这份文件对应 LLaMA-Factory 的 data/dataset_info.json。",
    "不要整份覆盖官方文件 —— 官方文件里已有上百个内置数据集条目,",
    "把下面 TODO 之后的键值对追加到文件尾部即可(注意前一条要补逗号)。",
    "键名 = 训练 yaml 里 dataset 字段要填的名字;file_name = data/ 目录下的实际文件名。",
    "正式使用时把本段 _说明 删掉,JSON 里留着它不会报错但没意义。"
  ],

  "qwen_dataset": {
    "file_name": "qwen_dataset.json"
  },

  "TODO_你的数据集名": {
    "file_name": "TODO_你的文件名.json",

    "_可选项1": "数据文件放在 data/ 下时只写文件名;放别处则在训练时用 --dataset_dir 指定目录",
    "_可选项2": "字段名与 alpaca 默认不一致时,用 columns 做映射,例如下面这段",

    "columns": {
      "prompt": "instruction",
      "query": "input",
      "response": "output"
    }
  },

  "chat-train": {
    "file_name": "train.jsonl",
    "_说明": "jsonl 形式的写法:每行一个 {instruction, input, output} 对象,file_name 指向 .jsonl 即可"
  }
}
| 模板里的段落 | 什么时候用它 | 注意 |
|---|---|---|
"qwen_dataset" | 最常见的情况:JSON 数组,字段名就是标准三字段 | 两行就够,不需要写 columns |
"TODO_你的数据集名" | 字段名与标准不一致时 | 用 columns 把你的字段名映射到 prompt / query / response 上 |
"chat-train" | 数据是 JSON Lines | file_name 指向 .jsonl,文件内容必须真的是一行一个对象 |
_说明 字段 | 仅供阅读 | 正式使用时删掉。留着不会报错,但没有意义 |
sample_dataset.template.json 定标注规范,发给标注员 · ② 标注结果整理成 JSON Lines 原始语料 · ③ build_dataset.py --raw 原始.jsonl --out qwen_dataset.json · ④ check_dataset.py qwen_dataset.json --cutoff 1024,退出码 0 才往下走 · ⑤ 把数据集文件放进 data/,照登记表模板追加一段到 dataset_info.json。做完这五步,训练配置里
dataset: 填上你的键名就能点火了。
check_dataset.py 有致命问题时退出码为 1,加 --strict 时警告也算不通过。把它串进流水线时记得判断退出码,别只看屏幕输出——体检不通过还硬训,等于明知食材有问题还是端上桌了。
06易错点汇总
按「立项 / 选型 / 标注 / 构造 / 注册 / 验收」六类归并,每一条都会在训练日志里静默通过
⚠️ 一、立项阶段
- 把知识型缺口当成微调需求。 「模型不知道我们公司的报销标准」不是微调能解决的。判断方法:把答案贴进提示词,模型能答对就说明它缺知识,该上 RAG;贴了还是不按格式输出,才是微调的活。
- 四件事没定完就开训。 训到一半改指令句式、改分隔符、换基座,前面烧掉的算力全部作废。这不是「再调一下」,是从头再来。
- 只算显卡钱,不算标注钱。 微调真正的成本大头是成对标注的整理工作量,通常远超训练本身。立项时把标注人天漏掉,项目一定延期。
- 没留独立评测集。
val_size: 0.1划出来的是验证集,训练过程中每轮都会看到它。拿它报验收分数,只能证明模型记住了这批数据。
⚠️ 二、基座选型
- 照着对比表从上往下挑「看起来不错的」。 表是死的,判断链是活的:先问跑在什么设备上(定上限),再问任务属于哪一类(定下限),最后问要不要更高质量(定要不要付多卡的钱)。
- 以为越大越好。 转换型任务上尺寸的边际收益掉得极快,7B 换 14B 可能只涨一两个点,显存却翻倍。真正能拉高指标的几乎永远是数据质量。
- 拿推理显存去准备训练机器。 表里 7B 写
≥10GB指的是推理;同一个 7B 全量微调实测 42.18GB。按推理显存备机,一开训就撞CUDA out of memory。 - 先上大模型再调流程。 正确顺序是拿最小尺寸把数据管线和训练流程整条跑通,再换目标尺寸。反过来,一个字段名写错就浪费几小时。
- 换了基座忘了换
template。 模板与基座必须匹配,合并 Qwen2 权重时template务必设为qwen。模板不对,训练不报错,但对话格式全错。
⚠️ 三、标注阶段
- 指令句式每人一套。 「请提取以下内容中的摘要信息」「帮我总结一下」「提炼要点」混在一起,模型学到的是「指令栏随便写」,任务映射反而散了。用
build_dataset.py输出里的「instruction 种类数」盯住这一点,不是 1 就有人写飘了。 - 分隔符一半顿号一半逗号。 上线后输出的分隔符随机漂移,下游按顿号切分的代码全部失效。
- 漏标条目。 原文列了 5 条只标 3 条,等于在教模型「漏掉两条也算对」。条目级覆盖率就是抓这个的。
- 标注里加了原文没有的信息。 抽取类任务的底线。出现一次,模型就学会了幻觉——而在金融、医疗场景里这是事故级的。
- 改写了
input。 把换行压成一行、把编号删掉、把全角改半角,都会削弱模型判断条目边界的能力。input只许strip(),不许重写。 - 脱敏拖到训练前才做。 权重训进去之后没有任何办法单独删除某条信息,只能整个重训。脱敏必须砍在语料入库那一刻。
⚠️ 四、增强与构造
- 回译没锁住专有名词和数字。 「8 杯水」回译成「一些水」,标注立刻对不上,制造出一条错误样本。
- 实体替换只换了原文没换标注。 原文里的公司名换了,
output里还留着旧的,等于亲手造了一条「编造」样本,比不增强更糟。 - 增强样本混进了评测集。 增强样本与训练样本同源,拿去评测分数会虚高。增强只服务训练集,界线要在切分那一步就划。
- 不做长度过滤。 超长样本的尾部被
cutoff_len截掉,截掉的正好是排在最后的output。样本看着在,实际是一道没答案的题,而训练日志上一点异常都不会有。 json.dump忘了ensure_ascii=False。 中文全变成\u5b66\u4e60,框架读得了,人复查不了,标注错误从此没法用肉眼发现。- 把清洗和构造混在一步做。 出问题时分不清是清洗规则错了还是构造逻辑错了。清洗属于语料入库,构造属于生成样本,两件事分开。
⚠️ 五、注册数据集
- 整份覆盖
dataset_info.json。 官方文件里有上百个内置条目,覆盖了就全没了。要追加,不要覆盖。 - 追加时漏逗号。 在最后一个条目后直接粘一段,JSON 解析立刻失败。粘完跑一次
python3 -c "import json;json.load(open('data/dataset_info.json',encoding='utf-8'))"。 - 键名与训练配置里的
dataset:对不上。 直接报找不到数据集,这个反而是好事——报错总比静默出错强。 - 字段名不标准却没写
columns映射。 这条最阴:框架读出来全是空,训练照常跑完,loss 也在降,学到的却是噪声。 - 文件内容是数组,文件名写成
.jsonl(或反过来)。 两种格式都行,但一个项目只能选一种,且后缀要和内容对得上。
⚠️ 六、验收与指标
- 校验脚本误报。 用「短语的字必须出现在原文里」算覆盖率,会把正确的概括全判成编造——「每天至少饮用 8 杯水」标成「多喝水」,字面覆盖率只有 0.33。误报比不报更危险,它会逼标注员把正确的概括改成机械的复制。
- 把项目自报的指标当普适结论。 显存 16GB→6GB、吞吐 120→320、F1 92.1%→91.5%、ROUGE-L 78.3→77.8,都是该项目在自己的数据和硬件上的数字。换数据、换卡、换 batch 配置,数字全会变。
- 只盯 F1 不做人工抽检。 编造在 F1 上可能只掉一两个点,但在金融、医疗业务里是致命的。抽 100 条逐条看有没有原文没有的信息,这一步没法用指标替代。
- 先定压缩方案再看掉了多少分。 顺序反了。该先定「业务能接受掉几个点」,再去挑满足这个约束的压缩力度。
07自测题
点击题目展开答案;这 12 题答得下来,立项会就能自己主持了
动手训练之前必须钉死哪四件事?顺序能不能换?
任务边界 → 基座选型 → 数据格式 → 评价指标,顺序不能换。边界决定任务难度,难度决定要多大的基座;基座的上下文长度上限反过来卡住原文能写多长;指标必须贴着输出格式定——输出是顿号短语才可能用抽取 F1,输出是整段摘要就得换 ROUGE-L。倒过来定一定互相打架。
怎么判断一个需求该用微调、RAG 还是提示词?
把答案直接贴进提示词试一次。模型能答对,说明它缺的是知识,上 RAG(文档会更新,焊进权重的话改一份文档就要重训一次);贴了答案还是不按你要的格式输出,那才是行为型缺口,归微调;只是想让它客气点、分点作答,一句系统提示词就够了。实时数据(股价、天气、库存)任何训练方式都追不上,归 Function Call。
微调项目最大的成本项通常是什么?
标注,不是显卡。几千条高质量成对样本的整理工作量通常远超训练本身。这也是为什么要在立项会上就把数据格式定死——格式定错,标注返工的代价是成倍的。
基座选型的判断链是哪三问?每一问砍掉什么?
问 1「跑在什么设备上」定上限——要塞进手机或 IoT,就只能在 0.5B~1.8B 里选,后两问都不用问。问 2「任务属于哪一类」定下限——摘要、抽取、分类这类转换型任务,7B 是性价比甜点;法律医疗这类长链条推理、术语密集的才值得上 14B。问 3「要不要更高质量」定要不要付多卡的钱——要且有多卡上 72B,要但只有一张卡就走 MoE 稀疏激活。本项目三问答下来唯一剩余项就是 Qwen-7B。
Qwen 1.0 为什么被本项目直接排除?
看上下文长度那一行。1.0 是 4k~32k tokens,而本项目要处理法律文书、科研文献这类原文动辄数千字的场景,4k 起步的档位不够用。选代次就是看这一行;选量化路线看「推理效率优化」那一行;商用合规看「开源协议」那一行。
参数量对照表里 Qwen-7B 写「显存 ≥10GB」,为什么按它备机会出事?
因为那是推理显存。同一个 7B 模型训练要贵得多——全量微调实测 42.18GB、LoRA 20.17GB、QLoRA 10.97GB。按 10GB 备训练机,一开训就撞 CUDA out of memory。
「MoE 激活参数量 1.8B,等效 14B」这句话怎么理解?
模型总参数很大,但每次前向只激活其中一小部分专家,所以算得像 1.8B 那么快、答得像 14B 那么好。代价是总参数仍要装进显存——省的是算力不是全部存储。就像后厨挂了二十口锅,每道菜只点着两口。
instruction 为什么要全数据集固定成同一句?
为了让模型建立稳定的任务映射关系。映射建稳之后,实际应用时用户即使换了说法(「请总结以下要点」「帮我提炼一下」),模型仍能正确响应。反过来,训练时指令就有十几种写法,模型学到的是「指令这一栏随便写什么都行」,映射反而散了。写法上要用祈使句,并且与后面的 input 连起来是一句完整的话。
output 的六条约束分别是什么?
① 从 input 中提炼核心名词 / 动宾短语,不写成整句;② 用中文顿号「、」分隔;③ 无顺序要求(除非原文有优先级);④ 平均 3~5 个短语;⑤ 100% 覆盖 input 条目;⑥ 不添加原文未提及的信息。最后两条是质量控制的核心,前四条是形态约束。
原文写「每天至少饮用 8 杯水,促进新陈代谢」,标注成「多喝水」,算不算违反「100% 覆盖」?
不算,这是正确的概括。覆盖率是条目级的——原文列了几条,成品就要给几个短语——不是要求短语的字必须出现在原文里。标注的本职就是概括,字面对不上恰恰说明概括做对了。把覆盖率理解成字面包含,做出来的校验脚本会把正确标注全判成编造(这条样本的字符覆盖率只有 0.33)。
为什么 input 里的换行和编号一个都不能删?
「1. 2. 3.」「① ② ③」这些结构信号是模型判断原文列了几条的依据,也是条目级覆盖率的分母来源。压成一行会直接削弱模型的条目对齐能力。input 只许 strip() 去首尾空白,正文一个字都不许改写。
为什么 build_dataset.py 把 MAX_INPUT_CHARS 定成 900 而不是 1024?
训练配置里 cutoff_len: 1024,中文按 1 字符 ≈ 1 token 保守估,还要给 instruction 和 output 留位置,所以给原文留 900、余量 100 多。这个数是从训练参数倒推的,不是拍脑袋定的。不做这个过滤,超长样本的尾部会被截断,而被截掉的正好是排在最后的 output——样本还在,实际是一道没答案的题,训练日志上看不出任何异常。
把数据集注册到 dataset_info.json 时,最阴的一个坑是什么?
字段名不标准却没写 columns 映射。你的文件里字段叫 prompt/query/response,框架默认找 instruction/input/output,读出来全是空——但训练照常跑完,loss 也在降,学到的却是噪声。相比之下「键名与 yaml 里的 dataset: 对不上」反而是好事,它会直接报错。另外两个高频事故是整份覆盖官方文件(会删掉上百个内置条目,要追加不要覆盖)和追加时漏逗号。
回译和实体替换各自撑开了什么?各自最容易出什么事?
回译撑开句式与措辞的多样性,让模型明白「同一个意思换个说法,该抽的短语还是那几个」;风险是它会改写原文用词,专有名词、数字、单位必须锁住不译,否则「8 杯水」可能变成「一些水」,标注立刻对不上。实体替换撑开实体覆盖面,防止模型把某个具体实体名和某种输出模式绑死;风险是标注必须跟着一起换,原文换了而 output 里还留着旧实体,就亲手造了一条编造样本。另外,增强样本一律不许进评测集。
项目报出「显存 16GB→6GB、吞吐 120→320、F1 92.1%→91.5%」,该怎么向别人转述这组数字?
要说明这是该项目在自己的数据和硬件上报出的目标 / 实测值,不是这条技术路线的普适结论——换数据、换卡、换 batch 配置,数字都会变。这张表真正该记住的是它的形状:左边是成本(显存、吞吐),右边是质量(F1、ROUGE-L),压缩永远是拿右边换左边。立项时该判断的是「业务能接受右边掉几个点」,再去挑满足这个约束的压缩力度。另外吞吐 120→320 同时吃了量化和推理引擎两份红利,不能全记在量化头上。
附术语表
这一页出现过的名词,一句话说清各自管什么
| 术语 | 一句话解释 |
|---|---|
| 指令微调 Instruction Tuning | 用「指令 + 输入 + 期望输出」成对样本训练模型,让它学会按指令办事。本项目的数据格式就是它的标准形态。 |
instruction | 三字段之一,说明要执行的任务类型。全数据集固定一句祈使句,用来建立稳定的任务映射。 |
input | 三字段之一,待处理的原始文本。只许 strip(),保留换行与编号。 |
output | 三字段之一,期望结果。顿号分隔的核心短语,100% 覆盖原文条目,不加原文没有的信息。 |
cutoff_len | 训练时输入序列的最大 token 长度,超出部分被截断。本项目取 1024,它反向决定了原文能写多长。 |
val_size | 从训练集里划出来做验证的比例(本项目 0.1)。它不是验收用的评测集——验证集训练中每轮都会被看到。 |
dataset_info.json | LLaMA-Factory 的数据集登记表,位于 data/ 下。键名是数据集名称,file_name 指向实际文件。只能追加,不能覆盖。 |
columns | 登记表里的字段映射。当你的字段名不是标准三字段时,用它映射到 prompt / query / response。 |
| JSON Lines | 一行一个 JSON 对象的文件格式,后缀 .jsonl。适合大数据量,可流式读取。与 JSON 数组二选一,一个项目内不要混用。 |
| CN-DBpedia | 中文实体识别公开数据集,本项目用来给抽取能力打底。 |
| LCSTS | 中文短文本摘要公开数据集,本项目用来给摘要能力打底。 |
| 回译 Back Translation | 原文译成外语再译回来,得到说法不同、意思相同的新样本。撑开句式多样性,但要锁住专有名词和数字。 |
| 实体替换 Entity Swapping | 把原文里的实体换成同类型的另一个。撑开实体覆盖面,标注必须跟着一起换。 |
| F1 | 精确率与召回率的调和平均。本项目的主指标,因为输出本来就是一个短语集合,适合用集合指标去量。 |
| ROUGE-L | 按最长公共子序列(LCS)衡量生成摘要与参考摘要的重合度。本项目的辅指标,用来盯住输出会不会越写越长。 |
| LoRA | 冻结主干参数、只训练低秩旁路矩阵的微调方法,大幅降低显存与训练参数量。原理见下一页。 |
| DeepSpeed | 微软开源的大规模训练优化库,提供 ZeRO 显存分片、Offload、混合精度等能力。详见下一页。 |
| GPTQ | 训练后权重量化方法,把权重压到 4-bit,换来推理提速与显存下降,代价是少量精度损失。 |
| LoraQ | 针对 LoRA 适配器本身做的 4-bit 量化,压缩微调参数体积。 |
| vLLM | 高性能推理引擎,基于 PagedAttention 支持批量请求并行处理,用来把线上吞吐顶上去。 |
| MoE 混合专家 | 每次前向只激活一小部分专家的稀疏架构。算得像小模型那么快,答得像大模型那么好,但总参数仍要占显存。 |
template | 对话模板,必须与基座匹配。Qwen 系列一律填 qwen;填错不报错,但对话格式全乱。 |