【案例】大健康行业智能问诊系统 · 语料与数据集构建
模型的上限在数据这一侧就定死了:先把原始问答脱敏去重,再构造成只对答案计分的指令样本。
30″30 秒看懂数据这一侧
上一讲那位通才毕业生要去导诊台上岗了。他缺的不是脑子,是一本岗前教材——上百张「病人这样问、就该这样答」的标准应答卡。这一讲干的就是编教材这件事。
教材的原料是科室里那本乱糟糟的旧值班本:字迹潦草、格式各异、有的记了半句、还夹着病人的姓名和电话。要把它变成能用的教材,得走四道工序——先把姓名电话涂黑,再统一成同一种卡片格式,然后抽出一小叠封存起来当期末考卷,剩下的才是平时练习册。
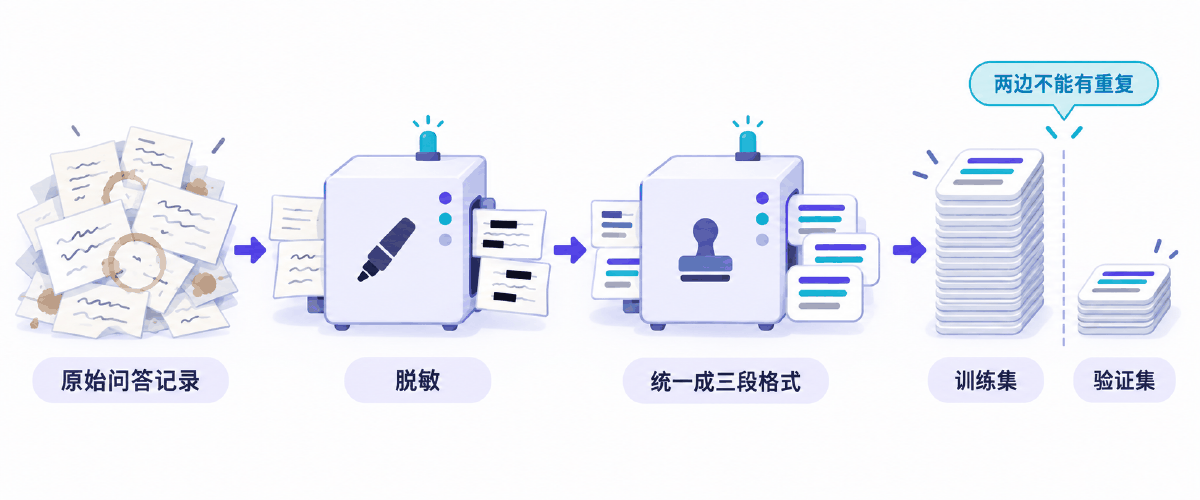
| 比喻里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 旧值班本 | 原始问答记录 | 格式不统一、长度参差、含个人信息的一手语料 |
| 把姓名电话涂黑 | 去标识化 | 清掉姓名、电话、证件号、住址等字段,在任何数据离开原始库之前完成 |
| 标准应答卡 | 三段式指令样本 | instruction / input / output,全库同一种结构 |
| 卡片正面的问题 | 提示词部分 | 是条件,标签置 -100,不参与计分 |
| 卡片背面的答案 | output 部分 | 唯一参与计算损失的部分,模型要学的就是它 |
| 平时练习册 | 训练集 | 反复做、允许背下来 |
| 期末考卷 | 验证集 | 封存,只在每轮结束时开封判分 |
这一讲的顺序就是这四道工序:先统计(不统计就定不了截断长度)、再脱敏、再构造、最后划分并验证。每一道都配一份能直接跑的脚本,跑出来的数字就是下一道工序的输入。
01概念:这份语料特殊在哪
问诊语料与通用指令语料的差别、样本量的底线、以及这个系统能力边界的技术定义
1.1 问诊语料的三个特点
同样是「一问一答」,医疗问诊的语料和写周报、改代码那类通用指令数据有三处结构性差别,每一处都会反过来影响后面的训练配置。
| 特点 | 具体表现 | 对下游的影响 |
|---|---|---|
| 问短答长 | 实测问题平均 35 字,答案平均 72.7 字 | 答案是问题的两倍长,而只有答案参与计分,所以有效计分长度比直觉中长得多 |
| 长度分布拖尾 | 大部分样本很短,少数特别长 | 按最长样本定 max_length 会让绝大多数批次在补空位,必须按分位数取值 |
| 含个人信息 | 姓名、年龄、电话、就诊号混在自由文本里 | 去标识化是前置工序,不是收尾工作;漏一条就是一次真实的信息泄露 |
第三点值得单独强调:去标识化必须发生在数据离开原始库之前。一旦带着个人信息的语料被复制到训练目录、被打包成 jsonl、被喂进显卡,它就已经扩散了,后面再清是清不干净的。
1.2 样本要多少条才够
这是最常被问、也最容易被糊弄过去的问题。诚实的回答是:取决于你要模型学的是什么。
| 要学的东西 | 大致量级 | 为什么 |
|---|---|---|
| 固定的输出格式 | 几十 ~ 几百条 | 格式是强模式,重复几十次模型就能稳定复现 |
| 某种语气与措辞习惯 | 几百 ~ 几千条 | 风格比格式松散,需要更多样例才能收敛 |
| 一个领域的表达方式 | 几千条以上 | 要覆盖足够多的问法和场景,否则一换问法就垮 |
| 大量具体事实 | 再多也不合适 | 这是检索该干的活。微调学不牢零散事实,堆数据也解决不了 |
1.3 把能力边界写进技术设计
这个系统学到的是「一段健康科普该怎么组织」——用什么结构、什么措辞、什么详略去回应一个身体不适的描述。它学到的不是诊断能力:训练数据里没有检查结果、没有体征、没有病史,模型也没有任何手段去核实它说出口的内容。
所以在产品形态上,它的输出是导诊参考信息,不构成诊疗建议,必须保留一条随时转人工的通道。这句话不是贴在页面角落的免责声明,它是一组具体的技术约束,会直接落到代码里:
| 边界 | 落到哪一层 | 具体做法 |
|---|---|---|
| 不给确定性结论 | 数据侧 | 构造样本时就把「确诊是 X」这类表述筛掉,不让模型有样学样 |
| 不给处方剂量 | 数据侧 + 服务侧 | 训练数据里剔除;上线后再加一道规则拦截 |
| 急症要升级 | 服务侧 | 在模型生成之前就识别,命中直接给急救指引,不走模型 |
| 可转人工 | 产品侧 | 兜底话术里始终保留人工入口 |
这一讲负责的是表里的「数据侧」那两行——把不该学的东西在源头就挡掉。服务侧那两道闸门留到最后一讲。
02原理:四道工序各自在解决什么
统计、脱敏、构造、划分,以及贯穿其中的标签屏蔽与截断长度
2.1 四道工序的顺序不能换
这四步之间是有依赖的,顺序错了会白做返工。
| 工序 | 输入 | 产出 | 为什么排在这个位置 |
|---|---|---|---|
| ① 统计 | 原始记录 | 长度分布、异常样本清单 | 不统计就定不了截断长度,也不知道该清掉哪些脏数据 |
| ② 脱敏 | 原始记录 | 去标识化文本 | 必须在数据离开原始库之前完成,越晚做扩散面越大 |
| ③ 构造 | 脱敏文本 | 三段式样本 | 格式统一之后才谈得上批处理 |
| ④ 划分 | 三段式样本 | 训练集 / 验证集 | 必须在去重之后划分,否则重复样本会同时落到两边,直接造成泄漏 |
最后一行是最容易踩的:先划分再去重,看起来只是顺序问题,实际会让验证集失效——同一条内容的两个副本分别落进两个集合,模型在训练集上背下来,到验证集上正好答对。
2.2 去标识化要清哪些字段
「脱敏」不是把名字换成「某某」就算完。要清的是一切能单独或组合起来指向具体某个人的信息。
| 类别 | 例子 | 处理方式 |
|---|---|---|
| 直接标识 | 姓名、身份证号、手机号、就诊卡号 | 整段替换为占位符,不保留任何位数或格式线索 |
| 准标识 | 精确年龄、生日、详细住址、单位名 | 年龄归入区间,住址只保留到城市级 |
| 时间 | 具体就诊日期、住院时间 | 改为相对表述(「三天前」),去掉绝对时间点 |
| 罕见特征 | 极罕见病名 + 地区的组合 | 组合起来就可能锁定到人,这类要人工复核 |
2.3 只对答案计分
一条样本送进模型时,提示词和答案是拼在同一个序列里的。模型在每个位置都会预测下一个 token,但我们只希望它为「答案说得对不对」负责。实现方式是把提示词位置的标签置成一个特殊值 -100。
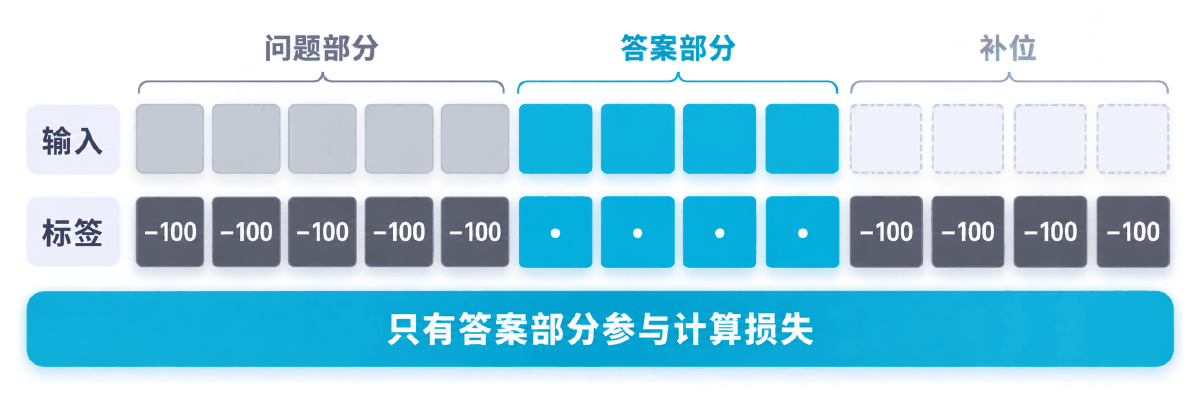
| 位置 | 输入里放什么 | 标签放什么 | 效果 |
|---|---|---|---|
| 问题部分 | 真实 token | -100 | 模型读得到,但答错不扣分 |
| 答案部分 | 真实 token | 真实 token | 唯一计分的区间 |
| 补位 | 填充 token | -100 | 不让补位污染损失 |
-100 这个数不是随便选的,它是 PyTorch 交叉熵损失的默认 ignore_index——遇到这个值就跳过该位置。所以不需要自己写掩码逻辑,把标签填对就行。
labels 给模型时它内部会自动做这件事,但你自己写评估函数时必须手动对齐,忘了会算出一个偏低且看不出原因的准确率。
2.4 截断长度怎么定
max_length 定小了长答案被砍,定大了每个批次都在为补位烧显存。正确做法是先统计再取分位数。
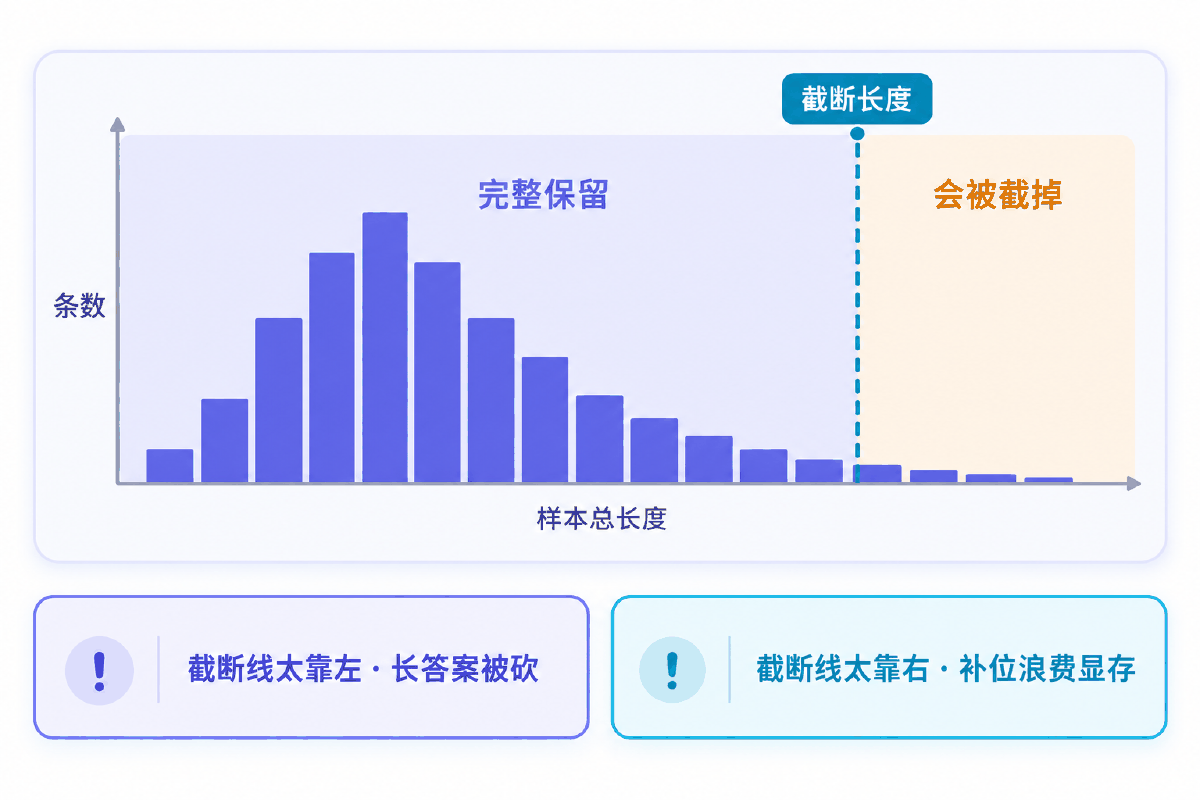
实测这份语料:p90 的总长度是 251,据此推出的建议截断长度是 352(在 p90 基础上留出余量并对齐到较整的数)。如果直接按最长样本取值,实测补位浪费会达到 54.7%——超过一半的算力花在了填空位上。
| 取值策略 | 后果 |
|---|---|
| 按最长样本 | 一条都不截断,但补位浪费极高 |
| 按 p90 ~ p95 留余量 | 推荐。牺牲最长的那几条,换回大部分算力 |
| 按平均值 | 近一半样本的答案被砍掉尾巴,模型会学会说半句话 |
2.5 划分与泄漏
划分本身很简单——打乱、按比例切开。真正要做的是切完之后去证明它没泄漏。
| 检查项 | 怎么查 | 为什么必须查 |
|---|---|---|
| 完全重复 | 两个集合的文本取交集,必须为空 | 最直接的泄漏,一条都不能有 |
| 近似重复 | 去掉标点空格后再取一次交集 | 同一条记录换个标点就绕过了精确匹配 |
| 数量守恒 | 两边条数之和等于去重后总数 | 能挡住切片写错、样本被吞掉的情况 |
| 固定随机种子 | 划分前设定种子 | 不固定的话每次跑出来的验证集都不一样,两次实验的分数不可比 |
最后一项常被忽略:没固定种子的对比实验是没有意义的,你分不清分数变化来自模型改动还是来自换了一批考题。
03最小代码:一条样本的完整变形
从一行原始文本到可以喂进模型的张量,中间只有四步
先不管几百条数据怎么批处理,把一条样本的完整变形过程走一遍。看懂这一条,后面所有批处理代码都只是把它套进循环。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""把「一问一答」的原始语料,改造成带指令的三元组数据集。

原始语料只有问题和答案两列,模型看到的是「这句后面该接哪句」。
加上 instruction 之后,模型学到的是「在这个任务下,这句后面该接哪句」——
同一个底座就能同时承载分诊引导、科室推荐、术语解释几种任务,
而不是把它们混成一锅。

同时在这一步做清洗:去重、长度过滤、答非所问过滤。
清洗必须在划分训练/验证集之前做完,否则重复样本会横跨两边,
验证集分数虚高,而你还以为模型学得很好。

纯标准库,可直接运行。
"""
import hashlib
import json
import os
import re

from corpus_stats import load_pairs
from deidentify import deidentify

HERE = os.path.dirname(os.path.abspath(__file__))
DATA = os.environ.get(
    "MEDICAL_CORPUS",
    os.path.join(HERE, "..", "..", "src", "health-consult-data", "medical_sample.txt"))

# 按问题的说法,判定它属于哪一类任务,配上对应的指令。
# 不写死成一条指令,是因为同一个底座要承载多种任务;
# 也不逐条人工标,用可维护的规则表来分派。
TASK_RULES = [
    (re.compile(r"(就诊科室|挂什么科|看哪个科|哪个科室)"),
     "根据描述判断应当就诊的科室,并说明判断依据。"),
    (re.compile(r"(临床表现|症状有些什么|有什么症状|表现有些什么)"),
     "列出该疾病的常见临床表现。"),
    (re.compile(r"(辅助治疗|治疗有些什么|怎么治疗|如何治疗|手术治疗)"),
     "介绍该疾病常用的治疗手段,供了解,不替代医生处方。"),
    (re.compile(r"(检查|化验|影像学)"),
     "说明该情况通常需要做哪些检查项目。"),
    (re.compile(r"(发病部位|好发部位|病因|发病原因)"),
     "说明该疾病的发病部位或成因。"),
]
DEFAULT_INSTRUCTION = "根据患者的描述给出健康咨询答复,并在需要时提示就医。"

# 明显不该进训练集的答案
BAD_ANSWER = re.compile(r"^(无|暂无|不详|没有|null|none)$", re.I)


def classify(question):
    """给一条问题配一条指令。"""
    for pat, instruction in TASK_RULES:
        if pat.search(question):
            return instruction
    return DEFAULT_INSTRUCTION


def normalize(text):
    """统一空白与全半角标点,让去重能真正去掉「看起来不一样其实一样」的。"""
    text = text.replace("\u3000", " ").strip()
    text = re.sub(r"\s+", " ", text)
    # 原始语料里中英文逗号句号混用,归一化后再算指纹
    for a, b in ((",", ","), (";", ";"), ("?", "?"), ("!", "!")):
        text = text.replace(a, b)
    return text


def fingerprint(question):
    """只按问题算指纹:同一个问题配不同答案,也算重复,只留一条。"""
    return hashlib.md5(normalize(question).encode("utf-8")).hexdigest()


def clean(pairs, min_q=4, min_a=6, max_total=400):
    """返回 (保留的样本, 各类丢弃原因的计数)。"""
    kept, dropped = [], {}
    seen = set()

    def drop(reason):
        dropped[reason] = dropped.get(reason, 0) + 1

    for q, a in pairs:
        q, a = normalize(q), normalize(a)

        # 原始语料里有「小孩发烧又吐怎么办?,无」这类把占位符写进问题的
        q = re.sub(r"[,,]\s*无$", "", q)

        if len(q) < min_q:
            drop("问题过短"); continue
        if len(a) < min_a:
            drop("答案过短"); continue
        if BAD_ANSWER.match(a):
            drop("答案是占位符"); continue
        if len(q) + len(a) > max_total:
            drop("超长"); continue
        if normalize(q) == normalize(a):
            drop("问答相同"); continue

        fp = fingerprint(q)
        if fp in seen:
            drop("重复问题"); continue
        seen.add(fp)

        kept.append((q, a))
    return kept, dropped


def to_records(pairs):
    """产出最终的三元组。

    input 放患者原话,instruction 放任务要求——
    这样换任务时只改 instruction,不用重做数据。
    """
    records = []
    for q, a in pairs:
        q_safe, _ = deidentify(q)
        a_safe, _ = deidentify(a)
        records.append({
            "instruction": classify(q_safe),
            "input": q_safe,
            "output": a_safe,
        })
    return records


def dump_jsonl(records, path):
    with open(path, "w", encoding="utf-8") as f:
        for r in records:
            f.write(json.dumps(r, ensure_ascii=False) + "\n")
    return os.path.getsize(path)


if __name__ == "__main__":
    pairs, broken = load_pairs(DATA)
    print("读入 %d 条,格式异常 %d 段" % (len(pairs), len(broken)))

    kept, dropped = clean(pairs)
    print("\n一、清洗结果")
    print("  保留 %d 条(%.1f%%)" % (len(kept), 100.0 * len(kept) / len(pairs)))
    for reason, n in sorted(dropped.items(), key=lambda kv: -kv[1]):
        print("  丢弃 %-10s %d 条" % (reason, n))

    records = to_records(kept)

    print("\n二、指令分派情况")
    dist = {}
    for r in records:
        dist[r["instruction"]] = dist.get(r["instruction"], 0) + 1
    for ins, n in sorted(dist.items(), key=lambda kv: -kv[1]):
        print("  %3d 条  %s" % (n, ins))

    print("\n三、抽两条最终样本")
    for r in records[:2]:
        print("  " + json.dumps(r, ensure_ascii=False)[:150] + "…")

    out = os.path.join(HERE, "medical_sft.jsonl")
    size = dump_jsonl(records, out)
    print("\n已写出 %s(%d 字节,%d 行)" % (os.path.basename(out), size, len(records)))

    # 同一份输入跑两次必须得到同样的结果,否则划分数据集时会串
    again, _ = clean(pairs)
    assert [q for q, _ in again] == [q for q, _ in kept], "清洗过程不是确定性的"
    print("断言通过:清洗过程可复现")
这份脚本做的事按顺序是:
| 步骤 | 在干什么 |
|---|---|
| ① 读入并切分 | 把一行「问题—答案」拆成两段。格式不规整的行直接丢弃并计数,不要试图猜它原本想表达什么 |
| ② 填三个字段 | instruction 写任务描述,input 放患者原话,output 放应答。全库用同一句任务描述,不要每条都变着花样写 |
| ③ 质量筛 | 丢掉太短的、答案里含确定性结论的、含处方剂量的。这一步是能力边界落到数据侧的地方 |
| ④ 写出 jsonl | 一行一个 JSON 对象。这个格式的好处是可以流式读、可以用 wc -l 数条数,出问题时肉眼就能定位到具体哪一行 |
构造完的样本要拼成模型真正看到的那个序列,并把标签填对。这一步是整个数据侧最容易写错、又最不容易发现写错的地方:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""Dataset + collate_fn:把三元组变成模型真正吃的张量。

两个职责要分清,混在一起是这一步最常见的结构性错误:
  Dataset.__getitem__  只管「第 index 条怎么变成一串 id」,不管长度对齐
  collate_fn           只管「这一批怎么补齐成矩形」,不管单条怎么编码

分开的好处是换 batch_size 不用改编码逻辑,换模板不用改补齐逻辑。
"""
import json
import os

import torch
from torch.nn.utils.rnn import pad_sequence
from torch.utils.data import DataLoader, Dataset
from transformers import AutoTokenizer

HERE = os.path.dirname(os.path.abspath(__file__))
VOCAB = os.environ.get("VOCAB_PATH", "vocab/vocab.txt")
MAX_LEN = int(os.environ.get("MAX_LEN", "352"))

PROMPT_TEMPLATE = (
    "### 指令:\n{instruction}\n\n"
    "### 输入:\n{input}\n\n"
    "### 回复:\n"
)


def load_jsonl(path):
    with open(path, "r", encoding="utf-8") as f:
        return [json.loads(line) for line in f if line.strip()]


class MedicalSFTDataset(Dataset):
    """一条样本 → input_ids + labels。

    labels 与 input_ids 等长,但提示词那一段被置成 -100。
    交叉熵损失会跳过 -100 的位置,所以模型只为「答复」部分负责,
    不会把「### 指令:」这种模板字样也当成要学的目标。
    """

    def __init__(self, records, tokenizer, max_len=MAX_LEN):
        super().__init__()
        self.records = records
        self.tok = tokenizer
        self.max_len = max_len

    def __len__(self):
        return len(self.records)

    def __getitem__(self, index):
        r = self.records[index]
        prompt = PROMPT_TEMPLATE.format(
            instruction=r["instruction"], input=r.get("input", ""))

        # 分别编码,才能知道提示词占了多少个 token。
        # 直接编码拼接好的整句再按字符数去切,中文会切错位置。
        prompt_ids = self.tok.encode(prompt, add_special_tokens=False)
        answer_ids = self.tok.encode(r["output"], add_special_tokens=False)

        # 收尾放一个 [SEP],推理时模型生成到它就知道该停了
        ids = [self.tok.cls_token_id] + prompt_ids + answer_ids + [self.tok.sep_token_id]
        # 开头的 [CLS] 也属于提示词部分,所以屏蔽长度要 +1
        n_mask = 1 + len(prompt_ids)

        labels = [-100] * n_mask + ids[n_mask:]

        # 截断要同时截 ids 和 labels,两边必须等长
        ids, labels = ids[:self.max_len], labels[:self.max_len]

        return {"input_ids": ids, "labels": labels}


def make_collate(pad_id):
    """按批内最长长度补齐。

    注意两个补齐值不一样:
      input_ids 补 pad_id —— 它要能被 embedding 查表,不能是负数
      labels    补 -100   —— 它要能被损失函数跳过
    补反了不会报错,但会让模型努力去预测一堆填充符。
    """
    def collate(batch):
        ids = [torch.tensor(b["input_ids"], dtype=torch.long) for b in batch]
        labs = [torch.tensor(b["labels"], dtype=torch.long) for b in batch]

        input_ids = pad_sequence(ids, batch_first=True, padding_value=pad_id)
        labels = pad_sequence(labs, batch_first=True, padding_value=-100)
        # 注意力掩码:让模型别去注意补出来的位置
        attention_mask = (input_ids != pad_id).long()

        return {"input_ids": input_ids,
                "labels": labels,
                "attention_mask": attention_mask}
    return collate


def get_dataloaders(train_path, valid_path, batch_size=4):
    tok = AutoTokenizer.from_pretrained(VOCAB)
    pad_id = tok.pad_token_id if tok.pad_token_id is not None else 0

    train_ds = MedicalSFTDataset(load_jsonl(train_path), tok)
    valid_ds = MedicalSFTDataset(load_jsonl(valid_path), tok)
    collate = make_collate(pad_id)

    train_loader = DataLoader(train_ds, batch_size=batch_size, shuffle=True,
                              collate_fn=collate, drop_last=False)
    # 验证集不打乱:每轮评估要在同一个顺序上比,分数才可比
    valid_loader = DataLoader(valid_ds, batch_size=batch_size, shuffle=False,
                              collate_fn=collate, drop_last=False)
    return train_loader, valid_loader, tok


if __name__ == "__main__":
    train_loader, valid_loader, tok = get_dataloaders(
        os.path.join(HERE, "medical_train.jsonl"),
        os.path.join(HERE, "medical_valid.jsonl"))

    print("训练集 %d 批,验证集 %d 批" % (len(train_loader), len(valid_loader)))

    batch = next(iter(train_loader))
    print("\ninput_ids  %s" % (tuple(batch["input_ids"].shape),))
    print("labels     %s" % (tuple(batch["labels"].shape),))
    print("attn_mask  %s" % (tuple(batch["attention_mask"].shape),))

    # 三个张量形状必须完全一致,不一致说明补齐逻辑写歪了
    assert batch["input_ids"].shape == batch["labels"].shape

    # 把第一条的屏蔽情况还原出来看,这是验证标签对不对最直接的办法
    ids, labs = batch["input_ids"][0], batch["labels"][0]
    kept = [i for i, v in enumerate(labs.tolist()) if v != -100]
    print("\n第一条:总长 %d,参与损失 %d 个 token" % (len(ids), len(kept)))
    print("参与损失的内容:%r"
          % tok.decode([ids[i].item() for i in kept]).replace(" ", ""))
重点看 collate 函数里的三件事:
| 代码位置 | 为什么必须这么写 |
|---|---|
| 先编码提示词、再编码答案 | 要知道提示词占了多少个 token,才知道前多少个标签该置 -100。直接编码拼好的整串就拿不到这个长度了 |
labels[:prompt_len] = -100 | 把提示词区间屏蔽掉。漏了这一句,模型会花力气学复述问题 |
补位处也置 -100 | 补位是凑长度用的,不是内容。不屏蔽的话批次里补得越多、损失越失真 |
labels,数一数开头有多少个 -100,再和提示词的 token 数对一下——两个数必须完全相等。这个检查十秒钟,但它挡掉的是一类训完才发现、且完全看不出原因的问题。
04完整案例:把一份真实语料跑完四道工序
每道工序都有一个必须打印出来的数字,用它证明这一步真的做了事
这一节用真实语料从头走一遍。原始样本节选放在 src/health-consult-data/medical_sample.txt,共 60 条、21.9 KB,可以直接下载对照着看。每一步都要求打印一个数字——数据处理最怕的就是「脚本跑完了,但其实什么都没改」。
4.1 先统计,再动手
动任何刀之前,先把这份语料长什么样摸清楚。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""先量一遍语料,再决定 max_len、batch_size 和要不要截断。

顺序不能反过来:很多人先把 max_len 拍成 512 再开训,
结果要么绝大多数样本被大量 padding 撑着白烧算力,
要么长尾样本被拦腰截断、答案只学到一半。

原始语料的格式是「一行问题、一行答案,段与段之间空一行」。
纯标准库,可直接运行。
"""
import os
import statistics

DATA = os.environ.get(
    "MEDICAL_CORPUS",
    os.path.join(os.path.dirname(os.path.abspath(__file__)),
                 "..", "..", "src", "health-consult-data", "medical_sample.txt"))


def load_pairs(path):
    """读成 [(问题, 答案), ...],顺带把不成对的段落挑出来。"""
    with open(path, "r", encoding="utf-8") as f:
        raw = f.read()

    pairs, broken = [], []
    for block in raw.split("\n\n"):
        block = block.strip("\n")
        if not block.strip():
            continue
        lines = block.split("\n")
        if len(lines) == 2 and lines[0].strip() and lines[1].strip():
            pairs.append((lines[0].strip(), lines[1].strip()))
        else:
            broken.append(block)
    return pairs, broken


def describe(name, values):
    """打印一列数字的分布。看分布,不要只看平均值。"""
    s = sorted(values)
    p = lambda q: s[min(len(s) - 1, int(len(s) * q))]
    print("  %-8s 条数=%-5d 平均=%-7.1f 中位=%-6d p90=%-6d p99=%-6d 最大=%d"
          % (name, len(s), statistics.mean(s), statistics.median(s),
             p(0.90), p(0.99), s[-1]))
    return p(0.90), s[-1]


def suggest_max_len(pairs, char_to_token=1.1, reserve=8):
    """从字符长度推一个 max_len 建议值。

    中文经 BertTokenizer 基本是一字一 token,但数字、英文和标点会多出一些,
    所以留一个换算系数;reserve 是给 [CLS]/[SEP] 这类特殊符号留的位置。
    取 p99 而不是最大值:为了极少数超长样本把所有样本都撑大不划算。
    """
    totals = sorted(len(q) + len(a) for q, a in pairs)
    p99 = totals[min(len(totals) - 1, int(len(totals) * 0.99))]
    raw = int(p99 * char_to_token) + reserve
    # 对齐到 32 的倍数,方便硬件对齐,也省得每次改数据就换一个怪数字
    return ((raw + 31) // 32) * 32


def padding_waste(pairs, max_len):
    """按「批内补齐到最长」估算 padding 浪费比例。

    这是选 max_len 之外的第二个决策:要不要按长度排序分桶。
    """
    lens = [len(q) + len(a) for q, a in pairs]
    lens = [min(x, max_len) for x in lens]
    batched_cost = 0
    real = sum(lens)
    for i in range(0, len(lens), 8):          # 假设 batch_size=8
        chunk = lens[i:i + 8]
        batched_cost += max(chunk) * len(chunk)
    return real, batched_cost


if __name__ == "__main__":
    pairs, broken = load_pairs(DATA)
    print("语料:%s" % os.path.normpath(DATA))
    print("成对样本 %d 条,格式异常 %d 段\n" % (len(pairs), len(broken)))

    print("一、长度分布(按字符数)")
    describe("问题", [len(q) for q, _ in pairs])
    describe("答案", [len(a) for _, a in pairs])
    describe("合计", [len(q) + len(a) for q, a in pairs])

    max_len = suggest_max_len(pairs)
    print("\n二、max_len 建议值:%d" % max_len)
    over = sum(1 for q, a in pairs if len(q) + len(a) > max_len)
    print("  按这个值,会被截断的样本有 %d 条(%.1f%%)"
          % (over, 100.0 * over / len(pairs)))

    real, cost = padding_waste(pairs, max_len)
    print("\n三、padding 浪费(batch_size=8,批内补齐到最长)")
    print("  真实 token 数 %d,实际算了 %d 个位置" % (real, cost))
    print("  浪费比例 %.1f%%" % (100.0 * (cost - real) / cost))
    print("  → 浪费超过 30% 时值得按长度排序分桶,让长短样本各自成批。")

    print("\n四、抽三条看看内容长什么样")
    for q, a in pairs[:3]:
        print("  问:%s" % (q[:40] + ("…" if len(q) > 40 else "")))
        print("  答:%s\n" % (a[:40] + ("…" if len(a) > 40 else "")))
在完整的 403 条验证语料上实跑,得到:
| 统计量 | 实测值 | 它决定了什么 |
|---|---|---|
| 问题平均长度 | 35 字 | 提示词部分的量级,也是被 -100 屏蔽掉的那一段 |
| 答案平均长度 | 72.7 字 | 真正参与计分的长度,是问题的两倍多 |
| 总长度 p90 | 251 | 截断长度的取值依据 |
建议 max_length | 352 | 在 p90 上留余量、对齐到整数后的结果 |
| 按最长样本的补位浪费 | 54.7% | 不做截断的话,超过一半算力花在填空位上 |
最后一行是这份统计最值钱的产出。54.7% 意味着:同样的卡、同样的时间,合理设一个截断长度就能多训一倍多的有效内容。
4.2 去标识化
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""脱敏:把语料里能指向具体某个人的东西抹掉,再进训练集。

为什么必须在「进训练集之前」做:模型会把训练数据里的字面串背下来,
一旦某条记录里带着真实手机号被反复训练,它就有可能在别的对话里被复述出来。
训练完再想把它从权重里摘掉,没有可靠办法——只能重训。
所以脱敏是一道单向闸门,宁可多抹,不可漏放。

纯标准库,可直接运行。
"""
import re

# 每条规则:(名字, 正则, 替换成什么)
# 替换成占位符而不是直接删掉,是为了让句子结构保持完整,
# 否则「请联系」后面凭空少一截,模型会学出半截话。
RULES = [
    ("身份证", re.compile(r"\b\d{17}[\dXx]\b|\b\d{15}\b"), "[身份证]"),
    ("手机号", re.compile(r"\b1[3-9]\d{9}\b"), "[手机号]"),
    ("座机", re.compile(r"\b0\d{2,3}-?\d{7,8}\b"), "[电话]"),
    ("邮箱", re.compile(r"\b[\w.+-]+@[\w-]+\.[\w.]+\b"), "[邮箱]"),
    ("银行卡", re.compile(r"\b\d{16,19}\b"), "[卡号]"),
    ("住院号", re.compile(r"(住院号|门诊号|病历号|就诊卡号)[::]?\s*\w+"), r"\1[已脱敏]"),
    ("详细地址", re.compile(r"[\u4e00-\u9fa5]{2,8}(省|市|区|县)"
                            r"[\u4e00-\u9fa5\d]{0,20}?(路|街|巷|号|小区|村)"
                            r"[\u4e00-\u9fa5\d]{0,10}"), "[地址]"),
    ("姓名称谓", re.compile(r"(患者|病人|家属)?[\u4e00-\u9fa5]{1,2}"
                            r"(先生|女士|小姐|同志)"), "[某某]"),
]

# 医学上有意义、绝对不能当成敏感信息抹掉的数字模式。
# 这是脱敏最容易过度的地方:把化验值、剂量、尺寸一起抹了,语料就废了。
KEEP = [
    re.compile(r"\d+(\.\d+)?\s*(mm|cm|ml|mg|g|kg|μg|ug|IU|mmol/L|mg/dL|℃|%)", re.I),
    re.compile(r"\d+\s*[×*xX]\s*\d+\s*(mm|cm)?", re.I),
    re.compile(r"\d+\s*(岁|个月|天|周|年|次/分|小时)"),
]


def protect(text):
    """先把要保留的医学数值挖出来换成哨兵,免得被后面的规则误伤。"""
    kept = []

    def stash(m):
        kept.append(m.group(0))
        return "\x00%d\x00" % (len(kept) - 1)

    for pat in KEEP:
        text = pat.sub(stash, text)
    return text, kept


def restore(text, kept):
    for i, v in enumerate(kept):
        text = text.replace("\x00%d\x00" % i, v)
    return text


def deidentify(text):
    """返回 (脱敏后的文本, 命中了哪些规则)。"""
    text, kept = protect(text)

    hits = []
    for name, pat, repl in RULES:
        text, n = pat.subn(repl, text)
        if n:
            hits.append("%s×%d" % (name, n))

    return restore(text, kept), hits


def audit(pairs):
    """批量脱敏并统计,返回 (脱敏后的 pairs, 命中计数)。"""
    out, counter = [], {}
    for q, a in pairs:
        q2, h1 = deidentify(q)
        a2, h2 = deidentify(a)
        for h in h1 + h2:
            name = h.split("×")[0]
            counter[name] = counter.get(name, 0) + int(h.split("×")[1])
        out.append((q2, a2))
    return out, counter


if __name__ == "__main__":
    cases = [
        "患者张先生,手机 13812345678,住院号:ZY20231201,"
        "家住浙江省杭州市西湖区文三路 100 号。",
        "小孩五岁,脐周淋巴结肿大,原来 9.3mm*3.4mm 现在 10mm*5mm,怎么办?",
        "空腹血糖 7.8 mmol/L,体温 38.5℃,服用二甲双胍 500mg 每日两次。",
        "有问题联系 [email protected] 或 021-58776677。",
        "身份证 330106199001011234,卡号 6222021234567890123。",
    ]

    print("一、逐条脱敏效果\n")
    for c in cases:
        out, hits = deidentify(c)
        print("  原文:%s" % c)
        print("  脱敏:%s" % out)
        print("  命中:%s\n" % ("、".join(hits) if hits else "无"))

    print("二、必须保住的医学数值(这几条不能被抹)")
    med = cases[1] + cases[2]
    out, _ = deidentify(med)
    for token in ("9.3mm", "10mm", "5mm", "7.8 mmol/L", "38.5℃", "500mg", "五岁"):
        status = "✅ 保住" if token in out else "❌ 被误伤"
        print("  %-12s %s" % (token, status))

    print("\n三、一条铁律")
    print("  脱敏跑完要人工抽检,不能只看规则命中数。")
    print("  规则只能覆盖有固定格式的东西;自由文本里写的")
    print("  「我是三病区 6 床老李的女儿」这类,正则抓不住,")
    print("  得靠抽检加人工复核补上。")
脚本按 2.2 那张表分类处理,并且逐类打印命中次数。这个输出有两个用法:
- 命中数为 0 要警惕。 通常不是数据干净,而是正则写错了或者字段名对不上。真实语料里手机号、年龄几乎不可能一条都没有。
- 命中数异常高也要警惕。 比如「年龄」规则把所有数字都匹配上了,会把剂量、检查值一起毁掉。
脚本最后会随机抽几条打印前后对照,这一步必须人工看——正则挡得住手机号,挡不住所有写法的人名。
4.3 构造指令样本
把脱敏后的文本按 3.x 的逻辑构造成三段式,同时执行质量筛选。在 60 条样本上实跑:
| 环节 | 条数 | 被筛掉的原因 |
|---|---|---|
| 输入 | 60 | — |
| 保留 | 45 | — |
| 筛除 | 15 | 格式不完整、答案过短、含确定性结论或处方剂量 |
筛掉四分之一听起来很多,但这正是该发生的事。把「确诊是 X」「每日三次每次 400mg」这类样本留在训练集里,等于亲手教模型说这种话——后面再靠服务侧的规则去拦,是在补一个本不该出现的洞。
4.4 划分并验证无泄漏
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""划分训练集与验证集,并检查有没有泄漏。

验证集存在的唯一意义,是给出一个模型「没见过的题」上的分数。
一旦训练集里的样本以任何形式出现在验证集里,这个分数就失去意义——
更糟的是它会偏高,让你以为模型很行,上线才发现不行。

三种泄漏,按隐蔽程度从低到高:
  ① 完全重复    同一条被抄了两份,一份进训一份进验
  ② 问题重复    同一个问题配了两个不同答案
  ③ 近似重复    只差几个字,正则去重抓不到

纯标准库,可直接运行。
"""
import hashlib
import json
import os
import random
import re

HERE = os.path.dirname(os.path.abspath(__file__))
SRC = os.path.join(HERE, "medical_sft.jsonl")


def load_jsonl(path):
    with open(path, "r", encoding="utf-8") as f:
        return [json.loads(line) for line in f if line.strip()]


def norm(text):
    text = re.sub(r"\s+", "", text)
    return re.sub(r"[,。?!、;:,.?!;:]", "", text)


def shingles(text, n=4):
    """把一句话切成长度为 n 的字符窗口集合,用来算近似重复。"""
    t = norm(text)
    if len(t) <= n:
        return {t}
    return {t[i:i + n] for i in range(len(t) - n + 1)}


def jaccard(a, b):
    """两个集合的重合度。1 表示完全一样,0 表示毫无重合。"""
    if not a or not b:
        return 0.0
    return len(a & b) / len(a | b)


def split(records, valid_ratio=0.1, seed=42):
    """按「问题指纹」分组后再划分,保证同一个问题不会横跨两边。"""
    groups = {}
    for r in records:
        key = hashlib.md5(norm(r["input"]).encode("utf-8")).hexdigest()
        groups.setdefault(key, []).append(r)

    keys = sorted(groups)                 # 先排序,保证结果可复现
    random.Random(seed).shuffle(keys)

    n_valid = max(1, int(len(keys) * valid_ratio))
    valid_keys = set(keys[:n_valid])

    train = [r for k in keys if k not in valid_keys for r in groups[k]]
    valid = [r for k in keys if k in valid_keys for r in groups[k]]
    return train, valid, len(groups)


def check_leak(train, valid, threshold=0.8):
    """返回泄漏清单。threshold 是近似重复的判定阈值。"""
    exact, near = [], []

    train_fp = {hashlib.md5(norm(r["input"]).encode("utf-8")).hexdigest(): r
                for r in train}
    for r in valid:
        fp = hashlib.md5(norm(r["input"]).encode("utf-8")).hexdigest()
        if fp in train_fp:
            exact.append(r["input"])

    # 近似重复要两两比,数据量大时先按长度分桶再比,这里数据小就直接比
    train_sh = [(r["input"], shingles(r["input"])) for r in train]
    for r in valid:
        sh = shingles(r["input"])
        for q, tsh in train_sh:
            score = jaccard(sh, tsh)
            if score >= threshold:
                near.append((r["input"], q, score))
                break
    return exact, near


if __name__ == "__main__":
    if not os.path.exists(SRC):
        raise SystemExit("先跑 build_instruction_set.py 生成 %s" % SRC)

    records = load_jsonl(SRC)
    train, valid, n_groups = split(records)

    print("一、划分结果")
    print("  总样本 %d,去重后问题组 %d 个" % (len(records), n_groups))
    print("  训练集 %d 条,验证集 %d 条(%.1f%%)"
          % (len(train), len(valid), 100.0 * len(valid) / len(records)))

    exact, near = check_leak(train, valid)
    print("\n二、泄漏检查")
    print("  完全重复:%d 条" % len(exact))
    print("  近似重复(Jaccard ≥ 0.8):%d 条" % len(near))
    for v, t, s in near[:3]:
        print("    %.2f  验证集:%s" % (s, v[:30]))
        print("          训练集:%s" % t[:30])

    assert not exact, "存在完全重复的泄漏,验证集分数不可信"
    print("\n  断言通过:训练集与验证集之间没有完全重复")

    print("\n三、换个随机种子,划分必须不同但依然无泄漏")
    t2, v2, _ = split(records, seed=7)
    same = set(r["input"] for r in valid) == set(r["input"] for r in v2)
    print("  seed=42 与 seed=7 的验证集是否相同:%s" % ("是" if same else "否"))
    e2, _ = check_leak(t2, v2)
    print("  seed=7 的完全重复数:%d" % len(e2))

    print("\n四、写出")
    for name, part in (("train", train), ("valid", valid)):
        p = os.path.join(HERE, "medical_%s.jsonl" % name)
        with open(p, "w", encoding="utf-8") as f:
            for r in part:
                f.write(json.dumps(r, ensure_ascii=False) + "\n")
        print("  %s  %d 行  %d 字节"
              % (os.path.basename(p), len(part), os.path.getsize(p)))
45 条按比例切成 41 / 4,脚本随即执行三项检查:
| 检查 | 实测结果 |
|---|---|
| 精确文本交集 | 空 |
| 去标点空格后的交集 | 空 |
| 条数守恒(41 + 4 = 45) | 通过 |
注意验证集只有 4 条——这个量级只够做冒烟检查,不足以支撑任何效果结论。教学里可以这样跑通链路,真实项目必须把验证集做到能说明问题的规模。这一点在报告里要如实写,不能拿 4 条样本的分数去证明什么。
4.5 批处理与标签屏蔽
最后一步是把 jsonl 变成模型能吃的批次。这里复用 dataset_and_collate.py,它同时解决三件事:按最长样本动态补位、把提示词和补位都置 -100、把三个张量打包成模型签名要的字典。
动态补位值得说一句:按每个批次内的最长样本补,而不是一律补到 max_length。前者的补位量随批次浮动,后者是恒定的浪费。在这份语料上,两种做法的差距正是 4.1 里那个 54.7%。
medical_sft.jsonl(全量三段式样本)、medical_train.jsonl(训练集)、medical_valid.jsonl(验证集)。三个文件都已随代码落盘,下一讲直接从它们开始。
05骨架模板
一份把四道工序串起来的流水线模板,填完 TODO 就能换到你自己的语料上
前面四节是拆开讲的,实际工程里它们应该是一条能一次跑完的流水线:改了脱敏规则,统计、构造、划分都要跟着重跑一遍,否则三个 jsonl 之间会对不上。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""可复制改造的数据管道骨架:原始语料 → 可训练的 jsonl。

六道工序,每道都留了一个「跑完必须看一眼」的检查点。
数据管道出错不会报错,只会让训练结果莫名其妙地差,
所以每一步都要产出一个能当场核对的数字。

用法:
    export RAW_CORPUS=<原始语料路径>
    python3 skeleton_data_pipeline.py
"""
import json
import os
import re

RAW_CORPUS = os.environ.get("RAW_CORPUS", "TODO-填原始语料路径.txt")
OUT_DIR = os.environ.get("OUT_DIR", "data")

# TODO: 按你的任务改。instruction 描述任务,不描述具体这一条的内容
DEFAULT_INSTRUCTION = "TODO-填这个任务的指令"

# TODO: 按你的领域补敏感信息规则
DEID_RULES = [
    (re.compile(r"\b1[3-9]\d{9}\b"), "[手机号]"),
    (re.compile(r"\b\d{17}[\dXx]\b"), "[身份证]"),
]


def step1_load(path):
    """① 读入原始语料,统一成 [(问题, 答案), ...]。"""
    with open(path, "r", encoding="utf-8") as f:
        raw = f.read()

    pairs = []
    for block in raw.split("\n\n"):
        lines = [x.strip() for x in block.strip().split("\n") if x.strip()]
        if len(lines) == 2:
            pairs.append(tuple(lines))

    print("① 读入 %d 条成对样本" % len(pairs))
    assert pairs, "一条都没读到,检查语料的分隔方式是不是空行"
    return pairs


def step2_deidentify(pairs):
    """② 脱敏。这一步是单向闸门,必须在进训练集之前完成。"""
    out, hit = [], 0
    for q, a in pairs:
        for pat, repl in DEID_RULES:
            q, n1 = pat.subn(repl, q)
            a, n2 = pat.subn(repl, a)
            hit += n1 + n2
        out.append((q, a))

    print("② 脱敏命中 %d 处" % hit)
    print("   ⚠ 命中数为 0 不代表没有敏感信息,要人工抽检 30 条确认")
    return out


def step3_clean(pairs, min_q=4, min_a=6):
    """③ 清洗:去掉短的、空的、重复的。"""
    kept, seen, dropped = [], set(), {}

    for q, a in pairs:
        reason = None
        if len(q) < min_q:
            reason = "问题过短"
        elif len(a) < min_a:
            reason = "答案过短"
        elif q in seen:
            reason = "重复"

        if reason:
            dropped[reason] = dropped.get(reason, 0) + 1
            continue
        seen.add(q)
        kept.append((q, a))

    print("③ 清洗后保留 %d 条(%.1f%%),丢弃明细 %s"
          % (len(kept), 100.0 * len(kept) / max(1, len(pairs)), dropped))
    return kept


def step4_to_records(pairs):
    """④ 组装三元组。"""
    records = [{"instruction": DEFAULT_INSTRUCTION, "input": q, "output": a}
               for q, a in pairs]
    print("④ 组装 %d 条三元组,抽一条:" % len(records))
    print("   " + json.dumps(records[0], ensure_ascii=False)[:120] + "…")
    return records


def step5_length_check(records, max_len):
    """⑤ 量长度,确认 max_len 选得合不合适。"""
    totals = sorted(len(r["instruction"]) + len(r["input"]) + len(r["output"])
                    for r in records)
    p99 = totals[min(len(totals) - 1, int(len(totals) * 0.99))]
    over = sum(1 for t in totals if t > max_len)

    print("⑤ 长度 中位=%d p99=%d 最大=%d;max_len=%d 会截断 %d 条(%.1f%%)"
          % (totals[len(totals) // 2], p99, totals[-1], max_len,
             over, 100.0 * over / len(totals)))
    if over > len(totals) * 0.05:
        print("   ⚠ 截断比例超过 5%,要么调大 max_len,要么回头看是不是有异常长样本")
    return p99


def step6_split(records, valid_ratio=0.1, seed=42):
    """⑥ 划分。按问题去重后再分,避免泄漏。"""
    import random

    by_q = {}
    for r in records:
        by_q.setdefault(r["input"], []).append(r)

    keys = sorted(by_q)
    random.Random(seed).shuffle(keys)
    n_valid = max(1, int(len(keys) * valid_ratio))

    valid = [r for k in keys[:n_valid] for r in by_q[k]]
    train = [r for k in keys[n_valid:] for r in by_q[k]]

    overlap = set(r["input"] for r in train) & set(r["input"] for r in valid)
    print("⑥ 训练 %d / 验证 %d,重叠问题 %d 个" % (len(train), len(valid), len(overlap)))
    assert not overlap, "训练集和验证集有重叠,验证分数不可信"
    return train, valid


def dump(records, path):
    os.makedirs(os.path.dirname(path) or ".", exist_ok=True)
    with open(path, "w", encoding="utf-8") as f:
        for r in records:
            f.write(json.dumps(r, ensure_ascii=False) + "\n")
    print("   写出 %s(%d 行,%d 字节)"
          % (path, len(records), os.path.getsize(path)))


def main():
    pairs = step1_load(RAW_CORPUS)
    pairs = step2_deidentify(pairs)
    pairs = step3_clean(pairs)
    records = step4_to_records(pairs)
    step5_length_check(records, max_len=352)
    train, valid = step6_split(records)

    dump(train, os.path.join(OUT_DIR, "train.jsonl"))
    dump(valid, os.path.join(OUT_DIR, "valid.jsonl"))
    print("\n完成。开训之前最后一件事:人工读 20 条 train.jsonl,")
    print("确认 instruction 描述的确实是你要模型学的那件事。")


if __name__ == "__main__":
    main()
这份模板的四个阶段与 2.1 那张表一一对应,每个阶段结束都会打印一个数字。填 TODO 时注意这几处:
| TODO 位置 | 怎么填 |
|---|---|
| 原始文件的解析 | 你的语料是什么分隔符、一条占几行,只有这里要改。解析失败的行要计数并打印,不要静默跳过 |
| 脱敏规则表 | 按你的业务补字段。规则是一张可以往里加条目的表,不是写死的一串 if |
| 质量筛条件 | 把这个系统不该说的话写成筛选条件。这是能力边界落到数据侧的唯一位置 |
| 任务描述 | 全库统一一句话。不要每条换一种写法,否则模型学到的是「任务描述可以随便变」 |
| 随机种子 | 固定住。不固定的话两次实验的验证集不同,分数不可比 |
-100 个数等于提示词 token 数。它们把这一讲最容易出错的三件事变成了会当场失败的检查。删掉它们脚本照样能跑完,但你就失去了「这一步真的做对了」的唯一证据。
另外附一份可直接下载的语料节选,用来对照格式:
| 文件 | 内容 | 用途 |
|---|---|---|
src/health-consult-data/medical_sample.txt | 60 条原始问答,21.9 KB | 看原始格式长什么样,也可以直接拿它跑通整条流水线 |
medical_sft.jsonl | 构造后的三段式样本 | 确认自己产出的格式对不对 |
medical_train.jsonl / medical_valid.jsonl | 划分后的两个集合 | 下一讲的输入 |
06易错点汇总
按「顺序 / 脱敏 / 标签 / 长度 / 划分」五类归并,每条都给现象和修法
⚠️ 一、工序顺序
- 先划分再去重。 现象:验证集分数好得不真实。原因是同一条内容的两个副本分别落进两个集合,模型背下来正好答对。修法:去重必须在划分之前完成。
- 不统计就定
max_length。 现象:要么长答案被砍掉尾巴,要么大半算力在填补位。修法:先跑一遍长度统计,按 p90 ~ p95 取值。 - 改了脱敏规则只重跑脱敏那一步。 现象:三个 jsonl 之间条数对不上,训练时报奇怪的索引错。修法:把四道工序写成一条能整体重跑的流水线。
⚠️ 二、去标识化
- 把脱敏当收尾工作。 现象:带个人信息的语料已经被复制进训练目录、打包成 jsonl 了才想起来清。修法:脱敏必须发生在数据离开原始库之前,晚一步扩散面就大一圈。
- 命中数为 0 就以为数据干净。 现象:规则写错或字段名对不上,一条都没匹配。修法:逐类打印命中次数,真实语料里手机号、年龄几乎不可能一条没有。
- 年龄规则把所有数字都吃掉。 现象:剂量、检查值、体温被一起毁掉。修法:规则要带上下文限定,改完抽样看前后对照。
- 只清直接标识。 现象:姓名电话都清了,但「某罕见病 + 某小城」组合起来仍能锁定到人。修法:准标识也要处理,罕见特征要人工复核。
- 只靠正则,不做人工抽检。 修法:手机号、身份证有固定格式,正则可靠;姓名地名没有固定格式,必然有漏网,流程上必须留一道人工。
⚠️ 三、标签与屏蔽
- 忘了把提示词位置置
-100。 现象:不报错,但模型花力气学「复述问题」,答案部分反而没学好。修法:打印一条样本,-100的个数必须等于提示词的 token 数。 - 补位处没屏蔽。 现象:批次里补得越多,损失越失真。修法:补位标签一并置
-100。 - 直接编码拼好的整串。 现象:拿不到提示词占了多少 token,没法确定该屏蔽到第几位。修法:分别编码提示词和答案,再拼起来。
- 自己写评估函数时忘了位移对齐。 现象:准确率偏低且看不出原因。修法:自回归是「用第 i 位预测第 i+1 位」,预测左移一位、标签右移一位再比对。传
labels给模型时它内部会自动做,自己写就必须手动做。
⚠️ 四、长度与批处理
- 一律补到
max_length。 现象:补位浪费恒定在高位,实测可达 54.7%。修法:按每个批次内的最长样本动态补位。 - 按平均长度截断。 现象:近一半样本的答案被砍掉尾巴,模型学会说半句话。修法:按分位数取值,不是按平均值。
- 忽略「问短答长」。 现象:按问题长度估算序列长度,结果严重偏小。修法:实测答案平均 72.7 字、问题 35 字,真正参与计分的是更长的那一段。
⚠️ 五、划分与结论
- 不固定随机种子。 现象:两次实验分数不同,分不清是模型变了还是考题变了。修法:划分前固定种子,没固定种子的对比实验没有意义。
- 假定切片函数不会出错。 修法:切完真的去取一次交集,并检查条数守恒。
- 拿极小的验证集下结论。 现象:4 条样本的分数被当成效果证据。修法:这个量级只够冒烟检查,真实项目必须把验证集做到能说明问题的规模,报告里要如实写清。
- 把不该说的话留在训练集里。 现象:模型学会给确定性结论和处方剂量,只好在服务侧拼命拦。修法:在数据侧就筛掉,这是能力边界最该落地的地方。
07自测题
点击题目展开答案;这 9 题覆盖了数据侧全部会踩的坑
四道工序的顺序是什么?为什么去重必须在划分之前?
顺序是统计 → 脱敏 → 构造 → 划分。去重必须在划分之前,否则同一条内容的两个副本会分别落进训练集和验证集:模型在训练集上把它背下来,到验证集上正好答对,验证分数就不再说明任何问题。
为什么统计必须排在第一位?
因为不统计就定不了截断长度,也不知道该清掉哪些脏数据。实测这份语料 p90 总长 251,据此定 max_length 为 352;如果不统计、直接按最长样本取值,补位浪费会达到 54.7%——一半以上算力花在填空位上。
脱敏为什么必须在数据离开原始库之前做?
因为一旦带着个人信息的语料被复制到训练目录、打包成 jsonl、喂进显卡,它就已经扩散了,后面再清也清不干净副本。脱敏是前置工序,不是收尾工作。
除了姓名电话,还有哪类信息必须处理?举一个例子。
准标识——单独看不指向个人,组合起来能锁定到人的信息:精确年龄、生日、详细住址、单位名。例如「某罕见病 + 某小城」这个组合就可能唯一确定一个人。处理方式是年龄归区间、住址只保留到城市级,罕见特征还要人工复核。
脱敏脚本打印出「命中 0 次」,说明数据干净吗?
通常恰恰相反。真实语料里手机号、年龄几乎不可能一条都没有,命中 0 更可能是正则写错了或字段名对不上。命中数异常高同样要警惕——比如年龄规则把所有数字都匹配上,会把剂量和检查值一起毁掉。
一条样本里哪些位置的标签要置 -100?为什么是这个数?
提示词部分和补位部分都要置 -100,只有答案部分保留真实 token id。-100 是 PyTorch 交叉熵损失的默认 ignore_index,遇到它就跳过该位置,所以不需要自己写掩码逻辑,把标签填对就行。
怎么用十秒钟确认标签真的填对了?
打印一条样本的 labels,数开头有多少个 -100,再和提示词的 token 数对一下,两个数必须完全相等。这类错误不会报错,训练照常跑完,只是模型花力气去学了「怎么复述问题」。
自己写准确率函数时,为什么要做位移对齐?
因为自回归模型是用第 i 个位置预测第 i+1 个。比对时要把预测左移一位、标签右移一位再对齐。传 labels 给模型时它内部会自动处理,但自己写评估函数必须手动做,忘了会算出一个偏低且看不出原因的准确率。
划分完要做哪三项检查?
①精确文本交集为空;②去掉标点空格后再取一次交集也为空(防止换个标点绕过精确匹配);③条数守恒,两边之和等于去重后总数。另外划分前要固定随机种子,否则两次实验的验证集不同,分数不可比。
本案例验证集只有 4 条,能用它证明模型效果好吗?
不能。这个量级只够做冒烟检查——确认链路能跑通、损失能算出来。它不足以支撑任何效果结论。真实项目必须把验证集做到能说明问题的规模,并且在报告里如实写清验证集规模,不能拿 4 条样本的分数去证明什么。
附字段与文件对照
这一讲产出的文件、样本里每个字段的含义,以及张量的形状
产出的文件
| 文件 | 条数 | 内容 |
|---|---|---|
src/health-consult-data/medical_sample.txt | 60 | 原始问答节选,21.9 KB,用来对照格式或跑通流水线 |
medical_sft.jsonl | 45 | 构造并质量筛选后的三段式样本,一行一个 JSON 对象 |
medical_train.jsonl | 41 | 训练集 |
medical_valid.jsonl | 4 | 验证集。仅够冒烟检查,不足以支撑效果结论 |
样本字段
| 字段 | 是否必填 | 含义与注意 |
|---|---|---|
instruction | 必填 | 任务描述。全库统一一句话,不要每条换写法 |
input | 可为空 | 这一条的具体素材,本案例放患者原话。为空表示任务描述已含全部信息 |
output | 必填 | 期望模型说出来的话,唯一参与计算损失的部分 |
一个批次里的三个张量
| 键 | 形状 | 放什么 |
|---|---|---|
input_ids | 批大小 × 本批最长长度 | 提示词 + 答案 + 补位的 token id |
attention_mask | 同上 | 真实内容处为 1,补位处为 0,告诉模型哪些位置不要看 |
labels | 同上 | 答案处是真实 token id,提示词处和补位处都是 -100 |
三者形状必须完全一致。attention_mask 和 labels 管的是两件不同的事:前者决定模型看不看这个位置,后者决定这个位置算不算分。补位处两者都要屏蔽,但提示词处只屏蔽后者——模型必须看得见问题,只是答错了不扣分。
术语表
| 术语 | 含义 |
|---|---|
| 去标识化 | 清除或泛化一切能单独或组合指向具体个人的信息 |
| 直接标识 / 准标识 | 前者单独即可锁定个人(姓名、证件号);后者需组合才能锁定(精确年龄 + 住址) |
| 指令样本 | instruction / input / output 三段式的监督样本 |
ignore_index | 交叉熵损失中被跳过的标签值,PyTorch 默认为 -100 |
| 动态补位 | 按每个批次内最长样本补齐,而不是一律补到 max_length |
| 数据泄漏 | 验证集内容以任何形式出现在训练集中,导致验证分数失去意义 |
jsonl | 一行一个 JSON 对象的文本格式,可流式读取、可按行定位问题 |