AIGC 全景与生成模型谱系
把「AI 生成内容」拆成一座三层的内容工厂:底层烧钱训模型,中层改造成行业工具,上层才交到用户手里;而工厂里真正干活的,是 VAE、GAN、扩散模型这三条产线。
30″30 秒看懂 AIGC
把 AIGC 想成一座三层楼的内容工厂:底下一层是发电机房,中间一层是改装车间,最上面一层才是交到顾客手里的门店。你在手机上点一下「生成」,这三层楼全都动了一遍。
一楼轰隆作响的是发电机——把几亿张图文、几百万小时音视频、成吨的代码喂进去,烧上几千张显卡,练出一个什么都懂一点的大模型。这层楼贵得离谱,全世界能建的没几家。二楼是改装车间,工人把一楼的通用机器拧一拧、接上行业数据,改成「专画古风插画的」「专写电商文案的」。三楼是门店,顾客根本看不见前两层,只看见一个输入框和一个按钮。
而工厂门口还站着一位质检员,拿着放大镜挨个看出货的东西。这个人不是摆设——机器造得再快再像,也不保证它说的是真的。
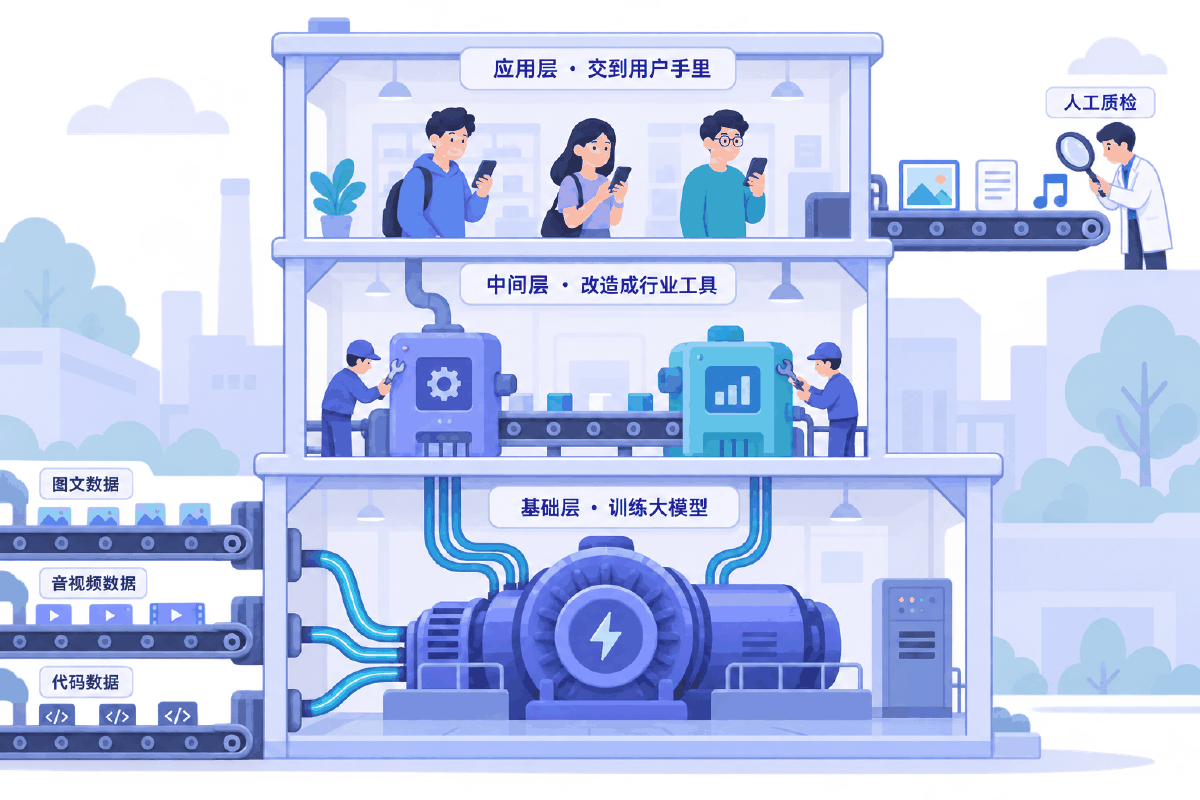
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 进料传送带 | 训练数据 | 图文、音视频、代码等海量样本,决定了这座工厂「见过什么」 |
| 一楼发电机 | 基础层(预训练大模型) | 烧算力练出通用能力,靠 API 调用费和平台订阅收钱 |
| 二楼改装车间 | 中间层(2B 的行业工具) | 不练底座,基于开源模型做垂直化、场景化、定制化改造 |
| 三楼门店 | 应用层(2C 的产品) | 网页、小程序、群聊机器人、App——用户唯一摸得到的一层 |
| 出货传送带 | 生成的内容 | 文本、图像、音频、视频,以及它们互相转换的多模态产物 |
| 门口的质检员 | 人的审核与核实 | 判断这批货能不能用、敢不敢发、有没有版权与事实风险 |
这条铁律会在本讲反复出现:讲扩散模型时它解释了为什么模型能画出根本不存在的建筑;讲产品形态时它解释了为什么二楼三楼的公司也得为内容合规负责;讲代码时它变成了一份必须落盘的溯源清单——记下是谁、用哪个模型、用什么提示词造出来的这张图。
01概念:AIGC 到底指什么
一个定义、两种分法、一条容易混淆的边界
1.1 AIGC 是什么
AIGC 全称 AI-Generated Content,人工智能内容生成。这个词描述的不是某一个模型,也不是某一项技术,而是一整类「由机器产出内容」的能力与产业。
它和两个老词是对照着出现的:
| 缩写 | 谁在生产 | 特点与代价 |
|---|---|---|
| PGC | 专业机构(Professionally Generated Content) | 质量稳定、有审校流程,但产能受限于人手,单位成本最高 |
| UGC | 普通用户(User Generated Content) | 产能大、成本低,但质量方差极大,平台要花大力气做审核 |
| AIGC | 模型(AI-Generated Content) | 边际成本趋近于零、产能几乎无上限;质量方差来自提示词和模型,而不是来自人的水平——所以质检的对象从「人」变成了「流程」 |
这张表决定了后面所有工程选择的方向:既然产能不再是瓶颈,瓶颈就转移到了「怎么批量生成 + 怎么批量筛选 + 怎么留下可追溯的记录」。本讲第 04 节的三个案例,正好对应这三件事。
1.2 按技术分:孪生、编辑、生成
第一种分法看的是「机器对原始内容做了多大改动」。改动从小到大,正好是三档:
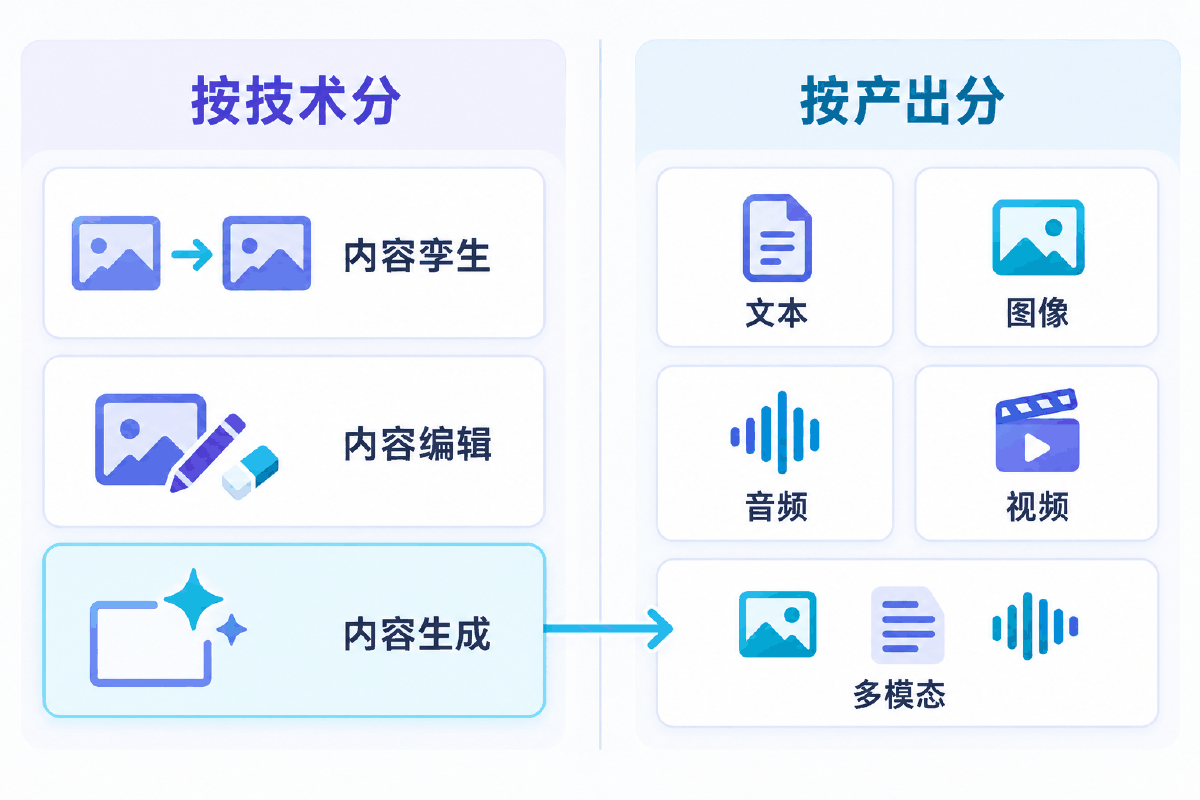
把内容映射到另一个模态,信息本身不变。包含智能增强(图像超分、老片修复)与智能转译(语音转字幕、文字转语音)。输入输出是同一份信息的两个形态。
理解内容及其属性,再有控制地修改。场景剪辑、虚拟试衣、人声分离都属于这一档。原始内容还在,被改掉的是其中某些属性。
从海量数据里学到抽象概念,再产出全新的内容。AI 绘画、AI 写作、视频生成、多模态生成都在这一档。没有对应的原始素材,产物是新造的。
这三档不是学术划分上的洁癖,它直接决定了风险等级——顺着铁律看一遍就明白:
| 档位 | 事实风险 | 版权风险 | 质检该看什么 |
|---|---|---|---|
| 内容孪生 | 低 | 低 | 转换有没有丢信息、超分有没有编出原图没有的细节 |
| 内容编辑 | 中 | 中 | 被改掉的属性是否越界(换脸、换声涉及肖像与声音权利) |
| 内容生成 | 高 | 高 | 事实是否存在、是否高度相似于某个已有作品、是否需要标注 |
换句话说:越往右,工厂门口那位质检员越不能省。做超分的产品可以自动上线,做文生图的产品必须留人工复核通道。
1.3 按产出分:文本、图像、音频、视频、多模态
第二种分法看的是「产出的是什么模态」。这是产品经理和采购最常用的分法,因为它直接对应能买到什么服务。
| 类别 | 细分 | 典型能力 |
|---|---|---|
| 文本生成 | 非交互式 / 交互式 | 摘要与标题生成、图生文;交互式即对话机器人,是目前最成熟、渗透最广的一类 |
| 图像生成 | 编辑修改 / 自主生成 | 超分、修复、人脸替换属编辑;文生图属自主生成,是本模块后面几页的主线 |
| 音频生成 | 语音 / 音乐 | 语音克隆、场景化语音合成、旋律与编曲生成 |
| 视频生成 | 编辑 / 自主生成 | 超分、修复、自动剪辑属编辑;文生视频属自主生成,成本与难度都最高 |
| 多模态生成 | 模态间转换 | 文生图、文生音频、文生视频、图生文、图生视频——把不同模态组合搭配 |
1.4 和「判别式模型」的区别
这是初学时最该先划清的一条线。工厂里的机器分两种:一种是检验台,你递给它一个东西,它告诉你「这是什么」;另一种是生产线,你给它一句话,它造一个东西出来。
| 对比项 | 判别式模型(检验台) | 生成式模型(生产线) |
|---|---|---|
| 学的是什么 | 条件概率 P(y|x):给定样本判类别 | 数据分布 P(x) 本身:这类数据「长什么样」 |
| 典型任务 | 图像分类、情感分析、目标检测 | 文生图、文本续写、语音合成 |
| 输出 | 一个标签或一个分数,可验证对错 | 一份全新的内容,只有「像不像」,没有唯一正确答案 |
| 评估方式 | 准确率、召回率、F1 —— 有标准答案 | 保真度、多样性 + 人工主观评分,指标和人的感受经常不一致 |
| 出错的样子 | 分错类,能被测试集抓到 | 一本正经地造出不存在的东西,测试集抓不到 |
最后一行就是铁律的技术根源:生成式模型的目标函数里从来没有「真实性」这一项。它优化的是「产出的东西看起来像不像训练数据里的东西」。所以它会画出结构错误的手、写出格式完美但根本不存在的文献条目——对它来说那些输出的「像样程度」得分很高,这不是 bug,是目标函数的定义如此。
02原理:三条产线和三层楼
生成模型在解什么问题、三条路线各自怎么干、为什么扩散模型赢了、以及这套能力怎么变成产业
2.1 生成模型到底在解什么问题
先把问题说清楚,不然后面三条路线都像变魔术。
假设世界上所有「好看的风景照」构成一个集合。这些图片并不是在 786432 维空间里均匀散布的——绝大多数随机像素组合都是雪花点,只有极小的一撮子集看起来像风景。生成模型要学的,就是这一撮子集的形状,术语叫数据分布 P(x)。
学会了形状,就能干一件事:从这个形状里随机摸一个出来——摸出来的必然「看着像风景」,但又不是训练集里任何一张。这就是「生成」。
难点在于:P(x) 这个形状极其复杂,没法直接写出公式。三条技术路线,本质上是三种绕开「直接写出公式」的办法。
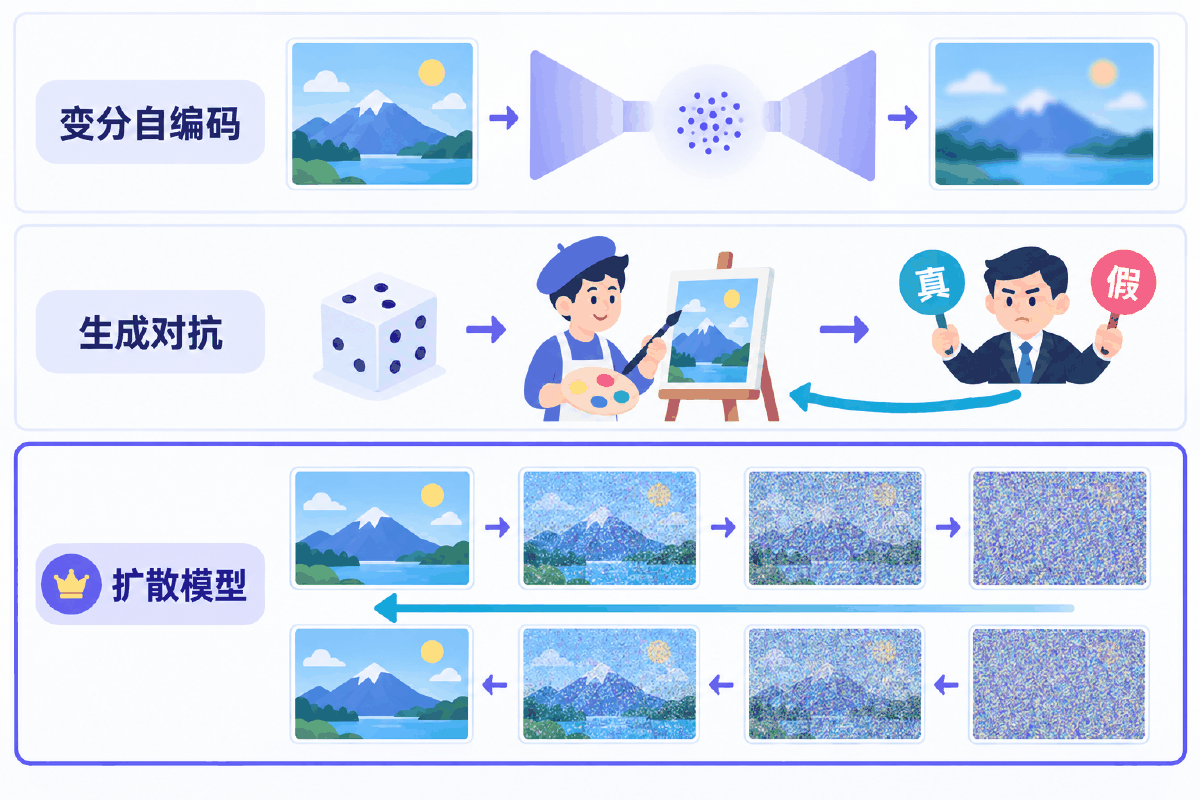
2.2 变分自编码 VAE:把形状压成一团概率云
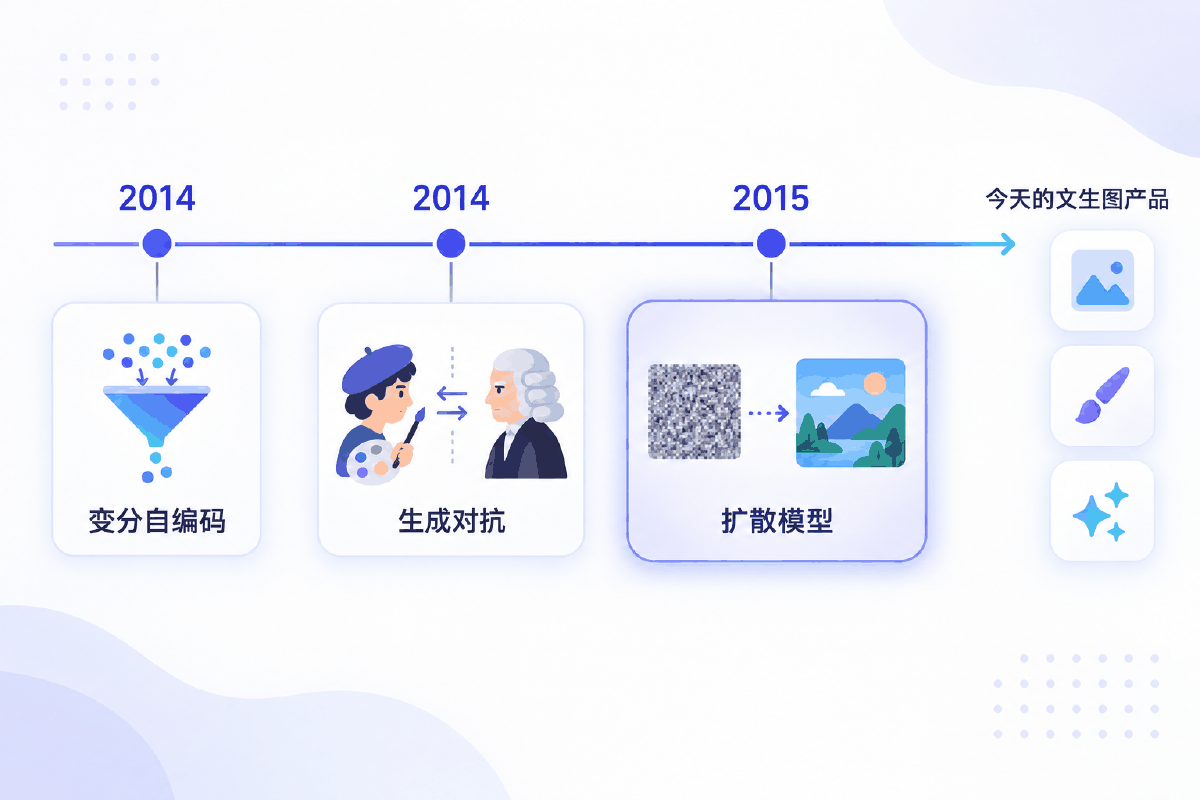
VAE(Variational Autoencoder,变分自编码器)由 Kingma 等人在 2014 年提出。它的思路是降维:既然高维空间里的形状太复杂,那就先压到低维再说。
它由两半组成:
| 组件 | 输入 → 输出 | 干了什么 |
|---|---|---|
| 编码器 Encoder | 高维图像 → 潜空间的概率分布 | 把一张图压成「一团概率云」的参数(均值与方差),而不是一组确定的数值 |
| 采样 | 概率分布 → 一个潜变量 | 从这团云里随机摸一个点出来 |
| 解码器 Decoder | 潜变量 → 重建的图像 | 把这个点还原成一张图 |
关键就在「概率云」而不是「确定数值」这一处。传统自编码器把图压成一组固定数字,目标只是尽量还原原图;而 VAE 压出来的是一片有范围的区域——于是这片区域里的每一个点,解码出来都是一张合理的图。微笑的程度、肤色的深浅、性别的倾向,都变成了这片区域里可以连续滑动的方向。
短处:生成的图普遍偏糊。因为重建损失倾向于「所有可能性的平均」,而多个清晰答案的平均就是一张模糊的图。
它没有消失:Stable Diffusion 里那个把潜空间还原成像素图的解码器,正是 VAE 的解码器部分——扩散模型接手了「生成」,VAE 留下来干「压缩与还原」。
2.3 生成对抗网络 GAN:让造假者和鉴定师互相较劲
GAN(Generative Adversarial Networks)同样是 2014 年,由 Ian Goodfellow 提出,是很长一段时间里最著名的生成模型。它用的是零和博弈:
输入一组随机向量(可以理解成「数字编号、字体、粗细、潦草程度」这类隐含设定),输出一张图。它的目标是骗过鉴定师。生成的数据作为鉴定师的负样本。
一个二分类模型,输入一张图,输出这张图是真实数据的概率。越接近 1 越可能是真的,越接近 0 越可能是生成的。它的目标是不被骗。
两者交替训练:鉴定师进步 → 造假者被迫画得更像 → 鉴定师又得更挑剔……理想情况下收敛到鉴定师完全分不出真假(输出恒为 0.5),此时生成器已经学到了数据分布。
以 GAN 为基础衍生出一大票变体——DCGAN、StyleGAN、CycleGAN,撑起了人脸替换、卡通头像生成、超分辨率重建、风格迁移这一整代应用。
2.4 扩散模型 Diffusion:把难题拆成几十个简单小题
扩散模型(Diffusion Model)2015 年提出,灵感来自非平衡热力学。它定义一条马尔可夫链,分两个方向:
| 过程 | 方向 | 发生了什么 |
|---|---|---|
| 前向过程(加噪) | x₀ → x₁ → … → xₙ | 对原图 x₀ 加一点高斯噪声得 x₁,再加一点得 x₂……加够多步之后,xₙ 已经近似服从标准高斯分布,看不出原图任何痕迹。这一步不需要训练,是纯粹的数学操作。 |
| 反向过程(降噪) | xₙ → xₙ₋₁ → … → x₀ | 随机生成一张纯高斯噪声图,一步步把噪声减掉,最终得到一张清晰的图。这一步才是模型要学的。 |
加噪过程像往清水里滴墨:墨滴一滴滴扩散,整杯水最终变浑,再也看不出最初那滴墨滴在哪。AI 绘画干的是反过来的事——从一杯浑水里,一点点把墨收回去,还原出一滴清晰的墨。
训练目标因此朴素得出奇:随机取一张训练图、随机取一个时间步 t、按公式给它加上已知的噪声 ε,让模型看着加噪后的图去预测 ε,用回归损失去拟合。没有博弈,没有两个网络打架——训练稳定性直接碾压 GAN。
扩散模型最初是为去噪设计的;随着降噪系统训练得越来越久、越来越好,人们发现可以直接把纯噪声当输入,让它「去噪」出一张本来不存在的逼真图片。今天的图像超分、图像上色、文本生成图片、全景图像生成,底下都是这套机制。各家的代表产品——DALL·E 2、Imagen、Stable Diffusion——全部建立在它之上。
2.5 三条路线横向对比
| 对比项 | VAE | GAN | 扩散模型 |
|---|---|---|---|
| 提出年份 | 2014 | 2014 | 2015 |
| 核心机制 | 压缩到概率潜空间再重建 | 生成器与判别器零和博弈 | 加噪成高斯,再学着一步步去噪 |
| 训练稳定性 | ✅ 稳 | ❌ 不稳,易模式崩溃 | ✅ 稳(就是个回归任务) |
| 生成质量 | 偏糊 | 清晰但多样性可能塌缩 | 清晰且多样 |
| 采样速度 | ✅ 一次前向 | ✅ 一次前向 | ❌ 要迭代几十步,最慢 |
| 可控性 | 潜空间可插值 | 需专门设计条件注入 | 天然适合逐步注入文本条件 |
| 今天的位置 | 给扩散模型当压缩/还原的编解码器 | 实时性要求高的窄场景仍在用 | 文生图的事实标准 |
结论一句话:扩散模型用采样速度换来了训练稳定性和生成质量——而速度这一项,后来被「把扩散搬进低维潜空间」这个工程手段补回来了一大截(下一页的主线)。
2.6 产品形态:三层楼各自靠什么活着
技术讲完,回到工厂那三层楼。这三层不是抽象比喻,它对应真实的产业分工和三种完全不同的商业模式。
| 层 | 谁在做 | 核心能力 | 怎么收钱 |
|---|---|---|---|
| 基础层 | 少数头部企业与研发机构 | 从零训练预训练大模型,属于基础设施 | API 调用费;基于基础设施开发的专业软件平台收费 |
| 中间层(2B) | 行业服务商 | 没有训练底座的能力,但能基于开源模型做改进、抽取、二次开发,产出场景化/垂直化/定制化的应用模型与工具 | 与基础层类似:接口调用费 + 平台费,另加交付与服务费 |
| 应用层(2C) | 面向终端用户的产品团队 | 基于前两层开发,更关注用户需求,通过网页、小程序、群聊、App 等载体呈现 | 订阅制、按次计费、增值服务、广告 |
• 站应用层,重点是产品体验、成本控制与内容合规,模型能力直接买——绝大多数团队都在这一层;
• 站中间层,重点是行业数据、微调方法与私有化交付,下一页的 LoRA 就是这一层的主力工具;
• 站基础层,重点是算力、数据与训练工程,门槛是几千张显卡起步。
把自己的层定错,技术选型会全盘跑偏——最常见的错误是应用层的团队一上来就想自己训底座。
值得留意的是:三层楼都要为最终内容负责。二楼三楼不能用「模型是别人的」推掉责任——用户看见的是你的产品。铁律在这里落成一条工程要求:无论你在哪一层,出货口都得有质检与溯源。这正是 4.3 那份溯源清单存在的理由。
03最小代码:一句话换一张图
三十行、零依赖,先把「工厂出货」这条路走通
理论讲完,先把最短的一条路跑通:一句中文描述进去,一张 PNG 出来。这段代码不依赖任何第三方库,只用标准库的 urllib,在任何装了 Python 3 的机器上都能直接跑。
"""最小可跑的文生图:把一句中文描述换成一张 PNG。

依赖:只用标准库(urllib / json / base64),不需要 pip 装任何东西。
环境变量:
    IMG_API_BASE   形如 https://xxx.example.com  (不带结尾斜杠)
    IMG_API_KEY    你的密钥,绝不写进源码
    IMG_MODEL      模型名,例如 gpt-image-2.5-sunburst
运行:
    export IMG_API_BASE=... IMG_API_KEY=... IMG_MODEL=...
    python3 min_text2img.py
"""
import base64
import json
import os
import urllib.request

# ① 三个配置项全部从环境变量读,源码里不出现任何密钥
API_BASE = os.environ.get("IMG_API_BASE", "").rstrip("/")
API_KEY = os.environ.get("IMG_API_KEY", "")
MODEL = os.environ.get("IMG_MODEL", "")

# ② 提示词:说清「画什么 + 什么风格 + 什么构图」,三要素缺一张图就飘
PROMPT = "一只橘猫坐在窗台上看雪,扁平插画风格,暖色调,构图居中"


def main():
    if not (API_BASE and API_KEY and MODEL):
        raise SystemExit("缺少环境变量:IMG_API_BASE / IMG_API_KEY / IMG_MODEL")

    # ③ 组请求体。OpenAI 兼容的图片接口只认这四个字段
    body = json.dumps({
        "model": MODEL,
        "prompt": PROMPT,
        "size": "1024x1024",
        "n": 1,
    }).encode("utf-8")

    req = urllib.request.Request(
        f"{API_BASE}/v1/images/generations",
        data=body,
        headers={
            "Authorization": f"Bearer {API_KEY}",
            "Content-Type": "application/json",
        },
        method="POST",
    )

    # ④ 出图是重活,超时给足。300 秒不算夸张
    with urllib.request.urlopen(req, timeout=300) as resp:
        payload = json.load(resp)

    # ⑤ 返回的是 base64 字符串,不是图片二进制,要自己解码落盘
    b64 = payload["data"][0]["b64_json"]
    with open("out.png", "wb") as fp:
        fp.write(base64.b64decode(b64))
    print("已保存 out.png,字节数:", os.path.getsize("out.png"))


if __name__ == "__main__":
    main()
这段代码里三个不显眼但关键的地方
| 位置 | 写法 | 为什么必须这样 |
|---|---|---|
| 密钥 | os.environ.get("IMG_API_KEY", "") | 密钥永远不进源码。硬编码的后果不是「不优雅」,而是一旦这个文件被提交、被截图、被贴进工单,密钥就泄漏了。密钥泄漏后对方花的是你的钱。 |
| 超时 | timeout=300 | 出图是慢接口,几十秒是常态。按默认超时或者按「调普通接口」的经验设 10 秒,会得到一堆莫名其妙的超时错误——而服务端其实正在正常出图。 |
| 返回值 | payload["data"][0]["b64_json"] | 接口返回的是 base64 文本,不是图片二进制。直接把响应体写进 .png 会得到一个打不开的文件——这是新手第一次调图片接口最常见的坑。 |
PROMPT 不是随便写的,它包含了三件事:画什么(一只橘猫坐在窗台上看雪)、什么风格(扁平插画风格,暖色调)、什么构图(构图居中)。三者缺一,出图就开始飘——只写「一只猫」,你会得到一张风格随机、构图随机的图,重跑一次又是另一个样子。提示词是这条产线唯一的方向盘。
IMG_API_BASE(服务根地址,不带结尾斜杠)、IMG_API_KEY(密钥)、IMG_MODEL(模型名)。三个缺一个,代码会直接退出并告诉你缺哪个——这比让 urllib 抛一个看不懂的 401 友好得多。让程序在第一行就为配置问题失败,不要等到第三十行。
这三十行能跑通,就意味着「一楼发电机 → 三楼门店」这条最短路径打通了。但它离能用还差得远:跑一次和跑一百次是两码事——会被限流、会 502、会跑到一半断掉、会不知道某张图是怎么来的。下一节的三个案例,逐个补上这些窟窿。
04完整案例:从「能跑一次」到「敢跑一百次」
三个案例分别补上批量、多模态、可追溯这三个窟窿
最小代码解决的是「通不通」。真正上线要回答的是另外三个问题:量大了怎么办、模态多了怎么办、事后查不到怎么办。三个案例逐个回答。
4.1 批量出图流水线
场景:运营要一批配图,三个题材 × 两种风格 = 六张,下周可能变成六百张。串行跑、跑挂了从头再来、跑完没人知道哪张对应哪个提示词——这三件事必须一次性解决。
| 真实问题 | 代码里的对策 | 关键细节 |
|---|---|---|
| 接口慢,串行等到天亮 | ThreadPoolExecutor 并发 | 并发数压在 3~5。再高会撞限流,反而更慢——出图接口的瓶颈在服务端 GPU,不在你的网络 |
| 偶发 502 / 限流 | 指数退避 + 随机抖动 | min(60, 2**attempt) + random.uniform(0,3)。抖动不能省:没有它,多个 worker 会在同一秒集体醒来再撞一次 |
| 跑一半断了 | 提示词哈希做文件名 + 已存在就跳过 | 同样的提示词永远落在同一个文件上,重跑即断点续跑 |
| 中途 Ctrl-C 留下半张坏图 | 先写 .part 再 os.replace() | 改名是原子操作,磁盘上要么是完整文件,要么没有文件 |
| 事后说不清图怎么来的 | 每张图追加一条 manifest.jsonl | 多线程写文件必须加锁,否则两条记录会交错成一行乱码 |
"""批量出图流水线:把一份「题材 × 风格」的组合表跑成一批图,并留下可追查的记录。

解决四个真实问题:
    1. 出图接口是慢接口,串行跑一百张要等到天亮 —— 用线程池并发;
    2. 出图接口会偶发 502 / 限流 —— 指数退避重试,别一失败就整批崩;
    3. 跑一半断了不该从头再来 —— 已存在的文件直接跳过(断点续跑);
    4. 事后没人说得清某张图是怎么来的 —— 每张图写一条 manifest 记录。

运行:
    export IMG_API_BASE=... IMG_API_KEY=... IMG_MODEL=...
    python3 batch_pipeline.py
"""
import base64
import hashlib
import json
import os
import random
import threading
import time
import urllib.error
import urllib.request
from concurrent.futures import ThreadPoolExecutor, as_completed

API_BASE = os.environ.get("IMG_API_BASE", "").rstrip("/")
API_KEY = os.environ.get("IMG_API_KEY", "")
MODEL = os.environ.get("IMG_MODEL", "")

OUT_DIR = "out_images"
MANIFEST = os.path.join(OUT_DIR, "manifest.jsonl")

# ① 题材与风格分开列,笛卡尔积展开成任务表。
#    这样加一个风格是加一行,不是复制粘贴一整段提示词。
SUBJECTS = [
    "一只橘猫坐在窗台上看雪",
    "雨后的老城巷口,青石板泛着水光",
    "深夜便利店的暖黄灯光",
]
STYLES = [
    ("flat", "扁平插画风格,纯色块,描边干净"),
    ("ink", "中国水墨风格,留白多,淡墨渐变"),
]

MAX_WORKERS = 3      # 并发数:太高会被限流,3~5 是常见的安全区间
MAX_RETRY = 4        # 每个任务最多重试次数
TIMEOUT = 300        # 单次请求超时(秒),出图是慢活

_lock = threading.Lock()


def build_tasks():
    """展开成任务列表,每个任务自带一个稳定的 id。"""
    tasks = []
    for si, subject in enumerate(SUBJECTS):
        for style_key, style_desc in STYLES:
            prompt = f"{subject},{style_desc}"
            # ② 用提示词的哈希做文件名前缀:同样的提示词永远落在同一个文件上,
            #    这是断点续跑和去重的基础。
            digest = hashlib.sha256(prompt.encode("utf-8")).hexdigest()[:10]
            tasks.append({
                "task_id": f"{si:02d}-{style_key}-{digest}",
                "prompt": prompt,
                "subject": subject,
                "style": style_key,
                "size": "1024x1024",
            })
    return tasks


def call_api(prompt, size):
    """调一次出图接口,返回 base64 字符串。失败直接抛异常,由上层决定要不要重试。"""
    body = json.dumps({
        "model": MODEL, "prompt": prompt, "size": size, "n": 1,
    }).encode("utf-8")
    req = urllib.request.Request(
        f"{API_BASE}/v1/images/generations",
        data=body,
        headers={"Authorization": f"Bearer {API_KEY}",
                 "Content-Type": "application/json"},
        method="POST",
    )
    with urllib.request.urlopen(req, timeout=TIMEOUT) as resp:
        payload = json.load(resp)
    return payload["data"][0]["b64_json"]


def run_one(task):
    """跑一个任务:已存在就跳过,失败就指数退避重试。"""
    path = os.path.join(OUT_DIR, task["task_id"] + ".png")
    if os.path.exists(path) and os.path.getsize(path) > 0:
        return {"task_id": task["task_id"], "status": "skipped", "path": path}

    last_err = None
    for attempt in range(1, MAX_RETRY + 1):
        try:
            b64 = call_api(task["prompt"], task["size"])
            data = base64.b64decode(b64)
            # ③ 先写临时文件再改名:中途被 Ctrl-C 也不会留下半张坏图
            tmp = path + ".part"
            with open(tmp, "wb") as fp:
                fp.write(data)
            os.replace(tmp, path)

            record = {
                "task_id": task["task_id"],
                "prompt": task["prompt"],
                "subject": task["subject"],
                "style": task["style"],
                "size": task["size"],
                "model": MODEL,
                "bytes": len(data),
                "sha256": hashlib.sha256(data).hexdigest(),
                "created_at": time.strftime("%Y-%m-%dT%H:%M:%S"),
                "attempt": attempt,
            }
            # ④ manifest 用 jsonl 追加写,多线程下加锁,别写串行
            with _lock:
                with open(MANIFEST, "a", encoding="utf-8") as fp:
                    fp.write(json.dumps(record, ensure_ascii=False) + "\n")
            return {"task_id": task["task_id"], "status": "ok", "path": path}

        except urllib.error.HTTPError as exc:
            last_err = f"HTTP {exc.code}"
            # 4xx 里只有 429(限流)值得重试,其余是请求本身错了,重试多少次都一样
            if exc.code < 500 and exc.code != 429:
                break
        except Exception as exc:                      # noqa: BLE001
            last_err = repr(exc)

        if attempt < MAX_RETRY:
            # ⑤ 指数退避 + 随机抖动:避免多个 worker 同时醒来再次撞在一起
            backoff = min(60, 2 ** attempt) + random.uniform(0, 3)
            time.sleep(backoff)

    return {"task_id": task["task_id"], "status": "failed", "error": last_err}


def main():
    if not (API_BASE and API_KEY and MODEL):
        raise SystemExit("缺少环境变量:IMG_API_BASE / IMG_API_KEY / IMG_MODEL")
    os.makedirs(OUT_DIR, exist_ok=True)

    tasks = build_tasks()
    print(f"任务总数 {len(tasks)},并发 {MAX_WORKERS}")

    done = []
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = {pool.submit(run_one, t): t for t in tasks}
        for fut in as_completed(futures):
            result = fut.result()
            done.append(result)
            print(f"[{len(done)}/{len(tasks)}] {result['status']:<7} {result['task_id']}")

    ok = sum(1 for r in done if r["status"] == "ok")
    skipped = sum(1 for r in done if r["status"] == "skipped")
    failed = [r for r in done if r["status"] == "failed"]
    print(f"\n完成 {ok} 张,跳过 {skipped} 张,失败 {len(failed)} 张")
    for r in failed:
        print("  失败:", r["task_id"], r.get("error"))


if __name__ == "__main__":
    main()
if exc.code < 500 and exc.code != 429: break。5xx 是服务端临时故障,重试有意义;429 是限流,等一会儿再来也有意义;
但 400(请求体写错了)、401(密钥不对)、403(没权限)重试一万次结果都一样,只会把配额烧光、把日志刷爆,还把真正的错误藏起来。分不清这两类,是重试逻辑最常见的写法错误。
跑起来是这个样子:
任务总数 6,并发 3
[1/6] ok      00-flat-3f9c2a1b7e
[2/6] ok      00-ink-8b1d4e6a02
[3/6] skipped 01-flat-c47a90e155
[4/6] ok      01-ink-2e8f71b3d9
[5/6] failed  02-flat-7a3c5d0f81
[6/6] ok      02-ink-6d92b4e738

完成 4 张,跳过 1 张,失败 1 张
  失败: 02-flat-7a3c5d0f81 HTTP 502
skipped 那条说明断点续跑生效了——这张图上一轮已经出过。failed 那条重试四次仍然 502,程序没有崩,只是如实报告:再跑一次命令,它会只补这一张。
4.2 多模态统一抽象层
场景:图已经能出了,产品又要加「给图配一句标题」和「把标题读出来」。三种模态、三家服务、三套 SDK——如果每接一家就在业务代码里写一遍 if provider == "xxx",接到第三家时这份代码就烂透了。
正确做法是把「接哪家服务」和「业务要什么」彻底分开。业务代码只说一句 router.generate(GenRequest("image", "一只橘猫...")),至于这次走的是哪家、失败了换谁顶上,全在抽象层里解决。
text / image / audio。业务只认能力名,永远不认厂商名。
一个具体服务的实现,声明自己支持哪些能力。加一家新服务 = 加一个子类,业务代码一行不改。
按能力派发,某家挂了自动换下一家,全挂了才抛异常。
"""多模态统一抽象层:一个 generate() 管住文本、图像、音频三种产出。

为什么要抽这一层:
    每接一家服务就在业务代码里写一遍 if provider == "xxx",接第三家的时候
    代码就烂透了。把「模态 → 能力 → 后端」三件事分开,业务只认能力名。

结构:
    Capability   一种能力(text / image / audio),声明入参与出参形状
    Backend      一个具体后端的实现,注册到某个能力上
    Router       按能力名派发,带兜底与降级

运行(不配任何密钥也能跑,会走 DryRun 后端打印请求):
    python3 modal_router.py
"""
import json
import os
import time
from dataclasses import dataclass, field
from typing import Any, Callable, Dict, List, Optional


# ---------------------------------------------------------------- 数据结构

@dataclass
class GenRequest:
    """一次生成请求。三种模态共用同一个请求对象,差异放在 options 里。"""
    capability: str                      # "text" / "image" / "audio"
    prompt: str
    options: Dict[str, Any] = field(default_factory=dict)


@dataclass
class GenResult:
    """一次生成的结果。content 的含义由 kind 决定,调用方据此处理。"""
    kind: str                            # "text" / "image_b64" / "audio_b64"
    content: str
    backend: str
    elapsed_ms: int
    meta: Dict[str, Any] = field(default_factory=dict)


class BackendError(RuntimeError):
    """后端失败。抛这个异常表示「这个后端不行,可以换下一个」。"""


# ---------------------------------------------------------------- 后端实现

class Backend:
    """所有后端的基类。加一家新服务 = 写一个子类 + 注册,业务代码一行不改。"""

    name = "base"
    capabilities: List[str] = []

    def available(self) -> bool:
        """环境变量齐不齐。不齐就别参与派发,省得每次都失败一遍。"""
        return True

    def run(self, req: GenRequest) -> GenResult:       # pragma: no cover
        raise NotImplementedError


class DryRunBackend(Backend):
    """不连网的占位后端:把请求原样打印出来。

    它的价值不是演示,是让整条链路在没有密钥的机器上也能跑通,
    这样写业务逻辑的人不必等密钥审批。
    """

    name = "dryrun"
    capabilities = ["text", "image", "audio"]

    def run(self, req: GenRequest) -> GenResult:
        start = time.time()
        payload = {"capability": req.capability,
                   "prompt": req.prompt,
                   "options": req.options}
        body = json.dumps(payload, ensure_ascii=False)
        kind = {"text": "text", "image": "image_b64", "audio": "audio_b64"}[req.capability]
        return GenResult(
            kind=kind,
            content=f"[dryrun] {body}",
            backend=self.name,
            elapsed_ms=int((time.time() - start) * 1000),
            meta={"note": "未真实调用任何服务"},
        )


class OpenAICompatImageBackend(Backend):
    """任何 OpenAI 兼容的图片接口。换厂商只改 base_url,业务代码不动。"""

    name = "openai-compat-image"
    capabilities = ["image"]

    def __init__(self):
        self.base = os.environ.get("IMG_API_BASE", "").rstrip("/")
        self.key = os.environ.get("IMG_API_KEY", "")
        self.model = os.environ.get("IMG_MODEL", "")

    def available(self) -> bool:
        return bool(self.base and self.key and self.model)

    def run(self, req: GenRequest) -> GenResult:
        import urllib.request                       # 局部导入:不走这条路就不加载

        start = time.time()
        body = json.dumps({
            "model": self.model,
            "prompt": req.prompt,
            "size": req.options.get("size", "1024x1024"),
            "n": 1,
        }).encode("utf-8")
        request = urllib.request.Request(
            f"{self.base}/v1/images/generations",
            data=body,
            headers={"Authorization": f"Bearer {self.key}",
                     "Content-Type": "application/json"},
            method="POST",
        )
        try:
            with urllib.request.urlopen(request, timeout=300) as resp:
                payload = json.load(resp)
            b64 = payload["data"][0]["b64_json"]
        except Exception as exc:                    # noqa: BLE001
            raise BackendError(f"{self.name} 失败:{exc!r}") from exc

        return GenResult(
            kind="image_b64",
            content=b64,
            backend=self.name,
            elapsed_ms=int((time.time() - start) * 1000),
            meta={"model": self.model},
        )


# ---------------------------------------------------------------- 路由器

class Router:
    """按能力派发,失败自动换下一个后端。"""

    def __init__(self):
        self._by_capability: Dict[str, List[Backend]] = {}
        self._hooks: List[Callable[[GenRequest, Optional[GenResult], Optional[Exception]], None]] = []

    def register(self, backend: Backend) -> "Router":
        for cap in backend.capabilities:
            self._by_capability.setdefault(cap, []).append(backend)
        return self

    def on_finish(self, hook) -> "Router":
        """注册一个回调,用来记账、埋点、写溯源清单。"""
        self._hooks.append(hook)
        return self

    def generate(self, req: GenRequest) -> GenResult:
        chain = [b for b in self._by_capability.get(req.capability, []) if b.available()]
        if not chain:
            raise BackendError(f"没有可用后端支持能力:{req.capability}")

        last_exc: Optional[Exception] = None
        for backend in chain:
            try:
                result = backend.run(req)
            except BackendError as exc:
                last_exc = exc
                for hook in self._hooks:
                    hook(req, None, exc)
                continue                              # 换下一家,不让整条链路死在一家身上
            for hook in self._hooks:
                hook(req, result, None)
            return result

        raise BackendError(f"能力 {req.capability} 的后端全部失败:{last_exc!r}")


def main():
    router = (Router()
              .register(OpenAICompatImageBackend())   # 优先走真实服务
              .register(DryRunBackend()))             # 兜底:密钥没配也能跑通链路

    def audit(req, result, exc):
        status = "ok" if result else "fail"
        who = result.backend if result else "-"
        print(f"  [{status}] cap={req.capability} backend={who} err={exc}")

    router.on_finish(audit)

    for req in [
        GenRequest("image", "一只橘猫坐在窗台上看雪,扁平插画风格", {"size": "1024x1024"}),
        GenRequest("text", "给这张图写一句二十字以内的中文标题"),
        GenRequest("audio", "把上面那句标题读出来,语速偏慢"),
    ]:
        print(f"请求:{req.capability}")
        result = router.generate(req)
        preview = result.content[:60].replace("\n", " ")
        print(f"  → kind={result.kind} backend={result.backend} "
              f"{result.elapsed_ms}ms content={preview}...\n")


if __name__ == "__main__":
    main()
| 设计点 | 为什么这样定 |
|---|---|
available() 预检 | 环境变量没配齐的后端直接不参与派发。否则每次调用都要先失败一遍才轮到下一家,白白浪费一次超时等待 |
DryRunBackend 兜底 | 它的价值不是演示,而是让整条链路在没有密钥的机器上也能跑通。写业务逻辑的人不必等密钥审批下来才能动工 |
局部 import | urllib 在 run() 里才导入:不走这条路径就不加载,启动更快,依赖也更清楚 |
on_finish 回调 | 埋点、计费、写溯源清单全挂在这里。观测能力要在抽象层留口子,等出了问题再加就要改遍所有调用点 |
GenResult.kind | 返回值自带类型标记(text / image_b64 / audio_b64),调用方据此处理,不靠猜 |
4.3 生成溯源清单
场景:三个月后有人指着一张图问「这张哪来的?提示词是什么?哪个模型?能重新生成一张同风格的吗?」——没有记录,这些问题一个都答不上来。
这正是铁律落到工程上的样子。质检员要能查账,账本就是这份清单。
"""生成溯源清单:让每一张出图都能回答「谁、用什么、怎么生成的」。

为什么必须做:
    出图一多,三个月后没人说得清某张图的提示词、模型版本、随机种子。
    想复现复现不了,想排查侵权风险也查不到源头。
    这份清单写的是「生成参数」,不是「内容真伪」—— 它证明不了图里的东西是真的。

功能:
    record()   追加一条生成记录(含文件指纹)
    verify()   按指纹校验文件有没有被换掉或损坏
    report()   汇总成 Markdown 表,交付时随包给出

运行:
    python3 provenance.py demo      # 造两条演示记录并校验
"""
import hashlib
import json
import os
import sys
import time
from typing import Dict, Iterator, List

LEDGER = "provenance.jsonl"


def file_sha256(path: str, chunk: int = 1 << 20) -> str:
    """分块算哈希:图片动辄几 MB,别一次性读进内存。"""
    digest = hashlib.sha256()
    with open(path, "rb") as fp:
        while True:
            block = fp.read(chunk)
            if not block:
                break
            digest.update(block)
    return digest.hexdigest()


def record(path: str, *, prompt: str, model: str, seed=None,
           extra: Dict = None, ledger: str = LEDGER) -> Dict:
    """给一个已生成的文件登记一条记录。"""
    if not os.path.exists(path):
        raise FileNotFoundError(path)

    entry = {
        "path": os.path.relpath(path),
        "bytes": os.path.getsize(path),
        "sha256": file_sha256(path),
        "prompt": prompt,
        "model": model,
        "seed": seed,
        "created_at": time.strftime("%Y-%m-%dT%H:%M:%S"),
        "generator": "ai",          # 明确标注这是机器生成的产物
    }
    if extra:
        entry.update(extra)

    with open(ledger, "a", encoding="utf-8") as fp:
        fp.write(json.dumps(entry, ensure_ascii=False) + "\n")
    return entry


def load(ledger: str = LEDGER) -> Iterator[Dict]:
    if not os.path.exists(ledger):
        return iter(())
    def _gen():
        with open(ledger, encoding="utf-8") as fp:
            for line in fp:
                line = line.strip()
                if line:
                    yield json.loads(line)
    return _gen()


def verify(ledger: str = LEDGER) -> List[Dict]:
    """逐条校验文件是否仍与登记时一致。返回有问题的条目。"""
    problems = []
    for entry in load(ledger):
        path = entry["path"]
        if not os.path.exists(path):
            problems.append({**entry, "issue": "文件已丢失"})
            continue
        if file_sha256(path) != entry["sha256"]:
            problems.append({**entry, "issue": "内容与登记时不一致"})
    return problems


def report(ledger: str = LEDGER) -> str:
    """汇总成 Markdown 表,直接贴进交付说明。"""
    rows = list(load(ledger))
    if not rows:
        return "(暂无记录)"
    lines = ["| 文件 | 模型 | seed | 生成时间 | 指纹前 12 位 |",
             "| --- | --- | --- | --- | --- |"]
    for r in rows:
        lines.append("| {path} | {model} | {seed} | {created_at} | `{short}` |".format(
            path=r["path"], model=r["model"],
            seed=r.get("seed") if r.get("seed") is not None else "-",
            created_at=r["created_at"], short=r["sha256"][:12]))
    return "\n".join(lines)


def _demo():
    os.makedirs("demo_assets", exist_ok=True)
    for name, text in [("a.txt", "第一张图的占位内容"), ("b.txt", "第二张图的占位内容")]:
        with open(os.path.join("demo_assets", name), "w", encoding="utf-8") as fp:
            fp.write(text)

    record("demo_assets/a.txt", prompt="一只橘猫坐在窗台上看雪,扁平插画",
           model="demo-image-model", seed=20260127)
    record("demo_assets/b.txt", prompt="雨后老城巷口,水墨风格",
           model="demo-image-model", seed=20260129)

    print(report())
    print("\n校验:", verify() or "全部一致 ✅")

    # 故意改动一个文件,验证校验确实能抓出来
    with open("demo_assets/b.txt", "a", encoding="utf-8") as fp:
        fp.write("(被人改过)")
    print("改动后校验:", verify())


if __name__ == "__main__":
    if len(sys.argv) > 1 and sys.argv[1] == "demo":
        _demo()
    else:
        print(report())
| 字段 | 例子 | 为什么要记 |
|---|---|---|
prompt | 一只橘猫坐在窗台上看雪… | 想再生成一批同风格的,靠它;想排查「为什么出了这种图」,也靠它 |
model | 模型名与版本 | 同一句提示词换个模型版本,出图可能完全不同。只记「用了 AI」等于没记 |
seed | 20260127 | 复现的关键。没有 seed,同样的提示词每次出的图都不一样 |
sha256 | 文件指纹 | 证明这个文件从登记到现在没被换过、没损坏 |
generator: "ai" | 固定值 | 明确标注这是机器产物。内部台账里把这件事写清楚,比事后靠回忆强得多 |
跑 python3 provenance.py demo 会看到它先出一张表,再做一次校验,然后故意改动一个文件、校验立刻报出问题:
| 文件 | 模型 | seed | 生成时间 | 指纹前 12 位 |
| --- | --- | --- | --- | --- |
| demo_assets/a.txt | demo-image-model | 20260127 | 2026-02-03T10:12:41 | `9f2c7a1b4d08` |
| demo_assets/b.txt | demo-image-model | 20260129 | 2026-02-03T10:12:41 | `4e81d35c6a97` |

校验: 全部一致 ✅
改动后校验: [{'path': 'demo_assets/b.txt', ..., 'issue': '内容与登记时不一致'}]
它不能证明图里的内容是真的——铁律在这里再说一遍:可追溯 ≠ 可信。溯源解决的是责任链问题,事实核查仍然要靠质检员去做。把这两件事混为一谈,是很多团队合规方案里最大的漏洞。
三个案例的关系
| 案例 | 解决的问题 | 什么时候必须有 |
|---|---|---|
| 批量流水线 | 量 | 要出的内容超过十几件,手点已经不现实 |
| 统一抽象层 | 复杂度 | 出现第二家供应商或第二种模态 |
| 溯源清单 | 责任 | 内容要对外发布的那一刻——不是上线后补,是上线前就得有 |
三者叠起来,就是一条能长期运转的内容产线:抽象层管派发,流水线管吞吐,清单管交代。
05骨架模板:拿去改就能用
一份统一客户端 + 一份批量任务配置,覆盖日常九成场景
5.1 统一客户端骨架
把 4.1 的重试退避、4.2 的多后端降级、4.3 的事件回调三件事合成一个文件。业务代码从此只写两行:client = AigcClient()、data = client.image("...")。
| 它替你扛了什么 | 对应代码位置 |
|---|---|
| 密钥不进源码 | 每个 provider 只登记环境变量名 env_key,值在运行时才读 |
| 一家挂了自动换下一家 | _dispatch() 按登记顺序遍历,顺序即优先级 |
| 该重试的才重试 | _call_with_retry() 只对 5xx 与 429 退避重试,4xx 直接抛出 |
| 环境没配齐的后端不参与 | p["base"] and os.environ.get(p["env_key"]) 预检 |
| 埋点、计费、溯源有地方挂 | on_event 回调,在成功与失败两条路径上都会触发 |
"""AIGC 统一客户端骨架 —— 复制后只改 TODO 处。

这份骨架把「接哪家服务」和「业务要什么」彻底分开:
    业务代码只说 client.image("一只橘猫..."),
    换厂商、加降级、加重试、加审计都在这个文件里改,业务代码一行不动。

依赖:标准库即可。
"""
import base64
import json
import os
import random
import time
import urllib.error
import urllib.request
from typing import Any, Callable, Dict, List, Optional

# ---------------------------------------------------------------------------
# TODO 1:把你要接的服务填在这里。
#   key      给业务代码用的短名字
#   base     服务根地址,不带结尾斜杠
#   env_key  存放密钥的环境变量名(密钥本身绝不写进源码)
#   model    默认模型名
#   caps     这家服务支持哪些能力
# ---------------------------------------------------------------------------
PROVIDERS: List[Dict[str, Any]] = [
    {
        "key": "primary",
        "base": os.environ.get("IMG_API_BASE", "").rstrip("/"),
        "env_key": "IMG_API_KEY",
        "model": os.environ.get("IMG_MODEL", ""),
        "caps": ["image"],
    },
    # TODO 2:要加第二家做降级就再补一段,顺序即优先级
    # {
    #     "key": "backup",
    #     "base": os.environ.get("BACKUP_API_BASE", "").rstrip("/"),
    #     "env_key": "BACKUP_API_KEY",
    #     "model": os.environ.get("BACKUP_MODEL", ""),
    #     "caps": ["image", "text"],
    # },
]

MAX_RETRY = 4        # TODO 3:重试次数与超时按你的服务实际情况调
TIMEOUT = 300


class AigcError(RuntimeError):
    pass


class AigcClient:
    def __init__(self, providers=None, on_event: Optional[Callable] = None):
        self.providers = providers if providers is not None else PROVIDERS
        # TODO 4:把埋点/审计/写溯源清单挂在这个回调上
        self.on_event = on_event or (lambda **kw: None)

    # ------------------------------------------------------------- 对外能力

    def image(self, prompt: str, size: str = "1024x1024", **opts) -> bytes:
        """文生图,返回图片二进制。"""
        payload = self._dispatch("image", prompt, {"size": size, **opts})
        return base64.b64decode(payload["data"][0]["b64_json"])

    def text(self, prompt: str, **opts) -> str:
        """文本生成。TODO 5:不同厂商的文本接口字段不一致,在这里对齐。"""
        payload = self._dispatch("text", prompt, opts)
        return payload["choices"][0]["message"]["content"]

    # ------------------------------------------------------------- 内部实现

    def _endpoint(self, capability: str) -> str:
        return {
            "image": "/v1/images/generations",
            "text": "/v1/chat/completions",
        }[capability]

    def _body(self, capability: str, provider: Dict, prompt: str, opts: Dict) -> bytes:
        if capability == "image":
            body = {"model": provider["model"], "prompt": prompt,
                    "size": opts.get("size", "1024x1024"), "n": 1}
        else:
            body = {"model": provider["model"],
                    "messages": [{"role": "user", "content": prompt}]}
            body.update({k: v for k, v in opts.items() if k != "size"})
        return json.dumps(body).encode("utf-8")

    def _dispatch(self, capability: str, prompt: str, opts: Dict) -> Dict:
        usable = [p for p in self.providers
                  if capability in p["caps"] and p["base"] and os.environ.get(p["env_key"])]
        if not usable:
            raise AigcError(f"没有可用服务支持能力 {capability};检查环境变量是否配齐")

        last_err = None
        for provider in usable:
            try:
                return self._call_with_retry(capability, provider, prompt, opts)
            except AigcError as exc:
                last_err = exc
                self.on_event(event="provider_failed", provider=provider["key"], error=str(exc))
        raise AigcError(f"全部服务失败:{last_err}")

    def _call_with_retry(self, capability, provider, prompt, opts) -> Dict:
        url = provider["base"] + self._endpoint(capability)
        key = os.environ[provider["env_key"]]
        body = self._body(capability, provider, prompt, opts)

        for attempt in range(1, MAX_RETRY + 1):
            req = urllib.request.Request(
                url, data=body,
                headers={"Authorization": f"Bearer {key}",
                         "Content-Type": "application/json"},
                method="POST")
            try:
                started = time.time()
                with urllib.request.urlopen(req, timeout=TIMEOUT) as resp:
                    payload = json.load(resp)
                self.on_event(event="ok", provider=provider["key"],
                              capability=capability, attempt=attempt,
                              elapsed_ms=int((time.time() - started) * 1000))
                return payload
            except urllib.error.HTTPError as exc:
                # 只有 5xx 和 429 值得重试;其余是请求本身写错了
                if exc.code < 500 and exc.code != 429:
                    raise AigcError(f"HTTP {exc.code},请求有问题,不重试") from exc
                err = f"HTTP {exc.code}"
            except Exception as exc:                      # noqa: BLE001
                err = repr(exc)

            if attempt == MAX_RETRY:
                raise AigcError(f"{provider['key']} 重试 {MAX_RETRY} 次仍失败:{err}")
            time.sleep(min(60, 2 ** attempt) + random.uniform(0, 3))

        raise AigcError("不可达")


if __name__ == "__main__":
    # TODO 6:换成你自己的调用
    client = AigcClient(on_event=lambda **kw: print("  事件:", kw))
    data = client.image("一只橘猫坐在窗台上看雪,扁平插画风格")
    with open("out.png", "wb") as fp:
        fp.write(data)
    print("已保存 out.png", len(data), "字节")
on_event · TODO 5 不同厂商文本接口字段不一致,在 text() 里对齐 · TODO 6 换成你自己的调用。其余代码不用动。
on_event 里记账并设一个单次请求的花费上限。降级策略要按计费模式定,不能照抄。
5.2 批量任务配置模板
把「要生成什么」从代码里搬到配置文件里。改需求时改 JSON,不动代码——这样非开发的同事也能提需求。
{
  "_说明": "批量出图的任务配置。题材与风格分开列,程序做笛卡尔积展开;加一个风格是加一行,不是复制一整段提示词。",
  "output_dir": "out_images",
  "manifest": "out_images/manifest.jsonl",
  "concurrency": 3,
  "max_retry": 4,
  "timeout_seconds": 300,
  "default_size": "1024x1024",
  "subjects": [
    {"key": "cat-snow", "text": "TODO:写清楚画什么,主体 + 场景 + 动作"},
    {"key": "old-alley", "text": "TODO:第二个题材"}
  ],
  "styles": [
    {"key": "flat", "text": "TODO:风格描述,例如 扁平插画风格,纯色块,描边干净"},
    {"key": "ink", "text": "TODO:第二种风格"}
  ],
  "negative_prompt": "TODO:不想要的东西,例如 文字、水印、多余的手指",
  "seed": null,
  "_seed说明": "填一个整数可复现同一张图;填 null 表示每次随机。要复现就必须记进 manifest。"
}
| 字段 | 怎么填 | 踩过的坑 |
|---|---|---|
subjects / styles | 分开列,程序做笛卡尔积 | 把风格直接写进每条题材里,加一种风格就要改 N 行,而且改漏一行不会报错,只会悄悄出一批风格不统一的图 |
key | 短、稳定、只用字母数字和连字符 | 它会进文件名。用中文或空格,在跨平台同步、打包下载时会出各种编码问题 |
concurrency | 3~5 起步,按限流调 | 调到 20 不会更快,只会让失败率飙升,然后重试把配额烧掉 |
negative_prompt | 写不想要的东西 | 文字、水印、多余的手指是最常见的三项。不填不是中性,是放任 |
seed | 要复现就填整数,否则 null | 填了但没记进 manifest,等于没填——下次照样复现不出来 |
5.3 两份模板怎么配合
这条链路的分工很清楚:配置管「要什么」,流水线管「怎么跑」,客户端管「找谁做」,清单管「怎么交代」。四者解耦之后,换供应商不影响配置,改需求不影响代码,出了问题能顺着清单一路查回提示词。
06易错点汇总
按「认知 / 分类 / 技术 / 工程 / 合规」五类归并,踩过一次就别再踩
⚠️ 一、认知层面
- 把「像」当成「对」。 生成式模型的目标函数里从来没有「真实性」这一项,它优化的是「看起来像不像训练数据」。所以格式完美但根本不存在的文献条目、结构错误的手、查无此处的地名,在模型眼里都是高分输出。这不是 bug,是定义如此。
- 以为 AIGC 是某一个模型。 它是一整类能力与产业,横跨文本、图像、音频、视频、多模态五个方向,底下至少三条技术路线。问「AIGC 用什么模型」等于问「制造业用什么机器」。
- 把 AIGC 和判别式模型混为一谈。 判别式学
P(y|x)给答案,有标准答案可验证;生成式学P(x)造新东西,只有「像不像」。两者的评估方式、失败形态、风险等级全都不同。 - 以为「生成模型 2022 年才出现」。 VAE 与 GAN 是 2014 年,扩散模型是 2015 年。这几年变的不是有没有,而是质量跨过了可用线,同时算力便宜到能大规模推理。
⚠️ 二、分类与选型
- 只用一种分法定位需求。 按技术分(孪生/编辑/生成)定的是风险与质检强度,按产出分(文本/图像/音频/视频/多模态)定的是买哪类服务、要多少算力。只看一边,要么低估风险,要么买错服务。
- 把「图像超分」和「文生图」按同一套流程上线。 前者是内容孪生,风险低,可以自动化;后者是内容生成,事实与版权风险都高,必须留人工复核通道。同一个团队用同一套审核策略覆盖两者,迟早出事。
- 站错产品层。 应用层团队一上来就想自己训底座,是最常见的资源错配——基础层的门槛是几千张显卡。先定自己在哪一层,再定技术方案。
- 以为中间层和应用层不用为内容负责。 用户看见的是你的产品,「模型是别人的」推不掉责任。无论哪一层,出货口都得有质检与溯源。
⚠️ 三、三条技术路线
- 以为 VAE 已经被淘汰了。 它作为「生成器」确实退场了(图偏糊),但作为压缩与还原的编解码器还在主力位置上——下一页要讲的潜空间扩散,最后那一步还原像素图用的就是 VAE 解码器。
- 说不清 GAN 为什么难训。 两个顽疾要记住:训练不稳定(两个网络实力失衡,判别器太强则生成器拿不到有效梯度)与模式崩溃(生成器只画某一种能骗过判别器的图,多样性归零)。
- 把扩散模型的前向过程也当成要训练的部分。 前向加噪是纯数学操作,不需要训练;要学的只有反向降噪——具体说是「预测本步混进来的噪声」这个回归任务。
- 问「扩散模型为什么不一步到位」答不上来。 因为「从纯噪声一步变清晰图」这个映射极难学;拆成几十步后,每一步都只是个简单回归题。难度被时间摊平,这就是它又稳又好的根本原因。
- 忽略扩散模型最大的代价。 采样要迭代几十步,速度是三条路线里最慢的。它能上生产,靠的是后来把扩散搬进低维潜空间这一工程手段。
⚠️ 四、工程实现
- 把响应体直接写成
.png。 接口返回的是b64_json—— base64 文本,不是图片二进制。必须先base64.b64decode(),否则得到一个打不开的文件。 - 按调普通接口的经验设超时。 出图几十秒是常态,
timeout至少给到 120~300 秒。设 10 秒会得到一堆超时错误,而服务端其实正在正常出图。 - 对所有错误一视同仁地重试。 5xx 与 429 重试有意义;400/401/403 重试一万次结果都一样,只会烧配额、刷爆日志,还把真正的错误藏起来。
- 重试退避不加随机抖动。 多个 worker 会在同一秒集体醒来,再次撞在一起,退避形同虚设。
- 并发开到几十。 瓶颈在服务端 GPU 不在你的网络,并发拉高只会让失败率飙升。3~5 起步,按限流实测调。
- 直接写目标文件。 中途中断会留下半张坏图,而且下次「已存在就跳过」的逻辑会把这张坏图当成功。先写
.part再os.replace(),改名是原子操作。 - 多线程写同一个日志文件不加锁。 两条记录会交错成一行乱码,事后无法解析。
- 密钥硬编码进源码。 后果不是不优雅,是这个文件一旦被提交、截图或贴进工单,密钥就泄漏了,对方花的是你的钱。一律
os.environ.get(...)。 - 提示词只写主体。 「一只猫」会得到风格随机、构图随机的图,重跑一次又是另一个样子。画什么 + 什么风格 + 什么构图,三要素缺一就飘。
- 每接一家服务就在业务代码里加一个
if provider == ...。 接到第三家时这份代码就烂透了。出现第二家或第二种模态,立刻抽统一抽象层。
⚠️ 五、合规与交付
- 把「可追溯」当成「可信」。 溯源清单能证明这张图是用哪个模型、哪句提示词、哪个 seed 生成的、之后没被掉包;它证明不了图里的内容是真的。事实核查仍然要人来做。
- 只记「用了 AI」。 没有模型名与版本、没有 seed、没有提示词,三个月后既复现不了也排查不了。等于没记。
- 填了 seed 却不记进清单。 下次照样复现不出来。
- 上线后才补溯源。 内容对外发布的那一刻就该有记录,事后补的账本没有证据价值。
- 用生成内容替代需要核实的事实。 数据、引用、条款、人名这类内容,模型给出的是「像那么回事的写法」,必须逐条外部核验后才能进正式材料。
07自测题
点击题目展开答案;能把这 16 题说清楚,这一讲就通了
AIGC 的全称是什么?一句话说清它和「AI 辅助工具」的区别。
AI Generated Content,人工智能生成内容。区别在于产出物本身由模型造出来:辅助工具帮你把已有内容改得更好,AIGC 直接交付一件此前不存在的内容(一段文案、一张图、一段配音)。
判别式模型与生成式模型学的东西有什么本质不同?
判别式学的是条件概率 P(y|x)——给定输入判断它属于哪一类,有标准答案可验证;生成式学的是数据分布 P(x)——学会「这类数据长什么样」,然后采样造新的,没有标准答案,只有像不像。评估方式、失败形态、风险等级全都因此不同。
为什么说生成模型「不保证正确,只保证像」?
因为它的目标函数里根本没有「真实性」这一项,优化的是「输出看起来像不像训练数据」。所以格式完美但查无此文的参考文献、结构错误的手、不存在的地名,在模型眼里都是高分输出。这不是 bug,是定义使然。
生成模型是这两年才出现的吗?
不是。VAE 与 GAN 是 2014 年,扩散模型的思想是 2015 年。这几年变的不是「有没有」,而是质量跨过了可用线,同时算力便宜到能大规模推理。
按技术手段,AIGC 分哪三类?各举一例。
内容孪生(老照片修复、图像超分,把已有内容搬进数字世界)、内容编辑(换背景、改风格、变声,在已有内容上改)、内容生成(文生图、写文案,从零造新内容)。风险从左到右递增。
为什么「图像超分」和「文生图」不能套同一套审核流程?
前者是内容孪生,输入输出强绑定,风险低,可以自动化;后者是内容生成,事实与版权风险都高,必须留人工复核通道。用一套策略覆盖两者,迟早出事。
按产出模态分,AIGC 有哪五个方向?这种分法定的是什么?
文本、图像、音频、视频、多模态。这种分法定的是买哪类服务、要多少算力、用什么评估指标;而按技术手段的分法定的是风险与质检强度。两种分法各管一件事,只看一边要么低估风险,要么买错服务。
产业三层分别是什么?应用层团队最容易犯的资源错配是什么?
基础层(训底座大模型)、中间层(在底座上做垂类微调与工具化)、应用层(面向终端用户的产品)。最常见的错配是应用层团队一上来就想自己训底座——那一层的门槛是几千张显卡。先定自己在哪一层,再定技术方案。
「模型是别人的,出了问题不怪我们」这个说法成立吗?
不成立。用户看见的是你的产品。无论处在哪一层,出货口都必须有质检与溯源。
VAE 被淘汰了吗?它现在主要用在哪?
作为生成器它退场了(出图偏糊),但作为压缩与还原的编解码器仍在主力位置上——潜空间扩散最后那一步把潜表示还原成像素图,用的就是 VAE 解码器。
GAN 的两个顽疾是什么?
训练不稳定:生成器与判别器实力失衡时训练就崩,判别器太强则生成器拿不到有效梯度。模式崩溃:生成器发现画某一种图就能骗过判别器,于是只画那一种,多样性归零。
扩散模型的前向加噪过程需要训练吗?真正要学的是什么?
前向加噪是纯数学操作,不需要训练。真正要学的只有反向降噪——具体说是「预测本步混进来的噪声是什么样」这个回归任务。
扩散模型为什么要拆成几十步,不一步到位?
因为「从纯噪声一步变成清晰图」这个映射极难学。拆成几十步后,每一步都只是一道简单的回归题,难度被时间摊平——这就是它又稳又好的根本原因。
扩散模型最大的工程代价是什么?靠什么手段压下去?
采样要迭代几十步,速度是三条路线里最慢的。它能上生产,靠的是把扩散过程从像素空间搬进低维潜空间——计算量按压缩倍数的平方级下降。
调文生图接口拿到 b64_json 后直接写进 .png,会发生什么?
得到一个打不开的文件。接口返回的是 base64 文本,不是图片二进制,必须先 base64.b64decode() 再以二进制写盘。这是第一次调图片接口最常见的坑。
批量出图时,哪些 HTTP 错误该重试、哪些不该?为什么退避还要加随机抖动?
5xx(服务端临时故障)与 429(限流)值得重试;400 / 401 / 403 重试一万次结果都一样,只会烧配额、刷爆日志、把真正的错误藏起来。抖动用来打散多个 worker 的唤醒时刻,否则它们会在同一秒集体醒来再撞一次,退避形同虚设。
溯源清单能证明什么、不能证明什么?至少要记哪几个字段?
能证明这张图是用哪个模型、哪句提示词、哪个 seed 生成的,并且之后没被掉包;不能证明图里的内容是真的——可追溯 ≠ 可信。必记字段:提示词、模型名与版本、seed、文件 sha256、生成时间、generator 标记。只记「用了 AI」等于没记。
08术语表
本页出现的术语,按「是什么 / 在哪用 / 别搞混」三栏对齐
| 术语 | 一句话是什么 | 在哪用 / 别搞混 |
|---|---|---|
| AIGC AI Generated Content | 由模型直接造出内容的一整类能力与产业 | 它不是某一个模型。横跨文本、图像、音频、视频、多模态五个方向,底下至少三条技术路线 |
| 判别式模型 Discriminative | 学 P(y|x),给定输入判断它属于哪一类 | 有标准答案可验证。分类、检测、打分都属于这类 |
| 生成式模型 Generative | 学数据分布 P(x),学会「这类数据长什么样」再采样造新的 | 没有标准答案,只有「像不像」。目标函数里没有真实性这一项 |
| 内容孪生 / 编辑 / 生成 | 按技术手段的三分法:搬进来 / 在已有内容上改 / 从零造 | 这套分法定的是风险与质检强度,不是买什么服务。风险从左到右递增 |
| 多模态 Multimodal | 同一个系统同时处理文本、图像、音频等多种信息形态 | 「图生文」「文生图」都算。与「多个单模态模型拼在一起」不同——真正的多模态在同一个表示空间里打通 |
| VAE Variational Auto-Encoder | 编码器把图压成低维向量,解码器再还原回去 | 作为生成器已退场(出图偏糊),作为编解码器仍是主力——潜空间扩散最后一步还原像素就靠它 |
| GAN Generative Adversarial Network | 生成器造假、判别器打假,对抗着一起变强 | 两个顽疾:训练不稳定(双方实力失衡就崩)、模式崩溃(只会画一种能骗过判别器的图) |
| 扩散模型 Diffusion Model | 先把图一步步加噪成雪花,再训一个网络一步步把噪声去掉 | 当前文生图的主流路线。代价是采样要迭代几十步,最慢 |
| 前向过程 Forward / Noising | 按固定公式逐步往图里加高斯噪声 | 纯数学操作,不需要训练。把它当成「要学的部分」是常见误解 |
| 反向过程 Reverse / Denoising | 从纯噪声出发,一步步预测并减去噪声,逐渐显出图像 | 真正训练的部分。每一步学的其实是「本步混进来的噪声长什么样」这个回归任务 |
| 潜空间 Latent Space | 图像被压缩后所处的低维表示空间 | 把扩散搬进潜空间,计算量按压缩倍数的平方级下降——这是扩散模型能上生产的工程前提 |
| 提示词 Prompt | 告诉模型要生成什么的那段自然语言 | 三要素缺一就飘:画什么 + 什么风格 + 什么构图。它是这条产线唯一的方向盘 |
| 负向提示词 Negative Prompt | 明确写出「不想要什么」 | 文字、水印、多余的手指是最常见三项。不填不是中性,是放任 |
| seed 随机种子 | 决定本次采样起点的那个整数 | 复现的关键。填了但没记进溯源清单,等于没填 |
| b64_json | 图片接口返回的 base64 编码文本字段 | 不是图片二进制。必须先 base64.b64decode() 再以二进制写盘,否则文件打不开 |
| 指数退避 Exponential Backoff | 失败后等待时间随重试次数翻倍 | 必须叠随机抖动,否则多个 worker 会在同一秒集体醒来再撞一次 |
| 限流 Rate Limit / HTTP 429 | 服务端限制单位时间内的请求数 | 值得重试的错误之一。并发 3~5 起步——瓶颈在服务端 GPU,不在你的网络 |
| 原子落盘 | 先写 .part 临时文件,再 os.replace() 改名 | 改名是原子操作。直接写目标文件,中断会留下半张坏图,而且下次会被「已存在就跳过」当成功 |
| 断点续跑 | 用提示词哈希做文件名,已存在就跳过 | 让「跑挂了重跑一次」变成只补缺失的那几张,而不是从头再来 |
| 统一抽象层 | 业务只声明要什么能力,由路由器决定派给哪家服务 | 出现第二家供应商或第二种模态就该补上。只接一家时它是过度设计 |
| 降级 Fallback | 首选服务失败时自动切到备选服务 | 模板里的降级是「换一家重做一次」。按 token 计费的长文本场景要另设花费上限 |
| 溯源清单 Provenance Manifest | 逐条记录每件产物的提示词、模型、seed、指纹、时间 | 能证明没被掉包,证明不了内容是真的——可追溯 ≠ 可信 |
| sha256 | 文件内容的指纹 | 用于校验文件从登记到现在没被换过、没损坏 |