【案例】大健康行业智能问诊系统 · 底座选型与训练
第一个批次的损失就能告诉你底座有没有加载上:把训练循环里每个不报错的坑都变成一个能当场核对的数字。
30″30 秒看懂训练这一侧
教材编好了,那位通才毕业生要正式开始岗前培训。麻烦在于:培训出了岔子,没有人会举手告诉你——课照上、时长照记、结业证照发,只是学出来的东西不对。
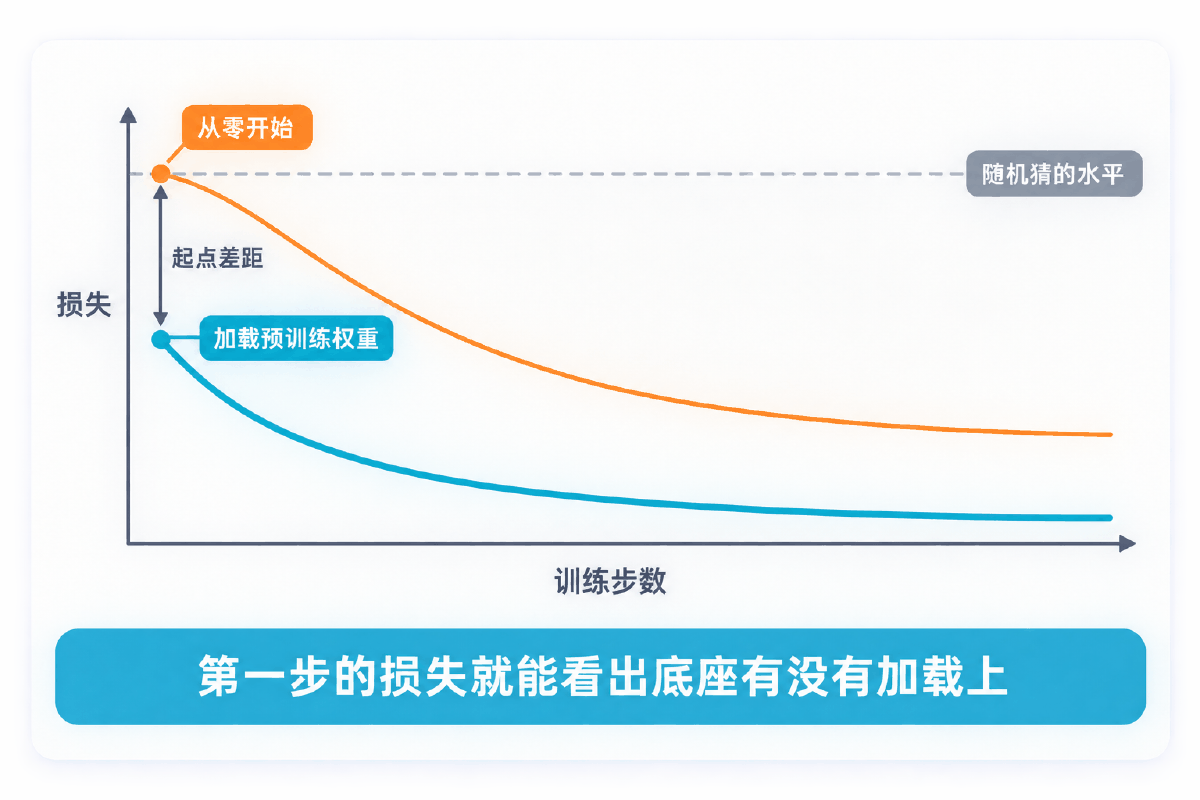
最典型的一种岔子是:人事部根本没把那位读过万卷书的毕业生送来,而是随便拉了个完全没上过学的人顶班。培训流程一模一样,谁也看不出区别。但有一个办法能当场识破——上课第一分钟先做一张随堂小测:真正的毕业生就算没受过岗位训练,也不至于全靠瞎蒙;而没上过学的那位,得分必然正好等于瞎蒙的水平。
| 比喻里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 开课第一分钟的随堂小测 | 第一个批次的损失 | 识破「底座没加载上」的唯一低成本手段 |
| 瞎蒙能得的分数 | ln(词表大小) | 随机初始化时交叉熵的理论值,本讲底座是 ln(21128) ≈ 9.96 |
| 攒够几次作业才批改一次 | 梯度累积 | 用小显存换大的等效批大小 |
| 给分数设一个上限 | 梯度裁剪 | 异常样本产生的巨大梯度按比例压回去,只改长度不改方向 |
| 先慢热再收尾 | 预热 + 衰减 | 开头小步试探,后期逐渐收小步子稳住 |
| 平时练习册 vs 期末考卷 | 训练集 vs 验证集 | 练习册成绩一直涨、考卷成绩开始跌,就是该收手的时刻 |
这一讲就是按这条铁律组织的:每讲一个环节,就给出它出错时的现象和一个十秒钟能打印出来的检查。
01概念:底座怎么选,训练怎么才算跑对
选底座的三个条件、「从零训练」与「继续训练」的本质区别、以及训练里那一类不报错的坑
1.1 选底座看三个条件
底座选错,后面调什么参数都救不回来。判断一个底座能不能用,看三件事,而且顺序不能反。
| 条件 | 怎么判断 | 不满足会怎样 |
|---|---|---|
| ① 语言对不对 | 看它的预训练语料是中文还是英文 | 拿英文底座训中文,分词就先崩了——一个汉字被拆成两三个字节 token,模型要先学会拼字,再学任务 |
| ② 任务类型对不对 | 自回归生成用 CausalLM,判别分类用 SequenceClassification | 问诊要的是「续写一段话」,用分类头的底座结构上就产不出句子 |
| ③ 规模跑不跑得动 | 套上一讲的显存账本 | 装不下就是装不下。这一条经常比效果更早卡住你 |
本案例选的是中文 GPT-2 底座 uer/gpt2-chinese-cluecorpussmall:中文语料预训练、自回归结构、102M 参数全量微调只要 1.52 GB。它不是最强的,但它是这三个条件同时满足、且能在教学环境里完整跑通的那个。
1.2 「从零训练」和「继续训练」的区别
同样一段训练代码,加载不加载预训练权重,是两件完全不同的事。
| 对比项 | 从零训练 | 继续训练(微调) |
|---|---|---|
| 起始参数 | 随机初始化 | 预训练好的权重 |
| 第一批损失 | ≈ ln(词表大小) | 明显低于这个值 |
| 要多少数据 | 海量,几十亿 token 起步 | 几百到几万条即可 |
| 几十条数据的结果 | 学不出任何语言能力,只会输出乱码 | 能学到格式与语气 |
代码上的区别只有一行:Model.from_pretrained(路径) 是继续训练,而 Model(config) 是从零开始。后者不会报错,也不会警告——它是一个完全合法的调用,只是干了件你不想要的事。
这不是假想的风险。本案例的参考实现里就有这个问题:它的训练日志第一个批次损失是 9.59,而 ln(21128) = 9.96——两个数几乎贴在一起,说明那一轮训练是从随机初始化开始的,预训练权重根本没进来。用几十条医疗问答从零训一个语言模型,结果只能是噪声。
1.3 训练里那一类特殊的坑
写业务代码时,错误通常会以异常的形式砸到你脸上。训练代码不一样,它有一整类「出错但不报错」的问题:
| 出错的地方 | 现象 | 能当场核对的证据 |
|---|---|---|
| 底座没加载上 | 照常训练,效果像噪声 | 第一批损失是否贴近 ln(词表) |
| LoRA 旁支没挂上 | 照常训练,等于什么都没训 | 可训练参数占比是否在零点几个百分点 |
| 调度器推进错对象 | 后半程学习率一直是 0 | 总更新次数是否等于 批次数 ÷ 累积步数 × 轮数 |
| 裁剪放错位置 | 累积出来的梯度方向失真 | 裁剪是否只在「攒够了」的那一步执行 |
| 准确率没位移对齐 | 数字偏低且看不出原因 | 预测左移一位、标签右移一位后再比对 |
| 保存了最后一轮 | 上线效果不如中间某一轮 | 验证损失最低的是第几轮 |
右边那一列是这一讲真正要教的东西。每个坑都配一个十秒钟能打印出来的数字——把它们串起来,就是一套开训前的检查清单。
02原理:把每个不报错的坑变成一个数字
损失起点、循环时序、裁剪与累积、调度器的横轴、准确率的位移对齐
2.1 用损失起点验证底座
交叉熵损失衡量的是「模型给正确答案分配了多大概率」。如果模型完全没学过语言,对词表里每个 token 都给同样的概率,那么每个位置的概率就是 1 / 词表大小,代入交叉熵:
loss = -ln(1 / V) = ln(V)
这就是瞎蒙基准线。本讲底座词表 21128,ln(21128) ≈ 9.96。于是第一个批次的损失有了明确的判读方式:
| 第一批损失 | 判读 | 该做什么 |
|---|---|---|
| 贴近 9.96 | 预训练权重没加载上 | 检查是不是误用了 Model(config) 而不是 from_pretrained(...) |
| 明显低于 9.96 | 底座生效了 | 可以继续 |
| 远高于 9.96 | 数据或标签有问题 | 检查标签是否错位、词表是否与分词器不匹配 |
ln(V) 没有关系。所以这个检查只在第一个批次做一次,做完就该关掉。
还有一个配套检查同样重要:分词器词表与模型词表必须相等。两者不一致时,分词器编出来的 id 可能超出模型嵌入表范围,报的是一个看不出是词表问题的越界错误。加载完直接断言一句,比事后排查便宜得多。
2.2 训练循环的正确时序
一个带梯度累积的训练循环,步骤顺序只有一种是对的:
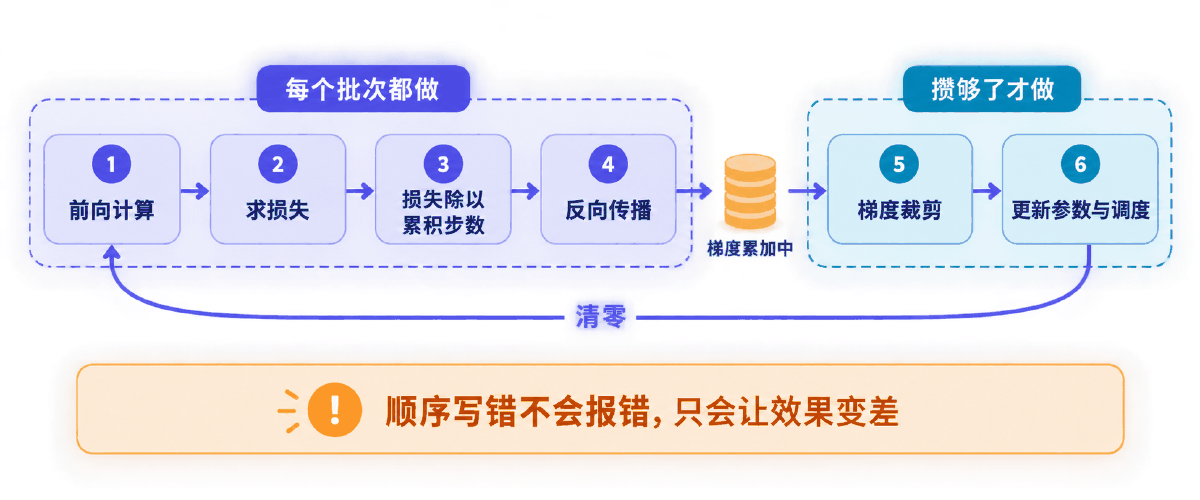
前向 → 算损失 → 损失 ÷ 累积步数 → 反向 → 【攒够了才】裁剪 → step → 调度 → 清零
| 步骤 | 频率 | 放错位置的后果 |
|---|---|---|
| 损失除以累积步数 | 每批 | 不除的话,累积 N 批相当于把梯度放大了 N 倍,等效于学习率悄悄翻了 N 倍 |
| 反向传播 | 每批 | —— |
| 梯度裁剪 | 攒够才做 | 每批都裁的话,累积到一半就把梯度削了,累积出来的方向失真 |
optimizer.step() | 攒够才做 | —— |
scheduler.step() | 攒够才做 | 每批都推的话,学习率曲线提前 N 倍跑完,后半程一直贴着 0 |
zero_grad() | 攒够才做 | 放在每批就等于没有累积;放在 step() 之前会把刚攒的梯度清掉 |
2.3 梯度裁剪与等效批大小
梯度裁剪处理的是异常样本。某一条特别怪的数据会产生极大的梯度,一次更新就能把模型推到很远的地方。裁剪的做法是:把所有梯度拼成一个大向量,算它的 L2 范数,超过阈值就整体等比缩小。
梯度累积处理的是显存。显存只够批大小 4,但任务需要批大小 32,就攒 8 个批次的梯度再更新一次:
等效批大小 = 单卡批大小 × 累积步数
显存按「单卡批 4」算,而模型感受到的是「批 32」。这是小显存上训大批次的唯一办法,代价是时间——同样的更新次数要跑 8 倍的前向反向。
2.4 学习率的横轴是更新次数
学习率调度是一条「先升后降」的曲线:开头预热,用很小的学习率试探,避免一上来就把预训练学到的东西冲垮;随后线性衰减,逐步收小步子让模型稳定收敛。
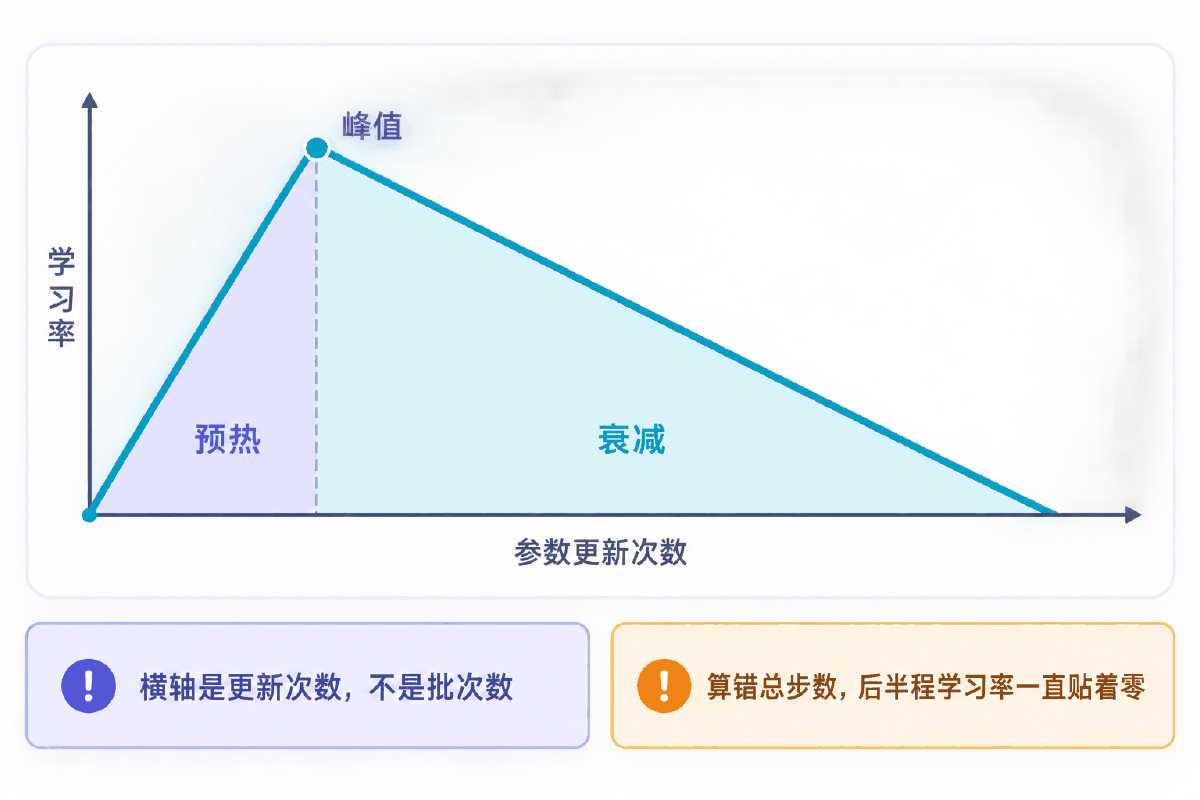
配置它只需要两个数:总步数和预热步数。但这里的「步」指的是参数更新次数,不是批次数。
总更新次数 = 批次数 ÷ 累积步数 × 轮数
忘了除以累积步数,调度器就会按一个放大了 N 倍的总步数去规划曲线——实际跑完时曲线才走到前 1/N,学习率始终维持在高位;反过来,如果每个批次都调用一次 scheduler.step(),曲线会提前 N 倍跑完,后半程一直贴着 0。两种错法方向相反,但都不会报错。
2.5 token 准确率与位移对齐
损失是个抽象的数,看多了没有直觉。token 准确率更直观:模型预测对了多少个位置。但算它有两个必须处理的细节。
| 细节 | 怎么做 | 忘了会怎样 |
|---|---|---|
| 位移对齐 | 预测去掉最后一个位置,标签去掉第一个位置 | 拿第 i 个位置的预测去比第 i 个标签,全部错位一格,准确率异常偏低且看不出原因 |
| 掩码 | 只统计标签不等于 -100 的位置 | 提示词和补位都被算进分母,补得越多准确率越虚高 |
位移这件事,传 labels 给模型让它自己算损失时,它内部会自动处理;但你自己写评估函数时必须手动做。这正是同一个概念在两个地方表现不一致、最容易出错的原因。
03最小代码:开训前的两个断言
十几行代码,把「底座没加载上」和「准确率没对齐」这两个最贵的错误挡在门外
训练脚本动辄几百行,但真正决定这一轮训练有没有意义的,是进入循环之前那两个检查。先把它们单独拎出来。
检查一:底座到底加载上了没有
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""选基座:随机初始化 vs 加载预训练权重,差别有多大。

这一步是整个项目最容易被轻轻放过、又最致命的一步。
同一份 config.json 有两种用法:

    GPT2LMHeadModel(config=cfg)              # 只借架构,权重随机
    GPT2LMHeadModel.from_pretrained(路径)     # 架构 + 预训练好的权重

两行代码长得像,打印出来的模型结构一模一样,参数量一模一样,
训练也照样能跑、loss 也照样会降——但前者等于从零开始学中文,
后者才是「微调」。用一万条医疗问答从零训一个语言模型,
学出来的只会是语法都不通的胡话。

纯标准库,可直接运行:用参数量和数据量算一笔账,说明为什么。
"""


def tokens_in_corpus(n_samples, avg_chars):
    """中文经 BertTokenizer 基本一字一 token,粗估即可。"""
    return n_samples * avg_chars


def chinchilla_tokens(n_params, ratio=20):
    """训练一个模型「应当」喂多少 token 的经验参考量级。

    这个比例来自缩放律研究的经验结论:参数量与训练 token 数大致同步增长,
    量级上每个参数配约 20 个 token。它不是精确公式,这里只用来看数量级差距。
    """
    return n_params * ratio


def fmt(n):
    for unit, base in (("万亿", 1e12), ("亿", 1e8), ("万", 1e4)):
        if n >= base:
            return "%.2f%s" % (n / base, unit)
    return "%d" % n


if __name__ == "__main__":
    N_PARAMS = 102_068_736      # 本项目使用的中文 GPT-2 规模
    N_SAMPLES = 20_000          # 手上的医疗问答条数
    AVG_CHARS = 109             # 实测的平均长度

    have = tokens_in_corpus(N_SAMPLES, AVG_CHARS)
    need = chinchilla_tokens(N_PARAMS)

    print("一、从零训练这个规模的模型,需要多少语料")
    print("  模型参数量            %s" % fmt(N_PARAMS))
    print("  从零训练的参考 token 量 %s" % fmt(need))
    print("  手上医疗语料的 token 量 %s" % fmt(have))
    print("  差距                  %.0f 倍" % (need / have))
    print("\n  → 差三个数量级。指望用这点数据从零学会中文,不现实。")

    print("\n二、两种写法的区别")
    rows = [
        ("模型结构", "完全相同", "完全相同"),
        ("参数量", "完全相同", "完全相同"),
        ("初始权重", "按正态分布随机采样", "预训练学到的值"),
        ("初始 loss", "≈ ln(词表大小)", "明显更低"),
        ("训练能不能跑", "能跑,loss 也会降", "能跑"),
        ("学到的东西", "从零学中文,数据远远不够", "把已有的中文能力调向医疗问答"),
        ("适用场景", "词表/架构大改,且有海量语料", "绝大多数业务场景"),
    ]
    print("  %-14s %-24s %s" % ("对比项", "随机初始化", "加载预训练权重"))
    for a, b, c in rows:
        print("  %-14s %-24s %s" % (a, b, c))

    import math
    print("\n三、开训第一步的 loss 能一眼认出用的是哪种")
    vocab = 21128
    print("  随机初始化时,模型对每个 token 等概率瞎猜,")
    print("  交叉熵 ≈ ln(%d) = %.2f" % (vocab, math.log(vocab)))
    print("  → 第一个 batch 打出 loss≈%.1f,说明权重是随机的;" % math.log(vocab))
    print("    打出 loss≈2~4,说明预训练权重确实加载上了。")
    print("  这是开训 30 秒内就能做的一次核对,别等训完才发现。")

    print("\n四、选基座的三条判据")
    for i, line in enumerate([
        "语言对不对:中文任务用中文语料训过的底座,别拿纯英文底座硬掰",
        "尺寸配不配:底座越大效果越好但显存越贵,先用小底座把流程跑通",
        "许可证准不准:商用项目要看清开源协议,这件事上线前一定会被问到",
    ], 1):
        print("  %d. %s" % (i, line))
这份脚本做三件事,每件都只有几行,但每件都挡掉一类不报错的错误:
| 检查 | 怎么判读 |
|---|---|
| 算出瞎蒙基准线 | ln(词表大小)。本讲底座是 ln(21128) ≈ 9.96,这个数要从模型配置读,不能写死 |
| 对比第一批损失 | 贴近 9.96 就是权重没加载上;明显更低才说明预训练生效了 |
| 断言词表一致 | 分词器词表 ≠ 模型词表时,编码出的 id 可能越界,报错信息完全看不出是词表问题 |
脚本还把「加载方式」这件事写成了对照:from_pretrained(路径) 是继续训练,Model(config) 是从零开始。两者都是合法调用,写错不会有任何提示——只有损失起点能揭穿它。
检查二:准确率算对了没有
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""token 准确率:位移对齐这一步,写错了分数会虚高。

自回归模型第 i 个位置的输出,预测的是第 i+1 个位置的 token。
所以拿 logits 和 labels 直接比是错位的,必须先对齐:

    logits = logits[:, :-1, :]   去掉最后一个位置的预测(它没有下文可对)
    labels = labels[:, 1:]       去掉第一个位置的标签(它没有上文来预测)

对齐之后再把 -100 的位置剔掉,剩下的才是「真正被预测、且该算分」的 token。

这里用纯 Python 列表把整个过程复现一遍,不依赖 torch,可直接运行。
"""

IGNORE = -100


def argmax(row):
    """手写 argmax,避免依赖任何第三方库。"""
    best_i, best_v = 0, row[0]
    for i, v in enumerate(row):
        if v > best_v:
            best_i, best_v = i, v
    return best_i


def calc_accuracy(logits, labels, ignore_index=IGNORE, shift=True):
    """返回 (正确数, 总数)。

    logits: [batch, seq_len, vocab]
    labels: [batch, seq_len]
    shift:  是否做位移对齐。设成 False 是为了演示不对齐会得到什么分数。
    """
    correct = total = 0

    for b in range(len(labels)):
        if shift:
            preds_src = logits[b][:-1]
            gold = labels[b][1:]
        else:
            preds_src = logits[b]
            gold = labels[b]

        for step, row in enumerate(preds_src):
            target = gold[step]
            if target == ignore_index:      # 提示词和 padding 不计分
                continue
            total += 1
            if argmax(row) == target:
                correct += 1

    return correct, total


def one_hot_logits(token_ids, vocab, peak=5.0):
    """造一组「预测完全正确」的 logits,用来做对照实验。"""
    out = []
    for tid in token_ids:
        row = [0.0] * vocab
        row[tid % vocab] = peak
        out.append(row)
    return out


if __name__ == "__main__":
    VOCAB = 10

    # 一条样本:前 3 个位置是提示词(屏蔽),后面是答案
    labels = [[-100, -100, -100, 4, 5, 6, 7]]

    # 造一个「完美模型」:位置 i 的输出正好等于位置 i+1 的标签
    perfect = [one_hot_logits([0, 0, 4, 5, 6, 7, 0], VOCAB)]

    print("一、对齐与不对齐,同一份预测两个分数")
    c1, t1 = calc_accuracy(perfect, labels, shift=True)
    c2, t2 = calc_accuracy(perfect, labels, shift=False)
    print("  做位移对齐:  %d/%d = %.1f%%" % (c1, t1, 100.0 * c1 / t1))
    print("  不做对齐:    %d/%d = %.1f%%" % (c2, t2, 100.0 * c2 / t2))
    assert c1 == t1, "完美预测在对齐后应当是 100%"
    print("  → 同一个模型,少写一行位移,分数从 100%% 掉到 %.0f%%。"
          % (100.0 * c2 / t2))
    print("    这个错误的方向不固定,有时虚高有时虚低,但一定是错的。")

    print("\n二、-100 到底挡掉了多少位置")
    flat = [x for row in labels for x in row]
    n_ignore = sum(1 for x in flat if x == IGNORE)
    print("  标签总长 %d,其中 -100 有 %d 个" % (len(flat), n_ignore))
    print("  对齐后参与计分的位置:%d 个" % t1)
    print("  → 如果把 -100 也算进分母,分数会被大量提示词位置稀释。")
    print("    这也是同一份模型在不同仓库里分数对不上的常见原因。")

    print("\n三、一个更接近真实的例子:预测对一半")
    half = [one_hot_logits([0, 0, 4, 5, 9, 9, 0], VOCAB)]   # 后两个猜错
    c3, t3 = calc_accuracy(half, labels)
    print("  正确 %d / 总数 %d = %.1f%%" % (c3, t3, 100.0 * c3 / t3))
    assert (c3, t3) == (2, 4)
    print("  断言通过:4 个待预测位置里对了 2 个")

    print("\n四、这个指标能说明什么、不能说明什么")
    print("  能说明:训练有没有在推进(它和 loss 应当同向变化)")
    print("  不能说明:答复对不对。token 级全对只意味着复述得一模一样,")
    print("           而同一个意思换种说法,token 准确率可能很低却完全正确。")
    print("  所以它只配当训练过程的监控指标,不能当验收标准。")
核心就三行,但每一行都容易漏:
| 代码 | 作用 |
|---|---|
logits = logits[:, :-1, :] | 去掉最后一个位置的预测——它预测的是序列之外的东西,没有对应标签 |
labels = labels[:, 1:] | 去掉第一个标签——它没有对应的前文预测。这两行合起来就是位移对齐 |
not_pad = labels.ne(-100) | 只统计参与计分的位置,把提示词和补位排除在分母之外 |
1.0。如果算出来是零点几,说明位移方向错了或者多移了一位。脚本里就带着这个自检——用一个必然为真的例子去验证函数本身,比盯着真实数据猜有效得多。
04完整案例:把这份语料真正训起来
核对底座、实测时序、跑完整脚本、换成 LoRA、决定保存哪一轮
上一讲产出的 medical_train.jsonl(41 条)和 medical_valid.jsonl(4 条)就是这一节的输入。本机没有 GPU,训练脚本不实跑——所以下面凡是标「实测」的都是纯逻辑脚本跑出来的真实数字,凡是涉及显卡的地方都会明确说明是未验证项。
4.1 核对底座规格
开工第一件事不是写训练循环,是把底座的规格从配置文件里读出来核对一遍。
| 规格项 | 实际配置值 | 它影响什么 |
|---|---|---|
| 词表大小 | 21128 | 瞎蒙基准线 ln(21128) ≈ 9.96;也决定嵌入层参数量 |
| 隐层维度 | 768 | LoRA 挂在注意力上时的 d_in |
| 层数 / 头数 | 12 / 12 | 决定要挂多少组旁支 |
| 参数总量 | 102,068,736 | 全量微调约需 1.52 GB 显存 |
拿这个基准线去看参考实现的训练日志,会发现一件很说明问题的事:它第一个批次的损失是 9.59,而基准线是 9.96。两个数几乎重合,意味着那一轮训练根本没有加载预训练权重,是从随机初始化开始的。用几十条医疗问答从零训一个语言模型,产出只能是噪声。
4.2 实测循环时序与裁剪
时序这件事光讲顺序记不住,把它做成一个能跑的模拟最直观。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""梯度累积、预热、裁剪三件事在同一个循环里怎么配合。

这三样都作用在「参数更新」这一步附近,顺序写错了不会报错,
但会让训练效果说不清道不明地变差。正确顺序只有一种:

    前向 → 算 loss → loss / accum → 反向 → 【攒够了才】裁剪 → step → 调度 → 清零

最常见的两个错位:
  ① 每个 batch 都裁剪:累积到一半就把梯度削了,累积出来的方向失真
  ② 每个 batch 都 scheduler.step():学习率按 batch 数推进,
     提前跑完整条曲线,后半程学习率一直贴着 0

纯标准库,把这个循环的时序完整模拟一遍,可直接运行。
"""
import math


class FakeScheduler:
    """线性预热 + 线性衰减,只记步数不碰真实参数。"""

    def __init__(self, base_lr, warmup, total):
        self.base_lr, self.warmup, self.total = base_lr, warmup, total
        self.step_count = 0

    def step(self):
        self.step_count += 1

    def get_lr(self):
        s = self.step_count
        if s < self.warmup:
            return self.base_lr * s / max(1, self.warmup)
        progress = (s - self.warmup) / max(1, self.total - self.warmup)
        return self.base_lr * max(0.0, 1.0 - progress)


def grad_norm(grads):
    """所有梯度拼成一个大向量之后的 L2 范数——裁剪判断的就是它。"""
    return math.sqrt(sum(g * g for g in grads))


def clip(grads, max_norm):
    """返回 (裁剪后的梯度, 缩放系数)。

    注意裁剪是「整体等比缩放」,不是逐个截断。
    所以它只改梯度的长度,不改方向。
    """
    total = grad_norm(grads)
    if total <= max_norm:
        return grads, 1.0
    scale = max_norm / (total + 1e-6)
    return [g * scale for g in grads], scale


def simulate(n_batches, accum, base_lr=2e-4, max_norm=1.0, warmup=3):
    """走一遍训练循环,记录每次真正更新时的状态。"""
    total_updates = n_batches // accum
    sched = FakeScheduler(base_lr, warmup, total_updates)

    buffer = [0.0, 0.0]          # 假装模型只有两个参数
    log = []

    for step in range(1, n_batches + 1):
        # 造一个有大有小的梯度,第 7 个 batch 故意来一个异常大的
        raw = [0.3 * step % 1.1, 0.2 * step % 0.9]
        if step == 7:
            raw = [8.0, 6.0]     # 异常样本

        loss_scale = 1.0 / accum         # ← 关键:loss 先除以累积步数
        buffer = [b + g * loss_scale for b, g in zip(buffer, raw)]

        if step % accum == 0:            # 攒够了才动手
            clipped, scale = clip(buffer, max_norm)
            sched.step()
            log.append({
                "batch": step,
                "update": sched.step_count,
                "norm_before": grad_norm(buffer),
                "scale": scale,
                "lr": sched.get_lr(),
            })
            buffer = [0.0, 0.0]          # 清零,必须在 step 之后
    return log, total_updates


if __name__ == "__main__":
    N_BATCHES, ACCUM = 24, 4

    log, total = simulate(N_BATCHES, ACCUM)
    print("一、正确时序:%d 个 batch,累积 %d 步 → %d 次参数更新"
          % (N_BATCHES, ACCUM, total))
    print("  %-8s %-8s %-12s %-8s %-10s"
          % ("batch", "update", "裁剪前范数", "缩放", "学习率"))
    for r in log:
        print("  %-8d %-8d %-12.4f %-8.3f %-10.3e"
              % (r["batch"], r["update"], r["norm_before"], r["scale"], r["lr"]))

    clipped_rows = [r for r in log if r["scale"] < 1.0]
    print("\n  发生裁剪的更新:%d 次(异常梯度被按比例压回 max_norm)"
          % len(clipped_rows))
    assert clipped_rows, "第 7 个 batch 的异常梯度应当触发裁剪"

    print("\n二、学习率曲线:先升后降")
    lrs = [r["lr"] for r in log]
    peak = lrs.index(max(lrs))
    print("  第 %d 次更新到达峰值 %.3e,之后单调下降"
          % (peak + 1, max(lrs)))
    assert lrs[-1] < max(lrs), "最后应当已经衰减下来"

    print("\n三、把 scheduler.step() 错放到每个 batch 会怎样")
    wrong = FakeScheduler(2e-4, warmup=3, total=total)
    for _ in range(N_BATCHES):
        wrong.step()
    print("  调度器被推进了 %d 次,而总步数只规划了 %d 次"
          % (wrong.step_count, total))
    print("  此时学习率 = %.3e(曲线早就跑完,后半程一直贴着 0)"
          % wrong.get_lr())

    print("\n四、等效批大小对照")
    print("  单卡批 4 × 累积 %d = 等效批 %d" % (ACCUM, 4 * ACCUM))
    print("  显存按「单卡批 4」算,而模型感觉到的是「批 %d」——" % (4 * ACCUM))
    print("  这正是小显存上训大批次的唯一办法。")
脚本模拟 24 个批次、累积步数 4,并在第 7 个批次故意塞一个异常大的梯度。实跑结果:
| 观测项 | 实测结果 | 说明 |
|---|---|---|
| 参数更新次数 | 6 次 | 24 ÷ 4 = 6,不是 24 次 |
| 触发裁剪的更新 | 1 次 | 异常梯度所在的那个累积周期,范数 2.93 被按 0.342 的系数压回阈值 |
| 学习率峰值位置 | 第 3 次更新 | 预热结束点,之后单调下降 |
错放 scheduler.step() | 推进 24 次 | 总步数只规划了 6 次,曲线早已跑完,学习率降到 0 |
| 等效批大小 | 4 × 4 = 16 | 显存按 4 算,模型感受到的是 16 |
倒数第二行就是把「调度器推错对象」这个抽象说法变成了一个具体数字:24 对 6。改一行代码的位置,差别就是这么大。
4.3 完整训练脚本
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""医疗问诊模型的完整训练脚本。

流程:加载数据 → 加载底座 → 逐轮训练 → 逐轮评估 → 保存最好的那一轮。
每一步都带一个能当场核对的输出,因为训练出问题时不会报错,
只会让最终效果不对,事后很难倒查。
"""
import json
import os
from datetime import datetime

import torch
from torch.optim import AdamW
from tqdm import tqdm
from transformers import (AutoTokenizer, GPT2LMHeadModel,
                          get_linear_schedule_with_warmup)

from dataset_and_collate import get_dataloaders


class Config:
    """所有能调的东西集中在这里,不散落在代码各处。"""
    # 底座:走环境变量,方便在本地目录与 Hub 名字之间切换
    base_model = os.environ.get("BASE_MODEL", "uer/gpt2-chinese-cluecorpussmall")
    vocab_path = os.environ.get("VOCAB_PATH", "vocab/vocab.txt")

    train_path = os.environ.get("TRAIN_PATH", "data/medical_train.jsonl")
    valid_path = os.environ.get("VALID_PATH", "data/medical_valid.jsonl")

    batch_size = 4
    grad_accum = 8          # 等效批大小 4 × 8 = 32
    epochs = 4
    lr = 2.6e-5
    eps = 1e-9
    max_grad_norm = 1.0
    warmup_ratio = 0.03

    log_every = 20
    save_dir = os.environ.get("SAVE_DIR", "checkpoints/best_model")
    device = "cuda" if torch.cuda.is_available() else "cpu"


def calc_accuracy(logits, labels, ignore_index=-100):
    """token 准确率。位移对齐这一步不能省。"""
    logits = logits[:, :-1, :]        # 去掉最后一个位置的预测
    labels = labels[:, 1:]            # 去掉第一个位置的标签

    preds = logits.argmax(dim=-1).reshape(-1)
    labels = labels.reshape(-1)

    not_pad = labels.ne(ignore_index)             # 提示词与 padding 不计分
    correct = preds.eq(labels).masked_select(not_pad).sum()
    return correct.item(), not_pad.sum().item()


def build_model(cfg):
    """加载底座并核对词表大小。

    词表对不上是这一步最容易踩的坑:分词器编出来的 id 超过模型词表范围,
    会在 embedding 查表时抛越界,而报错信息完全看不出是词表问题。
    """
    model = GPT2LMHeadModel.from_pretrained(cfg.base_model)
    tokenizer = AutoTokenizer.from_pretrained(cfg.vocab_path)

    assert tokenizer.vocab_size == model.config.vocab_size, (
        "分词器词表 %d 与模型词表 %d 不一致"
        % (tokenizer.vocab_size, model.config.vocab_size))

    n_param = sum(p.numel() for p in model.parameters())
    print("✅ 底座已加载,参数量 %d,词表 %d" % (n_param, model.config.vocab_size))
    return model.to(cfg.device), tokenizer


@torch.no_grad()
def evaluate(model, loader, cfg):
    """验证集上跑一遍,返回 (平均 loss, token 准确率)。"""
    model.eval()
    total_loss = correct = total = 0

    for batch in tqdm(loader, desc="评估", leave=False):
        batch = {k: v.to(cfg.device) for k, v in batch.items()}
        out = model(**batch)
        total_loss += out.loss.item()

        c, t = calc_accuracy(out.logits, batch["labels"])
        correct += c
        total += t

    return total_loss / max(1, len(loader)), correct / max(1, total)


def train_one_epoch(model, loader, optimizer, scheduler, cfg, epoch):
    model.train()
    started = datetime.now()
    total_loss = correct = total = 0

    bar = tqdm(loader, desc="第 %d 轮" % (epoch + 1))
    for step, batch in enumerate(bar):
        batch = {k: v.to(cfg.device) for k, v in batch.items()}

        # 传了 labels,模型内部就会自己算交叉熵,并自动做位移对齐
        out = model(**batch)
        loss = out.loss
        total_loss += loss.item()

        # 先按累积步数缩放,再反向。不缩放的话等效批大了、梯度也大了一倍
        (loss / cfg.grad_accum).backward()

        c, t = calc_accuracy(out.logits, batch["labels"])
        correct += c
        total += t

        # 攒够一个累积周期才真正更新
        if (step + 1) % cfg.grad_accum == 0:
            torch.nn.utils.clip_grad_norm_(model.parameters(), cfg.max_grad_norm)
            optimizer.step()
            scheduler.step()
            optimizer.zero_grad()

        if (step + 1) % cfg.log_every == 0:
            bar.set_postfix(loss=total_loss / (step + 1),
                            acc=correct / max(1, total),
                            lr=scheduler.get_last_lr()[0])

    print("第 %d 轮训练完成,平均 loss %.4f,token 准确率 %.4f,耗时 %s"
          % (epoch + 1, total_loss / max(1, len(loader)),
             correct / max(1, total), datetime.now() - started))
    return total_loss / max(1, len(loader)), correct / max(1, total)


def main():
    cfg = Config()
    print("设备:%s" % cfg.device)

    train_loader, valid_loader, _tok = get_dataloaders(
        cfg.train_path, cfg.valid_path, cfg.batch_size)
    print("✅ 训练 %d 批 / 验证 %d 批" % (len(train_loader), len(valid_loader)))

    model, tokenizer = build_model(cfg)

    optimizer = AdamW(model.parameters(), lr=cfg.lr, eps=cfg.eps)

    # 总步数按「参数更新次数」算,不是按 batch 数。
    # 这里除以累积步数是整个调度器配置里最容易写错的一处。
    total_steps = len(train_loader) // cfg.grad_accum * cfg.epochs
    scheduler = get_linear_schedule_with_warmup(
        optimizer,
        num_warmup_steps=int(total_steps * cfg.warmup_ratio),
        num_training_steps=total_steps)
    print("✅ 总参数更新次数 %d,其中预热 %d 次"
          % (total_steps, int(total_steps * cfg.warmup_ratio)))

    history, best_loss = [], float("inf")

    for epoch in range(cfg.epochs):
        tr_loss, tr_acc = train_one_epoch(
            model, train_loader, optimizer, scheduler, cfg, epoch)
        va_loss, va_acc = evaluate(model, valid_loader, cfg)

        print("第 %d 轮评估:loss %.4f,token 准确率 %.4f"
              % (epoch + 1, va_loss, va_acc))
        history.append({"epoch": epoch + 1, "train_loss": tr_loss,
                        "train_acc": tr_acc, "valid_loss": va_loss,
                        "valid_acc": va_acc})

        # 只保留验证 loss 最低的那一轮,而不是最后一轮。
        # 最后一轮往往已经开始过拟合了。
        if va_loss < best_loss:
            best_loss = va_loss
            os.makedirs(cfg.save_dir, exist_ok=True)
            model.save_pretrained(cfg.save_dir)
            tokenizer.save_pretrained(cfg.save_dir)
            print("✅ 第 %d 轮是目前最好的,已保存到 %s" % (epoch + 1, cfg.save_dir))

    with open(os.path.join(cfg.save_dir, "history.json"), "w", encoding="utf-8") as f:
        json.dump(history, f, ensure_ascii=False, indent=2)

    print("\n训练结束。逐轮记录:")
    for h in history:
        print("  轮次 %d  训练 loss %.4f  验证 loss %.4f  验证准确率 %.4f"
              % (h["epoch"], h["train_loss"], h["valid_loss"], h["valid_acc"]))
    print("\n判读方法:训练 loss 降而验证 loss 开始升的那一轮,就是过拟合的起点。")


if __name__ == "__main__":
    main()
这份脚本把前面所有检查都串进了流程。关键配置与它们的来由:
| 配置 | 取值 | 为什么 |
|---|---|---|
| 批大小 × 累积步数 | 4 × 8 | 等效批大小 32,显存只按 4 算 |
| 学习率 | 2.6e-5 | 全量微调的常规区间(1e-5 ~ 5e-5) |
| 预热比例 | 3% | 按总更新次数算,不是批次数 |
| 裁剪阈值 | 1.0 | 常用默认值,只在攒够的那一步执行 |
| 保存策略 | 验证损失最低的那一轮 | 不是最后一轮 |
脚本每轮结束都会打印训练损失、验证损失和 token 准确率,并把逐轮记录写进 history.json。这份记录就是 4.5 判读的依据。
4.4 换成 LoRA 只改三处
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""同一个任务换成 LoRA 训法,用来和全量微调那份逐行对照。

和 train_medical_gpt2.py 的差别只有三处,其余一模一样:
  ① 加载底座之后多一步 get_peft_model
  ② 学习率要调大一到两个数量级
  ③ 保存的是旁支而不是整个模型

把两份并排看,就能明白 PEFT 在工程上到底改变了什么:
训练循环没变,变的是「谁在被更新」和「产物有多大」。
"""
import os

import torch
from peft import LoraConfig, TaskType, get_peft_model
from torch.optim import AdamW
from transformers import (AutoTokenizer, GPT2LMHeadModel,
                          get_linear_schedule_with_warmup)

from dataset_and_collate import get_dataloaders
from train_medical_gpt2 import Config, evaluate, train_one_epoch


class LoraTrainConfig(Config):
    # 只训旁支,主干冻着,步子可以迈大得多。
    # 全量微调用 2.6e-5,这里用 2e-4,差了近十倍——
    # 照搬全量微调的学习率是 LoRA 效果差的头号原因。
    lr = 2e-4
    epochs = 4
    save_dir = os.environ.get("SAVE_DIR", "checkpoints/lora-adapter")


def build_lora_model(cfg):
    """加载底座并挂上旁支。"""
    model = GPT2LMHeadModel.from_pretrained(cfg.base_model)
    tokenizer = AutoTokenizer.from_pretrained(cfg.vocab_path)

    lora_cfg = LoraConfig(
        task_type=TaskType.CAUSAL_LM,
        r=8,
        lora_alpha=16,           # 惯例设成 r 的两倍,缩放系数 alpha/r = 2
        lora_dropout=0.05,
        bias="none",
        # GPT-2 把 Q/K/V 合并成一个 c_attn,所以只写这一个名字。
        # 换成 Qwen / LLaMA 要改成 q_proj / k_proj / v_proj / o_proj。
        target_modules=["c_attn"],
    )
    model = get_peft_model(model, lora_cfg)

    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
    total = sum(p.numel() for p in model.parameters())
    print("✅ 可训练参数 %d / %d = %.4f%%"
          % (trainable, total, 100.0 * trainable / total))

    # 占比应当落在零点几个百分点。接近 100% 说明 target_modules 名字写错了,
    # 旁支根本没挂上去,这一轮训的其实是全量微调。
    assert trainable / total < 0.05, "旁支没挂上,检查 target_modules"

    return model.to(cfg.device), tokenizer


def main():
    cfg = LoraTrainConfig()
    train_loader, valid_loader, _ = get_dataloaders(
        cfg.train_path, cfg.valid_path, cfg.batch_size)

    model, tokenizer = build_lora_model(cfg)

    # 只把需要梯度的参数交给优化器。
    # 把全部参数一股脑传进去也不会报错,但优化器会为冻结参数也分配状态,
    # LoRA 省下来的显存就这么白白还回去了。
    params = [p for p in model.parameters() if p.requires_grad]
    optimizer = AdamW(params, lr=cfg.lr, eps=cfg.eps)

    total_steps = len(train_loader) // cfg.grad_accum * cfg.epochs
    scheduler = get_linear_schedule_with_warmup(
        optimizer,
        num_warmup_steps=int(total_steps * cfg.warmup_ratio),
        num_training_steps=total_steps)

    best_loss = float("inf")
    for epoch in range(cfg.epochs):
        train_one_epoch(model, train_loader, optimizer, scheduler, cfg, epoch)
        va_loss, va_acc = evaluate(model, valid_loader, cfg)
        print("第 %d 轮评估:loss %.4f,token 准确率 %.4f"
              % (epoch + 1, va_loss, va_acc))

        if va_loss < best_loss:
            best_loss = va_loss
            os.makedirs(cfg.save_dir, exist_ok=True)
            # 这里存下来的只有旁支,几百 KB 量级,不是几百 MB 的整模型
            model.save_pretrained(cfg.save_dir)
            tokenizer.save_pretrained(cfg.save_dir)

    size = sum(os.path.getsize(os.path.join(cfg.save_dir, f))
               for f in os.listdir(cfg.save_dir))
    print("\n✅ 旁支已保存,目录总大小 %.2f MB" % (size / 1024 / 1024))
    print("部署时两种选择:")
    print("  ① 底座 + 旁支分开加载:一个底座可以挂多个任务的旁支,随时切换")
    print("  ② merge_and_unload() 合并回权重:推理零额外开销,但只对应这一个任务")


if __name__ == "__main__":
    main()
把这份脚本和上一份并排看,会发现训练循环一行没变。真正的差别只有三处:
| 差别 | 全量微调 | LoRA |
|---|---|---|
| 加载之后 | 直接用 | 多一步 get_peft_model(...),并断言可训练占比很小 |
| 学习率 | 2.6e-5 | 2e-4,高出近十倍 |
| 传给优化器的参数 | 全部 | 只传 requires_grad 为真的,否则优化器会为冻结参数也分配状态,省下的显存又还回去了 |
| 保存的产物 | 整个模型 | 只有旁支,几百 KB 量级 |
最后一行带来一个部署上的选择:底座和旁支分开加载(一个底座挂多个任务的旁支,随时切换),或者 merge_and_unload() 合并回权重(推理零额外开销,但只对应这一个任务)。
4.5 该保存哪一轮
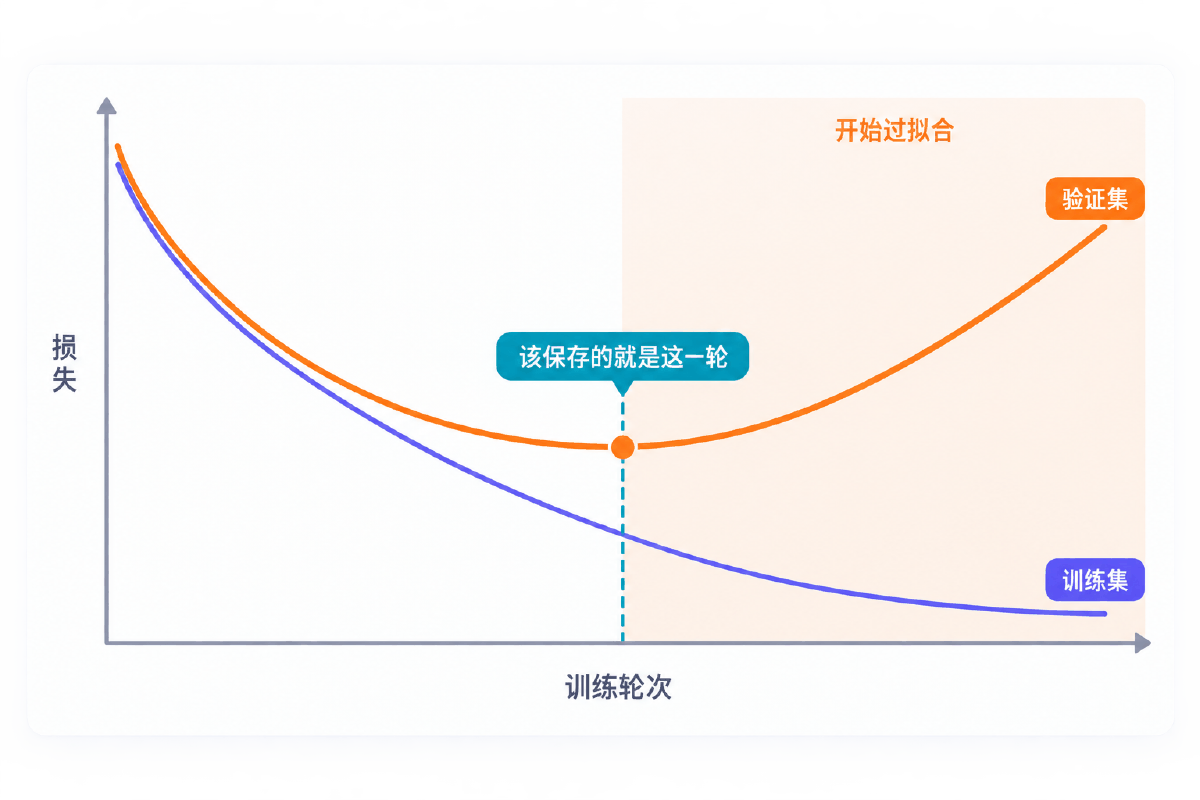
判读方法只有一句:训练损失一直降、验证损失开始升的那一轮,就是过拟合的起点;该保存的是它之前那一轮。
| 现象 | 判读 | 该做什么 |
|---|---|---|
| 两条都在降 | 还在正常学习 | 继续训 |
| 训练降、验证升 | 过拟合开始 | 停下,用验证损失最低的那一轮 |
| 两条都不动 | 学习率太小,或底座没加载 | 回头做 4.1 的检查 |
| 损失变成 NaN | 梯度爆炸 | 确认裁剪是否生效、学习率是否过大 |
05骨架模板:换任务只改标注的地方
一份剥掉业务的训练循环,把「每批做」和「攒够才做」的边界固化下来
前面那两份训练脚本是针对问诊任务写的。把业务部分抽掉,剩下的就是一个任何自回归微调任务都能直接套的循环——换任务时只改脚本里标了「改这里」的几行。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""可复制改造的训练循环骨架。

把 TODO 填完即可开训。刻意保留了四个「开训前必须看到」的证据点,
因为训练过程出错几乎从不报错,只会让结果变差:

  证据点 1  第一个 batch 的 loss ≈ ln(词表大小)?→ 底座没加载上
  证据点 2  可训练参数占比是不是预期的量级?
  证据点 3  总更新次数与预热次数是否合理?
  证据点 4  第一轮结束后 loss 有没有真的往下走?
"""
import math
import os

import torch
from torch.optim import AdamW
from transformers import (AutoModelForCausalLM, AutoTokenizer,
                          get_linear_schedule_with_warmup)

BASE_MODEL = os.environ.get("BASE_MODEL", "TODO-填底座")
SAVE_DIR = os.environ.get("SAVE_DIR", "checkpoints/best_model")

BATCH_SIZE = 4
GRAD_ACCUM = 8
EPOCHS = 3
LR = 2e-5              # TODO: 全量微调用 1e-5~5e-5;LoRA 用 1e-4~3e-4
MAX_GRAD_NORM = 1.0
WARMUP_RATIO = 0.03


def sanity_check_first_batch(model, batch, vocab_size):
    """证据点 1:用第一个 batch 的 loss 判断底座到底有没有加载上。"""
    model.eval()
    with torch.no_grad():
        loss = model(**batch).loss.item()

    expected_random = math.log(vocab_size)
    print("首个 batch loss = %.4f(随机初始化的参考值 ln(%d) = %.2f)"
          % (loss, vocab_size, expected_random))

    if loss > expected_random * 0.9:
        print("⚠ loss 贴近随机初始化的水平,底座很可能没加载上——")
        print("  检查是不是误用了 Model(config=...) 而不是 from_pretrained(...)")
    else:
        print("✅ loss 明显低于随机水平,预训练权重已生效")
    model.train()
    return loss


def report_trainable(model):
    """证据点 2:可训练参数占比。"""
    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
    total = sum(p.numel() for p in model.parameters())
    print("可训练参数 %d / %d = %.4f%%" % (trainable, total, 100.0 * trainable / total))
    return trainable, total


def build_scheduler(optimizer, n_batches):
    """证据点 3:总步数一定要除以累积步数。"""
    total_steps = n_batches // GRAD_ACCUM * EPOCHS
    warmup = max(10, int(total_steps * WARMUP_RATIO))
    print("总参数更新 %d 次,其中预热 %d 次(占 %.1f%%)"
          % (total_steps, warmup, 100.0 * warmup / max(1, total_steps)))
    if warmup > total_steps * 0.3:
        print("⚠ 预热占比过高,学习率可能全程都没进入衰减阶段")
    return get_linear_schedule_with_warmup(optimizer, warmup, total_steps)


def train(model, train_loader, valid_loader, device):
    optimizer = AdamW([p for p in model.parameters() if p.requires_grad], lr=LR)
    scheduler = build_scheduler(optimizer, len(train_loader))

    best_loss = float("inf")
    for epoch in range(EPOCHS):
        model.train()
        running = 0.0

        for step, batch in enumerate(train_loader):
            batch = {k: v.to(device) for k, v in batch.items()}
            loss = model(**batch).loss
            running += loss.item()

            (loss / GRAD_ACCUM).backward()

            if (step + 1) % GRAD_ACCUM == 0:
                torch.nn.utils.clip_grad_norm_(model.parameters(), MAX_GRAD_NORM)
                optimizer.step()
                scheduler.step()
                optimizer.zero_grad()

        train_loss = running / max(1, len(train_loader))

        # 证据点 4
        model.eval()
        with torch.no_grad():
            valid_loss = sum(
                model(**{k: v.to(device) for k, v in b.items()}).loss.item()
                for b in valid_loader) / max(1, len(valid_loader))

        print("轮次 %d  训练 loss %.4f  验证 loss %.4f"
              % (epoch + 1, train_loss, valid_loss))

        if valid_loss < best_loss:
            best_loss = valid_loss
            os.makedirs(SAVE_DIR, exist_ok=True)
            model.save_pretrained(SAVE_DIR)
            print("  ✅ 已保存(当前最好)")
        else:
            print("  验证 loss 没有改善,这一轮不保存——过拟合可能已经开始")

    return best_loss


def main():
    device = "cuda" if torch.cuda.is_available() else "cpu"
    tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)
    model = AutoModelForCausalLM.from_pretrained(BASE_MODEL).to(device)

    # TODO: 换成你自己的 dataloader
    raise SystemExit(
        "把 train_loader / valid_loader 接上之后,依次调用:\n"
        "  sanity_check_first_batch(model, next(iter(train_loader)), "
        "model.config.vocab_size)\n"
        "  report_trainable(model)\n"
        "  train(model, train_loader, valid_loader, device)")


if __name__ == "__main__":
    main()
| 要改的位置 | 换任务时填什么 |
|---|---|
| 底座名称 | 换成任务对应语言、对应结构的模型。换完记得重算 ln(词表),基准线是跟着词表走的 |
| 数据路径 | 指向你自己的 jsonl |
| 提示词拼接函数 | 按任务改三段式的拼法,改完必须重新核对 -100 的个数 |
| 超参三件套 | 学习率、批大小、累积步数。全量和 LoRA 的学习率差一个数量级 |
骨架固化下来的四条时序
| 位置 | 频率 | 为什么必须这样 |
|---|---|---|
| 损失除以累积步数 | 每批 | 不除等于把学习率悄悄放大了 N 倍 |
| 反向传播 | 每批 | 梯度要攒起来 |
| 裁剪 / step / 调度 / 清零 | 攒够才做 | 四件事绑在同一个判断里,任何一件漏进「每批」都不会报错 |
| 清零放在 step 之后 | 攒够才做 | 放在 step 之前会把刚攒好的梯度清掉,等于一直在用空梯度更新 |
ln(词表);② 分词器词表等于模型词表;③ 总更新次数 = 批次数 ÷ 累积步数 × 轮数;④ 用「预测全对」的假数据验一次准确率函数,结果必须是 1.0。四句都过了再让循环跑起来。
06易错点:全都不报错的那九个
每条都给现象、根因和一个十秒钟能打印出来的检查
Model(config) 加载,等于从零训练现象:训练正常跑完,损失也在下降,但产出是噪声。
根因:Model(config) 只按配置搭了个空壳,权重是随机初始化的;from_pretrained(路径) 才会把预训练权重装进去。两者都是合法调用。
检查:第一批损失是否贴近 ln(词表大小)。本讲底座是 9.96——参考实现的日志正好是 9.59,就是这么被发现的。
现象:一个完全看不出是词表问题的越界错误,或者损失异常高。
根因:分词器编出来的 id 超过了模型嵌入表的行数。
检查:加载完直接断言 len(tokenizer) == model.config.vocab_size,一行的事。
现象:损失剧烈震荡,或者直接变成 NaN。
根因:N 个批次的梯度直接相加而不取平均,相当于学习率偷偷翻了 N 倍。
检查:反向传播那一行必须是 (loss / 累积步数).backward()。
现象:训练能跑,但收敛比预期差,说不出哪里不对。
根因:累积到一半就把梯度削一次,攒出来的方向已经失真了。裁剪要裁的是「完整攒好的那一份梯度」。
检查:clip_grad_norm_ 必须和 step() 在同一个「攒够了」的判断里。
scheduler.step() 每批都调一次现象:训练后半程学习率一直是 0,损失纹丝不动。
根因:调度器按总更新次数规划曲线,却被推进了总批次数那么多下——实测模拟里是推 24 次对规划 6 次,曲线早跑完了。
检查:打印 总更新次数 = 批次数 ÷ 累积步数 × 轮数,和调度器被调用的次数对一下。
zero_grad() 的位置错了现象:放在每批 → 累积失效,等于没配;放在 step() 之前 → 参数几乎不动。
根因:前者每批清掉攒的梯度,后者把刚攒好的梯度在用之前清掉。
检查:顺序只有一种对:裁剪 → step → 调度 → 清零。
现象:准确率偏低,且怎么调都上不去。
根因:自回归模型是用第 i 个位置预测第 i+1 个。传 labels 给模型时它内部会自动位移,但你自己写评估函数时不会。
检查:构造一批「预测完全正确」的假数据,算出来必须是 1.0。
现象:显存没省下来,甚至比预想的还高。
根因:优化器会为它拿到的每一个参数分配状态,哪怕这个参数被冻结了。LoRA 省显存靠的正是优化器状态只覆盖旁支。
检查:只把 requires_grad 为真的参数传进去;同时断言可训练占比在零点几个百分点量级——挂载失败时这个数会是 100%。
现象:上线效果不如训练途中某个检查点。
根因:训练损失一直降,不代表验证损失还在降。两条线分叉之后,继续训就是在背答案。
检查:逐轮记录验证损失,取最低的那一轮。本案例验证集只有 4 条,这个判断在真实项目里必须建立在足够大的验证集上。
07自测题
点击题目展开答案;这 9 题对应训练侧的九个不报错的坑
选底座看哪三个条件?顺序为什么不能反?
语言 → 任务类型 → 规模。语言错了分词就先崩,一个汉字被拆成几个字节 token,模型要先学拼字;任务类型错了结构上就产不出句子;规模跑不动则是硬约束。顺序反了会在错误的候选里纠结参数。
第一个批次的损失是 9.6,词表 21128,说明什么?
ln(21128) ≈ 9.96,9.6 几乎贴着这条瞎蒙基准线,说明预训练权重根本没加载上,模型是从随机初始化开始的。多半是误用了 Model(config) 而不是 from_pretrained(路径)。参考实现的日志正好是 9.59。
这条基准线能用来判断训练中途的损失吗?
不能。它判断的是起点——「完全没学过语言时该是多少」。训到中途损失是多少和 ln(V) 没有任何关系。这个检查只在第一个批次做一次,做完就关掉。
带梯度累积的循环里,哪四件事是「攒够才做」?
梯度裁剪、optimizer.step()、scheduler.step()、zero_grad(),四件绑在同一个判断里。每批都做的只有前向、算损失、除以累积步数、反向。任何一件漏进「每批」都不报错。
梯度裁剪为什么是「等比缩小」而不是逐个截断?
因为逐个截断会改变各参数之间的相对比例,等于改了更新方向。等比缩放只改梯度向量的长度不改方向:把所有梯度拼成一个向量算 L2 范数,超过阈值就整体乘同一个系数压回去。实测模拟里那次触发的系数是 0.342。
批大小 4、累积步数 8,模型感受到的批大小是多少?显存按多少算?
等效批大小 4 × 8 = 32,而显存仍按 4 算。这是小显存上训大批次的唯一办法,代价是时间——同样的更新次数要多跑 8 倍前向反向。
24 个批次、累积 4、训 1 轮,调度器的总步数该填几?填错会怎样?
填 6(24 ÷ 4 × 1)。填 24 的话曲线只走完前 1/4,学习率始终维持高位;反过来如果每批都调用 scheduler.step(),曲线提前 4 倍跑完,后半程学习率一直贴着 0。两种错法方向相反,都不报错。
自己写 token 准确率,必须处理哪两件事?
①位移对齐:预测去掉最后一位、标签去掉第一位,因为模型是用第 i 个位置预测第 i+1 个;②掩码:只统计标签不等于 -100 的位置,否则补得越多准确率越虚高。验证方法是喂一批「预测全对」的假数据,结果必须是 1.0。
训练损失还在降、验证损失开始升,该怎么办?本案例能这样判断吗?
这是过拟合的起点,该停下并保存验证损失最低的那一轮,而不是最后一轮。但本案例验证集只有 4 条,波动极大,不足以支撑早停判断——链路可以这样跑通,结论必须建立在足够大的验证集上。
附超参与对照表
两条路线的超参差异、底座规格、以及开训前的检查清单
底座规格(从配置文件读出,不要从文章抄)
| 项 | 值 | 用途 |
|---|---|---|
| 模型 | uer/gpt2-chinese-cluecorpussmall | 中文语料预训练的自回归底座 |
| 词表大小 | 21128 | 瞎蒙基准线 ln(21128) ≈ 9.96 |
| 隐层维度 | 768 | LoRA 旁支的输入维度 |
| 层数 / 注意力头数 | 12 / 12 | 决定挂几组旁支 |
| 参数总量 | 102,068,736 | 全量微调约需 1.52 GB 显存 |
全量微调 vs LoRA:只有三处不同
| 超参 | 全量微调 | LoRA |
|---|---|---|
| 学习率 | 2.6e-5 | 2e-4(高出近十倍,因为只更新新初始化的小矩阵) |
| 单卡批大小 | 4 | 4 |
| 累积步数 | 8 | 8 |
| 等效批大小 | 32 | 32 |
| 预热比例 | 3%(按更新次数算) | 3% |
| 裁剪阈值 | 1.0 | 1.0 |
| 传给优化器的参数 | 全部 | 只传 requires_grad 为真的 |
| 保存的产物 | 整个模型 | 只有旁支,几百 KB 量级 |
| 训练循环 | 完全相同,一行不改 | |
常用公式
| 要算什么 | 怎么算 |
|---|---|
| 瞎蒙基准线 | ln(词表大小);本讲为 ln(21128) ≈ 9.96 |
| 等效批大小 | 单卡批大小 × 累积步数 |
| 总更新次数 | 批次数 ÷ 累积步数 × 轮数——调度器要的是这个数 |
| 预热步数 | 总更新次数 × 预热比例 |
术语表
| 术语 | 含义 |
|---|---|
| 交叉熵损失 | 衡量模型给正确答案分配了多大概率;完全随机时等于 ln(词表大小) |
| 梯度累积 | 攒够 N 个批次的梯度再更新一次,用时间换显存 |
| 梯度裁剪 | 梯度范数超过阈值就整体等比缩小,只改长度不改方向 |
| 预热 | 训练开头用很小的学习率试探,避免一上来冲垮预训练权重 |
| 线性衰减 | 预热结束后学习率随更新次数线性降到接近 0 |
| 位移对齐 | 自回归比对时预测左移一位、标签右移一位;传 labels 时模型内部自动做,自写评估要手动做 |
| token 准确率 | 参与计分的位置里预测正确的比例,比损失更直观 |
| 过拟合 | 训练损失继续降而验证损失开始升,模型在背训练集 |
merge_and_unload() | 把 LoRA 旁支合并回底座权重,推理零额外开销,但只对应这一个任务 |
开训前的四句检查
| # | 检查 | 通过标准 |
|---|---|---|
| 1 | 第一批损失 | 明显低于 ln(词表) |
| 2 | 词表一致性 | 分词器词表 = 模型词表 |
| 3 | 总更新次数 | 等于 批次数 ÷ 累积步数 × 轮数 |
| 4 | 准确率函数 | 喂「预测全对」的假数据,结果为 1.0 |