LCEL 与链的组合
一个竖线就把提示词、模型、解析器接成了一条流水线——而它自己一个 token 也不算。
30″30 秒看懂 LCEL 与链
上一讲里,菜谱卡、厨师、摆盘台三个工位都已经各就各位了。问题是:它们之间还没有传送带。你得自己端着半成品,从菜谱卡走到厨师面前,再从厨师那儿端到摆盘台——每一步都要亲手接、亲手递。
链(Chain)干的就是装传送带这一件事。装好之后,你只需要在入口放进一份原料,成品会自己从出口出来。而装传送带用的工具,就是一个竖线:|。
写出来只有一行:chain = prompt | model | parser。这行代码什么都没做——它没连网、没调模型、没生成一个字,它只是把三段履带咬合到了一起。真正干活,要等到你喊一声 chain.invoke(...)。
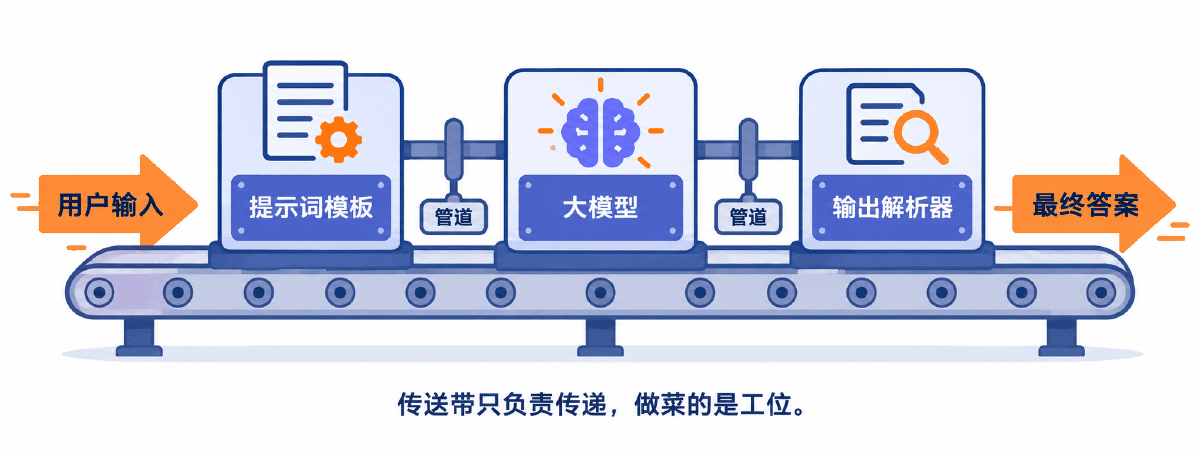
| 比喻里的角色 | 对应的技术概念 | 它到底干了什么 |
|---|---|---|
| 传送带 / 履带 | Chain(链) | 把若干工位按顺序咬合起来,形成一条可复用的工作流 |
| 咬合两节履带的卡扣 | 管道符 | | 只负责接线:把上一节的出口对准下一节的入口,自己不加工任何东西 |
| 每个工位的统一接口尺寸 | Runnable 协议 | 强制所有组件都长一样的「口」,所以任意两节都能咬上 |
| 按下开机键 | invoke / batch / stream | 整条传送带同时转起来,原料才真正被加工 |
| 中间的搬运工 | RunnablePassthrough 等 | 把上一步的东西原样带下去,或者复制几份分给不同支线 |
| 岔道口的分拣员 | 路由链 | 看一眼原料是什么,决定送去 A 车间还是 B 车间 |
| 不执行任何计算。它只是把上一个 Runnable 的输出接到下一个的输入;真正干活的还是链上的每一个组件。把管道符误当成「运算」,后面所有关于中间变量、并行、流式的困惑都会从这里长出来。
01概念:为什么需要「链」
手动搬运的代价、LCEL 的三段构成,以及链与邻近概念的边界
1.1 没有链的时候,代码长什么样
三个工位都准备好了,要产出一句答案,你得自己走三趟:
PromptValueAIMessagestr三步本身不难,难的是中间那两次交接:上一步吐出来的类型,恰好是下一步能吃的类型吗?三步还能忍,等到流程长到七八步、还要分叉合流、还要批量跑一千条的时候,这些临时变量就会变成一团乱麻。
链要替你接管的就是「交接」这件事,而不是替你做任何一步的计算。
# -*- coding: utf-8 -*-
"""
不用链 与 用链:同一件事的两种写法
==================================
同一个任务——「给定话题,讲一个简短笑话」——分别用
① 手动分步 invoke
② LCEL 管道组合
两种方式实现,输出完全一致。

环境:Python 3.10+
依赖:pip install langchain langchain-openai python-dotenv
"""

import os

from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_openai import ChatOpenAI

load_dotenv()

# 密钥只从环境变量读,不写进源码
os.environ["OPENAI_API_KEY"] = os.environ.get("OPENAI_API_KEY", "")
os.environ["OPENAI_BASE_URL"] = os.environ.get("OPENAI_BASE_URL", "")

model = ChatOpenAI(model="gpt-4o-mini", temperature=0.7)

prompt = PromptTemplate.from_template("给我讲一个关于 {topic} 话题的简短笑话")
parser = StrOutputParser()


# ---------------------------------------------------------------- 写法一
def run_step_by_step(topic: str) -> str:
    """手动分三步:自己端着中间结果从一个组件搬到下一个组件。"""
    prompt_value = prompt.invoke({"topic": topic})   # PromptValue
    message = model.invoke(prompt_value)             # AIMessage
    text = parser.invoke(message)                    # str
    return text


# ---------------------------------------------------------------- 写法二
# 管道符只负责「接线」:把上一个 Runnable 的输出接到下一个的输入。
# 这一行本身不调用模型,也不产生任何网络请求。
chain = prompt | model | parser


def run_with_chain(topic: str) -> str:
    """交给链:三个组件的调用与中间结果传递由 LCEL 统一处理。"""
    return chain.invoke({"topic": topic})


if __name__ == "__main__":
    topic = "冰淇淋"

    a = run_step_by_step(topic)
    print("【分步写法】", a)
    print("返回类型:", type(a))

    b = run_with_chain(topic)
    print("【管道写法】", b)
    print("返回类型:", type(b))

    # 看一眼链是由什么拼成的:RunnableSequence,里面按顺序装着三个组件
    print("链的类型:", type(chain).__name__)
    print("链上的步骤:", [type(s).__name__ for s in chain.steps])

    # 输出示例:
    # 链的类型: RunnableSequence
    # 链上的步骤: ['PromptTemplate', 'ChatOpenAI', 'StrOutputParser']
type(chain).__name__ 打出来是 RunnableSequence,chain.steps 里整整齐齐装着三个组件。管道符的产物是一个「装配清单」,不是一个「计算结果」——这是本讲铁律最直观的证据。
1.2 LCEL 是什么
LCEL(LangChain Expression Language,LangChain 表达式语言)是一种声明式的组合方式:你不写「先做什么、再做什么」的过程代码,而是直接声明这条流水线由哪几节组成,剩下的调度交给框架。
它的基本构成只有三段:
一个 BasePromptTemplate。吃一个变量字典,吐一个 PromptValue。PromptValue 既能当字符串交给 LLM,也能当消息序列交给聊天模型。
吃 PromptValue。如果是聊天模型,吐出来的是一条 BaseMessage;这是链上唯一真正生成内容的一节。
一个 BaseOutputParser。字符串或 BaseMessage 都吃得下,吐出你要的最终形态——纯文本、字典、对象皆可。
三段拼起来就是那条最著名的式子:chain = prompt | model | output_parser,然后 chain.invoke({"input": "..."})。
1.3 | 这个符号是从哪儿来的
它和 shell 里的管道是同一个意思:cat a.txt | grep 错误 | wc -l。前一个命令的标准输出,直接变成后一个命令的标准输入。管道本身不做任何文本处理,处理是 grep 和 wc 做的。
LCEL 把这套心智模型原样搬了过来:用户输入先进提示词模板,模板的输出进模型,模型的输出进解析器。差别只在于流动的不再是字节流,而是有类型的 Python 对象。
技术上它是 Python 的运算符重载:Runnable 实现了 __or__,所以 a | b 会返回一个新的 RunnableSequence,里面按顺序记着 [a, b]。仅此而已。
1.4 链、Function Call、Agent 的边界
这三个概念经常被混着说,但它们回答的是完全不同的问题:
| 维度 | 链(本讲) | Function Call | Agent |
|---|---|---|---|
| 回答的问题 | 这几步按什么顺序走 | 模型想委托你办什么事 | 下一步该不该继续 |
| 路线谁定 | 你在代码里写死 | 模型选函数,你执行 | 模型在循环里自己决定 |
| 执行次数 | 固定,写几节走几节 | 一次委托,一来一回 | 不定,循环到它说停 |
| 可预测性 | 完全可预测 | 较高 | 最低,但最灵活 |
一句话记住:链是写死的流水线,Agent 是带回路的流水线。协议层上「模型怎么把要办的事写成一张结构化委托单」那些细节,在 Function Call 那一讲已经拆得很细,这里不再重复;本讲只关心「已经确定要走这几步」的情况下,怎么把这几步接得又稳又好维护。
02原理:管道符背后的 Runnable 协议
统一接口解决了什么、五个调用入口、数据在链上怎么流、四个接线件
2.1 如果没有统一协议,会是什么样
设想每个组件各说各话:提示词渲染叫 .format(),模型调用叫 .generate(),解析器解析叫 .parse(),工具执行叫 .run()。那么代码只能写成这样:
prompt.format(topic="猫")model.generate(prompt_text)parser.parse(model_out)三个组件三种叫法,每次组合都要手动适配。更要命的是:这种代码没法自动组合——框架不可能知道你这个自定义组件该调哪个方法、吃什么吐什么。
2.2 Runnable:强制所有组件长一样的「口」
Runnable 是 LangChain 定义的一个抽象接口(Protocol),它强制要求所有 LCEL 组件实现同一组标准方法。任何实现了这些方法的对象,都被视为 LCEL 兼容组件,都能进管道。
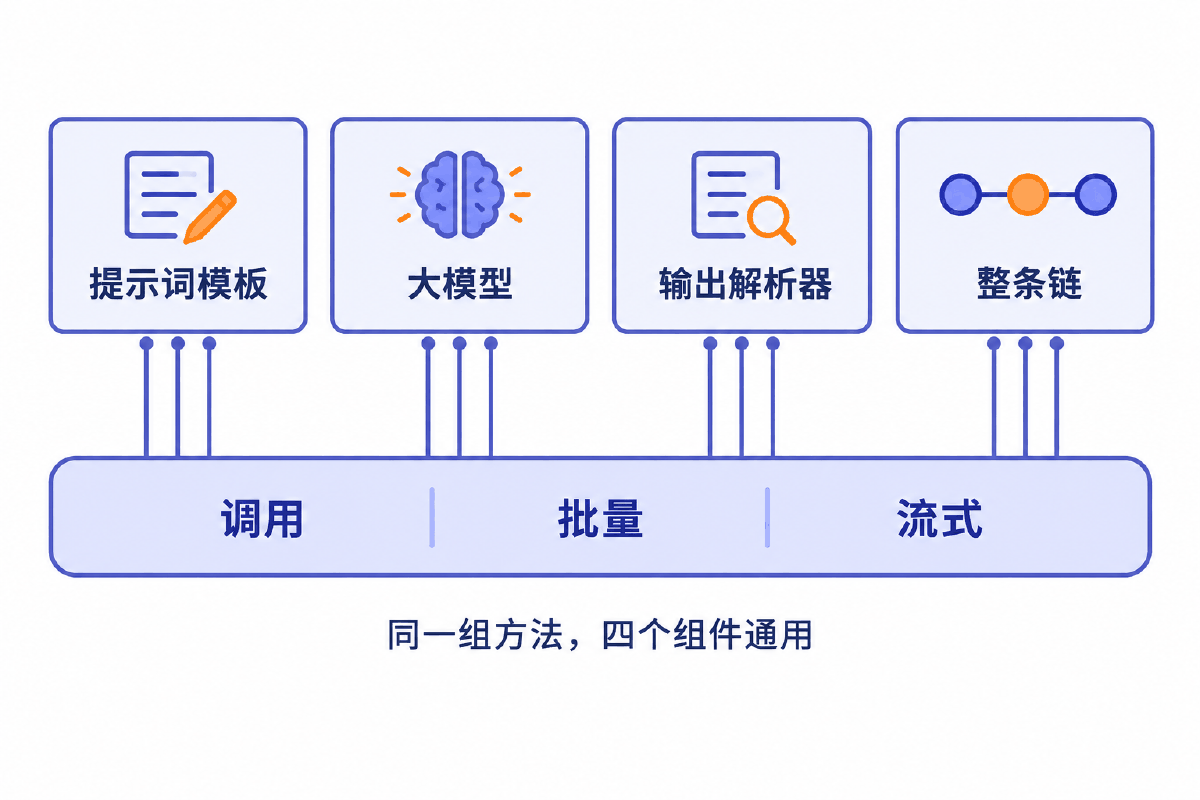
| 方法 | 输入 → 输出 | 什么时候用 |
|---|---|---|
invoke | 单个输入 → 单个输出 | 最常用。一问一答、脚本处理、接口里处理一次请求。 |
batch | 输入列表 → 等长的输出列表 | 一次跑很多条。内部可并发,用 config={"max_concurrency": N} 限流。 |
stream | 单个输入 → 输出的迭代器 | 要让用户尽快看见第一个字。聊天界面的标配。 |
ainvoke | 同 invoke,协程版 | 在 async 框架(FastAPI 等)里,避免阻塞事件循环。 |
astream | 同 stream,异步迭代器 | 异步服务里做流式响应。还有 astream_events 能看到链上每一步的事件。 |
关键在于:这组方法不只属于「链」,也属于链上的每一个组件。提示词模板能 invoke,模型能 invoke,解析器也能 invoke——所以调试的时候,你可以把任意一节单独拎出来试,不用改任何代码。
# -*- coding: utf-8 -*-
"""
Runnable 协议的五个统一入口
===========================
invoke / batch / stream 是同步三件套,ainvoke / astream 是对应的异步版本。
链上的每个组件,以及组合出来的整条链,用的都是这同一组方法名。

依赖:pip install langchain langchain-openai python-dotenv
"""

import asyncio

from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI

load_dotenv()

model = ChatOpenAI(model="gpt-4o-mini")
prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一位擅长用一句话讲清概念的技术讲师"),
    ("human", "用一句话解释:{term}"),
])
chain = prompt | model | StrOutputParser()


def demo_invoke():
    """单输入单输出:最常用的一个。"""
    out = chain.invoke({"term": "管道符"})
    print("[invoke]", out)


def demo_batch():
    """批量:一次传一个列表,返回等长的结果列表,内部可并发。"""
    terms = [{"term": "Runnable"}, {"term": "LCEL"}, {"term": "顺序链"}]
    outs = chain.batch(terms, config={"max_concurrency": 3})
    for t, o in zip(terms, outs):
        print("[batch]", t["term"], "->", o[:40], "...")


def demo_stream():
    """流式:边生成边吐,首字延迟显著低于 invoke。"""
    print("[stream] ", end="", flush=True)
    for chunk in chain.stream({"term": "流式输出"}):
        # 因为链尾是 StrOutputParser,这里每个 chunk 已经是字符串片段
        print(chunk, end="", flush=True)
    print()


async def demo_async():
    """异步:ainvoke 与 astream,方法名只是多了一个 a 前缀。"""
    out = await chain.ainvoke({"term": "异步调用"})
    print("[ainvoke]", out)

    print("[astream] ", end="", flush=True)
    async for chunk in chain.astream({"term": "并发"}):
        print(chunk, end="", flush=True)
    print()


def demo_same_methods_everywhere():
    """同一组方法,在单个组件上也成立。"""
    print("[组件级 invoke] 提示词模板 ->", prompt.invoke({"term": "协议"}))
    print("[组件级 invoke] 解析器 ->", StrOutputParser().invoke("一段文本"))


if __name__ == "__main__":
    demo_invoke()
    demo_batch()
    demo_stream()
    demo_same_methods_everywhere()
    asyncio.run(demo_async())
prompt | model | parser 这一行执行完,一个 token 都没有生成。它做的全部事情是:检查两两之间能不能咬合,然后返回一个 RunnableSequence。真正触发计算的是 invoke / batch / stream 这一声「开机」。
2.3 数据在链上到底怎么流
管道符接线时,唯一的约束是上一节的输出类型,必须是下一节吃得下的类型。三段式标准链的类型演变是这样的:
| 位置 | 流动的东西 | 说明 |
|---|---|---|
| 入口 | dict | 键名就是提示词模板花括号里的变量名,少一个键就报错 |
| 模板 → 模型 | PromptValue | 一个中间形态,既能转成字符串也能转成消息列表 |
| 模型 → 解析器 | AIMessage | 带 content、元数据、可能还有工具调用信息 |
| 出口 | str 或结构化对象 | 取决于你挂了哪个解析器 |
由此可以推出一条实用经验:报错发生在哪一节,看类型对不对就知道了。提示「缺少变量」就是入口字典不全;提示收到的是 AIMessage 而想要 str,就是忘了挂解析器。
2.4 四个接线件:让数据拐弯、分叉、带着走
纯直线的链很快就不够用了。最常见的需求是:第三步想用到最初的输入,但它早就被第一步吃掉了。解决这类问题的是下面几个「接线件」,它们本身也都是 Runnable。
什么都不做,原样透传。真正常用的是它的 .assign():保留已有的键,再算出一个新键。链上流动的字典因此越走越厚,前面的信息一路都在。
把同一份输入同时喂给多个分支,结果汇成一个字典。分支是真并发的,总耗时接近最慢的那一支,而不是几支之和。写成普通 dict 也会被自动包装成它。
把任意 Python 函数变成链上的一节。清洗文本、改字段名、做个判断……凡是模型干不了的杂活都交给它。函数直接写进管道时会被自动包装。
岔道口。按条件挑一条子链走下去,最后一个参数是兜底分支。路由链就是靠它实现的,详见第 04 节。
# -*- coding: utf-8 -*-
"""
RunnablePassthrough 与 RunnableParallel
=======================================
链上每一步只吃上一步的输出。想让后面的步骤还能看见最初的输入,
就要靠这两个「接线件」把数据原样带下去、或者分叉再汇合。

依赖:pip install langchain langchain-openai python-dotenv
"""

from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnableParallel, RunnablePassthrough
from langchain_openai import ChatOpenAI

load_dotenv()

model = ChatOpenAI(model="gpt-4o-mini")
parser = StrOutputParser()


# ------------------------------------------------ 1. 原样透传
# RunnablePassthrough 什么都不做,把输入原封不动交给下一步。
print(RunnablePassthrough().invoke({"product": "耳机"}))
# -> {'product': '耳机'}


# ------------------------------------------------ 2. 透传 + 补一个字段
# assign 在保留原有键的基础上,再算出一个新键。
price_prompt = ChatPromptTemplate.from_template(
    "请给出 {product} 的一个合理市场价,只回答数字,不要单位和多余文字"
)
add_price = RunnablePassthrough.assign(price=price_prompt | model | parser)

# 输入 {"product": "耳机"},输出 {"product": "耳机", "price": "399"}
# 原来的 product 还在,后面的提示词才能同时用到商品名和价格。


# ------------------------------------------------ 3. 并行分叉
# RunnableParallel 把同一份输入同时喂给多个分支,结果汇成一个字典。
# 写成普通 dict 也可以,LCEL 会自动包装成 RunnableParallel。
selling_point = ChatPromptTemplate.from_template("用一句话说出 {product} 最大的卖点")
target_user = ChatPromptTemplate.from_template("{product} 最适合哪类人群?一句话")

fan_out = RunnableParallel(
    point=selling_point | model | parser,
    user=target_user | model | parser,
    product=RunnablePassthrough(),          # 把原始输入也留一份
)


# ------------------------------------------------ 4. 分叉之后再汇合
copy_prompt = ChatPromptTemplate.from_template(
    "为 {product} 写一条 50 字以内的促销文案。\n卖点:{point}\n目标人群:{user}"
)


def build_chain():
    """先补价格,再并行取卖点与人群,最后汇合成文案。"""
    return (
        add_price
        | RunnableParallel(
            product=lambda d: d["product"],
            price=lambda d: d["price"],
            point=selling_point | model | parser,
            user=target_user | model | parser,
        )
        | copy_prompt
        | model
        | parser
    )


if __name__ == "__main__":
    print("[并行分支]", fan_out.invoke({"product": "降噪耳机"}))

    chain = build_chain()
    print("[汇合结果]", chain.invoke({"product": "降噪耳机"}))

    # 并行分支是真的并发跑的:两个分支各自请求一次模型,总耗时接近单次而不是两次之和。
assign 和 RunnableParallel
两者都产出字典,区别在于要不要保留原有的键:RunnablePassthrough.assign(price=...) 是「原来的键都留着,再加一个 price」;RunnableParallel(price=...) 是「只要我列出来的这几个键,其余一律丢掉」。想收窄输出就用后者,想一路攒着就用前者。
2.5 两个配置开关:.bind() 与 .with_config()
这两个方法挂在任意 Runnable 上,返回的仍是一个 Runnable,所以照样能进管道。
| 方法 | 管的是 | 典型用法 |
|---|---|---|
.bind(...) | 调用参数 | 把 temperature=0、max_tokens、stop 预先焊在模型上,之后每次调用自动带上,不用在调用处重复传。同一个模型实例可以 bind 出好几个不同脾气的版本。 |
.with_config(...) | 运行期配置 | 起名字(run_name)、打标签(tags)、限并发(max_concurrency)。名字和标签会跟着追踪信息走,排查长链时能一眼看出卡在哪一节。 |
# -*- coding: utf-8 -*-
"""
RunnableLambda / .bind() / .with_config()
=========================================
三个把「普通 Python 世界」接进链里的开关:
  RunnableLambda   把任意函数变成链上的一个工位
  .bind()          给某个组件预先锁死一部分调用参数
  .with_config()   给某个组件或整条链挂运行期配置(标签、并发、超时)

依赖:pip install langchain langchain-openai python-dotenv
"""

import json
import re

from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnableLambda
from langchain_openai import ChatOpenAI

load_dotenv()

model = ChatOpenAI(model="gpt-4o-mini")
parser = StrOutputParser()


# ---------------------------------------------------------- RunnableLambda
def clean_text(text: str) -> str:
    """去掉模型爱加的代码围栏和首尾空白。"""
    text = re.sub(r"^```(?:json|python)?|```$", "", text.strip(), flags=re.M)
    return text.strip()


def to_dict(text: str) -> dict:
    """把清洗后的字符串解析成字典;失败就原样兜住,不让整条链崩掉。"""
    try:
        return json.loads(text)
    except json.JSONDecodeError:
        return {"raw": text, "parsed": False}


extract_prompt = ChatPromptTemplate.from_template(
    "从下面这句话里抽取城市和日期,只输出 JSON,键为 city 和 date:\n{sentence}"
)

# 普通函数放进管道时,LCEL 会自动包成 RunnableLambda;
# 显式写出来可读性更好,也方便后面单独 .with_config() 起名字。
extract_chain = (
    extract_prompt
    | model
    | parser
    | RunnableLambda(clean_text).with_config({"run_name": "清洗围栏"})
    | RunnableLambda(to_dict).with_config({"run_name": "解析字典"})
)


# ---------------------------------------------------------------- .bind()
# bind 把参数「焊」在组件上,之后每次调用都自动带上,不用在调用处重复传。
strict_model = model.bind(temperature=0, max_tokens=256)

# 也可以绑定停止词:让模型生成到某个标记就停下
short_model = model.bind(stop=["\n\n"])


# ----------------------------------------------------------- .with_config()
# 配置挂在链上,对整条链生效;批量调用时用来限制并发。
traced_chain = extract_chain.with_config({
    "run_name": "信息抽取链",
    "tags": ["extract", "demo"],
    "max_concurrency": 4,
})


if __name__ == "__main__":
    sentence = "帮我看看 2025 年 12 月 10 日郑州的天气"
    print("[抽取结果]", extract_chain.invoke({"sentence": sentence}))

    # bind 之后的组件仍然是一个 Runnable,照样能进管道
    determin_chain = extract_prompt | strict_model | parser
    print("[temperature=0]", determin_chain.invoke({"sentence": sentence}))

    print("[带配置批量]", traced_chain.batch([
        {"sentence": "订一张 2026 年 1 月 3 日去上海的票"},
        {"sentence": "查一下明天北京冷不冷"},
    ]))
.bind() 返回的是新对象,原来的模型实例不受影响。所以 strict = model.bind(temperature=0) 之后,model 还是原来那个 model。想让整条链都用严格版,必须在装配时用 strict 而不是 model。
03最小代码:跑通第一条链
五步,二十行,把传送带真正转起来
剥掉所有花样之后,一条能跑的链只需要五步。对着代码里的编号看:
prompt | model | parser,不发请求invoke,三个工位依次动起来# -*- coding: utf-8 -*-
"""
最小可跑的一条链
================
提示词模板 | 大模型 | 输出解析器,三行装配,一行调用。
这是 LCEL 的最短路径,后面所有花样都是从这三步长出来的。
依赖:pip install langchain langchain-openai python-dotenv
环境变量:OPENAI_API_KEY
"""
from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
load_dotenv() # 从 .env 读 OPENAI_API_KEY
# ① 工位一:菜谱卡。花括号里的 topic 是待填的变量
prompt = ChatPromptTemplate.from_template("用一句话解释什么是 {topic}")
# ② 工位二:厨师。真正生成内容的是它
model = ChatOpenAI(model="gpt-4o-mini")
# ③ 工位三:摆盘。把 AIMessage 剥成纯字符串
parser = StrOutputParser()
# ④ 传送带:管道符把三个工位接成一条流水线。
# 这一行不发任何请求,只是把接线接好。
chain = prompt | model | parser
# ⑤ 开机:invoke 才真正让三个工位依次动起来
answer = chain.invoke({"topic": "管道符"})
print(answer)
print(type(answer)) # <class 'str'>
pip install langchain langchain-openai python-dotenv。在项目根目录建一个 .env 写上 OPENAI_API_KEY=你的KEY,代码里用 load_dotenv() 读进来。不要把 KEY 硬编码进源码,更不要连 .env 一起提交进 Git。
ChatOpenAI(model="gpt-4o-mini") 换成 ChatOllama(model="qwen3:8b"),下面的链一个字都不用动——因为两者都是 Runnable,都长着同样的「口」。这正是统一协议给你的红利,第 04 节最后有一份完整的本地模型版本。
3.1 把链拆开单步调试
链跑不通的时候,不必往里加打印语句。因为每一节自己就是 Runnable,直接挨个 invoke 一遍,哪一节的输出不对一目了然:
| 单步调用 | 应该拿到什么 | 拿到别的说明 |
|---|---|---|
prompt.invoke({"topic": "管道符"}) | 一个 PromptValue | 报缺变量 → 入口字典的键名和模板对不上 |
model.invoke(prompt_value) | 一条 AIMessage | 鉴权/超时报错 → 与链无关,是模型配置问题 |
parser.invoke(message) | 一个 str | 解析异常 → 模型输出格式不符合解析器预期 |
这条排查法则贯穿整讲:链出问题,先定位是哪一节,再看那一节的输入输出类型。
04完整案例:顺序 · 路由 · 流式 · 查库
四种最常见的链形态,外加一份旧写法到管道组合的迁移
4.1 单入单出的顺序链:剧名 → 大纲 → 剧评
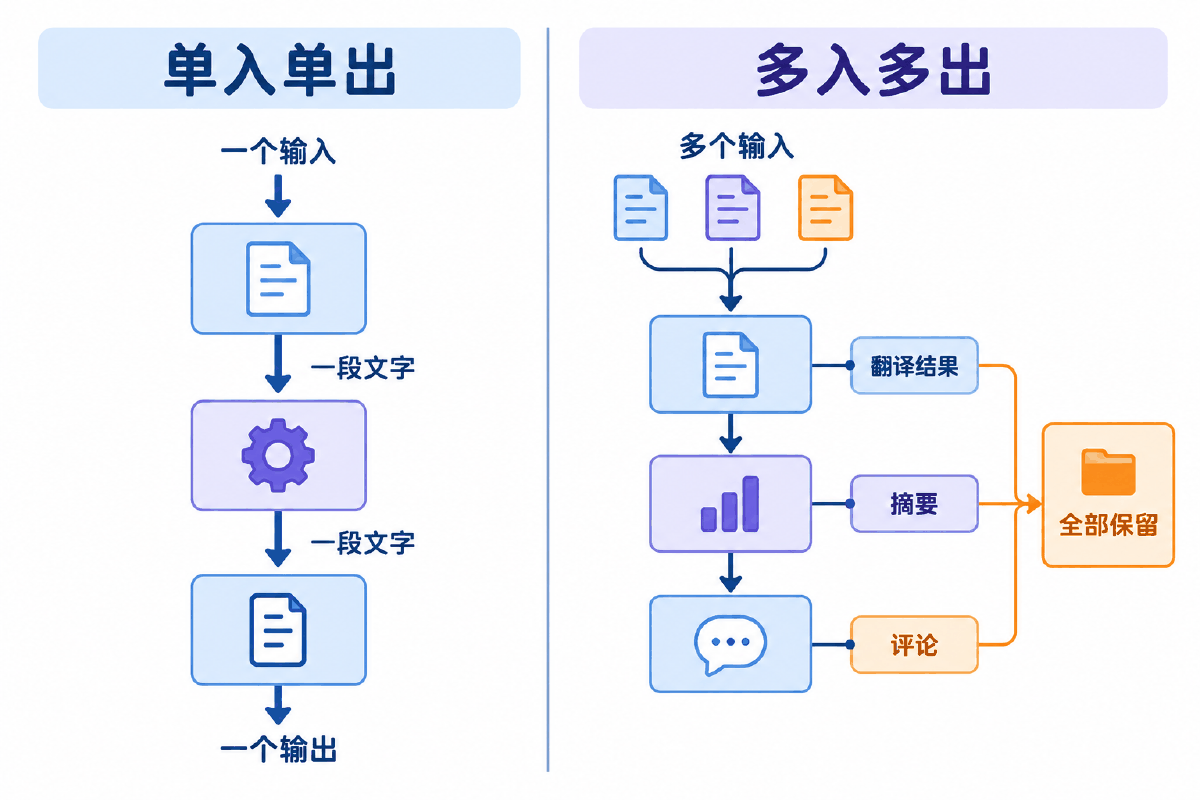
顺序链(Sequential Chain)指的是把多条链首尾相接,前一条的输出作为后一条的输入,形成一条特定场景的流水线。按输入输出的个数分两类,先看简单的那一类。
场景:给一个剧本标题,第一段写分幕大纲,第二段照着大纲写剧评。每一段都只吃一段文字、吐一段文字,中间不需要复杂映射。
# -*- coding: utf-8 -*-
"""
单入单出的顺序链:剧名 → 大纲 → 剧评
=====================================
第一段的输出就是第二段的输入,中间不需要任何字段映射。
这是最简单的一类流水线,用管道符直接接起来即可。

依赖:pip install langchain langchain-openai python-dotenv
"""

from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI

load_dotenv()

model = ChatOpenAI(model="gpt-4o-mini")
parser = StrOutputParser()


# ------------------------------------------------ 第一段:给剧名写大纲
synopsis_prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一名剧作家。给定剧本标题,写出一份分幕大纲。"),
    ("human", "剧本标题:{title}"),
])
synopsis_chain = synopsis_prompt | model | parser


# ------------------------------------------------ 第二段:给大纲写剧评
review_prompt = ChatPromptTemplate.from_messages([
    ("system", "你是《纽约时报》的剧评家。读完剧情大纲后写一篇剧评。"),
    ("human", "剧情大纲:\n{synopsis}"),
])
review_chain = review_prompt | model | parser


# ------------------------------------------------ 串成一条
# 第一段吐出的是一个纯字符串,第二段的提示词要的是 {synopsis},
# 中间用一个 dict 把字符串装进正确的键里。
full_chain = synopsis_chain | (lambda text: {"synopsis": text}) | review_chain


# ------------------------------------------------ 中途也想拿到大纲?
# 上面那条链只返回剧评,大纲被丢掉了。想两样都留下,用 assign:
from langchain_core.runnables import RunnablePassthrough  # noqa: E402

keep_both = (
    RunnablePassthrough.assign(synopsis=synopsis_chain)
    | RunnablePassthrough.assign(review=review_chain)
)
# 输入 {"title": "..."},输出 {"title": ..., "synopsis": ..., "review": ...}


if __name__ == "__main__":
    title = "日落海滩上的悲剧"

    review = full_chain.invoke({"title": title})
    print("=" * 30, "剧评", "=" * 30)
    print(review)

    both = keep_both.invoke({"title": title})
    print("=" * 30, "两段都留下", "=" * 30)
    print("键:", list(both.keys()))
    print("大纲前 60 字:", both["synopsis"][:60])
    print("剧评前 60 字:", both["review"][:60])

    # 想看每一步的中间结果,不必加 verbose 参数,直接用 stream 观察事件:
    # for ev in keep_both.stream({"title": title}):
    #     print(ev)
{synopsis} 这个变量。所以要有一步把字符串装进正确的键里:(lambda text: {"synopsis": text})。这一步看着琐碎,但它把「接线」这件事明明白白摆在了代码里——旧写法里这一步是框架偷偷帮你做的,出错时反而难查。
上面那条链只返回剧评,中途的大纲被丢掉了。想两样都留下,把链改成「字典进、字典出」,用 assign 逐段往里加键,代码最后一段的 keep_both 就是这么写的。这是顺序链从「单出」走向「多出」的转折点。
4.2 多入多出的顺序链:翻译 → 摘要 → 识别语种 → 评论
真实业务很少这么线性。更常见的是:四段处理,每段要读到前面某一段(不一定是紧邻的上一段)的结果,而且四段的产物最后都要交出去。
做法只有一条原则:让链上流动的东西始终是一个字典,每段用 assign 往字典里加一个新键。字典越走越厚,谁想用哪一段的结果,按键名取就行。
# -*- coding: utf-8 -*-
"""
多入多出的顺序链:翻译 → 摘要 → 识别语种 → 评论
=================================================
四段处理,每段都要读到前面某一段的结果,而且四段的结果最后都要留下来。
做法:让链上流动的始终是一个 **字典**,每一段用 assign 往字典里加一个键。

依赖:pip install langchain langchain-openai python-dotenv
"""

from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_openai import ChatOpenAI

load_dotenv()

model = ChatOpenAI(model="gpt-4o-mini")
parser = StrOutputParser()


def step(template: str):
    """把一段提示词包成「提示词 | 模型 | 解析器」的小链。"""
    return PromptTemplate.from_template(template) | model | parser


# 四段各自的小链。花括号里的变量名,就是它要从流动字典里取的键。
translate = step("把下面内容翻译成中文:\n\n{content}")
summarize = step("用一句话总结下面内容:\n\n{chinese_review}")
detect = step("下面内容是什么语言?只回答语言名称:\n\n{chinese_summary}")
comment = step(
    "请使用指定的语言对以下内容进行评论。\n\n"
    "内容:{chinese_summary}\n\n语言:{language}"
)


# ---------------------------------------------------------------- 串起来
# 每个 assign 都是「保留已有的键,再加一个新键」,所以字典越走越厚。
overall_chain = (
    RunnablePassthrough.assign(chinese_review=translate)
    | RunnablePassthrough.assign(chinese_summary=summarize)
    | RunnablePassthrough.assign(language=detect)
    | RunnablePassthrough.assign(comment=comment)
)


# ---------------------------------------------------------------- 只要部分输出
# 最后挂一个字典,挑出需要的键,等价于旧写法里的 output_variables。
pick_output = overall_chain | {
    "chinese_summary": lambda d: d["chinese_summary"],
    "comment": lambda d: d["comment"],
}


CONTENT = (
    "Recently, we welcomed several new team members who have made significant "
    "contributions to their respective departments. Furthermore, please remember "
    "that the open enrollment period for our employee benefits program is fast "
    "approaching."
)


if __name__ == "__main__":
    result = overall_chain.invoke({"content": CONTENT})

    print("最终字典里有这些键:", list(result.keys()))
    for k in ("chinese_review", "chinese_summary", "language", "comment"):
        print("-" * 60)
        print(k, ":", result[k])

    print("=" * 60)
    print("只取两个键:", pick_output.invoke({"content": CONTENT}).keys())

    # 注意:assign 之间是有先后依赖的,顺序不能随便调。
    # 把 language 那一步提到 chinese_summary 之前,会因为字典里还没有
    # chinese_summary 这个键而直接报 KeyError。
| 走到第几段 | 字典里有哪些键 | 这一段读了谁 |
|---|---|---|
| 入口 | content | — |
| 翻译后 | content、chinese_review | 读 content |
| 摘要后 | 再加 chinese_summary | 读 chinese_review |
| 识别语种后 | 再加 language | 读 chinese_summary |
| 评论后 | 再加 comment | 同时读 chinese_summary 和 language |
chinese_summary 这个键,会直接抛 KeyError。判断方法很简单:某一段模板花括号里的每个变量名,必须在它之前就已经出现在字典里。
4.3 路由链:按输入分发到不同子链
前面两类链的路径都是写死的。路由链(Router Chain)让链动态选择下一条链:先分析用户的需求,再引导到最适合的那条子链去执行。
典型场景:三条子链分别对应三个学科的问答,而用户的提问是随机的——这次是数学题,下次可能是历史题。期待的效果是自动分拣到对应的子链。
RunnableBranch 按分类挑一条子链# -*- coding: utf-8 -*-
"""
路由链:按输入内容把请求分发到不同的子链
========================================
三个学科各有一条子链,外加一条兜底子链。
先让模型给问题分类,再用 RunnableBranch 按分类结果选一条路走下去。
依赖:pip install langchain langchain-openai python-dotenv
"""
from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnableBranch, RunnablePassthrough
from langchain_openai import ChatOpenAI
load_dotenv()
model = ChatOpenAI(model="gpt-4o-mini")
parser = StrOutputParser()
# ------------------------------------------------------------ 1. 分类器
# 只让模型吐一个词,方便下面做精确匹配。temperature=0 让分类结果稳定。
classify_prompt = ChatPromptTemplate.from_template(
"下面的问题属于哪一类?只回答一个词:数学、物理、历史、其他。\n\n问题:{question}"
)
classifier = classify_prompt | model.bind(temperature=0) | parser
# ------------------------------------------------------------ 2. 各科子链
def expert(role: str, style: str):
p = ChatPromptTemplate.from_messages([
("system", f"你是一位{role}。{style}"),
("human", "{question}"),
])
return p | model | parser
math_chain = expert("数学教授", "先列出关键公式,再一步步推导,最后给出答案。")
physics_chain = expert("物理学教授", "先说清物理图像,再给出定量结论。")
history_chain = expert("历史学者", "先交代时代背景,再叙述事件与影响。")
default_chain = expert("耐心的通识讲师", "用平实的语言直接回答,不要装作自己是专家。")
# ------------------------------------------------------------ 3. 路由
# RunnableBranch 依次检查每个判断函数,命中就走对应的子链;
# 最后一个参数是兜底分支,所有条件都不满足时走它——这条一定要写。
branch = RunnableBranch(
(lambda d: "数学" in d["topic"], math_chain),
(lambda d: "物理" in d["topic"], physics_chain),
(lambda d: "历史" in d["topic"], history_chain),
default_chain,
)
# 先算出 topic 这个键,再把带着 topic 的整份字典交给 branch。
router_chain = RunnablePassthrough.assign(topic=classifier) | branch
# ------------------------------------------------------------ 4. 纯规则版路由
# 分类这一步不一定要花一次模型调用。关键词能判清楚时,直接写函数更快更省。
KEYWORDS = {
"数学": ("方程", "求导", "积分", "概率", "几何"),
"物理": ("加速度", "电场", "熵", "波长", "动量"),
"历史": ("朝代", "战争", "条约", "王朝", "年间"),
}
def rule_classify(d: dict) -> dict:
q = d["question"]
topic = next((k for k, kws in KEYWORDS.items() if any(w in q for w in kws)), "其他")
return {**d, "topic": topic}
fast_router = rule_classify | branch
if __name__ == "__main__":
for q in ["请解释一下二次方程的求根公式", "唐朝的均田制是怎么回事", "今天适合出门吗"]:
print("=" * 60)
print("问题:", q)
print("回答:", router_chain.invoke({"question": q})[:80], "...")
print("=" * 60)
print("[纯规则路由]", fast_router.invoke({"question": "帮我求导 x^2"})[:60], "...")
RunnableBranch 的最后一个参数就是默认分支,必须设置,用来兼容输入不满足任意一项的情况。少了它,遇到没见过的输入时链会直接失败——而用户的输入永远比你预设的分类多。
实践中常用的是两者叠加:关键词先兜一遍,兜不住的再交给模型——这正是路由骨架模板里
classify() 的写法。
4.4 流式输出:让用户尽快看见第一个字
同样一段两百字的回答,invoke 要等模型全部生成完才返回,用户盯着空白等好几秒;stream 则是生成一点吐一点,首字延迟通常是前者的几分之一。内容总量没变,变的是用户的等待体感。
# -*- coding: utf-8 -*-
"""
流式输出:stream / astream / astream_events
===========================================
链上只要有一个组件不支持流式,流式就会在那里断掉,退化成「等它算完再一次性吐」。
这份代码演示三种粒度的流式读取,以及一个会把流式打断的典型写法。

依赖:pip install langchain langchain-openai python-dotenv
"""

import asyncio
import json
import time

from dotenv import load_dotenv
from langchain_core.output_parsers import JsonOutputParser, StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnableLambda
from langchain_openai import ChatOpenAI

load_dotenv()

model = ChatOpenAI(model="gpt-4o-mini")
prompt = ChatPromptTemplate.from_template("写一段 200 字左右的短文,主题是:{topic}")
chain = prompt | model | StrOutputParser()


# ------------------------------------------------------------ 1. 同步流式
def demo_stream():
    t0 = time.time()
    first = None
    for chunk in chain.stream({"topic": "清晨的地铁"}):
        if first is None:
            first = time.time() - t0
        print(chunk, end="", flush=True)
    print()
    print("首字延迟:%.2f 秒" % first)


# ------------------------------------------------------------ 2. 异步流式
async def demo_astream():
    async for chunk in chain.astream({"topic": "夜里的便利店"}):
        print(chunk, end="", flush=True)
    print()


# ------------------------------------------------------------ 3. 逐事件流式
async def demo_astream_events():
    """想知道「现在流的是链上哪一步」,用 astream_events。"""
    async for ev in chain.astream_events({"topic": "雨天的球场"}):
        kind = ev["event"]
        if kind == "on_chat_model_stream":
            print(ev["data"]["chunk"].content, end="", flush=True)
        elif kind in ("on_chain_start", "on_chain_end"):
            print("\n<%s %s>" % (kind, ev.get("name")))
    print()


# ------------------------------------------------------------ 4. 会打断流式的写法
def take_all(text: str) -> str:
    """普通函数必须拿到完整输入才能返回,链在这里必然攒齐再往下走。"""
    return text.upper()


blocked = chain | RunnableLambda(take_all)
# blocked.stream(...) 仍然能调用,但只会在最后一次性吐出一整块。


# 输出结构化数据时,换成支持增量解析的 JsonOutputParser,流式才有意义。
json_prompt = ChatPromptTemplate.from_template(
    "列出 3 个 {topic} 相关的关键词,输出 JSON 数组,键名为 keywords"
)
json_chain = json_prompt | model | JsonOutputParser()


async def demo_json_stream():
    async for partial in json_chain.astream({"topic": "向量数据库"}):
        # 每次拿到的是「到目前为止能解析出来的那部分」,字典会逐步长大
        print(json.dumps(partial, ensure_ascii=False))


if __name__ == "__main__":
    demo_stream()
    asyncio.run(demo_astream())
    asyncio.run(demo_astream_events())
    asyncio.run(demo_json_stream())
| 方法 | 拿到的是 | 适用 |
|---|---|---|
stream / astream | 最终输出的增量片段 | 聊天界面逐字显示,最常用 |
astream_events | 链上每一步的事件 | 想知道「现在流的是哪一节」、要在界面上显示进度 |
现象是:代码里明明写了
stream,但界面还是卡半天然后整段蹦出来。排查方法:把可疑的那一节摘掉再试一次。要输出结构化数据又想保留流式,就换成支持增量解析的解析器。
4.5 SQL 查询链:自然语言 → SQL → 结果 → 人话
SQL 查询链把自然语言转换成数据库的 SQL 查询。要点是看清它的职责边界:它只负责写 SQL,不负责执行 SQL。执行仍然是你的代码做的——本讲的铁律在这里依然成立。
# -*- coding: utf-8 -*-
"""
SQL 查询链:自然语言 → SQL → 结果 → 人话
========================================
create_sql_query_chain 只负责「把问题翻译成一条 SQL」,它不执行 SQL。
执行由 SQLDatabase.run 完成,最后再用一段提示词把查询结果讲成人话。

依赖:pip install langchain langchain-classic langchain-community
      langchain-openai pymysql python-dotenv
"""

import os

from dotenv import load_dotenv
from langchain_classic.chains import create_sql_query_chain
from langchain_community.utilities import SQLDatabase
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_openai import ChatOpenAI

load_dotenv()

# 连接串里的账号口令一律走环境变量,不要写进源码,更不要提交进版本库
DB_USER = os.environ.get("DB_USER", "readonly")
DB_PASSWORD = os.environ.get("DB_PASSWORD", "")
DB_HOST = os.environ.get("DB_HOST", "127.0.0.1")
DB_PORT = os.environ.get("DB_PORT", "3306")
DB_NAME = os.environ.get("DB_NAME", "itcast")

db = SQLDatabase.from_uri(
    f"mysql+pymysql://{DB_USER}:{DB_PASSWORD}@{DB_HOST}:{DB_PORT}/{DB_NAME}"
)

print("数据库方言:", db.dialect)
print("可用数据表:", db.get_usable_table_names())

model = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# 这一步产出的是一段 SQL 文本,不是查询结果
write_sql = create_sql_query_chain(llm=model, db=db)


def clean_sql(text: str) -> str:
    """模型有时会带上 `SQLQuery:` 前缀或 Markdown 围栏,先剥干净。"""
    text = text.strip()
    if text.lower().startswith("sqlquery:"):
        text = text.split(":", 1)[1]
    text = text.replace("```sql", "").replace("```", "")
    return text.strip().rstrip(";") + ";"


def guard(sql: str) -> str:
    """只放行只读查询,并强制加上行数上限。"""
    low = sql.lower().strip()
    if not low.startswith("select"):
        raise ValueError("只允许 SELECT 查询")
    if ";" in low[:-1]:
        raise ValueError("不允许多条语句")
    if " limit " not in low:
        sql = sql.rstrip(";") + " LIMIT 50;"
    return sql


answer_prompt = ChatPromptTemplate.from_template(
    "根据下面的信息,用中文回答用户的问题。\n\n"
    "问题:{question}\nSQL:{query}\n查询结果:{result}\n\n回答:"
)

full_chain = (
    RunnablePassthrough.assign(query=write_sql | clean_sql | guard)
    | RunnablePassthrough.assign(result=lambda d: db.run(d["query"]))
    | answer_prompt
    | model
    | StrOutputParser()
)


if __name__ == "__main__":
    q = "employees 表里一共有多少个员工?"

    sql = guard(clean_sql(write_sql.invoke({"question": q})))
    print("模型写出的 SQL:", sql)
    print("直接执行的结果:", db.run(sql))

    print("整条链的回答:", full_chain.invoke({"question": q}))

    # 限制模型只看某几张表,可以显著降低写错表名的概率:
    # write_sql.invoke({"question": q, "table_names_to_use": ["employees"]})
DELETE、DROP,也可能一把拉走整张表。两层防护缺一不可:① 代码层校验——只允许 SELECT、拒绝多语句、强制 LIMIT、设超时;② 数据库层只读账号——就算校验被绕过,这一层也执行不了写操作。另外,模型能不能写对 SQL,很大程度取决于你有没有把表结构连同中文字段注释一起交给它;多表时还要写清表之间的关联,否则它写不出正确的
JOIN。
4.6 把旧写法改成管道组合
在 LCEL 出现之前,链是一批具体的类:LLMChain 是最基础的一个,至少包含一个提示模板和一个语言模型,用于单次问答、无记忆;顺序链则由 SimpleSequentialChain(单入单出)和 SequentialChain(多入多出)承担。
这些类现在住在 langchain-classic 包里:装上就还能跑,线上老项目也还在用,但它们不再是推荐写法。新项目直接用管道组合。
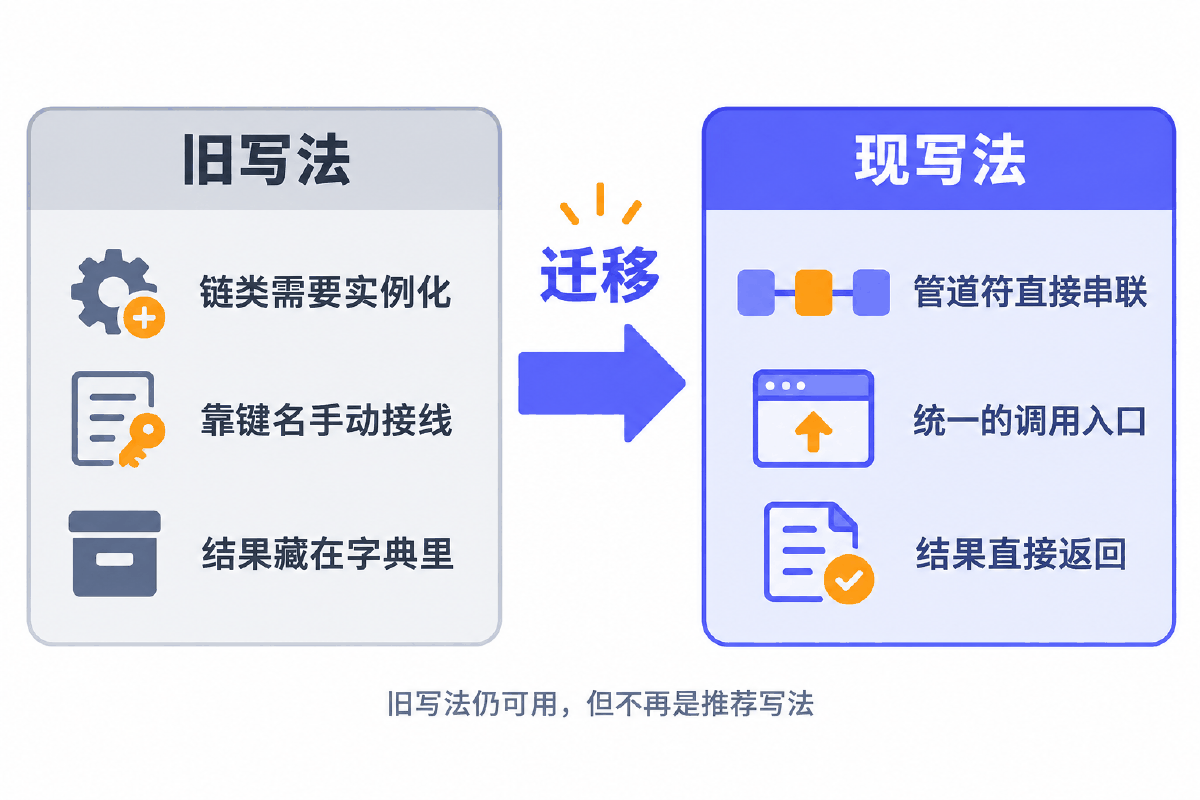
| 旧写法 | 当代写法 | 差在哪 |
|---|---|---|
LLMChain(llm=..., prompt=...) | prompt | llm | parser | 旧的返回字典,答案藏在 "text" 键里;新的直接返回你要的类型 |
SimpleSequentialChain | a | 映射函数 | b | 旧的把入口键写死成 input、出口写死成 output;新的键名自己定 |
SequentialChain | 一串 assign | 旧的靠 output_key 与 input_variables 手动对齐,名字写错要等运行时才报错 |
verbose=True 看过程 | stream / astream_events | 旧的只能打到终端;新的是结构化事件,能送进界面或日志 |
导入 langchain.chains | 导入 langchain_classic.chains | 1.x 收窄了 langchain 的命名空间,旧功能搬到了新包 |
先看旧写法原本长什么样,读懂线上老代码要靠它:
# -*- coding: utf-8 -*-
"""
旧写法:LLMChain / SimpleSequentialChain / SequentialChain
==========================================================
这三个类现在住在 langchain-classic 包里,仍然可以安装、可以跑,
但它们已经不是推荐写法。放在这里是为了让你读懂线上还在跑的老代码。

安装:pip install langchain-classic langchain-openai python-dotenv
"""

from dotenv import load_dotenv
from langchain_classic.chains import LLMChain, SequentialChain, SimpleSequentialChain
from langchain_core.prompts import ChatPromptTemplate, PromptTemplate
from langchain_openai import ChatOpenAI

load_dotenv()

llm = ChatOpenAI(model="gpt-4o-mini")


# ------------------------------------------------------- 1. 最基础的 LLMChain
prompt = PromptTemplate.from_template("桌上有 {number} 个苹果、四个桃子和 3 本书,一共有几个水果?")
llm_chain = LLMChain(llm=llm, prompt=prompt)

# 注意返回值:是一个字典,答案在 "text" 键里,而且原始输入也被塞了进去
# {'number': 2, 'text': '一共有 6 个水果。'}
print(llm_chain.invoke({"number": 2}))


# verbose=True 会把渲染后的提示词打印到终端,这是旧写法的调试手段
chat_template = ChatPromptTemplate.from_messages([
    ("system", "你是一位{area}领域具备丰富经验的高端技术人才"),
    ("human", "给我讲一个 {adjective} 笑话"),
])
verbose_chain = LLMChain(llm=llm, prompt=chat_template, verbose=True)
print(verbose_chain.invoke({"area": "互联网", "adjective": "上班的"}))


# --------------------------------------- 2. SimpleSequentialChain:单入单出
first = LLMChain(llm=llm, prompt=PromptTemplate.from_template(
    "我的邻居姓 {lastname},他生了个儿子,给他儿子起个名字"))
second = LLMChain(llm=llm, prompt=PromptTemplate.from_template(
    "邻居的儿子名字叫 {child_name},给他起一个小名"))

overall = SimpleSequentialChain(chains=[first, second], verbose=True)

# 调用时既不用 lastname 也不用 child_name,而是固定用 input;
# 返回值里的答案也固定在 output 键上——这两个键写死在源码里。
print(overall.invoke({"input": "王"}))


# ------------------------------------------- 3. SequentialChain:多入多出
translate = LLMChain(
    llm=llm,
    prompt=PromptTemplate.from_template("把下面内容翻译成中文:\n\n{content}"),
    output_key="chinese_review",
)
summarize = LLMChain(
    llm=llm,
    prompt=PromptTemplate.from_template("用一句话总结下面内容:\n\n{chinese_review}"),
    output_key="chinese_summary",
)

seq = SequentialChain(
    chains=[translate, summarize],
    input_variables=["content"],
    output_variables=["chinese_review", "chinese_summary"],
    verbose=True,
)

# 链与链之间靠 output_key / 模板变量名手动对齐,名字写错要等到运行时才报错
print(seq.invoke({"content": "Hello team, the enrollment period is approaching."}))
再看同样三件事改成管道之后的样子,两两并排:
# -*- coding: utf-8 -*-
"""
把旧链改写成管道组合
====================
同一件事,上面是 langchain-classic 的旧写法,下面是当代的管道写法。
三组改写各自独立,可以单独运行任意一组。

依赖:pip install langchain langchain-classic langchain-openai python-dotenv
"""

from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_openai import ChatOpenAI

load_dotenv()

llm = ChatOpenAI(model="gpt-4o-mini")
parser = StrOutputParser()


# ========================================================== 一、LLMChain
def old_llm_chain():
    from langchain_classic.chains import LLMChain

    prompt = PromptTemplate.from_template("给我讲一个关于 {topic} 的笑话")
    chain = LLMChain(llm=llm, prompt=prompt)
    out = chain.invoke({"topic": "程序员"})
    return out["text"]          # 返回字典,答案要从 "text" 键里取


def new_llm_chain():
    prompt = PromptTemplate.from_template("给我讲一个关于 {topic} 的笑话")
    chain = prompt | llm | parser
    return chain.invoke({"topic": "程序员"})   # 直接就是字符串


# =============================================== 二、SimpleSequentialChain
def old_simple_sequential():
    from langchain_classic.chains import LLMChain, SimpleSequentialChain

    a = LLMChain(llm=llm, prompt=PromptTemplate.from_template(
        "我的邻居姓 {lastname},给他刚出生的儿子起个名字"))
    b = LLMChain(llm=llm, prompt=PromptTemplate.from_template(
        "名字叫 {child_name},再起一个小名"))
    chain = SimpleSequentialChain(chains=[a, b])
    return chain.invoke({"input": "王"})["output"]


def new_simple_sequential():
    a = PromptTemplate.from_template("我的邻居姓 {lastname},给他刚出生的儿子起个名字") | llm | parser
    b = PromptTemplate.from_template("名字叫 {child_name},再起一个小名") | llm | parser
    # 中间那个 lambda 就是旧写法帮你做的「把上一段的字符串塞进下一段的变量名」
    chain = a | (lambda name: {"child_name": name}) | b
    return chain.invoke({"lastname": "王"})


# ===================================================== 三、SequentialChain
def old_sequential():
    from langchain_classic.chains import LLMChain, SequentialChain

    one = LLMChain(llm=llm, output_key="chinese",
                   prompt=PromptTemplate.from_template("翻译成中文:\n{content}"))
    two = LLMChain(llm=llm, output_key="summary",
                   prompt=PromptTemplate.from_template("一句话总结:\n{chinese}"))
    chain = SequentialChain(chains=[one, two],
                            input_variables=["content"],
                            output_variables=["chinese", "summary"])
    return chain.invoke({"content": "Good morning, everyone."})


def new_sequential():
    one = PromptTemplate.from_template("翻译成中文:\n{content}") | llm | parser
    two = PromptTemplate.from_template("一句话总结:\n{chinese}") | llm | parser
    chain = (RunnablePassthrough.assign(chinese=one)
             | RunnablePassthrough.assign(summary=two))
    return chain.invoke({"content": "Good morning, everyone."})


if __name__ == "__main__":
    print("[旧] LLMChain          ->", old_llm_chain())
    print("[新] prompt | llm      ->", new_llm_chain())
    print("[旧] SimpleSequential  ->", old_simple_sequential())
    print("[新] a | 映射 | b       ->", new_simple_sequential())
    print("[旧] SequentialChain   ->", old_sequential())
    print("[新] assign 链         ->", new_sequential())
LLMChain(llm=m, prompt=p) 换成 p | m | StrOutputParser();② 把取 result["text"] 的地方改成直接用返回值;③ 顺序链先判断是单出还是多出,单出用管道直连加一个映射,多出改成一串 assign;④ 最后把 verbose=True 的调试依赖换成 stream。一次只改一条链,改完立刻跑一遍对比输出。
4.7 换成本地模型,链一个字不用改
最后一个案例用来验证统一协议的价值:把云端模型换成本地 Ollama 模型,只有创建模型那一行变了,装配、调用、批量、流式全部原样。
# -*- coding: utf-8 -*-
"""
本地模型上的同一条链
====================
换厂商只换最前面那一行模型实例,链的写法一个字不用改——
这正是 Runnable 统一协议带来的好处。

依赖:pip install langchain langchain-ollama
前置:本机已 ollama pull qwen3:8b,服务跑在 http://localhost:11434
"""

import os

from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_ollama import ChatOllama

BASE_URL = os.environ.get("OLLAMA_BASE_URL", "http://localhost:11434")

# 本地模型:langchain-ollama 是官方伙伴包,取代早期的社区版 Ollama 封装
model = ChatOllama(model="qwen3:8b", base_url=BASE_URL, temperature=0.7)

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一位取名很有讲究的长辈,只给出名字和一句解释。"),
    ("human", "我的邻居姓{lastname},刚生了个儿子,帮忙起个名字"),
])

name_chain = prompt | model | StrOutputParser()


# ---------------------------------------------- 两段本地链串起来
nickname_prompt = ChatPromptTemplate.from_template(
    "大名叫「{full_name}」,帮忙起一个亲切的小名,只回答小名本身"
)
nickname_chain = nickname_prompt | model | StrOutputParser()

full_chain = name_chain | (lambda text: {"full_name": text}) | nickname_chain


# ---------------------------------------------- 换成云端模型只改这一行
# from langchain_openai import ChatOpenAI
# model = ChatOpenAI(model="gpt-4o-mini")
#
# 或者用统一入口,按字符串挑模型:
# from langchain.chat_models import init_chat_model
# model = init_chat_model("gpt-4o-mini", model_provider="openai")


if __name__ == "__main__":
    print("[大名]", name_chain.invoke({"lastname": "王"}))

    print("[小名]", end=" ", flush=True)
    for chunk in full_chain.stream({"lastname": "王"}):
        print(chunk, end="", flush=True)
    print()

    print("[批量]", name_chain.batch([
        {"lastname": "李"}, {"lastname": "赵"}, {"lastname": "钱"},
    ]))
langchain-ollama 的 ChatOllama,它取代了早期社区包里的 Ollama 封装。本地模型的拉取与服务启动属于部署环节,在本地模型那一讲里已经讲过,这里只关心它作为链上一节怎么用。
05骨架模板:拿去改就能用
通用链、多段流水线、路由链,三份模板覆盖绝大多数场景
5.1 通用链骨架(先拿这份)
把装配、单次调用、批量、流式、异步五件事一次性封好,只留五处 TODO。绝大多数「一问一答」类需求,改完 TODO 就能上线。
| 它替你做好的事 | 为什么 |
|---|---|
| 模型构建单独成函数 | 换厂商、换模型、调超时与重试都只动一处,链的装配代码不受影响 |
| 四种调用方式各一个入口 | 同一条链,脚本里用 invoke、批处理用 batch、界面上用 stream,不用重写 |
with_config 起好名字 | 链一长,出问题得知道卡在哪一节;名字和标签会跟着追踪信息走 |
| 附带一个「保留中间结果」的版本 | 需求十有八九会从「只要答案」长成「答案加上中间那几步」 |
# -*- coding: utf-8 -*-
"""
LCEL 链骨架(通用版)
=====================
一条可直接改造的流水线:装配 → 单次调用 → 批量 → 流式 → 异步。
改五处 TODO 就是你自己的链。

依赖:pip install langchain langchain-openai python-dotenv
环境变量:OPENAI_API_KEY(必填)、OPENAI_BASE_URL(走代理或第三方网关时填)
"""

import asyncio
import os

from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import Runnable, RunnablePassthrough
from langchain_openai import ChatOpenAI

load_dotenv()


# ---------------------------------------------------------------- TODO 1
# 换模型。密钥一律从环境变量读,不要写成字面量。
def build_model() -> ChatOpenAI:
    return ChatOpenAI(
        model=os.environ.get("CHAT_MODEL", "gpt-4o-mini"),
        temperature=0.3,
        timeout=60,
        max_retries=2,
    )


# ---------------------------------------------------------------- TODO 2
# 换提示词。花括号里的变量名,就是调用时字典要传的键。
SYSTEM = "你是一位严谨的技术文档作者,回答简洁、不说套话。"
HUMAN = "请用不超过 200 字说明:{question}"


def build_prompt() -> ChatPromptTemplate:
    return ChatPromptTemplate.from_messages([("system", SYSTEM), ("human", HUMAN)])


# ---------------------------------------------------------------- TODO 3
# 换后处理。不需要就把这一段从管道里去掉。
def postprocess(text: str) -> str:
    return text.strip()


# ---------------------------------------------------------------- 装配
def build_chain() -> Runnable:
    """提示词 | 模型 | 解析器 | 后处理。

    管道符不执行任何计算,它只负责把上一步的输出接到下一步的输入;
    真正干活的是链上的每一个组件。
    """
    return (
        build_prompt()
        | build_model()
        | StrOutputParser()
        | postprocess
    ).with_config({"run_name": "通用链"})          # TODO 4:起个便于追踪的名字


# ---------------------------------------------------------------- 想多留几个中间结果
def build_chain_keep_all() -> Runnable:
    """输入输出都是字典,每一步往字典里加一个键,中间结果全部保留。"""
    inner = build_prompt() | build_model() | StrOutputParser()
    return (
        RunnablePassthrough.assign(answer=inner)
        | RunnablePassthrough.assign(length=lambda d: len(d["answer"]))
    )


# ---------------------------------------------------------------- 四种调用方式
def run_once(chain: Runnable, question: str) -> str:
    return chain.invoke({"question": question})


def run_batch(chain: Runnable, questions: list) -> list:
    return chain.batch([{"question": q} for q in questions],
                       config={"max_concurrency": 5})


def run_stream(chain: Runnable, question: str) -> None:
    for chunk in chain.stream({"question": question}):
        print(chunk, end="", flush=True)
    print()


async def run_async(chain: Runnable, question: str) -> str:
    return await chain.ainvoke({"question": question})


if __name__ == "__main__":
    chain = build_chain()

    # TODO 5:换成你自己的问题
    q = "为什么链上的组件都要实现同一组方法?"

    print("[invoke]", run_once(chain, q))
    print("[batch ]", run_batch(chain, ["什么是 LCEL?", "什么是 Runnable?"]))

    print("[stream] ", end="")
    # 注意:后处理函数会打断流式,演示流式时用不带后处理的版本
    run_stream(build_prompt() | build_model() | StrOutputParser(), q)

    print("[ainvoke]", asyncio.run(run_async(chain, q)))
    print("[keep all]", build_chain_keep_all().invoke({"question": q}).keys())
5.2 多段流水线骨架(多入多出)
处理步骤超过两段、而且中间结果都要留下时用它。所有段落写在一个列表里,装配过程自动生成,加一段只需要往列表里加一行,不用手改管道。
# -*- coding: utf-8 -*-
"""
多入多出流水线骨架
==================
链上流动的始终是一个字典,每一段用 assign 往字典里加一个键,
所有中间结果都能保留到最后,再按需要挑几个键输出。

依赖:pip install langchain langchain-openai python-dotenv
"""

import os

from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import Runnable, RunnableParallel, RunnablePassthrough
from langchain_openai import ChatOpenAI

load_dotenv()

model = ChatOpenAI(model=os.environ.get("CHAT_MODEL", "gpt-4o-mini"))
parser = StrOutputParser()


def step(template: str) -> Runnable:
    """一段处理 = 提示词 | 模型 | 解析器。"""
    return PromptTemplate.from_template(template) | model | parser


# ---------------------------------------------------------------- TODO 1
# 逐段定义。花括号里的变量名必须是此前字典里已经存在的键,
# 否则会在运行时报 KeyError。
STEPS = [
    ("draft", "根据下面的要点写一段 150 字的初稿:\n\n{outline}"),
    ("polish", "润色下面这段文字,保持原意,语气更专业:\n\n{draft}"),
    ("title", "给下面这段文字起一个不超过 12 字的标题:\n\n{polish}"),
]


# ---------------------------------------------------------------- TODO 2
# 需要并行跑的段落放这里:同一份输入同时喂给多个分支,互不等待。
PARALLEL_STEPS = {
    "keywords": step("列出下面文字的 3 个关键词,用顿号分隔:\n\n{polish}"),
    "summary": step("用一句话总结下面文字:\n\n{polish}"),
}


# ---------------------------------------------------------------- TODO 3
# 最终要交出去的键。想全都要就把这一行设成 None。
OUTPUT_KEYS = ["title", "polish", "keywords", "summary"]


def build_pipeline() -> Runnable:
    chain: Runnable = RunnablePassthrough()

    for key, template in STEPS:
        chain = chain | RunnablePassthrough.assign(**{key: step(template)})

    if PARALLEL_STEPS:
        chain = chain | RunnablePassthrough.assign(**PARALLEL_STEPS)

    if OUTPUT_KEYS:
        chain = chain | RunnableParallel(
            **{k: (lambda d, k=k: d[k]) for k in OUTPUT_KEYS}
        )
    return chain.with_config({"run_name": "多段流水线"})


if __name__ == "__main__":
    pipeline = build_pipeline()

    # TODO 4:换成你自己的初始输入,键名要和第一段模板里的变量对上
    result = pipeline.invoke({"outline": "为什么链上的每个组件都要实现同一组方法"})

    for k, v in result.items():
        print("-" * 60)
        print(k, ":", v)

    # 批量跑多份输入,并限制并发,避免打爆上游限流
    batch = pipeline.batch(
        [{"outline": "什么是路由链"}, {"outline": "流式输出为什么会断"}],
        config={"max_concurrency": 2},
    )
    print("批量结果条数:", len(batch))
STEPS 列表有顺序含义。每一段模板花括号里的变量名,必须在它之前就已经进了字典——要么来自最初的输入,要么来自前面某一段的产出。调换两行的位置就可能直接 KeyError。能并行的段落放进 PARALLEL_STEPS,它们彼此不依赖,会真正并发跑。
5.3 路由链骨架(带兜底)
一个入口、多条业务线时用它。路由表是个字典,加一路只需要加一项,不用写一长串 if/else;分类采用「关键词先兜、兜不住再交给模型」的两级策略,省掉大部分的分类调用。
# -*- coding: utf-8 -*-
"""
路由链骨架
==========
按输入把请求分发到不同的子链,并且一定带兜底分支。
注册表写法:加一路只需要往 ROUTES 里加一项,不用改 if/else。

依赖:pip install langchain langchain-openai python-dotenv
"""

import os

from dotenv import load_dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import Runnable, RunnableBranch, RunnablePassthrough
from langchain_openai import ChatOpenAI

load_dotenv()

model = ChatOpenAI(model=os.environ.get("CHAT_MODEL", "gpt-4o-mini"))
parser = StrOutputParser()


def make_branch(system_prompt: str) -> Runnable:
    """一路子链 = 一段人设提示词 + 模型 + 解析器。"""
    p = ChatPromptTemplate.from_messages([
        ("system", system_prompt),
        ("human", "{question}"),
    ])
    return p | model | parser


# ---------------------------------------------------------------- TODO 1
# 路由表:键是分类名,值是这一路的子链。加一路就在这里加一项。
ROUTES = {
    "售前": make_branch("你是售前顾问,重点讲清产品能力边界与适用场景,不承诺没有的功能。"),
    "售后": make_branch("你是售后工程师,先复述问题,再给出排查步骤,最后给出联系方式。"),
    "账单": make_branch("你是账单专员,只回答计费与发票相关的问题,金额一律以系统记录为准。"),
}

# ---------------------------------------------------------------- TODO 2
# 兜底分支:所有分类都没命中时走它。这一路一定要写。
FALLBACK = make_branch("你是客服接线员,礼貌说明这个问题需要转接人工,并请用户补充信息。")


# ---------------------------------------------------------------- TODO 3
# 分类器。规则能判清楚就别花一次模型调用;判不清楚再交给模型。
KEYWORDS = {
    "售前": ("能不能", "支持吗", "多少钱", "试用"),
    "售后": ("报错", "打不开", "崩溃", "退货", "维修"),
    "账单": ("发票", "扣费", "账单", "续费"),
}

classify_prompt = ChatPromptTemplate.from_template(
    "下面的问题属于哪一类?只回答一个词:" + "、".join(ROUTES) + "、其他。\n\n问题:{question}"
)
model_classifier = classify_prompt | model.bind(temperature=0) | parser


def classify(d: dict) -> str:
    q = d["question"]
    for name, words in KEYWORDS.items():
        if any(w in q for w in words):
            return name
    return model_classifier.invoke(d)


# ---------------------------------------------------------------- 装配
def build_router() -> Runnable:
    """先算出 route 键,再按它选一条子链。"""
    branch = RunnableBranch(
        *[(lambda d, k=k: k in d["route"], chain) for k, chain in ROUTES.items()],
        FALLBACK,
    )
    return RunnablePassthrough.assign(route=classify) | branch


if __name__ == "__main__":
    router = build_router()

    # TODO 4:换成你自己的问题
    for q in ["你们支持私有化部署吗", "登录页一直报错 500", "上个月的发票怎么开", "在吗"]:
        print("=" * 60)
        print("问题:", q)
        print("回答:", router.invoke({"question": q})[:80], "...")
FALLBACK。它是 RunnableBranch 的兜底分支,用来接住所有没命中分类的输入。线上百分之百会出现你没预设的问法,少了这一路,那些请求就是直接失败。
5.4 三份模板怎么选
| 模板 | 适用 | 特点 |
|---|---|---|
chain_skeleton.py | 一问一答、单条流水线 | 装配 + 四种调用方式齐活,日常首选 |
multi_output_skeleton.py | 多段处理、中间结果都要留 | 段落写成列表,自动装配,支持并行段 |
router_skeleton.py | 一个入口分发到多条业务线 | 注册表式路由 + 两级分类 + 兜底分支 |
三份模板可以叠:路由骨架的每一路子链,完全可以换成一条多段流水线。因为它们都是 Runnable,任何一份的产物都能当作另一份的一节。
06易错点汇总
按「概念 / 装配 / 数据流 / 顺序链 / 路由与流式 / 版本与迁移」六类归并
⚠️ 一、概念层面
- 以为
|会执行计算。 写完prompt | model | parser就去找结果,只会拿到一个RunnableSequence对象。装配和执行是两件事,执行要靠invoke/batch/stream。 - 以为链能让模型变聪明。 链只管接线,内容永远是模型生成的。答案质量不好,该改的是提示词和模型,不是链的结构。
- 把链和 Agent 混为一谈。 链的路径是你写死的,走几节就是几节;Agent 是带回路的,跑几轮由模型决定。步骤固定就用链,别为了显得高级上 Agent。
- 以为链自带记忆。 链本身是无状态的,跑完这次不记得上次。多轮对话要靠会话历史,那是下一讲的事。
⚠️ 二、装配与类型
- 忘了挂输出解析器。 链的返回值是
AIMessage而不是字符串,于是后面.strip()直接抛AttributeError。要纯文本就在链尾接StrOutputParser()。 - 调用时传了字符串而不是字典。 模板里有变量时,入口必须是
{"topic": "猫"}这样的字典,键名与花括号里的名字逐字一致。只有单变量的某些模板才容忍裸值,别指望它。 - 两节之间类型对不上。 上一节吐字符串、下一节要字典,中间必须加一个映射函数。报错信息通常会直接告诉你收到了什么、期望什么,照着补一节就行。
- 把
.bind()的返回值丢掉了。model.bind(temperature=0)返回新对象,原来的model不变。写成一句光秃秃的model.bind(...)等于什么都没做。 - 分不清
assign和RunnableParallel。 前者保留原有的键再加新键,后者只保留自己列出的键。用错了就会发现「前面的字段莫名其妙不见了」。
⚠️ 三、数据流与中间结果
- 第三步想用最初的输入,却发现它早没了。 链上每一步只吃上一步的输出。要让原始输入一路带下去,用
RunnablePassthrough.assign(),别在链外面拿全局变量凑合。 - 只拿到最后一步的结果,中间步骤全丢了。 直管道天然只返回末端产物。中间结果有价值就改成「字典进、字典出」的写法。
- 并行分支里偷偷共享了可变对象。
RunnableParallel的分支是真并发的,往同一个 list 或 dict 里写会出竞态。分支函数只读输入、只返回新对象。 - 批量调用不限并发。
batch默认会并发跑,一次丢几百条进去很容易撞上游限流,返回一堆 429。加上config={"max_concurrency": N}。
⚠️ 四、顺序链
- 把段落顺序调乱。 某段模板里的变量名,必须在它之前就已经进了字典。顺序一乱就是
KeyError,而且报的是键名,不会告诉你「你调错了顺序」。 - 键名写错一个字。
chinese_summary写成chinese_summry,装配阶段一切正常,运行时才炸。这类错误靠单步invoke逐段验证最快。 - 段落之间的中间产物没做清洗就往下传。 模型爱加 Markdown 围栏、爱加「好的,以下是……」的客套话。下一段要的是干净内容时,中间加一个
RunnableLambda剥一层。 - 把明明可以并行的段落串成了直线。 两段都只依赖同一份输入、彼此不依赖,就该放进并行分支,串起来白白多等一轮。
⚠️ 五、路由与流式
- 路由链没写兜底分支。 所有条件都不命中时链直接失败。
RunnableBranch的最后一个参数就是默认分支,必须给。 - 分类器的输出没有约束。 让模型「回答一个词」,它却回了一整句「这个问题属于数学领域」。判断条件要用包含匹配而不是全等,并且把分类器的
temperature绑成 0。 - 为了分类多花一次模型调用而不自知。 模型分类版每次请求都是两次往返,延迟和成本翻倍。能用关键词判清的先用关键词。
- 流式被中间某一节打断。 链上只要有一节必须拿到完整输入(比如普通的后处理函数),流就在那里断了,表现为「等半天然后整段蹦出来」。摘掉可疑的那一节验证。
- 流式还挂着普通的结构化解析器。 要一边流一边解析 JSON,得用支持增量解析的解析器,否则只能等全部生成完再解析。
⚠️ 六、版本与迁移
- 照着老资料写
from langchain.chains import LLMChain。 1.x 收窄了langchain的命名空间,这些 legacy 链搬到了langchain-classic,导入路径要跟着改,包也要单独装。 - 把「搬了家」理解成「被删了」。
LLMChain这些类仍然能装能跑,只是不再是推荐写法。老项目不必连夜重写,新代码别再用就是了。 - 迁移时忘了改取值方式。 旧的
LLMChain.invoke()返回字典,答案在"text"键里;换成管道后返回值直接就是结果。忘了改就会拿到一个字符串却当字典去索引。 - 迁移顺序链时漏了那一步映射。 旧的
SimpleSequentialChain帮你把上一段的字符串塞进下一段的变量里,管道写法要你自己写这一步。 - 把密钥写死在源码里。 与任何一讲同理,
os.environ.get(...)读环境变量,.env不进版本库。数据库口令同理。 - 把模型写的 SQL 直接执行。 这是 SQL 链最大的安全坑:只读账号 + 只允许 SELECT + 禁多语句 + 强制 LIMIT + 超时,一个都不能少。
07自测题
点击题目展开答案;能把这 19 题说清楚,这一讲就通了
什么是 Chain?它解决的是什么问题?
链用于把多个组件(提示模板、模型、解析器、工具等)连接起来,形成可复用的工作流,完成单一组件做不到的复杂任务。它解决的是「组件之间怎么交接」的问题——不是让某一步算得更好,而是把中间结果的搬运工作标准化。
LCEL 是什么?它的基本构成有哪三段?
LCEL 是 LangChain Expression Language,一种声明式的组件组合方式,通过 Python 原生的管道符 | 把组件连成可执行流程。基本构成是 提示(Prompt)+ 模型(Model)+ 输出解析器(OutputParser),即 chain = prompt | model | output_parser。
chain = prompt | model | parser 这一行执行完,模型被调用了吗?
没有。这一行只是装配,返回一个 RunnableSequence 对象,里面按顺序记着三个组件,一个 token 都没生成。真正触发计算的是 invoke / batch / stream。这就是本讲的铁律:| 不执行任何计算,它只是把上一个 Runnable 的输出接到下一个的输入。
链和 Agent 的区别是什么?什么时候该用链?
链的执行路径是你在代码里写死的,写几节走几节,完全可预测;Agent 是带回路的,跑几轮由模型自己决定。只要流程的步骤是固定的,就用链——出问题时一眼能看出卡在第几节,排查成本比 Agent 低一个量级。
Runnable 是什么?它强制要求实现哪几个方法?
Runnable 是 LangChain 定义的抽象接口(Protocol),强制所有 LCEL 组件实现同一组标准方法:invoke(单输入单输出)、batch(批量处理)、stream(流式输出),以及对应的异步版本 ainvoke / astream。任何实现了这些方法的对象都被视为 LCEL 兼容组件,都能进管道。
为什么需要统一的调用方式?不统一会怎样?
假如提示词渲染用 .format()、模型调用用 .generate()、解析器用 .parse()、工具用 .run(),那么每次组合都要手动适配,而且框架无法自动串联任意组件。统一之后有两个好处:一致性(无论组件多复杂,调用方式完全相同)和组合性(管道符背后自动处理类型匹配与中间结果传递)。
一条链跑不通,怎么最快定位是哪一节的问题?
把每一节单独拎出来 invoke 一遍——因为组件本身也是 Runnable,不用改任何代码。正常情况下:prompt.invoke(...) 给 PromptValue,model.invoke(...) 给 AIMessage,parser.invoke(...) 给 str。哪一步的输出类型不对,问题就在那一节。
.bind() 和 .with_config() 分别管什么?
.bind() 管调用参数:把 temperature、max_tokens、stop 等预先焊在组件上,之后每次调用自动带上。.with_config() 管运行期配置:run_name、tags、max_concurrency,主要服务于追踪与限流。两者都返回新对象,原对象不变。
链的第三步想用到最初的输入,但它早被第一步吃掉了,怎么办?
用 RunnablePassthrough.assign():它保留字典里已有的键,再算出一个新键,于是流动的字典越走越厚,前面的信息一路都在。反面做法是在链外面用全局变量凑合,那样链就不可复用、也不能批量跑了。
RunnablePassthrough.assign() 和 RunnableParallel 的区别?
两者都产出字典,区别在于要不要保留原有的键:assign 是「原来的都留着,再加一个」,适合一路攒中间结果;RunnableParallel 是「只要我列出的这几个键,其余丢掉」,适合在链尾收窄输出。用错的典型现象是「前面的字段莫名其妙不见了」。
并行分支真的是并发执行的吗?有什么要注意的?
是。RunnableParallel 的各分支真正并发,总耗时接近最慢的那一支而不是几支之和。要注意两点:① 分支函数只读输入、只返回新对象,不要往同一个可变对象里写,否则出竞态;② 并发会放大对上游的请求压力,批量场景配合 max_concurrency 限流。
顺序链的两种类型分别对应什么场景?
单入单出:每一步只有一个输入、一个输出,上一步的输出就是下一步的输入,无需手动映射,比如「剧名 → 大纲 → 剧评」。多入多出:支持在链之间传递多个变量、同时返回多个输出变量,需要靠精准的键名明确链之间的关系,比如「翻译 → 摘要 → 识别语种 → 评论」,最后一步同时用到了前面两步的产物。
多段链里把「识别语种」提到「摘要」前面会发生什么?为什么?
直接抛 KeyError。因为识别语种那一段的模板里写的是 {chinese_summary},而此时字典里还没有这个键。判断法则:某一段模板花括号里的每个变量名,必须在它之前就已经进了字典——要么来自最初的输入,要么来自前面某一段的产出。
路由链是干什么的?为什么必须设置默认子链?
路由链用于动态选择下一条链:先分析输入属于哪一类,再把输入传给对应的子链执行。必须设默认(兜底)子链,用来兼容输入内容不满足任意一项时的情况——线上一定会出现你没预设的问法,少了兜底那些请求就是直接失败。
路由的分类一定要交给模型做吗?
不一定。模型分类准确、能应付千变万化的措辞,但每次请求多一次往返,延迟和成本翻倍。关键词能判清的场景直接写规则函数,零延迟零成本。实践中常用两级策略:关键词先兜一遍,兜不住的再交给模型。
代码里明明调了 stream,界面却还是等半天才整段蹦出来,为什么?
链上有一节不支持流式。流是一节一节往下传的,只要中间某一节必须拿到完整输入才能工作(最常见的就是一个普通的 Python 后处理函数),流就在那里断了,后面只能等它攒齐再一次性吐出。排查办法:把可疑的那一节摘掉再试。要边流边解析结构化数据,就换成支持增量解析的解析器。
SQL 查询链里,SQL 是谁写的、谁执行的?该怎么防住危险语句?
SQL 由模型写,由你的代码连库执行——本讲铁律在这里依然成立,链只负责把自然语言翻译成 SQL。防护必须做在代码和数据库两层:① 代码层只允许 SELECT、拒绝多语句、强制追加 LIMIT、设置超时;② 数据库层使用只读账号,即使校验被绕过也执行不了写操作。另外,模型能否写对 SQL 取决于你有没有把表结构连同中文字段注释一起给它,多表时还要写清关联关系。
LLMChain 现在还能用吗?导入路径有什么变化?
能用。它属于 legacy 链,随着 1.x 收窄 langchain 的命名空间,搬到了 langchain-classic 包:导入从 from langchain.chains import LLMChain 改成 from langchain_classic.chains import LLMChain,包也要单独安装。它不再是推荐写法,新代码请用 prompt | llm | parser。注意措辞:是搬家,不是删除。
把 LLMChain 改写成管道后,有一处最容易漏改,是哪里?
取值方式。旧的 LLMChain.invoke() 返回一个字典,答案藏在 "text" 键里,而且原始输入也被塞了进去;改成管道之后返回值直接就是结果本身。忘了改就会拿着一个字符串去做字典索引。另外迁移 SimpleSequentialChain 时还要自己补上那一步「把上一段的字符串塞进下一段变量名」的映射。
词术语表
| 术语 | 含义 |
|---|---|
| Chain | 链。把多个组件按顺序连接成的可复用工作流,本身不生成内容 |
| LCEL | LangChain Expression Language,用管道符声明式组合组件的表达式语言 |
管道符 | | 接线符号。把上一个 Runnable 的输出接到下一个的输入,不执行任何计算 |
| Runnable | 统一抽象接口,强制所有 LCEL 组件实现同一组标准方法 |
RunnableSequence | 管道符的产物。按顺序装着若干组件的「装配清单」 |
invoke / batch / stream | 三个同步调用入口:单次、批量、流式;异步版本为 ainvoke / astream |
astream_events | 逐事件流式读取,能看到链上每一步的开始与结束 |
PromptValue | 提示词模板的产物,既能转成字符串也能转成消息序列 |
RunnablePassthrough | 原样透传;.assign() 在保留已有键的基础上再加一个新键 |
RunnableParallel | 把同一份输入并发喂给多个分支,结果汇成字典,只保留列出的键 |
RunnableLambda | 把任意 Python 函数变成链上的一节 |
RunnableBranch | 按条件挑一条子链走,最后一个参数是必须提供的兜底分支 |
.bind() | 把调用参数预先焊在组件上,返回新对象 |
.with_config() | 挂运行期配置:名称、标签、并发上限,返回新对象 |
| 顺序链 | 多条链首尾相接的流水线;分单入单出与多入多出两类 |
| 路由链 | 先判断输入属于哪一类,再分发到对应子链执行 |
langchain-classic | legacy 链与已弃用功能的新家,LLMChain 等搬到了这里 |