【案例】物流行业信息问答系统
建库脚本和问答脚本是两个程序,却被同一个 Embedding 模型绑死——这是整个系统里唯一一处改了不报错、只是结果全错的地方。
30″30 秒看懂这个系统
前三讲把零件讲完了:怎么切活页、怎么编坐标、怎么让资料员把该用的那张拿准。这一讲把它们装成一台真正在跑的机器——一个物流公司的信息问答系统。
客服每天被问的就那么几类:「我的货从哪发的?」「现在到哪了?」「几天能到?」「深圳仓能存什么?」答案全写在运单、线路手册、仓储制度里,只是没人愿意一份份翻。
所以这台机器要做的事很朴素:把这些文档变成一个能问的库,问一句,答一句,并且告诉你这句话是从哪一页抄来的。
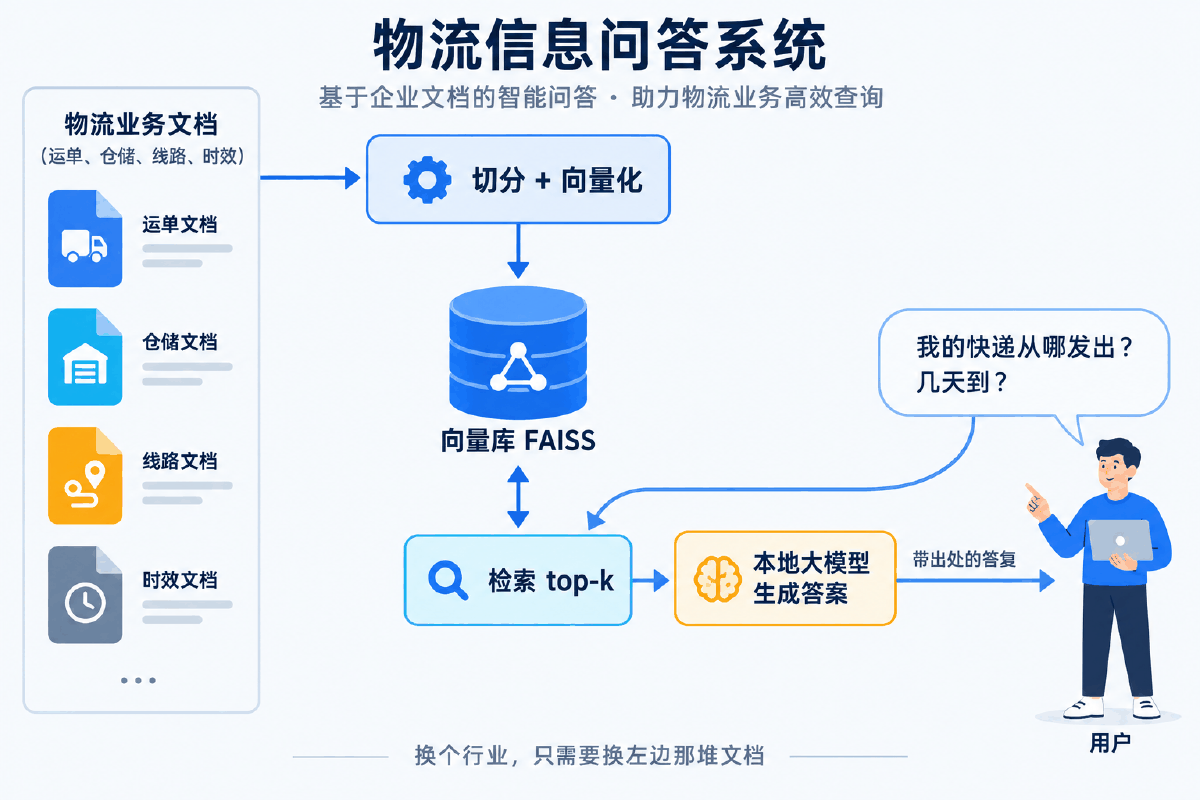
| 系统里的部件 | 这个案例用的 | 为什么这么选 |
|---|---|---|
| 资料来源 | 物流业务 PDF(运单、仓储、线路) | 真实业务文档,页码能追溯 |
| 切分 | 递归切分,300 字 / 重叠 50 | 分隔符带中文标点,避免一路降级到硬切 |
| Embedding | 本地 Ollama 模型 | 业务数据不出内网,也不用申请密钥 |
| 向量库 | FAISS,落盘成目录 | 进程内跑,不用起服务,几千块绰绰有余 |
| 回答模型 | 本地 Ollama 对话模型 | 同上,全链路离线可跑 |
| 出口 | 命令行 + Streamlit 网页 | 先跑通再做界面,界面只是壳 |
SEPARATORS 常量,L2 阈值方向相反变成 score <= SCORE_MAX,k=3 就到顶变成实测出来的 TOP_K=3。看到眼熟的地方就对了,这一讲不引入新概念,只做落地。
01先讲通用方法:行业知识库怎么立项
换成法务、医疗、制造,流程一模一样,只有资料和验收标准不同
1.1 先判断这件事该不该用 RAG
不是所有「公司内部问答」都适合做成知识库。立项前先把问题分一遍类:
| 问题类型 | 例子 | 该走哪条路 |
|---|---|---|
| 文档里写死的事实 | 「深圳仓存什么类型的货?」 | RAG |
| 制度、流程、条款 | 「国际件报关要哪些材料?」 | RAG |
| 实时系统状态 | 「这单现在到哪了?」 | Function Call 查接口 |
| 数值计算 | 「运费一公斤多少钱?」 | 查价表 + 写计算逻辑 |
| 统计聚合 | 「本月哪个仓发货最多?」 | 模型写 SQL 或调统计接口 |
1.2 四步立项法
- 收集真实问题:从客服记录、工单系统里捞 50~100 条真实提问,不要自己编。编出来的问题会不自觉地贴合你的资料。
- 按上面那张表分类:算出「能靠 RAG 解决」的占比。这个数字决定项目值不值得做。
- 盘资料:这些问题的答案分别写在哪份文档里?找不到文档的那些问题,就是这个项目的天花板。
- 定验收口径:见 1.4,必须在动手之前定。
1.3 资料先体检,再进切分器
行业文档和教学用的小文本差别极大:扫描件、拍平的表格、编码乱码、重复的页眉页脚。这些问题在切分之后就很难发现了,必须在入库前拦住。第 03 节有一份可运行的六项体检脚本。
1.4 验收分两层,不能合成一个数
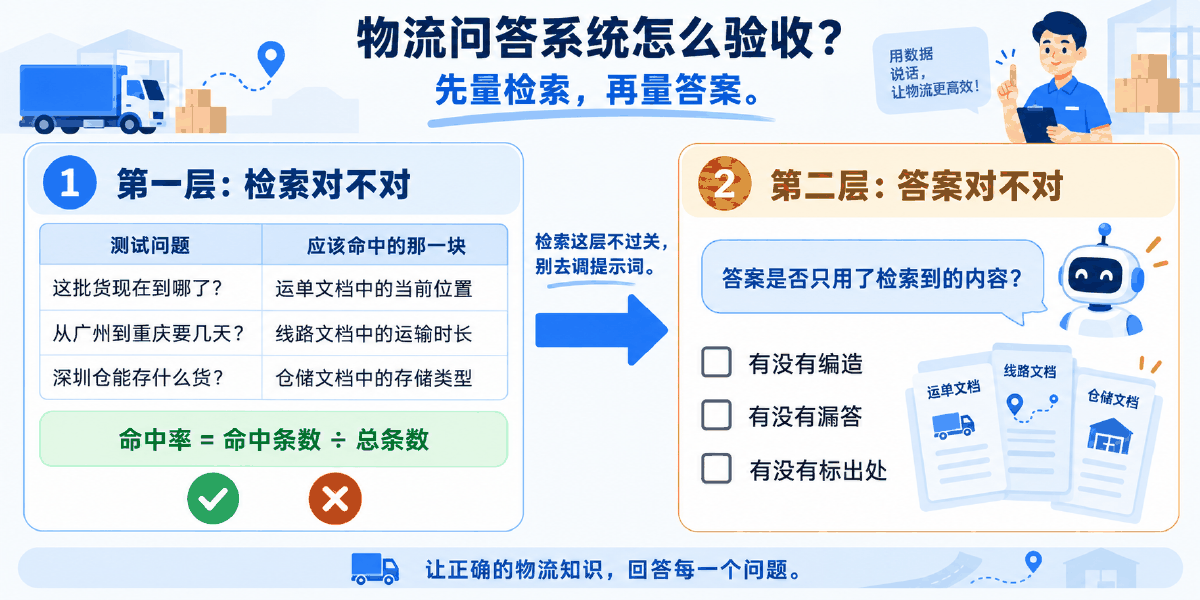
| 层 | 量什么 | 能不能自动 | 指标 |
|---|---|---|---|
| 第一层 | 检索对不对 | 能 | 命中率、MRR |
| 第二层 | 答案对不对 | 不能,必须人工 | 有无编造、有无漏答、有无出处 |
第一层只要准备「问题 → 应该命中哪一块」的对照表,就能全自动跑。第二层目前没有可靠的自动方案——
1.5 上线前必须一并定下的三件事
| 事项 | 不定会怎样 |
|---|---|
| 谁负责更新资料、多久一次 | 文档改了库没改,系统笃定地给出过期答案 |
| 答不上来时说什么 | 没有拒答话术,超纲问题一律得到编造的答案 |
| 界面上要不要显示命中原文 | 不显示,出错时分不清是检索错了还是模型答错了 |
第三条对行业系统尤其重要:用户看不到依据,就没法判断这个答案能不能信;运维看不到依据,就没法排查。把命中的原文和来源折叠显示在答案下方,是成本最低、收益最大的一个设计。
02原理:两个脚本,一条硬绑定
建库跑一次,问答跑无数次,中间隔着一个磁盘目录
2.1 为什么要拆成两个程序
初学时最自然的写法是把八步塞进一个文件:读 PDF、切块、算向量、然后马上开始问答。跑一次没问题,第二次提问时你会发现——它又把 PDF 重读了一遍、向量重算了一遍。
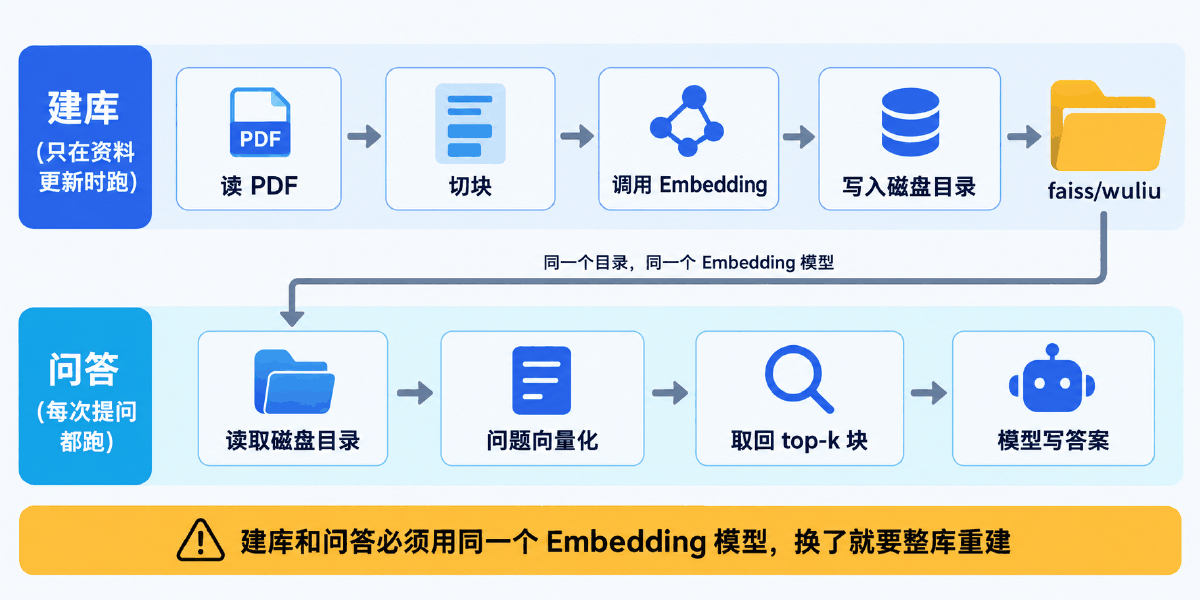
建库脚本 local_db.py | 问答脚本 local_qa.py | |
|---|---|---|
| 什么时候跑 | 资料更新时,跑一次 | 每次提问都跑 |
| 耗时 | 分钟级到小时级 | 秒级 |
| 输入 | PDF 文件 | 磁盘上的索引目录 + 一个问题 |
| 输出 | ./faiss/wuliu 目录 | 一条带出处的答案 |
| 要不要 GPU | 视 Embedding 模型而定 | 同上,加一次对话模型推理 |
拆开之后还有一个隐含好处:建库可以在夜里批量跑,问答服务全程不用重启。这也是为什么中间必须落盘——磁盘目录是这两个程序之间唯一的接口。
2.2 那条把两个脚本绑死的约束
两个脚本各自独立,唯独 Embedding 模型必须完全一致:
| 脚本 | 那一行 |
|---|---|
| local_db.py | EMBED_MODEL = os.environ.get("RAG_EMBED_MODEL", "mxbai-embed-large") |
| local_qa.py | EMBED_MODEL = os.environ.get("RAG_EMBED_MODEL", "mxbai-embed-large") |
两行一模一样,而且都从同一个环境变量读。这不是偷懒,是防呆:改模型时只改一处,两个脚本自动同步。要是一边写死字面量、另一边读环境变量,早晚会出现「改了一半」的状态——而这种状态不报错,只是检索结果全是噪声。
2.3 这个案例里的四个参数是怎么来的
| 参数 | 取值 | 依据 |
|---|---|---|
SEPARATORS | 含中文句号、分号、逗号 | 不加中文标点,递归切分会一路降级到按字数硬切,单号被劈成两半 |
CHUNK_SIZE | 300 | 中文场景的稳妥起点,且远低于 Embedding 的输入上限 |
CHUNK_OVERLAP | 50 | 约为 chunk_size 的 17%,够覆盖一两句话的长度 |
TOP_K | 3 | 实测出来的:k=3 时命中率 1.000、MRR 0.917,再加不涨 |
2.4 FAISS 的分数方向,和相似度是反的
问答脚本里这一行很容易写错:
| 写法 | 含义 | 对不对 |
|---|---|---|
score <= SCORE_MAX | 距离小于阈值才保留 | 对,FAISS 默认返回 L2 距离 |
score >= SCORE_MIN | 相似度大于阈值才保留 | 照着余弦的写法抄,会把最相关的全过滤掉 |
similarity_search_with_score 这个方法名里写着 score,返回的却是距离——越小越近。这就是上一讲说的「接新库先拿一条相关、一条无关各查一次」要解决的问题。
2.5 反序列化那个开关
加载本地 FAISS 索引时要写 allow_dangerous_deserialization=True。这个参数名不是吓唬人的:FAISS 的本地索引用 pickle 存元数据,反序列化会执行代码。
03动手第一步:先给资料体检
六项检查,不通过就别进切分器
3.1 为什么这一步不能跳
教学用的小文本是干净的,行业文档不是。下面这些问题一旦进了切分器就很难再发现——因为切完之后你看到的是几百个碎块,没人会逐块去读:
| 问题 | 现象 | 后果 |
|---|---|---|
| 扫描件 PDF | 抽出 0 个字 | 建出一个空库,问什么都答不出 |
| 编码乱码 | 正文里一堆替换字符(U+FFFD) | 向量是乱的,检索永远不准 |
| 表格被拍平 | 单行几百字,列全挤在一起 | 切分怎么调都读不通 |
| 页眉页脚重复 | 同一句话出现几十次 | 挤占 top-k 名额 |
| 没有切分锚点 | 没有空行、没有句号 | 递归切分一路降级到硬切 |
| 时效性内容 | 带日期、带版本号 | 会过期,而向量库不会自己知道 |
3.2 体检脚本
"""入库前文档体检:先看资料值不值得入库,再谈检索。

RAG 项目最贵的一类返工,是文档已经全量灌完、上线问了几十句才发现
资料本身有问题——扫描件没文字、表格被拉成一行、同一条制度有三个版本。
这些在入库前花十分钟就能查出来。

六项体检,逐项给出结论和处理建议。纯标准库,直接运行。
"""
import os
import re
import sys

MIN_CHARS = 50            # 一份文档少于这么多字,基本可以判定抽取失败
LONG_LINE = 200           # 单行超过这个长度,多半是表格被拍平了
DUP_WINDOW = 30           # 判定重复段落时比较的前缀长度


def read(path):
    with open(path, encoding="utf-8", errors="replace") as f:
        return f.read()


def check_extractable(text):
    """① 抽不抽得出文字。扫描件走到这一步会是空的或者几个零散字符。"""
    n = len(text.strip())
    ok = n >= MIN_CHARS
    return ok, "抽出 %d 字" % n, "少于 %d 字:多半是扫描件,要先过 OCR" % MIN_CHARS


def check_garbled(text):
    """② 有没有编码事故。U+FFFD 是解码失败留下的指纹。"""
    n = text.count("\ufffd")
    return n == 0, "替换字符 %d 个" % n, "有乱码:换编码重新抽取,别把乱码灌进库"


def check_long_lines(text):
    """③ 有没有被拍平的表格。

    表格转成纯文本后经常变成一行几百字,切块时要么被拦腰截断,
    要么整块超长——这类内容应该单独抽成结构化数据,不走向量检索。
    """
    lines = text.splitlines()
    bad = [i for i, ln in enumerate(lines, 1) if len(ln) > LONG_LINE]
    return not bad, "超长行 %d 条" % len(bad), \
        "表格被拍平了:结构化字段建议入数据库,别指望语义检索去查数值"


def check_duplicates(text):
    """④ 有没有大段重复。同一条制度复制到多份文档里非常常见。"""
    paras = [p.strip() for p in re.split(r"\n\s*\n", text) if len(p.strip()) > DUP_WINDOW]
    seen, dup = set(), 0
    for p in paras:
        key = p[:DUP_WINDOW]
        if key in seen:
            dup += 1
        seen.add(key)
    return dup == 0, "重复段落 %d 处" % dup, \
        "有重复:入库前去重,否则同一句话会在提示词里出现好几遍"

def check_structure(text):
    """⑤ 有没有可用的切分锚点。

    一份通篇没有空行也没有标点的文本,任何切分器都只能按字数硬切。
    """
    blank = text.count("\n\n")
    cn_stop = len(re.findall(r"[。;!?]", text))
    ok = blank > 0 or cn_stop > 3
    return ok, "空行 %d 处,中文句末标点 %d 个" % (blank, cn_stop), \
        "没有可用锚点:切分只能按字数硬切,块会拦腰断句"


def check_dates(text):
    """⑥ 有没有时效性内容。

    带日期的内容会过期,而向量库不会自己知道这件事。
    这类资料必须配一个更新机制,否则半年后系统会一本正经地讲旧规定。
    """
    dates = re.findall(r"\d{4}[-/年]\d{1,2}[-/月]\d{1,2}", text)
    return True, "日期 %d 处" % len(dates), ""


CHECKS = [
    ("① 能否抽出文字", check_extractable),
    ("② 有无编码乱码", check_garbled),
    ("③ 有无拍平表格", check_long_lines),
    ("④ 有无重复段落", check_duplicates),
    ("⑤ 有无切分锚点", check_structure),
    ("⑥ 有无时效内容", check_dates),
]


def main():
    path = sys.argv[1] if len(sys.argv) > 1 else os.path.join(
        os.path.dirname(os.path.abspath(__file__)), "wuliu_kb.txt")
    text = read(path)

    print("体检对象:%s(%d 字节)\n" % (os.path.basename(path), os.path.getsize(path)))
    print("%-18s %-8s %-24s" % ("检查项", "结论", "实测"))
    print("-" * 70)

    failed = []
    for name, fn in CHECKS:
        ok, fact, advice = fn(text)
        print("%-18s %-8s %-24s" % (name, "通过" if ok else "注意", fact))
        if not ok and advice:
            failed.append((name, advice))

    print()
    if failed:
        print("需要处理的项:")
        for name, advice in failed:
            print("  %s → %s" % (name, advice))
    else:
        print("六项全部通过,这份资料可以进入切分环节。")

    dates = re.findall(r"\d{4}[-/年]\d{1,2}[-/月]\d{1,2}", text)
    if dates:
        print()
        print("⚠️ 文档里有 %d 处日期(如 %s)。" % (len(dates), dates[0]))
        print("   这类内容会过期,而向量库不会自己知道。上线时要一并定好:")
        print("   谁负责更新、多久更新一次、更新后哪些块需要重新入库。")


if __name__ == "__main__":
    main()
拿这个案例的物流知识库跑一遍:
物流公司:速达物流
公司总部:北京市
业务范围:国际快递、仓储管理

货物追踪:
货物编号:ABC123456
发货日期:2023-01-15
当前位置:上海分拨中心
预计到达日期:2023-01-20

运输方式:
运输公司:快运通
运输方式:陆运
出发地:广州
目的地:重庆
预计运输时间:3天

仓储信息:
仓库名称:东方仓储中心
仓库位置:深圳市
存储货物类型:电子产品
存储条件:常温仓储
当前库存量:1000件
| 检查项 | 结论 | 实测 |
|---|---|---|
| ① 能否抽出文字 | 通过 | 抽出 211 字 |
| ② 有无编码乱码 | 通过 | 替换字符 0 个 |
| ③ 有无拍平表格 | 通过 | 超长行 0 条 |
| ④ 有无重复段落 | 通过 | 重复段落 0 处 |
| ⑤ 有无切分锚点 | 通过 | 空行 3 处,中文句末标点 0 个 |
| ⑥ 有无时效内容 | 通过 | 日期 2 处 |
3.3 两个值得停下来看的结果
第 ⑤ 项:空行 3 处,中文句末标点 0 个。这份资料是「字段:值」的格式,通篇没有一个句号。它之所以还能通过,是因为有空行做锚点——换成一份通篇没有空行也没有句号的表格导出文本,这一项就会亮红灯,那时候就该考虑按行切或者按字段切,而不是套递归切分。
第 ⑥ 项:日期 2 处(2023-01-15、2023-01-20)。这是本案例里最真实的一个隐患:
04完整案例:建库、问答、网页、评测
四个脚本,一条完整的链路
4.1 建库:四步 + 一次自检
"""建库脚本:把物流文档变成一个可检索的向量目录。

只在资料更新时跑,跑完在磁盘上留下一个目录,问答脚本直接读它。
四步:加载 → 切分 → 向量化 → 落盘。

依赖:langchain、langchain-community、faiss-cpu、pymupdf,
Embedding 走本地 Ollama,不需要任何云端密钥。
"""
import os

from langchain_community.document_loaders import PyMuPDFLoader
from langchain_community.embeddings import OllamaEmbeddings
from langchain_community.vectorstores import FAISS
from langchain.text_splitter import RecursiveCharacterTextSplitter

# 路径与模型都从环境变量取,换文档、换模型不用改代码
PDF_PATH = os.environ.get("RAG_PDF", "物流信息.pdf")
INDEX_DIR = os.environ.get("RAG_INDEX", "./faiss/wuliu")
EMBED_MODEL = os.environ.get("RAG_EMBED_MODEL", "mxbai-embed-large")

# 中文标点必须进分隔符列表,否则递归切分会一路降级到按字数硬切
SEPARATORS = ["\n\n", "\n", "。", ";", ",", " ", ""]

CHUNK_SIZE = int(os.environ.get("RAG_CHUNK_SIZE", "300"))
CHUNK_OVERLAP = int(os.environ.get("RAG_CHUNK_OVERLAP", "50"))


def load(pdf_path):
    """第一步:加载。PyMuPDFLoader 按页返回 Document,页码在 metadata 里。"""
    loader = PyMuPDFLoader(pdf_path)
    docs = loader.load()
    print("加载完成:%d 页" % len(docs))
    total = sum(len(d.page_content) for d in docs)
    print("正文合计 %d 字" % total)
    if total == 0:
        raise SystemExit(
            "抽出来 0 个字:这份 PDF 多半是扫描件,文字是图片。\n"
            "这种情况要先过 OCR,直接进切分器只会得到一个空库。")
    return docs


def split(docs):
    """第二步:切分。块大小与重叠都影响后面每一步,改之前先想清楚。"""
    splitter = RecursiveCharacterTextSplitter(
        separators=SEPARATORS,
        chunk_size=CHUNK_SIZE,
        chunk_overlap=CHUNK_OVERLAP,
    )
    chunks = splitter.split_documents(docs)
    print("切分完成:%d 块,平均 %.0f 字"
          % (len(chunks), sum(len(c.page_content) for c in chunks) / max(len(chunks), 1)))
    for i, c in enumerate(chunks[:3], 1):
        preview = c.page_content.replace("\n", " ")[:50]
        print("  样例块 %d(%d 字):%s…" % (i, len(c.page_content), preview))
    return chunks


def build(chunks):
    """第三、四步:逐块向量化并落盘。

    ⚠️ 这里用的 Embedding 模型,问答时必须原样再用一次。
    换模型等于换了坐标系,旧库里的向量全部作废,必须整库重建。
    """
    embeddings = OllamaEmbeddings(model=EMBED_MODEL)
    db = FAISS.from_documents(chunks, embeddings)
    os.makedirs(os.path.dirname(INDEX_DIR) or ".", exist_ok=True)
    db.save_local(INDEX_DIR)
    print("已写入 %s(Embedding 模型:%s)" % (INDEX_DIR, EMBED_MODEL))
    return db


def main():
    docs = load(PDF_PATH)
    chunks = split(docs)
    db = build(chunks)

    # 建完立刻自检一次:能不能把一个已知答案原样找回来
    probe = "出发地是哪里"
    hits = db.similarity_search(probe, k=2)
    print("-" * 56)
    print("建库自检,问「%s」取回 %d 块:" % (probe, len(hits)))
    for i, d in enumerate(hits, 1):
        print("  [%d] %s" % (i, d.page_content.replace("\n", " ")[:60]))
    print("取回的内容对不上题,说明切分或模型有问题,别急着往下做问答。")


if __name__ == "__main__":
    main()
三处值得注意的写法:
| 位置 | 做法 | 为什么 |
|---|---|---|
load() | 抽出 0 字就直接退出并说明原因 | 扫描件的 PDF 文字是图片,不拦住就会静默建出一个空库 |
split() | 分隔符列表里放中文标点 | 不放的话递归切分一路降级到按字数硬切,单号会被劈成两半 |
main() 末尾 | 建完立刻问一句已知答案 | 建库自检:取回的内容对不上题,说明切分或模型有问题,别急着往下做问答 |
最后这条自检很省事:一行 similarity_search,就能在花时间写问答之前先确认库是不是建对了。把验证放在最靠近出错点的地方,是这类多步骤管线的通用做法。
4.2 问答:读盘、检索、拼词、生成
"""问答脚本:读磁盘上的向量目录,检索 top-k,拼提示词,交给本地模型。

每次提问都跑,不重建库。和建库脚本唯一的硬约束是:
Embedding 模型必须一模一样,否则检索出来的东西毫无意义。
"""
import os
import time

from langchain_community.embeddings import OllamaEmbeddings
from langchain_community.llms import Ollama
from langchain_community.vectorstores import FAISS
from langchain.prompts import PromptTemplate

INDEX_DIR = os.environ.get("RAG_INDEX", "./faiss/wuliu")
EMBED_MODEL = os.environ.get("RAG_EMBED_MODEL", "mxbai-embed-large")
LLM_MODEL = os.environ.get("RAG_LLM_MODEL", "qwen2.5:7b")
TOP_K = int(os.environ.get("RAG_TOP_K", "3"))
SCORE_MAX = float(os.environ.get("RAG_SCORE_MAX", "1.2"))

PROMPT_TEMPLATE = """你是物流信息查询助手。请只根据【已知信息】回答【问题】。

规则:
1. 只使用【已知信息】里出现过的内容,不允许补充任何外部知识。
2. 【已知信息】不足以回答时,回复「资料中未提及」,不要推测。
3. 每个结论后面用方括号标出所依据的编号,例如 [1]。

【已知信息】
{context}

【问题】
{question}"""

PROMPT = PromptTemplate(input_variables=["context", "question"],
                        template=PROMPT_TEMPLATE)


def load_db():
    """读盘。

    allow_dangerous_deserialization=True 是因为 FAISS 的本地索引用 pickle
    存元数据,反序列化会执行代码。只对自己生成的目录开这个开关,
    从外部拿到的索引文件不要直接加载。
    """
    embeddings = OllamaEmbeddings(model=EMBED_MODEL)
    return FAISS.load_local(INDEX_DIR, embeddings,
                            allow_dangerous_deserialization=True)


def retrieve(db, question, k=TOP_K):
    """带分数检索。

    FAISS 默认返回的是 L2 距离,越小越近——和余弦相似度方向相反,
    所以这里的阈值是「大于就丢掉」,别照着相似度的写法写反了。
    """
    pairs = db.similarity_search_with_score(question, k=k)
    kept = [(doc, score) for doc, score in pairs if score <= SCORE_MAX]
    return kept


def build_context(pairs):
    lines = []
    for i, (doc, score) in enumerate(pairs, 1):
        page = doc.metadata.get("page")
        src = doc.metadata.get("source", "未知来源")
        where = "%s 第 %s 页" % (os.path.basename(str(src)), page + 1) if page is not None else src
        text = doc.page_content.replace("\n\n", "\n").strip()
        lines.append("[%d] (来源:%s,距离 %.3f)%s" % (i, where, score, text))
    return "\n".join(lines)


def answer(db, question):
    pairs = retrieve(db, question)
    if not pairs:
        return "资料中未提及。", []

    prompt_text = PROMPT.format(context=build_context(pairs), question=question)
    model = Ollama(model=LLM_MODEL)
    return model.invoke(prompt_text), pairs


def main():
    db = load_db()
    questions = [
        "我的快递出发地是哪?预计几天的时间到达?",
        "货物现在在哪个分拨中心?",
        "深圳的仓库存的是什么类型的货?",
        "公司的年假制度是怎么规定的?",
    ]
    for q in questions:
        start = time.time()
        text, pairs = answer(db, q)
        print("=" * 60)
        print("问:%s" % q)
        print("检索到 %d 块,耗时 %.2f 秒" % (len(pairs), time.time() - start))
        for i, (doc, score) in enumerate(pairs, 1):
            print("  [%d] 距离 %.3f  %s"
                  % (i, score, doc.page_content.replace("\n", " ")[:46]))
        print("答:%s" % text)


if __name__ == "__main__":
    main()
提示词模板里那三条规则,就是前一讲讲过的三件事:圈范围、给拒答话术、要求标编号。而第三条能生效,靠的是 build_context() 里给每块加了 [1] [2] 和来源——规则和编号必须成对存在。
build_context() 还把 metadata 里的页码拼进了来源(page + 1,因为 PyMuPDF 的页码从 0 开始)。来源信息在加载那一步如果没保住,这里就再也拼不出来了。
local_db.py、local_qa.py、web_qa.py 依赖 langchain、faiss-cpu 与本地 Ollama,本页只做了静态校验,没有在本机实跑过。本页其余所有数字(评测结果、体检结果)来自纯标准库脚本的真实运行。
4.3 网页:把出处摆出来
"""Web 问答界面:把问答链包成一个能对外用的页面。

依赖 streamlit。启动:
    streamlit run web_qa.py

界面只做三件事:收问题、显示答案、把检索到的原文摆出来让人自己核对。
第三件最重要——没有出处的知识库问答是不可验收的。
"""
import os

import streamlit as st
from langchain_community.embeddings import OllamaEmbeddings
from langchain_community.llms import Ollama
from langchain_community.vectorstores import FAISS
from langchain.prompts import PromptTemplate

INDEX_DIR = os.environ.get("RAG_INDEX", "./faiss/wuliu")
EMBED_MODEL = os.environ.get("RAG_EMBED_MODEL", "mxbai-embed-large")
LLM_MODEL = os.environ.get("RAG_LLM_MODEL", "qwen2.5:7b")

PROMPT = PromptTemplate(
    input_variables=["context", "question"],
    template="""你是物流信息查询助手。请只根据【已知信息】回答【问题】。
【已知信息】里没有的内容,回复「资料中未提及」,不要推测。
每个结论后面用方括号标出所依据的编号。

【已知信息】
{context}

【问题】
{question}""")

st.set_page_config(page_title="物流行业信息咨询系统", layout="wide")
st.title("物流行业信息咨询系统")


@st.cache_resource(show_spinner="正在加载向量库…")
def load_db():
    """缓存住,别每问一句就重新加载一次索引。

    不加缓存时,每次交互都会重新读盘并重建 Embedding 客户端,
    几百毫秒的操作被放大成每轮都等——这是这类页面最常见的卡顿来源。
    """
    embeddings = OllamaEmbeddings(model=EMBED_MODEL)
    return FAISS.load_local(INDEX_DIR, embeddings,
                            allow_dangerous_deserialization=True)


@st.cache_resource
def load_llm():
    return Ollama(model=LLM_MODEL)


def build_context(pairs):
    lines = []
    for i, (doc, score) in enumerate(pairs, 1):
        page = doc.metadata.get("page")
        src = os.path.basename(str(doc.metadata.get("source", "未知")))
        where = "%s 第 %s 页" % (src, page + 1) if page is not None else src
        lines.append("[%d] (%s)%s" % (i, where, doc.page_content.strip()))
    return "\n".join(lines)


with st.sidebar:
    st.subheader("检索参数")
    top_k = st.slider("取回多少块(top-k)", 1, 10, 3)
    score_max = st.slider("距离上限(越小越严)", 0.1, 2.0, 1.2, 0.1)
    st.caption("先固定阈值调 k,再固定 k 调阈值;两个一起动就说不清是谁起的作用。")

if "messages" not in st.session_state:
    st.session_state.messages = []

for msg in st.session_state.messages:
    with st.chat_message(msg["role"]):
        st.markdown(msg["content"])

if prompt := st.chat_input("请输入你的问题:"):
    st.session_state.messages.append({"role": "user", "content": prompt})
    with st.chat_message("user"):
        st.markdown(prompt)

    with st.chat_message("assistant"):
        db = load_db()
        pairs = db.similarity_search_with_score(prompt, k=top_k)
        pairs = [(d, s) for d, s in pairs if s <= score_max]

        if not pairs:
            reply = "资料中未提及。"
            st.markdown(reply)
        else:
            text = PROMPT.format(context=build_context(pairs), question=prompt)
            reply = load_llm().invoke(text)
            st.markdown(reply)
            # 把检索到的原文摊开,答案对不对由人当场核对
            with st.expander("查看检索到的原文(%d 块)" % len(pairs)):
                for i, (doc, score) in enumerate(pairs, 1):
                    st.markdown("**[%d]** 距离 `%.3f`" % (i, score))
                    st.text(doc.page_content.strip())

        st.session_state.messages.append({"role": "assistant", "content": reply})
界面只做三件事:收问题、显示答案、把检索到的原文摆出来让人自己核对。第三件最重要——没有出处的知识库问答是不可验收的:用户判断不了这个答案能不能信,运维也分不清是检索错了还是模型答错了。
还有一处工程细节:@st.cache_resource 把向量库缓存住。不加这一行,每问一句都要重新加载一次索引,库稍微大一点界面就卡住了。
4.4 评测:第一层自动跑
"""召回评测:给这套物流问答系统一个可验收的数字。

不做评测的 RAG 项目,调参全靠感觉——改完一个参数问两句觉得"好像好点了",
然后就上线了。这个脚本把验收拆成可重复的两步:

    第一层  检索对不对:命中率 / MRR,能自动算
    第二层  答案对不对:只能人工核,脚本负责把核对表生成出来

纯标准库,直接运行,不依赖向量库和模型。
换成真实系统时,把 retrieve() 换成对 FAISS 的调用即可。
"""
import math
import re
from collections import Counter

# 知识库:与建库脚本切出来的块对应
CHUNKS = [
    "物流公司:速达物流。公司总部:北京市。业务范围:国际快递、仓储管理。",
    "货物编号:ABC123456。发货日期:2023-01-15。当前位置:上海分拨中心。",
    "预计到达日期:2023-01-20。",
    "运输公司:快运通。运输方式:陆运。出发地:广州。目的地:重庆。预计运输时间:3天。",
    "仓库名称:东方仓储中心。仓库位置:深圳市。存储货物类型:电子产品。",
    "存储条件:常温仓储。当前库存量:1000件。",
]

# 测试集:问题 → 允许命中的块下标集合。
# 这张表是整个评测的地基,必须由懂业务的人来标,不能让模型自己生成。
TESTSET = [
    ("我的快递出发地是哪?", {3}),
    ("这批货预计几天能到?", {3}),
    ("货物现在到哪个分拨中心了?", {1}),
    ("预计到达日期是哪天?", {2}),
    ("仓库在哪个城市?", {4}),
    ("仓库里存的是什么货?", {4}),
    ("当前库存还有多少?", {5}),
    ("公司总部在哪?", {0}),
]

# 这些问题库里根本没有,系统必须答"资料中未提及"
OUT_OF_SCOPE = [
    "公司的年假制度是怎么规定的?",
    "运费一公斤多少钱?",
]


def tokenize(t):
    return re.findall(r"[a-z0-9]+", t.lower()) + re.findall(r"[\u4e00-\u9fff]", t)


def embed(t):
    return Counter(tokenize(t))


def cosine(a, b):
    common = set(a) & set(b)
    dot = sum(a[k] * b[k] for k in common)
    na = math.sqrt(sum(v * v for v in a.values()))
    nb = math.sqrt(sum(v * v for v in b.values()))
    return dot / (na * nb) if na and nb else 0.0


INDEX = [(i, c, embed(c)) for i, c in enumerate(CHUNKS)]


def retrieve(question, k):
    """换成真实系统时,这里替换成 db.similarity_search_with_score(question, k)。"""
    qv = embed(question)
    scored = [(cosine(qv, v), i) for i, _c, v in INDEX]
    scored.sort(key=lambda x: x[0], reverse=True)
    return scored[:k]


def evaluate(k):
    """命中率:标准块在不在 top-k 里。
       MRR:标准块排第几名,取名次倒数再平均——排第 1 得 1 分,排第 3 得 0.33 分。
       命中率只看"进没进来",MRR 还看"排得靠不靠前",两个一起看才完整。
    """
    hit, rr_sum, detail = 0, 0.0, []
    for question, gold in TESTSET:
        got = retrieve(question, k)
        idxs = [i for _s, i in got]
        rank = next((r for r, i in enumerate(idxs, 1) if i in gold), None)
        if rank:
            hit += 1
            rr_sum += 1.0 / rank
        detail.append((question, gold, idxs, rank))
    n = len(TESTSET)
    return hit / n, rr_sum / n, detail


def main():
    print("知识库 %d 块,测试集 %d 条,范围外问题 %d 条\n"
          % (len(CHUNKS), len(TESTSET), len(OUT_OF_SCOPE)))

    print("=== 第一层:检索对不对(自动算) ===\n")
    print("%-4s %-10s %-10s %s" % ("k", "命中率", "MRR", "没命中的问题"))
    print("-" * 64)
    best_k, best_mrr = None, -1
    for k in (1, 2, 3, 4, 5):
        rate, mrr, detail = evaluate(k)
        misses = [q for q, _g, _i, rank in detail if rank is None]
        if mrr > best_mrr:
            best_k, best_mrr = k, mrr
        print("%-4d %-10.3f %-10.3f %s"
              % (k, rate, mrr, "、".join(misses) if misses else "无"))

    print("\nMRR 最高的是 k=%d(%.3f)。" % (best_k, best_mrr))
    print("注意 MRR 会随 k 增大而饱和:命中率还在涨、MRR 已经不动时,")
    print("多出来的那几条都排在很后面,基本只是在给提示词加噪声。")

    print("\n=== 逐条明细(k=3) ===\n")
    _rate, _mrr, detail = evaluate(3)
    for question, gold, idxs, rank in detail:
        flag = "第%d名" % rank if rank else "未命中"
        print("  %-18s 期望 %-6s 实取 %-12s %s"
              % (question, sorted(gold), idxs, flag))

    print("\n=== 范围外问题:必须被挡住 ===\n")
    for question in OUT_OF_SCOPE:
        top = retrieve(question, 1)
        score = top[0][0] if top else 0.0
        print("  %-22s 最高分 %.4f" % (question, score))
    print("  这几条的最高分要明显低于上面那批,阈值才卡得住。")
    print("  分数区分不开时,别去调阈值,先回头看切分和向量化。")

    print("\n=== 第二层:答案对不对(人工核对表) ===\n")
    print("把下面这张表打印出来,逐行人工判定,不要让模型自己给自己打分:\n")
    print("  %-20s %-8s %-8s %-8s %s" % ("问题", "有编造", "有漏答", "标了出处", "判定"))
    print("  " + "-" * 60)
    for question, _gold in TESTSET[:4]:
        print("  %-20s %-8s %-8s %-8s %s" % (question, "□", "□", "□", "□通过 □不通过"))
    print("\n  三列全部为否、且标了出处,才算这一条通过。")


if __name__ == "__main__":
    main()
测试集是 8 条业务问题 + 2 条范围外问题,每条标注了「应该命中哪一块」。扫描 k:
| k | 命中率 | MRR | 没命中的问题 |
|---|---|---|---|
| 1 | 0.875 | 0.875 | 这批货预计几天能到? |
| 2 | 0.875 | 0.875 | 这批货预计几天能到? |
| 3 | 1.000 | 0.917 | 无 |
| 4 | 1.000 | 0.917 | 无 |
| 5 | 1.000 | 0.917 | 无 |
k=3 是拐点,这就是 local_qa.py 里 TOP_K=3 的来历——不是拍的,是量出来的。
注意 MRR 在 k=3 之后停在 0.917 不动了:命中率已经满分,但有一条问题的正确块排在第 3 名(「这批货预计几天能到?」实取 [2, 1, 3]),把它提到第 1 名是 Rerank 的活,不是加 k 能解决的。
4.5 范围外问题必须被挡住
| 范围外问题 | 最高分 | 对照:库内问题的最低分 |
|---|---|---|
| 运费一公斤多少钱? | 0.2762 | 库内 8 条全部高于这个区间 |
| 公司的年假制度是怎么规定的? | 0.1746 |
「运费一公斤多少钱」拿到 0.2762 是有原因的:问题里的「公斤」「多少」跟仓储那几块有字面重合。这类「看着像、其实答不了」的问题,正是阈值最难卡的一批——所以阈值要在真实问题上量,不能只拿明显无关的问题去试。
05骨架模板:换个行业只改四项
物流换成法务、医疗、制造,改的是配置和测试集,不是流程
把上一节四个脚本的共性抽出来,就是下面这份模板。它把「跟行业有关的东西」全部收进文件顶部的几个常量里,下面的函数体一行都不用动:
"""行业知识库骨架:换个行业只改配置,不改流程。

这份模板把「物流」这三个字全部收进了配置区。换成法务、医疗、制造,
改的是 DOMAIN 里的四项内容,下面的建库与问答流程一行都不用动。

用法
    1. 改 DOMAIN 与 PATHS
    2. 把 TESTSET 换成自己行业的验收问题(这一步不能省)
    3. python3 rag_industry_skeleton.py build    建库
    4. python3 rag_industry_skeleton.py eval     跑验收
    5. python3 rag_industry_skeleton.py ask "问题"
"""
import os
import sys

# ------------------------------------------------------------ 配置区
DOMAIN = {
    # TODO: 换行业时只改这四项
    "name": "物流",
    "role": "物流信息查询助手",
    "doc_types": ["运单", "仓储", "线路", "时效"],
    "refuse": "资料中未提及。",
}

PATHS = {
    "docs": os.environ.get("RAG_DOC_DIR", "./docs"),      # TODO: 资料目录
    "index": os.environ.get("RAG_INDEX", "./faiss/kb"),   # TODO: 索引落盘目录
}

MODELS = {
    # ⚠️ 建库与问答必须用同一个 embed,换了就要整库重建
    "embed": os.environ.get("RAG_EMBED_MODEL", "mxbai-embed-large"),
    "llm": os.environ.get("RAG_LLM_MODEL", "qwen2.5:7b"),
}

PARAMS = {
    "chunk_size": 300,
    "chunk_overlap": 50,
    "top_k": 3,
    "score_max": 1.2,     # FAISS 默认返回距离,越小越近
}

# 中文标点必须在列表里,否则递归切分会一路降级到按字数硬切
SEPARATORS = ["\n\n", "\n", "。", ";", ",", " ", ""]

PROMPT_TEMPLATE = """你是{role}。请只根据【已知信息】回答【问题】。

规则:
1. 只使用【已知信息】里出现过的内容,不允许补充任何外部知识。
2. 【已知信息】不足以回答时,回复「{refuse}」,不要推测。
3. 每个结论后面用方括号标出所依据的编号。

【已知信息】
{{context}}

【问题】
{{question}}""".format(role=DOMAIN["role"], refuse=DOMAIN["refuse"])

# TODO: 换行业时把这张表整张换掉。没有这张表就没有验收,只有感觉。
TESTSET = [
    ("我的快递出发地是哪?", "线路文档中的出发地字段"),
    ("这批货预计几天能到?", "线路文档中的运输时长"),
    ("货物现在到哪个分拨中心了?", "运单文档中的当前位置"),
    ("仓库里存的是什么货?", "仓储文档中的存储类型"),
]


# ------------------------------------------------------------ 建库
def build():
    """加载 → 切分 → 向量化 → 落盘。"""
    from langchain_community.document_loaders import (
        PyMuPDFLoader, TextLoader)
    from langchain_community.embeddings import OllamaEmbeddings
    from langchain_community.vectorstores import FAISS
    from langchain.text_splitter import RecursiveCharacterTextSplitter

    docs = []
    for name in sorted(os.listdir(PATHS["docs"])):
        path = os.path.join(PATHS["docs"], name)
        if name.lower().endswith(".pdf"):
            docs += PyMuPDFLoader(path).load()
        elif name.lower().endswith((".txt", ".md")):
            docs += TextLoader(path, encoding="utf-8").load()
    print("加载 %d 个文档片段" % len(docs))

    splitter = RecursiveCharacterTextSplitter(
        separators=SEPARATORS,
        chunk_size=PARAMS["chunk_size"],
        chunk_overlap=PARAMS["chunk_overlap"])
    chunks = splitter.split_documents(docs)
    print("切成 %d 块" % len(chunks))

    db = FAISS.from_documents(chunks, OllamaEmbeddings(model=MODELS["embed"]))
    db.save_local(PATHS["index"])
    print("索引已写入 %s(embed=%s)" % (PATHS["index"], MODELS["embed"]))


# ------------------------------------------------------------ 问答
def load_db():
    from langchain_community.embeddings import OllamaEmbeddings
    from langchain_community.vectorstores import FAISS
    return FAISS.load_local(PATHS["index"],
                            OllamaEmbeddings(model=MODELS["embed"]),
                            allow_dangerous_deserialization=True)


def retrieve(db, question):
    pairs = db.similarity_search_with_score(question, k=PARAMS["top_k"])
    return [(d, s) for d, s in pairs if s <= PARAMS["score_max"]]


def ask(question):
    from langchain_community.llms import Ollama

    db = load_db()
    pairs = retrieve(db, question)
    if not pairs:
        print(DOMAIN["refuse"])
        return

    context = "\n".join(
        "[%d] (%s)%s" % (i, os.path.basename(str(d.metadata.get("source", "未知"))),
                          d.page_content.strip())
        for i, (d, _s) in enumerate(pairs, 1))
    prompt = PROMPT_TEMPLATE.format(context=context, question=question)
    print(Ollama(model=MODELS["llm"]).invoke(prompt))
    print("\n检索到的块:")
    for i, (d, s) in enumerate(pairs, 1):
        print("  [%d] 距离 %.3f  %s" % (i, s, d.page_content.replace("\n", " ")[:50]))


# ------------------------------------------------------------ 验收
def evaluate():
    """跑测试集,人工核对命中的是不是「应该命中的那一块」。"""
    db = load_db()
    print("%-22s %-24s %s" % ("问题", "期望命中", "实际取回"))
    print("-" * 78)
    for question, expect in TESTSET:
        pairs = retrieve(db, question)
        got = pairs[0][0].page_content.replace("\n", " ")[:28] if pairs else "(空)"
        print("%-22s %-24s %s" % (question, expect, got))
    print("\n逐行判断实际取回的是不是期望的那一块,算出命中率再决定调什么。")


def main():
    cmd = sys.argv[1] if len(sys.argv) > 1 else "help"
    if cmd == "build":
        build()
    elif cmd == "eval":
        evaluate()
    elif cmd == "ask":
        ask(sys.argv[2] if len(sys.argv) > 2 else "TODO: 写一个测试问题")
    else:
        print(__doc__)


if __name__ == "__main__":
    main()
5.1 换行业要改的四项
| 位置 | 物流的值 | 换成法务时 |
|---|---|---|
DOMAIN["name"] | 物流 | 法务 |
DOMAIN["role"] | 物流信息查询助手 | 合同条款查询助手 |
DOMAIN["refuse"] | 资料中未提及 | 该条款在现有合同中未约定 |
TESTSET | 8 条物流问题 | 整张换掉 |
5.2 三个入口,对应三种日常操作
| 命令 | 跑什么 | 什么时候用 |
|---|---|---|
python rag_industry_skeleton.py build | 建库 | 资料更新后 |
python rag_industry_skeleton.py ask "问题" | 问一句 | 手工验证、排查 |
python rag_industry_skeleton.py eval | 跑测试集 | 每次改动之后 |
把评测做成一个命令,是这份模板最值钱的地方:改动和验证之间的摩擦越小,你越会真的去验证。要是每次都得手工准备数据、手工比对,第三次之后就没人跑了。
5.3 换行业时真正会变的是什么
流程不变,但下面三件事会跟着行业变,模板留了位置但需要自己填:
| 维度 | 物流 | 法务 / 医疗 |
|---|---|---|
| 资料形态 | 运单、手册,结构规整 | 长篇条款、病历,层级深,切分要按条款/章节 |
| 阈值偏向 | 可以宽一点 | 必须严,宁可漏答也不能瞎答 |
| 验收标准 | 答对即可 | 必须标出处,且出处要能定位到条款号 |
06易错点汇总
按「资料 / 建库 / 问答 / 界面 / 上线」五类归并
⚠️ 一、资料
- PDF 是扫描件,抽出 0 个字。 文字是图片,切分器拿到空字符串,静默建出一个空库,问什么都答不出来。建库脚本里必须拦一道:抽出 0 字就直接退出并说明要先过 OCR。
- 表格被拍平成一行。 PDF 里的表格抽出来常常是几百字挤在一行,列与列之间只剩空格。这种块无论怎么切都读不通,要么单独走表格解析,要么把表格内容改成结构化存储。
- 页眉页脚重复几十次。 同一句话占掉多个块,挤占 top-k 名额。入库前去重。
- 资料里通篇没有句末标点。 本案例的知识库就是这样(实测中文句末标点 0 个,靠 3 处空行做锚点)。这类「字段:值」格式的资料应当按行或按字段切,套递归切分是碰运气。
- 把时效性内容当成静态知识灌进去。 实测这份资料里有 2 处日期。「当前位置:上海分拨中心」写下来那一刻是对的,一周后就是错的,而系统会用一样笃定的语气说出来。定不下更新约定,这类内容就该走实时接口。
⚠️ 二、建库
- 分隔符列表里没有中文标点。 递归切分会一路降级到按字数硬切,单号
ABC123456被劈成两半,从此永远检索不到完整单号。 - 建完库不自检就去写问答。 花半天写完问答发现答不对,再回头查是切分还是模型的问题。建库脚本末尾加一行
similarity_search,问一句已知答案,三十秒就能确认库建没建对。 - 加载时把页码丢了。
metadata里没有page和source,后面就拼不出来源,整个系统的可验收性归零。 - 把建库和问答写进一个脚本。 每次提问都重读 PDF、重算向量。这两件事的运行频率差好几个数量级,必须拆开,中间用磁盘目录当接口。
- 换了 Embedding 模型不删旧索引。 维度不同会抛异常(算运气好),维度恰好相同则连异常都不抛,只是检索结果全是噪声。正确动作:改环境变量 → 删旧索引目录 → 重建 → 重跑评测。
- 两个脚本的模型名一边写死、一边读环境变量。 早晚出现「改了一半」的状态。两边都读同一个环境变量是最省心的防呆。
⚠️ 三、问答
- 把 FAISS 的分数当相似度用。
similarity_search_with_score方法名里写着score,返回的却是 L2 距离,越小越近。照着余弦写成score >= 阈值,会把最相关的全过滤掉,而且不报错。 - 阈值凭感觉拍。 本案例实测:范围外问题「运费一公斤多少钱」最高分 0.2762,比另一条范围外问题(0.1746)高得多——因为「公斤」「多少」跟仓储块有字面重合。这类「看着像、其实答不了」的问题才是阈值的真正考验,只拿明显无关的问题去试会把阈值设得过松。
- TOP_K 拍脑袋定。 本案例 k=3 是量出来的:命中率 1.000、MRR 0.917,k=4、5 两个指标都不再变化。
- 命中率满分就以为万事大吉。 MRR 停在 0.917 说明还有一条问题的正确块排在第 3 名——加 k 解决不了排名问题,那是 Rerank 的活。
- 要求标出处,却不给每块编号。 规则和
[1] [2]编号必须成对存在,否则模型只能瞎编。 - 对外部来源的索引文件开
allow_dangerous_deserialization。 FAISS 本地索引用 pickle 存元数据,反序列化会执行代码。只对自己生成的目录开。要交换向量库,就交换原始文档和建库脚本。
⚠️ 四、界面
- 只显示答案,不显示命中的原文。 用户判断不了能不能信,运维分不清是检索错了还是模型答错了。没有出处的知识库问答是不可验收的。
- 不缓存向量库。 每问一句重新加载一次索引,库稍大界面就卡死。Streamlit 里用
@st.cache_resource。 - 先做界面再调效果。 界面最不影响效果,却最容易占掉时间。先跑通命令行,效果调对了再包壳。
⚠️ 五、立项与上线
- 把所有问题都塞给 RAG。 实时状态查接口、数值计算查价表、统计聚合写 SQL。立项时先把真实问题分一遍类,算出 RAG 能覆盖的占比,这个数字决定项目值不值得做。
- 测试问题自己编。 编出来的问题会不自觉贴合你的资料,分数虚高。从客服记录、工单系统里捞 50~100 条真实提问。
- 把两层验收合成一个数。 第一层(检索对不对)能自动算,第二层(答案对不对)必须人工核:有无编造、有无漏答、有无标出处,三项全过才算通过。
- 让模型给自己打分。 得到的只是一个好看的数字。
- 上线时没定更新约定。 谁负责更新、多久一次、更新后哪些块要重新入库——三个问题必须在上线前有答案,否则系统会持续输出过期信息。
07自测题
点击题目展开答案;这 12 题过了,就能自己起一个行业知识库项目
客服的哪些问题适合做成 RAG,哪些不适合?
适合:文档里写死的事实(「深圳仓存什么货」)、制度流程条款(「国际件报关要哪些材料」)。不适合:实时系统状态(走 Function Call)、数值计算(查价表 + 写逻辑)、统计聚合(写 SQL)。立项时先把真实问题分一遍类,算出 RAG 能覆盖的占比,这个数字决定项目值不值得做。
测试问题为什么不能自己编?
编出来的问题会不自觉地贴合你的资料,量出来的分数虚高。要从客服记录、工单系统里捞 50~100 条真实提问。另外,找不到对应文档的那些问题,就是这个项目的天花板——这件事越早知道越好。
入库前的六项资料体检分别查什么?哪一项失败是完全静默的?
① 能否抽出文字 ② 有无编码乱码 ③ 有无拍平表格 ④ 有无重复段落 ⑤ 有无切分锚点 ⑥ 有无时效内容。第 ① 项最危险:扫描件 PDF 的文字是图片,抽出 0 字,切分器拿到空字符串,静默建出一个空库,全程不报任何错。
本案例的知识库「中文句末标点 0 个」却通过了体检,为什么?换成什么情况就该亮红灯?
因为它有 3 处空行做切分锚点。这份资料是「字段:值」格式,通篇没有句号。换成通篇没有空行也没有句号的表格导出文本,这一项就该亮红灯——那时应该按行或按字段切,而不是套递归切分。
为什么建库和问答要拆成两个脚本?中间靠什么连接?
运行频率差好几个数量级:建库只在资料更新时跑一次(分钟到小时级),问答每次提问都跑(秒级)。写在一起会导致每问一句就重读 PDF、重算向量。中间靠磁盘上的索引目录连接——这是两个程序之间唯一的接口,也让建库能在夜里批量跑而问答服务不用重启。
这两个脚本之间唯一的硬绑定是什么?怎么防呆?
Embedding 模型必须完全一致。防呆做法:两个脚本都从同一个环境变量读模型名,改的时候只改一处。一边写死字面量、另一边读环境变量,早晚出现「改了一半」的状态——而这种状态不报错,只是检索结果全是噪声。
换 Embedding 模型的正确动作顺序是什么?少一步会怎样?
改环境变量 → 删掉旧索引目录 → 重跑建库 → 重跑评测。少了删旧索引:维度不同会抛异常(运气好),维度恰好相同则连异常都不抛(如 bge-large-zh-v1.5 和 bge-m3 都是 1024 维),只是结果全错。
FAISS 的 similarity_search_with_score 返回的是什么?阈值该怎么写?
返回的是 L2 距离,越小越近,尽管方法名里写着 score。阈值要写成 score <= SCORE_MAX。照着余弦写成 score >= 阈值,会把最相关的全过滤掉——而且不报错。
allow_dangerous_deserialization=True 为什么叫「dangerous」?
FAISS 的本地索引用 pickle 存元数据,反序列化会执行代码。所以只对自己生成的目录开这个开关,外部拿到的索引文件不要直接加载。需要交换向量库时,交换原始文档和建库脚本,让对方自己建。
本案例 TOP_K=3 是怎么来的?
量出来的:k=1、2 时命中率 0.875(「这批货预计几天能到?」没命中),k=3 时命中率 1.000、MRR 0.917,k=4、5 两个指标都不再变化。所以 3 是拐点,再往上只加噪声和成本。
命中率已经 1.000,MRR 却停在 0.917,说明什么?
说明还有一条问题的正确块排在第 3 名(「这批货预计几天能到?」实取 [2, 1, 3])。命中率量「在不在」,MRR 量「排第几」。加 k 解决不了排名问题,那是 Rerank 的活。
两条范围外问题的最高分是 0.2762 和 0.1746,为什么差这么多?这对定阈值有什么提示?
「运费一公斤多少钱」里的「公斤」「多少」跟仓储那几块有字面重合,所以分数更高。提示是:「看着像、其实答不了」的问题才是阈值的真正考验。只拿明显无关的问题去试,会把阈值设得过松。
知识库问答的验收为什么必须分两层?第二层能自动化吗?
第一层检索对不对:准备「问题 → 应命中哪块」的对照表,命中率和 MRR 全自动算。第二层答案对不对:必须人工核,逐条看有无编造、有无漏答、有无标出处,三项全过才算通过。不要让模型给自己打分,那只会得到一个好看的数字。
词术语表
| 术语 | 含义 |
|---|---|
| 建库脚本 | 离线跑的那一半:加载 → 切分 → 向量化 → 落盘,产物是磁盘上的索引目录 |
| 问答脚本 | 在线跑的那一半:读索引 → 检索 → 拼提示词 → 生成,每次提问都跑 |
| FAISS | 进程内运行的向量检索库,索引可落盘成目录,不需要额外起服务 |
| Ollama | 本地跑开源模型的运行时,这里同时提供 Embedding 与对话模型,数据不出内网 |
| PyMuPDFLoader | 按页读取 PDF 的加载器,页码保留在 metadata 里,是标出处的前提 |
| RecursiveCharacterTextSplitter | 递归切分器,按分隔符列表从粗到细尝试,最后才按字数硬切 |
| metadata | 与块一起保存的结构化字段(source、page),用于拼来源和条件过滤 |
| L2 距离 | FAISS 默认返回的分数,越小越近,阈值写法与余弦相反 |
| 资料体检 | 入库前的六项检查:能否抽文字、有无乱码、有无拍平表格、有无重复段落、有无切分锚点、有无时效内容 |
| 建库自检 | 建完立刻用一个已知答案查一次,确认库建对了再往下做问答 |
| 命中率 | 第一层验收指标:正确块出现在返回的 k 条里的比例 |
| MRR | 第一层验收指标:正确块名次倒数的平均值,量的是排名而非有无 |
| 人工核对表 | 第二层验收:逐条判定有无编造、有无漏答、有无标出处,三项全过才算通过 |
| pickle 反序列化 | 加载 FAISS 本地索引时会执行代码,只对自己生成的目录开启 |