【案例】Qwen 微调实战 · LoRA / QLoRA 与 DeepSpeed
主力机床一颗螺丝都不动,换活儿只换那套快换夹具——冻结原权重、只训低秩旁路,再把夹具图纸压成 4-bit 存起来。
30″30 秒看懂 LoRA 与 QLoRA
车间里有一台价值千万的主力机床,精度是几十年攒出来的。现在来了一批新活儿,要加工一种没做过的零件。
最笨的办法是把机床整个重新校一遍——拆下来、改导轨、重调主轴。新活儿是能干了,但老活儿的精度也一起被改没了,而且停机几个月。聪明的办法是:机床本体一颗螺丝都不动,另做一套快换夹具装上去。换活儿只换夹具,夹具很轻、很便宜、随时能摘。
再进一步:夹具图纸太占地方,那就压缩存放——压缩包不能直接上机,用的时候解开就是了。这就是 QLoRA 比 LoRA 多做的那一步。
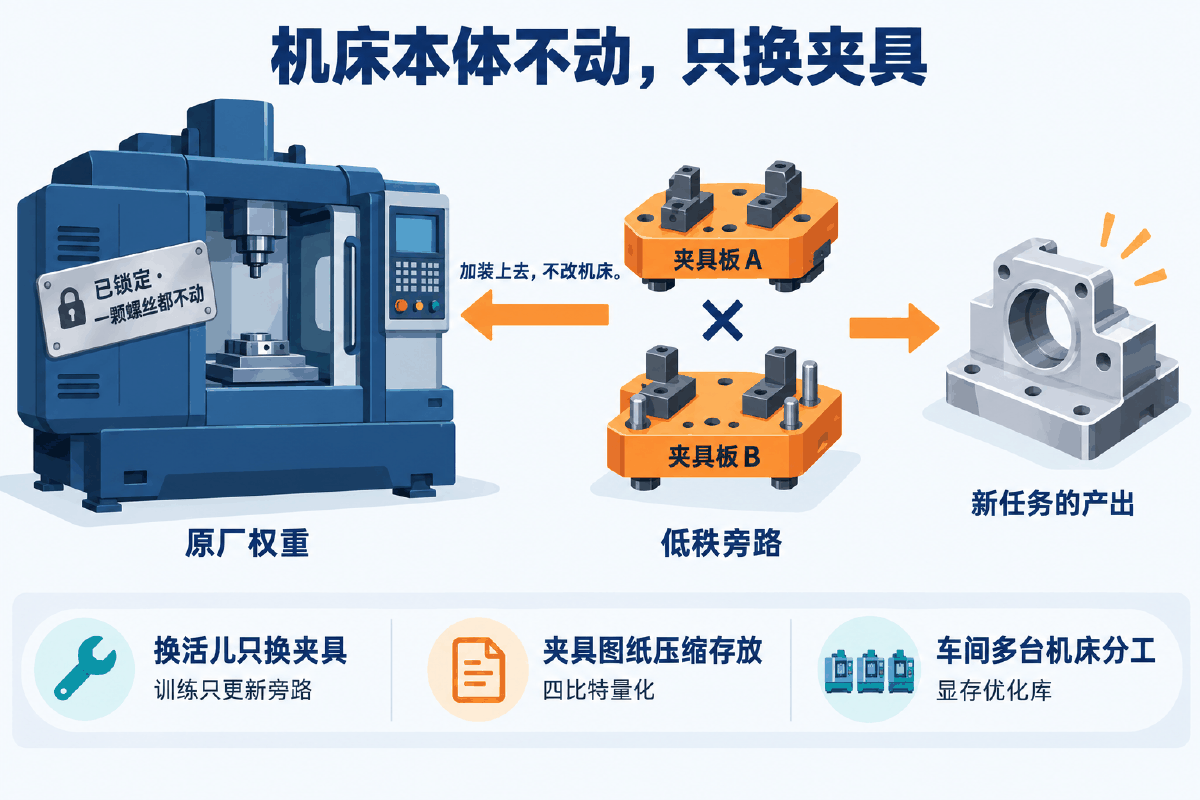
| 车间里的东西 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 主力机床本体 | 预训练权重 W | 训练全程冻结,梯度不流过它,一个数都不改 |
| 快换夹具(两块板) | 低秩旁路 A 与 B | 唯一被训练的东西。A·B 去逼近「本该对 W 做的那点改动」 |
| 夹具的厚度档位 | lora_rank(秩 r) | 决定夹具能有多复杂,也线性决定要训多少参数 |
| 夹具用多大力 | lora_alpha | 缩放系数,控制旁路输出在最终结果里占多大权重 |
| 图纸压缩存放 | 4-bit 量化(NF4) | QLoRA 的第一块。存 4-bit,算的时候反量化回高精度 |
| 压缩包目录再压一次 | 双重量化 | 第二次量化只作用在第一次产生的量化常数上 |
| 料架放不下先挪到隔壁 | 分页优化 | 显存不够时把优化器状态自动换出到主机内存,要用再取回 |
| 车间里多台机床分工 | DeepSpeed 并行与 ZeRO | 把料、把矩阵、把网络层分给不同的卡,再把该存的东西切开分摊 |
W 从头到尾不动。所有学到的东西都在旁路里,所有省下来的显存都来自「不用为 W 存梯度和优化器状态」。量化改的只是存放方式,不是计算方式——算的时候仍要反量化回高精度。谁要是说「QLoRA 是在 4-bit 上做矩阵乘法」,那是把存和算混为一谈了。
cutoff_len: 1024、val_size: 0.1 这些数,在这一页会以训练参数的身份重新出现。
01概念:为什么不能整台机床重新校
全量微调的三个缺陷、LoRA 的应对思路,以及 LoRA 与 QLoRA 到底差在哪一步
1.1 全量微调的三个缺陷
全量微调(finetuning_type: full)就是把模型所有参数都放开来更新。它效果好、思路直接,但有三个绕不过去的缺陷:
需要更新千亿甚至万亿级别的参数,消耗大量计算资源。而且为了调整海量参数时不跑偏,还需要准备相当规模的数据集——算力和数据两头都贵。
全量微调的训练周期比较长,有些场合需要快速迭代,这个速度跟不上业务的节奏。等训完,需求可能已经变了。
全量微调要根据新任务调整和重构预训练模型的所有参数,有可能导致原有的知识表征被破坏——新任务上表现虽好,旧任务上急剧下降。这就是大模型的灾难性遗忘。
第三点是最致命的,也最符合直觉:把整台机床拆开重调,新活儿是能干了,几十年攒下来的老精度也一起改没了。前两点还能靠加钱、加时间解决,遗忘是加钱也买不回来的。
1.2 LoRA 的思路:不改机床,另做夹具
先想清楚全量微调在数学上做了什么:它把一个巨大的权重矩阵 W 改成了 W + ΔW。真正承载「新任务学到的东西」的,其实只是那个 ΔW。
那么,为了避免灾难性遗忘,训练时就不要去动原始矩阵 W,而是单独训一个同样大小的矩阵 ΔW,推理时用 W + ΔW 代替原来的 W。
问题是:ΔW 和 W 一样大,训练的参数量一点都没少。遗忘解决了,成本和时间没解决。
这时候借一个机器学习里的老思路——矩阵分解。PCA 用过它,潜在语义分析(LSA)用过它,推荐系统的协同过滤也用过它。做法是:
ΔW,而是训练两个小型矩阵 A 和 B,使得 A·B ≈ ΔW。只要这两个结果足够近似,在工程上就是可行的。如果秩 r 远小于 M 和 N,参数量就能被极大压缩。
三个缺陷于是被一一化解:
| 缺陷 | LoRA 的应对 | 为什么有效 |
|---|---|---|
| 训练成本高 | 只训 A 和 B | 可训练参数降到原来的万分之几,优化器状态跟着一起降——显存主要就省在这里 |
| 训练时间长 | 反向传播只更新旁路 | 要算梯度的参数少了几个数量级,单步更快;小数据集也能训得动 |
| 灾难性遗忘 | 原矩阵 W 完全冻结 | 原有知识表征在物理上不可能被破坏——梯度根本不流到它上面。夹具摘掉,机床还是原来那台 |
1.3 LoRA 与 QLoRA 差在哪一步
QLoRA(Quantized Low-Rank Adaptation)是 LoRA 的进一步扩展,结合了深度量化技术。它把预训练模型量化为低精度格式(如 4 位),并在训练过程中使用高精度格式(如 bf16)进行反量化。这样可以在保持模型精度的同时,进一步减少存储需求和计算复杂度。
| 维度 | 全量微调 | LoRA | QLoRA |
|---|---|---|---|
原权重 W | 参与更新 | 冻结,以 bf16/fp16 存放 | 冻结,以 4-bit 存放 |
| 训练的是 | 全部参数 | 低秩旁路 A、B | 低秩旁路 A、B(与 LoRA 相同) |
配置里的 finetuning_type | full | lora | 仍然是 lora,靠 quantization_bit: 4 区分 |
| 显存(7B 实测) | 42.18GB | 20.17GB | 10.97GB |
| 额外代价 | — | 旁路只是近似,表达能力弱于全量 | 在 LoRA 之上再叠一层量化误差,且反量化有额外计算开销 |
| 典型学习率 | 1e-5 | 1e-4 | 1e-4 |
finetuning_type 写的还是 lora。QLoRA = LoRA + 基座 4-bit 量化,差别只有 quantization_bit 和 quantization_method 这两行。把它当成一种独立方法去找「qlora」这个选项,是会找不到的。同理,合并权重时 finetuning_type 也一律填 lora,无论当初是 LoRA 还是 QLoRA 训的。
02原理:夹具怎么算、图纸怎么压、车间怎么分工
参数量推导、初始化的讲究、量化的两套公式、NF4 与双重量化、并行策略与 ZeRO
2.1 低秩分解:把一个胖矩阵换成两个瘦矩阵
假设要适配的权重矩阵 W 是 M × N。全量微调要更新 M × N 个参数;LoRA 冻结 W,改为训练 A(M × r)与 B(r × N),用 A·B 去逼近 ΔW。
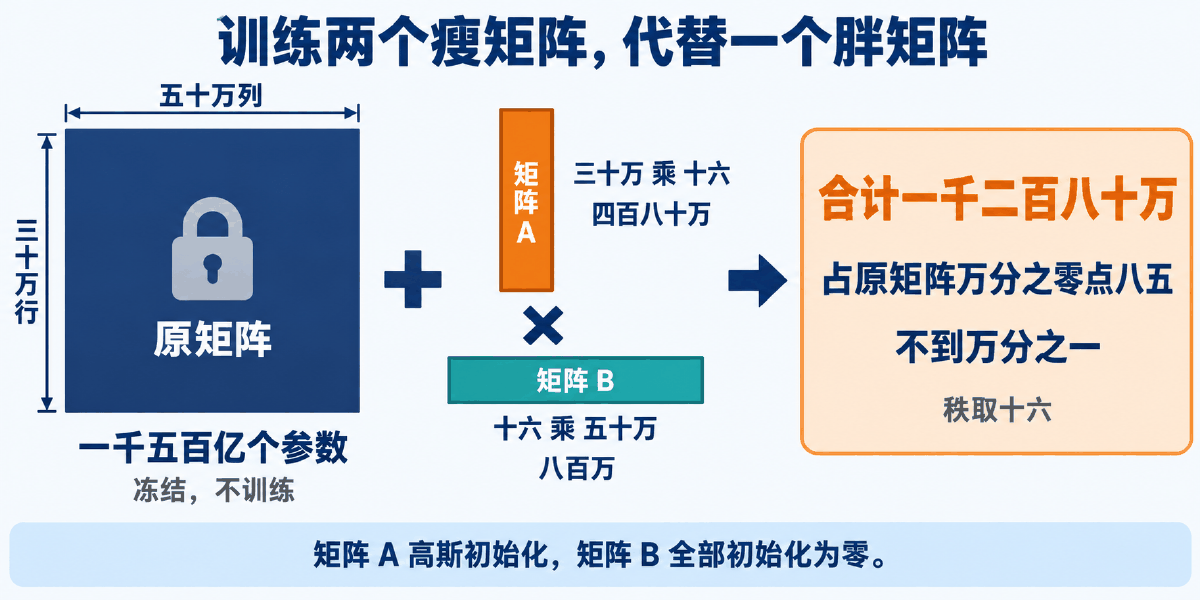
把数代进去算一遍——取 M = 300000,N = 500000,r = 16:
| 对象 | 形状 | 参数量 | 说明 |
|---|---|---|---|
原矩阵 W | 300000 × 500000 | 1500 亿 | 全量微调要更新的量;LoRA 里它冻结不训 |
矩阵 A | 300000 × 16 | 480 万 | M × r |
矩阵 B | 16 × 500000 | 800 万 | r × N |
| 旁路合计 | — | 1280 万 | 480 万 + 800 万 |
| 占比 | — | 0.008533% | 约为总参数量的 0.000085,即不到万分之一 |
这个账可以自己跑一遍验证,脚本在 03 节。这里先看两个由它直接推出来的结论:
旁路参数量是 r × (M + N),r 翻倍,参数就翻倍。所以 lora_rank 不是越大越好——秩越高越接近全量微调,省显存的好处也就越少。
可训练参数少了几个数量级,AdamW 为每个可训练参数额外保存的两份动量也跟着少。显存降下来的主因在这里,而不是「模型变小了」——基座该占多少还占多少。
2.2 实际做法:每层都挂旁路,A 高斯、B 全零
做法有三条,前两条是结构,第三条是初始化,也是最容易被问倒的一条:
- 每个 transformer 层都添加低秩旁路。 不是只在最后一层加,而是逐层加——配置里
lora_target: all表示所有线性层都挂上。 - 矩阵
A高斯初始化。 - 矩阵
B初始化为全 0 矩阵。
A 和 B 全零时,B 的梯度正比于 A、A 的梯度正比于 B,两边互相为零,梯度恒为 0,参数永远停在原地。都高斯:一开始就把原模型搞坏了。 此时
A·B ≠ 0,训练还没开始,旁路就已经在往原输出上叠一堆随机噪声——第 0 步的模型就不是原模型了,相当于夹具还没调好就先把工件铣花了。一高斯一全零,两个问题同时解决:
B = 0 保证 A·B = 0,训练起点严格等于原模型;A ≠ 0 保证 B 的梯度不为零,模型立刻能学。
2.3 量化的基本盘:对称与非对称
在讲 NF4 之前,先把量化本身讲清楚。常用的量化方法包括对称量化(symmetric quantization)和非对称量化(asymmetric quantization),它们都是线性映射(linear mapping)的不同形式。
对称量化
核心思想是将浮点数量化为整数,且量化后的分布是关于零对称的。以量化为 Int8 为例:
| 步骤 | 公式 | 说明 |
|---|---|---|
| 算缩放系数 | Scale = |R_max| / Q_max | |R_max| 是原始浮点数范围内的最大绝对值,Q_max 是量化后整数的最大绝对值 |
| 量化 | Q = Round(R / Scale) | R 是要量化的浮点数,Q 是量化后的整数值,要取整 |
| 裁剪 | Q = Clip(Q, -127, 127) | 控制不要超出范围。工程上一般舍弃 -128,正负对称好算 |
| 反量化 | R' = Q × Scale | R' 是反量化后恢复的近似浮点值——注意是近似,不是原值 |
非对称量化
它并不是以零为中心对称的。它将浮点数范围中的最小值 β 和最大值 α 映射到量化范围的最小值和最大值,充分利用量化后的整数范围。实现上靠一个缩放因子(scale)和一个偏移量(zero-point):
| 步骤 | 公式 | 说明 |
|---|---|---|
| 算 Scale | Scale = (R_max − R_min) / (Q_max − Q_min) | 用的是区间宽度之比,而不是最大绝对值之比 |
| 算 Zero-point | Zero-point = Q_min − R_min / Scale | 结果要取整。它是「浮点 0 落在整数轴的哪个位置」 |
| 量化 | Q = Round(R / Scale + Zero-point) | 比对称量化多了一次平移 |
| 裁剪 | Q = Clip(Q, Q_min, Q_max) | 同样要夹在范围内 |
| 反量化 | R' = Scale × (Q − Zero-point) | 先减偏移再乘尺度,顺序不能反 |
量化到底换来了什么
假设有一个浮点输入矩阵 X_f 和一个浮点权重矩阵 W_f。先把两者做对称量化变成 X_q 和 W_q,那么两个浮点矩阵的乘法就变成了两个整数矩阵的乘法,计算速度提升,代价是精度误差:
X_f · W_f = (s_x · X_q) @ (s_w · W_q) = s_x · s_w · (X_q @ W_q)两个 s 是两个矩阵各自的缩放系数。整数矩阵乘完之后,再乘上两个标量就还原了尺度。
非对称量化多了 zero-point,展开之后会多出三项:
X_f · W_f = ((X_q − Z_x) · s_x) @ ((W_q − Z_w) · s_w)
= s_x · s_w · (X_q @ W_q − X_q @ Z_w − W_q @ Z_x + Z_x @ Z_w)| 维度 | 对称量化 | 非对称量化 |
|---|---|---|
| 是否需要 zero-point | 不需要 | 需要 |
| 整数范围利用率 | 数据偏向一侧时会浪费半边 | 充分利用整个整数范围 |
| 矩阵乘法展开项 | 1 项,最简洁 | 4 项,多出三项交叉修正 |
| 适合什么数据 | 关于 0 大致对称的数据,比如神经网络权重 | 明显偏向一侧的数据,比如 ReLU 之后的激活值 |
2.4 QLoRA 第一块:4 位标准浮点数量化(NF4)
QLoRA 的重点有三个。第一个是 4 位标准浮点数量化(4-bit NormalFloat Quantization),第二个是双重量化,第三个是分页优化。先说第一个。
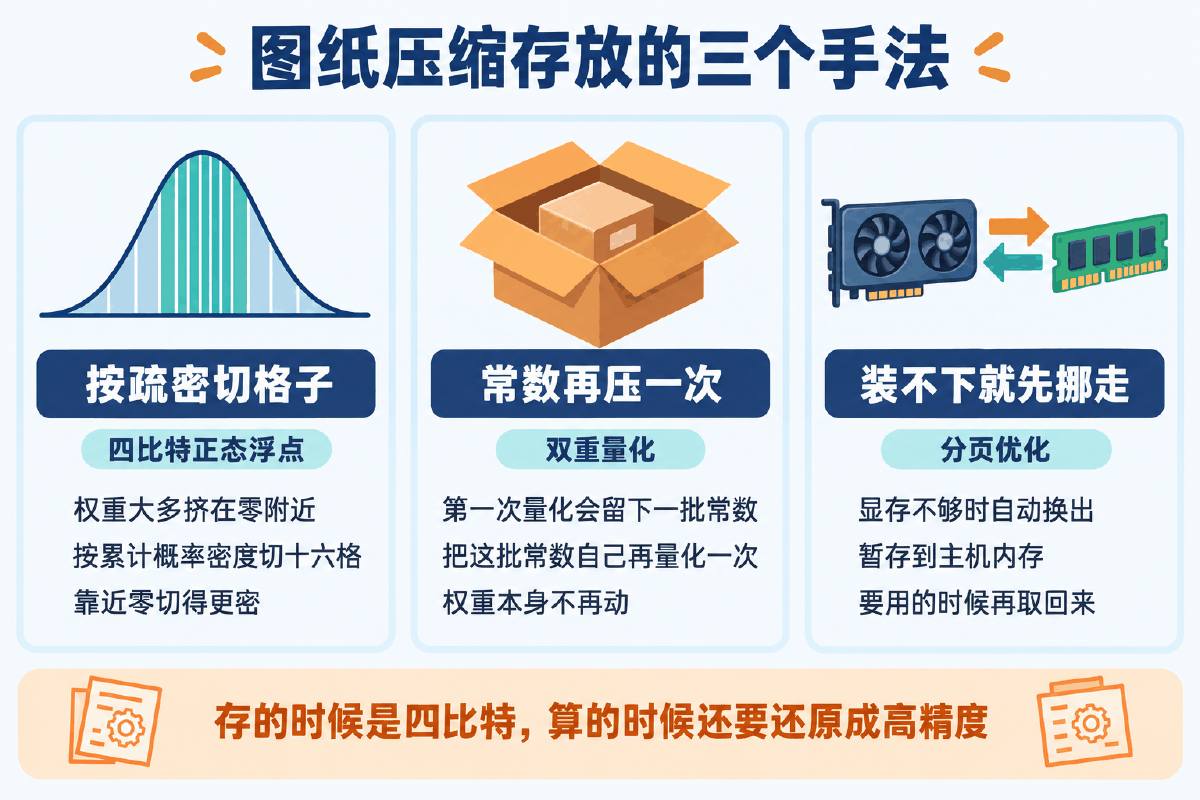
关键前提是一句观察:对于神经网络,一般参数值都符合正态分布——0 附近的参数很多,远离 0 的参数很少。用前面那种均匀切分的线性量化是不太合适的:它在几乎没有数据的两端浪费了大量档位,而在数据最密集的 0 附近分辨率反而不够。
NF4 的做法是:将正态分布按照其累计概率密度分为 16 个区域(因为 4-bit 量化后的整数正好有 16 个),对每个区间求出起始点和终止点对应的 X 值。结果就是越靠近 0 越密集,越远离 0 越稀疏。
走一遍完整流程
输入向量 X = [0.32, -1.76, 0.025, -1.22]:
| 步骤 | 动作 | 结果 |
|---|---|---|
| ① | 求 absmax(X) | 1.76 |
| ② | 归一化 X / absmax(X) | [0.1818, -1, 0.0142, -0.6932],全部落进 [-1, 1] |
| ③ | 按 NF4 分位点舍入 | 取最近的那个分位点,实际存下来的只有 0~15 的索引 |
| ④ | 反量化 | 索引查表取回分位点,再乘回 absmax |
NF4 的 16 个分位点:
NF4 = [-1.0000, -0.6962, -0.5251, -0.3949, -0.2844, -0.1848, -0.0911,
        0.0796,  0.1609,  0.2461,  0.3379,  0.4407,  0.5626, 0.7230, 1.0000]
把相邻间隔算出来就能看见那句「靠近 0 更密」是真的:两端的间隔是 0.3038 和 0.2770,而中间几段只有 0.08 上下。
2.5 QLoRA 第二块与第三块:双重量化与分页优化
双重量化(Double Quantization)
定义很直接:双重量化是量化「量化常数」以进一步减少内存的过程。它将第一次量化的常数作为第二次量化的输入,进行第二级的量化,进一步减小所需的空间。
分页优化(Paged Optimizer)
它用于管理大语言模型训练期间的内存使用。在训练具有数十亿个参数的大型模型时,GPU 内存不足是一个常见问题,分页优化器就是用来解决训练期间发生的这些内存峰值的。
机制是:NVIDIA 统一内存可实现 CPU 和 GPU 之间的自动页面到页面传输,以便在 GPU 显存不够的情况下仍能正常处理。具体来说,在 GPU 内存不足时,自动将其移出到 CPU 的 RAM 中,并在优化器更新步骤需要时取回到 GPU 显存中。
2.6 DeepSpeed 的并行策略
DeepSpeed 是微软开发的开源库,专为大规模模型训练设计。它基于 PyTorch 构建,只需要简单修改即可迁移。它提供多种并行化策略,适应不同训练场景。
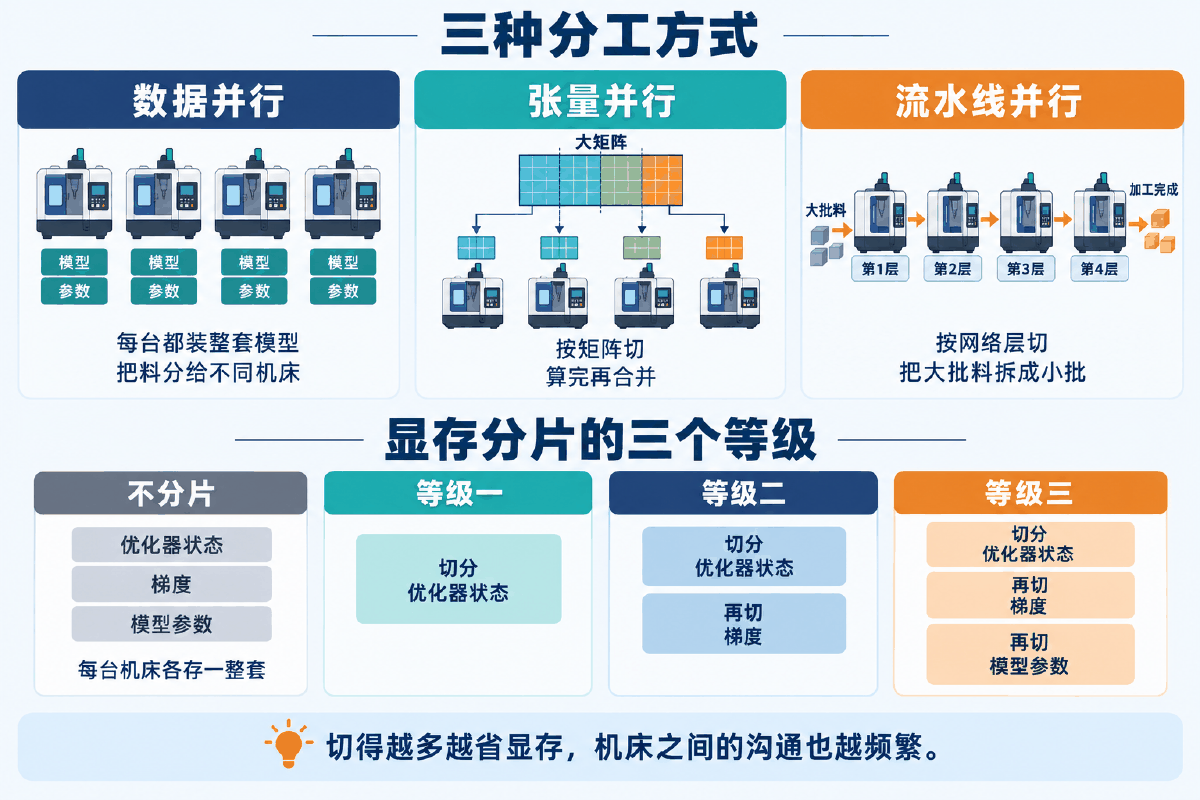
数据并行
把大型数据集分割成小块,在多个处理器上并行处理。在多个 GPU 的情况下,将模型分发到每个 GPU 上,每个 GPU 都保留一个完整的模型参数;把每个 batch 的样本平均分配到每个 GPU 上进行梯度计算,然后汇总每个 GPU 上的梯度,再将汇总梯度重新分发回每个 GPU,各自根据汇总梯度更新参数。
比喻:每台机床都装一整套模具,把料分给不同机床同时干。前提是每台机床都装得下整套模具——装不下就得换下面两种。
流水线并行
将模型划分为多个阶段,在不同处理器上并行处理这些阶段。假如网络有 6 层,把模型分成两组,分别放在 GPU0 与 GPU1 上。前向传播时数据从第一层依次往后算,第三层传到第四层时会有 GPU 之间的通信开销;反向传播同理。
同一节点上不同 GPU 的通信开销较少,多机多卡时涉及跨节点通信,开销会非常大。
谷歌提出的 GPipe 就是来修这个的。它引入一个超参数 chunks,将每一个 mini-batch 数据划分到 chunks 个 micro-batch 上。以 chunks = 4 为例:
| 时段 | 发生了什么 | 在工作的 GPU 数 |
|---|---|---|
| t0 | device0 计算第 1 个 micro-batch 在第一组网络上的前向 | 1 台 |
| t1 | device1 接着算第 1 个 micro-batch;同时 device0 开始算第 2 个 micro-batch | 2 台 |
| t2 | 依次往后推 | 3 台 |
| t3 | 流水线填满 | 4 台全部在工作 |
反向传播时则依次从 device3 至 device0 计算。DeepSpeed 通过 GPipe 优化流水线并行的实现,减少了处理器之间的通信开销。
比喻:四台机床排成一条流水线,把一大批料拆成小批陆续投进去——第一批还在第二道工序时,第二批已经进了第一道工序,四台机床就都转起来了。
张量并行
张量并行(TP)也是模型并行的一种形式。如果流水线并行是按网络层切分,那张量并行就是进行矩阵切分,充分利用矩阵分块乘法的原理。
核心思想是:每个 GPU 仅处理矩阵的一部分,当算子需要整个矩阵的时候再进行矩阵聚合。无论横向切分还是竖向切分,都可以把切分后的矩阵放到不同 GPU 上计算,最后合并结果。
以 MLP 层为例,数学表达是 Y = GeLU(XA),Z = Dropout(YB)。并行化的做法是权重 A 矩阵竖着切,B 矩阵横向切分,最后合并。
2.7 ZeRO:把该存的东西切开分摊
DeepSpeed 采用的内存优化技术叫 ZeRO(Zero Redundancy Optimizer,零冗余优化器)。它在 GPU 集群上以最佳系统吞吐量的三到五倍的速度训练具有 1000 亿个参数的模型。
它的思路是:通过在数据并行进程之间划分模型状态(参数、梯度、优化器状态)来消除内存冗余,而不是复制它们;同时在训练期间使用动态通信调度在设备之间共享必要的状态,以保持数据并行的计算粒度和通信量。
为什么能这么干?因为这些状态只会在对应算子计算时才被用到:optimizer states 只在最终做 update 时用到;数据并行中 gradients 只在最后做 AllReduce 和 update 时用到;参数 W 只在做 forward 和 backward 的那一刻用到。既然平时用不上,就没必要每张卡都各存一整份。
| 等级 | 切分什么 | 省了多少 | 代价 |
|---|---|---|---|
| Baseline | 禁用所有分片,仅使用 DDP | 每张卡各存一整套,最费 | 通信最少 |
| ZeRO-1 | 把优化器状态分片到每个数据并行进程(每个 GPU) | 优化器状态通常是大头(AdamW 每参数两份动量) | update 时需要额外通信 |
| ZeRO-2 | 优化器状态 + 梯度 | 在 ZeRO-1 基础上再省一份梯度 | 梯度规约的通信模式变复杂 |
| ZeRO-3 | 优化器状态 + 梯度 + 模型参数 | 最省,大到单卡放不下的模型也能训 | 通信最频繁,参数要用时才从别的卡取回来 |
ZeRO-Offload
除此之外,DeepSpeed 还提供 ZeRO-Offload,能够同时利用 CPU 和 GPU 内存来训练大型模型,核心是将优化器状态和梯度卸载到 CPU 内存中。用户在使用带有单张 V100 GPU 的机器时,可以在不耗尽显存的情况下运行多达 130 亿个参数的模型,模型规模扩展至现有方法的 10 倍,并保持有竞争力的吞吐量。
| 选项 | 在哪一级之上 | 把什么下沉到 CPU 内存或硬盘 |
|---|---|---|
| Optimizer Offload | ZeRO-2 基础上 | 梯度和优化器状态 |
| Param Offload | ZeRO-3 基础上 | 模型参数 |
2.8 混合精度
混合精度训练是同时使用不同精度的浮点数进行训练的方法,通常结合单精度(FP32)和半精度(FP16)。使用混合精度可以显著减少内存占用和计算时间,同时降低能耗。
| 类型 | 精度范围 | 显存占用 | 适用场景 |
|---|---|---|---|
| FP16 | 5.96e-8 ~ 65504 | 低 | 大多数 NVIDIA GPU |
| BF16 | 1.18e-38 ~ 3.39e38 | 中 | 大模型训练 |
| TF32 | 1.18e-19 ~ 3.40e38 | 高 | 数学运算加速 |
bf16: true
看「精度范围」那一列:FP16 的上限只有 65504,大模型训练中一旦某个中间值超过它就会溢出成 inf,loss 直接变 NaN——这正是 FP16 要配一整套 loss scaling(loss_scale、loss_scale_window、initial_scale_power)的原因。BF16 的范围和 FP32 几乎一样(3.39e38),牺牲的是尾数精度而不是动态范围,不用调 loss scaling 就能稳定训练。代价是需要 Ampere 架构以上的卡。
03最小代码:把两笔账自己算一遍
参数量账与量化账都不需要 GPU,用标准库跑一遍,前面的推导就变成手感
3.1 十行看懂 LoRA 省在哪
整个低秩分解的账,剥掉打印之后就是三个乘法:
M, N, r = 300000, 500000, 16

full = M * N          # 原矩阵 W:全量微调要更新的参数量
a    = M * r          # 矩阵 A
b    = r * N          # 矩阵 B
side = a + b          # 旁路合计,这才是 LoRA 真正训练的东西

print(full, a, b, side)            # 150000000000 4800000 8000000 12800000
print("%.6f%%" % (side / full * 100)) # 0.008533%三个数字就够说明问题:1500 亿 → 1280 万,占比 0.008533%,不到万分之一。
把它扩成能回答更多问题的版本,就是下面这份脚本——它还能按真实模型结构逐层累加,算出「挂满旁路之后可训练参数占全模型的百分之几」:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""lora_param_calc.py —— 算清楚 LoRA 到底省了多少参数。

回答三个问题:
  1. 一个 M×N 的权重矩阵,换成秩为 r 的旁路 A(M×r)·B(r×N) 之后,参数量从多少变成多少?
  2. 压缩比是多少?低秩旁路占原矩阵的百分之几?
  3. 按一个真实模型的所有目标层累加,可训练参数占全模型的比例是多少?

纯标准库,直接运行:
    python3 lora_param_calc.py                 # 跑内置的三个算例
    python3 lora_param_calc.py -M 300000 -N 500000 -r 16
    python3 lora_param_calc.py --model qwen7b -r 16
"""

import argparse


# ---------------------------------------------------------------------------
# 单个矩阵的账
# ---------------------------------------------------------------------------
def lora_params(m, n, r):
    """返回 (原矩阵参数量, A 的参数量, B 的参数量, 旁路合计)。

    原矩阵 W 是 M×N,全量微调要更新全部 M*N 个参数。
    LoRA 不动 W,只训练 A(M×r) 与 B(r×N),用 A·B 去逼近 ΔW。
    只要 r 远小于 M 和 N,M*r + r*N 就会远小于 M*N。
    """
    full = m * n
    a = m * r
    b = r * n
    return full, a, b, a + b


def fmt(x):
    """把大整数写成人能读的量级,避免一串零看花眼。"""
    units = [(1e12, "万亿"), (1e8, "亿"), (1e4, "万")]
    for scale, name in units:
        if x >= scale:
            v = x / scale
            return ("%.4g%s" % (v, name)).replace(".0000", "")
    return str(x)


def report_matrix(m, n, r, title=""):
    full, a, b, side = lora_params(m, n, r)
    ratio = side / full
    print("-" * 66)
    if title:
        print(title)
    print("  原矩阵 W:%d × %d = %s 个参数" % (m, n, fmt(full)))
    print("  矩阵 A  :%d × %d = %s" % (m, r, fmt(a)))
    print("  矩阵 B  :%d × %d = %s" % (r, n, fmt(b)))
    print("  旁路合计:%s" % fmt(side))
    print("  占原矩阵:%.6f%%  ≈ 1/%d" % (ratio * 100, round(1 / ratio)))
    return ratio


# ---------------------------------------------------------------------------
# 按真实模型结构累加
# ---------------------------------------------------------------------------
# 只记录算 LoRA 需要的几个形状;这些是公开的模型结构参数,不含任何权重。
MODELS = {
    "qwen7b": {
        "label": "7B 级别模型(28 层,hidden 3584,中间层 18944)",
        "layers": 28,
        "hidden": 3584,
        "inter": 18944,
        "kv_hidden": 512,        # 分组查询注意力,k/v 的输出维度比 q 小
        "total": 7_615_616_512,
    },
    "qwen1_8b": {
        "label": "1.8B 级别模型(24 层,hidden 2048,中间层 5504)",
        "layers": 24,
        "hidden": 2048,
        "inter": 5504,
        "kv_hidden": 2048,
        "total": 1_836_828_672,
    },
}


def target_matrices(cfg):
    """lora_target: all 时被挂上旁路的线性层形状清单(每层)。"""
    h, i, kv = cfg["hidden"], cfg["inter"], cfg["kv_hidden"]
    return [
        ("q_proj", h, h),
        ("k_proj", h, kv),
        ("v_proj", h, kv),
        ("o_proj", h, h),
        ("gate_proj", h, i),
        ("up_proj", h, i),
        ("down_proj", i, h),
    ]


def report_model(key, r):
    cfg = MODELS[key]
    print("=" * 66)
    print("模型:%s" % cfg["label"])
    print("LoRA 秩 r = %d,lora_target = all(每层 7 个线性层都挂旁路)" % r)
    print("=" * 66)

    per_layer_full = 0
    per_layer_side = 0
    print("  每一层的账:")
    for name, m, n in target_matrices(cfg):
        full, _, _, side = lora_params(m, n, r)
        per_layer_full += full
        per_layer_side += side
        print("    %-10s %6d × %-6d  原 %-10s 旁路 %s"
              % (name, m, n, fmt(full), fmt(side)))

    layers = cfg["layers"]
    total_side = per_layer_side * layers
    total_full = cfg["total"]

    print("  单层合计:原 %s / 旁路 %s" % (fmt(per_layer_full), fmt(per_layer_side)))
    print("  全部 %d 层:可训练参数 %s" % (layers, fmt(total_side)))
    print("  全模型参数:%s" % fmt(total_full))
    print("  可训练占比:%.4f%%" % (total_side / total_full * 100))
    print()
    print("  读法:全量微调要更新 %s 个参数,LoRA 只更新 %s 个。"
          % (fmt(total_full), fmt(total_side)))
    print("  优化器状态(AdamW 每个可训练参数额外存两份动量)也按这个比例缩小,")
    print("  这才是显存真正降下来的原因 —— 不是模型变小了,是要存的中间量变少了。")


def main():
    ap = argparse.ArgumentParser(description="LoRA 参数量与压缩比计算")
    ap.add_argument("-M", type=int, help="原矩阵行数")
    ap.add_argument("-N", type=int, help="原矩阵列数")
    ap.add_argument("-r", type=int, default=16, help="LoRA 的秩,默认 16")
    ap.add_argument("--model", choices=sorted(MODELS), help="按真实模型结构累加")
    args = ap.parse_args()

    if args.model:
        report_model(args.model, args.r)
        return

    if args.M and args.N:
        report_matrix(args.M, args.N, args.r, "自定义矩阵")
        return

    # 默认算例:教科书里的那一组数
    print("=" * 66)
    print("算例一:M=300000,N=500000,r=16")
    print("=" * 66)
    report_matrix(300000, 500000, 16)

    print()
    print("=" * 66)
    print("算例二:同一个矩阵,r 取不同值时压缩比怎么变")
    print("=" * 66)
    print("  %-6s %-14s %-12s" % ("r", "旁路参数量", "占原矩阵"))
    for r in (1, 2, 4, 8, 16, 32, 64, 128):
        _, _, _, side = lora_params(300000, 500000, r)
        print("  %-6d %-14s %.6f%%" % (r, fmt(side), side / (300000 * 500000) * 100))
    print("  注意:旁路参数量随 r 线性增长,秩翻倍参数就翻倍。")
    print("  r 不是越大越好 —— 秩越高越接近全量微调,省显存的好处也就越少。")

    print()
    print("=" * 66)
    print("算例三:一个 7B 模型挂满旁路之后的真实占比")
    print("=" * 66)
    report_model("qwen7b", 16)


if __name__ == "__main__":
    main()
$ python3 lora_param_calc.py
  r      旁路参数量          占原矩阵
  1      80万            0.000533%
  2      160万           0.001067%
  4      320万           0.002133%
  8      640万           0.004267%
  16     1280万          0.008533%
  32     2560万          0.017067%
  64     5120万          0.034133%
  128    1.024亿         0.068267%
注意:旁路参数量随 r 线性增长,秩翻倍参数就翻倍。$ python3 lora_param_calc.py --model qwen7b -r 16
模型:7B 级别模型(28 层,hidden 3584,中间层 18944)
LoRA 秩 r = 16,lora_target = all(每层 7 个线性层都挂旁路)
每一层的账:
q_proj 3584 × 3584 原 1285万 旁路 11.47万
k_proj 3584 × 512 原 183.5万 旁路 6.554万
v_proj 3584 × 512 原 183.5万 旁路 6.554万
o_proj 3584 × 3584 原 1285万 旁路 11.47万
gate_proj 3584 × 18944 原 6790万 旁路 36.04万
up_proj 3584 × 18944 原 6790万 旁路 36.04万
down_proj 18944 × 3584 原 6790万 旁路 36.04万
单层合计:原 2.33亿 / 旁路 144.2万
全部 28 层:可训练参数 4037万
全模型参数:76.16亿
可训练占比:0.5301%r×(M+N),原矩阵是 M×N,两者的比值随矩阵变小而变大。所以别记「LoRA 永远省到万分之一」,要记公式:占比 =
r×(M+N) / (M×N)。矩阵越大、秩越小,越划算。
3.2 十几行看懂 NF4 在干什么
量化那一套公式,写成代码只有三步:求 absmax、归一化、找最近的分位点。
NF4 = [-1.0000, -0.6962, -0.5251, -0.3949, -0.2844, -0.1848, -0.0911,
        0.0796,  0.1609,  0.2461,  0.3379,  0.4407,  0.5626, 0.7230, 1.0000]

X = [0.32, -1.76, 0.025, -1.22]

absmax = max(abs(x) for x in X)            # 1.76 —— 这就是「量化常数」
normed = [x / absmax for x in X]           # [0.1818, -1.0, 0.0142, -0.6932]

idxs = [min(range(len(NF4)), key=lambda i: abs(v - NF4[i])) for v in normed]
print(idxs)                                 # [8, 0, 7, 1] —— 每个只占 4 bit

back = [NF4[i] * absmax for i in idxs]      # 反量化:查表取回,再乘回常数
print(["%.4f" % v for v in back])           # ['0.2832','-1.7600','0.1401','-1.2253']
注意最后一行的第三个数:原值 0.025,反量化回来变成 0.1401。这就是量化误差,它不是 bug,是这笔交易的价码。
完整版脚本还演示了分块量化与双重量化,并把存储账按位算清楚:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""nf4_quantize_demo.py —— 把 4-bit NormalFloat 量化算一遍给自己看。

演示四件事,全部用标准库,不需要 GPU、不需要 bitsandbytes:
  1. absmax 归一化:把一组权重按最大绝对值缩放到 [-1, 1]
  2. NF4 分位点舍入:按 16 个分位点取最近的那个,存下来的只是 0~15 的索引
  3. 反量化与误差:乘回 absmax,看看和原值差了多少
  4. 分块量化与双重量化:每块一个量化常数,再把这批常数自己量化一次

运行:
    python3 nf4_quantize_demo.py                 # 跑课堂上那个四元素例子 + 分块演示
    python3 nf4_quantize_demo.py --block 64 --n 512
"""

import argparse
import random


# ---------------------------------------------------------------------------
# NF4 的 16 个分位点
# ---------------------------------------------------------------------------
# 神经网络权重近似服从正态分布:0 附近很密,远离 0 很稀。
# 所以不按等距切,而是按正态分布的累计概率密度切成 16 个区域,
# 取每个区域的代表值。结果就是下面这串数 —— 靠近 0 的间隔明显更小。
NF4_LEVELS = [
    -1.0000, -0.6962, -0.5251, -0.3949, -0.2844, -0.1848, -0.0911,
    0.0796, 0.1609, 0.2461, 0.3379, 0.4407, 0.5626, 0.7230, 1.0000,
]


def nearest_level(x, levels=NF4_LEVELS):
    """返回 (最近分位点的索引, 该分位点的值)。

    真实实现用查表或二分,这里直接线性找,胜在看得清楚在干什么。
    """
    best_i, best_v, best_d = 0, levels[0], abs(x - levels[0])
    for i, v in enumerate(levels):
        d = abs(x - v)
        if d < best_d:
            best_i, best_v, best_d = i, v, d
    return best_i, best_v


# ---------------------------------------------------------------------------
# 单块量化:absmax 归一化 → 分位点舍入 → 反量化
# ---------------------------------------------------------------------------
def quantize_block(xs):
    """把一个块量化成 (索引列表, 量化常数)。

    量化常数就是这一块的 absmax。它必须原样存下来,否则反量化时无从还原尺度——
    而这些常数本身也占空间,正是双重量化要处理的对象。
    """
    absmax = max(abs(x) for x in xs) or 1.0
    normed = [x / absmax for x in xs]
    idxs = [nearest_level(v)[0] for v in normed]
    return idxs, absmax


def dequantize_block(idxs, absmax, levels=NF4_LEVELS):
    """索引查表取回分位点,再乘回量化常数。"""
    return [levels[i] * absmax for i in idxs]


# ---------------------------------------------------------------------------
# 演示一:课堂上那个四元素例子
# ---------------------------------------------------------------------------
def demo_four():
    xs = [0.32, -1.76, 0.025, -1.22]
    print("=" * 68)
    print("演示一:四个数走完整个 NF4 流程")
    print("=" * 68)
    print("  原始输入 X = %s" % xs)

    absmax = max(abs(x) for x in xs)
    print("\n  第 1 步 求 absmax(X) = %.4g" % absmax)

    normed = [x / absmax for x in xs]
    print("  第 2 步 归一化 X / absmax(X):")
    print("         %s" % ["%.4f" % v for v in normed])
    print("         归一化之后所有值都落进 [-1, 1],才能和分位点比")

    print("\n  第 3 步 按 NF4 的 16 个分位点舍入:")
    print("    %-10s %-10s %-8s %-10s" % ("归一化值", "最近分位点", "索引", "存几位"))
    idxs = []
    for v in normed:
        i, lv = nearest_level(v)
        idxs.append(i)
        print("    %-10.4f %-10.4f %-8d %-10s" % (v, lv, i, "4 bit"))
    print("    实际存下来的只有索引:%s —— 每个 4 bit,一共 %d bit"
          % (idxs, 4 * len(idxs)))
    print("    外加一个量化常数 absmax = %.4g(这个是 FP32 或 FP16,不是 4 bit)" % absmax)

    back = dequantize_block(idxs, absmax)
    print("\n  第 4 步 反量化并看误差:")
    print("    %-10s %-12s %-12s %-10s" % ("原值", "反量化值", "绝对误差", "相对误差"))
    for o, b in zip(xs, back):
        err = abs(o - b)
        rel = err / abs(o) if o else 0.0
        print("    %-10.4f %-12.4f %-12.4f %.2f%%" % (o, b, err, rel * 100))

    print("\n  读法:绝对值大的数误差小,接近 0 的数相对误差反而大 ——")
    print("  因为分位点虽然在 0 附近更密,但归一化之后小数被压得更靠近 0。")
    print("  这就是量化的本质交易:拿精度换显存和速度。")


# ---------------------------------------------------------------------------
# 演示二:分块量化 + 双重量化
# ---------------------------------------------------------------------------
def demo_blocks(n, block, seed=7):
    print()
    print("=" * 68)
    print("演示二:分块量化与双重量化(%d 个权重,块大小 %d)" % (n, block))
    print("=" * 68)

    rnd = random.Random(seed)
    # 用正态分布造一批权重 —— NF4 的整个设计前提就是权重近似正态分布
    weights = [rnd.gauss(0, 0.05) for _ in range(n)]

    blocks = [weights[i:i + block] for i in range(0, len(weights), block)]
    all_idx, consts = [], []
    for blk in blocks:
        idxs, absmax = quantize_block(blk)
        all_idx.extend(idxs)
        consts.append(absmax)

    # 还原并统计误差
    recovered = []
    for blk_idx, c in zip(
            [all_idx[i:i + block] for i in range(0, len(all_idx), block)], consts):
        recovered.extend(dequantize_block(blk_idx, c))

    errs = [abs(a - b) for a, b in zip(weights, recovered)]
    mean_abs = sum(abs(w) for w in weights) / len(weights)
    print("  块数:%d,每块一个量化常数" % len(blocks))
    print("  平均绝对误差:%.6f(权重平均绝对值 %.6f,相对 %.2f%%)"
          % (sum(errs) / len(errs), mean_abs, sum(errs) / len(errs) / mean_abs * 100))
    print("  最大绝对误差:%.6f" % max(errs))

    # ---- 存储账:这才是量化的目的 ----
    print("\n  存储账(按位算):")
    fp16_bits = n * 16
    nf4_bits = n * 4
    const_bits_fp32 = len(consts) * 32
    print("    原始 FP16 权重            :%8d bit" % fp16_bits)
    print("    NF4 索引                  :%8d bit" % nf4_bits)
    print("    量化常数(FP32,每块一个):%8d bit" % const_bits_fp32)
    print("    NF4 合计                  :%8d bit  压缩到 %.1f%%"
          % (nf4_bits + const_bits_fp32,
             (nf4_bits + const_bits_fp32) / fp16_bits * 100))

    # ---- 双重量化:把这批常数自己再量化一次 ----
    print("\n  双重量化:把上面那批量化常数当成一组新数据,再量化一次")
    d_idxs, d_absmax = quantize_block(consts)
    d_back = dequantize_block(d_idxs, d_absmax)
    d_err = sum(abs(a - b) for a, b in zip(consts, d_back)) / len(consts)
    const_bits_after = len(consts) * 4 + 32     # 索引 4 bit 一个,外加一个总常数
    print("    常数个数:%d" % len(consts))
    print("    量化前占用:%d bit(FP32)" % const_bits_fp32)
    print("    量化后占用:%d bit(4 bit 索引 + 一个 FP32 总常数)" % const_bits_after)
    print("    常数本身的平均误差:%.6f" % d_err)
    print("    NF4 + 双重量化合计:%d bit  压缩到 %.1f%%"
          % (nf4_bits + const_bits_after,
             (nf4_bits + const_bits_after) / fp16_bits * 100))
    print("\n  读法:第二次量化只作用在第一次产生的量化常数上,权重本身不再动。")
    print("  块越小,常数越多,这一步省下来的就越可观。")


def main():
    ap = argparse.ArgumentParser(description="NF4 量化演示")
    ap.add_argument("--n", type=int, default=256, help="演示二里权重个数")
    ap.add_argument("--block", type=int, default=64, help="分块大小")
    args = ap.parse_args()

    print("NF4 的 16 个分位点:")
    print("  %s" % NF4_LEVELS)
    gaps = [round(NF4_LEVELS[i + 1] - NF4_LEVELS[i], 4) for i in range(len(NF4_LEVELS) - 1)]
    print("  相邻间隔:%s" % gaps)
    print("  可以看到靠近 0 的地方间隔更小 —— 权重密集的区域分得更细。")
    print()

    demo_four()
    demo_blocks(args.n, args.block)


if __name__ == "__main__":
    main()
$ python3 nf4_quantize_demo.py
  第 4 步 反量化并看误差:
    原值         反量化值         绝对误差         相对误差
    0.3200     0.2832       0.0368       11.51%
    -1.7600    -1.7600      0.0000       0.00%
    0.0250     0.1401       0.1151       460.38%
    -1.2200    -1.2253      0.0053       0.44%

演示二:分块量化与双重量化(256 个权重,块大小 64)
  块数:4,每块一个量化常数
  平均绝对误差:0.004002(权重平均绝对值 0.040708,相对 9.83%)

  存储账(按位算):
    原始 FP16 权重            :    4096 bit
    NF4 索引                  :    1024 bit
    量化常数(FP32,每块一个):     128 bit
    NF4 合计                  :    1152 bit  压缩到 28.1%

  双重量化:把上面那批量化常数当成一组新数据,再量化一次
    量化前占用:128 bit(FP32)
    量化后占用:48 bit(4 bit 索引 + 一个 FP32 总常数)
NF4 + 双重量化合计:1072 bit 压缩到 26.2%| 输出里该注意的 | 说明 |
|---|---|
| 绝对值最大的那个数误差为 0 | 因为它就是 absmax,归一化后正好是 -1.0,而 -1.0 恰好是一个分位点。每块里至少有一个数是精确的 |
| 接近 0 的数相对误差最大 | 分位点在 0 附近虽然更密,但归一化之后小数被压得更靠近 0,仍然落不进合适的档位 |
| 压缩到 28.1% 而不是 25% | 4 bit / 16 bit 理论上是 25%,多出来的 3.1% 正是量化常数占的。块越小常数越多,这部分越显眼 |
| 双重量化把它压到 26.2% | 只动常数、不动权重,就把开销从 128 bit 压到 48 bit。这就是第二次量化的全部意义 |
nf4_quantize_demo.py 用线性查找找最近分位点,真实实现走查表或二分;块大小、常数精度也和 bitsandbytes 的实际参数不完全一致。它的作用是让你看清每一步在算什么,不要拿它去量化真实权重。真正干活的是配置里那行 quantization_method: bitsandbytes。
04完整案例:三份工艺卡逐段讲
LLaMA-Factory 环境、全量 / LoRA / QLoRA 三份配置的每一段、显存实测、学习率量级与权重合并
4.1 训练工具:LLaMA-Factory
LLaMA-Factory 是一个简单易用且高效的大模型训练框架,支持上百种大模型的训练。它把「改代码」变成了「改一份 yaml」,这也是本节能逐段讲配置的前提。
| 特性 | 覆盖范围 |
|---|---|
| 模型种类 | LLaMA、LLaVA、Mistral、Mixtral-MoE、Qwen、Yi、Gemma、Baichuan、ChatGLM、Phi 等 |
| 训练算法 | (增量)预训练、(多模态)指令监督微调、奖励模型训练、PPO、DPO、KTO、ORPO 等 |
| 运算精度 | 16 比特全参数微调、冻结微调、LoRA 微调,以及基于 AQLM/AWQ/GPTQ/LLM.int8/HQQ/EETQ 的 2/3/4/5/6/8 比特 QLoRA 微调 |
| 优化算法 | GaLore、BAdam、DoRA、LongLoRA、LLaMA Pro、Mixture-of-Depths、LoRA+、LoftQ、PiSSA |
| 加速算子 | FlashAttention-2、Unsloth |
| 推理引擎 | Transformers、vLLM |
| 实验面板 | LlamaBoard、TensorBoard、Wandb、MLflow 等 |
git clone --depth 1 https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory
pip install -e ".[torch,metrics]" -i https://mirrors.aliyun.com/pypi/simple/

# 验证安装:出现版本横幅即为成功
llamafactory-cli versionllamafactory-cli train xxx.yaml)适合固化流程、便于版本管理、能进 CI,本节全程用它。Web 界面(llamafactory-cli webui,默认 http://localhost:7860)适合第一次摸索参数,界面上每个选项对应的就是 yaml 里的一行。先用界面找手感,定型之后落成 yaml,是最省事的路径。
4.2 全量微调配置
先看最重的一份。它是基准线——后面两份都是在它的基础上做减法。
### 全量微调:所有参数都参与更新,显存占用最高
### 启动:FORCE_TORCHRUN=1 llamafactory-cli train qwen2-7b-full-sft.yaml

### model
# 基座模型的本地路径或在线模型 ID
model_name_or_path: TODO/换成你的基座模型路径
# 加载含自定义代码的模型时必须开启
trust_remote_code: true

### method
# 训练阶段:有监督微调
stage: sft
do_train: true
# 全参数微调
finetuning_type: full
# 全量微调几乎必须搭 DeepSpeed,否则单卡装不下优化器状态
deepspeed: TODO/换成 ds_config_zero3.json 的路径

### dataset
# 必须与 data/dataset_info.json 里登记的键名一致
dataset: TODO_你的数据集名
# 对话模板要与基座匹配,Qwen 系列填 qwen
template: qwen
# 输入序列最大 token 数,超出部分被截断
cutoff_len: 1024
# 数据集改动后置 true,强制重新预处理
overwrite_cache: true
# 预处理并行进程数,建议取 CPU 核心数的 50%~70%
preprocessing_num_workers: 16

### output
output_dir: saves/qwen2-7b/full/sft
logging_steps: 10
save_steps: 100
plot_loss: true
overwrite_output_dir: true

### train
# 每卡批次大小;实际总批次 = 此值 × gradient_accumulation_steps × 卡数
per_device_train_batch_size: 1
# 梯度累积步数,用来在小显存下模拟大批次
gradient_accumulation_steps: 16
# 全量微调动的是原始权重,学习率必须比 LoRA 小一个量级
learning_rate: 1.0e-5
num_train_epochs: 1.0
# 余弦退火
lr_scheduler_type: cosine
# 前 10% 的 step 用于线性预热,防止参数剧烈震荡
warmup_ratio: 0.1
# BF16 混合精度,需要 Ampere 架构以上的卡
bf16: true
# 分布式超时时间,单位毫秒
ddp_timeout: 180000000

### eval
# 从训练集里划 10% 做验证;它不是验收用的评测集
val_size: 0.1
per_device_eval_batch_size: 1
eval_strategy: steps
eval_steps: 500
| 段落 | 关键行 | 含义与注意 |
|---|---|---|
| model | model_name_or_path | 基座模型的本地路径或在线 ID。trust_remote_code: true 是加载含自定义代码的模型(Qwen、ChatGLM 等)的前提 |
| method | finetuning_type: full | 全参数微调。可选值 full / freeze / lora |
| method | deepspeed | 指向 DeepSpeed 配置文件。全量微调几乎必须配它,否则单卡装不下优化器状态 |
| dataset | dataset | 必须与 data/dataset_info.json 里登记的键名一致 |
| dataset | template: qwen | 对话模板要与基座架构匹配。填错不报错,但对话格式全乱 |
| dataset | cutoff_len: 1024 | 输入序列最大 token 数,超出部分被截断——这就是数据侧要做长度过滤的原因 |
| dataset | preprocessing_num_workers: 16 | 预处理并行进程数,建议设为 CPU 核心数的 50%~70% |
| train | per_device_train_batch_size: 1gradient_accumulation_steps: 16 | 这两行要合起来读:实际总 batch = 1 × 16 × 卡数。显存装不下大 batch 时,用梯度累积模拟大 batch——累积 16 步再更新一次参数,等效批次 16,显存却只按 1 算 |
| train | learning_rate: 1.0e-5 | 全量微调的典型值。它在动原始权重,学习率必须小;见 4.6 的量级表 |
| train | lr_scheduler_type: cosine | 余弦退火:学习率沿余弦曲线从峰值平滑降到接近 0,收尾阶段自动变细致 |
| train | warmup_ratio: 0.1 | 前 10% 的 step 用于线性预热。刚开始就用峰值学习率会让参数剧烈震荡,预热是防震的 |
| train | bf16: true | BF16 混合精度,需要 Ampere 架构以上的卡。为什么不用 FP16,见 2.8 |
| eval | val_size: 0.1 | 从训练集划 10% 做验证。它不是验收用的评测集,训练中每轮都会看到它 |
FORCE_TORCHRUN=1 llamafactory-cli train qwen2-7b-full-sft.yamlFORCE_TORCHRUN=1 的作用是强制用 PyTorch 的 torchrun 来启动分布式训练,适用于多 GPU 环境,或者自动检测失败、需要显式控制分布式初始化的时候。
配套的 DeepSpeed 配置
两份都给了:ZeRO-2 适合大多数场景,ZeRO-3 用在单卡实在装不下的时候。
{
    "fp16": {
        "enabled": "auto",
        "loss_scale": 0,
        "loss_scale_window": 1000,
        "initial_scale_power": 16,
        "hysteresis": 2,
        "min_loss_scale": 1
    },
    "bf16": {
        "enabled": "auto"
    },
    "optimizer": {
        "type": "AdamW",
        "params": {
            "lr": "auto",
            "betas": "auto",
            "eps": "auto",
            "weight_decay": "auto"
        }
    },
    "scheduler": {
        "type": "WarmupLR",
        "params": {
            "warmup_min_lr": "auto",
            "warmup_max_lr": "auto",
            "warmup_num_steps": "auto"
        }
    },
    "zero_optimization": {
        "stage": 2,
        "offload_optimizer": {
            "device": "none",
            "pin_memory": true
        },
        "allgather_partitions": true,
        "allgather_bucket_size": 2e8,
        "overlap_comm": true,
        "reduce_scatter": true,
        "reduce_bucket_size": 2e8,
        "contiguous_gradients": true
    },
    "gradient_accumulation_steps": "auto",
    "gradient_clipping": "auto",
    "steps_per_print": 100,
    "train_batch_size": "auto",
    "train_micro_batch_size_per_gpu": "auto",
    "wall_clock_breakdown": false
}
{
    "fp16": {
        "enabled": "auto",
        "loss_scale": 0,
        "loss_scale_window": 1000,
        "initial_scale_power": 16,
        "hysteresis": 2,
        "min_loss_scale": 1
    },
    "bf16": {
        "enabled": "auto"
    },
    "optimizer": {
        "type": "AdamW",
        "params": {
            "lr": "auto",
            "betas": "auto",
            "eps": "auto",
            "weight_decay": "auto"
        }
    },
    "scheduler": {
        "type": "WarmupLR",
        "params": {
            "warmup_min_lr": "auto",
            "warmup_max_lr": "auto",
            "warmup_num_steps": "auto"
        }
    },
    "zero_optimization": {
        "stage": 3,
        "offload_optimizer": {
            "device": "none",
            "pin_memory": true
        },
        "offload_param": {
            "device": "none",
            "pin_memory": true
        },
        "overlap_comm": true,
        "contiguous_gradients": true,
        "sub_group_size": 1e9,
        "reduce_bucket_size": "auto",
        "stage3_prefetch_bucket_size": "auto",
        "stage3_param_persistence_threshold": "auto",
        "stage3_max_live_parameters": 1e9,
        "stage3_max_reuse_distance": 1e9,
        "stage3_gather_16bit_weights_on_model_save": true
    },
    "gradient_accumulation_steps": "auto",
    "gradient_clipping": "auto",
    "steps_per_print": 100,
    "train_batch_size": "auto",
    "train_micro_batch_size_per_gpu": "auto",
    "wall_clock_breakdown": false
}
| 配置项 | 值 | 说明 |
|---|---|---|
"auto" 这一串 | train_batch_size、gradient_accumulation_steps、gradient_clipping、lr 等 | 写 auto 表示由 LLaMA-Factory 从 yaml 里推导后填进来。所以这些值要在 yaml 改,不要在 json 里写死——两边写死且不一致时会直接报冲突 |
zero_optimization.stage | 2 或 3 | 对应 2.7 讲的分片等级 |
offload_optimizer.device | "none" | 默认不下沉。显存实在不够时改成 "cpu",会明显变慢 |
offload_param.device | "none"(仅 ZeRO-3 有) | 把模型参数也下沉到 CPU,这是最后的手段 |
pin_memory: true | — | 使用锁页内存加速 CPU 与 GPU 之间的传输 |
fp16 那一整段 | loss_scale 等 | FP16 的 loss scaling 配置。用 BF16 时这段不生效,但留着无害——enabled: "auto" 会自己判断 |
stage3_gather_16bit_weights_on_model_save | true | ZeRO-3 下参数是分片的,保存时要先聚合成完整的 16 位权重。不开这个,存出来的 checkpoint 没法直接用 |
4.3 LoRA 配置
和全量那份比,method 段换了,train 段的学习率变了,其余几乎照抄。
### LoRA 微调:冻结主干,只训练低秩旁路
### 启动:llamafactory-cli train qwen2-7b-lora-sft.yaml

### model
model_name_or_path: TODO/换成你的基座模型路径
trust_remote_code: true

### method
stage: sft
do_train: true
# 低秩适配
finetuning_type: lora
# 给哪些线性层挂旁路;all 表示所有线性层
lora_target: all
# 秩 r,决定旁路能学到的信息丰富程度,同时线性决定可训练参数量
lora_rank: 16
# 缩放系数,控制旁路输出的权重;常取与 rank 相等
lora_alpha: 16
# 旁路层的 dropout,正则化手段,防止模型过度依赖旁路
lora_dropout: 0.05

### dataset
dataset: TODO_你的数据集名
template: qwen
cutoff_len: 1024
overwrite_cache: true
preprocessing_num_workers: 16

### output
output_dir: saves/qwen2-7b/lora/sft
logging_steps: 100
save_steps: 100
plot_loss: true
overwrite_output_dir: true

### train
per_device_train_batch_size: 1
gradient_accumulation_steps: 16
# 旁路是随机初始化的新模块,学习率比全量微调大一个量级
learning_rate: 1.0e-4
num_train_epochs: 1.0
lr_scheduler_type: cosine
warmup_ratio: 0.1
bf16: true
ddp_timeout: 180000000

### eval
val_size: 0.1
per_device_eval_batch_size: 1
eval_strategy: steps
eval_steps: 500
| 新增 / 变化的行 | 值 | 含义 |
|---|---|---|
finetuning_type | lora | 从 full 换过来 |
lora_target | all | 给所有线性层挂旁路。也可以只写某几个模块名,挂得越少越省,但效果也越弱 |
lora_rank | 16 | 秩 r,决定学到信息的丰富程度,同时线性决定可训练参数量 |
lora_alpha | 16 | 缩放系数,决定旁路的重要程度。常取与 rank 相等 |
lora_dropout | 0.05 | 随机丢弃旁路层权重的概率,是一种正则化手段,防止模型过度依赖旁路 |
learning_rate | 1.0e-4 | 比全量微调大一个量级。典型范围 1e-4 ~ 5e-4 |
没有 deepspeed 行 | — | LoRA 单卡通常就能跑,不强制配 DeepSpeed |
1e-5 这种量级慢慢挪。LoRA 训的是刚刚随机初始化出来的新模块,它从零开始学,用
1e-5 会慢到几乎不动。一句话:改老东西要轻,学新东西要快。
llamafactory-cli train qwen2-7b-lora-sft.yaml4.4 QLoRA 配置
和 LoRA 那份比,只多了两行。
### QLoRA 微调:把基座量化成 4-bit 之后再挂低秩旁路,显存最省
### 启动:llamafactory-cli train qwen2-7b-qlora-sft.yaml

### model
model_name_or_path: TODO/换成你的基座模型路径
trust_remote_code: true

### method
stage: sft
do_train: true
# 注意这里依然是 lora —— QLoRA 不是另一种微调类型,
# 它是「LoRA + 基座 4-bit 量化」,靠下面两行量化参数区分
finetuning_type: lora
lora_target: all
# 量化位数:4-bit
quantization_bit: 4
# 量化实现库;可选 bitsandbytes(4/8)、hqq(2/3/4/5/6/8)、eetq(8)
quantization_method: bitsandbytes
lora_rank: 16
lora_alpha: 16
lora_dropout: 0.05

### dataset
dataset: TODO_你的数据集名
template: qwen
cutoff_len: 1024
overwrite_cache: true
preprocessing_num_workers: 16

### output
output_dir: saves/qwen2-7b/qlora/sft
logging_steps: 100
save_steps: 100
plot_loss: true
overwrite_output_dir: true

### train
per_device_train_batch_size: 1
gradient_accumulation_steps: 16
learning_rate: 1.0e-4
num_train_epochs: 1.0
lr_scheduler_type: cosine
warmup_ratio: 0.1
# 基座存成 4-bit,但计算时反量化成 bf16 —— 精度靠这一行保住
bf16: true
ddp_timeout: 180000000

### eval
val_size: 0.1
per_device_eval_batch_size: 1
eval_strategy: steps
eval_steps: 500
| 多出来的行 | 值 | 含义 |
|---|---|---|
quantization_bit | 4 | 把基座量化成 4-bit。注意量化的是冻结的主干,旁路仍是高精度 |
quantization_method | bitsandbytes | 量化实现库。可选 bitsandbytes(4/8 位)、hqq(2/3/4/5/6/8 位)、eetq(8 位) |
finetuning_type | 仍然是 lora | 再说一次:没有叫 qlora 的选项 |
bf16: true | — | 这一行在 QLoRA 里格外重要:基座以 4-bit 存放,计算时反量化成 bf16。精度就靠它兜住 |
llamafactory-cli train qwen2-7b-qlora-sft.yaml4.5 三种方式的显存实测
使用上述训练配置,各个方法实测的显存占用如下:
| 训练方式 | 显存占用 | 相对全量 | 省在哪 |
|---|---|---|---|
| 全量参数训练 | 42.18GB | 100% | 基准线。模型权重 + 梯度 + 优化器状态全都是满的 |
| LoRA 训练 | 20.17GB | 约 48% | 主干冻结 → 不存主干的梯度和优化器状态。主干权重本身照样占着 |
| QLoRA 训练 | 10.97GB | 约 26% | 在 LoRA 基础上把主干权重也压成 4-bit,最后这块大头也削下去了 |
cutoff_len、换一个 per_device_train_batch_size、开不开梯度检查点,数字都会变。这三个数该记的是比例关系和省在哪一层,不是绝对值。
4.6 学习率量级怎么选
学习率是最影响整体效果的一个参数。按量级记,比背具体数字有用:
| 量级 | 典型用途 | 说明 |
|---|---|---|
0.1 | 一般只用于探索 | 没人会真的用它来训练,只是用来快速看看 loss 曲线的形状 |
0.01 | 从头训练的标准模型初始学习率 | 指的是从随机初始化开始训练的场景,不是微调 |
0.001 | 已经快接近优化目标时做细致调整 | 介于从头训练和微调之间 |
0.0001 | 模型接近收敛时做微调 | 就是 1e-4,LoRA / QLoRA 用的就是这一档 |
0.00005 | 预训练阶段的最后微调 | 即 5e-5,比 1e-4 更保守 |
全量微调用的 1e-5 比这张表的最后一档还要小一半——因为它直接改原始权重,是所有场景里最需要轻手轻脚的那一种。
0.01 的学习率训了 10 轮,为什么效果不好?」——两处都错了。学习率错了两个量级:0.01 是从头训练的档位,拿来微调会直接把预训练学到的东西冲垮。轮数也过多:数据集只有 1500 条却训 10 轮,模型会把这 1500 条背下来,典型过拟合。数据太小时正确的做法是减少轮数 + 做数据增强,而不是反复刷同一批数据。
4.7 训练完之后:合并权重
如果采用 LoRA 或者 QLoRA 进行训练,脚本只保存对应的 LoRA 权重,需要合并权重才能进行推理。全量参数训练无需执行此步骤。
llamafactory-cli export qwen2-7b-merge-lora.yaml| 参数 | 说明 |
|---|---|
model_name_or_path | 预训练模型的名称或路径 |
adapter_name_or_path | 训练出来的适配器路径,要与微调时的 output_dir 对应 |
template | 模型模板。合并 Qwen2 模型权重,务必设为 qwen |
finetuning_type | 无论 LoRA 还是 QLoRA 训练,合并时均为 lora |
export_dir | 导出路径 |
export_size | 最大导出模型文件大小(分片用) |
export_device | 导出设备 |
export_legacy_format | 是否使用旧格式导出 |
quantization_bit。原因回到铁律:合并是把 A·B 加回到原始的 W 上,这一步需要高精度的 W。在 4-bit 的主干上做加法,等于把量化误差永久焊进权重里。用车间的说法:把夹具的形状永久刻回机床之前,得先把机床恢复到全精度的原始状态——拿着压缩过的图纸直接刻,刻出来的就是失真的。
05骨架模板:拿去改就能用
四份工艺卡 + 两份车间配置,把 TODO 换成你的路径就能开训
5.1 六份文件各管什么
| 文件 | 什么时候用 | 改哪里 |
|---|---|---|
qwen2-7b-lora-sft.yaml | 默认从这份开始。绝大多数业务微调 | 两处 TODO:基座路径、数据集名 |
qwen2-7b-qlora-sft.yaml | 单卡显存紧张(12GB 级别) | 同上。多的两行 quantization_* 不用动 |
qwen2-7b-full-sft.yaml | 显存充足、要极致效果、不怕遗忘 | 三处 TODO:基座路径、DeepSpeed 配置路径、数据集名 |
qwen2-7b-merge-lora.yaml | LoRA / QLoRA 训完之后 | 两处 TODO:基座路径、适配器路径 |
ds_config_zero2.json | 全量微调的默认搭档 | 通常一行都不用改 |
ds_config_zero3.json | ZeRO-2 仍然装不下时 | 实在不够就把 offload_*.device 改成 "cpu" |
5.2 合并权重的模板
训练产出的只是那一小包旁路权重,要拿去推理、量化或部署,先把它加回主干导出成一个完整模型。
### 合并低秩旁路权重:把训练出来的适配器加回主干,导出成一个完整模型
### 启动:llamafactory-cli export qwen2-7b-merge-lora.yaml
### 注意:合并时不要使用量化模型,也不要带 quantization_bit

### model
# 原始的、未量化的基座模型
model_name_or_path: TODO/换成你的基座模型路径
# 训练产出的适配器目录,要与微调配置里的 output_dir 对应
adapter_name_or_path: TODO/换成你的适配器输出路径
# Qwen2 系列一律填 qwen
template: qwen
# 无论当初是 LoRA 还是 QLoRA 训的,这里都填 lora
finetuning_type: lora

### export
# 合并后完整模型的导出目录
export_dir: models/qwen2-7b-sft-lora-merged
# 单个权重文件的最大体积,单位 GB,超出则自动分片
export_size: 2
# 导出时用哪个设备做合并计算
export_device: cpu
# 是否使用旧版权重格式
export_legacy_format: false
data/dataset_info.json · ② 复制 qwen2-7b-lora-sft.yaml,把两处 TODO 换成真实路径与数据集名 · ③ 先用几百条样本、1 轮试跑,确认能跑完不报错 · ④ 换回完整数据正式训练,盯 logging_steps 打出来的 loss 和 eval_steps 的验证结果 · ⑤ 用 qwen2-7b-merge-lora.yaml 合并权重导出。
template 填错、路径拼错、显存装不下。跳过这一步直接开整轮训练,同样的错误要等几小时才会浮出来——而 ddp_timeout: 180000000 差不多是 50 小时,它不会替你早点失败。
5.3 三份训练配置的差异速查
三份 yaml 有八成内容是一样的,真正的差别只有下面这几行。改配置时对着这张表看,比逐行读三遍快:
| 配置行 | 全量 | LoRA | QLoRA |
|---|---|---|---|
finetuning_type | full | lora | lora |
deepspeed | 需要 | 不需要 | 不需要 |
lora_target | — | all | all |
lora_rank / lora_alpha | — | 16 / 16 | 16 / 16 |
lora_dropout | — | 0.05 | 0.05 |
quantization_bit | — | — | 4 |
quantization_method | — | — | bitsandbytes |
learning_rate | 1.0e-5 | 1.0e-4 | 1.0e-4 |
output_dir | .../full/sft | .../lora/sft | .../qlora/sft |
logging_steps | 10 | 100 | 100 |
| 启动命令 | FORCE_TORCHRUN=1 开头 | 直接 llamafactory-cli train | 直接 llamafactory-cli train |
| 训完要不要合并 | 不用 | 要 | 要 |
output_dir 一定要分开写
三份配置的输出目录各不相同,这不是凑数——overwrite_output_dir: true 会直接覆盖已有目录。三份 yaml 共用一个 output_dir 时,后跑的那次会把前一次的 checkpoint 整个抹掉,而且不会问你。
06易错点汇总
按「概念 / LoRA / 量化 / DeepSpeed / 配置 / 合并」六类归并,多数错误不会报错,只会悄悄变差
⚠️ 一、概念层面
- 以为 QLoRA 是「在 4-bit 上做矩阵乘法」。 量化改的只是存放方式。计算时必须反量化回高精度(配置里那行
bf16: true就是干这个的)。存和算是两件事。 - 去配置里找
finetuning_type: qlora。 没有这个选项。QLoRA = LoRA + 基座 4-bit 量化,finetuning_type写的还是lora,靠quantization_bit: 4区分。 - 以为 LoRA 之所以省显存是因为「模型变小了」。 基座该占多少还占多少。省的是梯度和优化器状态——AdamW 为每个可训练参数额外存两份动量,可训练参数少了几个数量级,这部分就跟着塌下去了。
- 显存明明够却上 QLoRA。 白白背上量化误差和反量化的计算开销。显存够就用 LoRA,这是默认答案。
- 把灾难性遗忘理解成「有点退步」。 它是某些能力整块塌掉:抽取变强了,但可能连正常对话都不会了。样本越少、训得越久,塌得越厉害。
⚠️ 二、LoRA 原理与参数
- 把 A 和 B 都初始化为 0。 两边梯度互相为零,梯度恒为 0,参数永远停在原地——训练日志上 loss 一动不动,很多人会以为是学习率太小。
- 把 A 和 B 都做高斯初始化。 此时
A·B ≠ 0,训练第 0 步的模型就已经不是原模型了,旁路在往原输出上叠随机噪声。正确做法是 A 高斯、B 全零。 - 以为
lora_rank越大越好。 旁路参数量是r×(M+N),r 翻倍参数就翻倍。秩越高越接近全量微调,省显存的好处也就越少。 - 把「省到万分之一」当成 LoRA 的固定属性。 那是 300000×500000 这种超大矩阵的数。真实 7B 模型挂满旁路后可训练参数约占 0.53%,因为实际矩阵小得多。要记公式
r×(M+N)/(M×N),不是记结论。 - 只在最后一层挂旁路。 实际做法是每个 transformer 层都添加低秩旁路,配置里
lora_target: all。挂得越少越省,但效果也越弱。
⚠️ 三、量化
- 用均匀分布的线性量化去量化权重。 神经网络权重近似正态分布,0 附近很密、远离 0 很稀。均匀切分会在几乎没有数据的两端浪费大量档位,而在最密集的 0 附近分辨率不够。NF4 按累计概率密度切 16 格,就是为了修这个。
- 省掉 absmax 归一化。 NF4 的分位点全部落在 [-1, 1],不先归一化就无法比较。而且归一化产生的那个 absmax 就是量化常数,必须原样存下来,否则反量化时无从还原尺度。
- 忘了量化常数本身也占空间。 理论压缩比是 4/16 = 25%,实测算出来是 28.1%,多出来的 3.1% 正是常数。块越小常数越多,这部分越显眼——这也正是双重量化存在的理由。
- 以为双重量化是「把权重量化两次」。 第二次量化只作用在第一次产生的量化常数上,权重本身一个字节都不再动。
- 把分页优化当成「显存可以随便超配」。 它治的是偶发峰值,不是让你长期超配。每一步都在换进换出时 PCIe 会成为瓶颈,训练慢得不像话——能跑完,但不报错。训练巨慢又查不出原因时,先看是不是一直在分页。
- 把分页优化和 ZeRO-Offload 混为一谈。 前者是 QLoRA 侧、靠统一内存自动换出;后者是 DeepSpeed 配置项、由你主动指定哪些状态常驻 CPU。触发方式和配置位置都不同。
⚠️ 四、DeepSpeed 与并行
- 以为朴素流水线并行天然高效。 恰恰相反:一个 GPU 在算时其他全闲着,四卡利用率最高只有四分之一。GPipe 用
chunks把 mini-batch 切成 micro-batch,让流水线填满,四卡才真的同时工作。 - 无脑上 ZeRO-3。 切得越多越省显存,卡之间的通信也越频繁。ZeRO-2 能装下就别上 3,否则换来的是通信瓶颈。
- 记混三个等级切的是什么。 ZeRO-1 切优化器状态;ZeRO-2 再切梯度;ZeRO-3 再切模型参数。顺序是固定的,后一级包含前一级。
- 在 json 里把
"auto"改成具体数字。train_batch_size、gradient_accumulation_steps、lr这些写auto是让 LLaMA-Factory 从 yaml 推导后填进来。两边都写死且不一致,会直接报冲突。要改就改 yaml。 - ZeRO-3 下没开
stage3_gather_16bit_weights_on_model_save。 参数是分片的,保存时不聚合成完整的 16 位权重,存出来的 checkpoint 没法直接用。 - 随手把
offload_optimizer.device改成"cpu"。 能让显存降下来,但训练会明显变慢。它是最后的手段,不是默认配置。
⚠️ 五、训练配置
- LoRA 用了全量微调的学习率(
1e-5)。 旁路是刚随机初始化的新模块,用1e-5慢到几乎不动。LoRA / QLoRA 用1e-4量级。反过来,全量微调用1e-4会把预训练学到的东西冲垮。 - 小数据集训很多轮。 1500 条训 10 轮,模型会把这批数据背下来,典型过拟合。数据太小时应当减少轮数 + 做数据增强,而不是反复刷同一批。
- 只看
per_device_train_batch_size判断批次大小。 实际总批次 = 它 ×gradient_accumulation_steps× 卡数。两行要合起来读。 template填错。 Qwen 系列一律qwen。填错不报错,但对话格式全乱,训出来的东西没法用。- 三份 yaml 共用一个
output_dir。overwrite_output_dir: true会直接覆盖,后跑的那次把前一次的 checkpoint 整个抹掉,而且不会问你。 - 跳过小样本试跑。 数据集名对不上、路径拼错、显存装不下这类问题,小样本几分钟就能暴露;直接开整轮训练要等几小时。而
ddp_timeout: 180000000约等于 50 小时,它不会替你早点失败。 - 不开
warmup_ratio。 一上来就用峰值学习率,参数会剧烈震荡。预热就是防这个的,建议一直开着。 - 忘了
overwrite_cache: true。 改完数据集却用着旧的预处理缓存,训练用的还是老数据——loss 曲线看着正常,改动完全没生效。
⚠️ 六、合并权重
- 全量微调之后还去执行合并。 不需要。全量训练直接产出完整模型,只有 LoRA / QLoRA 才只保存适配器。
- 用量化模型做合并,或带上
quantization_bit。 合并是把A·B加回原始W,需要高精度的 W。在 4-bit 主干上做加法,等于把量化误差永久焊进权重。 - QLoRA 训的模型,合并时把
finetuning_type写成别的。 无论当初 LoRA 还是 QLoRA,合并时一律填lora。 adapter_name_or_path指错。 它必须与微调时的output_dir对应;指到某个中间 checkpoint 还是最终目录,直接决定你合并的是哪一版权重。- 合并时漏了
template: qwen。 合并 Qwen2 模型权重务必设为qwen,否则导出的模型对话模板不对。
07自测题
点击题目展开答案;这 12 题答得下来,三份 yaml 就能自己改了
使用全参数微调有哪三个缺点?
① 训练成本高:需要更新千亿甚至万亿级别的参数,消耗大量计算资源,而且为了调整海量参数时不跑偏还需要准备相当规模的数据集。② 训练时间长:周期长,跟不上需要快速迭代的业务节奏。③ 灾难性遗忘:要调整和重构预训练模型的所有参数,可能破坏原有的知识表征,新任务表现好但旧任务急剧下降。
LoRA 微调为什么能避免灾难性遗忘?
因为原始矩阵 W 全程冻结,梯度根本不流到它上面,原有知识表征在物理上就不可能被破坏。学到的新东西全部存在旁路 A·B 里。用比喻说:机床本体一颗螺丝都不动,换活儿只换那套快换夹具——夹具摘掉,机床还是原来那台。
LoRA 微调为什么能减小训练参数量?
用矩阵分解:不去真正训练那个和 W 一样大的 ΔW,而是训练两个小矩阵 A(M×r)和 B(r×N),使 A·B ≈ ΔW。只要两个结果足够近似,工程上就可行;r 远小于 M 和 N 时参数量被极大压缩。这个思路和 PCA、潜在语义分析 LSA、推荐系统的协同过滤是同一套。
M=300000、N=500000、r=16 时,参数量从多少变成多少?占比多少?
原矩阵 W 是 300000×500000 = 1500 亿。A 是 300000×16 = 480 万,B 是 16×500000 = 800 万,合计 1280 万,约为总参数量的 0.000085,即不到万分之一。
LoRA 的 A、B 矩阵是怎样初始化的?为什么不能全部初始化为 0?为什么不能全部做高斯初始化?
A 高斯初始化,B 初始化为全 0 矩阵。
都为 0 学不动:B 的梯度正比于 A、A 的梯度正比于 B,两边互相为零,梯度恒为 0,参数永远停在原地。
都高斯则一开始就把原模型搞坏了:此时 A·B ≠ 0,训练第 0 步的模型输出就已经被随机噪声扰动,不再等于原模型。
一高斯一全零同时解决两个问题:B=0 保证起点严格等于原模型,A≠0 保证 B 的梯度不为零、立刻能学。另外,每个 transformer 层都要添加低秩旁路,不是只加最后一层。
lora_rank 是不是越大越好?
不是。旁路参数量是 r×(M+N),r 翻倍参数就翻倍;秩越高越接近全量微调,省显存的好处也就越少。秩的含义是「学到信息的丰富程度」,要按任务复杂度选,不是按「越大越强」选。
为什么真实 7B 模型挂满旁路后可训练参数占比是 0.53%,而不是 0.0085%?
两个数算的不是一回事。0.008533% 是单个 300000×500000 超大矩阵的压缩比;真实模型里最大的矩阵也就 3584×18944。占比公式是 r×(M+N) / (M×N)——M、N 越小,低秩分解的相对收益越小。要记公式,不要记结论。
QLoRA 的三个重点分别是什么?
① 4 位标准浮点数量化(NF4);② 双重量化,第二次量化只作用在第一次量化产生的量化常数上,可以进一步节约显存;③ 分页优化,使用 CPU 内存代替 GPU 显存保存部分状态。
为什么权重量化不用均匀分布的线性量化,而要用 NF4?
因为对于神经网络,一般参数值都符合正态分布——0 附近的参数很多,远离 0 的参数很少,用均匀分布不太合适。NF4 把正态分布按照累计概率密度分为 16 个区域(4-bit 量化后的整数正好 16 个),越靠近 0 越密集,越远离 0 越稀疏,把分辨率放在数据真正密集的地方。
把 X=[0.32, -1.76, 0.025, -1.22] 走一遍 NF4,前两步的结果是什么?
先找 absmax(X) = 1.76,再用 X / absmax(X) 归一化成 [0.1818, -1, 0.0142, -0.6932],然后按 NF4 的 16 个分位点舍入。归一化不能省——分位点都落在 [-1, 1] 区间,不缩放就没法比。而这个 absmax 就是量化常数,必须原样存下来,否则反量化时无从还原尺度。
对称量化和非对称量化的区别?为什么权重量化偏爱对称?
对称量化量化后的分布关于零对称,只需要 Scale = |R_max|/Q_max,量化 Q = Round(R/Scale) 再 Clip 到 -127~127(工程上舍弃 -128),反量化 R' = Q×Scale。非对称量化把浮点的最小值 β 和最大值 α 映射到整数范围两端,需要额外的 zero-point 偏移量,能充分利用整个整数范围。
矩阵乘法展开时,对称只有 1 项(s_x·s_w·(X_q@W_q)),非对称有 4 项。而神经网络权重本来就大致以 0 为中心对称,用非对称多背一个 zero-point、多算三项,收益却很小,所以权重量化偏爱对称。
「QLoRA 是在 4-bit 上做矩阵乘法」这句话对吗?
不对。量化改的只是存放方式,不是计算方式。QLoRA 把预训练模型量化为 4 位存放,但训练过程中使用高精度格式(如 bf16)进行反量化再参与计算——配置里那行 bf16: true 就是干这个的。存和算是两件事。
ZeRO-1/2/3 分别分片什么?代价是什么?
ZeRO-1 把优化器状态分片到每个数据并行进程;ZeRO-2 再加上梯度;ZeRO-3 再加上模型参数。后一级包含前一级。代价是切得越多、卡之间通信越频繁,所以 ZeRO-2 能装下就别上 3。另有 ZeRO-Offload:Optimizer Offload 在 Stage2 基础上把梯度和优化器状态下沉到 CPU 内存或硬盘,Param Offload 在 Stage3 基础上把模型参数也下沉。
朴素流水线并行最大的缺陷是什么?GPipe 怎么修的?
缺陷是 GPU 利用率太低:一个 GPU 计算时其他层的 GPU 都闲着,模型分成四组装到四块卡上,利用率最高只有四分之一。GPipe 引入超参数 chunks,把每个 mini-batch 划分成 chunks 个 micro-batch。以 chunks=4 为例:t0 只有 device0 在算第 1 个 micro-batch,t1 时 device1 接着算第 1 个、device0 同时开始算第 2 个(2 台在工作),t2 三台,t3 四台全部工作。反向传播则从 device3 依次到 device0。
为什么三份 yaml 都写 bf16: true 而不是 fp16?
看精度范围:FP16 上限只有 65504,大模型训练中一旦中间值超过就溢出成 inf、loss 变 NaN——这正是 FP16 要配一整套 loss scaling 的原因。BF16 范围是 1.18e-38 ~ 3.39e38,和 FP32 几乎一样,牺牲的是尾数精度而不是动态范围,不用调 loss scaling 就能稳定训练。代价是需要 Ampere 架构以上的 GPU。(TF32 范围 1.18e-19 ~ 3.40e38,显存占用高,用于数学运算加速。)
全量、LoRA、QLoRA 三种方式的实测显存各是多少?三刀分别砍在哪?
全量 42.18GB、LoRA 20.17GB、QLoRA 10.97GB。
第一刀(全量→LoRA)砍的是梯度和优化器状态,因为可训练参数少了几个数量级;第二刀(LoRA→QLoRA)砍的是冻结的主干权重本身,靠 4-bit 存放。两刀砍的不是同一块肉——这也解释了为什么 LoRA 只降到一半左右:主干权重那一大块它动不了。
注意这三个数与训练参数配置息息相关,换 cutoff_len、换 batch 大小数字都会变,该记的是比例关系和省在哪一层。
某人用 1500 条数据集、学习率 0.01、训练 10 轮,效果不好,问题在哪?
两处都错。学习率错了两个量级:0.01 是从头训练的标准初始学习率,拿来微调会把预训练学到的东西冲垮;微调该用 0.0001 量级(全量微调更要小到 1e-5)。轮数也过多:1500 条却训 10 轮,模型会把数据背下来,典型过拟合。数据太小时应当减少轮数 + 做数据增强。
训练启动后很快停止,日志报 torch.OutOfMemoryError: CUDA out of memory,怎么办?
显存不够。按代价从小到大依次试:① 调小 per_device_train_batch_size,用 gradient_accumulation_steps 把等效批次补回来;② 调小 cutoff_len(要同步检查数据侧的长度过滤);③ 换更省的训练方式——全量 42.18GB → LoRA 20.17GB → QLoRA 10.97GB;④ 上 DeepSpeed,ZeRO-2 不够再上 ZeRO-3;⑤ 最后才是把 offload_optimizer.device 改成 "cpu",能跑但会明显变慢。
LoRA 训完之后要做什么?合并时有哪几个坑?
LoRA / QLoRA 只保存适配器权重,必须合并才能推理(全量训练无需此步):llamafactory-cli export qwen2-7b-merge-lora.yaml。坑有三个:① 合并 Qwen2 权重务必把 template 设为 qwen;② 无论 LoRA 还是 QLoRA 训练,合并时 finetuning_type 均为 lora;③ 不要使用量化模型或带 quantization_bit——合并是把 A·B 加回原始 W,需要高精度的 W,在 4-bit 主干上做加法等于把量化误差永久焊进权重。另外 adapter_name_or_path 要与微调时的 output_dir 对应。
附术语表
这一页出现过的名词,一句话说清各自管什么
| 术语 | 一句话解释 |
|---|---|
| LoRA Low-Rank Adaptation | 冻结原权重 W,只训练低秩旁路 A·B 去逼近 ΔW 的微调方法。比喻里的「快换夹具」。 |
| QLoRA | LoRA + 基座 4-bit 量化。配置里 finetuning_type 仍是 lora,靠 quantization_bit 区分。 |
| 灾难性遗忘 | 全量微调重构所有参数后,原有知识表征被破坏,新任务好、旧任务塌。LoRA 靠冻结 W 从物理上规避。 |
lora_target | 给哪些线性层挂旁路。all 表示所有线性层,每个 transformer 层都加。 |
lora_rank(秩 r) | 旁路的维度,决定学到信息的丰富程度,同时线性决定可训练参数量(r×(M+N))。 |
lora_alpha | 缩放系数,决定旁路的重要程度,常取与 rank 相等。 |
lora_dropout | 随机丢弃旁路层权重的概率,正则化手段,防止模型过度依赖旁路。 |
| 对称量化 | 量化后分布关于零对称,Scale = |R_max|/Q_max,不需要 zero-point。适合权重这类以 0 为中心的数据。 |
| 非对称量化 | 把浮点区间两端映射到整数区间两端,需要 zero-point 偏移量,能充分利用整数范围,矩阵乘法展开有 4 项。 |
| Scale / Zero-point | 量化的两个系数:前者是尺度,后者是「浮点 0 落在整数轴的哪个位置」。反量化时先减偏移再乘尺度。 |
| NF4 4-bit NormalFloat | 按正态分布的累计概率密度把区间切成 16 个档位的 4-bit 数据类型,靠近 0 更密。 |
| 量化常数 | 每一块数据归一化时用的 absmax。必须原样存下,否则无法反量化;它本身也占空间。 |
| 双重量化 | 把第一次量化产生的那批量化常数再量化一次,权重本身不动。块越小越划算。 |
| 分页优化 Paged Optimizer | 靠 NVIDIA 统一内存,在显存不够时自动把状态换出到 CPU RAM,需要时取回。治的是偶发峰值。 |
| DeepSpeed | 微软开源的大规模训练库,基于 PyTorch,提供并行策略、ZeRO 显存分片、Offload 与混合精度。 |
| 数据并行 | 每张卡各存一整套模型,把 batch 分给不同卡,汇总梯度后再分发回去更新。 |
| 张量并行 | 按矩阵切:每个 GPU 只算矩阵的一部分,算子需要整个矩阵时再聚合。 |
| 流水线并行 | 按网络层切:模型分段放到不同卡上。朴素做法利用率只有 1/N。 |
GPipe / chunks | 把每个 mini-batch 切成 chunks 个 micro-batch,让流水线填满,多卡同时工作。 |
| ZeRO Zero Redundancy Optimizer | 在数据并行进程之间划分模型状态而不是复制它们。等级 1/2/3 依次切优化器状态、梯度、模型参数。 |
| ZeRO-Offload | 同时利用 CPU 与 GPU 内存。Optimizer Offload 下沉梯度与优化器状态,Param Offload 下沉模型参数。 |
| FP16 / BF16 / TF32 | 三种精度格式。FP16 上限 65504 易溢出需 loss scaling;BF16 动态范围接近 FP32,大模型训练首选;TF32 用于数学运算加速。 |
| 梯度累积 gradient accumulation | 累积多步梯度再更新一次参数,用来在小显存下模拟大批次。实际总批次 = 每卡批次 × 累积步数 × 卡数。 |
warmup_ratio | 前若干比例的 step 用于线性预热学习率,防止训练初期参数剧烈震荡。 |
lr_scheduler_type: cosine | 余弦退火:学习率沿余弦曲线从峰值平滑降到接近 0,收尾阶段自动变细致。 |
| LLaMA-Factory | 封装完善的大模型训练框架,支持命令行与 Web 界面,把「改代码」变成「改一份 yaml」。 |
FORCE_TORCHRUN=1 | 强制用 PyTorch 的 torchrun 启动分布式训练,用于多卡环境或需要显式控制分布式初始化时。 |
| 合并权重 export / merge | 把适配器 A·B 加回主干导出成完整模型。LoRA/QLoRA 必做,全量微调不需要;合并时不得使用量化模型。 |