大模型 API 开发入门
接口是无状态的——模型不记得上一轮,多轮记忆全靠你每次把完整 messages 重新发过去。
30″30 秒看懂大模型 API
调用大模型这件事,像给一位住在国外、没有记忆的枪手写信。
他文笔极好、什么都懂,但有一个古怪的毛病:每封信读完就彻底忘光。所以你想让他接着上次的话题往下写,就必须把之前所有的往来信件按顺序重新誊一遍,连同新问题一起寄过去。他读完整叠信,只回你一段新文字。
信封上写的地址是 base_url,信封里的邮票是 api_key,你要找哪位枪手是 model,那叠按顺序摞好的信纸就是 messages。至于他是把整篇写完一次性寄回,还是写一句念一句用电话读给你听——这就是非流式与流式的区别。
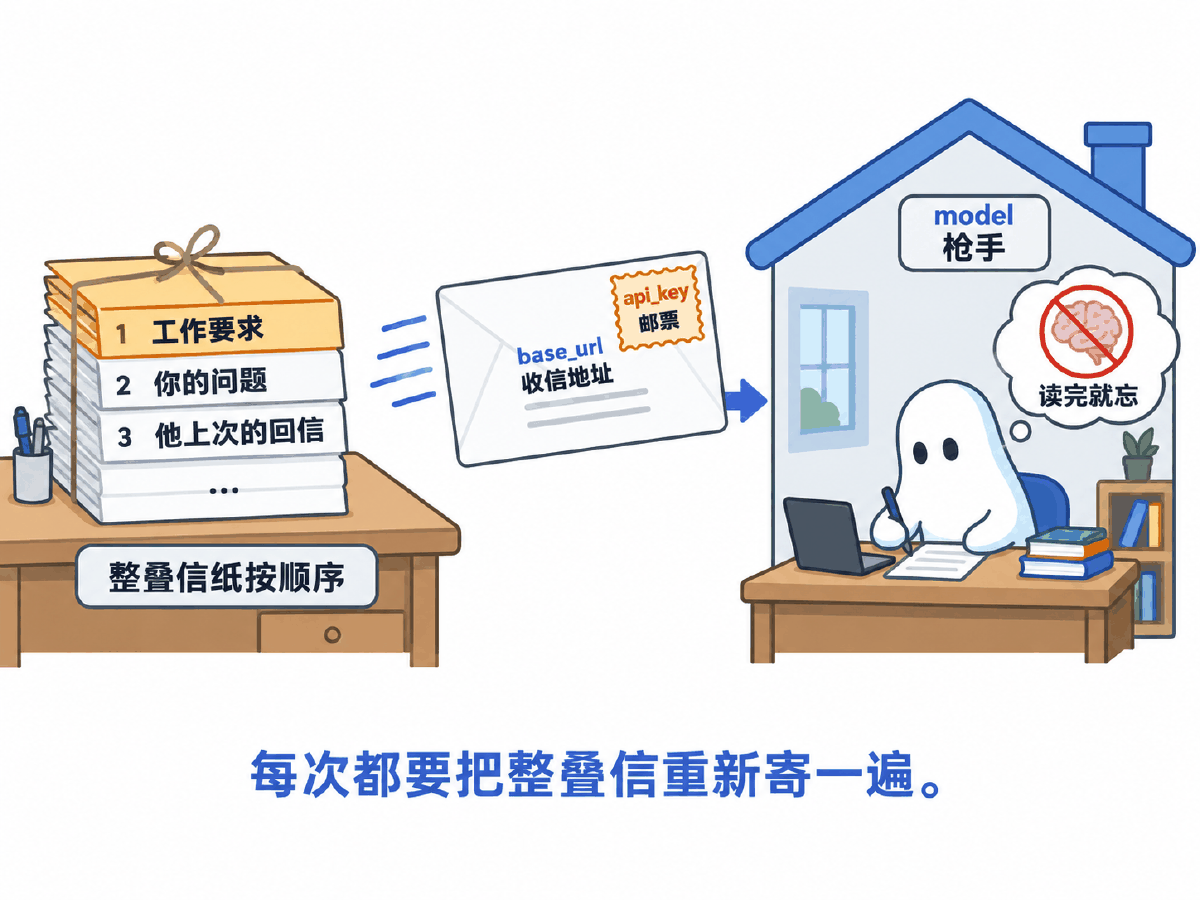
| 寄信里的角色 | 对应的技术概念 | 它到底是什么 |
|---|---|---|
| 收信地址 | base_url | 服务的网络访问点,换供应商主要就是换它 |
| 邮票 / 身份证明 | api_key | 鉴权凭证,只从环境变量读,绝不写进源码 |
| 找哪位枪手 | model | 模型名,同一个 base_url 下通常有多个可选 |
| 写在最上面的工作要求 | role: system | 人设与规则,整轮对话都生效 |
| 你写的那页 | role: user | 本次提问 |
| 他之前回的那页 | role: assistant | 模型此前的回答,要由你亲手放回信封 |
| 整叠按序摞好的信纸 | messages | 对话的全部上下文,只追加、不修改 |
| 一次性寄回 / 电话里一句句念 | stream=False / True | 等全部生成完再返回,还是边生成边推送 |
这条铁律解释了后面几乎所有现象:为什么 token 越聊越贵、为什么必须手动把 assistant 的回答追加回去、为什么上下文长度是硬上限、为什么要做历史裁剪。
01概念:为什么全行业都长成 OpenAI 的样子
一套接口格式、四个必填项,以及它和 SDK 的关系
1.1 OpenAI 兼容协议是什么
你会发现一件很奇怪的事:国内外几十家模型服务商,接口文档长得几乎一模一样——都是往 /chat/completions 发一个带 model 和 messages 的 JSON。这不是巧合,而是行业选择了一个事实标准。
各家官方文档里的表述非常直白。DeepSeek 的文档写着:「DeepSeek API 使用与 OpenAI 兼容的 API 格式,通过修改配置,你可以使用 OpenAI SDK 或兼容 OpenAI API 的软件来访问 DeepSeek API」;智谱的文档写着:「智谱提供与 OpenAI API 兼容的接口,你可以使用现有的 OpenAI SDK 代码,只需要简单修改 API 密钥和基础 URL,就能无缝切换」;阿里云百炼的文档写着:「你只需调整 API Key、BASE_URL 和模型名称,即可将原有 OpenAI 代码迁移」。
更重要的是:它让换模型变成一件低成本的事。上一讲说「换一组约束冠军就换人」,能换得动的前提,正是业务代码不和某一家绑死。
1.2 四个必填项
不管调哪一家,你要准备的东西就四样:
| 项 | 是什么 | 怎么拿 / 注意什么 |
|---|---|---|
base_url | 服务的网络访问点 | 官方文档首页一般直接给。注意有没有 /v1 后缀,各家不一致,写错就是 404 |
api_key | 鉴权凭证 | 在各家控制台申请。只从环境变量读,不硬编码、不提交 Git |
model | 模型名字符串 | 以官方模型列表为准,会改名、会下线;写错报 404 或 model_not_found |
messages | 对话消息列表 | 本讲的主角,下一节详细拆 |
环境要求也很统一:Python 3.7.1 以上、OpenAI SDK 版本不低于 1.0.0(这是智谱文档给出的明确下限)。旧版 SDK 的调用写法完全不同,是新手最常见的报错来源之一。
# 1. 装 SDK(版本必须 >= 1.0.0,旧版写法完全不同)
pip install --upgrade "openai>=1.0"

# 验证装好了
python3 -c "import openai; print(openai.__version__)"

# 2. 配好三个环境变量(写进 ~/.bashrc 或 .env,不要写进源码)
export LLM_API_KEY="你在控制台申请的key"
export LLM_BASE_URL="https://api.deepseek.com"
export LLM_MODEL="deepseek-flash"

# 3. 写代码之前,先用 curl 把这三个值验通
curl "$LLM_BASE_URL/chat/completions" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $LLM_API_KEY" \
  -d '{
        "model": "'"$LLM_MODEL"'",
        "messages": [{"role": "user", "content": "你好"}],
        "stream": false
      }'

# 能看到带 choices 的 JSON 就说明通了,可以进下一步。
# 注意:Authorization 头里必须用变量 $LLM_API_KEY,
#      不要把密钥明文粘进命令行——它会留在 shell 历史里。
1.3 三种调用方式,选哪种
同一个接口有三种调法,能力完全相同,差别只在工程体验:
| 方式 | 优点 | 什么时候用 |
|---|---|---|
curl / HTTP | 零依赖,最接近协议本身,排查问题时最可靠 | 接入第一步先用它验通;确认 key、base_url、模型名没问题 |
| OpenAI SDK | 自动处理鉴权、重试、流式解析;类型提示友好 | 日常开发的默认选择,本讲全部用它 |
| 各家自研 SDK | 能用上该家特有的功能 | 确实需要非标准能力时;代价是换供应商要重写 |
curl 成功之后,把同样的三个值填进 SDK,基本不会再出问题。
1.4 和邻近概念的区别
刚入门时最容易混的三组概念:
| A | B | 区别 |
|---|---|---|
| 调 API | 本地部署 | 调 API 是把数据发到别人的服务器算;本地部署是权重下载到自己机器上算。本地部署起的服务,通常也提供 OpenAI 兼容接口,所以业务代码一样 |
chat/completions | 旧的 completions | 前者是对话式接口,输入是带 role 的消息列表;后者是纯文本续写接口,早期产物。现在一律用前者 |
| SDK | 协议 | 协议是 HTTP + JSON 的约定,SDK 只是它的一层封装。SDK 出问题时,退回 curl 看原始请求响应,几乎总能定位 |
02原理:一次请求里到底发生了什么
messages 的结构、参数怎么调、响应怎么读、流式与多轮的真相
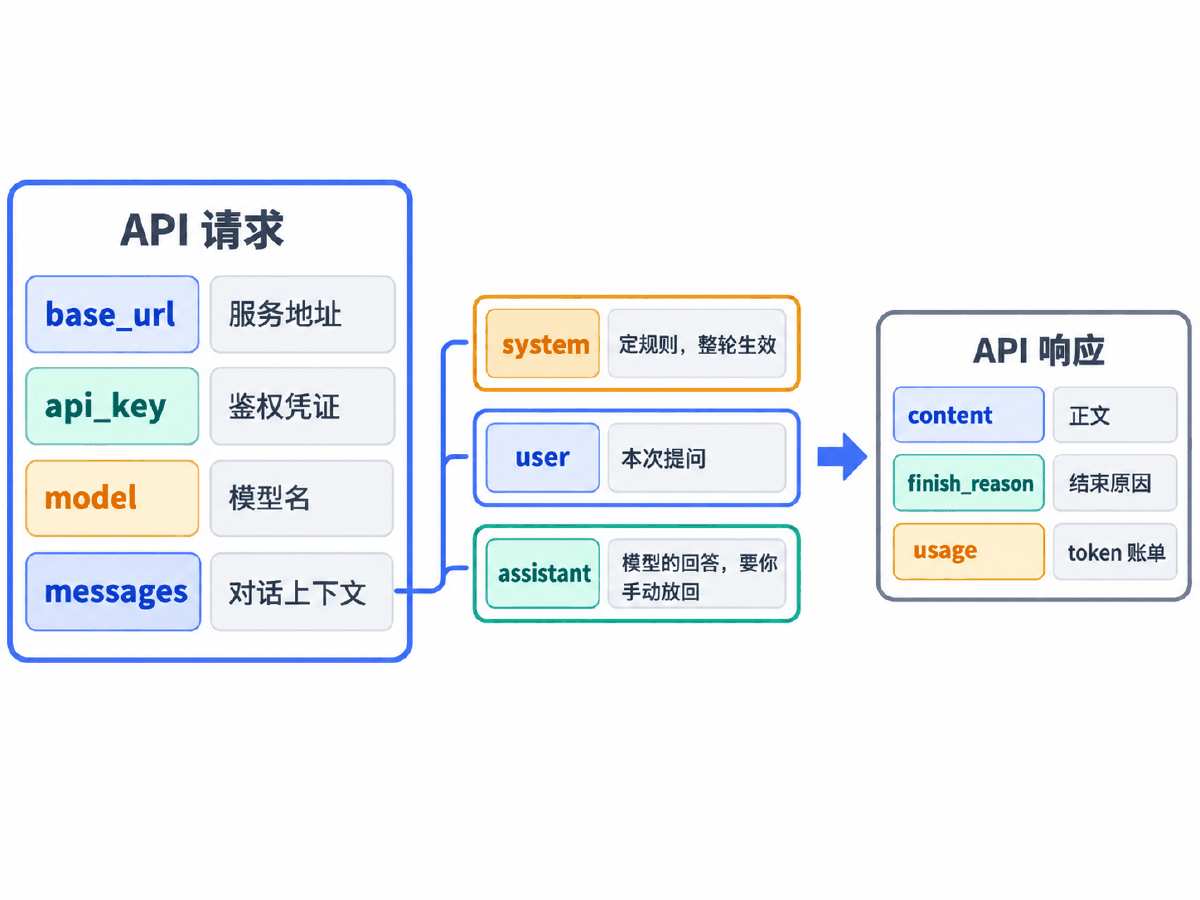
2.1 messages:三种 role 各司其职
messages 是一个列表,顺序就是对话发生的顺序。每条消息只有两个必填字段:role 和 content。
| role | 谁写的 | 作用 | 位置 |
|---|---|---|---|
system | 你 | 设定人设、规则、输出格式要求;整轮对话都生效 | 通常放在第一条,只有一条 |
user | 你 / 用户 | 本次提问或指令 | 交替出现 |
assistant | 模型 | 模型此前的回答;必须由你手动追加回列表 | 交替出现 |
user 消息,模型对第一轮一无所知。多轮对话的正确做法是:把 user 提问和 assistant 回答一条条追加进同一个 messages 列表,每次把整个列表重新发过去。所谓「记忆」,就是这么手工搬运出来的。
2.2 采样参数:控制「有多敢瞎说」
回到第一讲的铁律——模型在给下一个词算概率分布。采样参数干的事,就是决定怎么从这个概率分布里挑词。
| 参数 | 取值 | 官方定义 | 怎么用 |
|---|---|---|---|
temperature | 0 ~ 2 | 采样温度。更高的值(如 0.8)让输出更随机,更低的值(如 0.2)让输出更聚焦、更确定 | 抽取/分类/判定类任务压到 0;创意写作调高 |
top_p | 0 ~ 1 | 核采样(nucleus sampling)。只考虑累计概率质量排在前 top_p 的那些 token,0.1 表示只考虑概率质量前 10% 的 token | 作用与 temperature 类似 |
max_tokens | 正整数 | 限制生成的最大 token 数,可用来控制成本 | OpenAI 官方已标注该值现已弃用,改用 max_completion_tokens;但多数兼容服务仍只认 max_tokens |
stream | 布尔 | 设为 true 时,响应通过 server-sent events (SSE) 边生成边推送 | 交互式界面一律开;批处理不用开 |
n | 正整数 | 为每次输入生成几个候选回复 | 官方建议保持为 1 以降低成本——按所有候选的生成 token 总数计费 |
stop | 字符串/数组 | 最多 4 个停止序列,命中后停止生成,返回内容不含该序列 | 让模型在指定标记处收口 |
实践上:先固定 top_p 用默认值,只调 temperature。
2.3 响应结构:三个必看字段
非流式响应是一个对象,业务代码至少要读三处:
| 字段 | 含义 | 不读会怎样 |
|---|---|---|
choices[0].message.content | 模型生成的正文 | ——这是你要的答案 |
choices[0].finish_reason | 结束原因:stop 正常收尾、length 被长度截断、tool_calls 要调工具 | 把被截断的半句话当完整答案入库,是最隐蔽的线上事故 |
usage | token 账单:prompt_tokens / completion_tokens / total_tokens | 成本完全失控,出账单时才发现 |
另外还有一个 model 字段,返回实际服务你的模型名——上一讲说过,它可能和你请求的不一样。
2.4 流式:从「一个对象」变成「一串 chunk」
开启 stream=True 后,服务端通过 SSE 把结果一段段推过来。代码形态的变化只有两处:响应变成可迭代对象;每个 chunk 里拿到的是增量而不是全文。
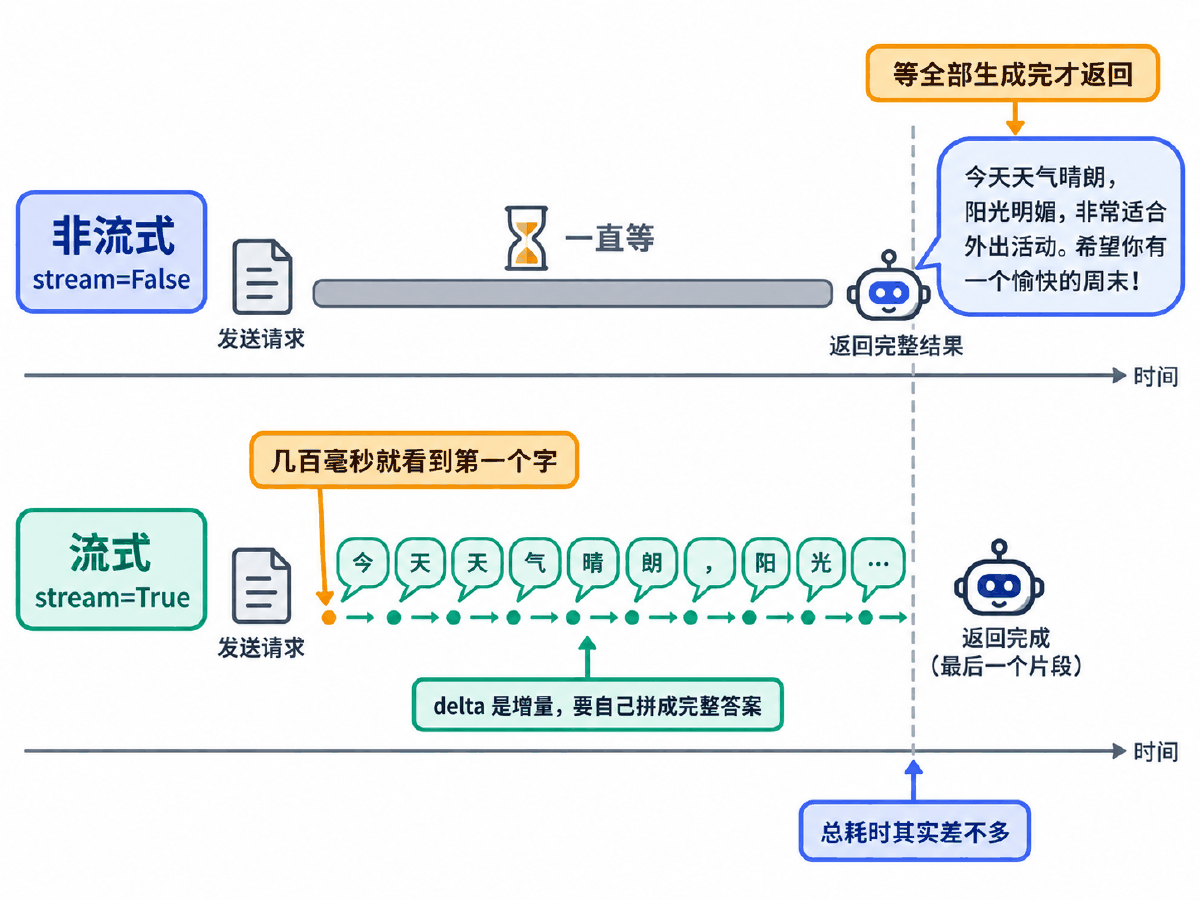
| 非流式 | 流式 | |
|---|---|---|
| 取正文 | choices[0].message.content | choices[0].delta.content(delta 是增量,不是累计) |
| 拿完整答案 | 直接就是 | 自己把所有增量拼接起来 |
| token 账单 | usage 直接有 | 需传 stream_options={"include_usage": True},在最后一个 chunk 里 |
| 首字延迟 | 等全部生成完 | 几百毫秒就能看到第一个字 |
choices 是空数组。直接写 chunk.choices[0] 会抛 IndexError,必须先判空。②
delta.content 可能是 None(例如只携带 role 或工具调用信息的 chunk)。不判空就拼接,会抛 TypeError。还有一个体验坑:打印时不
flush(),输出会被缓冲住,打字机效果白做。
2.5 多轮对话:messages 是怎么长大的
把铁律落到具体的列表变化上,一轮一轮看:
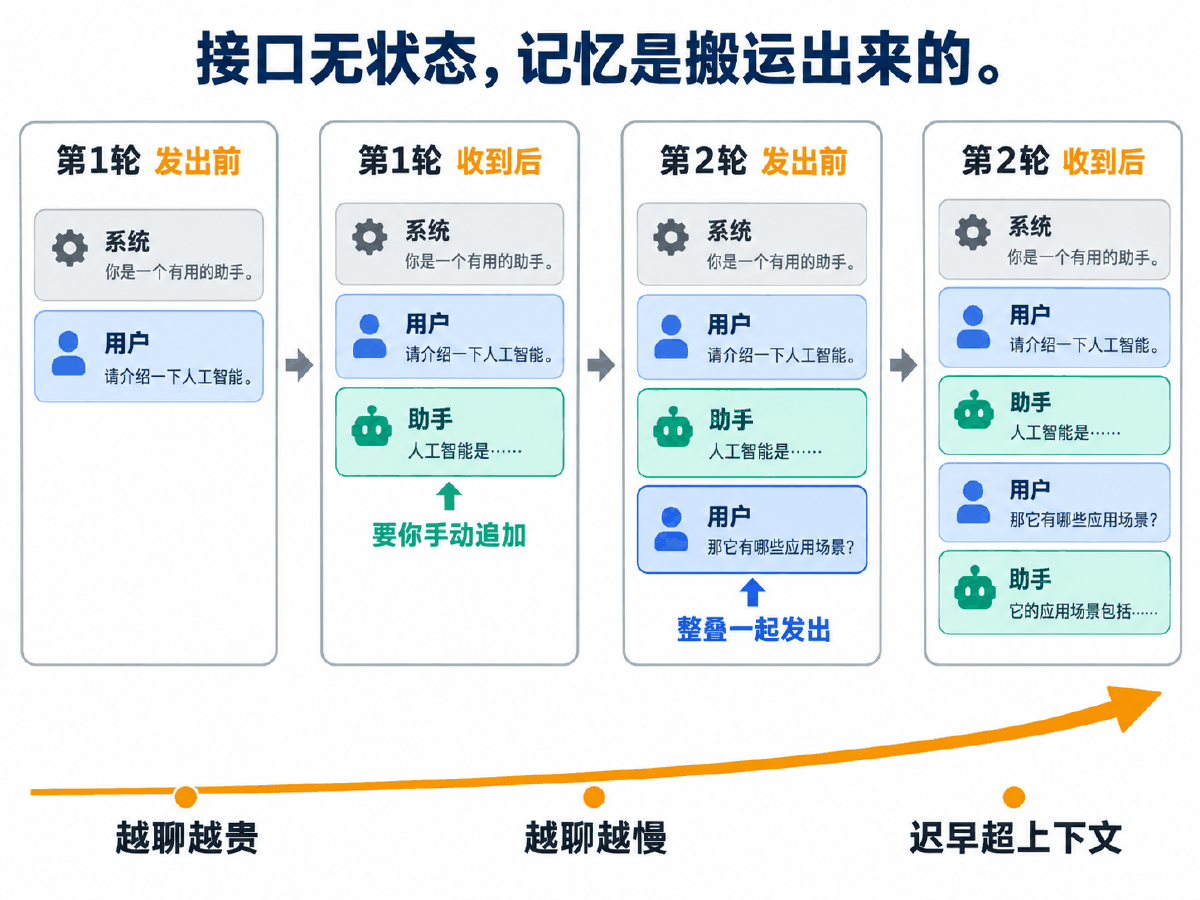
| 时刻 | messages 条数 | 内容 |
|---|---|---|
| 第 1 轮发出前 | 2 | system 人设 + user 第一个问题 |
| 第 1 轮收到后 | 3 | 追加 assistant 第一个回答——这一步要你自己写代码做 |
| 第 2 轮发出前 | 4 | 再追加 user 第二个问题,整个列表一起发出 |
| 第 2 轮收到后 | 5 | 追加 assistant 第二个回答 |
prompt_tokens 随轮数线性增长。② 越聊越慢:输入变长,处理时间也变长。
③ 迟早会爆:历史总长度超过模型上下文长度就会报错。所以真实应用必须做历史裁剪——保留 system + 最近 N 轮,或把更早的历史压缩成摘要。
2.6 错误处理:哪些该重试,哪些重试一万次也没用
把错误分成两类,是写健壮客户端的第一步:
| 类型 | 典型错误 | 该怎么办 |
|---|---|---|
| 瞬时故障(该重试) | 429 限流、超时、连接失败、5xx 服务端错误 | 指数退避 + 随机抖动后重试;服务端给了 Retry-After 就优先听它的 |
| 确定性错误(别重试) | 401 鉴权失败、404 模型名错、400 参数错、余额不足 | 立刻抛出。重试只会浪费时间、刷爆日志,甚至触发风控 |
加一个小的随机量(如 0~0.5 秒)把重试时刻打散,这一行代码的价值在高并发下非常高。
2.7 上下文管理:把「越聊越贵」算成具体数字
2.5 节推出了三个必然结论,但「越聊越贵」到底贵多少?不算清楚就不会真去做裁剪。拿一组典型参数推演一遍(代码与完整输出见 4.5 节):system 120 token、每轮提问 60、每轮回答 220。
| 轮次 | 本轮输入 token | 占 4096 上下文 | 状态 |
|---|---|---|---|
| 第 1 轮 | 180 | 4.4% | 轻松 |
| 第 5 轮 | 1300 | 31.7% | 开始有感觉 |
| 第 10 轮 | 2700 | 65.9% | 已经吃掉三分之二 |
| 第 15 轮 | 4100 | 100.1% | ❌ 爆了 |
| 第 20 轮 | 5500 | 134.3% | 早已无法请求 |
这里最关键的认识是:输入 token 是线性增长的,不是常数。第 20 轮的输入是第 1 轮的 30.6 倍。很多人估算成本时拿单轮用量乘轮数,结果真实账单出来相差十几倍。
三种裁剪策略的总账对比
同样聊 20 轮,三种做法的累计输入 token:
| 策略 | 累计输入 | 第 20 轮输入 | 是否爆上下文 | 代价 |
|---|---|---|---|---|
| 全量历史 | 56800 | 5500 | ❌ 第 15 轮爆 | 信息不丢,但贵且跑不完 |
| 滑动窗口(留最近 3 轮) | 18720 | 1020 | ✅ 安全 | 省 67%,但早期信息直接丢失 |
| 旧历史压缩成摘要 | 21120 | 1170 | ✅ 安全 | 省 63%,保住了早期要点 |
• 摘要压缩——贵一点(而且生成摘要本身还要再调一次模型),但适合长程任务助手、多轮需求澄清这类必须记得早期约定的场景。
• system 永远不裁——无论哪种策略,第一条
system 都要原封不动保留,否则模型会当场失忆人设与格式要求。
user 和它对应的 assistant 是一对,要删就成对地删。只删了 assistant 而留下孤零零的 user,模型会看到两条连着的用户提问,行为变得很奇怪,有些服务端还会直接报 400。同理,裁剪应该从最早的一轮开始删,而不是从中间挖一块走。
2.8 让输出能被代码直接读
真实业务里,模型的输出很少是给人看的,大多数时候要被下一段代码解析。而模型天生爱加开场白——「好的,以下是您要的 JSON:」,再包一层 ```json 代码围栏,json.loads() 直接报错。
治这个问题有三层手段,优先级从上到下:
| 手段 | 做法 | 可靠性 |
|---|---|---|
| ① 结构化输出参数 | 传 response_format 让服务端约束输出为 JSON | 最高,但各家支持度不一,兼容服务可能直接忽略这个参数 |
| ② 提示词约束 | system 里写死「只输出 JSON,不要任何解释文字和代码围栏」,并给出示例 | 中等,优点是所有服务都能用 |
| ③ 客户端傅佐 | 解析前先剥掉代码围栏、提取第一个 { 到最后一个 } 的片段 | 必须有——前两层都会偶尔失效 |
try/except,并在失败时把原始输出记进日志。不记原始输出的后果是:线上偶发解析失败,你手里只有一个
JSONDecodeError 堆栈,永远不知道模型当时到底吐了什么,连复现都做不到。
2.9 并发与限流:批量任务的第一道坑
单次调用跑通之后,第一个真实需求往往是「把一万条数据跑一遍」。这时候天真的写法是 for 循环里直接开一堆线程,结果就是成片 429。
限流通常不只一个维度,各家的命名不同但套路一致:
| 限制维度 | 含义 | 撞到了怎么办 |
|---|---|---|
| 并发数 | 同一时刻未返回的请求个数上限 | 用信号量(Semaphore)固定并发度,而不是有多少任务开多少线程 |
| 请求频率 | 每分钟请求次数上限 | 控制发送节奏,而不是只控并发数 |
| token 吞吐 | 每分钟 token 总量上限 | 长文本任务会先撞这个——请求数不多却已限流,很容易误判 |
② 重试要和限流配合:撞到 429 先听
Retry-After,没有才用指数退避,并且退避期间要把并发度降下来,否则重试流量会把自己再死一遍。③ 结果要随跑随落盘,不要攒在内存里最后统一写——跑到 90% 挂掉,前面的钱全白花。
④ 要可断点续跑:给每条任务一个稳定 id,启动时跳过已完成的。批量任务中途挂掉是常态,不是意外。
max_retries=2)会和你自己写的重试叠加成乘积:你以为最多重试 3 次,实际发出去九次请求。在限流场景下这会直接把配额烧光。自己接管重试时,把 SDK 的
max_retries 显式设为 0。
03最小代码:跑通第一次调用
五步,二十行,换任何一家服务只改两个字符串
剥掉所有业务之后,一次完整调用只有五步。对着代码里的编号看:
"""最小可运行的一次大模型调用:OpenAI 兼容协议。

换任何一家 OpenAI 兼容的服务,只改 base_url 和 model 两处,
下面的业务代码一个字都不用动。

运行前先配好环境变量:
    export LLM_API_KEY="你的key"
    export LLM_BASE_URL="https://api.deepseek.com"
    export LLM_MODEL="deepseek-flash"
依赖:pip install "openai>=1.0"
"""
import os

from openai import OpenAI

# ① 密钥只从环境变量读,绝不硬编码进源码
client = OpenAI(
    api_key=os.environ["LLM_API_KEY"],
    base_url=os.environ.get("LLM_BASE_URL", "https://api.deepseek.com"),
)

# ② messages 是一个列表,顺序就是对话发生的顺序
messages = [
    {"role": "system", "content": "你是一个简洁的中文助手,回答不超过两句话。"},
    {"role": "user", "content": "用一句话说明什么是大语言模型。"},
]

# ③ 发请求。temperature 控制随机性,max_tokens 给输出长度封顶
response = client.chat.completions.create(
    model=os.environ.get("LLM_MODEL", "deepseek-flash"),
    messages=messages,
    temperature=0.7,
    max_tokens=200,
)

# ④ 取正文:choices 是个数组,默认只生成 1 条,所以取 [0]
print("回复:", response.choices[0].message.content)

# ⑤ 两个必看字段:结束原因和 token 账单
print("结束原因:", response.choices[0].finish_reason)
print("token 用量: 输入 %d + 输出 %d = %d"
      % (response.usage.prompt_tokens,
         response.usage.completion_tokens,
         response.usage.total_tokens))
base_url 和 model——其余代码一个字都不用动。这正是 OpenAI 兼容协议的全部意义。换成本地的 Ollama 就是
base_url="http://127.0.0.1:11434/v1",换成别家云服务就填别家的地址。业务逻辑与供应商解耦,是接入阶段最该守住的东西。
os.environ["LLM_API_KEY"] 读取,不要硬编码进源码,更不要连同 .env 一起提交到 Git。用
os.environ[...] 而不是 os.environ.get(...) 是故意的:缺变量时立刻抛 KeyError,好过带着 None 跑出一个含糊的 401。
finish_reason 是 length 就说明答案被 max_tokens 截断了——这是最隐蔽的线上事故:程序不报错,入库的却是半句话。usage 是你唯一能实时看到的成本信号。第一天就把它打出来,比月底看账单强。
04完整案例:流式 · 重试 · 多轮
三个案例分别解决体验、稳定性、记忆三件事
4.1 流式输出:让字一个个吐出来
非流式调用要等模型把整段话生成完才返回,长答案可能等十几秒,用户会以为卡死了。流式把首字延迟压到几百毫秒。
"""流式输出:让字一个个吐出来,而不是等十几秒蹦出一整段。

关键差别只有两处:
  请求时加 stream=True;响应从「一个对象」变成「一串 chunk」。
运行前配置 LLM_API_KEY / LLM_BASE_URL / LLM_MODEL 三个环境变量。
"""
import os
import sys

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["LLM_API_KEY"],
    base_url=os.environ.get("LLM_BASE_URL", "https://api.deepseek.com"),
)

# stream_options 让最后一个 chunk 带上 usage,否则流式下拿不到 token 账单
stream = client.chat.completions.create(
    model=os.environ.get("LLM_MODEL", "deepseek-flash"),
    messages=[{"role": "user", "content": "用三句话讲讲 Transformer 为什么快。"}],
    temperature=0.7,
    stream=True,
    stream_options={"include_usage": True},
)

pieces = []      # 攒完整答案,落库/写进下一轮 messages 都要用它
usage = None
finish_reason = None

for chunk in stream:
    # 带 usage 的收尾 chunk 里 choices 是空数组,先判空再取下标
    if chunk.usage is not None:
        usage = chunk.usage
    if not chunk.choices:
        continue

    choice = chunk.choices[0]
    # delta 是「增量」:本次新增的那几个字,不是累计值
    piece = choice.delta.content
    if piece:
        pieces.append(piece)
        sys.stdout.write(piece)   # 边收边打印,这就是打字机效果
        sys.stdout.flush()        # 不 flush 会被缓冲住,白做流式
    if choice.finish_reason:
        finish_reason = choice.finish_reason

print("\n" + "-" * 40)
answer = "".join(pieces)
print("完整答案长度:", len(answer))
print("结束原因:", finish_reason)
if usage:
    print("token 用量: 输入 %d + 输出 %d" % (usage.prompt_tokens, usage.completion_tokens))
else:
    print("token 用量: 本次未随流返回")
if chunk.usage is not None —— 收尾 chunk 才带账单;②
if not chunk.choices: continue —— 带 usage 的收尾 chunk 里 choices 是空数组,不判空直接取 [0] 会 IndexError;③
if piece: —— delta.content 可能是 None,不判空拼接会 TypeError。再加一个
sys.stdout.flush():不 flush 的话输出被缓冲,打字机效果白做。
注意 pieces 这个列表:流式下你必须自己把增量拼成完整答案,因为落库、写进下一轮 messages 都要用它。只顾着打印不攒起来,是流式改造时最常见的疏漏。
4.2 重试封装:让网络抖动不再毁掉整个任务
真实环境里 429 限流、超时、5xx 都是常态。没有重试的批处理脚本,跑到一半失败是迟早的事。
"""带重试的调用封装:把「网络抖一下就整个任务失败」这件事解决掉。

三条工程原则写进了代码:
  1. 只重试「重试了可能会好」的错误,配额不足、参数写错重试一万次也没用;
  2. 指数退避 + 随机抖动,避免一批请求在同一毫秒集体重来把服务打垮;
  3. 尊重服务端给的 Retry-After,它比你的猜测准。
运行前配置 LLM_API_KEY / LLM_BASE_URL / LLM_MODEL。
"""
import os
import random
import time

from openai import (APIConnectionError, APITimeoutError, InternalServerError,
                    OpenAI, RateLimitError)

# 这几类是「瞬时故障」,退避后重试有意义
RETRYABLE = (RateLimitError, APITimeoutError, APIConnectionError, InternalServerError)

client = OpenAI(
    api_key=os.environ["LLM_API_KEY"],
    base_url=os.environ.get("LLM_BASE_URL", "https://api.deepseek.com"),
    timeout=60.0,      # 单次请求超时,不设的话可能挂死几分钟
    max_retries=0,     # 关掉 SDK 自带重试,避免和下面的逻辑叠加成指数级请求
)


def retry_after_seconds(err):
    """服务端在 429 响应头里给的等待时间,拿得到就优先用它。"""
    response = getattr(err, "response", None)
    if response is None:
        return None
    value = response.headers.get("retry-after")
    if not value:
        return None
    try:
        return float(value)
    except ValueError:
        return None


def chat(messages, model=None, max_attempts=5, base_delay=1.0, **kwargs):
    """调用模型,失败时按指数退避重试;全部失败则把最后一个异常抛出去。"""
    model = model or os.environ.get("LLM_MODEL", "deepseek-flash")
    last_error = None

    for attempt in range(1, max_attempts + 1):
        try:
            response = client.chat.completions.create(
                model=model, messages=messages, **kwargs)
            # 被长度截断时提醒一句,否则容易把半句话当完整答案入库
            if response.choices[0].finish_reason == "length":
                print("[warn] 输出被 max_tokens 截断,答案可能不完整")
            return response
        except RETRYABLE as err:
            last_error = err
            if attempt == max_attempts:
                break
            # 指数退避:1s、2s、4s、8s……再叠一个随机抖动打散并发
            delay = retry_after_seconds(err) or base_delay * (2 ** (attempt - 1))
            delay += random.uniform(0, 0.5)
            print("[retry] 第 %d 次失败(%s),%.1fs 后重试"
                  % (attempt, type(err).__name__, delay))
            time.sleep(delay)
        except Exception as err:
            # 参数错误、鉴权失败、余额不足等,重试没有意义,直接抛
            print("[fatal] 不可重试的错误:", type(err).__name__, err)
            raise

    raise RuntimeError("重试 %d 次仍失败" % max_attempts) from last_error


if __name__ == "__main__":
    resp = chat(
        [{"role": "user", "content": "一句话解释什么叫指数退避。"}],
        temperature=0.3,
        max_tokens=120,
    )
    print(resp.choices[0].message.content)
| 设计点 | 为什么这么写 |
|---|---|
max_retries=0 | 关掉 SDK 自带重试。不关的话会和自己的重试逻辑叠加,5×5 变成 25 次请求 |
RETRYABLE 元组 | 只重试限流、超时、连接失败、5xx。鉴权失败、参数错误、余额不足直接抛,重试没有意义 |
优先用 Retry-After | 服务端明确告诉你等多久时,它比任何猜测都准 |
| 退避 + 抖动 | 1s、2s、4s、8s 再叠 0~0.5s 随机量,避免一批请求同时重来造成雪崩 |
timeout=60.0 | 不设超时的话,一个卡住的请求能挂死几分钟 |
| 截断告警 | finish_reason == "length" 时打 warn,避免半句话被当成完整答案 |
盲目对所有异常重试,会把一个一眼能看出的配置错误,拖成半小时的诡异超时。
4.3 多轮对话:把「记忆」手工搬运出来
这个案例把前两个案例合起来,再加上本讲铁律的正面实现:每轮把完整 messages 重新发过去。
"""命令行多轮对话:一个能真正聊起来的最小完整程序。

它演示三件在最小调用里看不到的事:
  1. 多轮记忆靠的是「把历史原样带回去」,接口本身不记事;
  2. 上下文会被撑爆,所以要有裁剪策略;
  3. 流式 + 重试要能叠在一起用。
运行前配置 LLM_API_KEY / LLM_BASE_URL / LLM_MODEL,然后 python3 chat_cli.py。
输入 exit 退出,输入 clear 清空记忆。
"""
import os
import sys

from robust_call import chat

SYSTEM_PROMPT = "你是一个中文技术助手,回答简洁、准确,不确定时直说不知道。"

# 只保留最近 N 轮,防止 messages 无限膨胀把上下文和钱一起烧光
MAX_TURNS = 8


def trim(messages, max_turns=MAX_TURNS):
    """裁剪历史:system 永远留着,其余只保留最近 max_turns 轮问答。"""
    system = messages[:1]
    body = messages[1:]
    keep = max_turns * 2          # 一轮 = 一条 user + 一条 assistant
    if len(body) > keep:
        body = body[-keep:]
        # 裁剪后第一条必须是 user,否则有些服务会拒绝
        while body and body[0]["role"] != "user":
            body.pop(0)
    return system + body


def stream_answer(messages):
    """流式打印回答,并返回完整文本,便于写回历史。"""
    response = chat(messages, temperature=0.7, stream=True)
    pieces = []
    for chunk in response:
        if not chunk.choices:
            continue
        piece = chunk.choices[0].delta.content
        if piece:
            pieces.append(piece)
            sys.stdout.write(piece)
            sys.stdout.flush()
    print()
    return "".join(pieces)


def main():
    if not os.environ.get("LLM_API_KEY"):
        print("请先设置环境变量 LLM_API_KEY")
        return
    messages = [{"role": "system", "content": SYSTEM_PROMPT}]
    print("开始对话(exit 退出,clear 清空记忆)")

    while True:
        try:
            user_input = input("\n你: ").strip()
        except (EOFError, KeyboardInterrupt):
            print("\n再见")
            return
        if not user_input:
            continue
        if user_input == "exit":
            print("再见")
            return
        if user_input == "clear":
            messages = [{"role": "system", "content": SYSTEM_PROMPT}]
            print("记忆已清空")
            continue

        messages.append({"role": "user", "content": user_input})
        messages = trim(messages)

        print("助手: ", end="")
        answer = stream_answer(messages)
        # 关键一步:把模型的回答也追加进历史,下一轮它才知道自己说过什么
        messages.append({"role": "assistant", "content": answer})


if __name__ == "__main__":
    main()
它演示了三件在最小调用里看不到的事:
messages.append({"role": "assistant", ...}) 这一行如果漏掉,模型下一轮就不知道自己说过什么,对话会变得前言不搭后语。
trim() 保留 system + 最近 8 轮。不裁剪的话,token 线性增长,先变贵变慢,最后直接超出上下文长度报错。
它直接 from robust_call import chat,于是白拿了重试能力,同时又开了流式。薄封装的好处在这里显出来。
user,所以代码里有个 while body and body[0]["role"] != "user": body.pop(0)。如果裁剪后第一条是
assistant,有些服务会直接拒绝请求——对话历史必须是合法的一问一答交替结构。
4.4 算清楚裁剪到底省了多少钱
4.3 里的 chat_cli.py 已经做了裁剪,但裁与不裁究竟差多少?下面这份脚本不调任何模型,只做账本推演,不需要 API Key 就能跑:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""多轮对话的成本增长与三种历史裁剪策略对比。

只用标准库,直接 python3 token_cost.py 就能跑,不需要 API Key。
它不调用任何模型,只做账本推演——目的是让「越聊越贵」变成具体数字。

⚠️ token 数用固定估算值代替真实 tokenizer,只为演示增长趋势。
   真实用量必须读响应里的 usage 字段。
"""

# 每轮对话的估算 token 数(演示用的固定值)
SYSTEM_TOKENS = 120
USER_TOKENS = 60
ASSISTANT_TOKENS = 220

TURNS = 20
CONTEXT_LIMIT = 4096          # 假设模型上下文上限
KEEP_RECENT = 3               # 滑动窗口保留最近几轮
SUMMARY_TOKENS = 150          # 摘要压缩后的固定开销


def full_history(turns):
    """策略一:不裁剪,每轮把全部历史重发。"""
    prompt = SYSTEM_TOKENS
    rows = []
    for t in range(1, turns + 1):
        prompt += USER_TOKENS                      # 本轮提问
        rows.append((t, prompt, ASSISTANT_TOKENS))
        prompt += ASSISTANT_TOKENS                 # 模型回答追加进历史
    return rows


def sliding_window(turns, keep=KEEP_RECENT):
    """策略二:只保留 system + 最近 keep 轮。"""
    rows = []
    for t in range(1, turns + 1):
        kept = min(t - 1, keep)                    # 已完成的历史轮数
        prompt = SYSTEM_TOKENS + kept * (USER_TOKENS + ASSISTANT_TOKENS) + USER_TOKENS
        rows.append((t, prompt, ASSISTANT_TOKENS))
    return rows


def summarize_old(turns, keep=KEEP_RECENT):
    """策略三:最近 keep 轮保留原文,更早的历史压缩成一段摘要。"""
    rows = []
    for t in range(1, turns + 1):
        done = t - 1
        kept = min(done, keep)
        has_summary = done > keep
        prompt = SYSTEM_TOKENS
        if has_summary:
            prompt += SUMMARY_TOKENS
        prompt += kept * (USER_TOKENS + ASSISTANT_TOKENS) + USER_TOKENS
        rows.append((t, prompt, ASSISTANT_TOKENS))
    return rows


def report(name, rows, limit=CONTEXT_LIMIT):
    total_prompt = sum(r[1] for r in rows)
    total_out = sum(r[2] for r in rows)
    last_prompt = rows[-1][1]
    overflow = next((r[0] for r in rows if r[1] > limit), None)
    print("【%s】" % name)
    print("   第 1 轮输入 %d token,第 %d 轮输入 %d token(涨了 %.1f 倍)"
          % (rows[0][1], len(rows), last_prompt, last_prompt / rows[0][1]))
    print("   累计输入 %d token,累计输出 %d token" % (total_prompt, total_out))
    if overflow:
        print("   ❌ 第 %d 轮就超过 %d 的上下文上限" % (overflow, limit))
    else:
        print("   ✅ %d 轮下来始终未超过 %d 的上下文上限" % (len(rows), limit))
    print()
    return total_prompt


def main():
    print("=" * 70)
    print("设定:system %d token,每轮提问 %d token,每轮回答 %d token,共 %d 轮"
          % (SYSTEM_TOKENS, USER_TOKENS, ASSISTANT_TOKENS, TURNS))
    print("=" * 70)
    print()

    print("一、不裁剪时,每轮输入 token 是怎么涨的")
    print("%-8s %-14s %s" % ("轮次", "本轮输入", "占上下文上限"))
    print("-" * 46)
    rows = full_history(TURNS)
    for t, prompt, _ in rows:
        if t in (1, 2, 3, 5, 10, 15, 20):
            bar = "█" * int(prompt / CONTEXT_LIMIT * 30)
            print("%-8d %-14d %5.1f%% %s" % (t, prompt, prompt / CONTEXT_LIMIT * 100, bar))
    print()
    print("注意这是线性增长,不是常数——第 20 轮的输入是第 1 轮的十几倍。")
    print()

    print("=" * 70)
    print("二、三种策略的总账对比")
    print("=" * 70)
    a = report("策略一:全量历史", full_history(TURNS))
    b = report("策略二:滑动窗口(保留最近 %d 轮)" % KEEP_RECENT, sliding_window(TURNS))
    c = report("策略三:旧历史压缩成摘要", summarize_old(TURNS))

    print("=" * 70)
    print("三、结论")
    print("=" * 70)
    print("累计输入 token:全量 %d / 滑窗 %d / 摘要 %d" % (a, b, c))
    print("滑窗相比全量省了 %.0f%%,摘要省了 %.0f%%"
          % ((1 - b / a) * 100, (1 - c / a) * 100))
    print()
    print("滑窗最省,但它把更早的信息直接丢了——用户翻回去问前面的事就答不上来。")
    print("摘要贵一点,但保住了早期信息的要点。")
    print("选哪个取决于业务:客服问答适合滑窗,长程任务助手适合摘要。")


if __name__ == "__main__":
    main()
运行输出
======================================================================
设定:system 120 token,每轮提问 60 token,每轮回答 220 token,共 20 轮
======================================================================

一、不裁剪时,每轮输入 token 是怎么涨的
轮次       本轮输入           占上下文上限
----------------------------------------------
1        180              4.4% █
2        460             11.2% ███
3        740             18.1% █████
5        1300            31.7% █████████
10       2700            65.9% ███████████████████
15       4100           100.1% ██████████████████████████████
20       5500           134.3% ████████████████████████████████████████

注意这是线性增长,不是常数——第 20 轮的输入是第 1 轮的十几倍。

======================================================================
二、三种策略的总账对比
======================================================================
【策略一:全量历史】
   第 1 轮输入 180 token,第 20 轮输入 5500 token(涨了 30.6 倍)
   累计输入 56800 token,累计输出 4400 token
   ❌ 第 15 轮就超过 4096 的上下文上限

【策略二:滑动窗口(保留最近 3 轮)】
   第 1 轮输入 180 token,第 20 轮输入 1020 token(涨了 5.7 倍)
   累计输入 18720 token,累计输出 4400 token
   ✅ 20 轮下来始终未超过 4096 的上下文上限

【策略三:旧历史压缩成摘要】
   第 1 轮输入 180 token,第 20 轮输入 1170 token(涨了 6.5 倍)
   累计输入 21120 token,累计输出 4400 token
   ✅ 20 轮下来始终未超过 4096 的上下文上限

======================================================================
三、结论
======================================================================
累计输入 token:全量 56800 / 滑窗 18720 / 摘要 21120
滑窗相比全量省了 67%,摘要省了 63%

滑窗最省,但它把更早的信息直接丢了——用户翻回去问前面的事就答不上来。
摘要贵一点,但保住了早期信息的要点。
选哪个取决于业务:客服问答适合滑窗,长程任务助手适合摘要。
② 不裁剪的话第 15 轮就撞破 4096 上下文——不是贵不贵的问题,是直接报错跑不下去。
③ 滑动窗口省 67%,摘要省 63%——两者省的钱差不多,真正的差别在“早期信息丢不丢”,按业务选,不按价格选。
真实用量只有一个权威来源:响应里的
usage 字段。上生产后把每次调用的 prompt_tokens 和 completion_tokens 记进日志,才能真正看清钱花在哪里。
4.5 四个案例的关系
| 案例 | 解决的问题 | 关键 API | 可以省吗 |
|---|---|---|---|
min_call.py | 跑通 | chat.completions.create | 入门必看 |
stream_call.py | 体验 | stream=True + delta | 批处理可省,交互式不可省 |
robust_call.py | 稳定性 | 异常分类 + 退避 | 上生产不可省 |
chat_cli.py | 记忆 | messages 追加 + 裁剪 | 单轮任务可省,对话不可省 |
token_cost.py | 成本预估 | 不调模型,纯账本推演 | 报预算前不可省 |
05骨架模板:一个能换供应商的客户端
把「连哪家、怎么重试、怎么流式」收进一个类,业务只看见两个方法
前面三个案例各自解决一件事,但散着放进项目里会重复得厉害:每个调用点都要写一遍重试、每次换模型都要全局搜索替换。这份骨架把它们收口:上层业务只看见 ask() 和 ask_stream()。
"""通用 LLM 客户端骨架:换供应商只改配置,不改业务代码。

把「连哪家、用哪个模型、怎么重试、怎么流式」全收进一个类,
上层业务只看见 ask() 和 ask_stream() 两个方法。
复制后改 5 处 TODO 即可。
"""
import os
import random
import time

from openai import (APIConnectionError, APITimeoutError, InternalServerError,
                    OpenAI, RateLimitError)

RETRYABLE = (RateLimitError, APITimeoutError, APIConnectionError, InternalServerError)

# TODO 1:登记你要用的供应商。base_url 与模型名都以各家官方文档为准。
#         凡是标称「OpenAI 兼容」的服务,都能塞进这张表。
PROVIDERS = {
    "deepseek": {
        "base_url": "https://api.deepseek.com",
        "key_env": "DEEPSEEK_API_KEY",
        "model": "deepseek-flash",
    },
    "zhipu": {
        "base_url": "https://open.bigmodel.cn/api/paas/v4/",
        "key_env": "ZHIPU_API_KEY",
        "model": "glm-5.3-flash",
    },
    "local": {                       # Ollama / vLLM 等本地服务
        "base_url": "http://127.0.0.1:11434/v1",
        "key_env": "LOCAL_API_KEY",  # 本地服务通常不校验,给个占位值即可
        "model": "qwen3:8b",
    },
}


class LLMClient:
    """一层薄封装:统一重试、统一超时、统一默认参数。"""

    def __init__(self, provider="deepseek", model=None, timeout=60.0):
        conf = PROVIDERS[provider]
        api_key = os.environ.get(conf["key_env"])
        if not api_key:
            raise RuntimeError("缺少环境变量 %s" % conf["key_env"])

        self.model = model or conf["model"]
        self.client = OpenAI(
            api_key=api_key,
            base_url=conf["base_url"],
            timeout=timeout,
            max_retries=0,          # 重试逻辑自己管,避免叠加
        )
        # TODO 2:按业务改默认采样参数。抽取/分类类任务把 temperature 压到 0。
        self.defaults = {"temperature": 0.7, "max_tokens": 1024}

    # ----------------------------------------------------------------- 内部
    def _call(self, messages, max_attempts=5, **kwargs):
        params = dict(self.defaults)
        params.update(kwargs)
        last_error = None

        for attempt in range(1, max_attempts + 1):
            try:
                return self.client.chat.completions.create(
                    model=self.model, messages=messages, **params)
            except RETRYABLE as err:
                last_error = err
                if attempt == max_attempts:
                    break
                delay = 1.0 * (2 ** (attempt - 1)) + random.uniform(0, 0.5)
                time.sleep(delay)
            except Exception:
                raise      # 鉴权、参数、余额类错误直接抛,重试无意义
        raise RuntimeError("重试 %d 次仍失败" % max_attempts) from last_error

    # ----------------------------------------------------------------- 对外
    def ask(self, prompt, system=None, **kwargs):
        """一问一答,返回纯文本。"""
        messages = []
        if system:
            messages.append({"role": "system", "content": system})
        messages.append({"role": "user", "content": prompt})
        response = self._call(messages, **kwargs)
        return response.choices[0].message.content

    def ask_stream(self, prompt, system=None, **kwargs):
        """生成器版本:逐段 yield,前端可以边收边渲染。"""
        messages = []
        if system:
            messages.append({"role": "system", "content": system})
        messages.append({"role": "user", "content": prompt})
        stream = self._call(messages, stream=True, **kwargs)
        for chunk in stream:
            if not chunk.choices:
                continue
            piece = chunk.choices[0].delta.content
            if piece:
                yield piece


if __name__ == "__main__":
    # TODO 3:换成你要用的那一家
    llm = LLMClient(provider="deepseek")

    # TODO 4:换成你的提示词
    print(llm.ask("用一句话解释什么是上下文长度。", system="你是简洁的中文助手。"))

    # TODO 5:需要打字机效果时改用流式
    # for piece in llm.ask_stream("讲讲流式输出的好处。"):
    #     print(piece, end="", flush=True)
PROVIDERS 里登记你要用的服务(base_url / key 环境变量名 / 默认模型)· TODO 2 按业务改默认采样参数 · TODO 3 选用哪一家 · TODO 4 换提示词 · TODO 5 需要打字机效果时改用流式。其余代码不用动。
5.1 为什么值得多写这一层
| 收益 | 没有这层会怎样 |
|---|---|
| 换供应商只改一个字符串 | 每个调用点都写着 base_url,换一家要全局搜索替换,漏一处就是线上事故 |
| 重试策略只有一处 | 有的调用点写了重试、有的忘了;出问题时排查要翻遍全项目 |
| 默认参数统一 | 有的地方 temperature=0.7、有的地方忘了传,同一业务表现不一致 |
| 缺 key 时立刻报错 | 带着 None 一路跑到服务端,拿回一个含糊的 401 |
| 流式与非流式同一套入口 | 两套代码各写一遍异常处理,改一处忘一处 |
PROVIDERS 里特意留了一条 local——指向本地 Ollama。本地部署的服务同样提供 OpenAI 兼容接口,所以开发时用云端 API、上线切内网模型,业务代码一行都不用改。这正是下一个模块(私有化部署)能顺利接上的原因。
5.2 上生产之前还要补的三件事
每次调用记下模型名、usage、耗时、finish_reason。没有这些数据,成本和质量都无从优化。
各家都有并发上限。批量任务要用信号量控制并发数,否则一上量就被 429 打回来。
交互式接口超时设短些、快速失败;批处理任务可以放宽。一个全局 60 秒不适合所有场景。
提示词和业务逻辑应该留在各自的业务模块里。薄,才换得动。
5.3 每次调用该记哪些字段
5.2 说了「要埋点」,这里把字段列到可以直接拄进表结构的程度。原则只有一条:出事时你想知道什么,就提前记什么。
| 字段 | 来源 | 不记的后果 |
|---|---|---|
request_id | 自己生成(uuid) | 用户报障时无法把一次投诉定位到一次具体调用 |
model(响应里的) | response.model | 被静默降级到轻量版都不知道,效果变差查不出原因 |
prompt_tokens / completion_tokens | usage | 成本完全失控;也无法判断是输入胀了还是输出啰嗦 |
finish_reason | choices[0] | 截断事故零告警——半句话入库且永不曝露 |
| 耗时 / 首字耗时 | 自己计时 | 只有「感觉变慢了」,没有可对比的基线 |
| 重试次数 / 最终状态 | 重试逻辑 | 限流情况被重试掩盖,发现不了已经靠近配额天花板 |
| 解析失败时的原始输出 | 异常分支 | 只剩一个 JSONDecodeError 堆栈,连复现都做不到 |
api_key——包括报错时把整个请求对象 repr() 打进日志这种间接泄露。打日志前先把凭证字段抹掉。② 未脱敏的用户原文——对话内容里可能含手机号、身份证、病历。要么只记长度与哈希,要么脱敏后再落盘,并设定保留期。
finish_reason != "stop" 的比例做成一个监控指标,超过阈值就告警。它能同时捕捉两类问题:
max_tokens 设小了,以及提示词让模型写得越来越长。这两件事都不会抛异常,只会静静地损害质量。
06易错点汇总
按「环境与鉴权 / messages / 参数 / 流式 / 错误与成本」五类归并
⚠️ 一、环境与鉴权
- SDK 版本太旧。 必须
openai>=1.0.0,旧版的调用写法完全不同,照着新文档写会各种报错。先python3 -c "import openai; print(openai.__version__)"确认。 base_url的/v1后缀写错。 各家不一致——有的要带、有的不带、有的带斜杠结尾。写错直接 404,且报错信息往往很含糊。照官方文档原样复制。- 把 API-KEY 硬编码进源码。 一律
os.environ[...],且.env不要提交 Git。用os.environ["K"]而不是.get("K"),缺变量时立刻KeyError,好过带着None跑出含糊的 401。 - curl 测试时把密钥明文粘进命令行。 它会留在 shell 历史里。命令里必须用变量。
- Key 与 endpoint 地域不匹配。 有的平台 API Key 按地域绑定,跨地域调用会返回 401
Incorrect API key provided、错误码invalid_api_key——看着像 Key 失效,实际是地域错了。 - 不先用 curl 验通就直接写代码。 报错时分不清是 key、base_url、模型名还是自己代码的问题。
⚠️ 二、messages 与多轮
- 以为接口记得上一轮。 这是本讲铁律:接口无状态。第二轮只发新问题,模型对第一轮一无所知。
- 忘了把 assistant 的回答追加回列表。 漏掉
messages.append({"role":"assistant", ...}),对话立刻前言不搭后语。 - 不做历史裁剪。 token 随轮数线性增长,先变贵变慢,最后超出上下文长度直接报错。要保留
system+ 最近 N 轮,或把更早历史压缩成摘要。 - 裁剪后第一条是 assistant。 对话历史必须是合法的一问一答交替结构,裁完要把开头的非
user消息弹掉,否则有些服务直接拒绝。 - 把 system 写成一长串还每轮重复堆。
system只需一条放在最前面,它整轮生效;重复堆只会白烧 token。
⚠️ 三、参数
temperature和top_p一起调。 官方明确建议只改其中一个。两个都动,行为难以预测,出了问题说不清是哪个造成的。- 判定类任务不把
temperature压到 0。 每次结果都不一样,会误判成模型不稳定,其实是自己没锁随机性。 max_tokens设得太小。 答案被截断,finish_reason变成length,而程序不报错——半句话被当完整答案入库,这是最隐蔽的线上事故。- 分不清上下文长度与最大输出。 这是两个数。上下文 1M 不代表能一次吐出 1M。
- 把
n调大。 官方建议保持为 1 以降低成本——按所有候选的生成 token 总数计费。 - 用了超过 4 个
stop序列。 官方限制最多 4 个。
⚠️ 四、流式
- 直接写
chunk.choices[0]。 带usage的收尾 chunk 里choices是空数组,会抛IndexError。必须先判空。 - 不判
delta.content是否为None。 有的 chunk 只携带 role 或工具调用信息,直接拼接会TypeError。 - 把
delta当累计值。 它是增量,是本次新增的那几个字,不是到目前为止的全文。 - 只顾打印不攒完整答案。 落库、写进下一轮
messages都需要完整文本,必须自己拼。 - 忘了
flush()。 输出被缓冲住,打字机效果白做。 - 流式下直接读
usage。 需要传stream_options={"include_usage": True},且只在最后一个 chunk 里。
⚠️ 五、错误处理与成本
- 对所有异常一律重试。 401、404、400、余额不足重试一万次也不会变成 200,只会浪费时间、刷爆日志、甚至触发风控。先分类再决定。
- 忘了关掉 SDK 自带重试。 不设
max_retries=0,自带重试会和你的逻辑叠加成乘积,5×5 变 25 次请求。 - 退避不加随机抖动。 一批被限流的请求会在同一毫秒集体重来,把服务再打垮一次,形成雪崩。
- 不设
timeout。 一个卡住的请求能挂死几分钟,拖垮整个批处理。 - 批量任务有多少条就开多少线程。 必须用信号量固定并发度,从小(如 4)往上调。直接拉满的结果就是成片 429。
- 退避期间不降并发度。 重试流量叠在原有流量上,把自己再死一遍。撞 429 时要同时降并发。
- 把限流当成只有「请求数」一个维度。 还有 token 吞吐限制——长文本任务请求数不多却已被限流,很容易误判成服务异常。
- 结果攒在内存里最后统一写。 跑到 90% 挂掉,前面的钱全白花。随跑随落盘,并给每条任务稳定 id 以支持断点续跑。
- 把
api_key或未脱敏的用户原文打进日志。 包括报错时直接repr()整个请求对象这种间接泄露。对话内容里可能含手机号、身份证,要么只记长度与哈希,要么脱敏后再落盘。 - 不读
usage。 成本完全失控,出账单时才发现。第一天就把它打出来。 - 不核对响应里的
model字段。 别名、灰度、降级都会改写它,你以为在用旗舰版,实际被路由到轻量版。 - 拿单轮用量乘轮数估成本。 多轮对话的输入 token 是线性增长的。实测推演:第 20 轮的输入是第 1 轮的 30.6 倍,累计输入 56800 token。按单轮估算会错到离谱。
- 裁剪时把一轮对话拦腰切断。
user和它对应的assistant要成对地删,并且从最早一轮开始删。留下孤零零的user,模型行为会变得很奇怪,有些服务端直接报 400。 - 裁剪时把
system一起裁掉。 无论哪种策略,第一条system都要原封保留,否则模型当场失忆人设与格式要求。
⚠️ 六、结构化输出
- 直接把模型输出丢给
json.loads()。 模型爱加开场白和```json代码围栏,直接解析必爆。解析前先剥围栏、取第一个{到最后一个}。 - 以为传了
response_format就万无一失。 各家支持度不一,有的兼容服务会直接忽略这个参数。客户端的容错解析永远不能省。 - 解析失败时不记原始输出。 线上偶发解析失败,手里只有一个
JSONDecodeError堆栈,连复现都做不到。失败分支必须把模型原文记进日志。 - 只在提示词里写「输出 JSON」却不给示例。 给一个完整的目标格式示例,比写十句要求都管用。
07自测题
点击题目展开答案;能把这 15 题说清楚,这一讲就通了
什么是 OpenAI 兼容协议?它对开发者最大的价值是什么?
指各家模型服务采用与 OpenAI 相同的接口格式(往 /chat/completions 发带 model 和 messages 的 JSON)。各家官方文档的说法基本一致:只需修改 API Key、base_url 和模型名称,就能把原有 OpenAI 代码迁移过来。
最大价值是业务代码与供应商解耦——学一次通吃全行业,而且让「换模型」变成低成本操作。本地跑的 Ollama、vLLM 同样提供这套接口。
调用任何一家服务,需要准备哪四样东西?各自最容易出什么错?
base_url(注意 /v1 后缀各家不一致,写错就 404)、api_key(只从环境变量读)、model(会改名会下线,以官方列表为准)、messages(对话消息列表)。
环境要求:Python 3.7.1 以上、OpenAI SDK 不低于 1.0.0——旧版写法完全不同,是新手最常见的报错来源。
接入一个新服务,正确的顺序是什么?为什么不能直接写代码?
先用 curl 验通,再写代码。 直接上代码的话,一旦报错你分不清是 key 错了、base_url 错了、模型名错了,还是自己代码写错了。curl 成功后把同样三个值填进 SDK,基本不会再出问题。
注意 curl 命令里必须用变量引用密钥,明文粘贴会留在 shell 历史里。
本讲的铁律是什么?它能解释哪些现象?
接口是无状态的——模型不记得上一轮。 多轮对话的记忆是假象,靠的是你每次把完整 messages 重新发过去。
它解释了:① 为什么越聊越贵(每轮都要把全部历史作为输入重发,prompt_tokens 线性增长);② 为什么越聊越慢;③ 为什么迟早会超出上下文长度报错;④ 为什么必须手动把 assistant 的回答追加回去。
三种 role 各是什么作用?assistant 消息是谁放进列表的?
system:设定人设、规则、输出格式,整轮对话生效,通常只有一条放在最前;user:本次提问;assistant:模型此前的回答。
assistant 消息必须由你手动追加回列表——接口不会帮你存。漏掉这一步,对话立刻前言不搭后语。
为什么必须做历史裁剪?裁剪时有个容易忽略的细节是什么?
因为不裁剪的话 token 随轮数线性增长,先变贵变慢,最后超出模型上下文长度直接报错。常见策略是保留 system + 最近 N 轮,或把更早历史压缩成摘要。
容易忽略的细节:裁剪后第一条必须是 user。对话历史必须是合法的一问一答交替结构,如果裁完开头是 assistant,有些服务会直接拒绝请求。
temperature 和 top_p 分别是什么?为什么不要一起调?
temperature 是采样温度,取值 0~2,更高的值让输出更随机,更低的值让输出更聚焦、更确定;top_p 是核采样,只考虑累计概率质量排在前 top_p 的 token,0.1 表示只考虑前 10% 概率质量。
官方明确建议「修改这个或 top_p,但不要两个都改」——两个都动行为难以预测。实践上固定 top_p 用默认值,只调 temperature。判定类任务压到 0。
响应里哪三个字段必须读?不读 finish_reason 会有什么后果?
choices[0].message.content(正文)、choices[0].finish_reason(结束原因)、usage(token 账单)。
finish_reason 为 length 说明答案被 max_tokens 截断,而程序不会报错——半句话被当成完整答案入库,这是最隐蔽的线上事故。stop 是正常收尾,tool_calls 表示要调工具。
流式与非流式在代码上差别在哪?流式有哪两个必踩的坑?
差别两处:响应从一个对象变成可迭代的一串 chunk;正文从 message.content 变成 delta.content,而且 delta 是增量不是累计,要自己拼接成完整答案。
两个坑:① 带 usage 的收尾 chunk 里 choices 是空数组,直接取 [0] 会 IndexError;② delta.content 可能是 None,不判空拼接会 TypeError。另外流式下拿 usage 要传 stream_options={"include_usage": True}。
哪些错误该重试、哪些不该?退避为什么要加随机抖动?为什么要关掉 SDK 自带重试?
该重试(瞬时故障):429 限流、超时、连接失败、5xx;服务端给了 Retry-After 就优先听它的。不该重试(确定性错误):401 鉴权失败、404 模型名错、400 参数错、余额不足——重试一万次也不会变成 200。
随机抖动:一批同时被限流的请求如果都按 1s、2s、4s 退避,会在同一毫秒集体重来,把服务再打垮一次形成雪崩。
关掉 SDK 自带重试(max_retries=0):否则会和自己的重试逻辑叠加成乘积,5×5 变成 25 次请求。
多轮对话的输入 token 是怎么增长的?能不能拿单轮用量乘轮数估成本?
线性增长,不是常数——因为每轮都要把全部历史作为输入重发一遍。
实测推演(system 120、每轮提问 60、每轮回答 220):第 1 轮输入 180 token,第 20 轮 5500 token,涨了 30.6 倍,累计输入 56800 token。
所以绝对不能拿单轮乘轮数估算,那会错到离谱。
不做裁剪会出什么事?三种策略各自适合什么场景?
上面那组参数下,第 15 轮就撞破 4096 上下文上限——不是贵不贵的问题,是直接报错跑不下去。
• 全量历史:累计 56800 token,信息不丢但贵且跑不完;
• 滑动窗口(留最近 3 轮):18720 token,省 67%,适合客服 FAQ 这类上下文依赖弱的场景,缺点是早期信息直接丢;
• 摘要压缩:21120 token,省 63%,适合长程任务助手。
两者省的钱差不多,真正的差别在「早期信息丢不丢」,按业务选而不是按价格选。
裁剪历史时有哪三个不能犯的错?
① 不能把 system 裁掉——模型会当场失忆人设与格式要求;
② 不能把一轮对话拦腰切断——user 与对应的 assistant 要成对地删,留下孤零零的 user 会让模型行为变异,有些服务端直接报 400;
③ 要从最早一轮开始删,不是从中间挖一块走;并且裁完后第一条必须是 user。
要让输出能被 json.loads() 直接读,要做哪三层?哪一层不能省?
① 结构化输出参数 response_format:可靠性最高,但各家支持度不一,兼容服务可能直接忽略;
② 提示词约束:system 写死「只输出 JSON」并给出完整示例,所有服务都能用;
③ 客户端傅佐:剥代码围栏、取第一个 { 到最后一个 }。
第③层不能省——前两层都会偶尔失效。而且解析失败时必须把模型原始输出记进日志,否则线上偶发失败连复现都做不到。
真实 token 用量到底该以什么为准?
只有一个权威来源:响应里的 usage 字段(prompt_tokens / completion_tokens / total_tokens)。
估算脚本、字数折算、「1 汉字 = 1 token」都只能看趋势,不能对账单。流式下要拿 usage,还得传 stream_options={"include_usage": True},且它只在最后一个 chunk 里。
词术语表
| 术语 | 含义 |
|---|---|
| OpenAI 兼容协议 | 以 OpenAI 接口格式为事实标准;换供应商只需改 base_url、api_key、模型名 |
| base_url | 服务的网络访问点;注意 /v1 后缀各家不一致 |
| api_key | 鉴权凭证,一律从环境变量读取,不硬编码、不提交 Git |
| messages | 对话消息列表,顺序即对话顺序;只追加不修改,是上下文的全部载体 |
| role | 消息角色:system 定规则 / user 提问 / assistant 模型回答 |
| temperature | 采样温度,0~2;越高越随机,越低越聚焦确定 |
| top_p | 核采样;只考虑累计概率质量排前 top_p 的 token。与 temperature 不要同时调 |
| max_tokens | 生成的最大 token 数;OpenAI 已标注弃用、改用 max_completion_tokens,多数兼容服务仍用前者 |
| stop | 停止序列,最多 4 个;命中后停止生成,返回内容不含该序列 |
| stream | 是否流式返回;为 true 时通过 SSE 边生成边推送 |
| SSE | Server-Sent Events,服务端单向推送的协议,流式输出的底层机制 |
| delta | 流式 chunk 里的增量内容,不是累计全文,需自行拼接 |
| stream_options | 流式选项;传 {"include_usage": true} 才能在收尾 chunk 拿到 token 账单 |
| finish_reason | 结束原因:stop 正常 / length 被截断 / tool_calls 要调工具 |
| usage | token 账单:prompt_tokens、completion_tokens、total_tokens |
| 指数退避 | 重试间隔按 1s、2s、4s 倍增,并叠加随机抖动避免雪崩 |
| Retry-After | 服务端在限流响应头里给出的建议等待时间,优先级高于自己的猜测 |
| 信号量 Semaphore | 控制同时未返回请求个数的并发闸门;批量任务的并发度靠它固定,而不是有多少任务开多少线程 |
| token 吞吐限制 | 每分钟 token 总量上限;长文本任务往往先撞它,请求数不多却已限流,容易误判为服务异常 |
| 断点续跑 | 给每条任务稳定 id,重启时跳过已完成项;批量任务中途挂掉是常态而非意外 |
| max_retries | SDK 自带重试次数;自己接管重试时必须显式设为 0,否则两层重试叠加成乘积 |
| 无状态 | 接口不保存会话;多轮记忆靠每次重发完整 messages 实现 |
| 滑动窗口 | 历史裁剪策略:只保留 system + 最近 N 轮;实测 20 轮场景下相比全量历史省 67% 输入 token |
| 摘要压缩 | 历史裁剪策略:旧对话压成一段摘要;比滑窗略贵(省 63%),但保住早期信息要点 |
| response_format | 结构化输出参数,让服务端约束输出为 JSON;各家支持度不一,兼容服务可能直接忽略 |
| prompt_tokens | usage 里的输入计量;多轮对话中它随轮数线性增长,是成本失控的主因 |
| 前缀缓存 | 相同请求前缀命中时输入价格大幅下降;把固定 system 放最前且保持不变就能持续命中 |
手里有了一个能换供应商的客户端,后面的提示工程、私有化部署、应用开发,都是在这个地基上往上盖。